AIUnlimited
🌳

أسس الذكاء الاصطناعي

🌱
AI Seeds

Start from zero

🌿
AI Sprouts

Build foundations

🌳
AI Branches

Apply in practice

🏕️
AI Canopy

Go deep

🌲
AI Forest

Master AI

🔨

إتقان الذكاء الاصطناعي

✏️
AI Sketch

Start from zero

🪨
AI Chisel

Build foundations

⚒️
AI Craft

Apply in practice

💎
AI Polish

Go deep

🏆
AI Masterpiece

Master AI

📘

تطبيق الذكاء الاصطناعي

📖
فهم النماذج مفتوحة المصدر

أسس وموارد للنماذج مفتوحة المصدر

🎯
من المشكلة إلى مهمة النموذج

تحويل مشاكل الأعمال إلى مهام نموذجية

⚡
تشغيل نموذجك الأول

شاهد نتائجك الأولى في 30 دقيقة

🔧
التحسين الدقيق والتقييم

حسّن النماذج وقيّم الأداء

🚀
أنظمة التطبيقات

بناء تطبيقات ذكاء اصطناعي واقعية

🎨
الذكاء الاصطناعي التوليدي

استكشف نماذج AIGC مفتوحة المصدر

🤖
الوكيل

تعلم أطر عمل الوكيل وأدوات MCP

📐
أسس تكميلية

أساسيات LLM والتقييم

🎓

أكاديمية كلاود

🤖
Claude 101

Learn AI basics with Claude

💻
Claude Code 101

Code with Claude as your pair programmer

🤝
Introduction to Claude Cowork

Collaborate with Claude on complex projects

⚙️
Claude Platform 101

Build apps with the Claude API

المختبر

تم تحميل 7 تجارب
🧬ملعب الشبكة العصبية🤖ذكاء اصطناعي أم إنسان؟🥋دوجو التوجيهات🏁سباق الخوارزميات🧠مسابقة معلومات الذكاء الاصطناعي🏗️لوحة تصميم النظام
🎯مقابلة تجريبيةدخول المختبر→
🚀

التطوير المهني

🚀
منصة انطلاق المقابلات

ابدأ رحلتك

🌟
إتقان المقابلات السلوكية

أتقن المهارات الشخصية

💻
المقابلات التقنية

تفوّق في جولة البرمجة

🤖
مقابلات الذكاء الاصطناعي وتعلم الآلة

إتقان مقابلات تعلم الآلة

🏆
العرض وما بعده

احصل على أفضل عرض

ابدأ الآن
AIUnlimited

رخصة MIT

沪ICP备18025655号-11

تعلّم

  • أساسيات الذكاء الاصطناعي
  • تطبيق الذكاء الاصطناعي
  • أكاديمية كلاود
  • المختبر
  • التطوير المهني

المجتمع

  • عن المنصة
  • الأسئلة الشائعة

الدعم

  • footer.terms
  • footer.privacy
  • footer.contact
البرامج الأكاديمية للذكاء الاصطناعي والهندسة›📖 فهم النماذج مفتوحة المصدر›الدروس›Data: The Foundation of Fine-Tuning
📊
فهم النماذج مفتوحة المصدر • مبتدئ⏱️ 12 دقيقة للقراءة

Data: The Foundation of Fine-Tuning

البيانات: أساس تحسين نماذج مفتوحة المصدر

هل واجهت نموذجاً يبرمجة ويحل الرياضيات بشكل ممتاز، لكنه يجيب عشوائياً على الأسئلة اليومية؟

نعلم جميعاً لتحسين قدرة معينة أثناء التدريب، يجب العثور على نوع البيانات المناسب,

لكن العديد من مجموعات البيانات يصعب العثور عليها بالبحث المباشر. بوابة تنزيل موحدة توفر جهداً كبيراً.

على سبيل المثال، حصلت مجموعة بيانات الاستخلاص بالصينية من DeepSeek-R1 على جزء كبير من بياناتها الخام مباشرة من ModelScope,
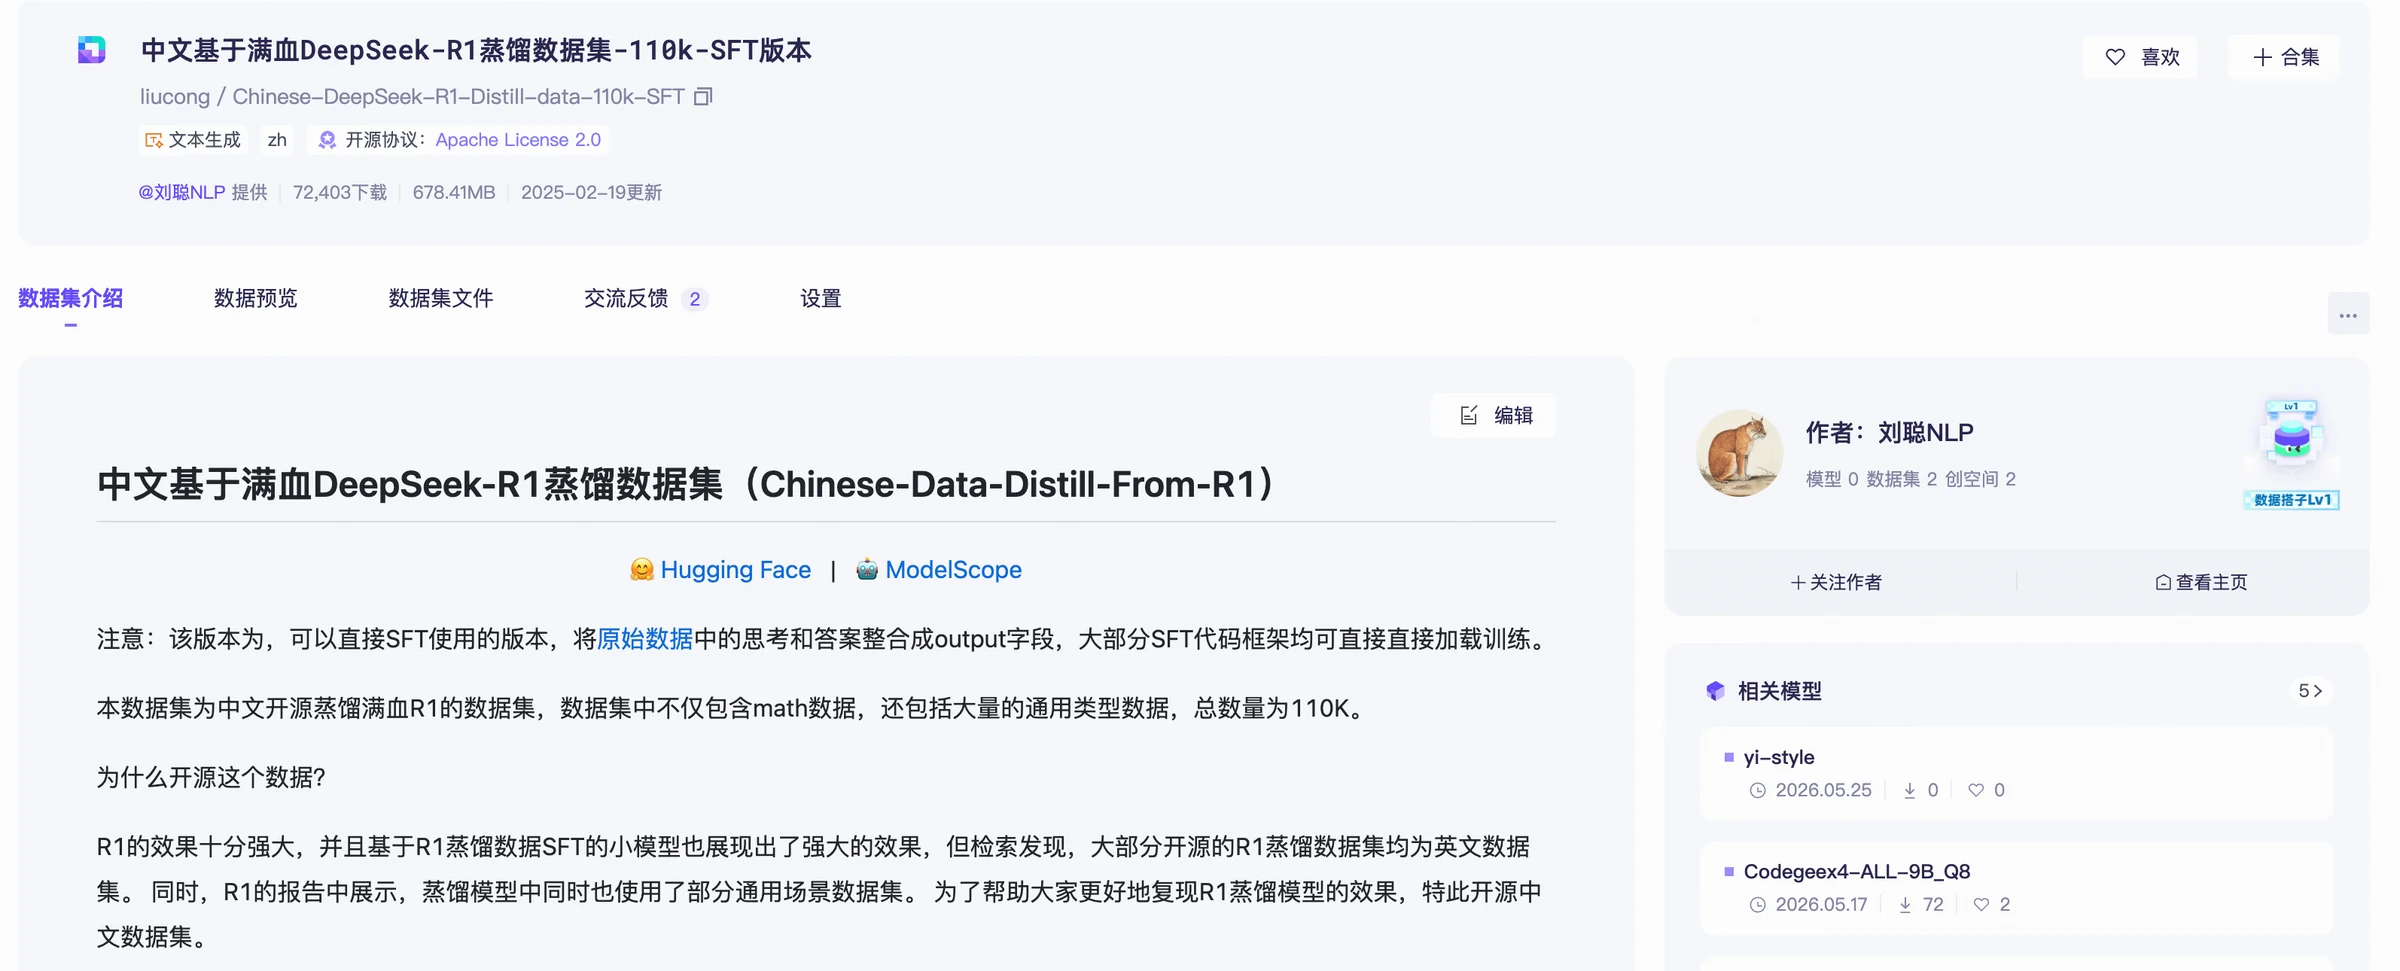
رسم توضيحي

يمكن بدء التحسين الدقيق للنموذج من مجموعة بيانات مفتوحة المصدر الموجودة، مما يسمح بسرعة تنفيذ العملية بأكملها.

العثور على البيانات يتطلب معرفة ما تخطط له

يوفر ModelScope أكثر من 40,000 مجموعة بيانات مفتوحة المصدر مع البحث والمعاينة وأوصاف الحقول والإصدارات.

يدعم ModelScope البحث بالكلمات المفتاحية وفئات المهام، مثل بيانات التصنيف النصي الثنائي بالصينية,
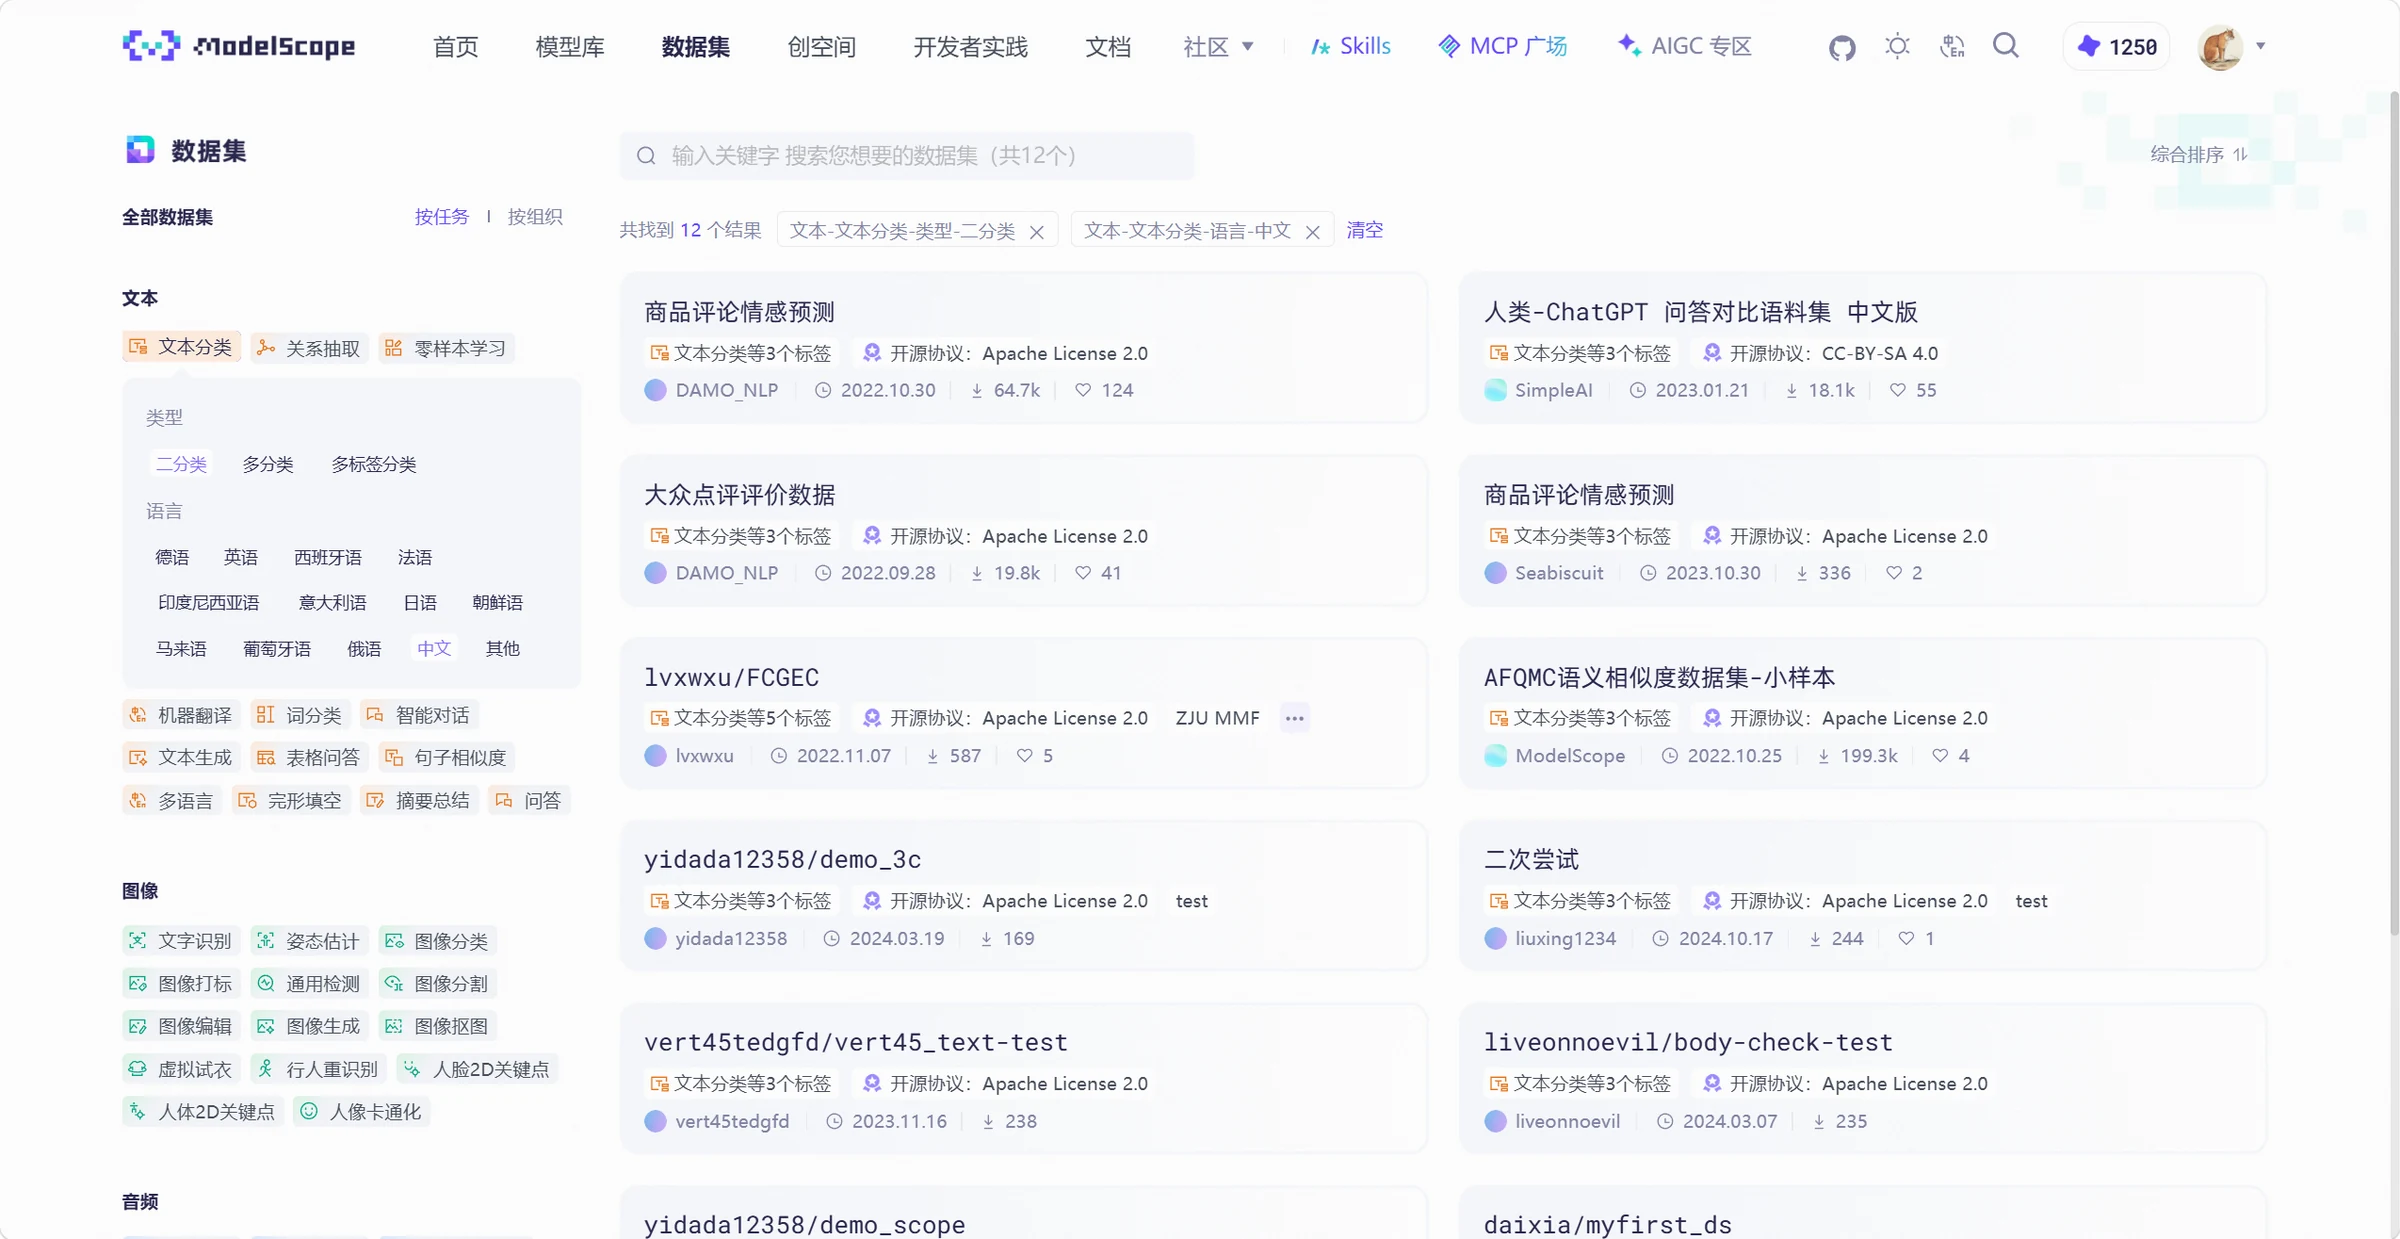
رسم توضيحي

قبل التنزيل، اطلع على بعض العينات

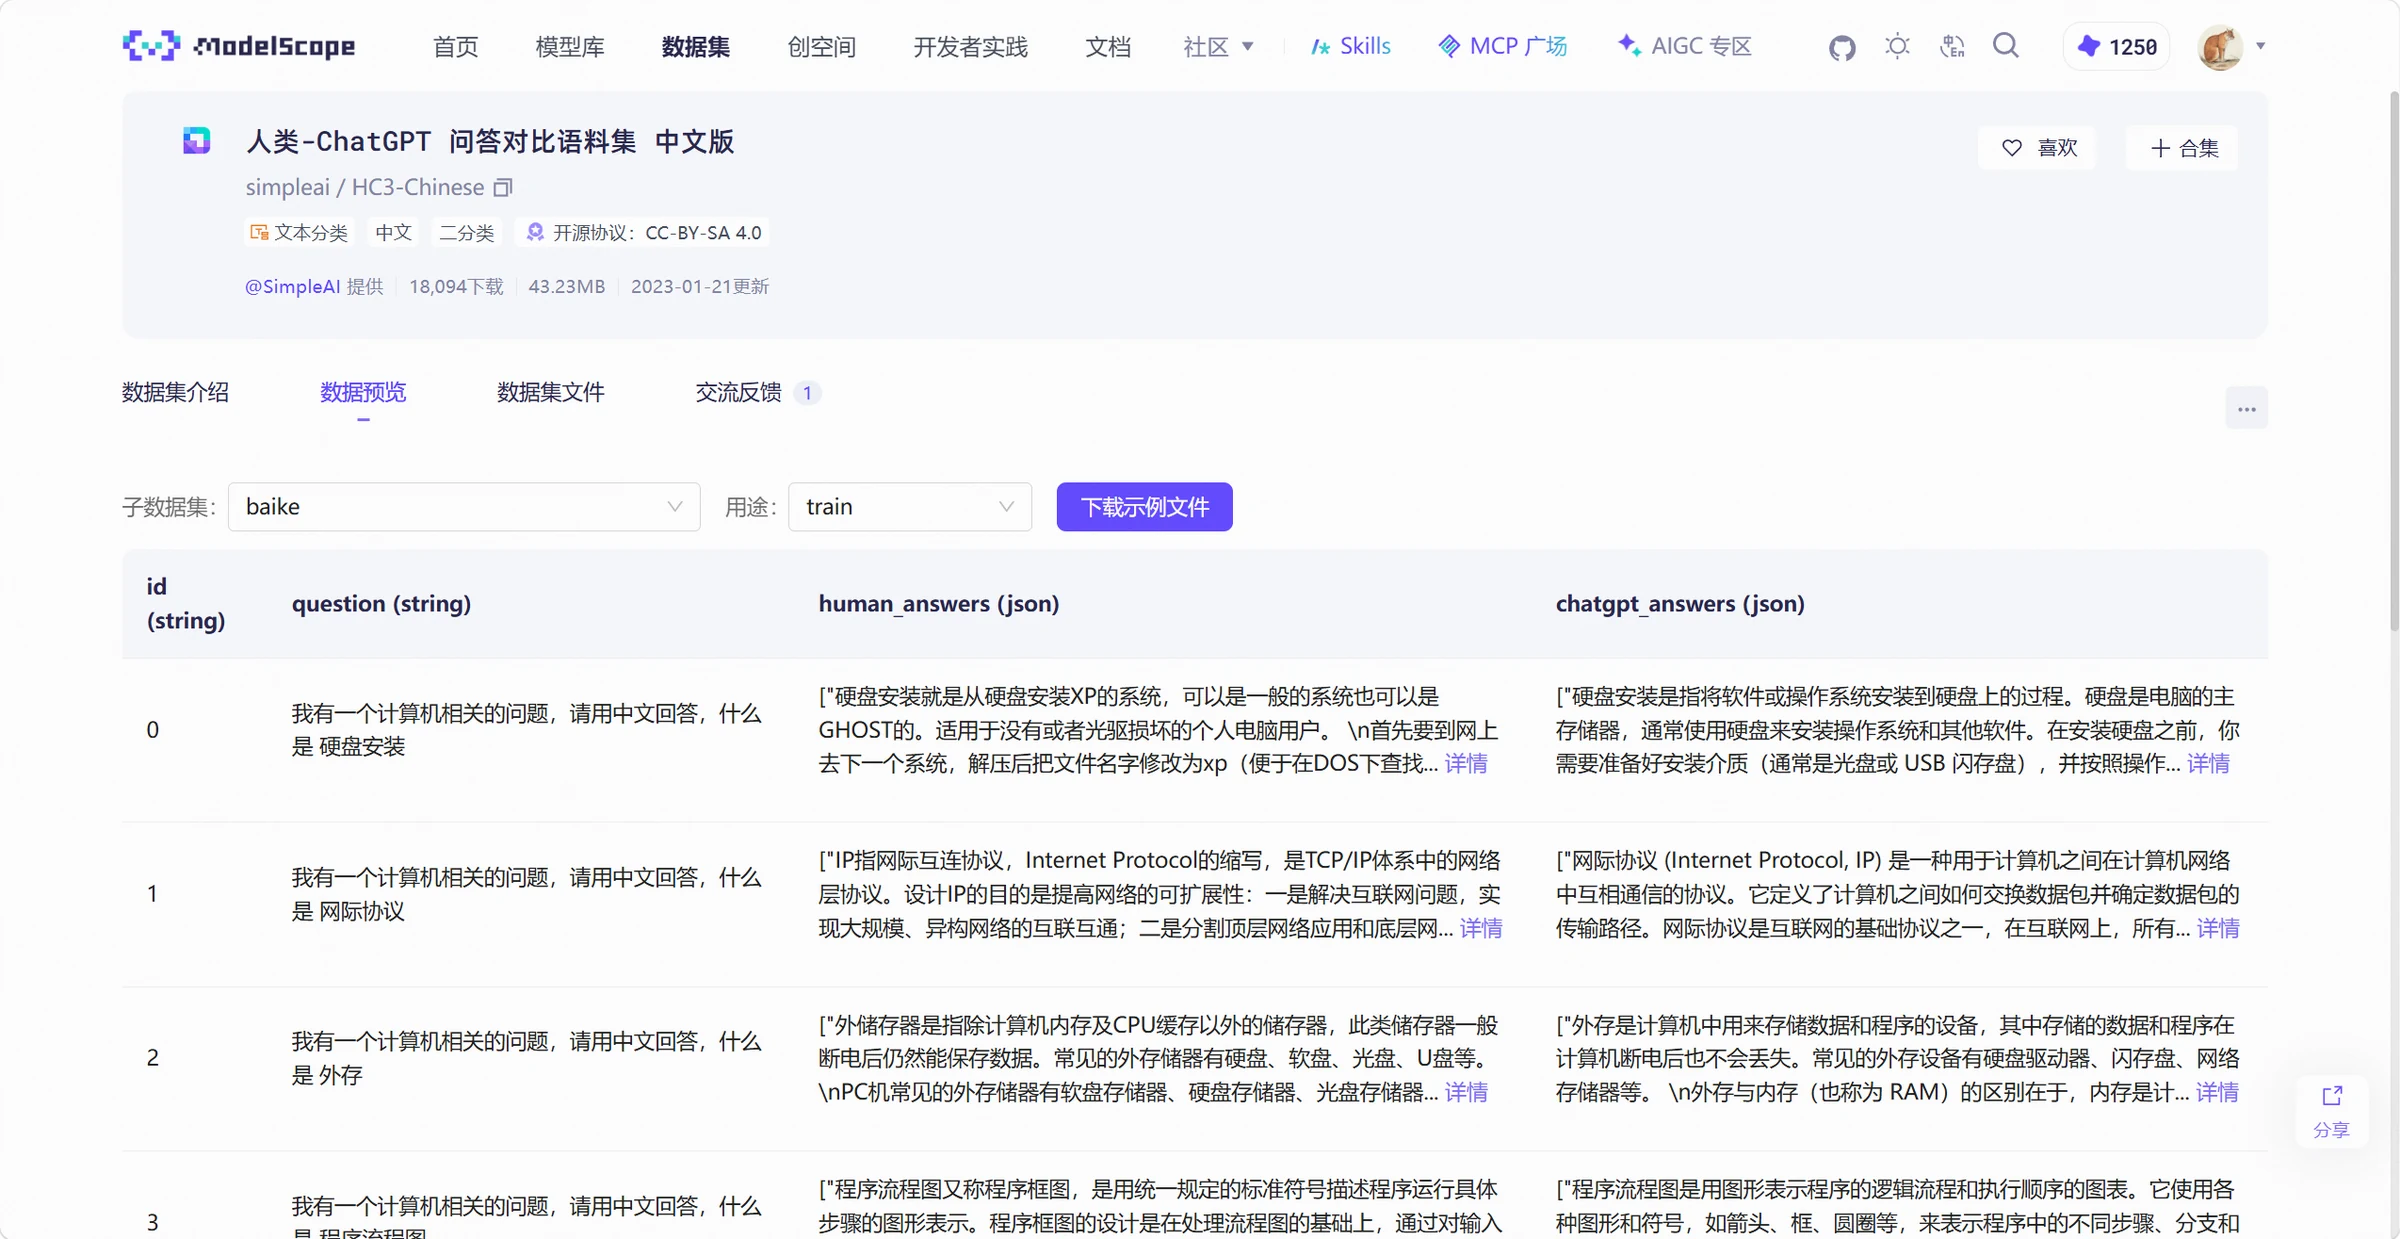
بعد التصفية، حدد مجموعة البيانات واضغط 'معاينة البيانات' لعرض العينات وأوصاف الحقول عبر الإنترنت.
رسم توضيحي

أي عمود يحتوي على السؤال، الجواب، التسميات، وما إذا كان كل سجل نصاً أو حواراً — يمكن التحقق من ذلك مسبقاً.

بالنسبة لبيانات الأسئلة والإجابة، قد تكون إجابات الإنسان والنموذج في حقول مختلفة. قرر أي حقول تقرأ وكيف تنظم قبل التدريب.

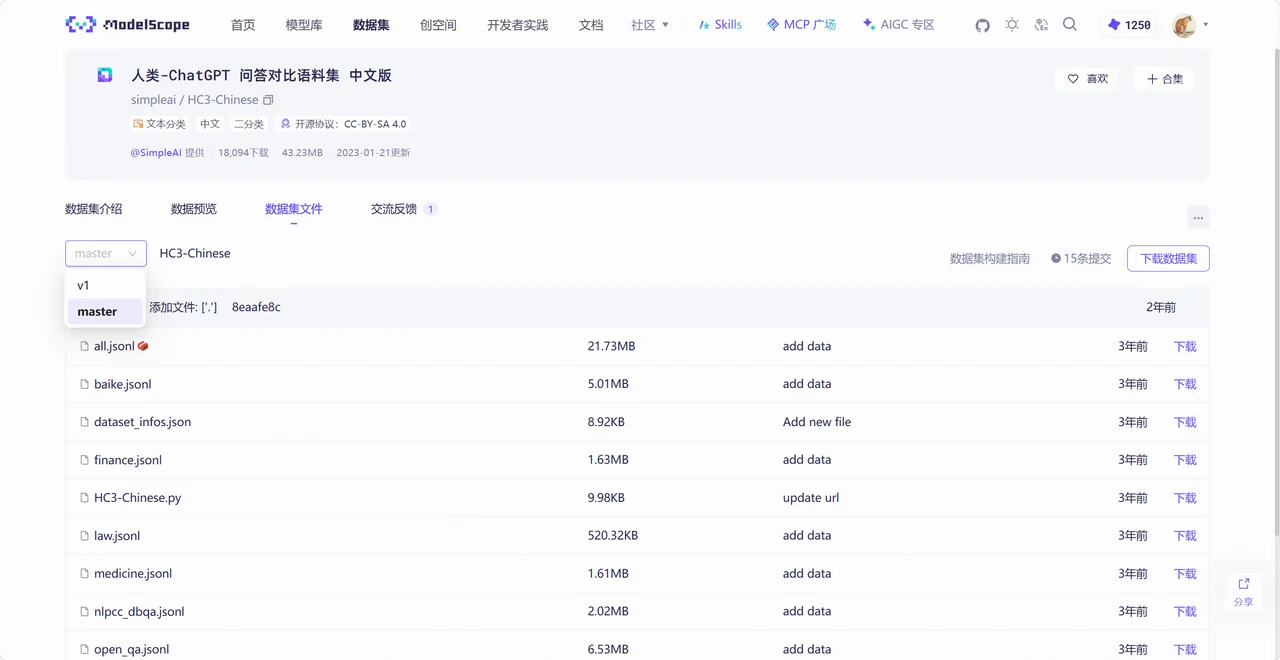
تحقق من الملفات والإصدارات. يتم تحديث مجموعات البيانات؛ سجّل الإصدار المستخدم لإمكانية التكرار.
رسم توضيحي

الوصف والترخيص تستحق المراجعة. قد يكون للبيانات المنزّلة متطلبات مختلفة للأبحاث أو التدريب أو الاستخدام التجاري.

احمِل البيانات أولاً، ثم قرر ما تستخدمه

يوفر ModelScope واجهة MsDataset.load لتحميل مجموعات البيانات في Python. بعد التثبيت، اتبع تعليمات صفحة مجموعة البيانات.

احمِل مجموعة بيانات كاملة أولاً

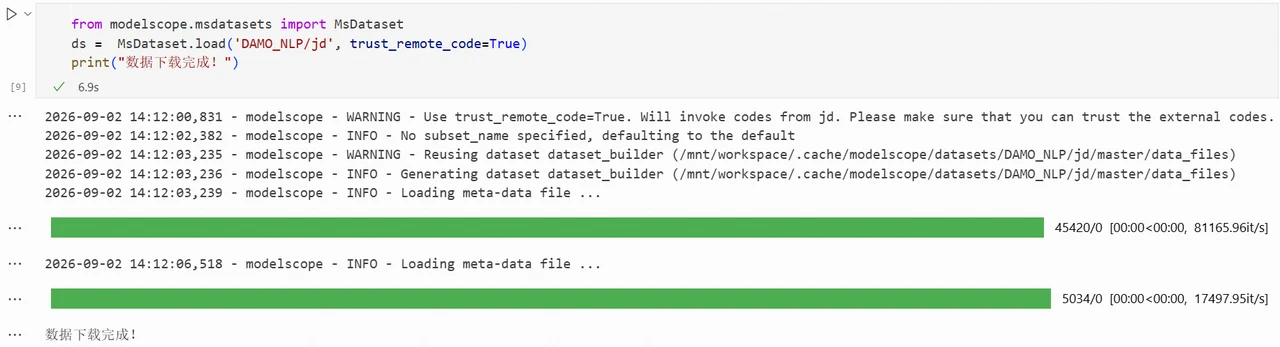
باستخدام DAMO_NLP/jd كمثال، يمكنك قراءة الإعداد الافتراضي بهذا الشكل,

from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'DAMO_NLP/jd',
    trust_remote_code=True,
)
print(ds)
رسم توضيحي

إذا كنت بحاجة لمجموعة فرعية فقط، حدد الاسم بوضوح

بعض مجموعات البيانات تفصل البيانات حسب المصدر أو المجال أو الاستخدام. إذا كنت بحاجة لجزء فقط، استخدم subset_name.

الدرس 3 من 40٪ مكتمل
←Model Discovery and Downloads

مناقشة

تسجيل الدخول للانضمام إلى النقاش
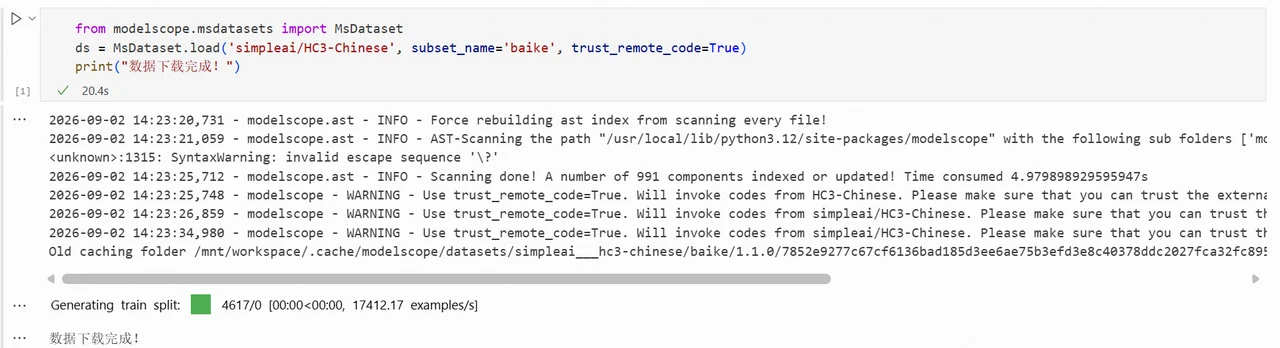
على سبيل المثال، حمّل المجموعة الفرعية baike من HC3-Chinese.

from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'simpleai/HC3-Chinese',
    subset_name='baike',
    trust_remote_code=True,
)
print(ds)
رسم توضيحي

عند تغيير مجموعة البيانات، تحقق من المجموعات الفرعية المتاحة. baike محدد لهذه المجموعة.

يمكن تحميل مجموعات التدريب والاختبار بشكل منفصل

المجموعة الفرعية تختار فئة البيانات، بينما split يختار تقسيم البيانات. الأكثر شيوعاً هو train و validation و test.

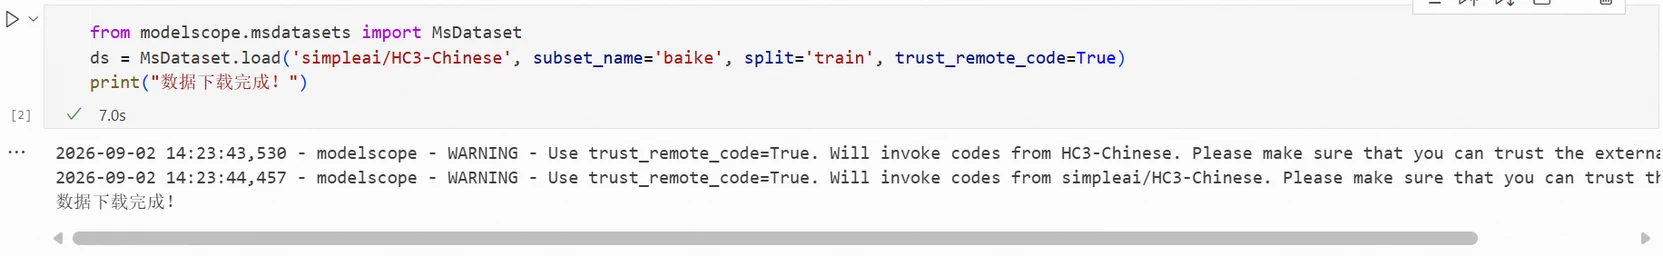
لتحميل مجموعة التدريب من baike فقط، أضف معاماً إضافياً.

from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'simpleai/HC3-Chinese',
    subset_name='baike',
    split='train',
    trust_remote_code=True,
)
print(ds[0])
رسم توضيحي

ليست جميع مجموعات البيانات تقدم التقسيمات الثلاثة. بعد الحصول على مجموعة التدريب، اطبع عيّنة للتحقق.

لتكرار التجارب، سجّل الإصدار أيضاً

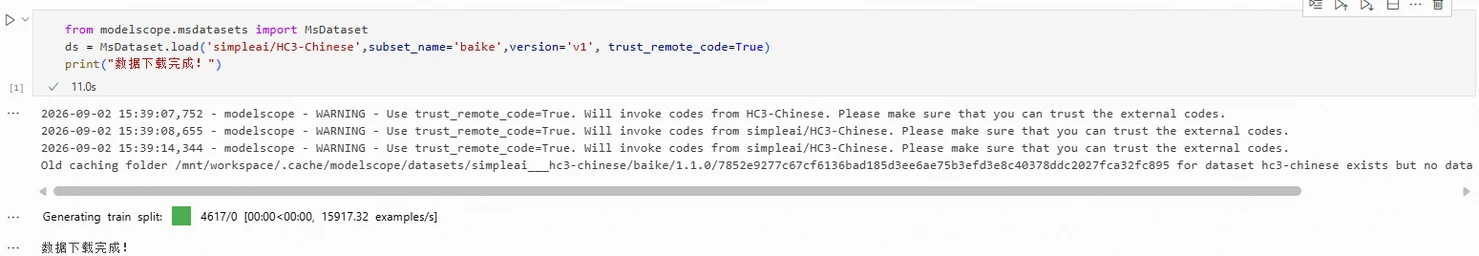
بعد التحديثات، قد يقرأ نفس الكود محتوىً مختلفاً. باستخدام HC3-Chinese v1 كمثال، حدد عبر version.

from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'simpleai/HC3-Chinese',
    subset_name='baike',
    version='v1',
    trust_remote_code=True,
)
print(ds)
رسم توضيحي

تحقق من الإصدارات المتاحة على صفحة مجموعة البيانات. إذا كان الإصدار قيد التحديث المستمر، احفظ الملفات أو بيانات التحقق المستخدمة.

تم تنزيل البيانات؟ لا تتعجل في إعطائها للنموذج

تحقق أولاً من بعض العينات بحثاً عن قيم فارغة أو أحرف مشوهة أو أخطاء واضحة، ثم تأكد من أن الحقول تلبي متطلبات الكود.

يجب فصل بيانات التدريب والاختبار. لا تخلط عينات الاختبار مع مجموعة التدريب.