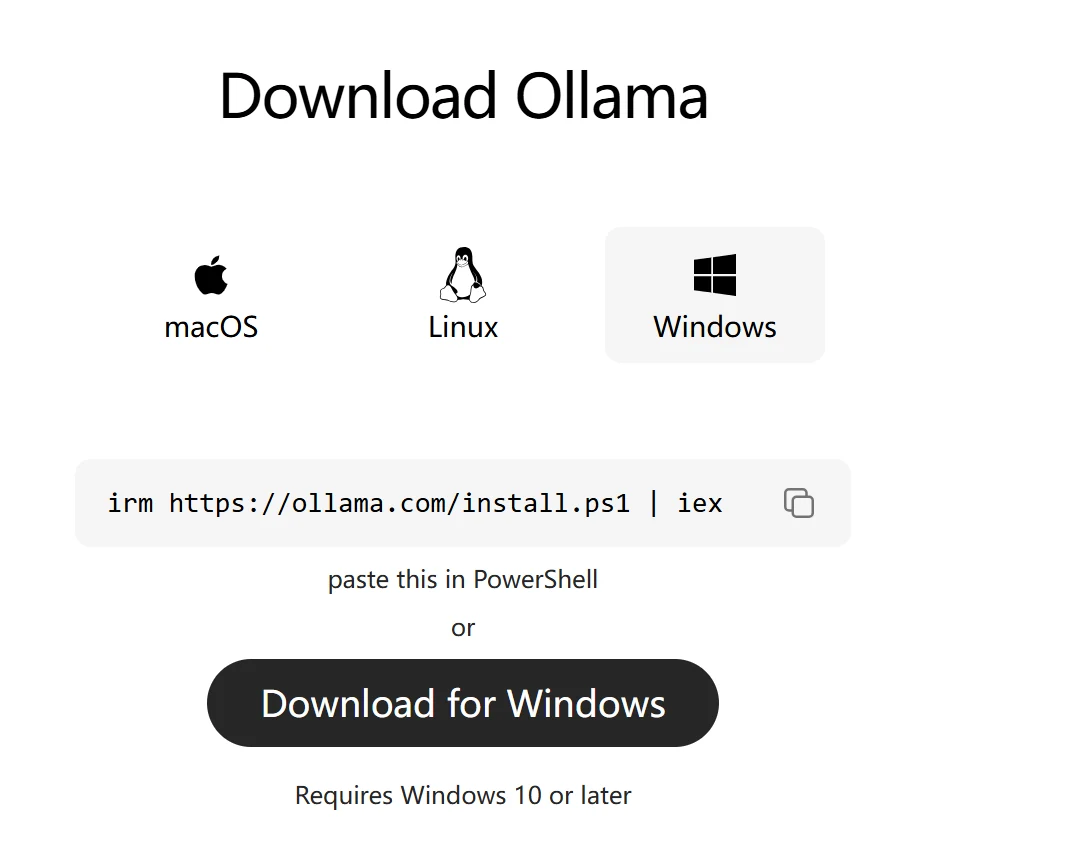
يمكن نشر النماذج محلياً أو في السحابة. تشمل الأجهزة المحلية الحواسيب المحمولة وأجهزة سطح المكتب وأجهزة الحافة الأخرى.
هناك أيضاً خيارات أدوات مختلفة للتشغيل المحلي: Ollama، بالإضافة إلى أطر عمل مثل vLLM و SGLang.
في هذا الفصل، سنشرح أولاً الاستخدام الأساسي لـ Ollama بوضوح. سيتم تغطية التكييف لأجهزة الحافة الأخرى واستخدام أطر عمل مثل vLLM و SGLama لاحقاً.
استدعاء النماذج الكبيرة عبر API هو النهج الأكثر راحة: أرسل الطلب، يقوم النموذج بالحساب وإرجاع النتيجة. لا يحتاج المستخدمون لشراء GPU أو صيانة البيئة الأساسية.
لكن نهج API له أيضاً قيود لا يمكن تجنبها،تتركز في الجوانب التالية:
لذا، إذا كانت أعمالك تتضمن حساسية البيانات أو تتطلب تشغيلاً خالياً تماماً من الاتصال أو لديها حجم مكالمات كبيرة، فإن النشر المحلي هو الخيار الأنسب.
Ollama هو أحد الأدوات الأكثر سهولة في الاستخدام حالياً، يجمع تحميل النماذج والإدارة المحلية وخدمات API معاً. لا يحتاج المستخدمون لكتابة كود لتحميل النماذج؛ بضعة أوامر فقط يمكنها بدء تشغيل النموذج مباشرة.
تعتمد قدرة النموذج على التشغيل المحلي بسلاسة إلى حد كبير على موارد الجهاز. يوفر Ollama دعماً جيداً لمنصات الأجهزة الشائعة، مع دعم Windows و Linux و macOS. سواء كان ذلك CPU عادياً أو GPU أو Mac مع Apple Silicon، يمكن استخدامها جميعاً لتشغيل النماذج.
التشغيل بواسطة CPU، حتى بدون بطاقة رسومات مخصصة، يمكنك تشغيل النماذج عبر CPU. نظراً لأن استدلال النماذج الكبيرة يتطلب حسابات واسعة، عادةً ما تكون سرعة التوليد أبطأ مع CPU، مما يجعلها أكثر ملاءمة لنماذج معاملات أصغر أو سيناريوهات لا تكون فيها متطلبات سرعة الاستجابة مرتفعة.
التشغيل بواسطة GPU، هذه هي الطريقة الأكثر شيوعاً حالياً لتشغيل النماذج الكبيرة. يمتلك GPU قدرات حساب متوازية قوية يمكنها تحسين سرعة توليد النموذج بشكل ملحوظ. كلما كان النموذج أكبر، كلما زادت ذاكرة الفيديو المطلوبة عادةً، لذا عند اختيار النموذج، تحتاج أن تنظر في ما إذا كان بطاقة الرسومات تمتلك ذاكرة فيديو كافية.
التشغيل بواسطة Apple Silicon، تستخدم شرائح Apple سلسلة M تصميم ذاكرة موحدة، حيث يمكن لـ CPU و GPU استخدام نفس الذاكرة. لمستخدمي Mac، إذا كان الجهاز يحتوي على 32GB أو 64GB أو أكثر من الذاكرة الموحدة، يمكنك محاولة تشغيل بعض النماذج المكممة ذات المعاملات الأكبر.
تسجيل الدخول للانضمام إلى النقاش
ollama run qwen3.5:2b
تُظهر خرج الصفحة أن النموذج قد بدأ بنجاح. في هذه النقطة، يمكنك إجراء محادثات مباشرة في العميل أو استدعاء API لاختبار النموذج.
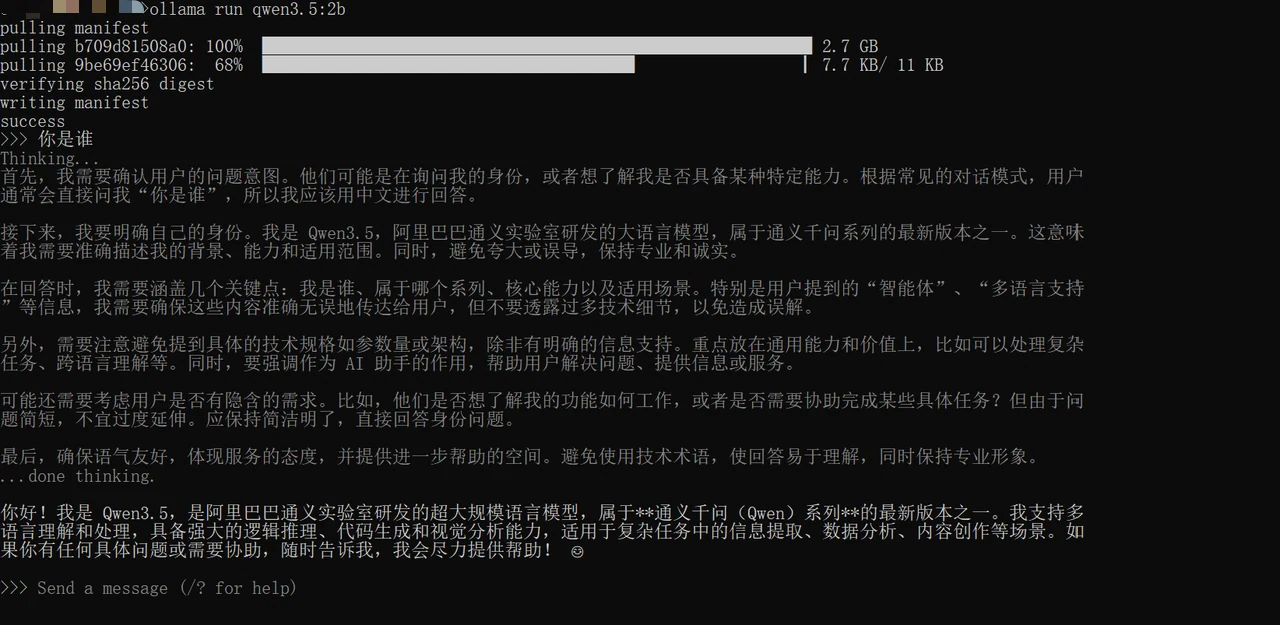
كود اختبار API:
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:11434/v1",
    api_key="ollama",
)

response = client.chat.completions.create(
    model="qwen3.5:2b",
    messages=[
        {
            "role": "system",
            "content": "أنت مساعد مفيد.",
        },
        {
            "role": "user",
            "content": "من أنت؟",
        },
    ],
    temperature=0,
    max_tokens=512,
)

print(response.choices[0].message.content)
النتيجة:
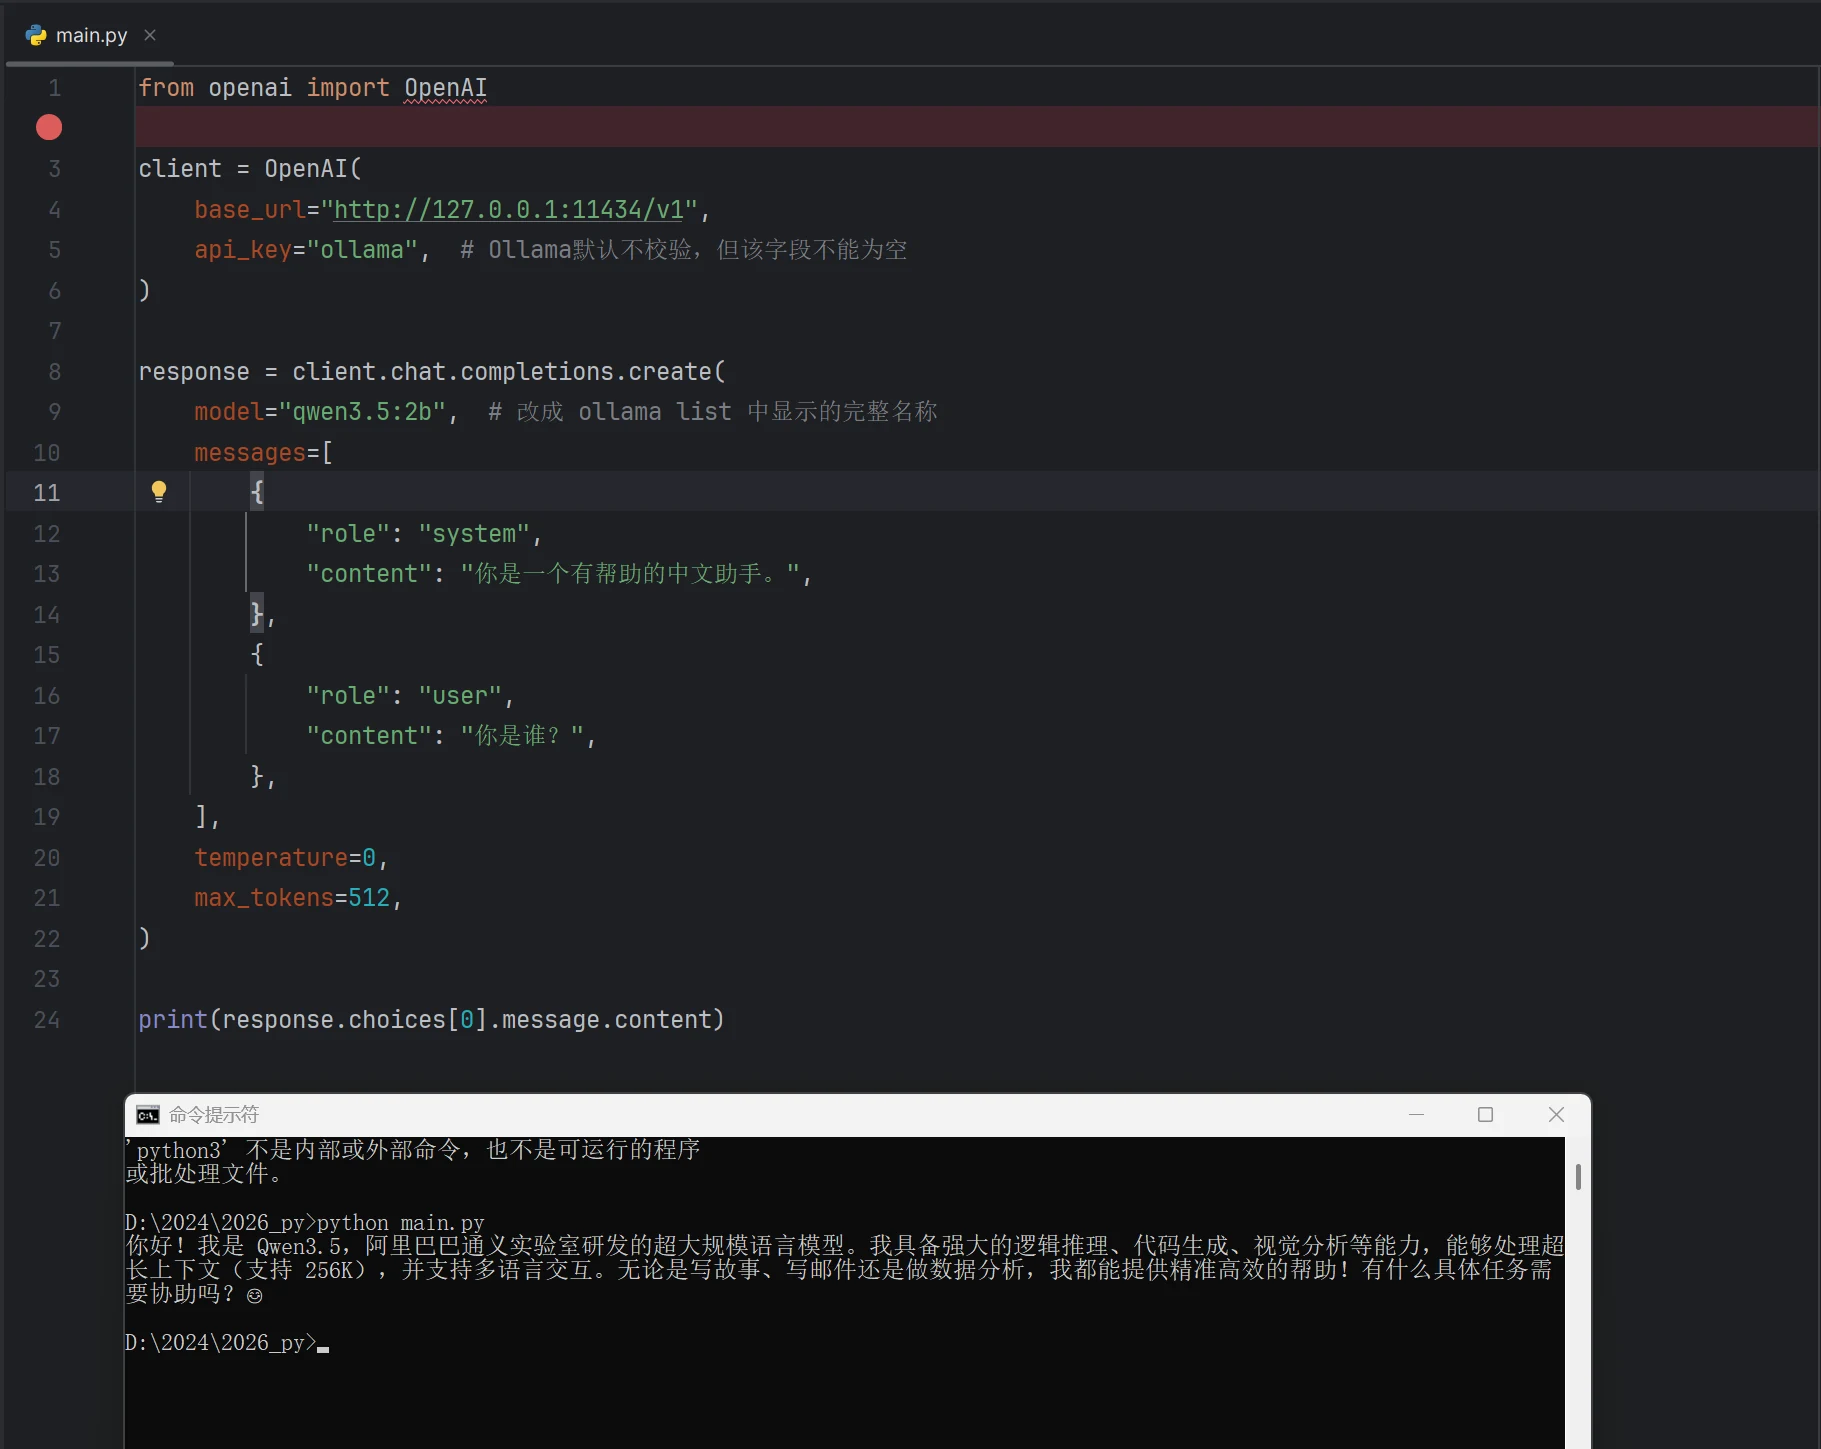
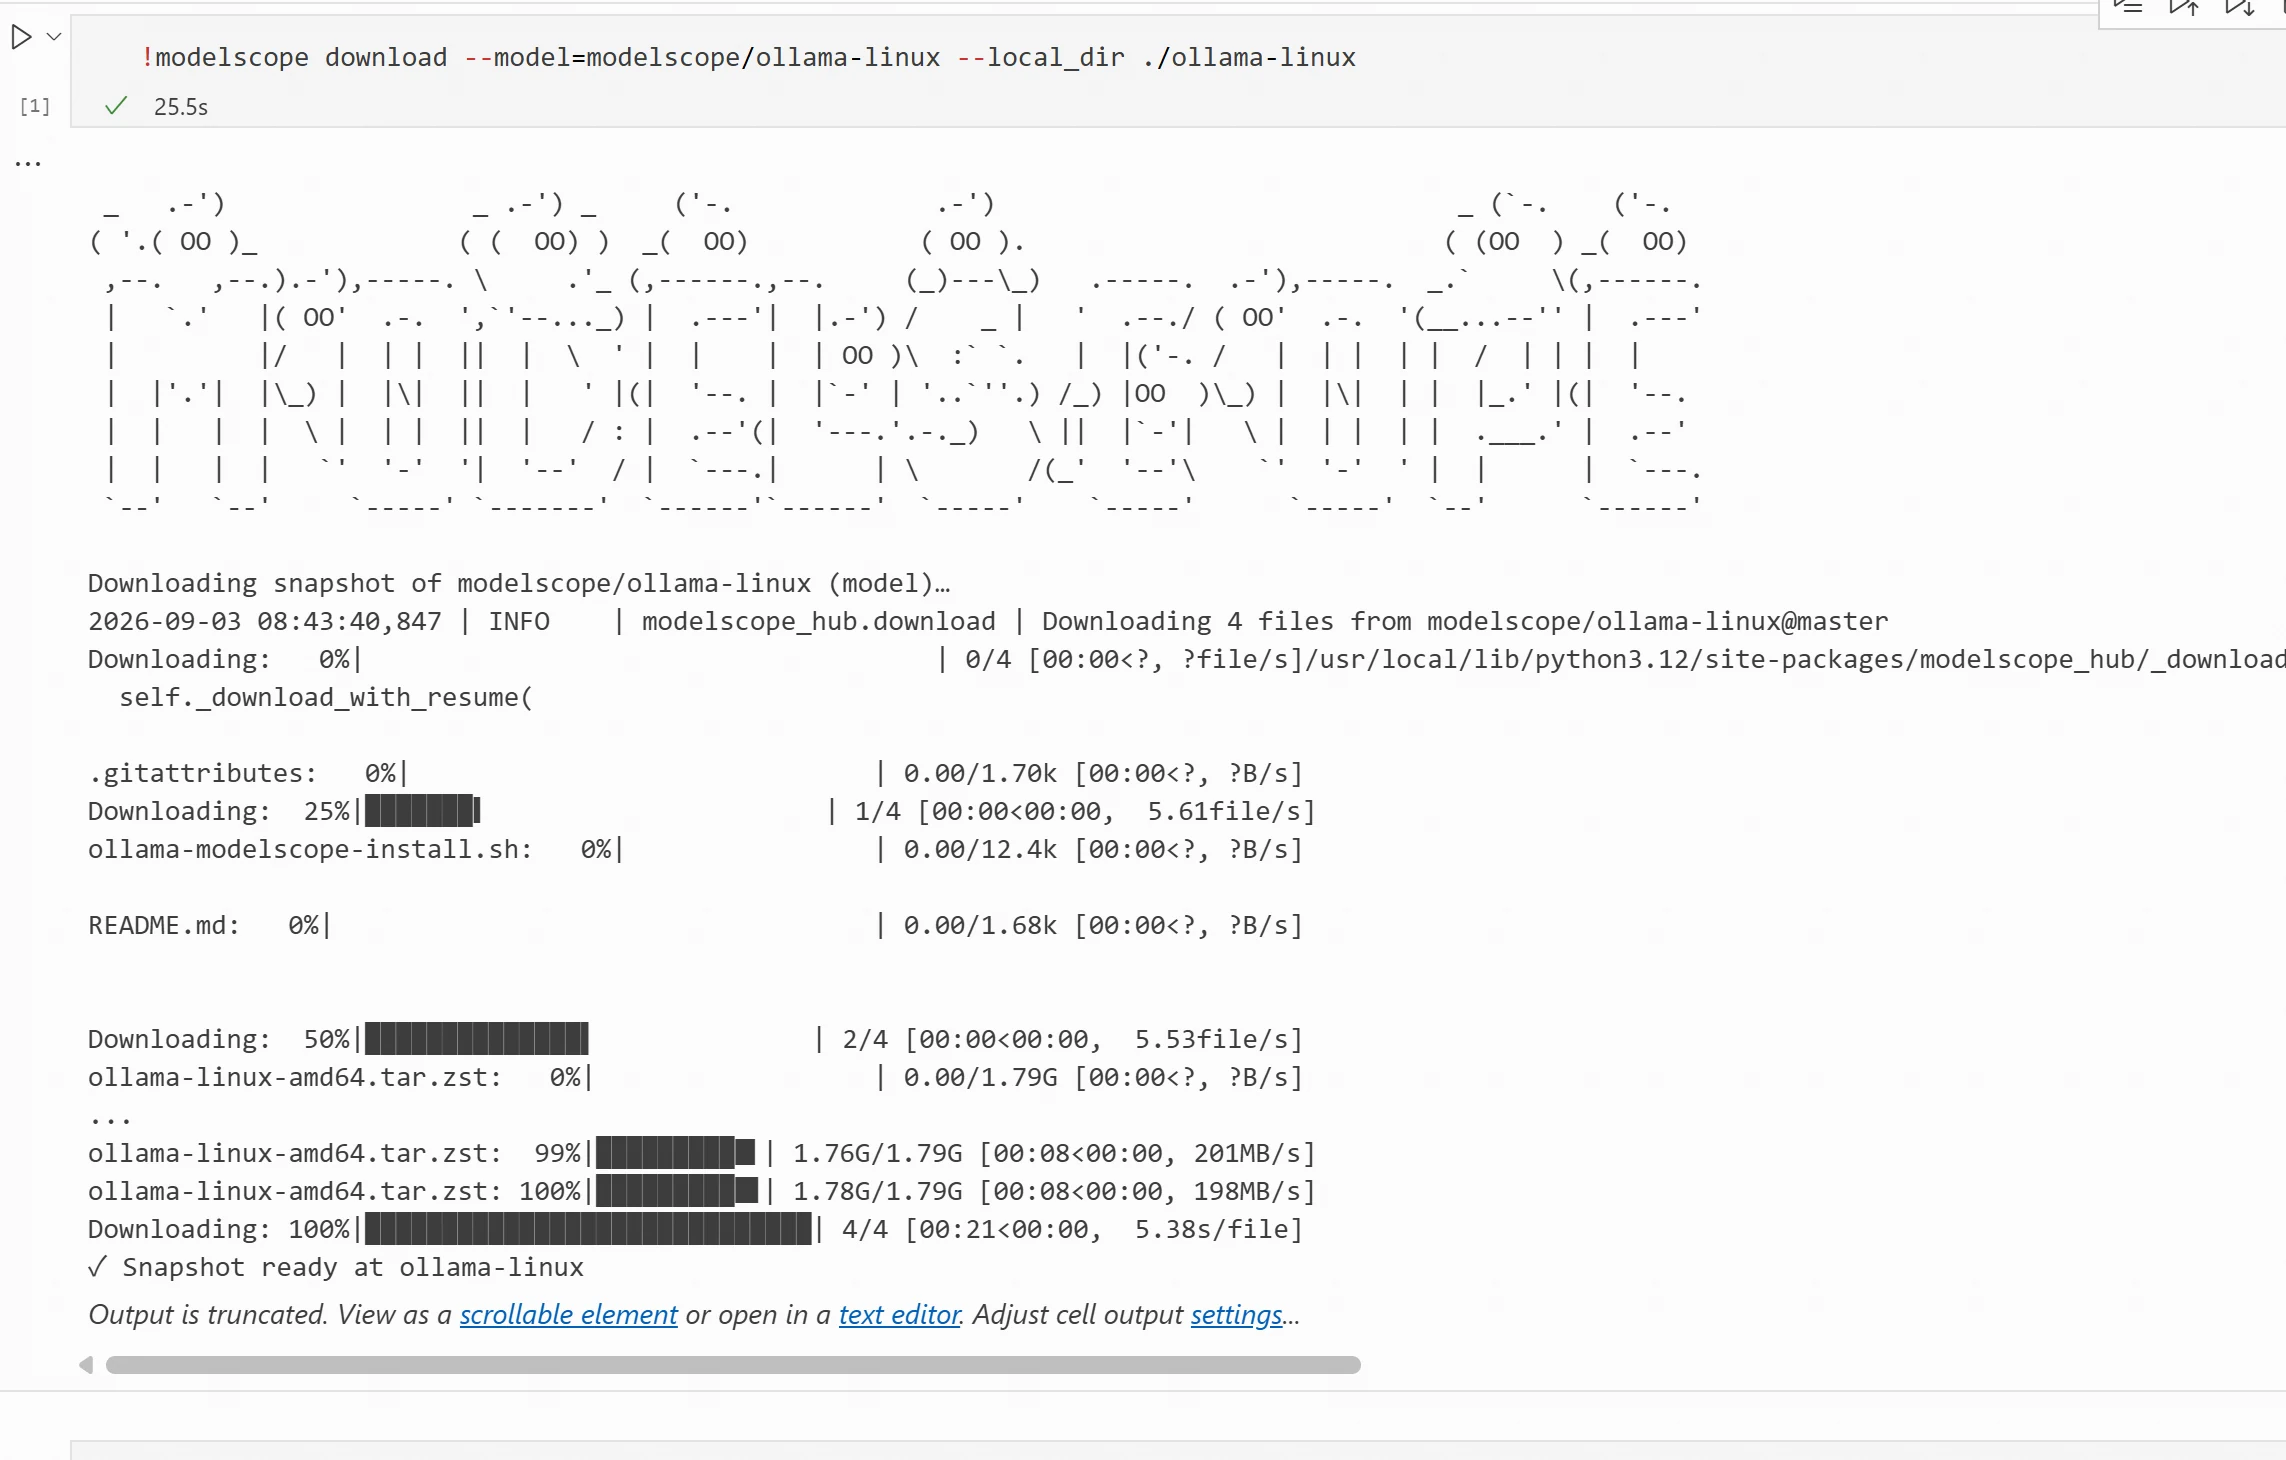
!modelscope download --model=modelscope/ollama-linux --local_dir ./ollama-linux
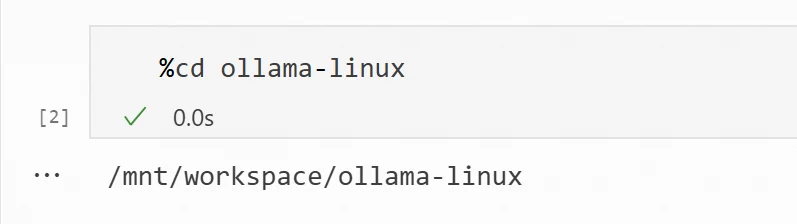
ollama-linux ونفذ الأمر التالي للتثبيت%cd ollama-linux
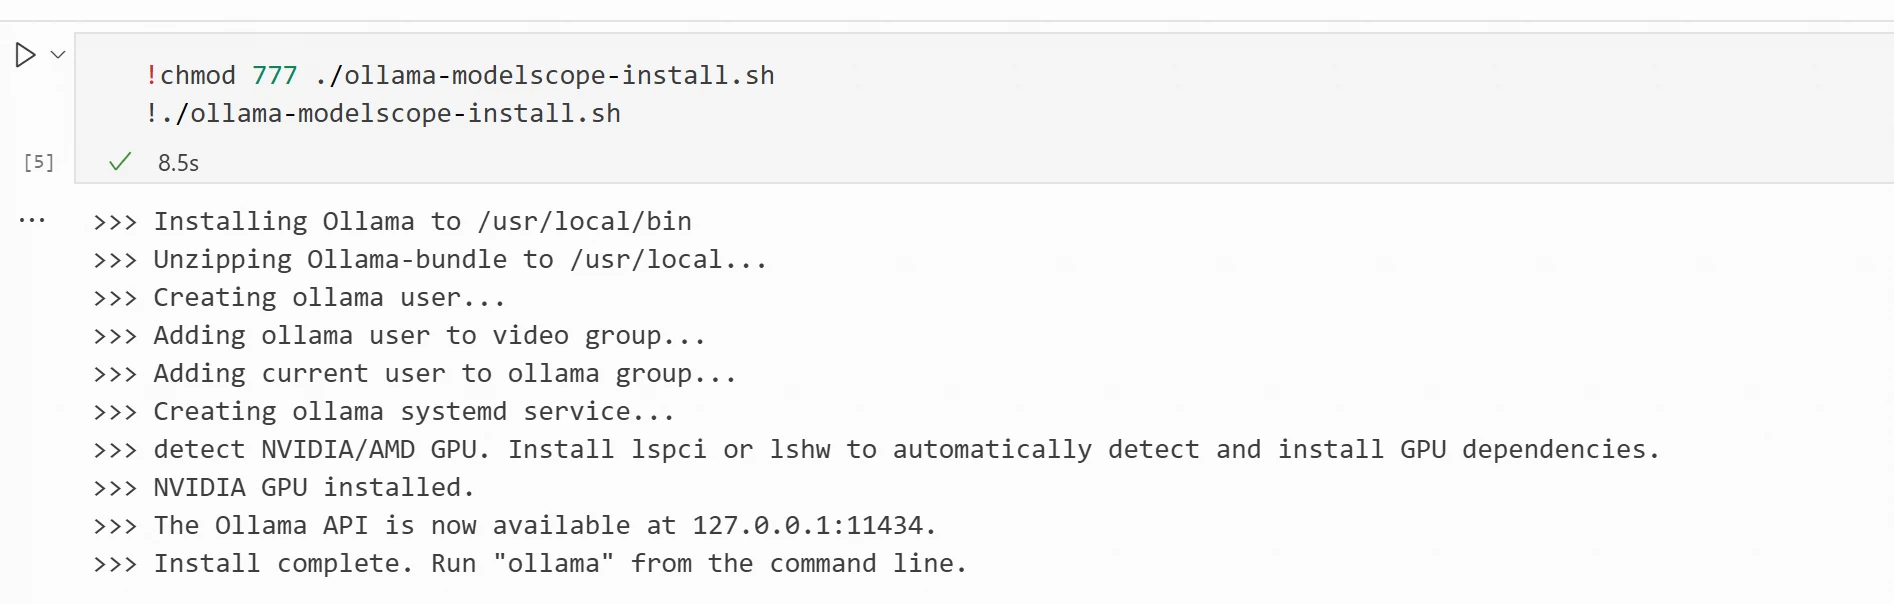
sudo chmod 777 ./ollama-modelscope-install.sh
./ollama-modelscope-install.sh
بعد التثبيت، سيُظهر معلومات نقطة نهاية API، الافتراضي 127.0.0.1:11434. إذا تمت إظهار المعلومات التالية، فإن التثبيت اكتمل.
خطوات التثبيت على Linux مidentical to تثبيت Ollama في ModelScope Notebook أعلاه.
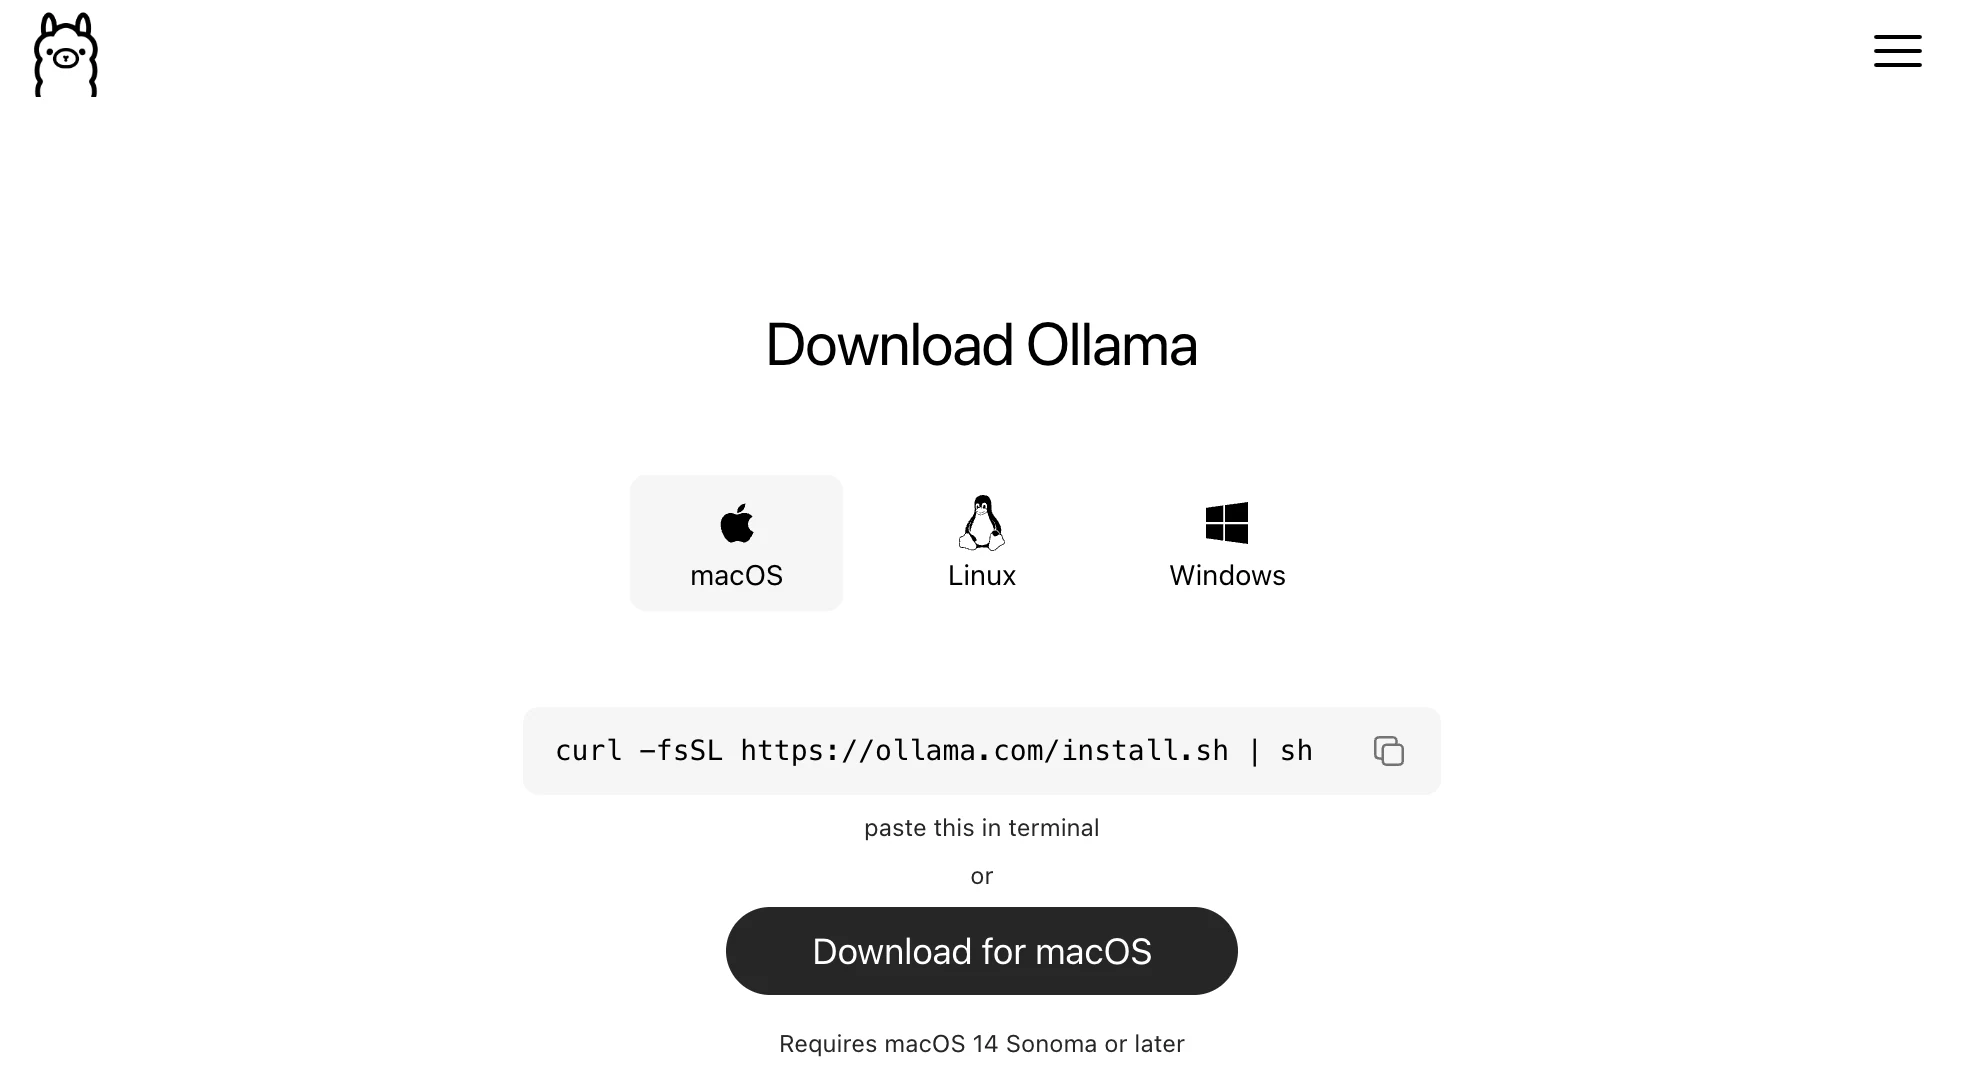
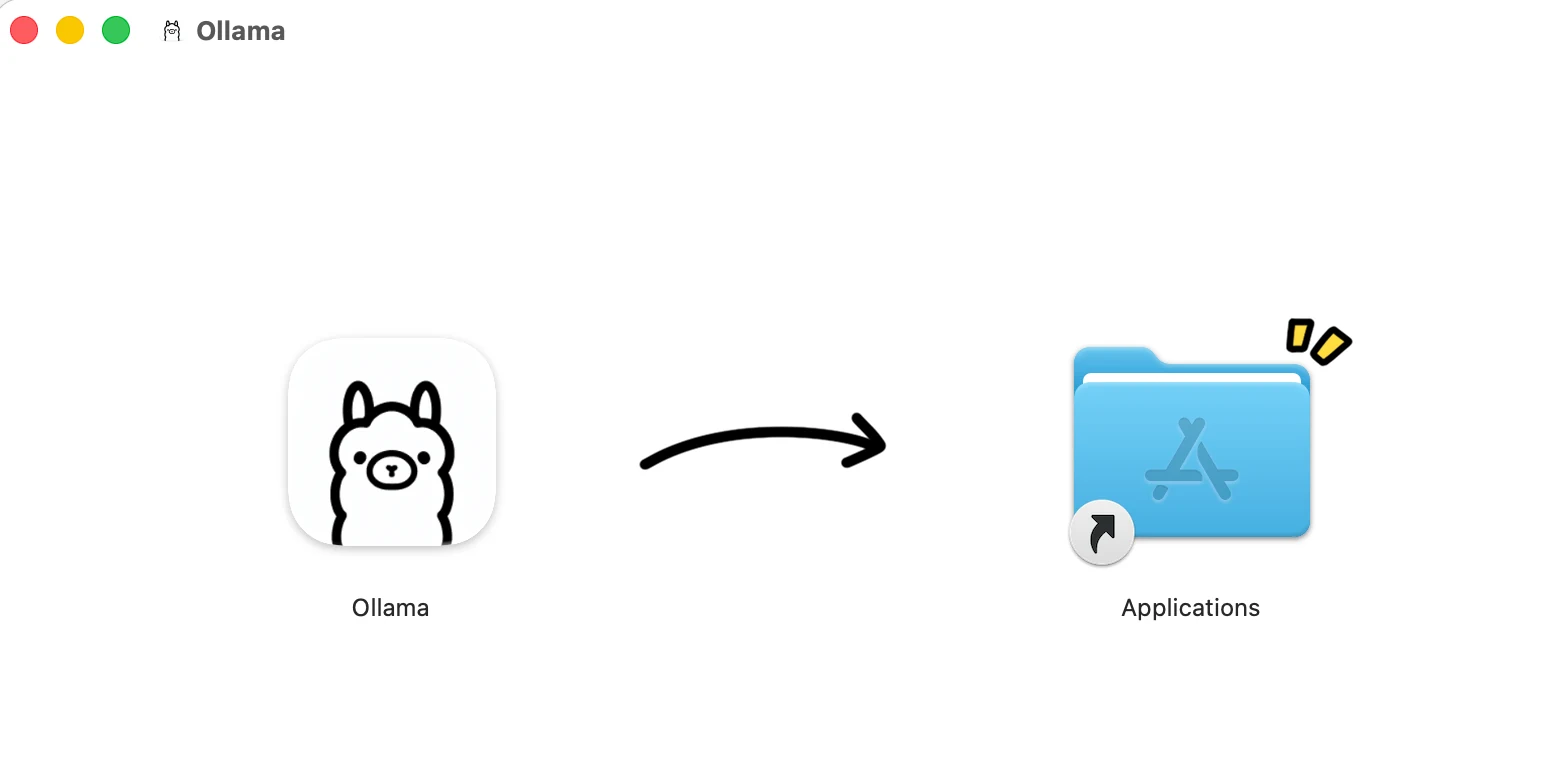
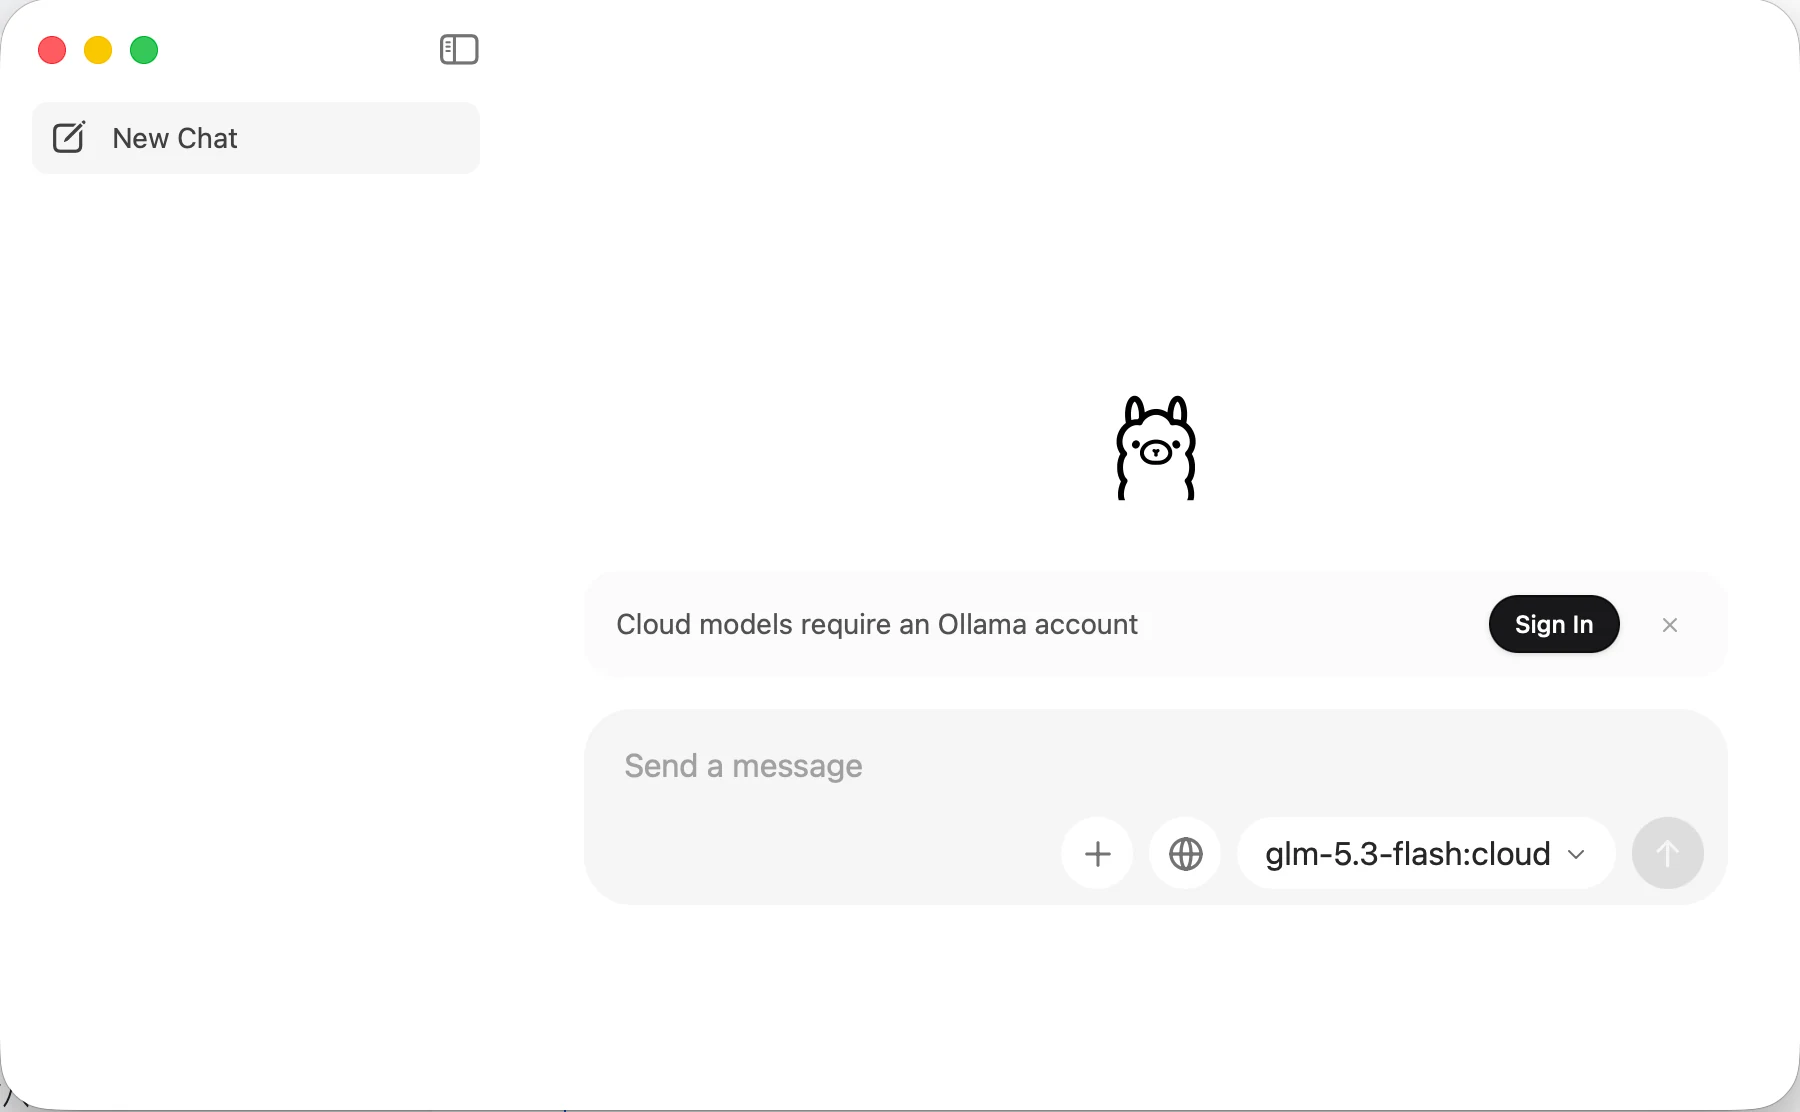
ollama run qwen3.5:2b
تُظهر خرج الصفحة أن النموذج قد بدأ بنجاح. في هذه النقطة، يمكنك إجراء محادثات مباشرة في العميل أو استدعاء API لاختبار النموذج.
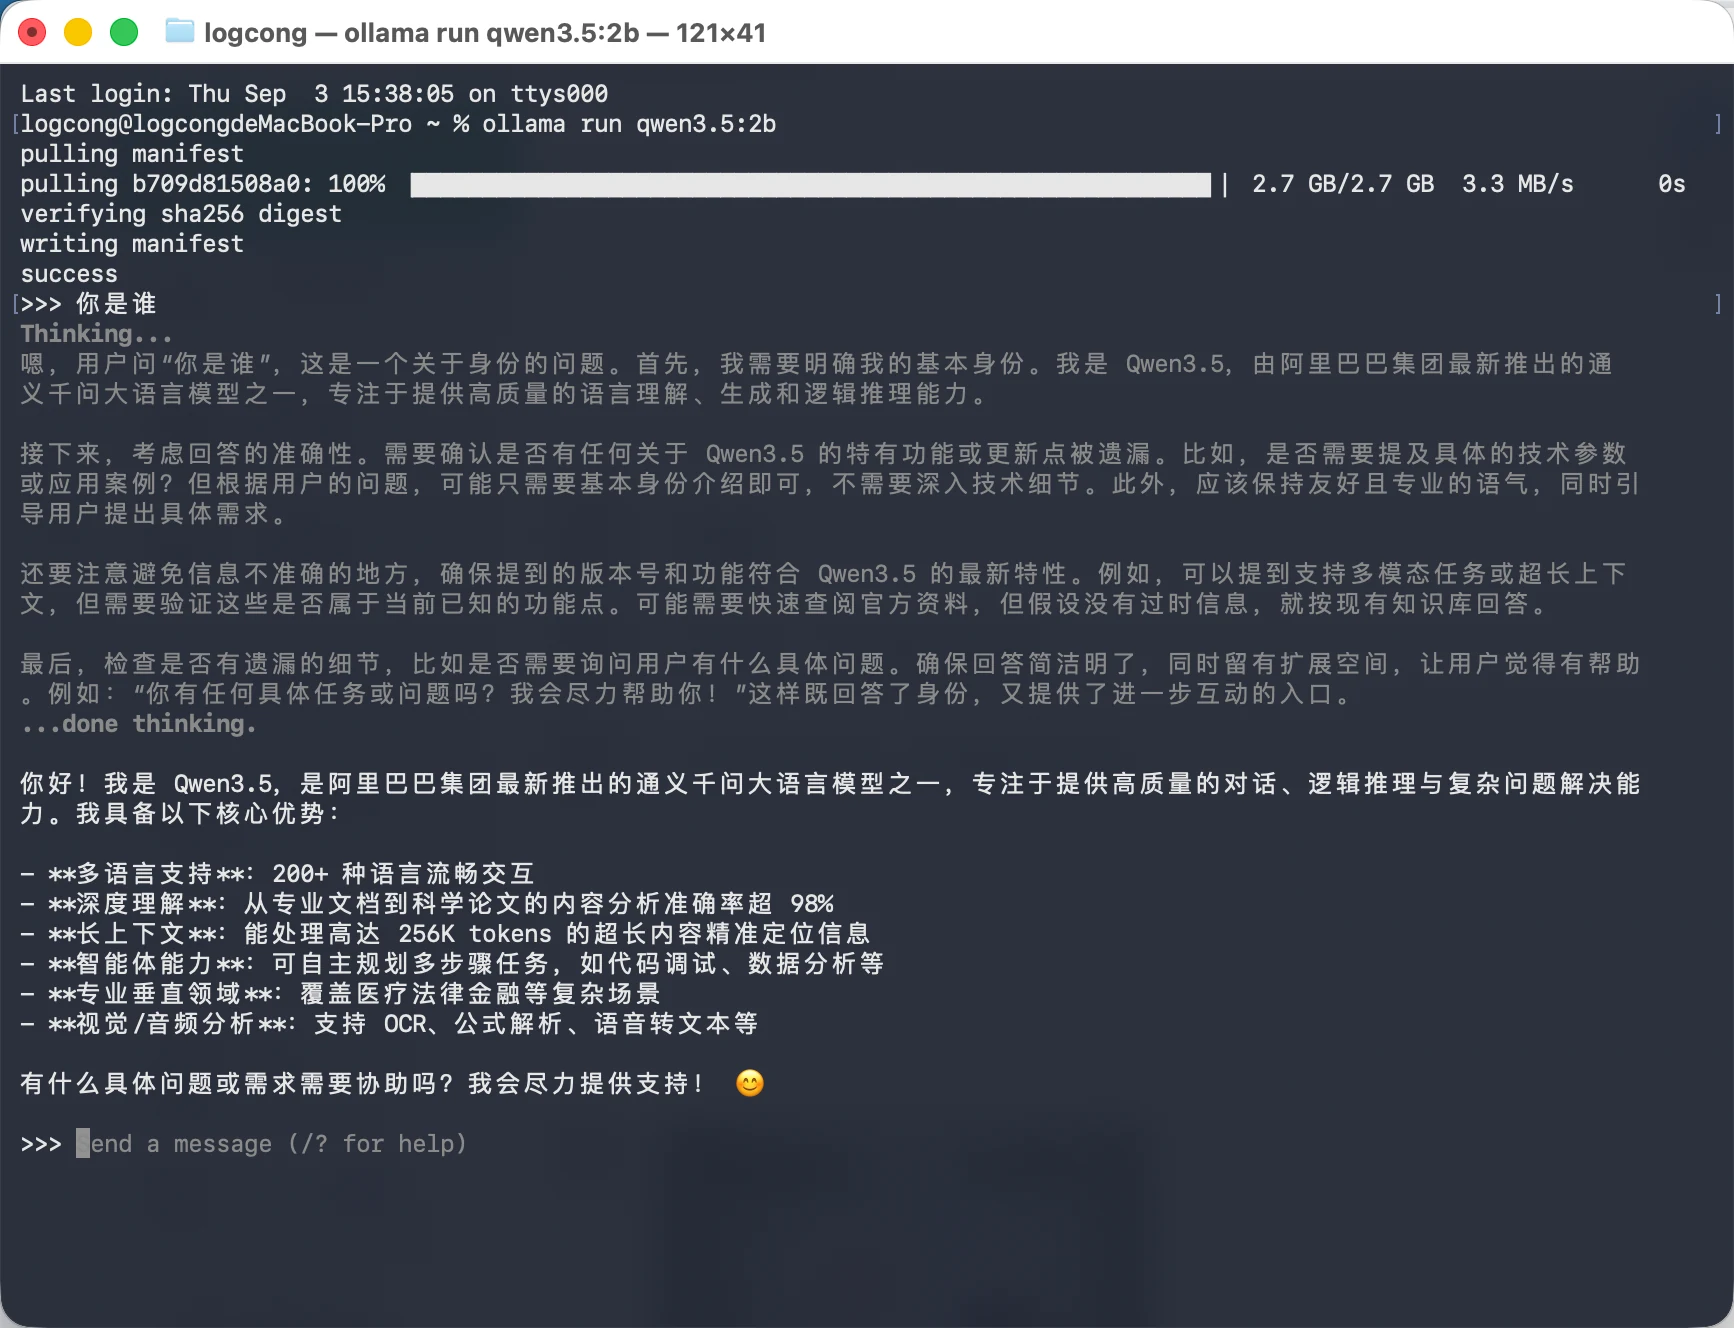
يمكنك أيضاً الدردشة في العميل.
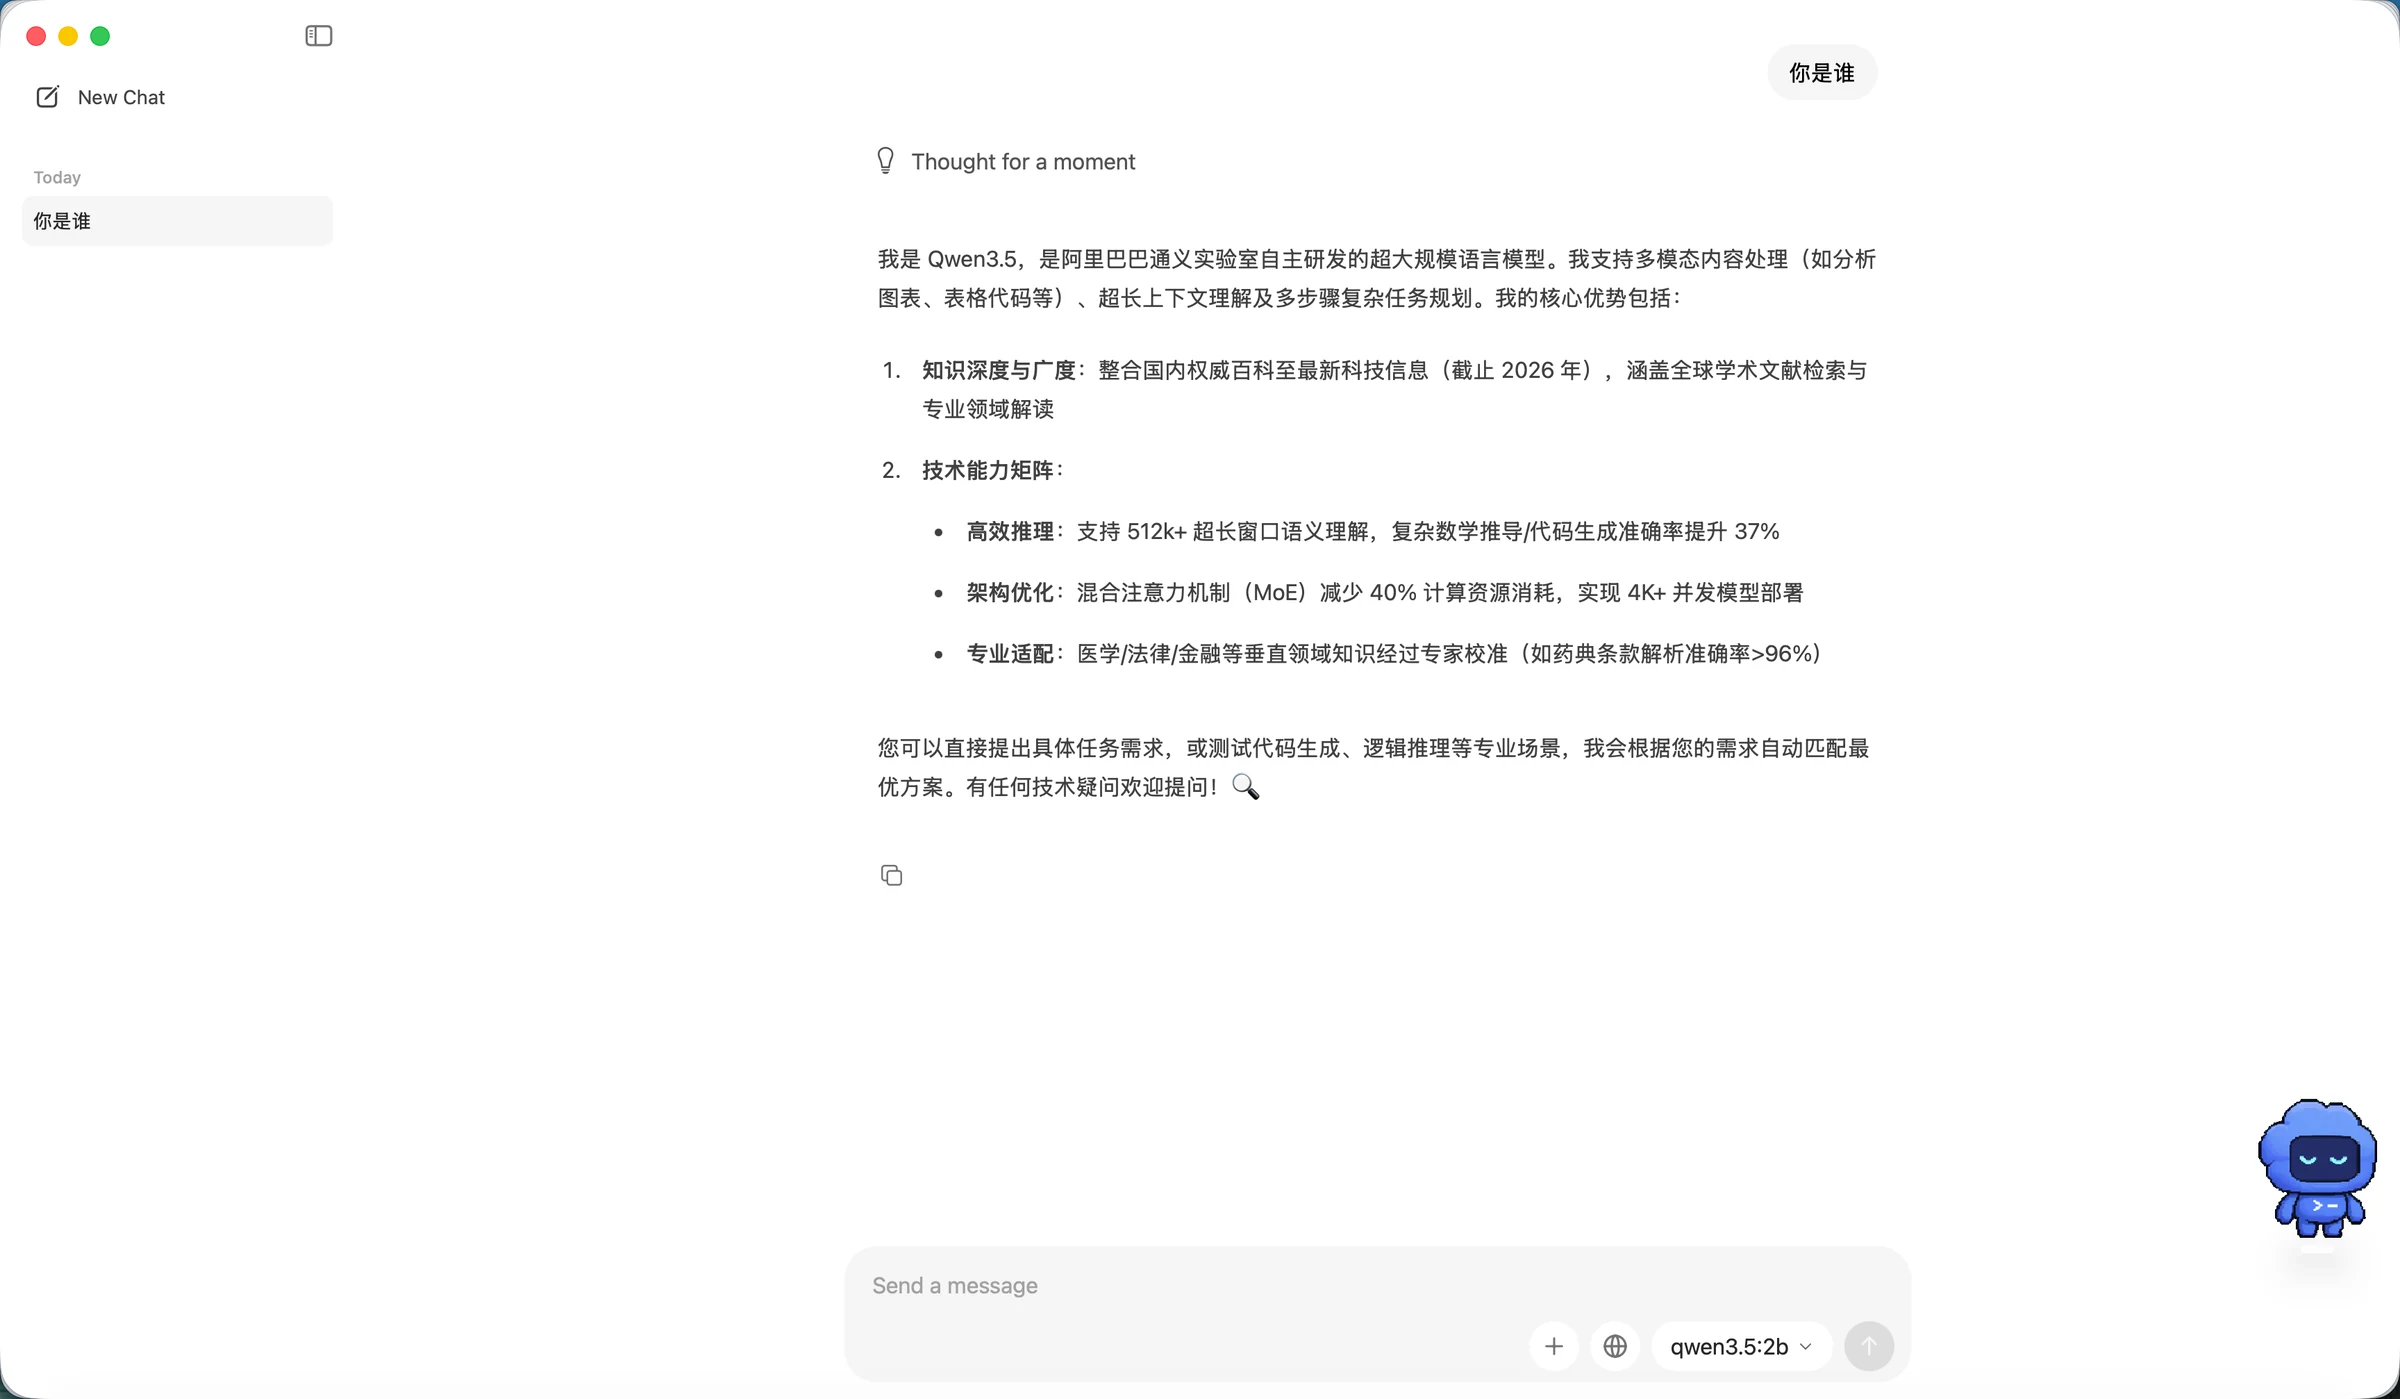
يوفر Ollama مستودعات نماذج كثيرة. يمكننا إيجاد النماذج التي نحتاجها في ModelScope وبدء تشغيلها مع Ollama.
للخدمات المستمرة، يمكن للنواة الواحدة في Jupyter تنفيذ خلية واحدة فقط في كل مرة، مما يصعب تنفيذ الخلايا اللاحقة. لذا يجب تنفيذ هذا الجزء في الطرفية. بعد فتح Notebook، اذهب مباشرة إلى مساحة العمل، حيث سترى "Terminal" في الأسفل. انقر عليه.
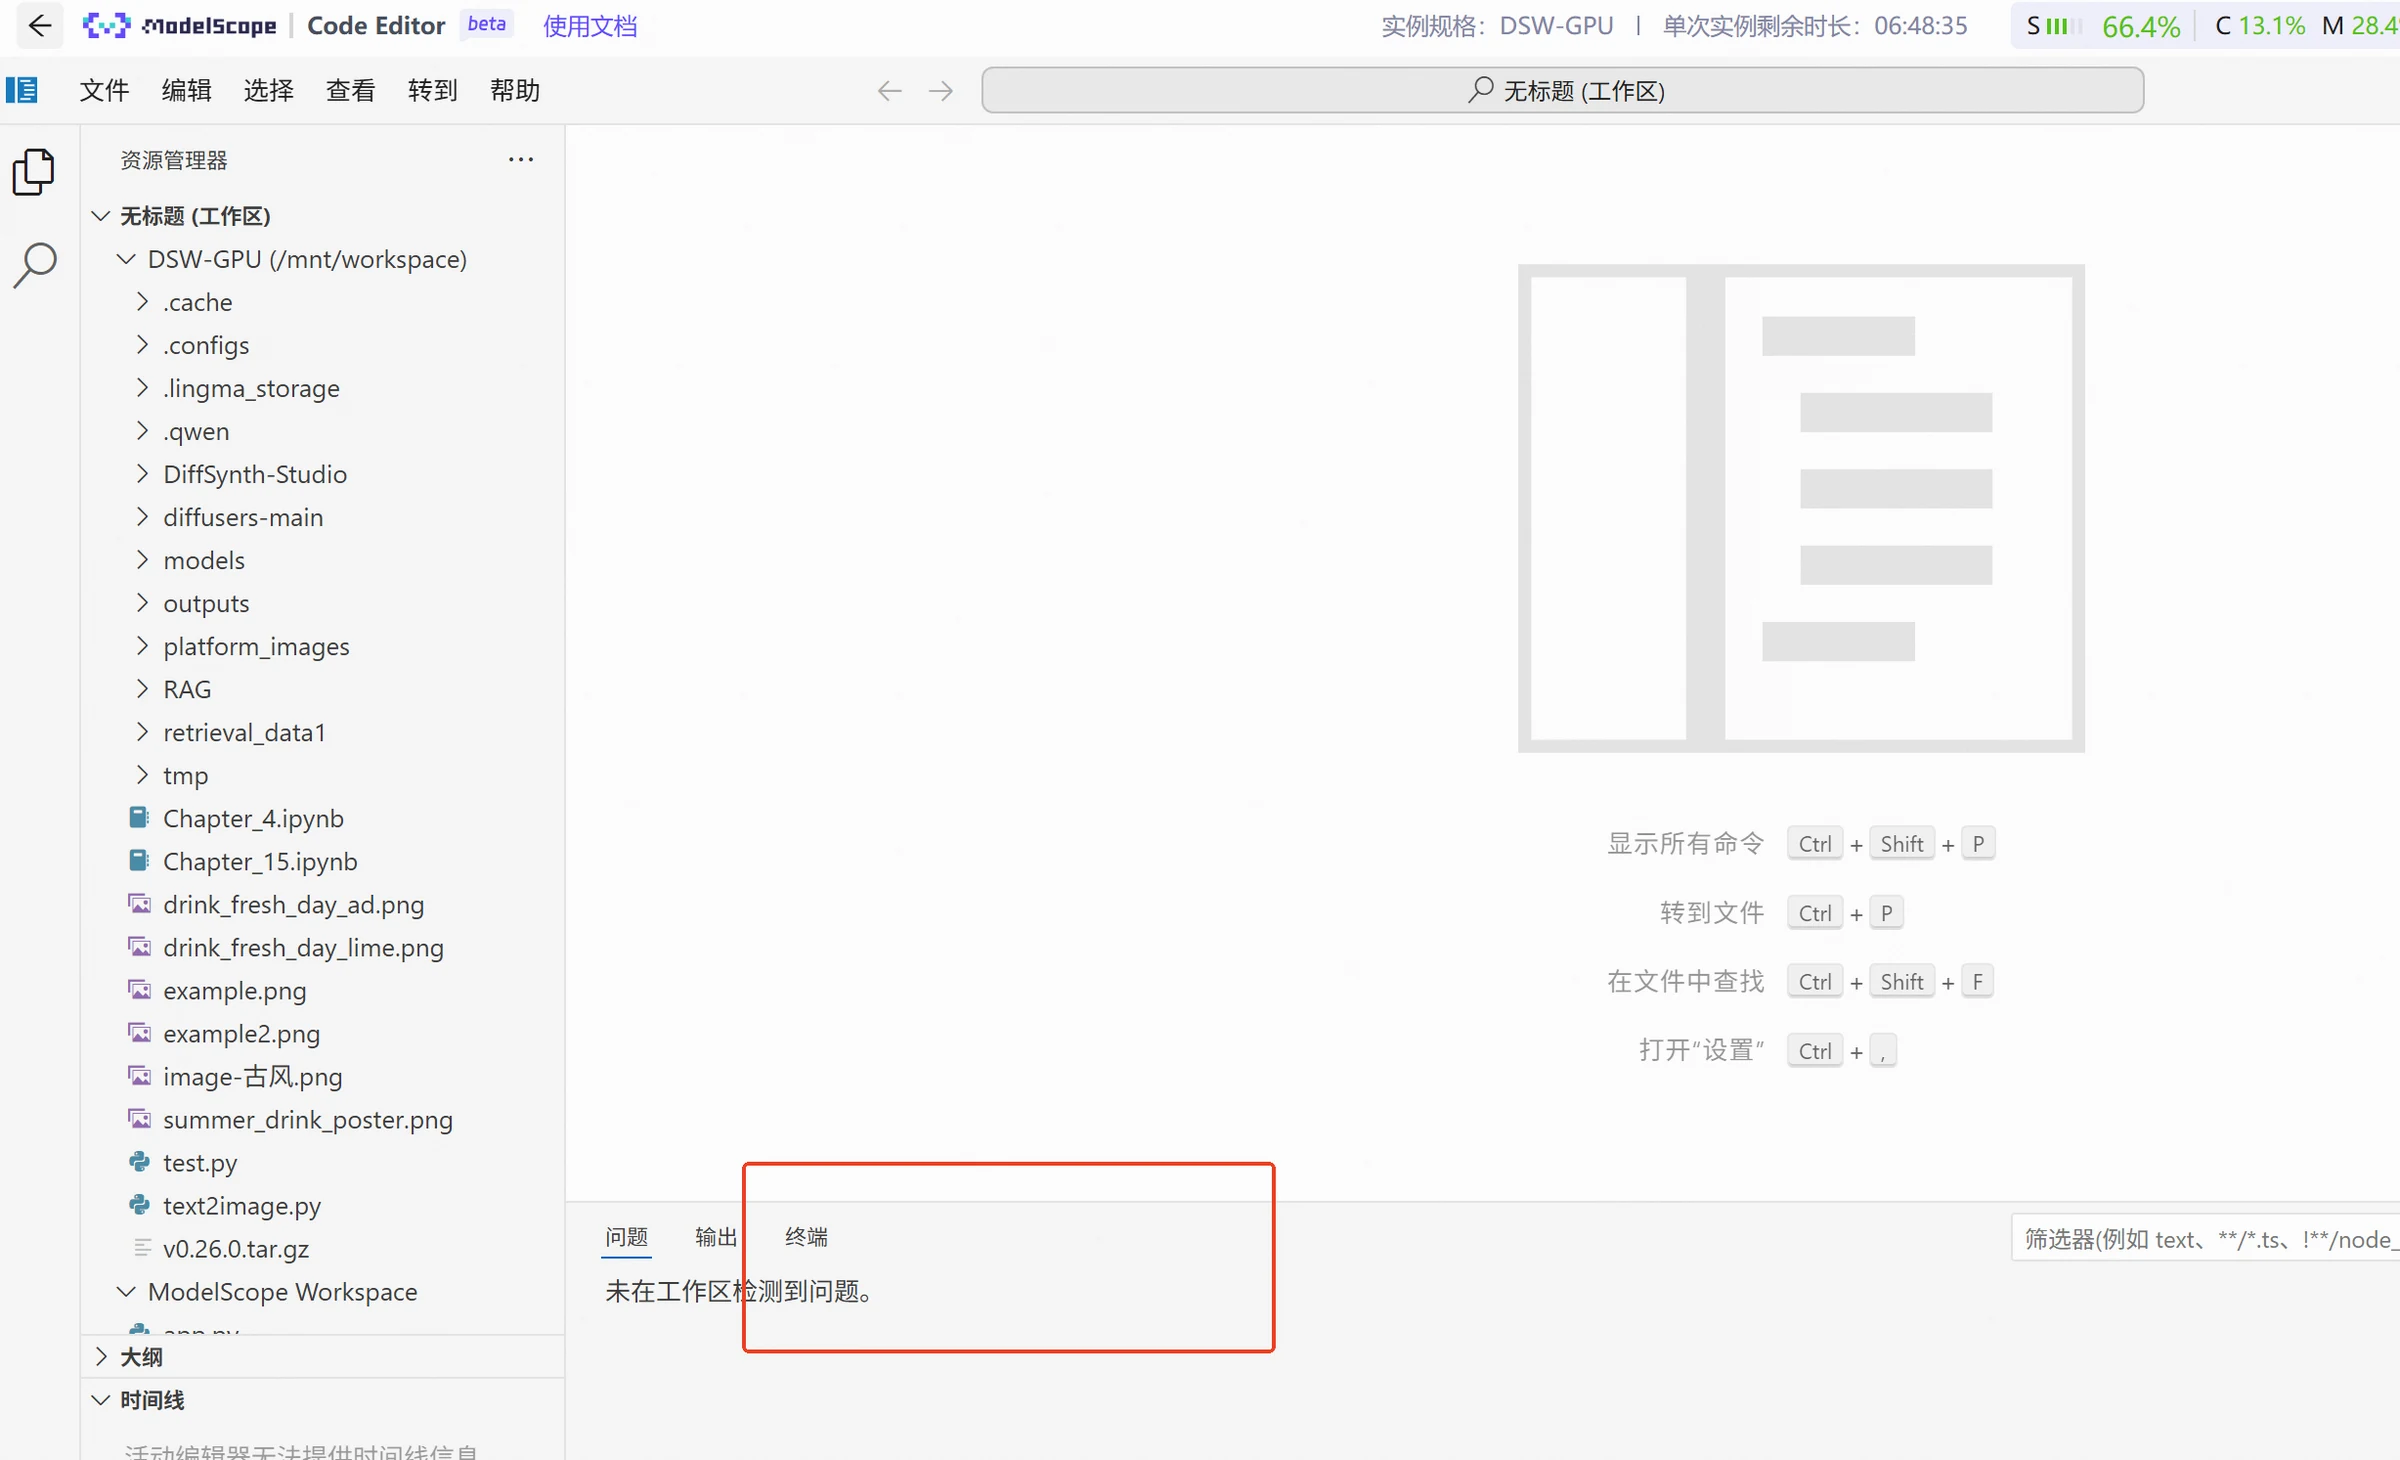
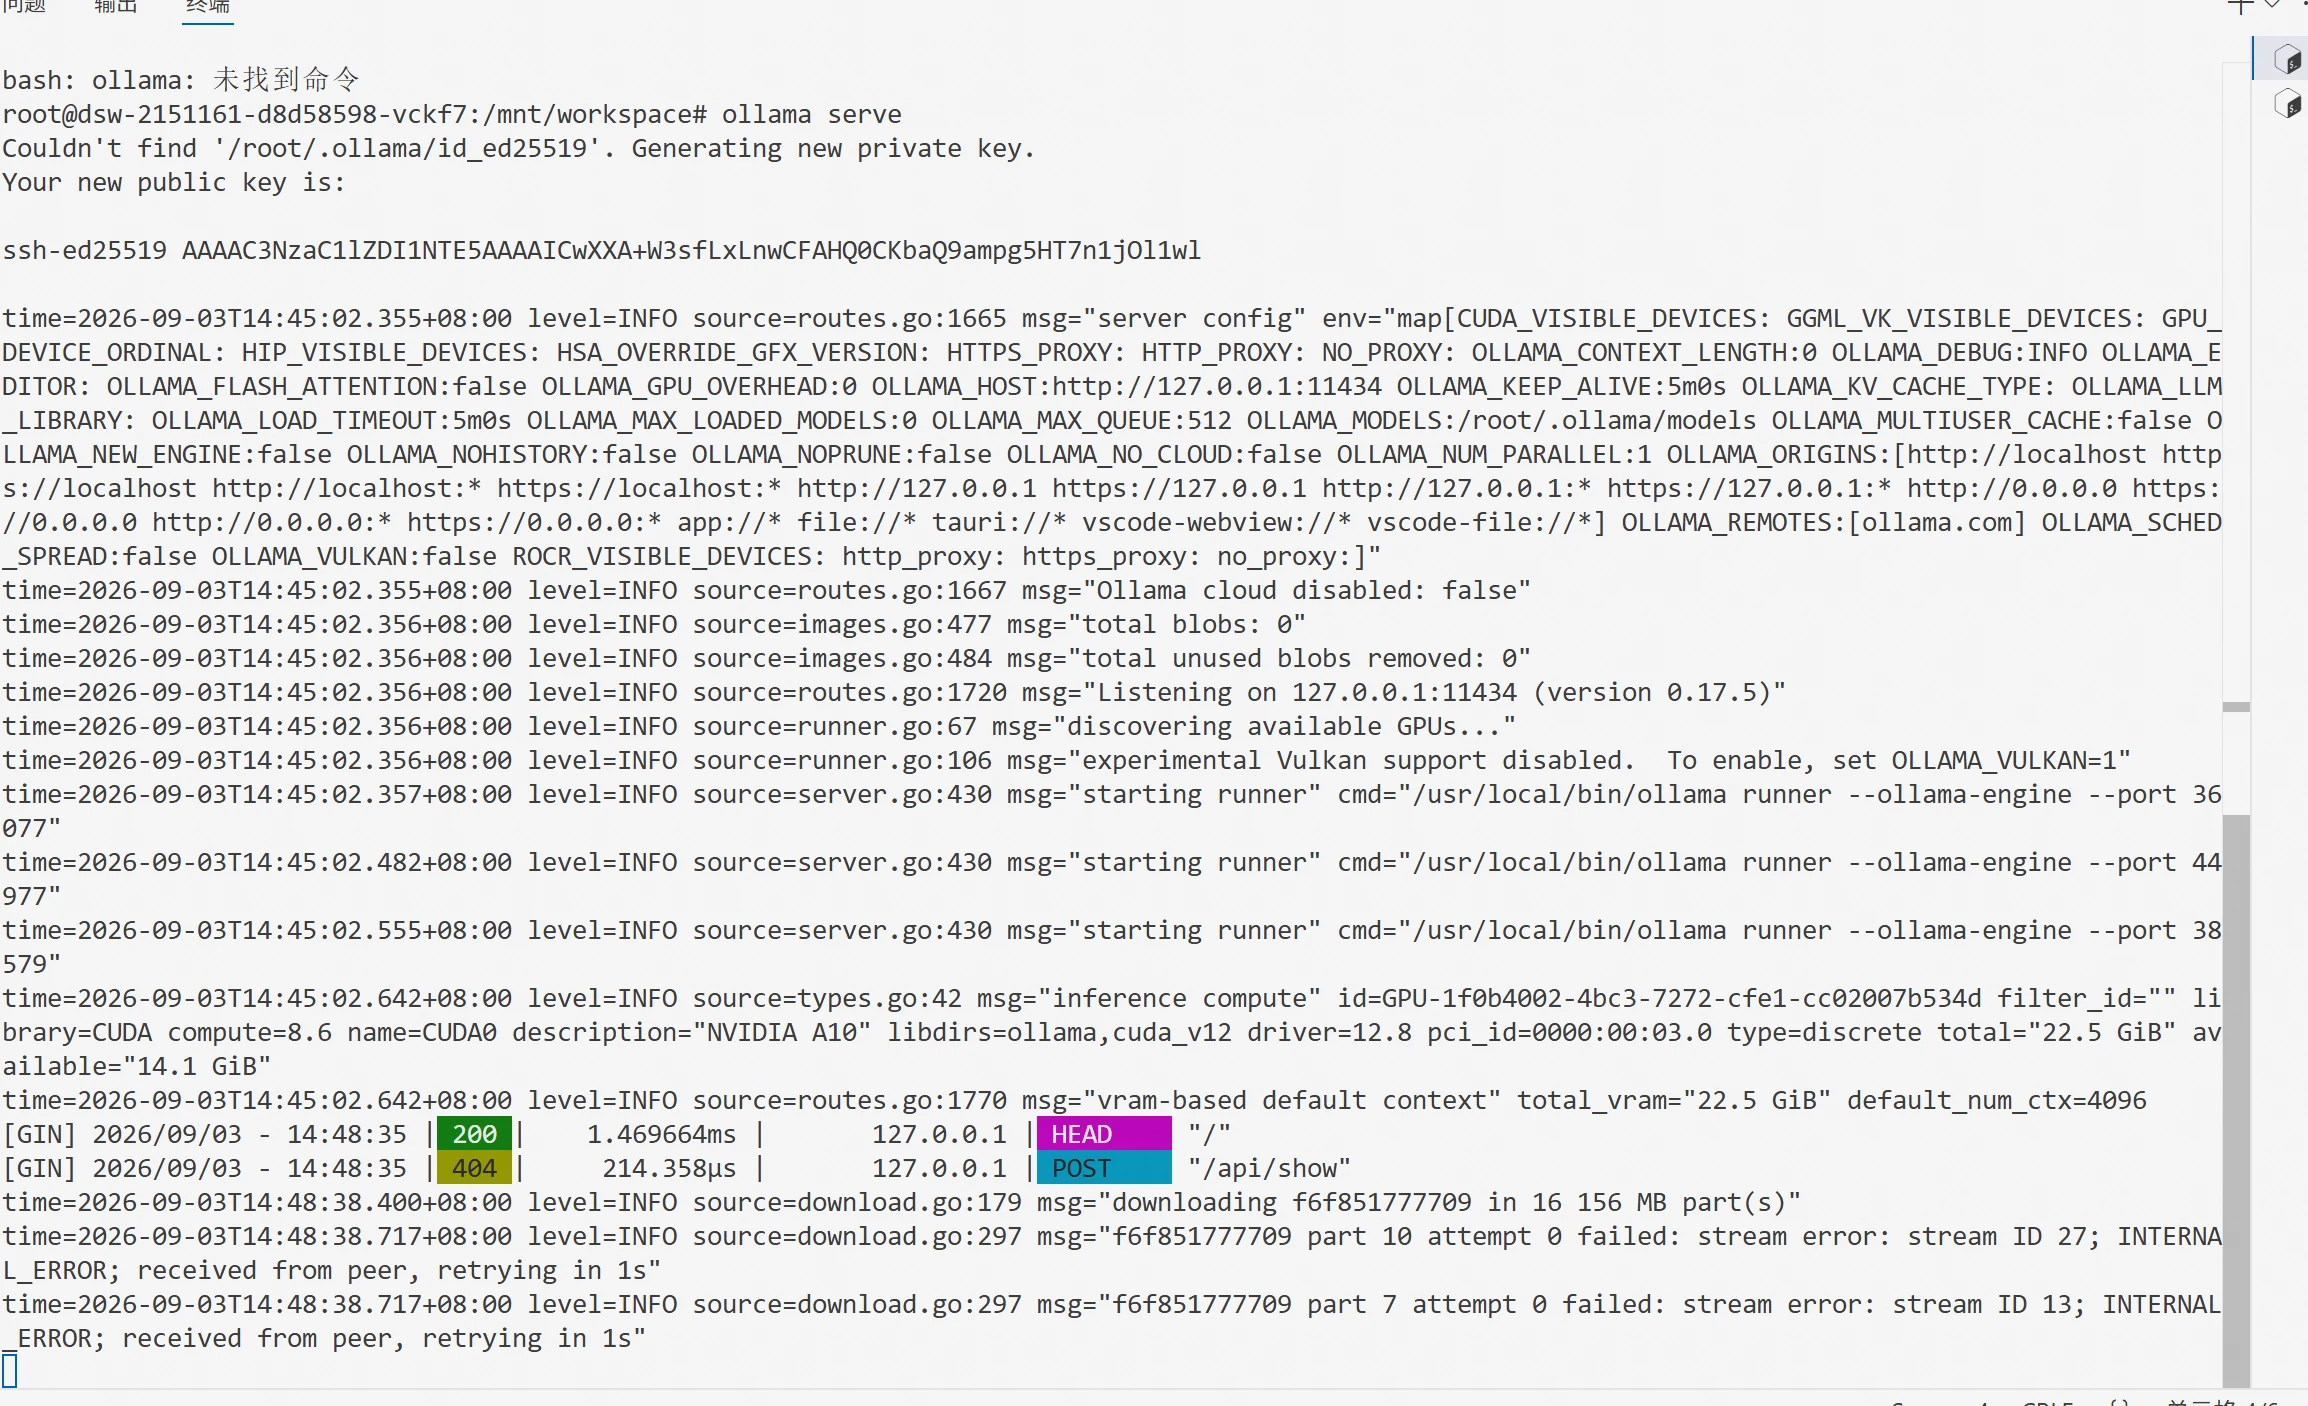
اكتب في الطرفية:
ollama serve
Qwen3-4B-GGUF. في المرة الأولى التي يعمل فيها النموذج، يحتاج إلى تنزيل الملفات المقابلة من مستودع النماذج. يجب أيضاً تنفيذ هذا الأمر في الطرفية. يمكنك فتح طرفية جديدة وتنفيذ الأمر التالي: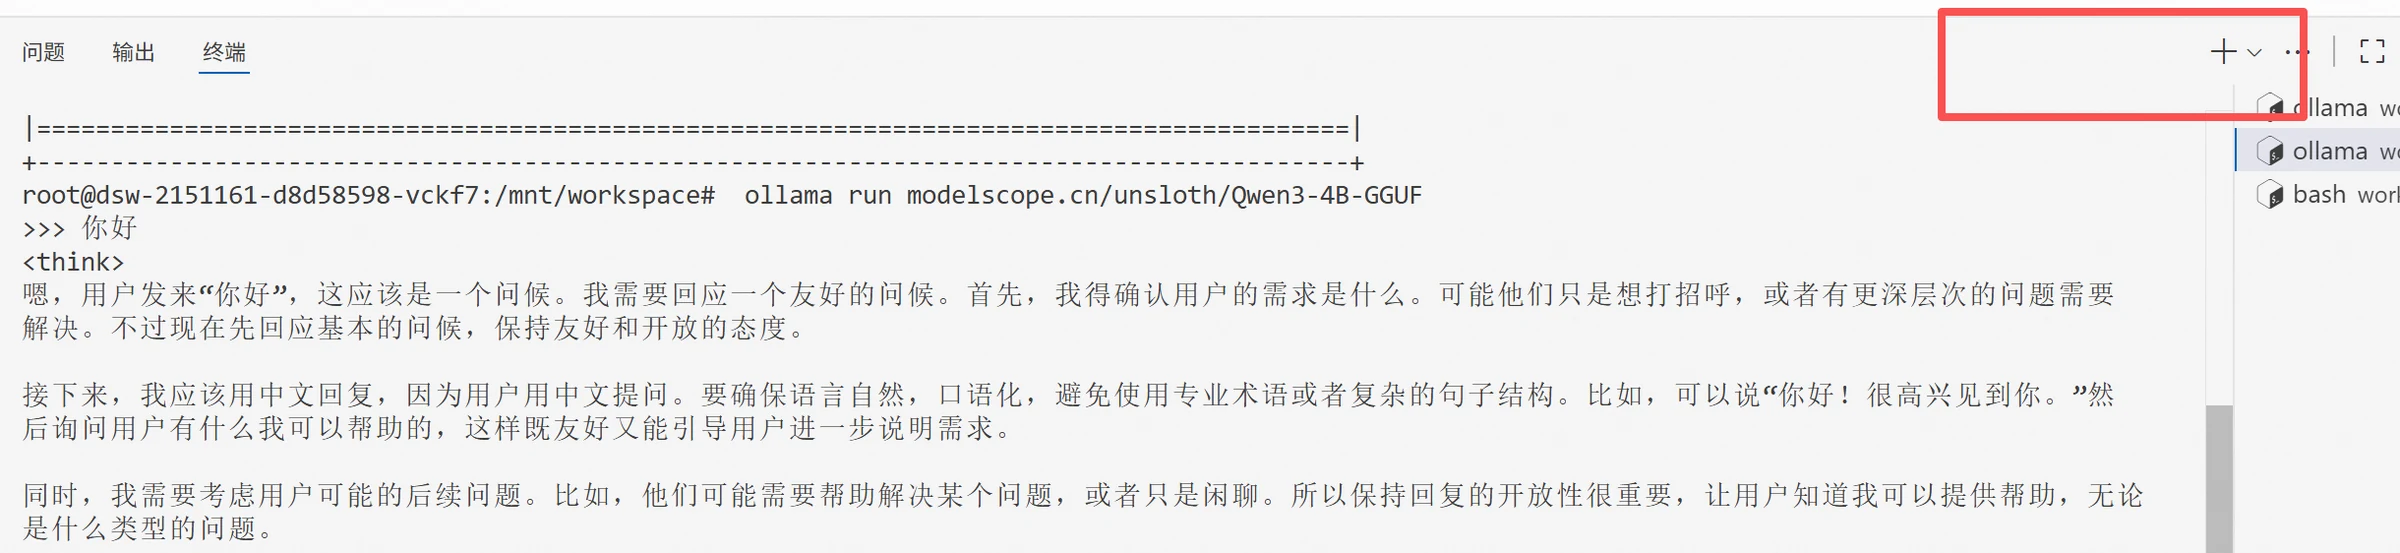
ollama run modelscope.cn/unsloth/Qwen3-4B-GGUF
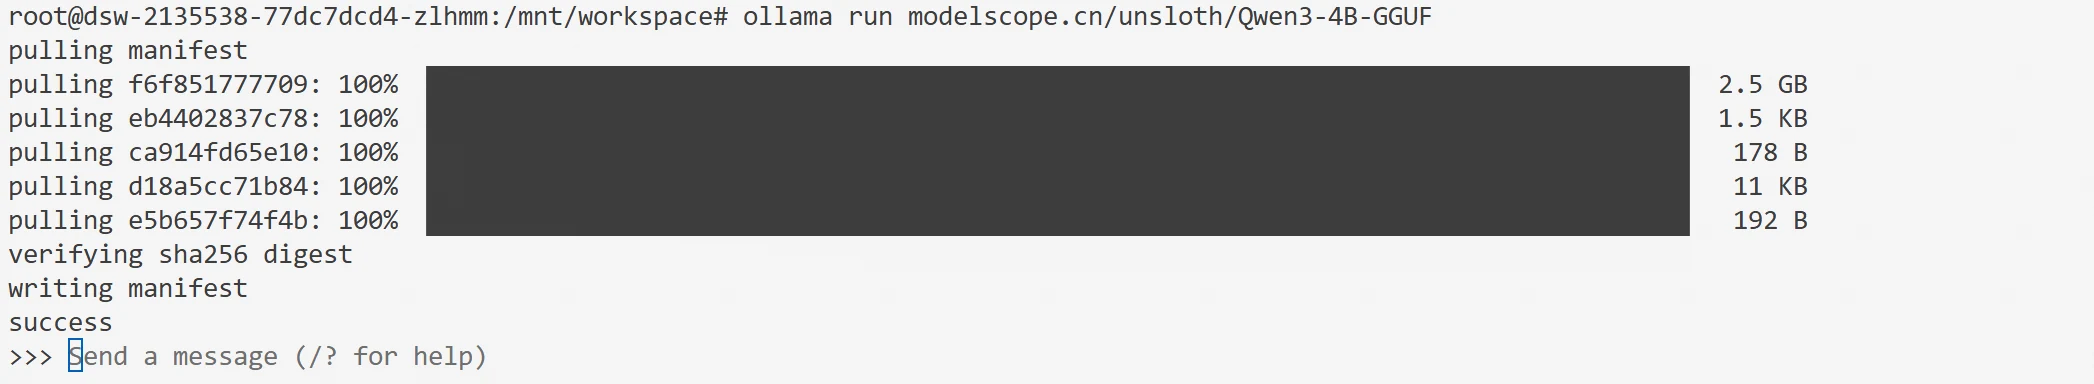
في هذه النقطة، بدأ النموذج. يمكنك استدعاء API لاختبار ما إذا كان نقطة نهاية النموذج متصلة. الكود كما يلي:
import requests
url = "http://127.0.0.1:11434/v1/chat/completions"
data = {
    "model": "modelscope.cn/unsloth/Qwen3-4B-GGUF",
    "messages": [
        {
            "role": "user",
            "content": "مرحباً، يرجى تقديم نفسك"
        }
    ],
    "max_tokens": 100
}

response = requests.post(url, json=data)

print("كود الحالة:", response.status_code)
print(response.text)
إذا كانت مكالمة النموذج ناجحة، ستُظهر نتيجة النموذج المقابلة.
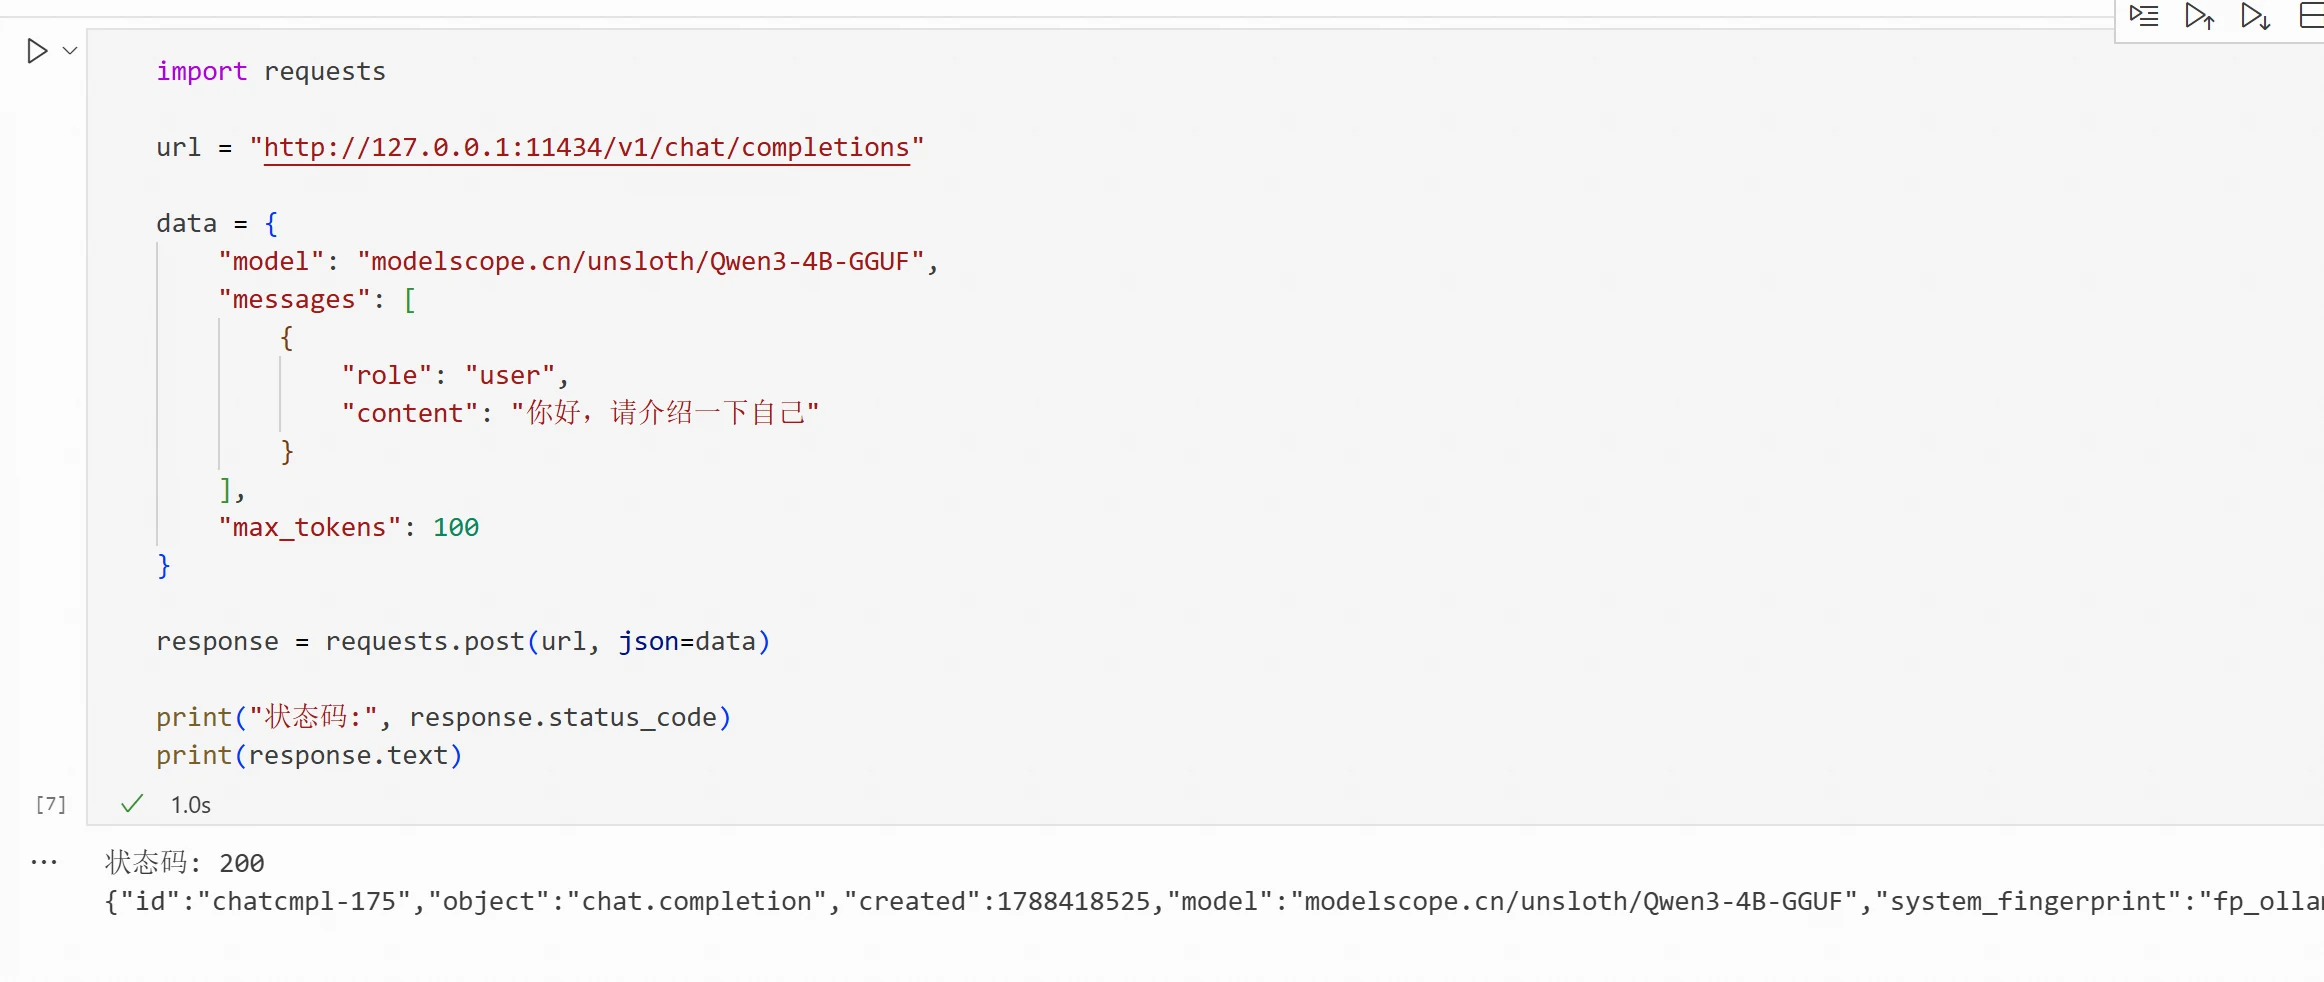
يمكنك الاطلاع على العملية التجريبية الكاملة لهذا الفصل على: https://modelscope.cn/gallery/liucong/b1ef397b-fe80-4fb9-812f-969fa25ea44c