التحسين الدقيق والتقييم • مبتدئ⏱️ 30 دقيقة للقراءة
Training Data Preparation
كيفية تحويل المواد التجارية إلى بيانات قابلة للتدريب
قبل تدريب نموذج، نواجه غالباً المشكلة التالية:
لديّ الكثير من المواد الخام وكتيبات المنتجات وأدلة التشغيل والمواصفات التجارية، كل منها بتنسيق خاص به، والمحتوى متفرق للغاية,
كيف يمكنني استخدام هذه البيانات؟
وإذا استخدمت مباشرة بيانات مجال أو سيناريو محدد، هل سيظل النموذج المدرب يملك القدرة على الإجابة عن أسئلة المعرفة العامة؟
لذلك، النقطة الرئيسية هي كيف يمكننا تحويل جميع المواد إلى بيانات تدريب يمكن للنموذج استخدامها.
في نفس الوقت، تنظيف البيانات وإزالة التكرار وإخفاء الهوية ضروريات أيضاً. ربما قمنا بتقطير البيانات، لكننا نحتاج لتكييفها مع النتائج المرجوة.
مثلاً، عند تدريب نموذج، إذا لم تكن بيانات التعرف على الذات مدربة بشكل صحيح، فقد يجيب بأنه نموذج ChatGPT أو نموذج Claude إلخ.
البيانات هي الأساس لكل شيء. في هذا الفصل، نبدأ من مصادر البيانات ونرى كيف تمر هذه المواد المتفرقة عبر التنظيف والتقطير وإزالة التكرار وإخفاء الهوية لتصبح بيانات قابلة لتدريب النموذج.
تعلم المهارات التجارية مع الحفاظ على القدرات العامة
جمع البيانات المدربة وتعليقاتها من الصفر يتطلب وقتاً وتكليفة كبيرين. للمهام الشائعة مثل تصنيف النصوص والأسئلة والإجابات وتوليد النصوص، يمكنك العثور على مجموعات بيانات مناسبة لتشغيلها في التدريب.
مجموعات البيانات العامة الشائعة تشمل:
تصنيف النصوص والاستدلال: GLUE و SuperGLUE و CLUE إلخ؛
فهم القراءة والأسئلة والإجابات: SQuAD و CMRC إلخ؛
ملخص النصوص: CNN/DailyMail إلخ؛
الحوار وضبط التعليمات: Alpaca و ShareGPT و OpenOrca إلخ؛
المهام متعددة الوسائط: COCO ومجموعات بيانات أخرى للصور والنصوص.
بالإضافة إلى الحصول على البيانات من مواقع مجموعات البيانات الرسمية، يمكنك أيضاً العثور على مجموعات بيانات مفتوحة المصدر واستخدامها عبر ModelScope Dataset Hub. يوفر Dataset Hub ميزات مثل البحث في مجموعات البيانات والمعاينة عبر الإنترنت والتنزيل. يمكن أيضاً تحميل بعض مجموعات البيانات مباشرة عبر ModelScope SDK للمعالجة والتدريب اللاحق. لطرق تنزيل مجموعات البيانات المحددة، راجع فصل "البيانات: أساس ضبط نماذج مفتوحة المصدر".
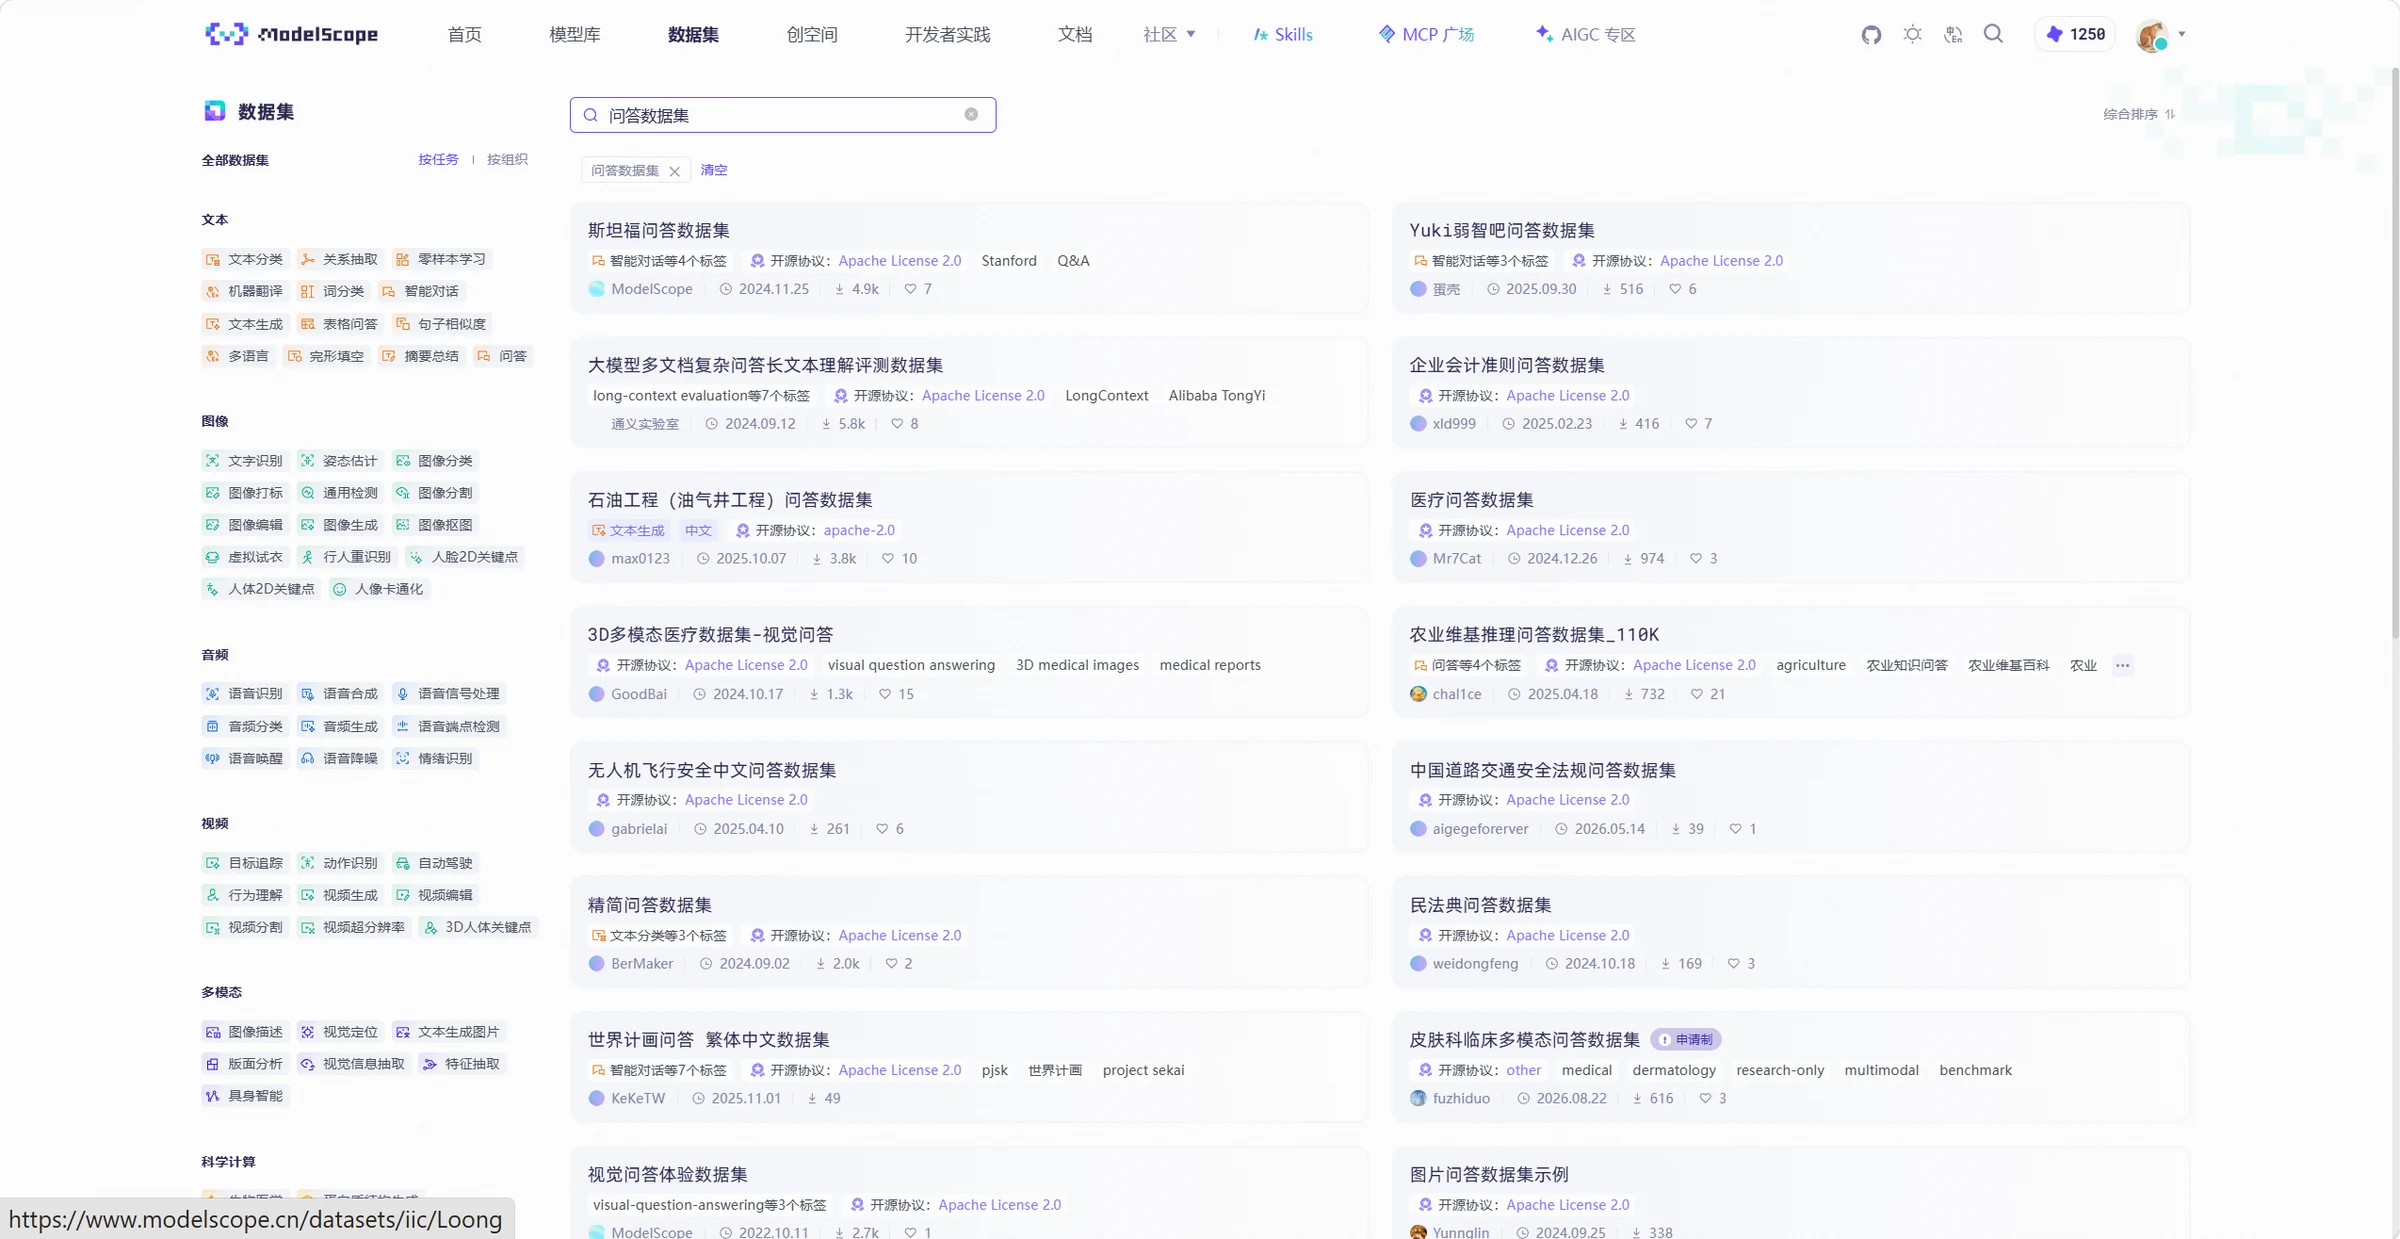
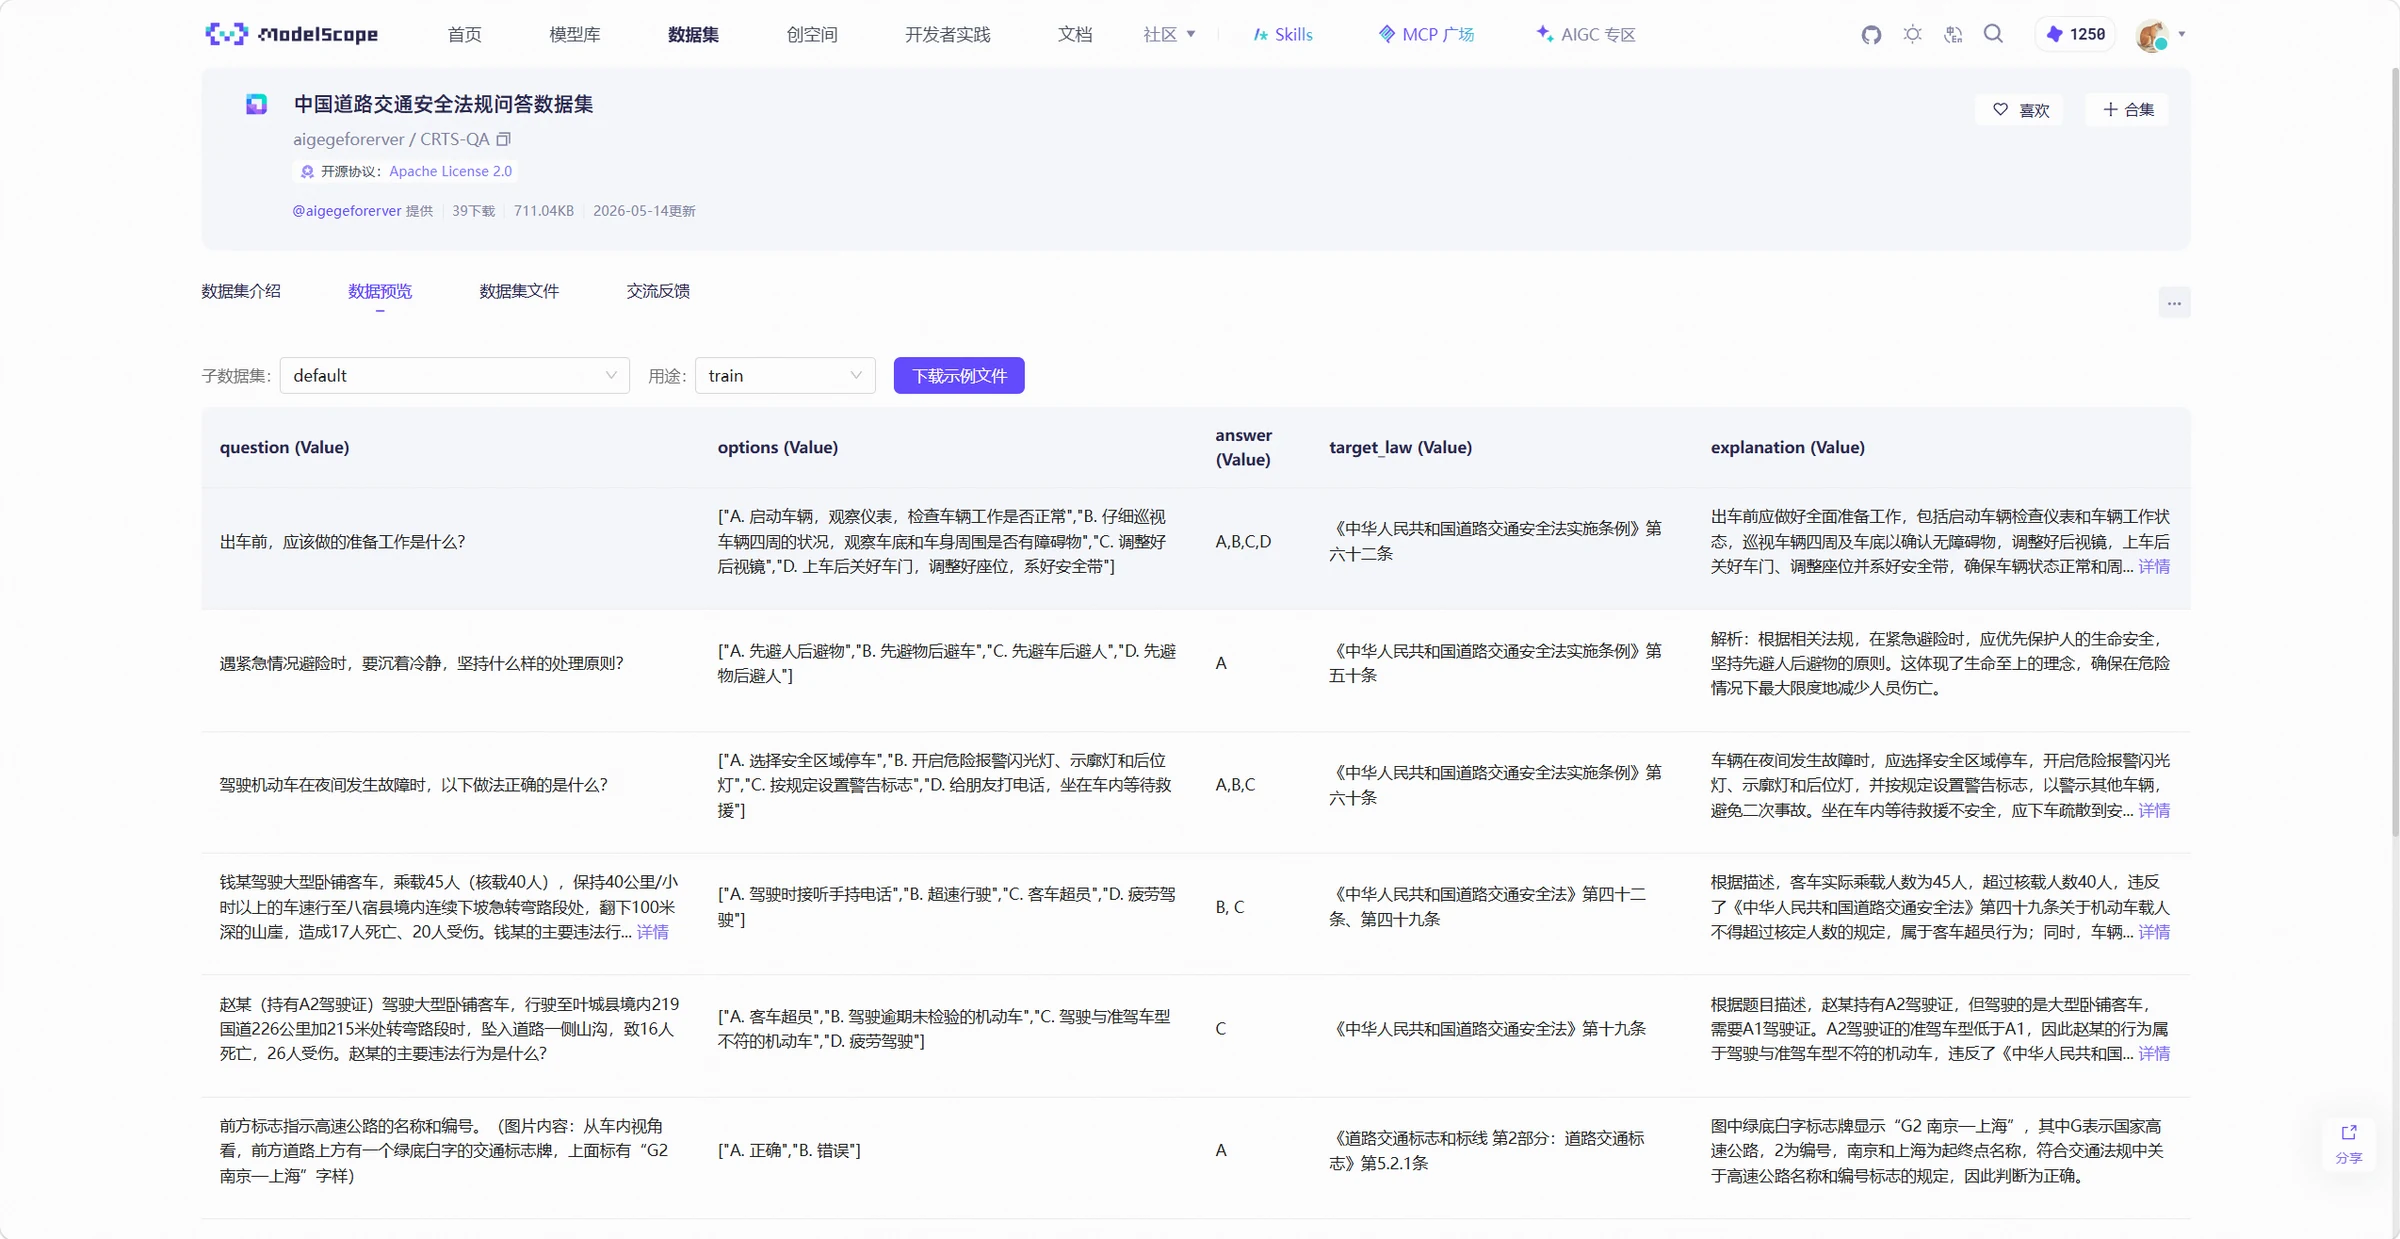
عند اختيار مجموعات البيانات مفتوحة المصدر، يجب عليك لا فقط التحقق مما إذا كان محتوى البيانات يتطابق مع مهمة التدريب، بل أيضاً التحقق من عدد العينات وتنسيق الحقول وأنواع التسميات وجودة البيانات لمعرفة ما إذا كانت تلبي متطلبات التدريب. ميزة معاينة البيانات المقدمة من ModelScope يمكن أن تساعد في عرض حقول مجموعات البيانات ومحتوى العينات بسرعة، كما هو موضح في المثال التالي:
البيانات مفتوحة المصدر تُستخدم بشكل أساسي لإكمال القدرات العامة للنموذج. إذا كان النموذج يحتاج لتعلم المنتجات الداخلية للمؤسسة والمصطلحات وقواعد الأعمال وسير العمل، فيجب إعداد البيانات التجارية المناسبة.
البيانات التجارية تأتي من أنظمة ومواد حقيقية داخل المؤسسة، مما يجعلها أقرب إلى السيناريوهات التي سيتم استخدام النموذج فيها في النهاية. بيانات الأسئلة والإجابات العامة يمكن أن تساعد النموذج في تعلم أنماط الأسئلة والإجابات الأساسية، بينما بيانات الأسئلة والإجابات الداخلية للمؤسسة يمكن أن تساعد النموذج بشكل إضافي في تعلم أسماء المنتجات والمصطلحات التجارية وقواعد المعالجة.
مصادر البيانات التجارية الشائعة تشمل:
وثائق المؤسسة: كتيبات المنتجات وأدلة التشغيل والمواصفات التجارية ووثائق العمليات، والتي يمكن استخراج معرفة المنتج وقواعد الأعمال والعمليات التشغيلية منها؛
سجلات خدمة العملاء: المحادثات التاريخية وأوراق العمل وسجلات الشكاوى بين المستخدمين وخدمة العملاء، والتي يمكن استخدامها لبناء التعرف على النية وبيانات الأسئلة والإجابات والحوار؛
الأسئلة الشائعة: الأسئلة والإجابات المعيارية التي جمعها موظفو الأعمال، والتي يمكن تحويلها مباشرة إلى بيانات تدريب الأسئلة والإجابات؛
حالات الخبراء: المشاكل النموذجية التي عالجها خبراء الأعمال وحلولها، والتي يمكن استخدامها لبناء بيانات تدريب لسيناريوهات الأعمال المعقدة.
البيانات التجارية لا يمكن استخدامها عموماً مباشرة لتدريب النموذج. كتيب أعمال من عدة عشرات الصفحات يحتاج أولاً إلى استخراج محتواه النصي من ملفات Word أو PDF أو غيرها، ثم تنظيمه في أزواج أسئلة وإجابات أو عينات تصنيف أو بيانات تعليمات وفقاً لمهمة التدريب. سجلات خدمة العملاء قد تحتوي أيضاً على رسائل النظام والمحادثات غير الصالحة والمحتوى المكرر، والتي تحتاج إلى فرزها وتنظيمها أولاً.
البيانات التجارية قد تحتوي أيضاً على معلومات حساسة مثل الأسماء وأرقام الهواتف وأرقام الهوية والعناوين وأرقام الحسابات. قبل الدخول إلى مجموعة بيانات التدريب، يجب إجراء إخفاء الهوية وفقاً لمتطلبات أمان البيانات في المؤسسة لتجنب استخدام المعلومات الحساسة الحقيقية مباشرة لتدريب النموذج.
فقط وثائق بدون أسئلة وإجابات؟ دع النموذج يساعد في توليد البيانات
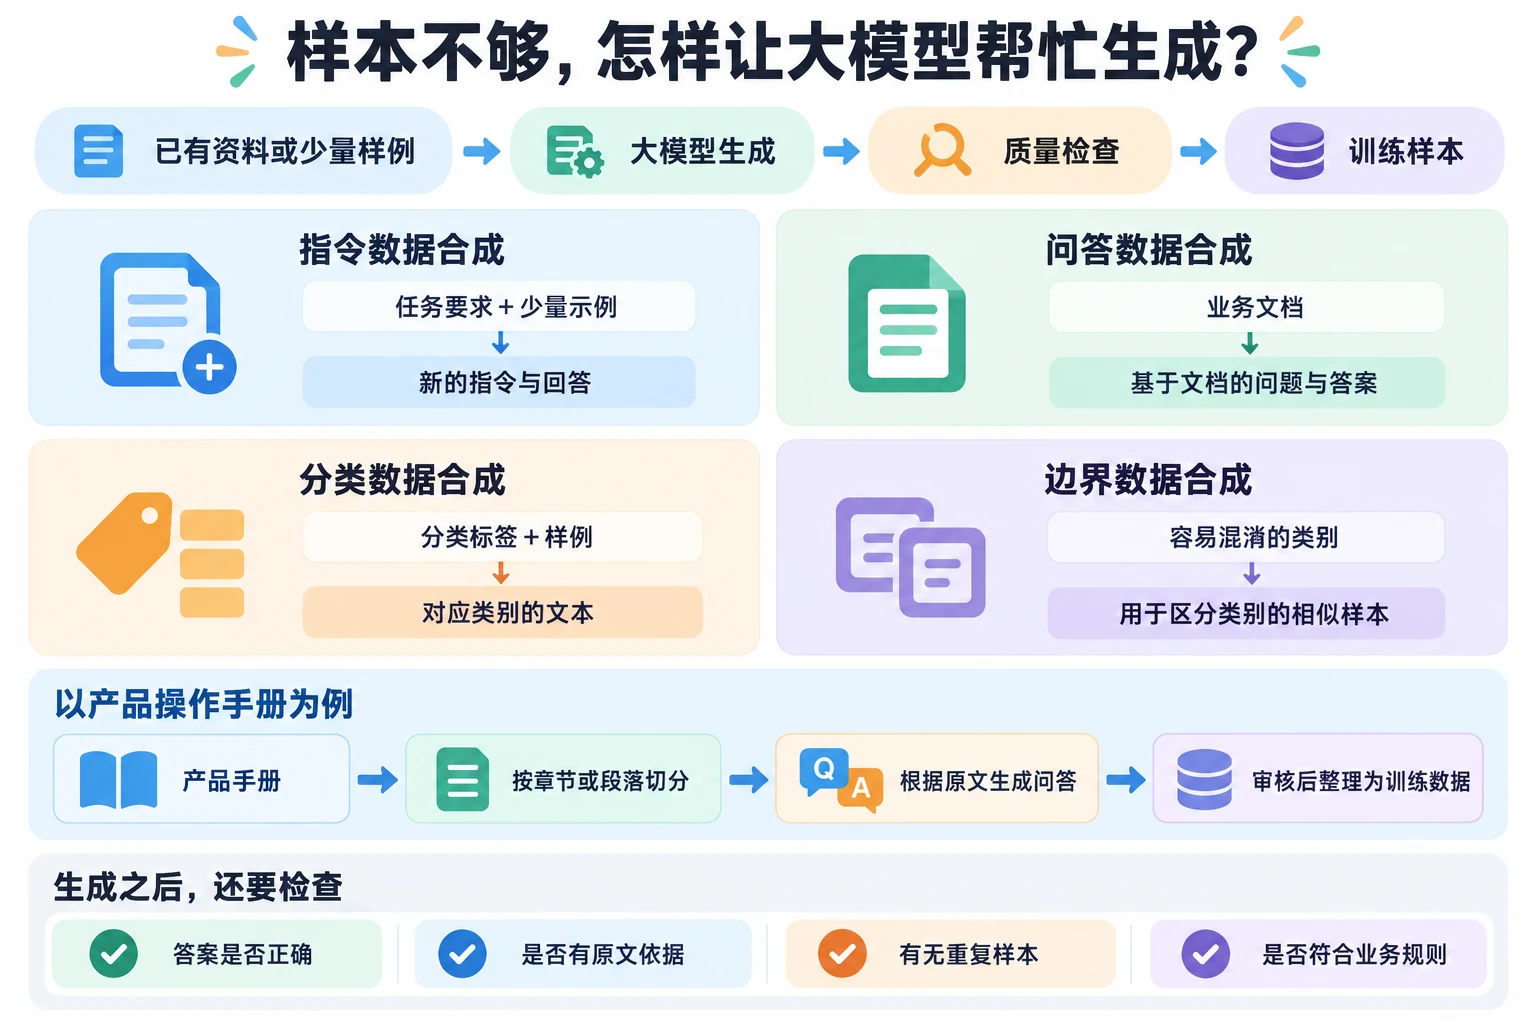
في المشاريع الحقيقية، قد لا تلبي البيانات الموجودة جميع متطلبات التدريب. بعض أنواع الأعمال لها فقط عينات قليلة، أو الوثائق الموجودة تحتوي على معرفة لكن لا تحتوي على بيانات أسئلة وإجابات قابلة للاستخدام مباشرة للتدريب. في هذه الحالات، يمكنك استخدام النماذج الكبيرة لتوليد عينات تدريب جديدة، وهي طريقة تُعرف باسم توليد البيانات.
طرق توليد البيانات الشائعة تشمل:
توليد بيانات التعليمات: بناءً على المهام الموجودة أو بعض الأمثلة، استخدم النموذج الكبير لتوليد تعليمات وإجابات جديدة؛
توليد بيانات الأسئلة والإجابات: أدخل وثائق واستخدم النموذج الكبير لتوليد أسئلة وإجابات بناءً على محتوى الوثيقة؛
توليد بيانات التصنيف: حدد تسميات التصنيف والأمثلة، واستخدم النموذج الكبير لتوليد نصوص للفئات المعنية؛
توليد بيانات الحدود: ولّد عينات مشابهة للفئات التي يسهل الخلط بينها لتعزيز قدرة النموذج على التمييز بين حدود الفئات.
مثلاً، إذا كان لدى مؤسسة فقط كتيبات تشغيل المنتجات بدون بيانات أسئلة وإجابات، فيجب أولاً تقسيم الكتيب إلى فقرات، ثم استخدام النموذج الكبير لتوليد عدة أسئلة وإجابات بناءً على محتوى الفقرة. بعد مراجعة النتائج، نظمها في بيانات تدريب الأسئلة والإجابات.
توليد البيانات يمكن أن يقلل من العبء اليدوي لكتابة عينات التدريب ويكمّل السيناريوهات حيث تكون البيانات الأصلية غير كافية. ومع ذلك، لا يمكن استخدام البيانات المولدة مباشرة للتدريب بعد التوليد. قد يولد النموذج الكبير إجابات خاطئة أو عينات مكررة أو يتخيّل منتجات أو قواعد أعمال غير موجودة، لذا الفحوصات لا تزال ضرورية.
لا تتعجل التدريب بالبيانات المولدة
جودة البيانات المولدة تؤثر مباشرة على فعالية تدريب النموذج. قبل إضافة البيانات المولدة إلى مجموعة التدريب، يجب التحقق من صحة المحتوى المولد وتصفية البيانات الخاطئة والمختلقة والمكررة والمتكررة جداً.
هل الإجابة تتطابق مع النص الأصلي؟
إذا كانت البيانات المولدة مبنية على وثائق الأعمال، يجب التحقق مما إذا كان المحتوى المولد متسقاً مع النص الأصلي.
مثلاً، تنص الوثيقة الأصلية على:
طلبات استرداد الأموال تتطلب مراجعة يدوية، ويمكن معالجة الاسترداد فقط بعد الموافقة.
بيانات الأسئلة والإجابات المولدة من النموذج:
س: هل يتطلب استرداد الأموال مراجعة؟
ج: يتم معالجة استرداد الأموال تلقائياً بعد التقديم، لا حاجة لمراجعة يدوية.
هذه الإجابة تتعارض مع قاعدة الأعمال. إذا تم استخدامها للتدريب، قد يتعلم النموذج عمليات أعمال خاطئة.
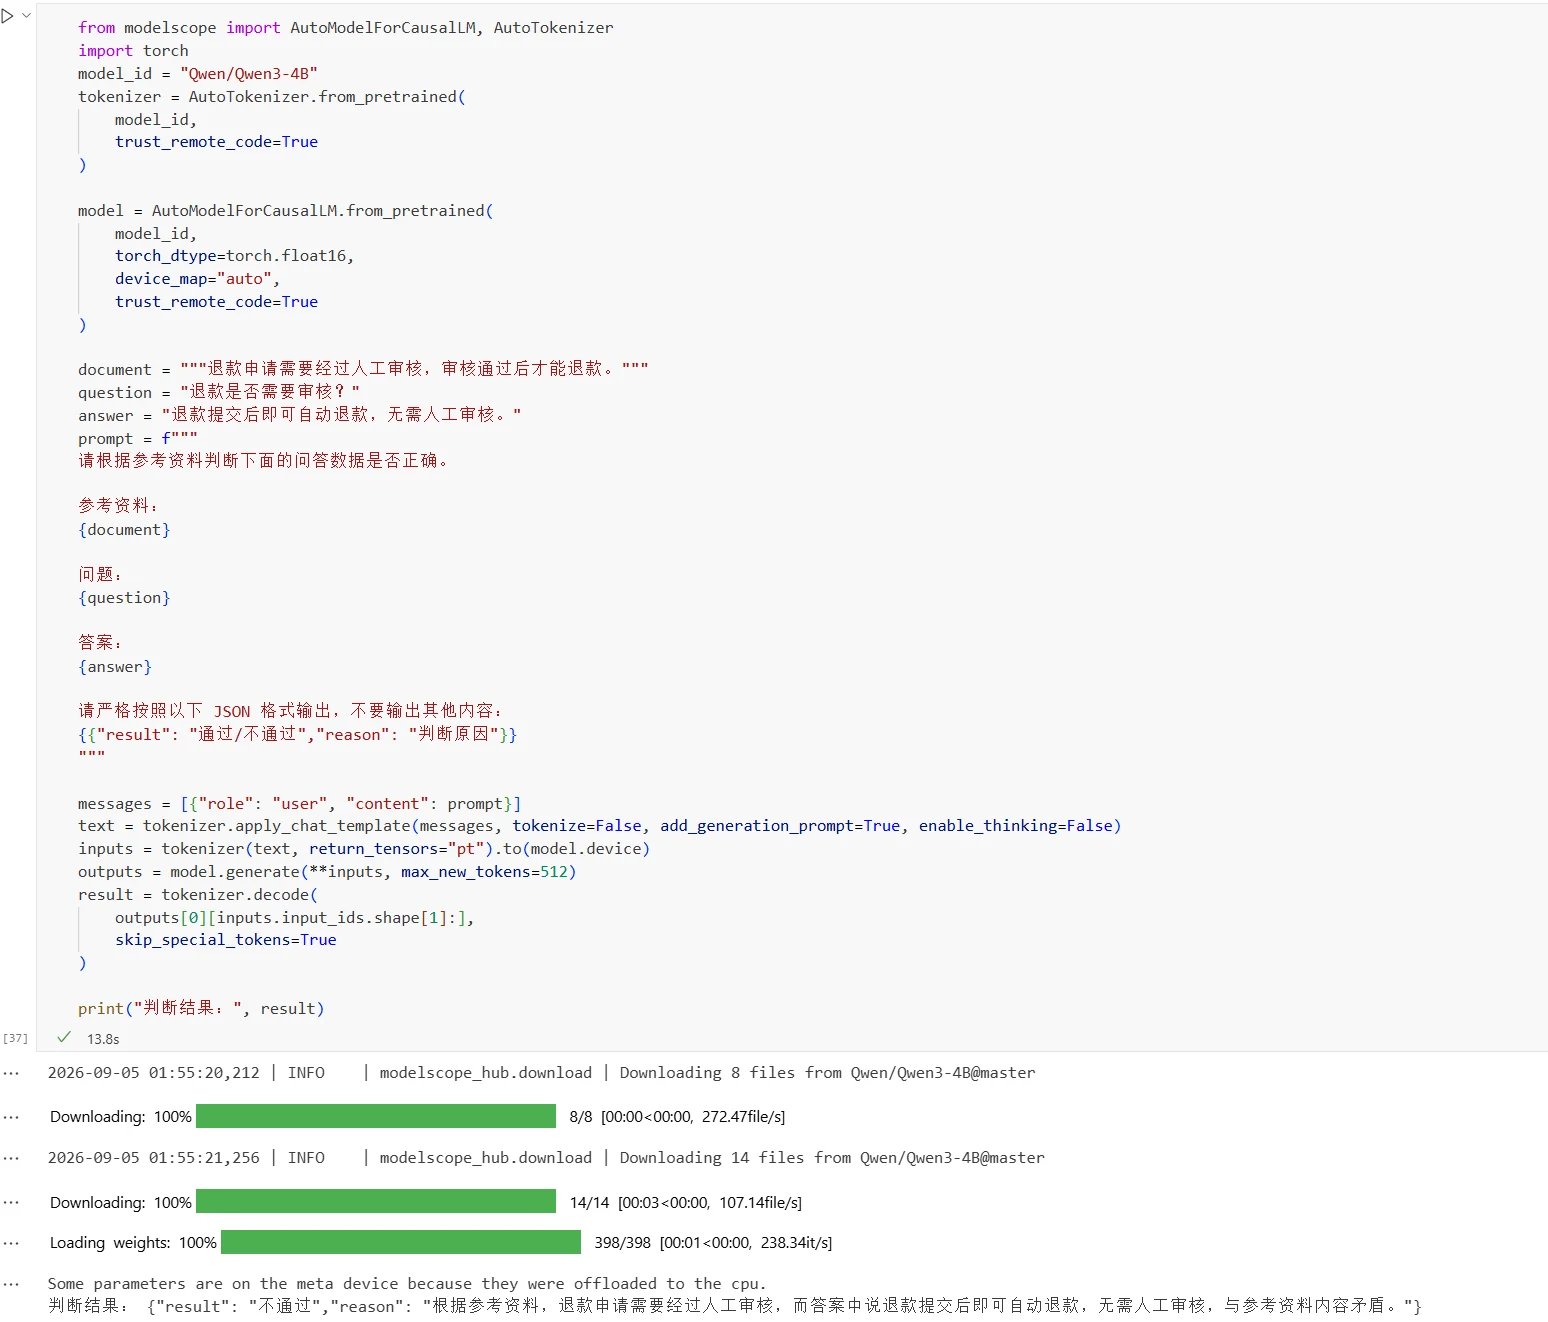
عملياً، يمكنك استخدام النموذج الكبير لإجراء تقييم الاتساق على البيانات المولدة. أدخل المادة الأصلية والسؤال والإجابة في النموذج في نفس الوقت لمعرفة ما إذا كانت الإجابة متسقة مع المادة. للبيانات التي تم الحكم عليها بأنها خاطئة، يمكن حذفها أو إعادة توليدها. معالجة الكود كما يلي:
from modelscope import AutoModelForCausalLM, AutoTokenizer
import torch
model_id = "Qwen/Qwen3-4B"
tokenizer = AutoTokenizer.from_pretrained(
    model_id,
    trust_remote_code=True
)

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.float16,
    device_map="auto",
    trust_remote_code=True
)

document = """طلبات استرداد الأموال تتطلب مراجعة يدوية، ويمكن معالجة الاسترداد فقط بعد الموافقة."""
question = "هل يتطلب استرداد الأموال مراجعة؟"
answer = "يتم معالجة استرداد الأموال تلقائياً بعد التقديم، لا حاجة لمراجعة يدوية."
prompt = f"""
يرجى تحديد ما إذا كانت بيانات الأسئلة والإجابات التالية صحيحة بناءً على المادة المرجعية.

المادة المرجعية:
{document}

السؤال:
{question}

الإجابة:
{answer}

يرجى الإخراج بصرامة بالتنسيق JSON التالي، ولا تخرج أي محتوى آخر:
{{"result": "ناجح/غير ناجح","reason": "سبب الحكم"}}
"""

messages = [{"role": "user", "content": prompt}]
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True, enable_thinking=False)
inputs = tokenizer(text, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=512)
result = tokenizer.decode(
    outputs[0][inputs.input_ids.shape[1]:],
    skip_special_tokens=True
)

print("نتيجة الحكم:", result)
النتائج:
لا تدع النموذج يخترع أشياء غير موجودة في النص الأصلي
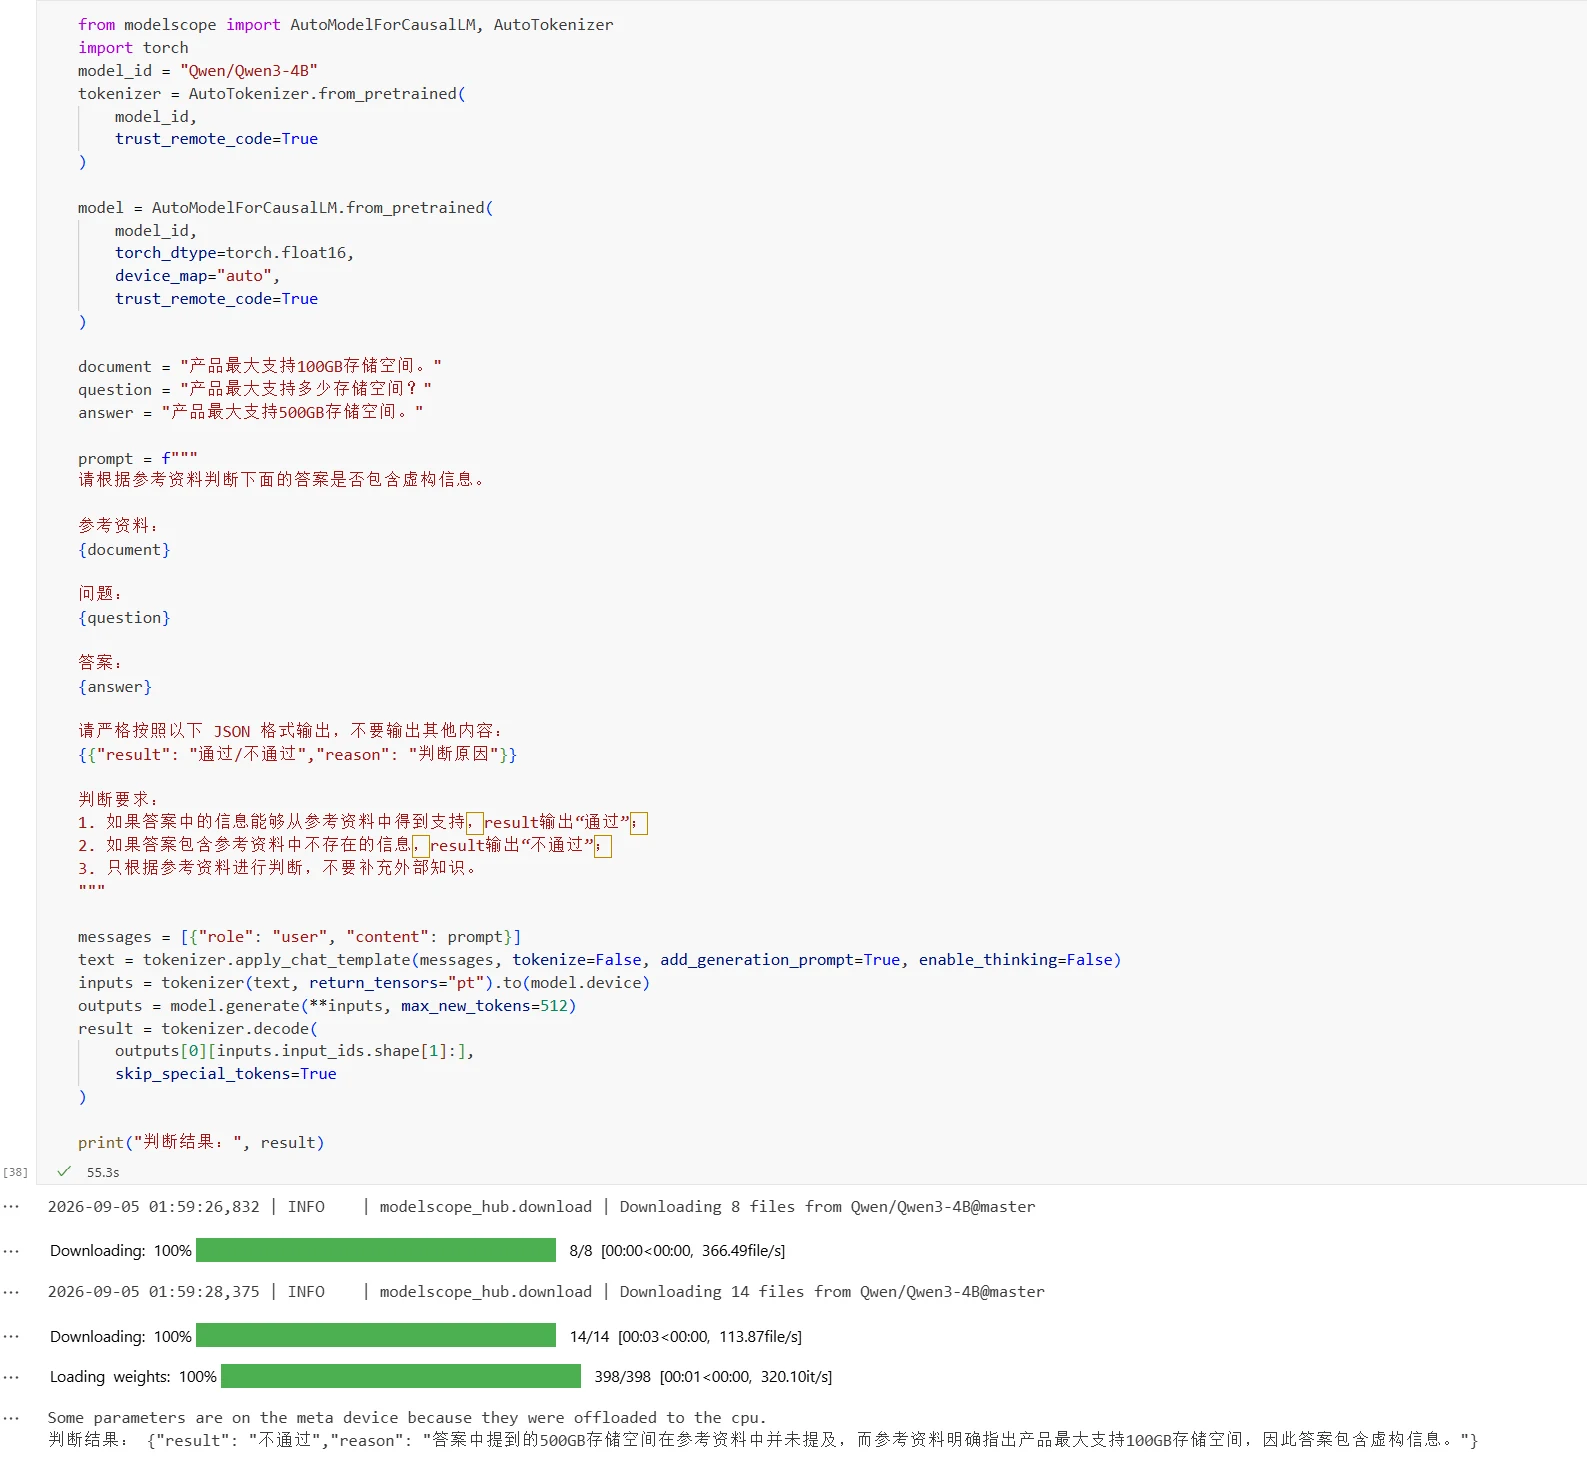
عندما يولد النموذج الكبير بيانات، قد ينتج معلومات غير موجودة في المواد الأصلية. تُعرف هذه المشكلة عادةً بالهلوسة. مثل توليد أسماء منتجات أو مواصفات منتجات أو عمليات أعمال غير موجودة.
مثلاً، تنص المادة الأصلية على:
يدعم المنتج مساحة تخزين تصل إلى 100 جيجابايت.
البيانات المولدة:
س: هل يدعم المنتج التوسع التلقائي؟
ج: نعم، سيتوسع النظام تلقائياً عندما تكون مساحة التخزين غير كافية
المادة الأصلية لا تنص على ما إذا كان المنتج يدعم التوسع التلقائي. لذلك الإجابة المولدة تفتقر للأساس في المادة الأصلية وتُعتبر معلومات مختلقة.
للبيانات المولدة بناءً على مواد الأعمال، يمكنك استخدام النموذج الكبير لفحص الأساس لمعرفة ما إذا كانت المعلومات الرئيسية في الإجابة يمكن دعمها بالمواد الأصلية. للبيانات التي تفتقر للأساس أو لا يمكن تأكيدها، يمكن حذفها أو إعادة توليدها أو مراجعتها يدوياً. عند تدخل قواعد أعمال مهمة، يمكن لموظفي الأعمال أيضاً إجراء عينات عشوائية. معالجة الكود كما يلي:
from modelscope import AutoModelForCausalLM, AutoTokenizer
import torch
model_id = "Qwen/Qwen3-4B"
tokenizer = AutoTokenizer.from_pretrained(
    model_id,
    trust_remote_code=True
)

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.float16,
    device_map="auto",
    trust_remote_code=True
)

document = "يدعم المنتج مساحة تخزين تصل إلى 100 جيجابايت."
question = "ما هي مساحة التخزين القصوى التي يدعمها المنتج؟"
answer = "يدعم المنتج مساحة تخزين تصل إلى 500 جيجابايت."

prompt = f"""
يرجى تحديد ما إذا كانت الإجابة التالية تحتوي على معلومات مختلقة بناءً على المادة المرجعية.

المادة المرجعية:
{document}

السؤال:
{question}

الإجابة:
{answer}

يرجى الإخراج بصرامة بالتنسيق JSON التالي، ولا تخرج أي محتوى آخر:
{{"result": "ناجح/غير ناجح","reason": "سبب الحكم"}}

متطلبات الحكم:
1. إذا كانت معلومات الإجابة يمكن دعمها بالمادة المرجعية، فإن النتيجة تخرج "ناجح"؛
2. إذا كانت الإجابة تحتوي على معلومات غير موجودة في المادة المرجعية، فإن النتيجة تخرج "غير ناجح"؛
3. الحكم فقط بناءً على المادة المرجعية، لا تكمل بمعرفة خارجية.
"""

messages = [{"role": "user", "content": prompt}]
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True, enable_thinking=False)
inputs = tokenizer(text, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=512)
result = tokenizer.decode(
    outputs[0][inputs.input_ids.shape[1]:],
    skip_special_tokens=True
)

print("نتيجة الحكم:", result)
النتائج:
الصياغة المختلفة قد تكون نفس السؤال
عندما يولد النموذج الكبير البيانات بشكل مجمع، يسهل إنتاج عينات مكررة أو شبيهة جداً. مثلاً: "كيف أغير كلمة مرور تسجيل الدخول؟" و"كيف أقوم بتغيير كلمة مرور الدخول؟". هذان السؤالان لهما تعبيرات مختلفة لكن المحتوى متماثل أساساً. إذا كان هناك الكثير من العينات المشابهة، فإن ذلك يقلل من المحتوى المعلوماتي الفعال لمجموعة البيانات.
بعد توليد البيانات، يجب التحقق من التكرار والتشابه بين العينات، وتصفية البيانات المكررة تماماً، والتحكم في عدد العينات المشابهة جداً، والاحتفاظ بالعينات التمثيلية. سيتم تقديم طرق إزالة التكرار المحددة في الأقسام التالية.
توحيد البيانات من مصادر مختلفة
سواء كانت البيانات من مجموعات البيانات مفتوحة المصدر أو بيانات الأعمال أو توليد النماذج الكبيرة، فإنها تحتاج إلى معالجة موحدة قبل استخدامها لتدريب النموذج. تشمل الخطوات الشائعة جمع البيانات وتنظيف البيانات وإزالة تكرار البيانات وإخفاء هوية البيانات.
اجمع المحتوى المطلوب أولاً ووحّد الحقول
يشمل جمع البيانات الحصول على البيانات المطلوبة من مصادر بيانات مختلفة وفقاً لمهمة التدريب وتنظيمها بشكل موحد.
قبل الجمع، يجب تحديد محتوى البيانات المطلوب لمهمة التدريب. مهام التصنيف تحتاج إلى نصوص وتصنيفات، وأسئلة وإجابات، وضبط التعليمات يحتاج إلى تعليمات وإجابات مرتبطة. أثناء الجمع، احتفظ فقط بالبيانات والحقول ذات الصلة بمهمة التدريب.
هياكل البيانات من مصادر مختلفة قد تختلف. مثلاً، مجموعة بيانات قد تستخدم حقول question وanswer، بينما مجموعة أخرى قد تستخدم query وresponse. بعد الجمع، يجب توحيد أسماء الحقول وهياكل البيانات للمعالجة اللاحقة.
للبيانات التي تفتقر إلى معلومات ضرورية، يمكن إكمالها أثناء الجمع. مثلاً، إضافة تصنيفات للبيانات التصنيفية، أو تنظيم إجابات مرجعية لبيانات الأسئلة والإجابات.
البيانات تحتاج إلى تنظيف أولاً
البيانات الخام قد تحتوي على محتوى غير صالح أو خاطئ، يحتاج إلى تنظيف قبل التدريب.
يشمل المعالجة الشائعة: حذف البيانات الفارغة والسجلات غير الصالحة، وإزالة وسوم HTML الزائدة والأحرف الخاصة، وتوحيد ترميز النص وتنسيقه، وتصحيح أخطاء التعرف الضوئي على الحروف الواضحة، إلخ.
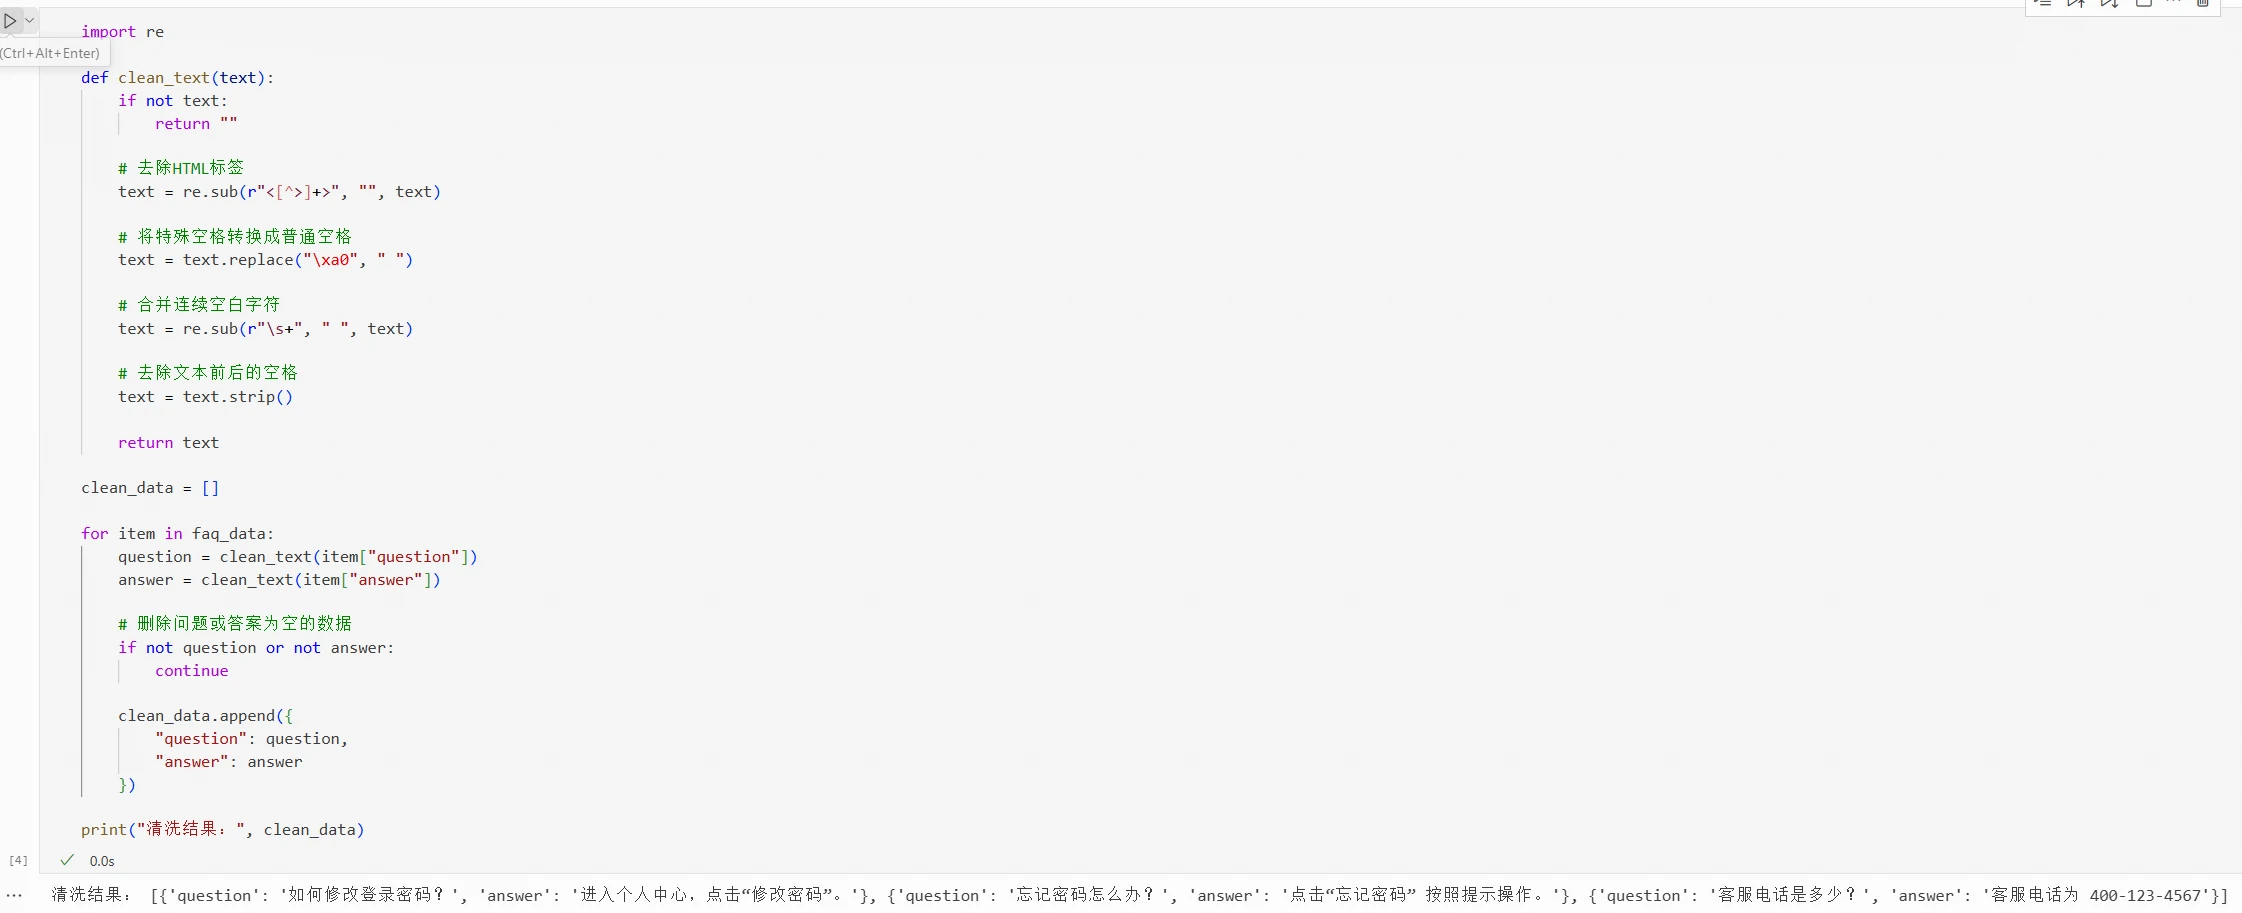
تنظيف البيانات لا يعني حذف كل المحتوى الخاص. الكود والصيغ والوحدات وعلامات الترقيم قد تكون جزءاً من محتوى التدريب نفسه، والاحتفاظ بها أو حذفها يعتمد على المهمة المحددة.
من مجموعات البيانات الشائعة للأسئلة الشائعة، البيانات الأصلية:
faq_data = [
    {
        "question": "  كيف أغير كلمة مرور تسجيل الدخول؟  ",
        "answer": "<p>انتقل إلى المركز الشخصي وانقر على تغيير كلمة المرور.</p>"
    },
    {
        "question": "",
        "answer": "يرجى الاتصال بالمسؤول."
    },
    {
        "question": "ماذا أفعل إذا نسيت كلمة المرور؟",
        "answer": "انقر على نسيت كلمة المرور\n\nواتبع التعليمات."
    },
    {
        "question": "ما هو رقم هاتف خدمة العملاء؟",
        "answer": "رقم خدمة العملاء هو 400-123-4567\xa0"
    }
]
كود التنظيف:
import re

def clean_text(text):
    if not text:
        return ""

    # إزالة وسوم HTML
    text = re.sub(r"<[^>]+>", "", text)

    # تحويل المسافات الخاصة إلى مسافات عادية
    text = text.replace("\xa0", " ")

    # دمج أحرف المسافة المتتالية
    text = re.sub(r"\s+", " ", text)

    # إزالة المسافات من بداية ونهاية النص
    text = text.strip()

    return text

clean_data = []

for item in faq_data:
    question = clean_text(item["question"])
    answer = clean_text(item["answer"])

    # حذف البيانات التي يكون السؤال أو الإجابة فارغاً
    if not question or not answer:
        continue

    clean_data.append({
        "question": question,
        "answer": answer
    })

print("نتيجة التنظيف:", clean_data)
نتائج التنظيف:
قواعد التنظيف المحددة في الأعمال الحقيقية تحتاج إلى تحديدها بناءً على خصائص البيانات.
هل تحتاج حقاً للحفاظ على جميع البيانات المكررة؟
بعد تجميع البيانات المجمعة من مصادر مختلفة، قد تظهر بيانات مكررة أو مشابهة. نفس الأسئلة الشائعة قد تظهر معاً في مجموعات البيانات العامة وكتيبات المنتجات وقواعد معرفة خدمة العملاء. البيانات المولدة قد تكون مشابهة أيضاً لمحتوى البيانات الموجودة. إذا كانت البيانات المكررة كثيرة جداً، فإنها تقلل من تنوع بيانات التدريب، مما يجعل النموذج يتعلم معرفة أو تعبيرات معينة بشكل مفرط. لذلك، إزالة التكرار الموحدة ضرورية قبل التدريب.
بناءً على درجة تكرار البيانات، يمكن تقسيم إزالة تكرار البيانات إلى إزالة تكرار البيانات المتماثلة وإزالة تكرار البيانات المشابهة:
إزالة تكرار البيانات المتماثلة: تحديد ما إذا كان محتوى قطعتين من البيانات متماثلاً تماماً. يمكن إزالة التكرار عبر مطابقة النصوص أو قيم التجزئة.
إزالة تكرار البيانات المشابهة: تحديد ما إذا كان محتوى قطعتين من البيانات مشابهاً رغم اختلاف الصياغة. يمكن استخدام طرق مثل MinHash أو SimHash أو التشابه المتجهي للكشف.
أنواع البيانات المختلفة تحتاج إلى قواعد إزالة تكرار مختلفة. من مجموعات البيانات الشائعة للأسئلة الشائعة، يمكن دمج السؤال والإجابة في نص واحد، ثم تحديد ما إذا كانت العينات المختلفة مكررة أو مشابهة.
إزالة تكرار البيانات المتماثلة
عينات البيانات:
faq_data = [
    {
        "question": "كيف أغير كلمة مرور تسجيل الدخول؟",
        "answer": "انتقل إلى المركز الشخصي وانقر على تغيير كلمة المرور."
    },
    {
        "question": "ماذا أفعل إذا نسيت كلمة المرور؟",
        "answer": "انقر على نسيت كلمة المرور واتبع التعليمات."
    },
    {
        "question": "كيف أغير كلمة مرور تسجيل الدخول؟",
        "answer": "انتقل إلى المركز الشخصي وانقر على تغيير كلمة المرور."
    }
]
(1) مطابقة النصوص
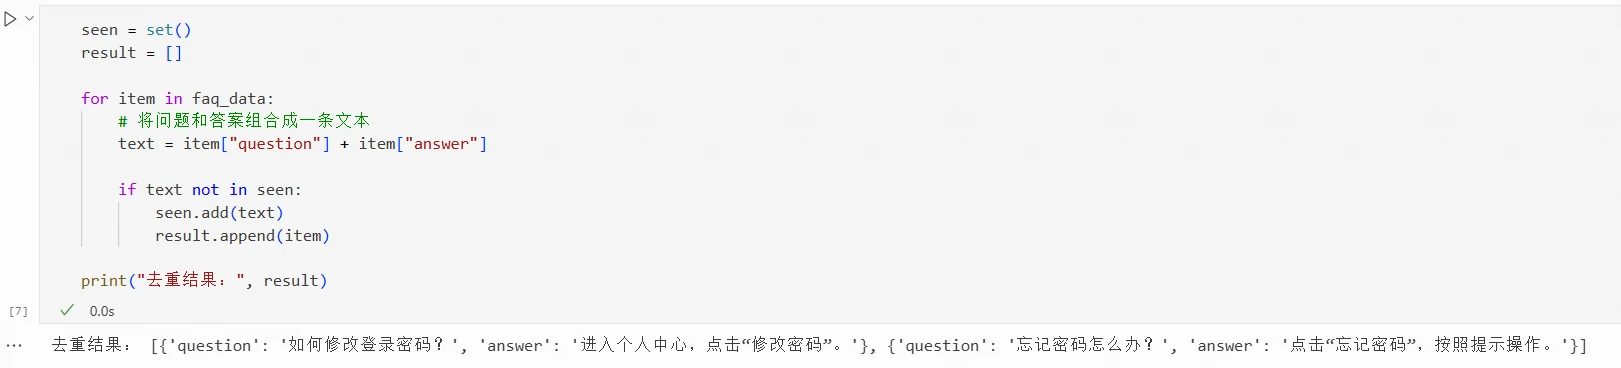
كود إزالة التكرار عبر مطابقة النصوص:
seen = set()
result = []

for item in faq_data:
    # دمج السؤال والإجابة في نص واحد
    text = item["question"] + item["answer"]

    if text not in seen:
        seen.add(text)
        result.append(item)

print("نتيجة إزالة التكرار:", result)
نتائج إزالة التكرار:
بعد المعالجة، يتم الاحتفاظ بواحد فقط من نفس الأسئلة الشائعة المتماثلة.
(2) قيم التجزئة
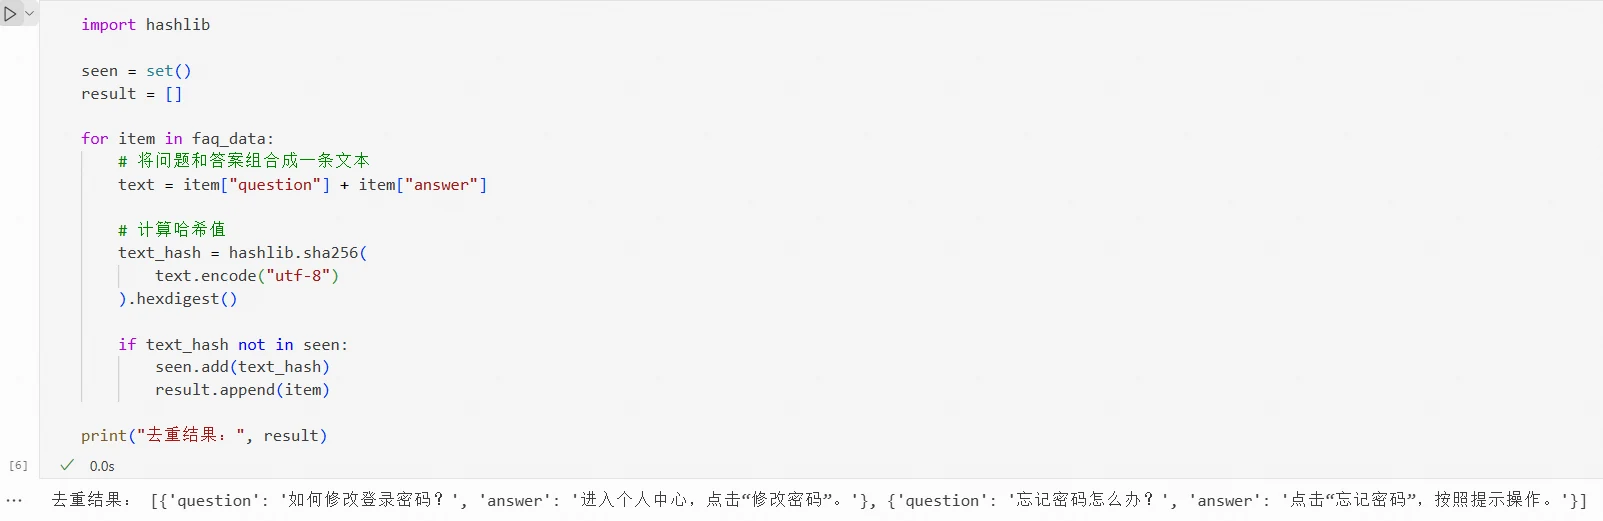
يمكن لخوارزمية التجزئة تحويل النص إلى قيمة طولها ثابت. النص المتماثل سينتج نفس قيمة التجزئة، مما يتيح تحديد ما إذا كانت البيانات مكررة عبر مقارنة قيم التجزئة. مثلاً:
import hashlib

seen = set()
result = []

for item in faq_data:
    # دمج السؤال والإجابة في نص واحد
    text = item["question"] + item["answer"]

    # حساب قيمة التجزئة
    text_hash = hashlib.sha256(
        text.encode("utf-8")
    ).hexdigest()

    if text_hash not in seen:
        seen.add(text_hash)
        result.append(item)

print("نتيجة إزالة التكرار:", result)
نتائج إزالة التكرار:
قيم التجزئة العادية يمكن استخدامها فقط لتحديد ما إذا كان المحتوى متماثلاً تماماً. بمجرد تغيير النص في السؤال أو الإجابة، ستكون قيمة التجزئة المحسوبة مختلفة. للبيانات التي لها صياغة مختلفة لكن محتوى مشابهاً، تحتاج إلى تقييم التشابه الإضافي.
إزالة تكرار البيانات المشابهة
عينات البيانات:
faq_data = [
    {
        "question": "كيف أغير كلمة مرور تسجيل الدخول؟",
        "answer": "انتقل إلى المركز الشخصي وانقر على تغيير كلمة المرور."
    },
    {
        "question": "كيف أقوم بتغيير كلمة مرور الدخول؟",
        "answer": "بعد الانتقال إلى المركز الشخصي، انقر على تغيير كلمة المرور."
    },
    {
        "question": "كيف أطلب فاتورة؟",
        "answer": "انتقل إلى صفحة الطلبات، واختر طلب الفاتورة وأرسل المعلومات."
    }
]
أسئلة وإجابات الأسئلة الشائعة الأولى والثانية تختلف في الصياغة لكنها تعبر عن محتوى مشابه بشكل عام. للبيانات المشابهة هذه، يمكن استخدام MinHash أو SimHash أو التشابه المتجهي للكشف.
(1) MinHash
يحدد MinHash التشابه أساساً بناءً على درجة تداخل الكلمات أو الأحرف في النص، مما يجعله أكثر ملاءمة للكشف عن البيانات المشابهة حرفياً. لبيانات الأسئلة الشائعة، يمكنك أولاً دمج السؤال والإجابة في نص واحد، ثم تقسيم النص إلى كلمات أو أحرف أو أجزاء أحرف للحساب.
يُستخدم MinHash عادةً لتقريب تشابه Jaccard:
J(A,B)=\frac{|A\cap B|}{|A\cup B|}
حيث تمثل A وB مجموعات الكلمات أو الأحرف الموجودة في نصين،
A\cap B
يمثل المحتوى المشترك بينهما،
A\cup B
يمثل كل المحتوى الموجود في كليهما. تتراوح نتيجة الحساب بين 0 و1، حيث تقترب القيم الأكبر من 1 من تشابه النصين.
في Python، يمكن استخدام مكتبة datasketch لتنفيذ MinHash:
!pip install datasketch
النتائج:
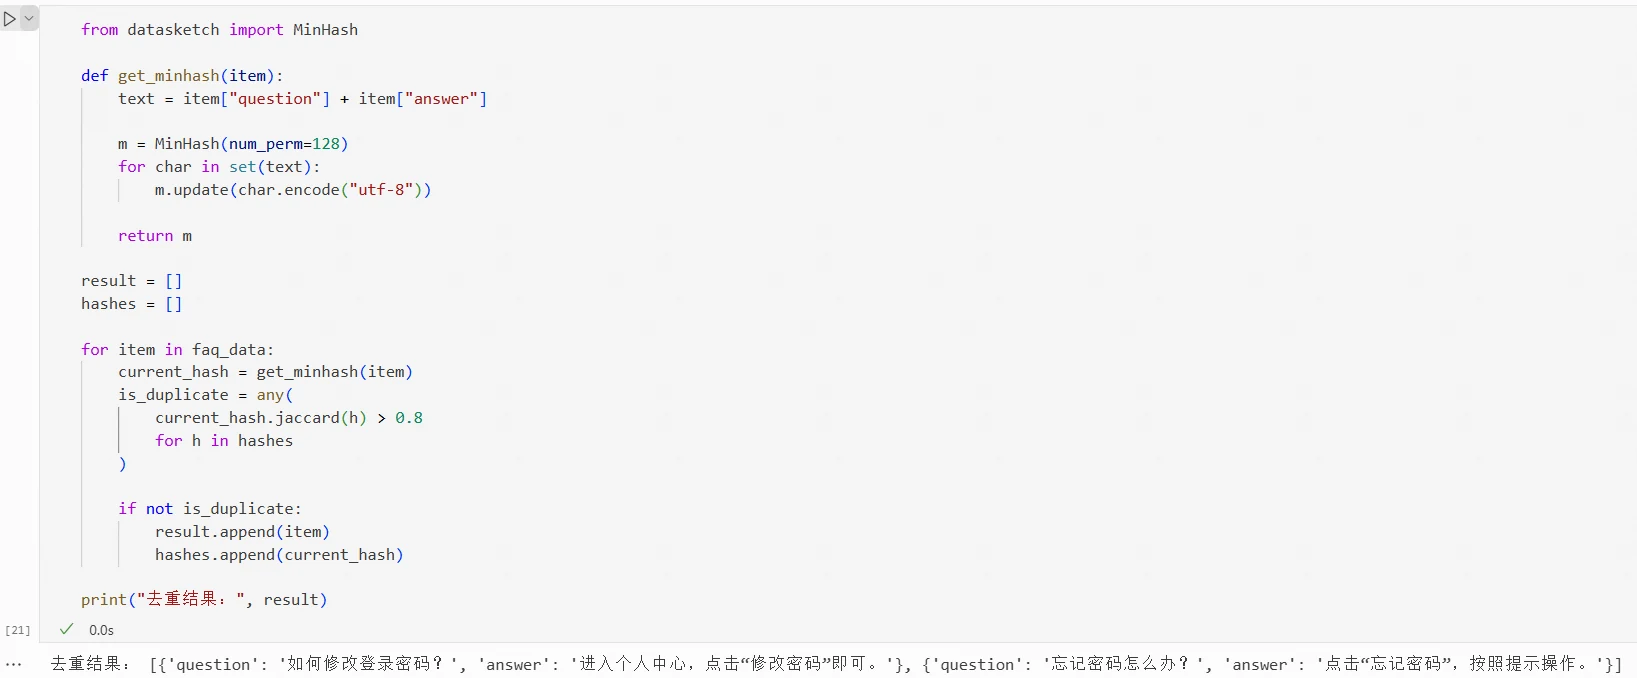
كود مثال:
from datasketch import MinHash

def get_minhash(item):
    text = item["question"] + item["answer"]

    m = MinHash(num_perm=128)
    for char in set(text):
        m.update(char.encode("utf-8")

    return m

result = []
hashes = []

for item in faq_data:
    current_hash = get_minhash(item)

    is_duplicate = any(
        current_hash.jaccard(h) > 0.8
        for h in hashes
    )

    if not is_duplicate:
        result.append(item)
        hashes.append(current_hash)

print("نتيجة إزالة التكرار:", result)
النتائج:
(2) SimHash
ينتج SimHash بصمة طولها ثابت بناءً على محتوى النص، ثم يستخدم المسافة بين البصمات لتحديد ما إذا كانت النصوص مشابهة.
على عكس الهاش العادي الذي يحدد أساساً ما إذا كان المحتوى متماثلاً تماماً، يمكن لـSimHash الكشف عن نصوص بها محتوى مشابه. كلما كانت المسافة بين بصمتين SimHash أصغر، كانت النصوص أكثر تشابهاً عادةً.
يجب تثبيت simhash:
!pip install simhash
النتائج:
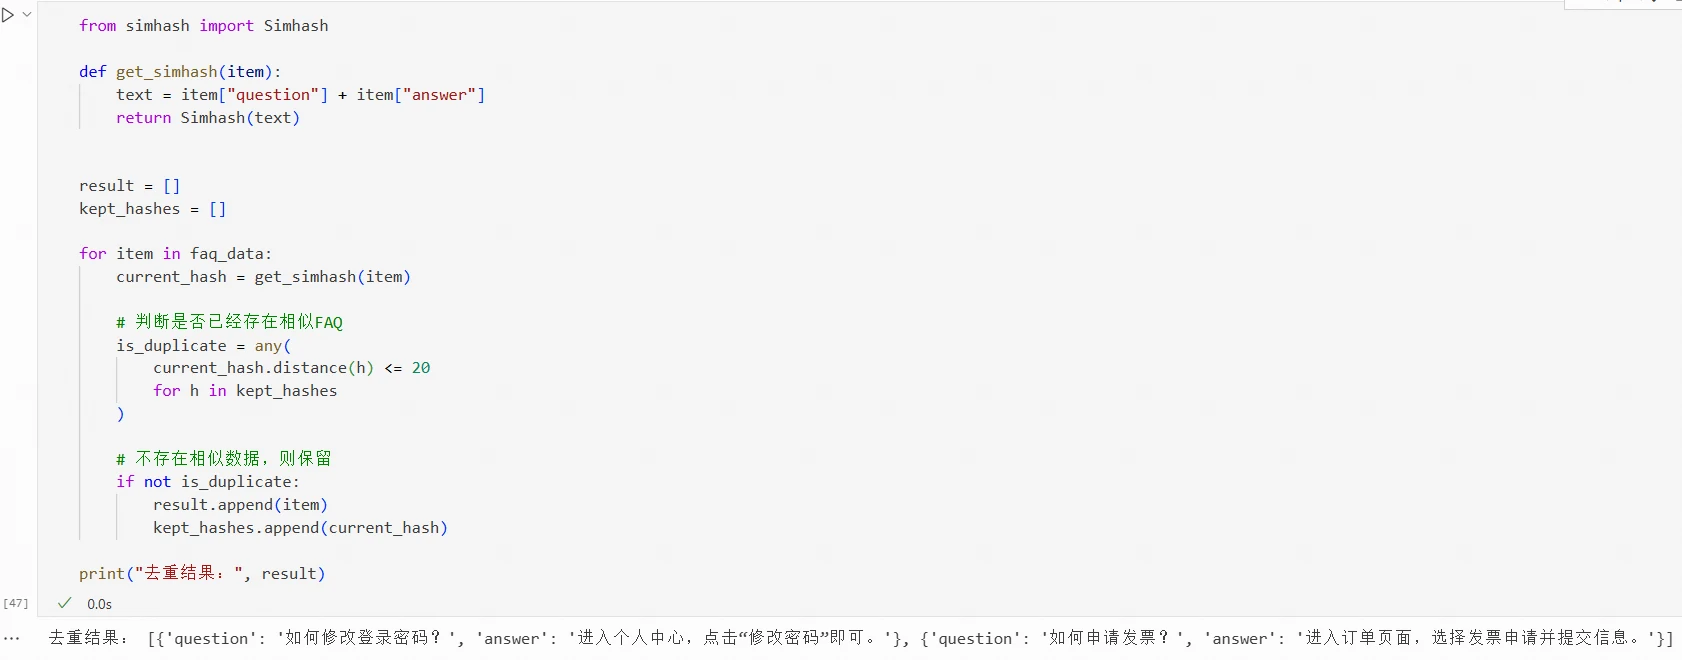
كود استخدام SimHash لإزالة البيانات المشابهة:
from simhash import Simhash

def get_simhash(item):
    text = item["question"] + item["answer"]
    return Simhash(text)

result = []
kept_hashes = []

for item in faq_data:
    current_hash = get_simhash(item)

    # التحقق مما إذا كانت هناك أسئلة شائعة مشابهة موجودة بالفعل
    is_duplicate = any(
        current_hash.distance(h) <= 20
        for h in kept_hashes
    )

    # إذا لم تكن هناك بيانات مشابهة، احتفظ بها
    if not is_duplicate:
        result.append(item)
        kept_hashes.append(current_hash)

print("نتيجة إزالة التكرار:", result)
النتائج:
(3) التشابه المتجهي
إذا كانت قطعتا البيانات تستخدم كلمات مختلفة لكنهما تعبران عن معانٍ مشابهة، فيمكن استخدام نموذج المتجهات النصية للتقييم.
يحول نموذج المتجهات النصية النص إلى متجه يتكون من مجموعة من القيم الرقمية. لبيانات الأسئلة الشائعة، ادمج السؤال والإجابة في نص واحد، ثم احسب التشابه الت delivered بين المتجهين النصيين:
حيث يمثل A وB متجهي النص المقابلين للأسئلة الشائعة. كلما زاد التشابه الت cosine، كانت المعاني للأسئلة الشائعة أقرب.
يُستخدم نموذج BAAI/bge-small-zh-v1.5 للحساب أدناه. هذا النموذج مصمم لمهام المتجهات النصية الصينية، بحجم نموذج حوالي 24 ميغابايت، وبُعد متجه الإخراج 512، وهو صغير نسبياً وسريع.
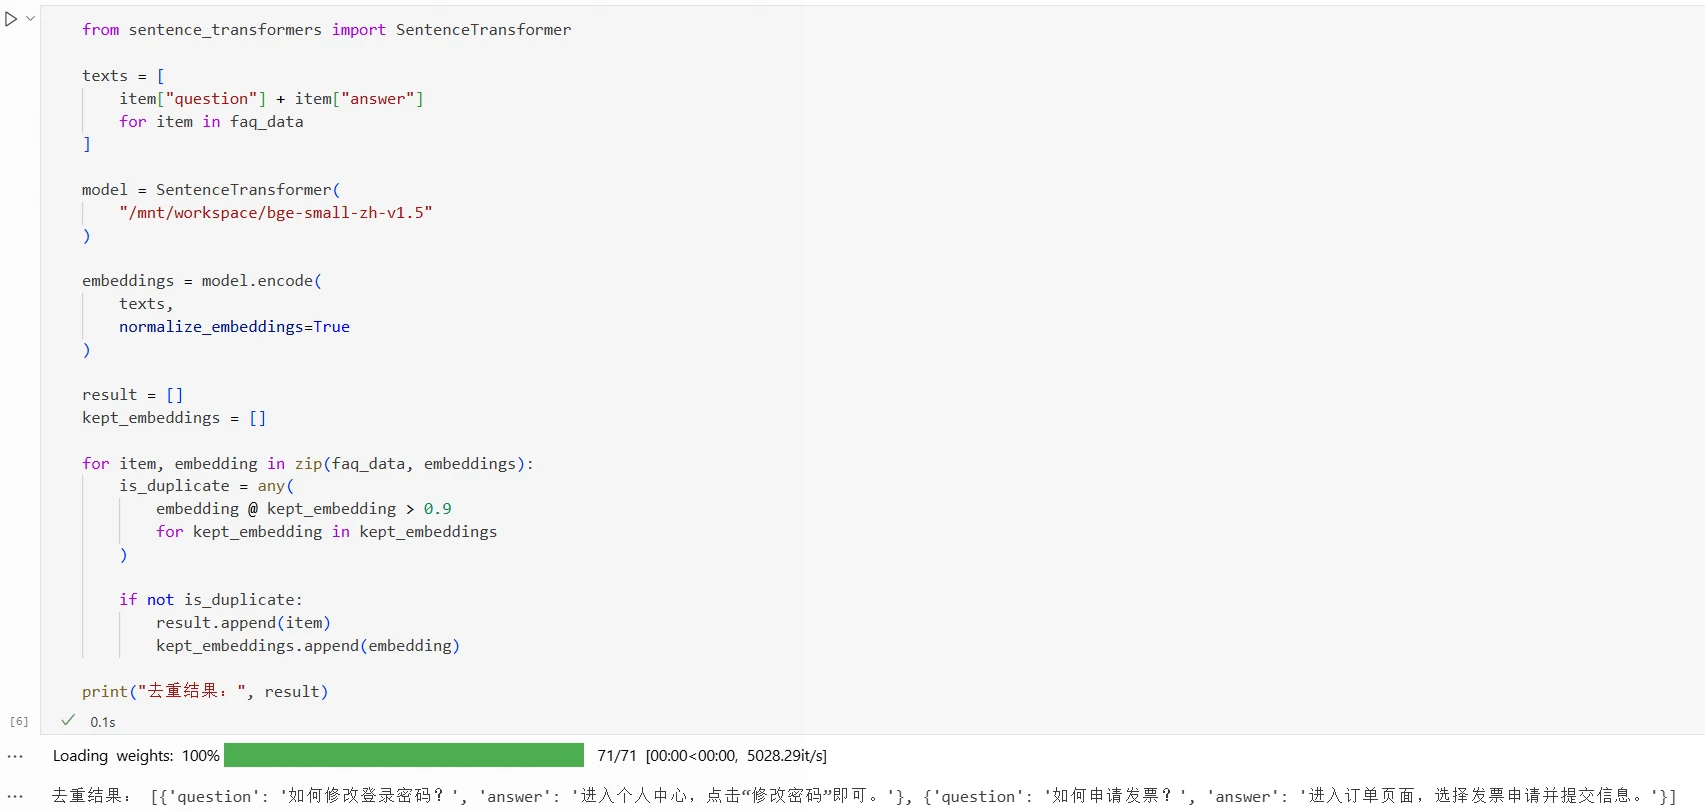
كود حساب التشابه المتجهي لإزالة البيانات المشابهة:
from sentence_transformers import SentenceTransformer

texts = [
    item["question"] + item["answer"]
    for item in faq_data
]

model = SentenceTransformer(
    "/mnt/workspace/bge-small-zh-v1.5"
)

embeddings = model.encode(
    texts,
    normalize_embeddings=True
)

result = []
kept_embeddings = []

for item, embedding in zip(faq_data, embeddings):
    is_duplicate = any(
        embedding @ kept_embedding > 0.9
        for kept_embedding in kept_embeddings
    )

    if not is_duplicate:
        result.append(item)
        kept_embeddings.append(embedding)

print("نتيجة إزالة التكرار:", result)
النتائج:
تختلف الطرق المناسبة لأنواع مختلفة من إزالة تكرار البيانات:
الطريقة
الأساس للحكم
السيناريوهات المناسبة
مطابقة النص مباشرة
ما إذا كان النص متماثلاً تماماً
كمية قليلة من البيانات المتماثلة
الهاش
ما إذا كانت قيم الهاش متماثلة
كمية كبيرة من البيانات المتماثلة
MinHash
درجة تداخل الكلمات أو الأحرف في النص
بيانات بها تشابه في المحتوى الحرفي
SimHash
المسافة بين بصمات النص
بيانات بها تشابه في المحتوى العام مع تعديلات طفيفة
التشابه المتجهي
التشابه الدلالي للنص
بيانات بتعابير مختلفة لكن معانٍ مشابهة
في الممارسة العملية، يمكنك أولاً إزالة البيانات المتماثلة تماماً عبر مطابقة النصوص أو الهاش، ثم استخدام MinHash أو SimHash أو التشابه المتجهي للكشف عن البيانات المشابهة. بالنسبة للبيانات المشابهة المكتشفة، يجب تحديد ما إذا كنت ستحذفها أو تدمجها أو تحتفظ بها بناءً على عتبة التشابه ومتطلبات الأعمال لتجنب الحذف العرضي للبيانات ذات قيمة التدريب.
المعلومات الحقيقية تحتاج إخفاء هوية قبل التدريب
بيانات الأعمال قد تحتوي على معلومات حساسة مثل الأسماء وأرقام الهواتف وأرقم الهوية والعناوين وأرقام الحسابات. قبل الدخول إلى مجموعة بيانات التدريب، يجب إخفاء هذا المحتوى وفقاً لمتطلبات أمان البيانات.
يحتاج إخفاء هوية البيانات أولاً إلى تحديد المعلومات الحساسة في البيانات، ثم اختيار طرق معالجة مناسبة بناءً على نوع المعلومات الحساسة.
طرق تحديد المعلومات الحساسة
قبل إجراء إخفاء الهوية، يجب تحديد أي محتوى في البيانات ينتمي إلى المعلومات الحساسة. للبيانات النصية، يمكن استخدام التعبيرات النمطية أو نماذج التعرف على المعلومات الحساسة.
(1) استخدام التعبيرات النمطية
تطابق التعبيرات النمطية النص بناءً على قواعد التنسيق المحددة مسبقاً، مما يجعلها مناسبة للتعرف على معلومات بتنسيق ثابت، مثل أرقام الهواتف وأرقام الهوية وأرقام البطاقات البنكية والعناوين الإلكترونية. كود استخدام التعبيرات النمطية:
import re

text = """
العميل Zhang San، رقم الهاتف 13812345678،
رقم الهوية 320102199001011234,
البريد الإلكتروني zhangsan@example.com.
"""

patterns = {
    "الهاتف": r"(?<!\d)(1[3-9]\d{9})(?!\d)",
    "رقم الهوية": r"(?<!\d)(\d{17}[\dXx])(?!\d)",
    "البريد الإلكتروني": r"([A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,})"
}

entities = []

for label, pattern in patterns.items():
    for match in re.finditer(pattern, text):
        entities.append({
            "label": label,
            "text": match.group(),
            "start": match.start(),
            "end": match.end()
        })

for entity in entities:
    print(entity)
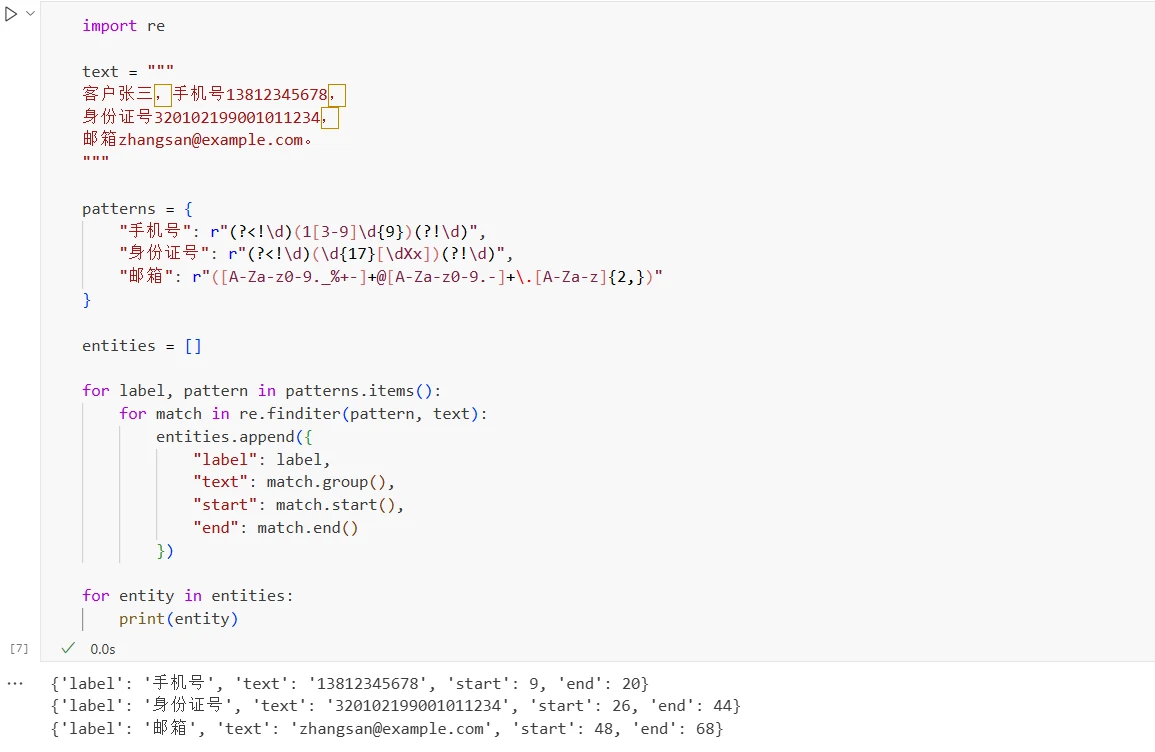
نتائج التنفيذ:
تستطيع التعبيرات النمطية الحصول على محتوى ونوع وموضع المعلومات الحساسة في النص الأصلي. التعبيرات النمطية تعتمد أساساً على سمات التنسيق وفعّالة للمعلومات بتنسيق ثابت. في الممارسة، يجب تطوير واختبار القواعد المناسبة بناءً على تنسيق البيانات. للمعلومات مثل الأسماء والعناوين التي تحتاج فهم السياق، التعبيرات النمطية وحدها صعبة التعرف بدقة.
(2) استخدام نماذج التعرف على المعلومات الحساسة
للمعلومات مثل الأسماء والعناوين والمؤسسات التي تحتاج فهمًا دلالياً، يمكن استخدام نماذج التعرف على المعلومات الحساسة.
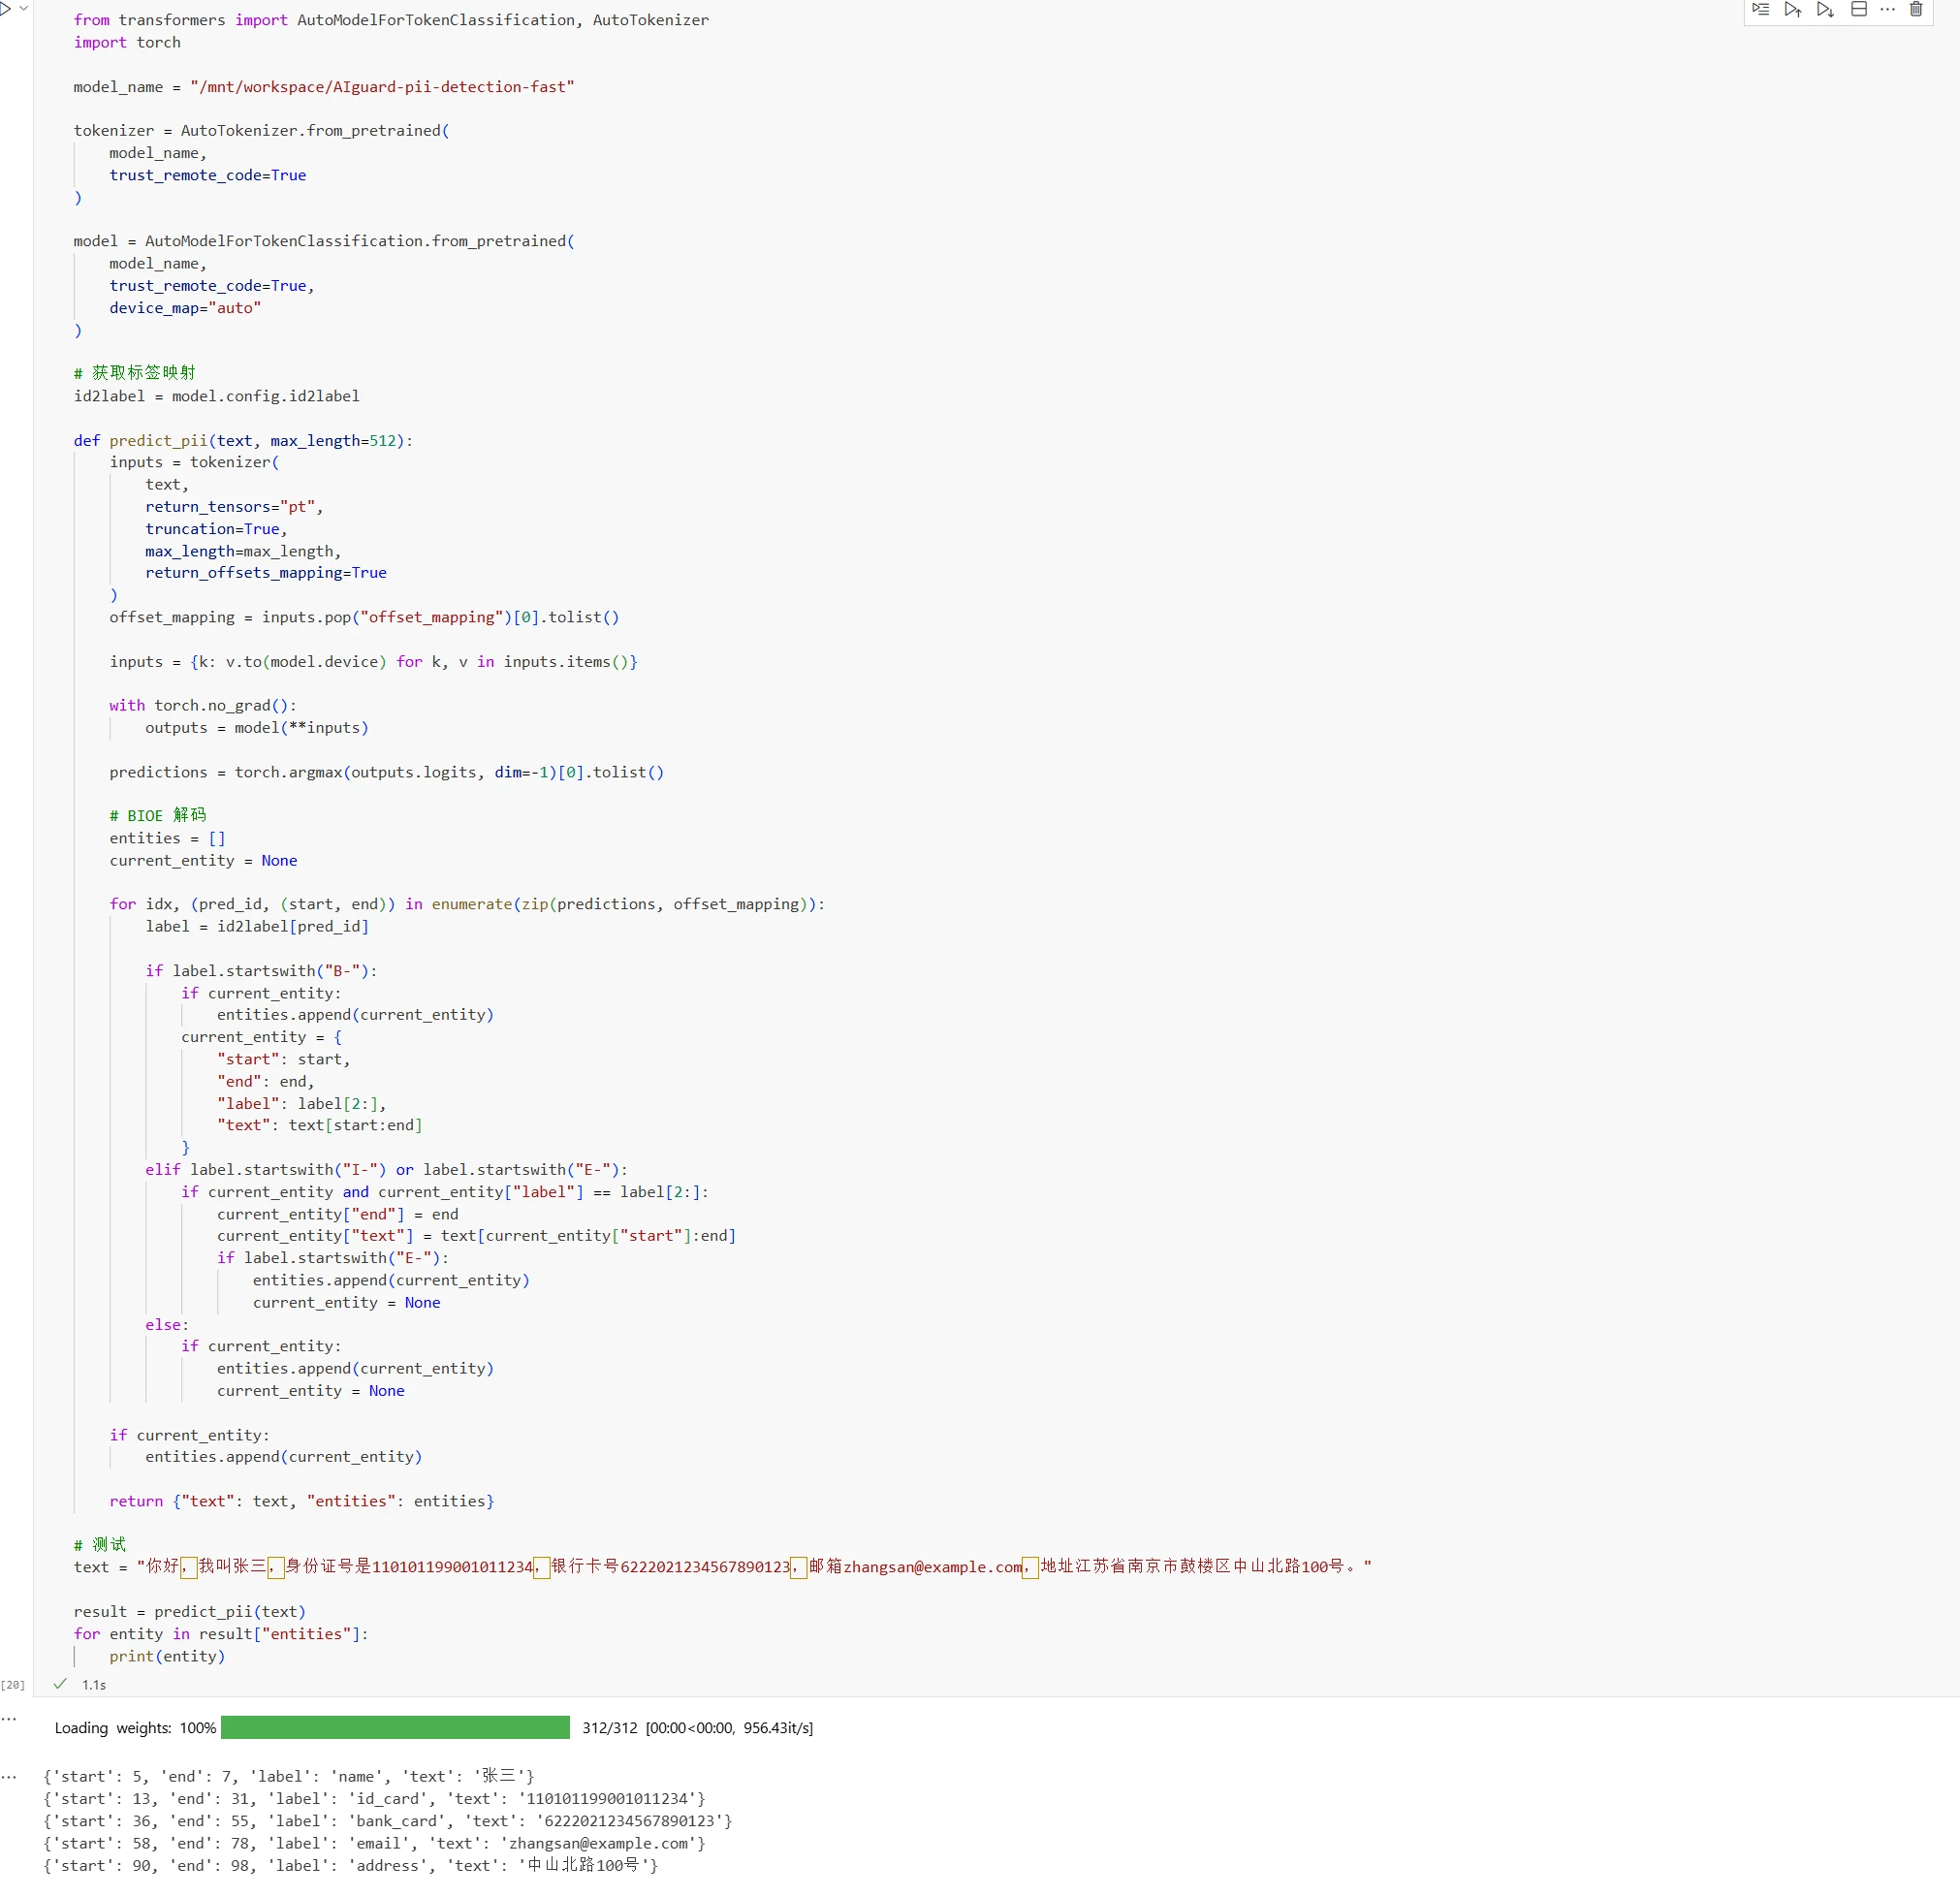
النموذج مفتوح المصدر ZJUICSR/AIguard-pii-detection-fast نموذج للكشف عن المعلومات الشخصية الحساسة باللغة الصينية، قادر على التعرف على معلومات حساسة متعددة مثل الأسماء وأرقام الهواتف وأرقام الهوية والعناوين والعناوين الإلكترونية.
from transformers import AutoModelForTokenClassification, AutoTokenizer
import torch

model_name = "/mnt/workspace/AIguard-pii-detection-fast"

tokenizer = AutoTokenizer.from_pretrained(
    model_name,
    trust_remote_code=True
)

model = AutoModelForTokenClassification.from_pretrained(
    model_name,
    trust_remote_code=True,
    device_map="auto"
)

id2label = model.config.id2label

def predict_pii(text, max_length=512):
    inputs = tokenizer(
        text,
        return_tensors="pt",
        truncation=True,
        max_length=max_length,
        return_offsets_mapping=True
    )
    offset_mapping = inputs.pop("offset_mapping")[0].tolist()

    inputs = {k: v.to(model.device) for k, v in inputs.items()}

    with torch.no_grad():
        outputs = model(**inputs)

    predictions = torch.argmax(outputs.logits, dim=-1)[0].tolist()

    entities = []
    current_entity = None

    for idx, (pred_id, (start, end)) in enumerate(zip(predictions, offset_mapping)):
        label = id2label[pred_id]

        if label.startswith("B-"):
            if current_entity:
                entities.append(current_entity)
            current_entity = {
                "start": start,
                "end": end,
                "label": label[2:],
                "text": text[start:end]
            }
        elif label.startswith("I-") or label.startswith("E-"):
            if current_entity and current_entity["label"] == label[2:]:
                current_entity["end"] = end
                current_entity["text"] = text[current_entity["start"]:end]
                if label.startswith("E-"):
                    entities.append(current_entity)
                    current_entity = None
        else:
            if current_entity:
                entities.append(current_entity)
                current_entity = None

    if current_entity:
        entities.append(current_entity)

    return {"text": text, "entities": entities}

text = "مرحباً، اسمي Zhang San، رقم الهوية 110101199001011234، رقم البطاقة المصرفية 6222021234567890123، البريد الإلكتروني zhangsan@example.com، العنوان 100 طريق Zhongshan الشمالي، حي Gulou، نانجينغ، مقاطعة جيانغسو."

result = predict_pii(text)
for entity in result["entities"]:
    print(entity)
النتائج:
تتضمن نتائج التعرف محتوى المعلومات الحساسة ونوعها وموضعها في النص الأصلي. بعد ذلك، يمكن اختيار طرق إخفاء هوية مناسبة بناءً على هذه المعلومات.
في الأعمال الحقيقية، تُستخدم التعبيرات النمطية ونماذج التعرف على المعلومات الحساسة معاً بشكل شائع. التعبيرات النمطية تعالج بسرعة المعلومات بتنسيق ثابت، بينما النماذج تعالج المعلومات التي تحتاج فهمًا دلالياً.
طرق إخفاء الهوية
بعد الانتهاء من تحديد المعلومات الحساسة، يجب اختيار طرق معالجة مناسبة بناءً على نوع المعلومات الحساسة ومتطلبات مهمة التدريب.
تشمل طرق إخفاء الهوية الشائعة:
(1) الاستبدال
يشمل الاستبدال استبدال المعلومات الحساسة الحقيقية بمحتوى آخر. يمكن تقسيم الاستبدال إلى استبدال ثابت واستبدال عشوائي:
الاستبدال الثابت: توليد نتائج الاستبدال وفقاً لقواعد ثابتة. مثلاً، استبدال الاسم الأول بـ"شخص معين"، "Zhang San" يصبح "Zhang شخص معين". نظراً لأن القواعد ثابتة، ستحصل نفس المعلومات دائماً على نفس النتيجة.
text = "العميل Zhang San قدم طلباً، و Li Si مسؤول عن المراجعة."

entities = [
    {"label": "الاسم", "text": "Zhang San"},
    {"label": "الاسم", "text": "Li Si"}
]

def replace_name(name):
    return name[0] + "شخص معين"

for entity in entities:
    if entity["label"] == "الاسم":
        entity["result"] = replace_name(entity["text"])
        text = text.replace(entity["text"], entity["result"])

print("بعد إخفاء الهوية:", text)
الاستبدال العشوائي: اختيار معلومات مختلقة عشوائياً لاستبدال المعلومات الحقيقية. إذا ظهر "Zhang San" في عدة مواقع، يجب أن تكون نتائج الاستبدال متسقة.
import random

text = "العميل Zhang San قدم طلباً، ثم اتصلت خدمة العملاء بـ Zhang San."
entities = [
    {"label": "الاسم", "text": "Zhang San"},
    {"label": "الاسم", "text": "Zhang San"}
]
fake_names = ["Li Ming", "Wang Qiang", "Zhao Wei"]
name_map = {}

def replace_name_random(name):
    if name not in name_map:
        name_map[name] = random.choice(fake_names)
    return name_map[name]

for entity in entities:
    if entity["label"] == "الاسم":
        entity["result"] = replace_name_random(entity["text"])
        text = text.replace(entity["text"], entity["result"])

print("بعد إخفاء الهوية:", text)
print("التعيين:", name_map)
(2) التمويه
يخفي التمويه جزءاً من المحتوى الحساس مع الحفاظ على معلومات جزئية مثل أرقام الهواتف وأرقام الهوية وأرقام البطاقات المصرفية والعناوين الإلكترونية.
text = "رقم هاتف العميل 13812345678، رقم الهوية 110101199001011234، رقم البطاقة المصرفية 6222021234567890123، البريد الإلكتروني zhangsan@example.com."

entities = [
    {"label": "الهاتف", "text": "13812345678"},
    {"label": "رقم الهوية", "text": "110101199001011234"},
    {"label": "البطاقة المصرفية", "text": "6222021234567890123"},
    {"label": "البريد الإلكتروني", "text": "zhangsan@example.com"}
]

def mask_value(entity):
    text = entity["text"]
    if entity["label"] == "الهاتف":
        return text[:3] + "****" + text[-4:]
    if entity["label"] == "رقم الهوية":
        return text[:6] + "********" + text[-4:]
    if entity["label"] == "البطاقة المصرفية":
        return text[:4] + "***********" + text[-4:]
    if entity["label"] == "البريد الإلكتروني":
        username, domain = text.split("@")
        return "***@" + domain
    return text

for entity in entities:
    result = mask_value(entity)
    text = text.replace(entity["text"], result)

print("بعد إخفاء الهوية:", text)
(3) التعمية
تقلل التعمية من دقة المعلومات. تُستخدم عادةً للمعلومات المستمرة مثل العناوين والأعمار والأوقات.
(4) الحذف
للحقول الحساسة غير ذات الصلة بمهمة التدريب، يمكن حذفها مباشرة.
data = {"الاسم": "Zhang San", "الهاتف": "13812345678", "السؤال": "كيف أعالج الخدمة؟", "الإجابة": "يمكنك تقديم طلب عبر الإنترنت."}
remove_fields = ["الاسم", "الهاتف"]
for field in remove_fields:
    data.pop(field, None)
print("بعد إخفاء الهوية:", data)
الخطوة الأخيرة: تنظيم بالتنسيق المطلوب للتدريب
بعد الانتهاء من معالجة البيانات، يجب تنظيمها في التنسيق المناسب وفقاً لمتطلبات إطار التدريب.
ضبط التعليمات هو طريقة ضبط رفيعة شائعة للنماذج الكبيرة. تتضمن بيانات التدريب تعليمات المستخدم والإجابات المتوقعة من النموذج.
تنسيق Alpaca
{
  "instruction": "ترجم النص الصيني التالي إلى الإنجليزية",
  "input": "الطقس جميل جداً اليوم.",
  "output": "The weather is very nice today."
}
تنسيق Messages
{
  "messages": [
    {"role": "system", "content": "أنت مساعد خدمة عملاء محترف."},
    {"role": "user", "content": "متى يصل طلبي؟"},
    {"role": "assistant", "content": "يرجى تقديم رقم الطلب وسأساعدك في التحقق."}
  ]
}
تنسيق ShareGPT
{
  "conversations": [
    {"from": "human", "value": "ترجم النص الصيني التالي: الطقس جميل جداً اليوم."},
    {"from": "gpt", "value": "The weather is very nice today."}
  ]
}
كيفية اختيار تنسيق البيانات
تنسيق البيانات
الميزات الرئيسية
السيناريوهات المناسبة
Alpaca
تنظيم البيانات باستخدام instruction وinput وoutput
تعليمات جولة واحدة، أسئلة وإجابات، تصنيف
Messages
استخدام messages لحفظ المحادثات
محادثات جولة واحدة أو متعددة
ShareGPT
استخدام conversations لحفظ المحادثات
محادثات جولة واحدة أو متعددة
يمكن عادةً تحويل التنسيقات المختلفة من بعضها البعض. أثناء التدريب الفعلي، يجب أولاً تأكيد تنسيقات البيانات والقوالب المدعومة.
كود النموذج والملفات ذات الصلة: https://www.modelscope.cn/gallery/liucong/b41e2395-f795-400f-bafd-e53ed7f5c8ca