في المرة الأولى التي تستعد فيها لتنزيل نموذج كبير، يمكن أن تكون علامات 7B و32B و128K وINT4 على صفحة النموذج مربكة: 7B يشير إلى حجم النموذج، و128K يبدو وكأنه يمكنه تغليف كتاب كامل، وINT4 يمكنه تقليل استخدام VRAM. كيف يعمل ذلك؟
عندما تبدأ في استخدام النموذج فعلياً، ستواجه مشاكل مثل عدم اكتمال محاضرات الاجتماعات، نسيان السياق في المحادثات الطويلة، عدم وجود أساس لإجابات النموذج، وتغير أداء النموذج عند تغيير طريقة التحويل.
للتحدد ما إذا كان النموذج مناسباً للمهمة الحالية، تحتاج إلى فهم كيفية دخول النص في النموذج، وكيف تتكون قدرات النموذج، ولماذا يستهلك النموذج الذاكرة وVRAM أثناء الاستدلال.
يمكن تنظيم هذا المعرفة على طول ثلاثة خطوط رئيسية: الخط الأول يبدأ بالبنية العامة لـ Transformer، ثم يعرض Token وEmbedding وAttention لشرح كيفية دخول النص في النموذج ومعالجته. الخط الثاني يغطي التدريب المسبق والضبط بالتعليمات والتدريب اللاحق لشرح تكوين قدرات النموذج. الخط الثالث يغطي طول السياق وKV Cache والتهيئة والعتاد، التي تحدد ما إذا كان النموذج يعمل بثبات على الأجهزة المستهدفة.
محتوى هذا الفصل هو استخلاص للمعرفة الأساسية من الفصول ذات الصلة في الأجزاء السابقة. على سبيل المثال، يمكن الرجوع إلى الفصول السادسة والسابعة فيما يتعلق باستدلال النموذج. بالنسبة إلى SFT للنماذج، يمكن الرجوع إلى إطار ms-swift للضبط الدقيق المدمج في ModelScope المذكور في الفصل التاسع. بالنسبة إلى التدريب اللاحق، يمكن الرجوع إلى محتوى مواءمة التفضيلات والتعلم المعزز المذكور في الفصل العاشر. بالنسبة إلى تطبيقات النموذج المتخصص ومشاكل الهلوسة، يمكن أيضاً الرجوع إلى طريقة RAG المذكورة في الفصل الثالث عشر، والتي تستخدم المعرفة الخارجية لتحسين أداء الإجابة على الأسئلة في المجال المحدد لتقليل هلوسة النموذج.
18.1 البنية الأساسية للTransformer
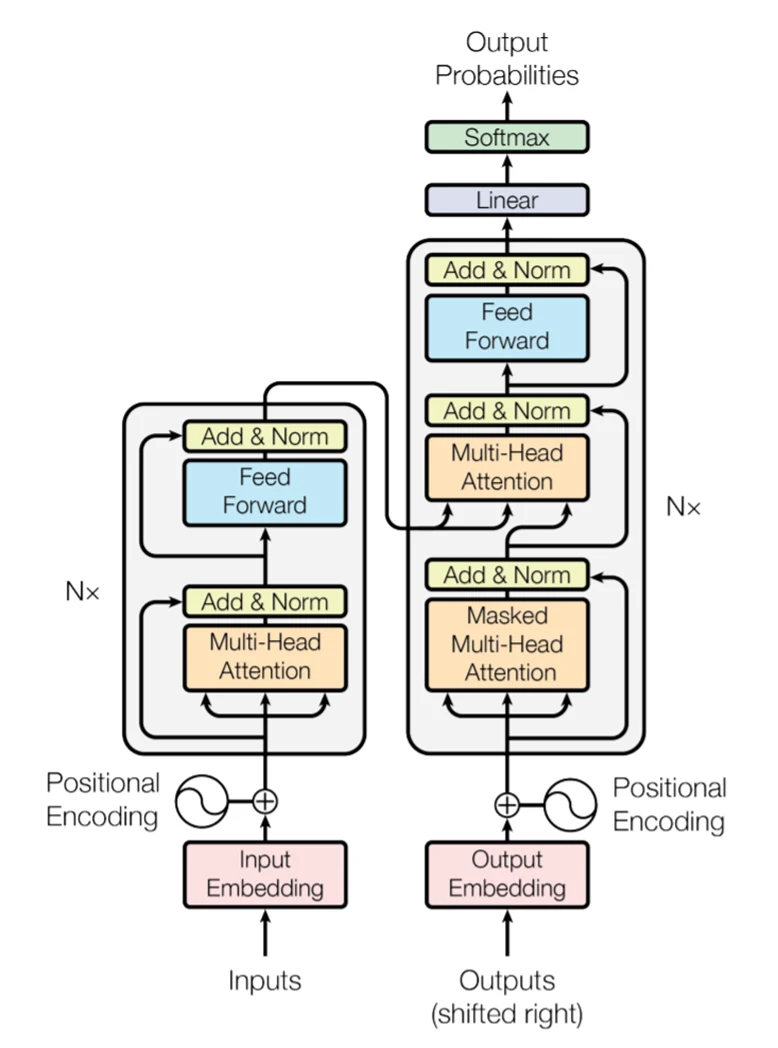
Transformer هو البنية الأساسية التي تستخدمها معظم نماذج اللغة الكبيرة اليوم. على عكس شبكات الأعصاب العودية المبكرة التي تعالج النص بشكل تسلسلي، يمكن لـ Transformer حساب مواقع متعددة بشكل متوازٍ أثناء التدريب ومعالجة المدخلات، وتحديد اتصالات بين المواقع المختلفة من خلال Attention. يتكون Transformer الكلاسيكي من المُرمِّز والمُفكِّر. عادةً ما يحتوي كل طبقة Transformer على Attention وشبكة التغذية الأمامية. تسمى شبكة التغذية الأمامية أيضاً FFN أو MLP، وتنطبق تحويلات غير خطية على متجهات كل موقع. تُستخدم أيضاً الاتصالات المتبقية وتطبيع الطبقات في الطبقة لمساعدة المعلومات على مرور الشبكة العميقة بشكل مستقر. بعد تكدس الطبقات المتشابهة العديدة، يمكن للنماذج تدريجياً تكوين تمثيلات نصية معقدة وقدرات توليد. تظهر البنية العامة لـ Transformer في الشكل أدناه، حيث يمثل الجانب الأيسر المُرمِّز والجانب الأيمن المُفكِّر. يشير N× في الرسم إلى تكرار وحدات متشابهة عبر عدة طبقات، وتختلف الأعداد الفعلية للطبقات حسب بنية النموذج وحجم المعاملات.
عندما يقوم النموذج بالاستدلال، عندما يُدخل المستخدم نصاً، تمر المعالجة الداخلية للنموذج بالتالي: تقوم نماذج اللغة الكبيرة أولاً بتقسيم النص الأصلي إلى رموز Token باستخدام Tokenizer، وتحويلها إلى معرّفات Token المقابلة. بعد ذلك، تقوم طبقة Embedding بتحويل معرّفات Token المنفصلة هذه إلى تمثيلات متجهية متواصلة، مع إضافة معلومات الموضع لإخبار النموذج بالترتيب التالي لكل Token في الجملة. بعد ذلك، تمر هذه المتجهات بعدة طبقات Transformer للمعالجة المتكررة، حيث يتحمل آلية Attention المسؤولية عن السماح للرموز المختلفة بالتفاعل وتبادل معلومات السياق، بينما تقوم شبكة التغذية الأمامية بمعالجة ميزات كل موقع بشكل أعمق. بعد عدة حسابات، يحصل النموذج على تمثيل شامل للسياق الحالي، وبناءً على ذلك يحسب توزيع احتمالات الرمز التالي، ويختار أو يأخذ عيّنة للرمز التالي، ويضيفه إلى السياق لإعادة هذه العملية حتى اكتمال التوليد الكامل.
لثلاثة أجزاء في Transformer الكلاسيكي أدوار مختلفة:
- بنية المُرمِّز فقط (Encoder-only): مسؤولة بشكل أساسي عن فهم المدخلات، ويمكنها الرجوع إلى مواقع مختلفة في تسلسل المدخلات في الوقت نفسه، مناسبة للمهام مثل التصنيف والاستخراج والتمثيل الدلالي؛
- بنية المُفكِّر فقط (Decoder-only): مسؤولة بشكل أساسي عن توليد المخرجات، ويمكنها فقط الاطلاع على المحتوى الذي ظهر بالفعل عند توليد الموقع الحالي؛
- بنية المُرمِّز-المُفكِّر (Encoder-Decoder): تفهم المدخلات أولاً، ثم تولد المخرجات تدريجياً، وشائعة في مهام تحويل التسلسلات مثل الترجمة والتلخيص.
لا تستخدم النماذج الكبيرة الحديثة بالضرورة المُرمّز والمُفكّر الكاملين في الوقت نفسه. فوق هذا الأساس، تفرعت عدة بنيات قائمة على Transformer، على سبيل المثال، نماذج التوليد من نوع GPT تستخدم عادةً بنية Decoder-only، ونماذج BERT تستخدم بشكل أساسي Encoder-only، بينما تحافظ نماذج T5 على بنية Encoder-Decoder.
18.2 Token: الوحدة الأساسية لمعالجة النص في النموذج
Token هو الوحدة الأساسية التي يستخدمها النموذج عند قراءة النص وتوليده. قد يكون حرفاً واحداً، أو كلمة، أو جزءاً من كلمة، أو علامة ترقيم، أو حتى مسافة أو علامة تحكم خاصة. على سبيل المثال، قد تختلف النتائج لنفس الجملة في Tokenizers مختلفة:
النص الأصلي: نماذج اللغة الكبيرة تغير طريقة العمل في المكاتب.

الفصل أ: نماذج / اللغة / الكبيرة / تغير / طريقة / العمل / في / المكاتب / .
الفصل ب: نم / وجه / ة / اللغة / الك / بيرة / تغي / ر / طري / قة / العمل / .
يعبر الناتجان عن نفس الجملة، لكن عدد الرموز غير متساوٍ. ما يتلقاه النموذج فعلياً هو رقم معرّف كل Token، أي Token ID. كمثال على ترتيب محضر اجتماع، فإن ما يراه النموذج ليس محضر اجتماع كاملة، بل سلسلة من معرّفات Token. يتناول اسم الاجتماع ومحتوى التحدث والوقت وعلامات الترقيم ومتطلبات الإخراج كلها من Tokens. يتم också النتائج والمخرجات التي يولّدها النموذج، مما يعني أن نفس المادة كلما زادت تفاصيل الإخراج المطلوبة، قلّت المساحة المتاحة للسجل الأصلي.
إذا تم التقسيم بالكامل حسب الأحرف، يمكن أن يكون المفردات صغيراً نسبياً، لكن التسلسل سيصبح طويلاً. إذا تم التقسيم بالكامل حسب الكلمات الكاملة، سيكون المفردات ضخماً جداً، وستواجه باستمرار كلمات جديدة وأحرف مختصرة وتنويعات إملائية. عادةً ما تستخدم النماذج الكبيرة تقسيم الكلمات الفرعية للعثور على التوازن بين الأحرف والكلمات الكاملة. BPE وWordPiece وUnigram وSentencePiece جميعها طرق شائعة.
18.3 Embedding: تحويل المحتوى إلى متجهات
عادةً، لا يمكن للنماذج إجراء عمليات المصفوفات مباشرة على النصوص أو الصور، ويجب تحويل المحتوى أولاً إلى متجهات رقمية. تسمى هذه العملية بالدمج أو التمثيل المتجهي (Embedding). بالنسبة للنصوص، يقوم Tokenizer أولاً بتحويل النص إلى Token ID، ثم تجد طبقة Embedding المتجه المقابل بناءً على المعرّف. عادةً ما لا يكون العدد الفردي في المتجه له معنى مباشر، لكن المتجه بأكمله يمكنه تمثيل ميزات Token داخل النموذج. كمثال على Token "اجتماع"، يمكن أن يكون Token ID المقابل رقم صحيحاً مثل "15872"، ويمكن أن يكون التمثيل المقابل (أي Embedding) متجهاً مثل: [0.12, -0.37, 0.08, ……]. يتم ضبط Embedding باستمرار أثناء عملية التدريب، وتحدث المتجهات التي تظهر في سياقات متشابهة سمات متشابهة. نظراً لاختلاف بنية النموذج وعملية التدريب، يمكن لنفس الكلمة تكوين تمثيلات مختلفة بناءً على السياق بعد مرورها بعدة طبقات Transformer.
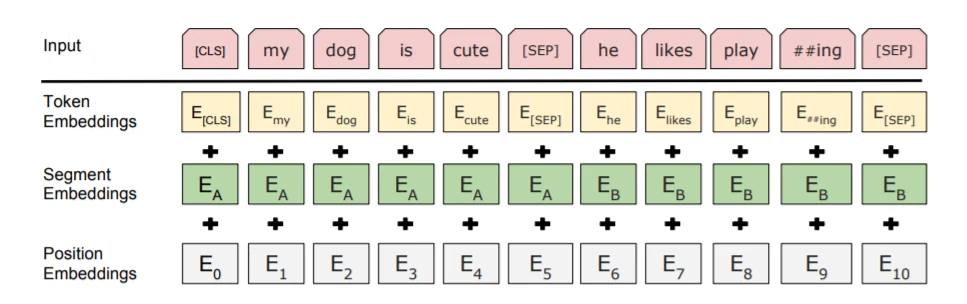
عندما يحصل النموذج على المعلومات الدلالية لمدخلات النص، لا يتعين عليه معرفة ما هو Token فحسب، بل גם معرفة موقعه. عند وجود Token Embedding فقط، تحتوي "تأجيل الاجتماع" و"اجتماع متأخر" على Tokens متشابهة، لكن بسبب اختلاف ترتيب الكلمات، تعبران عن معانٍ مختلفة. لذلك، يحتاج النموذج أيضاً إلى إضافة ترميز الموضع أو تمثيل الموضع. يظهر الشكل أدناه طبقة الدخول في BERT كمثال.
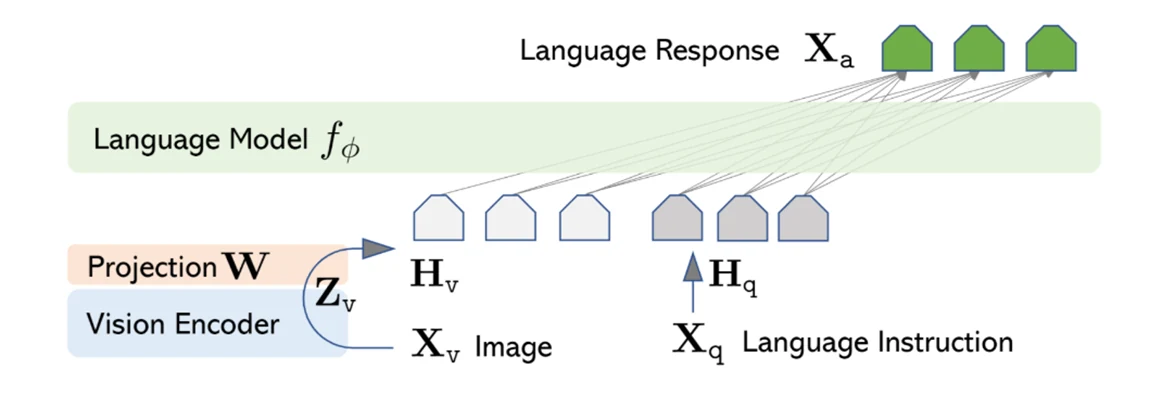
كما هو موضح في طريقة التمثيل المستخدمة في BERT أعلاه، يعرض طريقة دمج Token Embedding وSegment Embedding وPosition Embedding. بالطبع، تختلف الخطط الفعلية المستخدمة في بنى النماذج المختلفة وطرق التصميم. كمثال على النماذج الكبيرة متعددة الوسائط، يجب تحويل الصور والصوت وغيرها من المحتوى أيضاً إلى متجهات أولاً. عادةً ما تُقص الصور إلى قطع صور أولاً، ويقوم المُرمّز البصري باستخراج الميزات؛ يتم تحويل الصوت أولاً إلى ميزات صوتية، ثم يعالجها مُرمّز الصوت. تمر الميزات من الوسائط المختلفة عبر وحدة الإسقاط أو الربط (Projection) قبل أن تدخل الفضاء المتجهي الذي يمكن للنماذج الكبيرة معالجته. كما هو موضح في الشكل أدناه، يتم دمج معلومات الصورة والمعلومات الدلالية عبر وحدة الربط.
18.4 Attention: حساب الارتباط بين المدخلات
يتحمل Attention المسؤولية عن تحديد أي جزء من المدخلات يجب التركيز عليه في الموقع الحالي. يقوم بحساب درجة الارتباط على التمثيلات المتجهية التي تكونها النماذج بالفعل، وليس مجرد البحث عن الكلمات المتطابقة. على سبيل المثال، في جملة "تأخر المشروع، وشرح التقرير سبب عدم اكتماله في الموعد المحدد"، عند معالجة النموذج للضمير "هو"، يحتاج إلى تحديد ما إذا كان يشير إلى "المشروع" أو "التقرير" بناءً على السياق. عند استخراج المسؤول من محضر الاجتماع، يحتاج النموذج أيضاً إلى ربط وصف المهمة واسم الشخص والجملة التي توضح تقسيم العمل.
18.4.1 فهم Attention من خلال Q وK وV
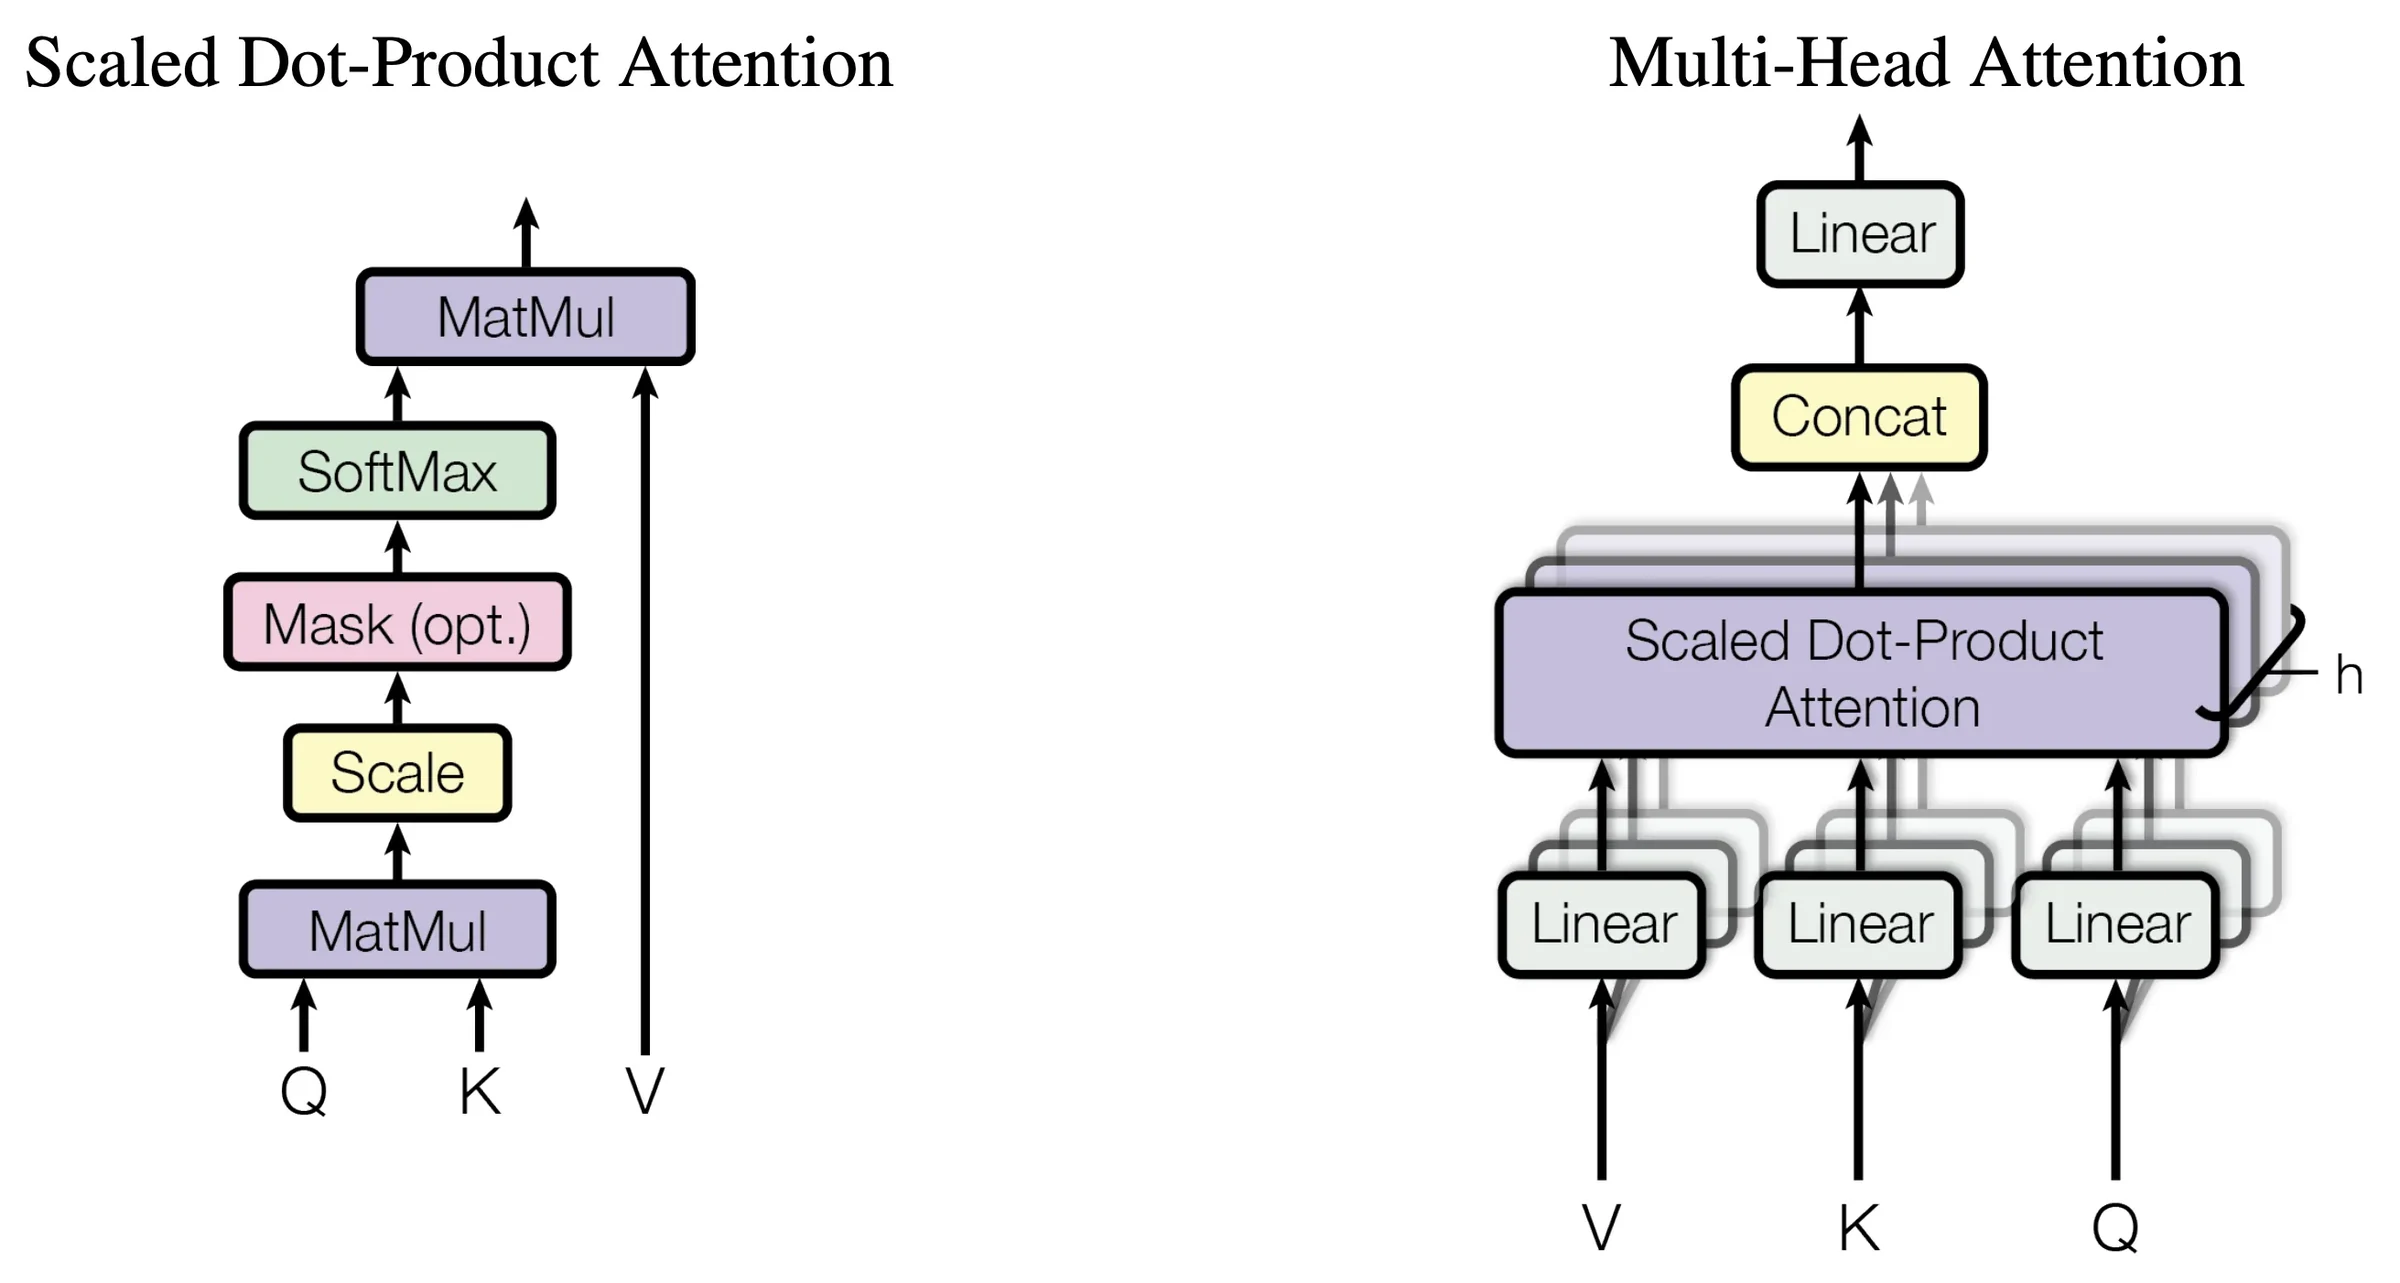
يمر كل متجه مدخل بتحويلات مختلفة لتشكيل Query وKey وValue، وعادةً ما تُ اختصر إلى Q وK وV. يمكن تبسيط صيغة حساب Attention كالتالي:
حيث يمثل Q ما يبحث عنه الموقع الحالي من معلومات، وتمثل K الميزات التي يمكن لكل موقع المطابقة بها، وتمثل V المحتوى الذي يجب استرداده بعد المطابقة. يقوم النموذج أولاً بمقارنة Q وK للحصول على درجة الارتباط بين الموقع الحالي والمواقع الأخرى؛ ثم يحول softmax الدرجات إلى أوزان، ويقوم بتجميع V بشكل مرجح وفقاً للأوزان. يمثل $d_k$ في الصيغة بُعد متجه Key، وقسمته على $\sqrt`$ هو لضبط مقياس الدرجات لجعل الحساب أكثر استقراراً.
إذا جاءت Q وK وV من نفس التسلسل، فهذا يسمى Attention الذاتي (Self-Attention)، ويستخدم لربط التسلسل الداخلي. إذا جاءت Q من تسلسل وK وV من تسلسل آخر، فهذا يسمى Attention المتقاطع (Cross-Attention). على سبيل المثال، يمكن لنموذج الترجمة Encoder-Decoder لـ Decoder استخدام Attention المتقاطع لقراءة المعلومات الأصلية التي يوفرها Encoder.
بالنسبة للنماذج الكبيرة التوليدية، يمكن للموقع الحالي فقط الرجوع إلى المحتوى الذي ظهر بالفعل، لذلك يجب إضافة قناع سببي إلى Attention لحجب المواقع اللاحقة. حتى مع حجب الرموز المستقبلية، لا يزال عدد الارتباطات التي يعالجها Attention السببي الكامل يزداد تقريباً بشكل تربيعي مع طول التسلسل. في الوقت نفسه، يجب حفظ K وV من الرموز السابقة أثناء مرحلة التوليد، مكونةً KV Cache الذي سيتم شرحه لاحقاً. مع زيادة طول السياق، يزداد تكلفة حساب Attention والتخزين المؤقت بشكل متزايد، والبنى المختلفة المذكورة أدناه تطورت تدريجياً لمعالجة هذه المشاكل.
18.4.2 Multi-Head Attention (MHA)
طُرح Multi-Head Attention (MHA) في ورقة Transformer لعام 2017 "Attention Is All You Need"، ثم طُبّق في BERT وLlama 2 7B و13B ونماذج أخرى. يضيف رؤوس انتباه متعددة متوازية إلى أساس حساب الانتباه الواحد، مما يسمح للنموذج باستخراج علاقات السياق من مساحات تمثيل مختلفة.
في MHA، لكل رأس معلمات إسقاط خاصة لتوليد Q وK وV، ويحسب الانتباه بشكل منفصل، ثم يصل نتائج جميع الرؤوس معاً لتشكيل المخرج عبر طبقة خطية. كما هو موضح في الشكل أدناه، يعرض الجانب الأيسر عملية حساب Dot-Product Attention المُقنّاة لمجموعة واحدة، والجانب الأيمن ينفذ هذه العملية بشكل متكرر عدة مرات بشكل متوازٍ، ثم يدمج النتائج. تتشكل أنماط الاهتمام المختلفة من التدريب، ويمكنها دعم تحديد المراجع والعلاقات الدلالية والاعتماد بعيد المدى بشكل مشترك.
حسّن MHA قدرة النموذج على تجميع أنواع المعلومات المختلفة، وسهّل الحساب المتوازٍ أثناء التدريب. ومع ذلك، أثناء التوليد لكل Token، يجب على كل رأس قراءة K وV الخاصة به من التاريخ. مع زيادة عدد طبقات النموذج وعدد الرؤوس وطول السياق، تستهلك هذه الكاشات والقراءات كميات كبيرة من الموارد. لذلك، ركّز التحسين اللاحق على ما إذا كان يمكن الحفاظ على عدة رؤوس Query في حين تقليل عدد رؤوس Key وValue المطلوب حفظها.
18.4.3 Multi-Query Attention (MQA)
طُرح Multi-Query Attention (MQA) في ورقة Noam Shazeer لعام 2019 "Fast Transformer Decoding: One Write-Head is All You Need"، ثم طُبّق في Falcon-7B ونماذج أخرى. يتناول بشكل أساسي مشكلة نطاق الذاكرة في مرحلة فك التشفير: عند توليد النموذج لكل Token جديد، يجب قراءة KV Cache الحالي، وإذا كانت كمية القراءة كبيرة جداً، فإن سرعة التوليد ستتأثر حتى مع وجود مساحة في وحدات الحساب.
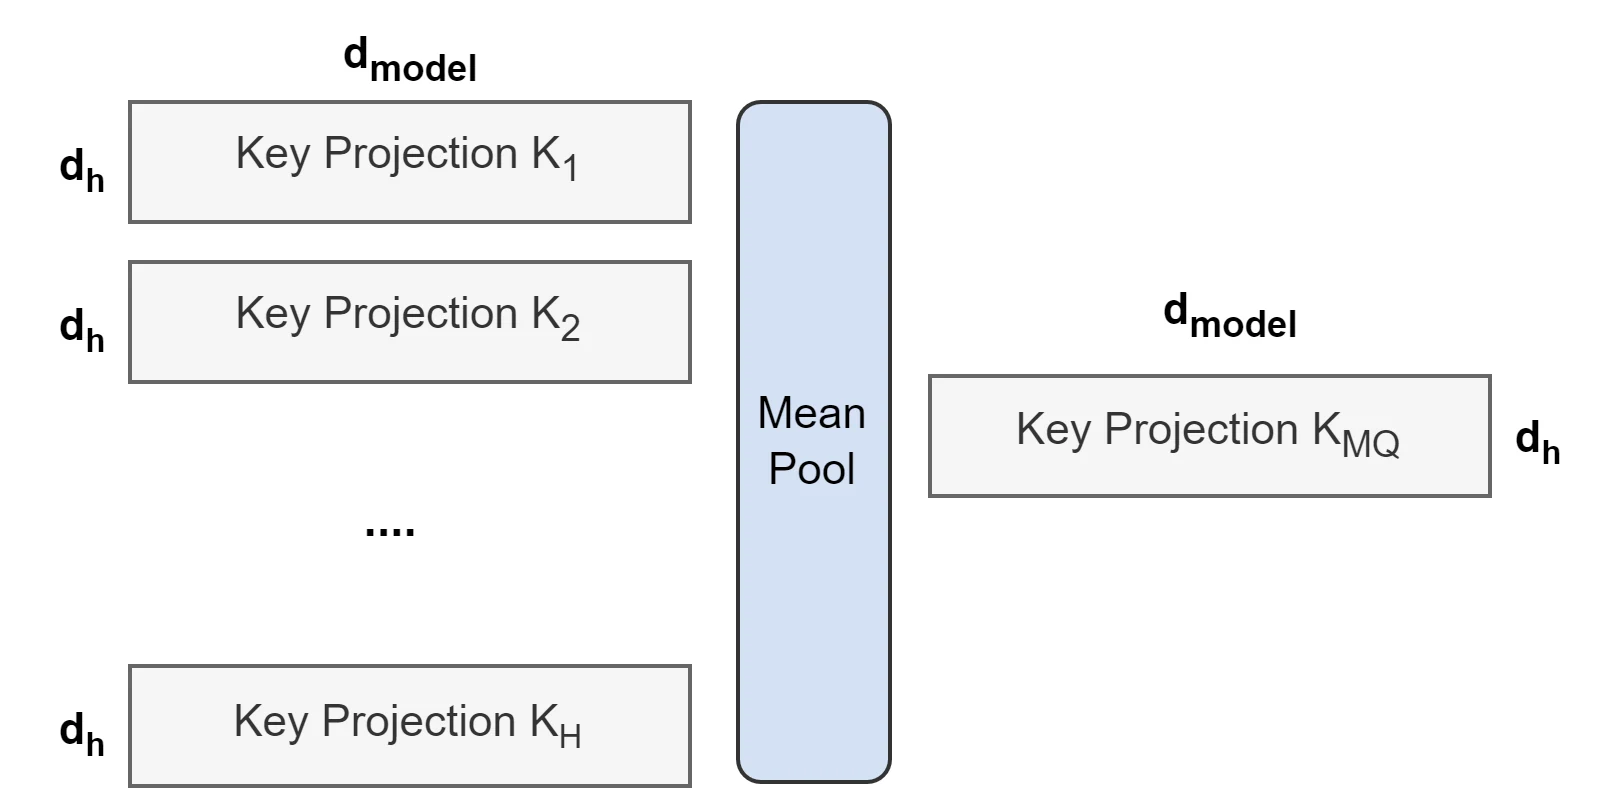
يحافظ MQA على عدة رؤوس Query، لكنها تشترك في مجموعة واحدة من Key وValue. بهذه الطريقة، لا تزال الرؤوس المختلفة قادرة على توليد استعلامات مختلفة، لكن الموقع التاريخي يحتاج فقط إلى حفظ مجموعة واحدة من K وV jointly يستخدمها جميع الرؤوس. يوضح الشكل أدناه طريقة تهيئة لتحويل نموذج MHA موجود إلى MQA: يقوم بمتوسطة مصفوفات إسقاط Key المتعددة للحصول على إسقاط مشترك، ويمكن معالجة إسقاط Value بنفس الطريقة؛ بعد التحويل، يجب الاستمرار في التدريب لجعل النموذج يتكيف مع البنية المشتركة الجديدة.
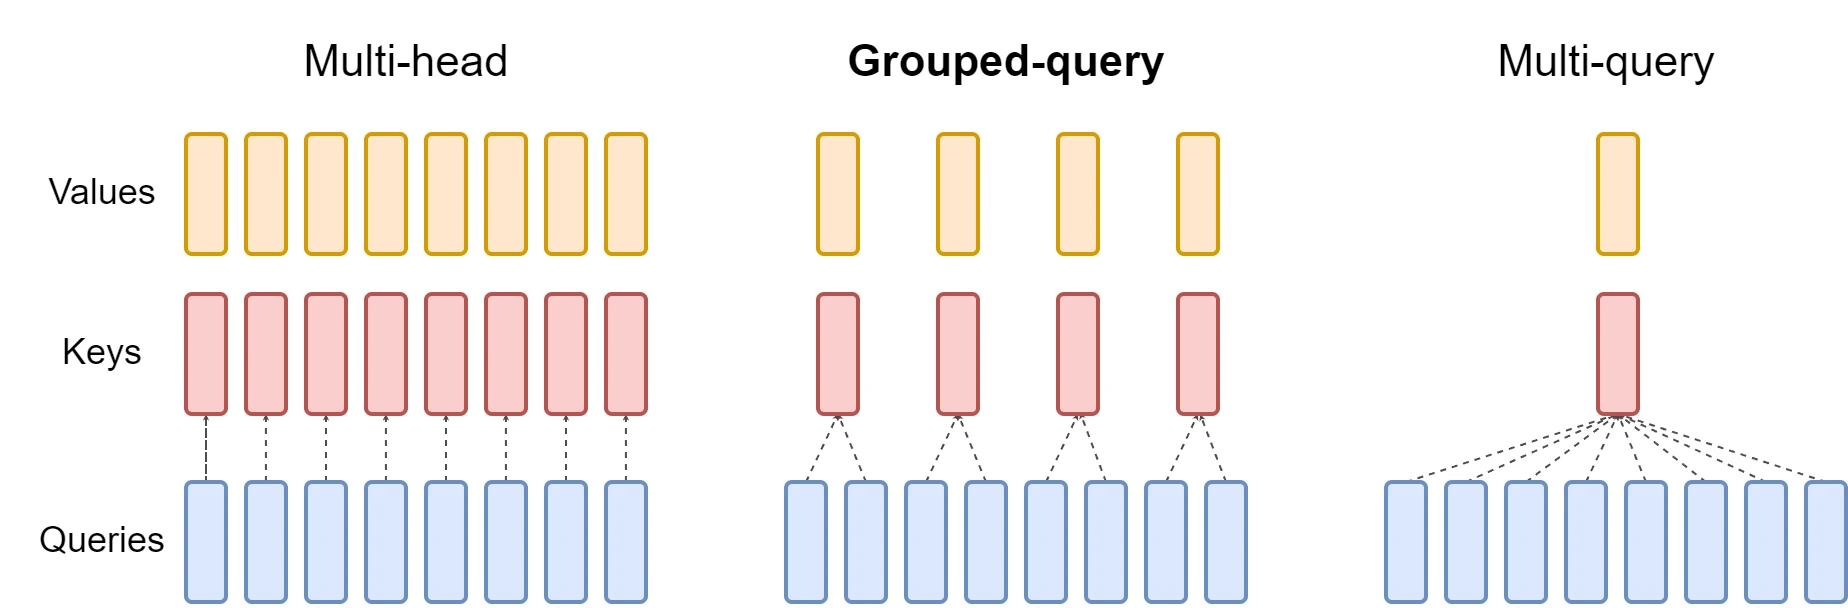
مع تبني هذه البنية، يمكن لـ MQA تقليل KV Cache بشكل ملحوظ وكمية القراءة لكل خطوة فك تشفير، مما يحرر مساحة للإدخالات الأطول أو الطلبات المتزامنة الأكبر. على سبيل المثال، يحتوي Falcon-7B على 71 رأس Query، لكنه يحتوي على رأس KV واحد فقط. مقارنة ببنية 71 مجموعة KV بنفس بُعد الرأس ونفس الدقة، فإن KV Cache النظري يكفي لنحو واحد وسبعون من المجموع. يقيّد المشاركة أيضاً سعة تمثيل K وV، لذلك يجب التحقق من تأثير هذا الكسب في الكفاءة على جودة المهمة من خلال التدريب والتقييم.
18.4.4 Grouped-Query Attention (GQA)
طُرح Grouped-Query Attention (GQA) بشكل منهجي من قبل فريق Google Research في ورقة GQA لعام 2023، وطُبّق في Llama 2 70B وMistral 7B ونماذج أخرى. يهدف إلى تحقيق التوازن بين قدرة التمثيل متعددة المجموعات في MHA وتكلفة التخزين المؤقت المنخفضة في MQA، وتجنب استخدام جميع رؤوس Query لنفس مجموعة K وV.
يقسم GQA رؤوس Query إلى عدة مجموعات، وتشارك كل مجموعة في مجموعة واحدة من Key وValue، وتحتفظ المجموعات المختلفة بتمثيلات K وV مختلفة. كما هو موضح في الشكل أدناه، يعيّن MHA K وV لكل رأس Query، ويجعل MQA جميع رؤوس Query تشترك في مجموعة واحدة من K وV، بينما GQA يشترك في المجموعة. عندما يساوي عدد المجموعات عدد رؤوس Query، فإن GQA يكافئ MHA؛ عندما يكون هناك مجموعة واحدة فقط، يكافئ MQA.
كمثال على Mistral 7B v0.1، يحتوي على 32 رأس Query و8 رؤوس KV، وتشارك كل 4 رؤوس Query في مجموعة واحدة من K وV. عند نفس بُعد الرأس ونفس الدقة، يكون هذا الكاش تقريباً ربع MHA. للنشر الفعلي، يفيد تقليل الكاش وكمية القراءة عادةً في تحسين القدرة المتزامنة وكفاءة فك التشفير؛ نظراً لاحتفاظ المجموعات المختلفة بـ K وV الخاصة بها، يحتفظ GQA بمساحة تمثيل أكبر من MQA الذي يشترك بالكامل. ما يتم تقليله هو عدد رؤوس KV، ولا يزال النموذج قادراً على حساب الانتباه لجميع المواقع التاريخية المسموح الوصول إليها.
18.4.5 Sliding Window Attention (SWA)
جاء Sliding Window Attention (SWA) من فكرة الانتباه المحلي في نمذجة التسلسلات الطويلة، واستخدمه Mistral 7B v0.1 مع GQA. قلل GQA من عدد رؤوس KV المطلوب حفظها لكل موقع، بينما يقيّد SWA أكثر من نطاق الانتباه المباشر لكل موقع لتقليل ضغط الحساب والتخزين المؤقت للنصوص الطويلة.
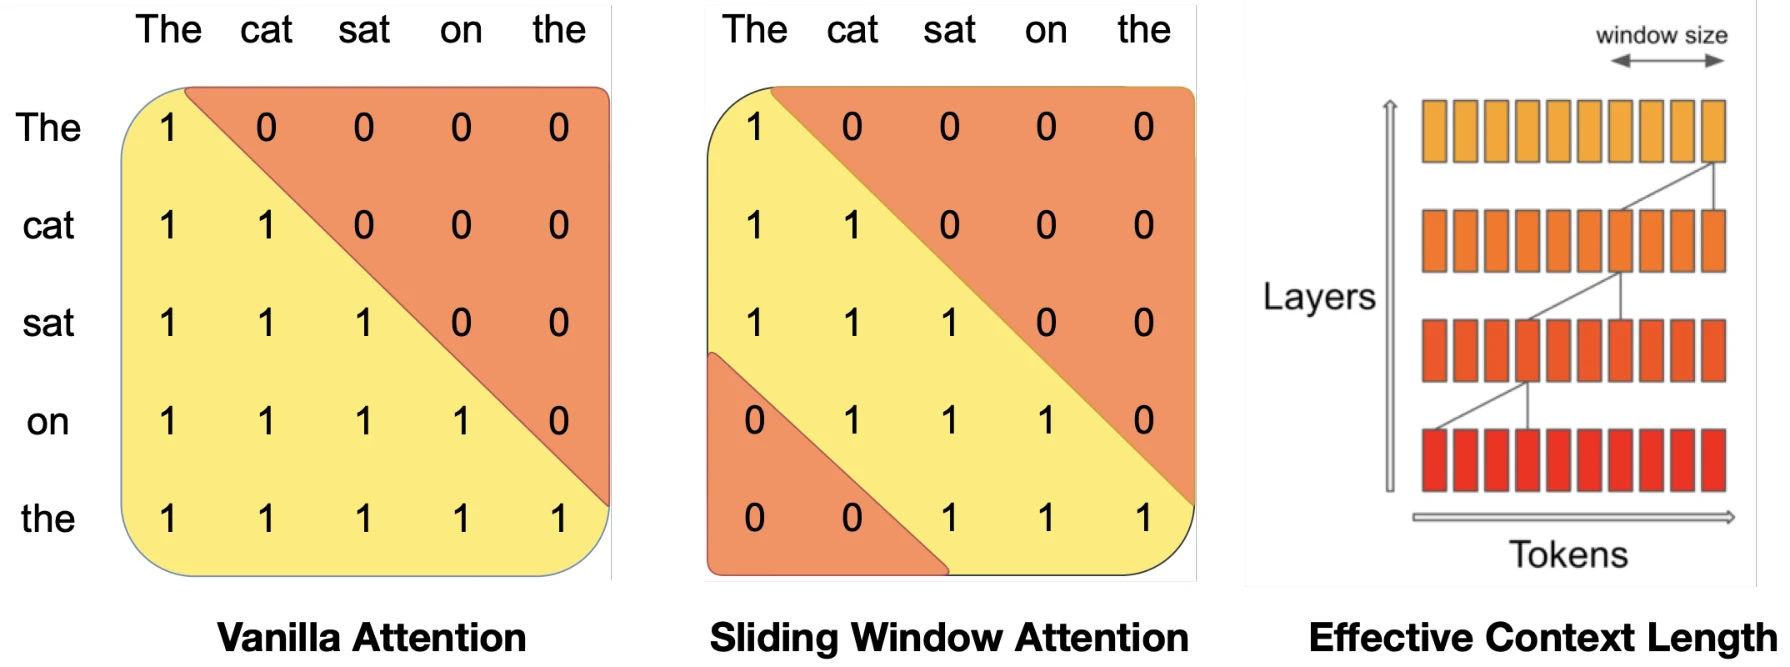
يضع SWA نافذة ثابتة الحجم لكل Token، ويحسب الانتباه فقط للمواقع الأخيرة داخل النافذة. يعرض الشكل أدناه على اليسار Attention السببي الكامل، وفي الوسط Attention النافذة المنزلقة، وعلى اليمين كيفية مرور المعلومات عبر عدة طبقات من الشبكة إلى الخلف. على الرغم من أن الطبقة الواحدة تقرأ فقط النطاق المحلي، فإن تمثيل Token في الطبقة السابقة يحتوي بالفعل على معلومات السياق الأقدم، لذلك يمكن للنموذج بعد عدة طبقات معالجة استخدام المحتوى خارج النافذة بشكل غير مباشر.
يستخدم Mistral 7B v0.1 نافذة من 4096 Token، ويستخدم تخزيناً أ.crticalاً لتغطية K وV القديمة التي خرجت من النافذة، للحفاظ على كاش الطبقات في نطاق ثابت. أفادت الورقة اختباراً على تسلسل 16K ونافذة 4096، وبعد تحسين النواة المناسب، كانت السرعة تقريباً ضعف الخط الأساسي للانتباه الكامل. يمكن لهذه البنية التحكم في نمو موارد النصوص الطويلة، لكن التفاصيل الأصلية البعيدة يجب تمريرها عبر تمثيلات وسيطة، لذلك لا يمكن اعتبار حجم النافذة المحلية مكافئاً لطول السياق الذي يمكن للنماذج استرجاعه بدقة.
18.4.6 Multi-head Latent Attention (MLA)
طُرح Multi-head Latent Attention (MLA) من قبل فريق DeepSeek في DeepSeek-V2، ثم استُخدم في DeepSeek-V3. يتناول أيضاً مشكلة KV Cache الكبير، لكنه يغير شكل التخزين المؤقت بشكل أعمق: من خلال تعلم تمثيل مشترك ضيق، يقلل البيانات المطلوب حفظها لكل Token مع دعم استخدام هذه المعلومات من قبل رؤوس الانتباه المتعددة.
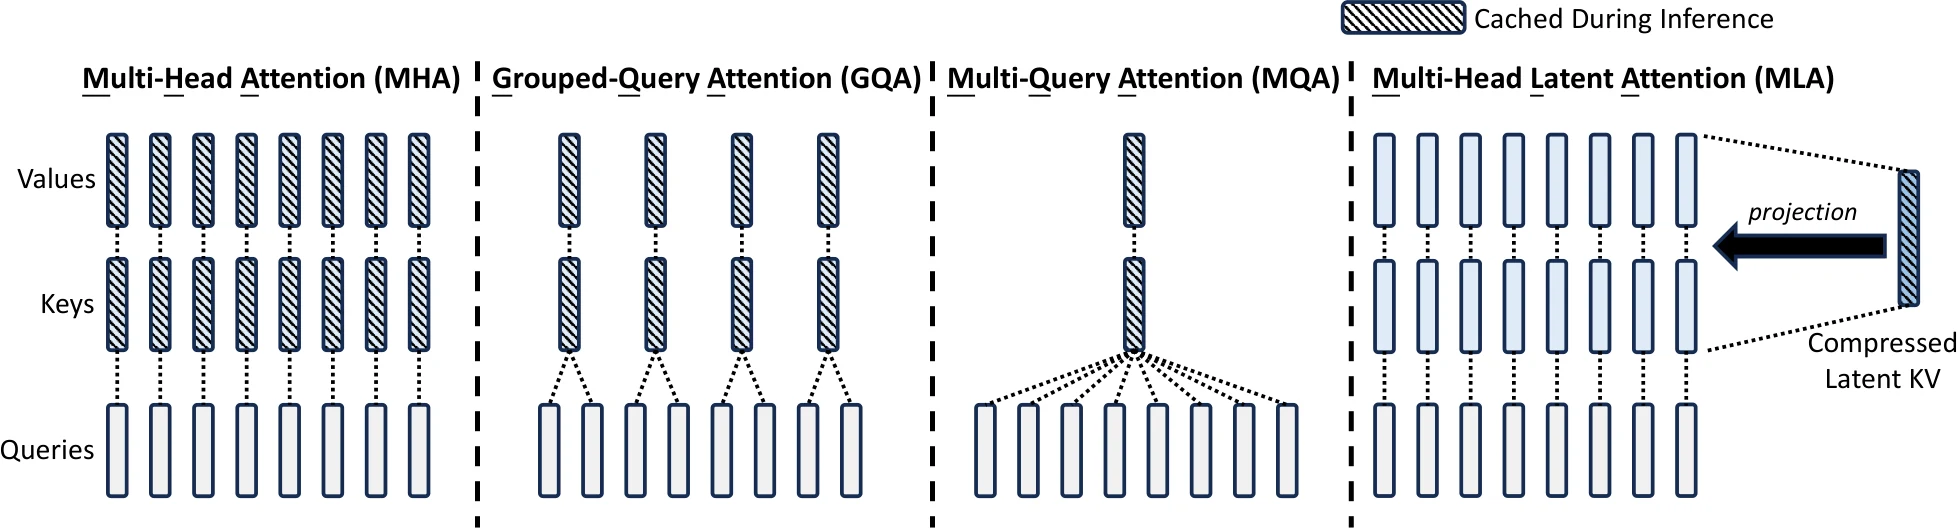
بشكل محدد، يقوم MLA أولاً باستخدام إسقاط منخفض الرتبة لتمثيل K وV بشكل مشترك في متجه كامن منخفض الأبعاد، وعند الاستدلال، يقوم بتخزين هذا المتجه بشكل مؤقت، بالإضافة إلى مكون Key الذي يحمل معلومات الموضع بشكل منفصل. يمكن لرؤوس Query المتعددة استخدام هذا التمثيل المشترك لإكمال المطابقة وتجميع المعلومات، ويمكن دمج بعض مصفوفات الإسقاط أثناء الاستدلال لتقليل عمليات التوسيع الصريحة لـ K وV الكاملة. المنطقة المائلة في الشكل أدناه تمثل المحتوى المطلوب تخزينه مؤقتاً، ويمكن رؤية أن MLA نقل كاش K وV المتعددة الرؤوس إلى التمثيل الكامن الأصغر على اليمين.
يتيح هذا التصميم لـ DeepSeek-V2 وV3 الحفاظ على قدرة التمثيل متعددة الرؤوس مع تقليل ضغط التخزين المؤقت في التوليد طويل السياق. في تقرير DeepSeek-V2، كان حجم KV Cache لكل Token في MLA يعادل GQA بـ 2.25 مجموعة فقط من رؤوس KV. ما يتم ضغطه هو بُعد التمثيل لكل موقع، بينما تظل المواقع التاريخية محفوظة، لذلك في وضع الانتباه الكامل، لا يزال النموذج يحتاج إلى قراءة وتطابق جميع الإدخالات التاريخية. لتقليل الإدخالات الفعلية المشاركة في الحساب لكل مرة، يجب إدخال الانتباه المتقطع.
18.4.7 DeepSeek Sparse Attention (DSA)
طُرح DeepSeek Sparse Attention (DSA) من قبل فريق DeepSeek، وطُبّق في DeepSeek-V3.2-Exp وDeepSeek-V3.2. يضيف آليت اختيار ديناميكية إلى أساس MLA لمعالجة مشكلة أن حتى إدخال KV واحد قد يكون صغيراً في السياق الطويل، لكن قراءة وحساب جميع الإدخالات التاريخية لا تزال باهظة التكلفة.
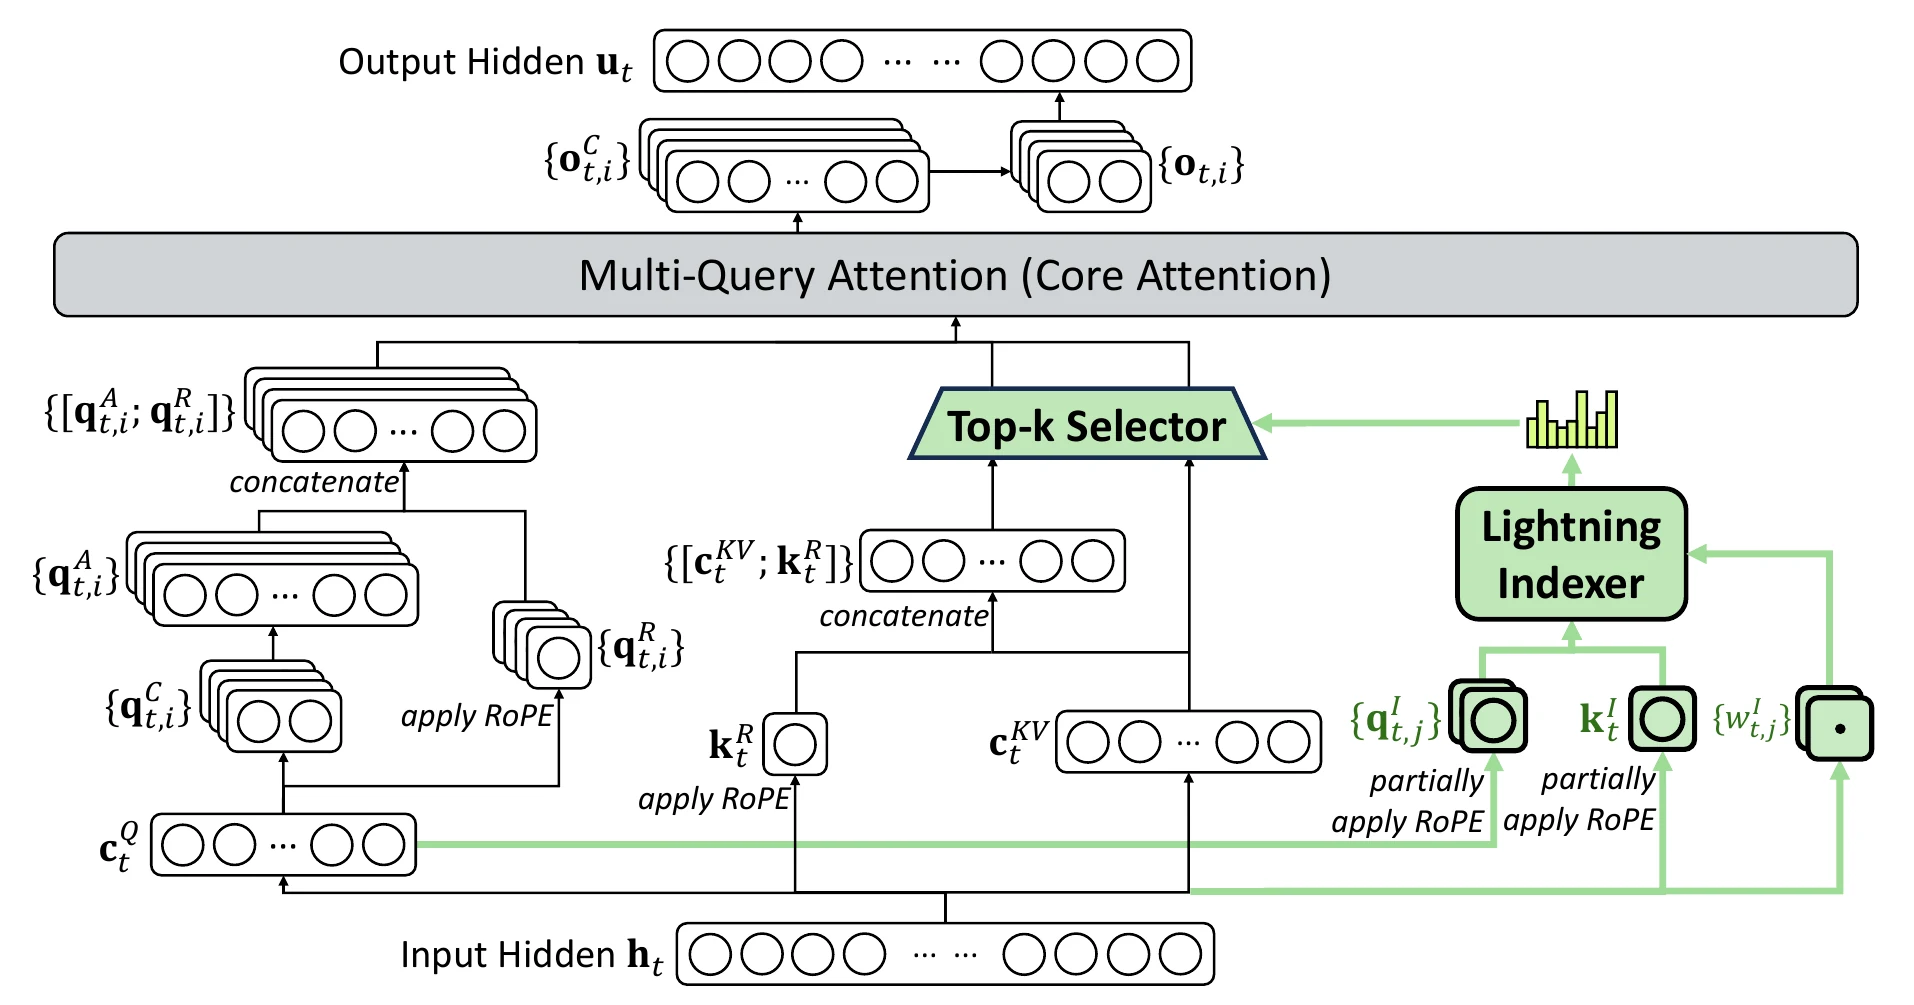
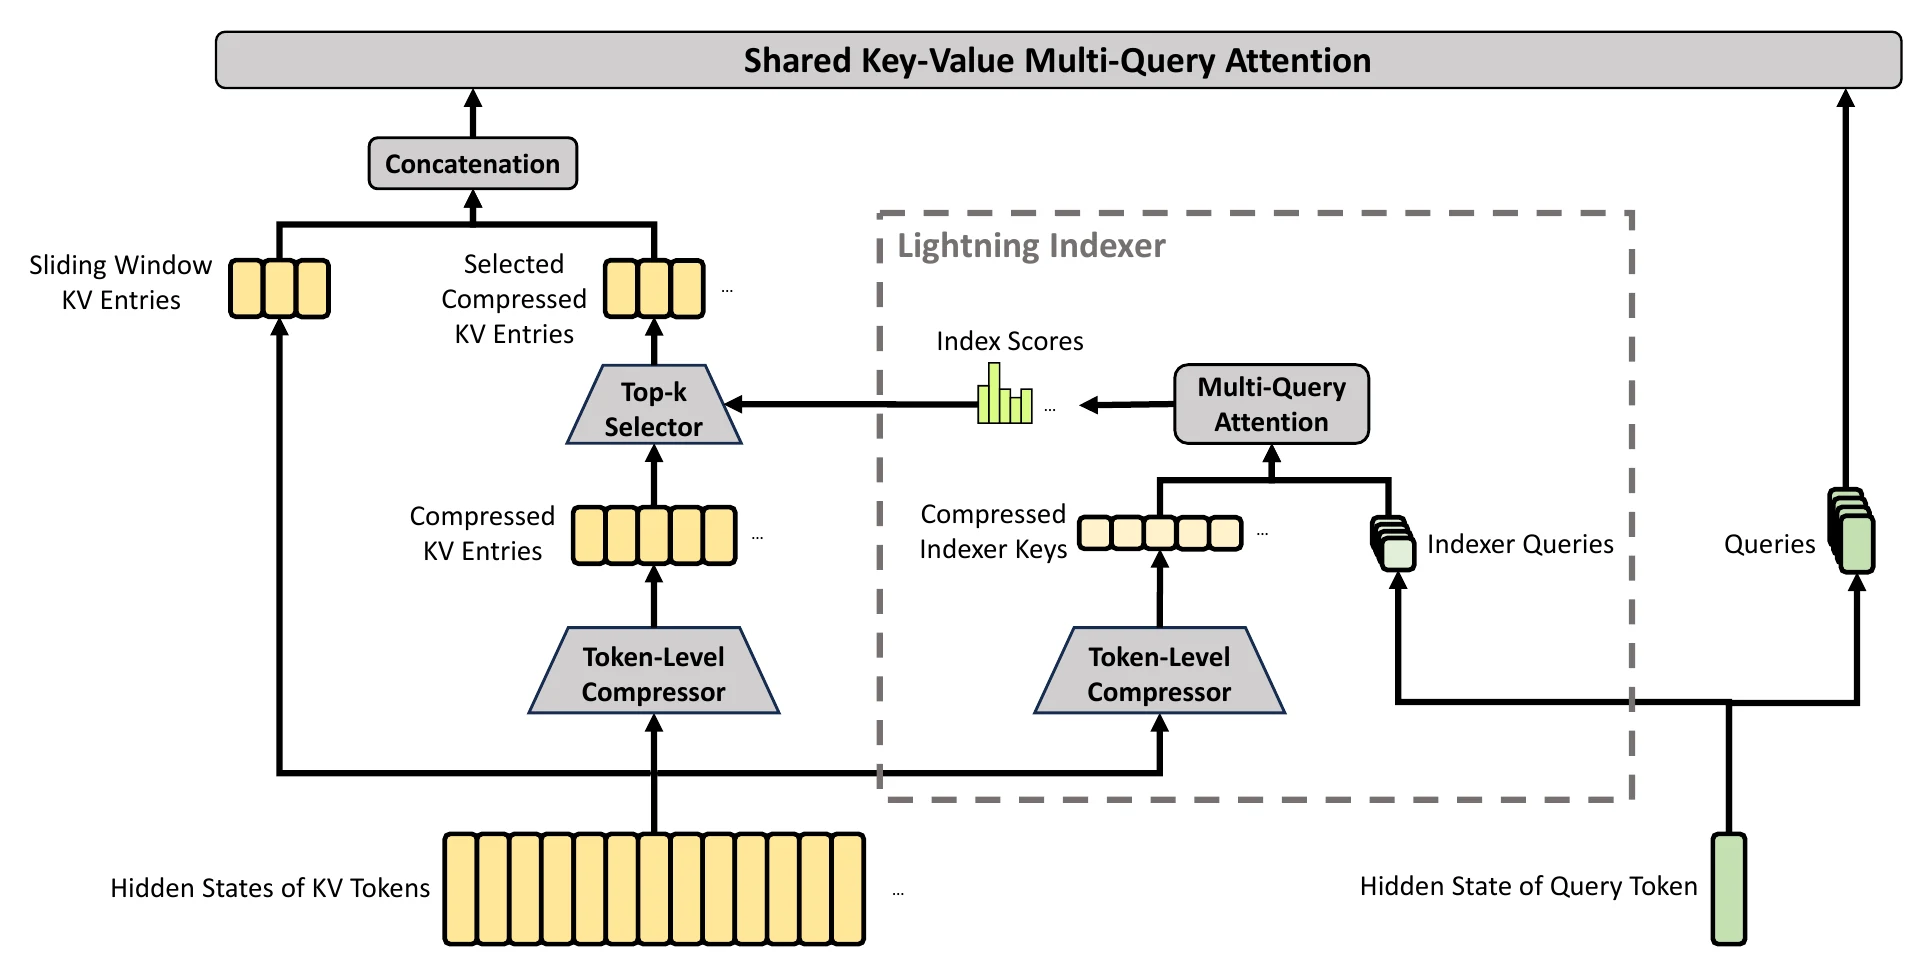
يقوم DSA أولاً بحساب درجات الارتباط بين الاستعلام الحالي والرموز التاريخية باستخدام فهرس خفيف الوزن Lightning Indexer، ثم يأخذ أعلى k مواقع ويمرها إلى Attention الرئيسي للحساب. الجزء الأخضر في الشكل أدناه يمثل عملية الفهرسة الجديدة، حيث يختار Top-k Selector المواقع، ويرفع Attention الرئيسي أعلاه كاش MLA المقابلة للمواقع المختارة. يستخدم الفهرس تمثيلاً أصغر ورؤوساً أقل للتصفية، وتكلفته الحسابية أقل من تنفيذ Attention الرئيسي الكامل مباشرة.
يحدد تقرير DeepSeek-V3.2 أن كل استعلام يمكنه اختيار ما يصل إلى 2048 إدخال KV. مع نمو السياق، يمكن لـ Attention الرئيسي التركيز على هذا النطاق المحدود، مما يقلل بشكل ملحوظ تكلفة معالجة الإدخالات الطويلة والتوليد اللاحق. الإدخالات التاريخية التي لم تُختار في هذه المرة لا تزال متاحة لاستعلامات لاحقة، لذلك يقلل الاختيار المتقطع بشكل أساسي من كمية القراءة والحساب في هذه المرة، وليس حذف جميع الكاش بنفس النسبة. لا يزال الفهرس نفسه يحتاج إلى معالجة المرشحين التاريخيين، والتكلفة الفعلية ستتأثر أيضاً بطول السياق.
18.4.8 MiniMax Sparse Attention (MSA)
طُرح MiniMax Sparse Attention (MSA) من قبل فريق MiniMax، وطُبّق في MiniMax-M3. يتناول مشاكل الكفاءة في سياقات المليون Token، مع مراعاة كيفية جعل الانتباه المتقطع مناسباً لحسابات GPU الدفعية، وليس مجرد تقليل الرموز المشاركة في الحساب نظرياً.
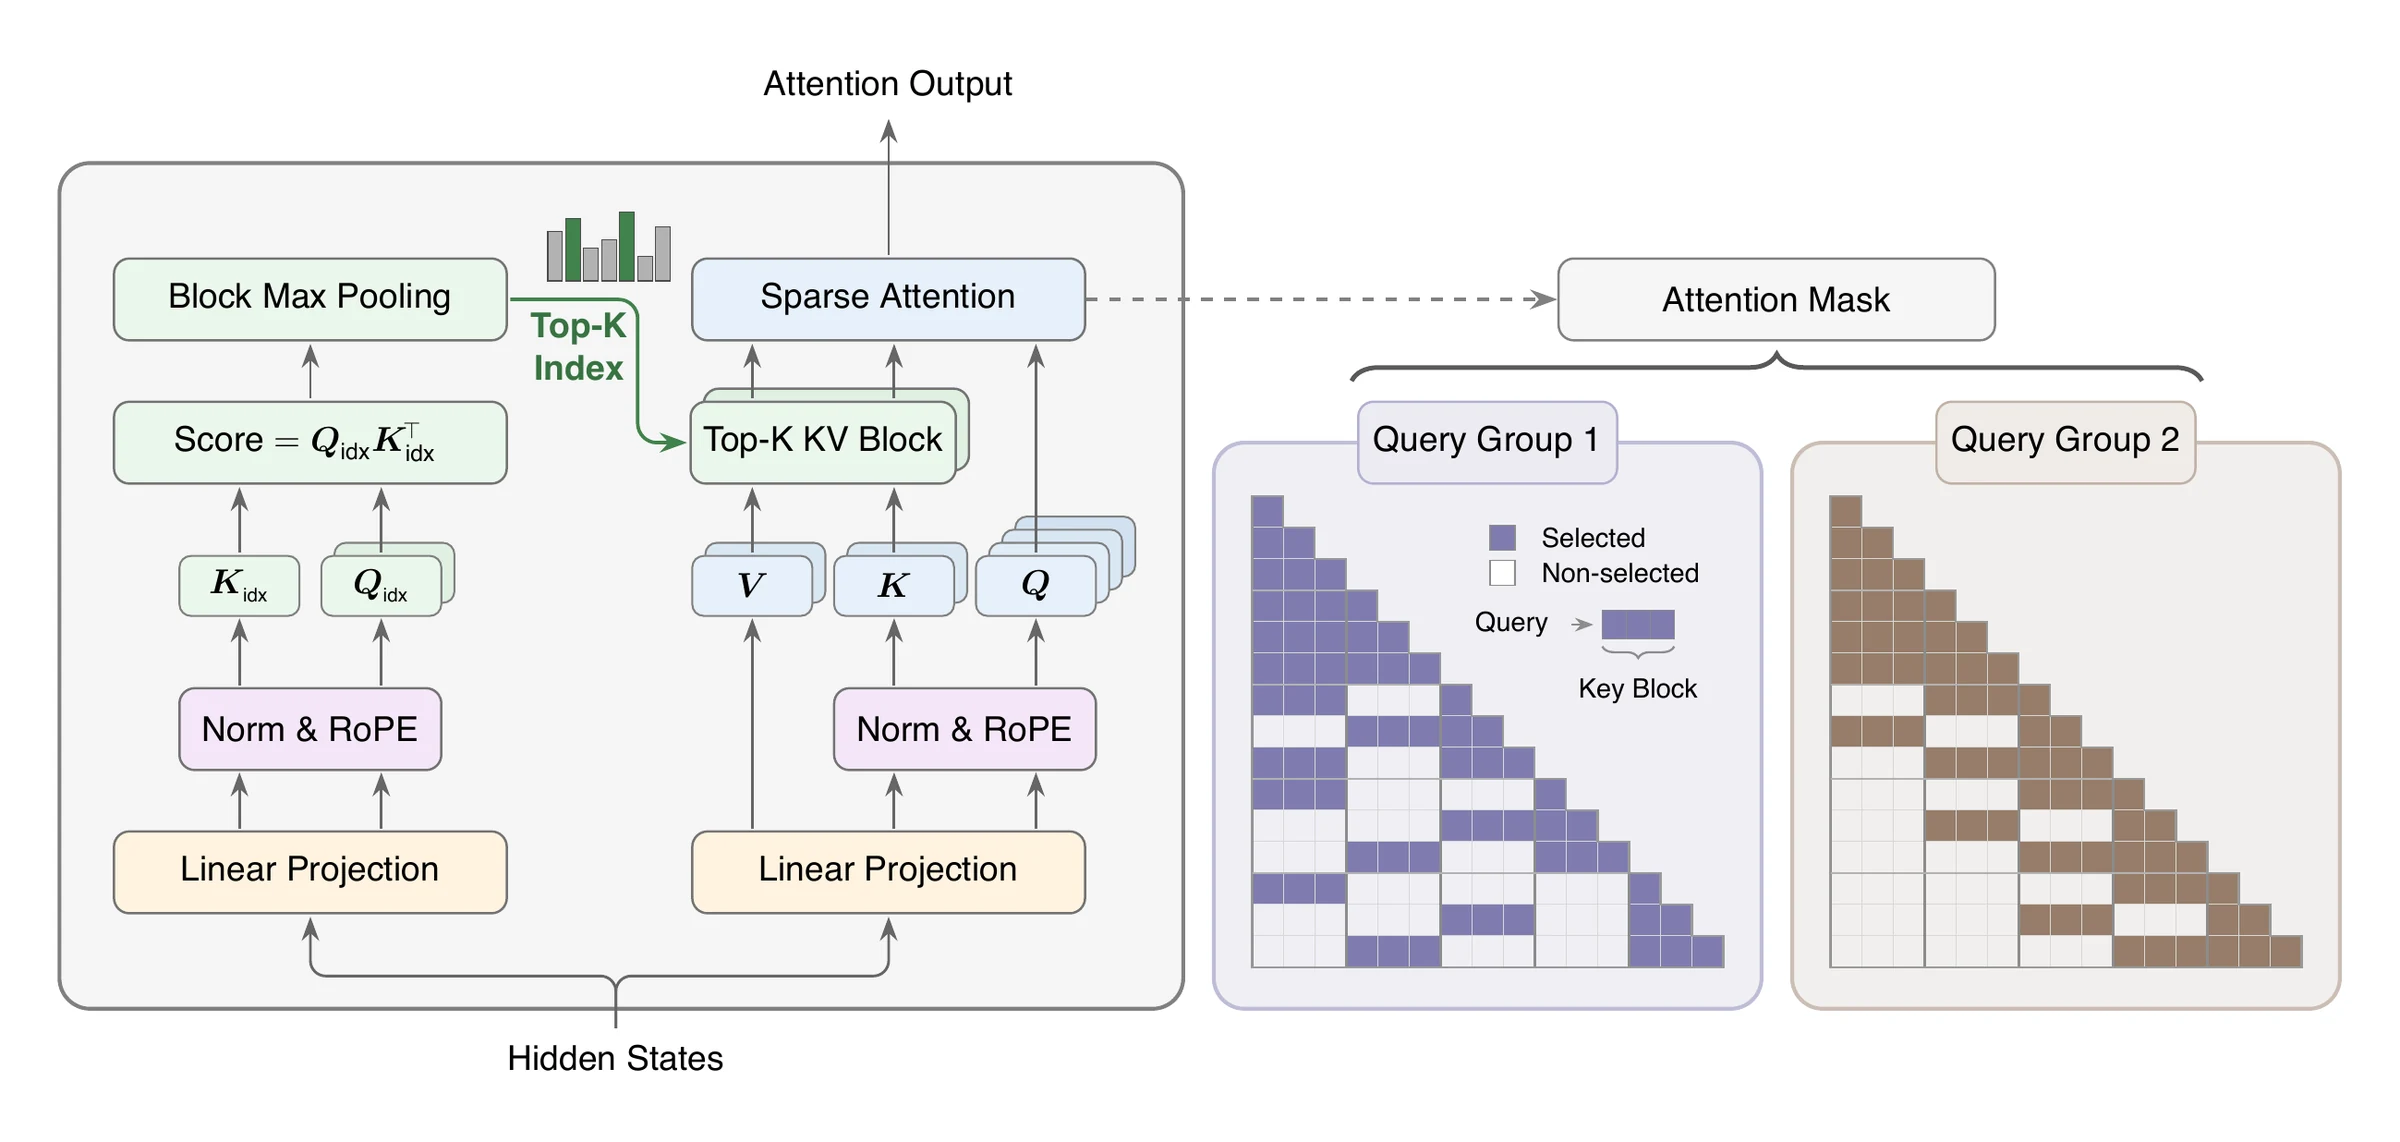
يُبنى MSA على أساس GQA، ويحتوي على فرع الفهرسة والفرع الرئيسي. يقوم فرع الفهرسة أولاً بحساب درجات الارتباط على مستوى Token، ثم يأخذ أعلى درجة في كل كتلة ككتلة درجة، ويختار Top-k كتل تاريخية لكل مجموعة GQA بشكل منفصل. يقوم الفرع الرئيسي بعد ذلك بقراءة K وV على مستوى Token التي تفي بالشروط السببية في الكتل المختارة، مع الحفاظ على الكتلة المحلية الحالية. كما هو موضح في الشكل أدناه، يمكن لمجموعتي الاستعلام اليمنيين تشكيل نطاقات اختيار مختلفة، وتشترك رؤوس الانتباه في نفس المجموعة في نتائج الاختيار.
تنظيم الوصول وفقاً للكتل يحسن انتظام معالجة البيانات في GPU، واختيار المجموعات يسمح للمجموعات المختلفة بالحفاظ على أنماط بحث مختلفة. في اختبار سياق 1M لنموذج تجريبي بـ 109B معامل، أفادت الورقة أن حساب الانتباه لكل Token في MSA كان تقريباً 1/28.4 من GQA؛ مع نواة مخصصة، حقق تسريعات في مرحلة Prefill لمعالجة الإدخال ومرحلة Decode للتوليد لكل Token بمعدل 14.2 و7.6 ضعف على التوالي على H800. هذا يشير إلى أن خوارزميات التشتت ونوى الحساب يجب تصميمها معاً، بحيث يمكن تحويل تقليل الحساب إلى مكاسب سرعة فعلية بشكل أكثر كفاءة.
18.4.9 Qwen Sparse Attention (QSA)
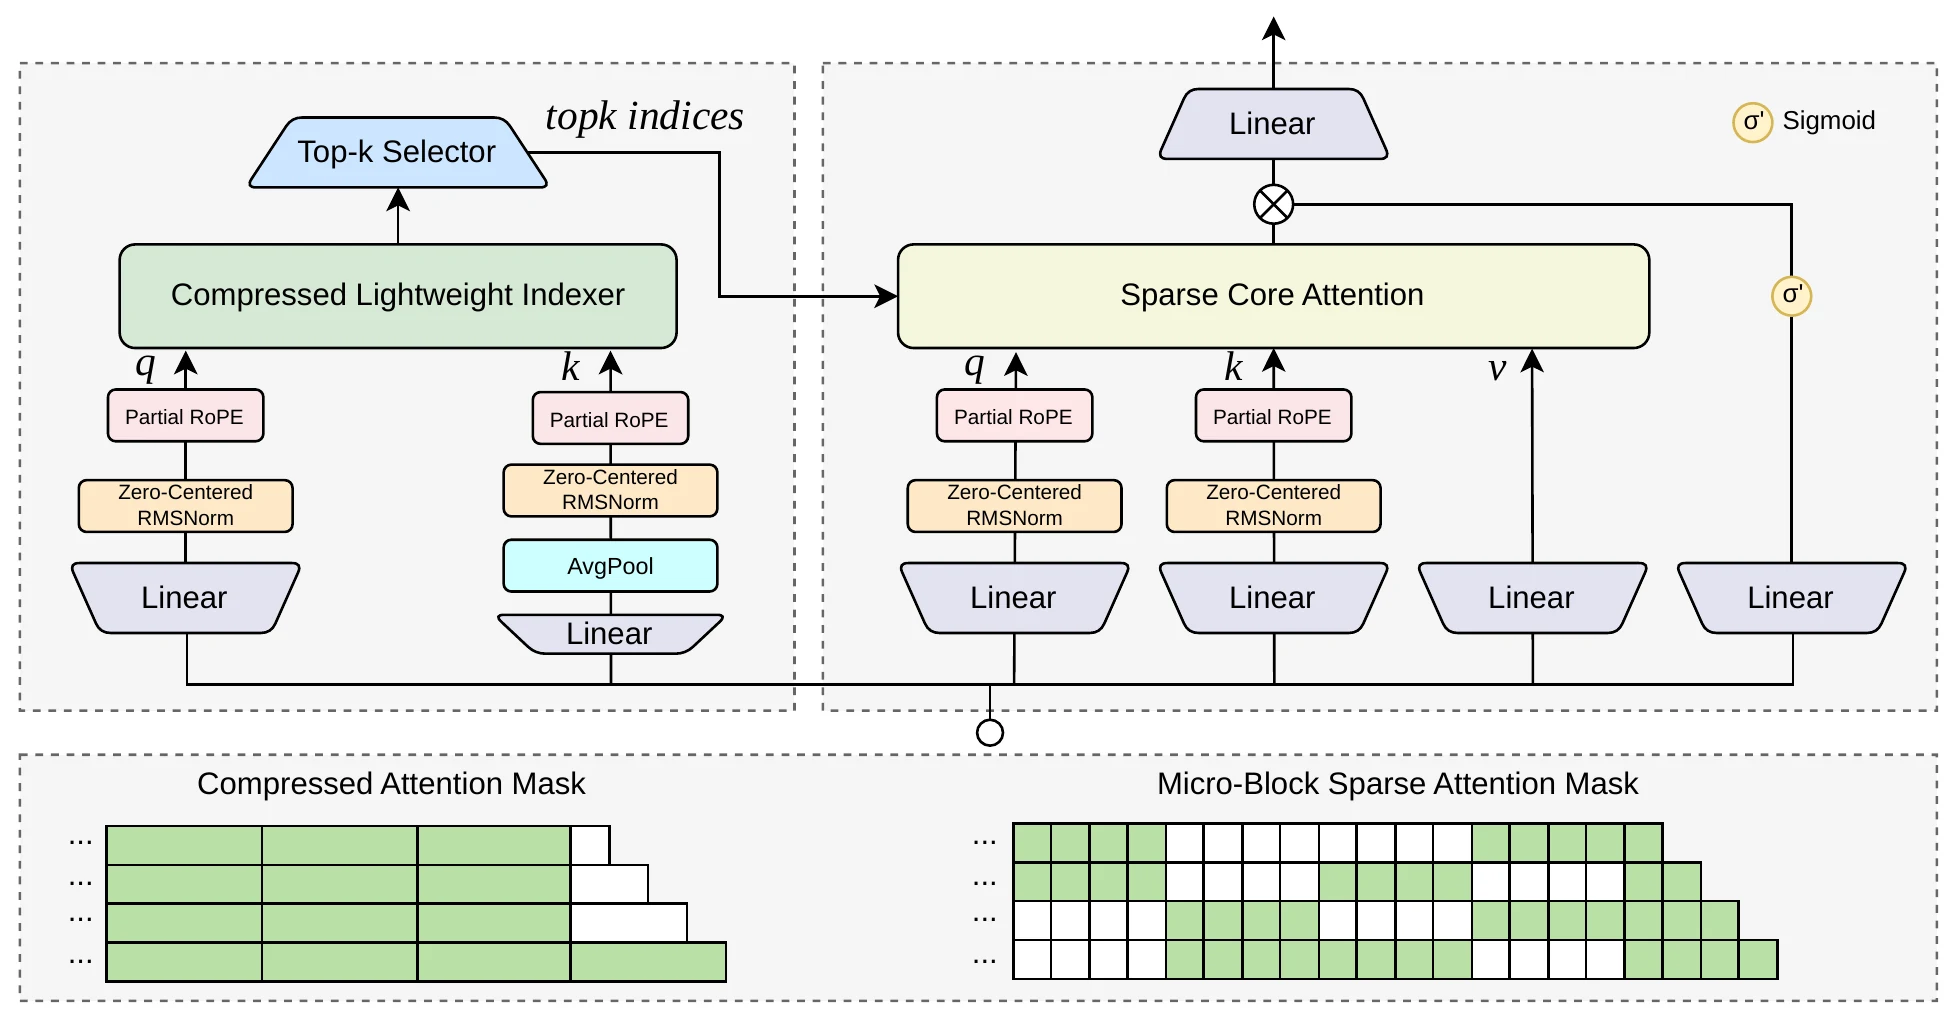
طُرح Qwen Sparse Attention (QSA) من قبل فريق Qwen، وطُبّق في Qwen3.8-Flash-Next. يستخدم هذا النموذج البنية الهجينة المكونة من ثلاث طبقات Gated DeltaNet وطبقة QSA واحدة: تتعامل الأولى مع التسلسل بكفاءة من خلال تحديث الحالة، بينما تحافظ الثانية على البحث المباشر عن الرموز التاريخية. المشكلة الرئيسية التي يعالجها QSA هي أن الفهرسة نفسها تكلفتها عالية في السياقات الطويلة.
لذلك، يقوم QSA أولاً بضغط مفاتيح الفهرسة لعدة رموز متتالية إلى تمثيلات كتل دقيقة باستخدام تجميع 미توسط، ويحسب درجات الارتباط على تسلسل الكتل الدقيقة الأقصر ويختار Top-k كتل. بعد الاختيار، يتم توسيع الكتل إلى مواقع Token الأصلية للسماح لـ Attention الرئيسي بقراءة K وV المقابلة؛ والرموز النهائية التي لم تكتمل في كتلة كاملة تظل محفوظة également. يعرض الشكل أدناه عملية فهرسة الضغط على اليسار، وQSA للكتل الدقيقة بناءً على نتائج الاختيار على اليمين، ويتم تمرير فهرس الموضع بين الجزأين.
بهذا النحو، يتم تقليل المواقع التي يصل إليها Attention الرئيسي وتقليل تسلسل الذي يحتاج الفهرس إلى فحصه. أفاد تقرير Qwen3.8-Flash-Next أن QSA حقق تسريعات في Prefill وDecode بمعدل 7.6 و4.9 ضعف على التوالي مقارنة بالانتباه الكثيف في اختبار نواة سياق 1M. عند فهم هذه البنية، يجب التمييز بين تمثيل الفهرسة وකාෂ Attention الرئيسي: يضغط QSA الأول لتقليل تكلفة التصفية، لكنه يقرأ K وV على مستوى Token بعد الاختيار، مما يسمح بالحفاظ على معلومات المنطقة المختارة بدقة.
18.4.10 Kimi Delta Attention (KDA)
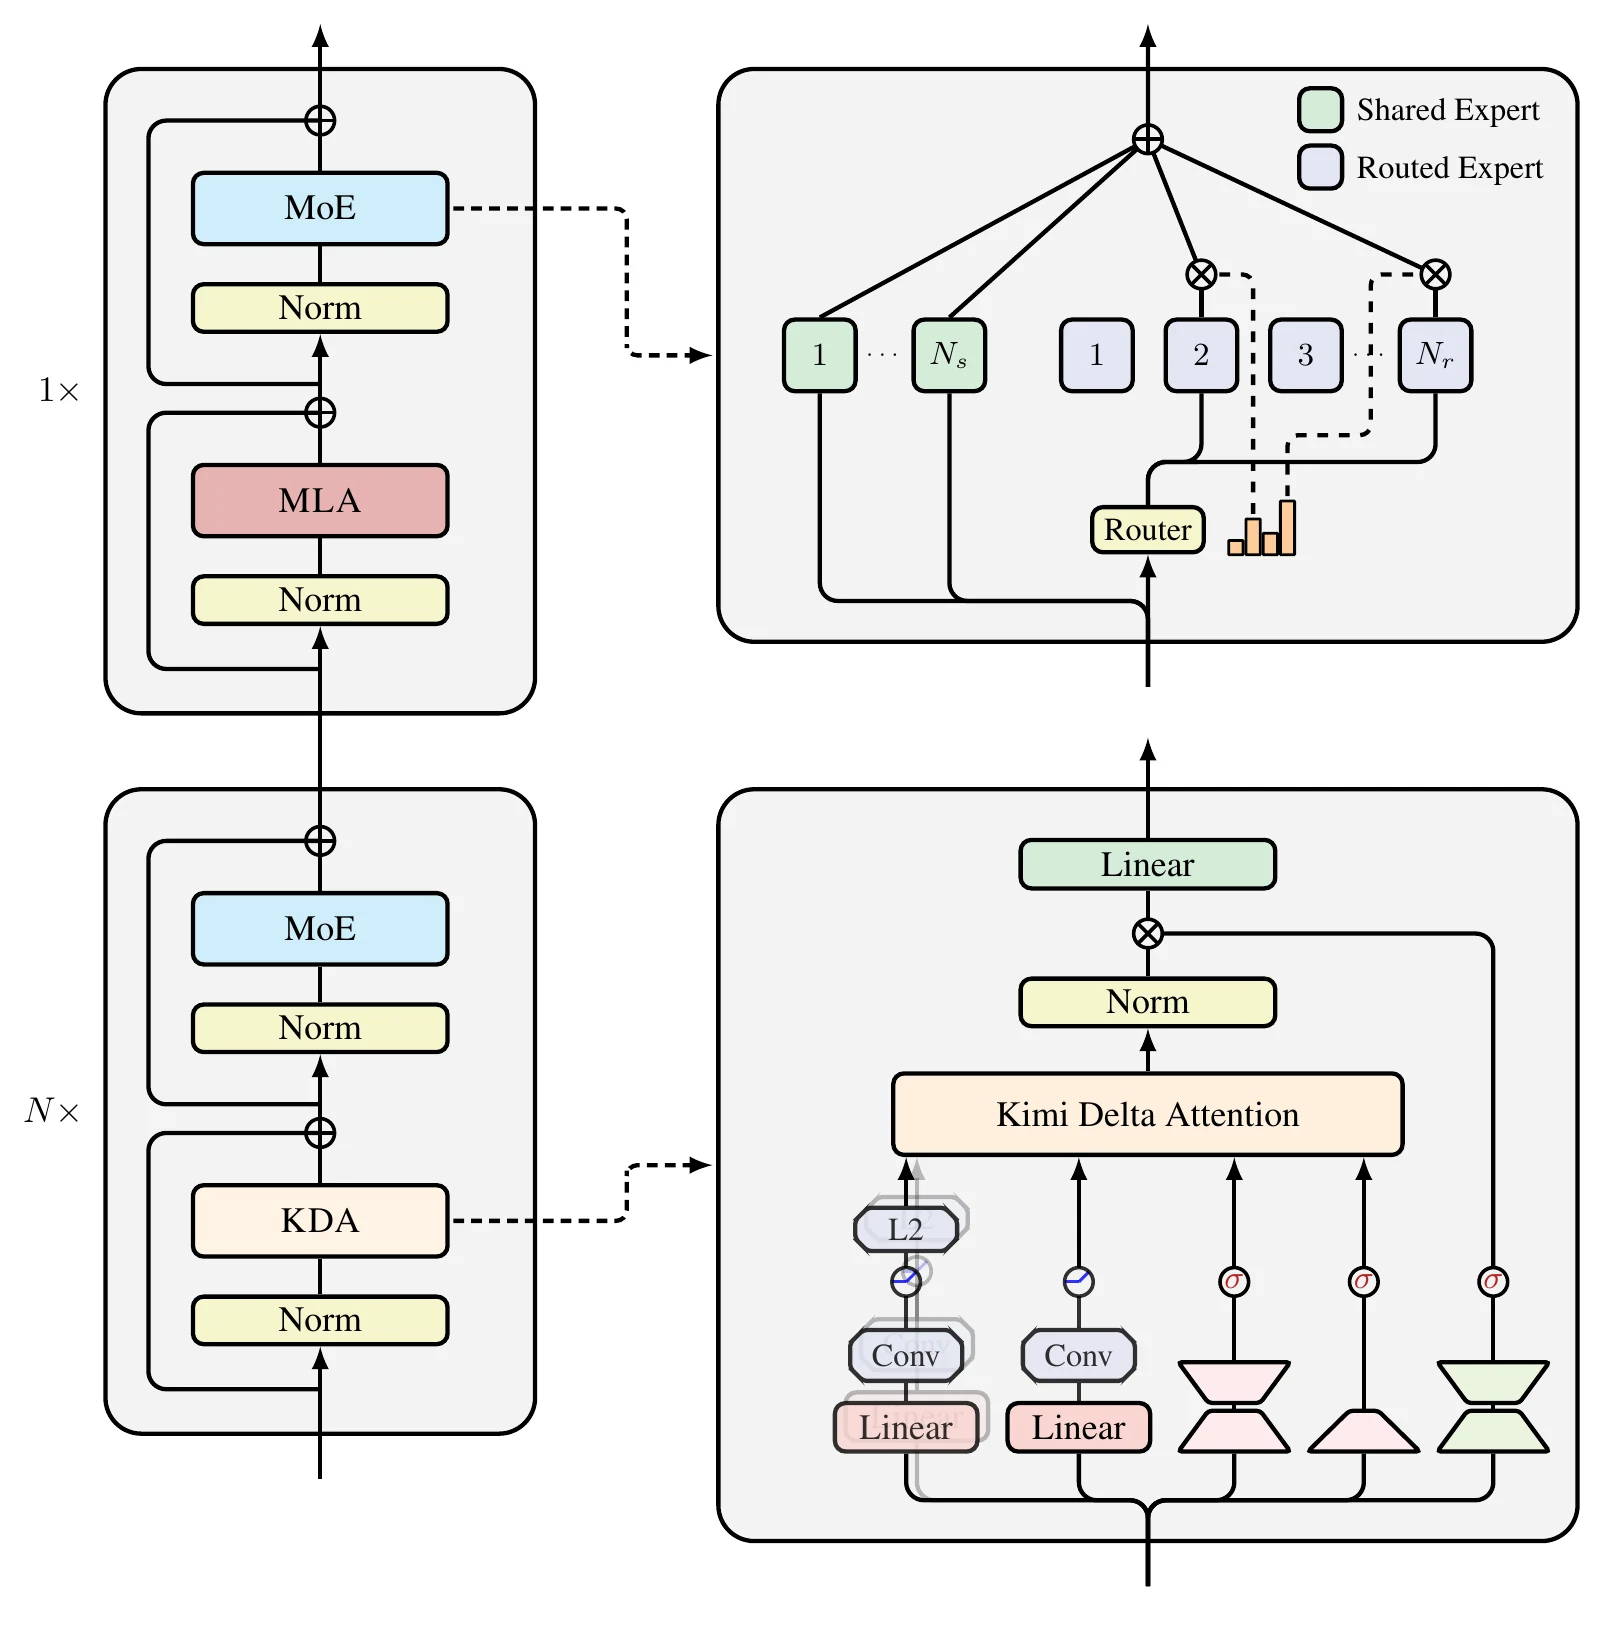
طُرح Kimi Delta Attention (KDA) من قبل فريق Moonshot AI في Kimi Linear، وطُبّق فعلياً في نموذج Kimi Linear بمعاملات 48B إجمالية و3B نشطة. يعتمد على فكرة الانتباه الخطي، ويدوم بالكتابة للمعلومات التاريخية في حالة ثابتة الحجم، لتقليل تكلفة قراءة التسلسل التاريخي الطويل بشكل متكرر في كل خطوة توليد.
يعتمد KDA على أساس Gated DeltaNet مع إضافة تحكم أدق الحجم. عند وصول Token جديد، يتحكم النموذج أولاً في درجة الاحتفاظ بالمعلومات في قنوات مختلفة من الحالة القديمة، ثم يorrect الارتباطات الرئيسية الحالية باستخدام قاعدة Delta. يمكن فهم هذا التحديث على أنه يستخدم الفرق بين الإدخال الجديد والمحتوى الذي توقعه الحالة الحالية لضبط المعلومات المحفوظة في الحالة. نظراً لivate بوابة التلاشي حسب القناة، يمكن لأجزاء مختلفة استخدام معدلات احتتفاظ مختلفة. أثناء الحساب، يمكن معالجة Token بشكل متوازٍ وفقاً للكتل لتحسين كفاءة GPU.
يوضح الشكل أعلاه كيفية استخدام Kimi Linear لثلاث طبقات KDA وطبقة MLA بشكل متناوب. تتبنى طبقة KDA حالة ثابتة الحجم لتقليل تكلفة التسلسلات الطويلة، بينما تكمل طبقة MLA البحث المباشر عن المواقع التاريخية المحددة لتخفيف مشكلة سعة الحالة الثابتة المحدودة. في المقارنة التي تستخدم نفس خطة التدريب في الورقة، قلل هذا النموذج الهجين ما يصل إلى 75% من KV Cache مقارنة بالخط الأساسي MLA الكامل، وحقق ما يصل إلى 6 أضعاف Throughput لفك التشفير في سياق 1M. هذه المكاسب تتوافق مع بنية Kimi Linear الهجينة، وليس التكوين الموحد لجميع نماذج Kimi.
18.4.11 Compressed Sparse Attention (CSA)
طُرح Compressed Sparse Attention (CSA) من قبل فريق DeepSeek في DeepSeek-V4، وطُبّق في DeepSeek-V4-Pro وDeepSeek-V4-Flash. بينما ضغط MLA السابق تمثيل KV لكل Token، يقلل CSA أكثر من عدد الإدخالات على طول التسلسل، ويلتقط معلومات عدة رموز في عدد أقل من إدخالات KV، ثم يختار بشكل متقطع.
يقوم CSA أولاً بمعالجة الرموز المتتالية باستخدام ضاغط قابل للتعلم على مستوى Token، ويدمج معلومات التراكب من الكتل المجاورة لتشكيل KV مضغوط. ثم يقوم Lightning Indexer بتقييم هذه الإدخالات المضغوطة واختيار Top-k إدخالات للمشاركة في Attention الرئيسي. في الشكل أدناه، يقع الضاغط قبل الفهرسة والاختيار، ويرفع Attention الرئيسي KV المضغوطة مباشرة؛ وعلى اليسار يوجد فرع نافذة منزلقة يمر الرموز غير المضغوطة الأخيرة معاً في الحساب للحفاظ على التفاصيل المحلية.
يحدد تقرير DeepSeek-V4 أن نسبة ضغط CSA هي 4، أي أن عدد إدخالات KV التاريخية ينخفض إلى نحو الربع، ثم يتم اختيار جزء من هذه الإدخالات للمشاركة في حساب Attention الرئيسي. لذلك، يقلل CSA كلاً من كمية التخزين المؤقت طويل المدى والمحتوى التاريخي الذي يتم قراءته وحسابه في كل مرة. بينما يعود QSA إلى Token الأصلية بعد ضغط الفهرسة، يكمل CSA تجميع المعلومات مباشرة على الإدخالات المضغوطة، مما يعني ضغط KV التاريخي نفسه أيضاً. هذا التصميم يتطلب من الضاغط الحفاظ على الميزات المفيدة، ويعتمد على النافذة المحلية لإضافة التفاصيل الأخيرة.
18.4.12 Heavily Compressed Attention (HCA)
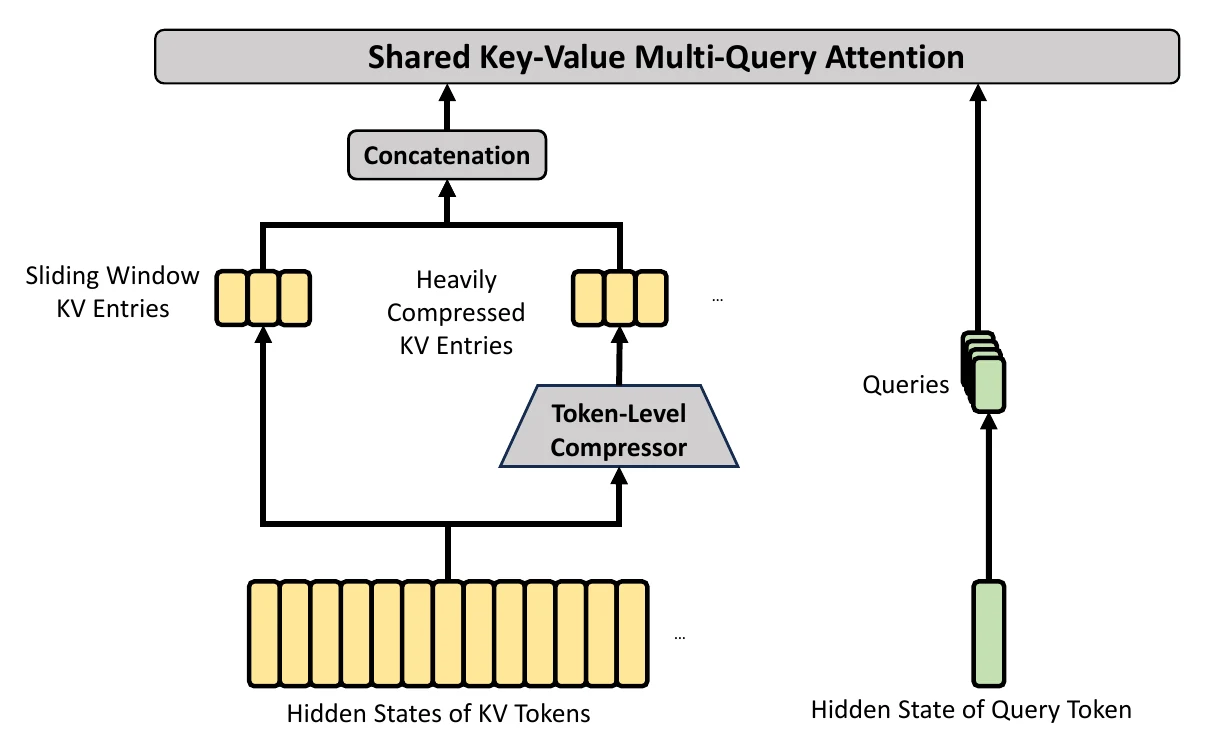
طُرح Heavily Compressed Attention (HCA) أيضاً من قبل فريق DeepSeek في DeepSeek-V4، ويُستخدم بالتناوب مع CSA في البنية متعددة الطبقات لـ DeepSeek-V4-Pro وFlash. يعتمد على ضغط تسلسلي أقوى، مما يسمح للنموذج تغطية معلومات تاريخية واسعة النطاق مع تخزين مؤقت أقل، مكملاً للقراءة الانتقائية في CSA.
نسبة ضغط HCA في التقرير 128، وهي أعلى بكثير من CSA البالغ 4. بعد تشكيل إدخال مضغوط واحد من عدة رموز عبر تجميع مرجح قابل للتعلم، يقوم الاستعلام الحالي بتنفيذ Attention على جميع التاريخ المضغوط المرئي سببياً، دون إجراء تصفية Top-k. كما هو موضح في الشكل أدناه، يحتفظ HCA بفرع ضغط وفرع نافذة منزلقة محلية، لكنه يستغني عن الفهرس والمنتقي في CSA. توفر النافذة تفاصيل الرموز الأخيرة، ويوفر التاريخ المضغوط معلومات سياق أوسع نطاقاً.
التكامل بين CSA وHCA يسمح لـ DeepSeek-V3.4 باستخدام تمثيلات تاريخية بأحجام مختلفة في نفس الوقت. في التقرير، في سياق 1M، كانت FLOPs لكل Token وKV Cache في DeepSeek-V4-Pro لكل منهما نحو 27% و10% من DeepSeek-V3.2. هذا هو التأثير الإجمالي للانتباه الهجين والحساب والتخزين منخفض الدقة معاً. بالنسبة للمستخدمين، فإن أهمية هذا النوع من البنية هي جعل السياقات الطويلة جداً أسهل في العمل على أجهزة محدودة؛ أما دقة النموذج المحدد في استخراج التفاصيل من المواد الطويلة، فتعتمد على طريقة الضغط وعملية التدريب والمهمة الفعلية.
من خلال تصميم هذه النماذج، يظهر أن تحسينات Attention ليست في اتجاه واحد فقط. تغير MHA وMQA وGQA Relationships بين الرؤوس بشكل أساسي، ويضغط MLA تمثيل KV لكل موقع، وقلل DSA وMSA وQSA من المواقع التي يصل إليها Attention الرئيسي، ومعالج KDA التاريخ عبر تحديث الحالة، بينما يضغط CSA وHCA الإدخالات التاريخية بشكل أعمق. يمكن للنماذج استخدام عدة طرق معاً، لذلك عند تحليل المتطلبات المرجعية، يجب أخذ عدد الطبقات وشكل التخزين المؤقت لكل بنية في الاعتبار. بغض النظر عن البنية المختارة، يتعامل Attention فقط مع تجميع معلومات السياق، وقدرة النموذج العامة لا تزال تتكون مشتركاً مع Embedding وشبكة التغذية الأمامية وعملية التدريب.
18.5 التدريب المسبق: تعلم القوانين الأساسية من البيانات الضخمة
تقرر بنية النموذج كيفية حساب المعلومات، وตัดم عملية التدريب ما ستعلمه النماذج في النهاية. عادةً ما يمكن تقسيم تدريب النماذج الكبيرة إلى عدة مراحل. أولاً، في مرحلة التدريب المسبق، يتعلم النموذج قوانين اللغة وهياكل المعرفة وأنماط الاستدلال الأساسية من كميات ضخمة من النصوص والرموز البرمجية والبيانات أخرى، ويكتسب قدرات عامة. ثم ينتقل إلى مرحلة الضبط بالتعليمات (Supervised Fine-Tuning، SFT)، حيث من خلال عينات "تعليم-إجابة" كبيرة، يتعلم النموذج فهم متطلبات المستخدم والإجابة وفقاً لشكل المهمة المحدد. على هذا الأساس، يتم بعد ذلك تحسين التفضيلات أو التعلم المعزز لضبط سلوك النموذج بناءً على الملاحظات البشرية أو القواعد، لجعل الإجابات أكثر تواكباً مع التوقعات من حيث الفائدة والدقةأسلوب التعبير والأمان والحدود السلوكية.
التدريب المسبق هو المرحلة التي يشكّل فيها النموذج قدراته الأساسية. يتم تدريب النموذج بشكل متكرر على كميات كبيرة من النصوص والرموز البرمجية أو البيانات متعددة الوسائط. بالنسبة لنماذج اللغة Decoder-only (مثل سلسلة GPT)، المهمة التدريبية الشائعة هي التنبؤ بالرمز التالي بناءً على المحتوى السابق، وضبط معلمات النموذج عند الخطأ في التنبؤ. بعد تكرار العينات الضخمة، يتعلم النموذج تدريجياً بنية اللغة وطرق التعبير والعلاقات الإحصائية بين المفاهيم المختلفة، ويكون التمثيل الأساسي وقدرات التوليد اللازمة لإكمال مهام مثل الأسئلة والتلخيص والترجمة وتوليد الأكواد البرمجية.
المعرفة التي يتعلمها النموذج في التدريب المسبق موزعة عبر معاملات كثيرة، وهي ليست مجموعة بيانات يمكن الاستعلام عنها سيراً. يمكنه دمج القوانين المكتسبة لتوليد محتوى لم يظهر كما هو في بيانات التدريب، أو دمج معلومات ذات صلة لكنها غير متطابقة تماماً لتشكيل إجابات خاطئة تبدو منطقية. بالطبع، لا تعني المزيد من بيانات التدريب بالضرورة جودة أعلى. المحتوى المكرر ومنخفض الجودة والمعلومات الخاطئة والبيانات الخاصة والمحتوى الضار جميعها تؤثر على النموذج. عادةً ما يكون هناك قبل التدريب المسبق تحليل للتنسيق واستبعاد التكرار وتصفية الجودة وفلترة السلامة وتنسيق البيانات. حجم البيانات يحدد كمية المحتوى الذي يمكن للنماذج التعامل معه، بينما جودة البيانات تؤثر بشكل مباشر على ما يمكن للنماذج تعلمه منها.
18.6 الضبط بالتعليمات: تعليم النموذج إكمال المهام وفقاً للمتطلبات
بعد الانتهاء من التدريب المسبق، يمكن للنماذج متابعة النصوص، لكنها قد لا تكمل المهام بشكل مستقر وفقاً لمتطلبات المستخدم. على سبيل المثال، إذا طلب المستخدم سرد ثلاث نقاط عمل، فقد يقوم النموذج الأساسي بمتابعة توسيع السؤال أو تجاهل التنسيق المحدد. يقوم الضبط بالتعليمات بتدريب النموذج باستخدام أمثلة مكونة من تعليمات وإجابات متوقعة. إليك مثالاً على الضبط بالتعليمات:
التعليمات: حوّل محضر الاجتماع التالي إلى بنود إجرائية.
المدخل: نص محضر الاجتماع.
المخرج: جدول يحتوي على المهام والمسؤولين والمواعيد النهائية.
بعد التدريب على أمثلة متنوعة مثل الأسئلة والتلخيص واستخراج المعلومات والأكواد البرمجية واستدعاء الأدوار ورفض الإجابات الآمنة، يتعلم النموذج تدريجياً التعرف على نية المستخدم والتزام متطلبات الإخراج. يعلم الضبط بالتعليمات النموذج كيفية استخدام قدراته الحالية بشكل أساسي. يمكنه تكميل بعض المعرفة، لكنه غير مناسب لحل جميع مشاكل تحديث المعرفة. المحتوى الذي يتطلب التحديث المتكرر أو تقديم المصادر يعتمد بشكل أفضل على قواعد المعرفة أو البحث أو الأدوات الخارجية أثناء التشغيل.
18.7 التدريب اللاحق: متابعة ضبط سلوك النموذج
التدريب اللاحق هو الاسم العام لمجموعة من التدريب والمواءمة التي يتم تنفيذها بعد اكتمال التدريب المسبق للنماذج. عادةً ما ينتمي الضبط بالتعليمات إلى جزء من التدريب اللاحق، وقد تظهر مراحل الضبط بالتعليمات (SFT) وتحسين التفضيلات والتعلم المعزز أيضاً في هذه المرحلة. لذلك، الضبط بالتعليمات والتدريب اللاحق ليسا خطوتين مستقلتين،الأولى طريقة محددة، والثانية مرحلة تضم طرقًا متعددة. يمكن فهم بعض طرق التدريب أولاً وفقاً للعلاقة التالية:
المرحلة أو الطريقة
البيانات الرئيسية المستخدمة
المشكلة الرئيسية التي تعالجها
التدريب المسبق
نصوص ورموز برمجية وبيانات متعددة وسائط ضخمة
تعليم النموذج القواعد الأساسية مثل اللغة والمعرفة
الضبط بالتعليمات / SFT
التعليمات والإجابات المتوقعة
تعليم النموذج الإخراج وفقاً لمتطلبات المهمة
تحسين التفضيلات
الإجابات الأفضل والإجابات الأسوأ لنفس السؤال
جعل النموذج يفضل الإجابات المتوافقة مع التفضيلات
التعلم المعزز
التلميحات وإجابات النموذج وإشارة المكافأة
ضبط استراتيجية التوليد بناءً على المكافأة
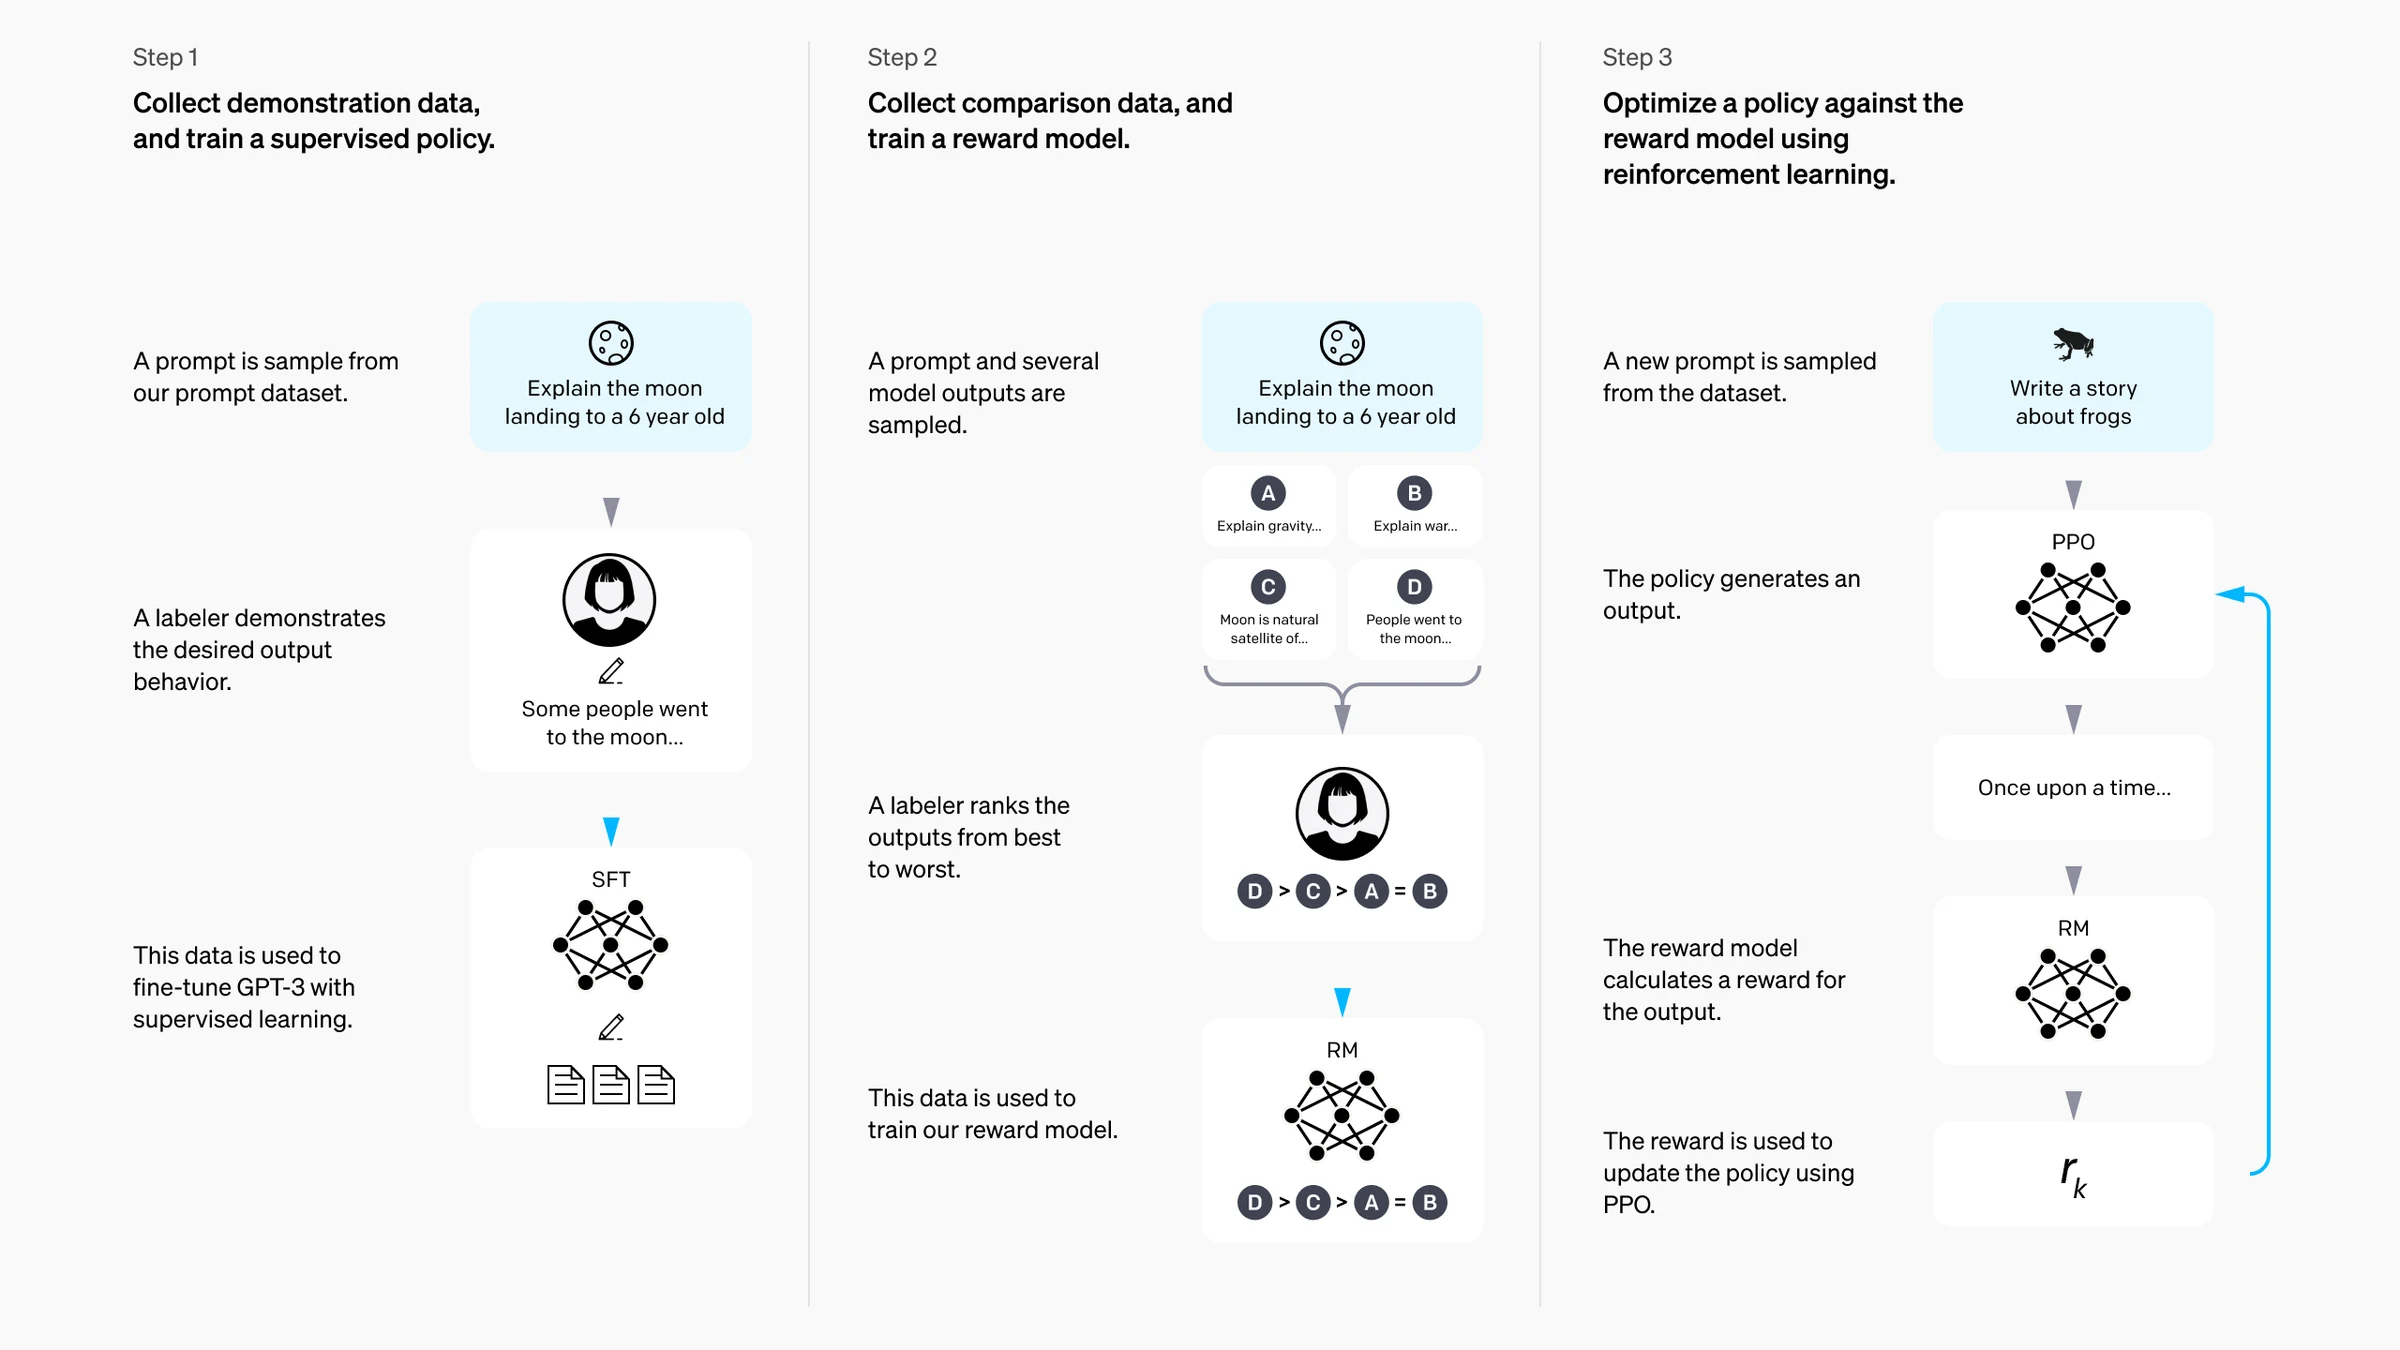
باستشارة إطار التعلم المعزز بال ملاحظات البشرية (Reinforcement Learning from Human Feedback، RLHF) المستخدم في InstructGPT، تشكلت بالفعل مسار تدريب لاحق كلاسيكي. عادةً ما يكمل الخطوة الأولى من RLHF SFT باستخدام بيانات العروض البشرية، والخطوة الثانية تدريب نموذج المكافأة باستخدام بيانات ترتيب الإجابات، والخطوة الثالثة تحسين استراتيجية التوليد في نموذج اللغة باستخدام PPO بناءً على الدرجات التي يعطيها نموذج المكافأة. تظهر العملية الفعلية في الشكل أدناه.
تمثل الدرجات التي يعطيها نموذج المكافأة تفضيلاً، وهي لا تساوي الحقيقة الموضوعية. إذا كانت بيانات التفضيلات غير مغطاة بشكل كافٍ، أو إذا كان تصميم قواعد المكافأة غير معقول، فقد يتعلم النموذج فقط التكيف مع أسلوب التقييم.
لا تستخدم النماذج الفعلية بالضرورة نفس المسار تماماً. بعضها يستخدم SFT مع DPO، وبعضها يستخدم SFT ونموذج مكافأة وPPO، وبعضها يضيف ملاحظات الذكاء الاصطناعي والمواءمة الآمنة وتدريب استخدام الأدوار وبيانات المحادثات المتعددة الجولات. شرح التدريب المسبق والضبط بالتعليمات والتدريب اللاحق السابق كيفية تكوين قدرات النموذج. بعد اكتمال تدريب النموذج، المشاكل التي يواجهها المستخدمون بشكل أكثر تكراراً هي كمية المحتوى التي يمكن إدخالها في المرة الواحدة، وكمية الذاكرة العشوائية المطلوبة أثناء التشغيل، والدقة التي يجب اختيارها للأجهزة المحدودة.
18.8 طول السياق: كمية المحتوى التي يمكن للنماذج معالجتها في المرة الواحدة
بعد اكتمال تدريب النموذج، ينتقل إلى مرحلة الاستدلال والنشر الفعلي. يحدد طول السياق كمية الرموز التي يمكن وضعها في طلب واحد. كلما كان السياق أطول، زاد كمية المواد التي يمكن للنماذج قراءتها، لكن حساب Attention واستهلاك KV Cache سيزداد أيضاً، مما يؤثر على سرعة الاستدلال واحتياجات الذاكرة العشوائية. السياق هنا يشمل التلميحات النظامية وسجل المحادثات والم الحالي ومحتوى الملفات ووصف الأدوار ونتائج أدوار المخرجات التي ولّدها النموذج بالفعل، ويمكن التعبير عنها بالصيغة التالية: استهلاك السياق = التعليمات النظامية + سجل المحادثات + المدخل الحالي + محتوى المرفق + معلومات الأدوار + مخرجات النموذج.
كما ذكرنا سابقاً، لا يتكون استهلاك السياق في النماذج الكبيرة فقط من محتوى المدخل الحالي للمستخدم، بل يتكون من عدة أجزاء تشمل التعليمات النظامية وسجل المحادثات السابق ومدخل المستخدم الحالي ومحتوى المرفقات ذات الصلة والمعلومات اللازمة لاستدعاء الأدوار والمخرجات التي ولّدها النموذج بالفعل. تستهلك جميع هذه المحتويات نافذة سياق النموذج، لذلك مع طول المحادثة أو زيادة المرفقات أو تعقيد معلومات الأدوار، تقل تدريجياً المساحة المتاحة للمدخلات والمخرجات اللاحقة. على سبيل المثال، إذا أشار النموذج إلى أن طول السياق المدعوم هو 128K، فعادةً ما يشير إلى إجمالي الرموز التي يمكن معالجتها في طلب واحد. ما إذا كان يشمل المخرجات وما هو الحد الأقصى للإخراج في المرة الواحدة يعتمد على قيود النموذج وواجهة الخدمة. عادةً، عند تجاوز السياق، قد يرفض المنصة الطلب أو يقطع جزءاً من المحتوى أو يضغط سجل المحادثة تلقائياً.
لتحسين كفاءة الاستدلال وجودة الإجابة في سيناريوهات المستندات الطويلة، يجب تنظيم المحتوى قدر الإمكان قبل تقديم مواد الإدخال، وحذف المعلومات غير ذات الصلة والمتكررة أو منخفضة القيمة، وإخبار النموذج بوضوح بالأقسام أو الحقول أو نطاق الأسئلة التي يجب التركيز عليها، لتجنب تشتيت انتباه النموذج في سياق غير ذي صلة ضخم. بالنسبة للمواد الطويلة جداً التي يصعب معالجتها بالكامل في المرة الواحدة، يمكن تقسيمها أولاً حسب الأقسام أو المواضيع أو الطول الثابت، وإكمال استخراج المعلومات والتلخيص أو التحليل لكل جزء بشكل منفصل، ثم تجميع نتائج الأجزاء بشكل موحد وتقديم حكم شامل. بالنسبة للنتائج الرئيسية والبيانات المهمة أو المحتوى الذي يتطلب مزيداً من التحقق، يجب أيضاً طلب من النموذج ذكر الموقع الأصلي أو القسم أو رقم الصفحة المقابلة لتسهيل الفحص البشري وتتبع النتائج لاحقاً، لتحسين الدقة والقدرة التفسيرية والموثوقية لعملية المعالجة الإجمالية.
18.9 KV Cache: استهلاك الذاكرة العشوائية في توليد النصوص الطويلة
تعتمد نماذج التوليد المبنية على بنية Transformer على توليد الرموز بشكل تدريجي. أثناء عملية التوليد، إذا أعدنا حساب معلومات انتباه جميع الرموز السابقة لكل رمز نولده، فسيؤدي ذلك إلى قدر كبير من العمل المكرر. لذلك، من الأفضل إدخال مجموعة مخزن مؤقت تسمى KV Cache. يحتفظ KV Cache بالKey والValue المحسوبة مسبقاً لكل طبقة، ولا يحتاج إلى حساب الجزء الجديد فقط عند توليد الرمز التالي، مما يحسن سرعة التوليد. مع زيادة Token واحد، يجب على كل طبقة Transformer حفظ K وV المقابلة. لذلك، يزداد KV Cache مع طول السياق وطول الإخراج وعدد الطلبات المتزامنة وعدد طبقات النموذج.
بالنسبة لنماذج Decoder-only الشائعة، يمكن فهم استهلاك الكاش للتسلسل المبسط واحد باستخدام الصيغة المبسطة التالية:
بعد تحميل أوزان النموذج، يكون الاستهلاك نسبياً ثابتاً، لكن KV Cache يتغير مع الطلبات. لذلك، قد يعمل نفس النموذج المحوّل بسلاسة في الأسئلة القصيرة، لكنه قد يعاني من نقص في الذاكرة العشوائية عند تبديل مستندات طويلة أو مستخدمين متزامنين. على سبيل المثال، قد يعمل الخادم بشكل طبيعي عند معالجة محضر اجتماع قصير واحد فقط، لكنه قد يزيد ضغط الذاكرة العشوائية بشكل ملحوظ إذا قام عشرة مستخدمين بتحميل سجلات طويلة في نفس الوقت. هذا يفسر أيضاً لماذا حتى مع وجود ملف النموذج في الذاكرة العشوائية، تتغير استهلاك موارد الحساب مع زيادة طول النص المدخل ونطاق التزامن. لذلك، في النشر الفعلي، يمكن تقليل السياق غير ذي الصلة أو تقليل أقصى طول للإخراج أو تقليل عدد الطلبات المتزامنة أو استخدام الكاش المصفحي أو اختيار نموذج يستخدم بنية GQA أو MQA لتقليل ضغط KV Cache وتحسين كفاءة خدمة الحساب.
18.10 حجم المعاملات والتحويل والعتاد
ملف النموذج يحتفظ فعلياً ببنية النموذج الحالية والمعاملات ذات الصلة، وهذه المعاملات هي في الأساس مجموعة من الأرقام. بالاستناد إلى مبادئ هندسة الحاسوب، عادةً ما تكون هذه المعاملات تعبيراً عن 0 و1 في الحاسوب، واستخدام أحجام بت مختلفة لتمثيل نفس الرقم يحدد النطاق الرقمي ويحدد أيضاً دقة الرقم. أثناء تدريب النماذج، عادةً ما تُستخدم صيغة النسبة العائمة مثل FP32 أو FP16 أو BF16، مما يعني فعلياً 32 بت أو 16 بت من 0 و1 لتمثيل رقم واحد. كلما زاد عدد الأ bits، زاد النطاق الرقمي ودقة الأرقام، لكن استهلاك الموارد الفعلي كبير أيضاً. لذلك، ل further تقليل استهلاك الموارد، تم اقتراح طريقة التحويل. التحويل هو تحويل هذه القيم النسبية العائمة متعددة البتات إلى تمثيلات منخفضة الدقة مثل INT8 بـ 8 بت أو INT4 بـ 4 بت، لتقليل استهلاك ملف النموذج والموارد أثناء التشغيل. يوضح الجدول أدناه سمات الدقة المقابلة:
الدقة
عدد البايتات النظرية لكل معامل
السمات النموذجية
FP32
4
دقة عالية، استهلاك موارد كبير
FP16/BF16
2
صيغة تدريب شائعة ودقة استدلال عالية
INT8
1
استهلاك الأوزان النظرية حوالي نصف 16 بت
INT4
0.5
استهلاك الأوزان النظرية حوالي ربع 16 بت
التحويل الفعلي لا يقوم فقط بتقريب جميع الأرقام العشرية بشكل بسيط، بل يقوم بتعيين مجموعة من القيم العشرية إلى نطاق محدود، وحفظ معامل التكبير ونقطة الصفر أو معلومات المجموعة. تشمل الأساليب الشائعة فقط ضغط أوزان النموذج، وتحويل الأوزان والتنشيط معاً، وإجراء تحويل ما بعد التدريب بعد اكتمال تدريب النموذج. لا يجب القلق بشأن التغيرات في الأرقام بسبب التحويل بشكل مفرط، لأن النموذج في النهاية يتنبأ باحتمالية كل رمز م كandidate كرمز تالي عند التوليد، وعند الاختيار، يتعلق بشكل أساسي بالترتيب النسبي والدرجات المُnormalizée. لذلك، على الرغم من وجود بعض الخسارة في دقة التحويل، إلا أنه يمكنه تحقيق توازن فعال مع تأثير التوليد الفعلي للنموذج تحت التحكم الصارم.
عند إجراء اختيار النموذج، يتعين عليك تحديد ما إذا كانت الذاكرة العشوائية كافية بشكل متكرر. يشير 7B و14B و70B في اسم النموذج عادةً إلى ما يقارب 7 مليار و14 مليار و70 مليار معامل. المعاملات هي الأرقام المكتسبة أثناء تدريب النموذج، وموزعة عبر Attention وشبكة التغذية الأمامية وEmbedding وغيرها من الوحدات.
لا يمكن تعادل عدد المعاملات مباشرة مع حجم ملف النموذج، يجب مراعاة الدقة المستخدمة لكل معامل أيضاً. عند حساب أوزان النموذج فقط، يمكن استخدام الصيغة التالية:
استهلاك الأوزان ≈ عدد المعاملات × عدد البايتات لكل معامل
حجم المعاملات
FP16/BF16
INT8
INT4
7B
حوالي 14GB
حوالي 7GB
حوالي 3.5GB
14B
حوالي 28GB
حوالي 14GB
حوالي 7GB
32B
حوالي 64GB
حوالي 32GB
حوالي 16GB
70B
حوالي 140GB
حوالي 70GB
حوالي 35GB
الأرقام في الجدول تمثل فقط الحد الأدنى النظري لأوزان النموذج. النماذج المحوّلة تحتاج أيضاً إلى حفظ معلومات مثل معاملات التكبير، والاستدلال الفعلي يحتاج أيضاً إلى KV Cache والنتائج الحسابية الوسيطة ومساحة عمل إطار الاستدلال وكاش الطلبات المتزامنة.
على سبيل المثال، أوزان INT4 لنموذج 14B نظرياً حوالي 7GB، لكنها على بطاقة رسومات 8GB لا تترك مساحة تقريباً لـ KV Cache وحدود التنفيذ. قد تعمل في سياقات قصيرة وطلب واحد، لكنها قد تعاني من نقص في الذاكرة العشوائية عند معالجة مستندات طويلة. استخدام 12GB أو 16GB من الذاكرة العشوائية أكثر راحة. أوزان INT4 لـ 70B حوالي 35GB، وتحتاج عادةً إلى 48GB أو أكثر من الذاكرة العشوائية. أثناء النشر، يمكن اختيار بطاقات حاسوب بذاكرة أكبر أو بطاقات متعددة أو استخدام ذاكرة CPU للاستدلال الهجين.
18.11 النماذج المتخصصة: جعل النماذج العامة تتكيف مع السيناريوهات المهنية
تحتاج النماذج الكبيرة العامة إلى تغطية كمية كبيرة من المعرفة والمهام، لكنها قد لا تكون على دراية بالمصطلحات المهنية وعمليات الأعمال وحدود المخاطر في سيناريوهات مثل الطب والمالية والقانون والبرمجة. عادةً ما يتم تدريب النماذج المتخصصة على نموذج أساسي عام باستخدام بيانات ومهام متخصصة لمواصلة التدريب أو التكييف، مما يجعل النموذج أكثر ملاءمة لمجال معين. لا يعني بالضرورة التدrey من الصفر، وليس فقط تعيين النموذج كمحترف من خلال التلميحات. تشمل طرق التدريب والتكييف الشائعة ما يلي:
متابعة التدريب المسبق باستخدام بيانات غير معلمة مثل الأدبيات المجالية واللوائح وقواعد الأكواد البرمجية.
إجراء ضبط بالتعليمات للمجال باستخدام بيانات أسئلة واستخراج معلومات وتقارير متخصصة.
إجراء مواءمة أمنية باستخدام تفضيلات الخبراء وقواعد الرفض وحالات المخاطر.
الربط بقواعد المعرفة المتخصصة وقواعد البيانات والأدوات الخارجية لتوفير معلومات قابلة للتحديث والتتبع.
هنا يجب التمييز بين النموذج المتخصص وتطبيق المجال. النموذج المتخصص تم تدريبه على بيانات متخصصة، وقدراته المهنية محفوظة في معاملات النموذج. تطبيق المجال يمكنه استخدام النموذج العام مباشرة ثم الربط بقواعد المعرفة والقواعد والأدوات المتخصصة. في الأنظمة الفعلية، يتم الجمع بين الطريقتين بشكل متكرر.
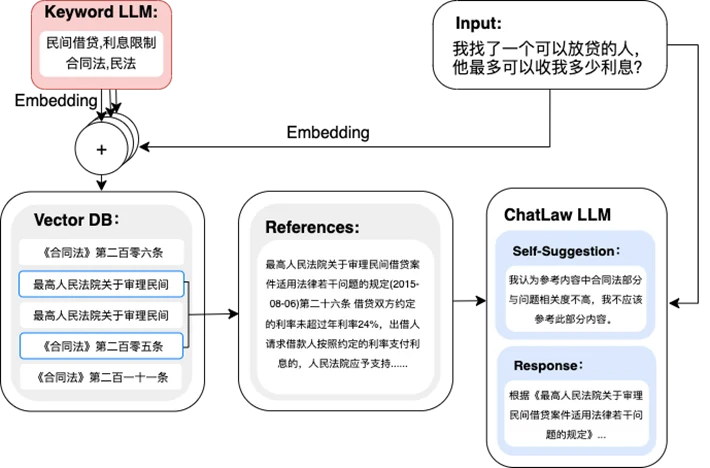
يوضح الشكل أدناه نظام الأسئلة والاستجابة القانوني الذي يستخرج أولاً الكلمات المفتاحية، ثم يبحث في قاعدة المعرفة القانونية عن المواد المرجعية، ثم يولد النموذج الإجابة بناءً على الأدلة. هذا يوضح أن القدرة المهنية لا تعتمد بالضرورة على معاملات النموذج فقط، بل الموارد الخارجية هي أيضاً جزء هام من تطبيقات المجال.
البيانات المتخصصة لا تعني بالضرورة الموثوقية المهنية. يجب على النماذج الطبية التحقق من الأدلة الطبية والحدود الآمنة، ونماذج القانون التحقق من الأدلة القانونية والمراجع، ونماذج المالية التحقق من حداثة البيانات ودقة الحسابات، ونماذج الأكواد البرمجية التحقق من التشغيل والاختبار. المهام العالية المخاطر مثل الطب والقانون والمالية والسلامة في الإنتاج يجب أيضاً أن تحتفظ بمراجعة خبراء.
18.13 هلوسة النماذج: تبدو منطقية لكنها تفتقر إلى الأساس
عند استخدام النماذج لترتيب محاضرات الاجتماعات، إذا لم يُذكر مسؤول في النص الأصلي لكن النموذج أضاف اسماً بنفسه؛ عند استخدام النماذج لاستخراج عقود، إذا لم يكن هناك مبلغ في النص الأصلي لكن النموذج ولّد رقماً محدداً، فهذه حالات هلوسة النموذج. تشير الهلوسة إلى النموذج الذي يولد محتوى سلس البنية لكنه لا يتوافق مع الحقائق أو المواد المدخلة أو المصادر القابلة للتحقق. قد تظهر أيضاً كpix policies أو أوراق بحثية أو روابط غير موجودة، أو خطأ في الأسماء والأوقات، أو كتابة مناقشات لم تُ kelompok كاستنتاجات مؤكدة.
المهمة الأساسية للنماذج الكبيرة هي التنبؤ بالرمز التالي بناءً على السياق، وأثناء عملية التوليد، لا يمكن للنماذج التحقق من صحة كل جملة. تشمل الأسباب التي تسبب الهلوسة معلومات خاطئة أو قديمة في بيانات التدريب المسبق، أو شروط أساسية مفقودة في سؤال المستخدم، أو تجاهل أو قطع الأدلة في النصوص الطويلة. إذا كان التدريب اللاحق يتضمن دالة مكافأة تشجع الإجابات الكاملة والسلسة بشكل أكبر، فقد يجعل النموذج يستمر في التوليد حتى بدون أساس.
18.13.1 أنواع الهلوسة الشائعة
هلوسة النماذج متنوعة أيضاً، ويمكن تقسيمها عادةً إلى هلوسة واقعية وهلوسة تطبيقية وهلوسة استدلالية، ويظهر التصنيف التفصيلي والأعراض النموذجية في الجدول أدناه:
النوع
الأعراض النموذجية
هلوسة واقعية
أسماء الشخصيات والتواريخ والأرقام والأحداث لا تتوافق مع الواقع
هلوسة الاستشهاد
pix أوراق بحثية أو قوانين قانونية أو روابط أو مصادر
هلوسة المدخلات
توليد استنتاجات وحقول غير موجودة في المواد الأصلية
هلوسة الاستدلال
أخطاء في الاستنتاج الوسيط، لكن الإجابة معروضة بثقة
هلوسة الأدوار
الادعاء بقراءة ملف أو استدعاء واجهة لم تنجح فعلياً
بالإضافة إلى النماذج العامة، النماذج المكتسبة بالتدريب المتخصص تولّد الهلوسة أيضاً. عادةً، يمكن للبيانات المتخصصة تحسين أداء المجال، لكنها لا تضمن دقة كل إجابة. البحث في قواعد المعرفة لا يحل جميع مشاكل الهلوسة أيضاً، فإذا كانت المواد المسترجعة غير ذات صلة أو قديمة أو تحتوي على أخطاء، فقد يصل النموذج إلى استنتاجات خاطئة مما يؤدي إلى مزيد من الهلوسة.
18.13.2 كيفية تقليل مخاطر الهلوسة
هلوسة النماذج الكبيرة هي مشكلة شائعة في عملية التطبيق الحالية. مجرد إضافة جملة "لا تختلق" أو "يرجى ضمان دقة الإجابة" في التلميح لا ي_chance عادةً القضاء على هذا المخاطر بشكل جذري. النماذج في جوهرها لا تزال تتنبأ بالمحتوى الأكثر احتمالاً بناءً على السياق، وعندما تكون معلومات المدخلات غير كافية أو توجد تضاريب في المواد أو يتجاوز السؤال نفسه نطاق المعرفة الموثوقة للنموذج، فقد يولد إجابات تبدو منطقية لكنها غير دقيقة في الواقع. لذلك، يعتمد تقليل مخاطر الهلوسة بشكل كبير على نظام يشمل قيود المدخلات والتحقق الخارجي ومراجعة بشرية.
أولاً، يجب توفير مواد واضحة وذات صلة ومتسقة للنموذج قدر الإمكان لتقليل تأثير المعلومات غير ذات الصلة والمعلومات المتناقضة على عملية الحكم. بالنسبة للمعلومات الحيوية مثل الحقائق والأرقام والبنود القانونية ونتائج التجارب، يمكن طلب من النموذج ذكر المصدر أو القسم أو الصفحة أو الموقع الأصلي المقابل لجعل الإجابة قابلة للتتبع وتسهيل التحقق اللاحق. بالنسبة للمعرفة التي يتم تحديثها بشكل متكرر مثل الأخبار والسياسات والأسعار والقوانين ومواصفات المنتجات، يجب عدم الاعتماد فقط على الذاكرة الداخلية للنموذج، بل استخدام محركات البحث وقواعد المعرفة وقواعد البيانات والواجهات البرمجية أو أدوات أخرى للحصول على أحدث المعلومات، ثم تحليلها من قبل النموذج بناءً على هذه المواد الموثوقة.
ثانياً، عندما تنقص معلومة معينة فعلياً من المواد الأصلية، يجب طلب من النموذج بوضوح استخدام عبارات مثل "في انتظار التحقق" أو "لم تقدمها النص الأصلي" أو "لا يمكن الحكم بناءً على المواد الحالية" للتعليم، بدلاً من التكميل بناءً على التجربة. بالنسبة للمحتوى القابل للتحقق الهيكلي مثل التواريخ والمبالغ وأرقام الهوية الوطنية والبيانات الإحصائية والصيغ ونتائج تنفيذ الأكواد البرمجية، يمكن أيضاً إدخال برامج للتحقق الآلي، مثل التحقق من نطاق الأرقام وتنسيق الحقول ودقة الحسابات وما إذا كان الكود قابلاً للتنفيذ فعلياً، مما يمنع النموذج من إنتاج نتائج بناءً على اللغة فقط.
علاوة على ذلك، بالنسبة للنتائج الرئيسية، خاصة تلك التي تؤثر على القرارات التجارية والمشاريع المستلمة وحقوق المستخدمين، يجب أيضاً الحفاظ على خطوة المراجعة البشرية. التعبير اللغوي السلس والمنطق الكامل ظاهرياً لا يعني بالضرورة صدق الحقائق، لذلك يجب عدم تعادل "يبدو حقيقياً" مباشرة مع "حقيقي بالفعل". في سيناريوهات عالية المخاطر مثل الطب والقانون والمالية والإنتاج الآمن، يجب تحديد بوضوح أن النموذج هو أداة مساعدة فقط، والاستنتاج النهائي يحتاج إلى مراجعة وتأكيد من متخصصين مؤهلين وذوي خبرة.
لذلك، الفكرة الأساسية لتقليل الهلوسة ليست طلب من النموذج "الإجابة دائماً"، بل تعليم النموذج التوقف بشكل مناسب عند عدم وجود أساس موثوق. عندما لا تدعم المعلومات الحالية الاستنتاج، قد يكون السلوك المناسب هو توضيح "أي مواد حيوية تفتقر حالياً" و"أي استنتاجات لا يمكن تأكيدها مؤقتاً"، وإخبار المستخدم بشكل أعمق بالبيانات أو المستندات أو الأدلة التي يحتاج إلى تكملتها. مقارنة بمتابكة توليد إجابة تبدو كاملة لكنها تفتقر إلى الأساس، هذا النهج أكثر موثوقية عادةً وأكثر ملاءمة لتطبيقات الأعمال الفعلية.