ओपन-सोर्स मॉडल को समझना • शुरुआती⏱️ 15 मिनट पढ़ने का समय
What Open-Source Models Are Changing
ओपन सोर्स मॉडल क्या बदल रहे हैं?
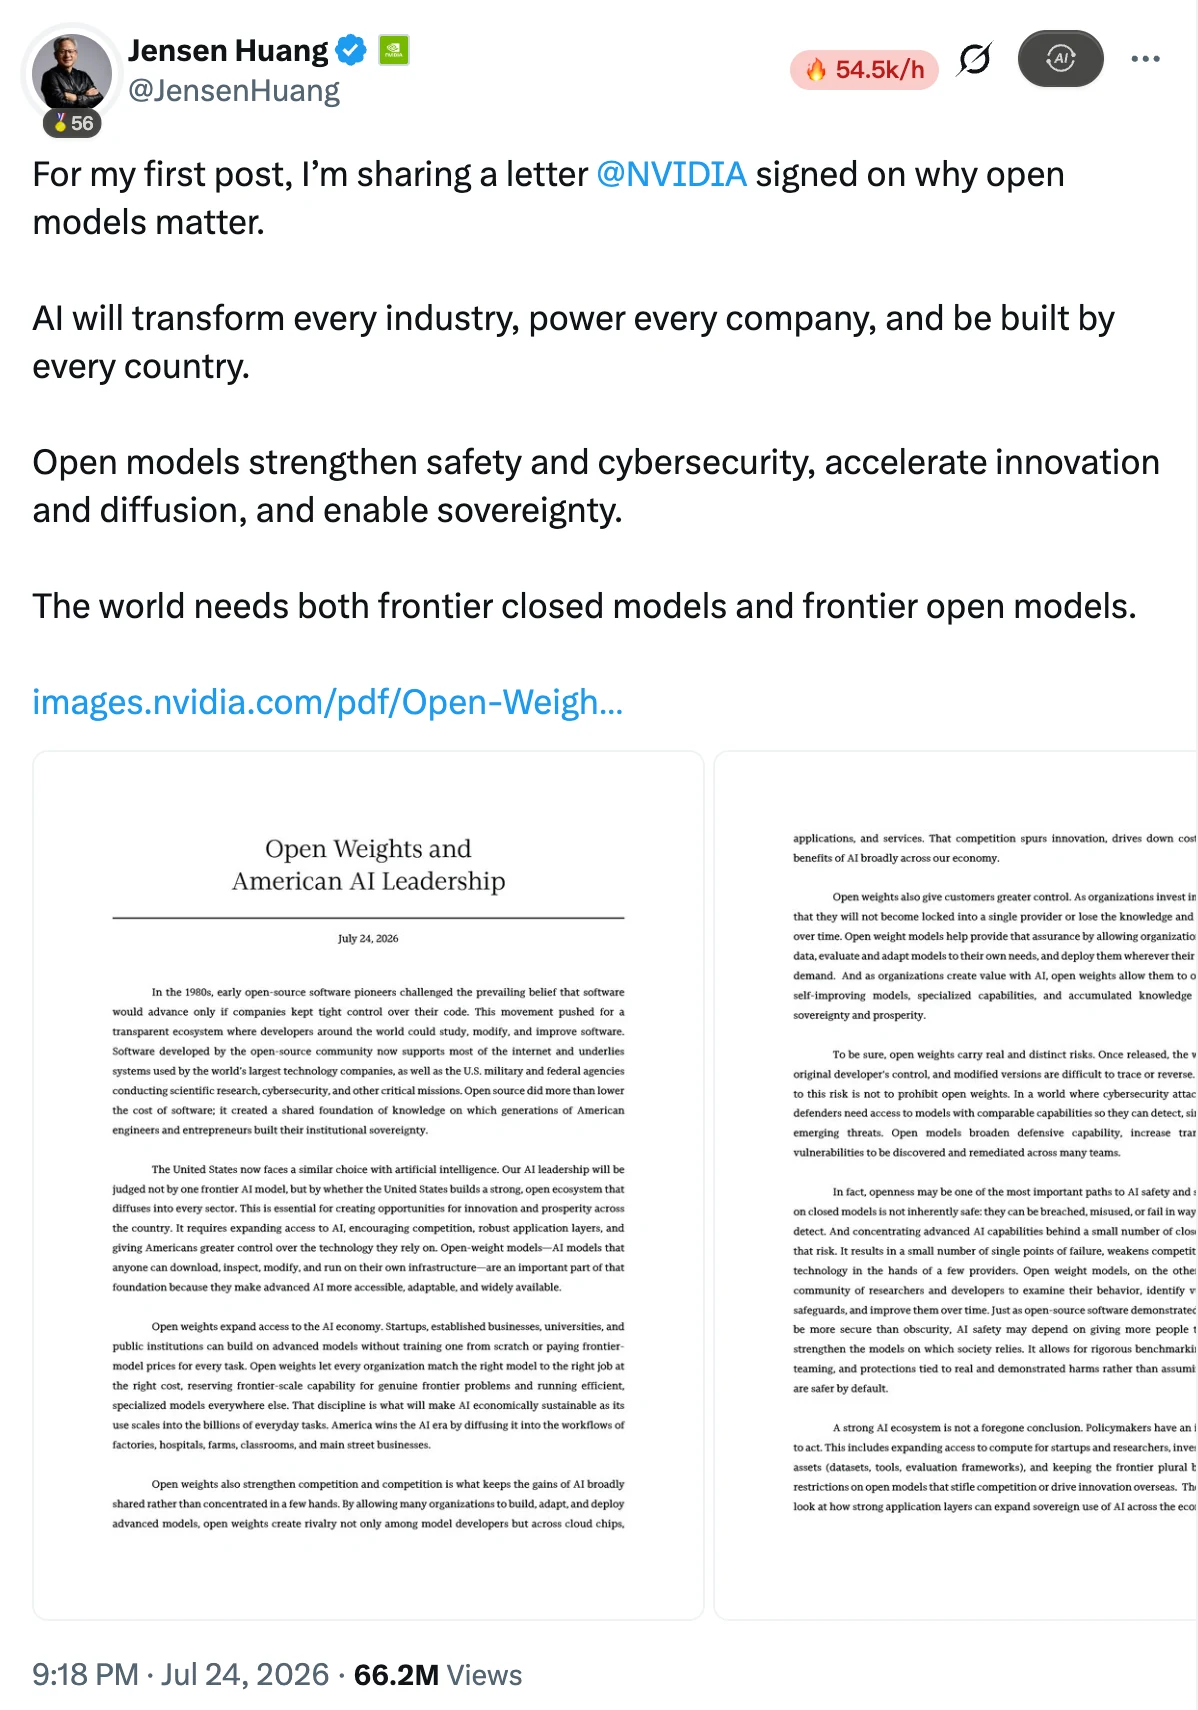
आप इसकी कल्पना भी नहीं कर सकते थे, लेकिन Nvidia के CEO जेन्सेन ह्वांग ने X पर अपनी पहली पोस्ट की, और वह ओपन सोर्स को समर्पित थी।
24 जुलाई 2026 को, उन्होंने Nvidia द्वारा हस्ताक्षरित एक खुला पत्र साझा किया, जिसमें चर्चा की गई कि खुले मॉडल क्यों महत्वपूर्ण हैं:
यह दुनिया सीमा पर बंद स्रोत मॉडल और सीमा पर खुले मॉडल दोनों की आवश्यकता है।
बहुत से लोग एक चैट विंडो खोलने, एक सवाल भेजने और AI के जवाब का इंतज़ार करने के आदी हो गए होंगे। लेकिन जब आप AI को लंबे समय तक कंपनी के डेटा को संसाधित करने या आंतरिक सिस्टम को एकीकृत करने के लिए उपयोग करना शुरू करते हैं, तो आपको निम्नलिखित समस्याओं का सामना करना पड़ सकता है: भेजे गए डेटा सुरक्षित हैं? अगर सेवा अचानक रेट लिमिट कर दे तो क्या होगा? क्या मॉडल सीख सकता है कि आपकी कंपनी डेटा कैसे संसाधित करती है?
ओपन सोर्स मॉडल इन समस्याओं का एक और समाधान प्रदान करते हैं। आप लाइसेंस की अनुमति के दायरे में मॉडल डाउनलोड कर सकते हैं, इसे अपने स्वयं के वातावरण में तैनात कर सकते हैं, इसे जारी रखकर फाइन-ट्यून कर सकते हैं, और उपयोगकर्ताओं को यह तय करने दे सकते हैं कि इसे कैसे उपयोग करना है।
निश्चित रूप से, बड़े मॉडल में ओपन सोर्स बनाम बंद स्रोत की बहस हमेशा एक अंतहीन चर्चा का विषय रही है। जेन्सेन ह्वांग के पत्र ने फिर से हमारे साथ गूंज पैदा की, और हमने कई सह-निर्माताओं के साथ साझेदारी करने का फैसला किया ताकि एक बैंगनी पुस्तिका में ओपन सोर्स मॉडल के व्यावहारिक अनुप्रयोगों की इस यात्रा की शुरुआत की जा सके। इस बार, हम आपके लिए ओपन सोर्स मॉडल अनुप्रयोगों की व्यावहारिक सामग्री लेकर आए हैं। ओपन सोर्स मॉडल समृद्ध हों!
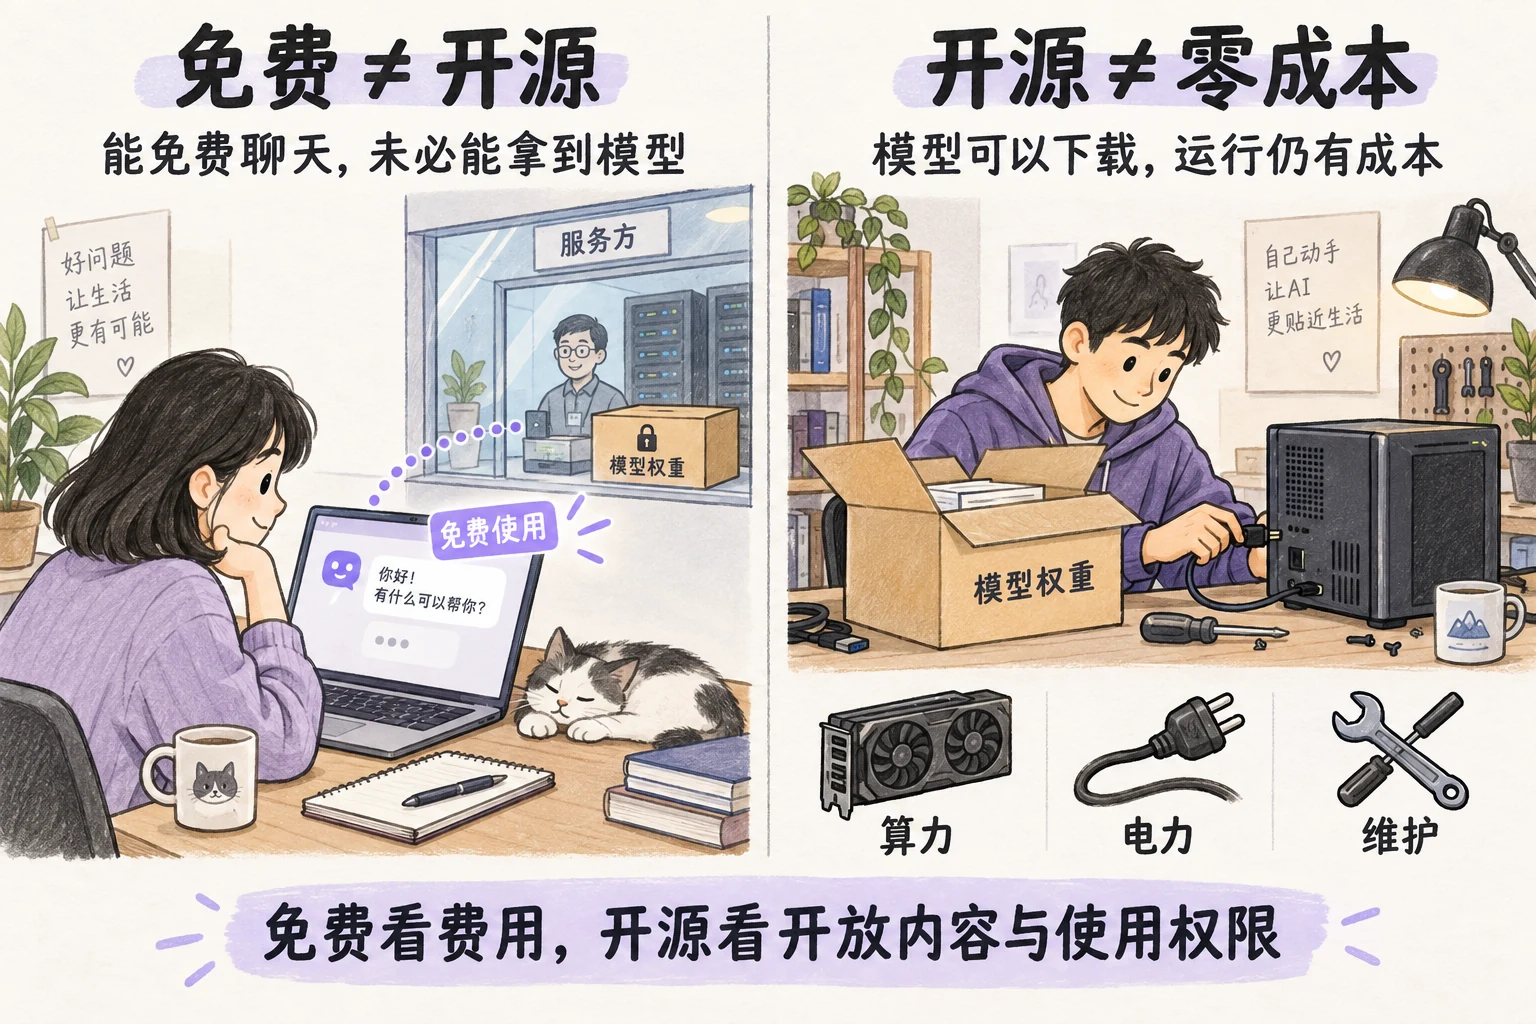
याद रखें, मुफ्त का मतलब जरूरी नहीं कि ओपन सोर्स हो, और ओपन सोर्स का मतलब जरूरी नहीं कि मुफ्त हो
जब आप किसी वेबसाइट पर AI से चैट करते हैं या API के माध्यम से मॉडल से पूछताछ करते हैं, तो आमतौर पर मॉडल को मॉडल प्रदाता द्वारा चलाया जाता है। आप इनपुट सबमिट करते हैं, और प्रदाता परिणाम लौटाता है। आपको आमतौर पर यह चिंता नहीं करनी होती कि सर्वर कैसे कॉन्फ़िगर किया गया है या मॉडल कैसे बनाए रखा जाता है।
ओपन सोर्स मॉडल एक और विकल्प प्रदान करते हैं, जो आपको प्रशिक्षण के बाद मॉडल पैरामीटर प्राप्त करने की अनुमति देते हैं, जिसे आमतौर पर वेट्स के रूप में जाना जाता है। उपयुक्त सॉफ़्टवेयर और हार्डवेयर के साथ, ये पैरामीटर आपके कंप्यूटर, सर्वर या प्राइवेट क्लाउड में चलाए जा सकते हैं। पहले बाहरी सेवाओं को भेजने वाले प्रश्न अब आपके स्वयं के वातावरण में संसाधित किए जा सकते हैं।
यहाँ दो चीजें हैं जो आसानी से भ्रमित हो सकती हैं।
«मुफ्त» इस बात को संदर्भित करता है कि आपको भुगतान करना है या नहीं; «ओपन सोर्स» इस बात को संदर्भित करता है कि आपको क्या प्राप्त हो सकता है और आपको इसे कैसे उपयोग करने की अनुमति है। एक चैट उत्पाद मुफ्त हो सकता है बिना मॉडल वेट्स प्रदान किए। एक मुफ्त में डाउनलोड किया जा सकने वाला मॉडल चलाने के लिए अभी भी कम्प्यूटिंग पावर और रखरखाव लागत की आवश्यकता होती है।
API बस मॉडल तक पहुँचने का एक तरीका है। ओपन सोर्स मॉडल को सेवा प्रदाताओं द्वारा होस्ट किया जा सकता है और API के माध्यम से आपको प्रदान किया जा सकता है। आपके द्वारा तैनात किए गए मॉडल को भी आंतरिक API के माध्यम से सहकर्मियों के लिए उपलब्ध कराया जा सकता है। इसलिए, «ओपन सोर्स बनाम बंद स्रोत» और «API कॉल करना बनाम स्वयं तैनात करना» को अलग-अलग देखा जाना चाहिए।
दैनिक चर्चाओं में, लोग अक्सर उन मॉडलों को सामूहिक रूप से ओपन सोर्स मॉडल कहते हैं जिनके वेट्स डाउनलोड किए जा सकते हैं। हम बाद के अध्यायों में भी इस सामान्य परंपरा का पालन करेंगे।
हालांकि, सख्त अंतर करते समय, हम स्पष्ट करेंगे कि ओपन वेट्स मॉडल की पूरी प्रशिक्षण प्रक्रिया के ओपन सोर्स के बराबर नहीं हैं। प्रशिक्षण डेटा, प्रशिक्षण कोड और उपयोग अनुमतियाँ अभी भी अलग-अलग जाँच की जानी चाहिए।
सभी ओपन सोर्स कहे जाते हैं, लेकिन जो खुला है वह अलग है~
एक मॉडल प्राप्त करने के बाद, आप शायद जिज्ञासु हैं कि यह कैसे प्रशिक्षित किया गया।
यहीं पर विभिन्न मॉडलों के बीच अंतर स्पष्ट हो जाता है। कुछ आपको पूर्ण प्रशिक्षण सामग्री का खुलासा किए बिना इसे डाउनलोड करने और चलाने की अनुमति देते हैं। अन्य प्रशिक्षण कोड और डेटा विवरण प्रदान करके और आगे जाते हैं, जिससे बाहरी डेवलपर मॉडल के प्रशिक्षण पथ का अध्ययन कर सकते हैं।
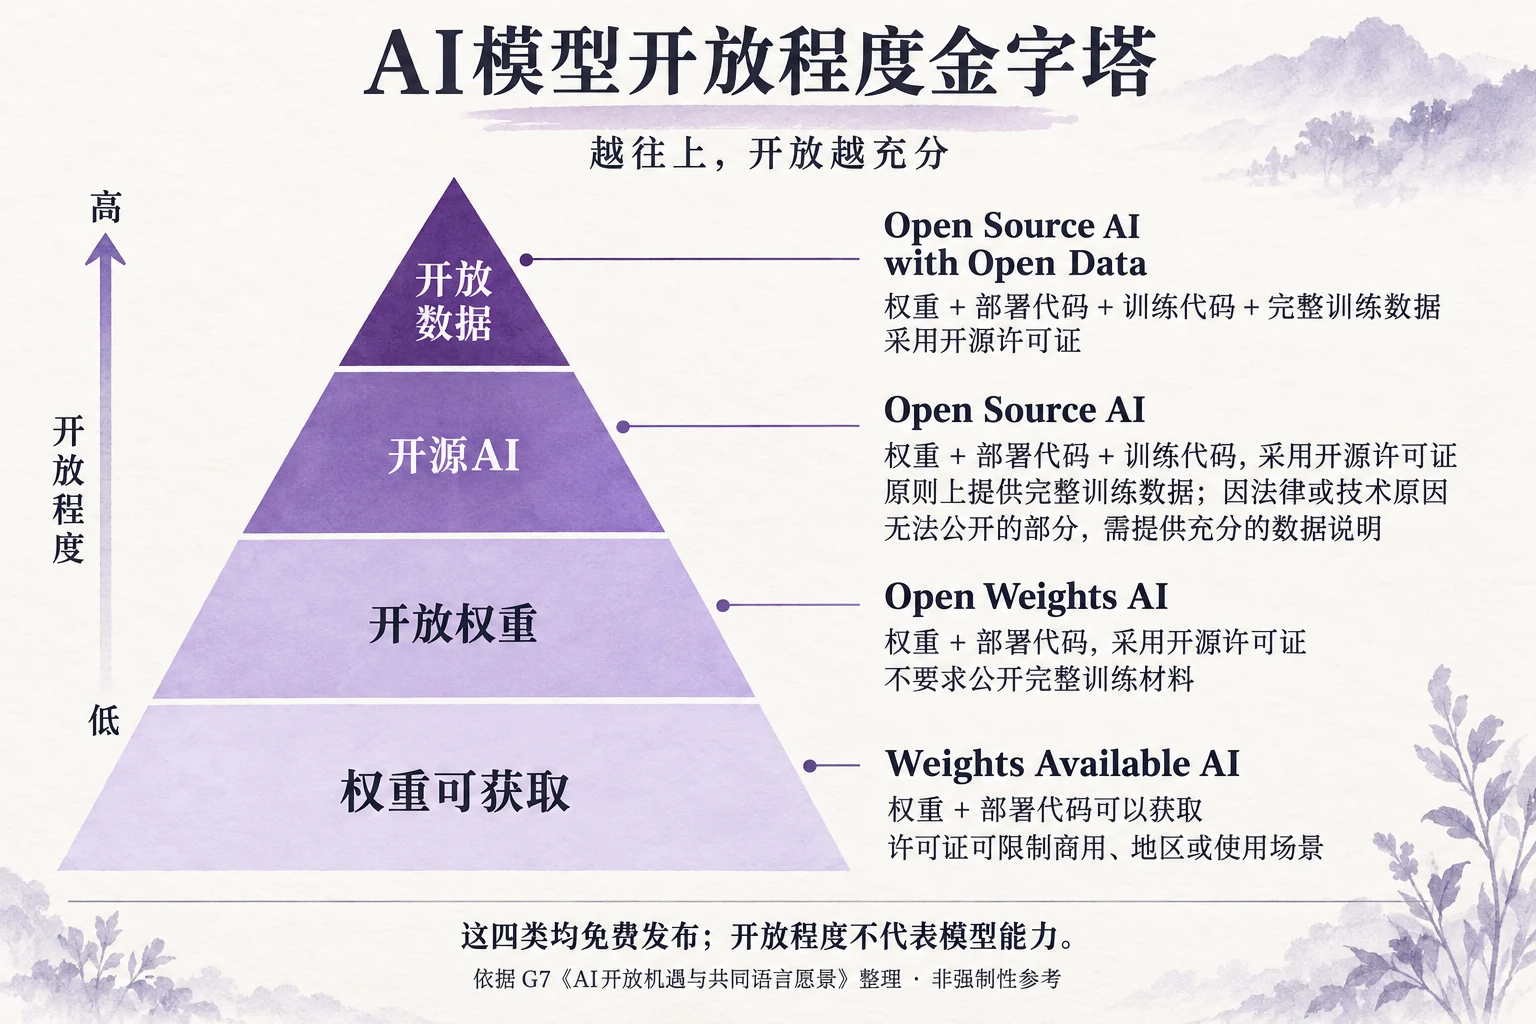
मई 2026 में, G7 ने AI ओपननेस पर एक सामान्य संदर्भ दस्तावेज़ प्रकाशित किया, जिसमें इन अंतरों को चार श्रेणियों में वर्गीकृत किया, ओपननेस के उच्चतम से निम्नतम तक:
पूर्ण प्रशिक्षण डेटा भी सार्वजनिक है। मॉडल वेट्स, तैनाती कोड, प्रशिक्षण कोड और पूर्ण प्रशिक्षण डेटा सभी ओपन सोर्स लाइसेंस के तहत प्रदान किए गए हैं, Open Source AI with Open Data के अनुरूप।
वेट्स और कोड सार्वजनिक हैं, प्रतिबंधित डेटा का विस्तृत विवरण है। Open Source AI के अनुरूप। पूर्ण प्रशिक्षण डेटा सिद्धांत रूप में प्रदान किया जाना चाहिए; कानूनी या तकनीकी कारणों से साझा नहीं किए जा सकने वाले हिस्सों को पर्याप्त डेटा दस्तावेज़ से बदला जाना चाहिए।
एक प्रशिक्षित मॉडल आपको चलाने और संशोधित करने के लिए दिया जाता है। Open Weights AI के अनुरूप, ओपन सोर्स लाइसेंस के तहत वेट्स और तैनाती कोड प्रदान करता है, लेकिन जरूरी नहीं कि पूर्ण प्रशिक्षण सामग्री का खुलासा करे।
डाउनलोड करने योग्य, लेकिन उपयोग करते समय अतिरिक्त शर्तों के साथ। Weights Available AI के अनुरूप, जहाँ वेट्स और तैनाती कोड प्राप्त किए जा सकते हैं, लेकिन लाइसेंस व्यावसायिक उपयोग, उपयोग क्षेत्रों या विशिष्ट परिदृश्यों को प्रतिबंधित कर सकते हैं।
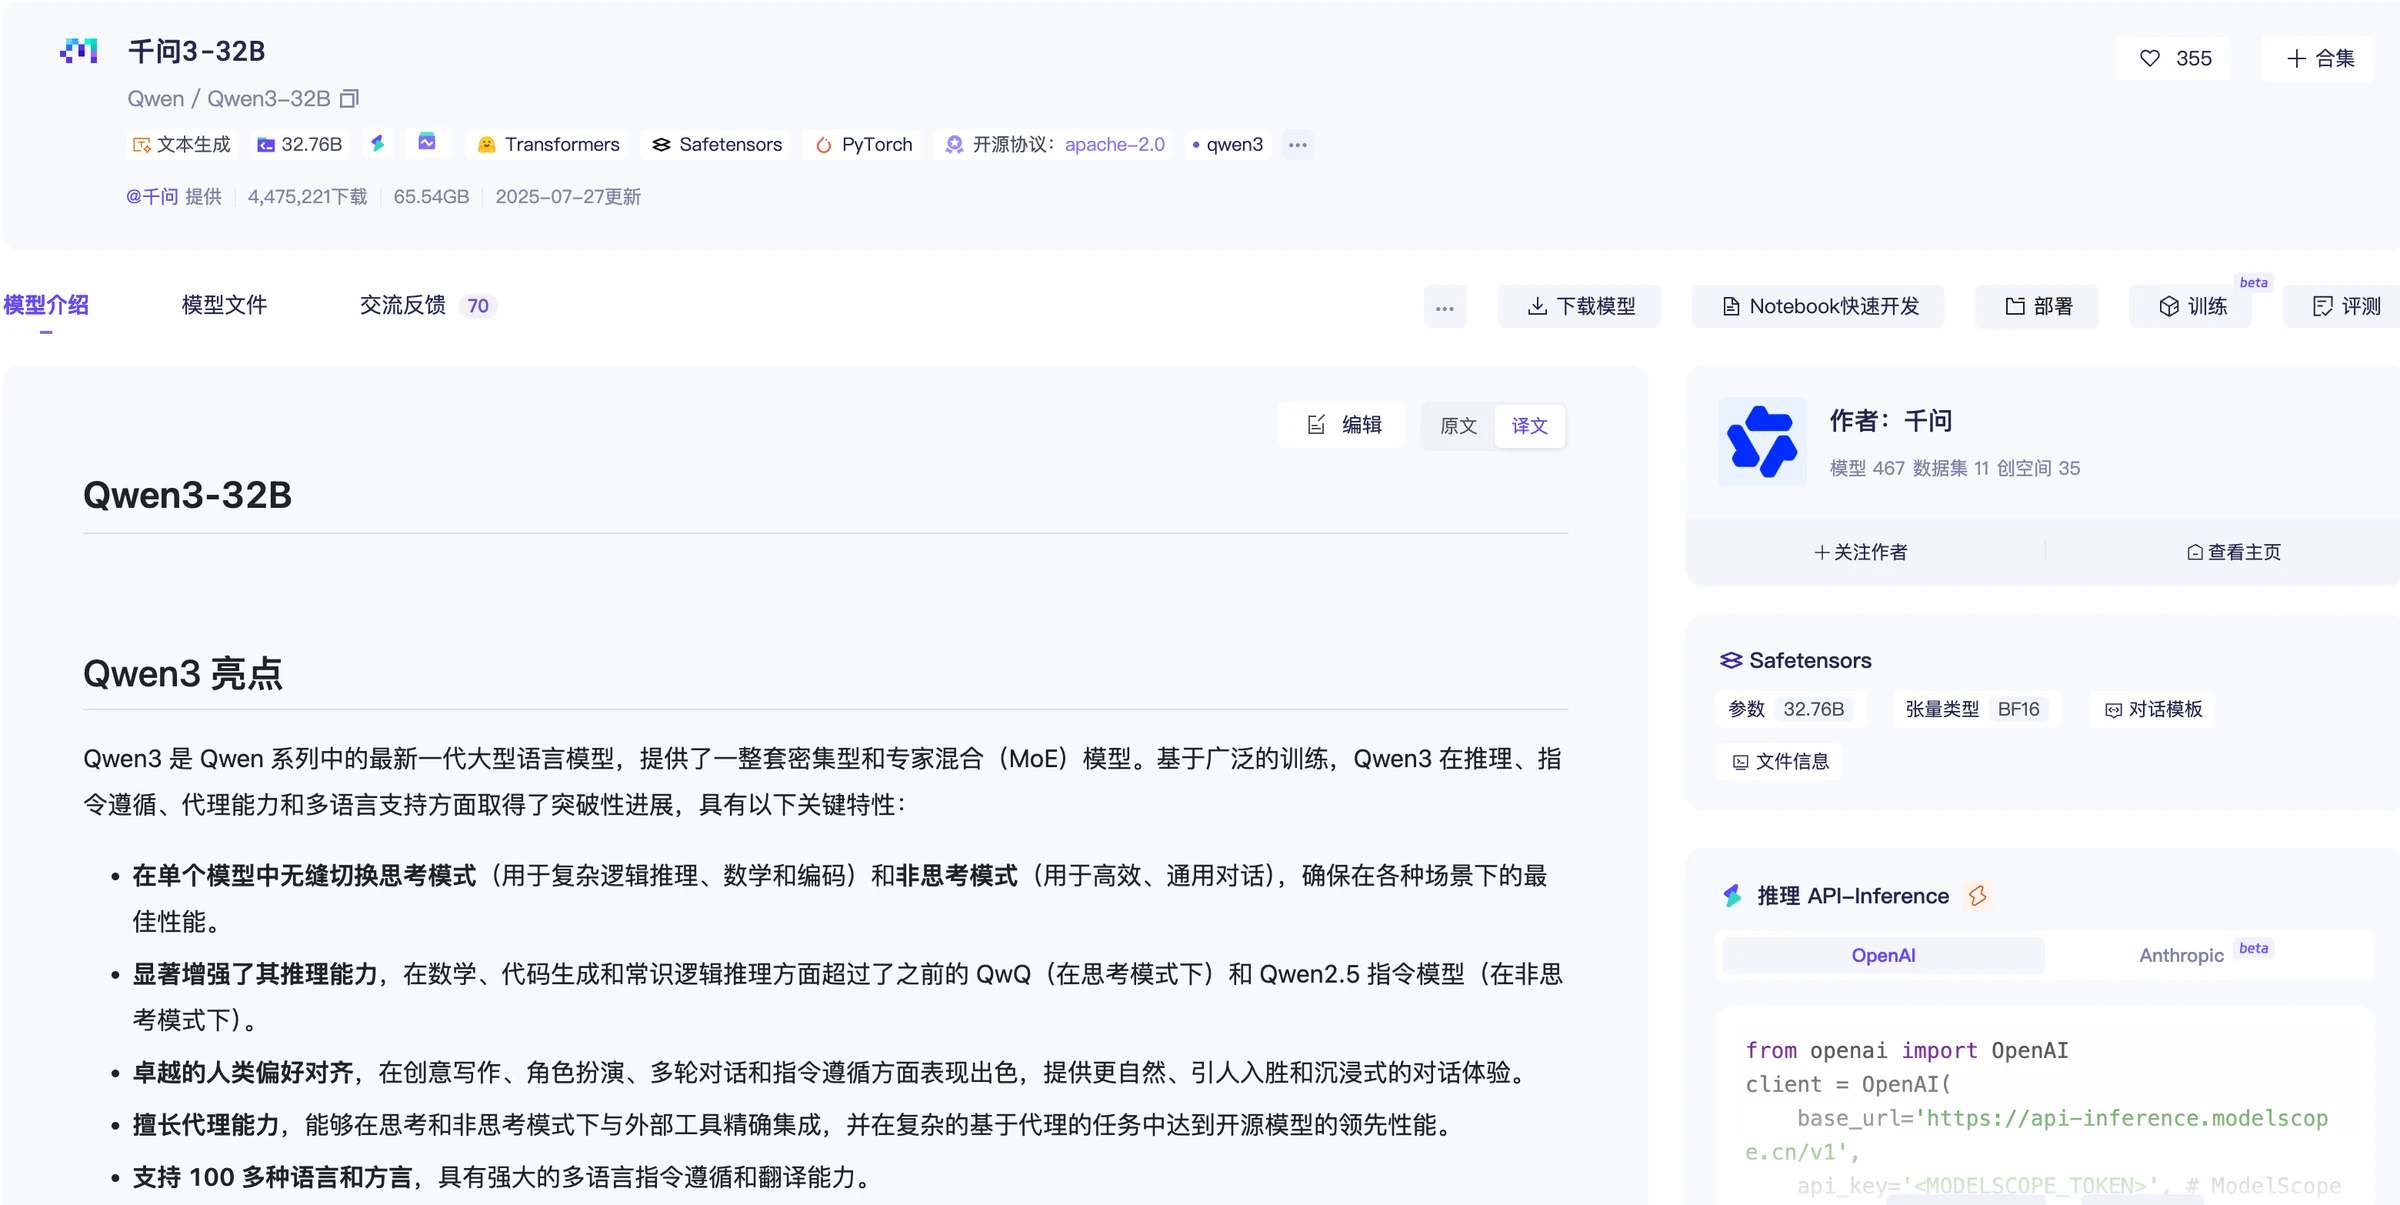
Qwen3 को उदाहरण के रूप में लेते हुए, आधिकारिक टीम स्थानीय रनिंग, तैनाती, क्वांटाइज़ेशन और फाइन-ट्यूनिंग के निर्देशों के साथ ओपन वेट्स मॉडल प्रदान करती है। डेवलपर्स Transformers, vLLM, SGLang जैसे टूल का उपयोग करके मॉडल चला सकते हैं, और प्रशिक्षण जारी रखने के लिए फाइन-ट्यूनिंग टूल का भी उपयोग कर सकते हैं। ऊपर दिए गए अंतरों के आधार पर, यह ओपन वेट्स स्तर के व्यावहारिक मूल्य को दर्शाता है।
अधिकांश उद्यमों को बड़े मॉडल का पूर्व-प्रशिक्षण दोबारा करने की आवश्यकता नहीं है - मौजूदा मॉडल चलाने, उन्हें अपने उपकरणों के अनुरूप बनाने और व्यापार नमूनों के साथ फाइन-ट्यून करने से पहले से ही कई विशिष्ट व्यापार समस्याओं का समाधान हो सकता है।
क्या ओपन सोर्स मॉडल सच में बंद स्रोत मॉडल से प्रतिस्पर्धा कर सकते हैं?
मॉडल स्वयं तैनात करना बहुत अच्छा है, लेकिन अगर मॉडल व्यापार परिदृश्यों में अक्सर गलतियाँ करता है, तो उसे वास्तविक काम सौंपना मुश्किल है।
अतीत में, ओपन सोर्स मॉडल ने कई लोगों को यह छाप दी कि वे अनुसंधान के लिए सुविधाजनक हैं लेकिन सबसे मजबूत बंद स्रोत मॉडल से कम हैं। मॉडल क्षमताओं के निरंतर अपडेट के साथ, इस मूल्यांकन की फिर से समीक्षा करने की आवश्यकता है।
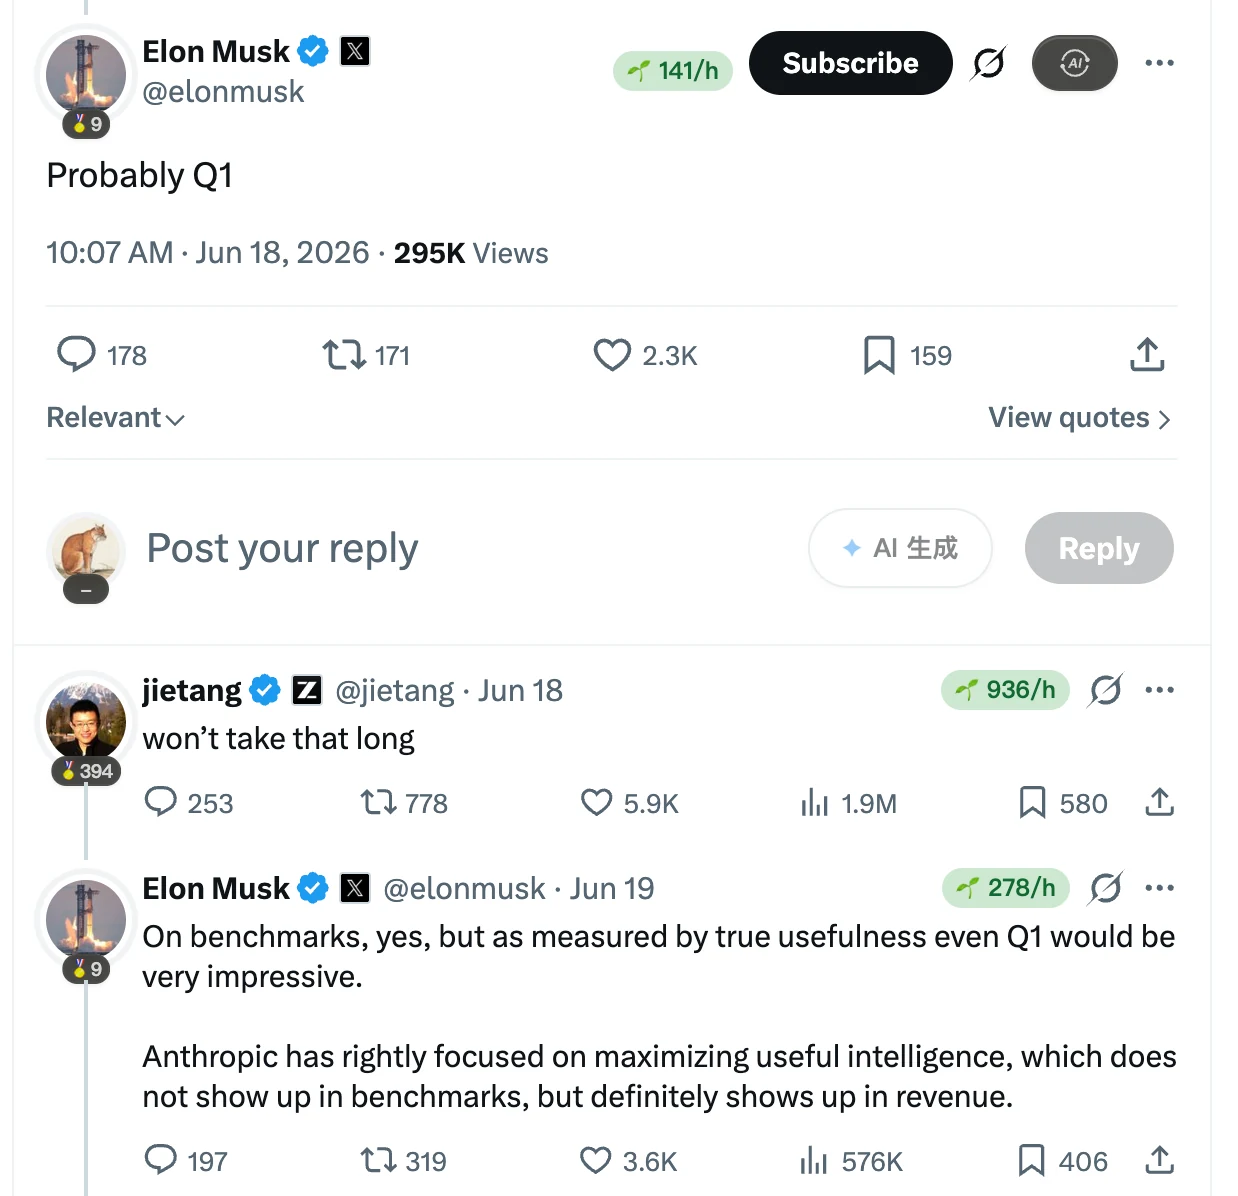
18 जून 2026 को, X पर काफी दिलचस्प बातचीत हुई। नेटिज़न चर्चा कर रहे थे कि चीनी मॉडल कब Anthropic frontier मॉडल के स्तर तक पहुँच सकते हैं, और एलोन मस्क ने भविष्यवाणी की कि 2027 की पहली तिमाही तक लग सकता है। Zhipu के सह-संस्थापक टैंग जी ने नीचे «won't take that long» लिखा।
दोनों की भविष्यवाणियाँ सच होंगी या नहीं, यह बाद के मॉडल प्रदर्शन पर निर्भर करता है। इस चर्चा का आकर्षक पहलू यह है कि ओपन सोर्स मॉडल पहले से ही पूरे बड़े मॉडल परिदृश्य की सीमा पर खड़े हैं।
जुलाई 2026 में Hugging Face द्वारा घोषित एक सुरक्षा घटना ने फिर से ओपन सोर्स मॉडल के महत्व को साबित किया।
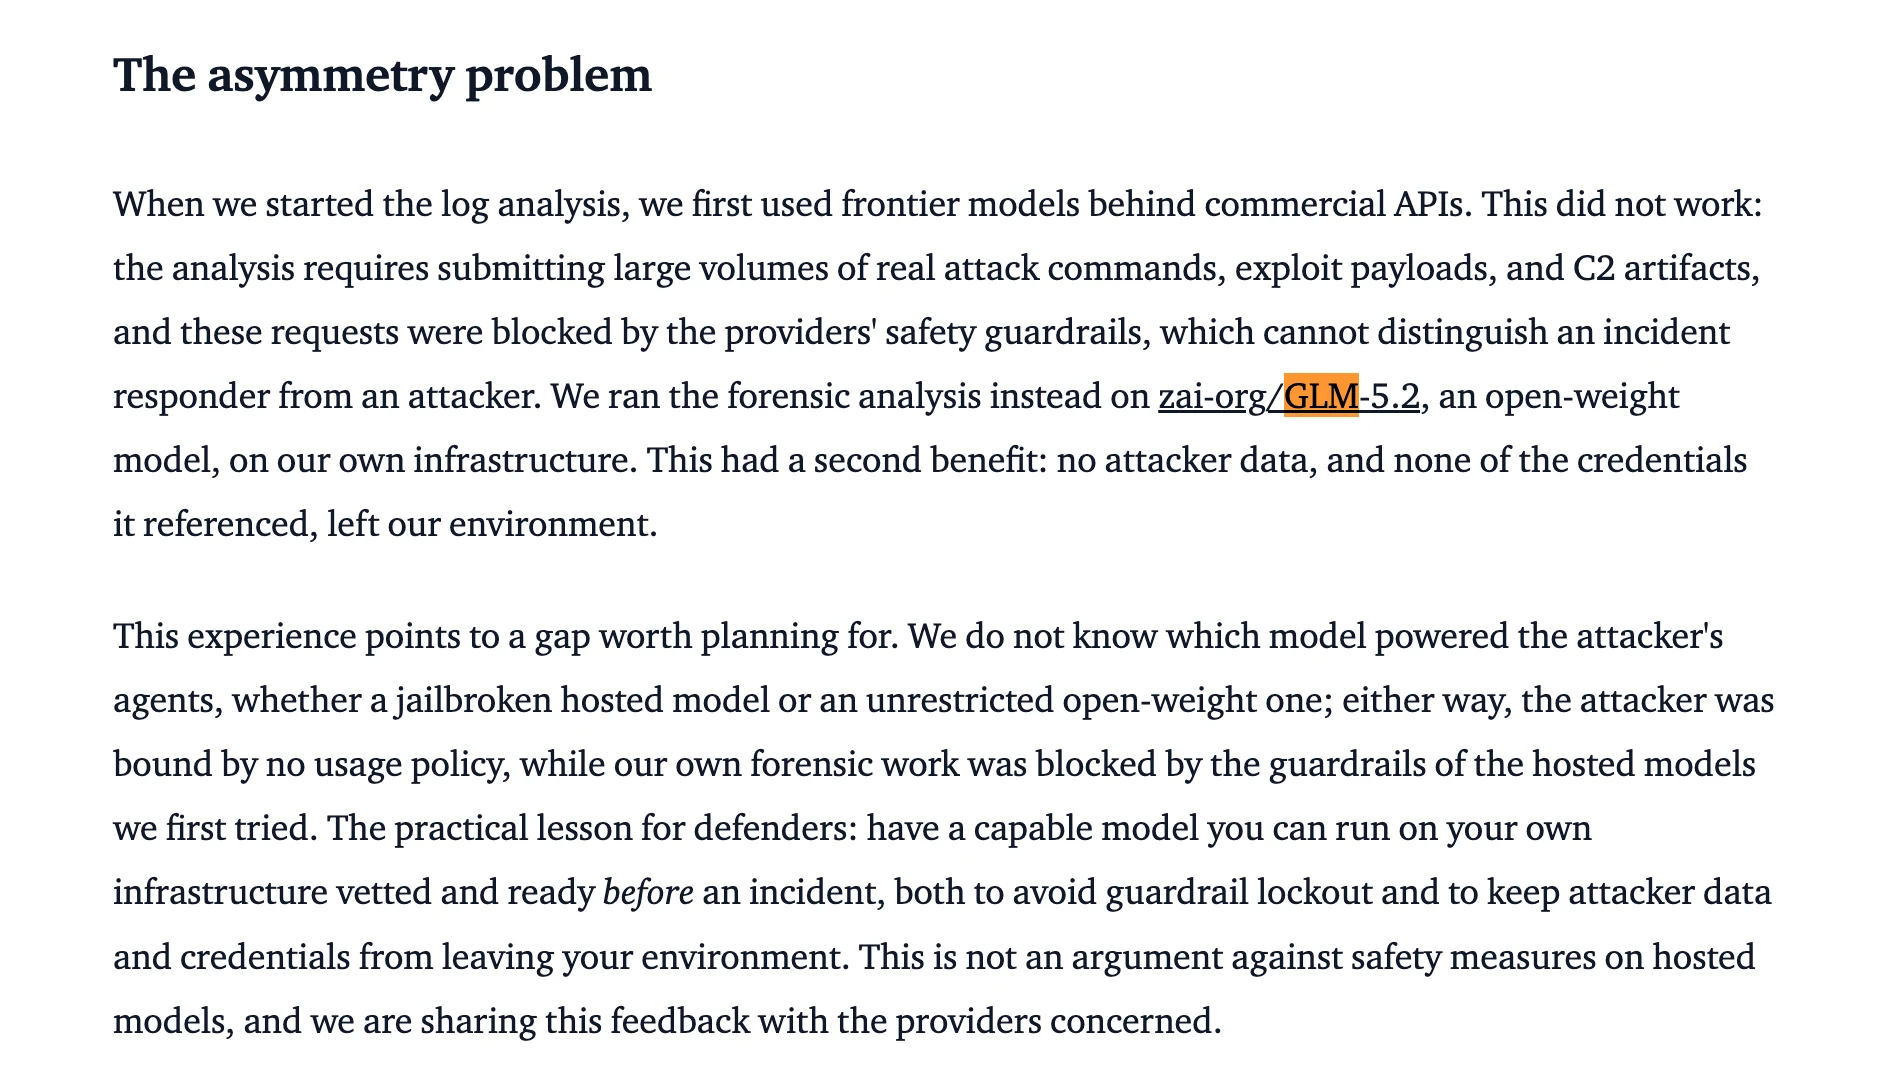
Hugging Face के उत्पादन अवसंरचना का एक हिस्सा हैक हो गया था, और सुरक्षा टीम को यह समझने के लिए हमले के रिकॉर्ड का विश्लेषण करना था कि हमलावरों ने क्या किया था, किन प्रमाणपत्रों को छुआ था, और प्रभाव कहाँ तक था। HF टीम ने पहले व्यावसायिक API के माध्यम से frontier मॉडल का उपयोग करने की कोशिश की, लेकिन एक अजीब समस्या का सामना किया। जाँच के लिए उपयोग किए गए वास्तविक हमले के आदेश और एक्सप्लॉइट सामग्री ने सेवा प्रदाता की सुरक्षा प्रतिबंधों को ट्रिगर किया, और विश्लेषण अनुरोध अवरुद्ध हो गए।
बाद में, टीम ने अपनी अवसंरचना पर ओपन वेट्स मॉडल GLM-5.2 का उपयोग करके फोरेंसिक विश्लेषण किया, जिससे जाँच जारी रही। संबंधित हमले डेटा और प्रमाणपत्र भी आंतरिक वातावरण में रहे।
बाद की तकनीकी समीक्षा में, Hugging Face ने आगे समझाया कि टीम ने लगभग 17,600 हमले कार्यों का पुनर्निर्माण किया और GLM-5.2 सहित ओपन वेट्स मॉडल का उपयोग करके विकृत और एन्क्रिप्टेड हमले पेलोड की व्याख्या की।
इस घटना ने ओपन सोर्स मॉडल के महत्व को साबित किया।
ओपन सोर्स मॉडल का उपयोग बंद स्रोत प्रतिबंधों के अधीन नहीं है। हम डेटा को स्थानीय रख सकते हैं, ऑफ़लाइन उपयोग कर सकते हैं, और कार्य निष्पादन को अधिक नियंत्रित बना सकते हैं।
किन परिदृश्यों में स्थानीय तैनाती के ओपन सोर्स मॉडल अधिक उपयुक्त हैं?
ऊर्ध्वाधर क्षेत्र भी ओपन सोर्स मॉडल के लिए एक महत्वपूर्ण अनुप्रयोग दिशा है। सामान्य बड़े मॉडल भारी मात्रा में सार्वजनिक डेटा से सीखते हैं, लेकिन उद्यम-आंतरिक उपकरण नाम, व्यापार प्रक्रियाओं, उद्योग शब्दावली और विशेषज्ञ ज्ञान की उनकी समझ अभी भी सीमित हो सकती है। ऊर्ध्वाधर क्षेत्र डेटा के साथ फाइन-ट्यूनिंग से, मॉडल इस विशेष ज्ञान को और सीख सकता है।
संवेदनशील डेटा को संसाधित करने वाले कार्यों के लिए, स्थानीय तैनाती के भी फायदे हैं। मॉडल उद्यम के आंतरिक नेटवर्क के भीतर अनुमान लगा सकते हैं और मौजूदा ज्ञान आधार, डेटाबेस और व्यापार सिस्टम से जुड़ सकते हैं, जिससे संवेदनशील डेटा को बाहरी सेवाओं को भेजने की आवश्यकता कम हो जाती है।
हालांकि, सभी कार्यों के लिए स्थानीय रूप से तैनात ओपन सोर्स मॉडल की आवश्यकता नहीं है।
कम मॉडल इन्वोकेशन, तेजी से बदलती व्यापार आवश्यकताओं या नवीनतम सामान्य मॉडल क्षमताओं के निरंतर उपयोग की आवश्यकता वाले कार्यों के लिए, सीधे API कॉल करना आमतौर पर अधिक सुविधाजनक होता है। कुछ दीर्घकालिक, स्थिर और बार-बार चलने वाले व्यापार कार्यों के लिए, ओपन सोर्स मॉडल में बड़ा अनुप्रयोग स्थान है।
उदाहरण के लिए, टेक्स्ट क्लासिफिकेशन, इंटेंट रिकग्निशन, इन्फॉर्मेशन एक्सट्रैक्शन, डॉक्यूमेंट समरी, नॉलेज बेस Q&A जैसे कार्यों में आमतौर पर स्पष्ट इनपुट और आउटपुट प्रारूप होते हैं। उद्यम कार्य की जटिलता के अनुसार उपयुक्त आकार के मॉडल चुन सकते हैं और अपने व्यापार डेटा का उपयोग करके प्रशिक्षण या फाइन-ट्यूनिंग कर सकते हैं। इन कार्यों के लिए, सबसे बड़े पैरामीटर वाले मॉडल का उपयोग करना जरूरी नहीं है।
याद रखें, मॉडल डाउनलोड करने में सक्षम होने का मतलब नहीं है कि आप इसे मनमर्जी से उपयोग कर सकते हैं
मॉडल चल रहा है और अच्छे परिणाम दे रहा है, लेकिन अगर आप इसे व्यावसायिक उत्पादों में उपयोग करना चाहते हैं या अपना फाइन-ट्यून किया गया संस्करण साझा करना चाहते हैं, तो आपको अभी भी LICENSE, यानी लाइसेंस की जांच करनी होगी।
डाउनलोड करने योग्य, व्यावसायिक रूप से उपयोग करने योग्य, और पुनर्वितरण के लिए संशोधन योग्य होना अलग-अलग अनुमतियाँ हैं।
आम तौर पर, MIT और Apache License 2.0 काफी उदार ओपन सोर्स लाइसेंस हैं जो व्यावसायिक उपयोग और संशोधन की अनुमति देते हैं, और सभी व्युत्पन्न कोड को सार्वजनिक करने की आवश्यकता नहीं होती। MIT लाइसेंस का उपयोग करने वाले सॉफ़्टवेयर को केवल कॉपीराइट और लाइसेंस अधिसूचना बनाए रखने की आवश्यकता होती है; Apache 2.0 पुनर्वितरण के दौरान संशोधन दस्तावेज़, संबंधित अधिसूचना बनाए रखने और NOTICE हैंडलिंग के लिए आवश्यकताएँ निर्धारित करता है, और स्पष्ट पेटेंट अनुदान शर्तें शामिल करता है।
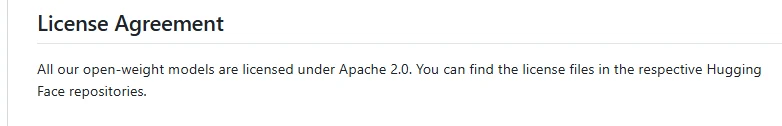
उदाहरण के लिए, Qwen3 श्रृंखला मॉडल Apache 2.0 का उपयोग करते हैं।
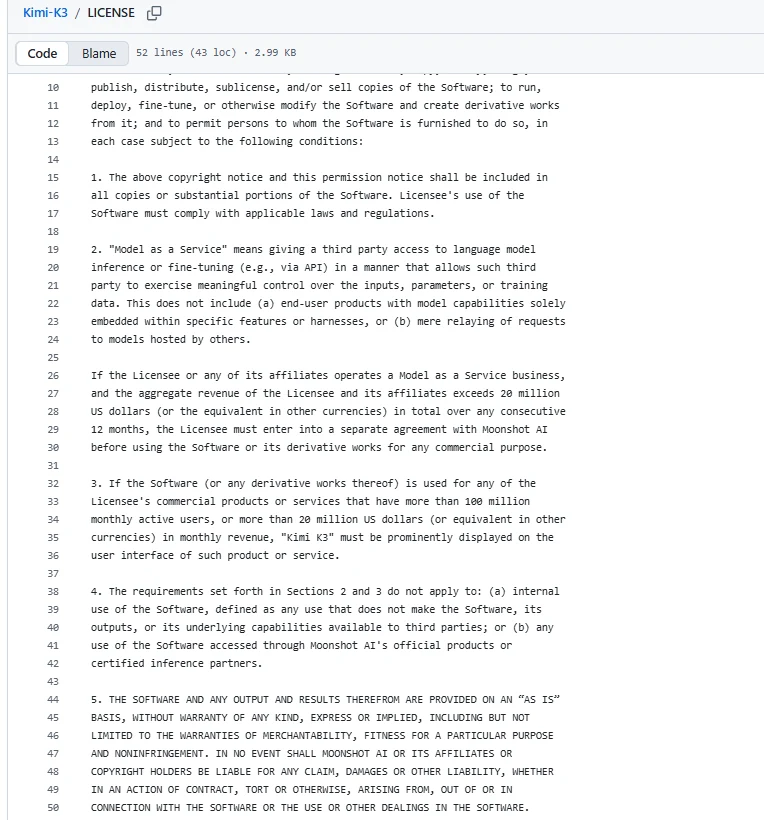
Kimi K3 कुछ व्यावसायिक उपयोगों के लिए अलग समझौते हैं, तैनाती, फाइन-ट्यूनिंग और व्युत्पन्न कार्य बनाने की अनुमति देता है, लेकिन जब मॉडल सेवाएँ निर्धारित राजस्व सीमा तक पहुँचती हैं, तो एक अलग समझौते की आवश्यकता होती है।
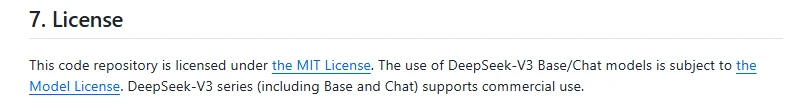
DeepSeek-V3 का कोड MIT लाइसेंस का उपयोग करता है।
इसलिए, जब हम मॉडल का उपयोग करते हैं, अगर हम फाइन-ट्यून किए गए मॉडल को सार्वजनिक रूप से प्रकाशित करना या अन्य उपयोगकर्ताओं को प्रदान करना चाहते हैं, तो हमें मूल मॉडल के लाइसेंस की फिर से जांच करनी होगी कि क्या ऐसा उपयोग अनुमत है, और क्या हमें मॉडल का नाम, लाइसेंस और स्रोत जानकारी बनाए रखने की आवश्यकता है।
अगर एक नया मॉडल कई मॉडलों को मिलाकर प्राप्त किया गया है, तो हमें प्रत्येक मॉडल के लाइसेंस की अलग-अलग जांच करनी होगी ताकि यह सुनिश्चित हो सके कि उनकी आवश्यकताएँ टकराव में न आएँ।