ओपन-सोर्स मॉडल डाउनलोड करने के बाद, आप इसे अपने लैपटॉप पर चला सकते हैं या क्लाउड सर्वर किराए पर ले सकते हैं, CPU, GPU और रनटाइम वातावरण को आवश्यकतानुसार कॉन्फ़िगर कर सकते हैं। अलग-अलग हार्डवेयर के लिए अलग-अलग तैयारी की आवश्यकता होती है।
यदि आप बस यह देखना चाहते हैं कि मॉडल क्या कर सकता है, तो ModelScope Notebook एक मुफ्त प्रवेश बिंदु प्रदान करता है। ब्राउज़र खोलें, एक चल रहे इंस्टेंस का चयन करें, और आप वेब पेज में सीधे कोड लिख सकते हैं, मॉडल डाउनलोड कर सकते हैं और परिणाम देख सकते हैं।
यह पाठ आपको Notebook बनाने, वातावरण जांचने और मॉडल लोड करने की प्रक्रिया में मार्गदर्शन करता है। अपना पहला परिणाम देखने के लिए इन चरणों का पालन करें।
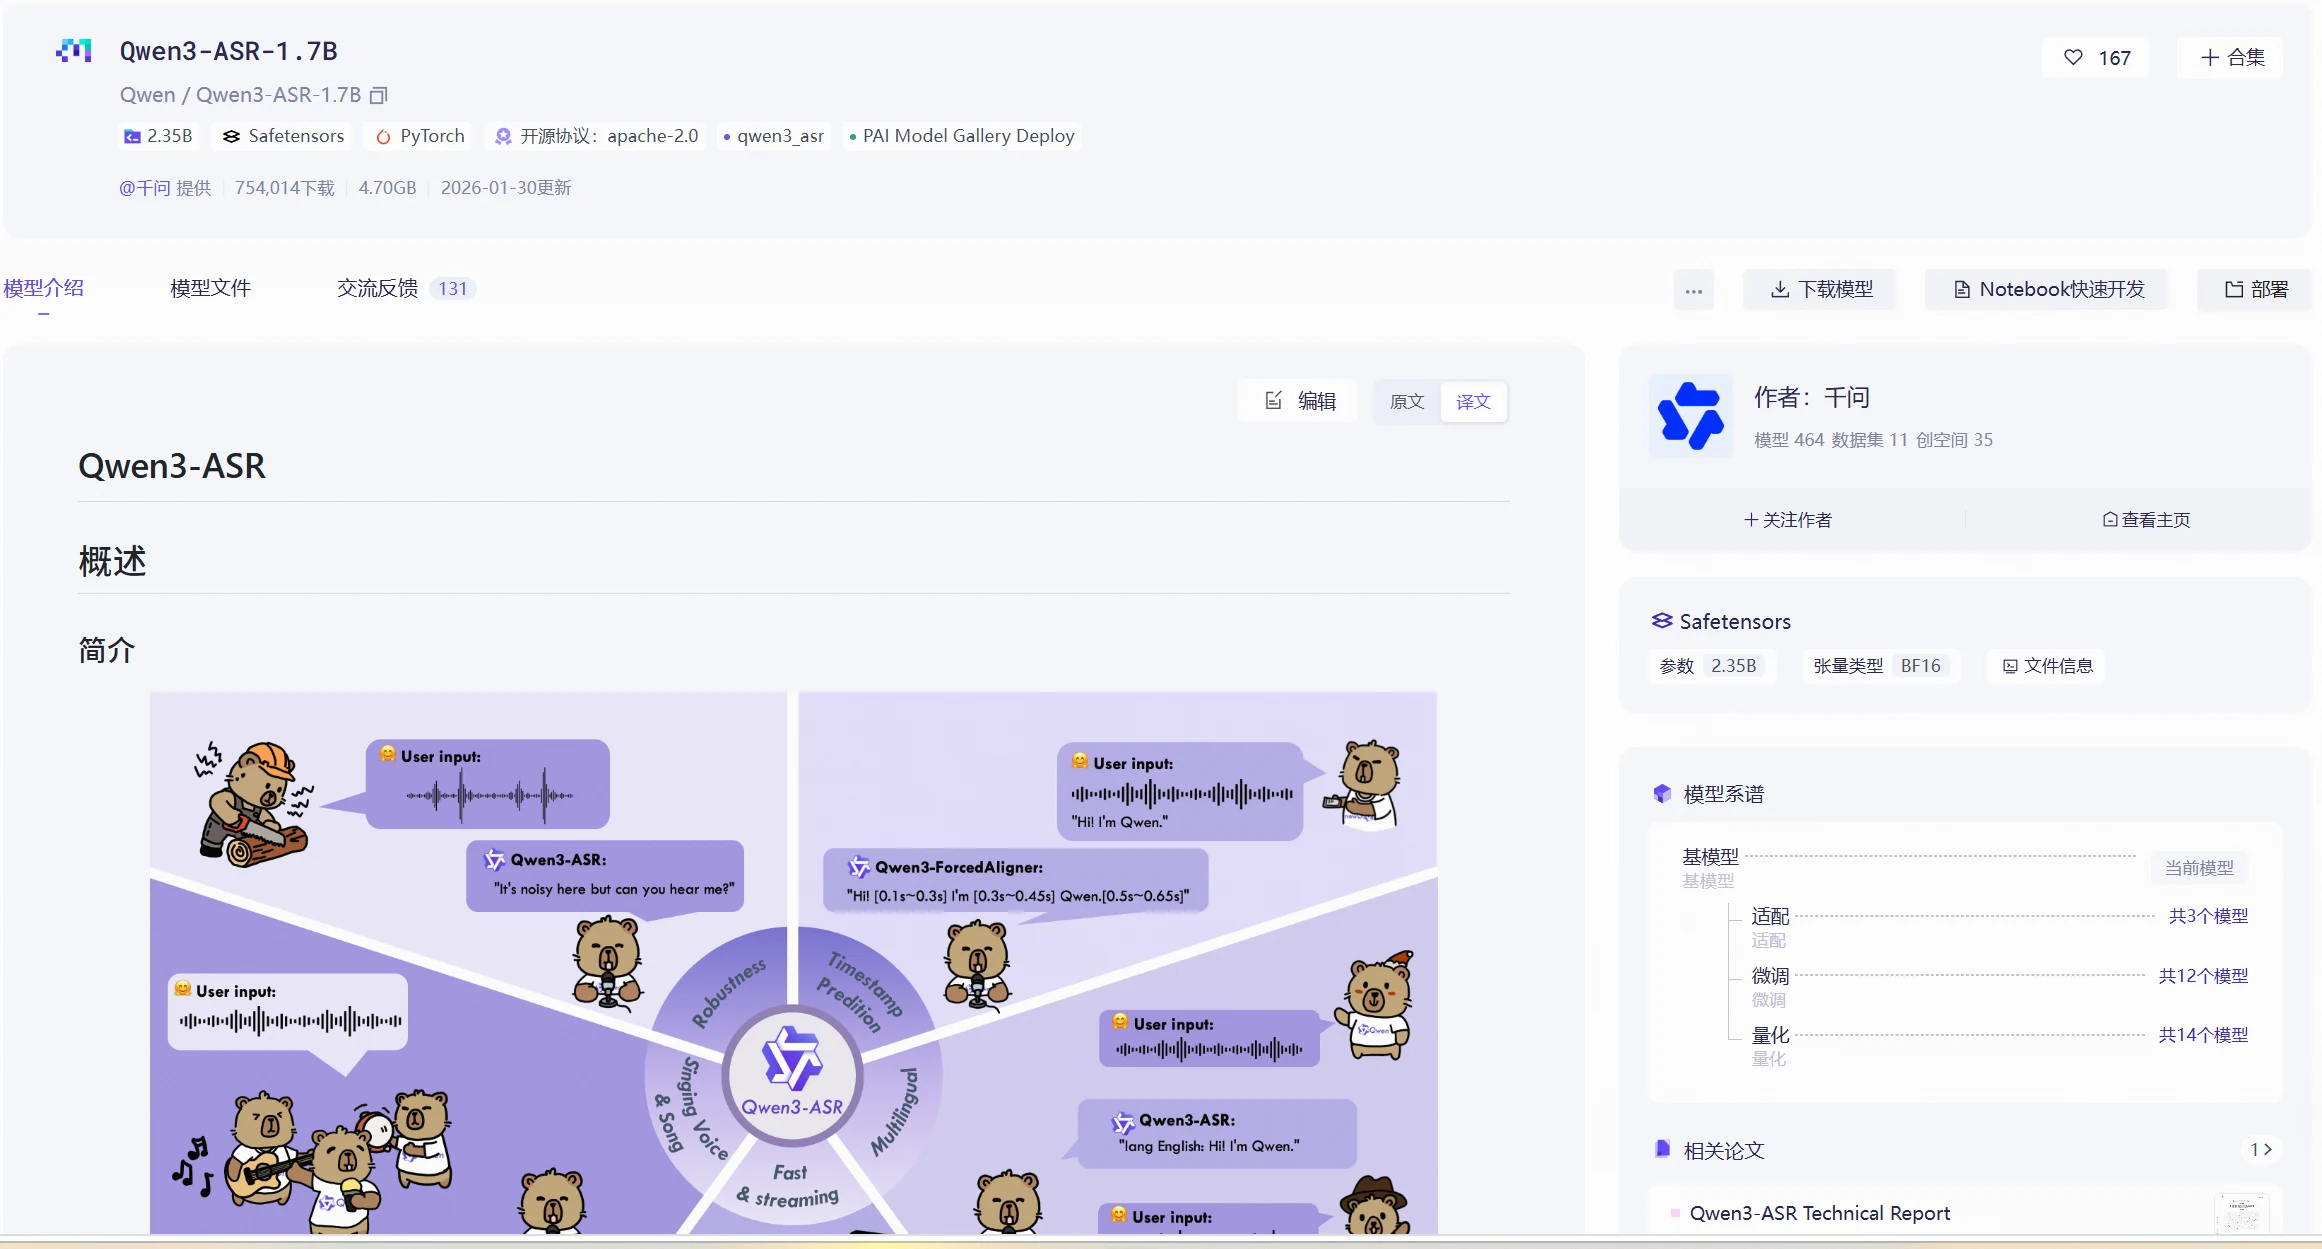
मॉडल हब पर जाएं, Qwen/Qwen3-ASR-1.7B मॉडल खोजें, और ModelScope Notebook बनाने के लिए दाईं ओर "Notebook Quick Development" पर क्लिक करें।
मॉडल लिंक: https://www.modelscope.cn/models/Qwen/Qwen3-ASR-1.7B
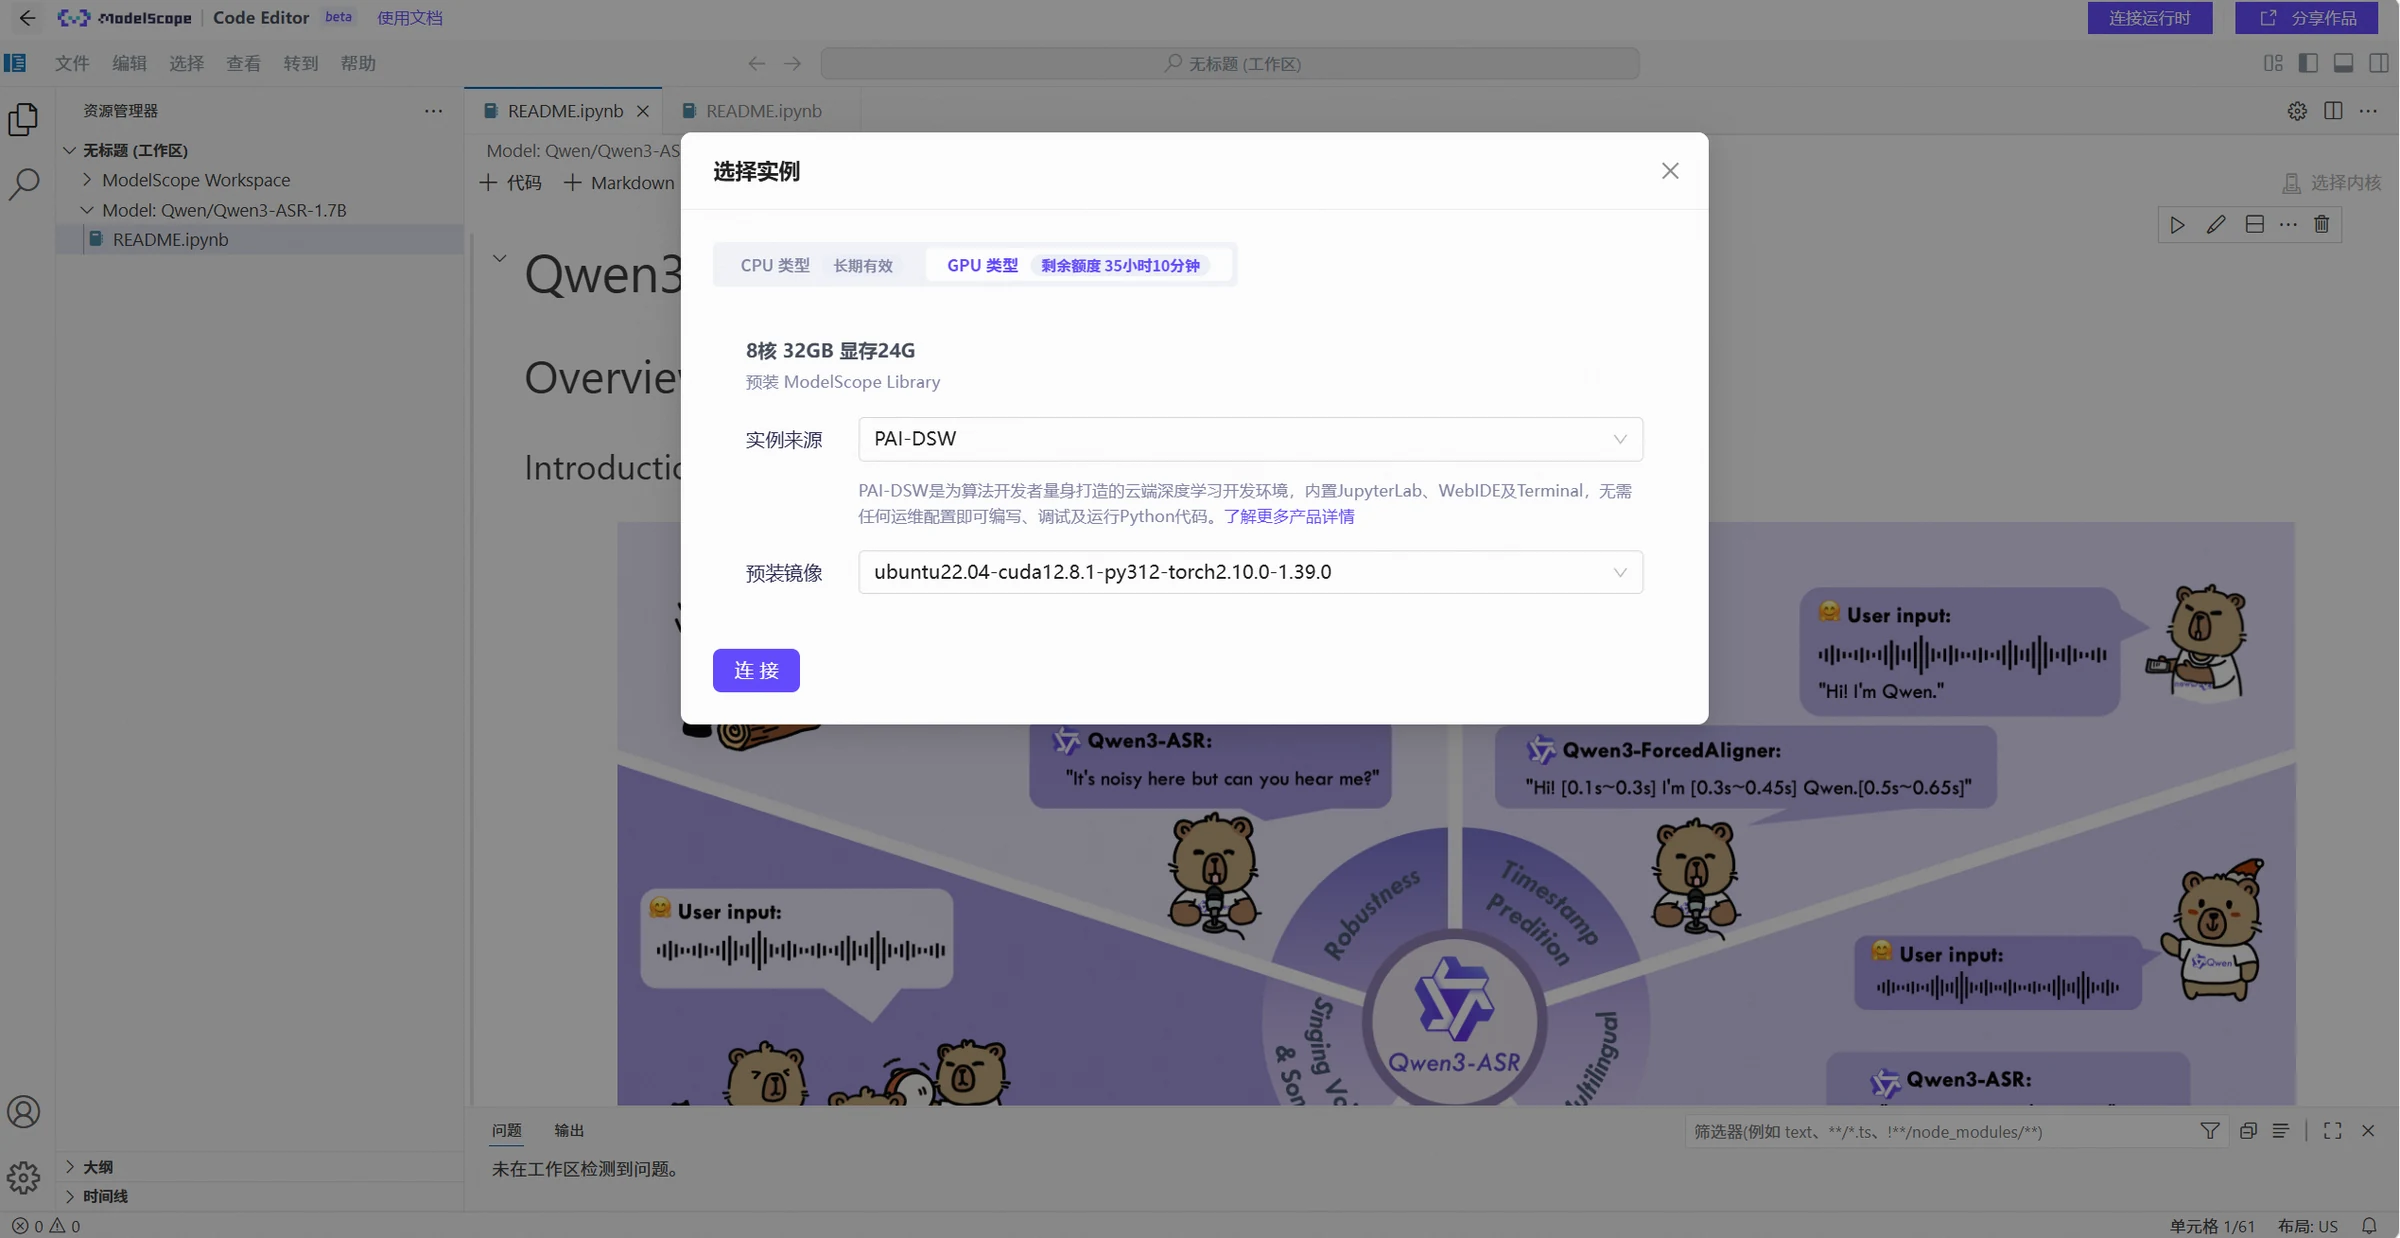
ऊपर दाईं ओर "Connect Runtime" पर क्लिक करें और एक इंस्टेंस चुनें। यहां हम प्रदर्शन के लिए GPU चुनते हैं। आप मॉडल की निर्भरता के अनुसार एक उपयुक्त प्री-इंस्टॉल किया गया इमेज चुन सकते हैं।
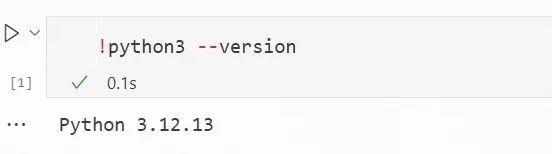
इंस्टेंस लोड करने के बाद, पहला कदम वर्तमान वातावरण की जांच करना है। आप नोटबुक में निम्नलिखित कमांड चला सकते हैं:
!python3 --version
परिणाम:
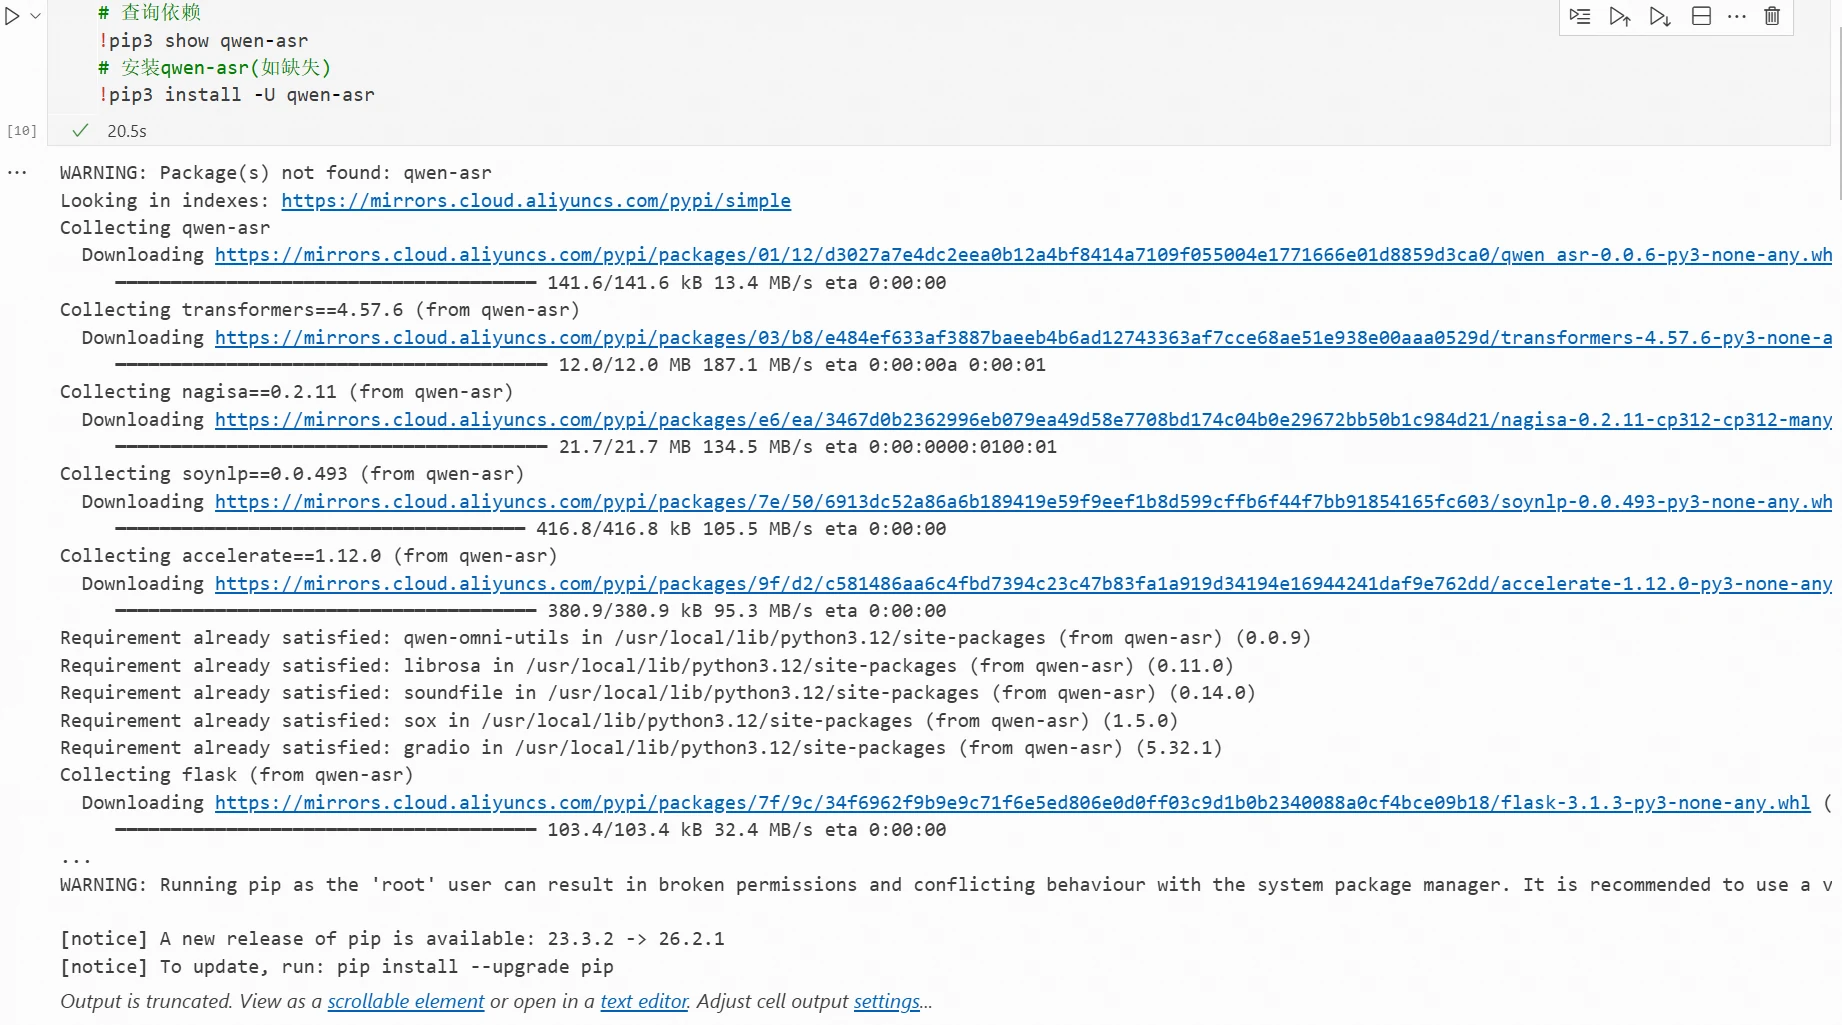
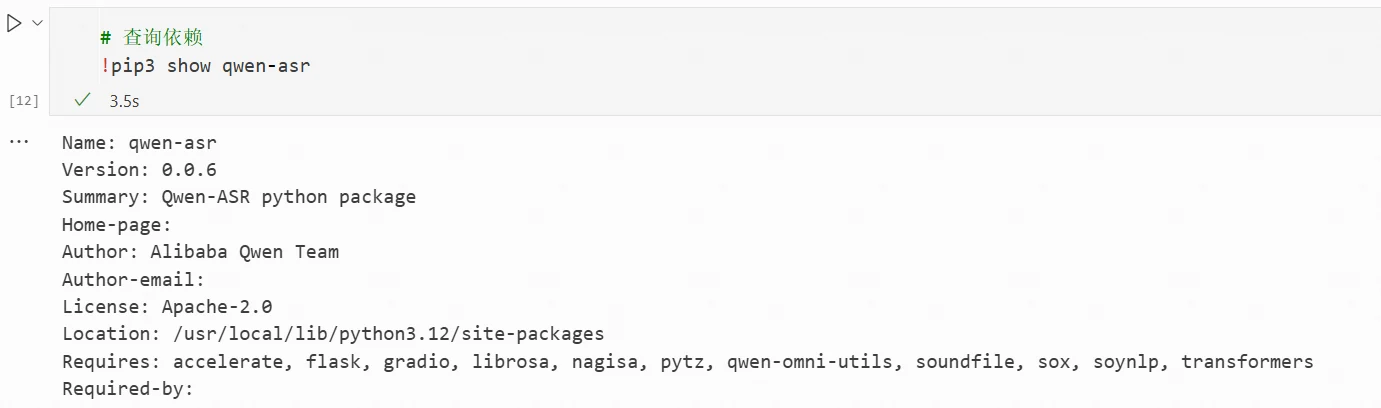
प्रत्येक मॉडल की अलग-अलग निर्भरताएं होती हैं। आपको जानकारी के लिए मॉडल कार्ड देखना होगा। Qwen3-ASR-1.7B मॉडल कार्ड के अनुसार, इन्फ़रेंस निर्भरता qwen3-asr है। यदि वातावरण में qwen3-asr गायब है, तो आपको इसे स्वयं इंस्टॉल करना होगा।
# निर्भरता जांचें
!pip3 show qwen-asr
# qwen-asr इंस्टॉल करें (यदि गायब है)
!pip3 install -U qwen-asr
परिणाम:
सफल इंस्टॉलेशन क्वेरी परिणाम:
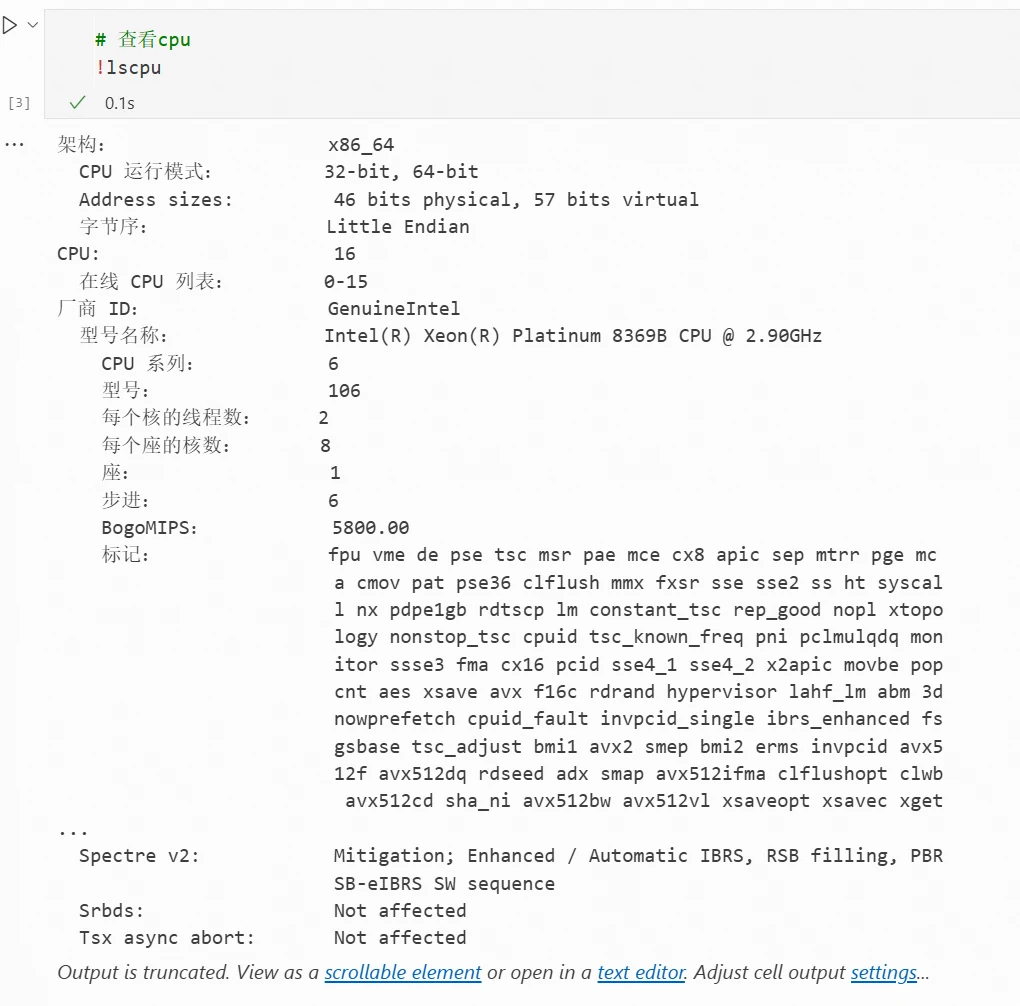
!lscpu
परिणाम:
साइन इन करें चर्चा में शामिल हों
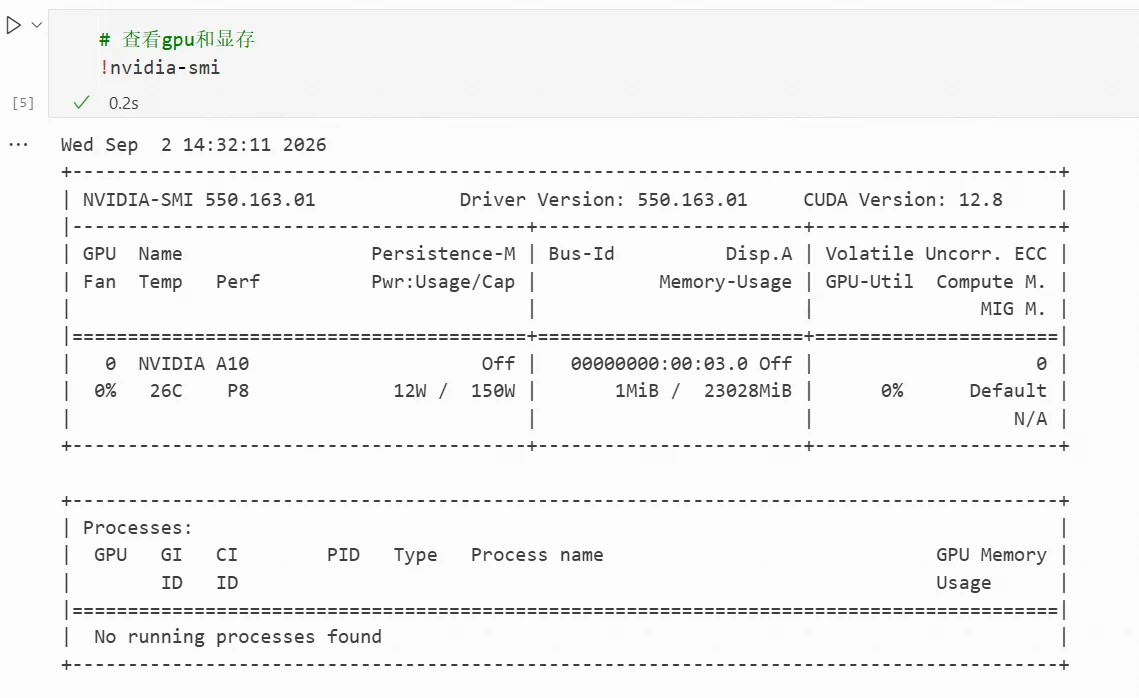
!nvidia-smi
परिणाम:

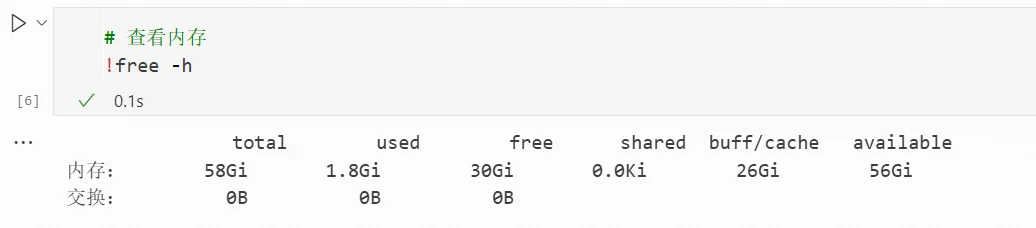
!free -h
परिणाम:

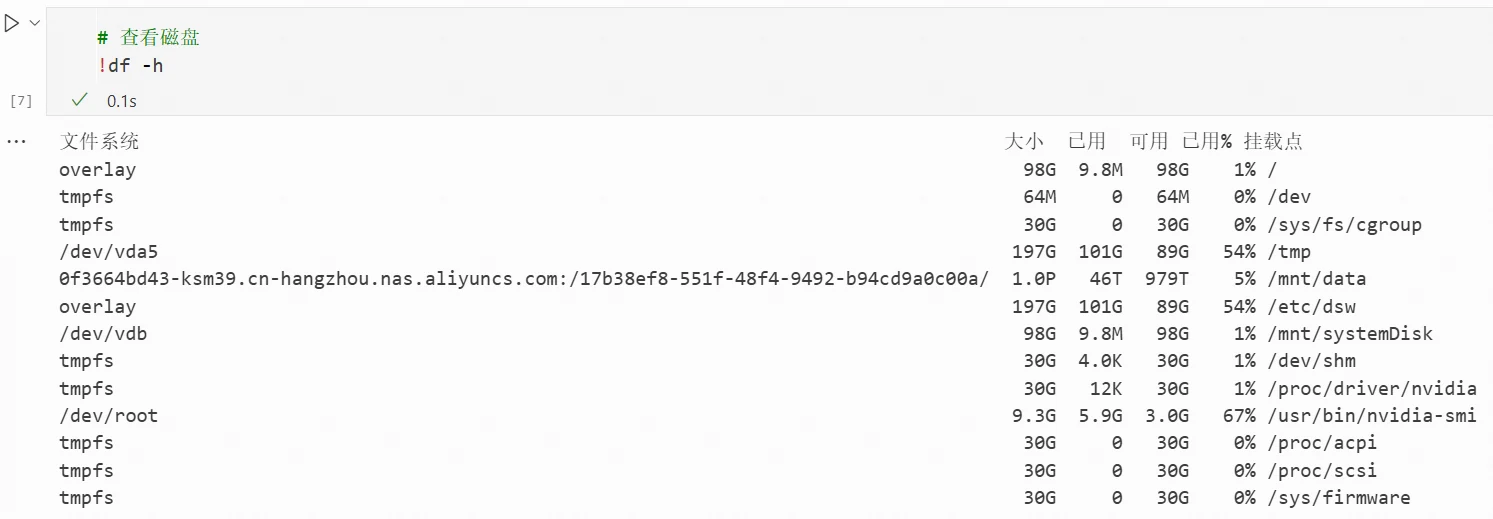
!df -h
परिणाम:

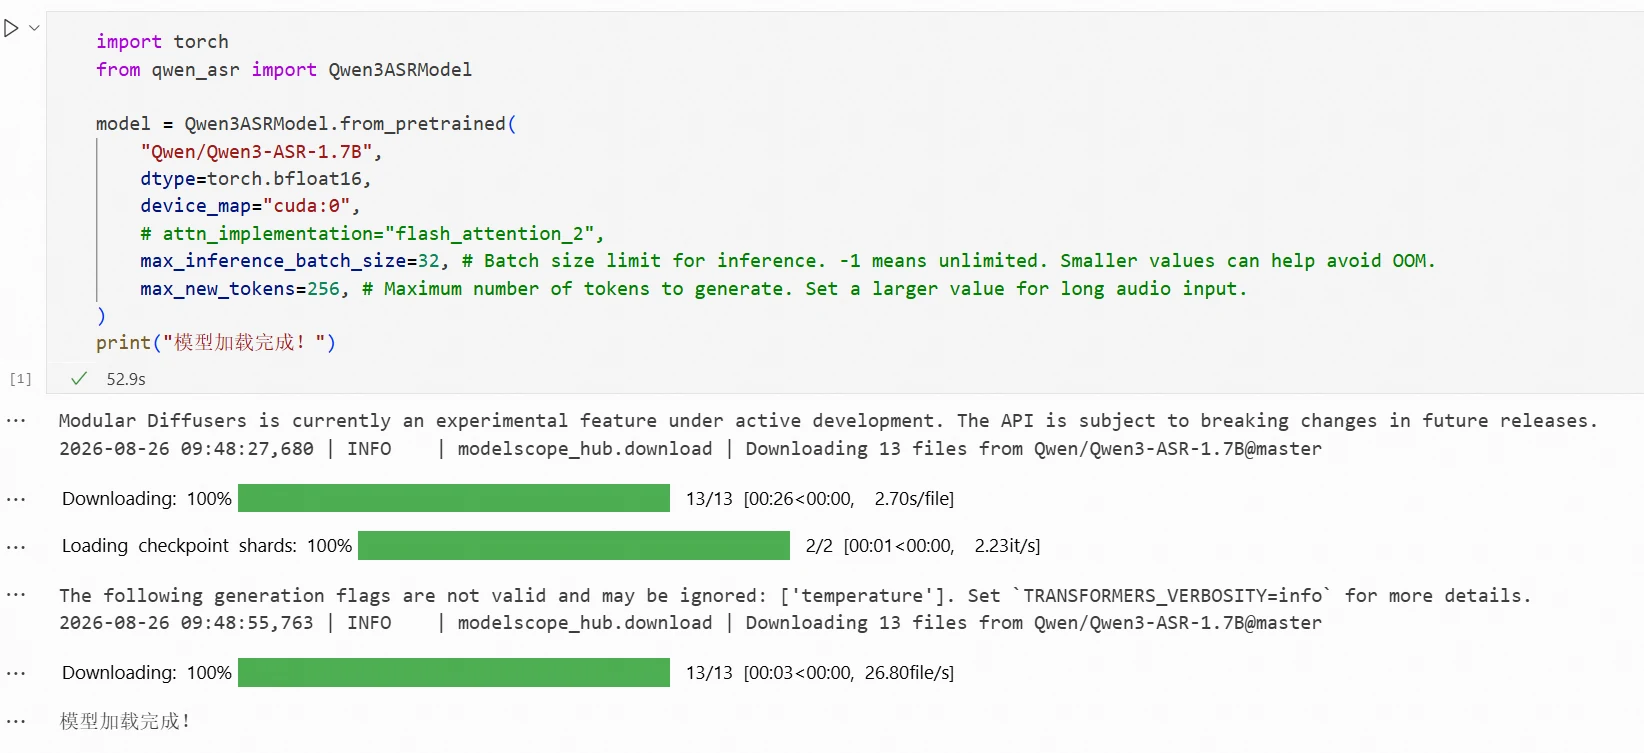
लोडिंग के लिए मॉडल कार्ड पर नमूना कोड देखें। आवश्यक मॉडल फ़ाइलें स्वचालित रूप से डाउनलोड हो जाएंगी।
import torch
from qwen_asr import Qwen3ASRModel
model = Qwen3ASRModel.from_pretrained(
"Qwen/Qwen3-ASR-1.7B",
dtype=torch.bfloat16,
device_map="cuda:0",
# attn_implementation="flash_attention_2",
max_inference_batch_size=32, # Batch size limit for inference. -1 means unlimited. Smaller values can help avoid OOM.
max_new_tokens=256, # Maximum number of tokens to generate. Set a larger value for long audio input.
)
print("मॉडल सफलतापूर्वक लोड हो गया!")
परिणाम:

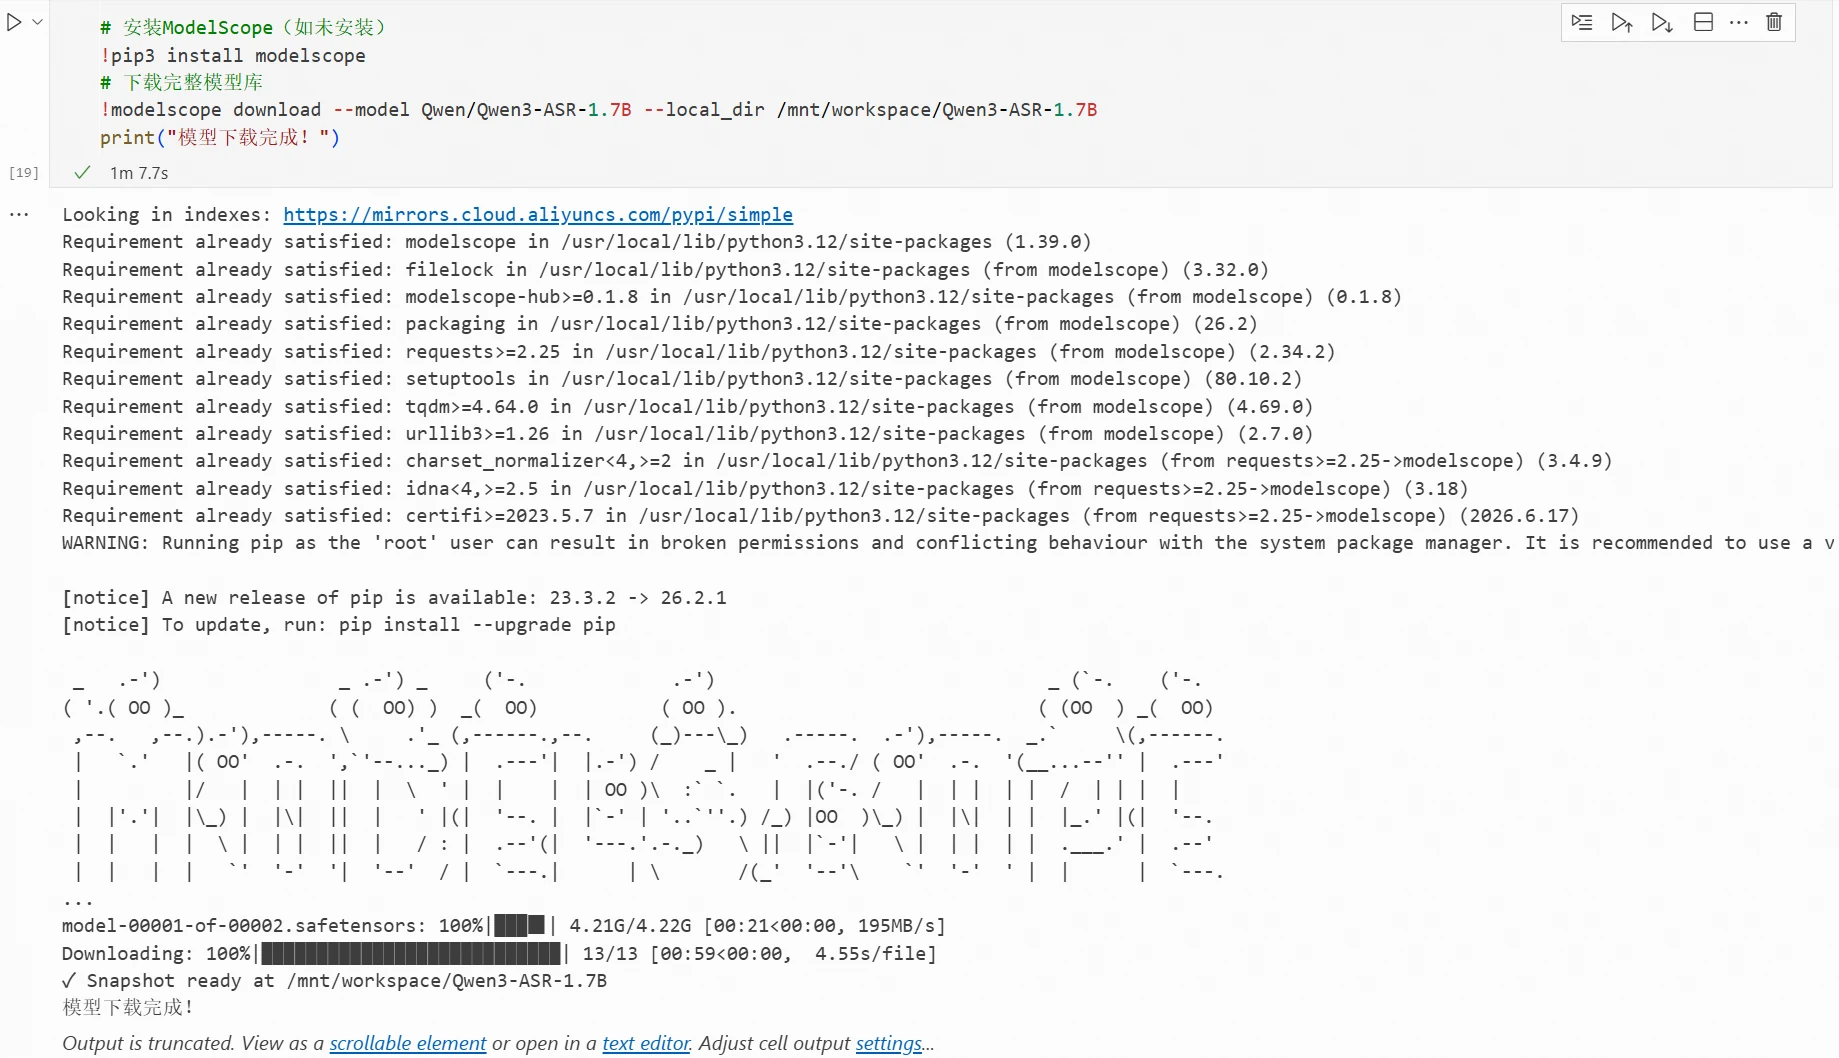
यदि आप मॉडल को अलग से डाउनलोड करना चाहते हैं, तो इस पुस्तक के अनुभाग 2.5 में मॉडल डाउनलोड विधि देखें। उदाहरण के लिए, मॉडल को /mnt/workspace/Qwen3-ASR-1.7B निर्देशिका में डाउनलोड करने के लिए, कमांड-लाइन डाउनलोड को उदाहरण के रूप में लेकर, टर्मिनल में निम्नलिखित कमांड चलाएं:
# ModelScope इंस्टॉल करें (यदि इंस्टॉल नहीं है)
!pip3 install modelscope
# पूर्ण मॉडल रिपॉज़िटरी डाउनलोड करें
!modelscope download --model Qwen/Qwen3-ASR-1.7B --local_dir /mnt/workspace/Qwen3-ASR-1.7B
परिणाम:

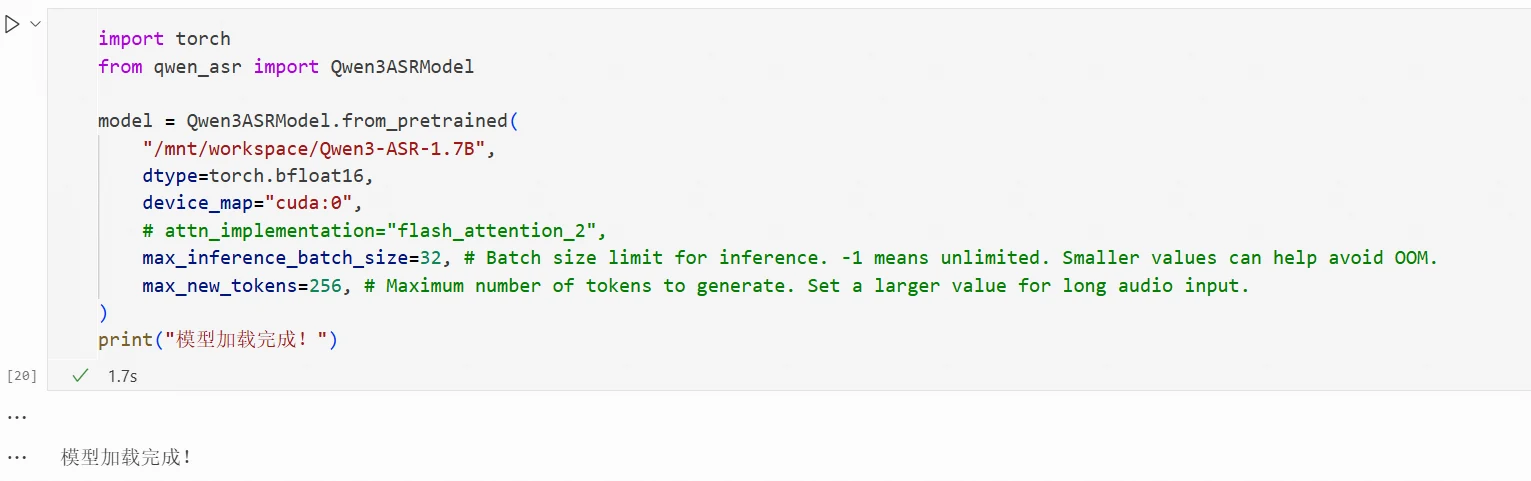
यदि आपके पास मॉडल फ़ाइलें डाउनलोड हो गई हैं, तो आप Qwen/Qwen3-ASR-1.7B को अपने मॉडल पथ से बदल सकते हैं।
import torch
from qwen_asr import Qwen3ASRModel
model = Qwen3ASRModel.from_pretrained(
"/mnt/workspace/Qwen3-ASR-1.7B",
dtype=torch.bfloat16,
device_map="cuda:0",
# attn_implementation="flash_attention_2",
max_inference_batch_size=32, # Batch size limit for inference. -1 means unlimited. Smaller values can help avoid OOM.
max_new_tokens=256, # Maximum number of tokens to generate. Set a larger value for long audio input.
)
print("मॉडल सफलतापूर्वक लोड हो गया!")
परिणाम:

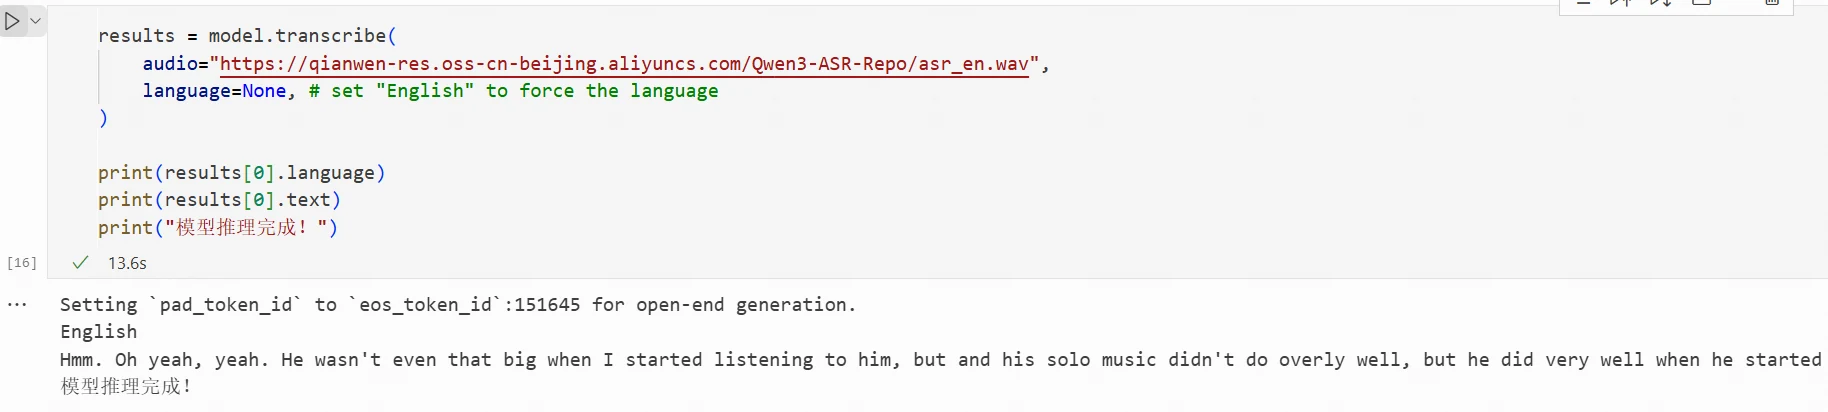
मॉडल लोड होने के बाद, आप मॉडल इन्फ़रेंस के लिए ऑडियो फ़ाइलें पास कर सकते हैं। आप audio मान को अपनी ऑडियो फ़ाइल पथ से बदल सकते हैं।
results = model.transcribe(
audio="https://qianwen-res.oss-cn-beijing.aliyuncs.com/Qwen3-ASR-Repo/asr_en.wav",
language=None, # set "English" to force the language
)
print(results[0].language)
print(results[0].text)
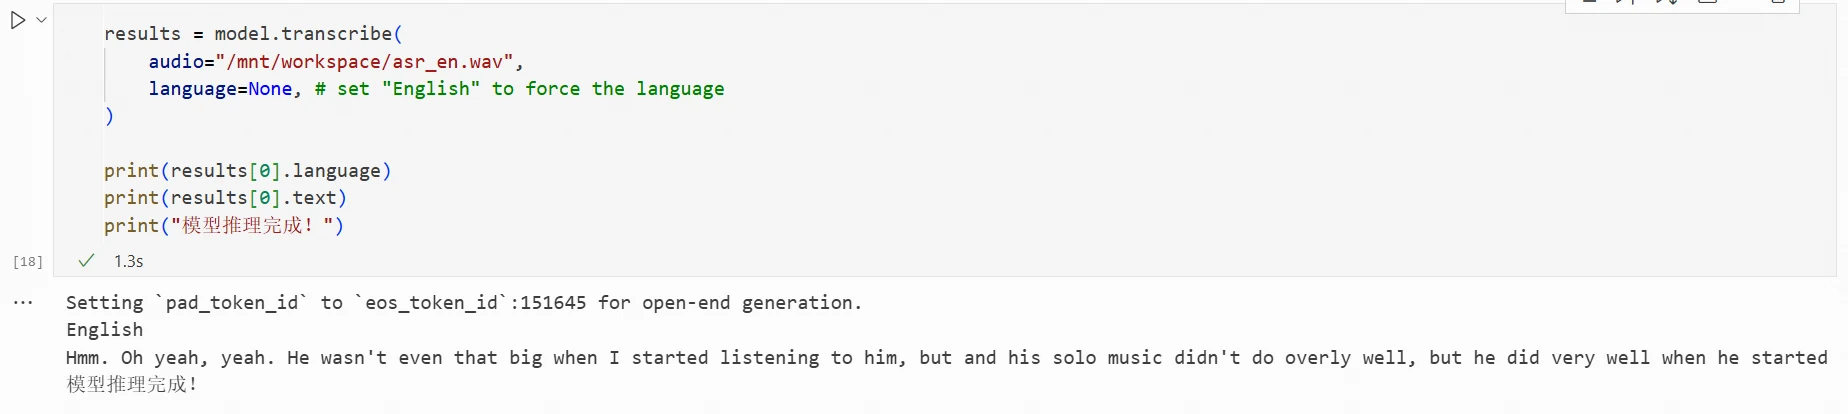
print("मॉडल इन्फ़रेंस पूरा हुआ!")
परिणाम:

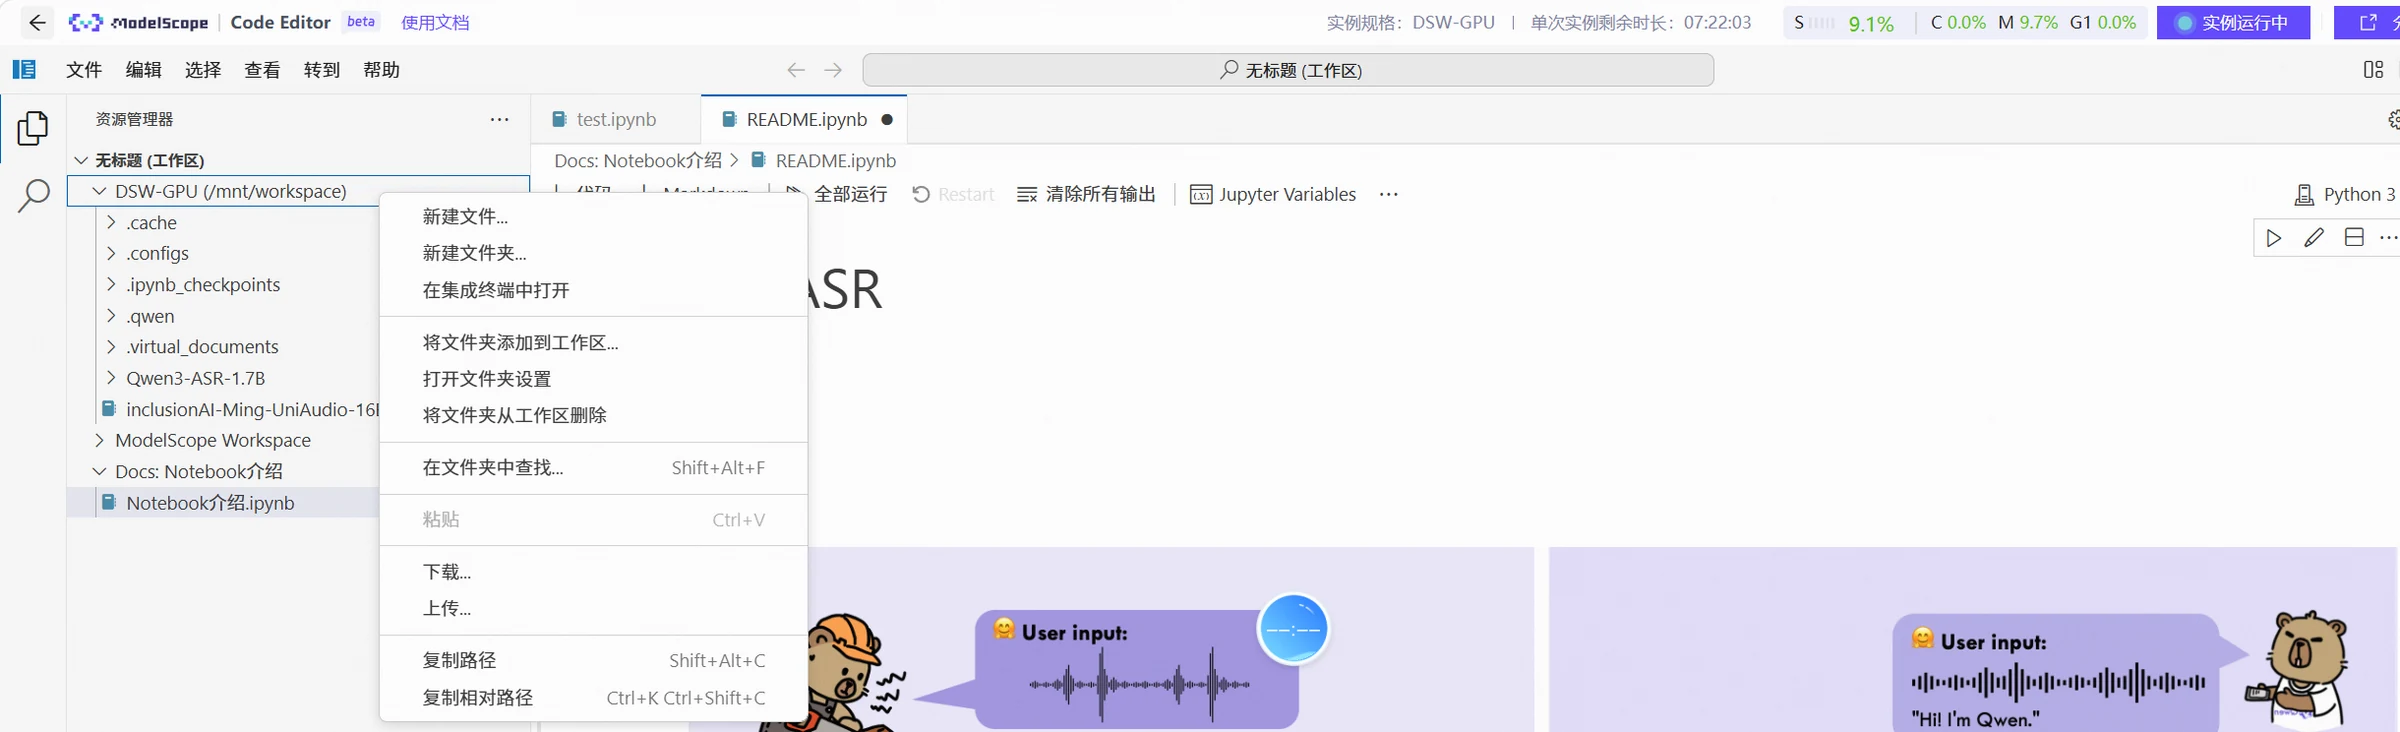
आप मॉडल इन्फ़रेंस के लिए audio मान को अपनी ऑडियो फ़ाइल पथ से बदल सकते हैं। बाईं ओर के वर्कस्पेस में "DSW-GPU" फ़ोल्डर पर राइट-क्लिक करें, "Upload" पर क्लिक करें, अपनी स्थानीय ऑडियो फ़ाइल चुनें, और यह Notebook वातावरण के "DSW-GPU" फ़ोल्डर में अपलोड हो जाएगी।

फिर कोड को इस प्रकार संशोधित करें:
results = model.transcribe(
audio="/mnt/workspace/asr_en.wav",
language=None, # set "English" to force the language
)
print(results[0].language)
print(results[0].text)
print("मॉडल इन्फ़रेंस पूरा हुआ!")
परिणाम:

इस अध्याय का कोड और संबंधित फ़ाइलें यहां देखी जा सकती हैं: https://www.modelscope.cn/gallery/liucong/54c2ca38-b797-43d1-97ab-4b9f569aaa95