Agent Framework Fundamentals
अतिरिक्त: एजेंट फ्रेमवर्क ज्ञान
प्रमुख एजेंट डेवलपमेंट फ्रेमवर्क
जब एजेंट अनुप्रयोग अधिक विस्तृत होते जाते हैं, डेवलपर्स को टूल कॉल, ज्ञान जोड़ने, स्टेट मैनेजमेंट और बहु-एजेंट सहयोग जैसे मुद्दों से निपटना पड़ता है। यदि इन सभी कार्यक्षमताओं को शुरुआत से डिजाइन करना हो, तो यह काफी भारी कार्य बनता है और विभिन्न मोड्यूल के बीच कनेक्शन और ऑपरेशनल नियंत्रण भी जटिल हो जाते हैं।
एजेंट फ्रेमवर्क इन सामान्य क्षमताओं को फैलोवर्ड करते हैं और एजेंट डेवलपमेंट के लिए एक समान अपनाने योग्य विधि प्रदान करते हैं। नीचे कुछ प्रतिनिधि एजेंट डेवलपमेंट फ्रेमवर्कों का वर्णन किया जाता है।
LangChain फ्रेमवर्क
LangChain ने 2022 में लॉन्च किया और बड़े मॉडल अनुप्रयोगों के निर्माण के लिए एक प्रारंभिक ओपन सोर्स फ्रेमवर्क में से एक था। LangChain का प्रारंभिक उपयोग बड़े मॉडल, प्राइमर टूल्स और बाहरी डेटा जैसे कम्पोनेंटों को जोड़ने में था, फिर यह टूल कॉल और एजेंट के लिए विस्तारित हुआ। वर्तमान में, LangChain ने एजेंट को फ्रेमवर्क का एक महत्वपूर्ण हिस्सा बना दिया और मॉडल, टूल, मध्यस्थी आदि कम्पोनेंट प्रदान करता है, जो टूल कॉल क्षमता वाले एजेंट को तेज़ी से बनाने के लिए उपयोगी होता है।
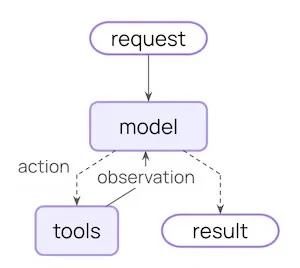
LangChain का केंद्रीय ऑपरेशनल मॉडल बड़े मॉडल और टूल को एक चक्र में बनाता है। बड़ा मॉडल उपयोगकर्ता कार्य को और उपयोग क्षमताओं को लेकर आता है और वर्तमान जानकारी के आधार पर निर्धारित करता है कि क्या परिणाम जमा करेगा, या किसी टूल को कॉल करेगा। यदि टूल कॉल करने का विकल्प चुना जाता है, फ्रेमवर्क उसी टूल को ऑपरेट करता है और टूल के परिणाम को बड़े मॉडल को प्रदान करता है। बड़ा मॉडल नए जानकारी के आधार पर फिर से निर्धारित करता है, जब तक कि टूल कॉल करने की आवश्यकता न बन जाए और अंतिम परिणाम उत्पन्न न किया जाए। ऑफिसियल इस प्रक्रिया को "Agent Loop" कहता है, जिसका नीचे दिया गया चित्र दिखाता है।
उदाहरण के लिए, एक पर्यटन सहायक को आवश्यक टूल जैसे मौसम जुटाने, नक्शा जुटाने और वेब सर्च जैसे टूल सेटअप किया जा सकता है। जब उपयोगकर्ता "मुझे कल शंघाई में एक दिन का दौरा योजना बनाओ" जैसा अनुरोध करता है, तो बड़ा मॉडल निर्यात कार्य को आधार बनाकर ज्ञान और दर्शनिक जानकारी जुटाने के लिए उपयुक्त टूल कॉल करता है, फिर इन परिणामों को जोड़कर यात्रा योजना तैयार करता है।
टूल बाहरी क्षमता को प्राप्त करने का महत्वपूर्ण तरीका है, जो निश्चित इनपुट और आउटपुट वाले कॉल करने योग्य फंक्शन है, जो रियल-टाइम डेटा प्राप्त करने, कोड को चलाने, डाटाबेस खोजने या बाहरी प्रणालियों को संचालित करने के लिए उपयोग किया जा सकता है। डेवलपर्स ने एजेंट को आवश्यक टूल दिए जाने के बाद, बड़ा मॉडल वर्तमान कार्य के आधार पर जब और किस टूल को कॉल करना है, और कॉल करते समय क्या पैरामीटर जरूरी है, यह निर्धारित कर सकता है।
यह कम्पोनेंटाइजेशन लैंगचेन का महत्वपूर्ण विशेषता है। लैंगचेन ने विभिन्न मॉडल और टूल के लिए एक समान इंटरफेस प्रदान किया है, डेवलपर्स इस फ्रेमवर्क में इन कम्पोनेंट्स को एक साथ मिलाने में सक्षम होते हैं, और विभिन्न मॉडल और बाहरी क्षमताओं के बीच कॉल लॉजिक को अलग-अलग रूप से हैंडल नहीं करना पड़ता। इसलिए, यह तेज़ी से टूल कॉल वाले एजेंट बनाने के लिए अच्छा अनुकूल होता है, और इसका उपयोग एजेंट के बुनियादी ऑपरेशनल प्रक्रिया को समझने में शुरुआती डेवलपर्स के लिए अच्छा होता है।
चर्चा
साइन इन करें चर्चा में शामिल हों