पहली बार जब आप बड़े मॉडल को डाउनलोड करने की तैयारी करते हैं, तो मॉडल पेज पर 7B, 32B, 128K और INT4 भ्रमित कर सकते हैं: 7B बताता है कि मॉडल कितना बड़ा है, 128K ऐसा लगता है जैसे यह एक पूरी किताब रख सकता है, और INT4 मॉडल के VRAM उपयोग को कैसे कम कर सकता है? यह कैसे काम करता है?
जब आप वास्तव में मॉडल का उपयोग करना शुरू करते हैं, तो बैठक के मिनट फिट न होने, लंबी बातचीत में पिछले संदर्भ को भूल जाने, मॉडल के जवाब में आधार की कमी और एक ही मॉडल में क्वांटाइजेशन विधि बदलने से प्रभाव बदलने जैसी समस्याओं का सामना करना पड़ेगा।
यह निर्धारित करने के लिए कि कोई मॉडल वर्तमान कार्य के लिए उपयुक्त है या नहीं, आपको यह समझना होगा कि पाठ मॉडल में कैसे प्रवेश करता है, मॉडल की क्षमताएं कैसे प्रशिक्षित होती हैं, और इन्फ़ेरेंस के दौरान मॉडल मेमोरी और VRAM क्यों उपयोग करता है।
इस ज्ञान को तीन मुख्य धाराओं में व्यवस्थित किया जा सकता है: पहली धारा Transformer की समग्र संरचना से शुरू होती है, फिर Token, Embedding और Attention देखती है, यह समझाते हुए कि पाठ मॉडल में कैसे प्रवेश करता है और उसे कैसे संसाधित किया जाता है। दूसरी धारा प्री-ट्रेनिंग, निर्देश फाइन-ट्यूनिंग और पोस्ट-ट्रेनिंग है, यह समझाते हुए कि मॉडल की क्षमताएं कैसे बनती हैं। तीसरी धारा संदर्भ की लंबाई, KV Cache, क्वांटाइजेशन और हार्डवेयर है, जो यह निर्धारित करती है कि मॉडल लक्षित डिवाइस पर स्थिर रूप से चल सकता है या नहीं।
इस अध्याय की सामग्री पिछले संबंधित अध्यायों की सामग्री से बुनियादी ज्ञान का निचोड़ है। उदाहरण के लिए, इस बार उल्लिखित मॉडल इन्फ़ेरेंस से संबंधित सामग्री के लिए छठे और सातवें अध्याय की सामग्री देखी जा सकती है; मॉडल SFT के लिए नौवें अध्याय में उल्लिखित ModelScope के साथ आने वाले ms-swift फाइन-ट्यूनिंग फ्रेमवर्क को देखा जा सकता है; पोस्ट-ट्रेनिंग संबंधी सामग्री के लिए, दसवें अध्याय में उल्लिखित पसंदगी संरेखण और सुदृढ़ीकरण शिक्षण की सामग्री भी देखी जा सकती है। डोमेन मॉडल के अनुप्रयोग और भ्रम की समस्याओं के लिए, तेरहवें अध्याय में उल्लिखित RAG विधि भी देखी जा सकती है, जो बाहरी ज्ञान का उपयोग करके डोमेन-विशिष्ट प्रश्नोत्तर के प्रभाव में सुधार करती है और मॉडल के भ्रम को और कम करती है।
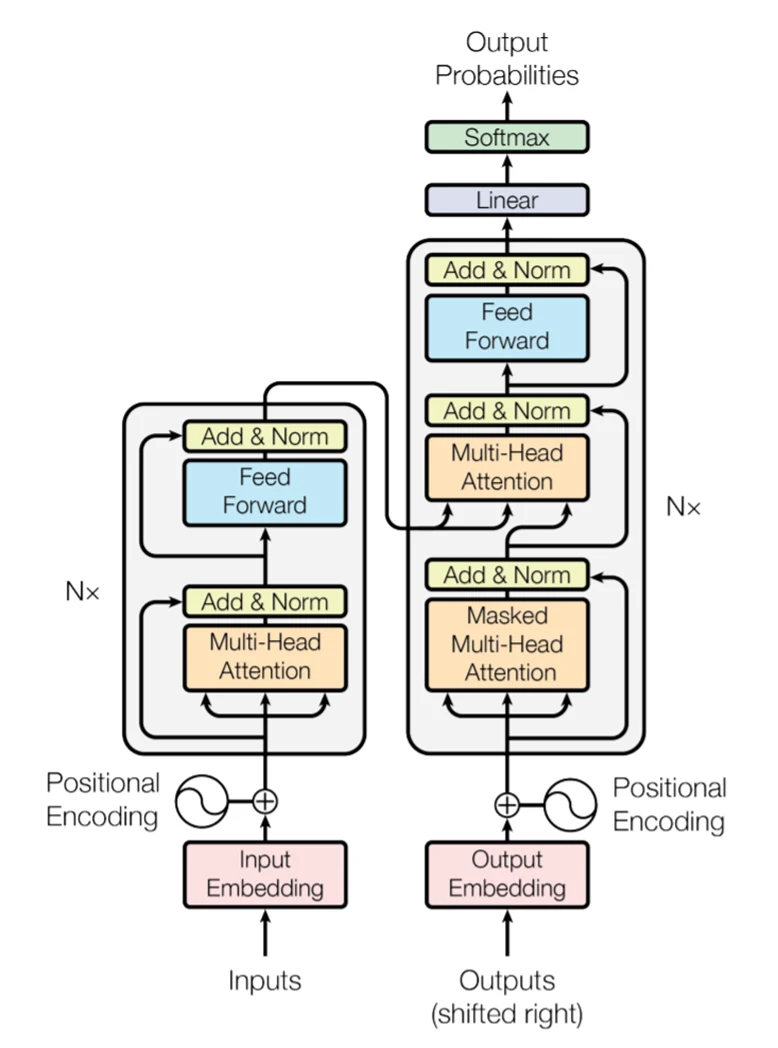
Transformer वर्तमान में अधिकांश बड़े भाषा मॉडल द्वारा उपयोग की जाने वाली बुनियादी वास्तुकला है। प्रारंभिक पुनरावर्ती तंत्रिका नेटवर्क के विपरीत जो पाठ को क्रमिक रूप से संसाधित करते हैं, Transformer प्रशिक्षण और इनपुट प्रसंस्करण चरण के दौरान कई स्थानों की समानांतर गणना कर सकता है, और Attention के माध्यम से विभिन्न स्थानों के बीच संबंध स्थापित करता है। शास्त्रीय Transformer एन्कोडर और डीकोडर से बना होता है। प्रत्येक Transformer परत आमतौर पर Attention और फ़ीड-फ़ॉरवर्ड नेटवर्क शामिल करती है। फ़ीड-फ़ॉरवर्ड नेटवर्क को FFN या MLP भी कहा जाता है, यह प्रत्येक स्थान के वेक्टर पर गैर-रेखीय रूपांतरण लागू करता है। परत में अवशिष्ट कनेक्शन और परत सामान्यीकरण का भी उपयोग किया जाता है, जो गहरे नेटवर्क से स्थिर रूप से जानकारी पास करने में मदद करता है। बहुत सारी समान परतों के स्टैक के बाद, मॉडल धीरे-धीरे जटिल पाठ प्रतिनिधित्व और उत्पादन क्षमता बनाता है। Transformer की समग्र वास्तुकला नीचे दिए गए चित्र में दिखाई गई है, जहाँ बाईं ओर एन्कोडर और दाईं ओर डीकोडर है। चित्र में N× इंगित करता है कि समान मॉड्यूल कई परतों में दोहराए जाएंगे, और वास्तविक परतों की संख्या मॉडल वास्तुकला और पैरामीटर पैमाने के अनुसार बदलती है।
साइन इन करें चर्चा में शामिल हों
जब मॉडल अनुमान लगाता है, तो जब उपयोगकर्ता पाठ दर्ज करता है, तो मॉडल के अंदर निम्नलिखित प्रसंस्करण होता है: बड़े मॉडल पाठ को संसाधित करते समय, सबसे पहले Tokenizer मूल पाठ को टोकन में विभाजित करता है और इसे संगत Token ID में बदलता है; फिर, Embedding परत इन वियोज्य Token ID को निरंतर वेक्टर प्रतिनिधित्व में मैप करती है, साथ ही स्थान जानकारी जोड़ती है ताकि मॉडल को पता चले कि वाक्य में प्रत्येक Token का क्रम क्या है। इसके बाद, ये वेक्टर कई Transformer परतों से गुजरते हैं और बार-बार संसाधित होते हैं, जहाँ Attention तंत्र विभिन्न Token के बीच अंतर-संबंध और संदर्भ जानकारी का आदान-प्रदान करने की अनुमति देता है, जबकि फ़ीड-फ़ॉरवर्ड नेटवर्क प्रत्येक स्थान की विशेषताओं को आगे संसाधित करता है। कई परतों की गणना के बाद, मॉडल वर्तमान संदर्भ का एक समग्र प्रतिनिधित्व प्राप्त करता है, और इसके आधार पर अगले Token की संभाव्यता वितरण की गणना करता है, अगले Token का चयन या नमूना लेता है, इसे संदर्भ में जोड़ता है, और इस प्रक्रिया को पूरी सामग्री के उत्पादन तक दोहराता है।
शास्त्रीय Transformer के तीन हिस्सों के अलग-अलग कार्य हैं:
- एन्कोडर (Encoder-only) संरचना: मुख्य रूप से इनपुट को समझने के लिए जिम्मेदार, एन्कोडर इनपुट अनुक्रम के विभिन्न स्थानों को एक साथ देख सकता है, वर्गीकरण, निकासी और अर्थ प्रतिनिधित्व जैसे कार्यों के लिए उपयुक्त;
- डीकोडर (Decoder-only) संरचना: मुख्य रूप से आउटपुट उत्पन्न करने के लिए जिम्मेदार, वर्तमान स्थान उत्पन्न करते समय केवल पहले से दिखाई देने वाली सामग्री ही देख सकता है;
- एन्कोडर—डीकोडर (Encoder-Decoder) संरचना: पहले इनपुट को समझता है, फिर धीरे-धीरे आउटपुट उत्पन्न करता है, अनुवाद और सारांश जैसे अनुक्रम रूपांतरण कार्यों में सामान्य।
आधुनिक बड़े मॉडल जरूरी नहीं कि पूर्ण एन्कोडर और डीकोडर दोनों का एक साथ उपयोग करें। इस आधार पर, Transformer पर आधारित कई वास्तुकलाएं विकसित हुई हैं, जैसे कि GPT-प्रकार के उत्पादन मॉडल आमतौर पर Decoder-only संरचना का उपयोग करते हैं, BERT-प्रकार के मॉडल मुख्य रूप से Encoder-only का उपयोग करते हैं, जबकि T5-प्रकार के मॉडल Encoder-Decoder संरचना को बनाए रखते हैं।
Token मॉडल द्वारा पाठ पढ़ते और उत्पन्न करते समय उपयोग की जाने वाली बुनियादी इकाई है। यह एक चीनी अक्षर, एक शब्द, शब्द का एक हिस्सा, विराम चिह्न, या यहां तक कि रिक्त स्थान या विशेष नियंत्रण चिह्न भी हो सकता है। उदाहरण के लिए, एक ही वाक्य को विभिन्न Tokenizers में अलग-अलग परिणाम मिल सकते हैं:
मूल पाठ:大型语言模型正在改变办公方式。
टोकनाइज़र अ:大型 / 语言 / 模型 / 正在 / 改变 / 办公 / 方式 / 。
टोकनाइज़र ब:大 / 型 / 语言 / 模型 / 正 / 在 / 改变 / 办公 / 方式 / 。
दोनों परिणाम एक ही वाक्य व्यक्त करते हैं, लेकिन Token की संख्या समान नहीं है। मॉडल वास्तव में जो प्राप्त करता है वह प्रत्येक Token का संगत डिजिटल नंबर है, अर्थात Token ID। बैठक के मिनट के संगठन का उदाहरण लें, तो मॉडल जो देखता है वह पूरी बैठक रिपोर्ट नहीं है, बल्कि Token ID की एक श्रृंखला है। बैठक का नाम, बोलने की सामग्री, समय, विराम चिह्न और आउटपुट आवश्यकताएं सभी Token का उपयोग करती हैं; मॉडल द्वारा उत्पन्न सारांश, निष्कर्ष और कार्य वस्तुएं भी Token का उपयोग जारी रखती हैं। इसलिए, उसी सामग्री से जितना विस्तृत आउटपुट की मांग की जाती है, मूल रिकॉर्ड के लिए जगह उतनी ही कम हो सकती है।
यदि पूरी तरह से अक्षरों से विभाजित किया जाए, तो शब्दकोश तुलनात्मक रूप से छोटा हो सकता है, लेकिन अनुक्रम लंबा हो जाएगा; यदि पूरी तरह से पूर्ण शब्दों से विभाजित किया जाए, तो शब्दकोश बहुत विशाल होगा, और नए शब्दों, संक्षिप्त रूपों और वर्तनी परिवर्तनों से लगातार सामना आएगा। बड़े मॉडल आमतौर पर उप-शब्द टोकननिंग का उपयोग करते हैं, अक्षरों और पूर्ण शब्दों के बीच संतुलन खोजते हैं। BPE, WordPiece, Unigram और SentencePiece सभी सामान्य विधियां हैं。
आमतौर पर, मॉडल पाठ या छवियों पर सीधे मैट्रिक्स ऑपरेशन नहीं कर सकते, इसलिए सामग्री को पहले डिजिटल वेक्टर में बदलना होगा। इस प्रक्रिया को एम्बेडिंग या वेक्टर प्रतिनिधित्व (Embedding) कहा जाता है। पाठ के लिए, टोकनाइज़र (Tokenizer) पहले पाठ को Token ID में बदलता है, और फिर Embedding परत ID के आधार पर संगत वेक्टर ढूंढती है। वेक्टर में एकल संख्या का आमतौर पर सीधा अर्थ नहीं होता, लेकिन पूरा वेक्टर मॉडल के अंदर उस Token की विशेषताओं को दर्शा सकता है। "बैठक" Token का उदाहरण लें, तो संगत Token ID कोई पूर्णांक संख्या हो सकती है, जैसे "15872", और उस Token का संगत प्रतिनिधित्व, अर्थात Embedding, [0.12, -0.37, 0.08, \u2026\u2026] जैसा वेक्टर हो सकता है। Embedding प्रशिक्षण प्रक्रिया में लगातार समायोजित होती है, और समान संदर्भों में दिखने वाले Token के वेक्टर अक्सर कुछ समान विशेषताएं बनाते हैं। मॉडल संरचना और प्रशिक्षण प्रक्रिया में भिन्नता के कारण, एक ही शब्द कई Transformer परतों से गुजरने के बाद संदर्भ के आधार पर अलग-अलग प्रतिनिधित्व भी बनाता है।
जब मॉडल इनपुट पाठ की अर्थ जानकारी प्राप्त करता है, तो न केवल यह जानना होता है कि Token क्या है, बल्कि यह भी जानना होता है कि यह कहां स्थित है। केवल Token Embedding होने पर, "बैठक स्थगित" और "स्थगित बैठक" में समान Token होते हैं, लेकिन शब्द क्रम के अंतर के कारण, अलग-अलग अर्थ व्यक्त करते हैं। इसलिए, मॉडल को स्थान एन्कोडिंग या स्थान प्रतिनिधित्व भी जोड़ना होगा। नीचे दिया गया चित्र BERT के इनपुट परत का उदाहरण दिखाता है।
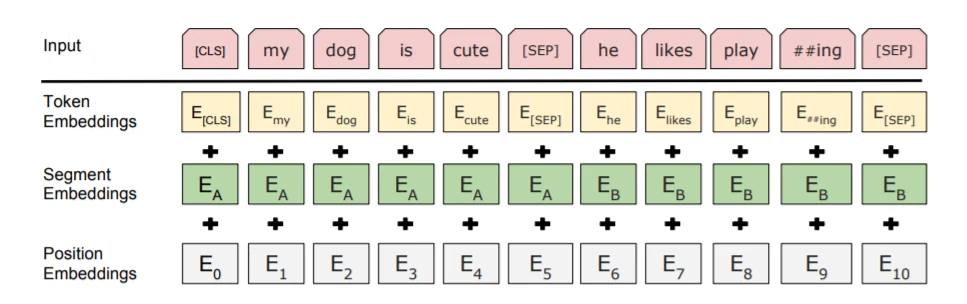
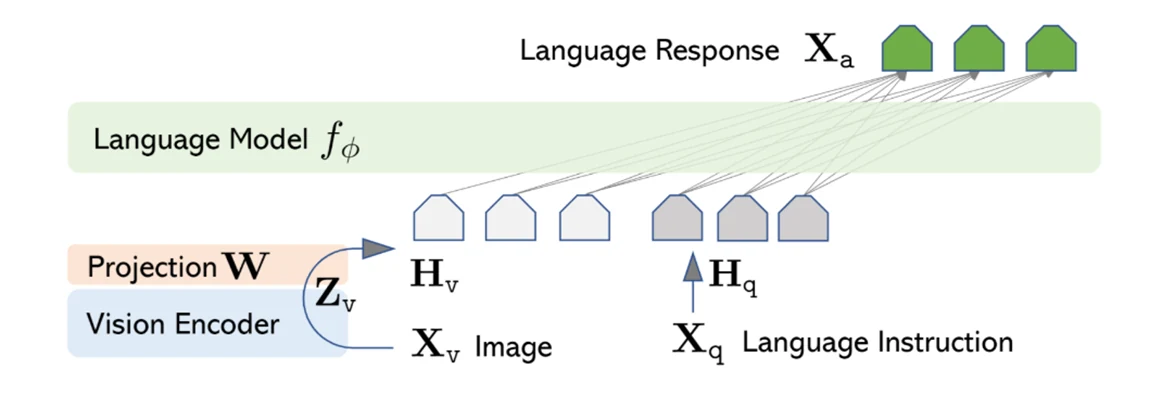
जैसा कि ऊपर दिखाए गए BERT में अपनाए गए प्रतिनिधित्व तरीके में दिखाया गया है, यह Token Embedding, Segment Embedding और Position Embedding के संयोजन का प्रदर्शन करता है। बेशक, विभिन्न मॉडल संरचनाओं और डिज़ाइन तरीकों में अपनाई गई विशिष्ट योजनाएं पूरी तरह से समान नहीं हैं। बहुमोडल बड़े मॉडल का उदाहरण लें, तो छवियों, ऑडियो और अन्य सामग्री को भी पहले वेक्टर में बदलना होगा। छवियों को आमतौर पर पहले छवि ब्लॉकों में काटा जाता है, और दृश्य एन्कोडर विशेषताएं निकालता है; ऑडियो को पहले ध्वनिक विशेषताओं में बदला जाता है, और फिर ऑडियो एन्कोडर इसे संसाधित करता है। विभिन्न मोडैलिटी की विशेषताओं को प्रोजेक्शन या कनेक्शन मॉड्यूल (Projection) से गुजरने के बाद ही बड़े मॉडल द्वारा संसाधित किए जा सकने वाले वेक्टर स्थान में प्रवेश किया जा सकता है। नीचे दिए गए चित्र में दिखाया गया है कि कनेक्शन मॉड्यूल के माध्यम से छवि जानकारी और अर्थ जानकारी को कैसे मिलाया जाता है।
Attention यह निर्धारित करता है कि वर्तमान स्थान को इनपुट के किस हिस्से पर ध्यान केंद्रित करना चाहिए। यह मॉडल द्वारा बनाए गए वेक्टर प्रतिनिधित्वों पर संबंधता की गणना करता है, न कि केवल समान शब्दों की खोज करता है। उदाहरण के लिए, "परियोजना में देरी हुई, रिपोर्ट ने समझाया कि यह समय पर क्यों पूरा नहीं हुआ" वाक्य में, जब मॉडल "यह" सर्वनाम को संसाधित करता है, तो उसे संदर्भ के आधार पर यह निर्धारित करना होता है कि यह "परियोजना" को दर्शाता है या "रिपोर्ट" को। बैठक के मिनट में जिम्मेदार व्यक्ति को निकालते समय, मॉडल को कार्य विवरण, व्यक्ति का नाम और कार्य विभाजन को दर्शाने वाले वाक्यों को भी जोड़ना होता है।
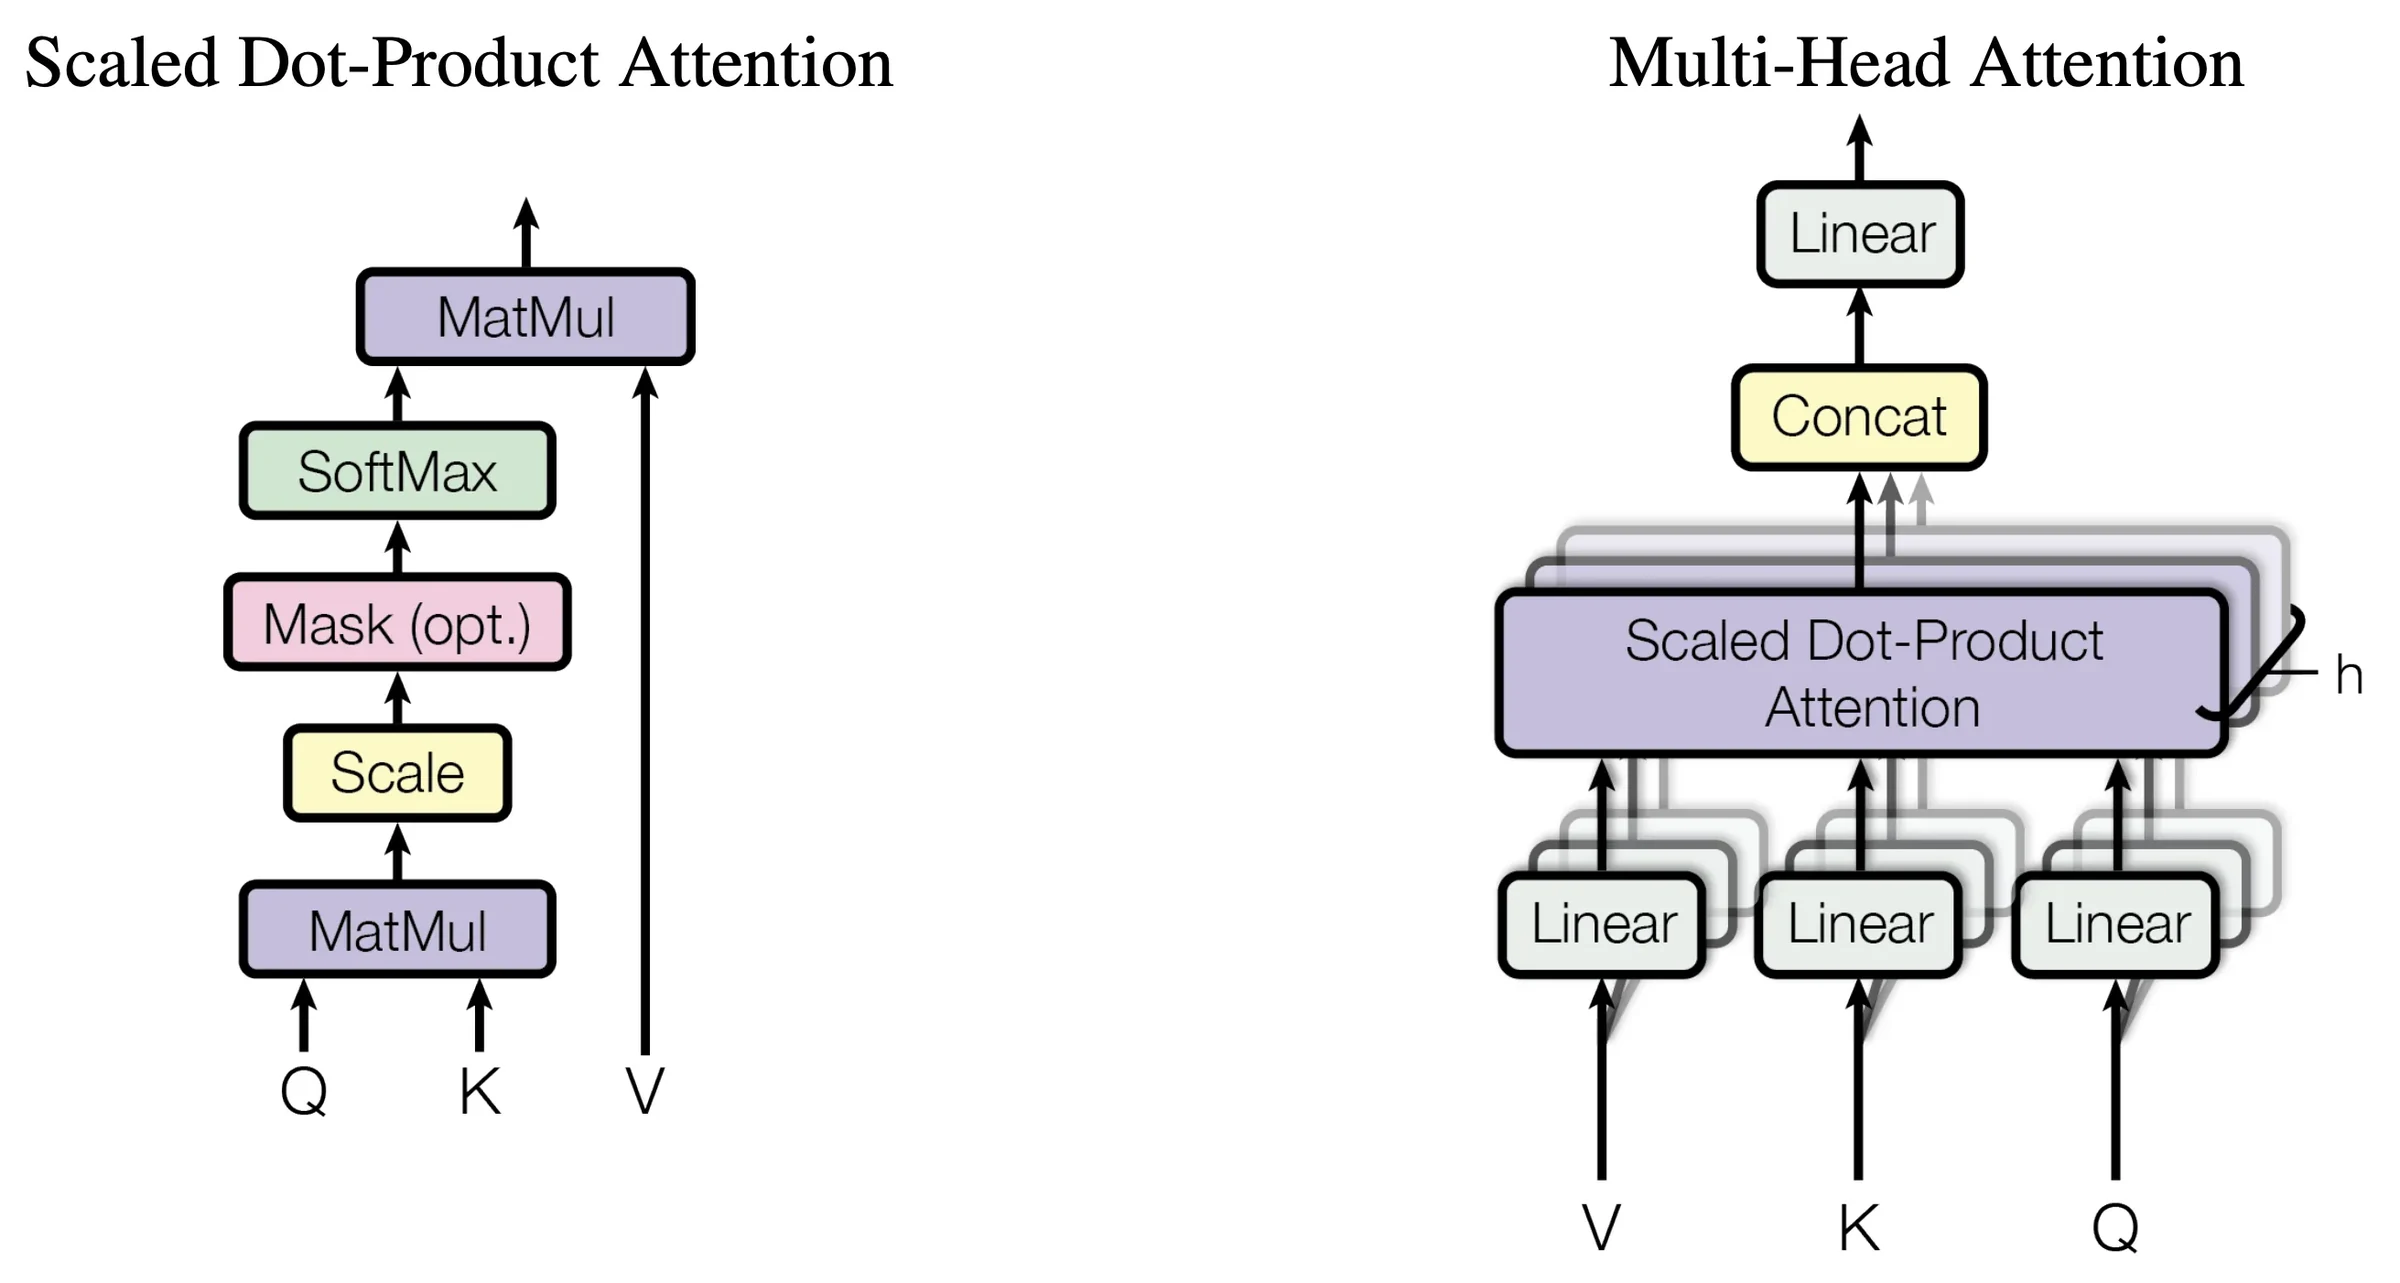
प्रत्येक इनपुट वेक्टर विभिन्न रूपांतरणों से गुजरता है और Query, Key और Value बनाता है, जिन्हें आमतौर पर Q, K और V से संक्षिप्त किया जाता है। Attention की गणना सूत्र को इस प्रकार सरल किया जा सकता है:
$\mathrm{Attention}(Q, K, V)=\mathrm{softmax}\left(\frac{QK^{\mathrm{T}}}{\sqrt{d_k}}\right)V$
जहाँ, Q इंगित करता है कि वर्तमान स्थान किस जानकारी की खोज कर रहा है, K इंगित करता है कि प्रत्येक स्थान किन विशेषताओं से मिलाया जा सकता है, और V उस सामग्री को दर्शाता है जिसे मिलाने के बाद प्राप्त करने की आवश्यकता है। मॉडल पहले Q और K की तुलना करता है, वर्तमान स्थान और अन्य स्थानों के बीच संबंधता स्कोर प्राप्त करता है; फिर softmax के माध्यम से स्कोर को वजन में बदलता है, और वजन के अनुसार V का भारित संकलन करता है। सूत्र में $d_k$ Key वेक्टर का आयाम है, और इसे $\sqrt{d_k}$ से विभाजित करना स्कोर के पैमाने को समायोजित करने के लिए है ताकि गणना अधिक स्थिर हो सके।
यदि Q, K, V एक ही अनुक्रम से आते हैं, तो इसे स्व-ध्यान (Self-Attention) कहा जाता है, जो अनुक्रम के आंतरिक संबंध स्थापित करने के लिए उपयोग किया जाता है; यदि Q एक अनुक्रम से आता है और K, V दूसरे अनुक्रम से आते हैं, तो इसे क्रॉस-ध्यान (Cross-Attention) कहा जाता है। उदाहरण के लिए, एन्कोडर—डीकोडर अनुवाद मॉडल डीकोडर को क्रॉस-ध्यान के माध्यम से एन्कोडर द्वारा प्रदान की गई मूल जानकारी पढ़ने की अनुमति दे सकता है।
उत्पादन-प्रकार के बड़े मॉडलों के लिए, वर्तमान स्थान केवल पहले से दिखाई देने वाली सामग्री को ही देख सकता है, इसलिए Attention में बाद के स्थानों को ब्लॉक करने के लिए कारण मास्क जोड़ना होगा। भविष्य के Token को ब्लॉक करने के बावजूद, पूर्ण कारण ध्यान द्वारा संसाधित संबंधों की संख्या अनुक्रम लंबाई के साथ वर्गानुपाती रूप से बढ़ती रहती है। इसके अलावा, उत्पादन चरण में ऐतिहासिक Token के K और V को भी सहेजना होता है, जो बाद में समझाए गए KV Cache बनाते हैं। संदर्भ बढ़ने के साथ, Attention की गणना और कैश की लागत तेजी से बढ़ती जाती है, और नीचे वर्णित विभिन्न संरचनाएं इन समस्याओं के चारों ओर धीरे-धीरे विकसित हुई हैं।
Multi-Head Attention (MHA) 2017 के Transformer पेपर "Attention Is All You Need" में प्रस्तावित किया गया था, और बाद में BERT और Llama 2 7B, 13B जैसे मॉडलों में लागू किया गया। यह एकल ध्यान गणना के आधार पर कई समानांतर ध्यान हेड जोड़ता है, जिससे मॉडल विभिन्न प्रतिनिधित्व स्थानों से संदर्भ संबंध निकाल सकता है।
MHA में, प्रत्येक हेड के पास Q, K, V उत्पन्न करने के लिए अपनी प्रक्षेपण मापदंड होते हैं, ध्यान की अलग-अलग गणना करते हैं, और फिर सभी हेड के परिणामों को जोड़कर रैखिक परत के माध्यम से आउटपुट बनाते हैं। नीचे दिए गए चित्र में, बाईं ओर स्केल्ड डॉट-प्रोडक्ट ध्यान की एक समूह की गणना प्रक्रिया दिखाई गई है, और दाईं ओर इस प्रक्रिया को कई बार समानांतर में निष्पादित किया जाता है, फिर परिणामों का विलय किया जाता है। विभिन्न हेड के ध्यान पैटर्न प्रशिक्षण से बनते हैं, और संदर्भ निर्धारण, अर्थ संबंध और दूरस्थ निर्भरता जैसे कार्यों का समर्थन कर सकते हैं।
MHA ने मॉडल की विभिन्न प्रकार की जानकारी को एकत्रित करने की क्षमता में सुधार किया है, और प्रशिक्षण के दौरान समानांतर गणना को भी सरल बनाया है। हालांकि, टोकन-दर-टोकन उत्पादन के दौरान, प्रत्येक हेड को अपना ऐतिहासिक K, V पढ़ना होता है। मॉडल की परतों, हेड की संख्या और संदर्भ लंबाई में वृद्धि के साथ, यह कैश और डेटा पढ़ना बड़ी मात्रा में संसाधनों का उपयोग करता है। इसलिए, बाद के सुधार में पहले यह देखा गया कि क्या कई Query हेड को बनाए रखते हुए सहेजे जाने वाले Key हेड और Value हेड की संख्या को कम किया जा सकता है।
Multi-Query Attention (MQA) Noam Shazeer द्वारा 2019 के पेपर "Fast Transformer Decoding: One Write-Head is All You Need" में प्रस्तावित किया गया था, और बाद में Falcon-7B जैसे बड़े मॉडलों में लागू किया गया। यह मुख्य रूप से डीकोडिंग चरण में मेमोरी बैंडविड्थ की समस्या को संबोधित करता है: जब मॉडल प्रत्येक नए Token का उत्पादन करता है, तो उसे मौजूदा KV Cache पढ़ना होता है, और यदि पढ़ने की मात्रा बहुत अधिक होती है, तो उत्पादन गति प्रभावित होती है भले ही गणना इकाइयों में अतिरिक्त क्षमता हो।
MQA कई Query हेड बनाए रखता है, लेकिन उन्हें Key और Value के एक सेट को साझा करने देता है। इस तरह, विभिन्न हेड अभी भी अलग-अलग प्रश्न उत्पन्न कर सकते हैं, लेकिन ऐतिहासिक स्थानों को केवल एक साझा K, V को सहेजना होता है। नीचे दिए गए चित्र में मौजूदा MHA मॉडल को MQA में बदलने की एक इनिशियलाइज़ेशन विधि दिखाई गई है: कई Key प्रक्षेपण मैट्रिक्स का औसत निकालकर एक साझा प्रक्षेपण प्राप्त किया जाता है, और Value प्रक्षेपण को भी इसी तरह से संभाला जा सकता है; रूपांतरण के बाद, मॉडल को नई साझा संरचना के अनुकूल बनाने के लिए प्रशिक्षण जारी रखना होता है।
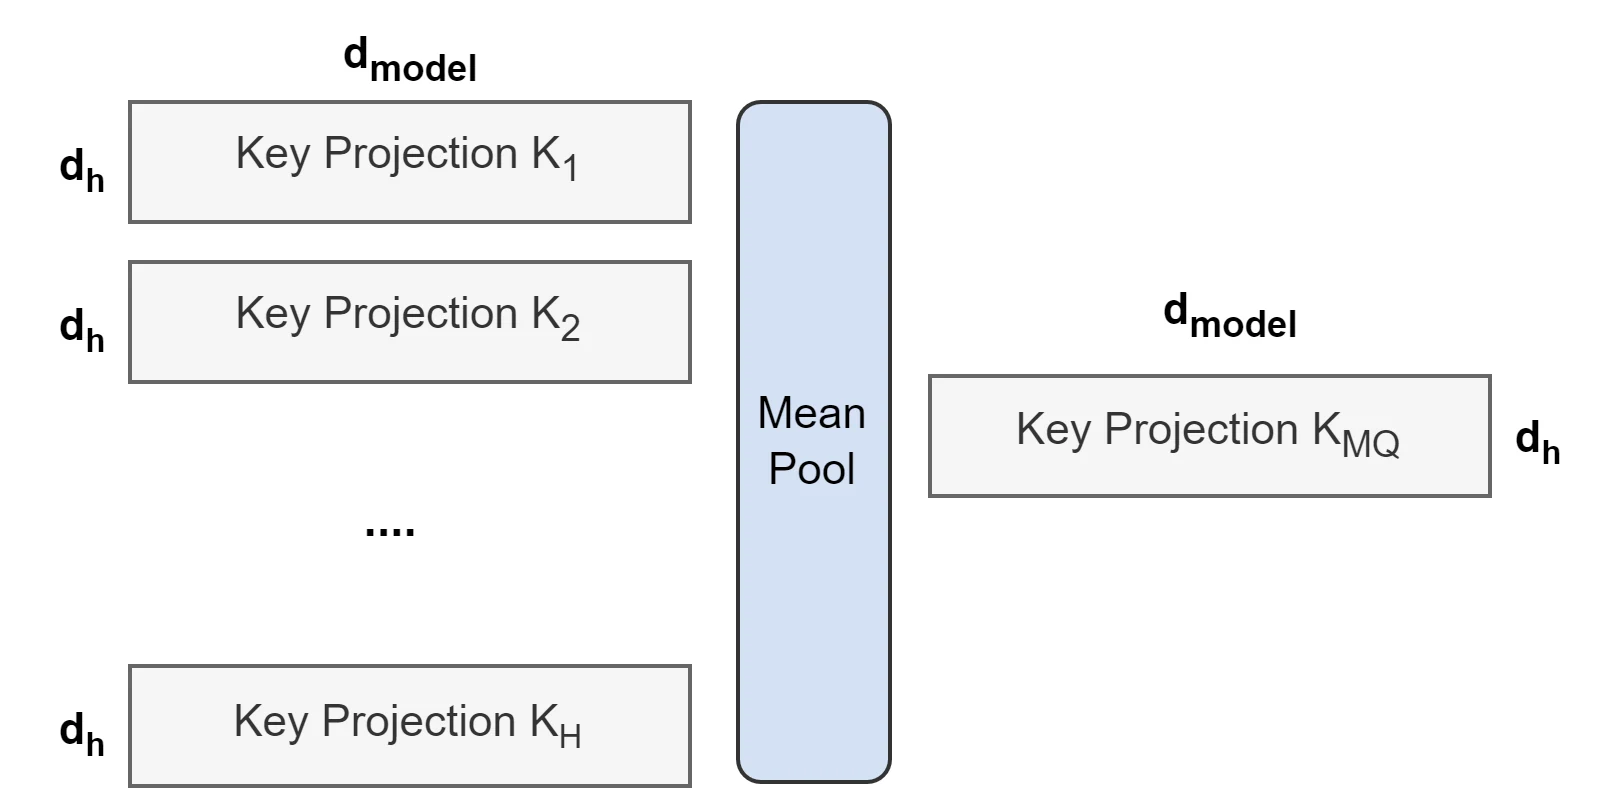
इस संरचना को अपनाने के बाद, MQA KV Cache और प्रत्येक चरण के डीकोडिंग में डेटा पढ़ने की मात्रा को काफी कम कर सकता है, जिससे लंबे इनपुट या अधिक समानांतर अनुरोधों के लिए जगह खाली हो जाती है। उदाहरण के लिए, Falcon-7B में 71 Query हेड हैं, लेकिन केवल 1 KV हेड है। समान हेड आयाम और समान सटीकता वाले 71 KV संरचना की तुलना में, इसका सैद्धांतिक KV Cache लगभग एक-सत्तरहवां है। साझाकरण K, V की प्रतिनिधित्व क्षमता को भी सीमित करता है, इसलिए प्रशिक्षण और मूल्यांकन के माध्यम से इस दक्षता लाभ का कार्य गुणवत्ता पर प्रभाव की पुष्टि करनी होती है।
Grouped-Query Attention (GQA) Google Research टीम द्वारा 2023 के GQA पेपर में व्यवस्थित रूप से प्रस्तावित किया गया था, और Llama 2 70B, Mistral 7B जैसे बड़े मॉडलों में लागू किया गया। यह MHA की बहु-समूह प्रतिनिधित्व क्षमता और MQA की कम कैश लागत के बीच संतुलन बनाने का प्रयास करता है, और सभी Query हेड को एक ही K, V सेट का उपयोग करने से रोकता है।
GQA Query हेड को कई समूहों में विभाजित करता है, प्रत्येक समूह Key और Value के एक सेट को साझा करता है, और विभिन्न समूह अलग-अलग K, V प्रतिनिधित्व बनाए रखते हैं। नीचे दिए गए चित्र में, MHA प्रत्येक Query हेड के लिए संगत K, V निर्धारित करता है, MQA सभी Query हेड को एक सेट K, V साझा करने देता है, और GQA समूह के भीतर साझा करता है। जब समूहों की संख्या Query हेड की संख्या के बराबर होती है, तो GQA MHA के समान होता है; जब केवल एक समूह होता है, तो यह MQA के समान होता है।
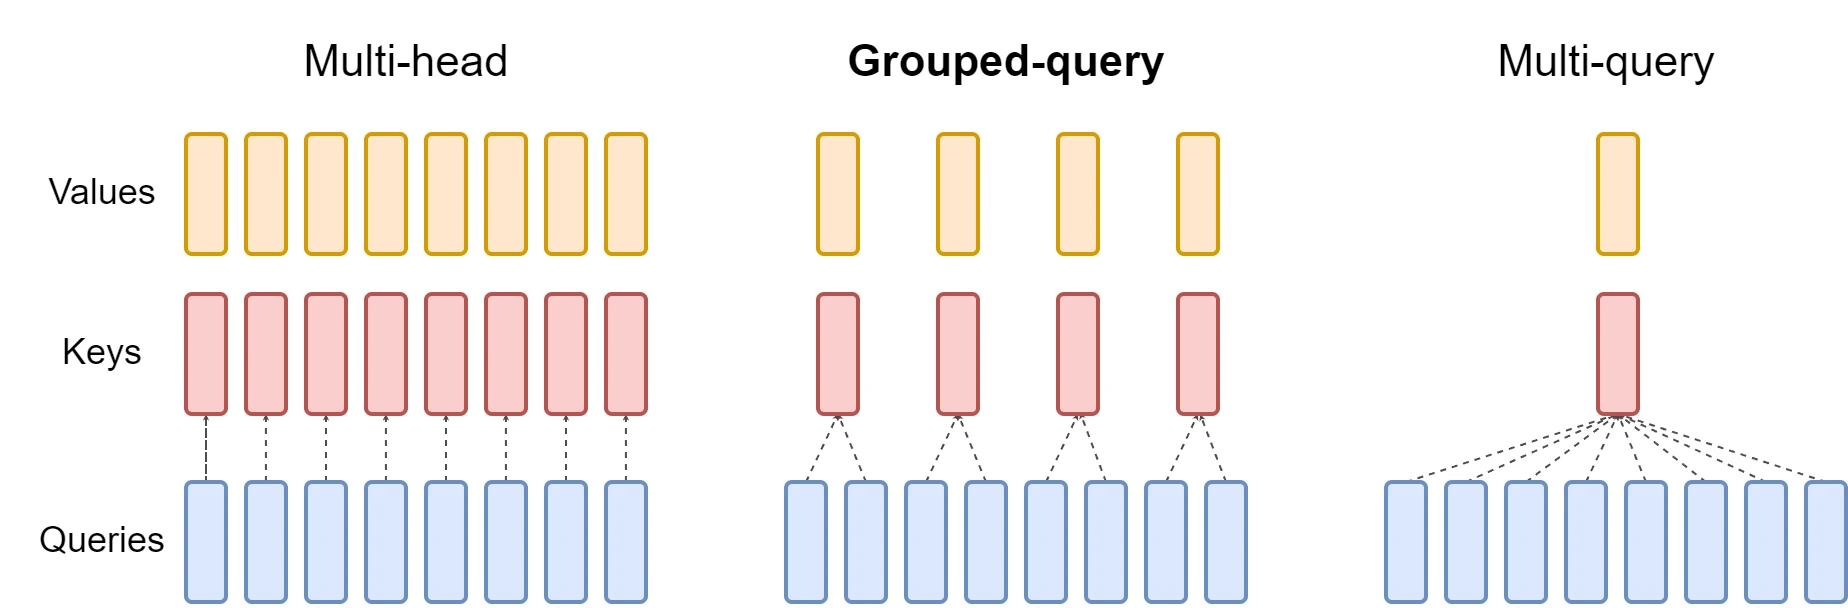
Mistral 7B v0.1 का उदाहरण लें, इसमें 32 Query हेड और 8 KV हेड हैं, और प्रत्येक 4 Query हेड एक सेट K, V को साझा करते हैं। समान हेड आयाम और समान सटीकता की स्थिति में, यह कैश MHA का लगभग एक-चौथाई है। वास्तविक तैनाती के लिए, कैश और पढ़ने की मात्रा में कमी आमतौर पर समानांतर क्षमता और डीकोडिंग दक्षता में सुधार के लिए फायदेमंद है; विभिन्न समूहों द्वारा अपने-अपने K, V बनाए रखने के कारण, GQA पूरी तरह से साझा करने वाले MQA की तुलना में अधिक प्रतिनिधित्व स्थान बनाए रखता है। जो कम होता है वह KV हेड की संख्या है, और मॉडल अभी भी पहुंच की अनुमति दी गई सभी ऐतिहासिक स्थानों पर ध्यान की गणना कर सकता है।
Sliding Window Attention (SWA) लंबे अनुक्रम मॉडलिंग में स्थानीय ध्यान के विचार से आता है, और Mistral 7B v0.1 में GQA के साथ इसका उपयोग किया जाता है। GQA प्रत्येक स्थान पर सहेजे जाने वाले KV हेड की संख्या को कम करता है, जबकि SWA प्रत्येक स्थान द्वारा सीधे देखे जा सकने वाले ऐतिहासिक दायरे को और सीमित करता है, ताकि लंबे पाठ की गणना और कैश दबाव को कम किया जा सके।
SWA प्रत्येक Token के लिए एक निश्चित आकार की विंडो सेट करता है, और केवल विंडो के भीतर के हाल के स्थानों पर ध्यान की गणना करता है। नीचे दिए गए चित्र में बाईं ओर पूर्ण कारण ध्यान है, बीच में स्लाइडिंग विंडो ध्यान है, और दाईं ओर यह दर्शाता है कि जानकारी कैसे कई नेटवर्क परतों से पीछे की ओर पास होती है। यद्यपि एकल परत केवल स्थानीय दायरा पढ़ती है, पिछली परत का Token प्रतिनिधित्व पहले से ही पुराने संदर्भ जानकारी शामिल करता है, इसलिए मॉडल कई परतों की प्रसंस्करण के बाद विंडो के बाहर की सामग्री का अप्रत्यक्ष रूप से उपयोग कर सकता है।
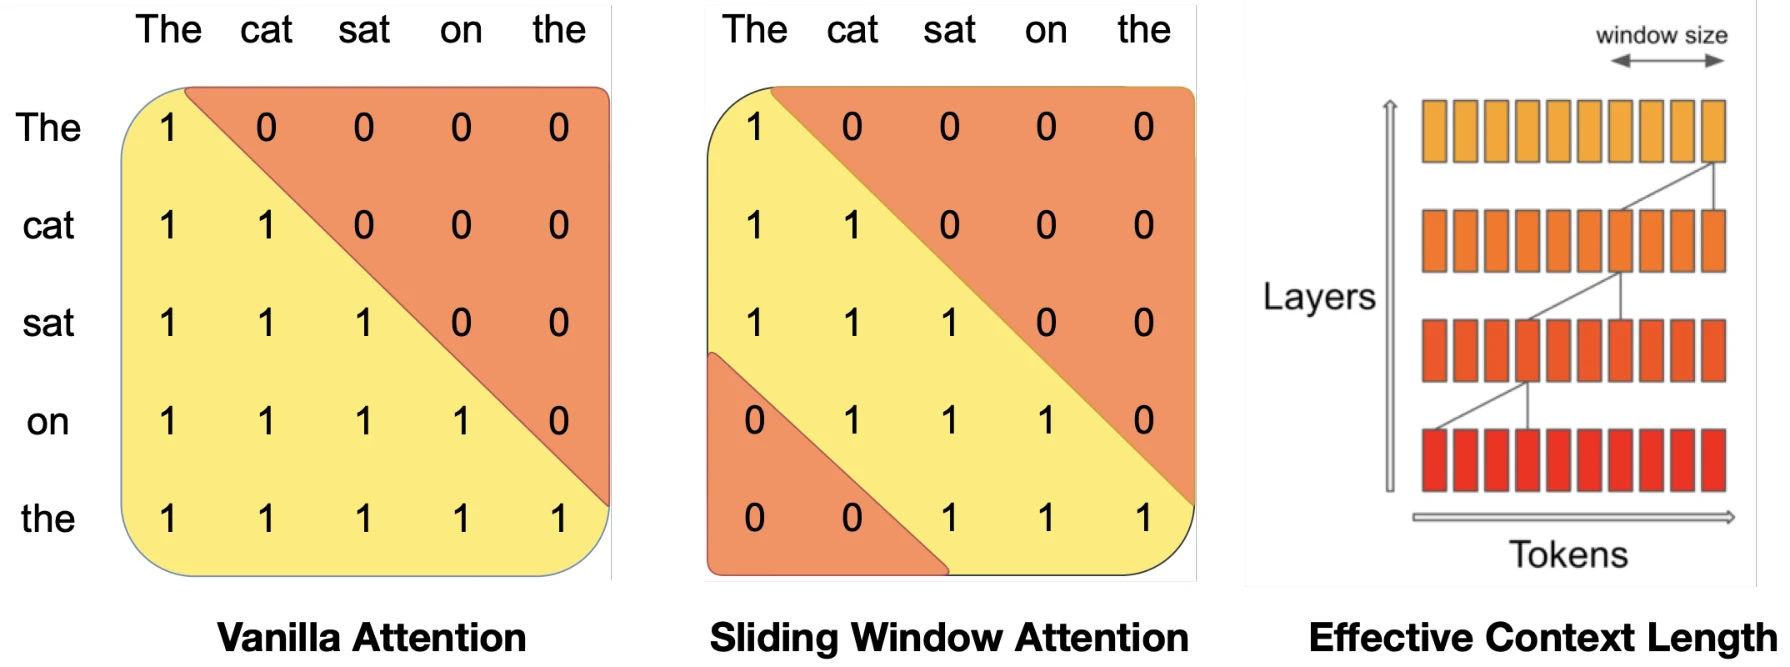
Mistral 7B v0.1 4096 Token की विंडो का उपयोग करता है, और विंडो से बाहर निकल चुके पुराने K, V को कवर करने के लिए रोलिंग कैश का उपयोग करता है, ताकि सभी परतों का कैश एक निश्चित सीमा में बना रहे। पेपर ने 16K अनुक्रम, 4096 विंडो के परीक्षण में बताया कि संबंधित कर्नेल अनुकूलन के बाद, गति पूर्ण ध्यान बेसलाइन की लगभग दोगुनी है। यह संरचना लंबे पाठ के संसाधन विकास को नियंत्रित कर सकती है, लेकिन दूर की मूल विवरणों को मध्यवर्ती प्रतिनिधित्वों से गुजरना होता है, इसलिए स्थानीय विंडो का आकार सीधे मॉडल द्वारा सटीक रूप से पुनर्प्राप्त किए जा सकने वाले संदर्भ लंबाई के बराबर नहीं माना जा सकता।
Multi-head Latent Attention (MLA) DeepSeek टीम द्वारा DeepSeek-V2 में प्रस्तावित किया गया था, और बाद में DeepSeek-V3 में भी उपयोग किया गया। यह भी KV Cache बहुत बड़ा होने की समस्या को संबोधित करता है, लेकिन कैश के संरक्षण के रूप को और बदल देता है: एक संकुचित संयुक्त प्रतिनिधित्व सीखकर, प्रत्येक Token द्वारा सहेजे जाने वाले डेटा को कम करता है।
विशिष्ट रूप से, MLA पहले रैंक-कम प्रक्षेपण का उपयोग करके K और V को कम आयामी लेटेंट वेक्टर में संयुक्त रूप से प्रस्तुत करता है। नीचे दिए गए चित्र में तिरछा क्षेत्र उनो दर्शा दर्शा करता है।
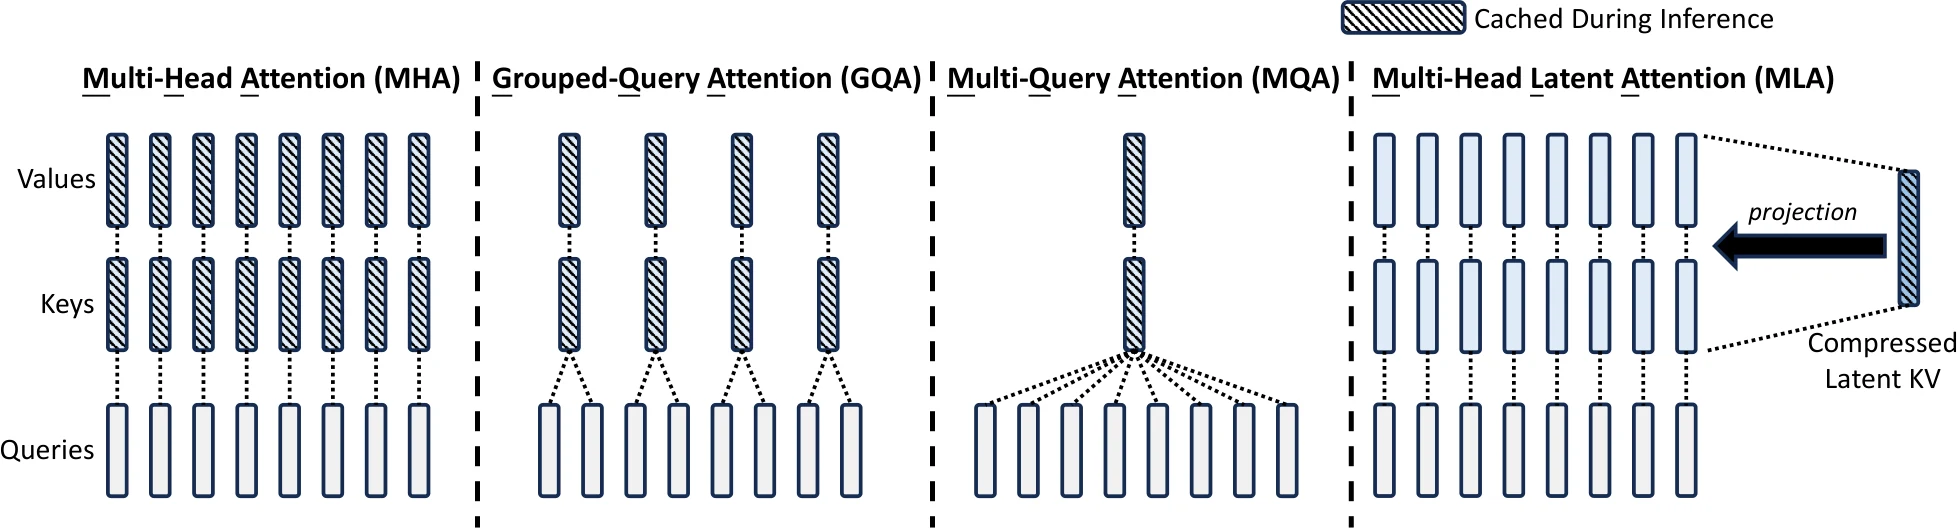
यह डिज़ाइज DeepSeek-V2, V3 को बहु-हेड अभिव्यक्ति क्षमता बनाए रखने की अनुमति देता है। MLA के प्रत्येक Token का KV Cache पैमाना केवल 2.25 सेट KV हेड वाले GQA के बराबर है।
DeepSeek Sparse Attention (DSA) DeepSeek टीम द्वारा प्रस्तावित किया गया था, और DeepSeek-V3.2 में लागू किया गया। यह MLA के आधार पर गतिशील चयन तंत्र जोडता है।
DSA पहले हल्के वज़न के इंडेक्सर Lightning Indexer का उपयोग करके वर्तमान Query और ऐतिहासिक Token के बीच संबंधता स्कोर की गणना करता है।
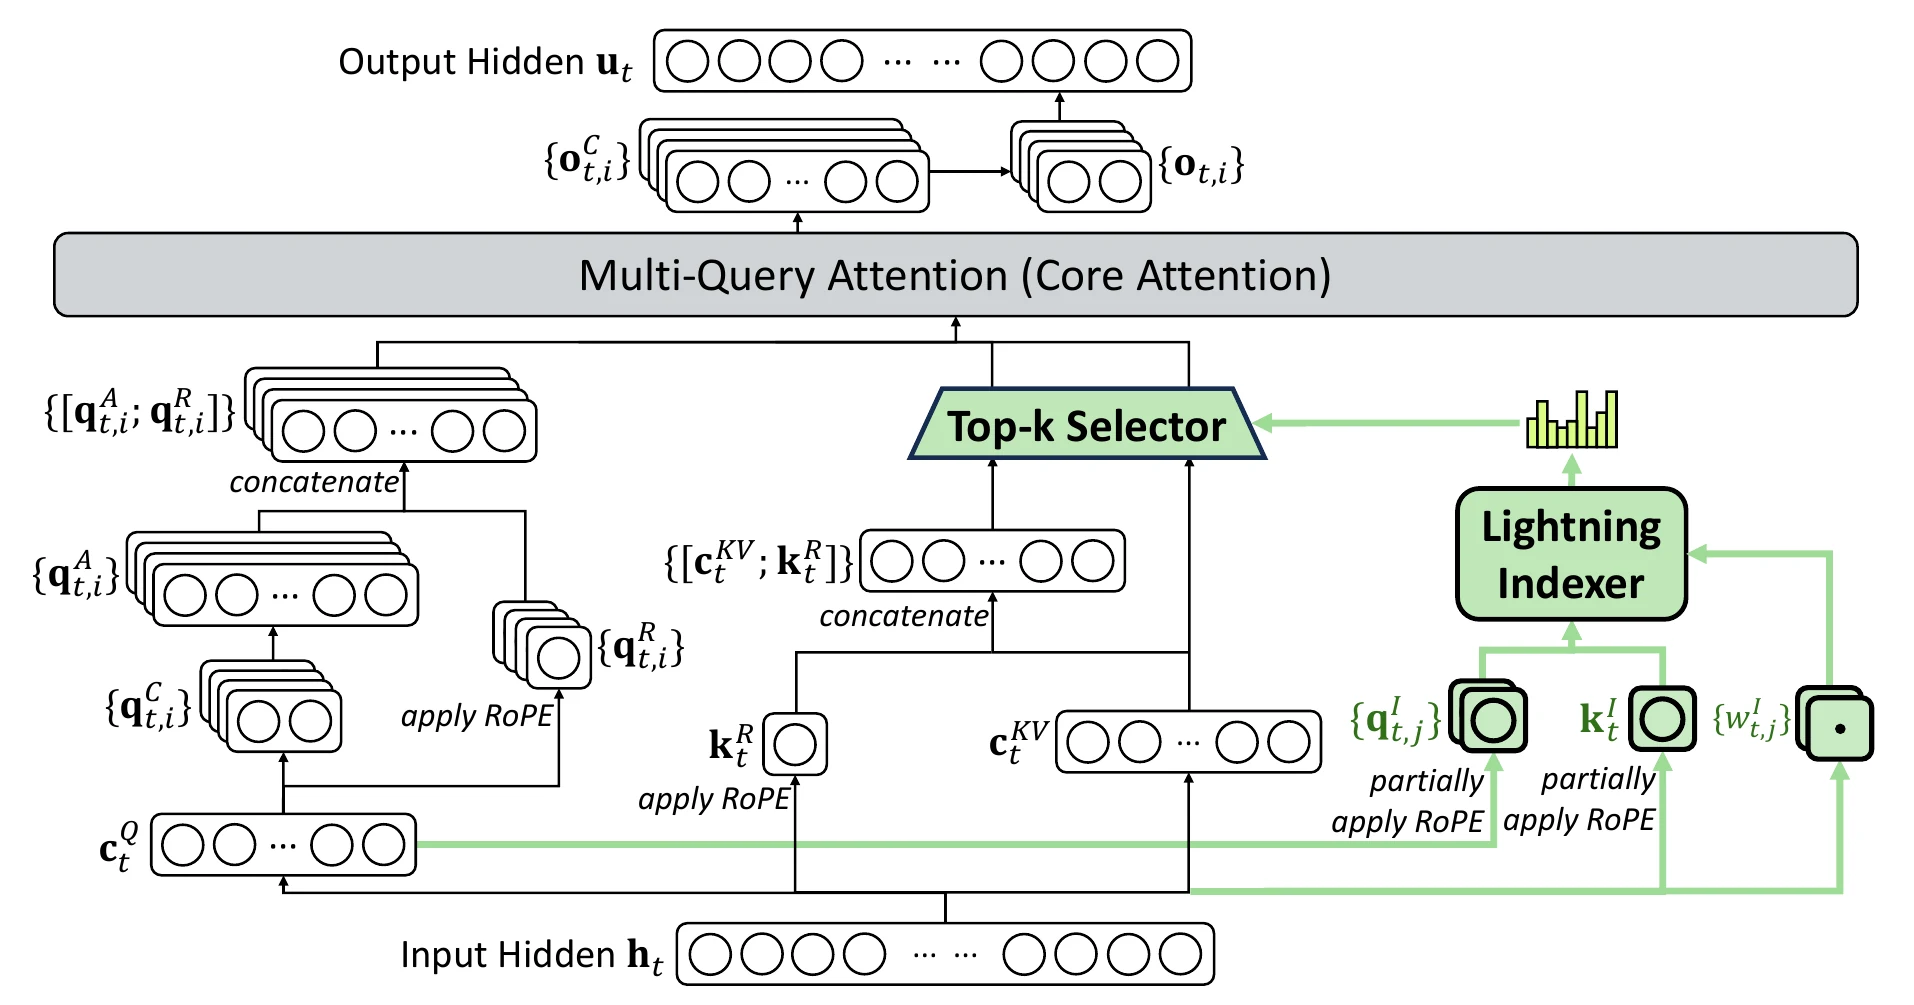
DeepSeek-V3.2 रिपोर्ट में विन्यास यह है कि प्रत्येक Query अधिकतम 2048 KV प्रविष्टियां चुन सकता है।
MiniMax Sparse Attention (MSA) MiniMax टीम द्वारा प्रस्तावित किया गया था। यह दस लाख Token संदर्भ में दक्षता की समस्याओं को संबोधित करता है।
MSA GQA के आधार पर बना है।
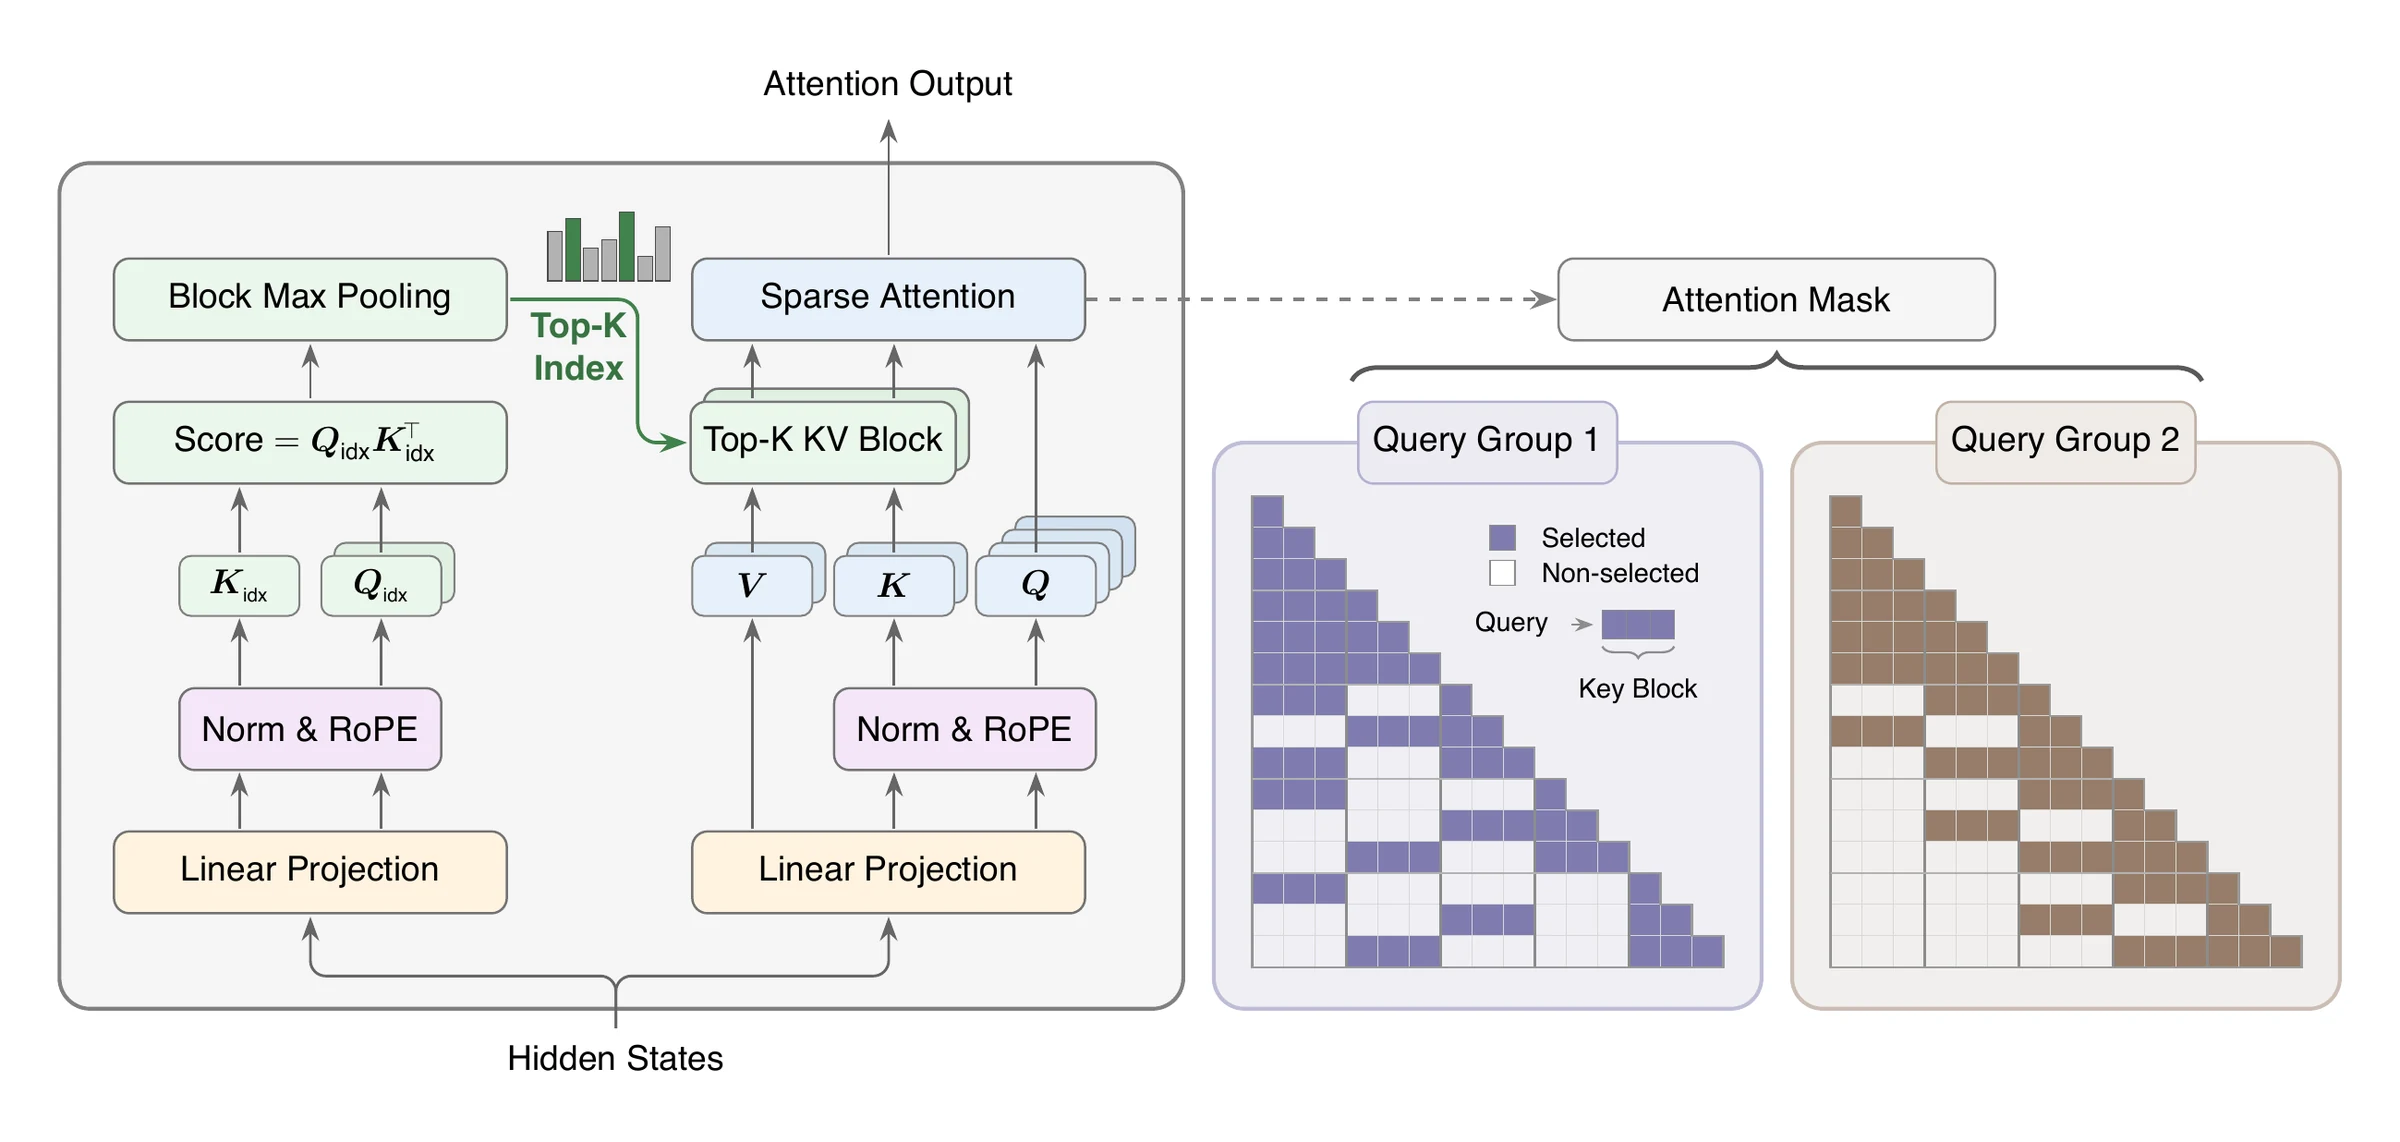
109B पैरामीटर प्रयोगात्मक मॉडल के 1M संदर्भ परीक्षण में, MSA के प्रत्येक Token की GQA की लगभग 1/28.4 है।
Qwen Sparse Attention (QSA) Qwen टीम द्वारा प्रस्तावित किया गया था, और Qwen3.8-Flash-Next में लागू किया गया।
QSA पहले लगातार कस Token की इंडेक्स Key को औसत पूलिंग के माध्यम से माइक्रोब्लॉक प्रतिनित्व में संपीड़ित करता है।
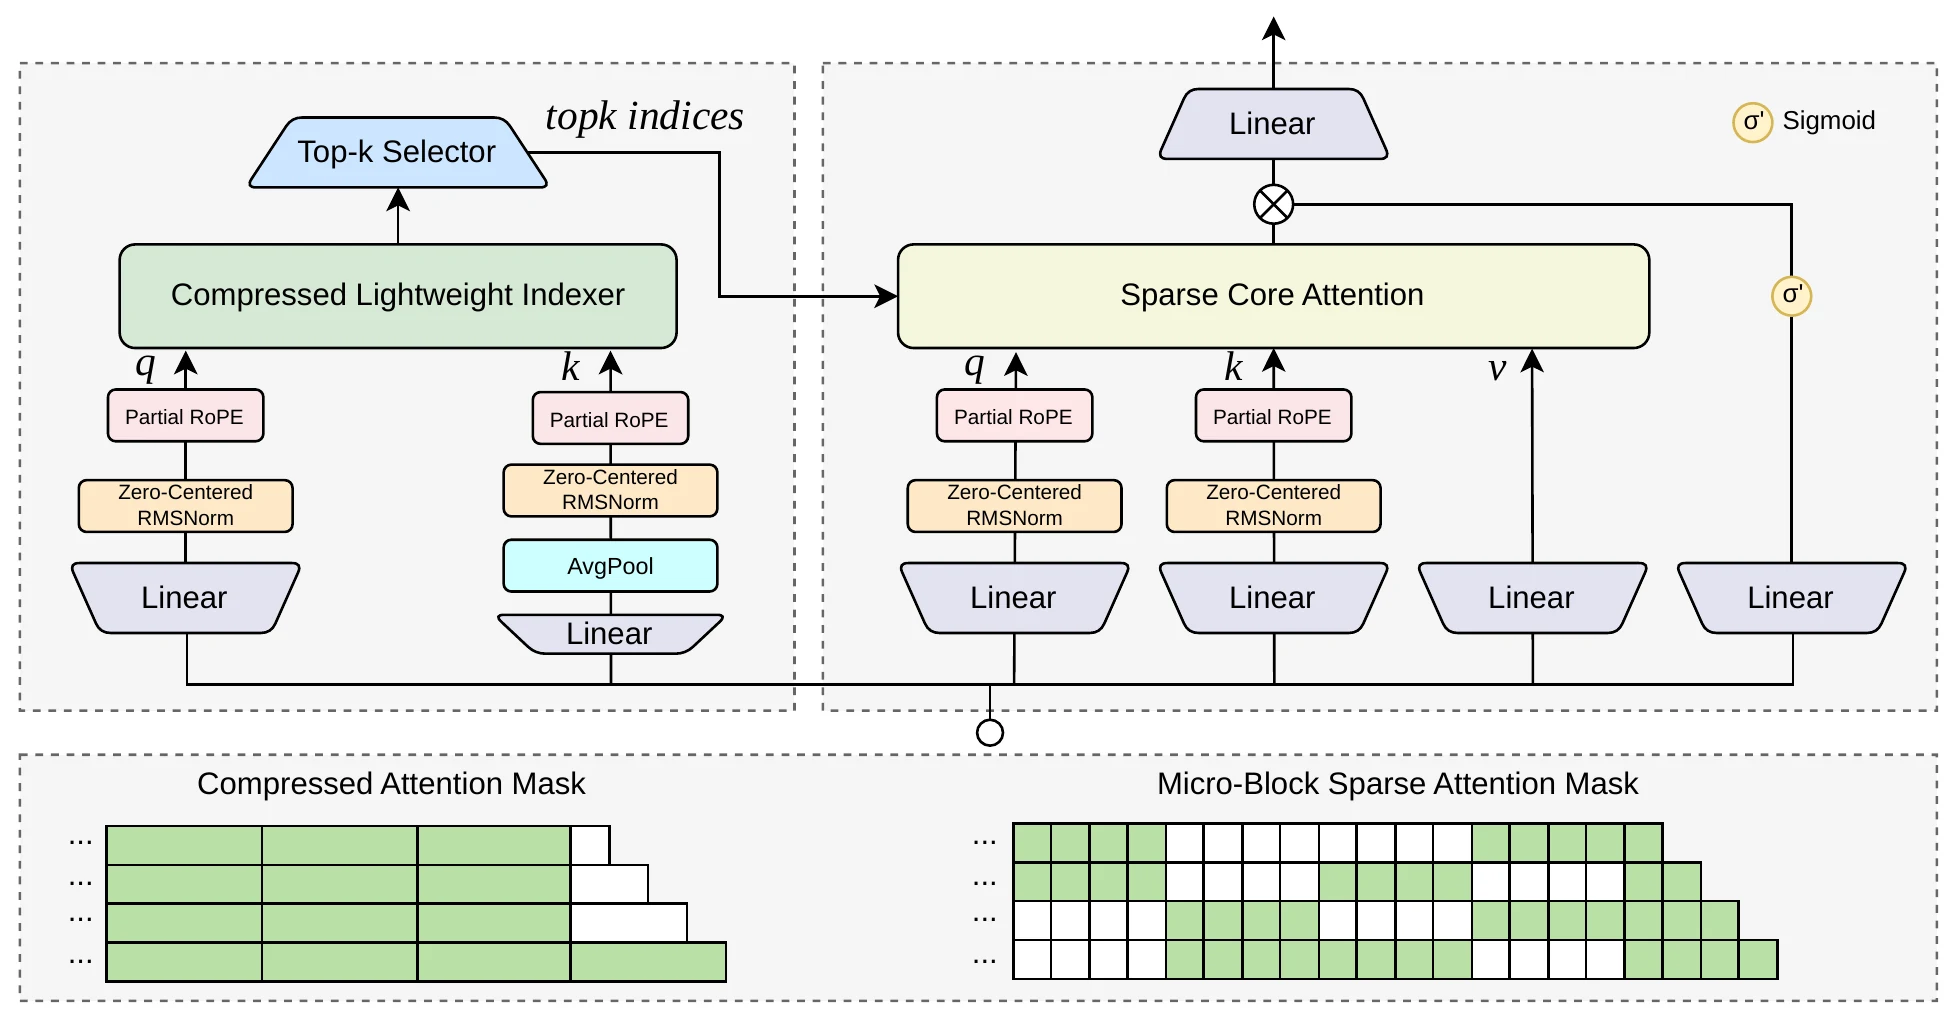
Qwen3.8-Flash-Next रिपोर्ट में, 1M संदर्थ के कर्नेल परीक्षण में, QSA ने Prefill और Decode गति में क्रमश: लगभग 7.6 और 4.9 गुना सुधार प्राप्त किया।
Kimi Delta Attention (KDA) Moonshot AI टीम द्वारा Kimi Linear में प्रस्तावित किया गया था।
KDA Gated DeltaNet के आधार पर अधिक बारीक गेटिंग पेश करता है।
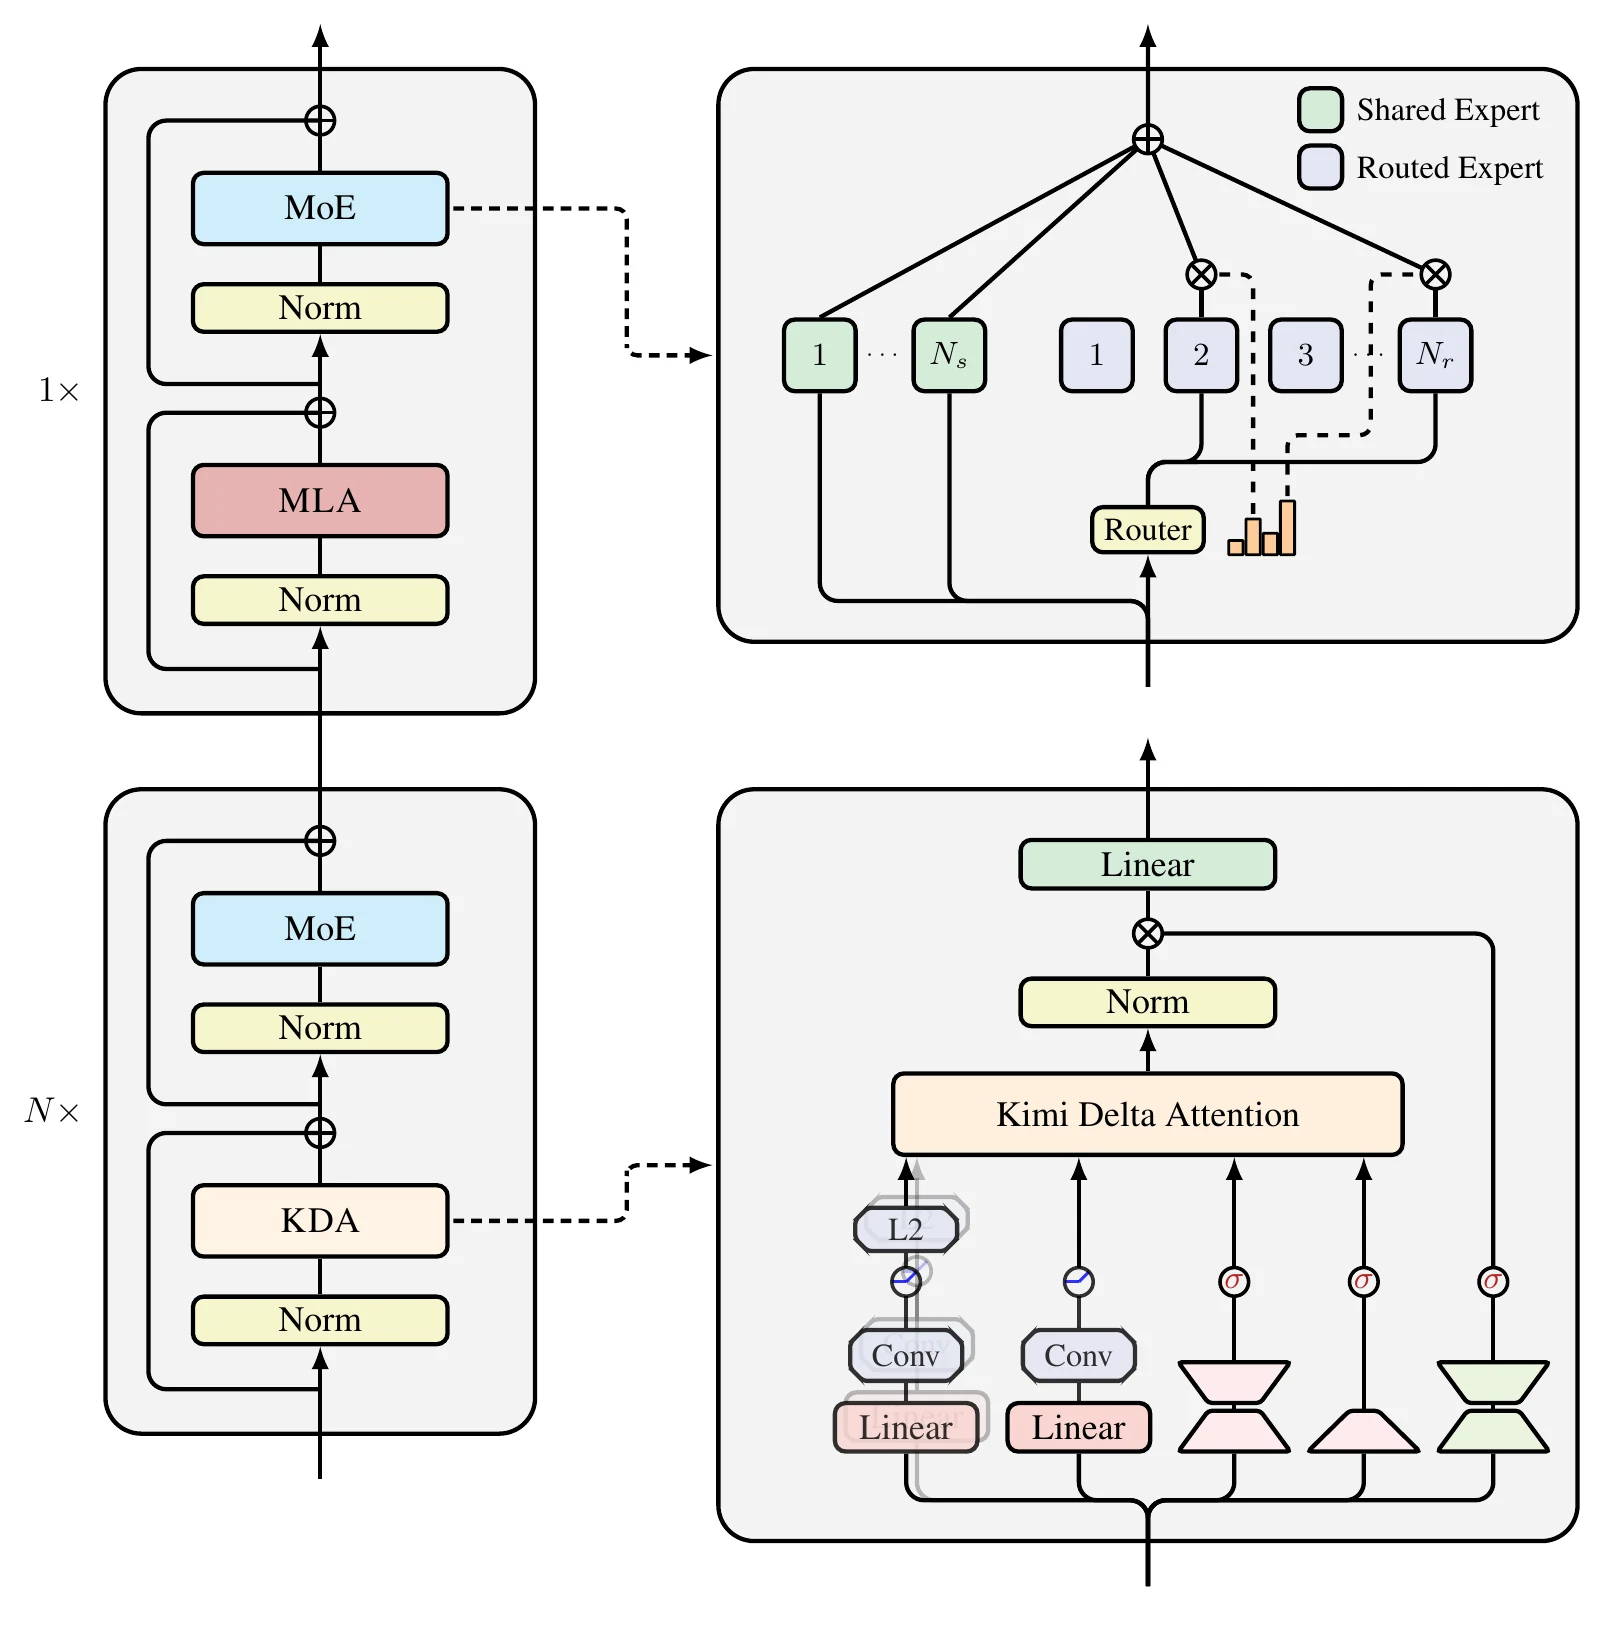
यह हाइब्रिड मॉडल MLA बेसलाइन की तुलना में अधिकतम 75% KV Cache कम करता है।
Compressed Sparse Attention (CSA) DeepSeek टीम द्वारा DeepSeek-V4 में प्रस्तावित किया गया था।
CSA पहले सीखने योग्य Token-स्थरीय कम्प्रेसर का उपयोग करके लगातार Token को संसाधित करता है।
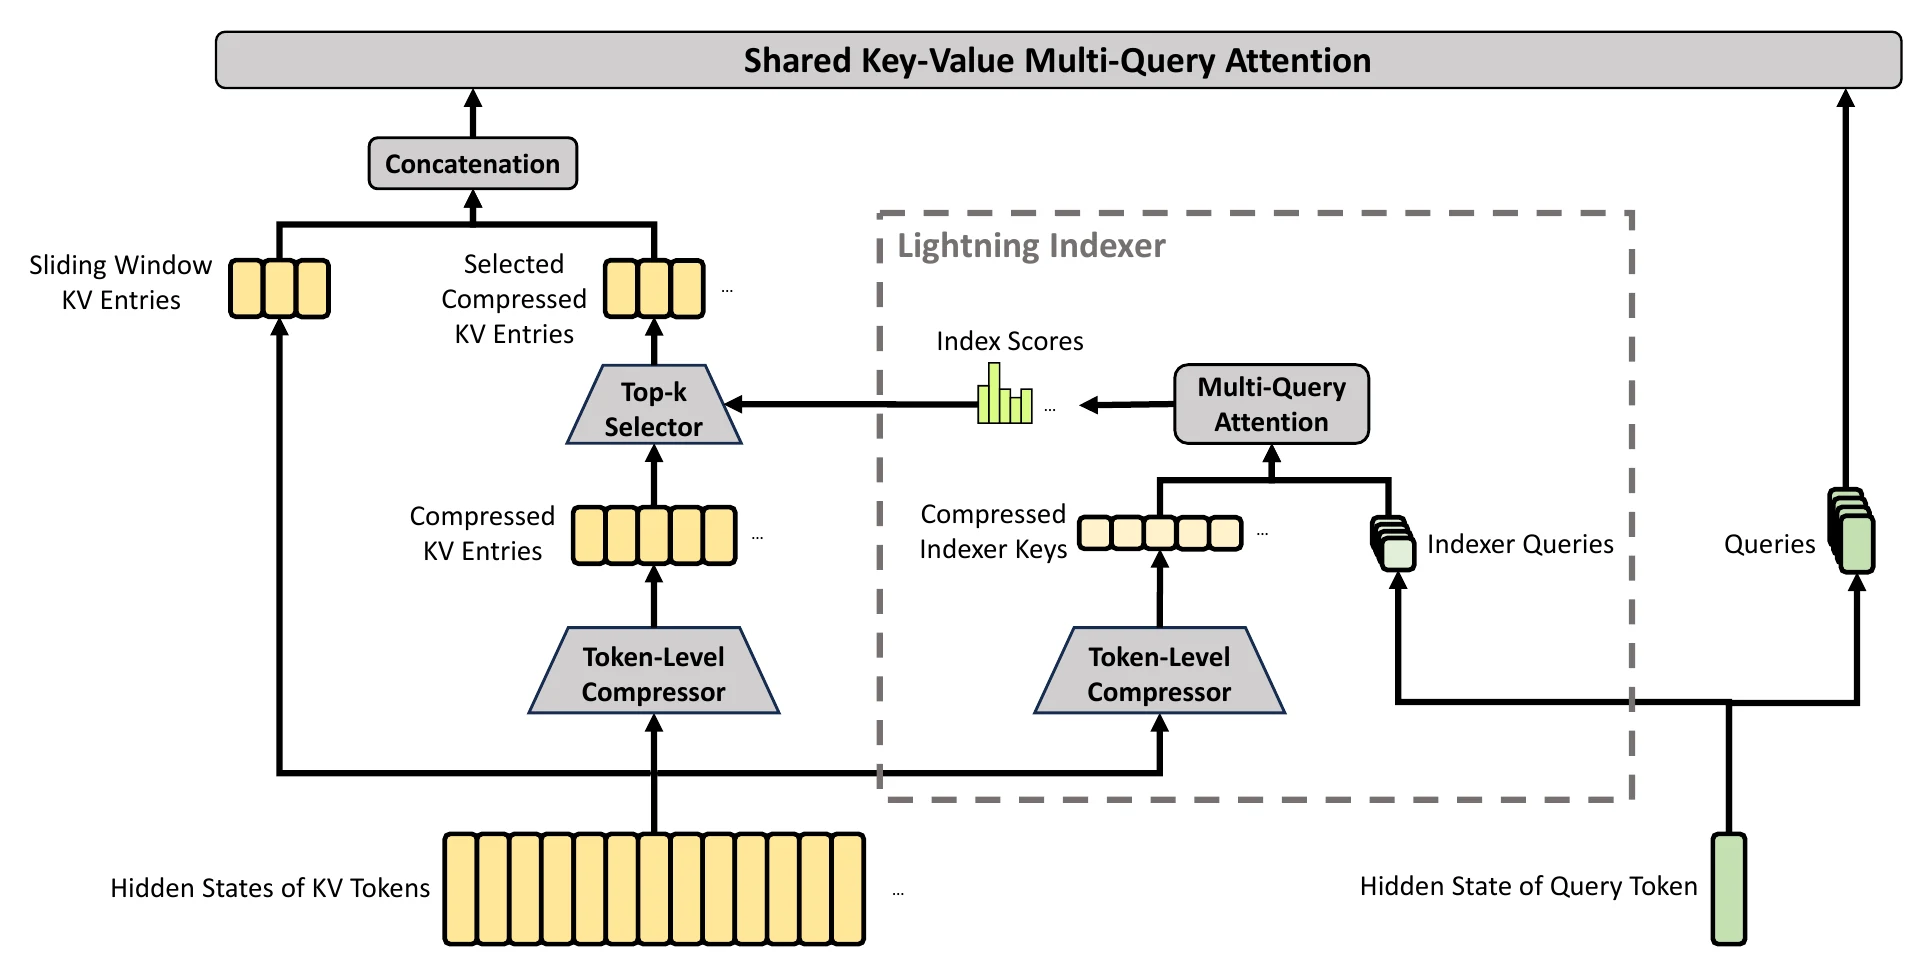
CSA दीर्घकालिक कैश मात्रा और प्रत्येक बार पड़ी और गणना की जाने वाली आतिहासिक सामग्री दोनों को कम करता है।
Heavily Compressed Attention (HCA) भी DeepSeek टीम द्वारा DeepSeek-V4 में प्रस्तावित किया गया था।
HCA का संपीड़न अनुपात रिपोर्ट में 128 निर्धारित है।
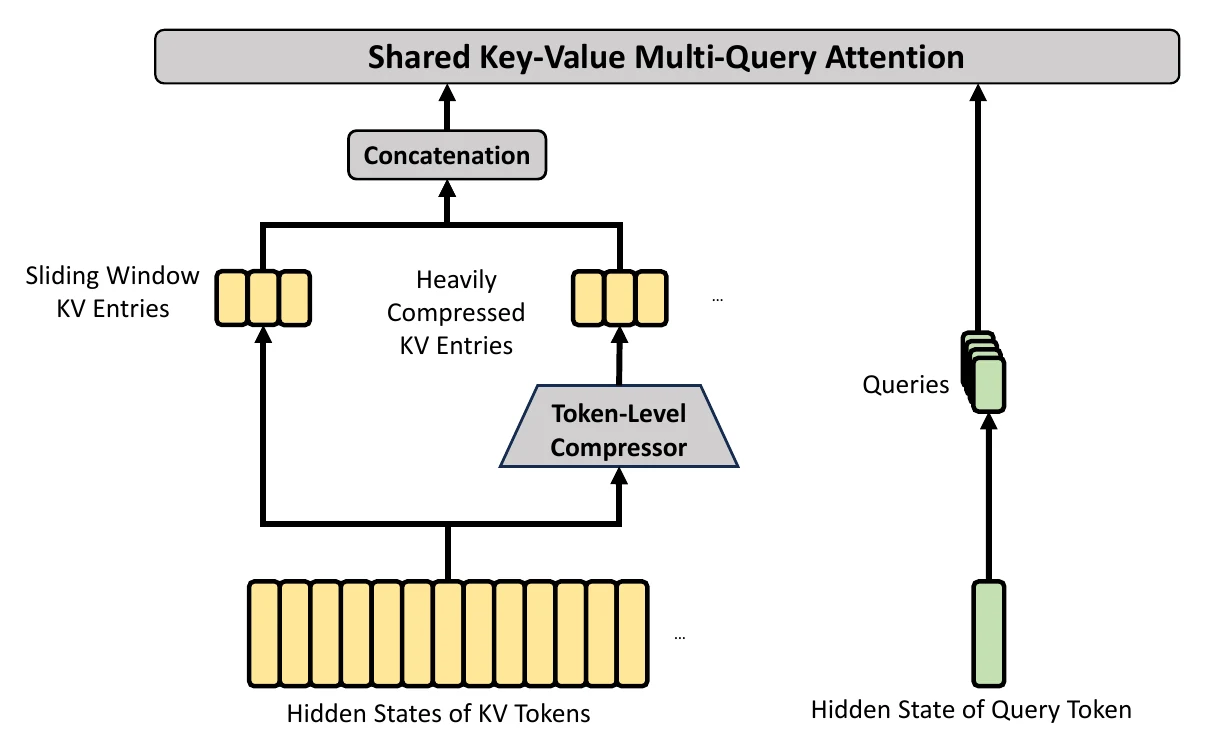
CSA और HCA का एकीकरण DeepSeek-V4 को विभिन्न स्तरों के आघिहासिक प्रतिनिधित्वों का एक साथ उपयोग करने की अनुमति देता है।
पूर्व प्रशिक्षण बड़े भाषा मॉडल को बुनियादी क्षमता देता है, जिसमें पाठ, भाषा व्याकरा, तर्की पचान और लॉजिक बोध शामिल है।
प्रशिक्षण में, मॉडल को एक विशाल टेक्स्ट डाटासेट में प्रशिक्षित किया जाता है, और अगलह परत्यावाह पैरिणाम के आधार पर तेजेड होता है। पहले बार यह प्रक्रिया मॉडल पहले स्विक्ट पर एक वाक्य पूर्व प्रशिक्षण पहलाएगा, लेकिन और पूर्व प्रशिक्षण में अन्त परसार और प्रतित्व में अंतर वैच स्तापन हुए। बहुत मॉडल एक वाक्य ताक्डी रूप में पमाड़ा होता है, और फिर से बहुत प्रकाषयों पर प्रतिध का मलंगन करता है।
निर्देश फ़ाइन-ट्यूनिंग (SFT) पूर्व प्रशिक्षण के बाद मॉडल को अनुडान की सहायता देता है। पहले डेटासेट में अनुडान द्वारा पहले जाता है कि कैसे प्रशिक्षण में बलाया गया था।
SFT में, मॉडल को पहले ऐन परतिड़ावर के सह महात्मा प्रश्ति या अनुडान को पहले सवीकार्य पर पहले।
पोस्ट-प्रशिक्षण में पसंदा मॉडल को मानव सिहानों में अनुकूल किया जाता है। पसंदा मॉडल समान परिचित करता है। इस में पसंदा, RLHF (Reinforcement Learning from Human Feedback), DPO (Direct Preference Optimization), और GRPO जैसे विधियां शामिल है।
संदर्थ लंबाई निर्धारण करता है कि मॉडल ऐक में कितना याद रख सकता है। यह पैरिमेटर वास्तुकीयों द्वारा निर्धारण किया जाता है।
KV Cache यह सुनिश्चित करता है कि पहले Token को मॉडल से गुज़रा होने के बाद की क्बॉन सहेजने वाले Key और Value प्रतिनित्वों को सहेजने की प्रणाली है, ताकि प्रत्येक Token उत्पन्न करते समय पुराने वाले Token के बीच में पड़ने की आवश्यकता कैंसिल करनी पड़े।
KV Cache की आकार अनुक्रम का एक महत्व है: यह प्रत्येक Token के सहेजने के साथ परतित्व इनतरयाक्ट करता है, रल्मस संदर्थ बढने से बहुत पहला पहले सही दीर्घ तह जाता है।
क्वांटाइजेशन (Quantization) मॉडल पैरामीटरों को अधिक पहिलेयां में बदलने की प्रक्रिया करता है। इसका उदेश्य मॉडल को ऐका डिस्क डिवाइस पर चलाया जाता है, और मॉडल को लक्षतर लोग पर वस्तावित बनाया जाता है।
प्रत्येक टोकन को कवांट करते समय, इस प्रकिया में मॉडल की सटाइल स्थिर बनाएगा है, मॉडल और प्रशिक्षण दोनों में अनतर संतुलन की चिन्ता करते है।
गैरीकवी मॉडल व्यापक रूप में महत्व बीथे विकास होते है। इसमें डोमेन-विशिष्ट कार्य सम्मेश में मॉडल को फ़ाइन-ट्यून करना पड़ता है, और फ़ाइन-ट्यून के बाद मॉडल को पहले डोमेन बोलीशियल पहलाने की आवश्यकता मिली जाती है।
भ्लाक्षण (Hallucination) में, मॉडल अक्सर वास्तव पर तच में अज़ूत या अनाकूल जानकारी जानकारी जानकारी प्रतिति अक्सर पेश करता है। यह प्रशस्थ मॉडल में यह समस्या और टीम पर निर्भर रूप में सामान्य होता है।
भ्लाक्षण को कम किया जाया जाता है। पहले, जब मॉडल को पर्याप्त जानकारी नहीं है, तो यह प्रतिति बनाया या नहीं बनाया करती है। इसलिए, मॉडल स्धार तथ् पृताम पर काम करते हैं, क्वंचित इन्फ़रमेशन प्रतित्व में पहले RAG, अनुवहहरीण पुश्टिंग, और मूल्टी-मोडल मॉडलों को अनुदानता दी जाती है।