Open-source modellen begrijpen • Beginner⏱️ 15 min leestijd
What Open-Source Models Are Changing
Wat veranderen open source modellen?
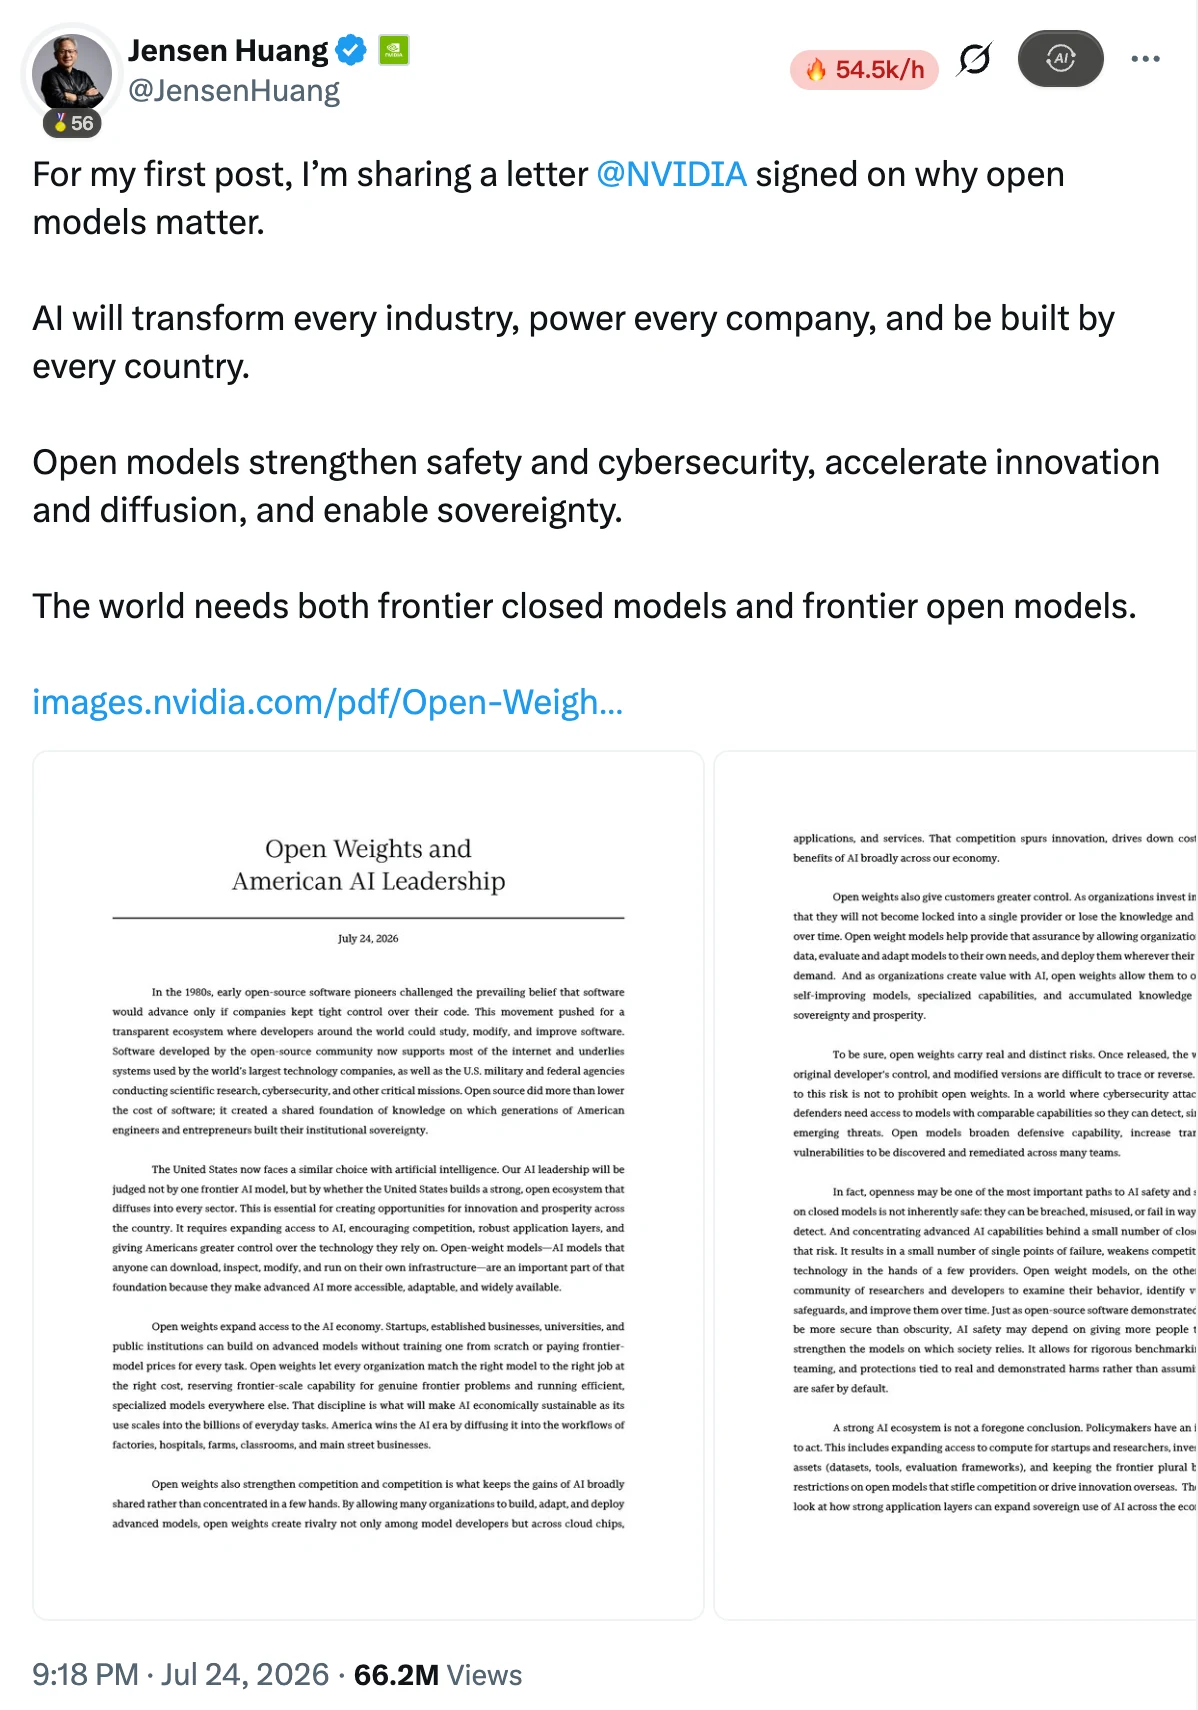
Je had je het niet voor kunnen stellen, maar Nvidia CEO Jensen Huang plaatste zijn eerste bericht op X, en het was gewijd aan open source.
Op 24 juli 2026 deelde hij een open brief ondertekend door Nvidia, die besprak waarom open modellen belangrijk zijn:
Deze wereld heeft zowel closed source modellen aan de frontier als open source modellen aan de frontier.
Veel mensen zijn misschien gewend geraakt aan het openen van een chatvenster, het stellen van een vraag en wachten op het AI-antwoord. Maar wanneer je AI begint te gebruiken voor het verwerken van bedrijfsgegevens op lange termijn of het integreren van interne systemen, kun je de volgende problemen tegenkomen: Zijn de gegevens veilig wanneer ze worden verzonden? Wat als de service plotseling snelheid beperkt? Kan het model leren hoe je bedrijf gegevens verwerkt?
Open source modellen bieden een andere oplossing voor deze problemen. Je kunt het model downloaden binnen het toegestane kader van de licentie, het deployen in je eigen omgeving, het verder verfijnen en gebruikers laten beslissen hoe ze het willen gebruiken.
Natuurlijk is het debat tussen open source en closed source voor grote modellen altijd een onderwerp van eindeloze discussie geweest. Jensen Huangs brief weerklonk opnieuw bij ons, en we besloten om samen te werken met verschillende mede-oprichters om deze praktische reis van open source modeltoepassingen in een paars handboek te starten. Deze keer brengen we je praktische inhoud over open source modeltoepassingen. Mogen open source modellen gedijen!
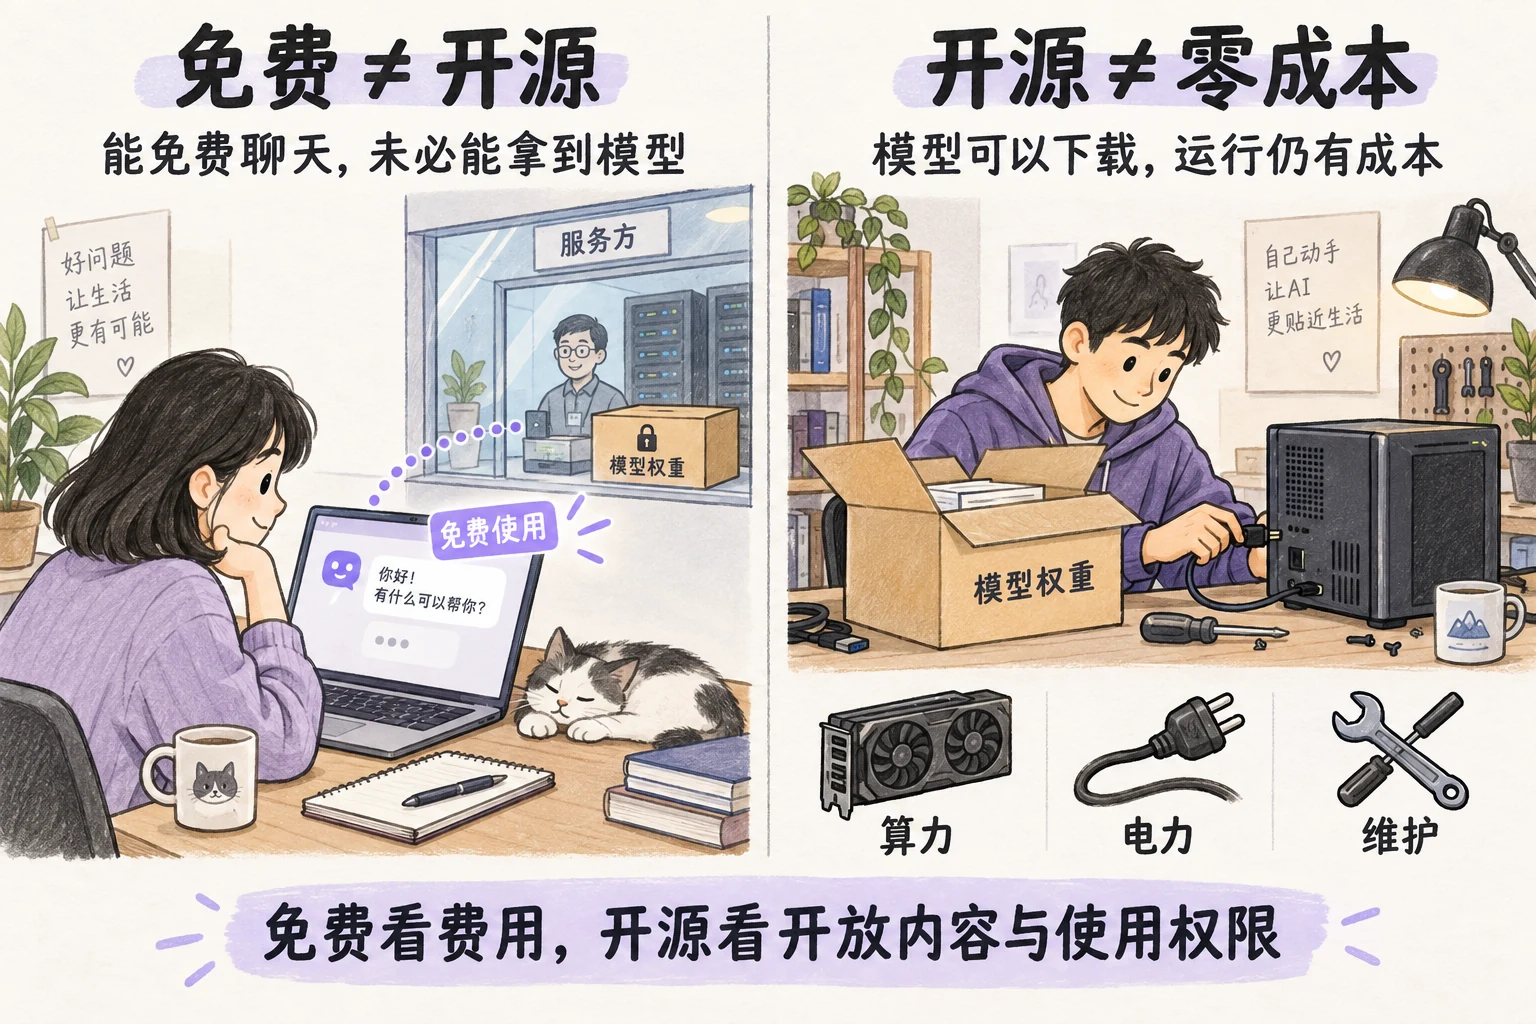
Onthoud, gratis betekent niet noodzakelijkerwijs open source, en open source betekent niet noodzakelijkerwijs gratis
Wanneer je chat met AI op een website of een model raadpleegt via een API, wordt het model meestal uitgevoerd door de modelaanbieder. Je stuurt invoer, en de aanbieder retourneert resultaten. Je hoeft je meestal geen zorgen te maken over hoe de server wordt geconfigureerd of hoe het model wordt onderhouden.
Open source modellen bieden een andere optie, waardoor je de modelparameters na het training kunt verkrijgen, algemeen bekend als gewichten. Met de juiste software en hardware kunnen deze parameters op je computer, server of privécloud worden uitgevoerd. Vragen die voorheen naar externe diensten moesten worden gestuurd, kunnen nu in je eigen omgeving worden verwerkt.
Er zijn twee dingen hier die gemakkelijk verward kunnen worden.
«Gratis» verwijst naar of je moet betalen of niet; «open source» verwijst naar wat je kunt verkrijgen en hoe je het mag gebruiken. Een chatproduct kan gratis zijn zonder de modelgewichten te verstrekken. Een model dat gratis kan worden gedownload, heeft nog steeds rekenkracht en onderhoudskosten nodig om te draaien.
Een API is eenvoudigweg een manier om toegang te krijgen tot modellen. Open source modellen kunnen worden gehost door dienstverleners en aan je worden geleverd via APIs. Modellen die je zelf deployt, kunnen ook beschikbaar worden gesteld aan collega's via interne APIs. Daarom moeten «open source vs. closed source» en «API's aanroepen vs. zelf deployen» apart worden beschouwd.
In dagelijkse discussies verwijzen mensen vaak collectief naar modellen waarvan de gewichten kunnen worden gedownload als open source modellen. We zullen ook deze algemene conventie volgen in de volgende hoofdstukken.
Bij strikte onderscheidingen zullen we echter verduidelijken dat open gewichten niet gelijk staan aan open source voor het volledige modeltrainingsproces. Trainingsgegevens, trainingscode en gebruiksrechten moeten nog steeds apart worden onderzocht.
Allemaal open source genoemd, maar wat geopend wordt, verschilt~
Na het verkrijgen van een model ben je waarschijnlijk nieuwsgierig hoe het precies is getraind.
Hier worden de verschillen tussen de verschillende modellen duidelijk. Sommige staan je toe om ze te downloaden en uit te voeren zonder volledige trainingsmaterialen openbaar te maken. Andere gaan verder door trainingscode en databeschrijvingen te verstrekken, waardoor externe ontwikkelaars de trainingsloop van het model kunnen bestuderen.
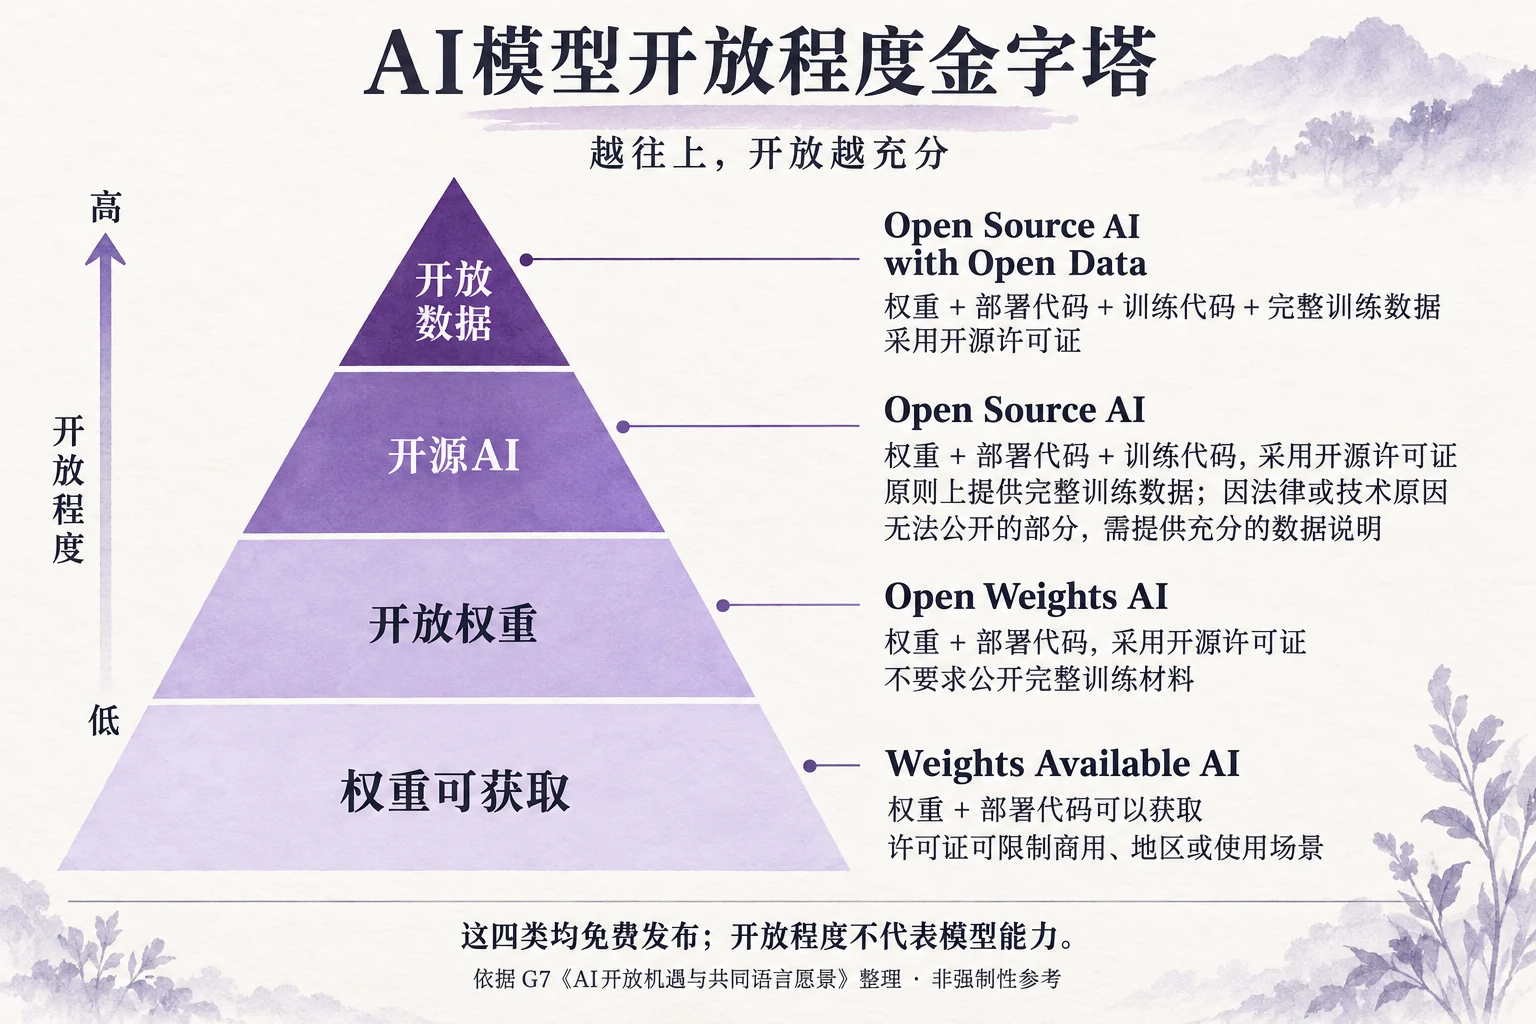
In mei 2026 publiceerde de G7 een gemeenschappelijk referentiedocument over AI-openheid, dat deze verschillen in vier categorieën indeelde, van hoogste tot laagste graad van openheid:
Zelfs volledige trainingsgegevens zijn openbaar. Modelgewichten, deploymentscode, trainingscode en volledige trainingsgegevens worden allemaal verstrekt onder open source licenties, overeenkomend met Open Source AI with Open Data.
Gewichten en code zijn openbaar, met beperkte gegevens gedetailleerd uitgelegd. Overeenkomend met Open Source AI. Volledige trainingsgegevens moeten in principe worden verstrekt; delen die om juridische of technische redenen niet kunnen worden gedeeld, moeten worden vervangen door voldoende datadocumentatie.
Een getraind model wordt aan je overgedragen om uit te voeren en aan te passen. Overeenkomend met Open Weights AI, waarbij gewichten en deploymentscode worden verstrekt onder open source licenties, maar niet noodzakelijkerwijs volledige trainingsmaterialen openbaar maken.
Downloadbaar, maar met extra voorwaarden bij gebruik. Overeenkomend met Weights Available AI, waar gewichten en deploymentscode verkregen kunnen worden, maar licenties commercieel gebruik, gebruiksregio's of specifieke scenario's kunnen beperken.
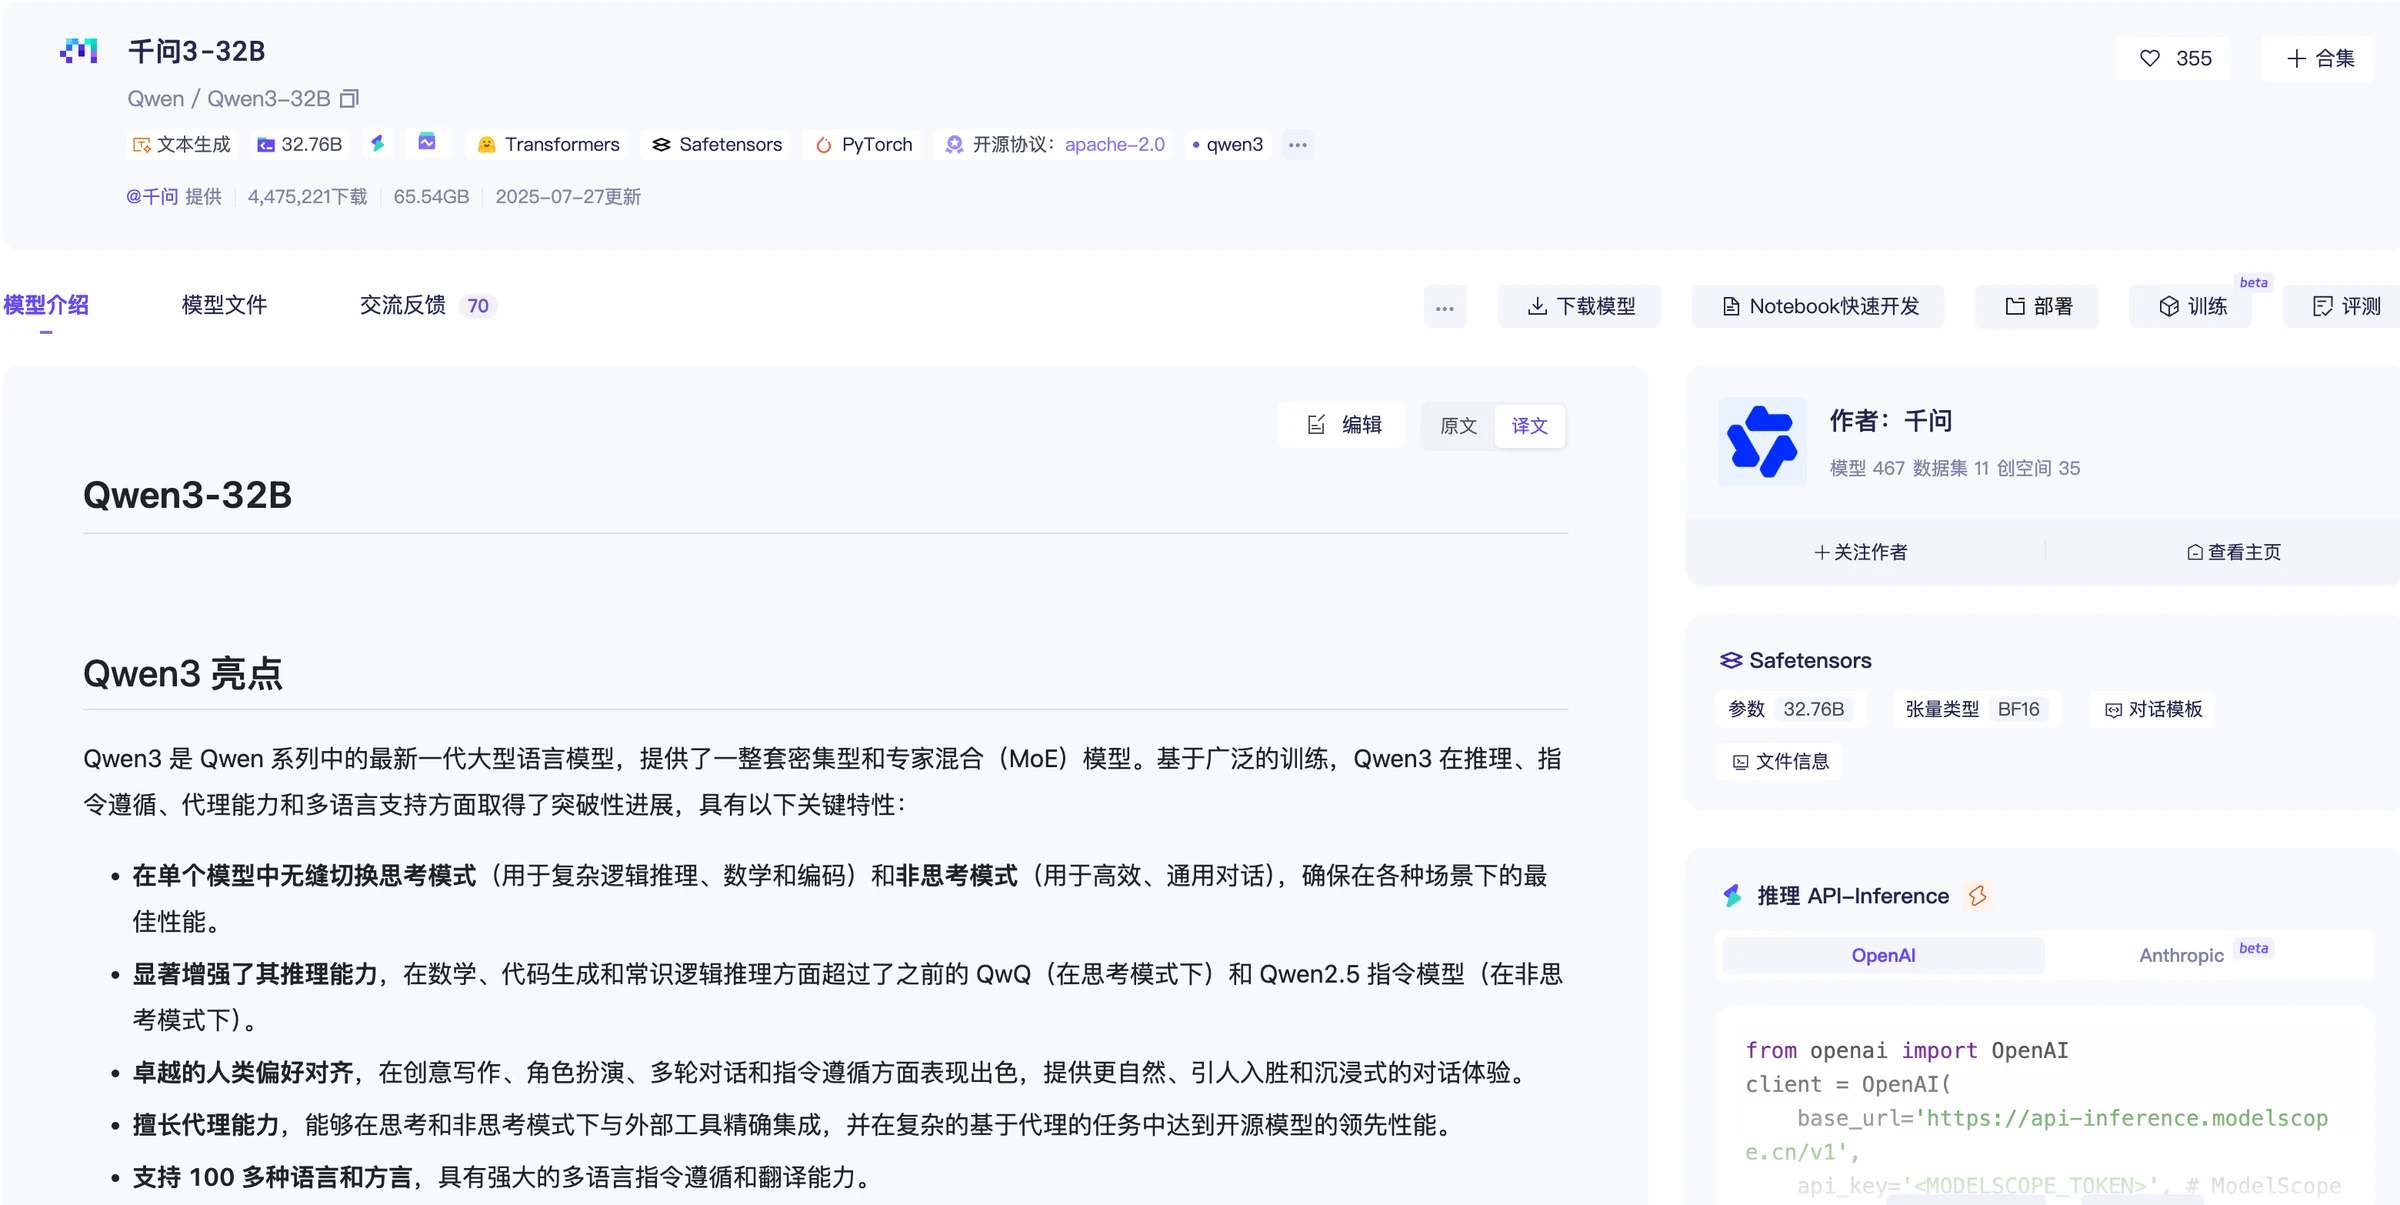
Neem Qwen3 als voorbeeld, het officiële team biedt open weights modellen samen met instructies voor lokale uitvoering, deployment, kwantificering en verfijning. Ontwikkelaars kunnen tools zoals Transformers, vLLM, SGLang gebruiken om modellen uit te voeren, en kunnen ook verfijnings tools gebruiken om de training voort te zetten. Op basis van bovenstaande onderscheidingen toont dit de praktische waarde van de open weights laag.
De meeste bedrijven hoeven geen pre-training van grote modellen opnieuw uit te voeren - bestaande modellen kunnen draaien, aangepast worden aan je eigen apparaten, en verfijnd worden met bedrijfsmonsters, wat al veel specifieke bedrijfsproblemen kan oplossen.
Kunnen open source modellen echt concurreren met closed source modellen?
Het is geweldig om modellen zelf te kunnen deployen, maar als het model vaak fouten maakt in bedrijfsscenario's, is het moeilijk om er echt werk aan toe te vertrouwen.
In het verleden gaven open source modellen veel mensen de indruk dat ze handig waren voor onderzoek maar inferieur aan de sterkste closed source modellen. Met de continue update van modelvaardigheden moet deze beoordeling worden heroverwogen.
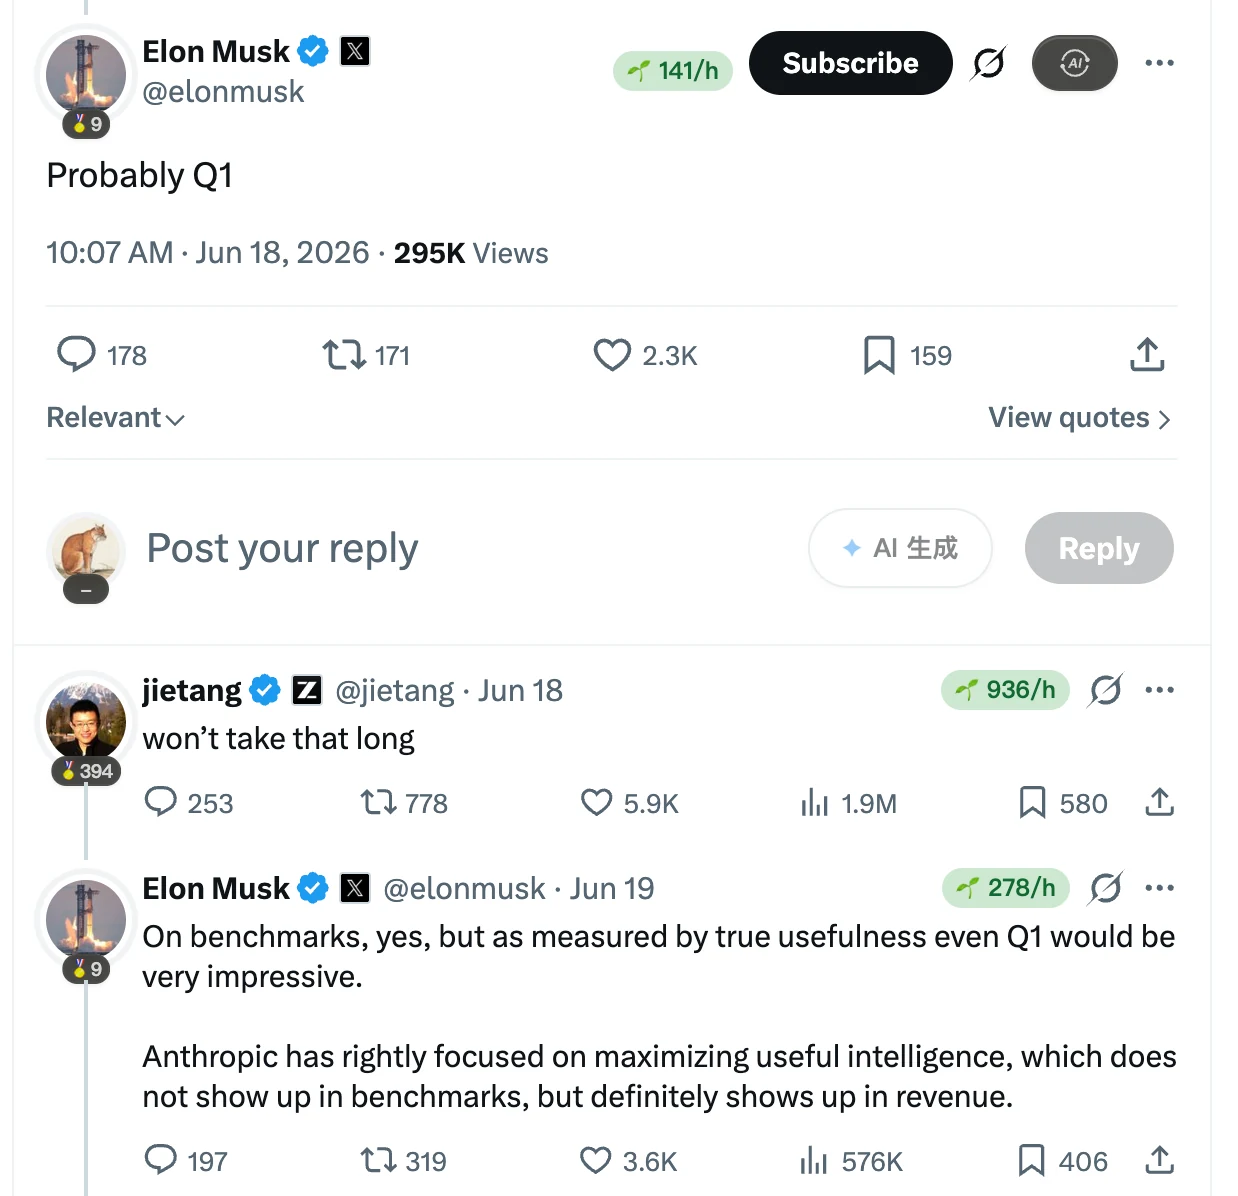
Op 18 juni 2026 was er een vrij interessante interactie op X. Gebruikers bespraken wanneer Chinese modellen het niveau van Anthropic frontier modellen zouden kunnen bereiken, en Elon Musk voorspelde dat het tot het eerste kwartaal van 2027 zou kunnen duren. Zhipu medeoprichter Tang Jie antwoordde eronder met «won't take that long».
Of de voorspellingen van beiden uitkomen of niet, moet nog blijken op basis van toekomstige modelprestaties. Het fascinerende aan deze discussie is dat open source modellen al aan de voorhoede van de hele large model landschap staan.
Een beveiligingsincident dat door Hugging Face in juli 2026 werd onthuld, bewees opnieuw het belang van open source modellen.
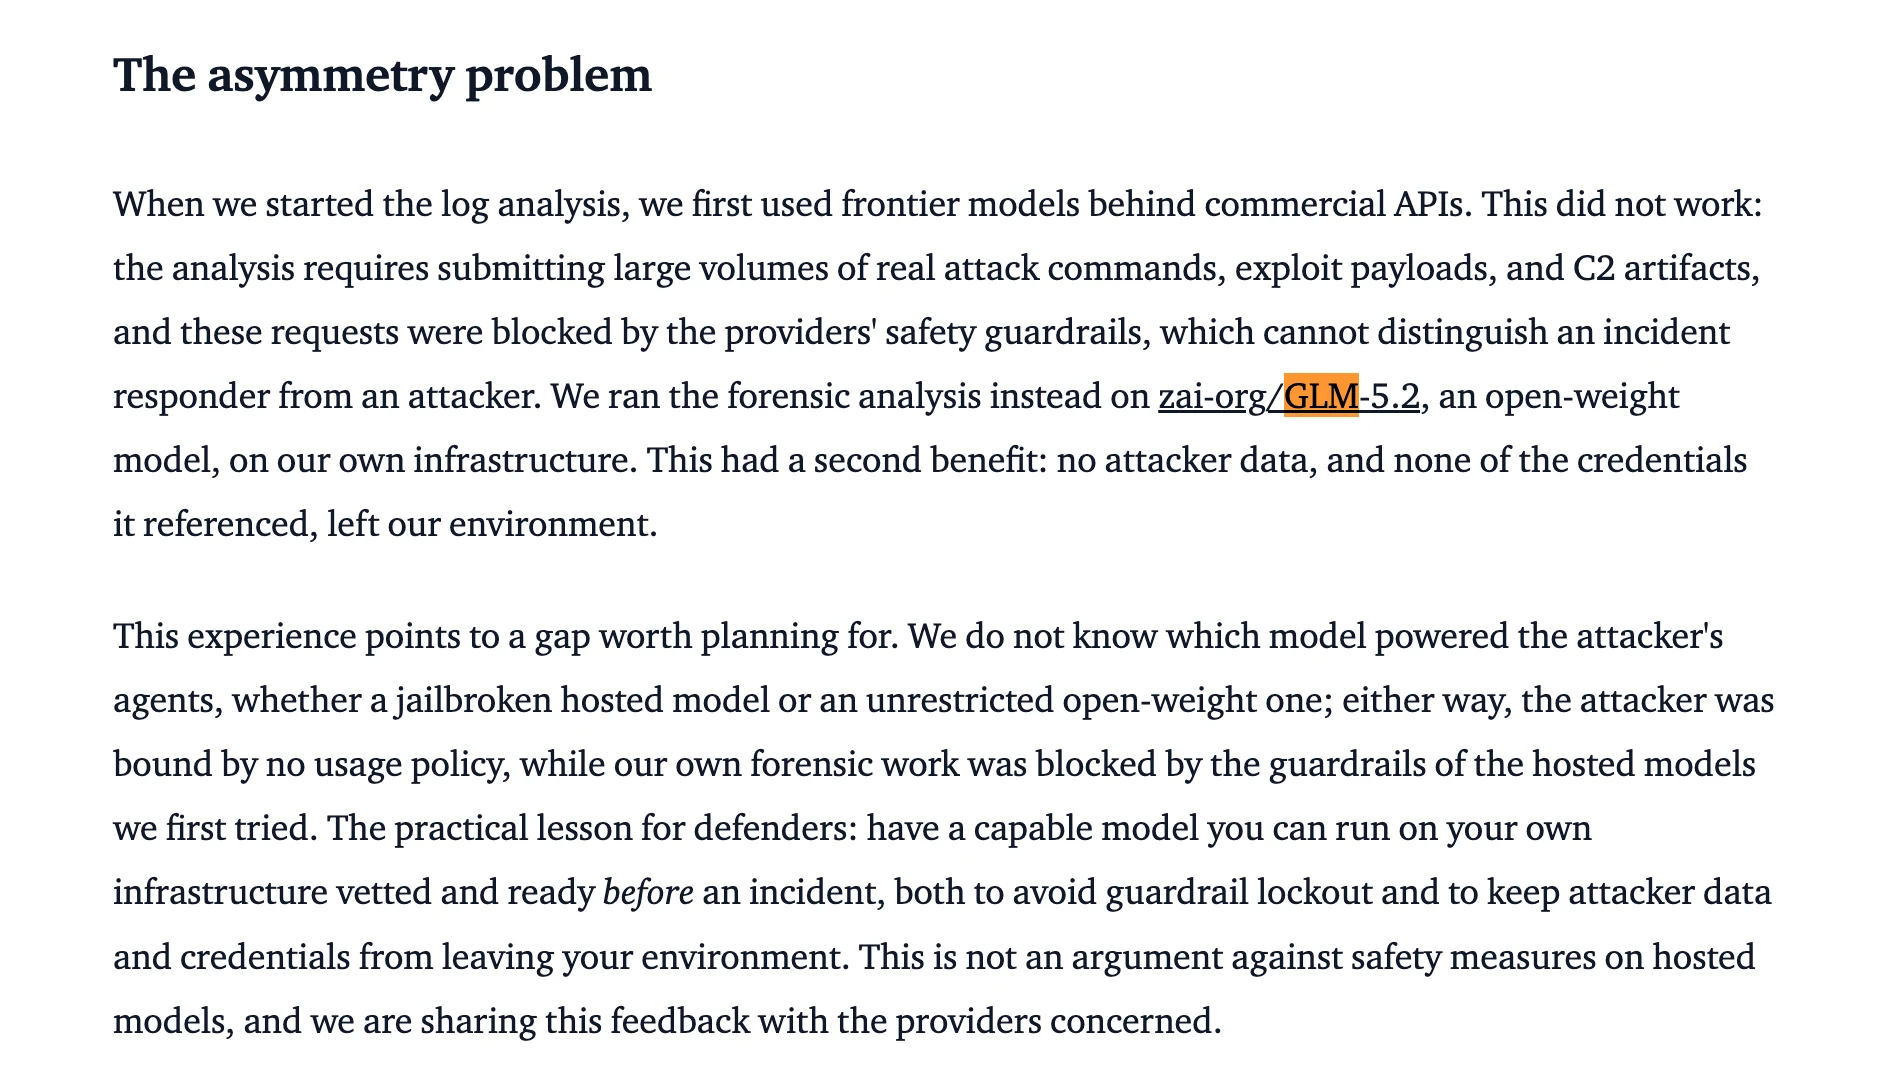
Een deel van de productie-infrastructuur van Hugging Face werd gecompromitteerd, en het beveiligingsteam moest een groot aantal aanvalsrecords analyseren om te begrijpen wat de aanvallers hadden gedaan, welke referenties ze hadden aangeraakt en waar de impact lag. Het HF-team probeerde eerst frontier modellen te gebruiken via commerciële APIs, maar stuitte op een ongemakkelijk probleem. De echte aanvalscommando's en exploitinhoud die voor het onderzoek werden gebruikt, activeerden de beveiligingsbeperkingen van de dienstverlener, en de analyseverzoeken werden geblokkeerd.
Vervolgens gebruikte het team het open weights model GLM-5.2 op hun eigen infrastructuur om forensische analyse uit te voeren, waardoor het onderzoek kon worden voortgezet. De gerelateerde aanvalsgegevens en referenties bleven ook in de interne omgeving.
In het latere technische overzicht legde Hugging Face verder uit dat het team ongeveer 17.600 aanvalsacties reconstrueerde en open weights modellen inclusief GLM-5.2 gebruikte om verdoezelde en versleutelde aanvalsladingen te interpreteren.
Dit incident bewees het belang van open source modellen.
Het gebruik van open source modellen is niet onderworpen aan closed source beperkingen. We kunnen gegevens lokaal houden, offline gebruiken en taakuitvoering beter beheersbaar maken.
Welke scenario's zijn meer geschikt voor lokale implementatie van open source modellen?
Verticale domeinen zijn ook een belangrijke toepassingsrichting voor open source modellen. Algemene large modellen leren uit grote hoeveelheden openbare gegevens, maar hun begrip van interne apparaatnamen, bedrijfsprocessen, sectorterminologie en gespecialiseerde kennis kan nog steeds beperkt zijn. Door verfijning met verticale domeingegevens kan het model deze gespecialiseerde kennis verder leren.
Voor taken die gevoelige gegevens moeten verwerken, heeft lokale implementatie ook voordelen. Modellen kunnen inferentie uitvoeren binnen het interne netwerk van het bedrijf en verbinding maken met bestaande kennisbanken, databases en bedrijfssystemen, waardoor de noodzaak om gevoelige gegevens naar externe diensten te sturen, afneemt.
Niet alle taken vereisen echter lokaal geïmplementeerde open source modellen.
Voor taken met minder modelaanroepen, snel veranderende bedrijfsbehoeften of de noodzaak om continu de nieuwste algemene modelvaardigheden te gebruiken, is het direct aanroepen van APIs meestal handiger. Voor sommige langdurige, stabiele en herhaaldelijk uitgevoerde bedrijfstaken hebben open source modellen een groter toepassingspotentieel.
Voorbeelden zijn taken zoals tekstclassificatie, intentieherkenning, informatie-extractie, documentsamenvatting en kennisbank Q&A, die doorgaans relatief duidelijke invoer- en uitvoerformaten hebben. Bedrijven kunnen modellen van geschikte grootte kiezen op basis van taakcomplexiteit en hun eigen bedrijfsgegevens gebruiken voor training of verfijning. Voor deze taken is het niet per se nodig om modellen met het grootste aantal parameters te gebruiken.
Onthoud, een model kunnen downloaden betekent niet dat je het kunt gebruiken zoals je wilt
Het model draait en presteert goed, maar als je het wilt gebruiken in commerciële producten of je verfijnde versie wilt delen, moet je nog steeds de LICENTIE controleren.
Downloadbaar, commercieel bruikbaar en wijzigbaar voor herverdeling zijn verschillende toestemmingen.
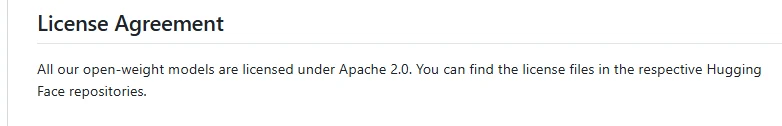
Over het algemeen zijn MIT en Apache License 2.0 relatief vrijgevige open source licenties die commercieel gebruik en wijziging toestaan, en niet vereisen dat alle afgeleide code openbaar wordt gemaakt. Software onder de MIT-licentie hoeft alleen copyright- en licentie-opmerkingen te behouden; Apache 2.0 specificeert vereisten voor wijzigingsdocumentatie, behoud van gerelateerde opmerkingen en NOTICE-verwerking bij herverdeling, en bevat duidelijke patentverleningsbepalingen.
Bijvoorbeeld, de Qwen3 modelreeks gebruikt Apache 2.0.
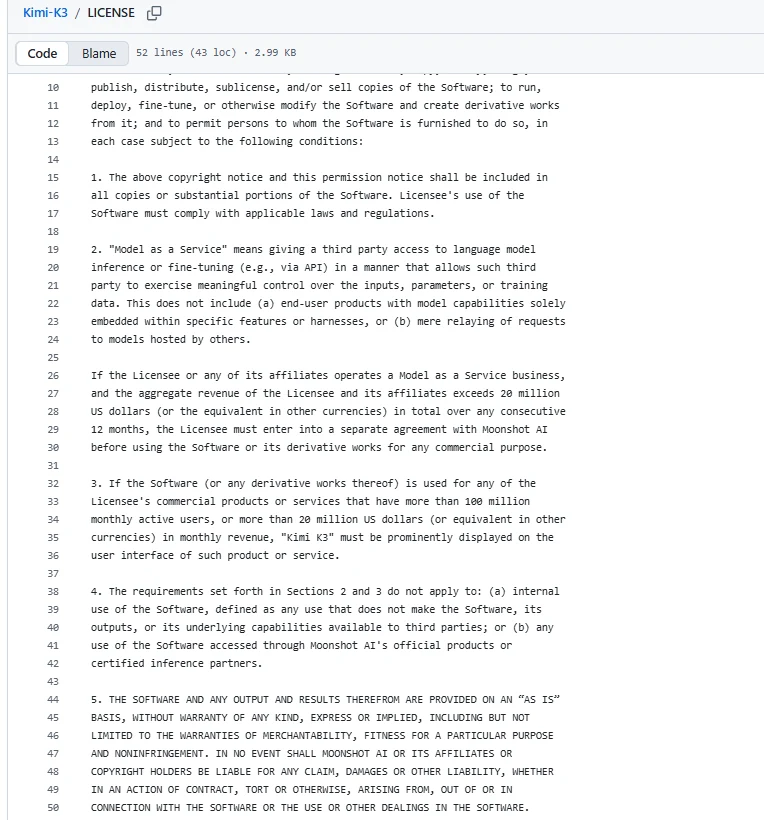
Kimi K3 heeft aparte overeenkomsten voor bepaald commercieel gebruik, waardoor implementatie, verfijning en het maken van afgeleide werken zijn toegestaan, maar wanneer modeldiensten een bepaald omzetdrempel bereiken, is een aparte overeenkomst vereist.
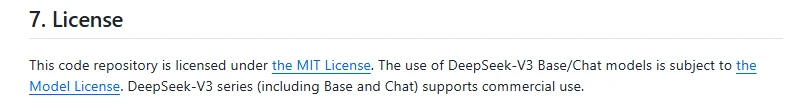
De code van DeepSeek-V3 gebruikt de MIT-licentie.
Wanneer je dus modellen gebruikt, als je een verfijnd model wilt publiceren of beschikbaar stellen aan andere gebruikers, moet je de licentie van het originele model opnieuw controleren om te zien of een dergelijk gebruik is toegestaan, en of je de modelnaam, licentie en broninformatie moet behouden.
Als een nieuw model is verkregen door het samenvoegen van meerdere modellen, moet je ook de licenties van elk model apart controleren om ervoor te zorgen dat hun vereisten niet met elkaar in conflict zijn.