Het model draait op uw laptop, u wilt een groter model proberen, of een afbeelding genereren — maar u heeft mogelijk niet het juiste hardware. U kunt berekeningen naar de cloud verplaatsen en de server het werk laten doen.
Cloudservers kunnen worden geconfigureerd naar behoefte. We gebruiken hier verder ModelScope Notebook — selecteer direct in de browser een CPU- of GPU-instantie, download het model en voer code uit. De pagina draait op uw computer; het model draait op de verbonden cloudinstantie.
Dit hoofdstuk heeft twee experimenten. Eerst CPU gebruiken om een 0.5B-niveau model te draaien en het sentiment van een beoordeling te beoordelen. Dan GPU gebruiken om een afbeeldingsgeneratiemodel te draaien en tekstbeschrijvingen om te zetten in afbeeldingen. Elk demonstreert gebruik onder verschillende resources met verschillende taken en modellen, dus u kunt CPU vs GPU niet direct vergelijken op looptijd.
Andere cloudserverresources worden later toegevoegd.Vanaf de ModelScope-modellpagina gaat u naar "Notebook Snelle Ontwikkeling", klik dan op "Runtime verbinden". Selecteer eerst een CPU-instantie voor sentimentanalyse, schakel dan over naar een GPU-instantie voor afbeeldingsgeneratie. Voor Notebook-paginabewerkingen raadpleeg het hoofdstuk "Bekijk uw eerste resultaat in 30 minuten".
Na het wisselen van instantie worden het oorspronkelijke Python-proces en de geladen modellen niet automatisch overgebracht naar de nieuwe instantie. U moet de afhankelijkheden in de huidige omgeving opnieuw controleren en de experimentcode opnieuw uitvoeren vanaf het begin.
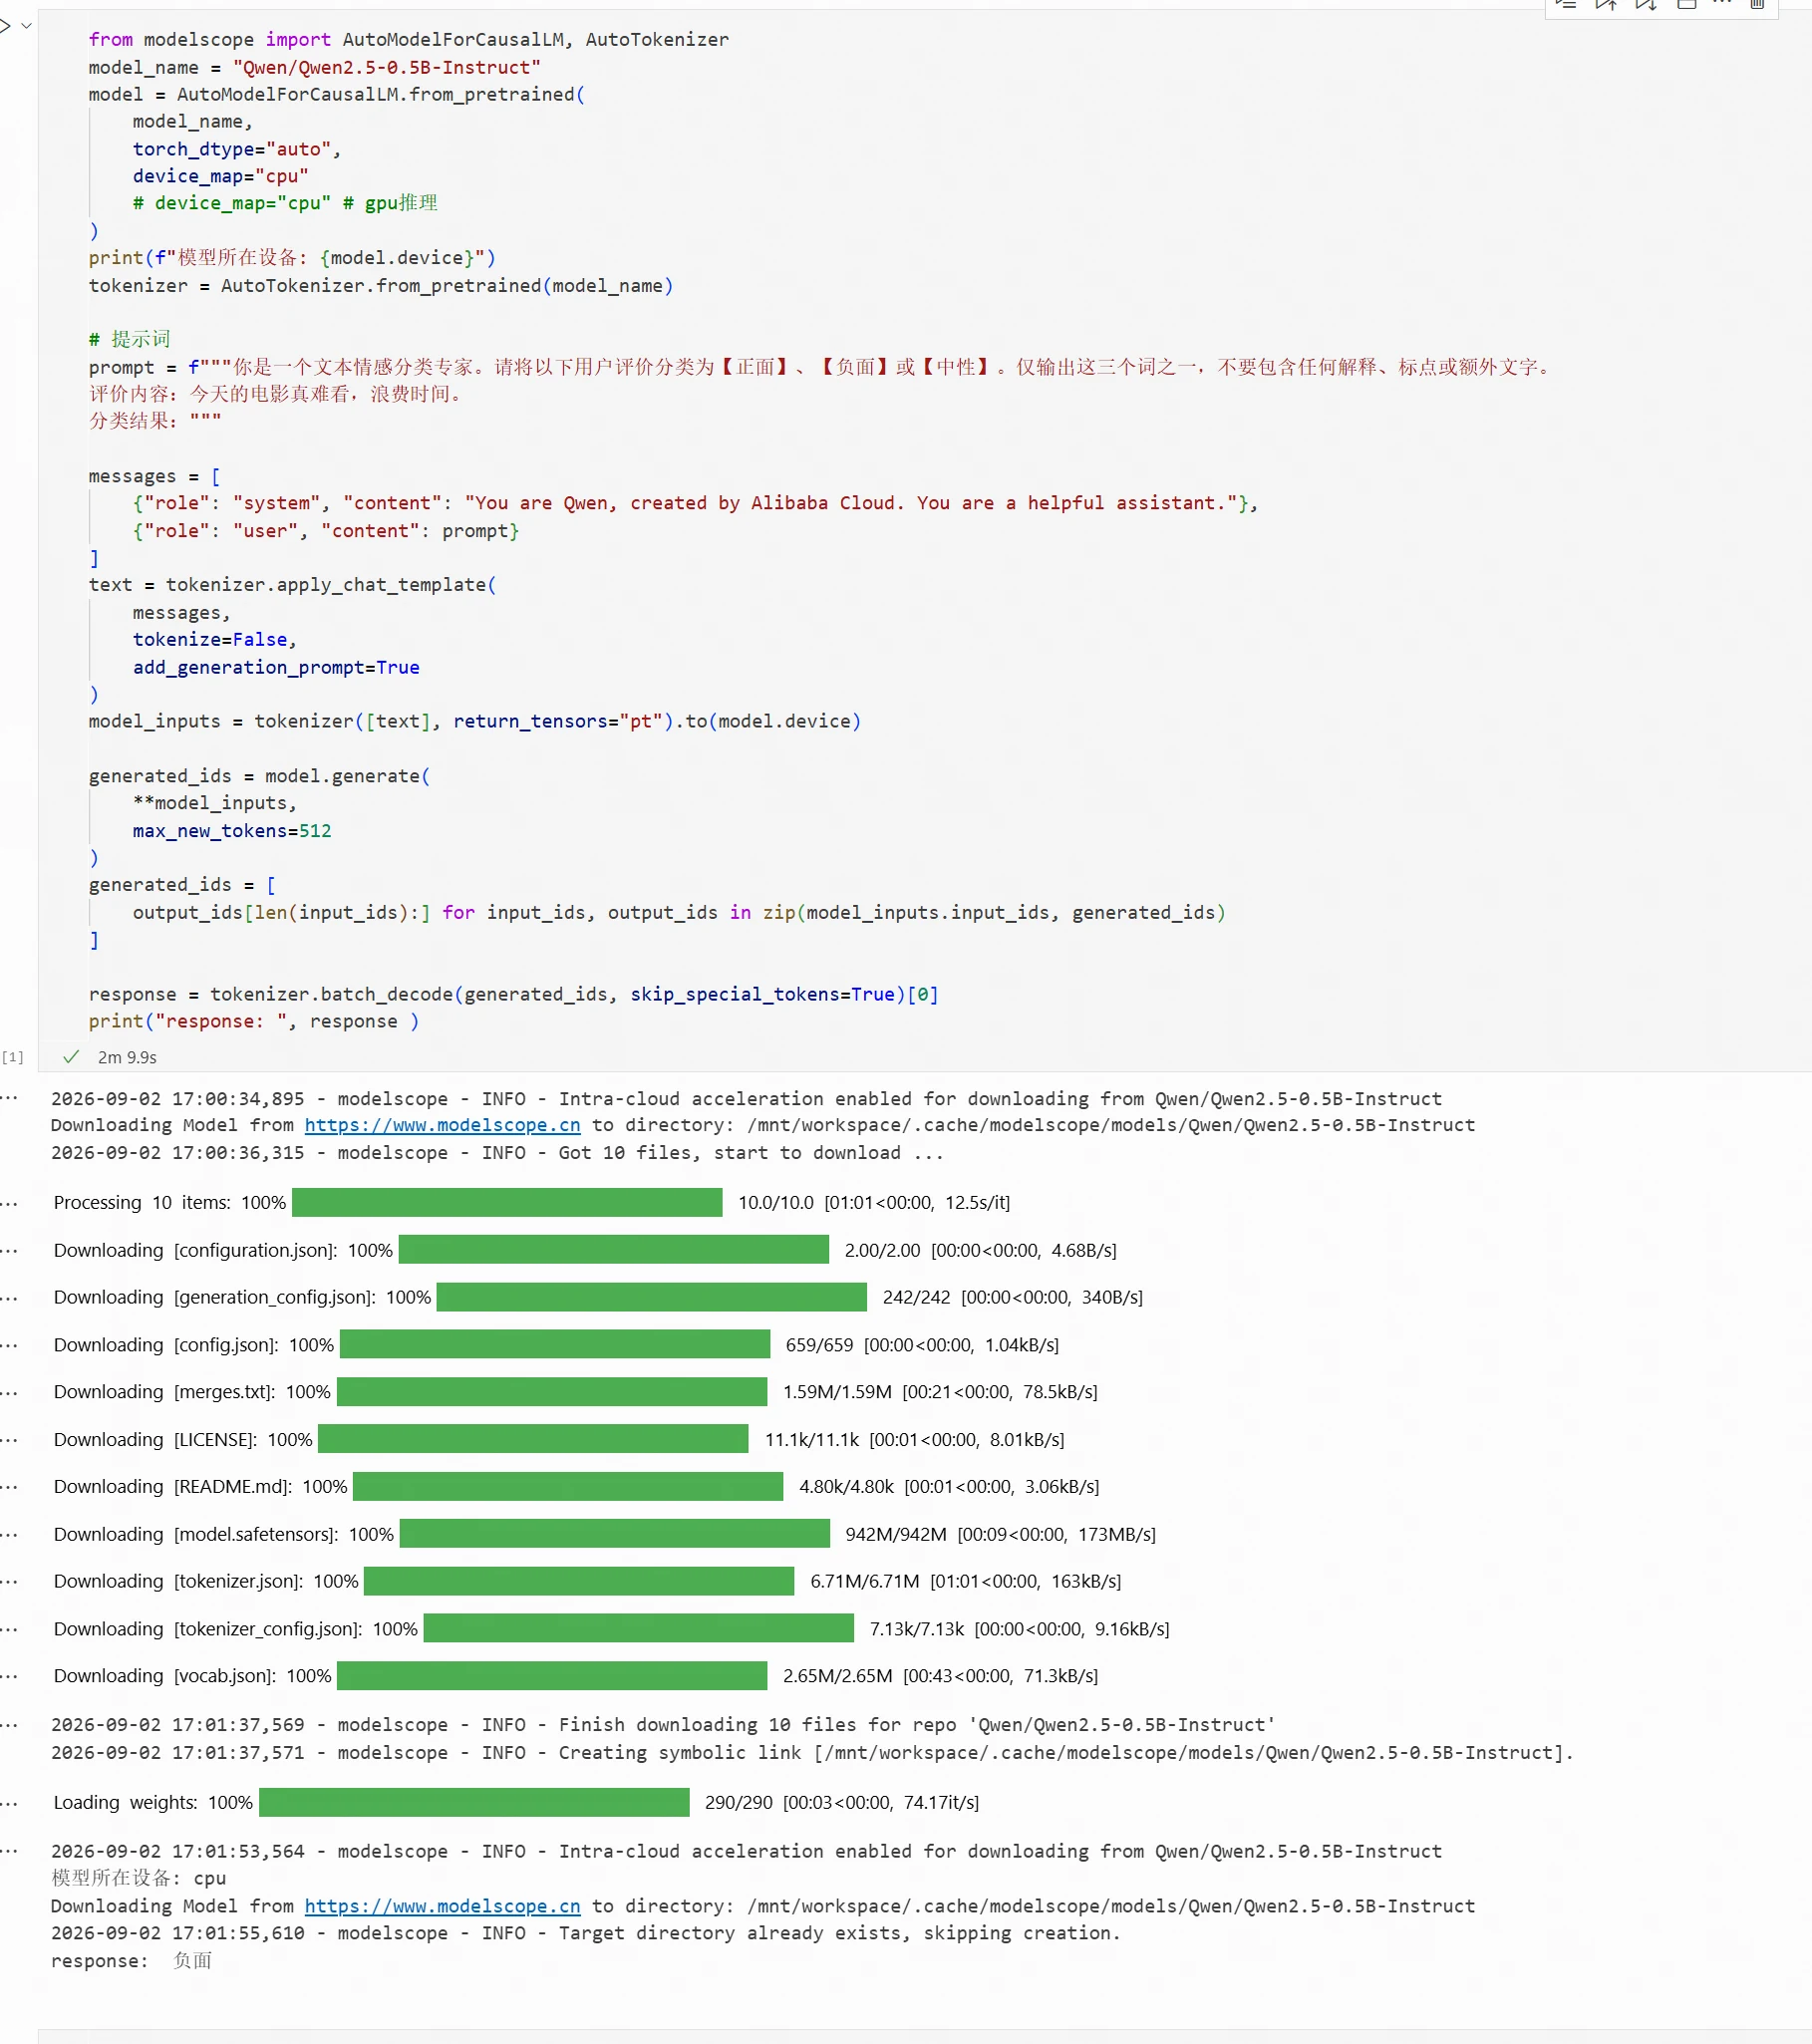
Met het Qwen/Qwen2.5-0.5B-Instruct model als voorbeeld, laten we zien hoe u een 0.5B-niveau model op CPU gebruikt voor sentimentanalyse.
Na het starten van de CPU-instantie, ga naar de Notebook-ontwikkelomgeving. Modelladings- en inferentiecode:
from modelscope import AutoModelForCausalLM, AutoTokenizer
model_name = "Qwen/Qwen2.5-0.5B-Instruct"
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype="auto",
    device_map="cpu"
    # device_map="cpu" # GPU-inferentie
)
print(f"Modelapparaat: {model.device}")
tokenizer = AutoTokenizer.from_pretrained(model_name)

# Prompt
prompt = f"""U bent een expert in tekstclassificatie op sentiment. Classificeer de volgende gebruikersbeoordeling als 【Positief】, 【Negatief】 of 【Neutraal】. Output slechts één van deze drie woorden, zonder uitleg, leestekens of extra tekst.
Beoordeling:今天的电影真难看,浪费时间。
Classificatieresultaat:"""

messages = [
    {"role": "system", "content": "You are Qwen, created by Alibaba Cloud. You are a helpful assistant."},
    {"role": "user", "content": prompt}
]
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True
)
model_inputs = tokenizer([text], return_tensors="pt").to(model.device)

generated_ids = model.generate(
    **model_inputs,
    max_new_tokens=512
)
generated_ids = [
    output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
]

response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]
print("response: ", response )
Inloggen deelnemen aan de discussie
Resultaat:
Met het Tongyi-MAI/Z-Image-Turbo model laten we zien hoe u een model op GPU laadt en een afbeeldingsgeneratietaak voltooit.
Na het starten van de GPU-instantie, ga naar de Notebook-ontwikkelomgeving.
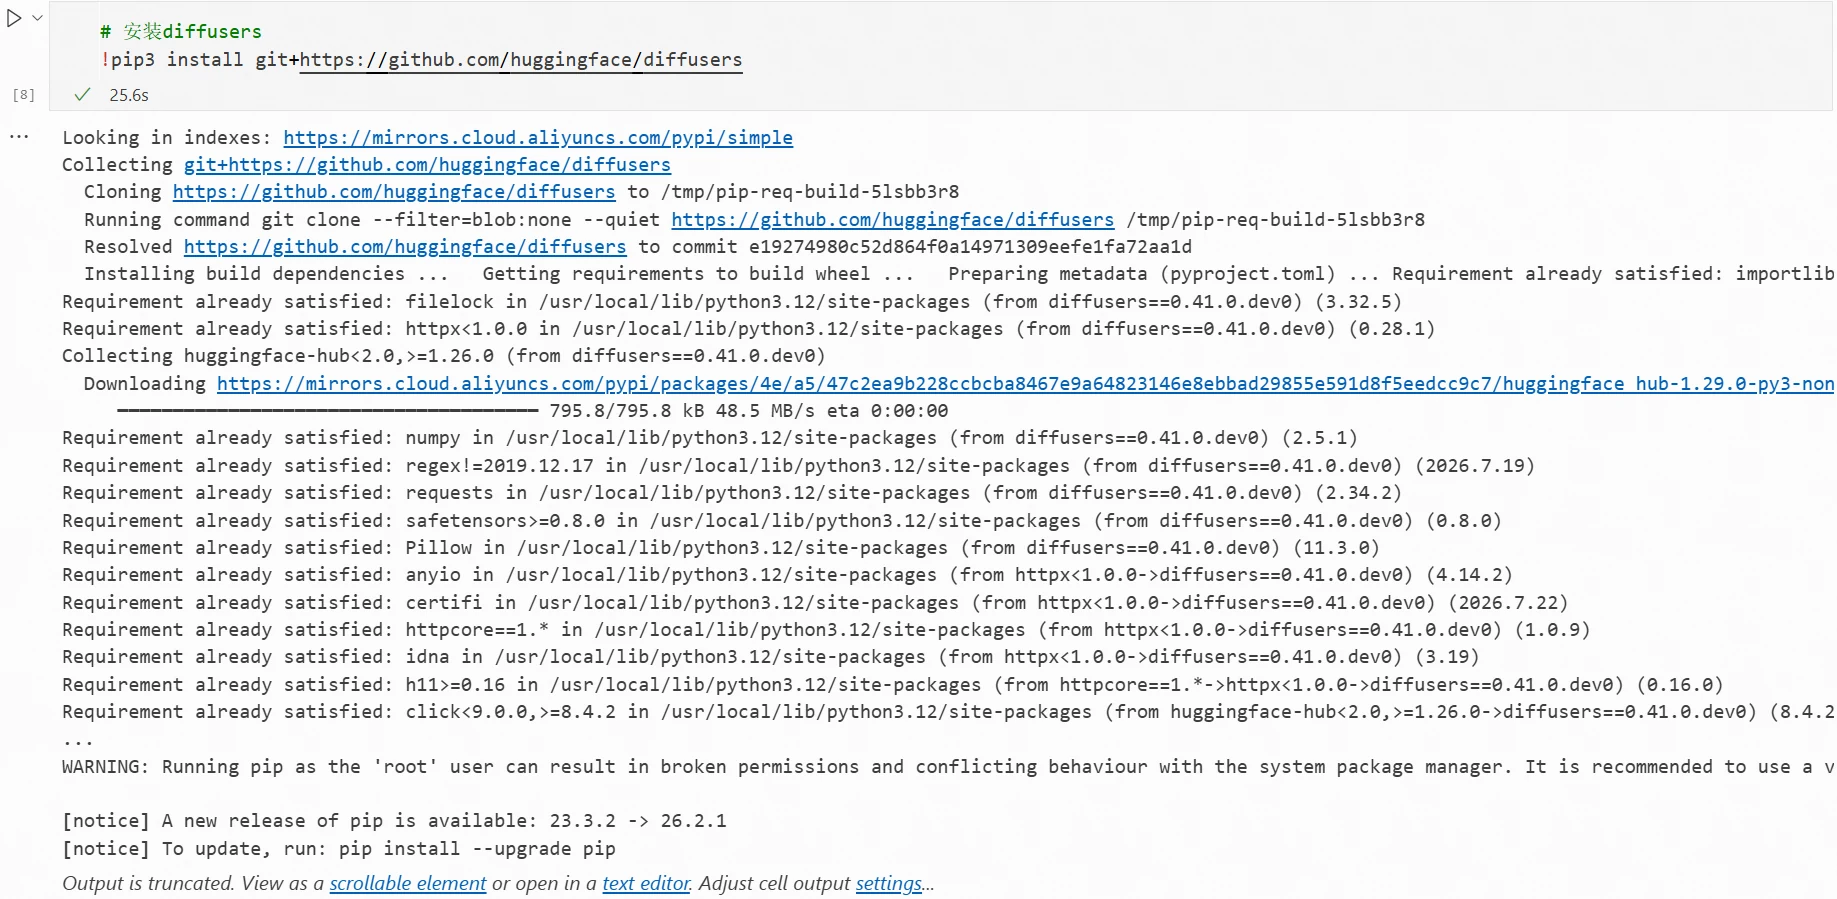
Volgens het modelkaart, installeer de nieuwste diffusers in de terminal:
!pip3 install git+https://github.com/huggingface/diffusers
Installatie voltooid:
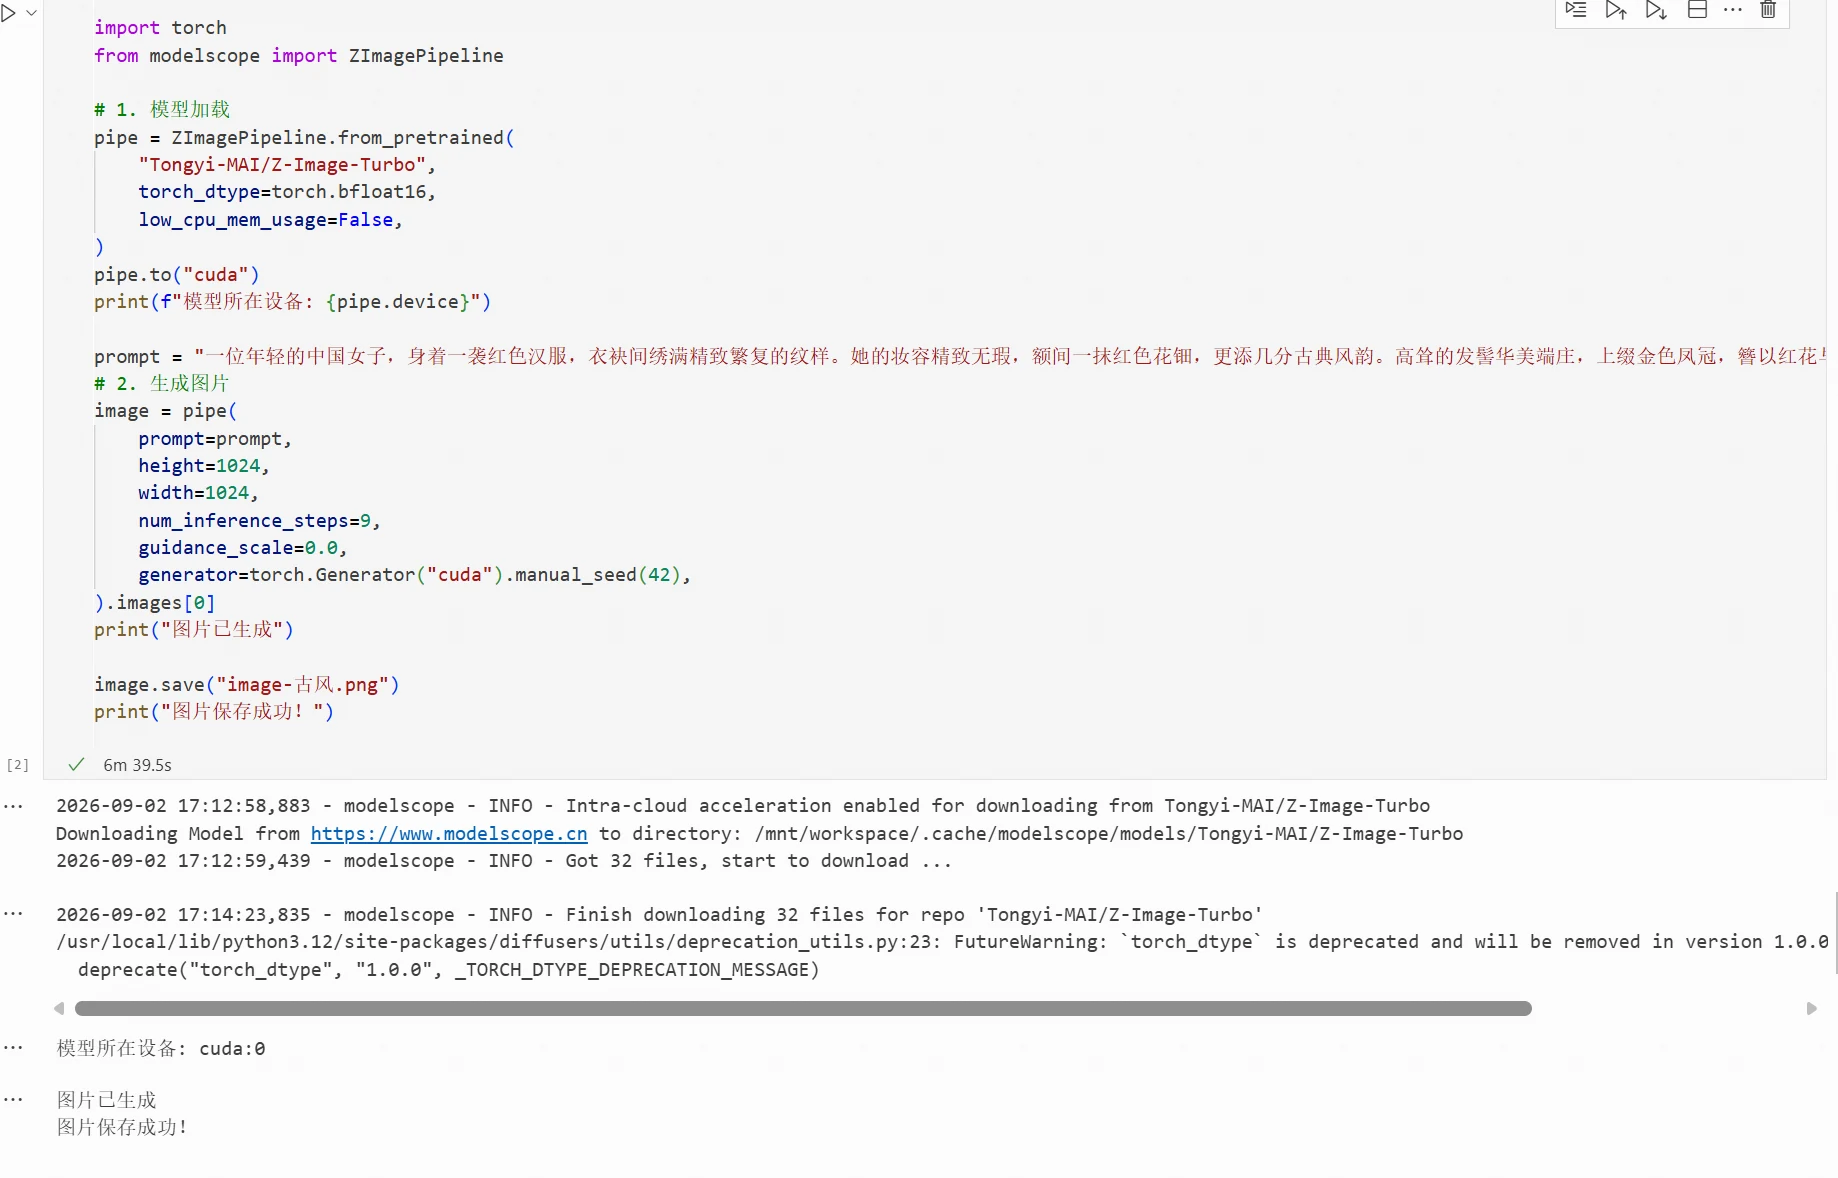
Modelladings- en inferentiecode:
import torch
from modelscope import ZImagePipeline

# 1. Model laden
pipe = ZImagePipeline.from_pretrained(
    "Tongyi-MAI/Z-Image-Turbo",
    torch_dtype=torch.bfloat16,
    low_cpu_mem_usage=False,
)
pipe.to("cuda")
print(f"Modelapparaat: {pipe.device}")

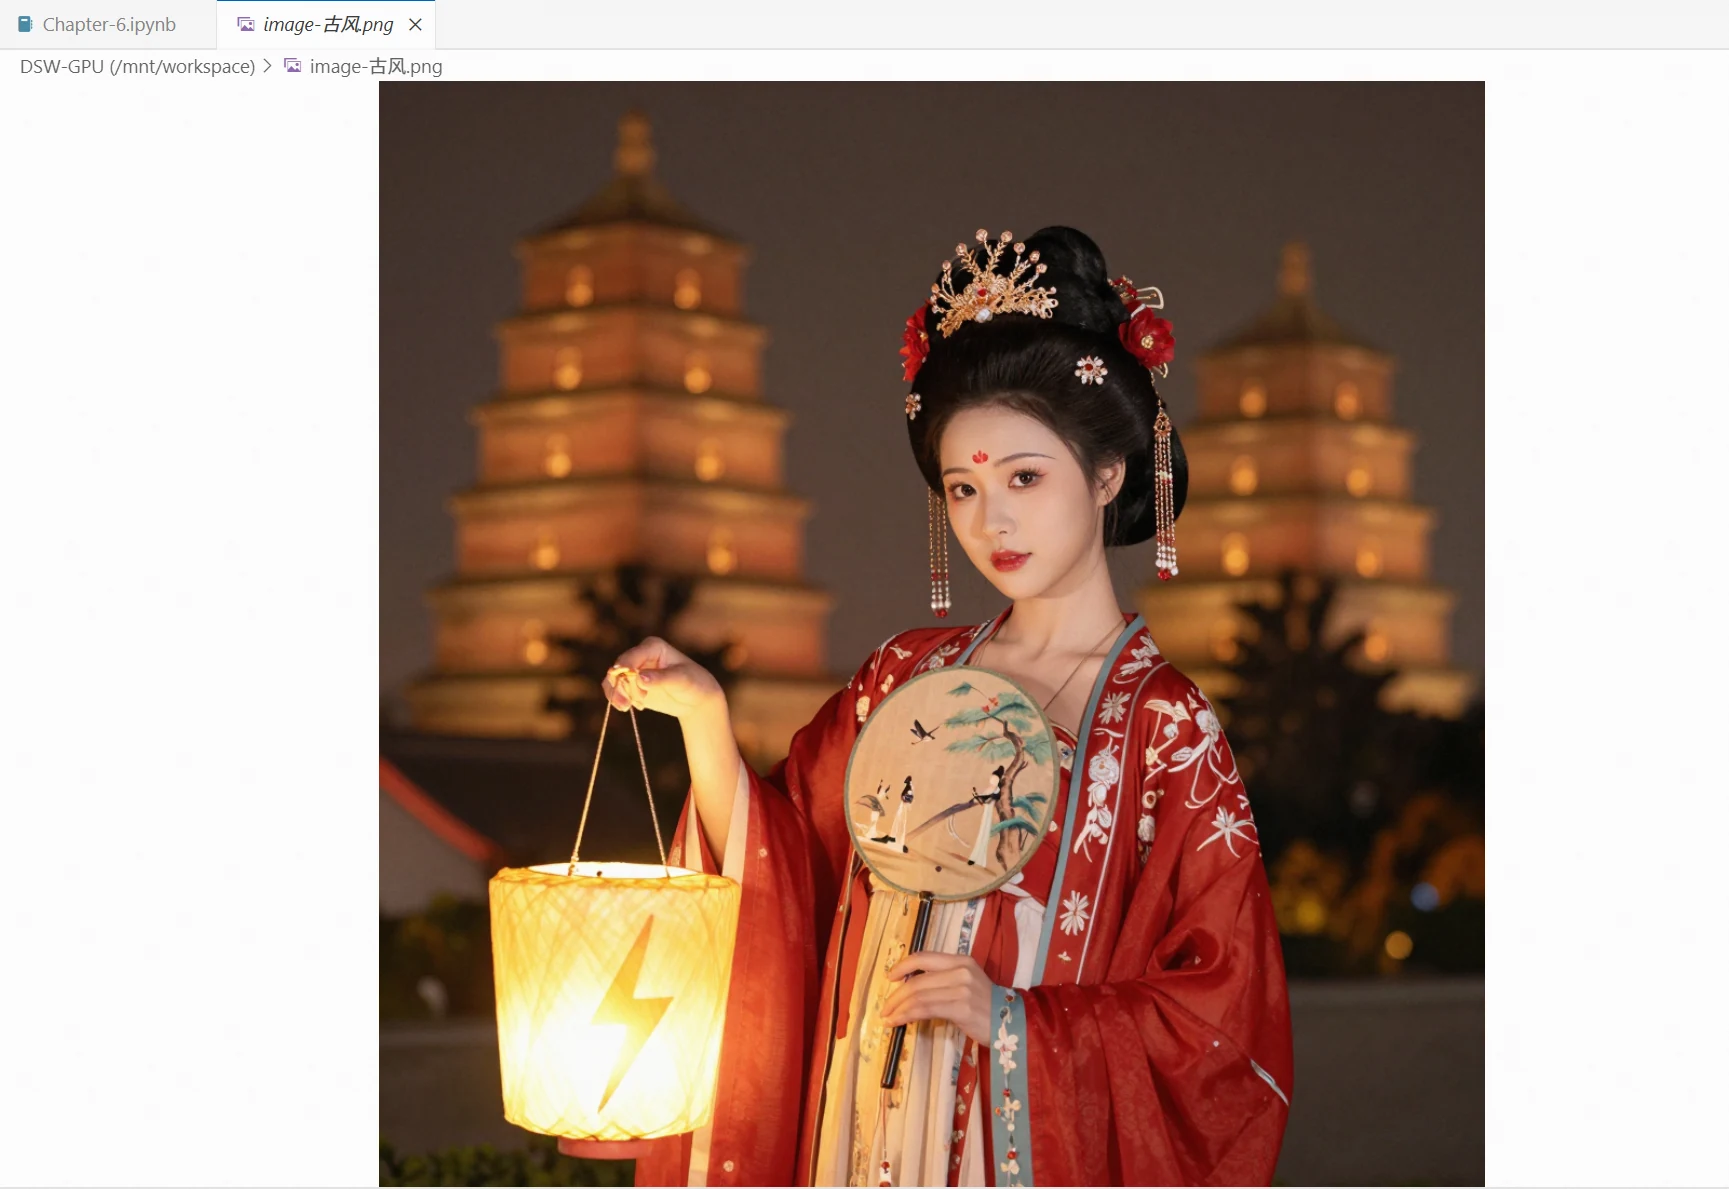
prompt = "一位年轻的中国女子,身着一袭红色汉服,衣袂间绣满精致繁复的纹样。她的妆容精致无瑕,额间一抹红色花钿,更添几分古典风韵。高耸的发髻华美端庄,上缀金色凤冠,簪以红花与珠串,摇曳生姿。她手中执一柄圆形折扇,扇面上绘有仕女、古树与飞鸟,意境悠然。一盏霓虹闪电造型的灯盏悬于她伸出的左掌之上,散发着明亮的暖黄色光芒。夜色温柔,灯火朦胧,远处西安大雁塔的塔身层层叠叠,隐现于柔和的光晕之中,背景光斑斑斓,如梦似幻。"
# 2. Afbeelding genereren
image = pipe(
    prompt=prompt,
    height=1024,
    width=1024,
    num_inference_steps=9,
    guidance_scale=0.0,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]
print("Afbeelding gegenereerd")

image.save("image-vintage.png")
print("Afbeelding succesvol opgeslagen!")
Resultaat:
Gegenereerde afbeelding:
Code en bijbehorende bestanden van dit hoofdstuk: https://www.modelscope.cn/gallery/liucong/4a8eb492-54dc-4062-82c0-65b17fd94d5f