Na het downloaden van een open-source model kunt u het op uw eigen laptop uitvoeren of een cloudserver huren, waarbij u de CPU, GPU en de runtime-omgeving naar behoefte configureert. Verschillende hardware vereist verschillende voorbereidingen.
Als u gewoon wilt proberen wat een model kan, biedt ModelScope Notebook een gratis toegangspunt. Open een browser, selecteer een draaiende instantie, en u kunt direct in de webpagina code schrijven, modellen downloaden en resultaten bekijken.
Deze les begeleidt u door het aanmaken van een Notebook, het controleren van de omgeving en het laden van een model. Volg de stappen om uw eerste resultaat te zien.
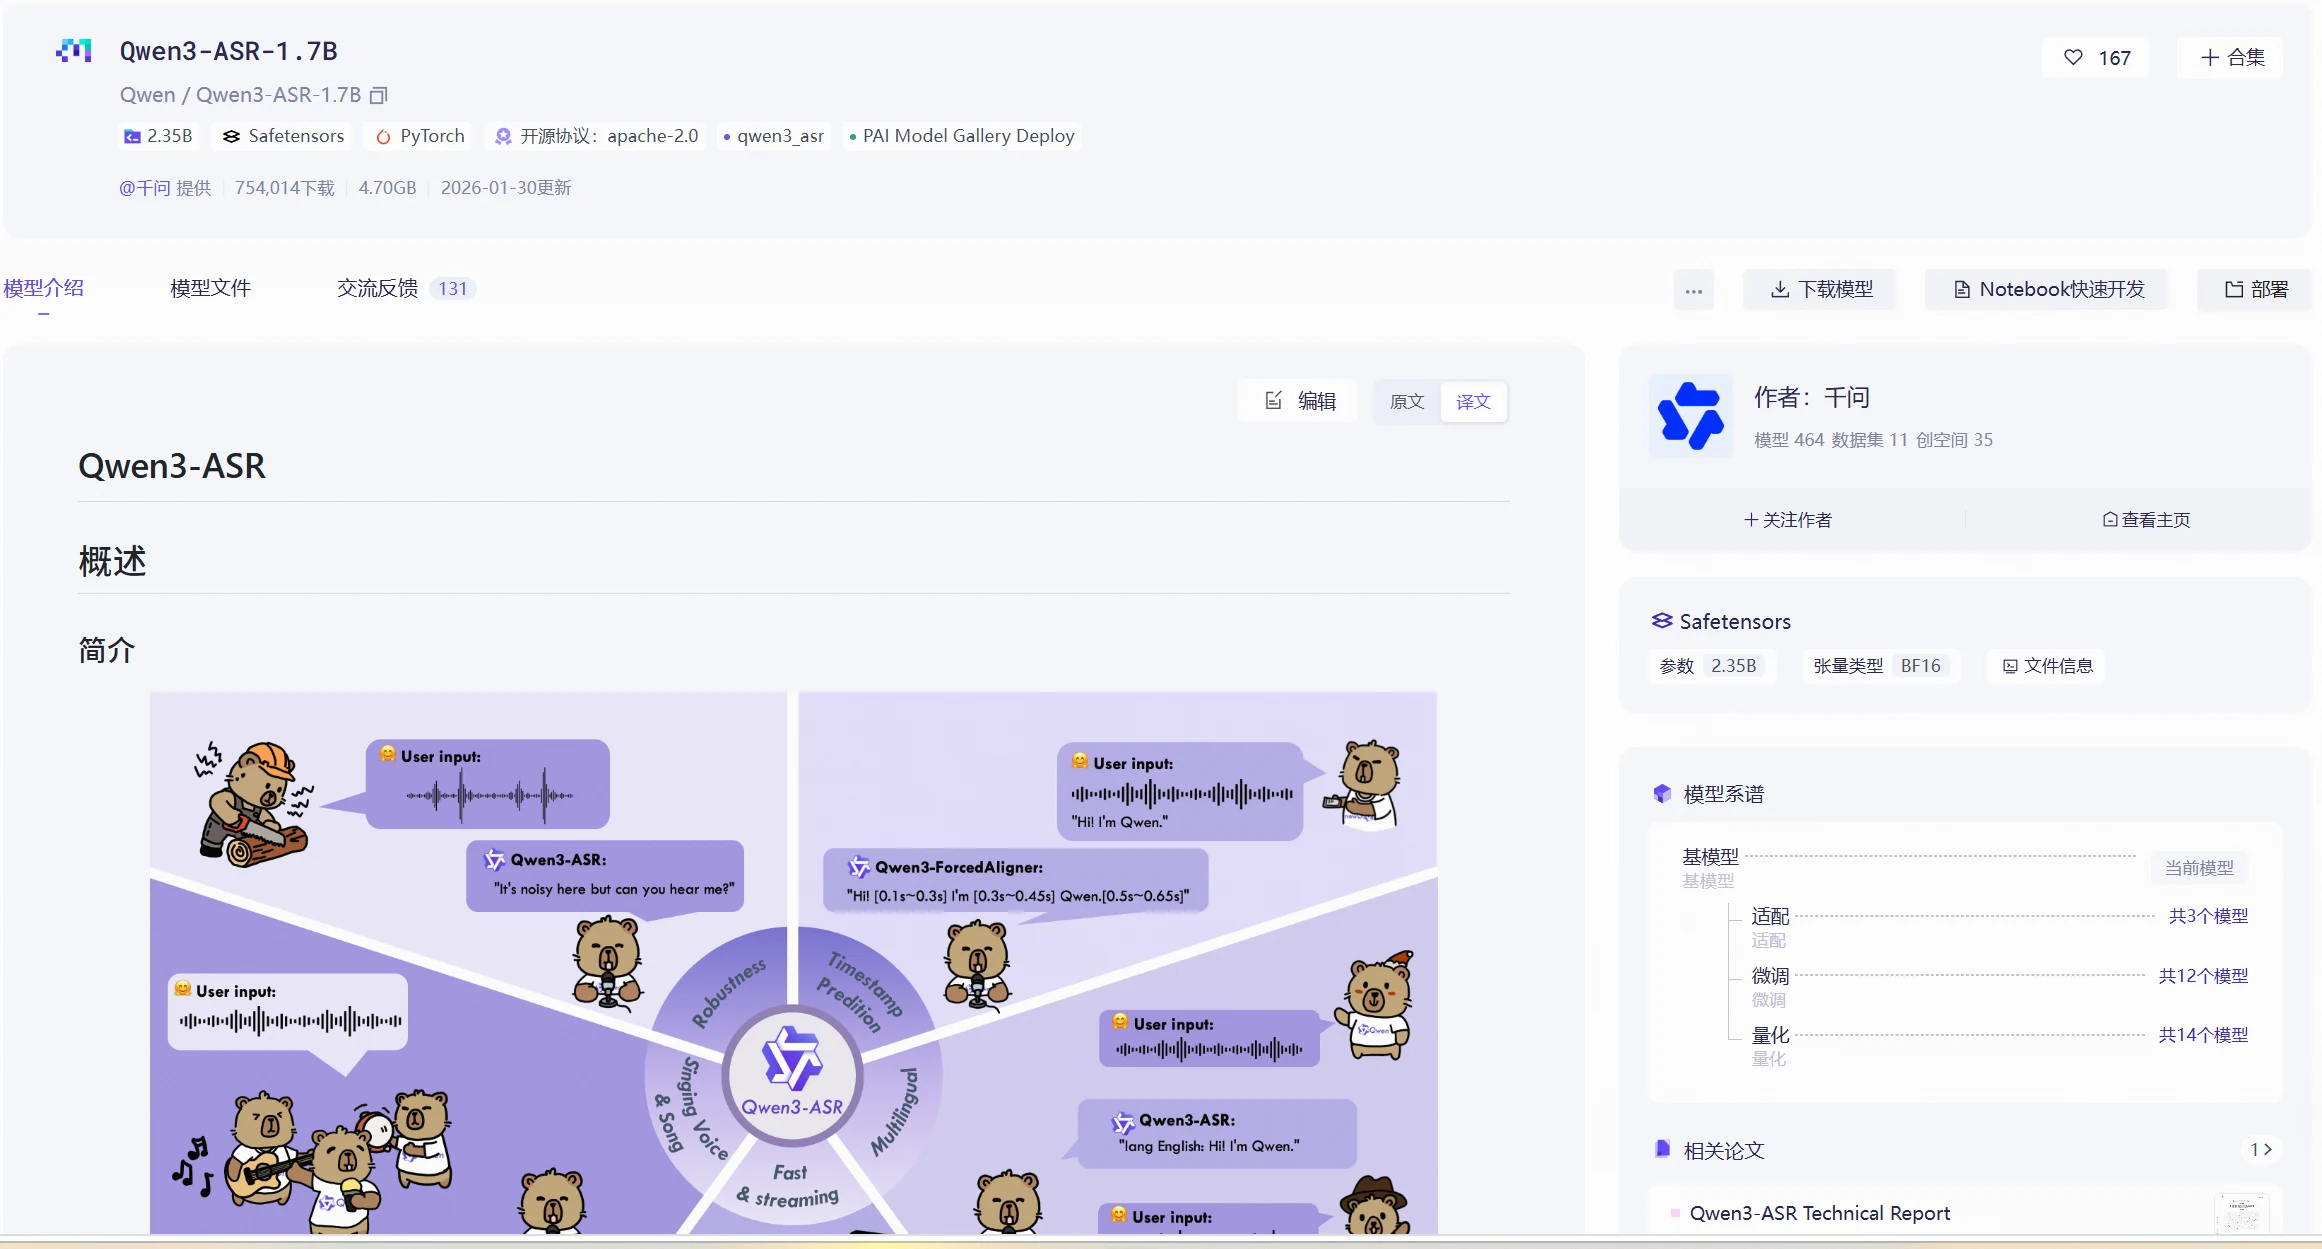
Ga naar de modelhub, vind het model Qwen/Qwen3-ASR-1.7B en klik rechts op "Notebook Quick Development" om een ModelScope-notebook aan te maken.
Modellink: https://www.modelscope.cn/models/Qwen/Qwen3-ASR-1.7B
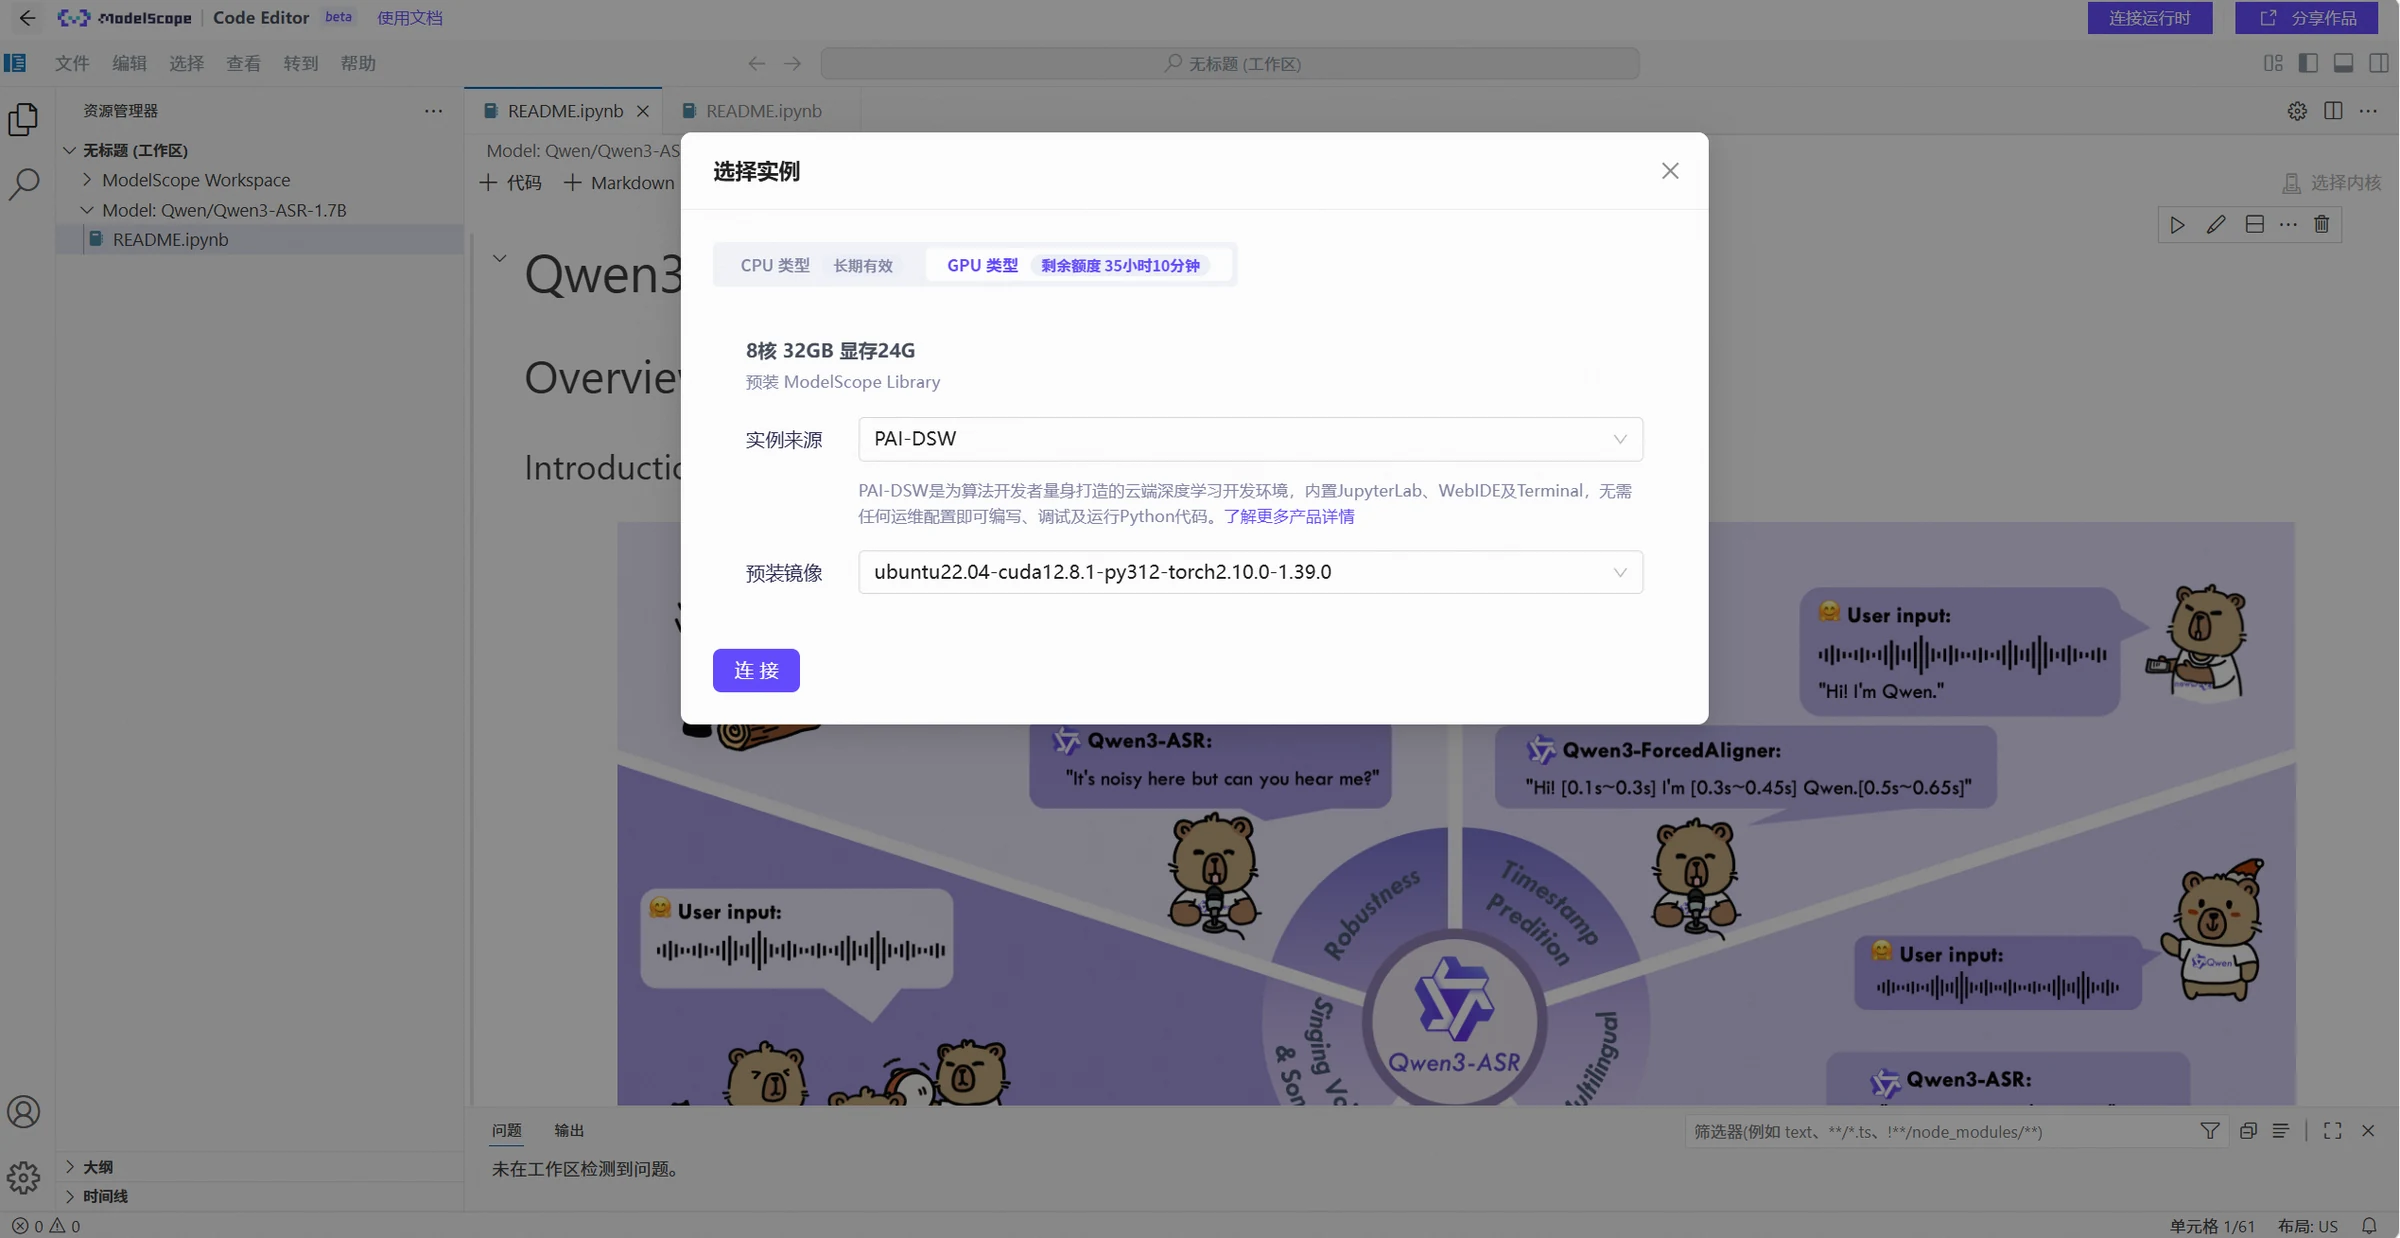
Klik rechtsboven op "Connect Runtime" om een instantie te selecteren. Hier kiezen we GPU voor de demonstratie. U kunt een geschikt vooraf geïnstalleerd image selecteren op basis van de modelafhankelijkheden.
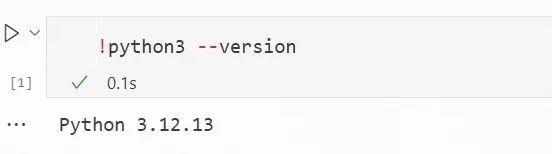
Na het laden van de instantie is de eerste stap om de huidige omgeving te controleren. U kunt de volgende opdrachten in het notebook uitvoeren:
!python3 --version
Resultaat:
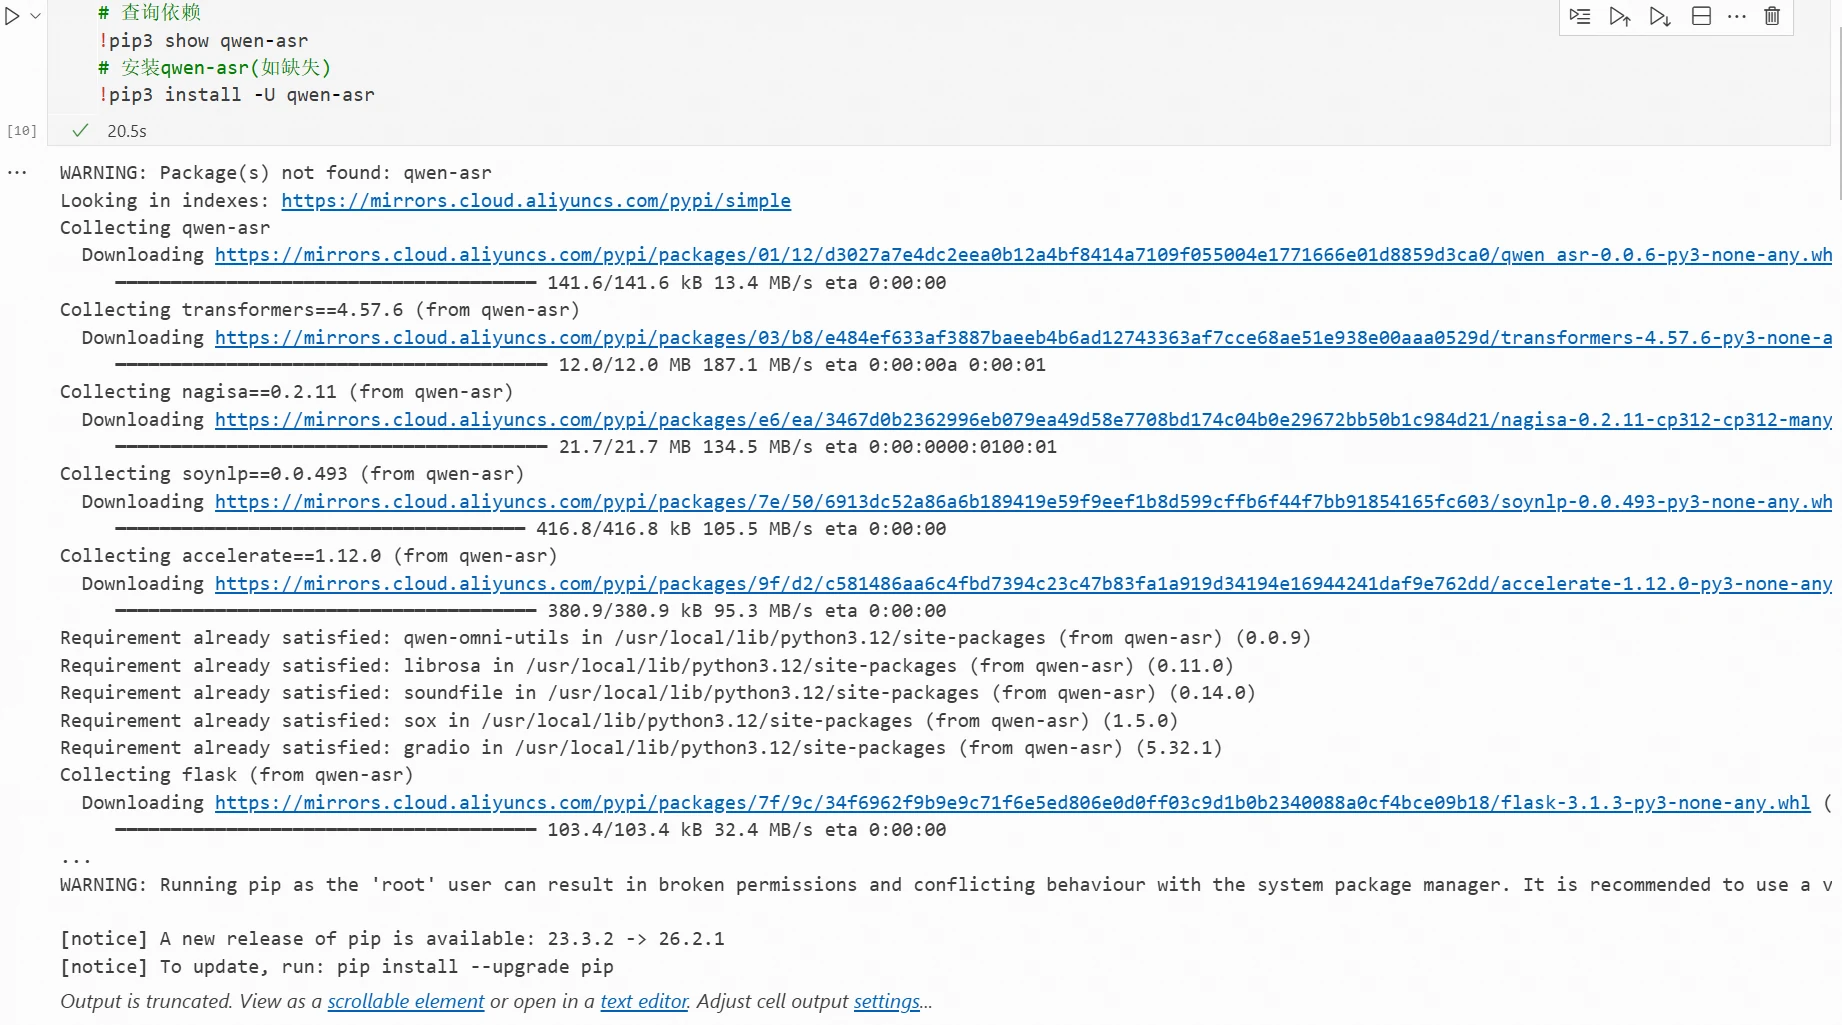
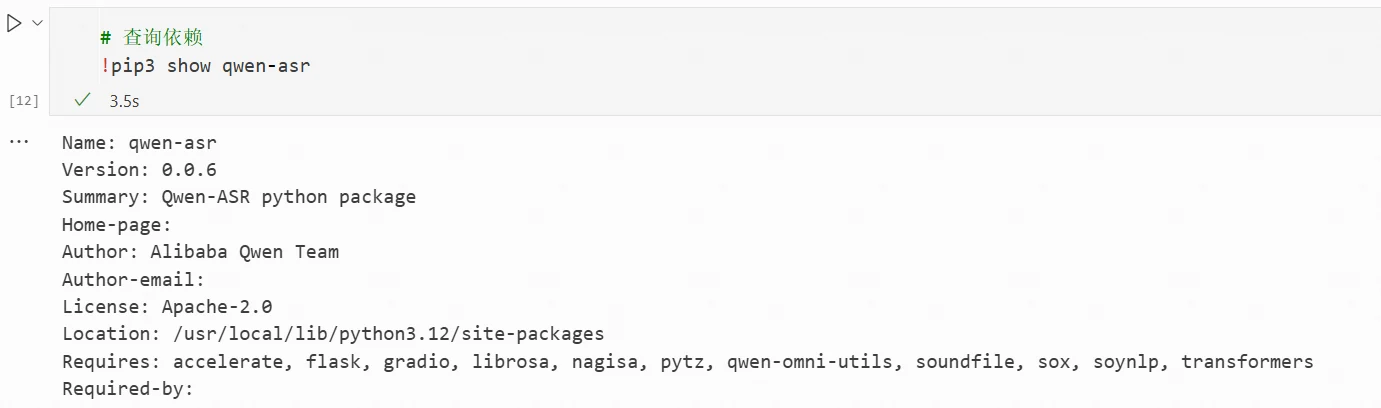
Elk model heeft verschillende afhankelijkheden. U moet het modelkaart raadplegen voor informatie. Volgens het modelkaart van Qwen3-ASR-1.7B is de inferentie-afhankelijkheid qwen3-asr. Als qwen3-asr ontbreekt in de omgeving, moet u het zelf installeren.
# Controleer afhankelijkheid
!pip3 show qwen-asr
# Installeer qwen-asr (indien ontbrekend)
!pip3 install -U qwen-asr
Resultaat:
Succesvolle installatie query resultaat:
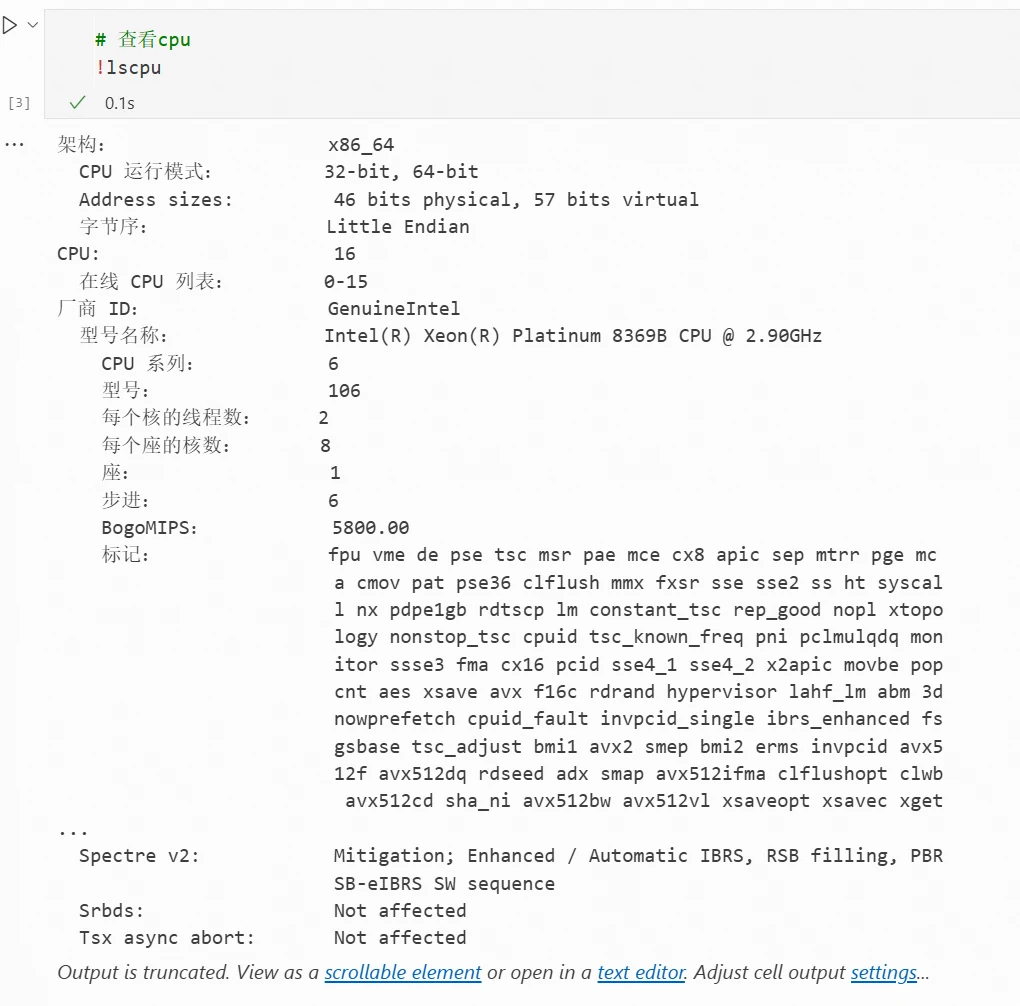
!lscpu
Resultaat:
Inloggen deelnemen aan de discussie
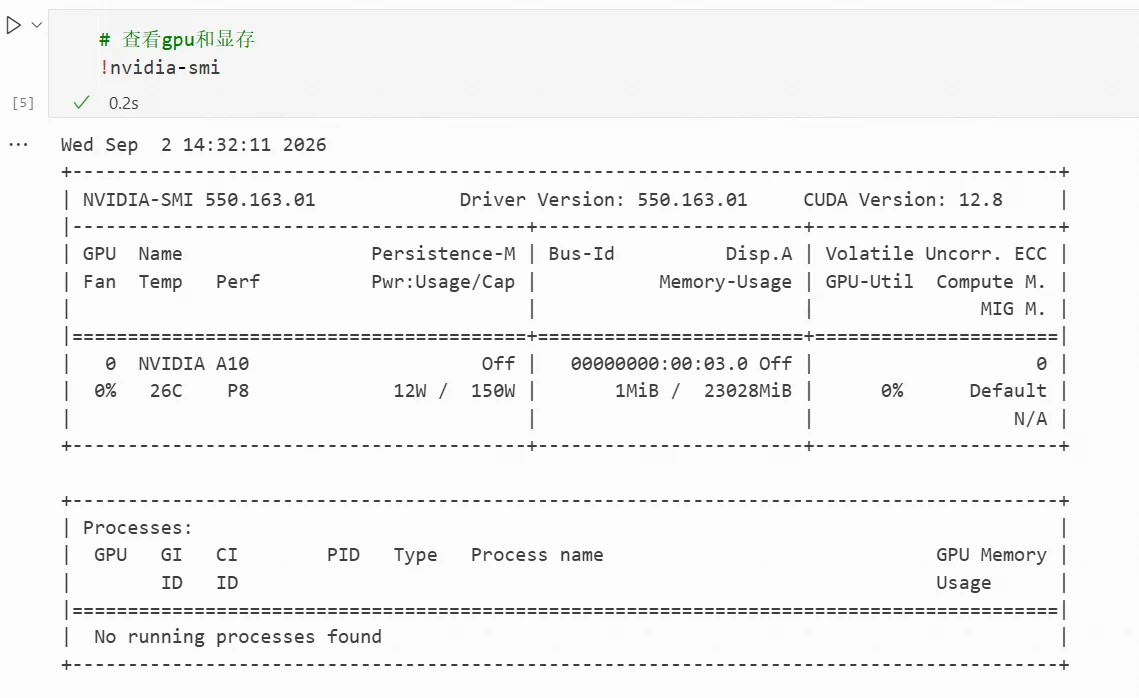
!nvidia-smi
Resultaat:

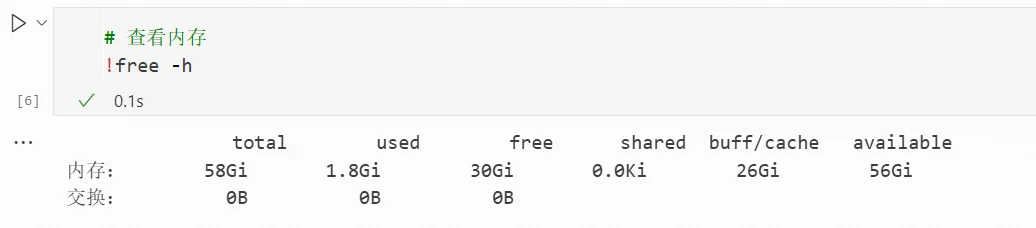
!free -h
Resultaat:

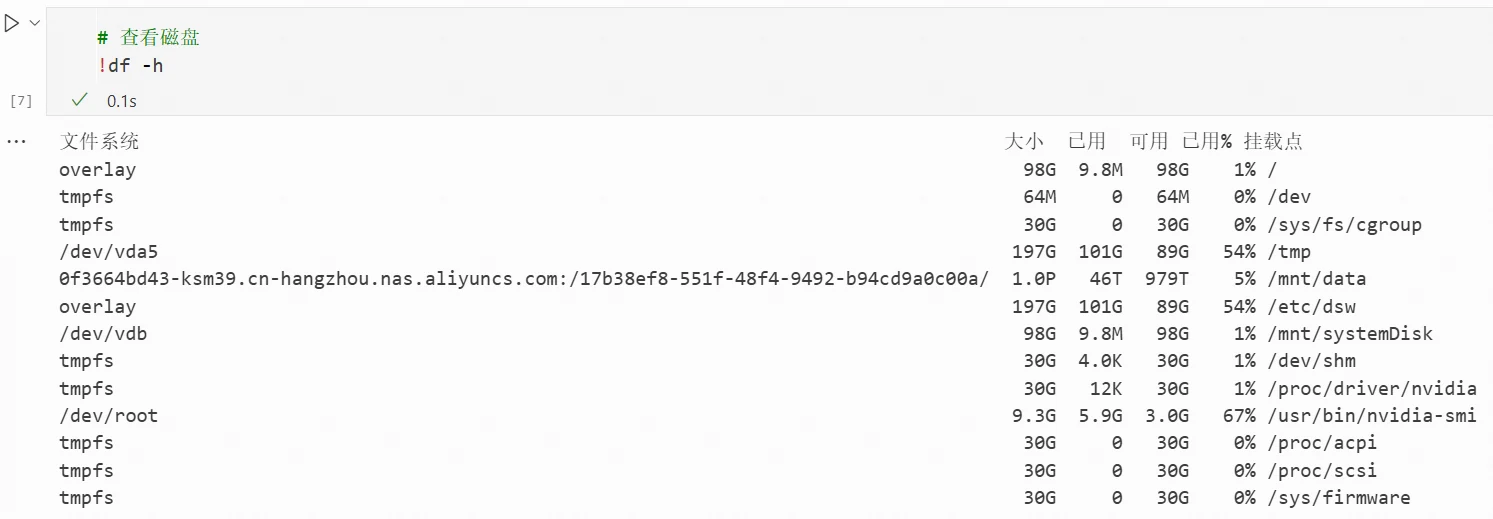
!df -h
Resultaat:

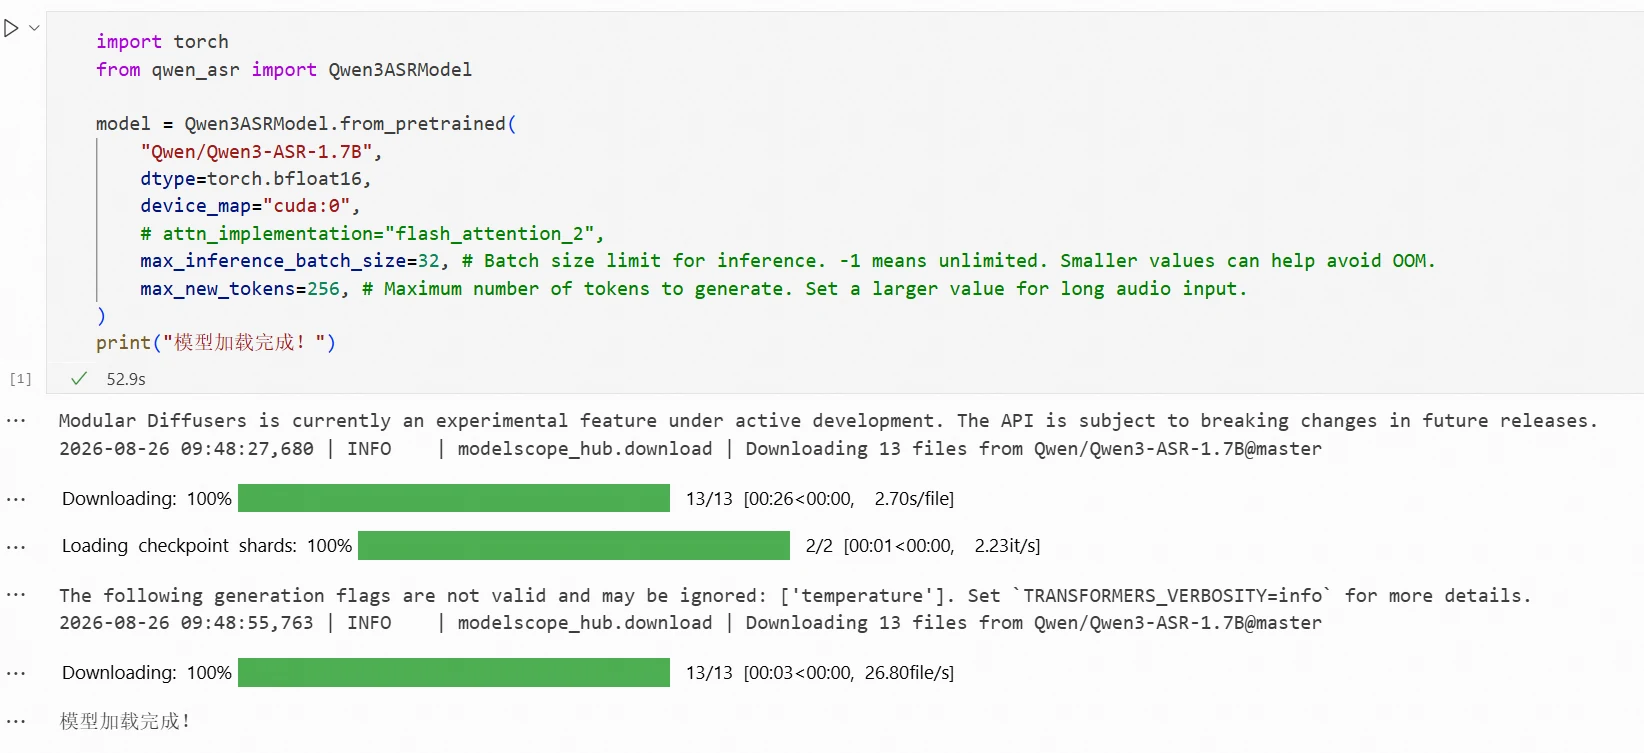
Raadpleeg de voorbeeldcode op het modelkaart voor het laden. De benodigde modelbestanden worden automatisch gedownload.
import torch
from qwen_asr import Qwen3ASRModel
model = Qwen3ASRModel.from_pretrained(
"Qwen/Qwen3-ASR-1.7B",
dtype=torch.bfloat16,
device_map="cuda:0",
# attn_implementation="flash_attention_2",
max_inference_batch_size=32, # Batch size limit for inference. -1 means unlimited. Smaller values can help avoid OOM.
max_new_tokens=256, # Maximum number of tokens to generate. Set a larger value for long audio input.
)
print("Model succesvol geladen!")
Resultaat:

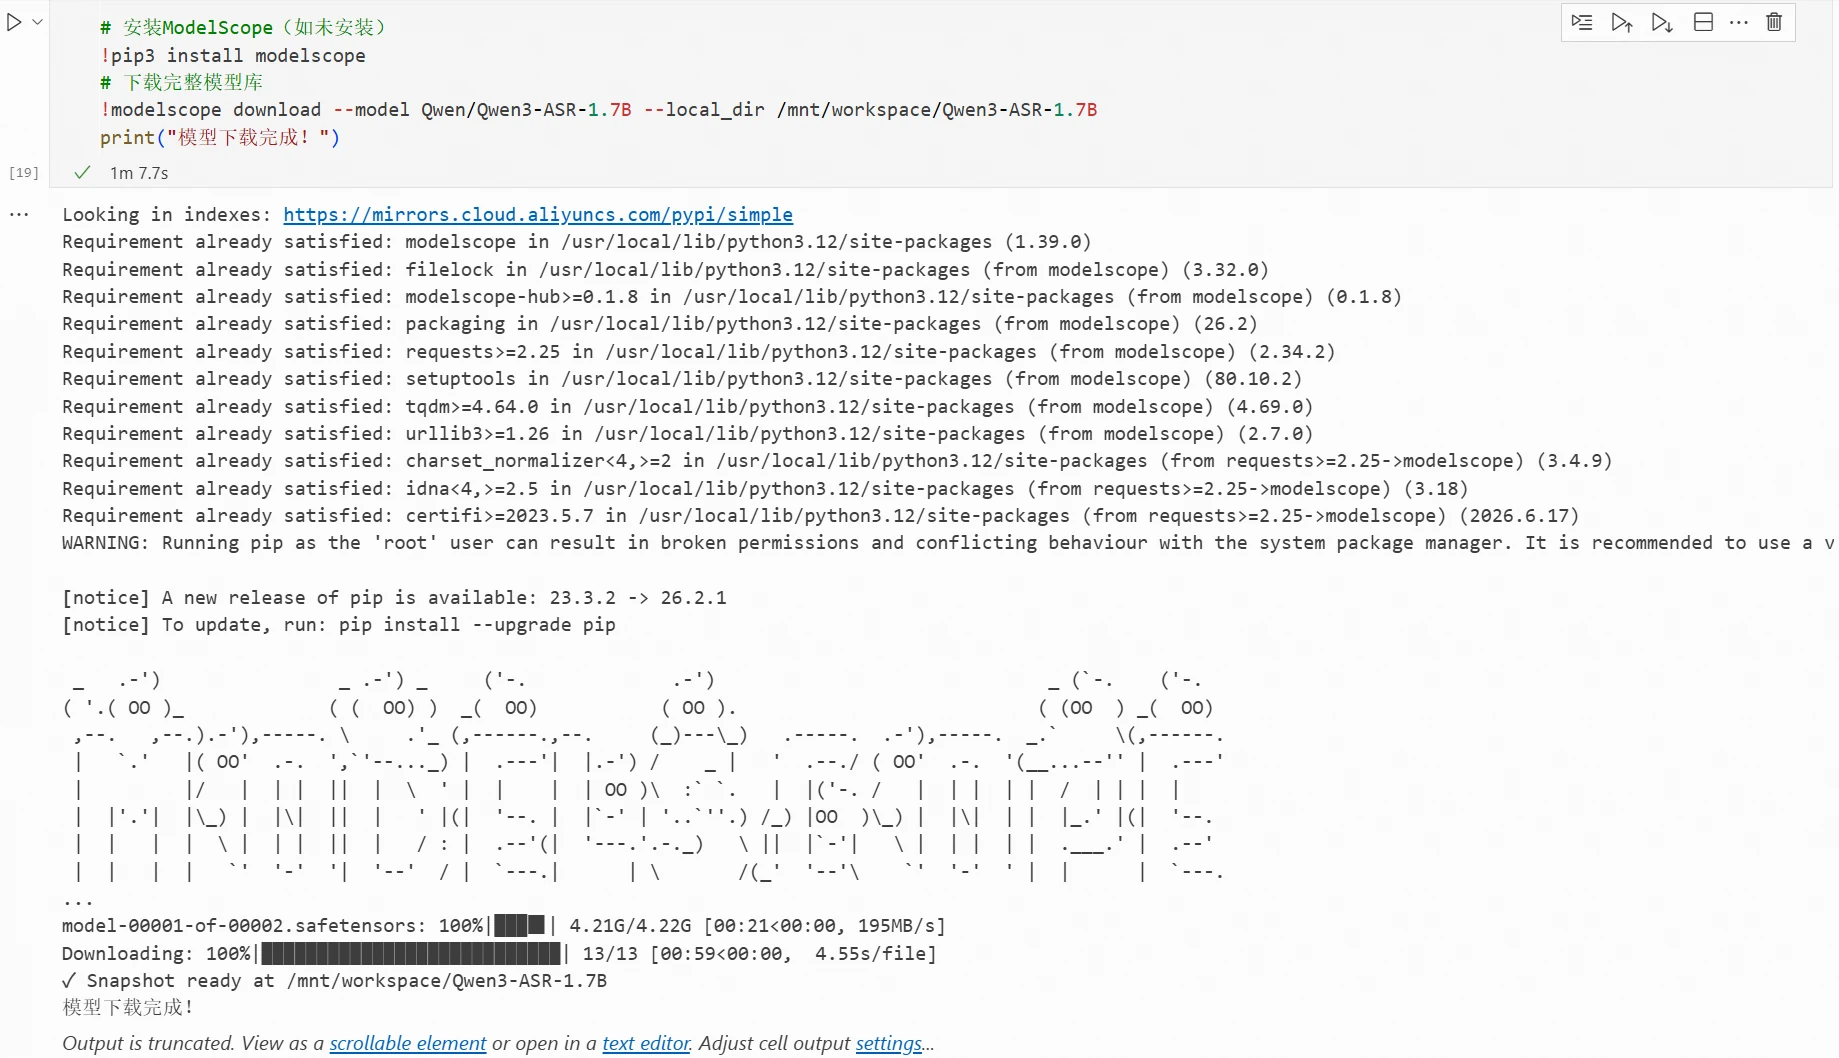
Als u het model apart wilt downloaden, raadpleeg de downloadmethode in sectie 2.5 van dit boek. Om het model bijvoorbeeld naar de directory /mnt/workspace/Qwen3-ASR-1.7B te downloaden, voert u de volgende opdracht in de terminal uit:
# Installeer ModelScope (indien niet geïnstalleerd)
!pip3 install modelscope
# Download de volledige modelrepository
!modelscope download --model Qwen/Qwen3-ASR-1.7B --local_dir /mnt/workspace/Qwen3-ASR-1.7B
Resultaat:

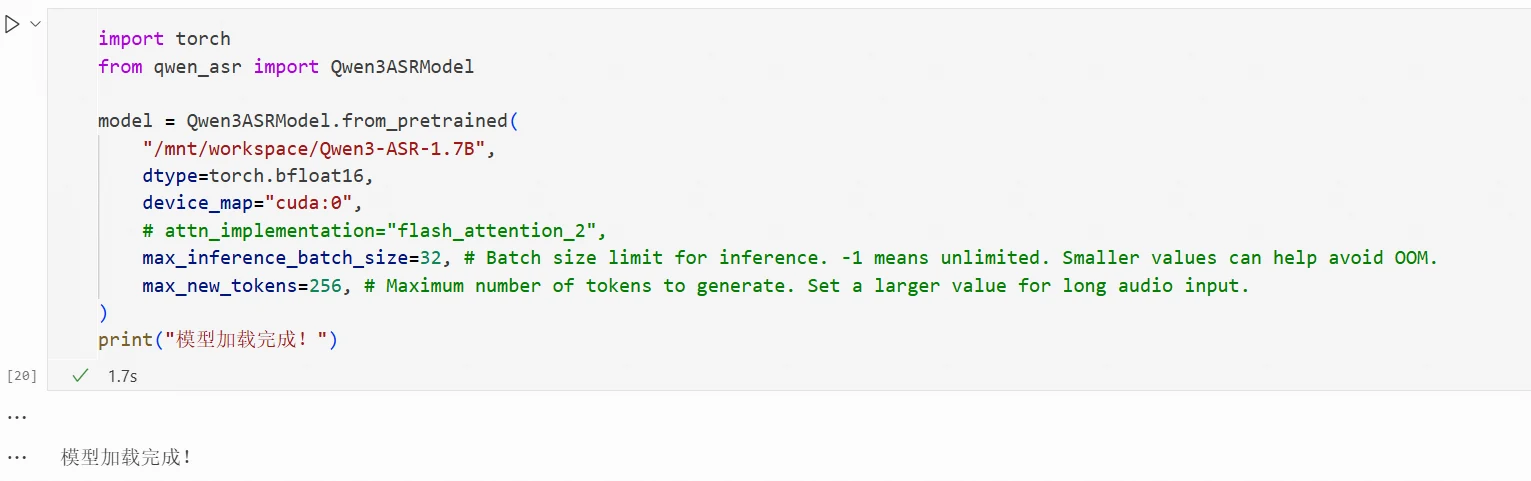
Als u de modelbestanden heeft gedownload, kunt u Qwen/Qwen3-ASR-1.7B vervangen door uw modelpad.
import torch
from qwen_asr import Qwen3ASRModel
model = Qwen3ASRModel.from_pretrained(
"/mnt/workspace/Qwen3-ASR-1.7B",
dtype=torch.bfloat16,
device_map="cuda:0",
# attn_implementation="flash_attention_2",
max_inference_batch_size=32, # Batch size limit for inference. -1 means unlimited. Smaller values can help avoid OOM.
max_new_tokens=256, # Maximum number of tokens to generate. Set a larger value for long audio input.
)
print("Model succesvol geladen!")
Resultaat:

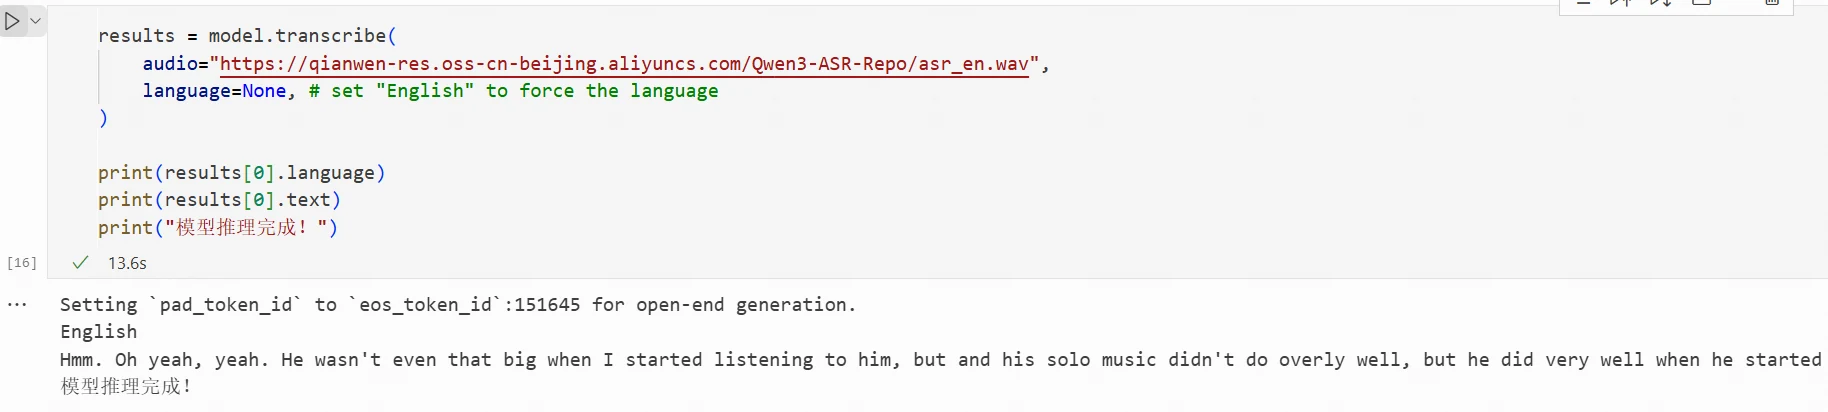
Nadat het model is geladen, kunt u audiobestanden doorgeven voor modelinferentie. U kunt de audio-waarde vervangen door het pad van uw audiobestand.
results = model.transcribe(
audio="https://qianwen-res.oss-cn-beijing.aliyuncs.com/Qwen3-ASR-Repo/asr_en.wav",
language=None, # set "English" to force the language
)
print(results[0].language)
print(results[0].text)
print("Modelinferentie voltooid!")
Resultaat:

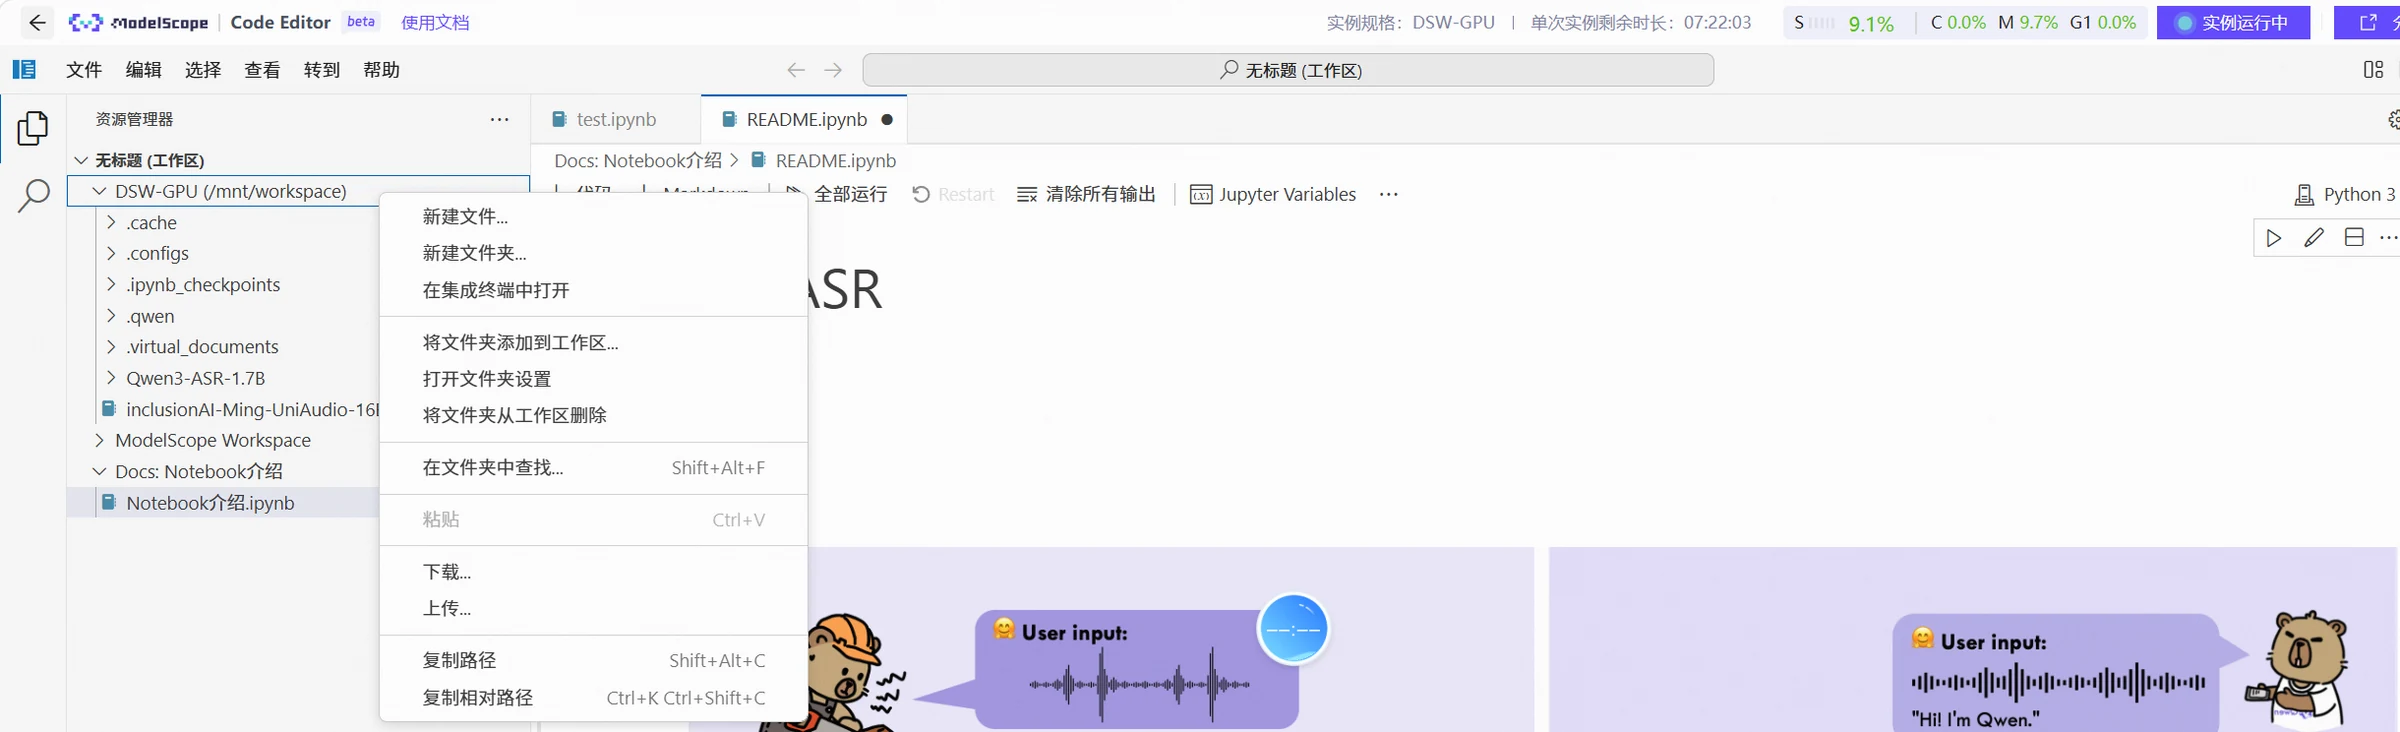
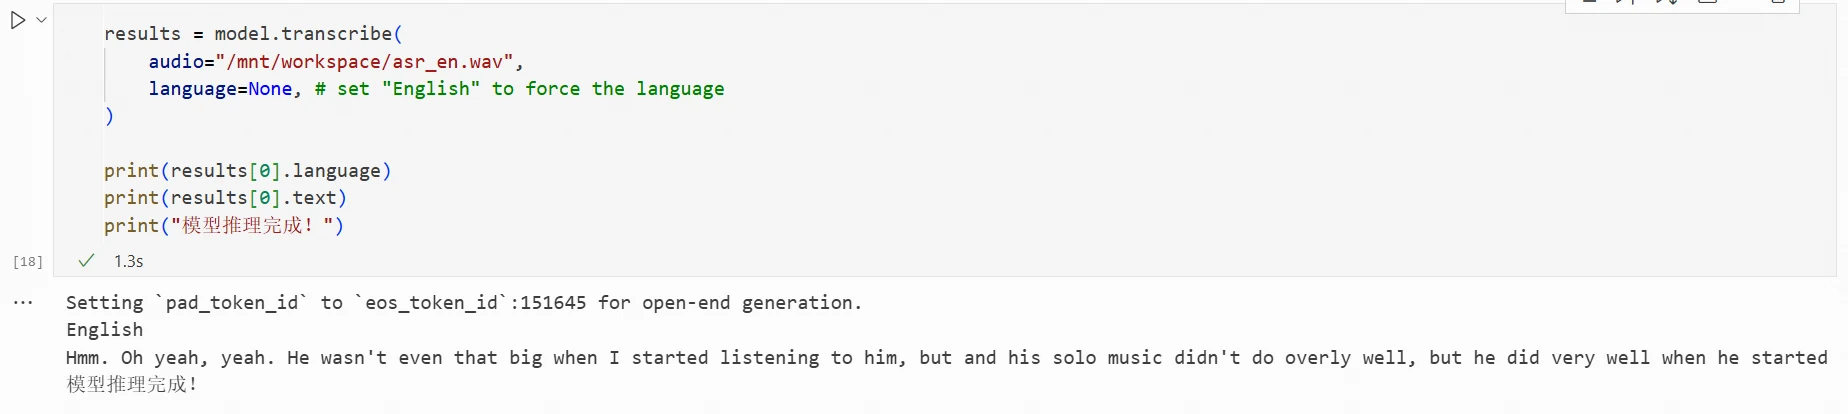
U kunt de audio-waarde vervangen door het pad van uw audiobestand voor modelinferentie. Klik met de rechtermuisknop op de map "DSW-GPU" in de werkruimte links, klik op "Upload", selecteer uw lokale audiobestand, en het wordt geüpload naar de map "DSW-GPU" van de Notebook-omgeving.

Wijzig vervolgens de code als volgt:
results = model.transcribe(
audio="/mnt/workspace/asr_en.wav",
language=None, # set "English" to force the language
)
print(results[0].language)
print(results[0].text)
print("Modelinferentie voltooid!")
Resultaat:

De code en bijbehorende bestanden van dit hoofdstuk zijn te vinden op: https://www.modelscope.cn/gallery/liucong/54c2ca38-b797-43d1-97ab-4b9f569aaa95