Fijntuning en evaluatie • Beginner⏱️ 30 min leestijd
Training Data Preparation
Hoe u zakelijke materialen omzet in trainbare data?
Voordat we een model trainen, komen we vaak met het volgende probleem:
Ik heb veel ruwe materialen, producthandleidingen, operationele gidsen en bedrijfsspecificaties, elk in hun eigen formaat, en de inhoud is nogal verspreid,
Hoe kan ik deze data gebruiken?
En als ik direct domein- of scenariospecifieke data gebruik, zal het getrainde model dan nog de capaciteit hebben om algemene kennisvragen te beantwoorden?
Daarom is het sleutelpunt hoe we alle materialen kunnen omzetten in trainbare data die door het model gebruikt kan worden.
Tegelijkertijd zijn dataopschoning, deduplicatie en anonimisering ook essentieel. We hebben de data mogelijk gedistilleerd, maar we moeten het aanpassen aan de gewenste resultaten.
Bijvoorbeeld, bij het trainen van een model, als de zelfidentificatiedata niet goed getraind is, zou het kunnen antwoorden dat het een ChatGPT-model is, een Claude-model, enz.
Data is de basis van alles. In dit hoofdstuk beginnen we bij de databronnen en bekijken hoe deze verspreide materialen door synthese, opschoning, deduplicatie en anonimisering uiteindelijk data worden die gebruikt kunnen worden voor modeltraining.
Bedrijfsvaardigheden leren en tegelijkertijd algemene vaardigheden behouden
Het verzamelen en annoteren van trainingsdata vanaf nul vereist aanzienlijke tijd en kosten. Voor veelvoorkomende taken zoals tekstclassificatie, vraag-en-antwoord en tekstgeneratie kunnen geschikte openbare datasets worden gevonden voor opname in de training.
Veelvoorkomende openbare datasets omvatten:
Tekstclassificatie en inferentie: GLUE, SuperGLUE, CLUE, enz.;
Leesbegrip en vraag-en-antwoord: SQuAD, CMRC, enz.;
Tekstsamenvatting: CNN/DailyMail, enz.;
Dialoog en instructiefijnafstemming: Alpaca, ShareGPT, OpenOrca, enz.;
Multimodale taken: COCO en andere beeld-tekst-datasets.
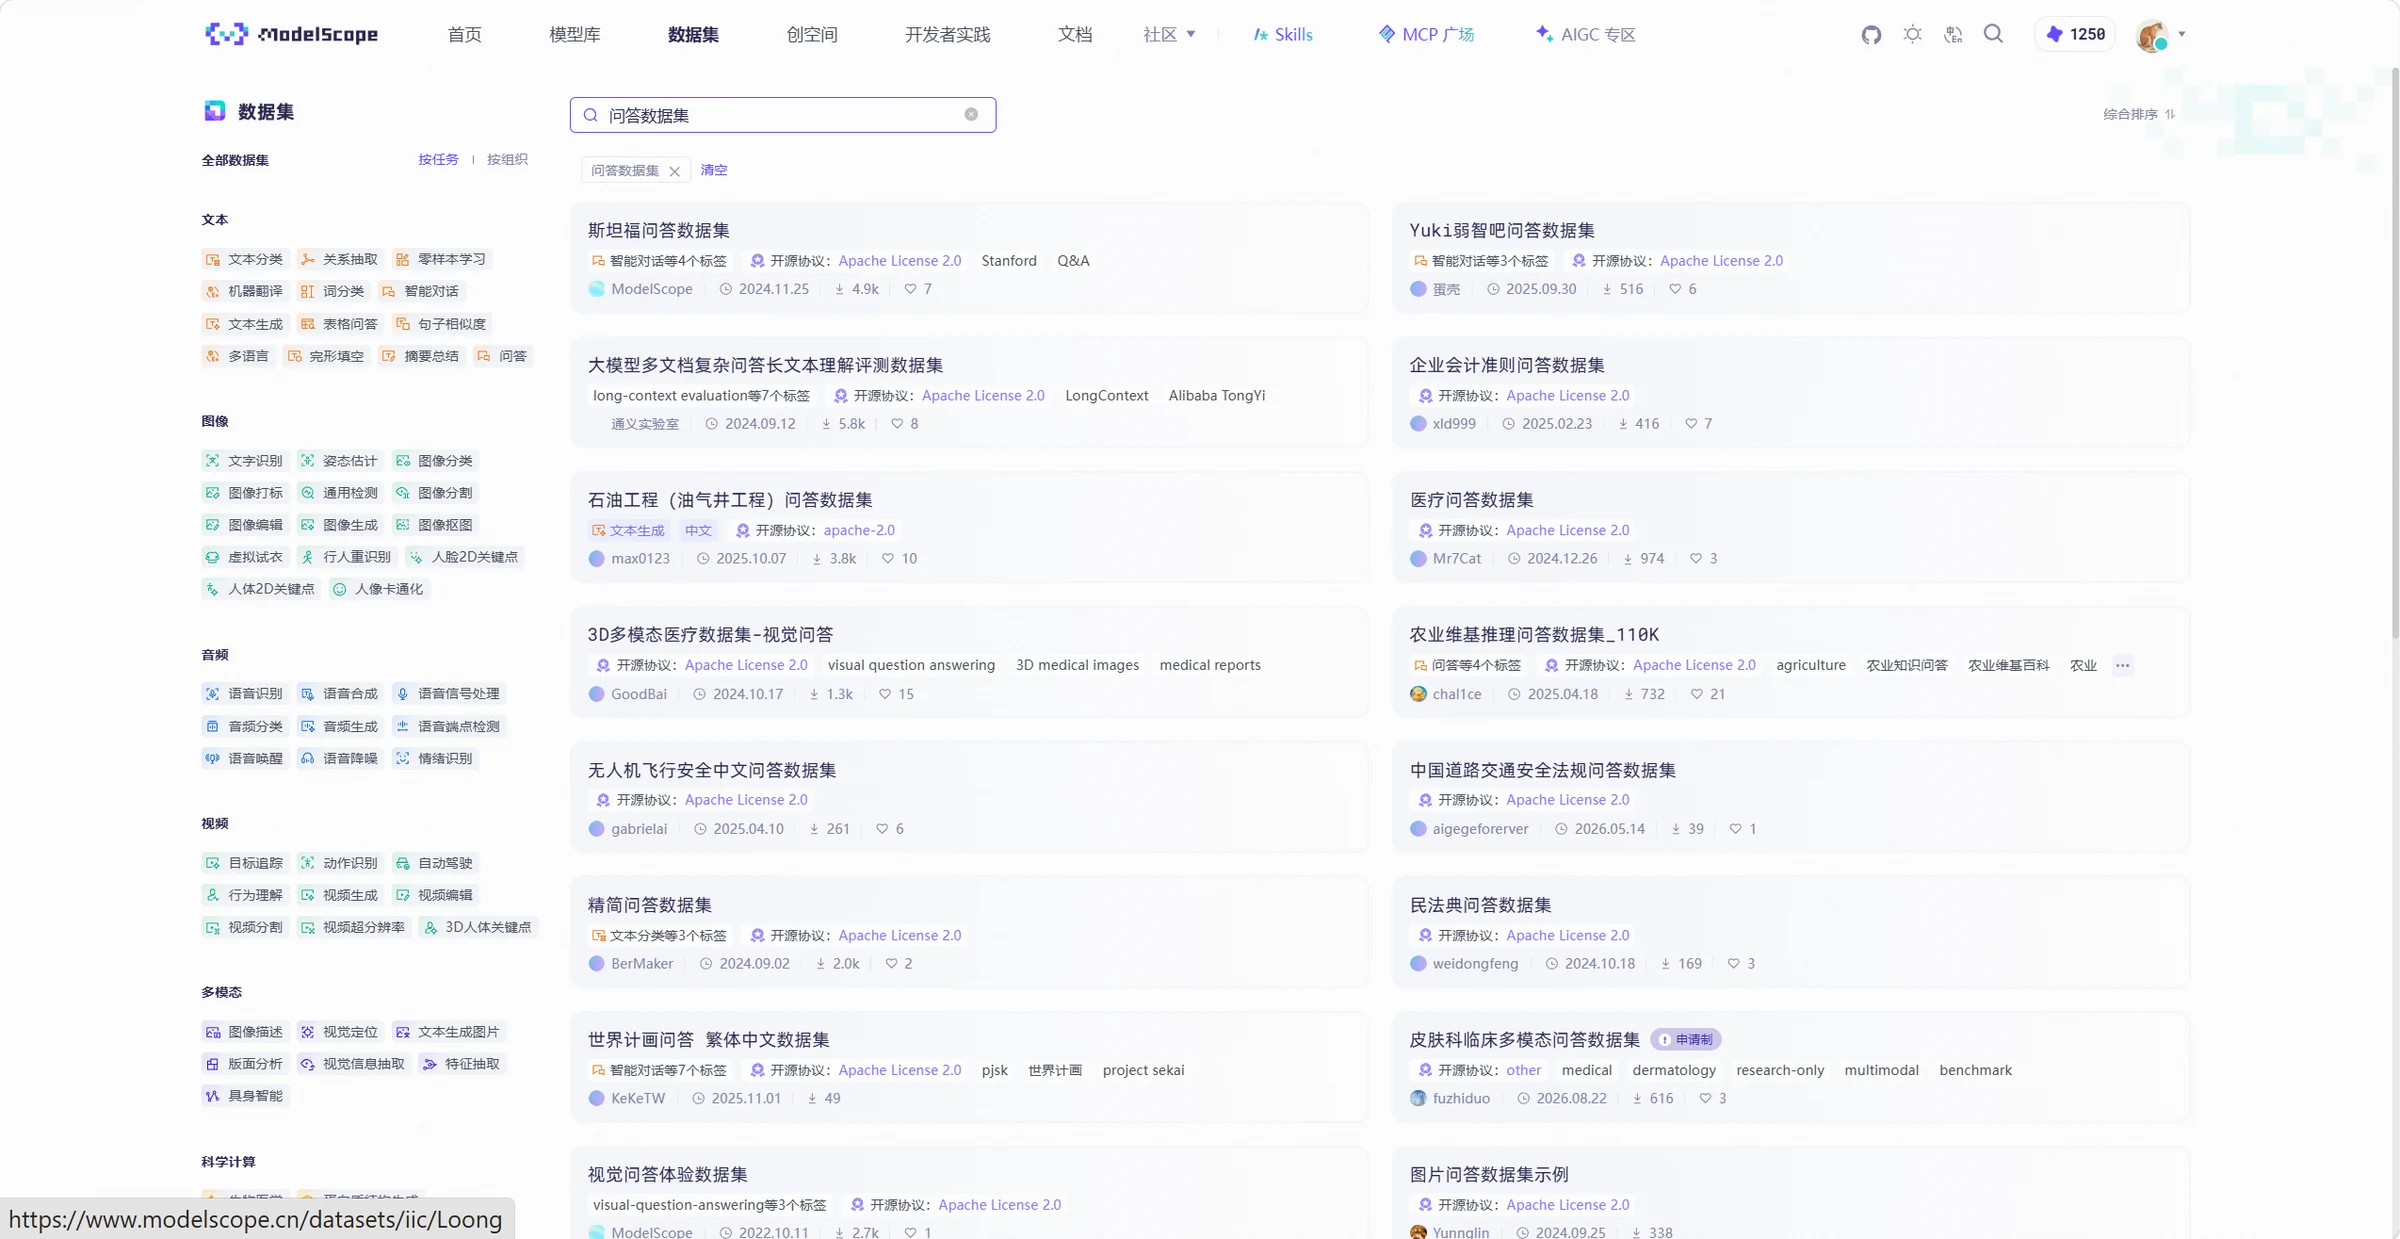
Naast het verkrijgen van data van officiële datasetwebsites, kunt u ook open-source datasets vinden en gebruiken via de ModelScope Dataset Hub. De Dataset Hub biedt functies zoals datasetzoek, online preview en download. Sommige datasets kunnen ook rechtstreeks via de ModelScope SDK worden geladen voor verdere verwerking en training. Specifieke datasetdownloadmethoden vindt u in het hoofdstuk "Data: De Basis voor Open-Source Model Fijnafstemming".
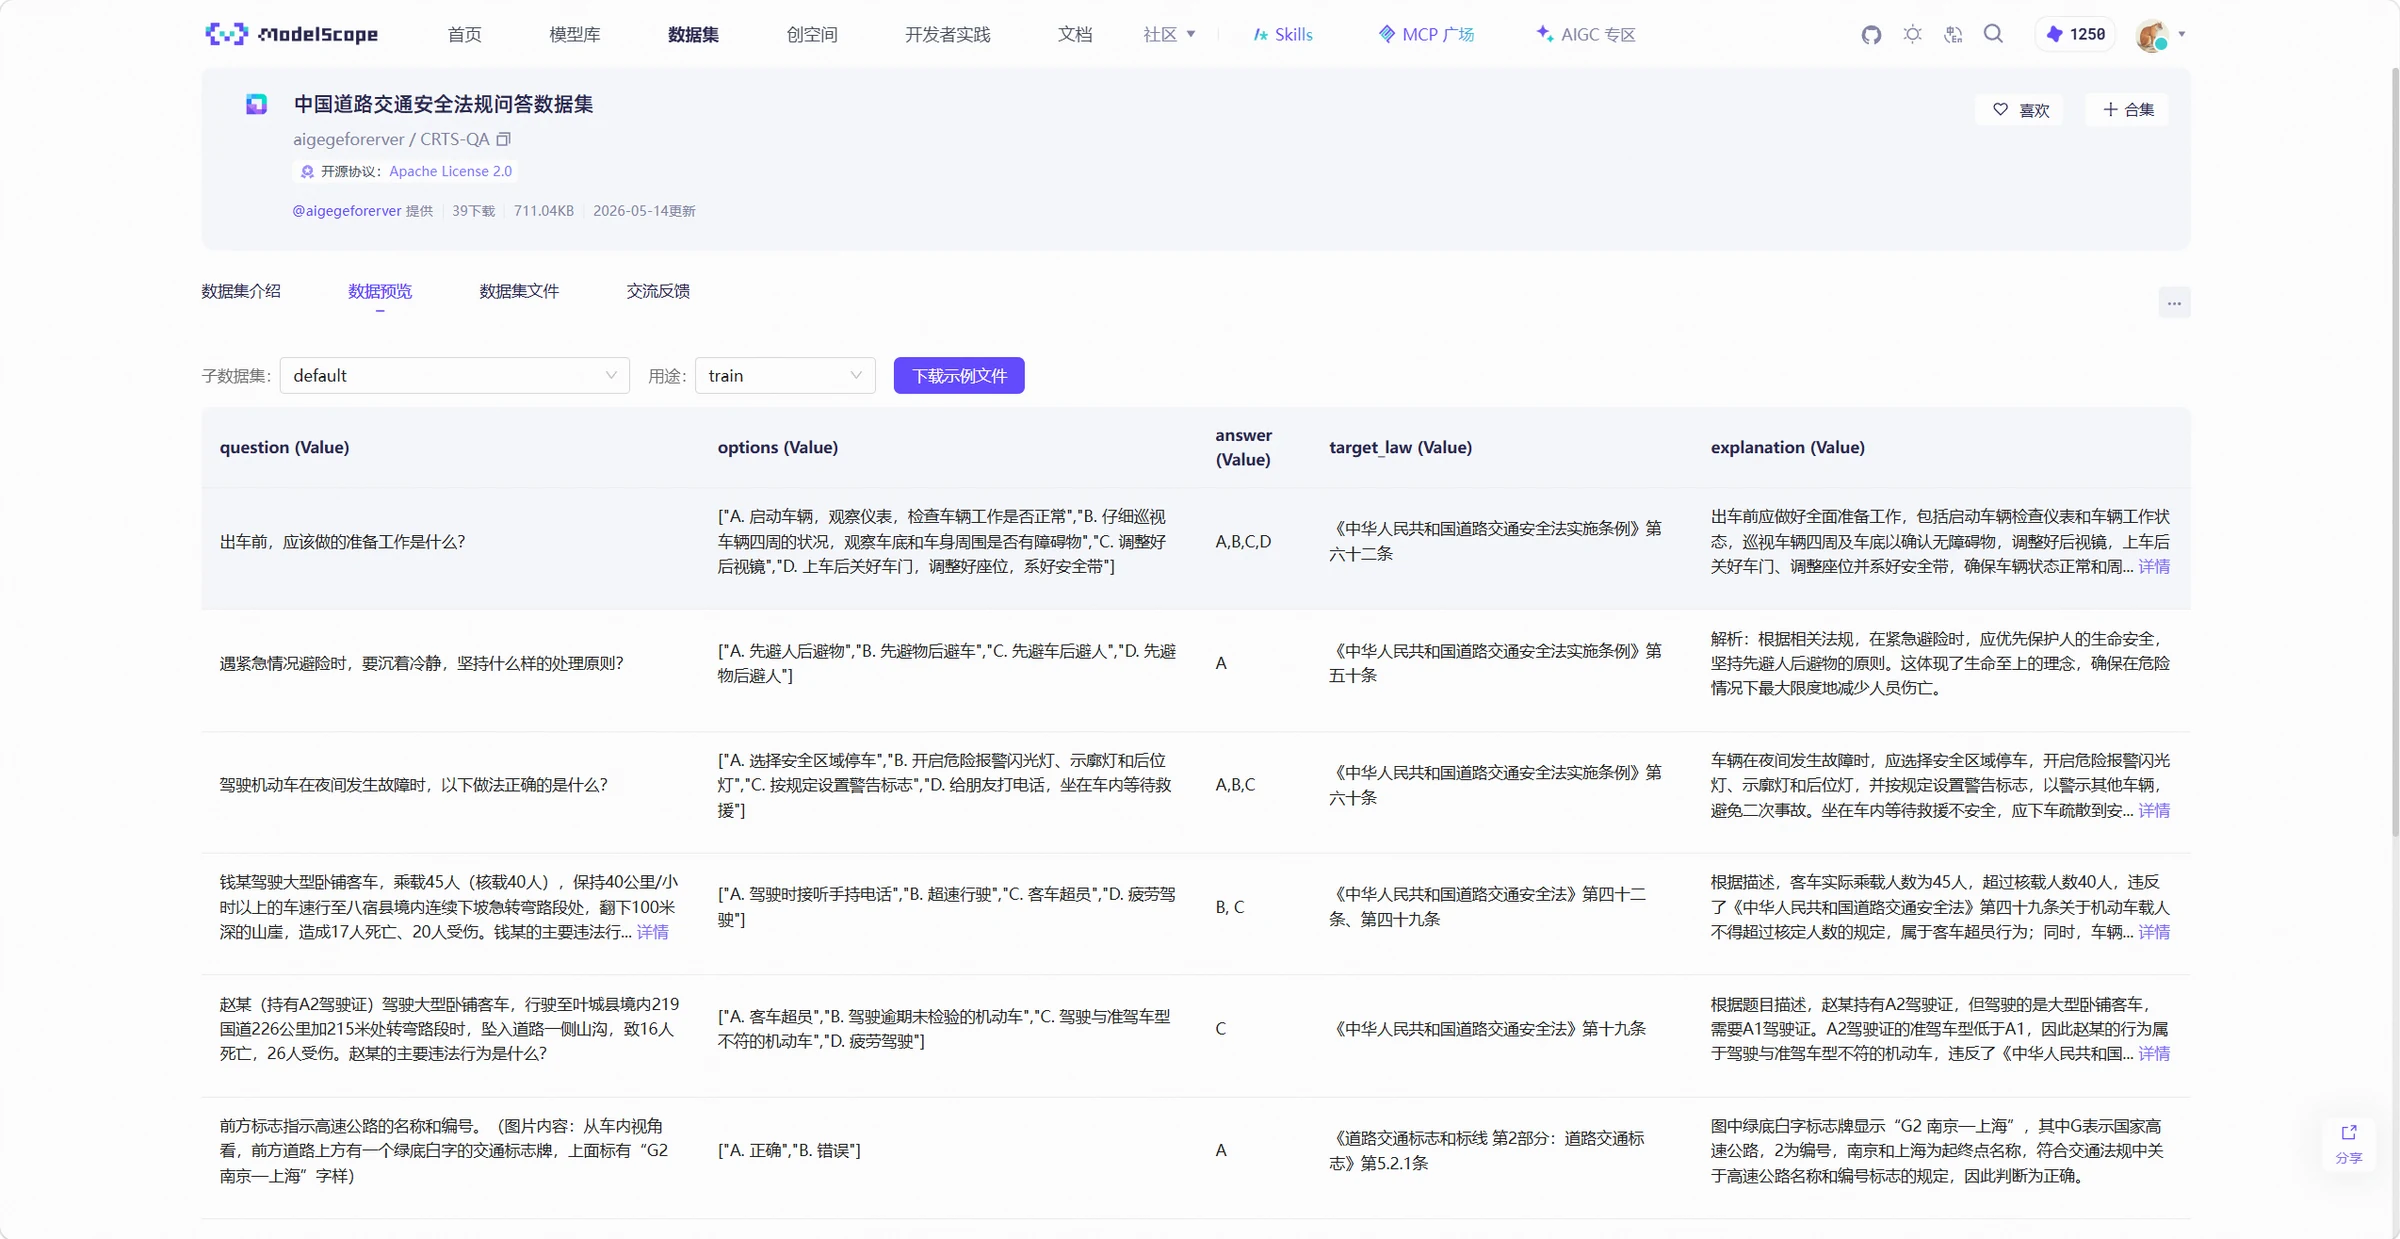
Bij het selecteren van open-source datasets moet u niet alleen controleren of de data-inhoud overeenkomt met de trainingsact, maar ook het aantal monsters, het veldformaat, de labeltypen en de datakwaliteit van de dataset verifiëren om te bepalen of het voldoet aan de trainingsvereisten. De datavoorbeeldfunctie van ModelScope kan helpen om datasetvelden en monsterinhoud snel te bekijken, zoals getoond in het volgende voorbeeld:
Open-source data wordt voornamelijk gebruikt om de algemene capaciteiten van het model aan te vullen. Als het model bedrijfsinterne producten, terminologie, bedrijfsregels en verwerkingsworkflows moet leren, moeten overeenkomstige bedrijfsdata worden voorbereid.
Hoe uw eigen bedrijfsmaterialen gebruiken?
Bedrijfsdata komt van daadwerkelijke bedrijfssystemen en -materialen binnen een bedrijf, waardoor ze dichter bij de scenario's liggen waar het model uiteindelijk zal worden gebruikt. Algemene vraag-en-antwoorddata kan het model helpen basale Q&A-patronen te leren, terwijl interne bedrijfs-Q&A-data het model verder kunnen helpen productnamen, bedrijfsterminologie en verwerkingsregels te leren.
Veelvoorkomende bedrijfsdatabronnen omvatten:
Bedrijfsdocumenten: producthandleidingen, operationele gidsen, bedrijfsspecificaties, procesdocumenten, enz., waaruit productkennis, bedrijfsregels en operationele processen kunnen worden geëxtraheerd;
Klantenservice records: historische gesprekken, werkbonnen en klachtenrecords tussen gebruikers en klantenservice, die kunnen worden gebruikt voor intentieherkenning, Q&A- en dialoogdata;
FAQ's: vragen en standaardantwoorden samengesteld door bedrijfspersoneel, die direct kunnen worden omgezet in Q&A-trainingsdata;
Expertcases: typische problemen behandeld door bedrijfsexperts en hun oplossingen, die kunnen worden gebruikt voor het bouwen van trainingsdata voor complexe bedrijfsscenario's.
Bedrijfsdata kan doorgaans niet direct worden gebruikt voor modeltraining. Een bedrijfshandleiding van enkele tientallen pagina's moet eerst de tekstinhoud extraheren uit Word-, PDF- of andere bestanden, en vervolgens worden georganiseerd in Q&A-paren, classificatiemonsters of instructiedata volgens de trainingsact. Klantenservice records kunnen ook systeemberichten, ongeldige gesprekken en dubbele inhoud bevatten, die eerst gefilterd en georganiseerd moeten worden.
Bedrijfsdata kan ook gevoelige informatie bevatten zoals namen, telefoonnummers, ID-nummers, adressen en rekeningnummers. Voordat ze het trainingsdataset betreden, moet anonimisering worden uitgevoerd volgens de vereisten van bedrijfsgegevensbeveiliging om te voorkomen dat echte gevoelige informatie direct wordt gebruikt voor modeltraining.
Alleen documenten zonder Q&A? Laat het model helpen data te synthetiseren
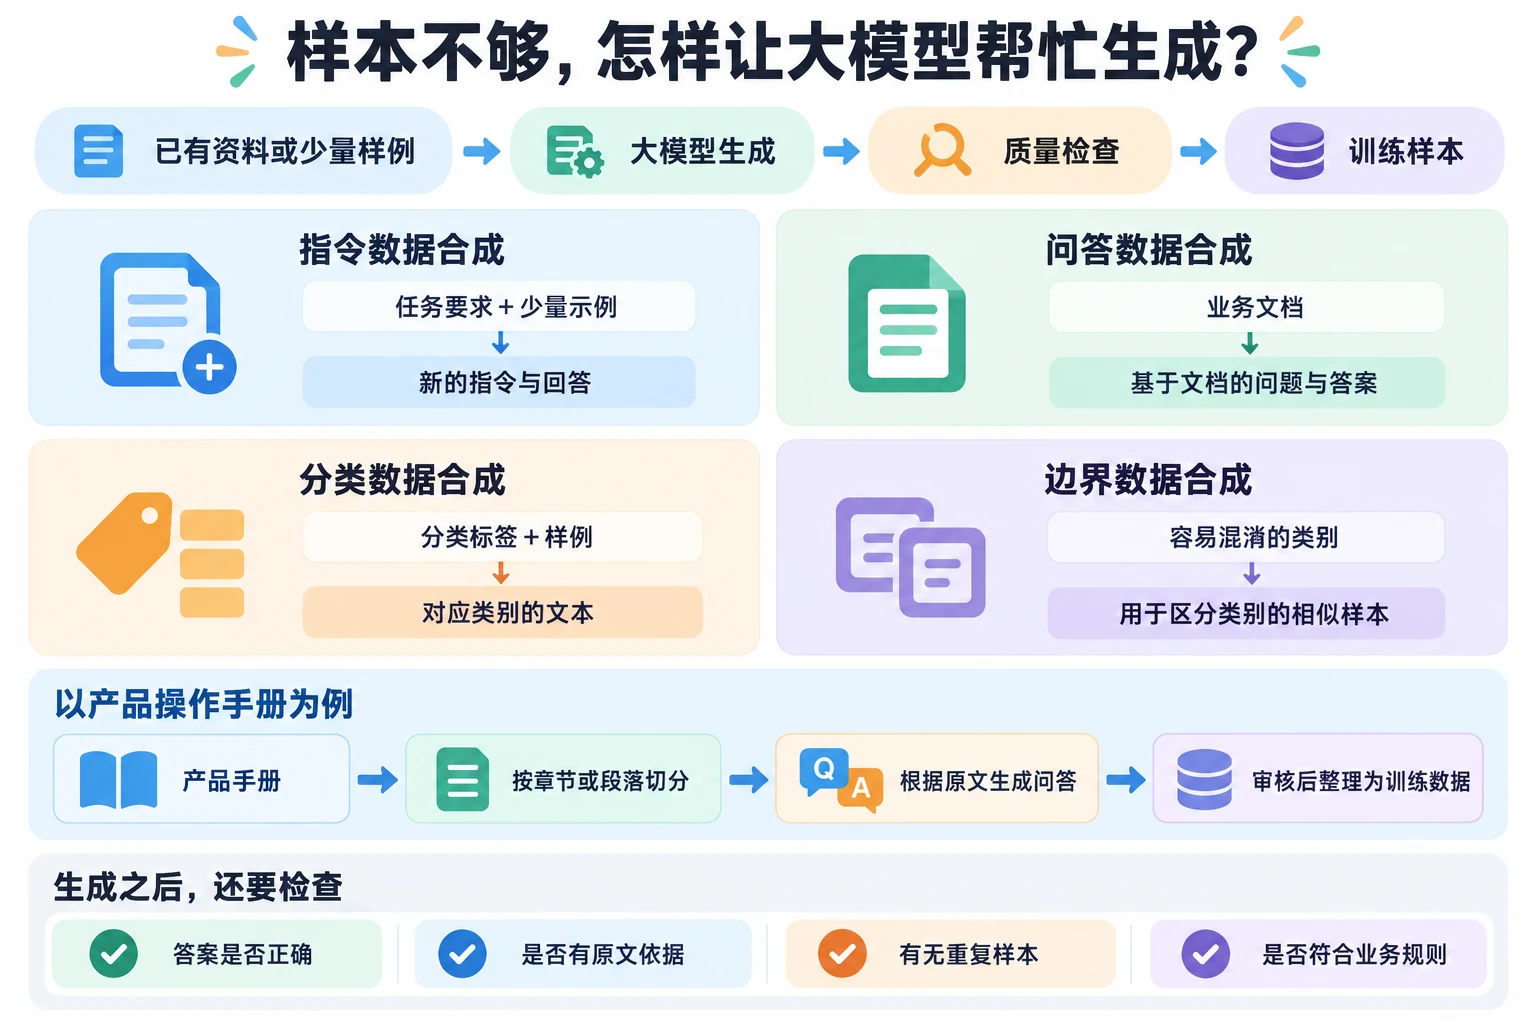
In echte projecten bestaat de kans dat bestaande data niet aan alle trainingsbehoeften voldoet. Sommige bedrijfstypen hebben bijvoorbeeld maar een paar monsters, of bestaande documenten bevatten kennis maar geen Q&A-data die direct bruikbaar is voor training. In dergelijke gevallen kunt u grote modellen gebruiken om nieuwe trainingsmonsters te genereren, een methode die dat synthese wordt genoemd.
Veelvoorkomende datasync-methoden omvatten:
Instructiedatasync: Gebaseerd op bestaande taken of enkele voorbeelden, gebruik een groot model om nieuwe instructies en antwoorden te genereren;
Q&A-datasync: Voer bedrijfsdocumenten in en gebruik het grote model om vragen en antwoorden te genereren op basis van de documentinhoud;
Classificatiedatasync: Specificeren classificatielabels en voorbeelden, en gebruik het grote model om tekst te genereren voor de overeenkomstige categorieën;
Grensdatasync: Genereer vergelijkbare monsters voor gemakkelijk verwarrende categorieën om het vermogen van het model om categoriegrenzen te onderscheiden te versterken.
Als een bedrijf bijvoorbeeld alleen producthandleidingen heeft zonder Q&A-data, moet de handleiding eerst worden opgesplitst in hoofdstukken of paragrafen, en kan het grote model worden gebruikt om enkele vragen en antwoorden te genereren op basis van de paragraafinhoud. Controleer de resultaten en organiseer ze in Q&A-trainingsdata.
Datasync kan de handmatige werklast van het schrijven van trainingsmonsters verminderen en scenario's aanvullen waar de oorspronkelijke data onvoldoende is. Gesynthetiseerde data kunnen echter niet direct worden gebruikt voor training na generatie. Het grote model kan foutieve antwoorden, dubbele monsters genereren of niet-bestaande producten of bedrijfsregels fabriceren, dus kwaliteitscontroles zijn nog steeds noodzakelijk.
Haast u niet om te trainen met gegenereerde data
De kwaliteit van gesynthetiseerde data heeft direct invloed op de effectiviteit van modeltraining. Voordat u gesynthetiseerde data toevoegt aan de trainingsset, moet u controleren of de gegenereerde inhoud correct is en foutieve, gefabriceerde, dubbele en te vergelijkbare data filteren.
Komt het antwoord overeen met de originele tekst?
Als de gesynthetiseerde data is gegenereerd uit bedrijfsdocumenten, moet u controleren of de gegenereerde inhoud overeenkomt met de originele tekst.
Bijvoorbeeld, het originele bedrijfsdocument specificeert:
Terugbetalingsaanvragen vereisen handmatige beoordeling, en terugbetalingen kunnen alleen worden verwerkt na goedkeuring.
Q&A-data gegenereerd door het model:
V: Vereist een terugbetalingsaanvraag beoordeling?
A: Terugbetalingen worden automatisch verwerkt na indiening, geen handmatige beoordeling vereist.
Dit antwoord conflicteert met de bedrijfsregel. Als het wordt gebruikt voor training, kan het model foutieve bedrijfsprocessen leren.
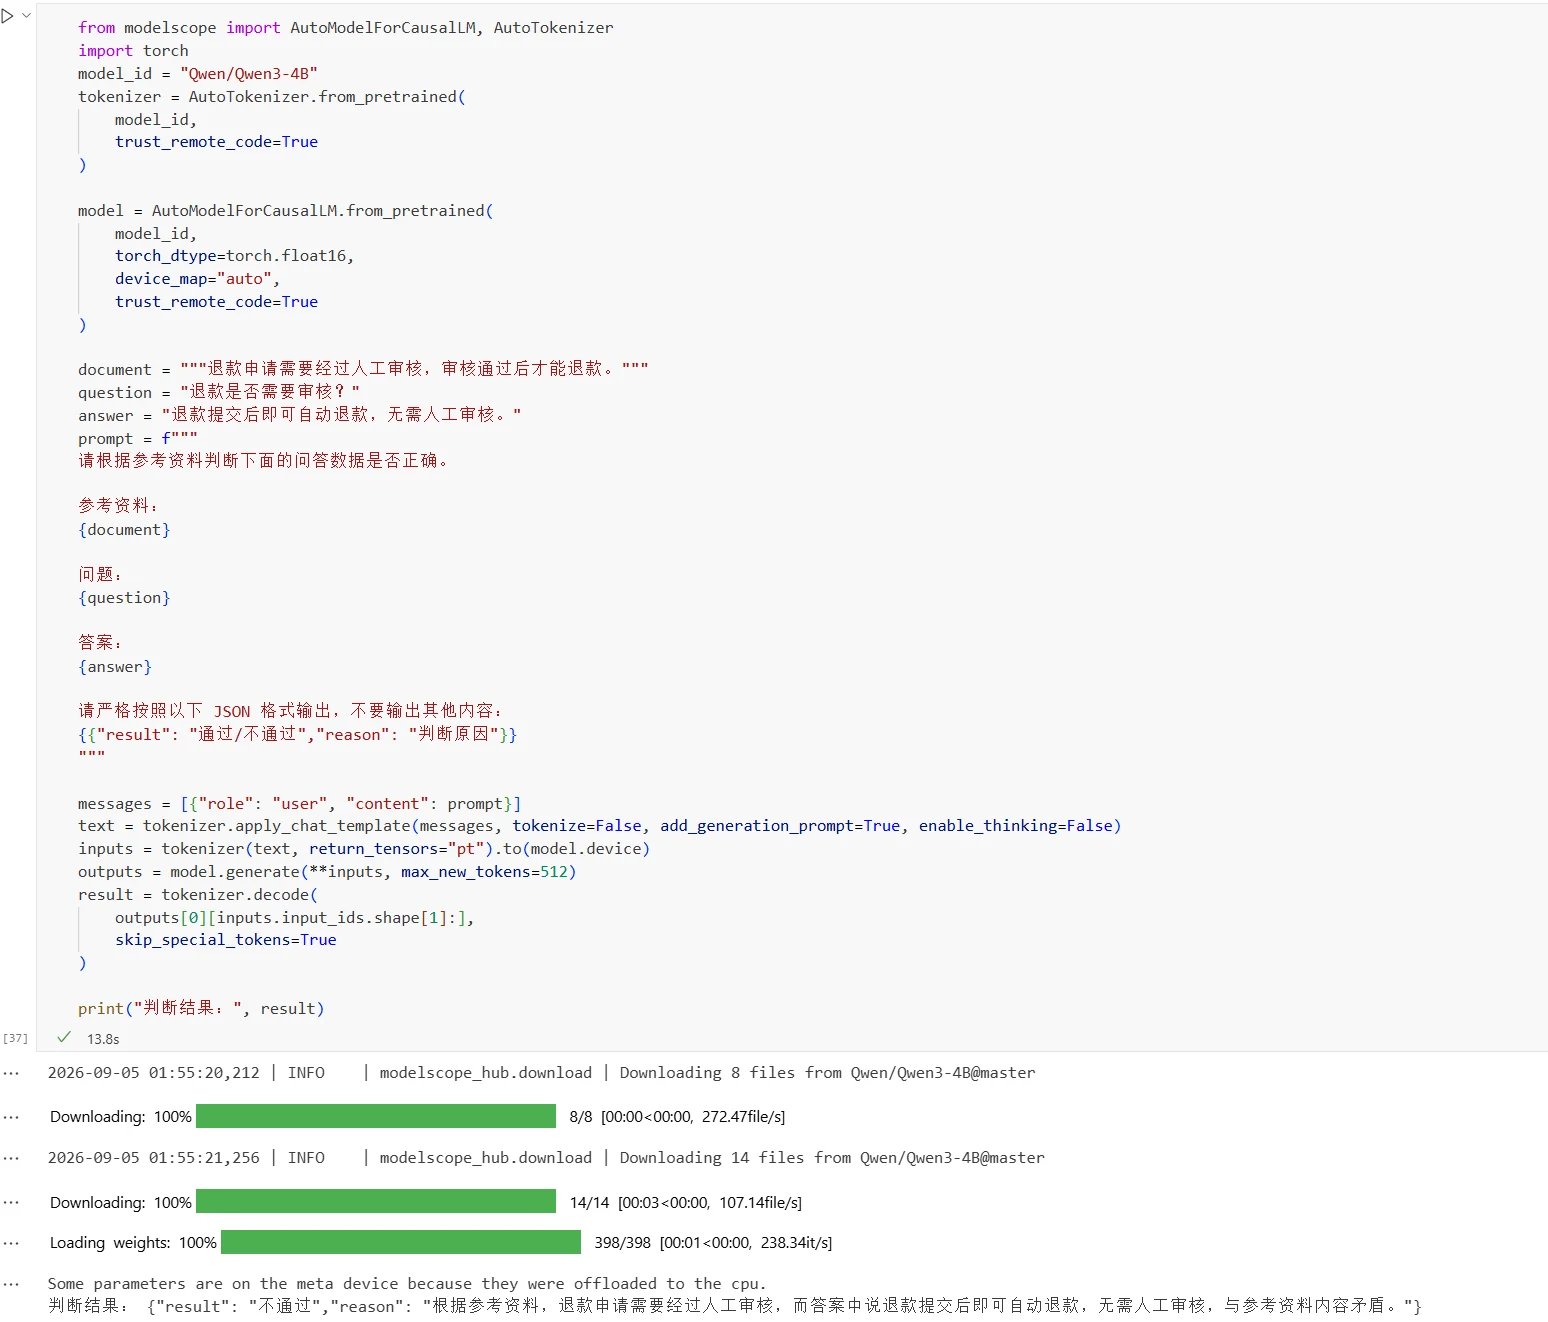
In de praktijk kunt u een groot model gebruiken om een consistentiebeoordeling uit te voeren op gesynthetiseerde data. Voer het originele materiaal, de vraag en het antwoord tegelijk in het model om te bepalen of het antwoord consistent is met het materiaal. Voor data die als foutief worden beoordeeld, kunnen worden verwijderd of opnieuw gegenereerd. De verwerkingscode is als volgt:
from modelscope import AutoModelForCausalLM, AutoTokenizer
import torch
model_id = "Qwen/Qwen3-4B"
tokenizer = AutoTokenizer.from_pretrained(
    model_id,
    trust_remote_code=True
)

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.float16,
    device_map="auto",
    trust_remote_code=True
)

document = """Terugbetalingsaanvragen vereisen handmatige beoordeling, en terugbetalingen kunnen alleen worden verwerkt na goedkeuring."""
question = "Vereist een terugbetalingsaanvraag beoordeling?"
answer = "Terugbetalingen worden automatisch verwerkt na indiening, geen handmatige beoordeling vereist."
prompt = f"""
Bepaal of de volgende Q&A-data correct is op basis van het referentiemateriaal.

Referentiemateriaal:
{document}

Vraag:
{question}

Antwoord:
{answer}

Producteer strikt in het volgende JSON-formaat en produceer geen andere inhoud:
{{"result": "geslaagd/niet geslaagd","reason": "reden voor het oordeel"}}
"""

messages = [{"role": "user", "content": prompt}]
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True, enable_thinking=False)
inputs = tokenizer(text, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=512)
result = tokenizer.decode(
    outputs[0][inputs.input_ids.shape[1]:],
    skip_special_tokens=True
)

print("Oordeelresultaat:", result)
Resultaten:
Laat het model niet dingen verzinnen die niet in de originele tekst staan
Wanneer een groot model data genereert, kan het informatie produceren die niet bestaat in de originele materialen. Dit probleem wordt gewoonlijk hallucinatie genoemd. Bijvoorbeeld het genereren van niet-bestaande productnamen, productparameters of bedrijfsregels.
Bijvoorbeeld, het originele materiaal stelt:
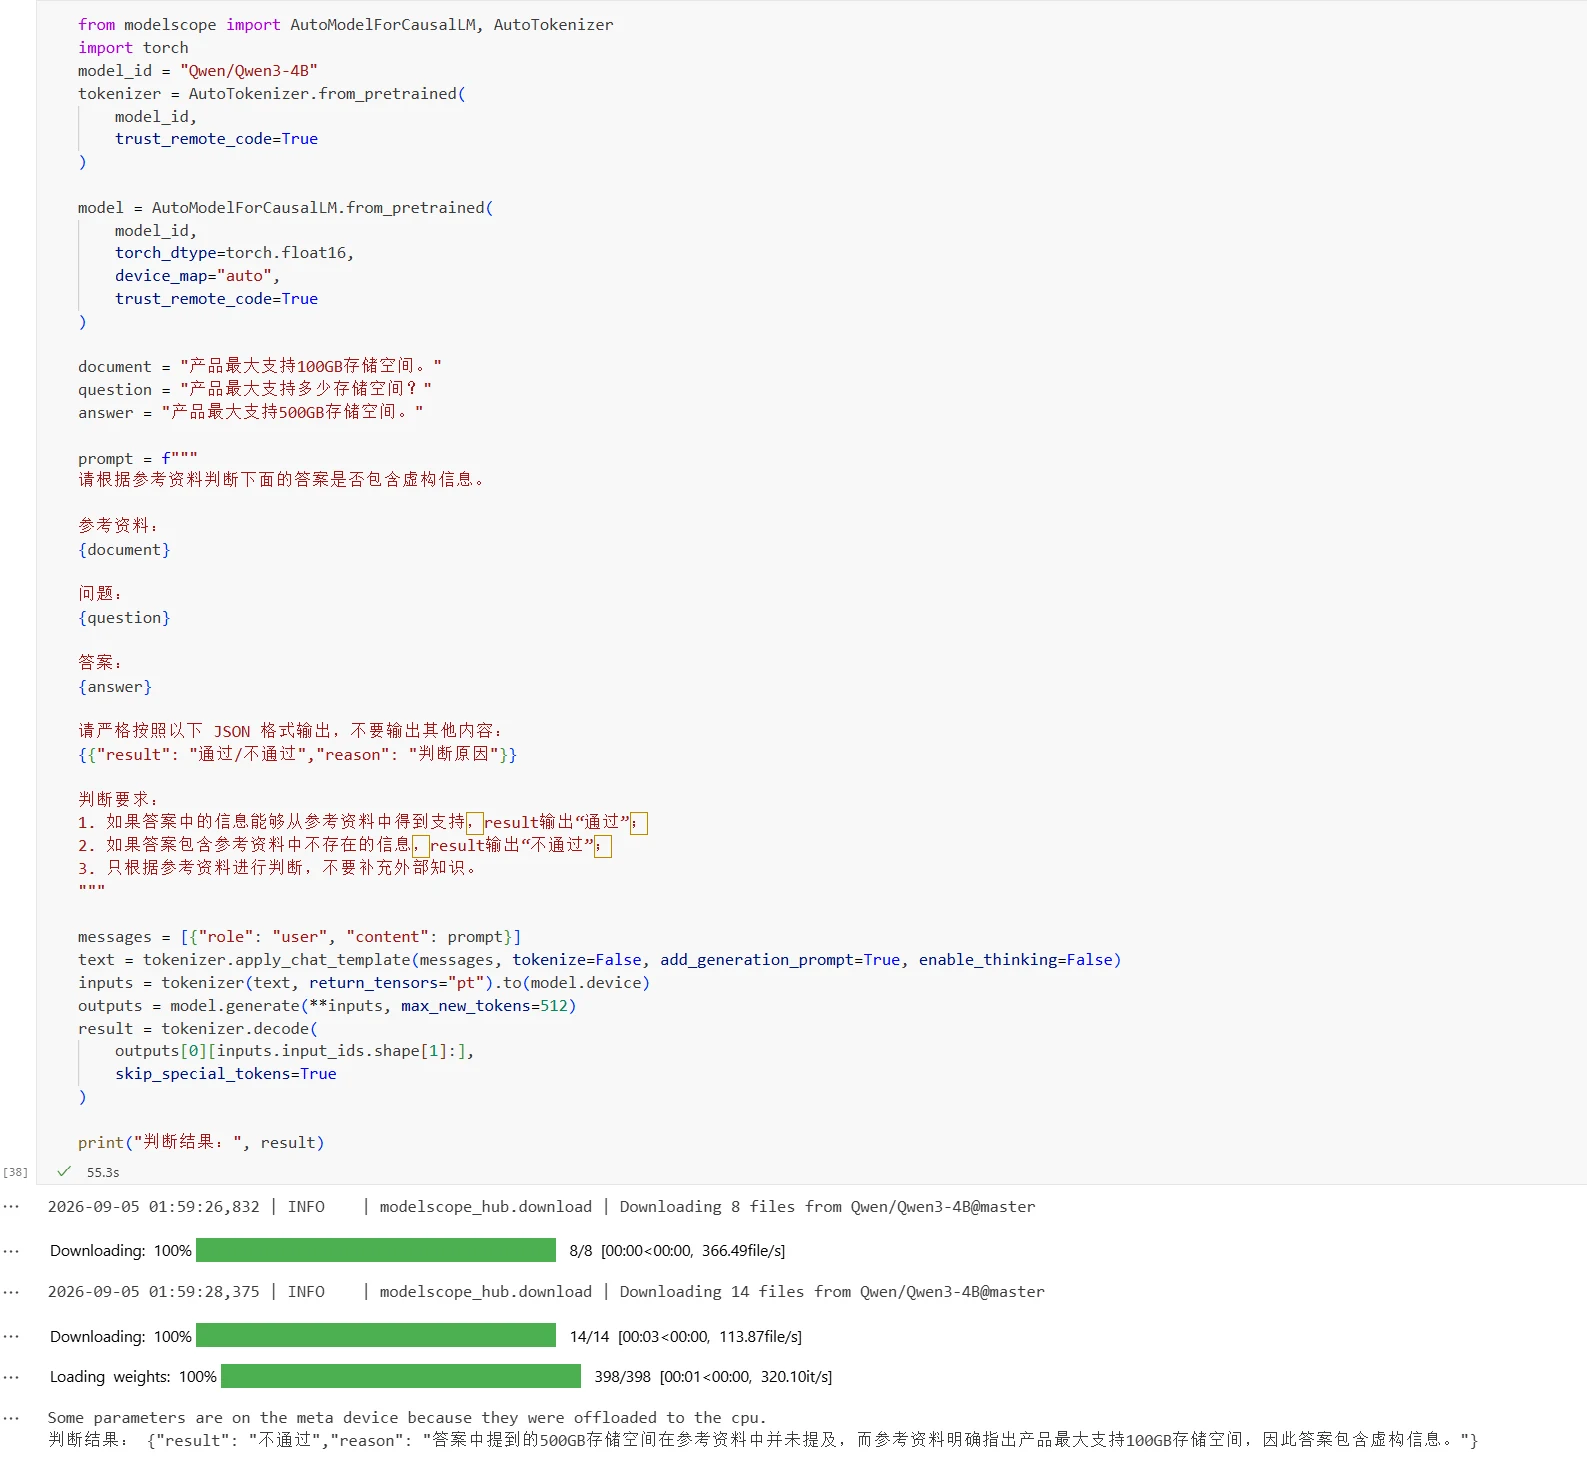
Het product ondersteunt maximaal 100GB opslagruimte.
Gegenereerde data:
V: Ondersteunt het product automatische schaling?
A: Ja, het systeem zal automatisch schalen wanneer de opslagruimte onvoldoende is
Het originele materiaal geeft niet aan of het product automatische schaling ondersteunt. Daarom mist het gegenereerde antwoord basis in het originele materiaal en vormt het gefabriceerde informatie.
Voor data die is gegenereerd op basis van bedrijfsmaterialen, kunt u een groot model gebruiken voor basiscontrole om te bepalen of de belangrijkste informatie in het antwoord wordt ondersteund door de originele materialen. Voor data die basis mist of die niet kunnen worden bevestigd, kunnen worden verwijderd, opnieuw gegenereerd of handmatig beoordeeld. Wanneer belangrijke bedrijfsregels betrokken zijn, kan bedrijfspersoneel ook steekproeven uitvoeren. De verwerkingscode is als volgt:
from modelscope import AutoModelForCausalLM, AutoTokenizer
import torch
model_id = "Qwen/Qwen3-4B"
tokenizer = AutoTokenizer.from_pretrained(
    model_id,
    trust_remote_code=True
)

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.float16,
    device_map="auto",
    trust_remote_code=True
)

document = "Het product ondersteunt maximaal 100GB opslagruimte."
question = "Wat is de maximale opslagruimte die het product ondersteunt?"
answer = "Het product ondersteunt maximaal 500GB opslagruimte."

prompt = f"""
Bepaal of het volgende antwoord gefabriceerde informatie bevat op basis van het referentiemateriaal.

Referentiemateriaal:
{document}

Vraag:
{question}

Antwoord:
{answer}

Producteer strikt in het volgende JSON-formaat en produceer geen andere inhoud:
{{"result": "geslaagd/niet geslaagd","reason": "reden voor het oordeel"}}

Oordeelvereisten:
1. Als de informatie in het antwoord wordt ondersteund door het referentiemateriaal, geeft het resultaat "geslaagd" uit;
2. Als het antwoord informatie bevat die niet aanwezig is in het referentiemateriaal, geeft het resultaat "niet geslaagd" uit;
3. Beoordeel alleen op basis van het referentiemateriaal, vul geen externe kennis aan.
"""

messages = [{"role": "user", "content": prompt}]
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True, enable_thinking=False)
inputs = tokenizer(text, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=512)
result = tokenizer.decode(
    outputs[0][inputs.input_ids.shape[1]:],
    skip_special_tokens=True
)

print("Oordeelresultaat:", result)
Resultaten:
Andere woorden kunnen nog steeds dezelfde vraag zijn
Wanneer een groot model data in batches genereert, is het gemakkelijk om dubbele of zeer vergelijkbare monsters te produceren. Bijvoorbeeld: "Hoe wijzig ik het inlogwachtwoord?" en "Hoe kan ik mijn inlogwachtwoord wijzigen?" Deze vragen hebben verschillende uitdrukkingen maar in wezen dezelfde inhoud. Als er te veel vergelijkbare monsters zijn, vermindert dit de effectieve informatie-inhoud van de dataset.
Na het synthetiseren van data moet u controleren op duplicaten en overeenkomsten tussen monsters, volledig dubbele data filteren, het aantal zeer vergelijkbare monsters beperken en representatieve monsters behouden. Specifieke datadeduplicatiemethoden worden in de volgende secties geïntroduceerd.
Consolideer data uit verschillende bronnen
Of data nu afkomstig is van open-source datasets, bedrijfsdata of grote modellensynthese, ze moeten verenigd worden verwerkt voordat ze worden gebruikt voor modeltraining. Veelvoorkomende verwerkingsstappen omvatten dataverzameling, dataopschoning, datadeduplicatie en dataanonimisering.
Verzamel eerst de benodigde inhoud en standaardiseer de velden
Dataverzameling houdt in dat de vereiste data wordt verkregen uit verschillende databronnen volgens de trainingsact en uniform wordt georganiseerd.
Voordat u verzamelt, moet u de data-inhoud bepalen die door de trainingsact wordt vereist. Classificatietaken hebben tekst en categorie labels nodig, Q&A-taken hebben vragen en antwoorden nodig, en instructiefijnafstemming heeft instructies en bijbehorende antwoorden nodig. Bij het verzamelen bewaart u alleen data en velden die verband houden met de trainingsact.
De gegevensstructuren van verschillende bronnen kunnen verschillen. Bijvoorbeeld, een dataset gebruikt de velden question en answer, terwijl een andere mogelijk de velden query en response gebruikt. Na verzameling moeten veldnamen en gegevensstructuren worden verenigd voor verdere verwerking.
Voor data die noodzakelijke informatie mist, kunnen ze worden aangevuld tijdens de verzameling. Bijvoorbeeld het toevoegen van categorielabels voor classificatiedata, of het organiseren van referentieantwoorden voor Q&A-data.
Data moet eerst worden opgeschoond
Ruwe data kan enkele ongeldige of foutieve inhoud bevatten, die vóór de training moeten worden opgeschoond.
Veelvoorkomende verwerking omvat: het verwijderen van lege data en ongeldige records, het verwijderen van overtollige HTML-tags en speciale tekens, het standaardiseren van tekstcodering en -formaat, en het corrigeren van voor de hand liggende OCR-herkenningsfouten, enz.
Dataopshoning betekent niet dat u alle speciale inhoud verwijdert. Code, formules, eenheden en leestekens kunnen zelf deel uitmaken van de trainingsinhoud, en of ze worden behouden hangt af van de specifieke taak.
Als voorbeeld een FAQ-dataset, de originele data:
faq_data = [
    {
        "question": "  Hoe wijzig ik het inlogwachtwoord?  ",
        "answer": "<p>Ga naar het persoonlijke centrum en klik op 'Wachtwoord wijzigen'.</p>"
    },
    {
        "question": "",
        "answer": "Neem contact op met de beheerder."
    },
    {
        "question": "Wat als ik mijn wachtwoord ben vergeten?",
        "answer": "Klik op 'Wachtwoord vergeten'\n\nen volg de instructies."
    },
    {
        "question": "Wat is het telefoonnummer van de klantenservice?",
        "answer": "Het klantenservicenummer is 400-123-4567\xa0"
    }
]
Opschoningscode:
import re

def clean_text(text):
    if not text:
        return ""

    # Verwijder HTML-tags
    text = re.sub(r"<[^>]+>", "", text)

    # Zet speciale spaties om naar normale spaties
    text = text.replace("\xa0", " ")

    # Voeg opeenvolgende wittekens samen
    text = re.sub(r"\s+", " ", text)

    # Verwijder spaties aan het begin en einde van de tekst
    text = text.strip()

    return text

clean_data = []

for item in faq_data:
    question = clean_text(item["question"])
    answer = clean_text(item["answer"])

    # Verwijder data waar vraag of antwoord leeg is
    if not question or not answer:
        continue

    clean_data.append({
        "question": question,
        "answer": answer
    })

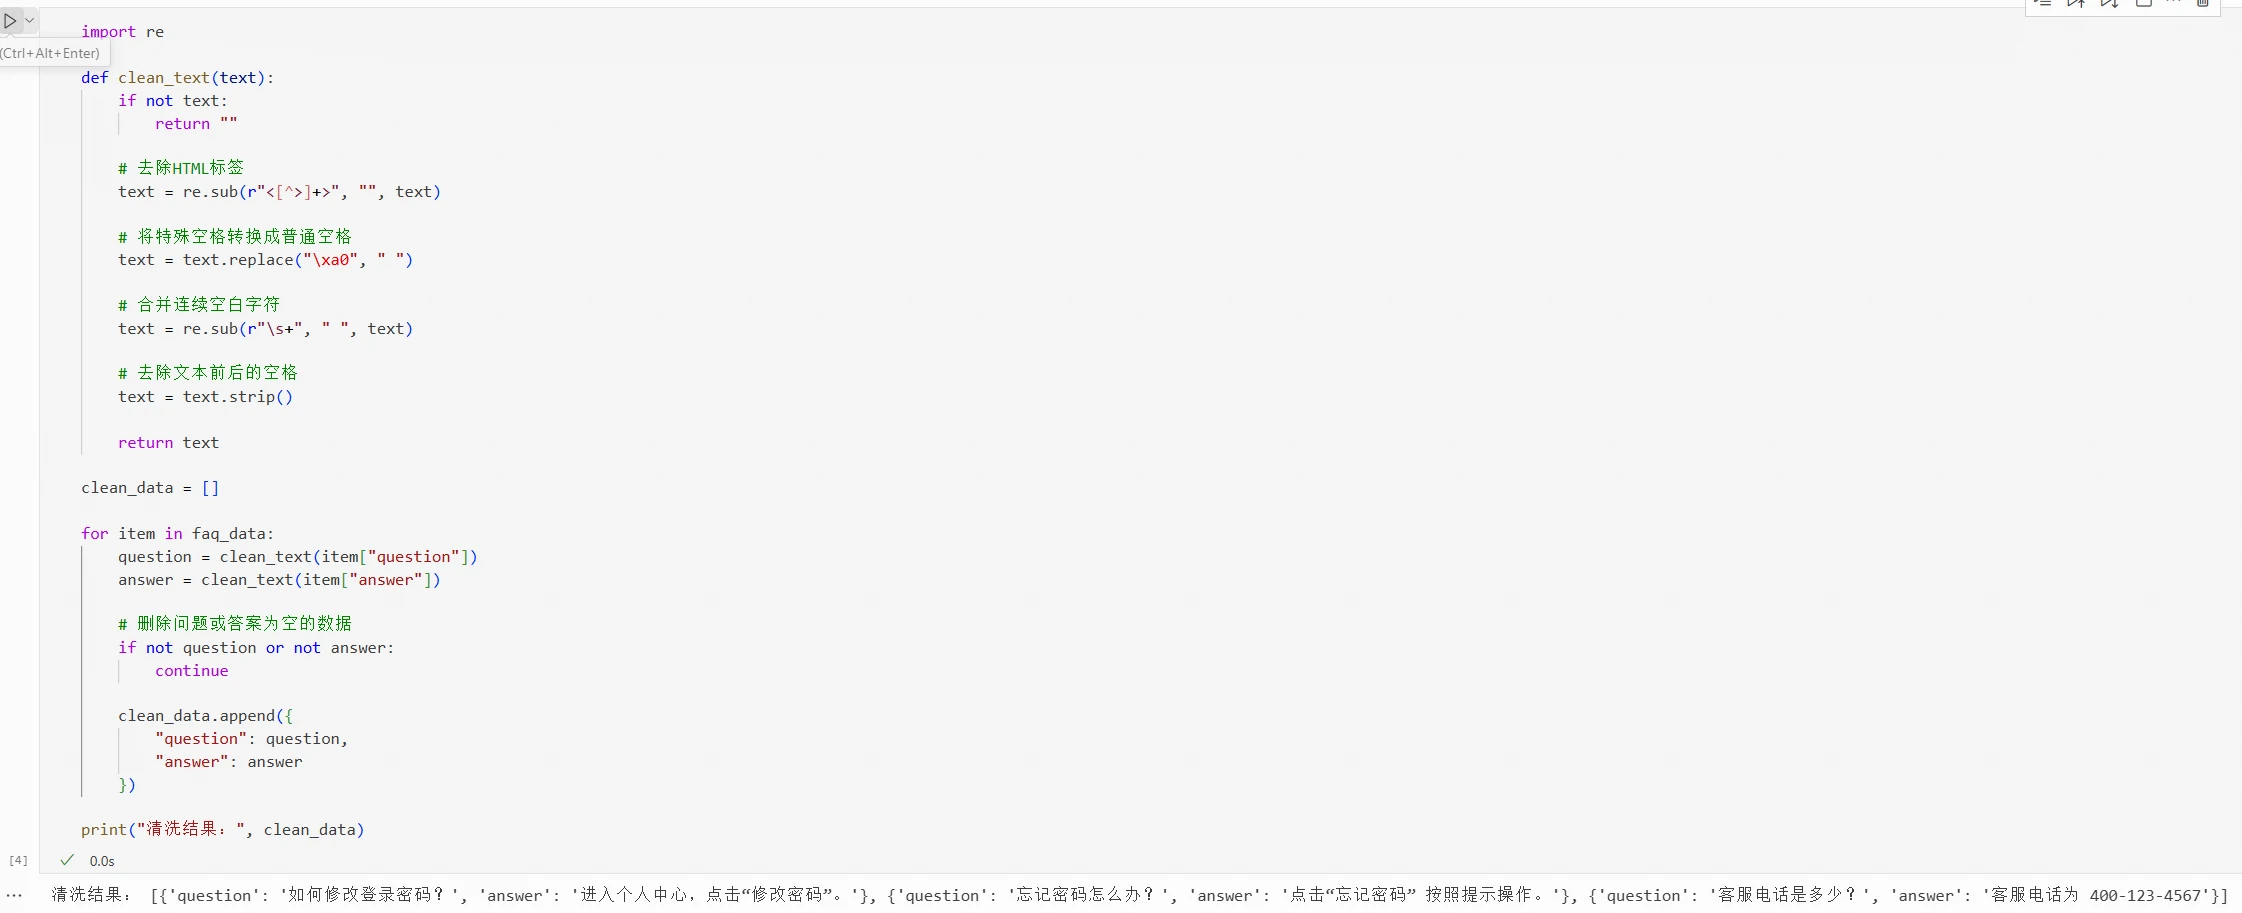
print("Opschoningsresultaat:", clean_data)
Opschoningsresultaten:
De specifieke opschoningsregels in echte bedrijven moeten worden bepaald op basis van de kenmerken van de data.
Moet u echt alle dubbele data bewaren?
Na het consolideren van data verzameld uit verschillende bronnen, kunnen dubbele of vergelijkbare data verschijnen. Dezelfde FAQ kan tegelijkertijd verschijnen in openbare datasets, producthandleidingen en klantenservice-kennisbanken. Gesynthetiseerde data kan ook vergelijkbaar zijn met de inhoud van bestaande data. Als er te veel dubbele data is, vermindert dit de diversiteit van de trainingsdata, waardoor het model bepaalde kennis of uitdrukkingen overleert. Daarom is een verenigde deduplicatie noodzakelijk vóór de training.
Afhankelijk van de mate van duplicatie van de data kan datadeduplicatie worden verdeeld in exacte datadeduplicatie en vergelijkbare datadeduplicatie:
Exacte datadeduplicatie: Bepalen of twee stukken data exact dezelfde inhoud hebben. Deduplicatie kan worden uitgevoerd door tekstmatching of hashwaarden.
Vergelijkbare datadeduplicatie: Bepalen of twee stukken data vergelijkbare inhoud hebben ondanks verschillende bewoordingen. Methoden zoals MinHash, SimHash of vectorgelijkenis kunnen worden gebruikt voor detectie.
Verschillende soorten data vereisen verschillende deduplicatieregels. Als voorbeeld een FAQ-dataset, kunnen de vraag en het antwoord worden gecombineerd tot één tekst, en dan bepalen of verschillende monsters duplicaten of vergelijkbaar zijn.
Exacte datadeduplicatie
Datamonsters:
faq_data = [
    {
        "question": "Hoe wijzig ik het inlogwachtwoord?",
        "answer": "Ga naar het persoonlijke centrum en klik op 'Wachtwoord wijzigen'."
    },
    {
        "question": "Wat als ik mijn wachtwoord ben vergeten?",
        "answer": "Klik op 'Wachtwoord vergeten' en volg de instructies."
    },
    {
        "question": "Hoe wijzig ik het inlogwachtwoord?",
        "answer": "Ga naar het persoonlijke centrum en klik op 'Wachtwoord wijzigen'."
    }
]
(1) Tekstmatching
Deduplicatiecode door tekstmatching:
seen = set()
result = []

for item in faq_data:
    # Combineer vraag en antwoord tot één tekst
    text = item["question"] + item["answer"]

    if text not in seen:
        seen.add(text)
        result.append(item)

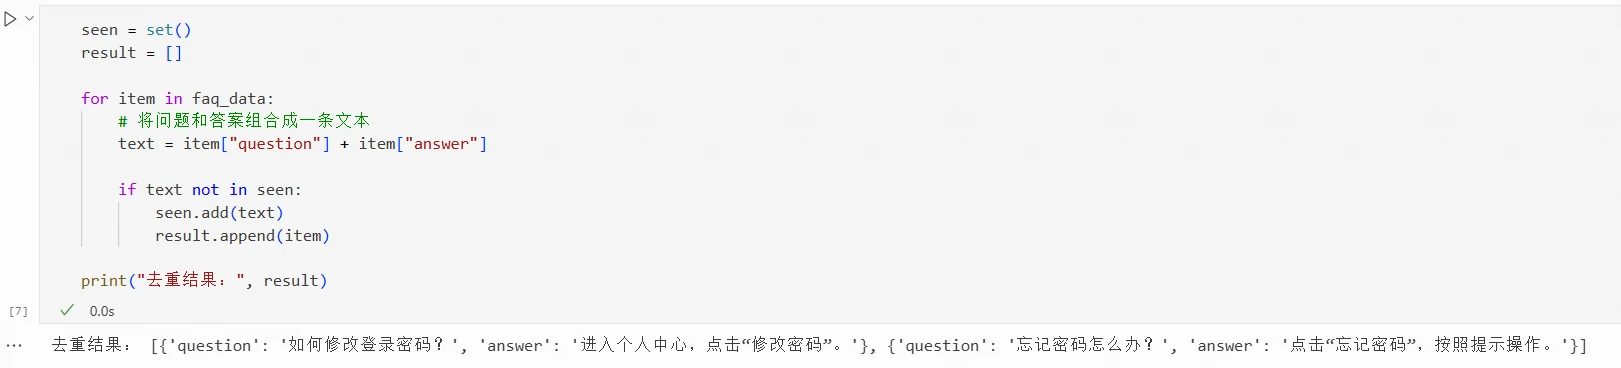
print("Deduplicatieresultaat:", result)
Deduplicatieresultaten:
Na verwerking wordt slechts een van de twee identieke FAQ's bewaard.
(2) Hashwaarden
Een hashalgoritme kan een tekst omzetten in een vaste-lengtewaarde. Identieke tekst zal dezelfde hashwaarde produceren, waarmee u kunt bepalen of data dubbel is door hashwaarden te vergelijken. Bijvoorbeeld:
import hashlib

seen = set()
result = []

for item in faq_data:
    # Combineer vraag en antwoord tot één tekst
    text = item["question"] + item["answer"]

    # Bereken hashwaarde
    text_hash = hashlib.sha256(
        text.encode("utf-8")
    ).hexdigest()

    if text_hash not in seen:
        seen.add(text_hash)
        result.append(item)

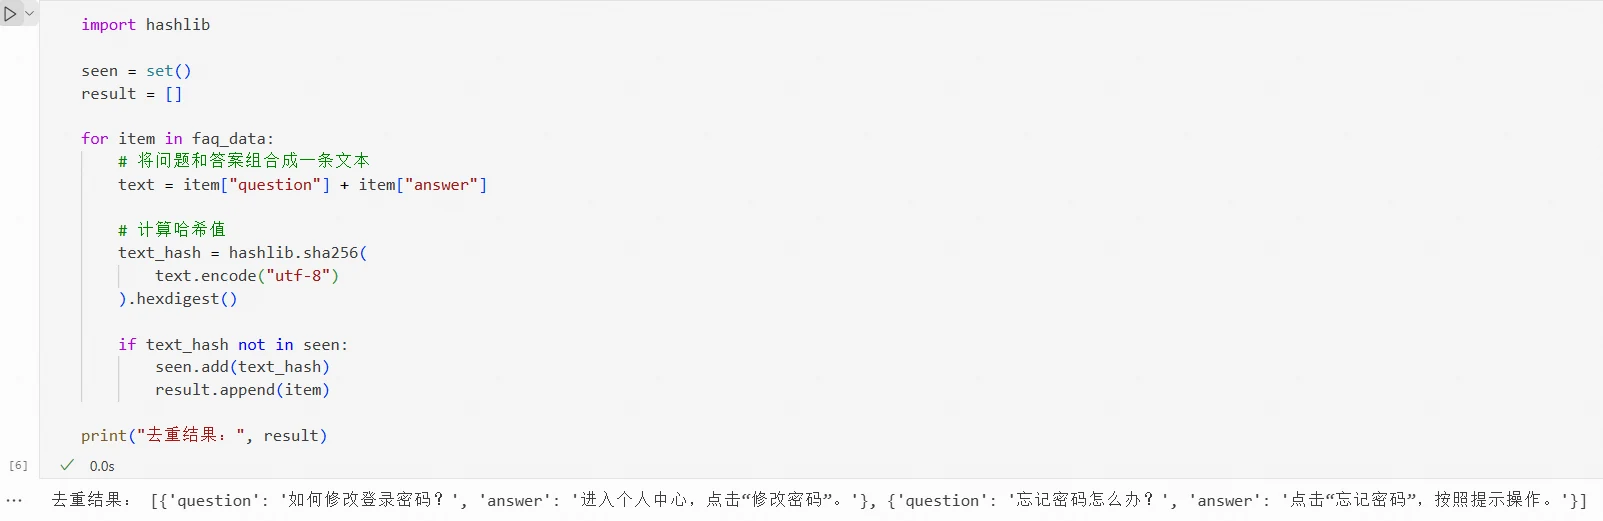
print("Deduplicatieresultaat:", result)
Deduplicatieresultaten:
Gewone hashwaarden kunnen alleen worden gebruikt om te bepalen of de inhoud exact dezelfde is. Zodra de tekst in de vraag of het antwoord verandert, zal de berekende hashwaarde verschillend zijn. Voor data met verschillende bewoording maar vergelijkbare inhoud is een verdere gelijkenisbeoordeling nodig.
Vergelijkbare datadeduplicatie
Datamonsters:
faq_data = [
    {
        "question": "Hoe wijzig ik het inlogwachtwoord?",
        "answer": "Ga naar het persoonlijke centrum en klik op 'Wachtwoord wijzigen'."
    },
    {
        "question": "Hoe kan ik mijn inlogwachtwoord wijzigen?",
        "answer": "Na naar het persoonlijke centrum te gaan, klikt u op 'Wachtwoord wijzigen'."
    },
    {
        "question": "Hoe vraag ik een factuur aan?",
        "answer": "Ga naar de bestelpagina, selecteer factuuraanvraag en dien de informatie in."
    }
]
De vragen en antwoorden van de eerste twee FAQ's verschillen in bewoording maar drukken over het algemeen een vergelijkbare inhoud uit. Voor dergelijke data kunnen MinHash, SimHash of vectorgelijkenis worden gebruikt voor detectie.
(1) MinHash
MinHash bepaalt de gelijkenis voornamelijk op basis van de overlap van woorden of tekens in de tekst, waardoor het meer geschikt is voor het detecteren van letterlijk vergelijkbare data. Voor FAQ-data kunt u eerst de vraag en het antwoord combineren tot één tekst, en dan de tekst opsplitsen in woorden, tekens of tekenfragmenten voor berekening.
MinHash wordt meestal gebruikt om de Jaccard-gelijkenis te benaderen:
J(A,B)=\frac{|A\cap B|}{|A\cup B|}
waarbij A en B de verzamelingen van woorden of tekens voorstellen die in twee teksten voorkomen,
A\cap B
stelt de door beide gedeelde inhoud voor,
A\cup B
stelt alle inhoud voor die in beide voorkomt. Het berekeningsresultaat ligt tussen 0 en 1, waar waarden dichter bij 1 aangeven dat de twee teksten meer vergelijkbaar zijn.
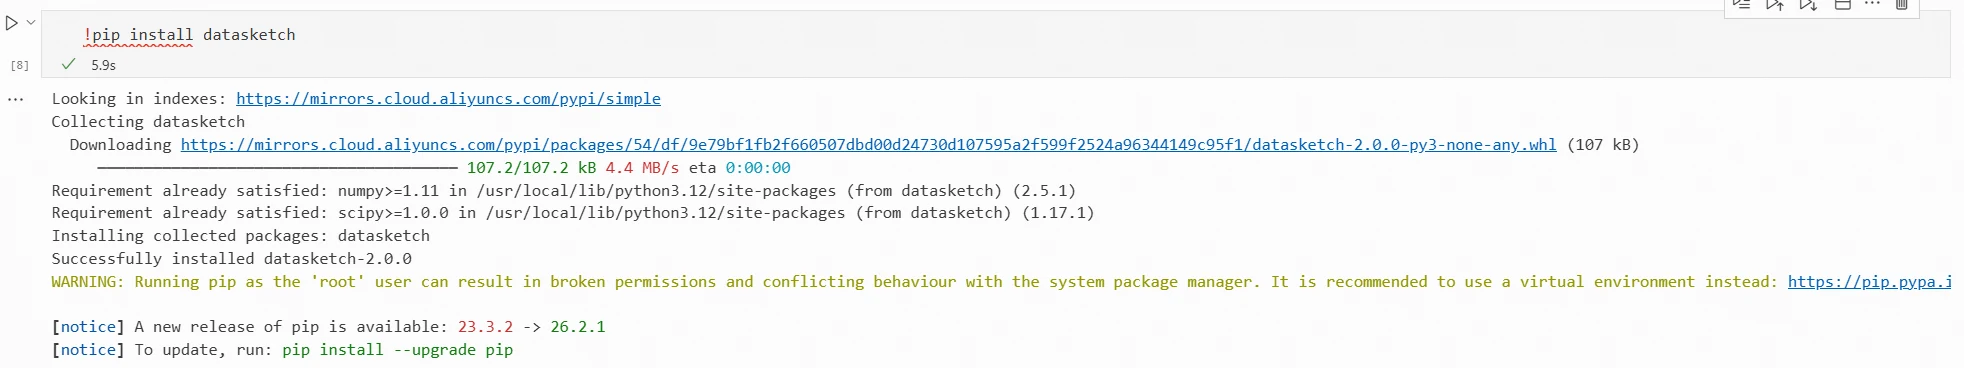
In Python kan de datasketch-bibliotheek worden gebruikt om MinHash te implementeren:
!pip install datasketch
Resultaten:
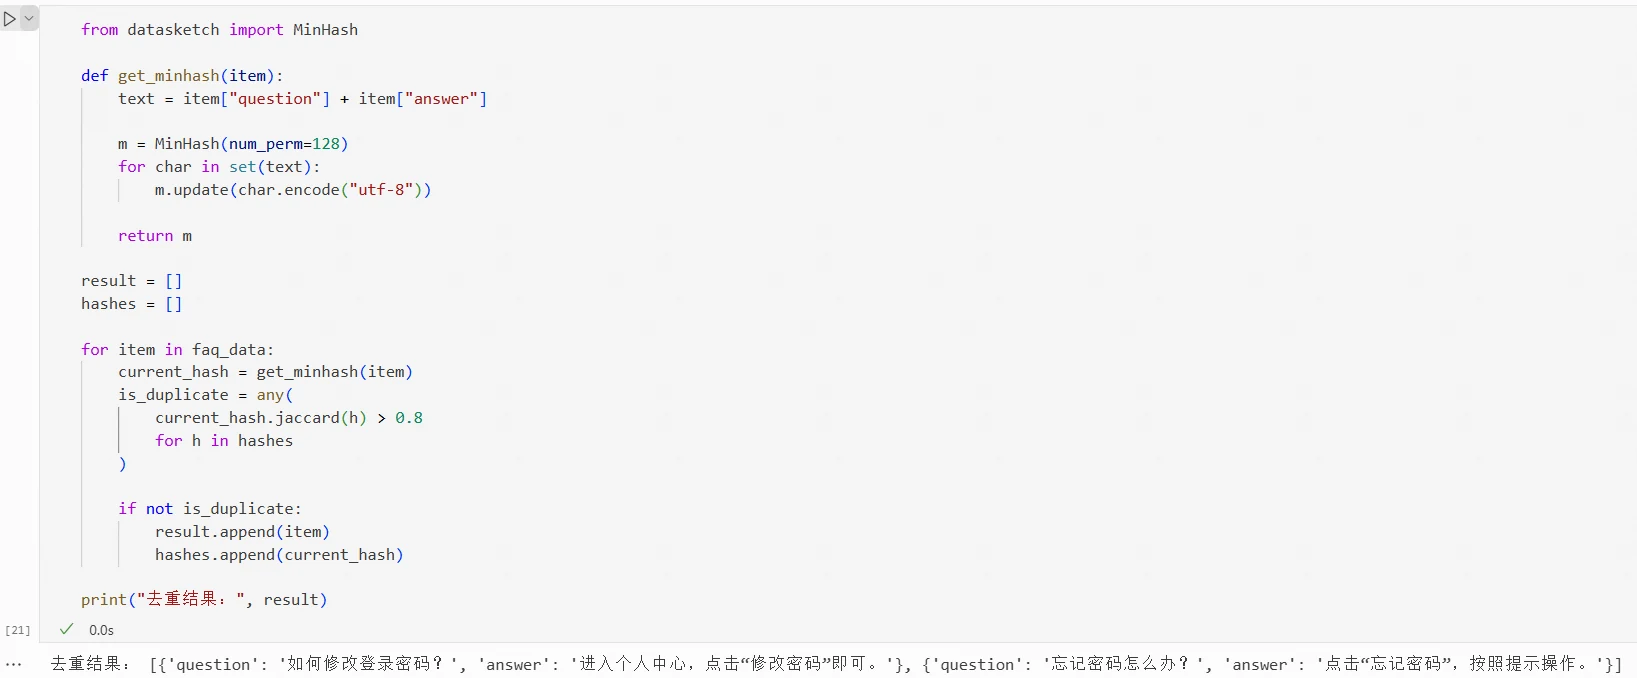
Voorbeeldcode:
from datasketch import MinHash

def get_minhash(item):
    text = item["question"] + item["answer"]

    m = MinHash(num_perm=128)
    for char in set(text):
        m.update(char.encode("utf-8")

    return m

result = []
hashes = []

for item in faq_data:
    current_hash = get_minhash(item)

    is_duplicate = any(
        current_hash.jaccard(h) > 0.8
        for h in hashes
    )

    if not is_duplicate:
        result.append(item)
        hashes.append(current_hash)

print("Deduplicatieresultaat:", result)
Resultaten:
(2) SimHash
SimHash genereert een vingerafdruk van vaste lengte op basis van de tekstinhoud, en gebruikt dan de Hamming-afstand tussen de vingerafdrukken om te bepalen of de teksten vergelijkbaar zijn.
In tegenstelling tot gewone Hash, dat voornamelijk bepaalt of de inhoud exact dezelfde is, kan SimHash teksten met vergelijkbare inhoud detecteren. Hoe kleiner de Hamming-afstand tussen twee SimHash-vingerafdrukken, hoe vergelijkbaarder de teksten over het algemeen zijn.
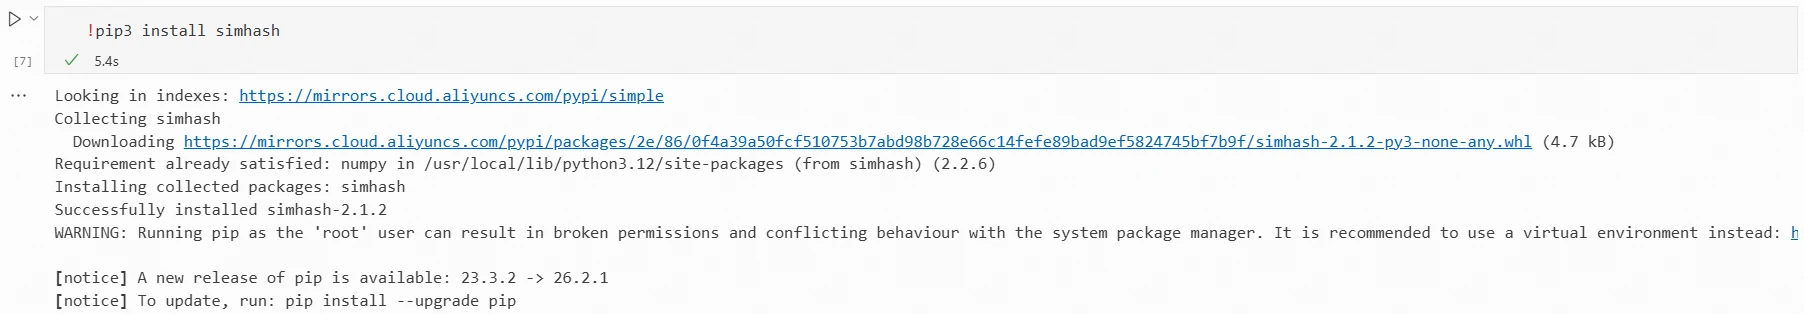
SimHash moet worden geïnstalleerd:
!pip install simhash
Resultaten:
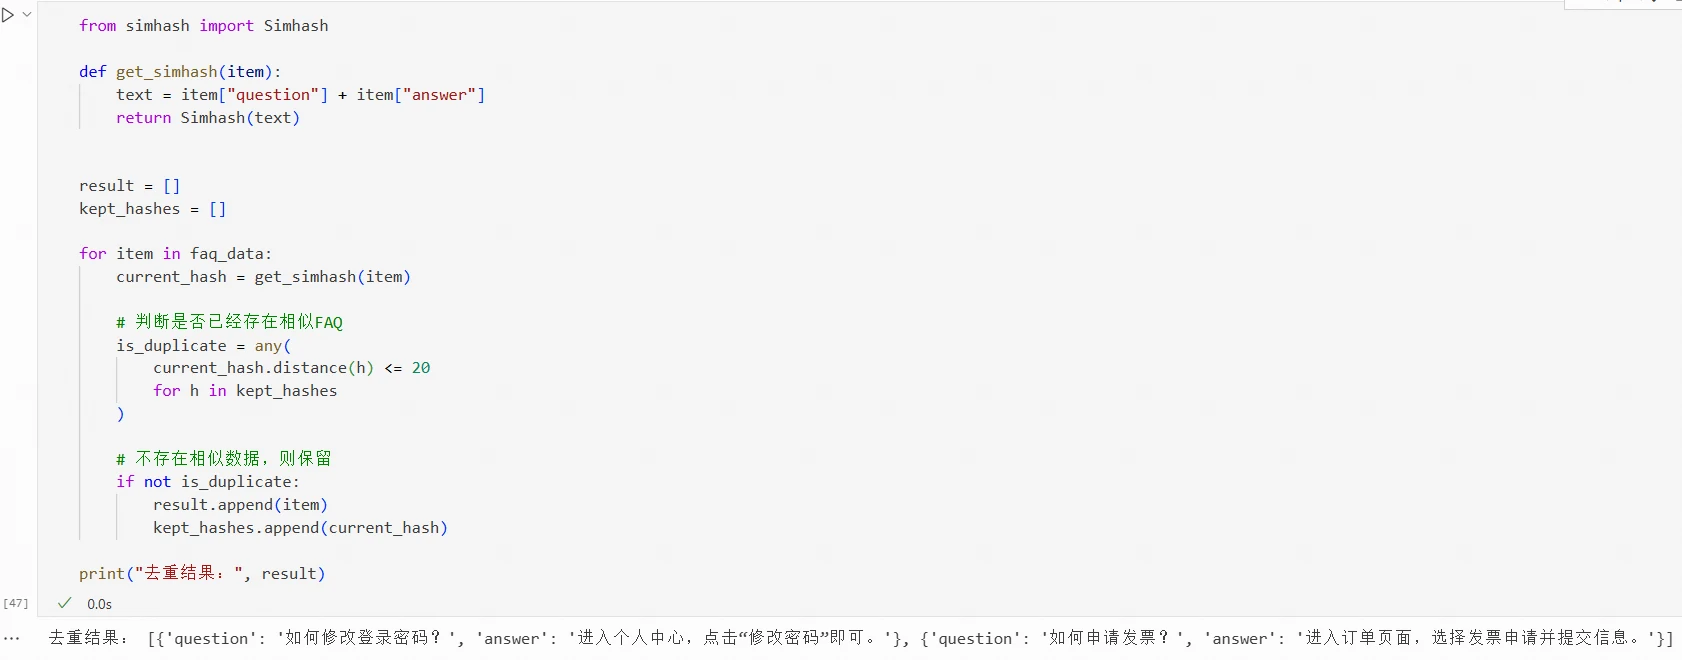
Code om SimHash te gebruiken om vergelijkbare data te verwijderen:
from simhash import Simhash

def get_simhash(item):
    text = item["question"] + item["answer"]
    return Simhash(text)

result = []
kept_hashes = []

for item in faq_data:
    current_hash = get_simhash(item)

    # Controleer of er al een vergelijkbare FAQ bestaat
    is_duplicate = any(
        current_hash.distance(h) <= 20
        for h in kept_hashes
    )

    # Als er geen vergelijkbare data is, bewaar
    if not is_duplicate:
        result.append(item)
        kept_hashes.append(current_hash)

print("Deduplicatieresultaat:", result)
Resultaten:
(3) Vectorgelijkenis
Als twee stukken data verschillende woorden gebruiken maar vergelijkbare semantiek uitdrukken, kan een tekstvectormodel worden gebruikt voor beoordeling.
Een tekstvectormodel zet tekst om in een vector bestaande uit een verzameling numerieke waarden. Voor FAQ-data combineert u de vraag en het antwoord tot één tekst, en berekent u dan de cosinusgelijkenis tussen de twee tekstvectoren:
waarbij A en B de tekstvectoren voorstellen die overeenkomen met de twee FAQ's. Hoe hoger de cosinusgelijkenis, hoe dichter de semantiek van de twee FAQ's bij elkaar liggen.
Hieronder wordt het model BAAI/bge-small-zh-v1.5 gebruikt voor berekening. Dit model is ontworpen voor Chinese tekstvector taken, met een modellengrootte van ongeveer 24M, een uitvoervectordimensie van 512, en is relatief klein en snel.
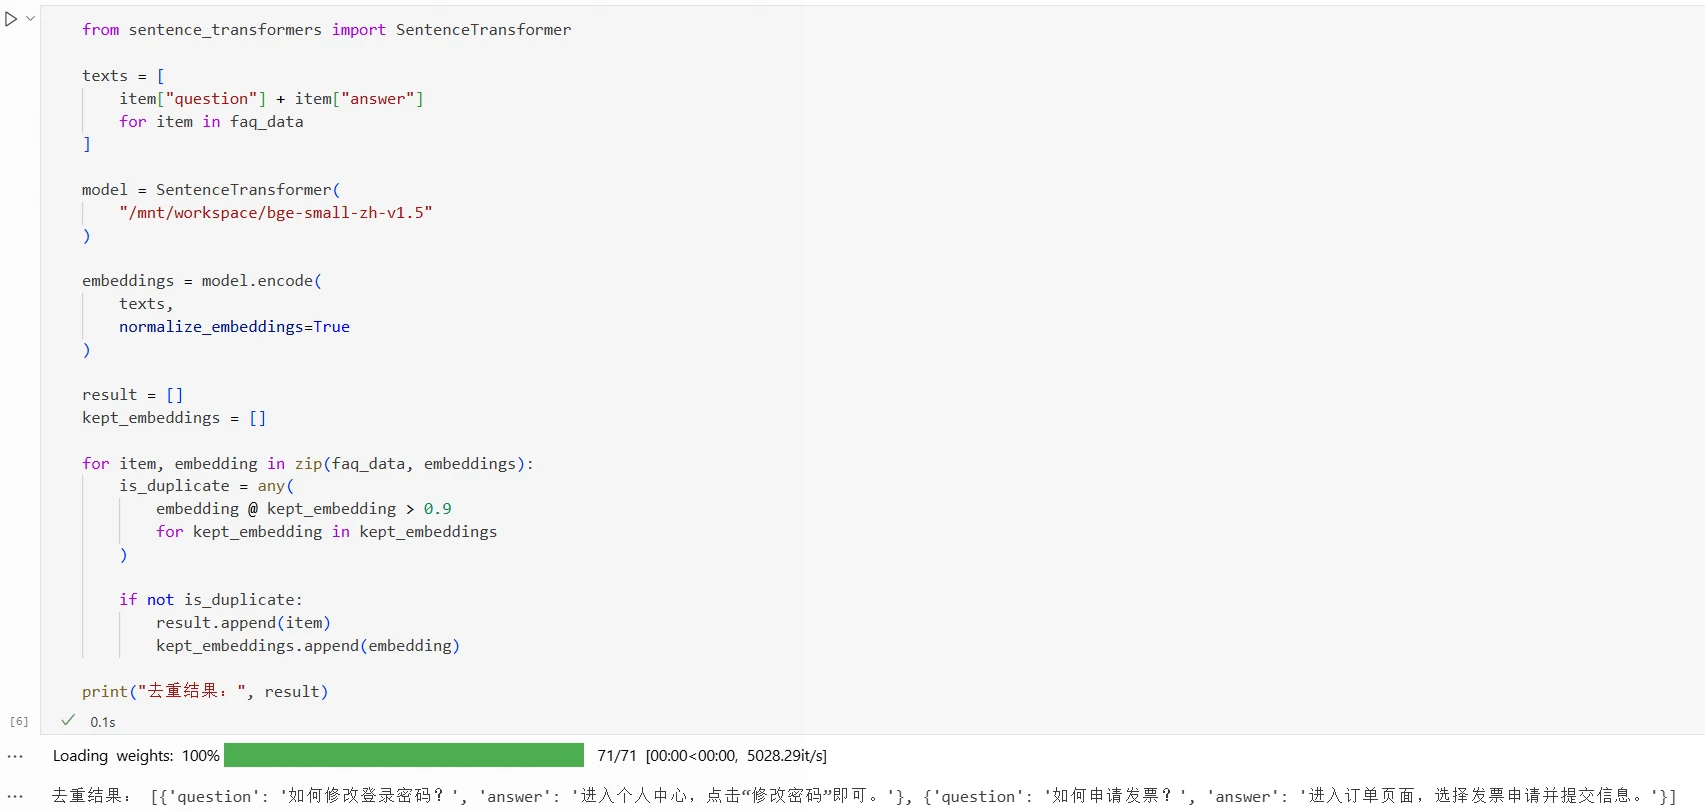
Code om vectorgelijkenis te berekenen en vergelijkbare data te verwijderen:
from sentence_transformers import SentenceTransformer

texts = [
    item["question"] + item["answer"]
    for item in faq_data
]

model = SentenceTransformer(
    "/mnt/workspace/bge-small-zh-v1.5"
)

embeddings = model.encode(
    texts,
    normalize_embeddings=True
)

result = []
kept_embeddings = []

for item, embedding in zip(faq_data, embeddings):
    is_duplicate = any(
        embedding @ kept_embedding > 0.9
        for kept_embedding in kept_embeddings
    )

    if not is_duplicate:
        result.append(item)
        kept_embeddings.append(embedding)

print("Deduplicatieresultaat:", result)
Resultaten:
Verschillende methoden zijn geschikt voor verschillende soorten datadeduplicatie:
Methode
Basis voor het oordeel
Geschikte scenario's
Directe tekstmatching
Of de tekst exact dezelfde is
Kleine hoeveelheid identieke data
Hash
Of de texthashwaarden identiek zijn
Grote hoeveelheid identieke data
MinHash
Overlap van woorden of tekens in de tekst
Data met letterlijke inhoudsgelijkenis
SimHash
Hamming-afstand tussen tekstvingerafdrukken
Data met algemene inhoudsgelijkenis maar kleine wijzigingen
Vectorgelijkenis
Semantische gelijkenis van de tekst
Data met verschillende uitdrukkingen maar vergelijkbare betekenissen
In de praktijk kunt u eerst volledig dubbele data verwijderen door tekstmatching of Hash, en dan MinHash, SimHash of vectorgelijkenis gebruiken om vergelijkbare data te detecteren. Voor gedetecteerde vergelijkbare data moet u beslissen om te verwijderen, samen te voegen of te bewaren op basis van de gelijkenisdrempel en bedrijfsvereisten om te voorkomen dat u per ongeluk data met trainingswaarde verwijdert.
Echte informatie heeft anonimisering nodig vóór training
Bedrijfsdata kan gevoelige informatie bevatten zoals namen, telefoonnummers, ID-nummers, adressen en rekeningnummers. Voordat ze het trainingsdataset betreden, moet deze inhoud worden geanonimiseerd volgens de vereisten van bedrijfsgegevensbeveiliging.
Dataanonimisering vereist eerst het identificeren van gevoelige informatie in de data, en dan het selecteren van geschikte verwerkingsmethoden op basis van het type gevoelige informatie.
Methoden voor het identificeren van gevoelige informatie
Voordat u anonimiseert, moet u bepalen welke inhoud in de data tot gevoelige informatie behoort. Voor tekstdata kunnen reguliere expressies of modellen voor herkenning van gevoelige informatie worden gebruikt voor identificatie.
(1) Gebruik van reguliere expressies
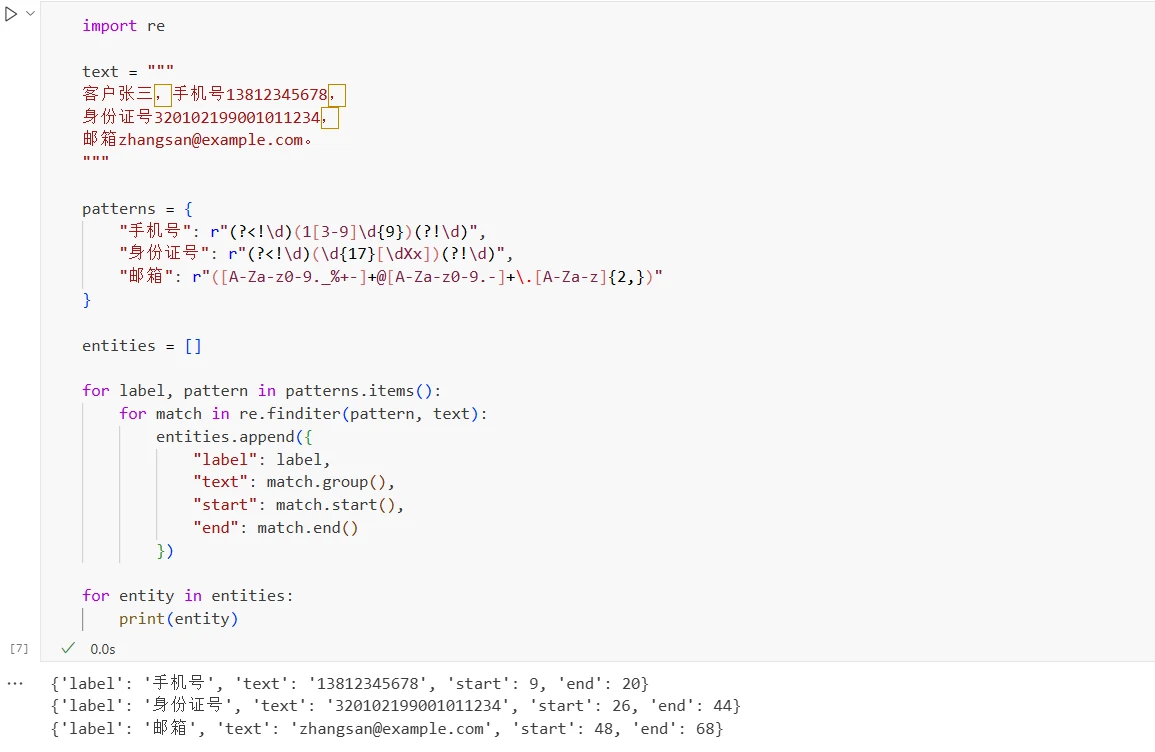
Reguliere expressies matchen tekst op basis van vooraf gedefinieerde formaatregels, waardoor ze geschikt zijn voor het identificeren van informatie met een vast formaat, zoals telefoonnummers, ID-nummers, bankrekeningnummers en e-mailadressen. Code om reguliere expressies te gebruiken voor het identificeren van gevoelige informatie:
import re

text = """
Klant Zhang San, telefoonnummer 13812345678,
ID-nummer 320102199001011234,
e-mail zhangsan@example.com.
"""

patterns = {
    "telefoon": r"(?<!\d)(1[3-9]\d{9})(?!\d)",
    "id_nummer": r"(?<!\d)(\d{17}[\dXx])(?!\d)",
    "e-mail": r"([A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,})"
}

entities = []

for label, pattern in patterns.items():
    for match in re.finditer(pattern, text):
        entities.append({
            "label": label,
            "text": match.group(),
            "start": match.start(),
            "end": match.end()
        })

for entity in entities:
    print(entity)
Uitvoerresultaten:
Reguliere expressies kunnen de inhoud, het type en de positie van gevoelige informatie in de originele tekst verkrijgen, die kunnen worden gebruikt voor verdere anonimiseringsverwerking. Reguliere expressies zijn voornamelijk gebaseerd op formaatkenmerken en zijn effectief voor informatie met een vast formaat. In de praktijk moeten overeenkomstige regels worden ontwikkeld en getest op basis van het formaat van bedrijfsdata. Voor informatie zoals namen en adressen die contextueel begrip vereisen, zijn reguliere expressies alleen moeilijk nauwkeurig te identificeren.
(2) Gebruik van modellen voor herkenning van gevoelige informatie
Voor informatie zoals namen, adressen en organisaties die semantisch begrip vereisen, kunnen modellen voor herkenning van gevoelige informatie worden gebruikt.
Bijvoorbeeld, de open-source ZJUICSR/AIguard-pii-detection-fast is een model ontworpen voor Chinese persoonlijke gevoelige informatie (PII)-herkenning, in staat om verschillende gevoelige informatie te identificeren zoals namen, telefoonnummers, ID-nummers, adressen en e-mailadressen.
Code om dit model te gebruiken voor het identificeren van gevoelige informatie:
from transformers import AutoModelForTokenClassification, AutoTokenizer
import torch

model_name = "/mnt/workspace/AIguard-pii-detection-fast"

tokenizer = AutoTokenizer.from_pretrained(
    model_name,
    trust_remote_code=True
)

model = AutoModelForTokenClassification.from_pretrained(
    model_name,
    trust_remote_code=True,
    device_map="auto"
)

# Haal labeltoewijzing op
id2label = model.config.id2label

def predict_pii(text, max_length=512):
    inputs = tokenizer(
        text,
        return_tensors="pt",
        truncation=True,
        max_length=max_length,
        return_offsets_mapping=True
    )
    offset_mapping = inputs.pop("offset_mapping")[0].tolist()

    inputs = {k: v.to(model.device) for k, v in inputs.items()}

    with torch.no_grad():
        outputs = model(**inputs)

    predictions = torch.argmax(outputs.logits, dim=-1)[0].tolist()

    # BIOE-decodering
    entities = []
    current_entity = None

    for idx, (pred_id, (start, end) in enumerate(zip(predictions, offset_mapping):
        label = id2label[pred_id]

        if label.startswith("B-"):
            if current_entity:
                entities.append(current_entity)
            current_entity = {
                "start": start,
                "end": end,
                "label": label[2:],
                "text": text[start:end]
            }
        elif label.startswith("I-") or label.startswith("E-"):
            if current_entity and current_entity["label"] == label[2:]:
                current_entity["end"] = end
                current_entity["text"] = text[current_entity["start"]:end]
                if label.startswith("E-"):
                    entities.append(current_entity)
                    current_entity = None
        else:
            if current_entity:
                entities.append(current_entity)
                current_entity = None

    if current_entity:
        entities.append(current_entity)

    return {"text": text, "entities": entities}

# Test
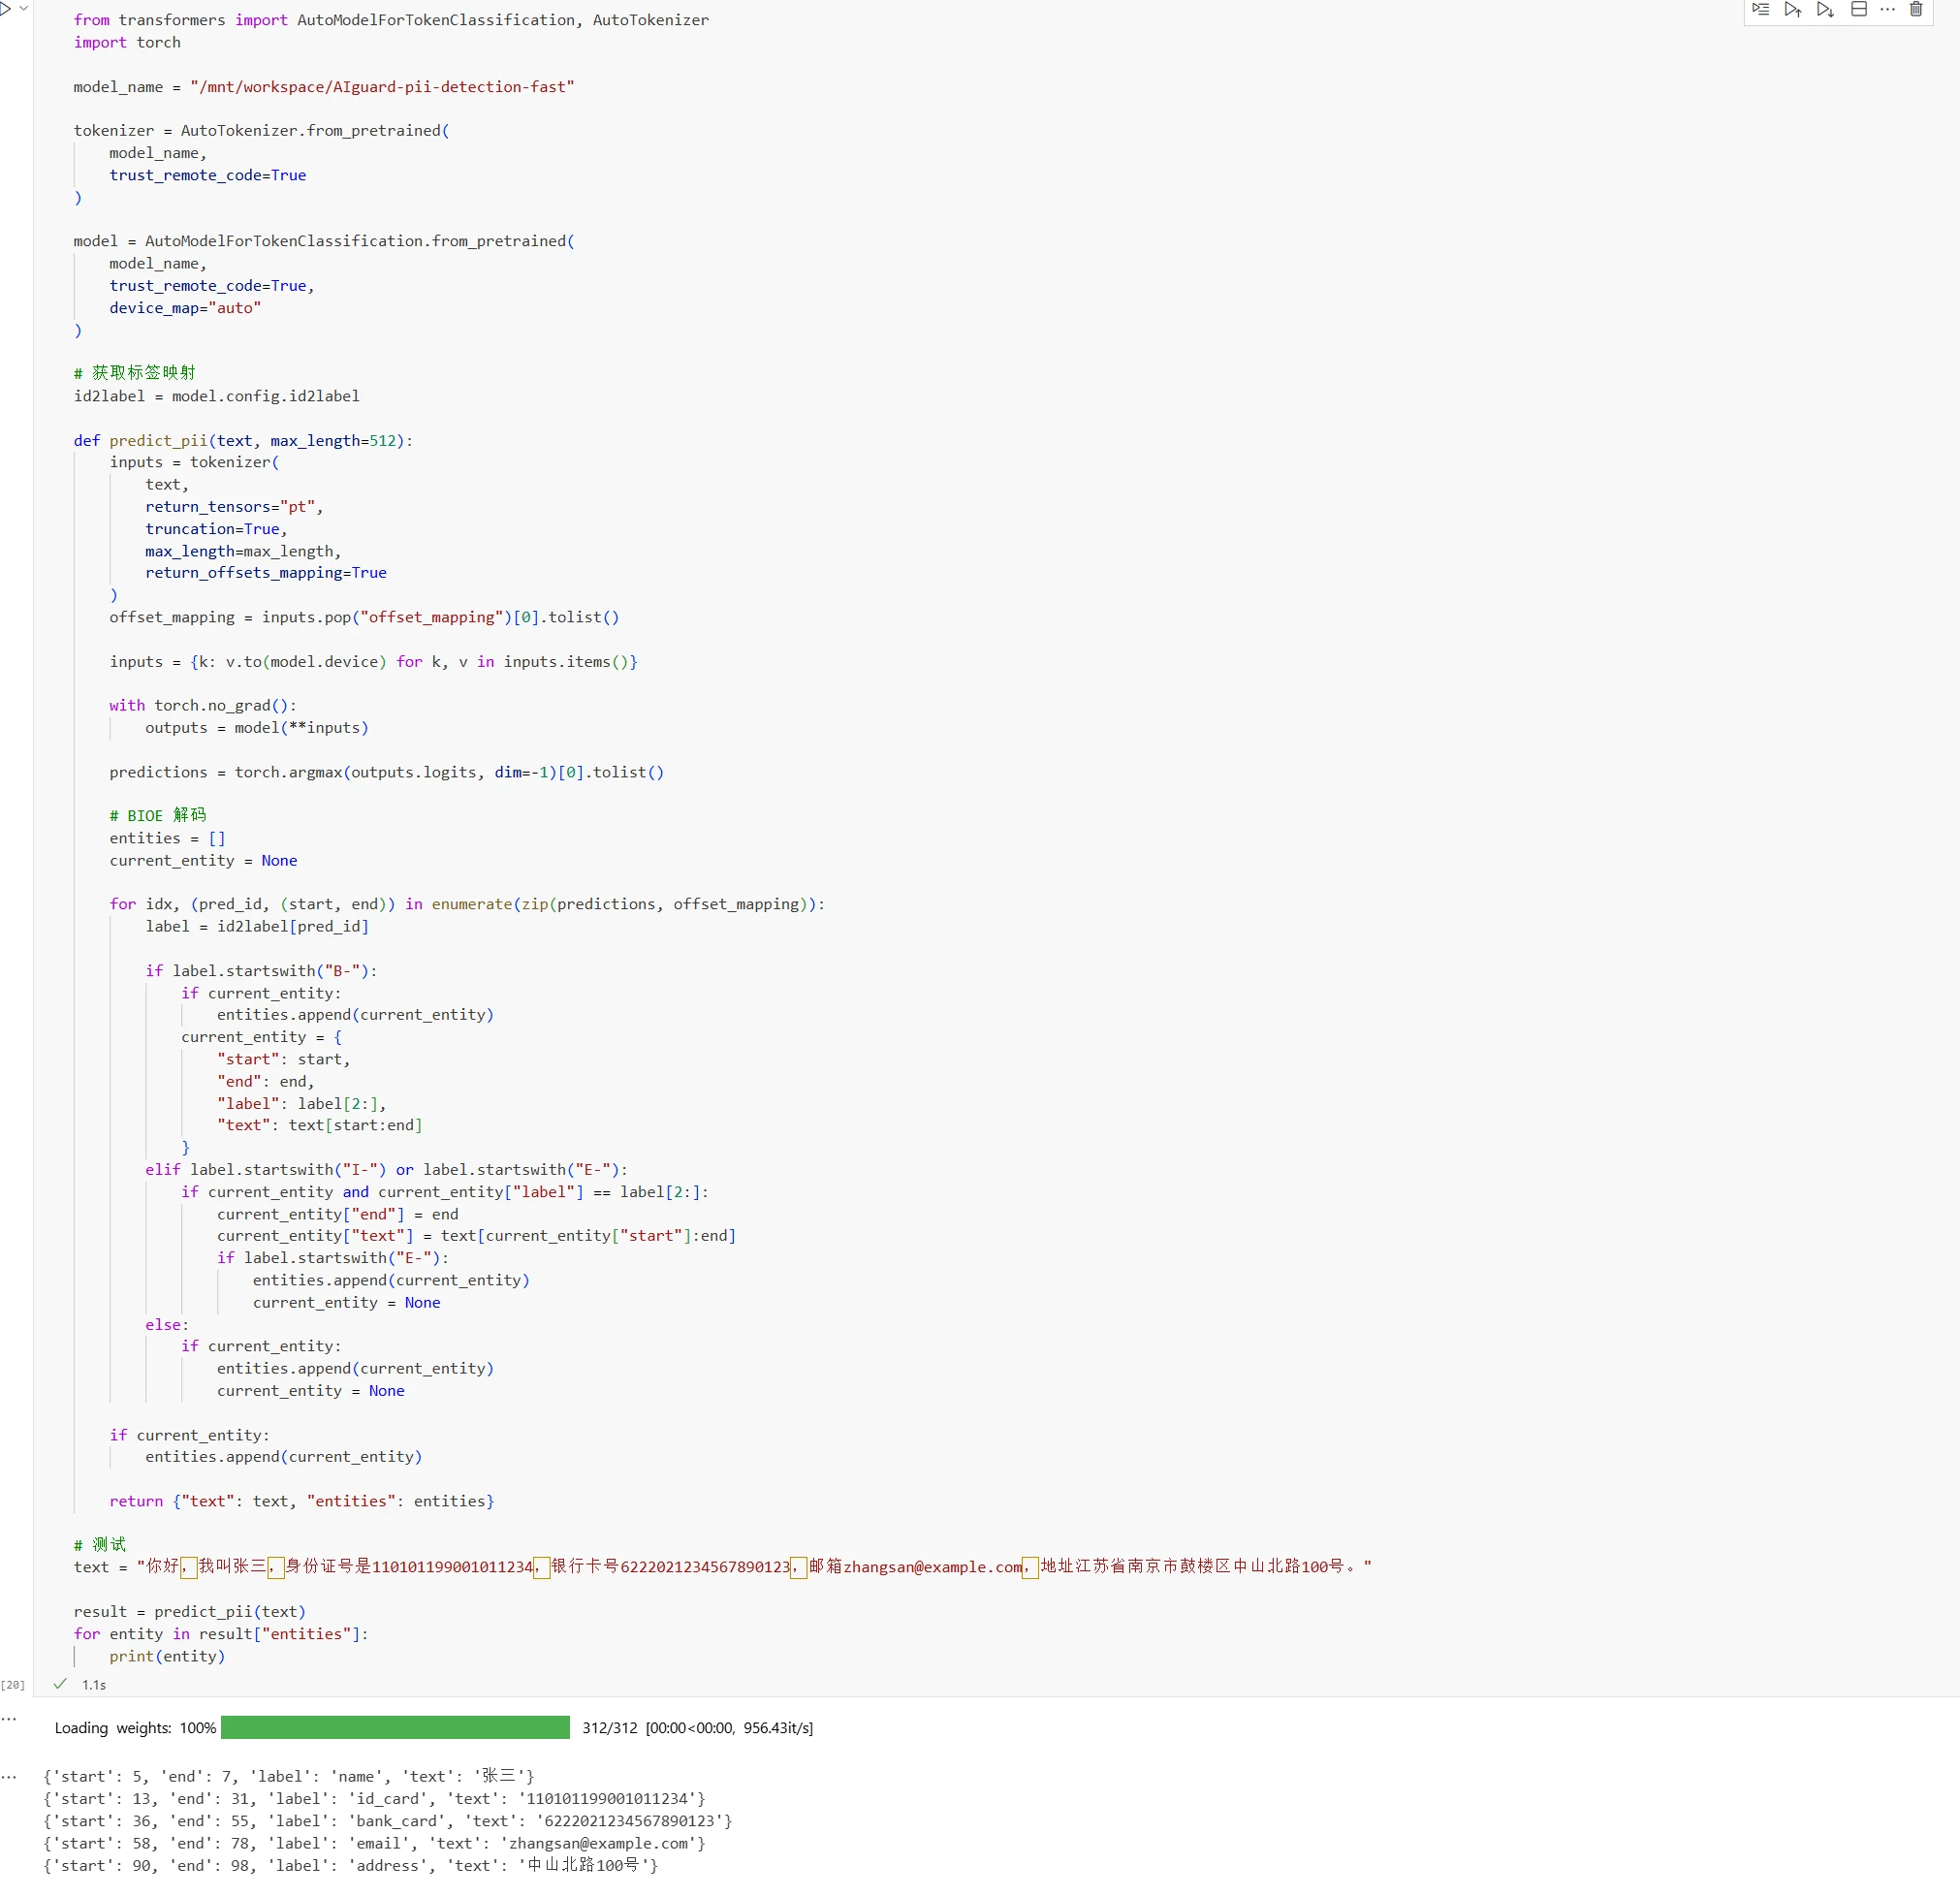
text = "Hallo, mijn naam is Zhang San, ID-nummer 110101199001011234, bankrekeningnummer 6222021234567890123, e-mail zhangsan@example.com, adres Zhongshan Noordstraat 100, District Gulou, Nanjing, Provincie Jiangsu."

result = predict_pii(text)
for entity in result["entities"]:
    print(entity)
Resultaten:
De herkenningsresultaten omvatten de inhoud van gevoelige informatie, het type gevoelige informatie en de positie in de originele tekst. Vervolgens kunnen geschikte anonimiseringsmethoden worden geselecteerd op basis van deze informatie.
In echte bedrijven worden reguliere expressies en modellen voor herkenning van gevoelige informatie vaak gecombineerd. Reguliere expressies verwerken snel informatie met een vast formaat, zoals telefoonnummers en e-mailadressen; modellen verwerken informatie die semantisch begrip vereist, zoals namen en adressen.
Anonimiseringsmethoden
Na het voltooien van de identificatie van gevoelige informatie, moeten geschikte verwerkingsmethoden worden geselecteerd op basis van het type gevoelige informatie en de vereisten van de trainingsact.
Veelvoorkomende anonimiseringsmethoden omvatten:
(1) Vervanging
Vervanging houdt in dat echte gevoelige informatie wordt vervangen door andere inhoud. Vervanging kan worden onderverdeeld in vaste vervanging en willekeurige vervanging:
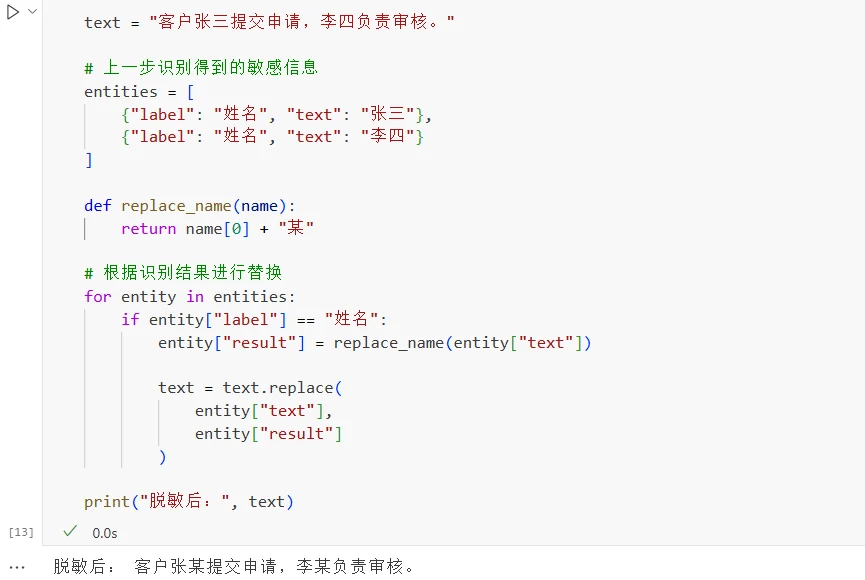
Vaste vervanging: Genereer vervangingsresultaten volgens vaste regels. Vervang bijvoorbeeld uniform de voornaam in namen door "bepaalde persoon", "Zhang San" wordt "Zhang bepaalde persoon", "Li Si" wordt "Li bepaalde persoon". Omdat de regels vast zijn, zal dezelfde informatie altijd hetzelfde resultaat opleveren, en hoeft er geen extra toewijzing te worden opgeslagen. Verwerkingscode:
text = "Klant Zhang San heeft een aanvraag ingediend, en Li Si is verantwoordelijk voor de beoordeling."

# Gevoelige informatie geïdentificeerd in de vorige stap
entities = [
    {"label": "naam", "text": "Zhang San"},
    {"label": "naam", "text": "Li Si"}
]

def replace_name(name):
    return name[0] + "bepaalde persoon"

# Vervang op basis van identificatieresultaten
for entity in entities:
    if entity["label"] == "naam":
        entity["result"] = replace_name(entity["text"])

        text = text.replace(
            entity["text"],
            entity["result"]
        )

print("Na anonimisering:", text)
Resultaten:
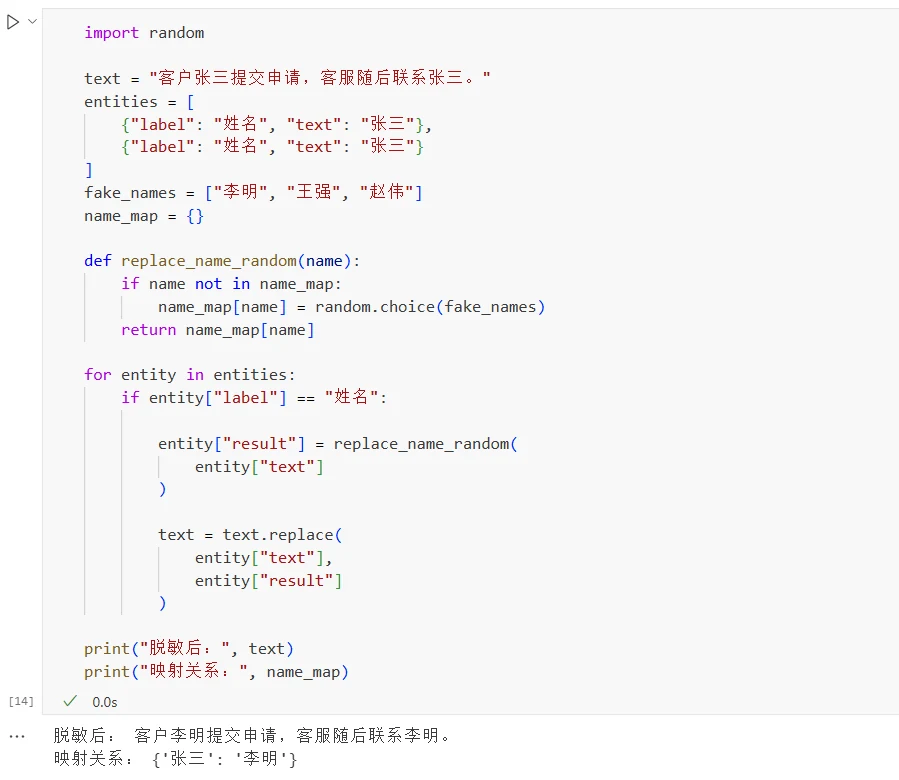
Willekeurige vervanging: Selecteer willekeurig gefabriceerde informatie om echte informatie te vervangen, bijvoorbeeld "Zhang San" vervangen door "Li Ming". Als dezelfde "Zhang San" op meerdere locaties verschijnt, moeten de vervangingsresultaten consistent zijn. Anders kunnen data die bij dezelfde entiteit horen, worden vervangen door verschillende identiteiten, waardoor de associaties in de data worden vernietigd. Daarom vereist willekeurige vervanging meestal het instellen van een toewijzingstabel: {"Zhang San":"Li Ming"}, en wanneer u "Zhang San" opnieuw tegenkomt, wordt "Li Ming" direct gebruikt. Verwerkingscode:
import random

text = "Klant Zhang San heeft een aanvraag ingediend, en de klantenservice heeft vervolgens contact opgenomen met Zhang San."
entities = [
    {"label": "naam", "text": "Zhang San"},
    {"label": "naam", "text": "Zhang San"}
]
fake_names = ["Li Ming", "Wang Qiang", "Zhao Wei"]
name_map = {}

def replace_name_random(name):
    if name not in name_map:
        name_map[name] = random.choice(fake_names)
    return name_map[name]

for entity in entities:
    if entity["label"] == "naam":

        entity["result"] = replace_name_random(
            entity["text"]
        )

        text = text.replace(
            entity["text"],
            entity["result"]
        )

print("Na anonimisering:", text)
print("Toewijzing:", name_map)
Resultaten:
(2) Maskering
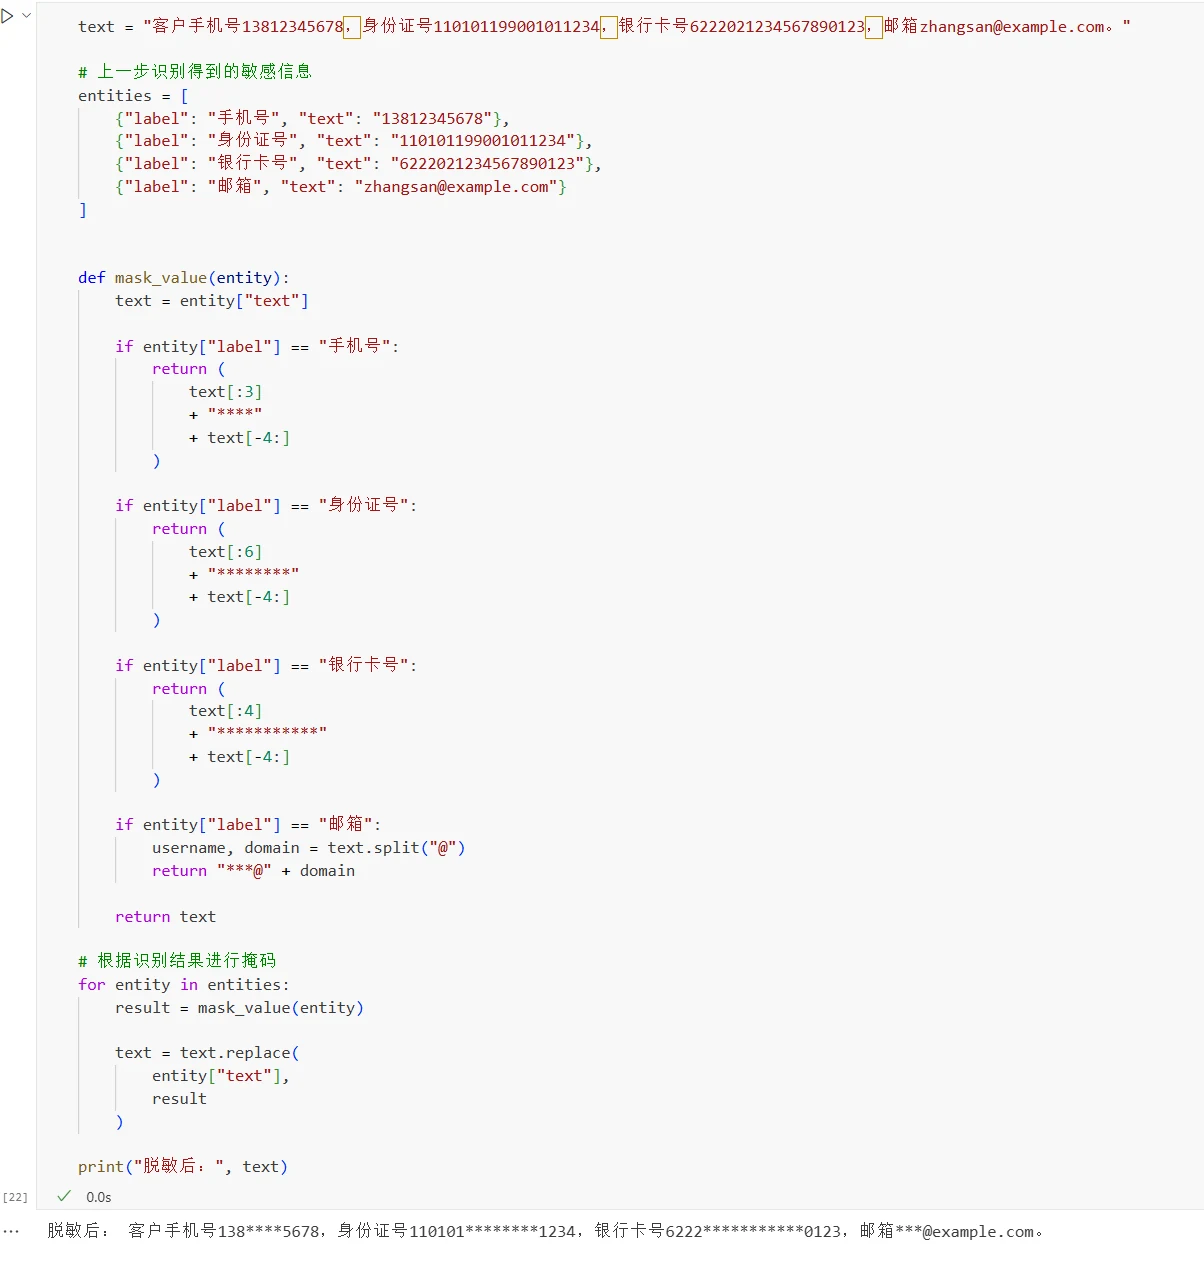
Maskering verbergt een deel van de gevoelige inhoud terwijl gedeeltelijke informatie wordt bewaard, zoals telefoonnummers, ID-nummers, bankrekeningnummers en e-mailadressen.
Verwerkingscode:
text = "Telefoonnummer van de klant 13812345678, ID-nummer 110101199001011234, bankrekeningnummer 6222021234567890123, e-mail zhangsan@example.com."

# Gevoelige informatie geïdentificeerd in de vorige stap
entities = [
    {"label": "telefoon", "text": "13812345678"},
    {"label": "id_nummer", "text": "110101199001011234"},
    {"label": "bankrekening", "text": "6222021234567890123"},
    {"label": "e-mail", "text": "zhangsan@example.com"}
]

def mask_value(entity):
    text = entity["text"]

    if entity["label"] == "telefoon":
        return (
            text[:3]
            + "****"
            + text[-4:]
        )

    if entity["label"] == "id_nummer":
        return (
            text[:6]
            + "********"
            + text[-4:]
        )

    if entity["label"] == "bankrekening":
        return (
            text[:4]
            + "***********"
            + text[-4:]
        )

    if entity["label"] == "e-mail":
        username, domain = text.split("@")
        return "***@" + domain

    return text

# Pas maskering toe op basis van identificatieresultaten
for entity in entities:
    result = mask_value(entity)

    text = text.replace(
        entity["text"],
        result
    )

print("Na anonimisering:", text)
Resultaten:
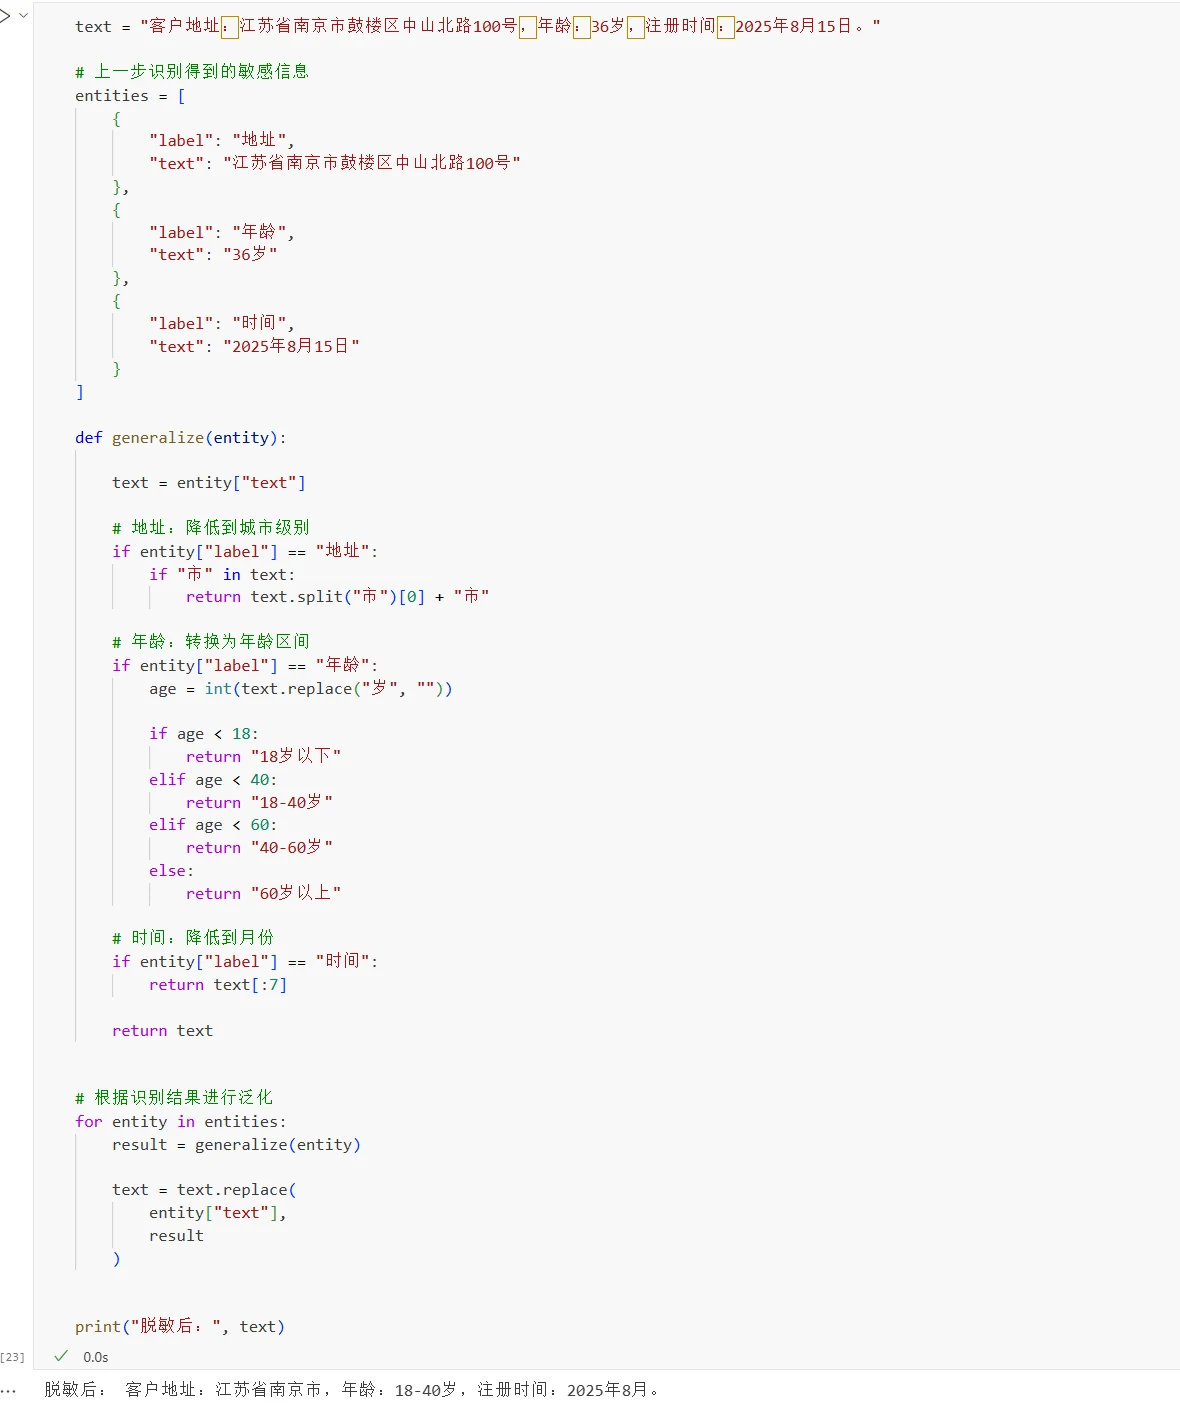
(3) Generalisatie
Generalisatie verlaagt de nauwkeurigheid van informatie, waardoor het vermogen om data te lokaliseren op specifieke objecten wordt verminderd. Het wordt vaak gebruikt voor continue informatie zoals adressen, leeftijden en tijden.
Verwerkingscode:
text = "Adres van de klant: Zhongshan Noordstraat 100, District Gulou, Nanjing, Provincie Jiangsu, leeftijd: 36 jaar, registratietijd: 15 augustus 2025."

# Gevoelige informatie geïdentificeerd in de vorige stap
entities = [
    {
        "label": "adres",
        "text": "Zhongshan Noordstraat 100, District Gulou, Nanjing, Provincie Jiangsu"
    },
    {
        "label": "leeftijd",
        "text": "36 jaar"
    },
    {
        "label": "tijd",
        "text": "15 augustus 2025"
    }
]

def generalize(entity):

    text = entity["text"]

    # Adres: terugbrengen naar stadsniveau
    if entity["label"] == "adres":
        if "stad" in text:
            return text.split("stad")[0] + "stad"

    # Leeftijd: omzetten naar leeftijdsbereik
    if entity["label"] == "leeftijd":
        age = int(text.replace("jaar", "")

        if age < 18:
            return "Onder 18"
        elif age < 40:
            return "18-40"
        elif age < 60:
            return "40-60"
        else:
            return "Boven 60"

    # Tijd: terugbrengen naar maandniveau
    if entity["label"] == "tijd":
        return text[:7]

    return text

# Pas generalisatie toe op basis van identificatieresultaten
for entity in entities:
    result = generalize(entity)

    text = text.replace(
        entity["text"],
        result
    )

print("Na anonimisering:", text)
Resultaten:
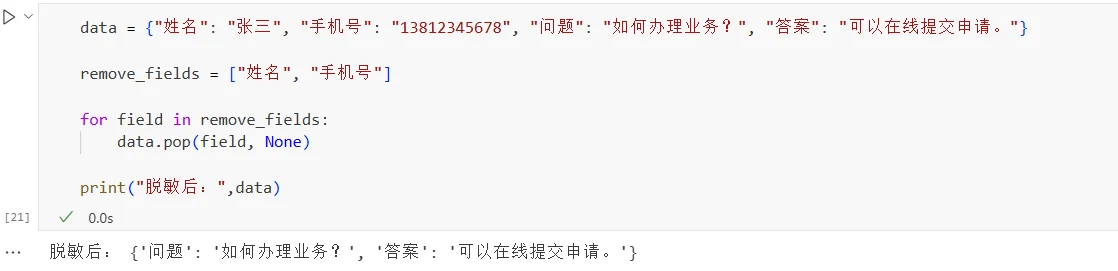
(4) Verwijdering
Voor gevoelige velden die geen verband houden met de trainingsact, kunnen ze direct worden verwijderd. Als de trainingsact alleen het leren van Q&A-relaties vereist, kunnen namen en telefoonnummers worden verwijderd.
data = {"naam": "Zhang San", "telefoon": "13812345678", "vraag": "Hoe verwerk ik de service?", "antwoord": "U kunt een aanvraag online indienen."}

remove_fields = ["naam", "telefoon"]

for field in remove_fields:
    data.pop(field, None)

print("Na anonimisering:", data)
Resultaten:
In de praktijk moet de anonimiseringsmethode worden geselecteerd op basis van de trainingsact en de kenmerken van de data. Wanneer het nodig is om associaties tussen verschillende monsters te behouden, kan vaste vervanging of willekeurige vervanging met toewijzing worden gebruikt; wanneer het nodig is om gedeeltelijke informatiekenmerken te behouden, kan maskering of generalisatie worden gebruikt; voor gevoelige informatie die geen verband houdt met de trainingsact, moet deze direct worden verwijderd.
Verschillende bedrijfsscenario's hebben verschillende datakenmerken, en specifieke anonimiseringsregels moeten worden aangepast aan de werkelijke vereisten. De code in deze sectie is alleen bedoeld om basale verwerkingsmethoden te illustreren.
Laatste stap: organiseer in het formaat dat vereist is voor training
Na het voltooien van de dataverwerking moeten de data nog worden georganiseerd in het overeenkomstige formaat volgens de vereisten van het trainingsframework.
Instructiefijnafstemming is een veelgebruikte fijnafstemmingsmethode voor grote taalmodellen. Trainingsdata omvat gebruikersinstructies en de door het model verwachte antwoorden, en leert het model hoe het taken moet voltooien volgens de instructies.
Verschillende trainingsframeworks kunnen verschillende data-velden gebruiken. Veelgebruikte instructiedata-formaten omvatten voornamelijk Alpaca, ShareGPT en Messages.
Alpaca-formaat
Het Alpaca-formaat heeft een eenvoudige structuur en gebruikt meestal drie velden: instruction, input en output. Het is geschikt voor instructiedata met één beurt.
{
  "instruction": "Vertaal de volgende Chinese tekst naar het Engels",
  "input": "Het weer is vandaag erg mooi.",
  "output": "The weather is very nice today."
}
waarbij: instruction de taak voorstelt die het model moet uitvoeren; input de invoerinhoud voorstelt die nodig is om de taak uit te voeren; output het antwoord voorstelt dat het model moet genereren.
Als de taak zelf geen extra invoer vereist, kan input ook leeg zijn.
Bijvoorbeeld:
{
  "instruction": "Leg uit wat machinaal leren is",
  "input": "",
  "output": "Machinaal leren is een methode waarmee computers patronen uit data kunnen leren."
}
Dit formaat heeft weinig velden en een duidelijke structuur, waardoor het geschikt is voor trainings taken met één beurt zoals Q&A, classificatie en tekstgeneratie.
Messages-formaat
Een andere veelgebruikte aanpak is het gebruik van messages om gesprekken op te slaan, waarbij elk bericht twee hoofdvelden bevat: role en content.
Bijvoorbeeld:
{
  "messages": [
    {
      "role": "system",
      "content": "U bent een professionele klantenservice-assistent."
    },
    {
      "role": "user",
      "content": "Wanneer komt mijn bestelling aan?"
    },
    {
      "role": "assistant",
      "content": "Geef alstublieft het bestelnummer op, en ik help u met het opzoeken."
    }
  ]
}
waarbij system wordt gebruikt om de modelrol, de taakvereisten of antwoordregels in te stellen, user de gebruikersinvoer voorstelt, en assistant het antwoord voorstelt dat het model moet genereren.
Het Messages-formaat ondersteunt ook gesprekken met meerdere beurten. U hoeft alleen maar door te gaan met het toevoegen van user- en assistant-berichten in de werkelijke gespreksvolgorde.
Bijvoorbeeld:
{
  "messages": [
    {
      "role": "system",
      "content": "U bent een professionele klantenservice-assistent."
    },
    {
      "role": "user",
      "content": "Hoe wijzig ik het inlogwachtwoord?"
    },
    {
      "role": "assistant",
      "content": "Ga naar de accountinstellingenpagina en selecteer 'Wachtwoord wijzigen'."
    },
    {
      "role": "user",
      "content": "Wat als ik het originele wachtwoord ben vergeten?"
    },
    {
      "role": "assistant",
      "content": "U kunt 'Wachtwoord vergeten' selecteren op de inlogpagina, verifiëren via telefoonnummer of e-mail, en dan het wachtwoord opnieuw instellen."
    }
  ]
}
ShareGPT-formaat
ShareGPT is een van de veelgebruikte dialoogdata-formaten in de training van open-source modellen. Het gebruikt meestal conversations om volledige gesprekken op te slaan en gebruikt human en gpt om tussen gebruikers en het model te onderscheiden.
Bijvoorbeeld:
{
  "conversations": [
    {
      "from": "human",
      "value": "Vertaal de volgende Chinese tekst naar het Engels: Het weer is vandaag erg mooi."
    },
    {
      "from": "gpt",
      "value": "The weather is very nice today."
    }
  ]
}
Het ShareGPT-formaat kan ook gesprekken met meerdere beurten opslaan:
{
  "conversations": [
    {
      "from": "human",
      "value": "Help me een verlofaanvraag e-mail te schrijven."
    },
    {
      "from": "gpt",
      "value": "Geef alstublieft de verloftijd en reden op."
    },
    {
      "from": "human",
      "value": "Ik heb een verkoudheid en heb twee dagen ziekteverlof nodig."
    },
    {
      "from": "gpt",
      "value": "Okay, hier is een verlofaanvraag e-mail..."
    }
  ]
}
Hoe een dataformaat kiezen
De formaten Alpaca, Messages en ShareGPT beschrijven in wezen de invoer en verwachte uitvoer van het model, maar met verschillende veldorganisaties.
U kunt kiezen op basis van het taaktype en het trainingsframework:
Dataformaat
Belangrijkste kenmerken
Geschikte scenario's
Alpaca
Organiseert data met instruction, input en output
Instructies met één beurt, Q&A, classificatie
Messages
Gebruikt messages om gesprekken op te slaan, onderscheidt rollen via role
Gesprekken met één beurt of meerdere beurten
ShareGPT
Gebruikt conversations om gesprekken op te slaan, onderscheidt rollen via from
Gesprekken met één beurt of meerdere beurten
De verschillende formaten kunnen over het algemeen in elkaar worden omgezet. Bijvoorbeeld, een Alpaca-stuk data kan worden omgezet in een reeks user- en assistant-berichten, en human en gpt in ShareGPT kunnen ook worden omgezet in respectievelijk user en assistant. Tijdens het trainen moet u eerst de door het trainingsframework ondersteunde dataformaten en modelsjablonen bevestigen, en dan de data organiseren volgens de overeenkomstige vereisten.
Modelcode en bijbehorende bestanden: https://www.modelscope.cn/gallery/liucong/b41e2395-f795-400f-bafd-e53ed7f5c8ca