Alhoewel algemene grote modellen over sterke kennis-vraag-en-antwoordmogelijkheden beschikken, gaan veel vragen in de praktijk van een bedrijf over interne productinformatie, technische documentatie, bedrijfsregels en handleidingen. Deze kennis is doorgaans niet opgenomen in de trainingsdata van het model en wordt bovendien voortdurend bijgewerkt.
RAG (Retrieval-Augmented Generation) biedt een oplossing: voordat het model een vraag beantwoordt, zoekt het eerst relevante inhoud op in de kennisbank van het bedrijf en geeft die zoekresultaten door aan het model om een antwoord te genereren.
De kerngedachte van RAG is: eerst zoeken, dan antwoorden. Traditionele vraag-en-antwoordmodellen maken voornamelijk gebruik van kennis die al in de modelparameters is opgeslagen. Wanneer een gebruiker bijvoorbeeld een vraag stelt, genereert het model op basis van de tijdens de training geleerde informatie direct een antwoord. RAG voegt hier een extra kenniszoekstap aan toe. Nadat de gebruiker een vraag heeft gesteld, zoekt het systeem eerst naar relevante inhoud in een externe kennisbank, waarna de vraag van de gebruiker samen met de gevonden kennis naar het grote model wordt gestuurd, dat op basis hiervan een definitief antwoord genereert.
Een basis RAG-proces kan als volgt worden weergegeven: gebruikersvraag → kennis zoeken → relevante inhoud ophalen → LLM genereert antwoord → resultaat retourneren. RAG zorgt er niet voor dat het model de kennis opnieuw leert; het verschaft het model tijdens het beantwoorden van vragen tijdelijk de referentiematerialen die voor de huidige vraag nodig zijn.
RAG is niet voor alle toepassingen van grote modellen noodzakelijk, maar komt veel voor bij bedrijfskennis-Q&A, intelligente klantenservice en documentassistenten.
Als bedrijfskennis voortdurend moet worden bijgewerkt, is RAG doorgaans een goede keuze. Denk aan productomschrijvingen, bedrijfsregels en werkinstructies die regelmatig worden aangepast. Wanneer deze kennis via modeltraining in het model wordt geschreven, moet het model bij elke wijziging opnieuw worden getraind — wat kostbaar is en moeilijk te onderhouden.
RAG maakt direct bijwerken van de externe kennisbank mogelijk. Wanneer documenten veranderen, volstaat het om de betreffende documenten opnieuw te verwerken en de index bij te werken; een volledige hertraining van het grote model is niet nodig. Als het antwoord een bronvermelding moet bevatten, is RAG ook zeer geschikt. Omdat het antwoord is gegenereerd op basis van opgehaalde documenten, kunnen tegelijkertijd documentnamen, hoofdstukken, paginanummers of fragmenten uit de brontekst worden geretourneerd, zodat de gebruiker weet waar het antwoord vandaan komt.
Zowel RAG als fijnafstemming van het model kunnen worden gebruikt om de prestaties van grote modellen in de praktijk te verbeteren, maar de aanpak voor het oplossen van problemen verschilt. RAG lost voornamelijk het probleem op dat het model bepaalde kennis mist, terwijl fijnafstemming voornamelijk het probleem oplost dat het model niet aan de gestelde vereisten voldoet.
Inloggen deelnemen aan de discussie
RAG wijzigt de parameters van het model zelf niet; het haalt voor het beantwoorden van vragen eerst relevante inhoud op uit een externe kennisbank en verschaft deze inhoud als referentiemateriaal aan het model.
Fijnafstemming werkt anders. Daarbij worden specifieke trainingsgegevens gebruikt om het model verder te trainen, waarbij de modelparameters worden aangepast zodat het model de verwerking van een specifieke taak stapsgewijs leert. Denk aan de in hoofdstuk 9 besproken taak van entiteitherkenning, waarbij het model een antwoord in een vast formaat moet produceren. Wanneer de taakeisen sterk veranderen, moeten doorgaans nieuwe trainingsgegevens worden voorbereid en moet de fijnafstemming opnieuw worden uitgevoerd.
In de praktijk kunnen verschillende methoden worden gekozen op basis van het op te lossen probleem: voor het aanvullen of bijwerken van kennis is RAG geschikter; voor het aanpassen van de taakvaardigheden, het uitvoerformaat of het gedrag van het model is fijnafstemming geschikter. RAG en fijnafstemming kunnen ook gecombineerd worden gebruiken. Zo kun je via fijnafstemming het model vaardigheden voor vraag-en-antwoord of instructieopvolging bijbrengen, en via RAG kennis uit een specifiek domein aanreiken, zodat het model zowel aan de bedrijfseisen kan voldoen als antwoorden kan genereren op basis van de meest actuele domeinkennis.
Een compleet RAG-systeem kan doorgaans worden opgesplitst in twee hoofdfasen: kennisbankopbouw en online Q&A. Bij de kennisbankopbouw worden bronbestanden zoals PDF, Word, Markdown en webpagina's verwerkt tot doorzoekbare kennis. Bij online Q&A wordt na het stellen van een vraag relevante inhoud opgehaald uit de opgebouwde kennisbank. In dit experiment wordt de online openbare “Reglement van de Volksrepubliek China voor de Uitvoering van de Wegverkeersveiligheidswet” als bron voor de documentbank gebruikt om een RAG-systeem over verkeersveiligheidswetgeving op te bouwen.
Bedrijfskennis bevindt zich doorgaans in verschillende bestandstypen zoals PDF, Word, Excel, Markdown en webpagina's. Omdat de indeling en interne structuur van deze bestanden sterk kunnen verschillen, moet men voor de opbouw van een RAG-kennisbank deze documenten doorgaans eerst omzetten tot een eenvormig, verwerkbaar tekst- of gestructureerd datatype; dit proces heet documentparsing. Voor een RAG-systeem moet een goed documentparsetool niet alleen de tekst herkennen, maar ook zoveel mogelijk de structuur van het oorspronkelijke document behouden, zoals: documenttitels, alinea's, tabellen, afbeeldingen, formules enzovoort.
Er bestaan momenteel tal van open-source tools voor documentparsing, waaronder:
1)MinerU is een open-source parsetool voor complexe documenten die PDF, afbeeldingen, Word, PPT en Excel kan omzetten naar Markdown, JSON en andere machine-leesbare formaten. Het herkent titels, hoofdtekst, tabellen, afbeeldingen, formules en meer, en herstelt de documentstructuur zoveel mogelijk in de volgorde waarin een mens het zou lezen; het is daarom goed geschikt als documentvoorverwerkingsinstrument in een RAG-systeem. opendatalab/MinerU
2)MonkeyOCR is een documentparsingsproject gebaseerd op multimodale modellen dat documenten analyseert via structuurerkenning, inhoudsherkenning en relatiemodellering. Het kan complexe inhoud zoals tekst, tabellen en formules verwerken en ondersteunt zowel Chinese als Engelse documenten. Voor PDF's met een gecompliceerde lay-out waarbij traditionele tekstextractietools niet goed werken, kun je deze op visuele modellen gebaseerde parsingsmethoden overwegen. Yuliang-Liu/MonkeyOCR
3)Dolphin is een documentafbeeldingsparsingsmodel van ByteDance dat documenten verwerkt met de aanpak “eerst analyseren, dan parsen”. Het herkent eerst de lay-out en leesvolgorde van de pagina en analyseert vervolgens verschillende typen documentelementen zoals tekst, tabellen, formules en code; het is geschikt voor PDF's met een gecompliceerde lay-out of gescande documenten. ByteDance/Dolphin
4)PaddleOCR is een OCR- en documentparsetool van PaddlePaddle. Naast de gebruikelijke tekstherkenning biedt het lay-outanalyse, tabelherkenning en gestructureerde documentparsing, waarmee de inhoud van PDF's en afbeeldingen kan worden omgezet in gestructureerde gegevens die beter geschikt zijn voor verdere verwerking door AI-systemen. Voor gescande PDF's, afbeeldingsdocumenten en documenten met veel Chinese tekst is PaddleOCR een veelgebruikte keuze. PaddlePaddle/PaddleOCR
De verschillende documentparsetools hebben elk hun eigen kenmerken; er bestaat geen tool die voor alle documenten geschikt is. Bij de daadwerkelijke opbouw van een RAG-systeem kan de keuze van de parsetool worden afgestemd op het type document, de complexiteit van de lay-out, de parsingsnauwkeurigheid en de kosten voor implementatie.
In dit experiment wordt MinerU gebruikt voor documentparsing. Eerst installeer je MinerU in de Notebook-omgeving van ModelScope met de volgende opdracht:
pip install -U "mineru[all]"
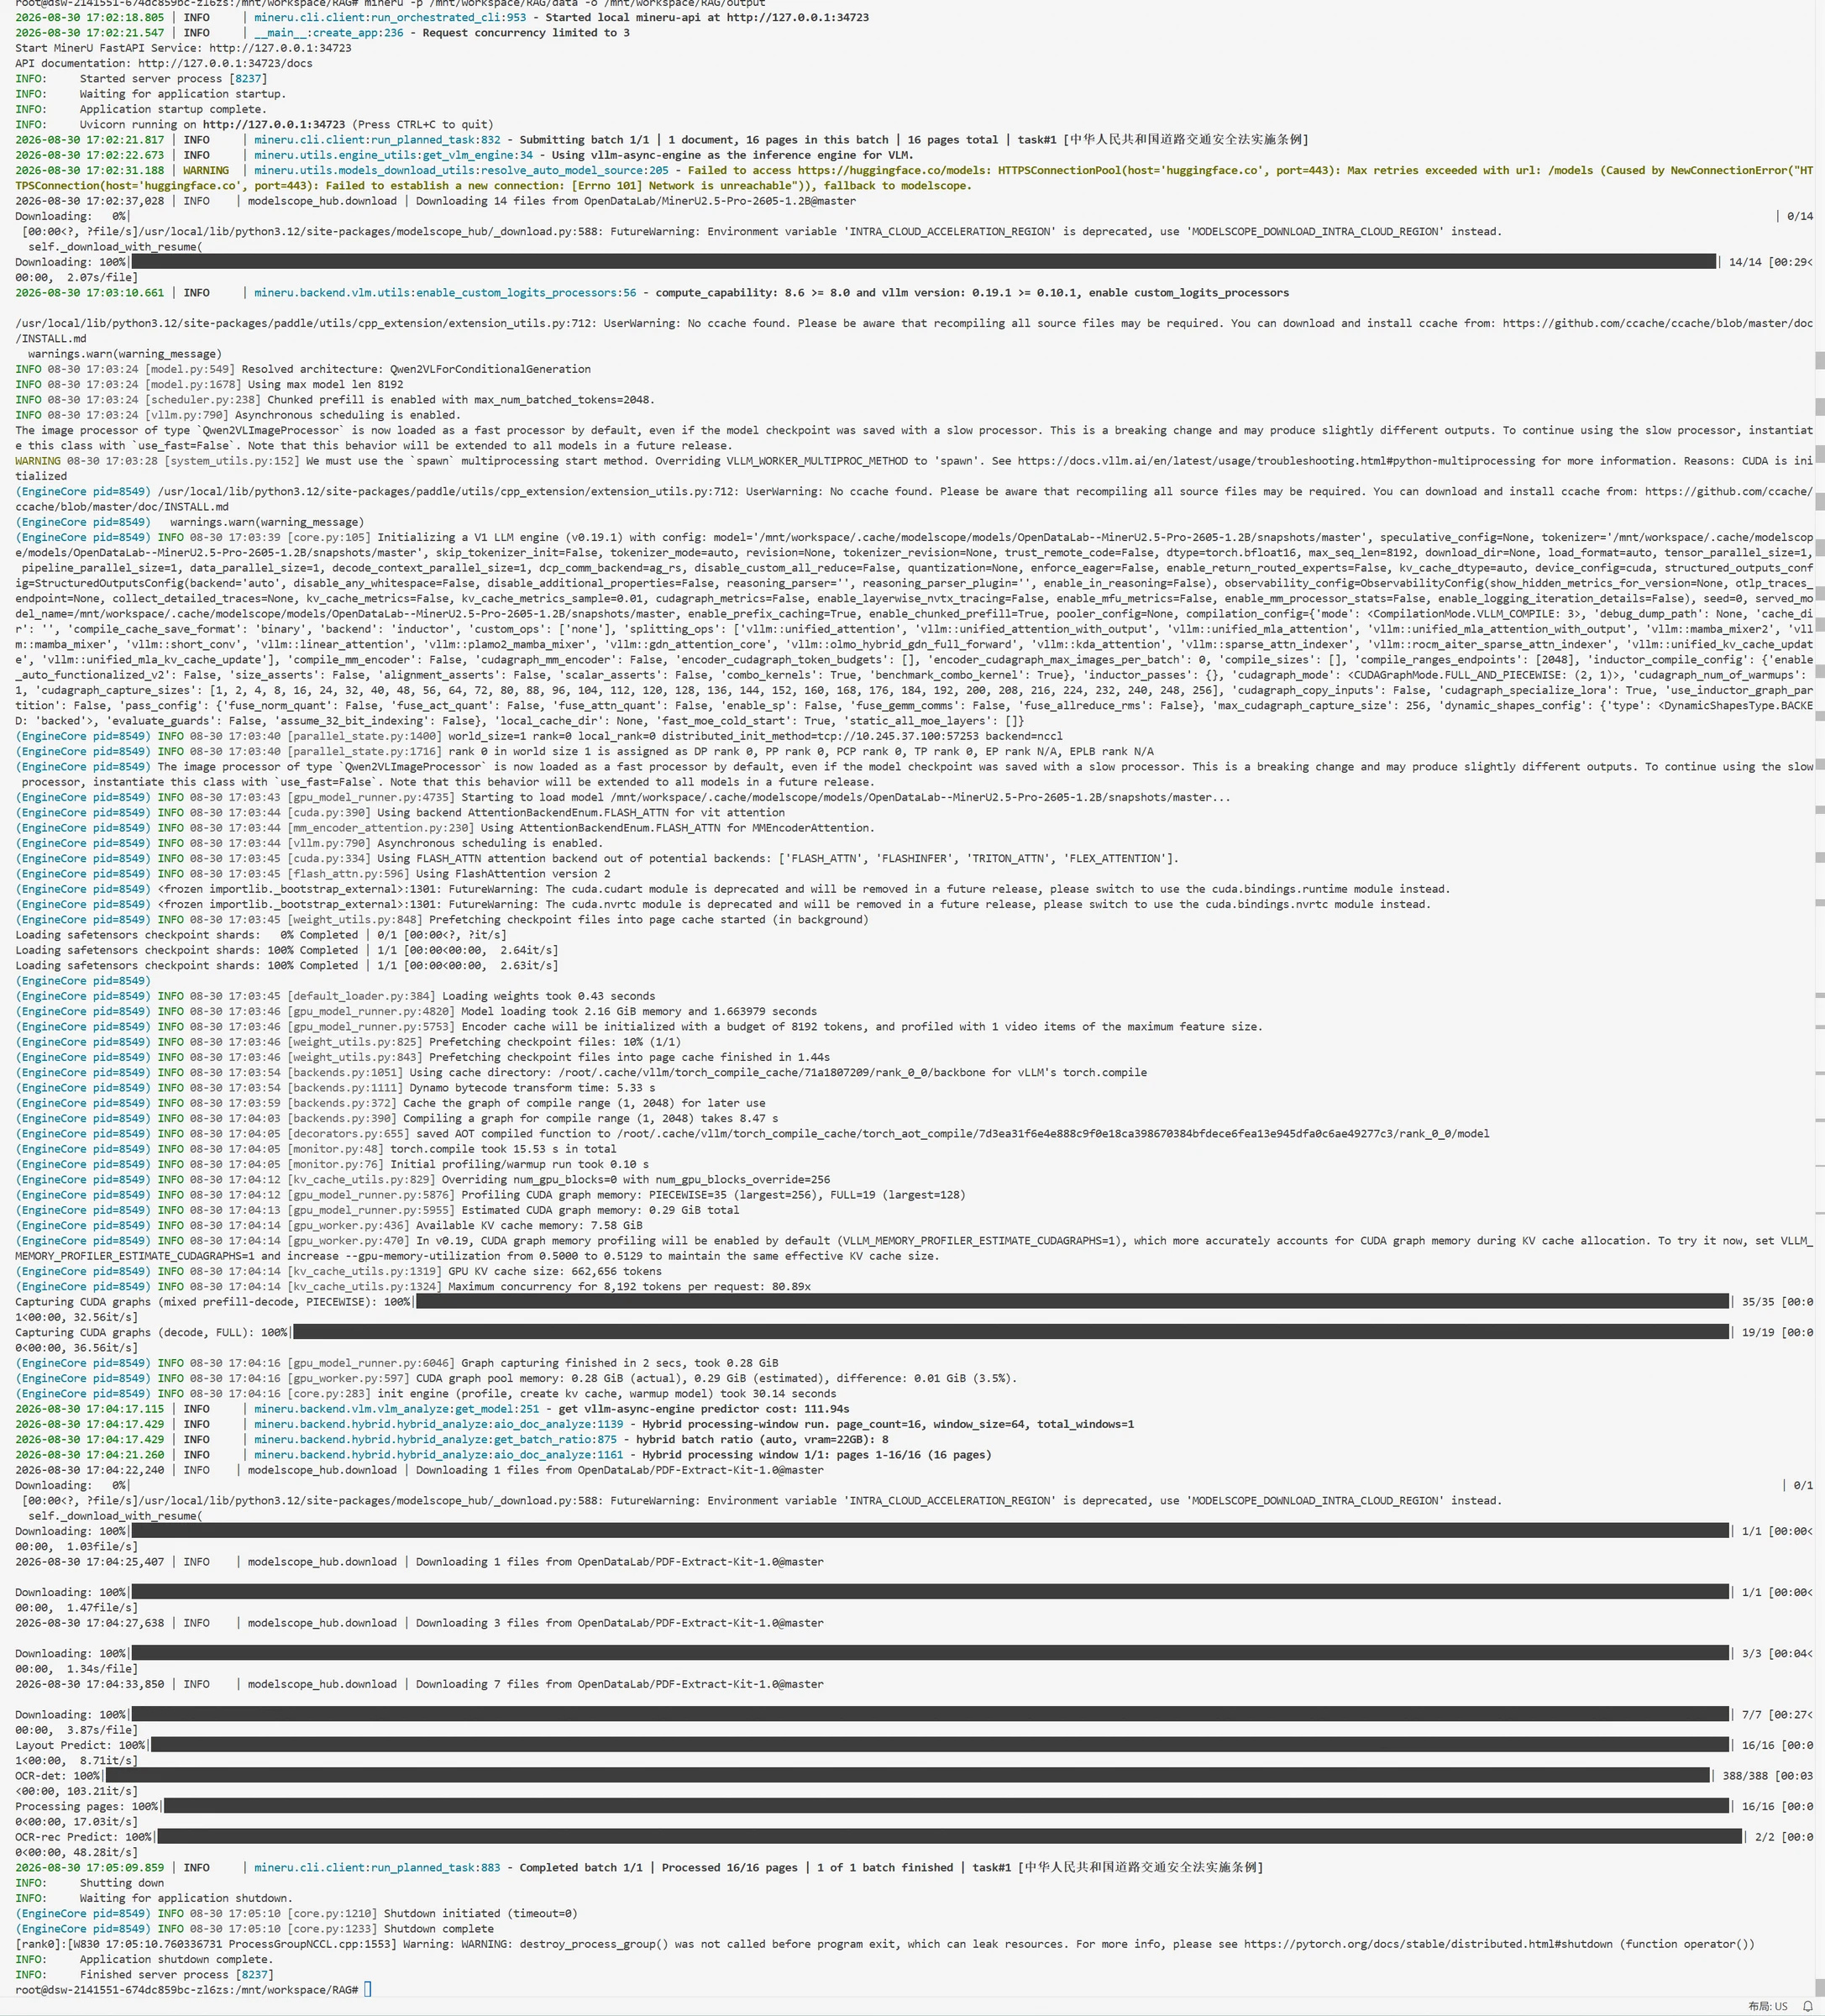
Na de installatie kun je direct documenten parsen door het pad van het te parsen bestand op te geven. Voer de volgende opdracht uit:
mineru -p /mnt/workspace/RAG/data -o /mnt/workspace/RAG/output
waarbij -p het pad van het invoerbestand is en -o het pad van de uitvoer van het model, oftewel de geparseerde tekst.
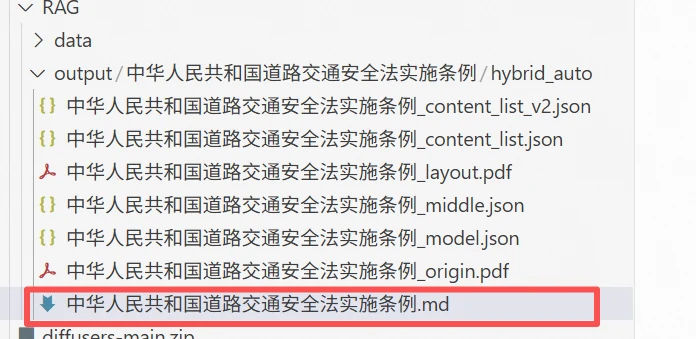
De geparseerde bestanden zien er als volgt uit; ze bevatten veel tussenbestanden waaruit je naar behoefte kunt kiezen. In dit experiment kiezen we het md-bestand als documentbron, dat de opmaakgegevens van de tekstalinea's bevat.
Na het voltooien van de documentparsing moeten lange documenten worden opgesplitst in meerdere kleinere tekstfragmenten, doorgaans chunks genoemd. In een RAG-systeem vormen embedding en zoeken doorgaans de basiseenheid per chunk, zodat een zinvolle documentsnijding bijdraagt aan de nauwkeurigheid van het latere zoeken.
Bij een geparseerd Markdown-document kun je de inhoud eerst splitsen in alinea's op basis van lege regels en vervolgens aangrenzende alinea's samenvoegen op basis van de ingestelde chunk_size. Wanneer de inhoud de opgegeven lengte overschrijdt, wordt een nieuwe chunk aangemaakt.
Om te voorkomen dat bij het snijpunt context verloren gaat, kun je chunk_overlap instellen zodat aangrenzende chunks een kleine hoeveelheid herhaalde inhoud behouden. Voorbeeld: chunk_size = 500, chunk_overlap = 50 betekent dat elke chunk ongeveer 500 tekens bevat en dat aangrenzende chunks ongeveer 50 tekens overlappen. Na het snijden kun je voor elke chunk informatie zoals id, content en file opslaan voor het latere vectoriseren, zoeken en vastleggen van de antwoordbron.
Hieronder volgt de code voor het snijden van chunks:
import os
import json
def load_markdown(file_path):
    with open(file_path, "r", encoding="utf-8") as f:
        return f.read()

def split_markdown(text, chunk_size=500, chunk_overlap=50):
    """
    Splits de Markdown-tekst in meerdere chunks
    chunk_size: hoeveel tekens bevat elke chunk ongeveer
    chunk_overlap: hoeveel herhaalde tekens tussen aangrenzende chunks behouden moeten blijven
    """
    paragraphs = text.split("\n\n")

    chunks = []
    current_chunk = ""

    for paragraph in paragraphs:
        paragraph = paragraph.strip()
        if not paragraph:
            continue
        if len(current_chunk) + len(paragraph) <= chunk_size:
            if current_chunk:
                current_chunk += "\n\n" + paragraph
            else:
                current_chunk = paragraph

        else:

            if current_chunk:
                chunks.append(current_chunk)
            overlap_text = current_chunk[-chunk_overlap:] if current_chunk else ""

            current_chunk = overlap_text + "\n\n" + paragraph
    if current_chunk:
        chunks.append(current_chunk)

    return chunks

def save_chunks(chunks, source_file, output_file):
    """
    Slaat de chunks op als JSONL-bestand
    """
    file_name = os.path.basename(source_file)

    with open(output_file, "w", encoding="utf-8") as f:
        for i, chunk in enumerate(chunks):
            data = {"id": i,"content": chunk,"file": file_name
            }

            f.write(
                json.dumps(data, ensure_ascii=False) + "\n"
            )

if __name__ == "__main__":

    file_path = "./output/中华人民共和国道路交通安全法实施条例/hybrid_auto/中华人民共和国道路交通安全法实施条例.md"

    text = load_markdown(file_path)
    chunks = split_markdown(
        text,
        chunk_size=500,
        chunk_overlap=50
    )
    print("Aantal chunks:", len(chunks)
    save_chunks(
        chunks,
        source_file=file_path,
        output_file="output/chunks.jsonl"
    )
Na uitvoering kun je zien dat er uit het zojuist geparseerde md-bestand in totaal 39 chunks zijn gesneden.

Na het snijden van de documenten moet een doorzoekbare documentbibliotheek worden opgebouwd. Omdat computers niet direct op basis van natuurlijke taal kunnen zoeken, is een Embedding-model nodig dat elke chunk omzet naar een vectorrepresentatie. Een Embedding-model kan tekst projecteren naar een hogedimensionale vectorruimte; hoe meer de betekenis van twee teksten overeenkomt, hoe dichter hun vectoren in de ruimte bij elkaar liggen. Na het stellen van een vraag door de gebruiker kan de vraag ook tot een vector worden omgezet en worden vergeleken met de chunkvectoren in de documentbibliotheek, waardoor de inhoud die semantisch het meest relevant is voor de vraag kan worden opgehaald.
In de open-source-community zijn inmiddels diverse Embedding-modellen beschikbaar, zoals BGE-M3 en Qwen3-Embedding. BGE-M3 is een meertalig Embedding-model van BAAI dat meer dan 100 talen ondersteunt en tekstinvoer tot 8192 tokens. In vergelijking met gewone Dense-Embedding-modellen ondersteunt BGE-M3 zowel dense retrieval, sparse retrieval als Multi-Vector retrieval, waardoor het zowel kan worden gebruikt voor veelgebruikte vector-semantische zoeksystemen als voor hybride zoekscenario's. FlagEmbedding。
Qwen3-Embedding is een reeks tekstvectormodellen van het Qwen-team, gebaseerd op de Qwen3-architectuur, gericht op tekstzoeken, tekstclusteren, tekstclassificatie en codezoeken. Qwen3-Embedding biedt verschillende parameterschalen zoals 0.6B, 4B en 8B, zodat de keuze kan worden afgestemd op de modelprestaties en beschikbare rekenkracht; het beschikt bovendien over uitstekende meertalige en langetekstverwerkingsmogelijkheden. Qwen3-Embedding。
In dit hoofdstuk wordt Qwen3-Embedding-0.6B als Embedding-model gebruikt. In hoofdstuk 9 is ms-swift al geïntroduceerd; naast het trainen en fijnafstemmen van grote modellen ondersteunt ms-swift ook de training en inferentie van de Qwen3-Embedding-serie. Daarom wordt in dit hoofdstuk ms-swift gebruikt om Qwen3-Embedding-0.6B te starten en worden via een API de vectoren van documentchunks en gebruikersvragen berekend.
De Embedding-service kun je starten met de volgende opdracht:
CUDA_VISIBLE_DEVICES=0 \
swift deploy \
    --model Qwen/Qwen3-Embedding-0.6B \
    --task_type embedding \
    --vllm_gpu_memory_utilization 0.2 \
    --vllm_max_model_len 512 \
    --host 0.0.0.0 \
    --port 18000
Na het starten van de service worden de volgende gegevens weergegeven:
Veelgebruikte vectortools zijn onder meer Faiss en Milvus. Faiss is een open-source bibliotheek voor vector-similariteitszoeken van Meta, bedoeld voor efficiënte vectorindexering en nabije-neighbor-zoekacties. Het is eenvoudig te implementeren, vereist geen aparte databaseservice en kan direct in Python-programma's worden gebruikt; het is daarom goed geschikt voor leerdoelen, experimenten en middelgrote RAG-systemen. Milvus is een vectordatabase voor grootschalige vectordata die naast vectorzoeken ook gegevenspersistentie, gedistribueerde opslag, indexbeheer en diverse querymogelijkheden biedt; het is beter geschikt voor scenario's met grote datavolumes, langdurige werking en productie-implementaties. In vergelijking met Faiss is Milvus functioneler, maar is de implementatie en het gebruik ook complexer.
In dit experiment wordt Faiss gebruikt voor vectoropslag en similariteitszoeken. Installeer eerst de Faiss-bibliotheek met de volgende opdracht:
pip install faiss-cpu
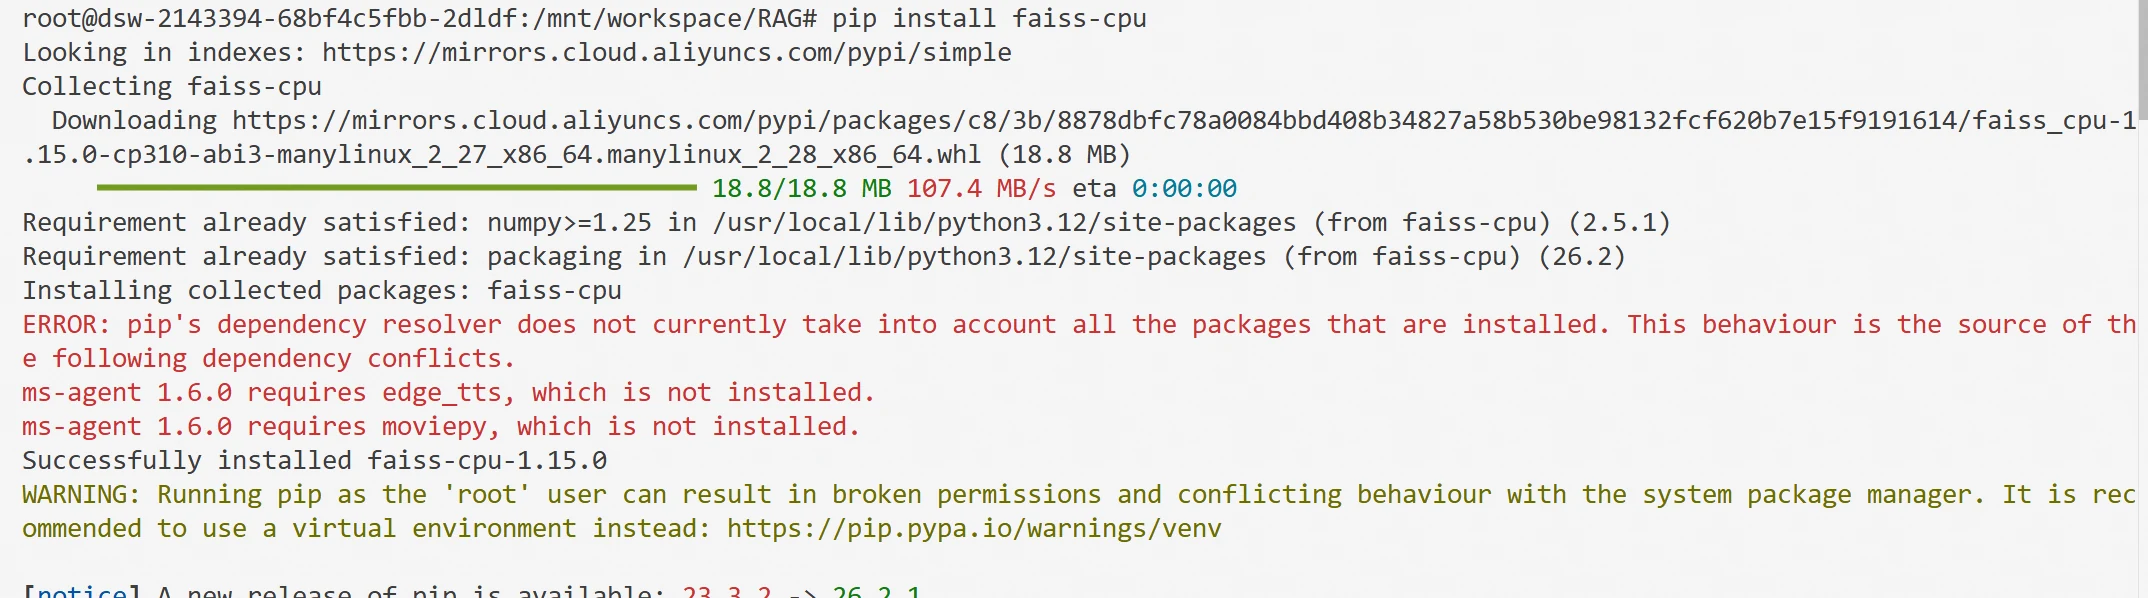
Na de installatie kun je de in de vorige sectie gegenereerde chunks een voor een naar de Embedding-API sturen, de bijbehorende vectoren verkrijgen en de vectoren koppelen aan de id, content en file van elke chunk. Dit maakt het mogelijk om later snel similariteitsberekeningen en kenniszoekacties uit te voeren.
De code voor het aanmaken van de index, bestand build_index.py, ziet er als volgt uit:
import json
import requests
import numpy as np
import faiss

EMBEDDING_URL = "http://localhost:18000/v1/embeddings"
MODEL_NAME = "Qwen3-Embedding-0.6B"

def get_embedding(text):
    payload = {"model": MODEL_NAME,"input": text}
    response = requests.post(
        EMBEDDING_URL,
        json=payload,
        timeout=60
    )
    response.raise_for_status()
    data = response.json()
    embedding = data["data"][0]["embedding"]
    return np.array(embedding, dtype="float32")

def load_chunks(file_path):
    chunks = []
    with open(file_path, "r", encoding="utf-8") as f:
        for line in f:
            chunks.append(json.loads(line)
    return chunks
def build_faiss_index(chunks,index_path="faiss.index", metadata_path="metadata.json"):

    embeddings = []
    for i, chunk in enumerate(chunks):
        text = chunk["content"]
        embedding = get_embedding(text)
        embeddings.append(embedding)
        print(f"Verwerkt {i + 1}/{len(chunks)}")
    embeddings = np.array(embeddings, dtype="float32")
    faiss.normalize_L2(embeddings)
    dimension = embeddings.shape[1]
    index = faiss.IndexFlatIP(dimension)
    index.add(embeddings)
    print("Aantal vectoren:", index.ntotal)
    print("Vector-dimensie:", dimension)
    faiss.write_index(index, index_path)
    with open(metadata_path, "w", encoding="utf-8") as f:
        json.dump(chunks,f,ensure_ascii=False,indent=2
        )
    print(f"Faiss-index opgeslagen in: {index_path}")
    print(f"Chunk-informatie opgeslagen in: {metadata_path}")

if __name__ == "__main__":

    chunks = load_chunks("output/chunks.jsonl")

    build_faiss_index(
        chunks,
        index_path="output/faiss.index",
        metadata_path="output/metadata.json"
    )
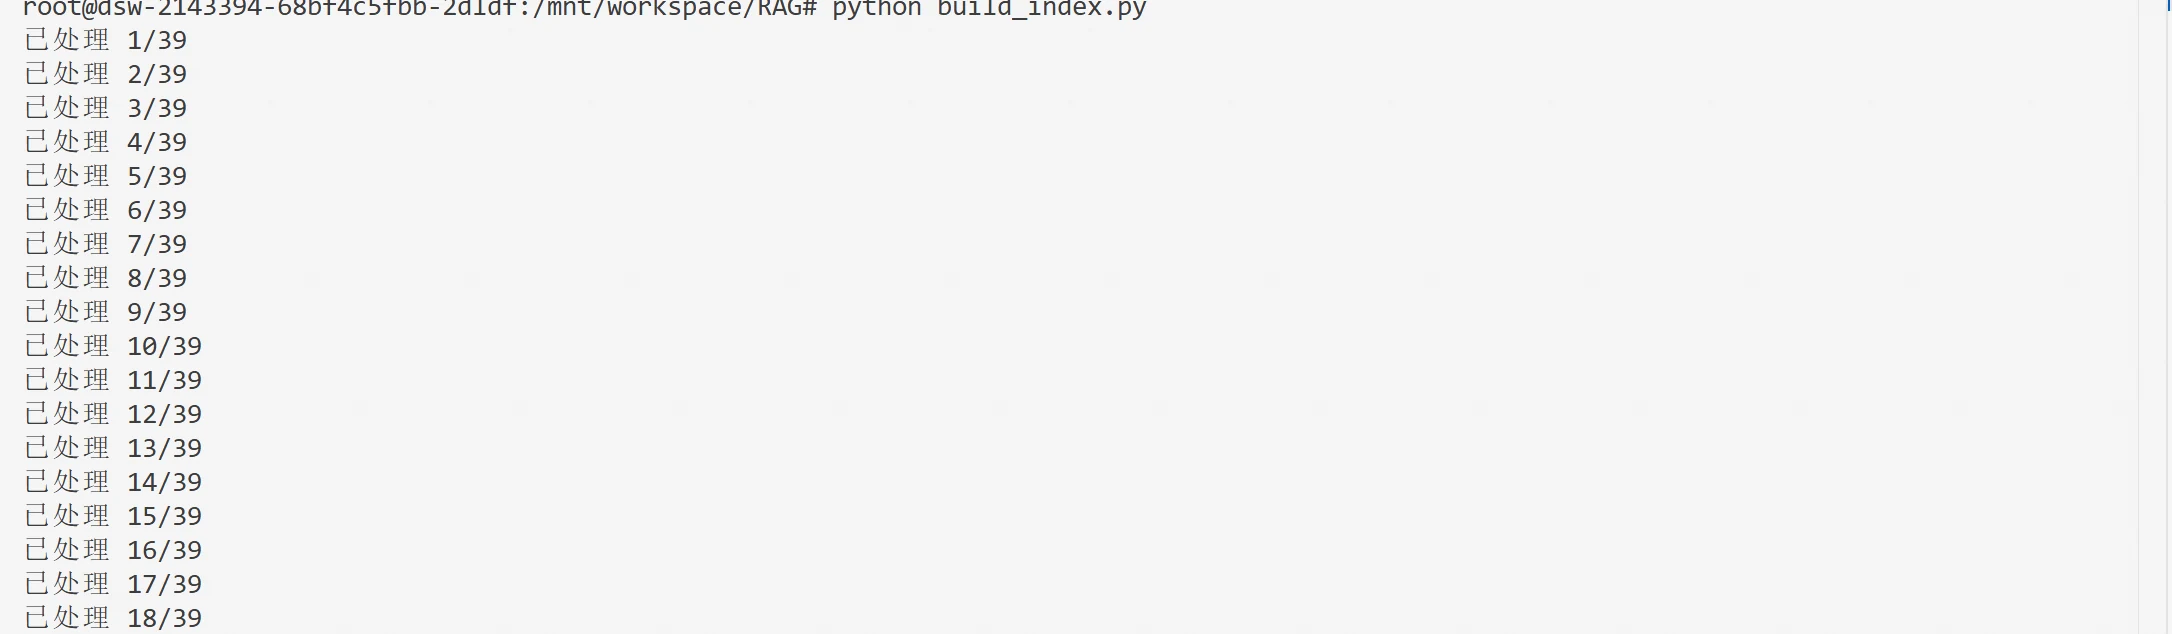
Na uitvoering worden de bijbehorende indexbestanden en vectoren weergegeven.
Een Embedding-model kan de vraag van de gebruiker en de documentchunks afzonderlijk omzetten naar vectoren en zoeken uitvoeren op basis van de afstand of similariteit tussen die vectoren. Het voordeel van deze aanpak is dat documentvectoren vooraf kunnen worden berekend en opgeslagen; wanneer de gebruiker een vraag stelt, volstaat het om één keer de vraagvector te berekenen om snel relevante inhoud uit een grote hoeveelheid documenten op te halen. Deze efficiënte zoekmethode kent echter beperkingen. Het Embedding-model codeert de query en de chunk apart en berekent de similariteit door de mate van overeenkomst tussen de twee vectoren in de vectorruimte te vergelijken. Een Reranker-model daarentegen werkt interactief: door de query en de kandidaat-chunks tegelijk in het model in te voeren, analyseert het model direct de onderlinge relatie tussen de twee tekstsegmenten, waardoor een nauwkeurigere semantische matching mogelijk is.
Daarom wordt in een RAG-systeem doorgaans een tweefasige zoekmethode gebruikt: Embedding recall + Reranker hersorting. Eerst worden met behulp van Embedding snel een aantal kandidaatresultaten uit de grote verzameling chunks geselecteerd, waarna de Reranker een fijnere beoordeling van de relevantie en een hersorting van het beperkte aantal kandidaatresultaten uitvoert. Hiermee wordt zowel de zoekefficiëntie gewaarborgd als de kwaliteit van de context die uiteindelijk aan het taalmodel wordt aangeboden, verder verbeterd.
In dit hoofdstuk wordt Qwen3-Reranker-0.6B als hersorteringsmodel gebruikt; de service kun je starten met ms-swift:
CUDA_VISIBLE_DEVICES=0 \
swift deploy \
    --model Qwen/Qwen3-Reranker-0.6B \
    --task_type generative_reranker \
    --infer_backend transformers \
    --host 0.0.0.0 \
    --port 18001
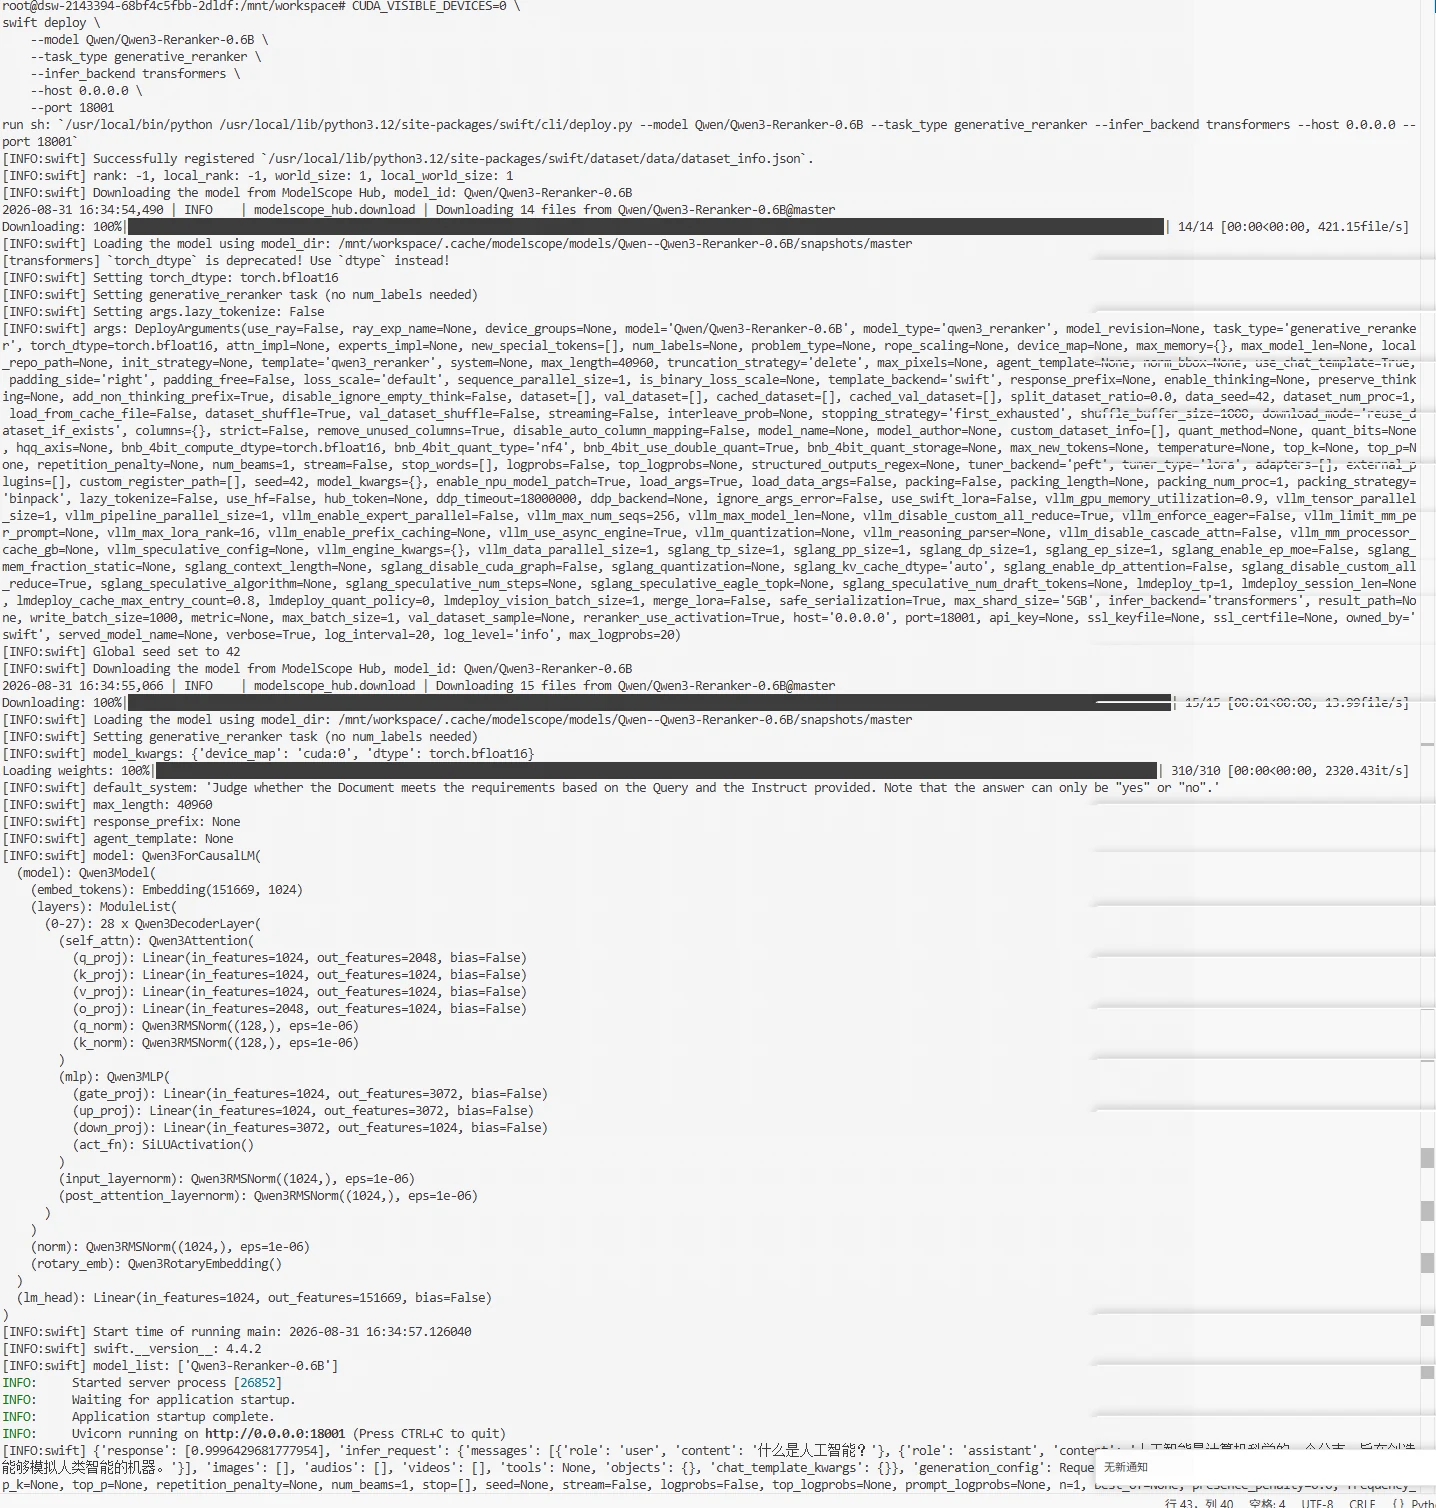
Na het starten van de service kun je de vraag van de gebruiker en de via Embedding gevonden kandidaat-chunks aan de Reranker aanbieden; op basis van de door het model berekende relevantiescores worden de chunks hersorteerd en de bovenste chunks geselecteerd als referentiemateriaal voor de latere antwoordgeneratie door het taalmodel.
In de vorige stappen zijn de Embedding-service, de Reranker-service en de Faiss-vectorindex opgebouwd. Op basis daarvan worden met de eerder genoemde tweefasige zoekmethode (Embedding recall + Reranker hersorting) kandidaat-chunks geselecteerd.
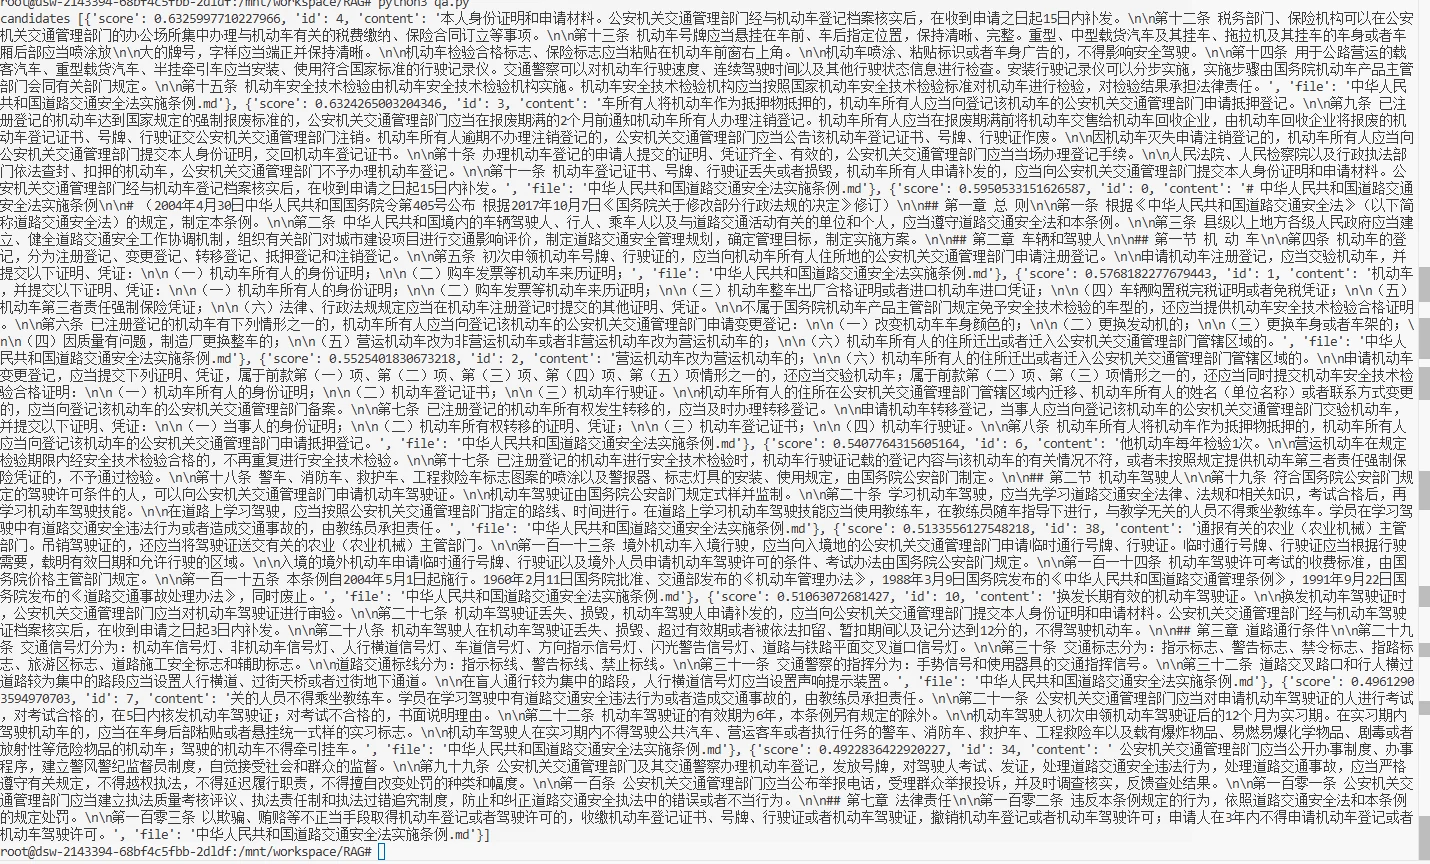
In de eerste fase wordt Faiss gebruikt voor vectorzoeken in de kennisbank; eerst worden de top 10 kandidaat-chunks op overeenkomstscore opgehaald. Hieronder volgt het resultaat van vectorzoeken (top 10) voor de vraag: "Bij welke afdeling moet men zich aanmelden voor de eerste aanvraag van een kentekenplaat en een rijbewijs voor een motorvoertuig?"
import json
import faiss
from build_index import get_embedding
def load_faiss_index(index_path="faiss.index",
                     metadata_path="metadata.json"):

    index = faiss.read_index(index_path)

    with open(metadata_path, "r", encoding="utf-8") as f:
        metadata = json.load(f)

    return index, metadata
def search(query,index,metadata,top_k=10):

    query_embedding = get_embedding(query)
    query_embedding = query_embedding.reshape(1, -1)
    faiss.normalize_L2(query_embedding)
    scores, indices = index.search(query_embedding,top_k)
    results = []
    for score, idx in zip(scores[0], indices[0]):
        if idx == -1:
            continue
        chunk = metadata[idx]
        results.append({
            "score": float(score),
            "id": chunk.get("id"),
            "content": chunk.get("content"),
            "file": chunk.get("file")
        })

    return results
index, metadata = load_faiss_index(
        "output/faiss.index",
        "output/metadata.json"
    )
query="初次申领机动车号牌、行驶证应向哪个部门申请注册登记?"
candidates = search(
    query=query,
    index=index,
    metadata=metadata,
    top_k=10
)

print("candidates",candidates)
In de tweede fase hersort de Reranker de kandidaatresultaten. De vraag van de gebruiker en de opgehaalde kandidaat-chunks worden aan de Reranker aangeboden, de relevantiescores worden opnieuw berekend en de chunks worden van hoog naar laag gesorteerd.
def rerank(query, candidates):
    results = []
    for candidate in candidates:
        response = rerank_client.chat.completions.create(
            model="Qwen3-Reranker-0.6B",
            messages=[
                {
                    "role": "user",
                    "content": query
                },
                {
                    "role": "assistant",
                    "content": candidate["content"]
                }
            ]
        )

        score = response.choices[0].message.content[0]
        item = candidate.copy()
        item["rerank_score"] = float(score)
        results.append(item)
    results.sort(
        key=lambda x: x["rerank_score"],
        reverse=True
    )
    for rank, item in enumerate(results, start=1):
        item["rerank_rank"] = rank

    return results
Hieronder volgt het resultaat van de hersorting door het Reranker-model voor de vraag: "Bij welke afdeling moet men zich aanmelden voor de eerste aanvraag van een kentekenplaat en een rijbewijs voor een motorvoertuig?"
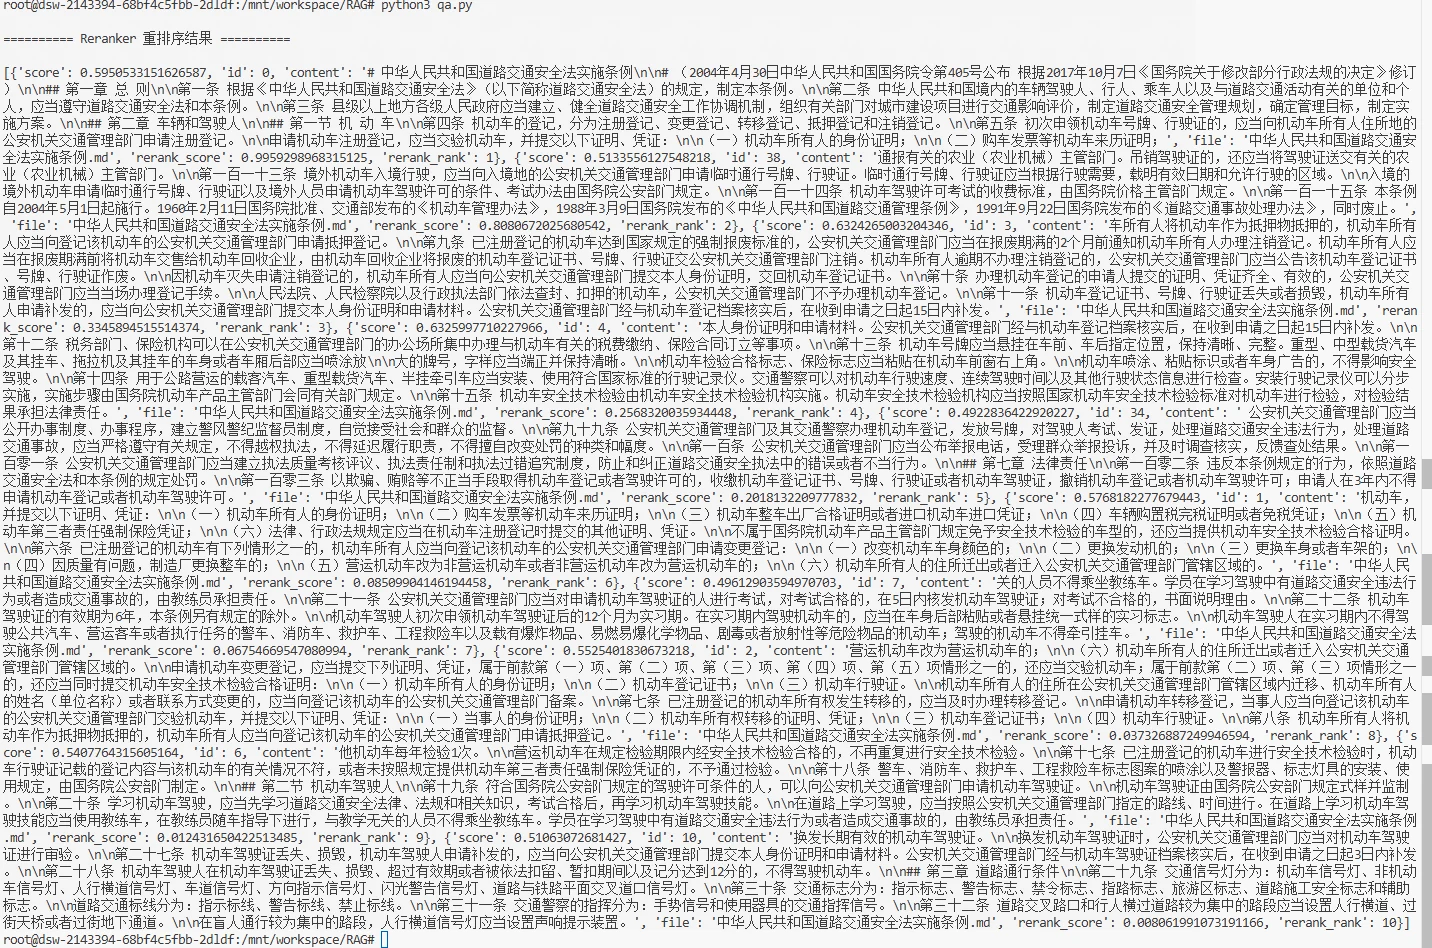
Uit de bovenstaande twee resultaten blijkt dat de sortering van de chunks na de hersorting duidelijk is gewijzigd. In de praktijk kun je de instellingen afstemmen op de omvang van de kennisbank, de chunklengte, de complexiteit van de vraag en het daadwerkelijke zoekresultaat. Voor vragen waarvan het antwoord over meerdere documentfragmenten is verspreid, kun je bijvoorbeeld het aantal uiteindelijk behouden chunks vergroten; je kunt ook op basis van de Reranker-score een relevantiedrempel instellen om inhoud met lage relevantie verder te filteren. Naast de bovengenoemde aanpak kunnen praktijk-RAG-systemen ook hybride zoeksystemen (Hybrid Search) gebruiken, waarbij vectorzoeken wordt gecombineerd met trefwoordzoeken zoals BM25, en de resultaten van de verschillende ophaalroutes worden samengevoegd voordat de hersorting plaatsvindt.
Na het voltooien van het zoeken en de hersorting heb je een aantal chunks verkregen die sterk relevant zijn voor de vraag van de gebruiker. Vervolgens moeten deze inhoud als referentiemateriaal samen met de vraag van de gebruiker aan de LLM worden aangeboden. Als de relevantie aan de vereisten voldoet, worden de opgehaalde inhoud naar het taalmodel gestuurd om een antwoord te genereren; als er in de kennisbank geen voldoende relevante inhoud is gevonden, wordt direct een afwijsantwoord geretourneerd om te voorkomen dat het model zonder basis een antwoord genereert.
Eerst start je de service voor het grote model in de Notebook; in dit experiment wordt het Qwen3-4B-model gebruikt. De startmethode is als volgt:
CUDA_VISIBLE_DEVICES=0 swift deploy \
  --model Qwen/Qwen3-4B \
  --load_args false \
  --infer_backend vllm \
  --enable_thinking false \
  --host 0.0.0.0 \
  --port 18002 \
  --api_key 123 \
  --vllm_gpu_memory_utilization 0.8 \
  --vllm_max_model_len 8000 \
  --max_new_tokens 2000
Na het starten worden de volgende gegevens weergegeven, wat aangeeft dat het model succesvol is gestart. Na het starten van de service kan Qwen3-4B worden aangeroepen via poort 18002.
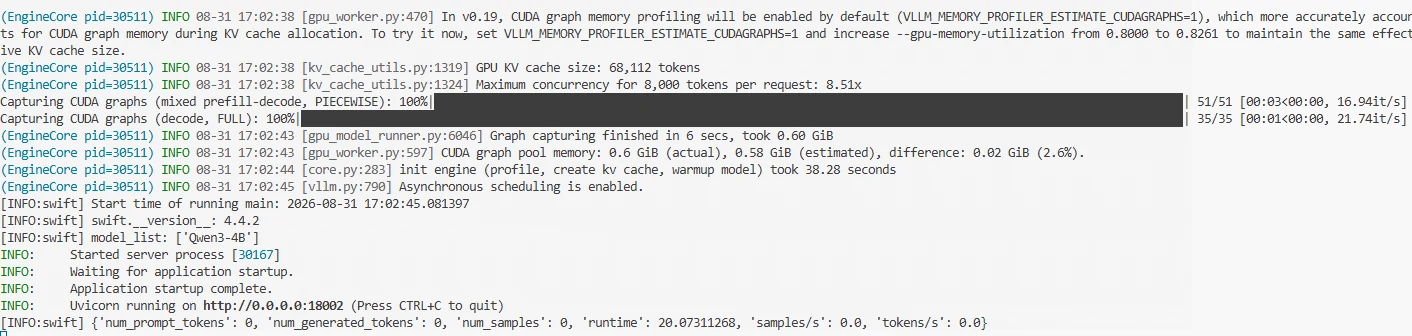
De Reranker past de sortering aan op basis van de relevantie van de kandidaat-chunks ten opzichte van de vraag van de gebruiker. In dit experiment worden direct de top 5 chunks als referentiemateriaal voor de LLM geselecteerd. Om het model zoveel mogelijk op basis van de kennisbankinhoud te laten antwoorden, kun je in de prompt het antwoordbereik duidelijk beperken. Tegelijkertijd wordt het model, wanneer het aangeboden referentiemateriaal onvoldoende is om de vraag te beantwoorden, gevraagd het antwoord direct te weigeren in plaats van de eigen kennis aan te vullen. De prompt ziet er als volgt uit:
prompt = f"""
Beantwoord de vraag van de gebruiker op basis van de onderstaande referentiematerialen.

Referentiematerialen:
{context}

Vraag van de gebruiker:
{query}

Vereisten:
1. Beantwoord de vraag uitsluitend op basis van de referentiematerialen;
2. Het antwoord moet nauwkeurig en beknopt zijn;
3. Vul geen informatie aan die niet in de referentiematerialen staat;
4. Als de referentiematerialen de vraag niet kunnen beantwoorden, antwoord dan:
   “Op basis van de huidige kennisbank kan deze vraag momenteel niet worden beantwoord.”
"""
Nadat het grote model een antwoord heeft gegenereerd, kun je naast het definitieve antwoord ook de documentbronnen retourneren waarop dit antwoord is gebaseerd. Bij bedrijfskennis-Q&A helpt de broninformatie de gebruiker te begrijpen uit welke kennisbankdocumenten het antwoord afkomstig is; wanneer verificatie nodig is, kan de gebruiker teruggaan naar de originele documenten om de relevante inhoud te bekijken. De broninformatie hoeft niet door het grote model te worden gegenereerd; deze wordt rechtstreeks uit de metadata van de zoekresultaten gehaald. Bij de opbouw van de kennisbank is voor elke chunk het bijbehorende file-veld bewaard gebleven; hieruit kunnen de bestandsnamen van de top 5 chunks van de Reranker worden geëxtraheerd en kunnen dubbele bestanden worden verwijderd.
Hieronder volgt de kerncode voor het aanroepen van het grote model om Q&A uit te voeren:
llm_client = OpenAI(
    api_key="123",
    base_url="http://127.0.0.1:18002/v1"
)
LLM_MODEL = "Qwen3-4B"

def generate_answer(query, top_chunks):

    context = "\n\n".join(
        [
            f"[Referentiemateriaal {i + 1}]\n{item['content']}"
            for i, item in enumerate(top_chunks)
        ]
    )
    prompt = f"""
Beantwoord de vraag van de gebruiker op basis van de onderstaande referentiematerialen.

Referentiematerialen:
{context}

Vraag van de gebruiker:
{query}

Vereisten:
1. Beantwoord de vraag uitsluitend op basis van de inhoud in de referentiematerialen;
2. Het antwoord moet nauwkeurig en beknopt zijn; vul geen informatie aan die niet in de referentiematerialen staat;
3. Als er in de referentiematerialen geen relevant antwoord op de vraag staat, antwoord dan:
   “Op basis van de huidige kennisbank kan deze vraag momenteel niet worden beantwoord.”
"""
    response = llm_client.chat.completions.create(
        model=LLM_MODEL,
        messages=[{"role": "user","content": prompt }],
        temperature=0.1,
        max_tokens=512
    )

    return response.choices[0].message.content
Hiermee is een bedrijfs-Q&A-assistent opgebouwd. Hierna kun je in de terminal een eenvoudige test uitvoeren; de testresultaten zien er als volgt uit:
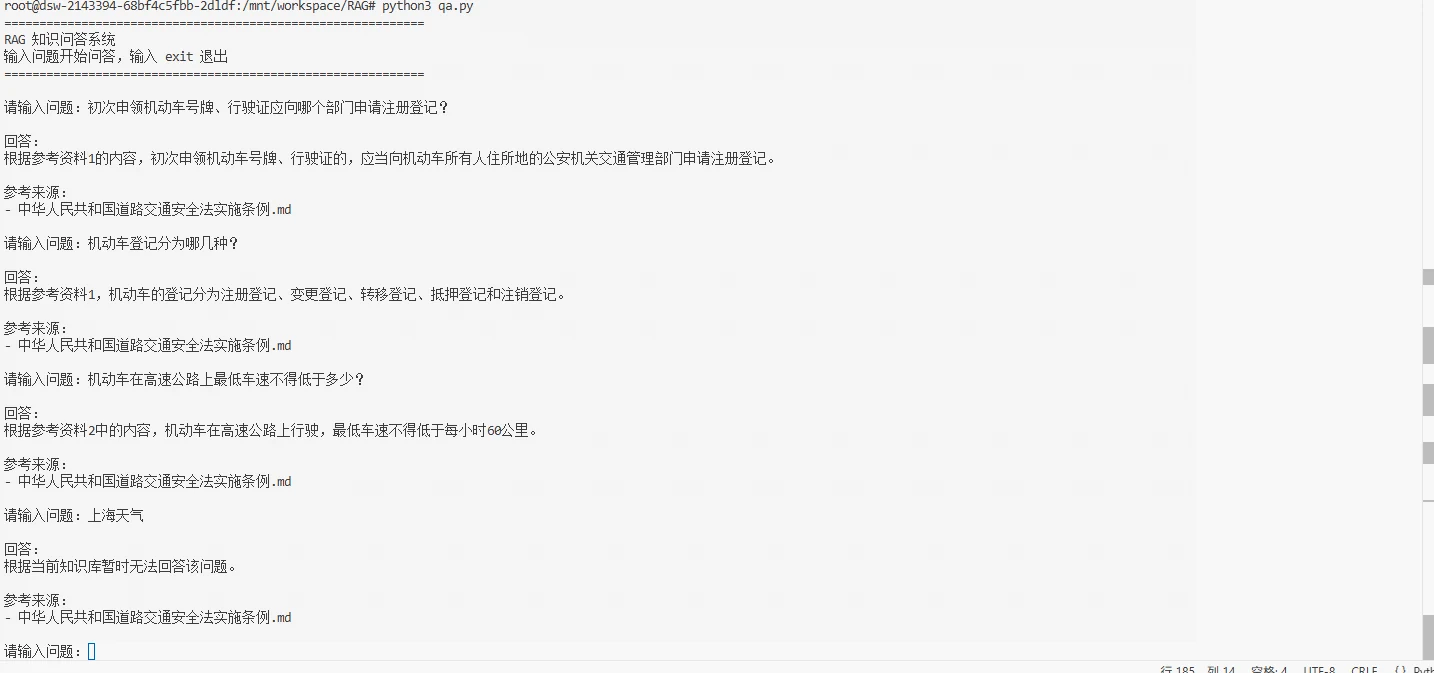
Na het voltooien van het RAG-systeem moet met evaluatie worden beoordeeld of het gehele Q&A-proces daadwerkelijk effectief is. In tegenstelling tot gewone vraag-en-antwoordmodellen worden de resultaten van RAG beïnvloed door zowel de kennisretrieval als de antwoordgeneratie. Daarom moet RAG-evaluatie doorgaans vanuit beide aspecten apart worden uitgevoerd.
De beoordelingsnorm voor de zoekfase is of het antwoord op de vraag van de gebruiker kan worden gevonden in de opgehaalde chunks; de veelgebruikte maatstaf hiervoor is Recall@K. Recall@K is een intuïtieve indicator die meet hoeveel relevante documenten worden bestreken door de top K zoekresultaten:
Recall@K: komen de juiste documenten voor in de top K zoekresultaten?
Recall@K =
\frac{\text{Top K 中检索到的相关文档数量}}
{\text{所有相关文档数量}}
Voorbeeld: een vraag heeft betrekking op 2 juiste kennisfragmenten; in de top 5 zoekresultaten worden beide gevonden; dan bedraagt Recall@5 100%.
Het ophalen van relevante kennis betekent niet dat het definitieve antwoord altijd correct is; de gegenereerde resultaten van de LLM moeten verder worden beoordeeld. Bij de generatiefase kan de focus liggen op de nauwkeurigheid, volledigheid, relevantie, juistheid van citaten en het voorkomen van hallucinaties. Hiervoor kun je verwijzen naar hoofdstuk 12.3 Evaluatie-indicatoren voor generatietaken. Met deze indicatoren kun je beoordelen of het model de opgehaalde kennis nauwkeurig kan benutten om antwoorden te genereren en verder problemen zoals ontbrekende antwoorden, inhoudsafwijkingen of ongegronde generatie opsporen. In de praktijk, wanneer de zoekresultaten al redelijk nauwkeurig zijn maar de generateprestaties nog steeds niet aan de vereisten voldoen, kun je overwegen een krachtiger model met meer parameters als RAG-generatiemodel te gebruiken om het begrips- en antwoordvermogen voor complexe vragen te verbeteren.
De in dit hoofdstuk gebruikte experimentele gegevens en code zijn beschikbaar op:https://modelscope.cn/gallery/liucong/a895ace8-420c-4421-ba43-4e3194392a95