Generatieve kunstmatige intelligentie (Artificial Intelligence Generated Content, AIGC) is een belangrijke ontwikkelingsrichting in de kunstmatige intelligentie sinds kort. In tegenstelling tot traditionele taken zoals classificatie, voorspelling en zoeken, heeft de doel van generatieve modellen om de waarschijnlijkheden van data te leren en nieuwe inhoud te genereren onder leiding van voorwaarden zoals tekst en afbeeldingen.
Van de vroege generatieve tegenoverwicht netwerken (GAN), variabele auto-encoder (VAE), tot de recentelijk breedgebruikte verspreiding modellen (Diffusion Model) en Diffusion Transformer (DiT), verbeteren generatieve modellen de kwaliteit van generatie, de traininstabiliteit, de semantische begripsvermogen en de redeneringsefficiëntie. Op deze basis hebben modellen zoals Stable Diffusion, FLUX, Qwen-Image, Z-Image furthered de toepassing van AIGC in scènes zoals inhoudscreatie, advertentieontwerp en marketingmateriaalproductie.
De kerndoel van generatieve modellen (Generative Model) is om de potentiele waarschijnlijkheidsverdeling en de innerlijke patronen in de trainingsdata te leren en nieuwe voorbeelden te genereren onder gegeven voorwaarden. In tegenstelling tot taken zoals classificatie en zoeken, selecteert een generatief model niet uit een voorafgegeven set van kandidaten, maar gebruikt de geleerde datapatronen om nieuwe inhoud zoals tekst, afbeeldingen, geluid of video te genereren.
Van een willekeurige modelleringssynspective, kan een conditiegeneratie taak worden weergegeven als: $p(x \mid c)$ betekent: de conditie waarschijnlijkheidsverdeling van het model om inhoud x te genereren onder voorwaarde c. Bijvoorbeeld de gebruikersinvoer van een Prompt, context, referentieafbeelding of andere controle-informatie; x betekent de te genereren doelinhoud. Het trainingsproces van het model is essentieel een proces van leren van de waarschijnlijkheden van verschillende mogelijke resultaten onder verschillende voorwaarden; het redeneringsproces is daarentegen op basis van deze waarschijnlijkheidsverdeling een specifiek resultaat te produceren.
Hoewel grote taalmodellen, afbeeldingsgeneratie-modellen en video-generatietechnieken alle tot generatieve modellen behoren, zijn hun specifieke generatiemethoden niet volledig hetzelfde.
Bijvoorbeeld voor grote taalmodellen, gebruikt de huidige populaire modellen meestal een autoregressieve (Autoregressive) methode voor tekstgeneratie. Gegeven een bestaande context, voorspelt het model de waarschijnlijkheidsverdeling van het volgende Token. Het model kiest of sampleert het volgende Token op basis van deze waarschijnlijkheidsverdeling en voegt het nieuw gegenereerde Token toe aan de context, om de voorspelling van de volgende Tokens voort te zetten. Door dit proces herhaaldelijk te herhalen, wordt uiteindelijk volledelijk tekstinhoud gevormd.
Afbeeldingsgeneratie-modellen gebruiken een andere generatiemechaniek. Bijvoorbeeld met de verspreiding model (Diffusion Model), begint het generatieproces met willekeurige lawaai en leidt tekstprompten en andere controle-informatie ertoe dat de lawaai geleidelijk wordt ontdooid, waardoor willekeurige lawaai geleidelijk een beeld met duidelijke structuur en semantiek vormt. Hoewel een autoregressief, verspreiding of andere generatiemechanieken worden gebruikt, is hun gezamenlijk doel: leren van de distributie van de echte data en nieuwe inhoud te genereren die voldoet aan deze patronen onder gegeven voorwaarden.
Inloggen deelnemen aan de discussie
Een belangrijke reden waarom generatieve modellen nieuwe inhoud kunnen genereren, is dat het model niet de eigenschappen van een specifieke tekst of afbeelding leert, maar de statistische relaties en kenmerkpatronen tussen grote hoeveelheden trainingsdata.
Bijvoorbeeld, na het leren van grote hoeveelheden reclameafbeeldingen van dranken, kan het model geleidelijk verbindingen opbouwen tussen visuele concepten zoals drankfles, ijsblokjes, waterdruppels, fruit, achtergrondkleuren, licht- en schaduwtoon en commerciële fotografiestijl. Wanneer "zomerse limonade reclame" wordt ingevoerd, kan het model op basis van deze geleerde patronen verschillende visuele elementen opnieuw organiseren en een nieuwe afbeeldingsresultaat vormen. De "generatie" van een generatief model is niet gelijk aan het zoeken naar een bestaand data-item in de trainingsset, maar het modelleert en combineert verschillende kenmerken en concepten op basis van de geleerde data-distributie.
Een andere belangrijke eigenschap van generatieve modellen is de diversiteit van de resultaten. Bijvoorbeeld voor dezelfde prompt "een kat zit aan de raam". Het model kan verschillende rassen, posities en kleuren van katten genereren, maar ook verschillende lichttoon, achtergrond en compositie van het beeld. Deze resultaten zijn semantisch compatibel met de ingevoerde voorwaarden, maar zijn specifiek niet volledig hetzelfde. De oorzaak hiervan is dat de Prompt alleen een bepaalde conditie beperking op de gegenereerde inhoud toepast, niet de volledige eindresultaat regelt. Gegeven een voorwaarde, bestaat er in de geleerde waarschijnlijkheidsverdeling van het model meestal meerdere redelijke resultaten. In de praktijk beïnvloeden factoren zoals de samplestrategie en het willekeurige seed de uiteindelijke uitvoer. In tegenstelling tot traditionele taken met een bepaalde antwoord, bestaat er in generatietaken meestal geen unieke optimale uitvoer, en kan eenzelfde invoervoorwaarde meerdere redelijke generatieresultaten corresponderen.
Textgeneratie-technologie heeft een belangrijke basisfunctie in de ontwikkeling van moderne generatieve kunstmatige intelligentie. Aangezien grote taalmodellen de AIGC-technologie hebben versneld verspreid, en omdat Tokenizer, Embedding, Transformer, waarschijnlijkheidsverdeling en samplestrategie niet alleen toepasbaar zijn voor tekstgeneratie, maar ook in latere taken zoals text-naar-afbeelding en multimodale generatie herhaaldelijk voorkomen. Vooral in de huidige AIGC-systemen is de tekst-Prompt een belangrijke manier om gebruikers om inhoud te genereren. Voor het genereren van een tekst, een afbeelding of een video, moet het model meestal eerst de natuurlijke taal van de gebruikersinvoer begrijpen.
Natuurlijke taal kan niet direct worden gebruikt in neurale netwerkberekeningen. Voorafgaand aan de tekstinputmodel, moet tekst eerst worden gesplitst door een Tokenizer en omgezet in corresponderende Token ID's. Een Token is de basisunit voor het verwerken van tekst door een taalmodel, het kan een Chinese karakter, een volledig woord zijn, maar ook een deel van een woord, de specifieke splitsing wordt bepaald door de modelgebruikte tokenisatie-algoritme en het woordboek. Een Token ID is essentieel de nummering van een Token in het woordboek, de grootte van de waarde geeft geen betekenisrelatie tussen Tokens weer. Bijvoorbeeld, twee Tokens met dichtbij nummers in de semantiek zijn niet noodzakelijkerwijs vergelijkbaar. Daarom moet een Token ID voordat het in een neurale netwerk voor berekeningen wordt gebruikt, worden door een Embedding-laag omgezet in een continue hoge-dimensionale vector. Dit idee van het gebruiken van continue vectoren om taal te weergeven is een belangrijke basis voor moderne natuurlijke taalverwerking. In 2013 stelden Mikolov en anderen Word2Vec voor, om door een neurale netwerk van grote hoeveelheden tekstcorpora de distributieve vectorweergave van woorden te leren. Het basisidee komt van de distributie-hipotese in de natuurlijke taal, dat woorden die in vergelijkbare contexten voorkomen, meestal vergelijkbare semantische of grammatische kenmerken hebben.
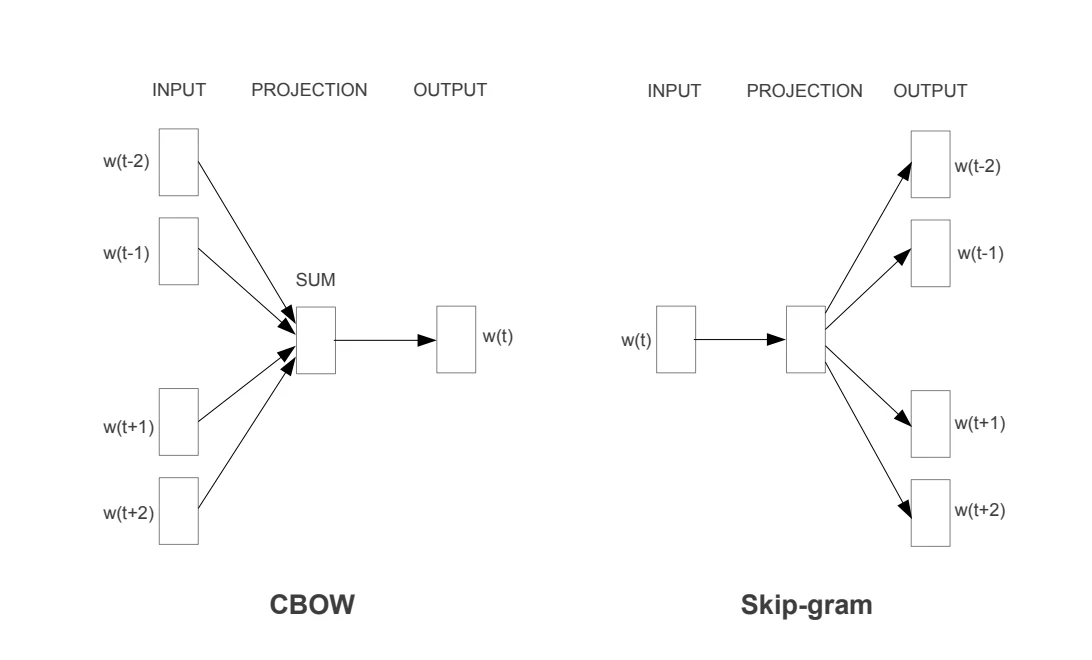
Word2Vec bevat twee hoofdretrainingstructuren: CBOW (Continuous Bag-of-Words) en Skip-gram. Beide leren woordvector door de relatie tussen het centrumwoord en de contextwoorden, maar de voorspellingsrichting is verschillend.
CBOW voorspelt het centrumwoord op basis van contextwoorden. Voor een woordreeks wordt eerst een centrumwoord gekozen en worden de woorden in een bepaalde raamgrootte rond het centrum als context. Het model gebruikt de vectorweergave van deze contextwoorden om het centrumwoord te voorspellen. Bijvoorbeeld, met "eten" als centrumwoord en "liever" en "vers" als contextwoorden.
Skip-gram voorspelt de contextwoorden op basis van het centrumwoord. In tegenstelling tot CBOW is de voorspellingsrichting anders. Voor dezelfde woordreeks, wanneer "eten" als centrumwoord wordt gebruikt, is de trainingsdoel van Skip-gram om op basis van de vectorweergave van "eten" de andere woorden die in een bepaalde raamgrootte kunnen voorkomen te voorspellen, zoals "liever", "vers" enzovoort. De belangrijkste verschillen tussen CBOW en Skip-gram liggen in de trainingsdoelstellingen. CBOW gebruikt meerdere contextwoorden om een centrumwoord te voorspellen; Skip-gram: gebruikt een centrumwoord om meerdere contextwoorden te voorspellen. Hoewel de voorspellingsrichting verschillend is, is het einddoel hetzelfde: door de grote hoeveelheid co-occurrencerelaties tussen woorden te leren woordvector. Na het trainen, kan elke woord een vaste dimensie van een continue vector worden weergegeven.
Word2Vec heeft de ontwikkeling van de distributieve woordweergave aangezet, maar zijn weergavewijze heeft nog bepaalde beperkingen. Word2Vec leert typische statische woordvector (Static Word Embedding), dat een woord na training meestal een vaste vector heeft, zonder te veranderen in specifieke contexten. Moderne taalmodellen gebruiken verder de contextueelweergave (Contextual Representation). Een Token krijgt eerst een initiale vector door een Embedding-laag, waarna door meerdere lagen neurale netwerken, op basis van informatie van andere Token in de reeks, de eigen weergave wordt voortdurend bijgewerkt. Daarom kan eenzelfde Token in verschillende contexten verschillende verborgen staten vormen, om de semantiek in de huidige context uit te drukken. De belangrijkste betekenis van Word2Vec ligt niet alleen in het voorstellen van een specifieke trainingstechniek voor woordvector, maar ook in het bevorderen van de toepassing van distributieve weergave in natuurlijke taalverwerking. Taal wordt niet alleen door discontineuze symbolen of nummers