10 usecases: wat kunnen open-source AIGC-modellen bereiken?
De krachtigste beeld- en videogeneratiemodellen op dit moment zijn waarschijnlijk GPT Images 2.5 en Seedance 2.5, die de grenzen van generatie nog verder opschuiven.
Als we ze als de eerste klasse van gesloten-bron-modellen beschouwen, op welk niveau zijn open-source-modellen dan vandaag? Zijn het speelgoed? Kunnen ze echt echte productiviteit leveren?
Dit artikel kijkt direct naar wat experts kunnen bereiken met open-source-modellen, met gebruik van Z-Image van Alibaba voor beeldgeneratie en MiniMax H3 voor videogeneratie.
Introductie van deze twee modellen
Z-Image is een 6B-beeldgeneratiemodel, uitgebracht onder de Apache 2.0-licentie. Het volledige Z-Image is een niet-gedistilleerd basismodel dat CFG, negatieve prompts en fine-tuning ondersteunt; de community gebruikt vaker Z-Image-Turbo, dat slechts 8 stappen gebruikt en snelheid prioriteert.
MiniMax H3 is een 33B-audio-videogeneratiemodel dat video's van 4 tot 15 seconden kan outputten, op 24fps, met stereogeluid. Strikt genomen is het een open-gewichtmodel met de MiniMax H3 Community License. Het open-source H3-Base kan lokaal 768p audio-video genereren, maar het officiële Context-IR-module voor het begrijpen van complexe invoer en het 2K-regeneratie-pipeline zijn niet volledig open-source uitgebracht.
Z-Image: voorbij het gewoon mooie gezichten tekenen
Veel beeldgeneratiemodellen kunnen vandaag mooie gezichten genereren. Naar één enkel geretoucheerd gezicht kijken is eerlijk gezegd niet erg indrukwekkend. De echte uitdagingen zijn: is de tekst correct geschreven? Is de telling juist? Kan hetzelfde product consistentie behouden over verschillende weergaven? Worden complexe ruimtelijke relaties correct begrepen?
Laten we eerst kijken naar een reeks lokale tests door @witcheer.
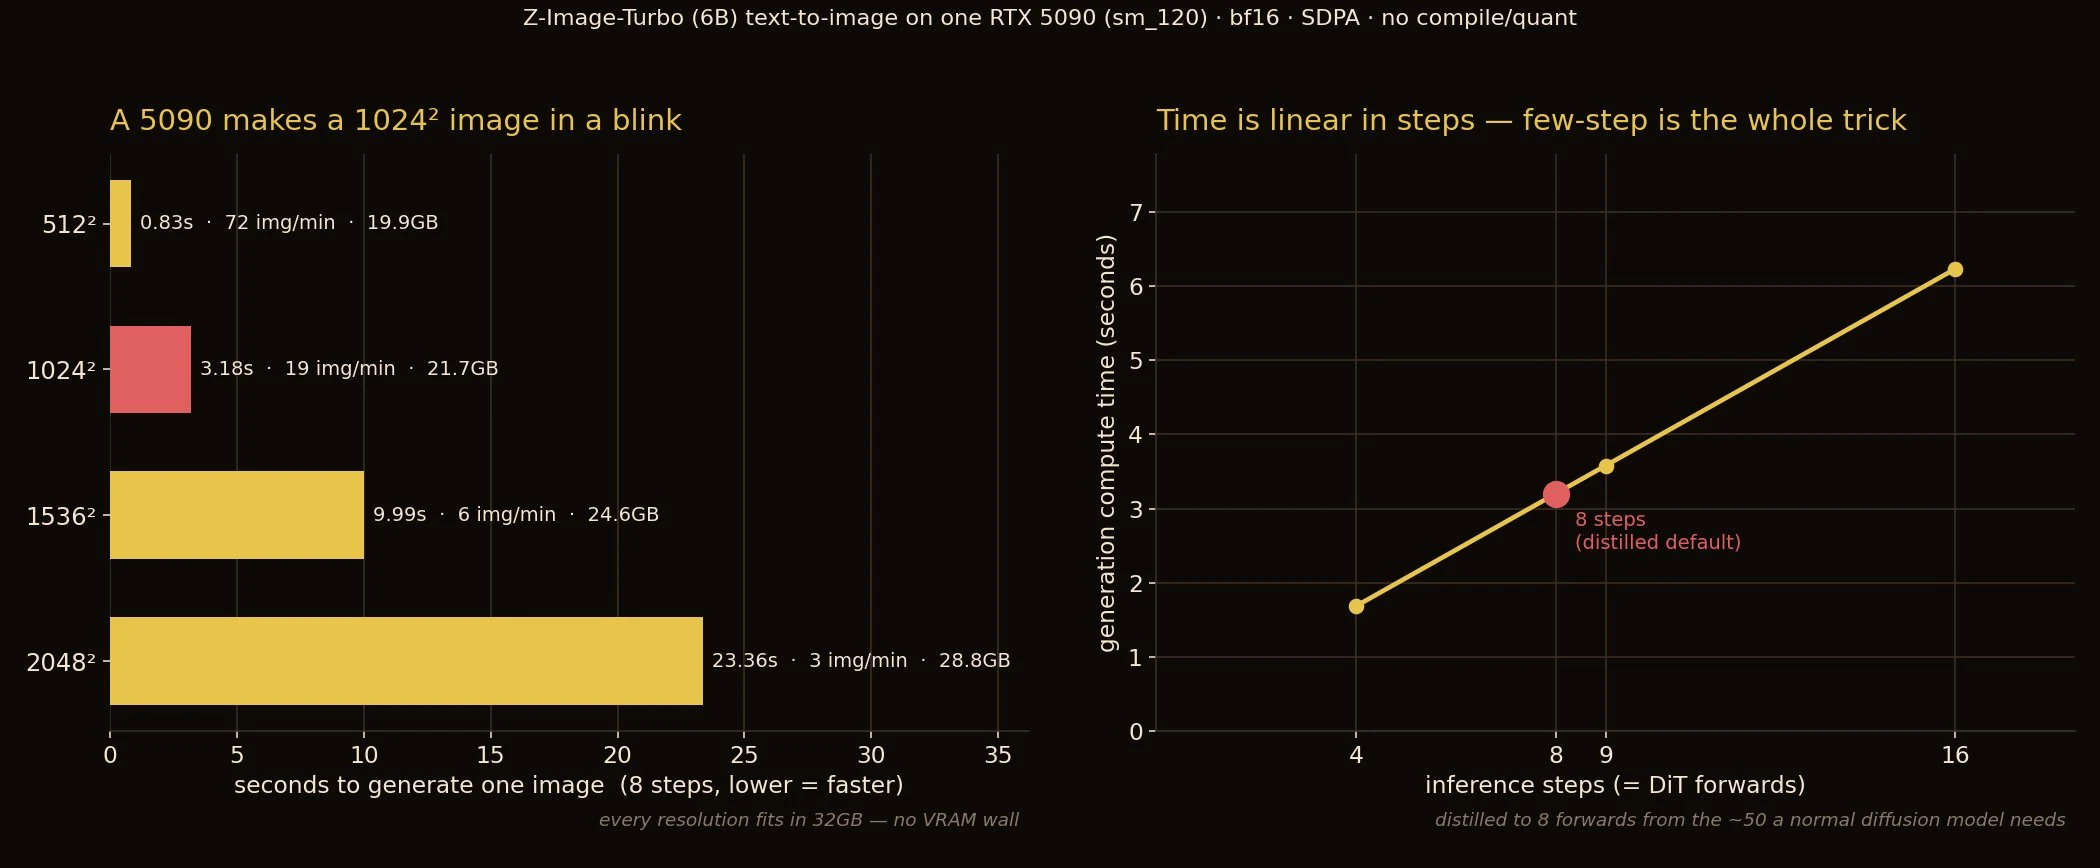
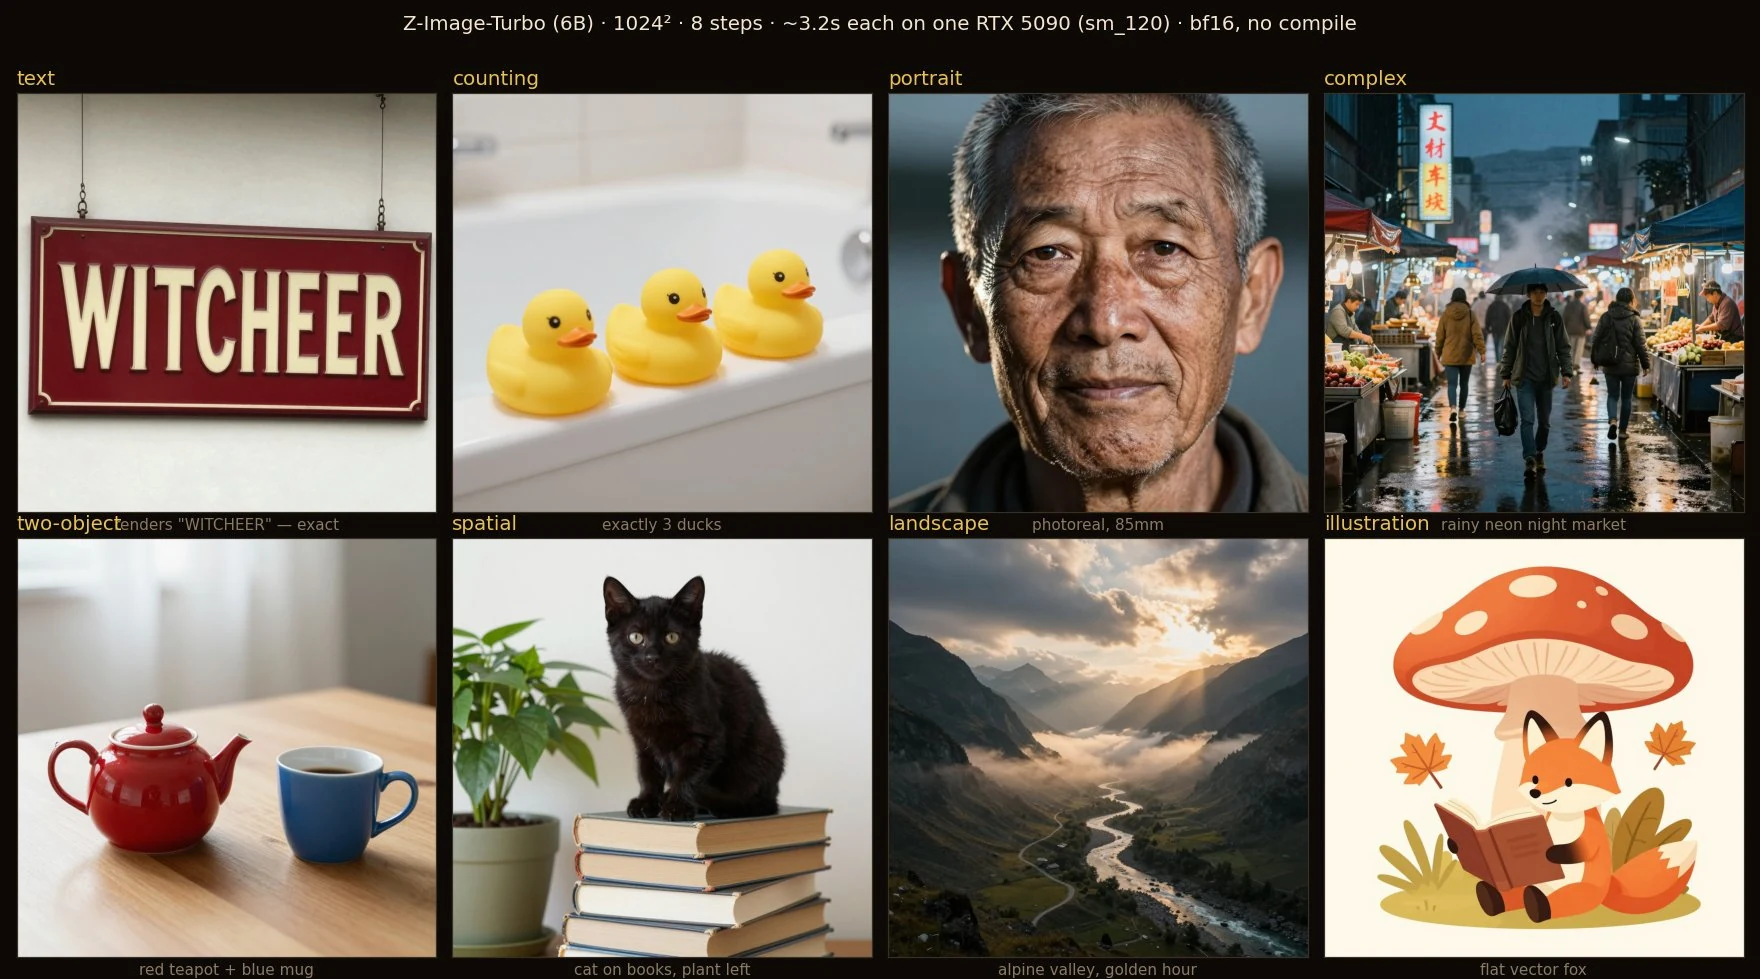
Hij draaide Z-Image-Turbo op een RTX 5090, en genereerde 1024px-afbeeldingen in ongeveer 3,2 seconden per stuk. De prompt vroeg om een winkelsbord met gespecificeerde woorden, plus "precies drie eenden", en zowel de tekst als de telling waren correct.
Deze twee taken lijken simpel, maar zijn eigenlijk hardnekkige uitdagingen voor diffusiemodellen. Letters vervagen gemakkelijk, en drie eenden worden vaak mysterieus vier of vijf.
Vervolgens een geval dichter bij e-commerce-levering.
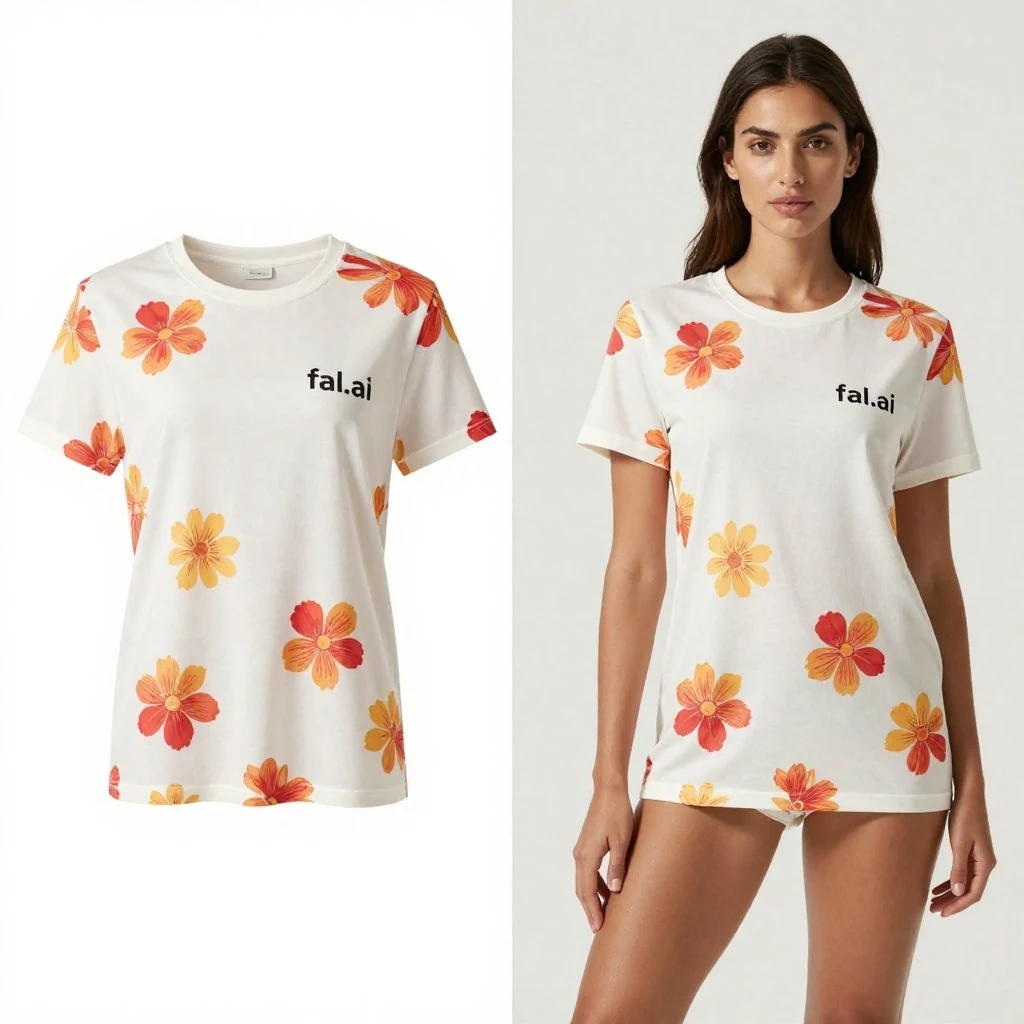
@rizavelioglu liet het model een naast elkaar gedeeld beeld genereren: links slechts een wit T-shirt met patroon, rechts een echt model dat hetzelfde kledingstuk draagt. De prompt vroeg ook om de print, stof, textiel, stiknaden en snit te behouden.
Het eindresultaat toonde dat de kleding aan beide kanten niet onafhankelijk werd gegenereerd — patronen en stijl kwamen goed overeen. Voor e-commerce-teams is dit veel waardevoller dan simpelweg een "mooie model-foto" genereren. Productafbeeldingen, draagafbeeldingen en marketingafbeeldingen kunnen allemaal doorgaan vanaf hetzelfde design.
Natuurlijk is dit slechts een succesvol monster, en er is nog een afstand tot stabiele batchproductie. Maar het bewijst ten minste dat de richting werkt.
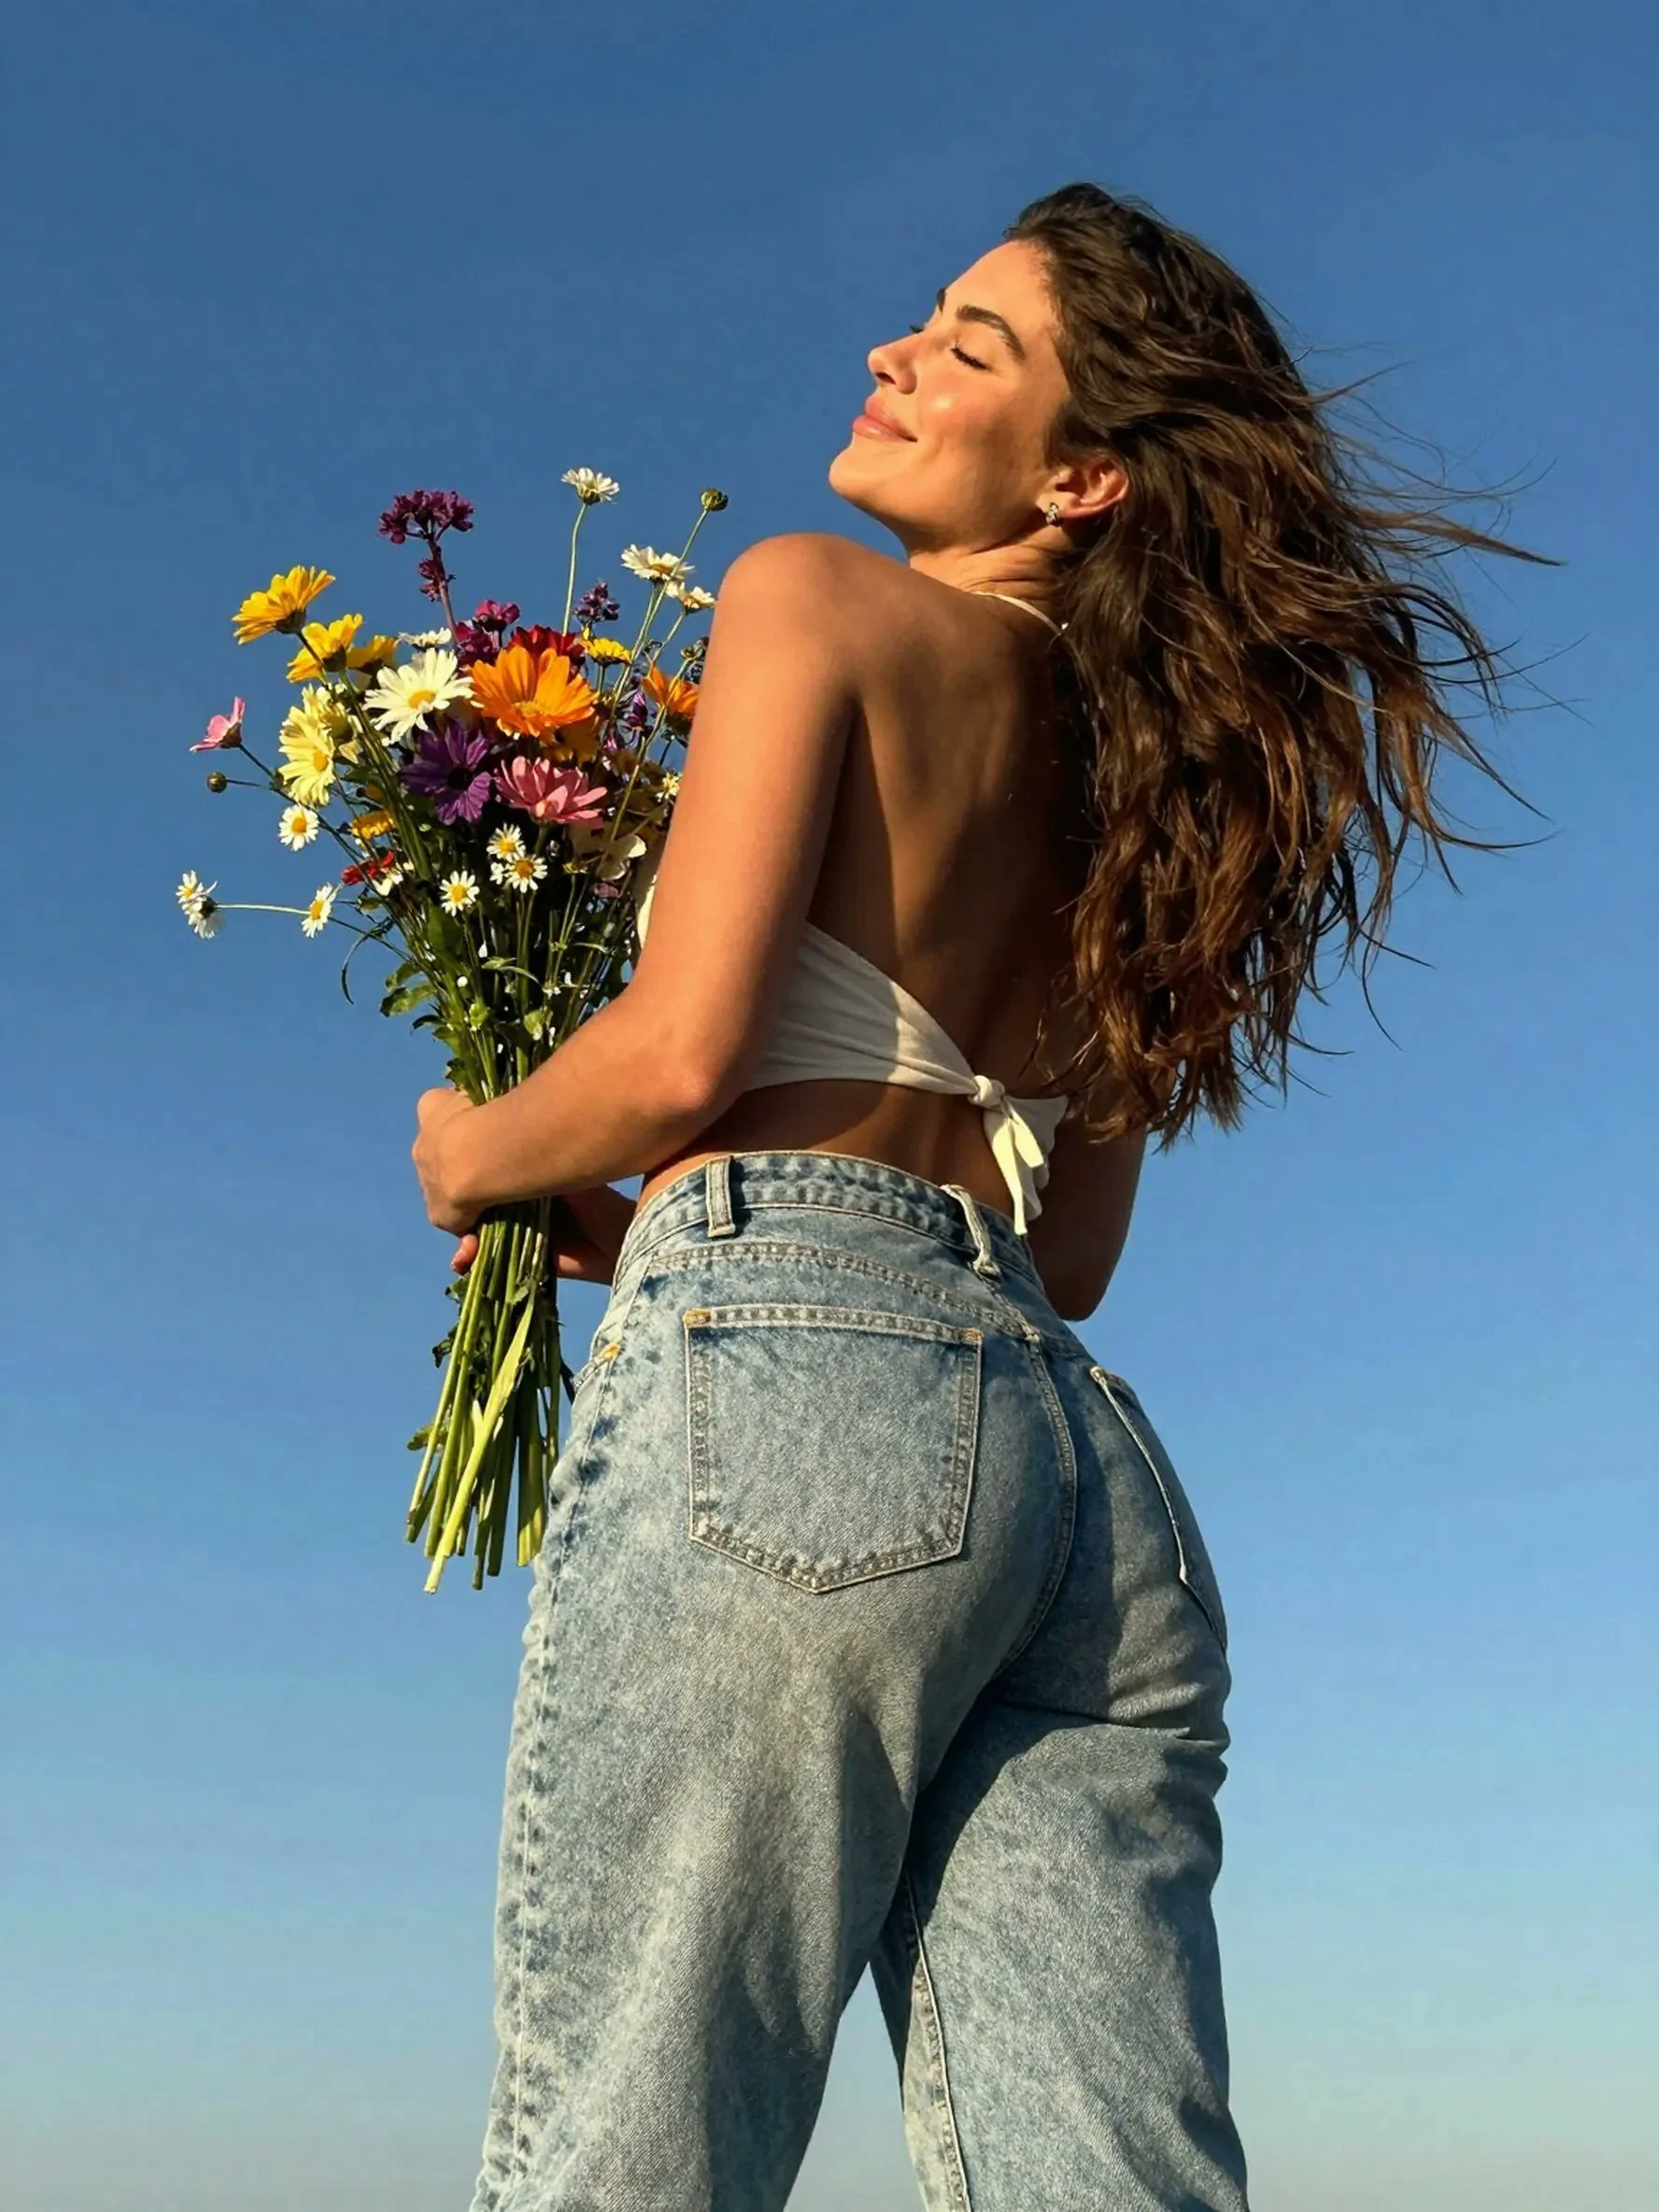
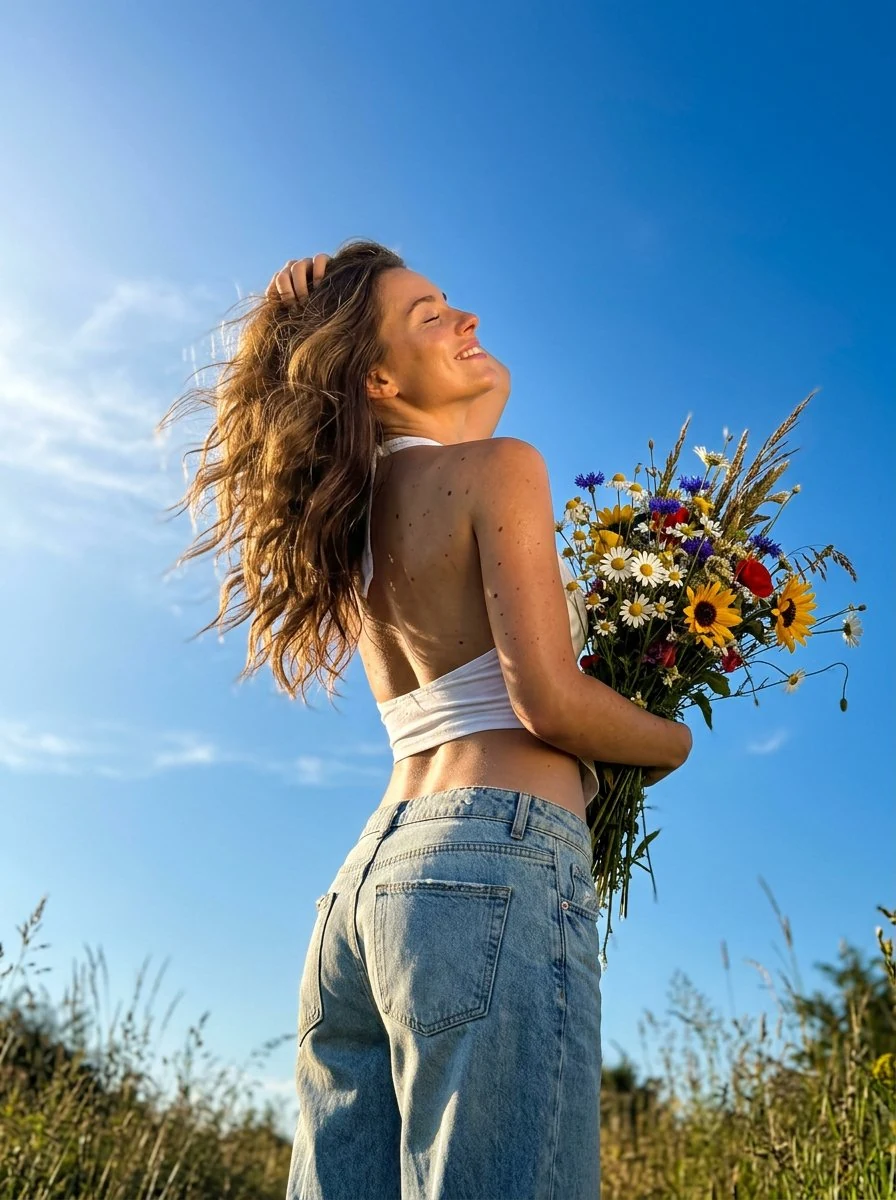
Voor realistische portretten heeft @dreamydigiarts een vergelijking gemaakt met dezelfde prompt.
Hij liet Z-Image-Turbo en Nano Banana 2 beide een telefoonfoto vanuit een lage hoek genereren: blauwe lucht, tegenlicht, persoon leunt achterover, houdt een groot boeket wilde bloemen vast, haar waait in de wind, terwijl de lichte korreligheid van telefoonfoto's behouden blijft.
Het Z-Image-resultaat had al een sterk snapshots-gevoel. Jeans, huid en tegenlicht versmolten niet tot een plastic laag, en de lage-hoek-compositie was solide. Voor atmosferische karakterafbeeldingen en social media-afbeeldingen is dit al ver boven speelgoedniveau.
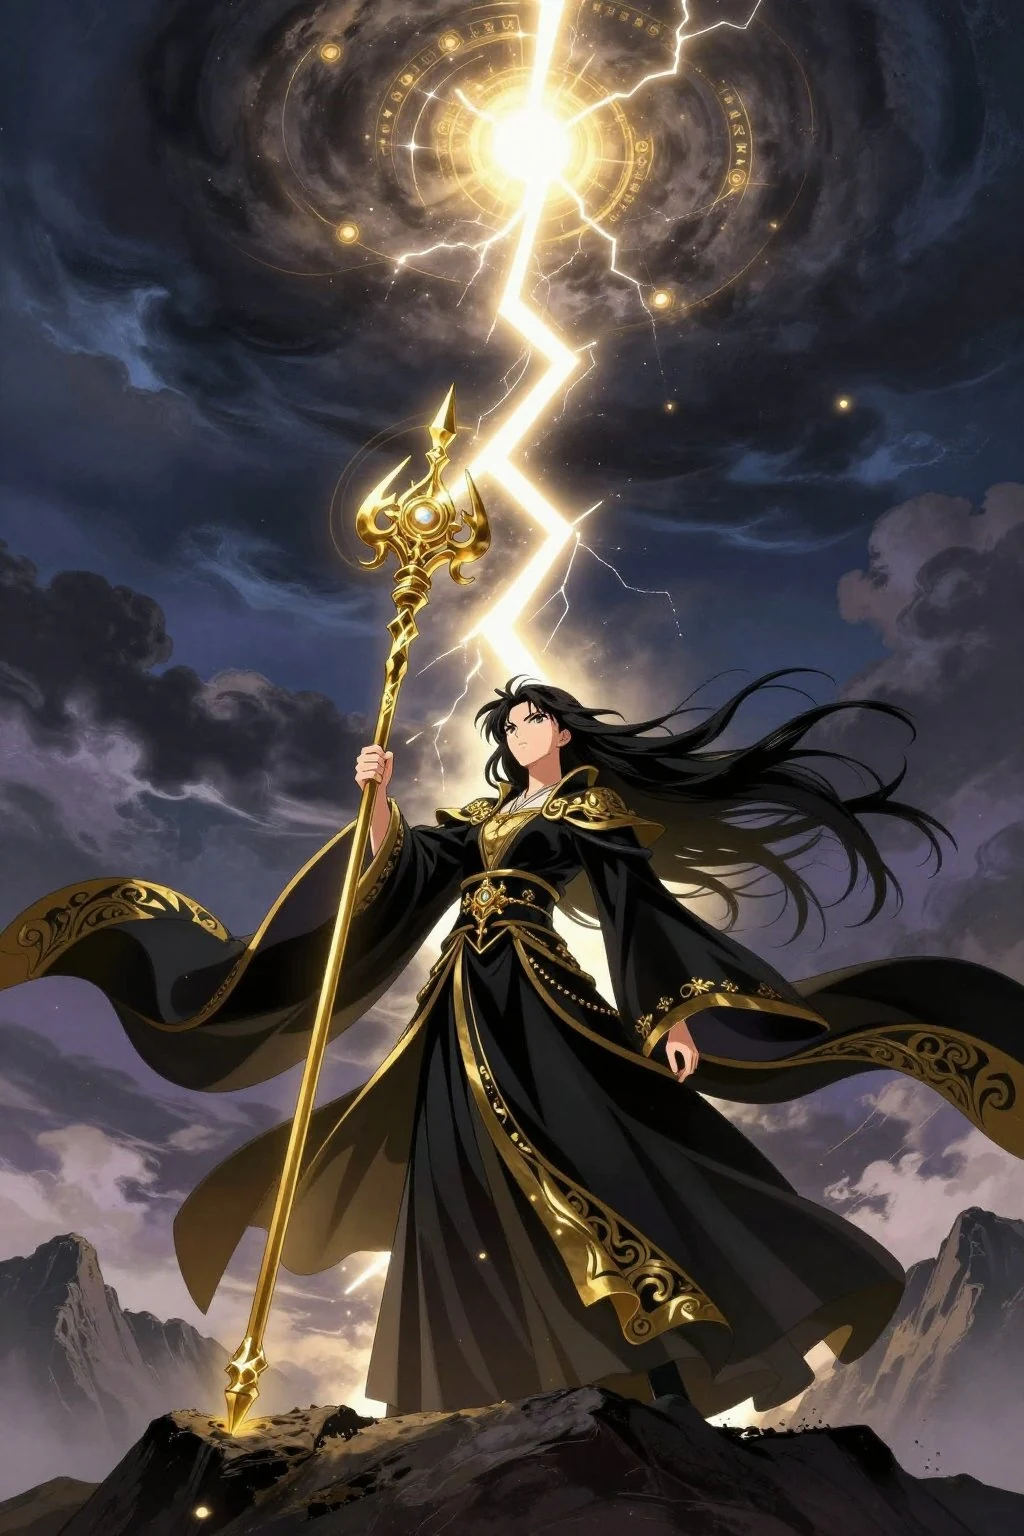
Z-Image beperkt zich ook niet tot realisme. @tisch_eins testte Boogu, Flux 2 Klein en Z-Image-Turbo met dezelfde prompt. De scène vereiste een zwart-geharde vrouwelijke tovenaar op een stormachtige bergtop, met een gouden staf volledig zichtbaar van hand tot top, een bliksemschicht die van de stafpunt naar de wolken schiet, plus lage-hoek, volledig-lichaam compositie, cape, runen, elektrische bogen en sterk gouden randlicht.
Dit soort prompts is gemakkelijk over het hoofd te zien: de staf wordt afgesneden, de bliksemschicht verkeerd verbonden, en het personage zou kunnen eindigen als slechts een groot hoofd. Z-Image's resultaat hield alle belangrijke relaties bij, wat duidt op sterke controle over complexe illustratiecomposities.
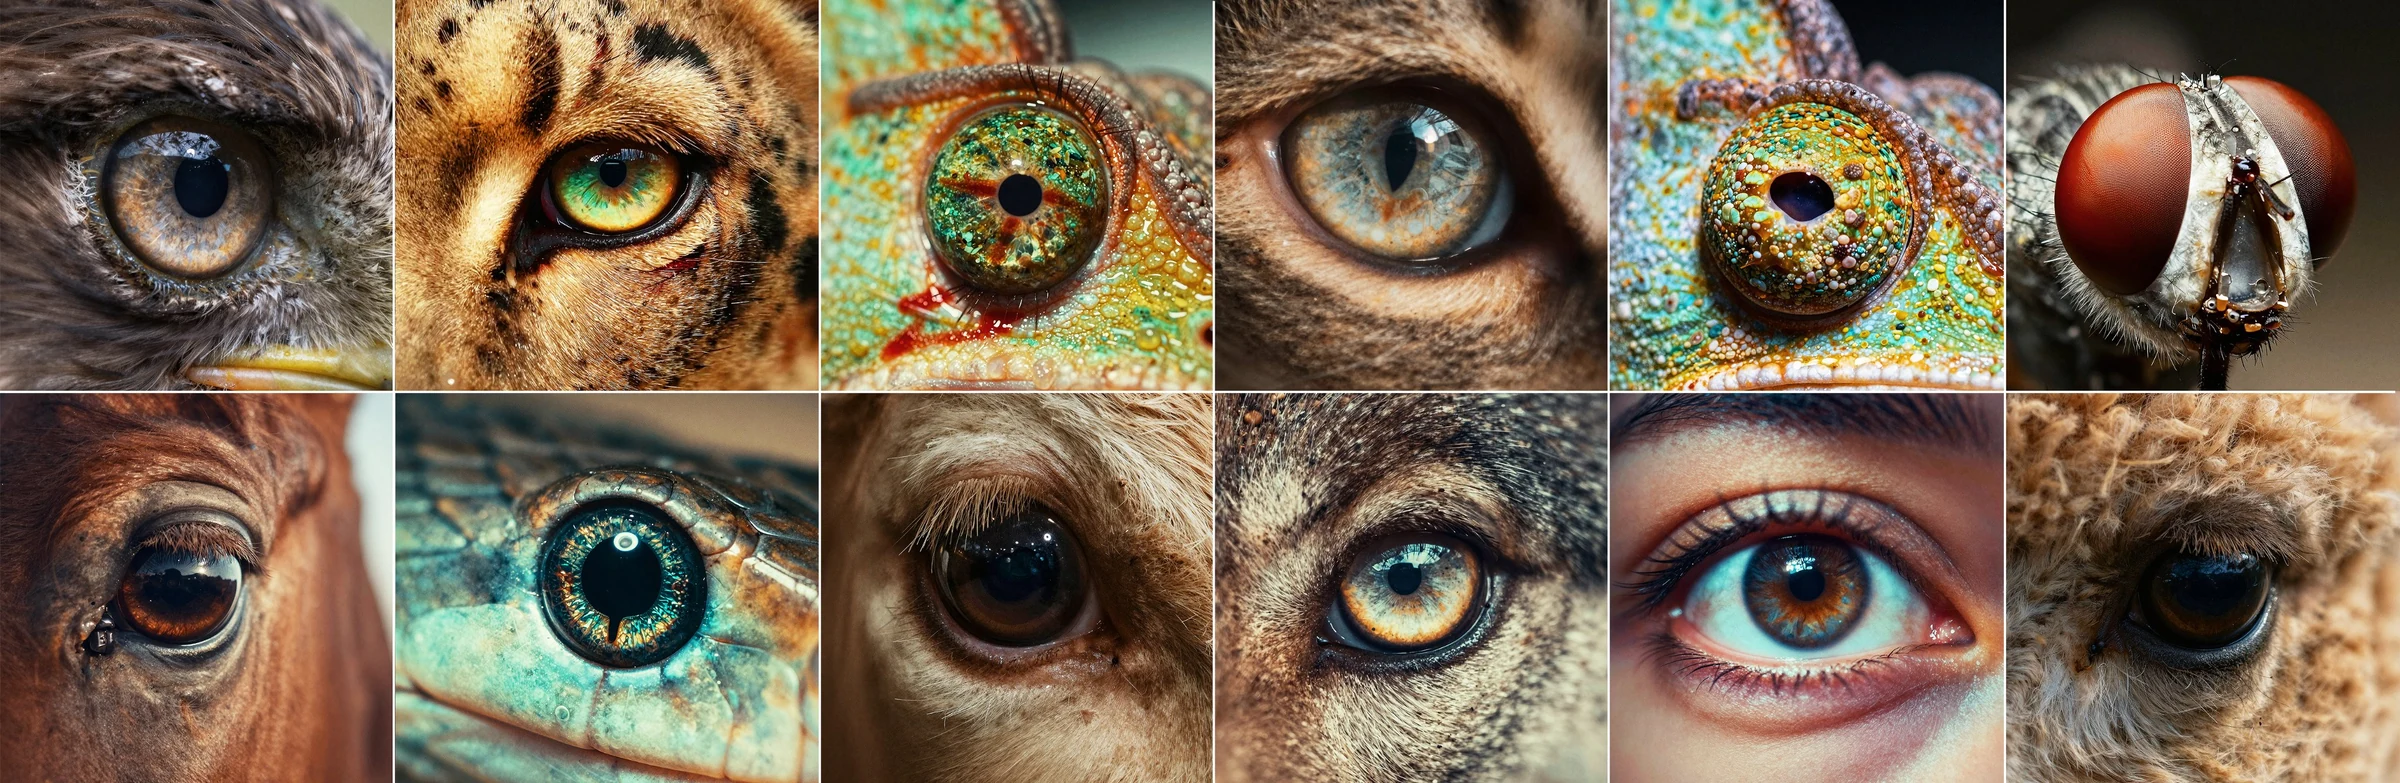
De laatste is extreme macro. @aisthetiic's prompt was erg kort: een dierlijke pupil die het hoofdframe vult, met dramatische verlichting vanuit de bovenhoek die de iris-textuur onthult, en een achtergrondverloop van donker naar helder bokeh.
Wat nog interessanter is, is dat het beeld niet instortte. De blik is stevig vergrendeld op de pupil, met licht, schaduw en achtergrond die allemaal hetzelfde onderwerp dienen. Bij het maken van poster-key visuals of emotionele covers is dit soort compositie-naleving nuttiger dan het stapelen van tienduizend "8K, meesterwerk, ultra-gedetailleerd" sleutelwoorden.
Als we deze 5 gevallen samen bekijken, zijn Z-Image's voordelen vrij duidelijk:
Het model is klein, snel, capabel in realisme, en kan relatief lange natuurlijke-taal-prompts begrijpen. Het volledige basismodel kan ook worden gebruikt voor LoRA, ControlNet en sectorale fine-tuning.
MiniMax H3: open-source video begint cinematografisch te aanvoelen
Videogeneratie is veel moeilijker dan beeldgeneratie. Eén verkeerd getekende vinger in een beeld kan soms worden bijgesneden. Maar in video: als het gezicht van het personage verandert gedurende 15 seconden, de camera de tijdlijn niet volgt, dialogen tussen personages worden gemengd, of geluidseffecten niet bij acties passen — elke fout verpest het hele stuk.
In H3's gevallen is het eerste dat de moeite waard is te onderzoeken de tweepersonage-consistentie.
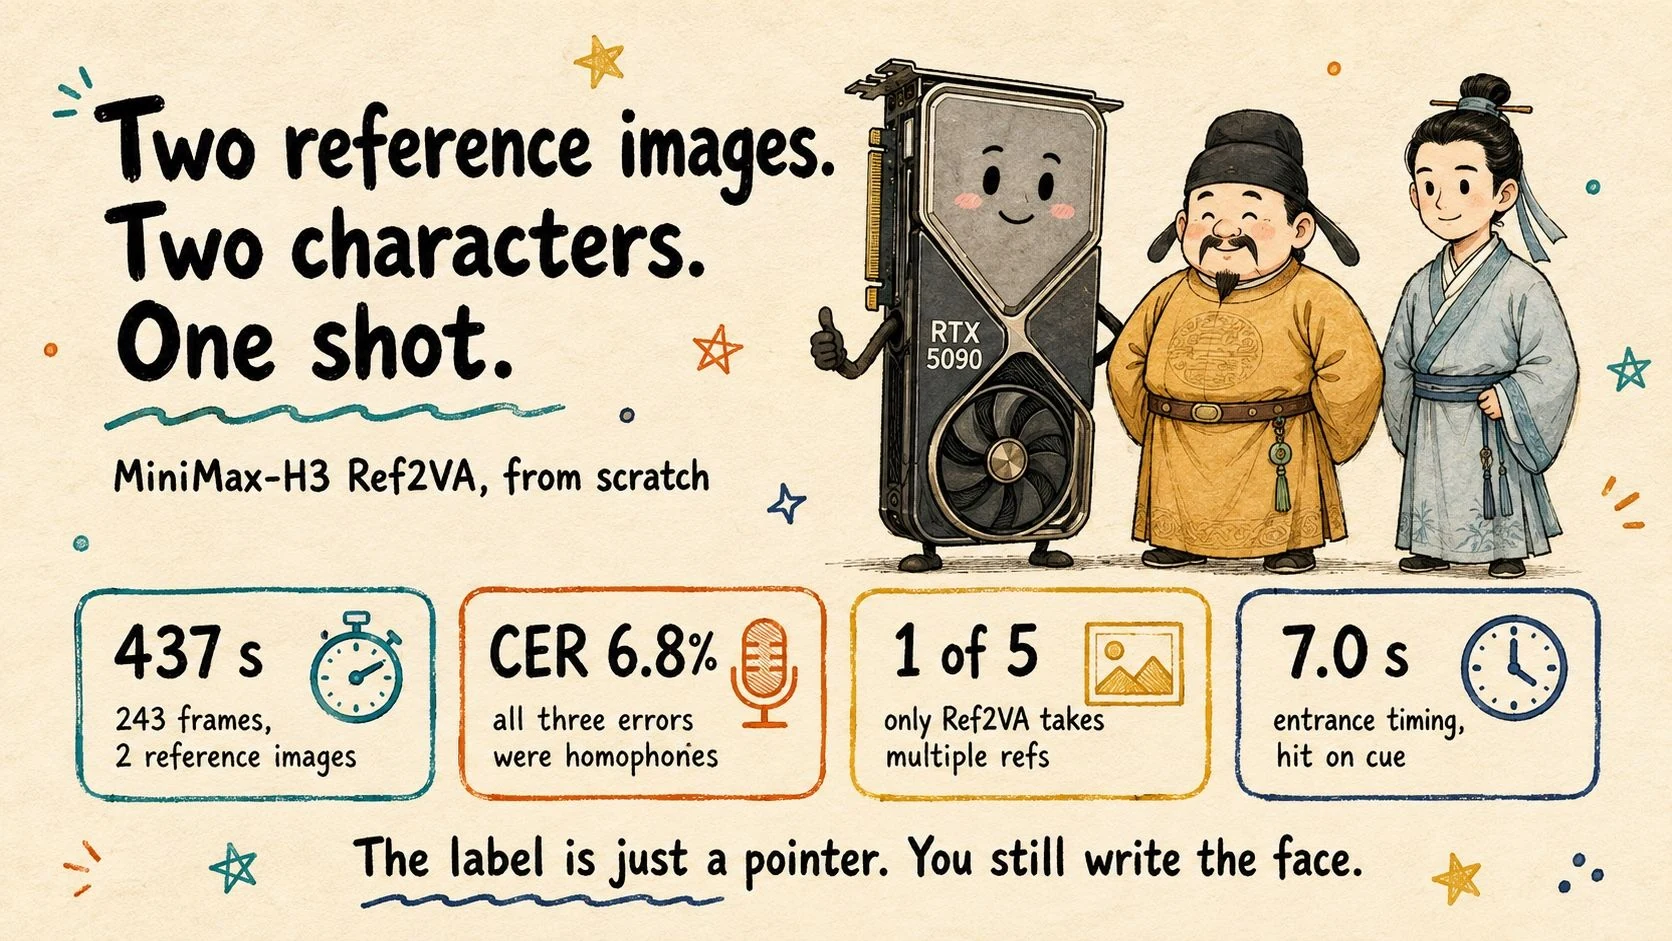
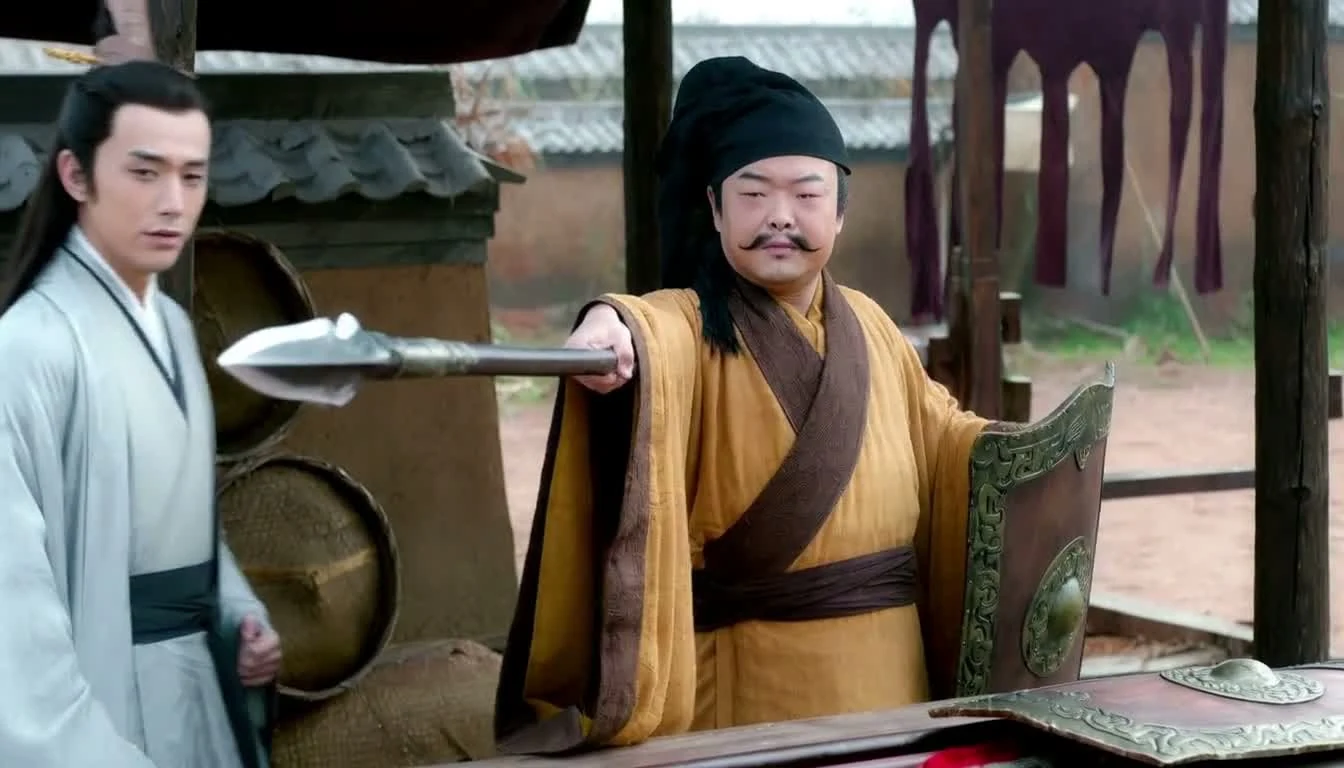
@coolthor voerde twee door Z-Image gegenereerde personage-ontwerpafbeeldingen in H3's Ref2VA-modus in. Eén draagt een okerkleurige tuniek, de andere blauwgrijze kleding, met opzettelijk verschillende uiterlijkheden. De prompt regelde de intrede van één personage tussen seconde 6 en 8 en bevatte drie regels Chinees dialoog.
In de 10,125-seconde video wisselden de twee personages geen gezichten of kleding. Het geplande personage verscheen niet in de eerste helft en kwam pas rond de 7e seconde. De auteur gebruikte vervolgens ASR om 44 Chinese tekens te verifiëren, met een tekensfoutpercentage van 6,8%, waarbij de fouten homoniemen waren.
Dit werd uitgevoerd op één enkele RTX 5090, en kostte 437 seconden voor 243 frames. De snelheid is niet extreem snel, maar tegelijkertijd personage, timing en dialoog kunnen beheren is al zeer indrukwekkend.
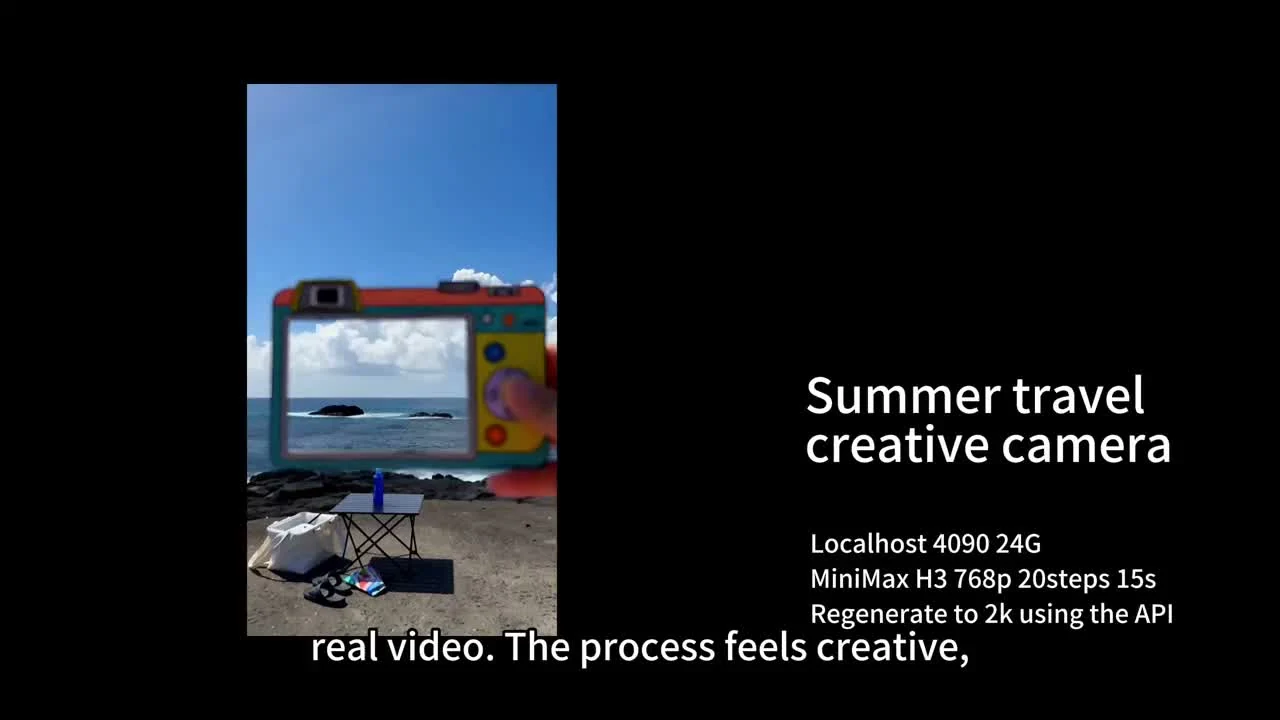
Met een RTX 4090 en ComfyUI deed hij drie pogingen: een vier-scène reiskortfilm, een muziekvideo die scènes wisselt met drumbeats, en een kustverhaal met 4 shots en omgevingsgeluid. Het eerste idee werd eerst naar MiniMax's officiële Prompt Writing Skill gestuurd om gestructureerde prompts met shots, timing, acties en geluiden te creëren, en vervolgens doorgegeven aan H3.
Het meest nuttige aspect van dit geval is dat het niet gewoon "mooie beelden" maakte. Wanneer de drumslag komt, verandert de scène daadwerkelijk; in de kustclip kwamen de vier shots, sfeer en achtergrondgeluid allemaal samen in één ronde.
Zijn benchmark-gegevens: 4090 doet er meer dan 200 seconden over voor een 15-seconden video in lage resolutie met 20 stappen; opschalen naar 768p kost meer dan 1000 seconden. Open source maakt herhaalde iteratie mogelijk, maar gratis betekent niet kosteloos — elektriciteit, VRAM en wachttijd zijn ook kosten.
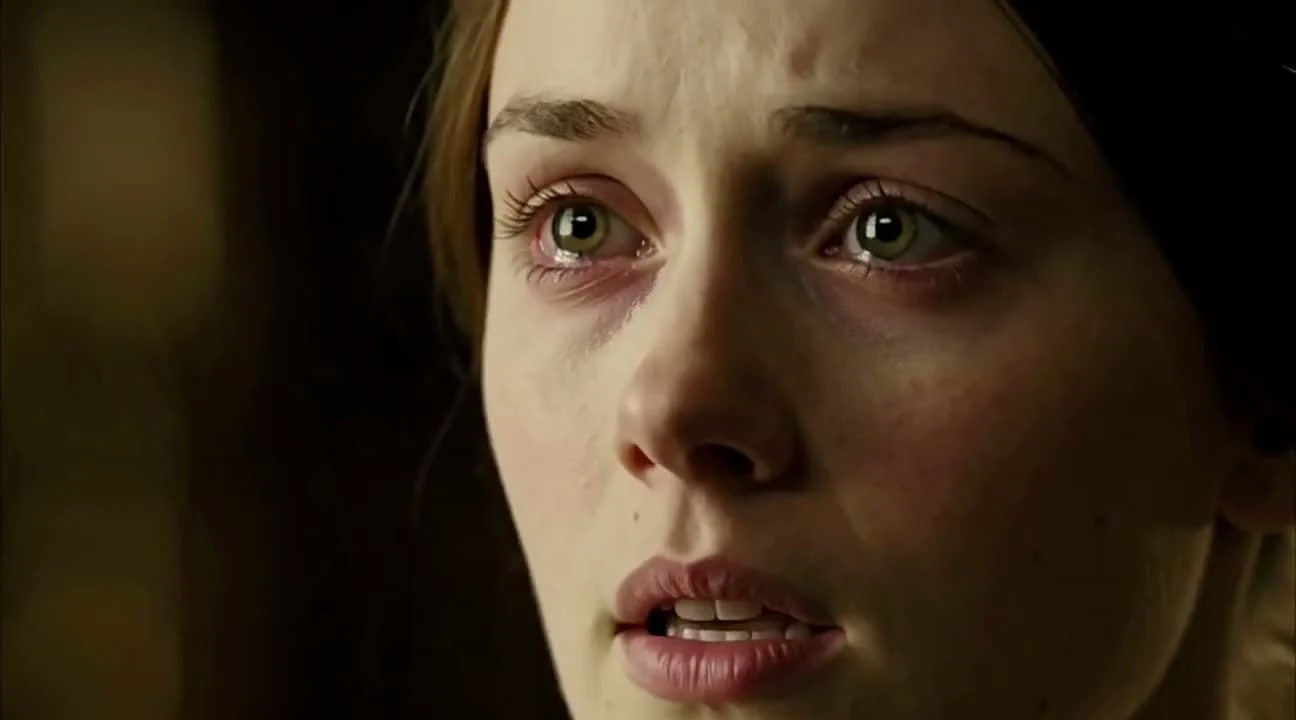
@PixelAigc's 30-seconden "Jane Eyre"-achtige Brits landgoed-segment is nog indrukwekkender.
Zijn prompt verdeelde de 30 seconden direct in 4 shots. Elk segment specificeerde brandpuntsafstand, camerahoek, personagepositionering, micro-expressies, dialogen, ademhaling, omgevingsgeluid en verboden items. Personage-emoties vorderden van aarzelend naar weerlegging tot ontroerd, met aparte stembeperkingen voor mannelijke en vrouwelijke stem.
Dit stuk gebruikte lokale ComfyUI met H3 Turbo LoRA, en genereerde eerst 480p, en schaalde dan op naar 1080p met Topaz. De auteur meldde dat 25 seconden ongeveer 13 tot 15 minuten kosten. Dit vertegenwoordigt niet de brute prestaties van het officiële model, maar het vertegenwoordigt het meest interessante aspect van het open-source-ecosysteem: één maand na de modellancering is de community al snelheid aan het aanpassen, lange video's aan het maken en automatische super-resolutie aan het integreren.
H3's officiële enkele-segmentlimiet is 15 seconden. Hoe maak je dan langere video's?
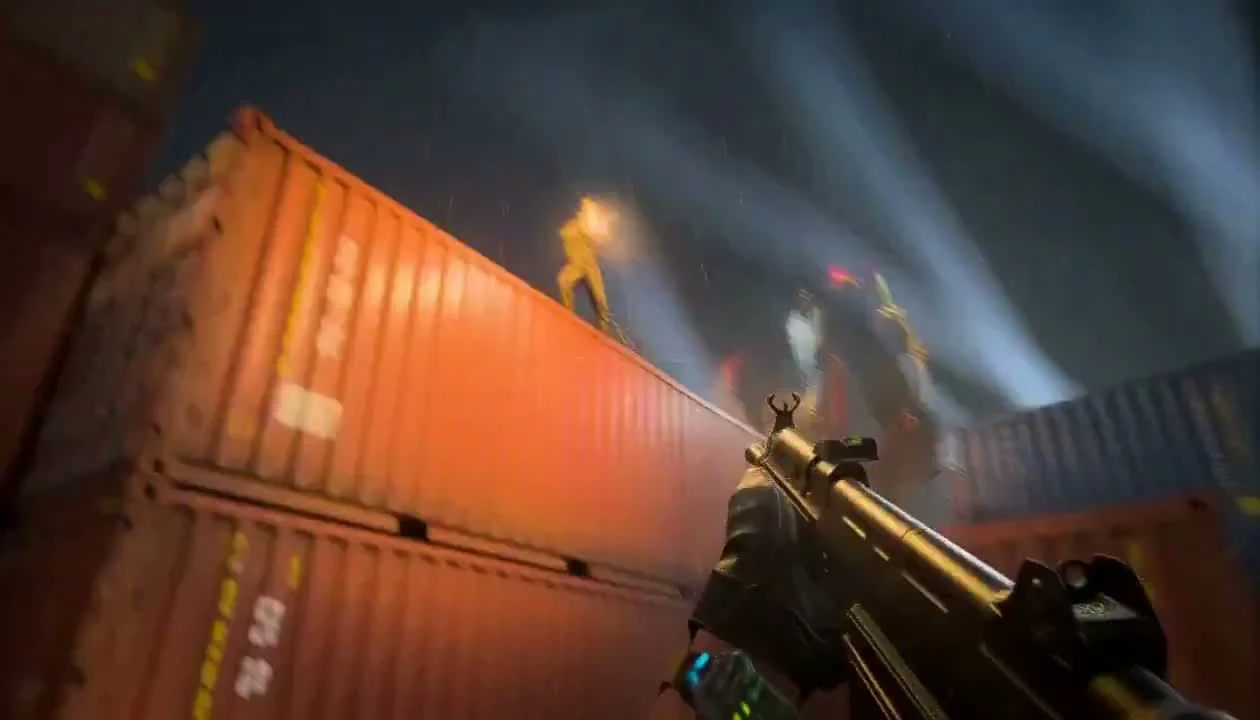
@superalesha gebruikte 4 RTX 3090's om een 30-seconden first-person actiefilm uit te voeren. Hij verbond twee 15-seconden-segmenten, hield het eerste opzettelijk op een stabiel beeld, zette de generatie voort vanuit hetzelfde beeld in het tweede segment, knipte de gedupliceerde beelden eruit, en liet het geluid doorgaan.
De naad is verborgen op de 15e seconde, nauwelijks zichtbaar bij normaal bekijken. Het hele stuk duurde 44 minuten van generatie tot voltooiing. De waarde van dit geval ligt niet in dat H3 plotseling de tijdsbeperking doorbrak, maar dat iemand de beperking begreep en er met een werkproces omheen werkte.
Er is ook een geval dat bijzonder nuttig is om te bestuderen "hoe je eigenlijk video-prompts schrijft".
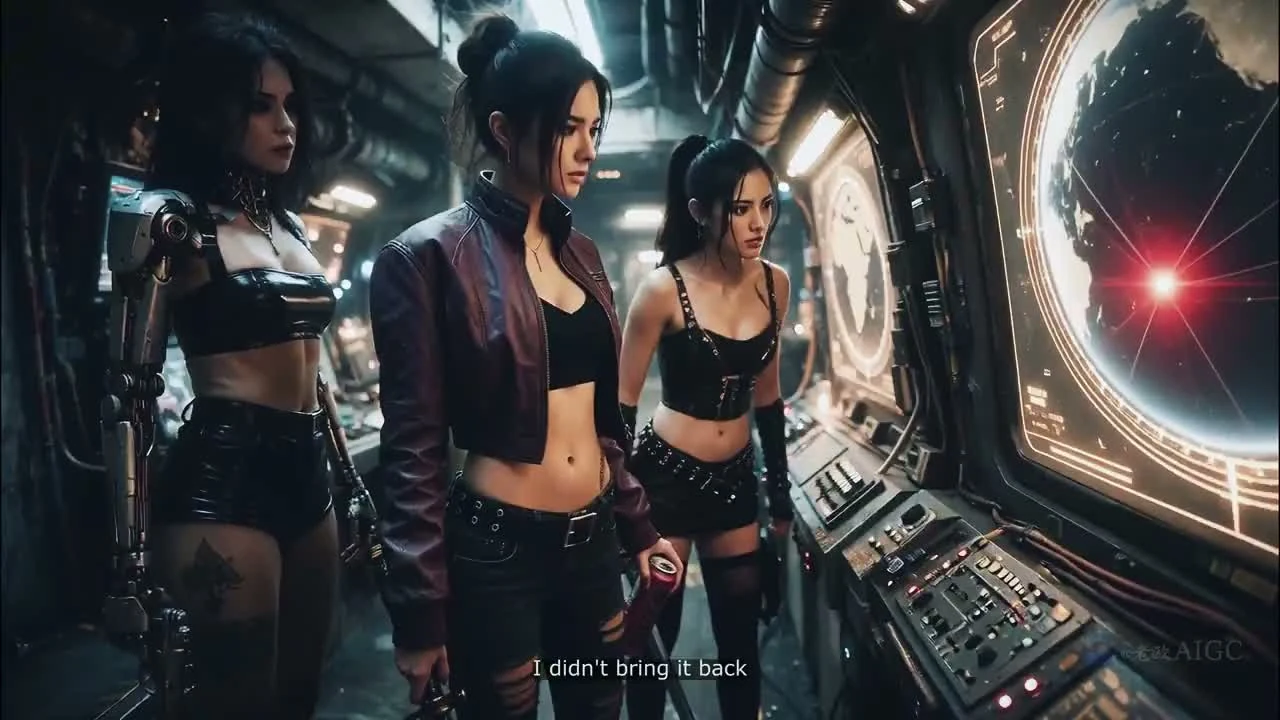
@ou_599 gebruikte lokale ComfyUI om een 15-seconden cyber ruimteschip kortfilm te maken. De scène bevatte drie vrouwelijke personages: één zit links, één staat in het midden met een mes, en één staat rechts voorin met een frisdrankblikje. De prompt beschreef niet alleen de verhaallijn — het specificeerde wie op welke seconde spreekt, dat stille personages hun lippen niet mogen bewegen, dat het frisdrankblikje de hele tijd in de rechterhand moet blijven, wanneer het rode trackingpunt op het scherm verschijnt, en ten slotte wanneer de schaduw buiten het patrijspoortje nadert.
Het moeilijkste deel van dit soort gevallen is het stabiel houden van de ruimte, het niet verliezen van rekwisieten, het niet mengen van dialogen, en het ervoor zorgen dat stille personages echt stil blijven. H3 heeft het al voor elkaar al deze beperkingen in een 15-seconden kortfilm te proppen. Het spel bij open-source video is duidelijk veranderd.
Als je gewoon snel een afgewerkt video wilt produceren, zijn gesloten-bron-modellen nog steeds de gemakkelijkste optie.
Maar als je herhaaldelijk wilt itereren, batch wilt genereren, je eigen stijl wilt trainen, of capaciteiten wilt integreren in een lokaal werkproces, zijn Z-Image en H3 een serieuze studie waard. Gebruik open-source-modellen om snel shots en materiaal te prototypen, en roep gesloten-bron-modellen alleen aan als je echt vastzit — de kosten zullen veel lager zijn.
Open-source-modellen voelden vroeger als een troostprijs voor wachtenden. Nu kunnen ze echt deelnemen aan echt creatief werk.
Voor mensen die dagelijks beelden en video's moeten maken, is de beste verandering dat je in de toekomst bij elk idee niet eerst hoeft te berekenen hoeveel credits deze ronde zal verbranden.