Naarmate Agent-toepassingen complexer worden, moeten ontwikkelaars omgaan met tool-aanroepen, kennisintegratie, statusbeheer en multi-Agent-samenwerking. Als al deze functionaliteiten vanaf nul zouden worden ontwikkeld, zou niet alleen de werklast groot zijn, maar ook de verbinding tussen de modules en de uitvoeringscontrole complex.
Agent-frameworks encapsuleren deze veelgebruikte vaardigheden en bieden een implementatiemethoden voor Agent-ontwikkeling. Hierna worden enkele representatieve Agent-ontwikkelingsframeworks gepresenteerd.
LangChain-framework
LangChain werd in 2022 uitgebracht en is een van de eerdere open-source frameworks voor het bouwen van Large-Language-Model-toepassingen. LangChain werd aanvankelijk voornamelijk gebruikt voor het organiseren van Large-Language-Modellen, prompts en externe gegevens, en breidde zich geleidelijk uit naar tool-aanroepen en Agent. Tegenwoordig heeft LangChain Agent als een essentieel onderdeel van het framework opgenomen en biedt het modellen, tools en middleware om snel Agent met tool-aanroepmogelijkheden te bouwen.
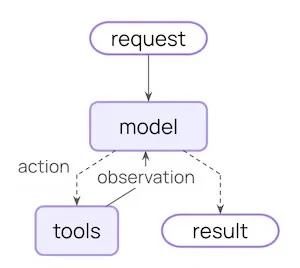
De kernwerking van LangChain bestaat uit het vormen van een lus tussen het Large-Language-Model en de tools. Het Large-Language-Model ontvangt de taak van de gebruiker en de beschikbare tools, en beoordeelt op basis van de huidige informatie of het direct een resultaat genereert of een tool aanroept. Als een tool-aanroep wordt gekozen, voert het framework de bijbehorende tool uit en levert het geretourneerde resultaat aan het Large-Language-Model. Het Large-Language-Model beoordeelt dan verder op basis van de nieuwe informatie totdat geen tool-aanroepen meer nodig zijn en een eindresultaat wordt gegenereerd. Het officiële proces heet Agent Loop, zoals hieronder weergegeven.
Bijvoorbeeld kan een reisassistent worden geconfigureerd met tools voor weervoorspelling, kaartzoeken en websearch. Wanneer een gebruiker "Help me een dagexcursie naar Hangzhou morgen te plannen" voorstelt, kan het Large-Language-Model bepalen dat weer- en attractie-informatie moeten worden opgevraagd, de bijbehorende tools aanroepen om de resultaten te verkrijgen, en deze vervolgens combineren om de reisroute te voltooien.
Tools zijn een belangrijke manier om externe mogelijkheden te realiseren. In essentie zijn het aanroepbare functies met duidelijke invoer en uitvoer, gebruikt om realtime gegevens op te halen, code uit te voeren, databases te raadplegen of externe systemen te bedienen. Wanneer ontwikkelaars de benodigde tools aan een Agent hebben verstrekt, kan het Large-Language-Model op basis van de huidige taak bepalen welke tool wanneer moet worden aangeroepen en welke parameters bij de aanroep moeten worden verstrekt.
Deze modulaire aanpak is een belangrijk kenmerk van LangChain. LangChain biedt relatief eenheit interfaces voor verschillende modellen en tools, waardoor ontwikkelaars deze componenten binnen hetzelfde framework kunnen combineren zonder de aanroeplogica tussen verschillende modellen en externe mogelijkheden apart te hoeven behandelen. Daarom is het bijzonder geschikt voor het snel opzetten van tool-aanroep-gebonden Agent en geschikt voor beginners om het basale Agent-proces te begrijpen.
LlamaIndex, uitgebracht in 2022, werd aanvankelijk voornamelijk gebruikt om verbindingsproblemen tussen Large-Language-Modellen en externe gegevens op te lossen. Het biedt mogelijkheden voor gegevens laden, indexeren, ophalen en raadplegen, waarmee externe gegevens zoals bedrijfsdocumenten en databases aan Large-Language-Model-toepassingen kunnen worden gekoppeld. Op basis daarvan heeft LlamaIndex geleidelijk functies zoals Agent en Workflows toegevoegd, waardoor Agent deze gegevens kunnen gebruiken om complexere taken uit te voeren.
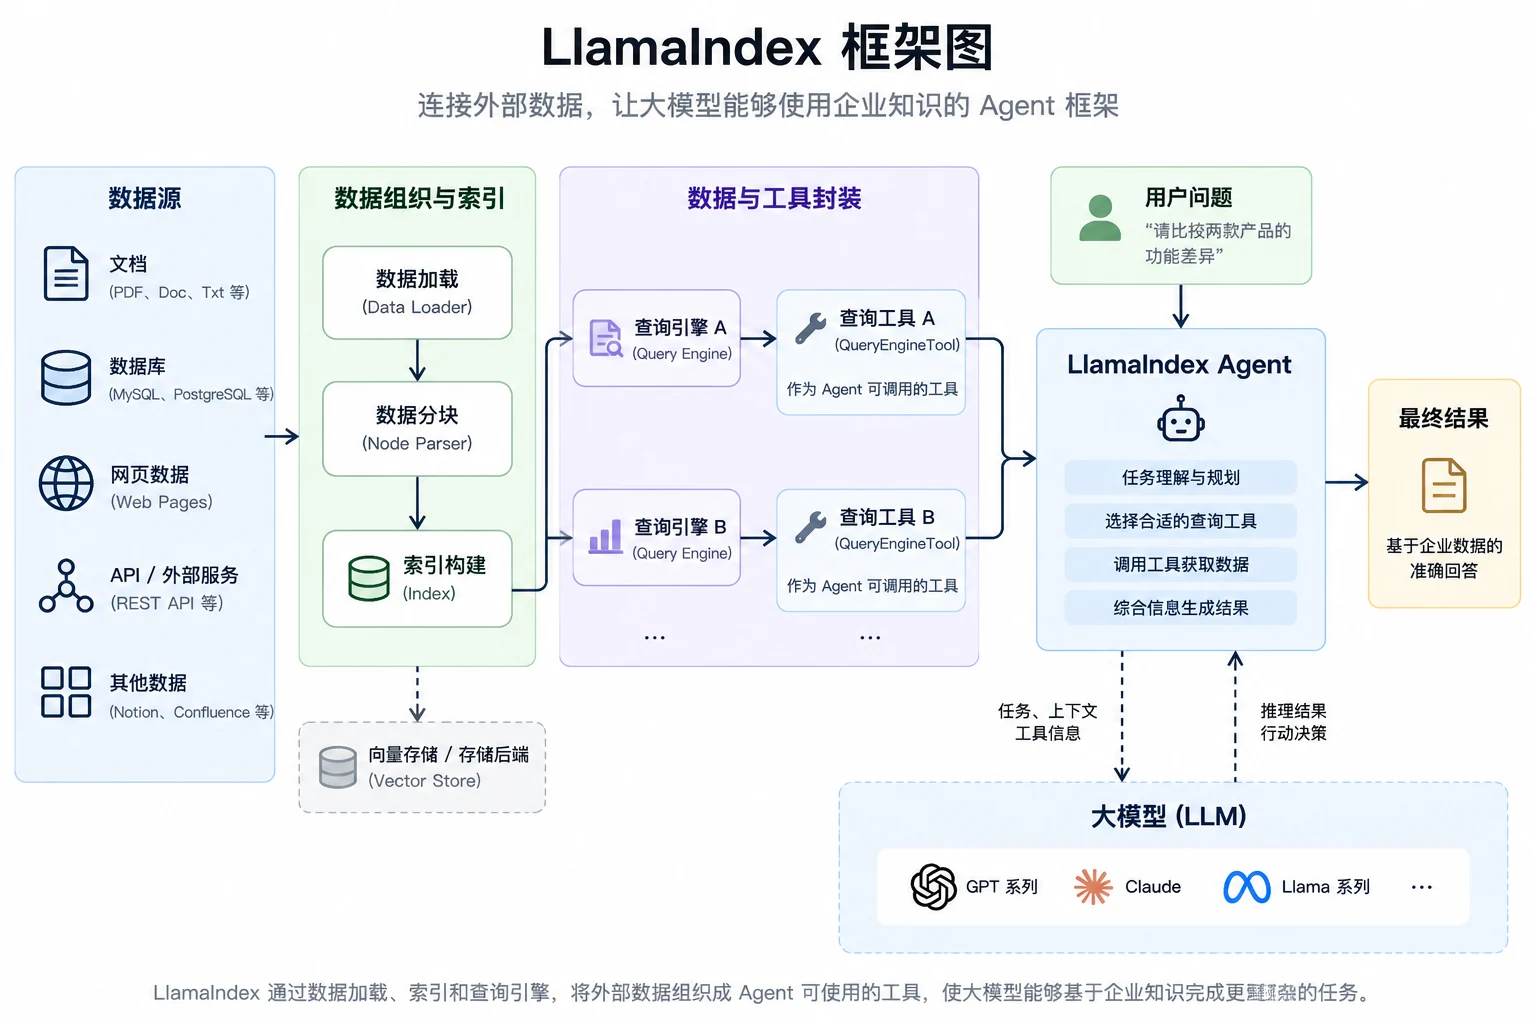
Large-Language-Modellen begrijpen van zichzelf geen externe gegevens zoals interne productdocumenten, bedrijfsgegevens en databases van het bedrijf. Wanneer een Agent deze gegevens moet gebruiken om een taak uit te voeren, moet het eerst relevante informatie voor de huidige taak vinden. LlamaIndex kan externe gegevens laden, organiseren en indexeren, en vervolgens zoeken en raadplegen via componenten zoals Retriever en Query Engine. De Query Engine kan natuurlijke taalvragen ontvangen, relevante gegevens in de index zoeken en ook worden ingepakt als een tool die door Agent kan worden aangeroepen. Zoals hieronder weergegeven, kan de Agent na ontvangst van de taak van de gebruiker indien nodig de bijbehorende raadplegingstool selecteren om informatie te verkrijgen, en deze vervolgens met het Large-Language-Model analyseren om het eindresultaat te genereren. Op deze manier hoeven niet alle externe gegevens direct in de context te worden geplaatst; de relevante gegevens kunnen op verzoek van de taak worden geraadpleegd en gebruikt.
Bijvoorbeeld kunnen voor een bedrijfsanalyse-Agent tools voor productdocumentraadpleging en bedrijfsgegevensraadpleging worden geconfigureerd. Wanneer de gebruiker functionele verschillen tussen twee producten wil vergelijken, roept de Agent de raadplegingstool voor productdocumenten aan; als de gebruiker doorgaat met vragen over de verkopen van de twee producten, roept hij de bedrijfsgegevens-raadplegingstool aan. Voor complexere vragen kan de Agent ook meerdere gegevensraadplegingstools achtereenvolgens aanroepen en vervolgens de resultaten van verschillende gegevensbronnen combineren om de taak te voltooien.
LlamaIndex was niet oorspronkelijk ontworpen voor Agent-ontwikkeling; de kenmerken weerspiegelen zich voornamelijk in gegevens- en kennisverwerking. Het stelt Large-Language-Modellen niet alleen in staat om documenten te zoeken, maar kan ook verschillende gegevens en raadplegingsmogelijkheden organiseren als tools die door Agent kunnen worden geselecteerd en gebruikt. Het is bijzonder geschikt voor kennisbank-vraag-en-antwoord-toepassingen, documentanalyse, meervoudige gegevensbronraadplegingen en Agent-toepassingen die toegang tot talrijke bedrijfsdocumenten, kennisbanken of gestructureerde gegevens vereisen.
AutoGen-framework
AutoGen werd in 2023 uitgebracht door het Microsoft Research-team en is een representatief open-source framework op het gebied van multi-Agent-ontwikkeling. Met Multi-Agent Conversation als kerndenken laat het meerdere Agent gezamenlijk taken uitvoeren via dialoog.
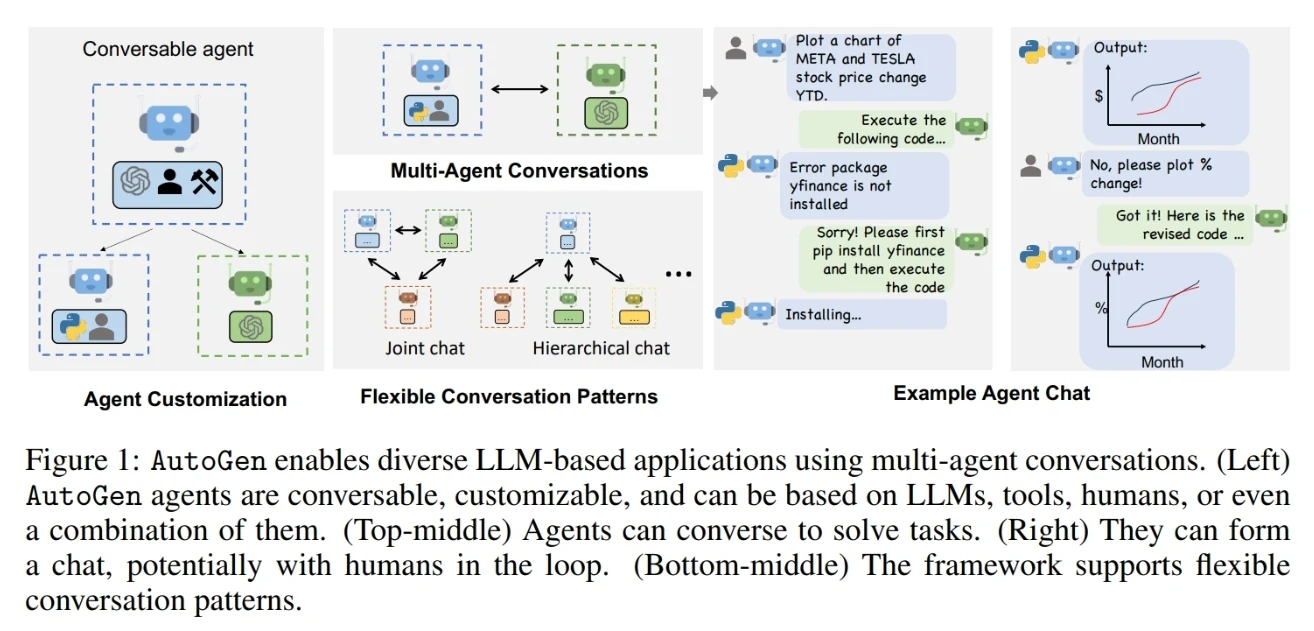
AutoGen ontwerpt Agent als dialogueerbare, aanpasbare entiteiten; een Agent kan bestaan uit een Large-Language-Model, tools, handmatige invoer of een combinatie van deze mogelijkheden. Ontwikkelaars kunnen ook de interactiewijze tussen Agent definiëren, waardoor verschillende Agent verschillende dialogmodi vormen. Het algemene ontwerp is hieronder weergegeven.
Dit diagram weerspiegelt twee belangrijke ontwerpprincipes van AutoGen. Ten eerste kunnen verschillende Agent verschillende mogelijkheden hebben. Ten tweede kunnen meerdere Agent worden georganiseerd via verschillende Conversation Patterns, waardoor ze op verschillende manieren communiceren en samenwerken.
Bijvoorbeeld kan bij een softwareontwikkelingstaak een Agent worden ingesteld om vereisten te analyseren, een Agent om code te schrijven en een andere Agent om resultaten te controleren. Nadat de programmeer-Agent code heeft gegenereerd, stuurt hij het resultaat naar de controle-Agent; als problemen worden gedetecteerd, kan de controle-Agent feedback geven aan de programmeer-Agent om door te gaan met aanpassen totdat de taakvereisten zijn voldaan.
Momenteel biedt AutoGen voornamelijk twee vermogensniveaus: AgentChat en Core. AgentChat is een high-level interface voor het bouwen van enkele Agent- en multi-Agent-toepassingen en biedt componenten zoals Agent en Team. Ontwikkelaars kunnen meerdere Agent combineren tot een Team en samenwerking organiseren via beurtwisseling, dynamische selectie van de volgende Agent, enz. Core gebruikt eventgestuurde methoden en biedt basisvaardigheden voor flexibelere en schaalbare multi-Agent-systemen.
Het kenmerk van AutoGen is dat het de communicatie en samenwerking tussen Agent als focus van het framework-ontwerp plaatst, wat geschikt is voor complexe taken waarbij meerdere Agent taken moeten verdelen. Multi-Agent-systemen vereisen extra ontwerp van de verantwoordelijkheden en samenwerkingswijzen van Agent; voor eenvoudige taken is het over het algemeen niet nodig om meerdere Agent te gebruiken.
CrewAI-framework
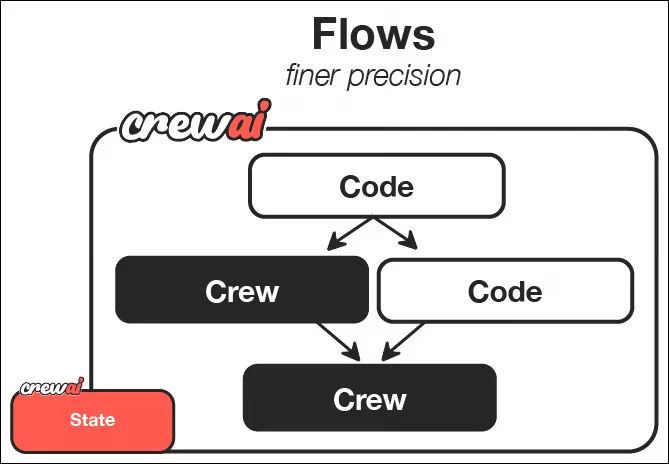
CrewAI richt zich ook op multi-Agent-samenwerking, maar past een organisatie toe die meer lijkt op echte teams. Ontwikkelaars kunnen rollen, doelen en tools definiëren voor verschillende Agent en deze vervolgens organiseren via taken en workflows om gezamenlijk te werken. CrewAI biedt voornamelijk twee organisatietypen: Crews benadrukken de autonome samenwerking tussen meerdere Agent, terwijl Flows gestuurde workflowcontrole benadrukken.
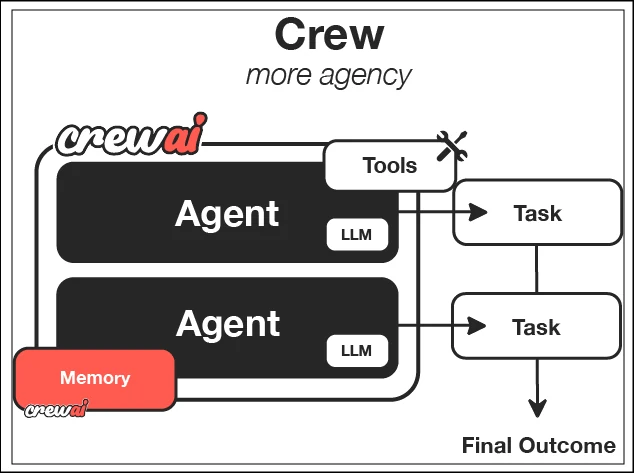
De door CrewAI officieel verstrekte frameworkstructuur is hieronder weergegeven.
In een Crew kunnen Agent worden begrepen als teamleden met specifieke verantwoordelijkheden, Tasks vertegenwoordigen de concrete taken die moeten worden uitgevoerd, Process bepaalt de uitvoeringswijze van Agent en taken, en Crew organiseert deze Agent en taken samen om het einddoel te bereiken.
Bijvoorbeeld kan voor het produceren van een sectorrapport een onderzoeks-Agent, een schrijf-Agent en een controle-Agent worden gemaakt. De onderzoeks-Agent is verantwoordelijk voor het vinden en organiseren van materiaal, de schrijf-Agent genereert het rapport op basis van de onderzoeksresultaten, en de controle-Agent controleert op problemen in het rapport. Verschillende Agent nemen verschillende verantwoordelijkheden op zich en werken samen via de koppeling van taken.
Flows kunnen taken organiseren volgens een voorgedefinieerd proces en capaciteiten zoals voorwaardelijke controle, lussen en statusbeheer ondersteunen. Crews en Flows kunnen ook worden gecombineerd; bijvoorbeeld kan een Flow het algemene bedrijfsproces sturen en in een complexe stap een Crew aanroepen, waarbij meerdere Agent samenwerken om de taak te voltooien.
Het kenmerk van CrewAI is dat het multi-Agent-samenwerking organiseert via rollen, taken en teams, met een algemeen ontwerp dat lijkt op echte teamwerk. Het is bijzonder geschikt voor multi-Agent-toepassingen met duidelijke rol- en taakgrenzen, zoals onderzoek, inhoudscreatie, data-analyse en controlescenario's.
LangGraph-framework
LangGraph werd in 2024 uitgebracht door het LangChain-team en is een orkestratieframework op laag niveau voor het bouwen en beheren van langlopende, toestandsbeheerde Agent. In tegenstelling tot het gebruik van voorgebouwde Agent stelt het ontwikkelaars in staat de uitvoeringsstructuur van Agent expliciet te definiëren en is het bijzonder geschikt voor Agent met complexe workflows zoals toestand, vertakking, lus en menselijke tussenkomst.
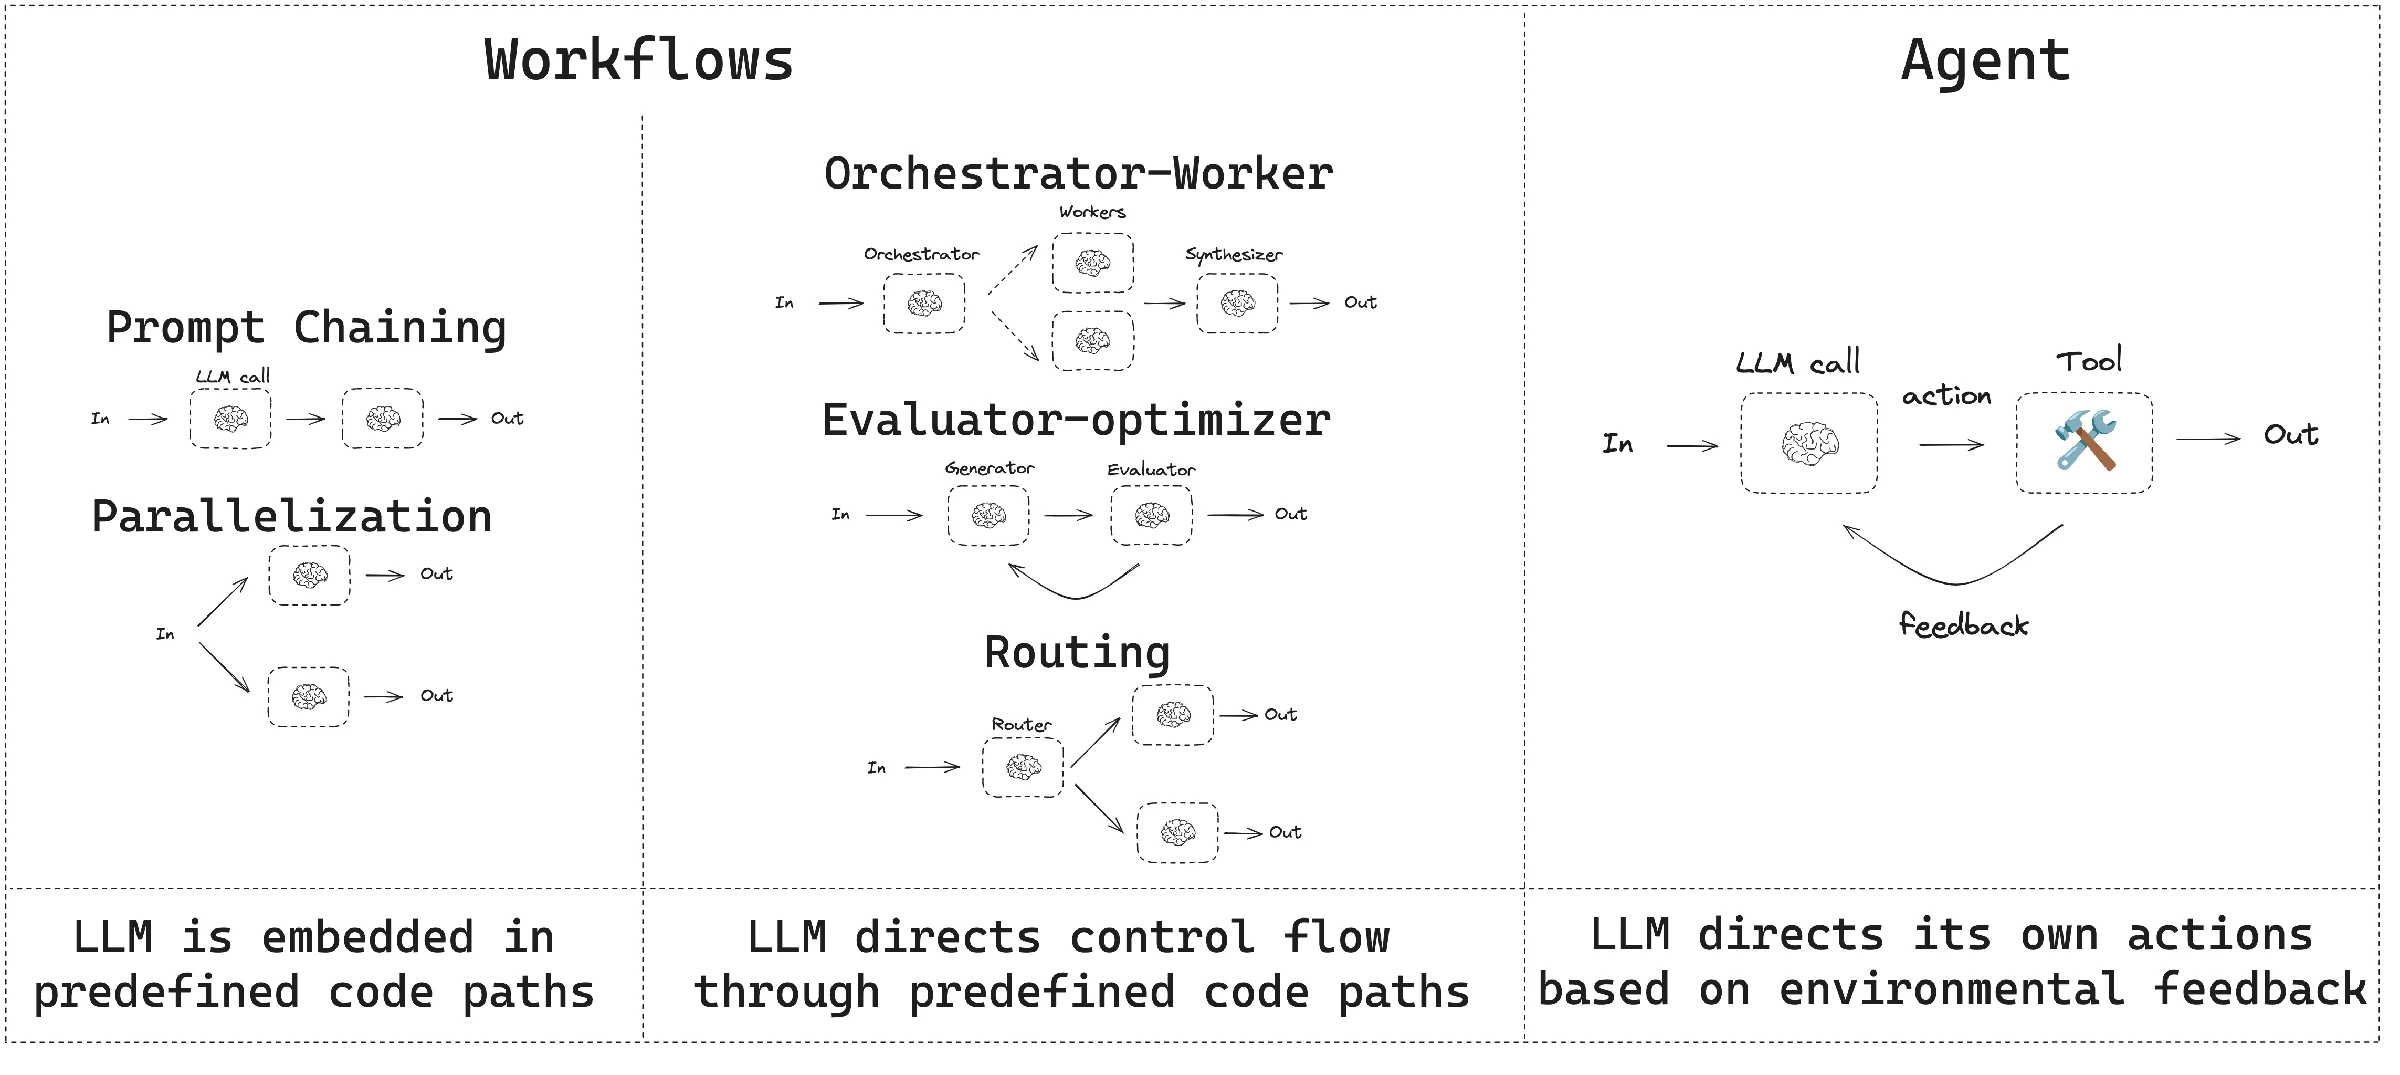
LangGraph kan zowel workflows met relatief duidelijke uitvoeringspaden bouwen als Agent die dynamisch door het Large-Language-Model worden bepaald. Workflows kunnen het uitvoeringspad van taken vooraf definiëren en verschillende stappen organiseren via sequentiële, parallelle, routerings- en lusmethoden; Agent kunnen de volgende handeling dynamisch bepalen op basis van de huidige toestand en toolresultaten. In de praktijk kunnen workflows en Agent ook worden gecombineerd, waarbij het workflow het algemene proces bepaalt en de Agent verantwoordelijk is voor de stappen die dynamische beslissingen vereisen.
De door LangGraph ondersteunde workflow- en Agent-modi zijn hieronder weergegeven.
Om deze verschillende uitvoeringspaden te realiseren, gebruikt LangGraph grafen om het uitvoeringsproces van taken te beschrijven, waarbij drie basisconcepten State, Node en Edge zijn. State dient om informatie op te slaan die tijdens de taakuitvoering moet worden gedeeld; Node vertegenwoordigt een concrete verwerkingsstap, zoals een Large-Language-Model aanroepen, kennis zoeken of een tool uitvoeren; Edge verbindt verschillende knooppunten en bepaalt in welk knooppunt de taak hierna terechtkomt.
Bijvoorbeeld kan een kennis-vraag-en-antwoord-Agent eerst de vraag van de gebruiker analyseren, vervolgens kennis zoeken, een antwoord genereren en het resultaat controleren. Als het antwoord de controle niet doorstaat, kan het via een voorwaardelijke vertakking opnieuw het zoekknooppunt binnengaan; als het wel doorstaat, gaat het naar het einduitvoerknooppunt. Gedurende het hele proces kunnen gebruikersvragen, zoekresultaten, tussenantwoorden en andere informatie worden opgeslagen in State en worden gedeeld tussen verschillende knooppunten.
Dit ontwerp verschilt van de volledige afhankelijkheid van het Large-Language-Model om de volgende handeling te bepalen. LangGraph staat toe dat de globale uitvoeringsstructuur van taken vooraf wordt voorgeschreven en Large-Language-Modellen worden gebruikt voor besluitvorming in knooppunten die beoordeling vereisen. Op deze manier blijft het vermogen van de Agent om dynamisch te beoordelen op basis van de werkelijke omstandigheden behouden en kan het kritieke uitvoeringspad worden gecontroleerd.
Naast graafstructuur en statusbeheer biedt LangGraph ook capaciteiten zoals Durable Execution en Human-in-the-loop. Langlopende taken kunnen de uitvoeringstoestand opslaan en na onderbreking doorgaan; voor belangrijke handelingen kan de Agent ook worden gepauzeerd om te wachten op handmatige controle of wijziging van toestand voordat de uitvoering wordt hervat. Daarom positioneert de officiële documentatie van LangGraph het als een orkestratieframework op laag niveau voor langlopende, toestandsbeheerde Agent.
LangGraph kan de toestand en het uitvoeringspad fijnmazig beheersen, maar vereist ook meer workflowontwerp van ontwikkelaars. Voor eenvoudige tool-aanroep-Agent is het niet nodig om vanaf het begin complexe grafen te bouwen. De officiële documentatie van LangGraph beveelt ook aan dat beginners die beginnen met het leren over Agent of een hogere Agentabstractie nodig hebben, eerst beginnen met Agent van LangChain.
MS-Agent-framework
MS-Agent is een lichtgewicht Agent-ontwikkelingsframework van de ModelScope-gemeenschap, voornamelijk gericht op taken die autonoom verkennen en meerstapuitvoering vereisen, en biedt modelaanroepen, toolintegratie en multi-Agent-samenwerking, en kan worden gebruikt om diep onderzoek, documentanalyse en codegeneratie-toepassingen te bouwen.
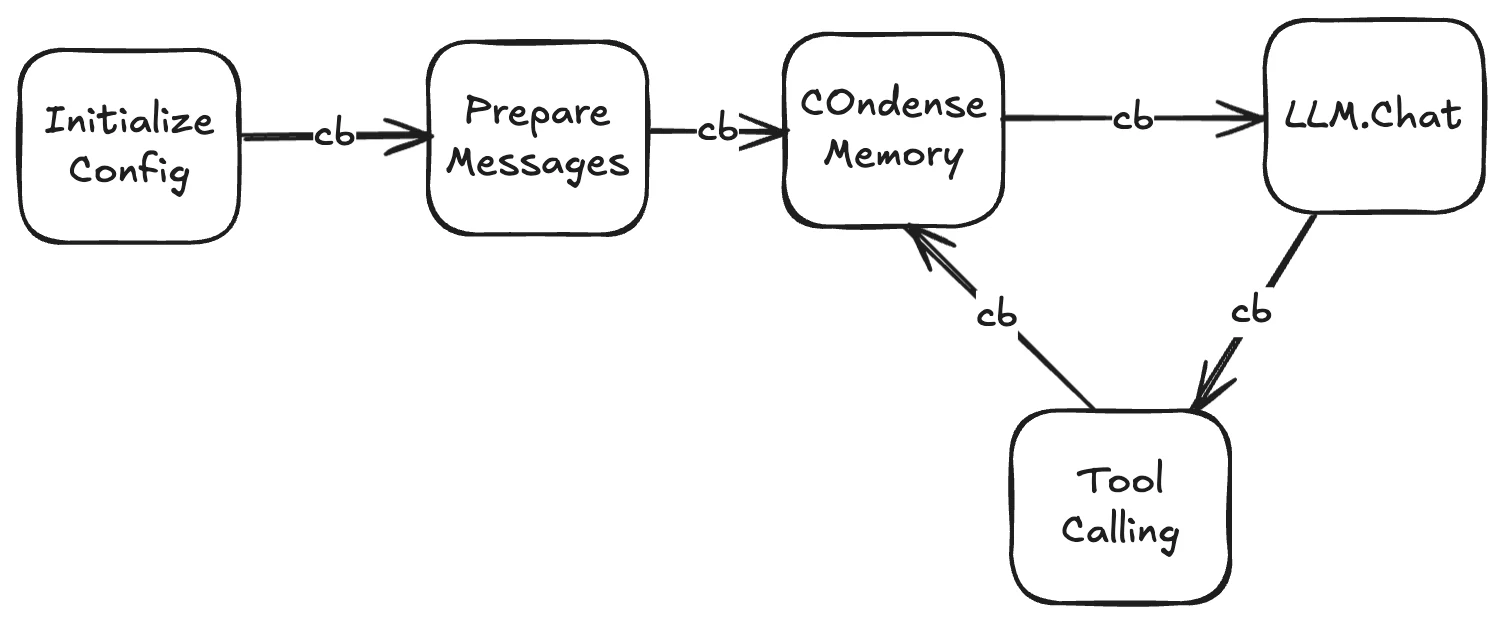
De basiscomponent van MS-Agent is LLMAgent, verantwoordelijk voor het organiseren van Large-Language-Model-dialogen en toolaanroepen. Ontwikkelaars kunnen het model, prompts en tools specificeren via configuratiebestanden. Na ontvangst van de taak van de gebruiker verschaft LLMAgent de taak en de beschikbare tools aan het Large-Language-Model, dat de volgende handeling bepaalt. Als een toolaanroep nodig is, voert het framework de bijbehorende handeling uit en retourneert het resultaat aan het model voor verdere verwerking, totdat het model een antwoord genereert dat geen toolaanroepen meer bevat of het maximale aantal uitvoeringsrondes bereikt.
Het basisuitvoeringsproces van LLMAgent is hieronder weergegeven. Na voltooiing van de configuratie-initialisatie en voorbereiding van berichten, wisselt de Agent tussen modelaanroep en tenuitvoerlegging van tools en comprimeert indien nodig de context. De cb in het diagram staat voor callback; ontwikkelaars kunnen op de bijbehorende plaatsen logging of andere aangepaste verwerking toevoegen.
Toolintegratie is een belangrijk vermogen van MS-Agent. Het framework biedt ingebouwde tools zoals bestanden lezen/schrijven, code uitvoeren en taken splitsen, en ondersteunt ook de integratie van externe tools via MCP (Model Context Protocol). Ontwikkelaars kunnen bestaande MCP-diensten hergebruiken of aangepaste tools schrijven, waardoor Agent toegang krijgen tot de benodigde gegevens en externe systemen.
Voor taken die meerdere stappen vereisen, ondersteunt MS-Agent de combinatie van verschillende Agent via workflows. LLMAgent is verantwoordelijk voor stappen die Large-Language-Modelbeslissingen en -generatie vereisen, terwijl CodeAgent verantwoordelijk is voor deterministische handelingen van code-uitvoering. Ontwikkelaars kunnen gegevensanalyse, gegevensverwerking en resultaatsgeneratie organiseren in een workflow en de uitvoeringsrelatie van de individuele stappen specificeren via configuratiebestanden.
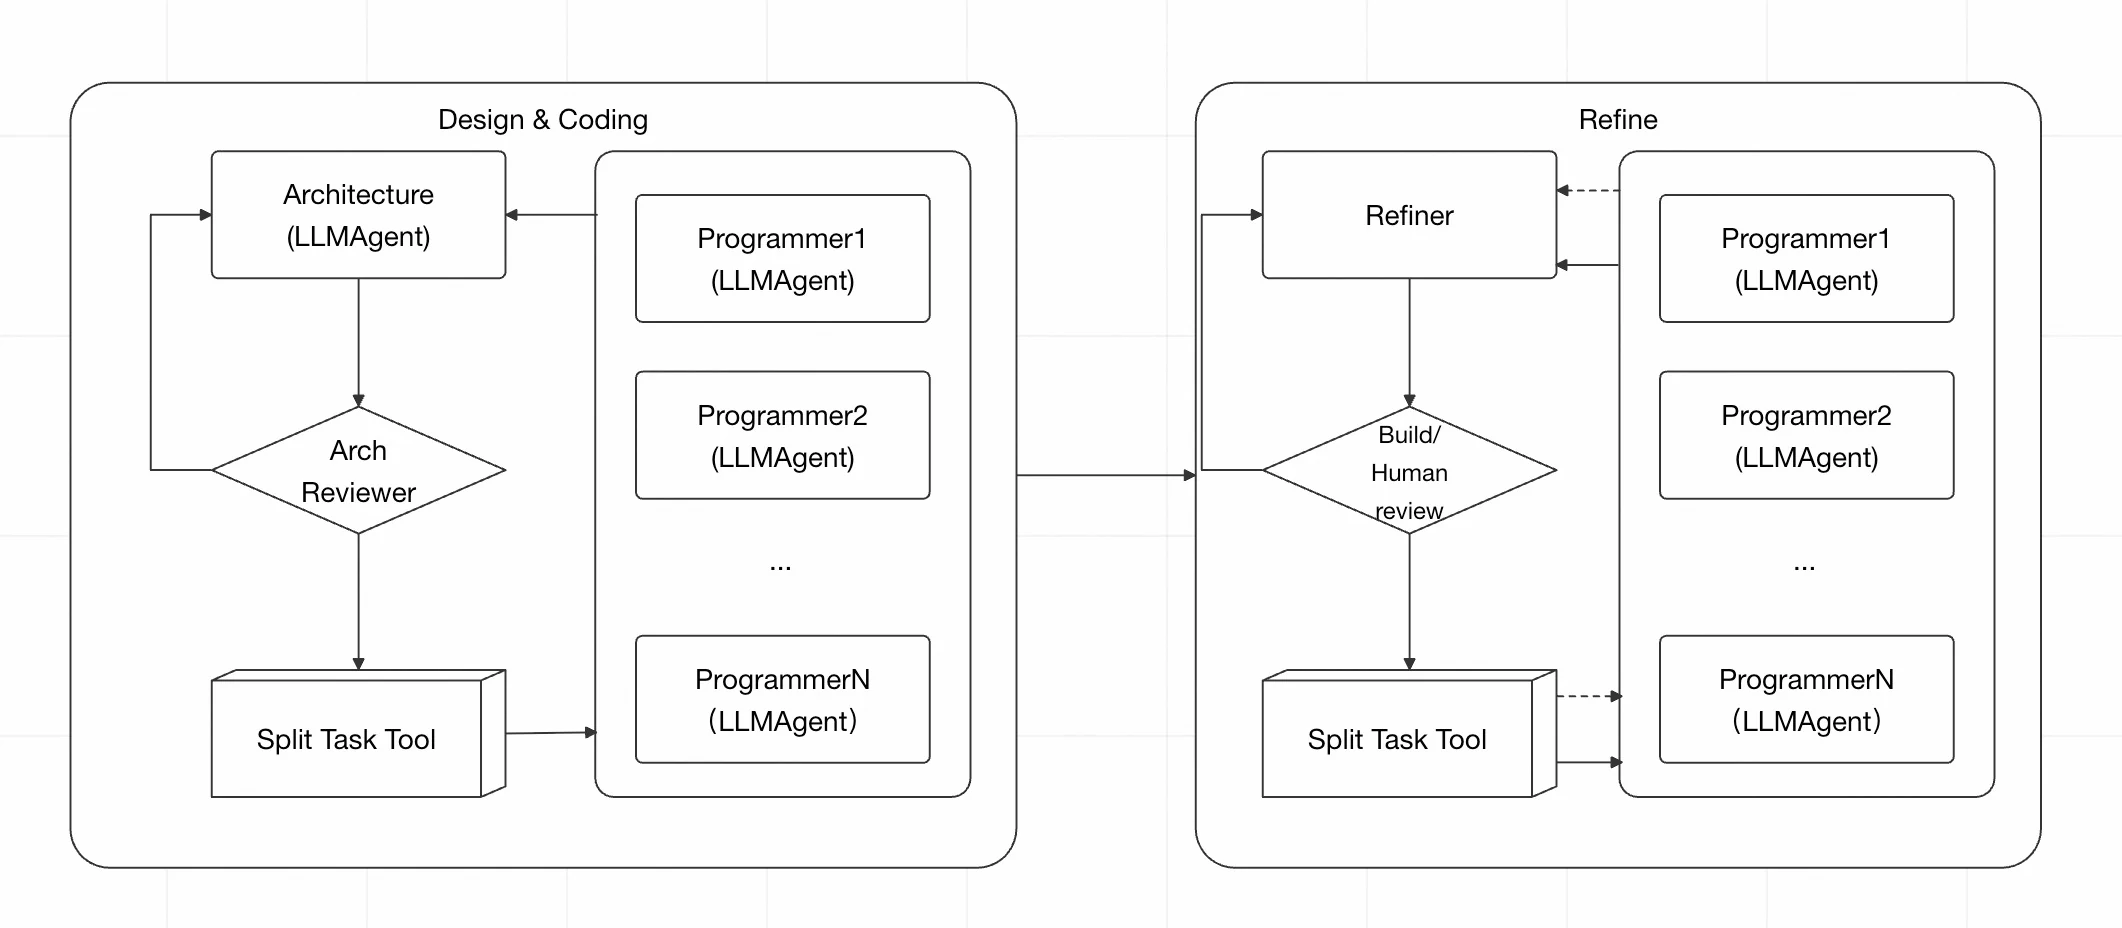
Bijvoorbeeld biedt het MS-Agent-project Code Genesis een voorbeeld van multi-Agent-samenwerking voor codegeneratie, waarbij het proces wordt opgesplitst in twee delen: ontwerp en codering, controle en optimalisatie. De architectuur-Agent is verantwoordelijk voor het ontwerp en het taaksplitsingsgereedschap verdeelt het werk over meerdere programmeer-Agent; bij overgang naar de optimalisatiefase worden wijzigingstaken verdeeld op basis van feedback van bouw- of handmatige controles en verder verwerkt door programmeer-Agent.
Agent SDK
Naast het gebruik van Agent-ontwikkelingsframeworks bieden ook enkele modelaanbieders Agent-ontwikkelingsmogelijkheden in de vorm van SDK's (Software Development Kit), waarbij modelaanroepen, toolaanroepen en taakuitvoering worden ingepakt in interfaces, klassen en componenten, waardoor ontwikkelaars worden geholpen om Agent in hun toepassingen te maken en uit te voeren. Zowel Agent-frameworks als Agent-SDK's kunnen worden gebruikt om Agent te bouwen en bieden overlappende mogelijkheden, maar verschillen in organisatie en focus. Hierna worden twee representatieve Agent-SDK's gepresenteerd.
OpenAI Agents SDK
OpenAI bracht in 2025 het OpenAI Agents SDK uit, dat het bouwen van Agent-toepassingen met weinig kernabstracties benadrukt. Met Agent als basisuitvoereenheid worden toolaanroepen, taakoverdracht, uitvoeringsbeperkingen en uitvoeringstracering rond Agent geboden. Tools dienen om gegevens op te halen, code uit te voeren, API's aan te roepen of andere externe systemen te bedienen; Handoffs stellen de huidige Agent in staat om taken over te dragen aan een andere Agent die meer geschikt is om de taak te verwerken; Guardrails controleren invoer, uitvoering en gedeeltelijk toolaanroepen van Agent; en Tracing legt modelgeneratie, toolaanroepen, taakoverdrachten en Guardrail-evenementen vast tijdens de Agent-uitvoering.
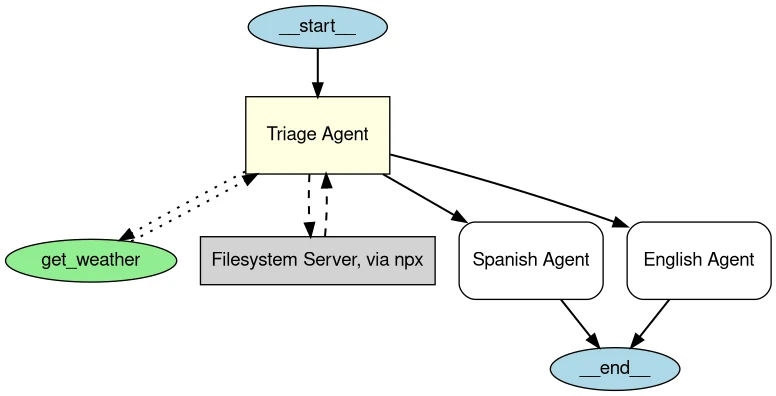
Het OpenAI Agents SDK biedt ook Agent Visualization, waarmee een graafstructuur kan worden gegenereerd voor de Agent en de ermee verbonden andere Agent, Tools en MCP Server. De gerichte verbindingen tussen Agent kunnen Handoffs weergeven, terwijl verbindingen tussen Tools en Agent toolaanroepen weergeven.
Bijvoorbeeld kan in een klantenservicessysteem een toegangs-Agent worden opgezet die vragen van gebruikers identificeert, en vervolgens order-, terugbetalings- en FAQ-Agent die verschillende bedrijfstypen verwerken. Wanneer een gebruiker een terugbetalingsvraag stelt, kan de toegangs-Agent de taak overdragen aan de terugbetalings-Agent via Handoff; de terugbetalings-Agent roept dan indien nodig tools aan voor orderconsultatie, terugbetalingsaanvraag, enz. om de taak te voltooien. Handoffs zijn bijzonder geschikt voor scenario's waarin verschillende gespecialiseerde Agent verschillende taken verwerken.
Guardrails en Tracing houden rekening met beperkingen en observatieproblemen tijdens de daadwerkelijke Agent-uitvoering. Guardrails kunnen controleren voor en na Agent-invoer, einduitvoering en aangepaste functietoolaanroepen; Tracing legt modelgeneratie, toolaanroepen, Handoffs en Guardrail-evenementen vast tijdens een Agent-uitvoering, waardoor ontwikkelaars helpen te begrijpen welke stappen de Agent heeft doorlopen en waar de problemen zich hebben voorgedaan.
Het kenmerk van het OpenAI Agents SDK is dat de kernconcepten relatief geconcentreerd zijn. Ontwikkelaars kunnen beginnen met een enkele Agent en Tools en geleidelijk multi-Agent-samenwerking, Guardrails en Tracing toevoegen. In vergelijking met LangGraph ligt de focus van de twee ontwerpen anders: LangGraph benadrukt fijnmazige controle over toestand en workflow; het OpenAI Agents SDK richt zich op uitgebreide mogelijkheden rond Agent zoals toolaanroepen, taakoverdracht, uitvoeringsbeperkingen en uitvoeringstracering.
Claude Agent SDK
Het Claude Agent SDK is een door Anthropic uitgebracht Agent-ontwikkelings-SDK, oorspronkelijk Claude Code SDK genaamd en later hernoemd tot Claude Agent SDK. Het stelt de Agent-mogelijkheden van Claude Code ter beschikking aan ontwikkelaars, waardoor ze in hun toepassingen Agent kunnen bouwen die tools kunnen gebruiken, toegang tot de uitvoeringsomgeving kunnen krijgen en taken continu kunnen uitvoeren.
In vergelijking met de eerder gepresenteerde Agent-ontwikkelingstools onderscheidt het Claude Agent SDK zich door een nadrukkelijkere focus op de toegang en werking van de Agent tot de daadwerkelijke uitvoeringsomgeving. Naast het aanroepen van externe tools biedt het ingebouwde mogelijkheden zoals lezen, wijzigen van bestanden en uitvoeren van opdrachten, waardoor Agent direct bestanden kunnen verwerken, programma's en opdrachten kunnen uitvoeren, en via MCP meer externe tools en gegevens kunnen koppelen. Bovendien biedt het mechanismen zoals machtigingscontrole, Hooks en Subagents; machtigingscontrole beperkt de handelingen die Agent kunnen uitvoeren; Hooks kunnen aangepaste verwerkingslogica invoegen in kritieke fasen zoals toolaanroepen; Subagents kunnen deeltaken overdragen aan onafhankelijke sub-Agent.
Tijdens de uitvoering beslist de Agent op basis van de huidige taak en context over de volgende handeling, zoals bestanden lezen, code wijzigen of opdrachten uitvoeren. Na tenuitvoerlegging van de tool worden de resultaten geretourneerd aan de Agent, die vervolgens doorgaat met beoordelen op basis van de nieuwe informatie totdat de taak is voltooid. Het Claude Agent SDK organiseert dit uitvoeringsproces en handelt daarin toolaanroepen, machtigingscontroles en contextoverdracht.
Bijvoorbeeld kan bij een softwareontwikkelingstaak aan de Agent worden gevraagd om de projectcode te lezen, bestanden aan te passen aan de eisen van de gebruiker en vervolgens tests uit te voeren. Als een test mislukt, kan de Agent foutinformatie lezen en doorgaan met aanpassen totdat de taak is voltooid. In dit proces is het Large-Language-Model verantwoordelijk voor het begrijpen van de taak en het nemen van de volgende beslissing, terwijl het Claude Agent SDK uitvoeringsmogelijkheden biedt zoals bestandssysteem, terminal en tools, en machtigingen en het taakuitvoeringsproces beheert.
Het Claude Agent SDK is bijzonder geschikt voor Agent-toepassingen die toegang tot bestanden en uitvoeringsomgeving vereisen, continue toolaanroepen en uitvoering van taken in meerdere stappen, met name voor scenario's zoals softwareontwikkeling en automatiseringstaken.
In de praktische Agent-ontwikkeling worden capaciteiten zoals uitvoeringsomgeving, contextbeheer, machtigingscontrole, taakstatus en uitvoeringsfeedback steeds meer gewaardeerd. Hoe deze capaciteiten rond het Large-Language-Model moeten worden georganiseerd en het taakuitvoeringsproces moet worden beheerd en gecontroleerd, is een belangrijk vraagstuk geworden in het ontwerp van Agent-systemen, en daarop richt het Harness zich.
Harness
Wat is een Harness?
Naarmate de mogelijkheden van Large-Language-Modellen toenemen, verschuift het probleem waarmee Agent worden geconfronteerd geleidelijk van "kan het model een bepaalde taak uitvoeren?" naar "kan het model een echte taak continu en betrouwbaar uitvoeren?". Bij een eenvoudige vraag-en-antwoord moet het Large-Language-Model alleen een resultaat genereren op basis van de invoer; maar bij complexe taken zoals softwareontwikkeling, data-analyse en bedrijfsautomatisering moet de Agent mogelijk langdurig werken, voortgang opslaan tussen meerdere stappen, verschillende tools aanroepen en op basis van de werkelijke uitvoeringsresultaten voortdurend volgende handelingen aanpassen. In dergelijke gevallen kan alleen vertrouwen op het redeneervermogen van het model niet garanderen dat de taak uiteindelijk correct wordt afgerond.
Bijvoorbeeld kan een code-Agent de eis "wijs een bepaalde functionaliteit aan" correct begrijpen en ook code van hoge kwaliteit genereren, maar tijdens het werkelijke uitvoeringsproces kunnen verschillende problemen optreden: code wijzigen zonder de projectspecificaties te lezen, tegelijkertijd te veel bestanden wijzigen, noodzakelijke stappen overslaan, eerdere taakvoortgang verliezen tijdens de uitvoering, of de taak als voltooid beschouwen voordat de code de tests doorstaat. Deze problemen komen niet volledig uit de vaardigheden van het model zelf, maar hebben betrekking op de werkomgeving van het model en de manier van taakuitvoering.
Harness is een werkomgeving en uitvoeringsmechanisme dat rond het Large-Language-Model is opgebouwd, om te bepalen welke informatie het model kan ontvangen, welke handelingen het kan uitvoeren, hoe de taakstatus moet worden opgeslagen, hoe moet worden bepaald of de taak is voltooid en hoe moet worden verwerkt wanneer zich problemen voordoen. Door deze mechanismen kunnen de eenmalige onafhankelijke redeneringen en handelingen van het model worden georganiseerd tot een beperkt, continu uit te voeren en resultaatverifieerbaar taakuitvoeringsproces.
De focus van Harness ligt niet op het verder verbeteren van de kennis of het redeneervermogen van het Large-Language-Model, maar op het waarborgen dat de bestaande mogelijkheden van het model betrouwbaarser kunnen worden toegepast op echte taken. Het model blijft verantwoordelijk voor het begrijpen van de taak, het analyseren van problemen en het nemen van de volgende beslissing; Harness is verantwoordelijk voor het scheppen van de werkvoorwaarden die het model nodig heeft om de taak te voltooien, en legt beperkingen en feedback op over het gehele uitvoeringsproces.
Vanuit het oogpunt van uitvoering vormt Harness een continue lus voor de Agent: de Agent beoordeelt op basis van de huidige taak en toestand, voert de bijbehorende handeling uit en verkrijgt nieuwe resultaten uit de uitvoeringsomgeving; deze resultaten worden na registratie, verificatie en feedback opnieuw de basis voor de volgende beslissing. Als de resultaten niet aan de vereisten voldoen, blijft de Agent aanpassen en uitvoeren; pas wanneer de vooraf gedefinieerde voltooiingsvoorwaarden zijn bereikt, is de taak echt afgerond.
Harness onderscheidt zich duidelijk van eenvoudige prompts of toolaanroepen. Prompt communiceert het model voornamelijk via instructies over de taakdoelen en gedragsvereisten; tools stellen het model in staat om concrete handelingen uit te voeren; en Harness beschouwt bovendien hoe deze instructies en tools gedurende het gehele taakuitvoeringsproces worden georganiseerd en beheerd. Het moet de Agent doen weten waar hij begint, waar hij zich momenteel bevindt, welke handelingen kunnen worden uitgevoerd, hoe resultaten worden geverifieerd, wanneer hij kan eindigen en hoe na een taakonderbreking kan worden doorgegaan. Voor Agent die langdurig moeten worden uitgevoerd en meerstapuitvoeringen moeten verrichten, beïnvloeden deze mechanismen direct of de taak stabiel kan worden voltooid.
Hoofdcomponenten van het Harness
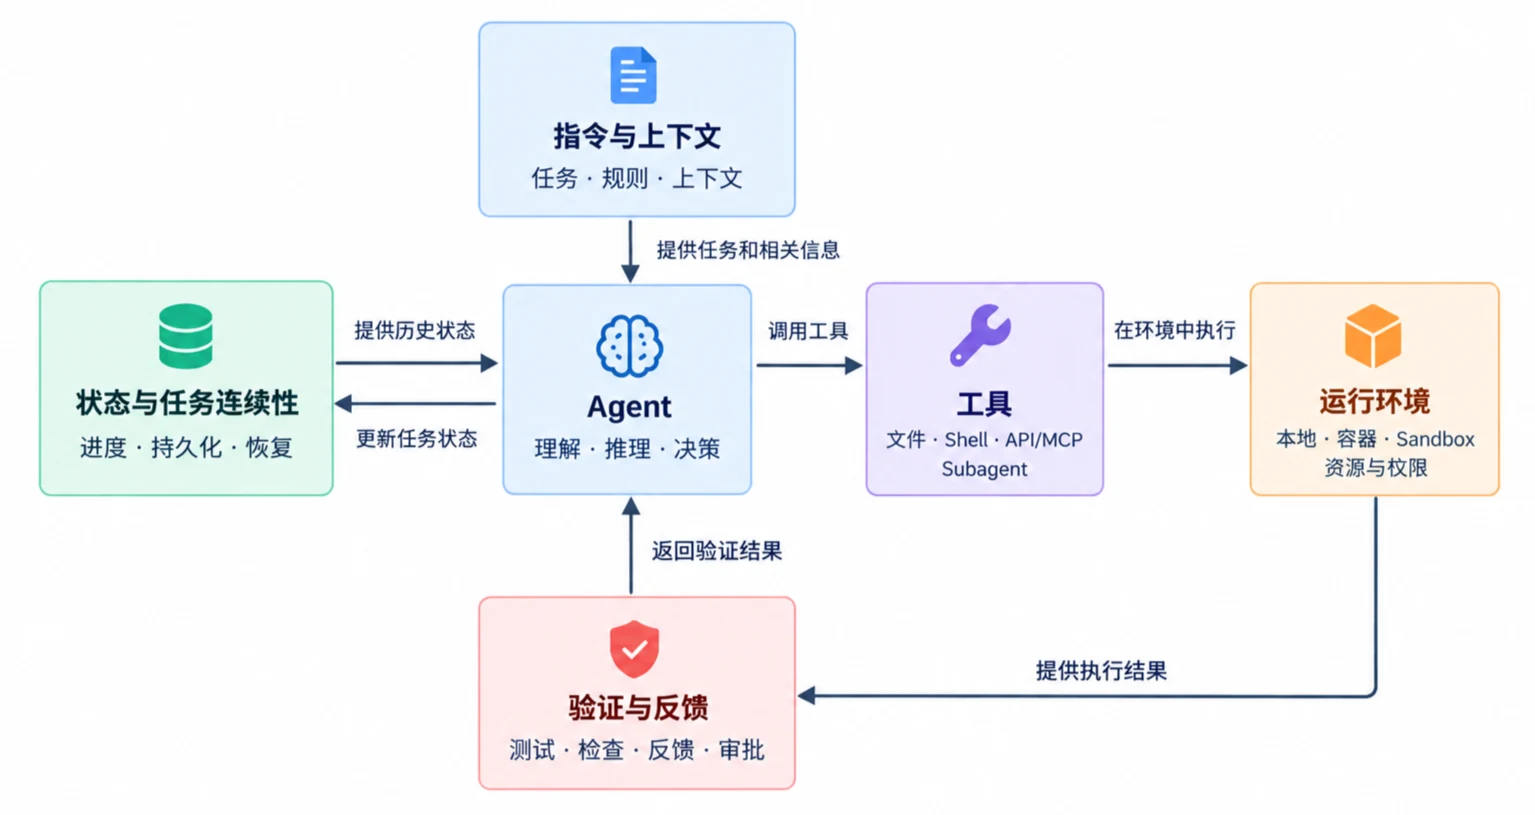
Harness heeft geen eenvoudige implementatie; verschillende Agent-systemen bieden verschillende uitvoeringsmechanismen afhankelijk van het taaktype. Vanuit het oogpunt van de problemen die tijdens de daadwerkelijke Agent-uitvoering moeten worden opgelost, kan Harness worden samengevat in vijf samenwerkende delen: instructies en context, tools, uitvoeringsomgeving, toestand en taakcontinueïteit, en verificatie en feedback.
(1) Instructies en context
Instructies en context bepalen wat een Agent in de huidige taak "weet" en "moet volgen".
Instructies omvatten niet alleen de huidige invoer van de gebruiker, maar ook systeem-prompts, projectregels, codestandaarden, bedrijfsbeperkingen, taakgrenzen en voltooiingsvoorwaarden. Bijvoorbeeld kan een programmeer-Agent de directorystructuur, ontwikkelingsstandaarden, testmethoden en geblokkeerde gebieden begrijpen via AGENTS.md, CLAUDE.md of projectdocumentatie.
Context verwijst naar relevante informatie die tijdens de uitvoering aan het model wordt verstrekt, waaronder gebruikerseisen, eerdere handelingen, bestandsinhoud, tooluitvoeringsresultaten en huidige taakstatus. Aangezien het modelcontextvenster beperkt is, moet Harness de context vaak selecteren, comprimeren en herorganiseren, zodat het model de informatie ontvangt die werkelijk nodig is voor de huidige taak, in plaats van eenvoudig de volledige geschiedenis continu toe te voegen.
Voor complexe taken kunnen hiërarchische instructies en progressieve contextlading worden gebruikt. Bijvoorbeeld kan de Agent eerst de algemene projectbeschrijving lezen en bij betreding van een module de lokale regels van die module laden; wanneer de taakuitvoering lang duurt en de context continu toeneemt, kunnen eerdere processen worden gecomprimeerd, waarbij alleen conclusies, taakstatus en informatie die nog nodig is voor de toekomst worden bewaard. Door deze mechanismen kan in het beperkte contextvenster continu relevante informatie voor de Agent worden verstrekt en kan het taakbereik en de gedragsgrenzen van de Agent via instructies worden beperkt.
(2) Tools
Large-Language-Modellen zijn voornamelijk verantwoordelijk voor begrijpen, redeneren en beslissingen genereren. Om daadwerkelijk externe informatie te lezen of concrete handelingen uit te voeren, moeten tools worden gebruikt. Tools bepalen dus welke handelingen een Agent daadwerkelijk kan uitvoeren.
Voor programmeer-Agent behoren tot de veelgebruikte tools bestanden lezen, bestanden wijzigen, code zoeken, Shell-opdrachten uitvoeren, Git-bewerkingen en testtools; voor bedrijfs-AGENT kunnen dat databaseconsultatie, kennisbankconsultatie, browser, bedrijfs-API's en externe systemen die via MCP zijn aangesloten.
Harness moet op dit niveau niet alleen een toollijst onderhouden, maar ook toolbeschrijvingen, parameterorganisatie, aanroep-routing, retourneren van uitvoeringsresultaten en uitzonderingsverwerking verwerken. Bijvoorbeeld moet Harness na het Large-Language-Modelbesluit "projecttests uitvoeren" de bijbehorende tool aanroepen, de testopdracht in de opgegeven omgeving uitvoeren en vervolgens standaarduitvoer, foutinformatie en exit-status gesorteerd aan het model retourneren, zodat de Agent op basis van de uitvoeringsresultaten de volgende handeling kan bepalen.
Toolaanroepen moeten worden gecoördineerd met passende beveiligings- en machtigingscontroles. Sommige tools kunnen alleen bestanden lezen, andere mogen inhoud wijzigen; bij het verwijderen van bestanden, toegang tot het netwerk, uitvoeren van systeemopdrachten of bedienen van productiesystemen kunnen beperkingen worden opgelegd op basis van risiconiveau, en indien nodig handmatige bevestigingen worden gevraagd. Hooks en andere mechanismen kunnen voor en na toolaanroepen worden ingevoegd om parameters te controleren, uitvoeringsprocessen te registreren of niet-regelconforme handelingen te blokkeren.
In systemen die Agent ondersteunen, kan de hoofd-Agent ook deeltaken overdragen aan gespecialiseerde Subagents. Bijvoorbeeld kunnen relatief onafhankelijke taken zoals cod zoeken, testanalyse of materiaalorganisatie worden verdeeld over verschillende Subagents en hun resultaten worden geconsolideerd. Op deze manier kan het taakverwerkingsvermogen van een enkele Agent worden uitgebreid en de druk van complexe taken in een enkel uitvoeringscontext worden verminderd.
(3) Uitvoeringsomgeving
Tools beantwoorden de vraag "wat kan een Agent doen?"; de uitvoeringsomgeving bepaalt "waar deze handelingen plaatsvinden".
Voor programmeer-Agent kan de uitvoeringsomgeving een lokaal projectdirectory, een container, een virtuele machine, een Sandbox in de cloud of een afzonderlijke Git Worktree zijn. De Agent moet een concrete uitvoeringsomgeving gebruiken om bestanden te lezen en te wijzigen, Shell-opdrachten uit te voeren, afhankelijkheden te installeren en tests uit te voeren.
Harness moet de uitvoeringsomgeving voorbereiden en beheren, zoals initialisatie van code-opslagplaatsen, installatie van afhankelijkheden, instelling van omgevingsvariabelen, start van noodzakelijke diensten en controle of de huidige omgeving aan de voorwaarden voor taakuitvoering voldoet. Voor langlopende taken moet ook worden voorkomen dat tijdens de uitvoering afhankelijkheidsgebreken, dienstanomalieën of inconsistenties in de hulpbronnenstatus optreden.
Omgevingsisolatie is ook een belangrijk onderdeel van het beheer van de uitvoeringsomgeving. Als meerdere Agent of meerdere taken tegelijkertijd hetzelfde project verwerken, kunnen directe bewerkingen in dezelfde werkdirectory leiden tot bestandsoverschrijvingen en toestandsconflicten. Voor verschillende taken kunnen onafhankelijke Sandboxes, containers of Worktrees worden aangemaakt, zodat verschillende taken in relatief geïsoleerde ruimtes draaien. Zelfs als een taak mislukt, kan de impact op andere taken en de gastomgeving worden verminderd.
De uitvoeringsomgeving neemt ook de controle van de toegangsgrenzen van hulpbronnen over. Bijvoorbeeld kan worden beperkt dat de Agent alleen toegang heeft tot gespecificeerde directories, alleen verbinding kan maken met specifieke netwerken, geen gevoelige systeembestanden kan lezen of voor verschillende taken verschillende toegangscertificaten kan configureren. Tools definiëren welke mogelijkheden een Agent kan gebruiken; de uitvoeringsomgeving beperkt op welke bestanden, processen, netwerken en systeemhulpbronnen deze mogelijkheden daadwerkelijk van toepassing kunnen zijn.
(4) Toestand en taakcontinueïteit
Een enkele Large-Language-Modeloproep heeft van zichzelf geen langetermijntaaktoestand, maar complexe Agent-taken kunnen minuten, uren of zelfs meerdere sessies duren. Als taakinformatie alleen in de huidige context bestaat, kan na comprimering van de context, onderbreking van het proces of herstart van de sessie de Agent mogelijk niet nauwkeurig beoordelen welke werkzaamheden al zijn voltooid.
Harness moet de taakstatus onderhouden, zoals huidig doel, taaksplitsingsresultaat, voltooide stappen, momenteel verwerkte stappen, gewijzigde bestanden, belangrijke tooluitvoeringsresultaten en de inhoud die hierna moet worden verwerkt.
Deze toestanden kunnen in het geheugen worden opgeslagen of worden weggeschreven naar taakbestanden, databases, Git-geschiedenis of andere externe opslagplaatsen. Voor langlopende Agent is persistente toestandsopslag bijzonder belangrijk. Nieuwe Agent-sessies kunnen de eerder opgeslagen taakvoortgang en kernresultaten lezen en doorgaan vanaf het vorige onderbrekingspunt, zonder de gehele taak opnieuw te hoeven analyseren.
Toestandsbeheer doordringt de gehele levenscyclus van de taak. Aan het begin van de taak wordt een begintoestand ingesteld; tijdens de uitvoering worden voortgang en kernresultaten continu geregistreerd; na voltooiing van de taak wordt de eindtoestand opgeslagen; als de taak wordt onderbroken vanwege anomalieën, time-outs of systeemherstart, kan via checkpoint-mechanismen worden teruggekeerd naar de vorige uitvoeringspositie. Voor complexe taken met Subagent kunnen voltooiingsstatus, uitvoeringsresultaten en afhankelijkheden tussen verschillende subtaken worden geregistreerd.
De focus van toestand en taakcontinueïteit is het onderhouden van een continu bij te werken, persistent en herstelbaar taakuitvoeringsproces, zodat de Agent, zelfs bij langlopende of oversijdelijke sessieuitvoering, weet waar de taak staat.
(5) Verificatie en feedback
Wanneer een Agent een handeling uitvoert, betekent dat niet dat de taak correct is voltooid. Bijvoorbeeld heeft het Agent een bestand met succes gewijzigd, maar de code compileert mogelijk niet; een analyserapport is gegenereerd, maar het mist mogelijk belangrijke gegevens; een bedrijfsoproep is gelukt, maar kan een resultaat opleveren dat niet voldoet aan de bedrijfsregels. Daarom moet Harness ook mechanismen voor verificatie en feedback opzetten, de uitvoeringsresultaten controleren en de verificatieresultaten opnieuw aan de Agent verstrekken.
De verificatiemethode hangt af van de specifieke taak. Voor softwareontwikkelingstaken kunnen eenheidstests, Lint, typecontrole, compilatie en eind-tot-eindtests worden gebruikt; voor bedrijfstaken kunnen bedrijfsregelcontroles, resultaatvergelijkingen of onafhankelijke beoordelaars worden ingezet. De kern van verificatie is het verstrekken van een verifieerbare basis voor taakvoltooiing, in plaats van alleen te vertrouwen op het oordeel van het model dat "de taak is voltooid".
Feedback verstrekt de verificatieresultaten opnieuw aan de Agent. Bijvoorbeeld kan Harness na een mislukte test foutinformatie en bijbehorende logs aan het model retourneren; de Agent analyseert op basis van deze informatie verder de oorzaak, wijzigt de code en test opnieuw, waardoor een lus "uitvoering → verificatie → feedback ontvangen → correctie → herverificatie" ontstaat. Zo'n lus stelt de Agent in staat om op basis van werkelijke uitvoeringsresultaten eerdere beslissingen continu te corrigeren, in plaats van de taak direct na een handeling te beëindigen.
Harness kan in dit proces ook uitvoeringscontroles invoegen. Bijvoorbeeld mag code alleen worden ingediend nadat alle tests zijn geslaagd; na meerdere opeenvolgende uitvoeringsfouten wordt de taak gestopt of overgedragen aan handmatige verwerking; bij betrokkenheid bij wijzigingen in productieomgevingen, verwijdering van gegevens en andere hoogrisicohandelingen, wordt de taak gepauzeerd voordat de daadwerkelijke uitvoering plaatsvindt en wordt handmatige goedkeuring gevraagd. Na bevestiging wordt de uitvoering hervat; zonder bevestiging wordt de handeling beëindigd of aangepast.
Deze vijf delen ondersteunen gezamenlijk de continue uitvoering van de Agent: instructies en context verstrekken taakdoelen, regels en noodzakelijke informatie; tools verstrekken daadwerkelijke actiemogelijkheden; uitvoeringsomgeving herbergt deze handelingen en beperkt hulpbronngrenzen; toestand en taakcontinueïteit registreren de taakvoortgang en ondersteunen herstel; verificatie en feedback controleren uitvoeringsresultaten en drijven de Agent aan om door te gaan met corrigeren of de taak te voltooien. Door deze mechanismen organiseert Harness de eenmalige modeloproepen van de Agent tot een volledig taakuitvoeringsproces dat continu kan worden uitgevoerd, beperkt en geverifieerd.
Relatie tussen Harness en Agent
Agent en Harness zijn geen twee concepten die elkaar vervangen, maar bevinden zich op verschillende niveaus. Tijdens de uitvoering van de Agent is het Large-Language-Model voornamelijk verantwoordelijk voor het begrijpen van de taak, het analyseren van huidige informatie en het nemen van de volgende handeling; Harness voorziet de Agent van instructies en context, tools, uitvoeringsomgeving, statusbeheer, verificatie en feedback, zodat de beslissingen van de Agent daadwerkelijk worden uitgevoerd en tijdens het uitvoeringsproces worden beperkt en geverifieerd.
De relatie tussen de twee is een "ondersteuning van besluitvorming en uitvoering". De Agent beoordeelt op basis van de huidige taak en beschikbare informatie wat er hierna moet gebeuren; Harness is verantwoordelijk voor het verstrekken van de tools en de omgeving om deze handeling uit te voeren, en registreert de tijdens het uitvoeringsproces ontstane toestanden en resultaten. Na voltooiing van de uitvoering kan Harness de resultaten verifiëren via tests, regelcontroles, enz. en het feedback aan de Agent geven. De Agent beoordeelt de volgende handeling op basis van de nieuwe toestand en feedback, en zo verder, totdat de voltooiingsvoorwaarden van de taak zijn bereikt.
Bijvoorbeeld beoordeelt een programmeer-Agent dat login.py moet worden gewijzigd en tests moeten worden uitgevoerd. De analyse van de code en de beslissing hoe te wijzigen zijn voornamelijk afhankelijk van de begrips- en redeneervermogens van het Large-Language-Model; maar of login.py mag worden gewijzigd, waar het bestand vandaan komt, met welke tool het wordt gewijzigd, in welke Sandbox de testopdracht wordt uitgevoerd, hoe de wijzigingsvoortgang wordt opgeslagen, hoe het testresultaat wordt geverifieerd en hoe na een fout wordt doorgegaan, vereist uitvoeringsmechanismen die door Harness worden verstrekt. Na een testfout worden foutinformatie opnieuw aan de Agent verstrekt, die op basis van deze informatie de oorzaak analyseert en het volgende wijzigingsplan bepaalt.
De volmaaktheid van Harness beïnvloedt de taaktypen die een Agent kan verwerken. Een eenvoudig Harness biedt mogelijk slechts weinig tools en een basisaanroepmechanisme, en is geschikt voor taken met weinig stappen; een uitgebreider Harness kan bovendien contextbeheer, omgevingsisolatie, persistente taakstatus, machtigingscontrole, automatische verificatie, herstel na fouten en handmatige goedwerkingsmechanismen bieden, waardoor Agent langere en complexe taken continu kunnen uitvoeren. Zelfs met hetzelfde Large-Language-Model kunnen de verschillende uitvoeringsvoorwaarden die verschillende Harness bieden, leiden tot aanzienlijke verschillen in het taakverwerkingsvermogen en de stabiliteit van de Agent bij complexe taken.
Er is zekere overlapping tussen Harness en Agent-frameworks; beide gaan over toolaanroepen, contextbeheer, statusbeheer en controle van taakuitvoering, maar de focus verschilt. Agent-frameworks richten zich meer op ontwikkelingsmogelijkheden voor Agent-bouw en taakorganisatie, zoals Agent-definitie, toolaanroepen, statusbeheer, workflow-orchestratie en multi-Agent-samenwerking; Harness richt zich meer op ondersteunings- en controlesystemen rond de Agent-uitvoering, zoals contextorganisatie, verstrekking van tools en uitvoeringsomgeving, handhaving van taakcontinueïteit en verificatie van uitvoeringsresultaten. Met de voortdurende ontwikkeling van Agent-frameworks en Agent-SDK's worden sommige Harness-mogelijkheden steeds meer geïntegreerd in frameworks of SDK's, zodat er in de praktische implementatie geen absolute functionele grenzen tussen de twee bestaan.
In het algemeen kan de relatie tussen de drie als volgt worden samengevat: Large-Language-Modellen leveren intelligentie, Agent organiseren besluitvorming, Harness waarborgt uitvoering.
Naarmate de complexiteit van de door Agent uitgevoerde taken toeneemt, wordt de rol van Harness duidelijker.
DeepSeek Harness
Hierna wordt aan de hand van het voorbeeld van DeepSeek Harness uitgelegd hoe Harness in werkelijke Agent-systemen wordt georganiseerd.
DeepSeek Harness is een door DeepSeek in 2026 uitgebracht open-source Agent-Harness, wiens kenmerk bestaat uit het organiseren van tools, Skills, sessies, Sandboards en taakuitvoeringsmogelijkheden die nodig zijn voor het functioneren van het model via een plugin-gebaseerde architectuur, waardoor Agent uitbreidbare uitvoeringsondersteuning wordt geboden.
DeepSeek begrijpt een uitvoerbare Agent als:
Agent = Model + Harness
Waarbij het Model verantwoordelijk is voor het begrijpen van taken en het nemen van beslissingen, en het Harness de tools, context en uitvoeringsomgeving organiseert die het model nodig heeft om de taak te voltooien.
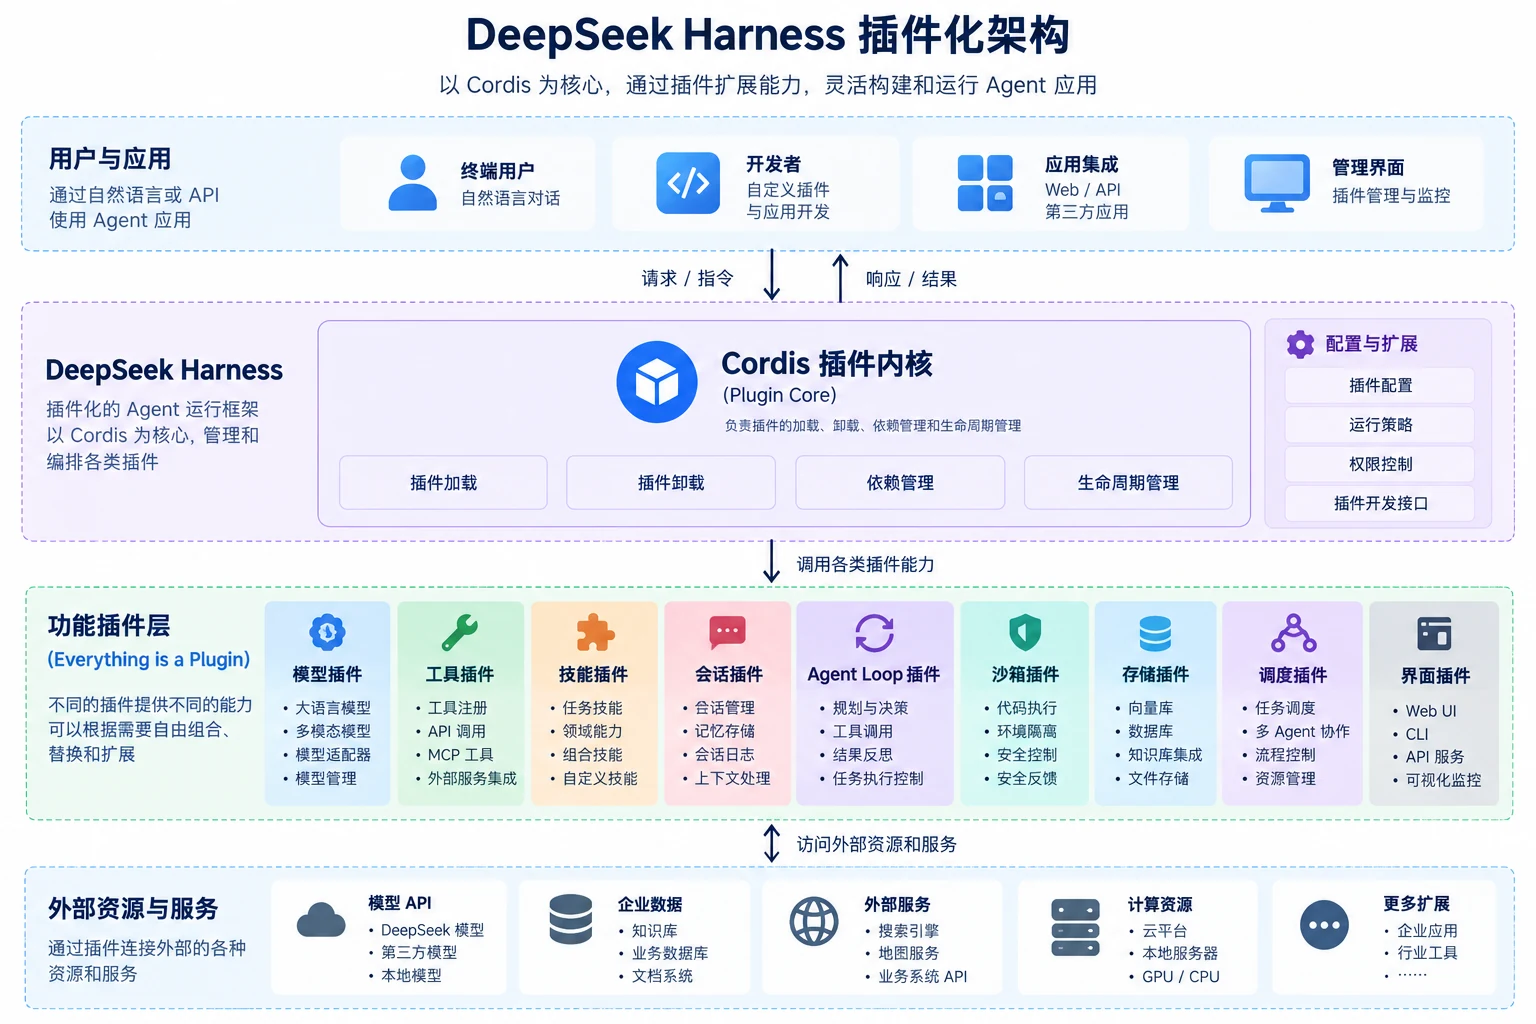
Het kerndesign van DeepSeek Harness is "Everything is a Plugin" (Alles is een Plugin). Mogelijkheden zoals modellen, tools, Skills, sessies, Sandboards, opslag, uitvoeringslussen, taakplanning en sub-Agent kunnen allemaal worden verstrekt via plugins, georganiseerd door het onderliggende Cordis-pluginsysteem. Cordis is verantwoordelijk voor het laden, verwijderen, afhankelijkheidsbeheer en levenscyclusbeheer van plugins, terwijl de specifieke Agent-mogelijkheden worden verstrekt door verschillende plugins. Ontwikkelaars kunnen op basis van de werkelijke behoefte verschillende plugins combineren, vervangen of uitbreiden.
De algemene plugin-architectuur is hieronder weergegeven.
Bijvoorbeeld kan met DeepSeek Harness een data-analyse-Agent worden gebouwd. De Agent leest gegevensbestanden die door de gebruiker zijn verstrekt, roept op basis van de taak de bijbehorende tools aan voor gegevensverwerking en -analyse, en kan Skills gebruiken voor specifieke data-analysetaken. Als de taak complex is, kan een deel van het werk worden overgedragen aan Subagent. Het model is verantwoordelijk voor het bepalen van de volgende handeling, terwijl Harness de mogelijkheden verschaft en organiseert die nodig zijn om deze handelingen uit te voeren.
Naast het plugin-gebaseerde design biedt DeepSeek Harness ook mechanismen zoals sessie- en uitvoeringsprocesregistratie. Systeem-prompts, toolaanroepen en hun resultaten, Subagent-planning en contextinjectie die het model ziet, kunnen worden geregistreerd in sessielogs en worden bekeken via Trajectory. Op basis van deze registraties kunnen taken worden hersteld, vertakt, opgehaald en afgespeeld, wat ontwikkelaars helpt bij het observeren en debuggen van het Agent-uitvoeringsproces.
Momenteel bevindt DeepSeek Harness zich nog in de Developer Preview-fase, met kernplugins en API's in voortdurende iteratie. Daarom is het meer geschikt om als een representatief voorbeeld te worden beschouwd voor het begrijpen van het plugin-gebaseerde design en de technische implementatie van Harness, in plaats van de huidige interfaces te beschouwen als vastgestelde ontwikkelingsstandaarden.