De eerste keer dat u zich voorbereidt op het downloaden van een groot model, kunnen de 7B, 32B, 128K en INT4 op de modell pagina verwarrend zijn: 7B geeft aan hoe groot het model is, 128K klinkt alsof het een heel boek zou kunnen bevatten, en INT4 kan het VRAM-gebruik verminderen. Hoe werkt dat?
Wanneer u het model daadwerkelijk begint te gebruiken, zult u te maken krijgen met problemen zoals vergaderingsnotities die niet passen, lange gesprekken waarbij de vorige context wordt vergeten, modelantwoorden zonder onderbouving en veranderingen in effectiviteit bij het wisselen van kwantiseringsmethode voor hetzelfde model.
Om te bepalen of een model geschikt is voor een bepaalde taak, moet u begrijpen hoe tekst het model binnenkomt, hoe de mogelijkheden van het model worden getraind, en waarom het model geheugen en VRAM verbruikt tijdens inferentie.
Deze kennis kan in drie hoofdlijnen worden verdeeld: de eerste begint bij de algehele Transformer-structuur, bekijkt vervolgens Token, Embedding en Attention, en legt uit hoe een stuk tekst het model binnenkomt en wordt verwerkt; de tweede behandelt pre-training, instruction fine-tuning en post-training, en legt uit hoe de mogelijkheden van het model worden gevormd; de derde gaat over contextlengte, KV Cache, kwantizering en hardware, die bepalen of het model stabiel kan draaien op het doelapparaat.
De inhoud van dit hoofdstuk is een samenvatting van de basiskennis uit de voorgaande relevante hoofdstukken. Bijvoorbeeld, de hier genoemde modinferentie-gerelateerde inhoud kan worden bekeken in het zesde en zevende hoofdstuk; voor model SFT kan het ms-swift fijnafstemmingsframework van ModelScope dat in het negende hoofdstuk wordt geïntroduceerd, worden geraadpleegd; voor post-training gerelateerde inhoud kan ook worden verwezen naar het tiende hoofdstuk over preferentie-afstemming en versterkingsleren. Voor toepassingen van domeinmodellen en hallucinatieproblemen kan ook het dertiende hoofdstuk over de RAG-methode worden geraadpleegd, dat met externe kennis de vraag-antwoordprestaties van grote modellen in domeinen verbetert en de hallucinaties van het model verder vermindert.
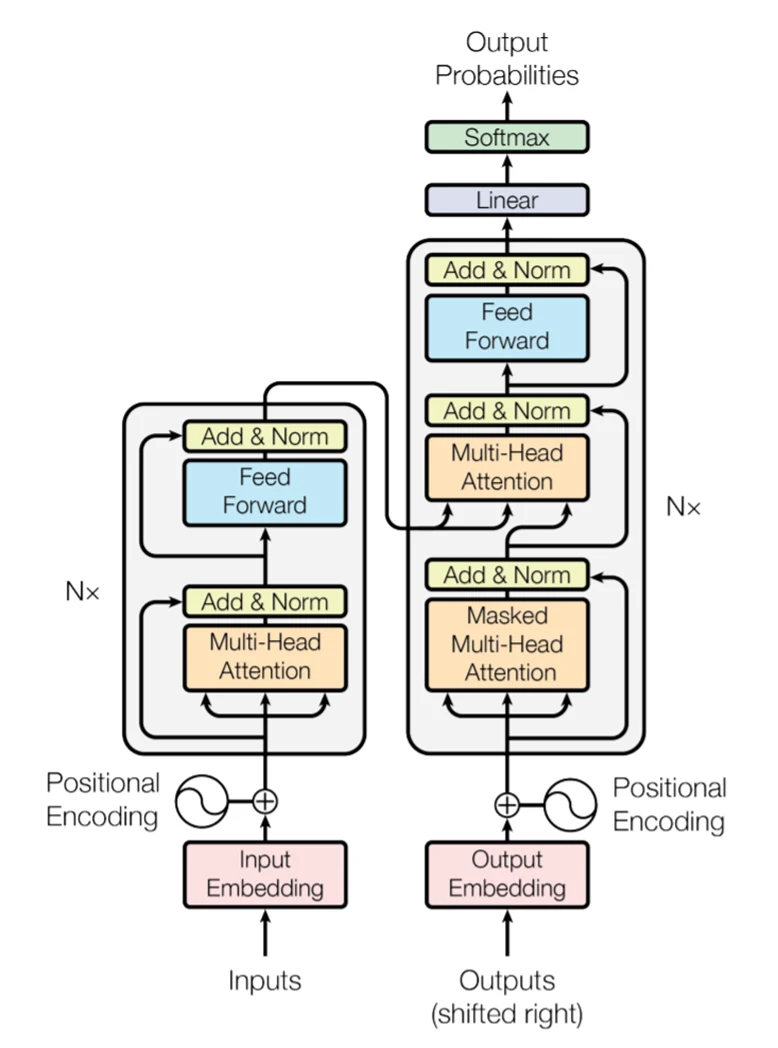
Transformer is de fundamentele architectuur die door de meeste grote taalmodellen van tegenwoordig wordt gebruikt. In tegenstelling tot eerdere recurrente neurale netwerken die tekst sequentieel verwerken, kan Transformer tijdens training en inputverwerking meerdere posities parallel berekenen en verbindt het verschillende posities via Attention. De klassieke Transformer bestaat uit een encoder en decoder. Elke Transformer-laag bevat meestal Attention en een feed-forward netwerk. Het feed-forward netwerk wordt ook FFN of MLP genoemd en voert niet-lineaire transformaties uit op de vector van elke positie. Residuele connecties en laagnormalisatie worden ook gebruikt in de laag, wat helpt om informatie stabiel door diepe netwerken te laten stromen. Na het stapelen van veel vergelijkbare lagen, kan het model geleidelijk complexe tekstrepresentaties en generatievermogen opbouwen. De algehele architectuur van Transformer is weergegeven in de figuur hieronder, waarbij links de encoder en rechts de decoder staat. De in de figuur geeft aan dat vergelijkbare modules meerdere lagen worden herhaald, en het werkelijke aantal lagen varieert afhankelijk van de modelarchitectuur en parameterschaal.
Inloggen deelnemen aan de discussie
N\u00d7Wanneer het model een voorspelling maakt, vindt de volgende verwerking plaats binnen het model nadat de gebruiker tekst invoert: bij het verwerken van tekst splitsen grote modellen de originele tekst eerst in tokens met de Tokenizer en converteren deze naar overeenkomstige Token ID's; vervolgens projecteert de Embedding-laag deze losse Token ID's naar continue vectorrepresentaties en voegt positie-informatie toe, zodat het model weet in welke volgorde de tokens in de zin staan. Deze vectoren worden vervolgens herhaaldelijk verwerkt door meerdere Transformer-lagen, waarbij het Attention-mechanisme ervoor zorgt dat verschillende tokens elkaar opmerken en contextinformatie uitwisselen, terwijl het feed-forward netwerk de kenmerken van elke positie verder verwerkt. Na meerdere lagen van berekening krijgt het model een samengestelde representatie van de huidige context en berekent op basis daarvan de kansverdeling van het volgende token, selecteert of samplet het volgende token, voegt het toe aan de context en herhaalt dit proces totdat de volledige inhoud is gegenereerd.
De drie delen van de oorspronkelijke Transformer hebben verschillende functies:
- Encoder-only structuur: is voornamelijk verantwoordelijk voor het begrijpen van de invoer, kan tegelijkertijd verschillende posities in de invoerreeks refereren, geschikt voor classificatie, extractie en semantische representatie;
- Decoder-only structuur: is voornamelijk verantwoordelijk voor het genereren van uitvoer, kan bij het genereren van de huidige positie alleen de reeds verschenen inhoud bekijken;
- Encoder-Decoder structuur: begrijpt eerst de invoer en genereert vervolgens geleidelijk de uitvoer, veel voorkomend bij sequentietransformatietaken zoals vertaling en samenvatting.
Moderne grote modellen gebruiken niet noodzakelijkerwijs tegelijkertijd een volledige encoder en decoder. Op basis hiervan zijn verschillende Transformer-gebaseerde architecturen ontwikkeld, zoals GPT-gebaseerde generatiemodellen die doorgaans een Decoder-only structuur gebruiken, BERT-gebaseerde modellen die voornamelijk Encoder-only gebruiken, en T5-gebaseerde modellen die de Encoder-Decoder structuur behouden.
Token is de basisseenheid die wordt gebruikt wanneer het model tekst leest en genereert. Het kan een enkel teken, een woord, een woorddeel, leestekens, of zelfs witruimte of speciale besturingsmarkeringen zijn. Bijvoorbeeld, dezelfde zin kan verschillende resultaten opleveren in verschillende Tokenizers:
Originele tekst\uff1a\u5927\u578b\u8bed\u8a00\u6a21\u578b\u6b63\u5728\u6539\u53d8\u529e\u516c\u65b9\u5f0f\u3002
Tokenizer A\uff1a\u5927\u578b / \u8bed\u8a00 / \u6a21\u578b / \u6b63\u5728 / \u6539\u53d8 / \u529e\u516c / \u65b9\u5f0f / \u3002
Tokenizer B\uff1a\u5927 / \u578b / \u8bed\u8a00 / \u6a21\u578b / \u6b63 / \u5728 / \u6539\u53d8 / \u529e\u516c / \u65b9\u5f0f / \u3002
Beide resultaten drukken dezelfde zin uit, maar het aantal tokens is niet gelijk. Het model ontvangt eigenlijk het bijbehorende nummer van elk token, oftewel Token ID. Als we het organiseren van vergaderingsnotities als voorbeeld nemen, ziet het model niet een volledig vergaderingsnotitie, maar een reeks Token ID's. De naam van de vergadering, de inhoud van de toespraak, de tijd, leestekens en uitvoervereisten zullen alle tokens in beslag nemen; de samenvatting, conclusies en actiepunten die door het model worden gegenereerd, zullen ook doorgaan met het in beslag nemen van tokens. Daarom kan hetzelfde materiaal, hoe gedetailleerder de uitvoer wordt gevraagd, des te minder ruimte er overblijft voor het originele record.
Als het volledig op tekens wordt gesplitst, kan de woordenboeklijst relatief klein zijn, maar de reeks zal langer worden; als het volledig op volledige woorden wordt gesplitst, zal de woordenboeklijst erg groot zijn, en zal het constant te maken krijgen met nieuwe woorden, afkortingen en spellingwijzigingen. Grote modellen gebruiken doorgaans subword tokenization, en zoeken een evenwicht tussen tekens en volledige woorden. BPE, WordPiece, Unigram en SentencePiece zijn allemaal veelgebruikte methoden.
Normaal gesproken kan het model geen matrixbewerkingen uitvoeren op tekst of afbeeldingen; het moet de inhoud eerst omzetten naar numerieke vectoren. Dit proces wordt Embedding of vectorrepresentatie genoemd. Voor tekst splitst de Tokenizer de tekst eerst in Token ID's en zoekt de Embedding-laag vervolgens de bijbehorende vector op basis van het ID. Een enkel getal in de vector heeft doorgaans geen intuitieve betekenis, maar de volledige vector kan de kenmerken van dat token binnen het model representeren. Als we het token "vergadering" als voorbeeld nemen, kan het bijbehorende Token ID een bepaald geheel getal zijn, bijvoorbeeld "15872", en de bijbehorende representatie van dat token, oftewel Embedding, kan een vector zijn zoals: [0.12, -0.37, 0.08, \u2026\u2026]. Embedding wordt voortdurend aangepast tijdens het trainingsproces, en tokens die in vergelijkbare contexten voorkomen, vormen vaak enigszins vergelijkbare kenmerken in hun vectoren. Vanwege verschillen in modelstructuur en trainingsproces kan hetzelfde woord na verwerking door meerdere Transformer-lagen ook verschillende representaties vormen op basis van de context.
Wanneer het model de semantische informatie van invoertekst verkrijgt, moet het niet alleen weten wat een token is, maar ook waar het zich bevindt. Alleen met Token Embedding bevatten bijvoorbeeld "vergadering uitstellen" en "uitgestelde vergadering" vergelijkbare tokens, maar door verschillen in woordvolgorde drukken ze verschillende betekenissen uit. Daarom moet het model ook positionele codering of positionele representatie toevoegen. De onderstaande figuur gebruikt de invoerlaag van BERT als voorbeeld.
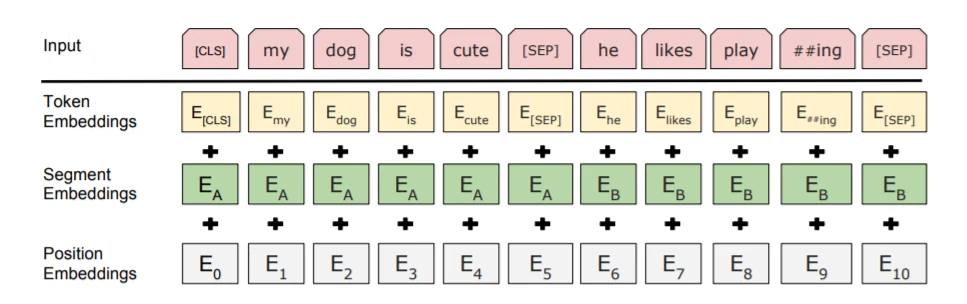
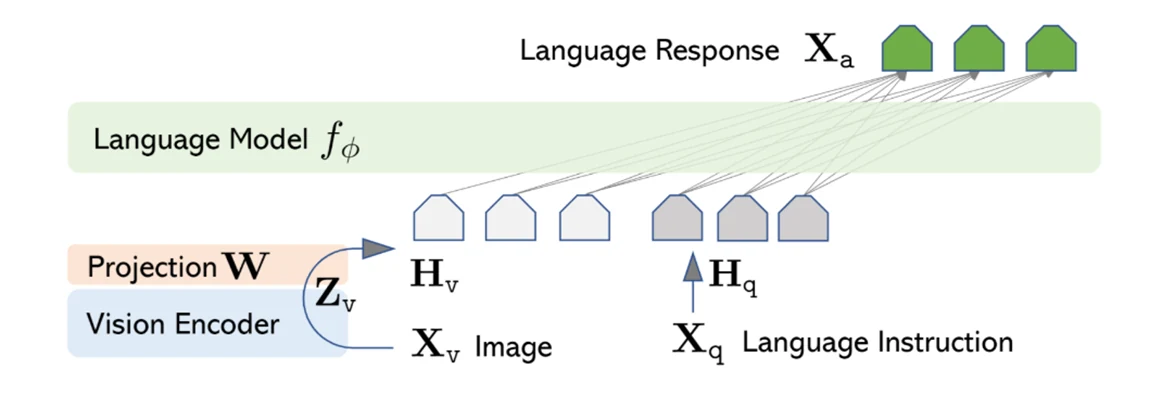
Zoals getoond in de bovenstaande BERT-representatiemethode, demonstreert het de combinatie van Token Embedding, zinsegment-Embedding en positionele Embedding. Natuurlijk zijn de specifieke schema's die door verschillende modelstructuren en ontwerpmethoden worden gebruikt, niet volledig hetzelfde. Als we multimodale grote modellen als voorbeeld nemen, moeten afbeeldingen, audio en andere inhoud ook eerst worden omgezet naar vectoren. Afbeeldingen worden meestal eerst in beeldblokken gesneden en extracteert de visuele encoder kenmerken; audio wordt eerst omgezet naar akoestische kenmerken en vervolgens verwerkt door de audio-encoder. De kenmerken van verschillende modaliteiten kunnen pas het vectorruimte binnengaan dat door grote modellen kan worden verwerkt, nadat ze door een projectie- of verbindingsmodule (Projection) zijn gegaan. Zoals getoond in de onderstaande figuur, wordt de afbeeldingsinformatie en semantische informatie gefuseerd via de verbindingsmodule.
Attention is verantwoordelijk voor het bepalen welke delen van de invoer de huidige positie moet focussen. Het berekent de mate van relatie op de al gevormde vectorrepresentaties van het model, en niet alleen naar identieke woorden. Bijvoorbeeld, in de zin "het project is uitgesteld, het rapport legt uit waarom het niet op tijd is voltooid", moet het model bij het verwerken van het voornaamwoord "het" de context combineren om te bepalen of het waarschijnlijker verwijst naar "het project" of "het rapport". Bij het extraheren van de verantwoordelijke persoon uit vergaderingsnotities, moet het model ook de taakbeschrijving, de naam van de persoon en de zinnen die de taakverdeling aanduiden, met elkaar verbinden.
Elke invoervector ondergaat verschillende transformaties en vormt Query, Key en Value, die doorgaans worden afgekort als Q, K en V. De Attention-berekeningsformule kan als volgt worden vereenvoudigd:
$\mathrm{Attention}(Q, K, V)=\mathrm{softmax}\left(\frac{QK^{\mathrm{T}}}{\sqrt{d_k}}\right)V$
Waarbij Q aangeeft welke informatie de huidige positie zoekt, K aangeeft met welke kenmerken elke positie kan worden gematcht, en V de inhoud vertegenwoordigt die na het matchen moet worden opgehaald. Het model vergelijkt eerst Q en K, verkrijgt de relevantiescores tussen de huidige positie en andere posities; converteert vervolgens de scores naar gewichten via softmax, en voert een gewogen samenvatting van V uit op basis van de gewichten. $d_k$ in de formule is de dimensie van de Key-vector, en delen door $\sqrt{d_k}$ dient om de schaal van de scores aan te passen, zodat de berekening stabieler wordt.
Als Q, K, V afkomstig zijn van dezelfde reeks, heet dit Self-Attention, dat wordt gebruikt om verbindingen binnen de reeks tot stand te brengen; als Q afkomstig is van \u00e9\u00e9n reeks en K, V van een andere reeks, heet dit Cross-Attention. Bijvoorbeeld, een encoder-decoder vertaalmodel kan de decoder via cross-attention de originele tekstinformatie laten lezen die door de encoder wordt geleverd.
Voor generatieve grote modellen kan de huidige positie alleen de reeds verschenen inhoud refereren, daarom moet een causaal masker worden toegevoegd aan Attention om latere posities te blokkeren. Zelfs met het blokkeren van toekomstige tokens, zal het aantal verbanden dat door volledige causale attention wordt verwerkt, ongeveer kwadratisch groeien met de lengte van de reeks. Tegelijkertijd moeten de K en V van historische tokens worden opgeslagen tijdens de generatiefase, wat de KV Cache vormt die later wordt uitgelegd. Naarmate de context langer wordt, worden de berekenings- en cache-kosten van Attention steeds opvallender, en de verschillende structuren die hieronder worden ge\u00efntroduceerd, zijn precies rond deze problemen geleidelijk ontwikkeld.
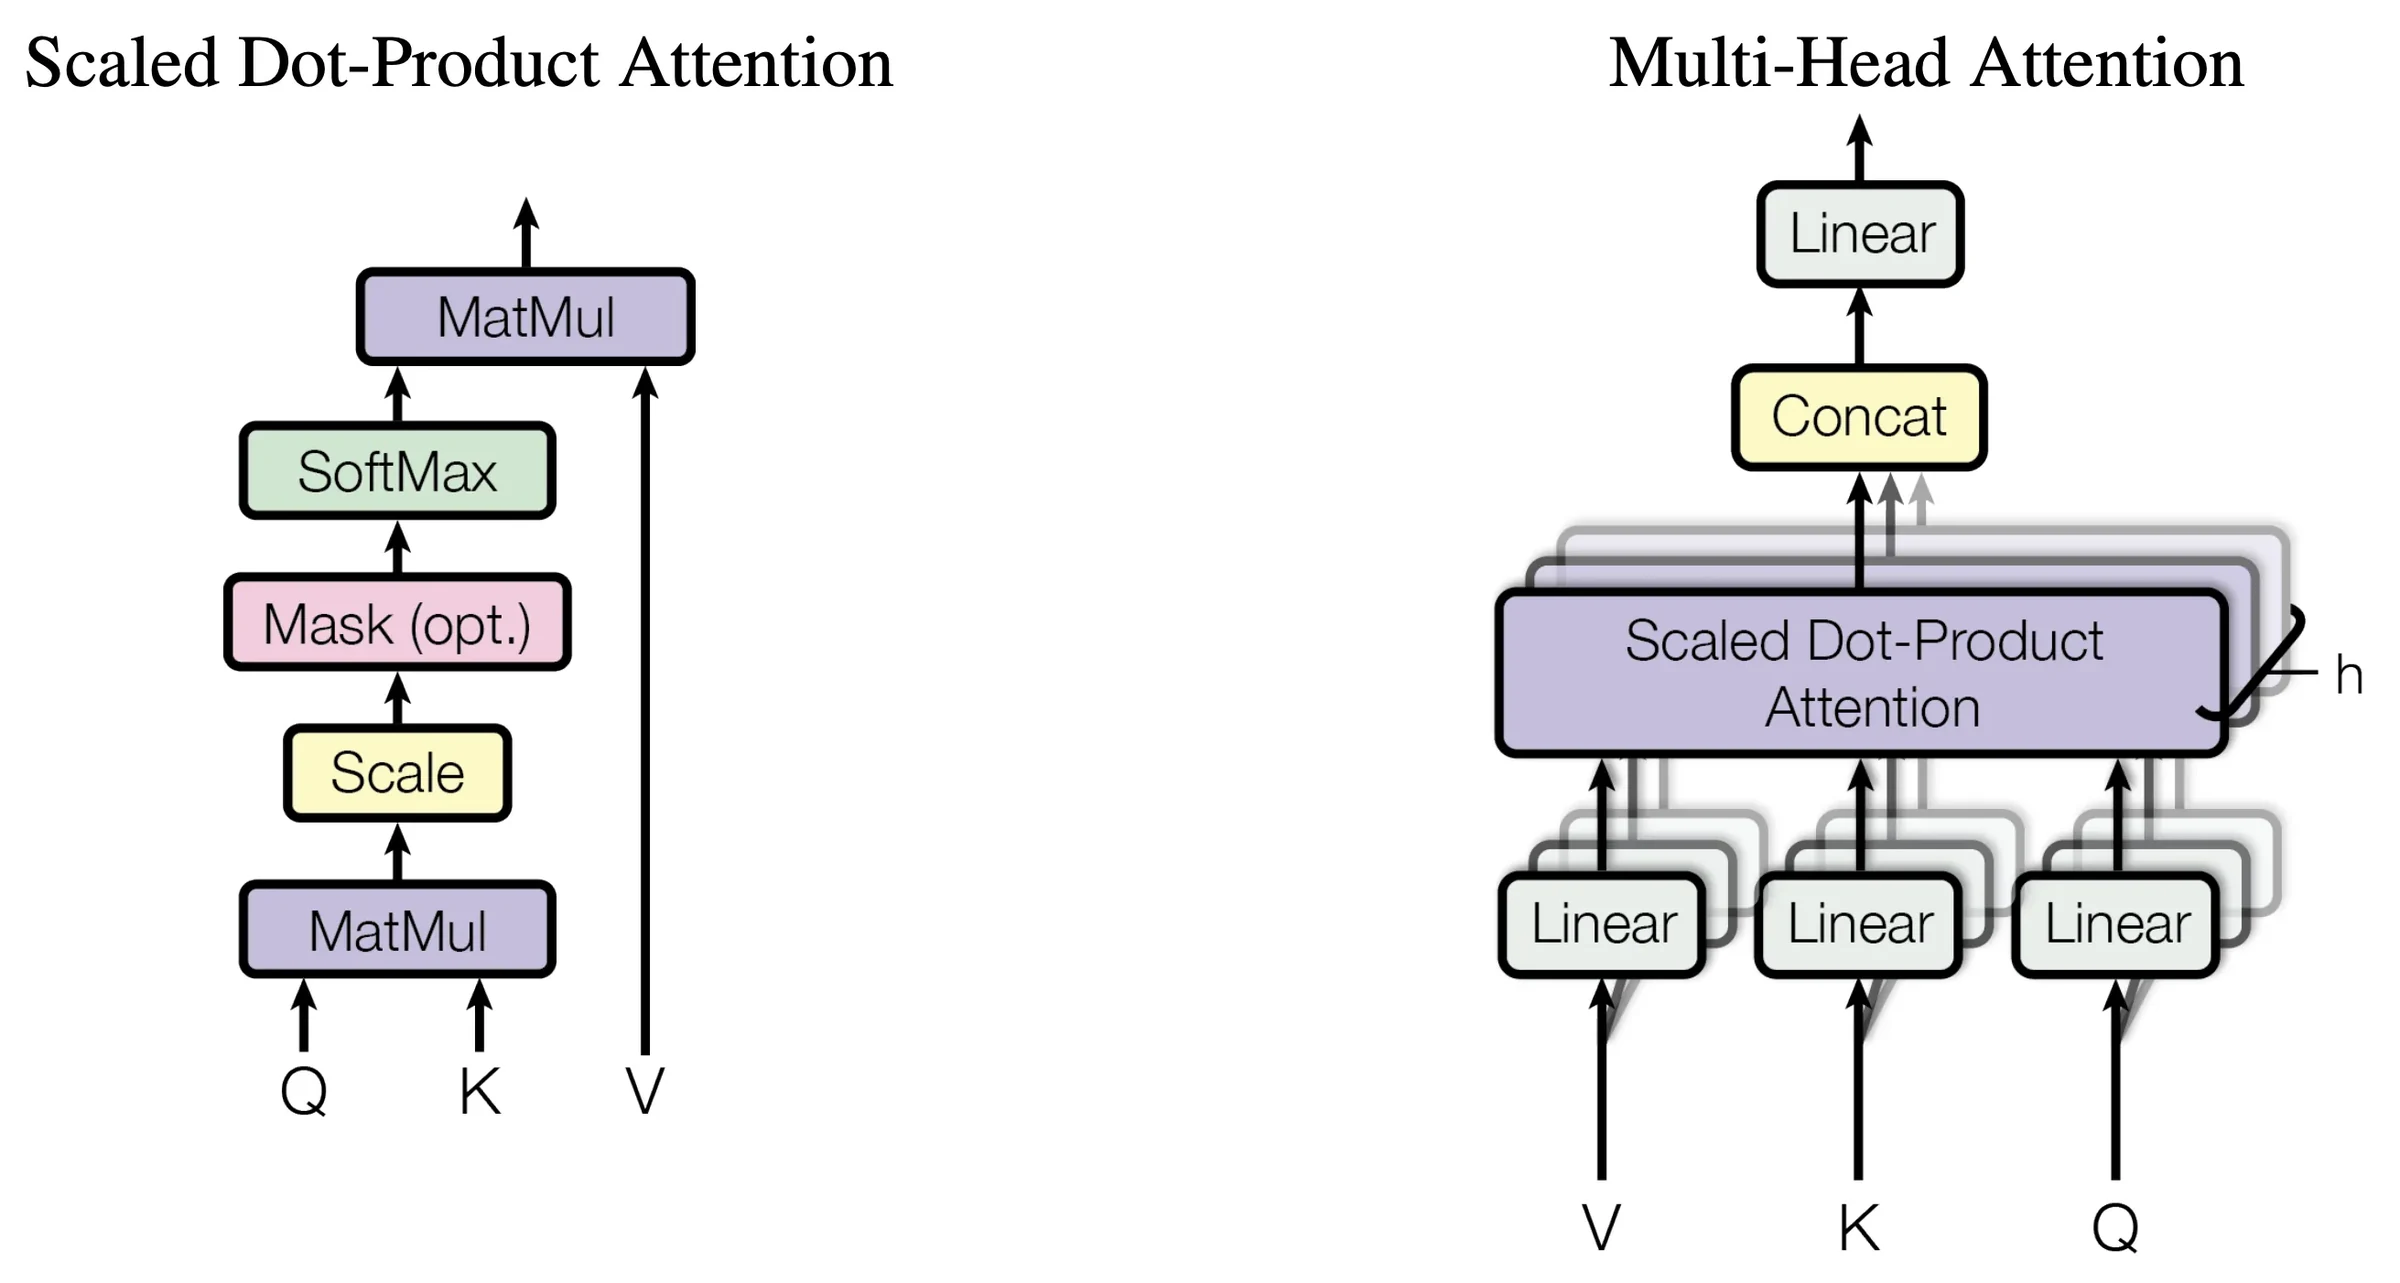
Multi-Head Attention (MHA) werd voorgesteld in de Transformer-paper uit 2017 "Attention Is All You Need" en later toegepast op modellen zoals BERT en Llama 2 7B, 13B. Het voegt meerdere parallelle attention-hoofden toe op basis van enkelvoudige attention-berekening, waardoor het model contextuele relaties kan extraheren uit verschillende representatieruimten.
In MHA heeft elk hoofd zijn eigen projectieparameters voor het genereren van Q, K en V, berekenen ze afzonderlijk attention, en verbinden vervolgens de resultaten van elk hoofd via een lineaire laag om de uitvoer te vormen. Zoals getoond in de onderstaande figuur, toont de linkerzijde het berekeningsproces van een schaalbaar product-aandachtsset, en de rechterzijde voert dit proces meerdere keren parallel uit en voert vervolgens resultaatfusie uit. De focuspatronen van verschillende hoofden worden gevormd door training en kunnen gezamenlijk taken zoals antecedentbepaling, semantische relaties en afhankelijkheden op grote afstand ondersteunen.
MHA heeft het vermogen van het model om verschillende soorten informatie te aggregeren verbeterd, en maakt ook parallelle berekening tijdens training gemakkelijker. Bij token-voor-token generatie moet elk hoofd echter zijn eigen historische K, V lezen. Naarmate het aantal lagen, hoofden en contextlengte van het model toeneemt, zullen deze cache en gegevenslezing grote hoeveelheden bronnen in beslag nemen. Daarom overweegt de volgende verbetering eerst of het behouden van meerdere Query-hoofden mogelijk is, terwijl het aantal Key-hoofden en Value-hoofden dat moet worden opgeslagen, wordt verminderd.
Multi-Query Attention (MQA) werd voorgesteld door Noam Shazeer in het paper "Fast Transformer Decoding: One Write-Head is All You Need" uit 2019 en later toegepast op grote modellen zoals Falcon-7B. Het richt zich voornamelijk op het probleem van geheugenbandbreedte in de decodeerfase: wanneer het model elk nieuw token genereert, moet het de bestaande KV Cache lezen, en wanneer het leesvolume te groot is, zelfs als de rekenuneenheid nog steeds capaciteit heeft, zal de generatiesnelheid worden beperkt.
MQA behoudt meerdere Query-hoofden, maar laat ze een set Key en Value delen. Op deze manier kunnen verschillende hoofden nog steeds verschillende queries genereren, maar historische posities hoeven slechts \u00e9\u00e9n K, V op te slaan die door alle hoofden wordt gedeeld. De onderstaande figuur toont een initialisatiemethode bij het omzetten van een bestaand MHA-model naar MQA: door meerdere Key-projectiematrijzen te gemiddeld, wordt een gedeelde projectie verkregen, en Value-projectie kan op dezelfde manier worden behandeld; na de omzetting moet doorgaan met trainen om het model aan te passen aan de nieuwe gedeelde structuur.
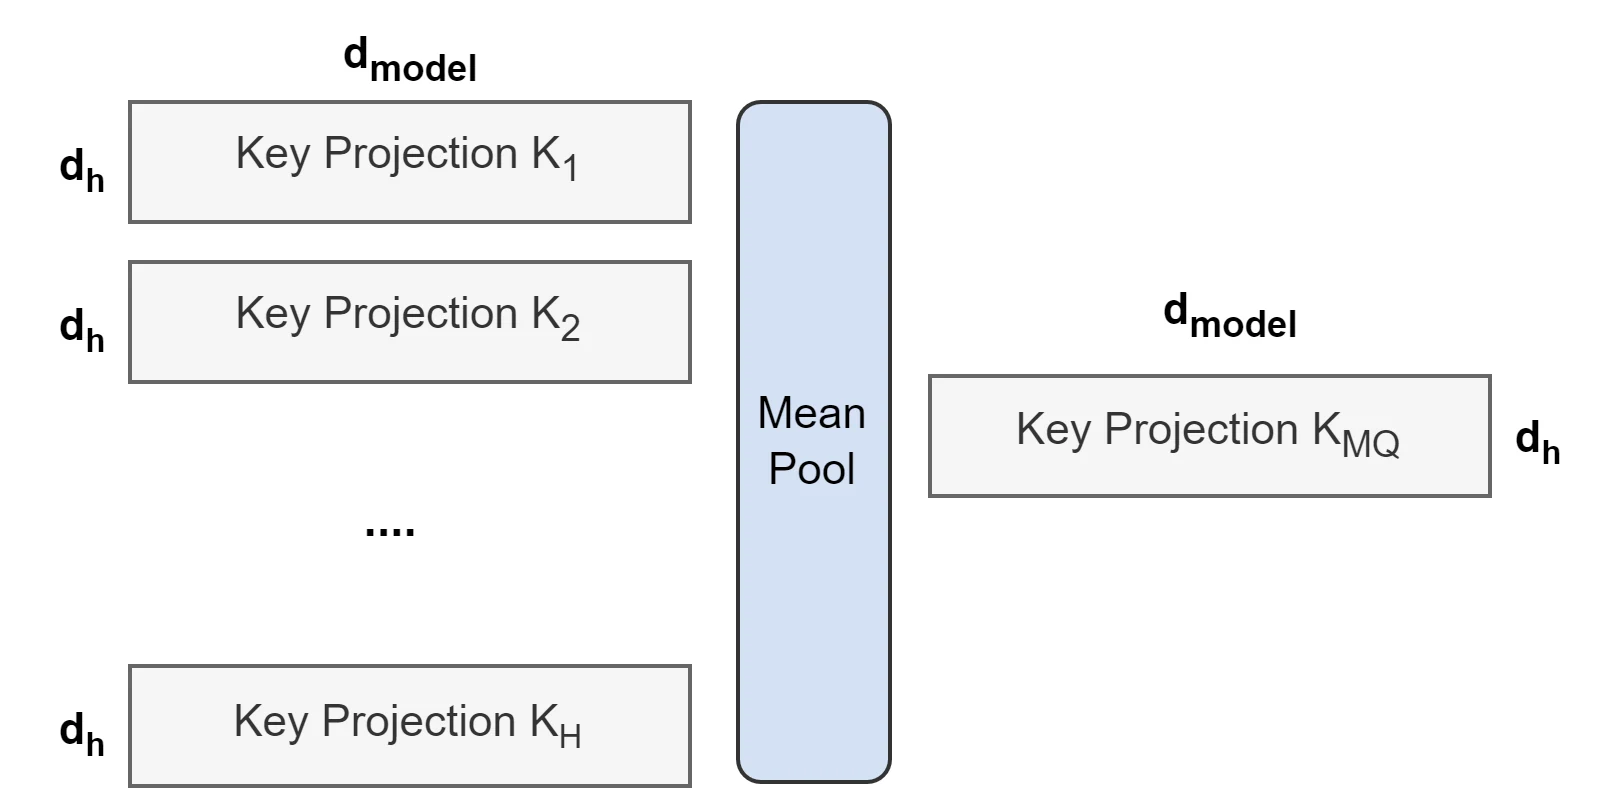
Na het aannemen van deze structuur kan MQA de KV Cache en het gegevensleesvolume per decodestap aanzienlijk verminderen, waardoor ruimte vrijkomt voor langere invoer of meer gelijktijdige verzoeken. Bijvoorbeeld, Falcon-7B heeft 71 Query-hoofden maar slechts 1 KV-hoofd. In vergelijking met 71 KV-structuren met dezelfde hoofddimensie en precisie, is de theoretische KV-cache slechts ongeveer een eenenzeventigste. Delen zal ook de representatiecapaciteit van K, V beperken, dus training en evaluatie zijn nodig om het effect van deze effici\u00ebntiewinst op taakkwaliteit te bevestigen.
Grouped-Query Attention (GQA) werd systematisch voorgesteld door Google Research in het GQA-paper uit 2023 en toegepast op grote modellen zoals Llama 2 70B, Mistral 7B. Het probeert een evenwicht te vinden tussen de multi-set representatiecapaciteit van MHA en de lage cache-kosten van MQA, en voorkomt dat alle Query-hoofden slechts dezelfde set K, V kunnen gebruiken.
GQA verdeelt Query-hoofden in verschillende groepen, elke groep deelt een set Key en Value, en verschillende groepen behouden verschillende K, V representaties. Zoals getoond in de onderstaande figuur, configureert MHA de bijbehorende K, V voor elk Query-hoofd, laat MQA alle Query-hoofden dezelfde set K, V delen, en deelt GQA binnen de groep. Wanneer het aantal groepen gelijk is aan het aantal Query-hoofden, is GQA equivalent aan MHA; wanneer er slechts \u00e9\u00e9n groep is, is het equivalent aan MQA.
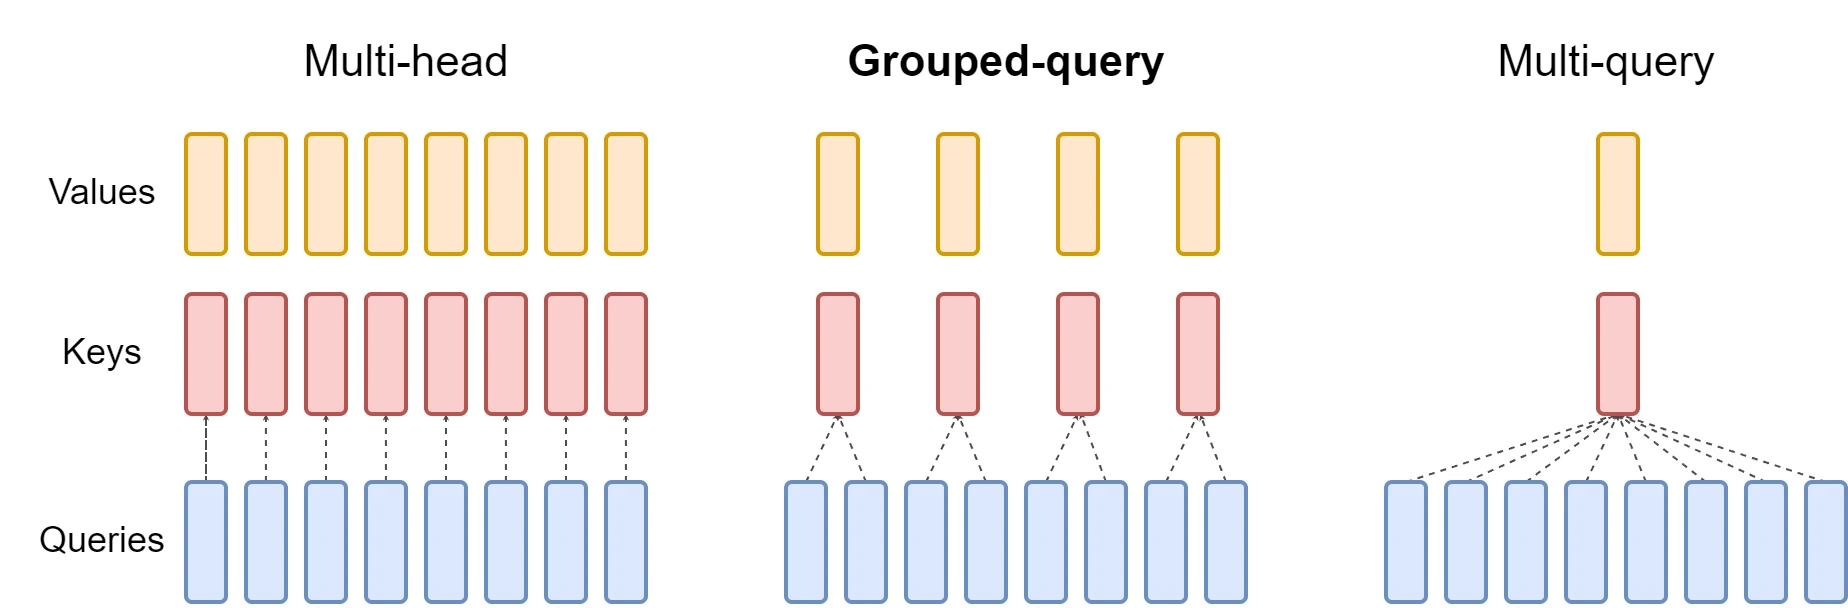
Als we Mistral 7B v0.1 als voorbeeld nemen, heeft het 32 Query-hoofden en 8 KV-hoofden, en delen elke 4 Query-hoofden een set K, V. Onder dezelfde hoofddimensie en precisie, is deze cache ongeveer een kwart van MHA. Voor daadwerkelijke inzet kan het verminderen van cache en leesvolume doorgaans helpen de gelijktijdige capaciteit en decodeereffici\u00ebntie te verbeteren; aangezien verschillende groepen nog steeds hun eigen K, V behouden, behoudt GQA ook meer representatieruimte dan volledig gedeelde MQA. Wat hier wordt verminderd, is het aantal KV-hoofden, en het model kan nog steeds attention berekenen voor alle historische posities die toegankelijk zijn.
Sliding Window Attention (SWA) komt van het idee van lokale attention in het modelleren van lange reeksen, en Mistral 7B v0.1 gebruikt het samen met GQA. GQA vermindert het aantal KV-hoofden dat per positie moet worden opgeslagen, terwijl SWA het historische bereik dat elke positie direct kan waarnemen verder beperkt, om de berekenings- en cache-druk van lange teksten te verminderen.
SWA stelt een venster van vaste grootte in voor elk token en berekent alleen attention voor recente posities binnen het venster. De onderstaande figuur toont links volledige causale attention, in het midden sliding window attention, en rechts hoe informatie via meerdere lagen van het netwerk naar achteren wordt doorgegeven. Hoewel een enkele laag alleen het lokale bereik leest, bevat de token-representatie van de vorige laag al eerdere contextinformatie, dus het model kan na verwerking door meerdere lagen indirect inhoud buiten het venster gebruiken.
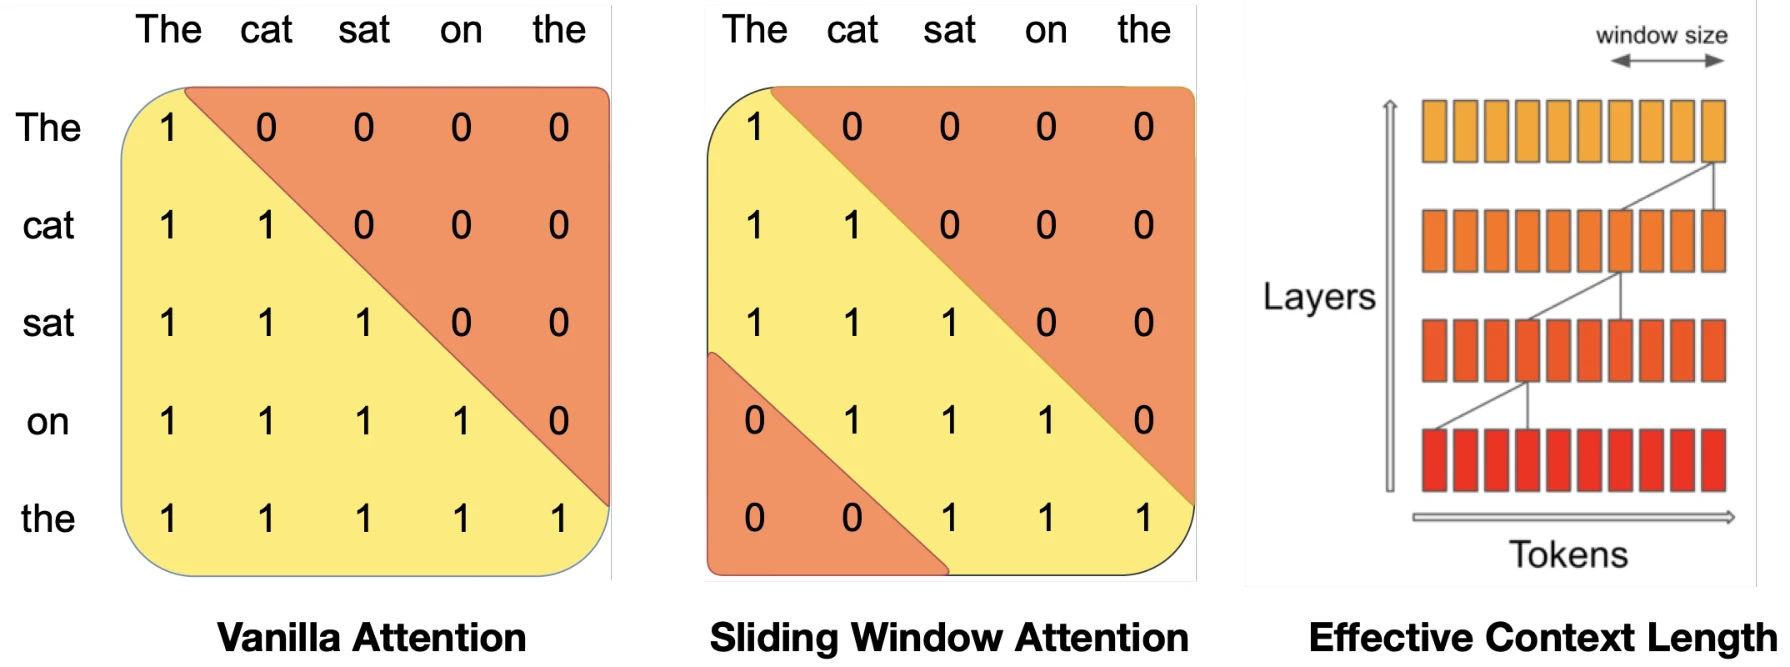
Mistral 7B v0.1 gebruikt een venster van 4096 tokens en een rollende cache om de oude K, V die het venster hebben verlaten, te bedekken, zodat de cache van elke laag within een vast bereik kan worden gehouden. Het paper rapporteert in tests met 16K reeksen en 4096 vensters, dat na bijbehorende kerneloptimalisatie, de snelheid ongeveer 2 keer de baseline van volledige attention is. Deze structuur kan de bronngroei van lange teksten beheersen, maar verre originele details moeten worden doorgegeven via tussenliggende representaties, dus de grootte van het lokale venster kan niet direct worden gelijkgesteld aan de contextlengte die het model nauwkeurig kan ophalen.
Multi-head Latent Attention (MLA) werd voorgesteld door DeepSeek in DeepSeek-V2 en later ook gebruikt in DeepSeek-V3. Het richt zich ook op het probleem van een te grote KV Cache, maar verandert de opslagvorm van de cache verder: door een compacte gezamenlijke representatie te leren, vermindert het de gegevens die per token moeten worden opgeslagen, terwijl het meerdere attention-hoofden ondersteunt om deze informatie te gebruiken.
Specifiek, MLA gebruikt eerst een lager-rank projectie om K en V gezamenlijk te representeren als een vector van lagere dimensie, cache deze vector voornamelijk tijdens inferentie, plus een Key-component die roterende positie-informatie alleen draagt. Meerdere Query-hoofden kunnen deze gedeelde representatie gebruiken om matching en informatieaggregatie te voltooien, en sommige projectiematrijzen kunnen tijdens inferentie worden samengevoegd om expliciete uitbreiding van volledige K, V operaties te verminderen. Het schaduwgebied in de onderstaande figuur geeft de inhoud aan die gecachet moet worden, en men kan zien dat MLA de multi-head K, V cache heeft overgebracht naar de kleinere latente representatie rechts.
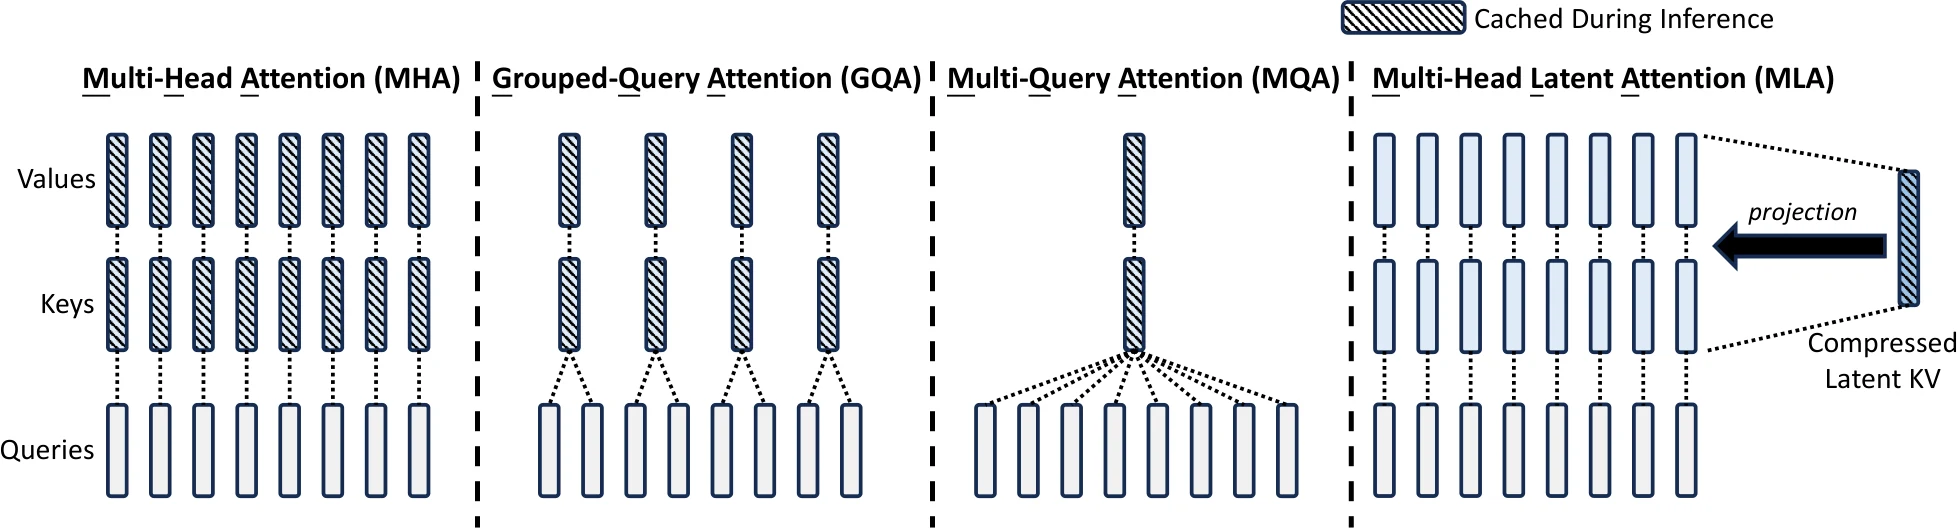
Dit ontwerp stelt DeepSeek-V2, V3 in staat om de multi-head expressiecapaciteit te behouden terwijl de cache-druk in lange contextgeneratie wordt verminderd. In het DeepSeek-V2-rapport is de KV-cache-omvang per token van MLA equivalent aan GQA met slechts 2.25 sets KV-hoofden. Het comprimeert de representatiedimensie per positie, terwijl historische posities zelf behouden blijven, dus in de volledige attention-modus moet het model nog steeds alle historische items lezen en matchen. Om het aantal items dat daadwerkelijk aan de berekening deelneemt verder te verminderen, moet sparse attention worden ge\u00efntroduceerd.
DeepSeek Sparse Attention (DSA) werd voorgesteld door DeepSeek en toegepast op DeepSeek-V3.2-Exp en DeepSeek-V3.2. Het voegt een dynamisch selectiemechanisme toe op basis van MLA en lost het probleem op dat het lezen en berekenen van alle historische items in lange context nog steeds duur is, zelfs als een enkel KV-item al klein is.
DSA berekent eerst de relevantiescores van de huidige Query en historische tokens via een lichtgewicht indexer (Lightning Indexer), neemt vervolgens de Top-k posities met de hoogste scores en geeft ze door aan de hoofd-Attention voor berekening. Het groene gedeelte in de onderstaande figuur is het nieuw toegevoegde indexeringsproces, de Top-k Selector is verantwoordelijk voor het selecteren van posities, en de kern-Attention erboven leest de bijbehorende MLA-cache van de geselecteerde posities. De indexer gebruikt kleinere representaties en minder hoofden omscreening te voltooien, en de rekenkosten zijn lager dan het direct uitvoeren van de volledige hoofd-Attention.
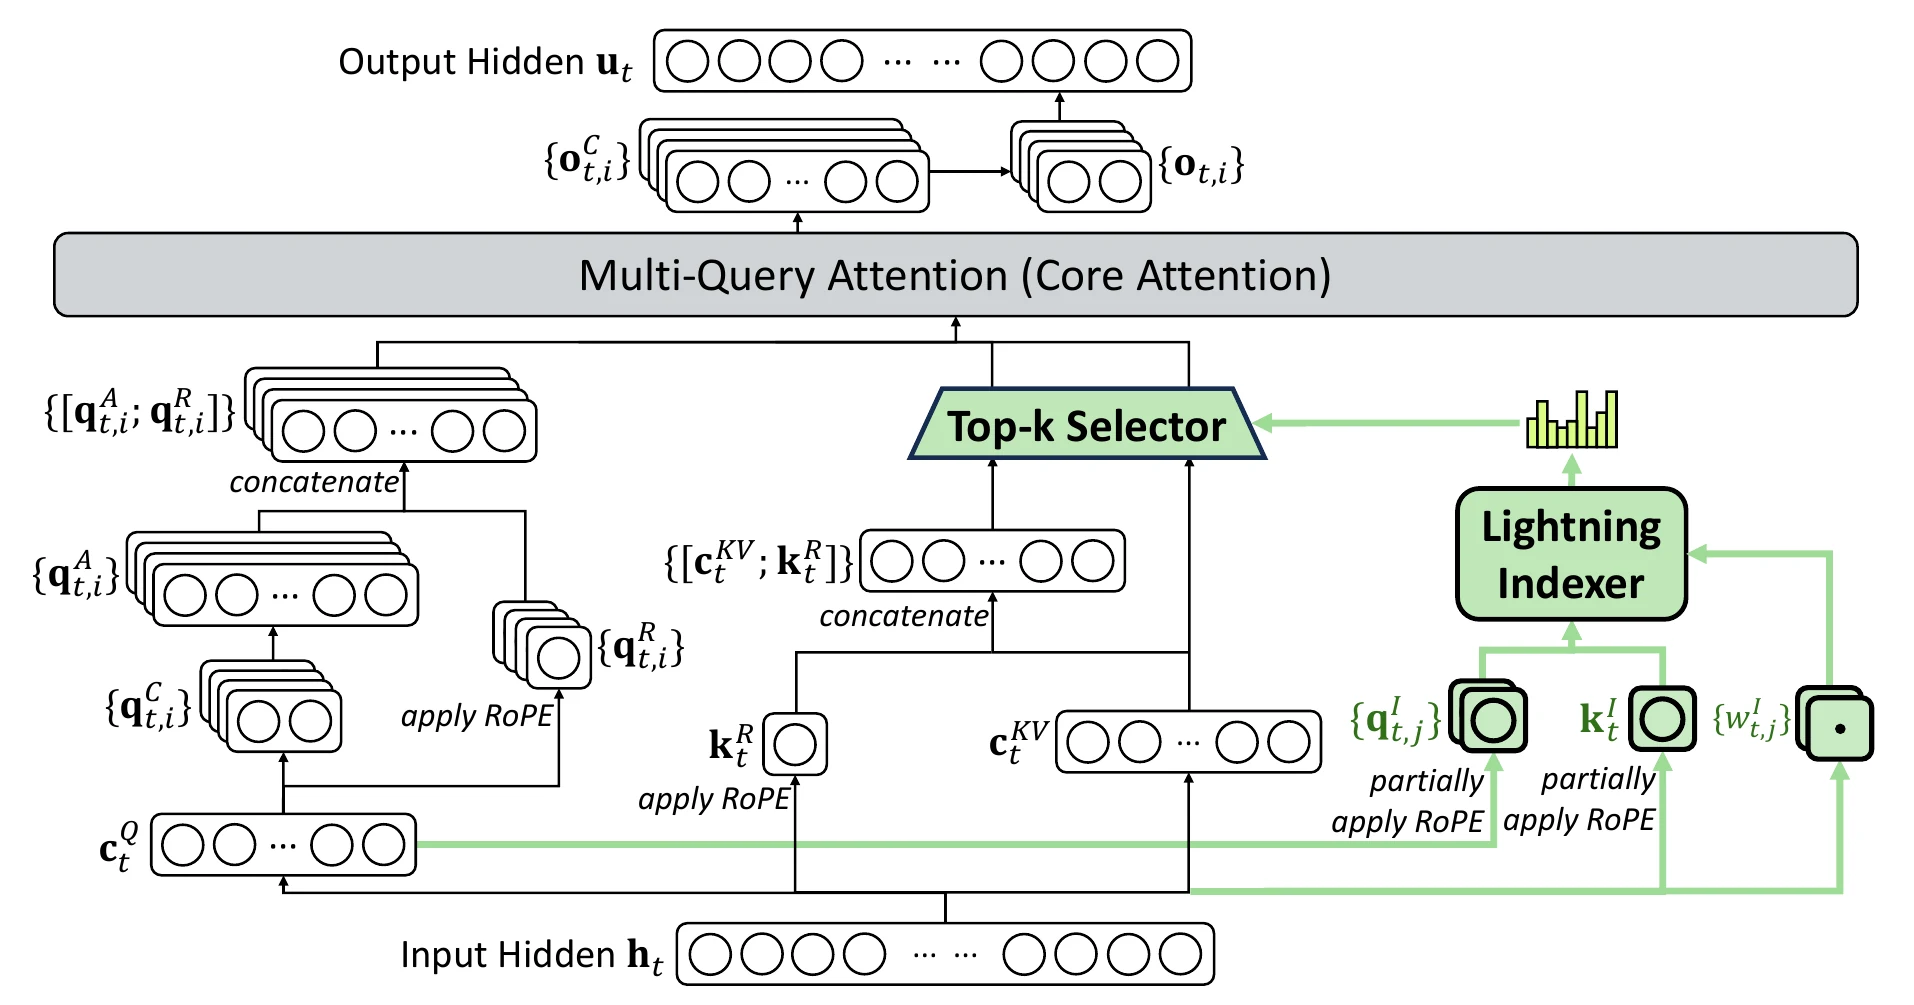
De configuratie in het DeepSeek-V3.2-rapport is dat elke Query maximaal 2048 KV-items kiest. Naarmate de context groeit, kan de kern-Attention nog steeds deze beperkte range verwerken, waardoor de kosten van lange invoerverwerking en latere generatie aanzienlijk worden verminderd. Historische items die niet door deze selectie zijn gekozen, zijn nog steeds beschikbaar voor latere Query-retrieval, dus sparse selectie vermindert voornamelijk het lees- en berekeningsvolume van deze keer, en niet het verwijderen van alle cache in dezelfde verhouding. De indexer zelf moet nog steeds historische kandidaten verwerken, en de werkelijke kosten worden ook be\u00efnvloed door de contextlengte.
MiniMax Sparse Attention (MSA) werd voorgesteld door MiniMax en toegepast op MiniMax-M3. Het richt zich op effici\u00ebntieproblemen in miljoenen-token-contexten, en overweegt specifiek hoe sparse attention geschikt te maken voor GPU-batchberekening, niet alleen om het aantal deelnemende tokens theoretisch te verminderen.
MSA is gebaseerd op GQA en omvat een indextak en een hoofdtak. De indextak berekent eerst token-niveau relevantiescores, neemt vervolgens de hoogste score in elk blok als blokscore, en selecteert Top-k historische blokken voor verschillende GQA-groepen. De hoofdtak leest vervolgens de token-niveau K, V die voldoen aan de causale voorwaarde in de geselecteerde blokken, en behoudt tegelijkertijd het lokale blok waarin het zich bevindt. Zoals getoond in de onderstaande figuur, kunnen de twee Query-groepen rechts verschillende selectiebereiken vormen, en de Query-hoofden binnen dezelfde groep delen de selectieresultaten.
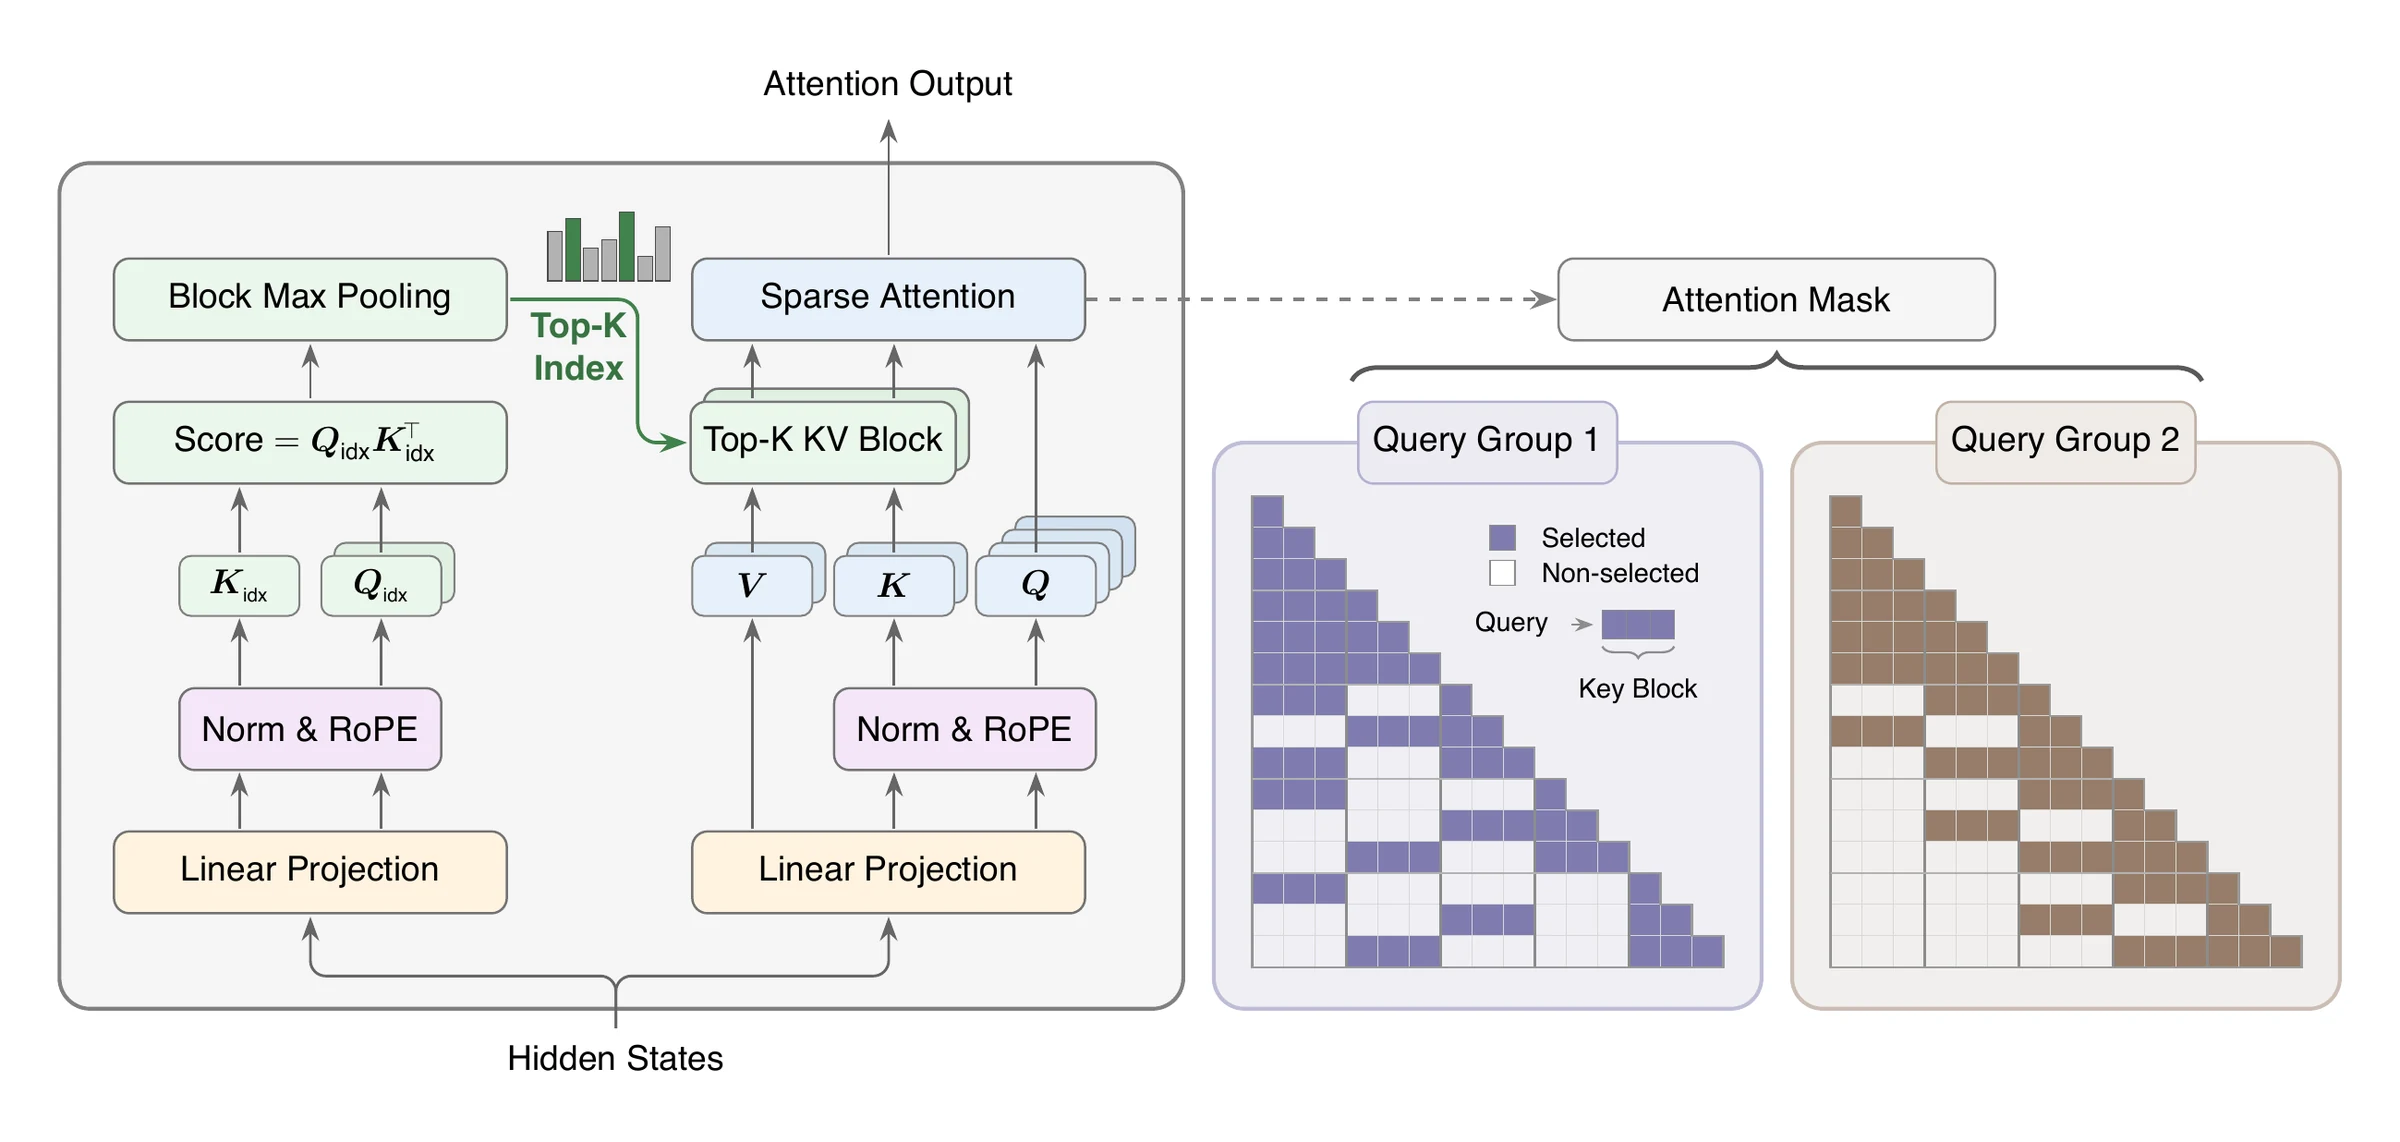
Het organiseren van toegang per blok kan de regulariteit van gegevensverwerking op GPU verbeteren, en groepsselectie stelt verschillende groepen in staat om verschillende retrievalpatronen te behouden. In tests met een 109B-parameter experimenteel model op 1M context, rapporteert het paper dat de aandachtsberekening per token van MSA ongeveer 1/28.4 is van GQA; met gespecialiseerde kernen werden snelheidsverbeteringen van respectievelijk ongeveer 14.2 en 7.6 keer bereikt op H800 voor de Prefill-fase van invoerverwerking en de Decode-fase van token-voor-token generatie. Dit vertelt dat sparse algoritmen en rekenkernen gezamenlijk moeten worden ontworpen, zodat rekeningsvermindering effectiever kan worden omgezet in daadwerkelijke snelheidswinst.
Qwen Sparse Attention (QSA) werd voorgesteld door Qwen en toegepast op Qwen3.8-Flash-Next. Dit model gebruikt een hybride structuur van drie lagen Gated DeltaNet met \u00e9\u00e9n laag QSA: de eerste verwerkt reeksen effici\u00ebnt via status updates, terwijl de laatste directe retrieval van historische tokens behoudt. Het probleem dat QSA specifiek aanpakt, is dat de indexer in lange contexten zelf ook aanzienlijke kosten genereert.
Daarom comprimeert QSA eerst de index-keys van opeenvolgende tokens via gemiddelde pooling tot microblokrepresentaties, berekent relevantiescores op kortere microblokreeksen en selecteert Top-k blokken. Na selectie worden de blokken uitgebreid naar originele token-posities, zodat de kern-Attention de bijbehorende K, V kan lezen; de laatste tokens die geen volledig blok kunnen vormen, worden ook behouden. De linkerzijde van de onderstaande figuur is het compressie-indexeringsproces, de rechterzijde is de microblok-sparse Attention op basis van de selectieresultaten, en tussen de twee delen worden positie-indexen overgedragen.
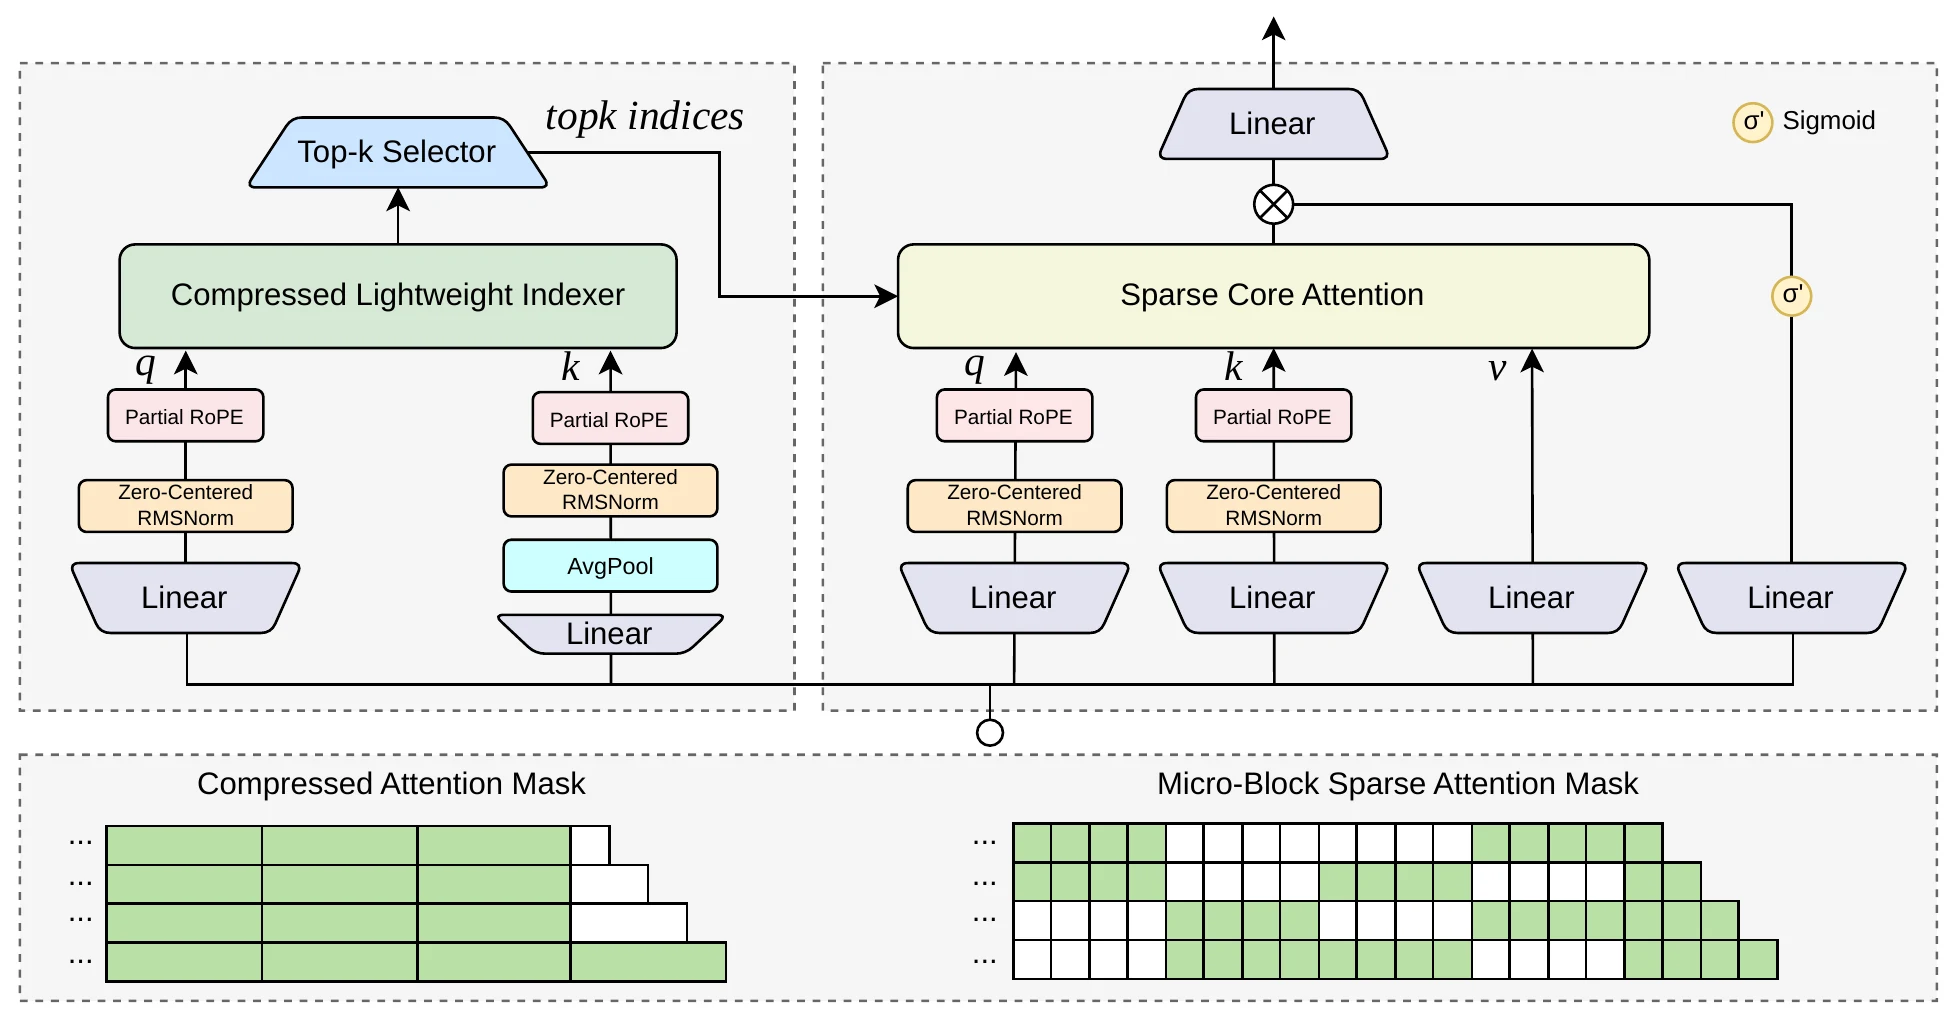
Op deze manier wordt het aantal posities dat door de hoofd-Attention wordt bezocht verminderd, en wordt de reeks die door de indexer moet worden gescand verkort. In het Qwen3.8-Flash-Next-rapport, in kernetests met 1M context, bereikte QSA prestatieverbeteringen van respectievelijk ongeveer 7.6 en 4.9 keer voor Prefill en Decode in vergelijking met dense attention. Bij het begrijpen van deze structuur moet onderscheid worden gemaakt tussen indexrepresentatie en hoofd-Attention-cache: QSA comprimeert de eerste omscreeningkosten te verminderen, leest na selectie nog steeds token-niveau KV, en kan dus de fijne-grained informatie van het geselecteerde gebied behouden.
Kimi Delta Attention (KDA) werd voorgesteld door Moonshot AI in Kimi Linear en daadwerkelijk toegepast in het Kimi Linear-model met 48B totale parameters en 3B actieve parameters. Het gebruikt het idee van lineaire attention en schrijft historische informatie voortdurend in een vaste grootte status, om de kosten van het herhaaldelijk lezen van lange historische reeksen bij elke generatiestap te verminderen.
KDA voegt fijnere granulariteit gate control toe op basis van Gated DeltaNet. Wanneer een nieuw token aankomt, beheerst het model eerst de informatiebehoudsgraad van verschillende kanalen in de oude status, en corrigeert vervolgens de bestaande key-value-relaties via de Delta-regel. Deze update kan worden begrepen als het aanpassen van de informatie die in de status wordt opgeslagen met behulp van het verschil tussen de nieuwe invoer en de voorspelling van de huidige status. Aangezien het vervalgate per kanaal varieert, kunnen verschillende delen verschillende behoudssnelheden gebruiken. Tijdens de berekening kunnen tokens ook parallel per blok worden verwerkt om de GPU-effici\u00ebntie te verbeteren.
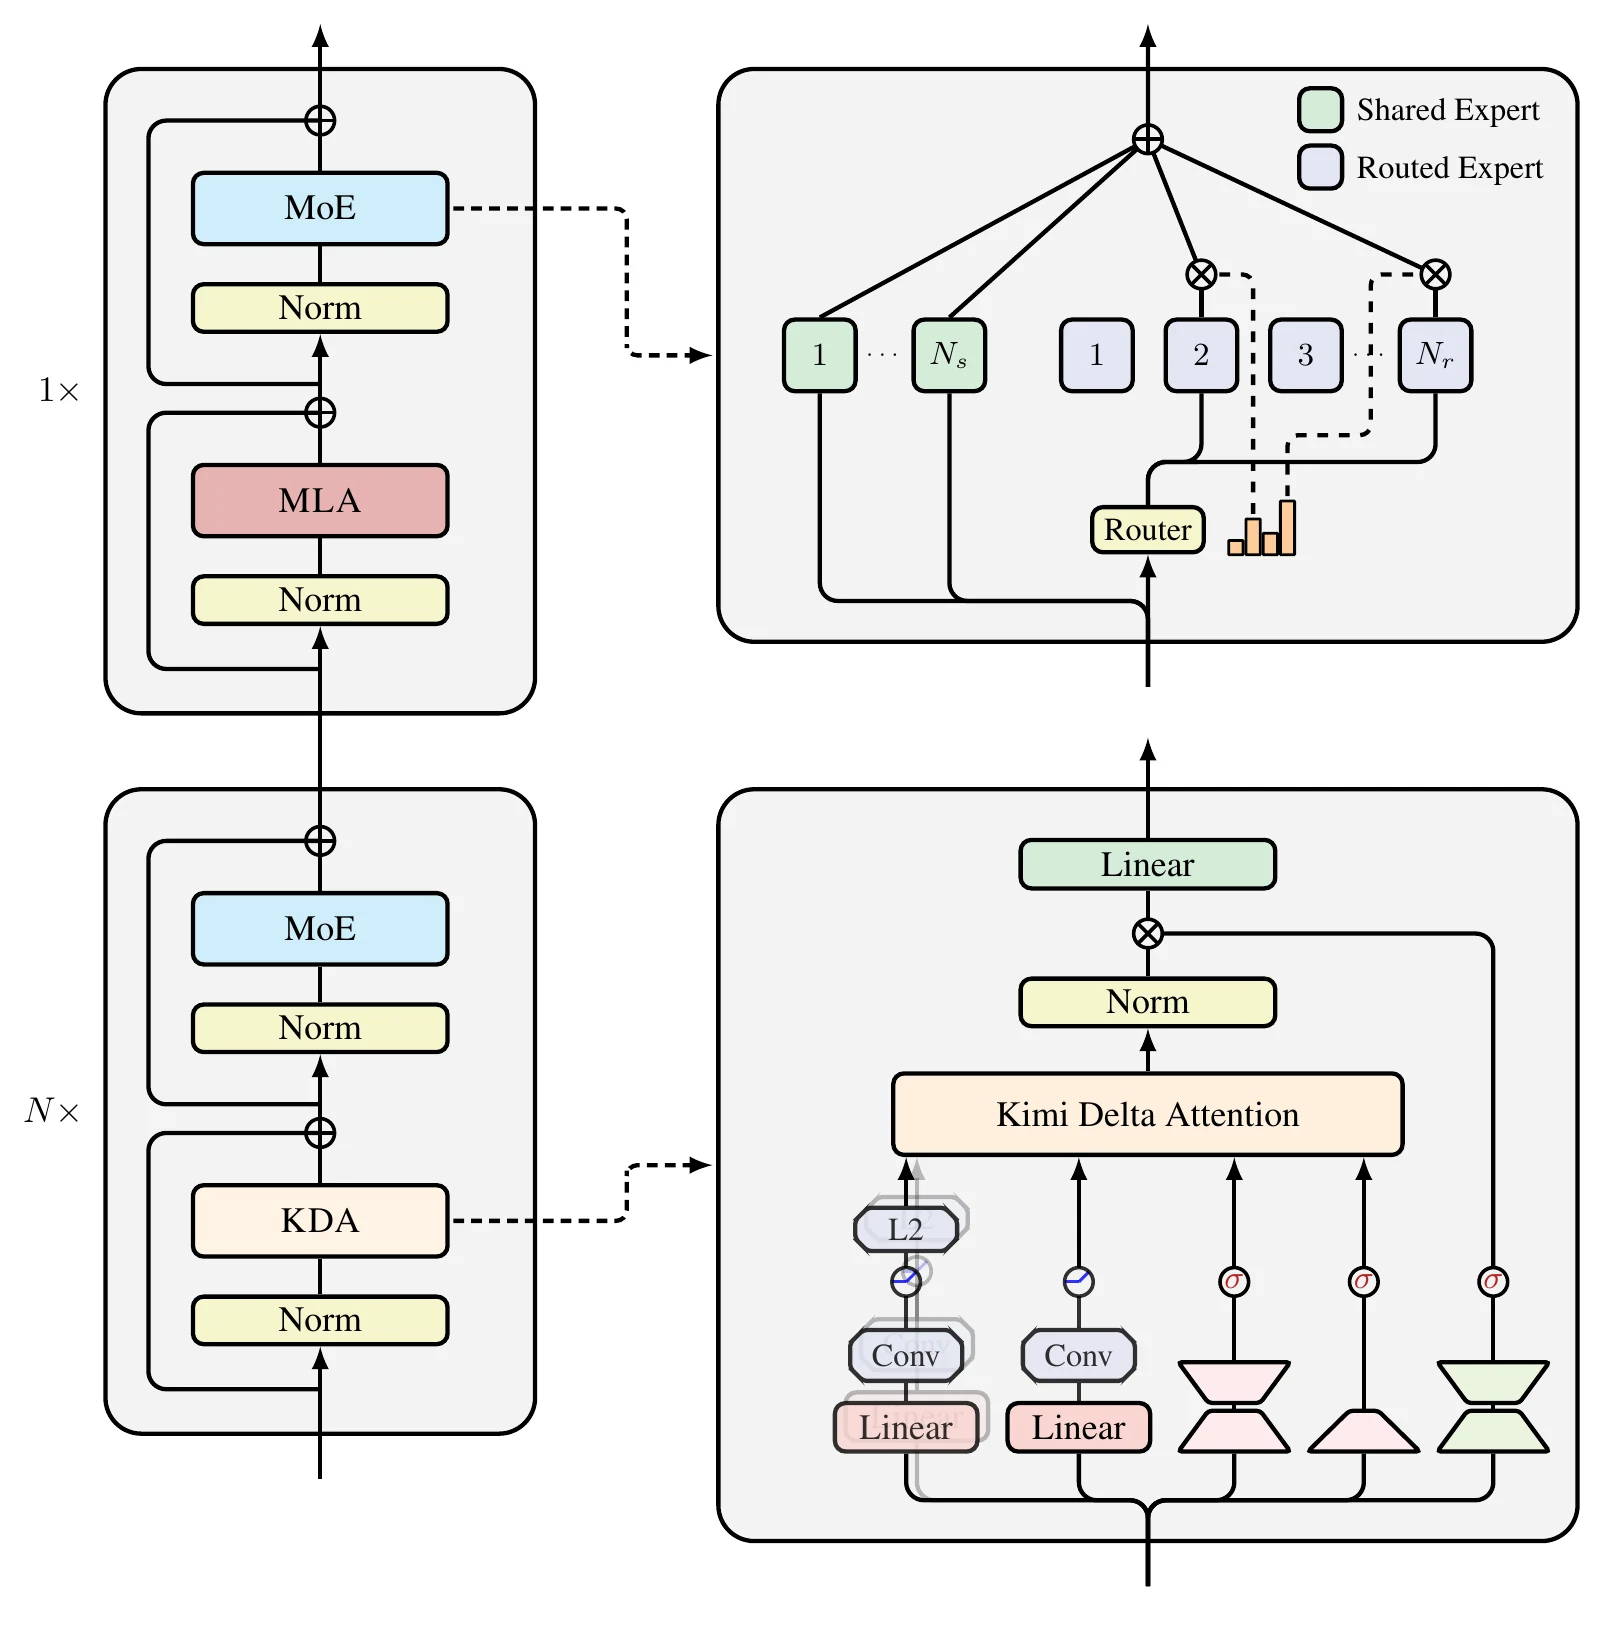
De bovenstaande figuur toont hoe Kimi Linear drie lagen KDA en \u00e9\u00e9n laag MLA afwisselend gebruikt. KDA-lagen verlagen de kosten van lange reeksen met vaste grootte statussen, terwijl MLA-lagen aanvullende directe retrieval van specifieke historische posities bieden, waardoor de beperking van vaste statuscapaciteit wordt verlicht. In vergelijking met dezelfde trainschema's die in het paper worden gebruikt, vermindert dit hybride model maximaal 75% KV Cache ten opzichte van de volledige MLA-baseline, en bereikt maximaal ongeveer 6 keer decode-throughput in 1M-context. Deze effecten komen overeen met de hybride architectuur van Kimi Linear, niet met de uniforme configuratie van alle Kimi-modellen.
Compressed Sparse Attention (CSA) werd voorgesteld door DeepSeek in DeepSeek-V4 en toegepast op DeepSeek-V4-Pro en DeepSeek-V4-Flash. Terwijl het vorige MLA voornamelijk de KV-representatie per token comprimeert, vermindert CSA verder het aantal items in de richting van de reeks, converteert de informatie van meerdere tokens naar minder KV-items en voert vervolgens sparse selectie uit.
CSA verwerkt opeenvolgende tokens eerst met een leerbaar token-niveau comprimeerder, combineert overlappende informatie van aangrenzende blokken en vormt gecomprimeerde KV. Vervolgens scoort de Lightning Indexer deze gecomprimeerde items en selecteert Top-k items voor deelname aan de hoofd-Attention. In de onderstaande figuur staat de comprimeerder v\u00f3̀r de indexering en selectie, en de hoofd-Attention leest direct de gecomprimeerde KV; links is er ook een sliding window-tak die recente niet-gecomprimeerde tokens samen naar de berekening stuurt en lokale details behoudt.
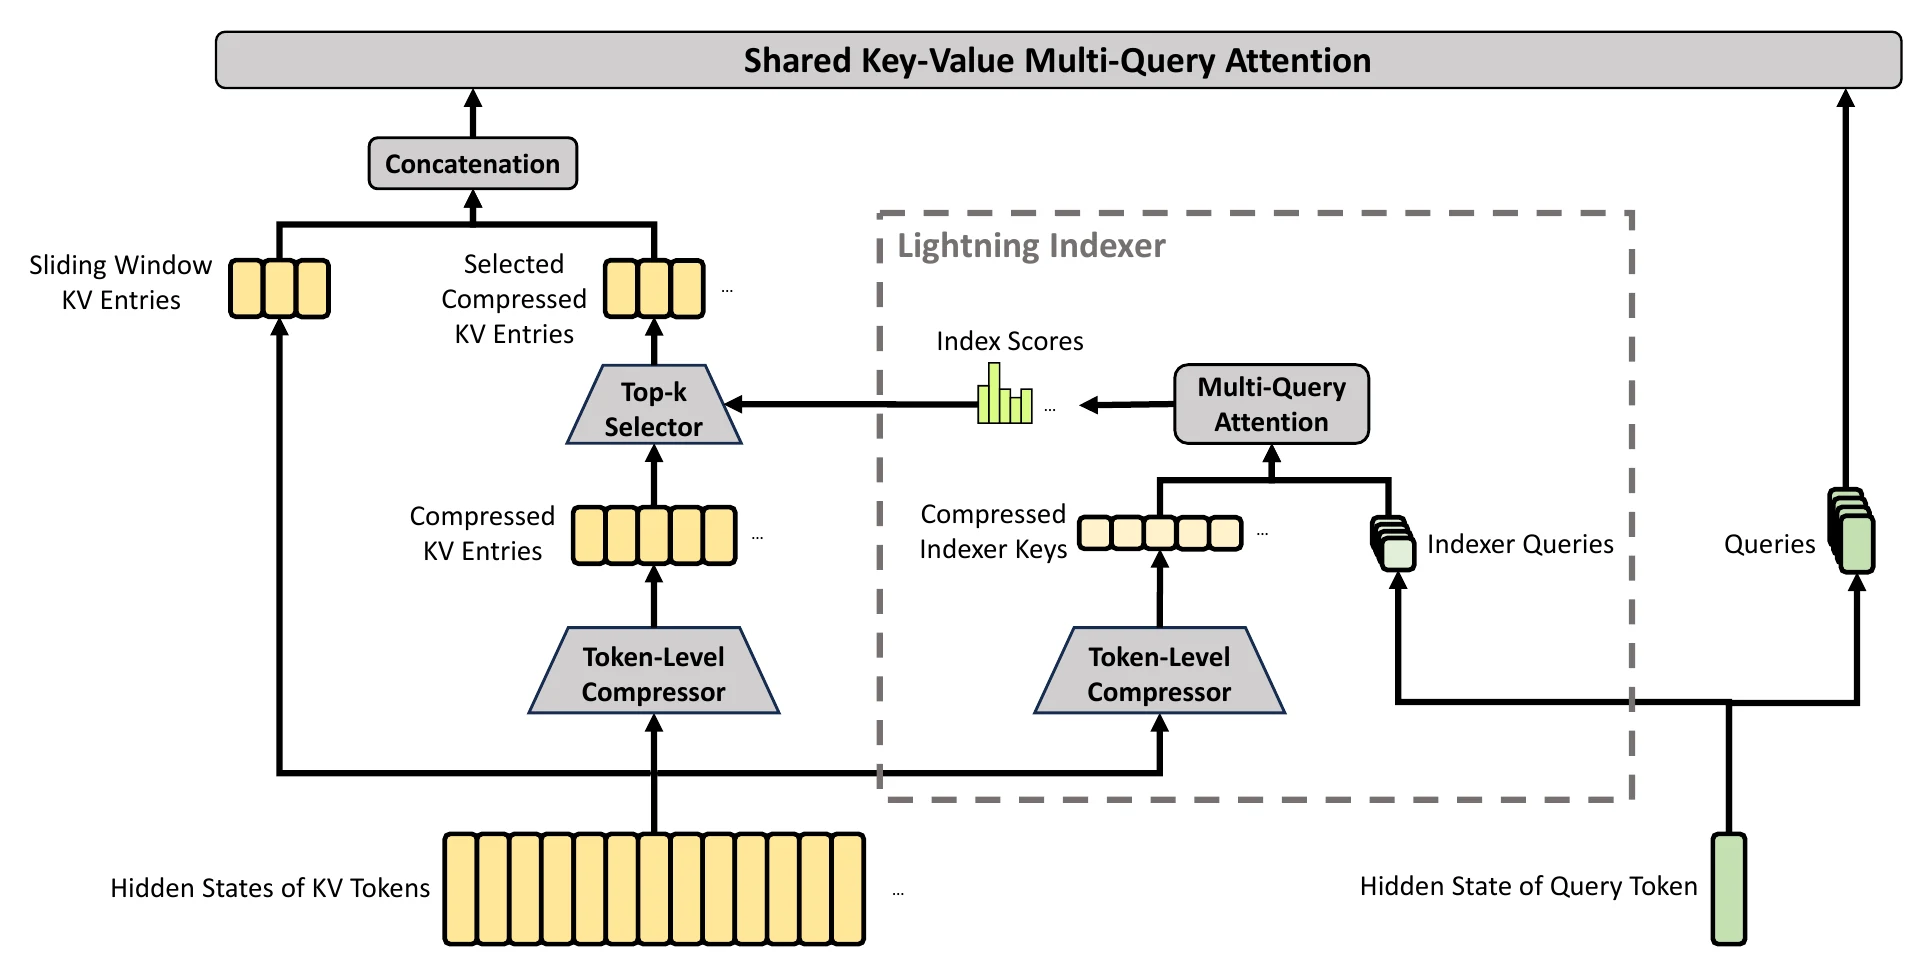
In het DeepSeek-V4-rapport is de compressieratio van CSA 4, dat wil zeggen dat het aantal historische KV-items ongeveer wordt verminderd tot een kwart, en vervolgens een deel van de items wordt geselecteerd voor kern-Attention-berekening. Daarom vermindert CSA zowel de langetermijn-cachehoeveelheid als de historische inhoud die per keer wordt gelezen en berekend. Terwijl QSA na compressie-indexering terugkeert naar de originele tokens, voltooit CSA informatieaggregatie direct op gecomprimeerde items, en comprimeert dus ook de historische KV zelf. Dit ontwerp vereist dat de comprimeerder nuttige kenmerken behoudt, en wordt aangevuld met lokale vensters voor recente details.
Heavily Compressed Attention (HCA) werd ook voorgesteld door DeepSeek in DeepSeek-V4 en wordt afwisselend gebruikt met CSA in de multi-laagstructuur van DeepSeek-V4-Pro en Flash. Het gebruikt sterkere reekscompressie, zodat het model grote historische informatie kan bestrijken met minder cachebehoud, wat een aanvulling vormt op de selectieve lezing van CSA.
De compressieratio van HCA is vastgesteld op 128 in het rapport, veel hoger dan de 4 van CSA. Nadat meerdere tokens via leerbaar gewogen agglomeratie \u00e9\u00e9n gecomprimeerd item vormen, voert de huidige Query Attention uit op alle causaal zichtbare gecomprimeerde geschiedenis, zonder Top-kscreening. Zoals getoond in de onderstaande figuur, behoudt HCA de compressietak en lokale sliding window-tak, maar slaat de indexer en selector van CSA over. Het venster biedt details van recente tokens, en de gecomprimeerde geschiedenis biedt bredere contextinformatie.
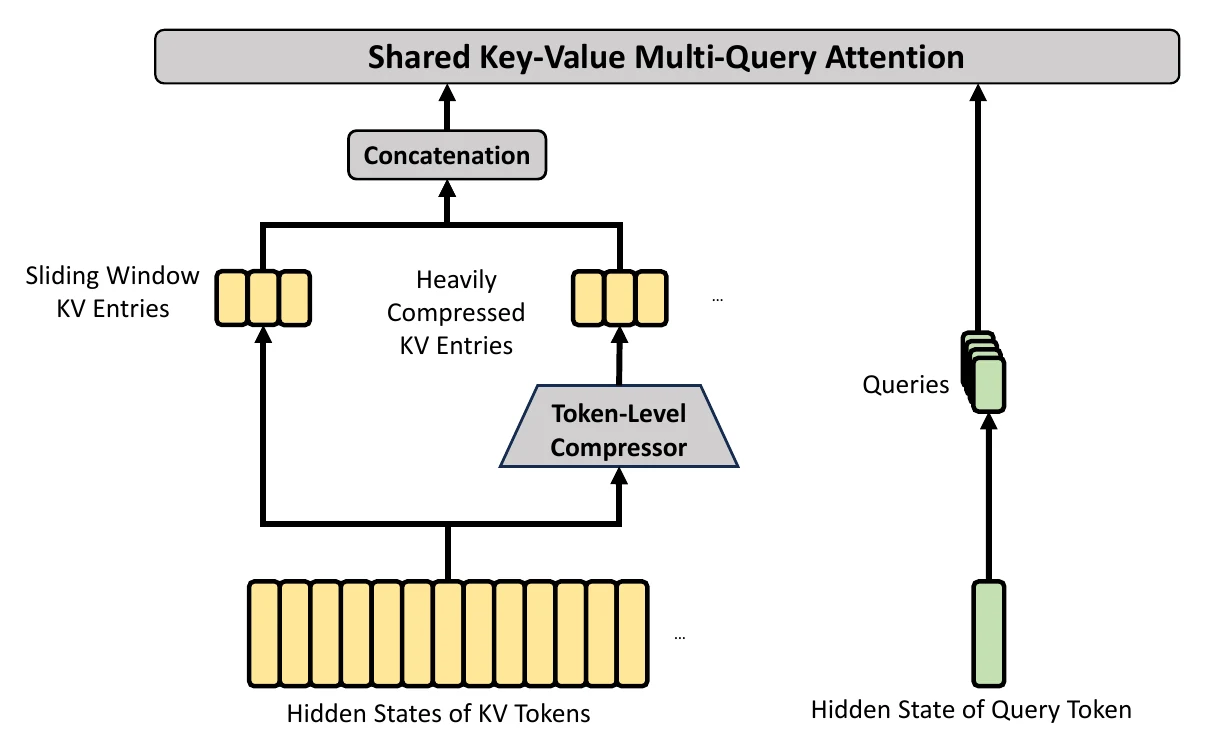
CSA en HCA worden afwisselend geconfigureerd, waardoor DeepSeek-V4 verschillende granulariteiten van historische representaties tegelijkertijd kan benutten. In het rapport, bij 1M context, zijn de enkele-token inferentie FLOPs en KV Cache van DeepSeek-V4-Pro respectievelijk ongeveer 27% en 10% van die van DeepSeek-V3.2. Dit is het gecombineerde effect van hybride attention en lage-precisie berekening en opslag. Voor gebruikers is het belang van dit type structuur dat het ultralange context gemakkelijker maakt om op beperkte hardware te draaien; of een specifiek model details uit lang materiaal nauwkeurig kan extraheren, hangt nog steeds af van de compressiemethode, het trainingsproces en de werkelijke taak.
Uit het ontwerp van deze modellen blijkt dat de verbetering van attention niet in slechts \u00e9\u00e9n richting gaat. MHA, MQA en GQA veranderen voornamelijk de delingsrelatie tussen hoofden, MLA comprimeert de KV-representatie per positie, DSA, MSA en QSA verminderen de posities die door de kern-Attention worden bezocht, KDA verwerkt geschiedenis via statusupdates, en CSA, HCA comprimeren historische items verder. Modellen kunnen meerdere van deze methoden combineren, dus bij het analyseren van bronnenbehoeften moet rekening worden gehouden met het aantal lagen en de cachevorm van elke structuur. Ongeacht welke structuur wordt gebruikt, is Attention alleen verantwoordelijk voor het aggregeren van contextinformatie, en het algehele vermogen van het model wordt nog steeds gevormd door de combinatie met Embedding, feed-forward netwerken en het trainingsproces.
De modelstructuur bepaalt hoe informatie wordt berekend, en het trainingsproces bepaalt wat het model uiteindelijk leert. De training van grote modellen kan doorgaans in verschillende fasen worden verdeeld. Eerst, in de pre-trainingfase, leert het model taalregels, kennisstructuren en basisredeneerpatronen op massa's tekst, code en andere data, en verkrijgt het algemene vermogen; vervolgens gaat het door naar de instruction fine-tuning (Supervised Fine-Tuning, SFT) fase, waar het via grote hoeveelheden "instructie-antwoord" monsters leert om de vereisten van de gebruiker te begrijpen en te antwoorden in de voorgeschreven taakvorm; op basis daarvan vindt ook preferentieoptimalisatie of versterkingsleren plaats, waarbij het gedrag van het model wordt aangepast op basis van menselijke feedback of regels, zodat de antwoorden meer voldoen aan de verwachtingen op het gebied van bruikbaarheid, nauwkeurigheid, expressiestijl, veiligheid en gedragslimieten.
Pre-training is de fase waarin het model basismogelijkheden opbouwt. Het model wordt herhaaldelijk getraind op grote hoeveelheden tekst, code of multimodale data. Voor Decoder-only taalmodellen (zoals de GPT-serie) is de gebruikelijke taak het voorspellen van het volgende token op basis van de voorgaande inhoud, en het aanpassen van modelparameters wanneer de voorspelling fout is. Na het herhaaldelijk verwerken van massa's monsters, leert het model geleidelijk taalstructuur, expressiewijzen en statistische relaties tussen verschillende concepten, en bouwt het de basisrepresentatie en het generatievermogen op die nodig zijn voor taken zoals vraag-antwoord, samenvatting, vertaling en codegeneratie.
De kennis die het model tijdens pre-training leert, is verspreid over grote hoeveelheden parameters en is niet een database die item voor item kan worden geraadpleegd. Het kan de geleerde patronen combineren om inhoud te genereren die niet in de oorspronkelijke trainingsdata voorkomt, of relevante maar niet volledig overeenkomende informatie combineren om ogenschijnlijk redelijke maar onjuiste antwoorden te vormen. Natuurlijk is meer trainingsdata niet altijd beter. Herhaalde inhoud, lage-kwaliteit websites, onjuiste kennis, priv\u00e9gegevens en schadelijke inhoud kunnen het model allemaal be\u00efnvloeden. V\u00f3̀r pre-training zijn doorgaans formaatanalyse, duplicaatverwijdering, kwaliteitsscreening, veiligheidsfiltering en dataproporties nodig. De omvang van de data bepaalt hoeveel inhoud het model kan tegenkomen, en de kwaliteit van de data be\u00efnvloedt direct wat het model eruit kan leren.
Na het voltooien van pre-training kan het model tekst voortzetten, maar het hoeft niet noodzakelijkerwijs stabiel taken uit te voeren volgens de vereisten van de gebruiker. Bijvoorbeeld, als de gebruiker vraagt om drie actiepunten op te sommen, kan het basismodel doorgaan met het uitbreiden van de vraag, of het opgegeven formaat negeren. Instruction fine-tuning gebruikt voorbeelden bestaande uit instructies en gewenste antwoorden om het model verder te trainen. Hier is een voorbeeld van instruction fine-tuning:
Instructie: Organiseer de onderstaande vergaderingsnotities in actiepunten.
Invoer: Tekst van de vergaderingsnotities.
Uitvoer: Een tabel met taken, verantwoordelijken en deadlines.
Na training op verschillende soorten voorbeelden zoals vraag-antwoord, samenvatting, informatie-extractie, code, toolaanroepen en veilige weigering, leert het model geleidelijk om de intentie van de gebruiker te herkennen en uitvoervereisten te volgen. Instruction fine-tuning leert het model voornamelijk hoe het zijn bestaande vermogen moet gebruiken. Het kan een deel van de kennis aanvullen, maar is niet geschikt om alle kennisupdates op te lossen. Voor inhoud die frequent moet worden bijgewerkt of waarvoor bronvermelding vereist is, is het meer geschikt om via kennisbanken, retrieval of externe tools tijdens uitvoering te worden verstrekt.
Post-training is de verzamelnaam voor alle trainings- en afstemmingswerkzaamheden die worden uitgevoerd nadat het model pre-training heeft voltooid. Instruction fine-tuning maakt doorgaans deel uit van post-training, en verdere instruction fine-tuning (SFT), preferentieoptimalisatie en versterkingsleren kunnen ook in deze fase verschijnen. Daarom zijn instruction fine-tuning en post-training niet twee onafhankelijke stappen; het eerste is een specifieke methode, en het tweede is een fase die meerdere methoden omvat. Enkele trainingsmethoden kunnen eerst als volgt worden begrepen:
Fase of methode | Voornamelijk gebruikte data | Voornamelijk opgelost probleem |
Pre-training | Grote hoeveelheden tekst, code en multimodale data | Het model basisregels van taal en kennis laten leren |
Instruction fine-tuning / SFT | Instructies en gewenste antwoorden | Het model leren uitvoeren volgens taakvereisten |
Preferentieoptimalisatie | Betere en slechtere antwoorden op dezelfde vraag | Het model meer neigen naar antwoorden die voldoen aan voorkeuren |
Versterkingsleren | Proompt, modelantwoorden en beloningsignalen | Generatiestrategie verder aanpassen op basis van beloningen |
Als we de op menselijke feedback gebaseerde versterkingsleren (Reinforcement Learning from Human Feedback, RLHF) raadplegen die in InstructGPT wordt gebruikt, is er nu een klassieke post-training-route gevormd. RLHF gebruikt doorgaans in de eerste stap menselijke demonstratiedata om SFT te voltooien, in de tweede stap rangordsgegevens van antwoorden om een beloningsmodel te trainen, en in de derde stap de scores van het beloningsmodel om de generatiestrategie van het taalmodel te optimaliseren met PPO. Het specifieke proces is weergegeven in de onderstaande figuur.
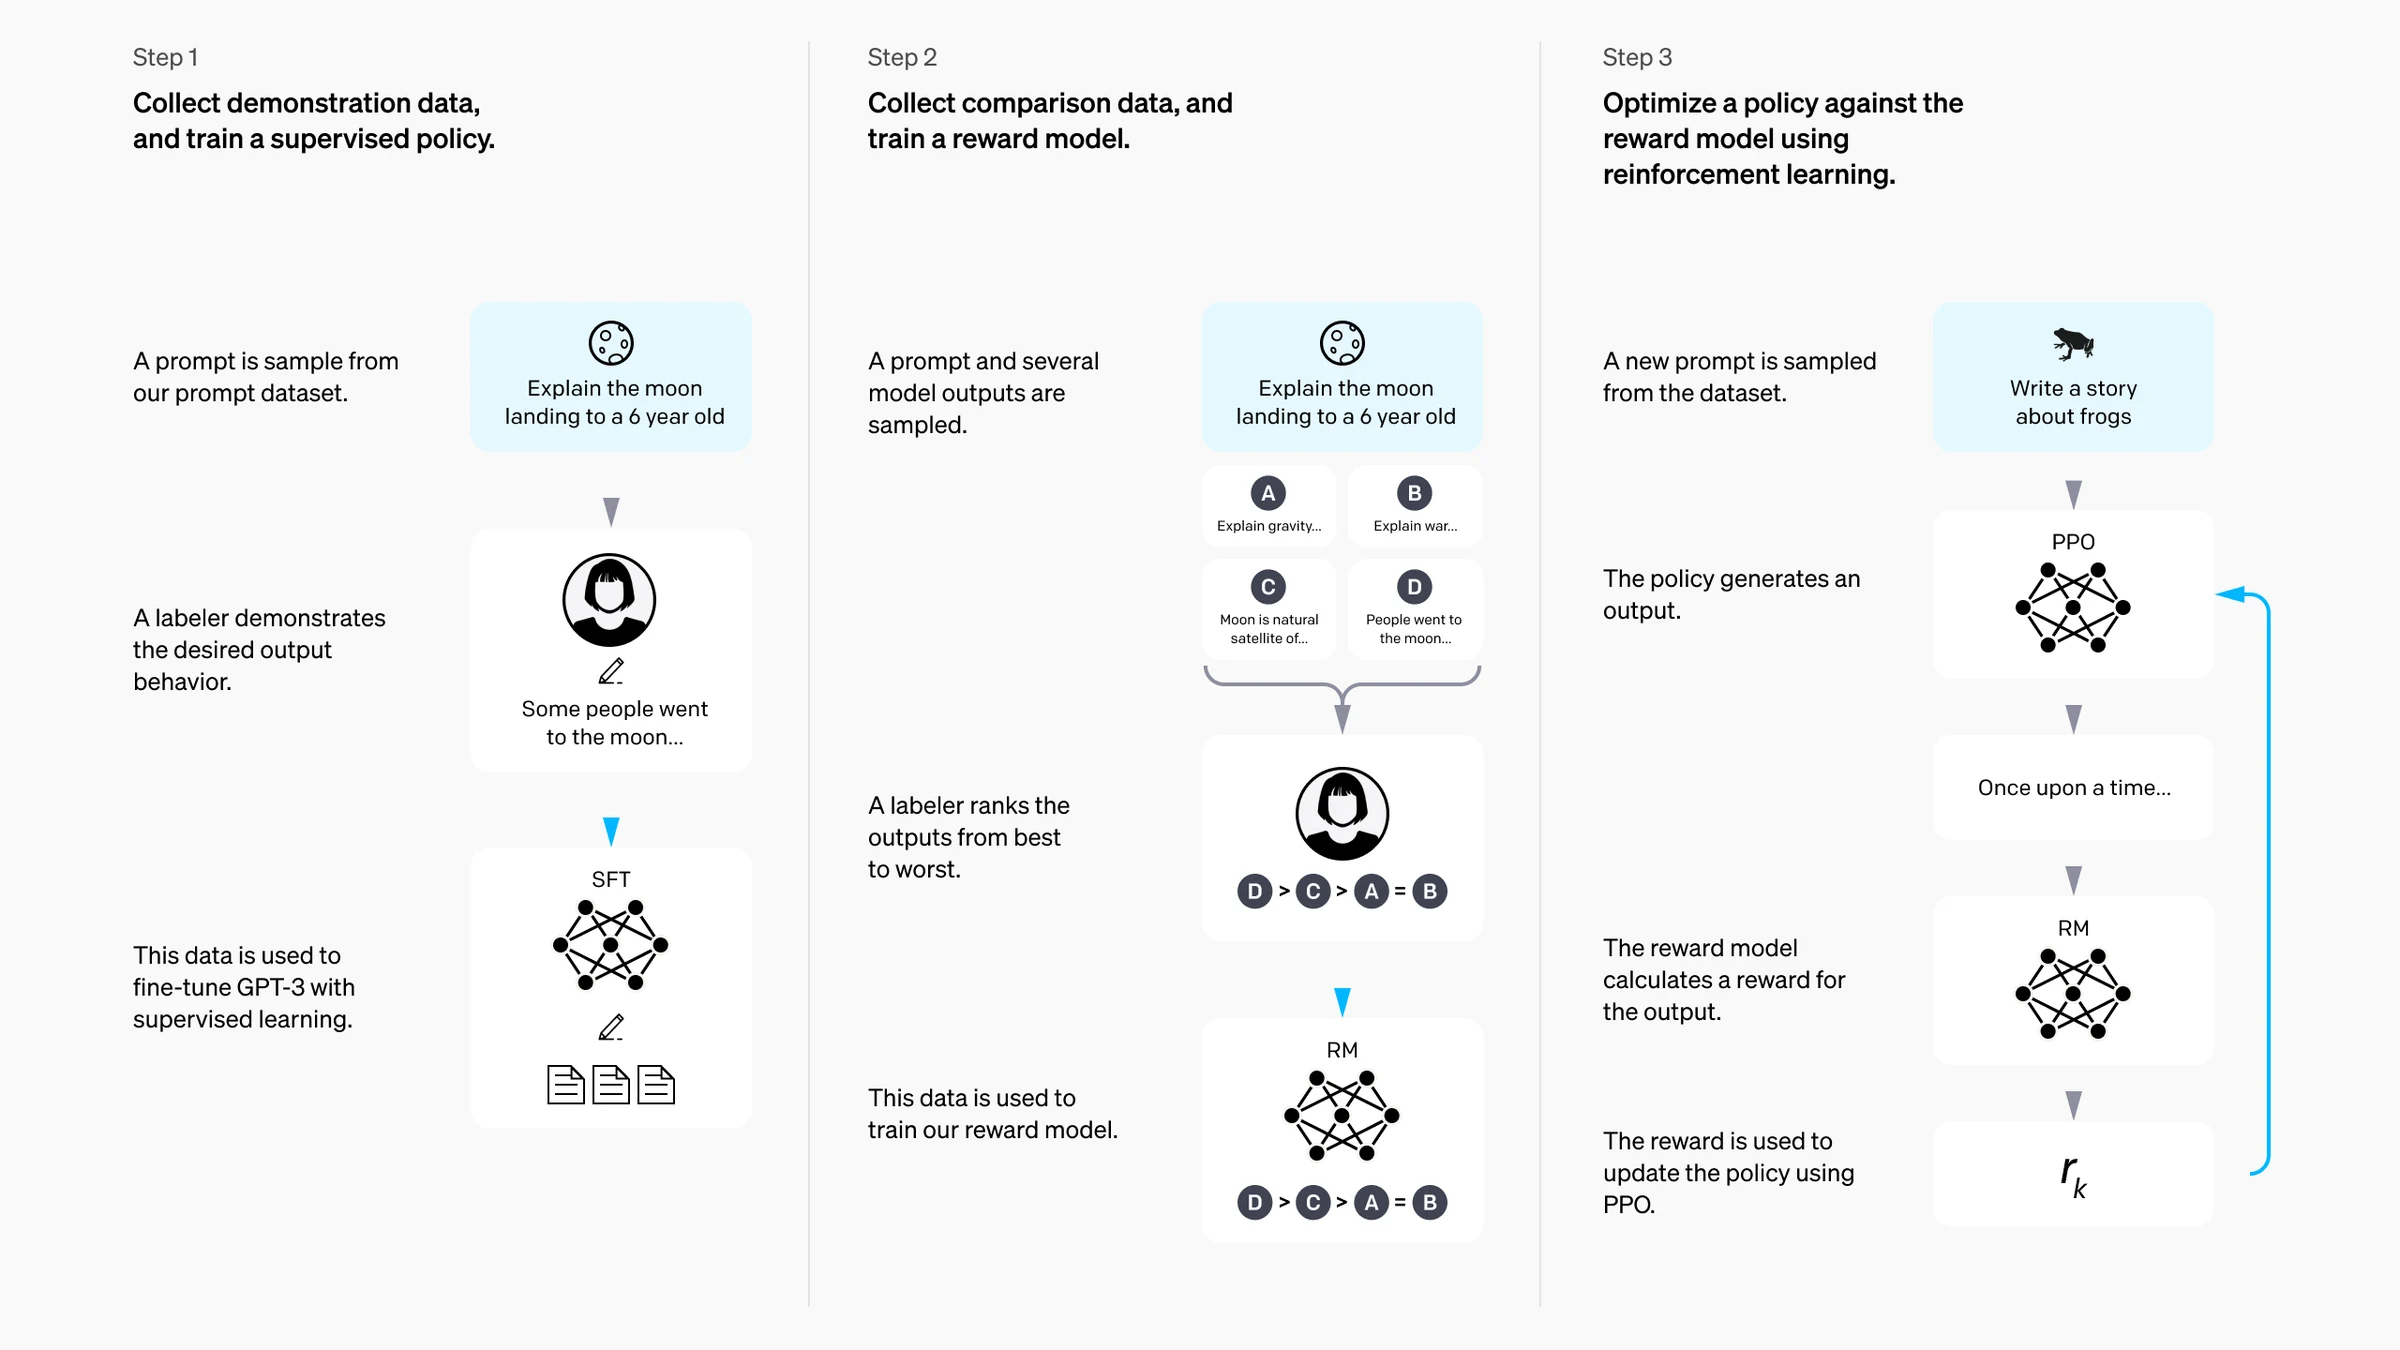
Waarbij de scores die door het beloningsmodel worden gegeven een voorkeur vertegenwoordigen en niet gelijk zijn aan objectieve waarheid. Als de voorkeursdata onvoldoende worden gedekt, of als de beloningsregels niet redelijk zijn ontworpen, kan het model alleen leren om de scoresmethode tegemoet te komen.
Werkelijke modellen gebruiken niet noodzakelijkerwijs exact dezelfde route. Sommige modellen gebruiken SFT plus DPO, sommige gebruiken SFT, beloningsmodel en PPO, en sommige voegen ook AI-feedback, veiligheidsafstemming, toolgebruiktraining en multi-turn dialoogdata toe. De voorgaande pre-training, instruction fine-tuning en post-training leggen uit hoe de mogelijkheden van het model worden gevormd. Nadat de modeltraining is voltooid, zijn de problemen waarmee gebruikers vaker te maken krijgen: hoeveel inhoud kan er in één keer worden ingevoerd, hoeveel VRAM is nodig tijdens uitvoering, en welke precisie moet worden gekozen voor beperkte hardware.
Nadat het model zijn training heeft voltooid, treedt het daadwerkelijke inferentie- en inzetfase in. De contextlengte bepaalt hoeveel tokens in één verzoek kunnen worden opgenomen; hoe langer de context, hoe meer materiaal het model kan lezen, maar de Attention-berekening en KV Cache-verbruik nemen ook toe, wat de inferentiesnelheid en VRAM-behoeften be\u00efnvloedt. Hier verwijst context naar het systeempropt, de dialooggeschiedenis, de huidige invoer, bestandsinhoud, toolbeschrijvingen, toolretourresultaten en de inhoud die door het model al is gegenereerd in één verzoek, en kan worden uitgedrukt met de volgende formule: Contextgebruik = Systeeminstructies + Dialooggeschiedenis + Huidige invoer + Bijlageinhoud + Toolinformatie + Modeluitvoer.
Zoals hierboven vermeld, is de contextbezetting van grote modellen niet alleen de inhoud die de gebruiker momenteel invoert, maar bestaat uit meerdere delen, waaronder systeeminstructies, de eerdere dialooggeschiedenis, de huidige invoer van de gebruiker, relevante inhoud in bijlagen, informatie die nodig is voor toolaanroepen en de uitvoer die door het model al is gegenereerd. Al deze inhoud neemt de contextwindow van het model in beslag, dus naarmate de dialoog langer wordt, bijlagen toenemen of toolinformatie complexer wordt, zal de contextruimte die beschikbaar is voor verdere invoer en generatie geleidelijk afnemen. Bijvoorbeeld, als het model een contextlengte van 128K ondersteunt, geeft dit doorgaans het totale Token-niveau aan dat in één verzoek kan worden verwerkt. Of uitvoer is inbegrepen, wat de maximale uitvoer per keer is, hangt ook af van de beperkingen van het model- en service-interfaces. Doorgaans, wanneer de context wordt overschreden, kan het platform verzoeken weigeren, een deel van de inhoud afsnijden, of de geschiedenis automatisch comprimeren.
Om de inferentie-effici\u00ebntie en antwoordkwaliteit van het model in lange documentscenario's te verbeteren, moet de inhoud v\u00f3̀r het invoeren van materiaal zoveel mogelijk worden geordend, onnodige, herhaalde of minder waardevolle informatie worden verwijderd, en moet het model duidelijk worden verteld welke secties, velden of vraaggebieden de bijzondere aandacht verdienen, om te voorkomen dat het model de aandacht verspreidt over grote hoeveelheden onnodige context. Voor materiaal dat bijzonder lang is en moeilijk in één keer volledig kan worden verwerkt, kan het eerst worden opgesplitst in secties, onderwerpen of vaste lengtes, zodat het model afzonderlijk informatie-extractie, samenvatting of analyse kan voltooien, en vervolgens de resultaten van elk deel kan samenvoegen en synthetiseren. Voor belangrijke conclusies, belangrijke gegevens of inhoud die verder moet worden geverifieerd, moet het model ook de bijbehorende originele positie, sectie of paginanummer vermelden voor handmatige controle en resultaattraceerbaarheid, waardoor de nauwkeurigheid, uitlegbaarheid en betrouwbaarheid van het algehele verwerkingsproces worden verbeterd.
Op basis van de Transformer-architectuur genereren generatieve modellen doorgaans tokens een voor een. Tijdens het genereren, als voor elk token opnieuw alle aandachtsinformatie van voorgaande tokens wordt berekend, ontstaat er een grote hoeveelheid herwerk. Daarom kan een cachesysteem worden ge\u00efntroduceerd, namelijk KV Cache. KV Cache slaat de Key en Value op die al in elke laag zijn berekend, en bij het genereren van het volgende token hoeft alleen het nieuwe deel te worden berekend, waardoor de generatiesnelheid wordt verbeterd. Bij elk token moeten alle Transformer-lagen de bijbehorende K en V opslaan. Daarom neemt KV Cache toe met de contextlengte, uitvoerlengte, gelijktijdig aantal en het aantal lagen van het model.
Voor veelgebruikte Decoder-only modellen kan de cachebezetting van één reeks met de volgende vereenvoudigde formule worden begrepen:
$\text{KV Cache-gebruik} = 2 \times \text{aantal lagen} \times \text{aantal tokens} \times \text{aantal KV-hoofden} \times \text{dimensie per hoofd} \times \text{bytes per getal}$
Nadat de modelgewichten zijn geladen, is de bezetting relatief vast, maar KV Cache verandert met verzoeken. Daaroor kan hetzelfde gekwantiseerde model soepel draaien bij korte vraag-antwoordtaken, maar kan het bij lange documenten of meerdere gelijktijdige gebruikers nog steeds een tekort aan VRAM hebben. Bijvoorbeeld, dezelfde server kan normaal draaien wanneer slechts één kort vergaderingsnotitie wordt verwerkt, maar als tien gebruikers tegelijkertijd lange notities uploaden, moet het model voor meerdere reeksen afzonderlijk KV Cache opslaan, en de VRAM-druk neemt aanzienlijk toe. Dit verklaart ook dat, zelfs als het modelbestand in de VRAM past, met de toename van de tekstlengte en het gelijktijdige aantal van de invoer, het verbruik van rekenbronnen ook verandert. Daarom kan bij daadwerkelijke inzet de druk op KV Cache worden verminderd en de effici\u00ebntie van reken services worden verbeterd door onnodige context in te korten, de maximale generatielengte te beperken, het gelijktijdige aantal te verminderen, paging-cache te gebruiken, of modellen met GQA- of MQA-structuur te kiezen.
Modelbestanden slaan daadwerkelijk de huidige modelstructuur en bijbehorende parameters op, en deze parameters zijn in wezen een reeks getalen. In overeenstemming met de principes van computeropbouw, zijn deze parameters doorgaans een uitdrukking van nullen en enen in de computer, en verschillende bitlengtes om hetzelfde getal uit te drukken, dat wil zeggen het gespecificeerde bereik van getalen, bepalen ook de precisie van de getallen. Bij modeltraining worden doorgaans FP32, FP16 of BF16floating-pointformaten gebruikt voor berekeningen, wat in wezen 32 bits of 16 bits nullen en enen gebruikt om een getal uit te drukken. Hoe meer bits, hoe groter het bereik van de uitgedrukte getallen en de numerieke precisie, maar het werkelijke bronverbruik is ook erg groot. Daarom is kwantizering voorgesteld om verder bronverbruik te verminderen. Kwantizering converteert deze oorspronkelijk meerdere bitsfloating-pointgetallen naar 8-bits INT8, 4-bits INT4 of lagere precisie representaties, waardoor het bronverbruik van modelbestanden en runtime wordt verminderd. De onderstaande tabel toont de kenmerken die overeenkomen metfloating-pointprecisie:
Precisie | Theoretisch aantal bytes per parameter | Typische kenmerken |
FP32 | 4 | Hoge precisie, groot bronverbruik |
FP16/BF16 | 2 | Veelgebruikt trainings- en hoge-precisie inferentieformaat |
INT8 | 1 | Theoretisch gewichtsgebruik ongeveer de helft van 16-bits |
INT4 | 0.5 | Theoretisch gewichtsgebruik ongeveer een kwart van 16-bits |
Werkelijke kwantizering is niet het eenvoudig afronden van alle decimalen, maar het mappen van een reeksfloating-pointgetallen naar een beperkt bereik en het opslaan van schaalco\u00ebffici\u00ebnten, nulpunten of groepsinformatie. Gebruikelijke praktijken zijn onder meer het alleen comprimeren van modelgewichten, het gelijktijdig kwantiseren van gewichten en activeringen, en het uitvoeren van post-training kwantizering nadat de modeltraining is voltooid. We hoeven ons geen zorgen te maken over getalveranderingen veroorzaakt door kwantizering, omdat het model bij generatie voorspelt hoe waarschijnlijk elk kandidaat-token het volgende woord is, en bij selectie meer belang hecht aan rangschikking en genormaliseerde scores. Daaroor heeft kwantizatieprecisie wel verlies, maar kan onder strikte controle effectief het generatie-effect van het model zelf in evenwicht brengen.
Bij het kiezen van een model moet vaak worden beoordeeld of de VRAM voldoende is. De namen 7B, 14B en 70B in de modelnaam geven doorgaans ongeveer 7 miljard, 14 miljard en 70 miljard parameters aan. Parameters zijn getalen die tijdens de modeltraining zijn geleerd, en zijn verspreid over modules zoals Attention, feed-forward netwerken en Embedding.
Het aantal parameters kan niet direct worden gelijkgesteld aan de grootte van het modelbestand; de precisie die per parameter wordt gebruikt, moet ook worden meegewogen. Bij het alleen berekenen van modelgewichten kan de volgende formule worden gebruikt:
$\text{Gewichtsbezetting} \approx \text{aantal parameters} \times \text{bytes per parameter}$
Parameterschaal | FP16/BF16 | INT8 | INT4 |
7B | ongeveer 14GB | ongeveer 7GB | ongeveer 3.5GB |
14B | ongeveer 28GB | ongeveer 14GB | ongeveer 7GB |
32B | ongeveer 64GB | ongeveer 32GB | ongeveer 16GB |
70B | ongeveer 140GB | ongeveer 70GB | ongeveer 35GB |
De getallen in de tabel vertegenwoordigen alleen de theoretische ondergrens van modelgewichten. Gekwantiseerde modellen moeten ook schaalco\u00ebffici\u00ebnten en andere informatie opslaan, en daadwerkelijke inferentie vereist ook KV Cache, tussenliggende berekeningsresultaten, inferentieframeworkwerkruimte en gelijktijdige verzoekcache.
Bijvoorbeeld, de INT4-gewichten van een 14B-model zijn theoretisch ongeveer 7GB, maar op een 8GB-kaart is er bijna geen ruimte over voor KV Cache en runtime-buffers. Het kan mogelijk draaien bij korte context en enkel verzoek, maar heeft bij het verwerken van lange documenten gemakkelijk een tekort aan VRAM. Het gebruik van 12GB of 16GB VRAM is meer ontspannen. 70B INT4-gewichten zijn ongeveer 35GB, en vereisen doorgaans 48GB of meer VRAM. Bij inzet kunnen rekenkaarten met grotere VRAM, meerdere kaarten of CPU-geheugen voor hybride inferentie worden gekozen.
Generieke grote modellen moeten grote hoeveelheden kennis en taken bestrijken, maar zijn in professionele scenario's zoals medisch, financieel, juridisch en code niet noodzakelijk bekend met brancheterminologie, bedrijfsprocessen en risicogrenzen. Domeinmodellen worden doorgaans voortgezet getraind of aangepast met professionele data en taken op basis van een generiek basismodel, waardoor het model beter geschikt wordt voor een bepaald domein. Het hoeft niet vanaf nul te worden getraind, en is niet alleen het instellen van het model als professional via een prompt. Veelgebruikte trainings- en aanpassingsmethoden zijn onder meer:
Hier moet onderscheid worden gemaakt tussen domeinmodellen en domeintoepassingen. Domeinmodellen zijn getraind met professionele data, en professioneel vermogen is al in de modelparameters geschreven; domeintoepassingen kunnen direct generieke modellen gebruiken en vervolgens professionele kennisbanken, regels en tools verbinden. Werkelijke systemen combineren vaak ook beide methoden.
Het onderstaande juridische Q&A-systeem extraheert eerst trefwoorden, haalt vervolgens referentiebepalingen op uit de vectorbank van regelgeving, en genereert tenslotte een antwoord met behulp van het juridische grote model op basis van bewijs. Dit toont aan dat professioneel vermogen niet noodzakelijkerwijs alleen afhankelijk is van modelparameters; externe materialen zijn ook een belangrijk onderdeel van domeintoepassingen.
Professionele data betekenen niet noodzakelijkerwijs professioneel betrouwbaar. Medische modellen moeten nog steeds medisch bewijs en veiligheidsgrenzen controleren, juridische modellen moeten wetten en citaten controleren, financiële modellen moeten datualiteit en berekeningsresultaten controleren, en codemodellen moeten worden geverifieerd door uitvoering en tests. Hoge-risicotaken zoals medisch, juridisch en financieel moeten ook professionele goedkeuring behouden.
Wanneer het model wordt gebruikt om vergaderingsnotities te organiseren, als de originele tekst geen verantwoordelijke persoon specificeert, maar het model vult zelf een naam aan; wanneer het model wordt gebruikt om contracten te extraheren, als de originele tekst geen bedrag bevat, maar het model een specifiek cijfer genereert, dit zijn allemaal voorbeelden van modelhallucinatie. Modelhallucinatie verwijst naar inhoud die door grote modellen wordt gegenereerd die taalkundig vloeiend en structureel compleet is, maar niet consistent is met feiten, invoermaterialen of verifieerbare bronnen. Het kan zich ook manifesteren als het verzinnen van niet-bestaande beleidsregels, papers of websites, het verkeerd schrijven van personen en tijden, of het schrijven van niet-gevormde discussies als reeds vastgestelde conclusies.
De kerntaak van grote modellen is het voorspellen van het volgende token op basis van context, en tijdens het genereren kan het model niet verifiëren of elke zin waar is. Er zijn veel redenen voor modelhallucinatie: de pre-trainingdata kan fouten of verouderde informatie bevatten; vragen van gebruikers kunnen essentiële voorwaarden missen; bewijs in lange teksten kan ook worden genegeerd of afgesneden. Als de beloningsfunctie in post-training is ontworpen om volledige, vloeiende antwoorden meer aan te moedigen, kan het model ook doorgaan met genereren wanneer er geen onderbouwing is.
In de praktijk komen de volgende situaties vaak voor: het model vult niet-bestaande namen, datums, aantallen of andere specifieke details aan wanneer de originele tekst deze niet bevat; het model genereert niet-bestaande beleidsregels, reguliere bepalingen, onderzoeksrapporten of geloofsbrieven; het model maakt fouten bij het schrijven van personen, tijd, locatie of andere feitelijke informatie; het model schrijft niet-gevormde discussies of meningsverschillen als reeds vastgestelde conclusies; het model maakt fouten bij het citeren van wetten, bepalingen, normen of andere referentiematerialen; het model genereert onjuiste statistische gegevens, formules of rekenresultaten.
Hallucinatie door grote modellen is een veelvoorkomend probleem bij huidige toepassingen. Het toevoegen van een zin zoals "verzin niet" of "zorg voor nauwkeurige antwoorden" in de prompt kan dit risico doorgaans niet fundamenteel elimineren. Het model voorspelt in wezen nog steeds de meest waarschijnlijke inhoud op basis van context. Wanneer de invoerinformatie onvoldoende is, materialen conflicteren, of de vraag zelf buiten het betrouwbare kennisbereik van het model valt, kan het nog steeds antwoorden genereren die er redelijk uitzien maar eigenlijk onnauwkeurig zijn. Daarom is het verminderen van hallucinatierisico meer afhankelijk van een compleet stelsel van invoerbeperkingen, externe verificatie en menselijke beoordelingsmechanismen.
Allereerst moet zoveel mogelijk duidelijk, relevant en consistent materiaal aan het model worden verstrekt, om de verstoring van het beoordelingsproces door onnodige en conflicterende informatie te verminderen. Voor belangrijke inhoud zoals feiten, cijfers, bepalingen van beleid en experimentele resultaten, kan het model worden gevraagd de bijbehorende bron, sectie, paginanummer of oorspronkelijke positie aan te geven, zodat het antwoord traceerbaar is en gemakkelijk kan worden geverifieerd. Voor kennis die vaak wordt bijgewerkt, zoals nieuws, beleid, prijzen, regelgeving en productspecificaties, moet men niet alleen vertrouwen op het interne geheugen van het model, maar moet informatie worden verkregen via zoekmachines, kennisbanken, databases, API's of andere externe tools, en vervolgens moet het model analyses uitvoeren op basis van deze betrouwbare materialen.
Ten tweede, wanneer de originele materialen bepaalde informatie echt ontberen, moet het model duidelijk worden gevraagd om markeringen te gebruiken zoals "te bevestigen", "niet vermeld in de originele tekst", "kan niet worden beoordeeld op basis van beschikbaar materiaal", in plaats van aan te vullen op basis van ervaring. Voor inhoud die geschikt is voor gestructureerde controle, zoals datums, bedragen, identiteitskaartnummers, statistische gegevens, formules en code-uitvoerresultaten, kan ook programmatuur worden ge\u00efntroduceerd voor automatische verificatie, zoals het controleren van waardenbereiken, veldformaten, berekeningsresultaten en of code daadwerkelijk kan worden uitgevoerd, om te voorkomen dat het model alleen op basis van taal generatie-resultaten produceert.
Bovendien, voor belangrijke conclusies, met name inhoud die bedrijfsbeslissingen, projectacceptatie of gebruikersrechten be\u00efnvloedt, moet een schakel voor menselijke beoordeling worden behouden. Vloeiende taaluitdrukking en schijnbaar complete logica betekenen niet noodzakelijkerwijs dat feiten correct zijn, dus "klinken als de waarheid" mag niet direct worden gelijkgesteld met "is de waarheid". In hoog-risicoscenario's zoals medisch, juridisch, financieel en veilig productie, moet duidelijk worden gesteld dat het model slechts een hulpmiddel is, en dat de uiteindelijke conclusies moeten worden beoordeeld en bevestigd door professionals met de juiste kwalificaties en ervaring.
Daarom is de kerngedachte bij het verminderen van hallucinatie niet het model vragen om "altijd te antwoorden", maar het model leren om redelijkerwijs te stoppen wanneer er geen betrouwbare basis is. Wanneer beschikbare informatie onvoldoende is om een conclusie te ondersteunen, is het meest geschikte gedrag mogelijk om duidelijk uit te leggen "welke essentiële materialen momenteel ontbreken" en "welke conclusies tijdelijk niet kunnen worden bevestigd", en de gebruiker verder te vertellen welke gegevens, documenten of bewijs moeten worden aangevuld. In vergelijking met het doorgaan met het genereren van een ogenschijnlijk compleet maar ongegrond antwoord, is deze aanpak doorgaans betrouwbaarder en meer geschikt voor praktische bedrijfstoepassingen.