AIUnlimited
🌳

AI基础

🌱
AI 种子

从零开始

🌿
AI 萌芽

打好基础

🌳
AI 枝干

付诸实践

🏕️
AI 树冠

深入探索

🌲
AI 森林

精通AI

🔨

AI精通

✏️
AI 草图

从零开始

🪨
AI 雕刻

打好基础

⚒️
AI 匠心

付诸实践

💎
AI 打磨

深入探索

🏆
AI 杰作

精通AI

📘

AI实战

📖
理解开源模型

开源模型的基础知识和资源

🎯
问题到模型任务

将业务问题转化为模型任务

⚡
跑通第一个模型

30分钟快速看到第一个结果

🔧
微调与评测

微调模型并评估性能

🚀
应用系统

构建实际AI应用系统

🎨
生成式AI

探索AIGC的开源模型

🤖
Agent智能体

学习Agent框架和MCP工具

📐
基础补充

LLM基础知识和评测

🎓

Claude 学院

🤖
Claude 101 入门

用 Claude 学习 AI 基础知识

💻
Claude Code 101 入门

让 Claude 成为你的结对编程伙伴

🤝
Claude Cowork 入门

与 Claude 协作完成复杂项目

⚙️
Claude 平台 101

使用 Claude API 构建应用

实验室

已加载 7 个实验
🧬神经网络沙盒🤖AI 还是人类?🥋提示工程道场🏁算法竞速🧠AI 知识挑战🏗️系统设计画布
🎯模拟面试进入实验室→
🚀

职业发展

🚀
面试发射台

开启你的旅程

🌟
行为面试精通

掌握软技能

💻
技术面试

通过编程轮次

🤖
AI与ML面试

ML面试精通

🏆
Offer与未来

拿下最好的Offer

立即开始
AIUnlimited

AI 教育平台

沪ICP备18025655号-11

学习

  • AI基础
  • AI实战
  • Claude学院
  • 实验室
  • 职业发展

社区

  • 关于
  • 常见问题

支持

  • 服务条款
  • 隐私政策
  • 联系我们
AI & 工程学习计划›📖 理解开源模型›课程›开源模型正在改变什么
📖
理解开源模型 • 入门⏱️ 15 分钟阅读

开源模型正在改变什么

开源模型正在改变什么

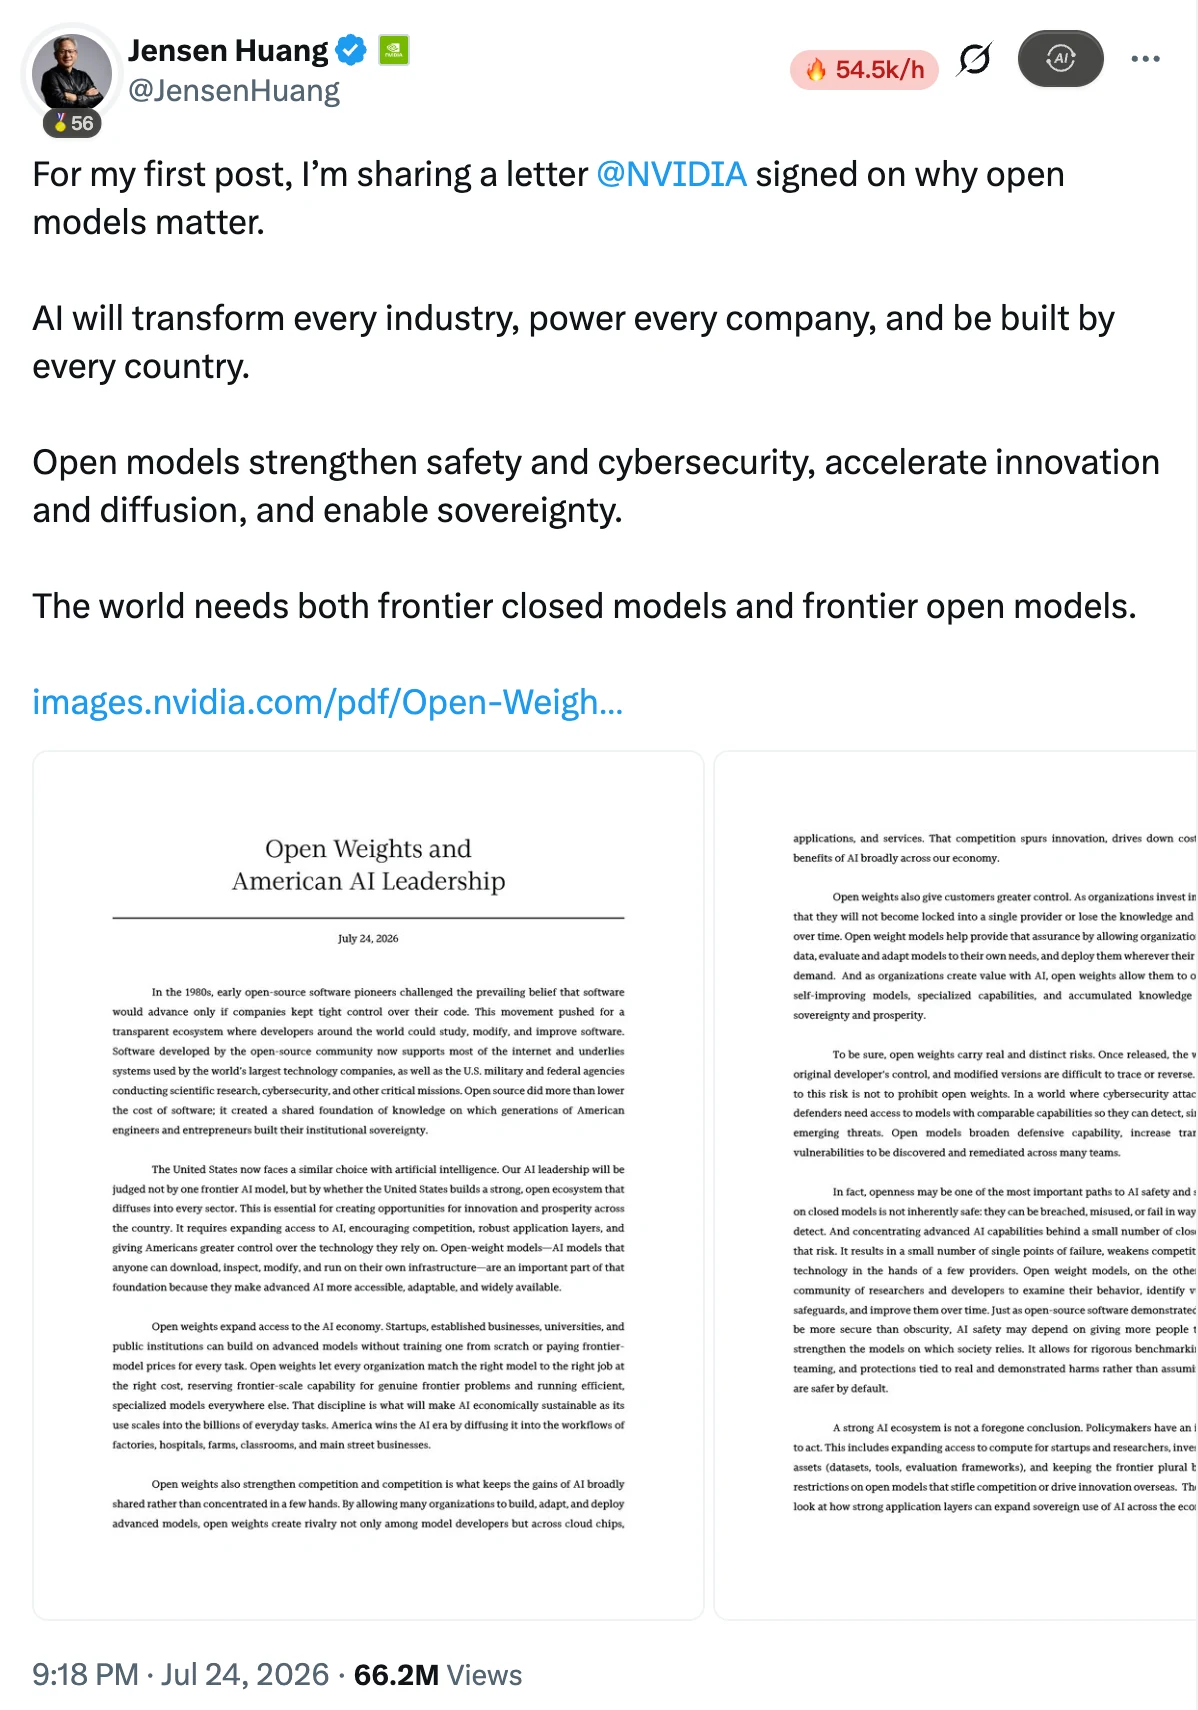
你可能想象不到,Nvidia CEO 黄仁勋在X上发出了自己的第一条帖子,竟然献给了开源。
正文配图

2026年7月24日,他分享了一封英伟达参与签署的公开信,谈的是开放模型为什么重要,

这个世界既需要前沿的闭源模型,也需要前沿的开放模型。

可能很多人已经习惯了打开一个聊天窗口,把问题发过去,等AI回答。但当你准备用AI长期处理公司资料、接入内部系统时,可能就会出现以下问题:资料发过去安全吗?服务突然限流怎么办?能不能让模型学会公司数据的处理方式?

开源模型可以让这些问题多一种解法。你可以在许可证允许的范围内,把模型下载下来,部署在自己的环境里,继续微调它,让用户自己决定如何使用。

当然,大模型的开源闭源之争,一直也是讨论不休,老黄的这一封信,也再次引起了我们的共鸣,决定联合几个共建者,开始这个开源模型应用实战紫皮书之旅。这次把开源模型应用实战内容带给大家,愿开源模型繁荣昌盛~

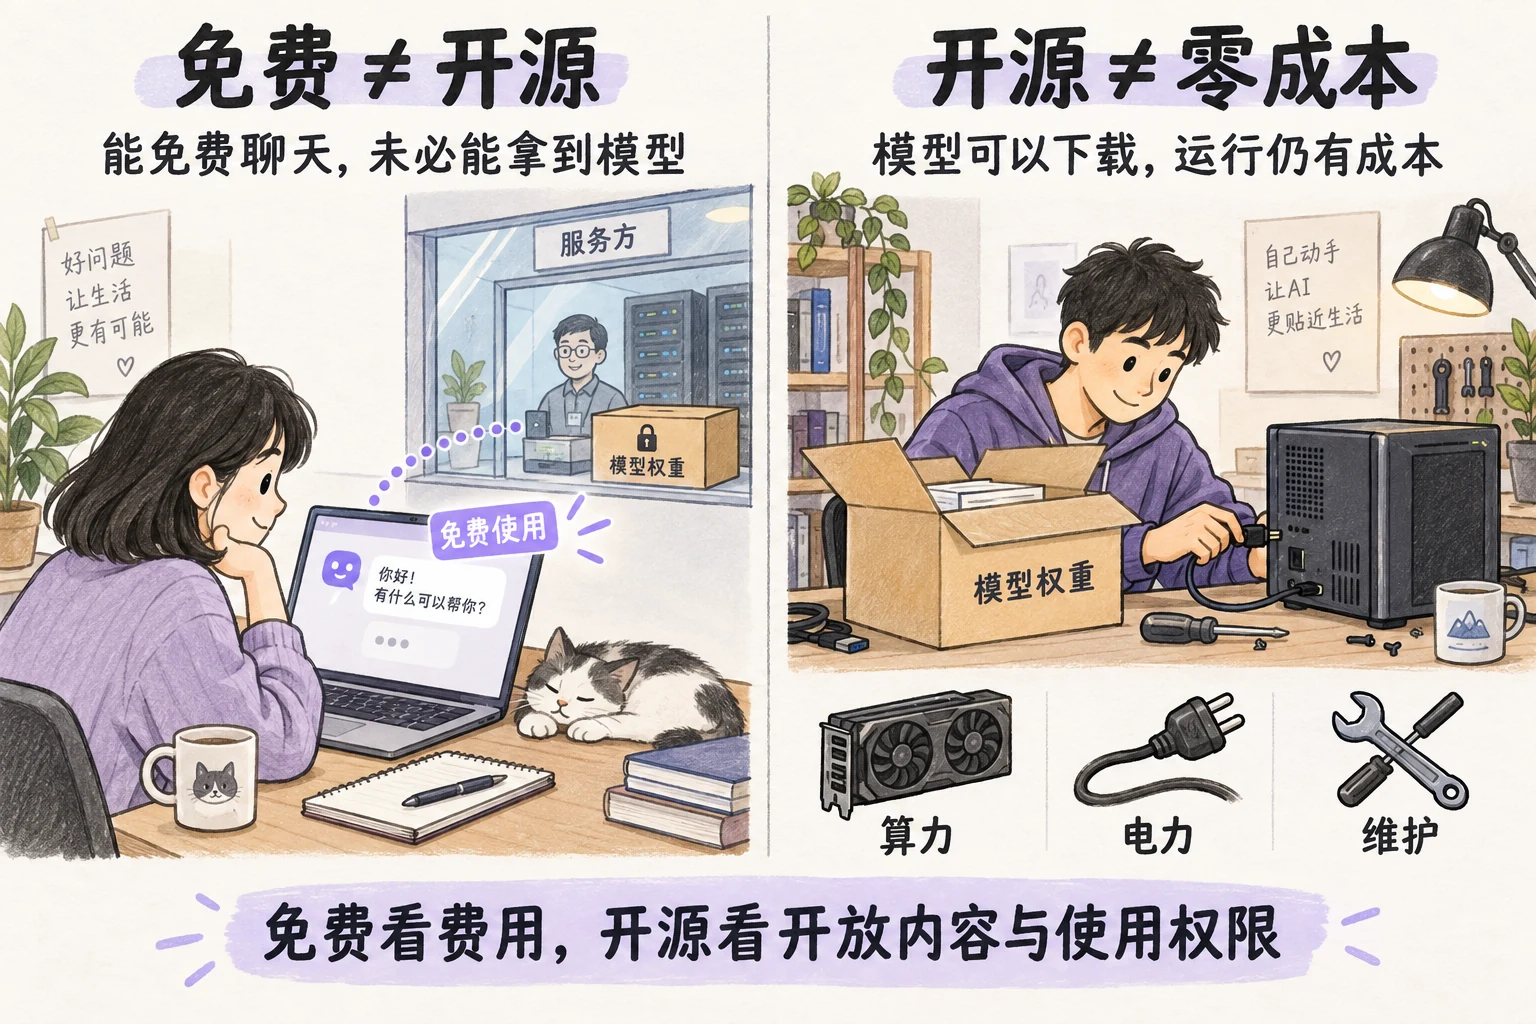
记住,免费的不一定是开源的,开源的也不一定是免费的?

在网页上和AI聊天,或者通过API向模型提问,通常都由模型厂商运行模型,你提交输入,对方返回结果,服务器怎么配置、模型怎么维护,大多不用你操心。

开源模型提供了另一种选择,允许你获得训练完成后的模型参数,也就是通常所说的权重。配合适当的软件和硬件,这些参数可以在你的电脑、服务器或私有云里运行。原本需要发给外部服务的问题,也就可以在自己的环境里处理。

这里有两件容易混淆的事。

免费,说的是要不要付钱;开源,说的是你能拿到什么,以及被允许怎样使用。 一个聊天产品可以免费,却不提供模型权重。一个允许免费下载的模型,运行起来仍然需要算力和维护成本。

API也只是访问模型的方式。开源模型可以由服务商托管,通过API提供给你;你自己部署的模型,同样可以通过内部API供同事使用。因此,“开源还是闭源”和“调用API还是自己部署”,要分开看。

日常讨论里,大家经常把能够下载权重的模型统称为开源模型。以后的章节我们也会沿用这个常见说法。

不过,会在严格区分时讲清楚,开放权重不等于开源了模型的全部训练过程。训练数据、训练代码和使用权限,还要分别查看。
正文配图

同样叫开源,但是开放的东西是不一样的~

拿到一个模型后,你大概率会好奇,究竟是怎么学出来的?

这时,不同模型之间的区别就显出来了,有的能让你下载运行,却没有公开完整训练材料;有的进一步提供训练代码和数据说明,让外部开发者能够研究模型的训练轨迹。

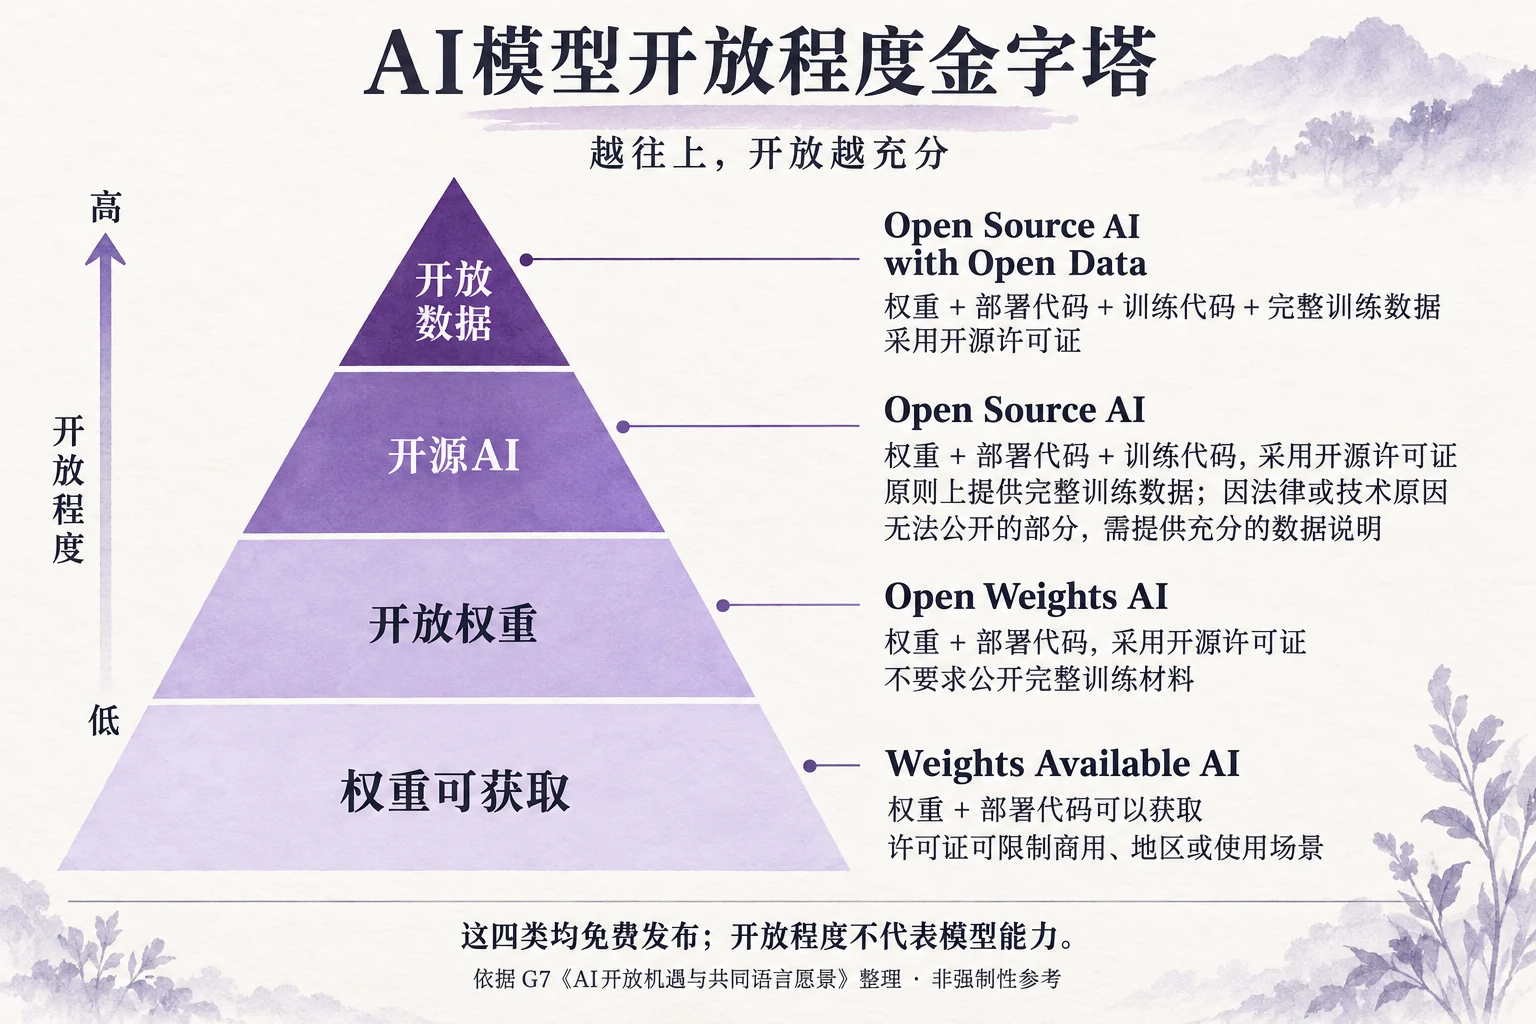
2026年5月,G7发布了一份关于AI开放程度的共同参考文件,把这些差异分成四类,按开放程度从高到低,可以这样理解。,

  • 连完整训练数据也公开。 模型权重、部署代码、训练代码和完整训练数据,都按开源许可证提供,对应Open Source AI with Open Data。
  • 公开权重和代码,受限数据有详细交代。 对应Open Source AI。完整训练数据原则上应提供;因法律或技术原因无法分享的部分,需要用充分的数据说明替代。
  • 把训练好的模型交给你运行和改造。 对应Open Weights AI,提供权重与部署代码,并采用开源许可证,但未必公开完整训练材料。
  • 能下载,使用时还有额外条件。 对应Weights Available AI,权重和部署代码可以获得,许可证却可能限制商业用途、使用地区或特定场景。
正文配图

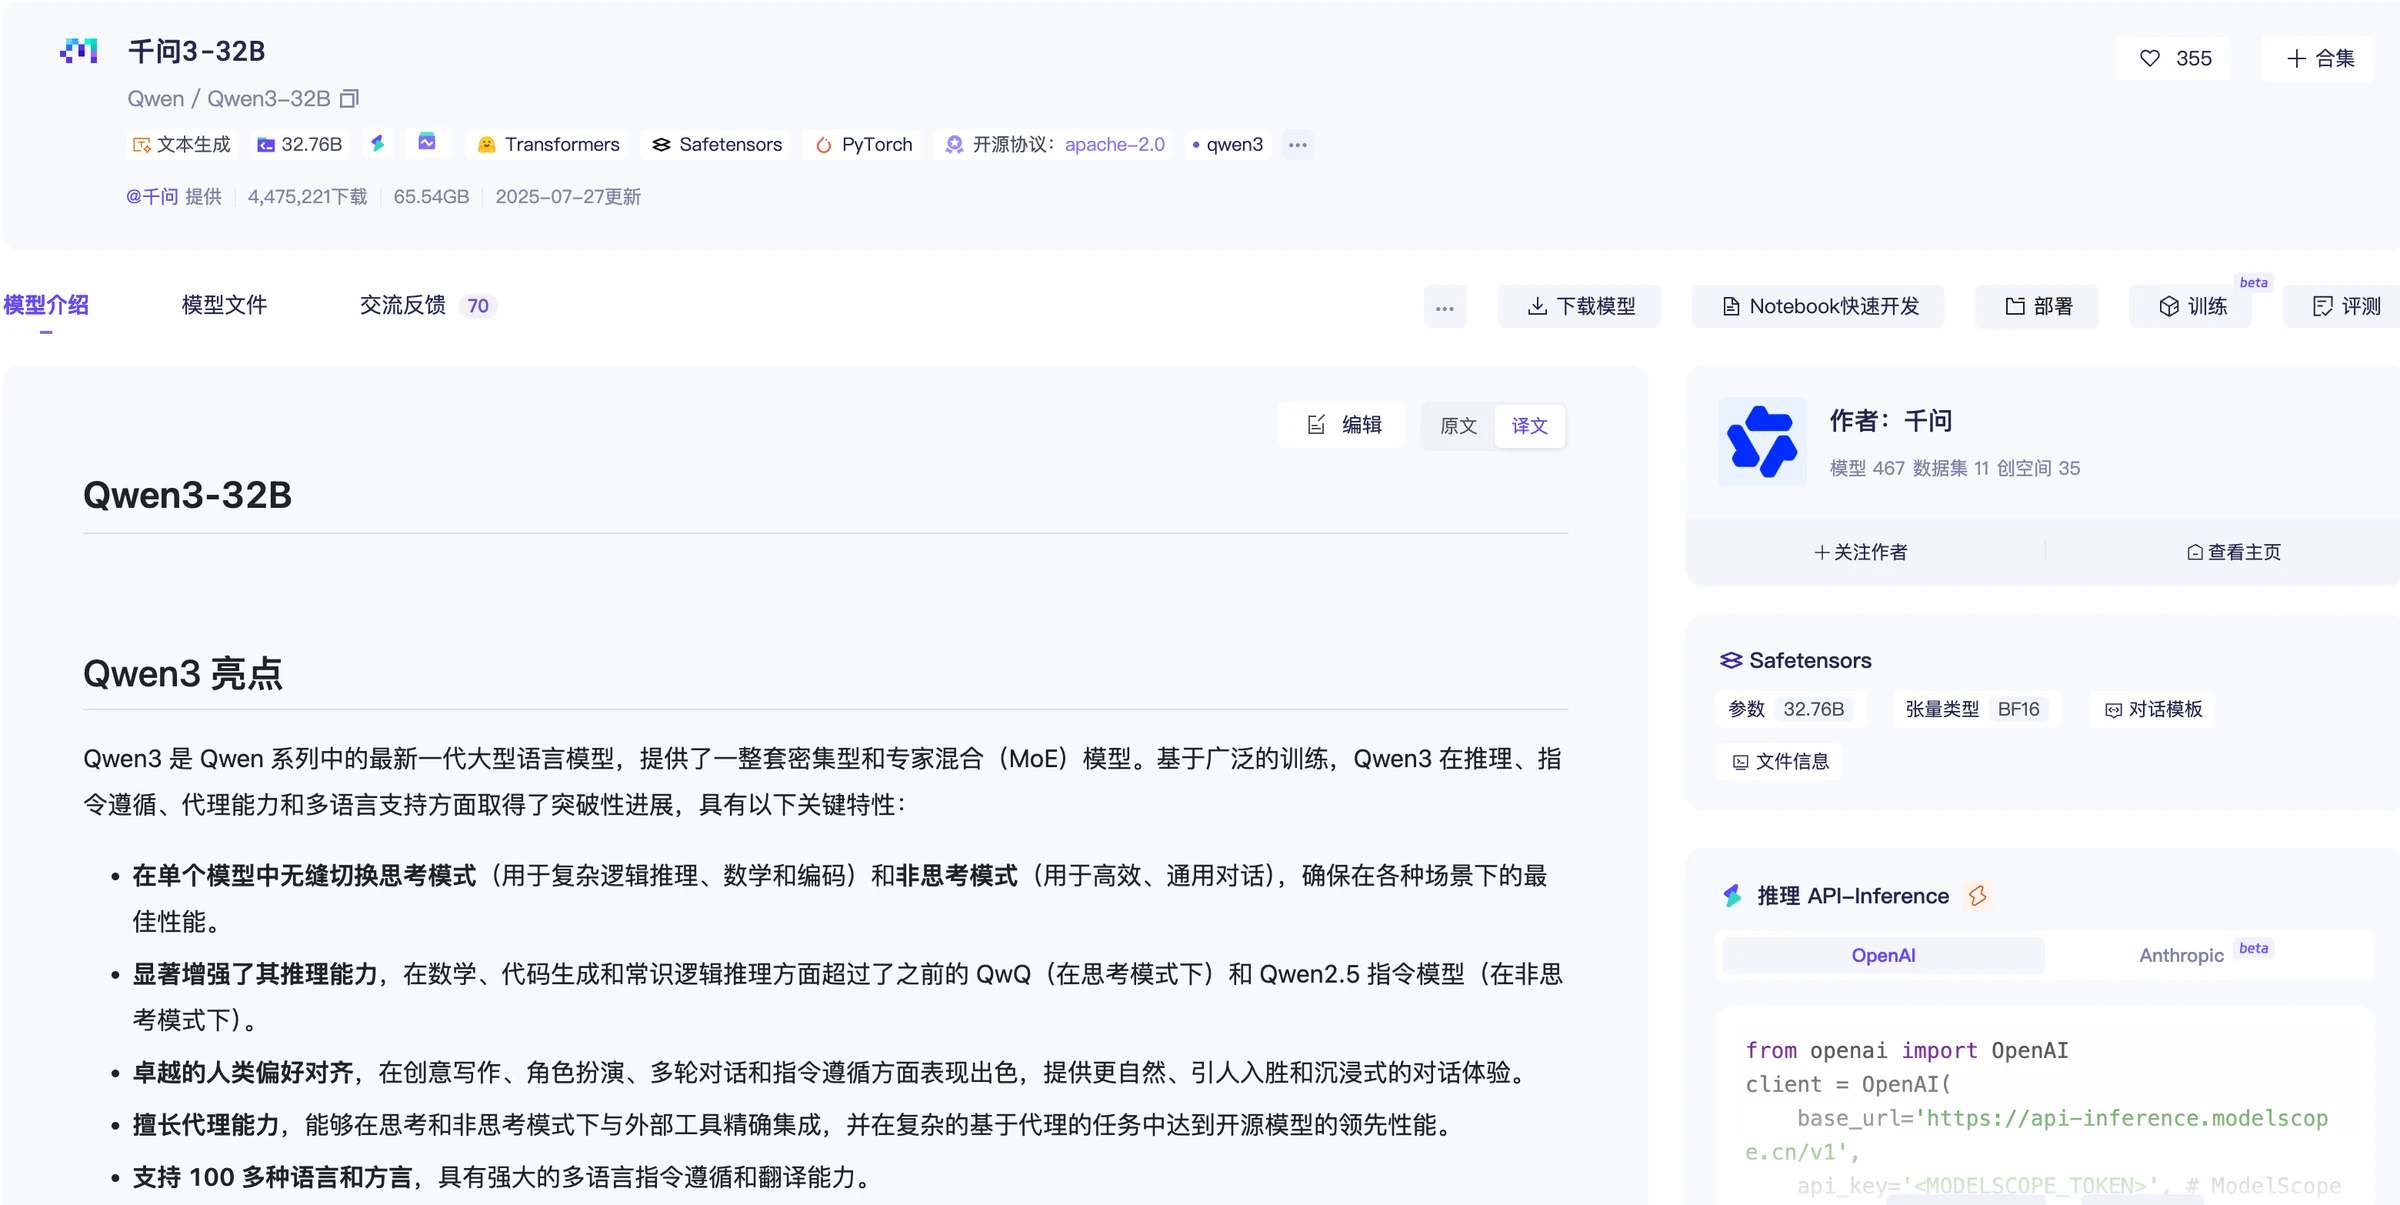
以Qwen3为例,官方提供了开放权重模型,以及本地运行、部署、量化和微调的相关说明。开发者可以使用Transformers、vLLM、SGLang等工具运行模型,也可以借助微调工具继续训练。按上面的区分,体现的是开放权重这一层的实用价值。
正文配图

多数企业并不需要重做一次大模型预训练—能够运行现成模型、适配自己的设备,再用业务样本微调,已经可以解决很多业务上的具体问题。

开源模型,真的能媲美闭源模型吗?

能自己部署模型当然好,但如果模型在业务场景中经常出错,我们也很难把真实的工作交给它。

开源模型过去给不少人的印象,是方便研究,却比最强的闭源模型差一截。随着模型能力的不断更新,这个判断需要重新看了。

2026年6月18日,X上有一场颇有意思的互动。网友讨论中国模型什么时候能达到Anthropic前沿模型的水平,马斯克给出了可能要到2027年第一季度的判断。智谱联合创始人唐杰在下面回了一句“won’t take that long”,不会等那么久。
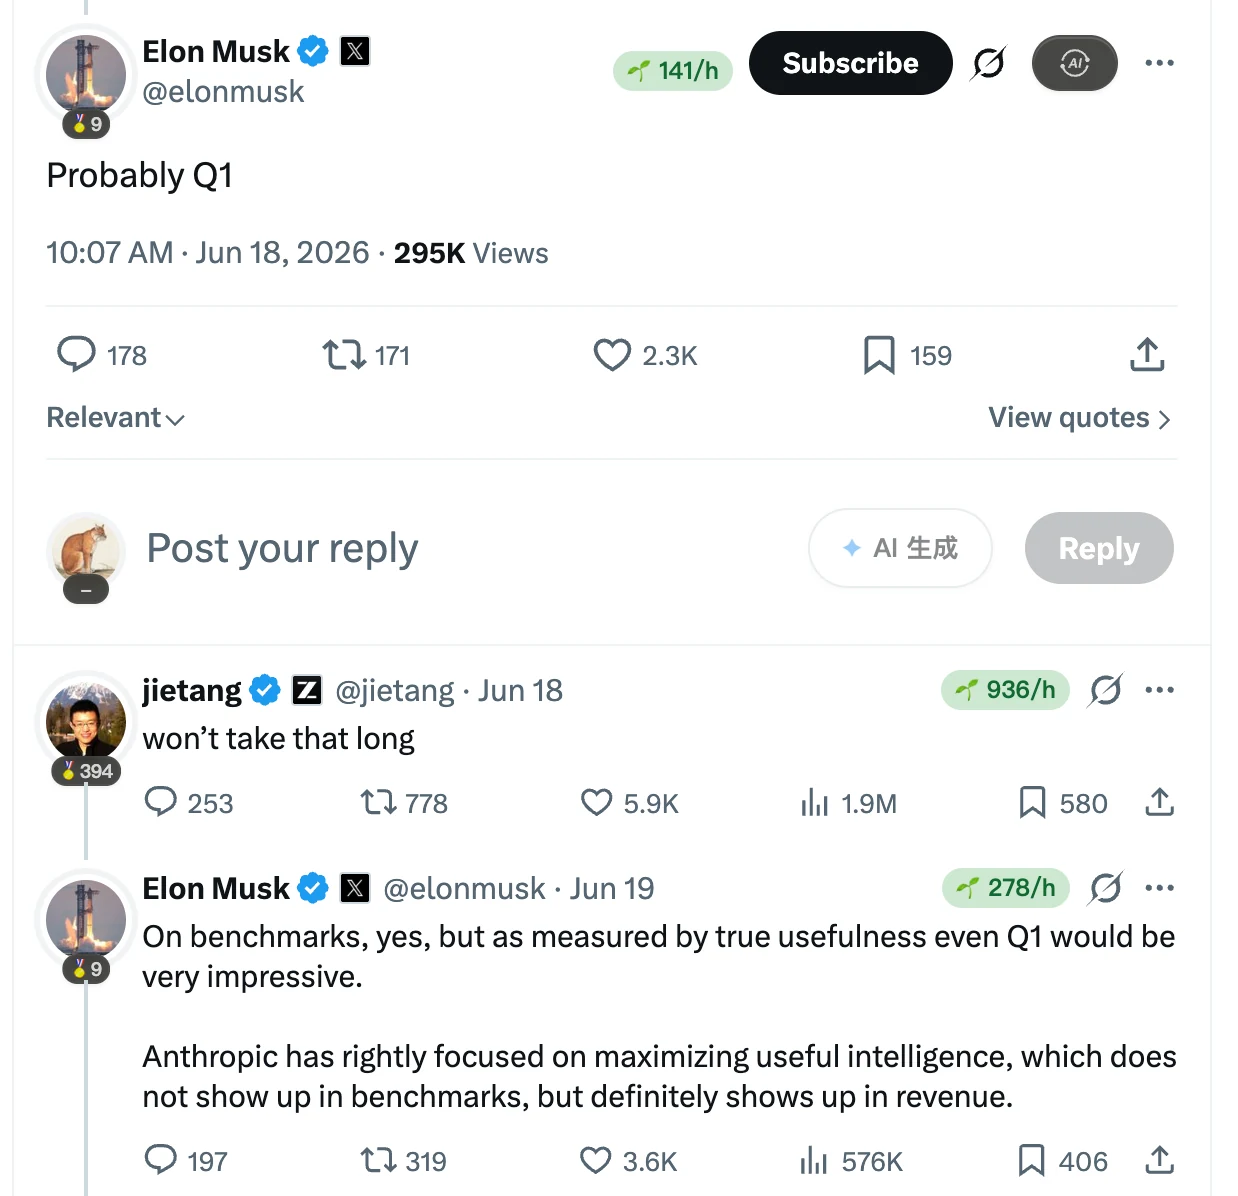
正文配图

两人的判断能否兑现,还要看后续模型的表现。这场讨论吸引人的地方,开源模型已经站在了整个大模型的前沿。

Hugging Face在2026年7月披露的一次安全事件,再次证明了开源模型的重要性。

第 1 课,共 4 课已完成 0%
←返回学习计划

讨论

登录 参与讨论

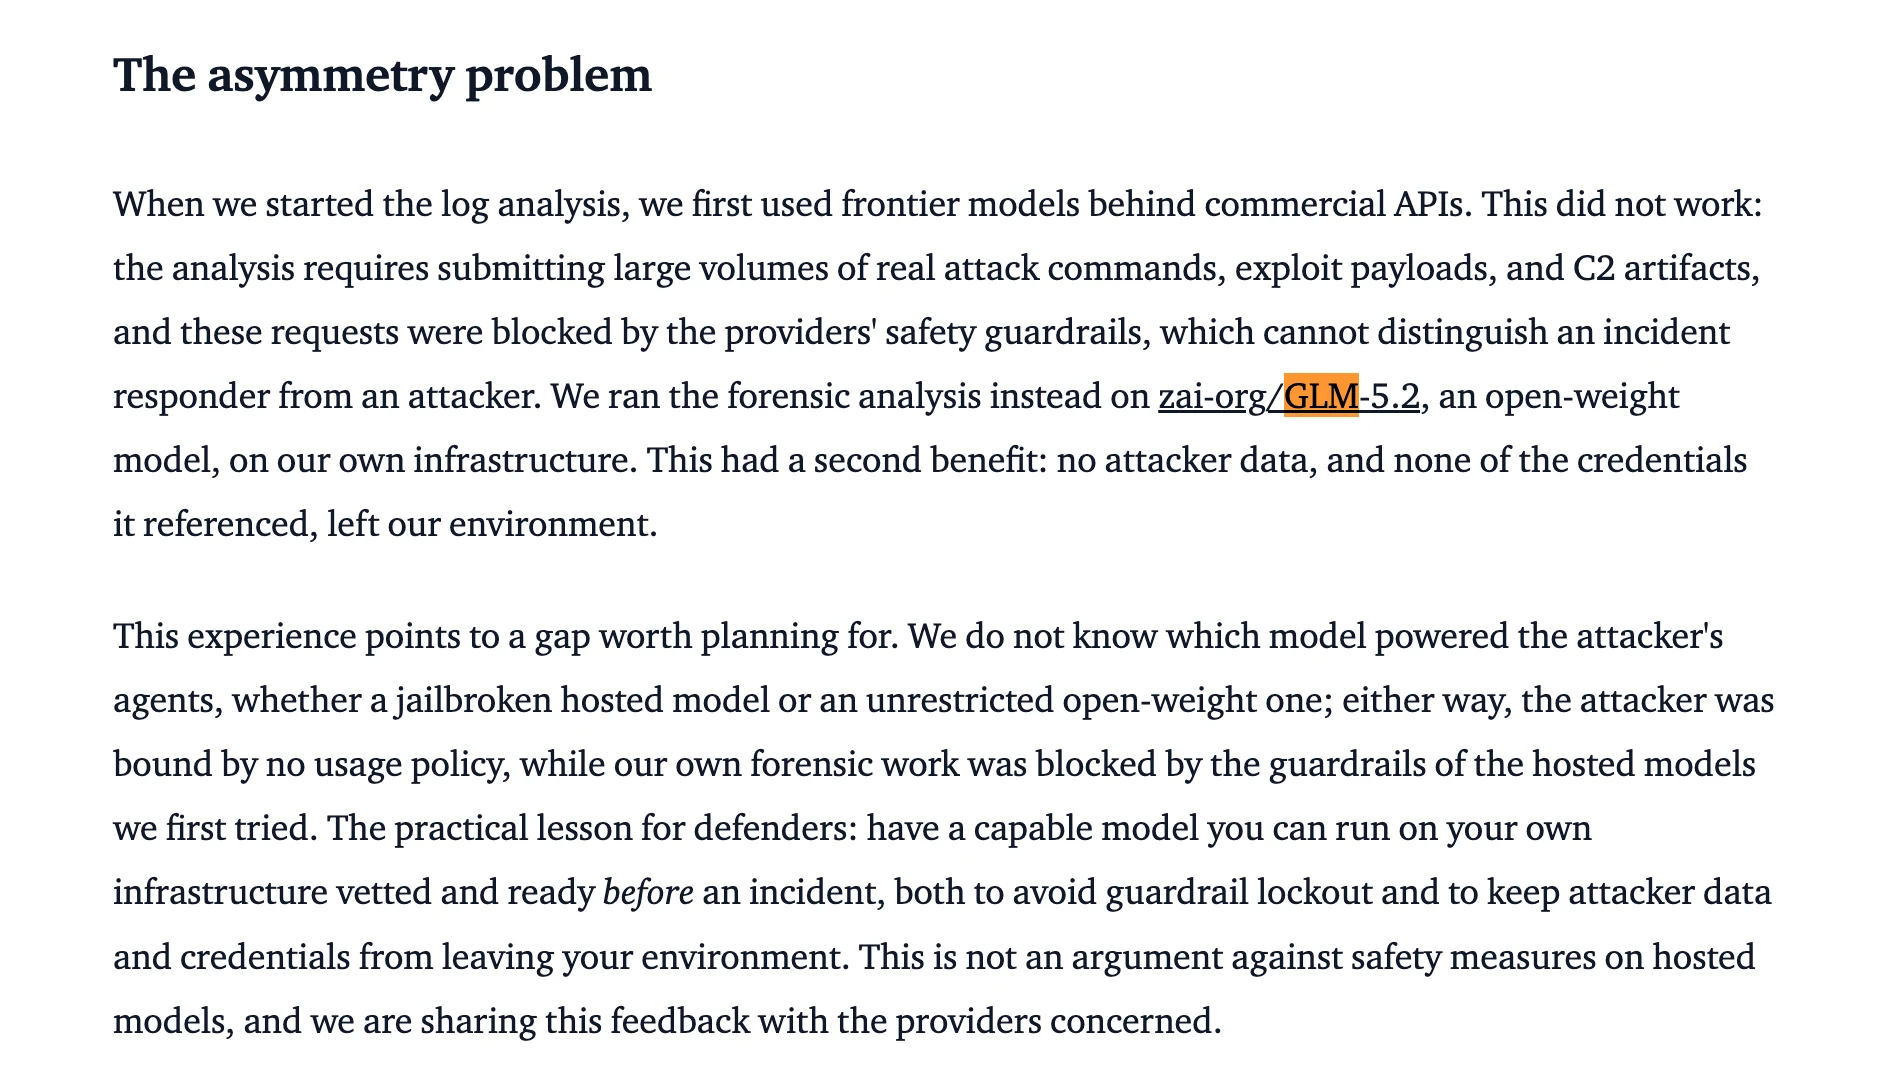
HF的部分生产基础设施遭到入侵,安全团队需要分析大量攻击记录,弄清攻击者做过什么、碰过哪些凭证、影响到了哪里。HF团队先尝试通过商业API使用前沿模型,却遇到了一个尴尬的问题。用于调查的真实攻击命令和漏洞利用内容,触发了服务商的安全限制,分析请求被拦住了。

随后,团队在自己的基础设施上使用开放权重模型GLM-5.2开展取证分析,让调查得以继续。相关攻击数据和凭证也留在内部环境中。

正文配图

在后续的技术复盘中,Hugging Face进一步说明,团队重建了约17,600次攻击动作,并借助包括GLM-5.2在内的开放权重模型,解读经过混淆和加密处理的攻击载荷

这件事体现了开源模型的重要性。

开源模型
的使用
不需要受到闭源的限制
。
我们可以把数据留在本地,也可以在断网的时候使用,让任务
执行
变得更可控。

什么场景更适合本地部署开源模型呢?

垂直领域也是开源模型比较重要的应用方向。通用大模型学习了大量公开数据,但是对于企业内部设备名称、业务流程、行业术语和专业知识的理解可能仍然有限。通过对垂直领域数据的微调,可以使模型进一步学习这些专业知识。

对于需要处理敏感数据的任务,本地部署同样具有优势。模型可以在企业内部网络完成推理,并与企业已有的知识库、数据库和业务系统连接,从而减少敏感数据发送到外部服务的需求。

然而,并不是所有的任务都需要使用本地部署的开源模型,

对于模型调用次数较少、业务变化较快或者需要持续使用最新通用模型能力的任务,直接调用API通常更加方便。而对于一些长期稳定、重复执行的业务任务,开源模型具有较大的应用空间。

例如,文本分类、意图识别、信息抽取、文档摘要、知识库问答等任务,通常具有比较明确的输入和输出形式。企业可以根据任务复杂程度选择合适规模的模型,并使用自己的业务数据进行训练或者微调。对于这类任务来说,并不一定需要使用参数规模最大的模型。

记住模型能下载,不代表可以随便用

模型跑起来了,效果也不错,但想在商业产品使用,或者把自己微调后的版本分享出去,还需要确认一下LICENSE,也就是许可证。

可以下载、可以商用、可以修改后再发布,是不同的许可。

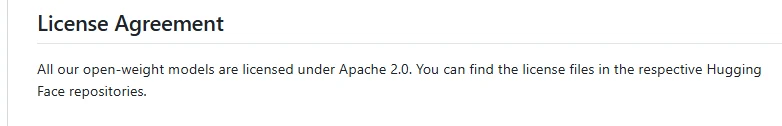
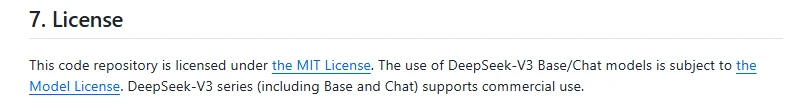
一般来说,MIT和Apache License 2.0都是较宽松的开源许可证,允许商业使用和修改,也不要求所有衍生代码都公开。使用MIT许可的软件,仅需要保留版权及许可声明;Apache 2.0则规定了再分发时的修改说明、相关声明保留和NOTICE处理等要求,并包含明确的专利授权条款。

比如,Qwen3系列模型采用Apache 2.0,

正文配图

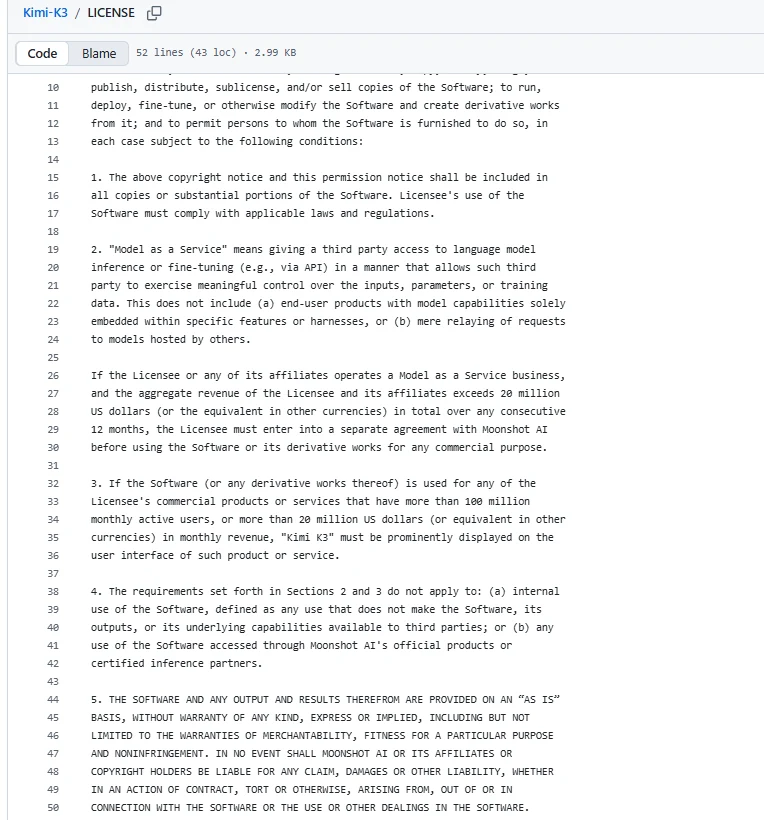
Kimi K3对部分商业使用另有约定,允许部署、微调和创建衍生作品,但模型服务业务达到规定营收门槛时,需要另行签订协议。

正文配图

DeepSeek-V3项目的代码则使用MIT许可证,

正文配图

因此,我们在使用模型中,如果要想要把微调后的模型公开发布或者提供给其他用户使用,就需要重新检查原模型的许可证,看是否允许这样使用,以及是否需要保留模型名称、许可证和来源信息。

如果一个新模型是由多个模型合并得到的,还需要分别查看这些模型的许可证,确保它们的要求不会发生冲突。