AIUnlimited
🌳

AI基础

🌱
AI 种子

从零开始

🌿
AI 萌芽

打好基础

🌳
AI 枝干

付诸实践

🏕️
AI 树冠

深入探索

🌲
AI 森林

精通AI

🔨

AI精通

✏️
AI 草图

从零开始

🪨
AI 雕刻

打好基础

⚒️
AI 匠心

付诸实践

💎
AI 打磨

深入探索

🏆
AI 杰作

精通AI

📘

AI实战

📖
理解开源模型

开源模型的基础知识和资源

🎯
问题到模型任务

将业务问题转化为模型任务

⚡
跑通第一个模型

30分钟快速看到第一个结果

🔧
微调与评测

微调模型并评估性能

🚀
应用系统

构建实际AI应用系统

🎨
生成式AI

探索AIGC的开源模型

🤖
Agent智能体

学习Agent框架和MCP工具

📐
基础补充

LLM基础知识和评测

🎓

Claude 学院

🤖
Claude 101 入门

用 Claude 学习 AI 基础知识

💻
Claude Code 101 入门

让 Claude 成为你的结对编程伙伴

🤝
Claude Cowork 入门

与 Claude 协作完成复杂项目

⚙️
Claude 平台 101

使用 Claude API 构建应用

实验室

已加载 7 个实验
🧬神经网络沙盒🤖AI 还是人类?🥋提示工程道场🏁算法竞速🧠AI 知识挑战🏗️系统设计画布
🎯模拟面试进入实验室→
🚀

职业发展

🚀
面试发射台

开启你的旅程

🌟
行为面试精通

掌握软技能

💻
技术面试

通过编程轮次

🤖
AI与ML面试

ML面试精通

🏆
Offer与未来

拿下最好的Offer

立即开始
AIUnlimited

AI 教育平台

沪ICP备18025655号-11

学习

  • AI基础
  • AI实战
  • Claude学院
  • 实验室
  • 职业发展

社区

  • 关于
  • 常见问题

支持

  • 服务条款
  • 隐私政策
  • 联系我们
AI & 工程学习计划›🎯 问题到模型任务›课程›要把业务问题转换成模型任务问题
🎯
问题到模型任务 • 入门⏱️ 15 分钟阅读

要把业务问题转换成模型任务问题

要把业务问题转换成模型任务问题

看到一个新模型发布,大家的第一想法一定是先下载试试。但轮到自己的业务,问题就具体了,能处理公司业务问题吗?能判断客户在问什么吗?我们有必要用这么大的模型吗?

所以在选开源模型之前,先把要做的事想清楚。

同样是处理合同,给合同分类、抽取金额和日期、生成摘要,需要关注的能力就不一样。目标明确了,再去模型库里找,才知道该看哪些模型更适配。

先想清楚,你想让模型做什么

业务方提出需求时,通常不会直接说“需要一个分类模型”或“需要一个信息抽取模型”,一般从实际业务出发描述问题,例如“帮我把合同里的关键信息抽出来”或“自动回复用户的提问”。

模型选型的第一步,就是把这些业务需求转换成模型任务。任务确定后,才能进一步判断需要什么类型的模型。

判断一个需求属于什么模型任务,可以先从两个方面入手:

1)任务目标

按照模型的工作目标,常见任务可分为以下几类:

任务类型核心定义通俗理解
生成任务根据输入内容生成新的文本、图片、音频等内容“写一段新内容”
分类任务根据输入内容判断其所属类别“判断属于哪一类”
信息抽取任务从原始数据中提取需要的信息,并按照一定格式输出“抽取出固定字段”
检索与排序任务从一批候选内容中找出相关内容,并按照相关程度排序“找出最匹配的并排序”
预测任务根据已有数据,对未来或未知的结果进行判断“预测一个数值或走势”

2)处理的数据类型

面对不同的数据类型,模型的处理方式和内部结构都不一样的,所以需要选择专门的模型来处理。常见的数据类型如下:

数据类型说明常见数据
文本处理文本内容文章、合同、聊天记录
语音处理音频录音、语音对话
图像处理单张图片照片、扫描件、商品图片
视频处理连续的图像和声音信息监控视频、短视频

还需要注意输入和输出是不是只涉及一种数据。当输入输出都是同一种数据类型时,就按这种数据类型来划分模型任务。

比如,输入输出都是图像,属于图像任务。当输入输出涉及两种或多种数据类型的任务时,属于多模态任务。常见的多模态任务有:语音转文字,输入是语音,输出是文本;根据图片回答问题,输入是图像和文本,输出是文本。

实际判断时,可以先看业务问题的最终目标,再看输入和输出的数据类型。样例如下:

样例一:判断用户评价为正面、负面或中性
该业务的目标是输出一个类别标签,输入是文本,这是文本分类任务。

样例二:上传一张图片,在商品库中找出最相似的商品并排序
该业务的目标是从候选中匹配最相关项并排序 ,属于检索与排序任务。处理的数据类型是图片,所以这是图像检索与排序任务。

样例三:根据一段文字描述,生成对应的图片
该业务的目标是生成图片,属于生成任务。输入是文本,输出是图片,输入输出数据类型不一样,这是多模态生成任务,是常说的文生图任务。

3.2 任务确定了,模型去哪里找?

找到模型任务后,就进入模型选型环节。魔搭平台提供了多种模型筛选方法,可以参考以下方法选择模型。

先按任务标签找一遍

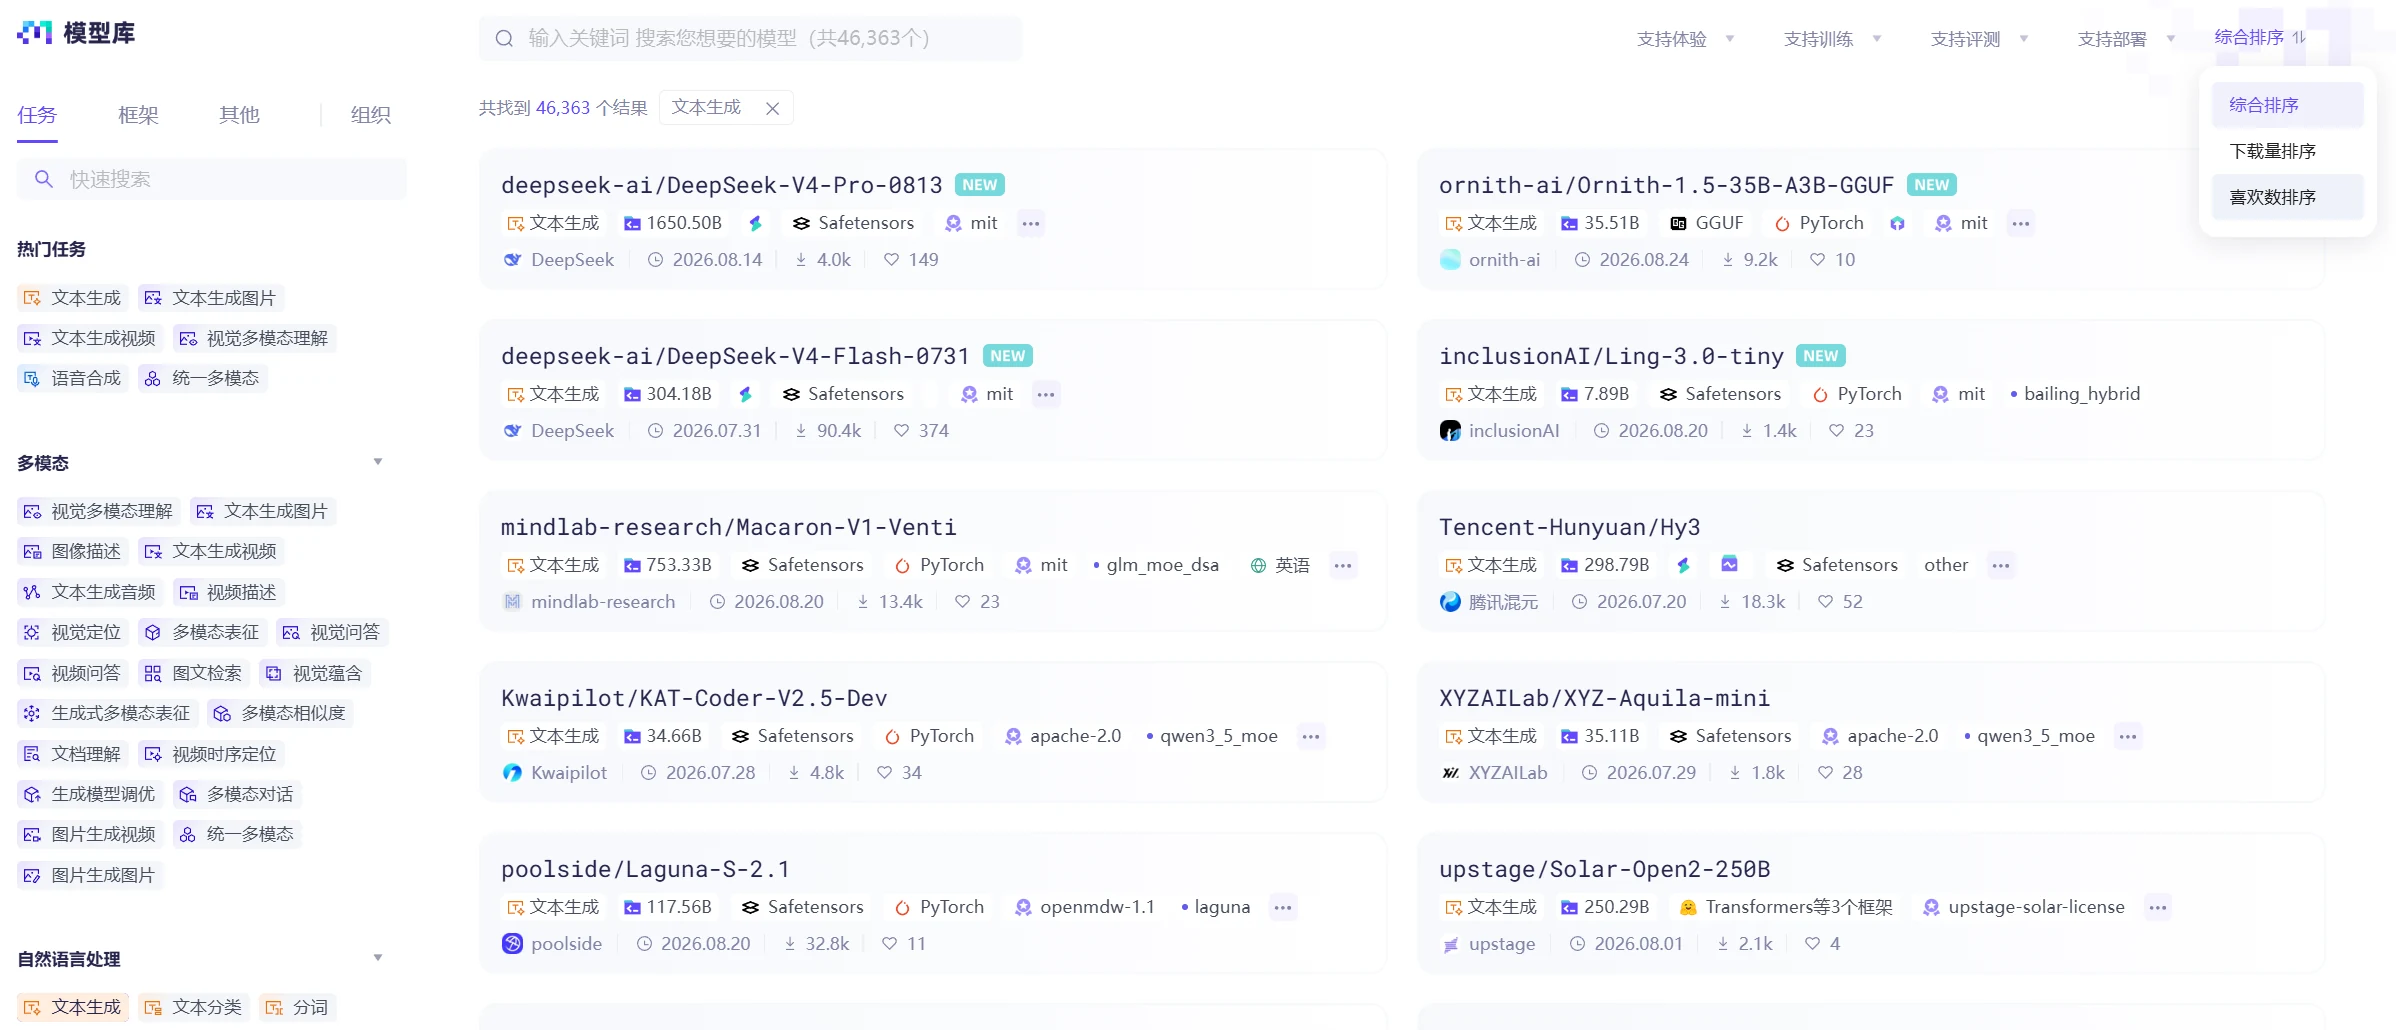
魔搭为每个模型标注了任务类型标签。在模型库页面中:

1.选择“模型库”进入模型浏览页;

2.在左侧筛选栏中选择“任务类型”;

3.选择对应的任务分类(如“文本分类”)。

平台会自动筛选出标注了该任务标签的模型列表。这是最直接的筛选方式,优先推荐使用。
正文配图

候选太多,就再加几个条件

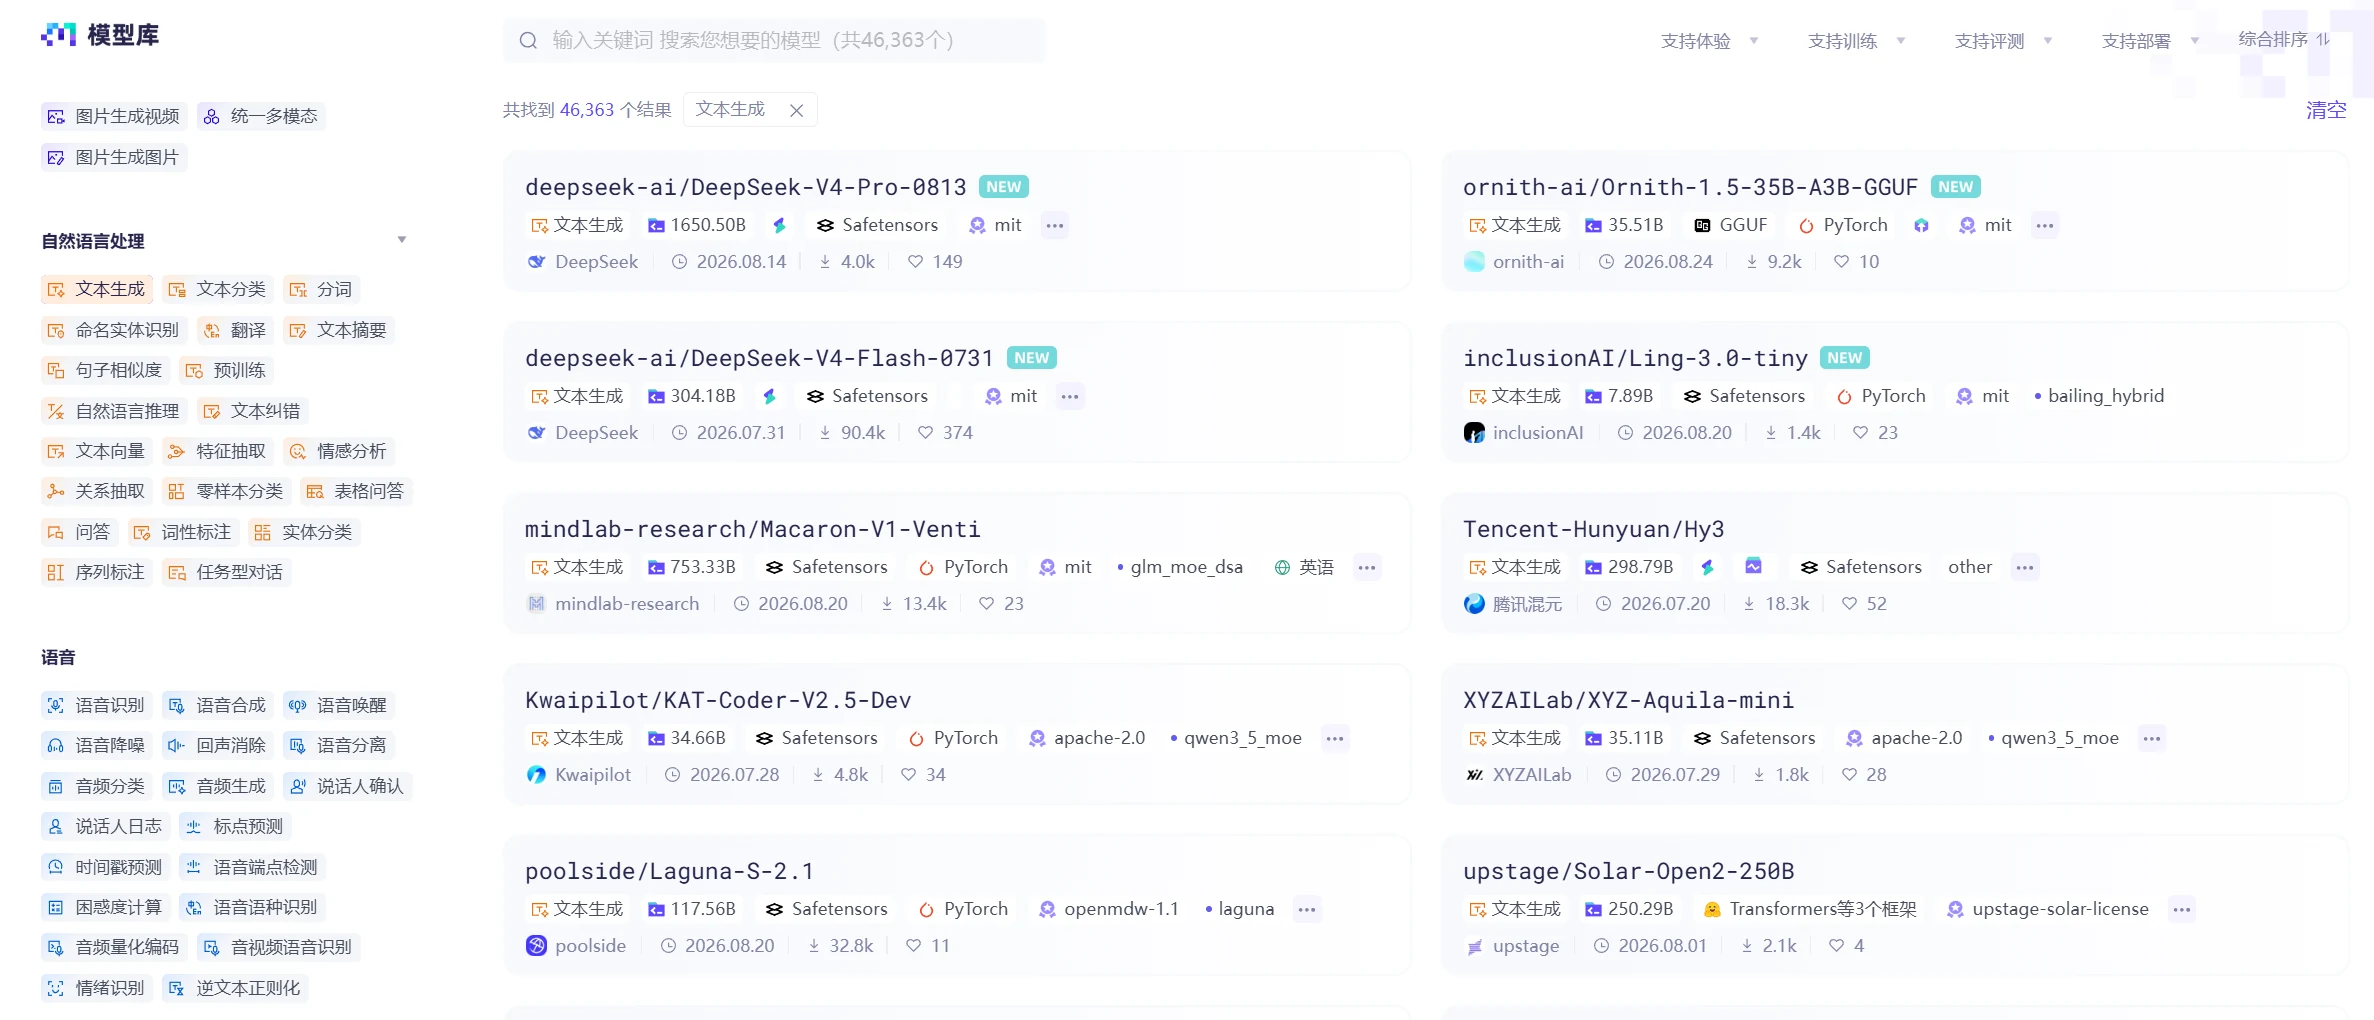
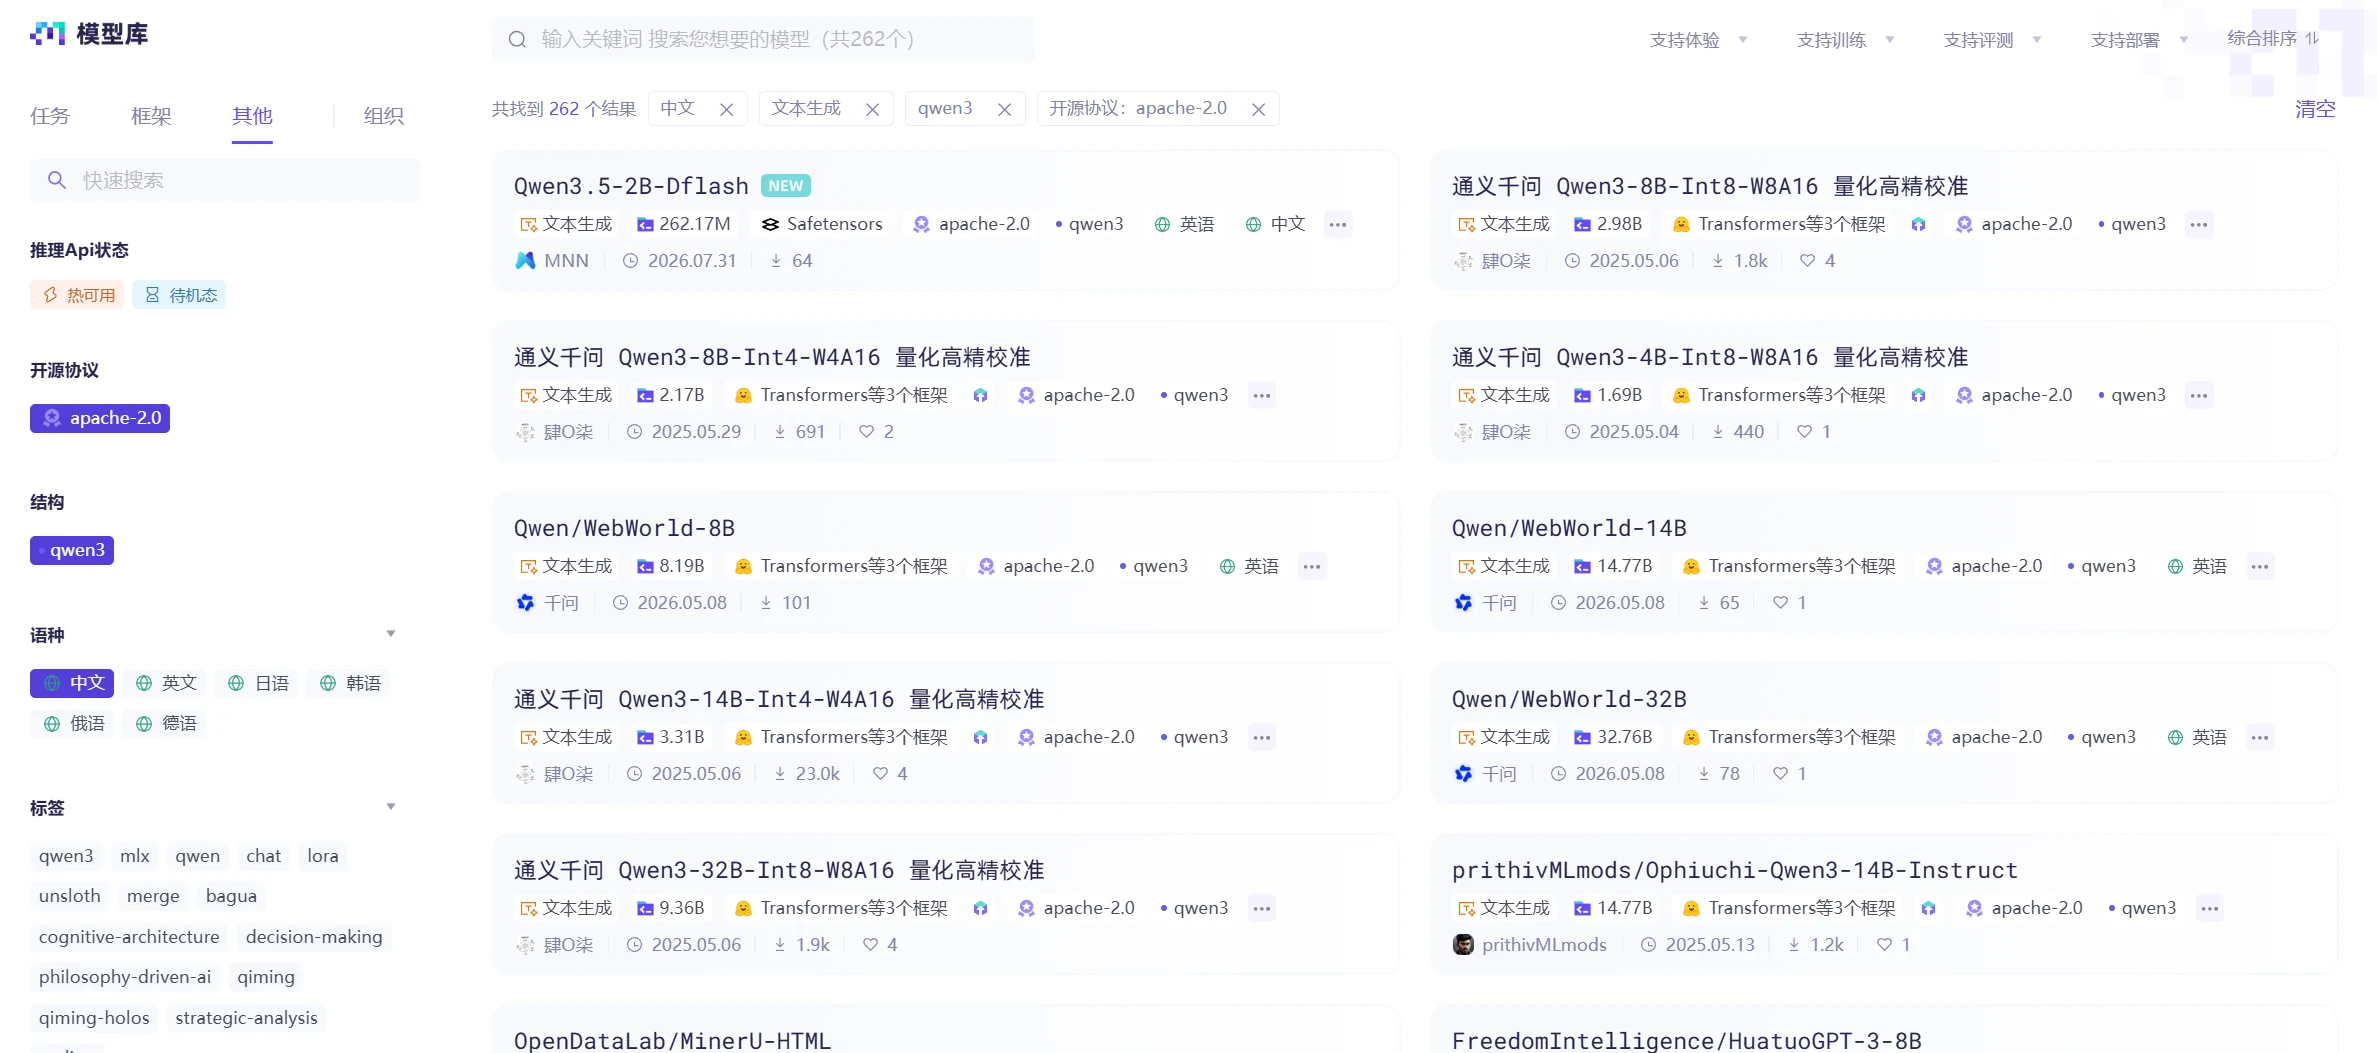
当任务标签筛选后的候选模型仍然较多时,可以在左侧的“框架”和“其他”栏增加其他标签来缩小范围:

框架:筛选PyTorch、TensorFlow等特定框架的模型;

开源协议:商用场景需筛选Apache 2.0、MIT等宽松许可证;

结构:筛选llama、qwen3、deepseek_v2等结构;

语种:选择任务需要支持的中文、英文、日语、韩语等语种。
正文配图

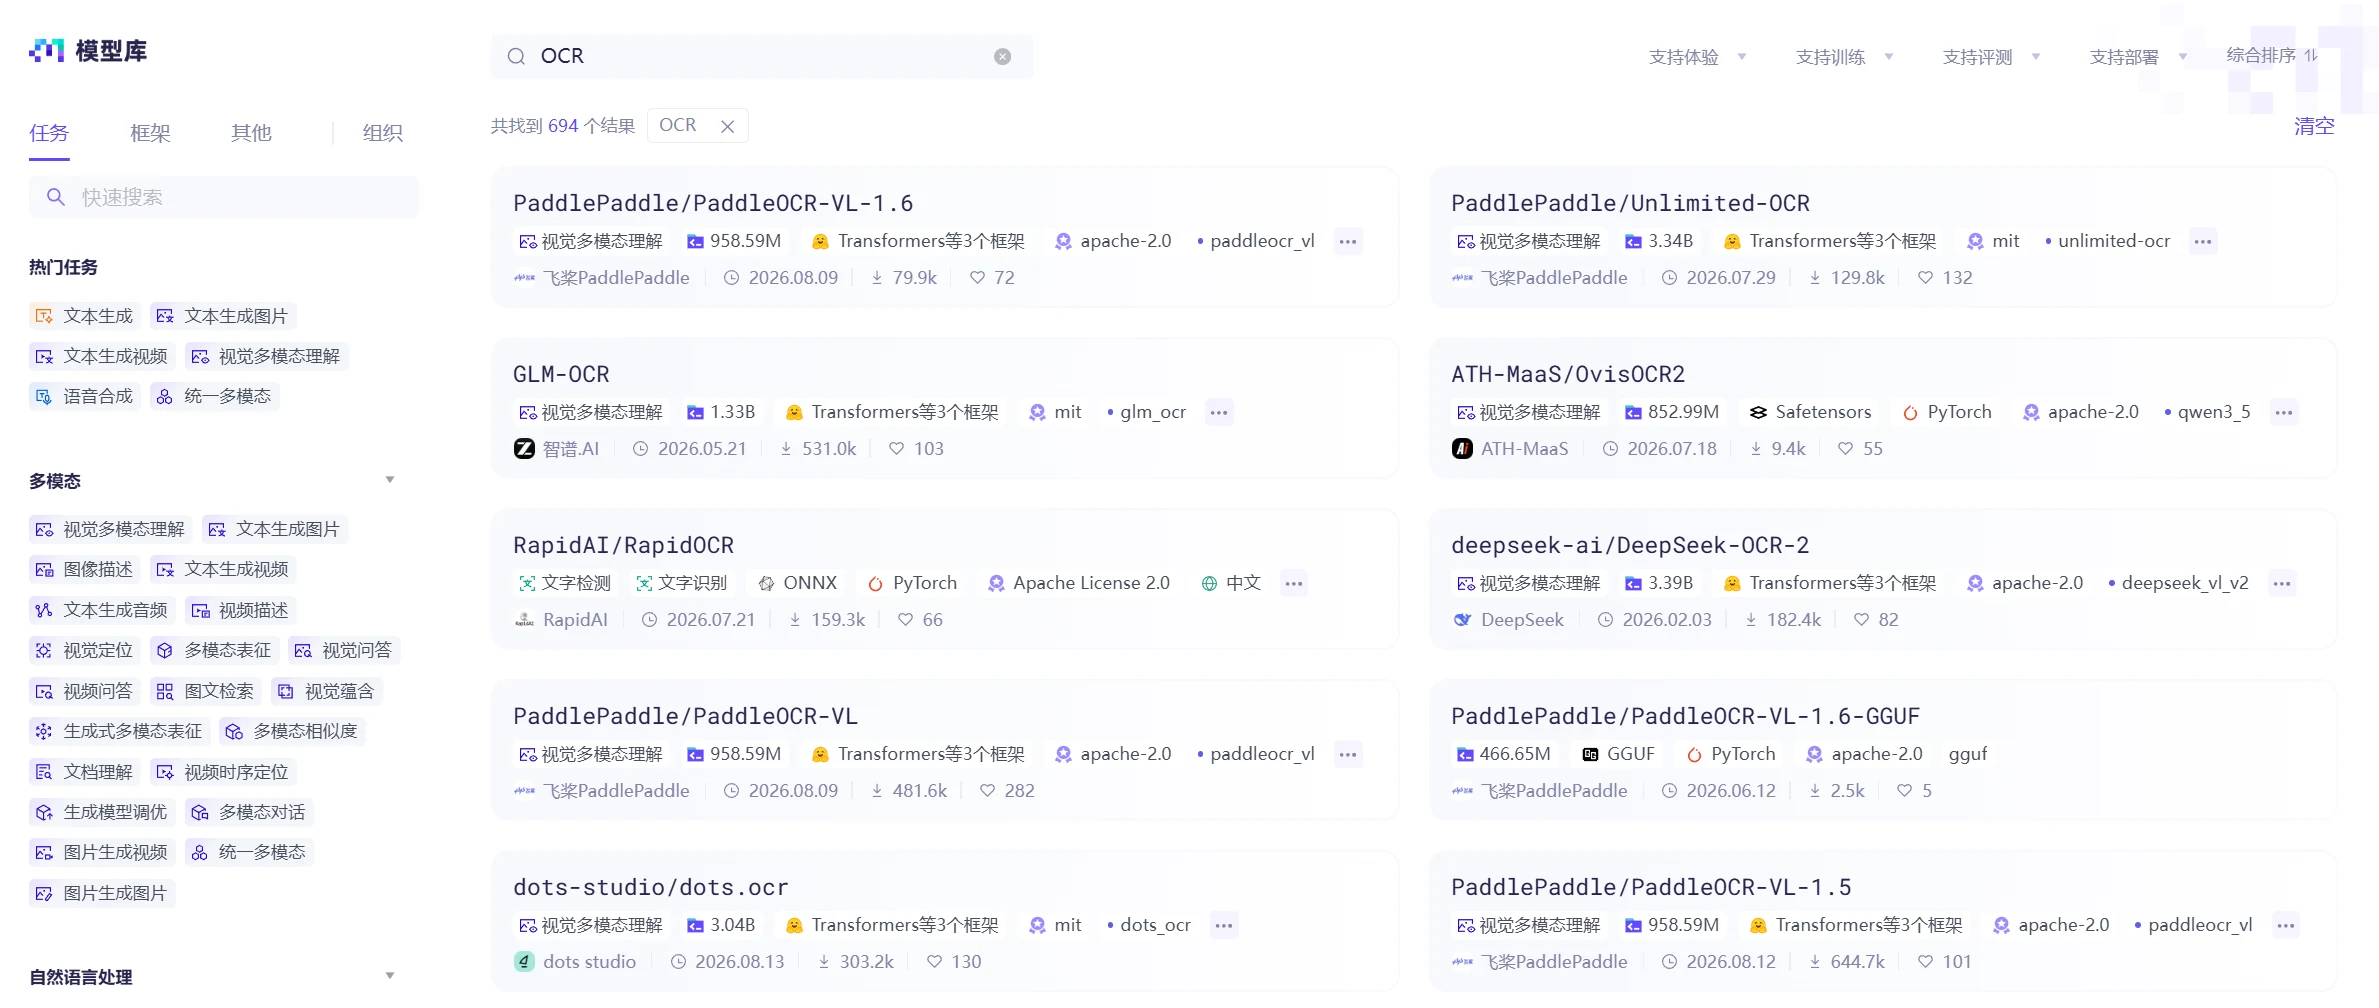
知道名字,直接搜就行

如果知道具体任务名称或模型名称,可以直接在搜索框中输入关键词检索,如“OCR”。
正文配图
第 1 课,共 2 课已完成 0%
←返回学习计划

讨论

登录 参与讨论

下载量高的模型,就一定适合你吗?

魔搭平台上对模型的热度也做了一定统计,可参考的指标如下:

指标

含义与用途

下载量

反映模型的整体使用频率。下载量越高,通常意味着模型经过了更多场景的验证

喜欢数

反映用户对模型的认可程度。收藏量高说明模型质量或场景适配度较好

更新时间

近期更新的模型通常具备更好的性能或更完善的生态支持。更新时间过久的模型可能存在兼容性问题

社区活跃度

Issue和Discussion区的问题响应速度、讨论热度间接反映模型的维护状态

平台支持根据下载量排序或喜欢数对筛选后的模型进行排序,在模型库右上角可以选择判断依据,同时还可以看到模型的更新时间。

正文配图

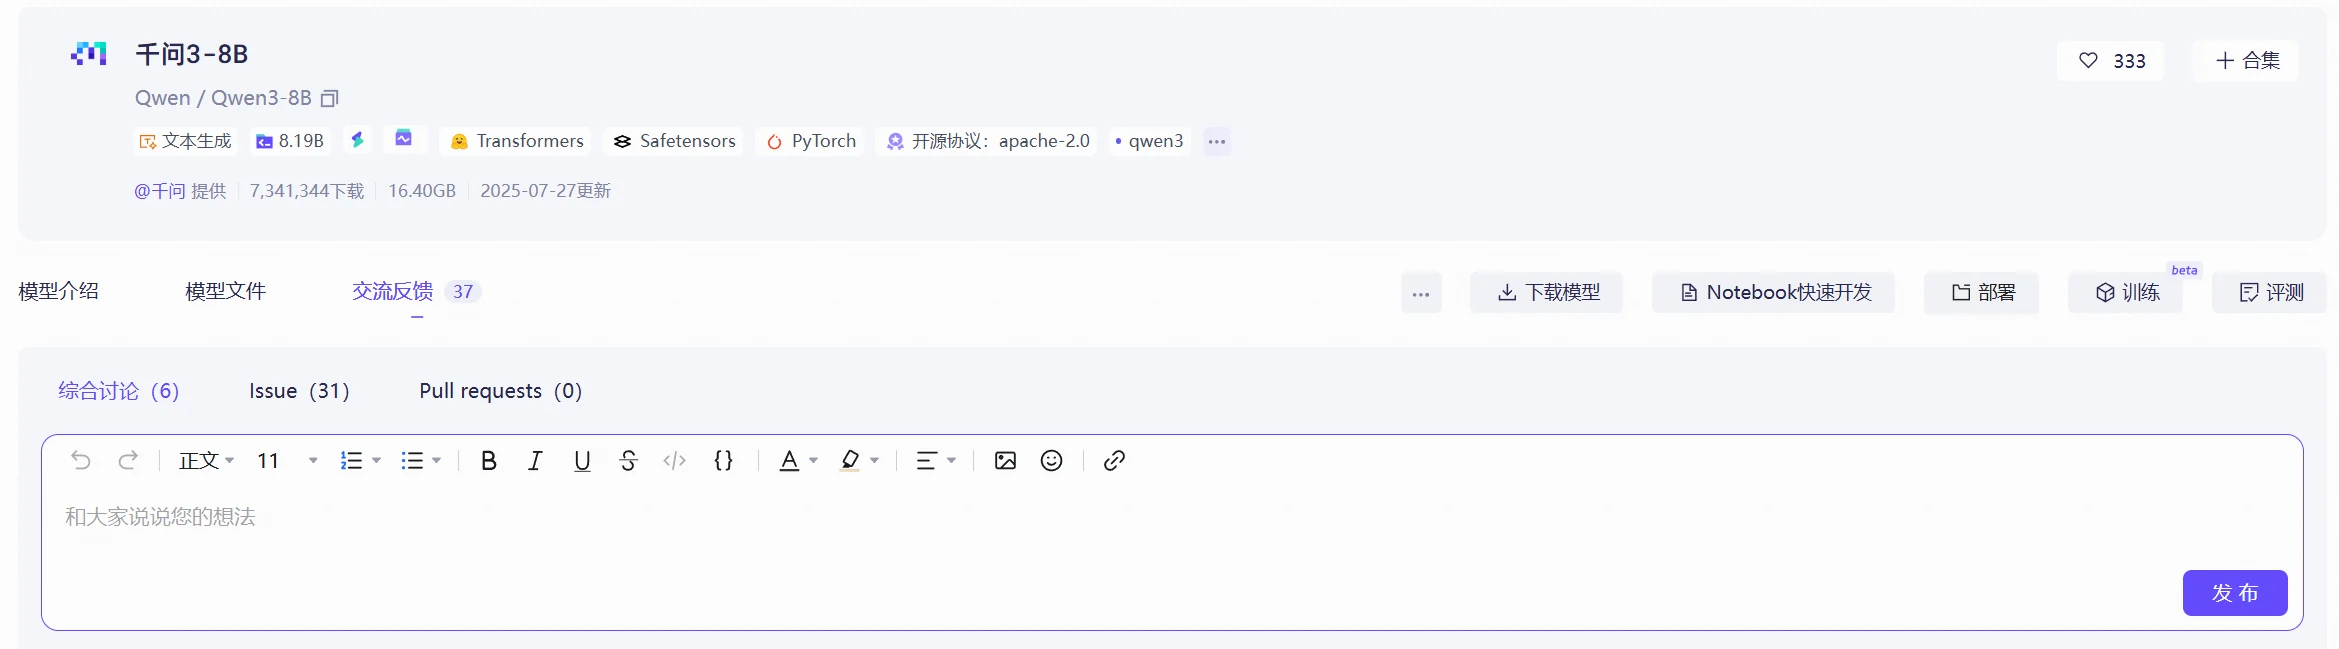
查看社区活跃度必须进入模型卡片页面,查看社区的交流反馈数。

正文配图

通用模型的下载量通常显著高于垂直领域专用模型,所以跨领域直接对比数值意义不大,建议在同类任务范围内进行比较。

通用大模型和专用模型,到底怎么选?

在实际使用大模型时,经常会遇到一个问题:应该选择通用大模型,还是针对具体任务训练的专用模型?

两者各有其特点,选择时主要看任务类型、数据量、推理速度和部署成本等因素。

通用大模型,方便先试起来

通用大模型通常在大量、多领域的数据上进行预训练,可以处理多种类型的任务,例如文本分类、内容生成、信息抽取和问答等。不针对某一个具体任务进行优化,而是希望在更多场景下都能使用。

优势:一个模型可以处理多种任务,通常只需要调整Prompt,就可以让模型完成不同的工作。对于数据量较少的任务,也可以先通过少样本或零样本的方式进行尝试,不一定要先准备大量标注数据。

劣势:通用大模型通常参数量较大,因此对计算资源的要求也比较高。模型越大,推理时占用的显存和计算资源通常越多,在高并发场景下还需要考虑推理速度和部署成本。另外,在某些比较明确的专业任务上,经过针对性训练的专用模型可能会有更好的效果。

通用大模型比较适合任务类型比较多、还处于探索阶段,或者暂时没有足够数据训练专用模型的场景。如果需要快速验证一个新的应用方向,直接使用通用大模型通常是比较方便的选择。

专用模型,适合把固定任务做好

专用模型主要针对某一类任务或某个领域进行训练和优化。例如,用于文本分类、OCR、语音识别、目标检测等任务的模型,都可以看作专用模型。

优势:由于模型针对特定任务进行了优化,通常不需要处理大量无关任务,因此在推理速度、资源占用和任务效果方面都有一定优势。对于任务比较固定的应用,还可以根据实际数据进一步训练模型,使模型更适合自己的业务。

劣势:专用模型的适用范围相对有限,换一个任务后可能就无法直接使用。例如,一个用于文本分类的模型,并不能直接拿来完成文本生成。如果业务需求发生变化,原来的模型可能需要重新训练或调整。同时,如果一个系统中使用了很多不同的专用模型,也需要分别管理这些模型的版本和部署环境。

专用模型比较适合任务比较明确、业务需求相对稳定,而且对推理速度、资源占用或部署成本有要求的场景。如果已经积累了比较好的训练数据,使用专用模型通常更容易针对具体任务进行优化。

不用非得二选一

实际项目中不一定要在通用大模型和专用模型之间二选一,两者经常搭配着使用。

例如,在智能客服中,可以先使用通用大模型理解用户的问题,判断用户想解决什么事情;确定任务后,再交给对应的专用模型处理。

在实际选型时,可以先从任务本身出发。如果任务还比较模糊,或者需要同时处理多种类型的问题,可以优先考虑通用大模型;如果任务已经比较明确,而且对速度、成本或稳定性要求较高,则可以进一步考虑专用模型。

一件事,也可以让几个模型一起做

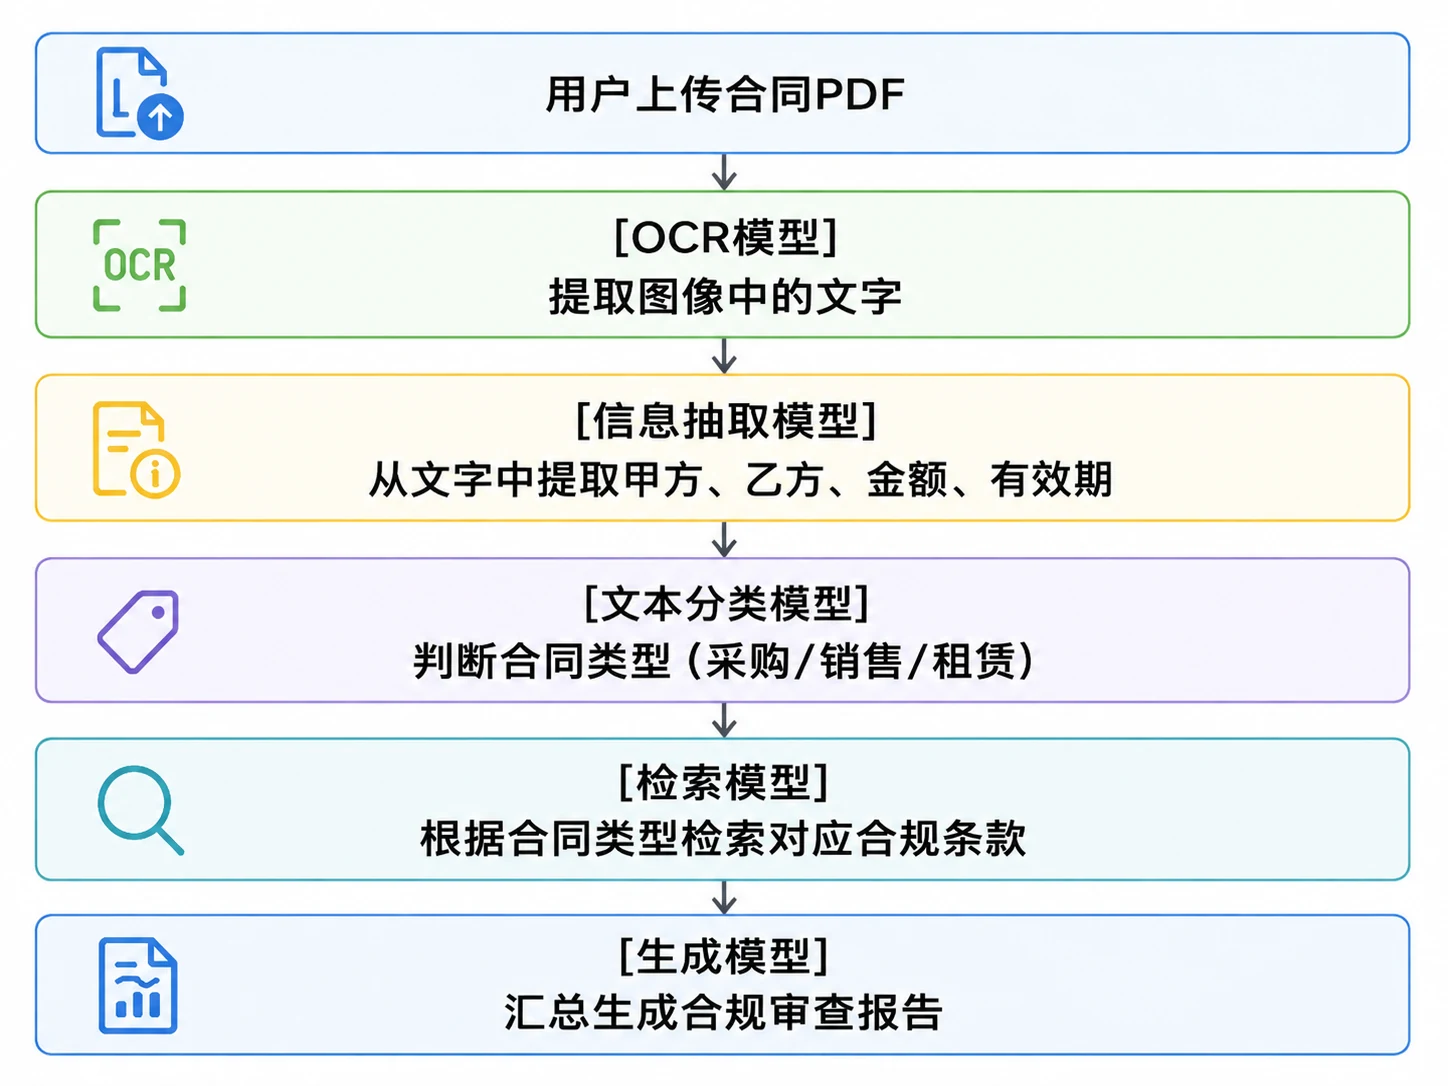
一个业务系统通常不只使用一个模型。根据具体任务的复杂程度,可以让一个模型完成全部工作,也可以将不同模型组合起来,让每个模型负责其中一个环节。例如,在一个智能文档处理系统中,从文档输入到最终结果输出,可能会经过文档分类、OCR、版面分析、表格识别、信息抽取等多个步骤:

正文配图

在这个系统中,每个模型分别处理不同任务。多模型组合通常有以下几个特点:

  • 每个模型负责一个独立任务。 如OCR模型负责识别文字,版面分析模型负责判断元素位置,信息抽取模型负责从识别结果中提取需要的内容。
  • 如果某一个环节的效果不好,可以只替换这个环节的模型,不需要重新修改整个系统。没有依赖关系的任务可以并行处理,从而减少整体处理时间。
  • 对准确率要求高的任务选择大模型,对速度要求高、任务简单的环节则使用轻量模型。

但多模型组合也存在模型衔接问题,前一个模型的输出格式必须能够被后一个模型正确解析,这要求设计系统时,需要提前考虑不同模型之间的数据格式。例如OCR输出的是带坐标信息的文本块,而信息抽取模型更适合处理纯文本,这就需要在中间增加数据转换环节,将OCR结果转为目标格式。

在进行模型选型时,不能只看某一个模型的效果,还要看它放到整个处理流程中是否合适。一个单独测试效果很好的模型,如果输出格式难以和其他模型衔接,在实际系统中也可能并不好用。