⚡
跑通第一个模型 • 入门⏱️ 25 分钟阅读
30分钟带你快速看到第一个结果
30分钟带你快速看到第一个结果
开源模型下载下来,可以在自己的笔记本上跑,也可以租一台云服务器,按需要配置CPU、GPU和运行环境。设备不同,准备工作也不一样。
如果只是想先试一下模型能做什么,魔搭Notebook提供了一个免费的入口。打开浏览器,选择运行实例,就能在网页里写代码、下载模型并查看结果。
这一篇从创建Notebook、检查环境到加载模型,跟着做完,就能看到第一个结果。
打开Notebook,先连上运行实例
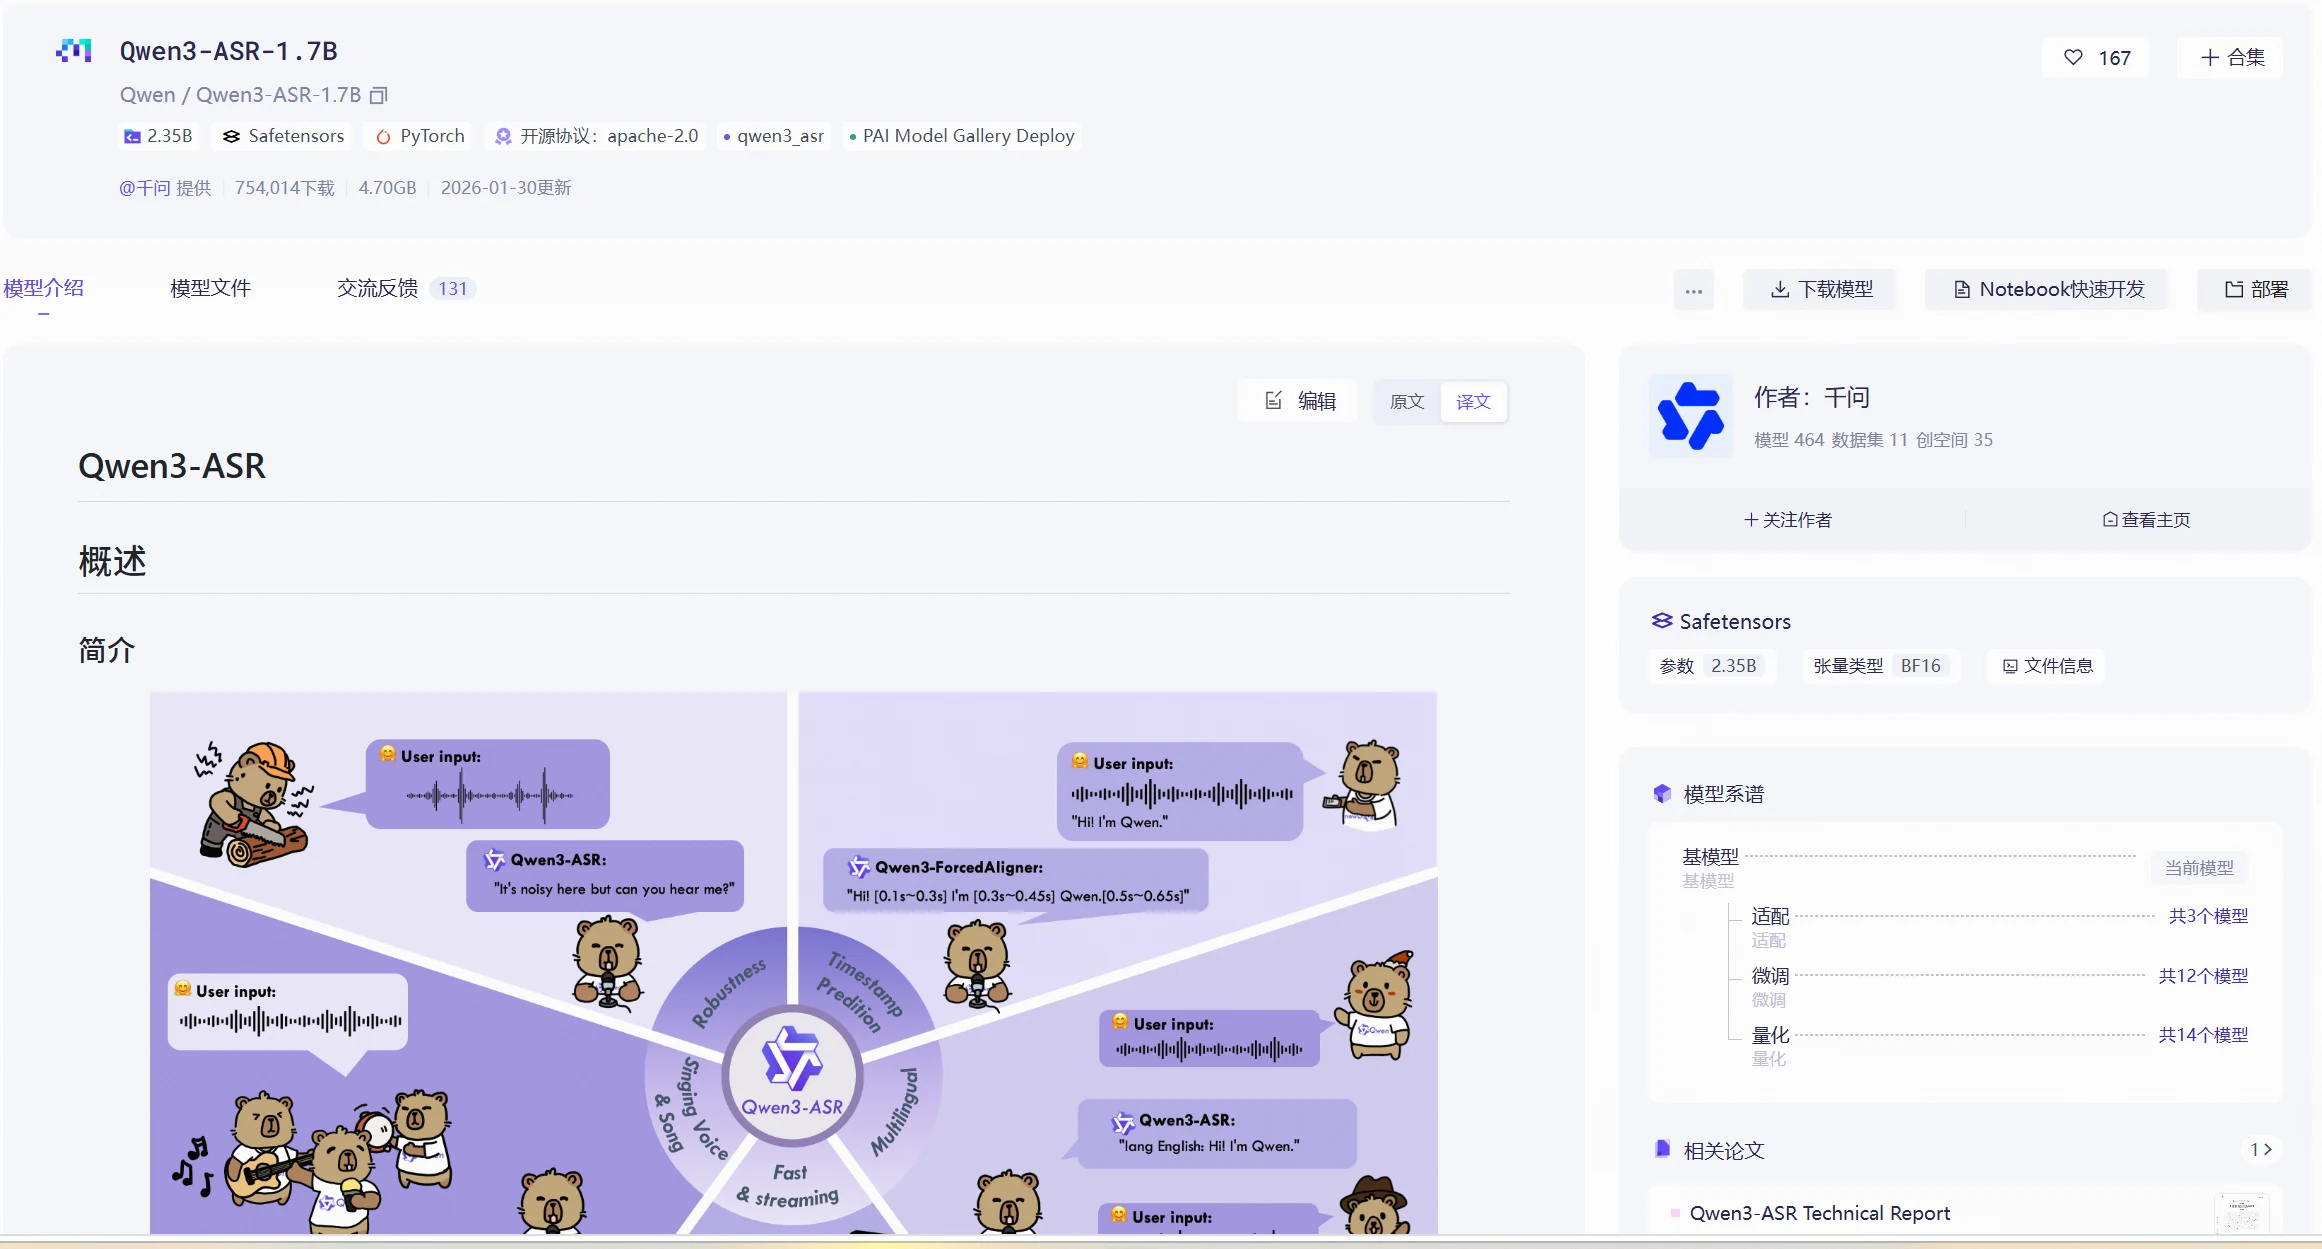
进入模型库,找到Qwen/Qwen3-ASR-1.7B模型,点击右侧的“Notebook快速开发”即可创建魔搭Notebook。
模型链接:https://www.modelscope.cn/models/Qwen/Qwen3-ASR-1.7B
点击右上角的“连接运行时”选择实例,这里我们选择GPU进行演示,可以根据模型依赖选择合适的预装镜像。
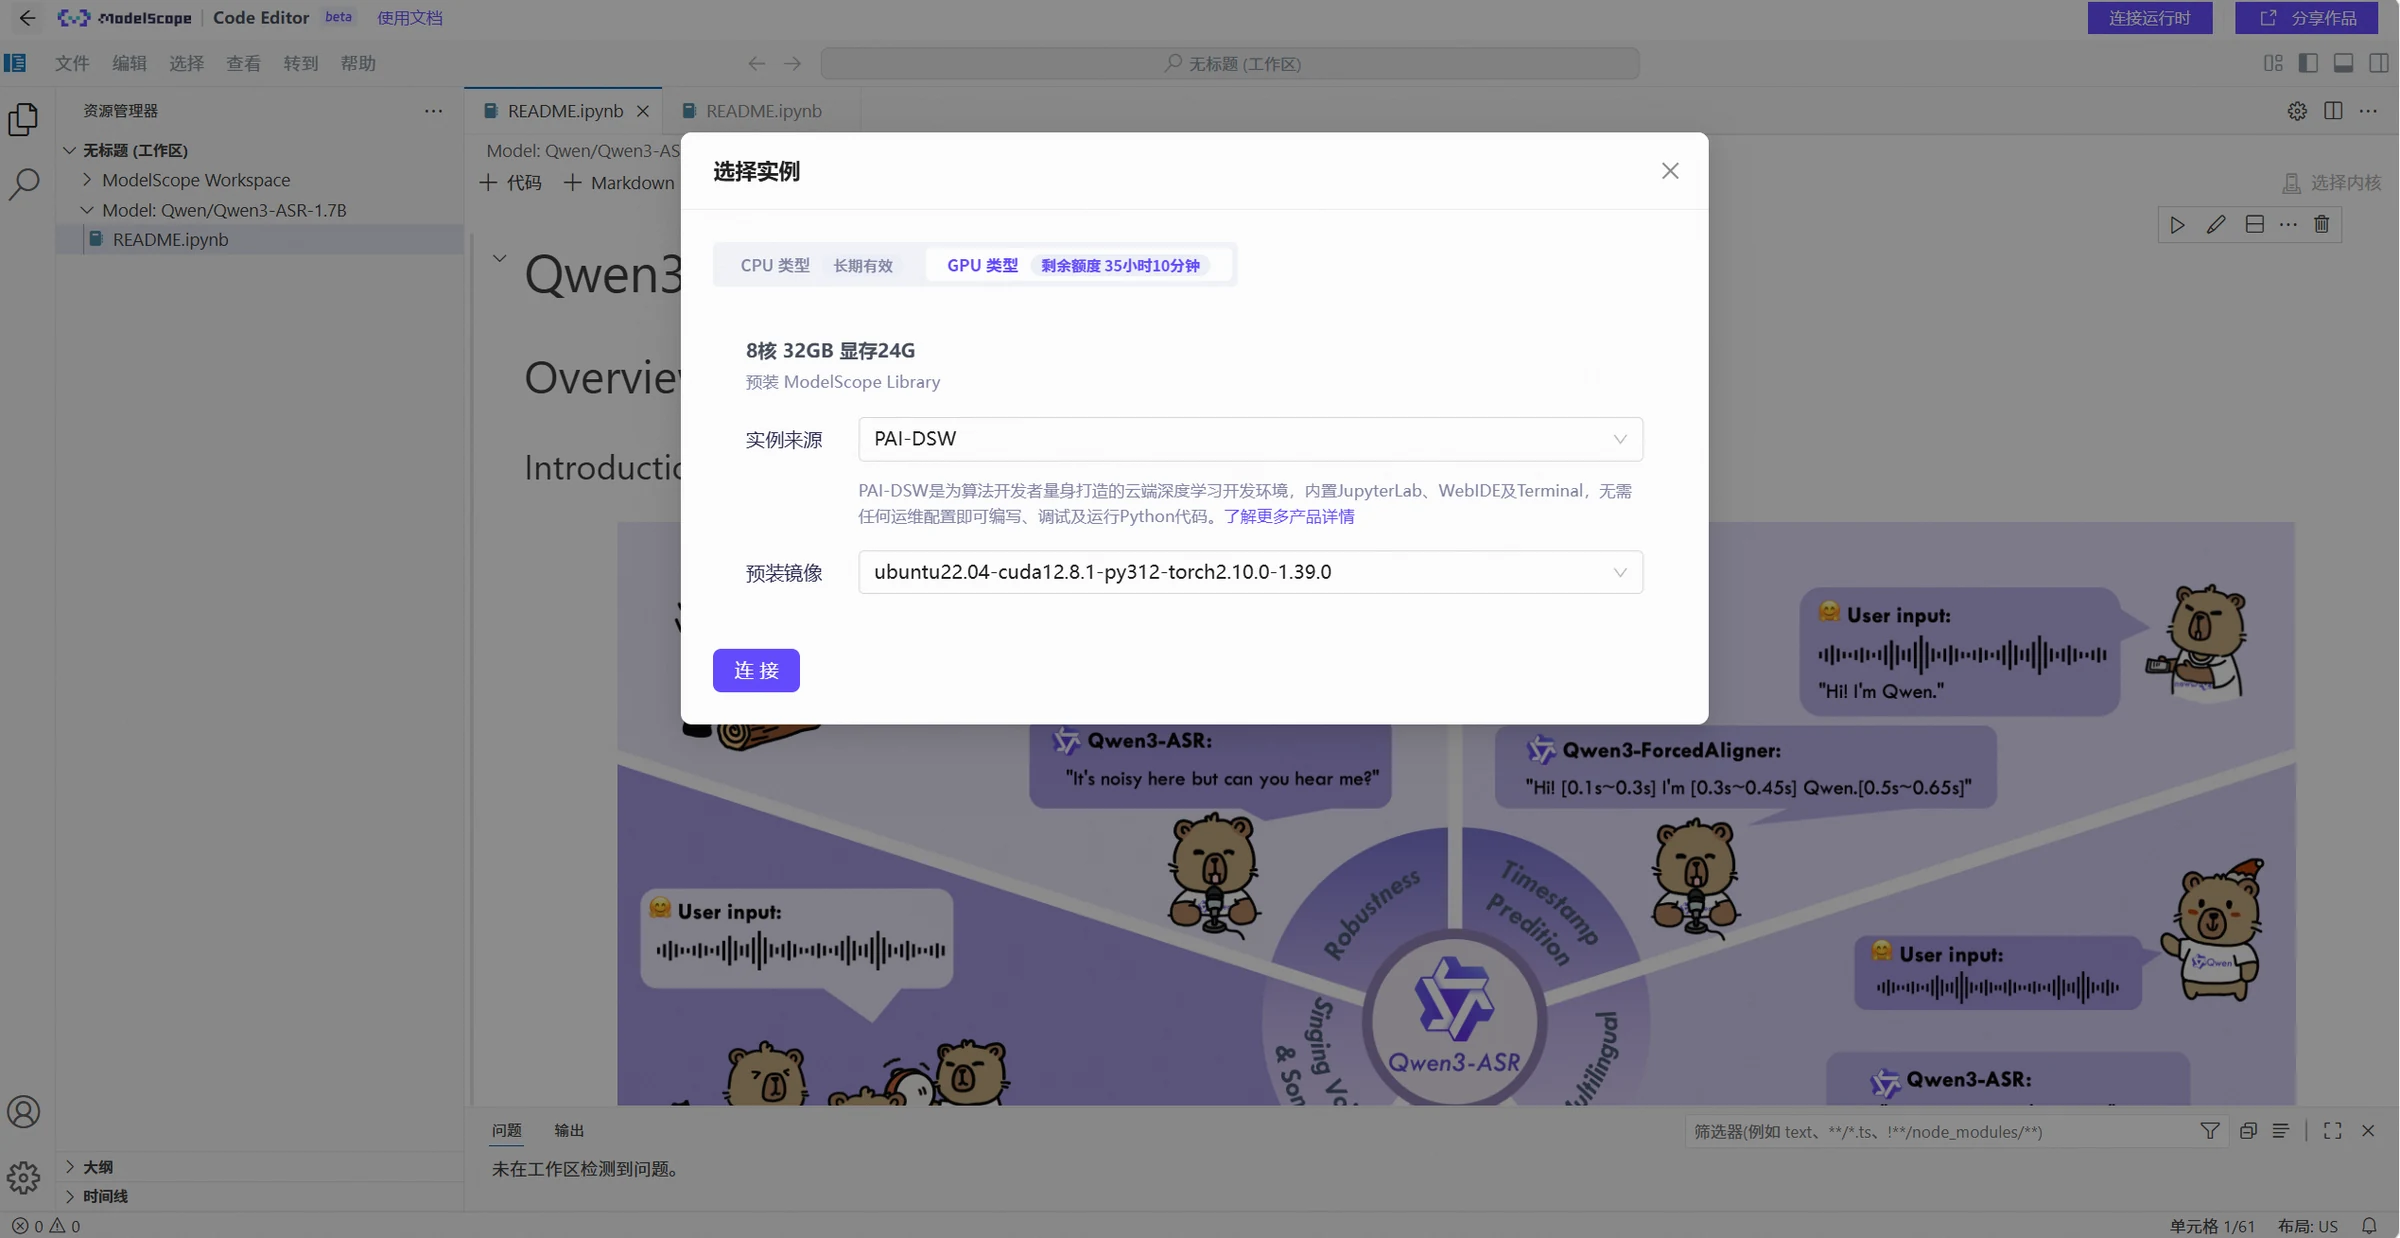
检查一下环境准备好了没有
加载实例后,首先需要检查当前环境,可以在notebook执行以下命令:
1.查看python版本
!python3 --version
结果展示:
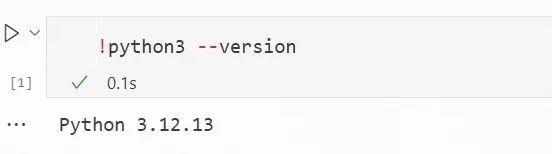
2.查看相关依赖
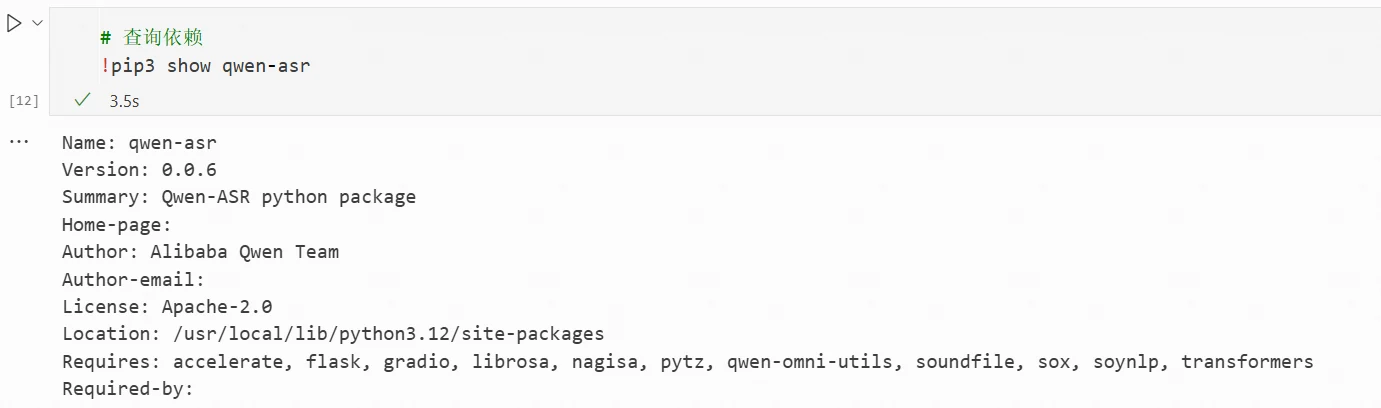
不同模型的依赖不同,需要查看模型卡片了解信息,根据Qwen3-ASR-1.7B模型的模型卡片,了解到其推理依赖qwen3-asr。如果环境缺失qwen3-asr,需要自行安装
# 查询依赖
!pip3 show qwen-asr
# 安装qwen-asr(如缺失)
!pip3 install -U qwen-asr
结果展示:
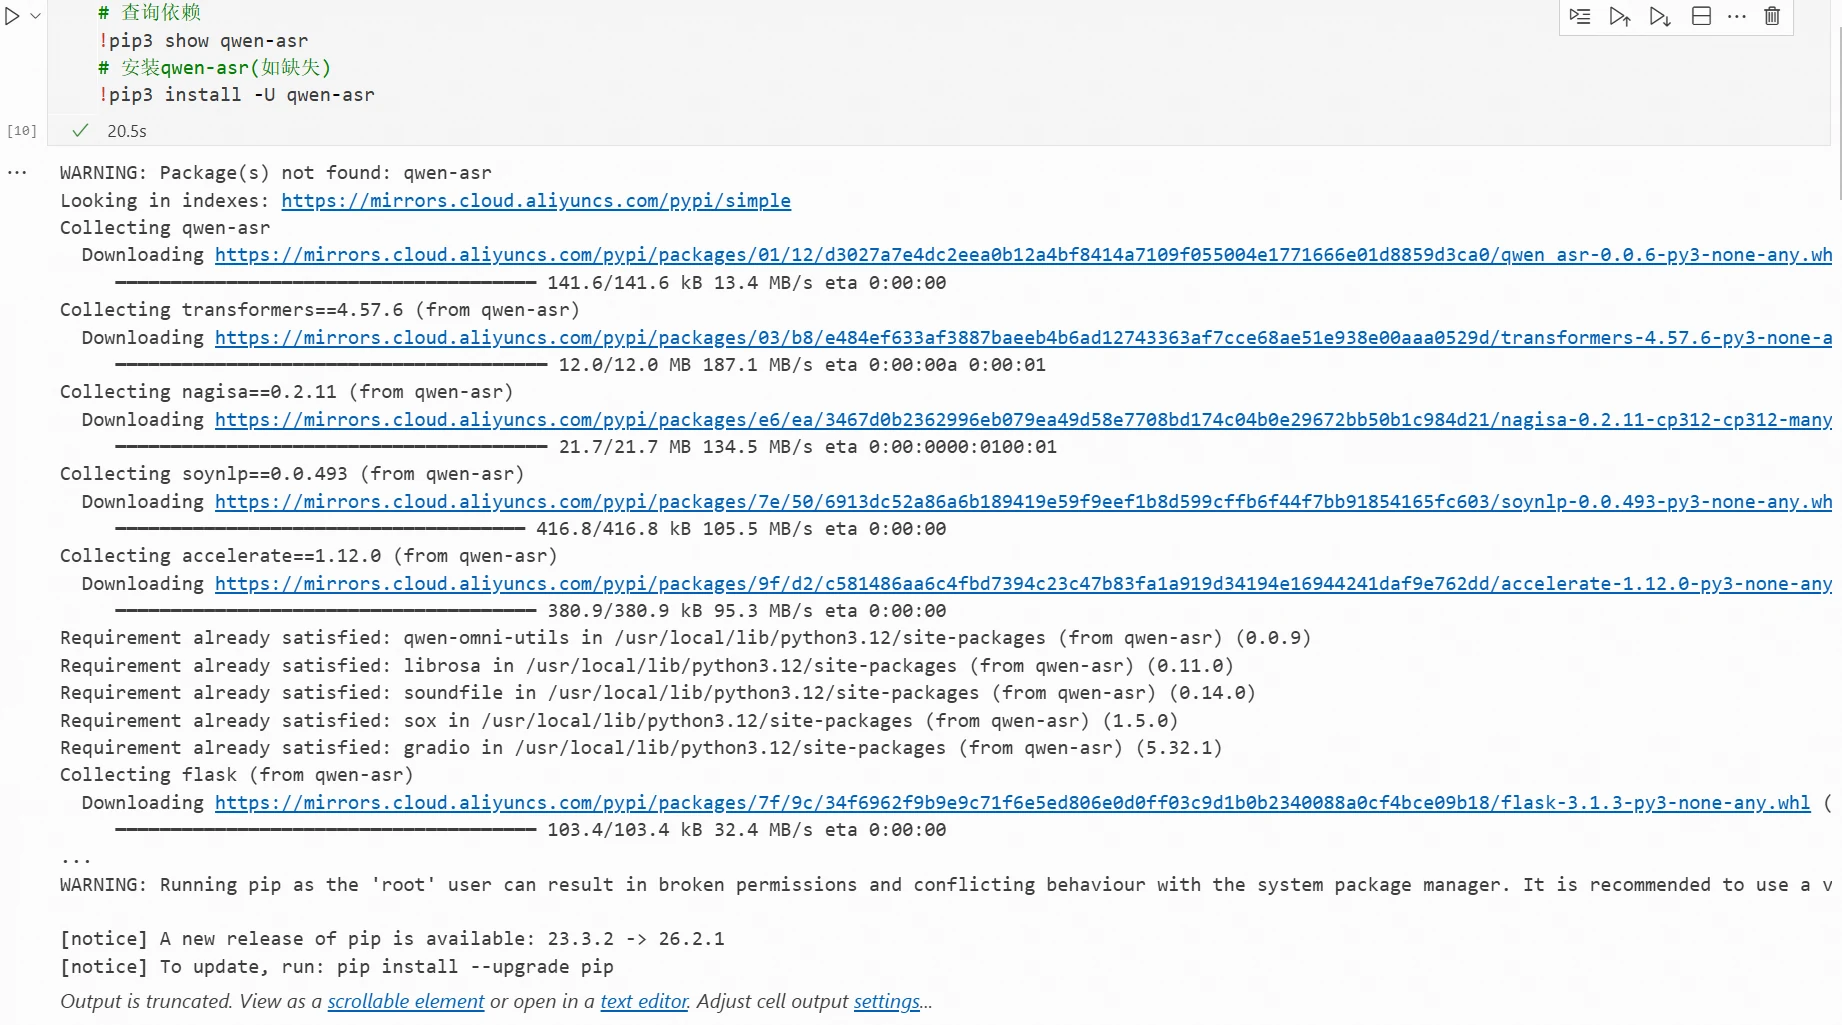
安装成功的查询结果:
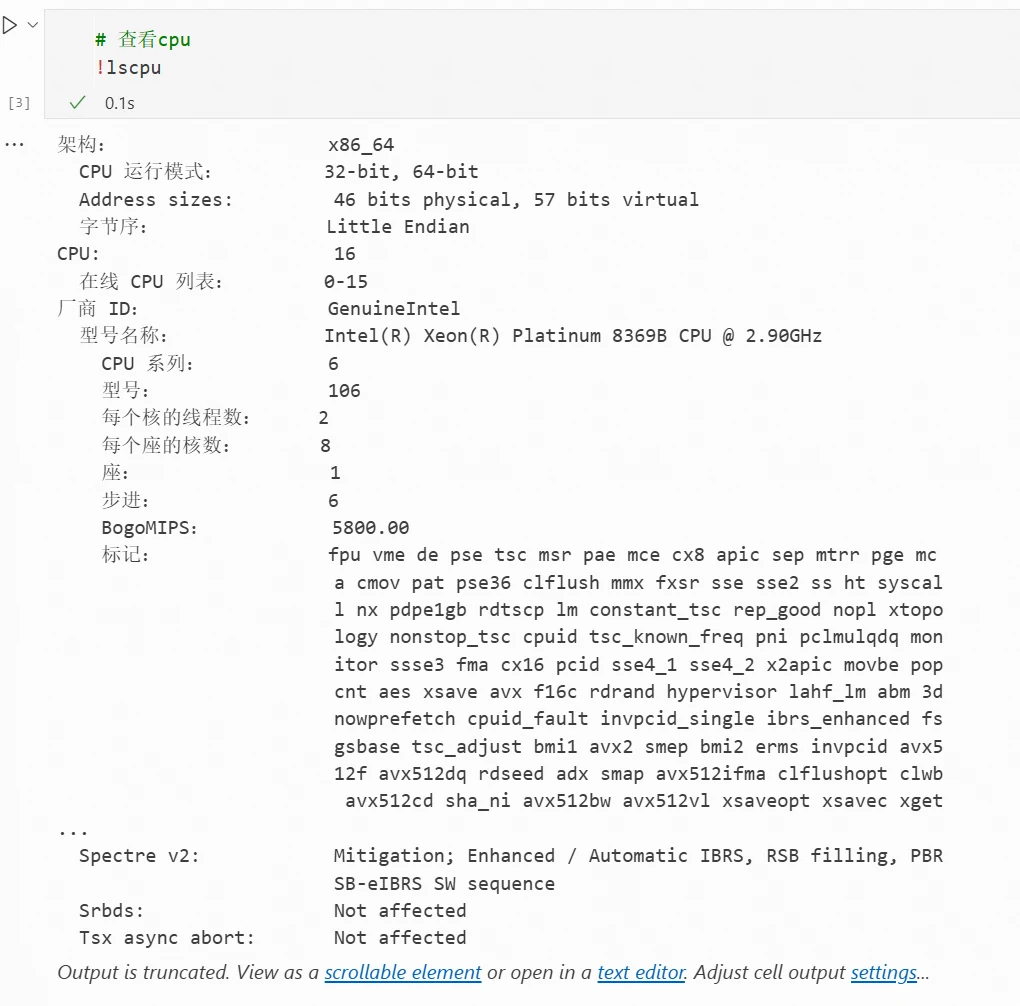
3.查看CPU配置
!lscpu
结果展示:
4.查看GPU及显存
!nvidia-smi
结果展示:
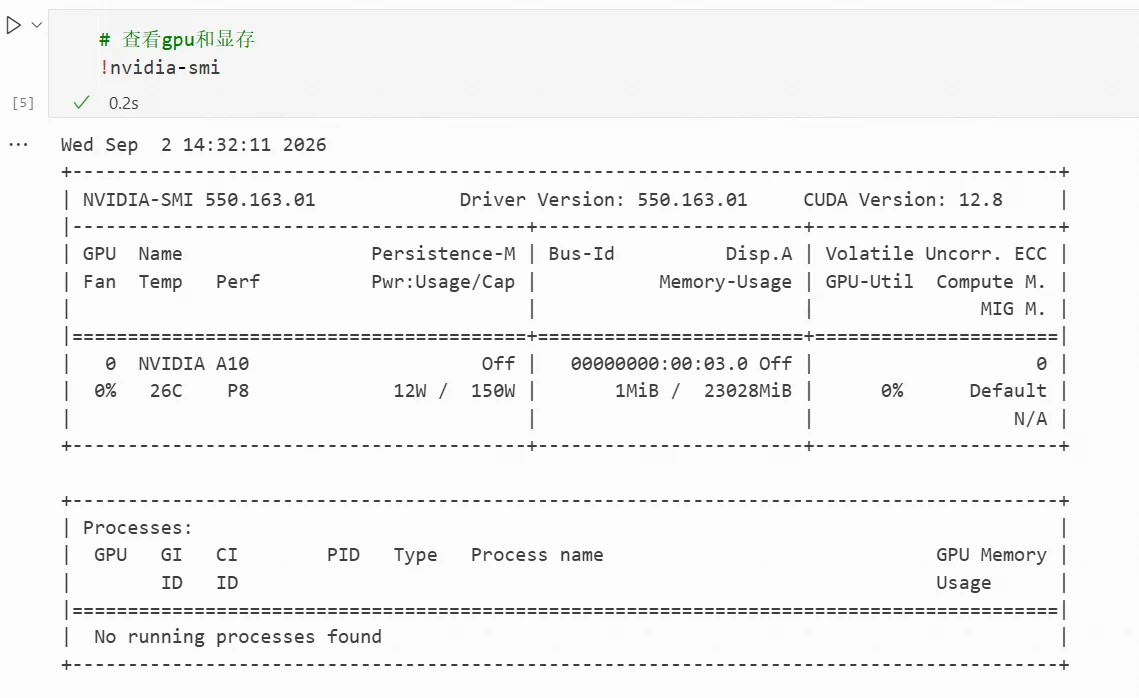
5.查看内存
!free -h
结果展示:
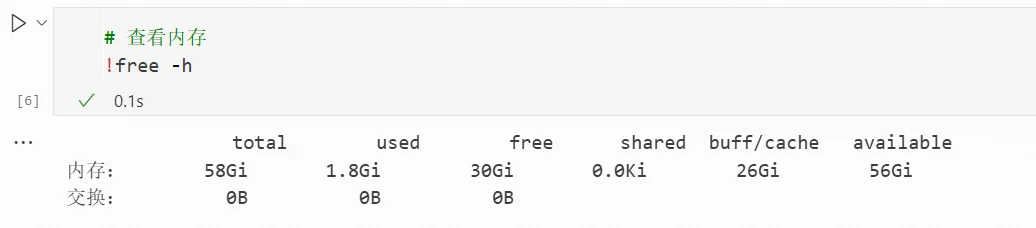
6.查看磁盘
!df -h
结果展示:
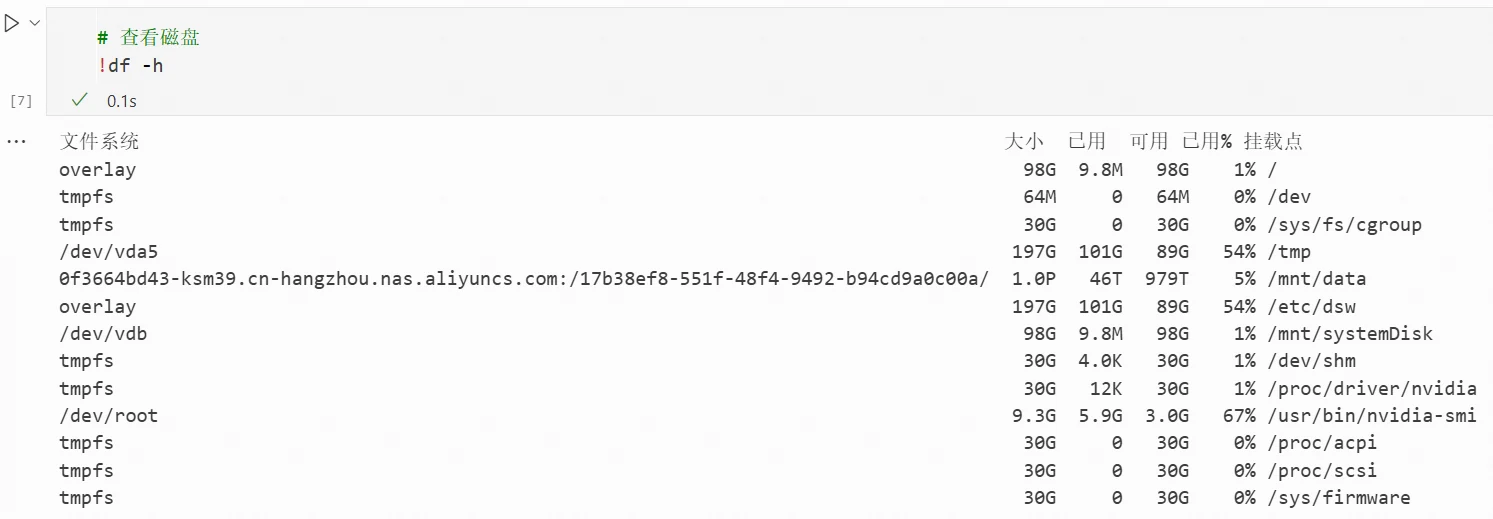
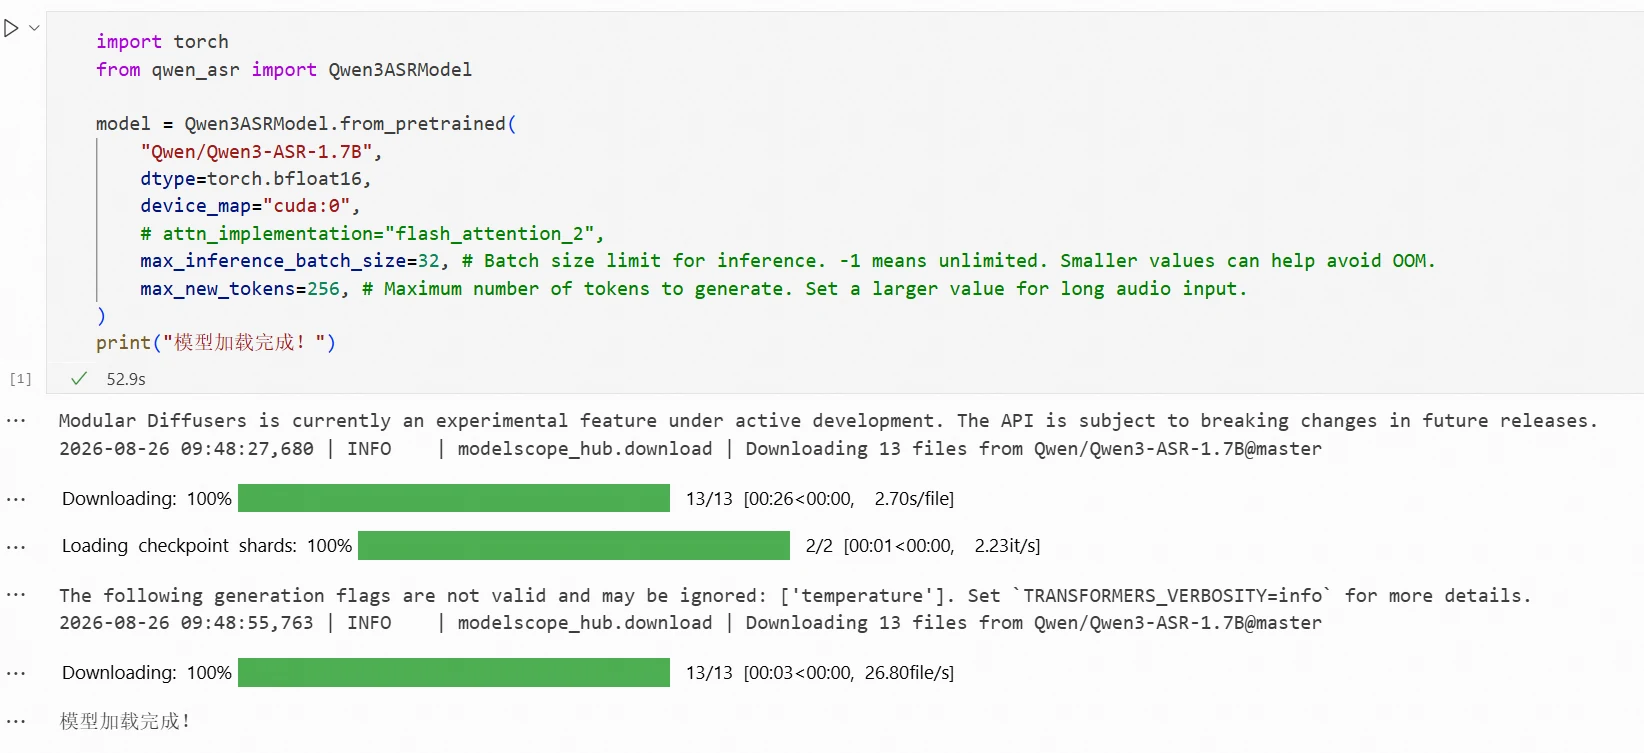
直接按模型名称加载模型
参考模型卡片示例代码进行模型加载,这里会自动下载需要的模型文件。
import torch
from qwen_asr import Qwen3ASRModel

model = Qwen3ASRModel.from_pretrained(
    "Qwen/Qwen3-ASR-1.7B",
    dtype=torch.bfloat16,
    device_map="cuda:0",
    # attn_implementation="flash_attention_2",
    max_inference_batch_size=32, # Batch size limit for inference. -1 means unlimited. Smaller values can help avoid OOM.
    max_new_tokens=256, # Maximum number of tokens to generate. Set a larger value for long audio input.
)
print("模型加载完成!")
结果展示:
第 1 课,共 5 课已完成 0%
讨论
登录 参与讨论