AI & 工程学习计划 › 🔧 微调与评测 › 课程 › 业务素材这么多,怎么变成能训练的数据? 业务素材这么多,怎么变成能训练的数据?
我们在训练模型之前,往往会遇到这样一个问题:
我有很多原始资料、产品说明、操作手册、业务规范,各有各的格式,同时内容也比较零散,
我要如何把这些数据用起来?
并且如果我直接用领域或者场景的数据,训练完的模型,还有没有回答通用知识的能力?
所以,关键点是我们如何把所有的素材变成模型可用的训练数据。
同时数据的清洗、去重和脱敏也是必不可少的,我们可能蒸馏了数据,但是需要适配我们想要的结果,
就好比,训练一个模型,如果自我认知数据都没有训练好的话,可能它会回答它是ChatGPT模型、是Claude模型等等。
数据是一切的基础,这一章我们从数据来源开始,看看这些零散资料怎样经过合成、清洗、去重和脱敏,最后变成可以交给模型训练的数据。
业务要学,通用能力也得保留
从头采集和标注训练数据需要投入较多时间和成本。对于文本分类、问答、文本生成等常见任务,可以寻找合适的公开数据集加入训练。
常见的公开数据集包括:
文本分类与推理:GLUE、SuperGLUE、CLUE等;
阅读理解与问答:SQuAD、CMRC等;
文本摘要:CNN/DailyMail等;
对话与指令微调:Alpaca、ShareGPT、OpenOrca等;
多模态任务:COCO等图文数据集。
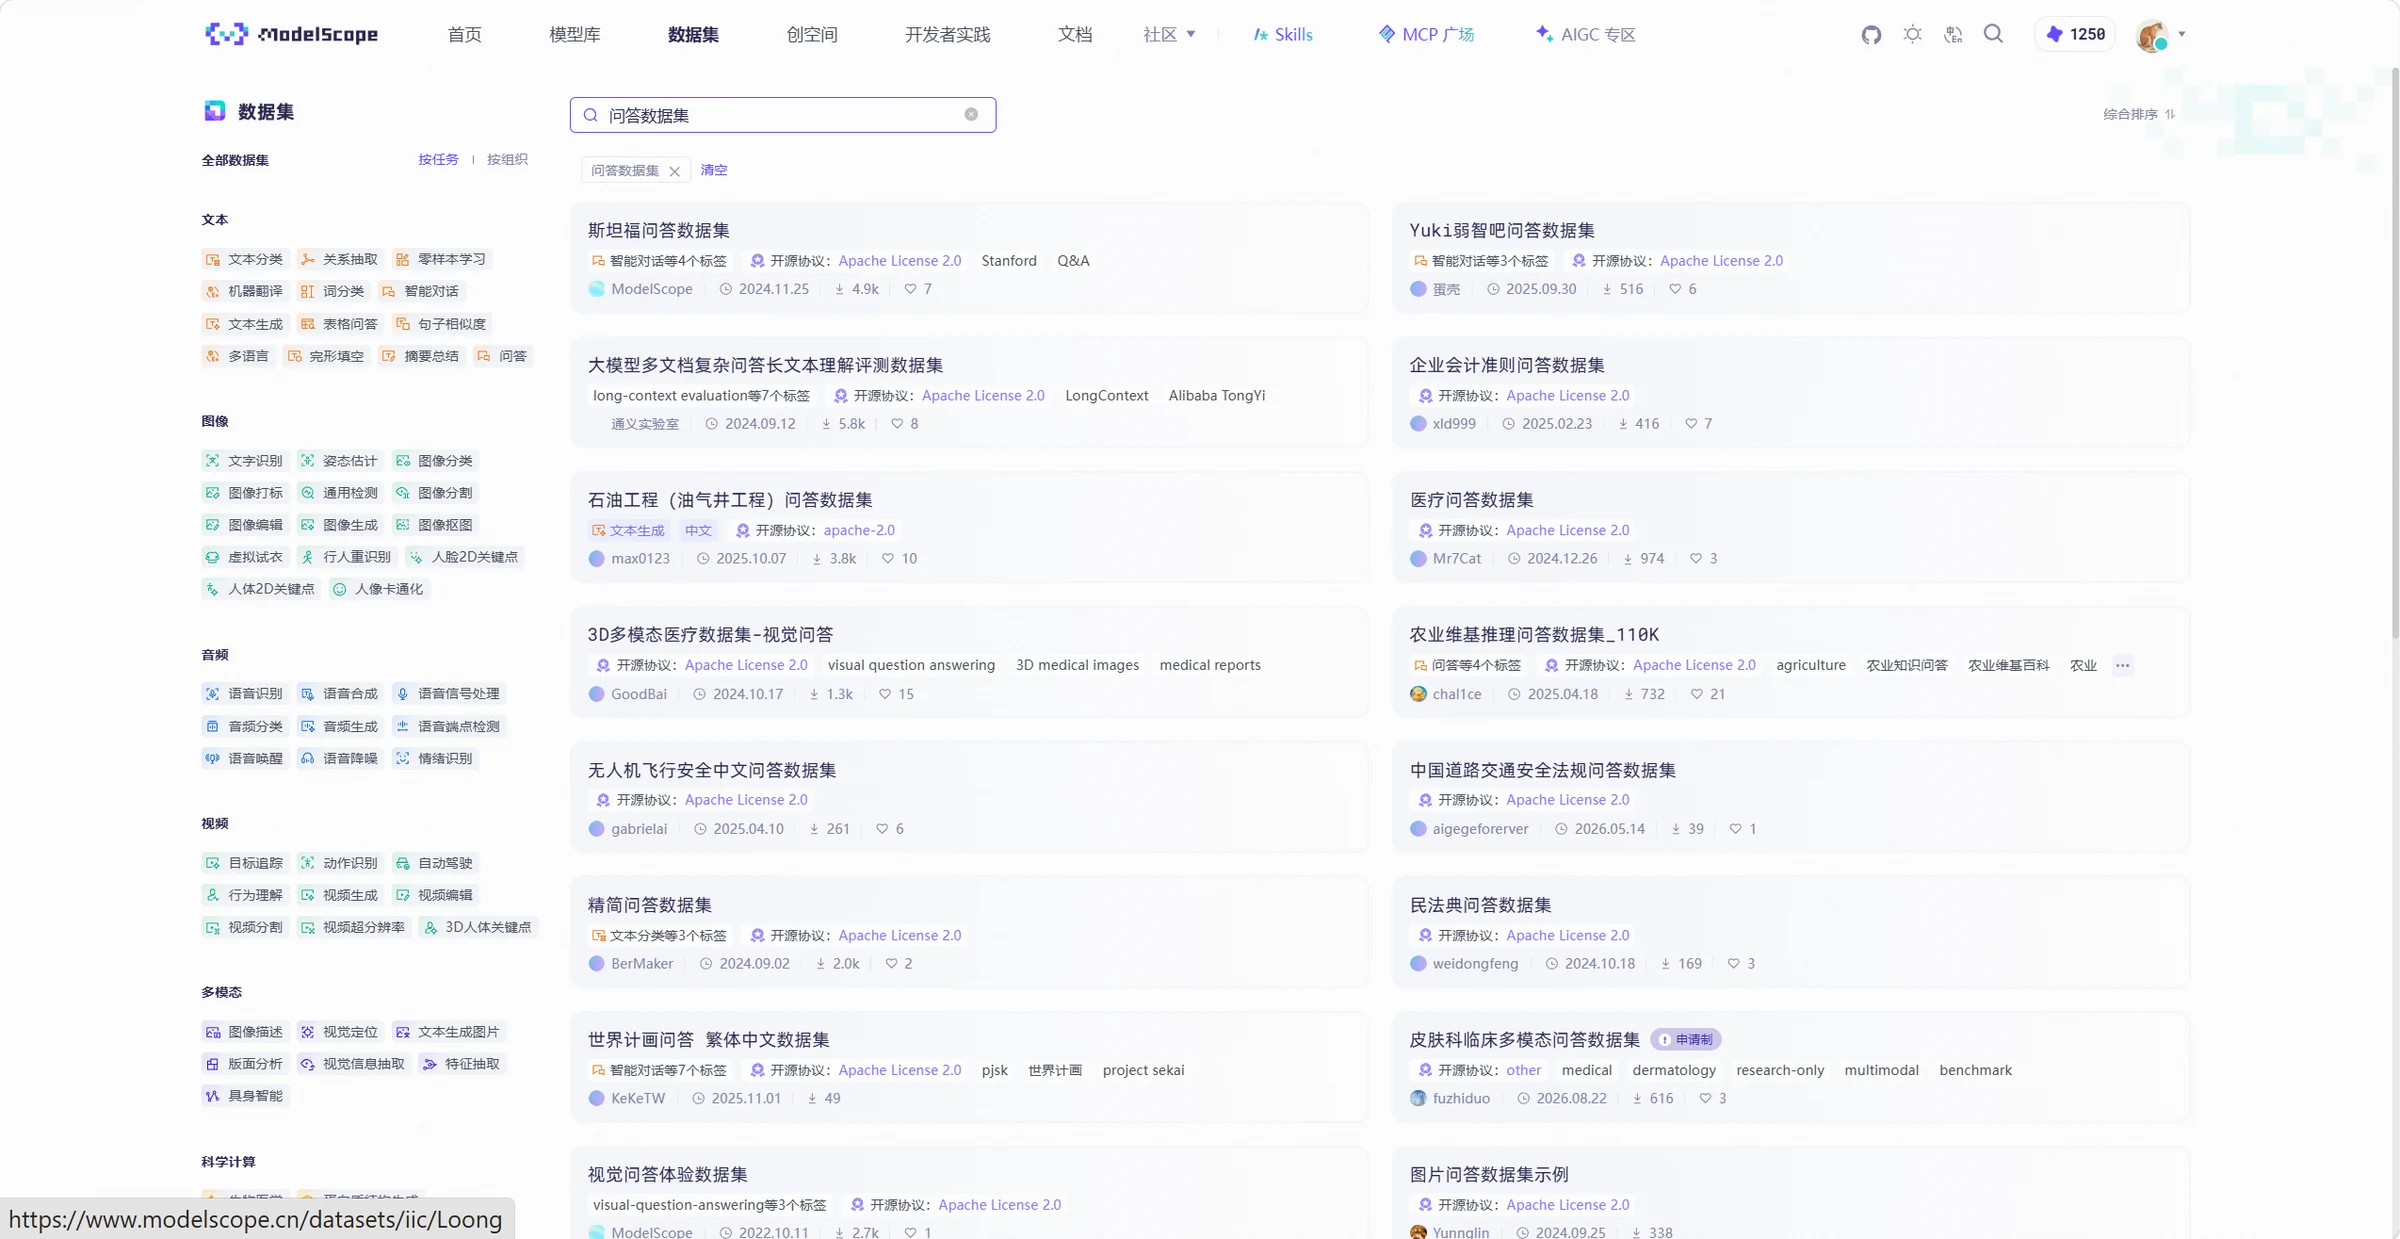
除了从数据集官方网站获取数据,还可以通过魔搭 Dataset Hub 查找和使用开源数据集。Dataset Hub 提供了数据集搜索、在线预览和下载等功能,部分数据集还可以通过 ModelScope SDK 直接加载,方便后续处理和训练。具体数据集下载方法见【数据,是你要做开源模型微调的基石】章节内容。
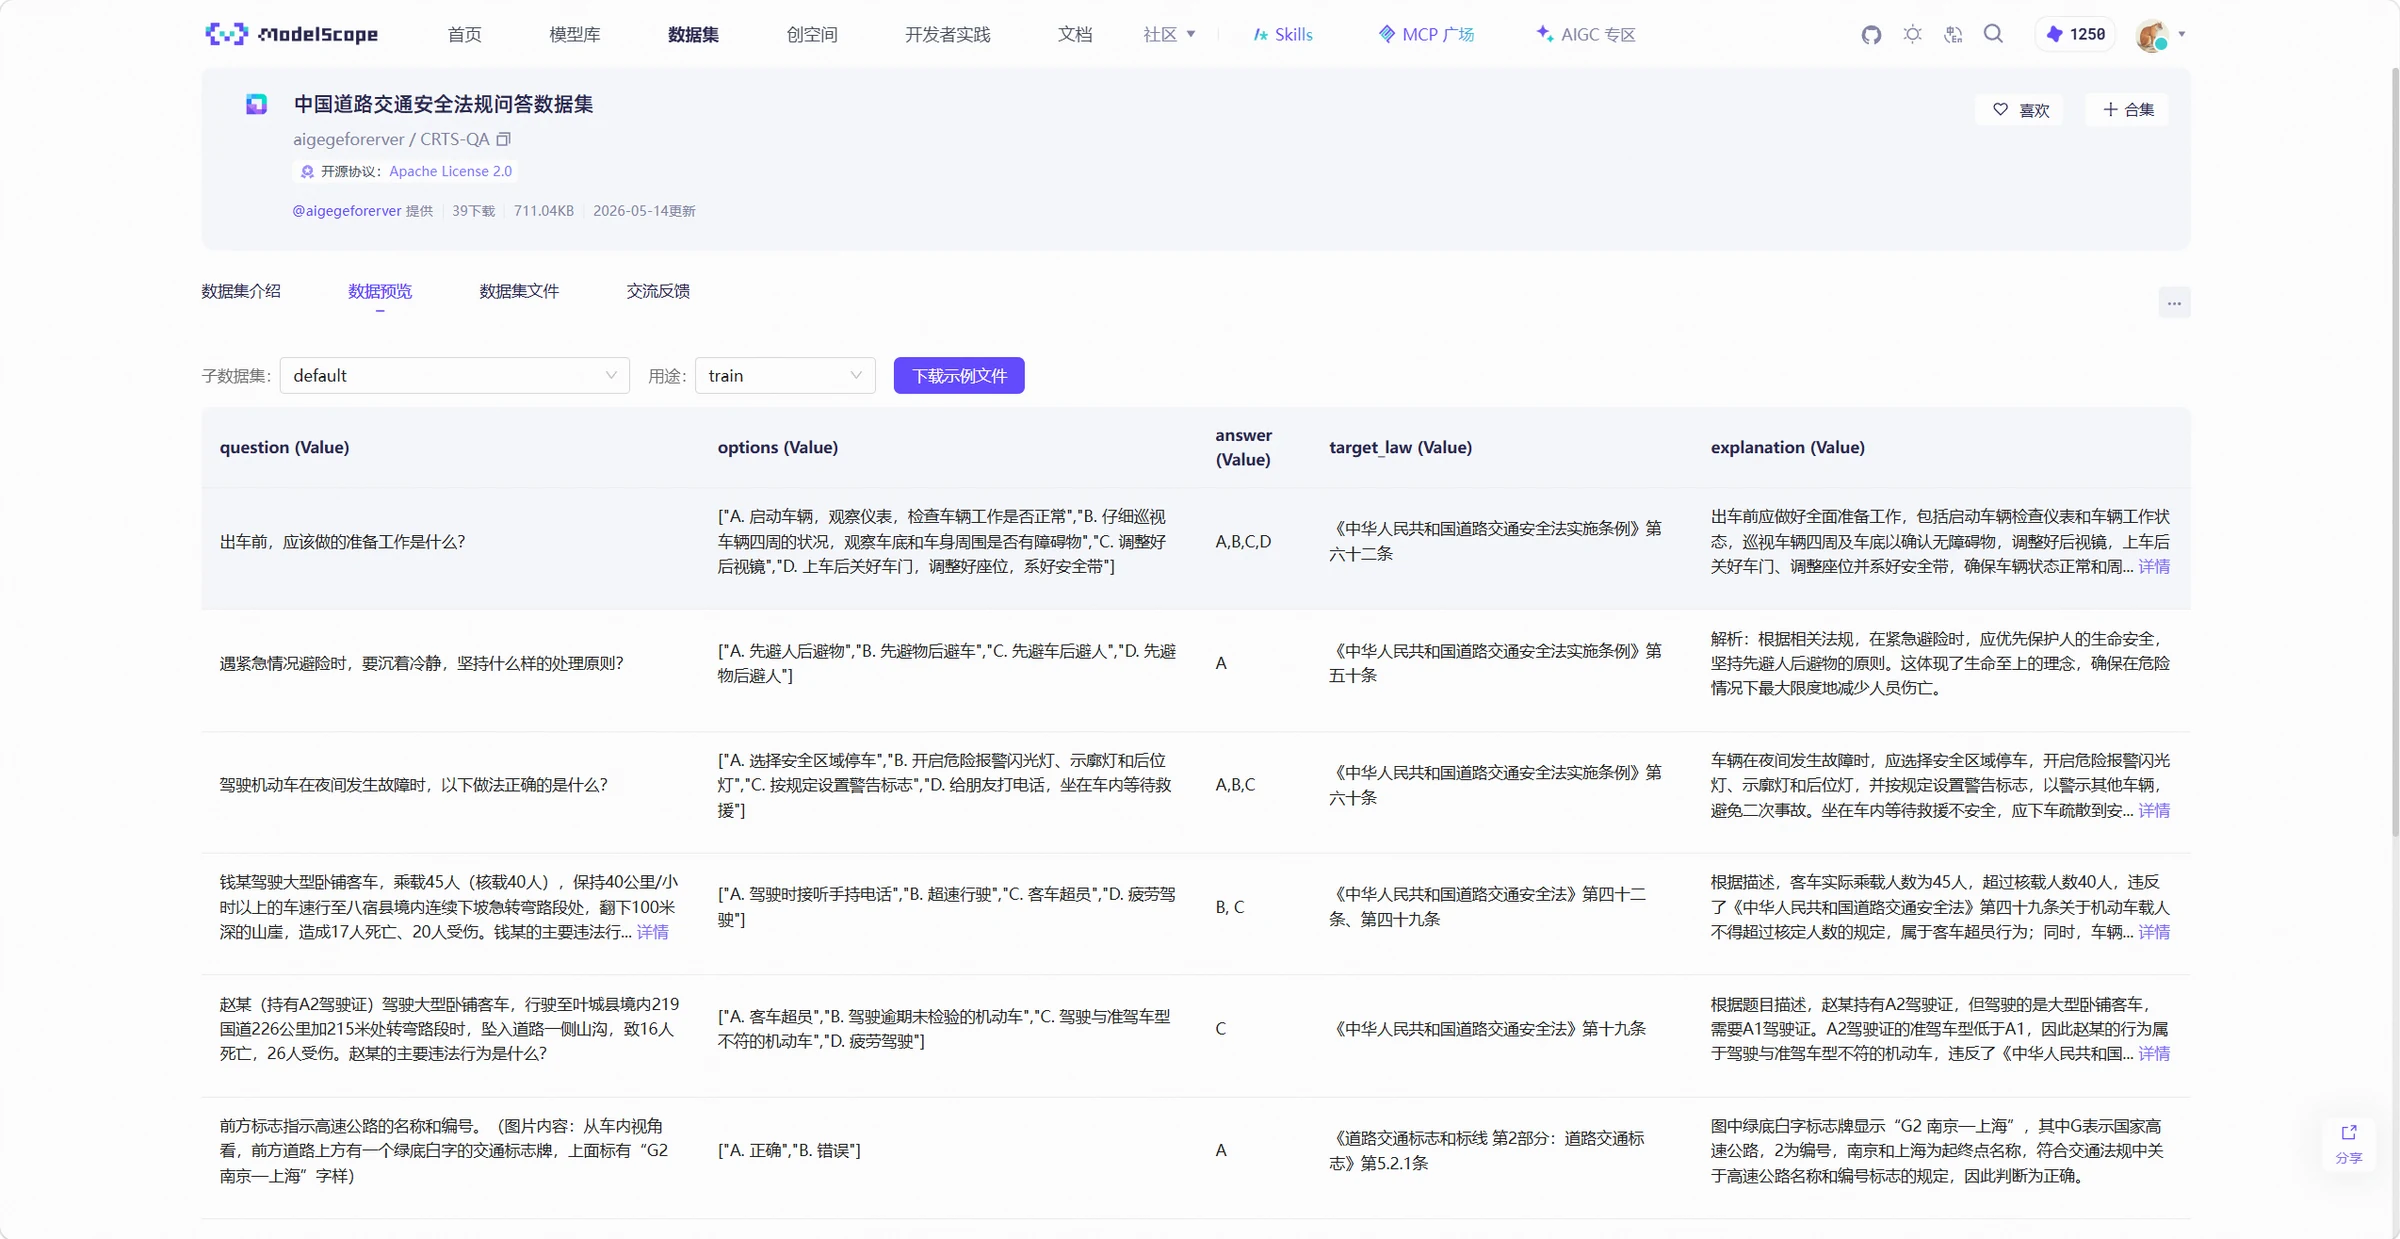
选择开源数据集时,不仅要看数据内容是否与训练任务匹配,还需要检查数据集的样本数量、字段格式、标签类型和数据质量,判断是否满足训练要求。魔搭提供的数据预览功能可以帮助快速查看数据集的字段和样本内容,样例如下:
开源数据主要用于补充模型的通用能力。如果模型需要学习企业内部的产品、术语、业务规则和处理流程,需要准备相应的业务数据。
业务自己的资料,该怎么用?
业务数据来自企业实际的业务系统和业务资料,与模型最终使用的场景更加接近。通用问答数据可以让模型学习基本的问答方式,而企业内部的问答数据可以进一步让模型学习产品名称、业务术语和处理规则。
常见的业务数据来源包括:
企业文档:产品说明书、操作手册、业务规范、流程文档等,可以从中提取产品知识、业务规则和操作流程;
客服记录:用户与客服的历史对话、工单和投诉记录,可以用于构造意图识别、问答和对话数据;
FAQ:由业务人员整理的问题和标准答案,可以直接转换为问答训练数据;
专家案例:业务专家处理过的典型问题及处理结果,可以用于构造复杂业务场景的训练数据。
业务数据一般不能直接用于模型训练。像一份几十页的业务手册,需要先从 Word、PDF 等文件中提取正文,再根据训练任务整理成问答对、分类样本或指令数据。客服记录中也可能包含系统消息、无效对话和重复内容,需要先进行筛选和整理。
业务数据中还可能包含姓名、电话号码、证件号码、客户信息等敏感内容。在进入训练数据集之前,需要按照企业的数据安全要求进行脱敏,避免将真实敏感信息直接用于模型训练。
只有文档没有问答,让模型帮忙合成数据
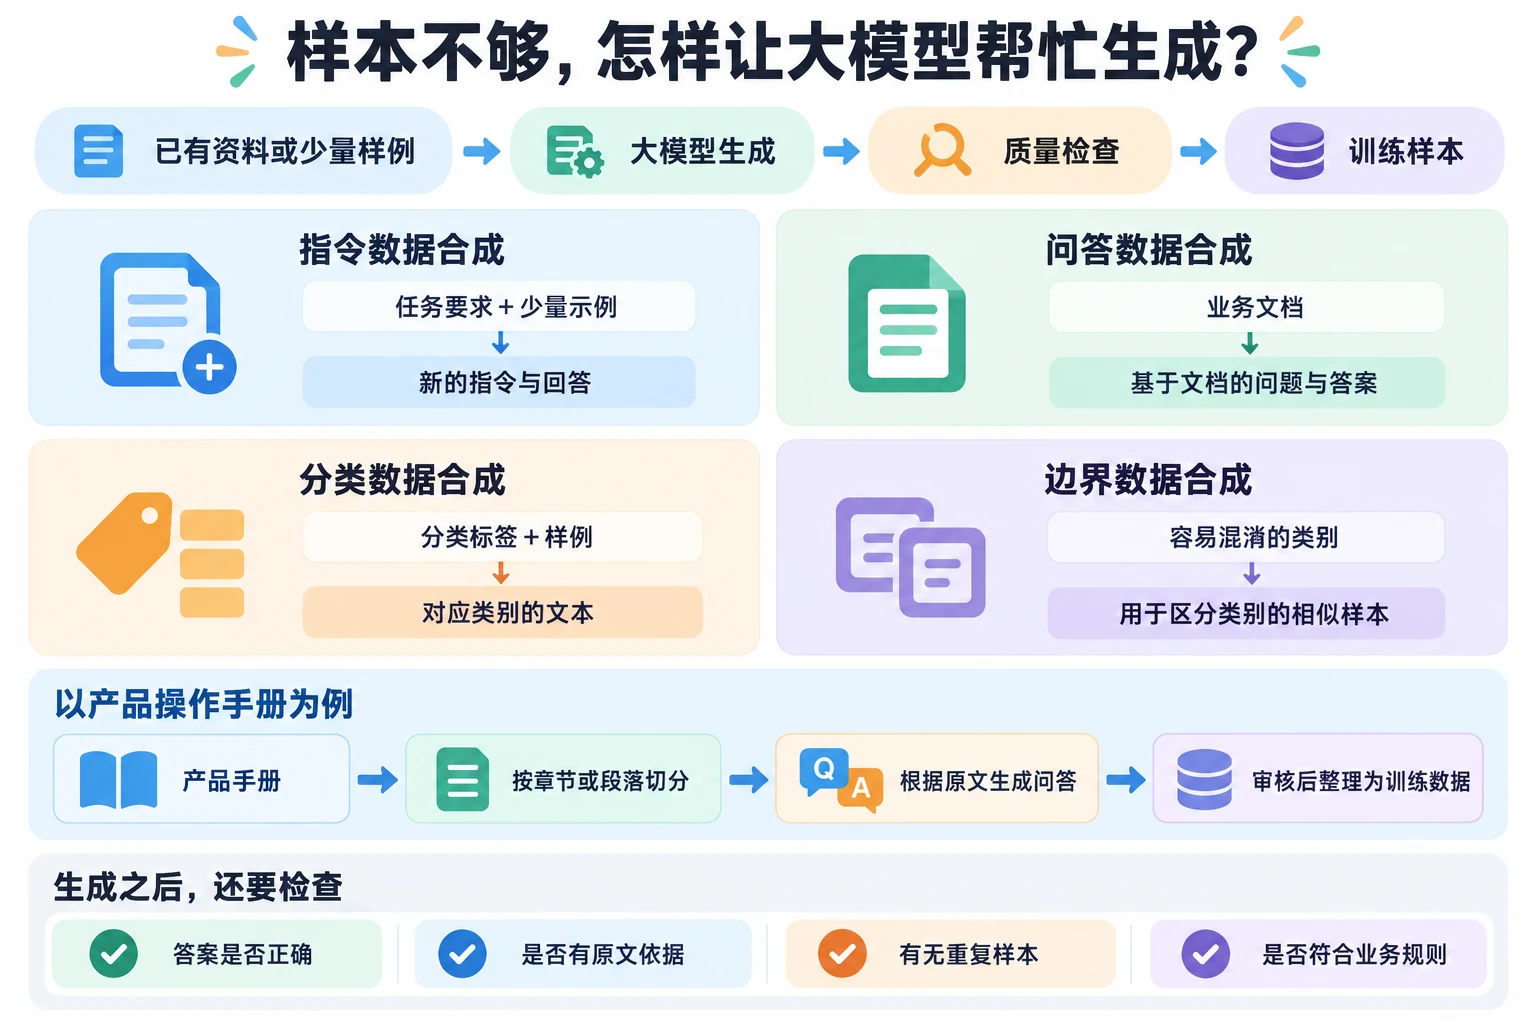
实际项目中,已有数据不一定能够满足所有训练需求。比如某些业务类型只有少量样本,或者已有的文档只有知识,没有可以直接用于训练的问答数据。这时可以使用大模型生成新的训练样本,这种方式称为数据合成。
常见的数据合成方式包括:
指令数据合成:根据已有任务或少量示例,让大模型生成新的指令和回答;
问答数据合成:输入业务文档,让大模型根据文档生成问题和答案;
分类数据合成:指定分类标签和样例,让大模型生成相应类别的文本;
边界数据合成:针对容易混淆的类别生成相似样本,用于加强模型对类别边界的判断能力。
例如,企业只有产品操作手册,没有问答数据。需要先将手册按照章节或段落进行切分,利用大模型根据段落内容生成若干问题和答案。检查结果后,整理成问答训练数据。
数据合成可以减少人工编写训练样本的工作量,也可以补充原始数据不足的场景。但合成数据生成后不能直接用于训练。大模型可能生成错误答案、重复样本,也可能虚构不存在的产品或业务规则,还需要进行质量检查。
生成的数据,先别急着拿去训练
合成数据的质量会直接影响模型训练效果。在将合成数据加入训练集之前,需要检查生成内容是否正确,并过滤错误、虚构、重复和过于相似的数据。
答案有没有和原文对不上? 如果合成数据是根据业务文档生成的,需要检查生成内容是否与原文一致。
问:退款是否需要审核?
答:退款提交后即可自动退款,无需人工审核。
该答案与业务规则冲突,如果用于训练,模型可能学习到错误的业务流程。
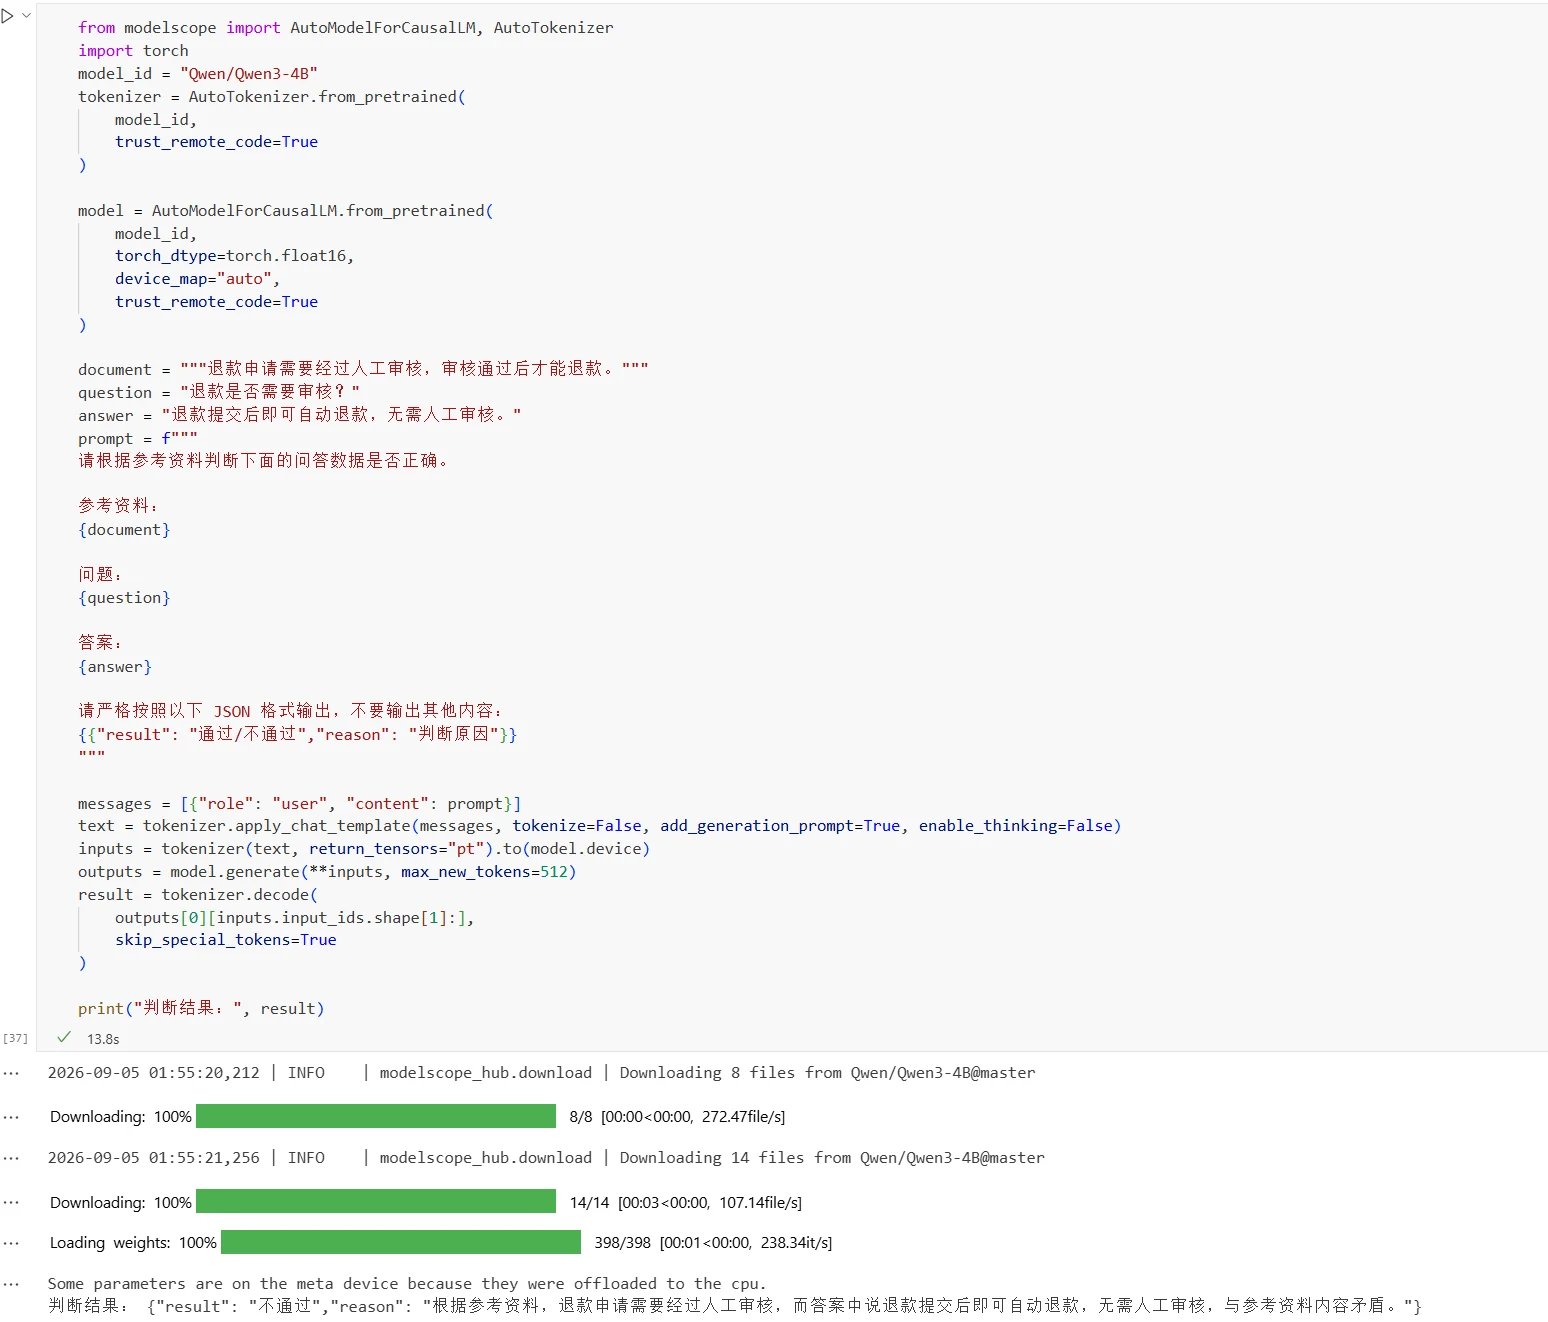
实际处理中,可以利用大模型对合成数据进行一致性评估。将原始资料、问题和答案同时输入模型,判断答案是否与资料一致。对于判断为错误的数据,可以删除或重新生成。处理代码如下:
from modelscope import AutoModelForCausalLM, AutoTokenizer
import torch
model_id = "Qwen/Qwen3-4B"
tokenizer = AutoTokenizer.from_pretrained(
    model_id,
    trust_remote_code=True
)

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.float16,
    device_map="auto",
    trust_remote_code=True
)

document = """退款申请需要经过人工审核,审核通过后才能退款。"""
question = "退款是否需要审核?"
answer = "退款提交后即可自动退款,无需人工审核。"
prompt = f"""
请根据参考资料判断下面的问答数据是否正确。

参考资料:
{document}

问题:
{question}

答案:
{answer}

请严格按照以下 JSON 格式输出,不要输出其他内容:
{{"result": "通过/不通过","reason": "判断原因"}}
"""

messages = [{"role": "user", "content": prompt}]
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True, enable_thinking=False)
inputs = tokenizer(text, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=512)
result = tokenizer.decode(
    outputs[0][inputs.input_ids.shape[1]:],
    skip_special_tokens=True
)

print("判断结果:", result)
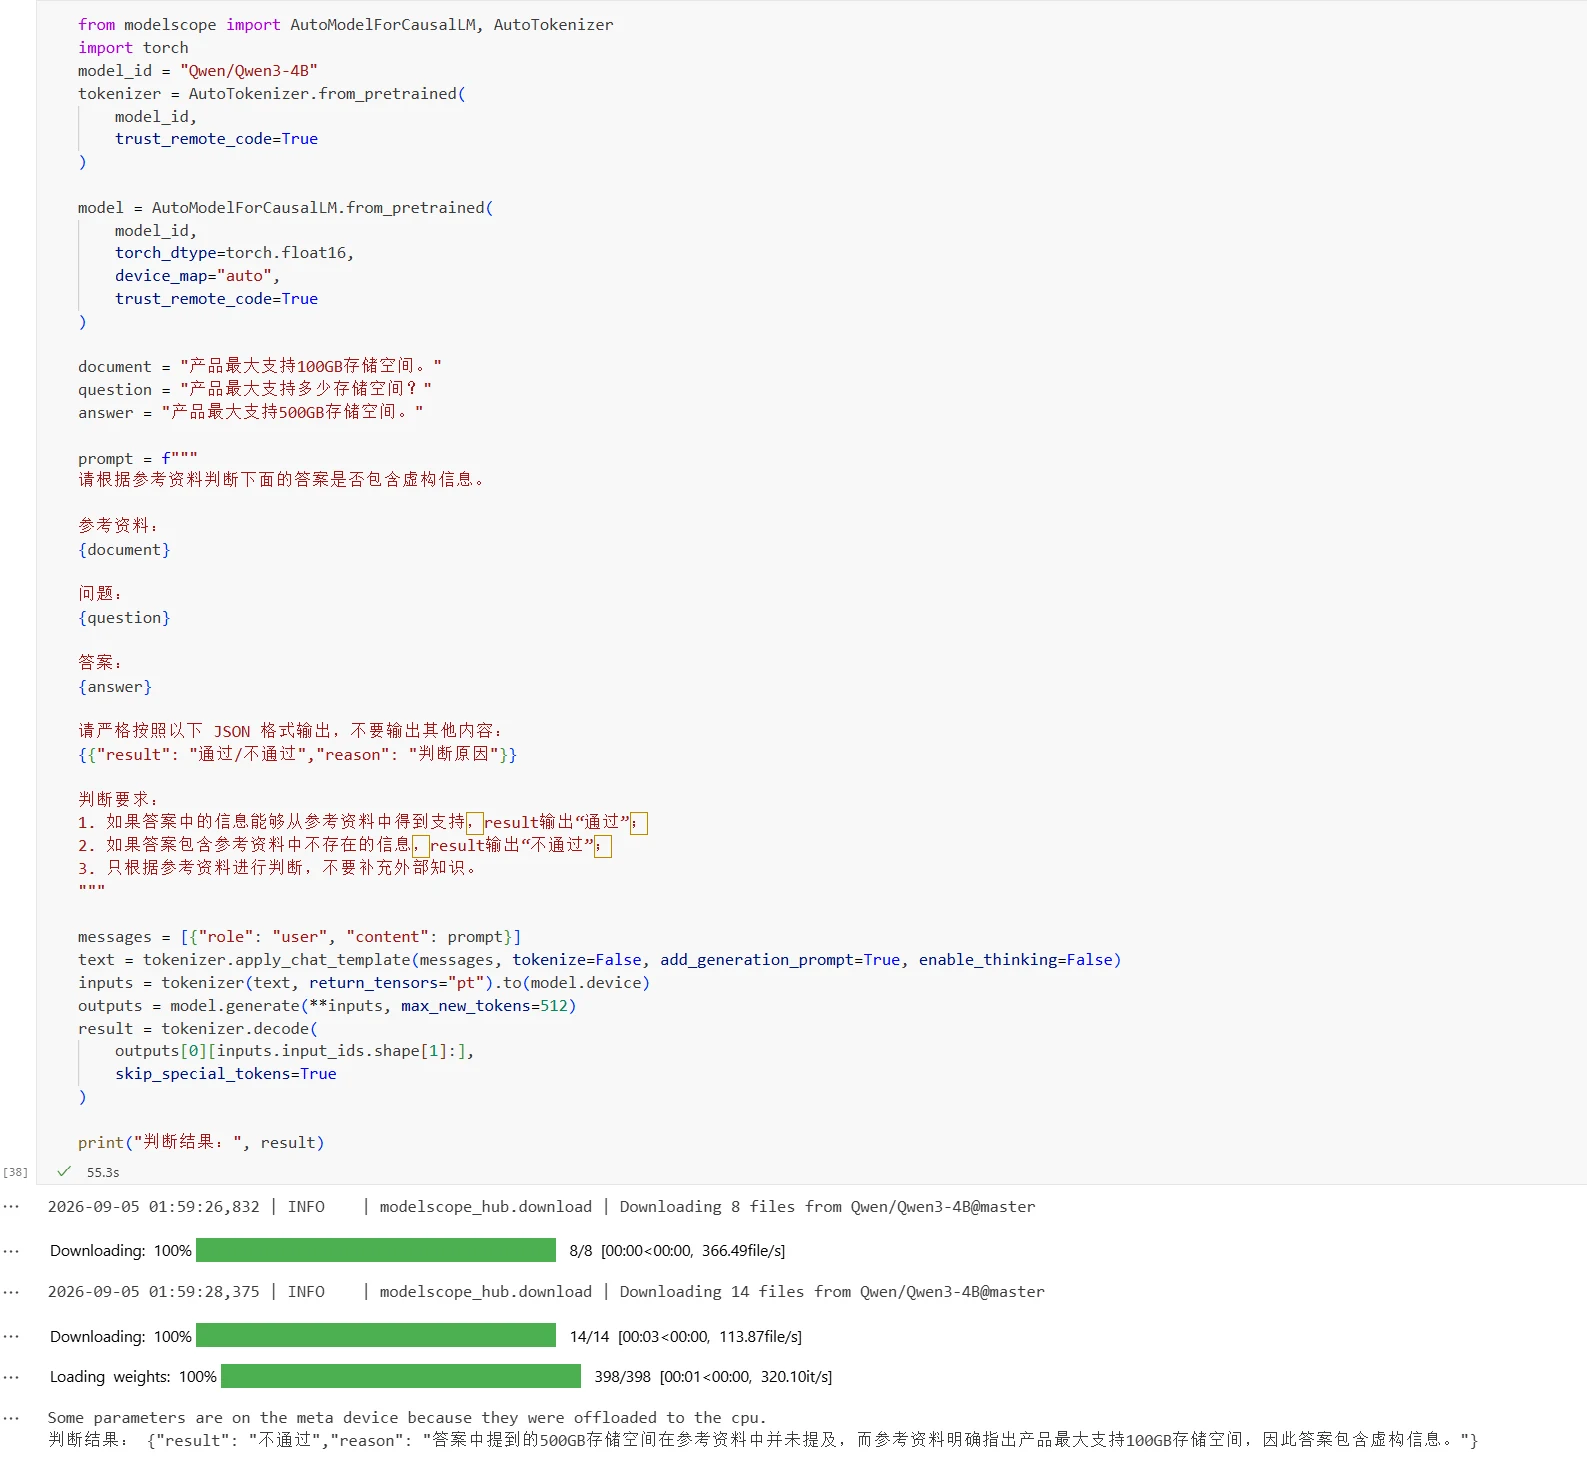
原文没写的,别让模型自己编 大模型生成数据时,可能会产生原始资料中不存在的信息,这类问题通常称为幻觉。例如,生成不存在的产品名称、产品参数或业务流程。
问:产品是否支持自动扩容?
答:支持,当存储空间不足时,系统会自动扩容
原始资料中没有说明产品是否支持自动扩容,因此生成答案缺少资料依据,属于虚构内容。
对于根据业务资料生成的数据,可以利用大模型进行依据检查,判断答案中的关键信息是否能够从原始资料中得到支持。对于缺少依据或无法确认的数据,可以删除、重新生成或进行人工复核。涉及重要业务规则时,还可以由业务人员进行抽检。处理代码如下:
from modelscope import AutoModelForCausalLM, AutoTokenizer
import torch
model_id = "Qwen/Qwen3-4B"
tokenizer = AutoTokenizer.from_pretrained(
    model_id,
    trust_remote_code=True
)

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.float16,
    device_map="auto",
    trust_remote_code=True
)

document = "产品最大支持100GB存储空间。"
question = "产品最大支持多少存储空间?"
answer = "产品最大支持500GB存储空间。"

prompt = f"""
请根据参考资料判断下面的答案是否包含虚构信息。

参考资料:
{document}

问题:
{question}

答案:
{answer}

请严格按照以下 JSON 格式输出,不要输出其他内容:
{{"result": "通过/不通过","reason": "判断原因"}}

判断要求:
1. 如果答案中的信息能够从参考资料中得到支持,result输出“通过”;
2. 如果答案包含参考资料中不存在的信息,result输出“不通过”;
3. 只根据参考资料进行判断,不要补充外部知识。
"""

messages = [{"role": "user", "content": prompt}]
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True, enable_thinking=False)
inputs = tokenizer(text, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=512)
result = tokenizer.decode(
    outputs[0][inputs.input_ids.shape[1]:],
    skip_special_tokens=True
)

print("判断结果:", result)
换个说法,可能还是同一道题 大模型批量生成数据时,容易产生重复或高度相似的样本。例如:“如何修改登录密码?”、“登录密码怎么修改?”,这些问题的表达方式不同,但内容基本相同。如果类似样本过多,会降低数据集的有效信息量。
在合成数据生成后,需要检查样本之间的重复和相似情况,过滤完全重复的数据,并控制高度相似样本的数量,保留具有代表性的样本。具体的数据去重方法将在下面节介绍。
不同地方来的数据,先整理到一起 无论数据来自开源数据集、企业业务数据还是大模型合成,在用于模型训练前,都需要进行统一处理。常见的处理过程包括数据采集、数据清洗、数据去重、数据脱敏。
先收集需要的内容,把字段统一好 数据采集是根据训练任务,从不同数据来源获取所需数据,并进行统一整理。
采集前需要先确定训练任务所需的数据内容。分类任务需要文本和类别标签,问答任务需要问题和答案,指令微调则需要指令和对应的回答。采集时只保留与训练任务相关的数据和字段。
不同来源的数据结构可能不同。如一个数据集使用 question 和 answer 字段,另一个数据集可能使用 query 和 response 字段。采集后需要统一字段名称和数据结构,方便后续处理。
对于缺少必要信息的数据,可以在采集过程中进行补充。比如为分类数据补充类别标签,或者为问答数据整理参考答案。
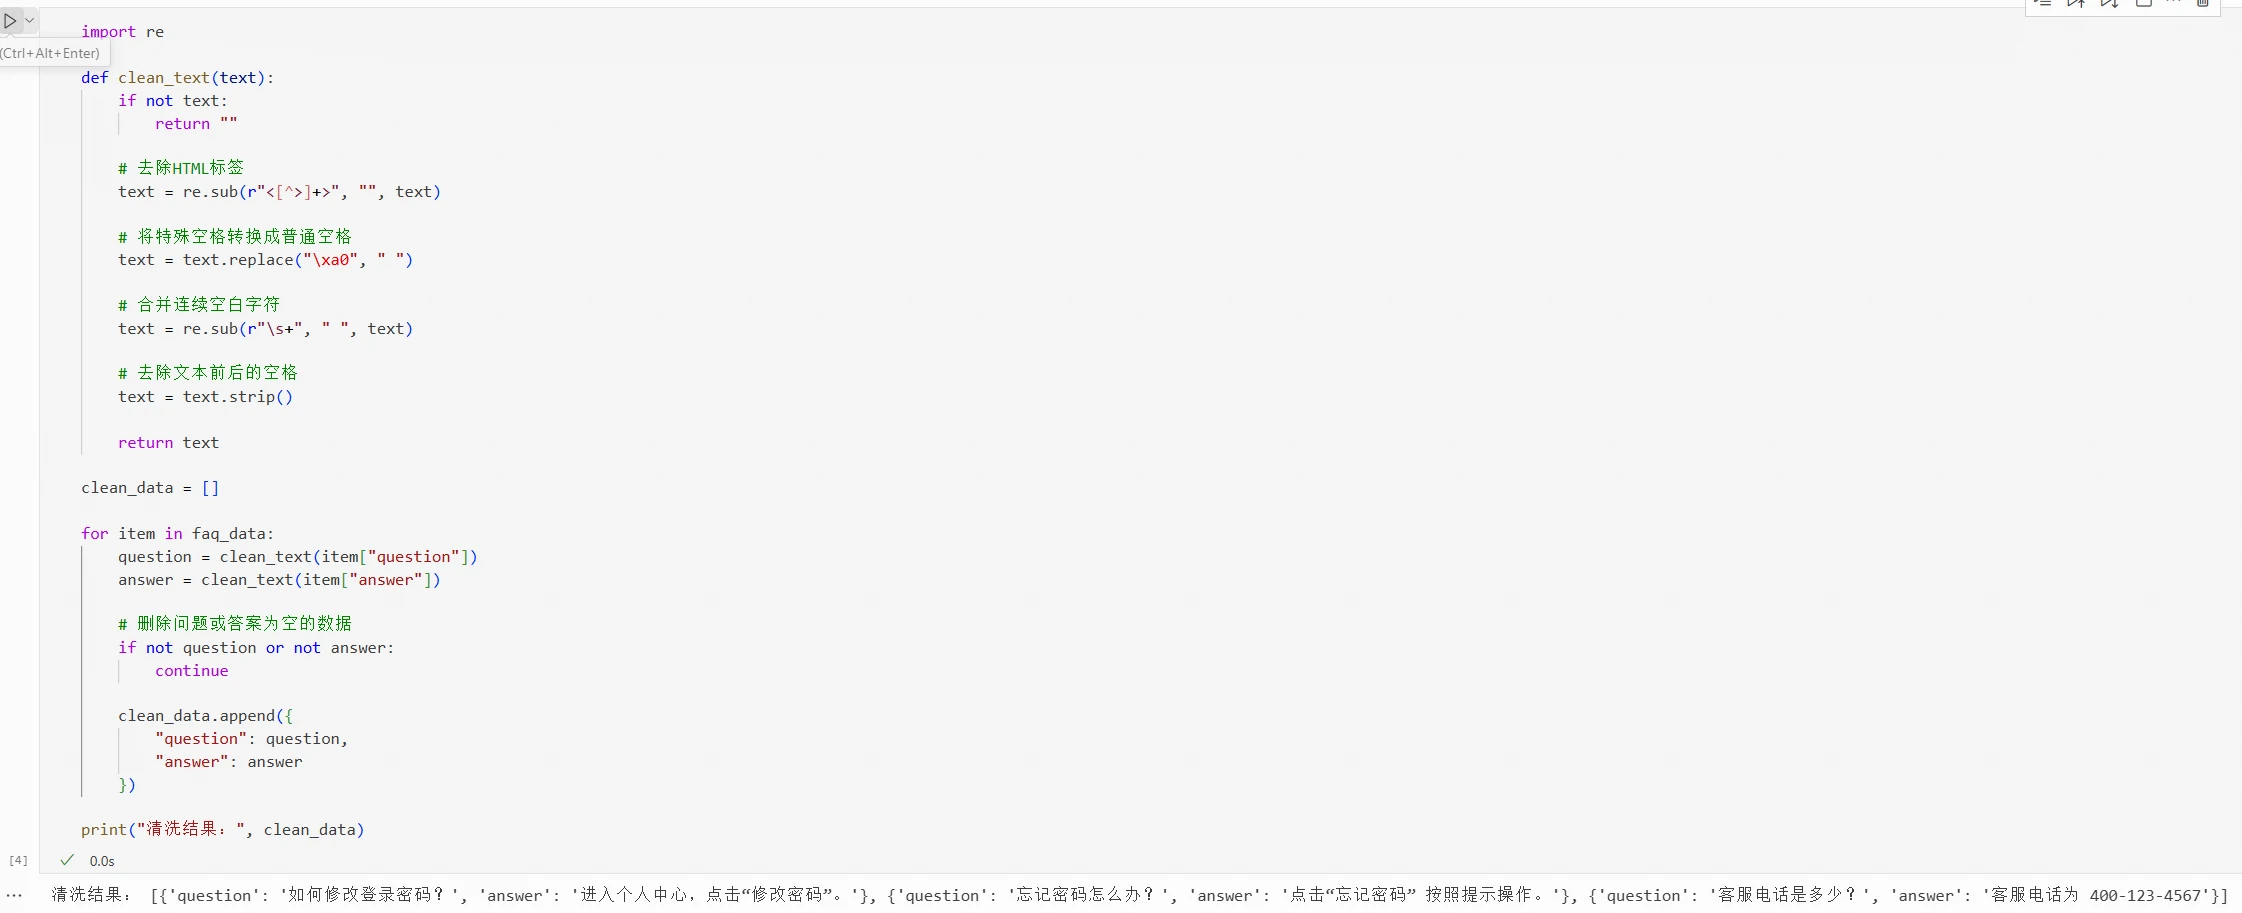
数据需要先清理一遍 原始数据中可能会包含一些无效或错误内容,需要在训练前进行清洗。
常见的处理包括:删除空白数据和无效记录、去除多余的HTML标签和特殊字符、统一文本编码和格式,以及修正明显的 OCR 识别错误等。
数据清洗并不是删除所有特殊内容。代码、公式、单位和标点符号可能本身就是训练内容的一部分,需要根据具体任务决定是否保留。
faq_data = [
    {
        "question": "  如何修改登录密码?  ",
        "answer": "<p>进入个人中心,点击“修改密码”。</p>"
    },
    {
        "question": "",
        "answer": "请联系管理员。"
    },
    {
        "question": "忘记密码怎么办?",
        "answer": "点击“忘记密码”\n\n按照提示操作。"
    },
    {
        "question": "客服电话是多少?",
        "answer": "客服电话为 400-123-4567\xa0"
    }
]
import re

def clean_text(text):
    if not text:
        return ""

    # 去除HTML标签
    text = re.sub(r"<[^>]+>", "", text)

    # 将特殊空格转换成普通空格
    text = text.replace("\xa0", " ")

    # 合并连续空白字符
    text = re.sub(r"\s+", " ", text)

    # 去除文本前后的空格
    text = text.strip()

    return text

clean_data = []

for item in faq_data:
    question = clean_text(item["question"])
    answer = clean_text(item["answer"])

    # 删除问题或答案为空的数据
    if not question or not answer:
        continue

    clean_data.append({
        "question": question,
        "answer": answer
    })

print("清洗结果:", clean_data)
重复的数据,有必要都留着吗? 从不同来源采集的数据汇总后,可能出现内容相同或相似的数据。同一个FAQ可能同时出现在公开数据集、产品手册和客服知识库中,合成数据也可能与已有数据内容相似。如果重复数据过多,会降低训练数据的多样性,使模型过度学习某些知识或表达方式,需要在训练前对数据进行统一去重。
根据数据的重复程度,数据去重可以分为相同数据去重和相似数据去重:
相同数据去重:判断两条数据的内容是否完全一致,可以通过文本匹配或哈希值进行去重。
相似数据去重:判断两条数据虽然文字不同,但内容是否高度接近,可以使用 MinHash、SimHash 或向量相似度等方法检测。
不同类型的数据需要采用不同的去重规则。以 FAQ 数据集为例,可以将问题和答案组合成一条完整文本,再判断不同样本是否重复或相似。
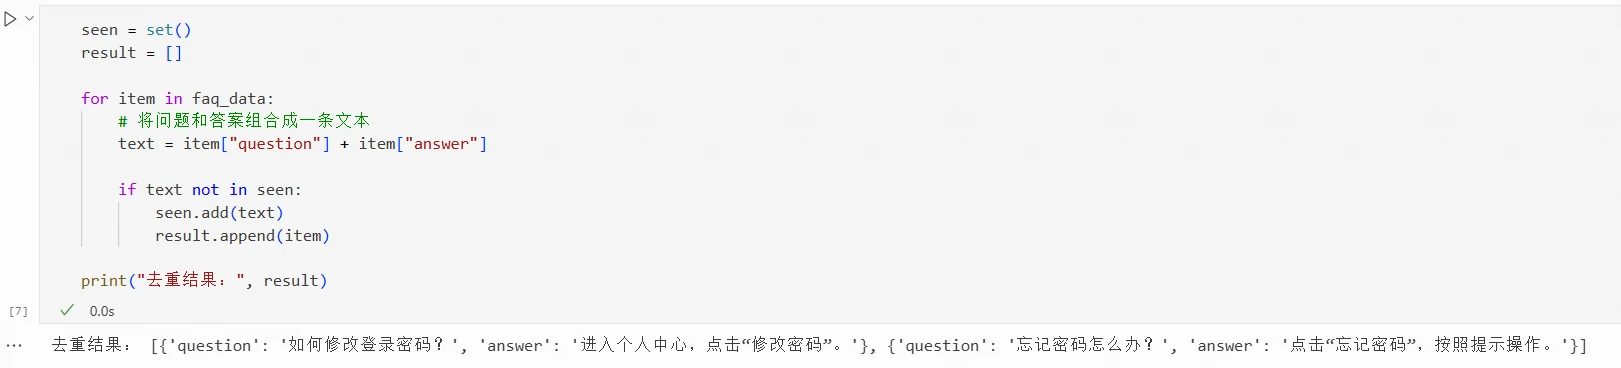
相同数据去重 faq_data = [
{
"question": "如何修改登录密码?",
"answer": "进入个人中心,点击“修改密码”。"
},
{
"question": "忘记密码怎么办?",
"answer": "点击“忘记密码”,按照提示操作。"
},
{
"question": "如何修改登录密码?",
"answer": "进入个人中心,点击“修改密码”。"
}
]
seen = set()
result = []

for item in faq_data:
    # 将问题和答案组合成一条文本
    text = item["question"] + item["answer"]

    if text not in seen:
        seen.add(text)
        result.append(item)

print("去重结果:", result)
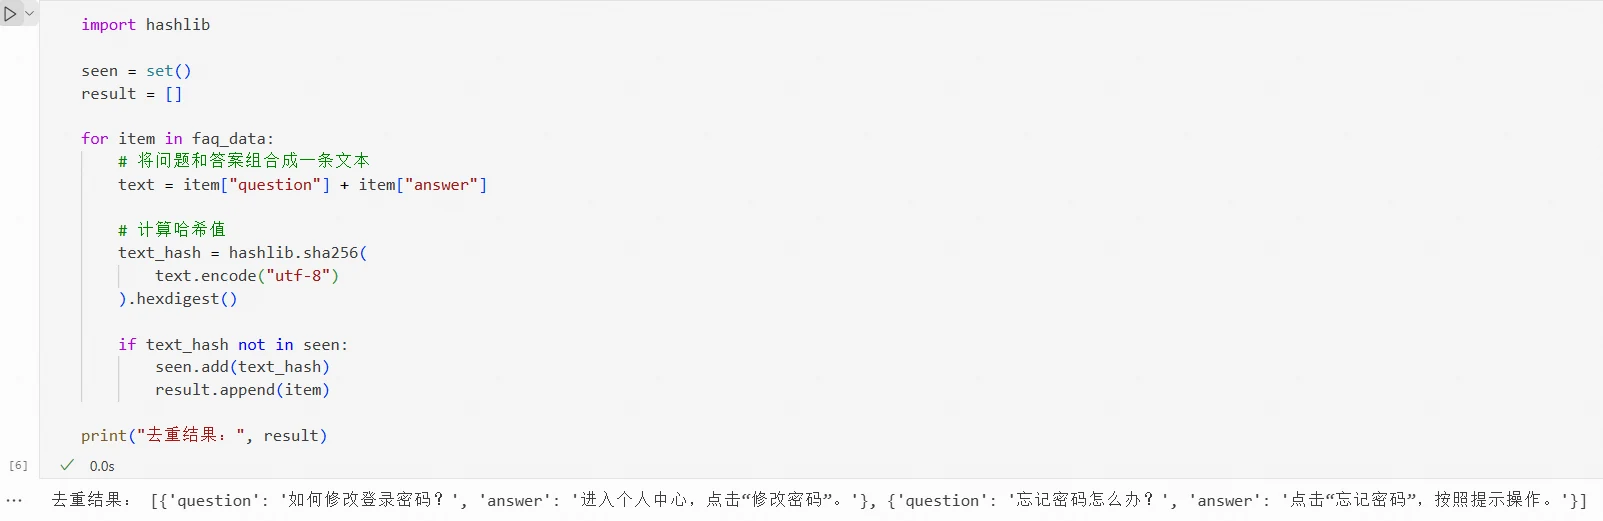
哈希算法可以将一段文本转换成固定长度的值,相同文本会得到相同的哈希值,可以通过比较哈希值判断数据是否重复。例如:
import hashlib

seen = set()
result = []

for item in faq_data:
    # 将问题和答案组合成一条文本
    text = item["question"] + item["answer"]

    # 计算哈希值
    text_hash = hashlib.sha256(
        text.encode("utf-8")
    ).hexdigest()

    if text_hash not in seen:
        seen.add(text_hash)
        result.append(item)

print("去重结果:", result)
普通哈希值只能用于判断内容是否完全相同。只要问题或答案中的文字发生变化,计算得到的哈希值就会不同。对于文字不同但内容相近的数据,还需要进一步进行相似度判断。
相似数据去重 faq_data = [
{
"question": "如何修改登录密码?",
"answer": "进入个人中心,点击“修改密码”即可。"
},
{
"question": "怎么修改登录密码",
"answer": "进入个人中心后,点击“修改密码”即可。"
},
{
"question": "如何申请发票?",
"answer": "进入订单页面,选择发票申请并提交信息。"
}
]
前两条FAQ的问题和答案在文字上存在差异,但整体表达的内容比较接近。对于这类数据,可以使用 MinHash、SimHash 或向量相似度进行检测。
(1)MinHash
MinHash 主要根据文本中词或字符的重合程度判断相似性,更适合检测字面相似的数据。对于FAQ数据,可以先将问题和答案组合成一条文本,再将文本拆分成词、字符或字符片段进行计算。
MinHash 通常用于近似计算 Jaccard 相似度:
J(A,B)=\frac{|A\cap B|}{|A\cup B|}
表示两者包含的全部内容。计算结果在0到1之间,越接近1,表示两段文本越相似。
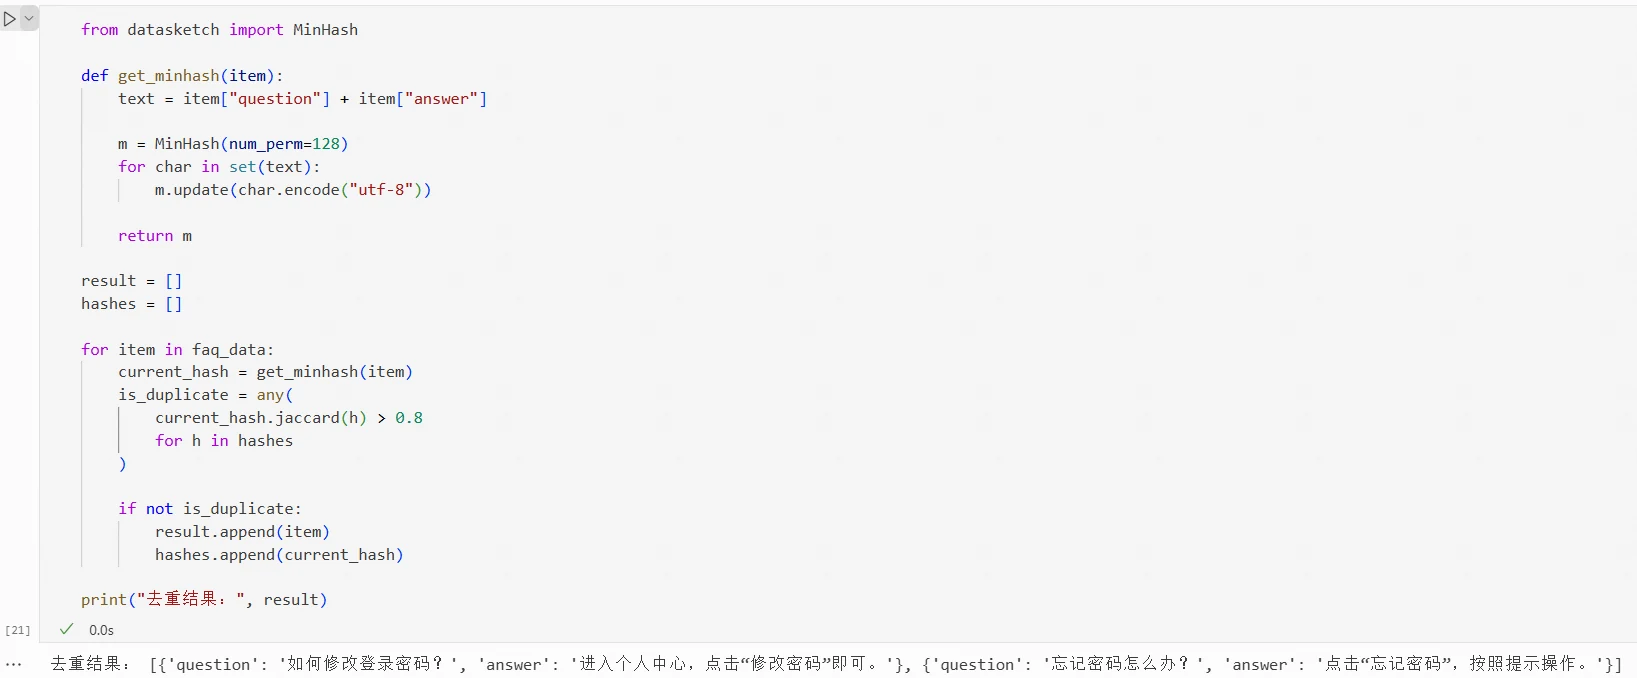
Python中可以使用datasketch库实现MinHash:
from datasketch import MinHash

def get_minhash(item):
    text = item["question"] + item["answer"]

    m = MinHash(num_perm=128)
    for char in set(text):
        m.update(char.encode("utf-8")

    return m

result = []
hashes = []

for item in faq_data:
    current_hash = get_minhash(item)

    is_duplicate = any(
        current_hash.jaccard(h) > 0.8
        for h in hashes
    )

    if not is_duplicate:
        result.append(item)
        hashes.append(current_hash)

print("去重结果:", result)
(2)SimHash
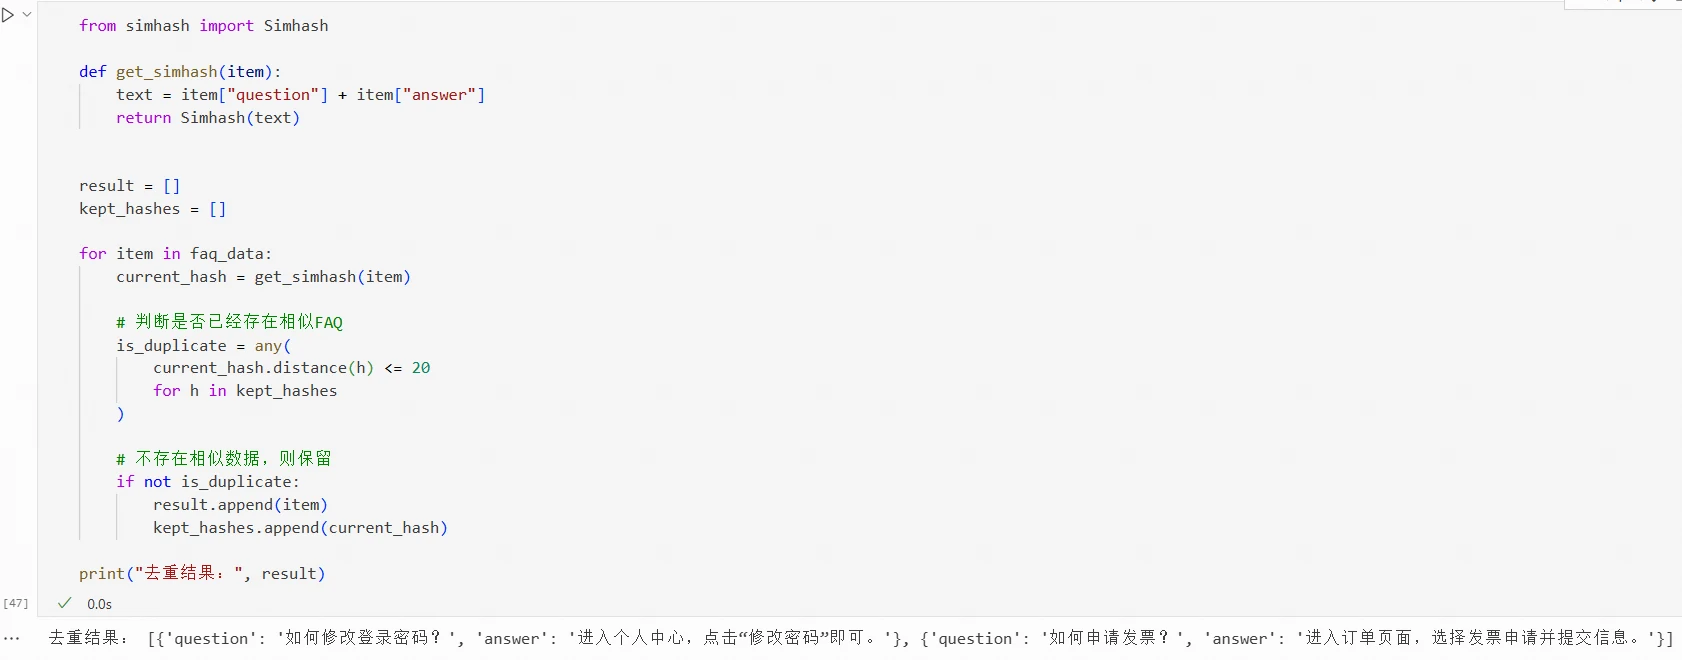
SimHash会根据文本内容生成一个固定长度的指纹,再通过指纹之间的汉明距离判断文本是否相似。
与普通Hash不同,普通Hash主要用于判断内容是否完全相同,而SimHash可以用于检测内容相近的文本。两个SimHash指纹之间的汉明距离越小,通常表示文本越相似。
from simhash import Simhash

def get_simhash(item):
    text = item["question"] + item["answer"]
    return Simhash(text)

result = []
kept_hashes = []

for item in faq_data:
    current_hash = get_simhash(item)

    # 判断是否已经存在相似FAQ
    is_duplicate = any(
        current_hash.distance(h) <= 20
        for h in kept_hashes
    )

    # 不存在相似数据,则保留
    if not is_duplicate:
        result.append(item)
        kept_hashes.append(current_hash)

print("去重结果:", result)
(3)向量相似度
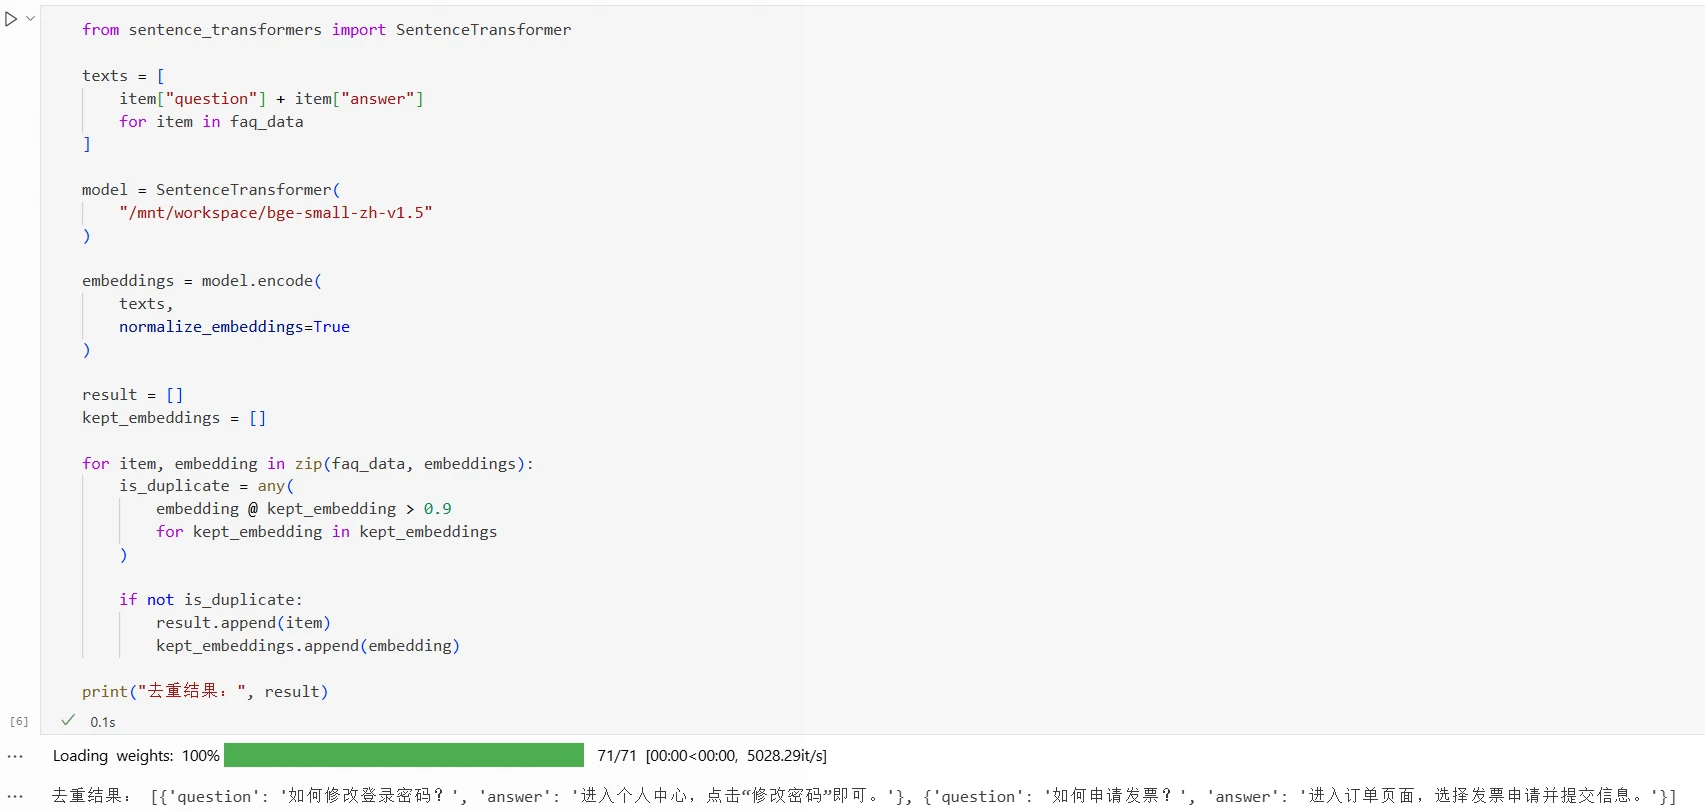
如果两条数据使用的文字不同,但表达的语义比较接近,可以使用文本向量模型进行判断。
文本向量模型可以将文本转换成一组数值组成的向量。对于FAQ数据,将问题和答案组合成一条文本,再计算两条文本向量之间的余弦相似度:
\operatorname{sim}(A,B) = \frac{A\cdot B}{\|A\|\|B\|}
其中,A和B表示两条FAQ对应的文本向量。余弦相似度越高,两条FAQ的语义越接近。
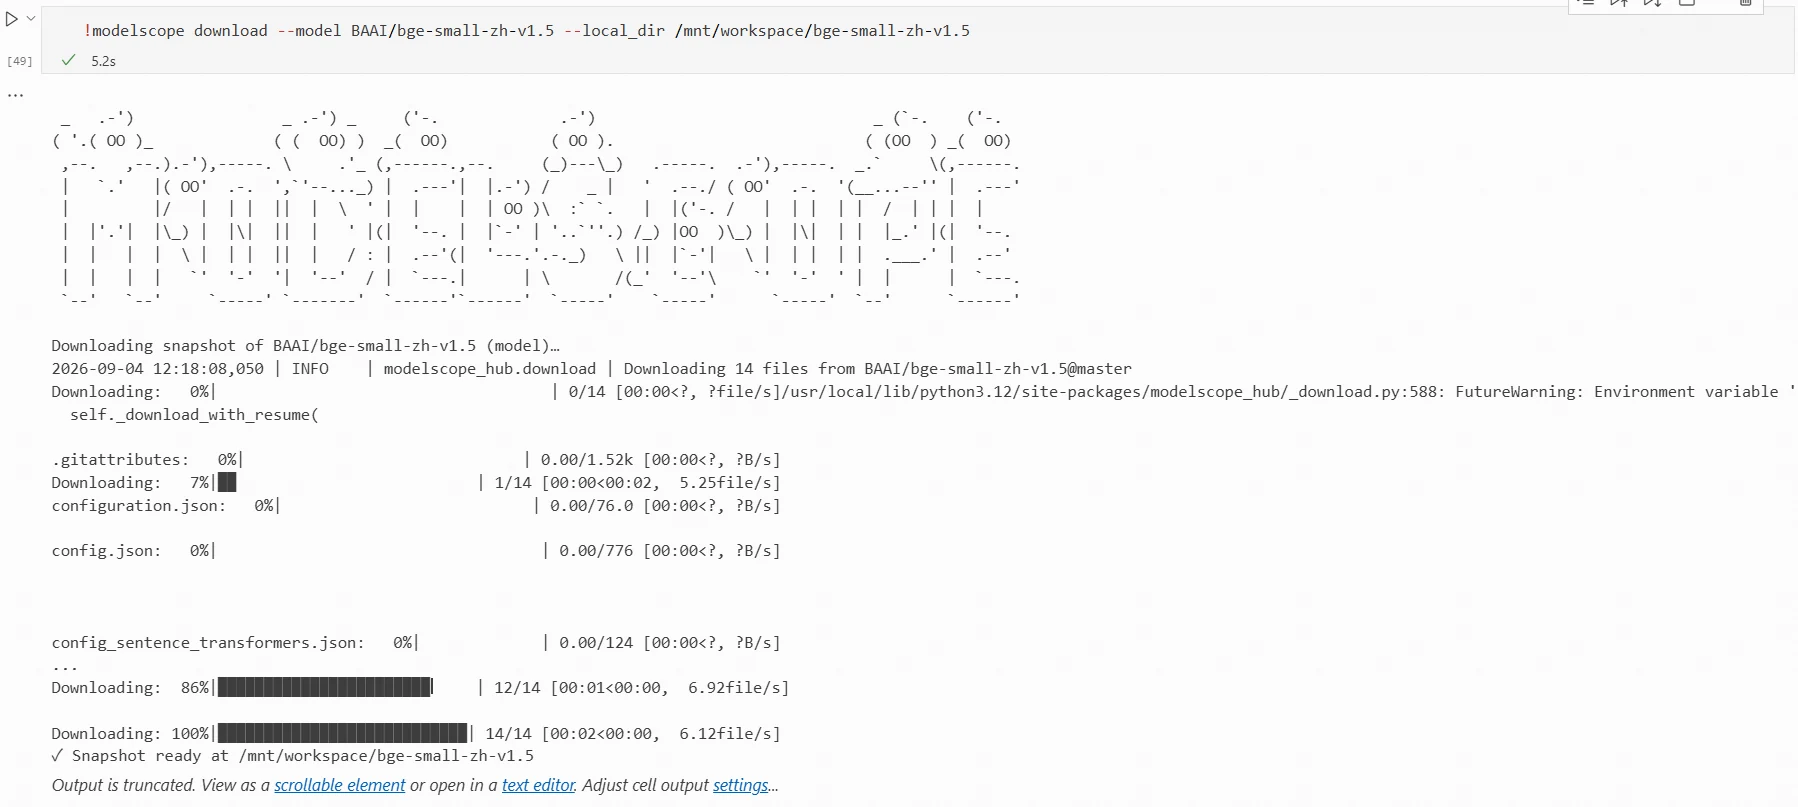
!modelscope download --model BAAI/bge-small-zh-v1.5 --local_dir /mnt/workspace/bge-small-zh-v1.5
!pip3 install -U sentence-transformers
from sentence_transformers import SentenceTransformer

texts = [
    item["question"] + item["answer"]
    for item in faq_data
]

model = SentenceTransformer(
    "/mnt/workspace/bge-small-zh-v1.5"
)

embeddings = model.encode(
    texts,
    normalize_embeddings=True
)

result = []
kept_embeddings = []

for item, embedding in zip(faq_data, embeddings):
    is_duplicate = any(
        embedding @ kept_embedding > 0.9
        for kept_embedding in kept_embeddings
    )

    if not is_duplicate:
        result.append(item)
        kept_embeddings.append(embedding)

print("去重结果:", result)
方法 判断依据 适合场景 文本直接匹配 文本是否完全相同 少量相同数据 Hash 文本的哈希值是否相同 大量相同数据 MinHash 文本中词或字符的重合程度 字面内容相似的数据 SimHash 文本指纹之间的汉明距离 整体内容相似但存在少量修改的数据 向量相似度 文本的语义相似程度 表达不同但含义相近的数据
实际处理数据时,可以先通过文本匹配或 Hash 去除完全相同的数据,再使用 MinHash、SimHash 或向量相似度检测相似数据。对于检测出的相似数据,需要根据相似度阈值和业务需求判断是否删除、合并或保留,避免误删除具有训练价值的数据。
真实信息,训练前先脱敏 企业业务数据中可能包含姓名、电话号码、证件号码、地址、账号等敏感信息。这些内容在进入训练数据集前,需要根据数据安全要求进行脱敏。
数据脱敏需要先识别数据中的敏感信息,再根据敏感信息类型选择合适的处理方式。
识别敏感信息方法 在进行脱敏之前,需要先确定数据中哪些内容属于敏感信息。对于文本数据,可以使用正则表达式或敏感信息识别模型进行识别。
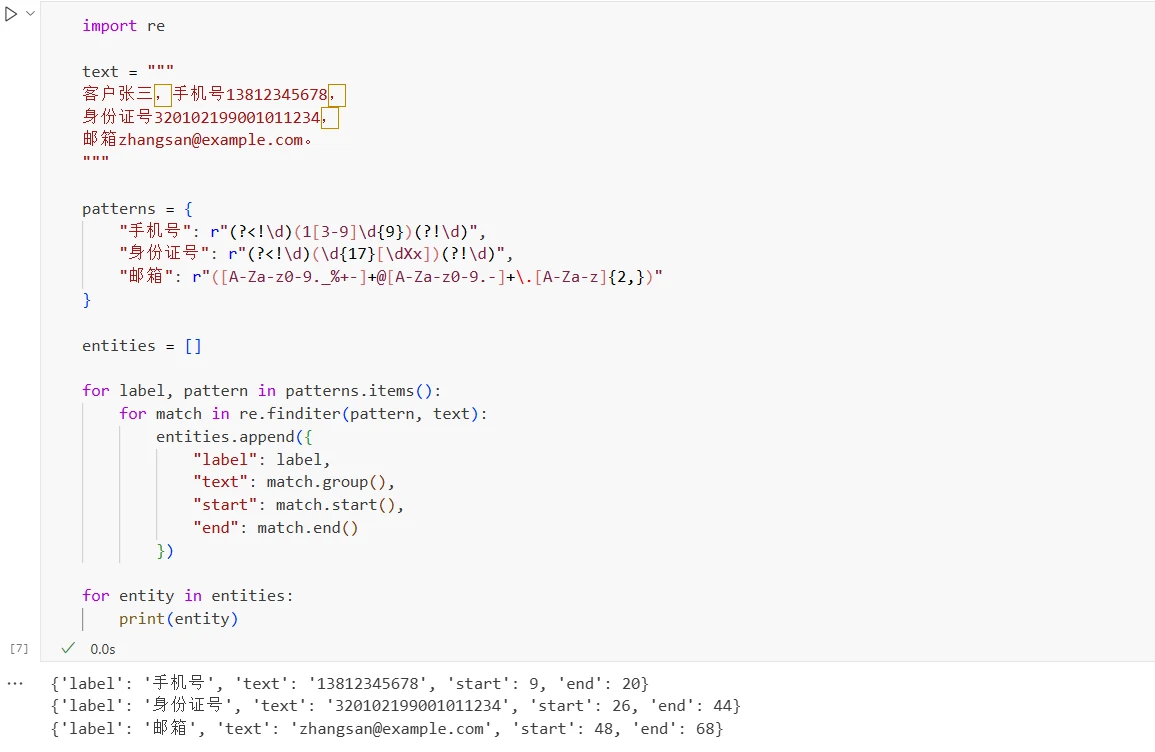
正则表达式根据预先定义的格式规则匹配文本,适合识别具有固定格式的信息,例如手机号、身份证号、银行卡号、邮箱等。使用正则表达式识别敏感信息的代码如下:
import re

text = """
客户张三,手机号13812345678,
身份证号320102199001011234,
邮箱zhangsan@example.com。
"""

patterns = {
    "手机号": r"(?<!\d)(1[3-9]\d{9})(?!\d)",
    "身份证号": r"(?<!\d)(\d{17}[\dXx])(?!\d)",
    "邮箱": r"([A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,})"
}

entities = []

for label, pattern in patterns.items():
    for match in re.finditer(pattern, text):
        entities.append({
            "label": label,
            "text": match.group(),
            "start": match.start(),
            "end": match.end()
        })

for entity in entities:
    print(entity)
通过正则表达式可以得到敏感信息的内容、类型及原文中的位置,后续可以根据这些信息进行脱敏处理。正则表达式主要依赖格式特征,对于结构固定的信息效果较好。实际使用时,需要根据业务数据的格式制定和测试相应的规则。对于姓名、地址这种需要结合上下文理解的信息,单纯依靠正则表达式较难准确识别。
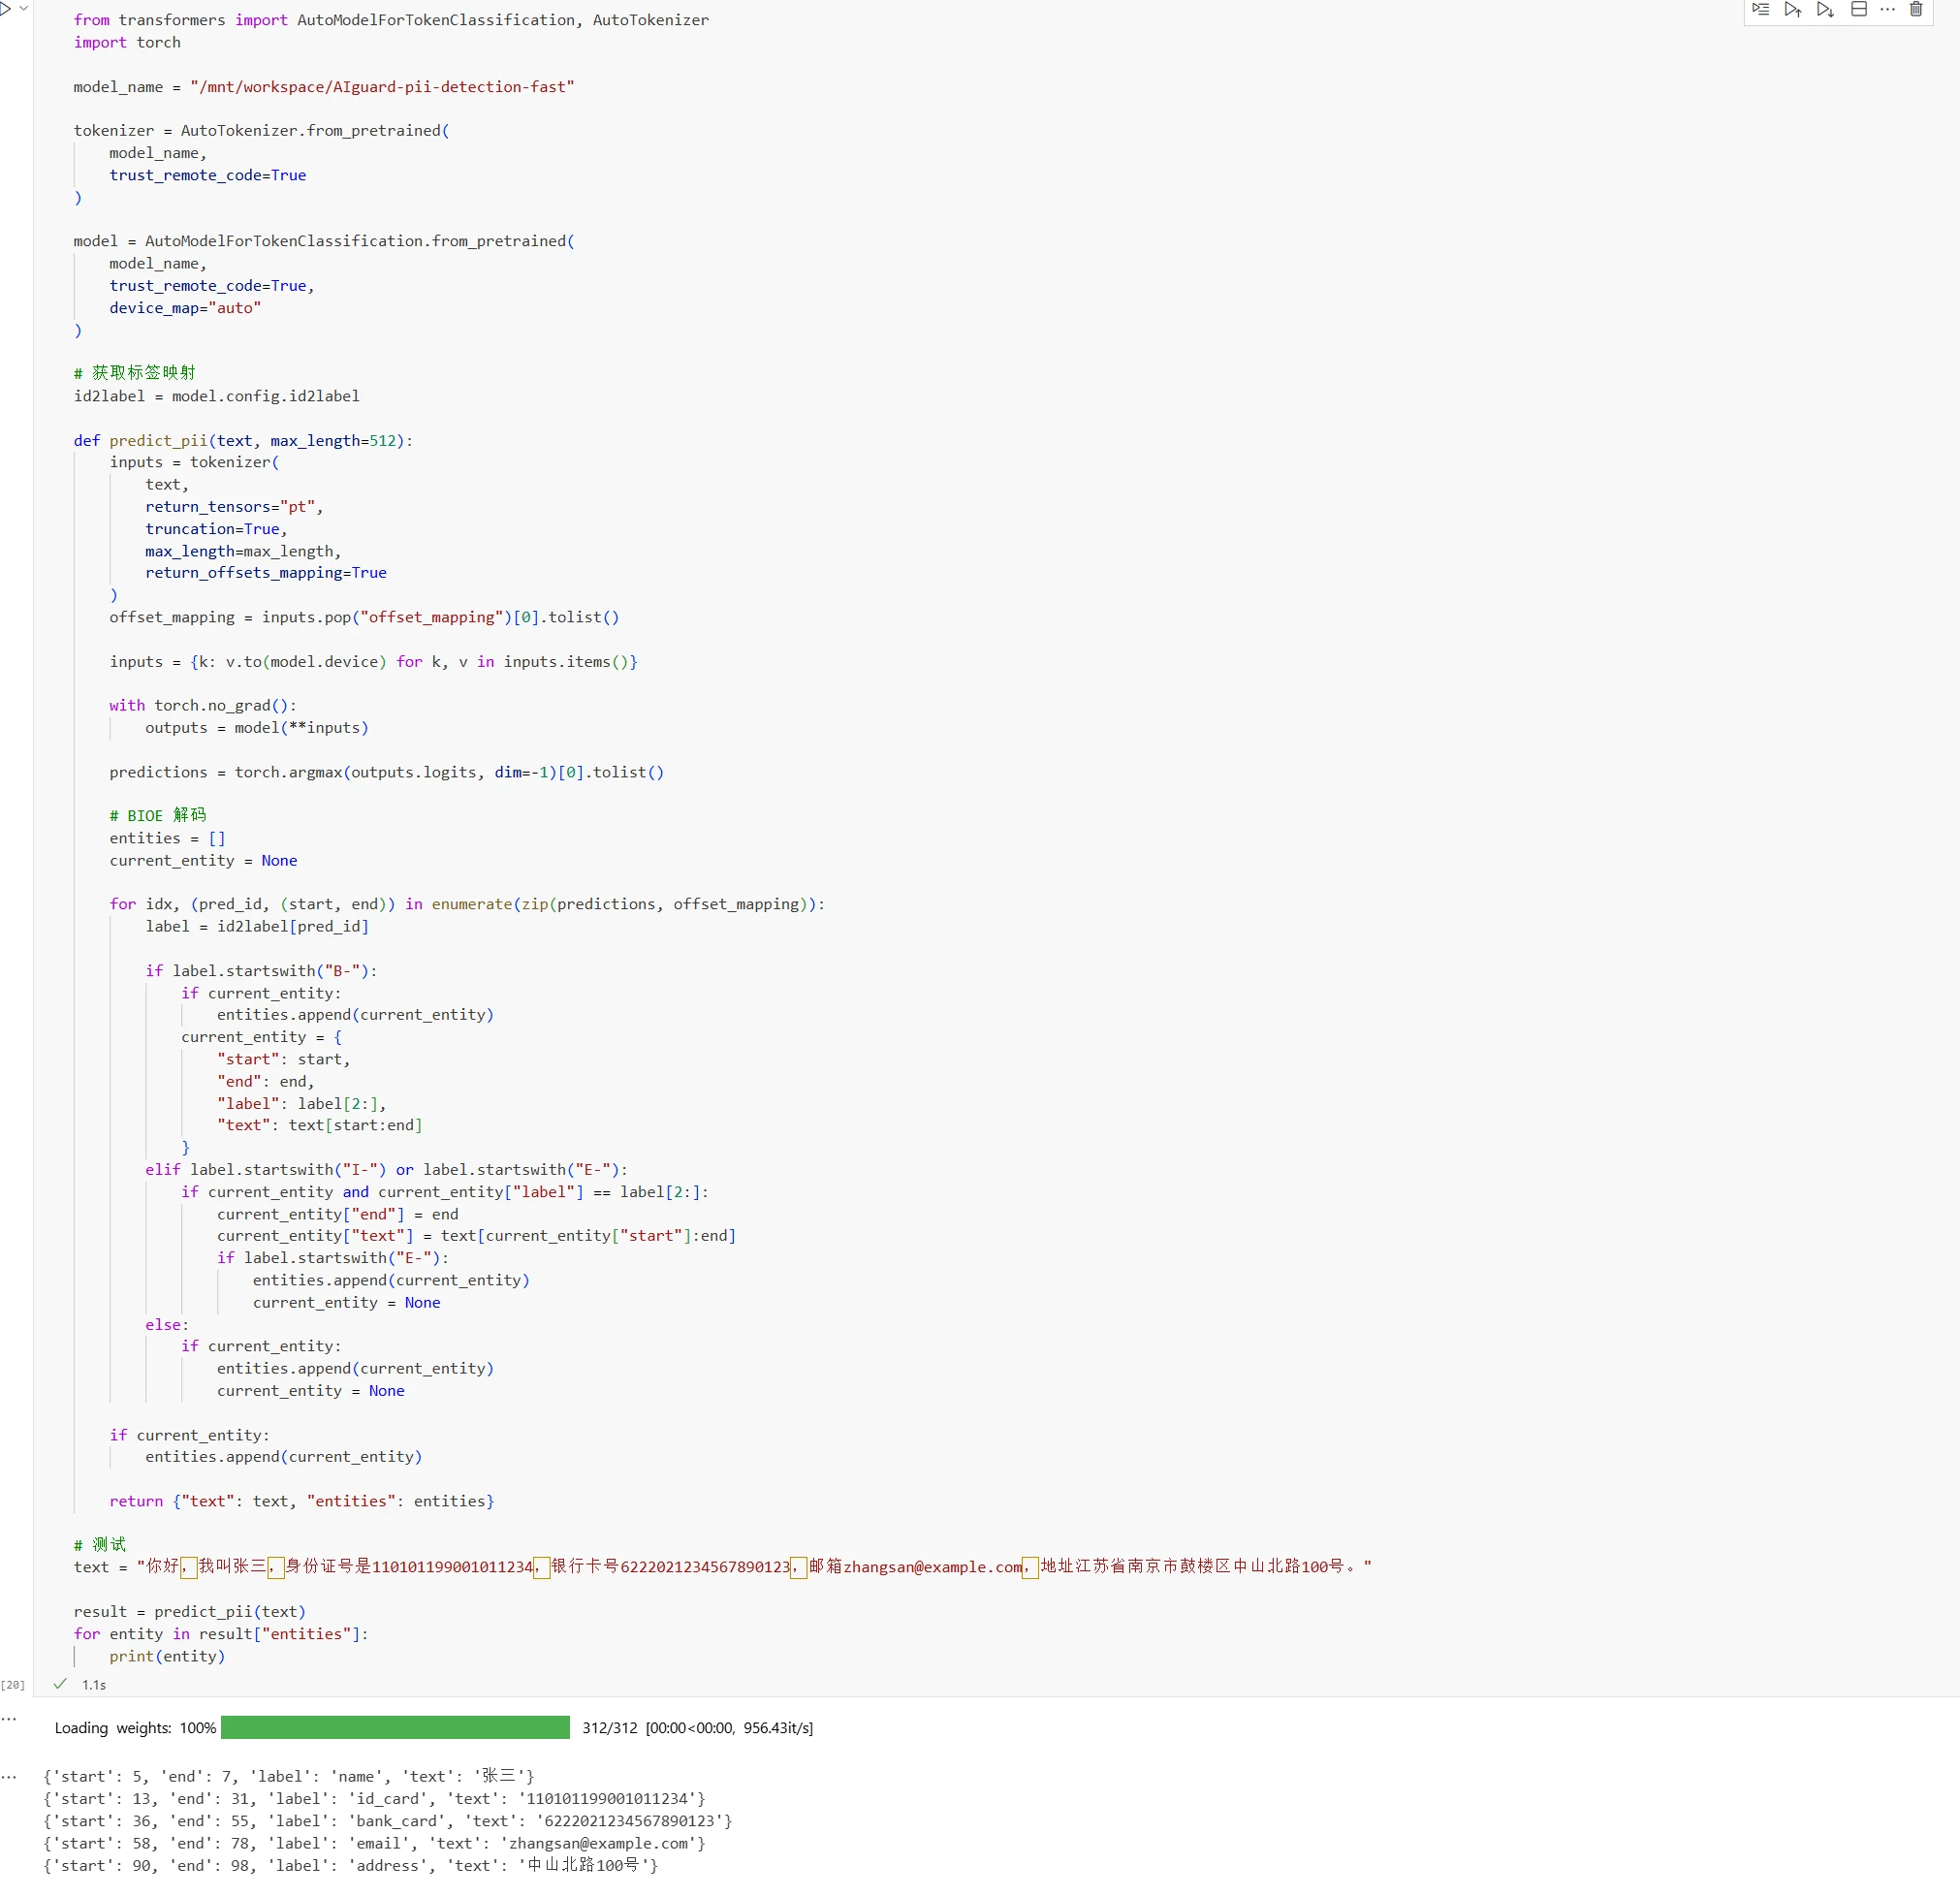
对于姓名、地址、组织机构等需要语义理解的信息,可以使用敏感信息识别模型。
from transformers import AutoModelForTokenClassification, AutoTokenizer
import torch

model_name = "/mnt/workspace/AIguard-pii-detection-fast"

tokenizer = AutoTokenizer.from_pretrained(
    model_name,
    trust_remote_code=True
)

model = AutoModelForTokenClassification.from_pretrained(
    model_name,
    trust_remote_code=True,
    device_map="auto"
)

# 获取标签映射
id2label = model.config.id2label

def predict_pii(text, max_length=512):
    inputs = tokenizer(
        text,
        return_tensors="pt",
        truncation=True,
        max_length=max_length,
        return_offsets_mapping=True
    )
    offset_mapping = inputs.pop("offset_mapping")[0].tolist()

    inputs = {k: v.to(model.device) for k, v in inputs.items()}

    with torch.no_grad():
        outputs = model(**inputs)

    predictions = torch.argmax(outputs.logits, dim=-1)[0].tolist()

    # BIOE 解码
    entities = []
    current_entity = None

    for idx, (pred_id, (start, end) in enumerate(zip(predictions, offset_mapping):
        label = id2label[pred_id]

        if label.startswith("B-"):
            if current_entity:
                entities.append(current_entity)
            current_entity = {
                "start": start,
                "end": end,
                "label": label[2:],
                "text": text[start:end]
            }
        elif label.startswith("I-") or label.startswith("E-"):
            if current_entity and current_entity["label"] == label[2:]:
                current_entity["end"] = end
                current_entity["text"] = text[current_entity["start"]:end]
                if label.startswith("E-"):
                    entities.append(current_entity)
                    current_entity = None
        else:
            if current_entity:
                entities.append(current_entity)
                current_entity = None

    if current_entity:
        entities.append(current_entity)

    return {"text": text, "entities": entities}

# 测试
text = "你好,我叫张三,身份证号是110101199001011234,银行卡号6222021234567890123,邮箱zhangsan@example.com,地址江苏省南京市鼓楼区中山北路100号。"

result = predict_pii(text)
for entity in result["entities"]:
    print(entity)
识别结果包含敏感信息内容、敏感信息类型、在原文本中的位置。 后续可以根据这些信息选择对应的脱敏方式。
实际业务中,正则表达式和敏感信息识别模型常结合使用,正则表达式负责快速处理格式固定的信息,例如手机号、邮箱; 模型负责处理需要语义理解的信息,例如姓名、地址。
脱敏方法 完成敏感信息识别后,需要根据敏感信息类型和训练任务要求选择合适的处理方式。
替换是将真实敏感信息替换为其他内容。替换可以分为固定替换和随机替换:
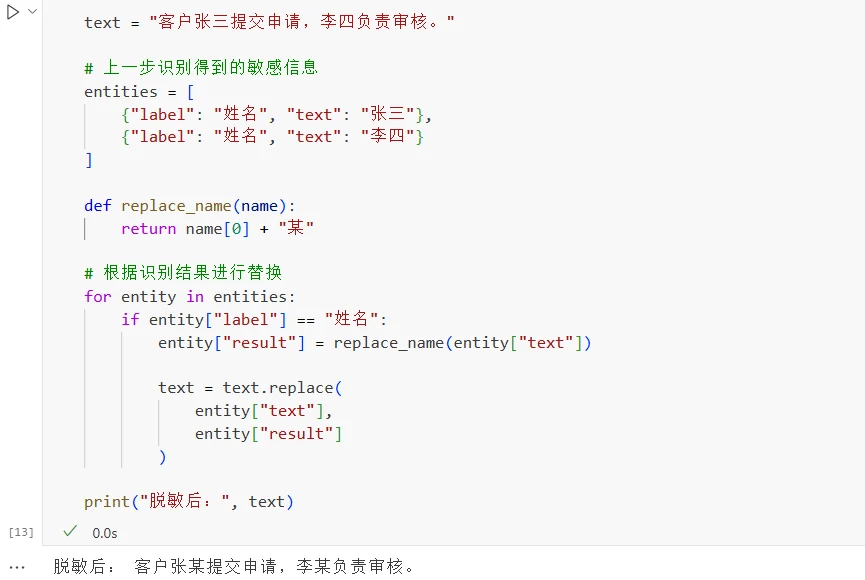
固定替换:按照固定规则生成替换结果,例如将姓名中的名字统一替换为“某”,“张三”替换为“张某”、“李四”替换为“李某”。由于规则固定,同一个信息每次都会得到相同结果,不需要额外保存映射关系。处理代码如下:
text = "客户张三提交申请,李四负责审核。"

# 上一步识别得到的敏感信息
entities = [
    {"label": "姓名", "text": "张三"},
    {"label": "姓名", "text": "李四"}
]

def replace_name(name):
    return name[0] + "某"

# 根据识别结果进行替换
for entity in entities:
    if entity["label"] == "姓名":
        entity["result"] = replace_name(entity["text"])

        text = text.replace(
            entity["text"],
            entity["result"]
        )

print("脱敏后:", text)
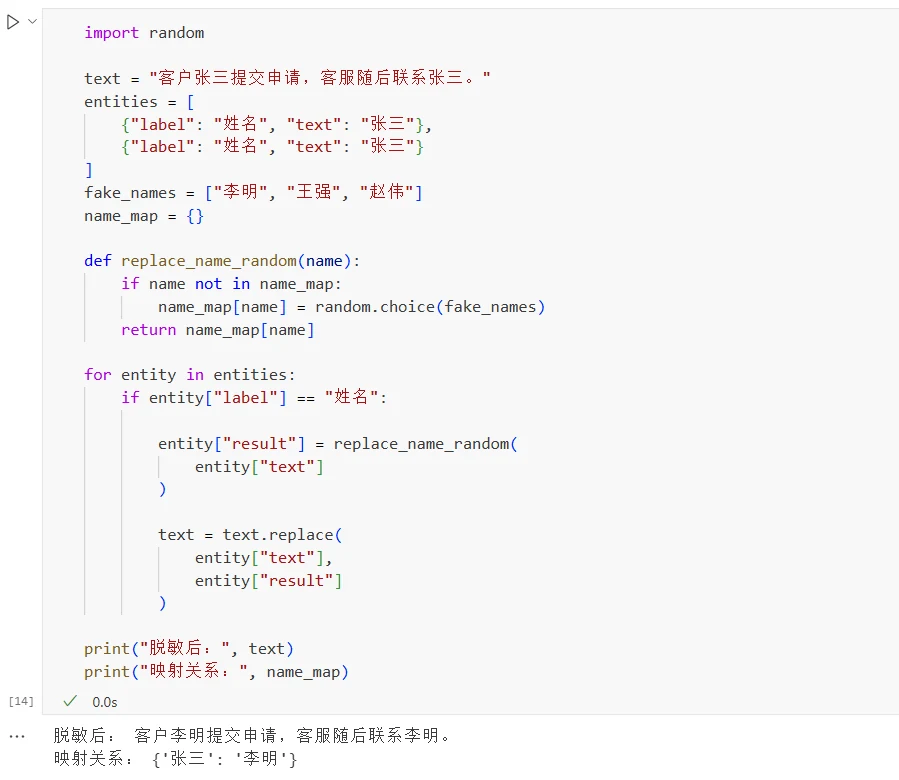
随机替换:随机选择虚构信息替换真实信息,如 “张三”替换为“李明”。如果同一个“张三”在多个位置出现,需要保证替换结果一致,否则原本属于同一对象的数据可能被替换成不同身份,破坏数据中的关联关系。因此,随机替换通常需要建立映射表:{"张三":"李明"},后续再次遇到“张三”时,直接使用“李明”。处理代码如下:
import random

text = "客户张三提交申请,客服随后联系张三。"
entities = [
    {"label": "姓名", "text": "张三"},
    {"label": "姓名", "text": "张三"}
]
fake_names = ["李明", "王强", "赵伟"]
name_map = {}

def replace_name_random(name):
    if name not in name_map:
        name_map[name] = random.choice(fake_names)
    return name_map[name]

for entity in entities:
    if entity["label"] == "姓名":

        entity["result"] = replace_name_random(
            entity["text"]
        )

        text = text.replace(
            entity["text"],
            entity["result"]
        )

print("脱敏后:", text)
print("映射关系:", name_map)
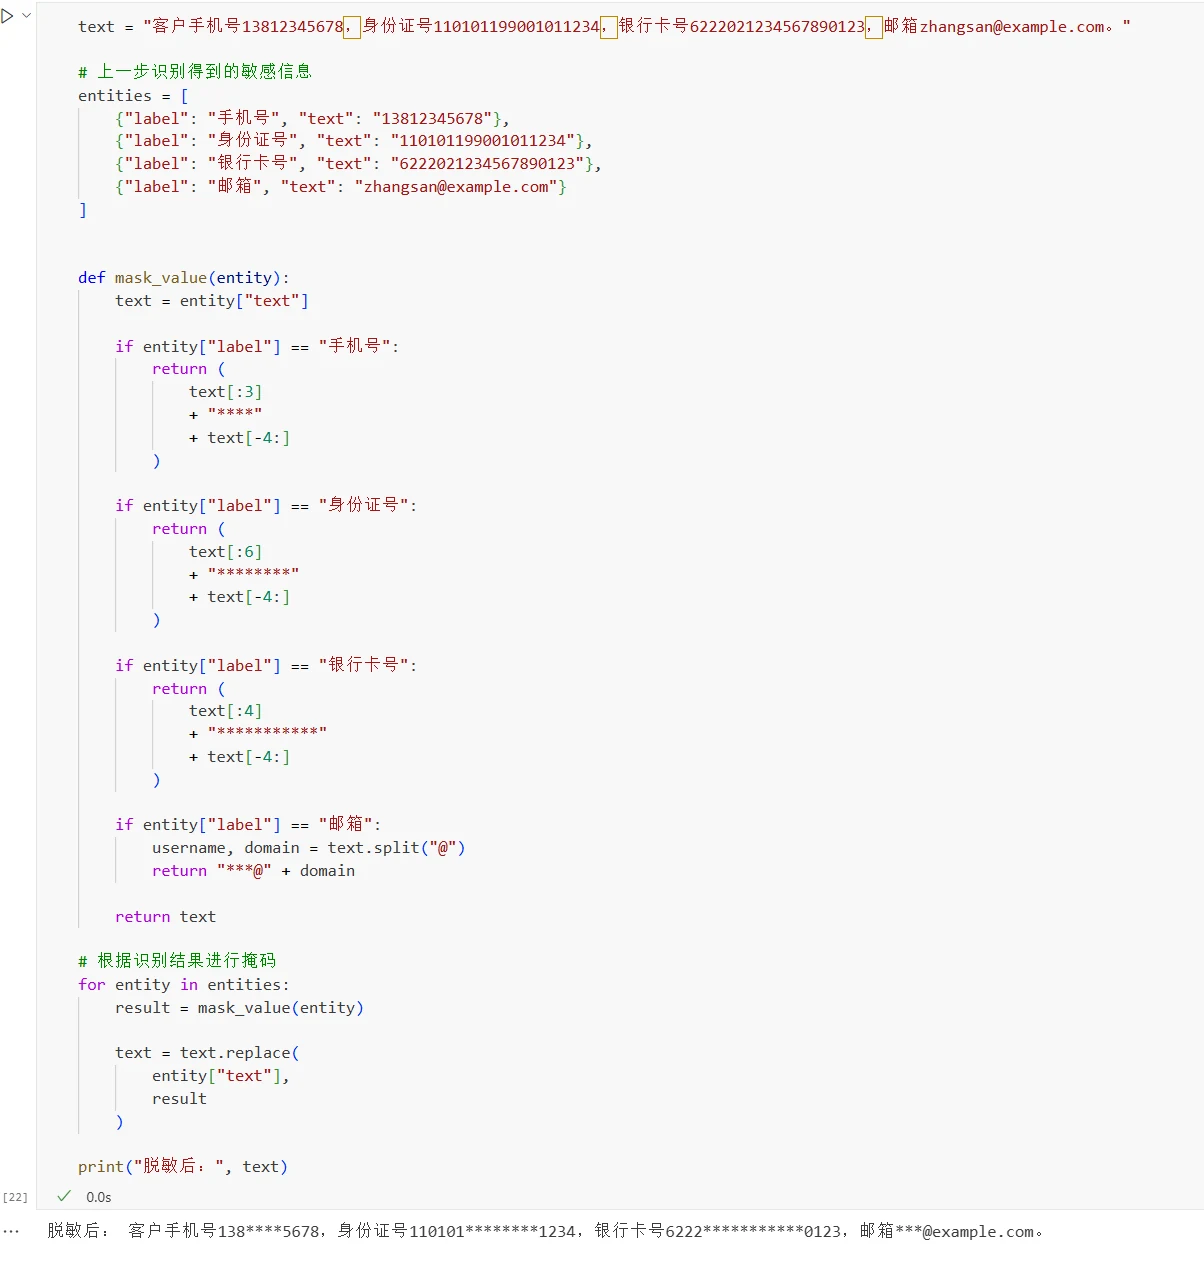
掩码是隐藏部分敏感内容,保留部分信息,如手机号、身份证、银行卡、邮箱等。
text = "客户手机号13812345678,身份证号110101199001011234,银行卡号6222021234567890123,邮箱zhangsan@example.com。"

# 上一步识别得到的敏感信息
entities = [
    {"label": "手机号", "text": "13812345678"},
    {"label": "身份证号", "text": "110101199001011234"},
    {"label": "银行卡号", "text": "6222021234567890123"},
    {"label": "邮箱", "text": "zhangsan@example.com"}
]

def mask_value(entity):
    text = entity["text"]

    if entity["label"] == "手机号":
        return (
            text[:3]
            + "****"
            + text[-4:]
        )

    if entity["label"] == "身份证号":
        return (
            text[:6]
            + "********"
            + text[-4:]
        )

    if entity["label"] == "银行卡号":
        return (
            text[:4]
            + "***********"
            + text[-4:]
        )

    if entity["label"] == "邮箱":
        username, domain = text.split("@")
        return "***@" + domain

    return text

# 根据识别结果进行掩码
for entity in entities:
    result = mask_value(entity)

    text = text.replace(
        entity["text"],
        result
    )

print("脱敏后:", text)
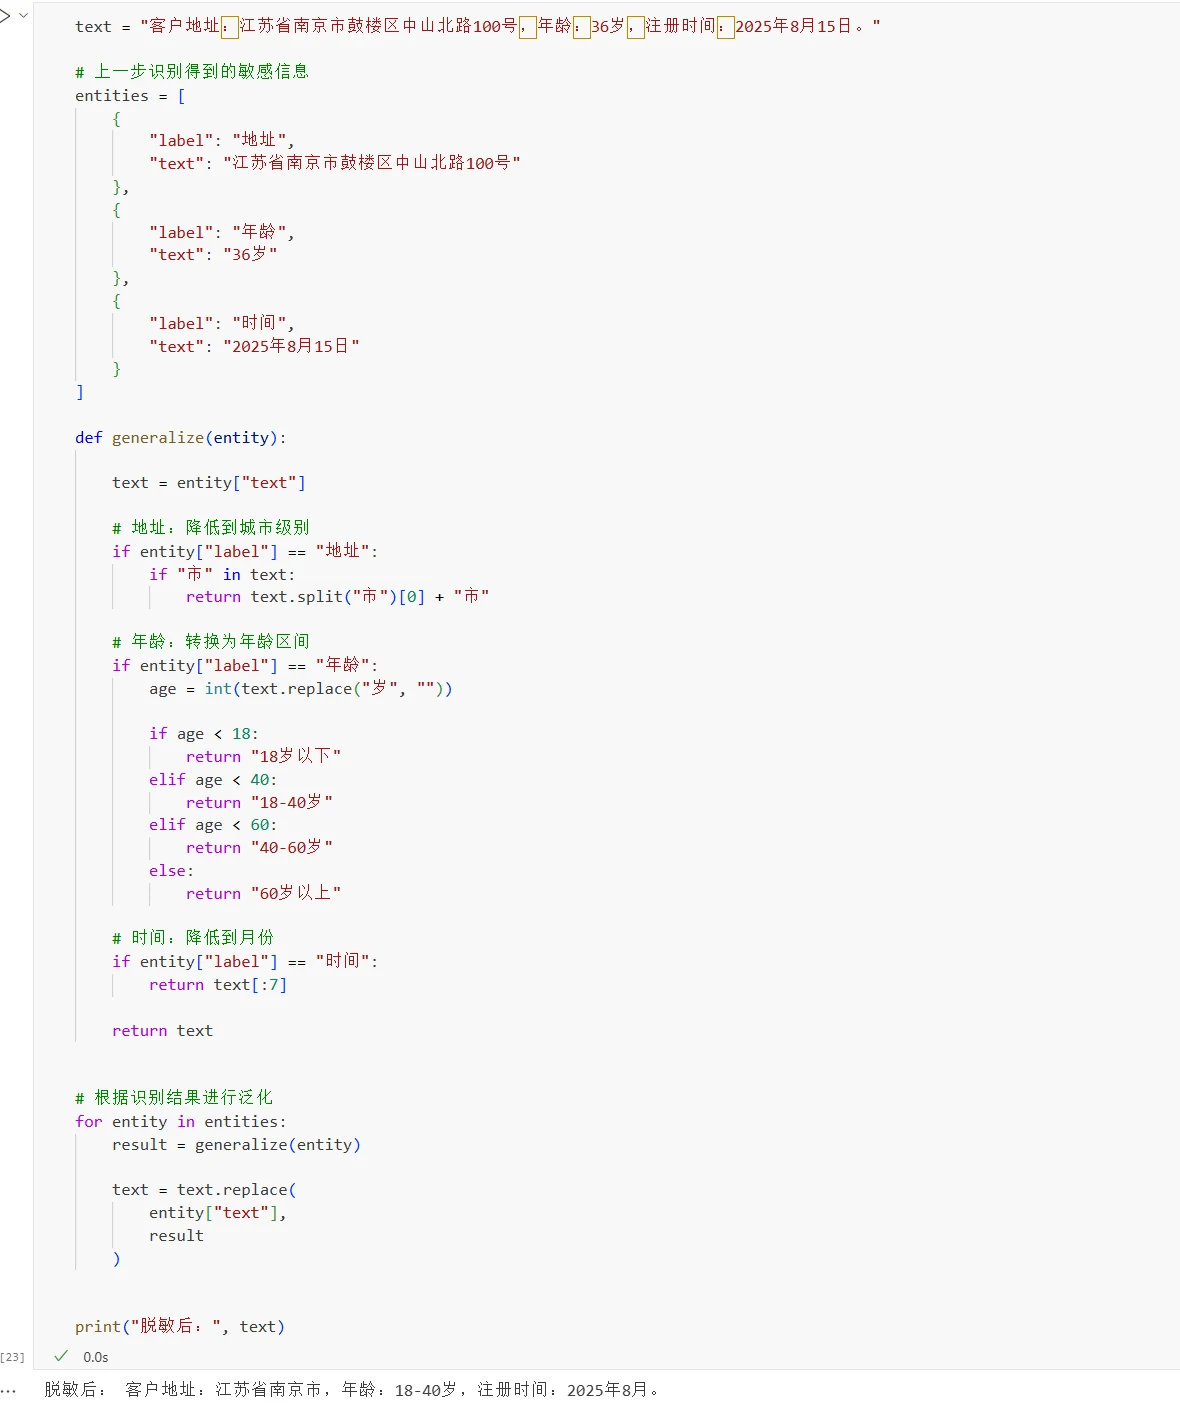
泛化是降低信息精度,减少数据定位到具体对象的能力。常用于地址、年龄、时间等连续型信息。
text = "客户地址:江苏省南京市鼓楼区中山北路100号,年龄:36岁,注册时间:2025年8月15日。"

# 上一步识别得到的敏感信息
entities = [
    {
        "label": "地址",
        "text": "江苏省南京市鼓楼区中山北路100号"
    },
    {
        "label": "年龄",
        "text": "36岁"
    },
    {
        "label": "时间",
        "text": "2025年8月15日"
    }
]

def generalize(entity):

    text = entity["text"]

    # 地址:降低到城市级别
    if entity["label"] == "地址":
        if "市" in text:
            return text.split("市")[0] + "市"

    # 年龄:转换为年龄区间
    if entity["label"] == "年龄":
        age = int(text.replace("岁", "")

        if age < 18:
            return "18岁以下"
        elif age < 40:
            return "18-40岁"
        elif age < 60:
            return "40-60岁"
        else:
            return "60岁以上"

    # 时间:降低到月份
    if entity["label"] == "时间":
        return text[:7]

    return text

# 根据识别结果进行泛化
for entity in entities:
    result = generalize(entity)

    text = text.replace(
        entity["text"],
        result
    )

print("脱敏后:", text)
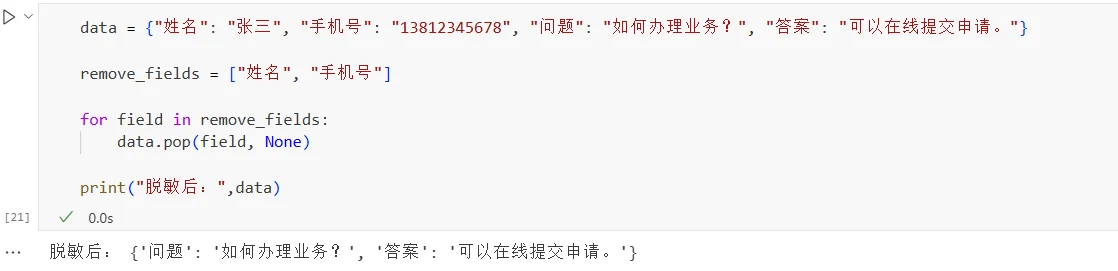
对于训练任务无关的敏感字段,可以直接删除。如果训练任务只需要学习问答关系,则可以删除姓名和手机号。
data = {"姓名": "张三", "手机号": "13812345678", "问题": "如何办理业务?", "答案": "可以在线提交申请。"}

remove_fields = ["姓名", "手机号"]

for field in remove_fields:
    data.pop(field, None)

print("脱敏后:",data)
实际处理时,脱敏方式需要结合训练任务和数据特点选择。需要保留不同样本之间关联关系时,可以采用固定替换或带映射关系的随机替换;需要保留部分信息特征时,可以采用掩码或泛化;对于训练任务无关的敏感信息,则直接删除。
不同业务场景的数据特点不同,具体脱敏规则需要根据实际需求进行调整。本节代码仅用于说明基本处理方法。
最后一步,整理成训练需要的格式 完成数据处理后,还需要按照训练框架要求将数据整理成相应的格式。
指令微调(Instruction Tuning)是大语言模型常用的微调方式。训练数据包含用户的指令以及模型期望生成的回答,让模型学习如何按照指令完成任务。
不同训练框架使用的数据字段可能不同。常见的指令数据格式主要包括 Alpaca、ShareGPT 和 Messages 等。
Alpaca 格式 Alpaca格式结构简单,通常使用 instruction、input 和 output 三个字段,适合单轮指令数据。
{
  "instruction": "将下面这段中文翻译成英文",
  "input": "今天天气很好。",
  "output": "The weather is very nice today."
}
其中:instruction 表示模型需要执行的任务;input 表示完成任务所需要的输入内容;output 表示模型期望生成的回答。
如果任务本身不需要额外输入,input 也可以为空。
{
  "instruction": "介绍一下什么是机器学习",
  "input": "",
  "output": "机器学习是一种让计算机从数据中学习规律的方法。"
}
这种格式字段少、结构清晰,适合问答、分类、文本生成等单轮训练任务。
Messages 格式 另一种常见方式是使用 messages 保存对话,每条消息包含 role 和 content 两个主要字段。
{
  "messages": [
    {
      "role": "system",
      "content": "你是一位专业的客服助手。"
    },
    {
      "role": "user",
      "content": "我的订单什么时候到货?"
    },
    {
      "role": "assistant",
      "content": "请提供订单号,我帮您查询。"
    }
  ]
}
其中,system 用于设置模型的角色、任务要求或回答规则,user 表示用户输入,assistant 表示模型期望生成的回答。
Messages 格式同样支持多轮对话,只需要按照实际对话顺序继续增加 user 和 assistant 消息即可。
{
  "messages": [
    {
      "role": "system",
      "content": "你是一位专业的客服助手。"
    },
    {
      "role": "user",
      "content": "如何修改登录密码?"
    },
    {
      "role": "assistant",
      "content": "进入账号设置页面,选择“修改密码”。"
    },
    {
      "role": "user",
      "content": "忘记原密码怎么办?"
    },
    {
      "role": "assistant",
      "content": "可以在登录页面选择“忘记密码”,通过手机号或邮箱完成验证后重新设置密码。"
    }
  ]
}
ShareGPT 格式 ShareGPT 是开源大模型训练中常见的对话数据格式之一。它通常使用 conversations 保存完整对话,并使用 human 和 gpt 区分用户与模型。
{
  "conversations": [
    {
      "from": "human",
      "value": "将下面这段中文翻译成英文:今天天气很好。"
    },
    {
      "from": "gpt",
      "value": "The weather is very nice today."
    }
  ]
}
{
  "conversations": [
    {
      "from": "human",
      "value": "帮我写一封请假邮件。"
    },
    {
      "from": "gpt",
      "value": "请告诉我请假的时间和原因。"
    },
    {
      "from": "human",
      "value": "感冒了,请两天病假。"
    },
    {
      "from": "gpt",
      "value": "好的,下面是一封请假邮件……"
    }
  ]
}
如何选择数据格式 Alpaca、Messages 和 ShareGPT 格式本质上都是在描述模型的输入和期望输出,只是字段组织方式不同。
数据格式 主要特点 适合场景 Alpaca 使用instruction、input和output组织数据 单轮指令、问答、分类 Messages 使用messages保存对话,通过role区分角色 单轮或多轮对话 ShareGPT 使用conversations保存对话,通过from区分角色 单轮或多轮对话
不同格式之间通常可以相互转换。例如,一条Alpaca数据可以转换成一组user和assistant消息,ShareGPT中的human和gpt也可以分别转换成user和assistant。实际训练时,应先确认训练框架支持的数据格式和模型模板,再按照相应要求整理数据。
模型代码及相关文件见:https://www.modelscope.cn/gallery/liucong/b41e2395-f795-400f-bafd-e53ed7f5c8ca