AI & 工程学习计划 › 🚀 应用系统 › 课程 › 智能客服质检:AI能从一通客服电话中分析出什么? 智能客服质检:AI能从一通客服电话中分析出什么?
一通客服电话结束了,用户的问题有没有解决,客服有没有漏掉重要条件,录音少的时候,可以逐条听;录音多了,人工抽听就很难顾及每一通电话。
传统客服质检主要依靠人工抽听,不仅需要投入较多时间,也很难覆盖全部通话。利用语音识别和音频多模态模型,可以从电话录音中分析通话内容、说话人、情绪、服务语气和双方互动,再由大语言模型按照质检规则完成评分并生成质检报告。
这一章就用语言培训机构的一段客服通话记录,把从录音到质检报告的过程跑一遍。
质检一通电话,我们到底要检查什么?
不同业务场景对客服服务质量的要求有所不同。在进行自动质检之前,需要先明确质检需要关注哪些问题,并根据实际业务要求制定相应的质检规则。
先看客户问了什么,客服回应得怎么样
语言培训机构的客服通常需要通过电话处理课程咨询、开课通知、请假、课程调整、学习反馈和售后等业务。
质检时,需要检查客服是否正确理解客户需求,回答是否完整、准确,对于无法立即确定的问题是否给出了后续处理方式,以及是否存在不当承诺。同时,电话中的服务态度和沟通过程也会影响服务质量,例如客服是否存在不耐烦、敷衍或责怪,是否打断客户,客户是否出现负面情绪等。
这些信息并不能只通过电话转写文本获得,还需要结合说话人以及电话录音中的情绪、语气和双方互动等信息进行分析。
把服务要求写成具体的评分规则
确场景需求后,还需要将这些要求进一步整理为具体的质检规则,明确一通电话需要检查哪些内容,以及不同问题对应的评分标准,为后续自动判断和评分提供依据。
结合语言培训机构电话客服的服务要求,从需求回应、信息准确性、问题解决、服务态度、通话行为和客户情绪等方面制定质检规则,如下表所示。
质检项 主要检查内容 分值 开场与身份说明 是否主动问候,说明机构和本人身份,并询问客户需求 5 需求识别与回应完整性 是否识别客户提出的问题,并逐项进行有效回应 20 信息准确性与风险控制 是否编造不确定的信息,是否存在学习效果等不当承诺 15 问题解决与承诺闭环 客户核心问题是否解决,无法立即解决时是否说明后续处理方式 15 服务态度与专业措辞 是否存在不耐烦、责怪、敷衍、辱骂或推卸责任等表达 15 打断与通话节奏 是否频繁打断客户、抢话或存在明显影响沟通的异常节奏 10 客户情绪与服务修复 客户是否出现明显负面情绪,客服是否及时解释和安抚 10 结束语与待办确认 是否礼貌结束,并对尚未完成的事项进行确认 10 合计 100
后续自动质检将按照这些规则逐项进行判断和评分。不同质检项所需的信息并不相同,例如需求识别、信息准确性和问题解决情况主要根据通话内容判断,服务态度、客户情绪以及打断等情况需要结合电话录音进行分析,最后再根据这些分析结果完成综合质检。
从电话录音到质检报告,模型怎样分工?
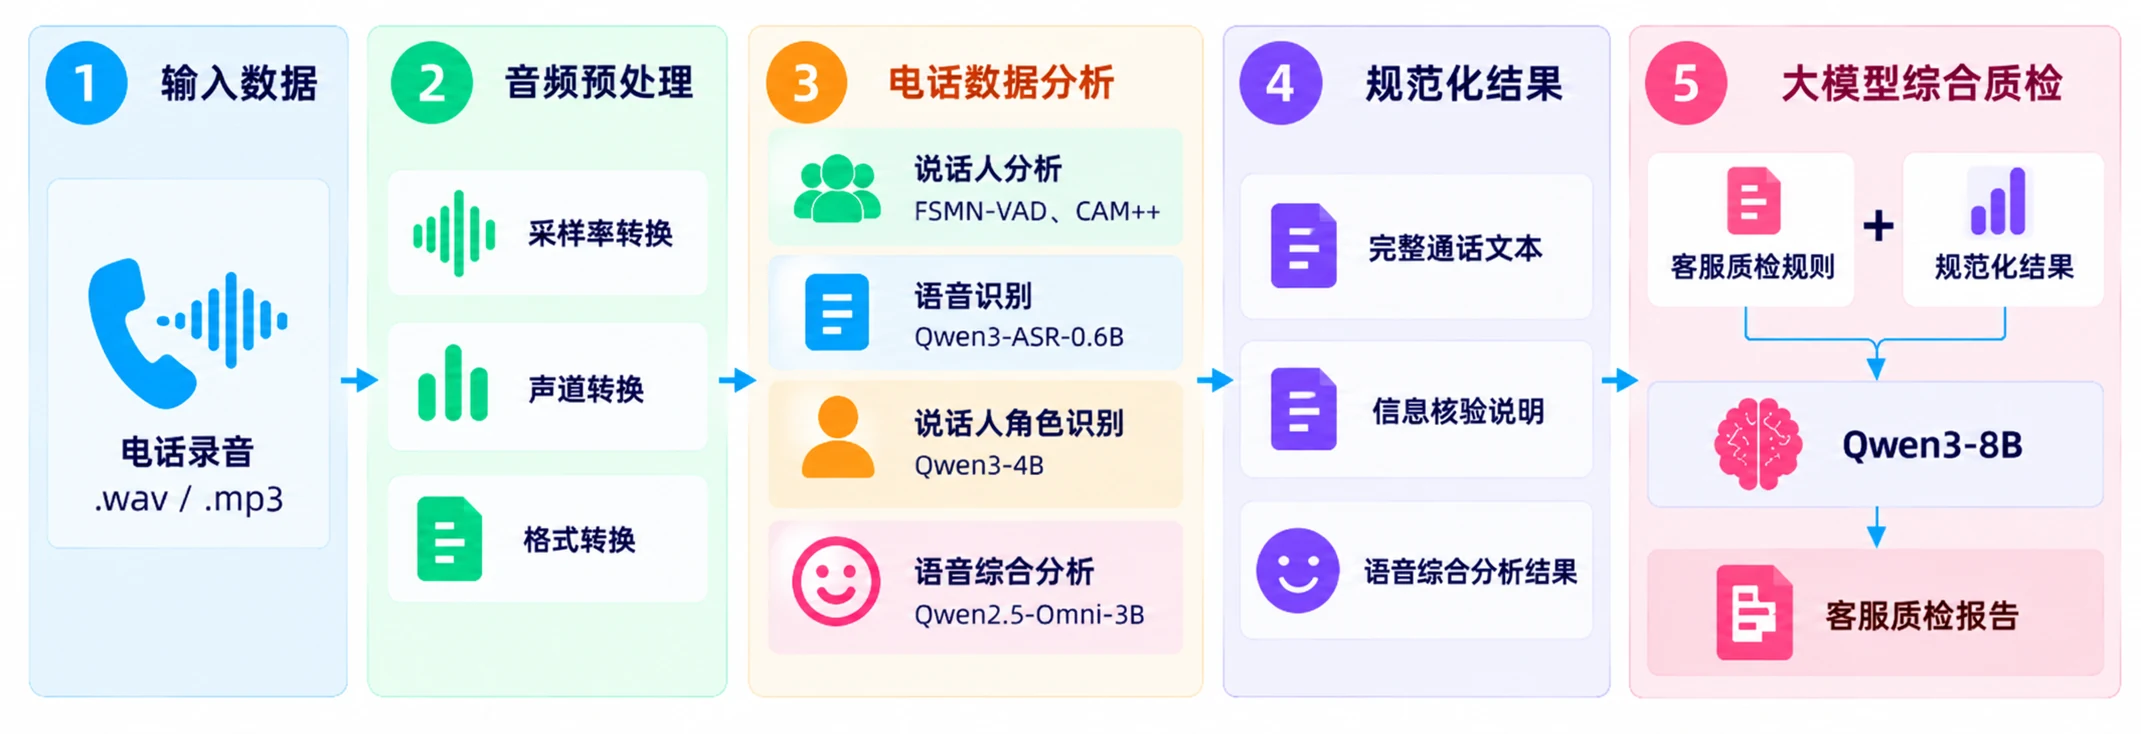
根据前面的场景需求,系统先从电话录音中获得通话文本和说话人信息,再结合录音分析客户情绪、客服服务语气和双方的互动情况,最后将这些分析结果与客服质检规则一起交给大语言模型进行综合判断、评分并生成质检报告。整个自动质检过程如下图所示。
整个过程可以分为电话数据分析和综合质检两个部分。
整理通话内容,也听听语气和互动
电话录音输入系统后,需要先统一音频格式,将采样率和声道转换为后续模型能够处理的形式。
处理后的音频使用FSMN-VAD检测有效语音区域,并结合CAM++区分不同说话人,得到每个说话人的发言时间。此时得到的是spk0、spk1等说话人编号,还不能直接确定其身份。
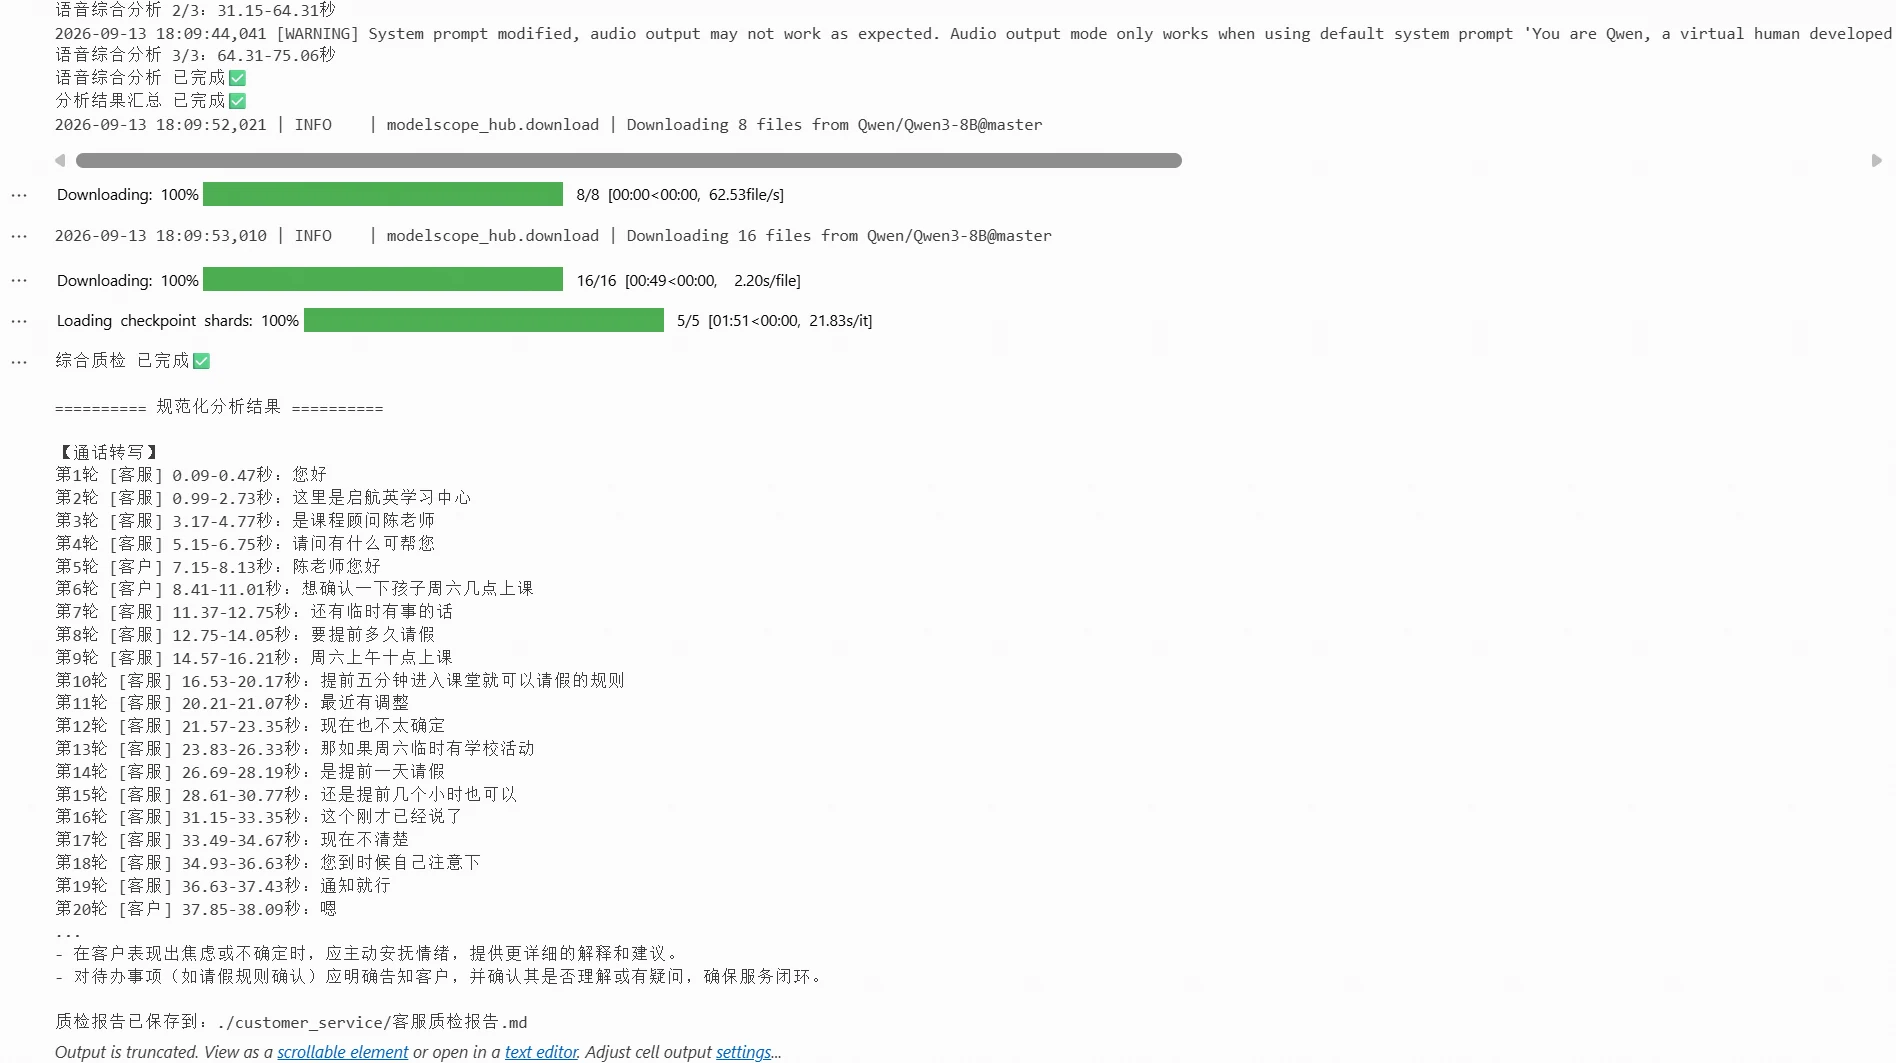
语音识别使用Qwen3-ASR-0.6B完成。模型将录音转换为文本,并通过时间戳记录每段文本对应的时间。将语音识别结果与说话人分析结果按照时间进行对齐,可以得到带有说话人编号和时间信息的通话文本。随后,根据不同说话人的对话内容,使用参数量较小的Qwen3-4B判断其在本次电话中的角色,并将说话人编号转换为“客服”和“客户”。最终可以得到带有角色和时间信息的完整通话文本,例如:
第1轮 [客服] 0.00-4.82秒:……
第2轮 [客户] 5.10-10.36秒:……
电话中的声音还包含文本无法直接反映的信息,例如客服的情绪和服务语气、客户的情绪变化以及双方的互动情况。使用Qwen2.5-Omni-3B对电话录音进行分析,并结合通话文本判断客服是否存在不耐烦、敷衍、责怪或语气生硬等情况,客户是否出现明显负面情绪以及客服是否进行了适当回应,同时分析通话过程中是否存在明显抢话或打断客户等问题。
分析任务 模型或组件 主要输出 语音识别 Qwen3-ASR-0.6B 带时间信息的识别文本 说话人分析 FSMN-VAD、CAM++ 不同说话人及说话时间 说话人角色识别 Qwen3-4B 客服、客户角色 语音综合分析 Qwen2.5-Omni-3B 客服情绪与服务语气、客户情绪与客服应对、通话互动
这些分析结果需要整理为统一格式,便于后续大语言模型直接读取。例如:
【通话转写】
第1轮 [客服] XX.XX-XX.XX秒:……
第2轮 [客户] XX.XX-XX.XX秒:……

【信息核验说明】
本次分析未提供企业业务规则或标准答案。
对于课程时间、请假规则等业务信息,只能判断客服是否进行了明确回应,无法核验其内容是否准确。

【语音综合分析】

客服情绪与服务语气:
情绪表现:……
服务语气:……
异常情况:……

客户情绪与客服应对:
客户情绪:……
情绪变化:……
客服应对:……

通话互动:
抢话:……
打断客户:……
其他异常:……

分析说明:……
规范化结果中保留完整通话文本、说话人角色以及语音综合分析结果。客户需求、回答完整性、问题解决、承诺和合规等业务内容不再提前单独分析,而是在后面的综合质检中由大语言模型结合完整通话内容统一判断。
按规则评分,让每个判断都有依据 完成电话数据分析后,将20.1.2节制定的客服质检规则和规范化分析结果一起输入Qwen3-8B。模型根据完整通话文本判断客户提出了哪些需求、客服如何回应以及问题是否得到处理,并结合客服情绪与服务语气、客户情绪与客服应对、通话互动等信息,对各项质检规则进行判断和评分。
对于课程时间、请假规则等需要企业业务规则才能验证的信息,如果没有提供相应的业务标准,只判断客服是否进行了明确回应,不直接判断其内容是否正确,并在报告中注明“现有信息无法核验”。
质检时按照20.1.2节的规则逐项评分。每个质检项除了给出得分,还需要说明判断结果和主要依据。发现问题时,可以引用对应的通话轮次、客服原话或语音综合分析结果作为证据,避免只给出“服务态度较差”“问题处理不到位”等缺少依据的结论。
客服质检报告

综合得分:XX/100
质检结论:……

一、总体评价
……

二、质检结果

1. 开场与身份说明:X/5
判断结果:……
主要依据:……
扣分原因:……

2. 需求识别与回应完整性:X/20
判断结果:……
主要依据:……
扣分原因:……

3. 信息准确性与风险控制:X/15
判断结果:……
主要依据:……
扣分原因:……

4. 问题解决与承诺闭环:X/15
判断结果:……
主要依据:……
扣分原因:……

5. 服务态度与专业措辞:X/15
判断结果:……
主要依据:……
扣分原因:……

6. 打断与通话节奏:X/10
判断结果:……
主要依据:……
扣分原因:……

7. 客户情绪与服务修复:X/10
判断结果:……
主要依据:……
扣分原因:……

8. 结束语与待办确认:X/10
判断结果:……
主要依据:……
扣分原因:……

三、主要问题
1. ……
2. ……

四、改进建议
1. ……
2. ……
动手做一次电话客服质检 下面按照前面的技术方案编写程序,逐步实现电话客服自动质检。
准备运行环境 !pip3 install modelscope transformers accelerate
!pip3 install funasr qwen-asr qwen-omni-utils
!pip3 install soundfile scipy
提前下载需要使用的模型,使后续加载时可以直接使用本地缓存。
from modelscope import snapshot_download

snapshot_download("iic/speech_fsmn_vad_zh-cn-16k-common-pytorch")
snapshot_download("iic/speech_campplus_sv_zh-cn_16k-common")
snapshot_download("Qwen/Qwen3-ASR-0.6B")
snapshot_download("Qwen/Qwen3-ForcedAligner-0.6B")
snapshot_download("Qwen/Qwen3-4B")
snapshot_download("Qwen/Qwen3-8B")
snapshot_download("Qwen/Qwen2.5-Omni-3B")
import os
import gc
import json
import torch
import soundfile as sf
from scipy.signal import resample_poly
from funasr import AutoModel
from qwen_asr import Qwen3ASRModel
from modelscope import AutoTokenizer, AutoModelForCausalLM, snapshot_download
from transformers import Qwen2_5OmniForConditionalGeneration, Qwen2_5OmniProcessor
from qwen_omni_utils import process_mm_info
音频预处理 将输入录音统一转换为16 kHz单声道WAV音频。
def preprocess_audio(audio_path, output_path="./customer_service/preprocessed.wav",
                     target_sr=16000):
    audio, sr = sf.read(audio_path)

    # 转单声道
    if audio.ndim > 1:
        audio = audio.mean(axis=1)

    # 重采样
    if sr != target_sr:
        audio = resample_poly(audio, target_sr, sr)
        sr = target_sr

    # 保存为统一的wav格式
    os.makedirs(os.path.dirname(output_path), exist_ok=True)
    sf.write(output_path, audio, sr)

    return output_path
说话人分析 使用FunASR组合FSMN-VAD和CAM++获得不同说话人的语音片段及时间信息。
def analyze_speakers(audio_path):
    model = AutoModel(
        model="paraformer-zh",
        vad_model="fsmn-vad",
        punc_model="ct-punc",
        spk_model="cam++",
        device="cuda:0"
    )

    result = model.generate(
        input=audio_path,
        batch_size_s=60,
        sentence_timestamp=True
    )

    sentence_info = result[0].get("sentence_info", [])
    segments = []

    for item in sentence_info:
        segments.append({
            "speaker": f"spk{item['spk']}",
            "start": round(item["start"] / 1000, 2),
            "end": round(item["end"] / 1000, 2)
        })

    del model
    gc.collect()
    torch.cuda.empty_cache()

    return segments
语音识别 使用Qwen3-ASR-0.6B识别整段录音,并通过ForcedAligner获得识别文本对应的时间戳。
def analyze_asr(audio_path, language="Chinese"):
    model_path = "Qwen/Qwen3-ASR-0.6B"
    aligner_path = "Qwen/Qwen3-ForcedAligner-0.6B"
    model = Qwen3ASRModel.from_pretrained(
        model_path, dtype=torch.bfloat16, device_map="cuda:0",
        max_inference_batch_size=1, max_new_tokens=2048,
        forced_aligner=aligner_path,
        forced_aligner_kwargs={"dtype": torch.bfloat16, "device_map": "cuda:0"}
    )

    result = model.transcribe(
        audio=audio_path, language=language, return_time_stamps=True
    )[0]

    segments = []
    if result.time_stamps:
        for item in result.time_stamps:
            segments.append({
                "start": round(item.start_time, 2), "end": round(item.end_time, 2),
                "text": item.text.strip()
            })

    output = {
        "language": result.language,
        "text": result.text.strip(),
        "segments": segments
    }

    del model
    gc.collect()
    torch.cuda.empty_cache()
    return output
说话人角色识别 使用Qwen3-4B根据不同说话人的对话内容判断其角色,并将说话人编号转换为“客服”和“客户”。
def identify_speaker_roles(segments):
    speaker_texts = {}
    for seg in segments:
        speaker_texts.setdefault(seg["speaker"], []).append(seg["text"])

    speaker_text = "\n".join(
        f"{speaker}:{''.join(texts)[:1000]}"
        for speaker, texts in speaker_texts.items()
    )

    model_name = "Qwen/Qwen3-4B"
    tokenizer = AutoTokenizer.from_pretrained(model_name)
    model = AutoModelForCausalLM.from_pretrained(
        model_name, torch_dtype=torch.bfloat16, device_map="cuda:0"
    )

    prompt = f"""下面是一段语言培训机构客服电话中不同说话人的对话内容。
请根据对话内容判断每个说话人的角色,将机构客服标记为“客服”,接受服务的一方标记为“客户”。

【对话内容】
{speaker_text}

只返回JSON,例如:
{{"spk0": "客户", "spk1": "客服"}}
不要输出其他内容。"""

    messages = [{"role": "user", "content": prompt}]
    text = tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True, enable_thinking=False
    )
    inputs = tokenizer(text, return_tensors="pt").to(model.device)
    outputs = model.generate(**inputs, max_new_tokens=128)
    outputs = outputs[:, inputs.input_ids.shape[1]:]
    role_map = json.loads(tokenizer.decode(outputs[0], skip_special_tokens=True)

    for seg in segments:
        seg["speaker"] = role_map.get(seg["speaker"], seg["speaker"])

    del model, tokenizer
    gc.collect()
    torch.cuda.empty_cache()
    return segments
语音综合分析 前面已经获得了带有角色和时间信息的通话文本,接下来使用Qwen2.5-Omni-3B结合电话录音,进一步分析客服情绪与服务语气、客户情绪与客服应对以及双方互动情况。
对于较长的电话录音,直接将完整音频一次输入模型会占用较多显存。根据前面得到的通话轮次对音频进行切分,不按照固定时间直接截断,而是在片段达到指定长度后,等待客服当前一轮发言结束再进行切分,使每个片段尽量保持完整的会话内容。Qwen2.5-Omni-3B只加载一次,依次分析各个音频片段,最后将结果按照对应的时间范围进行整理。
def split_audio_by_conversation(
    audio_path,
    segments,
    max_seconds=30,
    output_dir="./customer_service/audio_segments"
):
    audio, sr = sf.read(audio_path)
    os.makedirs(output_dir, exist_ok=True)

    groups = []
    current = []
    start_time = segments[0]["start"]

    # 按完整会话切分,达到指定长度后等待客服当前一轮发言结束
    for seg in segments:
        current.append(seg)

        if seg["end"] - start_time >= max_seconds and seg["speaker"] == "客服":
            groups.append(current)
            current = []
            start_time = seg["end"]

    if current:
        groups.append(current)

    results = []

    # 根据每组会话的时间范围截取音频
    for i, group in enumerate(groups):
        start = group[0]["start"]
        end = group[-1]["end"]

        segment_audio = audio[int(start * sr):int(end * sr)]
        output_path = os.path.join(output_dir, f"segment_{i + 1}.wav")
        sf.write(output_path, segment_audio, sr)

        results.append({
            "path": output_path,
            "start": start,
            "end": end,
            "segments": group
        })

    return results

def build_segment_transcript(segments):
    # 生成当前音频片段对应的通话文本
    return "\n".join(
        f"第{seg['turn_id']}轮 [{seg['speaker']}] "
        f"{seg['start']:.2f}-{seg['end']:.2f}秒:{seg['text']}"
        for seg in segments
    )

def format_audio_analysis(results):
    # 按时间范围整理各片段的语音分析结果
    return "\n\n".join(
        f"{item['start']:.2f}-{item['end']:.2f}秒语音综合分析结果:\n"
        f"{item['analysis']}"
        for item in results
    )

def analyze_audio(audio_path, segments, max_seconds=30):
    # 按完整会话切分长音频
    audio_segments = split_audio_by_conversation(
        audio_path,
        segments,
        max_seconds=max_seconds
    )

    # 模型只加载一次,依次分析所有音频片段
    model_path = snapshot_download("Qwen/Qwen2.5-Omni-3B")
    processor = Qwen2_5OmniProcessor.from_pretrained(model_path)
    model = Qwen2_5OmniForConditionalGeneration.from_pretrained(
    model_path,
    torch_dtype=torch.bfloat16,
    device_map="cuda:0",
    enable_audio_output=False
)

    analysis_results = []

    for i, item in enumerate(audio_segments):
        print(
            f"语音综合分析 {i + 1}/{len(audio_segments)}:"
            f"{item['start']:.2f}-{item['end']:.2f}秒"
        )

        transcript = build_segment_transcript(item["segments"])

        prompt = f"""
这是一段语言培训机构的客服电话录音。请结合录音和对应的通话文本,对这段通话中的语音表现进行分析。

【通话文本】
{transcript}

请重点分析以下内容:

1. 客服情绪与服务语气
分析客服整体情绪和服务语气,判断是否存在明显不耐烦、敷衍、责怪客户、语气生硬等情况。

2. 客户情绪与客服应对
分析客户的主要情绪及变化。如果客户出现明显不满、焦虑、生气等负面情绪,判断客服是否进行了适当解释、回应或安抚。

3. 通话互动
结合实际语音中的说话先后关系和双方同时说话情况,判断客服是否存在明显抢话或打断客户,以及是否存在其他明显影响沟通的问题。

只根据实际录音和提供的通话文本进行分析,不要猜测没有依据的问题。

请按照下面的格式输出:

客服情绪与服务语气:
情绪表现:……
服务语气:……
异常情况:……

客户情绪与客服应对:
客户情绪:……
情绪变化:……
客服应对:……

通话互动:
抢话:……
打断客户:……
其他异常:……

分析说明:……
"""

        conversation = [{
            "role": "user",
            "content": [
                {"type": "audio", "audio": item["path"]},
                {"type": "text", "text": prompt}
            ]
        }]

        text = processor.apply_chat_template(
            conversation,
            add_generation_prompt=True,
            tokenize=False
        )

        audios, images, videos = process_mm_info(
            conversation,
            use_audio_in_video=False
        )

        inputs = processor(
            text=text,
            audio=audios,
            images=images,
            videos=videos,
            return_tensors="pt",
            padding=True
        ).to(model.device)

        with torch.no_grad():
            output = model.generate(
                **inputs,
                use_audio_in_video=False,
                return_audio=False,
                max_new_tokens=500
            )

        output = output[:, inputs.input_ids.shape[1]:]

        analysis = processor.batch_decode(
            output,
            skip_special_tokens=True,
            clean_up_tokenization_spaces=False
        )[0]

        analysis_results.append({
            "start": item["start"],
            "end": item["end"],
            "analysis": analysis
        })

        # 每段推理后释放中间变量,模型继续保留
        del inputs, output, audios, images, videos
        gc.collect()
        torch.cuda.empty_cache()

    # 所有片段处理完成后释放模型
    del model, processor
    gc.collect()
    torch.cuda.empty_cache()

    return format_audio_analysis(analysis_results)
分析结果汇总 def format_analysis_result(transcript, audio_analysis):
result = f"""
【通话转写】
{transcript}
【信息核验说明】
本次分析未提供企业业务规则或标准答案。
对于课程时间、请假规则等业务信息,只能判断客服是否进行了明确回应,
无法核验其内容是否准确。
【语音综合分析】
{audio_analysis}
"""
return result.strip()
大模型综合质检 将规范化分析结果与20.1.2节制定的客服质检规则一起输入Qwen3-8B,由模型综合分析通话内容和各项分析结果,完成质检评分并生成报告。
def generate_qc_report(analysis_text, qc_rules):
    model_name = "Qwen/Qwen3-8B"

    tokenizer = AutoTokenizer.from_pretrained(model_name)
    model = AutoModelForCausalLM.from_pretrained(
        model_name,
        torch_dtype=torch.bfloat16,
        device_map="cuda:0"
    )

    prompt = f"""
你是一名语言培训机构电话客服质检人员。请严格按照客服质检规则,根据电话分析结果完成综合质检并生成质检报告。

【客服质检规则】
{qc_rules}

【电话分析结果】
{analysis_text}

【质检要求】
1. 按照8个质检项逐项检查,只根据提供的电话分析结果进行判断,不得猜测或补充未提供的信息。每项判断和扣分都需要有明确依据。
2. 采用从严评分原则。没有明确问题时不扣分;发现明确问题后,应根据问题严重程度充分扣分。明显违反质检规则、影响客户体验或带来业务风险的问题,应进行较大幅度扣分,不能因为客服整体表现尚可而从轻处理,也不能只扣1~2分作为象征性处罚。
3. 对课程时间、请假规则等需要企业业务规则才能验证的信息,如果没有提供相应依据,应标记为“现有信息无法核验”,不要自行判断正确或错误。对于学习效果等无法保证的事项,如果客服使用“保证”“一定”“肯定”等表述作出确定性承诺,应判定为不当承诺并明显扣分。
4. 服务态度、专业措辞和问题解决情况应同时结合通话文本进行判断;客服情绪、客户情绪以及抢话、打断等语音表现结合语音综合分析结果进行判断。语音情绪正常不能覆盖文本中明确存在的不当话术。
5. 各质检项按照其对应的检查内容进行判断,不要增加质检规则中没有规定的要求,也不要将问题归入无关的质检项。同一个问题原则上不要重复扣分;如果同一行为确实影响不同质检项,应分别说明对应依据。
6. 完成全部质检项后,检查分项得分、综合得分和质检结论是否一致。综合得分必须等于8个质检项得分之和。

【质检结论】
根据综合得分确定质检结论:
- 95~100分:优秀
- 90~94分:良好
- 80~89分:一般
- 80分以下:较差

【输出格式】
请使用标准Markdown格式输出,不要转义Markdown符号。

# 客服质检报告

## 一、综合结果
- 综合得分:XX/100
- 质检结论:优秀/良好/一般/较差
- 总体评价:简要概括本次客服服务质量,不超过3句话。

## 二、质检项结果

### 1. 开场与身份说明(X/5)
- 判断结果:
- 主要依据:
- 扣分原因:无/具体原因

### 2. 需求识别与回应完整性(X/20)
- 判断结果:
- 主要依据:
- 扣分原因:无/具体原因

### 3. 信息准确性与风险控制(X/15)
- 判断结果:
- 主要依据:
- 扣分原因:无/具体原因

### 4. 问题解决与承诺闭环(X/15)
- 判断结果:
- 主要依据:
- 扣分原因:无/具体原因

### 5. 服务态度与专业措辞(X/15)
- 判断结果:
- 主要依据:
- 扣分原因:无/具体原因

### 6. 打断与通话节奏(X/10)
- 判断结果:
- 主要依据:
- 扣分原因:无/具体原因

### 7. 客户情绪与服务修复(X/10)
- 判断结果:
- 主要依据:
- 扣分原因:无/具体原因

### 8. 结束语与待办确认(X/10)
- 判断结果:
- 主要依据:
- 扣分原因:无/具体原因

## 三、主要问题
只列出本次通话中有明确证据的主要问题。如果没有明显问题,写“未发现明显问题”。

## 四、改进建议
针对主要问题给出具体、简洁的改进建议。如果没有明显问题,可以给出简短的保持建议。
"""

    messages = [{"role": "user", "content": prompt}]

    text = tokenizer.apply_chat_template(
        messages,
        tokenize=False,
        add_generation_prompt=True,
        enable_thinking=False
    )

    inputs = tokenizer(
        text,
        return_tensors="pt"
    ).to(model.device)

    with torch.no_grad():
        outputs = model.generate(
            **inputs,
            max_new_tokens=4096
        )

    outputs = outputs[:, inputs.input_ids.shape[1]:]

    report = tokenizer.decode(
        outputs[0],
        skip_special_tokens=True
    )

    del model, tokenizer
    gc.collect()
    torch.cuda.empty_cache()

    return report
完整质检流程 主程序还需要定义几个辅助函数,用于根据时间将ASR文本与说话人片段对齐、生成完整通话文本以及保存质检报告。
def merge_asr_speakers(asr_segments, speaker_segments):
    results = [{"turn_id": i + 1, "speaker": seg["speaker"], "start": seg["start"], "end": seg["end"], "texts": []} for i, seg in enumerate(speaker_segments)]

    for item in asr_segments:
        best_index, best_overlap = None, 0
        for i, seg in enumerate(speaker_segments):
            overlap = min(seg["end"], item["end"]) - max(seg["start"], item["start"])
            if overlap > best_overlap:
                best_overlap, best_index = overlap, i
        if best_index is not None and best_overlap > 0:
            results[best_index]["texts"].append(item["text"])

    results = [item for item in results if item["texts"]]

    for i, item in enumerate(results):
        item["turn_id"] = i + 1
        item["text"] = "".join(item.pop("texts")

    return results

def build_transcript(segments):
    return "\n".join(
        f"第{seg['turn_id']}轮 [{seg['speaker']}] {seg['start']:.2f}-{seg['end']:.2f}秒:{seg['text']}"
        for seg in segments
    )

def save_report(report, output_path="./customer_service/客服质检报告.md"):
    os.makedirs(os.path.dirname(output_path), exist_ok=True)
    with open(output_path, "w", encoding="utf-8") as f:
        f.write(report)
    return output_path

QC_RULES = """
电话客服质检规则,总分100分:

1. 开场与身份说明(5分)
检查是否主动问候,说明机构和本人身份,并询问客户需求。

2. 需求识别与回应完整性(20分)
检查是否识别客户提出的问题,并逐项进行有效回应。

3. 信息准确性与风险控制(15分)
检查客服是否编造不确定的信息,是否对课程效果、学习成果等作出不当承诺。
需要特别注意学习效果相关的保证性表述。学习效果受到学员基础、学习投入、练习情况等多种因素影响,客服不得对学习效果作出确定性保证。
如果客服使用“保证”“一定可以”“肯定能”等确定性表述,或者明确承诺在固定时间内达到某种学习效果,应判定为不当承诺并扣分。

例如,“坚持一个月基本就能流利说英语”“这个效果可以保证”等表述,属于学习效果不当承诺。
4. 问题解决与承诺闭环(15分)
检查客户核心问题是否解决;无法立即解决时,是否说明后续处理方式。

5. 服务态度与专业措辞(15分)
检查是否存在不耐烦、责怪、敷衍、辱骂或推卸责任等表达。

6. 打断与通话节奏(10分)
检查是否频繁打断客户、抢话或存在明显影响沟通的异常节奏。

7. 客户情绪与服务修复(10分)
检查客户是否出现明显负面情绪,客服是否及时解释和安抚。

8. 结束语与待办确认(10分)
检查是否礼貌结束,并对尚未完成的事项进行确认。
"""

def main(audio_path, report_save_path):
    result = {}

    # 音频预处理
    audio_path = preprocess_audio(audio_path)
    print("音频预处理 已完成✅️")

    # 说话人分析
    speaker_segments = analyze_speakers(audio_path)
    print("说话人分析 已完成✅️")

    # 语音识别
    asr_result = analyze_asr(audio_path)
    print("语音识别 已完成✅️")

    # 文本与说话人对齐
    segments = merge_asr_speakers(asr_result["segments"], speaker_segments)
    print("文本与说话人对齐 已完成✅️")

    # 说话人角色识别
    segments = identify_speaker_roles(segments)
    result["transcript"] = build_transcript(segments)
    print("说话人角色识别 已完成✅️")

    # 语音综合分析
    result["audio_analysis"] = analyze_audio(audio_path, segments)
    print("语音综合分析 已完成✅️")

    # 汇总分析结果
    analysis_text = format_analysis_result(result["transcript"], result["audio_analysis"])
    print("分析结果汇总 已完成✅️")

    # 综合质检
    report = generate_qc_report(analysis_text, QC_RULES)
    print("综合质检 已完成✅️")

    # 保存并输出结果
    report_path = save_report(report, report_save_path)
    print("\n========== 规范化分析结果 ==========\n")
    print(analysis_text)
    print("\n========== 客服质检报告 ==========\n")
    print(report)
    print(f"\n质检报告已保存到:{report_path}")
    return report
运行测试 if __name__ == "__main__":
main(
audio_path="./customer_service/客服通话记录.wav",
report_save_path="./customer_service/客服质检报告.md"
)
本章代码及相关文件见:https://www.modelscope.cn/gallery/liucong/ae27f822-4e85-4baa-be70-74f73f07799a