通用大模型虽然具备较强的知识问答能力,但在企业实际应用中,很多问题涉及企业内部的产品资料、技术文档、业务制度和操作手册等内容。这些知识通常没有包含在模型的训练数据中,而且还会随着业务不断更新。
RAG(Retrieval-Augmented Generation,检索增强生成)提供了一种解决方案,在大模型回答问题之前,先从企业知识库中检索与问题相关的内容,再将检索结果提供给大模型生成答案。
RAG 的核心思想可以概括为:先检索,再回答。传统的大模型问答主要依赖模型参数中已经学习到的知识。例如,当用户提出一个问题时,模型会根据训练阶段学习到的信息直接生成答案。RAG 在这个过程中增加了一个知识检索步骤。当用户提出问题后,系统首先从外部知识库中查找与问题相关的内容,然后将用户问题和检索到的知识一起发送给大模型,由模型结合这些内容生成最终答案。
一个基本的 RAG 流程可以表示为:用户问题 → 知识检索 → 获取相关内容 → LLM 生成答案 → 返回结果。RAG 并不是让模型重新学习这些知识,而是在模型回答问题时,临时为模型提供当前问题所需要的参考资料。
RAG 并不是所有大模型应用都必须使用,但对于企业知识问答、智能客服和文档助手等场景非常常见。
如果业务知识需要持续更新,通常比较适合使用 RAG。例如企业的产品说明、业务制度和操作规范可能会不断调整。如果将这些知识通过模型训练的方式写入模型,每次知识发生变化都重新训练模型,成本较高,也不方便维护。
RAG 可以直接更新外部知识库。当文档发生变化后,只需要重新处理相关文档并更新索引,不需要重新训练整个大模型。如果回答需要提供来源依据,RAG 也比较适合。由于模型的回答是基于检索到的文档生成的,因此可以同时返回文档名称、章节、页码或者原文片段,让用户知道答案来自哪里。
RAG 和模型微调都可以用于提升大模型在实际业务中的表现,但两者解决问题的思路不同。RAG 主要解决“模型缺少相关知识”的问题,而模型微调主要解决“模型不能按照要求完成任务”的问题。
RAG 并不会修改模型本身的参数,而是在模型回答问题之前,先从外部知识库中检索与问题相关的内容,再将这些内容提供给模型作为回答依据。
模型微调的方式则不同。微调需要使用特定的训练数据进一步训练模型,并在训练过程中调整模型参数,使模型逐渐学习特定任务的处理方式。例如第九章中提到的实体识别任务,需要模型输出固定格式的回答。当任务要求发生较大变化时,通常需要准备新的训练数据并重新进行微调。
在实际应用中,可以根据需要解决的问题选择不同的方法:需要补充或更新知识时,更适合使用 RAG;需要调整模型的任务能力、输出格式或行为方式时,更适合使用模型微调。RAG 和模型微调两者可以结合使用。例如,可以通过微调让模型掌握问答或指令遵循能力,再通过 RAG 为模型提供领域内的知识,使模型既能够按照业务要求完成任务,又能够基于最新的领域知识生成回答。
一个完整的 RAG 系统通常可以分为两个主要阶段:知识库构建和在线问答。知识库构建主要负责将 PDF、Word、Markdown、网页等原始资料处理成可以被检索的知识。在线问答则是在用户提出问题之后,从已经建立的知识库中寻找相关内容,本次实验采用网上公开的《中华人民共和国道路交通安全法实施条例》作为文档库来源,搭建关于交通安全法问答的RAG系统。
企业知识通常分散在 PDF、Word、Excel、Markdown、网页等不同类型的文件中。由于不同文件的格式和内部结构存在较大差异,在构建 RAG 知识库之前,通常需要先将这些文档转换为统一、可处理的文本或结构化数据,这一过程称为文档解析。对于 RAG 系统而言,一个较好的文档解析工具不仅只是识别文本中的文字,还需要尽可能识别和保留原始文档中的结构信息,例如:文档标题、文档段落、表格、图片、公式等等。
目前已经有许多开源工具可以用于文档解析,比较常见的包括:
1)MinerU 是一个面向复杂文档的开源解析工具,可以将 PDF、图片、Word、PPT、Excel 等文档转换为 Markdown、JSON 等机器可读格式。它能够识别标题、正文、表格、图片、公式等内容,并尽可能按照人类阅读顺序还原文档结构,因此比较适合作为 RAG 系统中的文档预处理工具,opendatalab/MinerU
2)MonkeyOCR 是一个基于多模态模型的文档解析项目,通过结构识别、内容识别和关系建模对文档进行解析,能够处理文本、表格、公式等复杂内容,并支持中文和英文文档。对于版式比较复杂、传统文本提取工具效果不理想的 PDF,可以考虑使用这类基于视觉模型的解析方法,Yuliang-Liu/MonkeyOCR
3)Dolphin 是字节跳动开源的文档图像解析模型,采用“先分析、再解析”的方式处理文档。它能够先识别页面布局和阅读顺序,再进一步解析文本、表格、公式、代码等不同类型的文档元素,适合处理布局复杂的 PDF 或扫描类文档,ByteDance/Dolphin
4)PaddleOCR 是 PaddlePaddle 开源的 OCR 与文档解析工具。除了常见的文字识别之外,还提供版面分析、表格识别以及文档结构化解析等能力,可以将 PDF 和图片中的内容转换为更适合后续 AI 系统处理的结构化数据。对于扫描 PDF、图片型文档以及包含大量中文文字的文档,PaddleOCR 是一种常见的选择,PaddlePaddle/PaddleOCR
登录 参与讨论
不同文档解析工具各有特点,并不存在一种工具能够适用于所有文档。在实际构建 RAG 系统时,可以根据文档的类型、版式复杂程度、解析准确率以及部署成本等因素选择合适的解析工具。
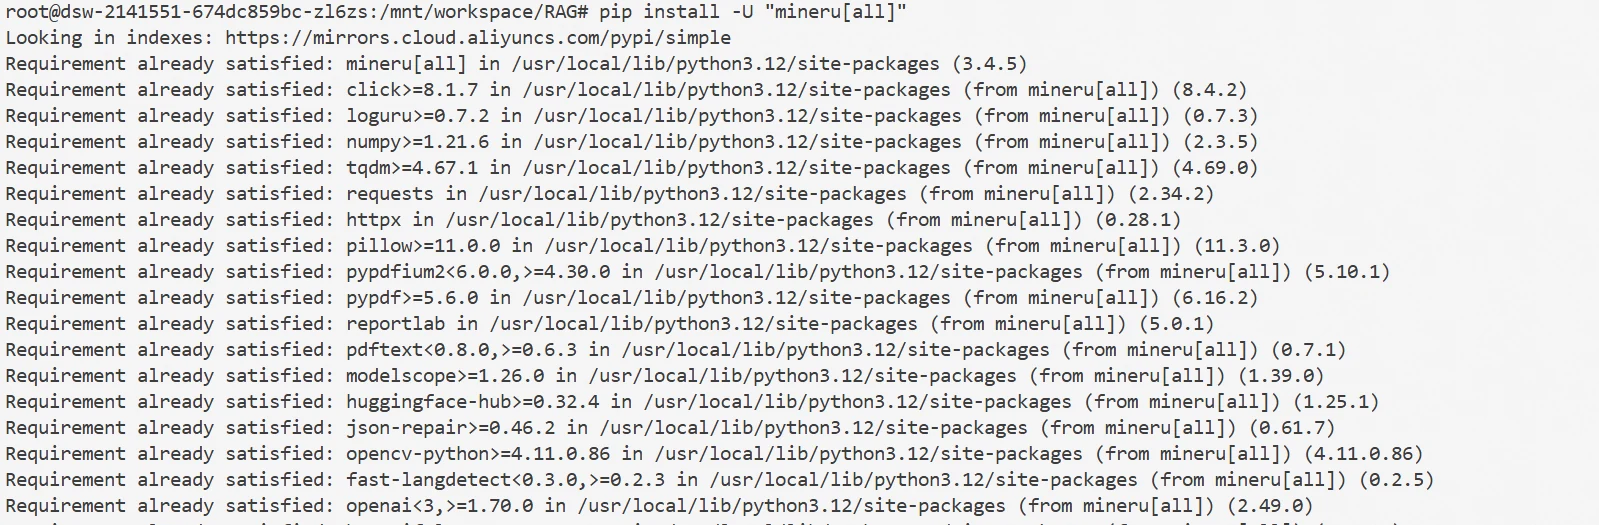
本次实验采用MinerU进行文档解析,首先在ModelScope的Notebook环境中安装MinerU,执行命令如下:
pip install -U "mineru[all]"
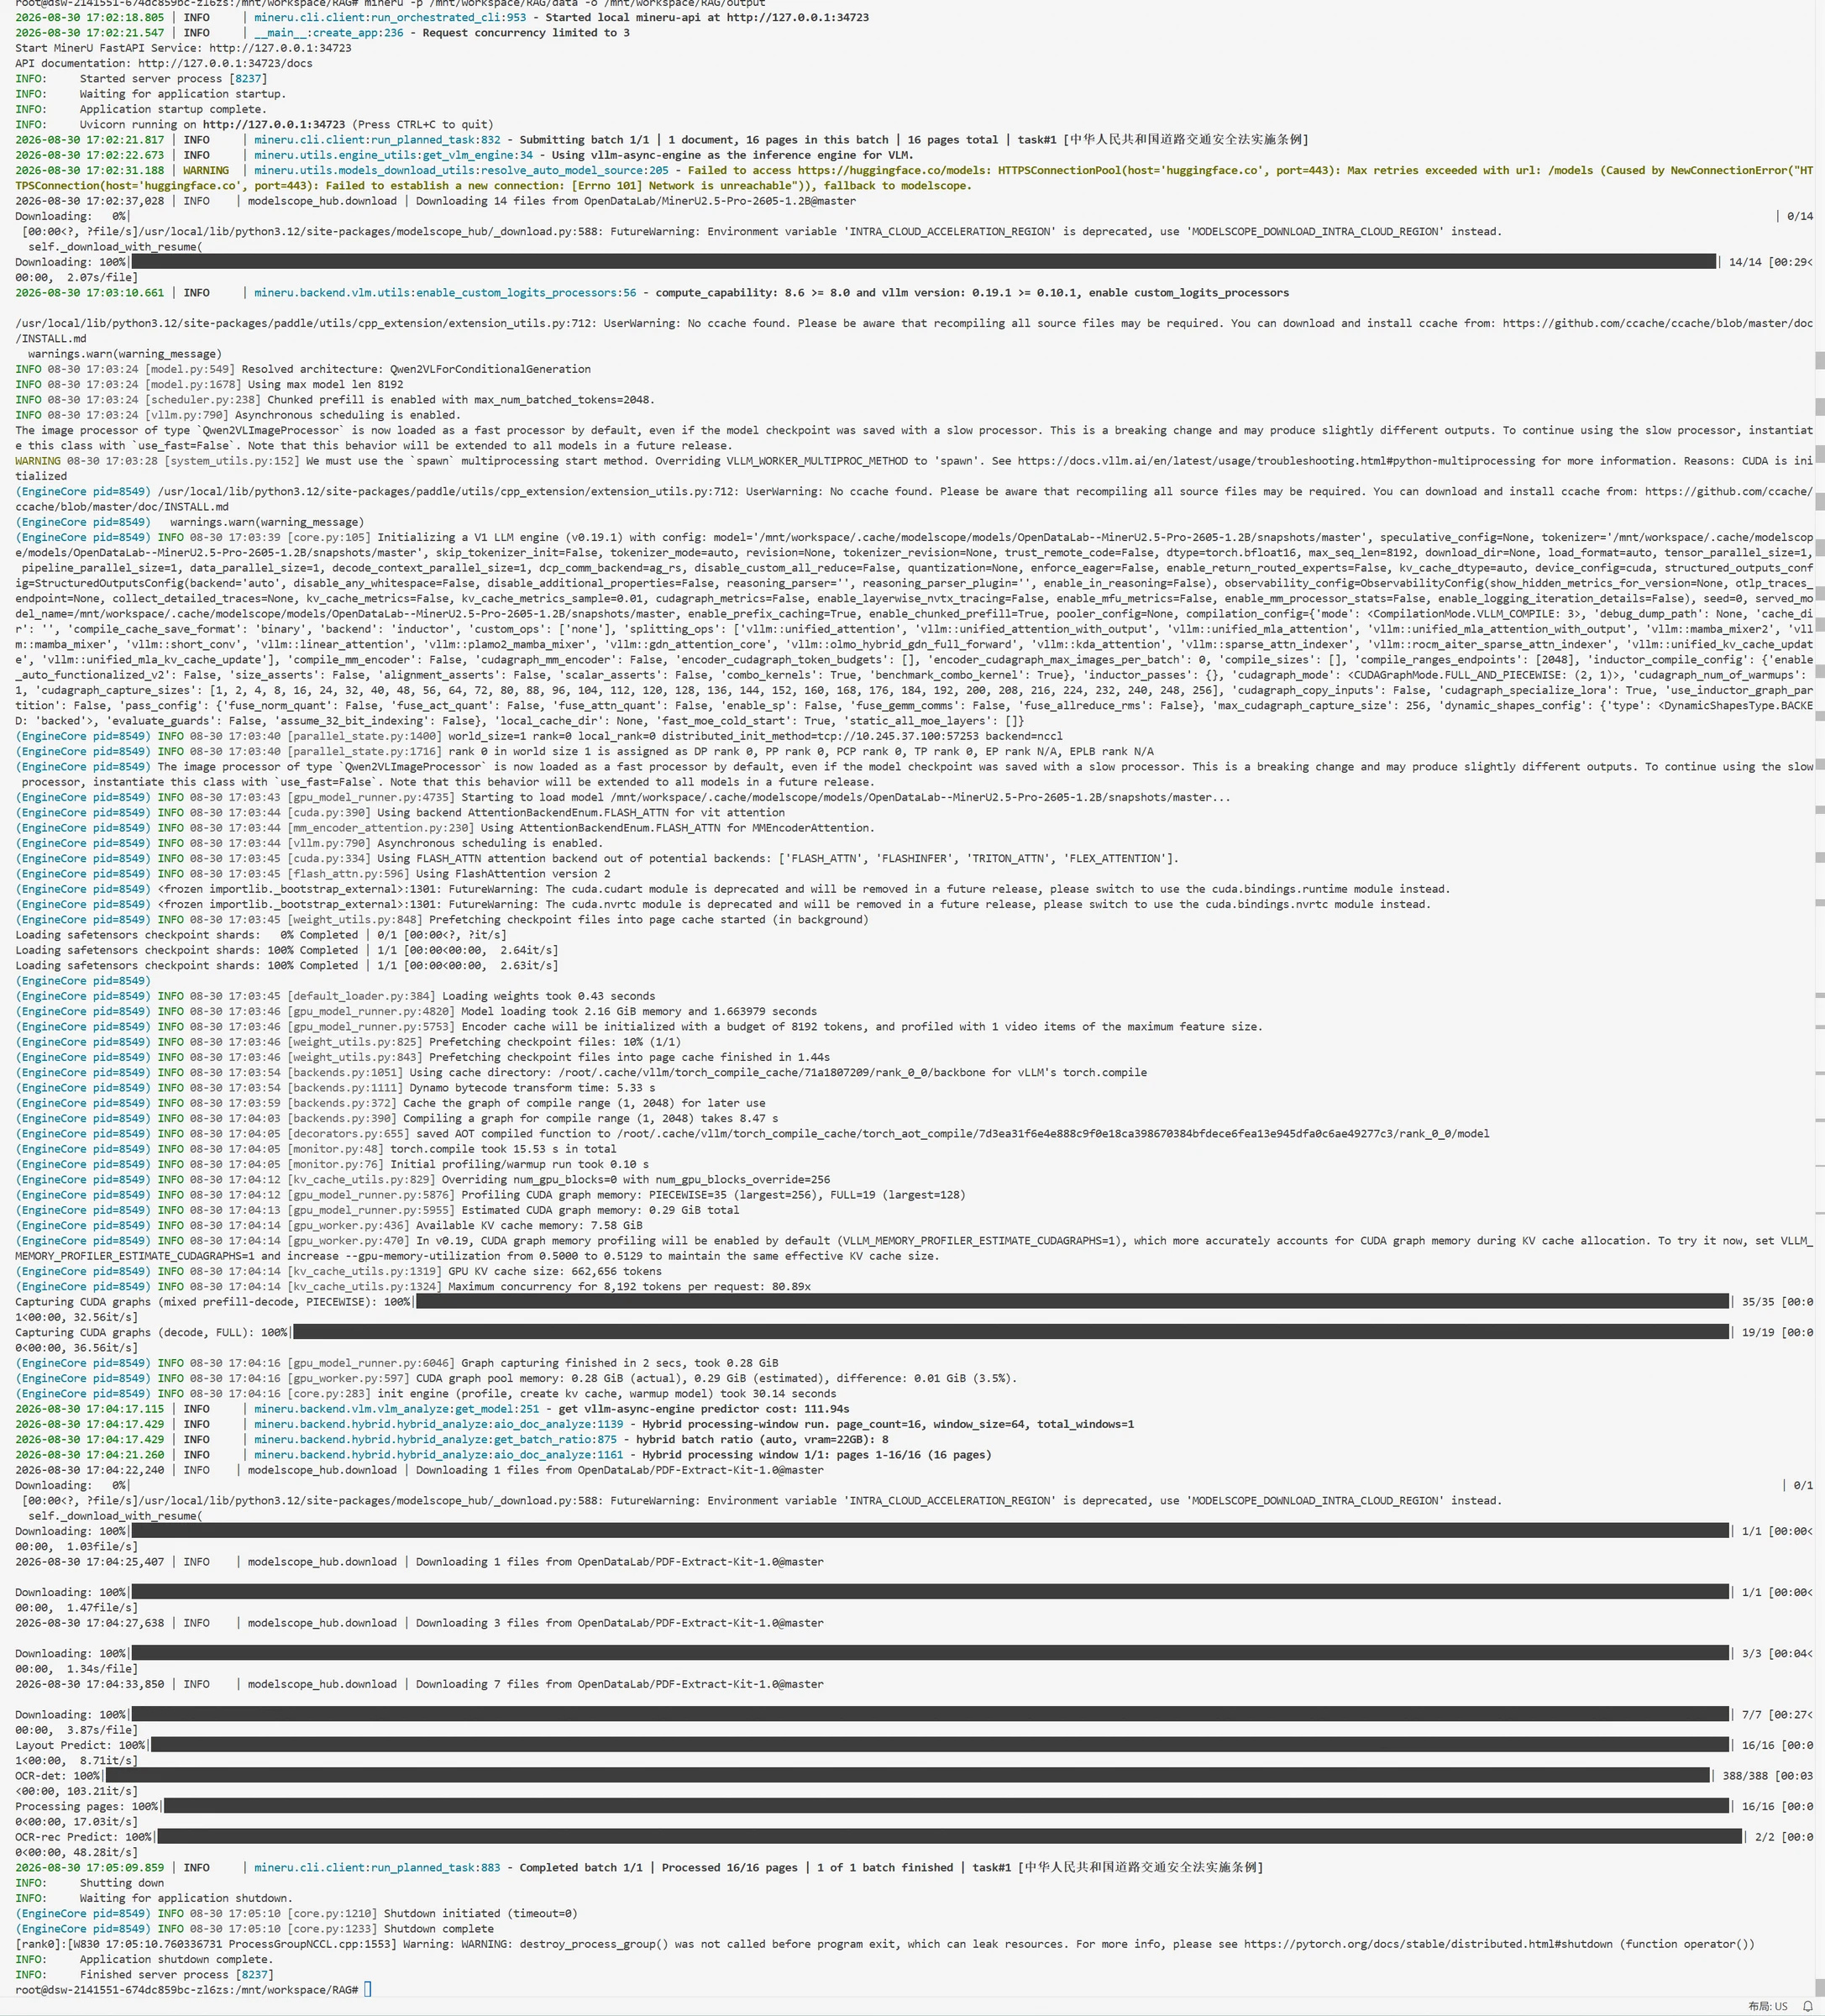
安装完成后,可以直接对文档解析,输入需要解析的文件路径,执行命令如下:
mineru -p /mnt/workspace/RAG/data -o /mnt/workspace/RAG/output
其中:-p是输入文件路径,-o是模型输出的文件路径,也就是解析后的文本。
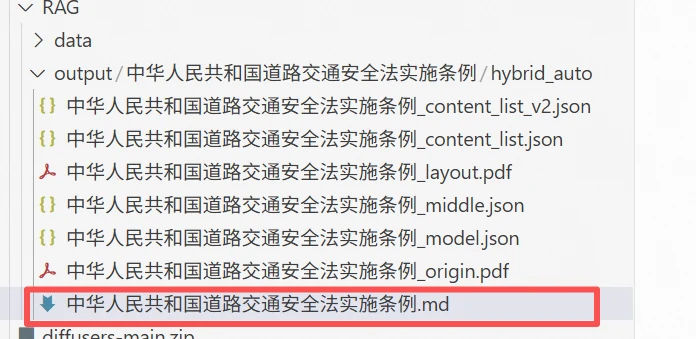
解析后的文件如下,里面包括了很多中间文件,可以按需选择,本次实验我们选择md文件作为文档源,里面包括了文本的段落格式信息。
完成文档解析后,需要将较长的文档拆分成多个较小的文本片段,这些文本片段通常称为 Chunk。在 RAG 系统中,Embedding 和检索通常以 Chunk 为基本单位,因此合理的文档切分有助于提高后续检索的准确性。
对于解析后的 Markdown 文档,可以先按照空行将内容拆分成段落,再按照设定的 chunk_size 将相邻段落依次合并。当内容超过指定长度时,则生成一个新的 Chunk。
为了避免切分位置造成上下文信息丢失,还可以设置 chunk_overlap,让相邻 Chunk 之间保留少量重复内容。例如:chunk_size = 500,chunk_overlap = 50,表示每个 Chunk 控制在 500 个字符左右,相邻 Chunk 保留约 50 个字符的重叠内容。切分完成后,可以为每个 Chunk 保存 id、content 和 file 等信息,方便后续进行向量化、检索以及答案来源定位。
下面是切分chunk的代码
import os
import json
def load_markdown(file_path):
    with open(file_path, "r", encoding="utf-8") as f:
        return f.read()

def split_markdown(text, chunk_size=500, chunk_overlap=50):
    """
    将 Markdown 文本切分成多个 Chunk
    chunk_size:每个 Chunk 大约包含多少个字符
    chunk_overlap:相邻 Chunk 之间保留多少个重复字符
    """
    paragraphs = text.split("\n\n")

    chunks = []
    current_chunk = ""

    for paragraph in paragraphs:
        paragraph = paragraph.strip()
        if not paragraph:
            continue
        if len(current_chunk) + len(paragraph) <= chunk_size:
            if current_chunk:
                current_chunk += "\n\n" + paragraph
            else:
                current_chunk = paragraph

        else:

            if current_chunk:
                chunks.append(current_chunk)
            overlap_text = current_chunk[-chunk_overlap:] if current_chunk else ""

            current_chunk = overlap_text + "\n\n" + paragraph
    if current_chunk:
        chunks.append(current_chunk)

    return chunks

def save_chunks(chunks, source_file, output_file):
    """
    将 Chunk 保存为 JSONL 文件
    """
    file_name = os.path.basename(source_file)

    with open(output_file, "w", encoding="utf-8") as f:
        for i, chunk in enumerate(chunks):
            data = {"id": i,"content": chunk,"file": file_name
            }

            f.write(
                json.dumps(data, ensure_ascii=False) + "\n"
            )

if __name__ == "__main__":

    file_path = "./output/中华人民共和国道路交通安全法实施条例/hybrid_auto/中华人民共和国道路交通安全法实施条例.md"

    text = load_markdown(file_path)
    chunks = split_markdown(
        text,
        chunk_size=500,
        chunk_overlap=50
    )
    print("Chunk 数量:", len(chunks)
    save_chunks(
        chunks,
        source_file=file_path,
        output_file="output/chunks.jsonl"
    )
执行完之后,可以看到刚才解析的md文件中,共切分出39个chunk。

完成文档切分后,需要进一步构建可检索的文档库。由于计算机无法直接根据自然语言的语义进行检索,因此需要使用 Embedding 模型将每个 Chunk 转换为向量表示。Embedding 模型可以将文本映射到高维向量空间,语义越相近的文本,其向量在空间中的距离也越接近。因此,在用户提出问题后,可以将问题同样转换为向量,再与文档库中的 Chunk 向量进行比较,从而检索出与问题语义最相关的内容。
目前开源社区已经提供了多种Embedding 模型,比如 BGE-M3 和 Qwen3-Embedding。BGE-M3 是 BAAI 推出的多语言 Embedding 模型,支持 100 多种语言以及最长 8192 Token 的文本输入。与普通的 Dense Embedding 模型相比,BGE-M3 同时支持稠密检索、稀疏检索和 Multi-Vector 检索,因此既可以用于常见的向量语义检索,也可以用于混合检索等场景FlagEmbedding。
Qwen3-Embedding 是 Qwen 团队推出的文本向量模型系列,基于 Qwen3 架构构建,主要面向文本检索、文本聚类、文本分类和代码检索等任务。Qwen3-Embedding 提供 0.6B、4B 和 8B 等不同参数规模,可以根据模型效果和计算资源进行选择,同时具有较好的多语言和长文本处理能力Qwen3-Embedding。
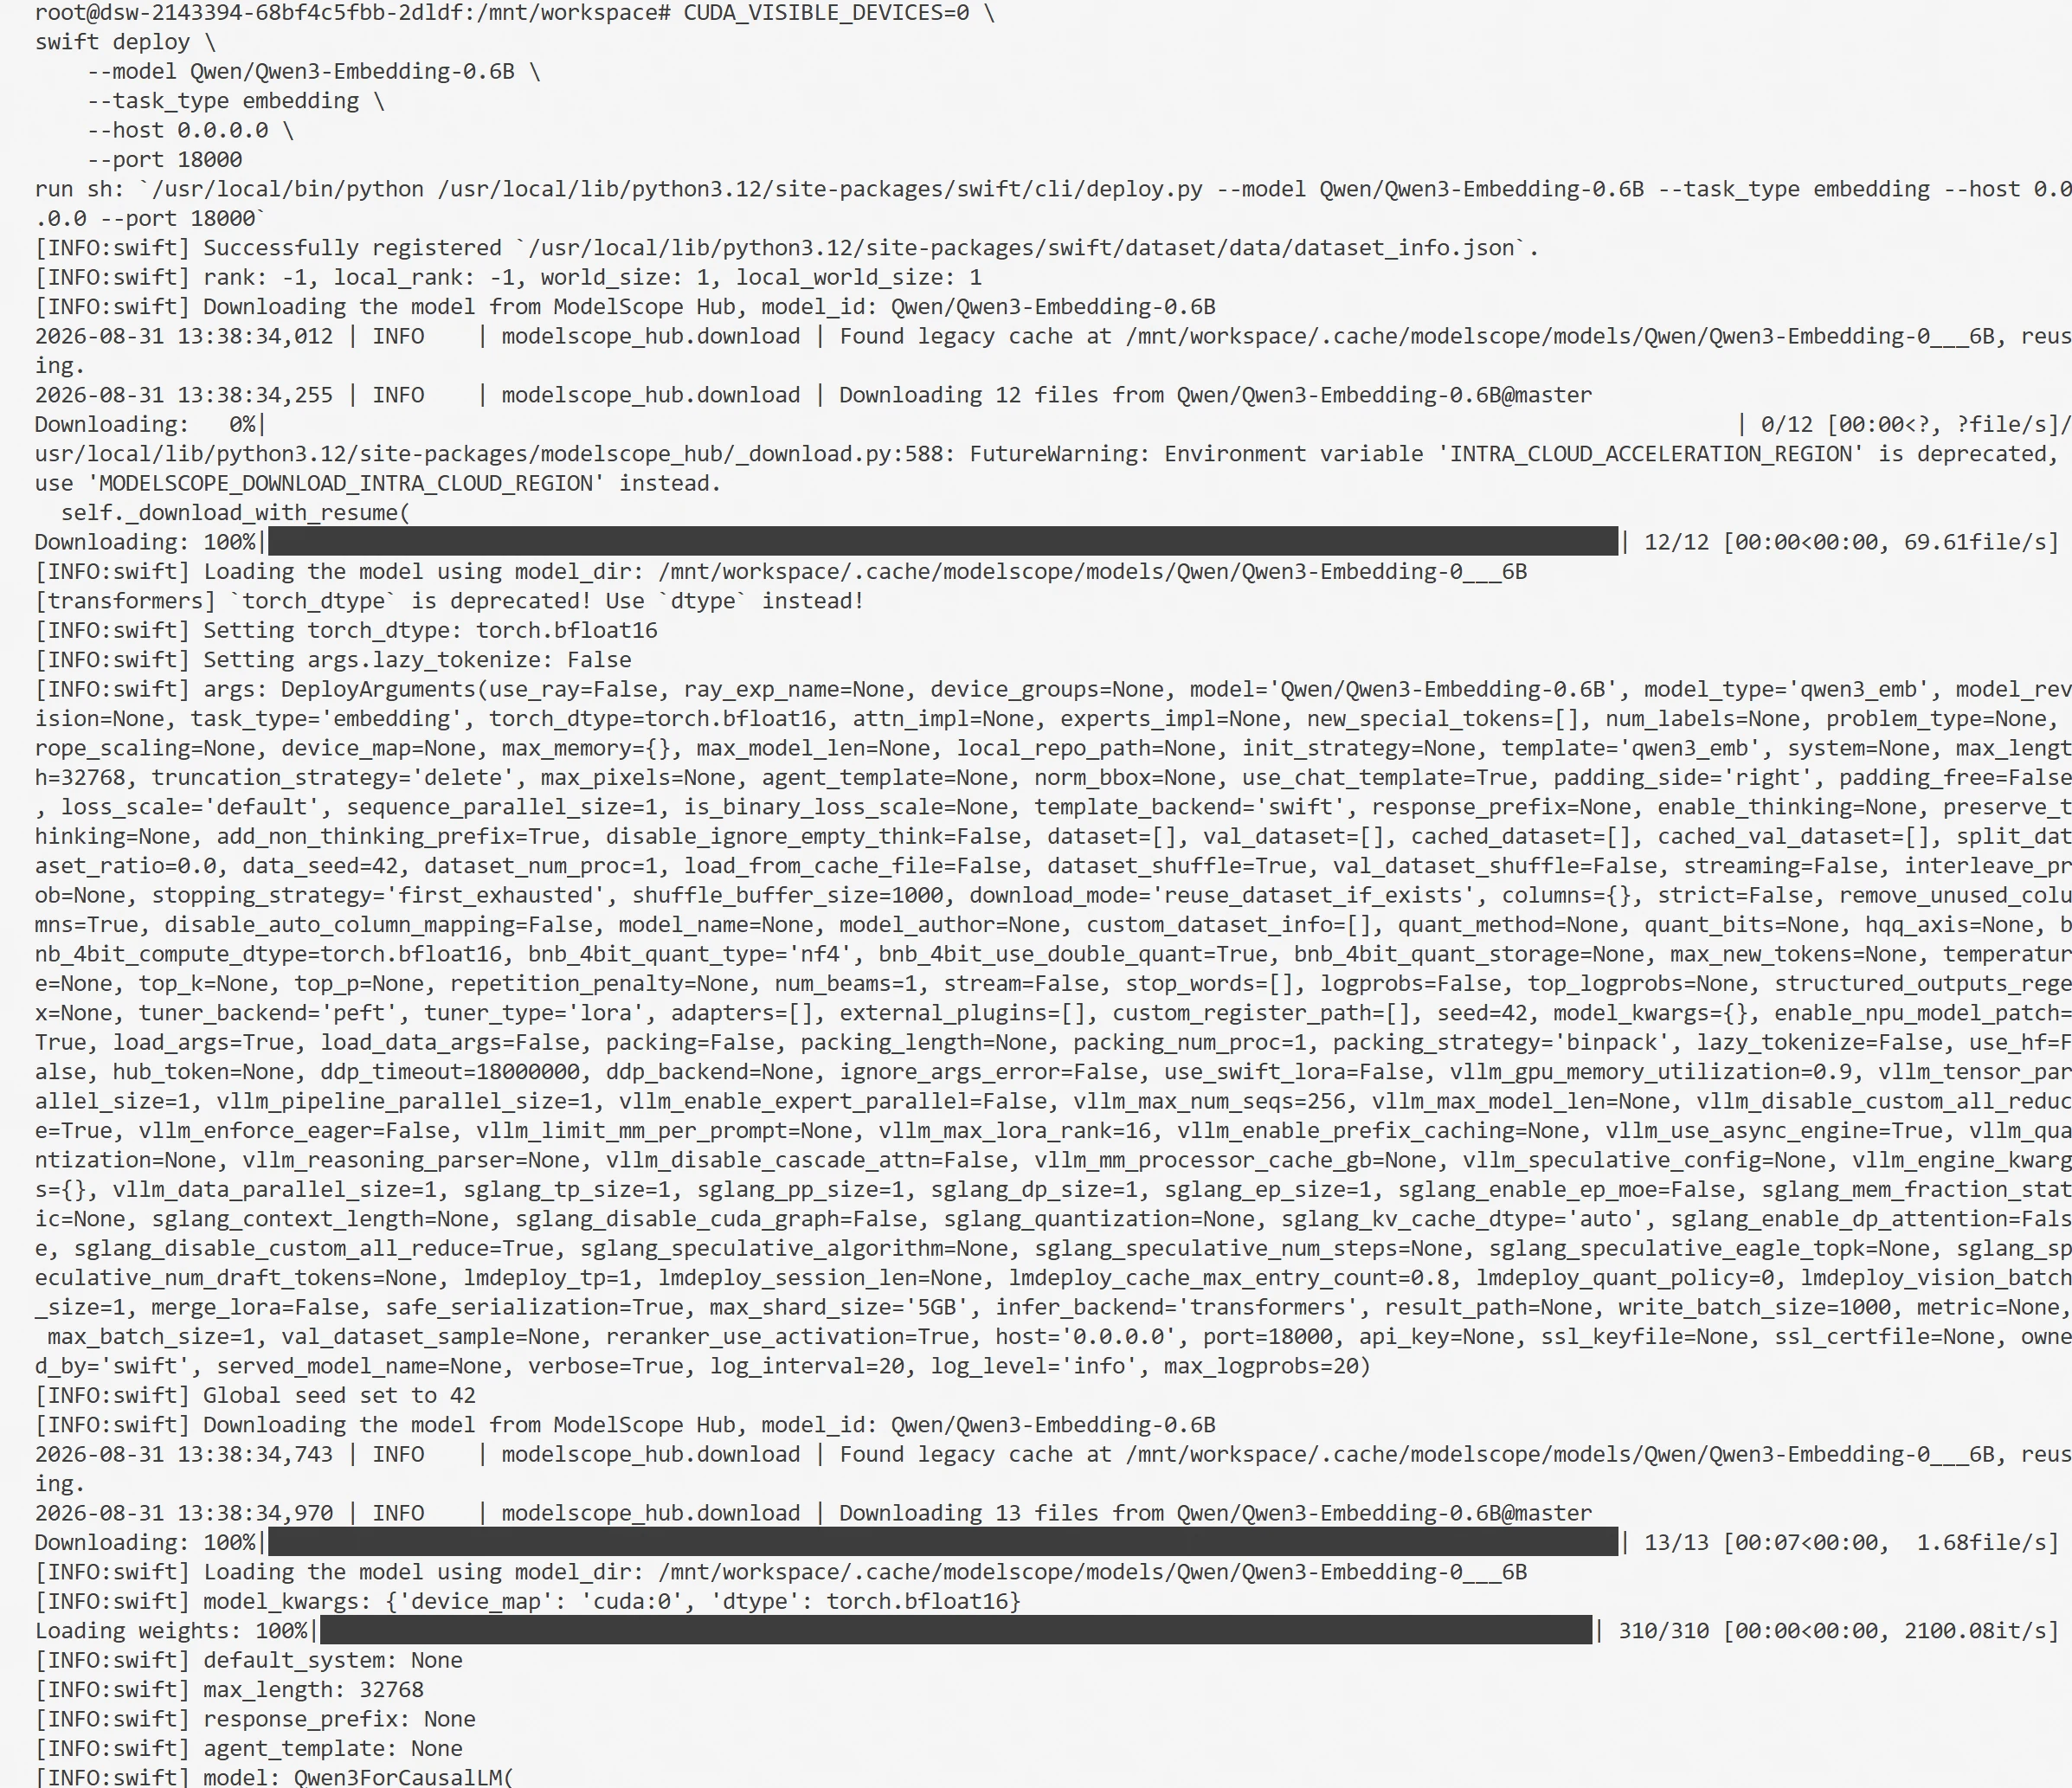
本节采用 Qwen3-Embedding-0.6B 作为 Embedding 模型进行实验,第九章已经介绍过 ms-swift,除了大模型训练和微调之外,ms-swift 也支持 Qwen3-Embedding 系列的训练和推理。因此,本节继续使用 ms-swift 启动 Qwen3-Embedding-0.6B,并通过接口的方式完成文档 Chunk 和用户问题的向量化。
可以使用如下命令启动 Embedding 服务:
CUDA_VISIBLE_DEVICES=0 \
swift deploy \
    --model Qwen/Qwen3-Embedding-0.6B \
    --task_type embedding \
    --vllm_gpu_memory_utilization 0.2 \
    --vllm_max_model_len 512 \
    --host 0.0.0.0 \
    --port 18000
服务启动后,显示如下信息:
目前常用的向量检索工具包括 Faiss 和 Milvus。Faiss 是 Meta 开源的向量相似度检索库,主要用于高效地进行向量索引和近邻搜索。它部署简单,不需要单独启动数据库服务,可以直接在 Python 程序中使用,比较适合学习、实验以及中小规模 RAG 系统。Milvus 是面向大规模向量数据的向量数据库,除了向量检索之外,还提供数据持久化、分布式存储、索引管理和多种查询能力,更适合数据规模较大、需要长期运行和工程化部署的场景。相比 Faiss,Milvus 的功能更加完整,但部署和使用过程也相对复杂。
本实验采用 Faiss进行向量存储和相似度检索,首先安装faiss库,执行命令如下:
pip install faiss-cpu
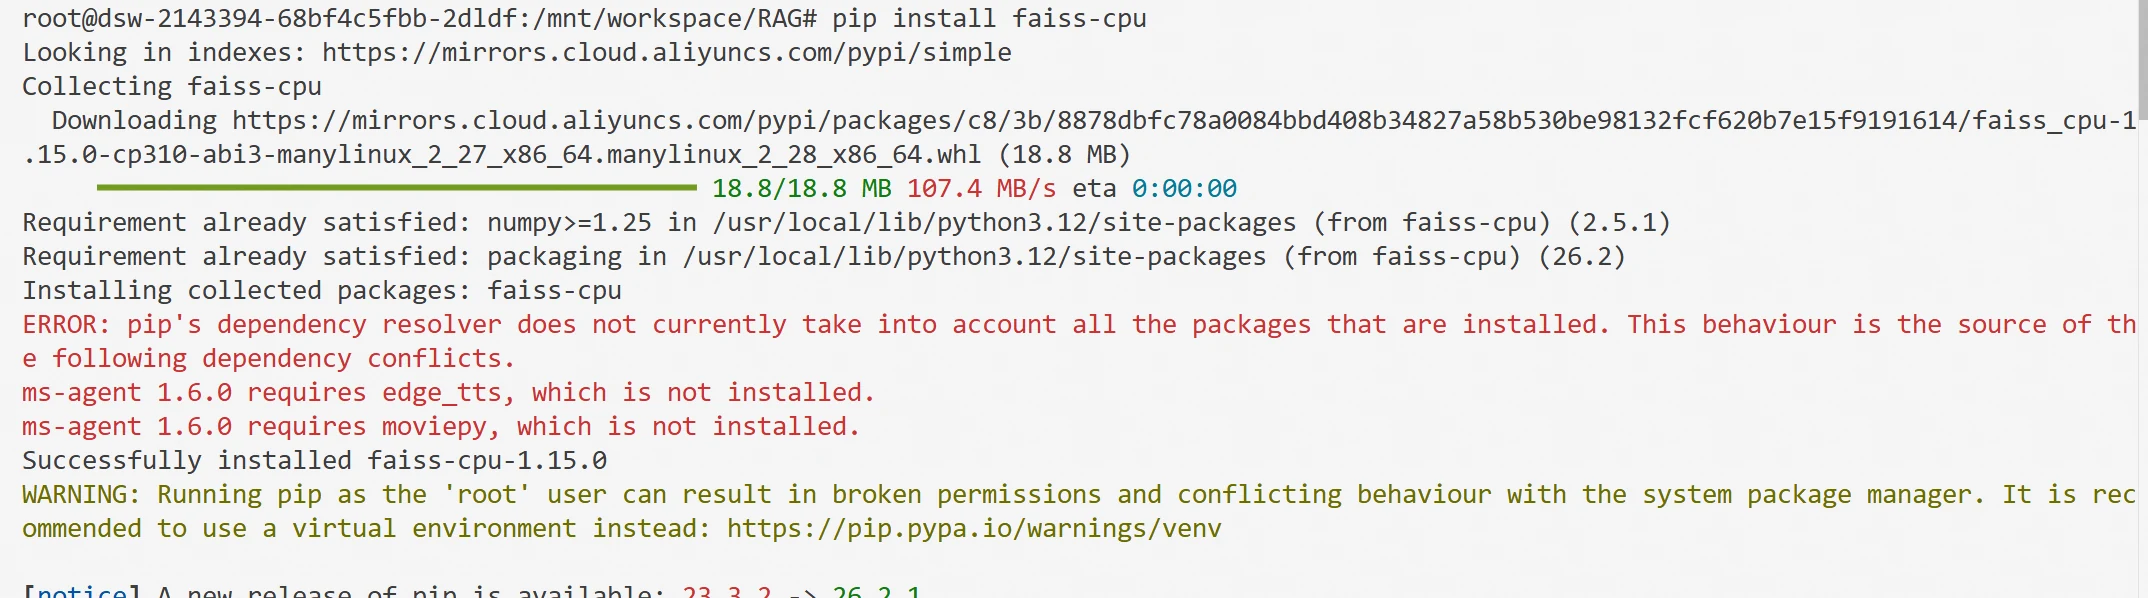
安装完成后,可以将上一节生成的 Chunk 依次发送给 Embedding 接口,获得对应的向量,并将向量与 Chunk 的 id、content、file 等信息建立对应关系。为了后续能够快速完成相似度计算和知识检索。
创建索引代码build_index.py如下:
import json
import requests
import numpy as np
import faiss

EMBEDDING_URL = "http://localhost:18000/v1/embeddings"
MODEL_NAME = "Qwen3-Embedding-0.6B"

def get_embedding(text):
    payload = {"model": MODEL_NAME,"input": text}
    response = requests.post(
        EMBEDDING_URL,
        json=payload,
        timeout=60
    )
    response.raise_for_status()
    data = response.json()
    embedding = data["data"][0]["embedding"]
    return np.array(embedding, dtype="float32")

def load_chunks(file_path):
    chunks = []
    with open(file_path, "r", encoding="utf-8") as f:
        for line in f:
            chunks.append(json.loads(line)
    return chunks
def build_faiss_index(chunks,index_path="faiss.index", metadata_path="metadata.json"):

    embeddings = []
    for i, chunk in enumerate(chunks):
        text = chunk["content"]
        embedding = get_embedding(text)
        embeddings.append(embedding)
        print(f"已处理 {i + 1}/{len(chunks)}")
    embeddings = np.array(embeddings, dtype="float32")
    faiss.normalize_L2(embeddings)
    dimension = embeddings.shape[1]
    index = faiss.IndexFlatIP(dimension)
    index.add(embeddings)
    print("向量数量:", index.ntotal)
    print("向量维度:", dimension)
    faiss.write_index(index, index_path)
    with open(metadata_path, "w", encoding="utf-8") as f:
        json.dump(chunks,f,ensure_ascii=False,indent=2
        )
    print(f"Faiss 索引已保存到: {index_path}")
    print(f"Chunk 信息已保存到: {metadata_path}")

if __name__ == "__main__":

    chunks = load_chunks("output/chunks.jsonl")

    build_faiss_index(
        chunks,
        index_path="output/faiss.index",
        metadata_path="output/metadata.json"
    )
执行后输出对应的索引文件以及向量
Embedding 模型能够将用户问题和文档 Chunk 分别转换为向量,并通过向量之间的距离或相似度进行检索。这种方式的优势是:文档向量可以提前计算并存储,在用户提问时只需要计算一次问题向量,就能够快速从大量文档中召回相关内容。但是,这种高效的检索方式也存在一定局限。Embedding 模型将Query 和 Chunk 分别进行编码,在计算相关性时,比较两个向量在向量空间中的相似程度。Reranker模型是交互式匹配。通过将 Query 和候选 Chunk 同时输入模型,让模型直接分析两段文本之间的相关关系,因此能够进行更加细致的语义匹配。
因此,在 RAG 系统中通常采用Embedding 召回 + Reranker 重排的两阶段检索方式:首先利用 Embedding 从大量 Chunk 中快速筛选出一批候选结果,再利用 Reranker 对少量候选结果进行更加精细的相关性判断和重新排序。这样既能够保证检索效率,又能够进一步提高最终提供给大语言模型的上下文质量。
本节采用 Qwen3-Reranker-0.6B 作为重排模型,可以使用 ms-swift 启动服务:
CUDA_VISIBLE_DEVICES=0 \
swift deploy \
    --model Qwen/Qwen3-Reranker-0.6B \
    --task_type generative_reranker \
    --infer_backend transformers \
    --host 0.0.0.0 \
    --port 18001
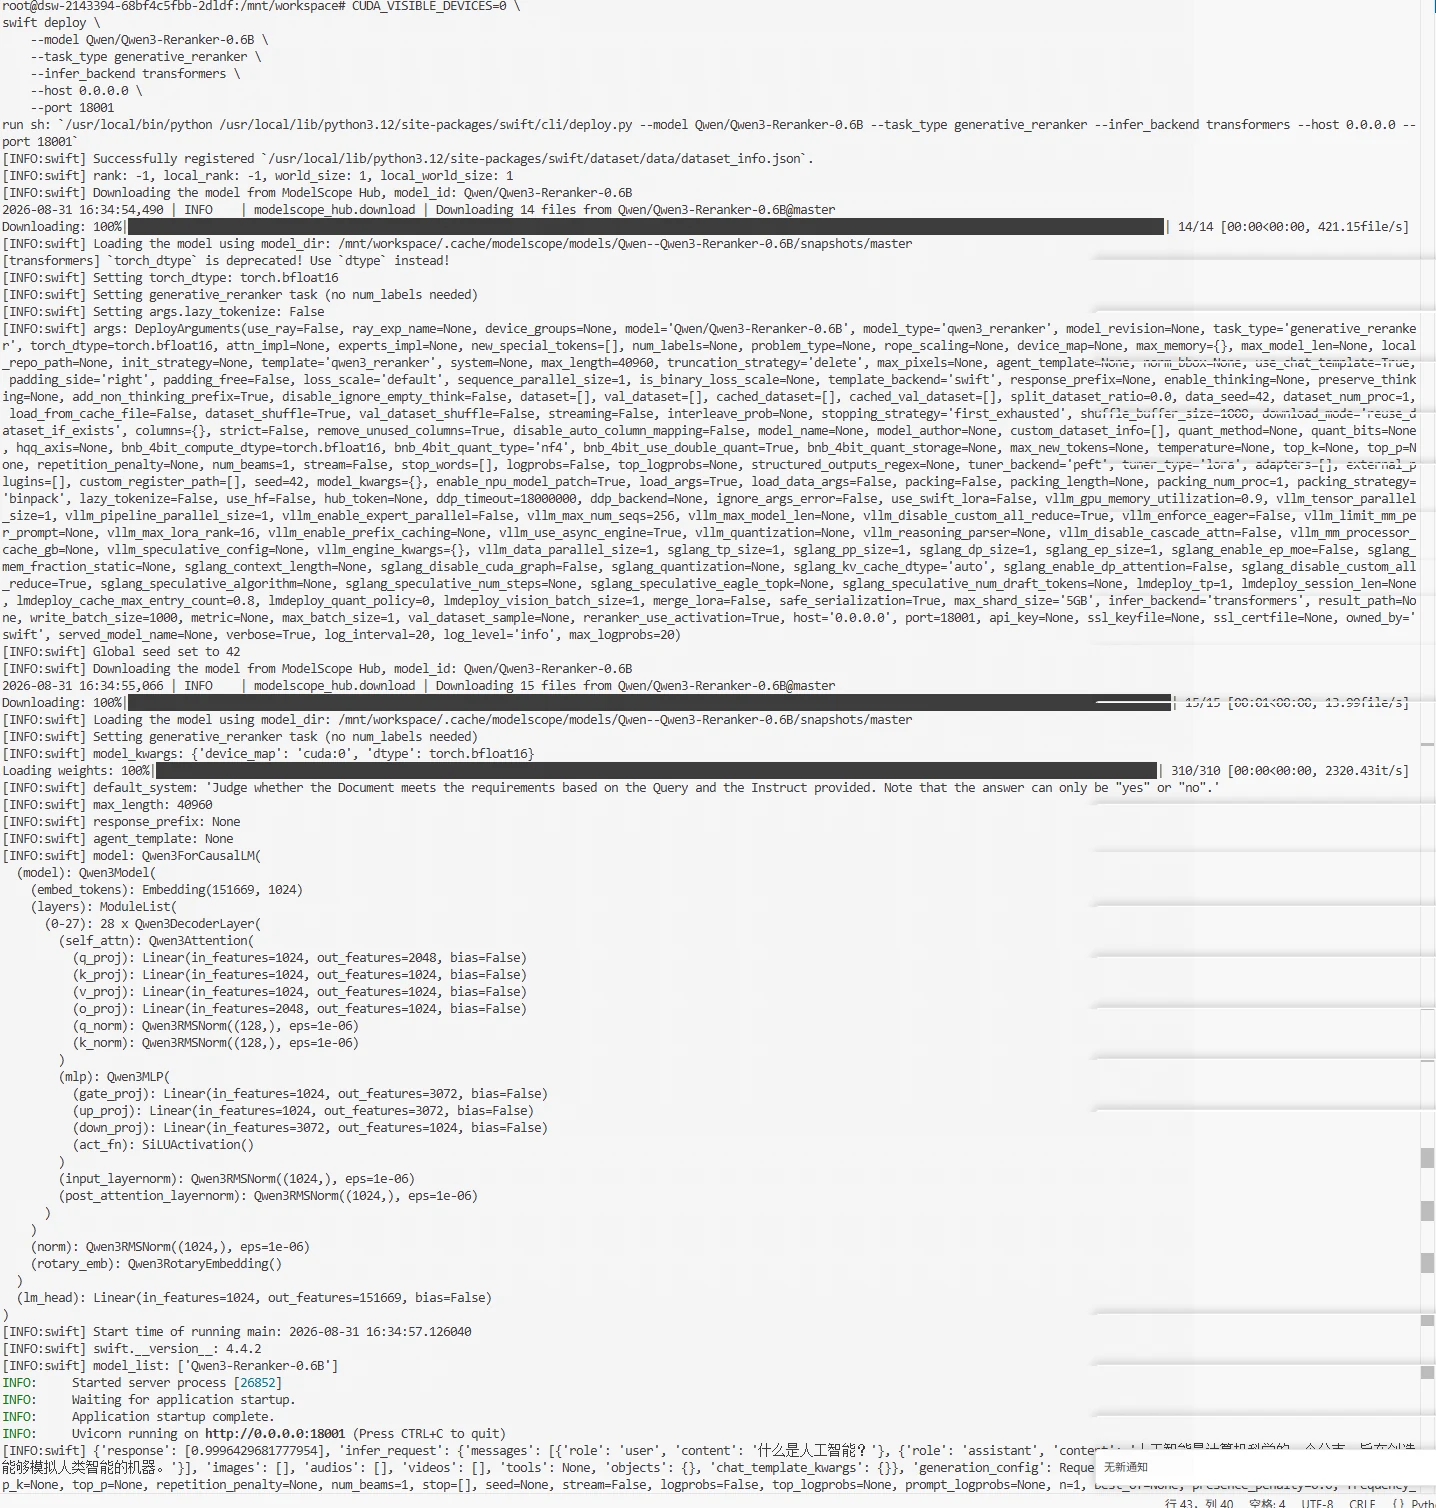
服务启动后,可以将用户问题和 Embedding检索得到的候选 Chunk 输入Reranker,根据模型计算得到的相关性分数重新排序,并选择排名靠前的 Chunk 作为后续大语言模型生成答案的参考内容。
前面经完成了 Embedding 服务、Reranker 服务以及 Faiss 向量索引的构建。在此基础上,按照提到的采用Embedding召回 + Reranker 重排的两阶段检索方式筛选出候选Chunk。
第一阶段使用 Faiss 从知识库中进行向量检索,首先获取相似度排名前 10 的候选 Chunk,下面是针对问题:初次申领机动车号牌、行驶证应向哪个部门申请注册登记?向量检索top10结果。
import json
import faiss
from build_index import get_embedding
def load_faiss_index(index_path="faiss.index",
                     metadata_path="metadata.json"):

    index = faiss.read_index(index_path)

    with open(metadata_path, "r", encoding="utf-8") as f:
        metadata = json.load(f)

    return index, metadata
def search(query,index,metadata,top_k=10):

    query_embedding = get_embedding(query)
    query_embedding = query_embedding.reshape(1, -1)
    faiss.normalize_L2(query_embedding)
    scores, indices = index.search(query_embedding,top_k)
    results = []
    for score, idx in zip(scores[0], indices[0]):
        if idx == -1:
            continue
        chunk = metadata[idx]
        results.append({
            "score": float(score),
            "id": chunk.get("id"),
            "content": chunk.get("content"),
            "file": chunk.get("file")
        })

    return results
index, metadata = load_faiss_index(
        "output/faiss.index",
        "output/metadata.json"
    )
query="初次申领机动车号牌、行驶证应向哪个部门申请注册登记?"
candidates = search(
    query=query,
    index=index,
    metadata=metadata,
    top_k=10
)

print("candidates",candidates)
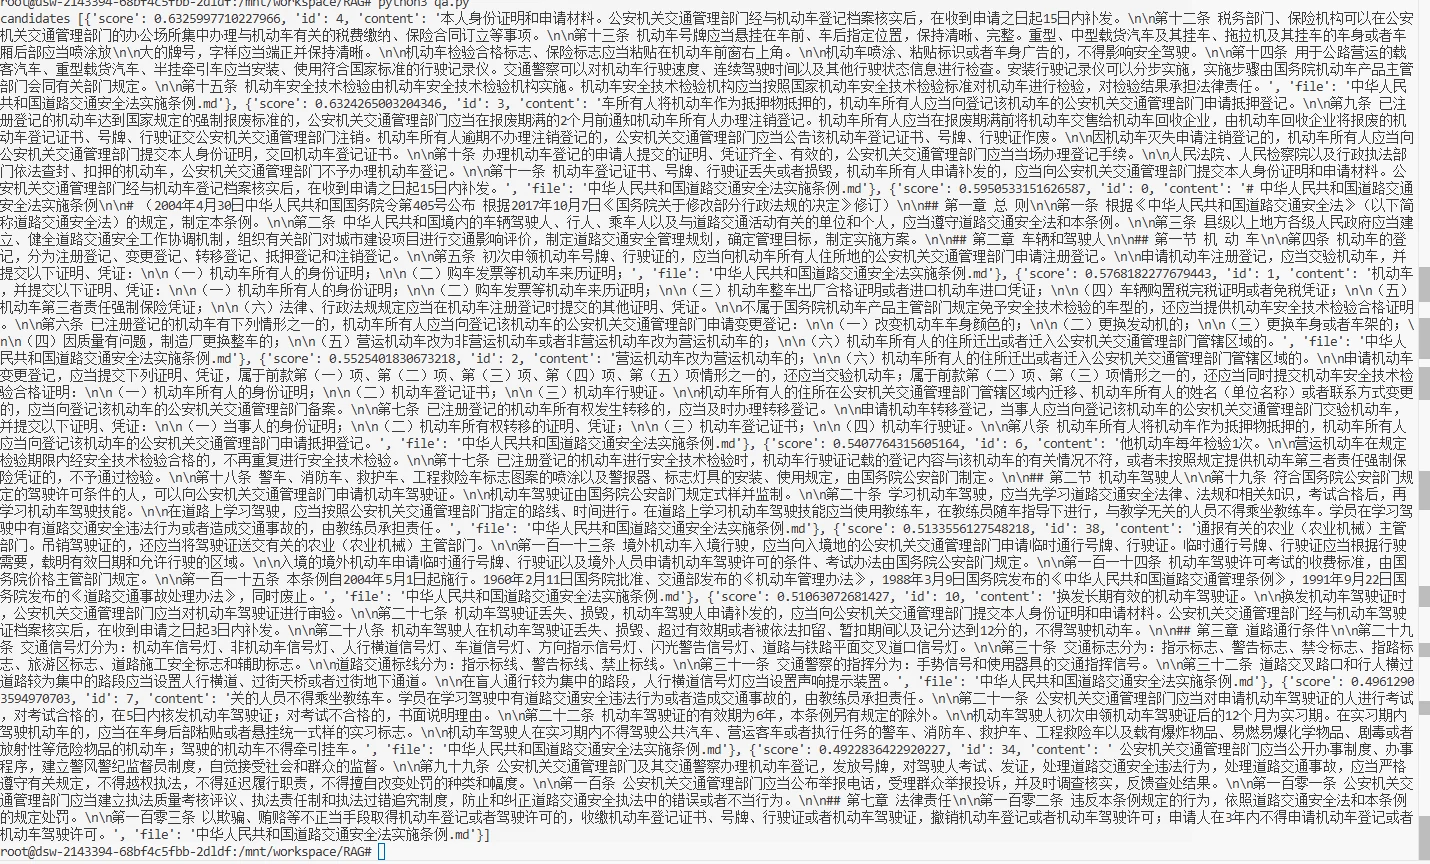
第二阶段使用 Reranker 对候选结果进行重排序。将用户问题和召回的候选 Chunk 提交给 Reranker,重新计算两者之间的相关性得分,并按照得分从高到低进行排序。
def rerank(query, candidates):
    results = []
    for candidate in candidates:
        response = rerank_client.chat.completions.create(
            model="Qwen3-Reranker-0.6B",
            messages=[
                {
                    "role": "user",
                    "content": query
                },
                {
                    "role": "assistant",
                    "content": candidate["content"]
                }
            ]
        )

        score = response.choices[0].message.content[0]
        item = candidate.copy()
        item["rerank_score"] = float(score)
        results.append(item)
    results.sort(
        key=lambda x: x["rerank_score"],
        reverse=True
    )
    for rank, item in enumerate(results, start=1):
        item["rerank_rank"] = rank

    return results
下面是针对问题:初次申领机动车号牌、行驶证应向哪个部门申请注册登记?经过Reranker模型重新排序后的结果:
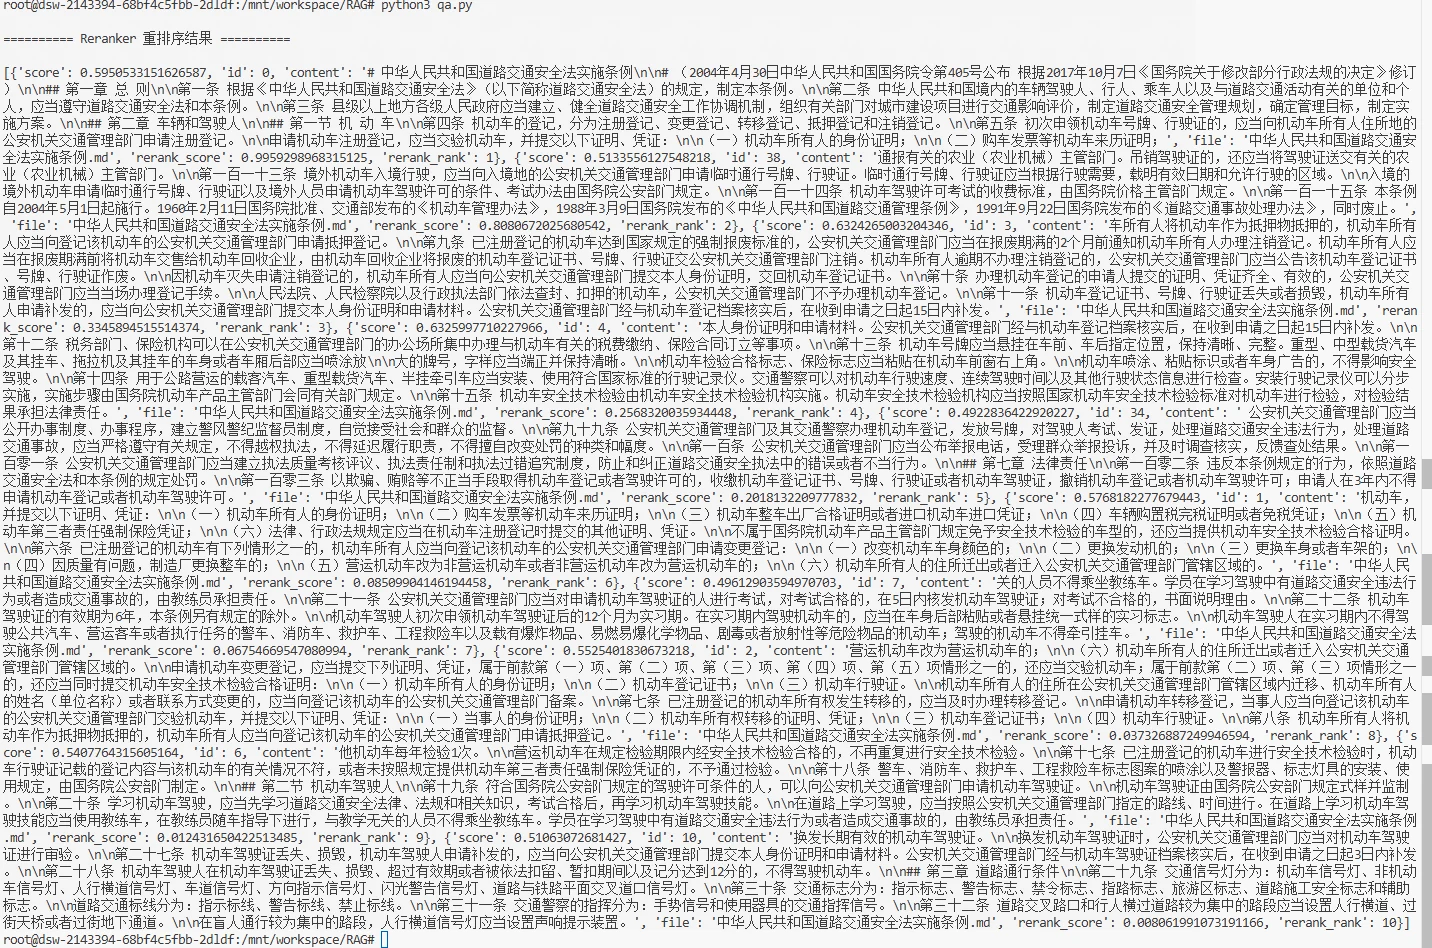
从上面两个结果可以看出,经过重排序后的Chunk,排序明显发生了变化,在实际应用中,在实际项目中,可以根据知识库规模、Chunk 长度、问题复杂程度以及实际检索效果进行调整。例如,对于答案分布在多个文档片段中的问题,可以适当增加最终保留的 Chunk 数量;也可以结合 Reranker 得分设置相关性阈值,进一步过滤相关性较低的内容。除了上述方式,实际 RAG 系统还可以采用混合检索(Hybrid Search),将向量检索与 BM25 等关键词检索方式结合,对多路召回结果进行融合后再进行重排序。
完成检索和重排序后,已经获得了与用户问题相关性较高的若干个 Chunk。接下来需要将这些内容作为参考资料,与用户问题一起提交给LLM,如果相关性满足要求,则将检索内容提交给大语言模型生成答案;如果知识库中没有找到足够相关的内容,则直接返回拒答结果,避免模型在缺少依据的情况下生成答案。
首先,在Notebook中启动大模型服务,本次实验采用Qwen3-4B模型,启动方式如下:
CUDA_VISIBLE_DEVICES=0 swift deploy \
  --model Qwen/Qwen3-4B \
  --load_args false \
  --infer_backend vllm \
  --enable_thinking false \
  --host 0.0.0.0 \
  --port 18002 \
  --api_key 123 \
  --vllm_gpu_memory_utilization 0.8 \
  --vllm_max_model_len 8000 \
  --max_new_tokens 2000
启动后显示如下,说明模型启动成功,服务启动后,即可通过 18002 端口调用 Qwen3-4B。
Reranker 会根据用户问题与候选 Chunk 的相关程度重新调整排序。本实验直接选择排名前 5 的 Chunk作为LLM的参考资料,为了使模型尽量依据知识库内容回答,可以在 Prompt 中明确限定回答范围。同时,当提供的参考资料无法回答用户问题时,要求模型直接拒答,而不是利用自身知识补充答案,prompt如下:
prompt = f"""
请根据下面的参考资料回答用户问题。

参考资料:
{context}

用户问题:
{query}

要求:
1. 仅根据参考资料回答问题;
2. 回答准确、简洁;
3. 不要补充参考资料中不存在的信息;
4. 如果参考资料无法回答该问题,请回答:
   “根据当前知识库暂时无法回答该问题。”
"""
大模型生成答案后,除了向用户返回最终回答,还可以同时返回本次回答所参考的文档来源。对于企业知识问答场景,来源信息可以帮助用户了解答案来自哪些知识库文档,在需要进一步确认时,也可以回到原始文档中查看相关内容。来源信息不需要由大模型生成,而是直接从检索结果的元数据中获取。前面构建知识库时,每个 Chunk 都保留了对应的 file 字段,因此可以从 Reranker 排名前 5 的 Chunk 中提取文件名称,并对重复的文件进行去重。
下面是调用大模型实现问答的核心代码:
llm_client = OpenAI(
    api_key="123",
    base_url="http://127.0.0.1:18002/v1"
)
LLM_MODEL = "Qwen3-4B"

def generate_answer(query, top_chunks):

    context = "\n\n".join(
        [
            f"[参考资料{i + 1}]\n{item['content']}"
            for i, item in enumerate(top_chunks)
        ]
    )
    prompt = f"""
请根据下面提供的参考资料回答用户问题。

参考资料:
{context}

用户问题:
{query}

要求:
1. 仅根据参考资料中的内容回答问题;
2. 回答应准确、简洁,不要补充参考资料中不存在的信息;
3. 如果参考资料中没有与问题相关的答案,请回答:
   “根据当前知识库暂时无法回答该问题。”
"""
    response = llm_client.chat.completions.create(
        model=LLM_MODEL,
        messages=[{"role": "user","content": prompt }],
        temperature=0.1,
        max_tokens=512
    )

    return response.choices[0].message.content
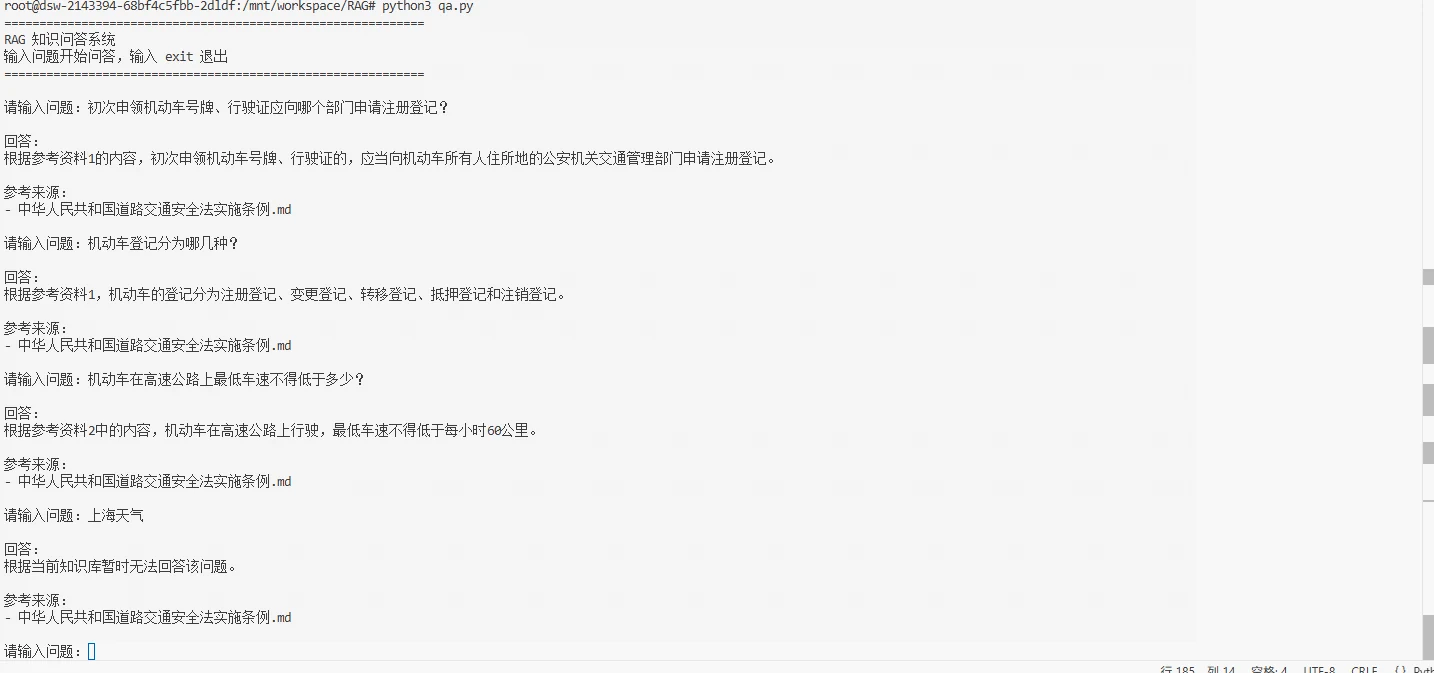
至此,一个企业问答助手已经搭建完成,下面我们可以在终端中进行简单测试,测试结果如下:
完成 RAG 系统后,还需要通过评测判断整个问答流程是否真正有效。与普通大模型问答不同,RAG 的结果同时受到知识检索和答案生成两个阶段的影响。因此,RAG 评测通常也需要从这两个方面分别进行。
1) 检索效果评测
检索阶段的评测标准是用户的问题是否可以在召回的Chunk中找到答案,常用指标为Recall@K。其中,Recall@K 是比较直观的指标,用于衡量前 K 个检索结果覆盖了多少相关文档:
Recall@K:正确的文档是否出现在前 K 个检索结果中。
Recall@K =
\frac{\text{Top K 中检索到的相关文档数量}}
{\text{所有相关文档数量}}
例如,一个问题对应 2 个正确的知识片段,在 Top 5 检索结果中找到了其中 2 个,则 Recall@5 为 100%。
2) 生成效果评测
检索到相关知识并不代表最终答案一定正确,还需要进一步评价 LLM 的生成结果,生成阶段可以重点关注答案正确性、完整性、相关性、引用准确性以及幻觉,此部分可参考第十二章中的12.3 生成任务评测指标,通过这些指标,可以判断模型是否能够准确利用检索到的知识生成答案,并进一步发现答案遗漏、内容偏差或无依据生成等问题。在实际应用中,如果检索结果已经较为准确,但生成效果仍然无法满足要求,可以考虑选择能力更强、参数规模更大的模型作为 RAG 的生成模型,以提升复杂问题的理解和回答能力。
此章节涉及到的实验数据以及实验代码,可参考:https://modelscope.cn/gallery/liucong/a895ace8-420c-4421-ba43-4e3194392a95