补充:AIGC理论知识
生成式人工智能(Artificial Intelligence Generated Content,AIGC)是近年来人工智能领域的重要发展方向。与传统的分类、预测和检索任务不同,生成式模型的目标是通过学习数据的概率分布,在文本、图像等条件的引导下生成新的内容。
从早期的生成对抗网络(GAN)、变分自编码器(VAE),到近年来广泛应用的扩散模型(Diffusion Model)和 Diffusion Transformer(DiT),生成模型在生成质量、训练稳定性、语义理解能力和推理效率等方面不断提升。在此基础上,Stable Diffusion、FLUX、Qwen-Image、Z-Image 等文生图模型进一步推动了 AIGC 在内容创作、广告设计和营销素材生产等场景中的应用。
生成式模型的本质
生成式模型(Generative Model)的核心目标,是学习训练数据中潜在的概率分布及其内在规律,并在给定条件下生成符合该分布的新样本。与分类、检索等任务不同,生成式模型并不是从预先给定的候选结果中选择一个答案,是利用已经学习到的数据规律,生成新的文本、图像、语音或视频等内容。
从概率建模的角度来看,条件生成任务可以表示为:$p(x \mid c)$表示:模型在给定条件 c的情况下,生成内容 x 的条件概率分布。例如用户输入的 Prompt、上下文、参考图像或其他控制信息;x 表示需要生成的目标内容。模型训练的过程,本质上就是学习在不同条件下,各种可能结果出现的概率;模型推理的过程,则是在这一概率分布基础上产生具体结果。
虽然大语言模型、图像生成模型和视频生成模型都属于生成式模型,但它们实现生成的具体方式并不完全相同。
以大语言模型为例,当前主流模型通常采用自回归(Autoregressive)方式生成文本。给定已有上下文后,模型预测下一个 Token 的概率分布,模型根据该概率分布选择或采样下一个 Token,并将新生成的 Token 加入上下文,继续预测后续 Token。通过不断重复这一过程,最终形成完整的文本内容。
图像生成模型则采用不同的生成机制,以扩散模型(Diffusion Model)为例,其生成过程通常从随机噪声开始,在文本提示词等条件的引导下逐步进行去噪,使随机噪声逐渐形成具有明确结构和语义的图像。无论采用自回归、扩散还是其他生成机制,其共同目标都是:学习真实数据的分布规律,并根据给定条件生成符合这些规律的新内容。
生成式模型能够生成新的内容,一个重要原因在于模型学习的并不是某一条文本或某一张图片本身,是大量训练数据之间存在的统计关系和特征规律。
例如,在学习大量饮料广告图片后,模型可能逐渐建立饮料瓶、冰块、水花、水果、背景颜色、光影以及商业摄影风格等视觉概念之间的关联。当输入“夏日青柠饮料商业广告”时,模型可以根据这些已经学习到的规律重新组织不同的视觉元素,形成新的图像结果。生成式模型的“生成”并不等同于从训练集中查找一条已有数据,是依据学习到的数据分布,对不同特征和概念进行建模与组合。
生成式模型的另一个重要特点是生成结果具有多样性。例如,对于相同的提示词一只猫坐在窗边。模型可能生成不同品种、姿态和毛色的猫,也可能采用不同的光照、背景和画面构图。这些结果在语义上都符合输入条件,但具体内容并不完全相同。产生这种现象的原因在于,Prompt 通常只是对生成内容施加一定的条件约束,不是完整规定最终结果。在给定条件下,模型学习到的概率分布中通常存在多个合理结果。在实际生成过程中,采样策略、随机种子等因素会进一步影响最终输出。与具有确定答案的传统任务不同,生成任务通常不存在唯一的最优输出,同一个输入条件可以对应多个合理的生成结果。
文本生成模型架构解析
文本生成技术在现代生成式人工智能的发展中具有重要的基础作用。一方面,大语言模型推动了AIGC 技术的快速普及;另一方面,Tokenizer、Embedding、Transformer、概率分布和采样等概念,不仅适用于文本生成,也会在后续文生图、多模态生成等任务中反复出现。特别是在当前的 AIGC 系统中,文本 Prompt 已经成为用户控制生成内容的重要方式。无论是生成一段文本、一张图片,还是一段视频,模型通常都需要首先理解用户输入的自然语言。
从文本到向量表示
自然语言本身不能直接参与神经网络计算。文本输入模型之前,首先需要经过 Tokenizer 进行切分,并转换为对应的 Token ID。Token 是语言模型处理文本的基本单位,可以是一个汉字、一个完整单词,也可以是单词的一部分,具体的切分方式由模型所采用的分词算法和词表决定。Token ID 本质上只是 Token 在词表中的编号,其数值大小并不表示 Token 之间的语义关系。例如,编号相近的两个 Token,在语义上并不一定相似。因此,在进入神经网络进行计算之前,还需要通过 Embedding 层将离散的 Token ID 映射为连续的高维向量,这种使用连续向量表示语言的思想,是现代自然语言处理的重要基础。2013 年,Mikolov 等人提出 Word2Vec,通过神经网络从大规模语料中学习词语的分布式向量表示。其基本思想来源于自然语言中的分布假设,即出现在相似上下文中的词语,通常具有相近的语义或语法特征。
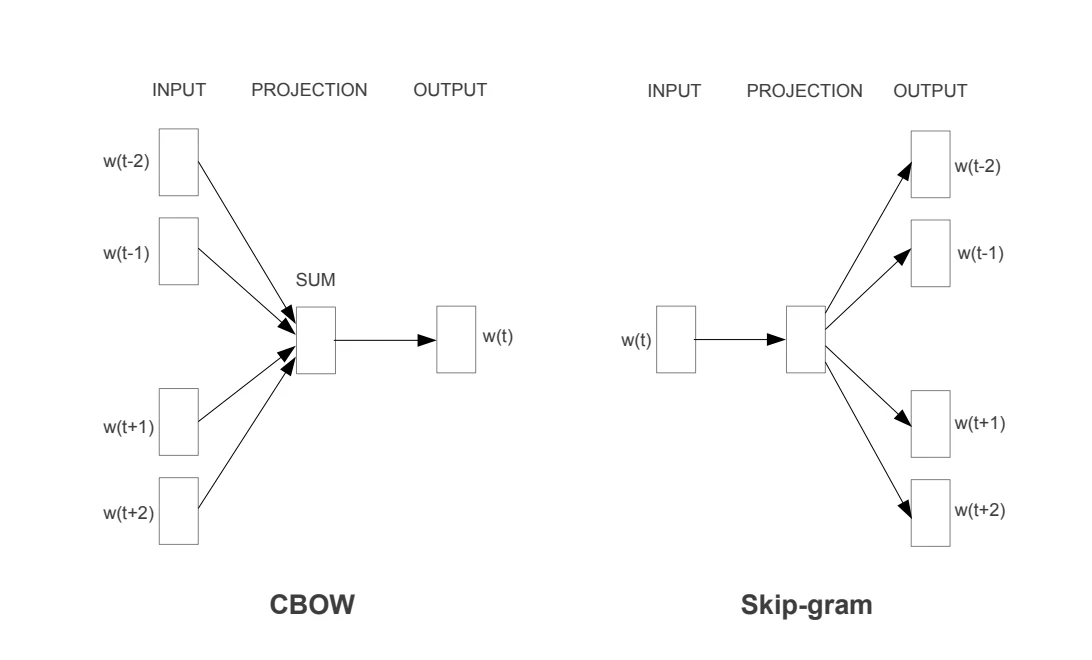
Word2Vec 主要包含两种训练结构:CBOW(Continuous Bag-of-Words)和 Skip-gram。二者均通过中心词与上下文词之间的关系学习词向量,但预测方向有所不同。
CBOW 根据上下文词预测中心词。 对于由词语组成的序列,首先选定一个中心词,并将其周围一定窗口范围内的词作为上下文。模型利用这些上下文词的向量表示预测中心词。比如,以“吃”为中心词,并选择其周围的“喜欢”和“新鲜”作为上下文。
Skip-gram 则根据中心词预测其周围的上下文词。 与 CBOW 相比,其预测方向相反。对于同一个词语序列,当“吃”作为中心词时,Skip-gram 的训练目标是根据“吃”的向量表示预测其一定窗口范围内可能出现的其他词语,例如“喜欢”“新鲜”等。CBOW 与 Skip-gram 的主要区别在于训练目标不同,CBOW利用多个上下文词预测一个中心词;Skip-gram:利用一个中心词预测多个上下文词。尽管二者的预测方向不同,其最终目的都是通过词语之间大量的共现关系学习词向量。训练完成后,每个词可以表示为一个固定维度的连续向量。
Word2Vec 的提出推动了分布式词表示的发展,但其表示方式仍然具有一定局限性。Word2Vec 学习的是典型的静态词向量(Static Word Embedding),即一个词在训练完成后通常对应一个固定的向量,而不会随着具体上下文发生变化。现代语言模型进一步采用了上下文化表示(Contextual Representation)。Token 首先通过 Embedding 层获得初始向量,随后经过多层神经网络,根据序列中其他 Token 的信息不断更新自身表示。因此,同一个 Token 在不同上下文中可以形成不同的隐藏状态,从而表达与当前语境相关的语义。Word2Vec 的重要意义不仅在于提出了一种具体的词向量训练方法,更在于推动了分布式表示在自然语言处理中的广泛应用。语言不再仅通过离散的符号或编号表示,还被映射到连续向量空间中,使神经网络能够进一步学习词语之间的语义和语法关系。后续自然语言处理技术进一步关注如何利用上下文动态调整词语表示。
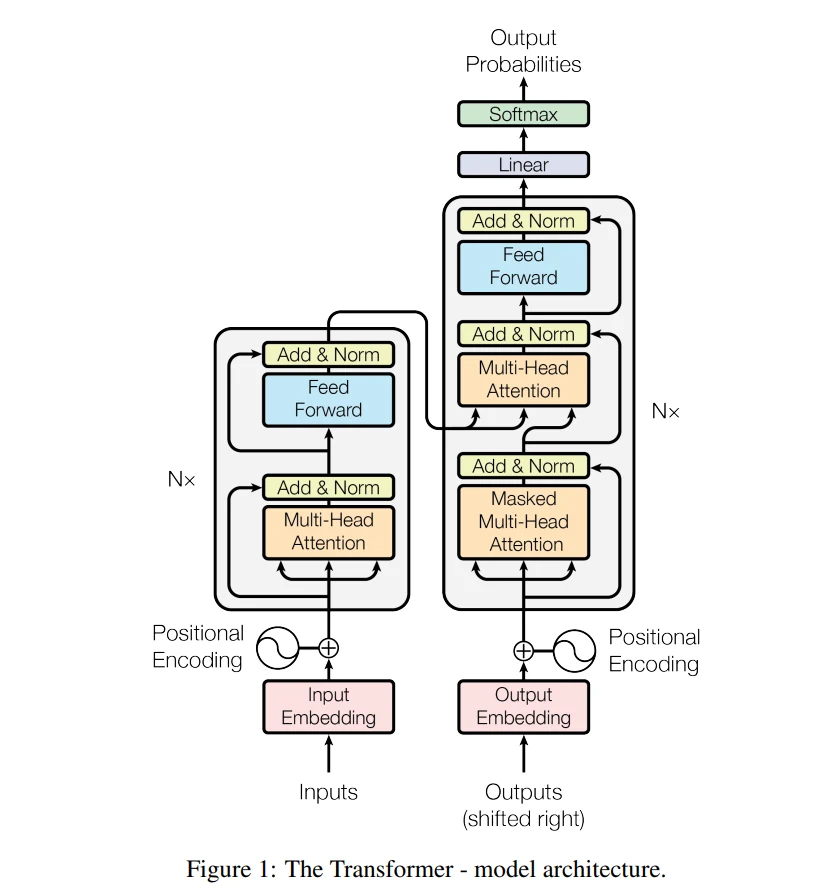
Transformer 与上下文建模 2017 年,提出 的Transformer 架构。Transformer 通过注意力机制建模序列中不同位置之间的关系,随后逐渐成为大语言模型的核心基础架构。Transformer 中最重要的机制之一是 Self-Attention,即自注意力机制,如下图:
自注意力机制的主要作用,是让模型在处理一个 Token 时,同时考虑序列中其他 Token 所包含的信息,并根据它们之间的关联程度动态分配不同的注意力权重。具体而言,每个 Token 的表示会分别映射为 Query(Q)、Key(K)和 Value(V)。模型通过 Query 与不同 Key 之间的匹配程度计算注意力权重,再利用这些权重对相应的 Value 进行加权组合,从而得到融合上下文信息后的新表示。
Transformer 通常由多个网络层堆叠构成。在不同层中,模型会不断更新各个 Token 的表示,使其逐步融合更丰富的上下文信息。经过多层 Transformer 处理之后,同一个 Token 在不同语境下可以形成不同的上下文表示,从而支持模型对词义、句法结构以及较复杂语义关系的建模。Transformer 的重要意义不仅在于引入了一种新的网络结构,更在于提供了一套能够有效建模上下文关系的机制。现代大语言模型正是在 Transformer 的基础上,通过扩大模型规模、训练数据规模以及上下文长度等方式,不断提升语言理解与生成能力。
自回归生成与解码策略 经过 Transformer 对输入序列进行上下文建模后,语言模型已经获得了包含上下文信息的 Token 表示。在此基础上,生成式语言模型需要进一步预测后续内容。GPT 等主流生成式大语言模型通常采用自回归生成(Autoregressive Generation)方式,即根据当前已经输入或生成的 Token,逐步预测并生成后续 Token。
对于一个由多个 Token 构成的序列,其生成概率可以分解为一系列条件概率:
p(x_1, x_2, \ldots, x_T) = \prod_{t=1}^{T} p(x_t \mid x_1, x_2, \ldots, x_{t-1})
其中,$x_t$ 表示当前需要生成的第 $t$ 个 Token,$x_1,x_2,\ldots,x_{t-1}$ 表示此前已经输入或生成的 Token。该公式表明,一个完整文本序列的生成过程可以分解为多个连续的下一个 Token 预测过程。
模型计算出下一个 Token 的概率分布之后,还需要通过解码策略(Decoding Strategy)确定实际输出的 Token。不同的解码策略会直接影响文本生成的稳定性、多样性和创造性。
最直接的方式是贪婪解码(Greedy Decoding),即每一步都选择当前概率最高的 Token。这种方式具有较强的确定性,但连续选择局部最高概率的 Token,并不一定能够获得整体质量最优的文本,同时生成内容也容易趋于单一。为了提高生成结果的多样性,生成式语言模型通常还可以采用随机采样,即按照模型预测的概率分布选择下一个 Token。概率越高的 Token 被选中的可能性越大,但其他合理的候选 Token 同样具有被选中的机会。在实际应用中,通常还会结合 Temperature、Top-k 和 Top-p 等方法进一步调整采样过程。
Temperature 用于调节概率分布的平滑程度,可以表示为:
p_i =
\frac{\exp(z_i / T)}
{\sum_j \exp(z_j / T)}
个 Token 对应的 Logit,$T$ 表示 Temperature。
当 $T$ 较小时,高概率 Token 的优势会进一步增强,模型更加倾向于选择概率较高的结果,生成内容通常更加稳定;当 $T$ 较大时,概率分布相对更加平缓,低概率 Token 获得更多被选择的机会,生成结果通常具有更高的多样性。
Top-k 则是在每一步生成时,仅保留概率最高的 $k$ 个候选 Token,并在这些候选 Token 中重新归一化概率后进行采样。该方法可以过滤大量概率较低的 Token,减少明显不合理内容被选中的可能性。
Top-p 不固定候选 Token 的数量,是按照概率从高到低排列,选择累计概率达到阈值 $p$ 的最小候选集合,再从该集合中进行采样。因此,Top-p 可以根据当前概率分布动态调整候选 Token 的范围。
例如,当模型对下一 Token 的预测较为确定时,少量 Token 的累计概率就可以达到设定阈值;而当模型存在多个合理候选结果时,则会保留更多 Token 参与采样。文本生成实际上包含两个紧密关联的过程:首先由语言模型根据上下文计算下一个 Token 的概率分布,再由解码与采样策略根据该概率分布确定实际生成的 Token。
型负责学习在当前上下文中哪些 Token 更有可能出现,而解码策略负责决定如何从这些候选 Token 中选择具体结果”。二者共同决定了最终文本的准确性、稳定性与多样性。
生成对抗网络(GAN)原理与局限 在深度学习生成模型的发展过程中,生成对抗网络(Generative Adversarial Network,GAN)是一类具有代表性的技术。2014 年,Goodfellow 等人提出 GAN,通过两个神经网络之间的对抗训练学习真实数据的分布规律。与传统的监督学习不同,GAN 不直接规定生成器应该输出怎样的图像,还引入一个判别器对生成结果进行评价,并利用判别结果不断改进生成器。GAN 提出后迅速应用于图像生成、人脸生成、图像风格迁移、超分辨率和图像编辑等任务,并形成了 CycleGAN、StyleGAN、ESRGAN 等一系列具有代表性的模型。
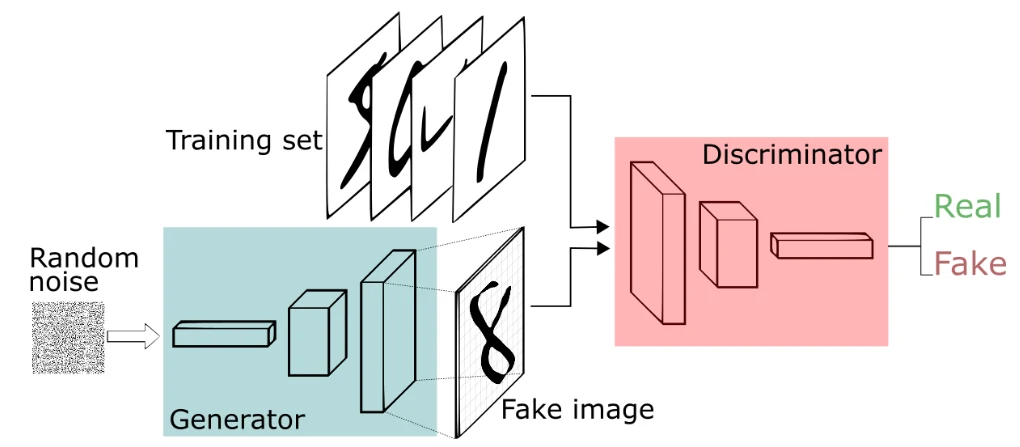
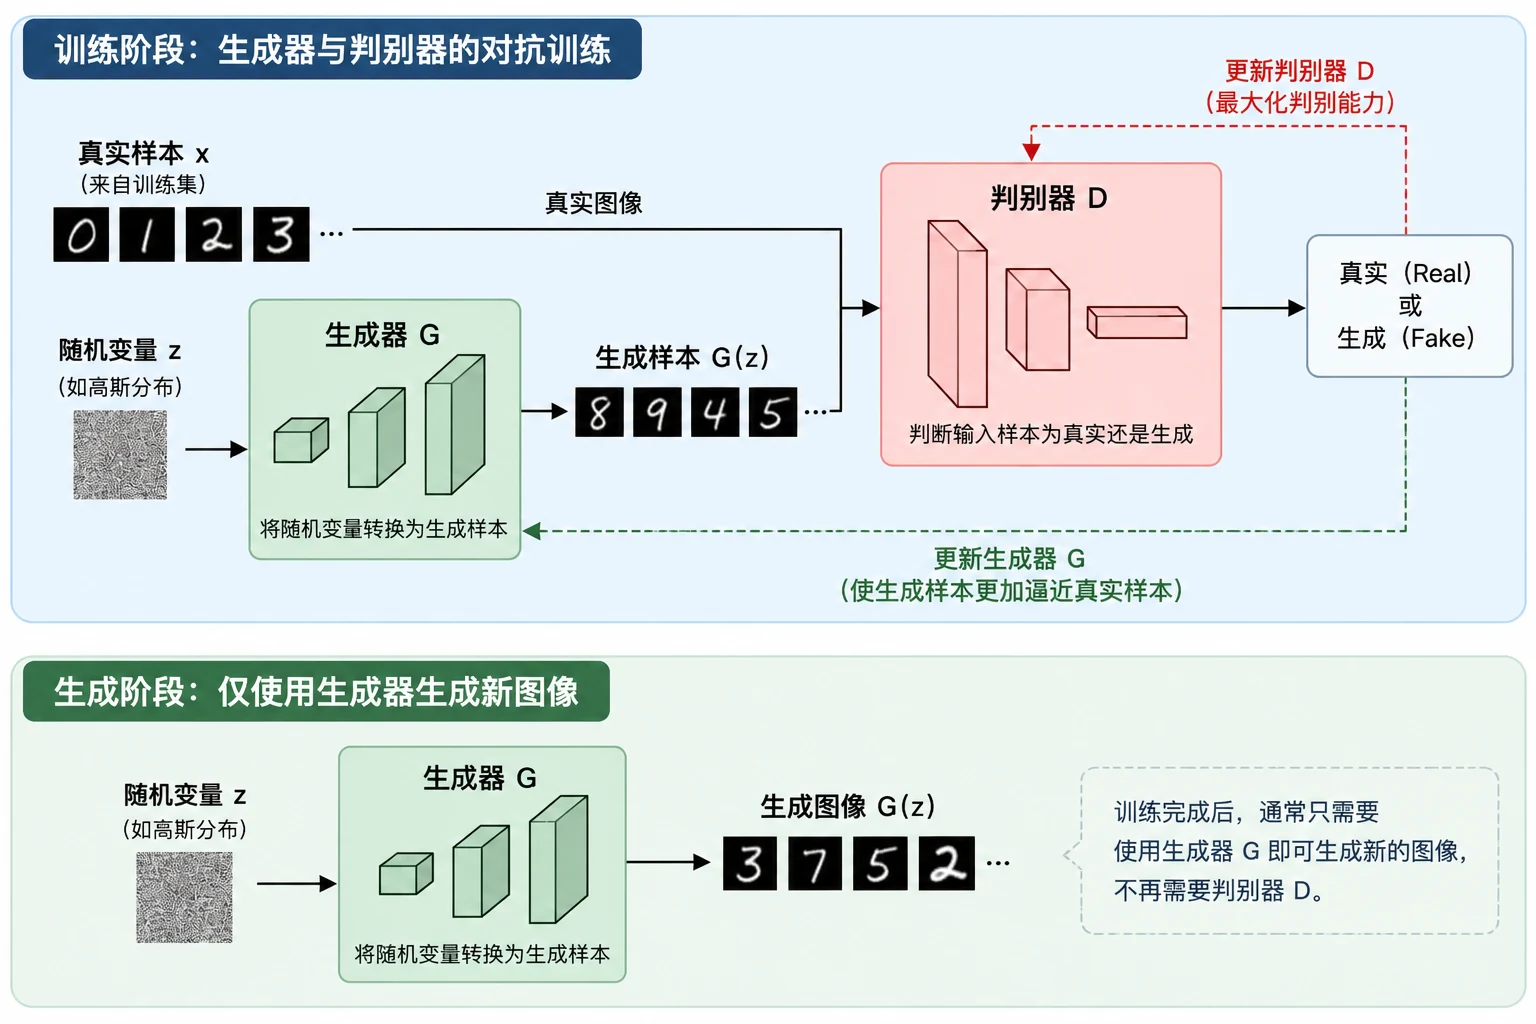
基本结构与训练机制 GAN 通过生成器(Generator)与 判别器(Discriminator)两个神经网络之间的对抗训练学习真实数据的分布,如图所示,在训练过程中,判别器同时接收来自训练集的真实样本和生成器产生的生成样本,并对两类样本进行区分;生成器则根据判别器提供的反馈不断调整自身参数,提高生成样本与真实样本之间的相似程度。
生成器记为 G。其输入通常是从某个简单概率分布中采样得到的随机变量 z,例如高斯分布或均匀分布。经过生成器的非线性映射后,随机变量被转换为生成样本:
\hat{x}=G(z), \qquad z\sim p_z(z)
在图像生成任务中,生成器的目标是将低维或高维的随机表示逐步映射为具有特定视觉结构的图像。
判别器记为 D。其输入包括训练集中的真实样本 x 和生成器产生的样本 G(z)。判别器通过学习两类数据的特征差异,输出输入样本来自真实数据分布的概率:
对于真实样本,判别器希望输出结果接近 1;对于生成样本,判别器希望输出结果接近 0。生成器与判别器具有相反的优化目标。判别器需要不断提高对真实样本和生成样本的区分能力,而生成器则需要不断提高生成样本的真实性,使生成样本在数据特征上更加接近真实样本。两个网络在交替优化过程中形成对抗关系。在原始论文中将 GAN 的训练目标定义为一个极小极大博弈(Minimax Game):
\min_G \max_D V(D,G)
=
\mathbb{E}_{x\sim p_{\mathrm{data}}(x)}
[\log D(x)]
+
\mathbb{E}_{z\sim p_z(z)}
[\log(1-D(G(z)]
其中,$p_{\mathrm{data}}$ 表示真实数据分布,$p_z$ 表示随机变量的先验分布。判别器 $D$ 通过最大化目标函数,提高对真实样本和生成样本的区分能力;生成器 $G$ 则通过优化自身参数,使生成数据的分布逐渐逼近真实数据分布。
GAN 的训练通常采用交替优化方式进行。首先利用真实样本和生成样本更新判别器 $D$,使其学习两类数据之间的差异;随后利用判别器产生的梯度信息更新生成器 $G$,使生成器逐步改善生成结果。随着训练不断进行,生成器与判别器的能力同时发生变化,从而形成一个动态的对抗学习过程。
生成器与判别器在 GAN 中承担不同的功能。判别器主要用于训练阶段,通过真假分类为生成器提供优化信号;当模型训练完成后,如果任务仅是生成新的图像,只需要使用生成器即可完成推理:
GAN 的优势与训练难点 GAN 在图像生成领域受到广泛关注,一个重要原因在于其生成过程较为直接。模型完成训练后,只需要将随机变量输入生成器,通过一次前向计算即可得到生成结果。与需要多步迭代生成的模型相比,GAN 通常具有较高的生成效率,因此在图像生成、超分辨率、视频增强以及交互式图像处理等任务中得到了广泛应用。GAN 的优势主要体现在生成阶段,其训练过程则相对复杂,主要存在以下问题。
GAN 需要同时训练生成器和判别器,两个网络具有相互对抗的优化目标。当生成器参数发生变化时,判别器面对的生成数据也随之发生变化;当判别器参数发生变化时,生成器接收到的优化信号同样会发生变化。因此,与在相对固定目标函数下进行优化的普通监督学习不同,GAN 的训练实际上是一个不断变化的动态博弈过程。如果判别器能力过强,生成样本可能很容易被识别,生成器难以获得有效的优化信号;如果判别器能力过弱,则无法准确反映真实样本与生成样本之间的差异,同样难以为生成器提供有效的训练反馈。因此,如何保持生成器与判别器之间相对稳定的训练状态,是 GAN 模型训练中的重要问题。
2)容易出现模式崩溃(Mode Collapse)
模式崩溃是 GAN 训练中的另一个典型问题。理想情况下,生成器不仅需要生成具有较高视觉质量的样本,还应当能够覆盖真实数据中的不同类型和特征。例如,假设训练数据中包含不同年龄、表情和外观特征的人脸,生成器应当能够产生具有相应多样性的人脸图像。但在实际训练过程中,生成器可能倾向于生成少数几类更容易获得判别器较高评价的样本,并不断产生相似结果。此时,单张生成图像可能具有较高的视觉质量,但大量生成结果之间的差异较小,无法充分覆盖真实数据的多样性。模式崩溃反映了生成模型中的一个重要问题:较高的单样本生成质量,并不意味着模型已经完整学习了真实数据的分布。
针对训练不稳定、模式崩溃以及生成质量等问题,研究者从网络结构、损失函数和训练策略等多个方面对 GAN 进行了改进,并形成了大量衍生模型。这些研究不仅提高了 GAN 的生成能力,也使其逐渐从基本的图像生成扩展到图像转换、可控图像编辑和图像超分辨率等不同任务。下面通过几个具有代表性的模型介绍 GAN 在这些方向中的典型应用。
GAN 的典型应用 随着 GAN 技术的发展,其应用范围逐渐从随机图像生成扩展到图像转换、图像编辑和图像增强等任务。不同模型通常针对具体任务重新设计生成器、判别器、损失函数或训练方式,从而形成具有不同功能的 GAN 衍生模型。其中CycleGAN、DragGAN、ESRGAN 和 Real-ESRGAN 分别代表了 GAN 在无配对图像转换、交互式图像编辑和图像超分辨率等方向的典型应用。
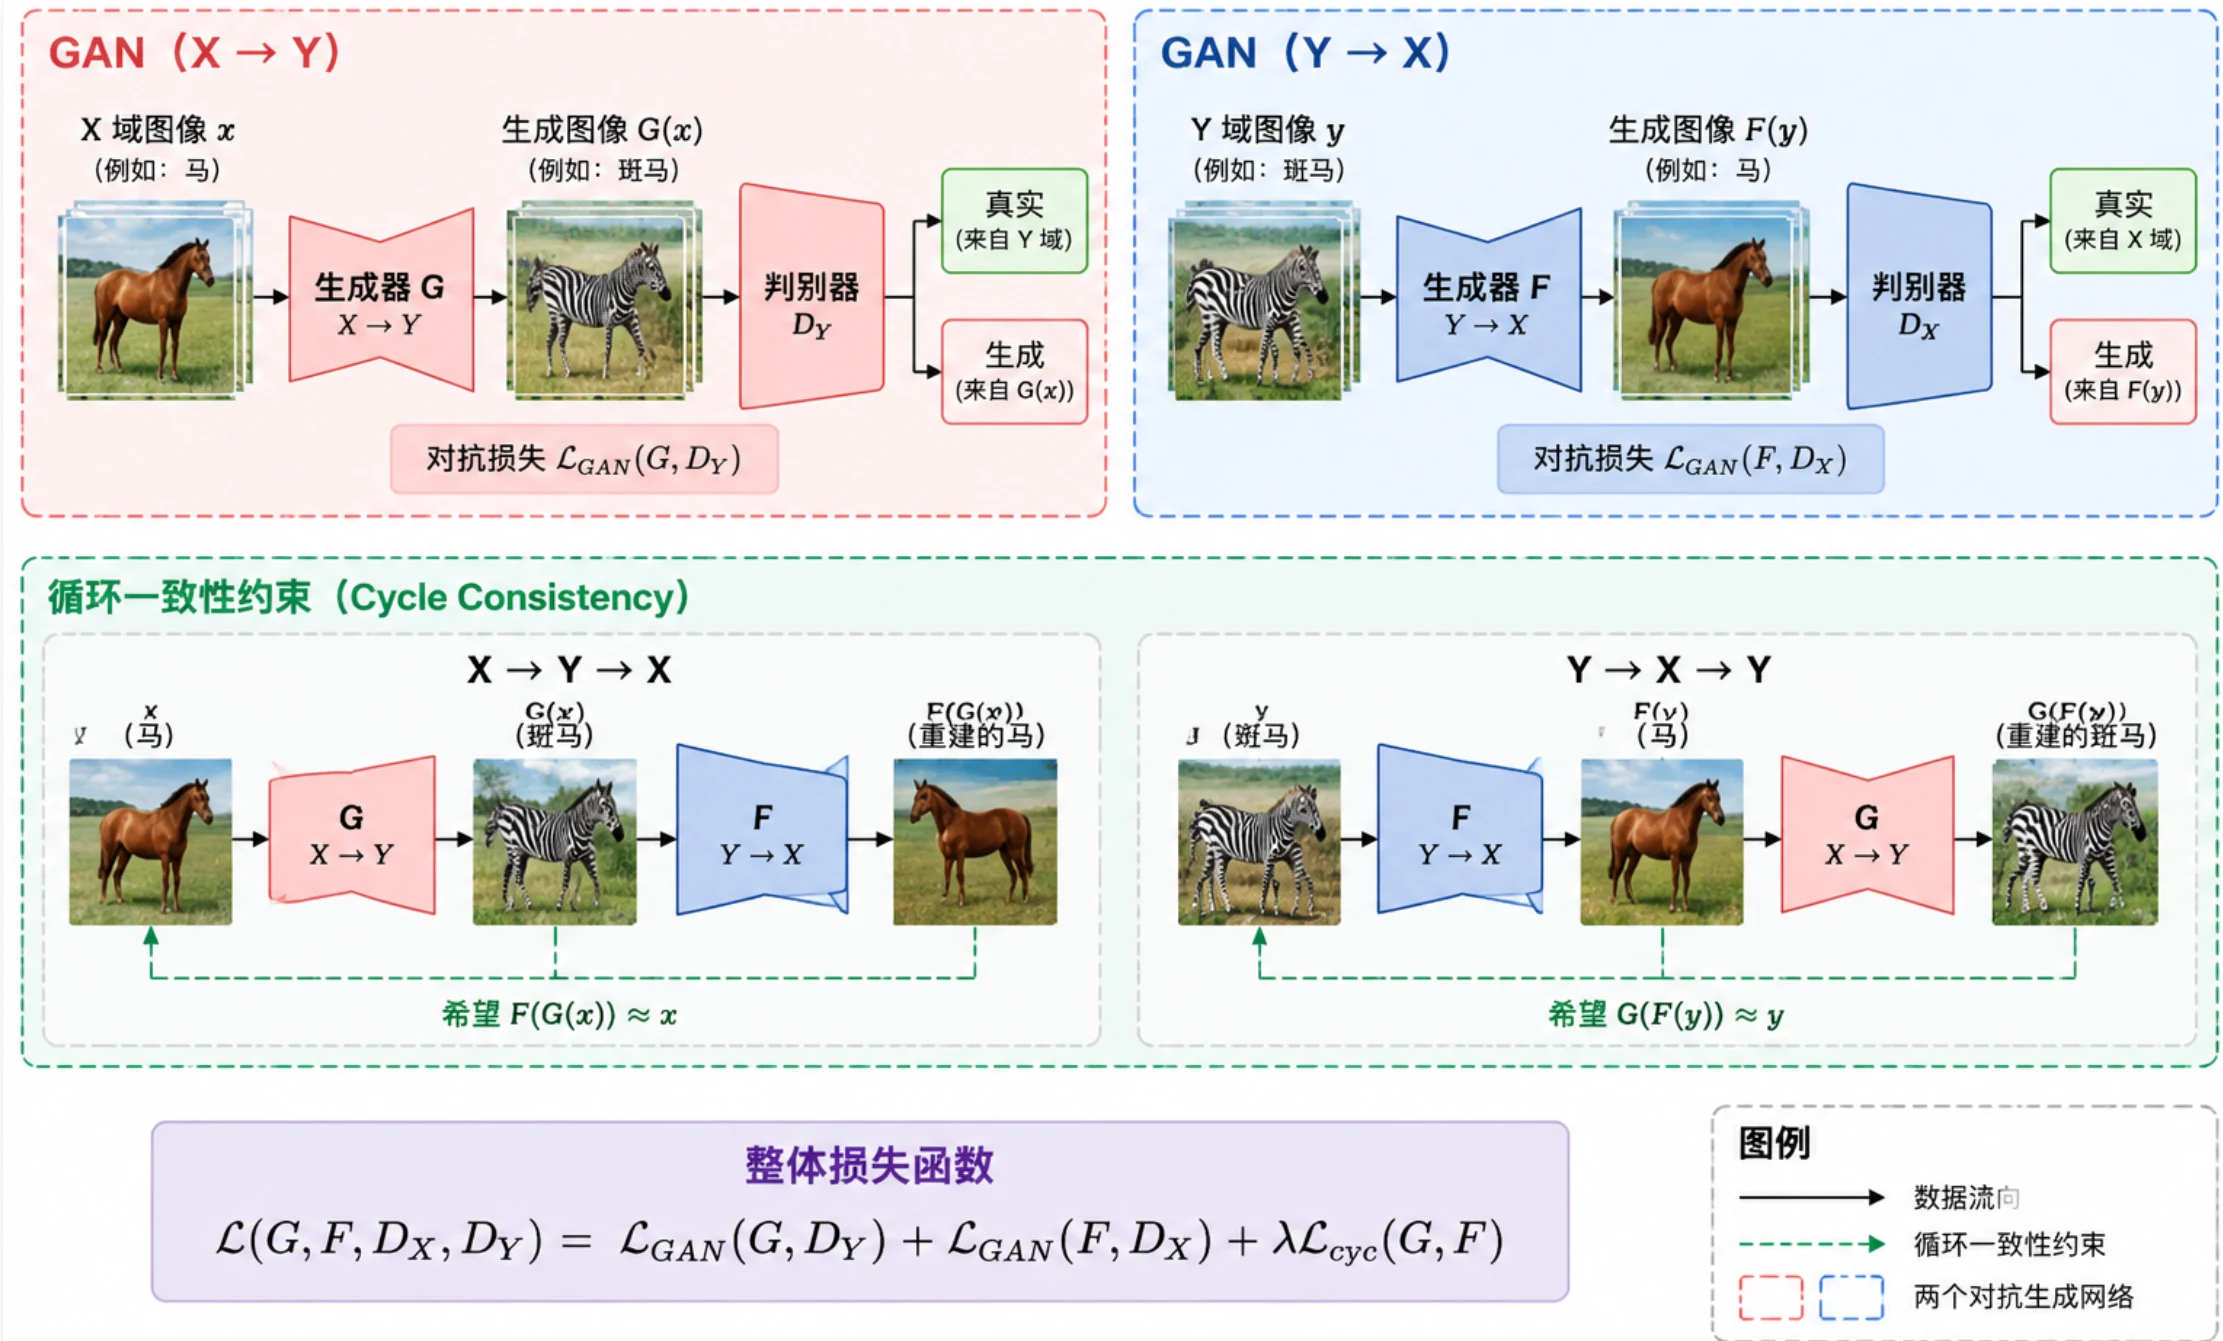
CycleGAN:无配对图像转换 2017 年,Zhu 等人提出 CycleGAN,主要用于解决无配对图像到图像转换(Unpaired Image-to-Image Translation)问题。与需要成对训练样本的图像转换方法不同,CycleGAN 不要求源图像与目标图像之间具有一一对应关系,只需要分别提供两个图像域的数据,即可学习两个图像域之间的转换关系。例如,在马 → 斑马的转换任务中,传统方法通常需要准备相互对应的马和斑马图像,而 CycleGAN 只需要分别准备一组马的图像和一组斑马的图像,无须建立两组图像之间的对应关系。如下图所示,CycleGAN 由两个生成器和两个判别器组成,并同时学习两个方向的图像转换。 假设马的图像属于图像域 $X$,斑马的图像属于图像域 $Y$,生成器 $G$ 负责完成从 $X$ 到 $Y$ 的转换,生成器 $F$ 则负责完成从 $Y$ 到 $X$ 的转换:
G:X\rightarrow Y,\qquad F:Y\rightarrow X
其中,判别器 $D_Y$ 用于判断生成的斑马图像是否符合真实斑马图像的分布,判别器 $D_X$ 则用于判断生成的马图像是否符合真实马图像的分布。因此,CycleGAN 实际包含两个方向的对抗学习过程:
仅通过两个方向的对抗训练,还不能保证转换后的图像与原始输入保持对应关系。例如,将一幅马的图像转换为斑马时,生成结果虽然可能具有真实的斑马纹理,但马的姿态、位置或背景结构可能发生较大变化。也就是不能充分保证转换前后的内容一致性。
为此,CycleGAN 进一步引入了循环一致性(Cycle Consistency)约束。如图中的下半部分所示,对于图像域 $X$ 中的马图像 $x$,首先通过生成器 $G$ 将其转换为斑马图像 $G(x)$,随后再通过生成器 $F$ 转换回马图像:
x\rightarrow G(x)\rightarrow F(G(x)
经过一次完整的正向和反向转换后,最终结果应尽可能接近原始图像:
同样,对于图像域 $Y$ 中的斑马图像 $y$,需要满足:
因此,模型形成了两个完整的转换循环:马 → 斑马 → 马,斑马 → 马 → 斑马。CycleGAN 中为了约束两个循环,模型引入循环一致性损失:
\mathcal{L}_{\mathrm{cyc}}(G,F)
=
\mathbb{E}_{x\sim p_{\mathrm{data}}(x)}
\left[\|F(G(x)-x\|_1\right]
+
\mathbb{E}_{y\sim p_{\mathrm{data}}(y)}
\left[\|G(F(y)-y\|_1\right]
其中,第一项约束马 → 斑马 → 马的重建结果,第二项约束斑马 → 马 → 斑马的重建结果。循环一致性损失越小,说明图像经过双向转换后,与原始图像的内容和结构越接近。CycleGAN 的训练主要包含对抗学习和循环一致性约束两个部分,二者共同作用,使 CycleGAN 能够在没有成对训练数据的情况下学习两个图像域之间的映射关系,从而实现马与斑马转换以及图像风格迁移等任务。
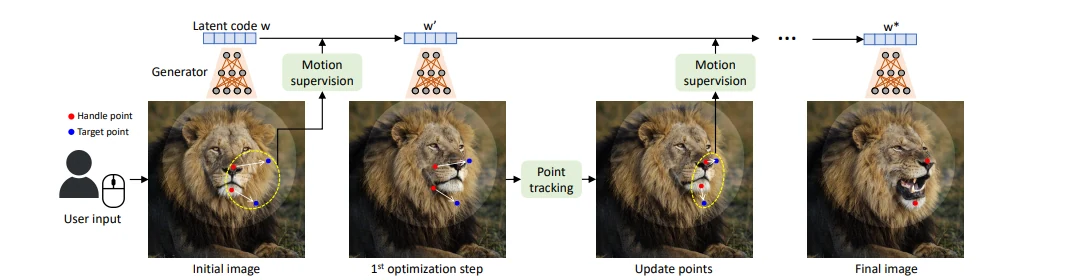
DragGAN:交互式图像编辑 2023 年,Pan 等人提出 DragGAN,通过在图像中设置控制点(Handle Point)和目标点(Target Point),实现对生成图像中物体位置、姿态和形状的交互式调整。与传统像素级编辑不同,DragGAN 没有直接移动图像中的像素,是通过调整 GAN 的潜在表示,使生成图像按照用户指定的方向发生变化。
DragGAN 的核心过程主要包括运动监督(Motion Supervision)和点跟踪(Point Tracking)两个部分。 用户首先在图像中选择需要调整的控制点,并指定其希望移动到的目标位置。例如,图中通过设置狮子嘴部附近的控制点和目标点,使狮子的嘴部逐渐张开。
在编辑过程中,DragGAN 保持预训练生成器的参数不变,不断优化输入生成器的潜在编码 $w$。初始图像可以表示为:
其中,$G$ 表示预训练的 GAN 生成器,$w$ 表示图像对应的潜在编码。通过调整 $w$,可以改变生成图像 $I$ 的内容和结构。运动监督用于推动控制点附近的图像特征向目标位置移动。经过一次优化后,潜在编码由 $w$ 更新为 $w'$,生成图像也随之发生变化。由于图像发生变化后,原来的控制点位置可能已经发生偏移,因此 DragGAN 还需要通过点跟踪重新确定控制点在新图像中的位置,再继续进行下一轮优化,也就是设置控制点与目标点→运动监督→优化潜在编码→生成新的图像→点跟踪并更新控制点→继续优化,直至接近目标位置,经过多次迭代后,控制点逐渐移动至用户指定的目标位置,最终得到编辑后的图像。由于这一过程是在 GAN 学习到的生成空间中进行优化,模型不仅会改变指定位置,还能够对周围相关结构进行相应调整。
DragGAN 的关键并不是简单地拖动像素,是将用户的拖拽操作转换为对 GAN 潜在表示的迭代优化,并通过运动监督和点跟踪控制图像中的语义结构向指定位置移动。这一方法展示了 GAN 在可控图像编辑方面的应用能力,使用户能够通过较为直观的点位操作调整物体的姿态、表情和形状等视觉属性。
ESRGAN :图像超分辨率 图像超分辨率(Super-Resolution,SR)是 GAN 的典型应用方向之一,其目标是根据低分辨率图像生成具有更高分辨率和更丰富视觉细节的图像。与简单的插值放大不同,超分辨率模型需要根据已有图像内容,对缺失的高频纹理和局部结构进行重建。2018 年,Wang 等人提出 ESRGAN[ESRGAN] ,在已有研究基础上进一步改进网络结构、对抗损失和感知损失,以改善超分辨率图像的纹理表现和视觉质量。
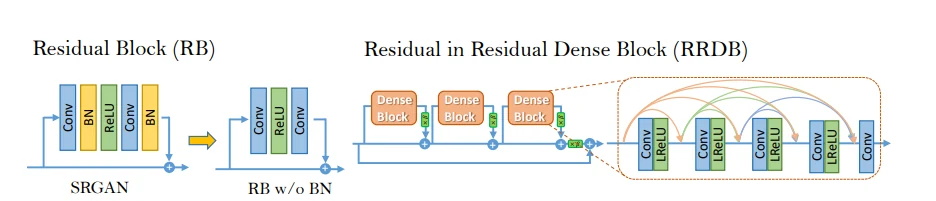
ESRGAN 在网络结构上的一个重要改进是引入 Residual-in-Residual Dense Block(RRDB)结构。 SRGAN 的生成器主要采用普通残差块(Residual Block,RB),其中包含卷积层、批归一化(Batch Normalization,BN)和激活函数。ESRGAN 首先移除了残差块中的 BN 层,并进一步将多个密集连接模块组合为 RRDB。
从图中可以看到,RRDB 内部由多个 Dense Block组成,并结合了密集连接与残差连接。在 Dense Block 内部,不同卷积层之间采用密集连接,后续层可以接收并利用前面多个层提取的特征;在多个 Dense Block 之间以及 RRDB 外部,则进一步通过残差连接传递特征。这种结构能够加强不同层之间的信息传递与特征复用,提高网络对图像纹理和细节特征的建模能力。除了网络结构上的改进,ESRGAN 还对训练目标进行了优化。传统超分辨率方法如果主要采用像素级误差进行训练,模型通常倾向于生成较为平滑的结果,虽然像素误差可能较小,但部分边缘和高频纹理容易出现模糊。ESRGAN 进一步结合感知损失和对抗训练,使生成结果在保持整体内容的同时获得更加清晰、自然的纹理细节。
生成式超分辨率并不等同于恢复已经丢失的原始信息。 当低分辨率图像中的部分高频信息已经丢失时,仅根据现有像素通常无法唯一确定原始细节。ESRGAN 实际上会结合输入图像以及训练过程中学习到的图像先验,生成视觉上合理的纹理。生成结果虽然可能更加清晰,但其中部分细节并不一定与原始高分辨率图像完全一致。这一特点使 ESRGAN 更适合强调视觉质量的图像增强任务。在医学影像、档案取证和科研图像等对信息真实性要求较高的场景中,则需要谨慎使用生成式超分辨率结果。
变分自编码器(VAE)机制与角色演变 GAN通过生成器与判别器之间的对抗训练学习真实数据分布,而变分自编码器(Variational Autoencoder,VAE)采用了另一种生成思路:首先将输入数据编码到一个连续的潜在空间,再从潜在空间中采样,并通过解码器生成或重建数据。2013 年,Kingma 和 Welling 提出了 Auto-Encoding Variational Bayes(AEVB)方法,并给出了后来广泛使用的 VAE 训练框架。VAE 将神经网络与变分推断结合,使模型能够通过端到端训练学习具有概率结构的潜在表示。
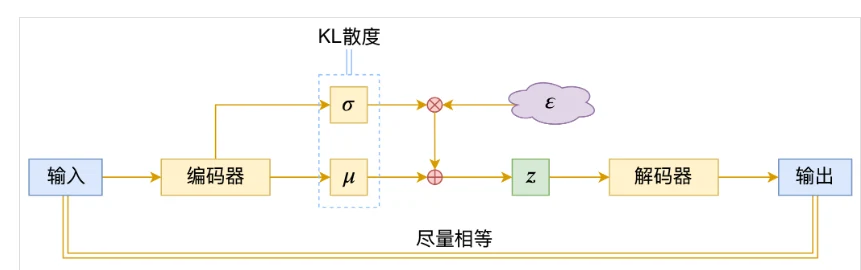
结构与训练方式 VAE 的基本结构由编码器(Encoder)和解码器(Decoder)组成。编码器负责将输入数据压缩到维度较低的潜在空间,解码器则根据潜在表示恢复输入数据。普通自编码器通常将输入 $x$ 直接编码为一个确定的潜在向量 $z$,再利用解码器进行重建。VAE 与其最大的区别在于,编码器并不直接输出一个确定的潜在向量,是输出潜在变量概率分布的参数。
上图中,VAE 的编码器并不会直接将输入数据 $x$ 转换为一个固定的潜在向量,还输出两个参数:均值 $\mu$ 和标准差 $\sigma$。这两个参数共同确定了潜在变量 $z$ 的概率分布。$\mu$ 决定潜在变量大致位于什么位置,$\sigma$ 则表示它可以在这个位置附近有多大的变化范围。
q_{\phi}(z\mid x)
=
\mathcal{N}
\left(
z;\mu_{\phi}(x),
\operatorname{diag}\left(\sigma_{\phi}^{2}(x)\right)
\right)
其中,$q_{\phi}(z\mid x)$ 表示编码器根据输入 $x$ 得到的潜在变量分布。与普通自编码器直接得到一个确定的 $z$ 不同,VAE 得到的是一个可以进行采样的分布,因此同一个输入可以在一定范围内得到不同的潜在表示。接下来,模型需要从这个分布中得到一个具体的潜在变量 $z$,再将其送入解码器。为了在引入随机性的同时保证模型能够正常进行反向传播,VAE 使用了重参数化技巧(Reparameterization Trick)。模型首先从标准正态分布中采样随机变量 $\epsilon$,然后结合编码器得到的 $\mu$ 和 $\sigma$ 计算潜在变量 $z$:
z=\mu+\sigma\odot\epsilon
可以理解为,$\mu$ 决定位置,$\sigma$ 决定变化范围,$\epsilon$ 提供随机性,三者共同得到最终的潜在变量 $z$。这种处理方式将随机采样从网络参数的计算过程中分离出来,使梯度仍然能够通过 $z$ 传递到编码器,从而实现整个 VAE 的端到端训练。得到潜在变量 $z$ 后,解码器根据 $z$ 生成重建结果 $\hat{x}$。VAE 的整个过程可以概括为:输入数据 → 编码器 → 潜在分布 → 采样得到 $z$ → 解码器 → 重建数据。
VAE 在训练过程中还需要同时考虑两个目标:一方面,希望解码器生成的结果尽可能接近原始输入;另一方面,希望不同输入对应的潜在分布不要过于杂乱,是形成一个相对连续、规则的潜在空间。为此VAE 的训练目标由重建项和 KL 散度项共同组成,通常通过证据下界(Evidence Lower Bound,ELBO)表示:
\mathcal{L}_{\mathrm{ELBO}}
=
\mathbb{E}_{q_{\phi}(z\mid x)}
\left[
\log p_{\theta}(x\mid z)
\right]
-
D_{\mathrm{KL}}
\left(
q_{\phi}(z\mid x)
\parallel
p(z)
\right)
其中,第一项可以理解为重建得好不好,用于衡量解码器能否根据 $z$ 恢复输入数据;第二项可以理解为潜在空间是否足够规则,通过 KL 散度约束编码器得到的潜在分布,使其接近预先设定的先验分布。这两个目标需要共同发挥作用。如果只关注重建效果,模型虽然可以将输入较好地恢复出来,但潜在空间可能比较分散,不方便直接从中随机采样;加入 KL 散度约束后,不同样本的潜在表示会受到统一先验分布的约束,使潜在空间更加规则,也更适合进行采样和生成。
生成能力局限 从生成过程来看,VAE 已经具备完整的生成能力。训练完成后,可以不再输入原始图像,能直接从标准正态分布中随机采样潜在变量 $z$再将 $z$ 输入解码器,即可生成新的图像。理论上,这一过程能够成立,是因为训练阶段通,过 KL 散度不断约束编码器产生的潜在分布,使其接近预先设定的标准正态分布。但在实际训练中,编码器产生的潜在分布通常难以与标准正态分布完全一致。如果约束过强,虽然潜在空间更加规则,却可能损失部分图像信息;如果约束过弱,又可能导致潜在空间分布不够规则,使直接从标准正态分布中随机采样得到的 $z$ 落在模型不熟悉的区域,进而影响解码结果。
与此同时,VAE 需要在重建质量和潜在空间规则性之间进行平衡。经典 VAE 的训练目标更强调对整体数据分布和潜在空间的建模,在图像生成过程中容易损失部分高频纹理和局部细节,生成结果往往比较平滑。这也是VAE 与 GAN 在图像生成效果上的一个明显区别。GAN 通过判别器直接约束生成图像的真实性,通常能够产生更加锐利的纹理;VAE 则更加关注潜在空间的连续性和概率结构,在直接生成高质量图像方面存在一定局限。
在现代模型中的作用 随着生成模型的发展,VAE 的作用逐渐从直接生成最终图像转变为图像空间与潜在空间之间的编码和解码工具。其中,一个具有代表性的应用就是潜在扩散模型(Latent Diffusion Model,LDM),早期扩散模型直接在像素空间中进行加噪和去噪。当图像分辨率较高时,模型需要反复处理大量像素,计算成本较高。Rombach 等人提出的潜在扩散模型将扩散过程转移到经过压缩的潜在空间中,从而降低扩散模型需要处理的数据维度。在这一结构中,首先利用编码器将原始图像压缩为潜在表示:原始图像 → Encoder → 潜在表示,这些潜在表示不再直接保存每一个像素,而是以更紧凑的形式保留图像中的主要结构和视觉信息。随后,扩散模型在这一潜在空间中进行加噪和去噪,而不再直接处理原始高分辨率图像。当扩散模型完成生成后,再利用解码器将生成的潜在表示恢复到像素空间,也就是生成的潜在表示 → Decoder → 最终图像。VAE 负责压缩和还原图像,扩散模型负责在潜在空间中生成图像内容。这种方式充分利用了 VAE 的潜在表示能力。扩散模型处理的不再是高维的原始像素,是经过压缩后的图像特征,从而显著降低后续扩散和去噪过程的计算量。
VAE 本身在直接生成高质量图像方面存在一定局限,但其编码器、潜在空间和解码器结构却成为现代潜在扩散模型的重要组成部分。这也体现了 VAE 角色的变化:从独立的生成模型,逐渐演变为高质量图像生成系统中的潜在表示模块。
扩散模型原理与技术突破 GAN 通常利用生成器通过一次前向计算完成图像生成,VAE 也可以从潜在变量出发,通过解码器直接得到生成结果。对于复杂的高维图像而言,让模型一次完成从随机变量到完整图像的映射并不是一件容易的事情。扩散模型(Diffusion Model)采用了不同的思路,将复杂的图像生成任务拆分为多个相对简单的步骤,每一步只对当前结果进行少量调整,经过多次迭代后逐渐得到完整图像。不要求模型一步生成最终结果,是通过多次去噪逐步完成生成。
扩散与去噪的基本原理 扩散模型主要包含两个方向相反的过程:前向扩散和反向去噪。前向扩散从真实数据 $x_0$ 开始,不断向其中加入少量随机噪声。随着时间步 $t$ 增大,图像中的原始信息逐渐减少,噪声逐渐增加,最终接近随机高斯噪声。真实图像 → 少量噪声 → 更多噪声 → …… → 随机噪声,在经典 DDPM 中,可以直接根据原始数据 $x_0$ 构造任意时间步的带噪数据:
x_t
=
\sqrt{\bar{\alpha}_t}x_0
+
\sqrt{1-\bar{\alpha}_t}\epsilon
\epsilon\sim\mathcal{N}(0,I)
表示原始数据,$\epsilon$ 表示随机高斯噪声,$\bar{\alpha}_t$ 用于控制当前时间步中原始数据与噪声所占的比例。时间步越靠后,原始信息越少,噪声越多。不同时间步对应不同的噪声水平(Noise Level),而这些噪声水平如何变化,则由噪声调度策略决定。
前向扩散本身并不需要模型学习。训练时可以按照预先定义的规则直接构造不同噪声程度的数据。模型真正需要学习的是相反的过程,即如何从带噪数据中逐渐恢复出更加清晰的数据。生成时,模型从随机噪声出发,每一步只进行一定程度的去噪:随机噪声→初步结构→轮廓逐渐清晰→纹理逐渐形成→最终图像。这种机制将一次完成的复杂生成任务拆分成多个相对简单的局部修正任务。模型不需要一次预测出完整图像,需要不断根据当前状态进行调整,这也是扩散模型能够实现高质量生成的重要原因之一。
DDPM 的训练与生成机制 经典 DDPM 中是建立两个方向相反的过程:前向扩散过程不断向真实数据中加入噪声,而反向生成过程则学习如何逐步去除噪声,使随机噪声最终恢复为具有真实数据特征的图像。
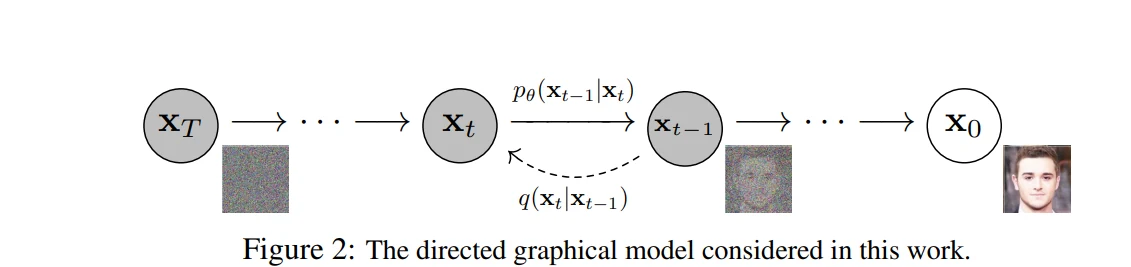
$x_0$ 表示真实图像,随着前向扩散不断加入高斯噪声,数据依次经过 $x_1,x_2,\ldots,x_T$,最终 $x_T$ 接近随机高斯噪声。图中的虚线 $q(x_t\mid x_{t-1})$ 表示前向扩散过程,而 $p_\theta(x_{t-1}\mid x_t)$ 表示模型需要学习的反向生成过程。前向过程可以理解为:真实图像 x₀ → x₁ → x₂ → …… → xₜ → …… → 随机噪声 xT,而真正生成图像时,则沿着相反方向进行:随机噪声 xT → …… → xₜ → xₜ₋₁ → …… → 最终图像 x₀。DDPM 的关键问题如何让模型学会从当前的 $x_t$ 得到噪声更少的 $x_{t-1}$。
在DDPM 中,反向过程由神经网络进行参数化。一种重要且常用的实现方式,是让神经网络预测 $x_t$ 中所加入的噪声。训练时,从真实图像 $x_0$ 出发,随机选择一个时间步 $t$,并采样高斯噪声
\epsilon\sim\mathcal{N}(0,I)
,根据前向扩散过程,可以直接构造时间步 $t$ 对应的带噪图像:
x_t
=
\sqrt{\bar{\alpha}_t}x_0
+
\sqrt{1-\bar{\alpha}_t}\epsilon
随后,将带噪图像 $x_t$ 和时间步 $t$ 输入神经网络,由模型预测其中的噪声
,这里的 $\theta$ 表示神经网络的参数。由于训练过程中加入的真实噪声 $\epsilon$ 是已知的,可以直接比较模型预测的噪声与真实噪声之间的差异。DDPM 的训练过程可以理解为:先主动给真实图像加入不同程度的噪声,再训练模型识别其中加入了哪些噪声。模型经过大量训练后,就能够处理不同时间步、不同噪声程度的数据,并利用噪声预测结果构造图中所示的反向过程 $p_\theta(x_{t-1}\mid x_t)$。生成阶段则不再需要真实图像,是直接从高斯噪声开始,模型首先根据 $x_T$ 得到噪声更少的 $x_{T-1}$,再根据 $x_{T-1}$ 得到 $x_{T-2}$,如此反复
x_T
\rightarrow
x_{T-1}
\rightarrow
x_{T-2}
\rightarrow
\cdots
\rightarrow
x_1
\rightarrow
x_0
随着反向过程不断进行,随机噪声中逐渐出现图像的整体结构、轮廓和纹理,最终得到完整的生成图像。DDPM 并不是让模型一次从噪声预测出完整图像,是学习多个噪声水平下的去噪能力,再通过多次反向迭代逐渐完成生成。 这种方式降低了单次生成任务的难度,也避免了 GAN 中生成器与判别器之间的对抗训练。不过,多步采样意味着生成一张图像需要多次执行神经网络推理,因此推理速度较慢也成为经典 DDPM 的主要局限之一。
从 DDPM 到 Flow Matching DDPM 将图像生成描述为一个逐步去噪过程,训练时向真实数据中加入噪声,并让模型学习预测噪声;生成时则从随机噪声出发,通过多次反向去噪逐渐得到图像。Flow Matching采用了另一种描述方式。在随机噪声分布与真实数据分布之间构造一条连续的概率路径,并训练模型学习这条路径上的变化方向,使随机噪声能够沿着学习到的方向逐渐转换为真实数据。
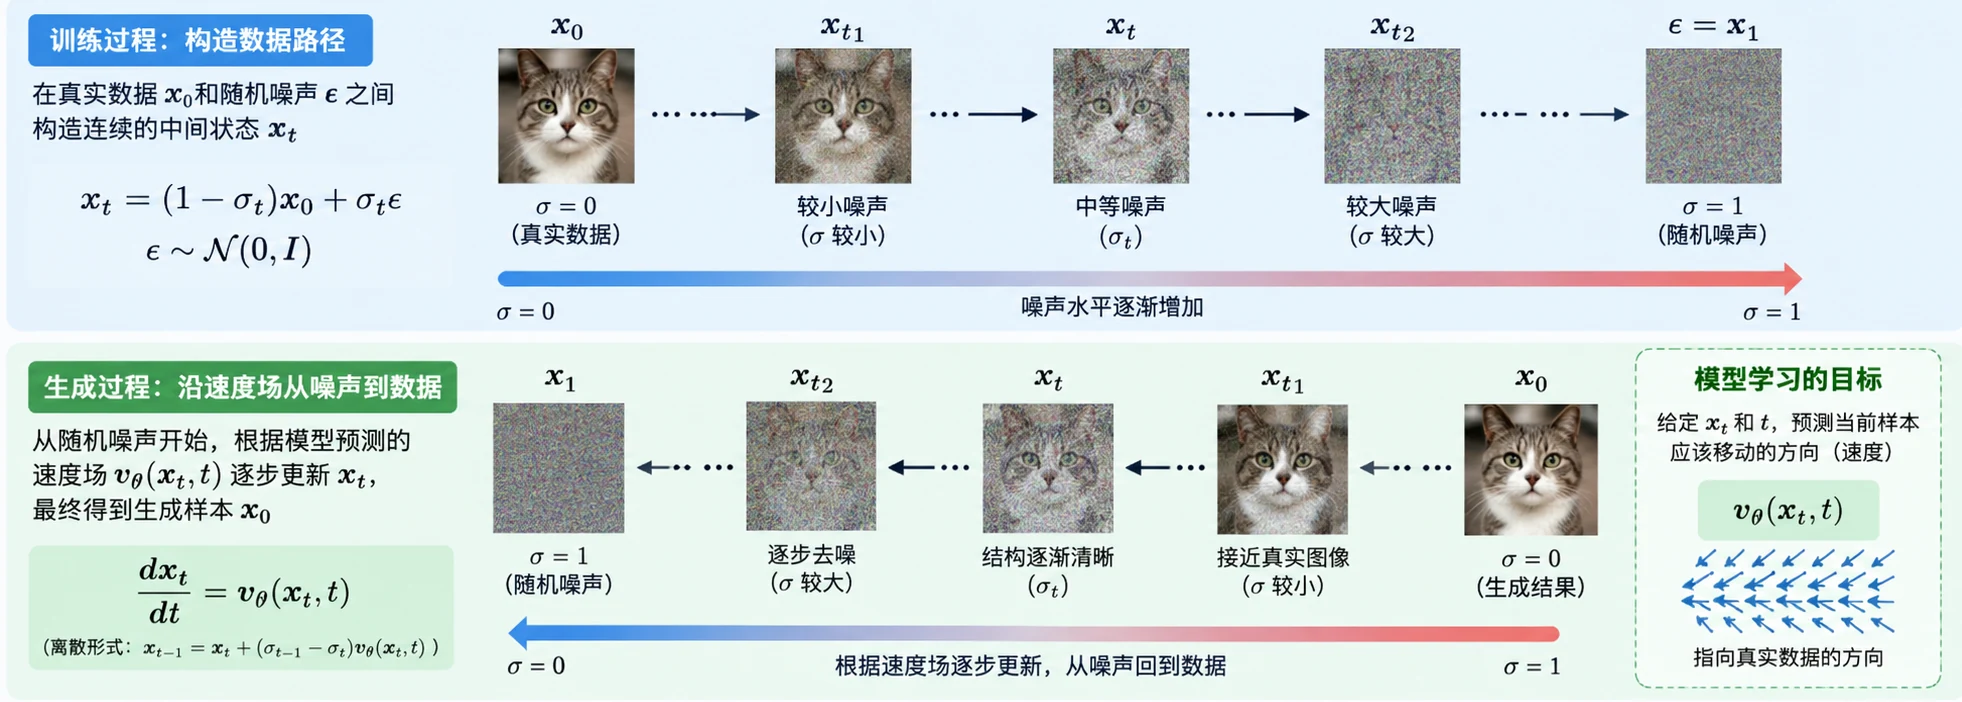
从实现过程来看,Flow Matching 主要包括路径构造、速度场学习和生成采样三个阶段。
训练时,首先从真实数据分布中采样一个样本 $x_0$,同时从标准高斯分布中采样随机噪声 $\epsilon$,为了建立真实数据与随机噪声之间的联系,可以在二者之间构造一系列连续的中间状态。一种较为直观的方式是采用线性插值:
x_t=(1-\sigma_t)x_0+\sigma_t\epsilon
,其中,$\sigma_t$ 用于控制真实数据与随机噪声在当前状态中的比例。为便于说明,可以令:
\sigma_0=0,\qquad \sigma_1=1
此时对应真实数据;当 $\sigma_t=1$ 时:
随着 $\sigma_t$ 从 0 逐渐增加到 1,$x_t$ 可以表示真实数据与随机噪声之间的一系列连续中间状态:真实数据 → 少量噪声 → 中等噪声 → 大量噪声 → 随机噪声,训练时通过随机选择不同的 $t$,可以得到不同位置的中间状态,从而为模型学习整条路径上的变化规律提供训练样本。与 DDPM 中预先定义的逐步加噪过程相比,Flow Matching 更关心如何定义连接两个分布的连续路径,以及数据沿这条路径应该如何变化。
构造出连续路径后,下一步需要确定数据在路径上的变化方向和变化速度。Flow Matching 使用神经网络学习一个速度场(Velocity Field)
,其中,$x_t$ 表示当前中间状态,$t$ 表示当前所处的时间位置,$v_\theta(x_t,t)$ 表示模型预测的当前位置对应的变化速度。对于前面的线性路径:
x_t=(1-\sigma_t)x_0+\sigma_t\epsilon
训练过程中,可以根据已知的真实数据 $x_0$ 和随机噪声 $\epsilon$ 得到目标速度,并训练神经网络根据当前状态 $x_t$ 和时间 $t$ 预测相应的速度。Flow Matching 的训练目标也就是给定路径上的中间状态 $x_t$ 和时间 $t$,训练模型预测该位置对应的数据变化速度。当模型在大量训练样本上学习之后,不同位置对应的速度共同构成一个速度场。这个速度场描述了数据空间中不同位置应该如何变化,从而为后续从随机噪声生成数据提供方向。
训练阶段建立了真实数据与随机噪声之间的路径,并学习了路径上的速度场。生成阶段则从随机噪声出发,利用学习到的速度场逐渐向真实数据分布移动。这一过程可以表示为:随机噪声 → 中间状态 → 数据结构逐渐形成 → 最终生成数据,
x_{t-1}
=
x_t+
(\sigma_{t-1}-\sigma_t)
v_\theta(x_t,t)
模型在每个时间步根据当前状态重新预测速度,并更新 $x_t$。经过多次迭代后,初始随机噪声逐渐转变为具有完整结构和语义信息的生成数据。
从建模方式来看,DDPM 与 Flow Matching 都以简单的随机分布作为生成起点,但二者对生成过程的描述有所不同。DDPM 主要通过前向扩散和反向去噪描述数据变化,通常学习噪声预测;Flow Matching 则通过构造连接噪声与真实数据的连续路径,学习路径上的速度场,再从随机噪声出发沿速度场逐步生成数据。
文生图的演进 文生图(Text-to-Image)是指根据自然语言描述自动生成对应图像。与普通图像生成相比,文生图不仅要求模型能够生成具有较高视觉质量的图像,还需要正确理解文本中的主体、属性、数量、位置、风格以及不同对象之间的关系。在文生图的发展过程中,技术关注点也逐渐能否根据文字生成图像”,转向能否准确理解复杂指令,并以更高质量、更高效率和更强可控性完成生成。
早期探索到扩散模型 早期文生图研究主要基于 GAN 等生成模型。其基本方法是先将文本编码为向量,再将文本特征作为条件输入生成器,使生成结果与文本描述保持一致。这一阶段证明了文生图的可行性,但早期 GAN 在复杂场景生成、文本语义理解以及训练稳定性等方面仍存在明显限制。特别是当提示词中包含多个主体、复杂空间关系或较长文本描述时,模型较难准确还原其中的全部语义。2021 年,OpenAI 发布 DALL·E,使用基于 Transformer 的自回归方式处理文本和图像 Token,使文生图模型在复杂概念组合、属性控制等方面取得明显进展,也推动了大规模文生图模型的发展。与此同时,扩散模型开始进入文生图领域。GLIDE 将文本条件与扩散模型结合,并研究了 CLIP Guidance 和 Classifier-Free Guidance 等文本引导方式,表明扩散模型能够在文本控制下生成具有较高视觉质量的图像。2022 年,Google 提出的 Imagen 进一步将大型语言模型的文本理解能力与扩散模型的图像生成能力结合起来。Imagen 使用预训练的 T5 作为文本编码器,将 Prompt 转换为文本语义表示,再将其作为条件输入扩散模型。研究表明,增强文本编码器的语义理解能力,可以进一步提高生成图像与文本描述之间的一致性。随着 DALL·E、GLIDE 和 Imagen 等模型的发展,文生图逐渐形成了较为明确的技术流程:文生编码器→文本语义表示→扩散生成模型→逐步去噪→生成图像;扩散模型凭借较好的生成质量和训练稳定性,逐渐成为文生图领域的重要技术路线。
潜在扩散与 Stable Diffusion 早期扩散模型通常直接在像素空间中进行多次加噪和去噪。当图像分辨率不断提高时,直接处理大量像素会带来较高的训练和推理成本。2022 年,Rombach 等人提出潜在扩散模型(Latent Diffusion Model,LDM),将扩散过程从像素空间转移到经过压缩的潜在空间中,可以参考14.4.3中LDM介绍。Stable Diffusion 的重要意义不仅在于提高了文生图质量,更在于推动了开放权重文生图生态的发展。围绕其潜在扩散架构,逐渐形成了 LoRA、ControlNet、图生图、局部重绘等大量扩展技术,使文生图从单纯的图片生成逐渐发展为完整的视觉内容生产体系。
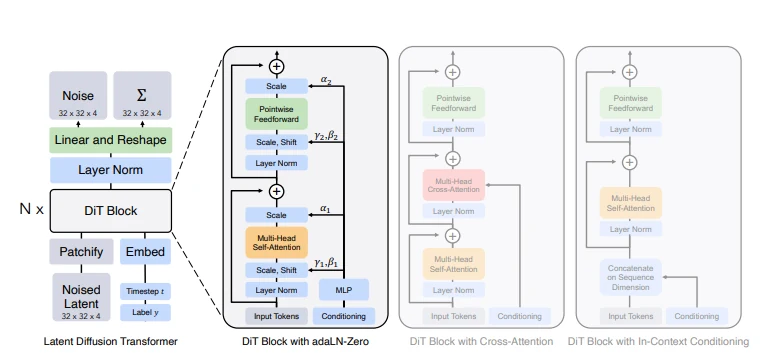
从 U-Net 到 Diffusion Transformer 早期扩散模型通常采用 U-Net 作为去噪网络。U-Net 通过多尺度特征提取和跳跃连接,能够较好地保留图像的空间结构,因此长期作为扩散模型的重要骨干网络。随着生成模型规模不断扩大,研究者开始探索使用 Transformer 替代 U-Net,以获得更好的模型扩展能力。2022 年,Peebles 和 Xie 提出了 Diffusion Transformer(DiT),使用 Transformer 替代扩散模型中常用的 U-Net 骨干网络。模型首先将潜在空间中的图像表示划分为多个 Patch,并将其转换为 Token 序列,再利用 Transformer 对这些 Token 进行建模,DIT架构图如下:
DiT 的研究进一步表明,可以通过增加 Transformer 的深度、宽度以及输入 Token 数量扩大模型的计算规模。在原论文实验中,随着模型计算量增加,生成质量总体呈现持续改善的趋势,说明 Transformer 架构在扩散模型中具有较好的可扩展性。DiT 的意义并不仅在于将 U-Net 替换为 Transformer,更重要的是为后续大规模图像生成模型提供了一种新的基础架构。此后,Transformer 逐渐成为文生图模型的重要技术路线,并进一步发展出同时处理文本 Token 与图像 Token的多模态 Transformer 架构,为 Stable Diffusion 3、FLUX.1 等新一代文生图模型的发展奠定了基础。
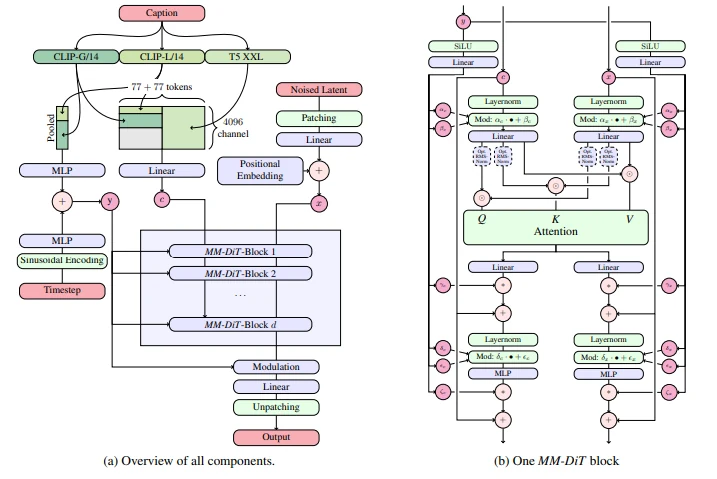
Flow Matching 与新一代文生图模型 随着 Transformer 逐渐成为文生图模型的重要骨干网络,图像生成过程本身也在不断演进。前面介绍的 DDPM 主要通过“前向加噪—学习反向过程—逐步去噪”描述数据生成,而 Flow Matching 则从连续概率路径和速度场的角度描述简单分布向真实数据分布的转换过程。2024 年,Stable Diffusion 3 相关研究将 Rectified Flow 与 Transformer 进一步结合,用于高分辨率文生图。该工作提出了新的 Multimodal Diffusion Transformer(MMDiT)架构。
与早期 DiT 主要处理图像潜在 Token 不同,MMDiT 分别对文本和图像表示使用独立的参数进行处理,同时通过联合注意力实现两种模态之间的信息交互,从而增强模型对文本内容、文字渲染以及复杂提示词的理解能力。同年发布的 FLUX.1 延续了 Transformer 与 Flow Matching 相结合的技术路线。FLUX.1 系列模型采用由多模态 Transformer Block 和并行 Diffusion Transformer Block组成的混合架构,并基于 Flow Matching 进行训练。公开的 FLUX.1 模型规模达到 12B 参数,进一步体现了 Transformer 图像生成模型向大规模化发展的趋势。从这一阶段开始,文生图模型的技术重点已经不再局限于提高图像的视觉质量,而是逐渐向复杂 Prompt 理解、图中文字生成、高分辨率生成、少步采样和图像编辑等方向扩展。文本与图像也开始更多地以 Token 的形式进入 Transformer,通过注意力机制实现跨模态信息交互。这一变化也为后续更加高效和统一的多模态生成模型奠定了基础。
高效生成与统一多模态的发展 随着文生图模型规模和生成质量不断提高,模型的实际应用开始面临新的问题。一方面,大规模生成模型通常需要较高的计算资源和较多的采样步骤;另一方面,实际 AIGC 应用已经不再局限于单一的文生图任务,还需要同时支持图像理解、图像生成、图像编辑以及参考图生成等能力。因此,降低生成成本和统一多模态能力逐渐成为文生图模型的重要发展方向。
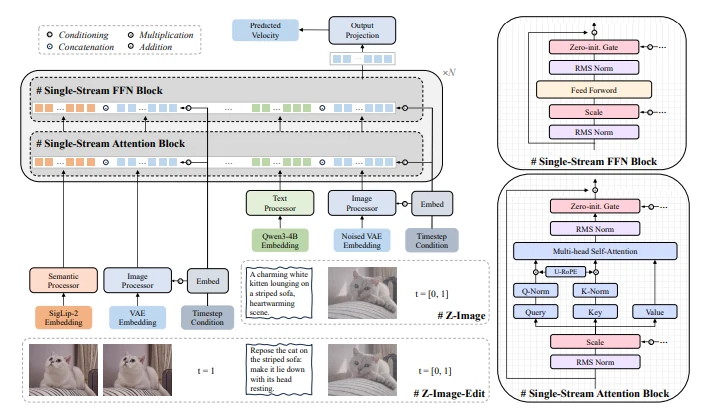
Z-Image系列采用 Scalable Single-Stream Diffusion Transformer(S3-DiT) 架构,模型规模为 6B 参数。S3-DiT 的一个重要特点是采用单流(Single-Stream)架构,将文本 Token、视觉语义 Token 和图像 VAE Token 在序列维度进行拼接,然后输入统一的 Transformer 进行处理。与分别处理不同模态的双流结构相比,这种方式能够在统一的数据流中完成不同类型信息之间的交互。Z-Image-Turbo 体现了现代文生图模型的一个重要发展方向:在保持较强生成能力的同时,通过模型蒸馏和少步采样降低推理成本,使大规模 Transformer 图像生成模型更加适合实际部署。
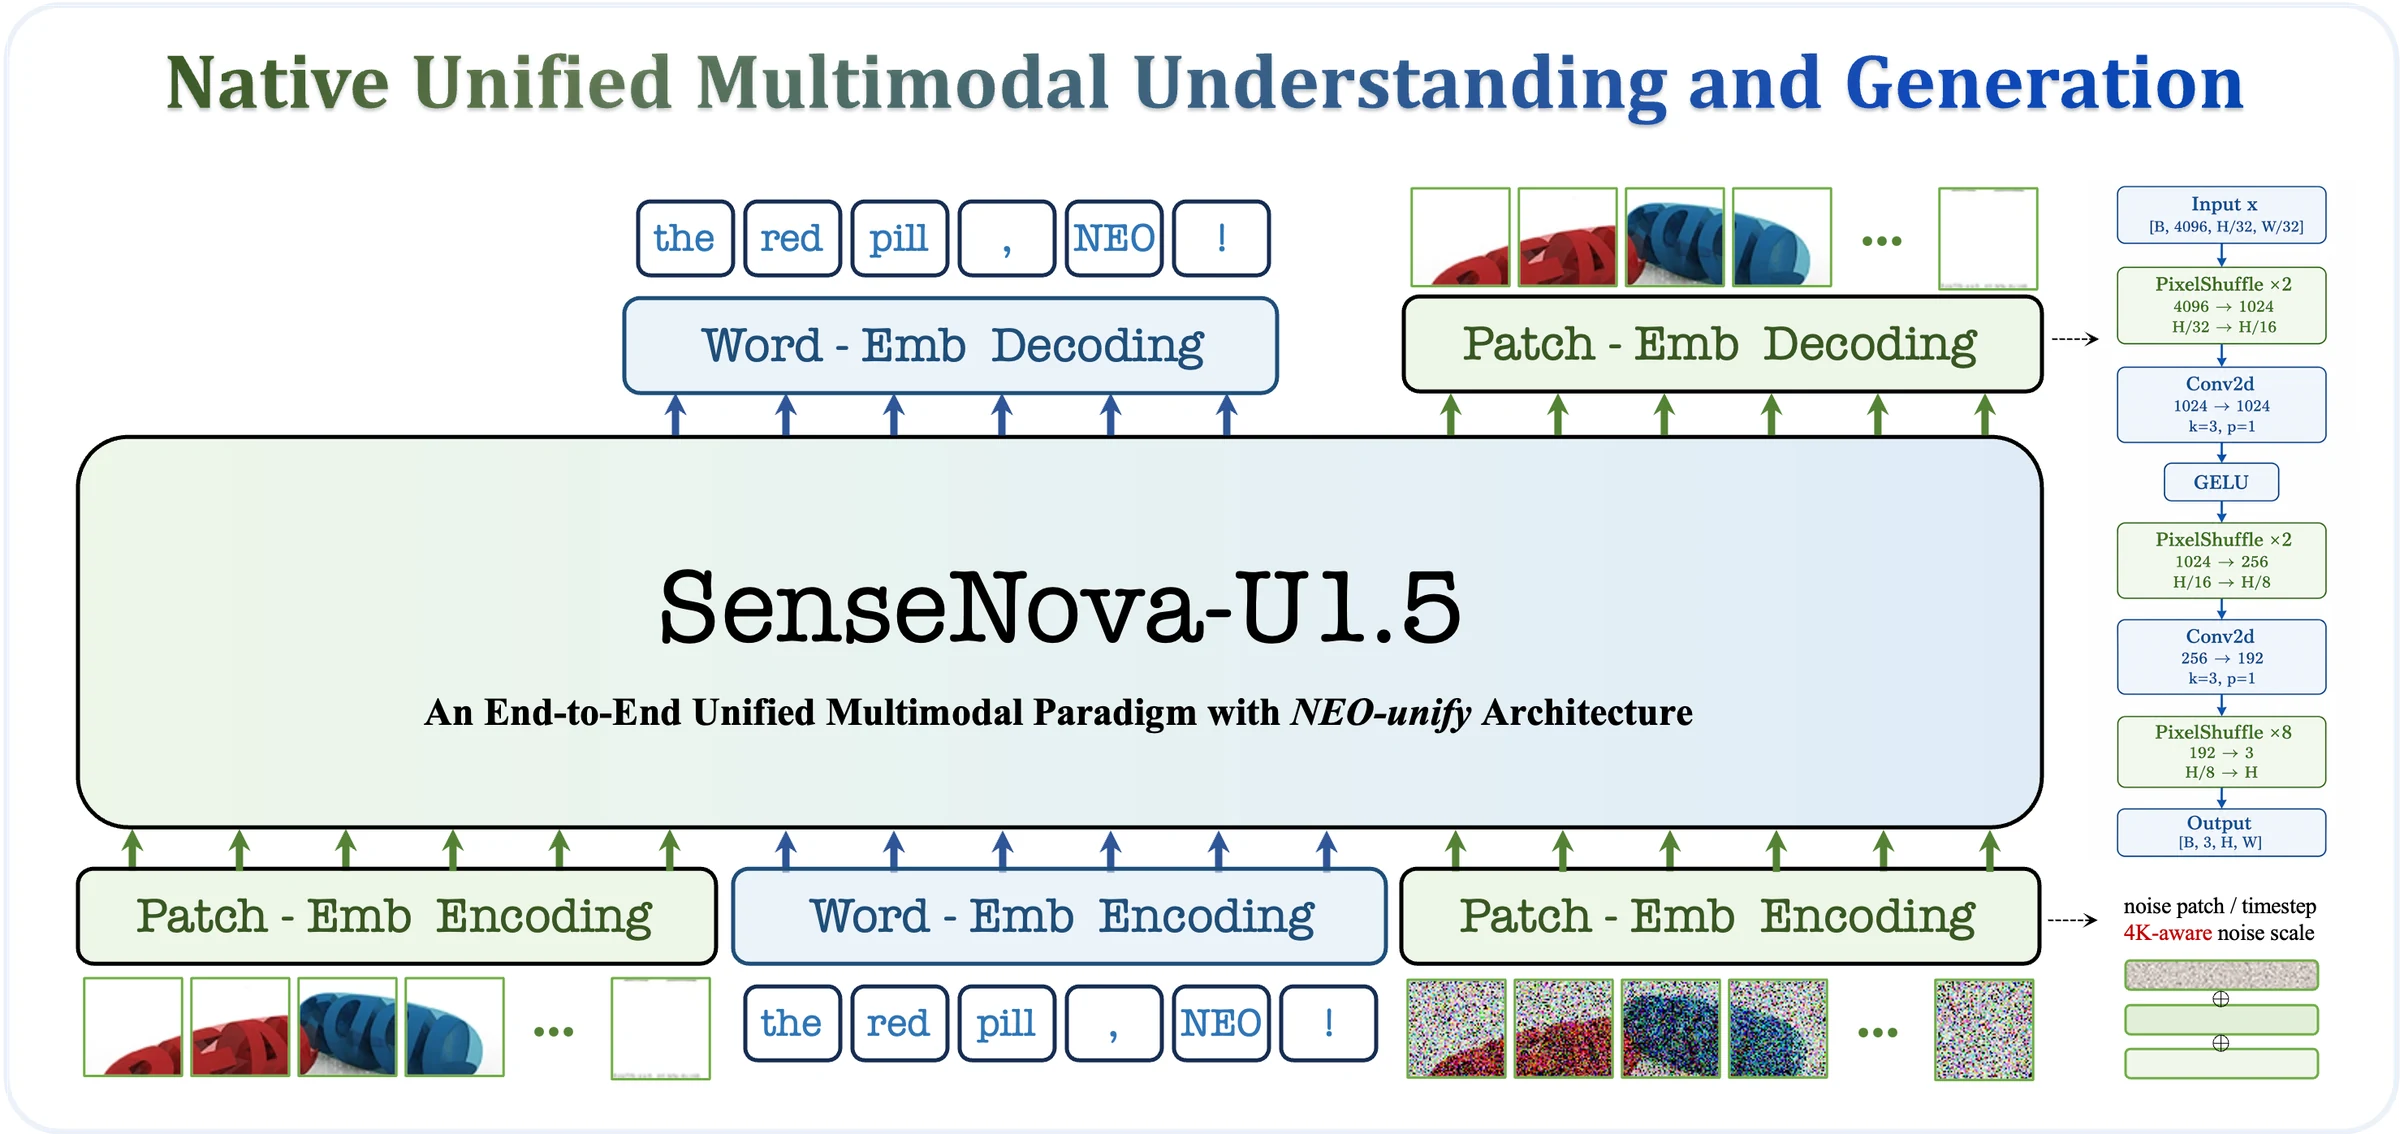
SenseNova-U1.5-8B-MoT从文生图走向统一多模态,除了提高生成效率之外,另一个重要方向是将过去相对独立的多模态理解与多模态生成能力进行统一。2026 年发布的 SenseNova-U1 提出了 NEO-unify 架构,尝试在统一模型中同时实现多模态理解和生成。在此基础上,SenseNova-U1.5-8B-MoT 进一步增强了图像生成和编辑能力。根据官方发布信息,正式版 SenseNova-U1.5-8B-MoT 于 2026 年 8 月发布,并进一步提升了指令遵循、文字与布局生成、原生 4K 图像生成、图像编辑和视觉控制等能力。
SenseNova-U1.5 建立在 NEO-unify 统一多模态架构之上,并采用新的图像 Patch 编码和解码机制。模型不仅可以根据文本描述生成图像,还可以结合输入图像与自然语言指令完成图生图、图像编辑以及视觉控制等任务。这意味着文生图模型正在逐渐从单一的内容生成工具,发展为能够同时处理理解与生成任务的统一多模态模型。