现在最强的生图、生视频模型应该是GPT Images 2.5 和 Seedance 2.5了,生图、生视频的上限又被往前推了一截。
那如果把它们当成闭源模型的第一梯队,那开源模型现在到底是什么水平?是玩具吗?是否能真正带来生产力?
这篇直接看看大佬们,能把开源模型玩到什么地步,其中生图选择阿里的Z-Image,生视频选择MiniMax H3。
Z-Image 是做的 6B 生图模型,采用 Apache 2.0 许可证。完整的 Z-Image 是非蒸馏底模,支持 CFG、负面提示词和微调;社区里更常见的是 Z-Image-Turbo,只用 8 步,追求的就是一个快。
MiniMax H3 则是 33B 的音视频生成模型,可以输出 4 到 15 秒、24fps、带立体声音频的视频。严格来说,它属于开放权重模型,使用的是 MiniMax H3 Community License。开源出来的 H3-Base 可以在本地生成 768p 音视频,但官方那套负责理解复杂输入的 Context-IR,以及 2K 再生成流程,没有完整开源。
现在很多生图模型都能生成美女,单看一张精修脸其实没啥意思。真正难的是:文字写对没有?数量数对没有?同一件商品能不能在不同视图里保持一致?复杂的空间关系有没有理解正确?
先看 @witcheer 做的一组本地测试。
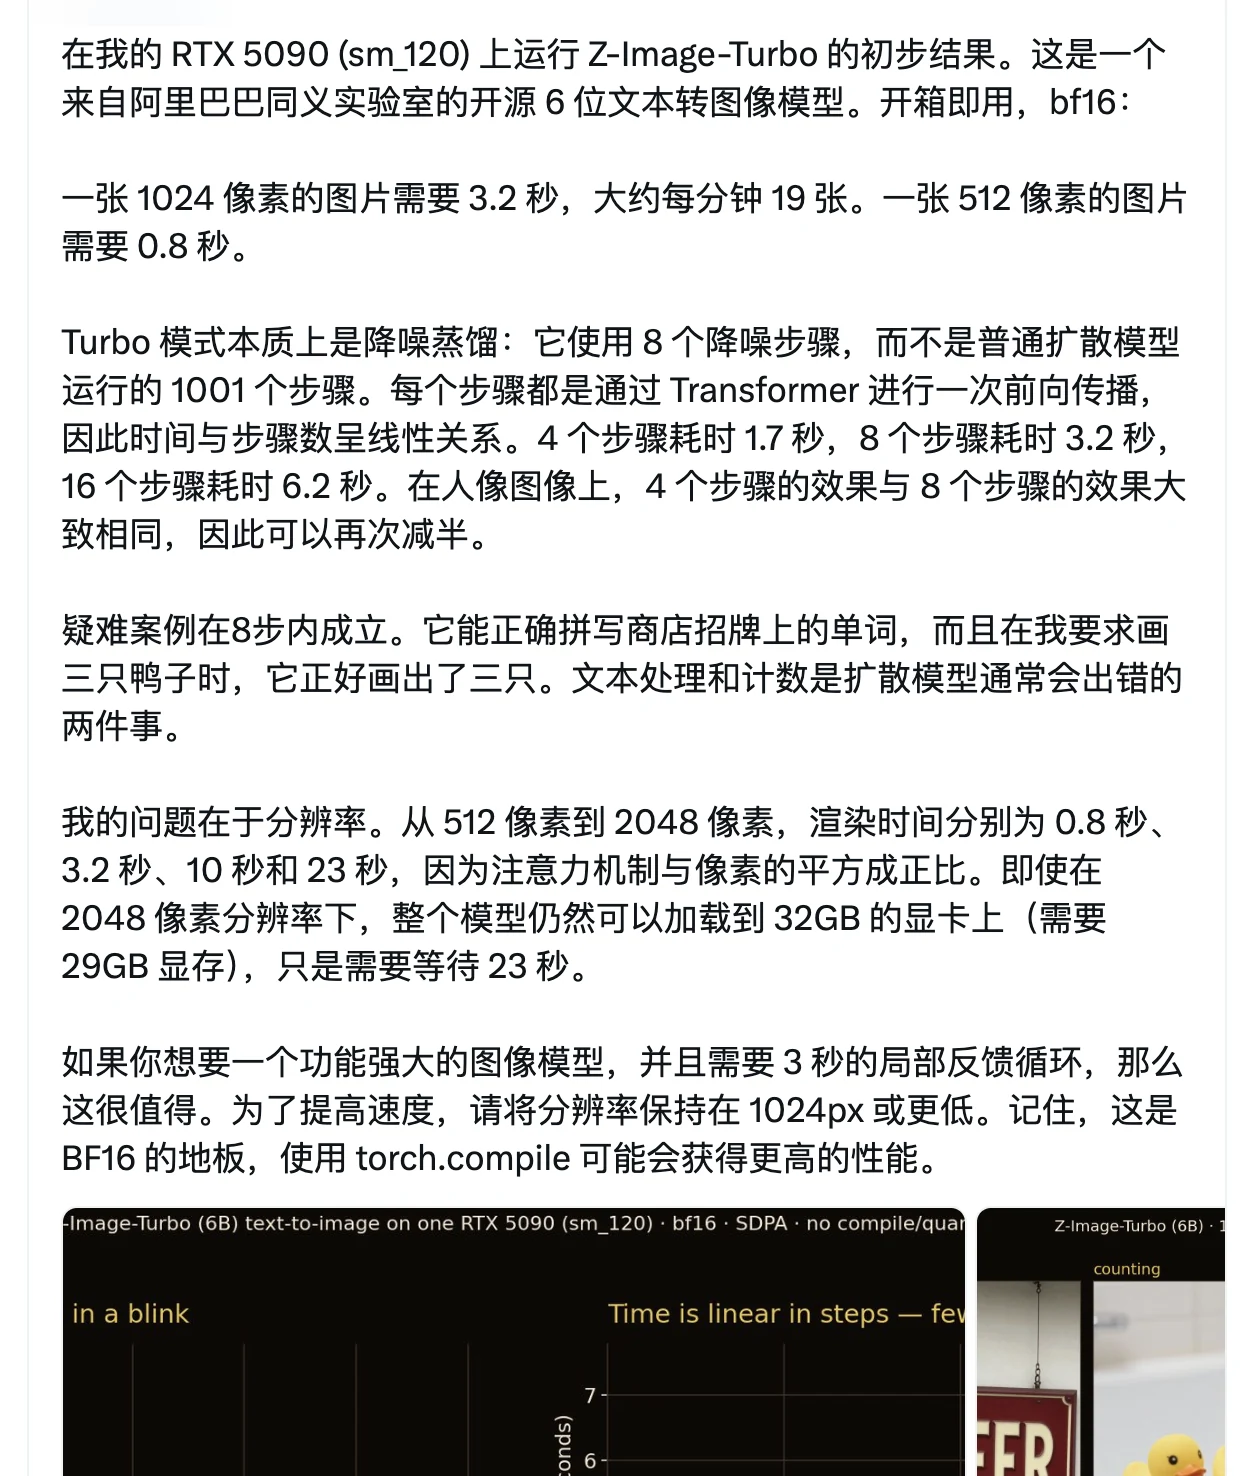
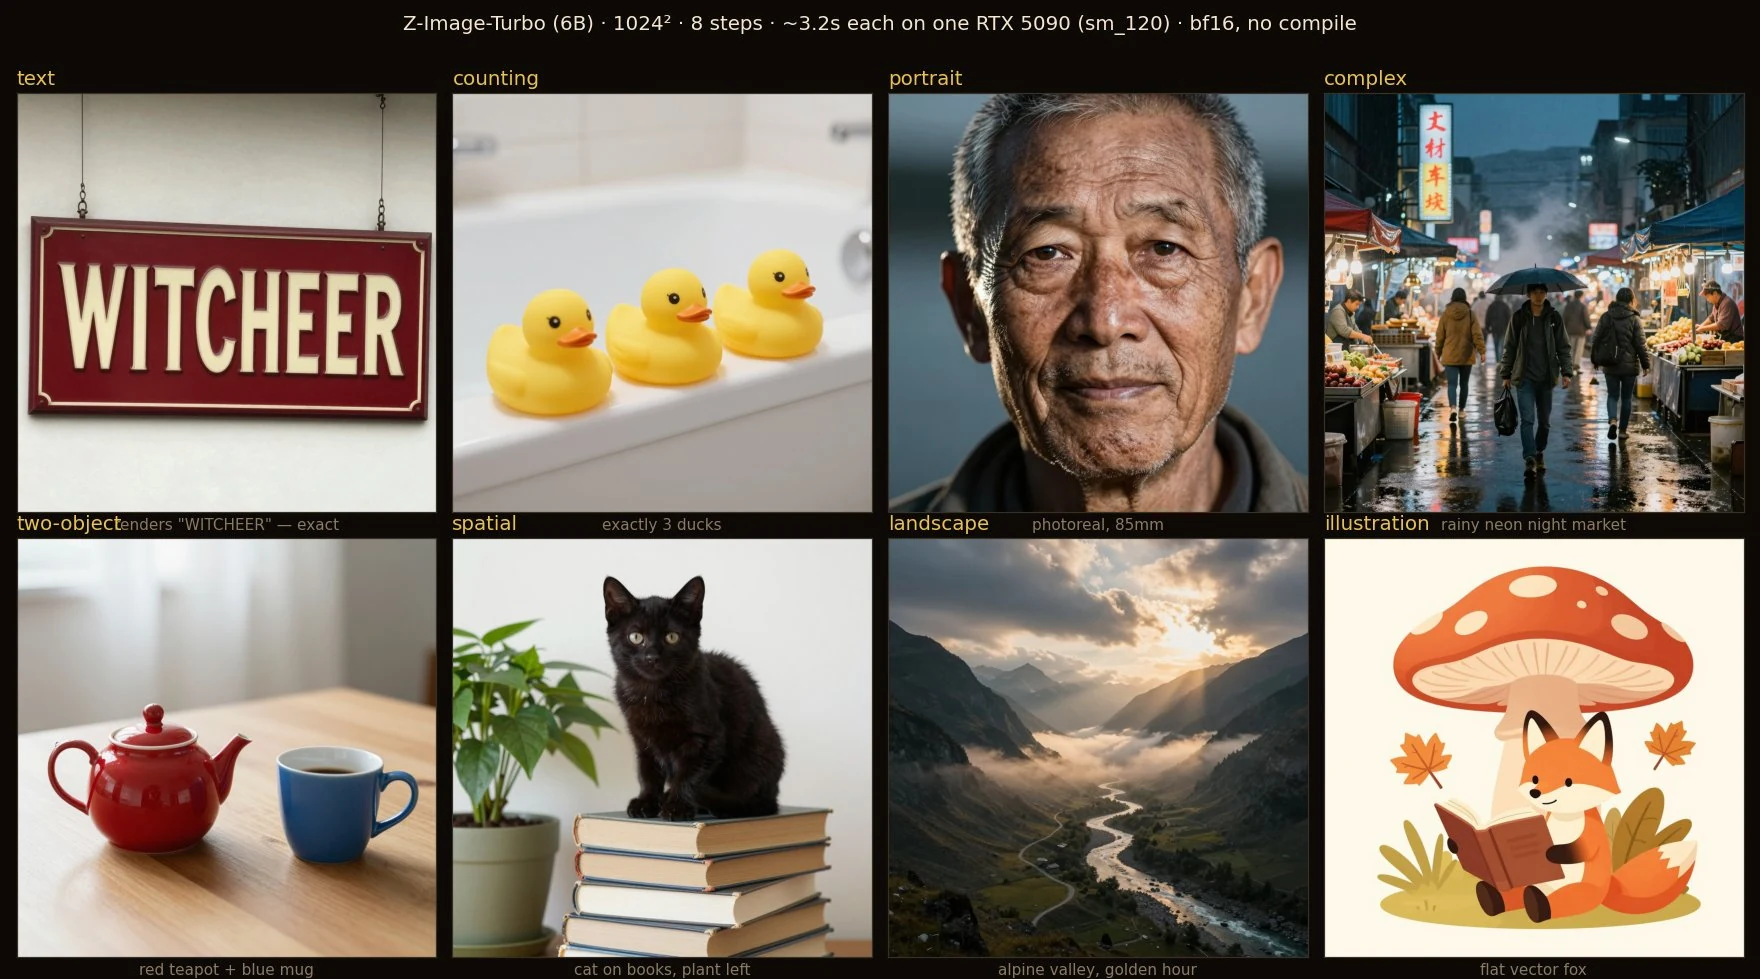
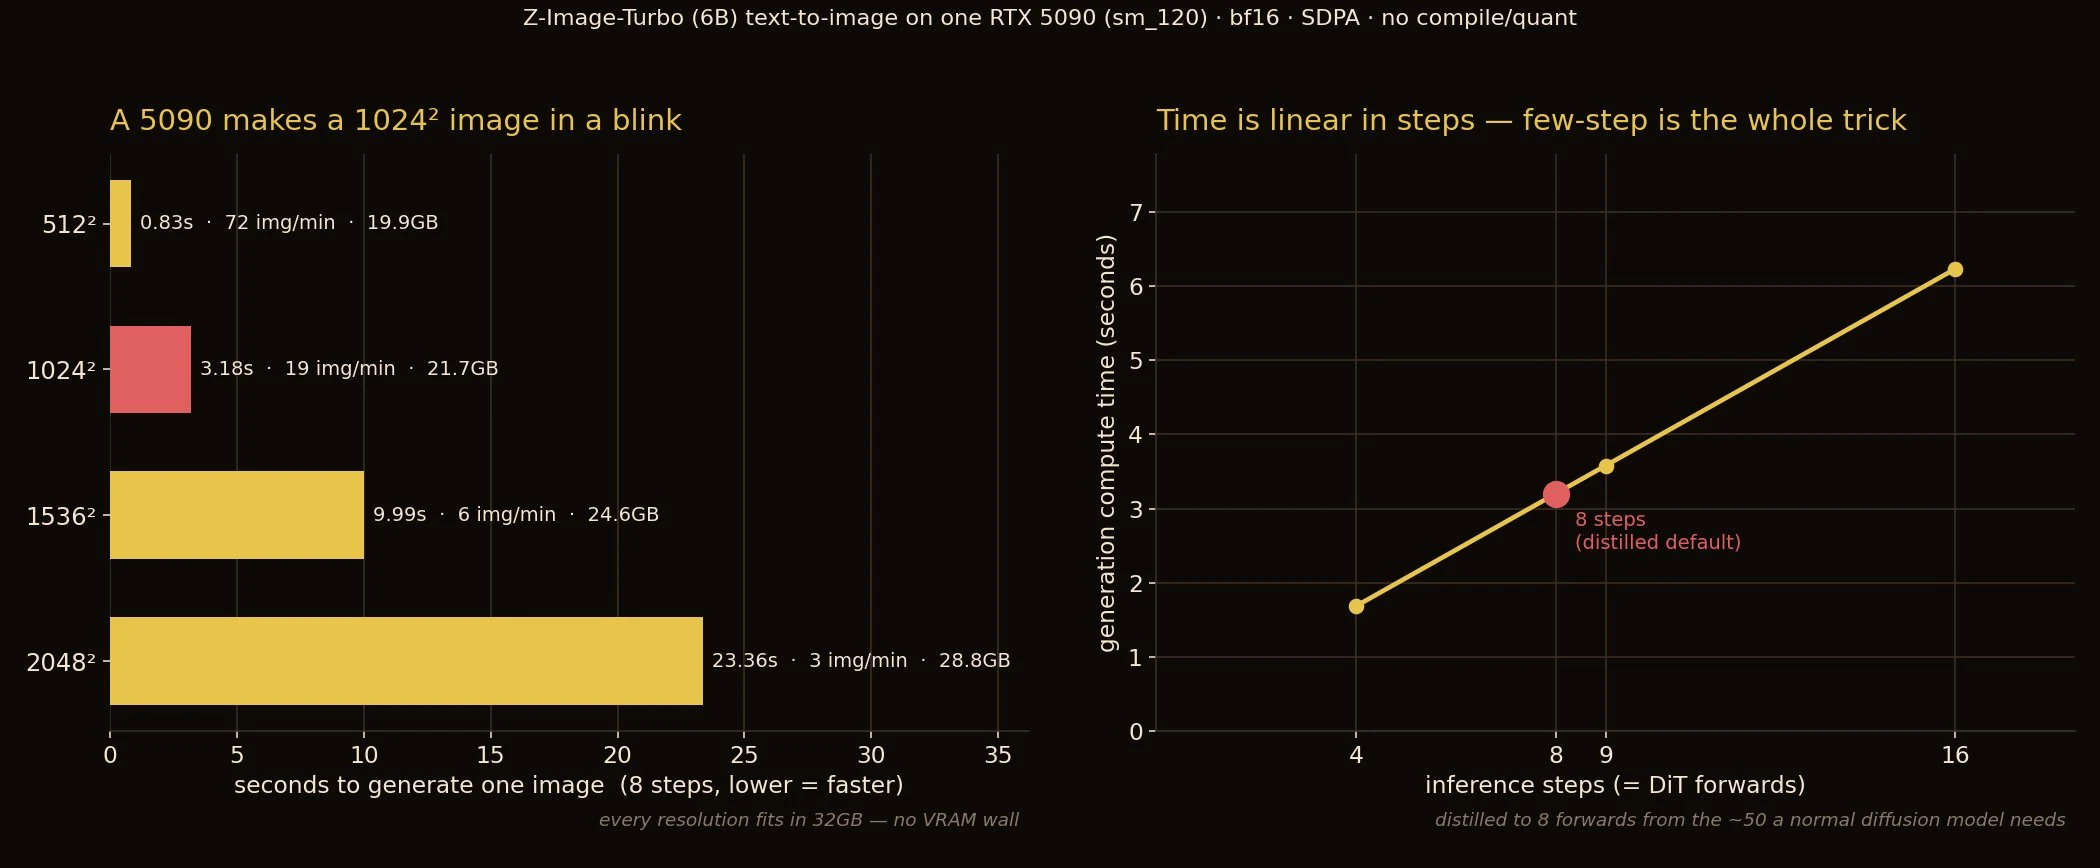
他在 RTX 5090 上跑 Z-Image-Turbo,1024px 图片大约只要3.2 秒一张。提示词里要求商店招牌写出指定单词,再画出“正好三只鸭子”,结果文字和数量都对了。
这两个任务看着幼稚,其实一直是扩散模型的老大难。字母容易糊,三只鸭子经常咔咔咔变成四五只。
原帖:https://x.com/witcheer/status/2074020722972758139
接着是一个更接近电商交付的 case。
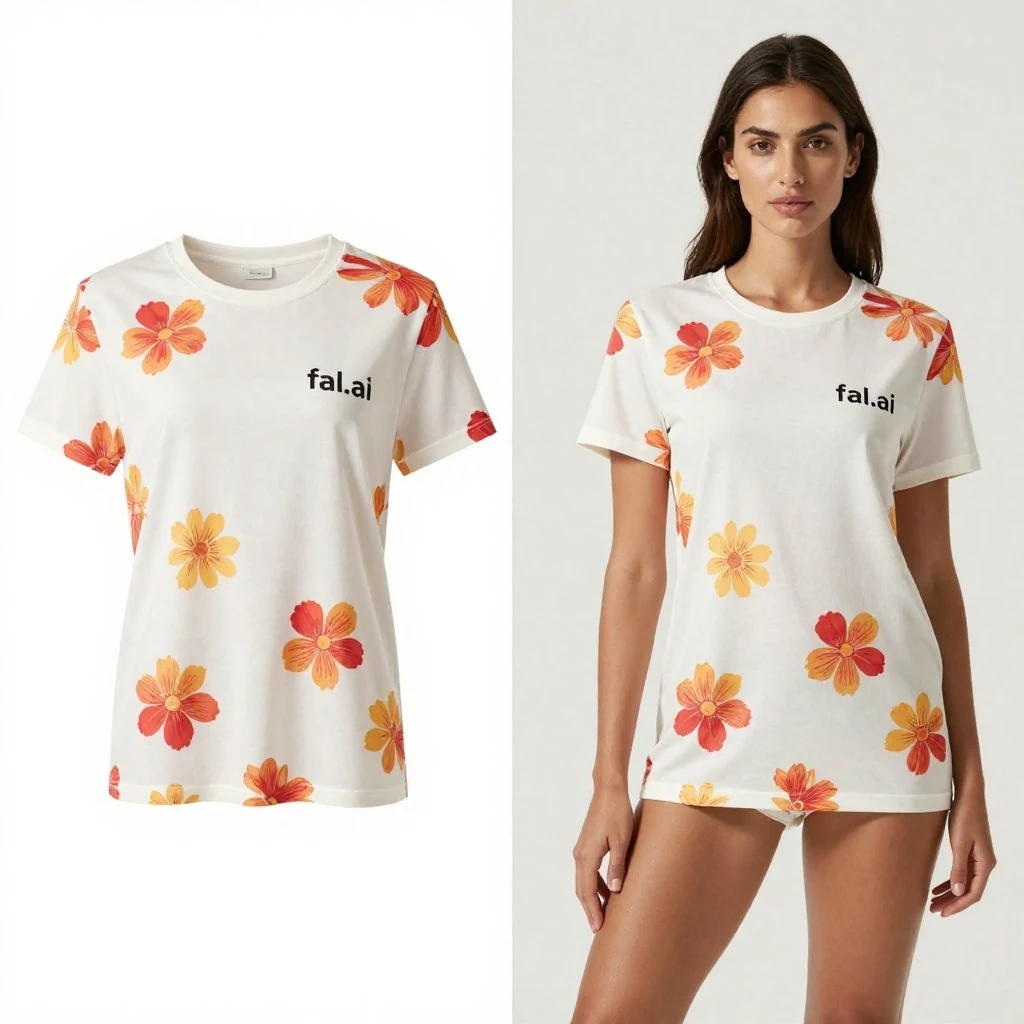
@rizavelioglu 让模型生成一张左右分栏图:左边只放一件白色花纹 T 恤,右边让真人模特穿上同一件衣服。提示词还要求保留印花、文字、面料、缝线和版型。
最后出来的图里,两边的衣服没有各画各的,花纹和款式基本能对上。对于电商团队来说,这比单纯生成一张“漂亮模特图”值钱多了。商品图、上身图、营销图可以从同一个设计继续往下做。
当然,这只是一张成功样本,离稳定批量出图还有距离。但它至少把方向跑通了。
原帖:https://x.com/rizavelioglu/status/2000012841525649621
写实人像这块,@dreamydigiarts 做了一组同提示词对比。
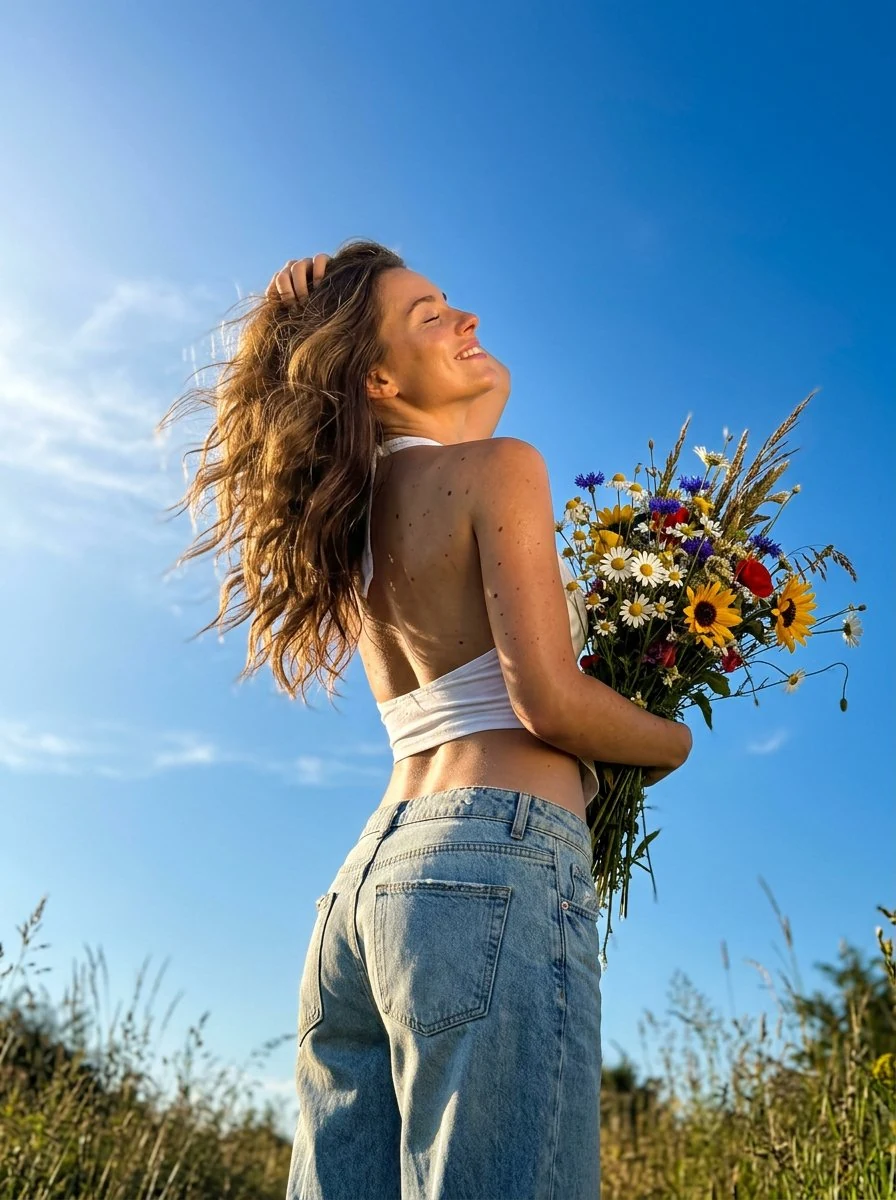
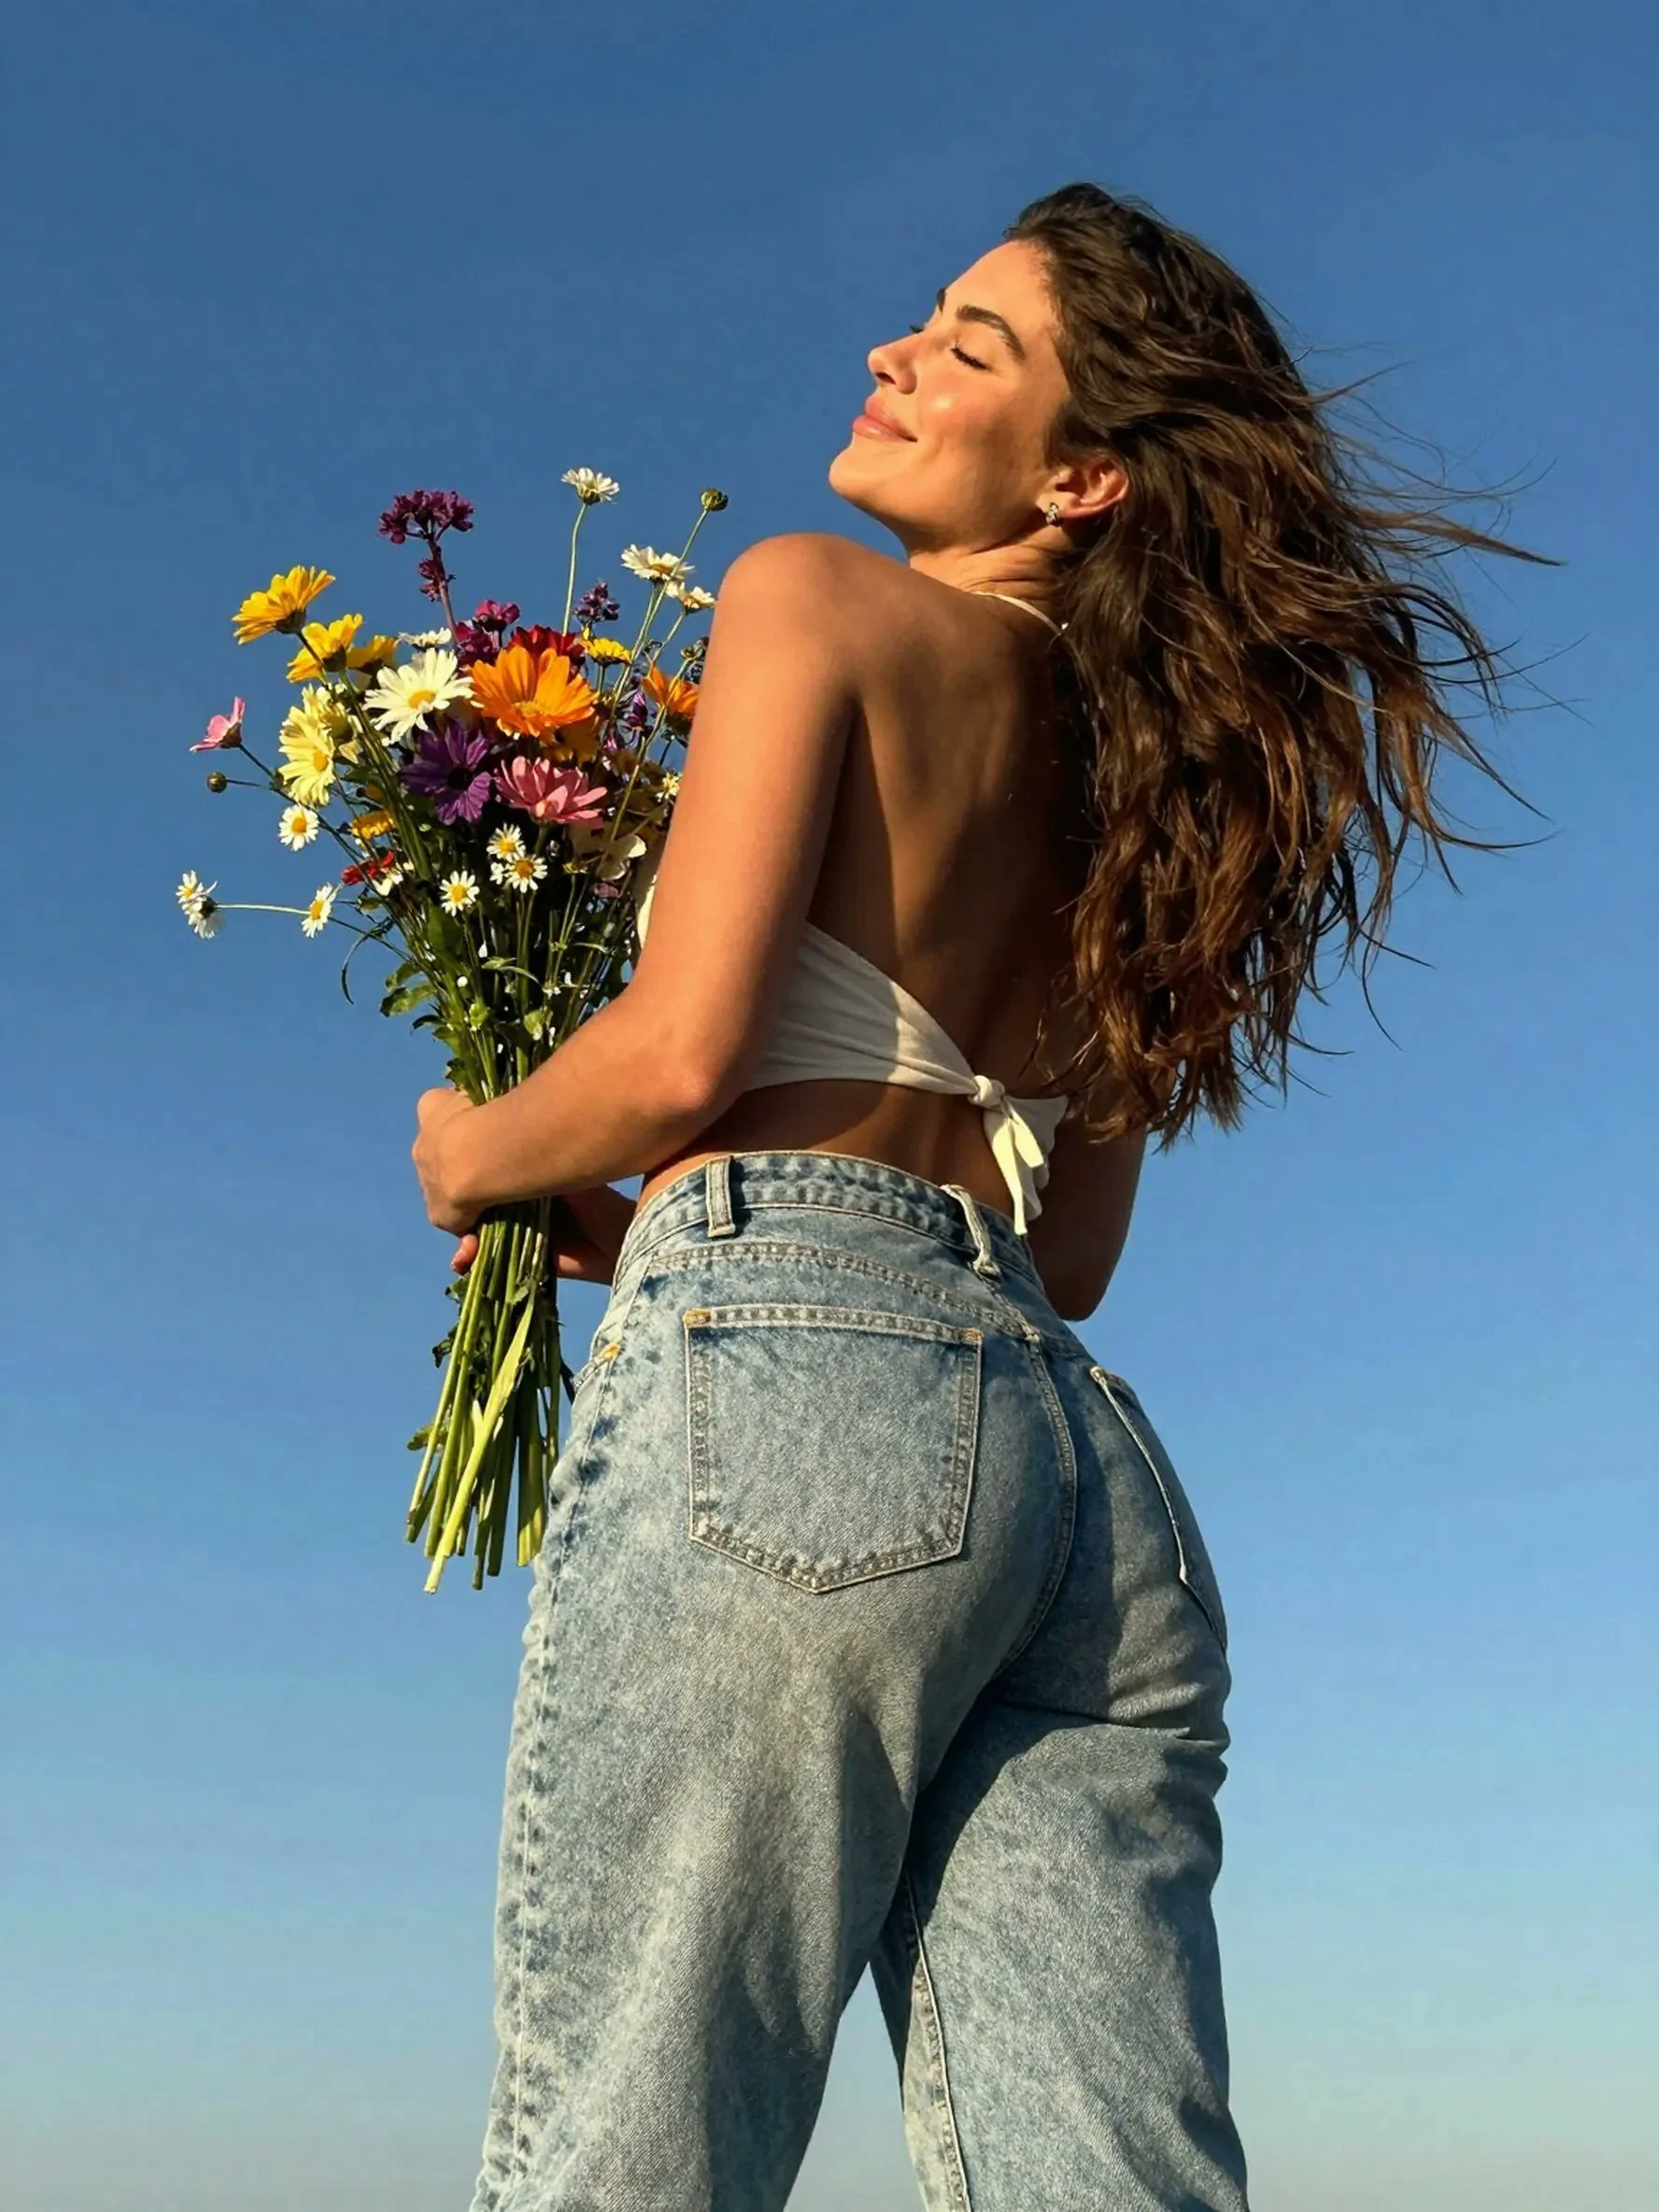
他让 Z-Image-Turbo 和 Nano Banana 2 同时生成一张手机仰拍:蓝天、逆光、人物后仰、手里抱着一大束野花,头发被风吹起来,还要求保留手机照片那种轻微颗粒感。
Z-Image 给出的画面已经有很强的随手拍味道。牛仔裤、皮肤和逆光没有糊成一层塑料,仰拍构图也没问题。拿来做人物氛围图、社媒配图,已经完全不是玩具级别。
原帖:https://x.com/dreamydigiarts/status/2084233075245171142
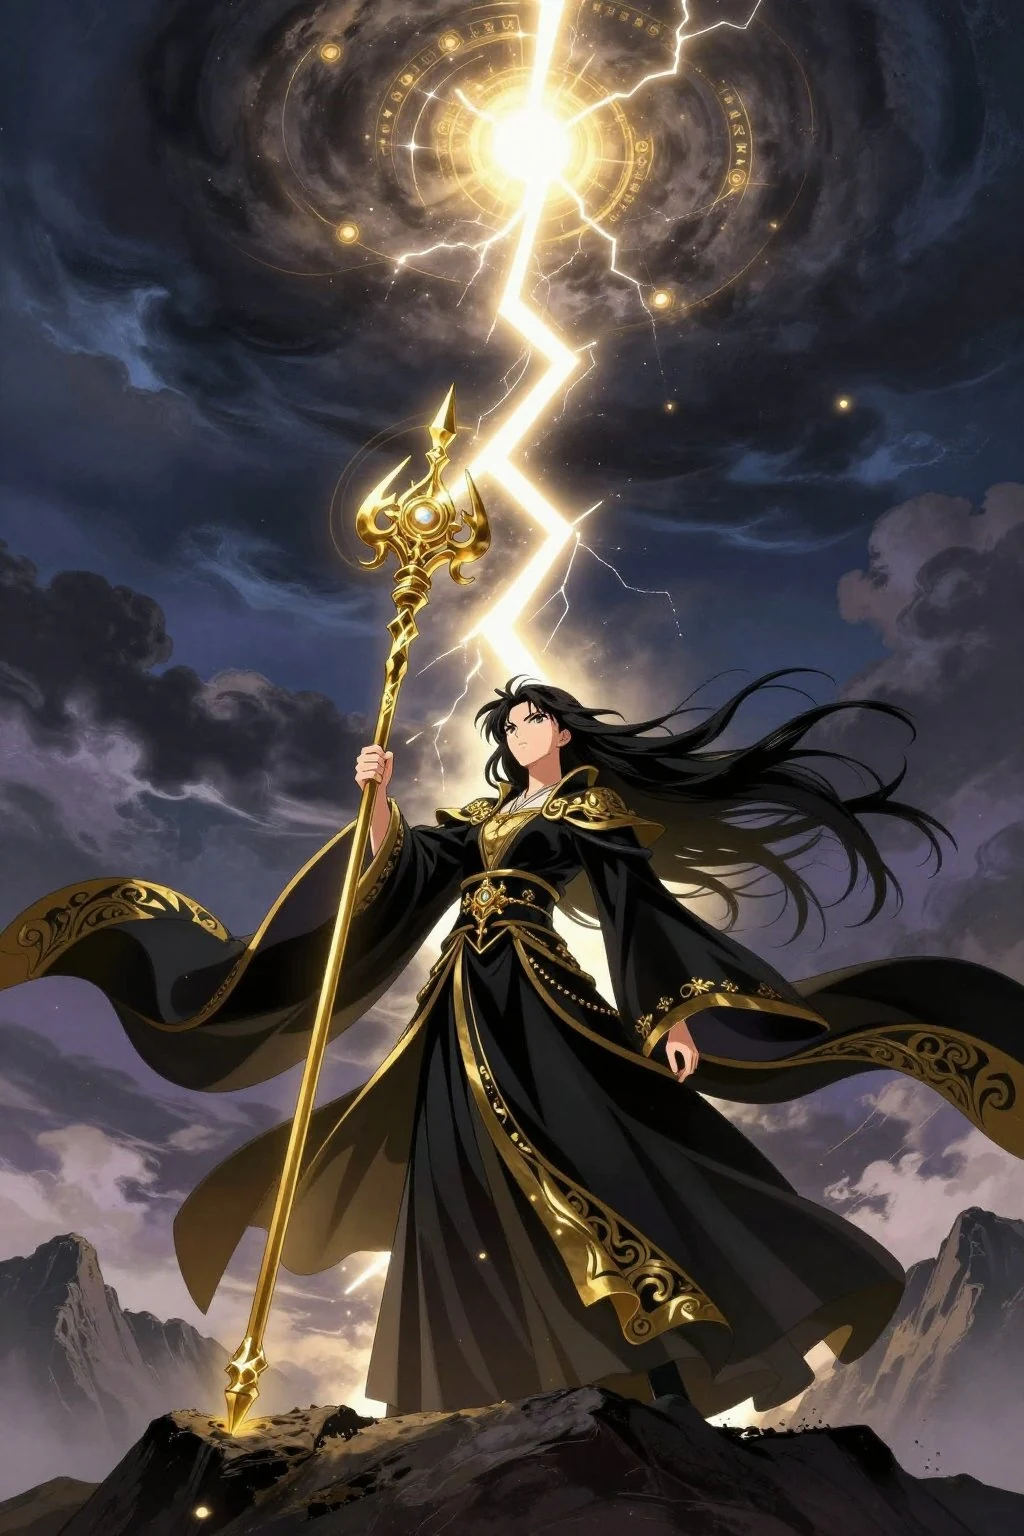
Z-Image 也不只会写实,@tisch_eins 用同一条提示词测试了 Boogu、Flux 2 Klein 和 Z-Image-Turbo。画面要求一个黑发女术士站在暴风雨山顶,手里的金色法杖必须从手到顶端完整出现,一道闪电从杖尖直冲云层,同时还要有低机位、全身构图、披风、符文、电弧和强烈的金色轮廓光。
这种 prompt 很容易顾此失彼:法杖被裁掉,闪电接错位置,人物也可能只剩一个大头。Z-Image 的结果把主要关系都保持住了,说明它对复杂插画构图也较强的控制力。
原帖:https://x.com/tisch_eins/status/2081490372405174375
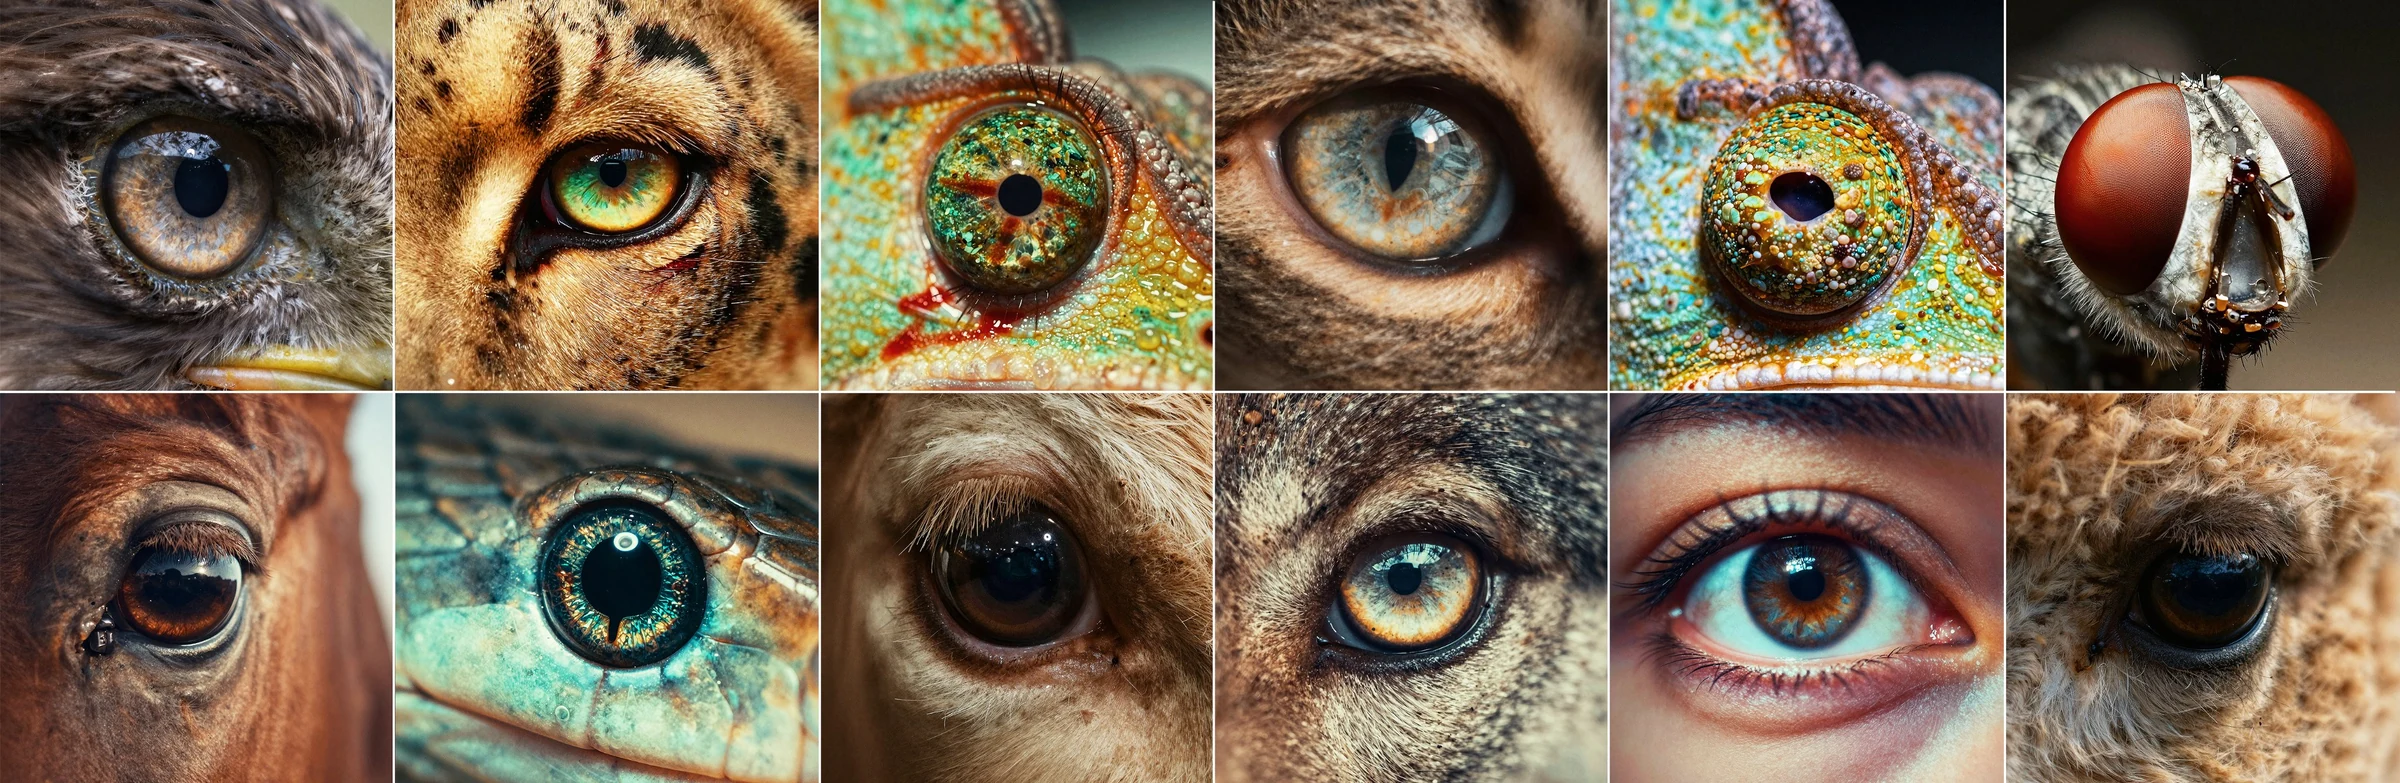
最后一个是极端微距,@aisthetiic 的提示词很短:让某种动物的瞳孔占据画面主体,用左上方的戏剧光线照出虹膜纹理,背景做成由暗到亮的虚化渐变。
更有意思的是,画面没有散。视线被牢牢锁定在瞳孔上,光线、阴影和背景都在给同一个主体服务。做海报主视觉或者情绪化封面时,这种构图服从度比堆一万句“8K、杰作、超细节”都有用。
登录 参与讨论
原帖:https://x.com/aisthetiic/status/1994424107451007336
这 5 个 case 放在一起看,Z-Image 的优势还是很明显了:
模型不大、速度快、写实能力在线,而且能听懂比较长的自然语言。完整底模还可以继续做 LoRA、ControlNet 和行业微调。
生视频比生图难得多,一张图里画错一根手指,有时候还能裁掉。视频里角色 15 秒不换脸、镜头按时间走、台词不串人、音效跟动作对上,任何一项掉链子,整条片子就废了。
H3 的 case 里,最值得先看的就是双角色一致性。
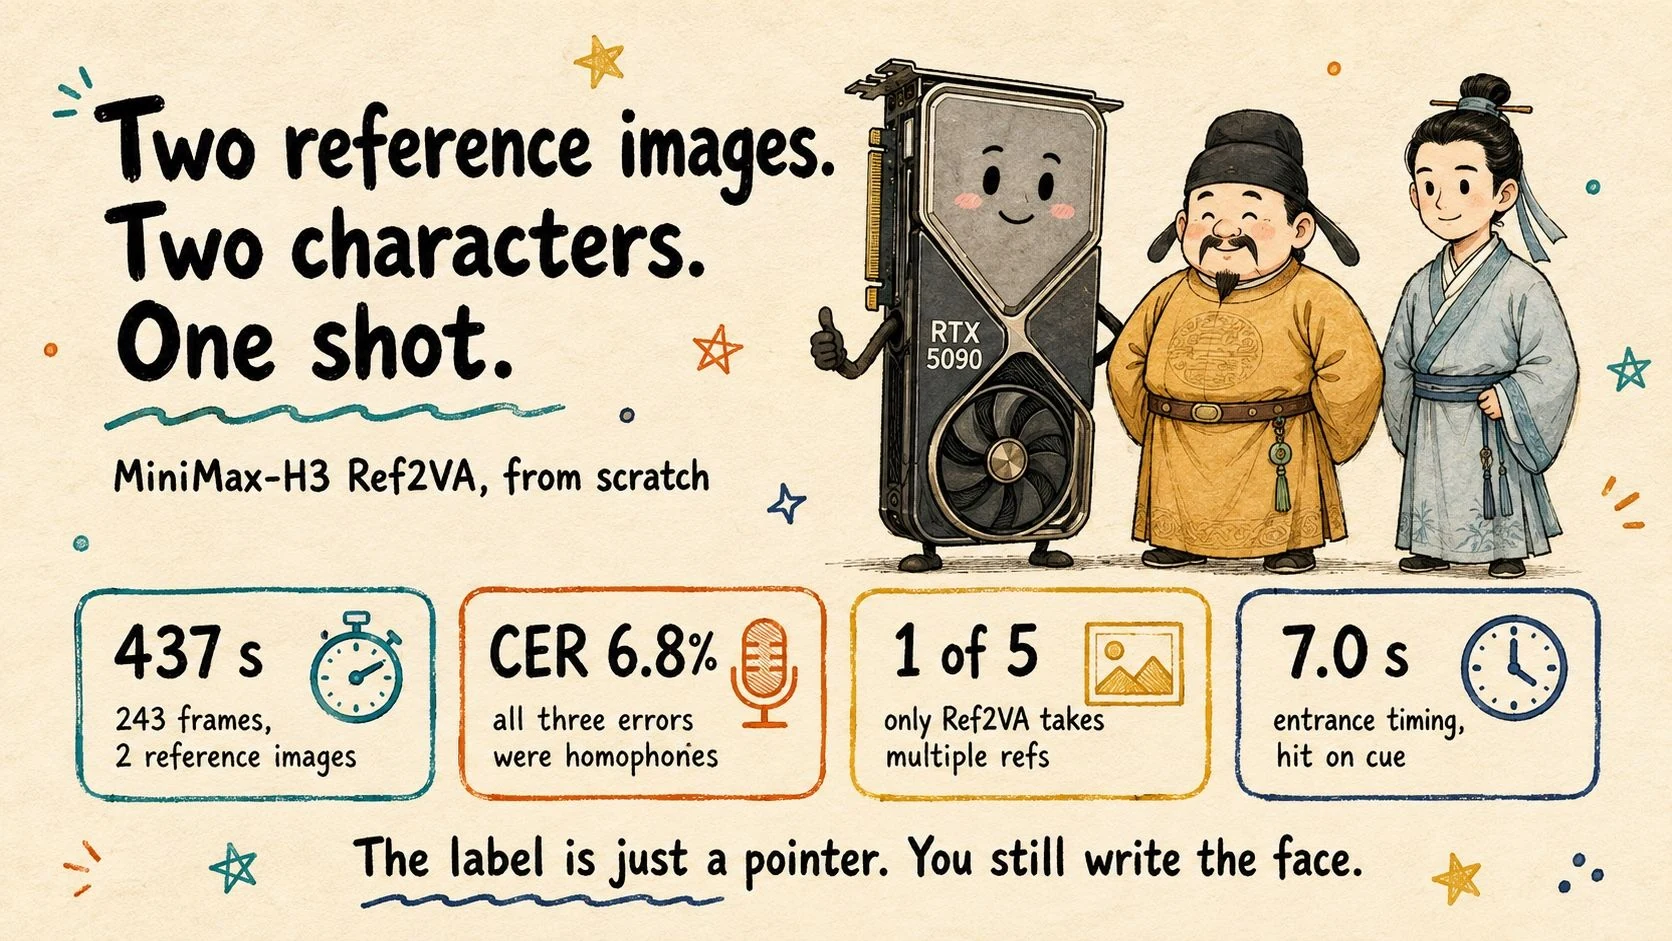
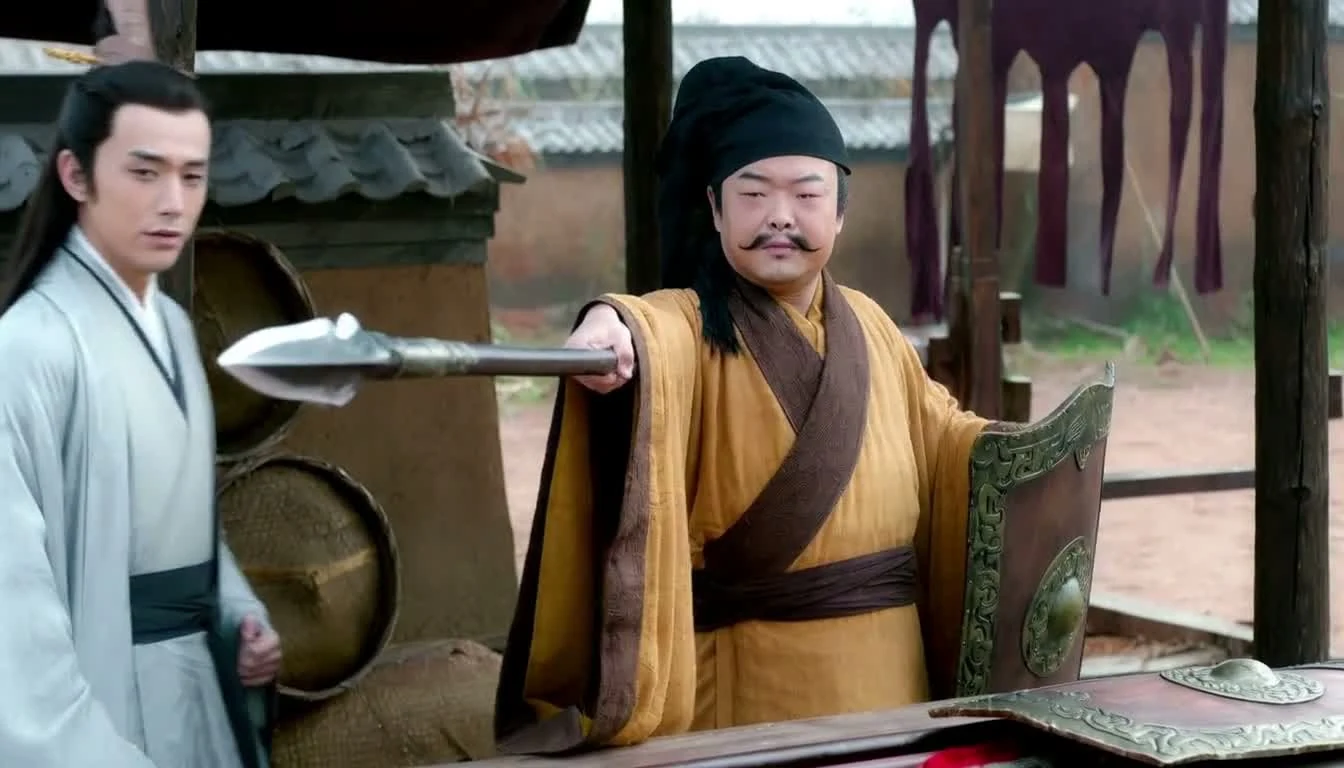
@coolthor 给 H3 的 Ref2VA 模式喂了两张 Z-Image 生成的角色设定图。一个穿赭色长袍,一个穿蓝灰色衣服,外形故意拉开差异。提示词安排其中一名角色在第 6 到 8 秒入场,还写了三句中文对白。
10.125 秒的视频里,两个人没有互相“串脸”“串衣服”。该入场的角色在前半段没出现,到 7 秒左右才进画面。作者又拿 ASR 对 44 个汉字做了核对,字符错误率是 6.8%,错的还是同音字。
这条是在单张 RTX 5090 上跑的,243 帧用了 437 秒。速度谈不上非常快,但角色、时间和对白可以一起控制,已经很能打了。


原帖:https://x.com/coolthor/status/2096779996320719307
另一条本地 case 来自 @Lumosous。
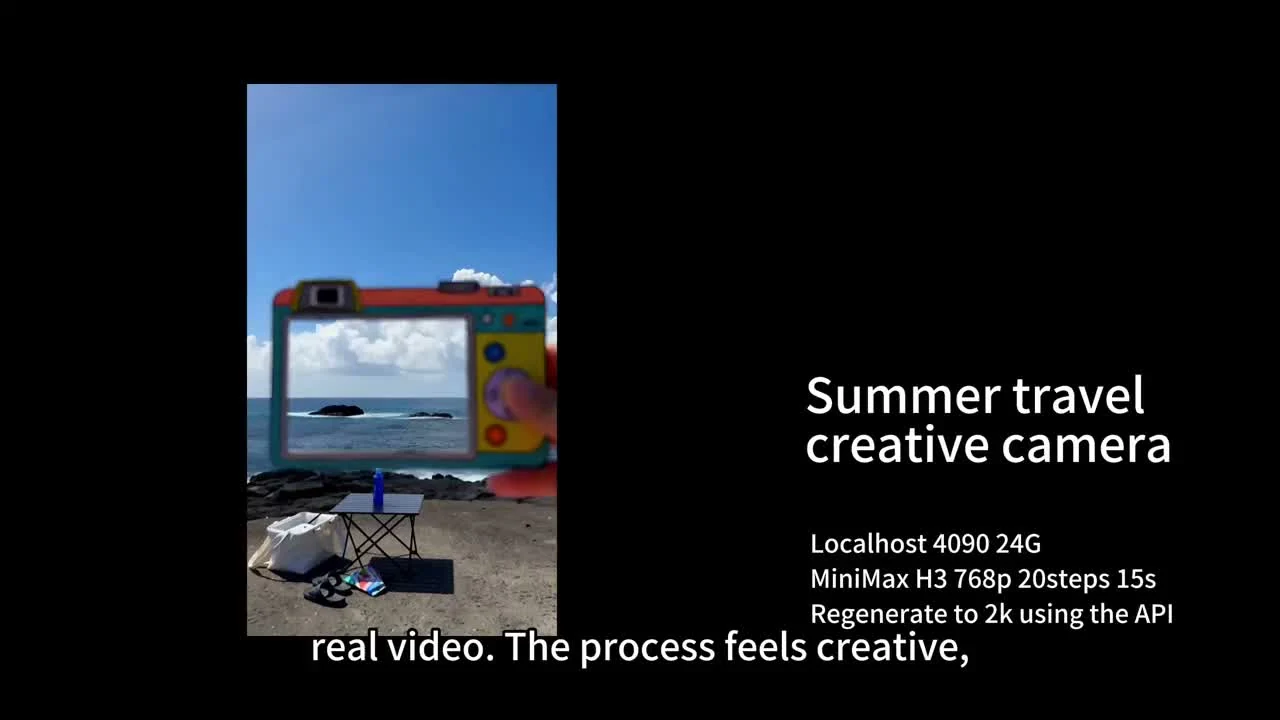
他用 RTX 4090 和 ComfyUI 做了三种尝试:四场景旅行短片、跟着鼓点切换画面的音乐视频,以及带 4 个镜头和环境声的海边故事。原始想法先交给 MiniMax 官方的 Prompt Writing Skill,整理成带镜头、时间、动作和声音的结构化提示词,再丢给 H3。
这条最有用的地方,是它不只把画面做得“挺漂亮”。鼓点到了,画面真会跟着换;海边那条里,四个镜头、氛围和背景音能在一轮里一起出来。
他的实测数据:4090 跑 15 秒、20 步的低分辨率视频要 200 多秒;升到 768p 就要 1000 多秒。开源可以让你反复改,但免费不等于没有成本,电费、显存和等待时间也是成本。

原帖:https://x.com/Lumosous/status/2089351551361937490
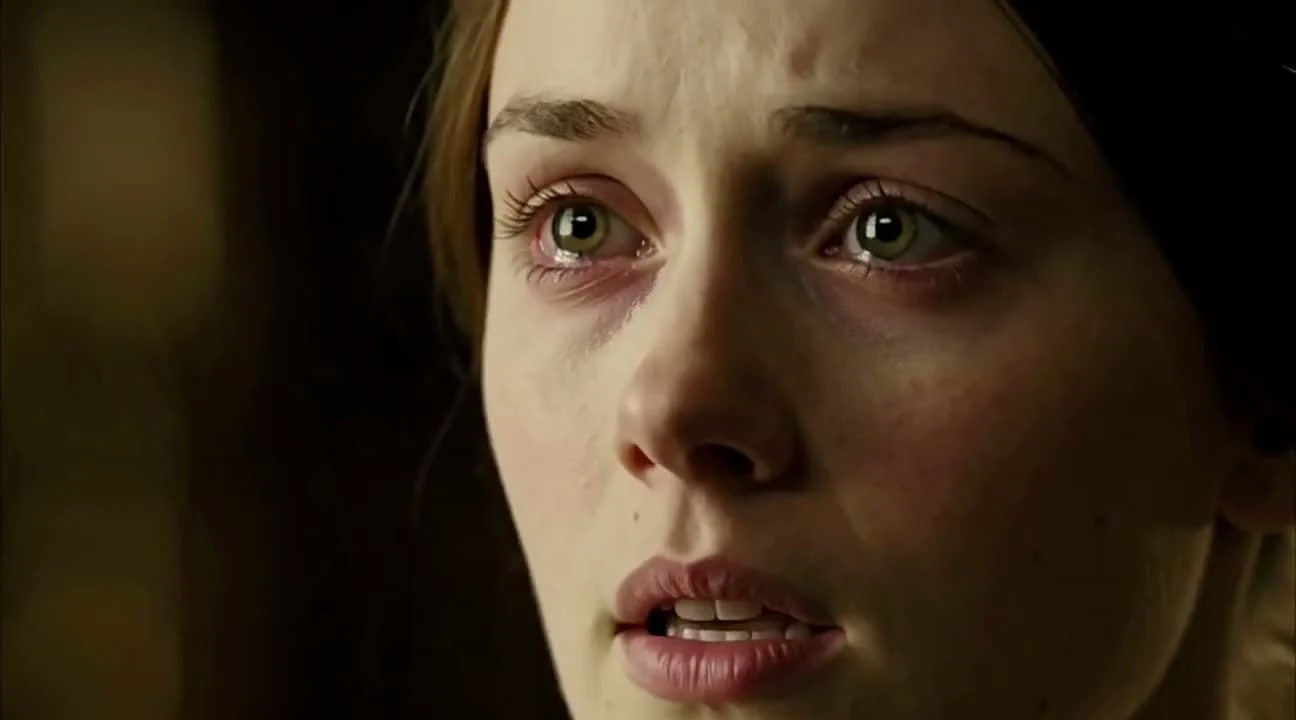
@PixelAigc 做的 30 秒《简·爱》式英伦庄园片段更夸张。
他的提示词直接把 30 秒拆成 4 个镜头。每段写清焦段、机位、人物站位、微表情、对白、呼吸、环境音和禁止项。人物情绪从试探、反驳一路走到动容,男女声线也分别约束。
这条片子用的是本地 ComfyUI、H3 Turbo LoRA,先出 480p,再用 Topaz 超到 1080p。作者给出的时间是,25 秒大约要 13 到 15 分钟。它不能代表官方原版模型的裸跑效果,但能代表开源生态最有意思的地方:模型出来一个月,社区已经开始改速度、做长视频、接自动超分了。

原帖:https://x.com/PixelAigc/status/2093563293306929579
H3 官方单段上限是 15 秒,那更长的视频怎么做?
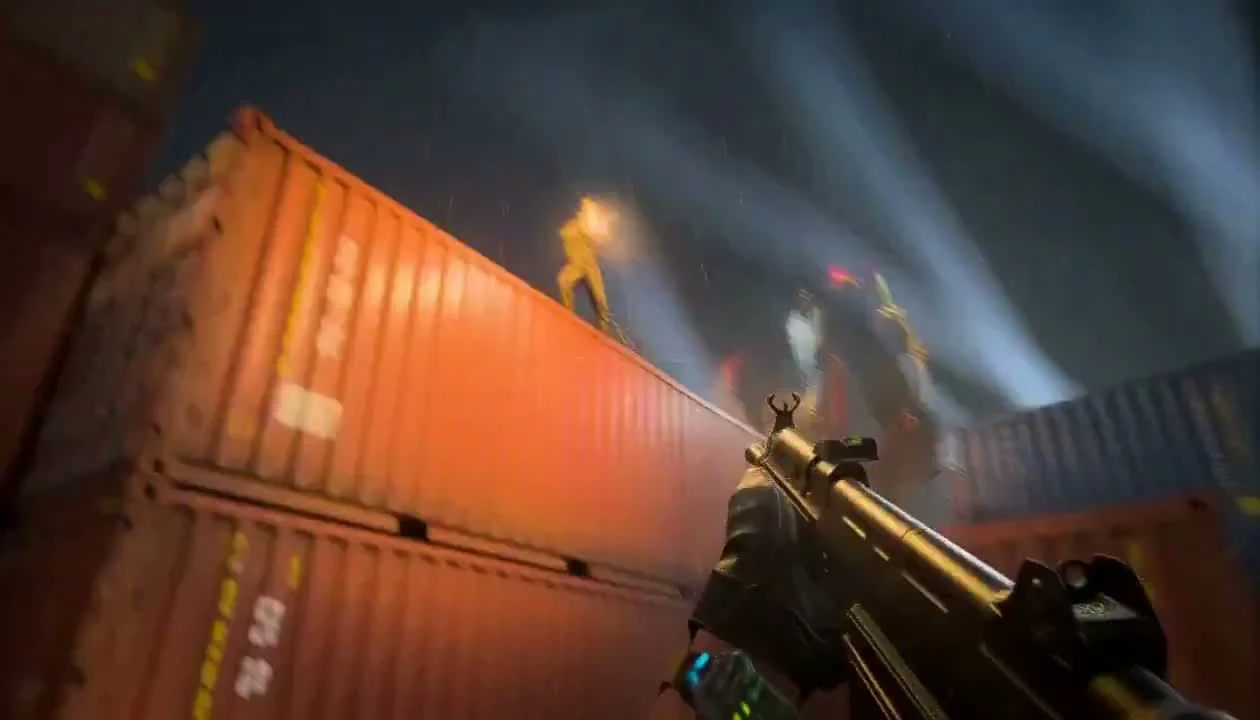
@superalesha 用 4 张 RTX 3090 跑了一条 30 秒第一人称动作片。他把两个 15 秒片段串起来,前一段故意停在一个稳定画面,后一段从同一帧接着生成,再把重复帧剪掉,声音继续往后走。
成片的接缝藏在第 15 秒,正常看很难发现。整条片从生成到完成用了 44 分钟。这个 case 的价值不在于 H3 突然突破了时长限制,而是有人把限制研究明白以后,用工作流绕过去了。

原帖:https://x.com/superalesha/status/2086171185134686509
还有一个特别适合拿来研究“视频提示词到底该怎么写”的 case。
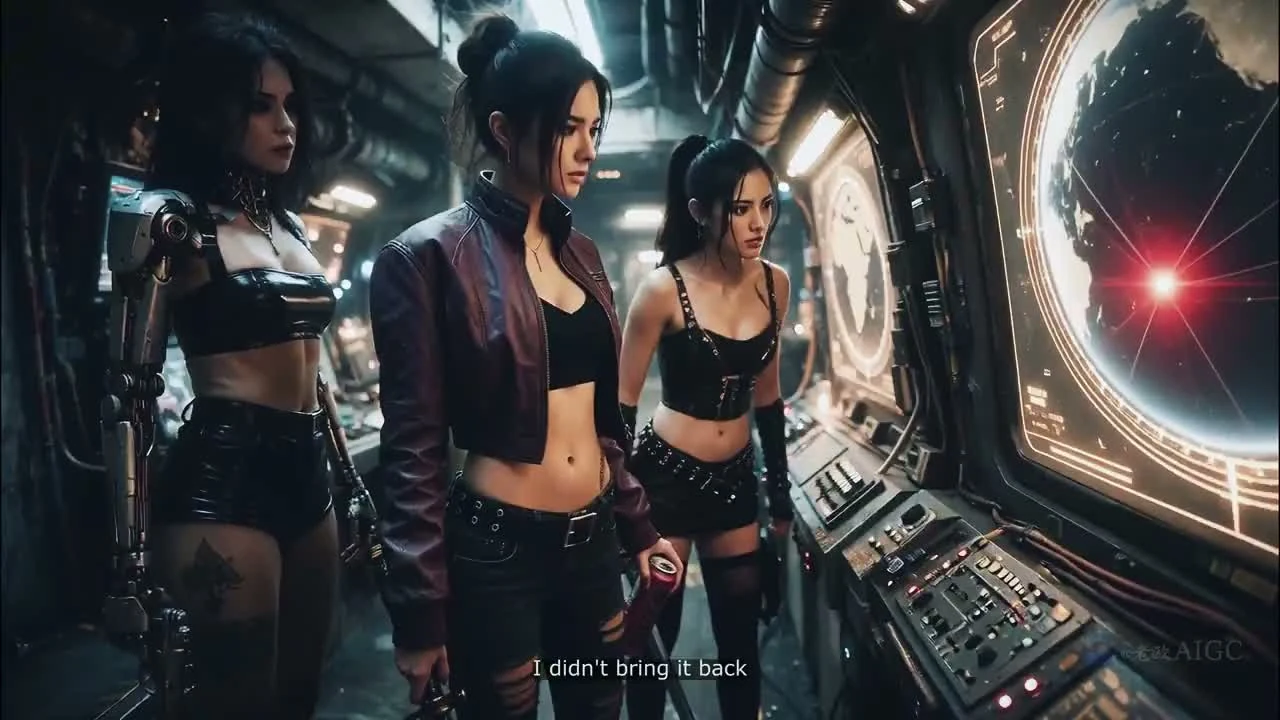
@ou_zhen599 用本地 ComfyUI 做了一段 15 秒赛博飞船短片。画面里有三名女性角色,一人一直坐在左边,一人站在中间拿刀,一人站在右前方拿汽水罐。提示词不只写剧情,还规定谁在第几秒说话、没说话的人不能动嘴、汽水罐必须一直留在右手、红色追踪点什么时候出现在屏幕上,最后舷窗外的阴影再压过来。
这种 case 最难的是空间别乱、道具别丢、台词别串、沉默的人真能闭嘴。H3 已经能把这么多约束塞进一条 15 秒短片里执行,开源视频的玩法明显变了。

原帖:https://x.com/ou_zhen599/status/2097988690102390893
总的来看,
如果你只是想最快出一条成片,闭源模型依然省事。
但如果你想反复试、批量生成、训练自己的风格,或者把能力装进本地工作流,Z-Image 和 H3 已经值得认真研究了。先用开源模型把镜头和素材咔咔咔试出来,真正卡住的时候再调用闭源模型,成本会低很多。
开源模型以前给人的感觉是等等党平替,现在它已经能参与真正的创作了。
对天天要做图、做视频的人来说,最爽的变化就是,以后每冒出一个想法,不用先算这一轮要烧掉多少积分。