التحسين الدقيق والتقييم • مبتدئ⏱️ 25 دقيقة للقراءة
Fine-Tuning with ms-swift
استخدم ms-swift بسرعة لإتمام التموين الخفيف للنماذج المفتوحة المصدر
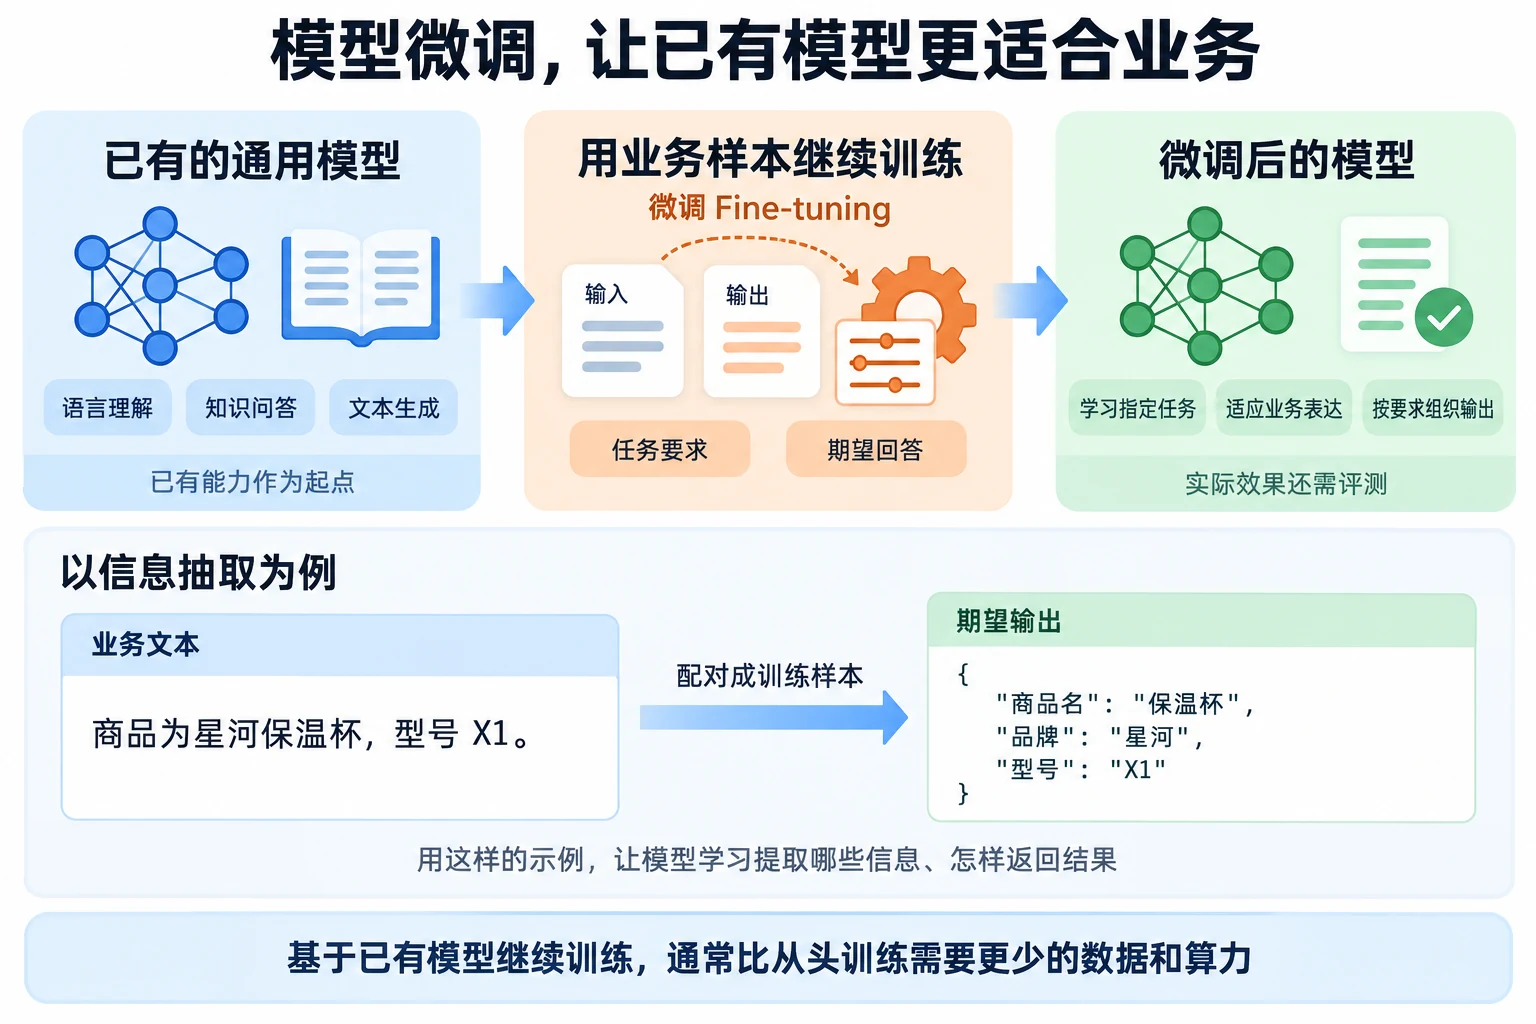
عندما لا يتمكن النموذج العام من تلبية احتياجات العمل المحددة بشكل مباشر، يمكنك استخدام بيانات عملك الخاصة لتتمين النموذج، مما يتيح له تعلم المهام وطرق الإخراج بشكل أعمق.
لنأخذ مهمة التعرف على الكيانات في التجارة الإلكترونية كمثال، نحتاج النموذج إلى استخراج أسماء المنتجات وأسماء العلامات التجارية والأسماء من النص، وإعطاء الفئات والمواقع المقابلة. قد يبدو النموذج على دراية جيدة بالمنتجات عند الحديث عنها، لكن عند الاستخدام الفعلي، يُطلب ألا تُهمل معلومات مستخرجة، ويجب أن تكون الحقول موحدة، وأن يكون تنسيق الإخراج مستقرًا.
إذا كانت المهمة ومتطلبات الإخراج واضحة بالفعل، وتم تجميع أمثلة منظمة، يمكنك محاولة استخدام هذه البيانات للتموين، بحيث يتعلم النموذج العمل الذي نريد إنجازه. أما فيما يتعلق بتحديث جميع المعلمات وما إذا كانت بطاقة الرسومات المتاحة كافية، فيجب اختيار ذلك بناءً على المهمة والموارد المتاحة.
سنستخدم ms-swift أدناه، بدءًا من جلسة تموين LoRA، لإتمام تحضير البيانات والتدريب ودمج الأوزان والاستدلال بالترتيب.
ما الذي يغيره التموين في النموذج بالضبط؟
تمتلك النماذج الكبيرة العامة بالفعل قدرات قوية في فهم اللغة والإجابة على الأسئلة المعرفية وإنشاء النصوص وغيرها من القدرات العامة. لكن في الأعمال العملية، قد لا تلبي أداء النماذج العامة المتطلبات المحددة بشكل مباشر.
على سبيل المثال، نريد من النموذج إنجاز مهمة استخراج معلومات معينة بدقة وإخراج النتائج وفقًا للتنسيق المحدد، أو الإجابة على أسئلة محددة بطريقة موحدة. وناءً على هذه المتطلبات، يمكن التدريب على بيانات محددة بناءً على النموذج الحالي، بحيث يتعلم النموذج متطلبات المهمة وطرق الإجابة المطلوبة بشكل أعمق. هذا العملية تسمى بالتموين (Fine-tuning).
التموين ليس إعادة تدريب نموذج من جديد، بل هو تعديل إضافي على القدرات الحالية للنموذج، مما يجعله أكثر ملاءمة لسيناريوهات التطبيق المحددة. مقارنةً بتدريب النماذج الكبيرة من الصفر، عادةً ما يتطلب التموين بيانات وموارد حسابية أقل.
في الوقت الحالي، الطريقة الأكثر شيوعًا في تموين النماذج الكبيرة هي SFT (Supervised Fine-Tuning، التموين الخاضع للإشراف). يستخدم SFT بيانات تحتوي على إجابات معيارية لتدريب النموذج، حيث تحتوي كل عينة تدريب عادةً على مدخل ومخرج مقابل، مما يتيح للنموذج تعلم ما يجب إنتاجه عند إدخال معين. على سبيل المثال، في مهمة استخراج المعلومات، يمكن استخدام نص كمدخل واستخراج الحقول الصحيحة كمخرج. يناسب SFT المهام التي يمكن فيها تحضير عينات تدريب واضحة، مثل تصنيف النصوص واستخراج المعلومات والإجابة على الأسئلة وإنشاء تنسيقات ثابتة.
بالإضافة إلى SFT، يمكن استخدام التعلم المعزز (Reinforcement Learning، RL) في تدريب النماذج الكبيرة. على عكس SFT الذي يوفر إجابات معيارية مباشرة، يعتمد التعلم المعزز بشكل أساسي على إشارات المكافأة لتقييم جودة النتائج المولدة من النموذج، ويعدّل سلوك الإخراج باستمرار بناءً على نتائج المكافأة. ينتمي كل من SFT والتعلم المعزز إلى مرحلة ما بعد التدريب (Post-training) للنماذج الكبيرة. ما بعد التدريب يشير إلى سلسلة من التدريبات التي تُجرى بعد اكتمال التدريب المسبق واسع النطاق للنموذج، بهدف تحسين قدرات اتباع الأوامر والاستدلال والمهام المحددة بشكل إضافي. عادةً ما يتعلم النموذج أولاً كيفية إنجاز المهام وفقًا للأوامر عبر SFT، ثم يُحسَّن جودة الإجابة والسلوك باستخدام التعلم المعزز وطرق أخرى.
بناءً على طريقة التدريب والموارد المادية، يمكنك اختيار LoRA أو QLoRA أو التموين الكامل المعلمات. تختلف الطرق المختلفة في عدد المعلمات المدربة واستخدام الذاكرة الفائقة والتكاليف الحسابية.
التموين الكامل المعلمات (Full Fine-Tuning): في عملية التدريب، تشارك جميع معلمات النموذج في التحديث، مما يمكن النموذج من إجراء تعديلات كافية. تتطلب الطريقة هذه موارد ذاكرة فائقة وموارد حسابية أكبر بشكل ملحوظ، مما يجعل تكلفة التدريب أعلى.
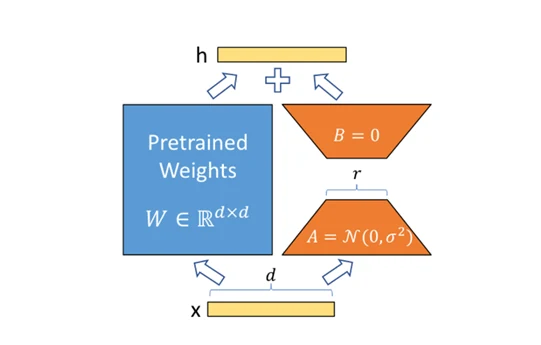
تموين LoRA (Low-Rank Adaptation): لتقليل متطلبات الموارد المادية لتموين النماذج الكبيرة، تتمثل الفكرة الأساسية لـ LoRA في تجميد أوزان النموذج المدرب مسبقًا وإدخال مصفوفات تفكيك الرتب القابلة للتدريب في كل طبقة من بنية Transformer، مما يقلل بشكل كبير من عدد المعلمات القابلة للتدريب في المهام التبعية. في عملية التدريب، تحتاج فقط إلى تثبيت معلمات النموذج الأصلي ثم تدريب مصفوفة تقليل الأبعاد A ومصفوفة تكبير الأبعاد B. الرسم التوضيحي لـ LoRA موضح في الصورة.
لỡحظر ذلك، لنفترض أن مصفوفة التدريب المسبق هي $W_0 \in \mathbb{R}^{d \times k}$، يمكن التعبير عن تحديثها كالتالي:
W = W_0 + \Delta W = W_0 + BA
حيث يمثل $\Delta W$ تغير الأوزان الذي يجب تعلمه أثناء عملية التموين،
B \in \mathbb{R}^{d \times r}, \quad
A \in \mathbb{R}^{r \times k}, \quad
r \ll \min(d,k)
، A و B هما معلمات جديدة أضيفت إلى LoRA وشاركت في التدريب. بعد اكتمال تدريب النموذج، ستحصل على ملف LoRA Adapter منفصل يحفظ المعلمات التي تم الحصول عليها من التموين. عند الاستخدام، يجب تحميل النموذج الأساسي والمرافق المقابل له معًا.
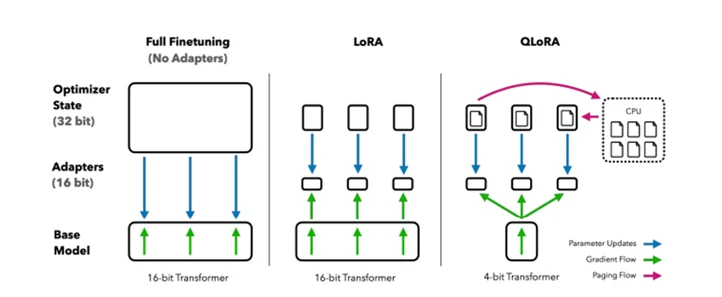
تموين QLoRA (Quantized LoRA): يقلل LoRA بشكل أساسي من استهلاك الموارد الناتج عن المعلمات القابلة للتدريب، لكن النموذج الأساسي نفسه لا يزال بحاجة إلى التحميل في الذاكرة الفائقة. إذا كان حجم النموذج كبيرًا، فقد يستغرق تحميل النموذج الأساسي ذاكرة فائقة كبيرة. لتقليل متطلبات الذاكرة الفائقة بشكل إضافي، يمكنك استخدام تموين QLoRA.
بنية النموذج المقابلة موضحة في الصورة. من الصورة، نلاحظ أن QLoRA هو تحسين لـ LoRA، والتحسين الرئيسي هو استخدام دقة 4 بت والتحسين التقسيمي معًا لتقليل استهلاك ذاكرة النموذج.
يمكن فهم QLoRA ببساطة كدمج بين التكميم و LoRA. يقوم بتكميم النموذج الأساسي بدقة أقل. تتكون ابتكارات QLoRA الرئيسية مما يلي:
4bit NormalFloat (NF4): نوع بيانات جديد، وهو الاختيار الأمثل من الناحية النظرية للمعلومات بالنسبة للأوزان ذات التوزيع الطبيعي.
تقنية التكميم المزدوج: تقلل من استخدام متوسط الذاكرة من خلال إعادة تكميم الثوابت المُكمّمة بالفعل.
المُحسّن التقسيمي: يساعد المُحسّن التقسيمي في إدارة ذروة الذاكرة، ومنع أخطاء نقص الذاكرة أثناء نقاط فحص التدرج.
كيفية اختيار طريقة التموين: انظر أولاً إلى المهمة وبطاقة الرسومات
اختيار طريقة التموين يعتمد بشكل أساسي على حجم النموذج ومتطلبات المهمة وموارد GPU وتكلفة التدريب. لكل طريقة مناسباتها الخاصة، وليس كلما زاد عدد المعلمات المحدثة، كانت نتيجة التموين أفضل بالضرورة. بالنسبة لمعظم مهام التموين، يمكنك تجربة LoRA أولًا. يتطلب LoRA تدريب عدد قليل فقط من المعلمات الجديدة، ومتطلبات GPU وموارد الحسابية منخفضة نسبيًا، وملف Adapter الناتج أصغر أيضًا، مما يسهل حفظه.
إذا كان حجم النموذج الأساسي كبيرًا، حتى مع استخدام LoRA، قد لا تتوفر ذاكرة فائقة كافية للتدريب بعد تحميل النموذج. يمكنك التفكير في QLoRA بشكل إضافي. يقلل QLoRA من استهلاك ذاكرة النموذج الأساسي من خلال التكميم، مما يتيح تموين نماذج أكبر ضمن موارد GPU محدودة. يناسب QLoRA سيناريوهات النماذج الكبيرة ذات GPU المحدود.
إذا كانت موارد GPU وفيرة، والمهمة تتطلب تعديلات أكثر شمولية على النموذج، يمكنك التفكير في التموين الكامل المعلمات. نظرًا لأن جميع معلمات النموذج تحتاج إلى التحديث أثناء التدريب، فإن التموين الكامل المعلمات يتطلب متطلبات أعلى للذاكرة الفائقة والموارد الحسابية وبيانات التدريب، وتكاليف تدريب وحفظ النموذج أعلى أيضًا. لذلك، عادةً ما يجب تقييم ما إذا كان من الضروري استخدامها بناءً على المهمة الفعلية.
في المشاريع العملية، يمكننا أولًا التحقق من النتيجة بتكلفة أقل، ثم اختيار ما إذا كان يجب زيادة تكلفة التدريب بناءً على الاحتياجات الفعلية. إذا تمكن LoRA بالفعل من تحقيق النتيجة المتوقعة، فعادةً لا يوجد داعٍ لاختيار التموين الكامل المعلمات لمجرد تحديث المزيد من المعلمات.
استخدام ms-swift لإتمام جلسة تموين واحدة
ما الذي يوفره ms-swift من العمل؟
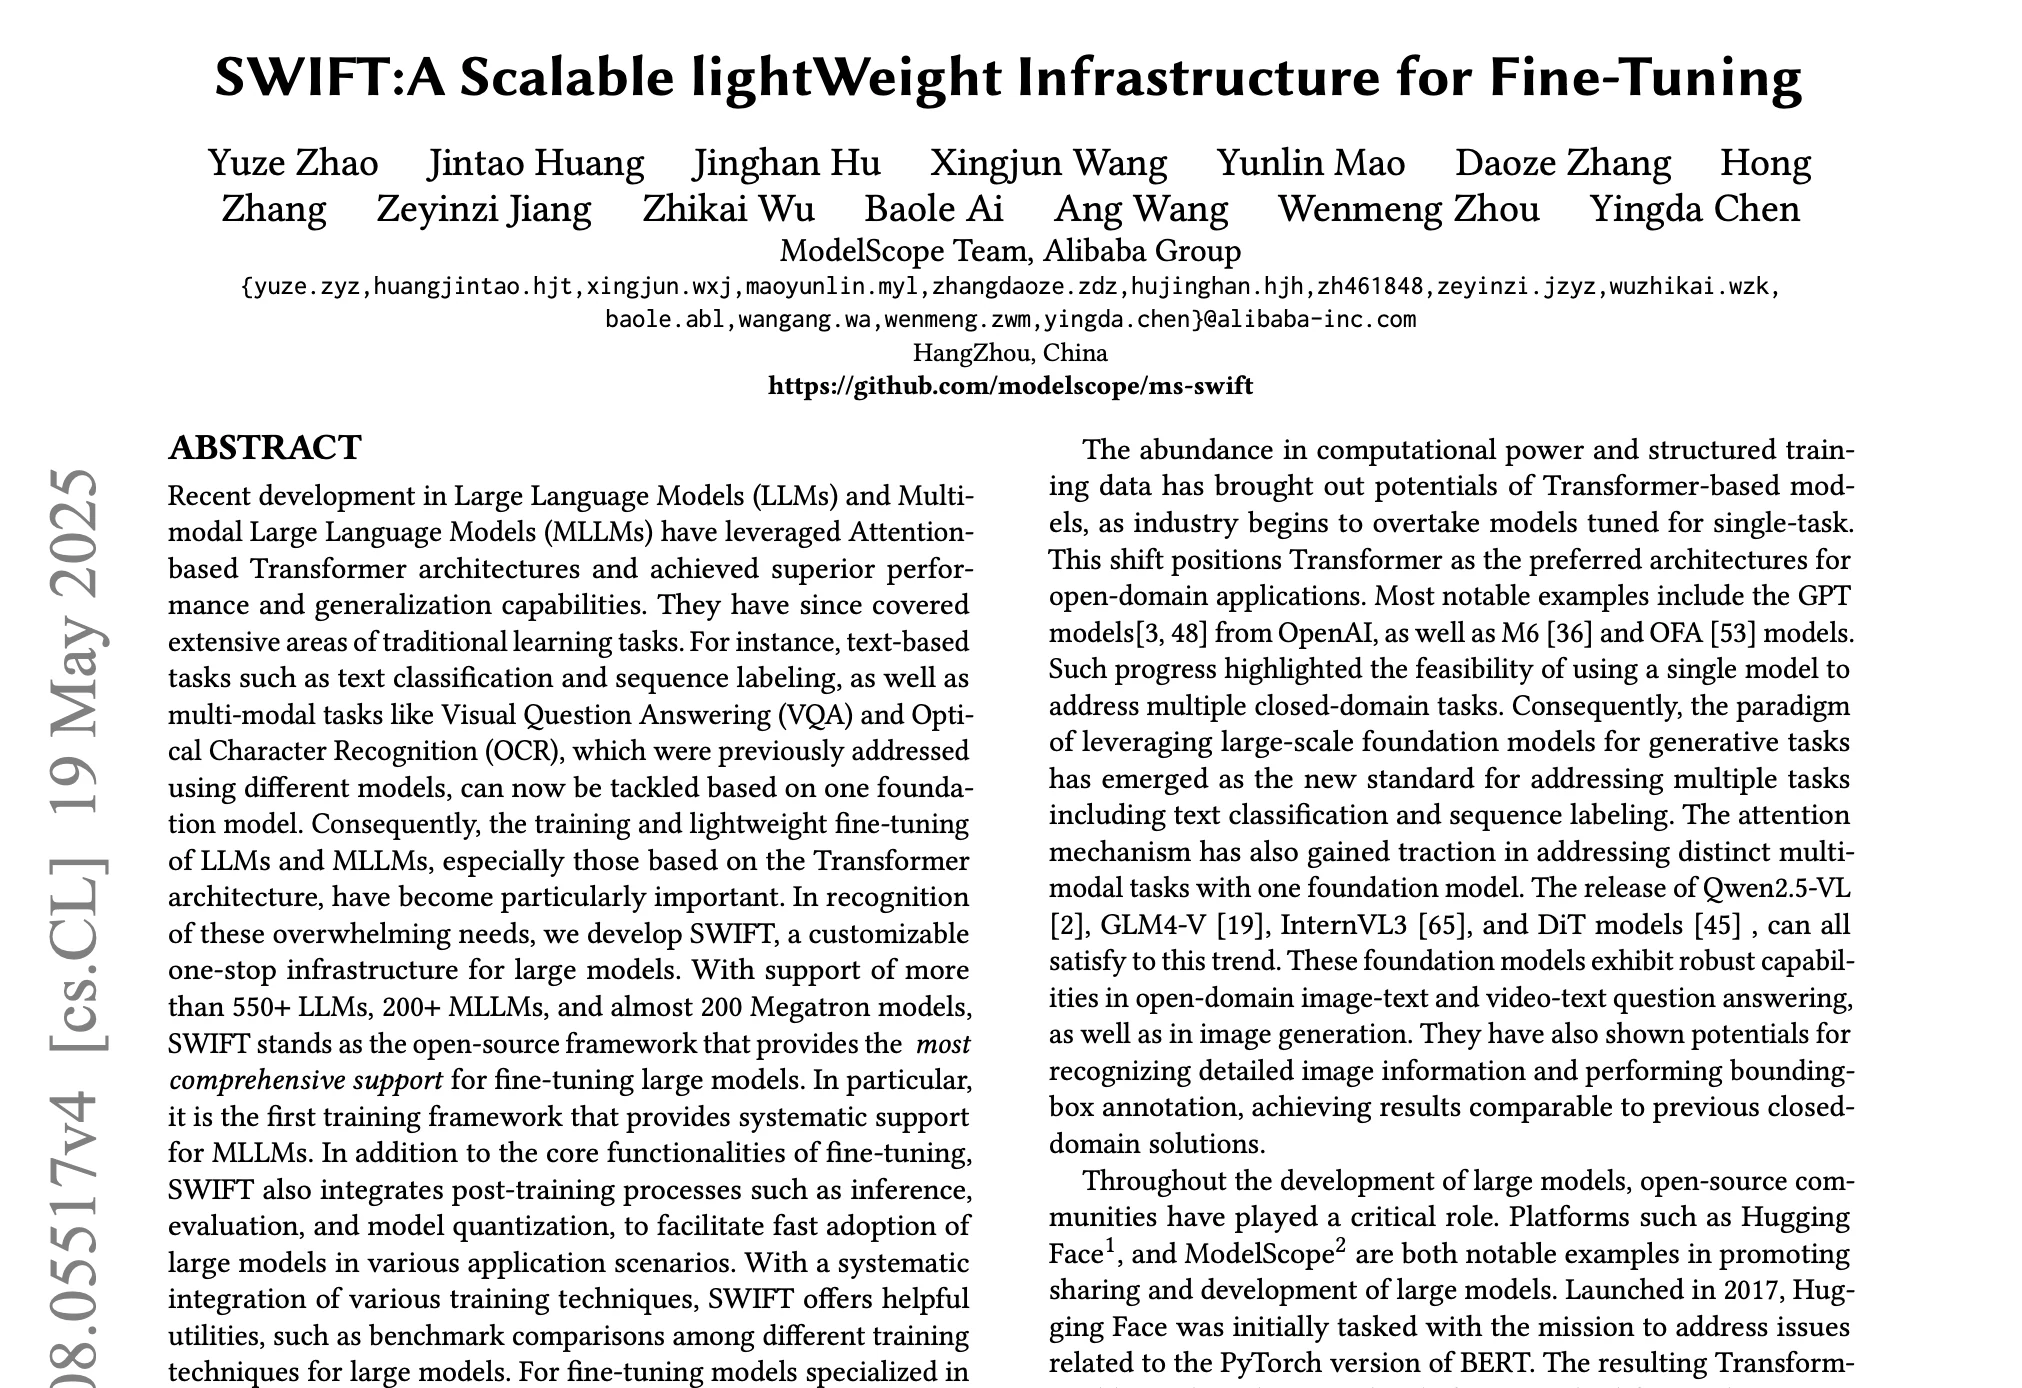
ms-swift (SWIFT، Scalable lightWeight Infrastructure for Fine-Tuning) هو إطار عمل مفتوح المصدر لتدريب ونشر النماذج الكبيرة من مجتمع ModelScope، موجه بشكل أساسي للنماذج اللغوية الكبيرة والنماذج الكبيرة متعددة الوسائط، ويوفر أدوات متكاملة من تدريب النموذج والتموين إلى الاستدلال والتقييم والنشر.
يدعم حاليًا نماذج اللغة الكبيرة الشائعة مثل Qwen و DeepSeek و Llama و GLM و InternLM، بالإضافة إلى النماذج متعددة الوسائط مثل Qwen-VL و InternVL، كما يدعم تدريب نماذج أو مهام التضمين وإعادة الترتيب وتصنيف النصوص.
يمكنك الاطلاع على المزيد من طرق الاستخدام على ms-swift.
بالإضافة إلى التدريب، يوفر ms-swift أيضًا سير عمل كاملًا لاستخدام النماذج. بعد اكتمال التدريب، يمكنك استخدام swift infer مباشرة لاستدلال النموذج، أو نشر النموذج كخدمة API متوافقة مع OpenAI عبر swift deploy. في جوانب الاستدلال والنشر، يمكنك أيضًا الدمج مع محركات الاستدلال مثل vLLM و SGLang و LMDeploy للتسريع.
من سمات ms-swift للمبتدئين أنه يجمع العديد من الإعدادات المعقدة في عملية تدريب النماذج الكبيرة في حزمة موحدة. عن طريق تحديد النموذج الأساسي وبيانات التدريب وطريقة التموين ومعلمات التدريب عبر معلمات سطر الأوامر، يمكنك إتمام تموين النموذج. في التجربة أدناه، سنستخدم ms-swift لإتمام سير عمل كامل لتموين النموذج، بما في ذلك تحضير بيانات التدريب وبدء تدريب LoRA وعرض نتائج التدريب ودمج أوزان LoRA وتحميل النموذج المموَّن للاستدلال والنشر.
بدء التدريب الفعلي مع مهمة التعرف على الكيانات
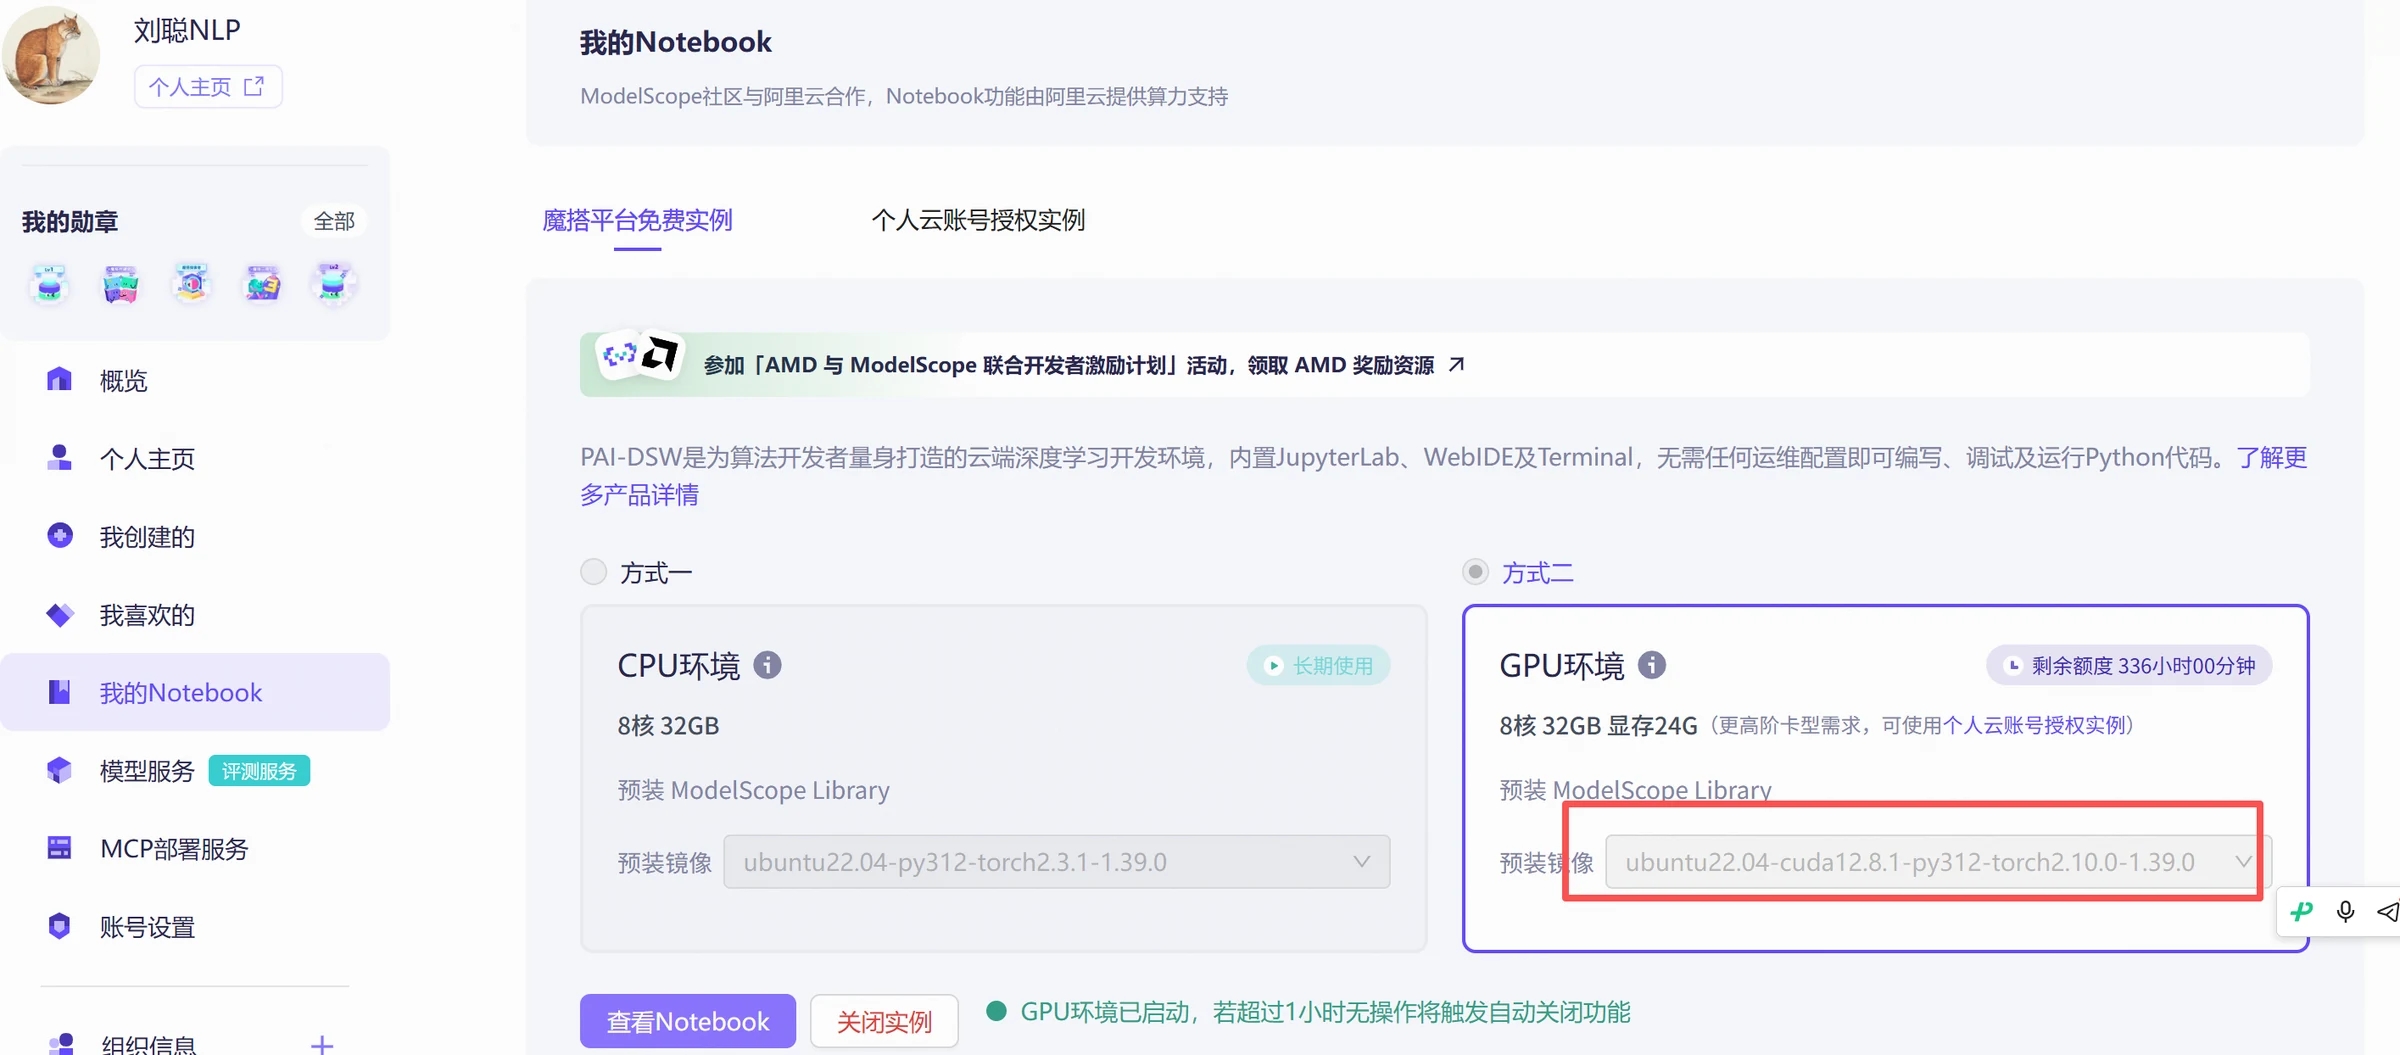
سنستخدم مهمة التعرف على الكيانات كمثال أدناه، لإظهار سير عمل كامل لتموين النموذج في بيئة ModelScope Notebook، بما في ذلك تحضير البيانات وتدريب النموذج والاستدلال بعد التموين. من خلال هذا المثال، يمكنك معرفة كيفية استخدام ms-swift لإتمام تموين النماذج الكبيرة من الصفر. تستمر هذه التجربة في استخدام صورة ubuntu22.04-cuda12.8.1-py312-torch2.10.0-1.39.0 كبيئة التشغيل.
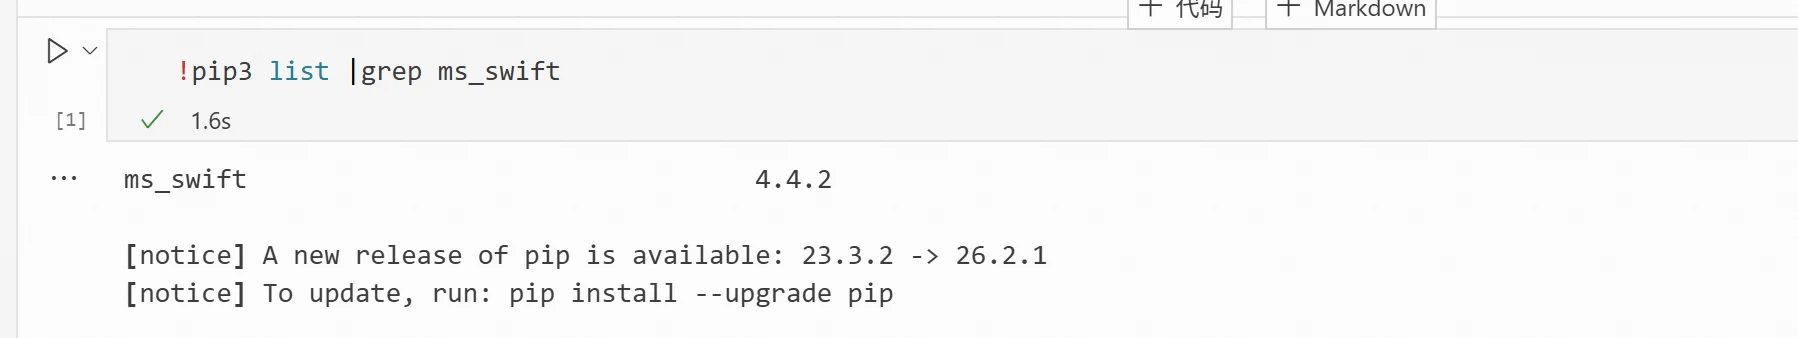
1) التحقق مما إذا كان ms-swift مثبتًا بالفعل في البيئة، لاحظ أن الحزمة هي ms_swift
!pip3 list |grep ms_swift
إذا ظهر الشكل التالي، فهذا يعني أنه تم تثبيت ms-swift بالفعل
إذا لم يكن مثبتًا، قم بتنفيذ
!pip3 install ms-swift
تحضير البيانات: تستخدم هذه التجربة بيانات مفتوحة المصدر، التعرف على الكيانات في التجارة الإلكترونية. يحتوي مجموعة البيانات على أربعة أنواع كيانات: HCCX اسم المنتج، HPPX اسم العلامة التجارية، XH اسم طراز المنتج، MISC تمثل كيانات أخرى، بما في ذلك الدول والأحجام والأسماء والأشخاص والأعمال وأسماء الأنشطة.
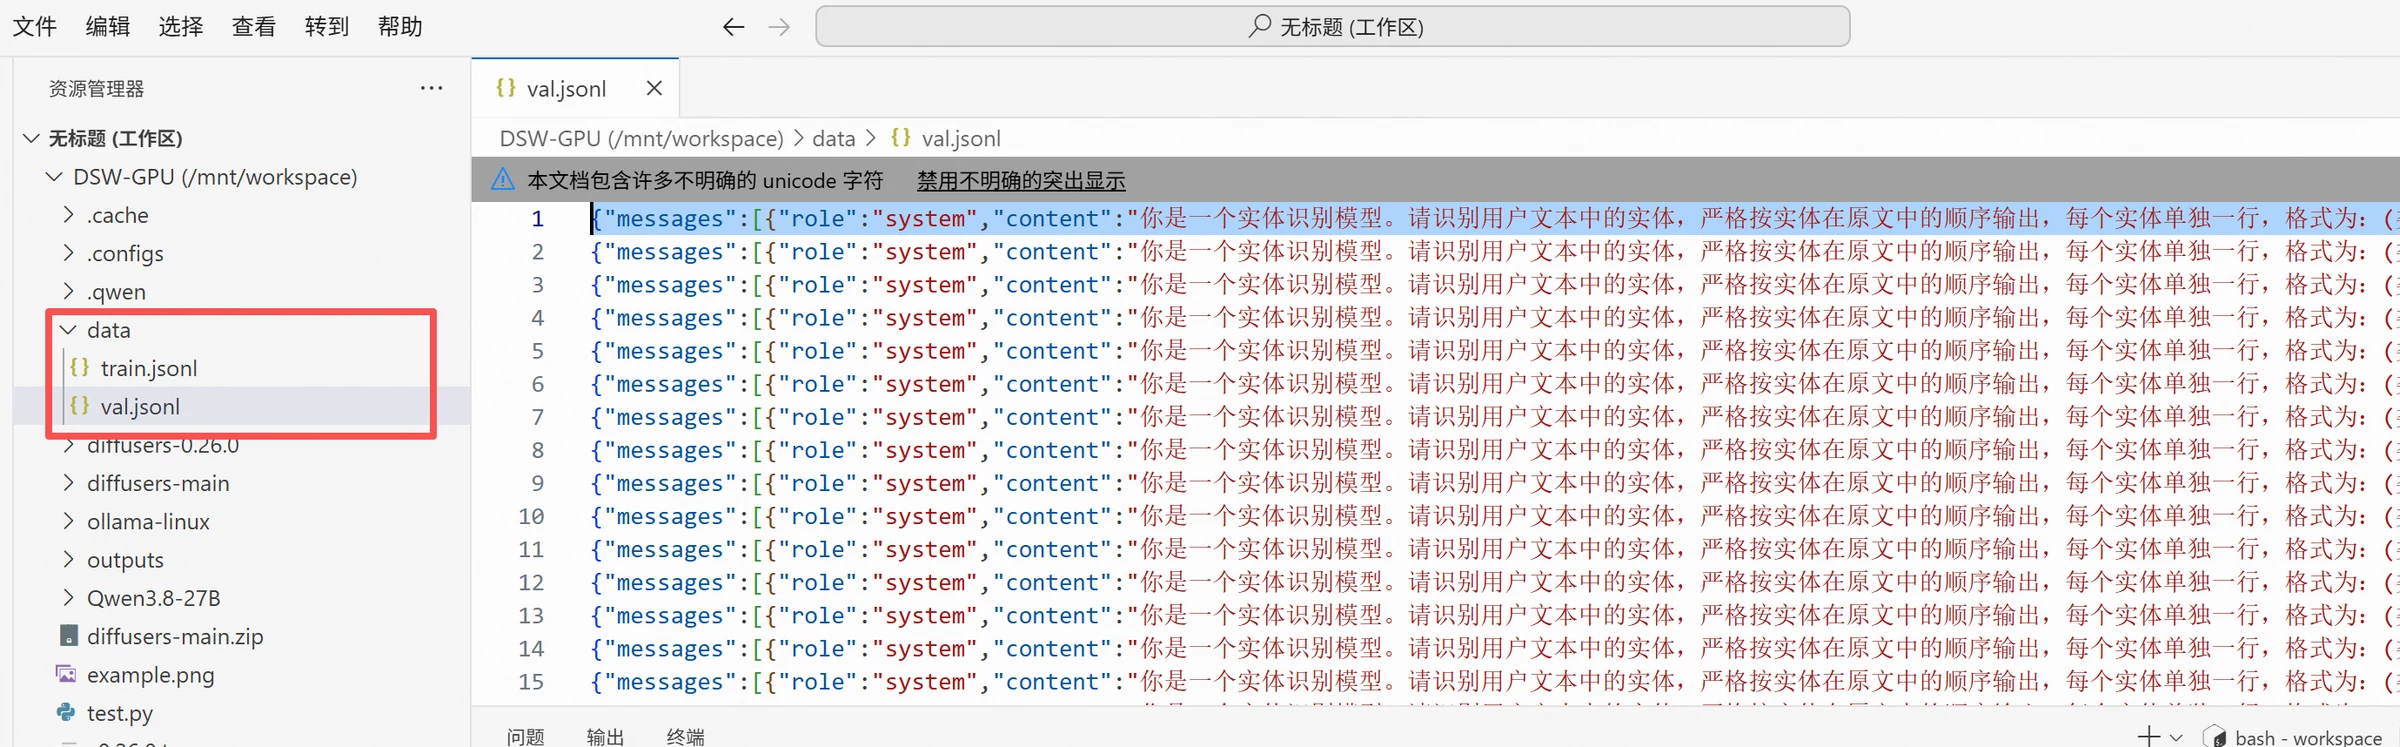
أولاً أنشئ مجلدًا باسم data، ثم ارفع البيانات إليه بالنقر السمين. شكل البيانات كالتالي. تطلب هذه المهمة من النموذج فقط إخراج فئة الكيان والكيان والموقع الابتدائي المقابل له في النص. تُقسم البيانات إلى مجموعة تدريب ومجموعة اختبار، حيث يحتوي train.jsonl على 5400 عينة و val.jsonl على 600 عينة.
{"messages":[{"role":"system","content":"You are an entity recognition model. Please identify entities in the user's text, output strictly in the order of entities in the original text, each entity on a separate line, format: (type, entity text, start position). Start position starts from 0; type can only be one of HCCX, HPPX, MISC, XH. When there are no entities, output only: no entity. Do not output explanations, Markdown or other content."},{"role":"user","content":"زيت زيتون لتدليك الجسم الكامل وعلاج الحلاقة الوجهية"},{"role":"assistant","content":"(HCCX,زيت الزيتون,10)\n(HCCX,زيت تدليك,20)\n(HCCX,زيت,24)\n(HCCX,زيت,27)"}]}
شكل المجلد كالتالي:
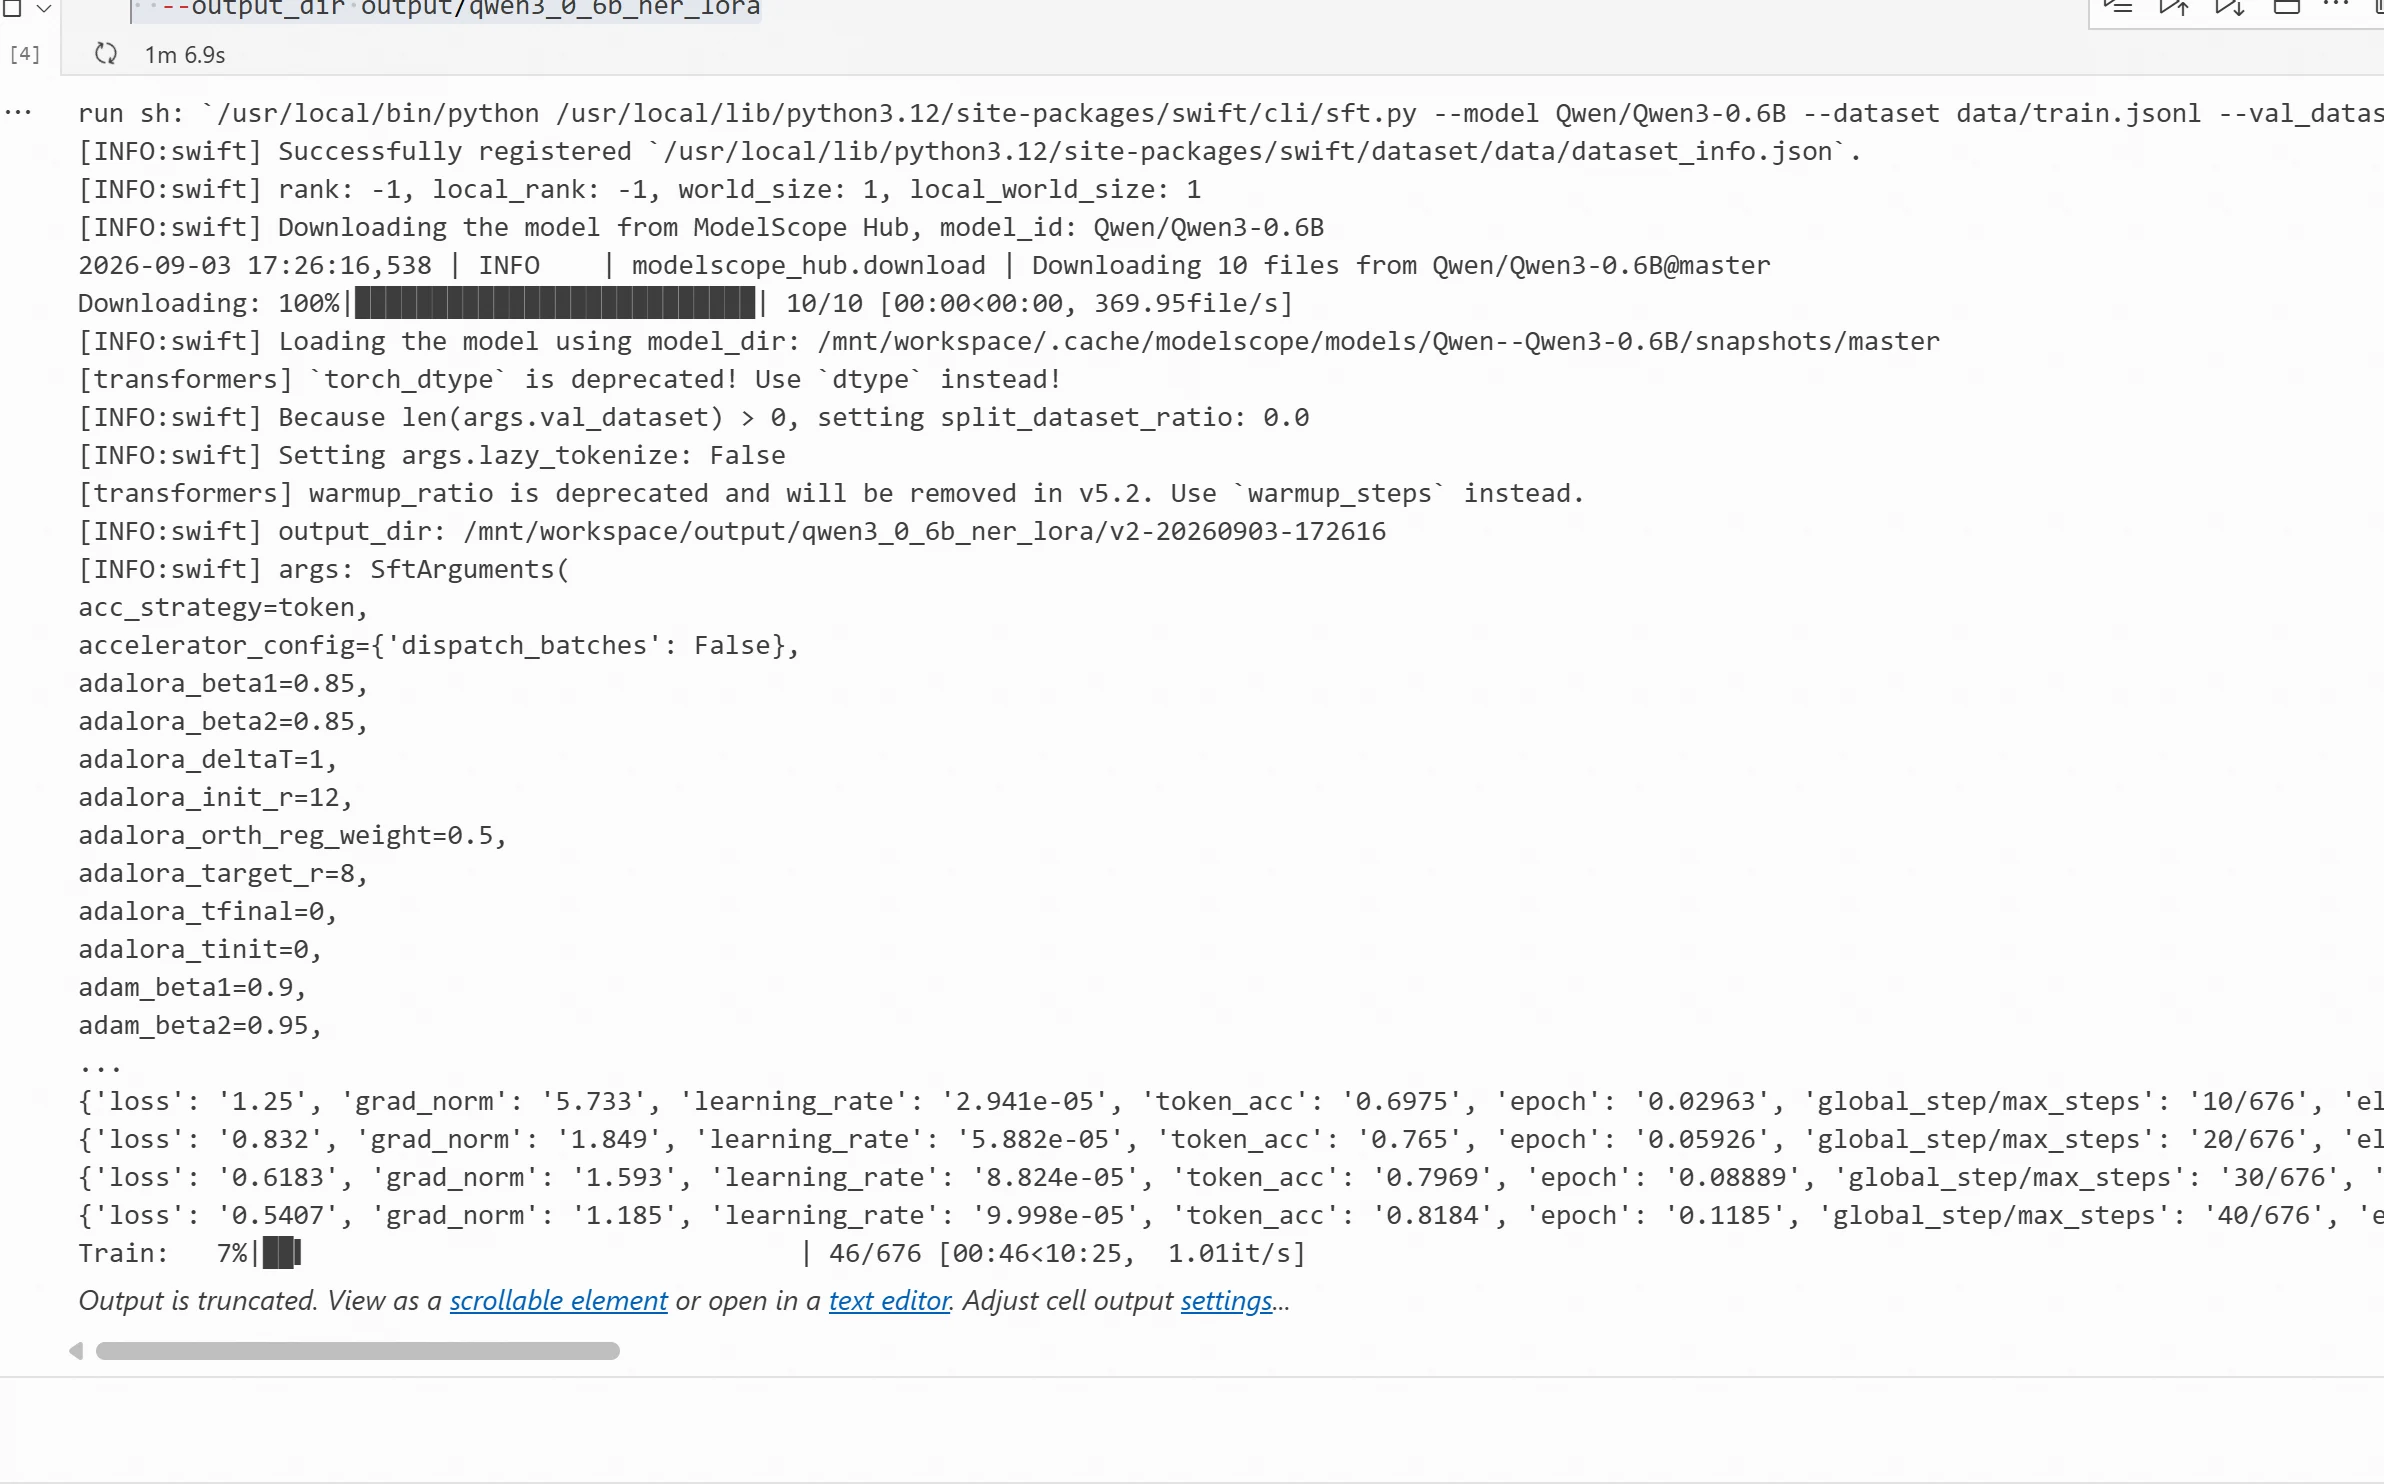
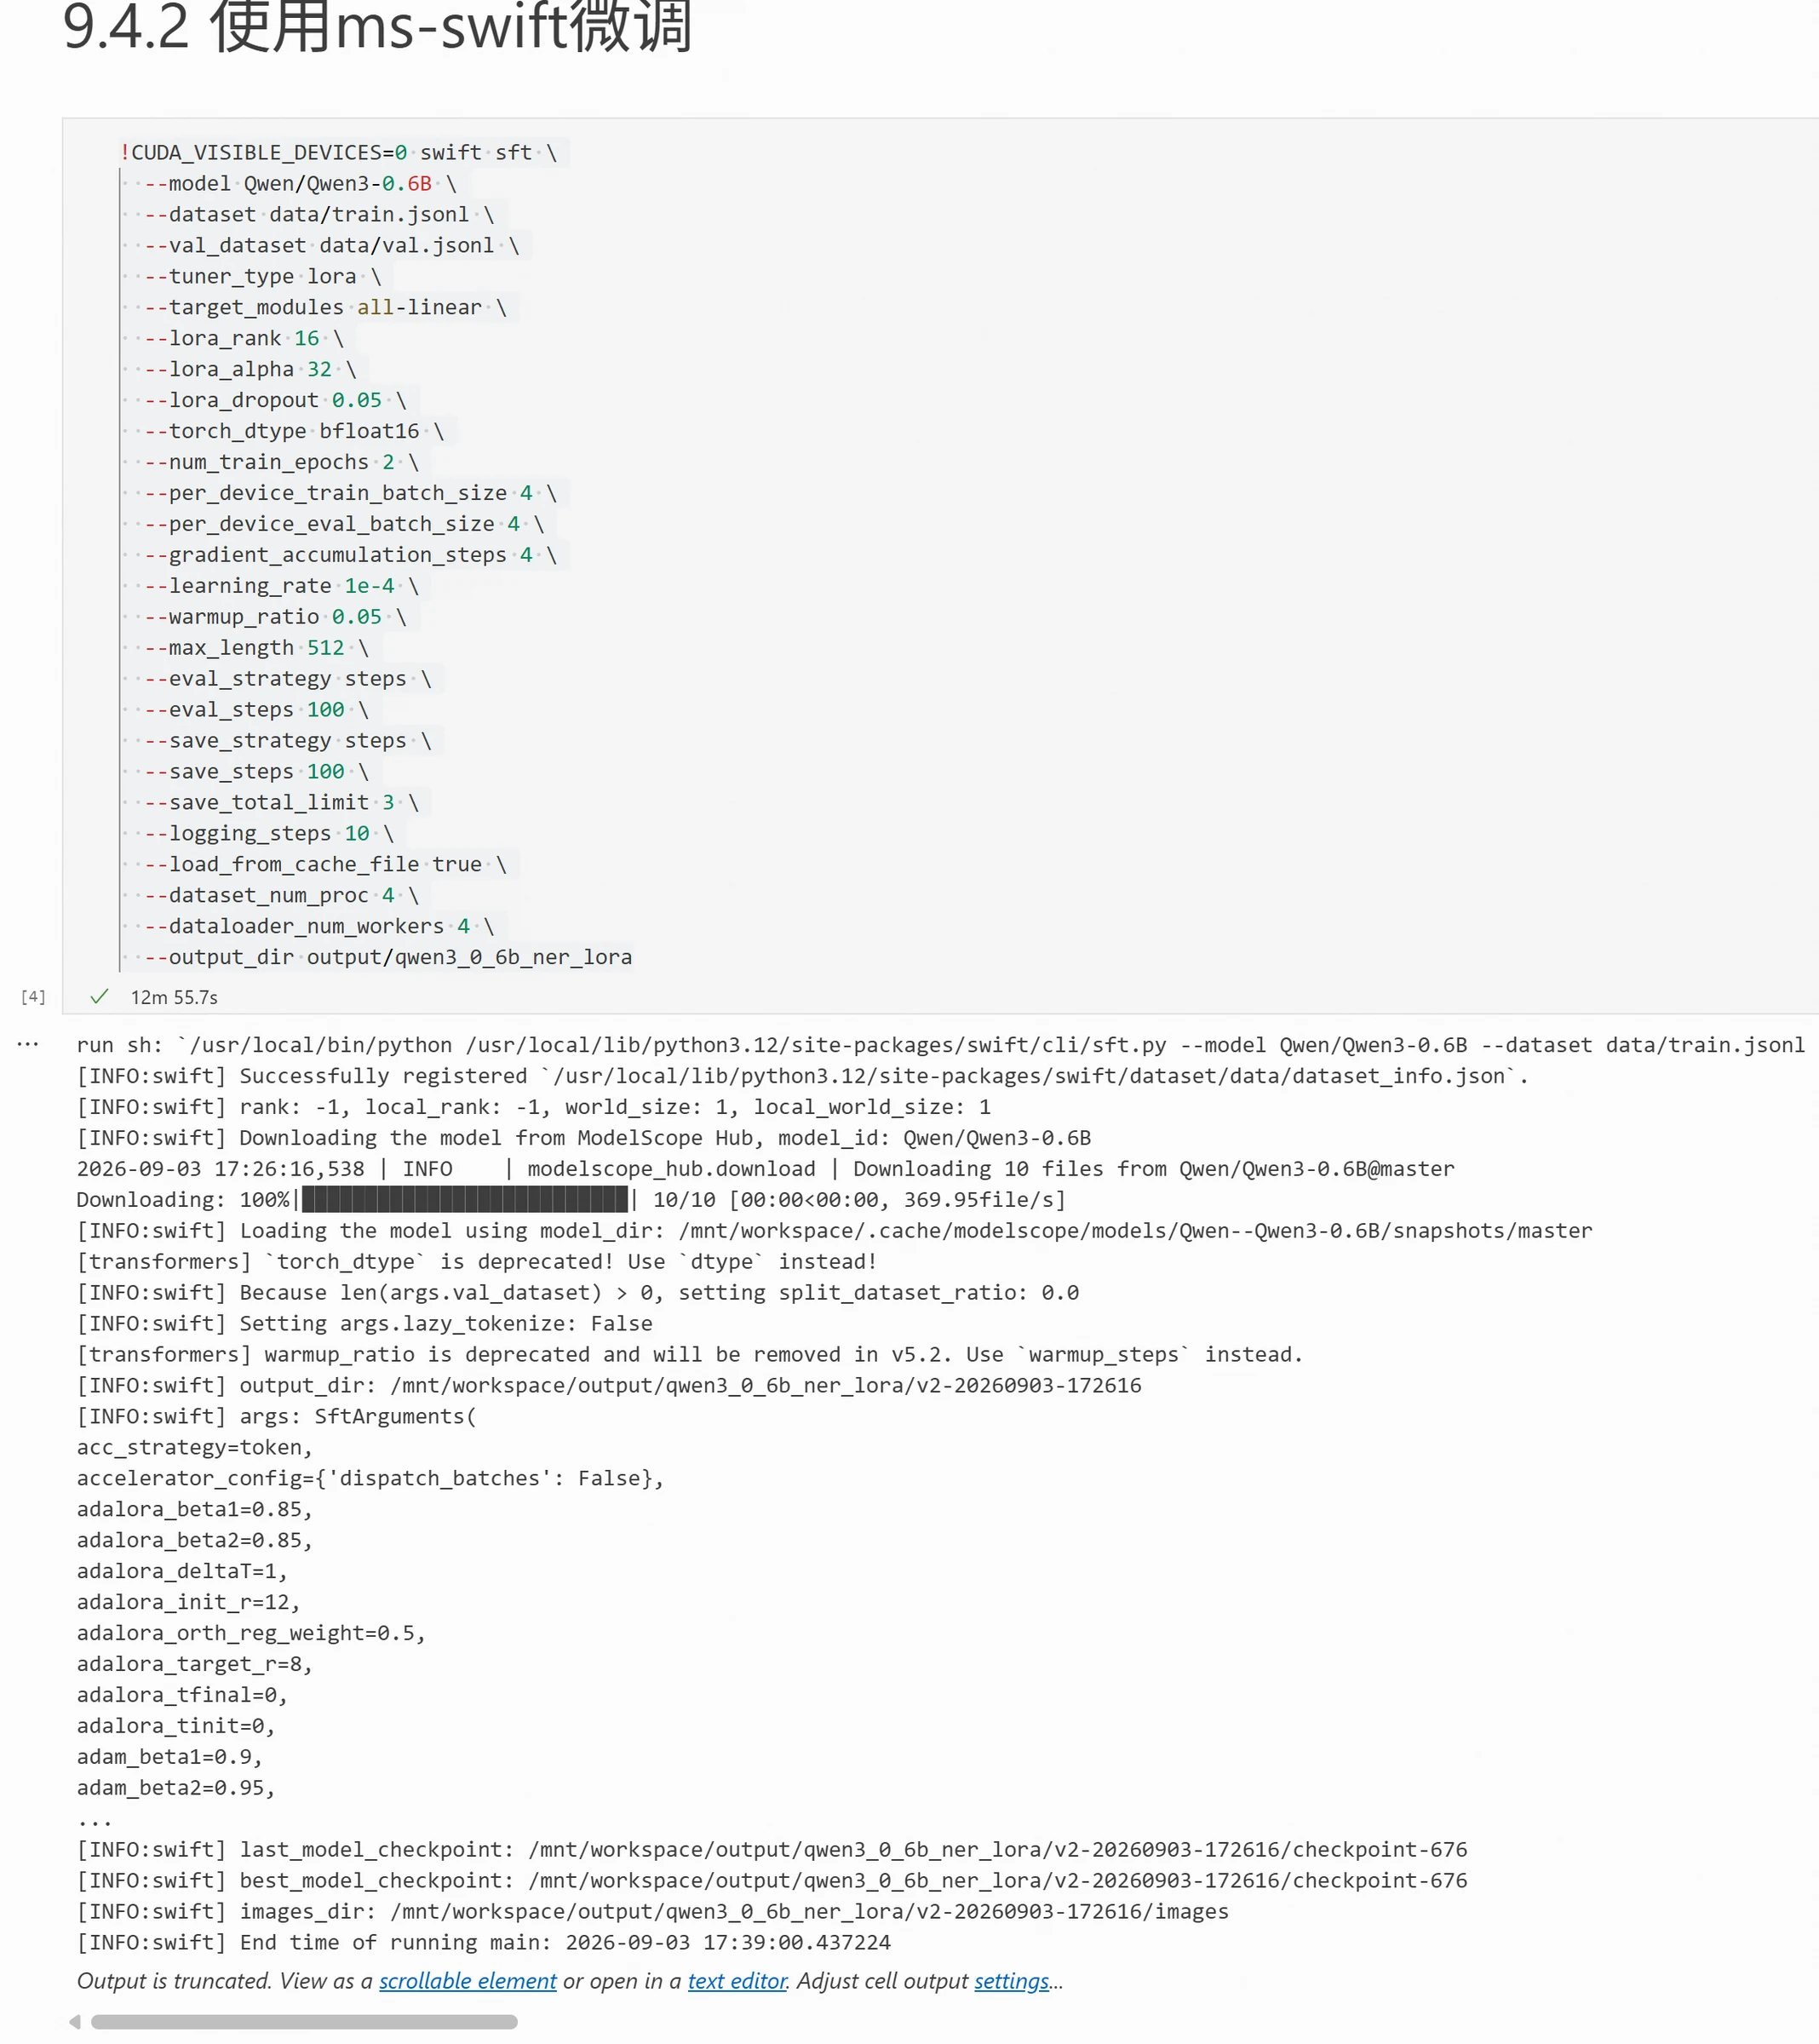
تدريب النموذج: يستخدم هذا الجزء Qwen/Qwen3-0.6B للتموين. يمكنك بدء التدريب عن طريق إدخال الأمر التالي مباشرة في الطرفية:
بعد بدء التدريب، سيقوم ms-swift بإخراج معلومات التدريب الحالية باستمرار، كالتالي:
بعد انتهاء التدريب، كيف يتم استخدام النموذج؟
دمج أوزان LoRA في النموذج الأساسي
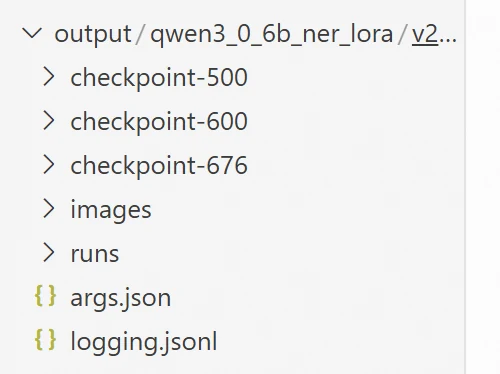
بعد اكتمال تدريب LoRA، سيتم حفظ مرافق LoRA المقابل. المرافق ليس نموذجًا كبيرًا كاملًا، لذلك تحتاج إلى تحميل النموذج الأساسي الأصلي عند الاستخدام. عبر output_dir في سكربت التدريب، يمكنك رؤية نقاط الفحص والملفات المرافقة في المجلد. في النشر الفعلي، يمكنك دمج مرافق LoRA مع النموذج الأساسي لإنتاج نموذج كامل، مما يسهل النشر غير المتصل أو نقل النموذج. شكل المجلد بعد اكتمال تدريب النموذج كالتالي:
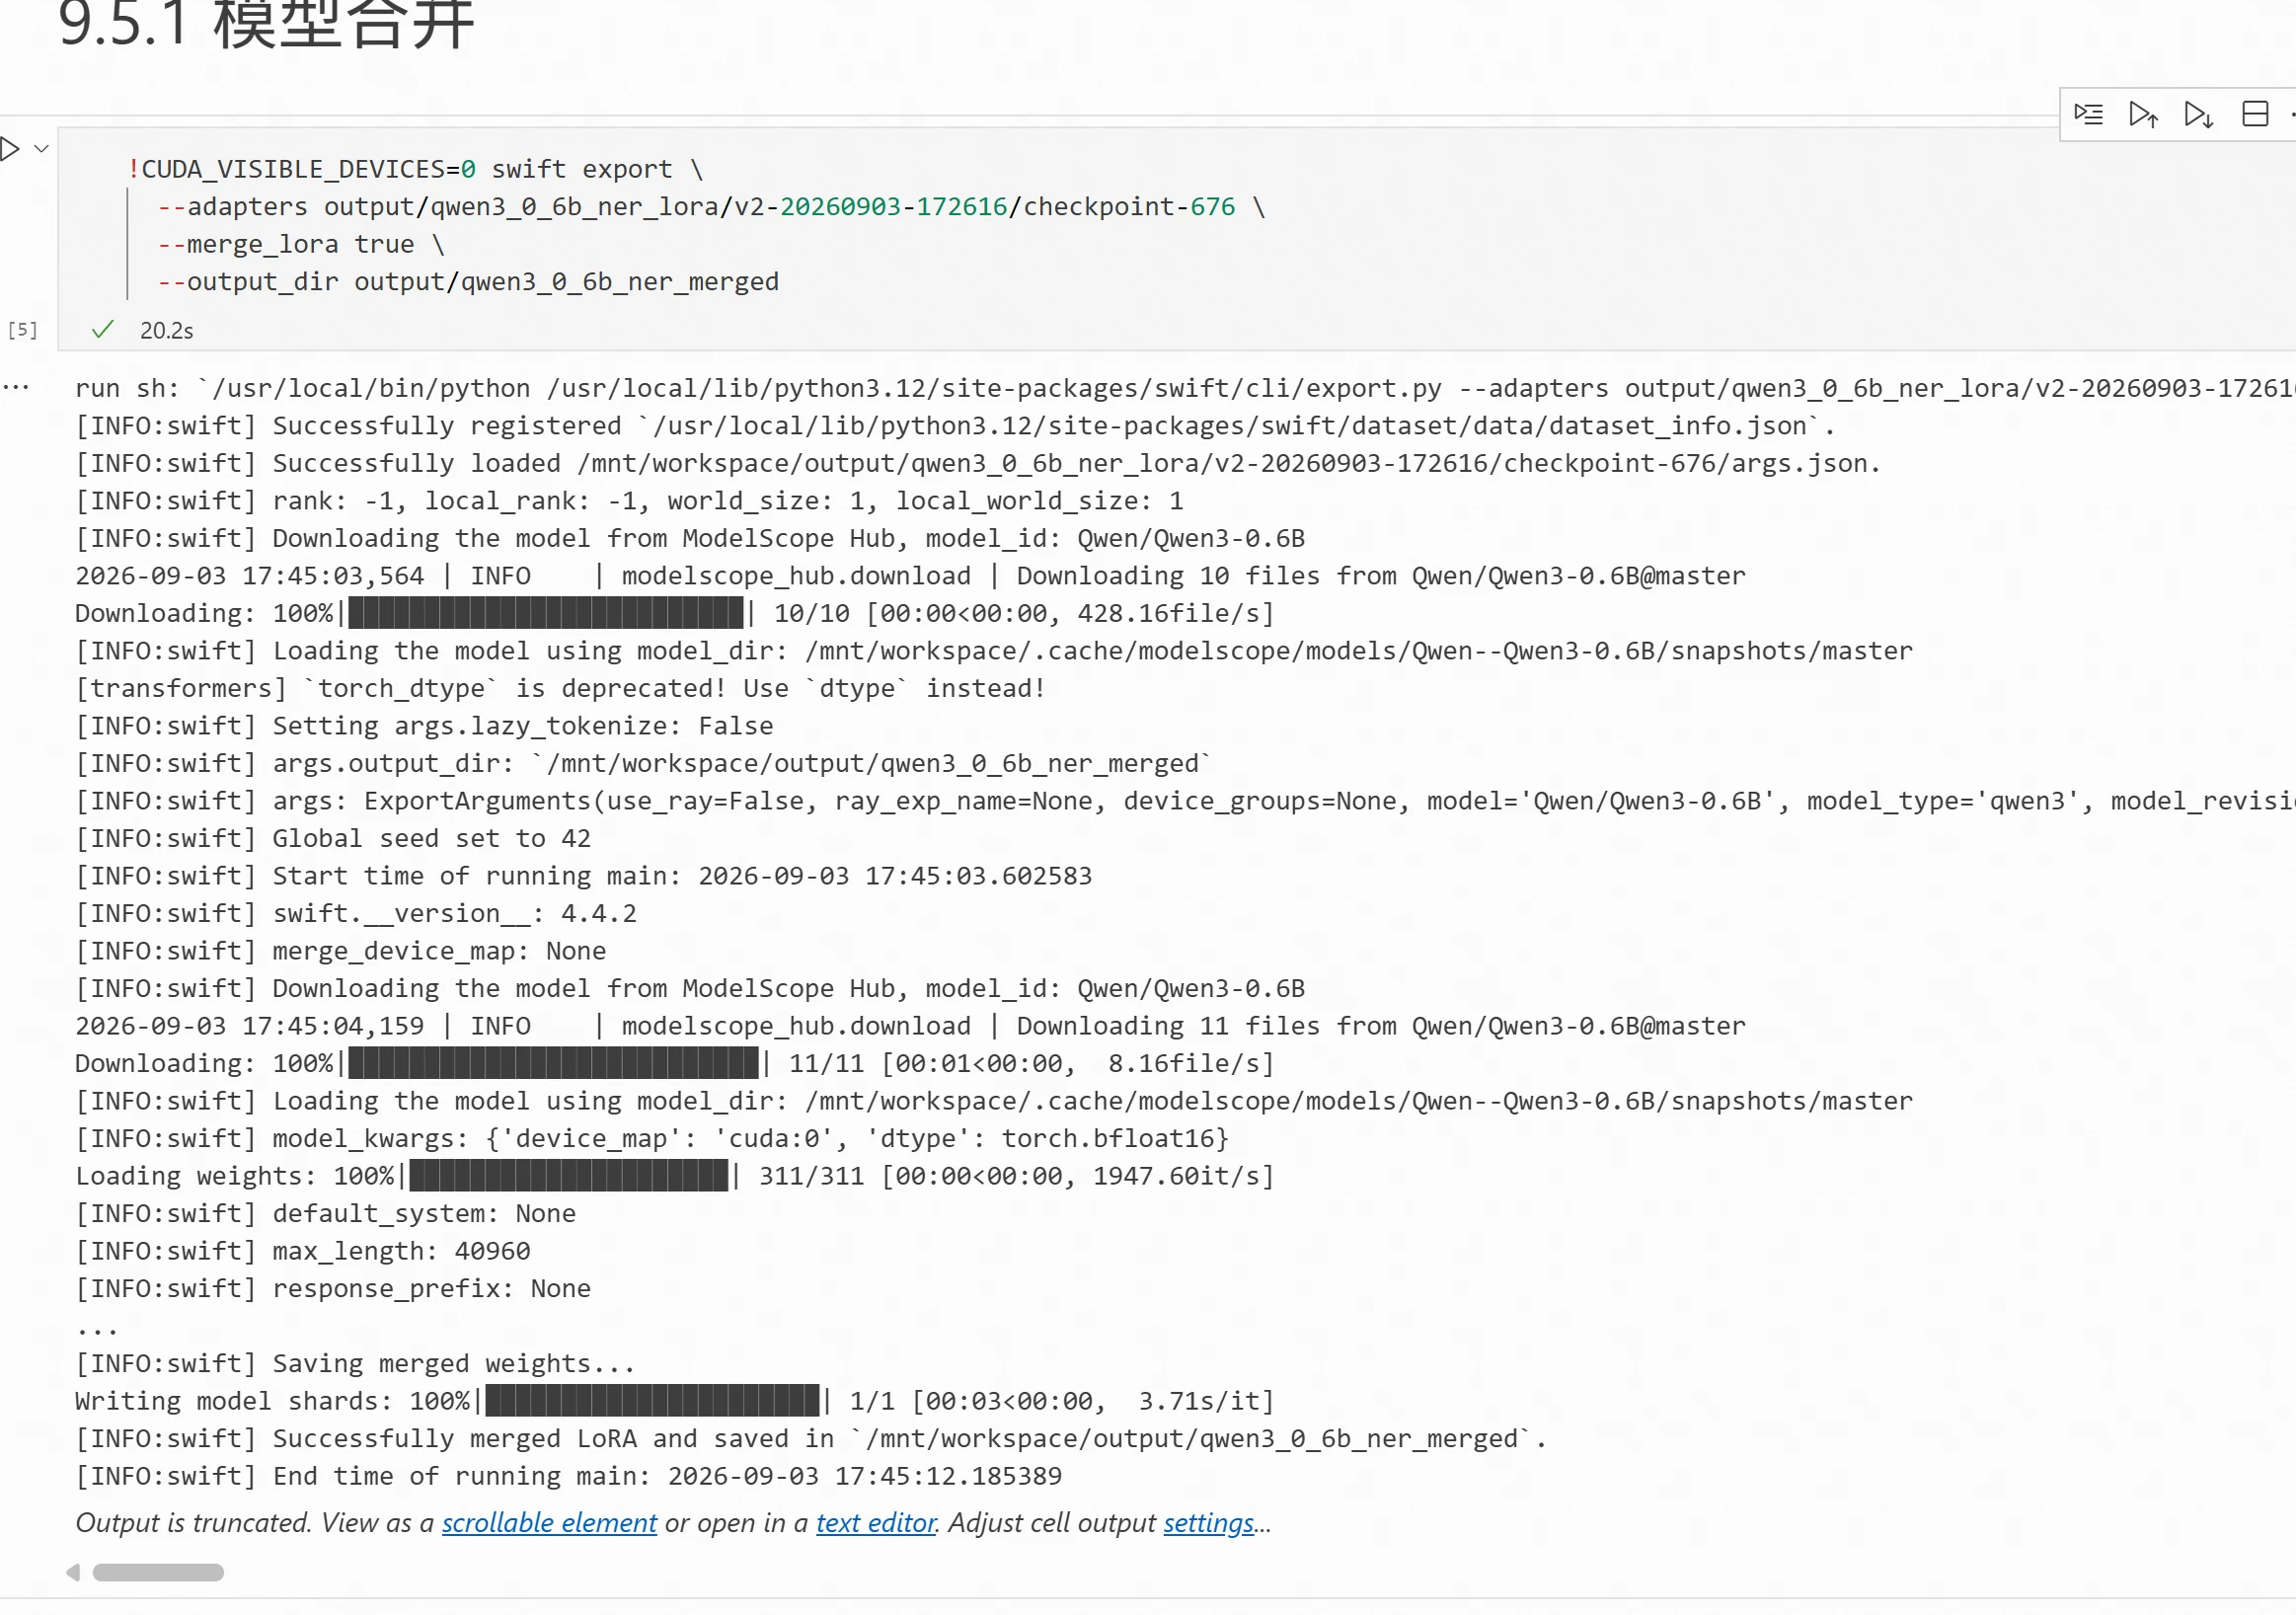
حيث يحدد --adapters مسار نقطة فحص LoRA الناتجة عن التدريب، ويعني --merge_lora true دمج معلمات LoRA مع النموذج الأساسي، ويحدد --output_dir مجلد حفظ النموذج المدمج.
نتيجة التنفيذ كالتالي:
تحميل النموذج المموَّن وتجربة النتيجة الفعلية
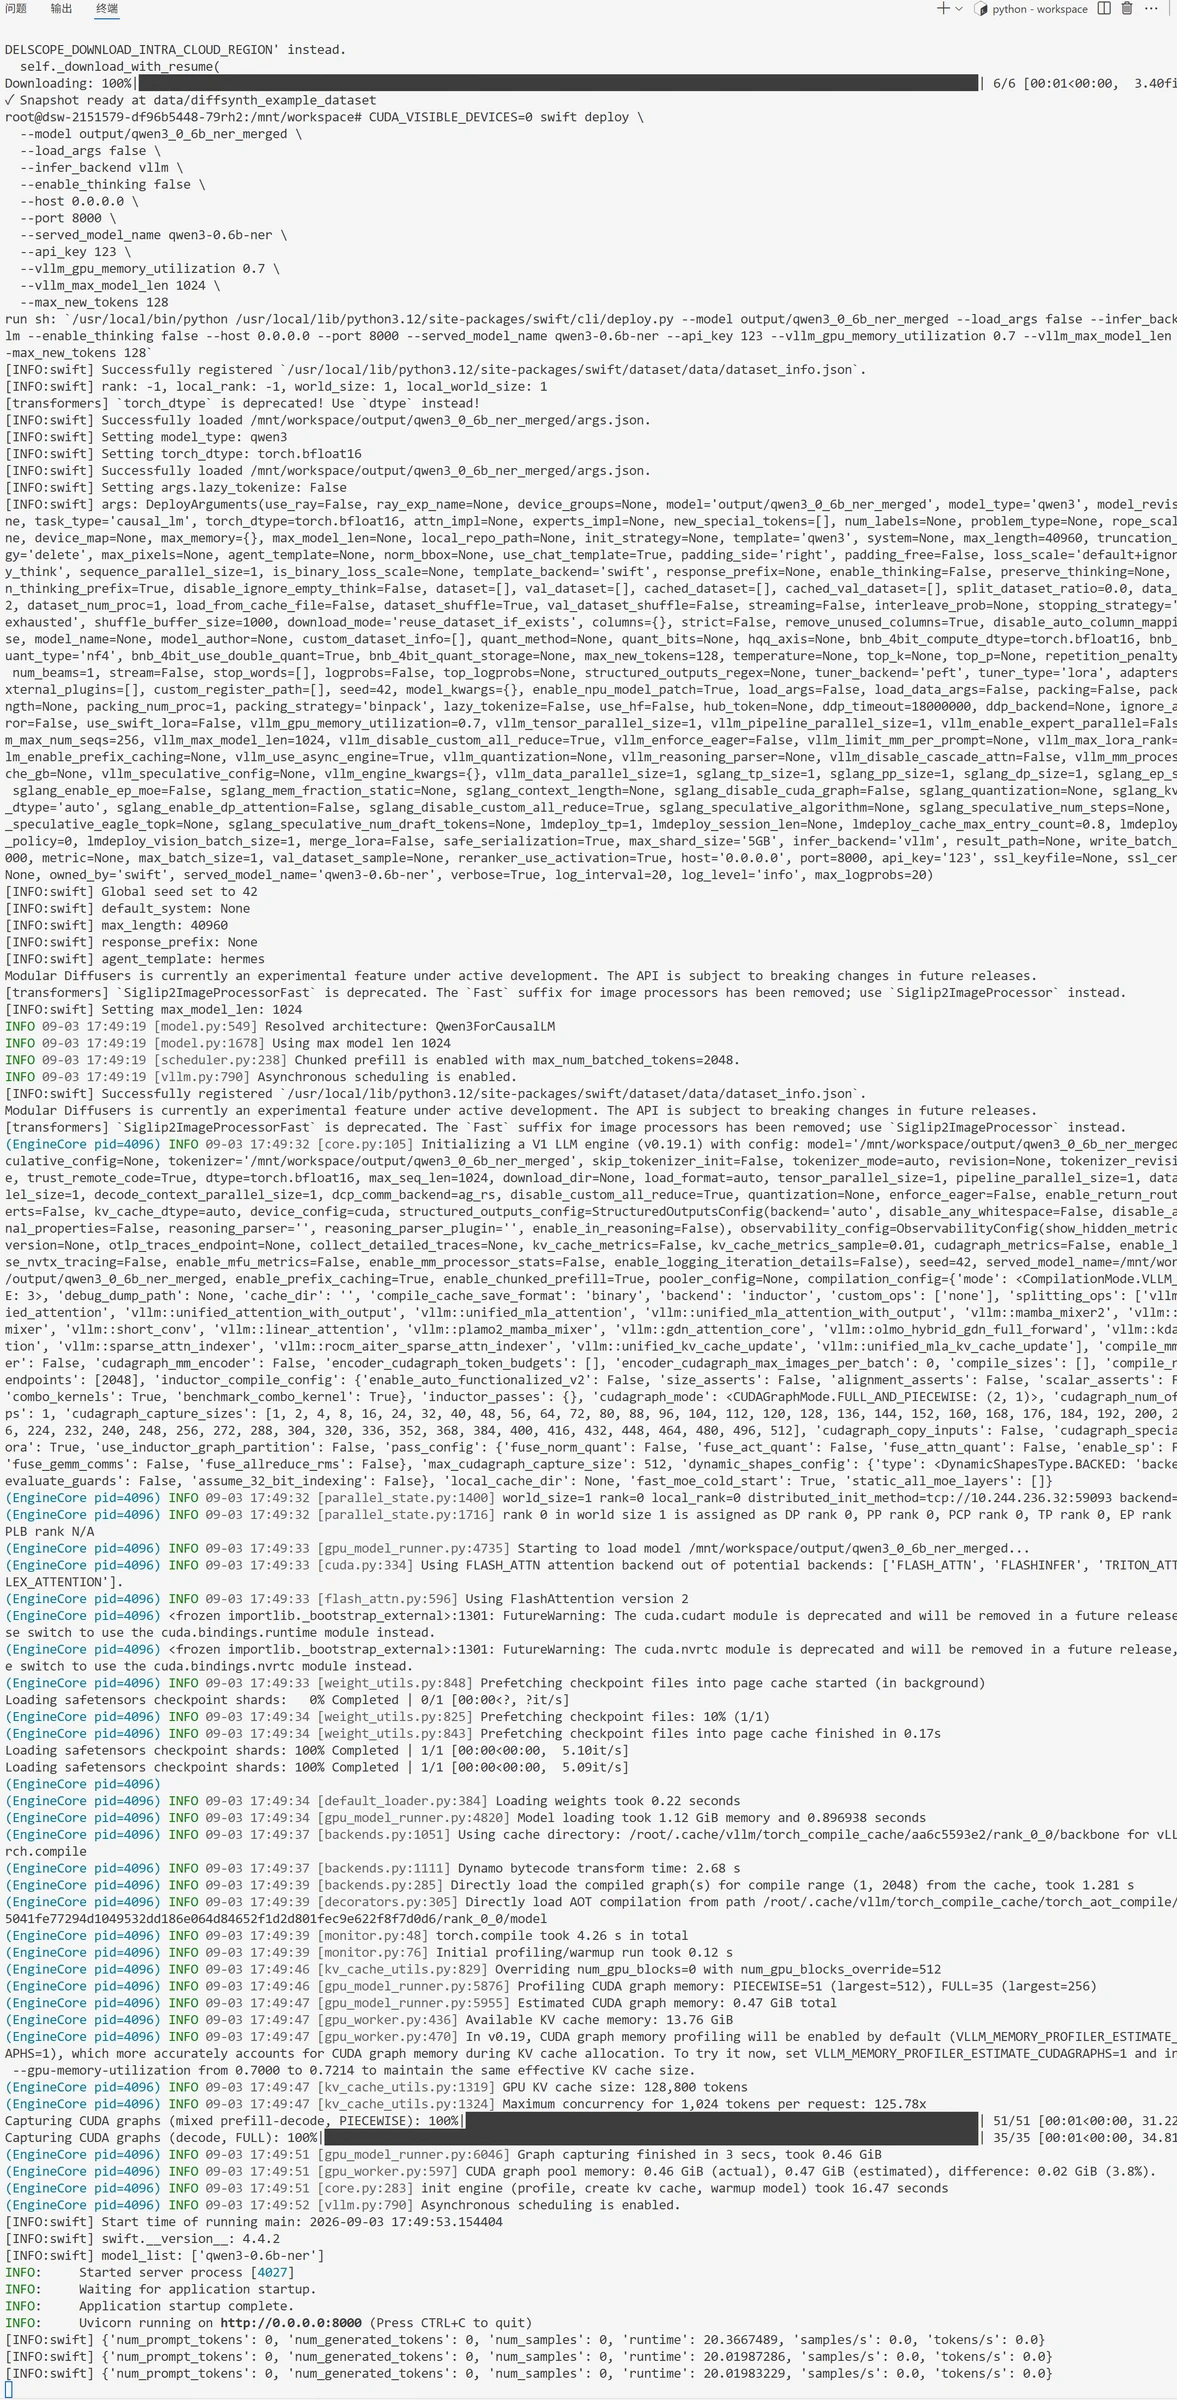
بعد اكتمال الدمج، يمكنك تحميل النموذج الكامل المُنشأ مباشرة للاستدلال. لتسهيل استدعاء التطبيقات، يمكنك أيضًا تشغيل النموذج كواجهة برمجة تطبيقات متوافقة مع OpenAI، بحيث يمكن الوصول إلى النموذج المموَّن عبر واجهة برمجة التطبيقات. هذا أيضًا خدمة مستمرة تحتاج إلى التشغيل من الطرفية. يمكنك الرجوع إلى الفصل السابع لمعرفة كيفية تشغيل أمر في الطرفية. أمر التشغيل كالتالي:
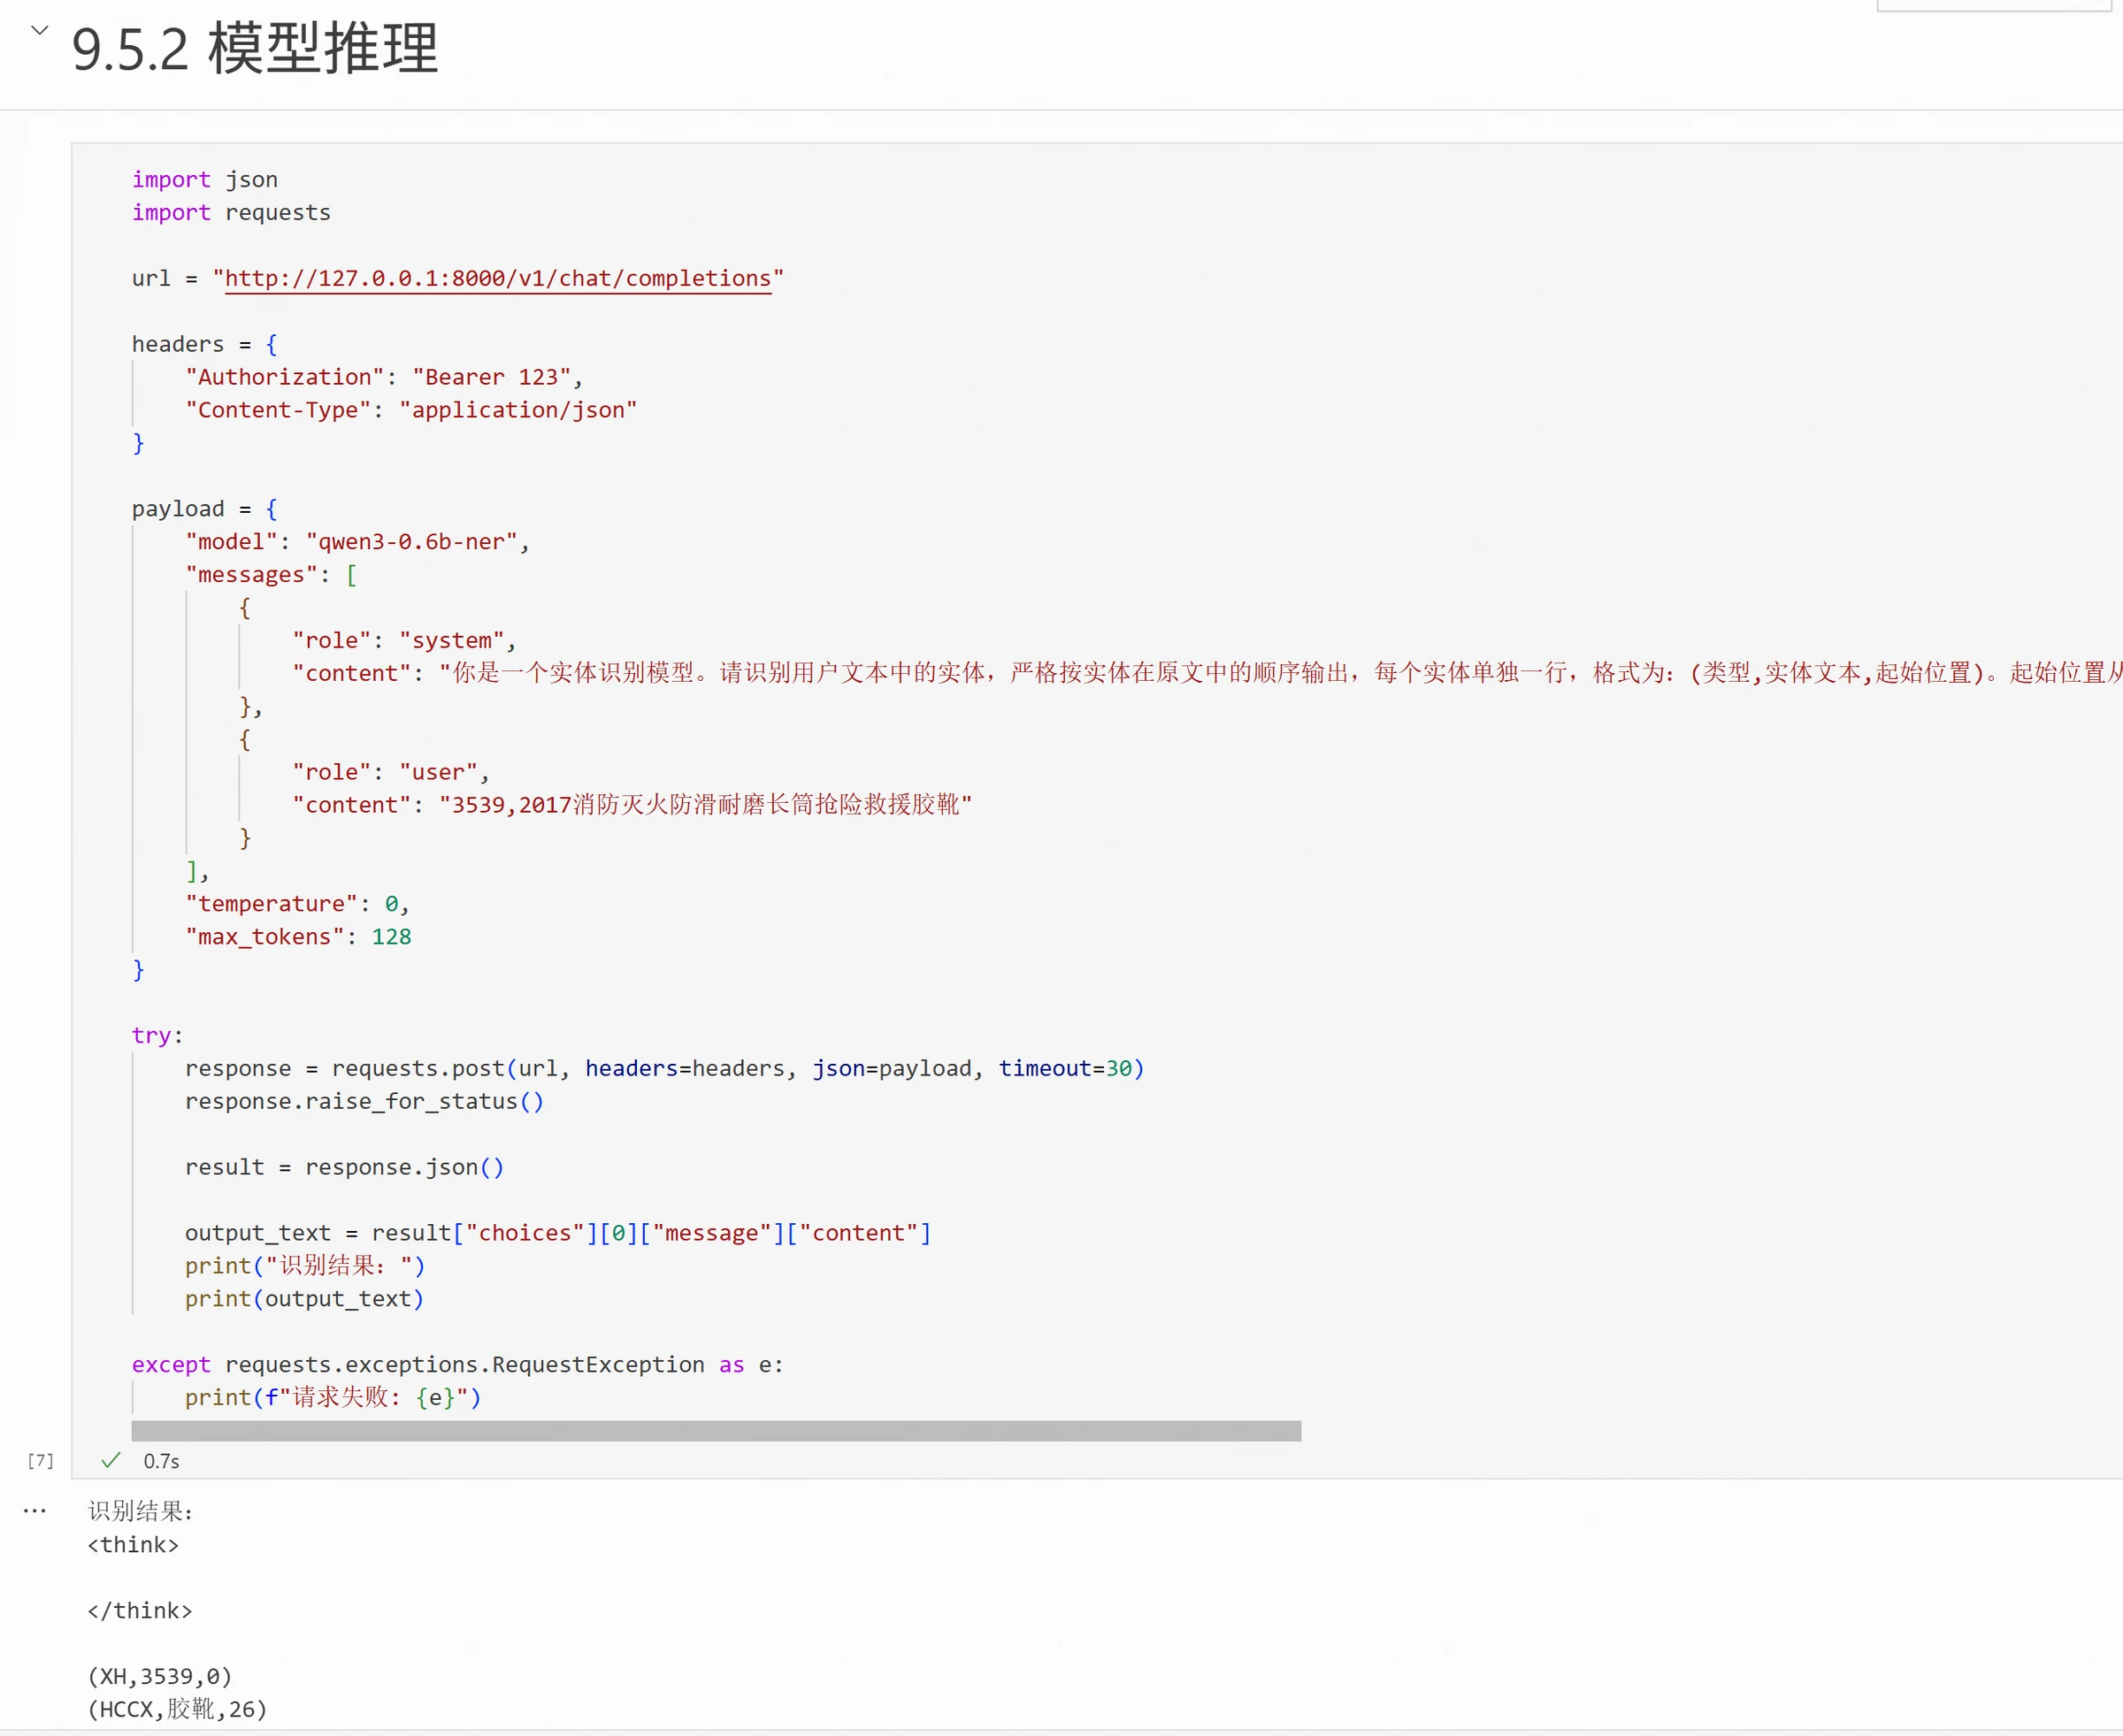
بعد اكتمال تشغيل النموذج، يمكنك اختبار الاتصال عبر الواجهة. الكود كالتالي:
import json
import requests

url = "http://127.0.0.1:8000/v1/chat/completions"

headers = {
    "Authorization": "Bearer 123",
    "Content-Type": "application/json"
}

payload = {
    "model": "qwen3-0.6b-ner",
    "messages": [
        {
            "role": "system",
            "content": "أنت نموذج التعرف على الكيانات. يرجى تحديد الكيانات في نص المستخدم، وإخراجها بدقة وفقًا لترتيب الكيانات في النص الأصلي، كل كيان في سطر منفصل، بالتنسيق: (النوع،نص الكيان،الموقع الابتدائي). يبدأ الموقع الابتدائي من 0؛ يمكن أن يكون النوع أحد هذه الأنواع فقط: HCCX، HPPX، MISC، XH. عند عدم وجود كيانات، أخرج فقط: لا يوجد كيانات. لا تخرج شروحات أو Markdown أو علامات think أو محتوى آخر."
        },
        {
            "role": "user",
            "content": "3539,2017 حذاء إنقاذ طويل مقاوم للاحتراق والانزلاق ومتين للإنقاذ"
        }
    ],
    "temperature": 0,
    "max_tokens": 128
}

try:
    response = requests.post(url, headers=headers, json=payload, timeout=30)
    response.raise_for_status()

    result = response.json()

    output_text = result["choices"][0]["message"]["content"]
    print("نتيجة التعرف:")
    print(output_text)

except requests.exceptions.RequestException as e:
    print(f"فشلت الطلب: {e}")
نتيجة الإخراج كالتالي، ويمكننا أيضًا استخدام التعبير النمطي لإزالة علامات think.
يمكنك الرجوع إلى جميع بيانات التجربة والكود في هذا الفصل عبر: https://modelscope.cn/gallery/liucong/ab458cbd-b47f-4830-91b6-314ea2036fc6