التحسين الدقيق والتقييم • مبتدئ⏱️ 20 دقيقة للقراءة
Preference Alignment
النموذج يستطيع الإجابة بالفعل، لماذا نحتاج إلى مواءمة التفضيلات؟
بعد ضبط النموذج الدقيق، يستطيع الإجابة على الأسئلة وفقًا للمتطلبات، ولكن عند وضع عدة إجابات معًا، نجد بينها ما هو جيد وما هو سيء، وبعضها يبدو أكثر راحة للمستخدم.
لنأخذ مثال استفسار استرداد الأموال: كلا الإجابتين تخبران المستخدم أين يتقدم بالطلب، لكن الإجابة الأولى تقدم فقط رابط الإجراء، بينما الإجابة الثانية توضح أيضًا أن الأمر يحتاج إلى مراجعة ويعتمد على حالة الطلب. كلا الإجابتين تذكران استرداد الأموال، لكن الثانية توضح الظروف التي قد يواجهها المستخدم بشكل أوضح وتقلل من سوء الفهم.
عندما نقوم بضبط SFT، نقوم بتنظيم مثل هذه الإجابات كأمثلة ليتعلم منها النموذج. والآن يمكننا أيضًا وضع إجابات مختلفة لنفس السؤال معًا وإخبار النموذج بأيها نفضل ومعايير التقييم.
هذا هو مواءمة التفضيلات، وسنبدأ من هنا.
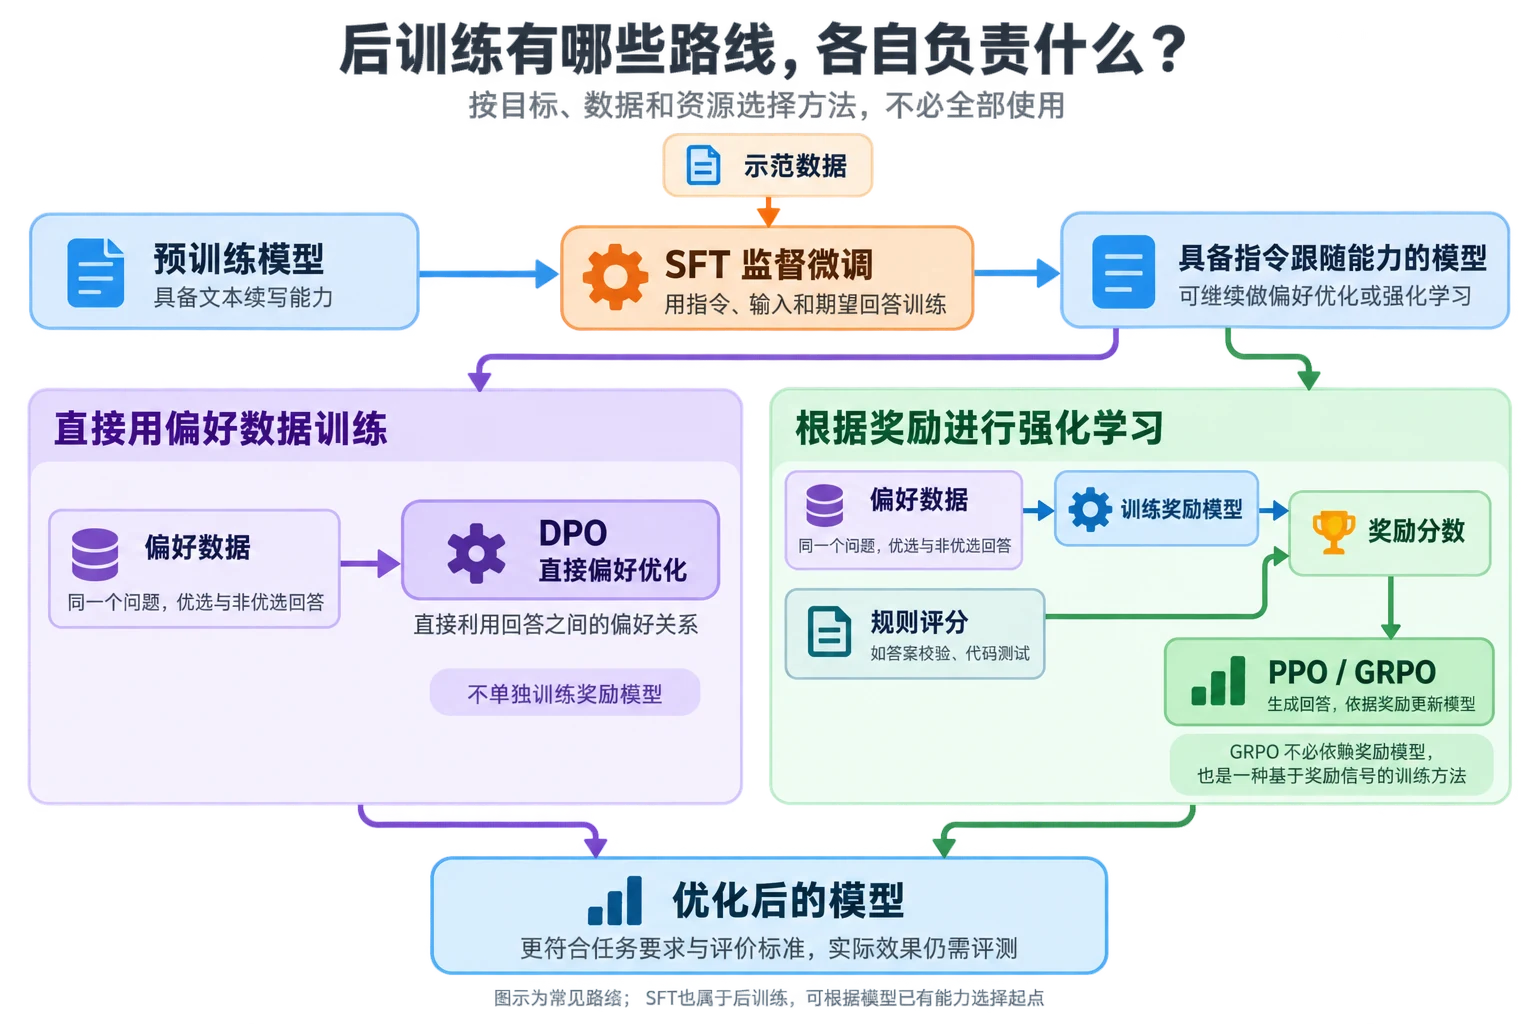
لنلخص أولاً: ما هي أساليب ما بعد التدريب؟
الغرض الرئيسي من تدريب النماذج الكبيرة ما بعد التدريب هو مساعدة النموذج الأساسي الذي يمتلك بالفعل قدرة على إكمال النص ليتحور تدريجيًا إلى نموذج قادر على الحوار المباشر واتباع التعليمات وإكمال المهام المحددة بشكل أفضل. ما بعد التدريب ليس خوارزمية ثابتة واحدة، بل هو مصطلح جماعي لمجموعة من أساليب التدريب، وتشمل الأساليب الشائعة SFT وتحسين التفضيلات وتدريب نموذج المكافأة والتعلم المعزز، وتختار النماذج المختلفة تركيبات مختلفة بناءً على أهداف التدريب وشروط البيانات والتكلفة.
من بينها، يستخدم SFT بشكل رئيسي بيانات بصيغة "التعليمات والمدخلات والمخرجات المرجعية" لتعلم النموذج كيفية فهم المهام واتباع التعليمات والإجابة بالتنسيق والأسلوب المرغوب. بالإضافة إلى ذلك، يمكن استخدام بيانات التفضيلات لموازنة النموذج بشكل أعمق، مثل إنشاء إجابات مفضلة وغير مفضلة لنفس السؤال، لتعليم النموذج معايير التقييم البشرية أو التجارية. يمكن استخدام بيانات التفضيلات لإعداد نموذج المكافأة وتحويل التفضيلات البشرية إلى درجات مكافأة قابلة للحساب، ثم دمجها مع أساليب التعلم المعزز مثل PPO وGRPO لتحسين استراتيجية توليد النموذج باستمرار؛ كما يمكن استخدام أساليب مثل DPO مباشرة لكتابة علاقة التفضيل بين الإجابات المفضلة وغير المفضلة مباشرة في هدف التدريب دون تدريب نموذج المكافأة بشكل منفصل.
لذلك، لا يوجد سير عمل ثابت واحد لتدريب النماذج الكبيرة ما بعد التدريب، وتحمل SFT ونموذج المكافأة وPPO وGRPO وDPO مسؤوليات مختلفة. يُستخدم SFT بشكل أساسي لبناء قدرة أساسية على ابتعاث التعليمات، ويلتزم نموذج المكافأة بتقديم إشارات تقييم قابلة للقياس، ويقوم PPO وGRPO بتحسين استراتيجية التوليد بناءً على إشارات المكافأة، بينما يستخدم DPO بيانات التفضيلات مباشرة لإكمال موازنة النموذج. في عملية التدريب الفعلية، قد لا تُستخدم جميع هذه الأساليب، وقد لا تُجمع بنفس الترتيب تمامًا، بل تُختار بمرونة بناءً على قدرات النموذج وأهداف التدريب وموارد التدريب.
عرض الأمثلة على النموذج: ما الذي يعلمه SFT؟
SFT هو الضبط الخاضع للإشراف، وهو يستخدم المدخلات والمخرجات المرجعية المنظمة بالفعل لمتابعة تدريب النموذج لزيادة احتمالية توليد الإجابة المرجعة عند رؤية مدخلات مشابهة.
يمكن كتابة بيانات SFT بشكل كالتالي:
{
  "instruction": "توليد رد خدمة عملاء بناءً على سؤال المستخدم",
  "input": "اشترك العضو بالأمس في التجديد التلقائي، وأريد تقديم طلب استرداد الأموال.",
  "output": "يرجى الدخول أولاً إلى صفحة الطلب للتحقق من حالة طلب التجديد. عند استيفاء شروط الاسترداد، يمكنك تقديم الطلب في تفاصيل الطلب؛ إذا لم يكن هناك رابط للاسترداد في الصفحة، يرجى التواصل مع خدمة العملاء للتحقق."
}
أثناء التدريب، يحوّل المُقسِّم (Tokenizer) التعليمات والمدخلات والإجابات إلى رموز (Tokens). يتوقع النموذج الرمز التالي بناءً على الرموز السابقة، ثم يحسب الفرق بين نتيجة التوقع والإجابة المرجعة لحساب الخسارة. عادةً ما يستخدم SFT خسارة الإنتروبيا المتقاطعة والتدريب بالإكراه التعليمي: عند كل موضع، يرى النموذج السياق الصحيح المحدد في البيانات بدلاً من المحتوى الخاطئ الذي ولّده للتو. تتطلب العديد من تطبيقات ضبط التعليمات حساب الخسارة فقط على جزء الإجابة، حيث تُستخدم التعليمات ومدخلات المستخدم لتوفير السياق دون إعادة توليد النموذج لها.
يغير SFT أولاً تنسيق المهمة. يفهم النموذج تدريجيًا أن المدخل عبارة عن استفسار مستخدم والمخرج عبارة عن رد خدمة عملاء بدلاً من استمرار كتابة سؤال المستخدم. عند استخدامه لاستخراج المعلومات، يمكنه تعلم توليد حقول JSON ثابتة؛ وعند استخدامه لمحاضر الاجتماعات، يمكنه تعلم تنظيم المحتوى وفقًا لمعلومات الاجتماع والاستنتاجات الرئيسية وعناصر العمل. ثانيًا، يغير SFT أسلوب إجابة النموذج. النبرة والطول وهياكل الفقرات ومدى التوضيح وطريقة رفض الإجابة في بيانات التدريب كلها ستكون موضوعات يحاكيها النموذج. إذا كانت الإجابات المرجعة مختصرة بشكل عام، سيميل النموذج إلى تفضيل تقديم الاستنتاج مباشرة؛ وإذا طلبت الأمثلة توضيح الأدلة أولاً ثم تقديم الخطوات، سيتعلم النموذج هذا النوع من التنظيم. يمكن لـ SFT أيضًا تعريض النموذج لأمثلة مجالية. بيانات خدمة العملاء مثل حالة الطلب وشروط استرداد الأموال وتصعيد الخدمة اليدوية، والبنية القانونية للشروط القانونية، واستخدامات الواجهات البرمجية في بيانات الكود، كلها ستؤثر على مخرجات النموذج في المهام ذات الصلة. ومع ذلك، لا يعني ذلك أن النموذج يمتلك بالفعل كل معرفة هذا المجال. يتعلم النموذج هذه الأنماط فقط إذا كانت بيانات SFT تغطي المهام وتحتوي على المصطلحات وأساليب المعالجة المناسبة.
الهدف الأساسي من تدريب SFT هو محاكاة المخرجات المرجعة. يمكنه إخبار النموذج بكيفية الإجابة على هذا النوع من الأسئلة عادةً، لكنه لا يضمن أن الحقائق في الإجابة تم التحقق منها، ولا يمكنه تعلم مقارنة جميع الإجابات الممكنة من مثال واحد فقط. قد يحصل نفس سؤال استرداد الأموال على إجابتين كالتالي:
الإجابة A: يرجى تقديم طلب استرداد الأموال في تفاصيل الطلب، إذا لم يتمكن من التنفيذ، يرجى التواصل مع خدمة العملاء.

الإجابة B: يمكنك أولاً التحقق من حالة الطلب. عند استيفاء شروط الاسترداد، يمكنك تقديم الطلب في تفاصيل الطلب؛ إذا لم يكن هناك رابط للاسترداد، يرجى التواصل مع خدمة العملاء للتحقق. نتائج الاسترداد ووقت الوصول تعتمد على المراجعة الفعلية.
كلا الإجابتين تتعلقان باسترداد الأموال، لكن الإجابة B توضح شروط المراجعة وتتجنب الالتزام بنتيجة استرداد محددة. إذا اهتممت الأعمال بمعلومات أكثر شمولية وحدود الامتثال، فإن الإجابة B أكثر ملاءمة. يمكن لـ SFT استخدام الإجابة B كمثال للنموذج، بينما يمكن لبيانات التفضيلات تقديم كلا الإجابتين A وB وإخبار النموذج بشكل واضح لماذا نفضل B. هذا هو السبب في الانتقال من التعلم الخاضع للإشراف إلى موازنة التفضيلات.
لنفس السؤال، أي إجابة أكثر ملاءمة؟
التركيز الرئيسي لموازنة التفضيلات ليس "هل يمكن للنموذج الإجابة؟"، بل عند مواجهة عدة إجابات قد تكون كلها صحيحة، أي نوع يجب تفضيله. عادةً ما يتم ذلك عن طريق مقارنة مزايا الإجابات المختلفة لنفس المدخل، وتحويل متطلبات الدقة والصلة والمساعدة والتعبير والأمان إلى إشارات تدريب. مقارنةً بـ SFT، يبدو أن SFT يعلم النموذج "كيف يجيب"، وعادةً ما يستخدم بيانات مدخل واحد مقابل مخرج مرجعي واحد لتعلم النموذج تنسيق المهمة وهيكل المحتوى والتعبيرات المجالية وأسلوب الإجابة الأساسي؛ بينما موازنة التفضيلات تعلم النموذج "كيف يجيب بشكل أفضل" بعد أن يمتلك بالفعل قدرة أساسية على الإجابة.
لنأخذ مثال سيناريو خدمة عملاء استرداد الأموال: إذا أخطأت إجابة في ذكر شروط المراجعة أو التزمت بمواعيد استلام محددة، أو وصفت أمورًا غير مؤكدة كنتائج مؤكدة، يمكن تصنيفها كإجابة أقل جودة؛ وإذا أوضحت إجابة أخرى مسار الإجراءات بوضوح وحافظت على حدود المراجعة اللازمة دون اختلاق سياسات، يمكن تصنيفها كإجابة أفضل. من خلال تدريب مقارنة كبير من هذا النوع، سيزيد النموذج تدريجيًا احتمالية توليد الإجابات المفضلة، وبالتالي يميل إلى إخراج نتائج تتوافق مع متطلبات الأعمال في الأسئلة المشابهة. يجب ملاحظة أن موازنة التفضيلات لا تتعلم مجموعة موحدة ومجردة من "القيم الإنسانية"، بل تحدد معايير التقييم بناءً على المهام المحددة مع وظائف المكافأة. تتطلب المهام المختلفة أنماط بيانات تفضيل تتوافق مع المهمة. لذلك، قبل بناء بيانات التفضيلات، يجب تحديد "ماذا يعني الأفضل؟" بشكل واضح، وإلا قد يختلف المعلمون بسبب فهمهم المختلف ويقدّموا خيارات متضاربة.
بالإضافة إلى ذلك، لا يمكن لموازنة التفضيلات أن تحل محل التحقق من الحقائق. قد تكون إجابة سلسة في التعبير وودية في النبرة، لكنها تقتبس سياسة خاطئة؛ وقد تكون إجابة أخرى صحيحة في الحقائق لكنها لا تتبع تنسيق المخرجات المطلوب. لذلك، يتطلب نظام التقييم الفعلي عادةً تحديد معايير منفصلة للصحة Facts وإكمال المهمة وأسلوب التعبير والامتثال والأمان. للمحتوى الذي يمكن التحقق منه تلقائيًا، يمكن أيضًا استخدام اختبارات الكود والتحقق من الإجابات وفحص التنسيق وقواعد الأعمال للتقييم لتقليل التحيز الناتج عن الاعتماد الكامل على الحكم الذاتي البشري.
كيفية إنشاء بيانات التفضيلات
بيانات التفضيلات (Preference Data) هي بيانات التدريب التي تخبر النموذج "أي إجابة أفضل بين عدة إجابات". أكبر فرق بينها وبين بيانات SFT هو أن SFT يوفر عادةً مدخلًا واحدًا وإجابة مرجعية واحدة، بينما بيانات التفضيلات تُعد عادةً عدة إجابات مرشحة لنفس المُحرّض (Prompt) وتوسم العلاقة بين مزاياها وعيوبها. تتألف بيانات التفضيلات الأكثر شيوعًا من مدخل واحد وإجابة مفضلة وإجابة غير مفضلة:
{
  "prompt": "اشترك العضو بالأمس في التجديد التلقائي، وأريد تقديم طلب استرداد الأموال.",
  "chosen": "يرجى التحقق أولاً من حالة الطلب. عند استيفاء شروط الاسترداد، يمكنك تقديم الطلب في تفاصيل الطلب؛ إذا لم يكن هناك رابط للاسترداد، يرجى التواصل مع خدمة العملاء للتحقق.",
  "rejected": "موافق، سيتم استرداد الأموال خلال ثلاثة أيام عمل."
}
حيث يمثل chosen الإجابة الأكثر ملاءمة بموجب معايير التقييم الحالية، ويرمز rejected إلى الإجابة الأقل ملاءمة. الإجابة غير المفضلة ليست بالضرورة خاطئة تمامًا، فقد تكون فقط ناقصة في الشروط الأساسية أو مطولة جدًا في التعبير أو نبرتها لا تتوافق مع المتطلبات، أو تتضمن التزامات غير مدعومة. بيانات التفضيلات تعبّر عن علاقة نسبية، وليست وضع علامة صحيحة أو خاطئة دائمة على كل إجابة.
تُنشأ بيانات التفضيلات عادةً وفقًا للعملية التالية:
تحضير مُحرّضات (Prompts) من الأعمال الحقيقية أو مجموعات الاختبار تمثل توزيع المهام;
استخدام النموذج الحالي أو نماذج مختلفة أو معايير أخذ عينات مختلفة لتوليد عدة إجابات مرشحة لنفس المُحرّض؛
وفقًا لمعايير تقييم موحدة، يُطلب من المعلمين مقارنة الإجابات pairwise أو ترتيبها بالكامل؛
تحويل نتائج الترتيب إلى أزواج بيانات مكونة من إجابات مفضلة وغير مفضلة؛
فحص اتساق العلامات، وتحويل العينات التي لا يمكن تحديد قرارها أو التي لا تتوفر لها أدلة كافية أو التي توجد فيها نزاعات إلى مراجعين للتعامل معها.
إذا ولّد المدخل نفسه أربع إجابات A وB وC وD، وكانت نتيجة التسمية B أفضل من A، وA أفضل من D، وD أفضل من C، فيمكن تحويلها إلى مجموعات متعددة من أزواج التفضيل. في الإنشاء الفعلي، لا يلزم استنفاد جميع التcombination. الإجابات التي تكون الفروق فيها صغيرة جدًا يصعب وضع علاماتها بشكل مستقر، والإجابات التي تكون الفروق فيها كبيرة جدًا قد تعلم النموذج فقط تجنب الأخطاء البسيطة. البيانات الأكثر قيمة تأتي عادةً من إجابات يمكن قراءتها جميعها، لكنها ت существ على فروقات واضحة في الشروط الرئيسية أو الحقائق أو إكمال المهام.
يتأثر وضع علامات التفضيلات عادةً ببعض العوامل السطحية. الإجابات الأطول تبدو أكثر اكتمالاً، والإجابات بصياغة أكثر ثقة تبدو أكثر موثوقية، والمرشحون المرتبون في المقدمة قد يكونون أسهل في التفضيل. لتقليل هذه التحيزات، يمكن عشوائيًا تعديل ترتيب المرشحات، وإخفاء اسم النموذج، وطلب من المعلمين فحص الحقائق وإكمال المهمة والأسلوب والأمان بشكل منفصل، وتخصيص عدة معلمين لإعادة وضع العلامات على بعض العينات. إذا اختلف المعلمون في نفس الدفعة بشكل متكرر، فهذا عادةً ما يدل على أن معايير التقييم غير واضحة بما فيه الكفاية، وليس على حذف الأقلية ببساطة.
كيف يتعلم نموذج المكافأة تقييم الإجابات؟
بيانات التفضيلات قد حددت بالفعل "أي إجابة أفضل تحت نفس المُحرّض" كعلاقة نسبية بين chosen وrejected. دور نموذج المكافأة (Reward Model, RM) هو استخدام بيانات التفضيلات هذه لتعلم وظيفة تقييم تلقائية، وتحويل نتائج المقارنة البشرية إلى إشارات مكافأة يمكن لخوارزميات التعلم المعزز اللاحقة استخدامها. تستخدم نماذج المكافأة الشائعة نموذج لغة كأساس، وتضيف طبقة تقييم لإخراج رقم مقياس (scalar) في النهاية. أثناء التدريب، يتم دمج المُحرّض والإجابة في تسلسل واحد، ويمر عبر النموذج للحصول على الحالة المخفية، ثم تخرج طبقة التقييم رقمًا واحدًا.
لا يحتاج نموذج المكافأة أن يعرف كم نقاط يجب أن تحصل كل إجابة، عليه فقط تعلم علاقة نسبية: تحت هذا المُحرّض، يجب أن تكون درجة chosen أعلى من rejected. لذلك، أثناء التدريب، يتم عادةً دمج المُحرّض مع كل من المرشحين وإدخالهما في نموذج المكافأة بشكل منفصل:
حيث يمثل rchosen وrrejected درجتين رقميتين تخرجهما نموذج المكافأة. هدف التدريب هو جعل درجة الإجابة المفضلة أعلى من غير المفضلة. يمكن كتابة خسارة الترتيب الزوجي الشائعة كالتالي:
حيث يمثلان r_chosen وr_rejected تقييم نموذج المكافأة للإجابة المفضلة وغير المفضلة على التوالي، ويمثل σ تحويل فرق الدرجات إلى النطاق بين 0 و1. كلما زادت درجة الإجابة المفضلة وقللت درجة غير المفضلة، قلت الخسارة. بعد تدريب كمية كبيرة من أزواج التفضيل، يمكن لنموذج المكافأة تقديم تقييم نسبي للإجابات التي لم يرها من قبل.
عادةً ما يستخدم نموذج المكافأة نموذج لغة كأساس، ويضيف رأس تقييم لإخراج درجة رقمية. المدخل لا يزال النص المكوّن من المُحرّض والإجابة، لكن المخرج لم يعد الرمز (Token) التالي، بل درجة مكافأة تمثل الجودة النسبية. هذه الدرجة لا تحمل معنى فيزيائيًا موحدًا، ولا يمكن فهمها مباشرة كـ "نسبة صحة" أو "درجة من 10". ما هو ذا معنى فعليًا هو الفرق في الدرجات بين الإجابات المختلفة تحت نفس نموذج المكافأة. على سبيل المثال، حصول إجابة على 6 نقاط وأخرى على 4 نقاط لا يدل إلا على أن الأولى تبدو أكثر توافقًا مع معايير التفضيل بموجب نموذج المكافأة الحالي، ولا يعني أنها "جودة 6 نقاط" بالمعنى المobjective.
يعتمد ما يتعلمه نموذج المكافأة إلى حد كبير على بيانات التفضيل التي تم بناؤها مسبقًا. إذا كان المعلمون في بيانات التفضيل يميلون دائمًا إلى اختيار الإجابات الأطول، فقد يفهم بشكل خاطئ نموذج المكافأة الطول بالجودة؛ وإذا ركّز المعلمون بشكل مفرط على سلاسة اللغة، فقد يمنح أيضًا درجات عالية لإجابات بديعة في الصياغة لكنها خاطئة في الحقائق. لذلك، لا يفهم نموذج المكافأة فعليًا ما هي الإجابة الصحيحة، بل يحاكي أنماط التقييم الموضحة في بيانات التفضيل. هذا هو السبب في أنه بعد اكتمال تدريب نموذج المكافأة، لا يجب الاعتماد فقط على خسارة التدريب، بل يجب إجراء تقييم منفصل.
بسبب أن نموذج المكافأة نفسه مسؤول فقط عن "التقييم"، ولا يعدل نموذج اللغة مباشرة. لذلك، في مراحل التعلم المعزز اللاحقة مثل PPO وGRPO، سيستمر نموذج اللغة في توليد إجابات جديدة، وسيقوم نموذج المكافأة بتقييم هذه الإجابات، ثم تقوم خوارزمية التعلم المعزز بتحديث معايير النموذج بناءً على نتائج المكافأة، مما يجعل النموذج يزيد تدريجيًا احتمالية توليد الإجابات عالية المكافأة. يجب ملاحظة أنه إذا اكتشف نموذج الاستراتيجية أن بعض الأنماط السطحية يمكن أن تحصل بشكل مستقر على درجات عالية، فقد يستخدم هذه الأنماط بشكل متكرر بدلاً من تحسين قدرات المهمة فعليًا، ويُعرف هذا الظاهرة عادةً بـ استغلال المكافأة (Reward Hacking). لذلك، يحتاج نموذج المكافأة ليس فقط إلى التمييز بين الإجابات الجيدة والسيئة في بيانات التدريب، بل يجب أيضًا تجنب الخداع بالخصائص السطحية البسيطة مثل الطول أو الصياغة الثابتة أو قوالب التنسيق.
RLHF: كيف تشارك الملاحظات البشرية في التدريب؟
RLHF (Reinforcement Learning from Human Feedback) يُعرف عادةً بالتعلم المعزز المبني على الملاحظات البشرية. يصف كيفية دخول الملاحظات البشرية في تدريب التعلم المعزز، وهو إطار تدريب وليس خوارزمية تحسين محددة أو بنية نموذج ثابتة.
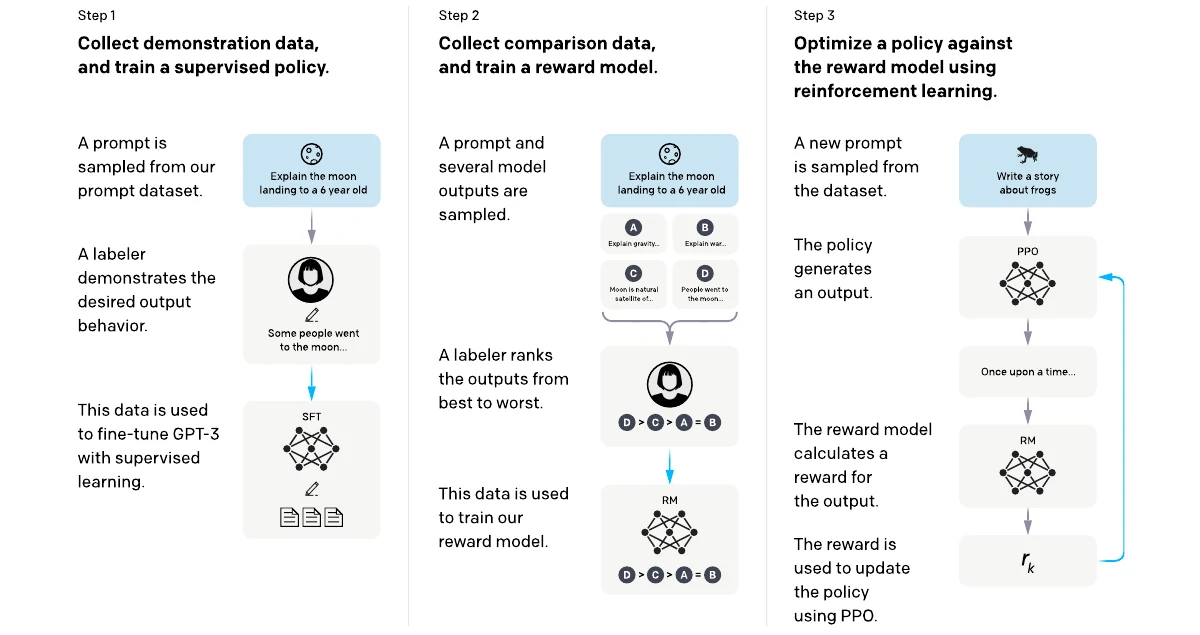
يتضمن RLHF الكلاسيكي عادةً ثلاث مراحل:
جمع بيانات التدريب البشري وإنشاء نموذج استراتيجية ابتدائي قادر على ابتعاث التعليمات من خلال SFT؛
ترتيب إجابات متعددة تحت نفس المُحرّض يدويًا واستخدام بيانات التفضيلات هذه لتدريب نموذج المكافأة؛
السماح لنموذج الاستراتيجية بتوليد إجابات جديدة وتقييمها من خلال نموذج المكافأة، ثم تحديث نموذج الاستراتيجية باستخدام خوارزميات التعلم المعزز مثل PPO.
يتكون المسار الكلاسيكي لـ RLHF من ثلاث مراحل متتالية كما هو موضح في الصورة أدناه. المرحلة الأولى يقوم المعلمون بكتابة إجابات تجريبية ويستخدمون هذه البيانات لإكمال SFT؛ المرحلة الثانية يسمح للنموذج بتوليد إجابات متعددة لنفس المُحرّض، ثم يقوم المعلمون بترتيبها ويستخدمون بيانات المقارنة لتدريب نموذج المكافأة؛ المرحلة الثالثة يسمح لنموذج الاستراتيجية بتوليد إجابات جديدة ويحسبها نموذج المكافأة وينقذها باستخدام PPO. البيانات الثلاثةتتحمل أدوارًا مختلفة: البيانات التجريبية تعلم النموذج كيف يجيب، وبيانات المقارنة تعلم نموذج المكافأة كيف يقيّم، والمُحرّض وإشارة المكافأة تُستخدمان للتعلم المعزز.
في سياق التعلم المعزز، نموذج اللغة هو نموذج الاستراتيجية، والمُحرّض والرموز المولّدة تشكل الحالة الحالية، واختيار النموذج للرمز التالي يعادل اتخاذ إجراء، ومن بداية الإجابة إلى توليد علامة النهاية يشكل مسارًا كاملًا.
في RLHF، يخرج نموذج المكافأة عادةً درجة كلية بعد انتهاء الإجابة، وتقرر خوارزمية التعلم المعزز يجب زيادة احتمالية اختيار أي رموز. عادةً ما يحتفظ تدريب RLHF أيضًا بنموذج مرجعي. النموذج المرجعي هو عادةً نموذج SFT مجمّد، يُستخدم لتقيد نموذج الاستراتيجية المدرب على عدم الانحراف كثيرًا عن القدرة اللغوية الأصلية.
PPO: ضبط النموذج تدريجيًا بناءً على المكافآت
تحسين الاستراتيجية التقريبية (Proximal Policy Optimization, PPO). وهي خوارزمية تدرج استراتيجية، هدفها الأساسي هو زيادة المكافأة مع تقييد نطاق تحديث المعايير في كل مرة. للنماذج الكبيرةكثير من معايير، وإذا غيّرنا استراتيجية بشكل كبير فقط لأن مجموعة من الإجابات حصلت على درجات عالية، فقد يميل النموذج بسرعة إلى نماذج مكافأة قليلة، بل قد يدمر القدرة اللغوية الأصلية. يؤكد PPO التقريبي على أن الاستراتيجية الجديدة يجب أن تُحدّث تدريجيًا بالقرب من الاستراتيجية القديمة. في تدريب النماذج الكبيرة ما بعد التدريب، يحتوي جولة PPO عادةً على مرحلتين. المرحلة الأولى هي أخذ العينات: سحب مجموعة من المدخلات من مجموعة بيانات المُحرّضات، والسماح لنموذج الاست략ية الحالي بتوليد إجابات، مع حفظ احتمال كل رمز تحت الاستراتيجية القديمة، ثم تقديم الدرجات من نموذج المكافأة. المرحلة الثانية هي التحديث: حساب الميزة بناءً على المكافأة وتقدير القيمة، واستخدام هذه العينات لتحديث نموذج الاستراتيجية ونموذج القيمة. بعد إكمال عدة تحديثات لدفعة صغيرة، يتم إعادة توليد البيانات بالاستراتيجية الجديدة.
يحتاج PPO إلى مقارنة الاحتمالات التي تقدمها الاستراتيجية الجديدة والقديمة لنفس الرمز. يمكن اختصار نسبة الاحتمالات كالتالي:
r_t(\theta)
=
\frac{نسبة احتمال الاستراتيجية الجديدة لاختيار الرمز الحالي}
{نسبة احتمال الاستراتيجية القديمة لاختيار الرمز الحالي}
حيث يمثل rₜ النتيجة المحسوبة،
ويمثل θ النموذج المراد تحسينه.
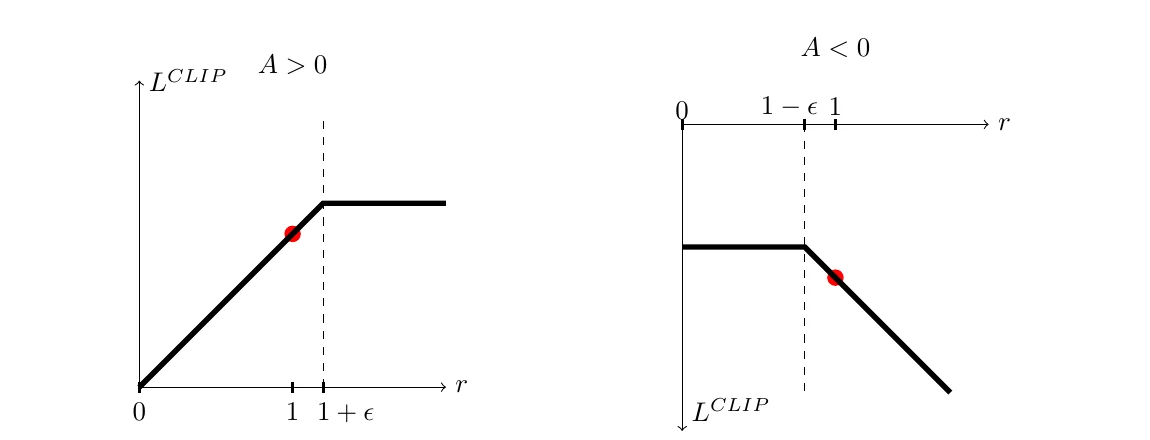
عندما يقترب rₜ من 1، يدل ذلك على أن الفرق بين الاستراتيجية الجديدة والقديمة بسيط؛ عندما يكون rₜ أكبر من 1 بشكل ملحوظ، يدل ذلك على أن الاستراتيجية الجديدة تميل إلى الرمز الحالي؛ وعندما يكون rₜ أصغر من 1 بشكل ملحوظ، يدل ذلك على أن الاستراتيجية الجديدة خفّضت احتماله. لا يكفي تغيير الاحتمالات بمفرده، بل نحتاج أيضًا إلى الميزة Aₜ لتقييم ما إذا كان هذا الرمز أفضل أو أسوأ من المتوسط الحالي. عندما تكون الميزة موجبة، يجب زيادة احتمال هذا الاختيار بشكل مناسب؛ وعندما تكون الميزة سالبة، يجب تقليل احتماله.
الجهة اليسرى من الصورة أعلاه تمثل حالة الميزة الموجبة. عندما تزداد نسبة الاحتمال من 1 إلى اليمين، يرتفع الهدف أولاً معها؛ بعد تجاوز 1+ε، يصبح المنحنى مسطحًا ولا يزيد زيادة الرمز الحالي الهدف بشكل إضافي. الجهة اليمنى تمثل حالة الميزة السالبة. عندما تنخفض نسبة الاحتمال إلى ما دون 1-ε، يتوقف الهدف أيضًا عن التحسن. يوضح المنحنيان معًا أن PPO يسمح بضبط الاستراتيجية في الاتجاه الصحيح، لكنه يضعف العائد الإضافي الناتج عن التحديثات الكبيرة.
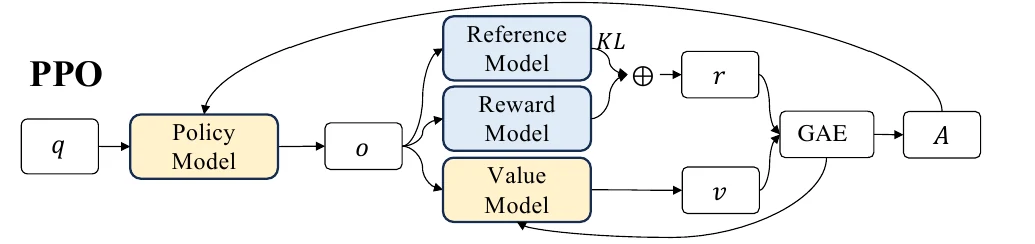
يتطلب تدريب PPO النموذجي للنماذج الكبيرة الحفاظ على عدة مكونات في نفس الوقت: نموذج الاستراتيجية مسؤول عن التوليد وقبول التحديثات؛ الاستراتيجية القديمة هي لقطة سريعة لمعايير الاستراتيجية أثناء أخذ العينات، تُستخدم لحساب نسبة الاحتمالات؛ النموذج المرجعي هو نموذج SFT مجمّد، يُستخدم لحساب قيد KL؛ نموذج المكافأة مسؤول عن تقييم الإجابات الكاملة؛ ونموذج القيمة مسؤول عن تقدير العائد المحتمل لكل موضع توليدي لاحق. يوجد فرق بين تقدير نموذج القيمة والمكافأة الفعلية، ويستخدم PPO عادةً أساليب مثل GAE لتنظيم هذه الفروق إلى ميزة لكل رمز. يتضح سير عمل PPO العام من الصورة أدناه. يولد نموذج الاستراتيجية الإجابة o بناءً على المدخل q، ويقوم نموذج المكافأة والنموذج المرجعي معًا بتشكيل المكافأة r، ويعطي نموذج القيمة تقدير القيمة v، ثم تحسب الميزة A عبر GAE. يتم تحديث نموذج الاستراتيجية بناءً على الميزة وهدف القص، بينما يتعلم نموذج القيمة تقدير عائد أكثر دقة عبر خسارة القيمة.
GRPO: الإجابة على نفس السؤال عدة مرات ثم مقارنة الدرجات
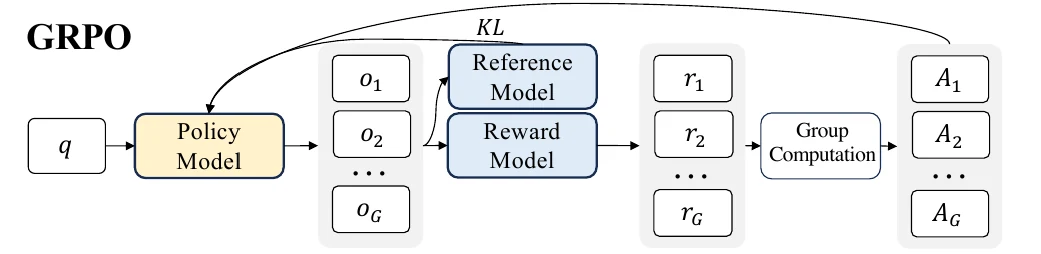
تحسين الاستراتيجية النسبي للمجموعات (Group Relative Policy Optimization, GRPO). وهي صورة من PPO، تحافظ على أفكار أخذ عينات الاستراتيجية ونسبة الprobability clipping وقيود KL، أما التغيير الرئيسي فهو عدم تدريب نموذج القيمة بشكل منفصل، بل استخدام الدرجات النسبية للإجابات المتعددة تحت نفس المُحرّض لتقدير الميزة. يتضح الإطار العام لـ GRPO من الصورة أدناه. للمدخل q نفسه، يولد نموذج الاستراتيجية مجموعة من الإجابات من o₁ إلى oG في المرة الواحدة، ويخرج نموذج المكافأة أو نظام القواعد r₁ إلى rG لكل منها.
يحسب النظام أولاً المتوسط والانحراف المعياري لمجموعة المكافآت هذه، ثم يحول درجة كل إجابة إلى ميزة نسبية داخل المجموعة، حيث تحصل الإجابات التي تتجاوز المتوسط على ميزة موجبة، وتحصل تلك التي تقل عن المتوسط على ميزة سالبة. للمهام التي تمنح مكافأة كلية فقط في نهاية الإجابة، تتشارك الرموز في نفس الإجابة الميزة النسبية الناتجة عنها؛ وإذا قدمت مكافأة أيضًا، يمكن تكوين تغذية راجعة أدق على مستوى الرموز. بعد ذلك، يقارن GRPO كما في PPO بين احتمالات الاستراتيجية الجديدة والقديمة، ويحدّث نموذج الاستراتيجية عبر هدف القص وقيود KL.
مقارنةً بـ PPO، يقلل GRPO من المعايير والذاكرة والتكاليف الناتجة عن نموذج القيمة، لكنه لا يعني أن تكلفة التدريب منخفضة بالضرورة. لكل مُحرّض، يجب توليد إجابات متعددة، واستخراج العينات بحد ذاته يستهلك موارد حسابية كبيرة. إذا حصلت جميع الإجابات في نفس المجموعة على نفس الدرجة واقترب الانحراف المعياري من 0، يصعب توفير اتجاه فعال من المقارنة داخل المجموعة، وتحتاج التنفيذ الفعلي إلى تخطي أو تنعيم أو إعادة أخذ عينات من هذه البيانات. تؤثر حجم المجموعة ودرجة حرارة أخذ العينات ومقياس المكافأة ومعامل KL أيضًا على استقرار التدريب. على سبيل المثال، لمسألة رياضية يتم توليد أربعة حلول، منها اثنان صحيحان وواحد به خطأ حسابي وواحد غير مكتمل. يمكن للنظام استخدام قواعد التحقق من الإجابة لتقييمها، ثم المقارنة داخل الأربعة نتائج. الإجابة الصحيحة والمكتملة تحصل على ميزة أعلى، والإجابة الخطأ أو غير المكتملة تحصل على ميزة أقل، ويزيد النموذج من احتمالية ظهور الحل الأفضل بناءً على ذلك. يمكن لمهام الكود أيضًا استخدام نتائج التجميع والاختبارات الفردية كمكافأة، وليست بالضرورة تدريب نموذج مكافأة مخصص أولاً.
DPO: التعلم المباشر من جودة الإجابات
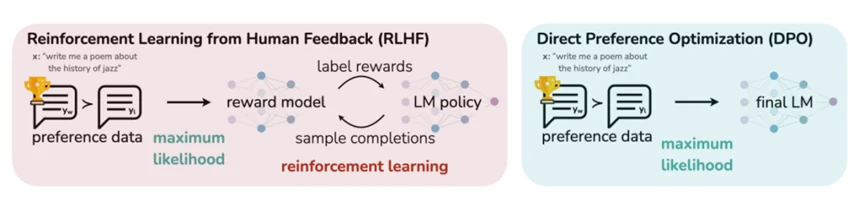
تحسين التفضيلات المباشر (Direct Preference Optimization, DPO). في عنوان ورقته البحثية، أوضح المؤلفون بوضوح أن نموذج التفضيلات قد لا يكون ضروريًا، وربما يكون نموذج اللغة الكبيرة الذي نبنيه هو نفسه النموذج التفضيلي المحتمل. تتخلى عن هذا الفكرة النمذجة المنفصلة لنموذج التفضيلات،بل من النموذج الأصلي مباشرة، وتضيف وظيفة خسارة مصممة خصيصًا لنموذج التفضيلات، مما يحسن نتائج توليد النموذج بشكل أعمق. يقوم DPO بتدريب نموذج اللغة مباشرة باستخدام الإجابات المفضلة وغير المفضلة التي تم جمعها بالفعل، دون الحاجة إلى تدريب نموذج مكافأة صريح، ودون تشغيل دورة تعلم معزز أونلاين مثل PPO أو GRPO.
تقارن الصورة أعلاه المسار الكلاسيكي لـ RLHF مع DPO. تُستخدم بيانات التفضيلات أولاً لتدريب نموذج المكافأة، ثم يولد نموذج الاستراتيجية إجابات جديدة ويتم التعلم المعزز بناءً على درجات نموذج المكافأة. في مسار DPO، تدخل بيانات التفضيلات مباشرة في تدريب نموذج اللغة. كلا المسارين ينبعان من علاقة المزايا بين الإجابات، لكنهما يختلفان في مراحل التدريب ومتطلبات الموارد. يتطلب سير عمل DPO العام مرحلتين فقط:
المرحلة الأولى، إنشاء عينات موجبة وسلبية لتوليد التفضيلات. هذه الخطوة مقارنةً بطريقة إنشاء عينات مرحلة الضبط السابقة، تحوّل مجموعة البيانات الأصلية "مدخل (Input)-مخرج (Output)" إلى "مدخل (Input)-تغذية راجعة إيجابية (Accept Response)-تغذية راجعة سلبية (Negative Response)". طريقة التدريب على العينات هذه ليست جديدة، وهي التعلم المقارن الذي نشأ في مجال الصور. اكتشف باحثو التعلم المقارن أن النموذج عند التعلم من العينات الإيجابية والسلبية معًا، يمكنه التقارب بسرعة وتحسين الأداء العام بشكل أكبر.
المرحلة الثانية، بناءً على وظيفة الخسارة المصممة، واستخدام أساليب التعلم المقارن ذات الصلة، عبر دالة الإمكان الأقصى، يتم تحسين معايير النموذج التوليدي الأصلي. هذا التصميم يلغي الحاجة إلى نموذج المكافأة الأصلي وعملية التعلم المعزز بالكامل، مما يزيد الكفاءة مع تحسن الدقة والاستقرار مقارنةً بـ PPO. من خلال تحسين المرحلة الثانية، تتحرك معايير النموذج باستمرار نحو العينات الإيجابية وتبعد عن السلبية، لتحقيق في النهاية موازنة تفضيلات توليد النموذج مع المحتوى الإيجابي.
يشبه شكل تدريب DPO سير عمل SFT العادي. بيانات التدريب تحتوي بالفعل على المُحرّض والإجابة المفضلة وغير المفضلة، ولا يحتاج النموذج إلى إعادة توليد المرشحات في كل خطوة، ولا يحتاج إلى تشغيل نموذج المكافأة ونموذج القيمة معًا في نفس الوقت. لذلك، ينتمي إلى تحسين التفضيلات غير المتصل، fewer مكونات، والذاكرة وهندسة التعقيد أقل عادةً من PPO. هذا التبسيط لم يلغي متطلبات جودة البيانات. يمكن لـ DPO فقط تعلم الفروق الموجودة بالفعل في بيانات التفضيل. إذا كانت الإجابة المفضلة بها خطأ في الحقائق، أو الإجابة غير المفضلة رديئة بشكل مفرط، أو البيانات تأتي بشكل أساسي من توزيع توليدي يختلف كثيرًا عن النموذج الحالي، فقد يتعلم النموذج الأسلوب السطحي بدلاً من القدرة المستهدفة. لن يستكشف DPO أيضًا إجابات جديدة باستمرار كما في التعلم المعزز الأونلاين، ثم يحصل على تغذية راجعة حول المشاكل الجديدة.
RLHF و PPO وGRPO و DPO: كيف نميز بينها ونختار؟
تم تعريف المبادئ الأساسية وطرق تدريب RLHF وPPO وGRPO وDPO في الأجزاء السابقة. لفهم العلاقات بينها بشكل أوضح، يمكن المقارنة من عدة أبعاد مثل موقع المنهج وهل يتطلب التدريب توليد إجابات أونلاين وهل يعتمد على نموذج المكافأة ونموذج القيمة. من خلال هذا المقارنة الأفقية، يمكن رؤية الفروق الرئيسية بين أساليب ما بعد التدريب المختلفة في مسارات التنفيذ وتكاليف التدريب وأساليب التطبيق بشكل أكثر وضوحًا. يلي جدول مقارنة النماذج ذات الصلة.
المفهوم
ينتمي إلى ماذا
هل يتم توليد إجابات جديدة أثناء التدريب
هل يتطلب نموذج مكافأة صريحًا
هل يتطلب نموذج قيمة
الخصائص الرئيسية
RLHF
إطار الملاحظات والتعلم المعزز
عادةً نعم
يتطلب المسار الكلاسيكي
يعتمد على خوارزمية التحسين المستخدمة
يحدد كيفية ربط الملاحظات البشرية والمكافآت وتحديث الاستراتيجية
PPO
خوارزمية تعلم معزز أونلاين
نعم
عادةً في RLHF الكلاسيكي
نعم
يحدّث الاستراتيجية بشكل مستقر عبر تقدير القيمة ونسبة الـ clipping
GRPO
خوارزمية تعلم معزز أونلاين
نعم، عادةً توليد مجموعة إجابات لنفس المُحرّض
يمكن استخدام نموذج مكافأة أو مكافآت قواعد
لا
يستخدم المكافآت النسبية داخل المجموعة لتقدير الميزة
DPO
منهج تحسين تفضيلات غير متصل
عادةً لا يتطلب توليدًا أونلاين
لا يتطلب تدريبًا منفصلًا
لا
يزيد مباشرة احتمال الإجابة المفضلة مقارنةً بالغير مفضلة
بشكل عام، على الرغم من أن RLHF وPPO وGRPO وDPO جميعها مرتبطة بموازنة التفضيلات للنماذج الكبيرة، إلا أنها تحل مشاكل مختلفة تمامًا. يميل RLHF إلى إطار متكامل من الملاحظات والتعلم المعزز، بينما PPO وGRPO هما خوارزميات تعلم معزز أونلاين تُستخدمان لتحديث نموذج الاستراتيجية ضمن هذا النوع من الأطر، بينما يستخدم DPO بيانات التفضيلات الحالية مباشرة لإكمال التحسين غير المتصل. من حيث آلية التدريب، يعتمد PPO على نموذج المكافأة ونموذج القيمة، وسلسلة الهندسة أكمل، لكن تكلفة التدريب والتعقيد الإعدادي أعلى؛ يقوم GRPO بتقدير الميزة من المكافآت النسبية داخل المجموعة ويغني عن نموذج القيمة، مما يجعله أكثر ملاءمة للمهام التي تملك مكافآت قواعد وتحقق إجابات gibi ملاحظات واضحة؛ لا يحتاج DPO إلى توليد إجابات أونلاين، ولا إلى تدريب منفصل لنموذج المكافأة ونموذج القيمة، لذلك إعداده أبسط نسبيًا، ومناسب كحل موازنة منخفض التكلفة عندما تكون بيانات التفضيلات كافية.
في التطبيقات الفعلية، يجب أن يبدأ اختيار المنهج من القدرات التي ينقصها النموذج حاليًا، وليس اتباع خوارزمية تدريب ببساطة. عندما لا يستطيع النموذج إكمال المهام بشكل مستقر، يجب أولًا بناء القدرات الأساسية عبر SFT؛ عندما يستطيع النموذج إكمال المهام لكن جودة الإجابات واختيارات التفضيل غير مستقرة، يمكن اتباع DPO أو PPO أو GRPO بشكل أعمق. عندما تكون بيانات التفضيلات عالية الجودة ويريد إكمال جولة الموازنة الأولى بسرعة، يمكن أولًا التفكير في DPO؛ عندما تكون المهام لديها مكافآت قابلة للتحقق ويريد استكشاف حلول أفضل بشكل نشط، يمكن التفكير في GRPO؛ عندما يكون نموذج المكافأة ونموذج القيمة وبنية التعلم المعزز ناضجة، ويتطلب التحكم بدقة في تحديث الاستراتيجية الأونلاين، يمكن استخدام PPO. بغض النظر عن المنهج المختار في النهاية، لا يجب الحكم على التأثير فقط من خسارة التدريب أو درجات المكافأة أو نسبة تفضيل الفوز، بل يجب العودة إلى المهام الفعلية لتقييم دقة النموذج وإكمال المهمة والأمان وحدود الأعمال والقدرات العامة بشكل مستمر. الهدف النهائي من ما بعد التدريب ليس تحقيق مكافآت أعلى، بل جعل النموذج أكثر استقرارًا وموثوقية في إكمال المهام المستهدفة في بيئة الاستخدام الفعلية.
استخدام ms-swift لتجربة DPO و GRPO
تم تعريف مبادئ موازنة التفضيلات والتعلم المعزز في الأجزاء السابقة، والآن سنستخدم ms-swift لإكمال تجريبتين محددين. التجربة الأولى تستخدم بيانات تفضيلات صينية لتدريب DPO لمراقبة كيفية تغير تفضيلات النموذج للإجابات المفضلة وغير المفضلة؛ والتجربة الثانية تستخدم مسائل رياضية لتدريب GRPO، حيث يولد النموذج إجابات مرشحة ثم يحصل على مكافآت بناءً على الإجابة والتنسيق. تستخدم كلتا التجربتين النموذج الأولي Qwen2.5-0.5B-Instruct الذي يمتلك بالفعل قدرة على ابتعاث التعليمات، ويُدرّب LoRA adapter منفصل لكل منهما.
تجهيز التجربة
تتم هذه التجربة في بيئة GPU أحادية الشرائح على ModelScope Notebook، ويتم تنزيل النموذج وملفات البيانات الأصلية من مجتمع ModelScope. يلي تكوين كلتا التجربتين:
البند
موازنة تفضيلات صينية DPO
تحسين إجابات رياضية GRPO
النموذج الأولي
Qwen/Qwen2.5-0.5B-Instruct
نفس أوزان Qwen2.5-0.5B-Instruct
مجموعة البيانات
AI-ModelScope/hh_rlhf_cn
AI-ModelScope/gsm8k
المجموعة الفرعية المستخدمة
helpful_base_cn
main
مجموعة التدريب
256 زوج تفضيل
128 مسألة
مجموعة التحقق
32 زوج تفضيل
16 مسألة
مجموعة الاختبار
32 زوج تفضيل
جميع 1319 مسألة من ملف الاختبار الرسمي
طريقة التدريب
LoRA، 20 خطوة تحديث لمُحسّن المعاملات
LoRA، 10 خطوات تحديث لمُحسّن المعاملات
الملاحظات أثناء التدريب
الإجابة المفضلة وغير المفضلة المحددة في البيانات
بعد توليد إجابة النموذج، يتم حساب المكافأة بواسطة القواعد
حجم التدريب هنا صغير، ويُستخدم بشكل أساسي لعرض السير الكامل. تمثل خطوات التدريب عدد مرات تحديث المُحسّن للمعايير، ولا تعادل جولات التدريب ولا تعني أن بيانات التدريب استُخدمت بالكامل. استخدمت هذه العملية فقط جزءًا صغيرًا من البيانات وعددًا قليلًا من خطوات التكرار، والتجربة للمرجع فقط.
فحص بيئة التشغيل.
بعد فتح Notebook المصاحب، تحقق أولاً مما إذا كان GPU متاحًا، وإصدار البرمجيات الفعلي المستخدم في النواة الحالية.
تجهيز النموذج ودليل التشغيل.
سيقوم الجزء المشترك من التجهيز بإنشاء دليل التخزين المؤقت ودليل التجربة الحالي. يلي الكود الأساسي لتكوين النموذج:
حيث komt snapshot_download من ModelScope، وytablish CACHE_DIR بواسطة كود التجهيز المشترك. بعد الانتهاء من التنزيل، تُستخدم اللقطة المحلية للنموذج التي يشير إليها MODEL_DIR في التدريب والاستدلال. ستُحفظ محتويات هذه العملية في دليل ms_swift_dpo_grpo_runs/. عند إعادة التشغيل من قبل القارئ، سينشئ البرنامج رقم تجربة جديد، ويجب استخدام دليل التشغيل الخاص بك في RUN_DIR اللاحق.
تجهيز بيانات تفضيلات DPO
يتطلب DPO إجابتين مرشحتين تحت نفس السياق. تستخدم التجربة المجموعة الفرعية helpful_base_cn من مجموعة بيانات HH-RLHF الصينية، حيث تحفظ context سجل المحادثة، وتحفظ chosen الإجابة المفضلة، وتحفظ rejected الإجابة غير المفضلة. المفضلة وغير المفضلة هنا تأتي من تسميات مجموعة البيانات، ولا تعني أن الحقائق في الإجابة تم التحقق منها تفصيليًا.
التحويل إلى تنسيق البيانات المستخدم في ms-swift.
بنية عينات التفضيل المستخدمة في ms-swift كالتالي. يلي فقط علاقة الحقول، والمحتوى الفعلي يُقرأ من مجموعة البيانات:
مقارنةً بعينات SFT في الدليل السريع لـ ms-swift لإكمال الضبط الخفيف للنماذج مفتوحة المصدر، تمت هنا إضافة rejected_response. يحفظ آخر رسالة في messages الإجابة المفضلة، وتصندف الإجابة غير المفضلة في حقل منفصل. رسائل المساعدة التاريخية في المحادثات متعددة الدورات لا تزال جزءًا من السياق، ولا يجب الخلط بينها وبين إجابات المقارنة الحالية. يلي دالة التحويل في Notebook:
def convert_dpo(row):
    role_map = {
        "human": "user", "user": "user",
        "assistant": "assistant", "system": "system"
    }
    context = [
        {"role": role_map[m["role"]], "content": m["text"].strip()}
        for m in row["context"]
    ]
    chosen = row["chosen"]["text"].strip()
    rejected = row["rejected"]["text"].strip()

    assert context and context[-1]["role"] == "user"
    assert chosen and rejected and chosen != rejected
    assert all(m["content"] for m in context)
    if context[0]["role"] != "system":
        context.insert(0, {"role": "system", "content": GENERAL_SYSTEM})

    return {
        "messages": context + [{"role": "assistant", "content": chosen}],
        "rejected_response": rejected,
    }
تنظيف البيانات وتقسيمها.
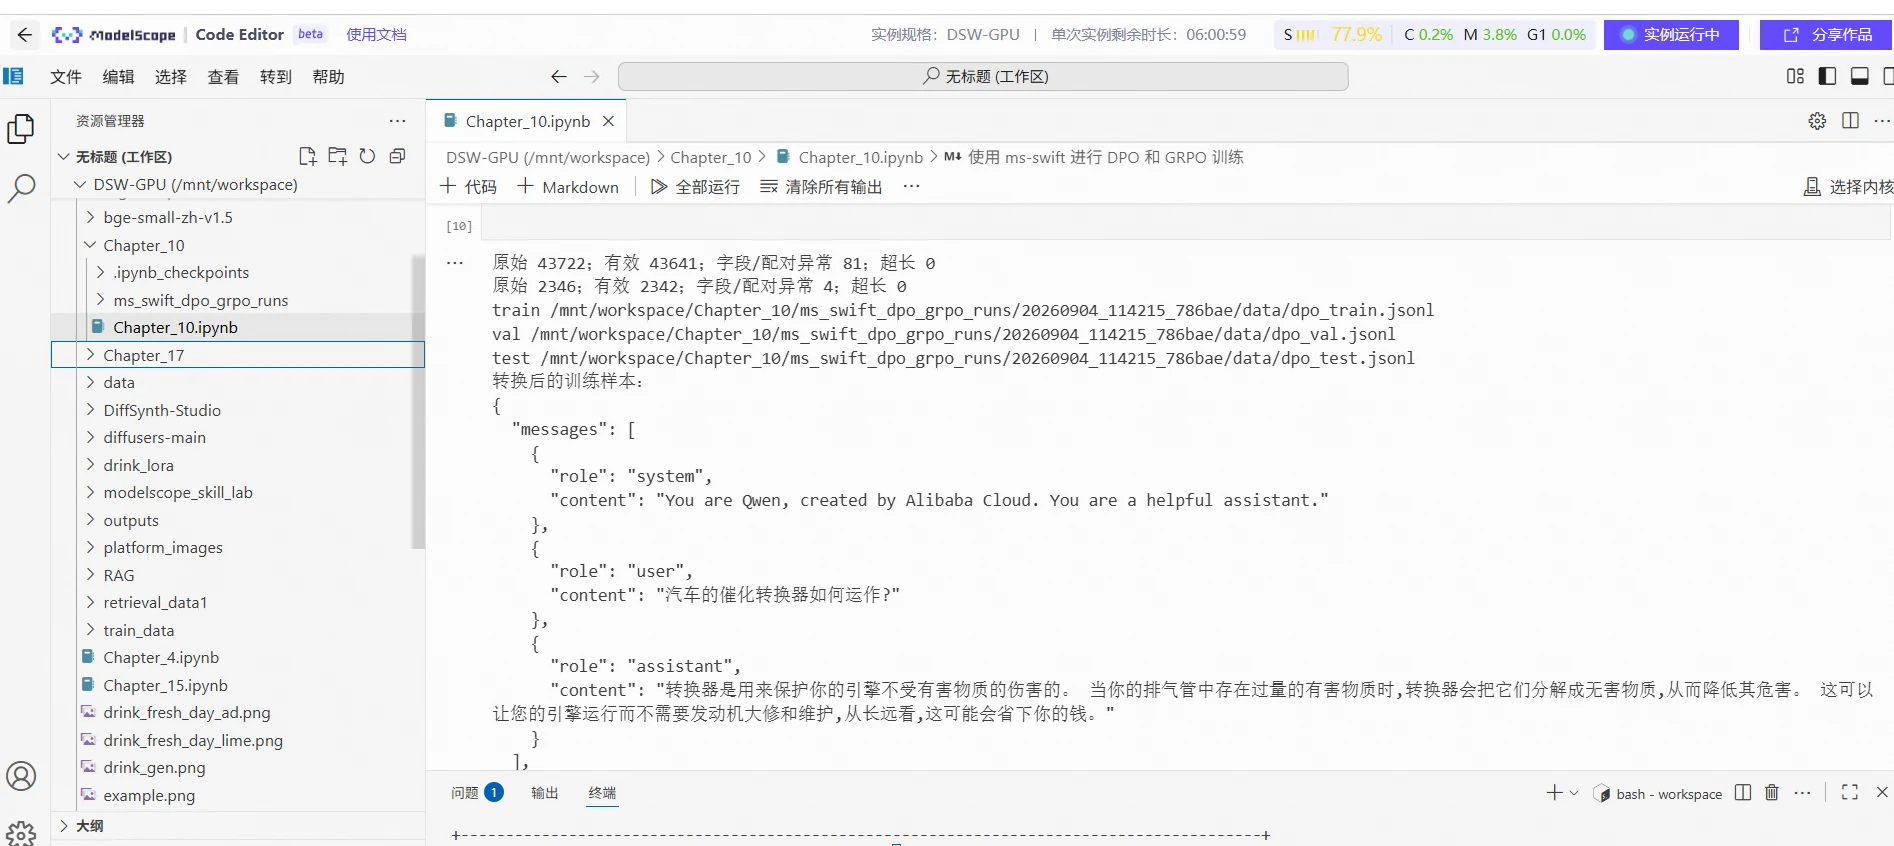
تم في هذه المرة حساب طول الإجابة المفضلة وغير المفضلة بعد دمجها مع السياق، ولا تُحتفظ إلا بالعينات التي لا يتجاوز أي منهما 1024 Token. عند التجاوز، يتم التخلي عن الزوج بالكامل لتجنب حذف المحتوى الحاسم الذي يحدد جودة الإجابة بعد القص. ثم يتم التخلص من التكرارات حسب السياق، ويتم تقسيم 256 بيانات تدريبية و32 بيانات تحقق من مصدر التدريب الأصلي. الملفات المعالجة هي dpo_train.jsonl وdpo_val.jsonl وdpo_test.jsonl، المحفوظة في مجلد data في دليل التشغيل الحالي. تتتحمل الملفات الثلاثة أدوارًا مختلفة: مجموعة التدريب لتحديث المعايير، ومجموعة التحقق لمراقبة عملية التدريب، ومجموعة الاختبار للمقارنة المستقلة بعد التدريب. يلي نتائج التنفيذ ذات الصلة:
بدء تدريب DPO
قبل التدريب، سجّل أداء النموذج الأولي على مجموعة الاختبار. تحسب dpo_evaluate() في Notebook الاحتمال اللوغاريتمي السلاسي لإجابات 32 زوجًا مرشحًا ثابتًا، وتولّد إجابات لـ 4 سياقات منها للمقارنة بعد التدريب:
def dpo_evaluate(adapter=None):
    def action(model):
        rows = []
        for index, row in enumerate(dpo_test):
            context = row["messages"][:-1]
            lp_chosen = response_logp(model, context, row["messages"][-1]["content"])
            lp_rejected = response_logp(model, context, row["rejected_response"])
            rows.append({"sample_id": index, "chosen_logp": lp_chosen,
                         "rejected_logp": lp_rejected, "gap": lp_chosen - lp_rejected})
        generations = [{"sample_id": i, "context": dpo_test[i]["messages"][:-1],
                        "response": generate_one(model, dpo_test[i]["messages"][:-1])}
                       for i in range(min(4, len(dpo_test))]
        return rows, generations
    return with_local_model(action, adapter)

dpo_before, dpo_before_text = dpo_evaluate()
يلي خطوات بدء تدريب DPO:
تعيين معايير التدريب.
تستخدم كلتا التجربتين common_options() لإعادة استخدام التكوين المشترك، بما في ذلك مسار النموذج المحلي وقالب محادثة Qwen والبذرة العشوائية ودقة bfloat16 وإعداد LoRA. يكون LoRA rank 8 وalpha 16، والوحدة المستهدفة all-linear. يلي تكوين التجربة الكاملة لـ DPO؛ يجب تشغيل الدالة المشتركة أولاً في Notebook المصاحب. تجمع الدالة common_options() المعايير المشتركة مع معايير هذه التجربة. يحوّل train_swift هذه المعايير إلى شكل سطر أوامر ويستدعي swift.cli.rlhf عبر Python في النواة الحالية لتنفيذ تدريب النموذج.
معالجة زوج تفضيل واحد لكل mini-batch تدريب على كل شريحة
gradient_accumulation_steps
8
تحديث المعايير مرة واحدة بعد تجميع 8 mini-batches
max_steps
20
إنهاء التدريب بعد إكمال 20 خطوة تحديث لمُحسّن المعاملات
eval_steps / save_steps
10 / 10
إجراء التحقق وحفظ نقاط الفحص كل 10 خطوات
عرض مخرجات التدريب.
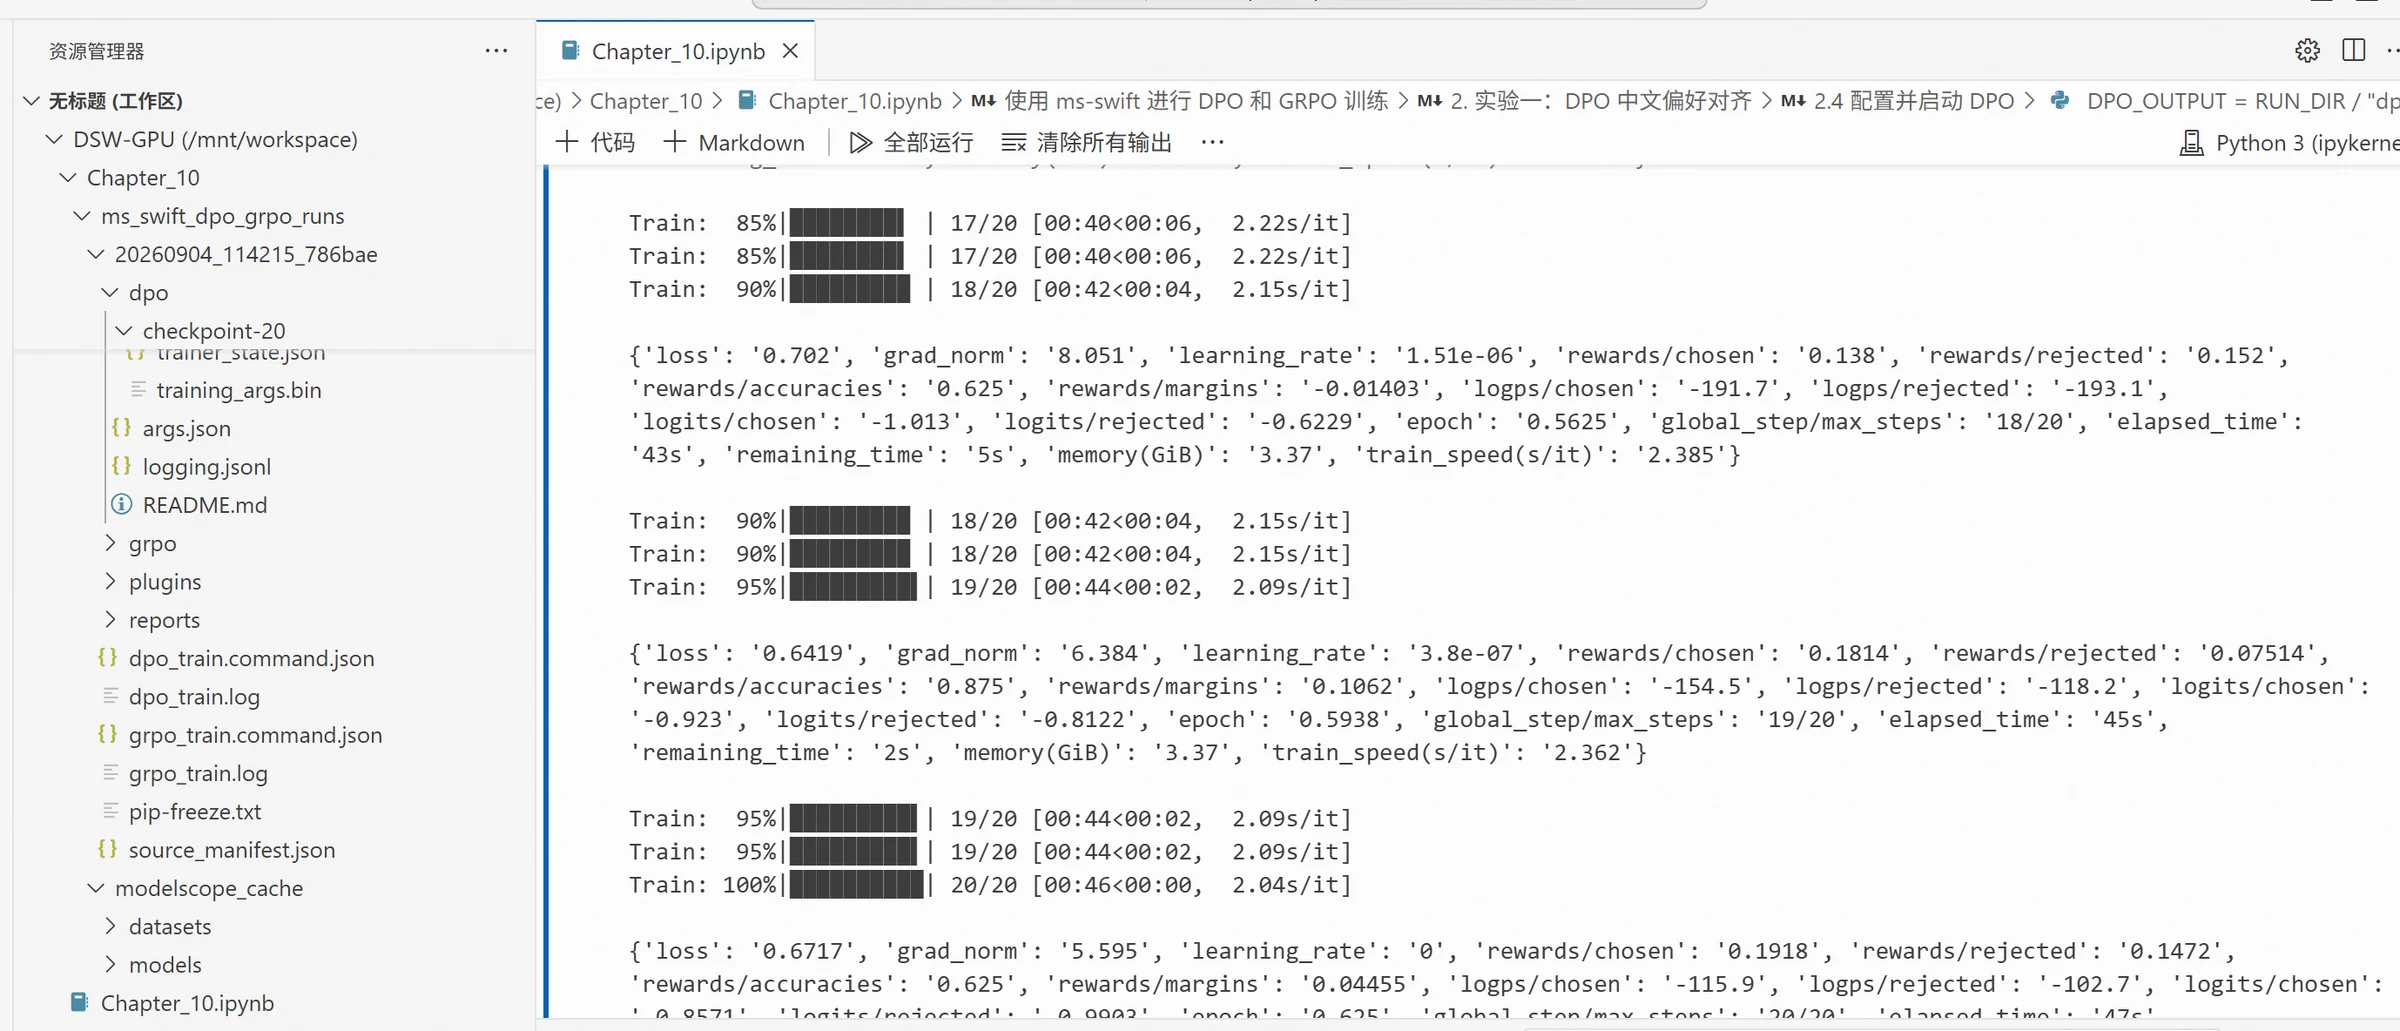
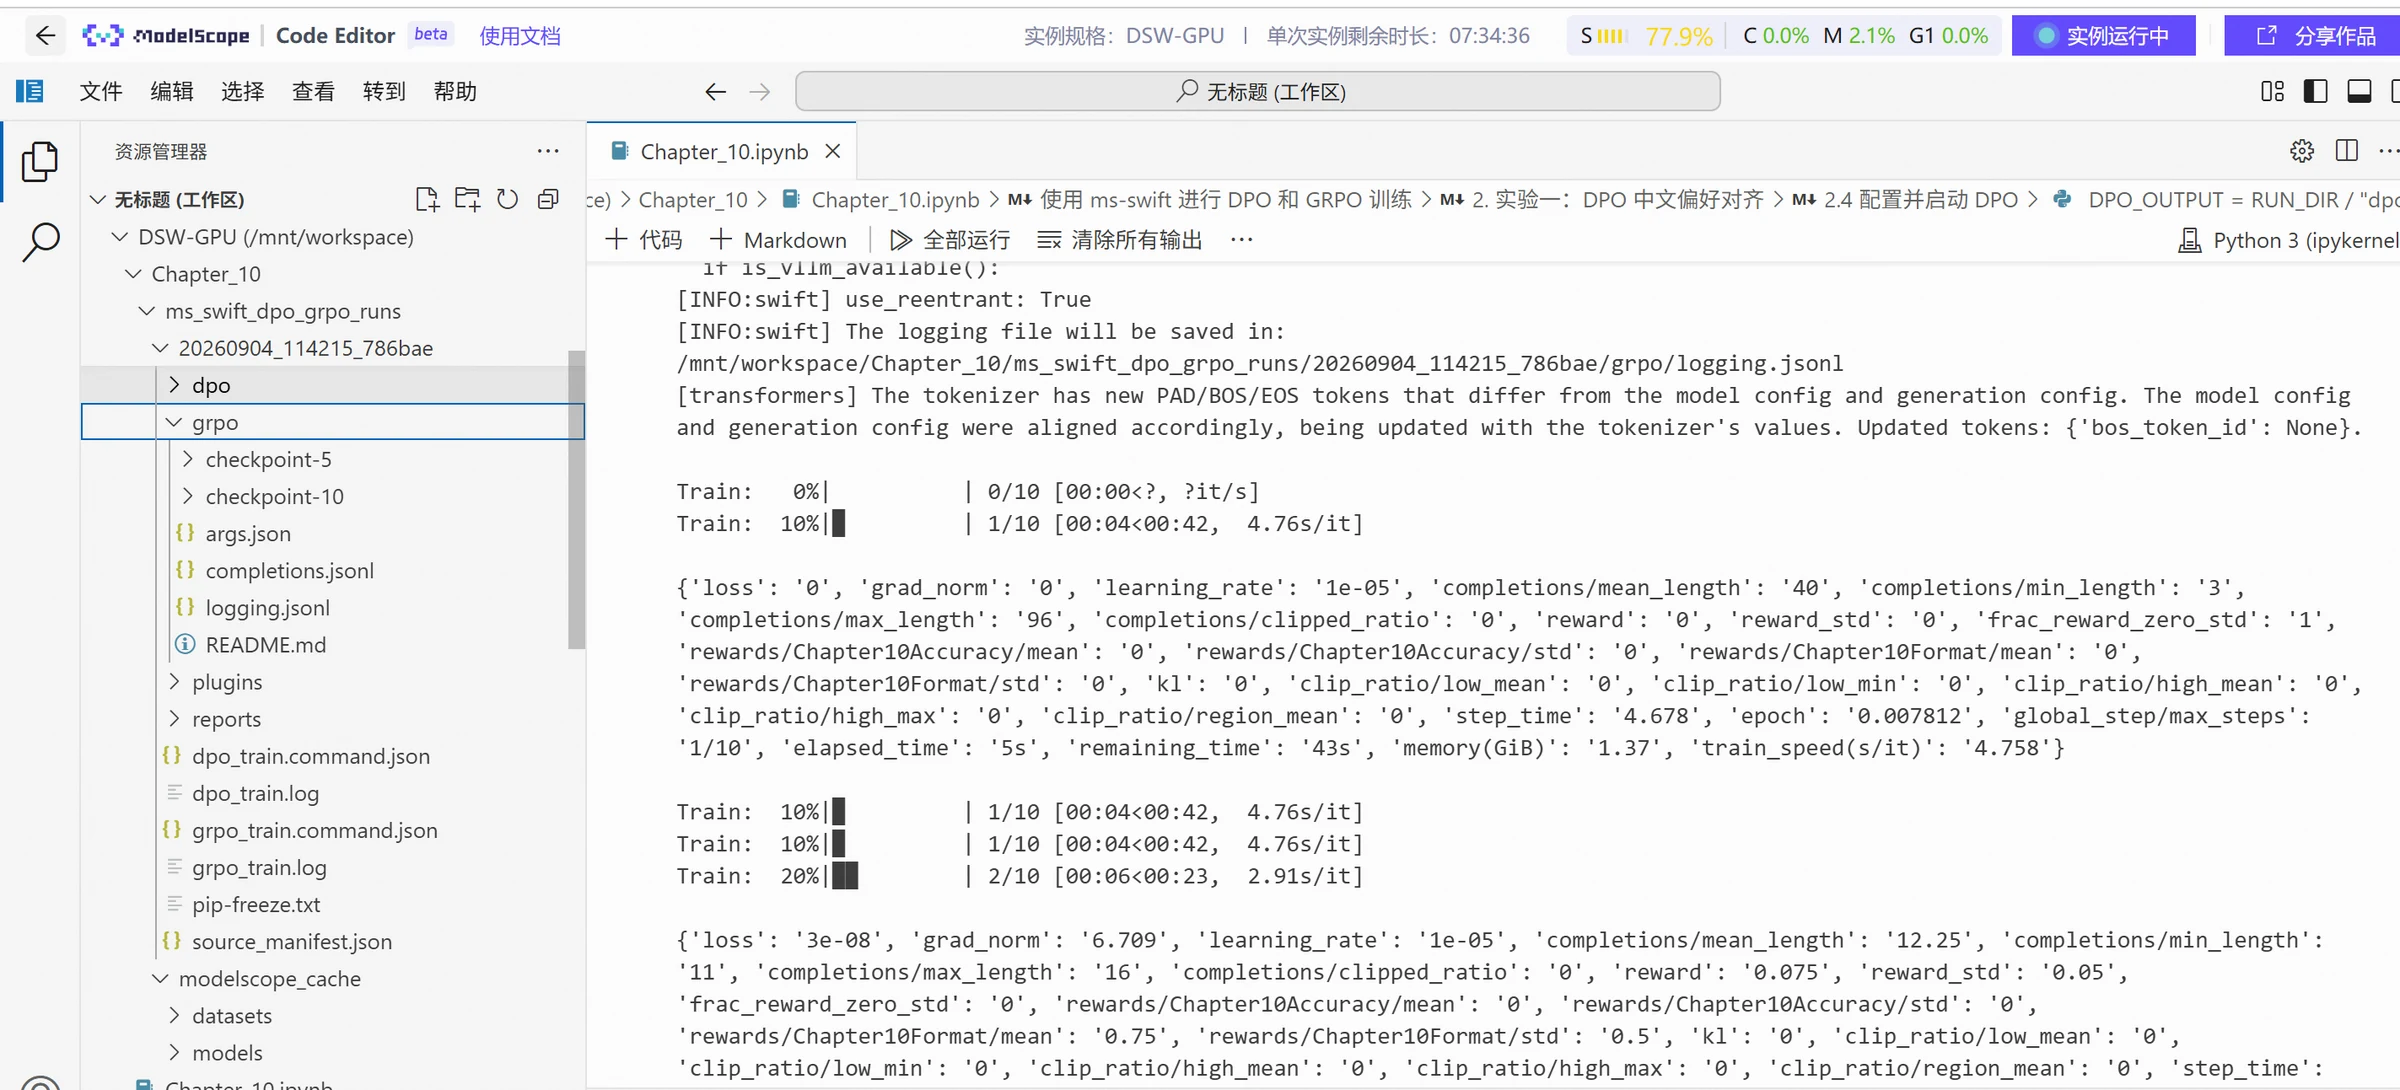
بمجرد بدء التدريب، سيقوم ms-swift بإخراج الخسارة والمكافأة الضمنية ومعايير التحقق وموقع حفظ نقاط الفحص. بعد الانتهاء من التدريب، سيُحفظ النموذج في دليل dpo/checkpoint. يلي نتائج تدريب النموذج وحفظه:
القيم rewards/chosen وrewards/rejected في السجلات هي مكافأة ضمنية محسوبة من الفرق في الاحتمال اللوغاريتمي بين الاستراتيجية والاستراتيجية المرجعية، وليست درجة صدرت من نموذج مكافأة خارجي لجودة الإجابة. تمثل rewards/accuracies نسبة ترتيب المكافآت الضمنية التي تتوافق مع تسميات التفضيل، ولا يمكن فهمها مباشرة كنسبة صحة إجابات النموذج المولّدة. يلي نتائج التنفيذ ذات الصلة في السجلات:
مقارنة النتائج قبل وبعد تدريب DPO
بعد تحميل DPO adapter، أعد استخدام بيانات الاختبار نفسها للتقييم. يجب الحفاظ على تناسق تنبيه النظام وقالب المحادثة ومعايير التوليد أثناء المقارنة، لتجنب خلط تغييرات التنبيه أو الترميز بتأثير التدريب.
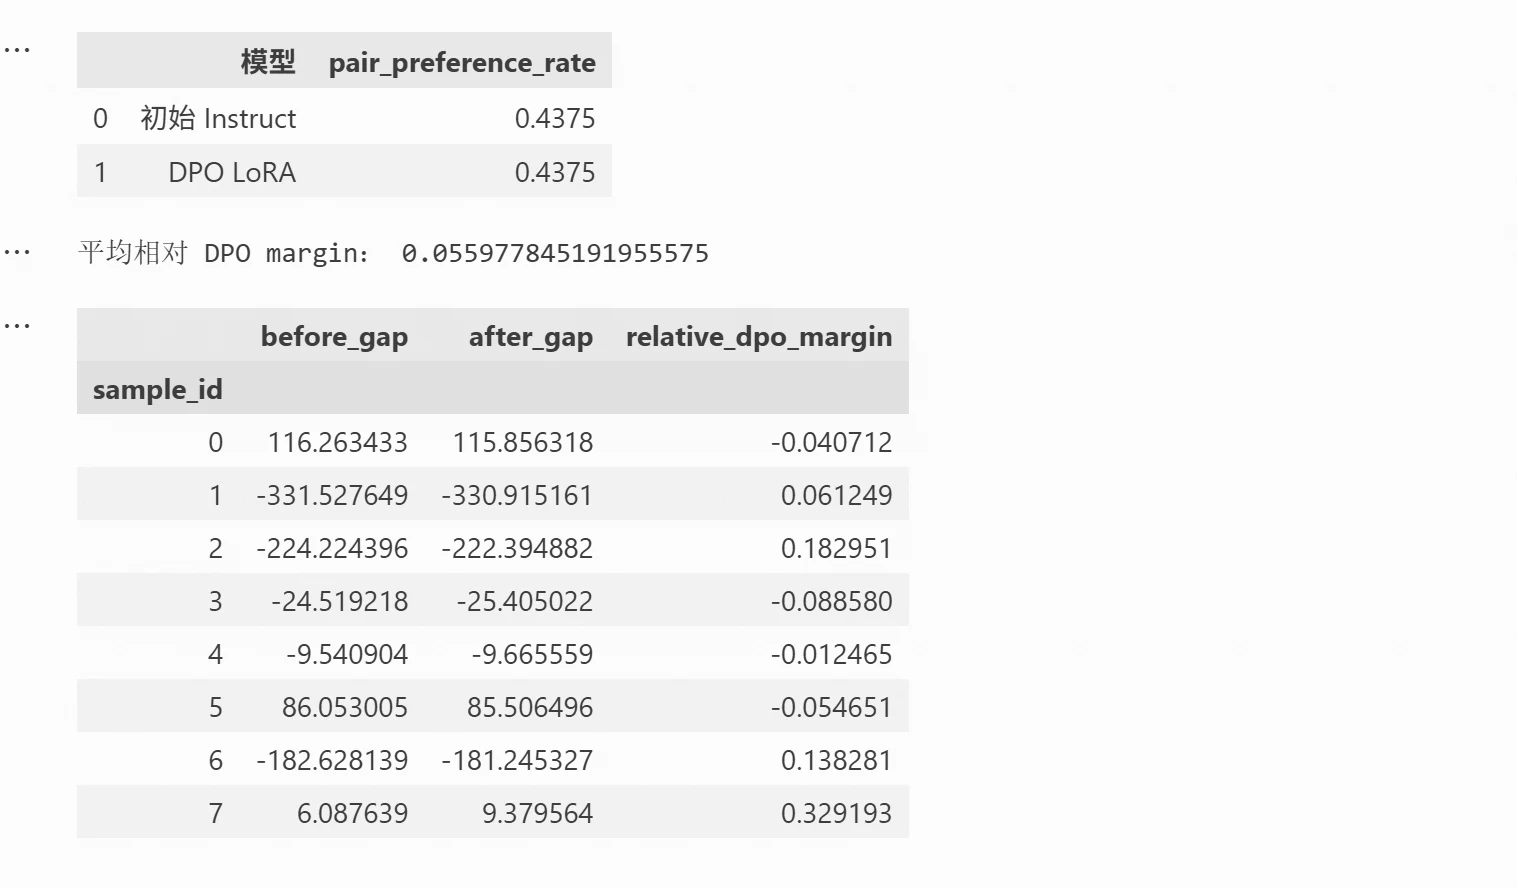
حيث يمثل gap الاحتمال اللوغاريتمي السلاسي للإجابة المفضلة مطروحًا منه الاحتمال اللوغاريتمي السلاسي للإجابة غير المفضلة. عندما يكون gap أكبر من 0، يدل ذلك على أن النموذج الحالي يعطي احتمالًا سلاسيًا أعلى للإجابة المفضلة المحددة. عند حساب نسبة هذا الشرط لعينات الاختبار، نحصل على pair_preference_rate.
يلي نتائج الاختبار الحالية:
بسبب قلة جولات التدريب، قد تزداد الفروق لبعض العينات لكنها لا تزال لم تتحول من السالب إلى الموجب، بعض العينات تتحسن وبعضها يسوء. لذلك، لا يعني أن هامش النسبة النسبية الموجبة سيزيد بالضرورة نسبة العينات التي تتفوق فيها الإجابة المفضلة. في هذه التجربة، كانت النسبة 43.75% قبل التدريب وبعده. لنأخذ مثالاً من مجموعة الاختبار حيث يسأل مستخدم عن إشارة شبكة المنزل:
المستخدم: ما هي الطرق التي يمكنني بها تقوية إشارة شبكتي المنزلية؟ يصعب على حاسوبي الاتصال بجهاز التوجيه!
تحتوي إجابة النموذج الأولي على المحتوى التالي، مقتصدة كما هي:
1. **استخدام جهاز توجيه لاسلكي**: إذا كان لديك جهازان أو أكثر في المنزل يحتاجان إلى الاتصال بالإنترنت، يمكنك التفكير في تثبيت جهاز توجيه لاسلكي. سيسمح لك هذا بالاتصال بالإنترنت عبر Wi-Fi.
تحتوي إجابة ما بعد تدريب DPO على:
3. **إعادة تشغيل جهاز التوجيه**: أحيانًا، يمكن لإعادة التشغيل البسيطة حل بعض مشاكل الاتصال بالشبكة. يرجى اتباع إرشادات جهاز التوجيه.
من المخرجات الكاملة، الإجابة الأولى تقترح أكثر تغيير أو إضافة أجهزة، بينما ما بعد التدريب يركز أكثر على إعدادات الشبكة والتعريف وإعادة التشغيل، مما يدل على أن التدريب غيّر المحتوى المولّد. غيّر تدريب DPO هذه المرة الاحتمالات النسبية لبعض المرشحات الثابتة وبعض الإجابات المولّدة، لكنه مقيد بجودة التدريب والبيانات، ويمكن للقارئ استخدام بيانات أكبر و-more جولات تدريب للمقارنة.
تجهيز بيانات GRPO ودالة المكافأة
يستخدم DPO إجابتين محددين بالفعل في البيانات، بينما يحتاج GRPO إلى توليد النموذج للإجابات المرشحة أثناء التدريب ثم تقييمها من خلال دالة المكافأة. تستخدم هذه التجربة مسائل GSM8K الرياضية، مع استخدام الرقم النهائي وتنسيق الإخرج كتغذية راجعة يمكن التحقق منها تلقائيًا، دون تدريب نموذج مكافأة منفصل.
فصل السؤال عن الإجابة المعيارية.
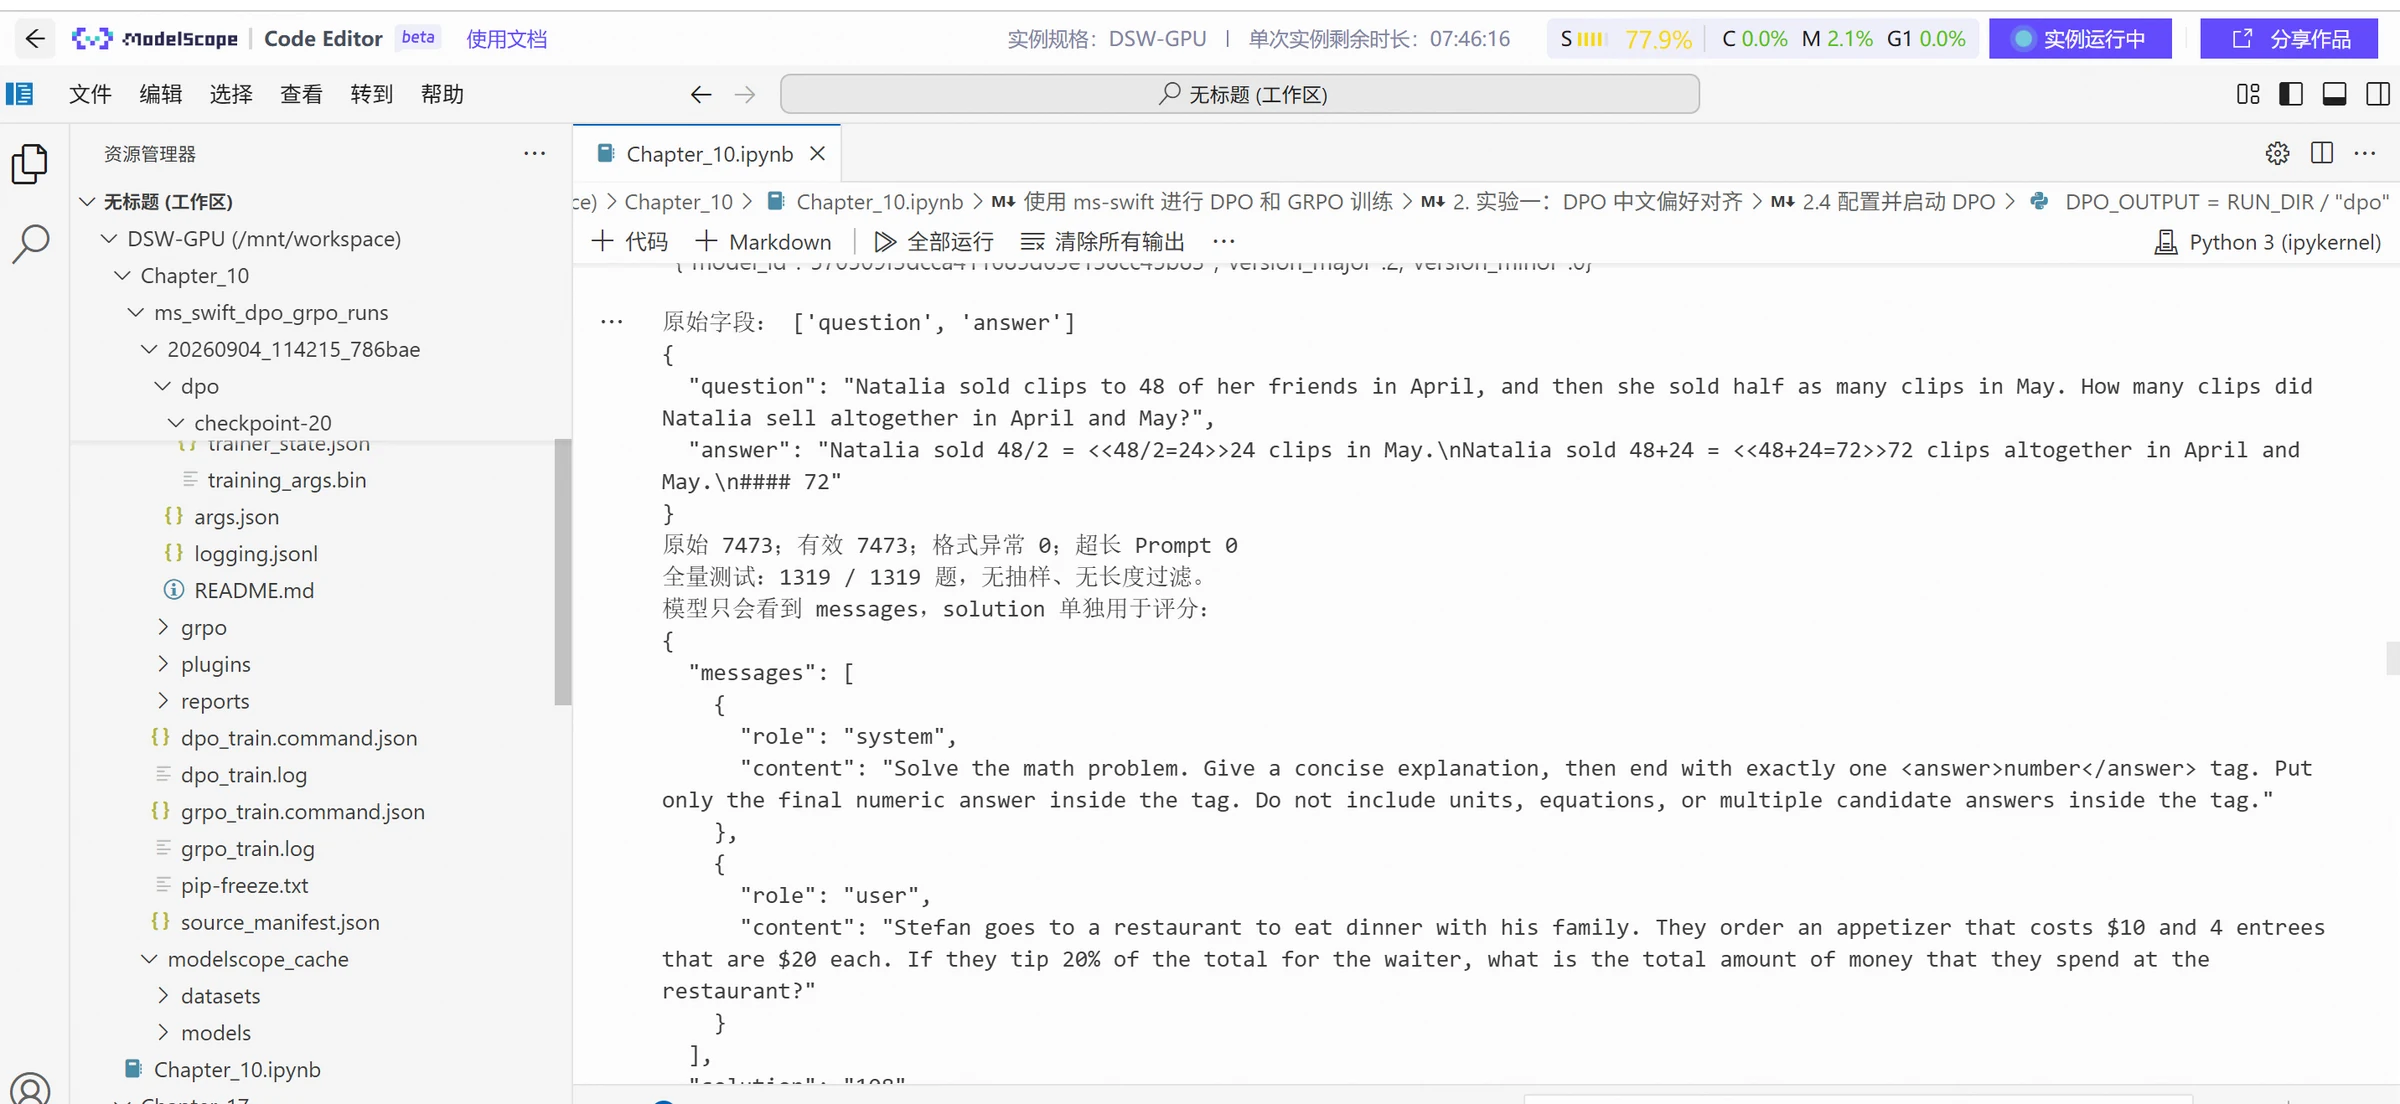
تحتوي بيانات GSM8K الأصلية على حقلين question وanswer. يحتوي answer على عملية حل المسألة بالإضافة إلى الرقم النهائي الموجود بعد ####. أثناء تحويل البيانات، يُ awarded فقط السؤال للنموذج، ويتم استخراج الرقم النهائي إلى حقل solution، ويلي الكود المتعلق:
def convert_grpo(row):
    question = row["question"].strip()
    original_answer = row["answer"].strip()
    assert question and "####" in original_answer
    answer = parse_numeric(original_answer.rsplit("####", 1)[-1])
    assert answer is not None
    return {
        "messages": [
            {"role": "system", "content": MATH_SYSTEM},
            {"role": "user", "content": question},
        ],
        "solution": str(answer),
    }
الرسائل المحولة messages لا تحتوي على عملية حل معيارية ولا على إجابة مساعدة للمحاكاة. يُقدّم solution كعمود بيانات إضافي لدالة المكافأة ولا يتم دمجها مع المُحرّض. بهذه الطريقة، يحتاج النموذج أثناء التدريب إلى توليد الإجابة بنفسه، ثم يقارن برنامج التقييمها مع الإجابة المعيارية. تم تنظيف وتنقيح البيانات وتقسيمها إلى 128 مسألة تدريب و16 مسألة تحقق من مصدر التدريب الأصلي. تم تقييد طول مُحرّضات التدريب والتحقق بـ 512 Token. اختبار جميع 1319 مسألة من ملف الاختبار الرسمي مع الحفاظ على الترتيب الأصلي دون حذف المسائل وفقًا لعتبة طول التدريب، والتحقق مما إذا كانت تتداخل مع بيانات التدريب والتحقق. يلي نتائج التنفيذ ذات الصلة:
تعريف مكافأة الصحة ومكافأة التنسيق.
المكافأة الإجمالية في هذه التجربة:
المكافأة الإجمالية = مكافأة الصحة + 0.1 × مكافأة التنسيق
تتطلب مكافأة الصحة أن يتوافق مخرج النموذج مع تنسيق التسمية المحدد، وأن يكون الرقم في التسمية مساويًا لـ solution، ويعطي 1 عند الاستيفاء و0 خلاف ذلك. تفحص مكافأة التنسيق فقط ما إذا كانت التسمية فريدة وتقع في نهاية الإجابة وما إذا كان المحتوى قابلاً للتحليل كرقم، وتعطي 1 عند الاستيفاء و0 خلاف ذلك. يلي الكود المتعلق:
def extract_answer(completion):
    if not isinstance(completion, str):
        return None
    if completion.count("<answer>") != 1 or completion.count("</answer>") != 1:
        return None
    match = re.search(r"<answer>\s*([^<>]+?)\s*</answer>\s*\Z", completion)
    return parse_numeric(match.group(1) if match else None

class Chapter10Accuracy(ORM):
    def __call__(self, completions, solution, **kwargs):
        if len(completions) != len(solution):
            raise ValueError("عدد الإجابات المرشحة لا يتطابق مع solution.")
        rewards = []
        for text, gold in zip(completions, solution):
            expected = parse_numeric(gold)
            if expected is None:
                raise ValueError(f"تنسيق الإجابة المعيارية غير صالح: {gold!r}")
            predicted = extract_answer(text)
            rewards.append(float(predicted is not None and predicted == expected)
        return rewards

class Chapter10Format(ORM):
    def __call__(self, completions, **kwargs):
        return [float(extract_answer(text) is not None) for text in completions]
حيث يمثل completions مجموعة الإجابات المولّدة من النموذج، ويرمز solution إلى الإجابة المعيارية المقابلة التي يقدمها المدرّب. تتحقق extract_answer أولاً من عدد التسميات، ثم تتأكد من أن التسمية تقع في نهاية الإجابة، وأخيرًا تستخرج الرقم منها. تفحص هذه المكافأة فقط النتيجة النهائية ولا تتحقق من عملية الحل. حتى لو لم يقدم النموذج شرحًا، طالما أخرج تسمية إجابة صحيحة، يمكنه الحصول على المكافأة بالكامل. "الشرح الموجز" في التنبيهSYSTEM لم يُšِل كشرط تقييم، لذلك لا يجب فهم الحصول على درجة عالية على أن النموذج تعلم الاستدلال الكامل والموثوق.
تحتاج فئة المكافأة أيضًا إلى التسجيل، وسمّي الإضافة المستخدمة في هذا المدرّب:
يحفظ Notebook الإضافة الكاملة كـ plugins/chapter10_rewards.py، ثم يحدد مسار الملف عبر external_plugins، ويحدد أسماء التسجيل المذكورة أعلاه عبر reward_funcs. يجب أن تحتوي الإضافة على الاستيرادات والدوال المساعدة الخاصة بها لأنها ستحمل بشكل مستقل في عملية التدريب الفرعية. يمكن الرجوع إلى نموذج إضافة المكافأة الرسمي في ms-swift 4.4.2 للتسجيل.
تحقق من دالة المكافأة أولاً، ثم ابدأ التدريب.
يلي نتائج التقييم لبعض الإجابات:
مخرج النموذج
الإجابة المعيارية
مكافأة الصحة
مكافأة التنسيق
المكافأة الإجمالية
We obtain twelve. <answer>12</answer>
12
1
1
1.1
<answer>12.0</answer>
12
1
1
1.1
<answer>13</answer>
12
0
1
0.1
The answer is 12.
12
0
0
0
<answer>11</answer><answer>12</answer>
12
0
0
0
<answer>12</answer> or maybe 13
12
0
0
0
وفقاً لطريقة حساب دالة المكافأة المستخدمة هنا، النص العادي The answer is 12. على الرغم من احتواءه على الرقم الصحيح، لم يلبي متطلبات التنسيق، لذلك تظل مكافأة الصحة الصارمة 0. لن تجتاز تسميات الإجابات المتعددة أيضًا الفحص، لتجنب حصول النموذج على المكافأة عبر سرد الإجابات.
بدء تدريب GRPO ومراقبة السجلات
بعد الانتهاء من تجهيز البيانات ودالة المكافأة، أكمل إعداد التجربة ومهام التدريب ذات الصلة.
تعيين مجموعة التوليد ومعايير التدريب.
تولّد هذه التجربة 4 إجابات مرشحة لكل مسألة، ويتم تعيين حجم التوليد أيضًا إلى 4، لذلك يقابل حجم توليد واحد 4 مرشحات لمسألة واحدة. ثم يعالج كل mini-batch تدريب مرشحًا واحدًا، ويتم تحديث المعايير مرة واحدة بعد تجميع 4 mini-batches.
يلي تكوين التجربة الحالية لـ GRPO. GRPO_PATHS وPLUGIN_PATH والتكوينات والمحتوى ذات الصلة.
يجب تنسيق حجم المجموعة مع حجم التوليد. يجب أن يكون حجم التوليد قابلًا للقسمة على حجم المجموعة، وقابلاً للقسمة أيضًا على ناتج mini-batch التدريب على كل شريحة مضروبًا بعدد عمليات GPU. هنا شريحة واحدة وعملية واحدة، وحجم التوليد 4 وحجم المجموعة 4 وmini-batch تدريب 1 تلبي هذه الشروط؛ أثناء التحقق يكون حجم الدفعة وحجم المجموعة أيضًا 4. عند تعديل حجم المجموعة، يجب التحقق من حجم التوليد وتراكم التدرج وتكوين التحقق في نفس الوقت. أكمل التدريب 10 خطوات في هذه المرة وحفظ grpo/checkpoint-10.
قراءة سجل التدريب.
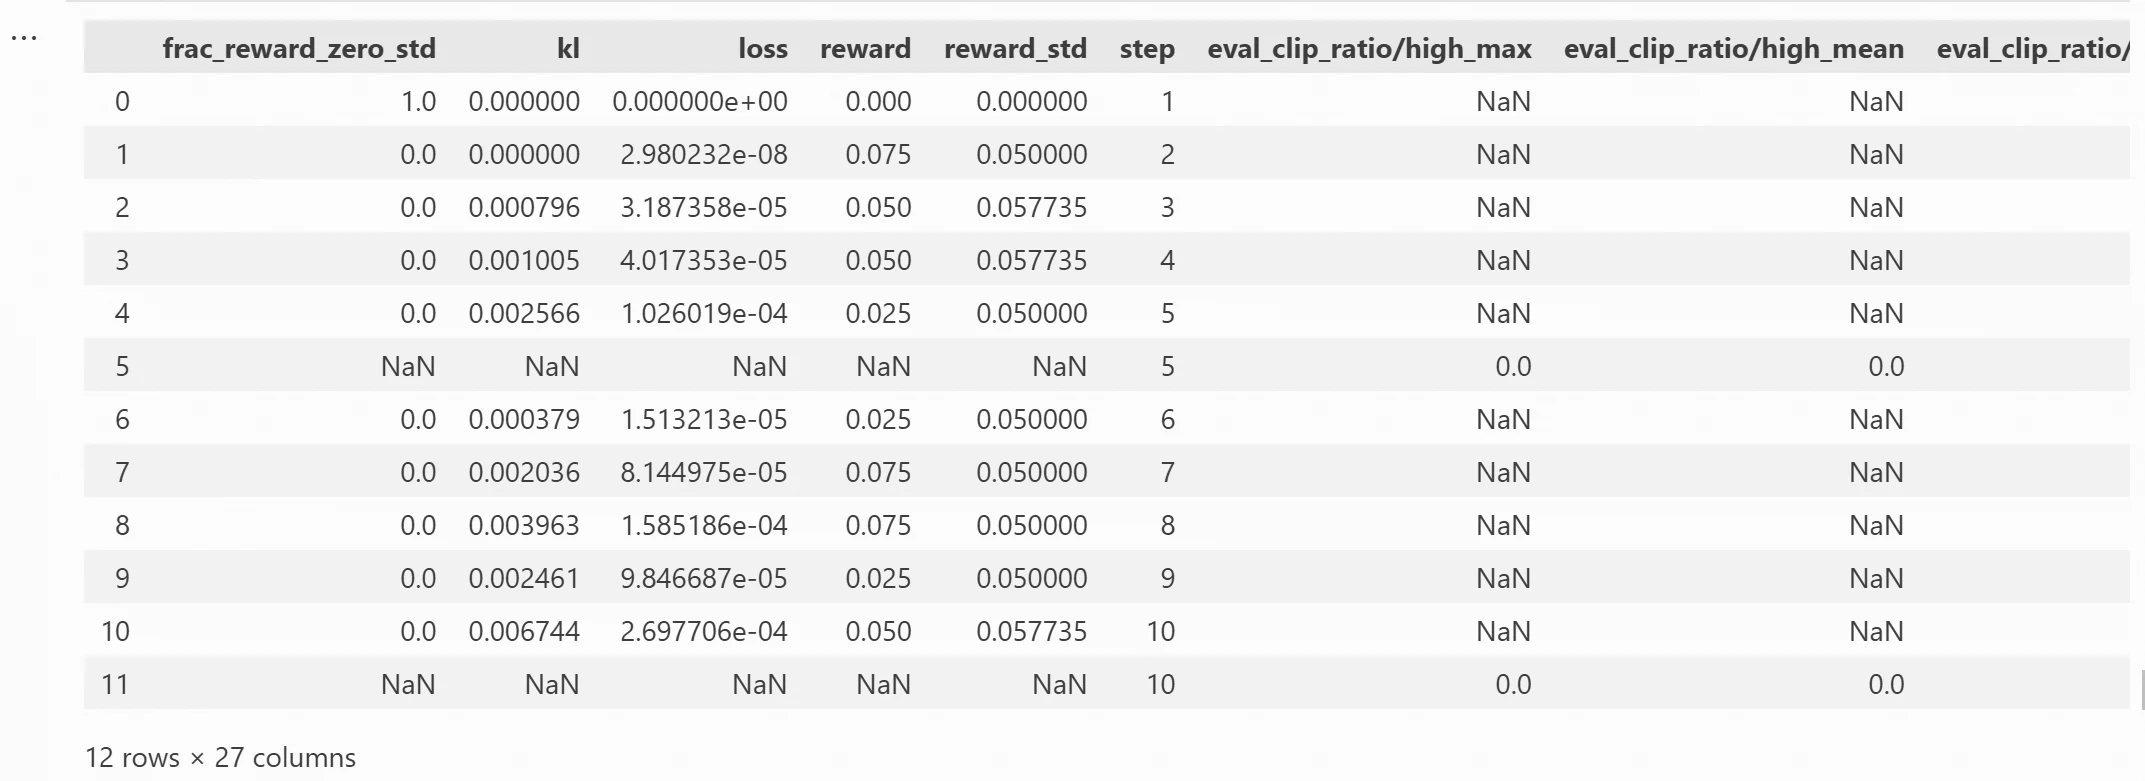
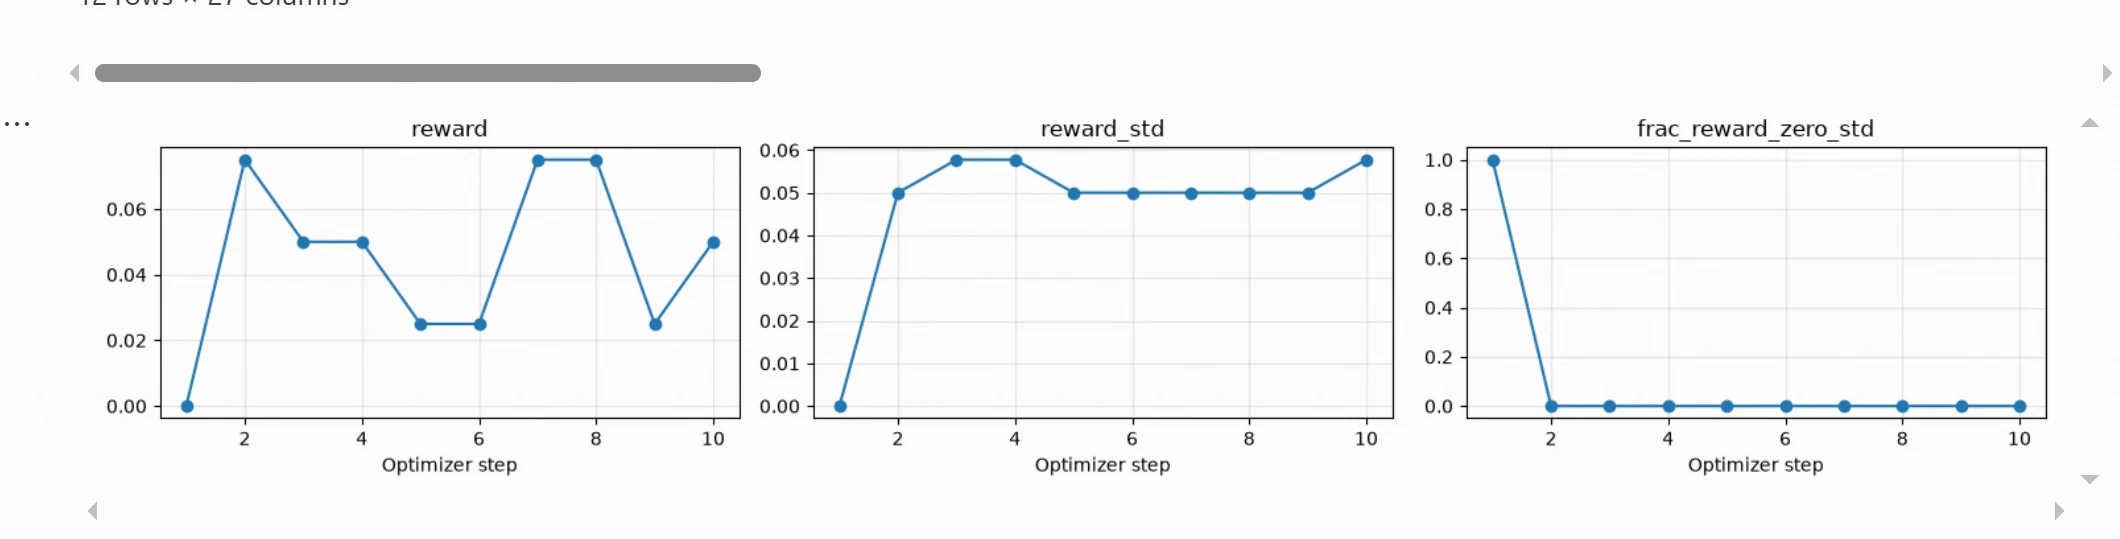
خسارة تدريب GRPO ليست نسبة صحة المسائل الرياضية. أثناء مراقبة التدريب، يجب وضع المكافأة الإجمالية والمكونات الفردية والفروق داخل المجموعة معًا. يمثل reward في السجلات المكافأة الحالية المجمّعة، وreward_std لمراقبة فروق المكافآت داخل المجموعة، وfrac_reward_zero_std نسبة المجموعات التي يكون فيها الانحراف المعياري للمكافآت داخل المجموعة صفرًا. يلي نتائج إحصائيات التدريب ذات الصلة والمُvisualization:
من الصورة نرى أن التدريب بدأ من الخطوة الثانية في إظهار فروق مكافآت داخلية غير صفريه، وانخفضت نسبة المجموعات متساوية الدرجات إلى 0، مما يدل على أن دالة المكافأة أصبحت قادرة على التمييز بين الإجابات المرشحة المختلفة، وتوفر إشارة تحسين فعالة لـ GRPO. تمت هذه المرة فقط 10 خطوات تدريب، ومكافأة الصحة نادرة نسبيًا، ونسبة صحة الإجابات الرياضية لم ترتفع بعد؛ يمكن لاحقًا زيادة جولات التدريب لتعريض النموذج لمسائل وإجابات مرشحة أكثر، ومن ثم قد يكون تأثير التدريب أوضح بالاقتران مع مجموعة التحقق.
التقييم الكامل وتحليل النتائج
تعكس سجلات التدريب المرشحات التي تم أخذ عينات منها أثناء التدريب، وأخيرًا نحتاج إلى استخدام مجموعة اختبار مستقلة لمقارنة أداء النموذج. لكل مسألة، يتم توليد إجابة واحدة فقط، وهي ليست تقييمًا يتم فيه اختيار أفضل إجابة بعد أخذ عينات عشوائية متعددة.
يحفظ النتائج الأولية grpo_evaluate() قبل التدريب. بعد الانتهاء من التدريب، أدخل GRPO adapter ثم لخّص النتائج على نفس المسائل. يلي استخراج التقييم والtetx_summarization؛ يتحقق Notebook أيضًا مما إذا كانت أرقام العينات والمسائل والإجابات المعيارية متطابقة بشكل 1:1.
grpo_after = grpo_evaluate(GRPO_ADAPTER)
grpo_summary = pd.DataFrame([
    {
        "النموذج": name,
        "نسبة صحة الإجابة الصارمة": np.mean([r["correct"] for r in rows]),
        "عدد المسائل الصحيحة": int(sum(r["correct"] for r in rows),
        "نسبة التنسيق الصحيح": np.mean([r["format_ok"] for r in rows]),
        "عدد المسائل المتفقة في التنسيق": int(sum(r["format_ok"] for r in rows),
        "متوسط المكافأة الإجمالية": np.mean([r["total_reward"] for r in rows]),
        "عدد مسائل الاختبار": len(rows),
    }
    for name, rows in [
        ("Instruct الأولي", grpo_before), ("GRPO LoRA", grpo_after)
    ]
])
display(grpo_summary)
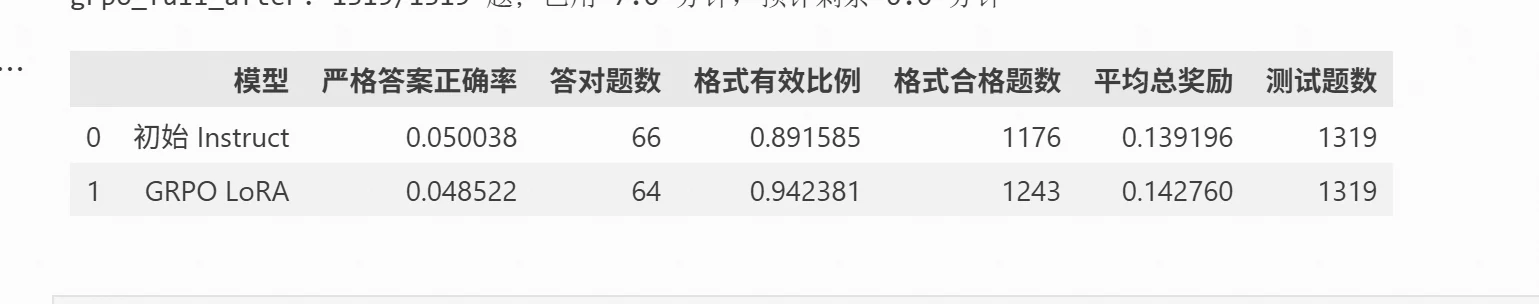
يلي نتائج التقييم الكامل:
بما في ذلك نتائج التقييم الكامل أعلاه، ارتفعت نسبة التنسيق الصحيح للنموذج من 89.16% إلى 94.24%، مما يعكس دور هذا التدريب في توحيد تنسيق الإخراج. يمكن في التجارب والتدريب اللاحق تعديل صعوبة المسائل أو تصميم المكافآت لتلقي نتائج لاحقة بردود صحة أكثر.
يمكن الرجوع إلى جميع بيانات التجربة والكود في هذا الفصل من خلال: https://modelscope.cn/gallery/liucong/8a5fefc5-6f90-42df-9a09-bc9781ed3da8