Open-Source-Modelle verstehen • Anfänger⏱️ 15 Min. Lesezeit
What Open-Source Models Are Changing
Was verändern Open-Source-Modelle?
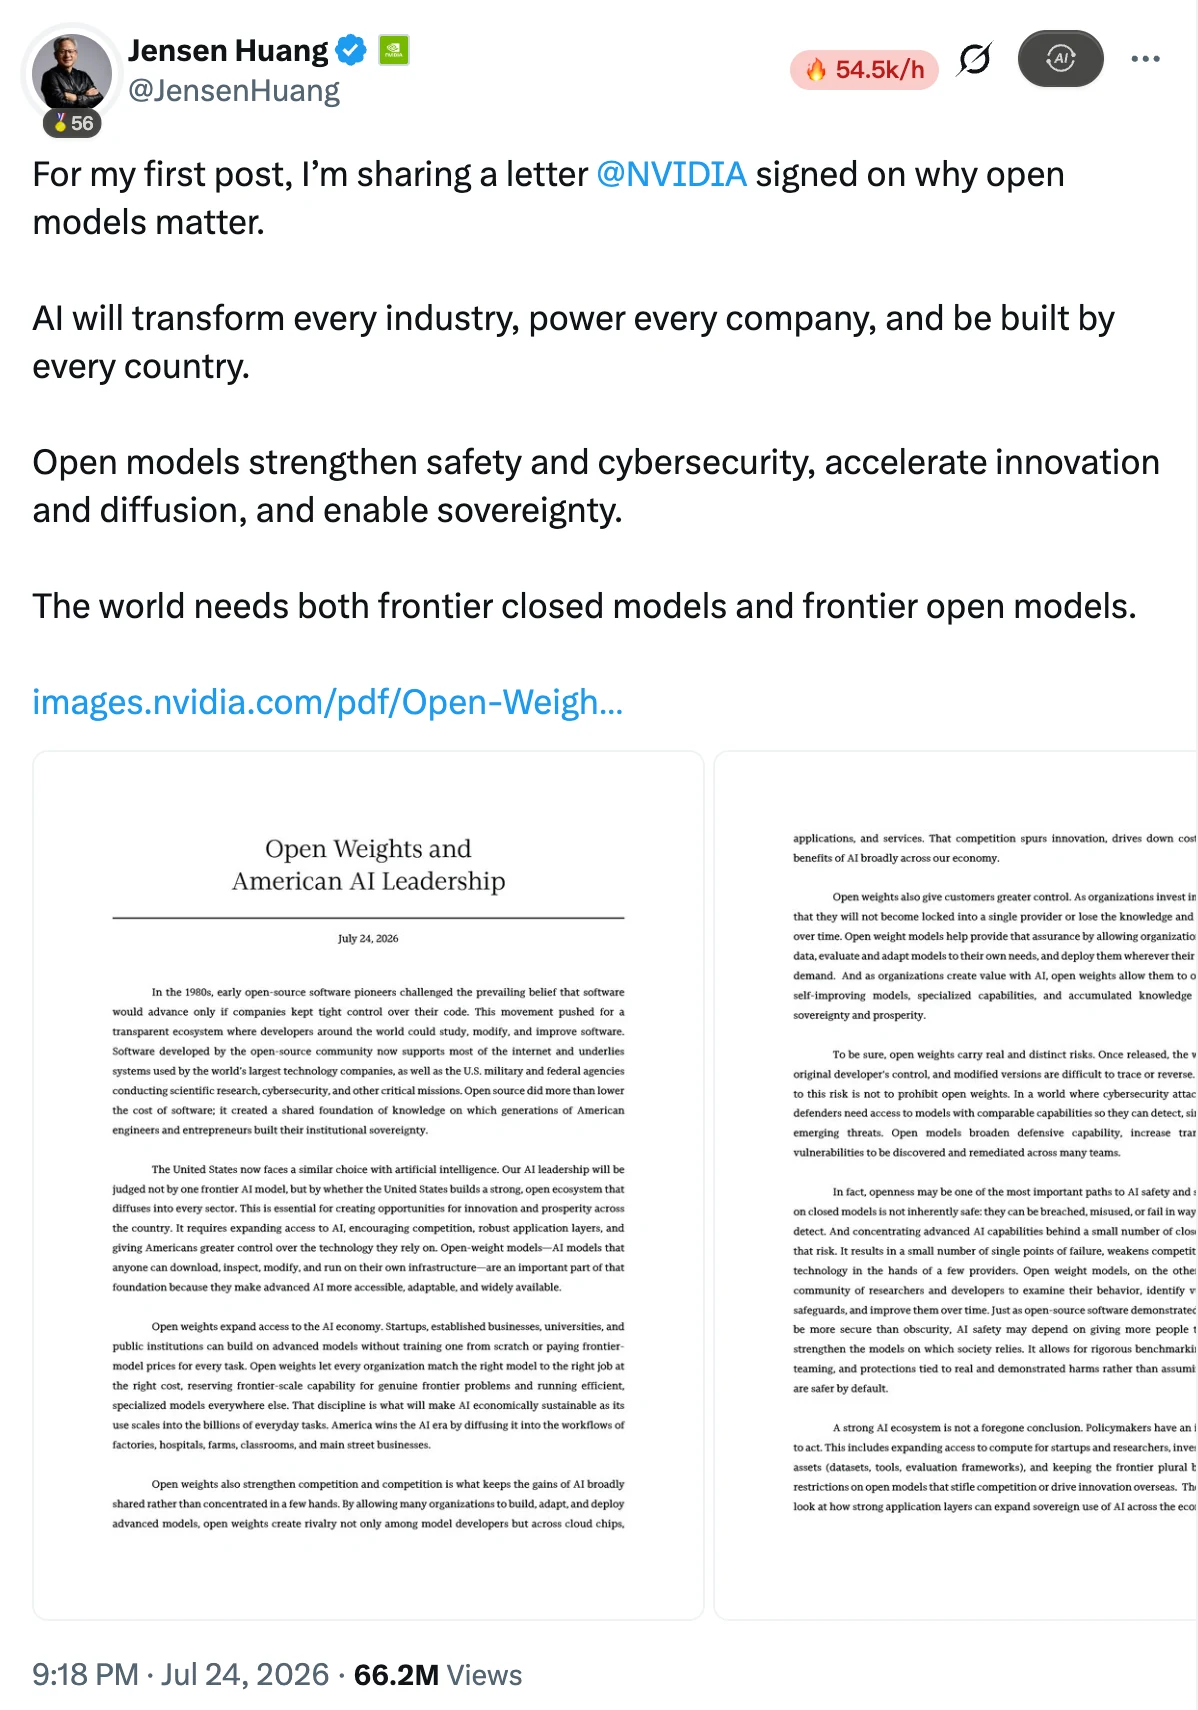
Du hättest es dir nicht vorstellen können, aber Nvidias CEO Jensen Huang hat seinen ersten Beitrag auf X gepostet, und er war dem Open Source gewidmet.
Am 24. Juli 2026 teilte er einen von Nvidia mitunterzeichneten offenen Brief, der diskutierte, warum offene Modelle wichtig sind:
Diese Welt braucht sowohl Closed-Source-Modelle an der Spitze als auch Open-Source-Modelle an der Spitze.
Viele Menschen haben sich vielleicht daran gewöhnt, ein Chatfenster zu öffnen, eine Frage zu stellen und auf die KI-Antwort zu warten. Aber wenn du anfängst, KI langfristig zur Verarbeitung von Unternehmensdaten zu verwenden oder interne Systeme zu integrieren, könnten folgende Probleme auftreten: Sind die Daten beim Versand sicher? Was passiert, wenn der Service plötzlich Raten begrenzt? Kann das Modell lernen, wie dein Unternehmen Daten verarbeitet?
Open-Source-Modelle bieten eine weitere Lösung für diese Probleme. Du kannst das Modell im Rahmen der Lizenz herunterladen, in deiner eigenen Umgebung bereitstellen, weiter verfeinern und den Nutzern überlassen, wie sie es verwenden möchten.
Natürlich war die Debatte zwischen Open Source und Closed Source für große Modelle schon immer ein endloses Diskussionsthema. Jensen Huangs Brief hat erneut bei uns Anklang gefunden, und wir haben beschlossen, uns mit mehreren Co-Erstattern zusammenzuschließen, um diese praktische Reise der Open-Source-Modellanwendungen in einem violetten Handbuch zu starten. Diesmal bringen wir dir praktische Inhalte zu Open-Source-Modellanwendungen. Mögen Open-Source-Modelle blühen!
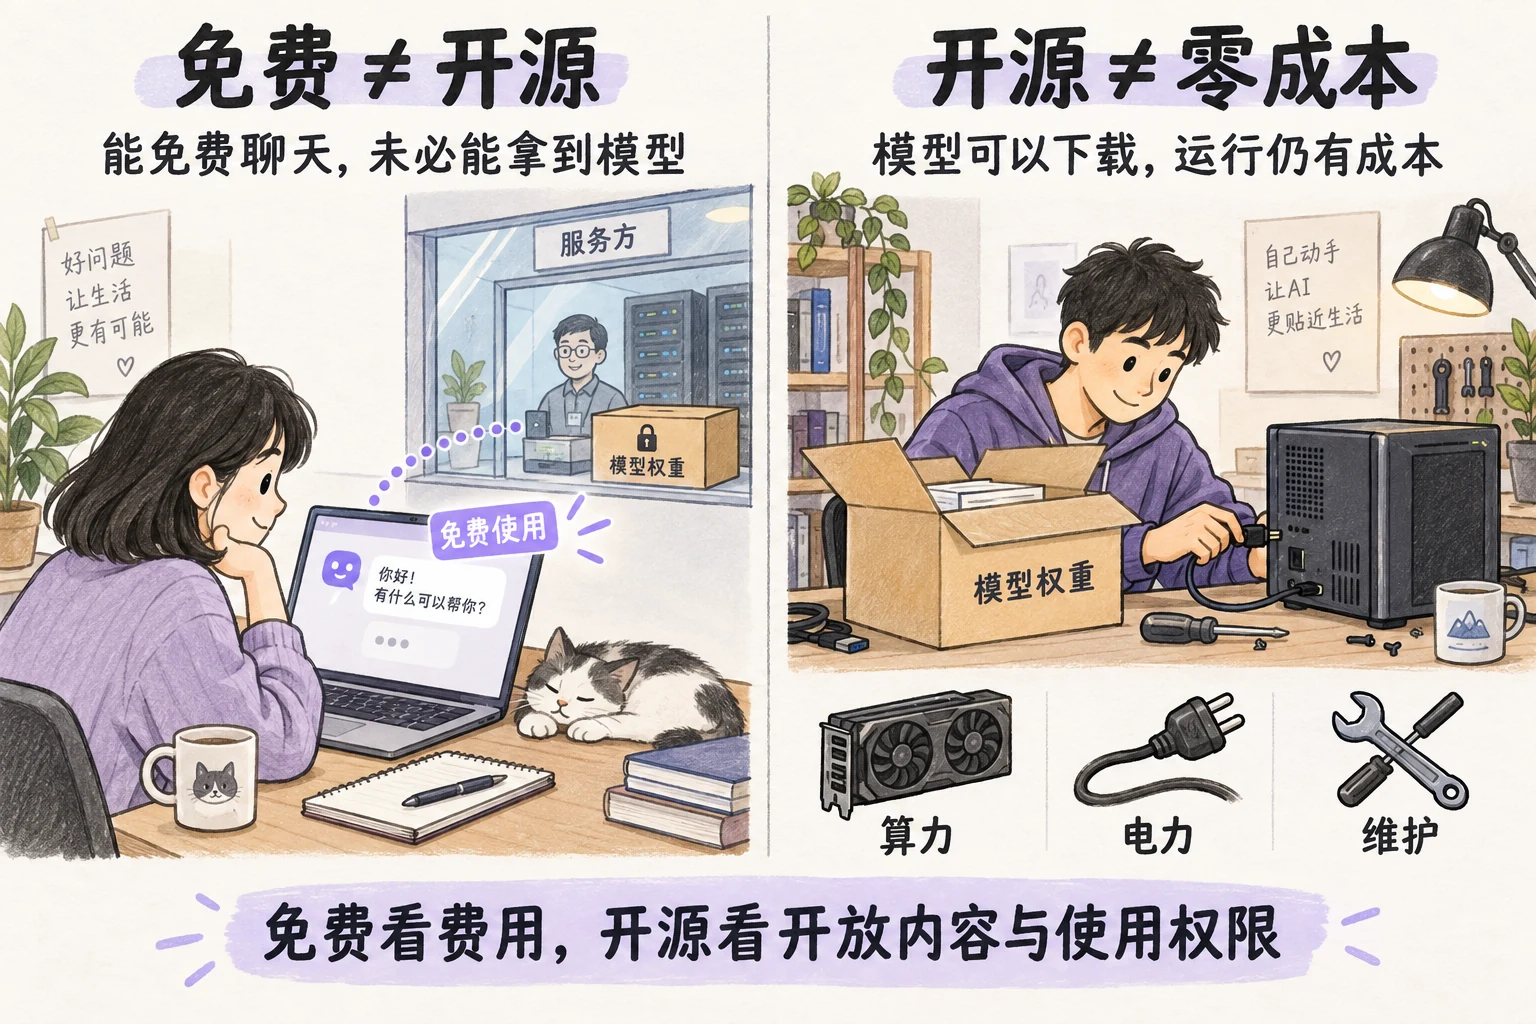
Denk daran, kostenlos bedeutet nicht unbedingt Open Source, und Open Source bedeutet nicht unbedingt kostenlos
Wenn du auf einer Webseite mit KI chattest oder ein Modell über eine API abfragst, wird das Modell normalerweise vom Modellanbieter ausgeführt. Du gibst Eingaben ein, und der Anbieter gibt Ergebnisse zurück. Du musst dich normalerweise nicht darum kümmern, wie der Server konfiguriert ist oder wie das Modell gewartet wird.
Open-Source-Modelle bieten eine andere Option und ermöglichen es dir, die Modellparameter nach dem Training zu erhalten, allgemein als Gewichte bekannt. Mit der passenden Software und Hardware können diese Parameter auf deinem Computer, Server oder in einer privaten Cloud ausgeführt werden. Fragen, die früher an externe Dienste gesendet werden mussten, können nun in deiner eigenen Umgebung verarbeitet werden.
Es gibt zwei Dinge, die hier leicht verwechselt werden können.
„Kostenlos" bezieht sich darauf, ob du zahlen musst oder nicht; „Open Source" bezieht sich darauf, was du erhalten darfst und wie du es verwenden darfst. Ein Chat-Produkt kann kostenlos sein, ohne die Modellgewichte bereitzustellen. Ein Modell, das kostenlos heruntergeladen werden kann, benötigt weiterhin Rechenleistung und Wartungskosten, um zu laufen.
Eine API ist einfach ein Zugangsweg zu Modellen. Open-Source-Modelle können von Dienstanbietern gehostet und dir über APIs bereitgestellt werden. Modelle, die du selbst bereitstellst, können ebenfalls über interne APIs für Kollegen verfügbar gemacht werden. Daher sollten „Open Source vs. Closed Source" und „APIs aufrufen vs. selbst bereitstellen" separat betrachtet werden.
In täglichen Diskussionen werden Modelle, deren Gewichte heruntergeladen werden können, oft kollektiv als Open-Source-Modelle bezeichnet. Wir werden auch in den folgenden Kapiteln dieser gängigen Konvention folgen.
Bei strengen Unterscheidungen werden wir jedoch klären, dass offene Gewichte nicht dem Open Source für den gesamten Modelltrainingsprozess entsprechen. Trainingsdaten, Trainingscode und Nutzungsrechte müssen weiterhin separat überprüft werden.
Alle als Open Source bezeichnet, aber was geöffnet wird, unterscheidet sich~
Nachdem du ein Modell erhalten hast, bist du wahrscheinlich neugierig, wie es trainiert wurde.
Hier zeigen sich die Unterschiede zwischen verschiedenen Modellen. Manche erlauben es dir, sie herunterzuladen und auszuführen, ohne vollständige Trainingsmaterialien offenzulegen. Andere gehen weiter und stellen Trainingscode und Datenbeschreibungen bereit, sodass externe Entwickler die Trainingslaufzeit des Modells studieren können.
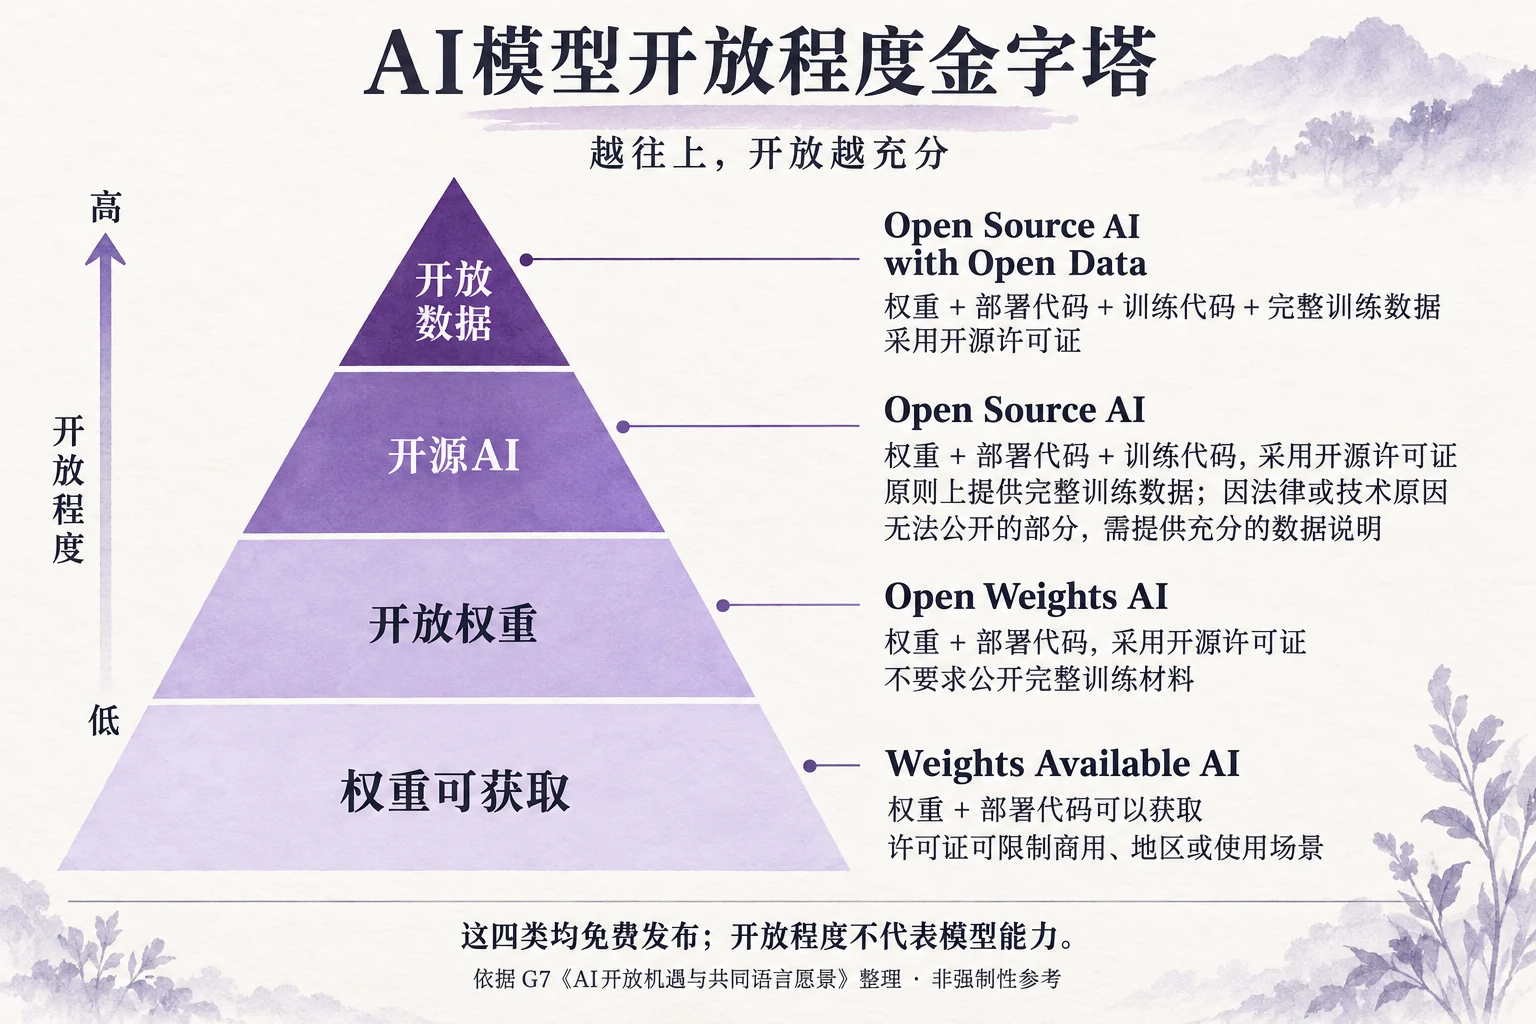
Im Mai 2026 veröffentlichte die G7 ein gemeinsames Referenzdokument über KI-Offenheit, das diese Unterschiede in vier Kategorien einteilte, vom höchsten bis zum niedrigsten Grad der Offenheit:
Sogar vollständige Trainingsdaten sind öffentlich. Modellgewichte, Bereitstellungscode, Trainingscode und vollständige Trainingsdaten werden unter Open-Source-Lizenzen bereitgestellt, entsprechend Open Source AI with Open Data.
Gewichte und Code sind öffentlich, mit eingeschränkten Daten, die im Detail erklärt werden. Entspricht Open Source AI. Vollständige Trainingsdaten sollten grundsätzlich bereitgestellt werden; Teile, die aus rechtlichen oder technischen Gründen nicht geteilt werden können, müssen durch angemessene Datendokumentation ersetzt werden.
Ein trainiertes Modell wird dir zur Ausführung und Änderung übergeben. Entspricht Open Weights AI und stellt Gewichte und Bereitstellungscode unter Open-Source-Lizenzen bereit, gibt aber nicht notwendigerweise vollständige Trainingsmaterialien preis.
Herunterladbar, aber mit zusätzlichen Bedingungen bei der Nutzung. Entspricht Weights Available AI, wo Gewichte und Bereitstellungscode erhalten werden können, aber Lizenzen die kommerzielle Nutzung, Nutzungsregionen oder spezifische Szenarien einschränken können.
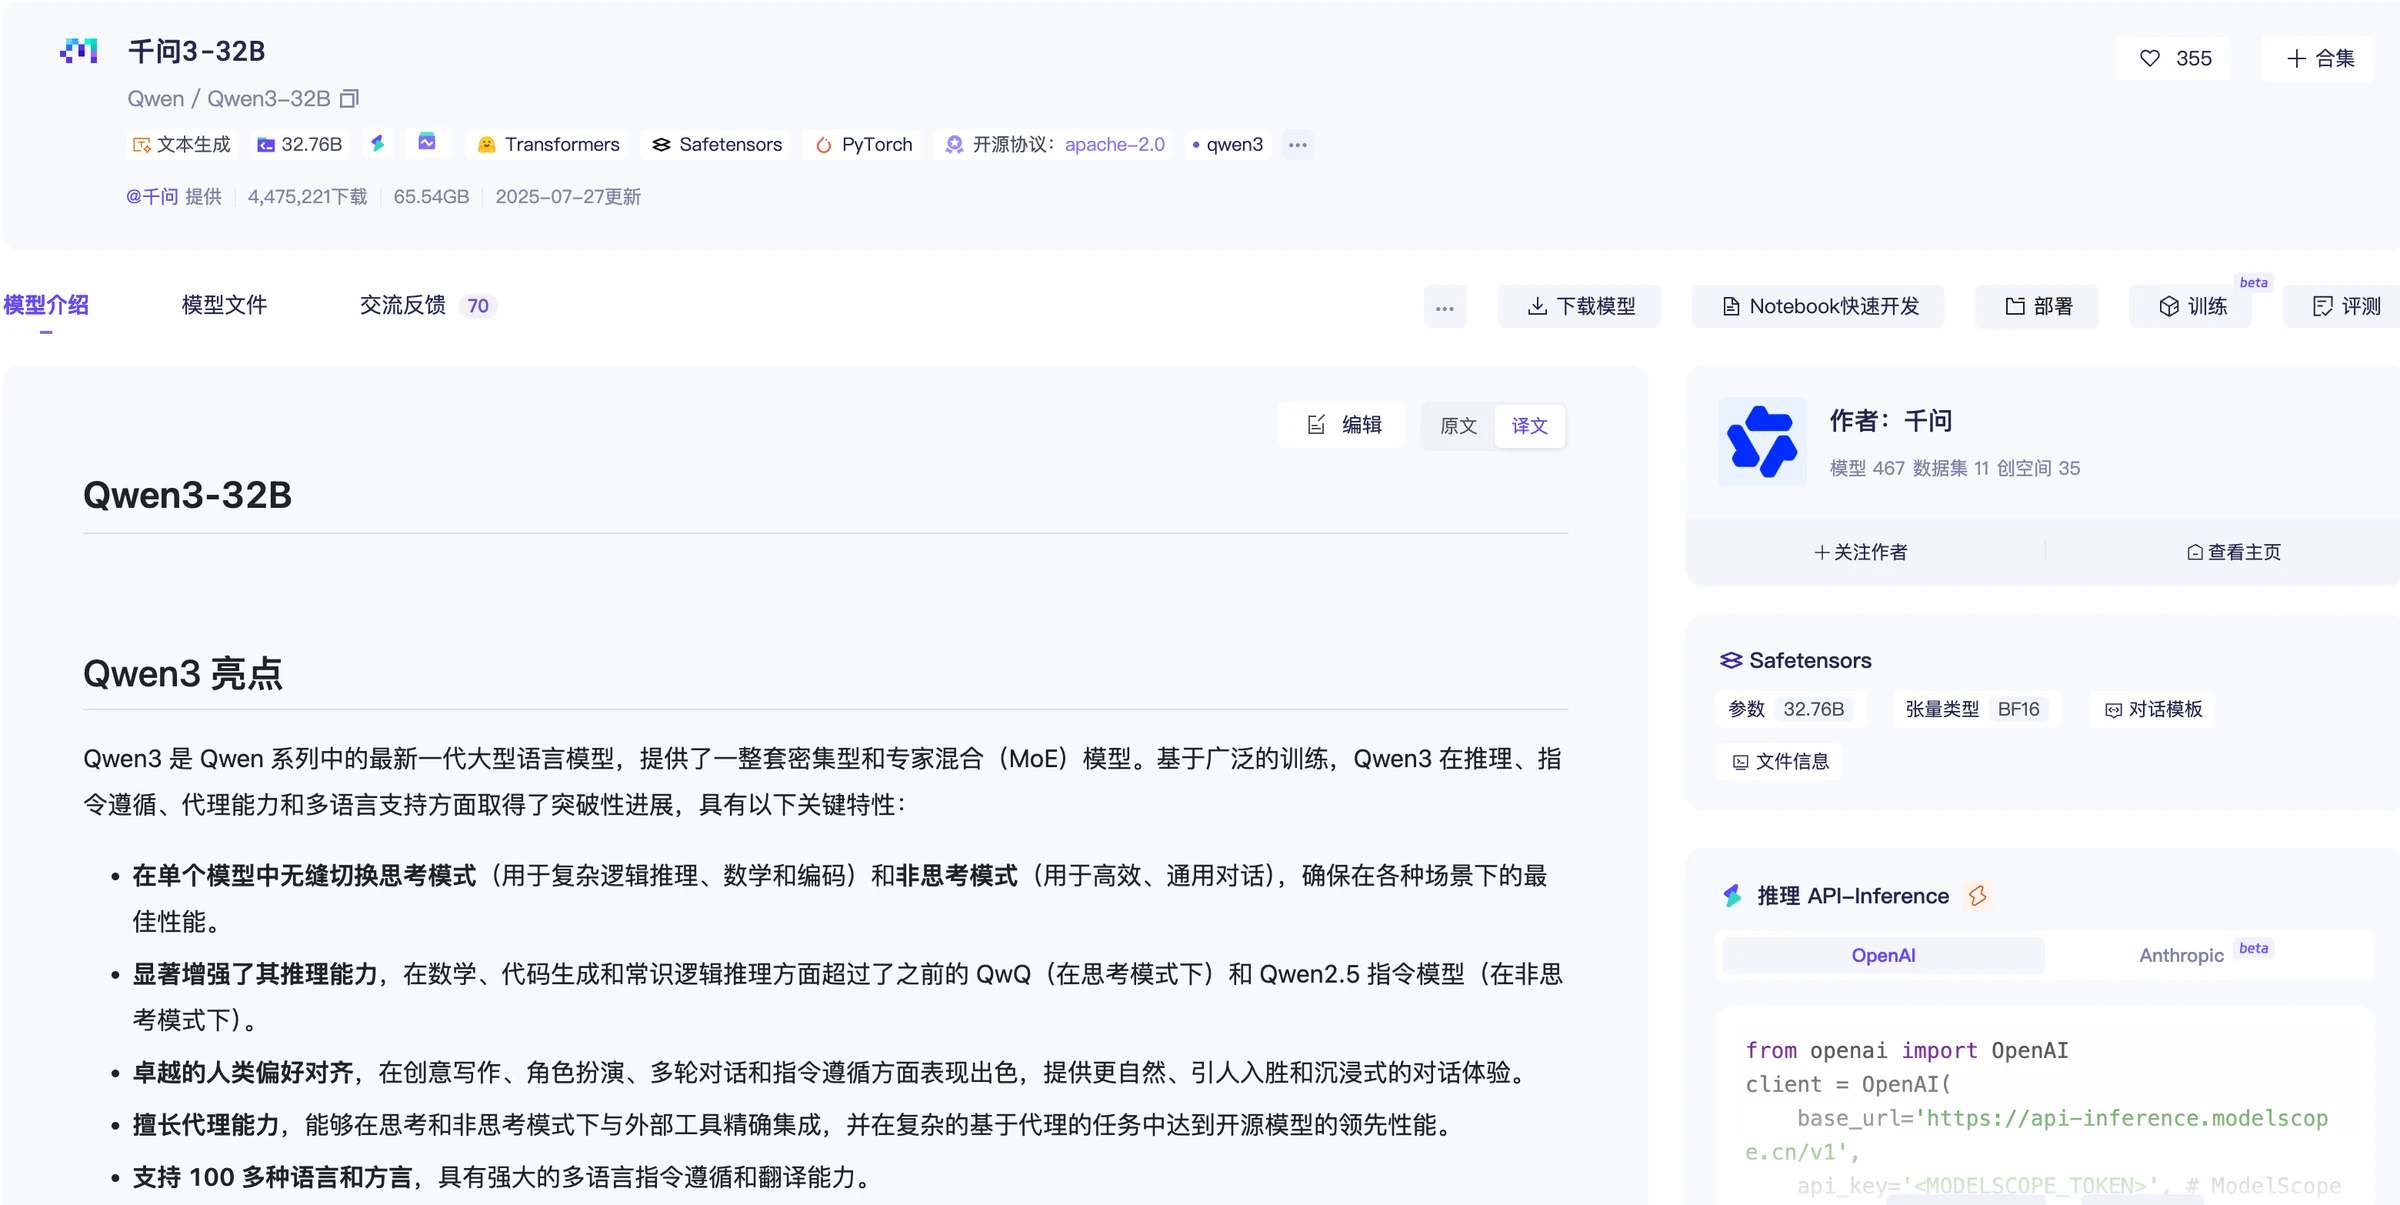
Am Beispiel von Qwen3 stellt das offizielle Team Open-Weights-Modelle zusammen mit Anleitungen für lokale Ausführung, Bereitstellung, Quantifizierung und Verfeinerung bereit. Entwickler können Tools wie Transformers, vLLM, SGLang zum Ausführen von Modellen verwenden und können auch Verfeinerungstools zum Fortsetzen des Trainings nutzen. Basierend auf den obigen Unterscheidungen zeigt dies den praktischen Wert der Open-Weights-Schicht.
Die meisten Unternehmen müssen kein erneutes Pre-Training großer Modelle durchführen — die Möglichkeit, vorhandene Modelle auszuführen, sie an eigene Geräte anzupassen und mit Geschäftsdaten zu verfeinern, kann bereits viele spezifische Geschäftsprobleme lösen.
Können Open-Source-Modelle wirklich mit Closed-Source-Modellen konkurrieren?
Es ist großartig, Modelle selbst bereitstellen zu können, aber wenn das Modell in Geschäftsszenarien häufig Fehler macht, ist es schwierig, ihm echte Arbeit anzuvertrauen.
In der Vergangenheit hinterließen Open-Source-Modelle vielen Menschen den Eindruck, dass sie für die Forschung bequem, aber den stärksten Closed-Source-Modellen unterlegen waren. Mit der kontinuierlichen Aktualisierung der Modellfähigkeiten muss diese Einschätzung überdacht werden.
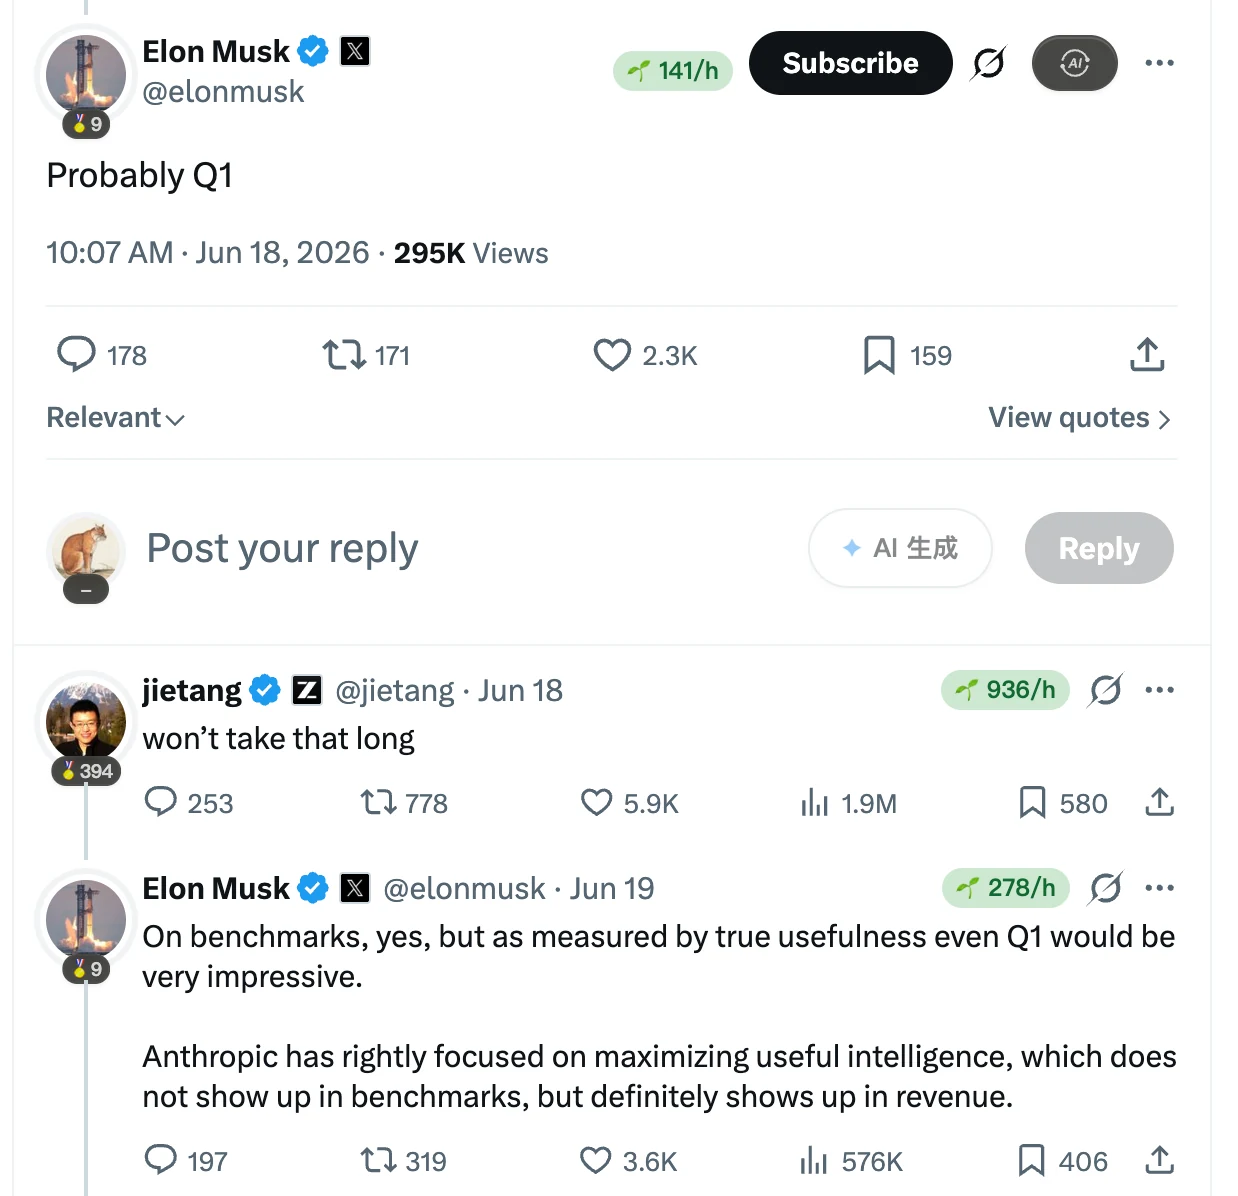
Am 18. Juni 2026 gab es eine ziemlich interessante Interaktion auf X. Nutzer diskutierten darüber, wann chinesische Modelle das Niveau der Frontier-Modelle von Anthropic erreichen könnten, und Elon Musk sagte voraus, dass es bis zum ersten Quartal 2027 dauern könnte. Zhipu-Mitgründer Tang Jie antwortete darunter mit „won't take that long".
Ob die Vorhersagen der beiden eintreffen werden, bleibt abzuwarten, je nach zukünftiger Modellleistung. Der faszinierende Aspekt dieser Diskussion ist, dass Open-Source-Modelle bereits an der Spitze der gesamten Large-Model-Landschaft stehen.
Ein Sicherheitsvorfall, der von Hugging Face im Juli 2026 offengelegt wurde, bewies erneut die Bedeutung von Open-Source-Modellen.
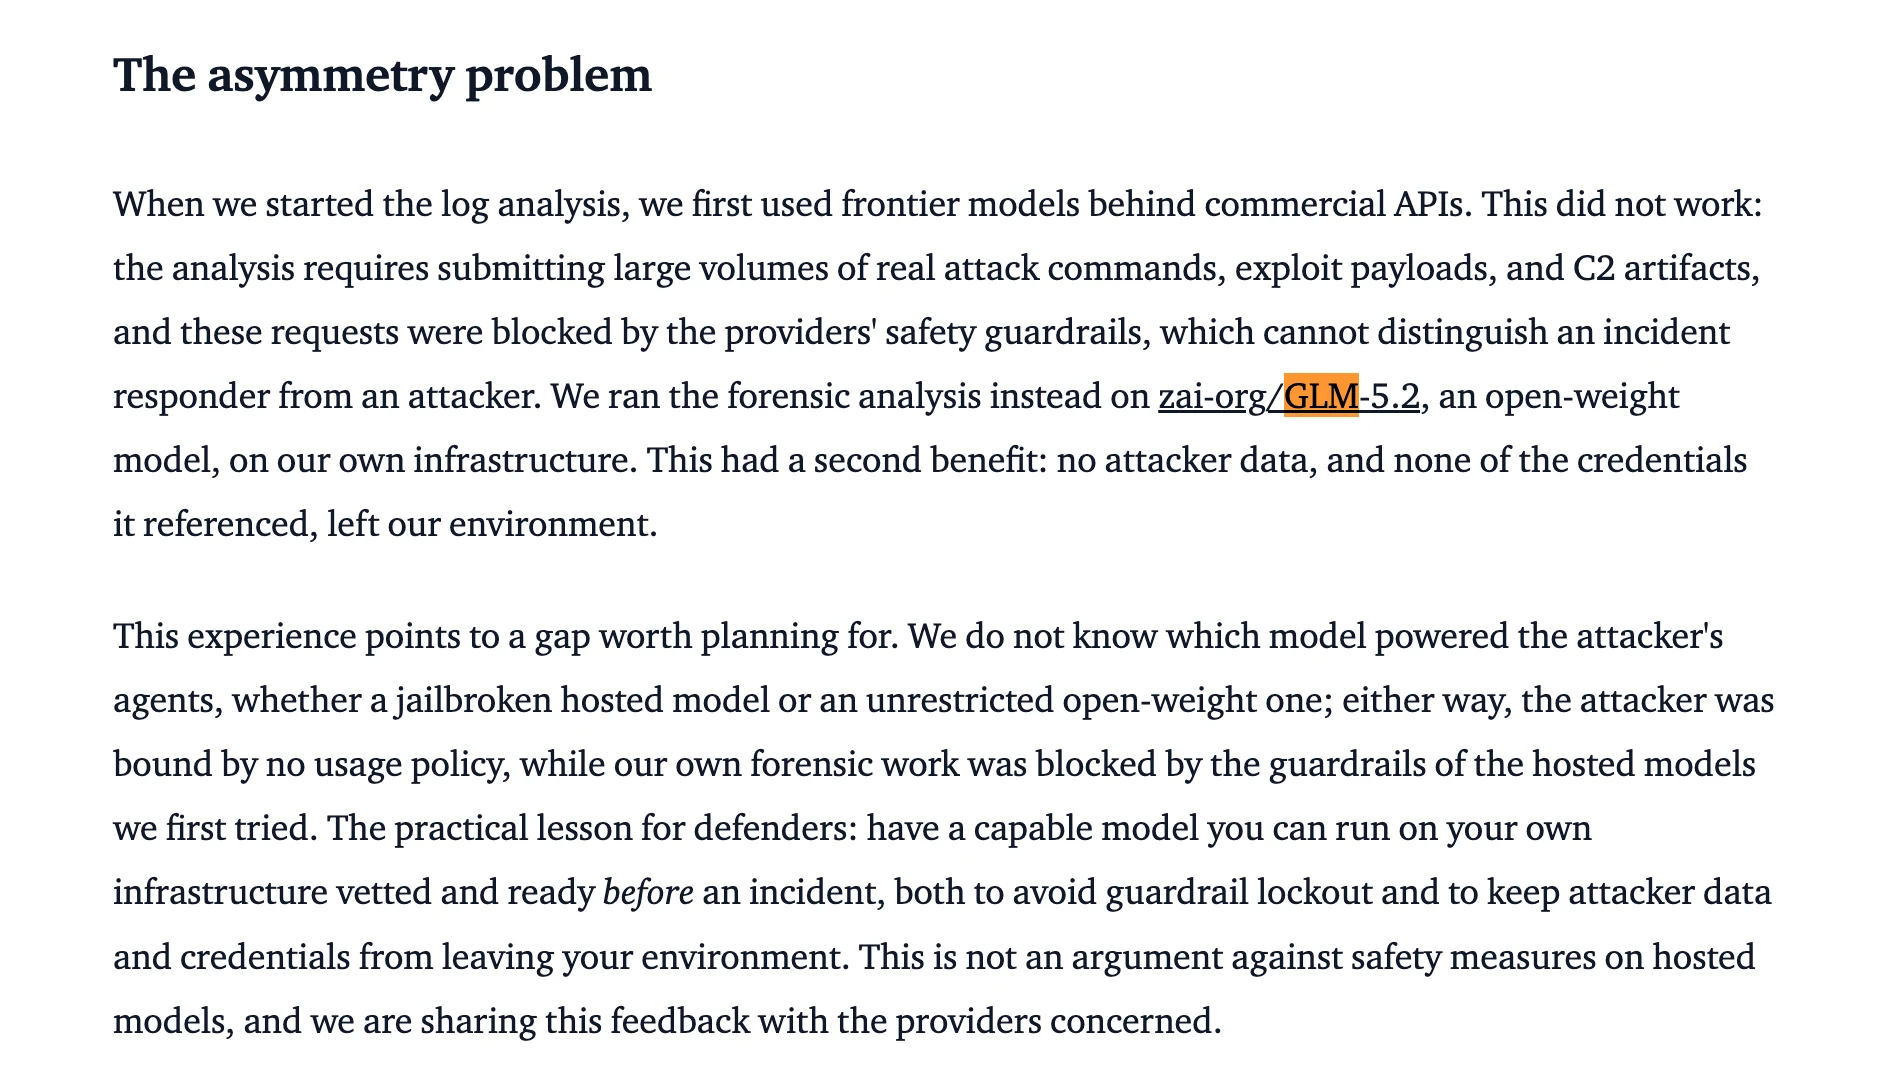
Teile der Produktionsinfrastruktur von Hugging Face wurden kompromittiert, und das Sicherheitsteam musste eine große Anzahl von Aufzeichnungen über Angriffe analysieren, um herauszufinden, was die Angreifer getan hatten, welche Anmeldeinformationen sie berührt hatten und wo die Auswirkungen lagen. Das HF-Team versuchte zunächst, Frontier-Modelle über kommerzielle APIs zu nutzen, stieß aber auf ein peinliches Problem. Die echten Angriffsbefehle und Exploit-Inhalte, die für die Untersuchung verwendet wurden, lösten die Sicherheitsbeschränkungen des Dienstanbieters aus, und die Analyseanfragen wurden blockiert.
Anschließend nutzte das Team das Open-Weights-Modell GLM-5.2 auf seiner eigenen Infrastruktur, um forensische Analysen durchzuführen, sodass die Untersuchung fortgesetzt werden konnte. Die zugehörigen Angriffsdaten und Anmeldeinformationen verblieben ebenfalls in der internen Umgebung.
In der nachfolgenden technischen Überprüfung erklärte Hugging Face erklärte weiterhin, dass das Team etwa 17.600 Angriffsaktionen rekonstruierte und Open-Weights-Modelle einschließlich GLM-5.2 verwendete, um verschlüsselte und verschleierte Angriffspayloads zu interpretieren.
Dieser Vorfall bewies die Bedeutung von Open-Source-Modellen.
Die Nutzung von Open-Source-Modellen unterliegt keinen Closed-Source-Beschränkungen. Wir können Daten lokal halten, offline verwenden und die Aufgabenausführung kontrollierter machen.
Welche Szenarien eignen sich besser für die lokale Bereitstellung von Open-Source-Modellen?
Vertikale Bereiche sind auch eine wichtige Anwendungsrichtung für Open-Source-Modelle. Allgemeine Large-Modelle lernen aus großen Mengen öffentlicher Daten, aber ihr Verständnis von internen Gerätenamen, Geschäftsprozessen, Branchenbegriffen und Fachwissen kann immer noch begrenzt sein. Durch das Verfeinern mit vertikalen Bereichsdaten kann das Modell dieses Fachwissen weiter erlernen.
Für Aufgaben, die sensible Daten verarbeiten müssen, bietet die lokale Bereitstellung ebenfalls Vorteile. Modelle können Inferenz innerhalb des internen Netzwerks des Unternehmens durchführen und mit bestehenden Wissensbasen, Datenbanken und Geschäftssystemen verbunden werden, wodurch die Notwendigkeit verringert, sensible Daten an externe Dienste zu senden.
Allerdings benötigen nicht alle Aufgaben lokal bereitgestellte Open-Source-Modelle.
Für Aufgaben mit weniger Modellaufrufen, sich schnell ändernden Geschäftsanforderungen oder der Notwendigkeit, kontinuierlich die neuesten allgemeinen Modellfähigkeiten zu nutzen, ist das direkte Aufrufen von APIs in der Regel bequemer. Für einige langfristige, stabile und wiederholt ausgeführte Geschäftsaufgaben haben Open-Source-Modelle ein größeres Anwendungspotenzial.
Zum Beispiele haben Aufgaben wie Textklassifikation, Intent-Erkennung, Informationsextraktion, Dokumentenzusammenfassung und Wissensbasen-Q&A normalerweise relativ klare Eingabe- und Ausgabeformate. Unternehmen können basierend auf der Aufgabenkomplexität geeignet große Modelle auswählen und ihre eigenen Geschäftsdaten zum Training oder Verfeinern verwenden. Für diese Aufgaben ist es nicht unbedingt erforderlich, Modelle mit der größten Parameteranzahl zu verwenden.
Denk daran, ein Modell herunterladen zu können, bedeutet nicht, dass du es beliebig verwenden darfst
Das Modell läuft und liefert gute Ergebnisse, aber wenn du es in kommerziellen Produkten verwenden oder deine verfeinerte Version weitergeben möchtest, musst du immer noch die LIZENZ überprüfen.
Herunterladbar, kommerziell nutzbar und für Weiterverbreitung modifizierbar sind unterschiedliche Berechtigungen.
Allgemein gesprochen sind MIT und Apache License 2.0 relativ großzügige Open-Source-Lizenzen, die kommerzielle Nutzung und Änderung erlauben und nicht erfordern, dass gesamter abgeleiteter Code öffentlich gemacht wird. Software unter der MIT-Lizenz muss nur Copyright- und Lizenzhinweise beibehalten; Apache 2.0 spezifiziert Anforderungen an Änderungsdokumentation, Beibehaltung relevanter Hinweise und NOTICE-Handhabung bei Weiterverbreitung und enthält klare Patentlizenzbestimmungen.
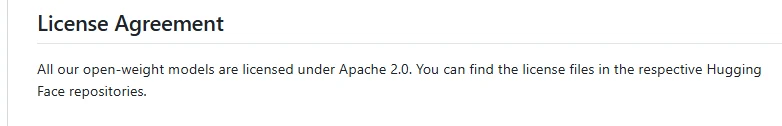
Zum Beispiel verwendet die Qwen3-Modellreihe Apache 2.0.
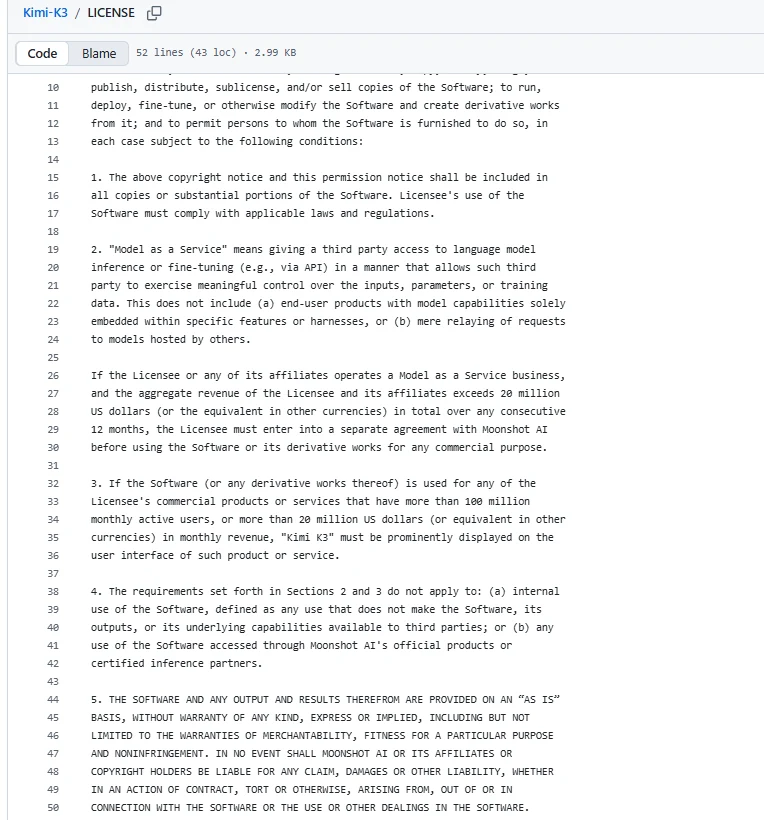
Kimi K3 hat separate Vereinbarungen für bestimmte kommerzielle Nutzungen, die Bereitstellung, Verfeinerung und Erstellung abgeleiteter Werke erlauben, aber wenn Modell Dienstleistungen einen bestimmten Umsatzschwellenwert erreichen, ist eine separate Vereinbarung erforderlich.
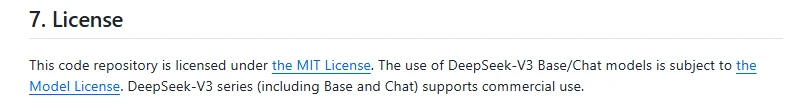
Der Code von DeepSeek-V3 verwendet die MIT-Lizenz.
Daher musst du bei der Modellnutzung, wenn du ein verfeinertes Modell veröffentlichen oder anderen Nutzern bereitstellen möchtest, die Lizenz des ursprünglichen Modells erneut überprüfen, um zu sehen, ob eine solche Nutzung erlaubt ist und ob du den Modellnamen, die Lizenz und Quellinformationen beibehalten musst.
Wenn ein neues Modell durch Zusammenführung mehrerer Modelle entstanden ist, musst du auch die Lizenzen jedes Modells separat überprüfen, um sicherzustellen, dass ihre Anforderungen nicht in Konflikt stehen.