Fine-Tuning und Evaluierung • Anfänger⏱️ 30 Min. Lesezeit
Training Data Preparation
So viel Geschäftsmaterial - wie wird es in Trainingsdaten umgewandelt?
Vor dem Training eines Modells stellen wir uns oft folgende Frage:
Ich habe viele Rohmaterialien, Produktbeschreibungen, Betriebshandbücher und Geschäftsspezifikationen, jeweils in unterschiedlichen Formatierungen, und der Inhalt ist ziemlich verstreut.
Wie kann ich diese Daten nutzen?
Und wenn ich direkt Daten aus einem bestimmten Bereich oder Szenario verwende, hat das trainierte Modell dann noch die Fähigkeit, allgemeines Wissen zu beantworten?
Der Schlüssel liegt also darin, wie wir alle Materialien in trainierbare Daten für das Modell umwandeln.
Gleichzeitig sind Datenbereinigung, Deduplizierung und Anonymisierung unverzichtbar. Wir haben möglicherweise Daten destilliert, aber müssen sie an unsere gewünschten Ergebnisse anpassen.
Ähnlich wie beim Training eines Modells: Wenn die Selbsterkennungsdaten nicht richtig trainiert sind, könnte das Modell antworten, es sei ein ChatGPT-Modell, ein Claude-Modell usw.
Daten sind die Grundlage für alles. In diesem Kapitel beginnen wir mit den Datenquellen und untersuchen, wie diese verstreuten Materialien durch Synthese, Bereinigung, Deduplizierung und Anonymisierung schließlich in trainierbare Daten für das Modell umgewandelt werden.
Geschäftliches lernen und Allgemeinwissen behalten
Das Sammeln und Annotieren von Trainingsdaten von Grund auf erfordert erheblichen Zeit- und Kostenaufwand. Für gängige Aufgaben wie Textklassifikation, Frage-Antwort und Textgenerierung können geeignete öffentliche Datensätze in das Training einbezogen werden.
Gängige öffentliche Datensätze umfassen:
Textklassifikation und -inferenz: GLUE, SuperGLUE, CLUE usw.;
Leseverständnis und Frage-Antwort: SQuAD, CMRC usw.;
Textzusammenfassung: CNN/DailyMail usw.;
Dialoge und Instruktionsoptimierung: Alpaca, ShareGPT, OpenOrca usw.;
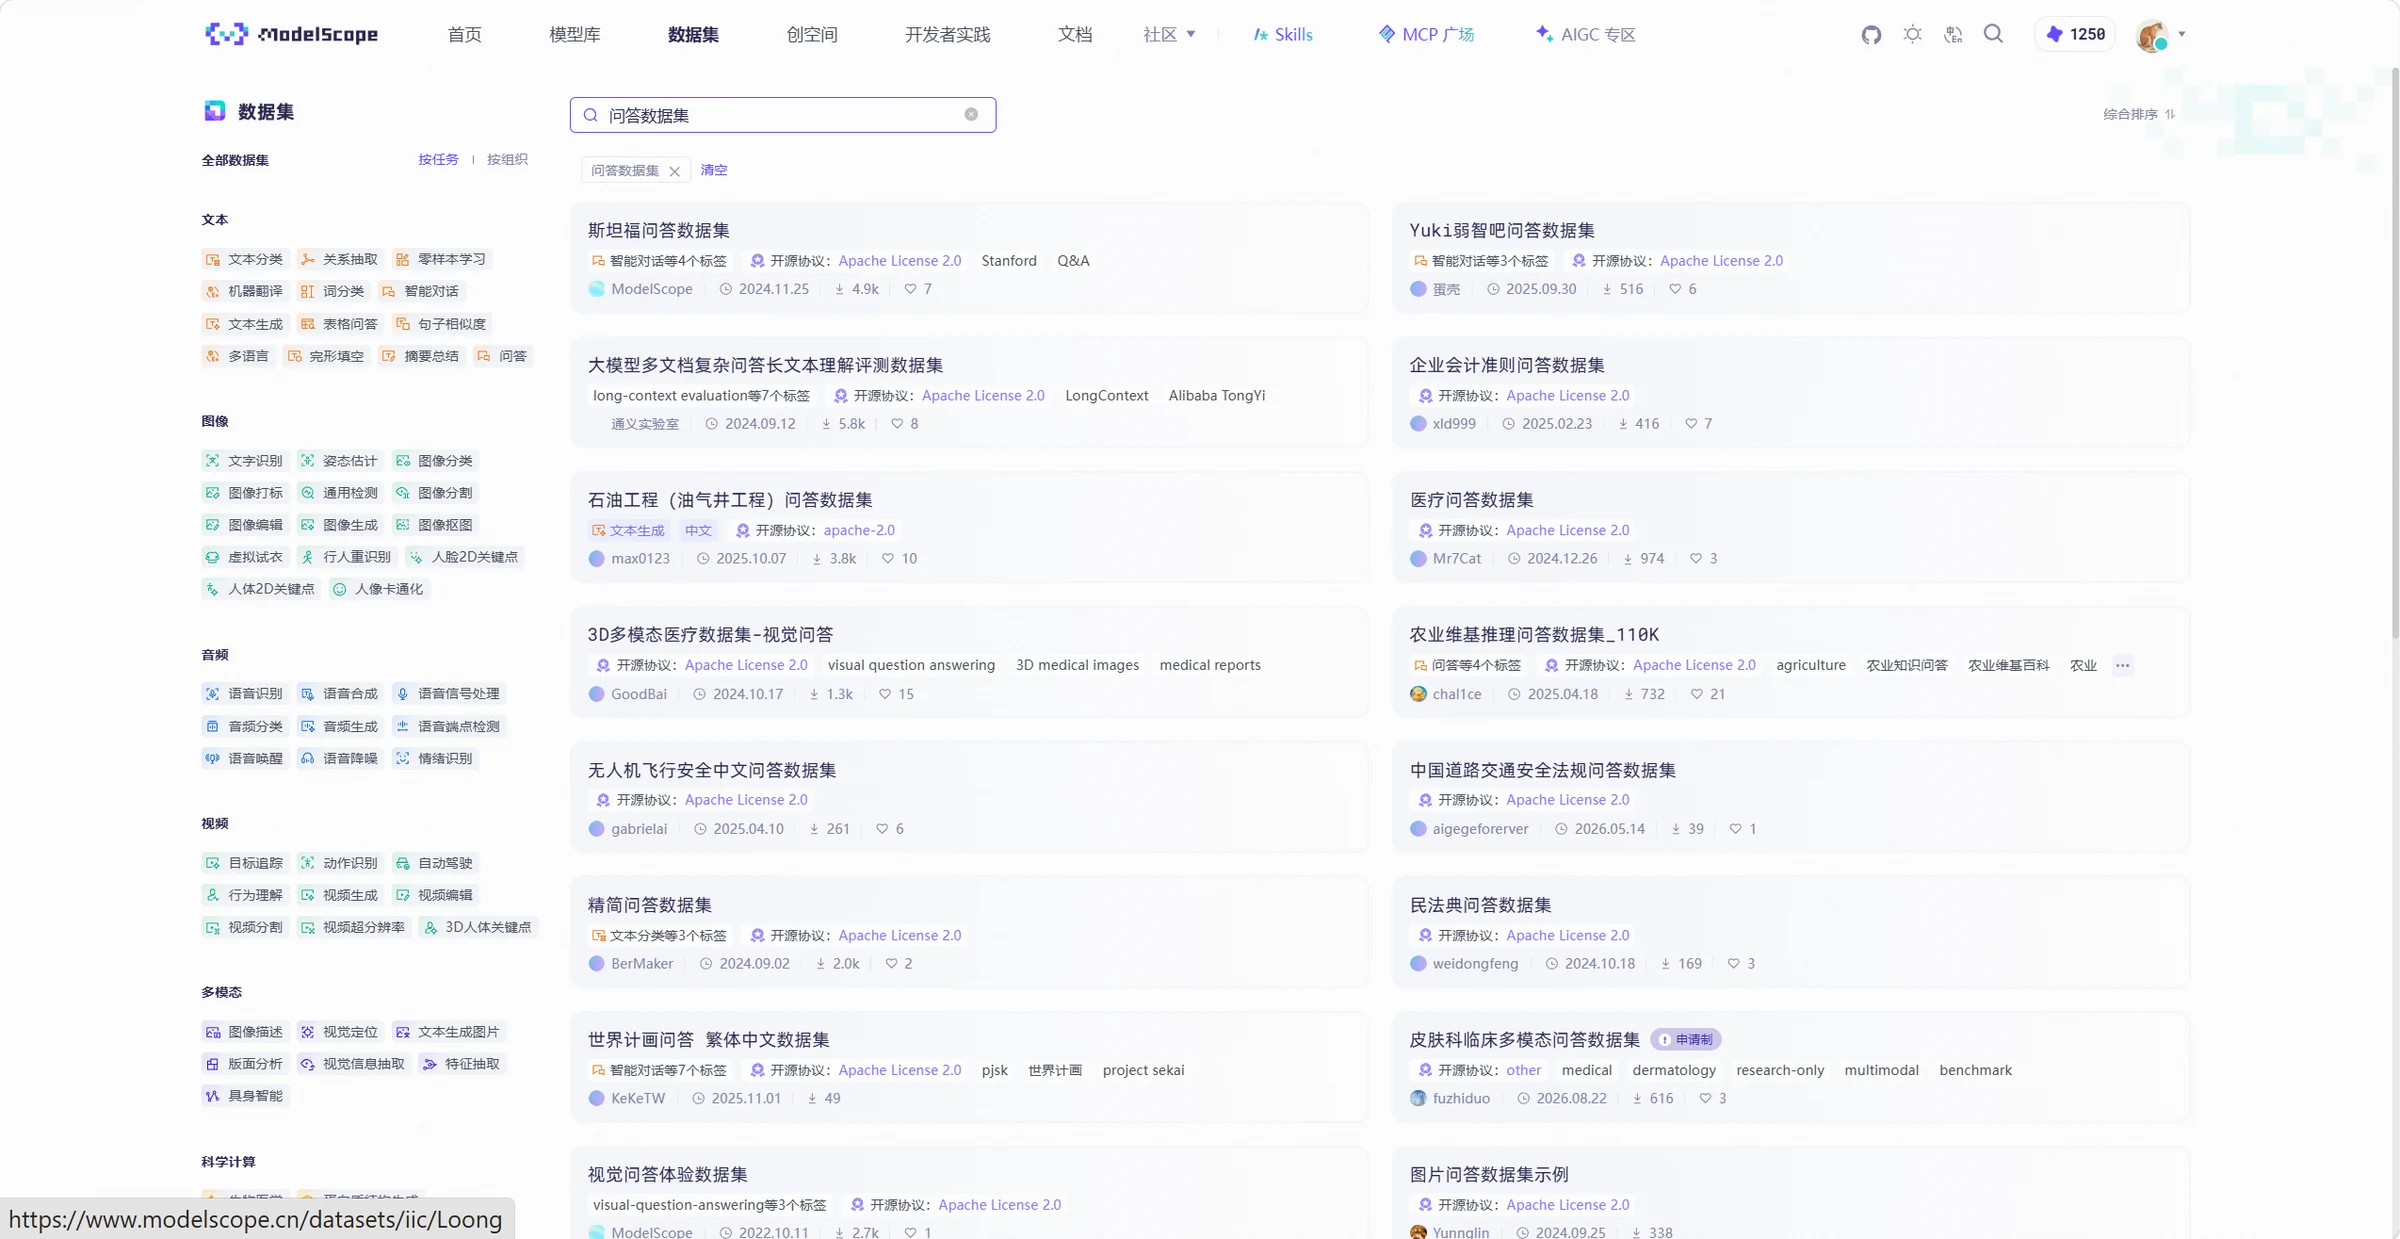
Neben dem Bezug von Daten über die offizielle Datensatz-Website können Open-Source-Datensätze auch über den ModelScope Dataset Hub gesucht und verwendet werden. Der Dataset Hub bietet Funktionen wie Datensatzsuche, Online-Vorschau und Download. Einige Datensätze können auch direkt über die ModelScope SDK geladen werden, was die nachfolgende Verarbeitung und das Training erleichtert. Die spezifischen Methoden zum Download von Datensätzen finden Sie im Abschnitt „Daten – die Grundlage für Feinabstimmung von Open-Source-Modellen".
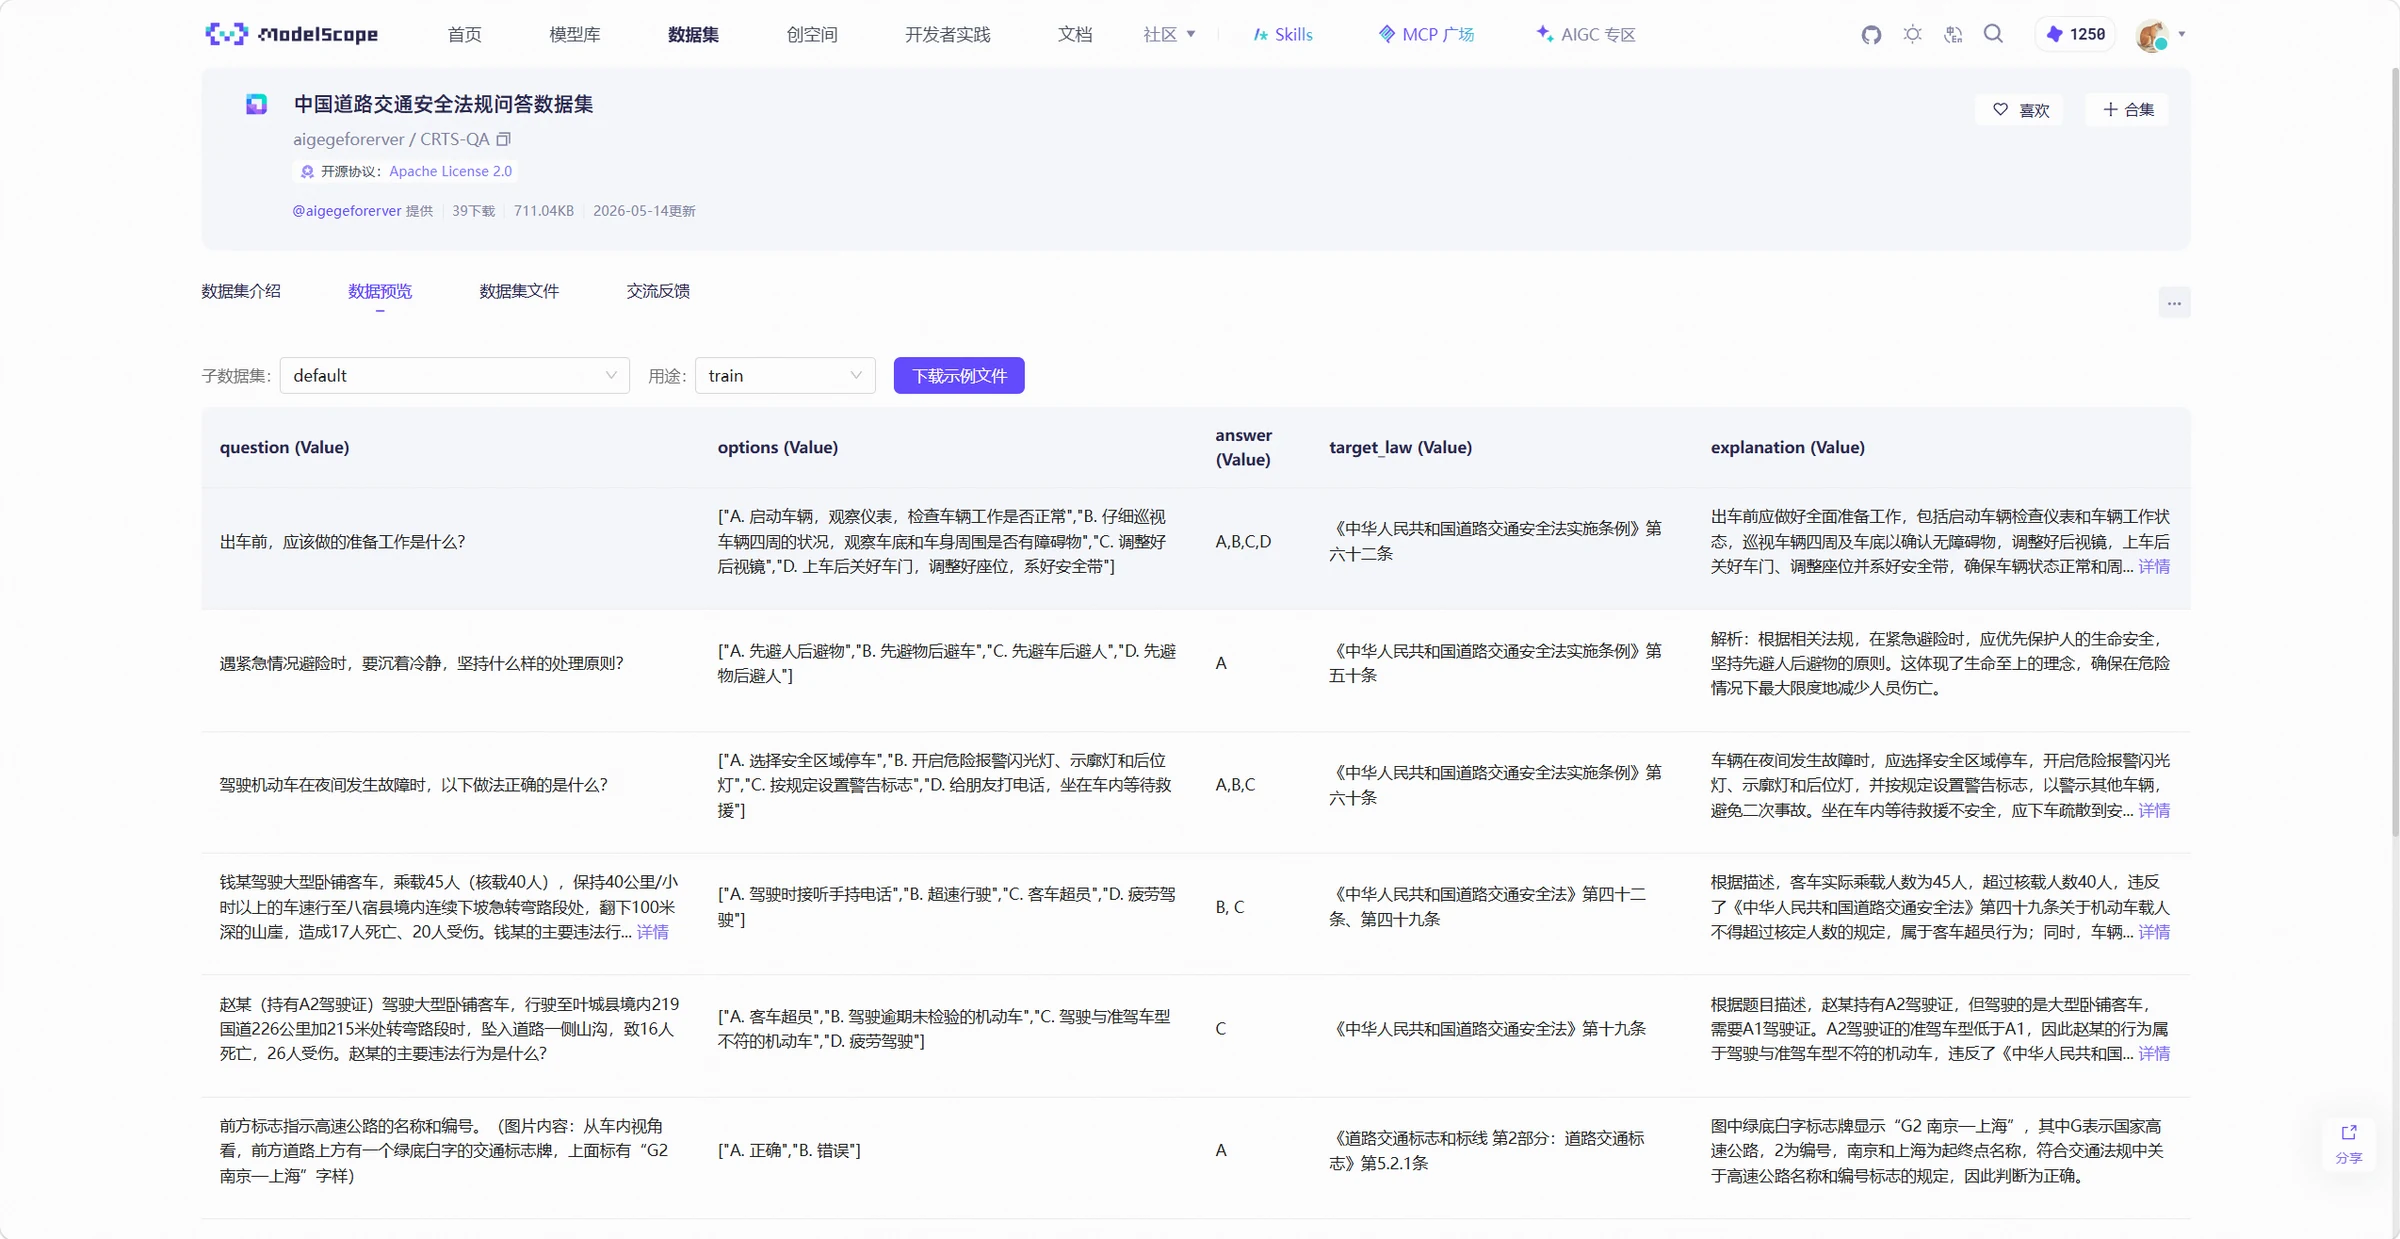
Bei der Auswahl von Open-Source-Datensätzen muss nicht nur geprüft werden, ob die Dateninhalte mit der Trainingsaufgabe übereinstimmen, sondern auch die Anzahl der Samples, das Feldformat, die Labeltypen und die Datenqualität des Datensatzes, um festzustellen, ob sie den Anforderungen entsprechen. Die von ModelScope bereitgestellte Datenvorschaufunktion hilft, die Felder und Sample-Inhalte eines Datensatzes schnell zu überprüfen. Ein Beispiel ist unten zu sehen:
Open-Source-Daten dienen hauptsächlich zur Ergänzung der allgemeinen Fähigkeiten des Modells. Wenn das Modell unternehmensinterne Produkte, Terminologie, Geschäftsregeln und Verarbeitungsprozesse lernen soll, müssen entsprechende Geschäftsdaten vorbereitet werden.
Wie werden eigene Geschäftsmaterialien verwendet?
Geschäftsdaten stammen aus den tatsächlichen Geschäftssystemen und Unterlagen des Unternehmens und stehen den Anwendungsszenarien des Modells näher. Allgemeine Frage-Antwort-Daten können dem Modell grundlegende Antwortmuster beibringen, während unternehmensinterne Frage-Antwort-Daten dem Modell Produktnamen, Fachbegriffe und Verarbeitungsregeln näher bringen können.
Gängige Geschäftsdatenquellen umfassen:
Unternehmensdokumente: Produktbeschreibungen, Betriebshandbücher, Geschäftsspezifikationen, Prozessdokumente usw., aus denen Produktwissen, Geschäftsregeln und Abläufe extrahiert werden können;
Kundenservice-Aufzeichnungen: Historische Dialoge zwischen Nutzern und Kundenservice, Ticket- und Beschwerdeaufzeichnungen, die zur Erstellung von Intentionserkennungs-, Frage-Antwort- und Dialogdaten verwendet werden können;
FAQ: Von Fachleuten zusammengestellte Fragen und Standardantworten, die direkt in Frage-Antwort-Trainingsdaten umgewandelt werden können;
Expertenfälle: Von Geschäftsexperten bearbeitete typische Probleme und deren Ergebnisse, die zur Erstellung von Trainingsdaten für komplexe Geschäftsszenarien verwendet werden können.
Geschäftsdaten können in der Regel nicht direkt für das Modelltraining verwendet werden. Ein mehrseitiges Geschäftshandbuch muss zunächst aus Word-, PDF- oder anderen Dateien extrahiert und dann je nach Trainingsaufgabe in Frage-Antwort-Paare, Klassifikationssamples oder Instruktionsdaten umgewandelt werden. Kundenservice-Aufzeichnungen können auch Systemnachrichten, ungültige Dialoge und doppelte Inhalte enthalten, die zuerst gefiltert und sortiert werden müssen.
Geschäftsdaten können auch sensible Inhalte wie Namen, Telefonnummern, Ausweisnummern und Kundeninformationen enthalten. Vor dem Einfügen in den Trainingsdatensatz müssen diese gemäß den Datenschutzanforderungen des Unternehmens anonymisiert werden, um zu verhindern, dass reale sensible Informationen direkt für das Modelltraining verwendet werden.
Nur Dokumente ohne Q&A – das Modell bei der Datensynthese unterstützen
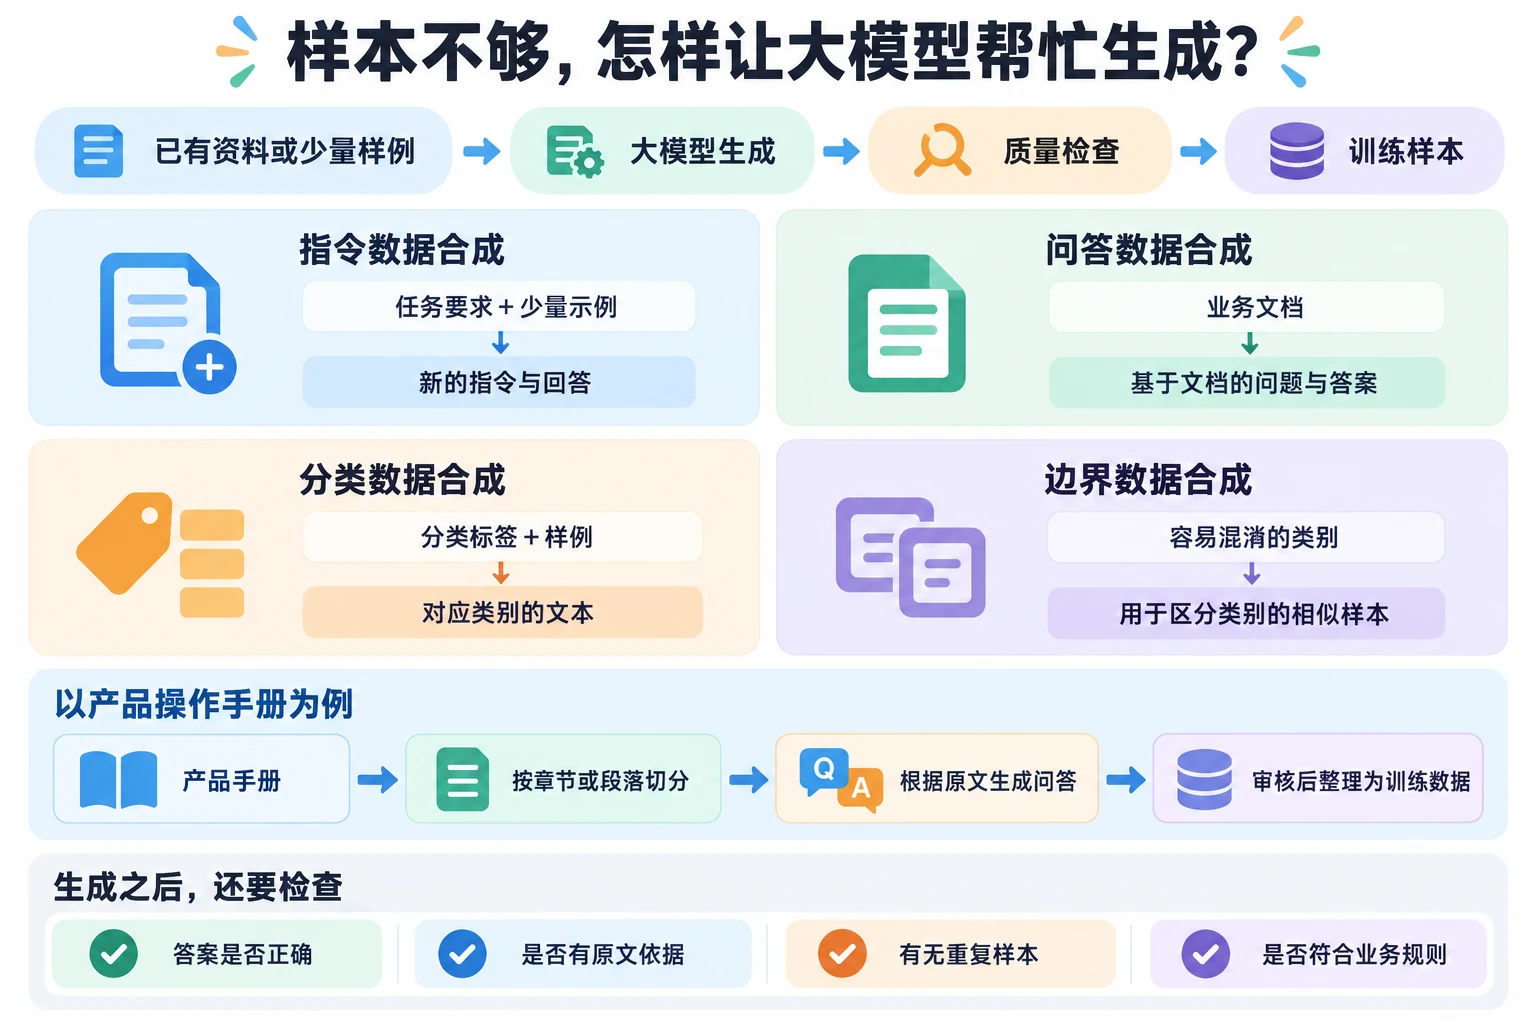
In realen Projekten reichen vorhandene Daten möglicherweise nicht aus, um alle Trainingsanforderungen zu erfüllen. Bei bestimmten Geschäftstypen gibt es beispielsweise nur wenige Samples, oder vorhandene Dokumente enthalten nur Wissen, aber keine direkt trainierbaren Frage-Antwort-Daten. In solchen Fällen kann ein großes Modell verwendet werden, um neue Trainingsproben zu erzeugen – ein Verfahren, das als Datensynthese bezeichnet wird.
Gängige Datensyntheseverfahren umfassen:
Instruktionsdatensynthese: Basierend auf vorhandenen Aufgaben oder wenigen Beispielen neue Anweisungen und Antworten durch ein großes Modell generieren;
Frage-Antwort-Datensynthese: Geschäftsunterlagen eingeben und das Modell basierend auf dem Dokument Fragen und Antworten generieren lassen;
Klassifikationsdatensynthese: Klassifikationslabel und Beispiele angeben und das Modell entsprechende Texte generieren lassen;
Grenzwertdatensynthese: Für leicht zu verwechselnde Kategorien ähnliche Samples erzeugen, um die Fähigkeit des Modells zur Grenzunterscheidung zu stärken.
Wenn ein Unternehmen beispielsweise nur ein Betriebshandbuch, aber keine Frage-Antwort-Daten hat, muss das Handbuch zunächst nach Kapiteln oder Abschnitten aufgeteilt und mit Hilfe eines großen Modells basierend auf dem Abschnittsinhalt mehrere Fragen und Antworten generiert werden. Nach Überprüfung der Ergebnisse werden diese in Frage-Antwort-Trainingsdaten umgewandelt.
Die Datensynthese kann den manuellen Aufwand für das Erstellen von Trainingsproben reduzieren und Szenarien mit unzureichenden Originaldaten ergänzen. Nach der Erstellung können synthetisierte Daten jedoch nicht direkt für das Training verwendet werden. Das große Modell könnte falsche Antworten, doppelte Proben erzeugen oder nicht existierende Produkte oder Geschäftsregeln erfinden. Eine Qualitätsprüfung ist daher erforderlich.
Generierte Daten nicht direkt zum Training verwenden
Die Qualität synthetisierter Daten wirkt sich direkt auf das Trainingsergebnis des Modells aus. Vor dem Hinzufügen synthetisierter Daten zum Trainingsset muss überprüft werden, ob die generierten Inhalte korrekt sind, und fehlerhafte, erfundene, doppelte und zu ähnliche Daten müssen gefiltert werden.
Stimmen die Antworten mit dem Original überein?
Wenn synthetisierte Daten auf Basis von Geschäftsunterlagen generiert wurden, muss überprüft werden, ob die generierten Inhalte mit dem Original übereinstimmen.
Beispiel: Die ursprüngliche Geschäftsunterlage schreibt vor:
Rückerstattungsanträge müssen einer manuellen Prüfung unterzogen werden; eine Rückerstattung erfolgt erst nach Bestätigung.
Vom Modell generierte Frage-Antwort-Daten:
Frage: Muss die Rückerstattung geprüft werden?
Antwort: Die Rückerstattung erfolgt automatisch nach Einreichung, eine manuelle Prüfung ist nicht erforderlich.
Diese Antwort widerspricht den Geschäftsregeln. Wenn sie für das Training verwendet wird, könnte das Modell falsche Geschäftsabläufe erlernen.
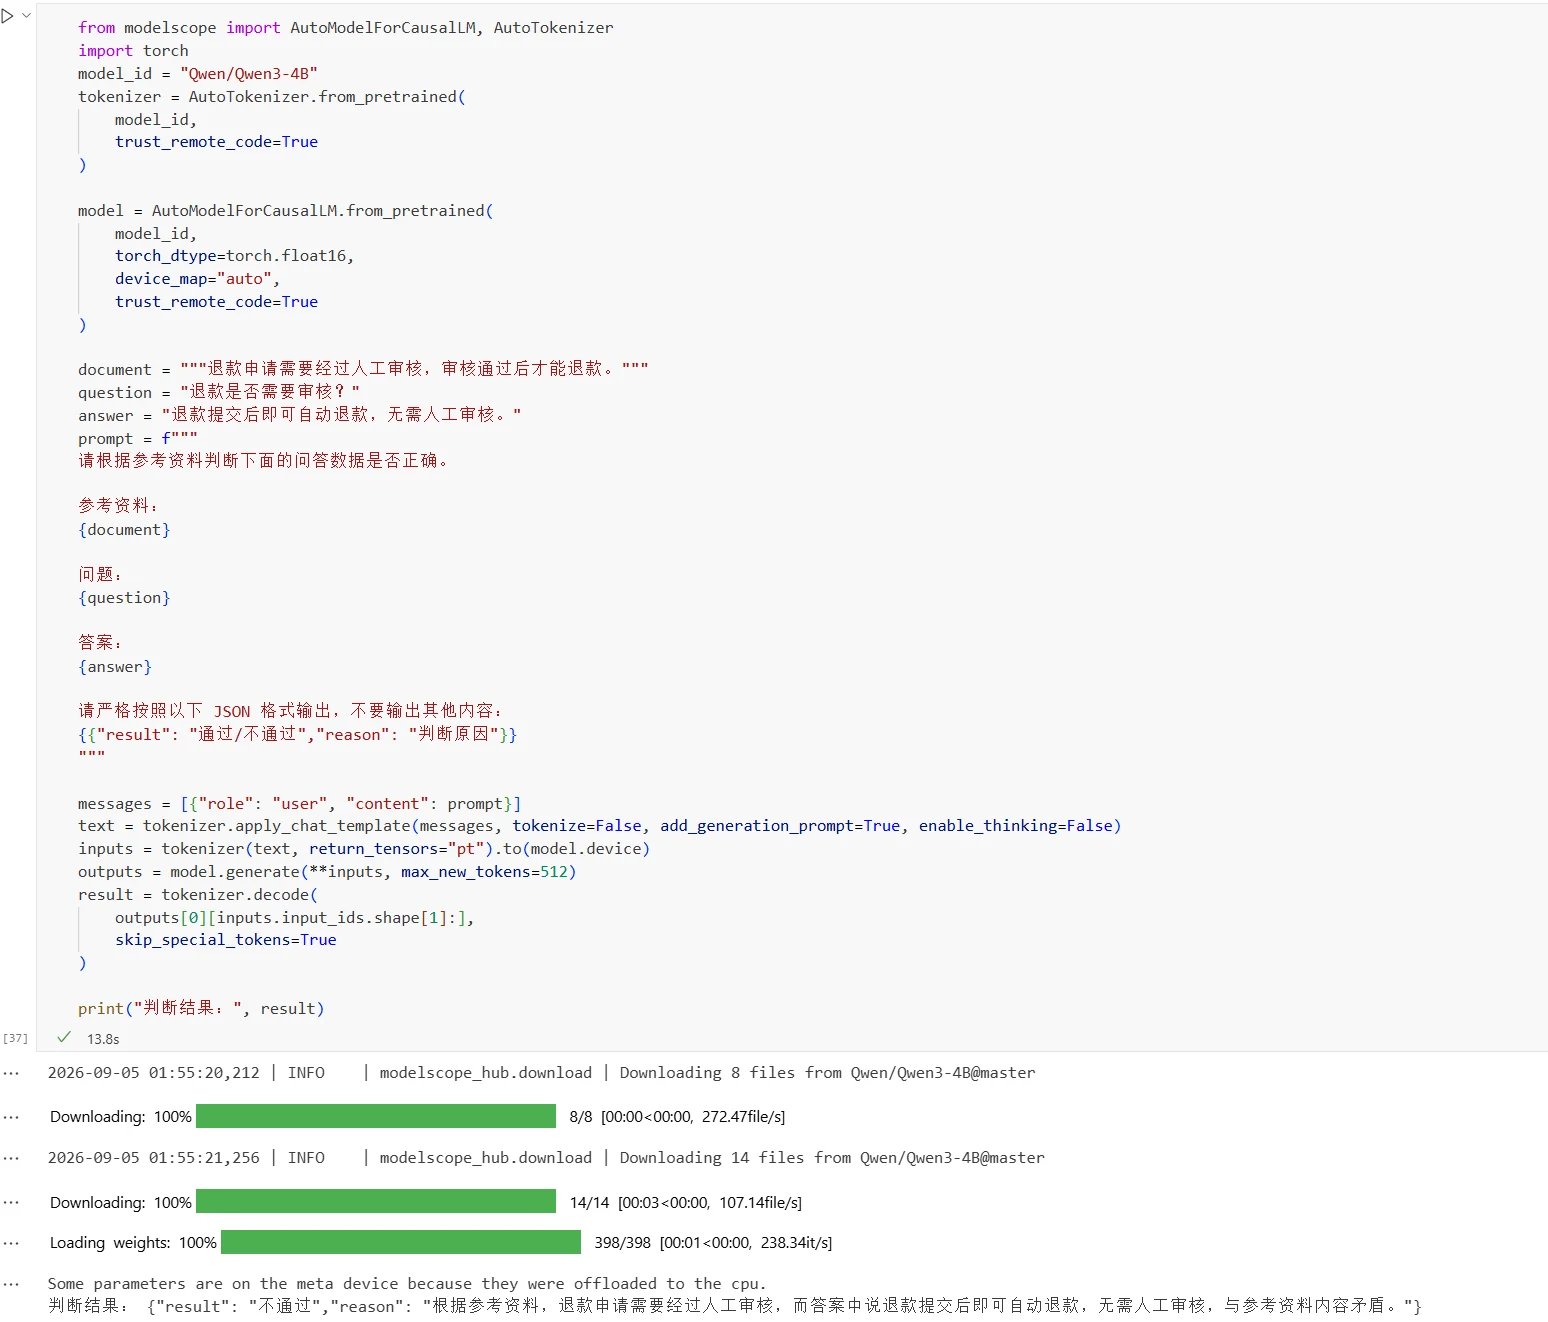
In der Praxis kann ein großes Modell zur Konsistenzbewertung synthetisierter Daten herangezogen werden. Das Originalmaterial, die Frage und die Antwort werden gleichzeitig dem Modell vorgegeben, um zu beurteilen, ob die Antwort mit dem Material übereinstimmt. Für als falsch bewertete Daten können diese gelöscht oder neu generiert werden. Der Verarbeitungscode lautet:
from modelscope import AutoModelForCausalLM, AutoTokenizer
import torch
model_id = "Qwen/Qwen3-4B"
tokenizer = AutoTokenizer.from_pretrained(
    model_id,
    trust_remote_code=True
)

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.float16,
    device_map="auto",
    trust_remote_code=True
)

document = """Rückerstattungsanträge müssen einer manuellen Prüfung unterzogen werden; eine Rückerstattung erfolgt erst nach Bestätigung."""
question = "Muss die Rückerstattung geprüft werden?"
answer = "Die Rückerstattung erfolgt automatisch nach Einreichung, eine manuelle Prüfung ist nicht erforderlich."
prompt = f"""
Bitte beurteilen Sie anhand der Referenzmaterialien, ob die folgenden Frage-Antwort-Daten korrekt sind.

Referenzmaterialien:
{document}

Frage:
{question}

Antwort:
{answer}

Bitte geben Sie strikt im folgenden JSON-Format aus und geben Sie keine anderen Inhalte aus:
{{"result": "Bestanden/Nicht bestanden","reason": "Begründung"}}
"""

messages = [{"role": "user", "content": prompt}]
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True, enable_thinking=False)
inputs = tokenizer(text, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=512)
result = tokenizer.decode(
    outputs[0][inputs.input_ids.shape[1]:],
    skip_special_tokens=True
)

print("Ergebnis:", result)
Ergebnisanzeige:
Was nicht im Original steht, soll das Modell nicht erfinden
Bei der Generierung von Daten durch große Modelle können Informationen entstehen, die im Originalmaterial nicht vorhanden sind – dieses Problem wird als Halluzination bezeichnet. Zum Beispiel die Erzeugung nicht existierender Produktnamen, Produktparameter oder Geschäftsabläufe.
Beispiel, Originalmaterial:
Das Produkt unterstützt maximal 100 GB Speicherplatz.
Generierte Daten:
Frage: Unterstützt das Produkt automatische Skalierung?
Antwort: Ja, wenn der Speicherplatz nicht ausreicht, erweitert das System automatisch.
Im Originalmaterial wird nicht erwähnt, ob das Produkt automatische Skalierung unterstützt. Die generierte Antwort hat daher keine Grundlage im Material und stellt einen erfundenen Inhalt dar.
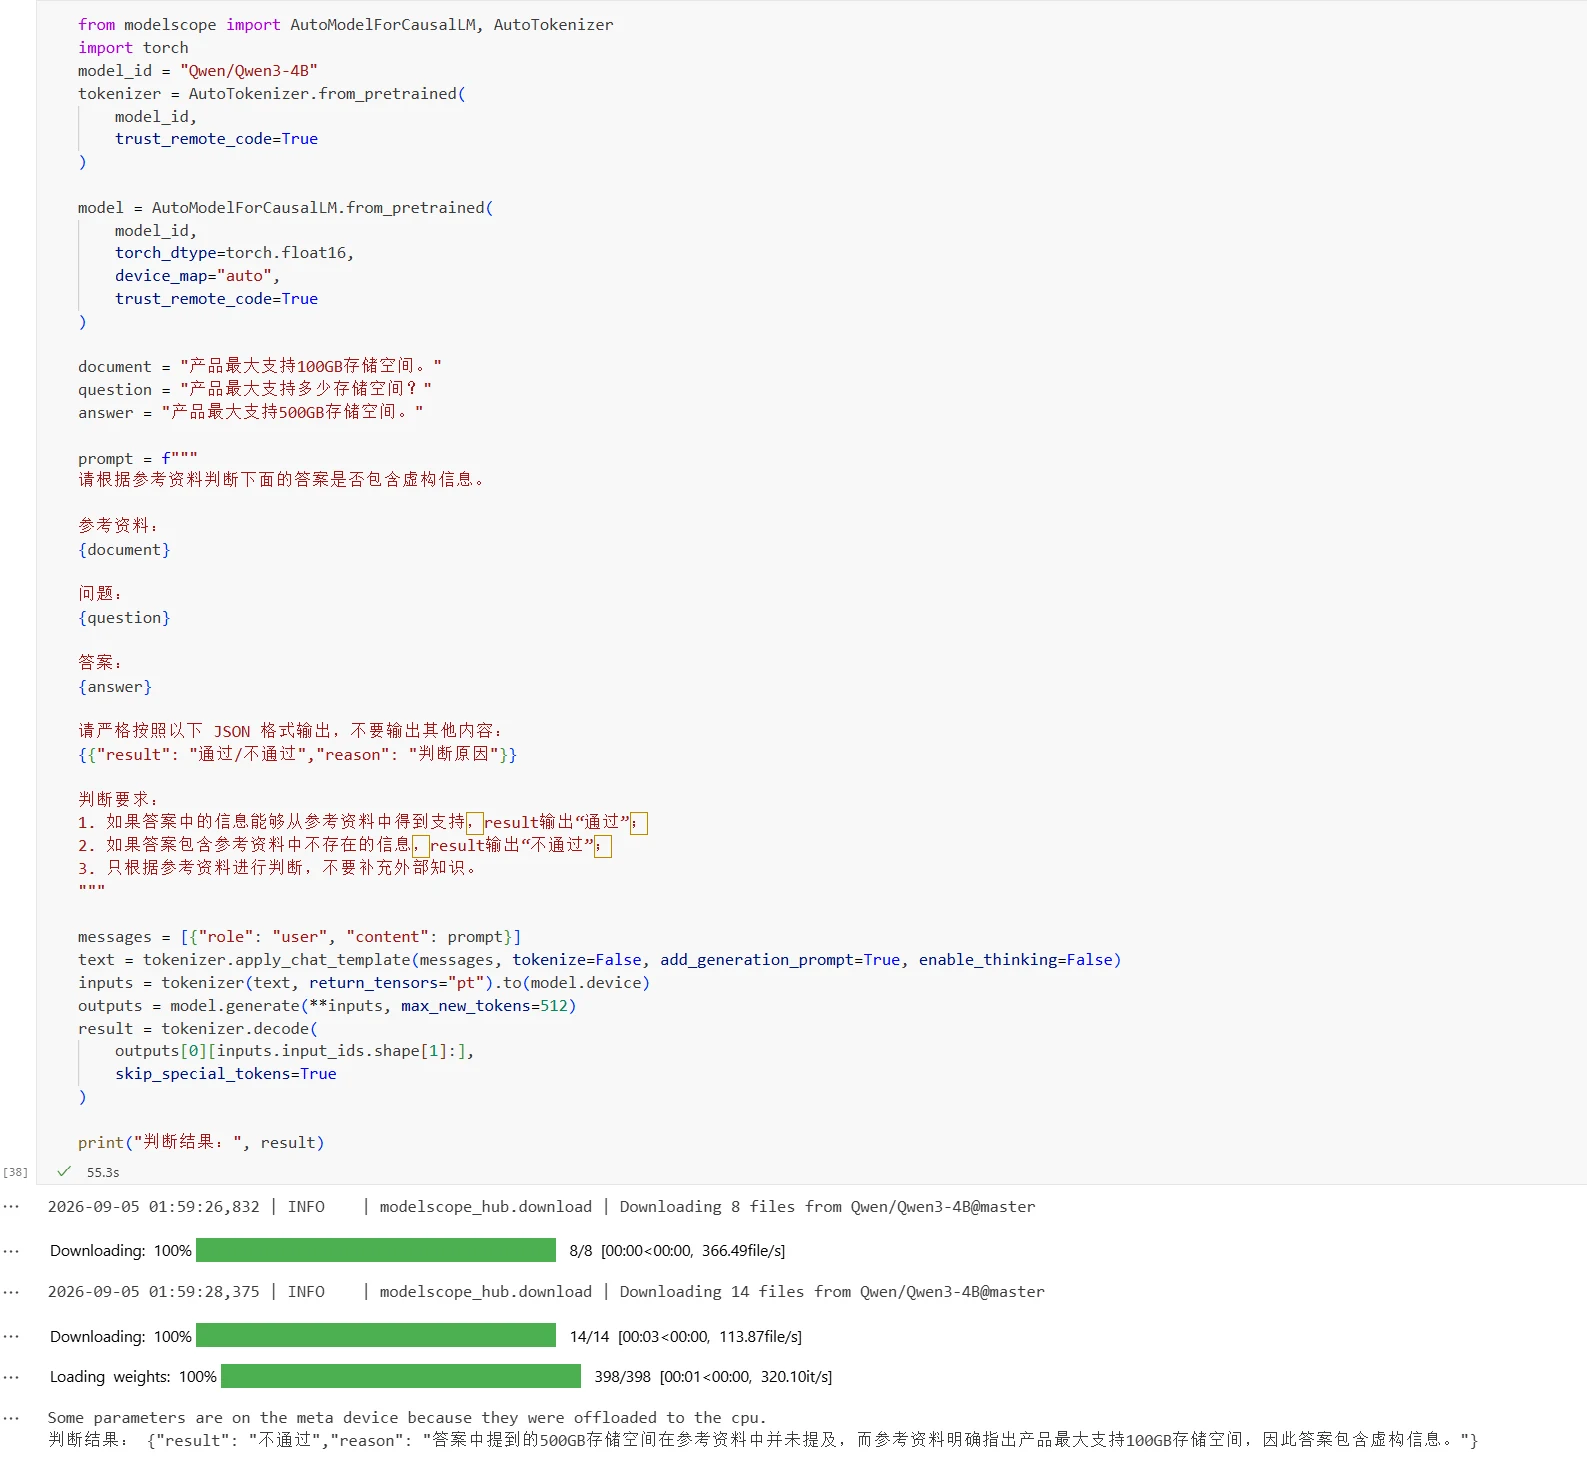
Für auf Geschäftsunterlagen basierende Daten kann ein großes Modell zur Überprüfung der Grundlage herangezogen werden, um festzustellen, ob die Schlüsselinformationen der Antwort durch das Originalmaterial gestützt werden. Für Daten ohne Grundlage oder die nicht bestätigt werden können, können diese gelöscht, neu generiert oder einer manuellen Nachprüfung unterzogen werden. Bei wichtigen Geschäftsregeln kann auch eine Stichprobe durch Fachleute erfolgen. Der Verarbeitungscode lautet:
from modelscope import AutoModelForCausalLM, AutoTokenizer
import torch
model_id = "Qwen/Qwen3-4B"
tokenizer = AutoTokenizer.from_pretrained(
    model_id,
    trust_remote_code=True
)

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.float16,
    device_map="auto",
    trust_remote_code=True
)

document = "Das Produkt unterstützt maximal 100 GB Speicherplatz."
question = "Wie viel Speicherplatz unterstützt das Produkt maximal?"
answer = "Das Produkt unterstützt maximal 500 GB Speicherplatz."

prompt = f"""
Bitte beurteilen Sie anhand der Referenzmaterialien, ob die folgende Antwort erfundene Informationen enthält.

Referenzmaterialien:
{document}

Frage:
{question}

Antwort:
{answer}

Bitte geben Sie strikt im folgenden JSON-Format aus und geben Sie keine anderen Inhalte aus:
{{"result": "Bestanden/Nicht bestanden","reason": "Begründung"}}

Bewertungsanforderungen:
1. Wenn die Informationen in der Antwort durch die Referenzmaterialien gestützt werden, geben Sie für result "Bestanden" aus;
2. Wenn die Antwort Informationen enthält, die in den Referenzmaterialien nicht vorhanden sind, geben Sie für result "Nicht bestanden" aus;
3. Beurteilen Sie ausschließlich anhand der Referenzmaterialien und ergänzen Sie kein externes Wissen.
"""

messages = [{"role": "user", "content": prompt}]
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True, enable_thinking=False)
inputs = tokenizer(text, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=512)
result = tokenizer.decode(
    outputs[0][inputs.input_ids.shape[1]:],
    skip_special_tokens=True
)

print("Ergebnis:", result)
Ergebnisanzeige:
Andere Formulierung, aber gleiche Frage
Bei der Massengenerierung von Daten durch große Modelle entstehen leicht doppelte oder hochgradig ähnliche Proben. Beispielsweise: „Wie ändere ich mein Anmeldepasswort?" und „Wie kann ich das Anmeldepasswort ändern?" – diese Fragen unterscheiden sich in der Formulierung, sind aber inhaltlich im Wesentlichen gleich. Wenn es zu viele solcher ähnlichen Samples gibt, verringert sich die effektive Informationsmenge des Datensatzes.
Nach der Erstellung synthetisierter Daten müssen Duplikate und Ähnlichkeiten zwischen den Samples überprüft, vollständig identische Daten gefiltert und die Anzahl hochgradig ähnlicher Samples begrenzt werden, wobei repräsentative Samples beibehalten werden. Die konkreten Deduplizierungsmethoden werden im folgenden Abschnitt vorgestellt.
Daten aus verschiedenen Quellen zusammenführen
Egal ob die Daten aus Open-Source-Datensätzen, Unternehmensgeschäftsdaten oder der Modellsynthese stammen – vor der Verwendung im Modelltraining müssen sie einheitlich verarbeitet werden. Gängige Verarbeitungsschritte umfassen Datensammlung, Datenbereinigung, Deduplizierung und Anonymisierung.
Benötigte Inhalte sammeln und Felder vereinheitlichen
Die Datensammlung besteht darin, anhand der Trainingsaufgabe die erforderlichen Daten aus verschiedenen Quellen zu beziehen und einheitlich zu ordnen.
Vor der Sammlung muss festgestellt werden, welche Dateninhalte für die Trainingsaufgabe benötigt werden. Klassifikationsaufgaben erfordern Text und Kategorie-Labels, Frage-Antwort-Aufgaben erfordern Fragen und Antworten, und Instruktionsoptimierung erfordert Anweisungen und entsprechende Antworten. Bei der Sammlung werden nur Daten und Felder behalten, die im Zusammenhang mit der Trainingsaufgabe stehen.
Die Datenstruktur kann je nach Quelle unterschiedlich sein. Ein Datensatz verwendet beispielsweise die Felder question und answer, ein anderer die Felder query und response. Nach der Sammlung müssen die Feldnamen und Datenstrukturen vereinheitlicht werden, um die nachfolgende Verarbeitung zu erleichtern.
Für Daten, denen notwendige Informationen fehlen, können diese im Sammlungsprozess ergänzt werden. Beispielsweise können Klassifikationsdaten mit Kategorie-Labels ergänzt oder Frage-Antwort-Daten mit Referenzantworten versehen werden.
Daten müssen zuerst bereinigt werden
Rohdaten können ungültige oder fehlerhafte Inhalte enthalten, die vor dem Training bereinigt werden müssen.
Gängige Verarbeitungsschritte umfassen: Löschen leerer Daten und ungültiger Einträge, Entfernen überflüssiger HTML-Tags und Sonderzeichen, Vereinheitlichung der Kodierung und des Formats sowie Korrektur offensichtlicher OCR-Erkennungsfehler.
Die Datenbereinigung bedeutet nicht, alle besonderen Inhalte zu löschen. Code, Formeln, Einheiten und Satzzeichen können selbst Teil des Trainingsinhalts sein. Ob sie beibehalten werden, hängt von der jeweiligen Aufgabe ab.
Am Beispiel eines FAQ-Datensatzes – Rohdaten:
faq_data = [
    {
        "question": "  Wie ändere ich mein Anmeldepasswort?  ",
        "answer": "<p>Gehen Sie in das persönliche Konto und klicken Sie auf „Passwort ändern\".</p>"
    },
    {
        "question": "",
        "answer": "Bitte kontaktieren Sie den Administrator."
    },
    {
        "question": "Was tun, wenn ich mein Passwort vergessen habe?",
        "answer": "Klicken Sie auf „Passwort vergessen"\n\nund folgen Sie den Anweisungen."
    },
    {
        "question": "Wie lautet die Kundenservice-Nummer?",
        "answer": "Die Kundenservice-Nummer lautet 400-123-4567\xa0"
    }
]
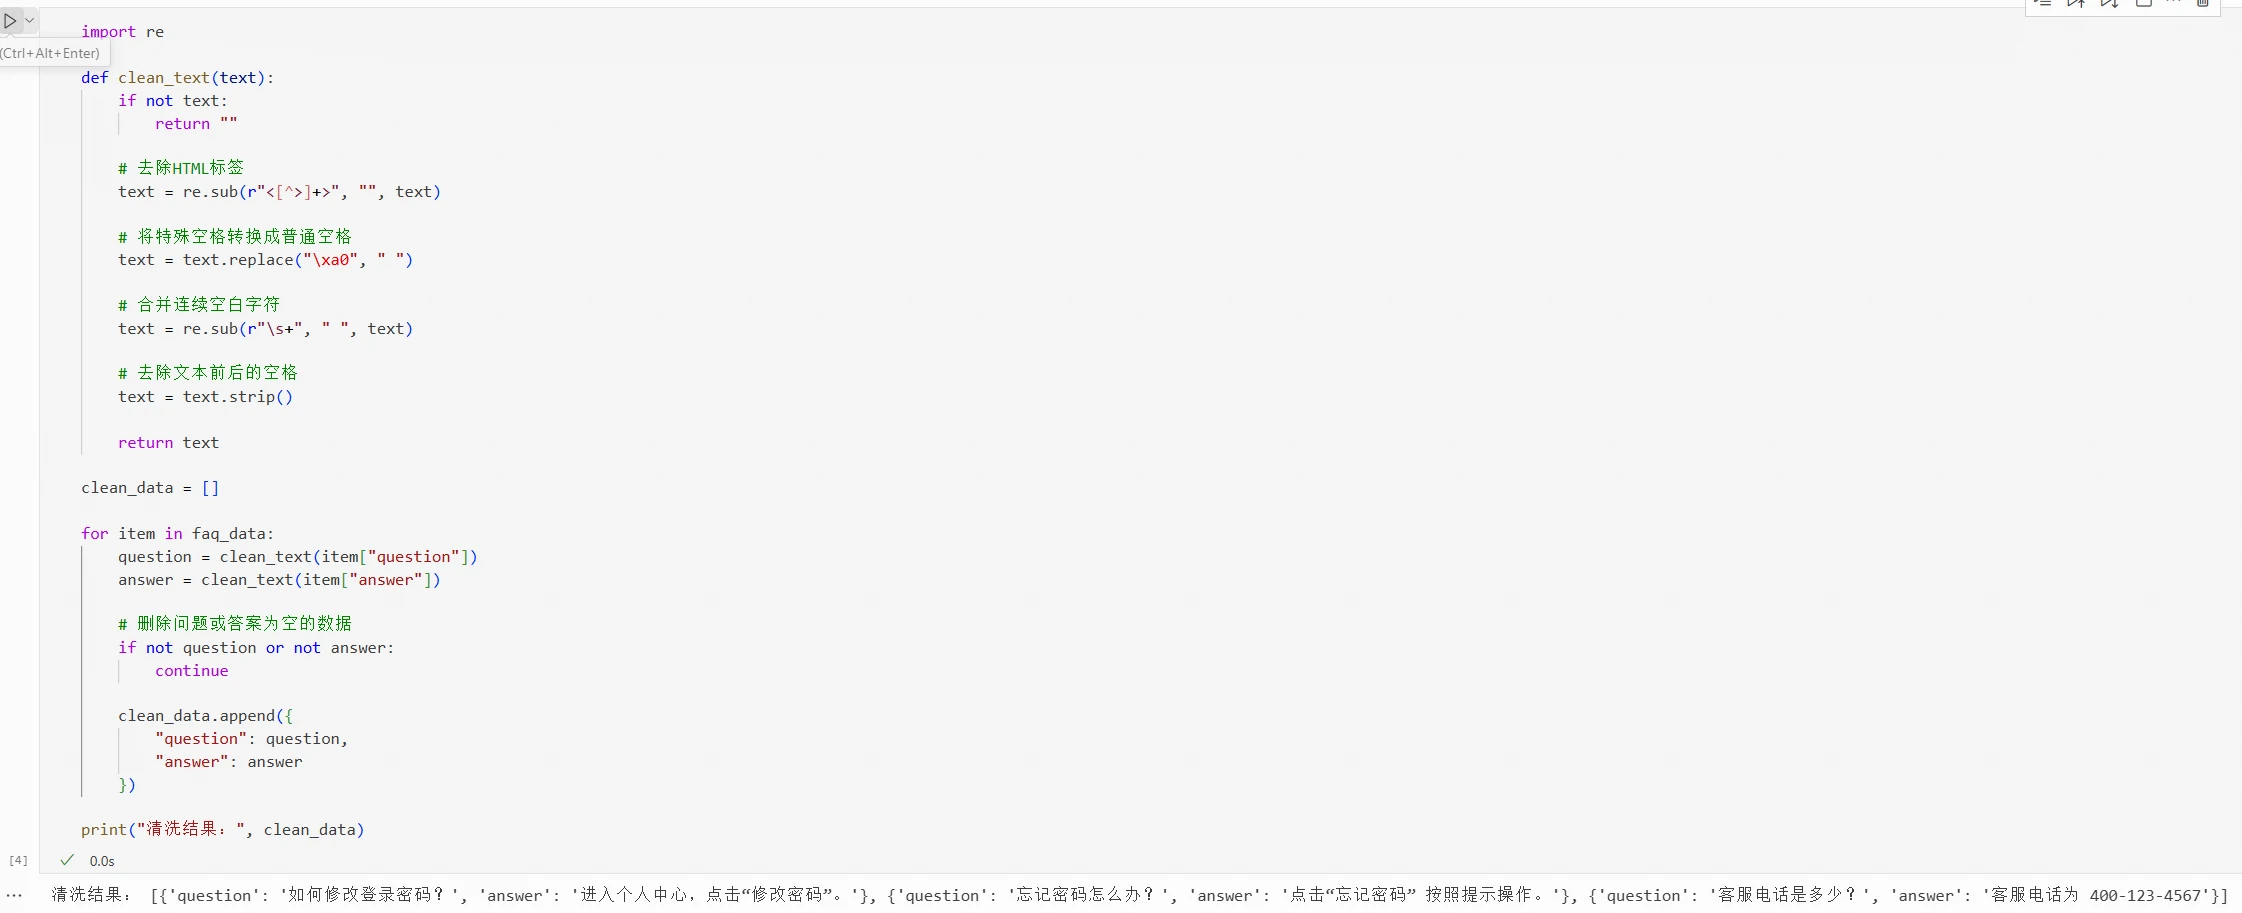
Der Bereinigungscode lautet:
import re

def clean_text(text):
    if not text:
        return ""

    # HTML-Tags entfernen
    text = re.sub(r"<[^>]+>", "", text)

    # Spezielle Leerzeichen in normale Leerzeichen umwandeln
    text = text.replace("\xa0", " ")

    # Aufeinanderfolgende Leerzeichen zusammenfassen
    text = re.sub(r"\s+", " ", text)

    # Leerzeichen am Anfang und Ende entfernen
    text = text.strip()

    return text

clean_data = []

for item in faq_data:
    question = clean_text(item["question"])
    answer = clean_text(item["answer"])

    # Daten mit leerer Frage oder Antwort löschen
    if not question or not answer:
        continue

    clean_data.append({
        "question": question,
        "answer": answer
    })

print("Bereinigungsergebnis:", clean_data)
Das Bereinigungsergebnis:
Die Bereinigungsregeln in der Praxis richten sich nach den Datenmerkmalen.
Müssen doppelte Daten alle aufbewahrt werden?
Nach dem Zusammenführen von Daten aus verschiedenen Quellen können inhaltlich identische oder ähnliche Daten auftreten. Dasselbe FAQ kann beispielsweise gleichzeitig in einem öffentlichen Datensatz, in einem Produktmanual und in einer Kundenservice-Wissensdatenbank vorkommen. Auch synthetisierte Daten können inhaltlich mit vorhandenen Daten übereinstimmen. Zu viele Duplikate verringern die Vielfalt der Trainingsdaten, führen dazu, dass das Modell bestimmtes Wissen oder Ausdrucksweisen überlernt, und erfordern daher eine einheitliche Deduplizierung vor dem Training.
Je nach Grad der Duplizierung lässt sich die Deduplizierung in die Deduplizierung identischer Daten und die Deduplizierung ähnlicher Daten unterteilen:
Deduplizierung identischer Daten: Prüfung, ob der Inhalt zweier Datensätze vollständig übereinstimmt, kann durch Textübereinstimmung oder Hashwerte erfolgen.
Deduplizierung ähnlicher Daten: Prüfung, ob zwei Datensätze zwar unterschiedlich formuliert sind, aber inhaltlich sehr nahe beieinander liegen. Hierfür können MinHash, SimHash oder Vektorähnlichkeit eingesetzt werden.
Unterschiedliche Datentypen erfordern unterschiedliche Deduplizierungsregeln. Am Beispiel eines FAQ-Datensatzes können Frage und Antwort zu einem vollständigen Text kombiniert und dann geprüft werden, ob verschiedene Samples dupliziert oder ähnlich sind.
Deduplizierung identischer Daten
Datenbeispiel:
faq_data = [
    {
        "question": "Wie ändere ich mein Anmeldepasswort?",
        "answer": "Gehen Sie in das persönliche Konto und klicken Sie auf „Passwort ändern"."
    },
    {
        "question": "Was tun, wenn ich mein Passwort vergessen habe?",
        "answer": "Klicken Sie auf „Passwort vergessen" und folgen Sie den Anweisungen."
    },
    {
        "question": "Wie ändere ich mein Anmeldepasswort?",
        "answer": "Gehen Sie in das persönliche Konto und klicken Sie auf „Passwort ändern"."
    }
]
(1) Textübereinstimmung
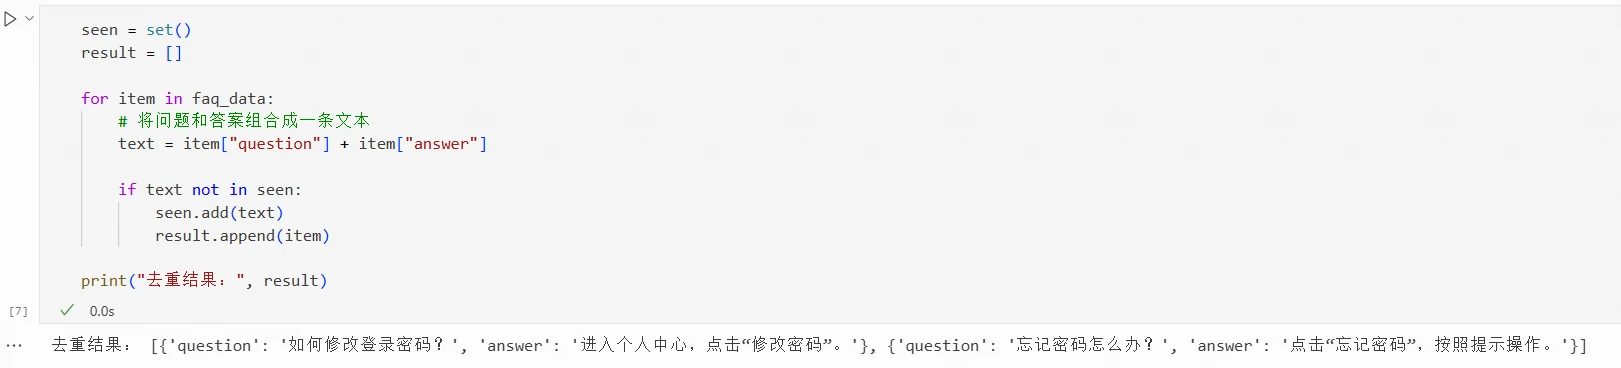
Der Code zur Textübereinstimmungs-Deduplizierung lautet:
seen = set()
result = []

for item in faq_data:
    # Frage und Antwort zu einem Text kombinieren
    text = item["question"] + item["answer"]

    if text not in seen:
        seen.add(text)
        result.append(item)

print("Deduplizierungsergebnis:", result)
Das Deduplizierungsergebnis:
Nach der Verarbeitung wird von zwei inhaltlich identischen FAQ-Einträgen nur einer beibehalten.
(2) Hashwerte
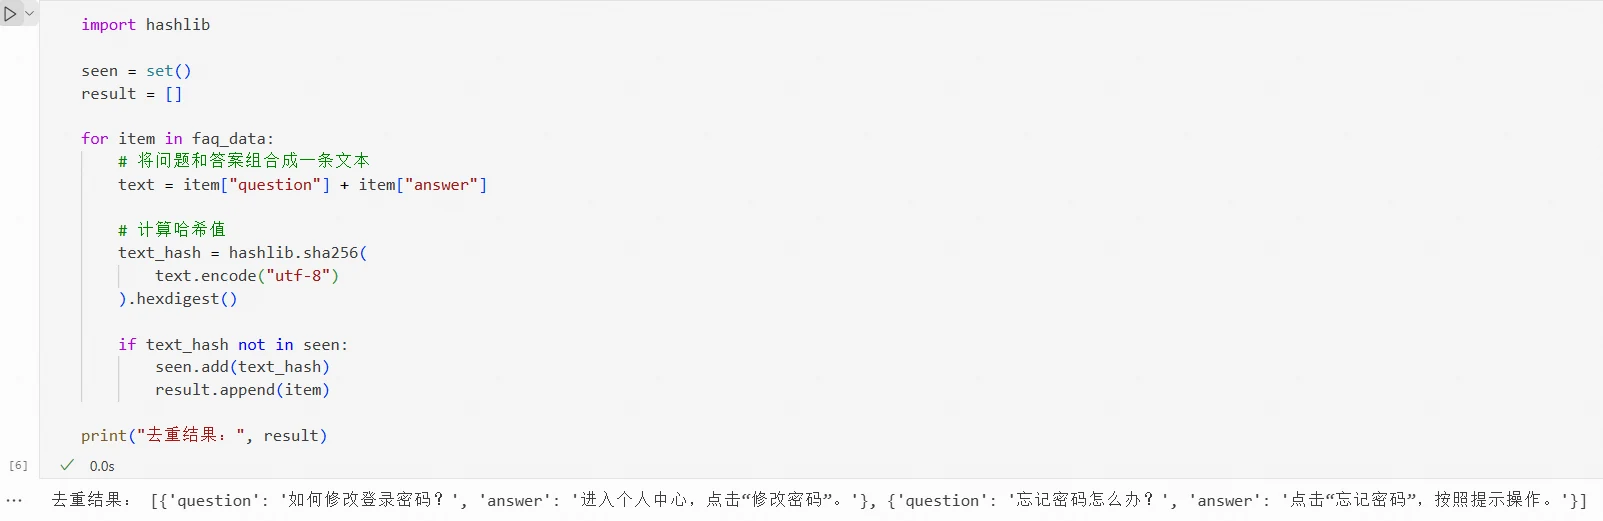
Der Hash-Algorithmus kann einen Text in einen Wert fester Länge umwandeln. Gleiche Texte ergeben denselben Hashwert. Durch Vergleich der Hashwerte kann festgestellt werden, ob Daten dupliziert sind. Beispiel:
import hashlib

seen = set()
result = []

for item in faq_data:
    # Frage und Antwort zu einem Text kombinieren
    text = item["question"] + item["answer"]

    # Hashwert berechnen
    text_hash = hashlib.sha256(
        text.encode("utf-8")
    ).hexdigest()

    if text_hash not in seen:
        seen.add(text_hash)
        result.append(item)

print("Deduplizierungsergebnis:", result)
Das Deduplizierungsergebnis:
Gewöhnliche Hashwerte können nur prüfen, ob der Inhalt vollständig identisch ist. Sobald sich der Text in Frage oder Antwort ändert, ändert sich auch der berechnete Hashwert. Für Daten mit unterschiedlichem Text, aber ähnlichem Inhalt ist eine weitergehende Ähnlichkeitsprüfung erforderlich.
Deduplizierung ähnlicher Daten
Datenbeispiel:
faq_data = [
    {
        "question": "Wie ändere ich mein Anmeldepasswort?",
        "answer": "Gehen Sie in das persönliche Konto und klicken Sie auf „Passwort ändern"."
    },
    {
        "question": "Wie kann ich das Anmeldepasswort ändern?",
        "answer": "Gehen Sie in das persönliche Konto und klicken Sie auf „Passwort ändern"."
    },
    {
        "question": "Wie beantrage ich eine Rechnung?",
        "answer": "Gehen Sie zur Bestellseite, wählen Sie die Rechnungsanfrage aus und übermitteln Sie die Informationen."
    }
]
Bei den ersten beiden FAQs unterscheiden sich Frage und Antwort textlich, aber der Gesamtinhalt ist recht ähnlich. Für solche Daten können MinHash, SimHash oder Vektorähnlichkeit zur Erkennung verwendet werden.
(1) MinHash
MinHash beurteilt die Ähnlichkeit hauptsächlich anhand des Überlappungsgrads von Wörtern oder Zeichen im Text und eignet sich besonders gut zur Erkennung wörtlich ähnlicher Daten. Für FAQ-Daten können Frage und Antwort zunächst zu einem Text kombiniert und dieser dann in Wörter, Zeichen oder Zeichenfolgen aufgeteilt werden.
MinHash wird üblicherweise zur approximativen Berechnung der Jaccard-Ähnlichkeit verwendet:
J(A,B)=\frac{|A\cap B|}{|A\cup B|}
wobei A und B die Mengen der Wörter oder Zeichen zweier Texte darstellen,
A\cap B
den gemeinsamen Inhalt beider darstellt,
A\cup B
den gesamten Inhalt beider darstellt. Das Ergebnis liegt zwischen 0 und 1; je näher es an 1 liegt, desto ähnlicher sind die beiden Texte.
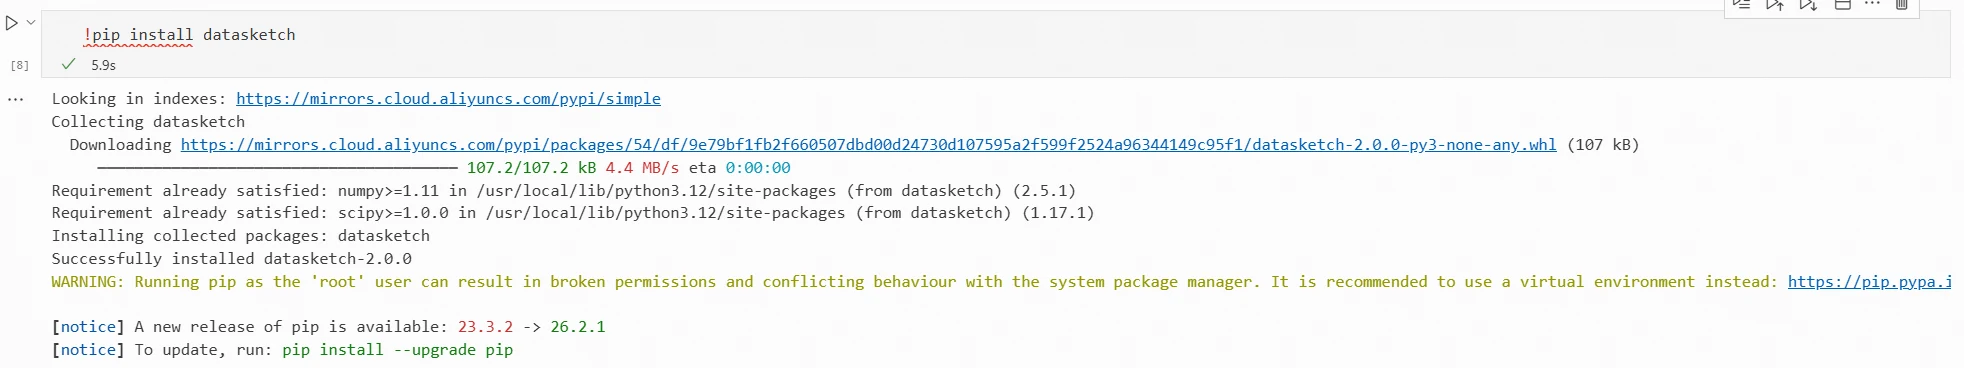
In Python kann die datasketch-Bibliothek zur Implementierung von MinHash verwendet werden:
!pip install datasketch
Ergebnisanzeige:
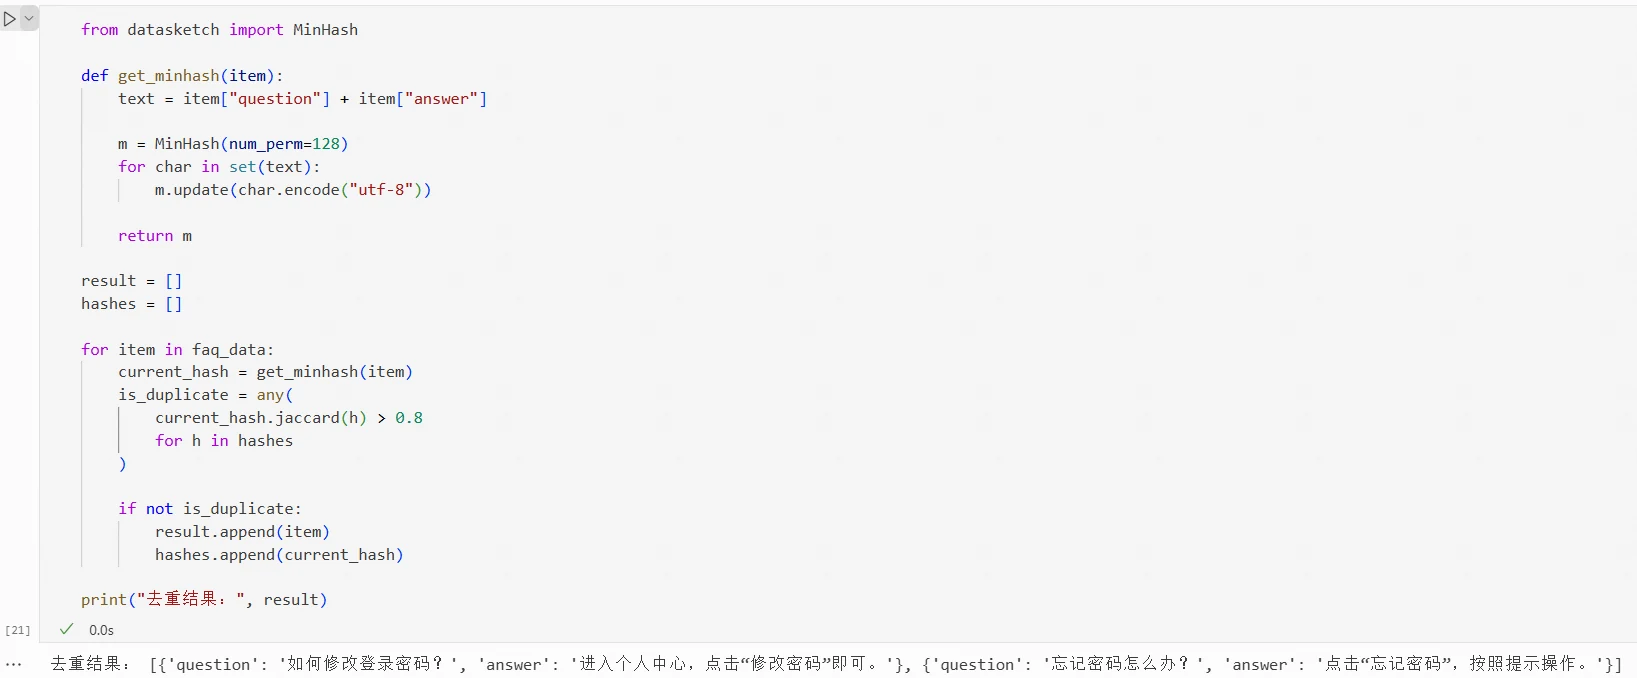
Der Beispielscode lautet:
from datasketch import MinHash

def get_minhash(item):
    text = item["question"] + item["answer"]

    m = MinHash(num_perm=128)
    for char in set(text):
        m.update(char.encode("utf-8")

    return m

result = []
hashes = []

for item in faq_data:
    current_hash = get_minhash(item)

    is_duplicate = any(
        current_hash.jaccard(h) > 0.8
        for h in hashes
    )

    if not is_duplicate:
        result.append(item)
        hashes.append(current_hash)

print("Deduplizierungsergebnis:", result)
Ergebnisanzeige:
(2) SimHash
SimHash erzeugt basierend auf dem Textinhalt einen Fingerabdruck fester Länge und beurteilt anhand der Hamming-Distanz zwischen den Fingerabdrücken, ob Texte ähnlich sind.
Im Gegensatz zu einem gewöhnlichen Hash, der nur prüft, ob der Inhalt vollständig identisch ist, kann SimHash zur Erkennung inhaltlich ähnlicher Texte verwendet werden. Je kleiner die Hamming-Distanz zwischen zwei SimHash-Fingerabdrücken ist, desto ähnlicher sind die Texte üblicherweise.
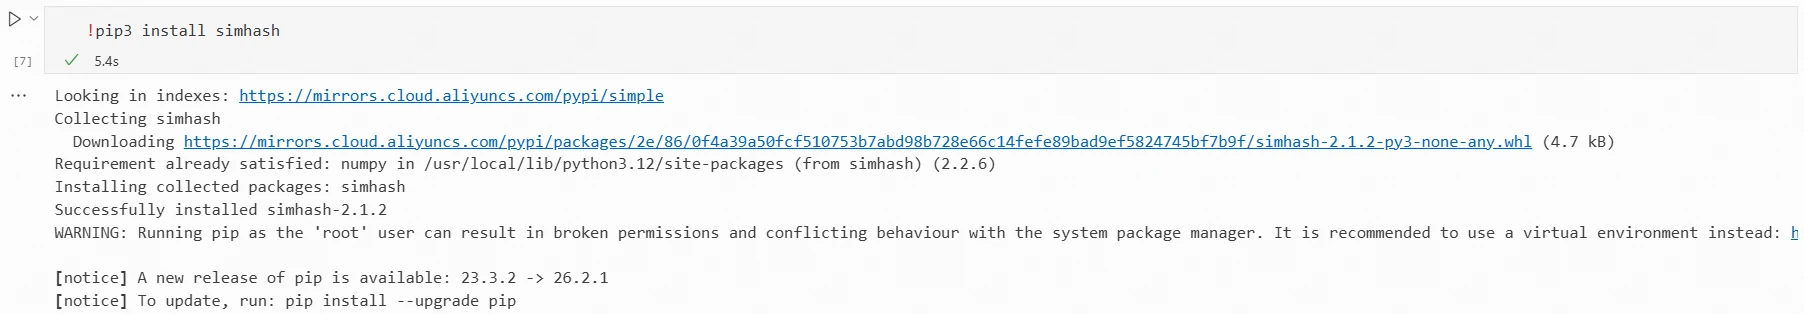
Installation von simhash:
!pip install simhash
Ergebnisanzeige:
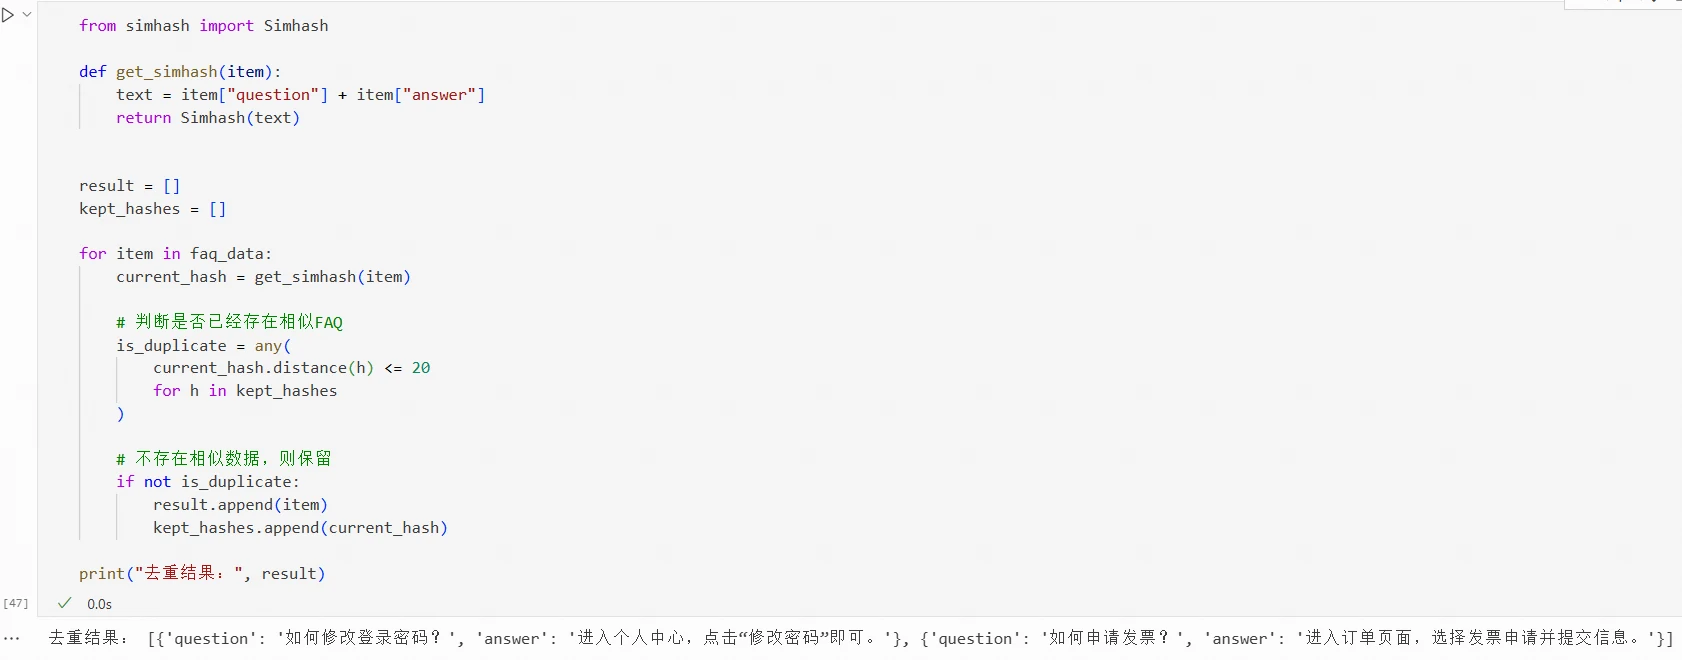
Der Code zur Entfernung ähnlicher Daten mit SimHash lautet:
from simhash import Simhash

def get_simhash(item):
    text = item["question"] + item["answer"]
    return Simhash(text)

result = []
kept_hashes = []

for item in faq_data:
    current_hash = get_simhash(item)

    # Prüfen, ob bereits ein ähnliches FAQ vorhanden ist
    is_duplicate = any(
        current_hash.distance(h) <= 20
        for h in kept_hashes
    )

    # Wenn keine ähnlichen Daten vorhanden sind, beibehalten
    if not is_duplicate:
        result.append(item)
        kept_hashes.append(current_hash)

print("Deduplizierungsergebnis:", result)
Ergebnisanzeige:
(3) Vektorähnlichkeit
Wenn zwei Datensätze unterschiedlichen Text verwenden, aber semantisch ähnlich sind, kann ein Textvektormodell zur Beurteilung herangezogen werden.
Textvektormodelle können Text in einen Vektor aus Zahlenwerten umwandeln. Für FAQ-Daten werden Frage und Antwort zu einem Text kombiniert und dann die Kosinusähnlichkeit zwischen den Textvektoren berechnet:
wobei A und B die Textvektoren der beiden FAQs darstellen. Je höher die Kosinusähnlichkeit, desto näher liegt die Semantik der beiden FAQs beieinander.
Im Folgenden wird das Modell BAAI/bge-small-zh-v1.5 zur Berechnung verwendet. Dieses Modell ist auf chinesische Textvektoraufgaben ausgerichtet, hat einen Umfang von ca. 24 Mio. Parametern, eine Vektordimension von 512 und ist relativ klein und schnell.
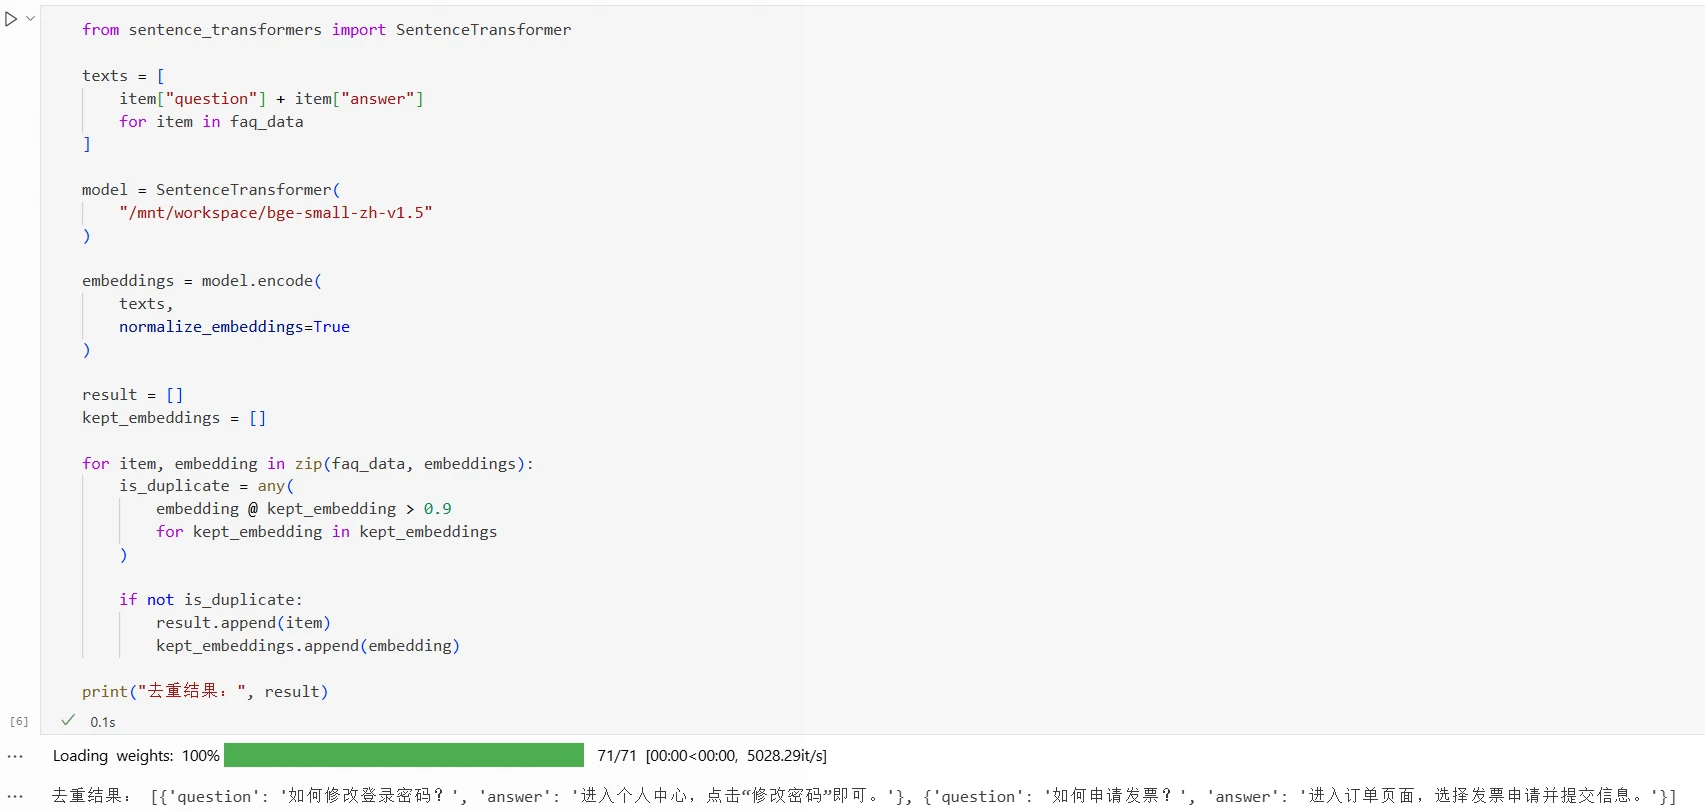
Der Code zur Berechnung der Vektorähnlichkeit und Entfernung ähnlicher Daten lautet:
from sentence_transformers import SentenceTransformer

texts = [
    item["question"] + item["answer"]
    for item in faq_data
]

model = SentenceTransformer(
    "/mnt/workspace/bge-small-zh-v1.5"
)

embeddings = model.encode(
    texts,
    normalize_embeddings=True
)

result = []
kept_embeddings = []

for item, embedding in zip(faq_data, embeddings):
    is_duplicate = any(
        embedding @ kept_embedding > 0.9
        for kept_embedding in kept_embeddings
    )

    if not is_duplicate:
        result.append(item)
        kept_embeddings.append(embedding)

print("Deduplizierungsergebnis:", result)
Ergebnisanzeige:
Verschiedene Methoden eignen sich für unterschiedliche Arten der Datendeduplizierung:
Methode
Bewertungsgrundlage
Geeignetes Szenario
Textdirektübereinstimmung
Vollkommen gleicher Text
Wenige identische Daten
Hash
Gleicher Hashwert des Texts
Viele identische Daten
MinHash
Überlappungsgrad von Wörtern oder Zeichen im Text
Wörtlich ähnliche Daten
SimHash
Hamming-Distanz zwischen Textfingerabdrücken
Inhaltlich ähnliche Daten mit geringen Änderungen
Vektorähnlichkeit
Semantische Ähnlichkeit des Texts
Unterschiedliche Formulierung, aber ähnliche Bedeutung
In der Praxis können zunächst durch Textübereinstimmung oder Hash vollständig identische Daten entfernt und anschließend mit MinHash, SimHash oder Vektorähnlichkeit ähnliche Daten erkannt werden. Für erkannte ähnliche Daten muss anhand des Ähnlichkeitsschwellenwerts und der Geschäftsanforderungen entschieden werden, ob sie gelöscht, zusammengeführt oder beibehalten werden, um versehentliches Löschen von Trainingsdaten zu vermeiden.
Echte Informationen: Vor dem Training anonymisieren
Unternehmensgeschäftsdaten können sensible Informationen wie Namen, Telefonnummern, Ausweisnummern, Adressen und Konten enthalten. Diese müssen vor dem Einfügen in den Trainingsdatensatz gemäß den Datenschutzanforderungen anonymisiert werden.
Die Anonymisierung erfordert zunächst die Erkennung sensibler Informationen in den Daten und dann die Auswahl der geeigneten Verarbeitungsmethode entsprechend dem Informationstyp.
Methoden zur Erkennung sensibler Informationen
Vor der Anonymisierung muss festgestellt werden, welche Inhalte in den Daten als sensible Informationen gelten. Für Textdateien können reguläre Ausdrücke oder Modelle zur Erkennung sensibler Informationen verwendet werden.
(1) Verwendung regulärer Ausdrücke
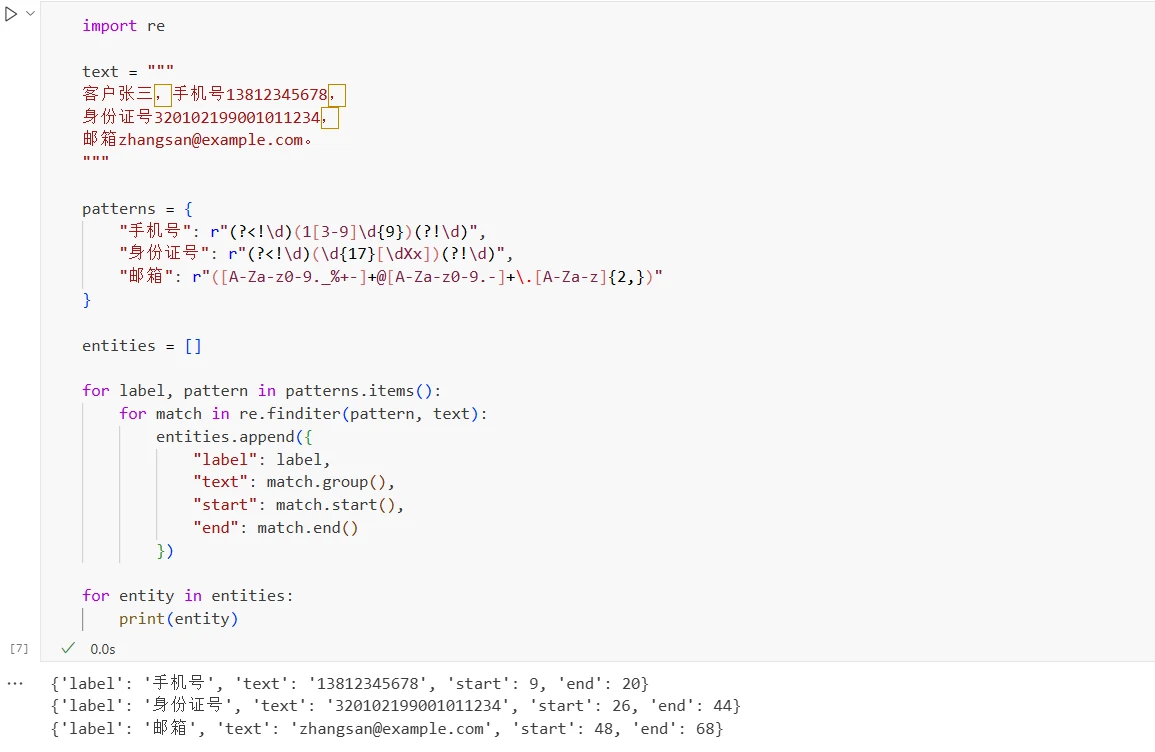
Reguläre Ausdrücke gleichen Text anhand vordefinierter Formatregeln ab und eignen sich zur Erkennung von Informationen mit festem Format wie Telefonnummern, Ausweisnummern, Bankkontonummern und E-Mail-Adressen. Der Code zur Erkennung sensibler Informationen mit regulären Ausdrücken lautet:
import re

text = """
Kunde Zhang San, Telefonnummer 13812345678,
Ausweisnummer 320102199001011234,
E-Mail zhangsan@example.com.
"""

patterns = {
    "Telefonnummer": r"(?<!\d)(1[3-9]\d{9})(?!\d)",
    "Ausweisnummer": r"(?<!\d)(\d{17}[\dXx])(?!\d)",
    "E-Mail": r"([A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,})"
}

entities = []

for label, pattern in patterns.items():
    for match in re.finditer(pattern, text):
        entities.append({
            "label": label,
            "text": match.group(),
            "start": match.start(),
            "end": match.end()
        })

for entity in entities:
    print(entity)
Ergebnis:
Mit regulären Ausdrücken lassen sich Inhalt, Typ und Position sensibler Informationen im Originaltext ermitteln. Reguläre Ausdrücke stützen sich hauptsächlich auf Merkmale des Formats und funktionieren gut bei Informationen mit festgelegter Struktur. In der Praxis müssen die entsprechenden Regeln an das Format der Geschäftsdaten angepasst und getestet werden. Für Informationen wie Namen und Adressen, die ein Kontextverständnis erfordern, sind reguläre Ausdrücke nur schwer genau einsetzbar.
(2) Verwendung eines Modells zur Erkennung sensibler Informationen
Für Informationen, die ein semantisches Verständnis erfordern, wie Namen, Adressen und Organisationen, kann ein Modell zur Erkennung sensibler Informationen verwendet werden.
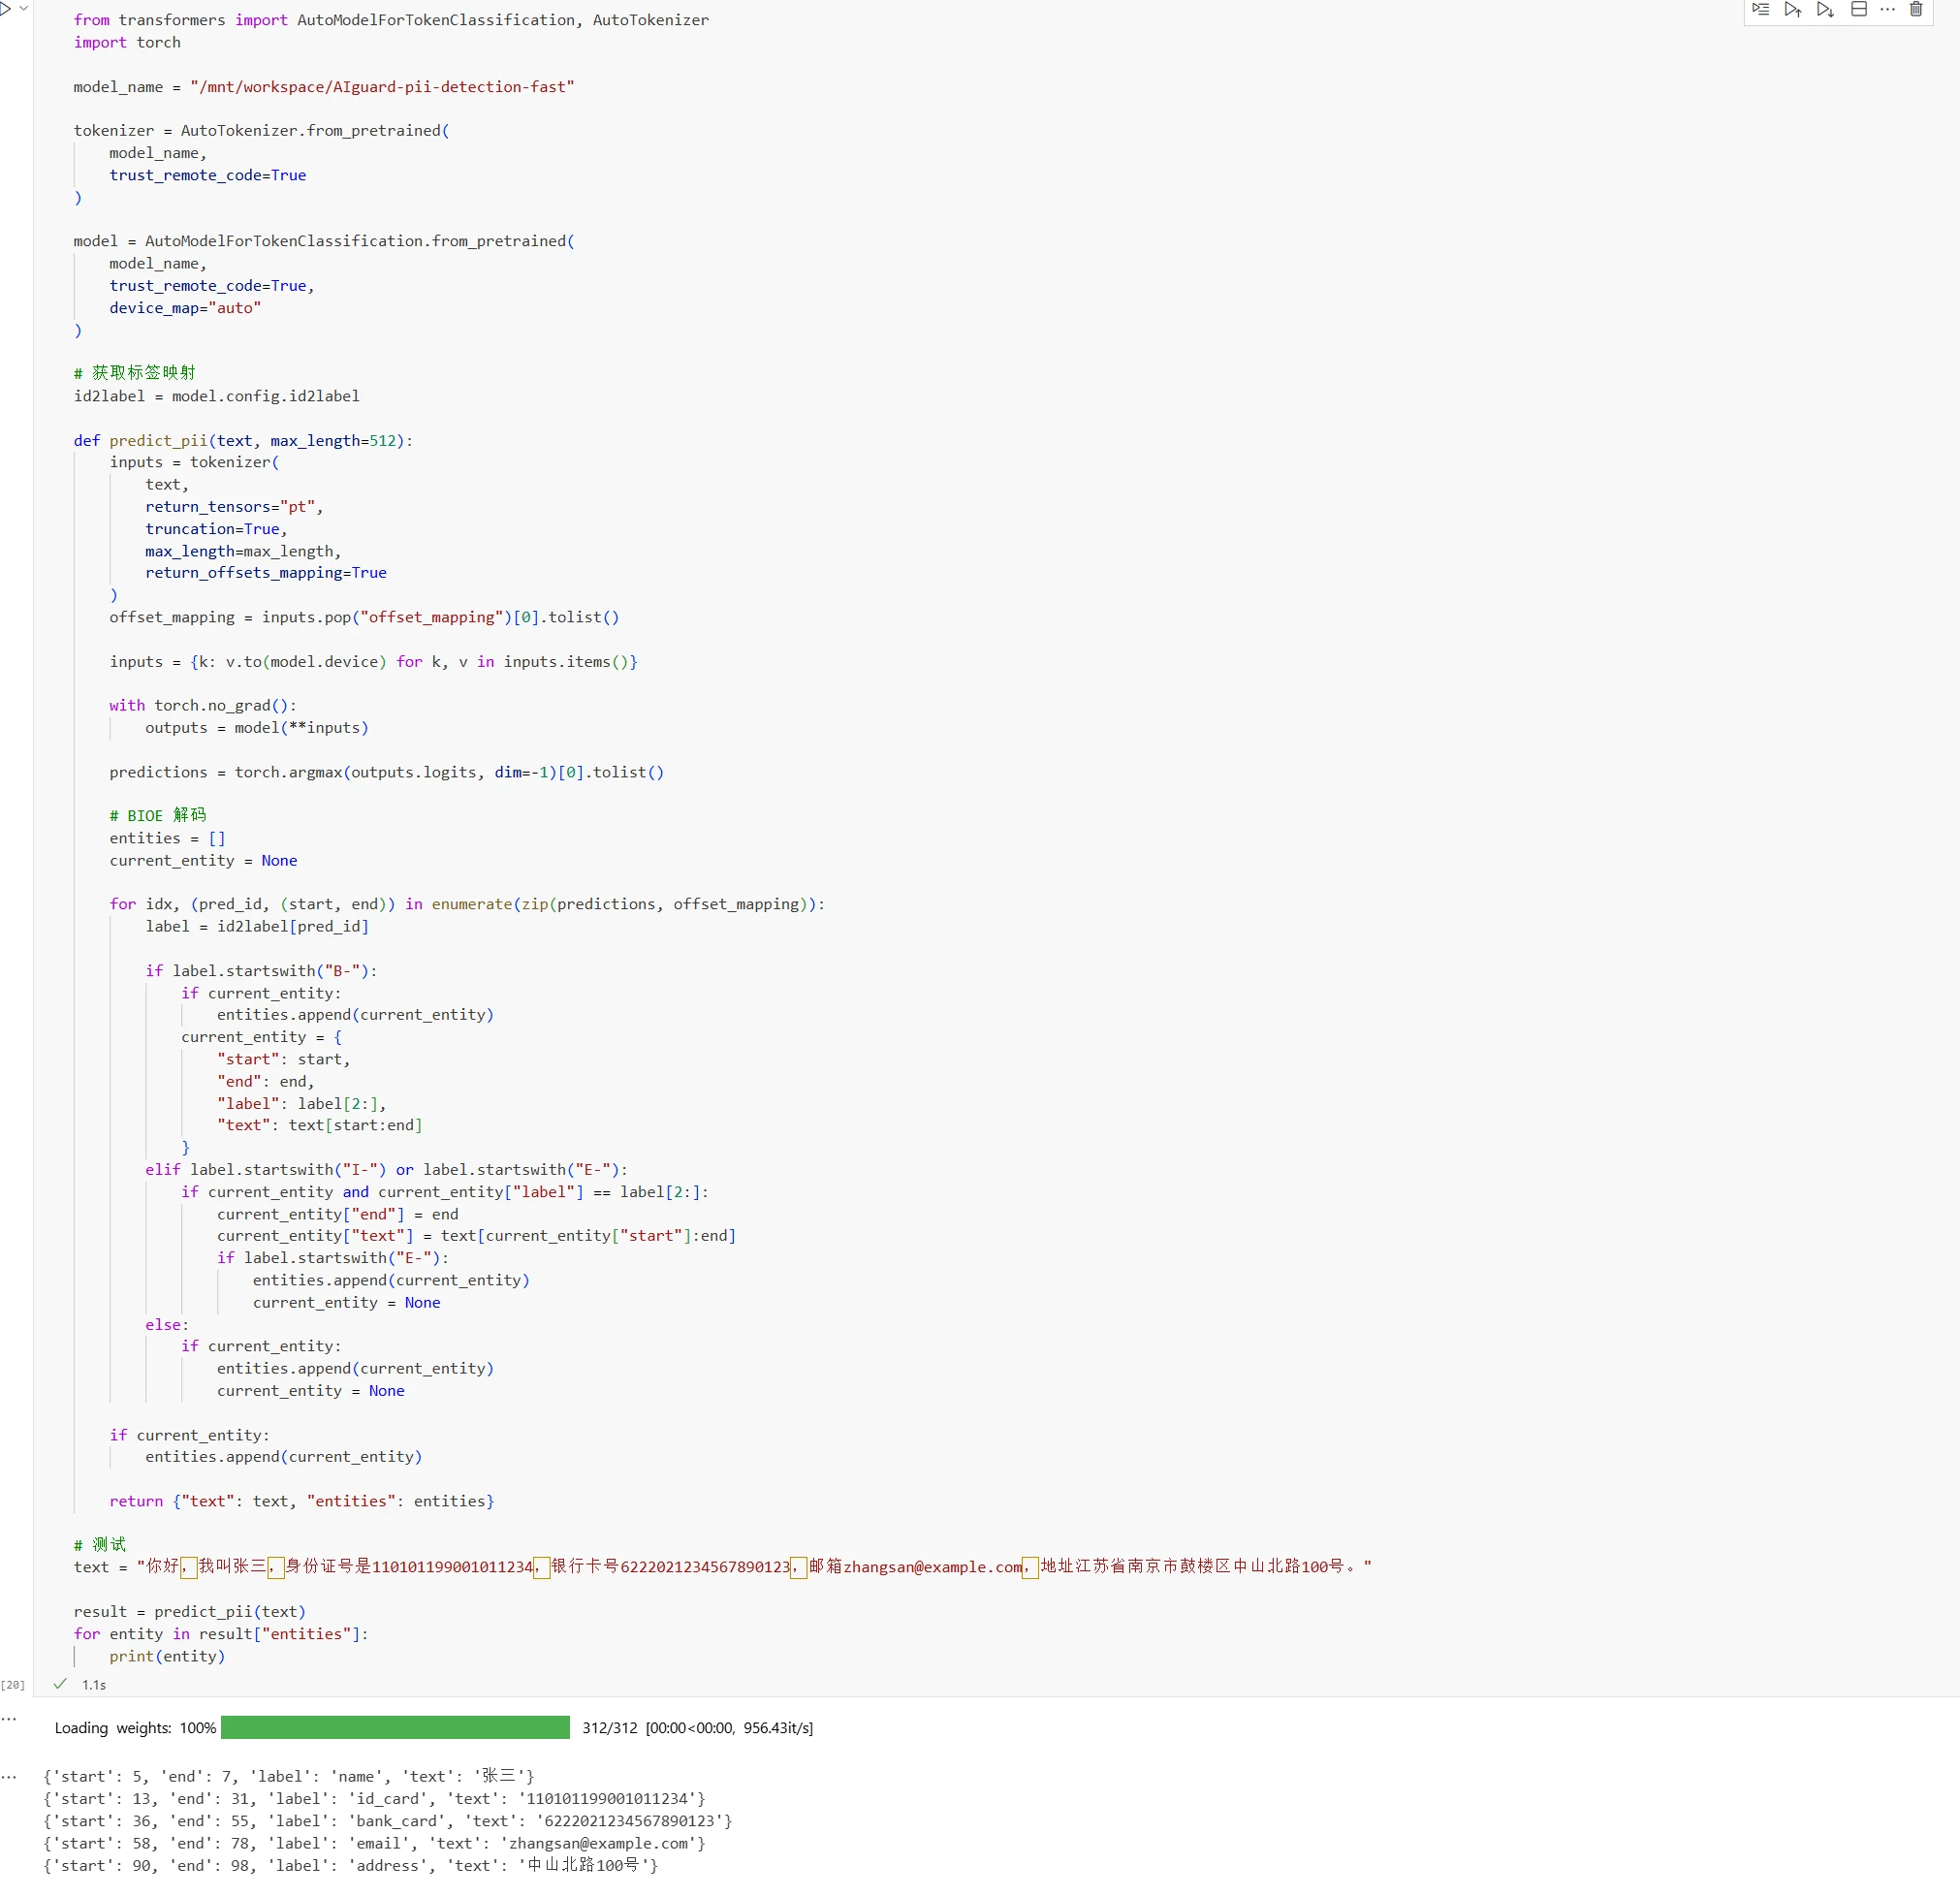
Beispielsweise ist das Open-Source-Modell ZJUICSR/AIguard-pii-detection-fast ein Modell zur Erkennung chinesischer persönlicher sensibler Informationen (PII), das Namen, Telefonnummern, Ausweisnummern, Adressen und E-Mail-Adressen erkennen kann.
Der Code zur Verwendung dieses Modells lautet:
from transformers import AutoModelForTokenClassification, AutoTokenizer
import torch

model_name = "/mnt/workspace/AIguard-pii-detection-fast"

tokenizer = AutoTokenizer.from_pretrained(
    model_name,
    trust_remote_code=True
)

model = AutoModelForTokenClassification.from_pretrained(
    model_name,
    trust_remote_code=True,
    device_map="auto"
)

# Label-Zuordnung abrufen
id2label = model.config.id2label

def predict_pii(text, max_length=512):
    inputs = tokenizer(
        text,
        return_tensors="pt",
        truncation=True,
        max_length=max_length,
        return_offsets_mapping=True
    )
    offset_mapping = inputs.pop("offset_mapping")[0].tolist()

    inputs = {k: v.to(model.device) for k, v in inputs.items()}

    with torch.no_grad():
        outputs = model(**inputs)

    predictions = torch.argmax(outputs.logits, dim=-1)[0].tolist()

    # BIOE-Dekodierung
    entities = []
    current_entity = None

    for idx, (pred_id, (start, end) in enumerate(zip(predictions, offset_mapping):
        label = id2label[pred_id]

        if label.startswith("B-"):
            if current_entity:
                entities.append(current_entity)
            current_entity = {
                "start": start,
                "end": end,
                "label": label[2:],
                "text": text[start:end]
            }
        elif label.startswith("I-") or label.startswith("E-"):
            if current_entity and current_entity["label"] == label[2:]:
                current_entity["end"] = end
                current_entity["text"] = text[current_entity["start"]:end]
                if label.startswith("E-"):
                    entities.append(current_entity)
                    current_entity = None
        else:
            if current_entity:
                entities.append(current_entity)
                current_entity = None

    if current_entity:
        entities.append(current_entity)

    return {"text": text, "entities": entities}

# Test
text = "Hallo, mein Name ist Zhang San, Ausweisnummer 110101199001011234, Bankkontonummer 6222021234567890123, E-Mail zhangsan@example.com, Adresse Zhongshan North Road 100, Gulou, Nanjing, Jiangsu."

result = predict_pii(text)
for entity in result["entities"]:
    print(entity)
Ergebnisanzeige:
Die Erkennungsergebnisse enthalten den Inhalt sensibler Informationen, den Typ der sensiblen Informationen und die Position im Originaltext. Anhand dieser Informationen kann die entsprechende Anonymisierungsmethode ausgewählt werden.
In der Praxis werden reguläre Ausdrücke und Modelle zur Erkennung sensibler Informationen häufig kombiniert eingesetzt. Reguläre Ausdrücke übernehmen die schnelle Verarbeitung von Informationen mit festem Format wie Telefonnummern und E-Mail-Adressen; das Modell übernimmt die Verarbeitung von Informationen, die ein semantisches Verständnis erfordern, wie Namen und Adressen.
Anonymisierungsmethoden
Nach Abschluss der Erkennung sensibler Informationen muss anhand des Typs der sensiblen Informationen und der Anforderungen der Trainingsaufgabe die geeignete Verarbeitungsmethode ausgewählt werden.
Gängige Anonymisierungsmethoden umfassen:
(1) Ersetzung
Ersetzung bedeutet, reale sensible Informationen durch andere Inhalte zu ersetzen. Die Ersetzung kann in feste Ersetzung und zufällige Ersetzung unterteilt werden:
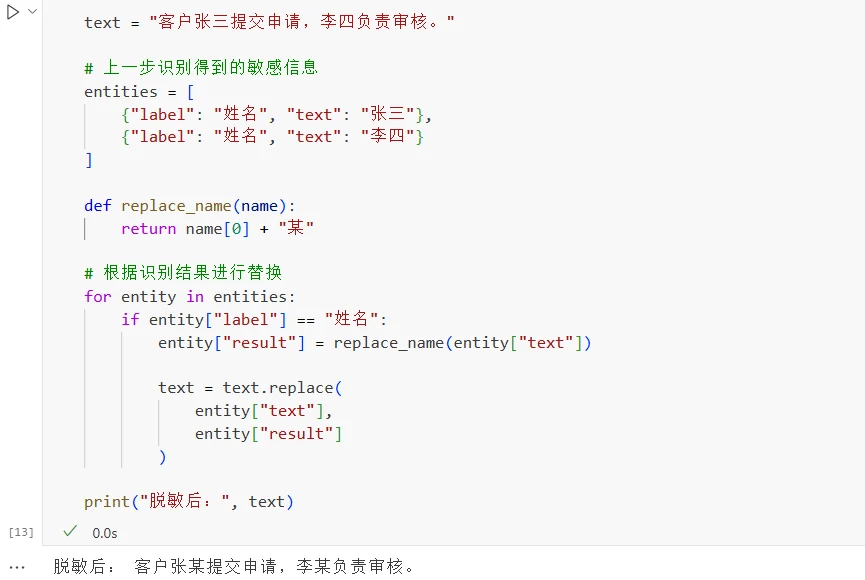
Feste Ersetzung: Das Ergebnis wird nach festen Regeln erzeugt. Beispielsweise wird der Vorname einheitlich durch „Mou" ersetzt: „Zhang San" wird zu „Zhang Mou", „Li Si" wird zu „Li Mou". Da die Regeln fest sind, ergibt dieselbe Information jedes Mal dasselbe Ergebnis, und es ist keine zusätzliche Zuordnungstabelle erforderlich. Der Verarbeitungscode lautet:
text = "Kunde Zhang San stellt Antrag, Li Si ist für die Prüfung zuständig."

# Im vorherigen Schritt erkannte sensible Informationen
entities = [
    {"label": "Name", "text": "Zhang San"},
    {"label": "Name", "text": "Li Si"}
]

def replace_name(name):
    return name[0] + "Mou"

# Anhand der Erkennungsergebnisse ersetzen
for entity in entities:
    if entity["label"] == "Name":
        entity["result"] = replace_name(entity["text"])

        text = text.replace(
            entity["text"],
            entity["result"]
        )

print("Nach Anonymisierung:", text)
Ergebnisanzeige:
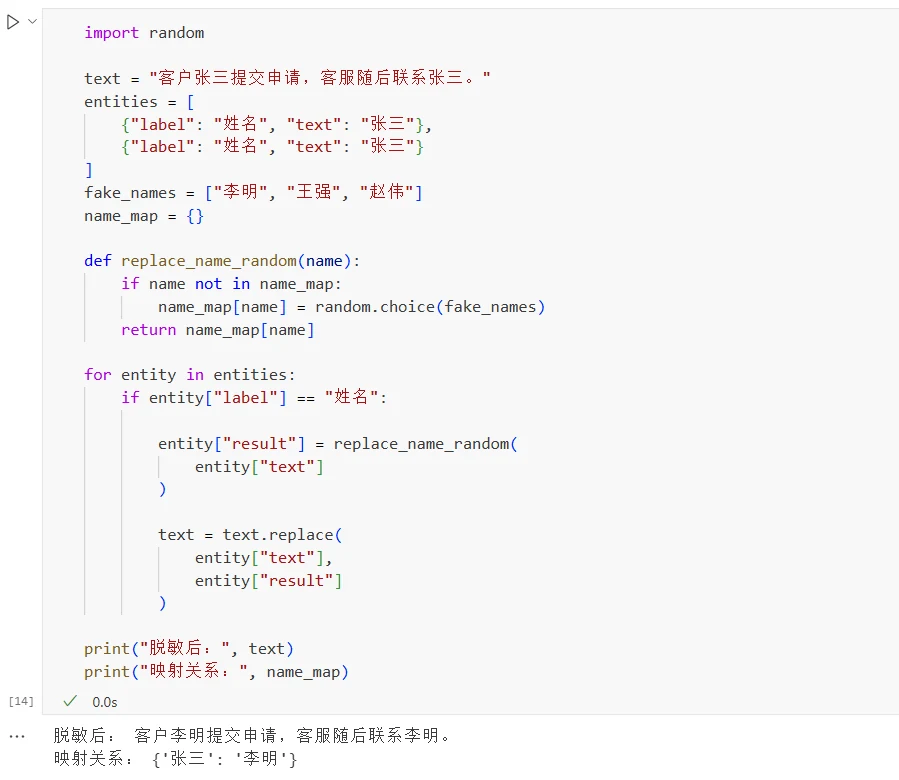
Zufällige Ersetzung: Zufällig wird eine fingierte Information zur Ersetzung der realen Information gewählt, beispielsweise „Zhang San" durch „Li Ming". Wenn „Zhang San" an mehreren Stellen vorkommt, muss sichergestellt werden, dass das Ersetzungsergebnis konsistent ist, da sonst Daten desselben Objekts auf unterschiedliche Identitäten verteilt werden und die Zusammenhänge in den Daten zerstört werden. Daher erfordert die zufällige Ersetzung üblicherweise den Aufbau einer Zuordnungstabelle: {"Zhang San":"Li Ming"}, sodass bei erneutem Auftreten von „Zhang San" direkt „Li Ming" verwendet wird. Der Verarbeitungscode lautet:
import random

text = "Kunde Zhang San stellt Antrag, der Kundenservice kontaktiert Zhang San."
entities = [
    {"label": "Name", "text": "Zhang San"},
    {"label": "Name", "text": "Zhang San"}
]
fake_names = ["Li Ming", "Wang Qiang", "Zhao Wei"]
name_map = {}

def replace_name_random(name):
    if name not in name_map:
        name_map[name] = random.choice(fake_names)
    return name_map[name]

for entity in entities:
    if entity["label"] == "Name":

        entity["result"] = replace_name_random(
            entity["text"]
        )

        text = text.replace(
            entity["text"],
            entity["result"]
        )

print("Nach Anonymisierung:", text)
print("Zuordnungstabelle:", name_map)
Ergebnisanzeige:
(2) Maskierung
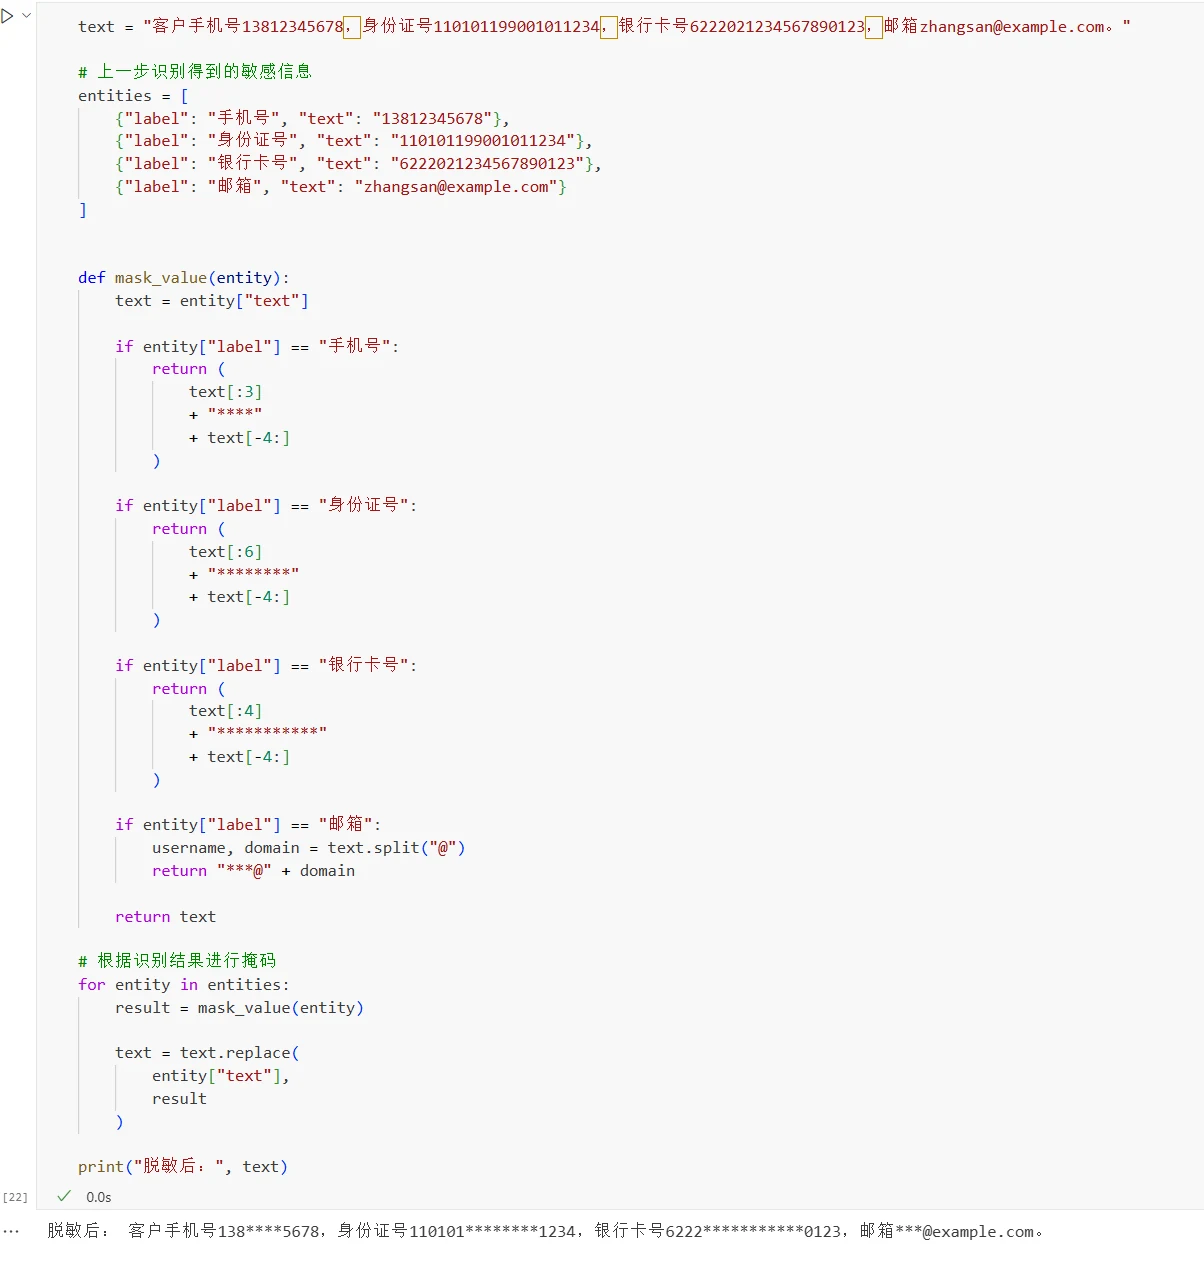
Maskierung bedeutet, einen Teil sensibler Inhalte zu verbergen und einen Teil der Informationen zu behalten, wie Telefonnummern, Ausweise, Bankkonten und E-Mail-Adressen.
Der Verarbeitungscode lautet:
text = "Kunde Telefonnummer 13812345678, Ausweisnummer 110101199001011234, Bankkontonummer 6222021234567890123, E-Mail zhangsan@example.com."

# Im vorherigen Schritt erkannte sensible Informationen
entities = [
    {"label": "Telefonnummer", "text": "13812345678"},
    {"label": "Ausweisnummer", "text": "110101199001011234"},
    {"label": "Bankkontonummer", "text": "6222021234567890123"},
    {"label": "E-Mail", "text": "zhangsan@example.com"}
]

def mask_value(entity):
    text = entity["text"]

    if entity["label"] == "Telefonnummer":
        return (
            text[:3]
            + "****"
            + text[-4:]
        )

    if entity["label"] == "Ausweisnummer":
        return (
            text[:6]
            + "********"
            + text[-4:]
        )

    if entity["label"] == "Bankkontonummer":
        return (
            text[:4]
            + "***********"
            + text[-4:]
        )

    if entity["label"] == "E-Mail":
        username, domain = text.split("@")
        return "***@" + domain

    return text

# Anhand der Erkennungsergebnisse maskieren
for entity in entities:
    result = mask_value(entity)

    text = text.replace(
        entity["text"],
        result
    )

print("Nach Anonymisierung:", text)
Ergebnisanzeige:
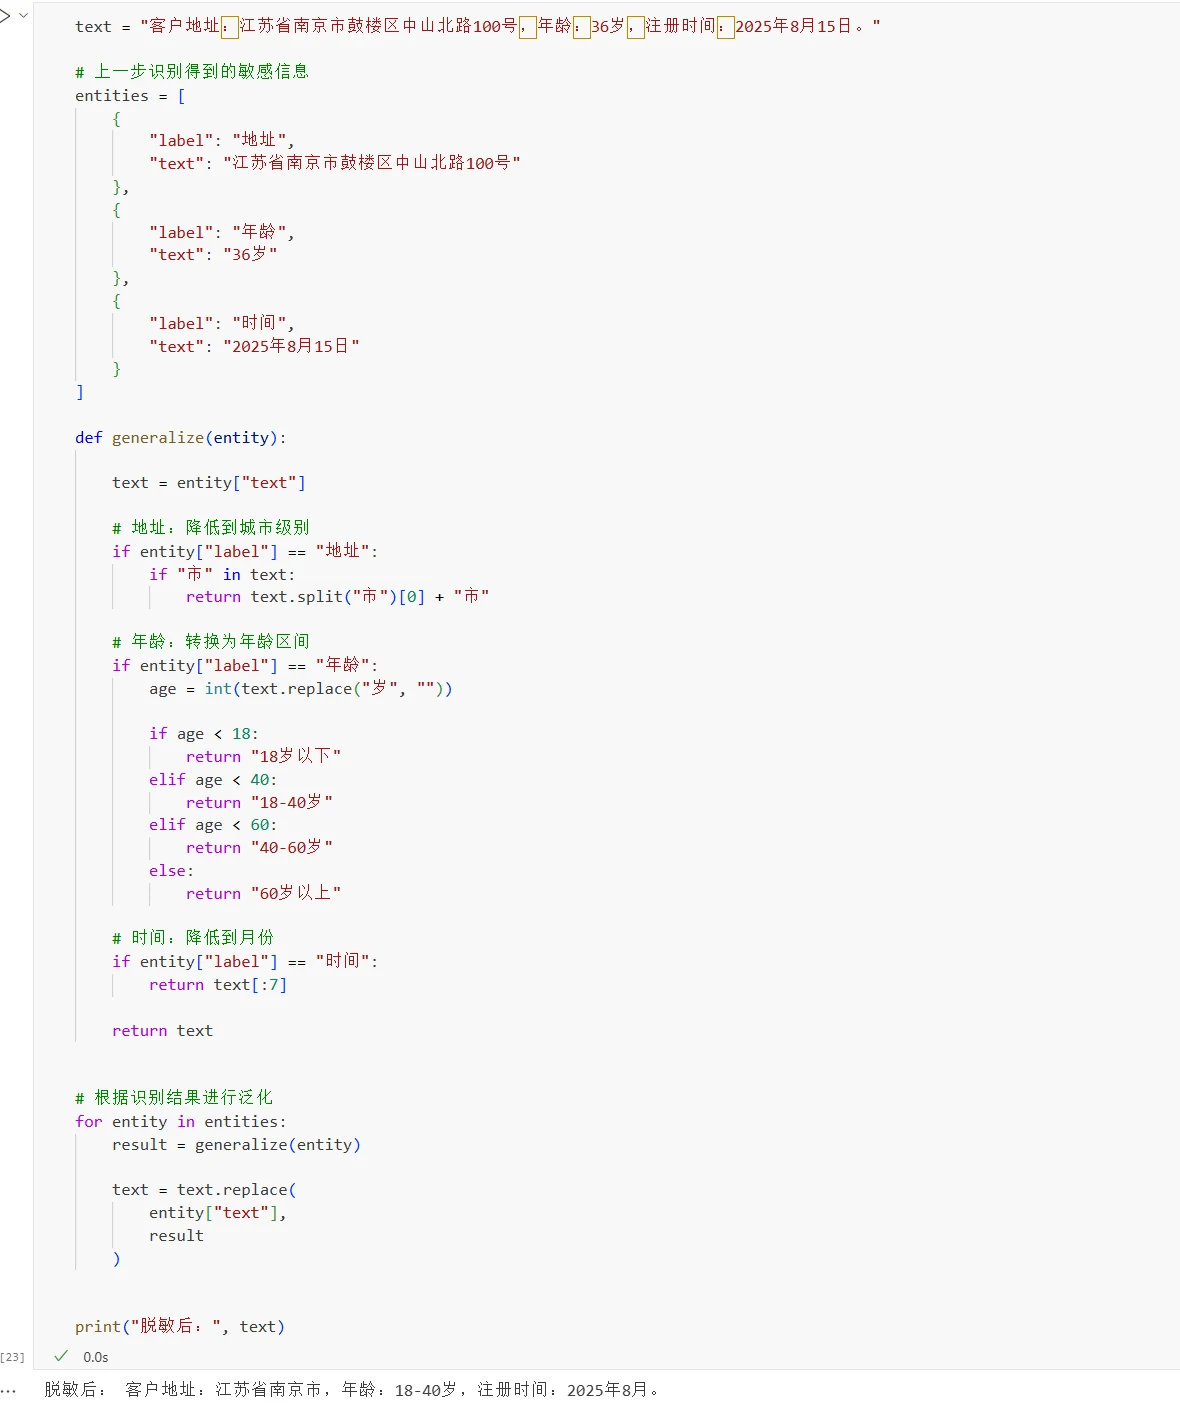
(3) Verallgemeinerung
Verallgemeinerung bedeutet, die Informationsgenauigkeit zu verringern und die Fähigkeit der Daten, ein bestimmtes Objekt zu lokalisieren, zu reduzieren. Wird üblicherweise für Adressen, Alter, Zeitangaben und andere kontinuierliche Informationen verwendet.
Der Verarbeitungscode lautet:
text = "Kundenadresse: Zhongshan North Road 100, Gulou, Nanjing, Jiangsu, Alter: 36 Jahre, Registrierungsdatum: 15. August 2025."

# Im vorherigen Schritt erkannte sensible Informationen
entities = [
    {
        "label": "Adresse",
        "text": "Zhongshan North Road 100, Gulou, Nanjing, Jiangsu"
    },
    {
        "label": "Alter",
        "text": "36 Jahre"
    },
    {
        "label": "Zeit",
        "text": "15. August 2025"
    }
]

def generalize(entity):

    text = entity["text"]

    # Adresse: Auf Stadtebene reduzieren
    if entity["label"] == "Adresse":
        if "Nanjing" in text:
            return "Nanjing"

    # Alter: In Altersbereich umwandeln
    if entity["label"] == "Alter":
        age = int(text.replace(" Jahre", ""))

        if age < 18:
            return "Unter 18 Jahre"
        elif age < 40:
            return "18-40 Jahre"
        elif age < 60:
            return "40-60 Jahre"
        else:
            return "Über 60 Jahre"

    # Zeit: Auf Monat reduzieren
    if entity["label"] == "Zeit":
        return text[:7]

    return text

# Anhand der Erkennungsergebnisse verallgemeinern
for entity in entities:
    result = generalize(entity)

    text = text.replace(
        entity["text"],
        result
    )

print("Nach Anonymisierung:", text)
Ergebnisanzeige:
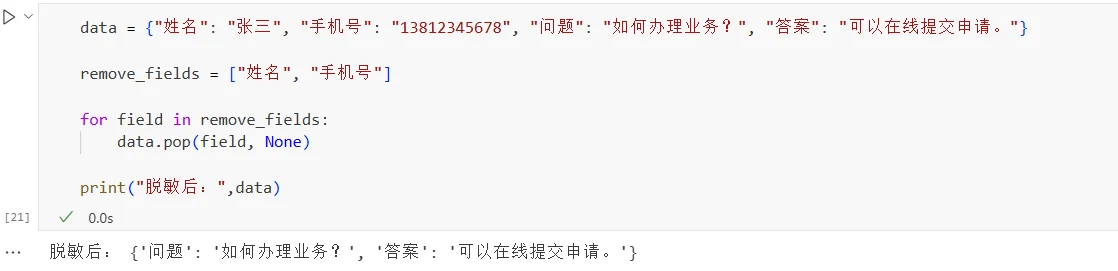
(4) Löschung
Für sensible Felder, die für die Trainingsaufgabe irrelevant sind, können diese direkt gelöscht werden. Wenn die Trainingsaufgabe nur die Beziehung zwischen Frage und Antwort erlernen muss, können Name und Telefonnummer gelöscht werden.
data = {"Name": "Zhang San", "Telefonnummer": "13812345678", "Frage": "Wie kann ich das Geschäft abwickeln?", "Antwort": "Sie können den Antrag online stellen."}

remove_fields = ["Name", "Telefonnummer"]

for field in remove_fields:
    data.pop(field, None)

print("Nach Anonymisierung:", data)
Ergebnisanzeige:
In der Praxis muss die Anonymisierungsmethode an die Trainingsaufgabe und die Datenmerkmale angepasst werden. Wenn Zusammenhänge zwischen verschiedenen Samples beibehalten werden sollen, können feste Ersetzungen oder zufällige Ersetzungen mit Zuordnungstabelle verwendet werden. Wenn ein Teil der Informationsmerkmale beibehalten werden soll, können Maskierung oder Verallgemeinerung eingesetzt werden. Für für die Trainingsaufgabe irrelevante sensible Informationen werden diese direkt gelöscht.
Die Datenmerkmale unterscheiden sich je nach Geschäftsszenario, und die spezifischen Anonymisierungsregeln müssen an die tatsächlichen Anforderungen angepasst werden. Der Code in diesem Abschnitt dient nur zur Veranschaulichung der grundlegenden Verarbeitungsmethoden.
Letzter Schritt: Formatierung für das Training
Nach Abschluss der Datenverarbeitung müssen die Daten entsprechend den Anforderungen des Trainingsframeworks in das richtige Format gebracht werden.
Instruktionsabstimmung (Instruction Tuning) ist eine gängige Methode der Feinabstimmung für große Sprachmodelle. Die Trainingsdaten enthalten die Anweisungen der Benutzer und die vom Modell erwarteten Antworten, sodass das Modell lernt, Aufgaben gemäß den Anweisungen auszuführen.
Verschiedene Trainingsframeworks verwenden möglicherweise unterschiedliche Datenfelder. Gängige Instruktionsdatenformate umfassen unter anderem Alpaca, ShareGPT und Messages.
Alpaca-Format
Das Alpaca-Format ist einfach aufgebaut und verwendet üblicherweise die drei Felder instruction, input und output. Es eignet sich für einstufige Instruktionsdaten.
{
  "instruction": "Übersetzen Sie den folgenden chinesischen Text ins Englische",
  "input": "Das Wetter ist heute sehr schön.",
  "output": "The weather is very nice today."
}
Dabei gibt instruction die vom Modell auszuführende Aufgabe an, input den für die Aufgabe benötigten Eingabeinhalt und output die vom Modell erwartete Antwort.
Wenn die Aufgabe keine zusätzliche Eingabe erfordert, kann input auch leer sein.
Beispiel:
{
  "instruction": "Erklären Sie, was maschinelles Lernen ist",
  "input": "",
  "output": "Maschinelles Lernen ist eine Methode, mit der Computer aus Daten Muster und Gesetzmäßigkeiten erlernen."
}
Dieses Format hat wenige Felder, eine klare Struktur und eignet sich für einstufige Trainingsaufgaben wie Frage-Antwort, Klassifikation und Textgenerierung.
Messages-Format
Eine weitere gängige Methode ist die Verwendung von messages zum Speichern von Dialogen, wobei jede Nachricht die beiden Hauptfelder role und content enthält.
Beispiel:
{
  "messages": [
    {
      "role": "system",
      "content": "Sie sind ein professioneller Kundenservice-Assistent."
    },
    {
      "role": "user",
      "content": "Wann kommt meine Bestellung an?"
    },
    {
      "role": "assistant",
      "content": "Bitte geben Sie Ihre Bestellnummer an, ich werde die Nachverfolgung für Sie durchführen."
    }
  ]
}
Dabei dient system zum Festlegen der Rolle, der Aufgabenanforderungen oder der Antwortregeln des Modells, user für Benutzereingaben und assistant für die vom Modell erwartete Antwort.
Das Messages-Format unterstützt auch mehrstufige Dialoge – es müssen lediglich in der tatsächlichen Dialogreihenfolge weitere user- und assistant-Nachrichten hinzugefügt werden.
Beispiel:
{
  "messages": [
    {
      "role": "system",
      "content": "Sie sind ein professioneller Kundenservice-Assistent."
    },
    {
      "role": "user",
      "content": "Wie ändere ich mein Anmeldepasswort?"
    },
    {
      "role": "assistant",
      "content": "Gehen Sie in die Kontoeinstellungen und wählen Sie „Passwort ändern"."
    },
    {
      "role": "user",
      "content": "Was tun, wenn ich das alte Passwort vergessen habe?"
    },
    {
      "role": "assistant",
      "content": "Auf der Anmeldeseite können Sie „Passwort vergessen" wählen und nach Verifizierung über Telefonnummer oder E-Mail ein neues Passwort festlegen."
    }
  ]
}
ShareGPT-Format
ShareGPT ist eines der gängigen Dialogdatenformate im Open-Source-Modelltraining. Es verwendet üblicherweise conversations zum Speichern vollständiger Dialoge und unterscheidet zwischen Benutzer und Modell mit human und gpt.
Beispiel:
{
  "conversations": [
    {
      "from": "human",
      "value": "Übersetzen Sie den folgenden chinesischen Text ins Englische: Das Wetter ist heute sehr schön."
    },
    {
      "from": "gpt",
      "value": "The weather is very nice today."
    }
  ]
}
Das ShareGPT-Format kann auch mehrstufige Dialoge speichern:
{
  "conversations": [
    {
      "from": "human",
      "value": "Schreiben Sie mir eine Abwesenheits-E-Mail."
    },
    {
      "from": "gpt",
      "value": "Bitte teilen Sie mir den Zeitraum und den Grund der Abwesenheit mit."
    },
    {
      "from": "human",
      "value": "Ich bin erkältet und brauche zwei Tage Krankheitsurlaub."
    },
    {
      "from": "gpt",
      "value": "Gut, hier ist ein Entwurf für die Abwesenheits-E-Mail..."
    }
  ]
}
Wie wählt man das Datenformat?
Die Formate Alpaca, Messages und ShareGPT unterscheiden sich im Wesentlichen nur in der Art der Feldorganisation und beschreiben alle die Eingabe und die erwartete Ausgabe des Modells.
Die Auswahl erfolgt je nach Aufgabentyp und Trainingsframework:
Datenformat
Hauptmerkmale
Geeignete Szenarien
Alpaca
Organisation der Daten über instruction, input und output
Dialogspeicherung über messages, Unterscheidung der Rollen über role
Ein- oder mehrstufige Dialoge
ShareGPT
Dialogspeicherung über conversations, Unterscheidung der Rollen über from
Ein- oder mehrstufige Dialoge
Die verschiedenen Formate sind in der Regel untereinander konvertierbar. Beispielsweise kann ein Alpaca-Eintrag in eine Gruppe von user- und assistant-Nachrichten umgewandelt werden, und human und gpt aus ShareGPT können jeweils in user und assistant umgewandelt werden. Vor dem eigentlichen Training sollte zunächst überprüft werden, welche Datenformate und Modellvorlagen vom Trainingsframework unterstützt werden, und dann die Daten entsprechend den Anforderungen aufbereitet werden.
Modellcode und zugehörige Dateien finden Sie unter: https://www.modelscope.cn/gallery/liucong/b41e2395-f795-400f-bafd-e53ed7f5c8ca