Artificial Intelligence Generated Content (AIGC) ist in den letzten Jahren ein wichtiger Entwicklungsbereich im Bereich der künstlichen Intelligenz geworden. Im Gegensatz zu traditionellen Klassifizierungs-, Vorhersage- und Aufgaben zielen generative Modelle darauf ab, die Wahrscheinlichkeitsverteilung der Daten zu erlernen und unter Anleitung von Bedingungen wie Text und Bildern neue Inhalte zu erzeugen.
Von früheren Generative Adversarial Networks (GANs) und Variational Autoencoders (VAEs) bis zu den in den letzten Jahren weit verbreiteten Diffusionsmodellen (Diffusion Model) und Diffusion Transformer (DiT) haben generative Modelle in Bezug auf Generierungsqualität, Trainingsstabilität, semantisches Verständnis und Inferenzleistung kontinuierlich verbessert. Auf dieser Grundlage haben Text-zu-Bild-Modelle wie Stable Diffusion, FLUX, Qwen-Image und Z-Image die AIGC-Anwendungen in der Inhaltserstellung, Werbegestaltung und Marketingmaterialproduktion weiter vorangetrieben.
Das Kernziel generativer Modelle ist es, die zugrunde liegende Wahrscheinlichkeitsverteilung und die inhärenten Muster in den Trainingsdaten zu erlernen und unter gegebenen Bedingungen neue Stichproben zu erzeugen, die dieser Verteilung entsprechen. Im Gegensatz zu Klassifizierungs- und Aufgaben wählen generative Modelle nicht eine Antwort aus vorgegebenen Kandidatenergebnissen; stattdessen verwenden sie erlernte Datenmuster, um neuen Text, Bilder, Sprache oder Videoinhalte zu erzeugen.
Aus probabilistischer Modellierungsperspektive können bedingte Generierungsaufgaben dargestellt werden als: $p(x \mid c)$ stellt die bedingte Wahrscheinlichkeitsverteilung des Modells dar, Inhalt x unter gegebener Bedingung c zu erzeugen. Zum Beispiel der eingegebene Prompt des Benutzers, der Kontext, das Referenzbild oder andere Kontrollinformationen; x stellt den zu erzeugenden Zielinhalt dar. Der Trainingsprozess des Modells ist im Wesentlichen das Erlernen der Wahrscheinlichkeit verschiedener möglicher Ergebnisse unter verschiedenen Bedingungen; der Inferenzprozess des Modells erzeugt dann konkrete Ergebnisse auf dieser Wahrscheinlichkeitsverteilung.
Obwohl große Sprachmodelle, Bildgenerierungsmodelle und Videogenerierungsmodelle alle zu generativen Modellen gehören, sind die spezifischen Wege, wie sie die Generierung erreichen, nicht vollständig gleich.
Am Beispiel großer Sprachmodelle verwenden aktuelle Mainstream-Modelle typischerweise autoregressive Generierung zur Texterzeugung. Bei gegebenem bestehendem Kontext prognostiziert das Modell die Wahrscheinlichkeitsverteilung des nächsten Tokens, wählt oder samplelt den nächsten Token basierend auf dieser Verteilung, fügt den neu generierten Token dem Kontext hinzu und prognostiziert die folgenden Tokens weiter. Durch wiederholtes Durchlaufen dieses Prozesses wird schließlich vollständiger Textinhalt gebildet.
Bildgenerierungsmodelle verwenden andere Generierungsmechanismen. Am Beispiel von Diffusionsmodellen beginnt der Generierungsprozess typischerweise mit zufälligem Rauschen und durchlaufe schrittweise eine Entrauschung unter Anleitung von Bedingungen wie Text-Prompts, wodurch das zufällige Rauschen allmählich Bilder mit klarer Struktur und Semantik bildet. Egal ob autoregressive, Diffusions- oder andere Generierungsmechanismen, ihr gemeinsames Ziel ist es, die Verteilungsmuster realer Daten zu erlernen und unter gegebenen Bedingungen neue Inhalte zu erzeugen, die diesen Mustern entsprechen.
Anmelden an der Diskussion teilnehmen
Generative Modelle können neue Inhalte erzeugen, und ein wichtiger Grund ist, dass das Modell nicht einen bestimmten Text oder ein bestimmtes Bild selbst erlernt, sondern die statistischen Beziehungen und Merkmalsmuster, die zwischen einer großen Menge von Trainingsdaten bestehen.
Zum Beispiel kann das Modell nach dem Lernen von vielen Getränke-Werbebildern allmählich Assoziationen zwischen visuellen Konzepten wie Getränkeflaschen, Eiswürfeln, Wassersprühten, Früchten, Hintergrundfarben, Beleuchtung und kommerziellen Fotografie-Stilen aufbauen. Bei Eingabe von „Sommer-Limonaden-Werbeanzeige" kann das Modell verschiedene visuelle Elemente basierend auf diesen erlernten Mustern neu organisieren, um neue Bilderzeugnisse zu bilden. Die „Generierung" generativer Modelle ist nicht gleichbedeutend mit dem Finden eines vorhandenen Datensatzes aus dem Trainingsset; sie modelliert und kombiniert verschiedene Merkmale und Konzepte basierend auf erlernten Datenverteilungen.
Eine weitere wichtige Eigenschaft generativer Modelle ist, dass Generierungsergebnisse vielfältig sind. Zum Beispiel kann dasselbe Prompt „eine Katze sitzt am Fenster" Katzen verschiedener Rassen, Haltungen und Fellfarben erzeugen und auch verschiedene Beleuchtungen, Hintergründe und Bildkompositionen verwenden. Diese Ergebnisse sind semantisch konsistent mit den Eingabebedingungen, aber der spezifische Inhalt ist nicht vollständig identisch. Der Grund für dieses Phänomen ist, dass das Prompt typischerweise nur bestimmte bedingte Einschränkungen auferlegt, anstatt das Endergebnis vollständig zu spezifizieren. Unter gegebenen Bedingungen gibt es normalerweise mehrere vernünftige Ergebnisse in der vom Modell erlernten Wahrscheinlichkeitsverteilung. Im tatsächlichen Generierungsprozess beeinflussen Faktoren wie Sampling-Strategien und Zufallsseeds das Endergebnis weiter. Im Gegensatz zu traditionellen Aufgaben mit deterministischen Antworten haben Generierungsaufgaben normalerweise keine einzigartige optimale Ausgabe; dieselben Eingabebedingungen können mehreren vernünftigen Generierungsergebnissen entsprechen.
Die Textgenerierungstechnologie spielt eine grundlegende Rolle in der Entwicklung moderner generativer KI. Einerseits haben große Sprachmodelle die rasche Verbreitung der AIGC-Technologie vorangetrieben; andererseits gelten Konzepte wie Tokenizer, Embedding, Transformer, Wahrscheinlichkeitsverteilung und Sampling nicht nur für die Textgenerierung, sondern werden auch in nachfolgenden Text-zu-Bild-, multimodalen Generierungs- und anderen Aufgaben wiederholt auftauchen. Insbesondere in aktuellen AIGC-Systemen sind Text-Prompts zu einem wichtigen Weg geworden, mit dem Benutzer den generierten Inhalt steuern kann. Egal ob Text, Bild oder Video erzeugt wird, die Modelle müssen normalerweise zunächst die natürliche Sprache verstehen, die der Benutzer eingibt.
Natürliche Sprache kann nicht direkt an neuronalen Netzwerkberechnungen teilnehmen. Bevor Text in das Modell eingegeben wird, muss er zunächst durch einen Tokenizer segmentiert und in entsprechende Token-IDs umgewandelt werden. Tokens sind die Basiseinheiten, mit denen Sprachmodelle Text verarbeiten; sie können ein chinesisches Zeichen, ein vollständiges Wort oder ein Teilwort sein. Die spezifische Segmentierungsmethode wird durch den vom Modell verwendeten Tokenisierungsalgorithmus und das Vokabular bestimmt. Token-IDs sind im Wesentlichen nur die Indexnummern der Tokens im Vokabular; ihre numerischen Werte stellen keine semantischen Beziehungen zwischen Tokens dar. Zum Beispiel sind zwei Tokens mit nahe beieinanderliegenden Indizes nicht notwendigerweise semantisch ähnlich. Daher müssen die diskreten Token-IDs vor dem Betreten des neuronalen Netzwerks zur Berechnung durch eine Embedding-Schicht in kontinuierliche hochdimensionale Vektoren projiziert werden. Diese Idee, kontinuierliche Vektoren zur Darstellung von Sprache zu verwenden, ist eine wichtige Grundlage der modernen Sprachverarbeitung. Im Jahr 2013 schlugen Mikolov et al. Word2Vec vor, das verteilte Vektorrepresentationen von Wörtern aus großem Korpora durch neuronale Netzwerke erlernt. Die grundlegende Idee stammt aus der Verteilungshypothese der natürlichen Sprache, wonach Wörter, die in ähnlichen Kontexten auftauchen, normalerweise ähnliche semantische oder grammatikalische Merkmale aufweisen.
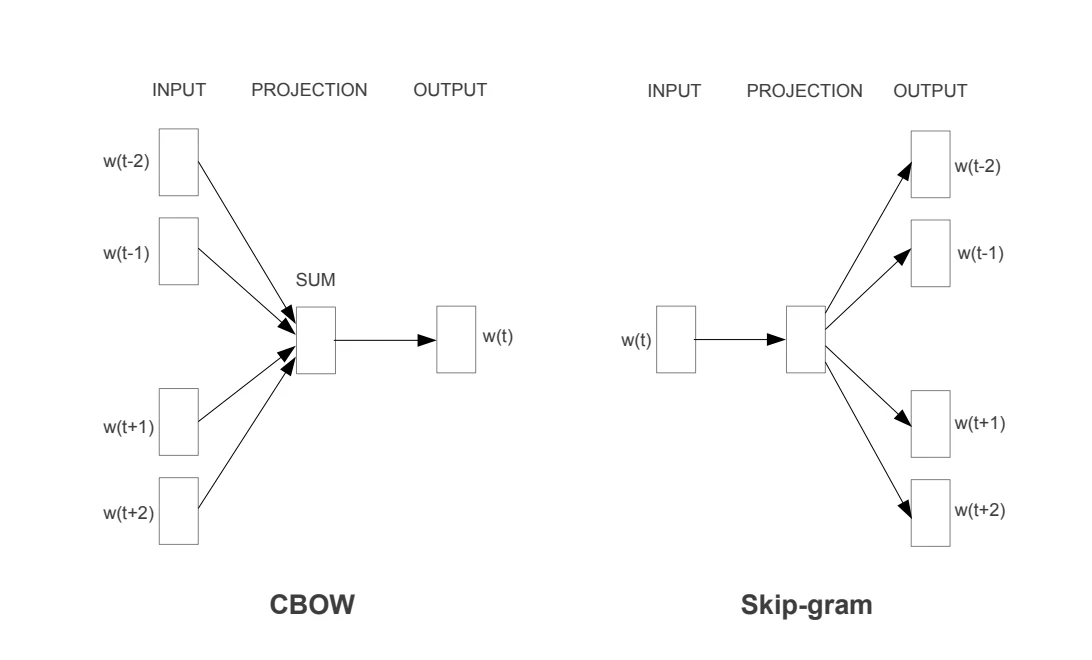
Word2Vec umfasst hauptsächlich zwei Trainingsstrukturen: CBOW (Continuous Bag-of-Words) und Skip-gram. Beide erlernen Wortvektoren über die Beziehung zwischen Zentralwörtern und Kontextwörtern, aber ihre Vorhersagerichtungen sind unterschiedlich.
CBOW prognostiziert das Zentralwort basierend auf Kontextwörtern. Für eine aus Wörtern bestehende Sequenz wird zunächst ein Zentralwort ausgewählt, und Wörter innerhalb eines bestimmten Fensters darum werden als Kontext verwendet. Das Modell verwendet die Vektorrepresentationen dieser Kontextwörter, um das Zentralwort vorherzusagen. Zum Beispiel mit „essen" als Zentralwort und Auswahl von „mögen" und „frisch" aus der Umgebung als Kontext.
Skip-gram hingegen prognostiziert Kontextwörter basierend auf dem Zentralwort. Im Vergleich zu CBOW ist seine Vorhersagerichtung umgekehrt. Für dieselbe Wortsequenz, wenn „essen" das Zentralwort ist, ist das Trainingsziel von Skip-gram, andere Wörter vorherzusagen, die innerhalb eines bestimmten Fensters basierend auf der Vektorrepresentation von „essen" auftauchen können, wie „mögen", „frisch" usw. Der Hauptunterschied zwischen CBOW und Skip-gram liegt in ihren Trainingszielen: CBOW verwendet mehrere Kontextwörter, um ein Zentralwort vorherzusagen; Skip-gram verwendet ein Zentralwort, um mehrere Kontextwörter vorherzusagen. Trotz ihrer unterschiedlichen Vorhersagerichtungen ist ihr ultimatives Ziel, Wortvektoren durch eine große Menge von Ko-Beziehungen zwischen Wörtern zu erlernen. Nach Abschluss des Trainings kann jedes Wort als kontinuierlicher Vektor fester Dimensionen dargestellt werden.
Die Vorschlag von Word2Vec förderte die Entwicklung verteilter Wortrepresentationen, aber seine Darstellungsmethode hat immer noch gewisse Einschränkungen. Word2Vec erlernt typische statische Wort-Embeddings, bei denen ein Wort nach dem Training normalerweise einem festen Vektor entspricht und sich nicht mit dem spezifischen Kontext ändert. Moderne Sprachmodelle verwenden weiterhin kontextuelle Representationen. Tokens erhalten zunächst Anfangsvektoren durch die Embedding-Schicht und durchlaufen dann mehrere Schichten neuronaler Netzwerke und aktualisieren ihre Representationen kontinuierlich basierend auf Informationen anderer Tokens in der Sequenz. Daher kann derselbe Token in verschiedenen Kontexten verschiedene versteckte Zustände bilden und damit die mit dem aktuellen Kontext verbundene Semantik ausdrücken. Die Bedeutung von Word2Vec liegt nicht nur in der Vorschlag eines spezifischen Wortvektor-Trainings, sondern auch in der Förderung der weit verbreiteten Anwendung verteilter Representationen in der Sprachverarbeitung. Sprache wird nicht mehr nur durch diskrete Symbole oder Indizes dargestellt, sondern auch in kontinuierliche Vektorräume projiziert, wodurch neuronale Netzwerke semantische und grammatikalische Beziehungen zwischen Wörtern weiter erlernen können. Nachfolgende Sprachverarbeitungstechnologien konzentrieren sich weiter darauf, wie der Kontext verwendet werden kann, um Wortrepresentationen dynamisch anzupassen.
Im Jahr 2017 wurde die Transformer-Architektur vorgeschlagen. Transformer modelliert Beziehungen zwischen verschiedenen Positionen in einer Sequenz über Aufmerksamkeitsmechanismen und wurde allmählich zur Kerninfrastruktur großer Sprachmodelle. Einer der wichtigsten Mechanismen in Transformer ist die Selbst-Aufmerksamkeit (Self-Attention), wie in der folgenden Abbildung gezeigt:
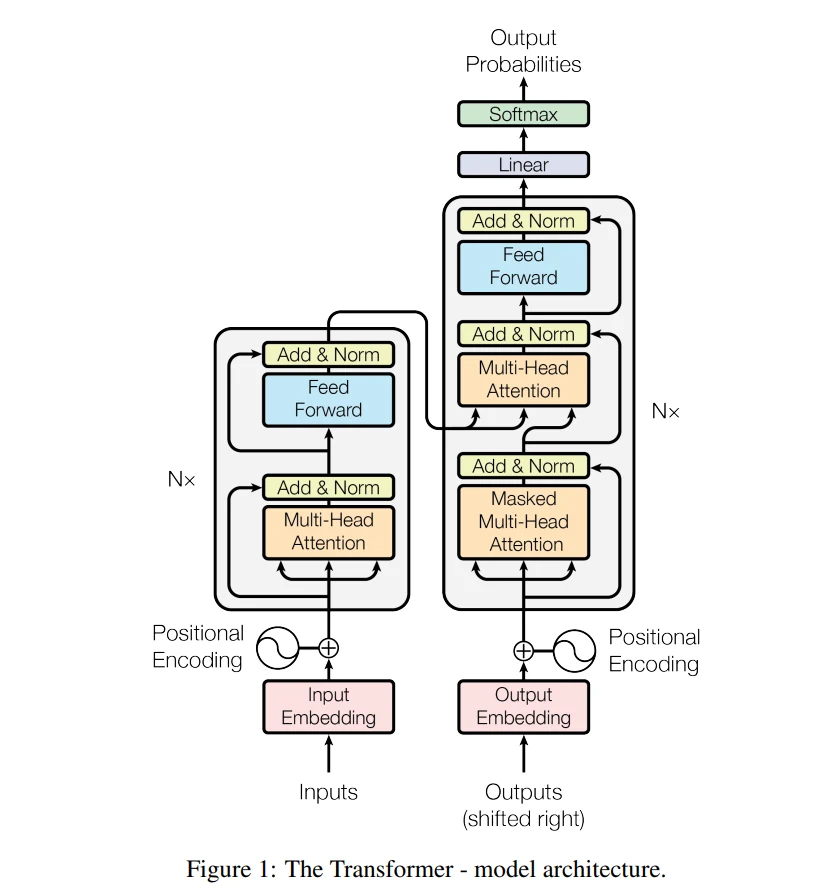
Die Hauptfunktion des Selbst-Aufmerksamkeitsmechanismus ist es, dem Modell zu ermöglichen, bei der Verarbeitung eines Tokens gleichzeitig die in anderen Tokens der Sequenz enthaltenen Informationen zu berücksichtigen und basierend auf dem Verbindungsgrad zwischen ihnen dynamisch verschiedene Aufmerksamkeitsgewichte zuzuweisen. Konkret wird die Representation jedes Tokens in Query (Q), Key (K) und Value (V) projiziert. Das Modell berechnet Aufmerksamkeitsgewichte durch den Übereinstimmungsgrad zwischen Query und verschiedenen Keys und verwendet dann diese Gewichte, um eine gewichtete Kombination der entsprechenden Values durchzuführen, wodurch eine neue Representation erhalten wird, die Kontextinformationen einbezieht.
Transformer besteht typischerweise aus mehreren gestapelten Netzwerkschichten. In verschiedenen Schichten aktualisiert das Modell kontinuierlich die Representation jedes Tokens und integriert schrittweise reichere Kontextinformationen. Nach Verarbeitung durch mehrere Transformer-Schichten kann derselbe Token in verschiedenen Kontexten verschiedene kontextuelle Representationen bilden und damit die Modellierung von Wortbedeutungen, syntaktischen Strukturen und komplexeren semantischen Beziehungen unterstützen. Die Bedeutung von Transformer liegt nicht nur in der Einführung einer neuen Netzwerkarchitektur, sondern auch in der Bereitstellung eines Mechanismus, der Kontextbeziehungen effektiv modellieren kann. Moderne große Sprachmodelle verbessern kontinuierlich die Sprachverständnis- und Generierungsfähigkeit durch Erweiterung der Modellskala, Trainingsdatenskalen und Kontextlänge, alles auf der Grundlage von Transformer.
Nachdem Transformer die Kontextmodellierung der Eingabesequenz durchgeführt hat, hat das Sprachmodell Token-Representationen erhalten, die Kontextinformationen einbeziehen. Auf dieser Grundlage müssen generative Sprachmodelle den folgenden Inhalt weiter prognostizieren. Mainstream-generative Sprachmodelle wie GPT verwenden typischerweise autoregressive Generierung, bei der die folgenden Tokens schrittweise vorhergesagt und erzeugt werden, basierend auf den aktuell eingegebenen oder erzeugten Tokens.
Für eine aus mehreren Tokens bestehende Sequenz kann ihre Generierungswahrscheinlichkeit in eine Reihe bedingter Wahrscheinlichkeiten zerlegt werden:
p(x_1, x_2, \ldots, x_T) = \prod_{t=1}^{T} p(x_t \mid x_1, x_2, \ldots, x_{t-1})
Wobei $x_t$ den $t$-ten Token darstellt, der aktuell erzeugt werden soll, $x_1,x_2,\ldots,x_{t-1}$ die zuvor eingegebenen oder erzeugten Tokens darstellt. Diese Formel zeigt, dass der Generierungsprozess einer vollständigen Textsequenz in mehrere aufeinanderfolgende Vorhersagen des nächsten Tokens zerlegt werden kann.
Nachdem das Modell die Wahrscheinlichkeitsverteilung des nächsten Tokens berechnet hat, muss es den tatsächlich ausgegebenen Token über Dekodierungsstrategien bestimmen. Verschiedene Dekodierungsstrategien wirken sich direkt auf Stabilität, Vielfalt und Kreativität der Textgenerierung aus.
Der direkteste Weg ist das gierige Decoding (Greedy Decoding), bei dem in jedem Schritt der Token mit der höchsten Wahrscheinlichkeit ausgewählt wird. Diese Methode hat eine starke Deterministik, aber das aufeinanderfolgende Auswählen von lokal höchstwahrscheinlichen Tokens liefert nicht unbedingt Text mit optimaler Gesamtqualität, und der erzeugte Inhalt tendiert zur Monotonie. Um die Vielfalt der Generierungsergebnisse zu verbessern, können generative Sprachmodelle auch zufälliges Sampling verwenden und den nächsten Token gemäß der vom Modell vorhergesagten Wahrscheinlichkeitsverteilung auswählen. Tokens mit höherer Wahrscheinlichkeit haben eine größere Auswahlchance, aber auch andere vernünftige Kandidaten-Tokens haben die Chance, ausgewählt zu werden. In der Praxis werden normalerweise Methoden wie Temperature, Top-k und Top-p kombiniert, um den Sampling-Prozess weiter anzupassen.
Temperature wird verwendet, um die Glätte der Wahrscheinlichkeitsverteilung anzupassen und kann dargestellt werden als:
p_i =
\frac{\exp(z_i / T)}
{\sum_j \exp(z_j / T)}
Wobei $z_i$ das Logit des $i$-ten Tokens darstellt, $T$ Temperature darstellt.
Wenn $T$ klein ist, wird der Vorteil von Tokens hoher Wahrscheinlichkeit weiter verstärkt, das Modell neigt dazu, Ergebnisse mit höherer Wahrscheinlichkeit auszuwählen, und der erzeugte Inhalt ist typischerweise stabiler; wenn $T$ groß ist, ist die Wahrscheinlichkeitsverteilung relativ flacher, Tokens niedriger Wahrscheinlichkeit erhalten mehr Auswahlchancen, und die Generierungsergebnisse haben typischerweise höhere Vielfalt.
Top-k behält in jedem Generierungsschritt nur die $k$ Kandidaten-Tokens mit der höchsten Wahrscheinlichkeit und resampelt nach Renormalisierung der Wahrscheinlichkeiten unter diesen Kandidaten-Tokens. Diese Methode kann eine große Anzahl von Tokens niedriger Wahrscheinlichkeit herausfiltern und die Möglichkeit verringern, dass eindeutig unvernünftige Inhalte ausgewählt werden.
Top-p fixiert nicht die Anzahl der Kandidaten-Tokens, sondern ordnet Wahrscheinlichkeiten von hoch nach niedrig und wählt die kleinste Kandidatenmenge aus, deren kumulative Wahrscheinlichkeit den Schwellenwert $p$ erreicht, und samplert dann aus dieser Menge. Daher kann Top-p den Bereich der Kandidaten-Tokens dynamisch an die aktuelle Wahrscheinlichkeitsverteilung anpassen.
Zum Beispiel, wenn die Vorhersage des Modells für den nächsten Token relativ sicher ist, kann die kumulative Wahrscheinlichkeit weniger Tokens den eingestellten Schwellenwert erreichen; während das Modell bei mehreren vernünftigen Kandidatenergebnissen mehr Tokens für das Sampling behält. Die Textgenerierung umfasst tatsächlich zwei eng verbundene Prozesse: Zuerst berechnet das Sprachmodell die Wahrscheinlichkeitsverteilung des nächsten Tokens basierend auf dem Kontext, dann bestimmen die Dekodierungs- und Sampling-Strategien den tatsächlich erzeugten Token basierend auf dieser Wahrscheinlichkeitsverteilung.
Das Modell ist dafür verantwortlich zu erlernen, welche Tokens im aktuellen Kontext wahrscheinlicher erscheinen, während die Dekodierungsstrategie dafür verantwortlich ist zu entscheiden, wie spezifische Ergebnisse aus diesen Kandidaten-Tokens ausgewählt werden. Zusammen bestimmen sie die Genauigkeit, Stabilität und Vielfalt des finalen Textes.
In der Entwicklung von Deep-Learning-Generatormodellen repräsentieren Generative Adversarial Networks (GANs) eine Klasse repräsentativer Techniken. Im Jahr 2014 schlugen Goodfellow et al. GAN vor, das die Verteilungsmuster realer Daten durch adversariales Training zwischen zwei neuronalen Netzwerken erlernt. Im Gegensatz zum traditionellen überwachten Lernen spezifiziert GAN nicht direkt, welche Art von Bildern der Generator erzeugen soll; es führt auch einen Diskriminator ein, um die Generierungsergebnisse zu bewerten, und verwendet die Diskriminierungsergebnisse, um den Generator kontinuierlich zu verbessern. Nach seinem Vorschlag wurde GAN schnell auf Aufgaben wie Bildgenerierung, Gesichtserzeugung, Bildstilübertragung, Super-Auflösung und Bildbearbeitung angewandt und bildete eine Reihe repräsentativer Modelle wie CycleGAN, StyleGAN und ESRGAN.
GAN erlernt die Verteilung realer Daten durch adversariales Training zwischen zwei neuronalen Netzwerken: dem Generator und dem Diskriminator. Wie in der Abbildung gezeigt, empfängt der Diskriminator während des Trainings sowohl reale Stichproben aus dem Trainingsset als auch vom Generator erzeugte Stichproben und unterscheidet zwischen den beiden Stichprobentypen; der Generator passt seine eigenen Parameter kontinuierlich basierend auf dem Feedback des Diskriminators an und verbessert die Ähnlichkeit zwischen erzeugten und realen Stichproben.
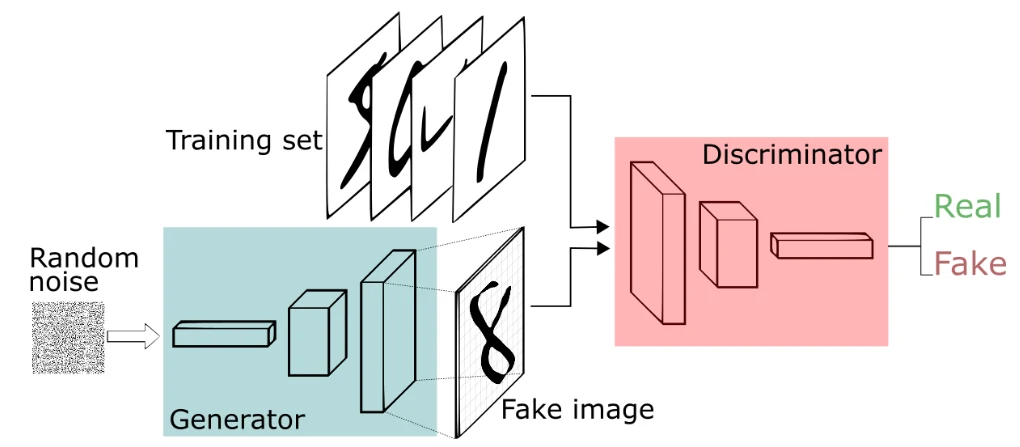
Der Generator wird als G bezeichnet. Seine Eingabe ist typischerweise eine Zufallsvariable z, die aus einer einfachen Wahrscheinlichkeitsverteilung wie einer Gaußschen oder Gleichverteilung gesampelt wird. Nach der nichtlinearen Abbildung des Generators wird die Zufallsvariable in eine erzeugte Stichprobe umgewandelt:
\hat{x}=G(z), \qquad z\sim p_z(z)
Bei Bildgenerierungsaufgaben besteht das Ziel des Generators darin, zufällige Darstellungen niedriger oder hoher Dimension schrittweise in Bilder mit spezifischen visuellen Strukturen zu projizieren.
Der Diskriminator wird als D bezeichnet. Seine Eingabe umfasst reale Stichproben x aus dem Trainingsset und vom Generator erzeugte Stichproben G(z). Durch das Erlernen der Merkmalsunterschiede zwischen den beiden Datentypen gibt der Diskriminator die Wahrscheinlichkeit aus, dass die Eingabestichprobe aus der realen Datenverteilung stammt:
D(x)\in[0,1]
Für reale Stichproben erhofft sich der Diskriminator, dass die Ausgabe nahe 1 liegt; für erzeugte Stichproben erhofft er sich, dass die Ausgabe nahe 0 liegt. Generator und Diskriminator haben gegensätzliche Optimierungsziele. Der Diskriminator muss seine Fähigkeit kontinuierlich verbessern, reale von erzeugten Stichproben zu unterscheiden, während der Generator die Authentizität erzeugter Stichproben kontinuierlich verbessern muss, sodass sie in Datenmerkmalen realen Stichproben ähnlicher werden. Die beiden Netzwerke bilden während des alternierenden Optimierungsprozesses eine adversariale Beziehung. Das Originalarbeit definiert das Trainingsziel von GAN als ein Minimax-Spiel:
\min_G \max_D V(D,G)
=
\mathbb{E}_{x\sim p_{\mathrm{data}}(x)}
[\log D(x)]
+
\mathbb{E}_{z\sim p_z(z)}
[\log(1-D(G(z)]
Wobei $p_{\mathrm{data}}$ die reale Datenverteilung darstellt, $p_z$ die Priorverteilung der Zufallsvariable darstellt. Der Diskriminator $D$ verbessert seine Fähigkeit, reale von erzeugten Stichproben zu unterscheiden, indem er die Zielfunktion maximiert; der Generator $G$ nähert sich der realen Datenverteilung schrittweise an, indem er seine eigenen Parameter optimiert.
Das Training von GAN verwendet typischerweise einen alternierenden Optimierungsansatz. Zuerst werden reale und erzeugte Stichproben verwendet, um den Diskriminator $D$ zu aktualisieren und ihm zu ermöglichen, die Unterschiede zwischen den beiden Datentypen zu erlernen; dann werden Gradienteninformationen des Diskriminators verwendet, um den Generator $G$ zu aktualisieren, wodurch der Generator die Generierungsergebnisse schrittweise verbessert. Mit fortschreitendem Training ändern sich die Fähigkeiten von Generator und Diskriminator gleichzeitig und bilden einen dynamischen adversarialen Lernprozess.
Generator und Diskriminator erfüllen in GAN unterschiedliche Funktionen. Der Diskriminator wird hauptsächlich in der Trainingsphase verwendet und liefert Optimierungssignale für den Generator durch Wahr/Falsch-Klassifizierung; nach Abschluss des Modelltrainings, wenn die Aufgabe nur darin besteht, neue Bilder zu erzeugen, wird nur der Generator für die Inferenz benötigt:
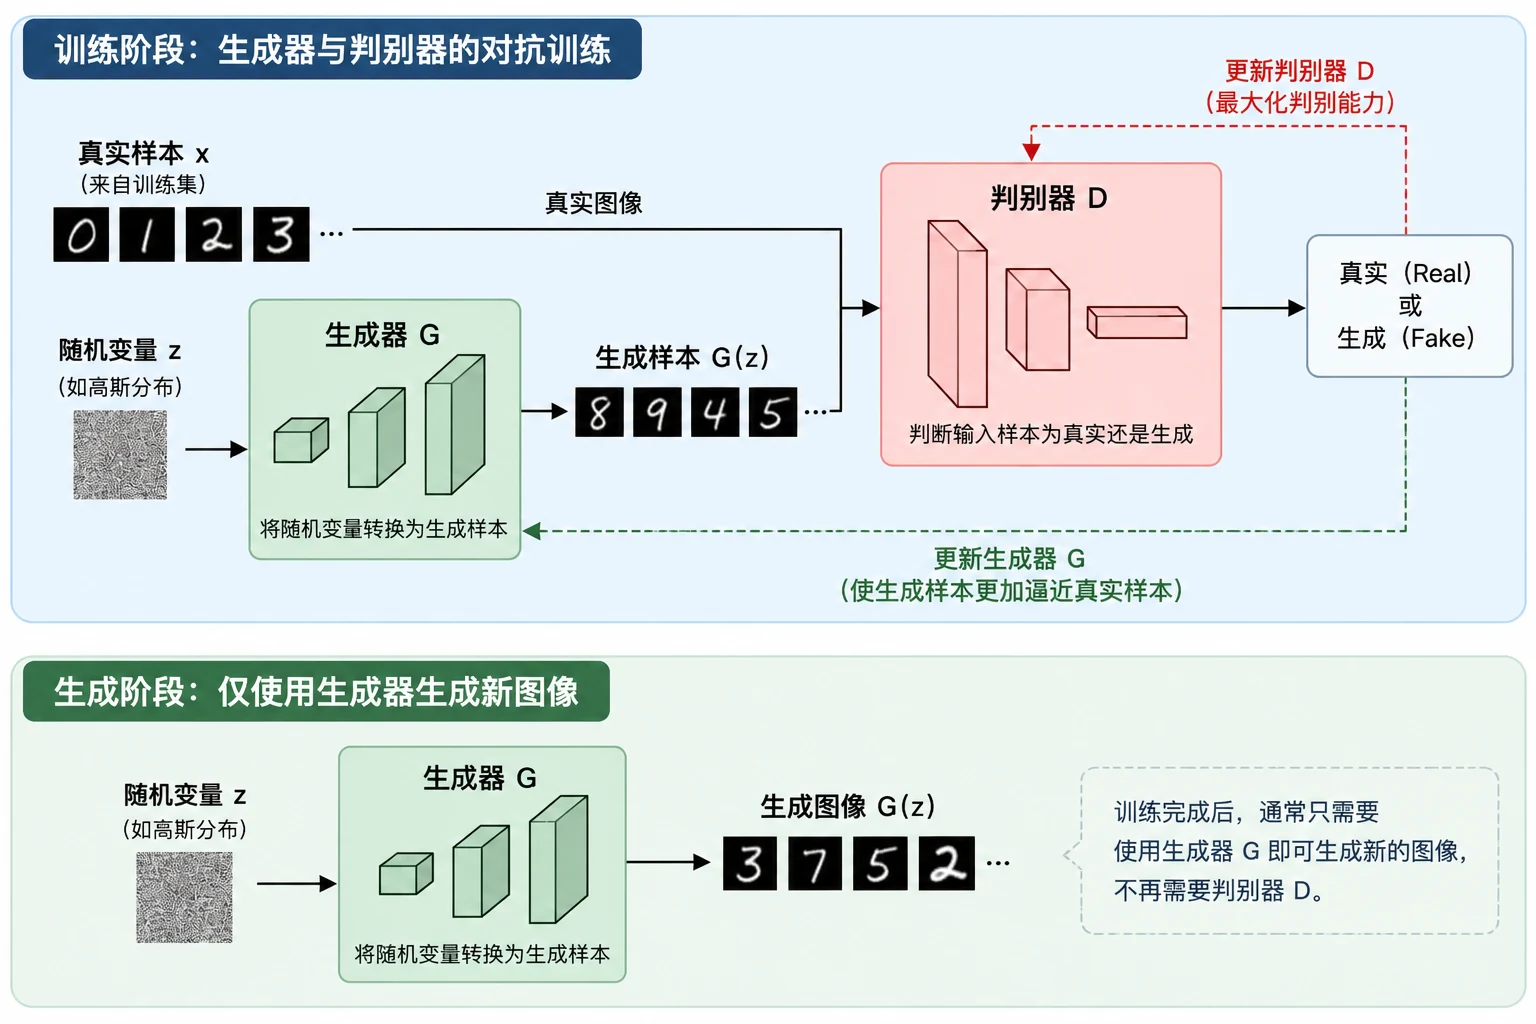
GAN hat im Bereich der Bildgenerierung große Aufmerksamkeit erfahren, und ein wichtiger Grund ist, dass sein Generierungsprozess relativ direkt ist. Nach Abschluss des Modelltrainings muss nur eine Zufallsvariable in den Generator eingegeben werden, und ein Generierungsergebnis kann durch eine einzige Vorwärtsberechnung erhalten werden. Im Vergleich zu Modellen, die eine mehrstufige iterative Generierung erfordern, hat GAN typischerweise eine höhere Generierungseffizienz und wurde daher weit verbreitet in Aufgaben wie Bildgenerierung, Super-Auflösung, Videoverbesserung und interaktiver Bildverarbeitung eingesetzt. Die Vorteile von GAN manifestieren sich hauptsächlich in der Generierungsphase, während sein Trainingsprozess relativ komplex ist und die folgenden Hauptprobleme aufweist.
GAN erfordert das gleichzeitige Training von Generator und Diskriminator, und die beiden Netzwerke haben sich gegenseitig adversariale Optimierungsziele. Wenn sich die Parameter des Generators ändern, ändern sich auch die vom Diskriminator erzeugten Daten; wenn sich die Parameter des Diskriminators ändern, ändern sich auch die vom Generator empfangenen Optimierungssignale. Daher ist das Training von GAN im Gegensatz zum gewöhnlichen überwachten Lernen, das unter einer relativ festen Zielfunktion optimiert, tatsächlich ein sich ständig verändernder dynamischer Spielprozess. Wenn der Diskriminator zu stark ist, können erzeugte Stichproben leicht erkannt werden und der Generator kann keine effektiven Optimierungssignale erhalten; wenn der Diskriminator zu schwach ist, kann er die Unterschiede zwischen realen und erzeugten Stichproben nicht genau widerspiegeln und kann dem Generator ebenfalls kein effektives Trainingsfeedback liefern. Daher ist die Aufrechterhaltung eines relativ stabilen Trainingszustands zwischen Generator und Diskriminator ein wichtiges Problem im GAN-Modelltraining.
Modus-Kollaps ist ein weiteres typisches Problem im GAN-Training. Idealerweise muss der Generator nicht nur Stichproben mit hoher visueller Qualität erzeugen, sondern sollte auch in der Lage sein, verschiedene Typen und Merkmale in den realen Daten abzudecken. Angenommen, die Trainingsdaten enthalten Gesichter unterschiedlichen Alters, differente Ausdrücke und unterschiedliche äußere Merkmale, sollte der Generator in der Lage sein, Gesichtsbilder mit entsprechender Vielfalt zu erzeugen. In der tatsächlichen Pumpfung neigt der Generator jedoch dazu, nur wenige Stichprobentypen zu erzeugen, die leichtere höhere Bewertungen vom Diskriminator erhalten, und kontinuierlich ähnliche Ergebnisse zu produzieren. In diesem Fall können einzelne erzeugte Bilder eine hohe visuelle Qualität haben, aber die Unterschiede zwischen einer großen Anzahl erzeugter Ergebnisse sind gering und können die Vielfalt der realen Daten nicht vollständig abdecken. Modus-Kollaps spiegelt ein wichtiges Problem generativer Modelle wider: Hohe Generierungsqualität einzelner Stichproben bedeutet nicht, dass das Modell die reale Datenverteilung vollständig erlernt hat.
Zu Problemen wie Trainingsinstabilität, Modus-Kollaps und Generierungsqualität haben Forscher GAN aus mehreren Aspekten verbessert, einschließlich Netzwerkstruktur, Verlustfunktionen und Trainingsstrategien, wodurch eine große Anzahl abgeleiteter Modelle entstanden sind. Diese Studien haben nicht nur die Generierungsfähigkeiten von GAN verbessert, sondern es auch schrittweise von der grundlegenden Bildgenerierung auf verschiedene Aufgaben wie Bildübersetzung, kontrollierbare Bildbearbeitung und Bildsuper-Auflösung erweitert. Nachfolgend stellen wir anhand mehrerer repräsentativer Modelle die typischen Anwendungen von GAN in diesen Bereichen vor.
Mit der Entwicklung der GAN-Technologie hat sich ihr Anwendungsbereich schrittweise von der zufälligen Bildgenerierung auf Aufgaben wie Bildübersetzung, Bildbearbeitung und Bildverbesserung erweitert. Verschiedene Modelle gestalten typischerweise Generatoren, Diskriminatoren, Verlustfunktionen oder Trainingsmethoden für spezifische Aufgaben neu und bilden GAN-abgeleitete Modelle mit unterschiedlichen Funktionen. Darunter repräsentieren CycleGAN, DragGAN, ESRGAN und Real-ESRGAN jeweils typische GAN-Anwendungen in unpaariger Bildübersetzung, interaktiver Bildbearbeitung und Bildsuper-Auflösung.
Im Jahr 2017 schlugen Zhu et al. CycleGAN vor, das hauptsächlich zur Lösung von Problemen der unpaarigen Bild-zu-Bild-Übersetzung (Unpaired Image-to-Image Translation) dient. Im Gegensatz zu Bildübersetzungsmethoden, die gepaarte Trainingsstichproben erfordern, erfordert CycleGAN keine Eins-zu-eins-Entsprechung zwischen Quell- und Zielbildern; es muss lediglich Daten aus zwei Bildbereichen separat bereitgestellt werden, um die Übersetzungsbeziehung zwischen ihnen zu erlernen. Zum Beispiel beim Übersetzungsauftrag Pferd → Zebra erfordern traditionelle Methoden normalerweise die Vorbereitung entsprechender Pferde- und Zebra-Bilder, während CycleGAN nur eine Gruppe von Pferdebildern und eine Gruppe von Zebra-Bildern separat vorbereiten muss, ohne eine Entsprechung zwischen den beiden Bildgruppen herzustellen. Wie unten gezeigt, besteht CycleGAN aus zwei Generatoren und zwei Diskriminatoren und erlernt gleichzeitig die Bildübersetzung in beide Richtungen. Angenommen, Pferdebilder gehören zum Bildbereich $X$, Zebra-Bilder gehören zum Bildbereich $Y$, ist Generator $G$ für die Übersetzung von $X$ nach $Y$ verantwortlich, und Generator $F$ ist für die Übersetzung von $Y$ nach $X$ verantwortlich:
G:X\rightarrow Y,\qquad F:Y\rightarrow X
Wobei Diskriminator $D_Y$ verwendet wird, um zu beurteilen, ob die erzeugten Zebra-Bilder der Verteilung realer Zebra-Bilder entsprechen, und Diskriminator $D_X$ verwendet wird, um zu beurteilen, ob die erzeugten Pferdebilder der Verteilung realer Pferdebilder entsprechen. CycleGAN enthält tatsächlich zwei gerichtete adversariale Lernprozesse:
G + D_Y:Pferd → Zebra
F + D_X:Zebra → Pferd
Allein das adversariale Training in zwei Richtungen kann nicht garantieren, dass übersetzte Bilder die Entsprechung mit der Originaleingabe beibehalten. Zum Beispiel kann beim Übersetzen eines Pferdebilds in ein Zebra das erzeugte Ergebnis zwar realistische Zebra-Texturen haben, aber die Haltung, Position oder Hintergrundstruktur des Pferdes können sich erheblich ändern. Das heißt, die inhaltliche Konsistenz vor und nach der Übersetzung kann nicht vollständig garantiert werden.
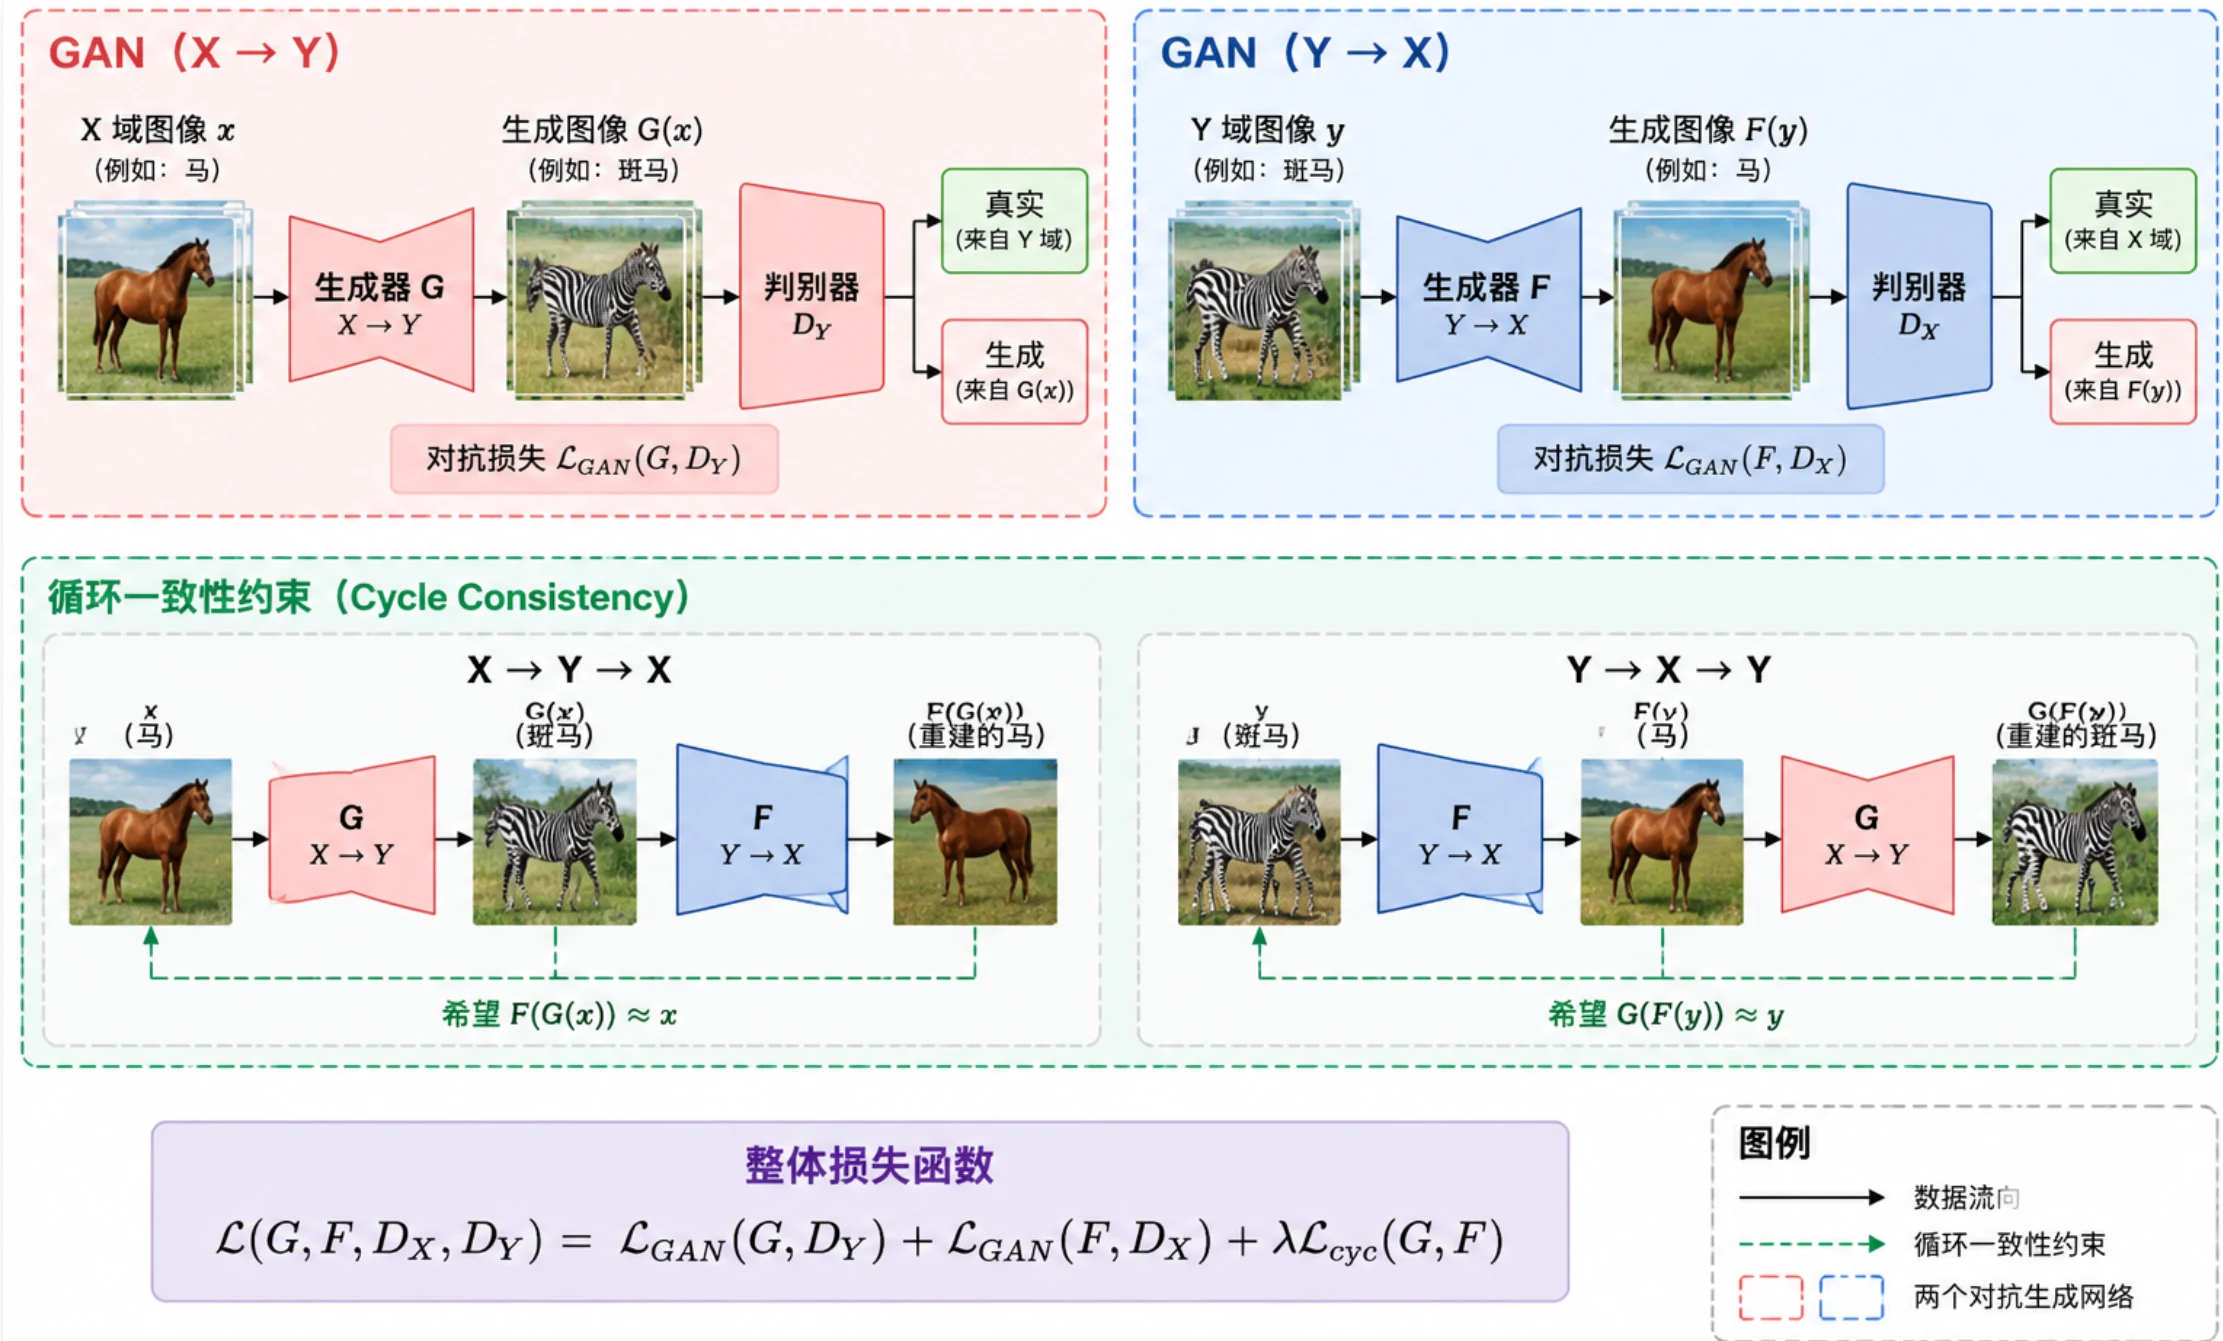
Aus diesem Grund führt CycleGAN zusätzlich Zyklikonsistenzbeschränkungen (Cycle Consistency) ein. Wie im unteren Teil der Abbildung gezeigt, wird für das Pferdebild $x$ im Bildbereich $X$ zunächst durch Generator $G$ in ein Zebra-Bild $G(x)$ übersetzt und dann durch Generator $F$ zurück in ein Pferdebild übersetzt:
x\rightarrow G(x)\rightarrow F(G(x)
Nach einer vollständigen Hin- und Rückübersetzung sollte das Endergebnis dem Originalbild so nahe wie möglich kommen:
F(G(x)\approx x
Ebenso muss für das Zebra-Bild $y$ im Bildbereich $Y$ gelten:
G(F(y)\approx y
Daher bildet das Modell zwei vollständige Übersetzungszyklen: Pferd → Zebra → Pferd, Zebra → Pferd → Zebra. CycleGAN führt einen Zyklikonsistenzverlust ein, um die beiden Zyklen einzuschränken:
\mathcal{L}_{\mathrm{cyc}}(G,F)
=
\mathbb{E}_{x\sim p_{\mathrm{data}}(x)}
\left[\|F(G(x)-x\|_1\right]
+
\mathbb{E}_{y\sim p_{\mathrm{data}}(y)}
\left[\|G(F(y)-y\|_1\right]
Wobei der erste Term das Pferd → Zebra → Pferd Rekonstruktionsergebnis einschränkt und der zweite Term das Zebra → Pferd → Zebra Rekonstruktionsergebnis einschränkt. Je kleiner der Zyklikonsistenzverlust, desto näher kommt das Bild dem Originalbild in Inhalt und Struktur nach der bidirektionalen Übersetzung. Das Training von CycleGAN umfasst hauptsächlich zwei Teile: adversariales Lernen und Zyklikonsistenzbeschränkungen, die zusammenwirken, um CycleGAN zu ermöglichen, die Mapping-Beziehung zwischen zwei Bildbereichen ohne gepaarte Trainingsdaten zu erlernen und damit Aufgaben wie Pferd-Zebra-Übersetzung und Bildstilübertragung zu erreichen.
Im Jahr 2017 schlugen Pan et al. DragGAN vor, das durch Festlegen von Kontrollpunkten und Zielpunkten im Bild die interaktive Anpassung von Objektposition, -haltung und -form in erzeugten Bildern erreicht. Im Gegensatz zur traditionellen Pixel-level-Bearbeitung verschiebt DragGAN keine Pixel direkt im Bild; stattdessen passt es die latente Repräsentation des GAN an, wodurch das erzeugte Bild in die vom Benutzer angegebene Richtung geändert wird.
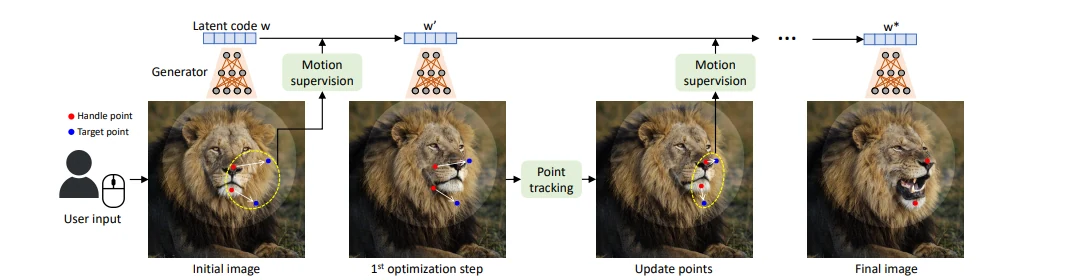
Der Kernprozess von DragGAN umfasst hauptsächlich Bewegungsüberwachung und Punktverfolgung. Der Benutzer wählt zunächst den anzupassenden Kontrollpunkt im Bild aus und gibt die Zielposition an, zu der er sich bewegen möchte. Zum Beispiel wird in der Abbildung durch Festlegen von Kontroll- und Zielpunkten in der Nähe des Löwenmauls das Löwenmaul allmählich geöffnet.
Während des Bearbeitungsprozesses hält DragGAN die Parameter des vortrainierten Generators unverändert und optimiert kontinuierlich den latenten Code $w$, der in den Generator eingegeben wird. Das Anfangsbild kann dargestellt werden als:
I = G(w)
Wobei $G$ den vortrainierten GAN-Generator darstellt, $w$ den latenten Code darstellt, der dem Bild entspricht. Durch Anpassung von $w$ können Inhalt und Struktur des erzeugten Bilds $I$ geändert werden. Die Bewegungsüberwachung wird verwendet, um Bildmerkmale in der Nähe des Kontrollpunkts in Richtung der Zielposition zu schieben. Nach einer Optimierung wird der latente Code von $w$ auf $w'$ aktualisiert, und das erzeugte Bild ändert sich entsprechend. Da sich die ursprüngliche Kontrollpunktposition nach der Bildänderung verschoben haben kann, muss DragGAN den Kontrollpunkt in dem neuen Bild durch Punktverfolgung neu bestimmen und dann mit der nächsten Optimierungsrunde fortfahren, nämlich: Kontroll- und Zielpunkt festlegen → Bewegungsüberwachung → latenten Code optimieren → neues Bild erzeugen → Punktverfolgung und Kontrollpunkt aktualisierung → Optimierung fortsetzen, bis Annäherung an die Zielposition. Nach mehreren Iterationen bewegt sich der Kontrollpunkt schrittweise zur benutzerdefinierten Zielposition und liefert schließlich das bearbeitete Bild. Da dieser Prozess im vom GAN erlernten Generierungsraum optimiert wird, ändert das Modell nicht nur die angegebene Position, sondern kann auch entsprechende Anpassungen an umgebenden verbundenen Strukturen vornehmen.
Der Schlüssel von DragGAN besteht nicht darin, Pixel einfach zu ziehen; es konvertiert die Ziehoperation des Benutzers in eine iterative Optimierung der latenten Repräsentation des GAN und steuert durch Bewegungsüberwachung und Punktverfolgung die semantische Struktur im Bild, um sich in Richtung der angegebenen Position zu bewegen. Diese Methode demonstriert die Anwendungsfähigkeit von GAN in der kontrollierbaren Bildbearbeitung und ermöglicht es Benutzern, die Haltung, den Ausdruck und die Form von Objekten intuitiv über Punktoperationen anzupassen.
Bildsuper-Auflösung ist eine der typischen Anwendungsrichtungen von GAN, deren Ziel es ist, aus niedrig aufgelösten Bildern Bilder mit höherer Auflösung und reicheren visuellen Details zu erzeugen. Im Gegensatz zu einer einfachen Interpolationsvergrößerung müssen Super-Auflösungsmodelle fehlende Hochfrequenztexturen und lokale Strukturen basierend auf dem vorhandenen Bildinhalt rekonstruieren. Im Jahr 2018 schlugen Wang et al. ESRGAN[ESRGAN] vor, das die Netzwerkstruktur, den adversarialen Verlust und den perzeptiven Verlust im Vergleich zu bestehenden Forschungen weiter verbesserte, um die Texturleistung und visuelle Qualität von Super-Auflösungsbildern zu steigern.
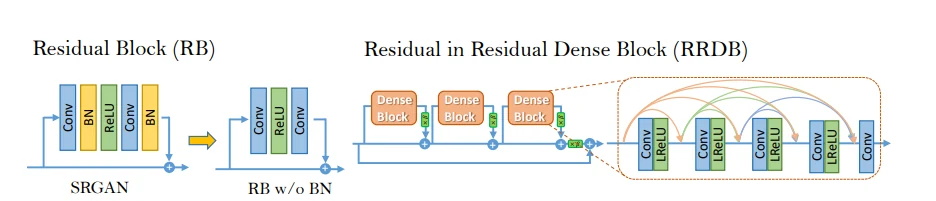
Eine wichtige Verbesserung in der Netzwerkstruktur von ESRGAN ist die Einführung der Residual-in-Residual Dense Block (RRDB)-Struktur. Der Generator von SRGAN verwendet hauptsächlich normale Residual Blöcke (RB), die Faltungsschichten, Batch Normalization (BN) und Aktivierungsfunktionen umfassen. ESRGAN entfernt zunächst die BN-Schicht aus den Residualblöcken und kombiniert weiter mehrere dichte Verbindungsmodule zu RRDB.
Wie in der Abbildung zu sehen ist, besteht RRDB intern aus mehreren Dense Blocks und kombiniert dichte Verbindungen mit Residualverbindungen. Innerhalb der Dense Blocks verwenden verschiedene Faltungsschichten dichte Verbindungen, bei denen nachfolgende Schichten Merkmale empfangen und nutzen können, die von mehreren vorherigen Schichten extrahiert wurden; zwischen mehreren Dense Blocks und außerhalb von RRDB werden Merkmale weiter durch Residualverbindungen übertragen. Diese Struktur kann den Informationsfluss und die Merkmalswiederverwendung zwischen verschiedenen Schichten verstärken und die Netzwerkkapazität für die Modellierung von Bildtexturen und Detailmerkmalen verbessern. Neben Netzwerkstrukturverbesserungen optimiert ESRGAN auch das Trainingsziel. Traditionelle Super-Auflösungsmethoden, wenn sie hauptsächlich mit Pixel-Fehlern trainiert werden, neigen dazu, relativ glatte Ergebnisse zu erzeugen; obwohl der Pixel-Fehler geringer sein kann, neigen einige Kanten und Hochfrequenztexturen dazu, unscharf zu werden. ESRGAN kombiniert weiter perzeptiven Verlust und adversariales Training, wodurch Generierungsergebnisse klarere, natürlichere Texturdetails erhalten und gleichzeitig der Gesamtinhalt beibehalten wird.
Generative Super-Auflösung ist nicht gleichbedeutend mit der Wiederherstellung verlorener Originalinformationen. Wenn Teile der Hochfrequenzinformationen in niedrig aufgelösten Bildern verloren gegangen sind, können vorhandene Pixel allein normalerweise die Originaldetails nicht eindeutig bestimmen. ESRGAN kombiniert tatsächlich das Eingabebild mit Bildprioritäten, die während des Trainings erlernt wurden, um visuell vernünftige Texturen zu erzeugen. Die Generierungsergebnisse können zwar klarer sein, aber einige Details stimmen möglicherweise nicht vollständig mit dem Original-Hochauflösungsbild überein. Diese Eigenschaft macht ESRGAN geeigneter für Bildverbesserungsaufgaben, die visuelle Qualität betonen. In Szenarien mit hohen Anforderungen an Informationsauthentizität wie medizinische Bildgebung, Archivforensik und wissenschaftliche Bildforschung sollten generative Super-Auflösungsergebnisse mit Vorsicht verwendet werden.
GAN erlernt die reale Datenverteilung durch adversariales Training zwischen Generator und Diskriminator, während der Variational Autoencoder (VAE) einen anderen Generierungsansatz verfolgt: Zuerst die Eingabedaten in einen kontinuierlichen latenten Raum zu kodieren, dann aus dem latenten Raum zu samplen und über einen Decoder Daten zu erzeugen oder zu rekonstruieren. Im Jahr 2013 schlugen Kingma und Welling die Auto-Encoding Variational Bayes (AEVB)-Methode vor und stellten das subsequently weit verbreitete VAE-Trainingsframework bereit. VAE kombiniert neuronale Netzwerke mit variationaler Inferenz und ermöglicht es dem Modell, latente Representationen mit probabilistischer Struktur durch End-zu-End-Training zu erlernen.
Die Grundstruktur von VAE besteht aus einem Encoder und einem Decoder. Der Encoder ist dafür verantwortlich, die Eingabedaten in einen latenten Raum niedrigerer Dimension zu komprimieren, während der Decoder die Eingabedaten basierend auf latenten Representationen wiederherstellt. Gewöhnliche Autoencoder kodieren die Eingabe $x$ normalerweise direkt in einen deterministischen latenten Vektor $z$ und verwenden dann den Decoder zur Rekonstruktion. Der größte Unterschied zwischen VAE und gewöhnlichen Autoencodern besteht darin, dass der Encoder nicht direkt einen deterministischen latenten Vektor ausgibt; er gibt stattdessen die Parameter der Wahrscheinlichkeitsverteilung der latenten Variable aus.
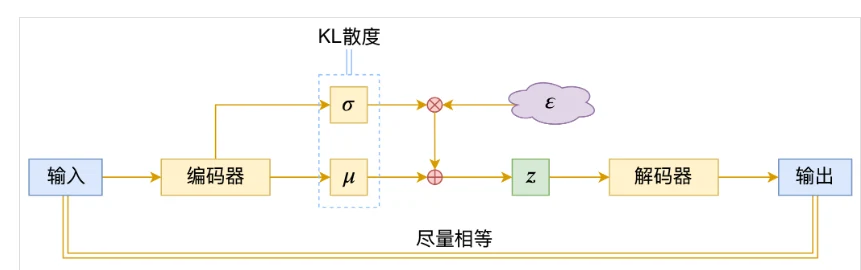
In der obigen Abbildung konvertiert der Encoder von VAE die Eingabedaten $x$ nicht direkt in einen festen latenten Vektor; er gibt auch zwei Parameter aus: den Mittelwert $\mu$ und die Standardabweichung $\sigma$. Diese beiden Parameter bestimmen gemeinsam die Wahrscheinlichkeitsverteilung der latenten Variable $z$. $\mu$ bestimmt ungefähr, wo sich die latente Variable befindet, und $\sigma$ gibt an, wie groß der Variationsbereich um diese Position sein kann.
VAE modelliert die latente Variable als Gaußsche Verteilung:
q_{\phi}(z\mid x)
=
\mathcal{N}
\left(
z;\mu_{\phi}(x),
\operatorname{diag}\left(\sigma_{\phi}^{2}(x)\right)
\right)
Wobei $q_{\phi}(z\mid x)$ die latente Variablenverteilung darstellt, die vom Encoder basierend auf der Eingabe $x$ erhalten wurde. Im Gegensatz zu gewöhnlichen Autoencodern, die direkt ein deterministisches $z$ erhalten, erhält VAE eine Verteilung, die gesampelt werden kann, sodass dieselbe Eingabe verschiedene latene Representationen innerhalb eines bestimmten Bereichs ergeben kann. Als nächstes muss das Modell eine spezifische latente Variable $z$ aus dieser Verteilung extrahieren und sie an den Decoder senden. Um Zufälligkeit einzuführen, während sichergestellt wird, dass das Modell normale Backpropagation durchführen kann, verwendet VAE den Reparameterisierungstrick. Das Modell sampelt zunächst eine Zufallsvariable $\epsilon$ aus einer Standardnormalverteilung und kombiniert dann die vom Encoder erhaltenen $\mu$ und $\sigma$, um die latente Variable $z$ zu berechnen:
z=\mu+\sigma\odot\epsilon
Man kann verstehen, dass $\mu$ die Position bestimmt, $\sigma$ den Variationsbereich bestimmt und $\epsilon$ Zufälligkeit bereitstellt; gemeinsam ergeben sie die finale latente Variable $z$. Diese Vorgehensweise trennt das zufällige Sampling vom Berechnungsprozess der Netzwerkparameter, sodass Gradienten weiterhin durch $z$ zum Encoder propagiert werden können, wodurch das End-zu-End-Training des gesamten VAE ermöglicht wird. Nach Erhalt der latenten Variable $z$ erzeugt der Decoder das Rekonstruktionsergebnis $\hat{x}$ basierend auf $z$. Der gesamte Prozess von VAE kann wie folgt zusammengefasst werden: Eingabedaten → Encoder → latente Verteilung → Sampling für $z$ → Decoder → rekonstruierte Daten.
VAE muss während des Trainings auch zwei Ziele gleichzeitig berücksichtigen: Einerseits erhofft er sich, dass die vom Decoder erzeugten Ergebnisse dem Original input so nahe wie möglich kommen; andererseits erhofft er sich, dass die verschiedenen Eingaben zugeordneten latenten Verteilungen nicht zu unordentlich sind, sondern einen relativ kontinuierlichen und regulären latenten Raum bilden. Daher besteht das Trainingsziel von VAE sowohl aus dem Rekonstruktionsterm als auch aus dem KL-Divergenzterm, typischerweise dargestellt durch die Evidence Lower Bound (ELBO):
\mathcal{L}_{\mathrm{ELBO}}
=
\mathbb{E}_{q_{\phi}(z\mid x)}
\left[
\log p_{\theta}(x\mid z)
\right]
-
D_{\mathrm{KL}}
\left(
q_{\phi}(z\mid x)
\parallel
p(z)
\right)
Wobei der erste Term als Wie gut die Rekonstruktion ist verstanden werden kann und misst, ob der Decoder die Eingabedaten basierend auf $z$ wiederherstellen kann; der zweite Term kann als Wie regular ist der latente Raum verstanden werden und schränkt die vom Encoder erhaltene latente Verteilung durch KL-Divergenz ein, um sie an die vorgegebene Priorverteilung anzunähern. Diese beiden Ziele müssen zusammenwirken. Wenn man sich nur auf die Rekonstruktionssqualität konzentriert, kann der latente Raum, obwohl das Modell die Eingabe gut wiederherstellen kann, ziemlich zerstreut sein, was das direkte Sampling unbequem macht; nach Hinzufügen der KL-Divergenzbeschränkungen werden die latenten Representationen verschiedener Stichproben durch eine einheitliche Priorverteilung eingeschränkt, wodurch der latente Raum regularer wird und für Sampling und Generierung besser geeignet ist.
Aus der Perspektive des Generierungsprozesses verfügt VAE bereits über vollständige Generierungsfähigkeit. Nach Abschluss des Trainings kann anstelle der Eingabe des Originalbilds direkt eine latente Variable $z$ aus einer Standardnormalverteilung gesampelt und in den Decoder eingegeben werden, um neue Bilder zu erzeugen. Theoretisch kann dieser Prozess funktionieren, da während des Trainings die vom Encoder erzeugte latente Verteilung durch KL-Divergenz kontinuierlich eingeschränkt wird, um sich der vorgegebenen Standardnormalverteilung anzunähern. In der tatsächlichen Pumpfung entspricht die vom Encoder erzeugte latente Verteilung normalerweise jedoch nicht vollständig der Standardnormalverteilung. Wenn die Beschränkung zu stark ist, wird der latente Raum zwar regularer, aber es können einige Bildinformationen verloren gehen; wenn die Beschränkung zu schwach ist, ist die Verteilung des latenten Raums möglicherweise nicht regular genug, sodass $z$, das durch direktes Sampling aus der Standardnormalverteilung erhalten wird, in unbekannte Bereiche des Modells fällt und die Decoder-Ergebnisse beeinträchtigt.
Gleichzeitig muss VAE ein Gleichgewicht zwischen Rekonstruktionssqualität und Regularität des latenten Raums finden. Das Trainingsziel von klassischem VAE betont mehr die Modellierung der gesamten Datenverteilung und des latenten Raums und neigt dazu, einige Hochfrequenztexturen und lokale Details bei der Bildgenerierung zu verlieren, wobei die Generierungsergebnisse oft relativ glatt sind. Dies ist auch ein offensichtlicher Unterschied zwischen VAE und GAN in Bezug auf die Bildgenerierungseffektivität. GAN schränkt die Authentizität erzeugter Bilder durch den Diskriminator direkt ein und erzeugt normalerweise schärfere Texturen; VAE konzentriert sich mehr auf die Kontinuität und probabilistische Struktur des latenten Raums und hat gewisse Einschränkungen bei der direkten Erzeugung hochwertiger Bilder.
Mit der Entwicklung generativer Modelle hat sich die Rolle von VAE allmählich von der direkten Erzeugung finaler Bilder zu einem Kodierungs- und Dekodierungsinstrument zwischen Bildraum und latentem Raum gewandelt. Eine repräsentative Anwendung ist das Latent Diffusion Model (LDM). Frühe Diffusionsmodelle führten Rauschzufügung und Entrauschung direkt im Pixelraum durch. Bei hoher Bildauflösung muss das Modell große Pixelmengen wiederholt verarbeiten, was zu hohen Berechnungskosten führt. Das von Rombach et al. vorgeschlagene latente Diffusionsmodell verlagert den Diffusionsprozession in einen komprimierten latenten Raum und reduziert so die Datendimensionen, die das Diffusionsmodell verarbeiten muss. In dieser Struktur komprimiert der Encoder das Originalbild zunächst in eine latente Repräsentation: Originalbild → Encoder → latente Repräsentation. Diese latenten Repräsentationen speichern nicht mehr direkt jedes Pixel, sondern bewahren die Hauptstruktur und visuelle Informationen des Bildes in kompakter Form. Anschließend führt das Diffusionsmodell Rauschzufügung und Entrauschung in diesem latenten Raum durch, anstatt das Original-Hochauflösungsbild direkt zu verarbeiten. Wenn das Diffusionsmodell die Generierung abschließt, stellt der Decoder die erzeugte latente Repräsentation im Pixelraum wieder her: erzeugte latente Repräsentation → Decoder → finales Bild. VAE ist für die Komprimierung und Wiederherstellung von Bildern verantwortlich, während das Diffusionsmodell für die Erzeugung von Bildinhalt im latenten Raum verantwortlich ist. Dieser Ansatz nutzt die latente Repräsentationsfähigkeit von VAE vollständig aus. Das Diffusionsmodell verarbeitet keine hochdimensionalen Originalpixel mehr, sondern komprimierte Bildmerkmale und reduziert so die Berechnungskosten nachfolgender Diffusions- und Entrauschungsprozesse erheblich.
VAE selbst hat gewisse Einschränkungen bei der direkten Erzeugung hochwertiger Bilder, aber sein Encoder, latenter Raum und Decoder-Struktur sind zu wichtigen Komponenten moderner latenter Diffusionsmodelle geworden. Dies spiegelt auch die Veränderung der Rolle von VAE wider: allmähliche Entwicklung von einem unabhängigen generativen Modell zu einem latenten Repräsentationsmodul in hochwertigen Bildgenerierungssystemen.
GAN verwendet typischerweise den Generator, um die Bildgenerierung durch eine einzige Vorwärtsberechnung abzuschließen, und VAE kann auch von latenten Variablen aus starten und Generierungsergebnisse direkt über den Decoder erhalten. Für komplexe hochdimensionale Bilder ist es nicht einfach, das Modell die Abbildung von Zufallsvariablen auf vollständige Bilder in einem Schritt abschließen zu lassen. Diffusionsmodelle verwenden einen anderen Ansatz und zerlegen die komplexe Bildgenerierungsaufgabe in mehrere relativ einfache Schritte, wobei jeder Schritt nur eine kleine Anpassung am aktuellen Ergebnis vornimmt und das vollständige Bild nach mehreren Iterationen schrittweise erhält. Das Modell muss das finale Ergebnis nicht in einem Schritt erzeugen; es schließt die Generierung schrittweise durch mehrere Entrauschungsschritte ab.
Diffusionsmodelle enthalten hauptsächlich zwei entgegengesetzte Prozesse: Vorwärtsdiffusion und Rückwärtsentrauschung. Die Vorwärtsdiffusion beginnt mit realen Daten $x_0$ und fügt kontinuierlich kleine Mengen zufälligen Rauschens hinzu. Mit zunehmendem Zeitschritt $t$ nimmt die Originalinformation im Bild allmählich ab und das Rauschen nimmt zu, nähert sich schließlich dem zufälligen Gaußschen Rauschen. Im klassischen DDPM können rauschbeladene Daten für jeden Zeitschritt direkt aus den Originaldaten $x_0$ konstruiert werden:
x_t
=
\sqrt{\bar{\alpha}_t}x_0
+
\sqrt{1-\bar{\alpha}_t}\epsilon
Wobei:
\epsilon\sim\mathcal{N}(0,I)
,
x_0
die Originaldaten darstellt, $\epsilon$ zufälliges Gaußsches Rauschen darstellt, $\bar{\alpha}_t$ verwendet wird, um das Verhältnis von Originaldaten und Rauschen am aktuellen Zeitschritt zu steuern. Je später der Zeitschritt, desto weniger Originalinformation und desto mehr Rauschen. Verschiedene Zeitschritte entsprechen verschiedenen Rauschpegeln, und wie sich diese Rauschpegel ändern, wird durch die Rauschplanungsstrategie bestimmt.
Die Vorwärtsdiffusion selbst erfordert kein Modelltraining. Während des Trainings können Daten mit verschiedenen Rauschpegeln direkt nach vordefinierten Regeln konstruiert werden. Was das Modell wirklich erlernen muss, ist der umgekehrte Prozess, also wie aus rauschbeladenen Daten allmählich klarere Daten wiederhergestellt werden. Während der Generierung beginnt das Modell mit zufälligem Rauschen und führt in jedem Schritt einen gewissen Grad an Entrauschung durch: zufälliges Rauschen → vorläufige Struktur → Umriss wird allmählich klar → Textur formt sich allmählich → finales Bild. Dieser Mechanismus zerlegt eine komplexe Generierungsaufgabe, die in einem Schritt abgeschlossen würde, in mehrere relativ einfache lokale Korrekturaufgaben. Das Modell muss das vollständige Bild nicht auf einmal vorhersagen; es muss sich kontinuierlich basierend auf dem aktuellen Zustand anpassen, was einer der wichtigen Gründe ist, warum Diffusionsmodelle hochwertige Generierung erreichen können.
Im klassischen DDPM werden zwei entgegengesetzte Prozesse etabliert: Der Vorwärtsdiffusionsprozess fügt kontinuierlich Rauschen zu realen Daten hinzu, während der Rückwärtsgenerierungsprozess erlernt, wie das Rauschen schrittweise entfernt wird, sodass zufälliges Rauschen schließlich zu Bildern mit realen Datenmerkmalen wiederhergestellt wird.
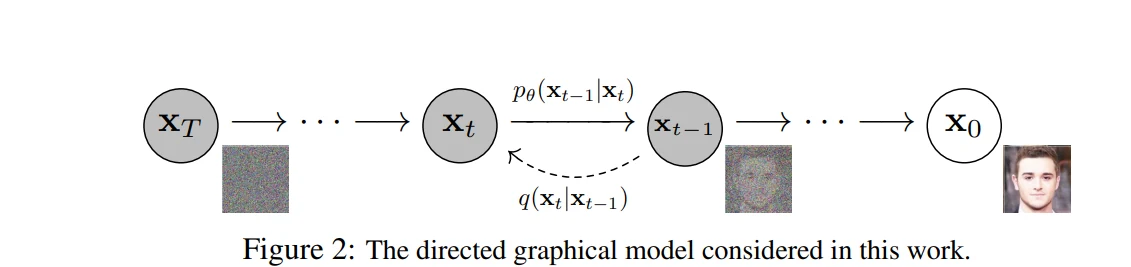
$x_0$ stellt das reale Bild dar. Mit fortschreitender Vorwärtsdiffusion, die kontinuierlich Gaußsches Rauschen hinzufügt, durchlaufen die Daten nacheinander $x_1,x_2,\ldots,x_T$ und nähern sich schließlich $x_T$ dem zufälligen Gaußschen Rauschen an. Die gestrichelte Linie $q(x_t\mid x_{t-1})$ in der Abbildung stellt den Vorwärtsdiffusionsprozess dar, während $p_\theta(x_{t-1}\mid x_t)$ den Rückwärtsgenerierungsprozess darstellt, den das Modell erlernen muss. Der Vorwärtsprozess kann wie folgt verstanden werden: reales Bild x₀ → x₁ → x₂ → …… → xₜ → …… → zufälliges Rauschen xT, während die tatsächliche Bildgenerierung in die entgegengesetzte Richtung verläuft: zufälliges Rauschen xT → …… → xₜ → xₜ₋₁ → …… → finales Bild x₀. Die Schlüsselfrage von DDPM ist, wie das Modell lernt, $x_{t-1}$ mit weniger Rauschen aus dem aktuellen $x_t$ zu erhalten.
In DDPM wird der Rückwärtsprozess durch ein neuronales Netzwerk parametrisiert. Ein wichtiger und häufig verwendeter Ansatz ist es, das neuronale Netzwerk das Rauschen vorhersagen zu lassen, das zu $x_t$ hinzugefügt wurde. Während des Trainings wird mit dem realen Bild $x_0$ begonnen, ein zufälliger Zeitschritt $t$ ausgewählt und Gaußsches Rauschen
\epsilon\sim\mathcal{N}(0,I)
gesampelt. Nach dem Vorwärtsdiffusionsprozession kann das rauschbeladene Bild dem Zeitschritt $t$ direkt konstruiert werden:
x_t
=
\sqrt{\bar{\alpha}_t}x_0
+
\sqrt{1-\bar{\alpha}_t}\epsilon
Anschließend werden das rauschbeladene Bild $x_t$ und der Zeitschritt $t$ in das neuronale Netzwerk eingegeben, und das Modell prognostiziert das Rauschen
\epsilon_\theta(x_t,t)
, wobei $\theta$ die Parameter des neuronalen Netzwerks darstellt. Da das während des Trainings hinzugefügte reale Rauschen $\epsilon$ bekannt ist, kann der Unterschied zwischen dem vom Modell prognostizierten Rauschen und dem realen Rauschen direkt verglichen werden. Der Trainingsprozess von DDPM kann wie folgt verstanden werden: Zuerst werden aktiv verschiedene Rauschpegel zu realen Bildern hinzugefügt, dann wird das Modell trainiert, zu identifizieren, welches Rauschen hinzugefügt wurde. Nach umfangreichem Training kann das Modell Daten mit verschiedenen Zeitschritten und verschiedenen Rauschpegeln verarbeiten und die Rauschprognoseergebnisse verwenden, um den in der Abbildung gezeigten Rückwärtsprozess $p_\theta(x_{t-1}\mid x_t)$ zu konstruieren. In der Generierungsphase werden reale Bilder nicht mehr benötigt; stattdessen beginnt das Modell direkt mit Gaußschem Rauschen und erhält zunächst $x_{T-1}$ mit weniger Rauschen aus $x_T$, dann $x_{T-2}$ aus $x_{T-1}$ und so weiter:
x_T
\rightarrow
x_{T-1}
\rightarrow
x_{T-2}
\rightarrow
\cdots
\rightarrow
x_1
\rightarrow
x_0
.
Mit fortschreitendem Rückwärtsprozess treten die Gesamtstruktur, der Umriss und die Textur des Bildes allmählich aus dem zufälligen Rauschen hervor und ergeben schließlich das vollständige erzeugte Bild. DDPM lässt das Modell das vollständige Bild nicht auf einmal aus dem Rauschen prognostizieren; es erlernt stattdessen Entrauschungsfähigkeiten bei verschiedenen Rauschpegeln und schließt die Generierung schrittweise durch mehrere Rückwärtsiterationen ab. Dieser Ansatz reduziert die Einzelschritt-Generierungsaufgaben und vermeidet das adversariale Training zwischen Generator und Diskriminator in GAN. Mehrstufiges Sampling bedeutet jedoch, dass die Generierung eines Bildes mehrere neuronale Netzwerkinferenzen erfordert, und langsame Inferenzgeschwindigkeit wurde daher zu einer der Hauptbeschränkungen des klassischen DDPM.
DDPM beschreibt die Bildgenerierung als einen schrittweisen Entrauschungsprozess, fügt während des Trainings Rauschen zu realen Daten hinzu und lässt das Modell erlernen, Rauschen vorherzusagen; während der Generierung beginnt es mit zufälligem Rauschen und erhält das Bild schrittweise durch mehrere Rückwärtstrauschungsschritte. Flow Matching verwendet einen anderen Beschreibungsansatz. Es konstruiert einen kontinuierlichen Wahrscheinlichkeitspfad zwischen der Rauschverteilung und der realen Datenverteilung und trainiert das Modell, die Änderungsrichtung entlang dieses Pfads zu erlernen, sodass zufälliges Rauschen entlang der erlernten Richtung allmählich in reale Daten umgewandelt wird.
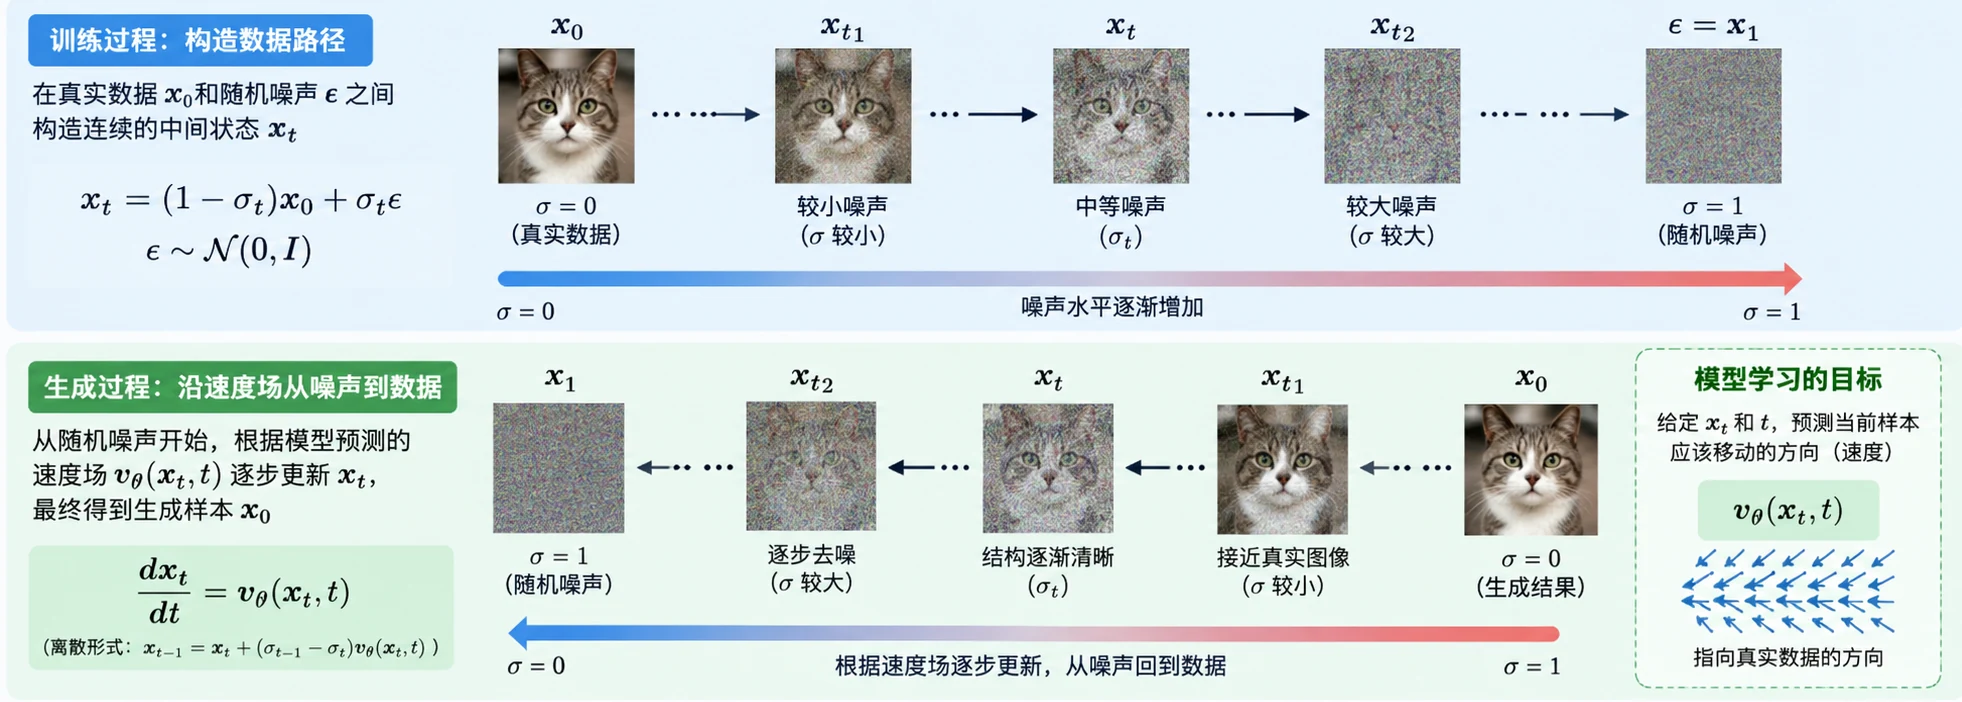
Aus der Implementierungsperspektive umfasst Flow Matching hauptsächlich drei Phasen: Pfadkonstruktion, Geschwindigkeitsfeldlernen und Generierungssampling.
Beim Training wird zunächst eine Stichprobe $x_0$ aus der realen Datenverteilung gesampelt und zufälliges Rauschen $\epsilon$ aus einer Standard-Gaußverteilung gesampelt. Um eine Verbindung zwischen realen Daten und zufälligem Rauschen herzustellen, kann eine Reihe kontinuierlicher Zwischenzustände zwischen ihnen konstruiert werden. Ein relativ intuitiver Ansatz ist die lineare Interpolation:
x_t=(1-\sigma_t)x_0+\sigma_t\epsilon
, wobei $\sigma_t$ das Verhältnis von realen Daten und zufälligem Rauschen im aktuellen Zustand steuert. Zur Vereinfachung der Darstellung setzen wir:
\sigma_0=0,\qquad \sigma_1=1
, wenn $\sigma_t=0$:
x_t=x_0
Dies entspricht realen Daten; wenn $\sigma_t=1$:
x_t=\epsilon
Dies entspricht zufälligem Rauschen.
Mit zunehmendem $\sigma_t$ von 0 bis 1 kann $x_t$ eine Reihe kontinuierlicher Zwischenzustände zwischen realen Daten und zufälligem Rauschen darstellen: reale Daten → leichtes Rauschen → mittleres Rauschen → starkes Rauschen → zufälliges Rauschen. Beim Training können durch zufällige Auswahl verschiedener $t$ Zwischenzustände an verschiedenen Positionen erhalten werden, dem Modell Trainingsstichproben zur Verfügung stellt, um die Änderungsmuster entlang des gesamten Pfads zu erlernen. Im Vergleich zum vordefinierten schrittweisen Rauschzufügungsprozess in DDPM interessiert sich Flow Matching mehr dafür, wie der kontinuierliche Pfad definiert wird, der zwei Verteilungen verbindet, und wie sich die Daten entlang dieses Pfads ändern sollten.
Nach Konstruktion des kontinuierlichen Pfads muss als nächstes die Richtung und Geschwindigkeit der Datenänderungen auf dem Pfad bestimmt werden. Flow Matching verwendet ein neuronales Netzwerk, um ein Geschwindigkeitsfeld (Velocity Field) zu erlernen
v_\theta(x_t,t)
, wobei $x_t$ den aktuellen Zwischenzustand darstellt, $t$ die aktuelle Zeitposition darstellt und $v_\theta(x_t,t)$ die vom Modell prognostizierte Änderungsgeschwindigkeit an der aktuellen Position darstellt. Für den obigen linearen Pfad:
x_t=(1-\sigma_t)x_0+\sigma_t\epsilon
Kann während des Trainings die Zielgeschwindigkeit aus den bekannten realen Daten $x_0$ und dem zufälligen Rauschen $\epsilon$ erhalten werden, und das neuronale Netzwerk kann trainiert werden, die entsprechende Geschwindigkeit basierend auf dem aktuellen Zustand $x_t$ und der Zeit $t$ vorherzusagen. Das Trainingsziel von Flow Matching ist es, das Modell zu trainieren, die Datenänderungsgeschwindigkeit vorherzusagen, die einer Position auf dem Pfad entspricht, wobei der Zwischenzustand $x_t$ und die Zeit $t$ gegeben sind. Nachdem das Modell an einer großen Anzahl von Trainingsstichproben gelernt hat, bilden die Geschwindigkeiten an verschiedenen Positionen gemeinsam ein Geschwindigkeitsfeld. Dieses Geschwindigkeitsfeld beschreibt, wie sich Daten an verschiedenen Positionen im Datenraum ändern sollten, und liefert so die Richtung für die nachfolgende Daten Generierung aus zufälligem Rauschen.
Die Trainingsphase etabliert den Pfad zwischen realen Daten und zufälligem Rauschen und erlernt das Geschwindigkeitsfeld auf dem Pfad. Die Generierungsphase beginnt mit zufälligem Rauschen und verwendet das erlernte Geschwindigkeitsfeld, um sich allmählich in Richtung der realen Datenverteilung zu bewegen. Dieser Prozess kann dargestellt werden als: zufälliges Rauschen → Zwischenzustand → Datenstruktur formt sich allmählich → finale generierte Daten,
x_{t-1}
=
x_t+
(\sigma_{t-1}-\sigma_t)
v_\theta(x_t,t)
Das Modell berechnet die Geschwindigkeit in jedem Zeitschritt basierend auf dem aktuellen Zustand neu und aktualisiert $x_t$. Nach mehreren Iterationen verwandelt sich das anfängliche zufällige Rauschen allmählich in generierte Daten mit vollständiger Struktur und semantischen Informationen.
Aus der Modellierungsperspektive verwenden sowohl DDPM als auch Flow Matching einfache zufällige Verteilungen als Generierungsausgangspunkt, aber ihre Beschreibung des Generierungsprozesses unterscheidet sich. DDPM beschreibt Datenänderungen hauptsächlich durch Vorwärtsdiffusion und Rückwärtstrauschung und erlernt typischerweise Rauschvorhersage; Flow Matching konstruiert einen kontinuierlichen Pfad, der Rauschen und reale Daten verbindet, erlernt das Geschwindigkeitsfeld auf dem Pfad und beginnt dann mit zufälligem Rauschen und erzeugt schrittweise Daten entlang des Geschwindigkeitsfelds.
Text-zu-Bild (Text-to-Image) bezeichnet das automatische Erzeugen entsprechender Bilder aus natürlichsprachlichen Beschreibungen. Im Gegensatz zur gewöhnlichen Bildgenerierung erfordert Text-zu-Bild nicht nur, dass das Modell Bilder mit hoher visueller Qualität erzeugt, sondern auch, dass es das Subjekt, die Attribute, die Menge, die Position, den Stil im Text und die Beziehungen zwischen verschiedenen Objekten korrekt versteht. Im Laufe der Entwicklung von Text-zu-Bild hat sich der technische Fokus auch allmählich von „können Bilder aus Text erzeugt werden?" hin zu „können komplexe Anweisungen genau verstanden und Generierung mit höherer Qualität, höherer Effizienz und stärkerer Steuerbarkeit abgeschlossen werden?" verschoben.
Frühe Text-zu-Bild-Forschung basierte hauptsächlich auf generativen Modellen wie GAN. Die grundlegende Methode bestand darin, Text zunächst in Vektoren zu kodieren, dann Textmerkmale als bedingte Eingabe an den Generator zu verwenden, sodass die Generierungsergebnisse mit Textbeschreibungen übereinstimmen. Dieses Stadium demonstrierte die Machbarkeit von Text-zu-Bild, aber frühe GAN hatte noch deutliche Einschränkungen bei der Generierung komplexer Szenen, dem Textverständnis und der Trainingsstabilität. Insbesondere wenn Prompts mehrere Subjekte, komplexe räumliche Beziehungen oder längere Textbeschreibungen enthielten, hatte das Modell Schwierigkeiten, die gesamte Semantik genau wiederherzustellen. Im Jahr 2021 veröffentlichte OpenAI DALL·E, das einen Transformer-basierten autoregressiven Ansatz zur Verarbeitung von Text- und Bild-Tokens verwendet, wodurch Text-zu-Bild-Modelle deutliche Fortschritte bei komplexen Konzeptkombinationen und Attributkontrolle erzielten und die Entwicklung großer Text-zu-Bild-Modelle vorantrieben. Gleichzeitig begannen Diffusionsmodelle, in den Text-zu-Bild-Bereich einzutreten. GLIDE kombinierte Textbedingungen mit Diffusionsmodellen und untersuchte CLIP Guidance und Classifier-Free Guidance, was zeigte, dass Diffusionsmodelle unter Textkontrolle Bilder mit hoher visueller Qualität erzeugen können. Im Jahr 2022 kombinierte Googles Imagen weiter die Textverständniskapazitäten großer Sprachmodelle mit den Bildgenerierungsfähigkeiten von Diffusionsmodellen. Imagen verwendete vortrainiertes T5 als Textencoder, konvertierte Prompts in semantische Textdarstellungen und gab sie als bedingte Eingabe an das Diffusionsmodell. Studien zeigten, dass die Stärkung der semantischen Verständniskapazität des Textencoders die Übereinstimmung zwischen erzeugten Bildern und Textbeschreibungen weiter verbessern kann. Mit der Entwicklung von Modellen wie DALL·E, GLIDE und Imagen hat sich Text-zu-Bild allmählich zu einem relativ klaren technischen Ablauf entwickelt: Textencoder → semantische Textdarstellung → Diffusionsgenerierungsmodell → schrittweise Entrauschung → erzeugtes Bild; Diffusionsmodelle sind aufgrund ihrer guten Generierungsqualität und Trainingsstabilität allmählich zu einem wichtigen technischen Weg im Text-zu-Bild-Bereich geworden.
Frühe Diffusionsmodelle führten typischerweise mehrere Rauschzufügungen und Entrauschungen direkt im Pixelraum durch. Mit zunehmender Bildauflösung erforderte die direkte Verarbeitung großer Pixelmengen hohe Trainings- und Inferenzkosten. Im Jahr 2022 schlugen Rombach et al. das latente Diffusionsmodell (Latent Diffusion Model, LDM) vor, das den Diffusionsprozession vom Pixelraum in einen komprimierten latenten Raum verlagert (siehe LDM-Einführung in 14.4.3). Die Bedeutung von Stable Diffusion liegt nicht nur in der Verbesserung der Text-zu-Bild-Qualität, sondern auch in der Förderung der Entwicklung eines offenen Gewichts-Text-zu-Bild-Ökosystems. Um seine latente Diffusionsarchitektur herum haben sich allmählich zahlreiche Erweiterungstechnologien gebildet, darunter LoRA, ControlNet, Bild-zu-Bild und lokale Nachbearbeitung, wodurch sich Text-zu-Bild von einem einfachen Bildgenerierungstool zu einem vollständigen visuellen Inhaltserstellungssystem weiterentwickelt hat.
Frühe Diffusionsmodelle verwendeten typischerweise U-Net als Entrauschungsnetzwerk. U-Net konnte dank multi-skaliertem Merkmalsextraktion und Skip-Verbindungen die räumliche Struktur von Bildern relativ gut bewahren und war daher lange als wichtiges Rückgratnetzwerk für Diffusionsmodelle im Einsatz. Mit der kontinuierlichen Erweiterung generativer Modellskala begannen Forscher, Transformer als Ersatz für U-Net zu erkunden, um eine bessere Modellskalierbarkeit zu erreichen. Im Jahr 2022 schlugen Peebles und Xie den Diffusion Transformer (DiT) vor, der Transformer als Ersatz für das in Diffusionsmodellen üblichen U-Net-Rückgratnetzwerk verwendet. Das Modell teilt zunächst die Bildrepräsentation im latenten Raum in mehrere Patches und konvertiert sie in Token-Sequenzen, dann verwendet Transformer, um diese Tokens zu modellieren. Die DiT-Architektur ist unten dargestellt:
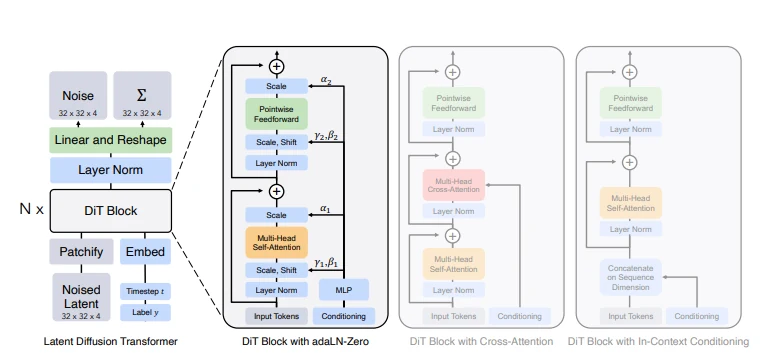
DiT-Forschung zeigte weiter, dass die Modellberechnungs skalala durch Erhöhung der Tiefe, Breite und Anzahl der Eingabe-Tokens von Transformer erweitert werden kann. In den Experimenten des Originalpapers verbesserte sich die Generierungsqualität mit zunehmender Modellberechnungs volumen allgemein weiter, was zeigte, dass die Transformer-Architektur in Diffusionsmodellen eine gute Skalierbarkeit aufweist. Die Bedeutung von DiT liegt nicht nur im Ersetzen von U-Net durch Transformer, sondern wichtiger noch in der Bereitstellung einer neuen Infrastruktur für nachfolgende große Bildgenerierungsmodelle. Seitdem sind Transformer allmählich zu einem wichtigen technischen Weg für Text-zu-Bild-Modelle geworden und haben sich weiter zu multimodalen Transformer-Architekturen entwickelt, die gleichzeitig Text- und Bild-Tokens verarbeiten und damit die Grundlage für neue Generationen von Text-zu-Bild-Modellen wie Stable Diffusion 3 und FLUX.1 gelegt haben.
Mit der allmählichen Entwicklung von Transformern zu einem wichtigen Rückgratnetzwerk für Text-zu-Bild-Modelle entwickelt sich auch der Bildgenerierungsprozess selbst weiter. Das zuvor eingeführte DDPM beschreibt die Datengenerierung hauptsächlich durch „Vorwärts-Rauschzufügen — Erlernen des Rückwärtsprozessions — schrittweise Entrauschung", während Flow Matching den Transformationsprozess von einfachen Verteilungen zu realen Datenverteilungen aus der Perspektive kontinuierlicher Wahrscheinlichkeitspfade und Geschwindigkeitsfelder beschreibt. Im Jahr 2024 kombinierte die mit Stable Diffusion 3 verbundene Forschung weiter Rectified Flow mit Transformern für hochauflösendes Text-zu-Bild. Diese Arbeit schlug eine neue Multimodal Diffusion Transformer (MMDiT)-Architektur vor.
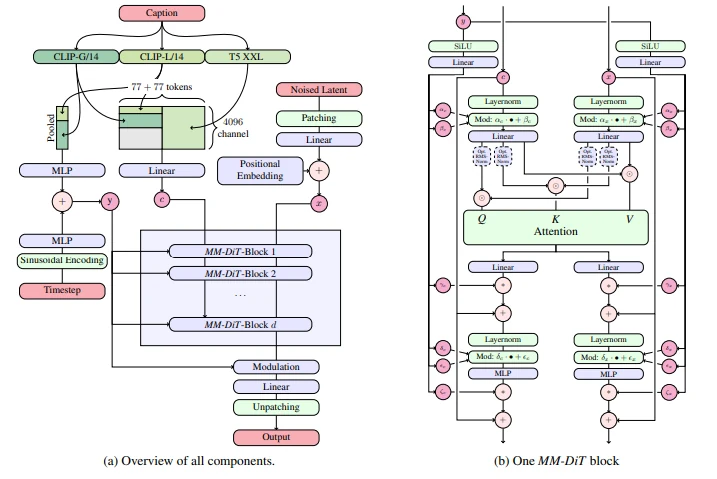
Im Gegensatz zu früheren DiT, die hauptsächlich latente Bild-Tokens verarbeiteten, verarbeitet MMDiT Text- und Bildrepräsentationen unter Verwendung unabhängiger Parameter, während es durch gemeinsame Aufmerksamkeit Informationsaustausch zwischen den beiden Modalitäten ermöglicht und damit die Verständniskapazität des Modells für Textinhalte, Textwiedergabe und komplexe Prompts verbessert. FLUX.1, das im selben Jahr veröffentlicht wurde, setzte den technischen Weg der Kombination von Transformern und Flow Matching fort. FLUX.1-Modellserien verwenden eine Hybridarchitektur, die aus multimodalen Transformer-Blöcken und parallelen Diffusion-Transformer-Blöcken besteht, und werden basierend auf Flow Matching trainiert. Das öffentlich verfügbare FLUX.1-Modell erreicht eine Skala von 12B Parametern und spiegelt weiter den Trend von Transformer-Bildgenerierungsmodellen zur großskaligen Entwicklung wider. Ab diesem Stadium hat sich der technische Fokus von Text-zu-Bild-Modellen nicht mehr nur auf die Verbesserung der visuellen Bildqualität beschränkt, sondern sich allmählich in Richtungen wie komplexes Prompt-Verständnis, Text-in-Bild-Generierung, hochauflösende Generierung, wenigschrittiges Sampling und Bildbearbeitung erweitert. Text und Bild sind auch zunehmend in Token-Form in Transformer eingetreten und erreichen durch Aufmerksamkeitsmechanismen informasionsaustausch zwischen Modalitäten. Diese Veränderung hat auch die Grundlage für effizientere und einheitlichere multimodale Generierungsmodelle gelegt.
Mit der kontinuierlichen Verbesserung von Text-zu-Bild-Modellskala und Generierungsqualität beginnen praktische Modellanwendungen, mit neuen Problemen konfrontiert zu werden. Einerseits erfordern großskalige Generierungsmodelle normalerweise hohe Rechenressourcen und viele Sampling-Schritte; andererseits sind praktische AIGC-Anwendungen nicht mehr auf einzelne Text-zu-Bild-Aufgaben beschränkt, sondern müssen auch Bildverständnis, Bildgenerierung, Bildbearbeitung und Referenzbildgenerierung gleichzeitig unterstützen. Daher sind die Reduktion von Generierungskosten und die Vereinheitlichung multimodaler Fähigkeiten allmählich zu wichtigen Entwicklungsrichtungen für Text-zu-Bild-Modelle geworden.
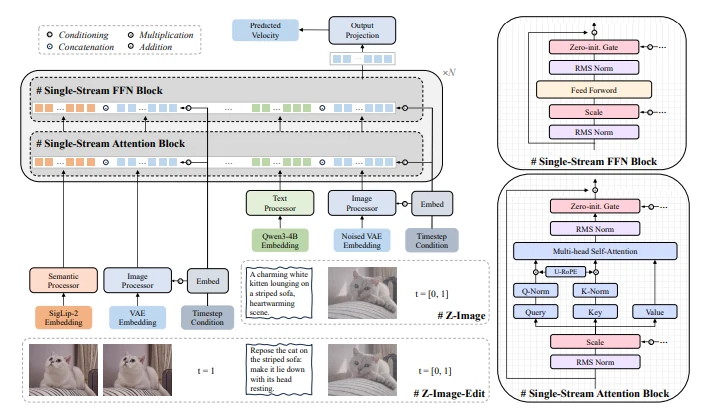
Die Z-Image-Serie verwendet die Scalable Single-Stream Diffusion Transformer (S3-DiT)-Architektur mit einer Modellskala von 6B Parametern. Ein wichtiges Merkmal von S3-DiT ist seine Single-Stream-Architektur, die Text-Tokens, visuelle semantische Tokens und Bild-VAE-Tokens in der Sequenzdimension concateniert und sie dann in einen einheitlichen Transformer zur Verarbeitung eingibt. Im Vergleich zu Dual-Stream-Strukturen, die verschiedene Modalitäten separat verarbeiten, kann dieser Ansatz Informationsaustausch zwischen verschiedenen Informationstypen in einem einheitlichen Datenstrom abschließen. Z-Image-Turbo demonstriert eine wichtige Entwicklungsrichtung moderner Text-zu-Bild-Modelle: Bei Beibehaltung starker Generierungsfähigkeiten werden Inferenzkosten durch Modelldestillation und wenigschrittiges Sampling reduziert, wodurch großskalige Transformer-Bildgenerierungsmodelle für den praktischen Einsatz besser geeignet sind.
SenseNova-U1.5-8B-MoT von Text-zu-Bild hin zu einheitlichem Multimodal, zusätzlich zur Verbesserung der Generierungseffizienz ist ein weiterer wichtiger Richtung die Vereinheitlichung der bisher relativ unabhängigen multimodalen Verständnis- und Generierungsfähigkeiten. SenseNova-U1, das 2026 veröffentlicht wurde, schlug die NEO-unify-Architektur vor und versucht, multimodales Verständnis und Generierung in einem einheitlichen Modell gleichzeitig zu erreichen. Auf dieser Basis hat SenseNova-U1.5-8B-MoT die Bildgenerierungs- und Bearbeitungsfähigkeiten weiter verbessert. Laut offiziellen Veröffentlichungsinformationen wurde die offizielle Version von SenseNova-U1.5-8B-MoT im August 2026 veröffentlicht und verbesserte weiter die Instruction-Following-, Text- und Layout-Generierung, native 4K-Bildgenerierung, Bildbearbeitung und visuelle Steuerungsfähigkeiten.
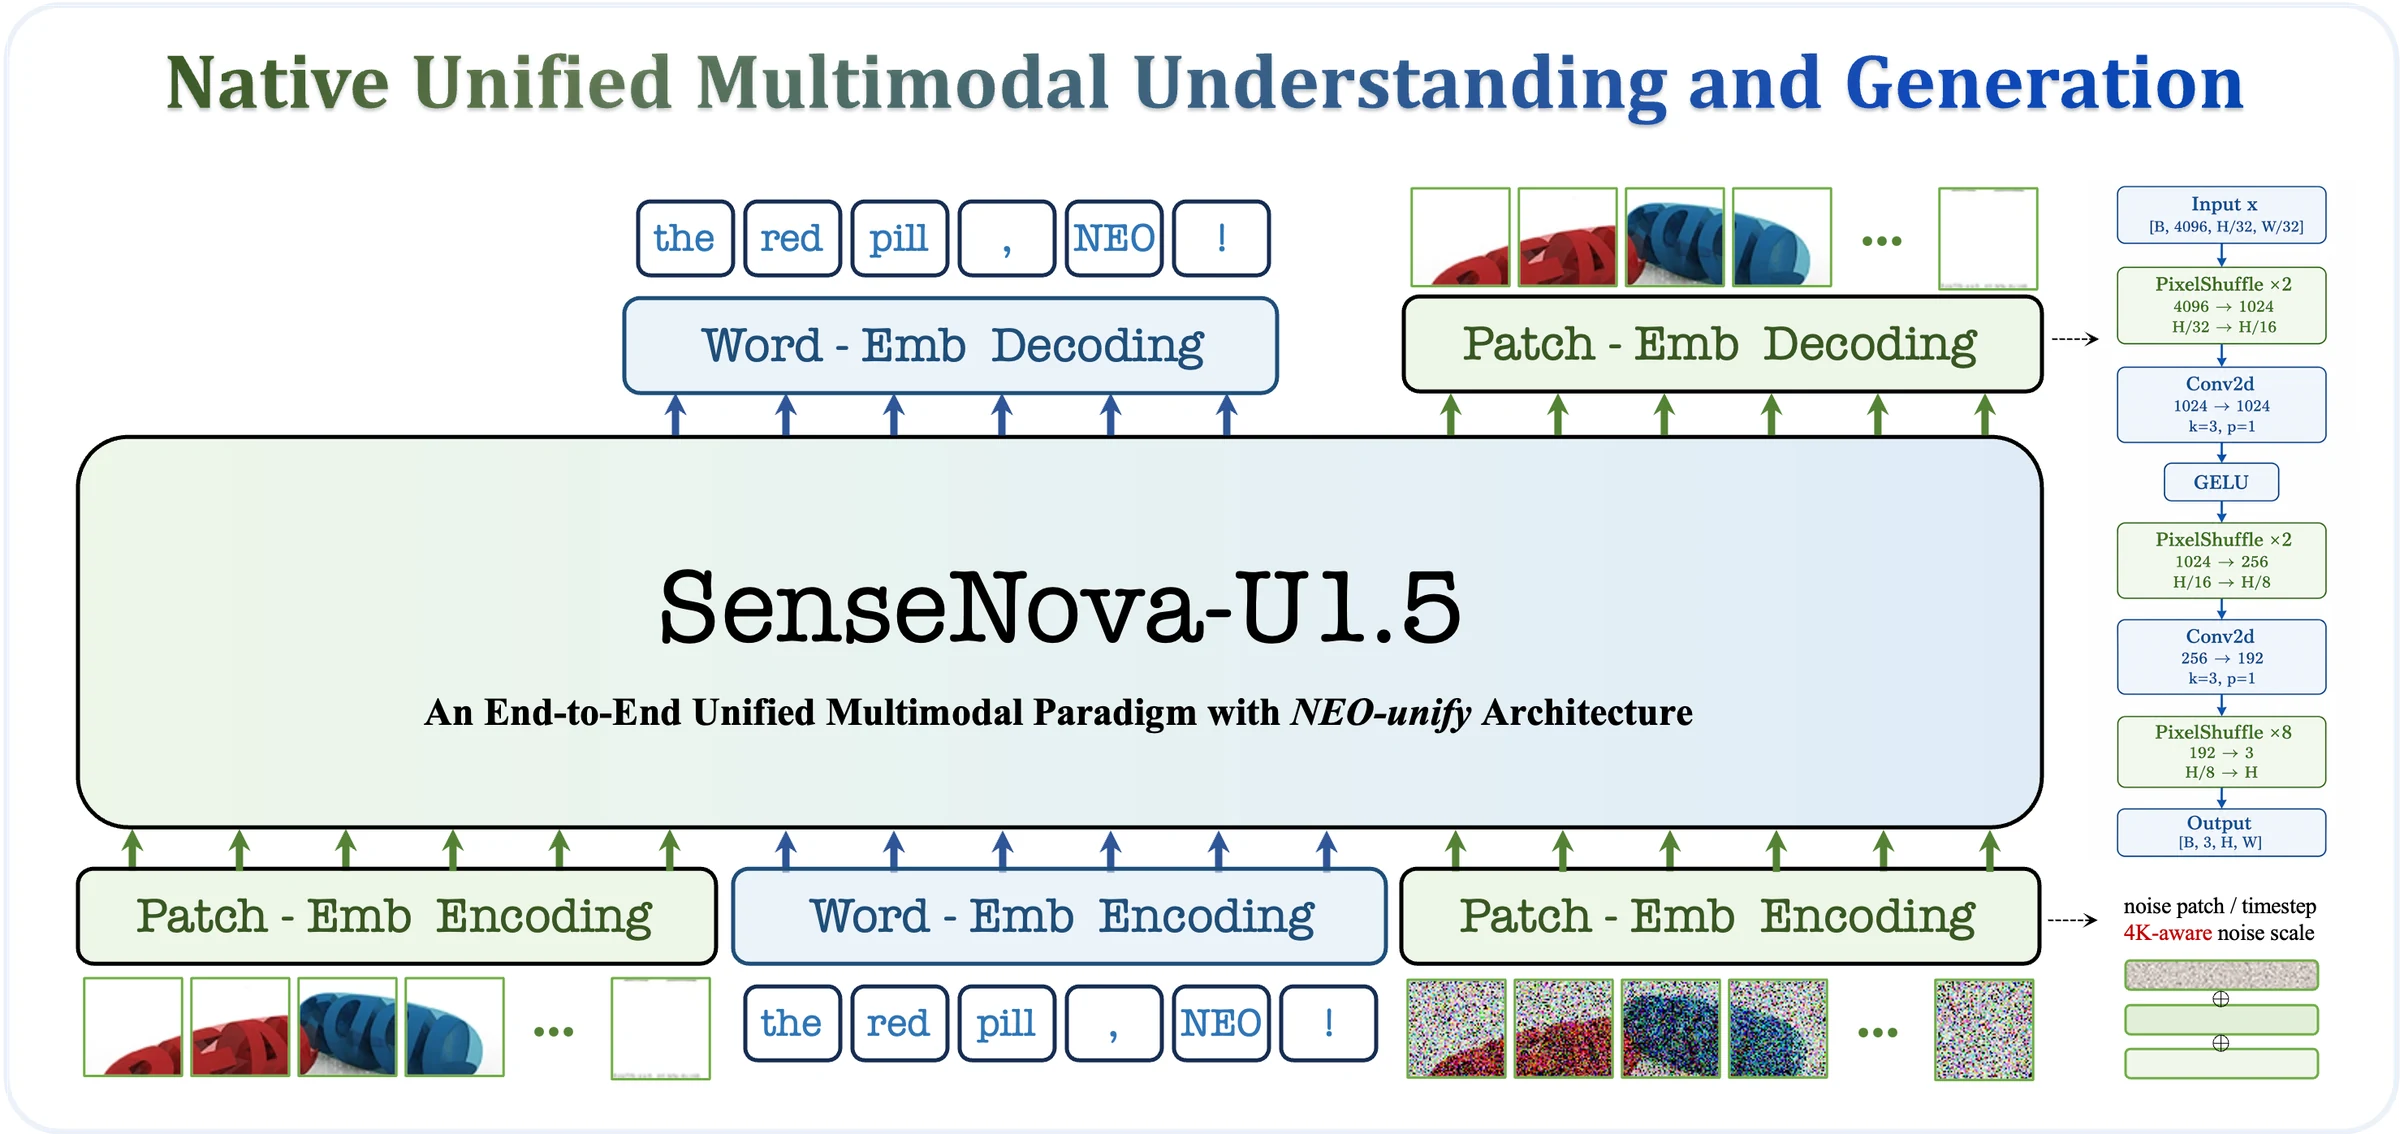
SenseNova-U1.5 basiert auf der NEO-unify einheitlichen multimodalen Architektur und verwendet einen neuen Bild-Patch-Kodierungs- und Dekodierungsmechanismus. Das Modell kann nicht nur Bilder basierend auf Textbeschreibungen erzeugen, sondern auch Eingabebilder mit natürlichsprachlichen Anweisungen kombinieren, um Bild-zu-Bild-, Bildbearbeitungs- und visuelle Steuerungsaufgaben abzuschließen. Dies bedeutet, dass Text-zu-Bild-Modelle sich allmählich von einfachen Inhaltserstellungswerkzeugen zu einheitlichen multimodalen Modellen weiterentwickeln, die Verständnis- und Generierungsaufgaben gleichzeitig bearbeiten können.