10 Anwendungsfälle: Was können Open-Source-Modelle von AIGC erreichen?
Die stärksten Bild- und Videogenerationsmodelle sind wahrscheinlich GPT Images 2.5 und Seedance 2.5, die die Grenzen der Generierung noch weiter verschieben.
Wenn wir sie als erste Liga der Closed-Source-Modelle betrachten, auf welchem Niveau sind dann Open-Source-Modelle heute? Sind sie nur Spielzeuge? Können sie wirklich echte Produktivität liefern?
Dieser Artikel betrachtet direkt, was Experten mit Open-Source-Modellen erreichen, unter Verwendung von Z-Image von Alibaba für Bildgenerierung und MiniMax H3 für Videogenerierung.
Einführung in diese beiden Modelle
Z-Image ist ein 6B-Bildgenerationsmodell unter der Apache 2.0-Lizenz. Das vollständige Z-Image ist ein nicht destilliertes Basismodell, das CFG, negative Prompts und Fine-Tuning unterstützt; die Community verwendet häufiger Z-Image-Turbo, das nur 8 Schritte verwendet und Geschwindigkeit priorisiert.
MiniMax H3 ist ein 33B-Audio-Videogenerationsmodell, das 4 bis 15 Sekunden lange Videos bei 24fps mit Stereoaudio ausgeben kann. Streng genommen ist es ein Open-Weight-Modell mit der MiniMax H3 Community License. Das Open-Source H3-Base kann lokal 768p Audio-Video generieren, aber das offizielle Context-IR-Modul zum Verständnis komplexer Eingaben und der 2K-Regenerations-Pipeline wurden nicht vollständig Open-Source veröffentlicht.
Z-Image: über das bloße Malen hübscher Gesichter hinaus
Viele Bildgenerationsmodelle können heute schöne Gesichter generieren. Ein einziges nachbearbeitetes Gesicht anzusehen ist ehrlich gesagt nicht besonders beeindruckend. Die wirklich schwierigen Aufgaben sind: Ist der Text korrekt geschrieben? Ist die Anzahl richtig? Kann dasselbe Produkt über verschiedene Ansichten hinweg Konsistenz bewahren? Werden komplexe räumliche Beziehungen richtig verstanden?
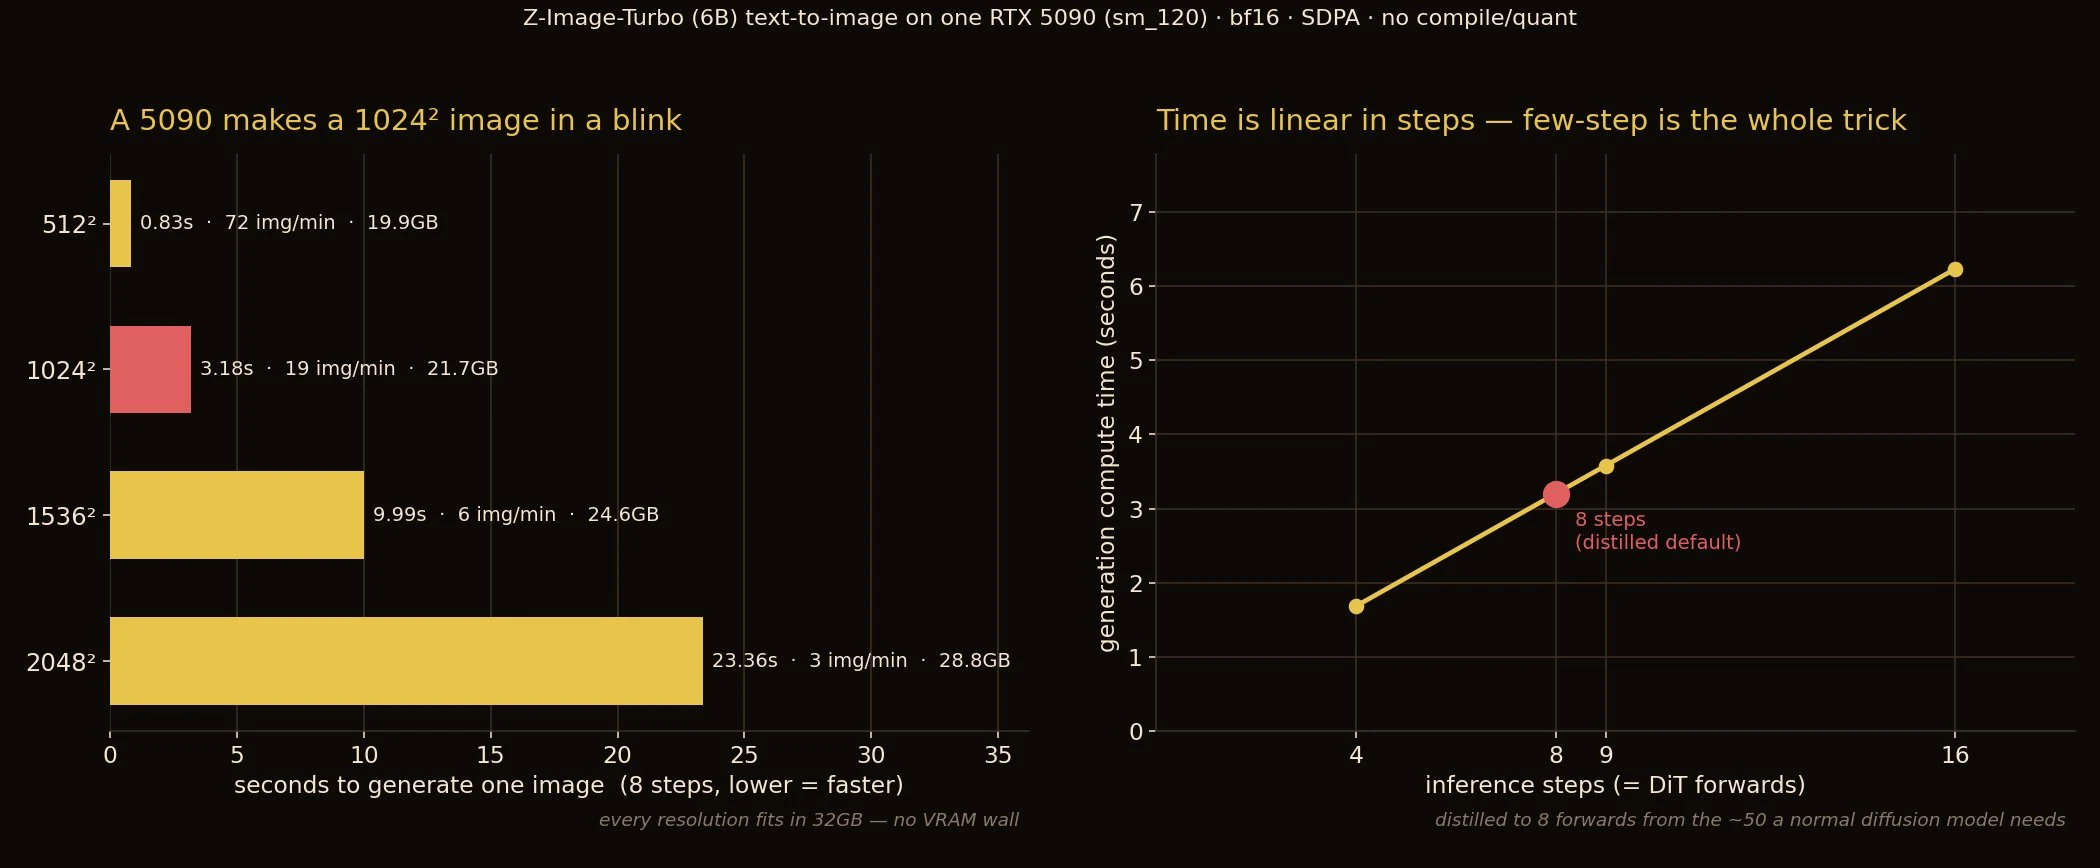
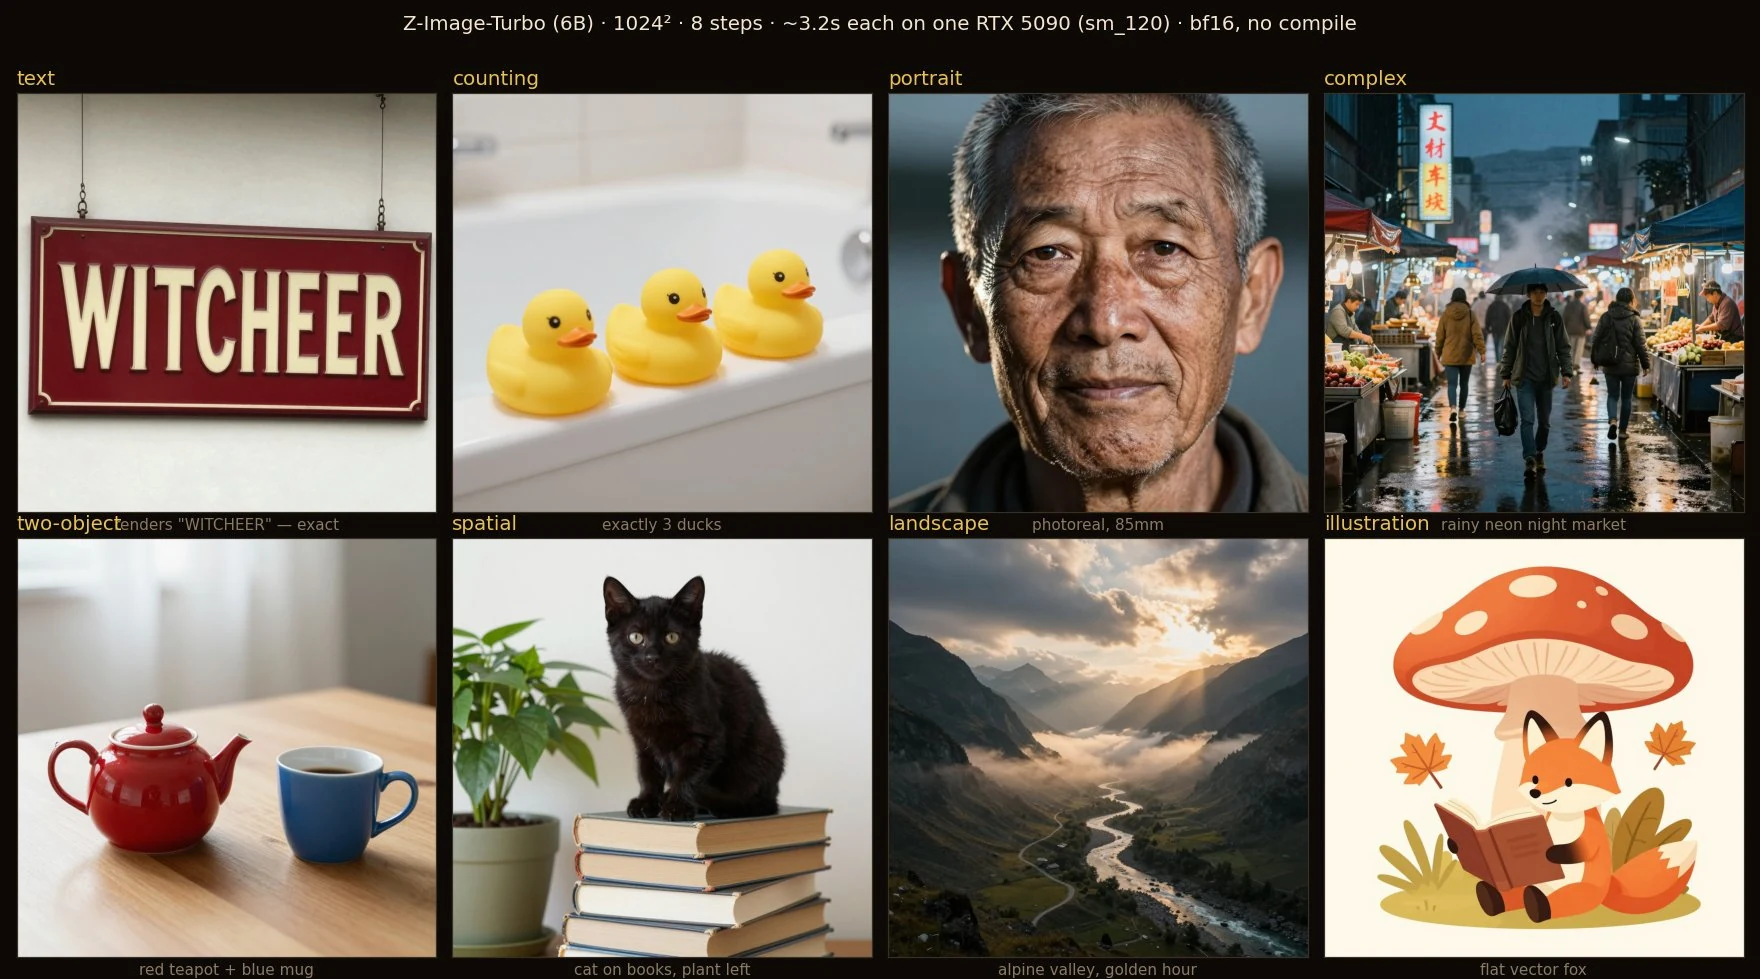
Schauen wir uns zuerst eine Reihe lokaler Tests von @witcheer an.
Er ließ Z-Image-Turbo auf einem RTX 5090 laufen und generierte 1024px-Bilder in etwa 3,2 Sekunden pro Stück. Der Prompt verlangte ein Ladenschild mit angegebenen Wörtern plus "genau drei Enten", und sowohl Text als auch Anzahl stimmten.
Diese beiden Aufgaben wirken einfach, sind aber eigentlich hartnäckige Herausforderungen für Diffusionsmodelle. Buchstaben verschwimmen leicht, und drei Enten werden oft seltsamerweise vier oder fünf.
Als nächstes ein Fall, der näher an der E-Commerce-Lieferung liegt.
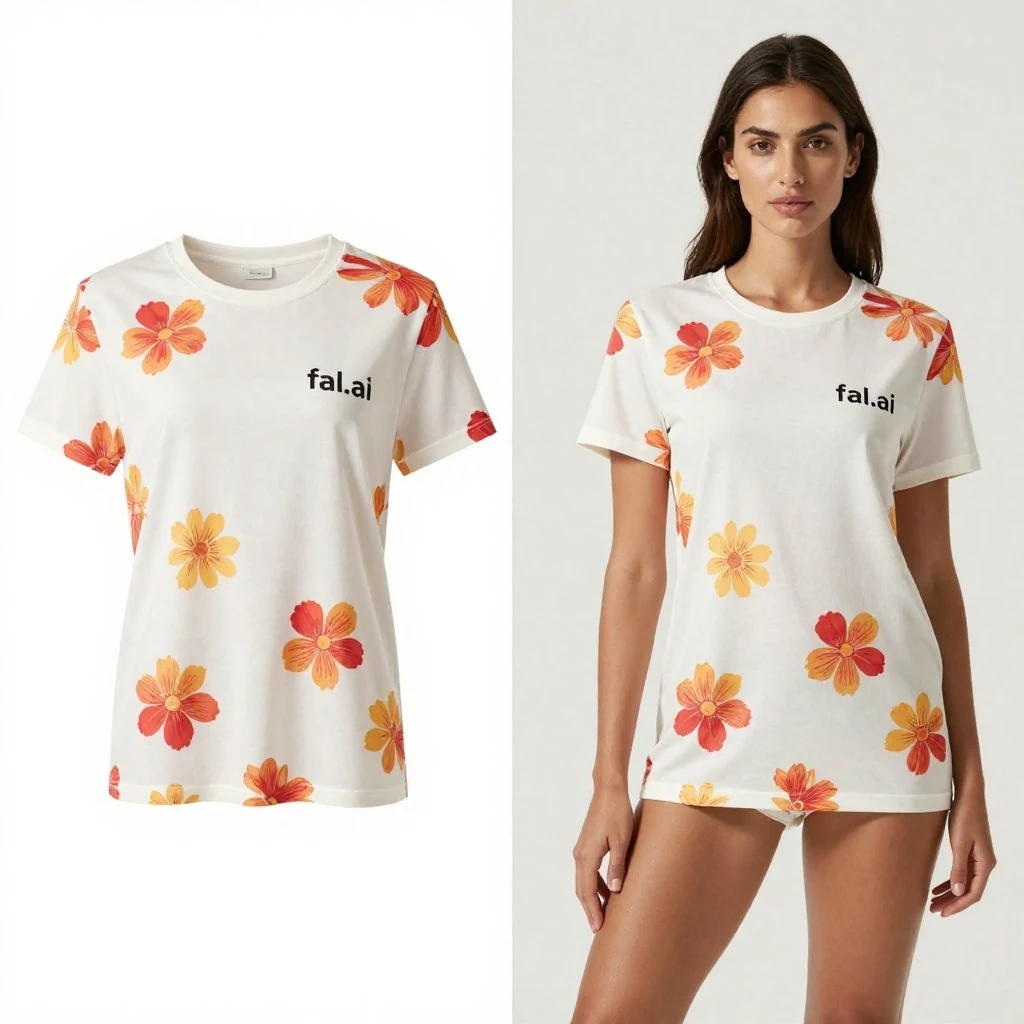
@rizavelioglu ließ das Modell ein nebeneinander geteiltes Bild generieren: links nur ein weißes gemustertes T-Shirt, rechts ein echtes Model im selben Kleidungsstück. Der Prompt verlangte auch, Druck, Text, Stoff, Nähte und Schnitt beizubehalten.
Das Endergebnis zeigte, dass die Kleidung auf beiden Seiten nicht unabhängig generiert wurde — Muster und Stil stimmten gut überein. Für E-Commerce-Teams ist das viel wertvoller als einfach ein "hübsches Model-Foto" zu generieren. Produktbilder, Körperbilder und Marketingbilder können alle vom selben Design weitergearbeiten.
Natürlich ist dies nur eine erfolgreiche Probe, und es gibt noch einen Weg bis zur stabilen Stapelgenerierung. Aber es beweist zumindest, dass die Richtung funktioniert.
Für realistische Porträts hat @dreamydigiarts einen Vergleich mit demselben Prompt erstellt.
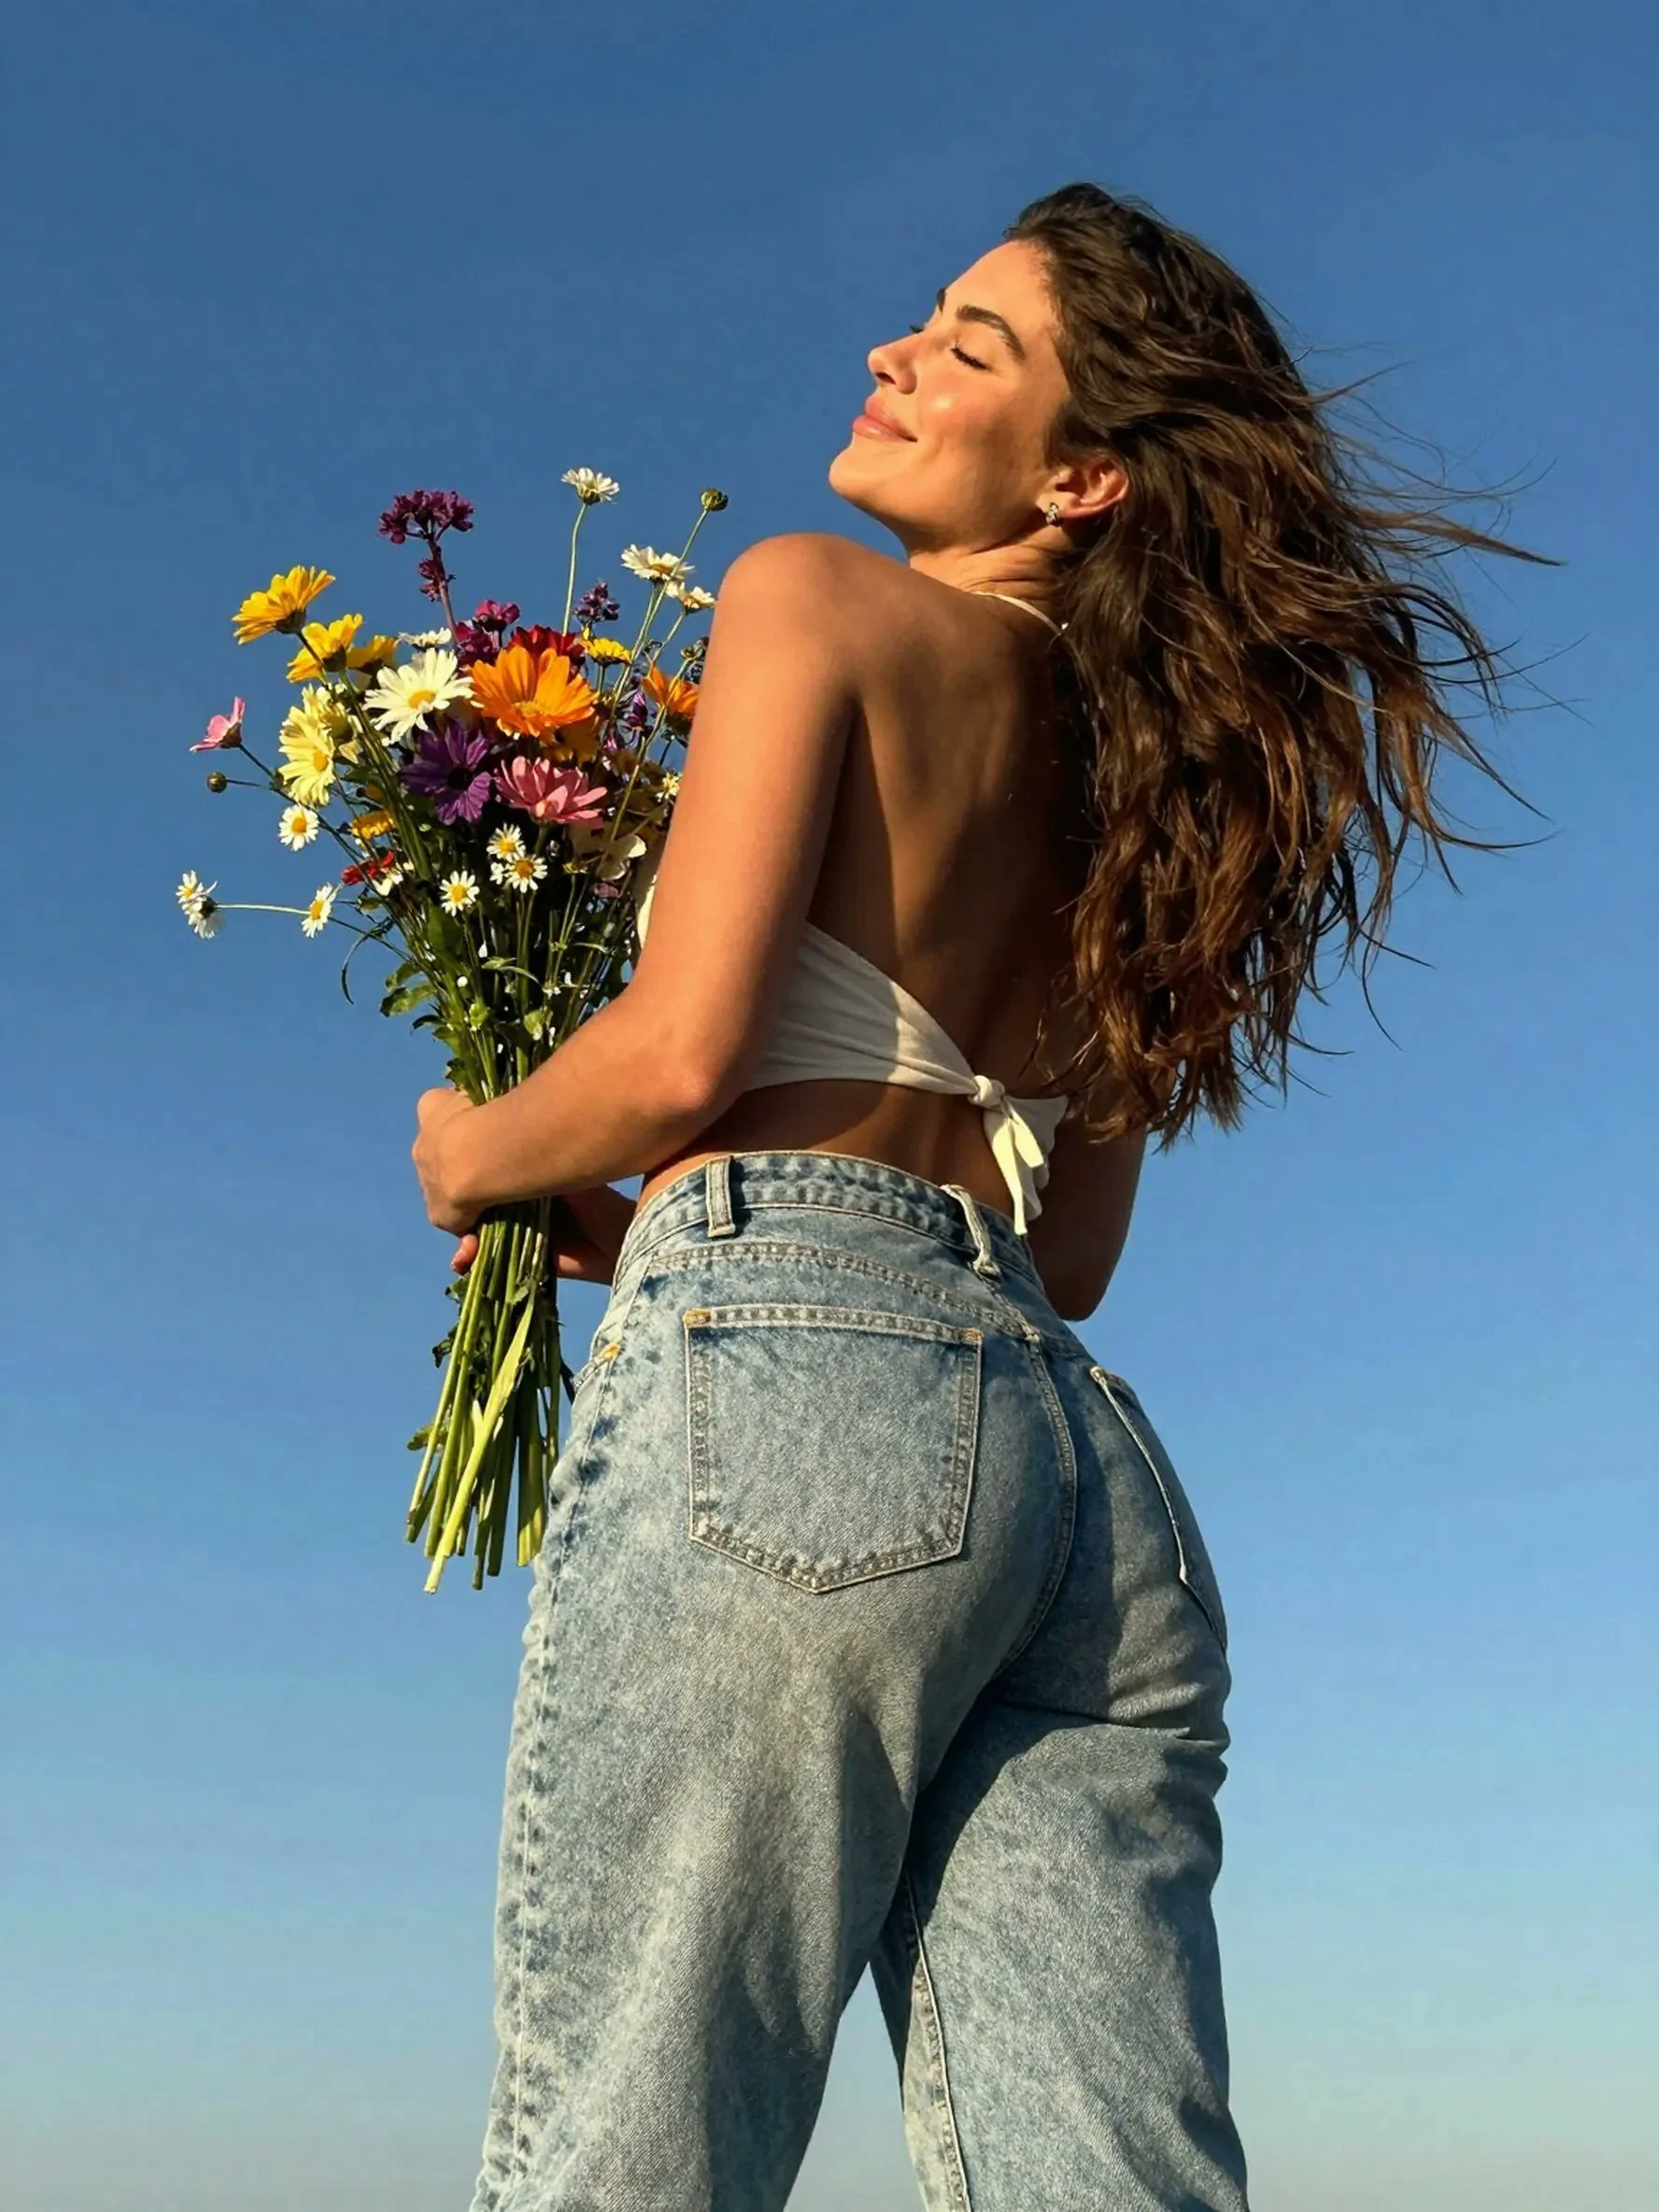
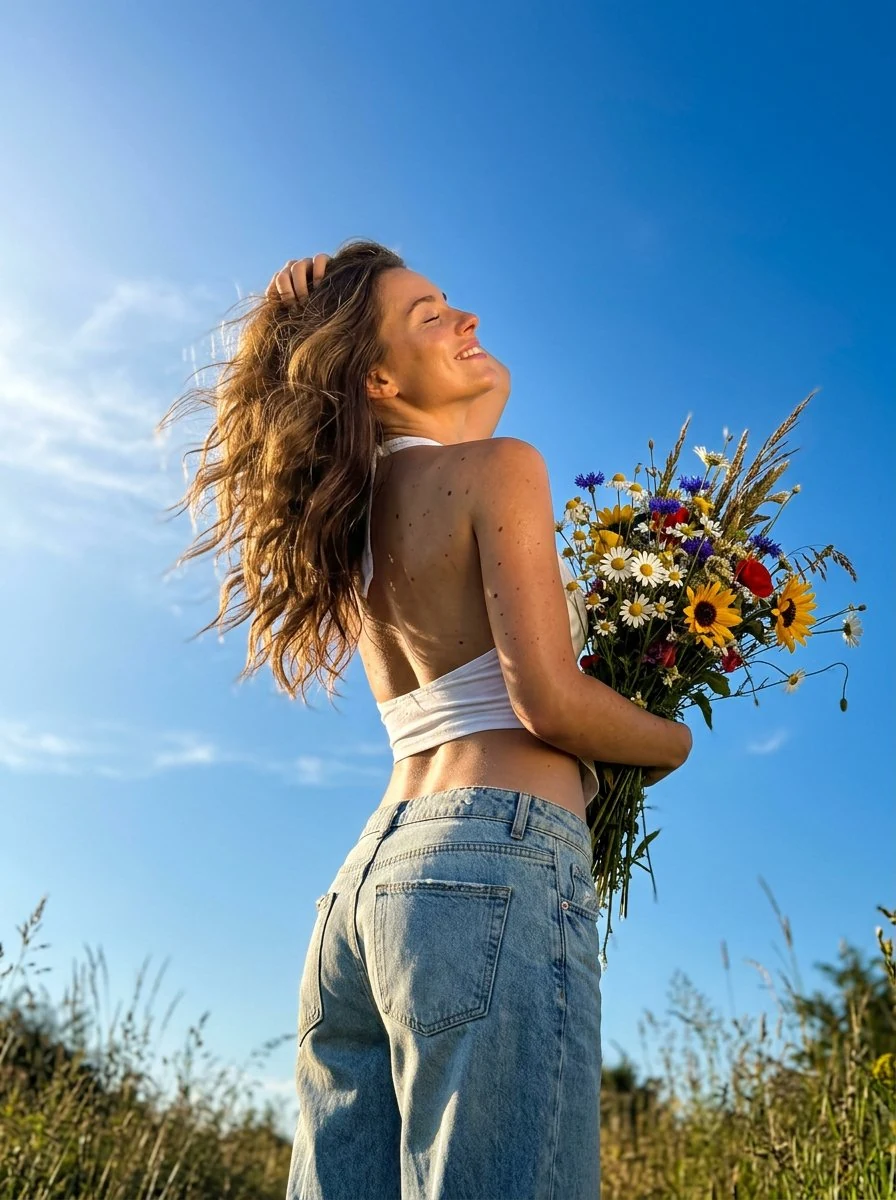
Er ließ Z-Image-Turbo und Nano Banana 2 beide ein Handy-Foto aus niedrigem Winkel generieren: blauer Himmel, Gegenlicht, Person lehnt zurück, hält einen großen Strauß Wildblumen, Haare wehen im Wind, unter Beibehaltung der leichten Körnung von Handyfotos.
Das Z-Image-Ergebnis hatte bereits einen starken Schnappschuss-Charakter. Jeans, Haut und Gegenlicht verschmolzen nicht zu einer plastischen Schicht, und die Komposition mit niedrigem Winkel war solide. Für atmosphärische Charakterbilder und Social-Media-Bilder ist das bereits weit über Spielzeugniveau.
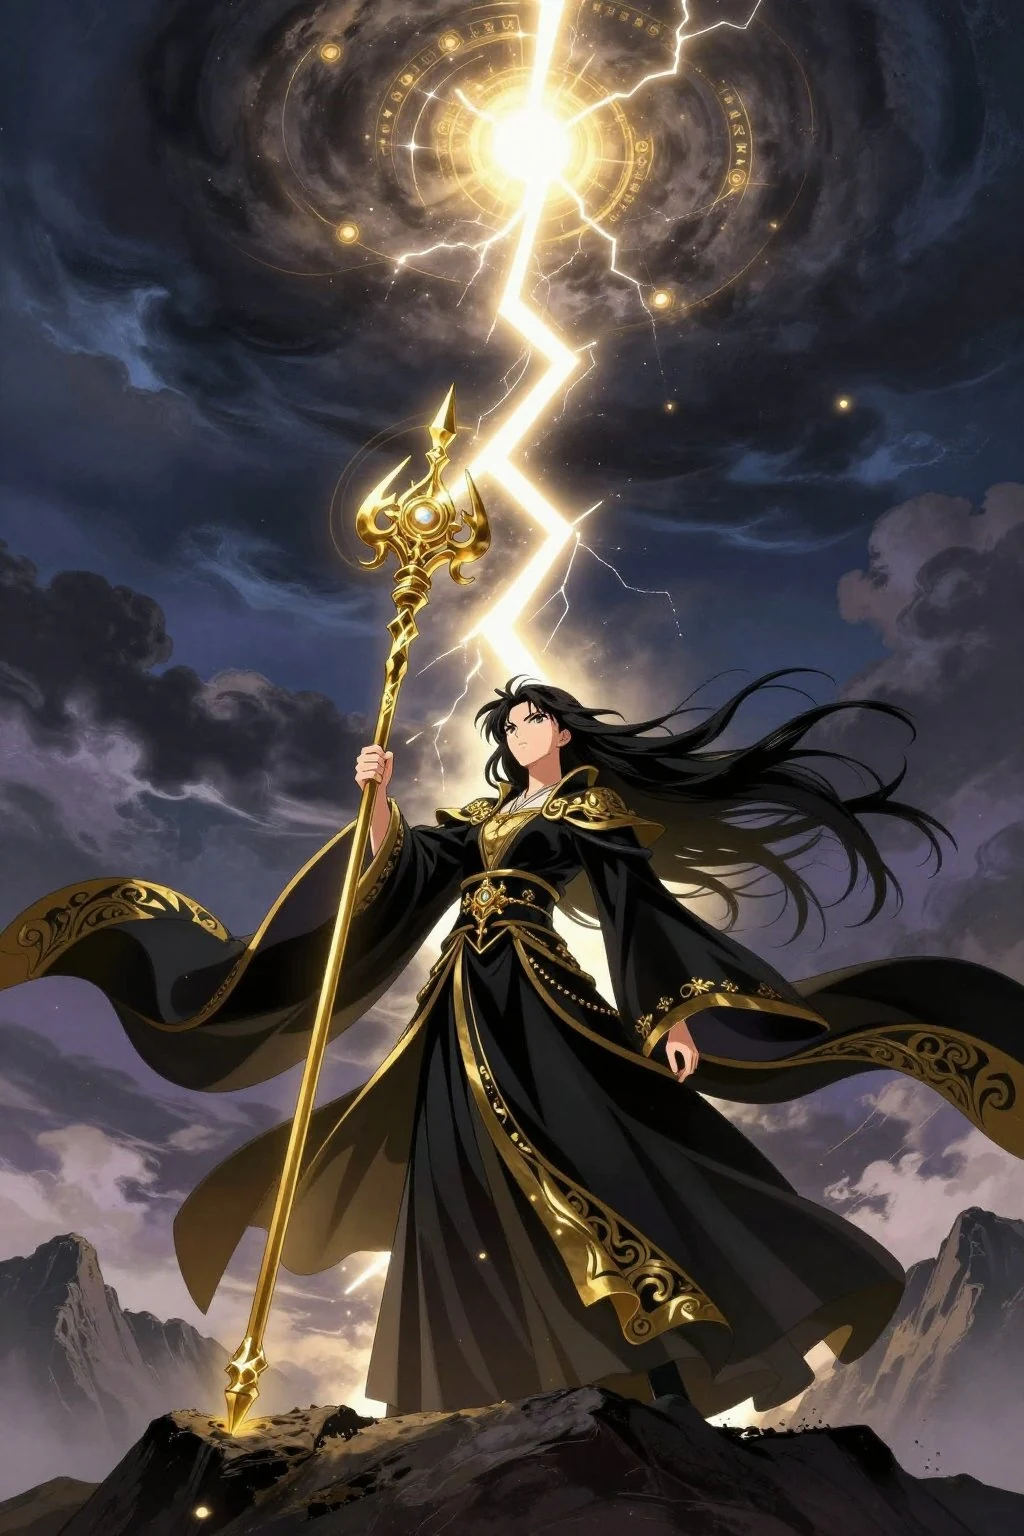
Z-Image beschränkt sich auch nicht auf Realismus. @tisch_eins testete Boogu, Flux 2 Klein und Z-Image-Turbo mit demselben Prompt. Die Szene verlangte eine schwarzhäarige weibliche Zaubererin auf einem stürmischen Berggipfel, mit einem goldenen Stab, der von Hand bis Spitze vollständig sichtbar ist, ein Blitz schießt von der Spitze des Stabes in die Wolken, plus Niedrigwinkel-, Ganzkörperkomposition, Umhang, Runen, elektrische Bögen und starkes goldenes Randlicht.
Diese Art von Prompt ist leicht zu übersehen: Der Stab wird beschnitten, der Blitz verbindet sich am falschen Ort, und das Character könnte nur als großer Kopf enden. Z-Image's Ergebnis hielt alle Hauptbeziehungen zusammen, was auf eine starke Kontrolle über komplexe Illustrationskompositionen hinweist.
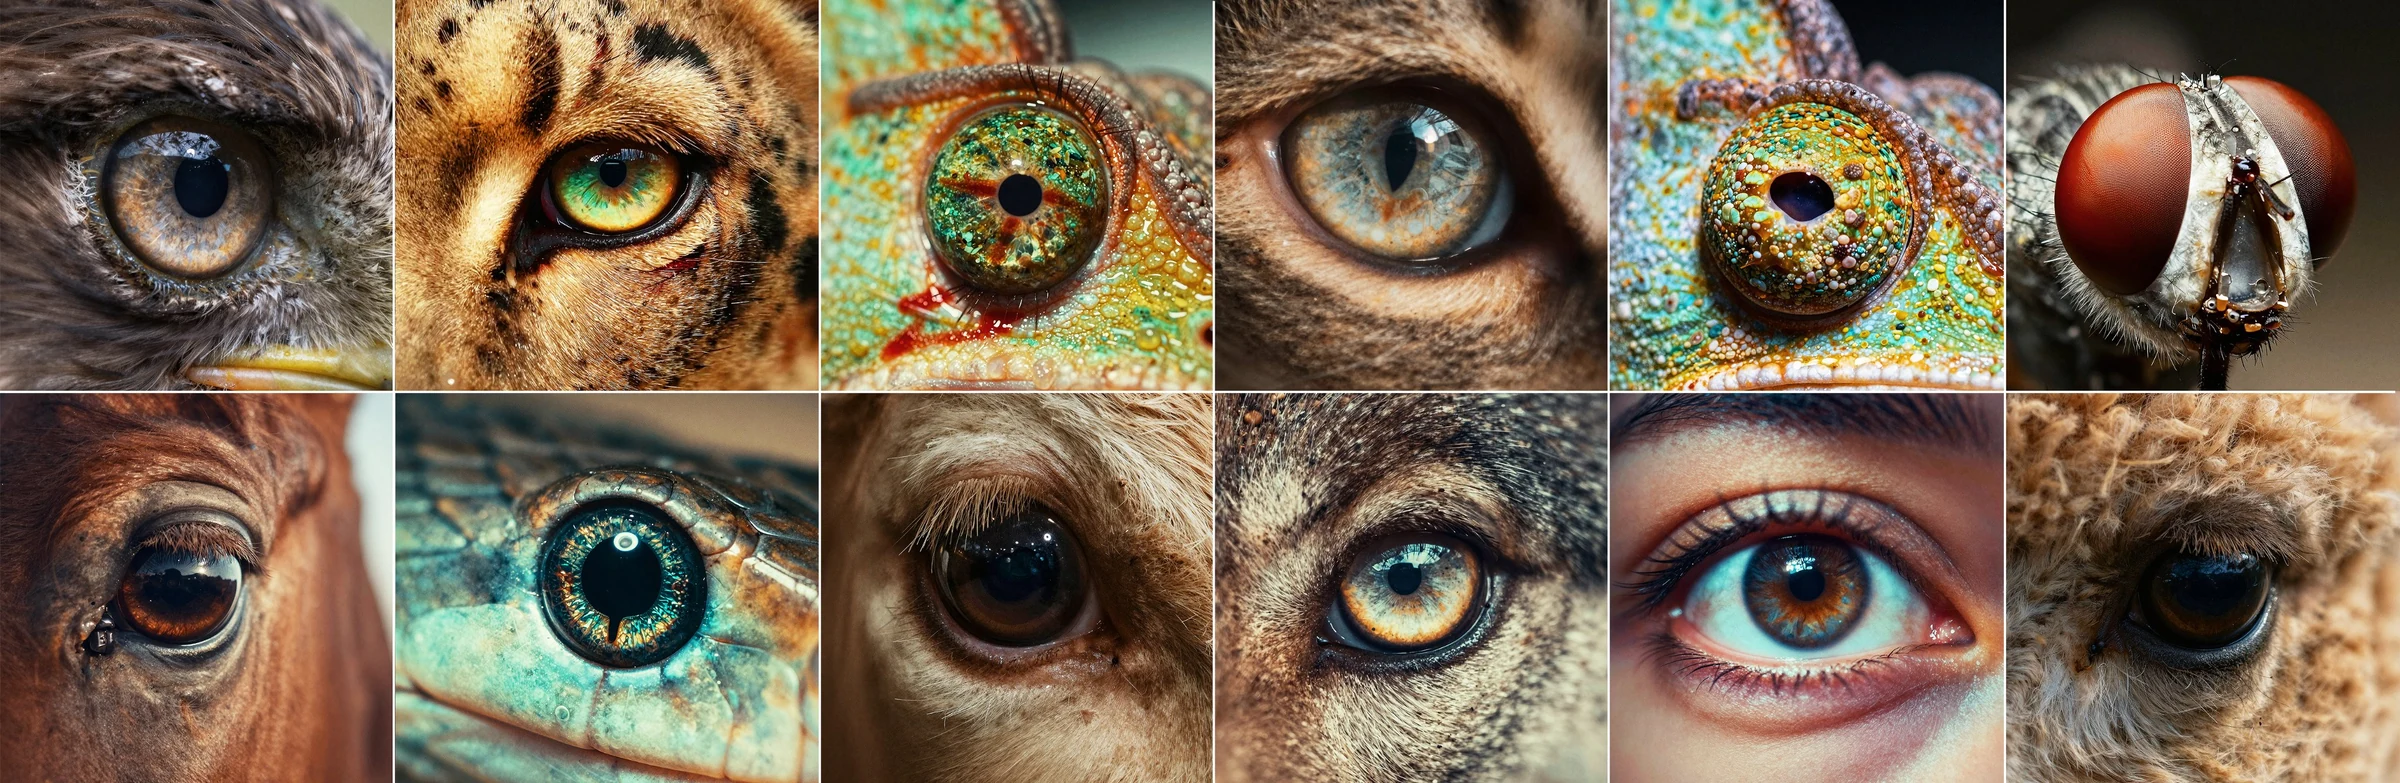
Das letzte ist Extreme-Makro. @aisthetiics Prompt war sehr kurz: Die Pupille eines Tieres füllt den Hauptbildschirm, mit dramatischem Licht von oben links, das die Iris-Textur enthüllt, und ein Hintergrundgradient von dunkel zu hellem Bokeh.
Noch interessanter ist, dass das Bild nicht zusammenbrach. Der Blick ist fest auf die Pupille gerichtet, mit Licht, Schatten und Hintergrund, die alle demselben Objekt dienen. Beim Erstellen von Plakat-Key visuals oder emotionalen Cover ist diese Art von Kompositionsnützlichkeit nützlicher als das Stapeln von zehntausend "8K, Meisterwerk, ultradetailliert"-Schlüsselwörtern.
Wenn man diese 5 Fälle zusammen betrachtet, sind Z-Image's Vorteile ziemlich klar:
Das Modell ist klein, schnell, fähig im Realismus und kann relativ lange Naturalsprach-Prompts verstehen. Das vollständige Basismodell kann auch für LoRA, ControlNet und branchenspezifisches Fine-Tuning verwendet werden.
MiniMax H3: Open-Source-Video beginnt sich cineastisch anzufühlen
Videogenerierung ist viel schwieriger als Bildgenerierung. Ein einziger falsch gezeichneter Finger in einem Bild kann manchmal zugeschnitten werden. Aber im Video: Wenn sich das Gesicht der Figur über 15 Sekunden ändert, die Kamera nicht der Zeitleste folgt, Dialoge zwischen Figuren vermischt werden, oder Soundeffekte nicht zu Aktionen passen — jeder Fehler verdirbt das gesamte Stück.
In H3's Fällen ist das Erste, was sich lohnt zu betrachten, die Zwei-Figuren-Konsistenz.
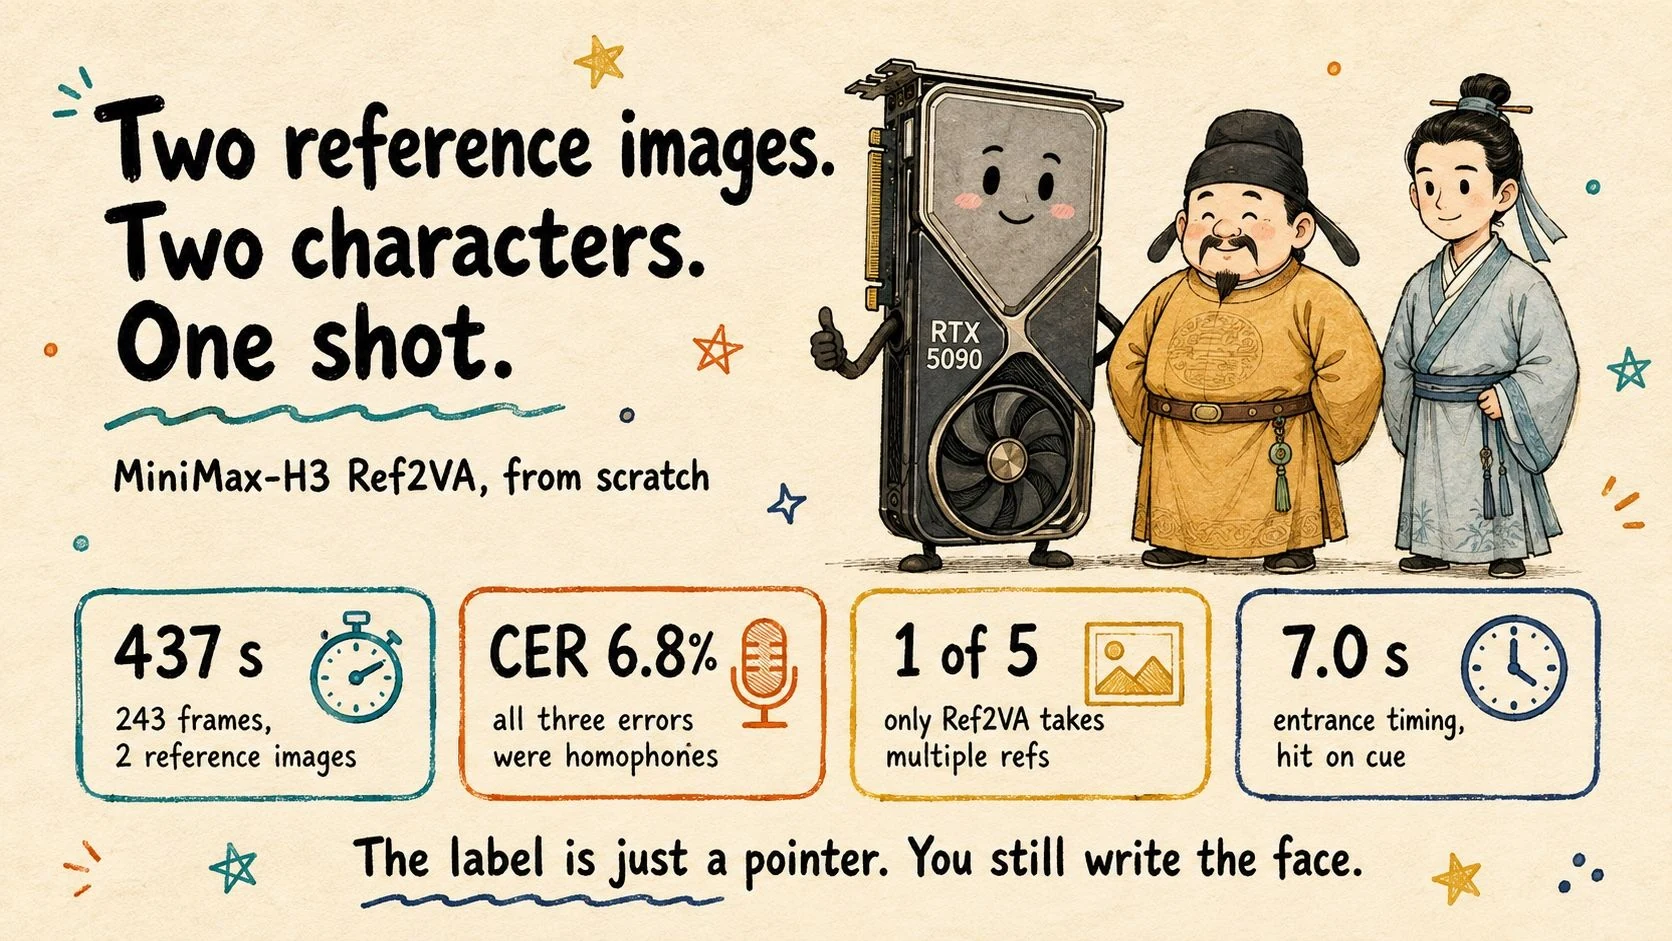
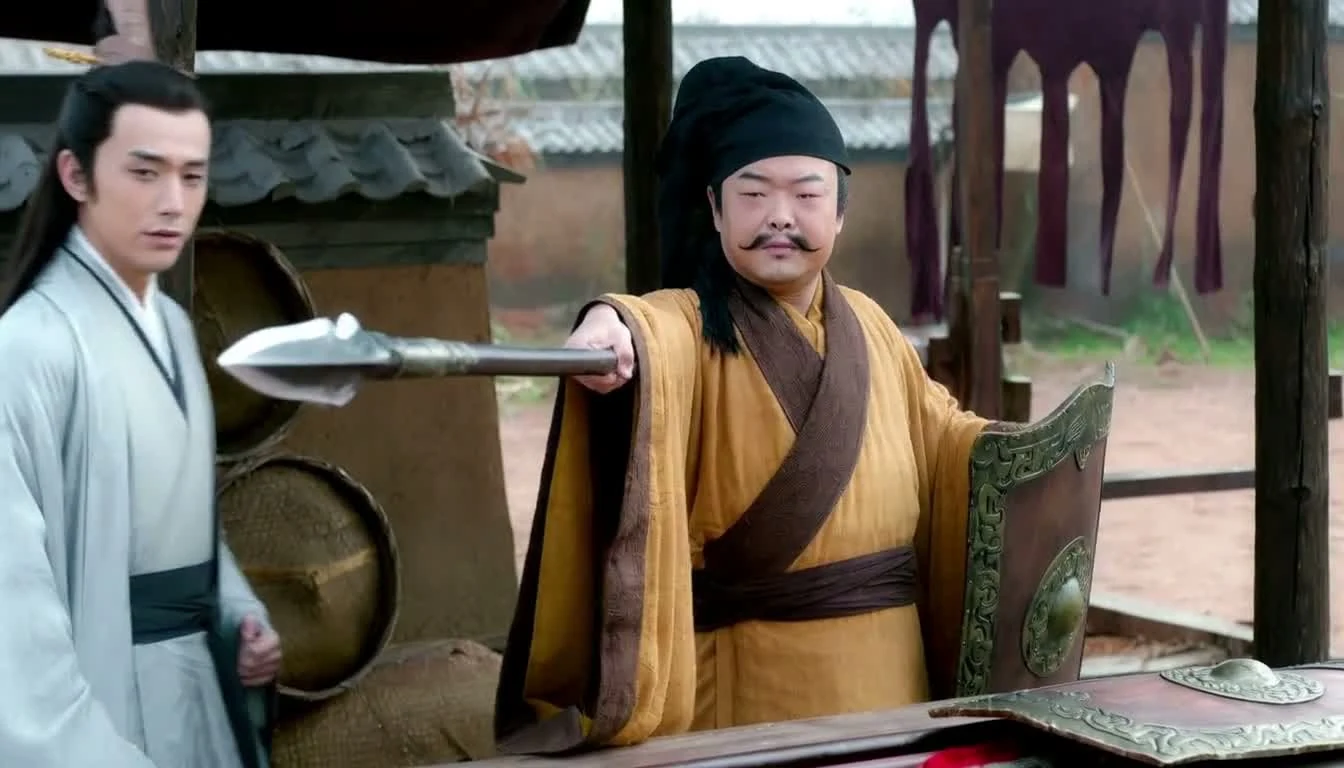
@coolthor speiste zwei von Z-Image generierte Charakterdesign-Bilder in H3's Ref2VA-Modus ein. Einer trägt eine ockerfarbene Robe, der andere blau-graue Kleidung, mit absichtlich unterschiedlichen Aussehen. Der Prompt plante den Eintritt einer Figur zwischen Sekunde 6 und 8 und enthielt drei Zeilen chinesischen Dialog.
Im 10,125-Sekunden-Video tauschten die beiden Figuren weder Gesichter noch Kleidung. Die Figur, die eintreten sollte, erschien nicht in der ersten Hälfte und kam erst um die 7-Sekunden-Marke. Der Autor nutzte dann ASR zur Überprüfung von 44 chinesischen Zeichen und erreichte eine Fehlerrate von 6,8%, wobei die Fehler Homophone waren.
Dies wurde auf einem einzelnen RTX 5090 ausgeführt und benötigte 437 Sekunden für 243 Frames. Die Geschwindigkeit ist nicht extrem schnell, aber Figuren, Zeitablauf und Dialog gleichzeitig steuern zu können, ist bereits sehr beeindruckend.
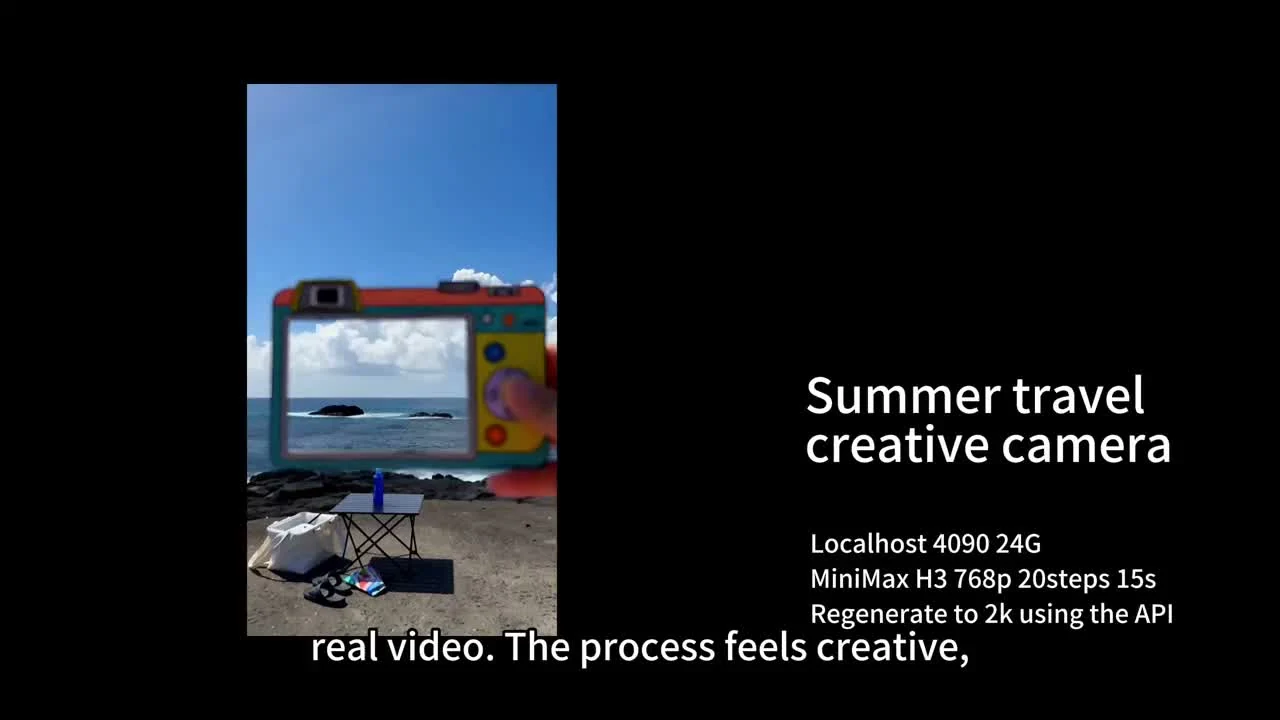
Mit einem RTX 4090 und ComfyUI machte er drei Versuche: einen vierszenen Reise-Kurzfilm, ein Musikvideo, das mit Trommelschlägen die Szenen wechselt, und eine Küstengeschichte mit 4 Aufnahmen und Ambient-Sound. Die anfängliche Idee wurde zuerst an MiniMax's offielles Prompt Writing Skill geschickt, um strukturierte Prompts mit Einstellungen, Zeitablauf, Aktionen und Geräuschen zu erstellen, dann an H3 weitergegeben.
Der nützlichste Aspekt dieses Falls ist, dass er nicht einfach "hübsche Bilder" machte. Wenn der Trommelschlag kommt, wechselt die Szene tatsächlich; im Küstenclip kamen die vier Einstellungen, Atmosphäre und Hintergrundgeräusche alle zusammen in einem Durchgang.
Seine Benchmark-Daten: 4090 benötigt über 200 Sekunden für ein 15-Sekunden-Video in niedriger Auflösung mit 20 Schritten; Hochskalieren auf 768p dauert über 1000 Sekunden. Open Source erlaubt wiederholtes Iterieren, aber kostenlos bedeutet nicht kostenfrei — Strom, VRAM und Wartezeit sind ebenfalls Kosten.
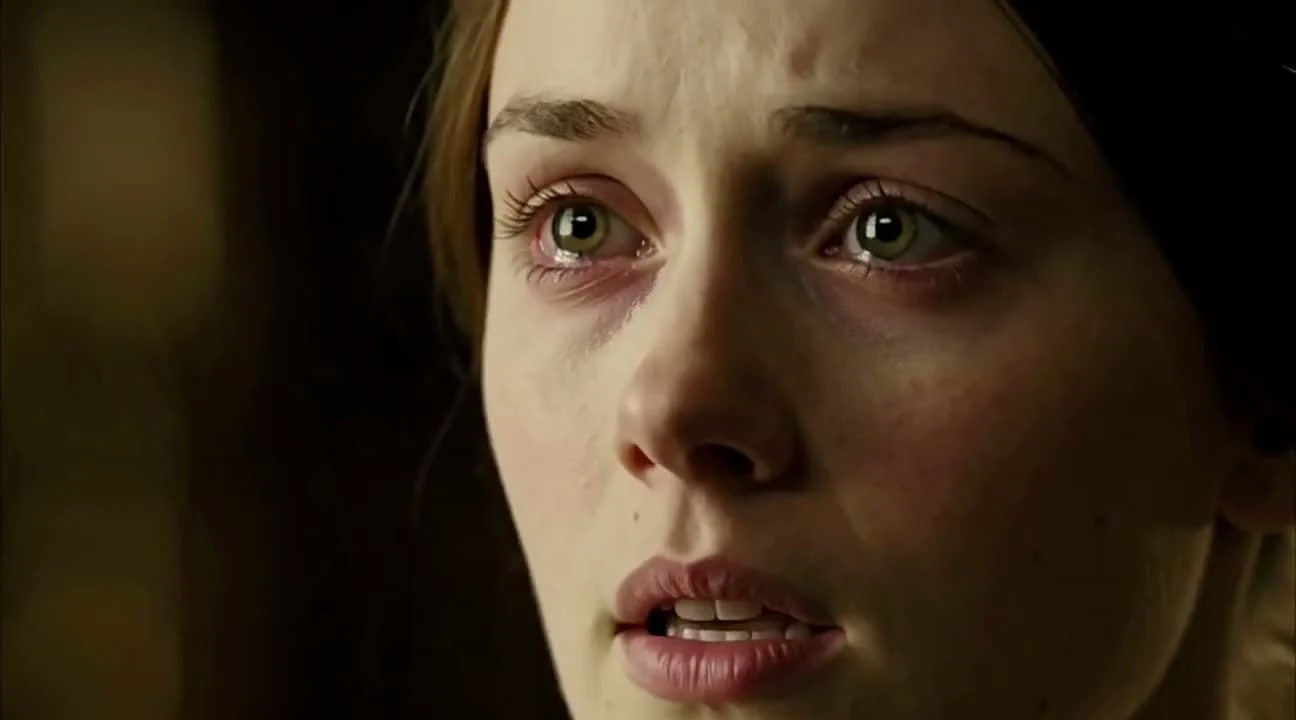
@PixelAigcs 30-Sekunden-"Jane Eyre"-Artiger Britisches Herrenhaus-Segment ist noch beeindruckender.
Sein Prompt teilte die 30 Sekunden direkt in 4 Aufnahmen. Jedes Segment spezifizierte Brennweite, Kamerawinkel, Figurenpositionierung, Mikroexpressionen, Dialoge, Atmung, Umgebungsgeräusche und verbotene Elemente. Figurenemotionen progressierten von zögerlich über Gegenargumentation bis zu berührt, mit separaten Stimmrestriktionen für männliche und weibliche Stimme.
Dieses Stück verwendete lokalen ComfyUI mit H3 Turbo LoRA, erzeugte zuerst 480p und skalierte dann mit Topaz auf 1080p hoch. Der Autor berichtete, dass 25 Sekunden etwa 13 bis 15 Minuten benötigen. Dies repräsentiert nicht die rohe Leistung des offiziellen Modells, aber es repräsentiert den interessantesten Aspekt des Open-Source-Ökosystems: Einen Monat nach der Modellveröffentlichung modifiziert die Community bereits die Geschwindigkeit, erstellt lange Videos und integriert automatische Super-Auflösung.
H3's offizielle Einzel-Segment-Obergrenze ist 15 Sekunden. Wie macht man dann längere Videos?
@superalesha nutzte 4 RTX 3090 für einen 30-Sekunden-Erstperson-Aktionsfilm. Er verknüpfte zwei 15-Sekunden-Segmente, hielt das erste absichtlich auf einem stabilen Bild an, setzte die Generierung vom selben Bild im zweiten Segment fort, schnitt die doppelten Bilder heraus und ließ den Audio weiterlaufen.
Die Naht ist bei Sekunde 15 verborgen und beim normalen Ansehen kaum zu entdecken. Das gesamte Stück dauerte 44 Minuten von der Generierung bis zur Fertigstellung. Der Wert dieses Falls liegt nicht darin, dass H3 plötzlich die Zeitschränke durchbrach, sondern dass jemand die Grenze verstand und mit einem Workflow umging.
Es gibt auch einen Fall, der besonders nützlich ist, um zu studieren, "wie man tatsächlich Video-Prompts schreibt".
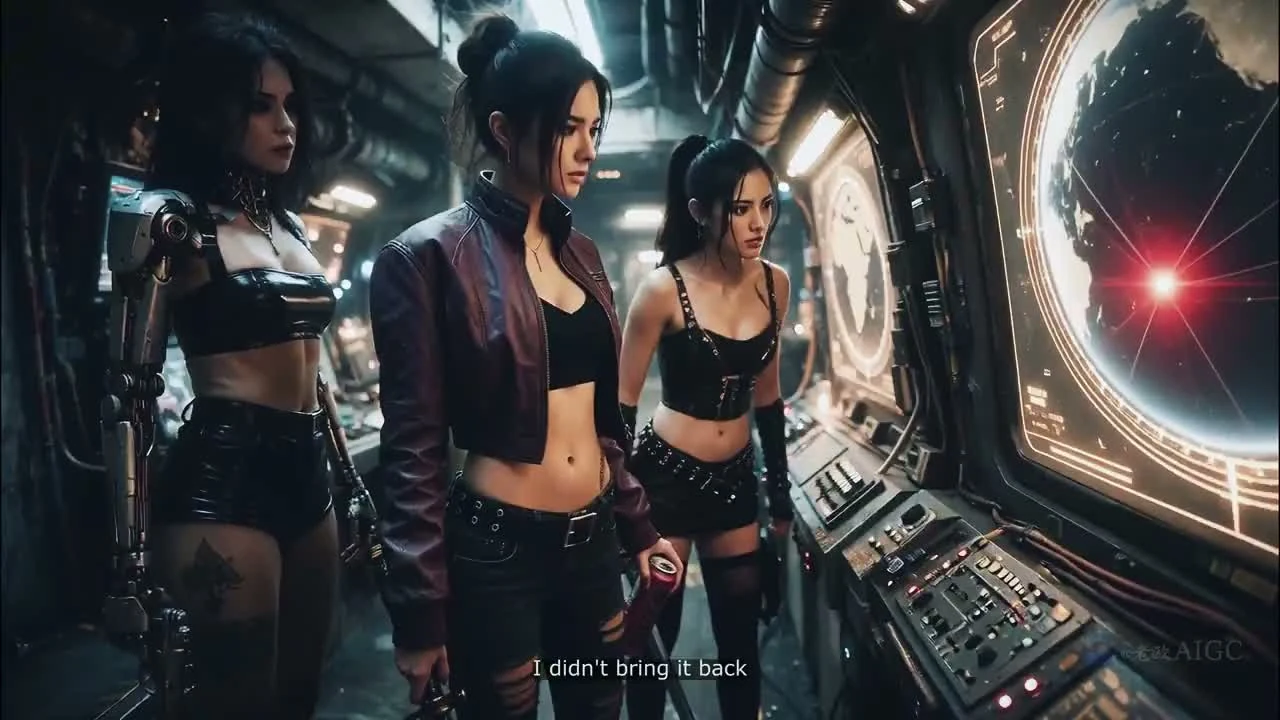
@ou_zhen599 nutzte lokalen ComfyUI für einen 15-Sekunden-Cyber-Raumschiff-Kurzfilm. Die Szene zeigt drei weibliche Figuren: eine links sitzend, eine in der Mitte stehend mit einem Messer, und eine vorne rechts stehend mit einer Coladosendose. Der Prompt beschrieb nicht nur die Handlung — er spezifizierte, wer in welcher Sekunde spricht, dass stumme Figuren die Lippen nicht bewehen dürfen, dass die Coladosendose die ganze Zeit in der rechten Hand bleiben muss, wann der rote Tracking-Punkt auf dem Bildschirm erscheint, und schließlich wann der Schatten außerhalb des Bullauges hereinkommt.
Der schwierigste Teil dieser Art von Fall ist, den Raum stabil zu halten, Requisiten nicht zu verlieren, Dialoge nicht zu vermischen und stumme Figuren wirklich schweigen zu lassen. H3 schaffte es bereits, all diese Beschränkungen in einen 15-Sekunden-Kurzfilm zu packen. Das Spiel beim Open-Source-Video hat sich eindeutig verändert.
Wenn du einfach schnell ein fertiges Video produzieren willst, sind Closed-Source-Modelle immer noch die einfachste Option.
Aber wenn du wiederholt iterieren, stapelgenerieren, deinen eigenen Stil trainieren oder Fähigkeiten in einen lokalen Workflow integrieren willst, sind Z-Image und H3 eine ernsthafte Untersuchung wert. Nutze Open-Source-Modelle, um schnell Aufnahmen und Material zu prototypen, und rufe Closed-Source-Modelle nur an, wenn du wirklich feststeckst — die Kosten werden viel niedriger sein.
Open-Source-Modelle fühlten sich früher wie ein Trostpflaster für Wartende an. Jetzt können sie tatsächlich an echter kreativer Arbeit teilnehmen.
Für Menschen, die täglich Bilder und Videos erstellen müssen, ist die beste Veränderung, dass du in Zukunft bei jeder Idee nicht erst berechnen musst, wie viele Credits diese Runde verbrennen wird.