Entendiendo modelos open-source • Principiante⏱️ 15 min de lectura
What Open-Source Models Are Changing
¿Qué están cambiando los modelos de código abierto?
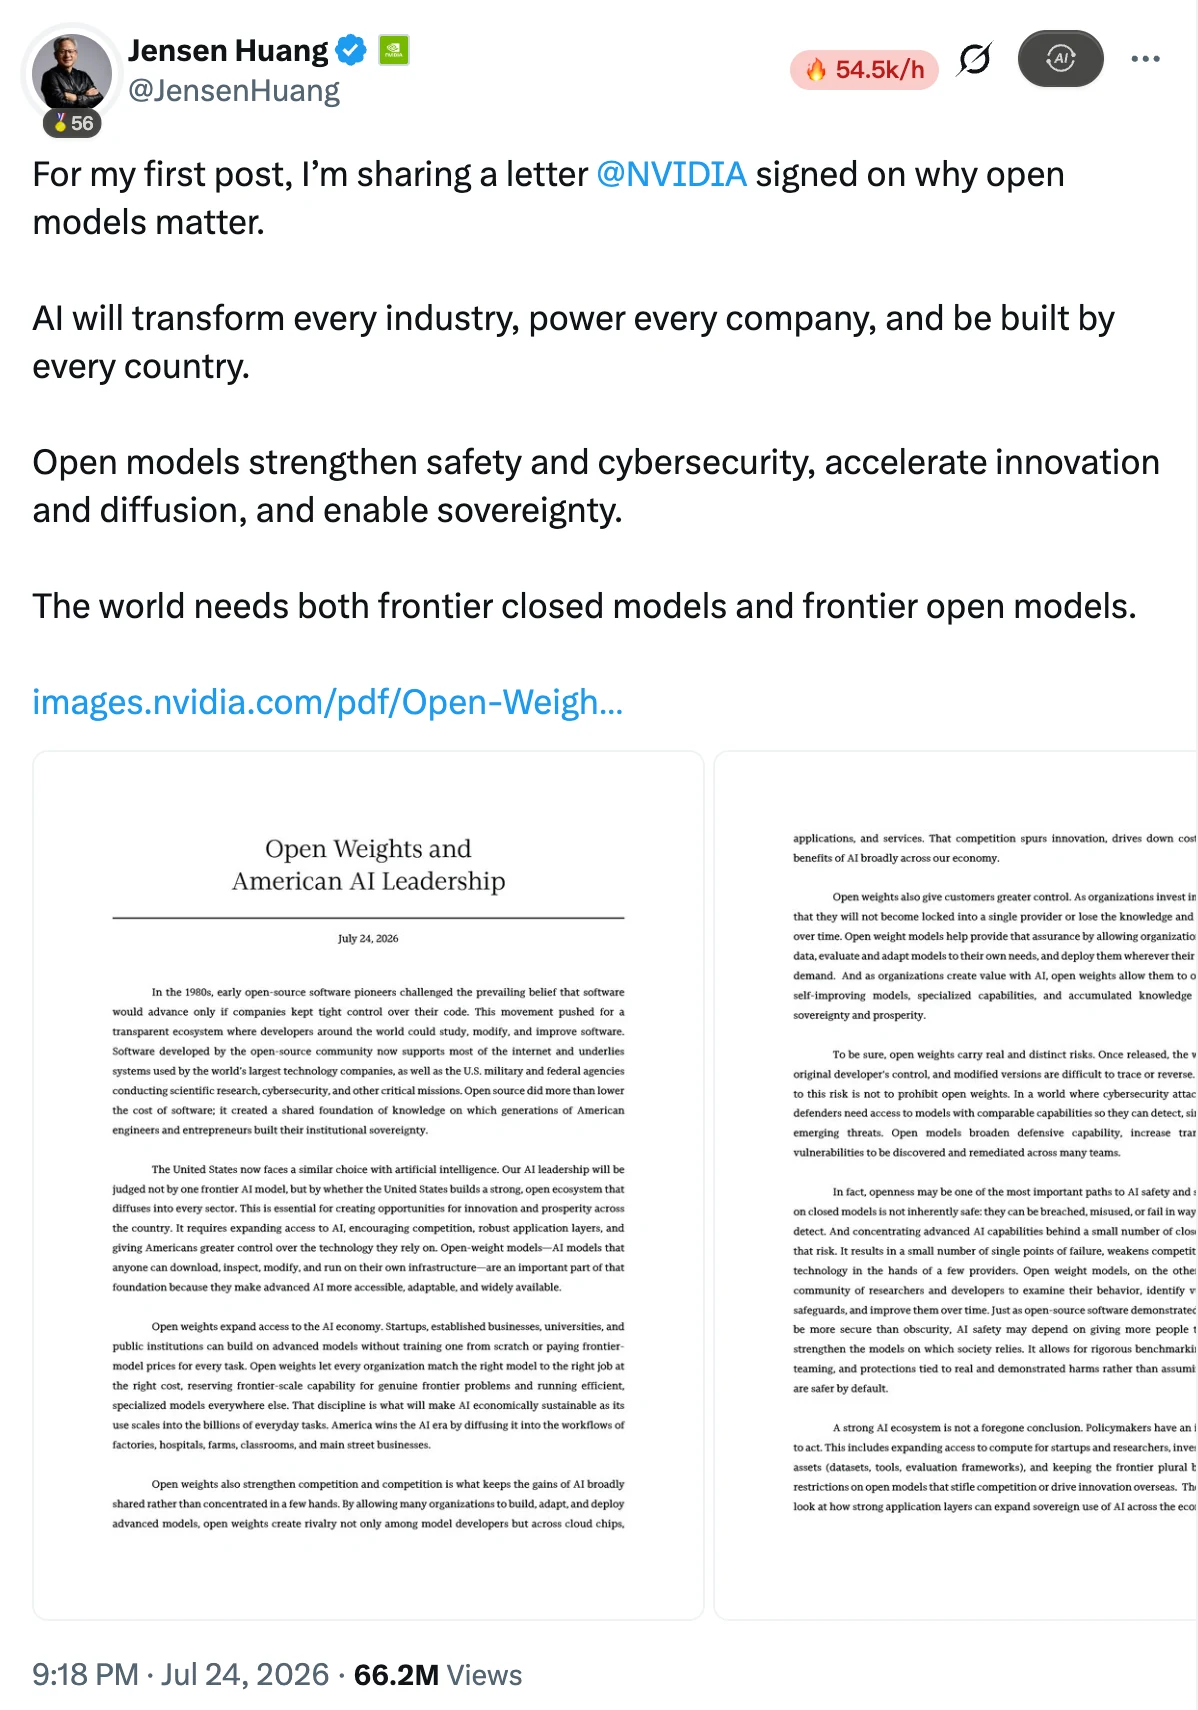
No lo habrías imaginado, pero el CEO de Nvidia, Jensen Huang, publicó su primer post en X, y estuvo dedicado al código abierto.
El 24 de julio de 2026, compartió una carta abierta firmada por Nvidia, discutiendo por qué los modelos abiertos son importantes:
Este mundo necesita tanto modelos propietarios de vanguardia como modelos abiertos de vanguardia.
Mucha gente puede haberse acostumbrado a abrir una ventana de chat, enviar una pregunta y esperar que la IA responda. Pero cuando comienzas a usar la IA para procesar datos de la empresa a largo plazo o integrar sistemas internos, podrías encontrar los siguientes problemas: ¿Son seguros los datos cuando se envían? ¿Qué pasa si el servicio repentinamente limita la tasa? ¿Puede el modelo aprender la forma en que tu empresa procesa los datos?
Los modelos de código abierto ofrecen otra solución a estos problemas. Puedes descargar el modelo dentro del alcance permitido por la licencia, desplegarlo en tu propio entorno, continuar afinándolo y dejar que los usuarios decidan cómo usarlo.
Por supuesto, el debate entre código abierto y propietario para los modelos grandes ha sido siempre un tema de discusión interminable. La carta de Jensen Huang resonó de nuevo con nosotros, y decidimos asociarnos con varios co-creadores para comenzar este viaje práctico de aplicaciones de modelos de código abierto en un libro púrpura. Esta vez, te traemos contenido práctico sobre aplicaciones de modelos de código abierto. ¡Que prosperen los modelos de código abierto!
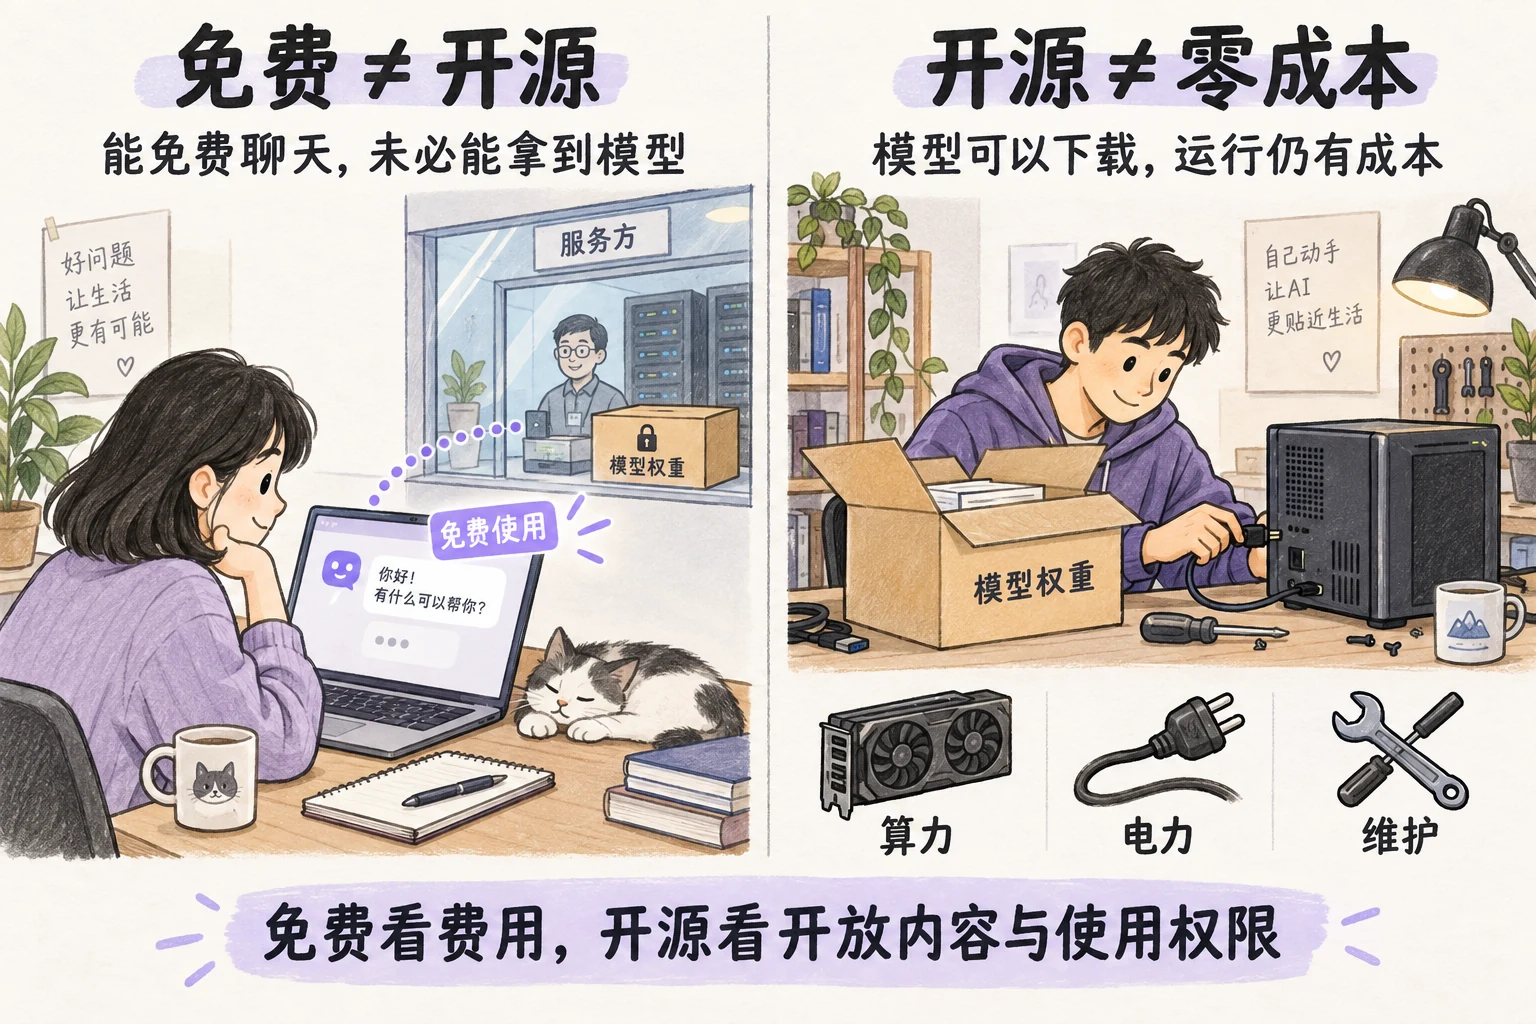
Recuerda, gratuito no necesariamente significa código abierto, y código abierto no necesariamente significa gratuito
Cuando chateas con una IA en un sitio web o haces preguntas a un modelo a través de una API, el modelo generalmente es ejecutado por el proveedor del modelo. Tú envías la entrada, y el proveedor devuelve los resultados. Generalmente no necesitas preocuparte por cómo se configura el servidor o cómo se mantiene el modelo.
Los modelos de código abierto ofrecen otra opción, permitiéndote obtener los parámetros del modelo después del entrenamiento, comúnmente conocidos como pesos. Con el software y hardware adecuados, estos parámetros pueden ejecutarse en tu computadora, servidor o nube privada. Las preguntas que anteriormente necesitaban enviarse a servicios externos ahora pueden procesarse en tu propio entorno.
Hay dos cosas aquí que son fácilmente confundidas.
«Gratuito» se refiere a si necesitas pagar o no; «código abierto» se refiere a qué puedes obtener y cómo estás autorizado a usarlo. Un producto de chat puede ser gratuito sin proporcionar los pesos del modelo. Un modelo que es gratuito para descargar aún requiere poder de cómputo y costos de mantenimiento para funcionar.
Una API es simplemente una forma de acceder a los modelos. Los modelos de código abierto pueden ser alojados por proveedores de servicios y entregados a ti a través de APIs. Los modelos que despliegues tú mismo también pueden estar disponibles para tus colegas a través de APIs internas. Por lo tanto, «código abierto vs. propietario» y «llamar APIs vs. auto-despliegue» deben considerarse por separado.
En las discusiones diarias, la gente a menudo se refiere colectivamente a los modelos cuyos pesos pueden descargarse como modelos de código abierto. También seguiremos esta convención común en los capítulos siguientes.
Sin embargo, al hacer distinciones estrictas, aclararemos que los pesos abiertos no equivalen al código abierto para todo el proceso de entrenamiento del modelo. Los datos de entrenamiento, el código de entrenamiento y los permisos de uso aún deben examinarse por separado.
Todos llamados código abierto, pero lo que se abre varía~
Después de obtener un modelo, probablemente tengas curiosidad por saber cómo fue entrenado.
Es aquí donde las diferencias entre los diferentes modelos se hacen evidentes. Algunos te permiten descargarlos y ejecutarlos sin divulgar los materiales completos de entrenamiento. Otros van más allá proporcionando código de entrenamiento y descripciones de datos, permitiendo a los desarrolladores externos estudiar la trayectoria de entrenamiento del modelo.
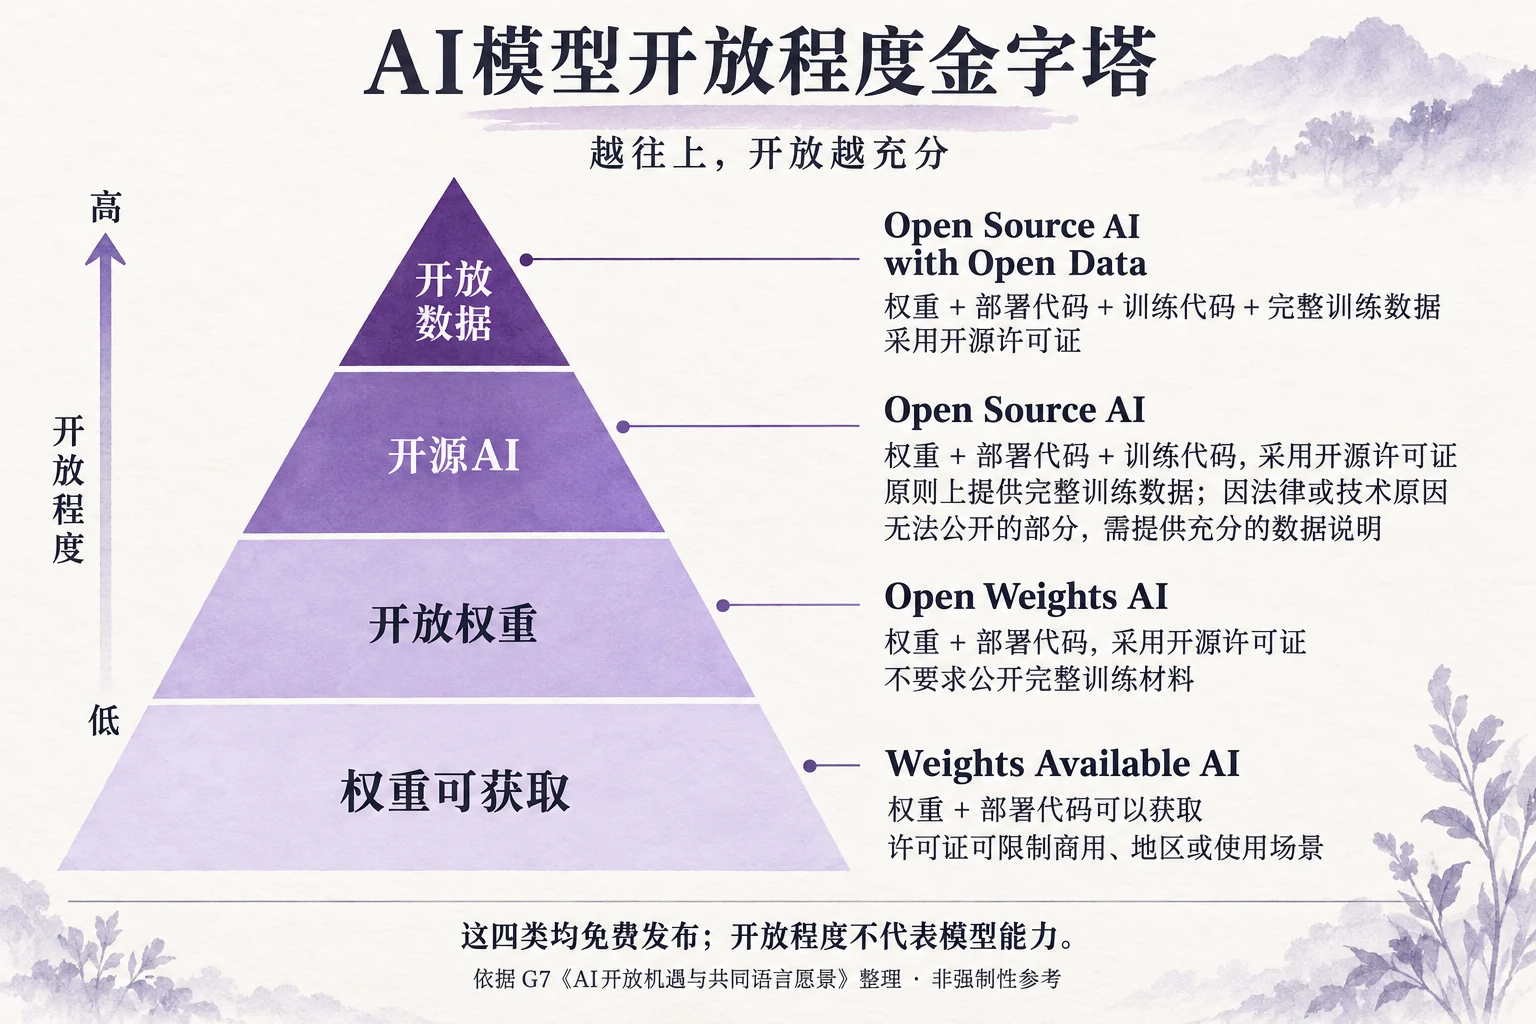
En mayo de 2026, el G7 publicó un documento de referencia común sobre la apertura de la IA, categorizando estas diferencias en cuatro tipos, del mayor al menor grado de apertura:
Incluso los datos de entrenamiento completos son públicos. Los pesos del modelo, el código de despliegue, el código de entrenamiento y los datos de entrenamiento completos se proporcionan bajo licencias de código abierto, correspondiendo a Open Source AI with Open Data.
Los pesos y el código son públicos, con datos restringidos explicados en detalle. Correspondiendo a Open Source AI. Los datos de entrenamiento completos en principio deben proporcionarse; las partes que no pueden compartirse por razones legales o técnicas deben reemplazarse adecuadamente con documentación de datos.
Un modelo entrenado se te entrega para ejecutar y modificar. Correspondiendo a Open Weights AI, proporcionando pesos y código de despliegue bajo licencias de código abierto, pero no necesariamente divulgando los materiales completos de entrenamiento.
Descargable, pero con condiciones adicionales al usar. Correspondiendo a Weights Available AI, donde los pesos y el código de despliegue se pueden obtener, pero las licencias pueden restringir el uso comercial, las regiones de uso o escenarios específicos.
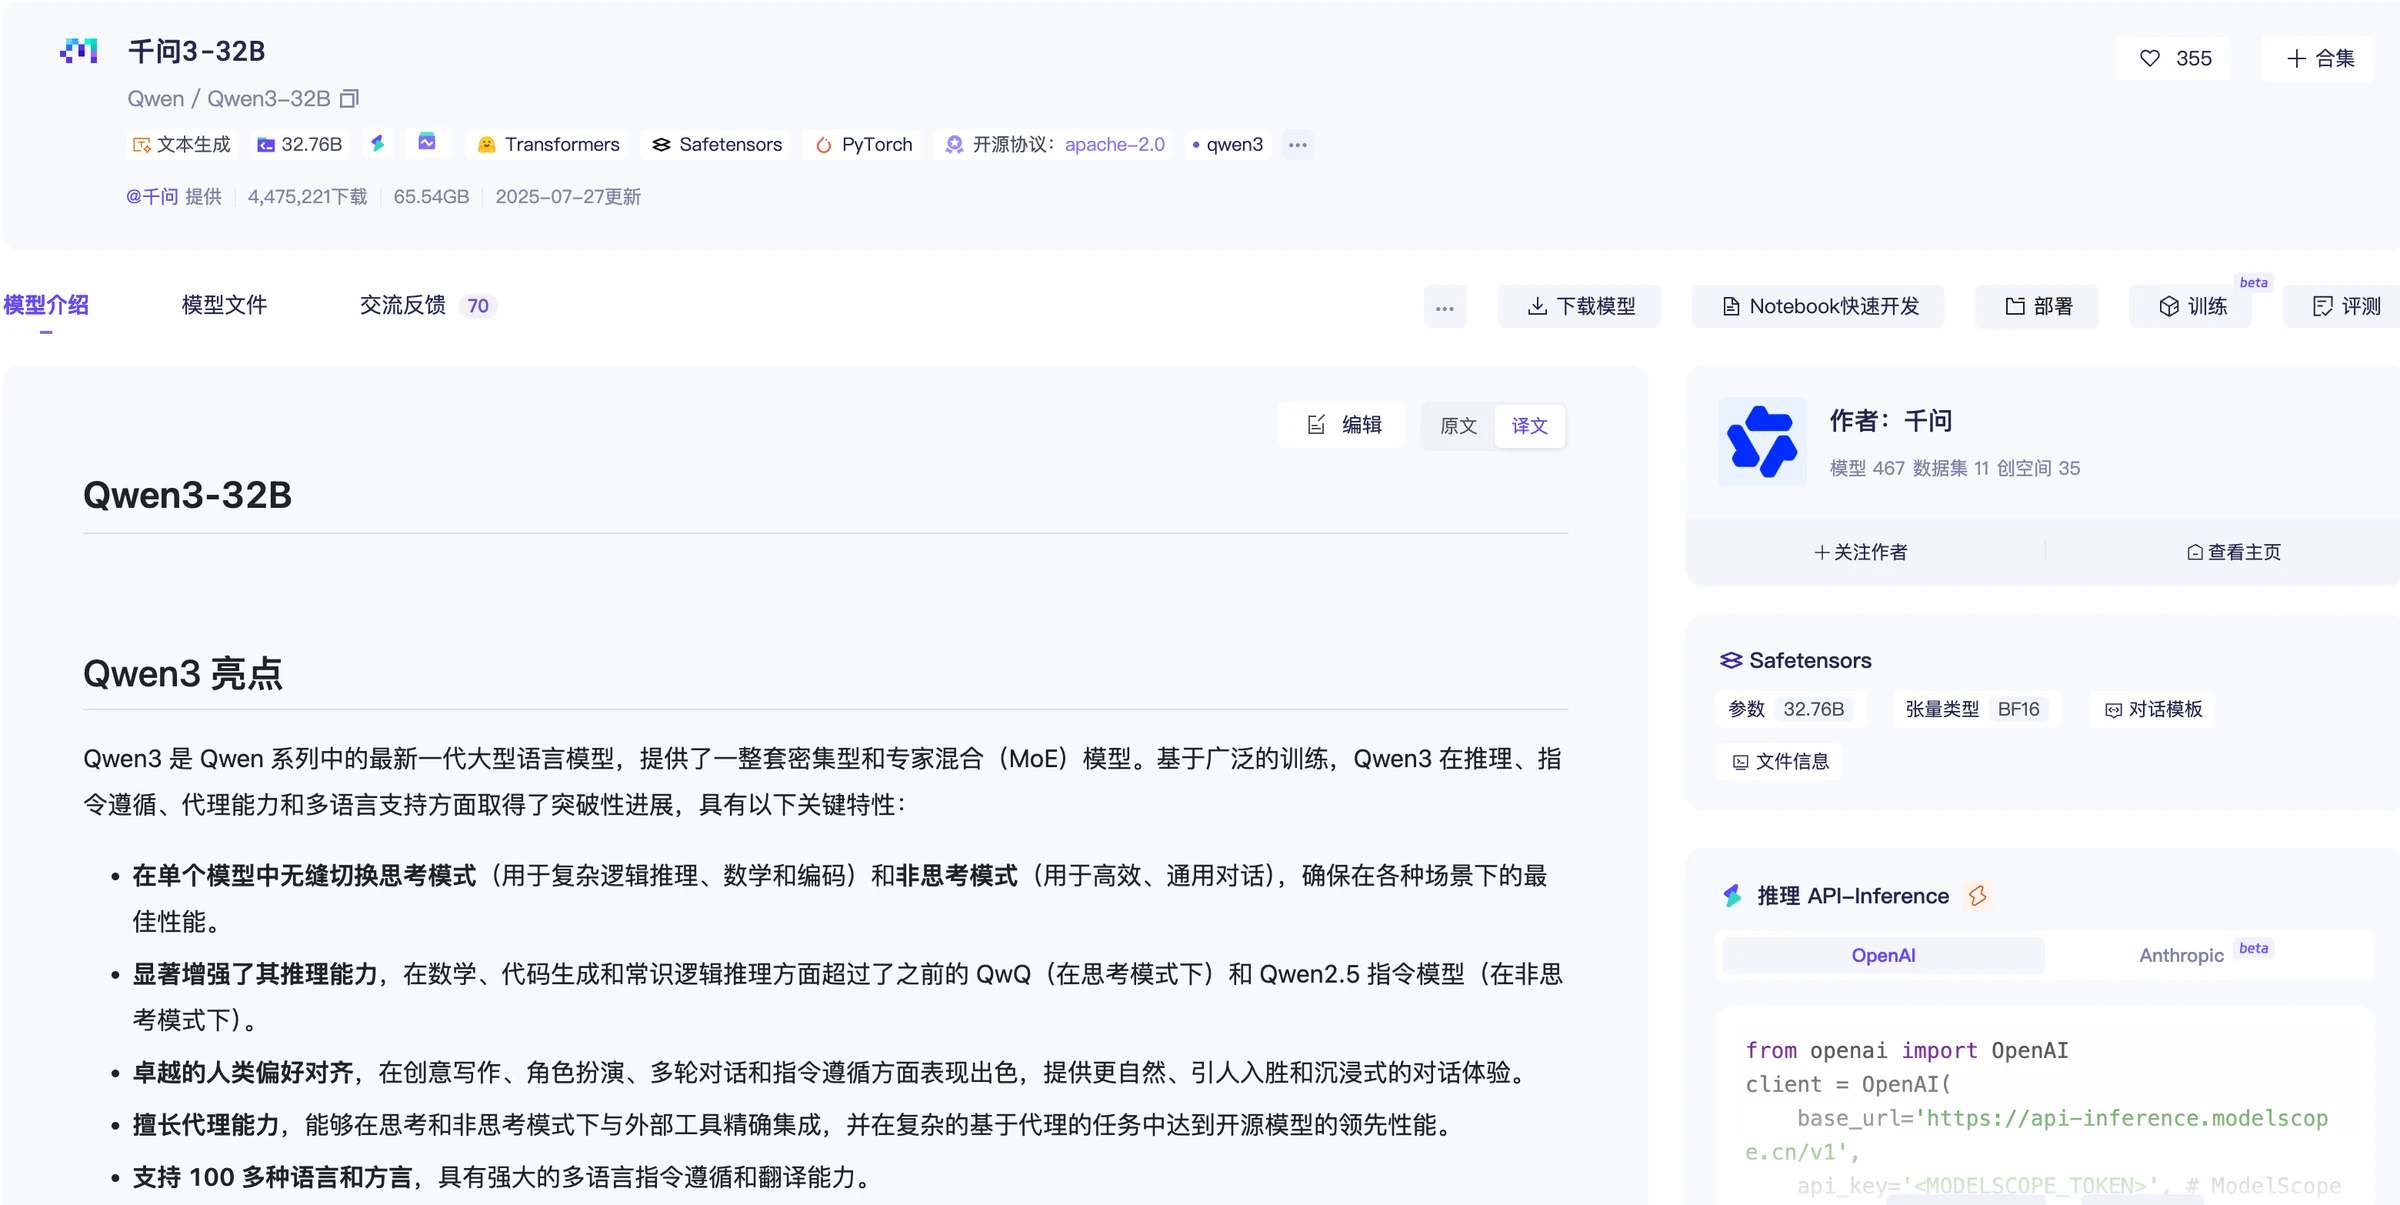
Tomando Qwen3 como ejemplo, el equipo oficial proporciona modelos con pesos abiertos junto con instrucciones para ejecución local, despliegue, cuantificación y afinamiento. Los desarrolladores pueden usar herramientas como Transformers, vLLM, SGLang para ejecutar modelos, y también pueden usar herramientas de afinamiento para continuar el entrenamiento. Según las distinciones anteriores, esto demuestra el valor práctico del nivel de pesos abiertos.
La mayoría de las empresas no necesitan repetir el pre-entrenamiento de modelos grandes — poder ejecutar modelos existentes, adaptarlos a tus propios dispositivos y afinarlos con muestras de negocio ya puede resolver muchos problemas de negocio específicos.
¿Los modelos de código abierto realmente pueden rivalizar con los modelos propietarios?
Poder desplegar modelos tú mismo es genial, pero si el modelo frecuentemente comete errores en escenarios de negocio, es difícil confiarle trabajo real.
En el pasado, los modelos de código abierto dieron a mucha gente la impresión de que eran convenientes para la investigación pero inferiores a los modelos propietarios más fuertes. Con la actualización continua de las capacidades de los modelos, esta evaluación necesita ser reconsiderada.
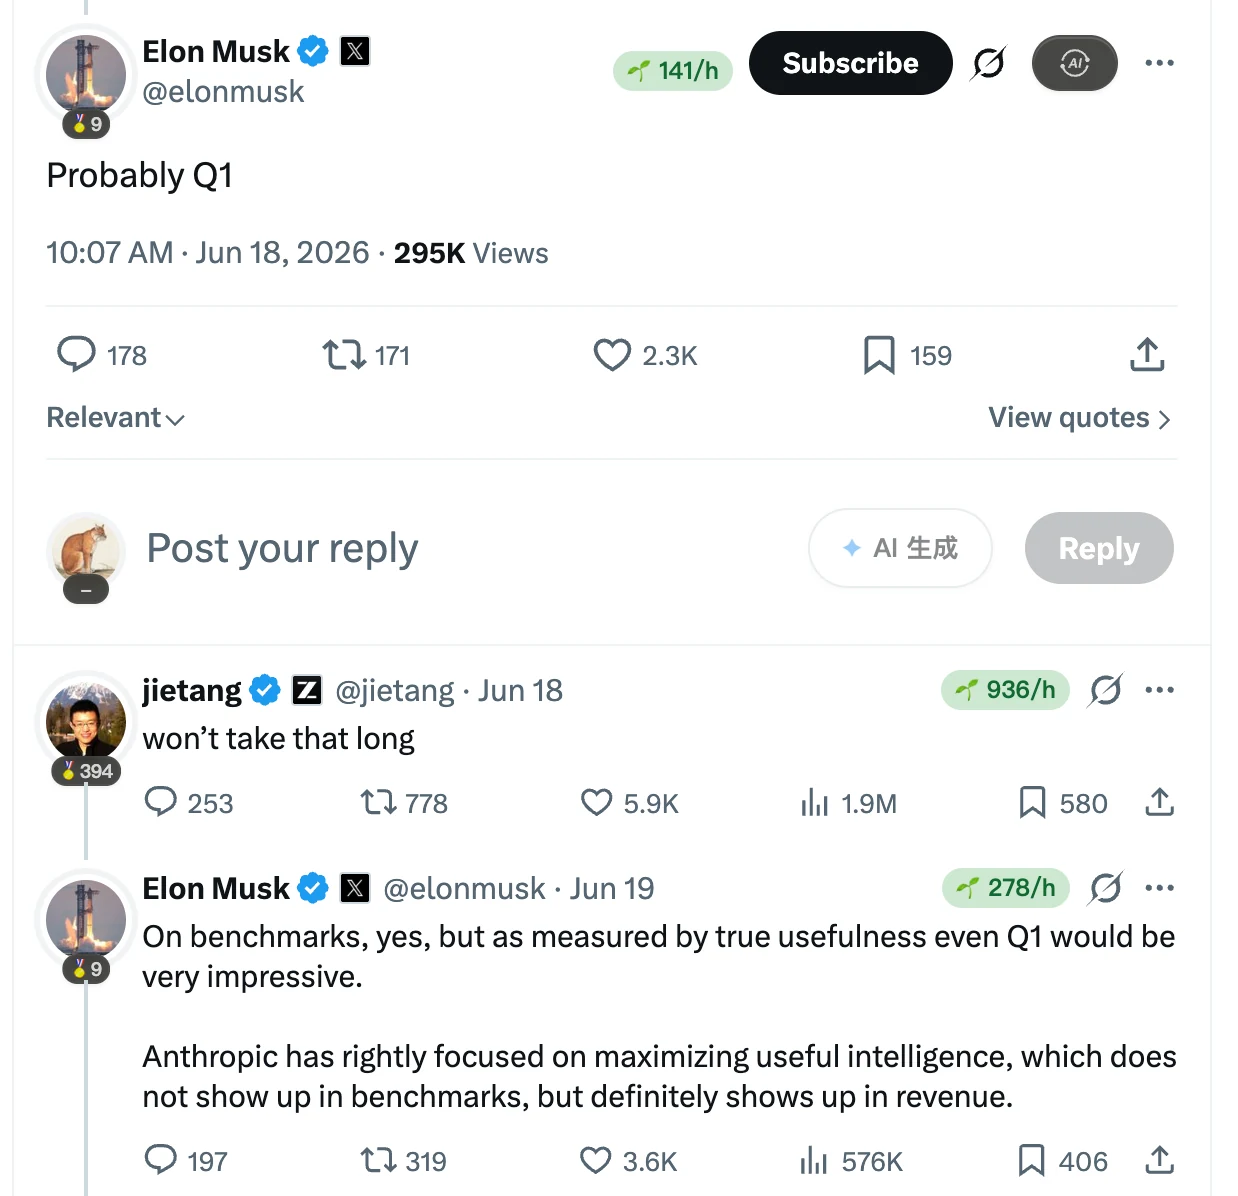
El 18 de junio de 2026, hubo una interacción bastante interesante en X. Los internautas discutían sobre cuándo los modelos chinos podrían alcanzar el nivel de los modelos frontier de Anthropic, y Elon Musk predijo que podría tomar hasta el primer trimestre de 2027. El cofundador de Zhipu, Tang Jie, respondió abajo con «won't take that long».
Si las predicciones de los dos se cumplirán o no sigue por verse según el rendimiento futuro de los modelos. El aspecto fascinante de esta discusión es que los modelos de código abierto ya se han situado en la vanguardia de todo el panorama de modelos grandes.
Un incidente de seguridad divulgado por Hugging Face en julio de 2026 demostró nuevamente la importancia de los modelos de código abierto.
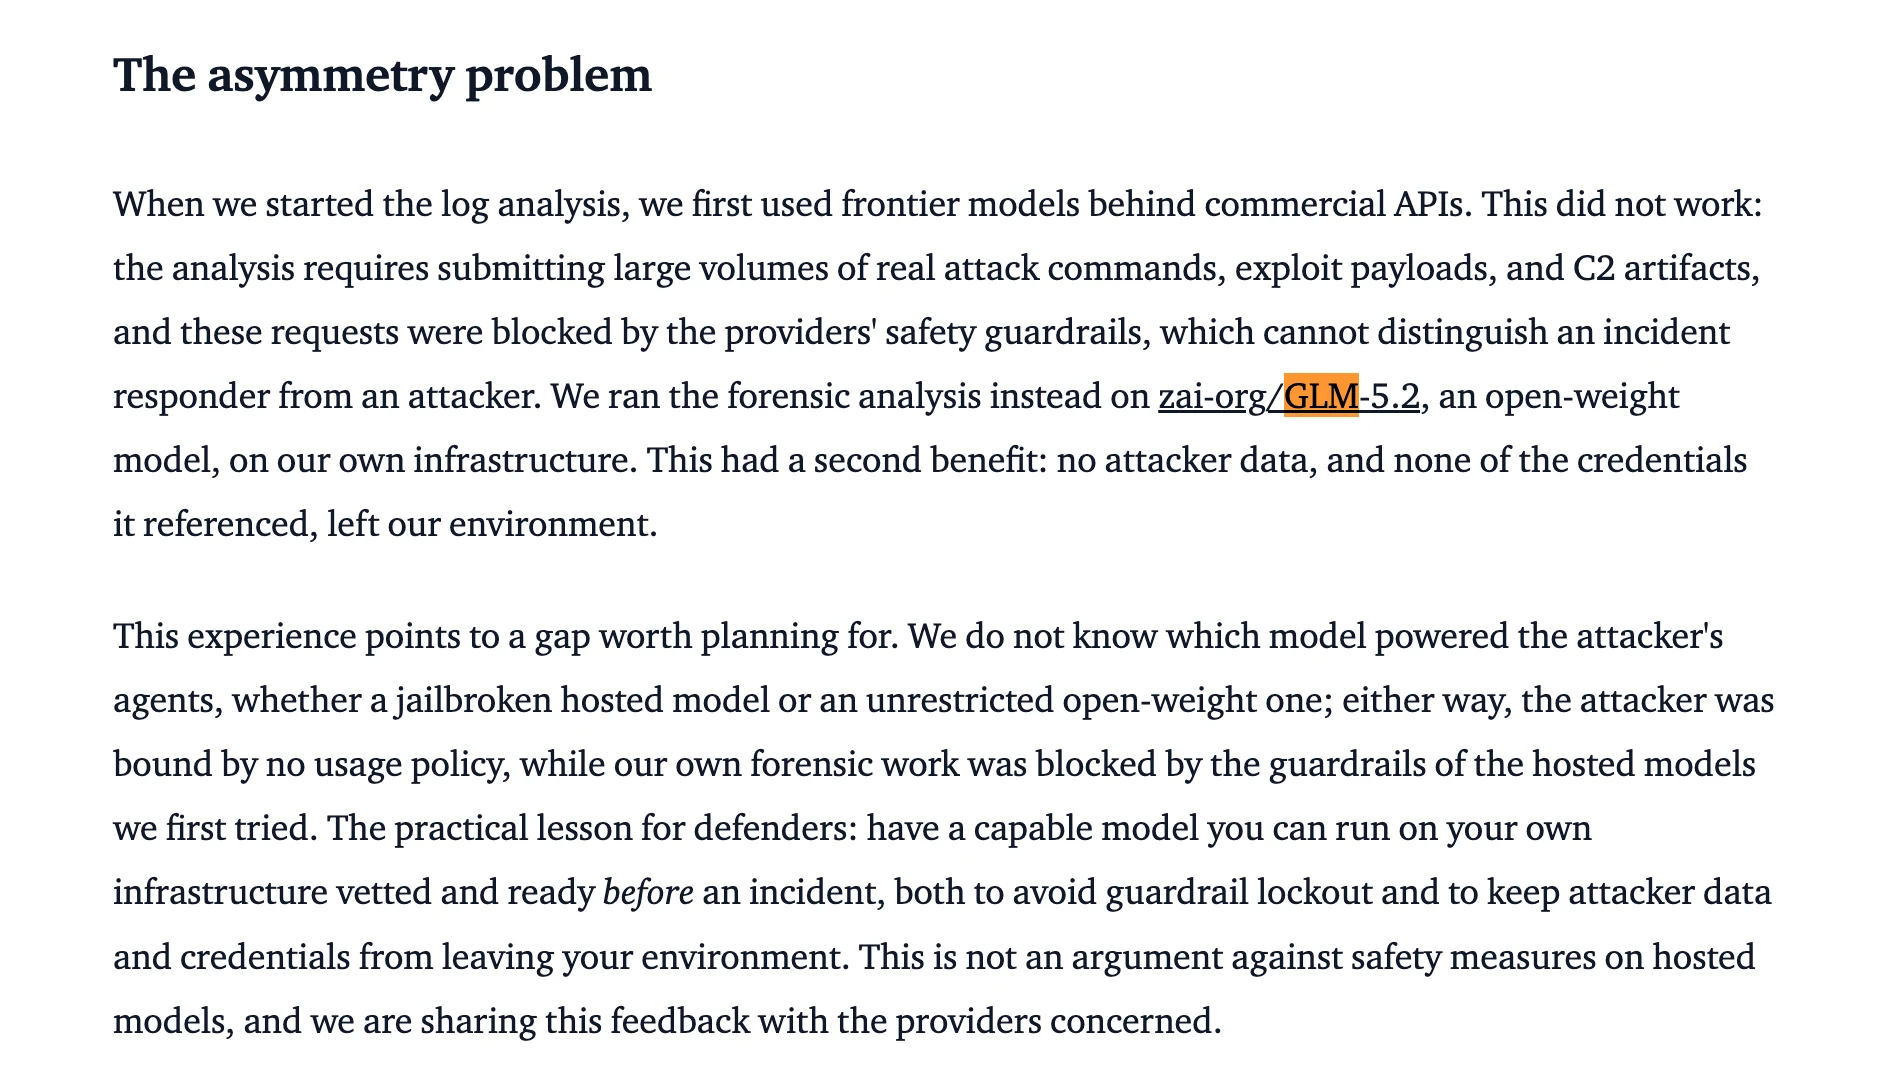
Parte de la infraestructura de producción de Hugging Face fue comprometida, y el equipo de seguridad necesitó analizar una gran cantidad de registros de ataque para entender qué habían hecho los atacantes, qué credenciales habían tocado y hasta dónde llegaba el impacto. El equipo de HF primero intentó usar modelos frontier a través de APIs comerciales pero se encontró con un problema embarazoso. Los comandos reales de ataque y contenido de explotación utilizados para la investigación activaron las restricciones de seguridad del proveedor de servicio, y las solicitudes de análisis fueron bloqueadas.
Posteriormente, el equipo utilizó el modelo de pesos abiertos GLM-5.2 en su propia infraestructura para realizar análisis forense, permitiendo que la investigación continuara. Los datos de ataque y credenciales relacionados también permanecieron en el entorno interno.
En la revisión técnica posterior, Hugging Face explicó además que el equipo reconstruyó aproximadamente 17,600 acciones de ataque y utilizó modelos de pesos abiertos incluyendo GLM-5.2 para interpretar las cargas de ataque ofuscadas y cifradas.
Este incidente demostró la importancia de los modelos de código abierto.
El uso de modelos de código abierto no está sujeto a restricciones propietarias. Podemos mantener los datos en local, usarlos sin conexión y hacer que la ejecución de tareas sea más controlable.
¿Qué escenarios son más adecuados para el despliegue local de modelos de código abierto?
Los dominios verticales también son una dirección de aplicación importante para los modelos de código abierto. Los modelos grandes generales aprenden de grandes cantidades de datos públicos, pero su comprensión de nombres de dispositivos internos de la empresa, procesos de negocio, terminología de la industria y conocimientos especializados puede seguir siendo limitada. A través del afinamiento con datos de dominio vertical, el modelo puede aprender más estos conocimientos especializados.
Para tareas que necesitan procesar datos sensibles, el despliegue local también tiene ventajas. Los modelos pueden realizar inferencia dentro de la red interna de la empresa y conectarse con bases de conocimiento, bases de datos y sistemas de negocio existentes, reduciendo así la necesidad de enviar datos sensibles a servicios externos.
Sin embargo, no todas las tareas requieren modelos de código abierto desplegados localmente.
Para tareas con menos invocaciones de modelos, necesidades de negocio de cambio rápido o que requieren uso continuo de las últimas capacidades del modelo general, llamar APIs directamente suele ser más conveniente. Para algunas tareas de negocio a largo plazo, estables y ejecutadas repetidamente, los modelos de código abierto tienen un mayor potencial de aplicación.
Por ejemplo, tareas como clasificación de texto, reconocimiento de intención, extracción de información, resumen de documentos y Q&A de bases de conocimiento suelen tener formatos de entrada y salida relativamente claros. Las empresas pueden elegir modelos de tamaño apropiado según la complejidad de la tarea y usar sus propios datos de negocio para entrenamiento o afinamiento. Para estas tareas, no necesariamente se requiere usar los modelos con el mayor número de parámetros.
Recuerda, poder descargar un modelo no significa que puedas usarlo como quieras
El modelo funciona y tiene buen rendimiento, pero si quieres usarlo en productos comerciales o compartir tu versión afinada, aún necesitas verificar la LICENCIA, que es la licencia.
Ser descargable, utilizable comercialmente y modificable para redistribución son permisos diferentes.
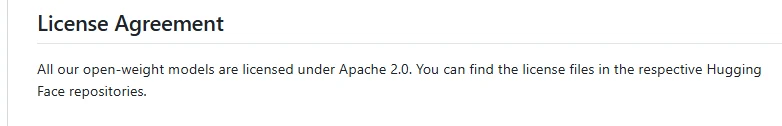
Generalmente hablando, MIT y Apache License 2.0 son licencias de código abierto relativamente permisivas que permiten uso comercial y modificación, y no requieren que todo el código derivado sea público. Un software que usa la licencia MIT solo necesita retener avisos de copyright y licencia; Apache 2.0 especifica requisitos de documentación de modificaciones, retención de avisos relacionados y manejo de NOTICES durante la redistribución, e incluye disposiciones claras de otorgamiento de patentes.
Por ejemplo, la serie de modelos Qwen3 usa Apache 2.0.
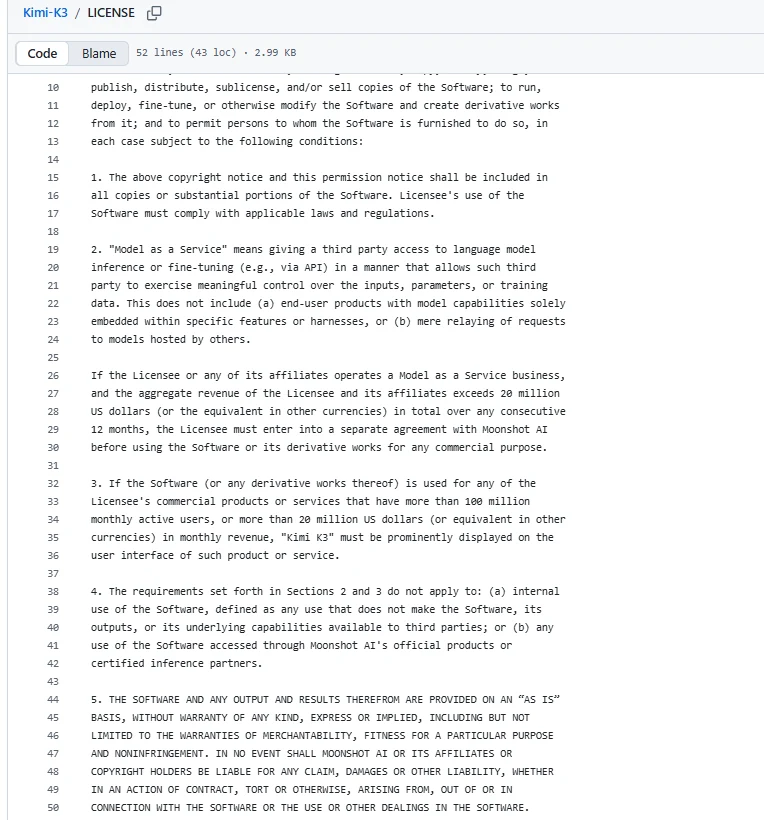
Kimi K3 tiene acuerdos separados para ciertos usos comerciales, permitiendo despliegue, afinamiento y creación de trabajos derivados, pero cuando los servicios de modelo alcanzan un umbral de ingresos especificado, se requiere un acuerdo separado.
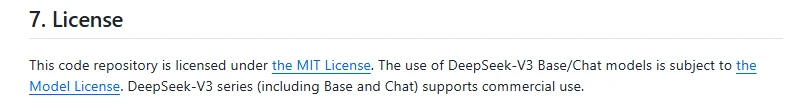
El código de DeepSeek-V3 usa la licencia MIT.
Por lo tanto, al usar modelos, si deseas publicar un modelo afinado o proporcionarlo a otros usuarios, necesitas reverificar la licencia del modelo original para ver si permite este uso, y si necesitas retener el nombre del modelo, la licencia y la información de origen.
Si un nuevo modelo se obtiene fusionando múltiples modelos, también necesitas verificar las licencias de cada modelo por separado para asegurar que sus requisitos no entren en conflicto.