AIUnlimited
🌳

Fundamentos de IA

🌱
AI Seeds

Empieza desde cero

🌿
AI Sprouts

Construye bases

🌳
AI Branches

Aplica en la práctica

🏕️
AI Canopy

Profundiza

🌲
AI Forest

Domina la IA

🔨

Maestría en IA

✏️
AI Sketch

Empieza desde cero

🪨
AI Chisel

Construye bases

⚒️
AI Craft

Aplica en la práctica

💎
AI Polish

Profundiza

🏆
AI Masterpiece

Domina la IA

📘

Práctica de IA

📖
Entendiendo modelos open-source

Fundamentos y recursos para modelos open-source

🎯
Del problema a la tarea del modelo

Convertir problemas de negocio en tareas de modelos

⚡
Ejecutando tu primer modelo

Mira tus primeros resultados en 30 minutos

🔧
Fine-tuning y evaluación

Ajusta modelos y evalúa el rendimiento

🚀
Sistemas de aplicación

Construye aplicaciones IA del mundo real

🎨
IA generativa

Explora modelos AIGC open-source

🤖
Agentes

Aprende frameworks Agent y herramientas MCP

📐
Fundamentos complementarios

Fundamentos LLM y evaluación

🎓

Claude Academia

🤖
Claude 101

Learn AI basics with Claude

💻
Claude Code 101

Code with Claude as your pair programmer

🤝
Introduction to Claude Cowork

Collaborate with Claude on complex projects

⚙️
Claude Platform 101

Build apps with the Claude API

Laboratorio

7 experimentos cargados
🧬Sandbox de Red Neuronal🤖¿IA o Humano?🥋Dojo de Prompt Engineering🏁Carrera de Algoritmos🧠Trivia de IA🏗️Lienzo de diseño de sistemas
🎯Entrevista simuladaEntrar al Laboratorio→
🚀

Desarrollo profesional

🚀
Plataforma de Entrevistas

Comienza tu camino

🌟
Dominio Conductual

Domina las habilidades blandas

💻
Entrevistas Técnicas

Supera la ronda de código

🤖
Entrevistas de IA y ML

Dominio en entrevistas de ML

🏆
Oferta y Más Allá

Consigue la mejor oferta

Empezar
AIUnlimited

Licencia MIT

沪ICP备18025655号-11

Aprender

  • Fundamentos de IA
  • Práctica de IA
  • Claude Academia
  • Laboratorio
  • Desarrollo profesional

Comunidad

  • Acerca de
  • Preguntas Frecuentes

Soporte

  • Términos de Servicio
  • Política de Privacidad
  • Contacto
Académicos de IA e Ingeniería›⚡ Ejecutando tu primer modelo›Lecciones›Your First Inference in 30 Minutes
⚡
Ejecutando tu primer modelo • Principiante⏱️ 25 min de lectura

Your First Inference in 30 Minutes

Obtén tu primer resultado en 30 minutos

Después de descargar un modelo de código abierto, puedes ejecutarlo en tu propia computadora portátil o alquilar un servidor en la nube, configurando CPU, GPU y el entorno de ejecución según sea necesario. El hardware diferente requiere diferentes preparativos.

Si solo quieres probar qué puede hacer un modelo primero, ModelScope Notebook ofrece un punto de entrada gratuito. Abre un navegador, selecciona una instancia en ejecución y puedes escribir código, descargar modelos y ver resultados directamente en la página web.

Esta lección te guía a través de crear un Notebook, verificar el entorno y cargar un modelo. Sigue los pasos para ver tu primer resultado.

Abre el Notebook y conéctate a una instancia en ejecución

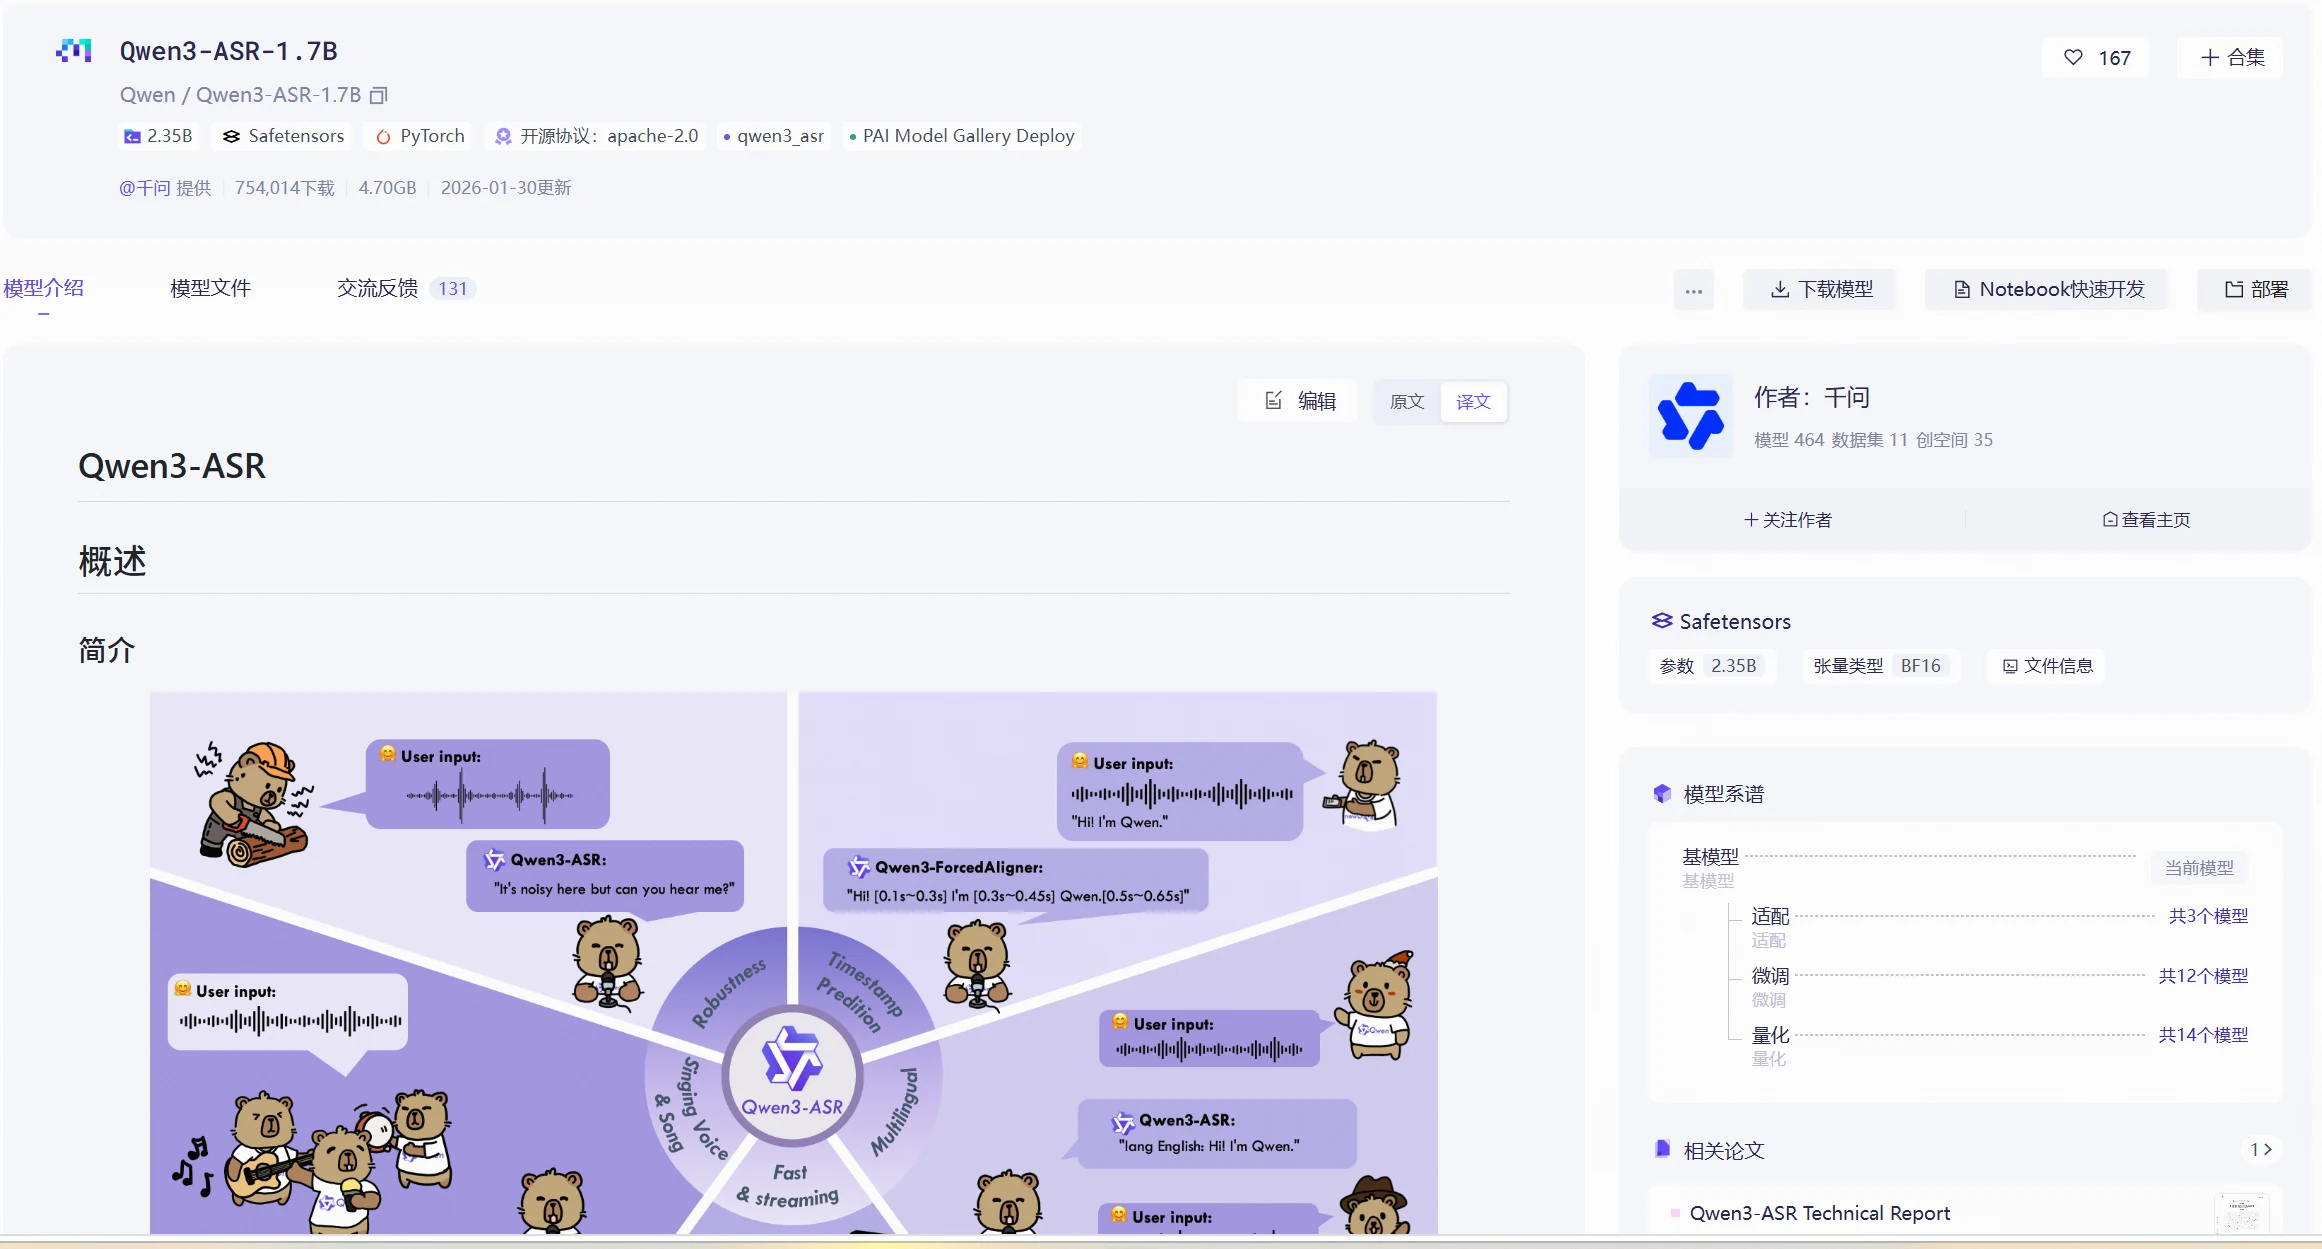
Ve al hub de modelos, encuentra el modelo Qwen/Qwen3-ASR-1.7B y haz clic en "Notebook Quick Development" a la derecha para crear un notebook de ModelScope.

Enlace del modelo: https://www.modelscope.cn/models/Qwen/Qwen3-ASR-1.7B
ilustración

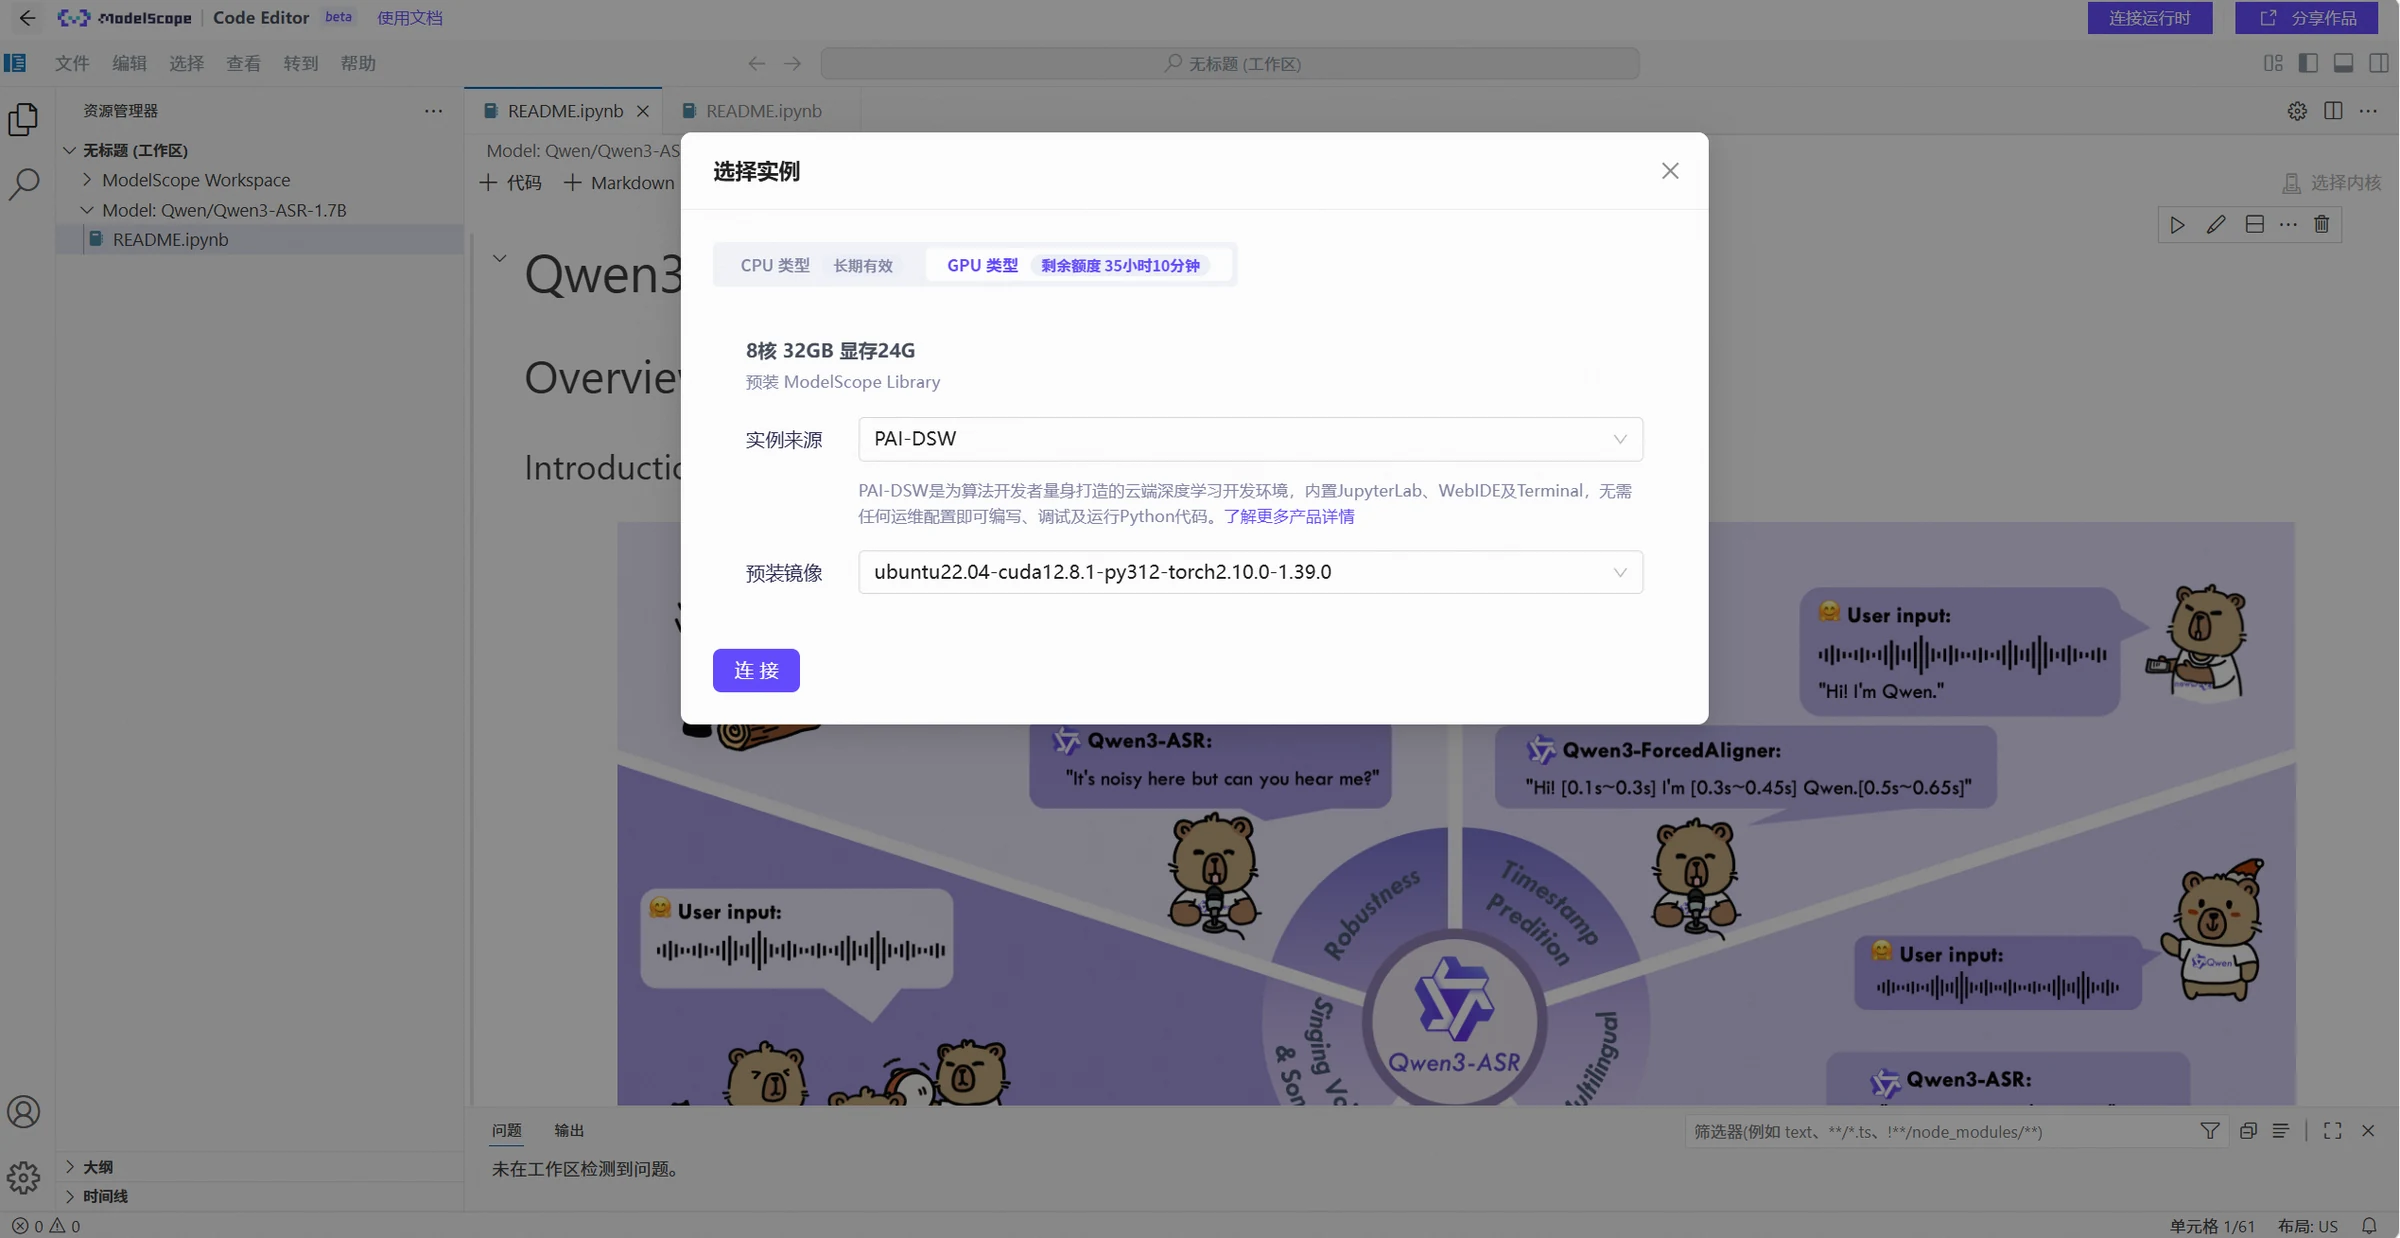
Haz clic en "Connect Runtime" en la esquina superior derecha para seleccionar una instancia. Aquí elegimos GPU para la demostración. Puedes seleccionar una imagen preinstalada adecuada según las dependencias del modelo.
ilustración

Verifica si el entorno está listo

Después de cargar la instancia, lo primero es verificar el entorno actual. Puedes ejecutar los siguientes comandos en el notebook:

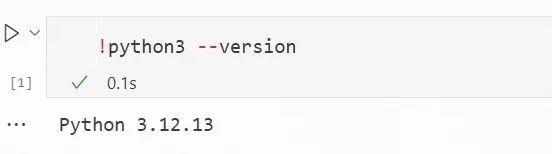
  1. Verificar la versión de Python
!python3 --version

Resultado:
ilustración
  1. Verificar las dependencias relacionadas

Cada modelo tiene dependencias diferentes. Necesitas consultar la tarjeta del modelo para obtener información. Según la tarjeta del modelo Qwen3-ASR-1.7B, la dependencia de inferencia es qwen3-asr. Si qwen3-asr falta en el entorno, necesitas instalarlo tú mismo.

# Verificar dependencia
!pip3 show qwen-asr
# Instalar qwen-asr (si falta)
!pip3 install -U qwen-asr

Resultado:
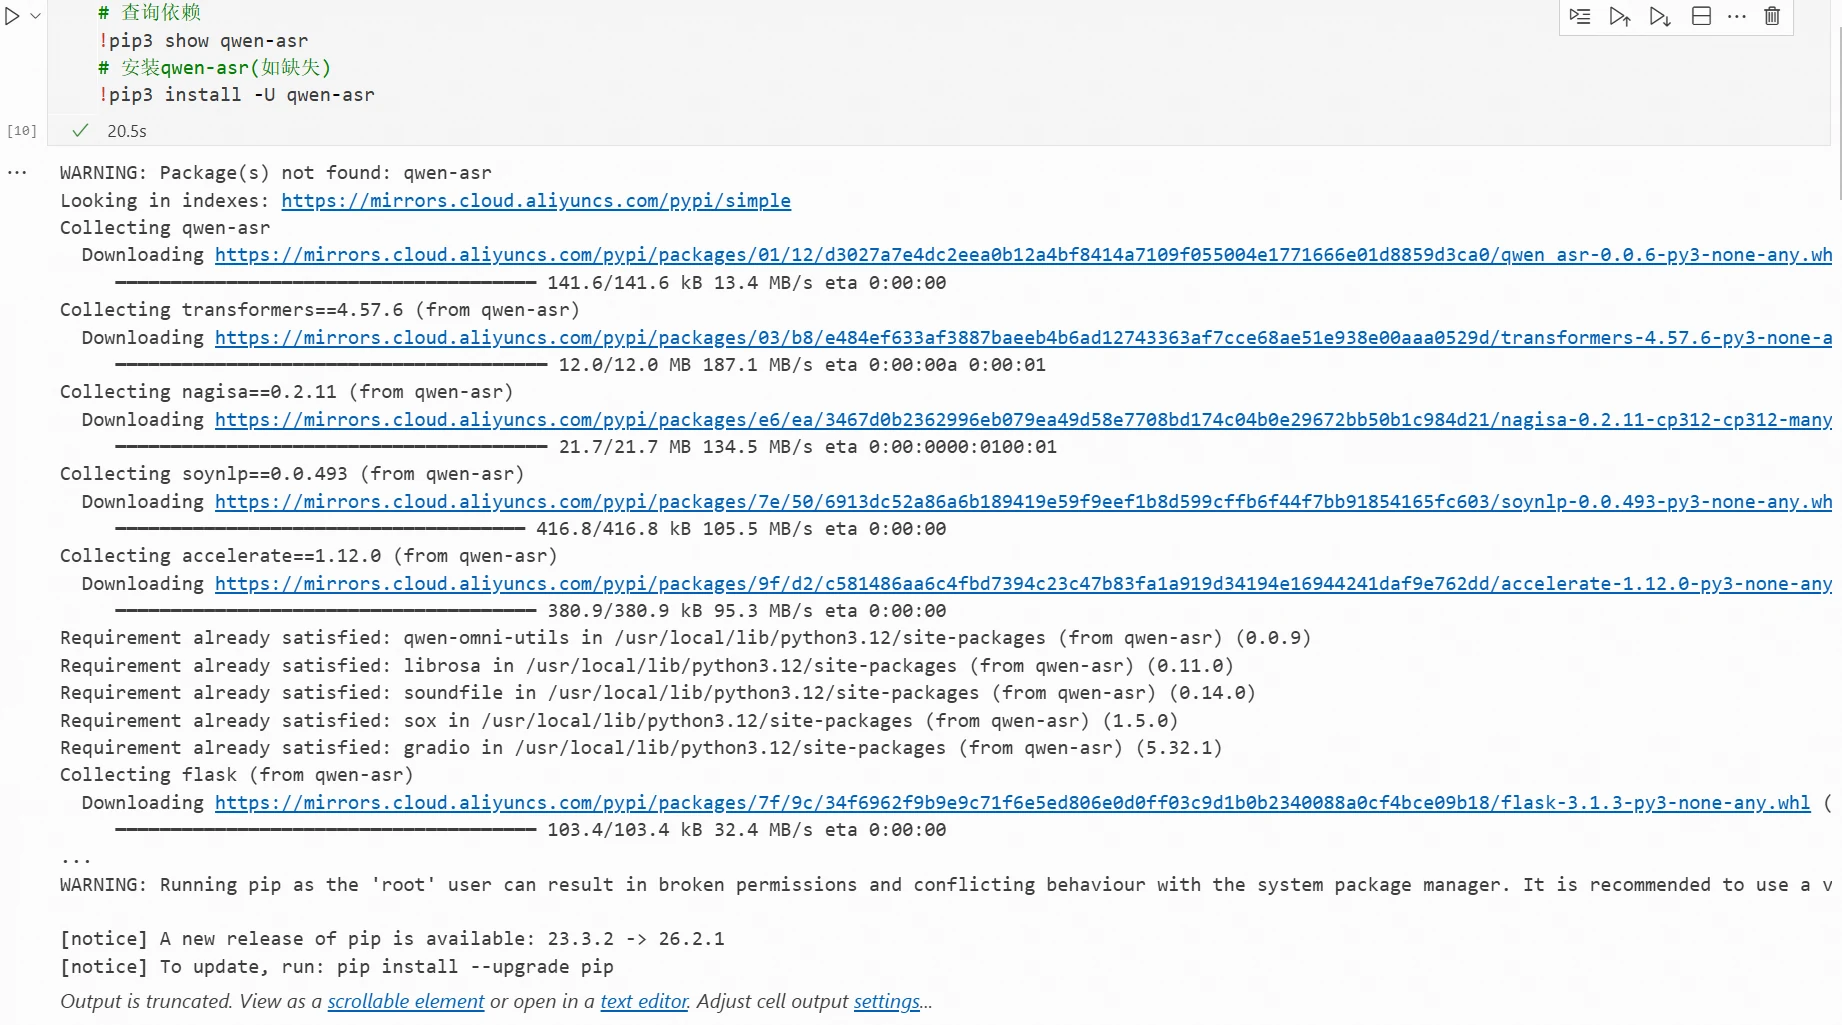
ilustración

Resultado de la consulta de instalación exitosa:
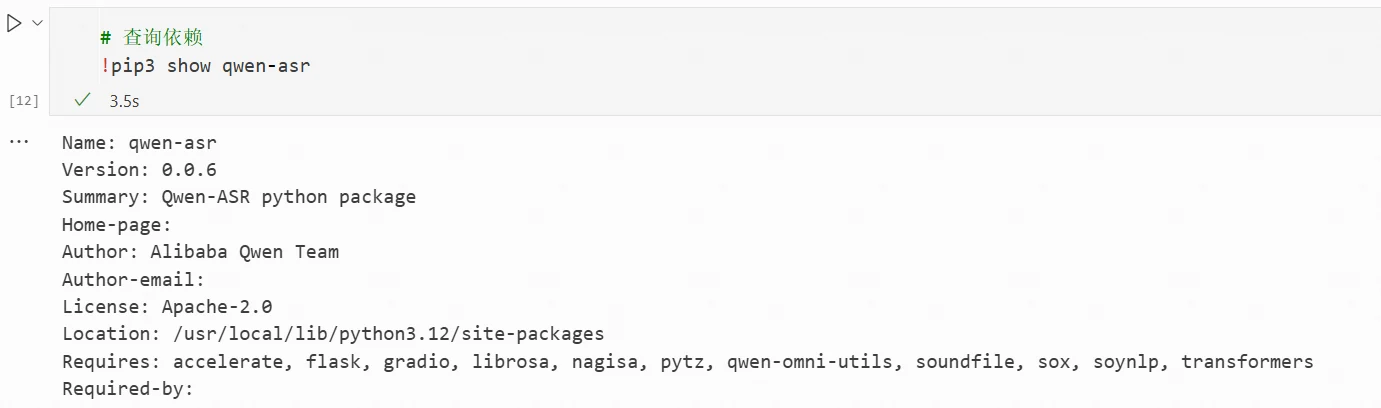
ilustración
  1. Verificar la configuración de CPU
!lscpu
Lección 1 de 50% completado
←Volver al programa

Discusión

Iniciar sesión unirse a la discusión
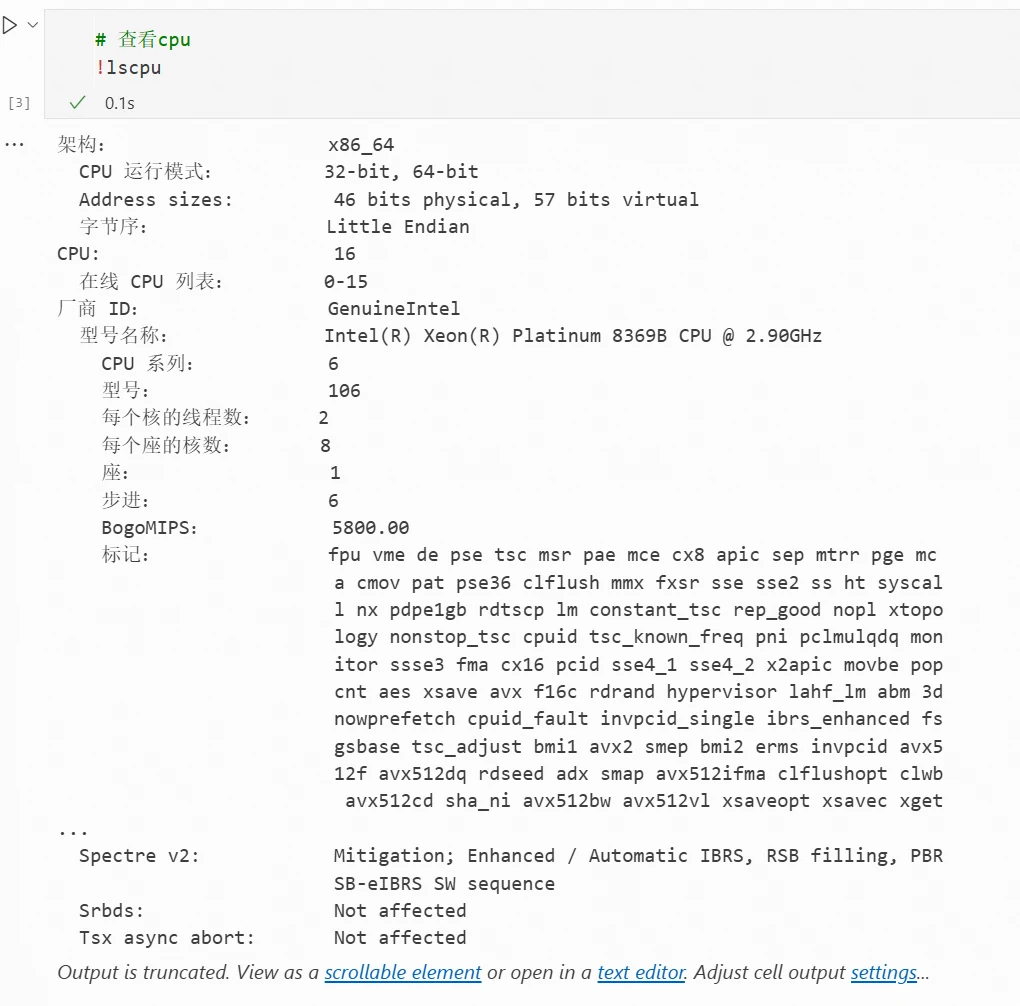
Resultado:

ilustración
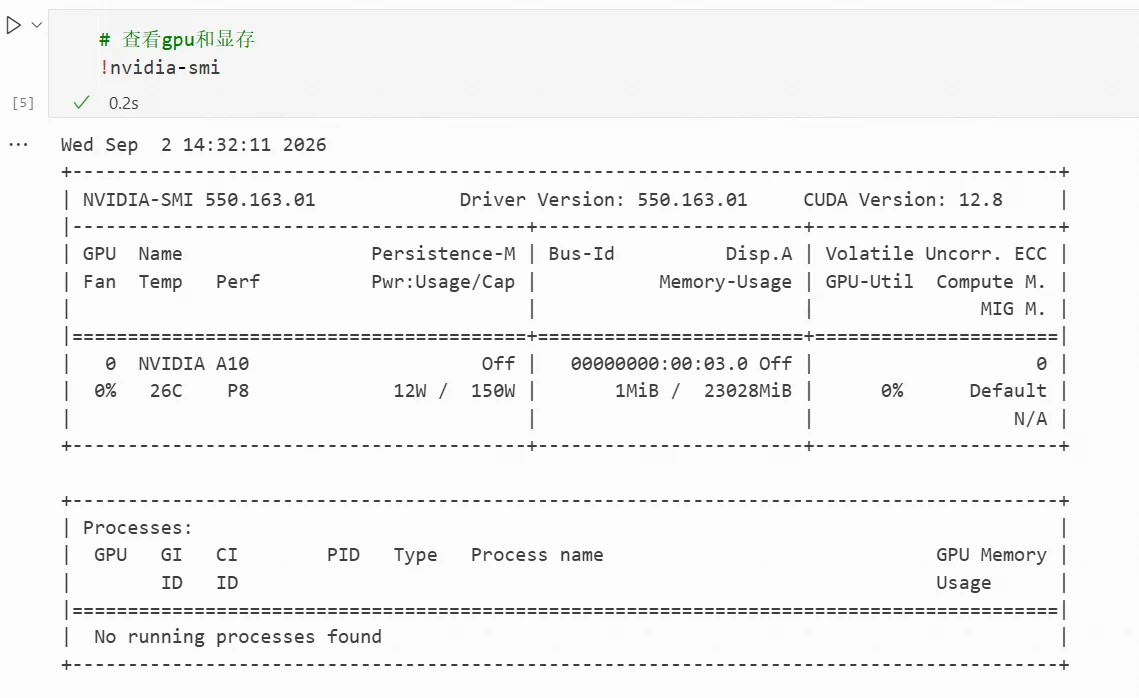
  1. Verificar GPU y memoria de video
!nvidia-smi

Resultado:

ilustración
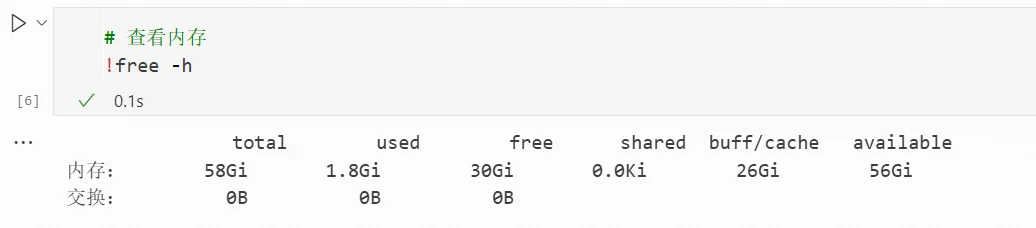
  1. Verificar memoria
!free -h

Resultado:

ilustración
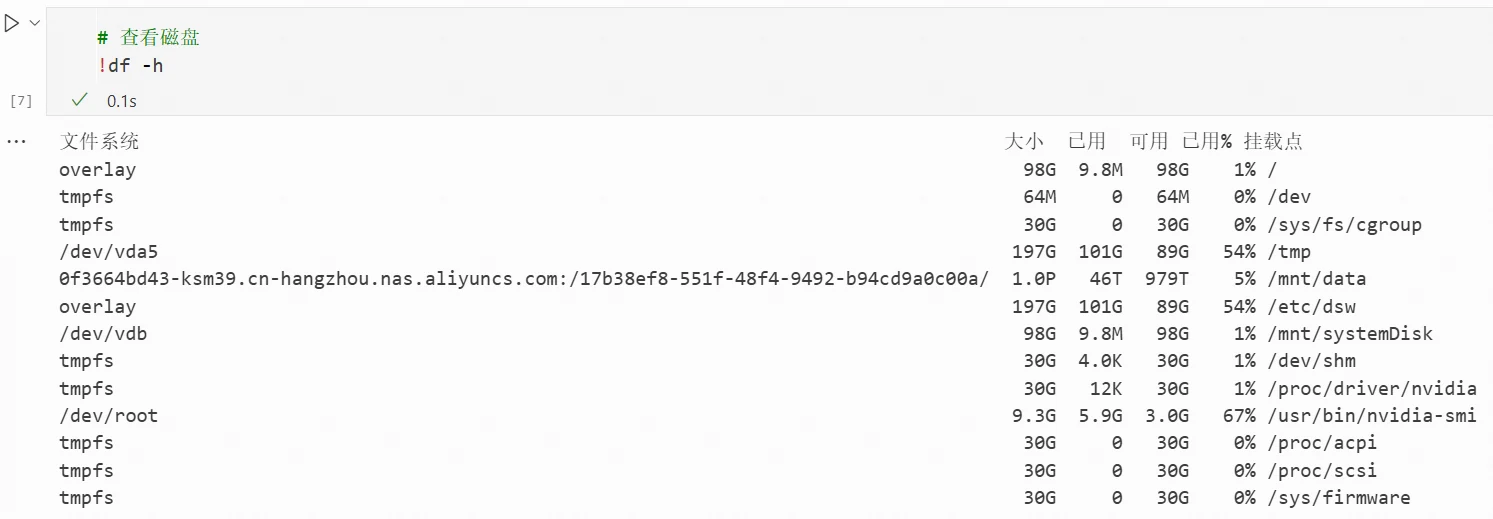
  1. Verificar disco
!df -h

Resultado:

ilustración

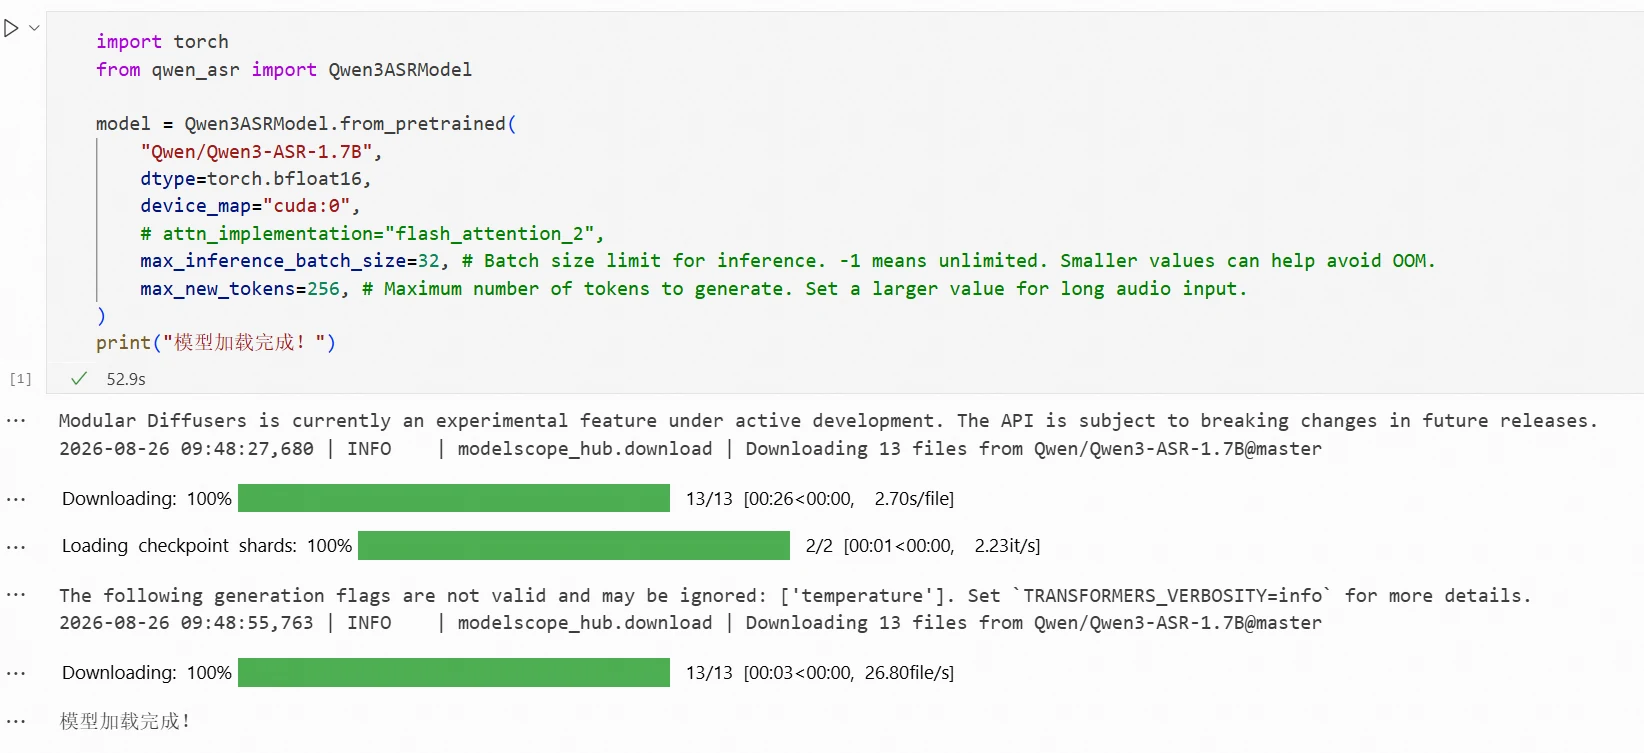
Carga el modelo directamente por su nombre

Consulta el código de ejemplo en la tarjeta del modelo para la carga. Los archivos del modelo necesarios se descargarán automáticamente.

import torch
from qwen_asr import Qwen3ASRModel
 
model = Qwen3ASRModel.from_pretrained(
    "Qwen/Qwen3-ASR-1.7B",
    dtype=torch.bfloat16,
    device_map="cuda:0",
    # attn_implementation="flash_attention_2",
    max_inference_batch_size=32, # Batch size limit for inference. -1 means unlimited. Smaller values can help avoid OOM.
    max_new_tokens=256, # Maximum number of tokens to generate. Set a larger value for long audio input.
)
print("¡Modelo cargado exitosamente!")

Resultado:

ilustración

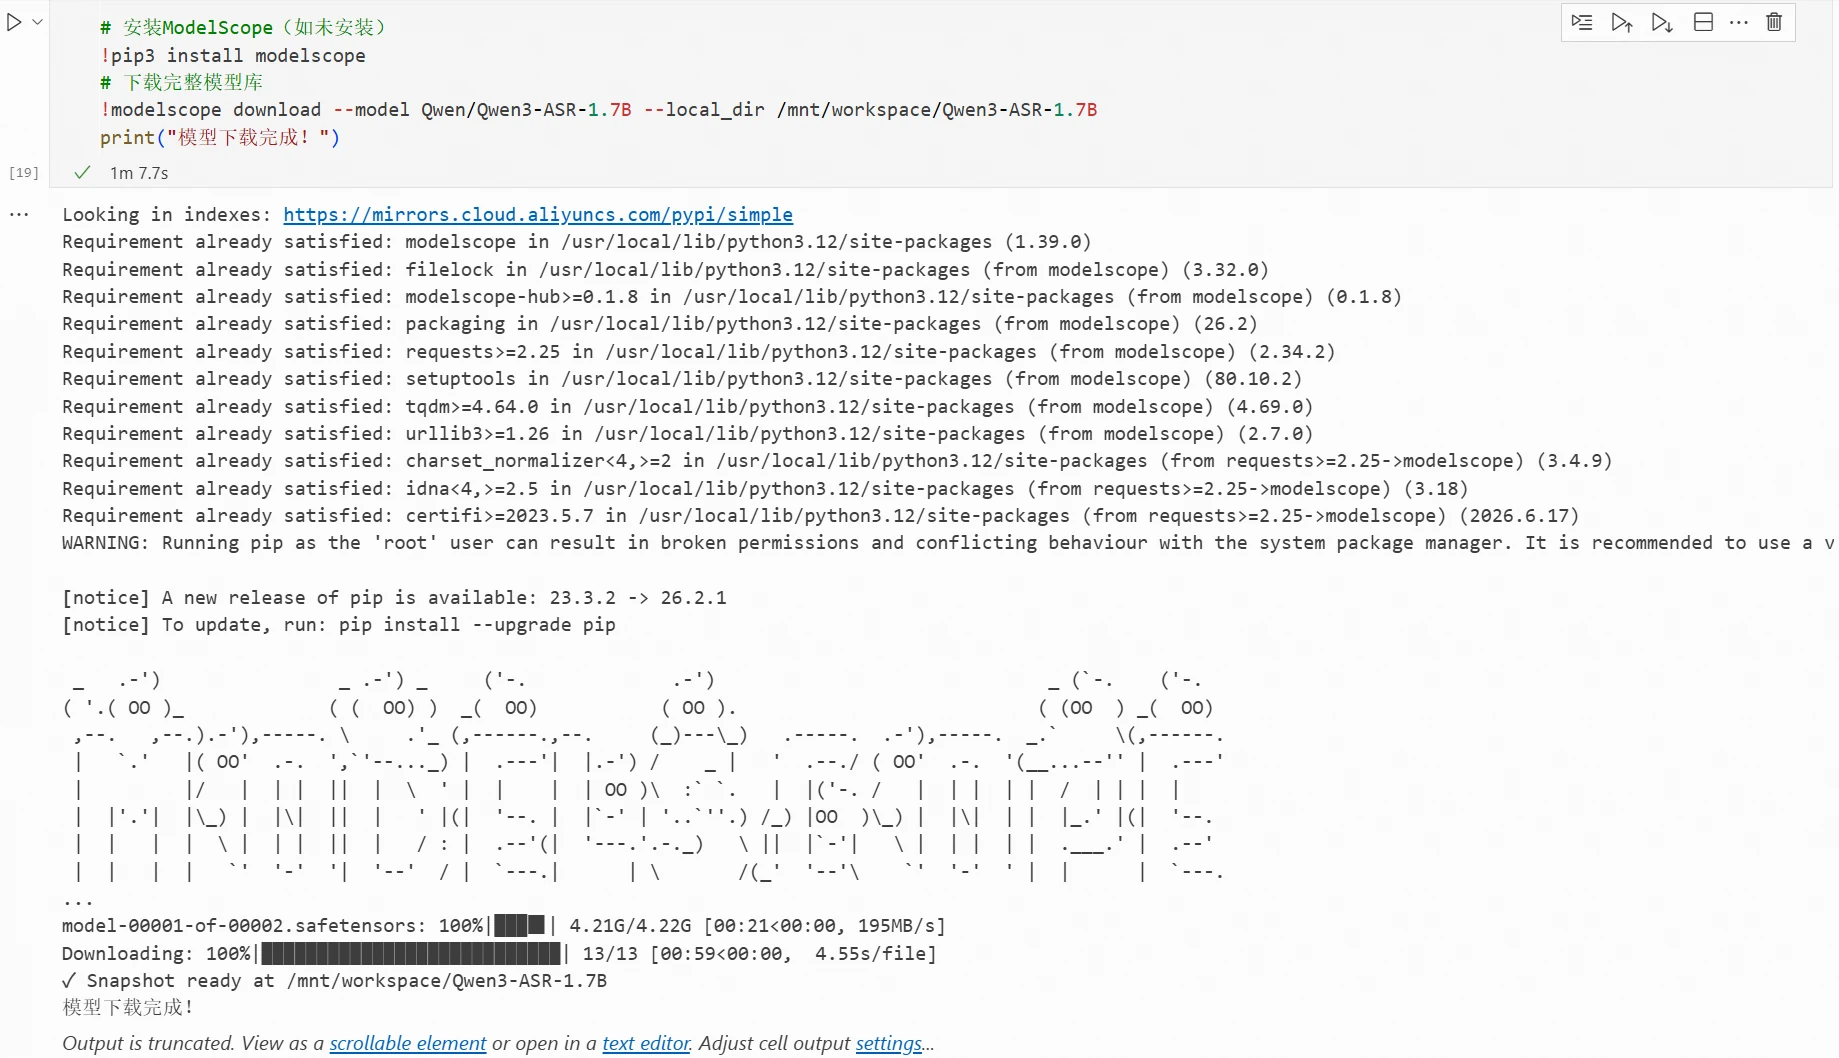
Si deseas descargar el modelo por separado, consulta el método de descarga de modelos en la sección 2.5 de este libro. Por ejemplo, para descargar el modelo en el directorio /mnt/workspace/Qwen3-ASR-1.7B, usando la descarga por línea de comando como ejemplo, ejecuta el siguiente comando en la terminal:

# Instalar ModelScope (si no está instalado)
!pip3 install modelscope
# Descargar el repositorio completo del modelo
!modelscope download --model Qwen/Qwen3-ASR-1.7B --local_dir /mnt/workspace/Qwen3-ASR-1.7B

Resultado:

ilustración

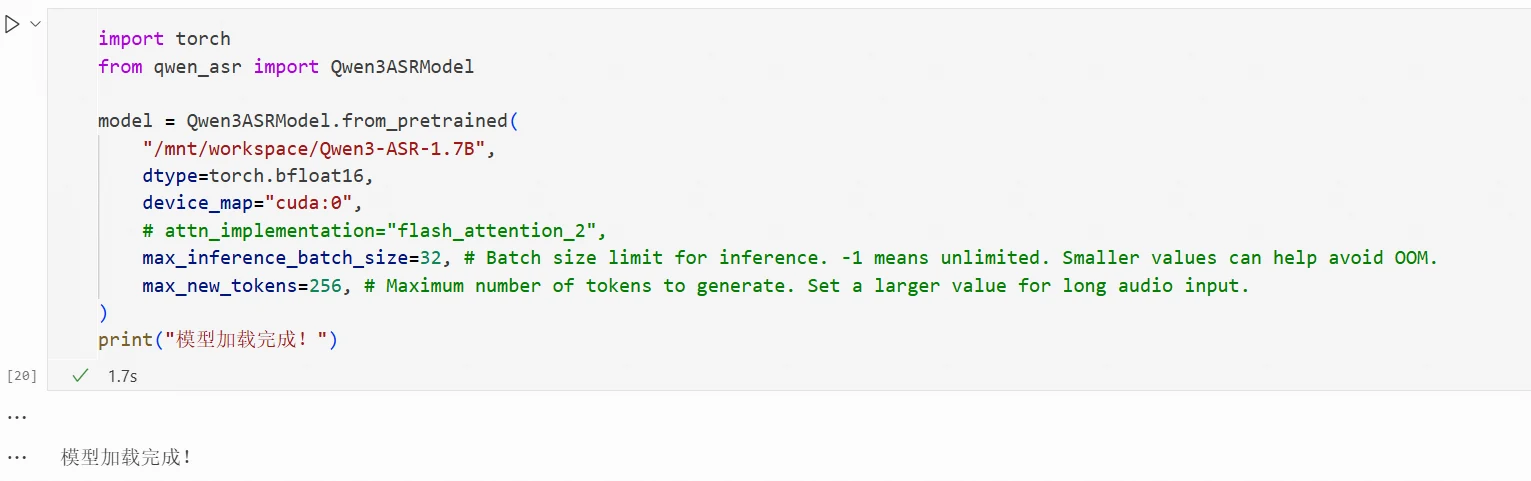
Si tienes los archivos del modelo descargados, puedes reemplazar Qwen/Qwen3-ASR-1.7B con la ruta de tu modelo.

import torch
from qwen_asr import Qwen3ASRModel

model = Qwen3ASRModel.from_pretrained(
    "/mnt/workspace/Qwen3-ASR-1.7B",
    dtype=torch.bfloat16,
    device_map="cuda:0",
    # attn_implementation="flash_attention_2",
    max_inference_batch_size=32, # Batch size limit for inference. -1 means unlimited. Smaller values can help avoid OOM.
    max_new_tokens=256, # Maximum number of tokens to generate. Set a larger value for long audio input.
)
print("¡Modelo cargado exitosamente!")

Resultado:

ilustración

Pasa un archivo de audio y ve qué reconoce

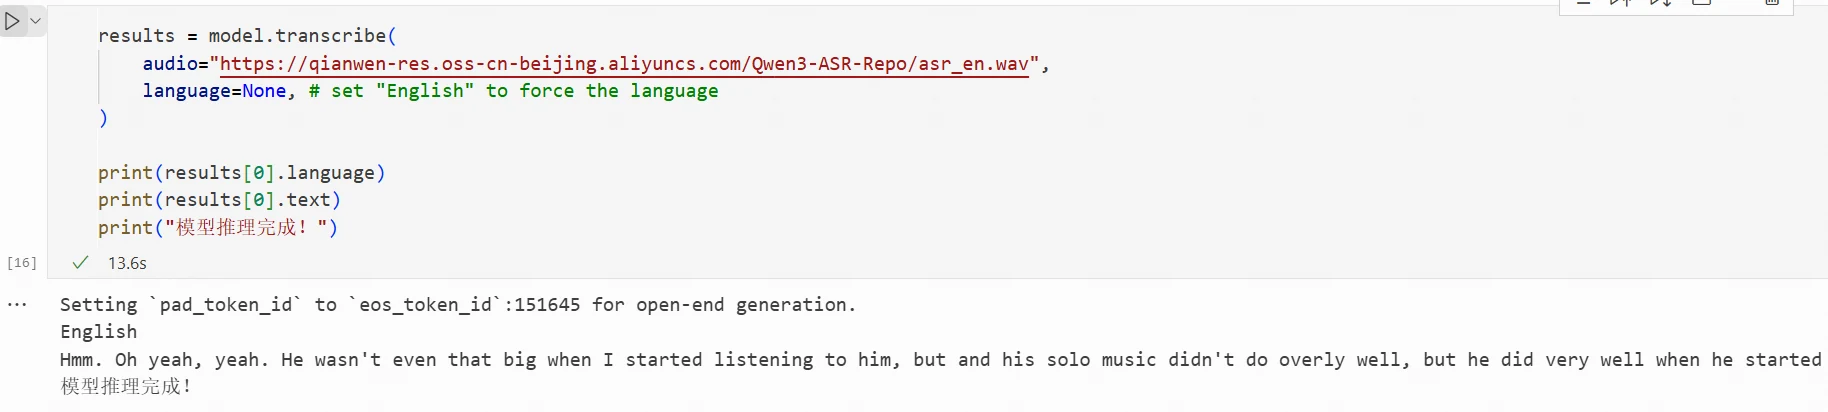
Una vez que el modelo está cargado, puedes pasar archivos de audio para la inferencia del modelo. Puedes reemplazar el valor de audio con la ruta de tu archivo de audio.

results = model.transcribe(
    audio="https://qianwen-res.oss-cn-beijing.aliyuncs.com/Qwen3-ASR-Repo/asr_en.wav",
    language=None, # set "English" to force the language
)
 
print(results[0].language)
print(results[0].text)
print("¡Inferencia del modelo completada!")

Resultado:

ilustración

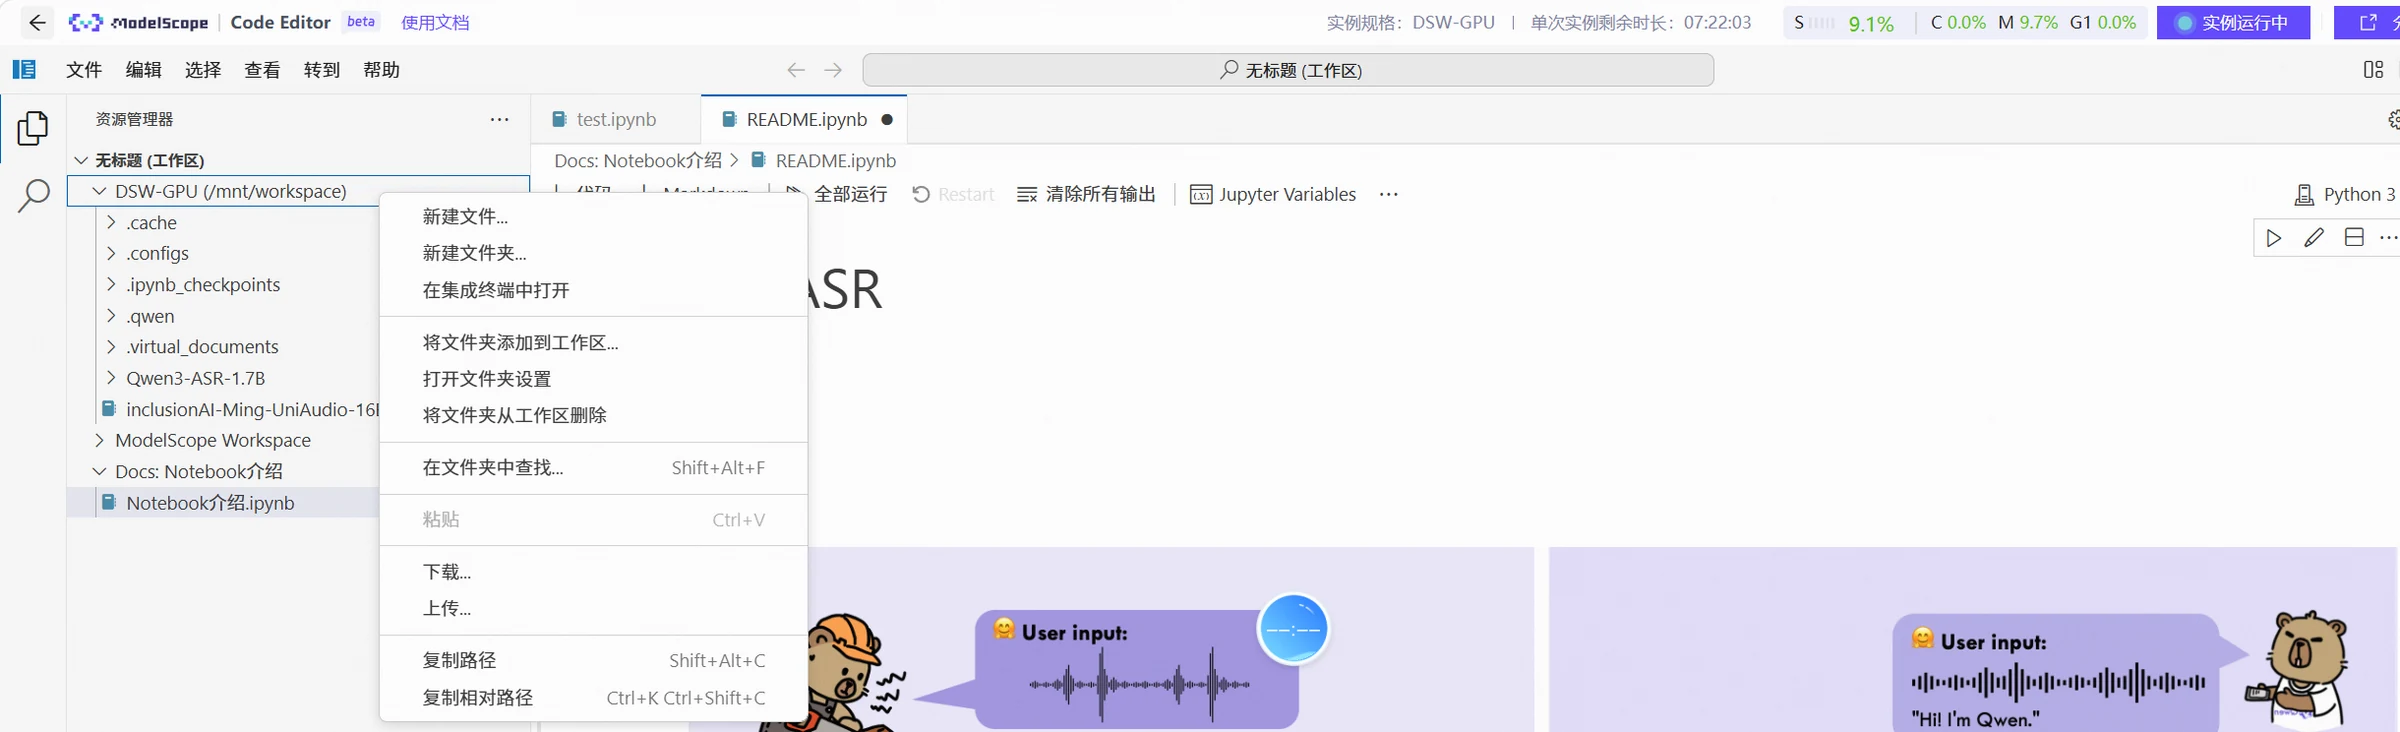
Puedes reemplazar el valor de audio con la ruta de tu archivo de audio para la inferencia del modelo. Haz clic derecho en la carpeta "DSW-GPU" en el espacio de trabajo izquierdo, haz clic en "Upload", selecciona tu archivo de audio local y se cargará en la carpeta "DSW-GPU" del entorno Notebook.

ilustración

Luego modifica el código de la siguiente manera:

results = model.transcribe(
    audio="/mnt/workspace/asr_en.wav",
    language=None, # set "English" to force the language
)
 
print(results[0].language)
print(results[0].text)
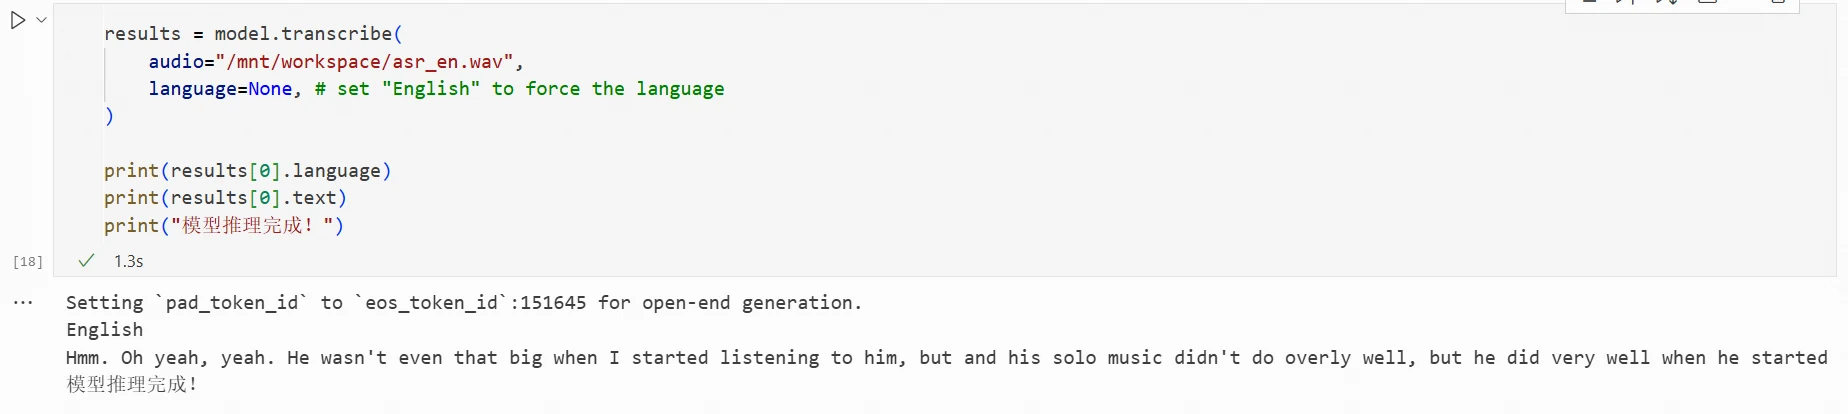
print("¡Inferencia del modelo completada!")

Resultado:

ilustración

El código y los archivos relacionados de este capítulo se encuentran en: https://www.modelscope.cn/gallery/liucong/54c2ca38-b797-43d1-97ab-4b9f569aaa95