Fine-tuning y evaluación • Principiante⏱️ 30 min de lectura
Training Data Preparation
¿Cómo transformar materiales de negocios en datos entrenables?
Antes de entrenar un modelo, a menudo nos encontramos con el siguiente problema:
Tengo muchos materiales brutales, manuales de productos, guías de operación y especificaciones de negocio, cada uno en su propio formato, y el contenido está bastante disperso,
¿Cómo puedo utilizar estos datos?
Y si utilizo directamente datos de dominio o escenario específicos, ¿el modelo entrenado seguirá teniendo la capacidad de responder preguntas de conocimientos generales?
Por lo tanto, el punto clave es cómo podemos transformar todos los materiales en datos de entrenamiento utilizables por el modelo.
Al mismo tiempo, la limpieza, deduplicación y anonimización de datos también son esenciales. Podemos haber destilado los datos, pero necesitamos adaptarlos a nuestros resultados deseados.
Por ejemplo, al entrenar un modelo, si los datos de auto-identificación no se entrenan correctamente, podría responder que es un modelo ChatGPT, un modelo Claude, etc.
Los datos son la base de todo. En este capítulo, comenzamos desde las fuentes de datos y vemos cómo estos materiales dispersos pasan por síntesis, limpieza, deduplicación y anonimización para finalmente convertirse en datos que pueden usarse para el entrenamiento del modelo.
Aprendiendo habilidades de negocio mientras se preservan las capacidades generales
La recopilación y anotación de datos de entrenamiento desde cero requiere una cantidad significativa de tiempo y costo. Para tareas comunes como clasificación de texto, preguntas y respuestas y generación de texto, se pueden encontrar conjuntos de datos públicos adecuados para incluir en el entrenamiento.
Los conjuntos de datos públicos comunes incluyen:
Clasificación de texto e inferencia: GLUE, SuperGLUE, CLUE, etc.;
Comprensión de lectura y preguntas y respuestas: SQuAD, CMRC, etc.;
Resumen de texto: CNN/DailyMail, etc.;
Diálogo y ajuste de instrucciones: Alpaca, ShareGPT, OpenOrca, etc.;
Tareas multimodales: COCO y otros conjuntos de datos imagen-texto.
Además de obtener datos de los sitios web oficiales de conjuntos de datos, también se pueden encontrar y usar conjuntos de datos de código abierto a través del Dataset Hub de ModelScope. El Dataset Hub proporciona funciones como búsqueda de conjuntos de datos, vista previa en línea y descarga. Algunos conjuntos de datos también se pueden cargar directamente a través del SDK de ModelScope para su posterior procesamiento y entrenamiento. Para métodos específicos de descarga de conjuntos de datos, consulte el capítulo "Datos: la base del ajuste fino de modelos de código abierto".
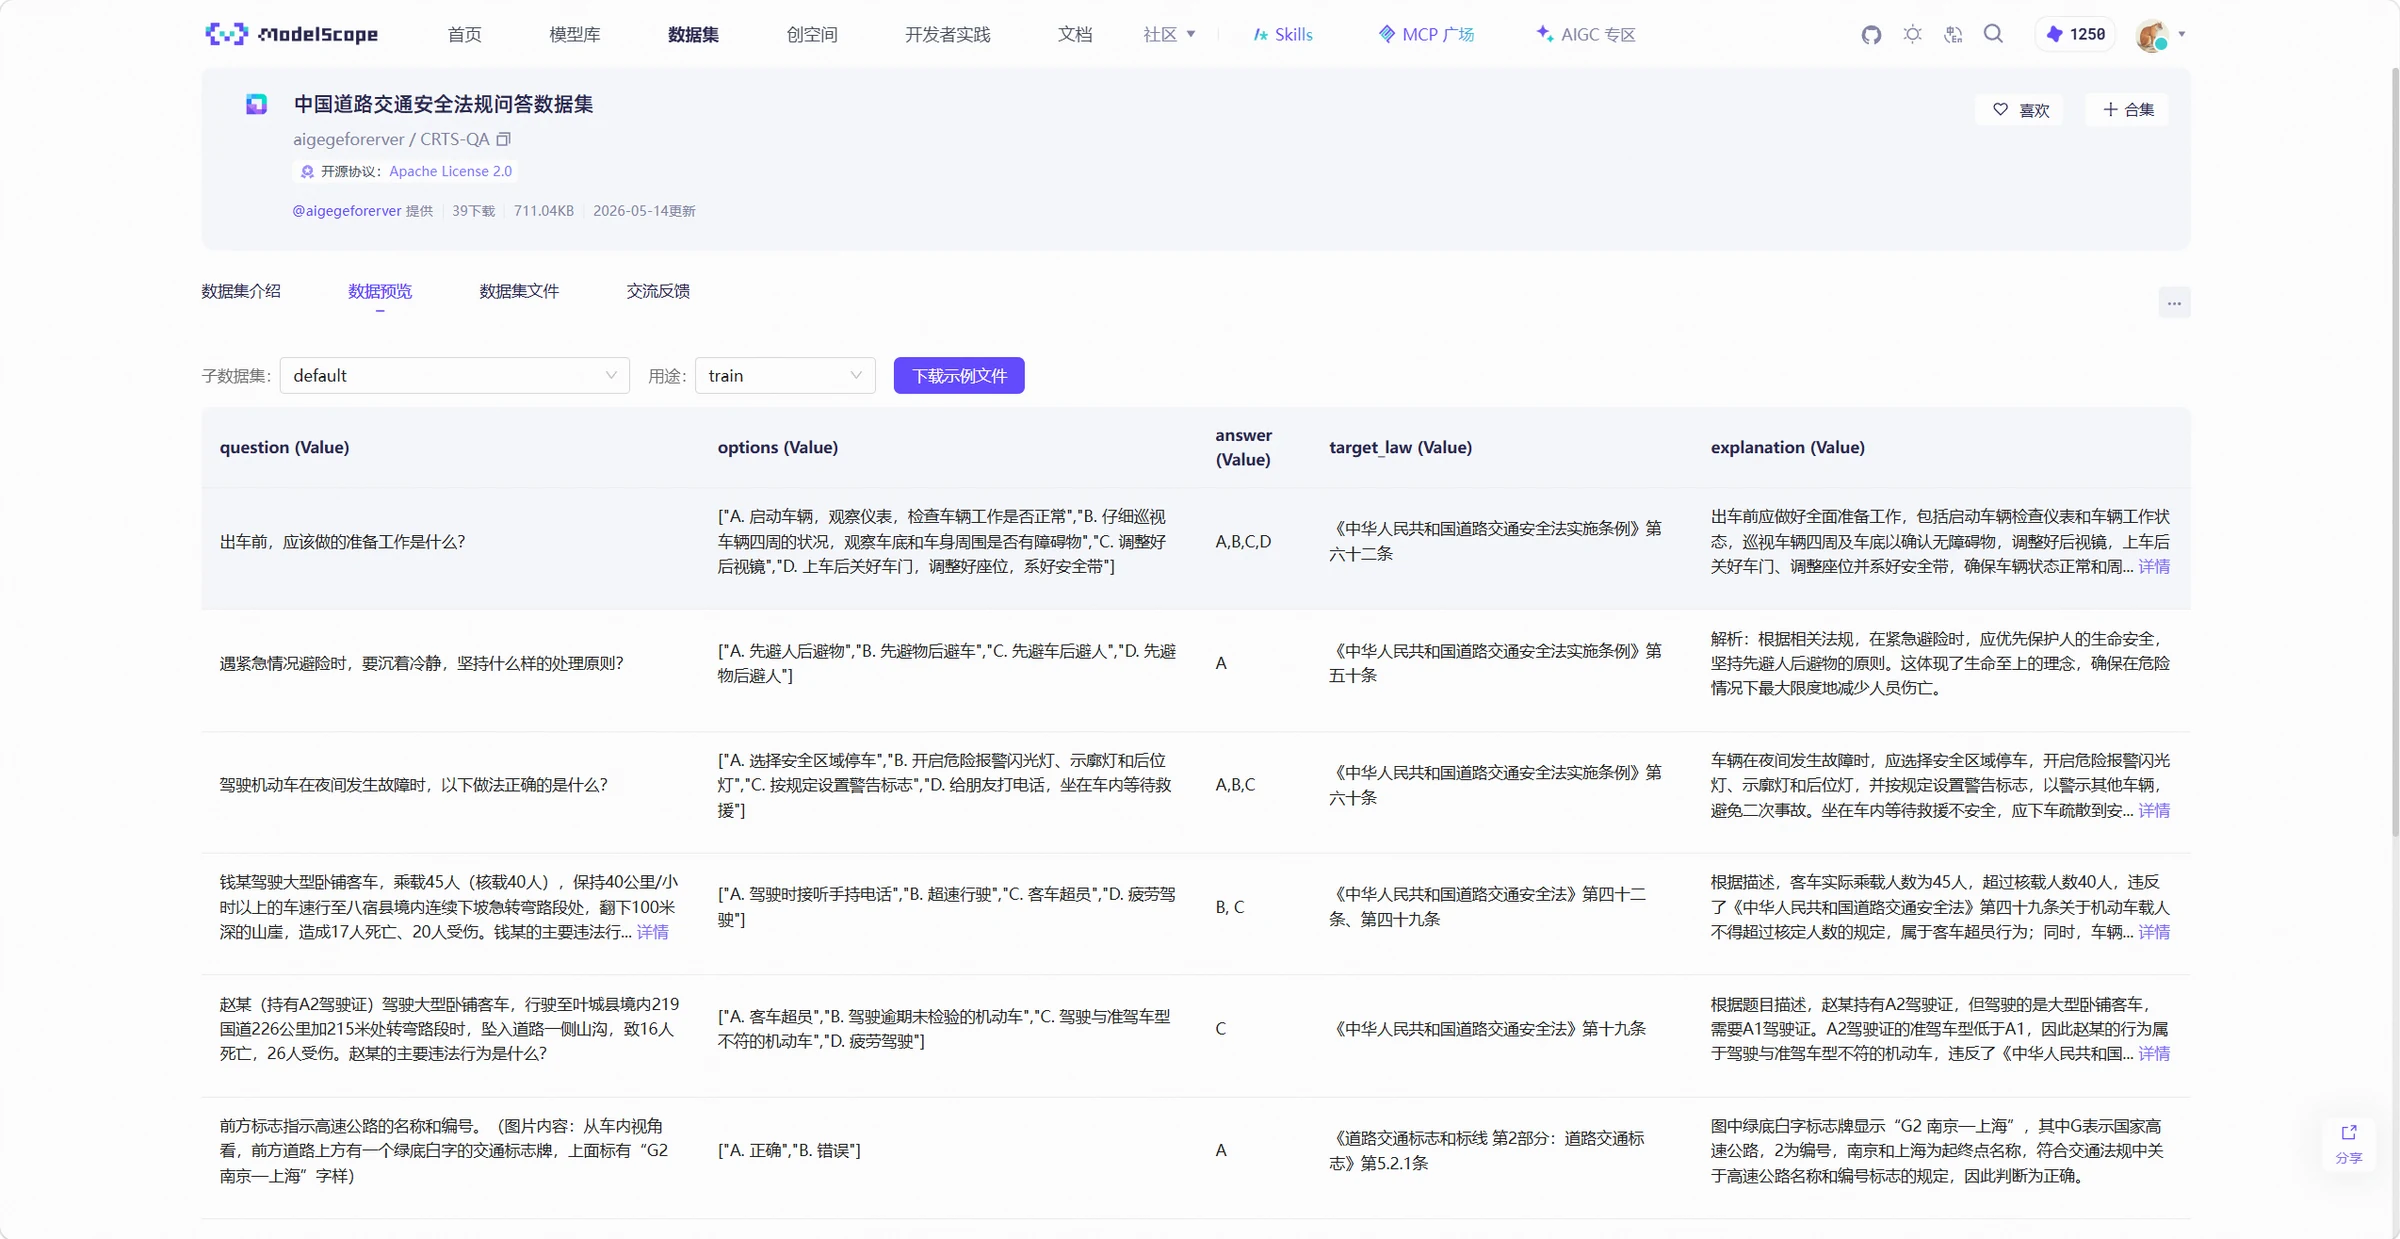
Al seleccionar conjuntos de datos de código abierto, no solo debe verificar si el contenido de los datos coincide con la tarea de entrenamiento, sino también verificar el número de muestras, el formato de los campos, los tipos de etiquetas y la calidad de los datos del conjunto de datos para determinar si cumple con los requisitos de entrenamiento. La función de vista previa de datos proporcionada por ModelScope puede ayudar a visualizar rápidamente los campos y el contenido de las muestras del conjunto de datos, como se muestra en el siguiente ejemplo:
Los datos de código abierto se utilizan principalmente para complementar las capacidades generales del modelo. Si el modelo necesita aprender productos internos de la empresa, terminología, reglas de negocio y procesos de trabajo, se deben preparar datos de negocio correspondientes.
¿Cómo utilizar sus propios materiales de negocio?
Los datos de negocio provienen de sistemas y materiales de negocio reales dentro de una empresa, lo que los hace más cercanos a los escenarios donde el modelo finalmente será utilizado. Los datos generales de preguntas y respuestas pueden ayudar al modelo a aprender patrones básicos de P&R, mientras que los datos internos de P&R de la empresa pueden ayudar al modelo a aprender nombres de productos, terminología de negocio y reglas de proceso.
Las fuentes de datos de negocio comunes incluyen:
Documentos empresariales: manuales de productos, guías de operación, especificaciones de negocio, documentos de proceso, etc., de los cuales se pueden extraer conocimientos del producto, reglas de negocio y procesos operativos;
Registros de atención al cliente: conversaciones históricas, órdenes de trabajo y registros de quejas entre usuarios y atención al cliente, que se pueden utilizar para construir reconocimiento de intención, datos de preguntas y respuestas y diálogo;
FAQ: preguntas y respuestas estándar compiladas por el personal de negocio, que se pueden convertir directamente en datos de entrenamiento de preguntas y respuestas;
Casos de expertos: problemas típicos manejados por expertos de negocio y sus soluciones, que se pueden utilizar para construir datos de entrenamiento para escenarios de negocio complejos.
Los datos de negocio generalmente no se pueden utilizar directamente para el entrenamiento del modelo. Por ejemplo, un manual de negocio de varias docenas de páginas necesita que su contenido de texto se extraiga primero de archivos Word, PDF u otros, y luego se organice en pares de preguntas y respuestas, muestras de clasificación o datos de instrucciones según la tarea de entrenamiento. Los registros de atención al cliente también pueden contener mensajes del sistema, conversaciones inválidas y contenido duplicado, que deben filtrarse y organizarse primero.
Los datos de negocio también pueden contener información sensible como nombres, números de teléfono, números de identificación, direcciones y números de cuenta. Antes de entrar en el conjunto de datos de entrenamiento, se debe realizar la anonimización de acuerdo con los requisitos de seguridad de datos de la empresa para evitar usar información sensible real directamente para el entrenamiento del modelo.
Solo documentos sin P&R, deja que el modelo ayude a sintetizar datos
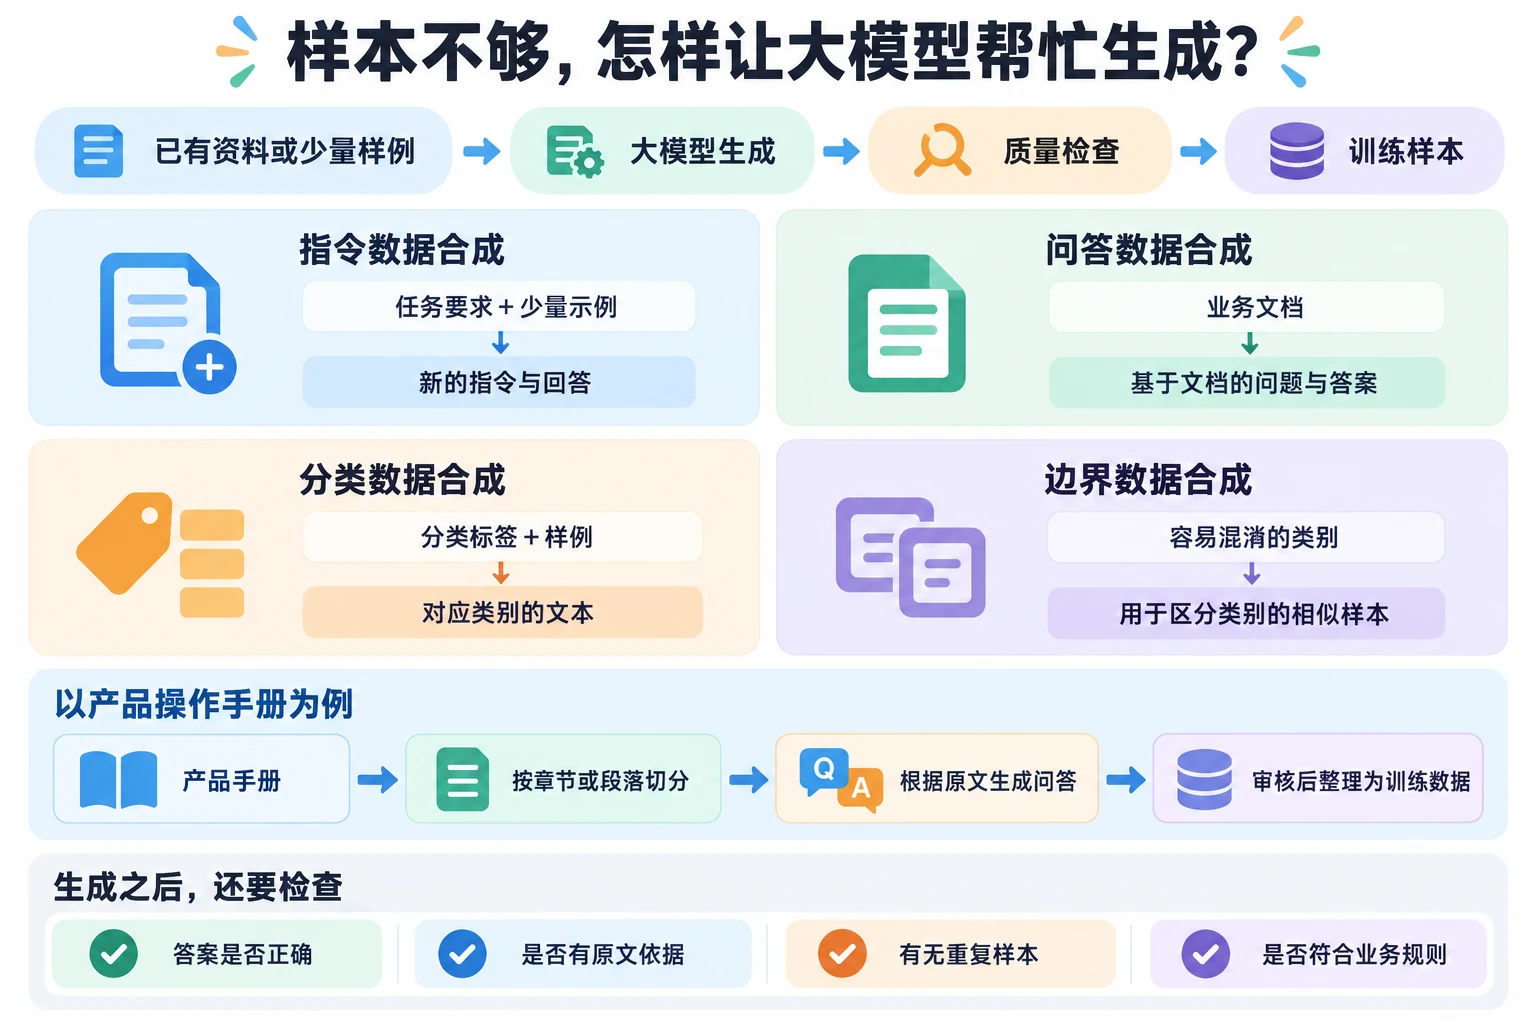
En proyectos reales, los datos existentes pueden no cumplir con todas las necesidades de entrenamiento. Por ejemplo, algunos tipos de negocio tienen solo unas pocas muestras, o los documentos existentes contienen conocimiento pero no datos de P&R directamente utilizables para el entrenamiento. En tales casos, se pueden usar grandes modelos para generar nuevas muestras de entrenamiento, un método conocido como síntesis de datos.
Los métodos comunes de síntesis de datos incluyen:
Síntesis de datos de instrucciones: Basándose en tareas existentes o algunos ejemplos, use un grande modelo para generar nuevas instrucciones y respuestas;
Síntesis de datos de preguntas y respuestas: Ingrese documentos de negocio y use el grande modelo para generar preguntas y respuestas basadas en el contenido del documento;
Síntesis de datos de clasificación: Especifique etiquetas de clasificación y ejemplos, y use el grande modelo para generar texto para las categorías correspondientes;
Síntesis de datos de frontera: Genere muestras similares para categorías fáciles de confundir para mejorar la capacidad del modelo para distinguir los límites de las categorías.
Por ejemplo, si una empresa solo tiene manuales de operación de productos sin datos de P&R, el manual debe segmentarse por capítulos o párrafos, y se puede usar el grande modelo para generar varias preguntas y respuestas basadas en el contenido de los párrafos. Después de revisar los resultados, organícelos en datos de entrenamiento de preguntas y respuestas.
La síntesis de datos puede reducir la carga de trabajo manual de redacción de muestras de entrenamiento y complementar escenarios donde los datos originales son insuficientes. Sin embargo, los datos sintetizados no se pueden utilizar directamente para el entrenamiento después de la generación. El grande modelo puede generar respuestas incorrectas, muestras duplicadas o fabricar productos o reglas de negocio inexistentes, por lo que las verificaciones de calidad siguen siendo necesarias.
No se apresure a entrenar con datos generados
La calidad de los datos sintetizados afecta directamente la efectividad del entrenamiento del modelo. Antes de agregar datos sintetizados al conjunto de entrenamiento, debe verificar si el contenido generado es correcto y filtrar datos erróneos, fabricados, duplicados y demasiado similares.
¿La respuesta coincide con el texto original?
Si los datos sintetizados se generan a partir de documentos de negocio, debe verificar si el contenido generado es consistente con el texto original.
Por ejemplo, el documento de negocio original especifica:
Las solicitudes de reembolso requieren revisión manual, y los reembolsos solo se pueden procesar después de la aprobación.
Datos de preguntas y respuestas generados por el modelo:
P: ¿Una solicitud de reembolso requiere revisión?
R: Los reembolsos se procesan automáticamente después de la presentación, sin revisión manual necesaria.
Esta respuesta entra en conflicto con la regla de negocio. Si se usa para entrenamiento, el modelo puede aprender procesos de negocio incorrectos.
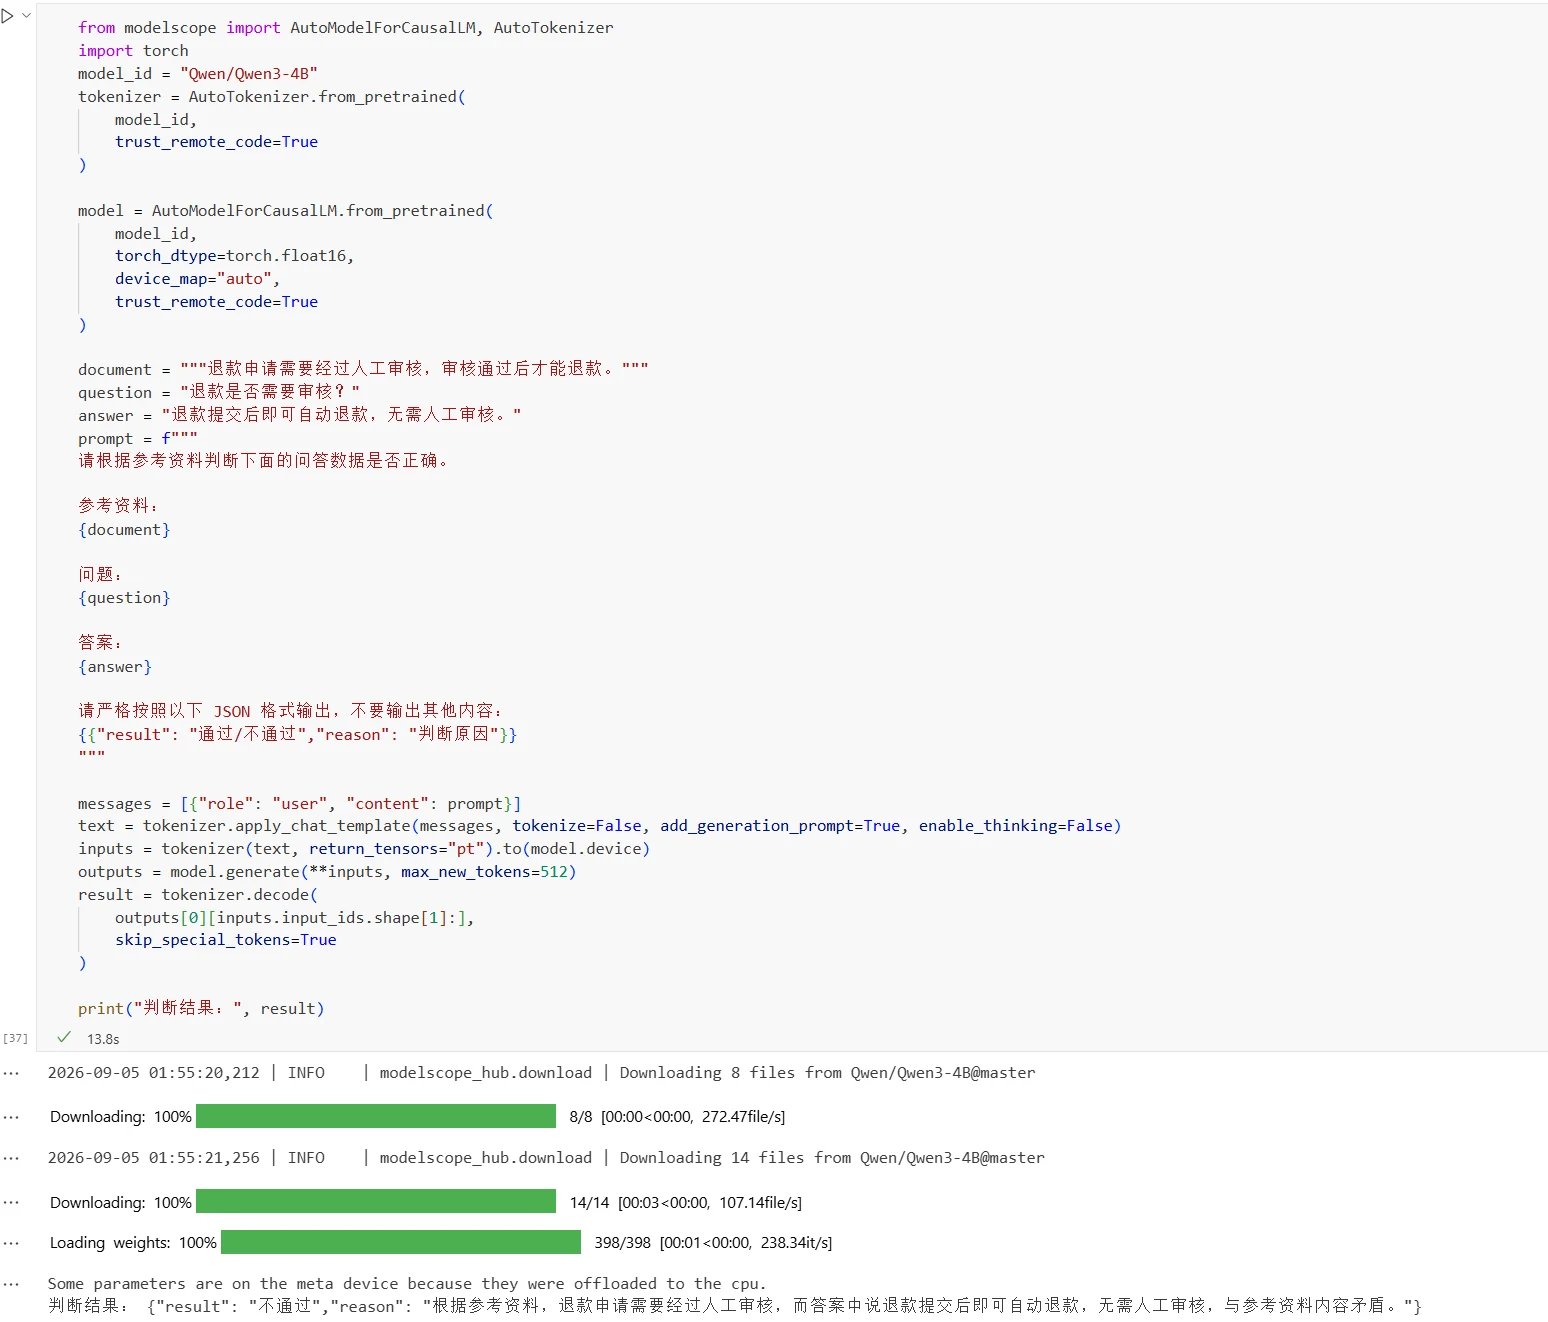
En la práctica, se puede usar un grande modelo para realizar una evaluación de consistencia en los datos sintetizados. Ingrese el material original, la pregunta y la respuesta en el modelo simultáneamente para determinar si la respuesta es consistente con el material. Para los datos juzgados como incorrectos, se pueden eliminar o regenerar. El código de procesamiento es el siguiente:
from modelscope import AutoModelForCausalLM, AutoTokenizer
import torch
model_id = "Qwen/Qwen3-4B"
tokenizer = AutoTokenizer.from_pretrained(
    model_id,
    trust_remote_code=True
)

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.float16,
    device_map="auto",
    trust_remote_code=True
)

document = """Las solicitudes de reembolso requieren revisión manual, y los reembolsos solo se pueden procesar después de la aprobación."""
question = "¿Una solicitud de reembolso requiere revisión?"
answer = "Los reembolsos se procesan automáticamente después de la presentación, sin revisión manual necesaria."
prompt = f"""
Por favor determine si los siguientes datos de preguntas y respuestas son correctos basándose en el material de referencia.

Material de referencia:
{document}

Pregunta:
{question}

Respuesta:
{answer}

Por favor produzca estrictamente en el siguiente formato JSON, y no produzca otro contenido:
{{"result": "aprobado/rechazado","reason": "razón del juicio"}}
"""

messages = [{"role": "user", "content": prompt}]
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True, enable_thinking=False)
inputs = tokenizer(text, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=512)
result = tokenizer.decode(
    outputs[0][inputs.input_ids.shape[1]:],
    skip_special_tokens=True
)

print("Resultado del juicio:", result)
Resultados:
No deje que el modelo invente lo que no está en el texto original
Cuando un grande modelo genera datos, puede producir información que no existe en los materiales originales. Este problema se conoce comúnmente como alucinación. Por ejemplo, generar nombres de productos, parámetros de productos o procesos de negocio inexistentes.
Por ejemplo, el material original indica:
El producto admite un máximo de 100GB de espacio de almacenamiento.
Datos generados:
P: ¿El producto admite escalado automático?
R: Sí, el sistema se escalará automáticamente cuando el espacio de almacenamiento sea insuficiente
El material original no indica si el producto admite escalado automático. Por lo tanto, la respuesta generada carece de base en el material original y constituye información fabricada.
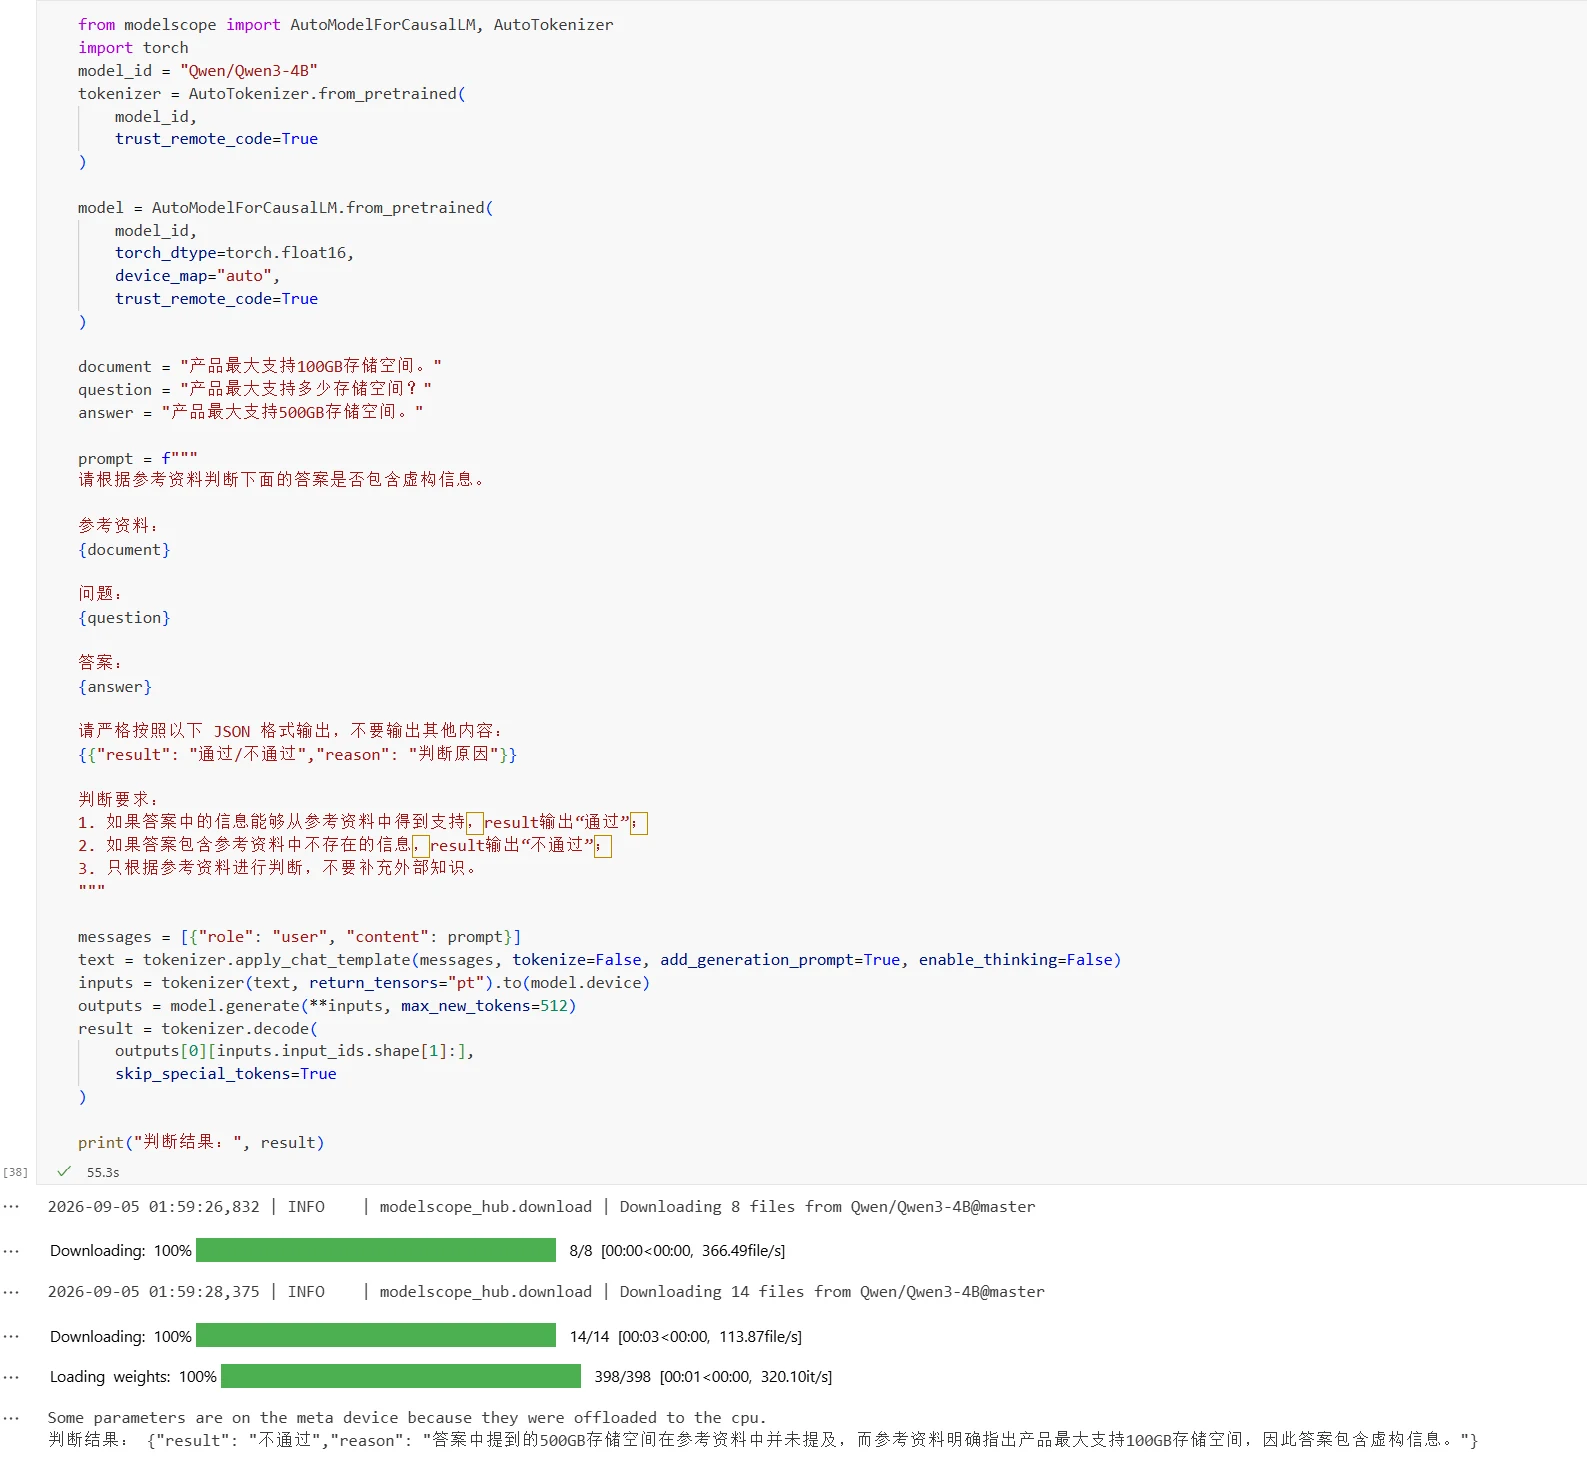
Para los datos generados a partir de materiales de negocio, se puede usar un grande modelo para la verificación de base, determinando si la información clave de la respuesta puede ser respaldada por los materiales originales. Para los datos que carecen de base o que no pueden confirmarse, se pueden eliminar, regenerar o revisar manualmente. Cuando se involucran reglas de negocio importantes, el personal de negocio también puede realizar verificaciones aleatorias. El código de procesamiento es el siguiente:
from modelscope import AutoModelForCausalLM, AutoTokenizer
import torch
model_id = "Qwen/Qwen3-4B"
tokenizer = AutoTokenizer.from_pretrained(
    model_id,
    trust_remote_code=True
)

model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.float16,
    device_map="auto",
    trust_remote_code=True
)

document = "El producto admite un máximo de 100GB de espacio de almacenamiento."
question = "¿Cuál es el espacio de almacenamiento máximo que admite el producto?"
answer = "El producto admite un máximo de 500GB de espacio de almacenamiento."

prompt = f"""
Por favor determine si la siguiente respuesta contiene información fabricada basándose en el material de referencia.

Material de referencia:
{document}

Pregunta:
{question}

Respuesta:
{answer}

Por favor produzca estrictamente en el siguiente formato JSON, y no produzca otro contenido:
{{"result": "aprobado/rechazado","reason": "razón del juicio"}}

Requisitos de juicio:
1. Si la información de la respuesta puede ser respaldada por el material de referencia, el resultado produce "aprobado";
2. Si la respuesta contiene información que no existe en el material de referencia, el resultado produce "rechazado";
3. Solo juzgue basándose en el material de referencia, no complemente con conocimiento externo.
"""

messages = [{"role": "user", "content": prompt}]
text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True, enable_thinking=False)
inputs = tokenizer(text, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=512)
result = tokenizer.decode(
    outputs[0][inputs.input_ids.shape[1]:],
    skip_special_tokens=True
)

print("Resultado del juicio:", result)
Resultados:
Reformular puede seguir siendo la misma pregunta
Cuando un grande modelo genera datos por lotes, es fácil producir muestras duplicadas o muy similares. Por ejemplo: "¿Cómo cambiar la contraseña de inicio de sesión?" y "¿Cómo puedo cambiar mi contraseña de inicio de sesión?" Estas preguntas tienen diferentes expresiones pero básicamente el mismo contenido. Si hay demasiadas muestras similares, reduce el contenido informativo efectivo del conjunto de datos.
Después de sintetizar datos, debe verificar duplicados y similitudes entre muestras, filtrar datos completamente duplicados, controlar el número de muestras muy similares y conservar las muestras representativas. Los métodos específicos de deduplicación de datos se introducirán en las siguientes secciones.
Consolidando datos de diferentes fuentes
Ya sea que los datos provengan de conjuntos de datos de código abierto, datos de negocio de la empresa o síntesis de grandes modelos, necesitan un procesamiento unificado antes de ser utilizados para el entrenamiento del modelo. Los pasos de procesamiento comunes incluyen recopilación de datos, limpieza de datos, deduplicación de datos y anonimización de datos.
Primero recopile el contenido necesario y unifique los campos
La recopilación de datos implica obtener los datos requeridos de diferentes fuentes de datos según la tarea de entrenamiento y organizarlos de manera uniforme.
Antes de la recopilación, debe determinar el contenido de datos requerido por la tarea de entrenamiento. Las tareas de clasificación necesitan texto y etiquetas de categoría, las tareas de preguntas y respuestas necesitan preguntas y respuestas, y el ajuste fino de instrucciones necesita instrucciones y las respuestas correspondientes. Durante la recopilación, solo conserve los datos y campos relacionados con la tarea de entrenamiento.
Las estructuras de datos de diferentes fuentes pueden diferir. Por ejemplo, un conjunto de datos usa los campos question y answer, mientras que otro puede usar los campos query y response. Después de la recopilación, los nombres de campos y las estructuras de datos deben unificarse para el procesamiento posterior.
Para los datos que faltan información necesaria, se pueden completar durante la recopilación. Por ejemplo, agregar etiquetas de categoría para datos de clasificación, o organizar respuestas de referencia para datos de preguntas y respuestas.
Los datos deben limpiarse primero
Los datos brutos pueden contener contenido inválido o incorrecto, que debe limpiarse antes del entrenamiento.
El procesamiento común incluye: eliminar datos vacíos y registros inválidos, eliminar etiquetas HTML y caracteres especiales excesivos, estandarizar la codificación y el formato del texto, y corregir errores evidentes de reconocimiento OCR, etc.
La limpieza de datos no significa eliminar todo contenido especial. El código, las fórmulas, las unidades y la puntuación pueden ser en sí mismas parte del contenido de entrenamiento, y si se conservan depende de la tarea específica.
Tomando un conjunto de datos de FAQ como ejemplo, los datos originales:
faq_data = [
    {
        "question": "  ¿Cómo cambiar la contraseña de inicio de sesión?  ",
        "answer": "<p>Vaya al centro personal y haga clic en 'Cambiar Contraseña'.</p>"
    },
    {
        "question": "",
        "answer": "Por favor contacte al administrador."
    },
    {
        "question": "¿Qué hago si olvidé mi contraseña?",
        "answer": "Haga clic en 'Olvidé mi Contraseña'\n\ny siga las instrucciones."
    },
    {
        "question": "¿Cuál es el número de teléfono de atención al cliente?",
        "answer": "El número de atención al cliente es 400-123-4567\xa0"
    }
]
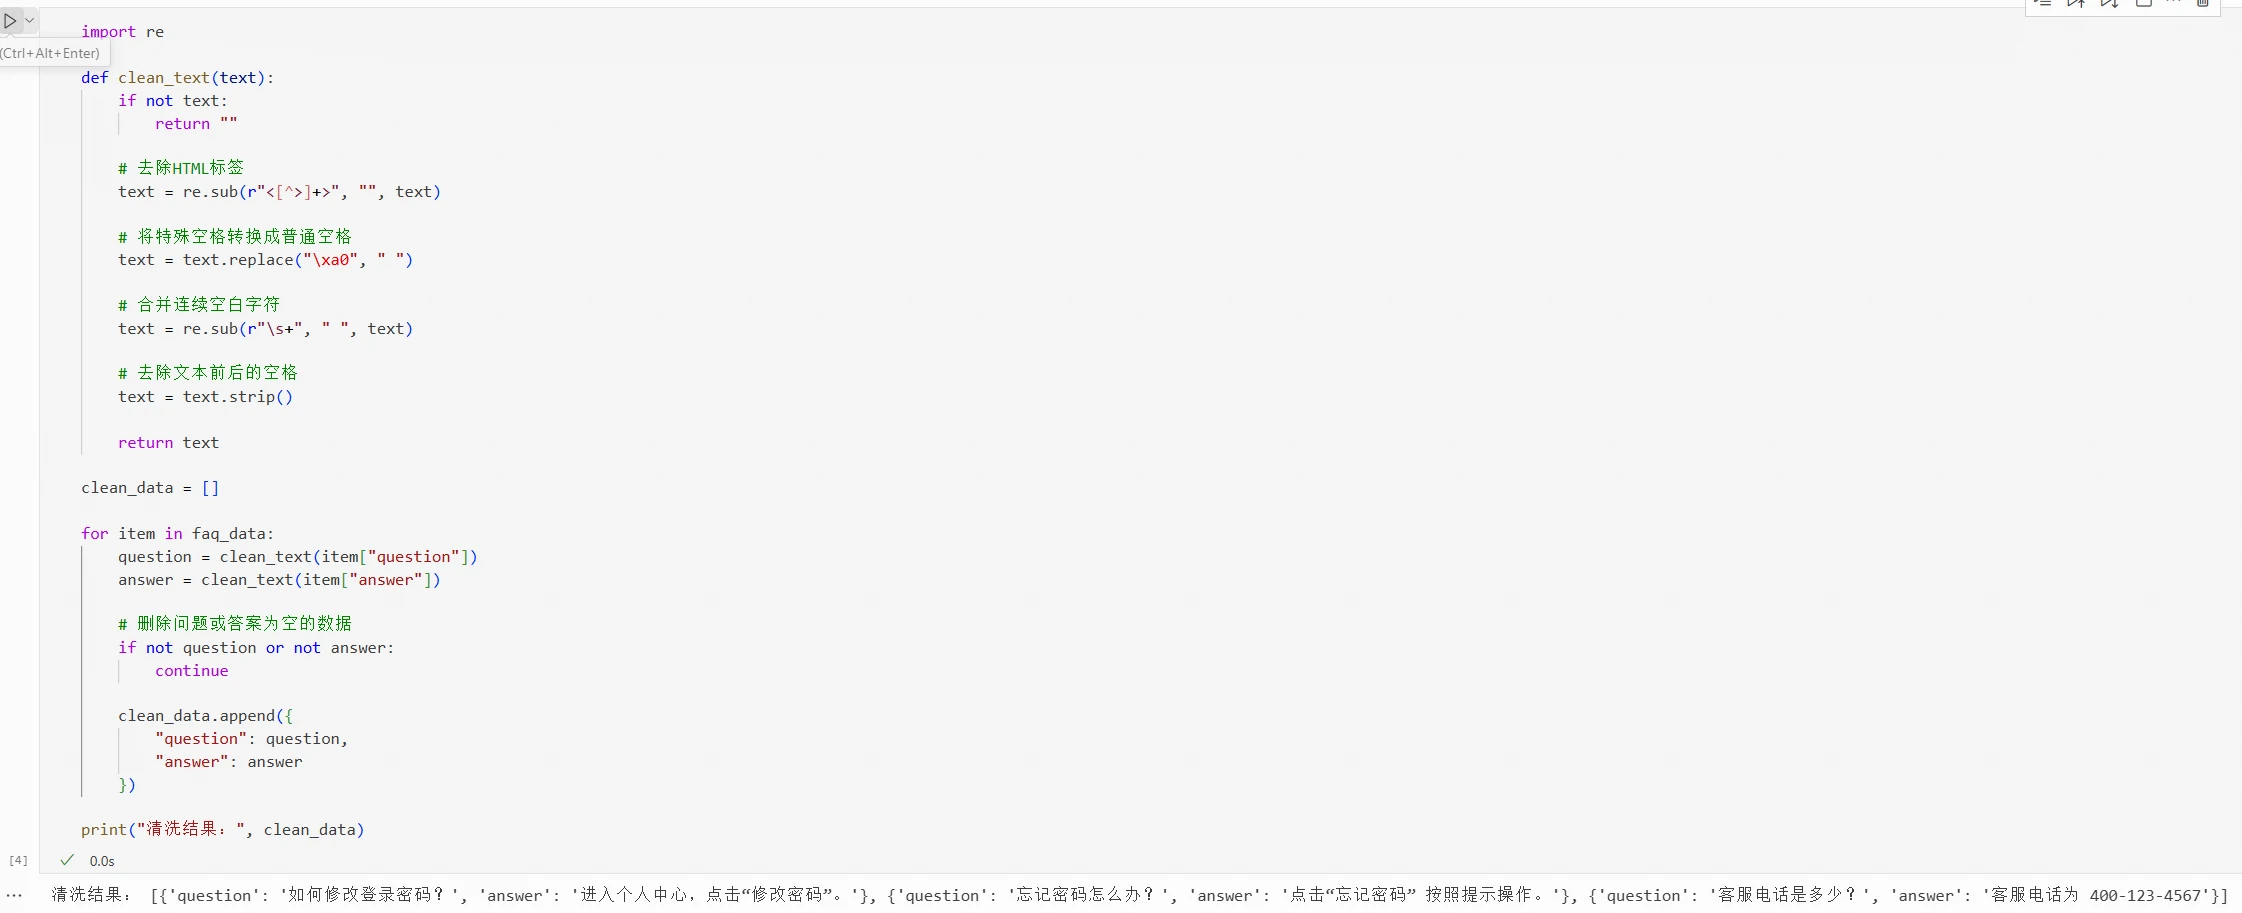
Código de limpieza:
import re

def clean_text(text):
    if not text:
        return ""

    # Eliminar etiquetas HTML
    text = re.sub(r"<[^>]+>", "", text)

    # Convertir espacios especiales a espacios normales
    text = text.replace("\xa0", " ")

    # Fusionar caracteres de espacio consecutivos
    text = re.sub(r"\s+", " ", text)

    # Eliminar espacios al inicio y final del texto
    text = text.strip()

    return text

clean_data = []

for item in faq_data:
    question = clean_text(item["question"])
    answer = clean_text(item["answer"])

    # Eliminar datos donde la pregunta o la respuesta está vacía
    if not question or not answer:
        continue

    clean_data.append({
        "question": question,
        "answer": answer
    })

print("Resultado de limpieza:", clean_data)
Resultados de limpieza:
Las reglas de limpieza específicas en negocios reales deben determinarse según las características de los datos.
¿Realmente necesita conservar todos los datos duplicados?
Después de consolidar los datos recopilados de diferentes fuentes, pueden aparecer datos duplicados o similares. La misma FAQ puede aparecer simultáneamente en conjuntos de datos públicos, manuales de productos y bases de conocimiento de atención al cliente. Los datos sintetizados también pueden ser similares al contenido de datos existentes. Si hay demasiados datos duplicados, reduce la diversidad de los datos de entrenamiento, haciendo que el modelo sobre-aprenda ciertos conocimientos o expresiones. Por lo tanto, una deduplicación unificada es necesaria antes del entrenamiento.
Según el grado de duplicación de los datos, la deduplicación de datos se puede dividir en deduplicación de datos exactos y deduplicación de datos similares:
Deduplicación de datos exactos: Determine si dos piezas de datos tienen exactamente el mismo contenido. La deduplicación se puede realizar mediante coincidencia de texto o valores hash.
Deduplicación de datos similares: Determine si dos piezas de datos tienen contenido similar a pesar de diferentes redacciones. Se pueden usar métodos como MinHash, SimHash o similitud de vectores para la detección.
Diferentes tipos de datos requieren diferentes reglas de deduplicación. Tomando un conjunto de datos de FAQ como ejemplo, la pregunta y la respuesta se pueden combinar en un solo texto, luego determine si diferentes muestras son duplicados o similares.
Deduplicación de datos exactos
Muestras de datos:
faq_data = [
    {
        "question": "¿Cómo cambiar la contraseña de inicio de sesión?",
        "answer": "Vaya al centro personal y haga clic en 'Cambiar Contraseña'."
    },
    {
        "question": "¿Qué hago si olvidé mi contraseña?",
        "answer": "Haga clic en 'Olvidé mi Contraseña' y siga las instrucciones."
    },
    {
        "question": "¿Cómo cambiar la contraseña de inicio de sesión?",
        "answer": "Vaya al centro personal y haga clic en 'Cambiar Contraseña'."
    }
]
(1) Coincidencia de texto
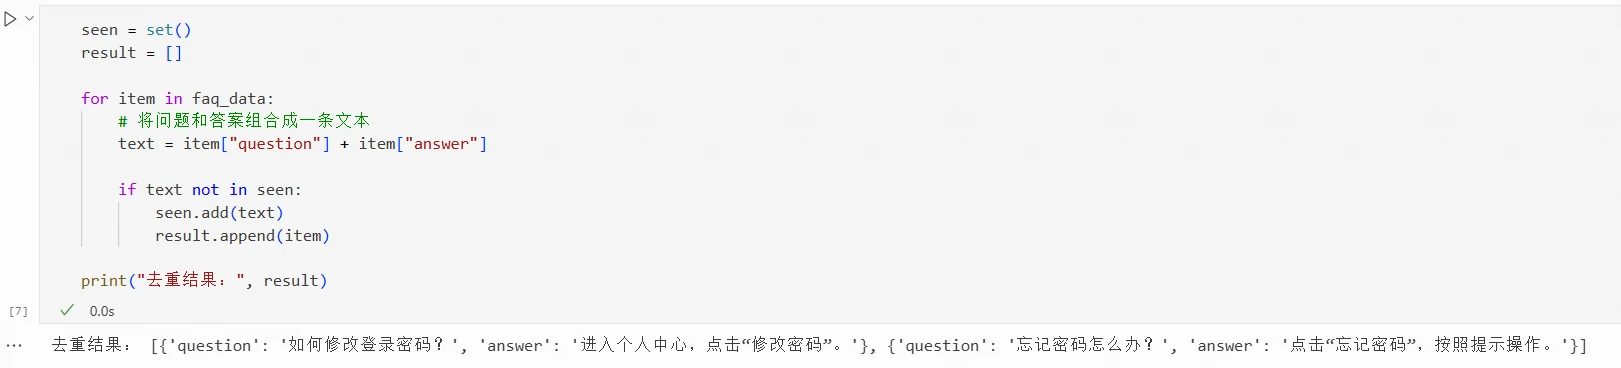
Código de deduplicación por coincidencia de texto:
seen = set()
result = []

for item in faq_data:
    # Combinar pregunta y respuesta en un solo texto
    text = item["question"] + item["answer"]

    if text not in seen:
        seen.add(text)
        result.append(item)

print("Resultado de deduplicación:", result)
Resultados de deduplicación:
Después del procesamiento, solo se conserva una de las dos FAQ idénticas.
(2) Valores hash
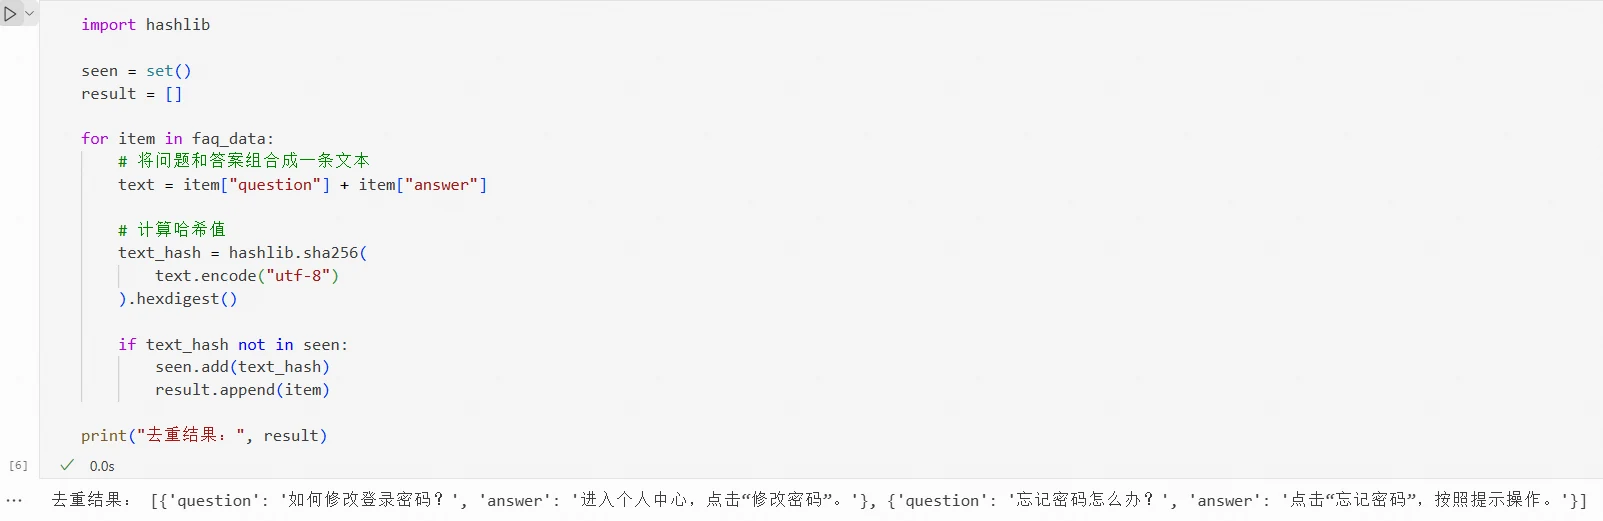
Un algoritmo hash puede convertir un texto en un valor de longitud fija. El texto idéntico producirá el mismo valor hash, lo que le permite determinar si los datos son duplicados comparando valores hash. Por ejemplo:
import hashlib

seen = set()
result = []

for item in faq_data:
    # Combinar pregunta y respuesta en un solo texto
    text = item["question"] + item["answer"]

    # Calcular valor hash
    text_hash = hashlib.sha256(
        text.encode("utf-8")
    ).hexdigest()

    if text_hash not in seen:
        seen.add(text_hash)
        result.append(item)

print("Resultado de deduplicación:", result)
Resultados de deduplicación:
Los valores hash ordinarios solo se pueden usar para determinar si el contenido es exactamente el mismo. En cuanto cambia el texto en la pregunta o la respuesta, el valor hash calculado será diferente. Para los datos con diferente redacción pero contenido similar, se necesita una evaluación adicional de similitud.
Deduplicación de datos similares
Muestras de datos:
faq_data = [
    {
        "question": "¿Cómo cambiar la contraseña de inicio de sesión?",
        "answer": "Vaya al centro personal y haga clic en 'Cambiar Contraseña'."
    },
    {
        "question": "¿Cómo puedo cambiar mi contraseña de inicio de sesión?",
        "answer": "Después de ir al centro personal, haga clic en 'Cambiar Contraseña'."
    },
    {
        "question": "¿Cómo solicitar una factura?",
        "answer": "Vaya a la página de pedidos, seleccione solicitud de factura y envíe la información."
    }
]
Las preguntas y respuestas de las dos primeras FAQ difieren en redacción pero expresan un contenido relativamente similar en general. Para estos datos, se pueden usar MinHash, SimHash o similitud de vectores para la detección.
(1) MinHash
MinHash determina principalmente la similitud basándose en la superposición de palabras o caracteres en el texto, lo que lo hace más adecuado para detectar datos literalmente similares. Para datos de FAQ, primero puede combinar la pregunta y la respuesta en un solo texto, luego dividir el texto en palabras, caracteres o fragmentos de caracteres para el cálculo.
MinHash se utiliza típicamente para aproximar la similitud de Jaccard:
J(A,B)=\frac{|A\cap B|}{|A\cup B|}
donde A y B representan los conjuntos de palabras o caracteres contenidos en dos textos,
A\cap B
representa el contenido compartido por ambos,
A\cup B
representa todo el contenido contenido en ambos. El resultado del cálculo está entre 0 y 1, donde los valores más cercanos a 1 indican que los dos textos son más similares.
En Python, la biblioteca datasketch se puede usar para implementar MinHash:
!pip install datasketch
Resultados:
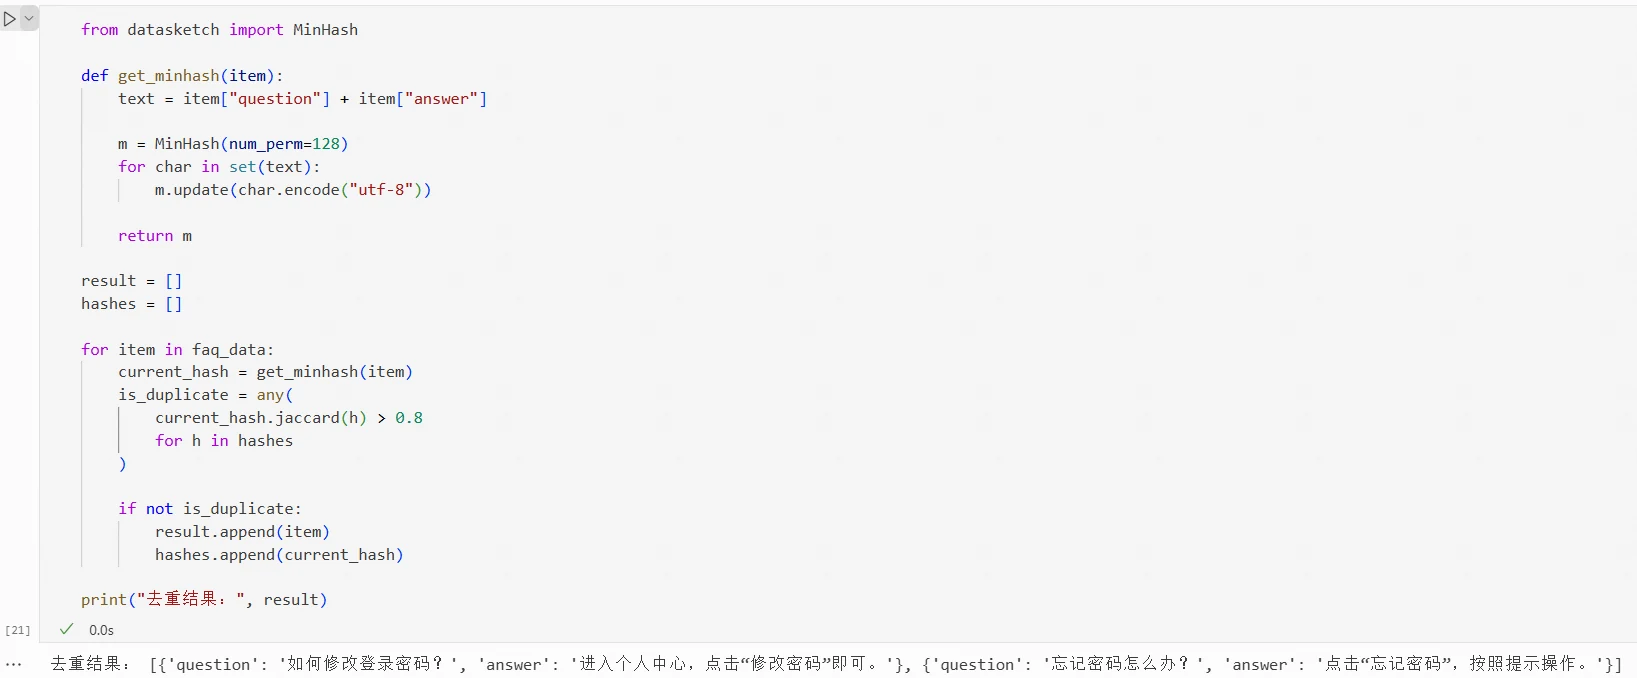
Código de ejemplo:
from datasketch import MinHash

def get_minhash(item):
    text = item["question"] + item["answer"]

    m = MinHash(num_perm=128)
    for char in set(text):
        m.update(char.encode("utf-8")

    return m

result = []
hashes = []

for item in faq_data:
    current_hash = get_minhash(item)

    is_duplicate = any(
        current_hash.jaccard(h) > 0.8
        for h in hashes
    )

    if not is_duplicate:
        result.append(item)
        hashes.append(current_hash)

print("Resultado de deduplicación:", result)
Resultados:
(2) SimHash
SimHash genera una huella digital de longitud fija basada en el contenido del texto, luego usa la distancia Hamming entre las huellas digitales para determinar si los textos son similares.
A diferencia del Hash ordinario, que determina principalmente si el contenido es exactamente el mismo, SimHash puede detectar textos con contenido similar. Cuanto menor sea la distancia Hamming entre dos huellas digitales de SimHash, más similares son generalmente los textos.
SimHash necesita ser instalado:
!pip install simhash
Resultados:
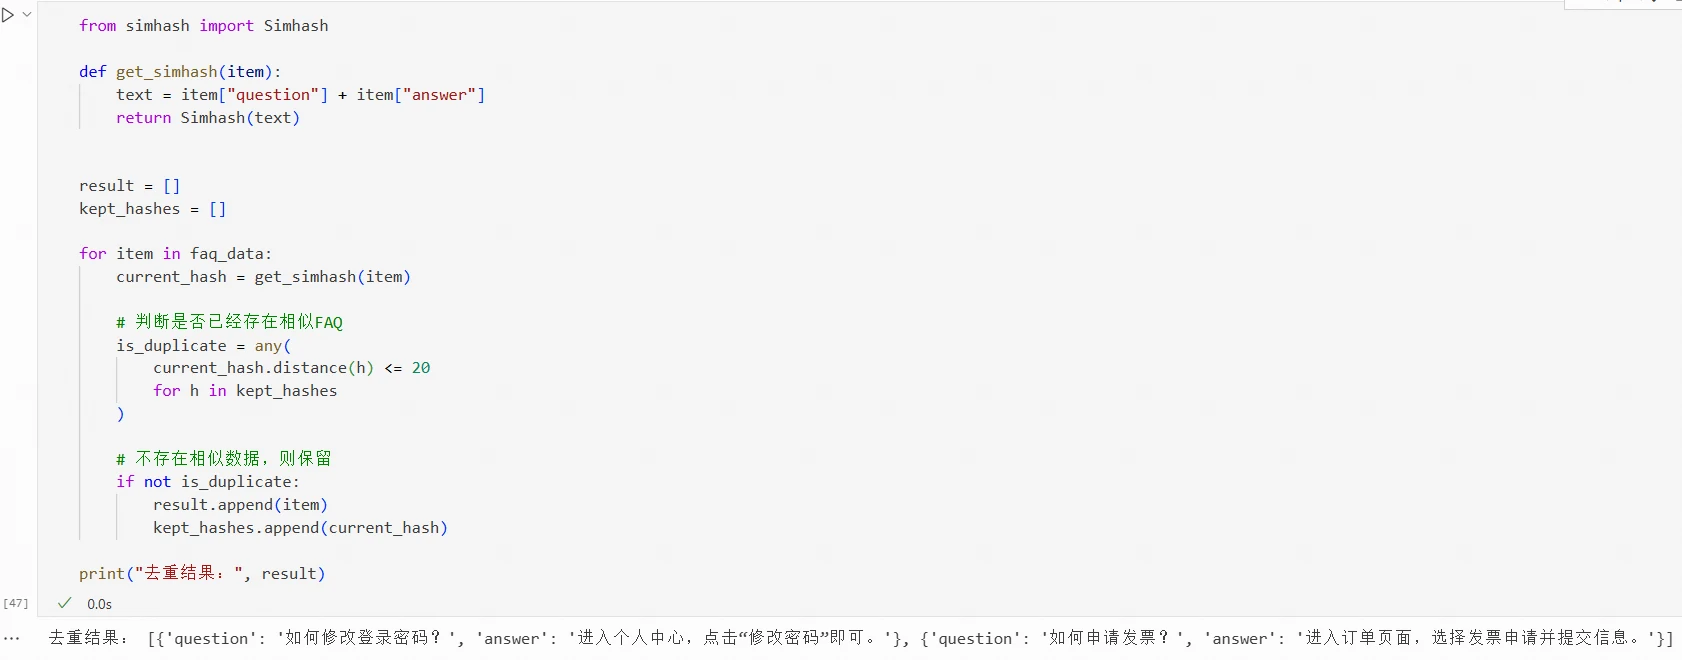
Código para usar SimHash para eliminar datos similares:
from simhash import Simhash

def get_simhash(item):
    text = item["question"] + item["answer"]
    return Simhash(text)

result = []
kept_hashes = []

for item in faq_data:
    current_hash = get_simhash(item)

    # Verificar si ya existe una FAQ similar
    is_duplicate = any(
        current_hash.distance(h) <= 20
        for h in kept_hashes
    )

    # Si no hay datos similares, conservar
    if not is_duplicate:
        result.append(item)
        kept_hashes.append(current_hash)

print("Resultado de deduplicación:", result)
Resultados:
(3) Similitud de vectores
Si dos piezas de datos usan diferentes palabras pero expresan semánticas similares, se puede usar un modelo de vectores de texto para la evaluación.
Un modelo de vectores de texto convierte el texto en un vector compuesto por un conjunto de valores numéricos. Para datos de FAQ, combine la pregunta y la respuesta en un solo texto, luego calcule la similitud coseno entre los dos vectores de texto:
donde A y B representan los vectores de texto correspondientes a las dos FAQ. Cuanto mayor sea la similitud coseno, más cercanas son las semánticas de las dos FAQ.
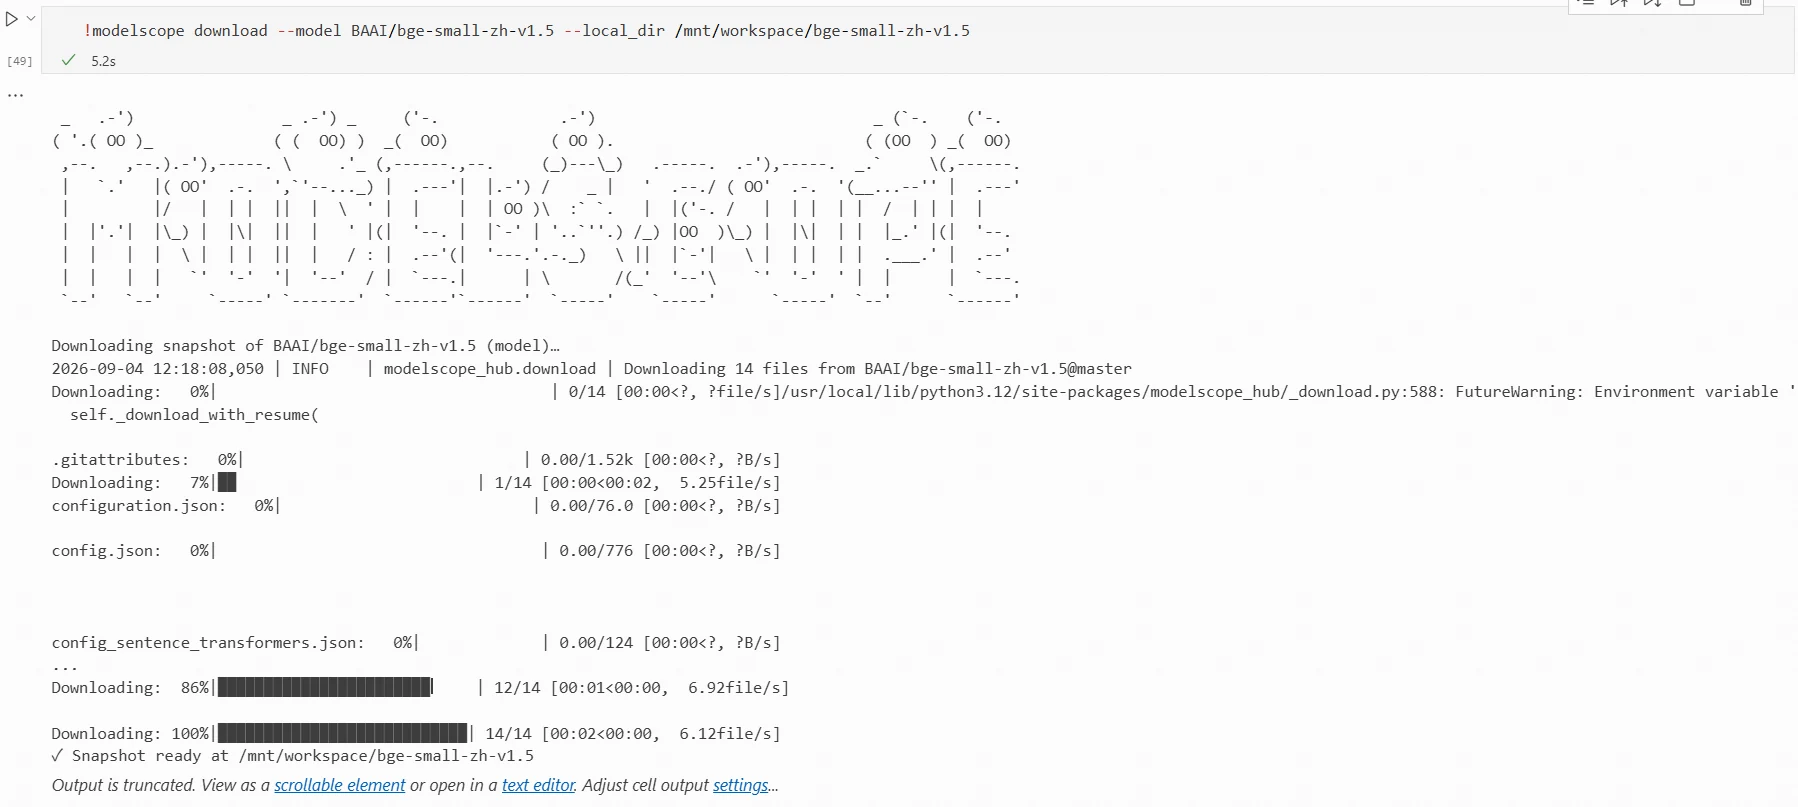
A continuación, se usa el modelo BAAI/bge-small-zh-v1.5 para el cálculo. Este modelo está diseñado para tareas de vectores de texto chino, con un tamaño de modelo de aproximadamente 24M, dimensión de vector de salida de 512, y es relativamente pequeño y rápido.
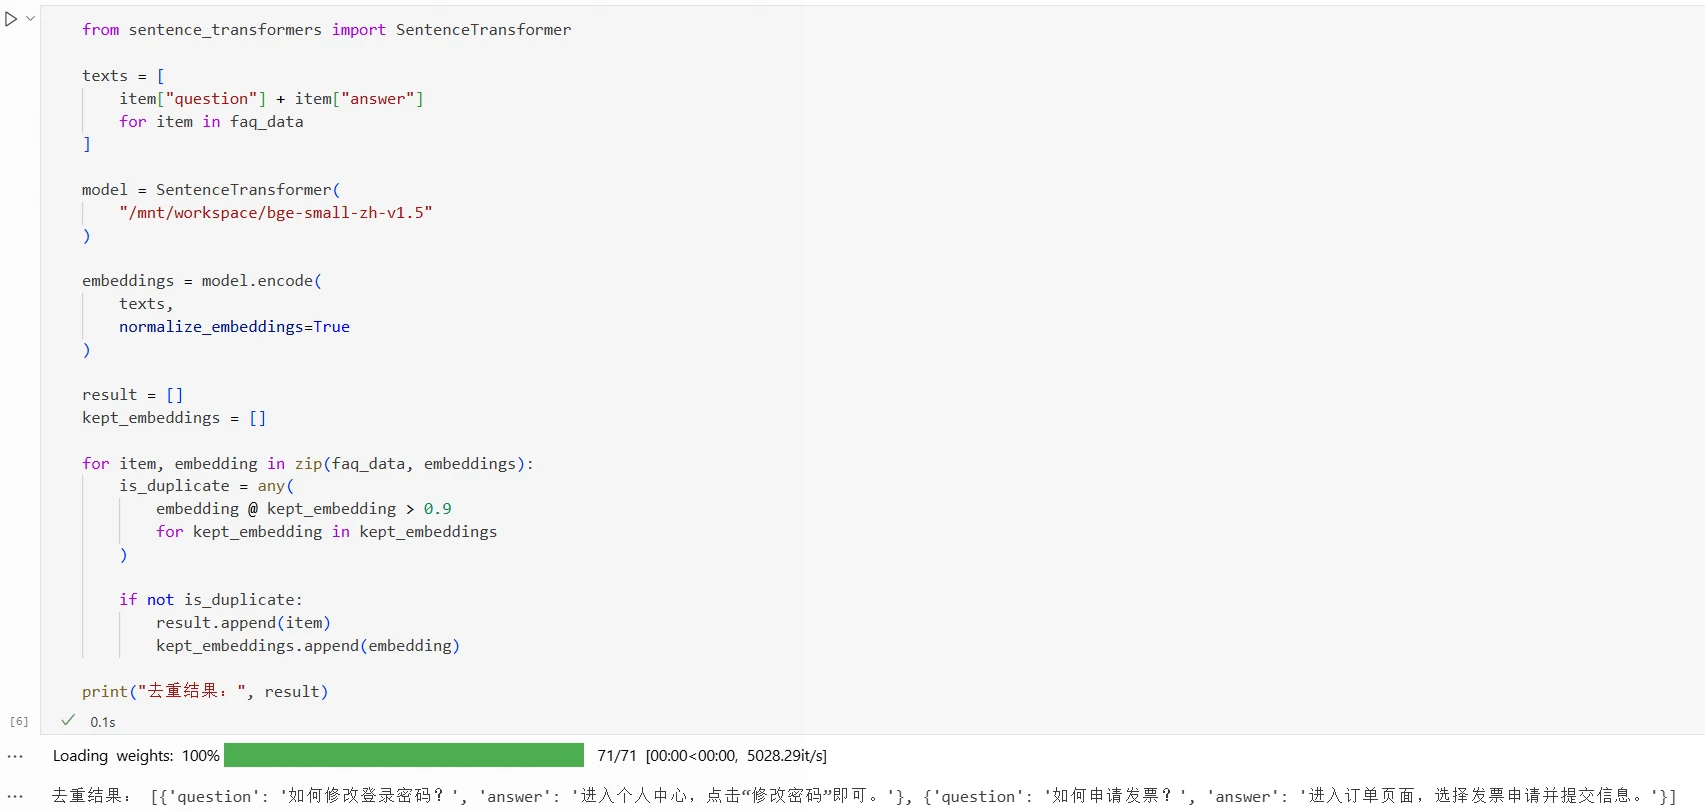
Código para calcular la similitud de vectores y eliminar datos similares:
from sentence_transformers import SentenceTransformer

texts = [
    item["question"] + item["answer"]
    for item in faq_data
]

model = SentenceTransformer(
    "/mnt/workspace/bge-small-zh-v1.5"
)

embeddings = model.encode(
    texts,
    normalize_embeddings=True
)

result = []
kept_embeddings = []

for item, embedding in zip(faq_data, embeddings):
    is_duplicate = any(
        embedding @ kept_embedding > 0.9
        for kept_embedding in kept_embeddings
    )

    if not is_duplicate:
        result.append(item)
        kept_embeddings.append(embedding)

print("Resultado de deduplicación:", result)
Resultados:
Diferentes métodos son adecuados para diferentes tipos de deduplicación de datos:
Método
Basis para el juicio
Escenarios adecuados
Coincidencia directa de texto
Si el texto es exactamente el mismo
Pequeña cantidad de datos idénticos
Hash
Si los valores hash del texto son idénticos
Gran cantidad de datos idénticos
MinHash
Superposición de palabras o caracteres en el texto
Datos con similitud de contenido literal
SimHash
Distancia Hamming entre huellas digitales de texto
Datos con similitud de contenido general pero modificaciones menores
Similitud de vectores
Similitud semántica del texto
Datos con diferentes expresiones pero significados similares
En la práctica, primero puede eliminar datos exactamente duplicados mediante coincidencia de texto o Hash, luego usar MinHash, SimHash o similitud de vectores para detectar datos similares. Para los datos similares detectados, debe decidir eliminar, fusionar o conservar según el umbral de similitud y los requisitos de negocio para evitar eliminar por error datos con valor de entrenamiento.
La información real necesita anonimización antes del entrenamiento
Los datos de negocio de la empresa pueden contener información sensible como nombres, números de teléfono, números de identificación, direcciones y números de cuenta. Antes de entrar en el conjunto de datos de entrenamiento, este contenido debe anonimizarse de acuerdo con los requisitos de seguridad de datos.
La anonimización de datos primero requiere identificar la información sensible en los datos, luego seleccionar métodos de procesamiento apropiados según el tipo de información sensible.
Métodos para identificar información sensible
Antes de realizar la anonimización, debe determinar qué contenido en los datos pertenece a información sensible. Para datos de texto, se pueden usar expresiones regulares o modelos de reconocimiento de información sensible para la identificación.
(1) Uso de expresiones regulares
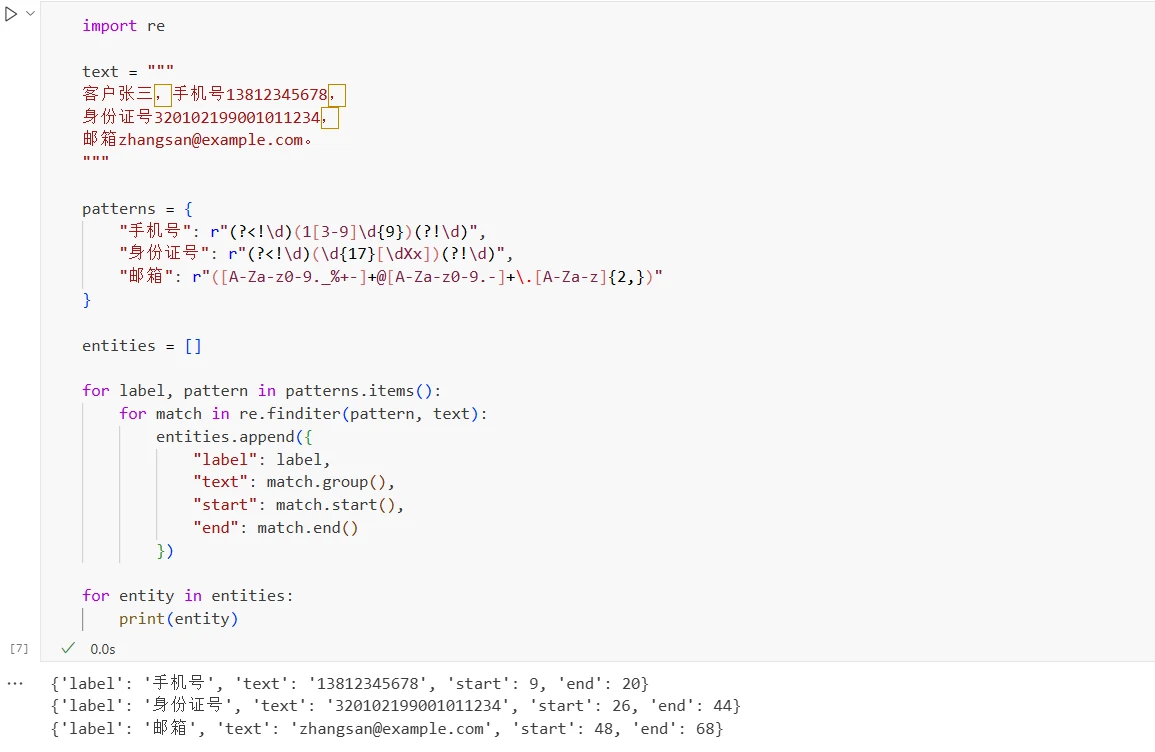
Las expresiones regulares coinciden con el texto basándose en reglas de formato predefinidas, lo que las hace adecuadas para identificar información con formato fijo, como números de teléfono, números de identificación, números de tarjetas bancarias y direcciones de correo electrónico. Código para usar expresiones regulares para identificar información sensible:
import re

text = """
Cliente Zhang San, número de teléfono 13812345678,
número de identificación 320102199001011234,
correo electrónico zhangsan@example.com.
"""

patterns = {
    "teléfono": r"(?<!\d)(1[3-9]\d{9})(?!\d)",
    "número_id": r"(?<!\d)(\d{17}[\dXx])(?!\d)",
    "correo": r"([A-Za-z0-9._%+-]+@[A-Za-z0-9.-]+\.[A-Za-z]{2,})"
}

entities = []

for label, pattern in patterns.items():
    for match in re.finditer(pattern, text):
        entities.append({
            "label": label,
            "text": match.group(),
            "start": match.start(),
            "end": match.end()
        })

for entity in entities:
    print(entity)
Resultados de ejecución:
Las expresiones regulares pueden obtener el contenido, el tipo y la posición de la información sensible en el texto original, que se pueden usar para el procesamiento de anonimización posterior. Las expresiones regulares se basan principalmente en características de formato y son efectivas para información con formato fijo. En la práctica, se deben desarrollar y probar reglas correspondientes según el formato de los datos de negocio. Para información como nombres y direcciones que requieren comprensión contextual, las expresiones regulares por sí solas son difíciles de identificar con precisión.
(2) Uso de modelos de reconocimiento de información sensible
Para información como nombres, direcciones y organizaciones que requieren comprensión semántica, se pueden usar modelos de reconocimiento de información sensible.
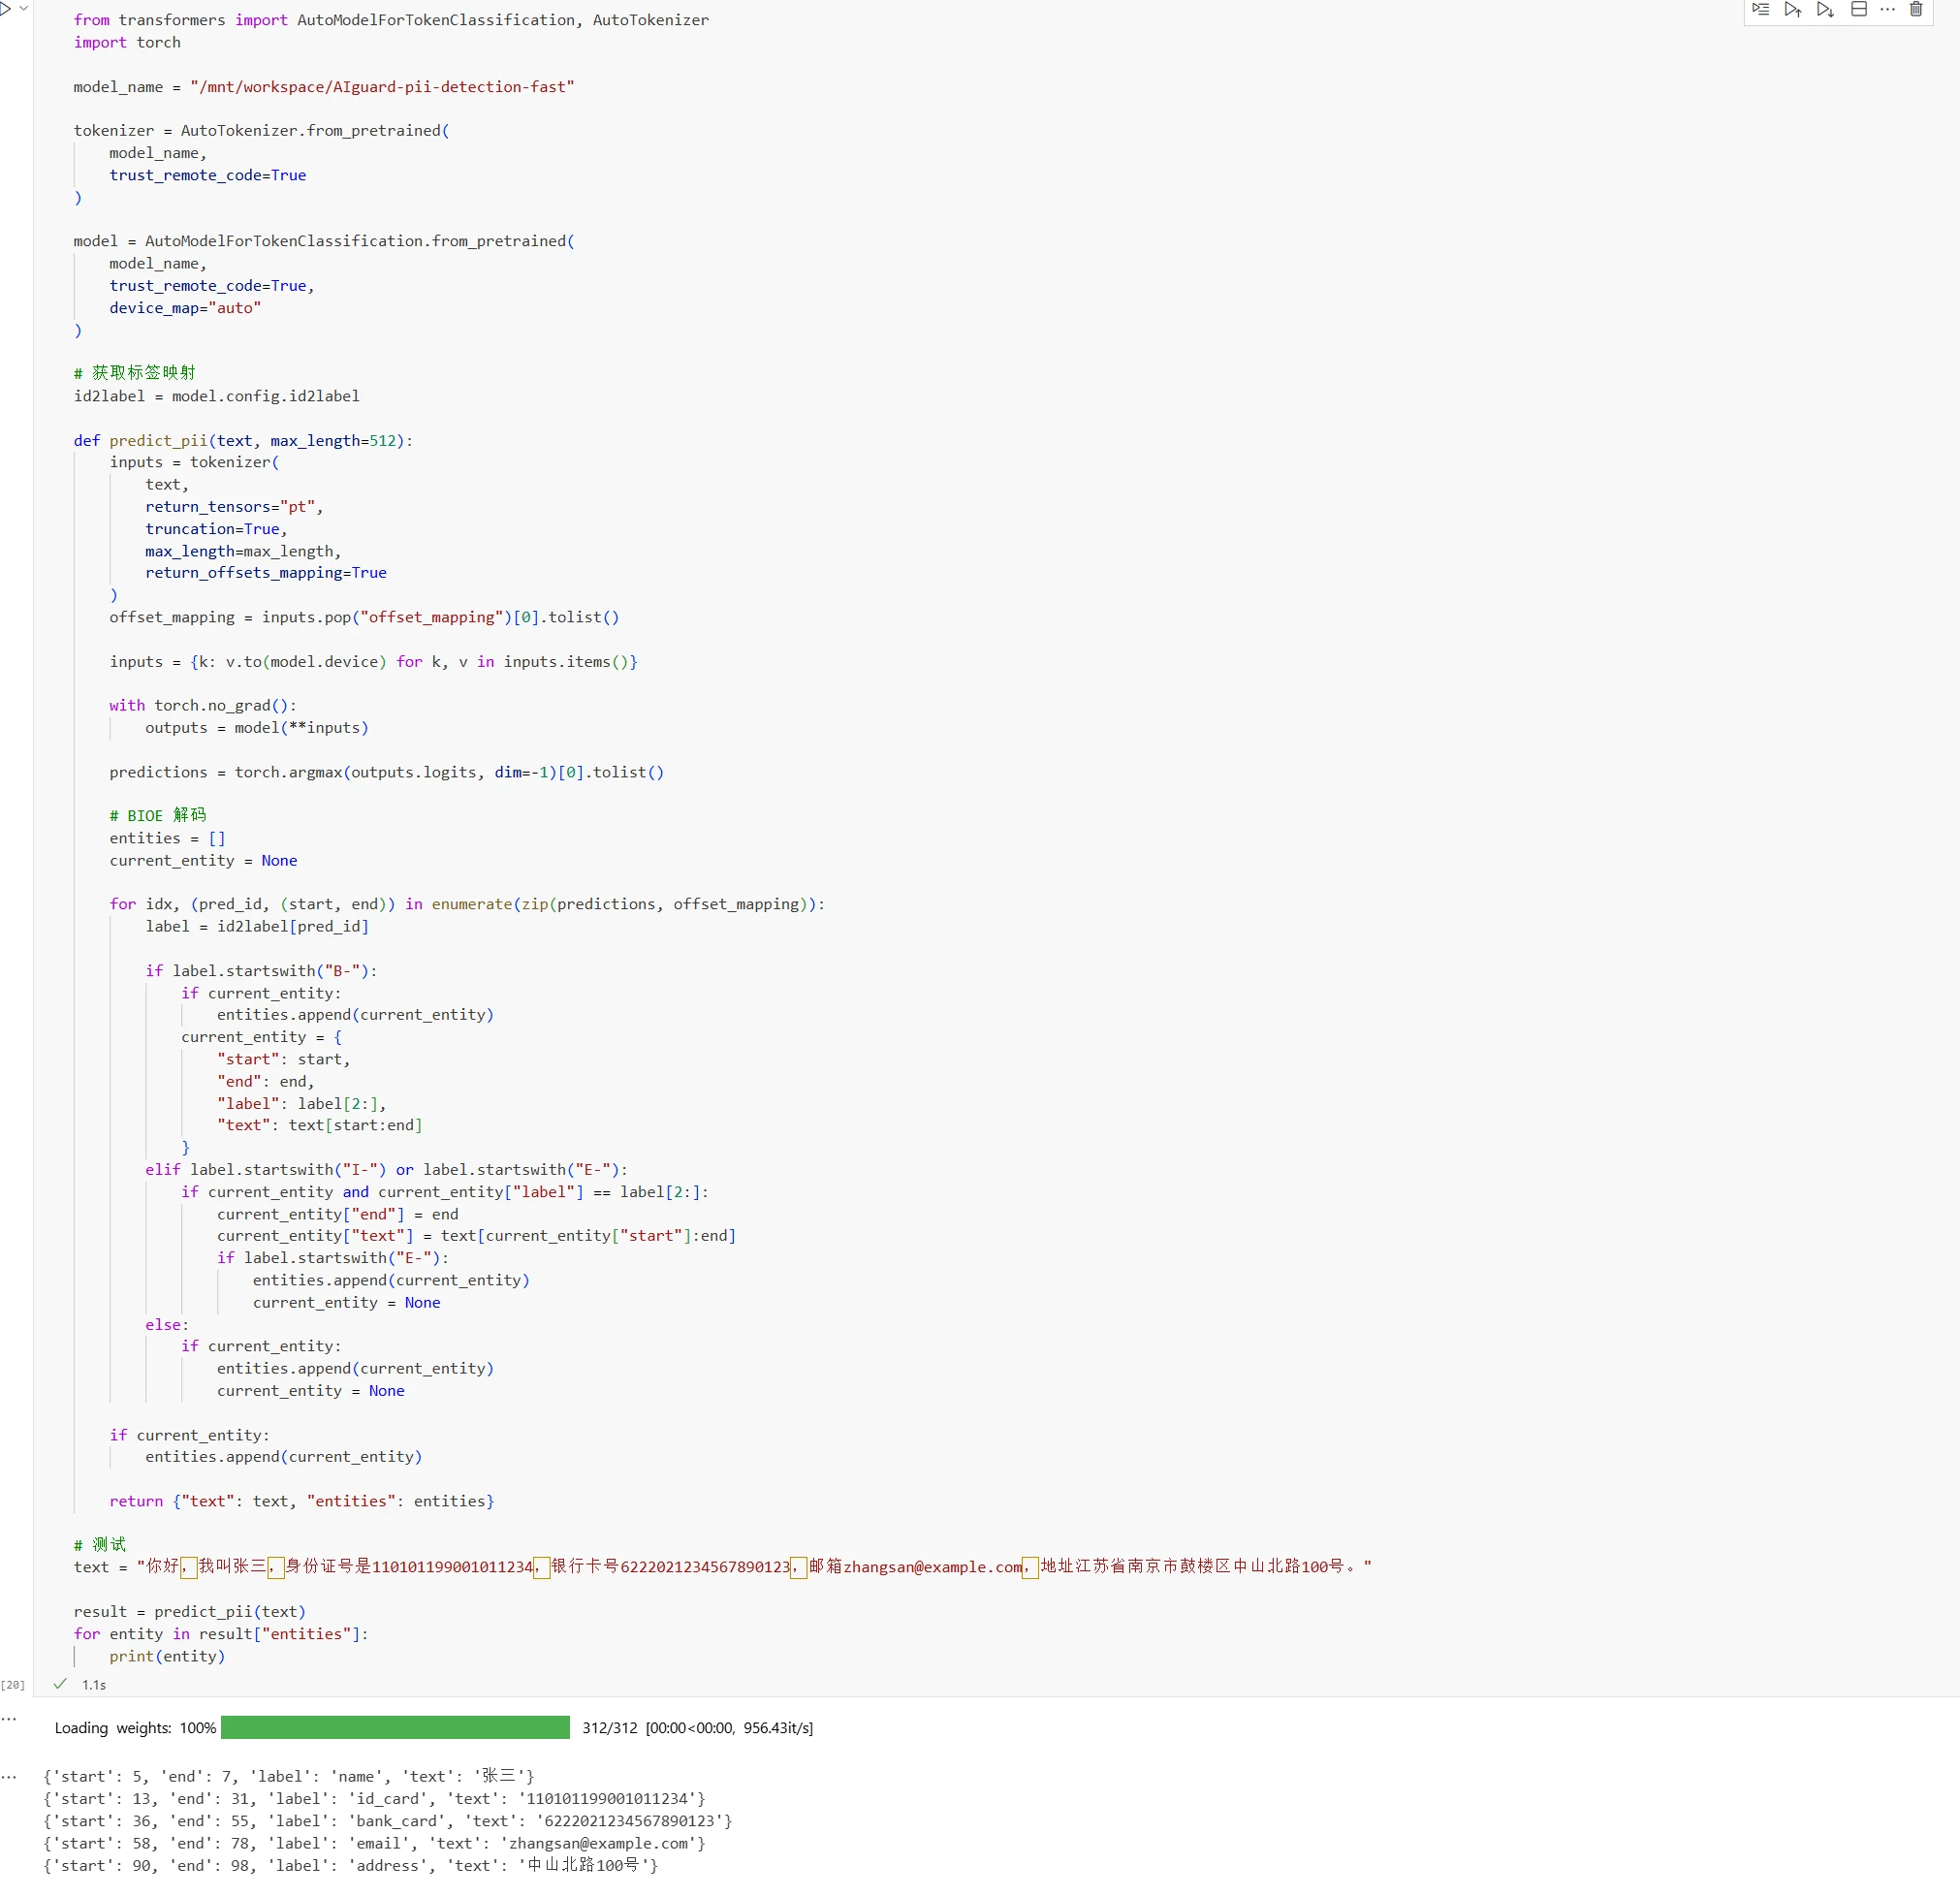
Por ejemplo, el código abierto ZJUICSR/AIguard-pii-detection-fast es un modelo diseñado para el reconocimiento de información personal sensible (PII) en chino, capaz de identificar diversas información sensible como nombres, números de teléfono, números de identificación, direcciones y direcciones de correo electrónico.
Código para usar este modelo para identificar información sensible:
from transformers import AutoModelForTokenClassification, AutoTokenizer
import torch

model_name = "/mnt/workspace/AIguard-pii-detection-fast"

tokenizer = AutoTokenizer.from_pretrained(
    model_name,
    trust_remote_code=True
)

model = AutoModelForTokenClassification.from_pretrained(
    model_name,
    trust_remote_code=True,
    device_map="auto"
)

# Obtener mapeo de etiquetas
id2label = model.config.id2label

def predict_pii(text, max_length=512):
    inputs = tokenizer(
        text,
        return_tensors="pt",
        truncation=True,
        max_length=max_length,
        return_offsets_mapping=True
    )
    offset_mapping = inputs.pop("offset_mapping")[0].tolist()

    inputs = {k: v.to(model.device) for k, v in inputs.items()}

    with torch.no_grad():
        outputs = model(**inputs)

    predictions = torch.argmax(outputs.logits, dim=-1)[0].tolist()

    # Decodificación BIOE
    entities = []
    current_entity = None

    for idx, (pred_id, (start, end) in enumerate(zip(predictions, offset_mapping):
        label = id2label[pred_id]

        if label.startswith("B-"):
            if current_entity:
                entities.append(current_entity)
            current_entity = {
                "start": start,
                "end": end,
                "label": label[2:],
                "text": text[start:end]
            }
        elif label.startswith("I-") or label.startswith("E-"):
            if current_entity and current_entity["label"] == label[2:]:
                current_entity["end"] = end
                current_entity["text"] = text[current_entity["start"]:end]
                if label.startswith("E-"):
                    entities.append(current_entity)
                    current_entity = None
        else:
            if current_entity:
                entities.append(current_entity)
                current_entity = None

    if current_entity:
        entities.append(current_entity)

    return {"text": text, "entities": entities}

# Prueba
text = "Hola, mi nombre es Zhang San, número de identificación 110101199001011234, número de tarjeta bancaria 6222021234567890123, correo electrónico zhangsan@example.com, dirección Calle Zhongshan Norte 100, Distrito Gulou, Nanjing, Provincia de Jiangsu."

result = predict_pii(text)
for entity in result["entities"]:
    print(entity)
Resultados:
Los resultados de reconocimiento incluyen contenido de información sensible, tipo de información sensible y posición en el texto original. Luego, se pueden seleccionar métodos de anonimización apropiados basándose en esta información.
En negocios reales, las expresiones regulares y los modelos de reconocimiento de información sensible a menudo se usan en combinación. Las expresiones regulares manejan rápidamente información con formato fijo, como números de teléfono y direcciones de correo electrónico; los modelos manejan información que requiere comprensión semántica, como nombres y direcciones.
Métodos de anonimización
Después de completar la identificación de información sensible, se deben seleccionar métodos de procesamiento apropiados según el tipo de información sensible y los requisitos de la tarea de entrenamiento.
Los métodos de anonimización comunes incluyen:
(1) Reemplazo
El reemplazo implica reemplazar la información sensible real con otro contenido. El reemplazo se puede dividir en reemplazo fijo y reemplazo aleatorio:
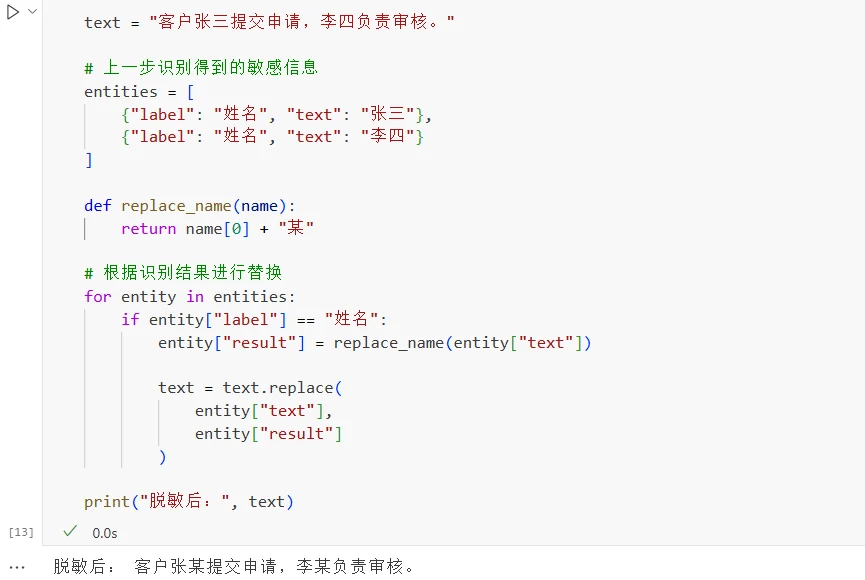
Reemplazo fijo: Genere resultados de reemplazo según reglas fijas. Por ejemplo, reemplace uniformemente el nombre de pila en los nombres con "cierta persona", "Zhang San" se convierte en "Zhang cierta persona", "Li Si" se convierte en "Li cierta persona". Dado que las reglas son fijas, la misma información siempre producirá el mismo resultado, y no es necesario guardar mapeos adicionales. Código de procesamiento:
text = "El cliente Zhang San envió una solicitud, y Li Si es responsable de la revisión."

# Información sensible identificada en el paso anterior
entities = [
    {"label": "nombre", "text": "Zhang San"},
    {"label": "nombre", "text": "Li Si"}
]

def replace_name(name):
    return name[0] + "cierta persona"

# Reemplazar basándose en los resultados de identificación
for entity in entities:
    if entity["label"] == "nombre":
        entity["result"] = replace_name(entity["text"])

        text = text.replace(
            entity["text"],
            entity["result"]
        )

print("Después de anonimización:", text)
Resultados:
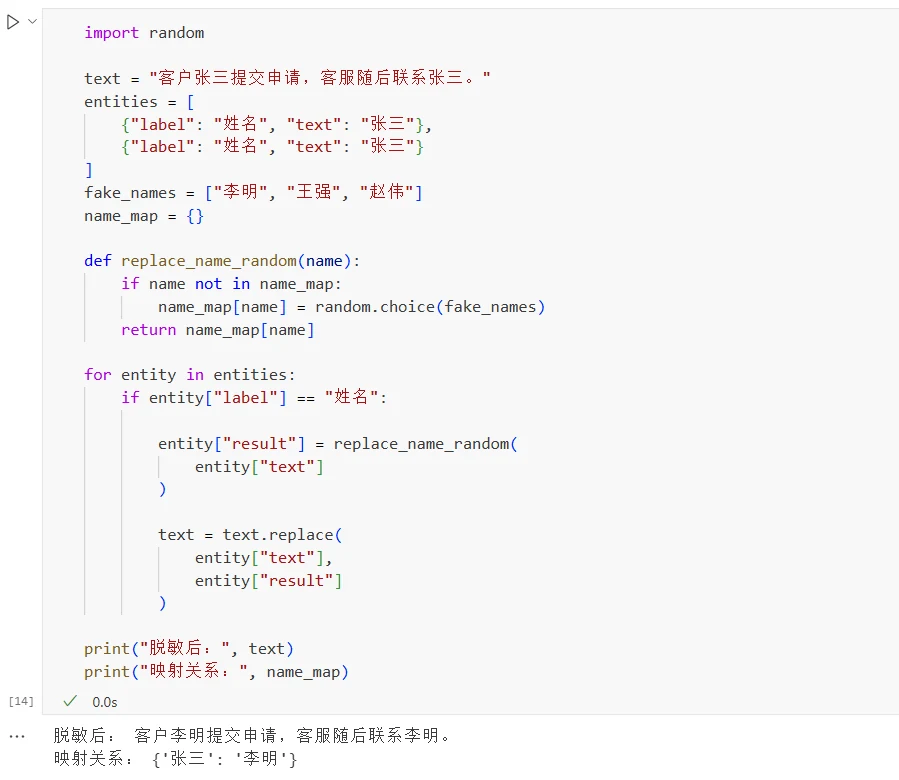
Reemplazo aleatorio: Seleccione aleatoriamente información fabricada para reemplazar la información real, por ejemplo, reemplazar "Zhang San" por "Li Ming". Si el mismo "Zhang San" aparece en múltiples ubicaciones, los resultados de reemplazo deben ser consistentes. De lo contrario, los datos que pertenecen a la misma entidad pueden ser reemplazados con diferentes identidades, destruyendo las asociaciones en los datos. Por lo tanto, el reemplazo aleatorio generalmente requiere establecer una tabla de mapeo: {"Zhang San":"Li Ming"}, y cuando se encuentre "Zhang San" nuevamente, se use "Li Ming" directamente. Código de procesamiento:
import random

text = "El cliente Zhang San envió una solicitud, y el servicio al cliente luego contactó a Zhang San."
entities = [
    {"label": "nombre", "text": "Zhang San"},
    {"label": "nombre", "text": "Zhang San"}
]
fake_names = ["Li Ming", "Wang Qiang", "Zhao Wei"]
name_map = {}

def replace_name_random(name):
    if name not in name_map:
        name_map[name] = random.choice(fake_names)
    return name_map[name]

for entity in entities:
    if entity["label"] == "nombre":

        entity["result"] = replace_name_random(
            entity["text"]
        )

        text = text.replace(
            entity["text"],
            entity["result"]
        )

print("Después de anonimización:", text)
print("Mapeo:", name_map)
Resultados:
(2) Enmascaramiento
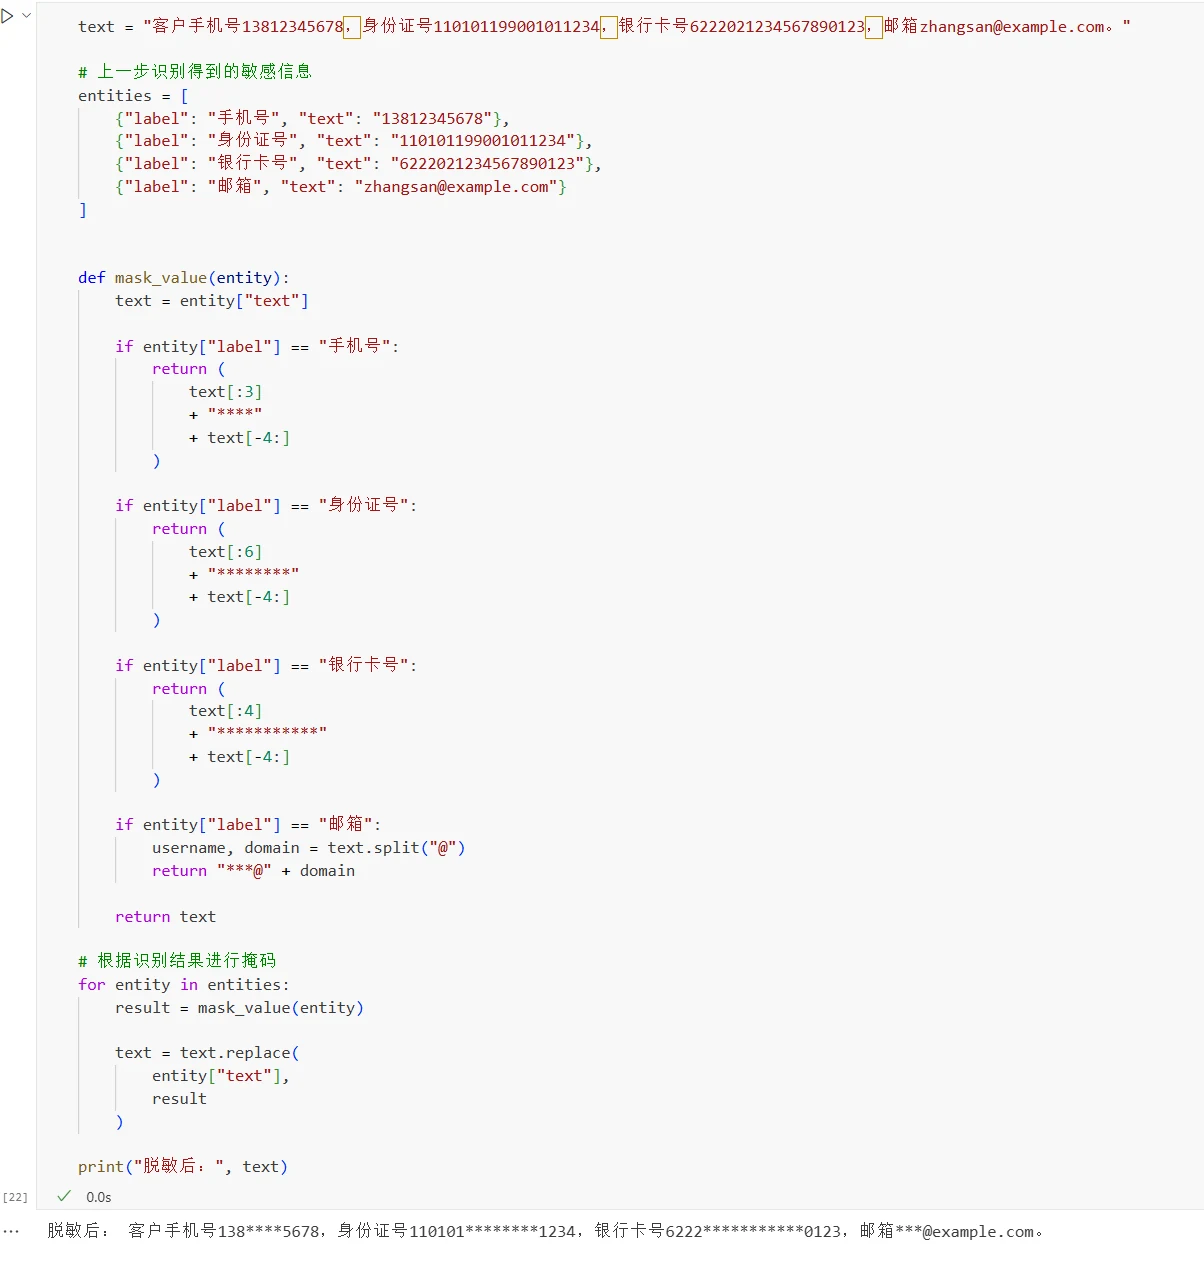
El enmascaramiento oculta parte del contenido sensible mientras preserva información parcial, como números de teléfono, números de identificación, números de tarjetas bancarias y direcciones de correo electrónico.
Código de procesamiento:
text = "Número de teléfono del cliente 13812345678, número de identificación 110101199001011234, número de tarjeta bancaria 6222021234567890123, correo electrónico zhangsan@example.com."

# Información sensible identificada en el paso anterior
entities = [
    {"label": "teléfono", "text": "13812345678"},
    {"label": "número_id", "text": "110101199001011234"},
    {"label": "tarjeta_bancaria", "text": "6222021234567890123"},
    {"label": "correo", "text": "zhangsan@example.com"}
]

def mask_value(entity):
    text = entity["text"]

    if entity["label"] == "teléfono":
        return (
            text[:3]
            + "****"
            + text[-4:]
        )

    if entity["label"] == "número_id":
        return (
            text[:6]
            + "********"
            + text[-4:]
        )

    if entity["label"] == "tarjeta_bancaria":
        return (
            text[:4]
            + "***********"
            + text[-4:]
        )

    if entity["label"] == "correo":
        username, domain = text.split("@")
        return "***@" + domain

    return text

# Aplicar enmascaramiento basándose en los resultados de identificación
for entity in entities:
    result = mask_value(entity)

    text = text.replace(
        entity["text"],
        result
    )

print("Después de anonimización:", text)
Resultados:
(3) Generalización
La generalización reduce la precisión de la información, reduciendo la capacidad de localizar datos en objetos específicos. Se usa comúnmente para información continua como direcciones, edades y horarios.
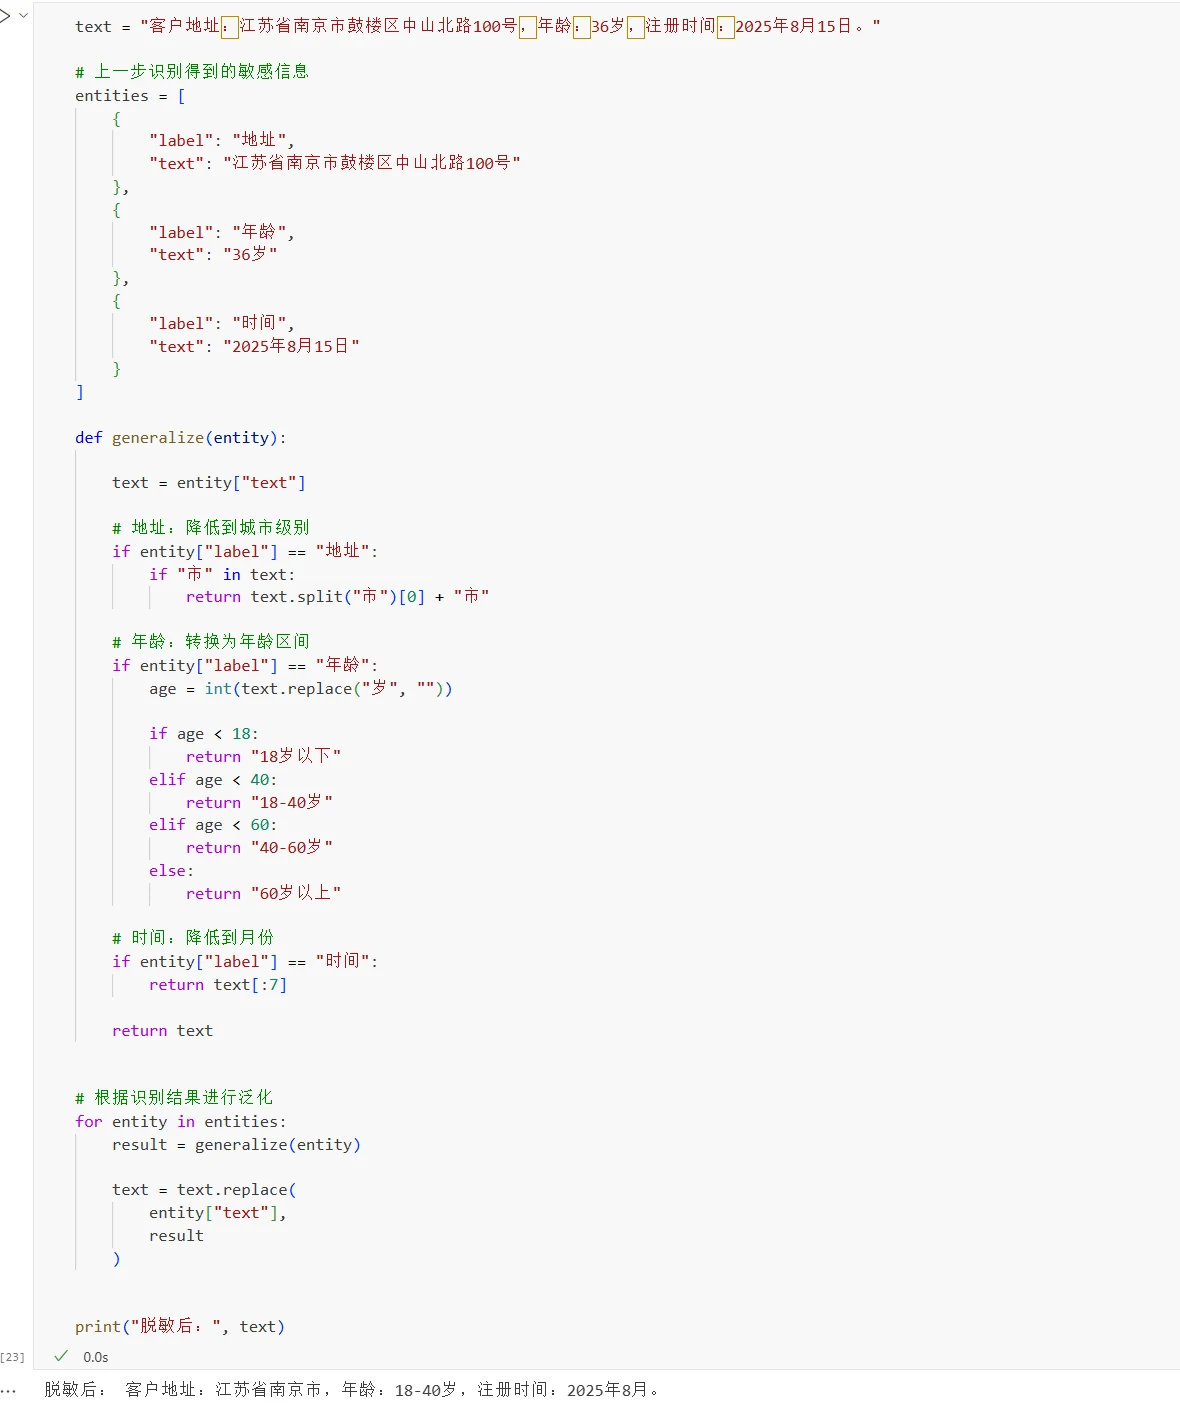
Código de procesamiento:
text = "Dirección del cliente: Calle Zhongshan Norte 100, Distrito Gulou, Nanjing, Provincia de Jiangsu, edad: 36 años, fecha de registro: 15 de agosto de 2025."

# Información sensible identificada en el paso anterior
entities = [
    {
        "label": "dirección",
        "text": "Calle Zhongshan Norte 100, Distrito Gulou, Nanjing, Provincia de Jiangsu"
    },
    {
        "label": "edad",
        "text": "36 años"
    },
    {
        "label": "tiempo",
        "text": "15 de agosto de 2025"
    }
]

def generalize(entity):

    text = entity["text"]

    # Dirección: reducir al nivel de ciudad
    if entity["label"] == "dirección":
        if "ciudad" in text:
            return text.split("ciudad")[0] + "ciudad"

    # Edad: convertir a rango de edad
    if entity["label"] == "edad":
        age = int(text.replace("años", "")

        if age < 18:
            return "Menores de 18"
        elif age < 40:
            return "18-40"
        elif age < 60:
            return "40-60"
        else:
            return "Mayores de 60"

    # Tiempo: reducir al nivel de mes
    if entity["label"] == "tiempo":
        return text[:7]

    return text

# Aplicar generalización basándose en los resultados de identificación
for entity in entities:
    result = generalize(entity)

    text = text.replace(
        entity["text"],
        result
    )

print("Después de anonimización:", text)
Resultados:
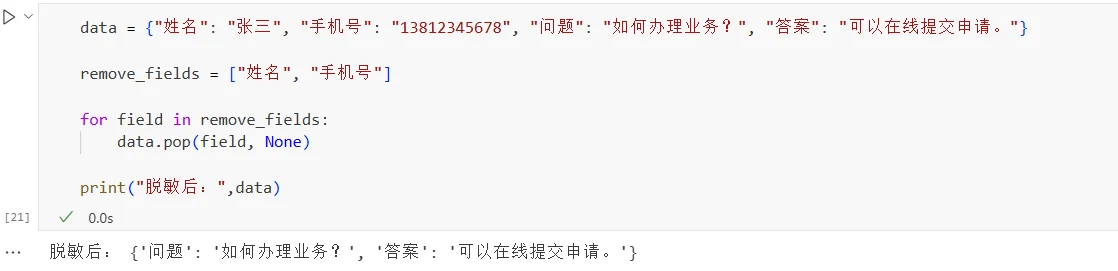
(4) Eliminación
Para campos sensibles no relacionados con la tarea de entrenamiento, se pueden eliminar directamente. Si la tarea de entrenamiento solo requiere aprender relaciones de preguntas y respuestas, se pueden eliminar nombres y números de teléfono.
data = {"nombre": "Zhang San", "teléfono": "13812345678", "pregunta": "¿Cómo procesar el servicio?", "respuesta": "Puede enviar una solicitud en línea."}

remove_fields = ["nombre", "teléfono"]

for field in remove_fields:
    data.pop(field, None)

print("Después de anonimización:", data)
Resultados:
En la práctica, el método de anonimización debe seleccionarse según la tarea de entrenamiento y las características de los datos. Cuando es necesario preservar las asociaciones entre diferentes muestras, se puede usar reemplazo fijo o reemplazo aleatorio con mapeo; cuando es necesario preservar características parciales de información, se puede usar enmascaramiento o generalización; para información sensible no relacionada con la tarea de entrenamiento, se debe eliminar directamente.
Diferentes escenarios de negocio tienen diferentes características de datos, y las reglas de anonimización específicas deben ajustarse según los requisitos reales. El código de esta sección es solo para ilustrar los métodos de procesamiento básicos.
Último paso: organice en el formato requerido para el entrenamiento
Después de completar el procesamiento de datos, los datos todavía necesitan organizarse en el formato correspondiente según los requisitos del framework de entrenamiento.
El ajuste fino de instrucciones es un método de ajuste fino común para los grandes modelos de lenguaje. Los datos de entrenamiento incluyen instrucciones de usuarios y las respuestas esperadas del modelo, enseñando al modelo cómo completar tareas según las instrucciones.
Diferentes frameworks de entrenamiento pueden usar diferentes campos de datos. Los formatos de datos de instrucciones comunes incluyen principalmente Alpaca, ShareGPT y Messages.
Formato Alpaca
El formato Alpaca tiene una estructura simple, usando típicamente tres campos: instruction, input y output. Es adecuado para datos de instrucciones de un solo turno.
{
  "instruction": "Traducir el siguiente texto chino al inglés",
  "input": "El tiempo es muy bueno hoy.",
  "output": "The weather is very nice today."
}
donde: instruction representa la tarea que el modelo debe realizar; input representa el contenido de entrada necesario para completar la tarea; output representa la respuesta que se espera que el modelo genere.
Si la tarea en sí no requiere entrada adicional, el input también puede estar vacío.
Por ejemplo:
{
  "instruction": "Presentar qué es el aprendizaje automático",
  "input": "",
  "output": "El aprendizaje automático es un método que permite a las computadoras aprender patrones de los datos."
}
Este formato tiene pocos campos y una estructura clara, lo que lo hace adecuado para tareas de entrenamiento de un solo turno como preguntas y respuestas, clasificación y generación de texto.
Formato Messages
Otro enfoque común es usar messages para almacenar conversaciones, donde cada mensaje contiene dos campos principales: role y content.
Por ejemplo:
{
  "messages": [
    {
      "role": "system",
      "content": "Eres un asistente profesional de atención al cliente."
    },
    {
      "role": "user",
      "content": "¿Cuándo llegará mi pedido?"
    },
    {
      "role": "assistant",
      "content": "Por favor proporcione el número de pedido, y le ayudaré a verificar."
    }
  ]
}
donde system se usa para establecer el rol del modelo, los requisitos de la tarea o las reglas de respuesta, user representa la entrada del usuario, y assistant representa la respuesta que se espera que el modelo genere.
El formato Messages también admite conversaciones de múltiples turnos. Solo necesita continuar agregando mensajes user y assistant en el orden real de la conversación.
Por ejemplo:
{
  "messages": [
    {
      "role": "system",
      "content": "Eres un asistente profesional de atención al cliente."
    },
    {
      "role": "user",
      "content": "¿Cómo cambiar la contraseña de inicio de sesión?"
    },
    {
      "role": "assistant",
      "content": "Vaya a la página de configuración de la cuenta y seleccione 'Cambiar Contraseña'."
    },
    {
      "role": "user",
      "content": "¿Qué hago si olvidé la contraseña original?"
    },
    {
      "role": "assistant",
      "content": "Puede seleccionar 'Olvidé mi Contraseña' en la página de inicio de sesión, verificar a través del número de teléfono o correo electrónico, y luego restablecer la contraseña."
    }
  ]
}
Formato ShareGPT
ShareGPT es uno de los formatos de datos de diálogo comunes en el entrenamiento de grandes modelos de código abierto. Típicamente usa conversations para almacenar diálogos completos y usa human y gpt para distinguir entre usuarios y el modelo.
Por ejemplo:
{
  "conversations": [
    {
      "from": "human",
      "value": "Traducir el siguiente texto chino al inglés: El tiempo es muy bueno hoy."
    },
    {
      "from": "gpt",
      "value": "The weather is very nice today."
    }
  ]
}
El formato ShareGPT también puede almacenar diálogos de múltiples turnos:
{
  "conversations": [
    {
      "from": "human",
      "value": "Ayúdame a escribir un correo electrónico de solicitud de permiso."
    },
    {
      "from": "gpt",
      "value": "Por favor dígame la duración y el motivo del permiso."
    },
    {
      "from": "human",
      "value": "Tengo un resfriado y necesito dos días de permiso por enfermedad."
    },
    {
      "from": "gpt",
      "value": "Está bien, aquí está un correo electrónico de solicitud de permiso..."
    }
  ]
}
Cómo elegir un formato de datos
Los formatos Alpaca, Messages y ShareGPT esencialmente describen la entrada y la salida esperada del modelo, solo con diferentes organizaciones de campos.
Puede elegir según el tipo de tarea y el framework de entrenamiento:
Formato de datos
Características principales
Escenarios adecuados
Alpaca
Organiza datos usando instruction, input y output
Instrucciones de un solo turno, preguntas y respuestas, clasificación
Messages
Usa messages para almacenar conversaciones, distingue roles mediante role
Diálogos de un solo turno o múltiples turnos
ShareGPT
Usa conversations para almacenar diálogos, distingue roles mediante from
Diálogos de un solo turno o múltiples turnos
Los diferentes formatos generalmente se pueden convertir entre sí. Por ejemplo, un dato Alpaca se puede convertir en un conjunto de mensajes user y assistant, y human y gpt en ShareGPT también se pueden convertir en user y assistant respectivamente. Durante el entrenamiento real, primero debe confirmar los formatos de datos y las plantillas de modelo admitidos por el framework de entrenamiento, luego organice los datos según los requisitos correspondientes.
Código del modelo y archivos relacionados: https://www.modelscope.cn/gallery/liucong/b41e2395-f795-400f-bafd-e53ed7f5c8ca