La Inteligencia Artificial Generativa de Contenido (AIGC) ha sido una dirección importante de desarrollo en el campo de la inteligencia artificial en los últimos años. A diferencia de las tareas tradicionales de clasificación, predicción y recuperación, los modelos generativos tienen como objetivo aprender la distribución de probabilidad de los datos y generar nuevo contenido bajo la guía de condiciones como texto e imágenes.
Desde las primeras Redes Generativas Antagónicas (GAN) y Autoencoders Variacionales (VAE), hasta los Modelos de Difusión (Diffusion Model) y Diffusion Transformer (DiT) ampliamente utilizados en los últimos años, los modelos generativos han mejorado continuamente en calidad de generación, estabilidad de entrenamiento, capacidad de comprensión semántica y eficiencia de inferencia. Sobre esta base, los modelos de texto a imagen como Stable Diffusion, FLUX, Qwen-Image y Z-Image han impulsado aún más las aplicaciones de AIGC en creación de contenido, diseño publicitario y producción de materiales de marketing.
El objetivo principal de los modelos generativos es aprender la distribución de probabilidad subyacente y los patrones inherentes en los datos de entrenamiento, y generar nuevas muestras que se ajusten a esa distribución bajo condiciones dadas. A diferencia de las tareas de clasificación y recuperación, los modelos generativos no seleccionan una respuesta de resultados candidatos predefinidos; en cambio, utilizan patrones de datos aprendidos para generar nuevo contenido de texto, imágenes, voz o video.
Desde una perspectiva de modelado probabilista, las tareas de generación condicional se pueden representar como: $p(x \mid c)$ representa la distribución de probabilidad condicional del modelo para generar el contenido x dado la condición c. Por ejemplo, el Prompt del usuario, el contexto, la imagen de referencia u otra información de control; x representa el contenido objetivo a generar. El proceso de entrenamiento del modelo es esencialmente aprender la probabilidad de varios resultados posibles bajo diferentes condiciones; el proceso de inferencia del modelo produce resultados concretos basados en esta distribución de probabilidad.
Aunque los grandes modelos de lenguaje, los modelos de generación de imágenes y los modelos de generación de video todos pertenecen a modelos generativos, las formas específicas en que logran la generación no son completamente iguales.
Tomando como ejemplo los grandes modelos de lenguaje, los modelos dominantes actuales típicamente usan generación autorresgresiva para producir texto. Dado el contexto existente, el modelo predice la distribución de probabilidad del siguiente Token, selecciona o extrae el siguiente Token basado en esta distribución, agrega el Token recién generado al contexto y continúa prediciendo los Tokens subsiguientes. Repitiendo continuamente este proceso, eventualmente se forma contenido de texto completo.
Iniciar sesión unirse a la discusión
Los modelos de generación de imágenes usan mecanismos de generación diferentes. Tomando como ejemplo los modelos de difusión, el proceso de generación típicamente comienza con ruido aleatorio y realiza una eliminación de ruido progresiva bajo la guía de condiciones como prompts de texto, permitiendo que el ruido aleatorio gradualmente forme imágenes con estructura y semántica claras. Ya sea mediante generación autorresgresiva, difusión u otros mecanismos de generación, su objetivo común es aprender los patrones de distribución de los datos reales y generar nuevo contenido que se ajuste a estos patrones basado en condiciones dadas.
Los modelos generativos pueden generar nuevo contenido, y una razón importante es que el modelo no aprende un texto o imagen específica en sí, sino las relaciones estadísticas y patrones de características que existen entre una gran cantidad de datos de entrenamiento.
Por ejemplo, después de aprender de un gran número de imágenes de publicidad de bebidas, el modelo puede establecer gradualmente asociaciones entre conceptos visuales como botellas de bebidas, cubos de hielo, salpicaduras de agua, frutas, colores de fondo, iluminación y estilos de fotografía comercial. Al ingresar "publicidad comercial de bebida de lima de verano", el modelo puede reorganizar diferentes elementos visuales basándose en estos patrones aprendidos para formar nuevos resultados de imagen. La "generación" de los modelos generativos no equivale a encontrar una entrada de datos existente del conjunto de entrenamiento; es modelar y combinar diferentes características y conceptos basándose en distribuciones de datos aprendidas.
Otra característica importante de los modelos generativos es que los resultados de generación son diversos. Por ejemplo, para el mismo prompt "un gato sentado junto a una ventana", el modelo puede generar gatos de diferentes razas, posturas y colores de pelaje, y también puede adoptar diferentes iluminaciones, fondos e composiciones de imagen. Estos resultados son semánticamente consistentes con las condiciones de entrada, pero el contenido específico no es completamente idéntico. La razón de este fenómeno es que el Prompt típicamente solo impone ciertas restricciones condicionales sobre el contenido generado en lugar de especificar completamente el resultado final. Bajo las condiciones dadas, generalmente hay múltiples resultados razonables en la distribución de probabilidad aprendida por el modelo. En el proceso de generación real, factores como las estrategias de muestreo y semillas aleatorias influirán aún más en la salida final. A diferencia de las tareas tradicionales con respuestas deterministas, las tareas de generación típicamente no tienen una salida óptima única; las mismas condiciones de entrada pueden corresponder a múltiples resultados de generación razonables.
La tecnología de generación de texto juega un papel fundamental en el desarrollo de la IA generativa moderna. Por un lado, los grandes modelos de lenguaje han impulsado la rápida popularización de la tecnología AIGC; por otro lado, conceptos como Tokenizer, Embedding, Transformer, distribución de probabilidad y muestreo no solo se aplican a la generación de texto sino que también reaparecerán en tareas posteriores de generación de texto a imagen, generación multimodal y otras. Especialmente en los sistemas AIGC actuales, los Prompts de texto se han convertido en una forma importante para que los usuarios controlen el contenido generado. Ya sea para generar un texto, una imagen o un video, los modelos típicamente primero necesitan comprender el lenguaje natural ingresado por el usuario.
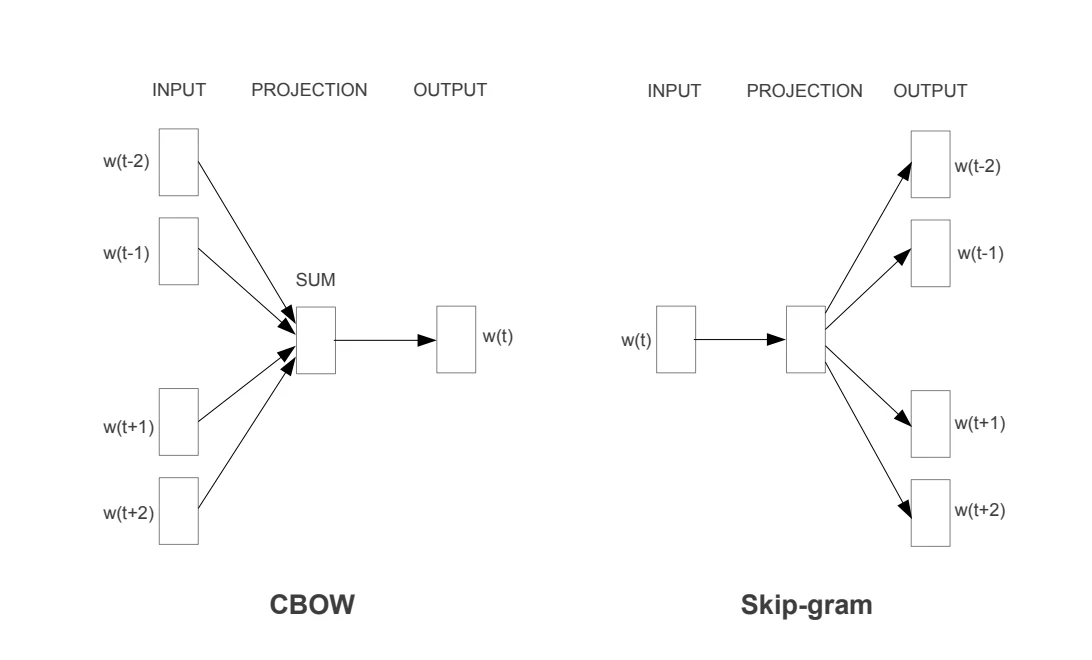
El lenguaje natural en sí no puede participar directamente en el cálculo de redes neuronales. Antes de que el texto se ingrese al modelo, primero necesita ser segmentado por un Tokenizer y convertido a Token IDs correspondientes. Los Tokens son las unidades básicas para que los modelos de lenguaje procesen texto; pueden ser un carácter chino, una palabra completa o parte de una palabra. El método de segmentación específico está determinado por el algoritmo de tokenización y vocabulario adoptado por el modelo. Los Token IDs son esencialmente solo los números de índice de los Tokens en el vocabulario; sus valores numéricos no representan relaciones semánticas entre Tokens. Por ejemplo, dos Tokens con índices cercanos no son necesariamente semánticamente similares. Por lo tanto, antes de entrar a la red neuronal para cálculo, los Token IDs discretos necesitan ser proyectados a vectores continuos de alta dimensión a través de una capa de Embedding. Esta idea de usar vectores continuos para representar el lenguaje es una base importante del procesamiento del lenguaje natural moderno. En 2013, Mikolov et al. propusieron Word2Vec, que aprende representaciones vectoriales distribuidas de palabras a partir de corpus a gran escala a través de redes neuronales. La idea básica proviene de la hipótesis de distribución en el lenguaje natural, es decir, que las palabras que aparecen en contextos similares generalmente tienen características semánticas o gramaticales similares.
Word2Vec incluye principalmente dos estructuras de entrenamiento: CBOW (Continuous Bag-of-Words) y Skip-gram. Ambos aprenden vectores de palabras a través de la relación entre palabras centrales y palabras de contexto, pero sus direcciones de predicción son diferentes.
CBOW predice la palabra central basándose en palabras de contexto. Para una secuencia compuesta por palabras, primero se selecciona una palabra central, y las palabras dentro de cierta ventana a su alrededor se usan como contexto. El modelo usa las representaciones vectoriales de estas palabras de contexto para predecir la palabra central. Por ejemplo, con "comer" como palabra central, seleccionando "gustar" y "fresco" de su entorno como contexto.
Skip-gram, por otro lado, predice palabras de contexto basándose en la palabra central. Comparado con CBOW, su dirección de predicción es opuesta. Para la misma secuencia de palabras, cuando "comer" es la palabra central, el objetivo de entrenamiento de Skip-gram es predecir otras palabras que pueden aparecer dentro de cierta ventana basándose en la representación vectorial de "comer", como "gustar", "fresco", etc. La principal diferencia entre CBOW y Skip-gram está en sus objetivos de entrenamiento: CBOW usa múltiples palabras de contexto para predecir una palabra central; Skip-gram usa una palabra central para predecir múltiples palabras de contexto. A pesar de sus diferentes direcciones de predicción, su objetivo final es aprender vectores de palabras a través de una gran cantidad de relaciones de co-ocurrencia entre palabras. Después de completar el entrenamiento, cada palabra puede representarse como un vector continuo de dimensiones fijas.
La propuesta de Word2Vec promovió el desarrollo de representaciones vectoriales distribuidas de palabras, pero su método de representación todavía tiene ciertas limitaciones. Word2Vec aprende embeddings de palabras estáticos típicos, donde una palabra generalmente corresponde a un vector fijo después del entrenamiento y no cambia con el contexto específico. Los modelos de lenguaje modernos adoptan más representaciones contextuales. Los Tokens primero obtienen vectores iniciales a través de la capa de Embedding, luego pasan a través de múltiples capas de redes neuronales, continuamente actualizando sus representaciones basándose en la información de otros Tokens en la secuencia. Por lo tanto, el mismo Token puede formar diferentes estados ocultos en diferentes contextos, expresando así la semántica relacionada con el contexto actual. La importancia de Word2Vec no solo radica en proponer un método específico de entrenamiento de vectores de palabras, sino también en promover la aplicación generalizada de representaciones distribuidas en el procesamiento del lenguaje natural. El lenguaje ya no se representa solo a través de símbolos discretos o índices, sino que también se proyecta a espacios vectoriales continuos, permitiendo que las redes neuronales aprendan más relaciones semánticas y gramaticales entre palabras. Las tecnologías posteriores de procesamiento del lenguaje natural se enfocan más en cómo usar el contexto para ajustar dinámicamente las representaciones de palabras.
En 2017, se propuso la arquitectura Transformer. El Transformer modela relaciones entre diferentes posiciones en una secuencia a través de mecanismos de atención y gradualmente se convirtió en la infraestructura central de los grandes modelos de lenguaje. Uno de los mecanismos más importantes en Transformer es la autoatención (Self-Attention), como se muestra en la siguiente figura:
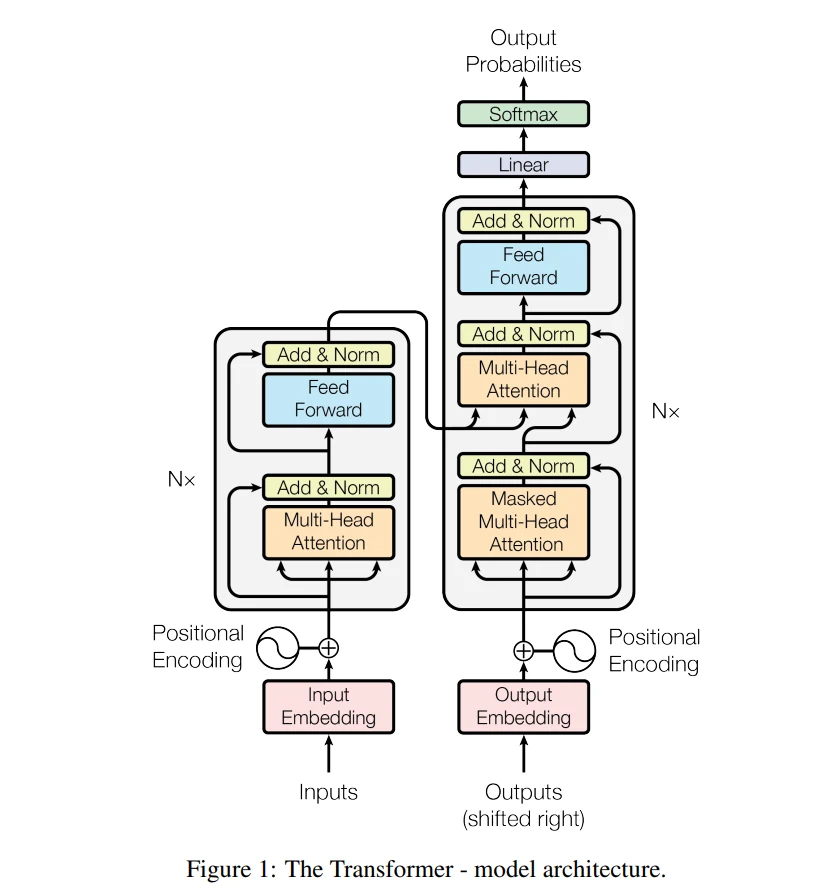
La función principal del mecanismo de autoatención es permitir que el modelo, al procesar un Token, considere simultáneamente la información contenida en otros Tokens en la secuencia y asigne dinámicamente diferentes pesos de atención basándose en el grado de asociación entre ellos. Específicamente, la representación de cada Token se proyecta a Query (Q), Key (K) y Value (V). El modelo calcula pesos de atención a través del grado de coincidencia entre Query y diferentes Keys, luego usa estos pesos para realizar una combinación ponderada de los Values correspondientes, obteniendo así una nueva representación que incorpora información contextual.
El Transformer típicamente se compone de múltiples capas de red apiladas. En diferentes capas, el modelo continuamente actualiza la representación de cada Token, incorporando progresivamente información contextual más rica. Después de pasar por múltiples capas de Transformer, el mismo Token puede formar diferentes representaciones contextuales en diferentes contextos, apoyando así el modelado de significados de palabras, estructuras sintácticas y relaciones semánticas más complejas por parte del modelo. La importancia del Transformer no solo radica en introducir una nueva arquitectura de red, sino también en proporcionar un mecanismo que puede modelar eficazmente las relaciones contextuales. Los grandes modelos de lenguaje modernos continuamente mejoran las capacidades de comprensión y generación del lenguaje expandiendo la escala del modelo, la escala de datos de entrenamiento y la longitud del contexto, todo sobre la base del Transformer.
Después de que Transformer realiza el modelado contextual de la secuencia de entrada, el modelo de lenguaje ha obtenido representaciones de Tokens que incorporan información contextual. Sobre esta base, los modelos de lenguaje generativos necesitan predecir aún más el contenido subsiguiente. Los modelos de lenguaje generativos dominantes como GPT típicamente usan generación autorresgresiva, que predice y genera progresivamente los Tokens subsiguientes basándose en los Tokens actualmente ingresados o generados.
Para una secuencia compuesta por múltiples Tokens, su probabilidad de generación puede descomponerse en una serie de probabilidades condicionales:
p(x_1, x_2, \ldots, x_T) = \prod_{t=1}^{T} p(x_t \mid x_1, x_2, \ldots, x_{t-1})
Donde $x_t$ representa el $t$-ésimo Token a generar actualmente, $x_1,x_2,\ldots,x_{t-1}$ representa los Tokens previamente ingresados o generados. Esta fórmula indica que el proceso de generación de una secuencia de texto completa puede descomponerse en múltiples procesos consecutivos de predicción del siguiente Token.
Después de que el modelo calcula la distribución de probabilidad del siguiente Token, necesita determinar el Token efectivamente salido a través de estrategias de decodación. Diferentes estrategias de decodación afectan directamente la estabilidad, diversidad y creatividad de la generación de texto.
El método más directo es la deccodificación codiciosa (Greedy Decoding), que selecciona el Token con la probabilidad más alta en cada paso. Este método tiene fuerte determinismo, pero la selección consecutiva de Tokens localmente más probables no necesariamente produce texto con calidad óptima general, y el contenido generado tiende a ser monótono. Para mejorar la diversidad de los resultados de generación, los modelos de lenguaje generativos también pueden usar muestreo aleatorio, seleccionando el siguiente Token según la distribución de probabilidad predicha por el modelo. Los Tokens con probabilidades más altas son más probables de ser seleccionados, pero otros Tokens candidatos razonables también tienen la posibilidad de ser seleccionados. En la práctica, típicamente se combinan métodos como Temperature, Top-k y Top-p para ajustar aún más el proceso de muestreo.
Temperature se usa para ajustar la suavidad de la distribución de probabilidad y puede representarse como:
p_i =
\frac{\exp(z_i / T)}
{\sum_j \exp(z_j / T)}
Donde $z_i$ representa el Logit del $i$-ésimo Token, $T$ representa Temperature.
Cuando $T$ es pequeño, la ventaja de los Tokens de alta probabilidad se fortalece aún más, el modelo tiende a seleccionar resultados con probabilidades más altas, y el contenido generado típicamente es más estable; cuando $T$ es grande, la distribución de probabilidad es relativamente más plana, los Tokens de baja probabilidad obtienen más oportunidades de ser seleccionados, y los resultados de generación típicamente tienen mayor diversidad.
Top-k solo retiene los $k$ Tokens candidatos con mayor probabilidad en cada paso de generación, y remuestrea después de renormalizar las probabilidades entre estos Tokens candidatos. Este método puede filtrar un gran número de Tokens de baja probabilidad, reduciendo la posibilidad de que se seleccionen contenidos claramente irrazonables.
Top-p no fija el número de Tokens candidatos; clasifica las probabilidades de mayor a menor y selecciona el conjunto más pequeño de candidatos cuya probabilidad acumulada alcanza el umbral $p$, luego muestrea de ese conjunto. Por lo tanto, Top-p puede ajustar dinámicamente el rango de Tokens candidatos basándose en la distribución de probabilidad actual.
Por ejemplo, cuando la predicción del modelo para el siguiente Token es relativamente segura, la probabilidad acumulada de un pequeño número de Tokens puede alcanzar el umbral establecido; mientras que cuando el modelo tiene múltiples resultados candidatos razonables, se retienen más Tokens para el muestreo. La generación de texto en realidad incluye dos procesos estrechamente relacionados: primero, el modelo de lenguaje calcula la distribución de probabilidad del siguiente Token basándose en el contexto, luego las estrategias de decodación y muestreo determinan el Token efectivamente generado basándose en esta distribución de probabilidad.
El modelo es responsable de aprender qué Tokens son más probables de aparecer en el contexto actual, mientras que la estrategia de decodación es responsable de decidir cómo seleccionar resultados específicos de entre estos Tokens candidatos. Juntos, determinan la exactitud, estabilidad y diversidad del texto final.
En el desarrollo de modelos generativos de aprendizaje profundo, las Redes Generativas Antagónicas (Generative Adversarial Network, GAN) representan una clase de técnicas representativas. En 2014, Goodfellow et al. propusieron GAN, que aprende los patrones de distribución de datos reales a través de entrenamiento antagónico entre dos redes neuronales. A diferencia del aprendizaje supervisado tradicional, GAN no especifica directamente qué tipo de imágenes debe producir el generador; también introduce un discriminador para evaluar los resultados de generación y usa los resultados de discriminación para mejorar continuamente el generador. Después de su propuesta, GAN rápidamente se aplicó a tareas como generación de imágenes, generación de rostros, transferencia de estilo de imagen, super-resolución y edición de imágenes, formando una serie de modelos representativos incluyendo CycleGAN, StyleGAN y ESRGAN.
GAN aprende la distribución de datos reales a través de entrenamiento antagónico entre dos redes neuronales: el Generador y el Discriminador. Como se muestra en la figura, durante el entrenamiento, el Discriminador recibe simultáneamente muestras reales del conjunto de entrenamiento y muestras generadas por el Generador, y distingue entre los dos tipos de muestras; el Generador continuamente ajusta sus propios parámetros basándose en la retroalimentación del Discriminador, mejorando la similitud entre muestras generadas y muestras reales.
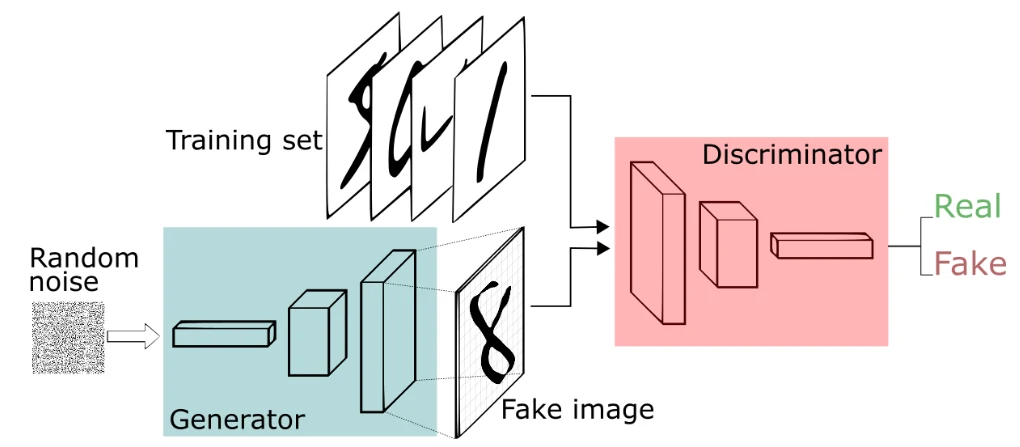
El Generador se denota como G. Su entrada típicamente es una variable aleatoria z muestreada de una distribución de probabilidad simple, como una distribución gaussiana o uniforme. Después del mapeo no lineal del Generador, la variable aleatoria se transforma en una muestra generada:
\hat{x}=G(z), \qquad z\sim p_z(z)
En tareas de generación de imágenes, el objetivo del Generador es proyectar progresivamente representaciones aleatorias de baja o alta dimensión en imágenes con estructuras visuales específicas.
El Discriminador se denota como D. Su entrada incluye muestras reales x del conjunto de entrenamiento y muestras generadas G(z) del Generador. Aprendiendo las diferencias de características entre los dos tipos de datos, el Discriminador produce la probabilidad de que la muestra de entrada provenga de la distribución de datos reales:
D(x)\in[0,1]
Para muestras reales, el Discriminador espera que la salida sea cercana a 1; para muestras generadas, espera que la salida sea cercana a 0. El Generador y el Discriminador tienen objetivos de optimización opuestos. El Discriminador necesita mejorar continuamente su capacidad para distinguir muestras reales de generadas, mientras que el Generador necesita mejorar continuamente la autenticidad de las muestras generadas, haciéndolas más similares a las muestras reales en términos de características de datos. Las dos redes forman una relación antagónica durante el proceso de optimización alternada. El paper original define el objetivo de entrenamiento de GAN como un juego en minimax:
\min_G \max_D V(D,G)
=
\mathbb{E}_{x\sim p_{\mathrm{data}}(x)}
[\log D(x)]
+
\mathbb{E}_{z\sim p_z(z)}
[\log(1-D(G(z)]
Donde $p_{\mathrm{data}}$ representa la distribución de datos reales, $p_z$ representa la distribución a priori de la variable aleatoria. El Discriminador $D$ mejora su capacidad para distinguir muestras reales de generadas maximizando la función objetivo; el Generador $G$ se aproxima progresivamente a la distribución de datos reales optimizando sus propios parámetros.
El entrenamiento de GAN típicamente adopta un enfoque de optimización alternada. Primero, las muestras reales y generadas se usan para actualizar el Discriminador $D$, permitiéndole aprender las diferencias entre los dos tipos de datos; luego, la información de gradiente del Discriminador se usa para actualizar el Generador $G$, permitiendo al Generador mejorar progresivamente los resultados de generación. A medida que el entrenamiento continúa, las capacidades del Generador y Discriminador cambian simultáneamente, formando un proceso de aprendizaje antagónico dinámico.
El Generador y Discriminador sirven diferentes funciones en GAN. El Discriminador se usa principalmente en la fase de entrenamiento, proporcionando señales de optimización para el Generador a través de clasificación verdadero/falso; después de completar el entrenamiento del modelo, si la tarea es solo generar nuevas imágenes, solo se necesita el Generador para la inferencia:
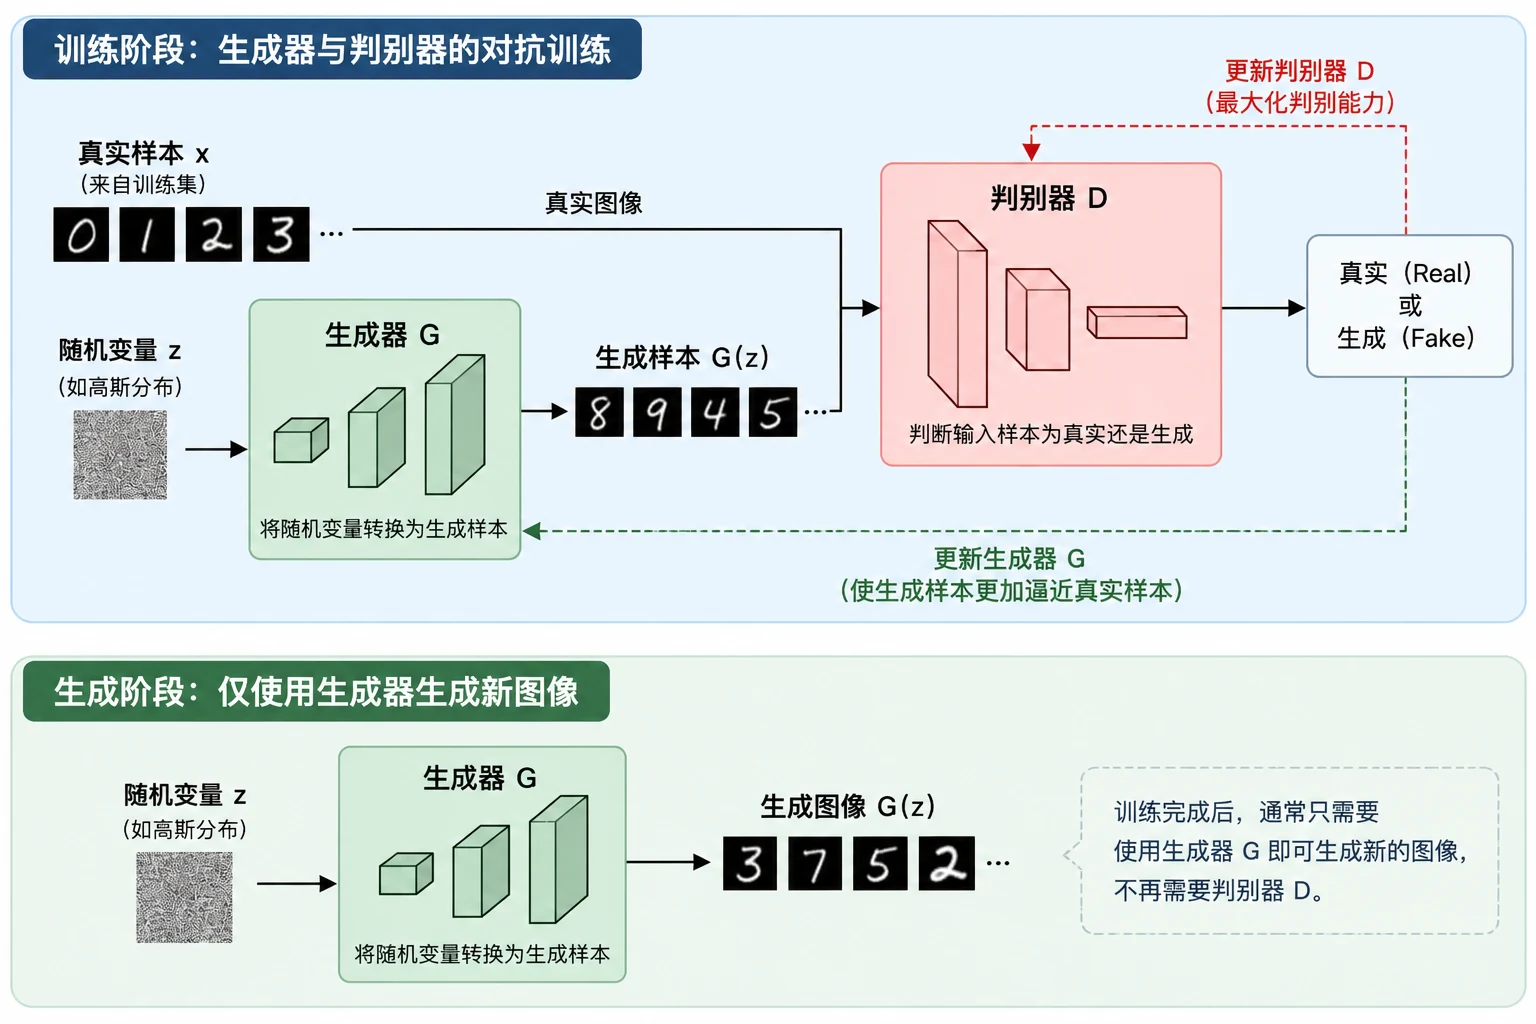
GAN ha recibido amplia atención en el campo de generación de imágenes, y una razón importante es que su proceso de generación es relativamente directo. Después de completar el entrenamiento del modelo, solo necesita ingresar variables aleatorias al Generador, y un resultado de generación se puede obtener a través de un solo cálculo directo. Comparado con modelos que requieren generación iterativa multi-paso, GAN típicamente tiene mayor eficiencia de generación, por lo que se ha ampliamente aplicado en tareas como generación de imágenes, super-resolución, mejora de video y procesamiento interactivo de imágenes. Las ventajas de GAN se manifiestan principalmente en la fase de generación, mientras que su proceso de entrenamiento es relativamente complejo, con los siguientes problemas principales.
GAN requiere entrenar simultáneamente el Generador y Discriminador, y las dos redes tienen objetivos de optimización mutuamente antagónicos. Cuando los parámetros del Generador cambian, los datos generados que enfrenta el Discriminador también cambian; cuando los parámetros del Discriminador cambian, la señal de optimización recibida por el Generador también cambia. Por lo tanto, a diferencia del aprendizaje supervisado ordinario que optimiza bajo una función objetivo relativamente fija, el entrenamiento de GAN es en realidad un proceso de juego dinámico en constante cambio. Si el Discriminador es demasiado fuerte, las muestras generadas pueden ser fácilmente identificadas y el Generador no puede obtener señales de optimización efectivas; si el Discriminador es demasiado débil, no puede reflejar con precisión las diferencias entre muestras reales y generadas, y tampoco puede proporcionar retroalimentación de entrenamiento efectiva al Generador. Por lo tanto, mantener un estado de entrenamiento relativamente estable entre el Generador y Discriminador es un problema importante en el entrenamiento de modelos GAN.
El colapso de modos es otro problema típico en el entrenamiento de GAN. Idealmente, el Generador no solo necesita generar muestras con alta calidad visual, sino que también debe poder cubrir diferentes tipos y características en los datos reales. Por ejemplo, asumiendo que los datos de entrenamiento contienen rostros de diferentes edades, expresiones y características de apariencia, el Generador debe poder producir imágenes de rostros con la diversidad correspondiente. Sin embargo, en el entrenamiento real, el Generador puede tender a generar un pequeño número de categorías de muestras que son más fáciles de recibir evaluaciones más altas del Discriminador, y continuamente producir resultados similares. En este punto, las imágenes generadas individualmente pueden tener alta calidad visual, pero las diferencias entre un gran número de resultados generadas son pequeñas, incapaces de cubrir completamente la diversidad de los datos reales. El colapso de modos refleja un problema importante en los modelos generativos: una alta calidad de generación de muestras individuales no significa que el modelo haya aprendido completamente la distribución de datos reales.
Respecto a problemas como inestabilidad de entrenamiento, colapso de modos y calidad de generación, los investigadores han mejorado GAN desde múltiples aspectos incluyendo estructura de red, funciones de pérdida y estrategias de entrenamiento, formando una gran cantidad de modelos derivados. Estos estudios no solo mejoraron las capacidades de generación de GAN, sino que también lo expandieron gradualmente desde generación básica de imágenes hasta diferentes tareas como traducción de imágenes, edición de imágenes controlable y super-resolución de imágenes. A continuación, a través de varios modelos representativos, presentamos las aplicaciones típicas de GAN en estas direcciones.
Con el desarrollo de la tecnología GAN, su alcance de aplicación se ha expandido gradualmente desde generación de imágenes aleatorias hasta tareas como traducción de imágenes, edición de imágenes y mejora de imágenes. Diferentes modelos típicamente rediseñan generadores, discriminadores, funciones de pérdida o métodos de entrenamiento para tareas específicas, formando modelos derivados de GAN con diferentes funciones. Entre ellos, CycleGAN, DragGAN, ESRGAN y Real-ESRGAN representan respectivamente las aplicaciones típicas de GAN en traducción de imágenes no apareadas, edición de imágenes interactiva y super-resolución de imágenes.
En 2017, Zhu et al. propusieron CycleGAN, utilizado principalmente para resolver problemas de traducción de imágenes no apareadas (Unpaired Image-to-Image Translation). A diferencia de los métodos de traducción de imágenes que requieren muestras de entrenamiento apareadas, CycleGAN no requiere una correspondencia uno a uno entre imágenes fuente y objetivo; solo necesita proporcionar datos de dos dominios de imágenes por separado para aprender la relación de traducción entre ellos. Por ejemplo, en la tarea de traducción caballo → cebra, los métodos tradicionales típicamente necesitan preparar imágenes correspondientes de caballos y cebras, mientras que CycleGAN solo necesita preparar separadamente un conjunto de imágenes de caballos y un conjunto de imágenes de cebras, sin establecer correspondencia entre los dos conjuntos de imágenes. Como se muestra a continuación, CycleGAN consta de dos generadores y dos discriminadores, aprendiendo simultáneamente la traducción de imágenes en ambas direcciones. Asumiendo que las imágenes de caballos pertenecen al dominio de imágenes $X$, las imágenes de cebras pertenecen al dominio de imágenes $Y$, el Generador $G$ es responsable de completar la traducción de $X$ a $Y$, y el Generador $F$ es responsable de completar la traducción de $Y$ a $X$:
G:X\rightarrow Y,\qquad F:Y\rightarrow X
Donde el Discriminador $D_Y$ se usa para juzgar si las imágenes de cebras generadas se ajustan a la distribución de imágenes de cebras reales, y el Discriminador $D_X$ se usa para juzgar si las imágenes de caballos generadas se ajustan a la distribución de imágenes de caballos reales. Por lo tanto, CycleGAN en realidad contiene dos procesos de aprendizaje antagónico direccionales:
G + D_Y:Caballo → Cebra
F + D_X:Cebra → Caballo
El entrenamiento antagónico en dos direcciones solo no puede garantizar que las imágenes traducidas mantengan correspondencia con la entrada original. Por ejemplo, al traducir una imagen de caballo a cebra, aunque el resultado generado puede tener texturas realistas de cebra, la postura, posición o estructura de fondo del caballo pueden cambiar significativamente. Es decir, la consistencia del contenido antes y después de la traducción no puede estar completamente garantizada.
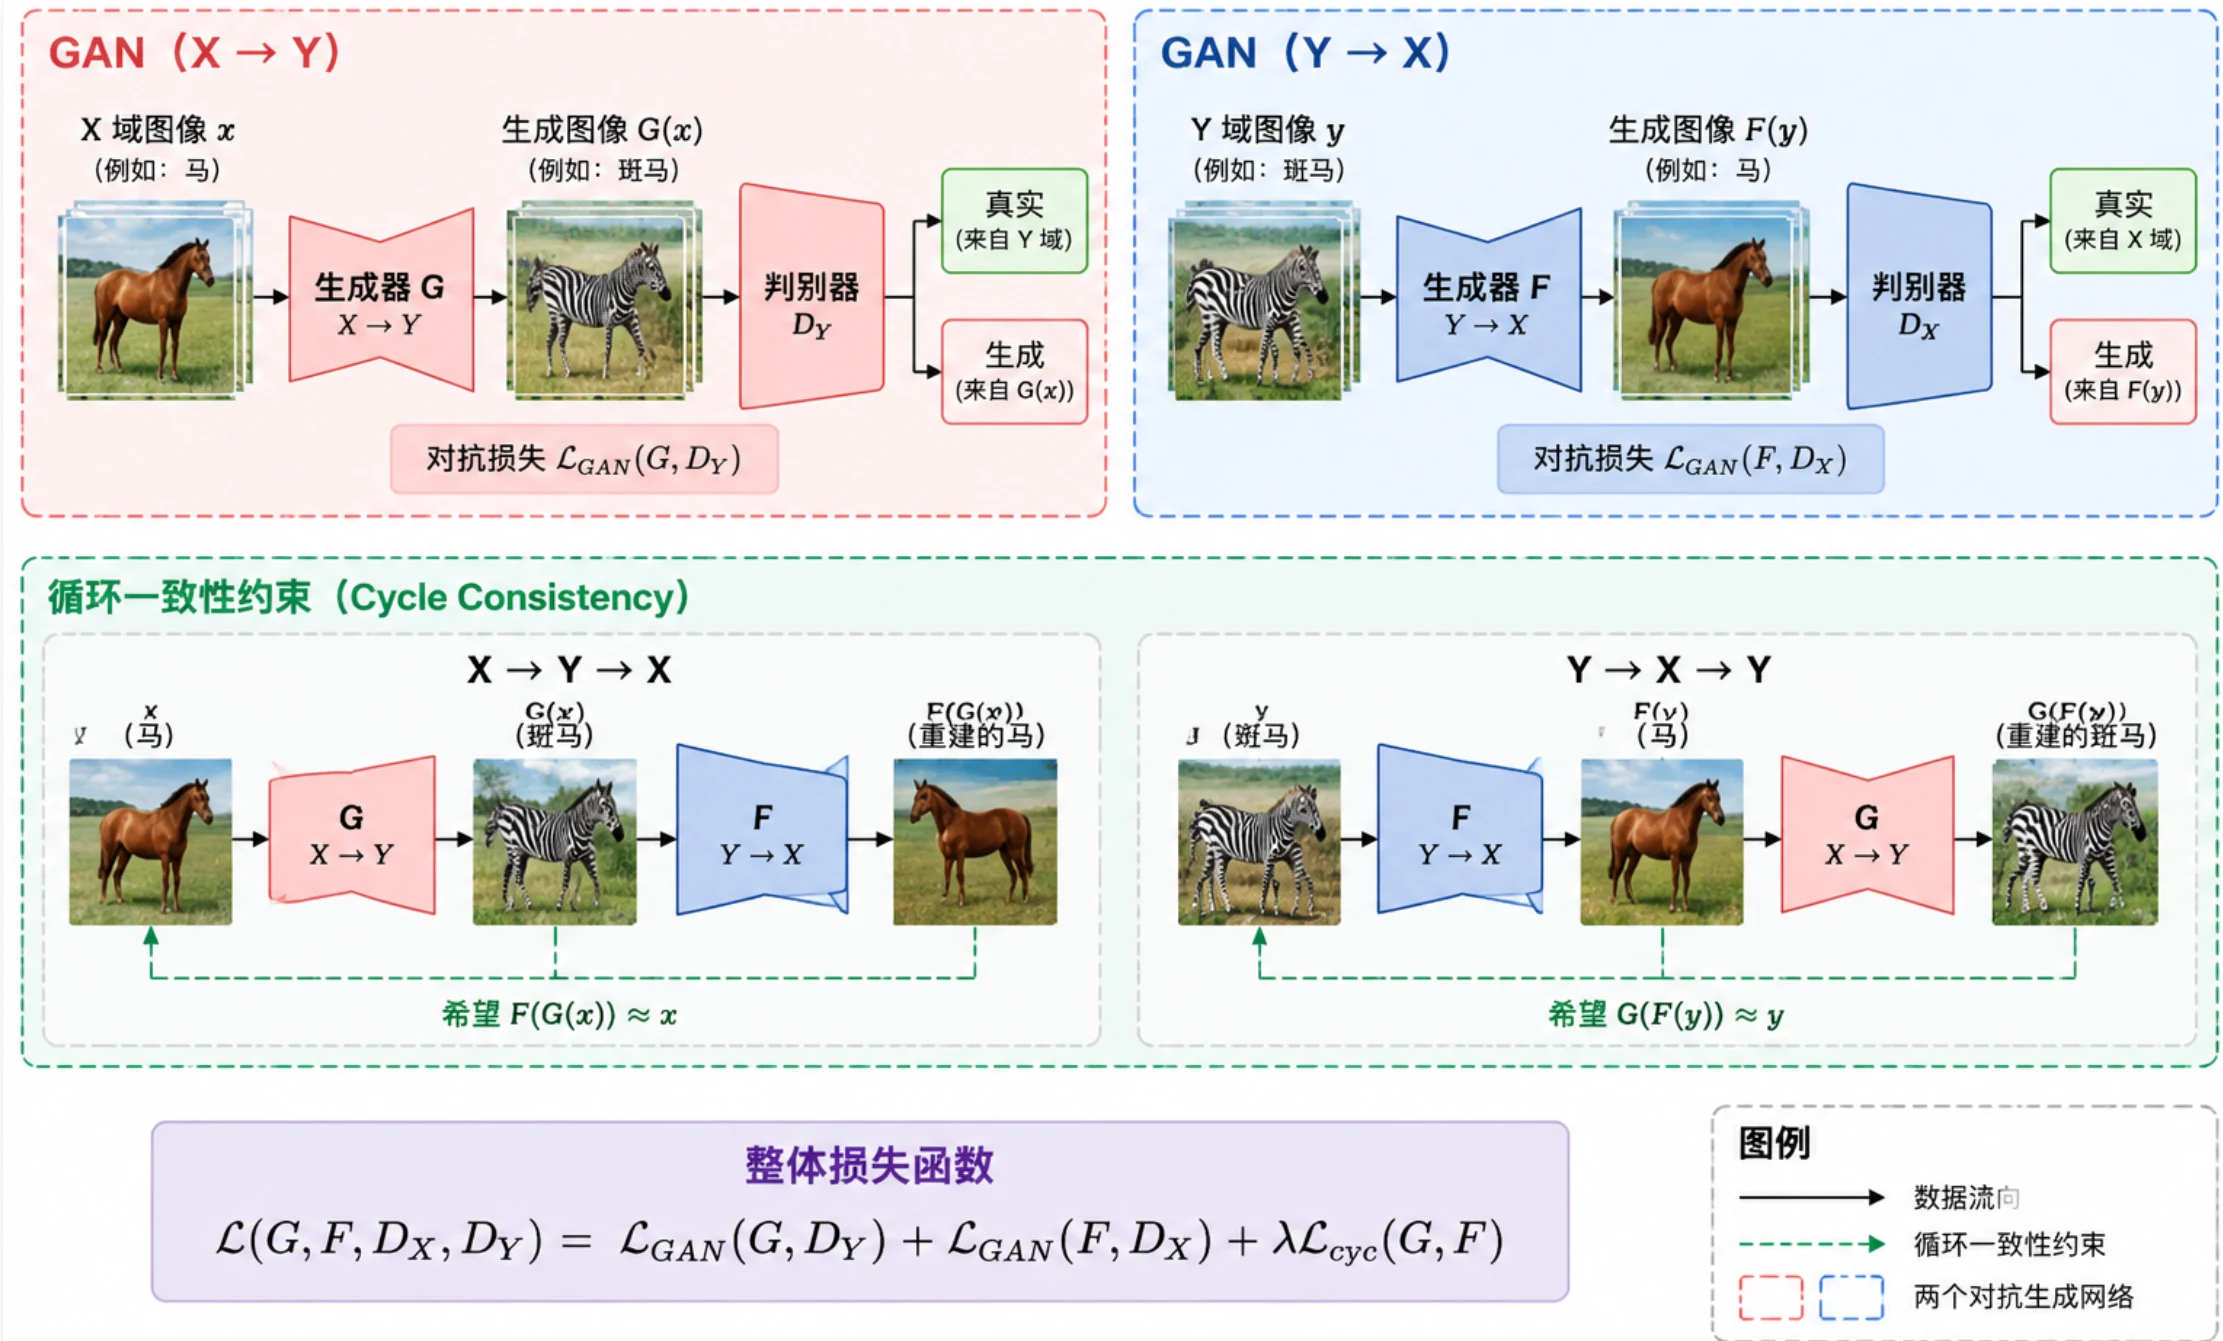
Por esta razón, CycleGAN introduce restricciones de consistencia cíclica (Cycle Consistency). Como se muestra en la parte inferior de la figura, para la imagen de caballo $x$ en el dominio de imágenes $X$, primero se traduce a imagen de cebra $G(x)$ a través del Generador $G$, luego se traduce de vuelta a imagen de caballo a través del Generador $F$:
x\rightarrow G(x)\rightarrow F(G(x)
Después de una traducción completa ida y vuelta, el resultado final debe estar lo más cerca posible de la imagen original:
F(G(x)\approx x
De manera similar, para la imagen de cebra $y$ en el dominio de imágenes $Y$, debe satisfacer:
G(F(y)\approx y
Por lo tanto, el modelo forma dos ciclos de traducción completos: Caballo → Cebra → Caballo, Cebra → Caballo → Cebra. CycleGAN introduce pérdida de consistencia cíclica para restringir los dos ciclos:
\mathcal{L}_{\mathrm{cyc}}(G,F)
=
\mathbb{E}_{x\sim p_{\mathrm{data}}(x)}
\left[\|F(G(x)-x\|_1\right]
+
\mathbb{E}_{y\sim p_{\mathrm{data}}(y)}
\left[\|G(F(y)-y\|_1\right]
Donde el primer término restringe el resultado de reconstrucción Caballo → Cebra → Caballo, y el segundo término restringe el resultado de reconstrucción Cebra → Caballo → Cebra. Cuanto menor sea la pérdida de consistencia cíclica, más cercana estará la imagen a la imagen original en contenido y estructura después de la traducción bidireccional. El entrenamiento de CycleGAN incluye principalmente dos partes: aprendizaje antagónico y restricciones de consistencia cíclica, que trabajan juntas para permitir que CycleGAN aprenda la relación de mapeo entre dos dominios de imágenes sin datos de entrenamiento apareados, logrando así tareas como traducción caballo-cebra y transferencia de estilo de imagen.
En 2023, Pan et al. propusieron DragGAN, que logra el ajuste interactivo de posición, postura y forma de objetos en imágenes generadas estableciendo puntos de control y puntos objetivo en la imagen. A diferencia de la edición tradicional a nivel de píxeles, DragGAN no mueve directamente píxeles en la imagen; ajusta la representación latente del GAN, haciendo que la imagen generada cambie según la dirección especificada por el usuario.
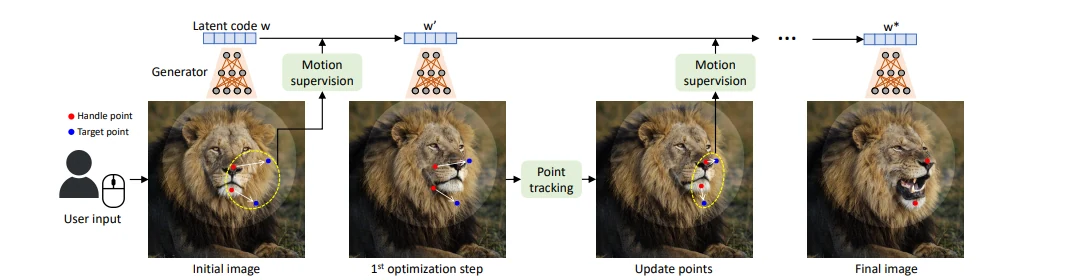
El proceso central de DragGAN incluye principalmente supervisión de movimiento y seguimiento de puntos. El usuario primero selecciona el punto de control a ajustar en la imagen y especifica la posición objetivo a la que desea mover. Por ejemplo, en la figura, estableciendo puntos de control y puntos objetivo cerca de la boca del león, la boca del león gradualmente se abre.
Durante el proceso de edición, DragGAN mantiene los parámetros del Generador pre-entrenado sin cambios y continuamente optimiza el código latente $w$ ingresado al Generador. La imagen inicial puede representarse como:
I = G(w)
Donde $G$ representa el Generador GAN pre-entrenado, $w$ representa el código latente correspondiente a la imagen. Al ajustar $w$, el contenido y la estructura de la imagen generada $I$ pueden cambiarse. La supervisión de movimiento se usa para empujar las características de la imagen cerca del punto de control hacia la posición objetivo. Después de una optimización, el código latente se actualiza de $w$ a $w'$, y la imagen generada cambia en consecuencia. Como la posición original del punto de control puede haberse desplazado después de que la imagen cambie, DragGAN también necesita determinar nuevamente la posición del punto de control en la nueva imagen a través del seguimiento de puntos, luego continuar con el siguiente ciclo de optimización, que es: establecer punto de control y punto objetivo → supervisión de movimiento → optimizar código latente → generar nueva imagen → seguimiento de puntos y actualizar punto de control → continuar optimizando hasta acercarse a la posición objetivo. Después de múltiples iteraciones, el punto de control gradualmente se mueve a la posición objetivo especificada por el usuario, resultando finalmente en la imagen editada. Como este proceso se optimiza en el espacio de generación aprendido por GAN, el modelo no solo cambia la posición especificada, sino que también puede hacer ajustes correspondientes a estructuras relacionadas circundantes.
La clave de DragGAN no es simplemente arrastrar píxeles; convierte la operación de arrastre del usuario en optimización iterativa de la representación latente del GAN, y a través de supervisión de movimiento y seguimiento de puntos, controla la estructura semántica en la imagen para moverse hacia la posición especificada. Este método demuestra la capacidad de aplicación de GAN en edición de imágenes controlable, permitiendo a los usuarios ajustar intuitivamente la postura, expresión y forma de objetos a través de operaciones basadas en puntos.
La super-resolución de imágenes es una de las direcciones de aplicación típicas de GAN, cuyo objetivo es generar imágenes con mayor resolución y detalles visuales más ricos a partir de imágenes de baja resolución. A diferencia de un simple escalado por interpolación, los modelos de super-resolución necesitan reconstruir texturas de alta frecuencia y estructuras locales faltantes basándose en el contenido de imagen existente. En 2018, Wang et al. propusieron ESRGAN[ESRGAN], mejorando aún más la estructura de red, pérdida antagónica y pérdida perceptual sobre la base de investigaciones existentes para mejorar el rendimiento de textura y la calidad visual de las imágenes de super-resolución.
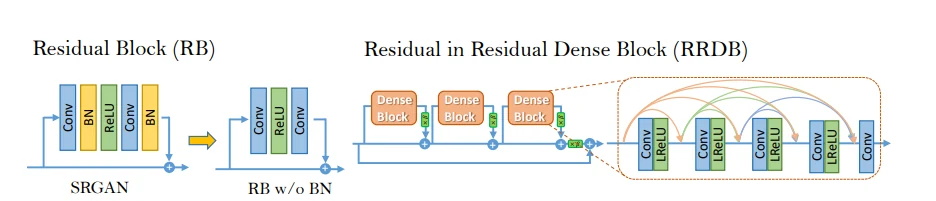
Una mejora importante en la estructura de red de ESRGAN es la introducción de la estructura Residual-in-Residual Dense Block (RRDB). El Generador de SRGAN usa principalmente bloques residuales ordinarios (Residual Block, RB), que incluyen capas de convolución, normalización por lotes (Batch Normalization, BN) y funciones de activación. ESRGAN primero elimina la capa BN de los bloques residuales y combina aún más múltiples módulos de conexión densa en RRDB.
Como se puede ver en la figura, RRDB internamente está compuesto por múltiples Dense Blocks y combina conexiones densas con conexiones residuales. Dentro de Dense Blocks, diferentes capas de convolución usan conexiones densas, donde las capas posteriores pueden recibir y utilizar características extraídas por múltiples capas anteriores; entre múltiples Dense Blocks y fuera de RRDB, las características se transmiten aún más a través de conexiones residuales. Esta estructura puede reforzar la transmisión de información y reutilización de características entre diferentes capas, mejorando la capacidad de modelado de la red para texturas y características detalladas de imágenes. Además de las mejoras en la estructura de red, ESRGAN también optimiza el objetivo de entrenamiento. Los métodos tradicionales de super-resolución, si se entrenan principalmente con error a nivel de píxeles, tienden a generar resultados relativamente suaves; aunque el error de píxel puede ser menor, algunas texturas de alta frecuencia y bordes tienden a volverse borrosos. ESRGAN combina aún más pérdida perceptual y entrenamiento antagónico, permitiendo que los resultados de generación obtengan detalles de textura más claros y naturales mientras mantienen el contenido general.
La super-resolución generativa no equivale a recuperar información original perdida. Cuando parte de la información de alta frecuencia en imágenes de baja resolución se ha perdido, los píxeles existentes por sí solos generalmente no pueden determinar únicamente los detalles originales. ESRGAN en realidad combina la imagen de entrada con conocimientos previos de imagen aprendidos durante el entrenamiento para generar texturas visualmente razonables. Los resultados generados pueden ser más claros, pero algunos detalles no necesariamente son completamente consistentes con la imagen de alta resolución original. Esta característica hace que ESRGAN sea más adecuado para tareas de mejora de imágenes que enfatizan la calidad visual. En escenarios con altos requisitos de autenticidad de información como imágenes médicas, forensic de archivos e imágenes de investigación científica, los resultados de super-resolución generativa deben usarse con precaución.
GAN aprende la distribución de datos reales a través de entrenamiento antagónico entre Generador y Discriminador, mientras que el Autoencoder Variacional (Variational Autoencoder, VAE) adopta un enfoque de generación diferente: primero codificar los datos de entrada en un espacio latente continuo, luego muestrear del espacio latente y generar o reconstruir datos a través de un decodificador. En 2013, Kingma y Welling propusieron el método Auto-Encoding Variational Bayes (AEVB) y proporcionaron el marco de entrenamiento VAE posteriormente ampliamente utilizado. VAE combina redes neuronales con inferencia variacional, permitiendo al modelo aprender representaciones latentes con estructura probabilista a través de entrenamiento de extremo a extremo.
La estructura básica de VAE está compuesta por un codificador (Encoder) y un decodificador (Decoder). El codificador es responsable de comprimir los datos de entrada a un espacio latente de menor dimensión, mientras que el decodificador restaura los datos de entrada basándose en representaciones latentes. Los autoencoders ordinarios típicamente codifican la entrada $x$ directamente en un vector latente determinista $z$, luego usan el decodificador para reconstrucción. La mayor diferencia entre VAE y los autoencoders ordinarios es que el codificador no produce directamente un vector latente determinista; produce los parámetros de la distribución de probabilidad de la variable latente.
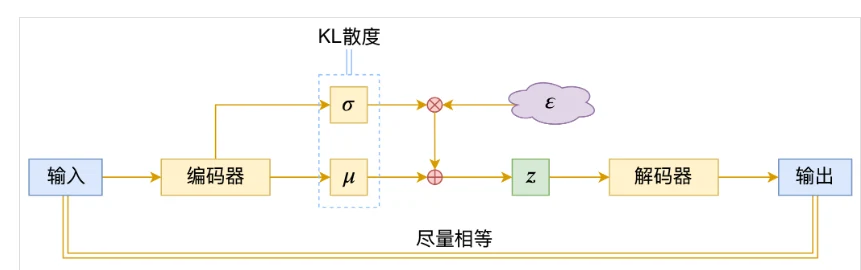
En la figura anterior, el codificador de VAE no convierte directamente los datos de entrada $x$ en un vector latente fijo; también produce dos parámetros: media $\mu$ y desviación estándar $\sigma$. Estos dos parámetros juntos determinan la distribución de probabilidad de la variable latente $z$. $\mu$ determina aproximadamente dónde se encuentra la variable latente, y $\sigma$ indica cuánto rango de variación puede tener alrededor de esta posición.
VAE modela la variable latente como una distribución gaussiana:
q_{\phi}(z\mid x)
=
\mathcal{N}
\left(
z;\mu_{\phi}(x),
\operatorname{diag}\left(\sigma_{\phi}^{2}(x)\right)
\right)
Donde $q_{\phi}(z\mid x)$ representa la distribución de variable latente obtenida por el codificador basándose en la entrada $x$. A diferencia de los autoencoders ordinarios que obtienen directamente un $z$ determinista, VAE obtiene una distribución que puede ser muestreada, por lo que la misma entrada puede producir diferentes representaciones latentes dentro de cierto rango. A continuación, el modelo necesita obtener una variable latente específica $z$ de esta distribución y enviarla al decodificador. Para introducir aleatoriedad mientras se garantiza que el modelo puede realizar retropropagación normal, VAE usa el truco de reparametrización. El modelo primero extrae una variable aleatoria $\epsilon$ de una distribución normal estándar, luego combina $\mu$ y $\sigma$ obtenidos por el codificador para calcular la variable latente $z$:
z=\mu+\sigma\odot\epsilon
Se puede entender que $\mu$ determina la posición, $\sigma$ determina el rango de variación, y $\epsilon$ proporciona aleatoriedad; juntos producen la variable latente final $z$. Este enfoque separa el muestreo aleatorio del proceso de cálculo de parámetros de red, permitiendo que los gradientes aún se propaguen a través de $z$ hasta el codificador, permitiendo así el entrenamiento de extremo a extremo de todo VAE. Después de obtener la variable latente $z$, el decodificador genera el resultado de reconstrucción $\hat{x}$ basándose en $z$. Todo el proceso de VAE se puede resumir como: datos de entrada → codificador → distribución latente → muestreo para obtener $z$ → decodificador → datos reconstruidos.
VAE también necesita considerar simultáneamente dos objetivos durante el entrenamiento: por un lado, espera que los resultados generados por el decodificador estén lo más cerca posible de la entrada original; por otro lado, espera que las distribuciones latentes correspondientes a diferentes entradas no sean demasiado desordenadas sino que formen un espacio latente relativamente continuo y regular. Por lo tanto, el objetivo de entrenamiento de VAE consiste tanto en el término de reconstrucción como en el término de divergencia KL, típicamente representado a través del Límite Inferior de Evidencia (Evidence Lower Bound, ELBO):
\mathcal{L}_{\mathrm{ELBO}}
=
\mathbb{E}_{q_{\phi}(z\mid x)}
\left[
\log p_{\theta}(x\mid z)
\right]
-
D_{\mathrm{KL}}
\left(
q_{\phi}(z\mid x)
\parallel
p(z)
\right)
Donde el primer término se puede entender como qué tan buena es la reconstrucción, midiendo si el decodificador puede restaurar los datos de entrada basándose en $z$ ; el segundo término se puede entender como qué tan regular es el espacio latente, restringiendo la distribución latente obtenida por el codificador a través de divergencia KL para hacerla cercana a la distribución a priori predefinida. Estos dos objetivos necesitan funcionar juntos. Si solo se enfoca en la calidad de reconstrucción, aunque el modelo puede restaurar bien la entrada, el espacio latente puede estar bastante disperso, haciendo inconveniente el muestreo directo; después de agregar restricciones de divergencia KL, las representaciones latentes de diferentes muestras están restringidas por una distribución a priori unificada, haciendo el espacio latente más regular y más adecuado para muestreo y generación.
Desde la perspectiva del proceso de generación, VAE ya tiene capacidad de generación completa. Después de completar el entrenamiento, en lugar de ingresar la imagen original, se puede extraer directamente la variable latente $z$ de una distribución normal estándar e ingresarla al decodificador para generar nuevas imágenes. Teóricamente, este proceso puede funcionar porque durante el entrenamiento, la distribución latente generada por el codificador está continuamente restringida a través de divergencia KL para acercarse a la distribución normal estándar predefinida. Sin embargo, en el entrenamiento real, la distribución latente generada por el codificador generalmente no puede coincidir completamente con la distribución normal estándar. Si la restricción es demasiado fuerte, aunque el espacio latente es más regular, se pueden perder algunas imágenes de información; si la restricción es demasiado débil, la distribución del espacio latente puede no ser lo suficientemente regular, haciendo que el $z$ obtenido por muestreo directo de la distribución normal estándar caiga en regiones no familiares del modelo, afectando así los resultados de decodificación.
Al mismo tiempo, VAE necesita encontrar un equilibrio entre calidad de reconstrucción y regularidad del espacio latente. El objetivo de entrenamiento de VAE clásico enfatiza más el modelado de la distribución general de datos y el espacio latente, tendiendo a perder algunas texturas de alta frecuencia y detalles locales durante la generación de imágenes, con resultados generados que a menudo son relativamente suaves. Esta es también una distinción evidente entre VAE y GAN en efectividad de generación de imágenes. GAN restringe directamente la autenticidad de las imágenes generadas a través del discriminador, típicamente produciendo texturas más nítidas; VAE se enfoca más en la continuidad y estructura probabilista del espacio latente, con ciertas limitaciones en la generación directa de imágenes de alta calidad.
Con el desarrollo de modelos generativos, el papel de VAE ha evolucionado gradualmente desde generar directamente imágenes finales hasta servir como herramienta de codificación y decodificación entre el espacio de imagen y el espacio latente. Una aplicación representativa es el Modelo de Difusión Latente (Latent Diffusion Model, LDM). Los primeros modelos de difusión realizaban directamente la adición de ruido y eliminación de ruido en el espacio de píxeles. Cuando la resolución de imagen es alta, el modelo necesita procesar repetidamente una gran cantidad de píxeles, resultando en altos costos computacionales. El modelo de difusión latente propuesto por Rombach et al. transfiere el proceso de difusión a un espacio latente comprimido, reduciendo así las dimensiones de datos que el modelo de difusión necesita procesar. En esta estructura, el codificador primero comprime la imagen original en una representación latente: imagen original → codificador → representación latente. Estas representaciones latentes ya no guardan directamente cada píxel, sino que retienen la estructura principal y la información visual de la imagen en una forma más compacta. Luego, el modelo de difusión realiza la adición de ruido y eliminación de ruido en este espacio latente en lugar de procesar directamente la imagen de alta resolución original. Cuando el modelo de difusión completa la generación, el decodificador restaura la representación latente generada al espacio de píxeles: representación latente generada → decodificador → imagen final. VAE es responsable de comprimir y restaurar imágenes, mientras que el modelo de difusión es responsable de generar contenido de imagen en el espacio latente. Este enfoque aprovecha completamente la capacidad de representación latente de VAE. El modelo de difusión ya no procesa píxeles originales de alta dimensión, sino características de imagen comprimidas, reduciendo significativamente el costo computacional de los procesos posteriores de difusión y eliminación de ruido.
VAE en sí tiene ciertas limitaciones en la generación directa de imágenes de alta calidad, pero su codificador, espacio latente y estructura de decodificador se han convertido en componentes importantes de los modelos de difusión latente modernos. Esto también refleja el cambio en el papel de VAE: evolucionando gradualmente desde un modelo generativo independiente hasta un módulo de representación latente en sistemas de generación de imágenes de alta calidad.
GAN típicamente usa el generador para completar la generación de imágenes a través de un solo cálculo directo, y VAE también puede comenzar con variables latentes para obtener resultados de generación directamente a través del decodificador. Para imágenes complejas de alta dimensión, hacer que el modelo complete el mapeo de variables aleatorias a imágenes completas en un paso no es fácil. Los modelos de difusión adoptan un enfoque diferente, dividiendo la tarea compleja de generación de imágenes en múltiples pasos relativamente simples, donde cada paso solo realiza un pequeño ajuste al resultado actual, obteniendo progresivamente la imagen completa a través de múltiples iteraciones. No se requiere que el modelo genere el resultado final en un paso; en cambio, completa progresivamente la generación a través de múltiples pasos de eliminación de ruido.
Los modelos de difusión contienen principalmente dos procesos en direcciones opuestas: difusión hacia adelante y eliminación de ruido hacia atrás. La difusión hacia adelante comienza con datos reales $x_0$ y agrega continuamente pequeñas cantidades de ruido aleatorio. A medida que el paso de tiempo $t$ aumenta, la información original en la imagen disminuye progresivamente y el ruido aumenta, acercándose eventualmente al ruido gaussiano aleatorio. En el DDPM clásico, los datos ruidosos en cualquier paso de tiempo se pueden construir directamente a partir de los datos originales $x_0$:
x_t
=
\sqrt{\bar{\alpha}_t}x_0
+
\sqrt{1-\bar{\alpha}_t}\epsilon
Donde:
\epsilon\sim\mathcal{N}(0,I)
,
x_0
representa los datos originales, $\epsilon$ representa el ruido gaussiano aleatorio, $\bar{\alpha}_t$ se usa para controlar la proporción de datos originales y ruido en el paso de tiempo actual. Cuanto más tarde el paso de tiempo, menos información original y más ruido. Diferentes pasos de tiempo corresponden a diferentes niveles de ruido, y cómo cambian estos niveles de ruido está determinado por la estrategia de programación de ruido.
La difusión hacia adelante en sí no necesita aprendizaje del modelo. Durante el entrenamiento, los datos con diferentes niveles de ruido se pueden construir directamente según reglas predefinidas. Lo que el modelo realmente necesita aprender es el proceso opuesto, es decir, cómo recuperar progresivamente datos más claros a partir de datos ruidosos. Durante la generación, el modelo comienza con ruido aleatorio, realizando cierto grado de eliminación de ruido en cada paso: ruido aleatorio → estructura preliminar → contorno gradualmente claro → textura gradualmente formada → imagen final. Este mecanismo divide una tarea de generación compleja que se completaría en un solo paso en múltiples tareas de corrección local relativamente simples. El modelo no necesita predecir la imagen completa de una vez; necesita ajustarse continuamente basándose en el estado actual, lo cual es una de las razones importantes por las que los modelos de difusión pueden lograr generación de alta calidad.
En el DDPM clásico, se establecen dos procesos en direcciones opuestas: el proceso de difusión hacia adelante agrega continuamente ruido a los datos reales, mientras que el proceso de generación hacia atrás aprende cómo eliminar progresivamente el ruido, permitiendo que el ruido aleatorio eventualmente recupere imágenes con características de datos reales.
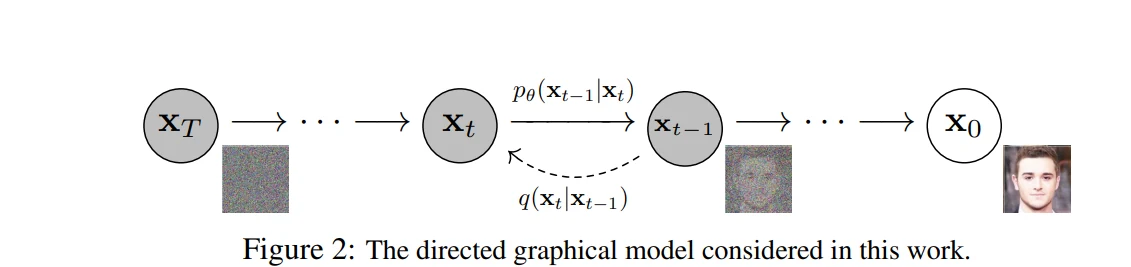
$x_0$ representa la imagen real. A medida que la difusión hacia adelante agrega continuamente ruido gaussiano, los datos pasan por $x_1,x_2,\ldots,x_T$ en secuencia, y eventualmente $x_T$ se acerca al ruido gaussiano aleatorio. La línea punteada $q(x_t\mid x_{t-1})$ en la figura representa el proceso de difusión hacia adelante, mientras que $p_\theta(x_{t-1}\mid x_t)$ representa el proceso de generación hacia atrás que el modelo necesita aprender. El proceso hacia adelante se puede entender como: imagen real x₀ → x₁ → x₂ → …… → xₜ → …… → ruido aleatorio xT, mientras que la generación real de imágenes procede en la dirección opuesta: ruido aleatorio xT → …… → xₜ → xₜ₋₁ → …… → imagen final x₀. La pregunta clave de DDPM es cómo hacer que el modelo aprenda a obtener $x_{t-1}$ con menos ruido del $x_t$ actual.
En DDPM, el proceso hacia atrás está parametrizado por una red neuronal. Un enfoque importante y comúnmente usado es hacer que la red neuronal prediga el ruido agregado a $x_t$. Durante el entrenamiento, comenzando con la imagen real $x_0$, se selecciona aleatoriamente un paso de tiempo $t$ y se extrae ruido gaussiano
\epsilon\sim\mathcal{N}(0,I)
, según el proceso de difusión hacia adelante, la imagen ruidosa correspondiente al paso de tiempo $t$ se puede construir directamente:
x_t
=
\sqrt{\bar{\alpha}_t}x_0
+
\sqrt{1-\bar{\alpha}_t}\epsilon
Luego, la imagen ruidosa $x_t$ y el paso de tiempo $t$ se ingresan a la red neuronal, y el modelo predice el ruido
\epsilon_\theta(x_t,t)
, donde $\theta$ representa los parámetros de la red neuronal. Dado que el ruido real $\epsilon$ agregado durante el entrenamiento es conocido, la diferencia entre el ruido predicho por el modelo y el ruido real se puede comparar directamente. El proceso de entrenamiento de DDPM se puede entender como: primero agregar activamente diferentes niveles de ruido a las imágenes reales, luego entrenar al modelo para identificar qué ruido se agregó. Después de un entrenamiento extenso, el modelo puede manejar datos en diferentes pasos de tiempo y diferentes niveles de ruido, y usar los resultados de predicción de ruido para construir el proceso hacia atrás $p_\theta(x_{t-1}\mid x_t)$ mostrado en la figura. Durante la fase de generación, ya no se necesitan imágenes reales; en cambio, comenzando directamente con ruido gaussiano, el modelo primero obtiene $x_{T-1}$ con menos ruido de $x_T$, luego obtiene $x_{T-2}$ de $x_{T-1}$, y así sucesivamente:
x_T
\rightarrow
x_{T-1}
\rightarrow
x_{T-2}
\rightarrow
\cdots
\rightarrow
x_1
\rightarrow
x_0
.
A medida que el proceso hacia atrás continúa, la estructura general, contorno y textura de la imagen emergen gradualmente del ruido aleatorio, resultando finalmente en la imagen generada completa. DDPM no hace que el modelo prediga la imagen completa a partir del ruido de una vez; en cambio, aprende capacidades de eliminación de ruido en múltiples niveles de ruido, luego completa progresivamente la generación a través de múltiples iteraciones hacia atrás. Este enfoque reduce la dificultad de las tareas de generación de un solo paso y evita el entrenamiento antagónico entre generador y discriminador en GAN. Sin embargo, el muestreo multi-paso significa que generar una imagen requiere múltiples ejecuciones de inferencia de red neuronal, por lo que la velocidad lenta de inferencia también se ha convertido en una de las principales limitaciones del DDPM clásico.
DDPM describe la generación de imágenes como un proceso de eliminación de ruido paso a paso, agregando ruido a los datos reales durante el entrenamiento y haciendo que el modelo aprenda a predecir el ruido; durante la generación, comenzando con ruido aleatorio, la imagen se obtiene progresivamente a través de múltiples pasos de eliminación de ruido hacia atrás. Flow Matching adopta un enfoque descriptivo diferente. Construye un camino de probabilidad continuo entre la distribución de ruido aleatorio y la distribución de datos reales, y entrena al modelo para aprender la dirección de cambio a lo largo de este camino, permitiendo que el ruido aleatorio se transforme progresivamente en datos reales según la dirección aprendida.
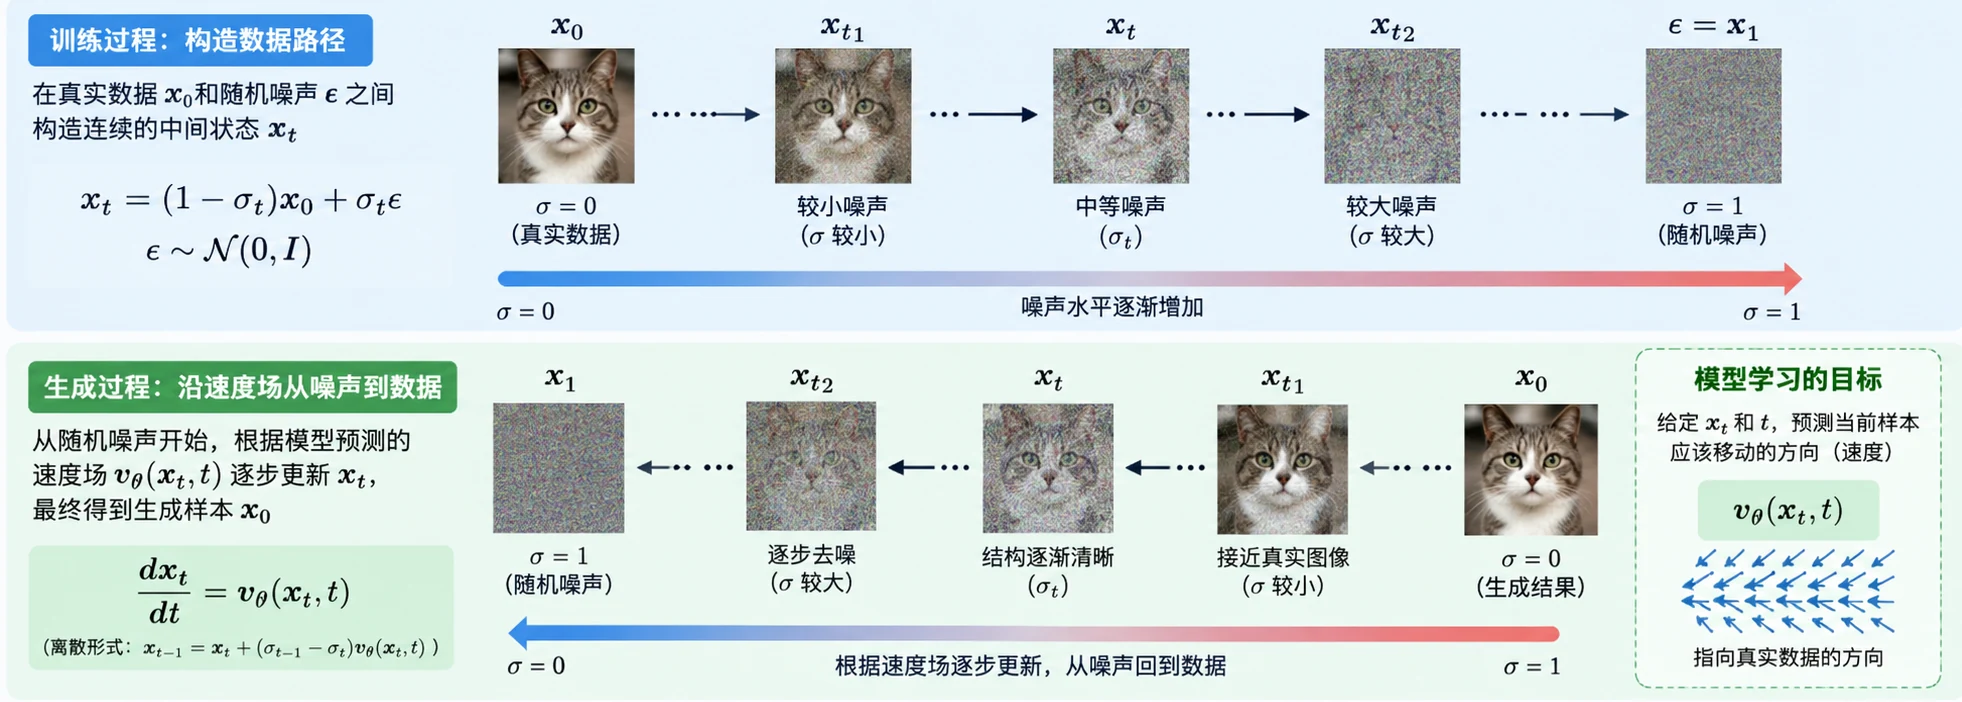
Desde la perspectiva del proceso de implementación, Flow Matching incluye principalmente tres etapas: construcción de caminos, aprendizaje de campo de velocidad y muestreo de generación.
Durante el entrenamiento, primero se extrae una muestra $x_0$ de la distribución de datos reales, y se extrae ruido aleatorio $\epsilon$ de una distribución gaussiana estándar. Para establecer una conexión entre datos reales y ruido aleatorio, se puede construir una serie de estados intermedios continuos entre ellos. Un enfoque relativamente intuitivo es usar interpolación lineal:
x_t=(1-\sigma_t)x_0+\sigma_t\epsilon
, donde $\sigma_t$ controla la proporción de datos reales y ruido aleatorio en el estado actual. Para facilitar la ilustración, establezcamos:
\sigma_0=0,\qquad \sigma_1=1
, cuando $\sigma_t=0$ :
x_t=x_0
Esto corresponde a datos reales; cuando $\sigma_t=1$ :
x_t=\epsilon
Esto corresponde a ruido aleatorio.
A medida que $\sigma_t$ aumenta gradualmente de 0 a 1, $x_t$ puede representar una serie de estados intermedios continuos entre datos reales y ruido aleatorio: datos reales → ruido ligero → ruido moderado → ruido intenso → ruido aleatorio. Durante el entrenamiento, seleccionando aleatoriamente diferentes $t$, se pueden obtener estados intermedios en diferentes posiciones, proporcionando muestras de entrenamiento para que el modelo aprenda los patrones de cambio a lo largo de todo el camino. Comparado con el proceso predefinido de adición de ruido paso a paso en DDPM, Flow Matching se preocupa más por cómo definir el camino continuo que conecta dos distribuciones y cómo los datos deben cambiar a lo largo de este camino.
Después de construir el camino continuo, el siguiente paso es determinar la dirección y velocidad de los cambios de datos en el camino. Flow Matching usa una red neuronal para aprender un campo de velocidad (Velocity Field)
v_\theta(x_t,t)
, donde $x_t$ representa el estado intermedio actual, $t$ representa la posición temporal actual, y $v_\theta(x_t,t)$ representa la velocidad de cambio predicha por el modelo en la posición actual. Para el camino lineal anterior:
x_t=(1-\sigma_t)x_0+\sigma_t\epsilon
Durante el entrenamiento, la velocidad objetivo se puede obtener a partir de los datos reales $x_0$ y ruido aleatorio $\epsilon$ conocidos, y se puede entrenar a la red neuronal para predecir la velocidad correspondiente basándose en el estado actual $x_t$ y tiempo $t$. El objetivo de entrenamiento de Flow Matching es entrenar al modelo para predecir la velocidad de cambio de datos correspondiente a una posición, dado el estado intermedio $x_t$ y tiempo $t$ en el camino. Después de que el modelo aprende de una gran cantidad de muestras de entrenamiento, las velocidades en diferentes posiciones juntas forman un campo de velocidad. Este campo de velocidad describe cómo los datos deben cambiar en diferentes posiciones en el espacio de datos, proporcionando así dirección para la generación posterior de datos a partir de ruido aleatorio.
La fase de entrenamiento establece el camino entre datos reales y ruido aleatorio y aprende el campo de velocidad en el camino. La fase de generación comienza con ruido aleatorio y usa el campo de velocidad aprendido para moverse progresivamente hacia la distribución de datos reales. Este proceso se puede representar como: ruido aleatorio → estado intermedio → estructura de datos gradualmente formada → datos generados finales,
x_{t-1}
=
x_t+
(\sigma_{t-1}-\sigma_t)
v_\theta(x_t,t)
El modelo recalcula la velocidad en cada paso de tiempo basándose en el estado actual y actualiza $x_t$. Después de múltiples iteraciones, el ruido aleatorio inicial se transforma progresivamente en datos generados con estructura completa e información semántica.
Desde la perspectiva del modelado, tanto DDPM como Flow Matching usan distribuciones aleatorias simples como punto de partida de generación, pero su descripción del proceso de generación difiere. DDPM describe principalmente los cambios de datos a través de difusión hacia adelante y eliminación de ruido hacia atrás, aprendiendo típicamente predicción de ruido; Flow Matching construye un camino continuo que conecta ruido y datos reales, aprende el campo de velocidad en el camino, luego comienza con ruido aleatorio y genera progresivamente datos a lo largo del campo de velocidad.
Texto a imagen (Text-to-Image) se refiere a generar automáticamente imágenes correspondientes a partir de descripciones en lenguaje natural. Comparado con la generación de imágenes ordinaria, texto a imagen no solo requiere que el modelo genere imágenes con alta calidad visual, sino que también necesita comprender correctamente el sujeto, atributos, cantidad, posición, estilo en el texto y las relaciones entre diferentes objetos. Durante el desarrollo de texto a imagen, el enfoque técnico también ha cambiado gradualmente desde "¿se pueden generar imágenes a partir de texto?" hacia "¿se pueden comprender con precisión instrucciones complejas y completar la generación con mayor calidad, mayor eficiencia y mayor controlabilidad?"
Las primeras investigaciones de texto a imagen se basaron principalmente en modelos generativos como GAN. El método básico era primero codificar el texto en vectores, luego usar las características del texto como entrada condicional al generador, haciendo que los resultados de generación fueran consistentes con las descripciones de texto. Esta etapa demostró la viabilidad de texto a imagen, pero los primeros GAN todavía tenían limitaciones evidentes en generación de escenas complejas, comprensión semántica de texto y estabilidad de entrenamiento. Especialmente cuando los prompts contenían múltiples sujetos, relaciones espaciales complejas o descripciones de texto más largas, el modelo tenía dificultades para restaurar con precisión toda la semántica. En 2021, OpenAI publicó DALL·E, usando un enfoque autorresgresivo basado en Transformer para procesar Tokens de texto e imagen, haciendo que los modelos de texto a imagen lograran progresos significativos en combinaciones de conceptos complejos, control de atributos, etc., y también impulsando el desarrollo de modelos de texto a imagen a gran escala. Al mismo tiempo, los modelos de difusión comenzaron a entrar en el campo de texto a imagen. GLIDE combinó condiciones textuales con modelos de difusión y estudió CLIP Guidance y Classifier-Free Guidance, demostrando que los modelos de difusión podían generar imágenes con alta calidad visual bajo control textual. En 2022, Imagen de Google combinó aún más las capacidades de comprensión textual de grandes modelos de lenguaje con las capacidades de generación de imágenes de modelos de difusión. Imagen usó T5 preentrenado como codificador de texto, convirtiendo Prompts en representaciones semánticas textuales, luego usándolos como entrada condicional al modelo de difusión. La investigación mostró que fortalecer la capacidad de comprensión semántica del codificador de texto podía mejorar aún más la coherencia entre las imágenes generadas y las descripciones textuales. Con el desarrollo de modelos como DALL·E, GLIDE e Imagen, el texto a imagen gradualmente formó un flujo técnico relativamente claro: codificador de texto → representación semántica textual → modelo de generación por difusión → eliminación de ruido paso a paso → imagen generada; los modelos de difusión, con su buena calidad de generación y estabilidad de entrenamiento, gradualmente se convirtieron en una ruta técnica importante en el campo de texto a imagen.
Los primeros modelos de difusión típicamente realizaban múltiples adiciones de ruido y eliminación de ruido directamente en el espacio de píxeles. A medida que la resolución de imagen aumentaba, el procesamiento directo de una gran cantidad de píxeles resultaba en altos costos de entrenamiento e inferencia. En 2022, Rombach et al. propusieron el Modelo de Difusión Latente (Latent Diffusion Model, LDM), transfiriendo el proceso de difusión de un espacio de píxeles a un espacio latente comprimido (ver introducción del LDM en 14.4.3). La importancia de Stable Diffusion no solo radica en mejorar la calidad de texto a imagen, sino también en impulsar el desarrollo de un ecosistema de texto a imagen de peso abierto. Alrededor de su arquitectura de difusión latente, gradualmente se han formado numerosas tecnologías de extensión, incluyendo LoRA, ControlNet, imagen a imagen y retoque local, haciendo que el texto a imagen evolucione gradualmente desde una simple herramienta de generación de imágenes hasta un sistema completo de producción de contenido visual.
Los primeros modelos de difusión típicamente usaban U-Net como red de eliminación de ruido. U-Net, a través de extracción de características multi-escala y conexiones de salto, podía preservar relativamente bien la estructura espacial de las imágenes, por lo que fue durante mucho tiempo importante red vertebral para modelos de difusión. Con la expansión continua de la escala de modelos generativos, los investigadores comenzaron a explorar el uso de Transformers para reemplazar U-Net para lograr mejor escalabilidad de modelo. En 2022, Peebles y Xie propusieron el Diffusion Transformer (DiT), usando Transformers para reemplazar la red vertebral U-Net comúnmente usada en modelos de difusión. El modelo primero divide la representación de imagen en el espacio latente en múltiples Patches y los convierte en secuencias de Tokens, luego usa Transformers para modelar estos Tokens. La arquitectura DiT se muestra a continuación:
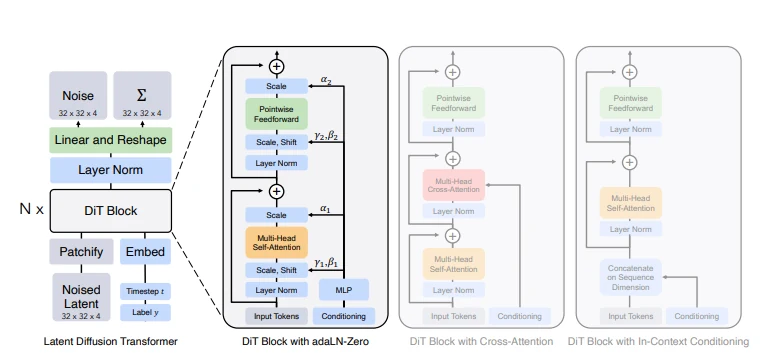
La investigación de DiT mostró aún más que la escala computacional del modelo podía expandirse aumentando la profundura, anchura y cantidad de Tokens de entrada del Transformer. En los experimentos del paper original, a medida que aumentaba el volumen computacional del modelo, la calidad de generación generalmente mostraba una tendencia de mejora continua, demostrando que la arquitectura Transformer tiene buena escalabilidad en modelos de difusión. La importancia de DiT no solo radica en reemplazar U-Net por Transformers, sino más importante aún en proporcionar una nueva infraestructura para modelos de generación de imágenes a gran escala posteriores. Desde entonces, los Transformers gradualmente se convirtieron en una ruta técnica importante para modelos de texto a imagen, y se desarrollaron aún más en arquitecturas de Transformer multimodales que procesan simultáneamente Tokens de texto e imagen, sentando las bases para modelos de texto a imagen de nueva generación como Stable Diffusion 3 y FLUX.1.
Con los Transformers convirtiéndose gradualmente en una importante red vertebral para modelos de texto a imagen, el proceso de generación de imágenes en sí también está evolucionando continuamente. El DDPM previamente introducido describe la generación de datos principalmente a través de "adición de ruido hacia adelante — aprendizaje del proceso hacia atrás — eliminación de ruido paso a paso", mientras que Flow Matching describe el proceso de transformación de distribuciones simples a distribuciones de datos reales desde la perspectiva de caminos de probabilidad continuos y campos de velocidad. En 2024, la investigación relacionada con Stable Diffusion 3 combinó aún más Rectified Flow con Transformers para texto a imagen de alta resolución. Este trabajo propuso una nueva arquitectura Multimodal Diffusion Transformer (MMDiT).
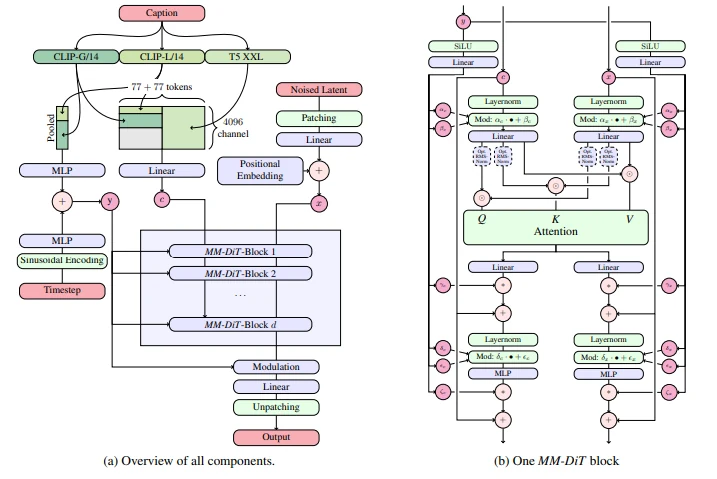
A diferencia de los primeros DiT que principalmente procesaban Tokens latentes de imagen, MMDiT procesa representaciones de texto e imagen usando parámetros independientes, mientras logra interacción de información entre las dos modalidades a través de atención conjunta, mejorando así la capacidad del modelo para comprender contenido textual, renderizado de texto y prompts complejos. FLUX.1 publicado en el mismo año continuó la ruta técnica de combinar Transformers con Flow Matching. Los modelos de la serie FLUX.1 adoptan una arquitectura híbrida compuesta por Bloques Transformer Multimodales y Bloques Diffusion Transformer paralelos, y son entrenados basándose en Flow Matching. El modelo FLUX.1 público alcanza una escala de 12B parámetros, reflejando aún más la tendencia de los modelos de generación de imágenes Transformer hacia el desarrollo a gran escala. Desde esta etapa, el enfoque técnico de los modelos de texto a imagen ya no se ha limitado a mejorar la calidad visual de las imágenes, sino que se ha expandido gradualmente a direcciones como comprensión de prompts complejos, generación de texto en imagen, generación de alta resolución, muestreo en pocos pasos y edición de imagen. Texto e imagen también han entrado cada vez más en forma de Tokens a los Transformers, logrando interacción de información entre modalidades a través de mecanismos de atención. Este cambio también ha sentado las bases para modelos de generación multimodal más eficientes y unificados.
Con la mejora continua de la escala y calidad de generación de modelos de texto a imagen, las aplicaciones prácticas de los modelos comienzan a enfrentar nuevos problemas. Por un lado, los modelos de generación a gran escala típicamente requieren altos recursos computacionales y muchos pasos de muestreo; por otro lado, las aplicaciones prácticas de AIGC ya no se limitan a tareas simples de texto a imagen, sino que también necesitan soportar simultáneamente comprensión de imagen, generación de imagen, edición de imagen y generación de imagen de referencia. Por lo tanto, la reducción de costos de generación y la unificación de capacidades multimodales se han convertido gradualmente en direcciones de desarrollo importantes para los modelos de texto a imagen.
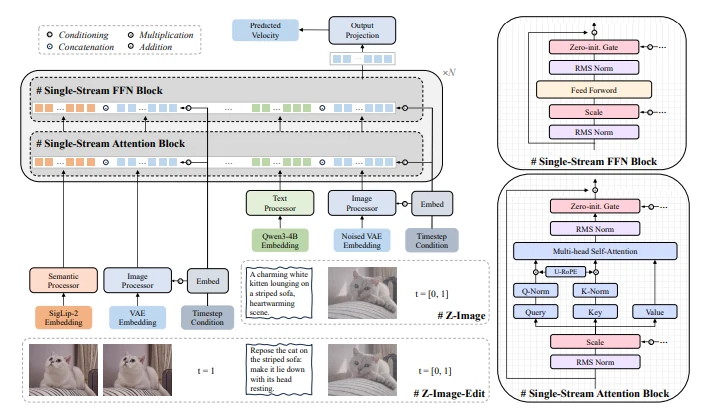
La serie Z-Image adopta la arquitectura Scalable Single-Stream Diffusion Transformer (S3-DiT) con una escala de modelo de 6B parámetros. Una característica importante de S3-DiT es su arquitectura de flujo único, que concatena Tokens de texto, Tokens semánticos visuales y Tokens VAE de imagen en la dimensión de secuencia, luego los ingresa a un Transformer unificado para procesamiento. Comparado con estructuras de doble flujo que procesan diferentes modalidades por separado, este enfoque puede completar interacciones entre diferentes tipos de información en un flujo de datos unificado. Z-Image-Turbo demuestra una dirección de desarrollo importante de los modelos de texto a imagen modernos: mientras mantiene fuertes capacidades de generación, reduce costos de inferencia a través de destilación de modelo y muestreo en pocos pasos, haciendo que los modelos de generación de imágenes Transformer a gran escala sean más adecuados para implementación práctica.
SenseNova-U1.5-8B-MoT de texto a imagen hacia multimodal unificado, además de mejorar la eficiencia de generación, otra dirección importante es unificar las capacidades previamente relativamente independientes de comprensión multimodal y generación multimodal. SenseNova-U1 publicado en 2026 propuso la arquitectura NEO-unify, intentando lograr comprensión y generación multimodales simultáneamente en un modelo unificado. Sobre esta base, SenseNova-U1.5-8B-MoT mejoró aún más las capacidades de generación y edición de imágenes. Según la información oficial de publicación, la versión oficial de SenseNova-U1.5-8B-MoT se publicó en agosto de 2026, mejorando aún más las capacidades de seguimiento de instrucciones, generación de texto y diseño, generación de imagen 4K nativa, edición de imagen y control visual.
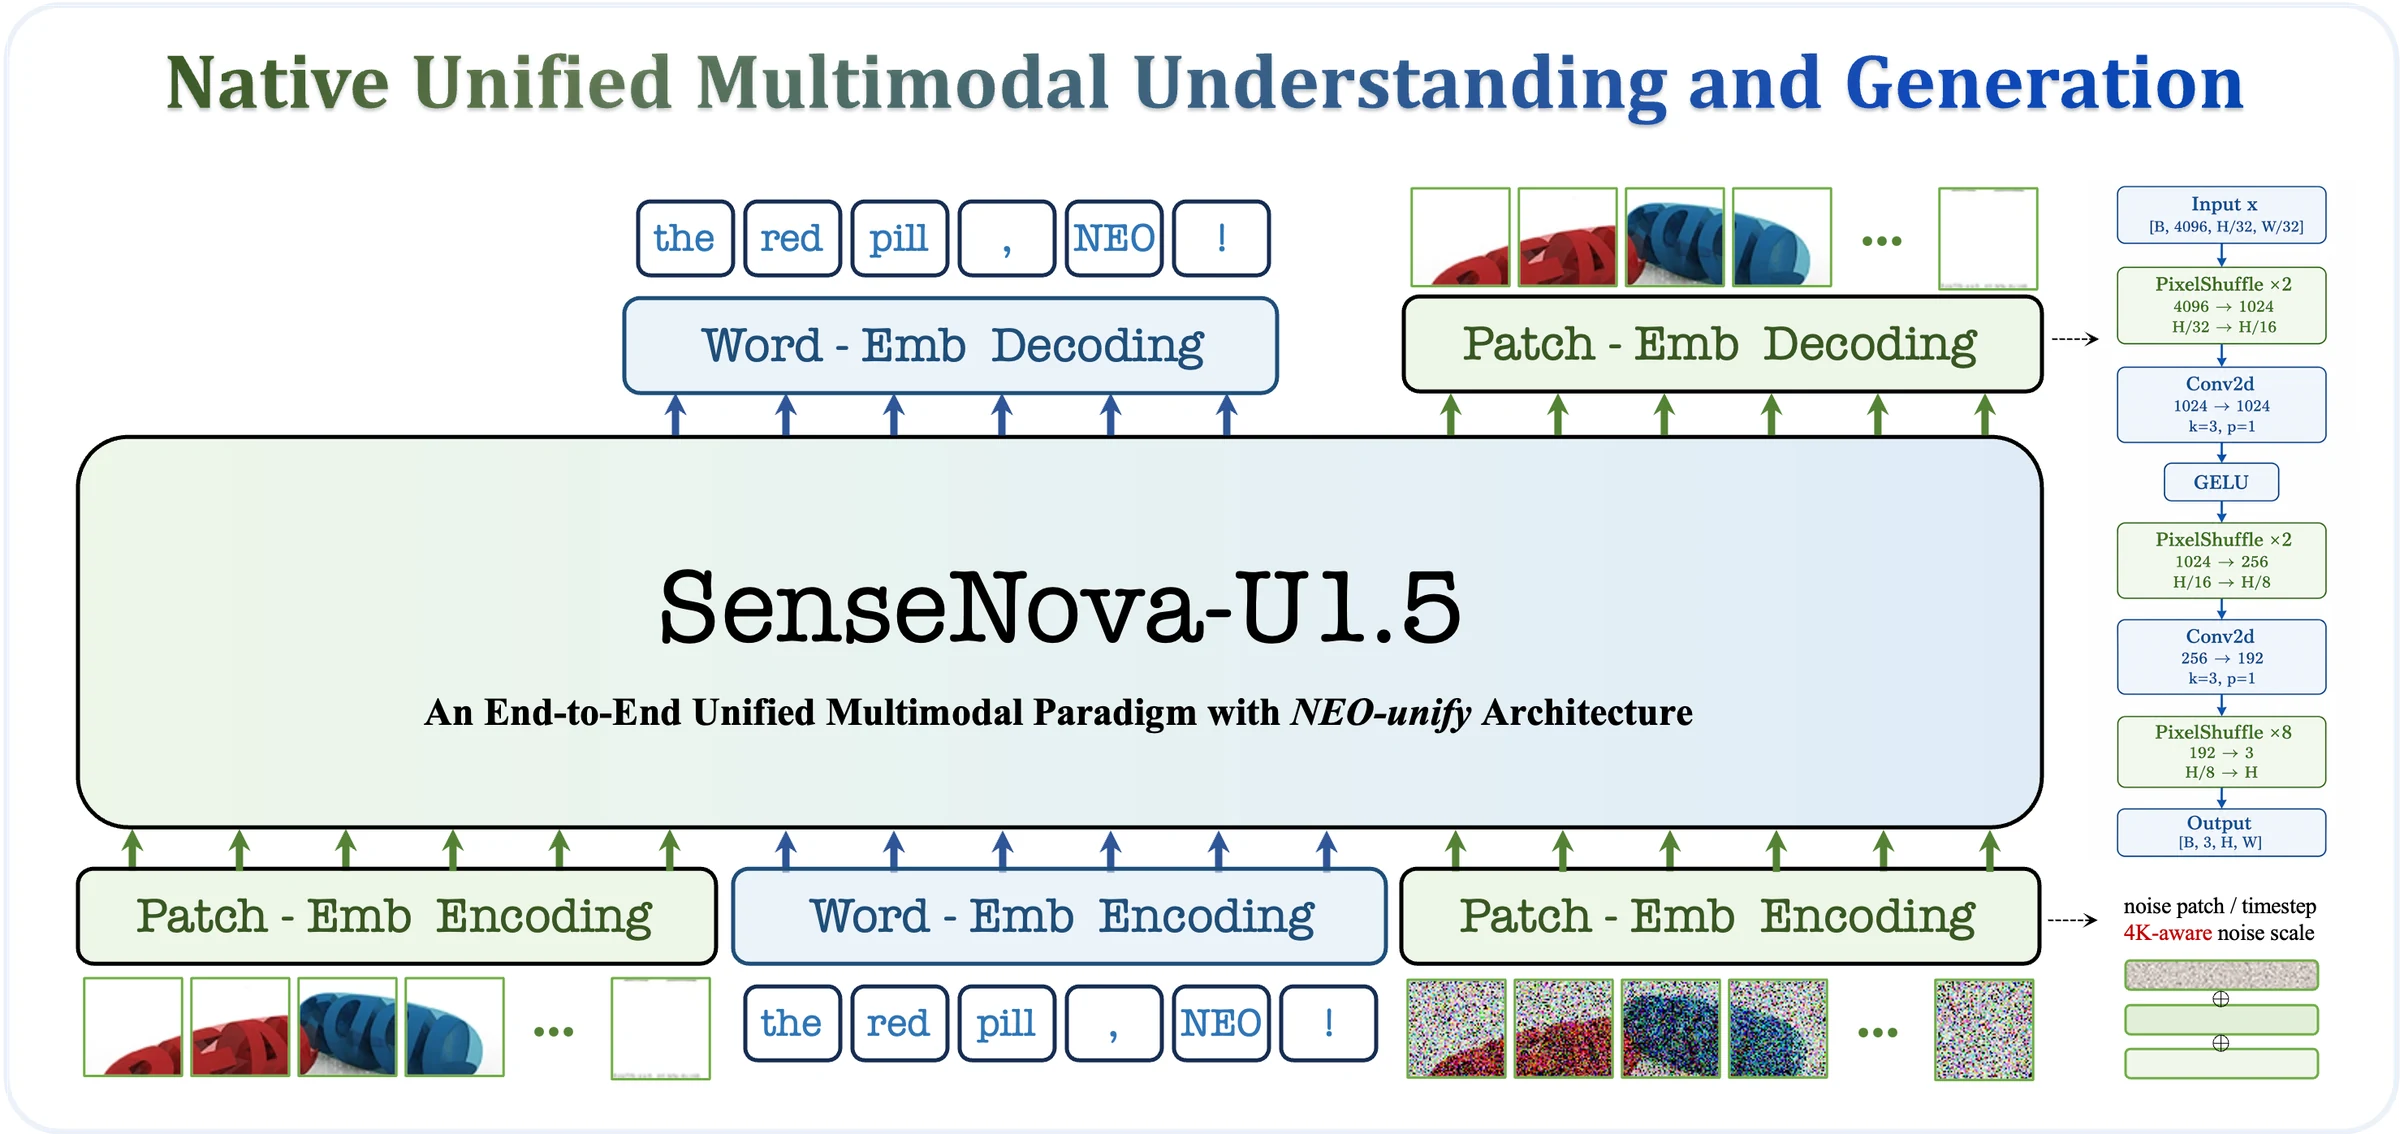
SenseNova-U1.5 está construido sobre la arquitectura multimodal unificada NEO-unify y adopta un nuevo mecanismo de codificación y decodificación de Patches de imagen. El modelo no solo puede generar imágenes basándose en descripciones textuales, sino también combinar imágenes de entrada con instrucciones en lenguaje natural para completar tareas de imagen a imagen, edición de imagen y control visual. Esto significa que los modelos de texto a imagen están evolucionando gradualmente desde simples herramientas de generación de contenido hasta modelos multimodales unificados capaces de manejar simultáneamente tareas de comprensión y generación.