10 casos de uso: ¿qué pueden lograr los modelos de código abierto de AIGC?
Los modelos de generación de imágenes y videos más potentes en este momento son probablemente GPT Images 2.5 y Seedance 2.5, empujando aún más los límites de la generación.
Si los consideramos como la primera categoría de modelos de código cerrado, ¿en qué nivel están los modelos de código abierto? ¿Son solo juguetes? ¿Pueden realmente aportar productividad real?
Este artículo examina directamente lo que los expertos logran con los modelos de código abierto, usando Z-Image de Alibaba para generación de imágenes y MiniMax H3 para generación de videos.
Presentación de estos dos modelos
Z-Image es un modelo de generación de imágenes de 6B parámetros, distribuido bajo la licencia Apache 2.0. El Z-Image completo es un modelo base no destilado que soporta CFG, prompts negativos y fine-tuning; la comunidad usa más comúnmente Z-Image-Turbo, que utiliza solo 8 pasos y prioriza la velocidad.
MiniMax H3 es un modelo de generación de audio-video de 33B parámetros, capaz de producir videos de 4 a 15 segundos, a 24 fps, con audio estéreo. Estrictamente hablando, es un modelo de pesos abiertos usando la MiniMax H3 Community License. El H3-Base de código abierto puede generar audio-video en 768p localmente, pero el módulo Context-IR oficial para comprensión de entradas complejas y el pipeline de regeneración 2K no han sido completamente open-source.
Z-Image: más allá de solo dibujar caras bonitas
Muchos modelos de generación de imágenes hoy pueden generar caras hermosas. Mirar un solo rostro retoque no es realmente impresionante. Las verdaderas dificultades son: ¿el texto está escrito correctamente? ¿El conteo es preciso? ¿Un mismo producto puede mantener consistencia en diferentes vistas? ¿Las relaciones espaciales complejas se entienden correctamente?
Comencemos mirando un conjunto de pruebas locales de @witcheer.
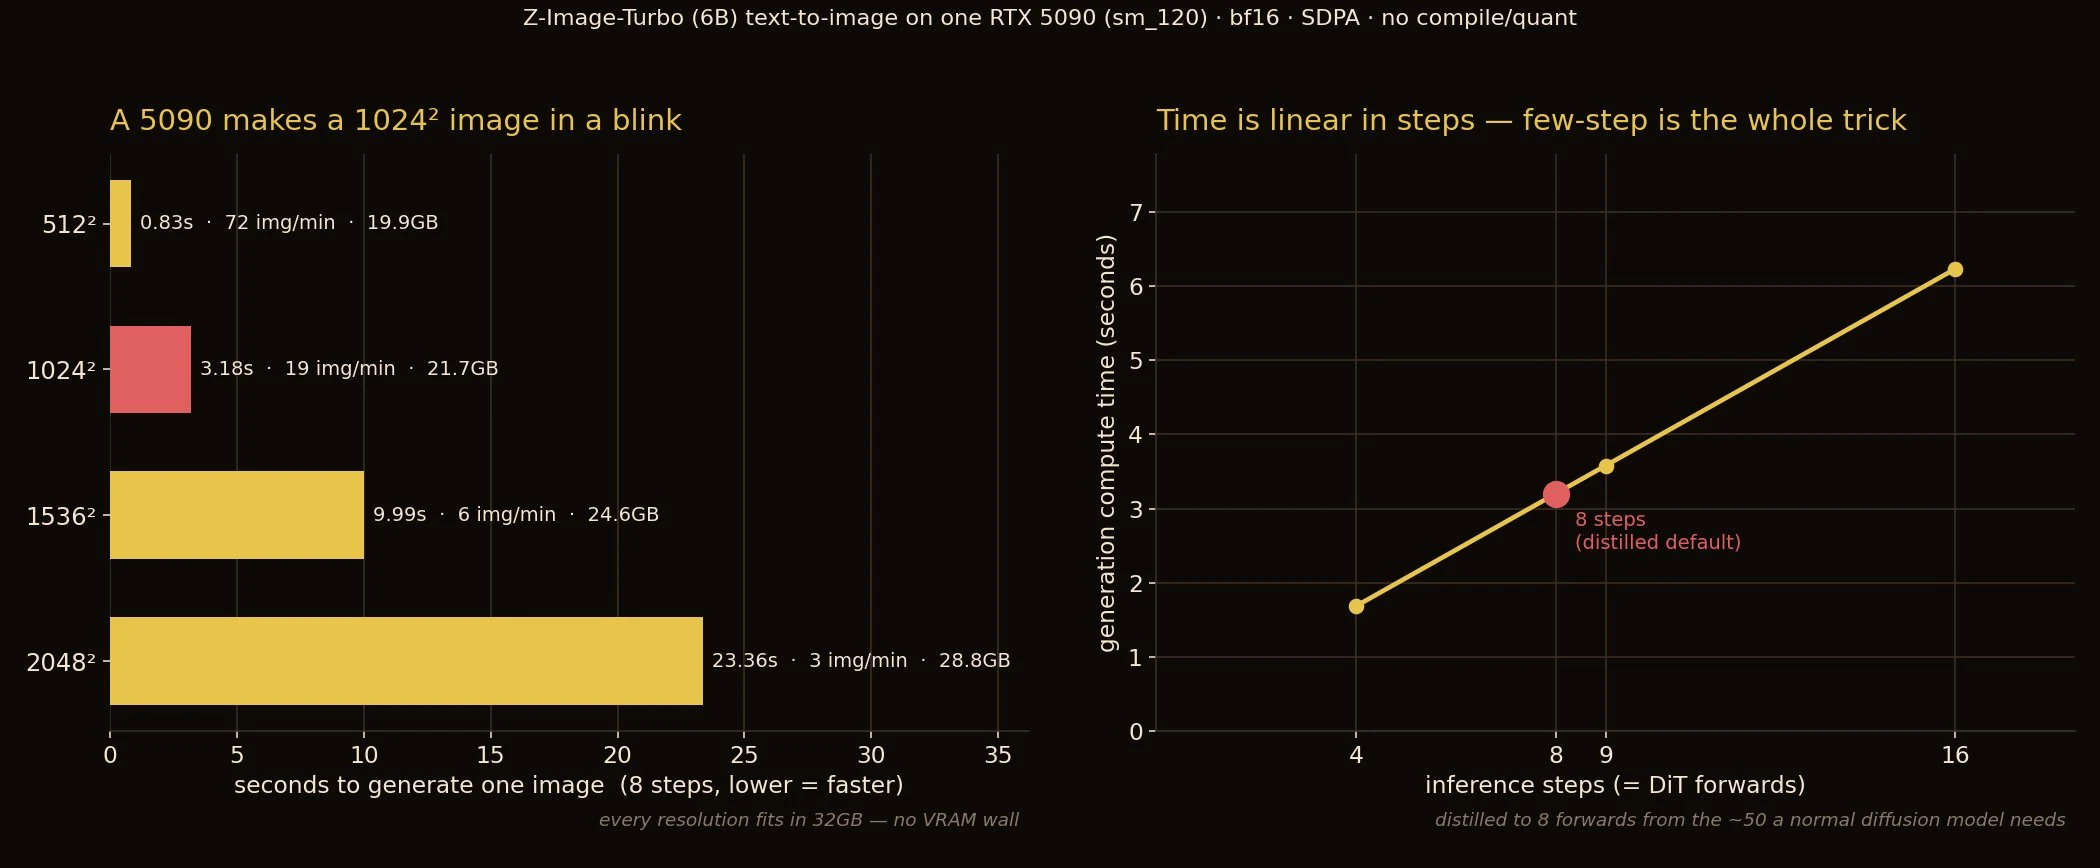
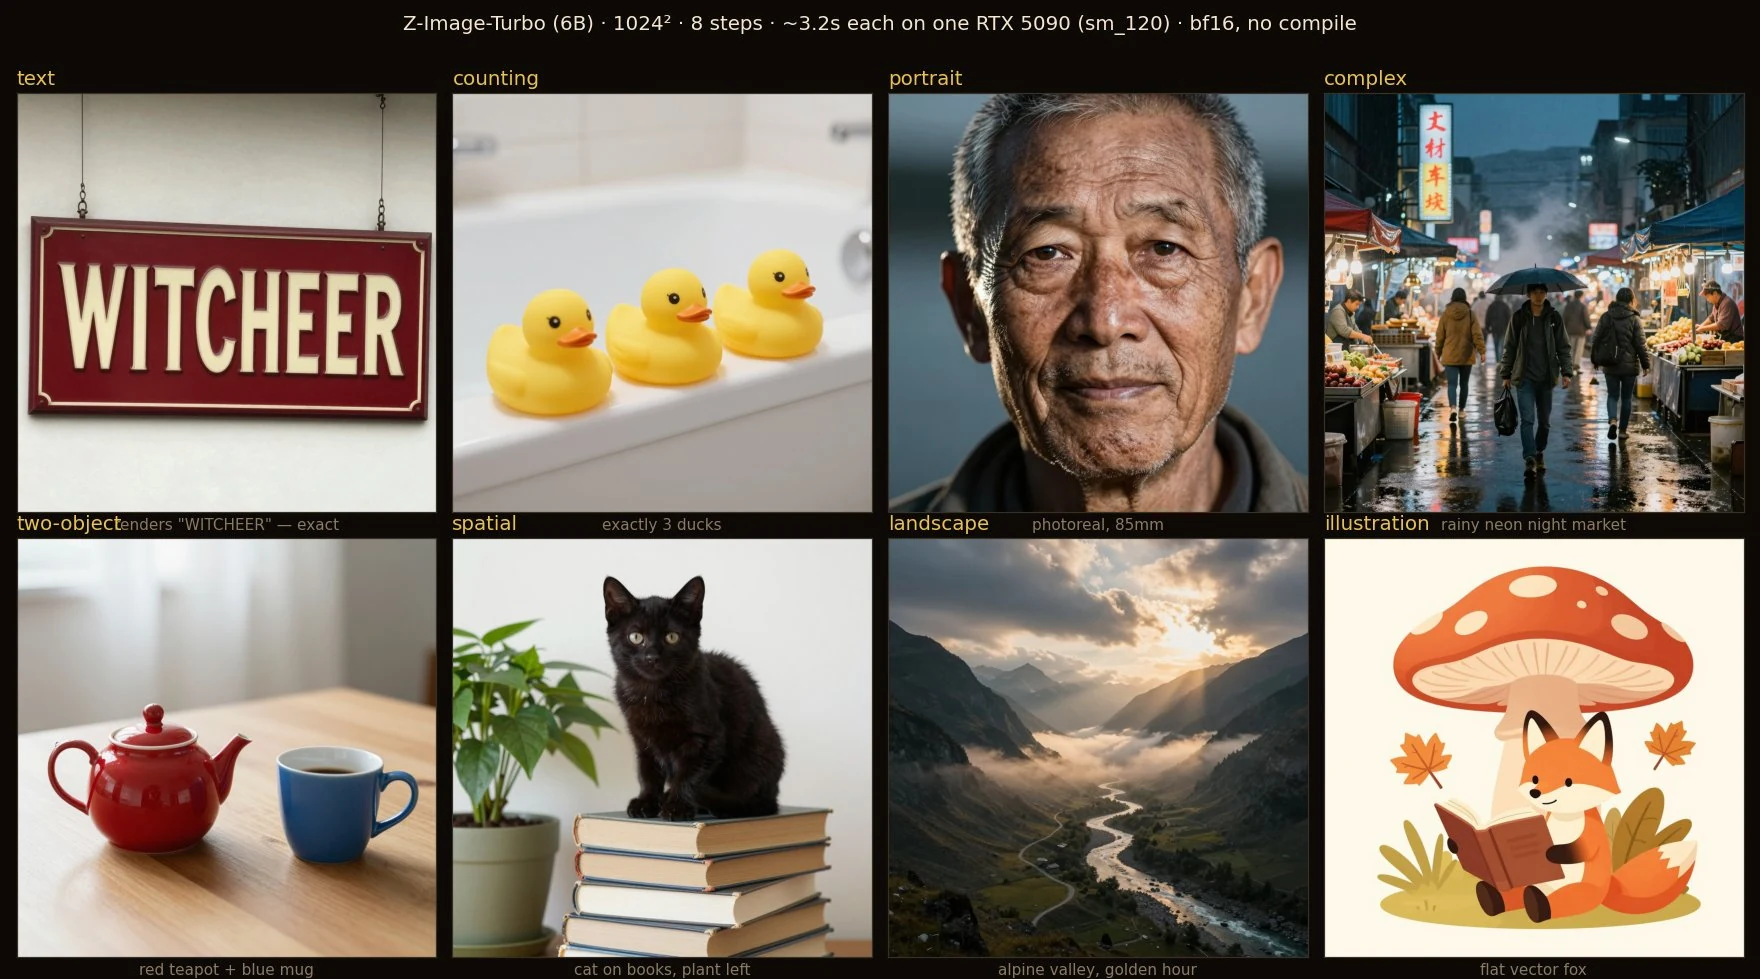
Ejecutó Z-Image-Turbo en un RTX 5090, generando imágenes de 1024px en aproximadamente 3,2 segundos cada una. El prompt pedía un letrero de tienda con palabras especificadas, más "exactamente tres patos", y tanto el texto como el conteo fueron correctos.
Estas dos tareas parecen simples, pero en realidad han sido desafíos persistentes para los modelos de difusión. Las tienden a difuminarse y tres patos a menudo se convierten misteriosamente en cuatro o cinco.
Luego, un caso más cercano a la producción de e-commerce.
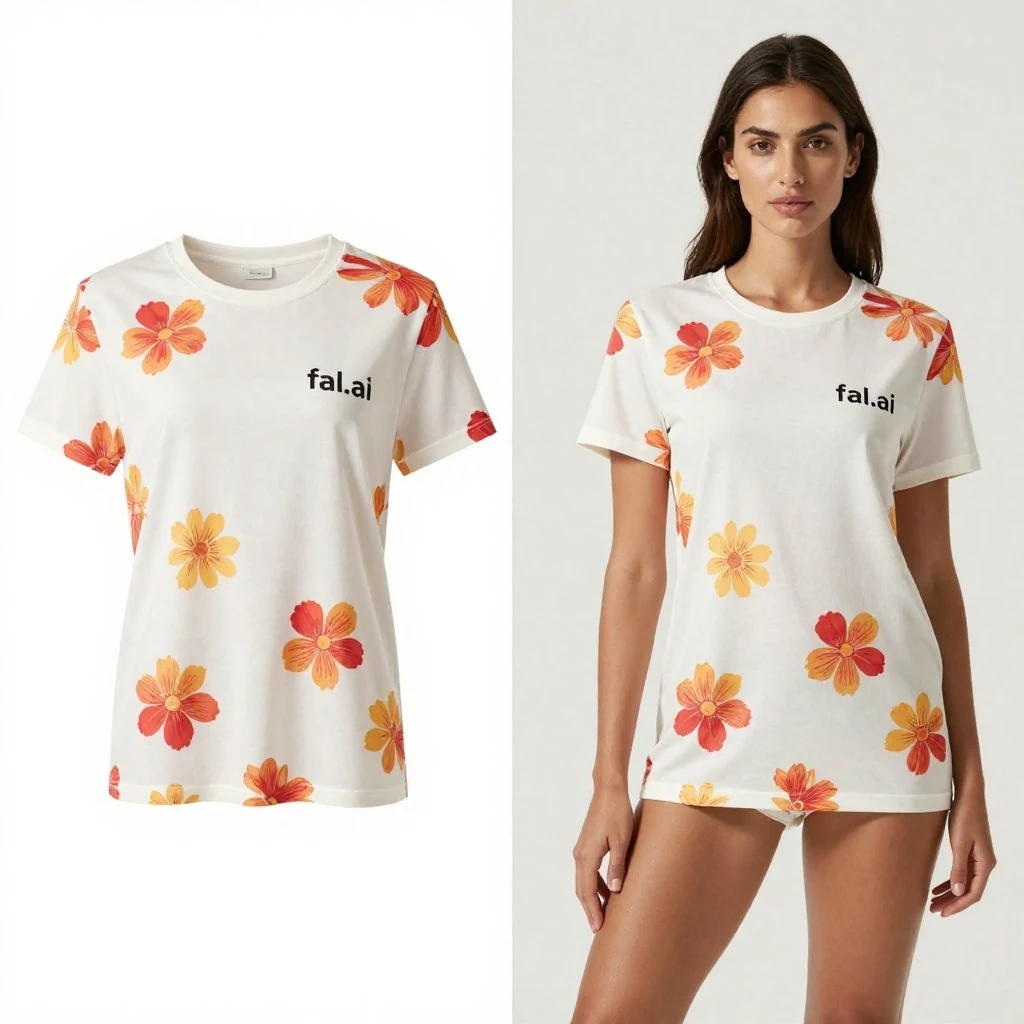
@rizavelioglu pidió al modelo que generara una imagen dividida lado a lado: a la izquierda solo una camiseta blanca con estampado, a la derecha un modelo real usando la misma prenda. El prompt también pedía preservar el estampado, el texto, la tela, las costuras y el corte.
El resultado final mostró que la ropa en ambos lados no se generó de forma independiente — los patrones y el estilo coincidían bien. Para los equipos de e-commerce, esto es mucho más valioso que simplemente generar una "bonita foto de modelo". Las imágenes de producto, las imágenes de uso y las imágenes de marketing pueden todas continuar desde el mismo diseño.
Por supuesto, esto es solo una muestra exitosa, y aún hay una distancia antes de la producción en lote estable. Pero al menos demuestra que la dirección funciona.
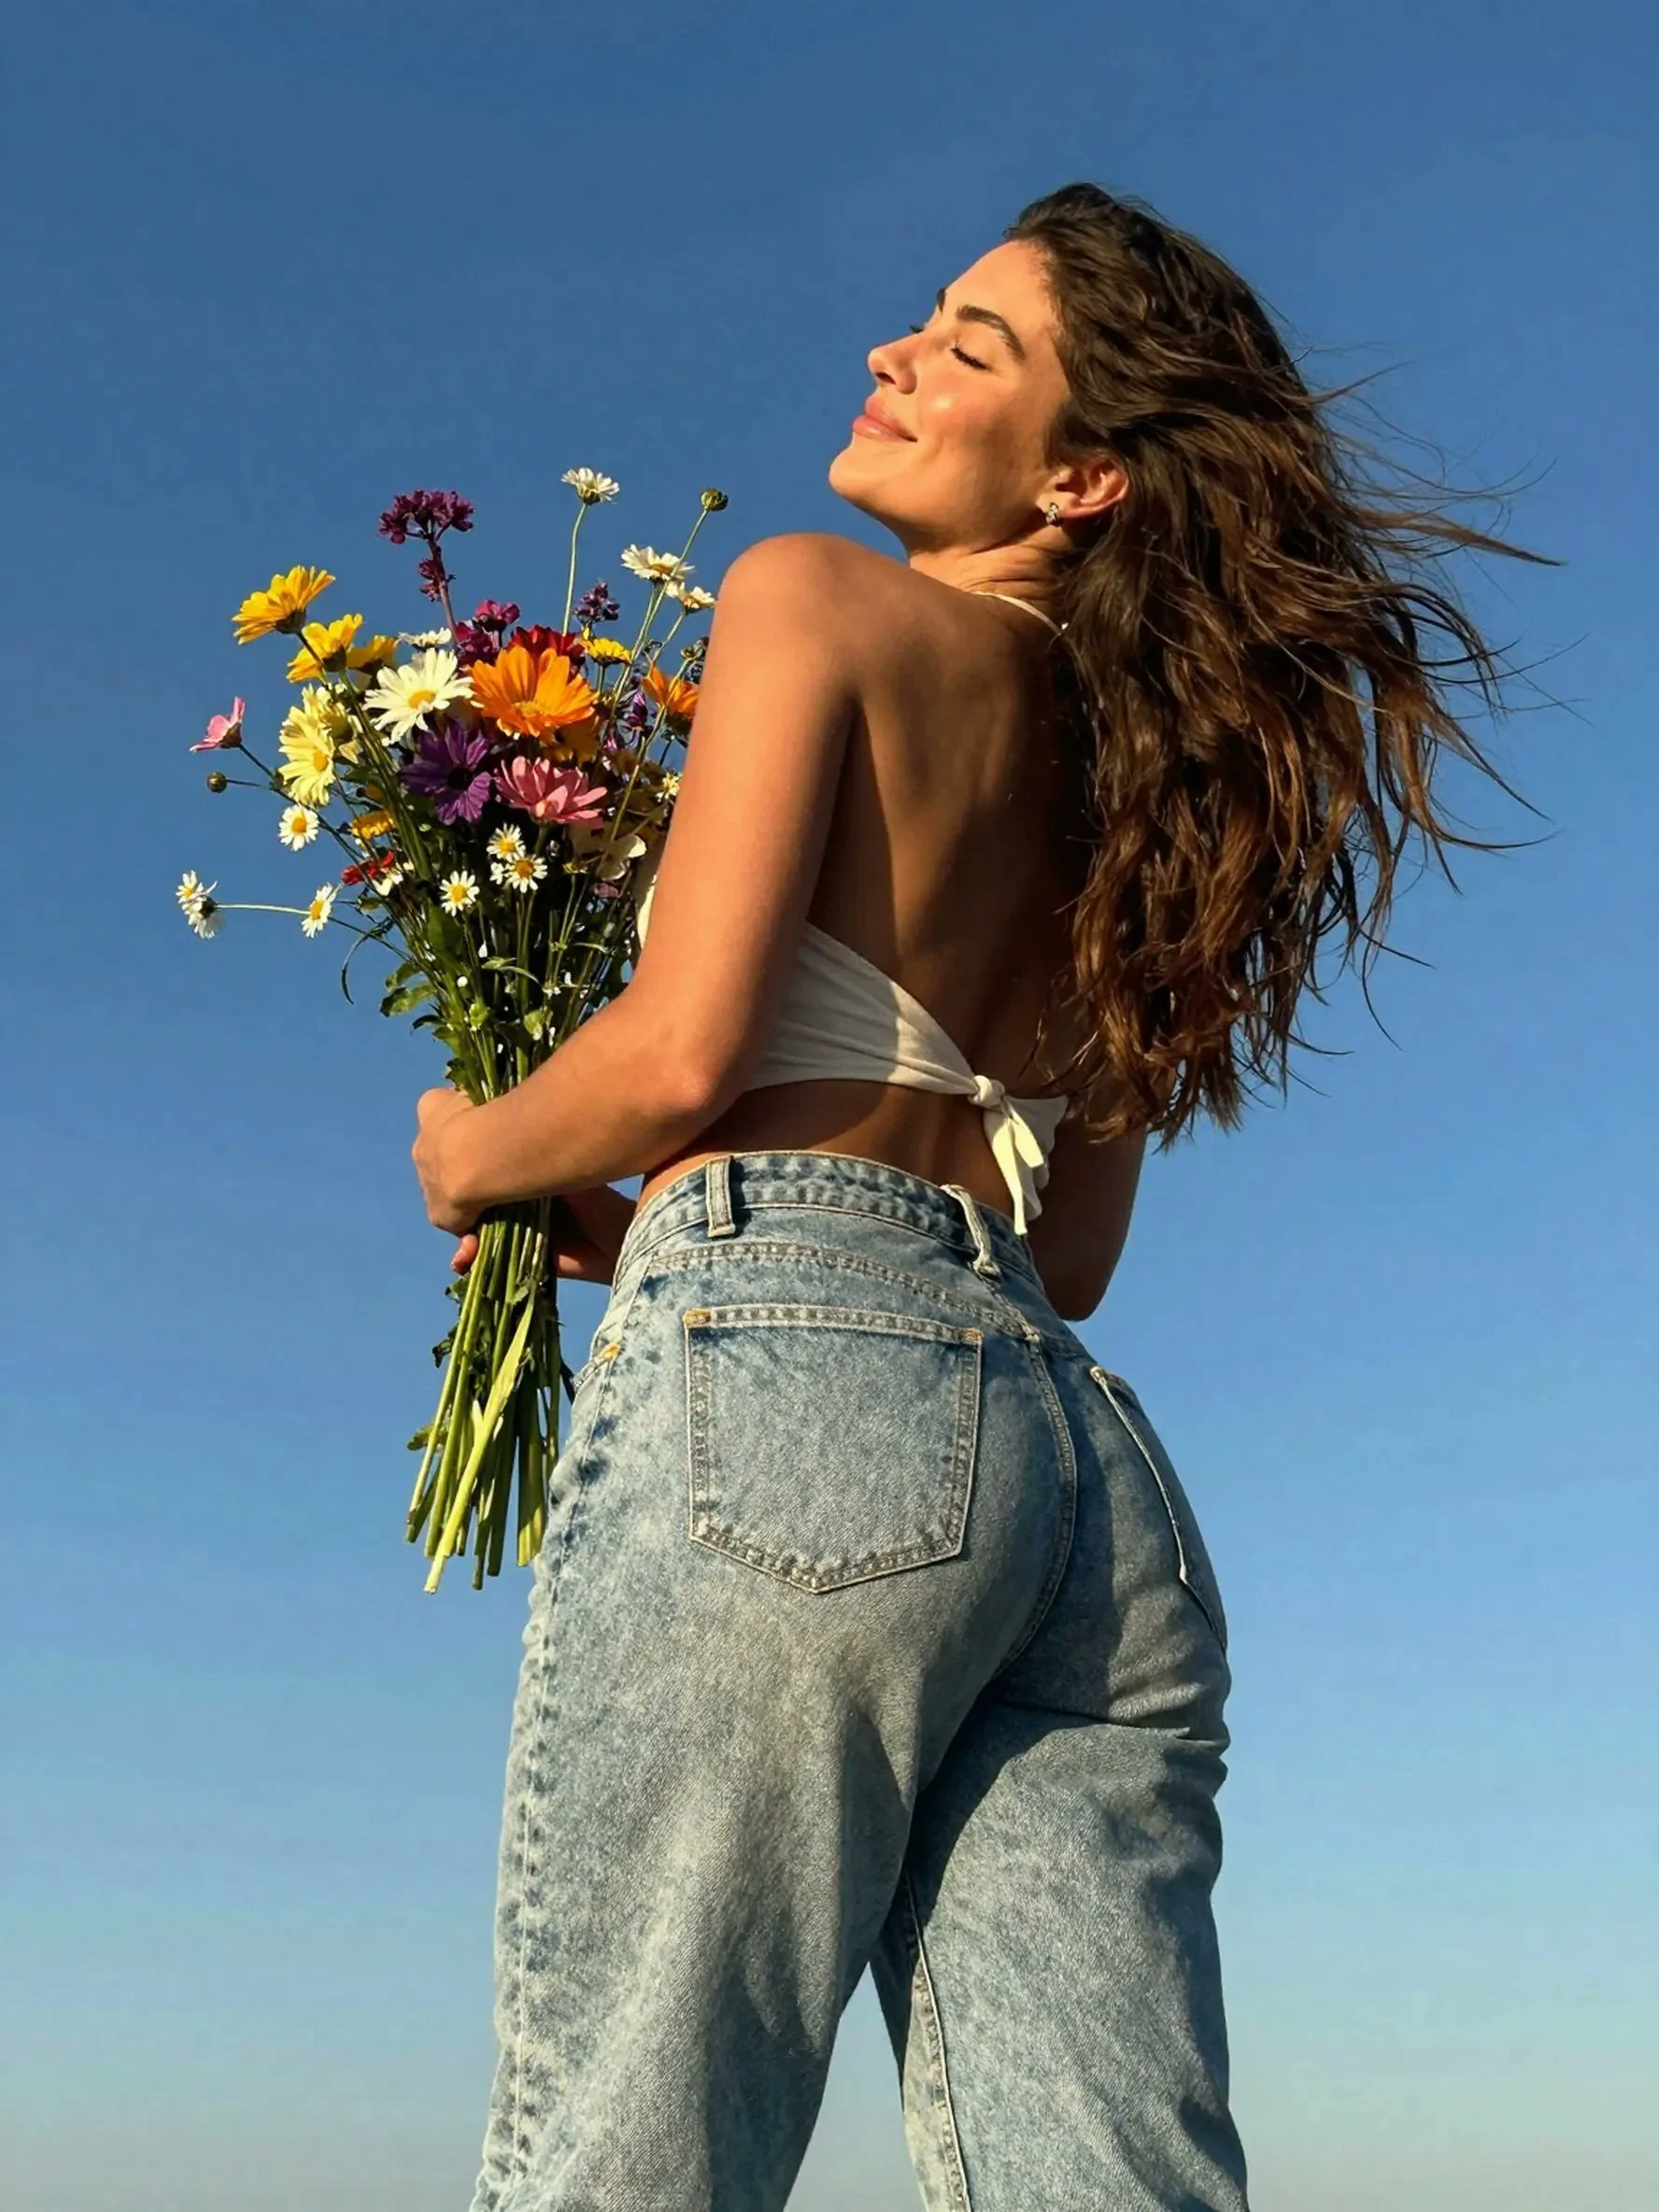
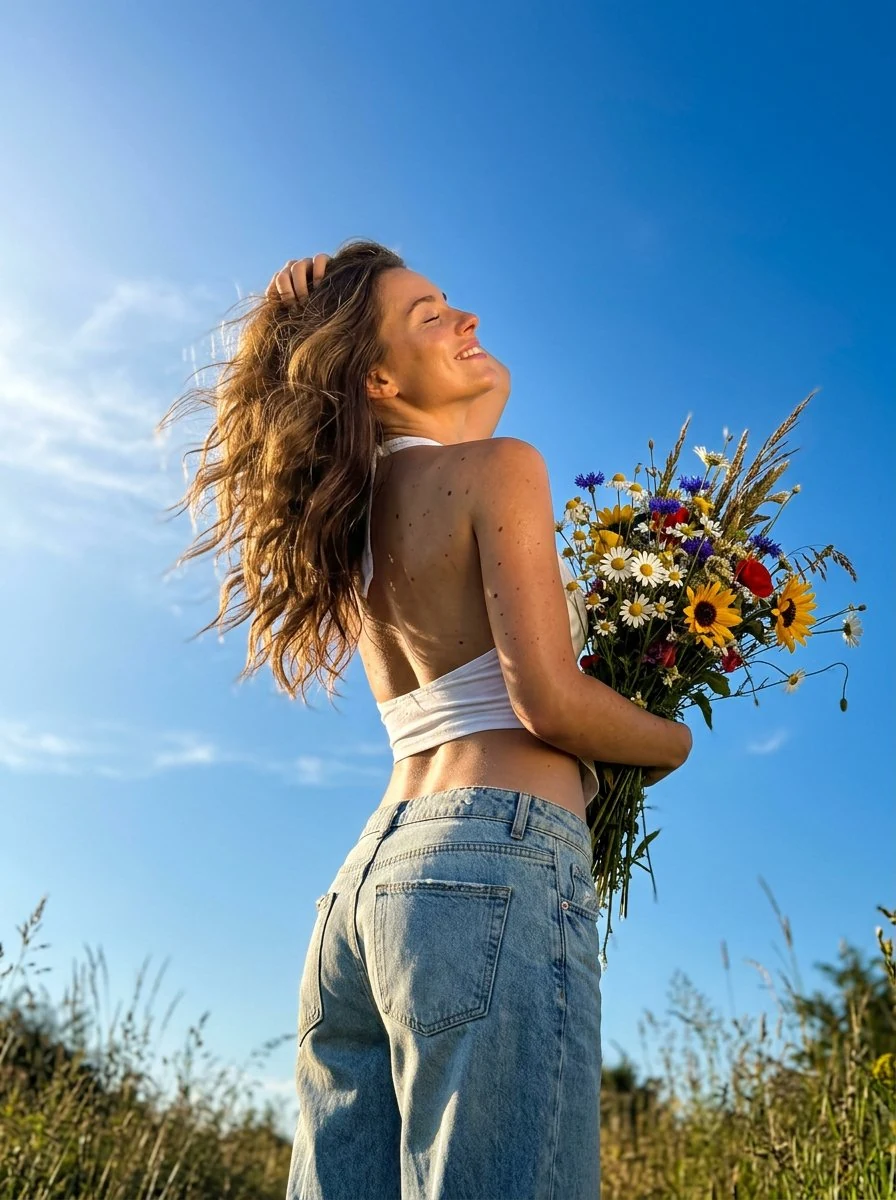
Para retratos realistas, @dreamydigiarts creó una comparación con el mismo prompt.
Pidió a Z-Image-Turbo y Nano Banana 2 que generaran ambos una foto con ángulo bajo desde teléfono: cielo azul, contraluz, persona inclinada hacia atrás, sosteniendo un gran ramo de flores silvestres, cabello soplando con el viento, preservando la ligera granulosidad de las fotos de teléfono.
El resultado de Z-Image ya tenía una fuerte sensación de foto candid. El jeans, la piel y el contraluz no se difuminaron en una capa plástica, y la composición con ángulo bajo fue sólida. Para fotos atmosféricas de personajes e imágenes de redes sociales, esto ya está muy por encima del nivel de juguete.
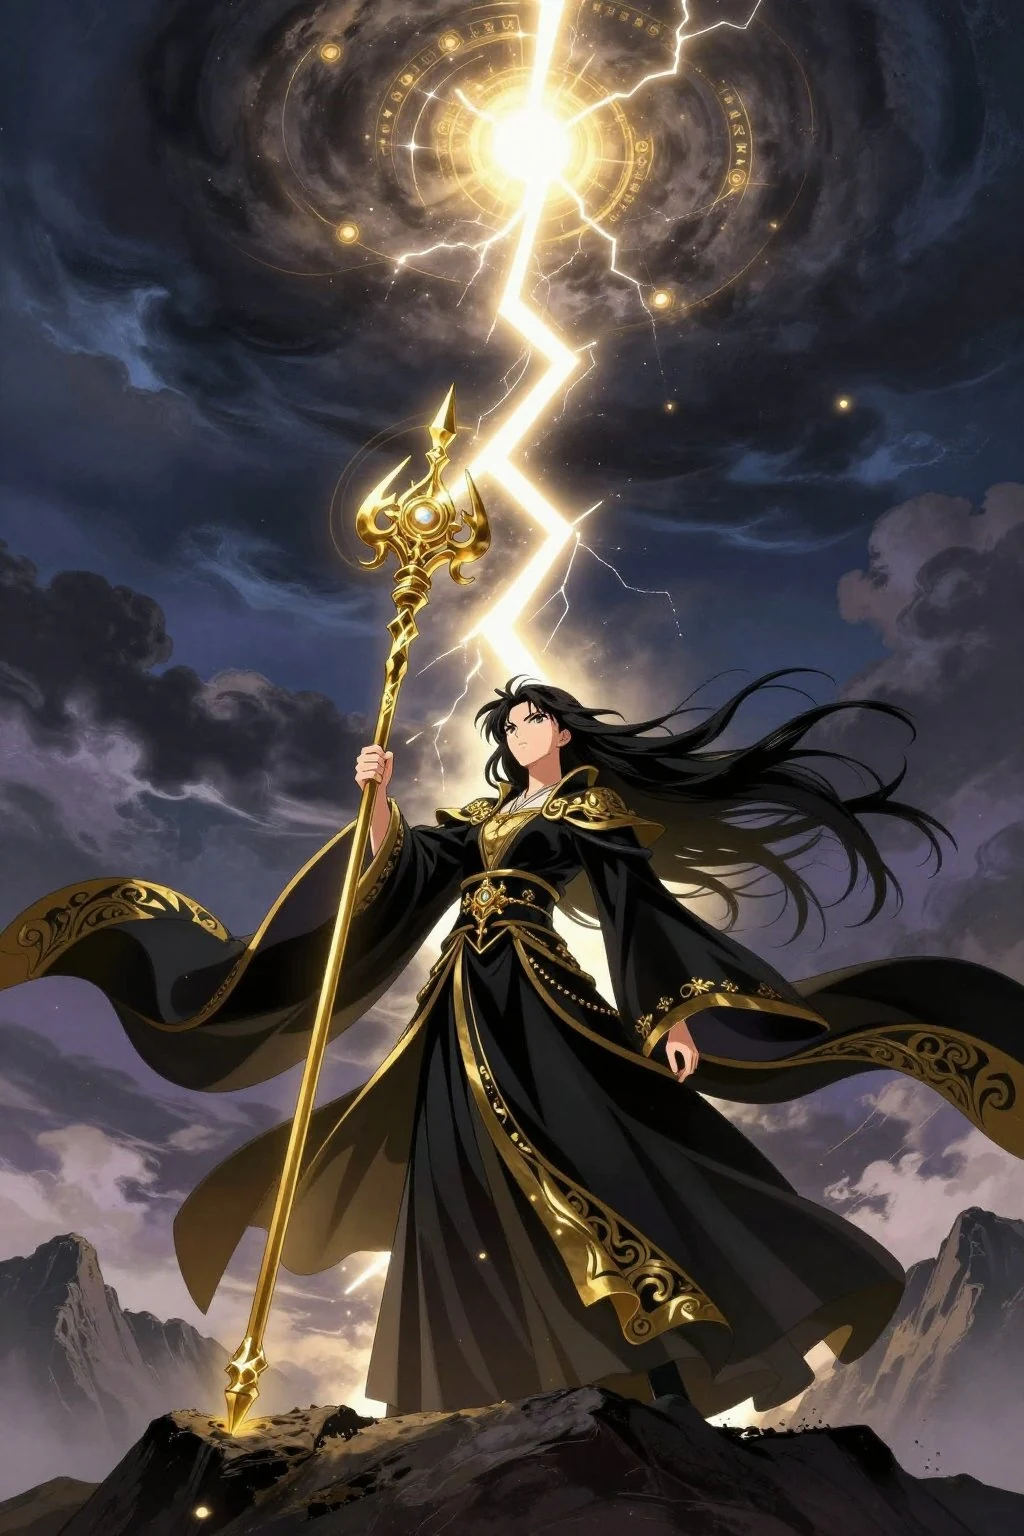
Z-Image tampoco se limita al realismo. @tisch_eins probó Boogu, Flux 2 Klein y Z-Image-Turbo con el mismo prompt. La escena requería una maga de cabello negro de pie en una cima montañosa tormentosa, con un bastón dorado completamente visible de la mano a la punta, un rayo disparándose de la punta del bastón hacia las nubes, además de composición con ángulo bajo, cuerpo completo, capa, runas, arcos eléctricos y fuerte iluminación dorada de borde.
Este tipo de prompt es fácilmente descuidado: el bastón se recorta, el rayo se conecta en la posición equivocada, y el personaje podría terminar como solo una cabeza grande. El resultado de Z-Image mantuvo todas las relaciones clave, demostrando un fuerte control sobre composiciones de ilustración complejas.
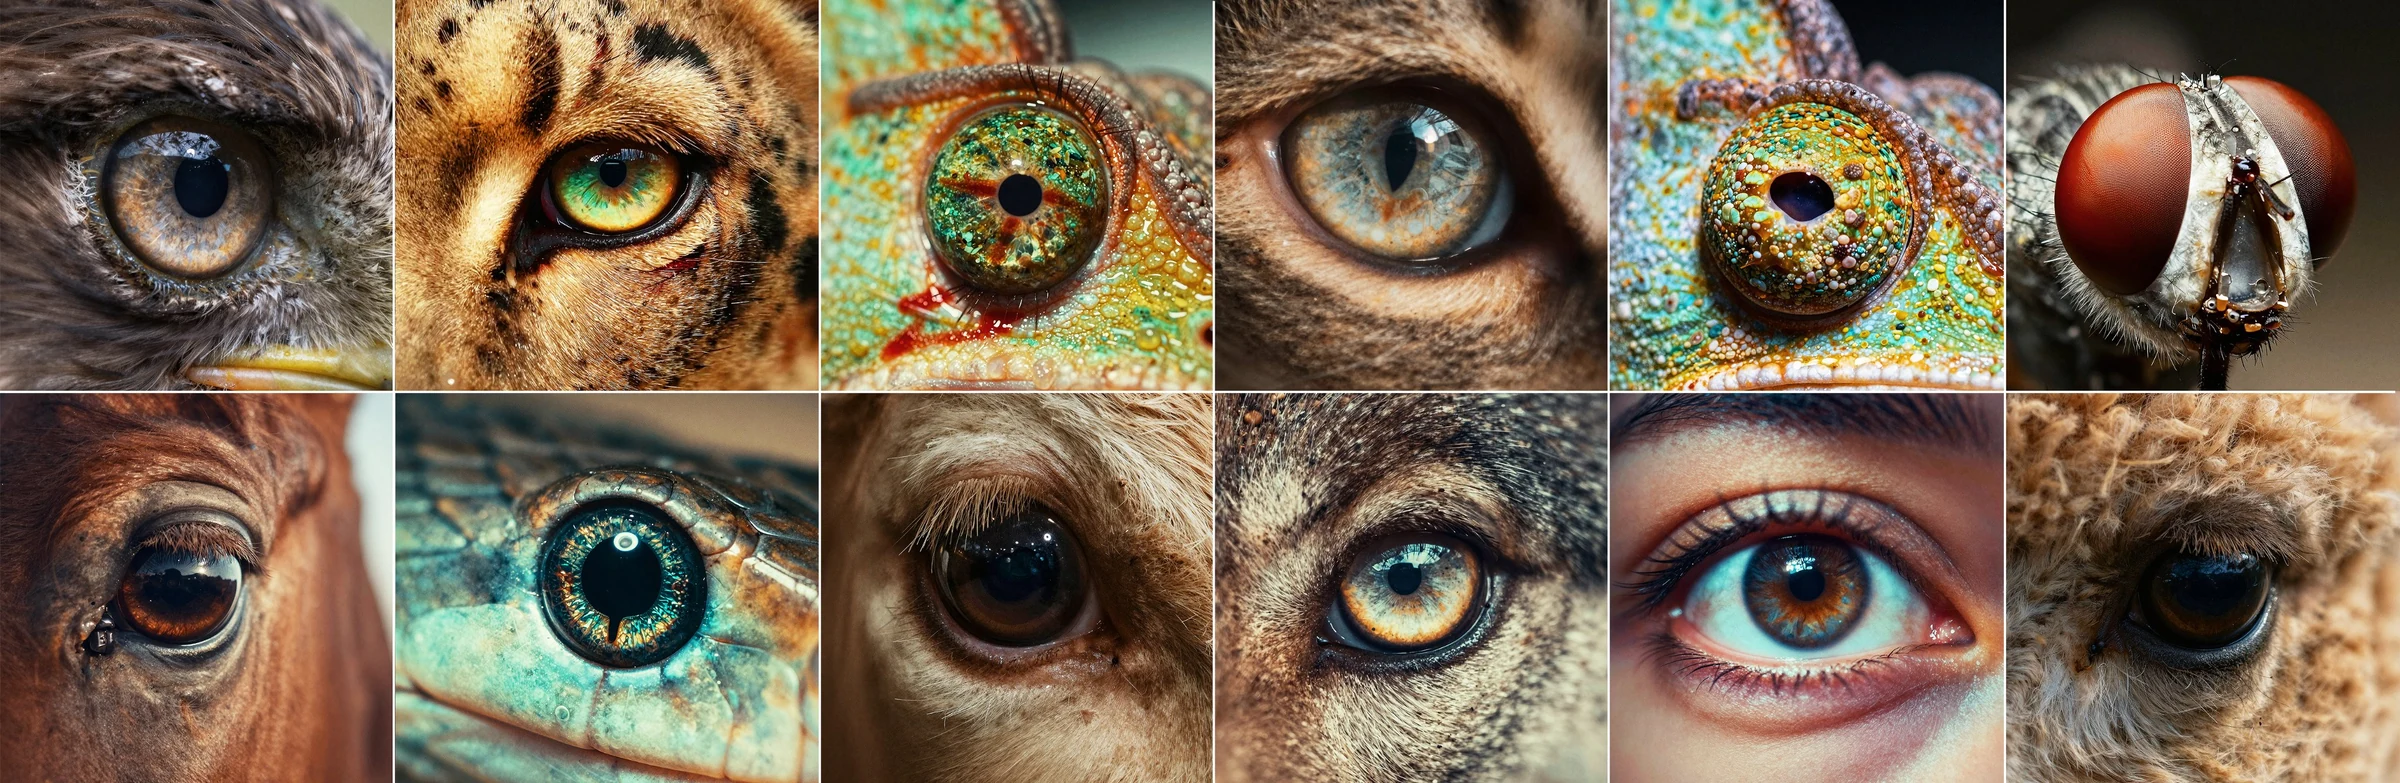
El último es macro extremo. El prompt de @aisthetiic era muy corto: la pupila de un animal llenando el marco principal, con iluminación dramática desde la esquina superior izquierda revelando la textura del iris, y un fondo con degradado de oscuro a bokeh claro.
Lo aún más interesante es que la imagen no se desmoronó. La mirada está firmemente fijada en la pupila, con luz, sombra y fondo todos sirviendo al mismo sujeto. Para crear visuales de pósters o portadas emotivas, este tipo de conformidad compositiva es más útil que apilar diez mil palabras clave "8K, obra maestra, ultra-detallado".
Mirando estos 5 casos juntos, las ventajas de Z-Image son bastante claras:
El modelo es pequeño, rápido, capaz en realismo, y puede entender prompts en lenguaje natural relativamente largos. El modelo base completo también puede usarse para LoRA, ControlNet y fine-tuning sectorial.
MiniMax H3: el video open-source empieza a tener un toque cinematográfico
La generación de video es mucho más difícil que la de imágenes. Un solo dedo mal dibujado en una imagen a veces puede recortarse. Pero en video, si el rostro del personaje cambia en 15 segundos, la cámara no sigue la línea temporal, los diálogos se mezclan entre personajes, o los efectos de sonido no coinciden con las acciones — cualquier error arruina toda la pieza.
En los casos de H3, lo primero que vale la pena examinar es la consistencia de personajes dobles.
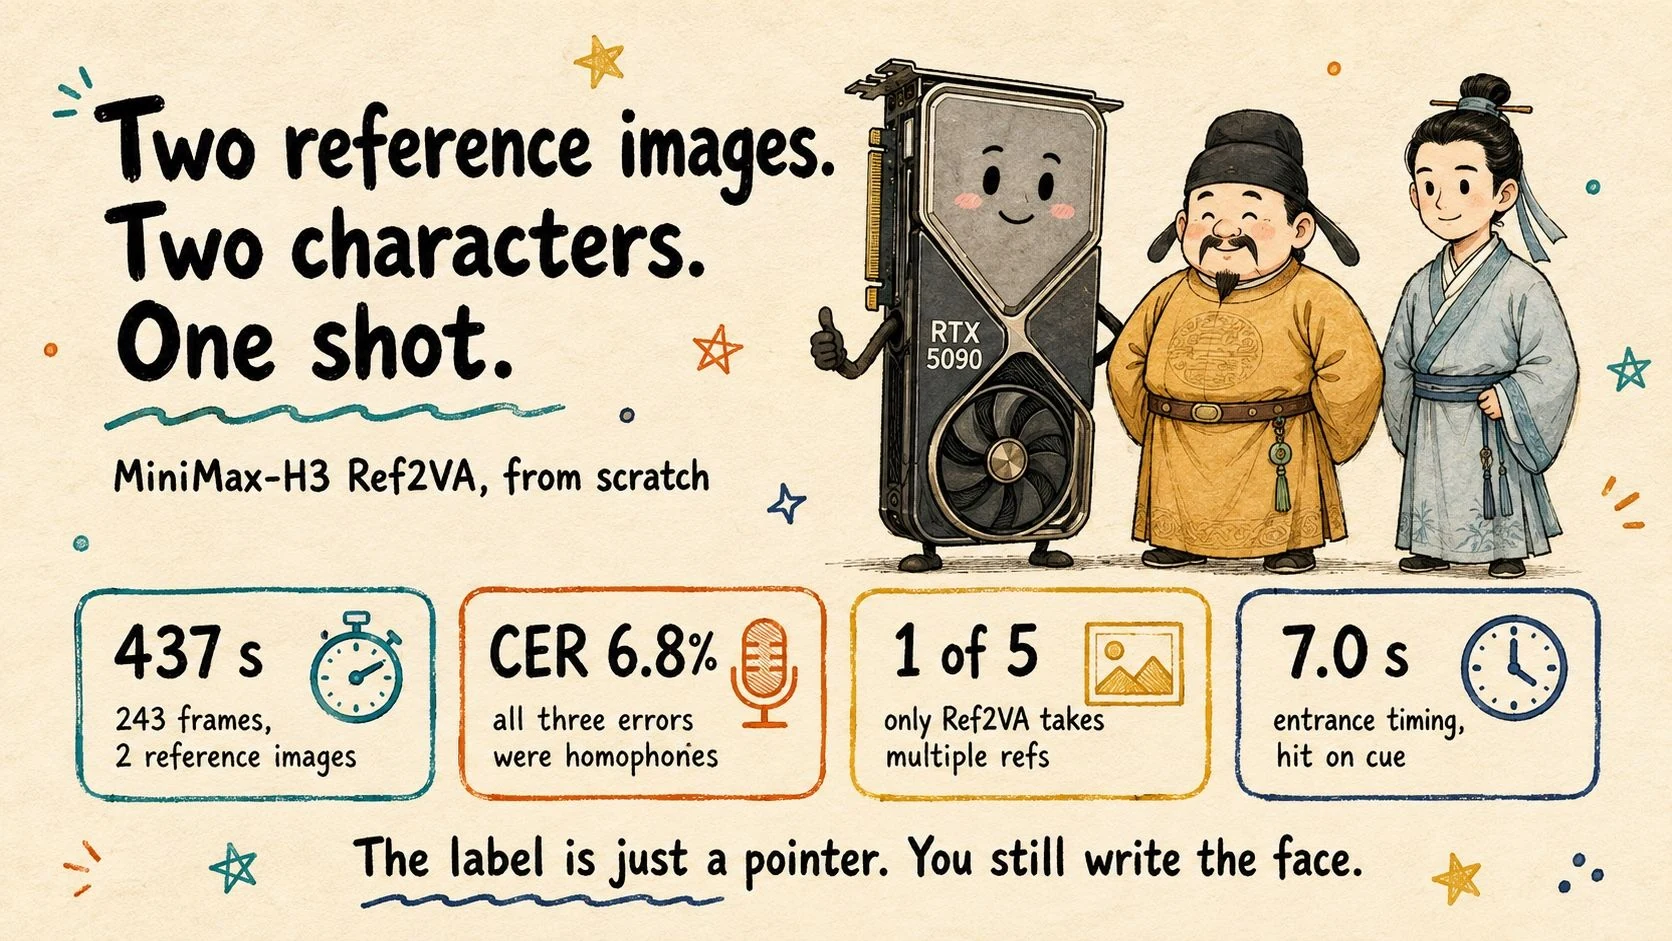
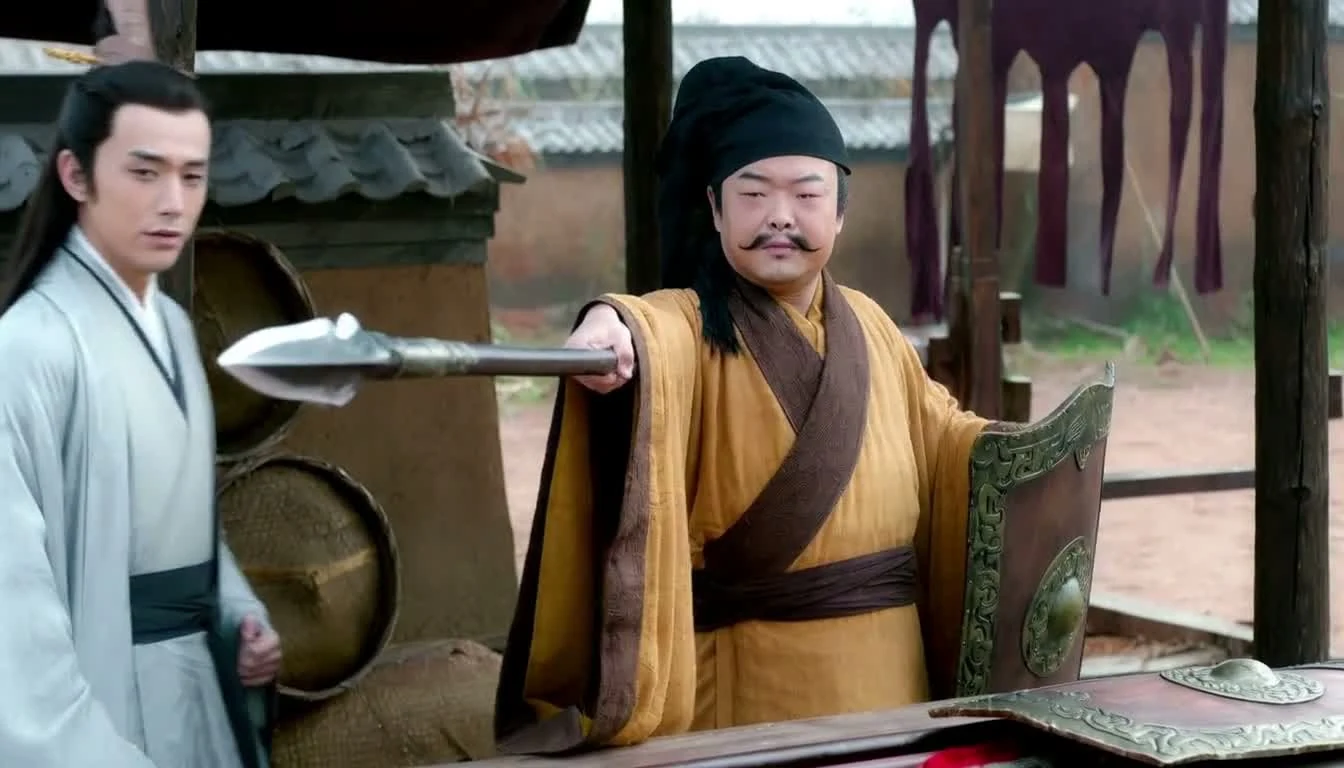
@coolthor alimentó dos imágenes de diseño de personajes generadas por Z-Image al modo Ref2VA de H3. Uno lleva una túnica ocre, el otro ropa azul-gris, con apariencias deliberadamente diferentes. El prompt programó la entrada de un personaje entre los segundos 6 e 8 e incluyó tres líneas de diálogo chino.
En el video de 10,125 segundos, los dos personajes no intercambiaron caras ni ropa. El personaje programado para entrar no apareció en la primera mitad y solo llegó alrededor del segundo 7. Luego, el autor usó ASR para verificar 44 caracteres chinos, logrando una tasa de error de caracteres del 6,8%, con errores que eran homófonos.
Esto se ejecutó en un solo RTX 5090, tomando 437 segundos para 243 cuadros. La velocidad no es extremadamente rápida, pero poder controlar simultáneamente personaje, temporización y diálogo ya es muy impresionante.
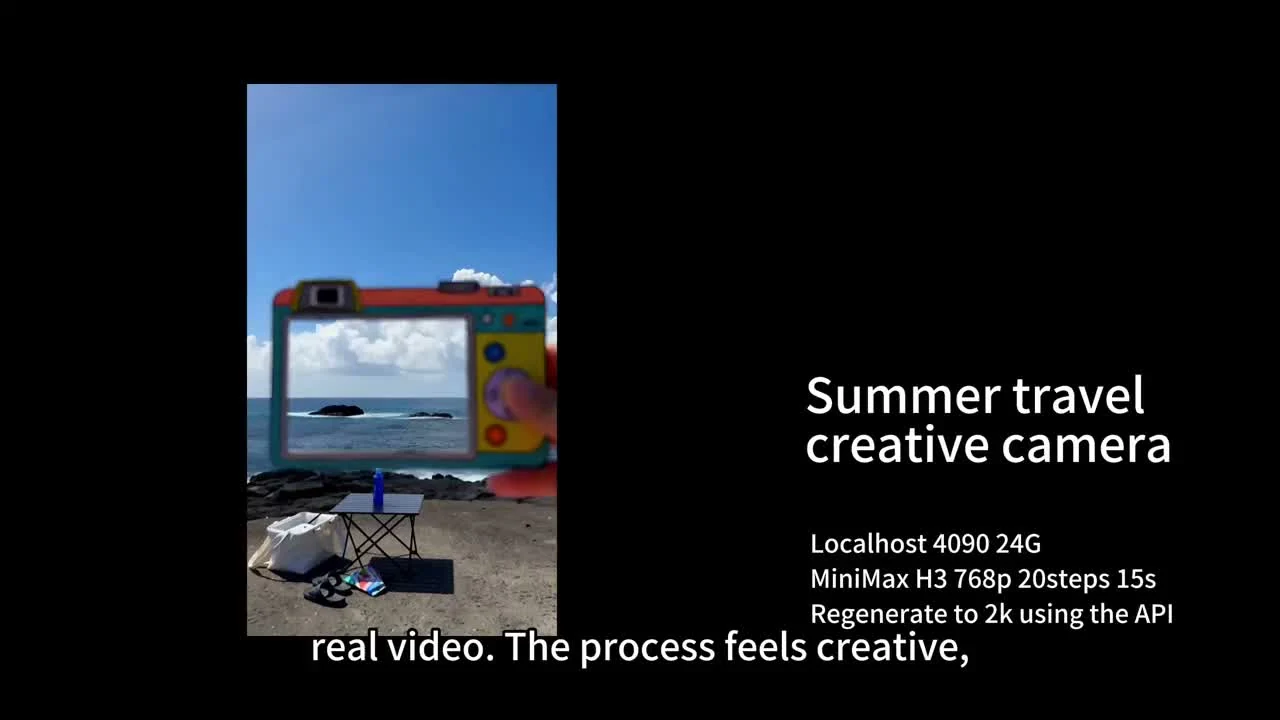
Usando un RTX 4090 y ComfyUI, hizo tres intentos: un cortometraje de viaje de cuatro escenas, un video musical que cambia de escena con los golpes de tambor, y una historia costera con 4 planos y sonido ambiental. La idea inicial se envió primero al Prompt Writing Skill oficial de MiniMax para crear prompts estructurados con planos, temporización, acciones y sonidos, y luego se pasó a H3.
El aspecto más útil de este caso es que no solo produjo "imágenes bonitas". Cuando el golpe de tambor llega, la escena realmente cambia; en el clip costero, los cuatro planos, la atmósfera y el sonido de fondo salieron todos juntos en una ronda.
Sus datos de benchmark: el 4090 toma más de 200 segundos para un video de 15 segundos en baja resolución a 20 pasos; subir a 768p toma más de 1000 segundos. El open source permite iterar repetidamente, pero gratis no significa sin costo — electricidad, VRAM y tiempo de espera también son costos.
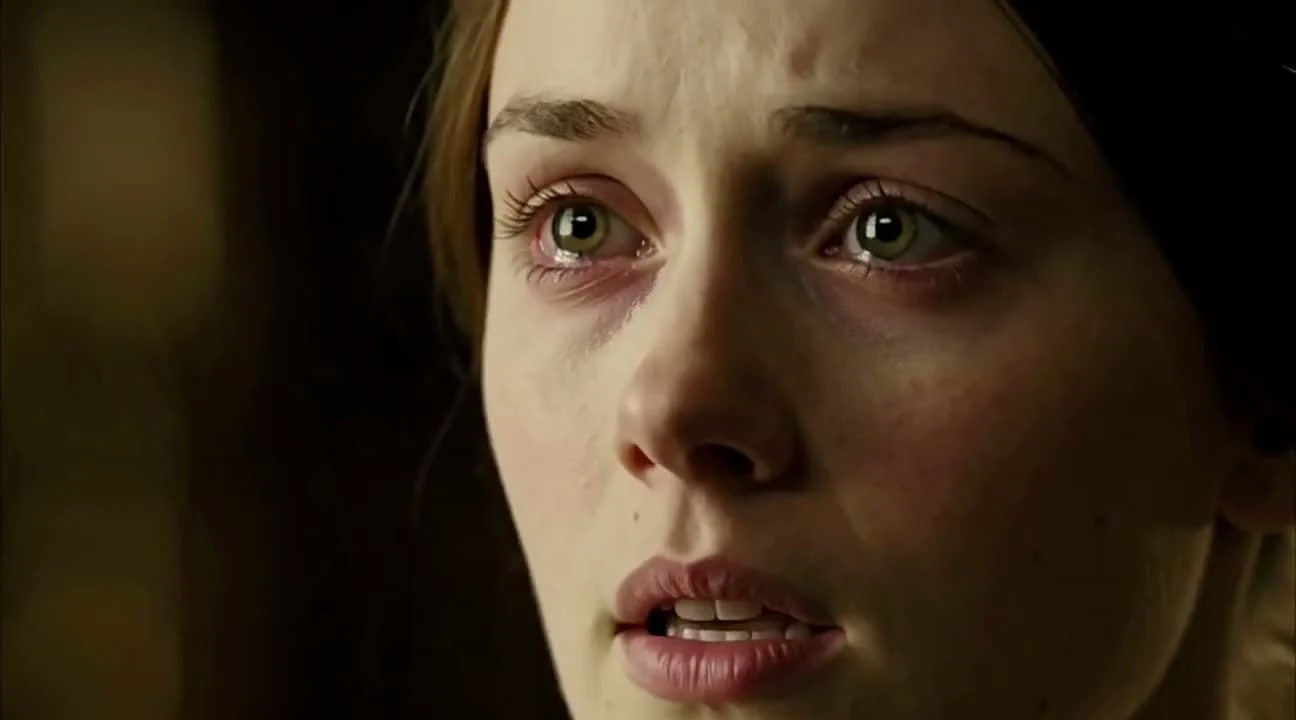
El segmento de 30 segundos al estilo "Jane Eyre" de una mansión británica de @PixelAigc es aún más impresionante.
Su prompt dividió directamente los 30 segundos en 4 planos. Cada segmento especificaba distancia focal, ángulo de cámara, posición de personajes, microexpresiones, diálogos, respiración, sonido ambiental e ítems prohibidos. Las emociones de los personajes progresaron desde la tentativa hasta la réplica hasta la emoción, con restricciones de voz separadas para voces masculina y femenina.
Esta pieza usó ComfyUI local con H3 Turbo LoRA, generando primero en 480p, luego subiendo a 1080p con Topaz. El autor reportó que 25 segundos toman aproximadamente 13 a 15 minutos. Esto no representa el rendimiento sin procesar del modelo oficial, pero representa el aspecto más interesante del ecosistema open-source: un mes después del lanzamiento del modelo, la comunidad ya está modificando velocidad, creando videos largos e integrando super-resolución automática.
El límite oficial de H3 para un solo segmento es de 15 segundos. Entonces, ¿cómo hacer videos más largos?
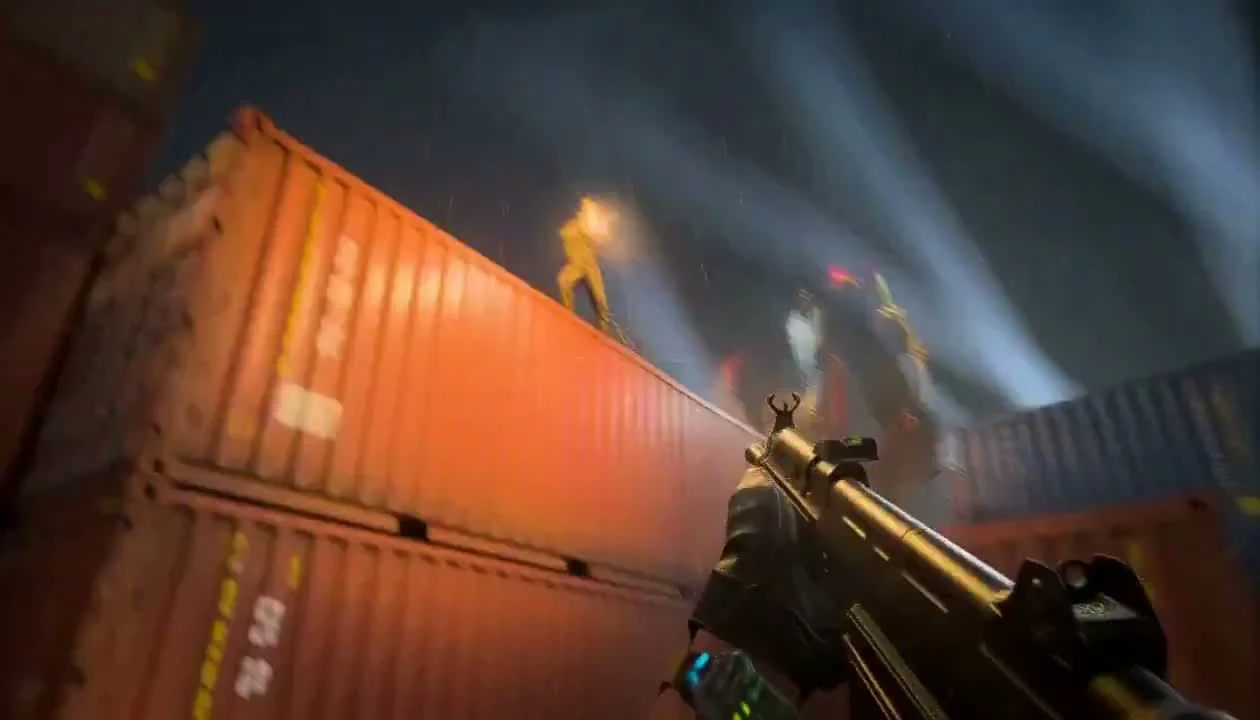
@superalesha usó 4 RTX 3090 para ejecutar una película de acción en primera persona de 30 segundos. Encadenó dos segmentos de 15 segundos, deteniendo deliberadamente el primero en un cuadro estable, continuando la generación desde el mismo cuadro en el segundo segmento, cortando los cuadros duplicados, y dejando que el audio continuara.
La unión está oculta en el segundo 15, casi invisible durante la visualización normal. La pieza completa tomó 44 minutos desde la generación hasta la finalización. El valor de este caso no es que H3 de repente haya superado el límite de duración, sino que alguien comprendió el límite y lo sorteo con un flujo de trabajo.
También hay un caso particularmente útil para estudiar "cómo realmente escribir prompts de video".
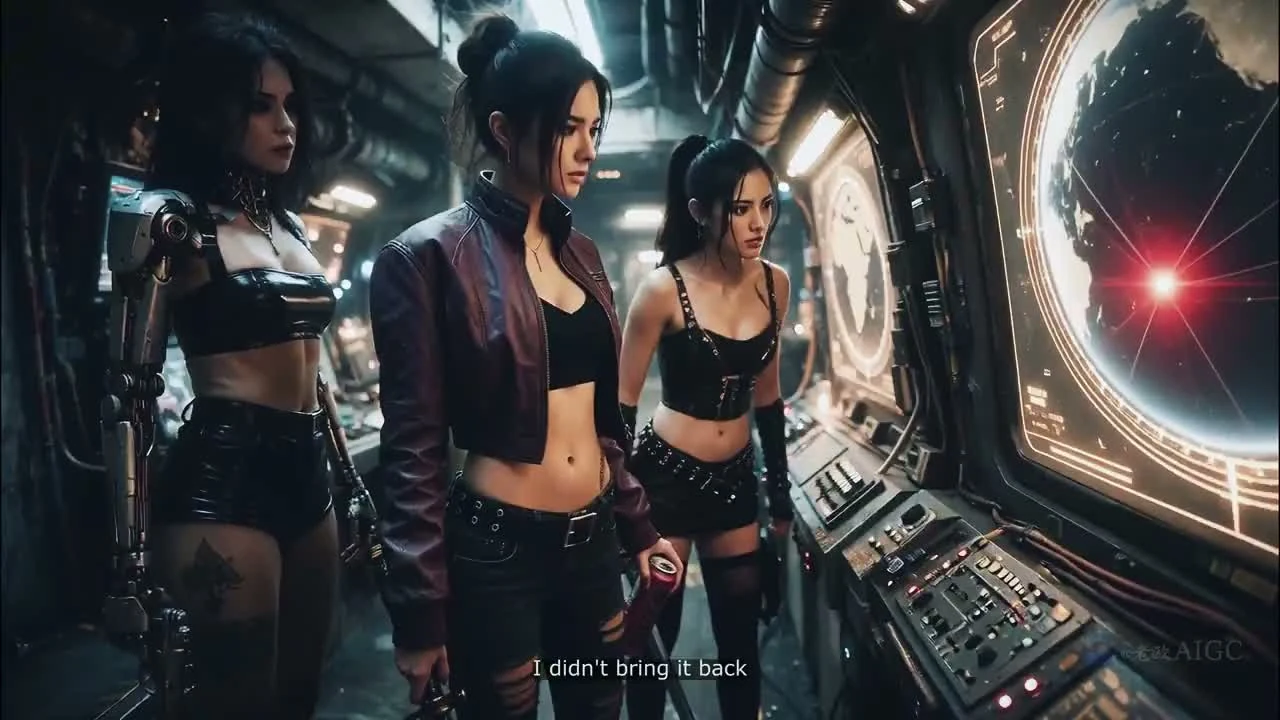
@ou_zhen599 usó ComfyUI local para crear un cortometraje de nave cibernética de 15 segundos. La escena presenta tres personajes femeninos: una sentada a la izquierda, otra de pie en el centro con un cuchillo, y una tercera de pie a la derecha sosteniendo una lata de refresco. El prompt no solo describía la trama — especificaba quién habla en qué segundo, que los personajes silenciosos no deben mover los labios, que la lata de refresco debe permanecer en la mano derecha durante todo el tiempo, cuándo aparece el punto de seguimiento rojo en pantalla, y finalmente cuándo la sombra afuera del portillo se acerca.
La parte más difícil de este tipo de caso es mantener el espacio estable, no perder accesorios, no mezclar diálogos, y hacer que los personajes silenciosos realmente se queden callados. H3 ya logró meter todas estas restricciones en un cortometraje de 15 segundos. El juego del video open-source claramente ha cambiado.
Si solo quieres producir rápidamente un video terminado, los modelos de código cerrado siguen siendo los más fáciles.
Pero si quieres iterar repetidamente, generar en lote, entrenar tu propio estilo, o integrar capacidades en un flujo de trabajo local, Z-Image e H3 merecen un estudio serio. Usa los modelos open-source para prototipar rápidamente planos y material primero, luego llama a los modelos de código cerrado solo cuando realmente estás atascado — los costos serán mucho menores.
Los modelos open-source solían sentirse como un premio de consolación para quienes esperaban. Ahora pueden genuinamente participar en un trabajo creativo real.
Para las personas que necesitan crear imágenes y videos diariamente, el mejor cambio es que en el futuro, cada vez que surja una idea, ya no tendrás que calcular primero cuántos créditos quemará esta ronda.