À mesure que les applications Agent deviennent de plus en plus complexes, les développeurs doivent gérer l'appel d'outils, l'intégration des connaissances, la gestion de l'état et la collaboration multi-Agent. Développer toutes ces capacités de zéro serait non seulement un travail considérable, mais rendrait également les connexions entre les modules et le contrôle de l'exécution complexes.
Los frameworks Agent encapsulan estas capacidades comunes, proporcionando métodos de implementación unificados para el desarrollo Agent. A continuación se presentan varios frameworks de desarrollo Agent representativos.
Framework LangChain
Lanzado en 2022, LangChain es uno de los primeros frameworks de código abierto para construir aplicaciones de grandes modelos. Inicialmente enfocado en organizar grandes modelos, prompts y datos externos, se expandió gradualmente para incluir invocación de herramientas y Agents. Actualmente, LangChain ha convertido a los Agents en un componente fundamental del framework, proporcionando modelos, herramientas y componentes de middleware para construir rápidamente Agents con capacidades de invocación de herramientas.
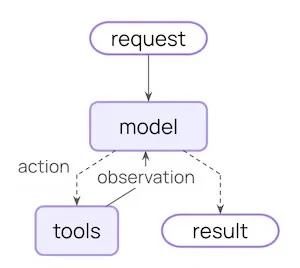
El método de ejecución principal de LangChain forma un bucle entre el gran modelo y las herramientas. El modelo recibe tareas del usuario y herramientas disponibles, luego decide en función de la información actual si generar un resultado directamente o llamar a una herramienta. Si se elige una llamada a herramienta, el framework ejecuta la herramienta correspondiente y devuelve el resultado al modelo. El modelo entonces toma más decisiones en función de la nueva información hasta que no se necesitan más llamadas a herramientas y se genera un resultado final. La documentación oficial llama a este proceso el Agent Loop, como se muestra a continuación.
Por ejemplo, se puede configurar un asistente de viajes con herramientas de consulta meteorológica, búsqueda de mapas y búsqueda web. Cuando un usuario pregunta "Ayúdame a planificar un día de excursión a Hangzhou mañana", el modelo puede determinar que necesita verificar el clima y la información de atracciones, llamar a las herramientas correspondientes para obtener resultados y combinarlos para completar el itinerario.
Las herramientas son una forma importante de implementar capacidades externas. Son esencialmente funciones invocables con entradas y salidas claras, utilizadas para obtener datos en tiempo real, ejecutar código, consultar bases de datos o operar sobre sistemas externos. Una vez que los desarrolladores proporcionan las herramientas necesarias a un Agent, el modelo decide cuándo llamar a qué herramienta y qué parámetros proporcionar en función de la tarea actual.
Este enfoque basado en componentes es una característica clave de LangChain. LangChain proporciona interfaces relativamente unificadas para diferentes modelos y herramientas, permitiendo a los desarrolladores combinar estos componentes dentro de un solo framework sin tener que manejar la lógica de llamada por separado para cada modelo y capacidad externa. Por lo tanto, es particularmente adecuado para construir rápidamente Agents basados en invocación de herramientas, y es ideal para que los principiantes comprendan el proceso básico de funcionamiento de un Agent.
LlamaIndex, lancé en 2022, était initialement utilisé principalement pour résoudre les problèmes de connexion entre les grands modèles et les données externes. Il offre des capacités de chargement de données, d'indexation, de recherche et de requête, permettant de connecter des données externes telles que des documents d'entreprise et des bases de données aux applications de grands modèles. Sur cette base, LlamaIndex a progressivement ajouté des fonctionnalités telles que les Agents et les Workflows, permettant aux Agents d'utiliser ces données pour accomplir des tâches plus complexes.
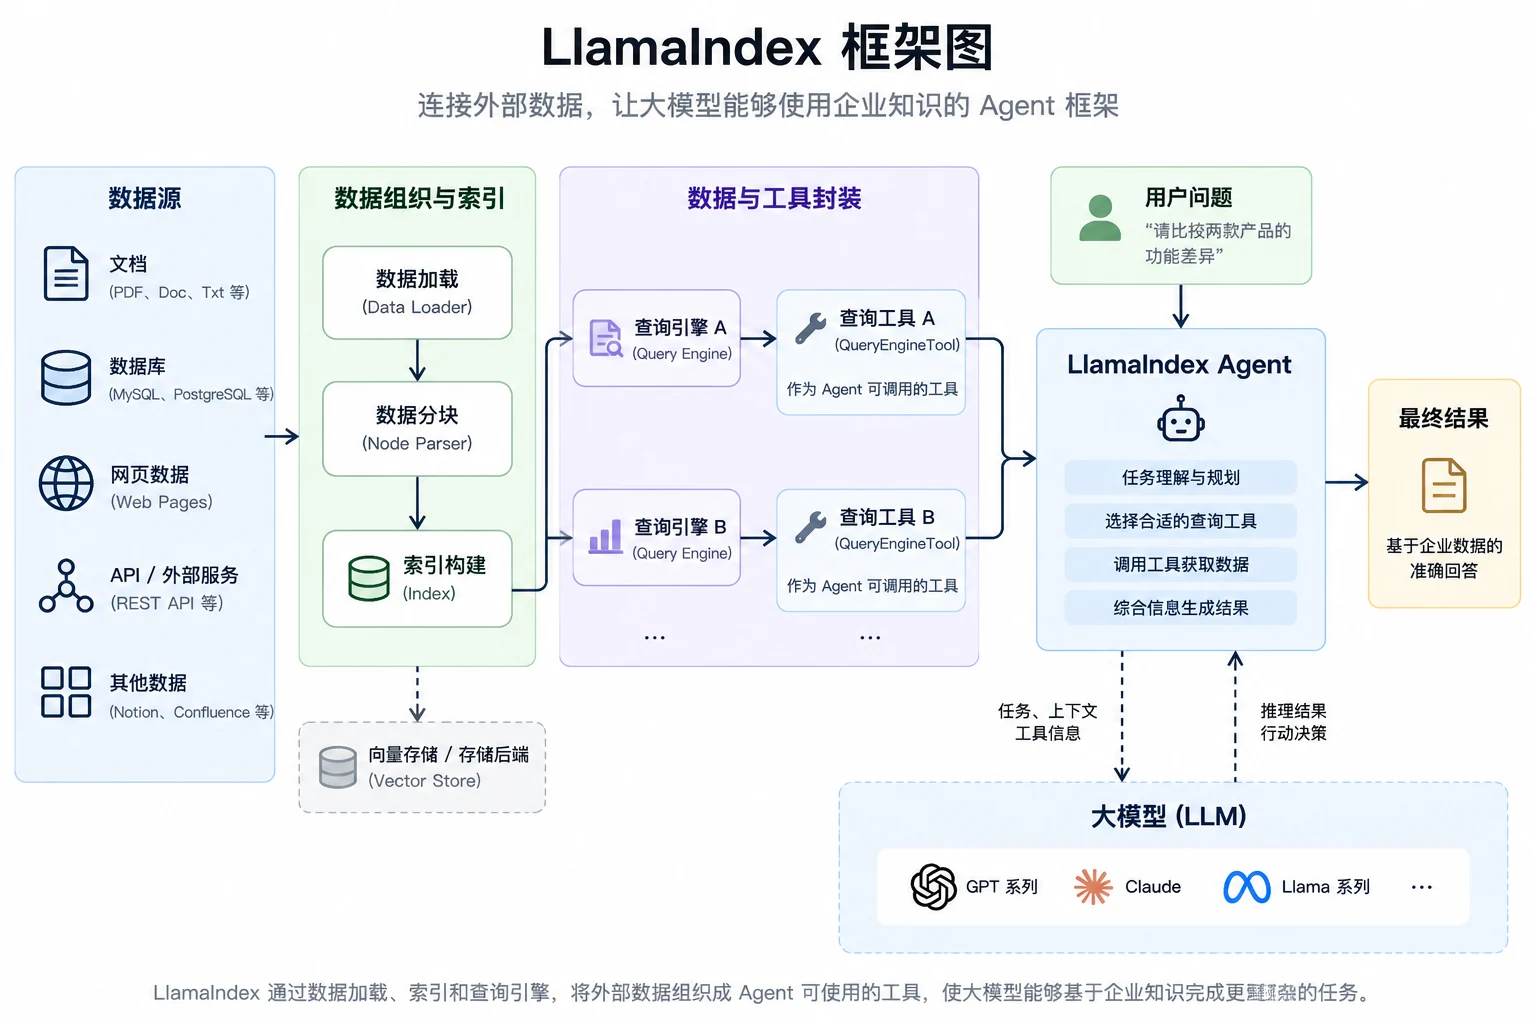
Les grands modèles eux-mêmes ne comprennent pas les données externes telles que les documents produits internes, les données métier et les bases de données de l'entreprise. Lorsqu'un Agent a besoin d'utiliser ces données pour accomplir une tâche, il doit d'abord trouver les informations pertinentes pour la tâche actuelle. LlamaIndex peut charger, organiser et indexer les données externes, puis effectuer des recherches et des requêtes via des composants tels que Retriever et Query Engine. Le Query Engine peut recevoir des questions en langage naturel, rechercher des données pertinentes dans l'index, et peut également être encapsulé en un outil que l'Agent peut appeler. Comme illustré ci-dessous, après avoir reçu la tâche de l'utilisateur, l'Agent peut sélectionner l'outil de requête approprié pour obtenir des informations selon les besoins, puis les analyser avec le grand modèle pour générer le résultat final. De cette manière, il n'est pas nécessaire de placer toutes les données externes directement dans le contexte ; les données pertinentes peuvent être interrogées et utilisées selon les besoins de la tâche.
Par exemple, pour un Agent d'analyse d'activité d'entreprise, on configure des outils de consultation de documentation produit et de données d'activité. Lorsque l'utilisateur demande de comparer les différences fonctionnelles entre deux produits, l'Agent appelle l'outil de consultation correspondant aux documents produits ; si l'utilisateur continue de poser des questions sur les ventes des deux produits, il appelle l'outil de consultation des données d'activité. Pour des questions plus complexes, l'Agent peut également appeler plusieurs outils de consultation de données de manière consécutive, puis combiner les résultats de différentes sources de données pour accomplir la tâche.
LlamaIndex n'a pas été conçu initialement pour le développement d'Agents ; ses caractéristiques se reflètent principalement dans le traitement des données et des connaissances. Il ne permet pas seulement aux grands modèles de rechercher des documents, mais peut également organiser différentes données et capacités de requête en outils que les Agents peuvent sélectionner et utiliser. Il est particulièrement adapté aux applications de questions-réponses sur les bases de connaissances, d'analyse de documents, de requêtes multi-sources de données, et aux applications Agent nécessitant l'accès à de nombreux documents d'entreprise, bases de connaissances ou données structurées.
Framework AutoGen
AutoGen, lancé par l'équipe de recherche de Microsoft en 2023, est un framework open-source représentatif dans le domaine du développement multi-Agent. Utilisant la conversation multi-Agent comme concept central, il permet à plusieurs Agents d'accomplir des tâches ensemble par le dialogue mutuel.
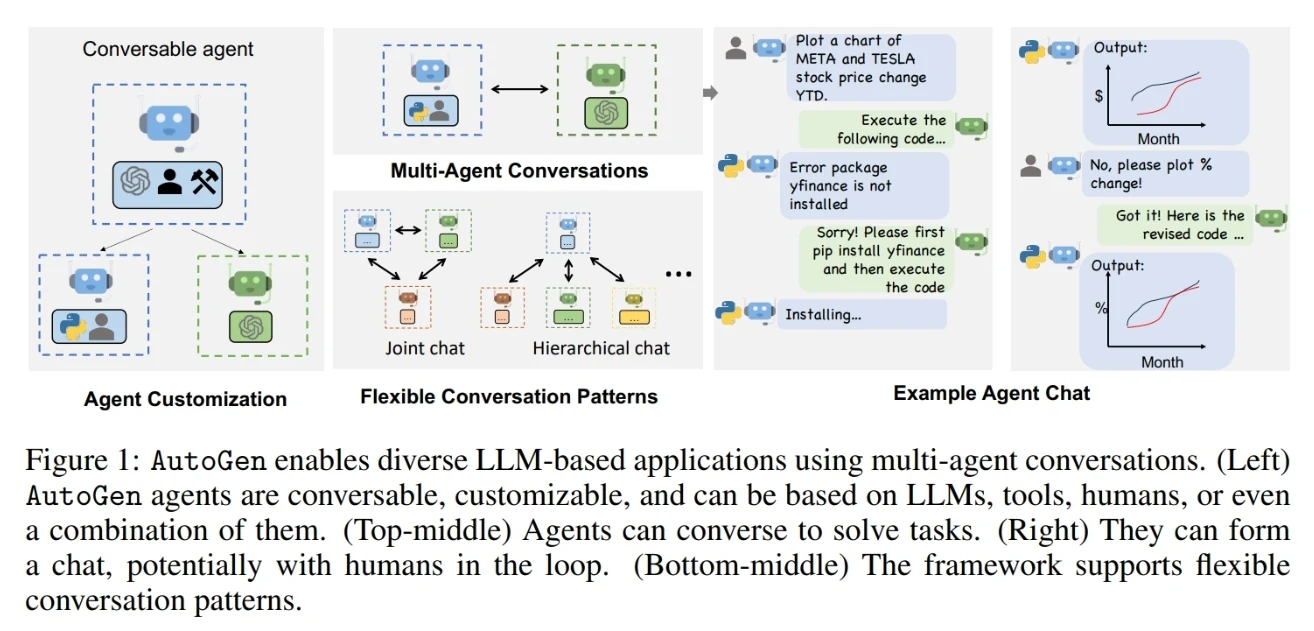
AutoGen conçoit les Agents comme des entités conversationnelles et personnalisables ; un Agent peut être composé d'un grand modèle, d'outils, d'entrées humaines ou d'une combinaison de ces capacités. Les développeurs peuvent également définir les modes d'interaction entre les Agents, permettant à différents Agents de former différents modes de dialogue. La conception globale est illustrée ci-dessous.
Cette image reflète deux importants concepts de conception d'AutoGen. Premièrement, différents Agents peuvent avoir des capacités différentes. Deuxièmement, plusieurs Agents peuvent être organisés via différents patterns de conversation, communiquant et collaborant de différentes manières.
Par exemple, dans une tâche de développement logiciel, on peut définir un Agent pour analyser les besoins, un Agent pour écrire le code, et un autre Agent pour vérifier les résultats. Après que l'Agent de programmation a généré le code, il envoie le résultat à l'Agent de vérification ; si des problèmes sont découverts, l'Agent de vérification peut faire un retour à l'Agent de programmation pour continuer les modifications jusqu'à ce que les exigences de la tâche soient satisfaites.
AutoGen fournit actuellement principalement des capacités à deux niveaux : AgentChat et Core. AgentChat est une interface de haut niveau pour construire des applications mono-Agent et multi-Agent, fournissant des composants tels que Agent et Team. Les développeurs peuvent combiner plusieurs Agents en une Team et organiser la collaboration en utilisant des méthodes telles que la prise de tour de parole et la sélection dynamique de l'Agent suivant. Core utilise une approche pilotée par les événements pour fournir des capacités de base à des systèmes multi-Agent plus flexibles et extensibles.
La caractéristique d'AutoGen est de mettre l'accent sur la communication et la collaboration entre les Agents dans la conception du framework, ce qui convient aux tâches complexes nécessitant la répartition du travail entre plusieurs Agents. Les systèmes multi-Agent nécessitent une conception supplémentaire des rôles et des modes de collaboration des Agents ; pour les tâches simples, il est généralement inutile d'utiliser plusieurs Agents.
Framework CrewAI
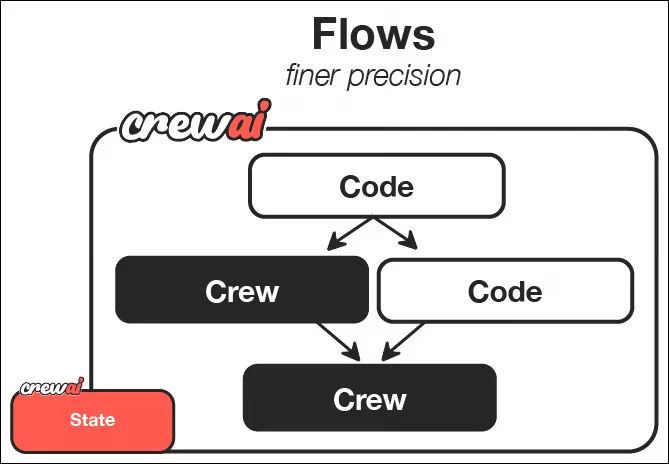
CrewAI s'adresse également à la collaboration multi-Agent, mais adopte une organisation plus proche des équipes réelles. Les développeurs peuvent définir des rôles, des objectifs et des outils pour différents Agents, puis organiser ces Agents pour accomplir le travail ensemble via des tâches et des flux de travail. CrewAI propose principalement deux modes d'organisation : Crews et Flows. Les Crews mettent l'accent sur la collaboration autonome entre plusieurs Agents, tandis que les Flows mettent l'accent sur le contrôle structuré du flux de travail.
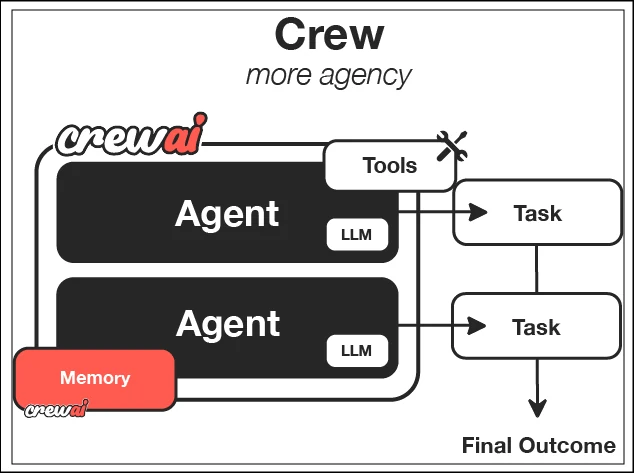
La structure du framework fournie officiellement par CrewAI est illustrée ci-dessous.
Dans un Crew, un Agent peut être considéré comme un membre d'équipe ayant des responsabilités spécifiques, une Task représente une tâche concrète à accomplir, un Process définit le mode d'exécution des Agents et des tâches, et un Crew organise ces Agents et tâches ensemble pour accomplir l'objectif final.
Par exemple, pour rédiger un rapport de recherche sur une industrie, on peut créer un Agent de recherche, un Agent de rédaction et un Agent de relecture. L'Agent de recherche est responsable de la collecte et de l'organisation des documents, l'Agent de rédaction forme le rapport à partir des résultats de la recherche, et l'Agent de relecture est responsable de la vérification du rapport. Les différents Agents assument différentes responsabilités et accomplissent l'ensemble du travail grâce à la liaison entre les tâches.
Les Flows peuvent organiser l'exécution des tâches selon un flux prédéfini et prennent en charge des fonctionnalités telles que les conditions, les boucles et la gestion de l'état. Les Crews et les Flows peuvent également être combinés ; par exemple, utiliser un Flow pour contrôler le processus métier global, et dans une étape complexe spécifique, appeler un Crew où plusieurs Agents collaborent pour accomplir la tâche.
La caractéristique de CrewAI est d'organiser la collaboration multi-Agent par les rôles, les tâches et les équipes, avec une conception globale proche de la répartition du travail dans les équipes réelles. Il est particulièrement adapté aux applications multi-Agent avec des rôles et des tâches clairement définis, telles que la recherche, la génération de contenu, l'analyse de données et la relecture.
Framework LangGraph
LangGraph, lancé par l'équipe LangChain en 2024, est un framework d'orchestration de base pour construire et gérer des Agents à longue durée d'exécution et à état persistant. Contrairement à l'utilisation directe d'Agents prédéfinis, LangGraph permet aux développeurs de définir explicitement la structure d'exécution des Agents, ce qui est particulièrement adapté aux Agents comportant des processus complexes tels que l'état, le branchement, les boucles et l'intervention humaine.
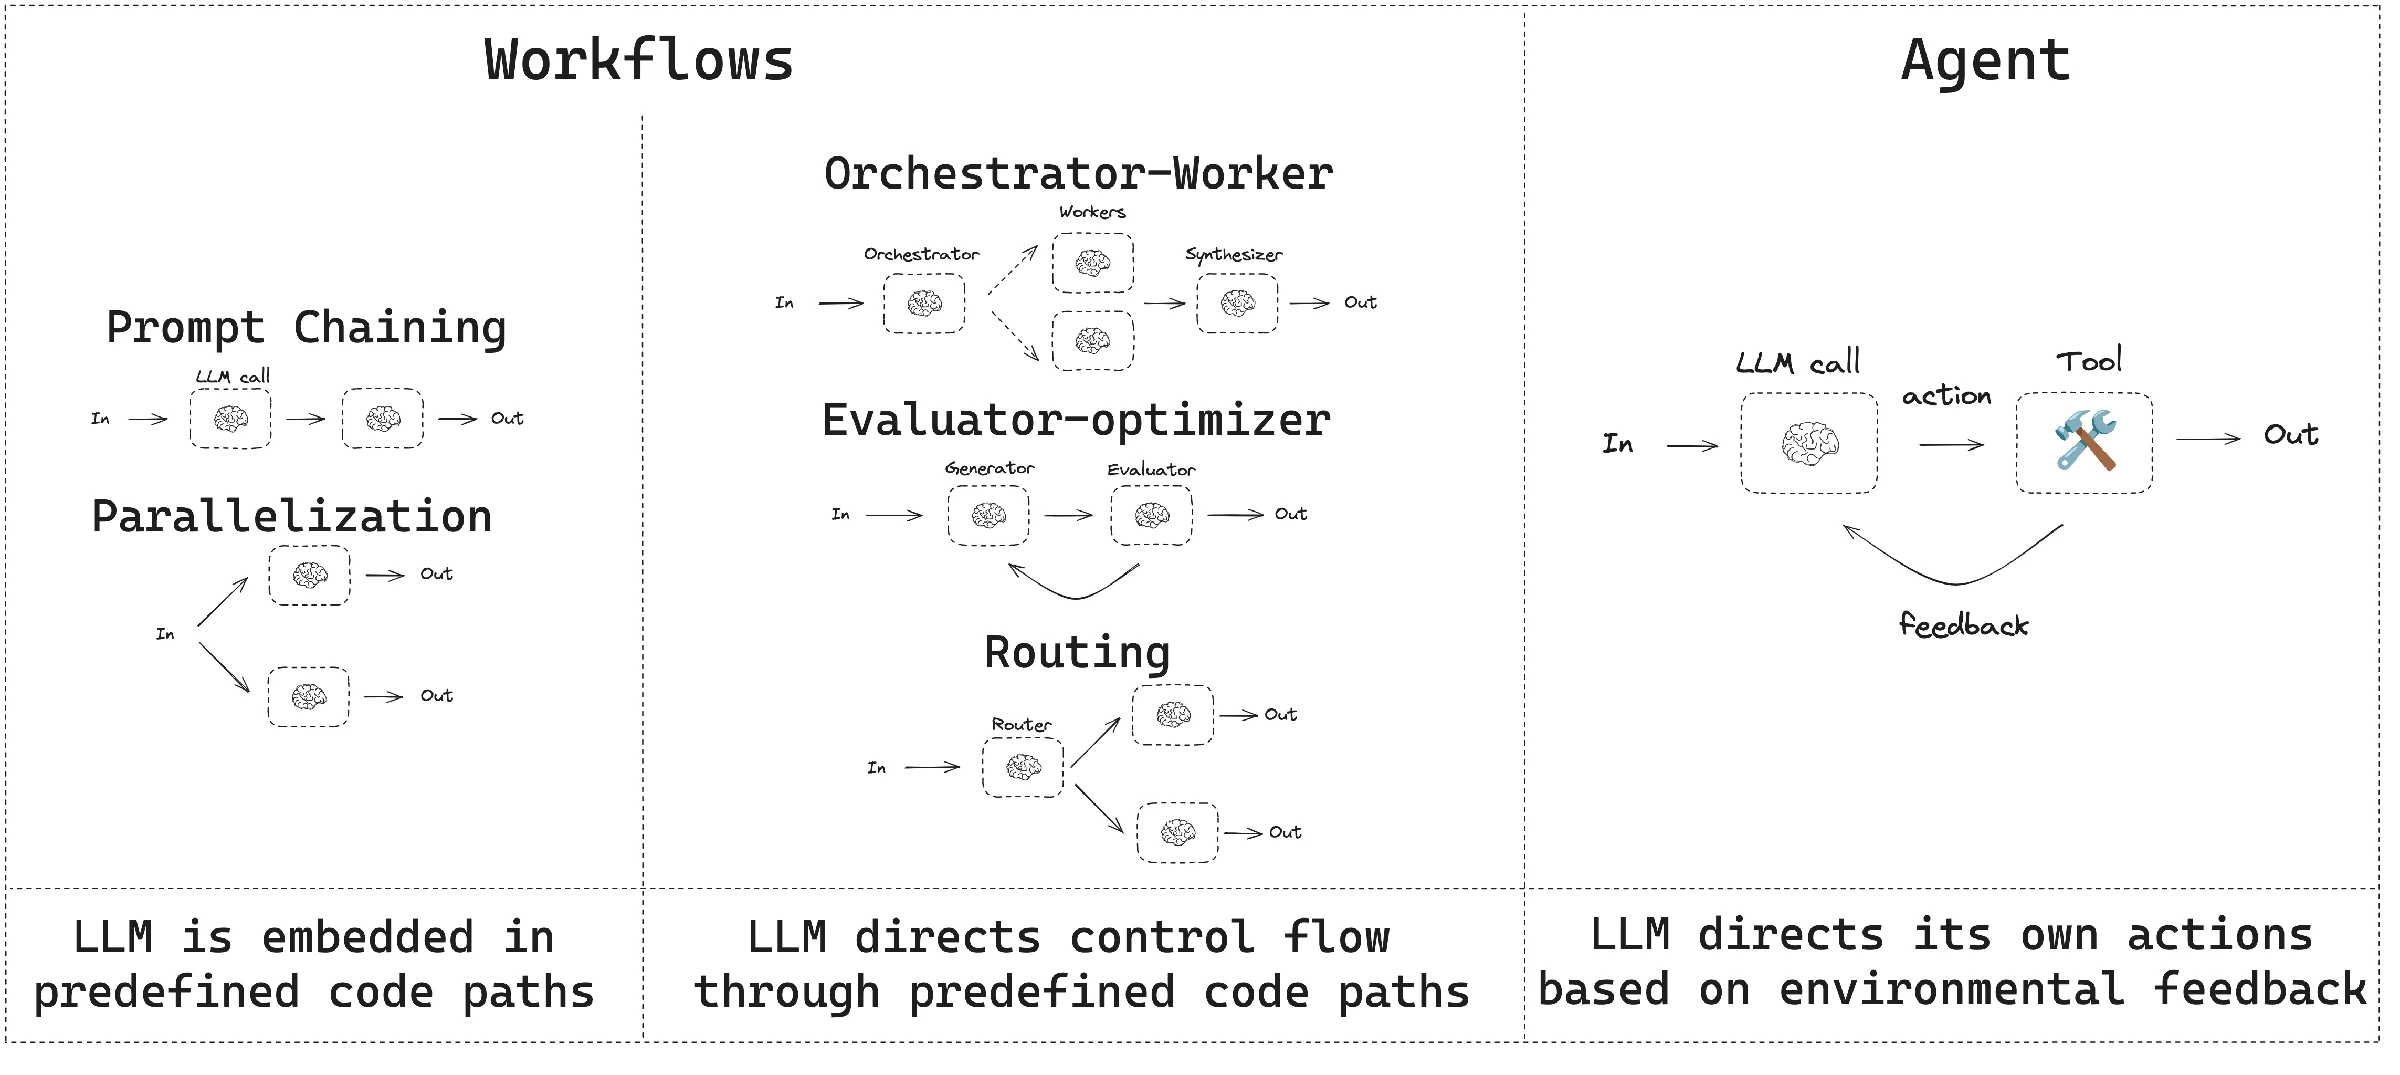
LangGraph peut à la fois construire des Workflows dont le chemin d'exécution est relativement clair, et des Agents dont les étapes suivantes sont décidées dynamiquement par le grand modèle. Les Workflows peuvent prédéfinir le chemin d'exécution des tâches et organiser les différentes étapes via des méthodes telles que la séquence, le parallélisme, le routage et les boucles ; les Agents peuvent décider dynamiquement de l'étape suivante en fonction de l'état actuel et des résultats retournés par les outils. Dans les applications pratiques, les Workflows et les Agents peuvent également être combinés, le Workflow déterminant le processus global et l'Agent gérant les étapes nécessitant des décisions dynamiques.
Les modes Workflow et Agent pris en charge par LangGraph sont illustrés ci-dessous.
Pour implémenter ces différents modes d'exécution, LangGraph utilise un graphe pour décrire le processus d'exécution des tâches, avec trois concepts fondamentaux : State, Node et Edge. State est utilisé pour sauvegarder les informations à partager pendant l'exécution de la tâche ; Node représente une étape de traitement concrète, telle que l'appel d'un grand modèle, la recherche de connaissances ou l'exécution d'un outil ; Edge connecte les différents nœuds et détermine dans quel nœud la tâche entrera ensuite.
Par exemple, un Agent de questions-réponses sur les connaissances peut d'abord analyser la question de l'utilisateur, puis rechercher les connaissances, générer une réponse et vérifier le résultat. Si la vérification de la réponse échoue, on peut revenir au nœud de recherche via une branche conditionnelle ; si la vérification passe, on entre dans le nœud de sortie finale. Tout au long du processus, les informations telles que la question de l'utilisateur, les résultats de la recherche et les réponses intermédiaires peuvent être sauvegardées dans le State et partagées entre les différents nœuds.
Cette conception est différente du fait de s'appuyer entièrement sur le grand modèle pour décider de l'étape suivante. LangGraph permet de prédéfinir la structure d'exécution globale de la tâche et d'utiliser le grand modèle pour prendre des décisions dans les nœuds nécessitant un jugement. Cela conserve à la fois la capacité de l'Agent à juger dynamiquement en fonction des circonstances réelles et le contrôle du chemin d'exécution clé.
Outre la structure en graphe et la gestion de l'état, LangGraph offre également des capacités telles que l'exécution durable et la boucle de rétroaction humaine. Les tâches de longue durée peuvent sauvegarder leur état d'exécution et reprendre après une interruption ; avant des opérations importantes, l'Agent peut également être mis en pause pour attendre une vérification ou une modification de l'état par un humain avant de reprendre. Par conséquent, le site officiel positionne LangGraph comme un framework d'orchestration de base pour les Agents à longue durée d'exécution et à état persistant.
LangGraph permet un contrôle fin de l'état et du chemin d'exécution, mais nécessite également plus de conception de la part des développeurs. Pour les simples Agents d'appel d'outils, il n'est pas nécessaire de construire un graphe complexe dès le début. Le site officiel de LangGraph recommande également que si vous commencez à apprendre les Agents ou si vous avez besoin d'abstractions de niveau supérieur, vous pouvez commencer par les Agents de LangChain.
Framework MS-Agent
MS-Agent est un framework léger de développement Agent open-source de la communauté ModelScope, principalement destiné aux tâches nécessitant une exploration autonome et une exécution multi-étapes, fournissant des capacités telles que l'appel de modèles, la connexion d'outils et la collaboration multi-Agent. Il peut être utilisé pour construire des applications telles que la recherche approfondie, l'analyse de documents et la génération de code.
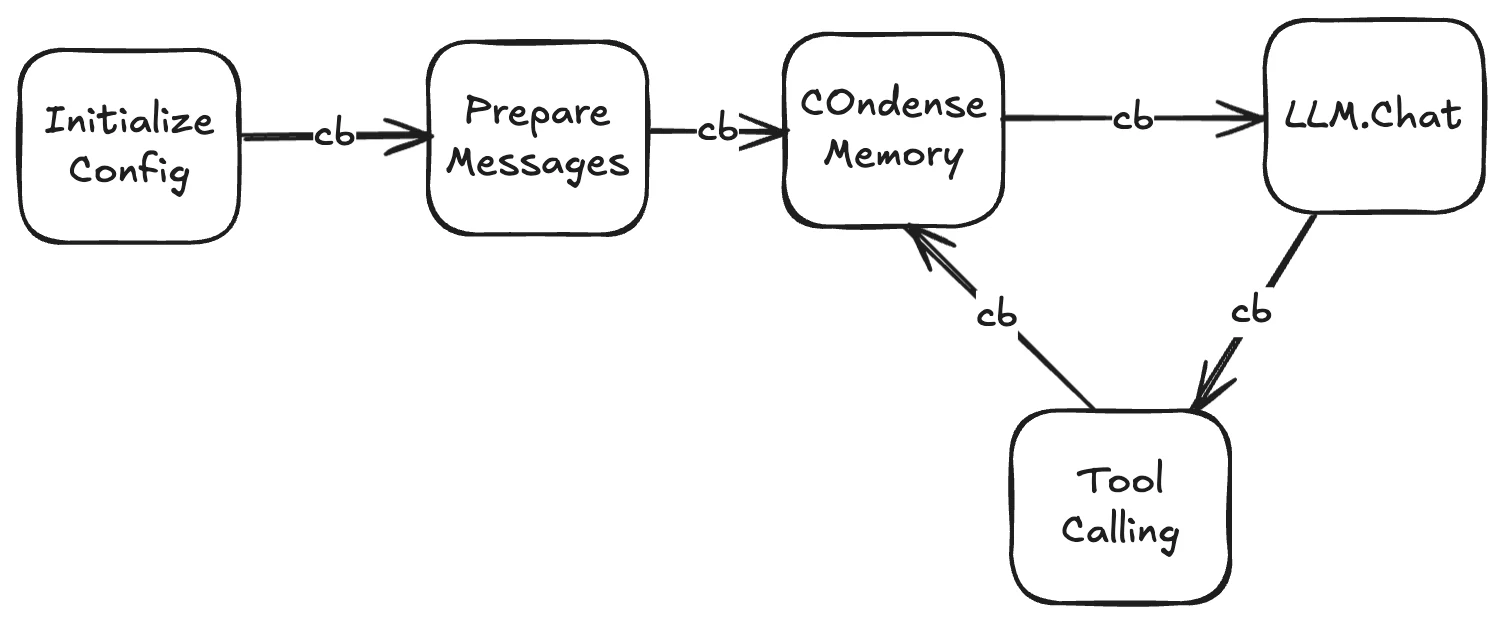
Le composant de base de MS-Agent est LLMAgent, qui organise les dialogues du grand modèle et les appels d'outils. Les développeurs peuvent spécifier le modèle, les prompts et les outils via un fichier de configuration. Après avoir reçu la tâche de l'utilisateur, LLMAgent fournit la tâche et les outils disponibles au grand modèle, qui détermine l'étape suivante. Si un outil doit être appelé, le framework exécute l'opération correspondante, puis fournit le résultat au modèle pour un traitement continu, jusqu'à ce que le modèle génère une réponse ne contenant plus d'appels d'outils, ou que le nombre maximum de cycles d'exécution défini soit atteint.
Le processus d'exécution de base de LLMAgent est illustré ci-dessous. Après l'initialisation de la configuration et la préparation des messages, l'Agent boucle entre l'appel du modèle et l'exécution des outils, en comprimant le contexte lorsque nécessaire. « cb » dans le diagramme représente les callbacks, permettant aux développeurs d'ajouter des enregistrements de logs ou d'autres traitements personnalisés aux étapes correspondantes.
La connexion d'outils est une capacité importante de MS-Agent. Le framework fournit des outils intégrés tels que la lecture/écriture de fichiers, l'exécution de code et la décomposition de tâches, et prend également en charge la connexion d'outils externes via MCP (Model Context Protocol). Les développeurs peuvent réutiliser des services MCP existants ou écrire des outils personnalisés pour permettre à l'Agent d'accéder aux données et aux systèmes externes nécessaires à la tâche.
Pour les tâches nécessitant la coordination de plusieurs étapes, MS-Agent prend en charge la combinaison de différents Agents via des workflows. LLMAgent est responsable des étapes nécessitant le jugement et la génération du grand modèle, tandis que CodeAgent est responsable des opérations déterministes exécutées selon le code. Les développeurs peuvent organiser l'analyse des documents, le traitement des données et la génération des résultats en un workflow, et spécifier les relations d'exécution de chaque étape via un fichier de configuration.
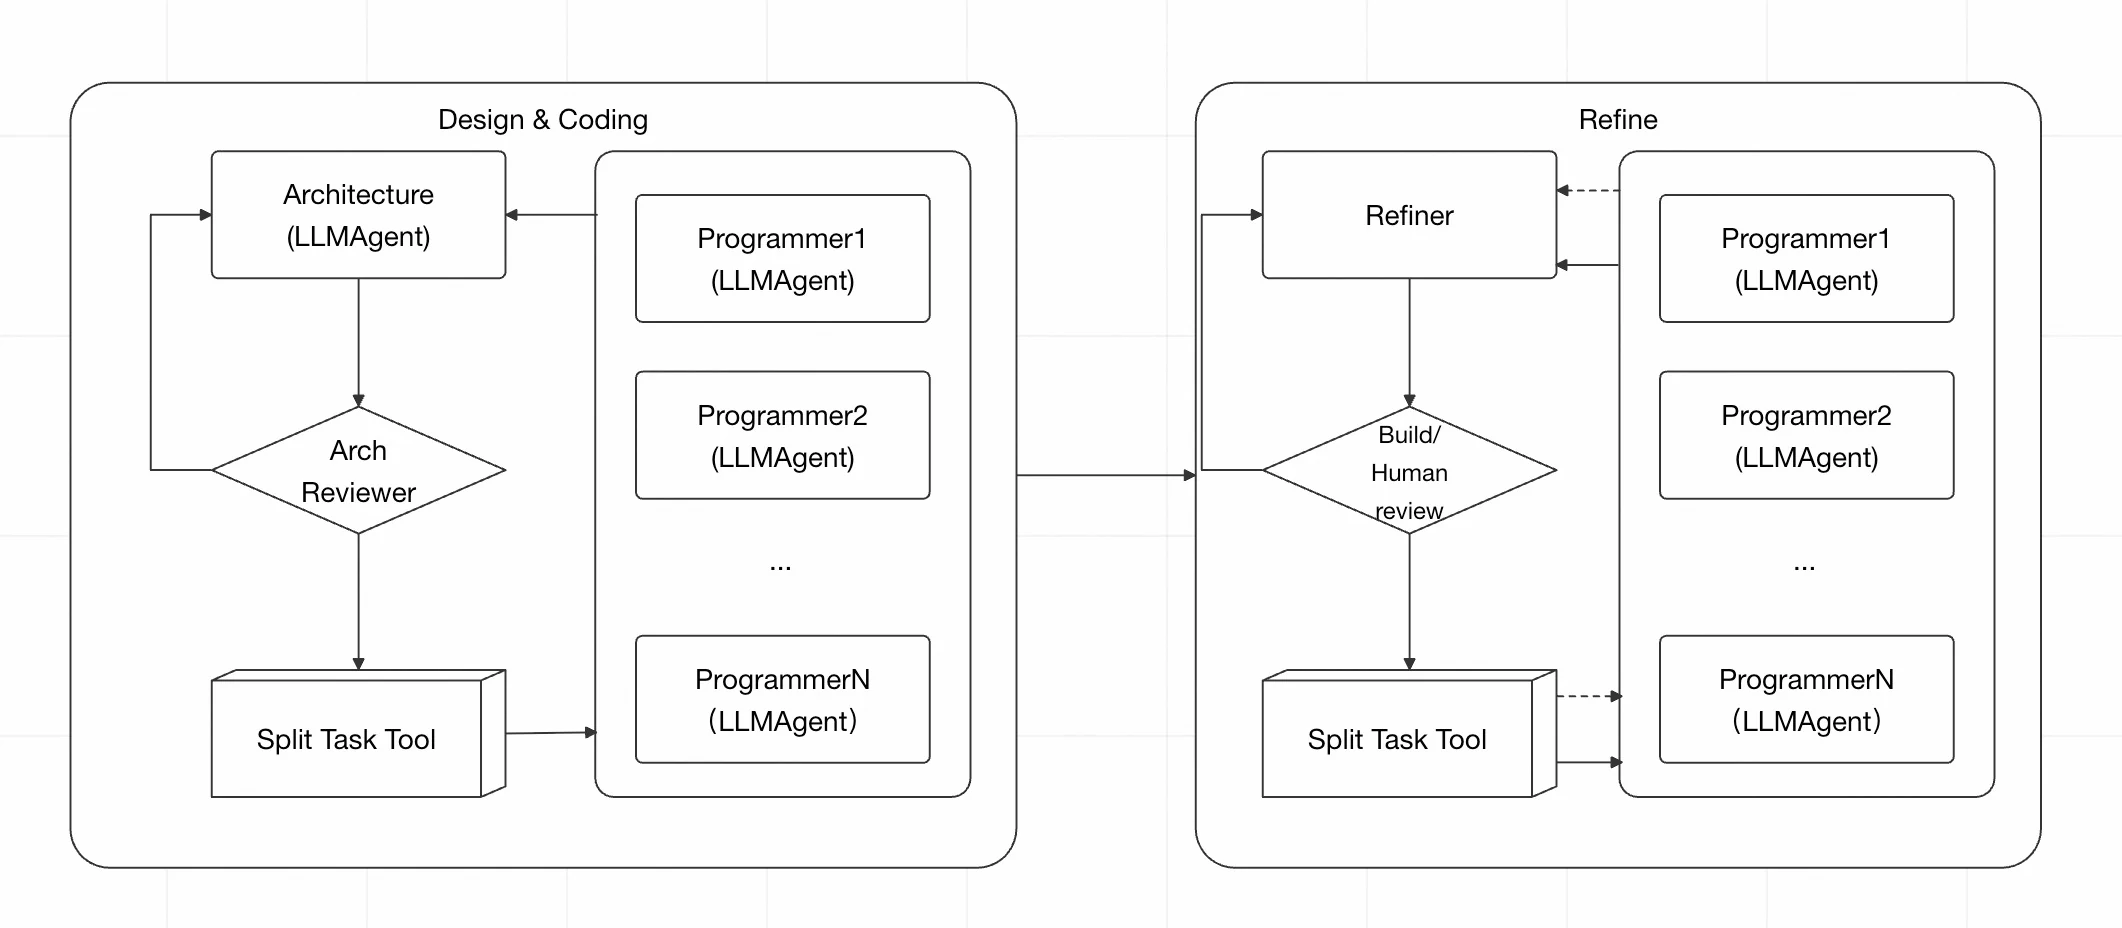
Par exemple, le projet MS-Agent Code Genesis fournit un exemple de collaboration multi-Agent pour la génération de code, divisant le processus en deux parties : conception et codage, vérification et optimisation. L'Agent d'architecture est responsable de la conception, l'outil de décomposition de tâches répartit le travail entre plusieurs Agents de programmation ; lors de la phase d'optimisation, les tâches de modification sont réparties en fonction des retours de la construction ou de la vérification humaine, et les Agents de programmation continuent le traitement.
Agent SDK
Au-delà de l'utilisation de frameworks de développement Agent, certains fournisseurs de modèles proposent également des capacités de développement Agent sous forme de SDK (Software Development Kit), encapsulant des capacités telles que l'appel de modèles, l'appel d'outils et l'exécution de tâches en interfaces, classes et composants, aidant les développeurs à créer et exécuter des Agents dans leurs propres applications. Les frameworks Agent et les Agent SDK peuvent tous deux être utilisés pour construire des Agents ; ils se chevauchent dans les capacités qu'ils offrent, mais diffèrent dans leur organisation et leurs points de focus. Voici deux Agent SDK représentatifs.
OpenAI Agents SDK
En 2025, OpenAI a lancé l'OpenAI Agents SDK, qui met l'accent sur la construction d'applications Agent avec un minimum d'abstractions principales. Utilisant l'Agent comme unité d'exécution de base, il fournit des capacités telles que l'appel d'outils, le transfert de tâches, les contraintes d'exécution et le traçage. Les Tools permettent de requérir des données, d'exécuter du code, d'appeler des API ou d'opérer sur d'autres systèmes externes ; les Handoffs permettent à l'Agent actuel de transférer la tâche à un autre Agent plus adapté ; les Guardrails vérifient les entrées, sorties et certains appels d'outils de l'Agent ; le Tracing enregistre les événements tels que la génération de modèles, les appels d'outils, les transferts de tâches et les Guardrails survenant pendant l'exécution de l'Agent.
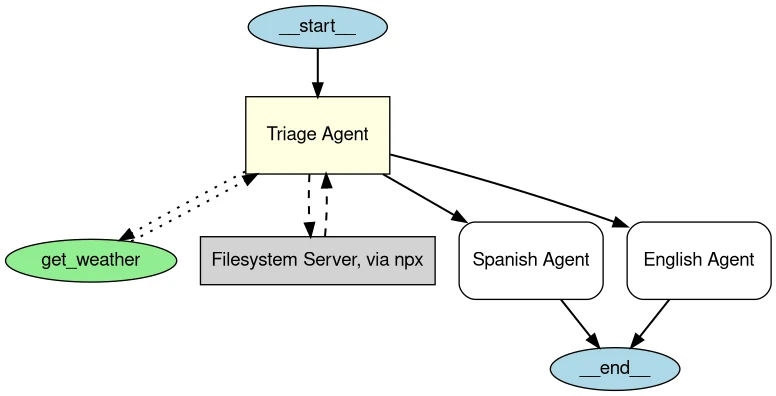
L'OpenAI Agents SDK fournit également l'Agent Visualization, qui peut générer une structure graphique de l'Agent ainsi que des autres Agents, Tools et MCP Server auxquels il est connecté. Les connexions dirigées entre les Agents peuvent représenter les Handoffs, tandis que les connexions entre les outils et les Agents représentent les appels d'outils.
Par exemple, dans un système de service client, on peut définir un Agent d'entrée responsable de l'identification des questions de l'utilisateur, puis configurer un Agent de commandes, un Agent de remboursement et un Agent FAQ pour traiter différents types d'opérations. Lorsqu'un utilisateur consulte un problème de remboursement, l'Agent d'entrée peut transférer la tâche à l'Agent de remboursement via un Handoff ; l'Agent de remboursement appelle ensuite les outils de consultation de commandes, de demande de remboursement, etc., selon les besoins pour accomplir la tâche. Les Handoffs sont particulièrement adaptés à ces scénarios où différents Agents spécialisés traitent différentes tâches.
Les Guardrails et le Tracing tiennent compte des contraintes et des problèmes d'observation lors de l'exécution réelle de l'Agent. Les Guardrails peuvent effectuer des vérifications avant et après l'exécution des entrées de l'Agent, des sorties finales et des fonctions personnalisées d'outils ; le Tracing enregistre les événements tels que la génération de modèles, les appels d'outils, les Handoffs et les Guardrails lors d'une exécution d'Agent, aidant les développeurs à comprendre les étapes parcourues par l'Agent et où se situent les problèmes.
La caractéristique de l'OpenAI Agents SDK est que les concepts principaux sont relativement concentrés. Les développeurs peuvent commencer par un seul Agent et des Tools, puis ajouter progressivement des capacités telles que la collaboration multi-Agent, les Guardrails et le Tracing. Comparé à LangGraph, les deux ont des points de focus différents : LangGraph met davantage l'accent sur le contrôle fin de l'état et du workflow ; l'OpenAI Agents SDK fournit autour de l'Agent des capacités courantes telles que l'appel d'outils, le transfert de tâches, les contraintes d'exécution et le traçage.
Claude Agent SDK
Le Claude Agent SDK est un SDK de développement Agent proposé par Anthropic, anciennement connu sous le nom de Claude Code SDK, puis renommé Claude Agent SDK. Il ouvre les capacités Agent de Claude Code aux développeurs, leur permettant de construire dans leurs propres applications des Agents capables d'utiliser des outils, d'accéder à l'environnement d'exécution et d'exécuter des tâches en continu.
Comparé aux outils de développement Agent présentés précédemment, une caractéristique distinctive du Claude Agent SDK est qu'il accorde plus d'attention à l'accès et à l'opération de l'Agent sur l'environnement d'exécution réel. En plus d'appeler des outils externes, il fournit des capacités intégrées telles que la lecture de fichiers, la modification de fichiers et l'exécution de commandes, permettant à l'Agent de traiter directement des fichiers, d'exécuter des programmes et de lancer des commandes, et de se connecter à plus d'outils et de données externes via MCP. De plus, il fournit des mécanismes tels que le contrôle des permissions, les Hooks et les Subagents, limitant les opérations que l'Agent peut exécuter via le contrôle des permissions ; les Hooks peuvent ajouter une logique de traitement personnalisée à des étapes clés telles que les appels d'outils ; les Subagents peuvent confier une partie des tâches à des sous-Agents indépendants.
Pendant l'exécution, l'Agent détermine l'étape suivante en fonction de la tâche actuelle et du contexte, telle que la lecture de fichiers, la modification de code ou l'exécution de commandes. Les résultats de l'exécution des outils sont retournés à l'Agent, qui continue ensuite à juger en fonction des nouvelles informations, jusqu'à ce que la tâche soit terminée. Le Claude Agent SDK organise ce processus d'exécution et gère les appels d'outils, les vérifications de permissions et la transmission du contexte.
Par exemple, dans une tâche de développement logiciel, on peut demander à l'Agent de lire le code du projet, de modifier des fichiers en fonction des besoins de l'utilisateur, puis d'exécuter les tests. Si les tests échouent, l'Agent peut lire les messages d'erreur et continuer les modifications jusqu'à l'achèvement de la tâche. Tout au long de ce processus, le grand modèle est responsable de la compréhension de la tâche et de la décision de l'étape suivante, tandis que le Claude Agent SDK fournit les capacités d'exécution telles que le système de fichiers, le terminal et les outils, et gère les permissions et le processus d'exécution de la tâche.
Le Claude Agent SDK est particulièrement adapté aux applications Agent nécessitant l'accès aux fichiers et à l'environnement d'exécution, l'appel continu d'outils et l'exécution de tâches multi-étapes, en particulier pour les scénarios de développement logiciel et d'automatisation de tâches.
Dans le développement Agent réel, les capacités telles que l'environnement d'exécution, la gestion du contexte, le contrôle des permissions, l'état des tâches et les retours d'exécution suscitent de plus en plus d'attention. La manière d'organiser ces capacités autour du grand modèle et de gérer et contrôler le processus d'exécution des tâches est devenue un problème important dans la conception des systèmes Agent. C'est précisément ces questions que le Harness aborde.
Harness
¿Qué es el Harness?
À mesure que les capacités des grands modèles s'améliorent, les problèmes auxquels les Agents font face passent progressivement de « le modèle peut-il accomplir une tâche » à « le modèle peut-il accomplir des tâches réelles de manière continue et fiable ». Dans un simple échange de questions et réponses, le grand modèle n'a besoin que de générer un résultat en fonction de l'entrée ; mais dans des tâches complexes telles que le développement logiciel, l'analyse de données et l'automatisation des processus métier, l'Agent peut devoir travailler pendant une longue période, sauvegarder la progression entre plusieurs étapes, appeler différents outils et ajuster continuellement les opérations suivantes en fonction des résultats réels. Dans ce cas, s'appuyer uniquement sur les capacités de raisonnement du modèle ne garantit pas que la tâche sera correctement accomplie.
Par exemple, un Agent de code peut comprendre correctement la demande de « modifier une fonctionnalité » et générer du code de bonne qualité, mais des problèmes peuvent encore survenir pendant l'exécution réelle : commencer à modifier le code sans lire les spécifications du projet, modifier trop de fichiers en même temps, omettre des étapes nécessaires, perdre la progression des tâches précédentes pendant l'exécution, ou considérer la tâche comme terminée avant que le code n'ait passé les tests. Ces problèmes ne proviennent pas entièrement des capacités du modèle lui-même, mais sont liés à l'environnement de travail du modèle et au mode d'exécution des tâches.
Le Harness est un ensemble d'environnement de travail et de mécanismes d'exécution établis autour du grand modèle, qui spécifie quelles informations le modèle peut obtenir, quelles opérations il peut exécuter, comment sauvegarder l'état des tâches, comment déterminer si une tâche est terminée, et comment traiter les problèmes lorsqu'ils surviennent. Grâce à ces mécanismes, les raisonnements et opérations indépendants du modèle peuvent être organisés en un processus d'exécution de tâches contraint, continu et vérifiable.
L'objectif du Harness n'est pas d'améliorer davantage les connaissances ou les capacités de raisonnement du grand modèle lui-même, mais de permettre aux capacités existantes du modèle d'agir de manière plus fiable sur les tâches réelles. Le modèle reste responsable de la compréhension des tâches, de l'analyse des problèmes et de la décision de l'étape suivante ; le Harness est responsable de la création des conditions de travail nécessaires à l'accomplissement des tâches par le modèle et de l'application de contraintes et de retours sur l'ensemble du processus d'exécution.
Du point de vue du processus d'exécution, le Harness fait former à l'Agent une boucle de rétroaction continue : l'Agent juge en fonction de la tâche et de l'état actuelles, exécute l'opération correspondante, puis obtient de nouveaux résultats de l'environnement d'exécution ; ces résultats, après enregistrement, vérification et rétroaction, deviennent la base de la décision suivante. Si les résultats ne sont pas satisfaisants, l'Agent continue de modifier et d'exécuter ; la tâche ne se termine réellement que lorsque les conditions de complétion prédéfinies sont atteintes.
Le Harness se distingue clairement des simples Prompts ou appels d'outils. Les Prompts indiquent principalement au modèle les objectifs de la tâche et les exigences de comportement via des instructions, les outils permettent au modèle d'exécuter des opérations concrètes, et le Harness accorde davantage d'attention à la manière dont ces instructions et outils sont organisés et gérés tout au long du processus d'exécution des tâches. Il doit indiquer à l'Agent par où commencer, où en est-il actuellement, quelles opérations peuvent être exécutées, comment vérifier les résultats, quand il peut se terminer, et comment reprendre après une interruption de la tâche. Pour les Agents nécessitant une exécution de longue durée et multi-étapes, ces mécanismes influencent directement la capacité à accomplir les tâches de manière stable.
Componentes principales del Harness
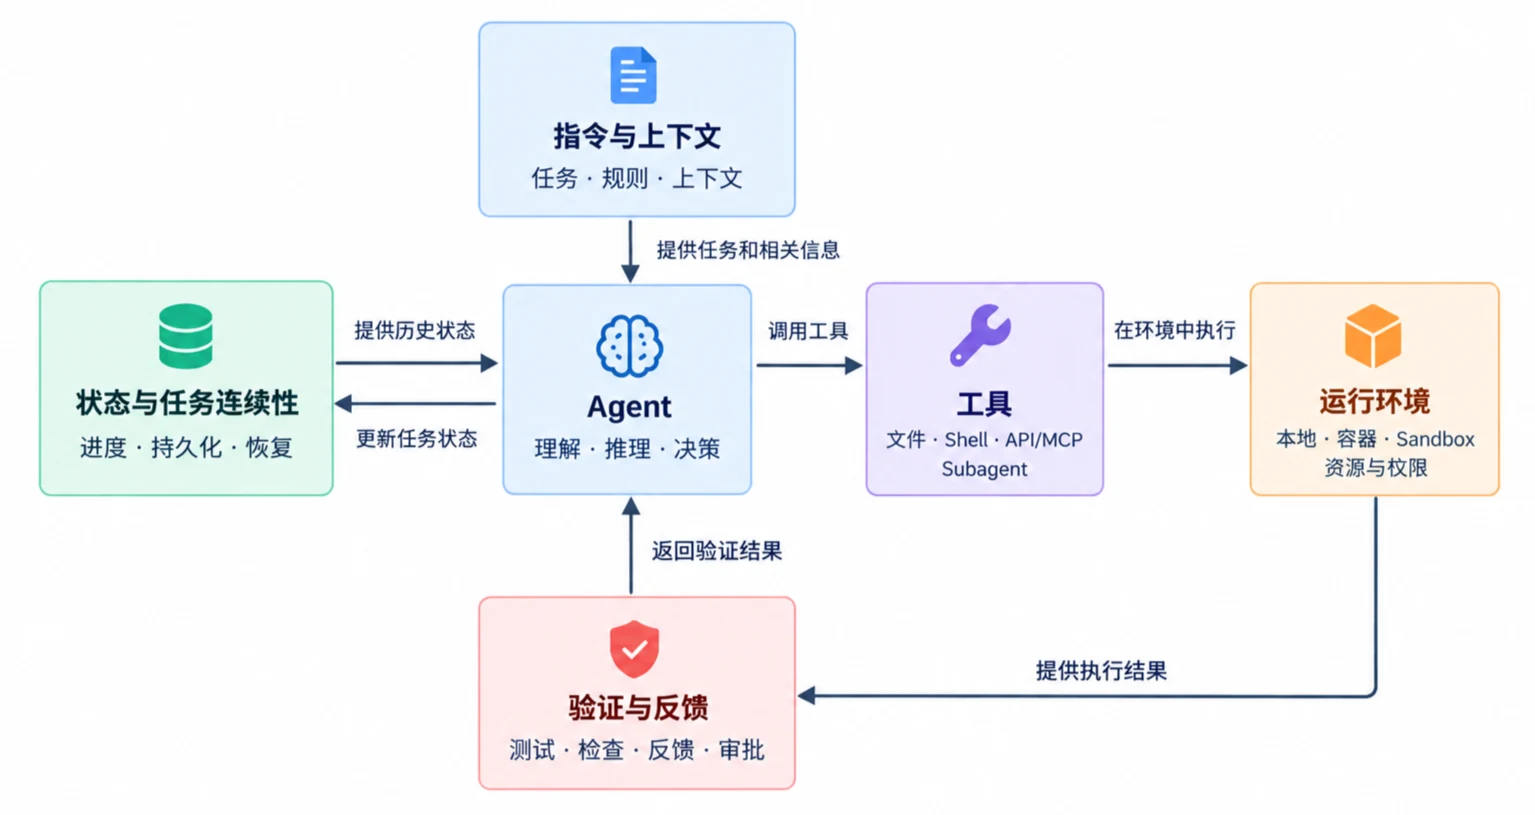
Le Harness n'a pas de mode d'implémentation unique ; différents systèmes Agent fournissent différents mécanismes d'exécution en fonction du type de tâche. En considérant les problèmes à résoudre lors de l'exécution réelle d'un Agent, le Harness peut être résumé en cinq parties complémentaires : instructions et contexte, outils, environnement d'exécution, état et continuité des tâches, vérification et rétroaction.
(1) Instructions et contexte
Les instructions et le contexte déterminent ce que l'Agent « sait » et ce qu'il « doit suivre » dans la tâche actuelle.
Les instructions incluent non seulement la tâche actuelle de l'utilisateur, mais aussi les prompts système, les règles du projet, les normes de code, les contraintes métier, les limites des tâches et les conditions de complétion. Par exemple, un Agent de programmation peut comprendre la structure des répertoires, les normes de développement, les méthodes de test et les zones interdites de modification via AGENTS.md, CLAUDE.md ou la documentation du projet.
Le contexte désigne les informations efficaces fournies au modèle pendant l'exécution, y compris les besoins de l'utilisateur, les opérations historiques, le contenu des fichiers, les résultats d'exécution des outils et l'état actuel de la tâche. Étant donné la fenêtre de contexte limitée du modèle, le Harness doit généralement sélectionner, comprimer et réorganiser le contexte pour que le modèle obtienne les informations réellement nécessaires à la tâche actuelle, plutôt que de simplement ajouter tout l'historique en continu.
Pour les tâches complexes, on peut adopter des instructions hiérarchiques et un chargement progressif du contexte. Par exemple, d'abord demander à l'Agent de lire la description globale du projet, puis charger les règles locales d'un module spécifique lorsqu'il entre dans ce module ; lorsque la durée d'exécution de la tâche est longue et que le contexte augmente continuellement, on peut comprimer les premières étapes et ne conserver que les conclusions clés, l'état de la tâche et les informations encore nécessaires pour la suite. Grâce à ces mécanismes, on peut fournir en continu des informations efficaces à l'Agent dans une fenêtre de contexte limitée, et contraindre la portée de la tâche et les limites de comportement de l'Agent via les instructions.
(2) Outils
Le grand modèle est principalement responsable de la compréhension, du raisonnement et de la génération de décisions. Pour véritablement lire des informations externes ou exécuter des opérations concrètes, il doit recourir aux outils. Par conséquent, les outils déterminent quelles opérations l'Agent peut réellement exécuter.
Pour un Agent de programmation, les outils courants incluent la lecture de fichiers, la modification de fichiers, la recherche de code, l'exécution de commandes Shell, les opérations Git et les outils de test ; pour un Agent d'entreprise, ils peuvent inclure l'interrogation de bases de données, la recherche dans les bases de connaissances, le navigateur, les API métier et les systèmes externes connectés via MCP.
Le Harness à ce niveau ne se contente pas de maintenir une liste d'outils, il doit également gérer les descriptions d'outils, l'organisation des paramètres, le routage des appels, le retour des résultats d'exécution et la gestion des erreurs. Par exemple, après que le grand modèle a décidé de « lancer les tests du projet », le Harness doit appeler l'outil correspondant, exécuter la commande de test dans l'environnement spécifié, puis organiser et retourner la sortie standard, les messages d'erreur et le code de sortie au modèle, permettant à l'Agent de décider de l'étape suivante en fonction des résultats d'exécution.
Les appels d'outils nécessitent un contrôle de sécurité et de permissions correspondant. Certains outils ne peuvent que lire des fichiers, d'autres autorisent la modification de contenu ; pour les opérations impliquant la suppression de fichiers, l'accès au réseau, l'exécution de commandes système ou l'exploitation de systèmes de production, des restrictions peuvent être appliquées en fonction du niveau de risque, et une confirmation humaine peut être requise si nécessaire. Des mécanismes tels que les Hooks peuvent être insérés avant et après les appels d'outils pour vérifier les paramètres, enregistrer le processus d'exécution ou bloquer les opérations non conformes aux règles.
Dans les systèmes prenant en charge les Subagents, l'Agent principal peut également confier une partie des tâches à des Subagents spécialisés. Par exemple, des travaux relativement indépendants tels que la recherche de code, l'analyse de tests ou l'organisation de documents peuvent être répartis entre différents Subagents, puis les résultats de retour peuvent être consolidés. Cela permet d'étendre les capacités de traitement des tâches d'un Agent unique et de réduire la pression d'un grand nombre de tâches complexes concentrées dans un seul contexte d'exécution.
(3) Environnement d'exécution
Les outils répondent à la question « que peut faire l'Agent ? », tandis que l'environnement d'exécution détermine « où se produisent ces opérations ».
Pour un Agent de programmation, l'environnement d'exécution peut être le répertoire local du projet, un conteneur, une machine virtuelle, un Sandbox cloud ou un Git Worktree indépendant. La lecture et la modification de fichiers par l'Agent, l'exécution de commandes Shell, l'installation de dépendances et l'exécution de tests dépendent toutes de l'environnement d'exécution concret.
Le Harness doit préparer et gérer l'environnement d'exécution, tels que l'initialisation du dépôt de code, l'installation des dépendances, la configuration des variables d'environnement, le démarrage des services nécessaires et la vérification que l'environnement actuel satisfait les conditions d'exécution de la tâche. Pour les tâches de longue durée, il faut également éviter que l'environnement ne présente des problèmes tels que des dépendances manquantes, des anomalies de service ou des incohérences d'état des ressources pendant l'exécution.
L'isolation de l'environnement est également un élément important de la gestion de l'environnement d'exécution. Si plusieurs Agents ou plusieurs tâches traitent simultanément le même projet, l'exploitation directe du même répertoire de travail peut entraîner des écrasements de fichiers et des conflits d'état. On peut établir des Sandbox, des conteneurs ou des Worktree indépendants pour différentes tâches, permettant à différentes tâches de s'exécuter dans des espaces relativement isolés. Même si une tâche échoue, l'impact sur les autres tâches et l'environnement hôte peut être réduit.
L'environnement d'exécution assure également le contrôle des limites d'accès aux ressources. Par exemple, limiter l'Agent à n'accéder qu'aux répertoires spécifiés, à ne se connecter qu'à des réseaux spécifiques, à ne pas lire les fichiers sensibles du système, ou à configurer des identifiants d'accès différents pour différentes tâches. Les outils définissent quelles capacités l'Agent peut utiliser, tandis que l'environnement d'exécution détermine sur quels fichiers, processus, réseaux et ressources système ces capacités peuvent réellement agir.
(4) État et continuité des tâches
Un appel unique d'un grand modèle n'a pas d'état de tâche à long terme inhérent, tandis que les tâches Agent complexes peuvent durer des dizaines de minutes, des heures, voire s'étendre sur plusieurs sessions. Si les informations de la tâche n'existent que dans le contexte actuel, dès que le contexte est comprimé, le processus interrompu ou la session redémarrée, l'Agent peut être incapable de déterminer avec précision ce qui a déjà été accompli.
Le Harness doit maintenir l'état de la tâche, tel que l'objectif actuel, les résultats de la décomposition des tâches, les étapes déjà accomplies, les étapes en cours de traitement, les fichiers modifiés, les résultats d'exécution des outils importants et ce qui doit être continué.
Cet état peut être sauvegardé en mémoire ou écrit dans des fichiers de tâche, des bases de données, l'historique Git ou d'autres stockages externes. Pour les Agents à longue durée, l'état persistant est particulièrement important. Les nouvelles sessions d'Agent peuvent lire la progression des tâches et les résultats clés précédemment sauvegardés, reprenant au dernier point d'interruption sans avoir à réanalyser l'ensemble de la tâche.
La gestion de l'état traverse l'ensemble du cycle de vie de la tâche. Au démarrage de la tâche, l'état initial est établi. Pendant l'exécution, la progression et les résultats clés sont enregistrés en continu. Après l'achèvement de la tâche, l'état final est sauvegardé. Si une tâche est interrompu en raison d'exceptions, de dépassements de temps ou de redémarrages système, elle peut être reprise au point d'exécution précédent via des mécanismes tels que les checkpoints. Pour les tâches complexes impliquant des Subagents, l'état d'achèvement, les résultats d'exécution et les interdépendances de chaque sous-tâche peuvent être enregistrés.
L'objectif de l'État et de la Continuité des tâches est de maintenir un processus d'exécution de tâches continuellement mis à jour, persistant et récupérable, permettant aux Agents de savoir où en est la tâche lors d'une exécution de longue durée ou inter-session.
(5) Vérification et rétroaction
Le fait qu'un Agent effectue une opération ne signifie pas que la tâche a été correctement accomplie. Par exemple, l'Agent a modifié avec succès un fichier de code, mais le code ne compile peut-être pas. Un rapport a été généré, mais il peut manquer des données clés. Un appel API métier a réussi, mais le résultat ne respecte peut-être pas les règles métier. Par conséquent, le Harness doit également établir des mécanismes de vérification et de rétroaction pour contrôler les résultats d'exécution et fournir les résultats à l'Agent.
Les méthodes de vérification dépendent des tâches spécifiques. Pour le développement logiciel, les tests unitaires, le linting, la vérification de type, la compilation et les tests de bout en bout peuvent être utilisés. Pour les tâches métier, les vérifications de règles métier, la comparaison de résultats ou des évaluateurs indépendants peuvent être utilisés. L'essentiel de la vérification est de fournir des critères vérifiables pour l'achèvement des tâches, plutôt que de s'appuyer uniquement sur le jugement du modèle selon lequel « la tâche est terminée ».
La rétroaction fournit les résultats de vérification à l'Agent. Par exemple, après un échec de test, le Harness peut retourner les messages d'erreur et les journaux associés au modèle. L'Agent analyse alors la cause, modifie le code et re-teste sur la base de ces informations, formant une boucle « exécuter → vérifier → obtenir la rétroaction → modifier → revérifier ». Cette boucle de rétroaction permet à l'Agent de corriger continuellement les décisions précédentes en fonction des résultats d'exécution réels, plutôt que de terminer la tâche après une seule opération.
Le Harness peut également ajouter un contrôle d'exécution dans ce processus. Par exemple, les commits de code ne peuvent être autorisés qu'après le passage de tous les tests. Après des échecs d'exécution consécutifs, la tâche peut être arrêtée ou remise aux humains. Pour les opérations à haut risque telles que les modifications de l'environnement de production ou la suppression de données, la tâche peut être mise en pause avant l'exécution réelle et une approbation humaine demandée. L'exécution se poursuit après confirmation, ou l'opération est terminée ou ajustée sans confirmation.
Ces cinq parties soutiennent conjointement le fonctionnement continu de l'Agent : les instructions et le contexte fournissent les objectifs de la tâche, les règles et les informations nécessaires. Les outils fournissent les capacités d'action réelles. L'environnement d'exécution porte ces opérations et définit les limites des ressources. L'état et la continuité des tâches enregistrent la progression des tâches et soutiennent la récupération. La vérification et la rétroaction vérifient les résultats d'exécution et poussent l'Agent à continuer de corriger ou d'achever les tâches. Grâce à ces mécanismes, le Harness organise les appels de modèle individuels en un processus de tâche complet capable d'exécution continue, d'opération contrainte et de résultats vérifiables.
Relación entre Harness y Agent
Agent et Harness ne sont pas deux concepts mutuellement remplaçables mais existent à des niveaux différents. Pendant le fonctionnement de l'Agent, le grand modèle est principalement responsable de la compréhension des tâches, de l'analyse des informations actuelles et de la décision des actions suivantes. Le Harness fournit un soutien autour de l'Agent comprenant les instructions et le contexte, les outils, l'environnement d'exécution, la gestion de l'état et la rétroaction de vérification, permettant aux décisions de l'Agent d'être réellement exécutées tout en étant contrôlées et vérifiées pendant l'exécution.
La relation entre les deux peut être décrite comme « décision et soutien à l'exécution ». L'Agent détermine ce qu'il faut faire ensuite en fonction des tâches actuelles et des informations disponibles. Le Harness fournit les outils et l'environnement nécessaires pour effectuer cette opération, et enregistre l'état et les résultats générés pendant l'exécution. Après l'exécution, le Harness peut également valider les résultats par des tests, des vérifications de règles et d'autres méthodes, puis fournir une rétroaction à l'Agent. L'Agent prend de nouvelles décisions en fonction du nouvel état et de la rétroaction, continuant ce cycle jusqu'à ce que les conditions d'achèvement de la tâche soient satisfaites.
Par exemple, un Agent de programmation détermine qu'il doit modifier login.py et exécuter les tests. L'analyse du code et la décision de la manière de le modifier reposent principalement sur les capacités de compréhension et de raisonnement du grand modèle. Mais la question de savoir si login.py peut être modifié, où lire le fichier, quel outil utiliser pour la modification, dans quel sandbox exécuter la commande de test, comment sauvegarder la progression des modifications, comment vérifier les résultats des tests et comment continuer l'exécution après un échec nécessitent tous que le Harness fournisse les mécanismes d'exécution correspondants. Après un échec de test, les messages d'erreur sont retournés à l'Agent, qui analyse la cause et décide du plan de modification suivant.
La complétude du Harness affecte les types de tâches qu'un Agent peut traiter. Un Harness simple peut ne fournir que quelques outils et mécanismes d'appel de base, adapté aux tâches avec peu d'étapes. Un Harness plus complet peut fournir davantage de gestion du contexte, d'isolation de l'environnement, de persistance de l'état des tâches, de contrôle des permissions, de vérification automatique, de récupération après échec et de mécanismes d'approbation humaine, permettant aux Agents d'exécuter en continu des tâches plus longues et plus complexes. Même avec le même grand modèle, différents Harnesses fournissant des conditions d'exécution différentes peuvent entraîner des différences significatives dans la capacité d'exécution et la stabilité de l'Agent pour des tâches complexes.
Il y a un certain chevauchement entre le Harness et les frameworks Agent, car les deux impliquent l'appel d'outils, la gestion du contexte, la gestion de l'état et le contrôle de l'exécution des tâches. Cependant, leur focus diffère. Les frameworks Agent penchent davantage vers la fourniture de capacités de développement pour la construction d'Agents et l'organisation des tâches, tels que la définition d'Agent, l'appel d'outils, la gestion de l'état, l'orchestration des workflows et la collaboration multi-Agent. Le Harness se concentre davantage sur les mécanismes de soutien et de contrôle construits autour du fonctionnement de l'Agent, tels que l'organisation du contexte, la fourniture d'outils et d'environnements d'exécution, le maintien de la continuité des tâches et la validation des résultats d'exécution. À mesure que les frameworks Agent et les Agent SDK se développent, certaines capacités de Harness sont également intégrées dans les frameworks ou les SDK, de sorte qu'il n'y a pas de frontière fonctionnelle absolue entre eux dans les implémentations spécifiques.
Dans l'ensemble, la relation entre les trois peut être résumée comme suit : les grands modèles fournissent l'intelligence, les Agents organisent les décisions, et le Harness garantit l'exécution.
À mesure que la complexité des tâches exécutées par les Agents augmente, le rôle du Harness devient plus évident.
DeepSeek Harness
En prenant DeepSeek Harness comme exemple, comprenons davantage comment le Harness est organisé dans les systèmes Agent réels.
DeepSeek Harness est un Agent Harness open-source lancé par DeepSeek en 2026. Sa caractéristique est d'organiser les outils, Skills, sessions, sandboxes et capacités d'exécution de tâches nécessaires au fonctionnement du modèle via une architecture basée sur des plugins, offrant un support d'exécution extensible aux Agents.
DeepSeek comprend un Agent exécutable comme :
Agent = Model + Harness
Où le Model est responsable de la compréhension des tâches et de la prise de décision, et le Harness organise les outils, le contexte et l'environnement d'exécution dont le modèle a besoin pour accomplir les tâches.
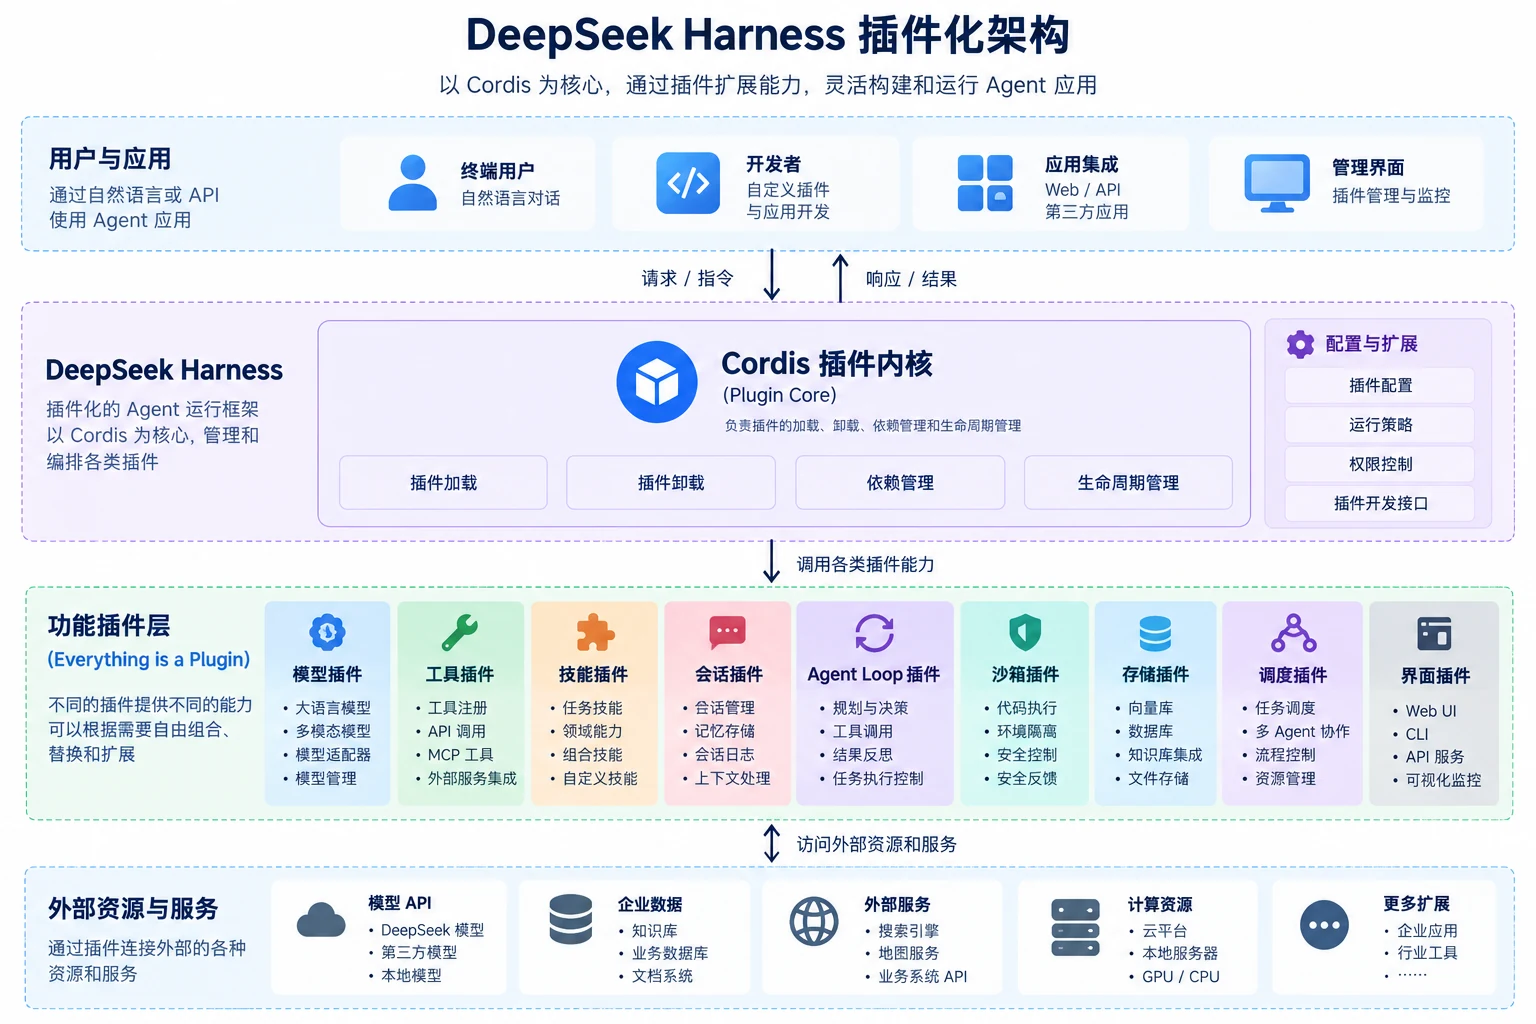
La conception centrale de DeepSeek Harness est « Tout est un Plugin ». Les capacités telles que les modèles, les outils, les Skills, les sessions, les sandboxes, le stockage, les boucles d'exécution, l'ordonnancement des tâches et les sub-Agents peuvent toutes être fournies par des plugins, organisés par le système de plugins Cordis sous-jacent. Cordis gère le chargement, le déchargement, la gestion des dépendances et la gestion du cycle de vie des plugins, tandis que les capacités Agent spécifiques sont fournies par différents plugins. Les développeurs peuvent combiner, remplacer ou étendre différents plugins en fonction des besoins réels.
L'architecture globale basée sur les plugins est illustrée ci-dessous.
Par exemple, utiliser DeepSeek Harness pour construire un Agent d'analyse de données. L'Agent lit les fichiers de données fournis par l'utilisateur, appelle les outils correspondants pour le traitement et l'analyse des données en fonction de la tâche, et peut également utiliser les Skills pour des tâches d'analyse de données spécifiques. Si la tâche est complexe, une partie du travail peut être déléguée à des Subagents. Le modèle gère la détermination de l'opération suivante à effectuer, tandis que le Harness fournit et organise les capacités nécessaires pour accomplir ces opérations.
Outre la conception basée sur des plugins, DeepSeek Harness fournit également des mécanismes d'enregistrement de session et d'exécution. Les informations telles que les prompts système, les appels d'outils et leurs résultats, l'ordonnancement des Subagents et l'injection de contexte vus par le modèle peuvent être enregistrées dans les journaux de session et consultées via Trajectory. Sur la base de ces enregistrements, les tâches peuvent être restaurées, bifurquées, récupérées et rejouées, aidant les développeurs à observer et à déboguer le processus d'exécution de l'Agent.
Actuellement, DeepSeek Harness est encore en phase de Developer Preview, ses plugins et API principaux étant encore en itération continue. Par conséquent, il est préférable de le considérer comme un cas représentatif pour comprendre la conception basée sur des plugins et l'implémentation technique du Harness, plutôt que de traiter les interfaces actuelles comme des standards de développement fixés.