La primera vez que se prepara para descargar un gran modelo, las indicaciones 7B, 32B, 128K e INT4 en la página del modelo pueden resultar confusas: 7B indica el tamaño del modelo, 128K suena como si pudiera contener un libro entero, e INT4 puede reducir el uso de VRAM. ¿Cómo funciona esto?
Después de comenzar a usar modelos, encontrará problemas adicionales: actas de reuniones que no caben, conversaciones largas donde se olvida el contexto anterior, respuestas del modelo sin fundamento, y el mismo modelo comportándose de manera diferente con diferentes métodos de cuantificación.
Para determinar si un modelo es adecuado para una tarea dada, necesita comprender cómo el texto entra en el modelo, cómo se forman las capacidades del modelo, y por qué el modelo consume memoria y VRAM durante la inferencia.
Estos conocimientos pueden organizarse a lo largo de tres hilos conductores. El primero parte de la arquitectura general del Transformer, luego cubre los Tokens, Embedding y Attention para explicar cómo un texto entra en el modelo y es procesado. El segundo cubre el preentrenamiento, el ajuste por instrucción y el postentrenamiento para explicar cómo se forman las capacidades del modelo. El tercero cubre la longitud del contexto, KV Cache, cuantificación y hardware, que determinan si un modelo puede ejecutarse de manera estable en dispositivos de destino.
Este capítulo destila conocimientos fundamentales de capítulos anteriores relacionados. Para la inferencia de modelos, puede consultar los capítulos 6 y 7. Para el SFT de modelos, puede consultar la presentación del framework de ajuste integrado ms-swift en el capítulo 9. Para el contenido de postentrenamiento, también puede consultar el capítulo 10 sobre alineamiento de preferencias y aprendizaje por refuerzo. Para aplicaciones de modelos de dominio y problemas de alucinación, también puede consultar la presentación de métodos RAG en el capítulo 13, que utilizan conocimientos externos para mejorar las preguntas y respuestas de dominio y reducir aún más las alucinaciones del modelo.
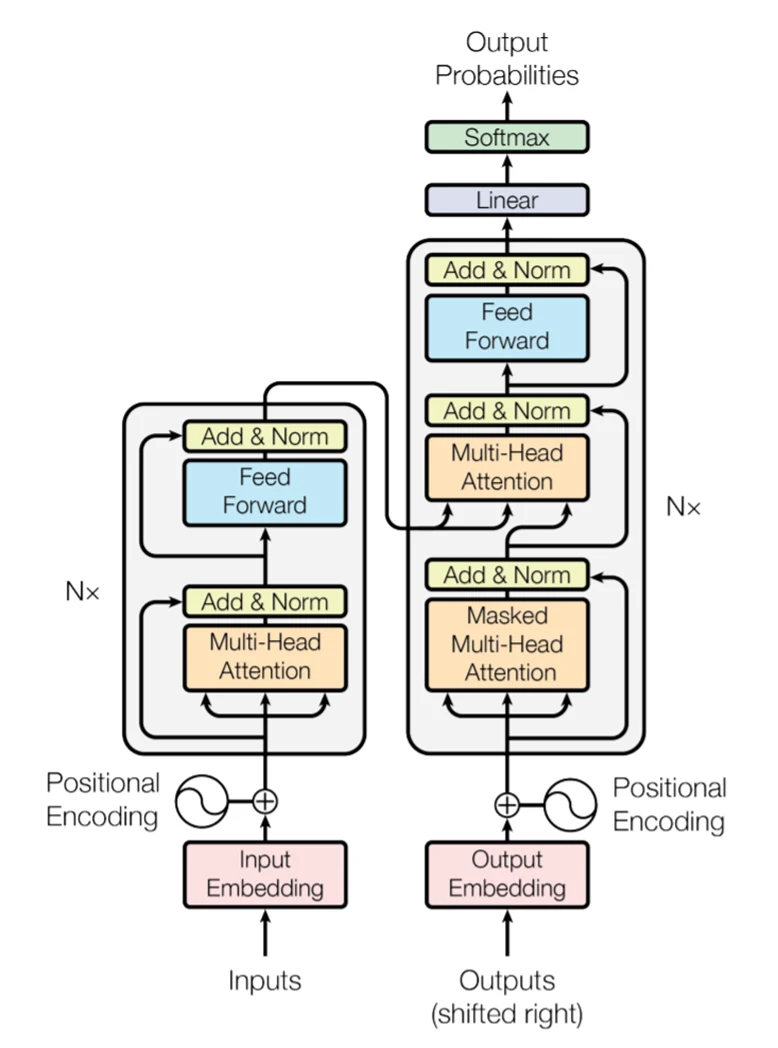
El Transformer es la arquitectura fundamental utilizada por la mayoría de los grandes modelos de lenguaje actuales. A diferencia de las redes neuronales recurrentes anteriores que procesan el texto secuencialmente, el Transformer puede calcular múltiples posiciones en paralelo durante el entrenamiento y el procesamiento de entradas, y establece conexiones entre diferentes posiciones a través de Attention. Un Transformer clásico consta de un Codificador y un Decodificador. Cada capa del Transformer típicamente contiene Attention y una red feed-forward. La red feed-forward, también llamada FFN o MLP, aplica transformaciones no lineales a los vectores en cada posición. Las conexiones residuales y la normalización por capa también se utilizan dentro de las capas para ayudar a que la información fluya de manera estable a través de redes profundas. Cuando se apilan muchas capas similares, el modelo desarrolla gradualmente capacidades complejas de representación y generación de texto. La arquitectura general del Transformer se muestra en la figura de abajo: el lado izquierdo es el Codificador y el lado derecho es el Decodificador. El en la figura indica que módulos similares se apilan múltiples veces; el número real de capas varía según la arquitectura del modelo y la escala de parámetros.
Iniciar sesión unirse a la discusión
N×Durante la inferencia del modelo, cuando un usuario ingresa un texto, el modelo undergoes el siguiente procesamiento: primero, el Tokenizer divide el texto bruto en Tokens individuales y los convierte en Token IDs correspondientes. Luego, la capa Embedding mapea estos Token IDs discretos en representaciones vectoriales continuas, mientras agrega información posicional para que el modelo conozca el orden de cada Token en la oración. A continuación, estos vectores pasan a través de múltiples capas del Transformer para procesamiento repetido, donde el mecanismo de Attention permite que diferentes Tokens se atiendan mutuamente e intercambien información contextual, y la red feed-forward procesa más las características en cada posición. Después de múltiples capas de cálculo, el modelo obtiene una representación integral del contexto actual, calcula la distribución de probabilidad para el siguiente Token, selecciona o muestrea el siguiente Token, y lo agrega al contexto para repetir este proceso hasta que se genere todo el contenido.
Los tres componentes del Transformer original cada uno tiene roles diferentes:
- Estructura de solo Codificador: Principalmente responsable de comprender la entrada; puede referenciar simultáneamente diferentes posiciones en la secuencia de entrada, adecuada para tareas como clasificación, extracción y representación semántica;
- Estructura de solo Decodificador: Principalmente responsable de generar salida; al generar la posición actual, solo puede consultar el contenido que ya ha aparecido;
- Estructura Codificador-Decodificador: Primero comprende la entrada, luego genera gradualmente la salida, comúnmente utilizada en tareas de secuencia a secuencia como traducción y resumen.
Los grandes modelos modernos no necesariamente usan Codificador y Decodificador completos simultáneamente. Sobre esta base, han surgido diversas arquitecturas derivadas del Transformer. Por ejemplo, los modelos generativos tipo GPT típicamente usan estructura de solo Decodificador, los modelos tipo BERT usan principalmente solo Codificador, y los modelos tipo T5 retienen la estructura Codificador-Decodificador.
Un Token es la unidad básica utilizada cuando el modelo lee y genera texto. Puede ser un carácter, una palabra, parte de una palabra, puntuación, o incluso espacio o marcadores de control especiales. Por ejemplo, la misma oración puede producir resultados diferentes con diferentes Tokenizers:
Original: Los grandes modelos de lenguaje están cambiando la forma de trabajar.

Tokenizer A: Los / grandes / modelos / de / lenguaje / están / cambiando / la / forma / de / trabajar / .
Tokenizer B: Los / grand / es / mode / los / de / lengua / je / est /án / cam / biando / la / forma / de / trabajar / .
Ambos resultados expresan la misma oración, pero el número de Tokens difiere. Lo que el modelo realmente recibe son los ID numéricos correspondientes a cada Token, conocidos como Token ID. Tomando las actas de reunión como ejemplo, lo que el modelo ve no es un registro completo de reunión sino una secuencia de Token IDs. El nombre de la reunión, el contenido hablado, la hora, la puntuación y los requisitos de salida todos consumen Tokens; el resumen, las conclusiones y los elementos de acción generados por el modelo también continúan consumiendo Tokens. Por lo tanto, cuanto más detallada sea la salida solicitada del mismo material, menos espacio queda para el registro original.
Si la tokenización se hace completamente por carácter, el vocabulario puede ser relativamente pequeño pero las secuencias se vuelven más largas. Si se hace completamente por palabras completas, el vocabulario se vuelve muy grande y constantly encontrará nuevas palabras, abreviaturas y variaciones ortográficas. Los grandes modelos típicamente usan tokenización por subpalabras, encontrando un equilibrio entre caracteres y palabras completas. BPE, WordPiece, Unigram y SentencePiece son métodos comunes.
Normalmente, el modelo no puede realizar directamente operaciones matriciales en texto o imágenes; primero necesita convertir el contenido en vectores numéricos. Este proceso se llama Embedding o representación vectorial. Para texto, el Tokenizer primero convierte el texto en Token IDs, y la capa Embedding luego busca los vectores correspondientes basándose en los IDs. Un solo número en un vector generalmente no tiene significado intuitivo, pero el vector completo puede representar las características de ese Token dentro del modelo. Tomando el Token "reunión" como ejemplo, el Token ID correspondiente podría ser un entero específico como "15872", y la representación de ese Token, es decir, su Embedding, podría ser un vector como [0.12, -0.37, 0.08, ...]. Los Embeddings se ajustan continuamente durante el entrenamiento, y los Tokens que aparecen en contextos similares tienden a formar características similares en sus vectores. Debido a diferencias en la arquitectura del modelo y el entrenamiento, la misma palabra procesada a través de múltiples capas del Transformer también formará diferentes representaciones según el contexto.
Cuando el modelo adquiere información semántica del texto de entrada, necesita saber no solo qué es el Token, sino también dónde se encuentra. Con solo Embedding de Token, por ejemplo, "reunión pospuesta" y "postergación de reunión" contienen Tokens similares pero expresan significados diferentes debido a las diferencias en el orden de las palabras. Por lo tanto, el modelo también necesita codificación posicional o representación posicional. La figura de abajo usa la capa de entrada de BERT como ejemplo.
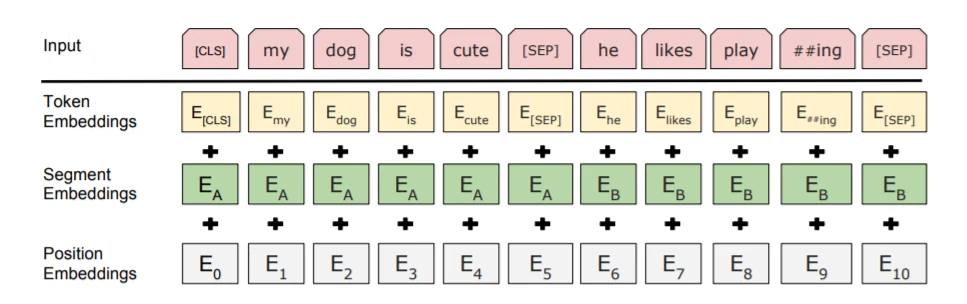
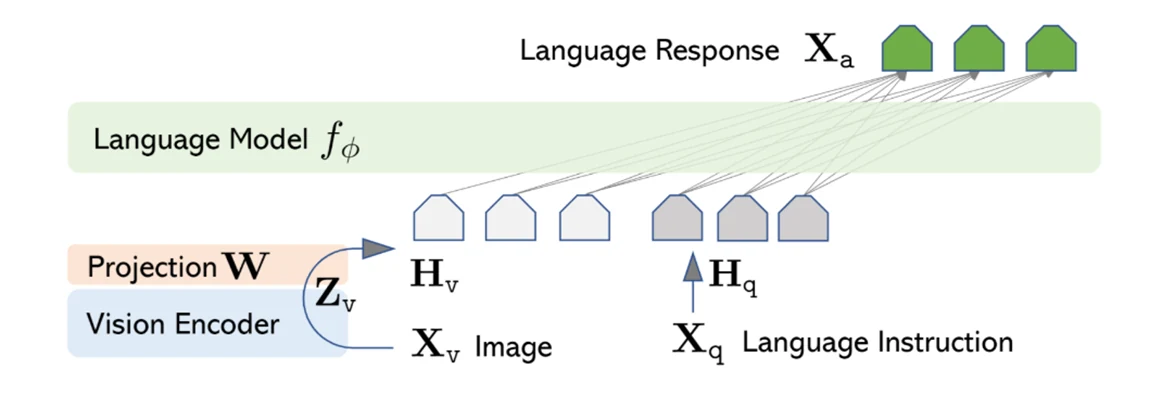
Como se muestra en el método de representación utilizado en BERT arriba, la figura demuestra la combinación de Embedding de Token, Embedding de Segmento y Embedding Posicional. Por supuesto, diferentes arquitecturas de modelos y enfoques de diseño usan diferentes métodos específicos. Para los grandes modelos multimodales, imágenes, audio y otro contenido también necesitan ser convertidos en vectores. Las imágenes típicamente se dividen en parches, con codificadores visuales extrayendo características; el audio primero se convierte en características acústicas, luego procesado por codificadores de audio. Las características de diferentes modalidades deben pasar a través de un módulo de Proyección antes de entrar al espacio vectorial que el gran modelo puede procesar. Como se muestra en la figura de abajo, el módulo de Proyección fusiona información de imagen con información semántica.
Attention determina en qué partes de la entrada debe enfocarse la posición actual. Calcula relevancia basándose en las representaciones vectoriales existentes del modelo, en lugar de simplemente hacer coincidir palabras idénticas. Por ejemplo, en la oración "El proyecto fue retrasado, y el informe explicó por qué no se completó a tiempo", cuando el modelo procesa el pronombre "él", necesita combinar el contexto para determinar si se refiere más probablemente al "proyecto" o al "informe". Al extraer personas responsables de las actas de reunión, el modelo también necesita conectar descripciones de tareas, nombres de personas y oraciones que indican división de trabajo.
Cada vector de entrada pasa por diferentes transformaciones para formar Query, Key y Value, comúnmente abreviados como Q, K y V. La fórmula de Attention puede simplificarse como:
$\mathrm{Attention}(Q, K, V)=\mathrm{softmax}\left(\frac{QK^{\mathrm{T}}}{\sqrt{d_k}}\right)V$
Aquí, Q representa qué información está buscando la posición actual, K representa qué características puede usar cada posición para ser emparejada, y V representa el contenido a recuperar después del emparejamiento. El modelo primero compara Q y K para obtener puntuaciones de relevancia entre la posición actual y otras posiciones, luego convierte las puntuaciones en pesos a través de softmax, y realiza una agregación ponderada de V según los pesos. El $d_k$ en la fórmula es la dimensión del vector Key; dividir por $\sqrt{d_k}$ ajusta la escala de las puntuaciones para hacer el cálculo más estable.
Si Q, K y V provienen de la misma secuencia, se llama Auto-Atención (Self-Attention), usada para establecer conexiones dentro de una secuencia. Si Q proviene de una secuencia mientras que K y V provienen de otra, se llama Atención Cruzada (Cross-Attention). Por ejemplo, un modelo de traducción Codificador-Decodificador puede permitir que el Decodificador lea información del texto fuente desde el Codificador a través de Atención Cruzada.
Para los grandes modelos generativos, la posición actual solo puede referenciar contenido que ya ha aparecido, por lo tanto Attention debe incluir una máscara causal para bloquear posiciones posteriores. Incluso con los futuros Tokens enmascarados, el número de relaciones procesadas por la atención causal completa aún crece aproximadamente de manera cuadrática con la longitud de la secuencia. Durante la fase de generación, los K y V históricos de los Tokens también deben almacenarse, formando el KV Cache descrito más adelante. A medida que el contexto se alarga, el cálculo de Attention y la sobrecarga del cache se vuelven cada vez más prominentes. Las diferentes estructuras introducidas abajo evolucionaron específicamente para abordar estos problemas.
La Attention Multi-Cabeza (MHA) fue propuesta en el artículo Transformer de 2017 "Attention Is All You Need" y luego aplicada a BERT y modelos como Llama 2 7B y 13B. Agrega múltiples cabezas de atención paralelas a un solo conjunto de cálculos de atención, permitiendo al modelo extraer relaciones contextuales de diferentes espacios de representación.
En MHA, cada cabeza tiene sus propios parámetros de proyección para generar Q, K y V, calcula atención por separado, y luego concatena los resultados de todas las cabezas y los pasa a través de una capa lineal para formar la salida. Como se muestra en la figura de abajo, el lado izquierdo muestra el proceso de cálculo para un conjunto de atención por producto escalar escalado, mientras que el lado derecho ejecuta este proceso múltiples veces en paralelo y luego fusiona los resultados. Los patrones de atención de diferentes cabezas se forman durante el entrenamiento y pueden soportar conjuntamente tareas como resolución de correferencia, asociación semántica y dependencias a larga distancia.
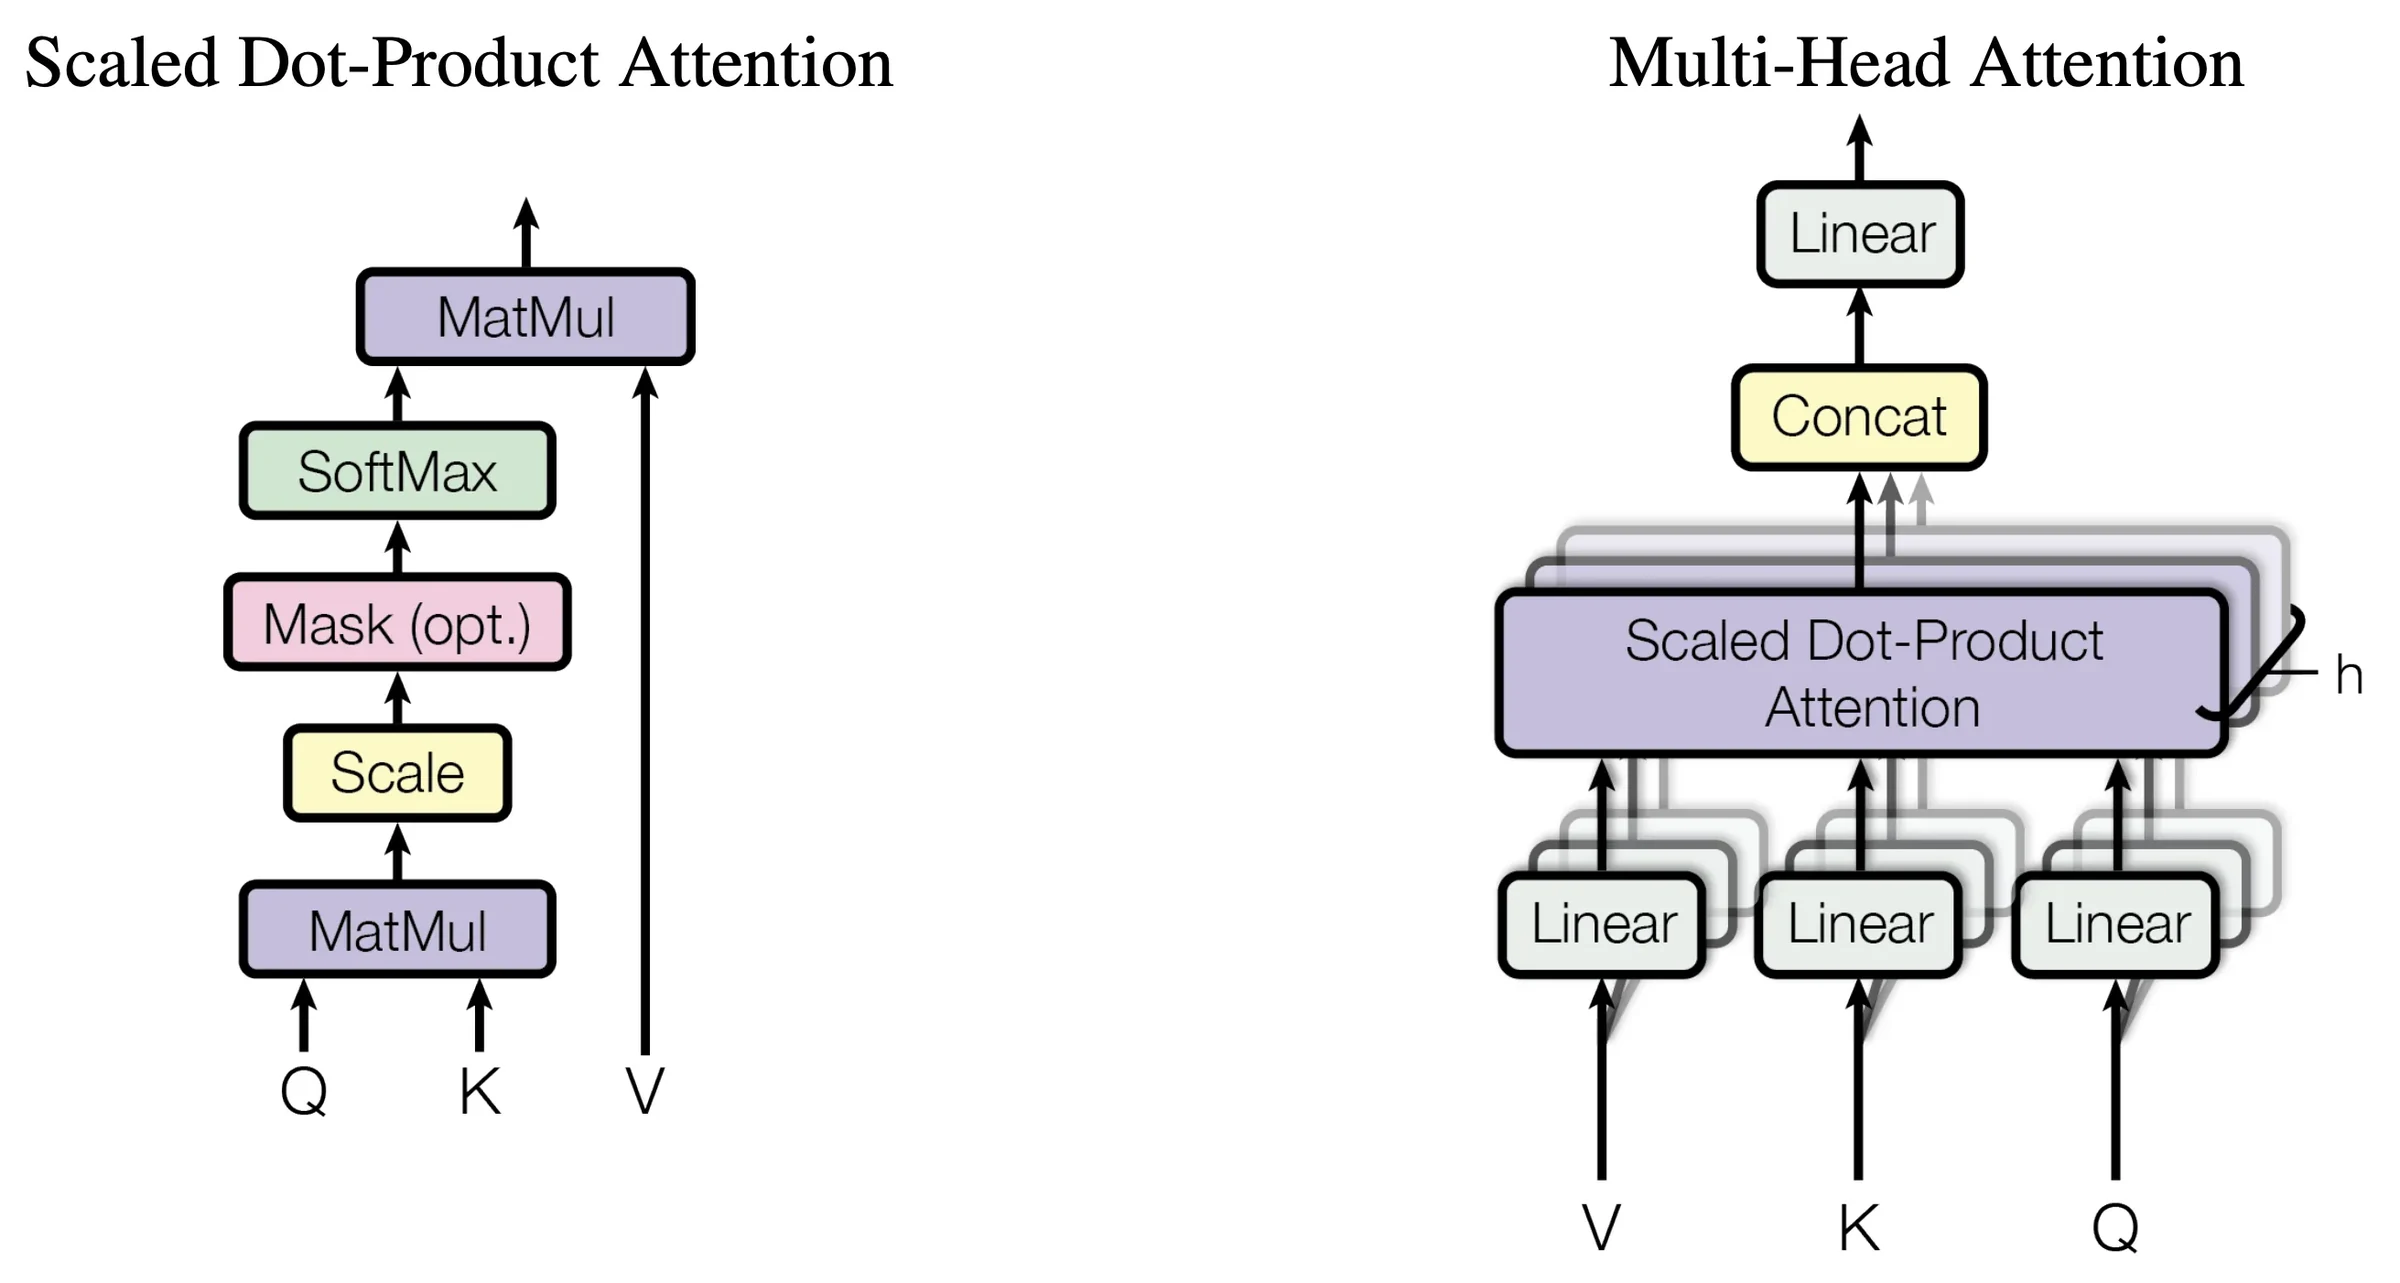
MHA mejora la capacidad del modelo para agregar diferentes tipos de información y facilita el cálculo paralelo durante el entrenamiento. Sin embargo, durante la generación Token por Token, cada cabeza debe leer sus propios K y V históricos. A medida que aumentan el número de capas, cabezas y longitud del contexto del modelo, este cache y esta lectura de datos consumen recursos significativos. Por lo tanto, las mejoras subsiguientes primero consideraron si múltiples cabezas Query podían retenerse mientras se reducía el número de cabezas Key y Value que necesitan almacenarse.
La Attention Multi-Consulta (MQA) fue propuesta por Noam Shazeer en el artículo de 2019 "Fast Transformer Decoding: One Write-Head is All You Need" y luego aplicada a grandes modelos como Falcon-7B. Aborda principalmente el problema de ancho de banda de memoria durante la decodificación: cuando el modelo genera cada nuevo Token, necesita leer el KV Cache existente. Cuando el volumen de lectura es demasiado grande, la velocidad de generación se limita incluso si las unidades de cálculo todavía tienen capacidad.
MQA retiene múltiples cabezas Query pero les permite compartir un solo conjunto de Key y Value. Así, diferentes cabezas pueden generar diferentes consultas, pero las posiciones históricas solo necesitan almacenar una copia de K y V para que todas las cabezas la compartan. La figura de abajo muestra un método de inicialización para convertir un modelo MHA existente a MQA: promediar múltiples matrices de proyección Key para obtener una proyección compartida, con la proyección Value tratada de la misma manera. Después de la conversión, se necesita entrenamiento adicional para adaptar el modelo a la nueva estructura compartida.
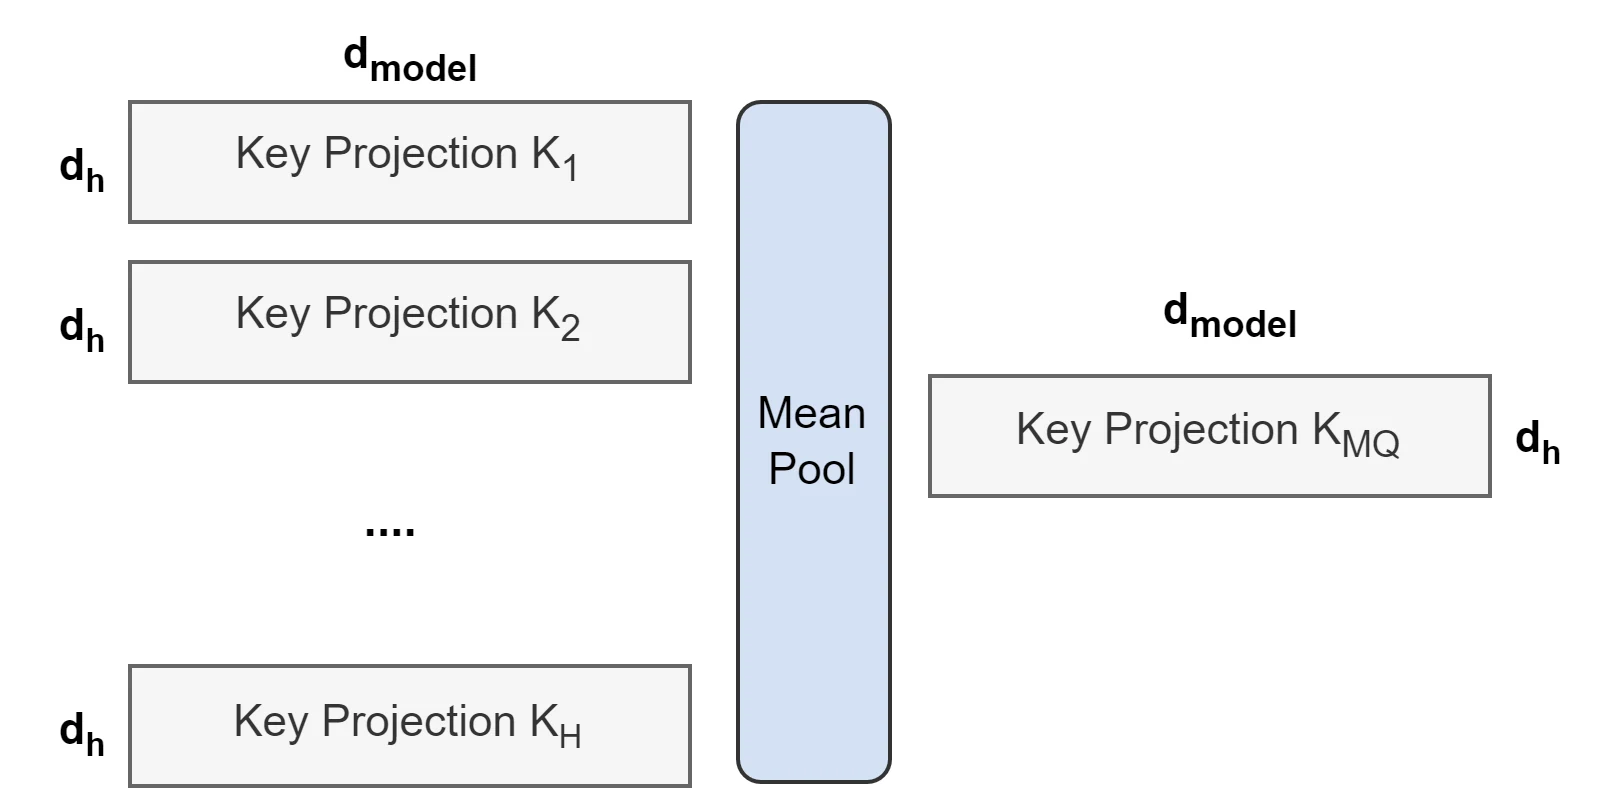
Con esta estructura, MQA puede reducir significativamente el KV Cache y el volumen de lectura de datos por paso de decodificación, liberando espacio para entradas más largas o más solicitudes concurrentes. Por ejemplo, Falcon-7B está configurado con 71 cabezas Query pero solo 1 cabeza KV. Comparado con una estructura KV de 71 grupos con la misma dimensión de cabeza y la misma precisión, su cache KV teórico es solo aproximadamente 1/71. Sin embargo, el compartir también restringe la capacidad de representación de K y V, por lo que se necesita entrenamiento y evaluación para confirmar el impacto de esta ganancia de eficiencia en la calidad de la tarea.
La Attention Agrupada por Consulta (GQA) fue propuesta sistemáticamente por el equipo de Google Research en el artículo GQA de 2023 y aplicada a grandes modelos como Llama 2 70B y Mistral 7B. Busca equilibrar la capacidad de representación multi-grupo de MHA con la baja sobrecarga de cache de MQA, evitando la situación donde todas las cabezas Query deben usar el mismo conjunto de K y V.
GQA divide las cabezas Query en varios grupos, con cada grupo compartiendo un solo conjunto de Key y Value, mientras diferentes grupos retienen diferentes representaciones K y V. Como se muestra en la figura de abajo, MHA configura un conjunto correspondiente de K y V para cada cabeza Query, MQA deja que todas las cabezas Query compartan un solo conjunto de K y V, y GQA comparte dentro de los grupos. Cuando el número de grupos es igual al número de cabezas Query, GQA es equivalente a MHA; cuando hay solo un grupo, es equivalente a MQA.
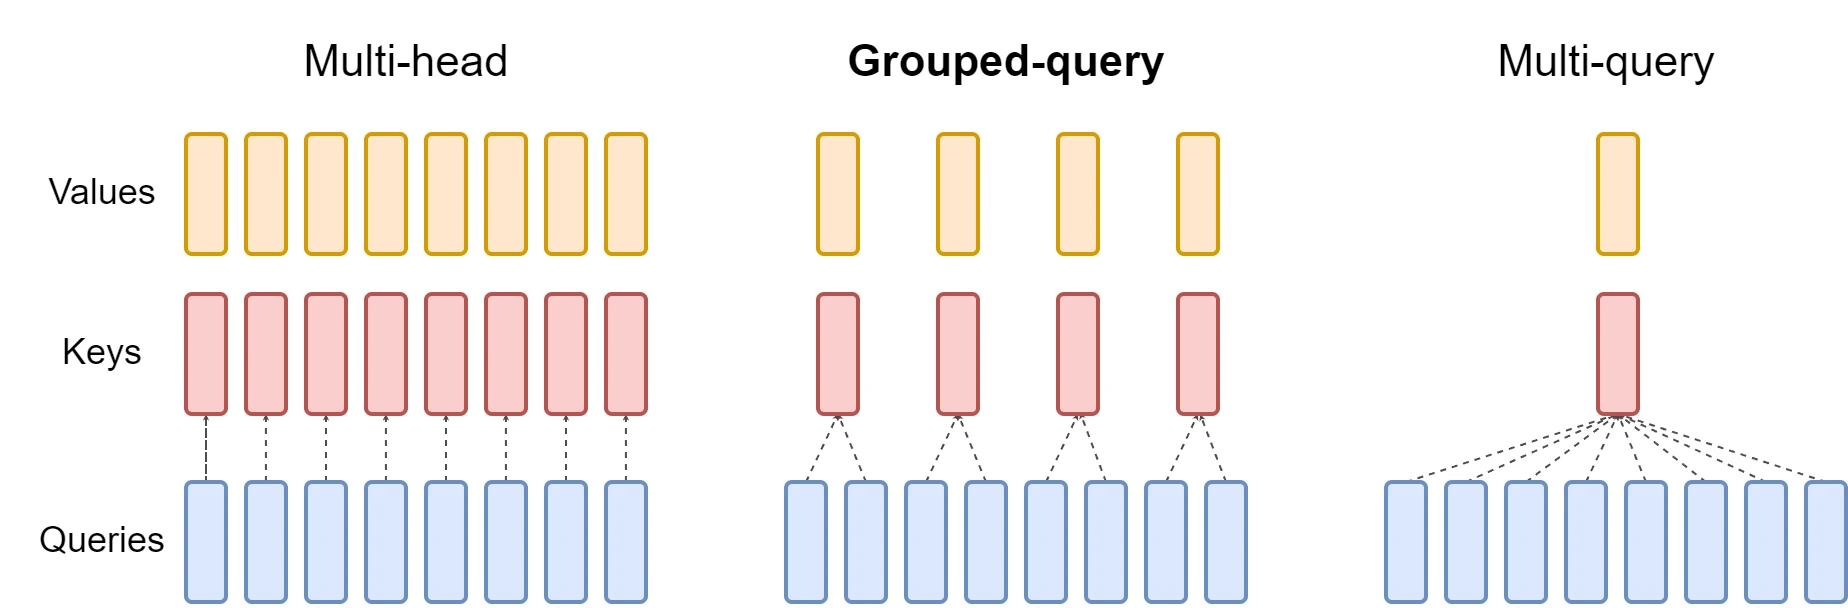
Tomando Mistral 7B v0.1 como ejemplo, tiene 32 cabezas Query y 8 cabezas KV, con 4 cabezas Query compartiendo un conjunto de K y V. Con la misma dimensión de cabeza y la misma precisión, este cache es aproximadamente 1/4 del de MHA. Para el despliegue práctico, reducir el cache y el volumen de lectura generalmente ayuda a mejorar la concurrencia y la eficiencia de decodificación. Dado que diferentes grupos aún retienen sus propios K y V, GQA también retiene más espacio de representación que MQA completamente compartida. Lo que se reduce aquí es el número de cabezas KV; el modelo aún puede calcular atención para todas las posiciones históricas a las que tiene permiso de acceder.
La Attention por Ventana Deslizante (SWA) proviene del enfoque de atención local en el modelado de secuencias largas. Mistral 7B v0.1 la utiliza en combinación con GQA. GQA reduce el número de cabezas KV que necesitan almacenarse por posición, mientras SWA limita aún más el rango histórico al que cada posición se atiende directamente, reduciendo la presión de cálculo y cache para textos largos.
SWA establece una ventana de tamaño fijo para cada Token, calculando atención solo para posiciones recientes dentro de la ventana. La figura de abajo muestra atención causal completa a la izquierda, Attention por Ventana Deslizante en el centro, y a la derecha, cómo la información pasa a través de múltiples capas de red hacia atrás. Aunque una sola capa solo lee el rango local, la representación del Token de la capa anterior ya contiene información contextual anterior, por lo que después de procesar a través de múltiples capas, el modelo puede utilizar indirectamente contenido más allá de la ventana.
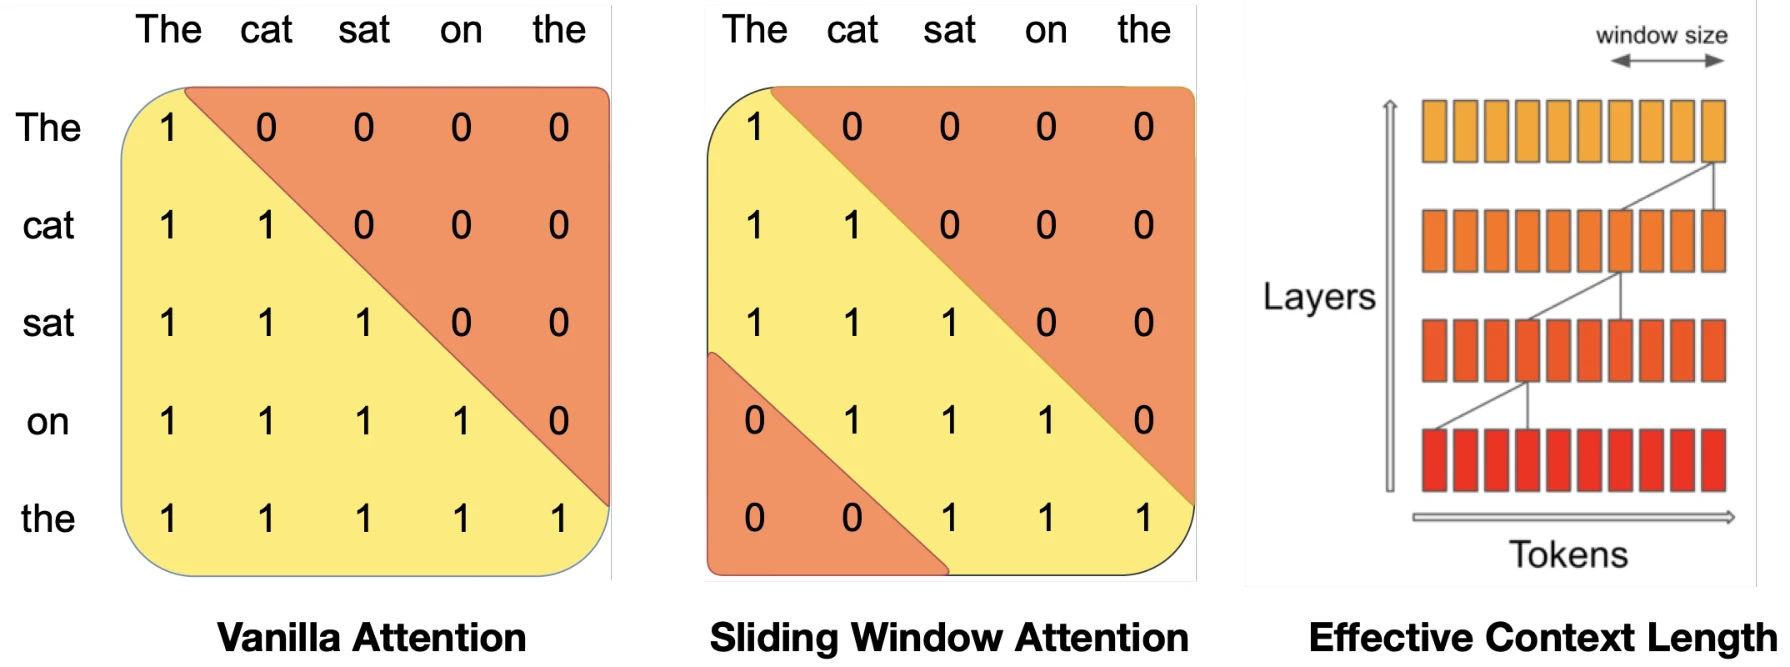
Mistral 7B v0.1 usa una ventana de 4096 Tokens y emplea un cache rotativo para cubrir los K y V antiguos que han salido de la ventana, permitiendo que cada capa mantenga su cache dentro de un rango fijo. En las pruebas del artículo con secuencia de 16K y ventana de 4096, con la optimización de kernel correspondiente, la velocidad fue aproximadamente 2 veces la de la línea base de atención completa. Esta estructura puede controlar el crecimiento de recursos para textos largos, pero los detalles originales remotos deben pasar a través de representaciones intermedias, por lo que el tamaño de la ventana local no puede equipararse directamente con la longitud de contexto que el modelo puede recuperar con precisión.
La Attention Latente Multi-Cabeza (MLA) fue propuesta por el equipo de DeepSeek en DeepSeek-V2 y luego usada en DeepSeek-V3. También aborda el problema de KV Cache excesivo pero modifica aún más el formato de almacenamiento: al aprender una representación conjunta compacta, reduce la cantidad de datos que necesitan almacenarse por Token mientras soporta múltiples cabezas de atención usando esta información.
Específicamente, MLA primero usa proyección de rango reducido para representar conjuntamente K y V como vectores latentes de menor dimensión. Durante la inferencia, solo este vector y el componente Key que porta independientemente información de posición rotativa se ponen en cache. Múltiples cabezas Query pueden usar esta representación compartida para emparejamiento y agregación de información, y algunas matrices de proyección pueden fusionarse durante la inferencia, reduciendo la necesidad de expandir explícitamente K y V completos. Las áreas sombreadas en la figura de abajo indican el contenido que necesita ponerse en cache, mostrando cómo MLA transfiere el cache multi-cabeza K y V a la representación latente más pequeña a la derecha.
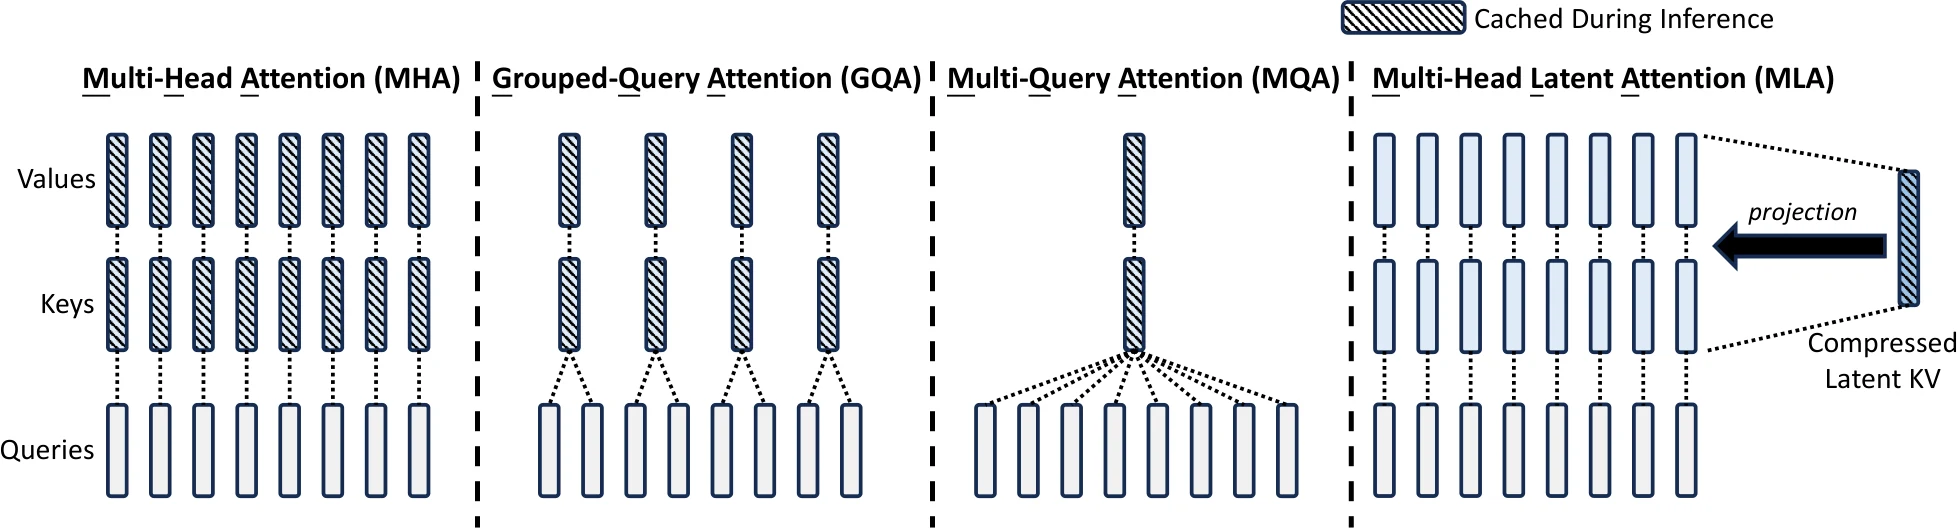
Este diseño permite que DeepSeek-V2 y V3 mantengan la capacidad expresiva multi-cabeza mientras reducen la presión de cache durante la generación de contexto largo. En el informe DeepSeek-V2, el tamaño de cache KV por Token de MLA es equivalente a solo 2.25 grupos de cabezas KV en GQA. Comprime la dimensión de representación en cada posición; las posiciones históricas en sí mismas aún se retienen, por lo que en modo de atención completa, el modelo aún necesita leer y emparejar todas las entradas históricas. Para reducir aún más el número de entradas que participan en el cálculo cada vez, se debe introducir atención dispersa.
La Attention Dispersa DeepSeek (DSA) fue propuesta por el equipo de DeepSeek y aplicada a DeepSeek-V3.2-Exp y DeepSeek-V3.2. Construyéndose sobre MLA, agrega un mecanismo de selección dinámica para abordar el problema donde, incluso cuando las entradas KV individuales ya son pequeñas, leer y calcular todas las entradas históricas en contextos largos sigue siendo costoso.
DSA primero usa un indexador ligero llamado Lightning Indexer para calcular puntuaciones de relevancia entre la Query actual y los Tokens históricos, luego selecciona las posiciones Top-k con las puntuaciones más altas para que la Attention principal las procese. El área verde en la figura de abajo es el nuevo proceso de indexación, donde el selector Top-k elige posiciones, y la Attention principal de arriba lee el cache MLA correspondiente a las posiciones seleccionadas. El indexador usa representaciones más pequeñas y menos cabezas para completar el filtrado, con costos de cálculo más bajos que ejecutar directamente la Attention principal completa.
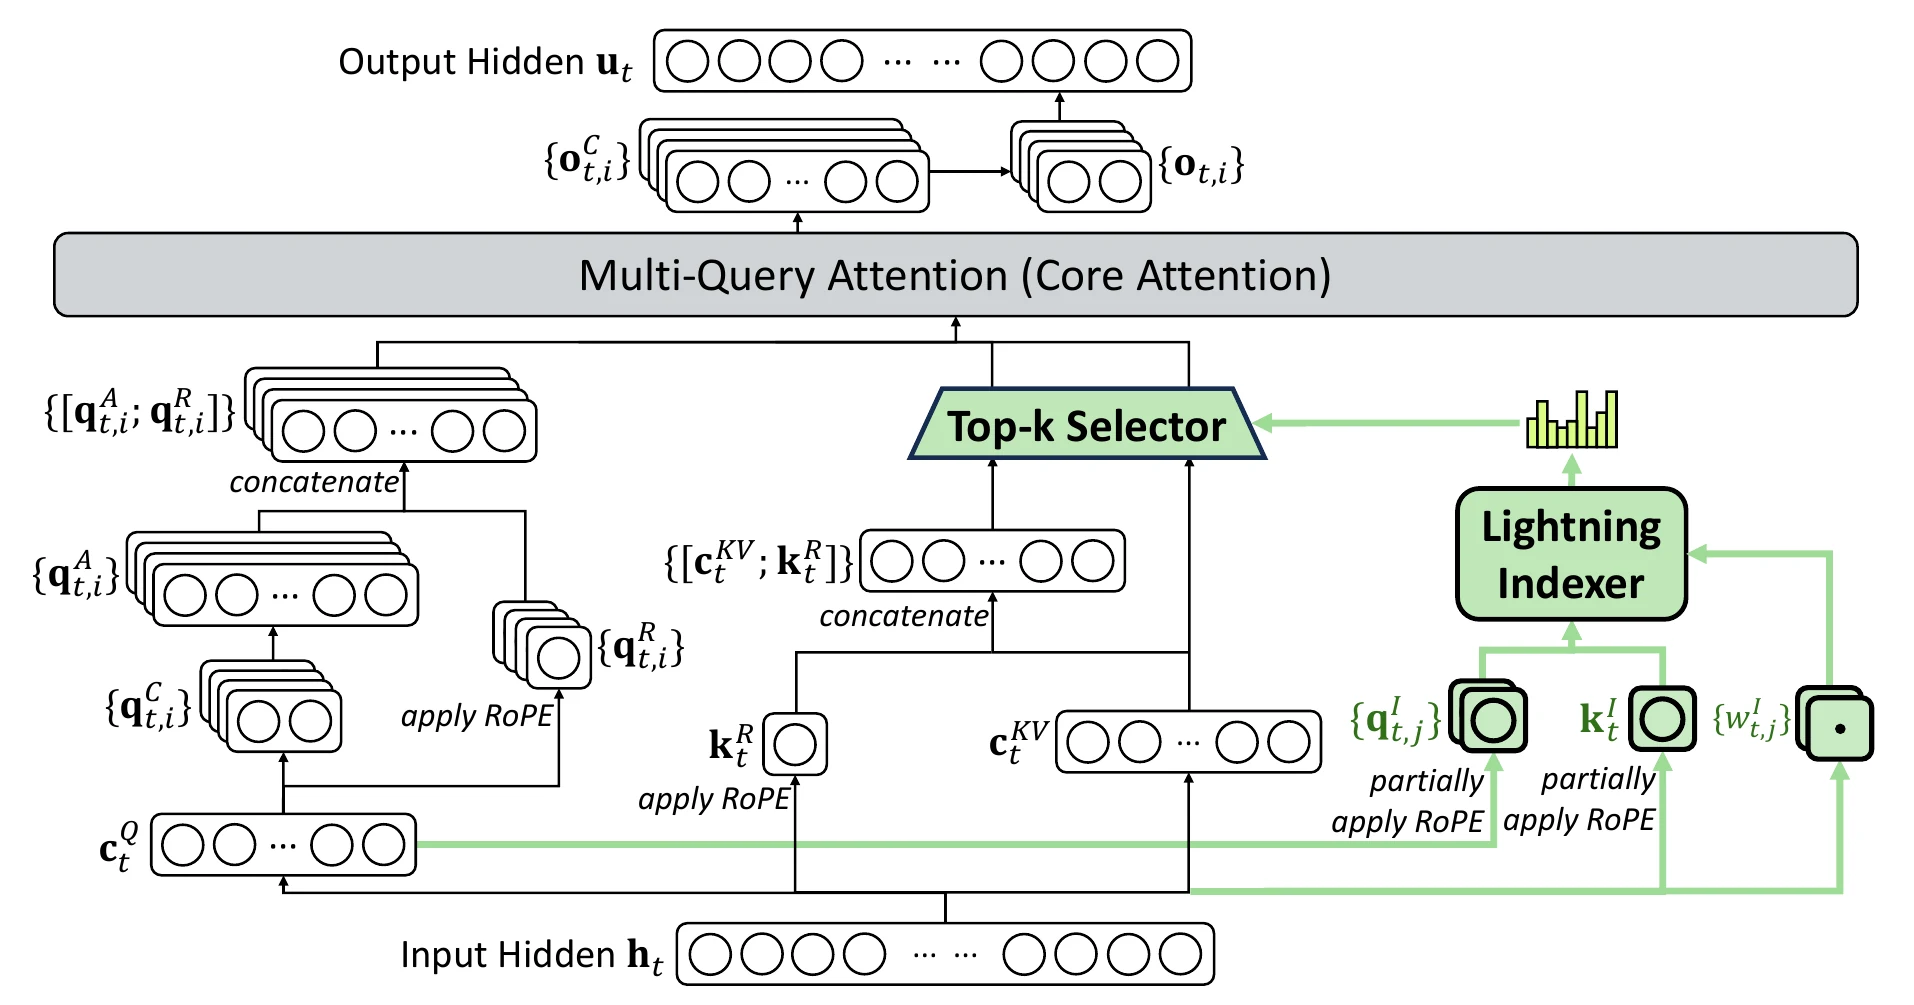
En el informe DeepSeek-V3.2, la configuración es que cada Query puede seleccionar hasta 2048 entradas KV. A medida que crece el contexto, la Attention principal puede concentrarse en este rango limitado, reduciendo significativamente el costo del procesamiento de entradas largas y la generación subsiguiente. Las entradas históricas no seleccionadas en esta ronda siguen disponibles para la recuperación de Queries subsiguientes, por lo que la selección dispersa reduce principalmente el volumen de lectura y cálculo esta vez, en lugar de eliminar todo el cache en la misma proporción. El indexador en sí mismo aún necesita procesar candidatos históricos, y el costo real también se ve afectado por la longitud del contexto.
La Attention Dispersa MiniMax (MSA) fue propuesta por el equipo de MiniMax y aplicada a MiniMax-M3. Aborda problemas de eficiencia en contextos de un millón de Tokens, considerando particularmente cómo hacer que la atención dispersa sea adecuada para el cálculo por lotes de GPU, en lugar de simplemente reducir teóricamente el número de Tokens que participan en el cálculo.
MSA se construye sobre GQA e incluye una rama de indexación y una rama principal. La rama de indexación primero calcula puntuaciones de relevancia a nivel de Token, luego toma la puntuación más alta dentro de cada bloque como puntuación de bloque, seleccionando Top-k bloques históricos para diferentes grupos GQA por separado. La rama principal luego lee K y V a nivel de Token de los bloques seleccionados que satisfacen las condiciones causales, mientras retiene el bloque local actual. Como se muestra en la figura de abajo, los dos grupos Query a la derecha pueden formar diferentes rangos de selección, mientras que las cabezas Query dentro del mismo grupo comparten resultados de selección.
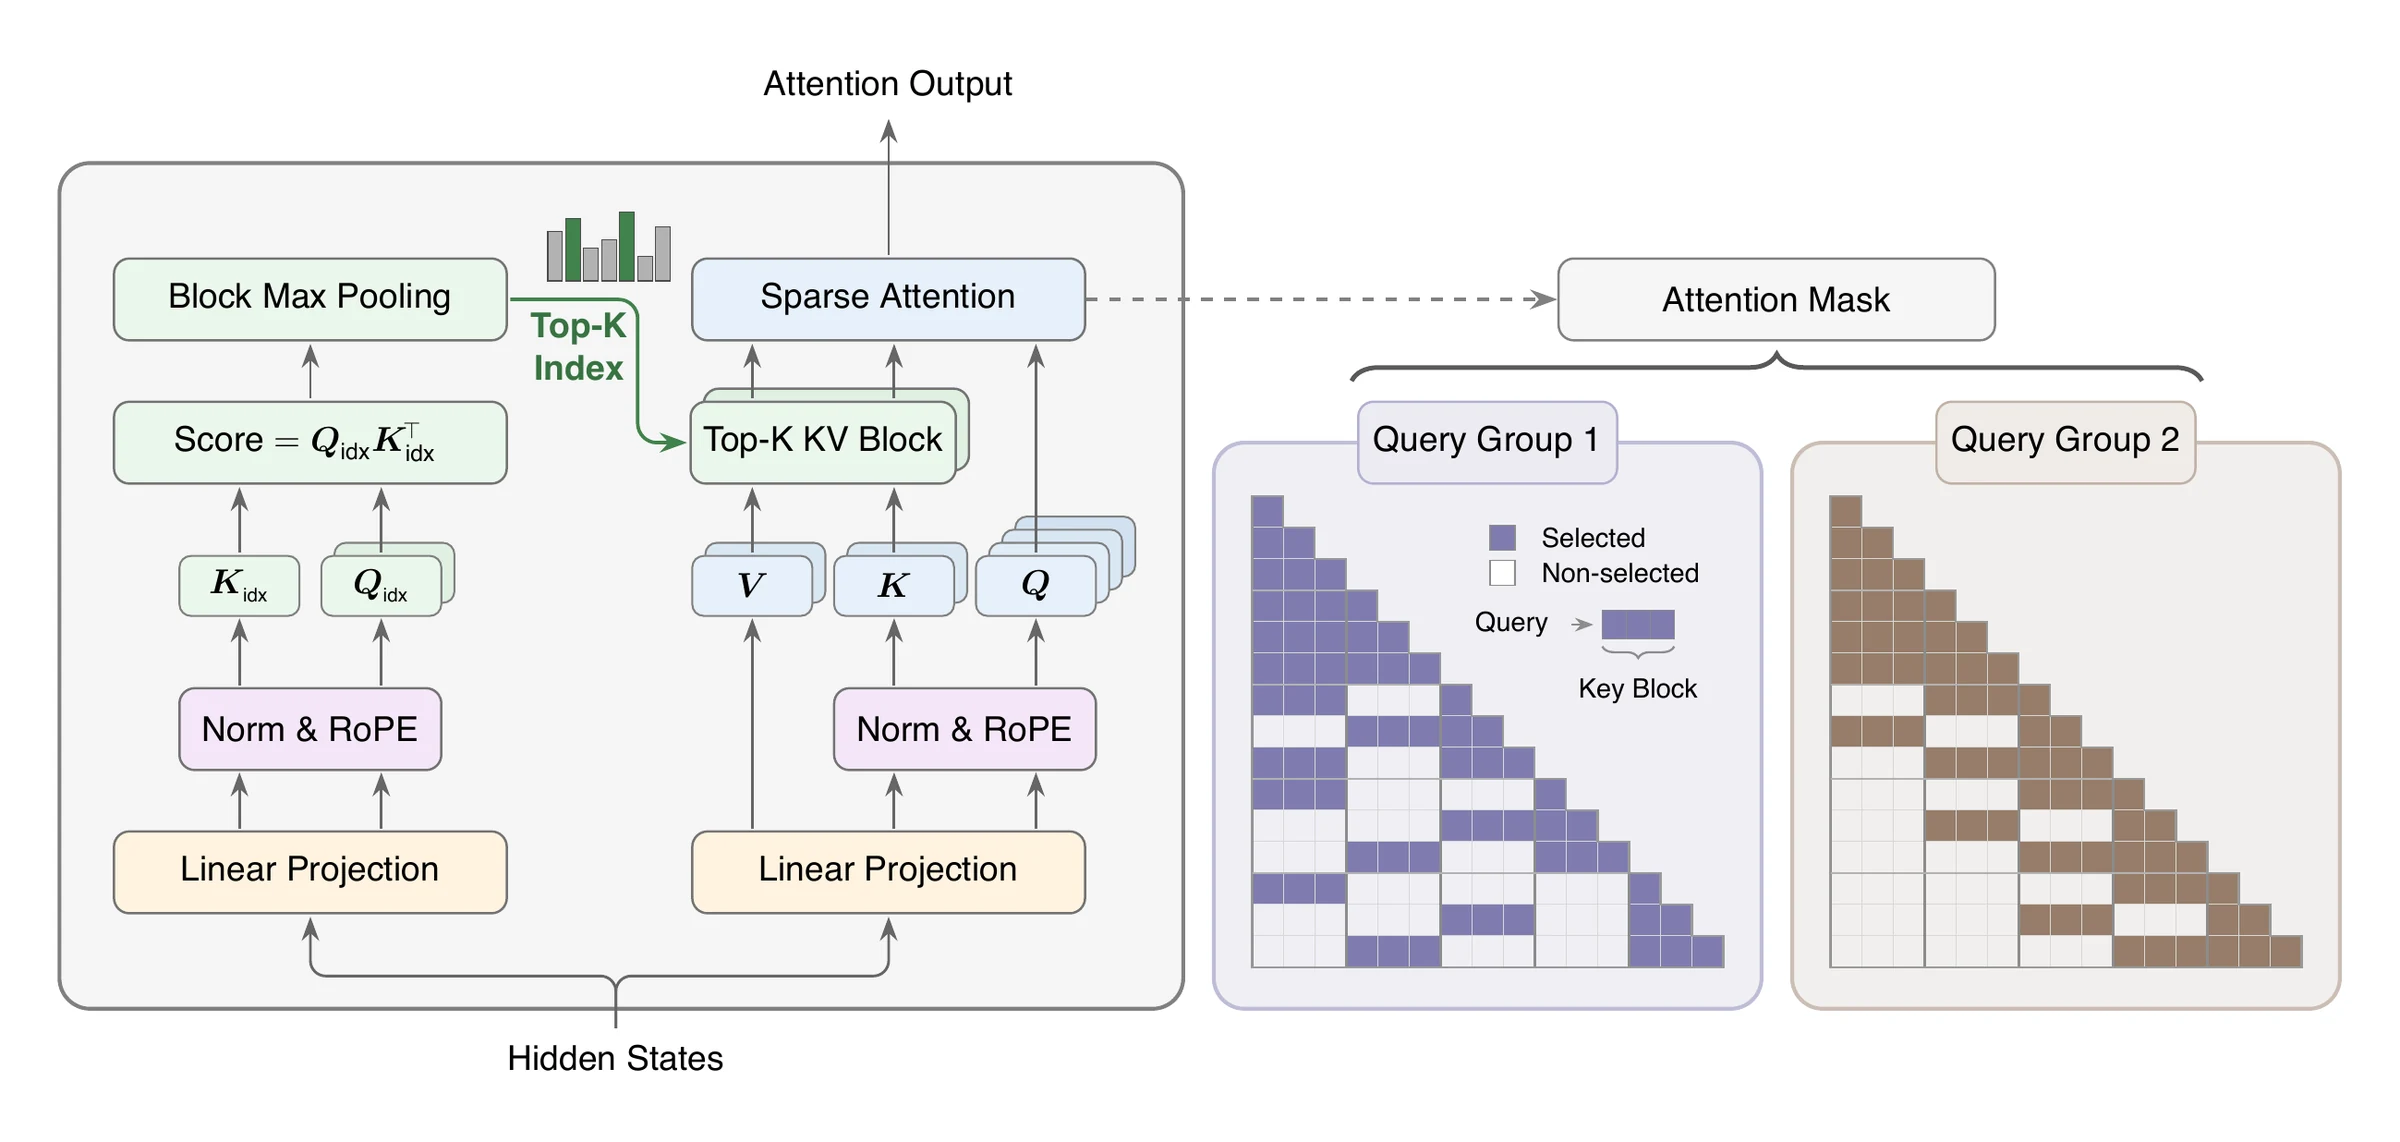
Organizar el acceso por bloques mejora la regularidad del procesamiento de datos por la GPU, y la selección agrupada permite que diferentes grupos retengan diferentes patrones de recuperación. En la prueba de contexto 1M del modelo experimental de 109B parámetros, el artículo reporta que el cálculo de atención por Token de MSA es aproximadamente 1/28.4 del de GQA. Con kernels especializados, la fase Prefill para procesamiento de entradas y la fase Decode para generación por Token en H800 lograron mejoras de velocidad de aproximadamente 14.2x y 7.6x respectivamente. Esto demuestra que los algoritmos dispersos y los kernels de cálculo deben ser co-diseñados; reducir el volumen de cálculo solo puede convertirse completamente en beneficios de velocidad reales a través de tal optimización conjunta.
La Attention Dispersa Qwen (QSA) fue propuesta por el equipo de Qwen y aplicada a Qwen3.8-Flash-Next. Este modelo usa una estructura híbrida de tres capas de Gated DeltaNet combinadas con una capa de QSA: la primera procesa eficientemente secuencias a través de actualizaciones de estado, mientras la segunda retiene la recuperación directa de Tokens históricos. El problema clave que QSA aborda es que los indexadores mismos generan una sobrecarga significativa en contextos largos.
Para esto, QSA primero comprime las claves de indexación de Tokens consecutivos en representaciones de micro-bloques mediante pooling promedio, calcula puntuaciones de relevancia en la secuencia de micro-bloques más corta y selecciona Top-k bloques. Después de la selección, expande los bloques de vuelta a las posiciones de Token originales, permitiendo que la Attention principal lea los K y V correspondientes. Los Tokens de cola que no han formado bloques completos también se retienen. El lado izquierdo de la figura de abajo muestra el proceso de indexación comprimido, y el lado derecho muestra la Attention dispersa de micro-bloques basada en resultados de selección, con índices de posición pasados entre las dos partes.
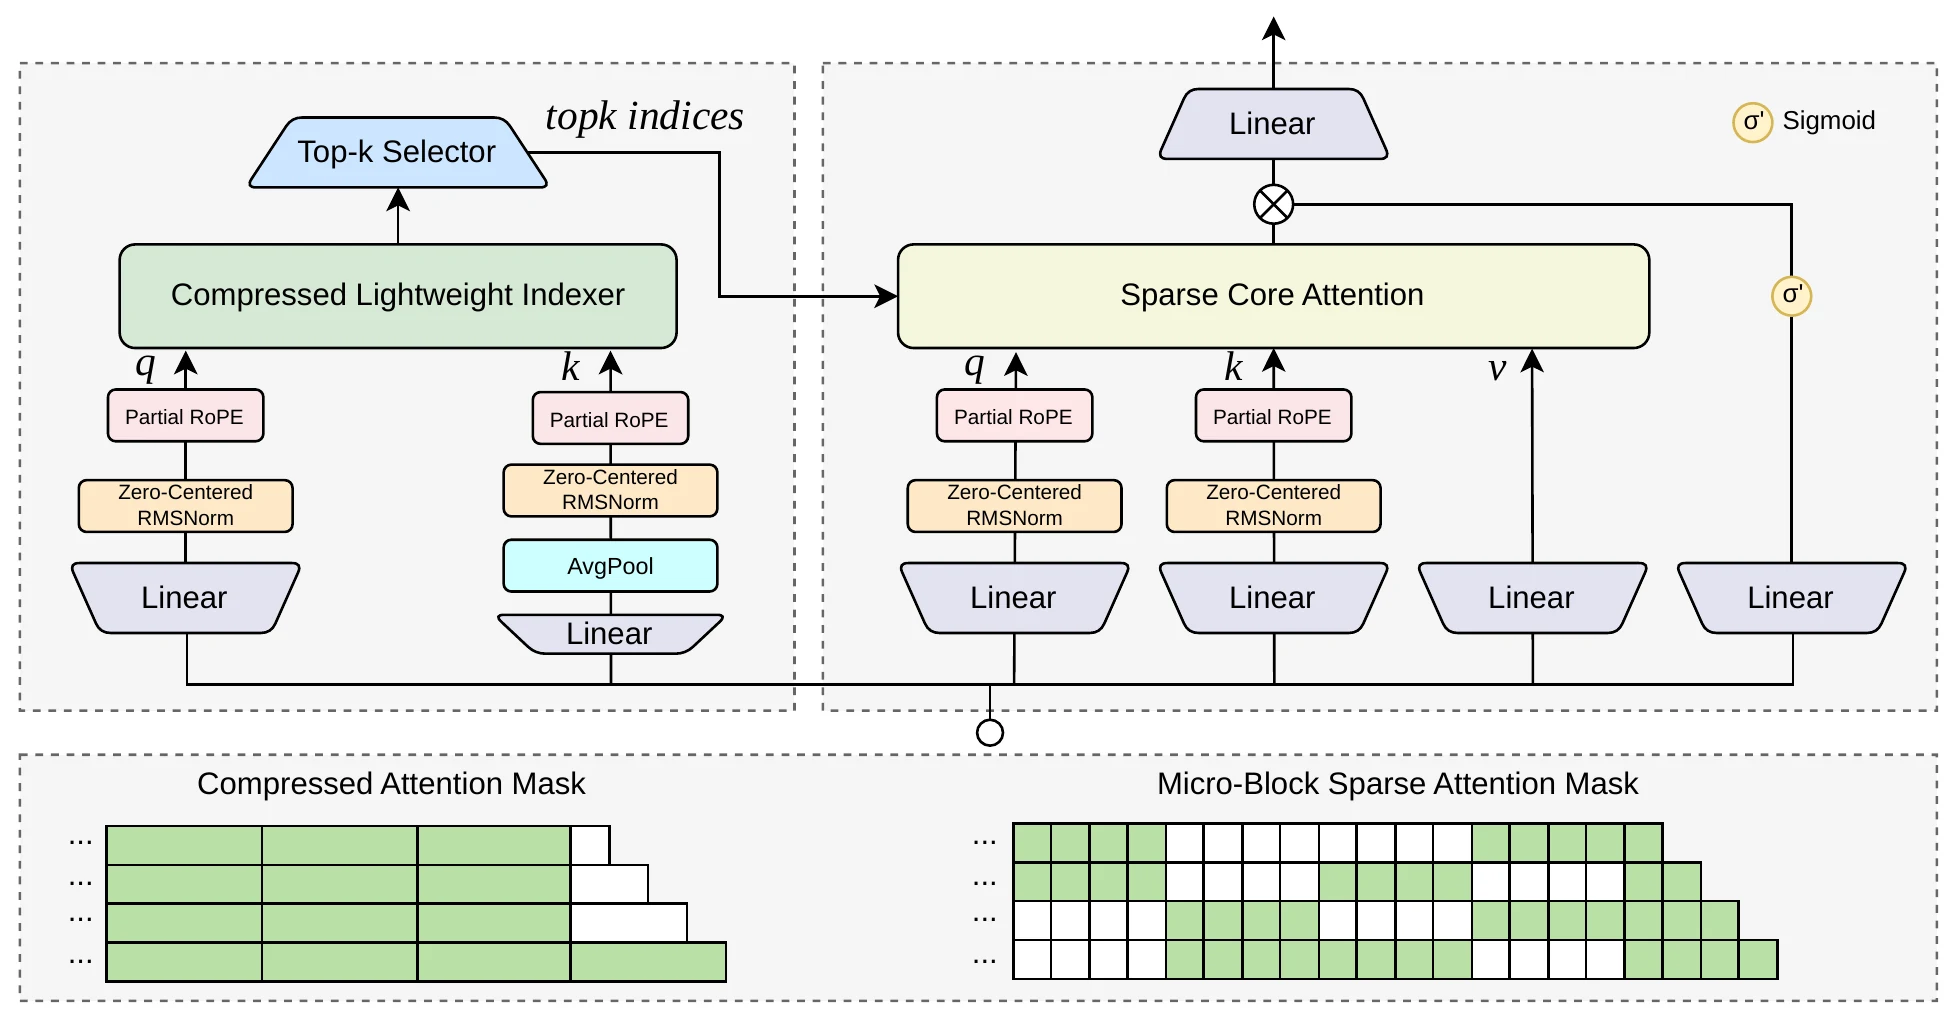
Esto tanto reduce las posiciones a las que accede la Attention principal como acorta la secuencia que el indexador necesita escanear. El informe Qwen3.8-Flash-Next muestra que en pruebas de kernel con 1M de contexto, QSA logró mejoras de velocidad de aproximadamente 7.6x y 4.9x en Prefill y Decode respectivamente comparado con atención densa. Para entender esta estructura, es importante distinguir entre la representación de indexación y el cache de Attention principal: QSA comprime la primera para reducir costos de filtrado, pero después de la selección aún lee KV a nivel de Token, por lo que la información detallada de la región seleccionada puede preservarse.
La Kimi Delta Attention (KDA) fue propuesta por el equipo de Moonshot AI en Kimi Linear y se aplica prácticamente en el modelo Kimi Linear con 48B parámetros totales y 3B parámetros activados. Adopta un enfoque de atención lineal, escribiendo continuamente información histórica en un estado de tamaño fijo, reduciendo la sobrecarga de lectura repetida de secuencias históricas largas en cada paso de generación.
KDA se construye sobre Gated DeltaNet e introduce un control más fino. Cuando llega un nuevo Token, el modelo primero controla el grado de retención de información para diferentes canales en el estado anterior, luego corrige las asociaciones clave-valor existentes a través de la regla Delta. Esta actualización puede entenderse como usar la diferencia entre la nueva entrada y el contenido predicho por el estado actual para ajustar la información almacenada en el estado. Dado que la puerta de decaimiento varía por canal, diferentes partes pueden usar diferentes tasas de retención. Durante el cálculo, bloques de Tokens también pueden procesarse en paralelo para mejorar la eficiencia de la GPU.
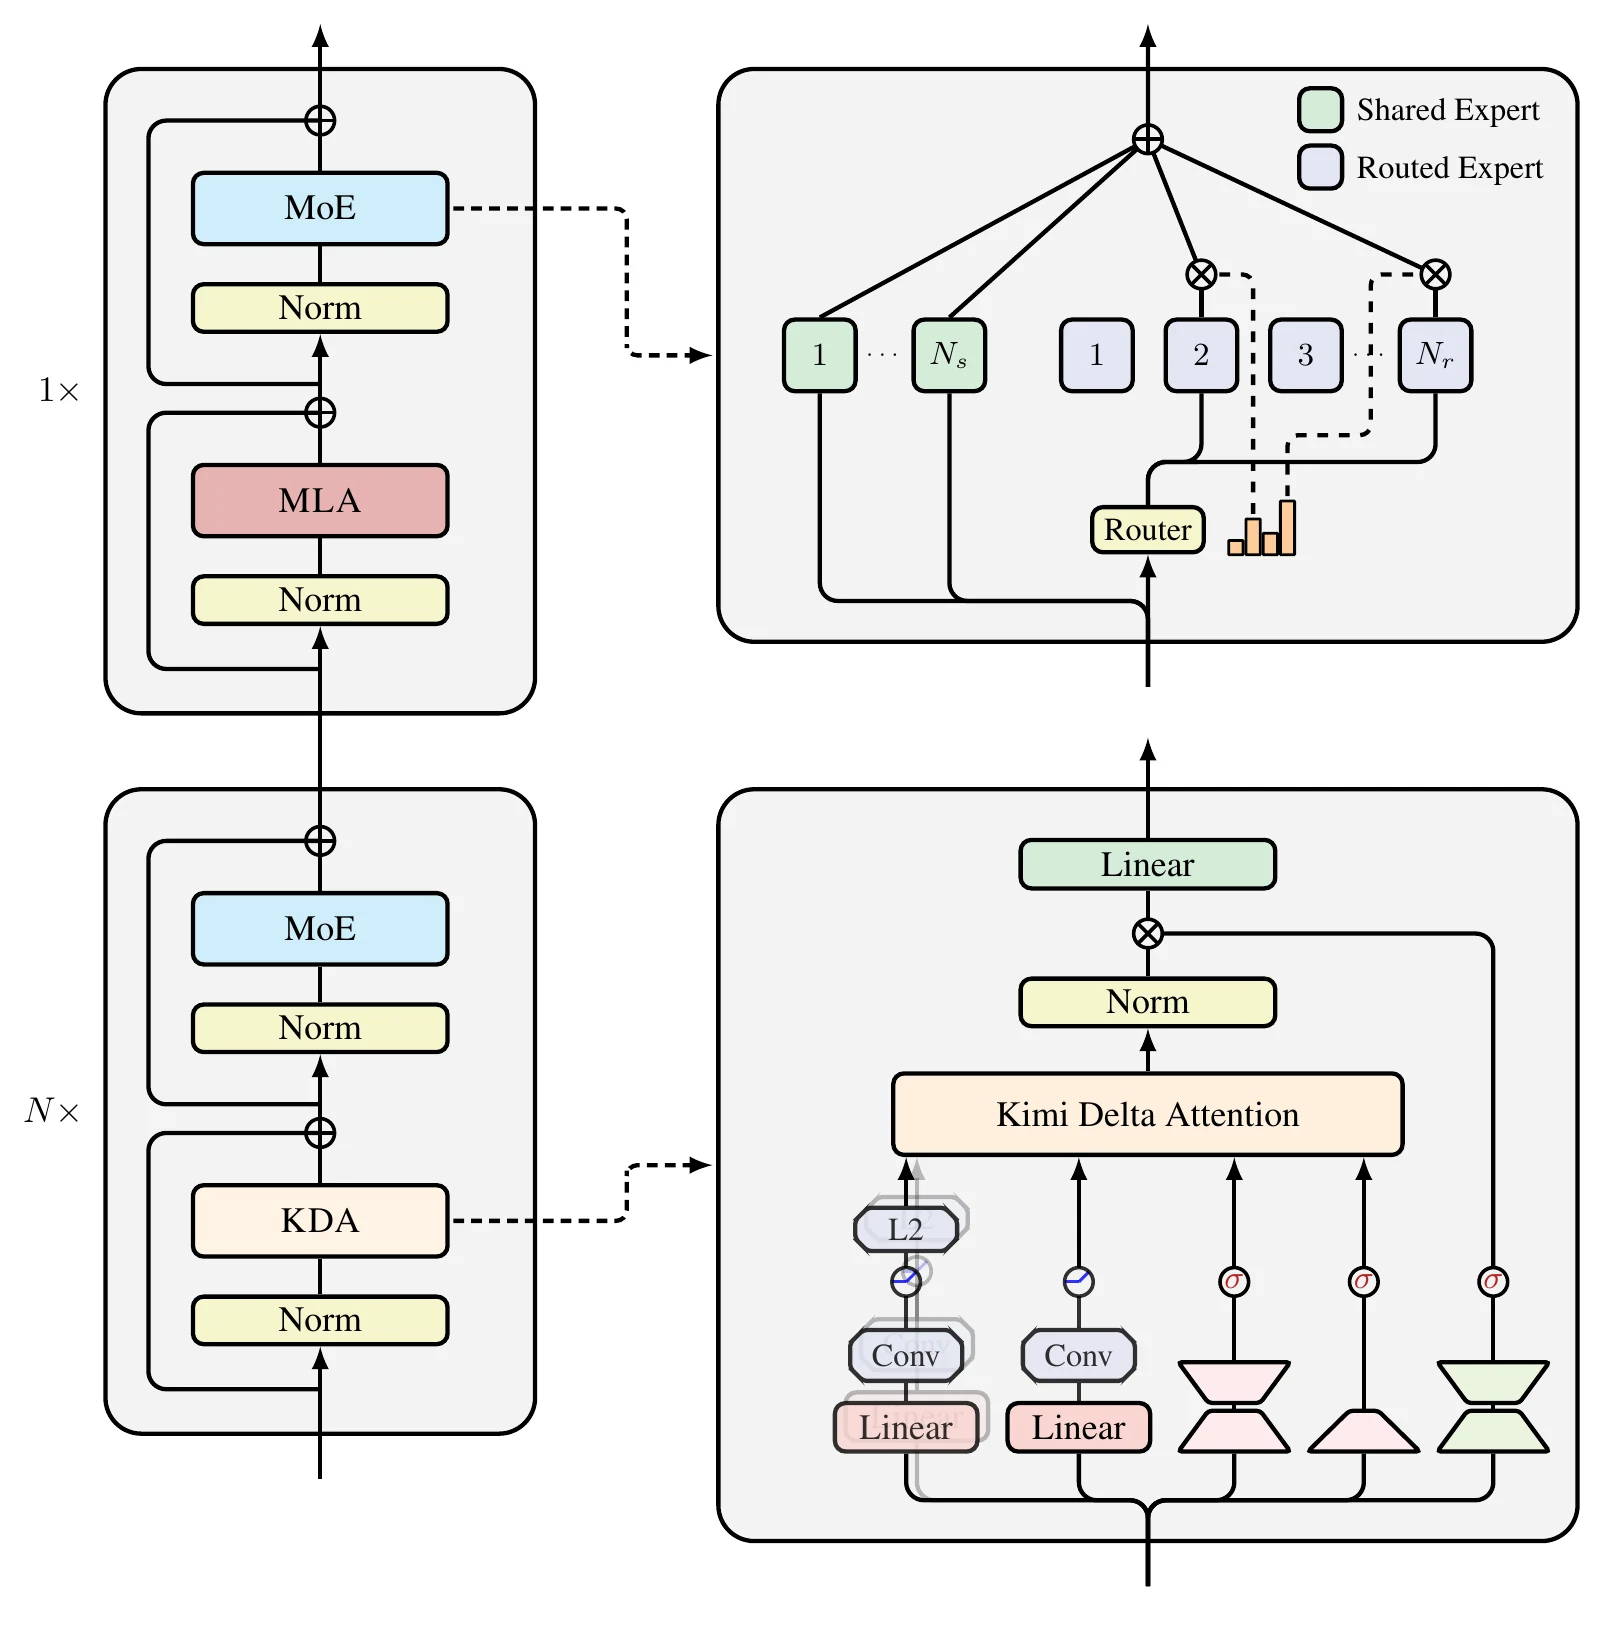
La figura de arriba muestra cómo Kimi Linear alterna tres capas de KDA con una capa de MLA. La capa KDA usa estado de tamaño fijo para reducir costos de secuencias largas, mientras la capa MLA complementa la recuperación directa de posiciones históricas específicas, aliviando la capacidad limitada del estado fijo. En comparaciones usando el mismo esquema de entrenamiento, este modelo híbrido redujo KV Cache hasta en un 75% comparado con la línea base MLA completa y logró hasta aproximadamente 6 veces el throughput de decodificación a 1M de contexto. Estos resultados corresponden a la arquitectura híbrida de Kimi Linear en lugar de ser una configuración uniforme de todos los modelos Kimi.
La Attention Dispersa Comprimida (CSA) fue propuesta por el equipo de DeepSeek en DeepSeek-V4 y aplicada a DeepSeek-V4-Pro y DeepSeek-V4-Flash. Mientras que la MLA anterior comprime principalmente la representación KV de cada Token, CSA reduce aún más el número de entradas a lo largo de la dimensión de secuencia, agregando información de múltiples Tokens en un número reducido de entradas KV, luego realizando selección dispersa.
CSA primero procesa Tokens consecutivos con un compresor a nivel de Token aprendible, combinando información de superposición de bloques adyacentes para formar KV comprimido. Luego, Lightning Indexer puntúa estas entradas comprimidas y selecciona entradas Top-k para la Attention principal. En la figura de abajo, el compresor está posicionado antes de la indexación y selección, y la Attention principal lee directamente el KV comprimido. A la izquierda, una rama de atención por ventana deslizante también envía Tokens recientes no comprimidos al cálculo, preservando detalles locales.
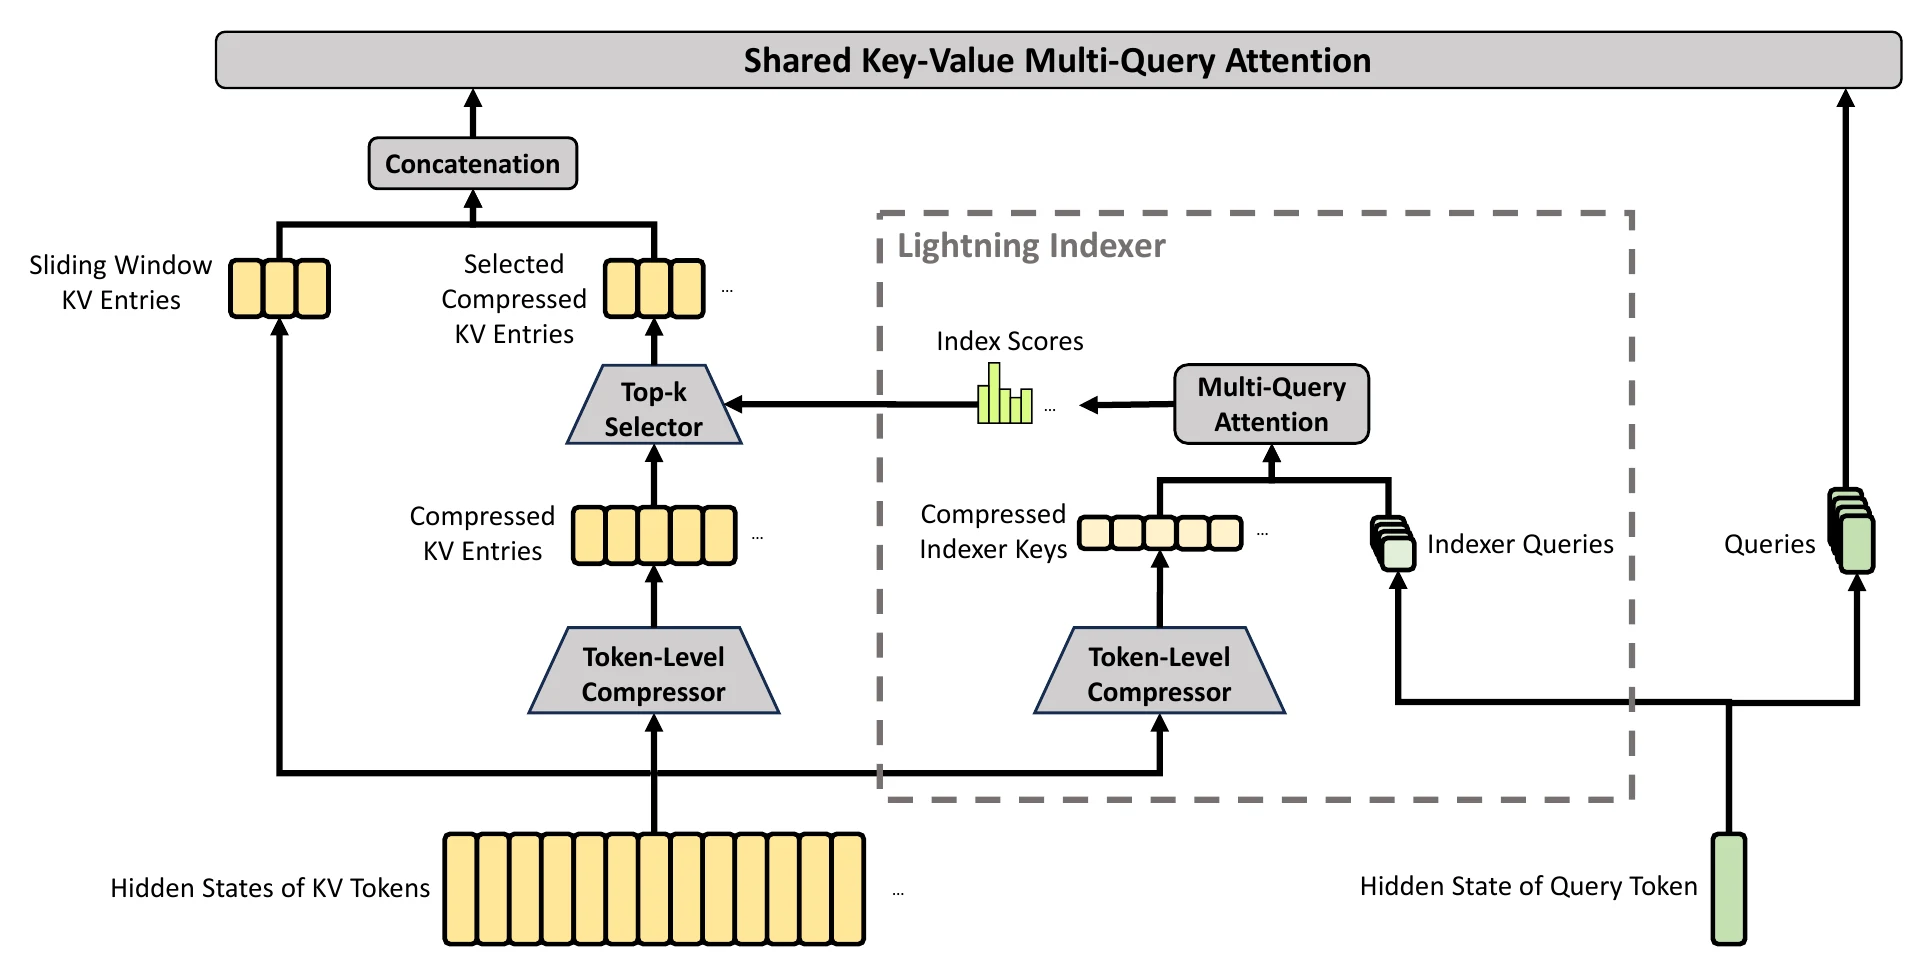
En el informe DeepSeek-V4, CSA tiene una tasa de compresión de 4, significando que las entradas KV históricas se reducen aproximadamente a un cuarto, con un subconjunto seleccionado para el cálculo de Attention principal. Por lo tanto, CSA tanto reduce el volumen de cache a largo plazo como disminuye el contenido histórico leído y calculado cada vez. QSA comprime el índice pero luego vuelve a los Tokens originales, mientras CSA completa directamente la agregación de información en entradas comprimidas, comprimiendo por lo tanto también el KV histórico en sí. Este diseño requiere que el compresor preserve características útiles, complementado por la ventana local para detalles recientes.
La Attention Fuertemente Comprimida (HCA) también fue propuesta por el equipo de DeepSeek en DeepSeek-V4 y se usa en alternancia con CSA en la estructura multicapa de DeepSeek-V4-Pro y Flash. Emplea una compresión de secuencia más fuerte, permitiendo al modelo retener cobertura de información histórica a gran escala con menos cache, complementando la selección de CSA.
La tasa de compresión de HCA se establece en 128 en el informe, muy superior a la de CSA (4). Después de que múltiples Tokens se agreguen en una sola entrada comprimida por suma ponderada aprendible, la Query actual ejecuta Attention sobre toda la historia comprimida causalmente visible sin selección Top-k. Como se muestra en la figura de abajo, HCA retiene la rama comprimida y la rama de atención por ventana deslizante local pero omite el indexador y selector de CSA. La ventana proporciona detalles de Tokens recientes, mientras la historia comprimida proporciona información contextual más amplia.
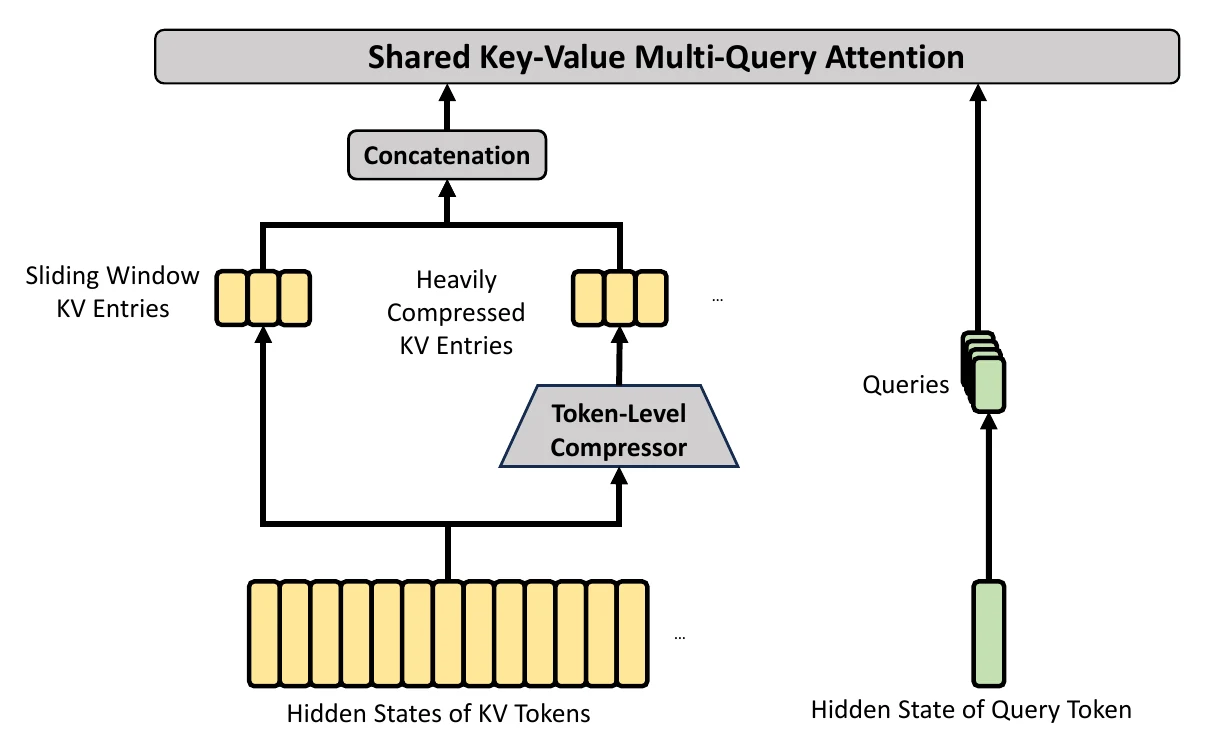
La configuración alternada de CSA y HCA permite que DeepSeek-V4 utilice simultáneamente representaciones históricas en diferentes granularidades. Según el informe, a 1M de contexto, los FLOPs de inferencia por Token y el KV Cache de DeepSeek-V4-Pro son aproximadamente el 27% y 10% de los de DeepSeek-V3.2 respectivamente. Este es el efecto combinado de la estructura híbrida de Attention junto con el cálculo y almacenamiento de baja precisión. Para los usuarios, la importancia de este tipo de estructura es que hace que los contextos ultra largos sean más fáciles de ejecutar en hardware limitado. La capacidad de un modelo específico para extraer con precisión detalles de materiales largos aún depende del método de compresión, el proceso de entrenamiento y la tarea real.
A partir de estos diseños de modelos, podemos ver que las mejoras de Attention no se limitan a una sola dirección. MHA, MQA y GQA cambian principalmente la relación de compartir entre cabezas; MLA comprime la representación KV en cada posición; DSA, MSA y QSA reducen las posiciones accedidas por Attention principal; KDA procesa historial a través de actualizaciones de estado; y CSA y HCA comprimen aún más las entradas históricas. Los modelos pueden combinar múltiples de estos métodos, por lo que al analizar requisitos de recursos, es necesario considerar el número de capas y el formato de cache para cada estructura. Independientemente de qué estructura se use, Attention solo es responsable de agregar información contextual; la capacidad general del modelo se forma conjuntamente por Attention junto con Embedding, la red feed-forward y el proceso de entrenamiento.
La arquitectura del modelo determina cómo se calcula la información, mientras que el proceso de entrenamiento determina qué aprende finalmente el modelo. El entrenamiento de grandes modelos típicamente se divide en varias etapas. Primero, en la etapa de preentrenamiento, el modelo aprende patrones de lenguaje, estructuras de conocimiento y patrones de razonamiento básico a partir de texto masivo, código y otros datos, adquiriendo capacidades generales. Luego, entra en la etapa de Ajuste por Instrucción (SFT), donde a través de numerosos ejemplos "instrucción-respuesta", el modelo aprende a comprender los requisitos de los usuarios y responder en el formato de tarea especificado. Sobre esta base, se realiza optimización de preferencias o aprendizaje por refuerzo adicional, ajustando el comportamiento del modelo basándose en retroalimentación humana o reglas para alinear mejor las respuestas con las expectativas en términos de utilidad, exactitud, estilo de expresión, seguridad y límites de comportamiento.
El preentrenamiento es la etapa donde el modelo forma sus capacidades fundamentales. El modelo se entrena repetidamente en texto, código o datos multimodales a gran escala. Para modelos de lenguaje de solo Decodificador (como la serie GPT), la tarea de entrenamiento común es predecir el siguiente Token basándose en el contenido anterior, ajustando los parámetros del modelo cuando las predicciones son incorrectas. Después de que se procesan repetidamente muestras masivas, el modelo gradualmente aprende la estructura del lenguaje, patrones de expresión y relaciones estadísticas entre diferentes conceptos, y desarrolla las capacidades de representación y generación fundamentales necesarias para tareas como preguntas y respuestas, resumen, traducción y generación de código.
El conocimiento adquirido durante el preentrenamiento está distribuido a través de un gran número de parámetros, no en una base de datos que se pueda consultar elemento por elemento. El modelo puede combinar patrones aprendidos para generar contenido que no aparece textualmente en los datos de entrenamiento, y también puede combinar información relacionada pero no completamente coincidente para formar respuestas aparentemente plausibles pero incorrectas. Por supuesto, más datos de entrenamiento no siempre es mejor. Contenido duplicado, páginas web de baja calidad, conocimiento erróneo, datos de privacidad y contenido dañino todos afectan al modelo. Antes del preentrenamiento, típicamente se requieren análisis de formato, deduplicación, filtrado por calidad, filtrado de seguridad y proporción de datos. La escala de datos determina cuánto contenido puede acceder el modelo, mientras que la calidad de datos afecta directamente qué puede aprender de ello.
Después de completar el preentrenamiento, el modelo ya puede continuar texto, pero no necesariamente completa confiablemente las tareas según los requisitos de los usuarios. Por ejemplo, si el usuario pide listar tres elementos de acción, el modelo base podría continuar desarrollando la pregunta o ignorar el formato especificado. El ajuste por instrucción usa ejemplos compuestos de instrucciones y respuestas esperadas para continuar entrenando el modelo. Aquí hay un ejemplo de ajuste por instrucción:
Instrucción: Organice las siguientes actas de reunión en elementos de acción.
Entrada: Texto de las actas de reunión.
Salida: Una tabla que contiene tareas, personas responsables y fechas límite.
Después del entrenamiento en diferentes tipos de ejemplos incluyendo preguntas y respuestas, resumen, extracción de información, código, llamadas a herramientas y rechazo de seguridad, el modelo gradualmente aprende a reconocer la intención del usuario y seguir los requisitos de salida. El ajuste por instrucción principalmente enseña al modelo cómo usar sus capacidades existentes. Puede complementar algo de conocimiento pero no es adecuado para resolver todos los problemas de actualización de conocimiento. El contenido que requiere actualizaciones frecuentes o debe proporcionar fuentes se sirve mejor a través de bases de conocimiento, recuperación o herramientas externas en tiempo de ejecución.
El postentrenamiento es el término colectivo para una serie de trabajos de entrenamiento y alineamiento realizados después de que el modelo completa el preentrenamiento. El ajuste por instrucción típicamente forma parte del postentrenamiento, y ajuste por instrucción (SFT) adicional, optimización de preferencias y aprendizaje por refuerzo también pueden aparecer en esta etapa. Por lo tanto, el ajuste por instrucción y el postentrenamiento no son dos pasos independientes; el primero es una categoría específica de métodos, mientras que el latter es una etapa que abarca múltiples métodos. Varios enfoques de entrenamiento pueden entenderse primero según la siguiente relación:
Etapa o Método | Datos principales utilizados | Problema principal resuelto |
Preentrenamiento | Texto, código y datos multimodales a gran escala | Enseñar al modelo patrones fundamentales como lenguaje y conocimiento |
Ajuste por Instrucción / SFT | Instrucciones y respuestas esperadas | Enseñar al modelo a producir según los requisitos de la tarea |
Optimización de preferencias | Mejores y peores respuestas a la misma pregunta | Hacer que el modelo prefiera respuestas alineadas con preferencias |
Aprendizaje por refuerzo | Prompts, respuestas del modelo y señales de recompensa | Continuar ajustando la estrategia de generación basándose en recompensas |
Refiriéndose al marco Reinforcement Learning from Human Feedback (RLHF) utilizado en InstructGPT, se ha establecido un pipeline clásico de postentrenamiento. RLHF típicamente usa datos de demostración humana para completar SFT en el primer paso, usa datos de clasificación de respuestas para entrenar un modelo de recompensa en el segundo paso, y usa PPO para optimizar la estrategia de generación del modelo de lenguaje basándose en las puntuaciones del modelo de recompensa en el tercer paso. El proceso específico se muestra en la figura de abajo.
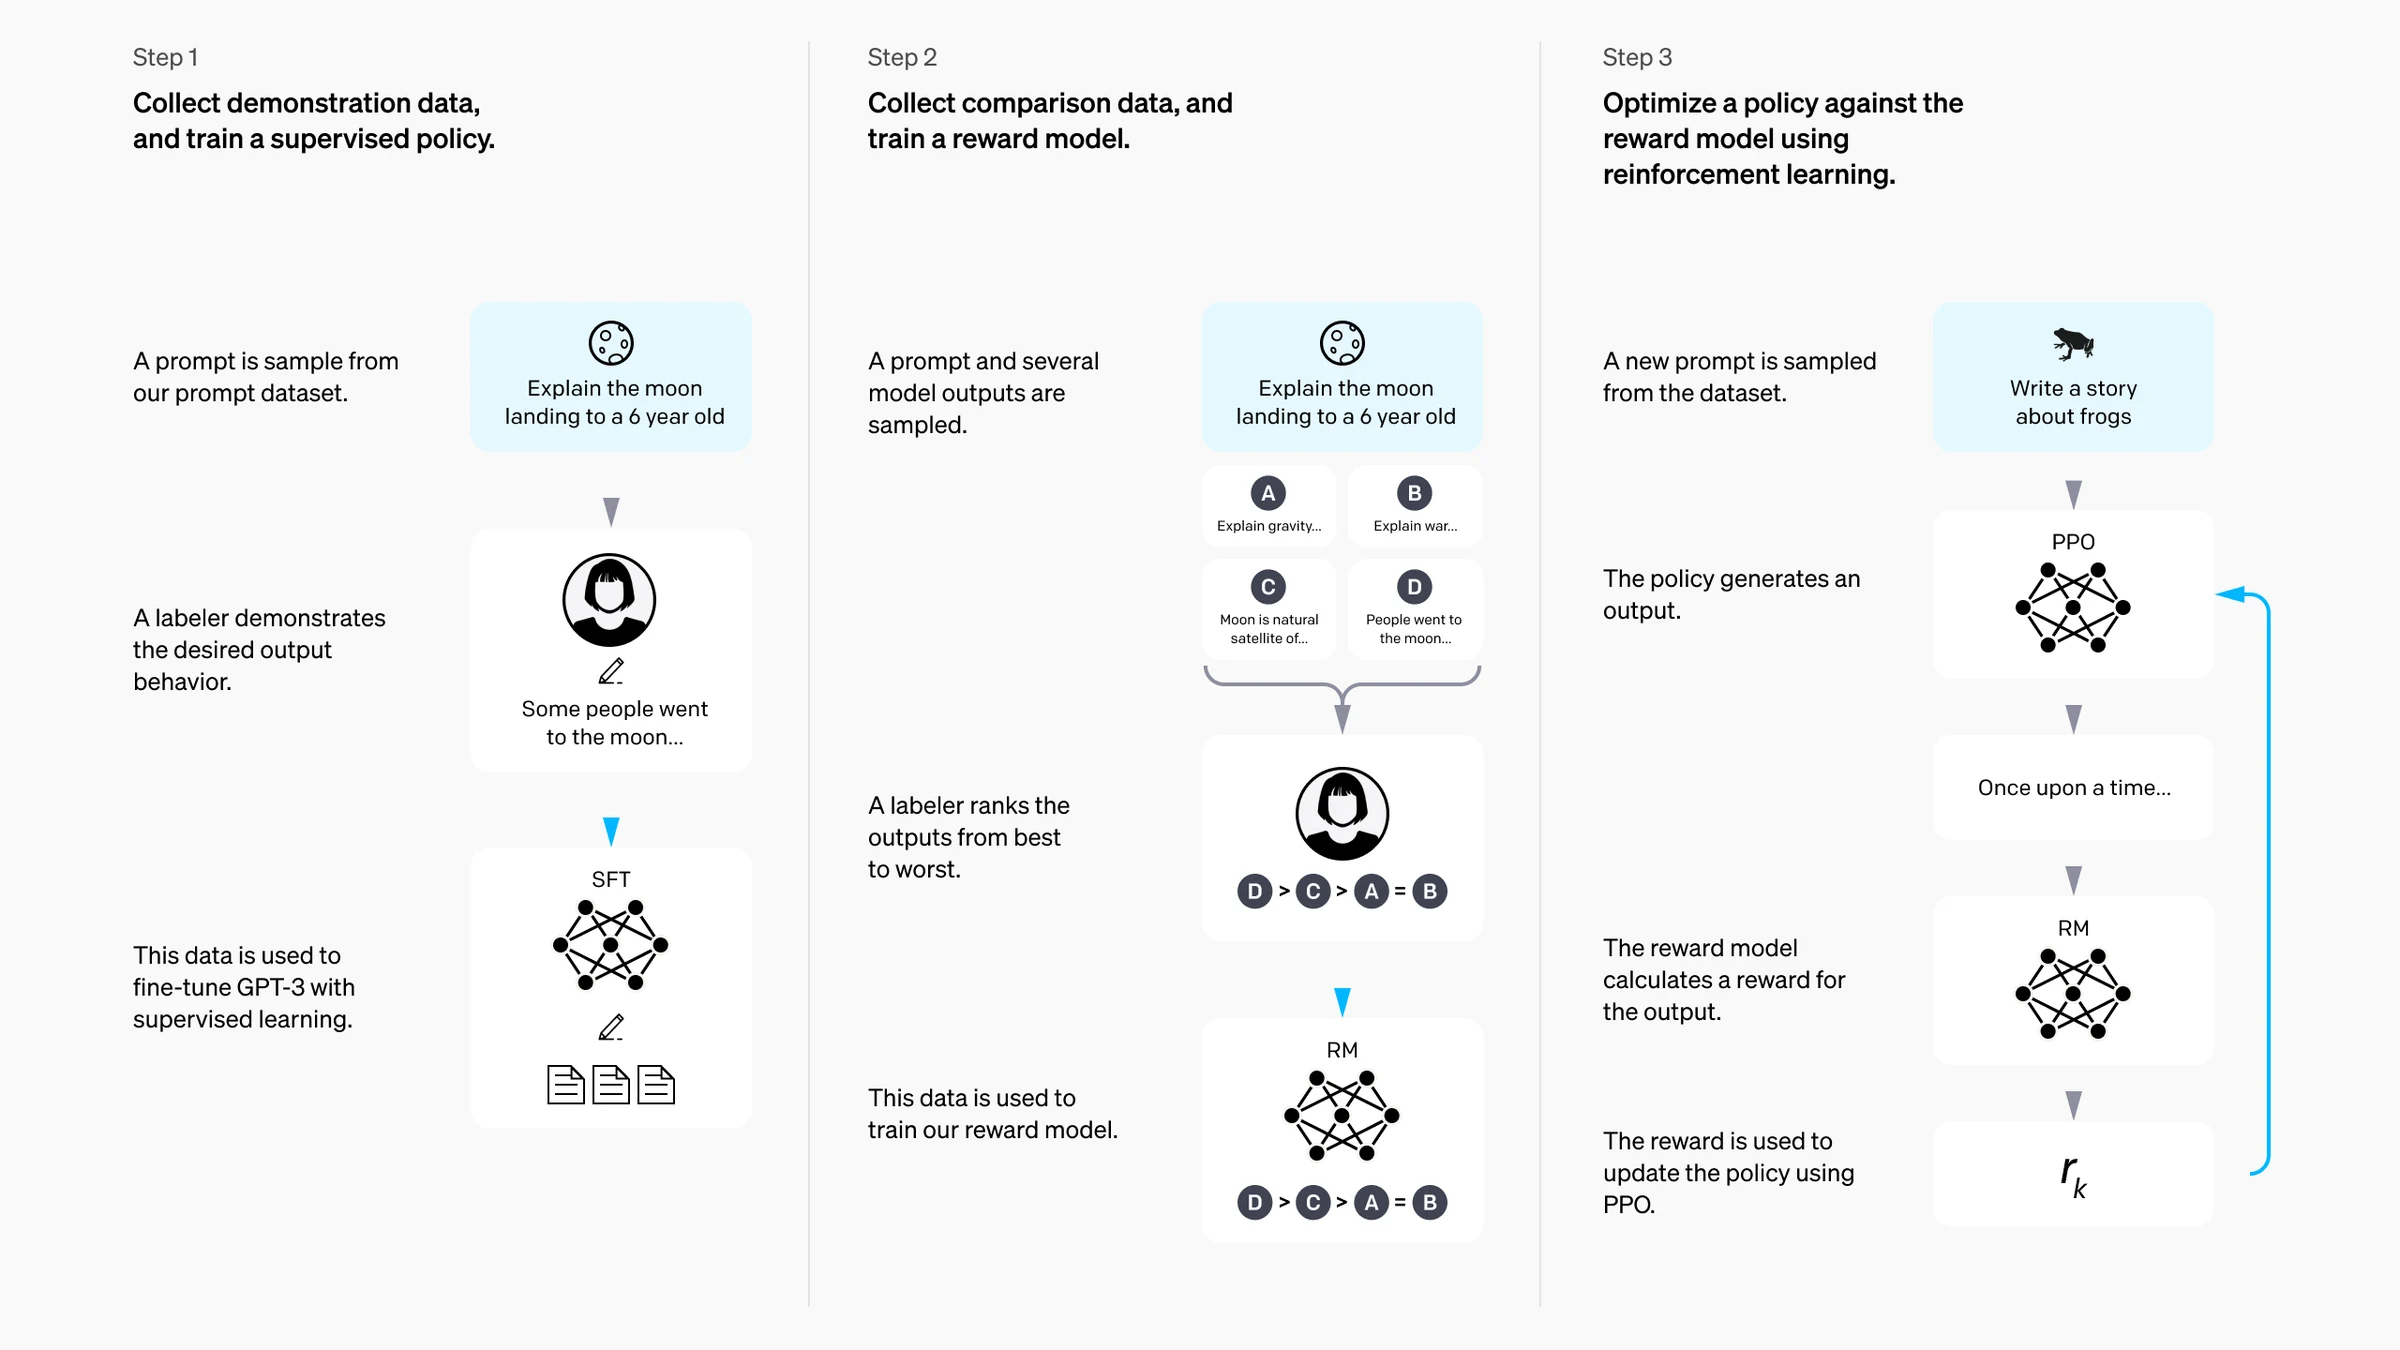
Las puntuaciones dadas por el modelo de recompensa representan una preferencia, no una verdad objetiva. Si la cobertura de datos de preferencia es insuficiente o el diseño de reglas de recompensa es irrazonable, el modelo puede simplemente aprender a adaptarse al método de puntuación.
Los modelos reales no necesariamente siguen exactamente el mismo pipeline. Algunos modelos usan SFT más DPO, otros usan SFT con modelo de recompensa y PPO, y otros incorporan retroalimentación de IA, alineamiento de seguridad, entrenamiento en uso de herramientas y datos de diálogo multi-ronda. El preentrenamiento, ajuste por instrucción y postentrenamiento anteriores explicaron cómo se forman las capacidades del modelo. Después de que el entrenamiento del modelo se completa, los problemas que los usuarios encuentran más frecuentemente son cuánto contenido se puede ingresar a la vez, cuánta VRAM se necesita en tiempo de ejecución, y qué precisión elegir para hardware limitado.
Después de que el modelo completa el entrenamiento, entra en la etapa real de inferencia y despliegue. La longitud del contexto determina cuántos Tokens puede contener una sola solicitud; cuanto más largo sea el contexto, más material puede leer el modelo, pero el cálculo de Attention y el uso de KV Cache también aumentan, afectando la velocidad de inferencia y los requisitos de VRAM. El llamado contexto aquí se refiere al prompt del sistema, historial de conversación, entrada actual, contenido del archivo, descripciones de herramientas, resultados de retorno de herramientas y contenido ya generado por el modelo en una sola solicitud, que puede expresarse como: Uso del contexto = Instrucciones del sistema + Historial de conversación + Entrada actual + Contenido de archivos adjuntos + Información de herramientas + Salida del modelo.
Como se mencionó anteriormente, el uso del contexto de un gran modelo no es solo la entrada actual del usuario sino que está compuesto de múltiples partes, incluyendo instrucciones del sistema, historial de conversaciones anteriores, la entrada actual del usuario, contenido relevante en archivos adjuntos, información requerida para llamadas a herramientas y salida ya generada por el modelo. Todo esto consume la ventana de contexto del modelo, por lo que a medida que las conversaciones se alargan, los archivos adjuntos aumentan o la información de herramientas se vuelve más compleja, el espacio de contexto disponible para entradas y generaciones subsiguientes disminuye gradualmente. Por ejemplo, si un modelo indica soporte para una longitud de contexto de 128K, esto típicamente representa el orden de magnitud total de Tokens que pueden procesarse en una sola solicitud. Si la salida está incluida, cuál es la máxima salida individual, depende de las limitaciones del modelo y la interfaz de servicio. Típicamente, cuando se excede el contexto, la plataforma puede rechazar solicitudes, truncar partes del contenido o comprimir automáticamente registros históricos.
Para mejorar la eficiencia de inferencia y calidad de respuesta del modelo en escenarios de documentos largos, el contenido debe organizarse tanto como sea posible antes de ingresar materiales, eliminando información no relevante para la tarea, duplicada o de bajo valor, e indicando claramente al modelo en qué secciones, campos o áreas de preguntas concentrarse, evitando que el modelo dispersa su atención en grandes cantidades de contexto no relevante. Para materiales particularmente largos difíciles de procesar completamente a la vez, pueden segmentarse por capítulo, tema o longitud fija primero, dejando que el modelo complete extracción de información, resumen o análisis por separado, luego unificando y evaluando de manera integral los resultados de cada parte. Para conclusiones claves, datos importantes o contenido que necesita verificación adicional, el modelo también debe ser llevado a indicar la ubicación original, capítulo o número de página correspondiente, facilitando la inspección manual y el rastreo de resultados subsiguientes, mejorando así la precisión general del procesamiento, interpretabilidad y confiabilidad.
Los modelos generativos basados en la arquitectura Transformer típicamente generan Tokens uno a la vez. Durante la generación, si la información de atención para todos los Tokens anteriores se recalculara para cada nuevo Token, produciría cantidades masivas de trabajo redundante. Por lo tanto, introducir un mecanismo de almacenamiento en caché conocido como KV Cache es beneficioso. KV Cache almacena los Key y Value que ya han sido calculados en cada capa, por lo que al generar el siguiente Token, solo las partes nuevas necesitan calcularse, mejorando la velocidad de generación. Por cada Token adicional, cada capa del Transformer debe guardar el K y V correspondiente. Por lo tanto, KV Cache crece con la longitud del contexto, longitud de salida, concurrencia y número de capas del modelo.
Para modelos comunes de solo Decodificador, el uso de cache para una sola secuencia puede entenderse usando la siguiente fórmula simplificada:
Uso de KV Cache
\approx
2 \times Número de capas
\times Número de Tokens
\times Número de cabezas KV
\times Dimensión por cabeza
\times Bytes por número
Después de que se cargan los pesos del modelo, su uso es relativamente fijo, pero KV Cache cambia con las solicitudes. Por lo tanto, el mismo modelo cuantizado puede funcionar sin problemas en preguntas y respuestas cortas pero quedarse sin VRAM al manejar documentos largos o múltiples usuarios concurrentes. Por ejemplo, el mismo servidor puede funcionar normalmente al procesar un solo registro corto de reunión, pero si diez usuarios suben simultáneamente registros largos, el modelo necesita almacenar KV Cache por separado para múltiples secuencias, y la presión de VRAM aumenta significativamente. Esto también explica por qué, incluso si el archivo del modelo cabe en la VRAM, el consumo de recursos de cálculo cambia a medida que aumentan la longitud del texto y la concurrencia. Por lo tanto, en el despliegue práctico, la presión de KV Cache puede reducirse y la eficiencia del servicio de cómputo mejorarse acortando el contexto no relevante, limitando la longitud máxima de generación, reduciendo la concurrencia, usando cache paginado, o eligiendo modelos que usen estructuras GQA o MQA.
Los archivos del modelo esencialmente almacenan la estructura actual del modelo y sus parámetros asociados, que son fundamentalmente un conjunto de números. Basándose en principios de arquitectura de computadora, estos parámetros típicamente se expresan como combinaciones de 0 y 1. Usando diferentes anchos de bits para representar el mismo valor, se define tanto el rango numérico como la precisión. Durante el entrenamiento del modelo, típicamente se usan formatos de punto flotante como FP32, FP16 o BF16 para el cálculo, representando un número con 32 bits o 16 bits de 0 y 1. Aunque más bits aumentan tanto el rango numérico como la precisión, el consumo real de recursos también es sustancial. Por lo tanto, se propusieron métodos de cuantificación para reducir aún más el consumo de recursos. La cuantificación convierte estos valores de punto flotante multi-bits en representaciones de menor precisión como INT8 de 8 bits o INT4 de 4 bits, reduciendo el tamaño del archivo del modelo y el uso de recursos en tiempo de ejecución. La siguiente tabla muestra las características correspondientes a diferentes precisiones de punto flotante:
Precisión | Bytes teóricos por parámetro | Características típicas |
FP32 | 4 | Mayor precisión, mayor uso de recursos |
FP16 / BF16 | 2 | Formato común de entrenamiento e inferencia de alta precisión |
INT8 | 1 | Pesos teóricos usando aproximadamente la mitad de 16 bits |
INT4 | 0,5 | Pesos teóricos usando aproximadamente un cuarto de 16 bits |
La cuantificación real no redondea simple todos los decimales; proyecta un grupo de valores de punto flotante en un rango finito mientras almacena factores de escala, puntos cero o información de grupo. Los enfoques comunes incluyen comprimir solo pesos del modelo, cuantificar tanto pesos como activaciones, y cuantificación post-entrenamiento después de que se completa el entrenamiento del modelo. No necesitamos preocuparnos excesivamente por los cambios numéricos causados por la cuantificación, porque durante la generación, el modelo predice la probabilidad de cada Token candidato como la siguiente palabra, y durante la selección, principalmente se preocupa por clasificación y puntuaciones normalizadas. Por lo tanto, aunque la cuantificación efectivamente pierde algo de precisión, bajo controles estrictos, puede efectivamente equilibrar la calidad de generación del modelo.
Al seleccionar modelos, a menudo es necesario determinar si la VRAM es suficiente. Los 7B, 14B y 70B en los nombres de modelo típicamente representan aproximadamente 7 mil millones, 14 mil millones y 70 mil millones de parámetros respectivamente. Los parámetros son los valores numéricos aprendidos durante el entrenamiento del modelo, distribuidos a través de módulos como Attention, redes feed-forward y Embedding.
El número de parámetros no puede equipararse directamente con el tamaño del archivo del modelo; la precisión usada para cada parámetro también debe considerarse. Al calcular solo los pesos del modelo, se puede usar la siguiente fórmula:
Uso de pesos ≈ Número de parámetros × Bytes por parámetro
Escala de parámetros | FP16 / BF16 | INT8 | INT4 |
7B | ~14GB | ~7GB | ~3,5GB |
14B | ~28GB | ~14GB | ~7GB |
32B | ~64GB | ~32GB | ~16GB |
70B | ~140GB | ~70GB | ~35GB |
Los números en la tabla solo representan el límite teórico inferior de los pesos del modelo. Los modelos cuantizados también necesitan almacenar factores de escala y otra información, y la inferencia real también requiere KV Cache, resultados de cálculo intermedio, espacios de trabajo del framework de inferencia y caches de solicitudes concurrentes.
Por ejemplo, los pesos INT4 de un modelo 14B son teóricamente aproximadamente 7GB, pero en una tarjeta gráfica de 8GB casi no queda espacio para KV Cache y buffers de ejecución. Puede funcionar con contexto corto y solicitudes únicas, pero es propenso a quedarse sin VRAM al procesar documentos largos. Usar 12GB o 16GB de VRAM es más cómodo. Los pesos INT4 de 70B son aproximadamente 35GB, generalmente requiriendo más de 48GB de VRAM. En el despliegue, las opciones incluyen usar tarjetas gráficas con más VRAM, configuraciones multi-tarjeta o usar memoria CPU para inferencia mixta.
Los grandes modelos generales necesitan cubrir extensos conocimientos y tareas. En escenarios especializados como salud, finanzas, derecho y código, pueden no estar familiarizados con la terminología de la industria, procesos de negocio y límites de riesgo. Los modelos de dominio típicamente se entrenan o adaptan sobre un modelo base general usando datos y tareas profesionales, haciendo el modelo más adecuado para un dominio particular. No necesariamente necesitan entrenarse desde cero, ni simplemente convertirse en expertos del dominio a través de prompts. Los métodos comunes de entrenamiento y adaptación incluyen:
Es importante distinguir entre modelos de dominio y aplicaciones de dominio. Los modelos de dominio han sido entrenados con datos profesionales, y las capacidades profesionales ya están incorporadas en los parámetros del modelo. Las aplicaciones de dominio pueden directamente usar modelos generales, luego conectarse a bases de conocimiento profesionales, reglas y herramientas. Los sistemas prácticos a menudo combinan ambos enfoques.
El sistema de preguntas y respuestas legales ilustrado en la figura de abajo primero extrae palabras clave, luego recupera artículos de referencia de la base vectorial legal, y finalmente, el gran modelo legal genera respuestas combinando evidencia. Esto demuestra que la capacidad profesional no necesariamente depende solo de los parámetros del modelo; los materiales externos también son un componente importante de las aplicaciones de dominio.
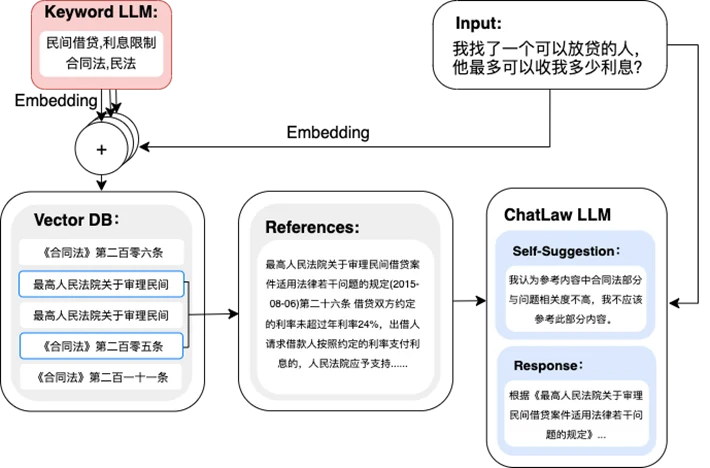
Los datos profesionales no equivalen a confiabilidad profesional. Los modelos médicos aún necesitan verificar evidencia médica y límites de seguridad, los modelos legales necesitan verificar artículos de ley y citas, los modelos financieros necesitan verificar actualidad de datos y resultados de cálculo, y los modelos de código necesitan verificación a través de ejecución y prueba. Las tareas de alto riesgo en salud, derecho y finanzas también deberían retener aprobación profesional.
Al usar un modelo para organizar actas de reunión, si el texto original no especifica una persona responsable pero el modelo inventa un nombre; al usar un modelo para extraer información de contratos, si el texto original no contiene un monto pero el modelo genera un número específico — estos son todos ejemplos de alucinación del modelo. La alucinación del modelo se refiere a cuando un gran modelo genera contenido que es lingüísticamente fluido y estructuralmente completo pero incompatible con hechos, materiales de entrada o fuentes verificables. También puede manifestarse como fabricación de políticas, artículos o URLs inexistentes, identificación errónea de personas y fechas, o presentación de discusiones no confirmadas como conclusiones establecidas.
La tarea central de los grandes modelos es predecir el siguiente Token basándose en contexto; durante la generación, el modelo no puede verificar si cada oración es verdadera. Hay muchas causas de alucinación del modelo. Por ejemplo, los datos de preentrenamiento pueden contener errores u obsoletos; las preguntas de los usuarios pueden faltar condiciones clave; y la evidencia en textos largos puede ser ignorada o truncada. Si el postentrenamiento diseña funciones de recompensa que favorecen respuestas completas y fluidas, también puede causar que el modelo continúe generando incluso sin base suficiente.
Las alucinaciones producidas por modelos también son diversas y típicamente pueden clasificarse como alucinación factual, alucinación de atribución, alucinación de razonamiento, etc. Las clasificaciones detalladas y manifestaciones típicas se muestran en la siguiente tabla:
Tipo | Manifestación típica |
Alucinación factual | Nombres, fechas, números y eventos inconsistentes con la realidad |
Alucinación de atribución | Artículos, disposiciones legales, enlaces o fuentes fabricados |
Alucinación de entrada | Generación de conclusiones y campos ausentes del material original |
Alucinación de razonamiento | Errores en el razonamiento intermedio, pero la respuesta expresada con certeza |
Alucinación de herramienta | Afirmación haber leído un archivo o llamado una interfaz sin haberlo logrado realmente |
Además de los modelos generales, los modelos de dominio entrenados con datos profesionales también pueden producir alucinaciones. Típicamente, los datos profesionales pueden mejorar el rendimiento de dominio pero no pueden garantizar que cada respuesta sea exacta. La recuperación de bases de conocimiento tampoco puede resolver completamente todos los problemas de alucinación. Si los materiales recuperados no son relevantes, están obsoletos o contienen errores, el modelo aún puede llegar a conclusiones incorrectas, llevando más a alucinaciones.
La alucinación del modelo es un problema relativamente común en las aplicaciones actuales. Simplemente agregar una oración como "no fabricar" o "por favor asegurar exactitud" al prompt generalmente no puede eliminar fundamentalmente este riesgo. El modelo es fundamentalmente aún prediciendo el contenido más probable basándose en contexto, y cuando la información de entrada es insuficiente, los materiales contienen conflictos, o la pregunta en sí excede el rango de conocimiento confiable del modelo, aún puede generar respuestas que parezcan plausibles pero son realmente inexactas. Por lo tanto, reducir el riesgo de alucinación depende más de un conjunto completo de restricciones de entrada, verificación externa y mecanismos de revisión humana.
Primero, los modelos deberían recibir materiales claros, relevantes e internamente consistentes tanto como sea posible, reduciendo la interferencia de información no relevante y conflictiva en el proceso de juicio. Para contenido clave como hechos, números, disposiciones regulatorias y resultados experimentales, el modelo puede ser llevado a indicar simultáneamente fuentes, secciones, números de página o ubicaciones originales correspondientes, haciendo las respuestas rastreables para verificación subsiguiente. Para conocimiento frecuentemente actualizado como noticias, políticas, precios, regulaciones y parámetros de productos, no se debería depender solo de la memoria interna del modelo sino obtener la información más reciente a través de motores de búsqueda, bases de conocimiento, bases de datos, APIs u otras herramientas externas, luego dejar que el modelo analice basándose en estos materiales confiables.
Segundo, cuando el material original genuinamente carece de cierta información, el modelo debería ser llevado explícitamente a marcarla usando expresiones como "pendiente de confirmación", "no proporcionado en el original" o "no se puede determinar basándose en materiales existentes", en lugar de completarla basándose en experiencia. Para contenido adecuado para verificación estructurada — como fechas, montos, números de identificación, datos estadísticos, fórmulas y resultados de ejecución de código — se pueden introducir programas para verificación automática, por ejemplo verificando rangos numéricos, formatos de campos, resultados de cálculo y si el código puede realmente ejecutarse, evitando así que el modelo genere resultados basándose solo en generación de lenguaje.
Además, para conclusiones importantes — especialmente aquellas que afectan decisiones de negocio, aceptación de proyectos o derechos de usuarios — se debería retener un paso de revisión humana. La expresión de lenguaje fluida y la lógica aparentemente completa no necesariamente significan que los hechos sean correctos, por lo tanto "suena como verdad" no debería equipararse directamente con "es realmente verdad". En escenarios de alto riesgo como salud, derecho, finanzas y seguridad de producción, debería quedar claro que el modelo es simplemente una herramienta auxiliar, y las conclusiones finales necesitan ser revisadas y confirmadas por profesionales calificados con la experiencia apropiada.
Por lo tanto, el enfoque central para reducir la alucinación no es exigir que el modelo "siempre responda" sino enseñar al modelo a detenerse razonablemente cuando carece de base confiable. Cuando la información existente es insuficiente para apoyar una conclusión, el comportamiento más apropiado puede ser indicar claramente "qué materiales clave faltan actualmente" e "qué conclusiones no se pueden confirmar en este momento", e informar más al usuario qué datos, documentos o evidencia necesitan suministrarse. Comparado con continuar generando una respuesta que parece completa pero carece de base, este enfoque generalmente es más confiable y más adecuado para aplicaciones de negocio prácticas.