Data: The Foundation of Fine-Tuning
डेटा: ओपन सोर्स मॉडल फाइन-ट्यूनिंग की नींव
क्या आपने कभी ऐसा मॉडल देखा है जो कोडिंग और गणित में उत्कृष्ट है, लेकिन रोज़मर्रा के सवालों का बेतरतीब जवाब देता है?
हम सभी जानते हैं कि प्रशिक्षण के दौरान किसी विशेष क्षमता को बेहतर बनाने के लिए उस प्रकार का डेटा खोजना होता है,
लेकिन कई डेटासेट सीधे इंटरनेट खोज में मिलना मुश्किल है। एक एकीकृत डाउनलोड पोर्टल प्रशिक्षकों के लिए बहुत मेहत बचाता है।
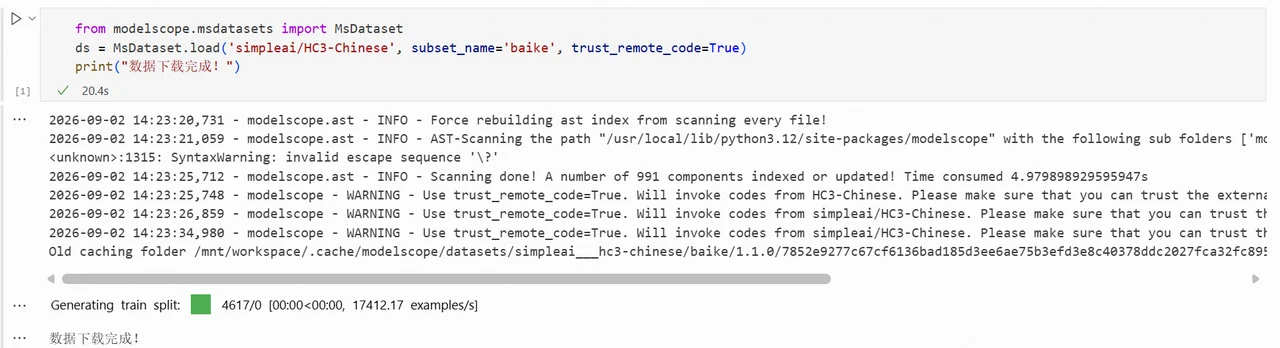
उदाहरण के लिए, हमारे चीनी DeepSeek-R1 डिस्टिल्ड डेटासेट का कच्चा डेटा ModelScope से सीधे डाउनलोड किया गया,
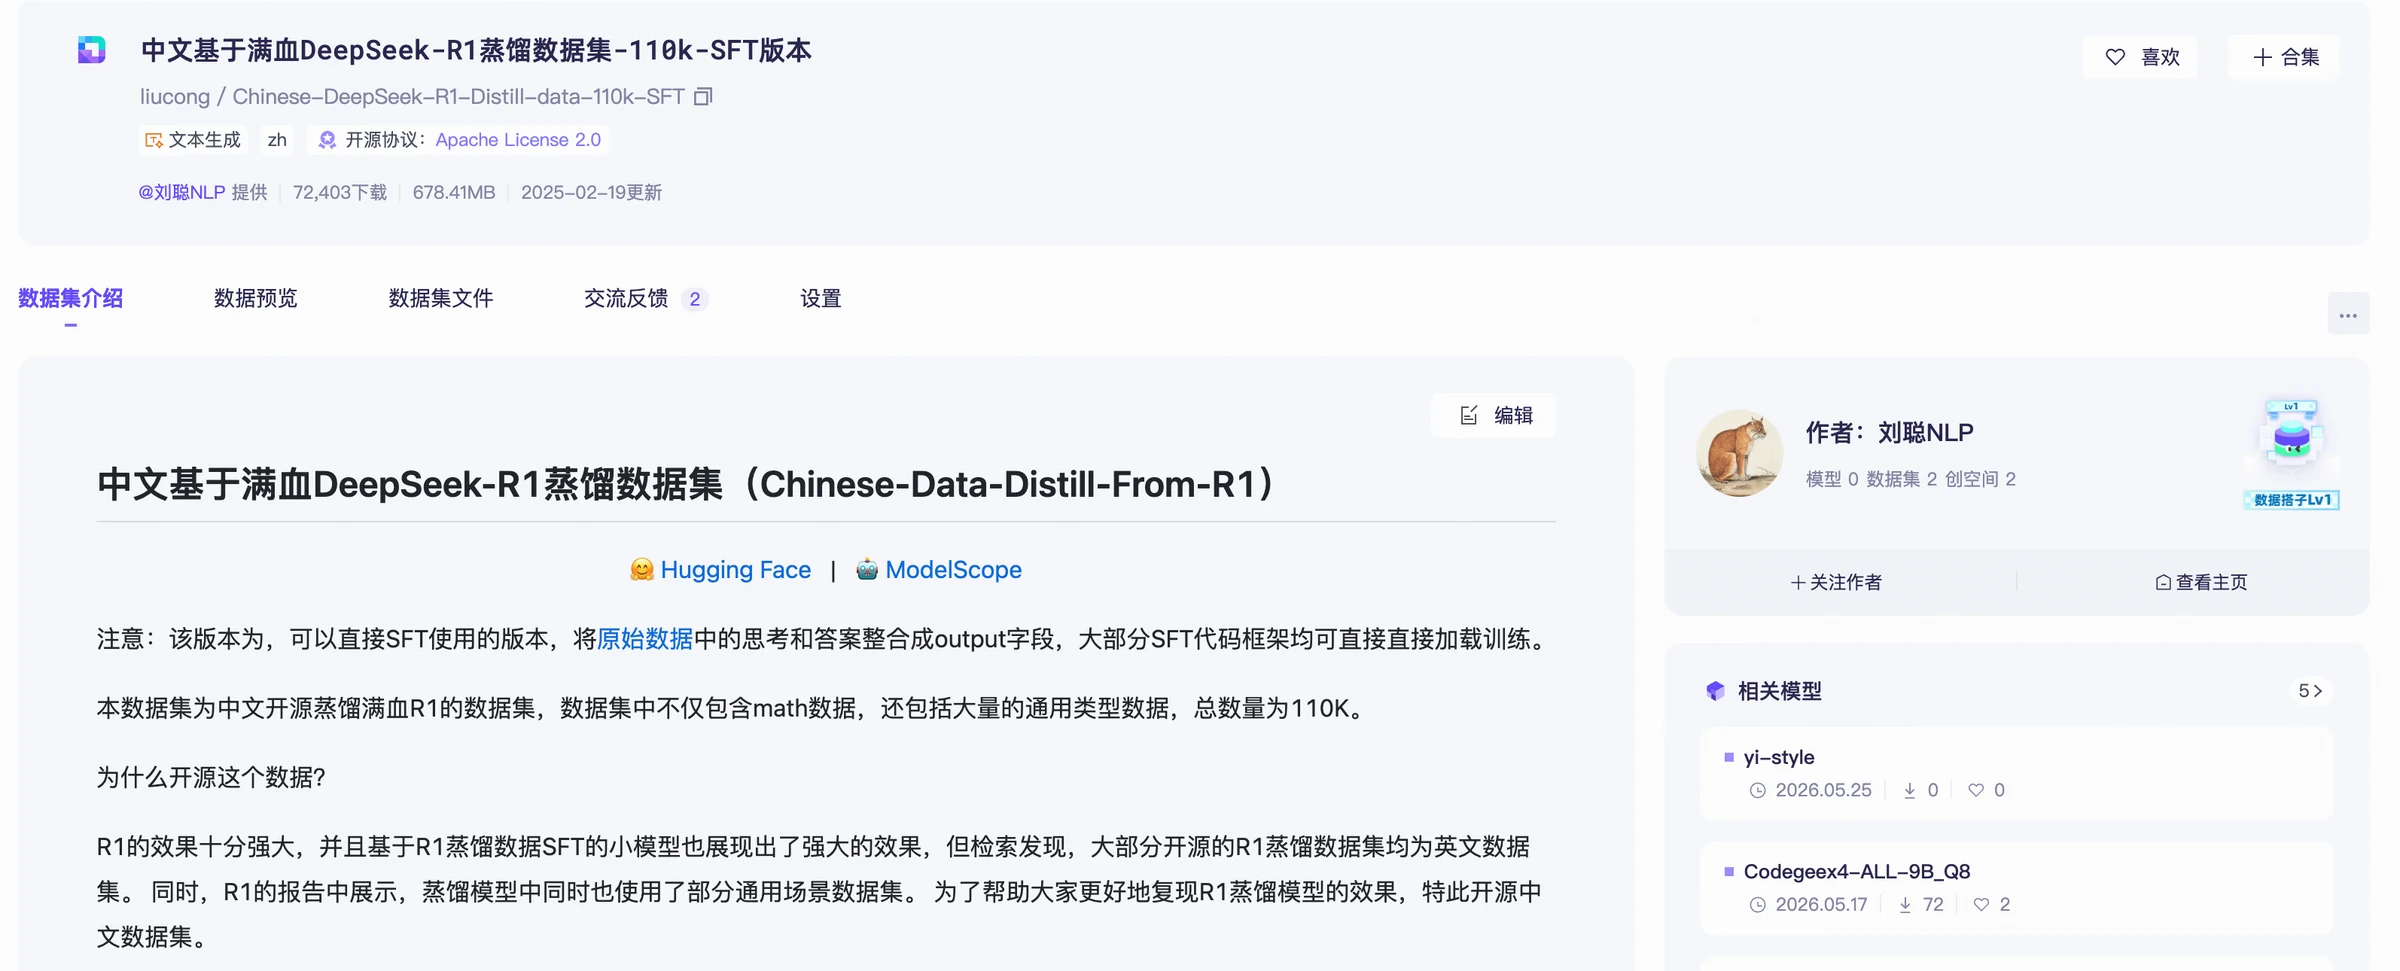
मॉडल की फाइन-ट्यूनिंग मौजूदा ओपन सोर्स डेटासेट से शुरू हो सकती है, जिससे पूरी प्रक्रिया जल्दी चलाई जा सकती है।
डेटा खोजना, पहले जानें आप क्या करने की योजना बना रहे हैं
ModelScope में 40,000 से अधिक ओपन सोर्स डेटासेट हैं, खोज, पूर्वावलोकन, फ़ील्ड विवरण और संस्करण प्रदान करता है।
ModelScope कीवर्ड टैग और कार्य श्रेणियों के अनुसार खोज का समर्थन करता है, जैसे चीनी बाइनरी टेक्स्ट वर्गीकरण डेटा।
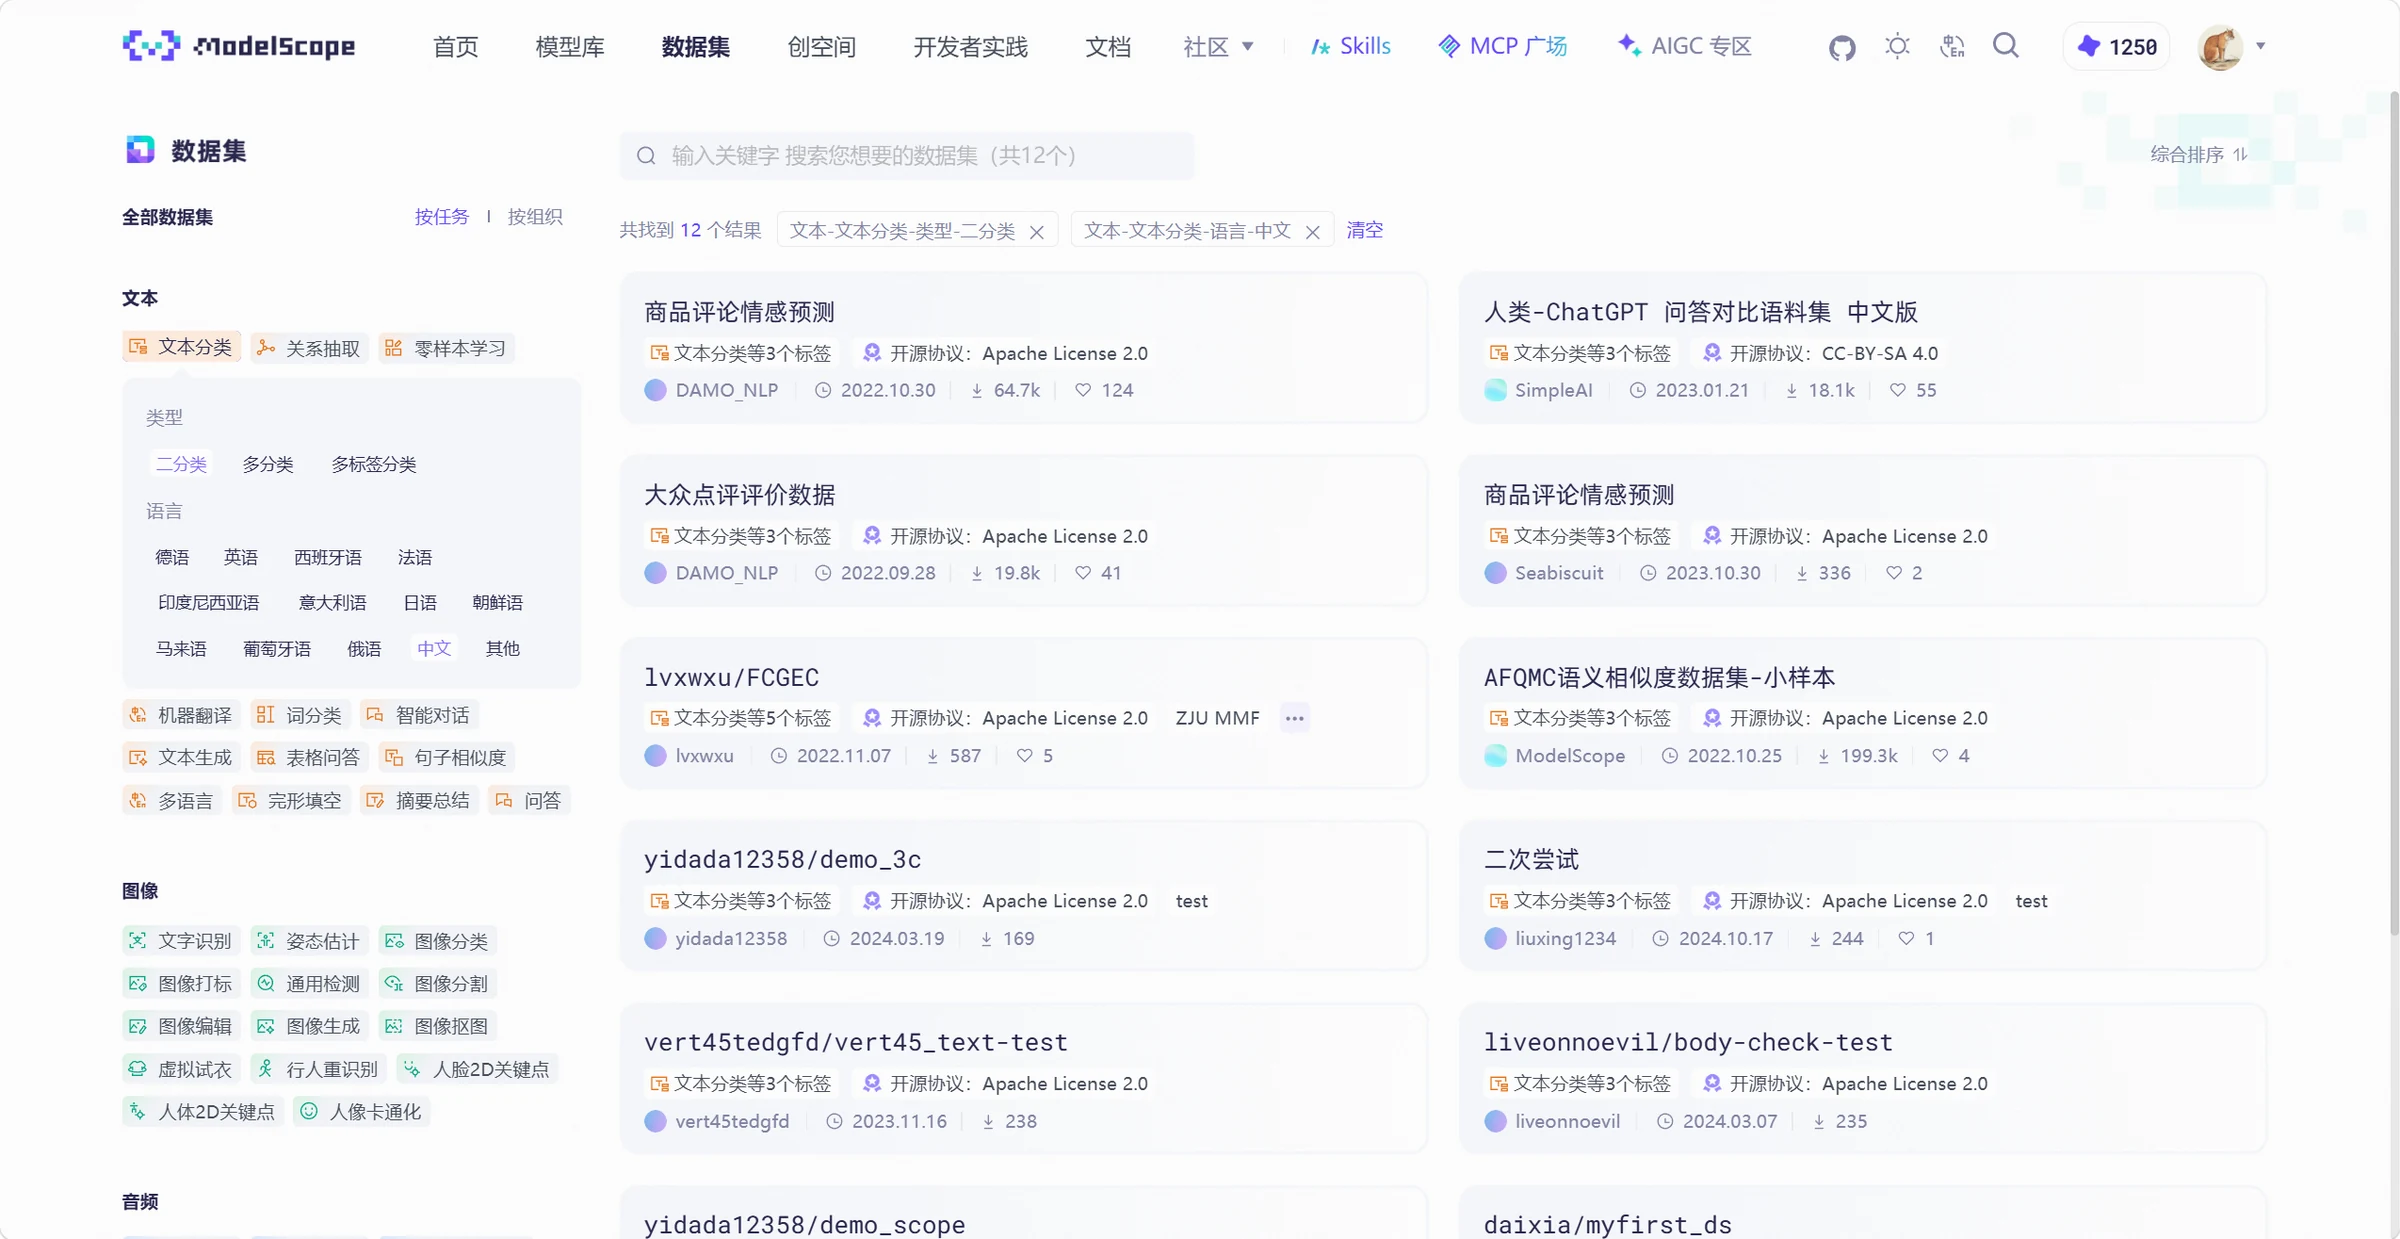
डाउनलोड करने से पहले, कुछ नमूने देखें
फ़िल्टरिंग के बाद, एक डेटासेट चुनें और 'डेटा पूर्वावलोकन' पर क्लिक करें। simpleai/HC3-Chinese जैसे।
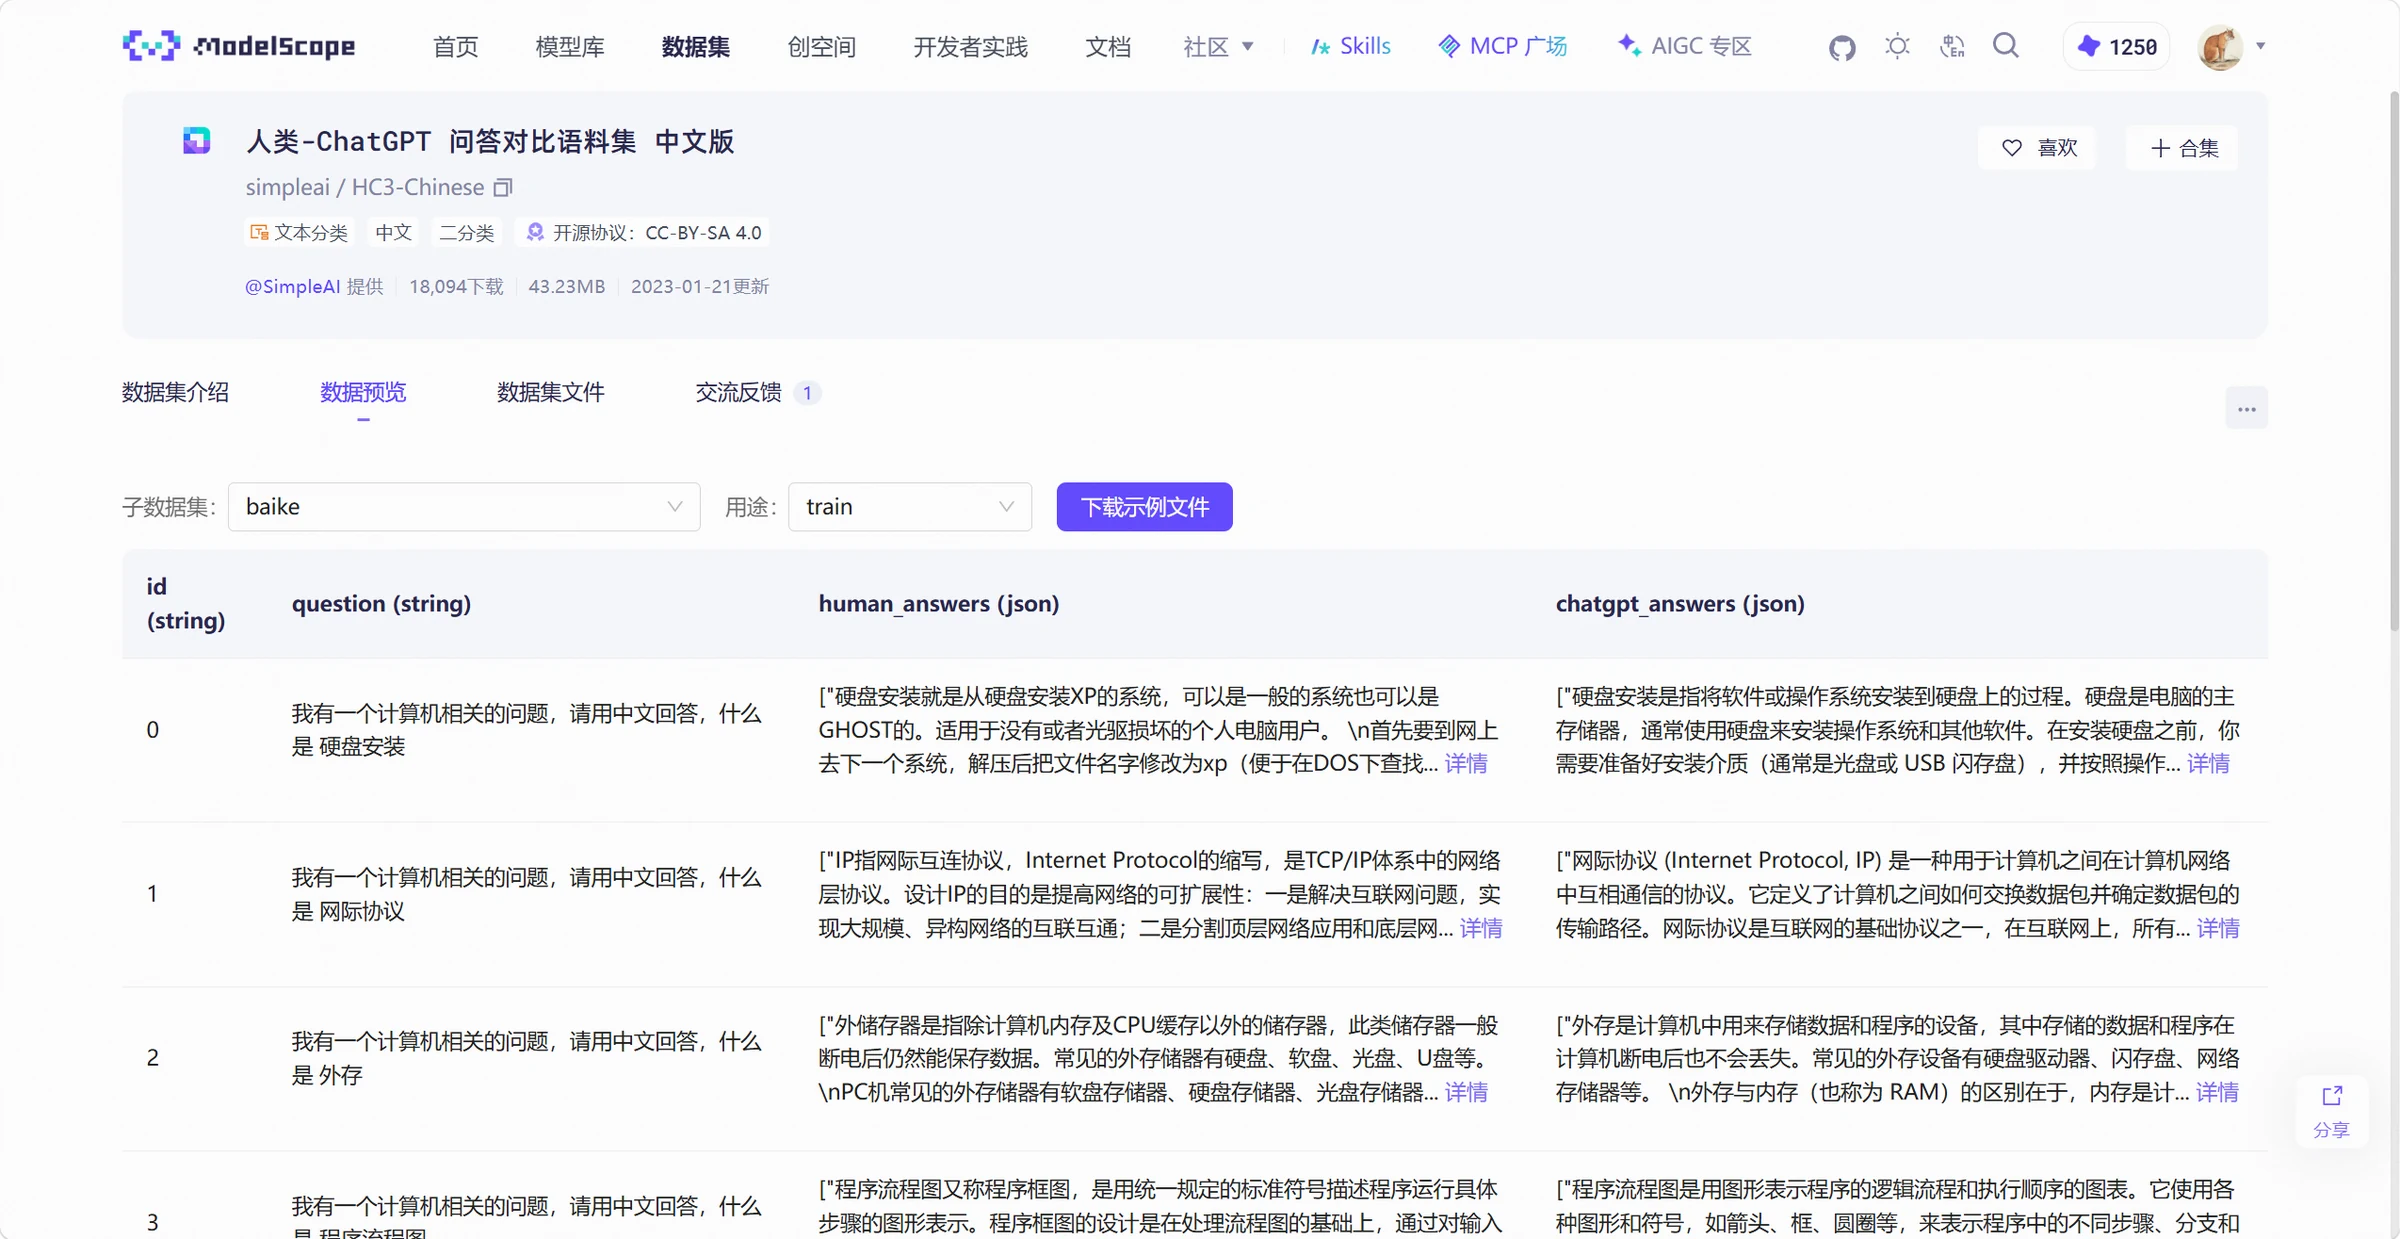
कौन सा कॉलम प्रश्न, उत्तर, लेबल रखता है, और क्या प्रत्येक रिकॉर्ड टेक्स्ट है या संवाद — यह सब पहले से जाँचा जा सकता है।
QA डेटा के लिए, मानव उत्तर और मॉडल उत्तर अलग-अलग फ़ील्ड में हो सकते हैं। प्रशिक्षण से पहले तय करें कि कौन से फ़ील्ड पढ़ने हैं।
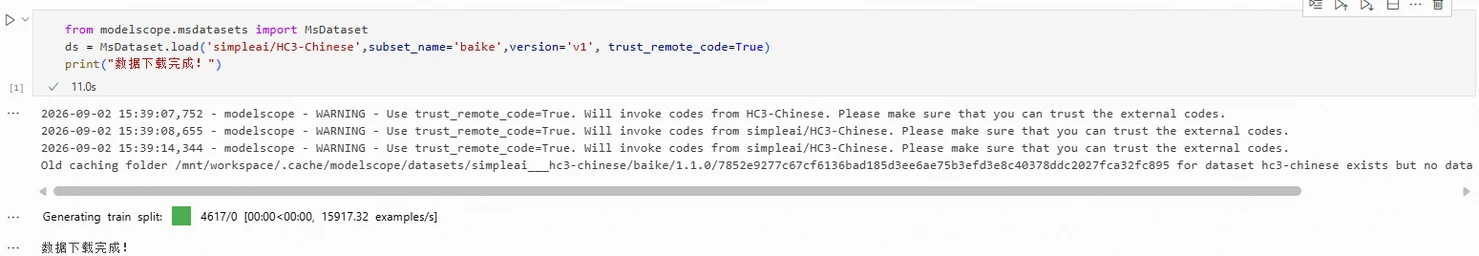
डेटासेट फ़ाइलें और संस्करण देखें। डेटासेट अपडेट होते हैं; पुनरुत्पादन के लिए उपयोग किया गया संस्करण नोट करें।
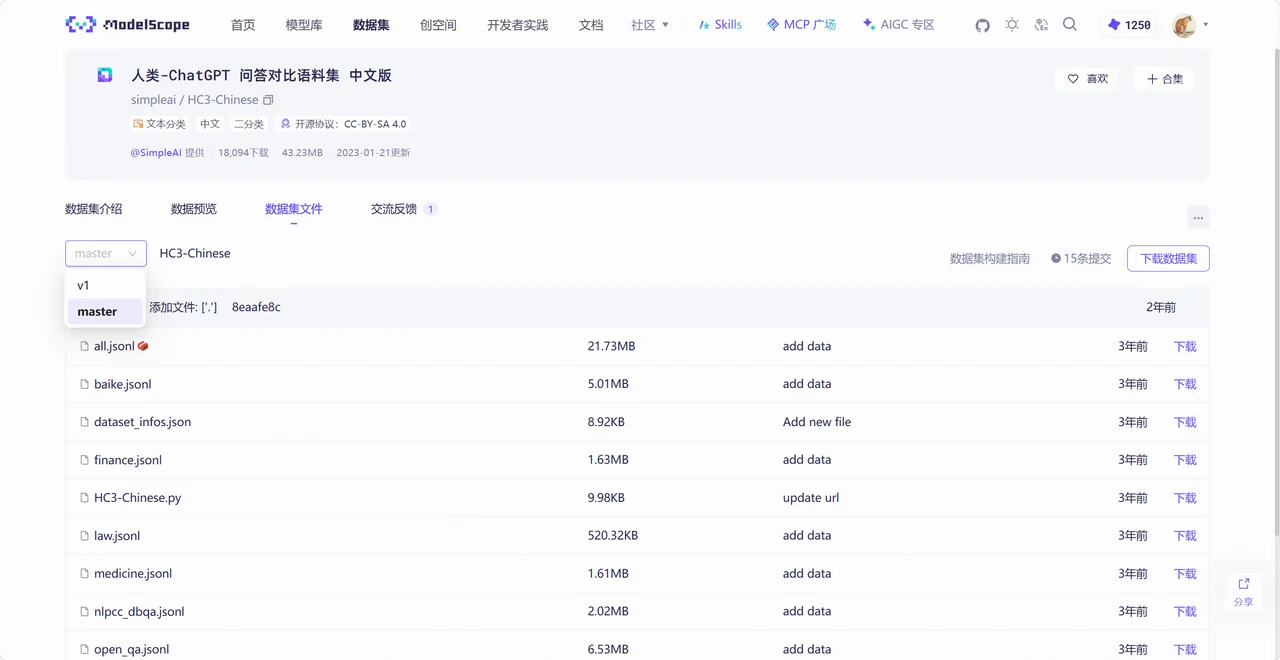
डेटासेट विवरण और लाइसेंस भी देखने योग्य हैं। डाउनलोड किया गया डेटा अनुसंधान, प्रशिक्षण या वाणिज्यिक उपयोग के लिए अलग-अलग आवश्यकताएं रख सकता है।
पहले डेटा लोड करें, फिर तय करें कि क्या उपयोग करना है
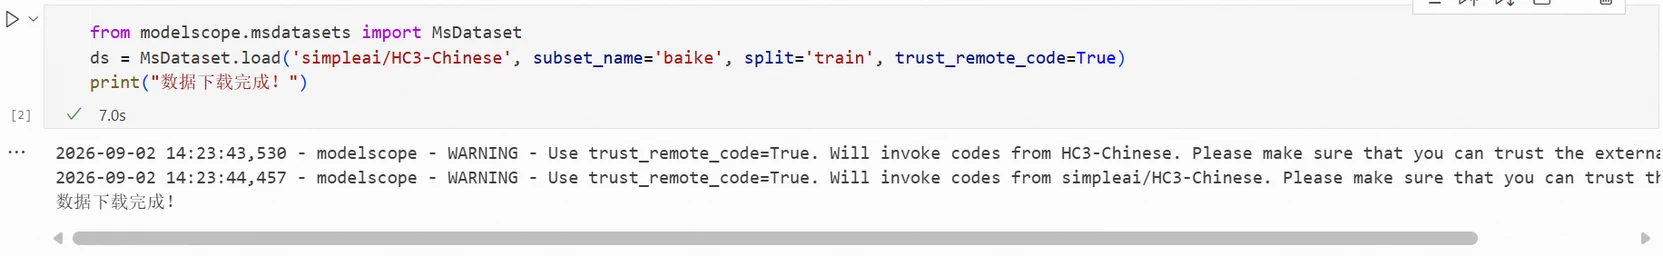
ModelScope MsDataset.load इंटरफ़ेस प्रदान करता है जिससे Python में डेटासेट लोड किए जा सकते हैं। इंस्टॉल के बाद, डेटासेट पेज के निर्देशों का पालन करें।
पहले एक पूर्ण डेटासेट लोड करें
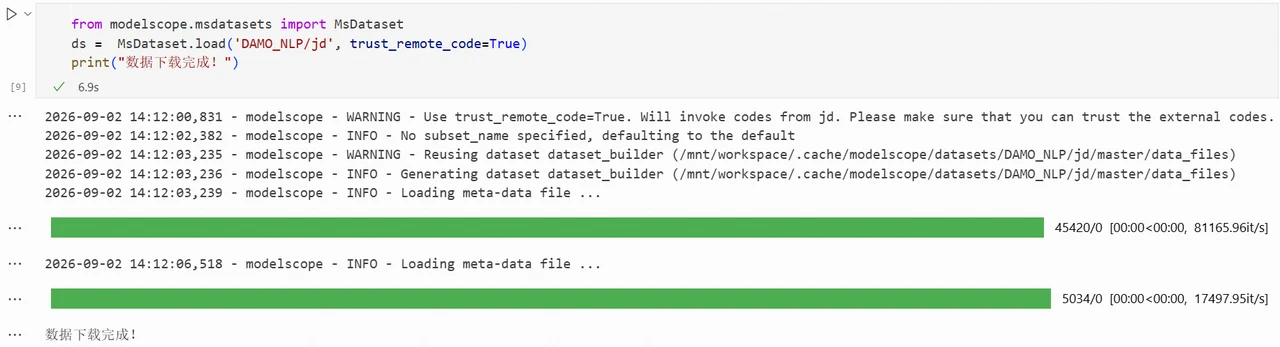
DAMO_NLP/jd उदाहरण के रूप में, डिफ़ॉल्ट कॉन्फ़िगरेशन इस तरह पढ़ा जा सकता है,
from modelscope.msdatasets import MsDataset

ds = MsDataset.load(
    'DAMO_NLP/jd',
    trust_remote_code=True,
)
print(ds)
यदि केवल एक सबसेट चाहिए, तो नाम स्पष्ट रूप से लिखें
चर्चा
साइन इन करें चर्चा में शामिल हों