फाइन-ट्यूनिंग और मूल्यांकन • शुरुआती⏱️ 25 मिनट पढ़ने का समय
Fine-Tuning with ms-swift
ms-swift ka upyog karke open-source model ka halka fine-tuning jaldi se poora karein
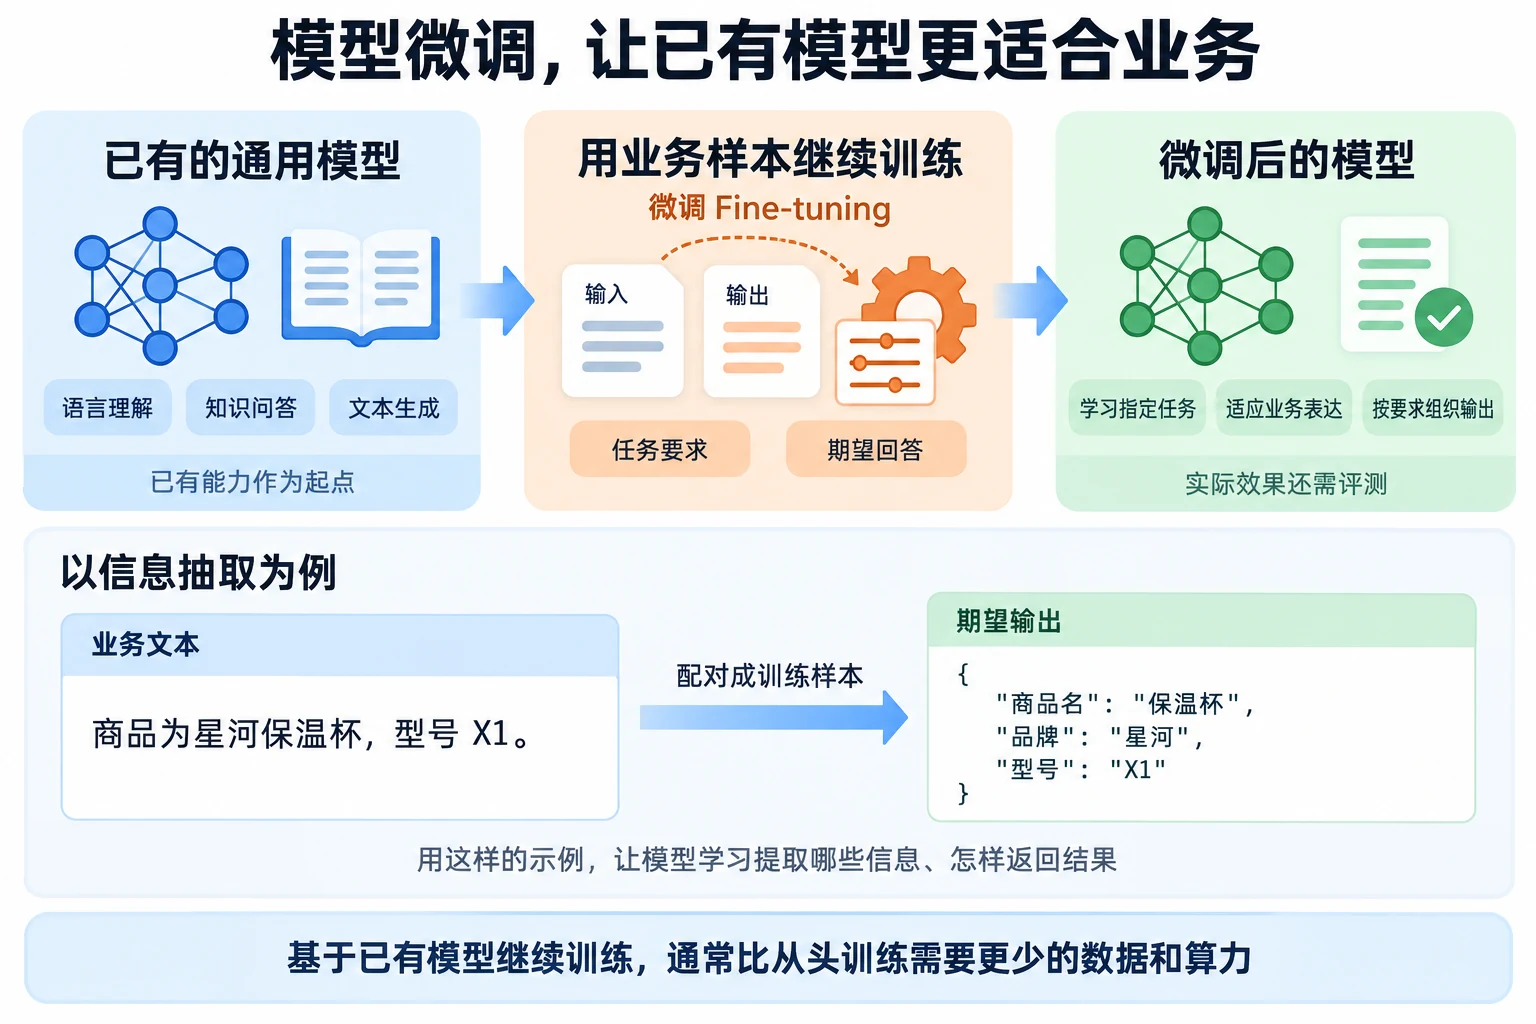
Jab aam model seedhe vyavasayik zarooraton ko poora nahi kar paata, toh apne vyavasayik data se model ka fine-tuning kar sakte hain, jisse model vishesh kaam aur output tarika aur acche se seekh sakta hai.
E-commerce entity recognition task ka example lete hain — hume model se text mein se product name, brand name, aur model nikalna hota hai, unka sahi category aur position dena hota hai. Model in products ke baare mein baat toh kar sakta hai, lekin jab use karte hain toh zaroori hai ki extracted information poori ho, fields uniform hon, aur output format stable rahe.
Jab task aur output ki demands spasht ho aur taiyaar udaharan bhi ho, toh in data se fine-tuning karke model ko sikha sakte hain ki hum kya chahte hain. Ki sabhi parameters update karne hain ya nahi, aur GPU kaafi hai ya nahi — ye task aur resources ke anusar decide karna hota hai.
Ab ms-swift se ek LoRA fine-tuning shuru karte hain aur data preparation, training, weight merging aur inference ek ek karke chalayenge.
Fine-tuning model ke kis hisse ko badalta hai?
Aam bade model pehle se hi bhasha samajh, knowledge-based prashno ke jawaab, text generation jaise kaafi kaabil hain. Lekin vastavik vyavasay mein, inka performance seedhe aam zarooraton ko poora nahi kar paata.
Udaharan ke liye, agar hum chahte hain ki model kisi vishesh jaankari nikaalne ke kaam ko sahi se kare, nirdhit format mein output de, ya kisi khaas sawaal ka ek unified tarike se jawaab de — toh in zarooraton ke liye maujooda model ko aur train karna padta hai. Is prakriya ko hi Fine-tuning (baarik samayojan) kehte hain.
Fine-tuning ka matlab naya model train karna nahi hai, balki maujooda model ki capability ko aur acche se vishesh paristhitiyon ke liye taiyaar karna hai. Shuru se bade model train karne ki tulna mein, fine-tuning ke liye kam data aur compute resources ki zaroorat hoti hai.
Abhi, bade model fine-tuning mein sabse aam tarika SFT (Supervised Fine-Tuning, dekhrekh wala samayojan) hai. SFT mein labeled data ka upyog karke model ko train kiya jaata hai — har training example mein input aur uska sahi output hota hai, jisse model seekhta hai ki diye gaye input ke liye kya result dena hai. Udaharan ke liye, jaankari nikaalne ke task mein, ek text ko input ke roop mein aur sahi field extraction ko output ke roop mein diya ja sakta hai. SFT un tasks ke liye sabse accha hai jinme spaasht training samples tayyar kiye ja sakte hain — jaise text classification, jaankari nikaalna, prashno ke jawaab dena, aur nirdhit format mein output banana.
SFT ke alawa, bade model training mein Reinforcement Learning (RL, sankariyan seekhne wala abhyas) bhi use hota hai. RL mein seedhe sahi jawaab dene ke bajaye, reward signal se model ke output ka evaluation hota hai aur uske anusaar model ki behavior ko sudhara jaata hai. SFT aur RL dono bade model ki Post-training (baad ki training) ka hissa hain. Post-training ka matlab hai ki jab model ka vishesh pre-training ho jaaye, toh aur behtar command following, reasoning, aur vishesh tasks ke liye training di jaati hai. Aamtaur pehle SFT se seekha jaata hai ki command ke anusar kaam kaise karna hai, phir RL se aur behtar jawaab quality aur behavior achieve kiya jaata hai.
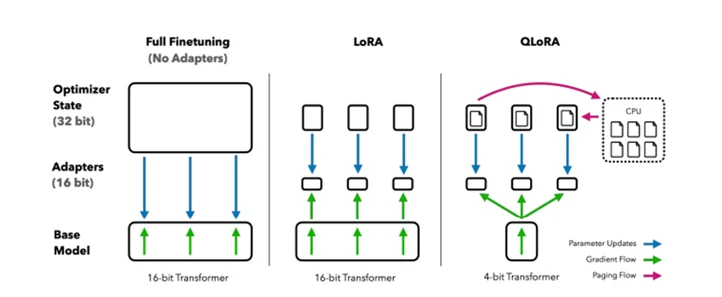
Training ka tarika aur hardware resources ke anusar LoRA, QLoRA, ya Full Fine-Tuning chun sakte hain. In tarikon mein training parameters ki sankhya, VRAM ki demand, aur compute cost mein antar hota hai.
Full Fine-Tuning (Poora Baarik Samayojan): Training mein model ke sabhi parameters update hote hain, isliye model kaafi achhi tarah se adjust ho sakta hai. Lekin iske liye zyada VRAM aur compute resources chahiye, isliye training cost bhi zyada hoti hai.
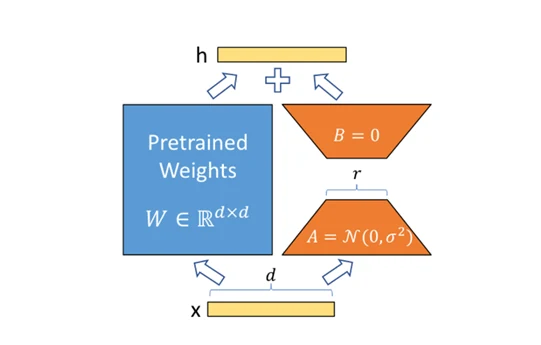
LoRA Fine-Tuning (Low-Rank Adaptation, Kam Rank Samayojan): Bade model fine-tuning ke liye hardware resources ki demand kam karne ke liye, LoRA ka mool vichar hai ki pre-trained model ke weights ko freeze karke, Transformer ke har layer mein chhote trainable rank decomposition matrices inject kiye jaayein, jisse downstream tasks mein trainable parameters ki sankhya kaafi kam ho jaati hai. Training mein, sirf original model ke parameters fix rakh ke, matrix A (kam rank) aur matrix B (zyada rank) train karte hain.
Vistar se samjhein toh, maan lijiye pre-trained matrix $W_0 \in \mathbb{R}^{d \times k}$ hai, toh iska update is tarah hota hai:
W = W_0 + \Delta W = W_0 + BA
Jahan, $\Delta W$ fine-tuning ke dauran seekhe jaane wale weight changes ko darshata hai,
B \in \mathbb{R}^{d \times r}, \quad
A \in \mathbb{R}^{r \times k}, \quad
r \ll \min(d,k)
A aur B LoRA ke naye parameters hain jo training mein participate karte hain. Model ki training poori hone ke baad, ek alag LoRA Adapter file milti hai jismein fine-tuned parameters save hote hain. Use karte waqt, base model aur uske saath ka Adapter dono load karna hota hai.
QLoRA Fine-Tuning (Quantized LoRA, Mapankit Kam Rank Samayojan): LoRA mainly training parameters ki resource cost kam karta hai, lekin base model ko bhi VRAM mein load karna padta hai. Agar model bada hai toh base model load karne mein bhi zyada VRAM lag sakta hai. Aur VRAM ki demand kam karne ke liye, QLoRA ka upyog kiya ja sakta hai.
QLoRA ko simple samajhein toh ye quantization aur LoRA ka combination hai. Ye base model ko kam precision par quantize karta hai. QLoRA ki mukhya novelties nimn hain:
4bit NormalFloat (NF4): NF4 ek nayi data type hai jo samanya vitaran (normal distribution) ke weights ke liye soochna siddhant ke anusar sabse optimal hai;
Double Quantization (dvigun mapankit): Isme pehle se mapankit constants ko dobara mapankit karke ausat memory upyog kam kiya jaata hai;
Paged Optimizer (prishthit anukulak): Ye memory peaks ko manage karne mein madad karta hai, jisse gradient checkpointing ke dauran memory ki kami ki galti nahi aati.
Fine-tuning ka tarika model ki size, task ki zarooraton, GPU resources, aur training cost par nirbhar karta hai. Har tarik ka apna kshetra hai — zyada parameters update karne se better result zaroori nahi hota. Zyadaatar fine-tuning tasks ke liye, pehle LoRA try karein. LoRA mein sirf chhote naye parameters train hote hain, isliye GPU memory aur compute resources ki demand kam hoti hai, aur Adapter file bhi chhoti hoti hai jisse save karna aasan hai.
Agar base model bada hai toh LoRA lagane ke baad bhi VRAM kam padta hai, toh QLoRA consider karein. QLoRA base model ko quantize karke VRAM kam karta hai, jisse bade models bhi limited GPU resources mein fine-tune ho sakte hain. QLoRA zyada model size aur limited VRAM ke scenarios ke liye accha hai.
Agar GPU resources kaafi hain aur task ke liye model ko zyada achhi tarah se adjust karna hai, toh Full Fine-Tuning bhi kar sakte hain. Kyunki sabhi parameters update hote hain, isliye zyada VRAM, compute resources, aur training data chahiye, aur training aur saving ka cost bhi zyada hota hai — isliye vastavik task ke anusaar decide karna padega.
Vyavasayik projects mein, pehle kam cost par result verify karein, phir actual zaroorat ke anusar training cost badhayein. Agar LoRA se kaam ho raha hai, toh sirf zyada parameters update karne ke liye Full Fine-tuning ki zaroorat nahi hai.
ms-swift ka upyog karke ek fine-tuning poora karein
ms-swift hamara kaun sa kaam bacha sakta hai?
ms-swift (SWIFT, Scalable lightWeight Infrastructure for Fine-Tuning) ModelScope community ka open-source bade model training aur deployment framework hai. Ye mukhya roop se bade language models aur multimodal models ke liye hai, jo model training, fine-tuning, inference, evaluation aur deployment tak poora toolset provide karta hai.
Ye Qwen, DeepSeek, Llama, GLM, InternLM jaise popular language models, aur Qwen-VL, InternVL jaise multimodal models ko support karta hai. Saath mein Embedding, Reranker, aur text classification jaise models aur tasks ki training bhi support karta hai.
Training ke alawa, ms-swift ek complete model usage pipeline bhi provide karta hai. Training poori hone ke baad, swift infer se seedhe model inference kar sakte hain ya swift deploy se model ko OpenAI-compatible API service ke roop mein deploy kar sakte hain. Inference aur deployment mein, vLLM, SGLang, LMDeploy jaise inference engines se acceleration bhi kar sakte hain.
Shuruaati ke liye, ms-swift ki ek khaas baat hai ki ye bade model training ki dher saari complex configurations ko ek unified aur simple tarike se package karta hai. Command line parameters se base model, training data, fine-tuning tarika, aur training parameters specify karke ek model fine-tuning poora kar sakte hain. Agle experiment mein, hum ms-swift se ek poora model fine-tuning pipeline chalayenge — training data taiyar karna, LoRA training shuru karna, training results dekhna, LoRA weights merge karna, aur fine-tuned model se inference aur deployment karna.
NER task se shuru karein — haath se prashikshan karein
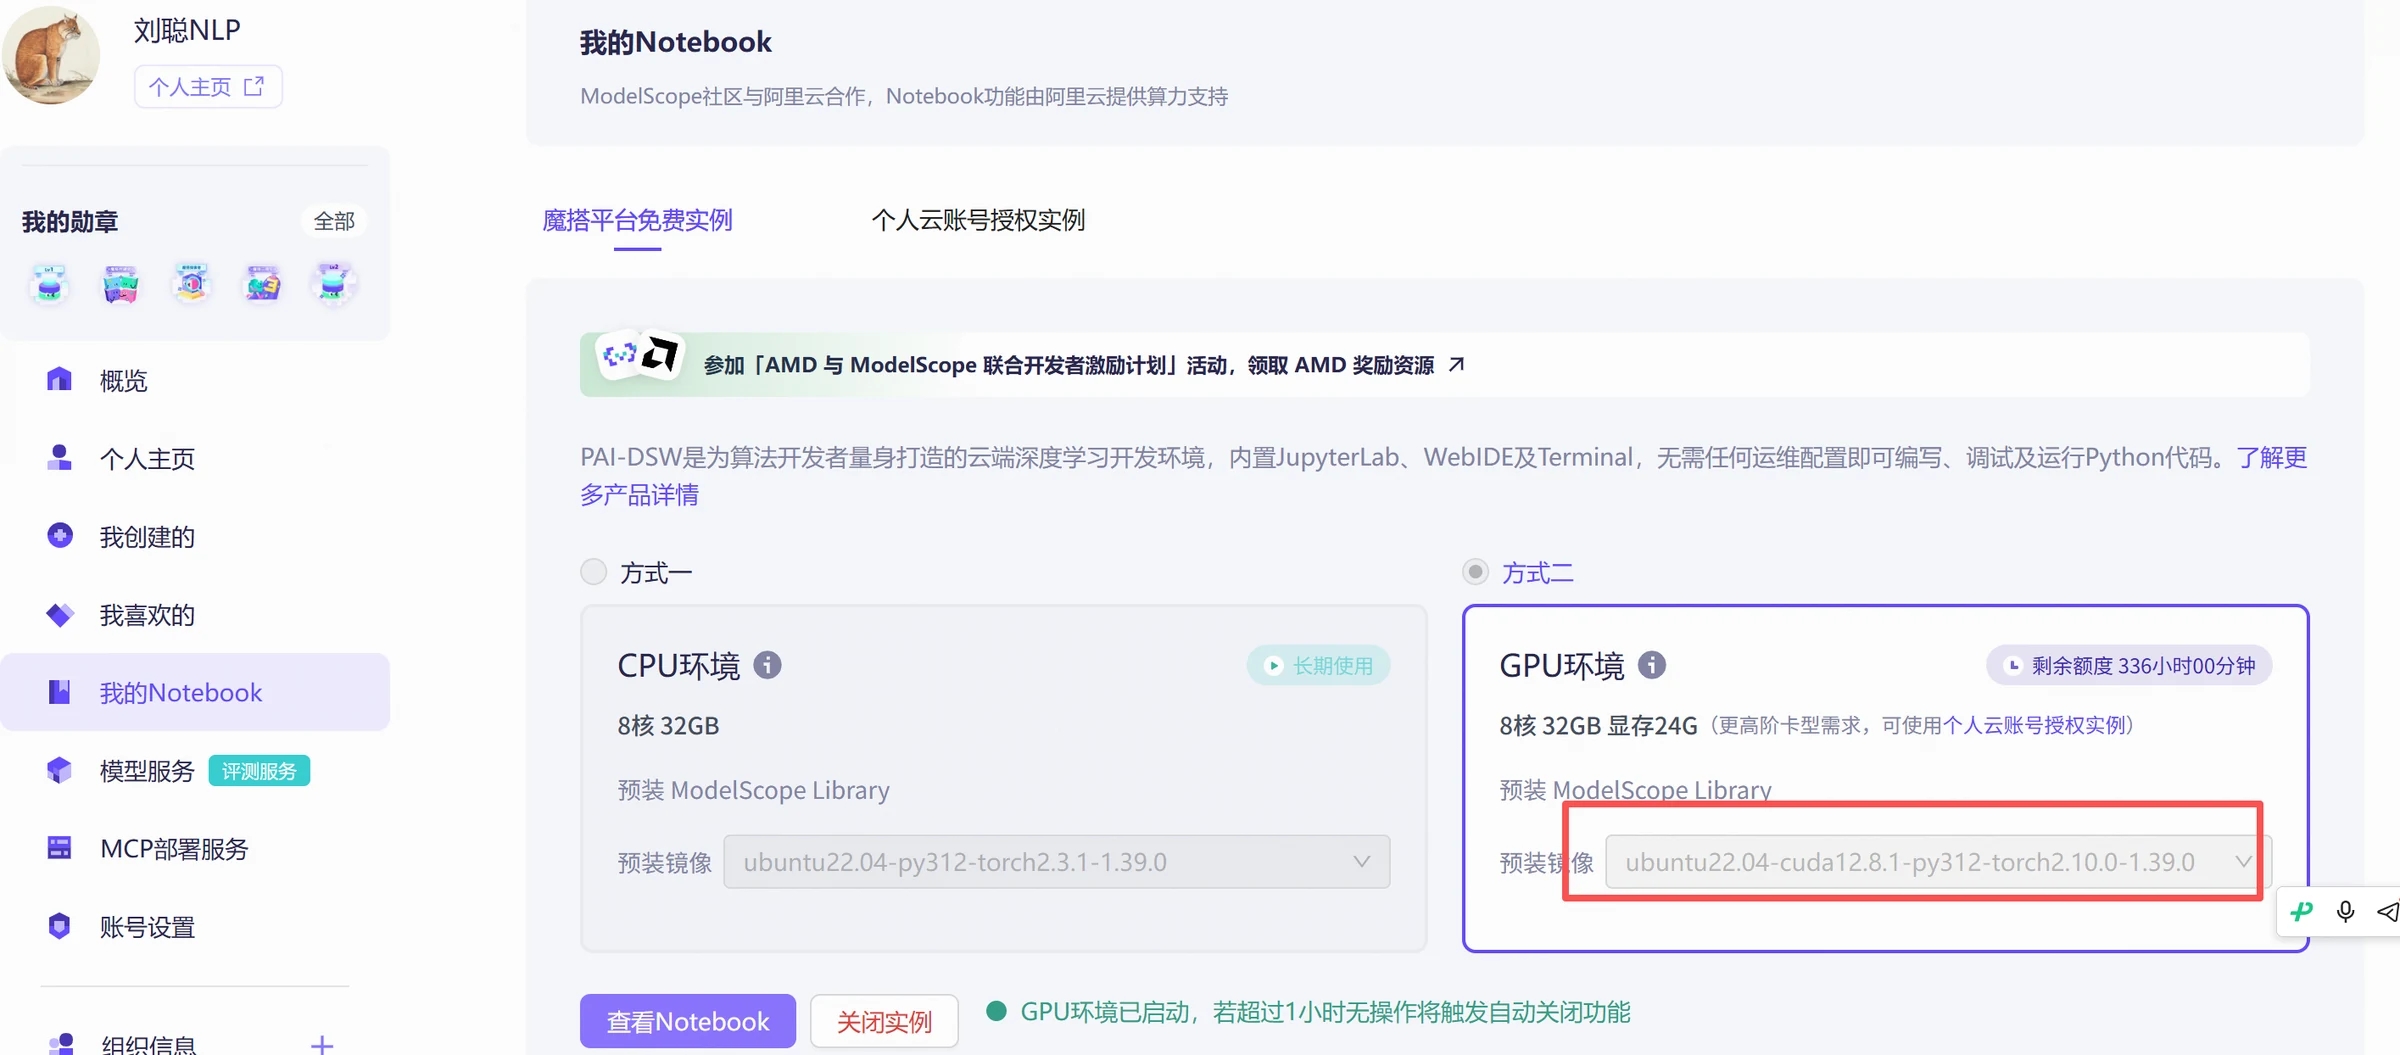
Ab hum ek NER (Named Entity Recognition, naamit entity pehchaan) task ka udaharan lekar ModelScope Notebook mein poora model fine-tuning pipeline dikhayenge — data taiyar karna, model training, aur fine-tuned model se inference tak. Is udaharan se aap samajh payenge ki ms-swift se shuru se bade model fine-tuning kaise karte hain. Is experiment mein ubuntu22.04-cuda12.8.1-py312-torch2.10.0-1.39.0 image ka upyog kiya ja raha hai.
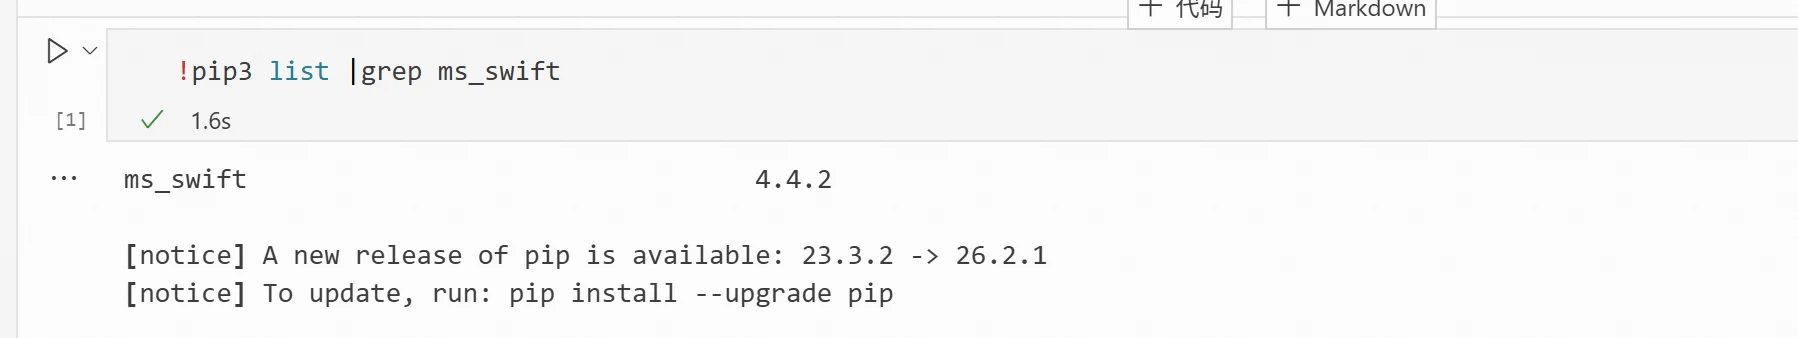
1) Dekhein ki ms-swift environment mein pehle se installed hai ya nahi. Dhyan dein ki package name ms_swift hai:
!pip3 list |grep ms_swift
Nimn tarah ki output dikhe toh samajh lein ki ms-swift installed hai:
Agar installed nahi hai toh ye command chalayein:
!pip3 install ms-swift
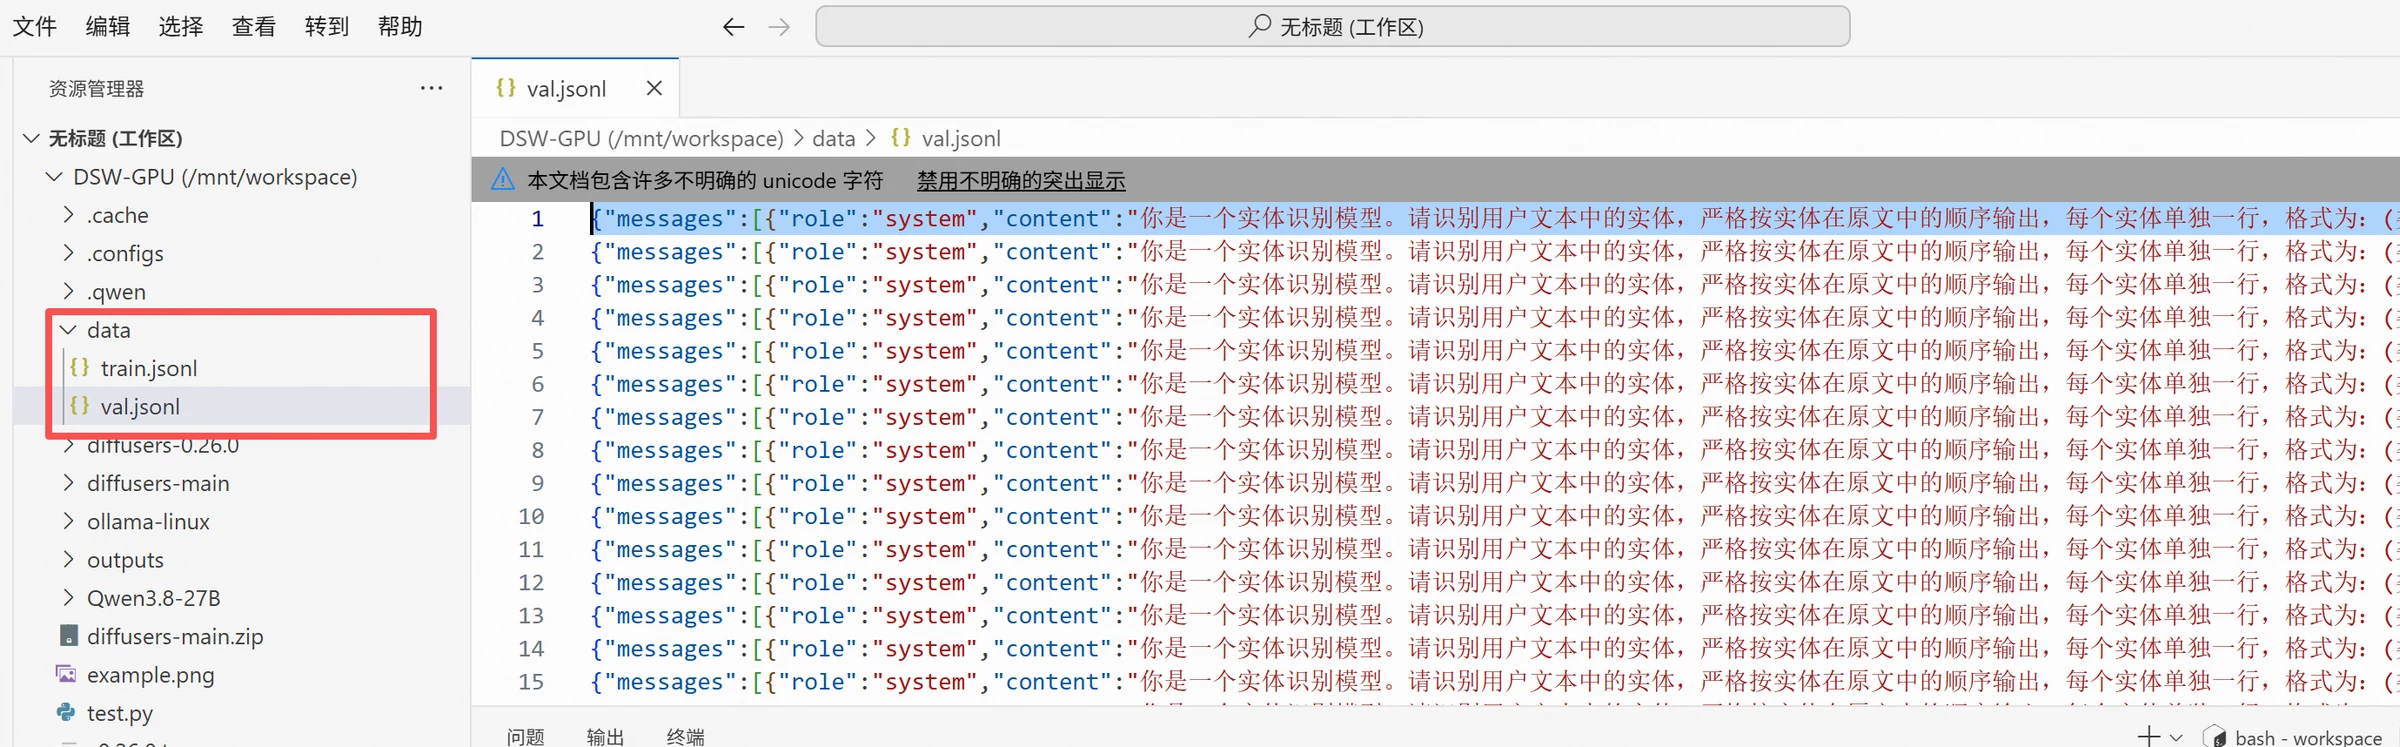
2)Data taiyari — Is experiment mein open-source data ka upyog kiya ja raha hai, jo e-commerce entity recognition ke liye hai. Dataset mein chaar entity types hain: HCCX — product name (utpaad ka naam), HPPX — brand name (braand ka naam), XH — product model (utpaad ka model), MISC — anya entities (anya sansthaa, desh, size, capacity, vyakti, kriti aur kaaryakram ke naam aadi).
3)Pehle ek data folder banayein aur data usme upload karein. Data ka format ye hai — is task mein model ko sirf entity category, entity text, aur entity ka starting position output karna hai. Data ko training set aur test set mein baanta gaya hai — train.jsonl mein 5400 samples aur val.jsonl mein 600 samples hain.
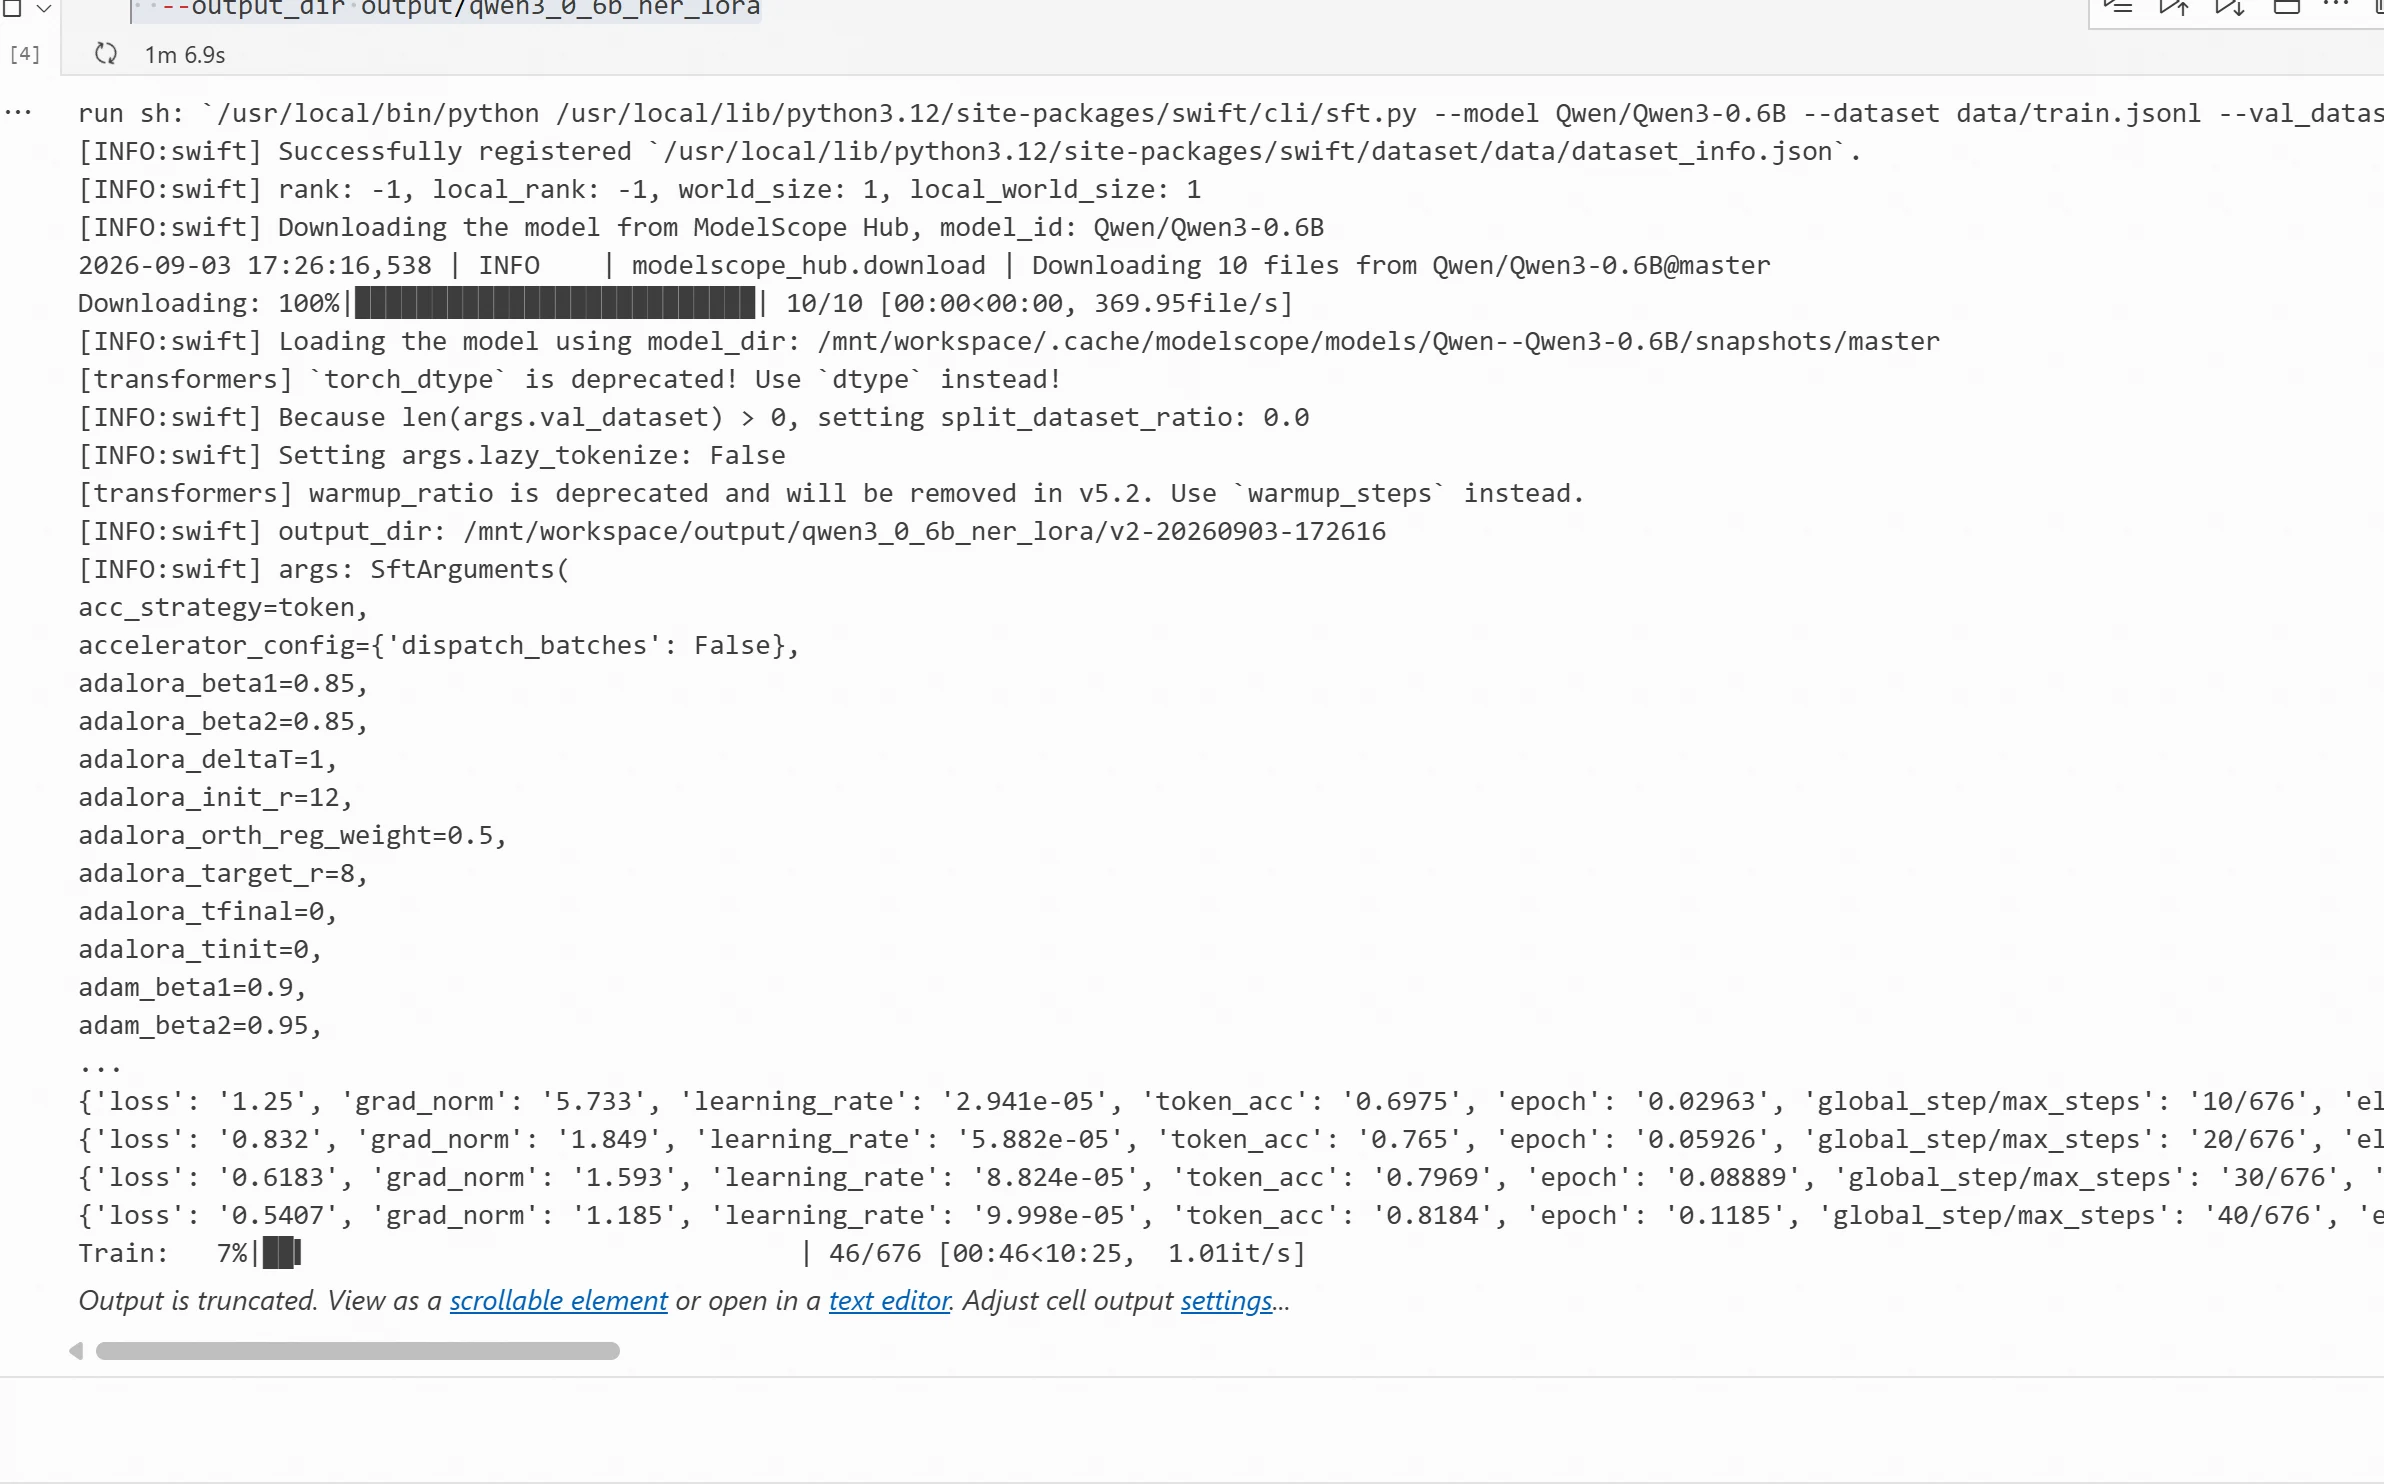
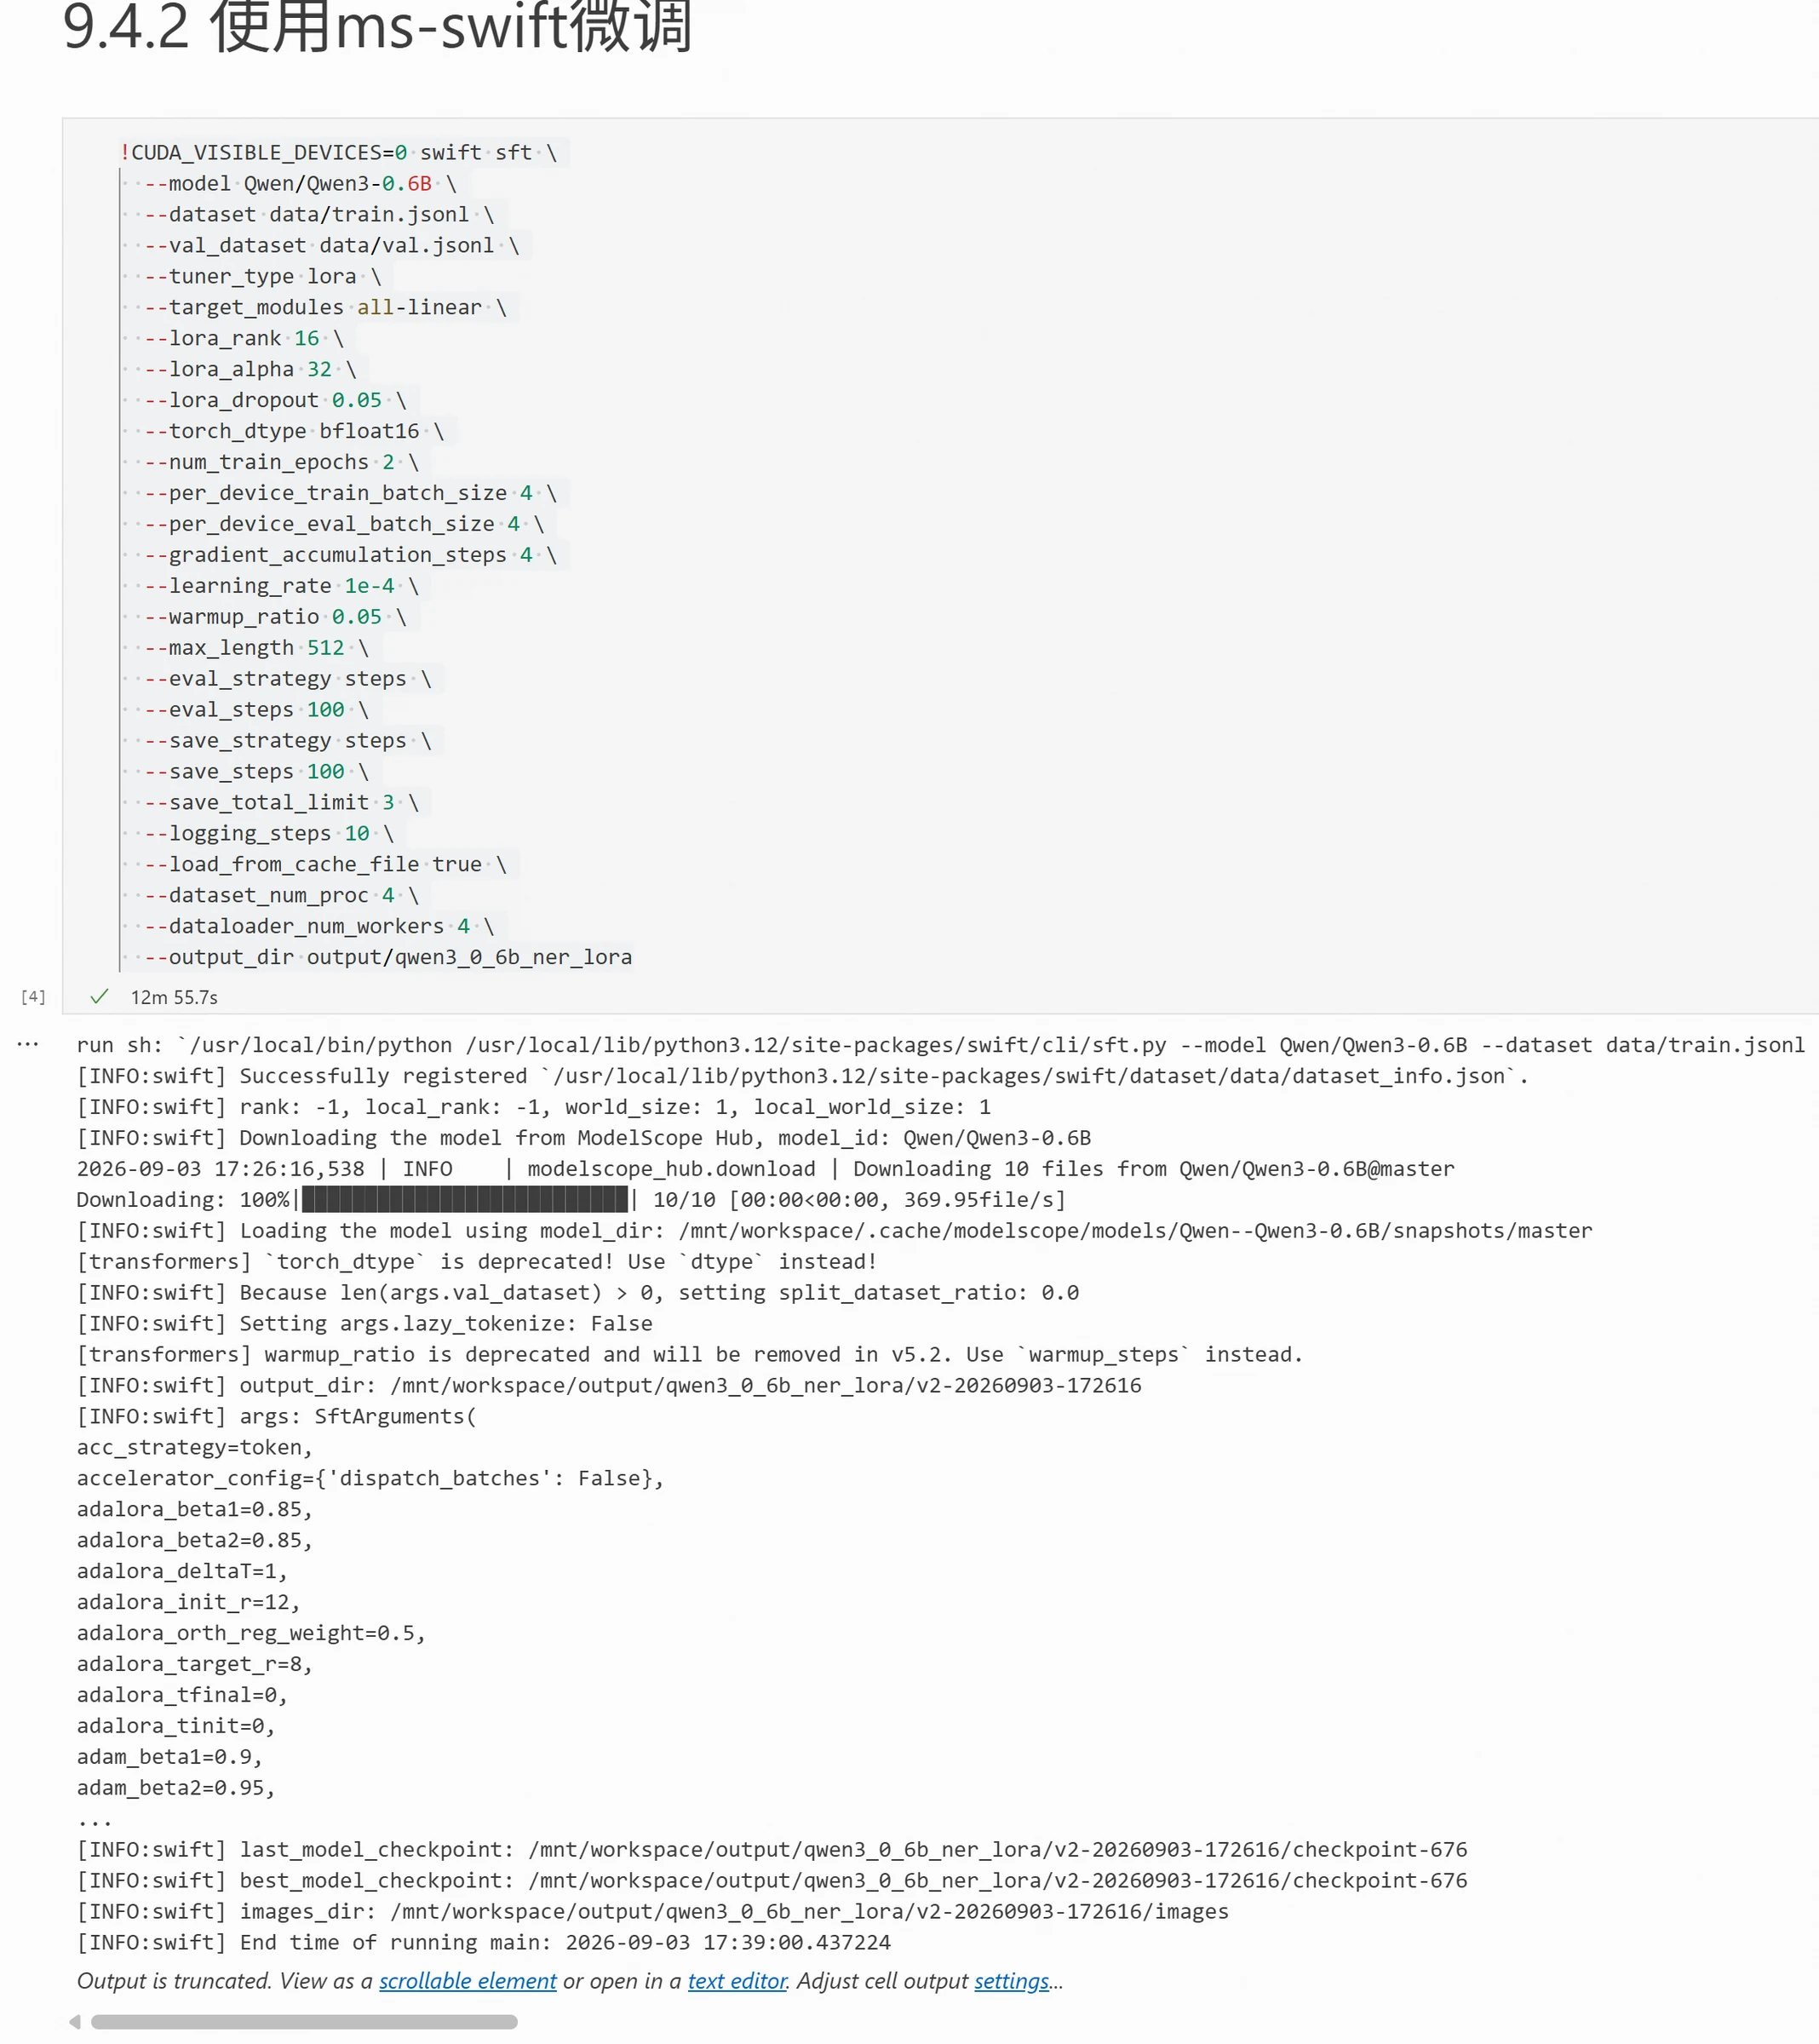
4)Model training — Is hisse mein Qwen/Qwen3-0.6B ka upyog karke fine-tuning ki ja rahi hai. Terminal mein neeche diye gaye command se training shuru ho jayegi:
Training shuru hone ke baad, ms-swift lagatar current training information dikhata hai:
Training ho gayi — ab model ka upyog kaise karein?
LoRA weights ko base model mein merge karein
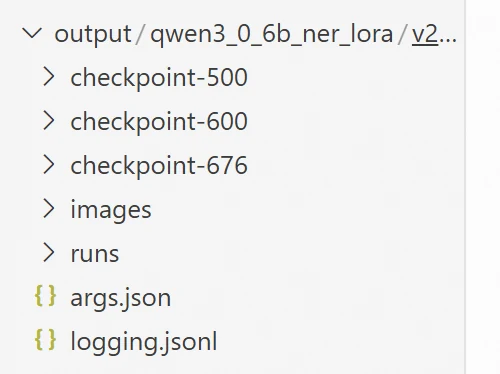
LoRA training poori hone ke baad, corresponding LoRA Adapter save hota hai. Adapter ek poora model nahi hota, isliye use karte waqt pehla base model load karna padta hai. Training script ke output_dir mein checkpoints aur corresponding Adapter files mil jaate hain. Vastavik deployment mein, LoRA Adapter ko base model mein merge karke ek poora model banaya ja sakta hai, jo offline deployment ya model transfer ke liye zyada suvidhaajanak hota hai. Training poori hone ke baad directory structure ye hai:
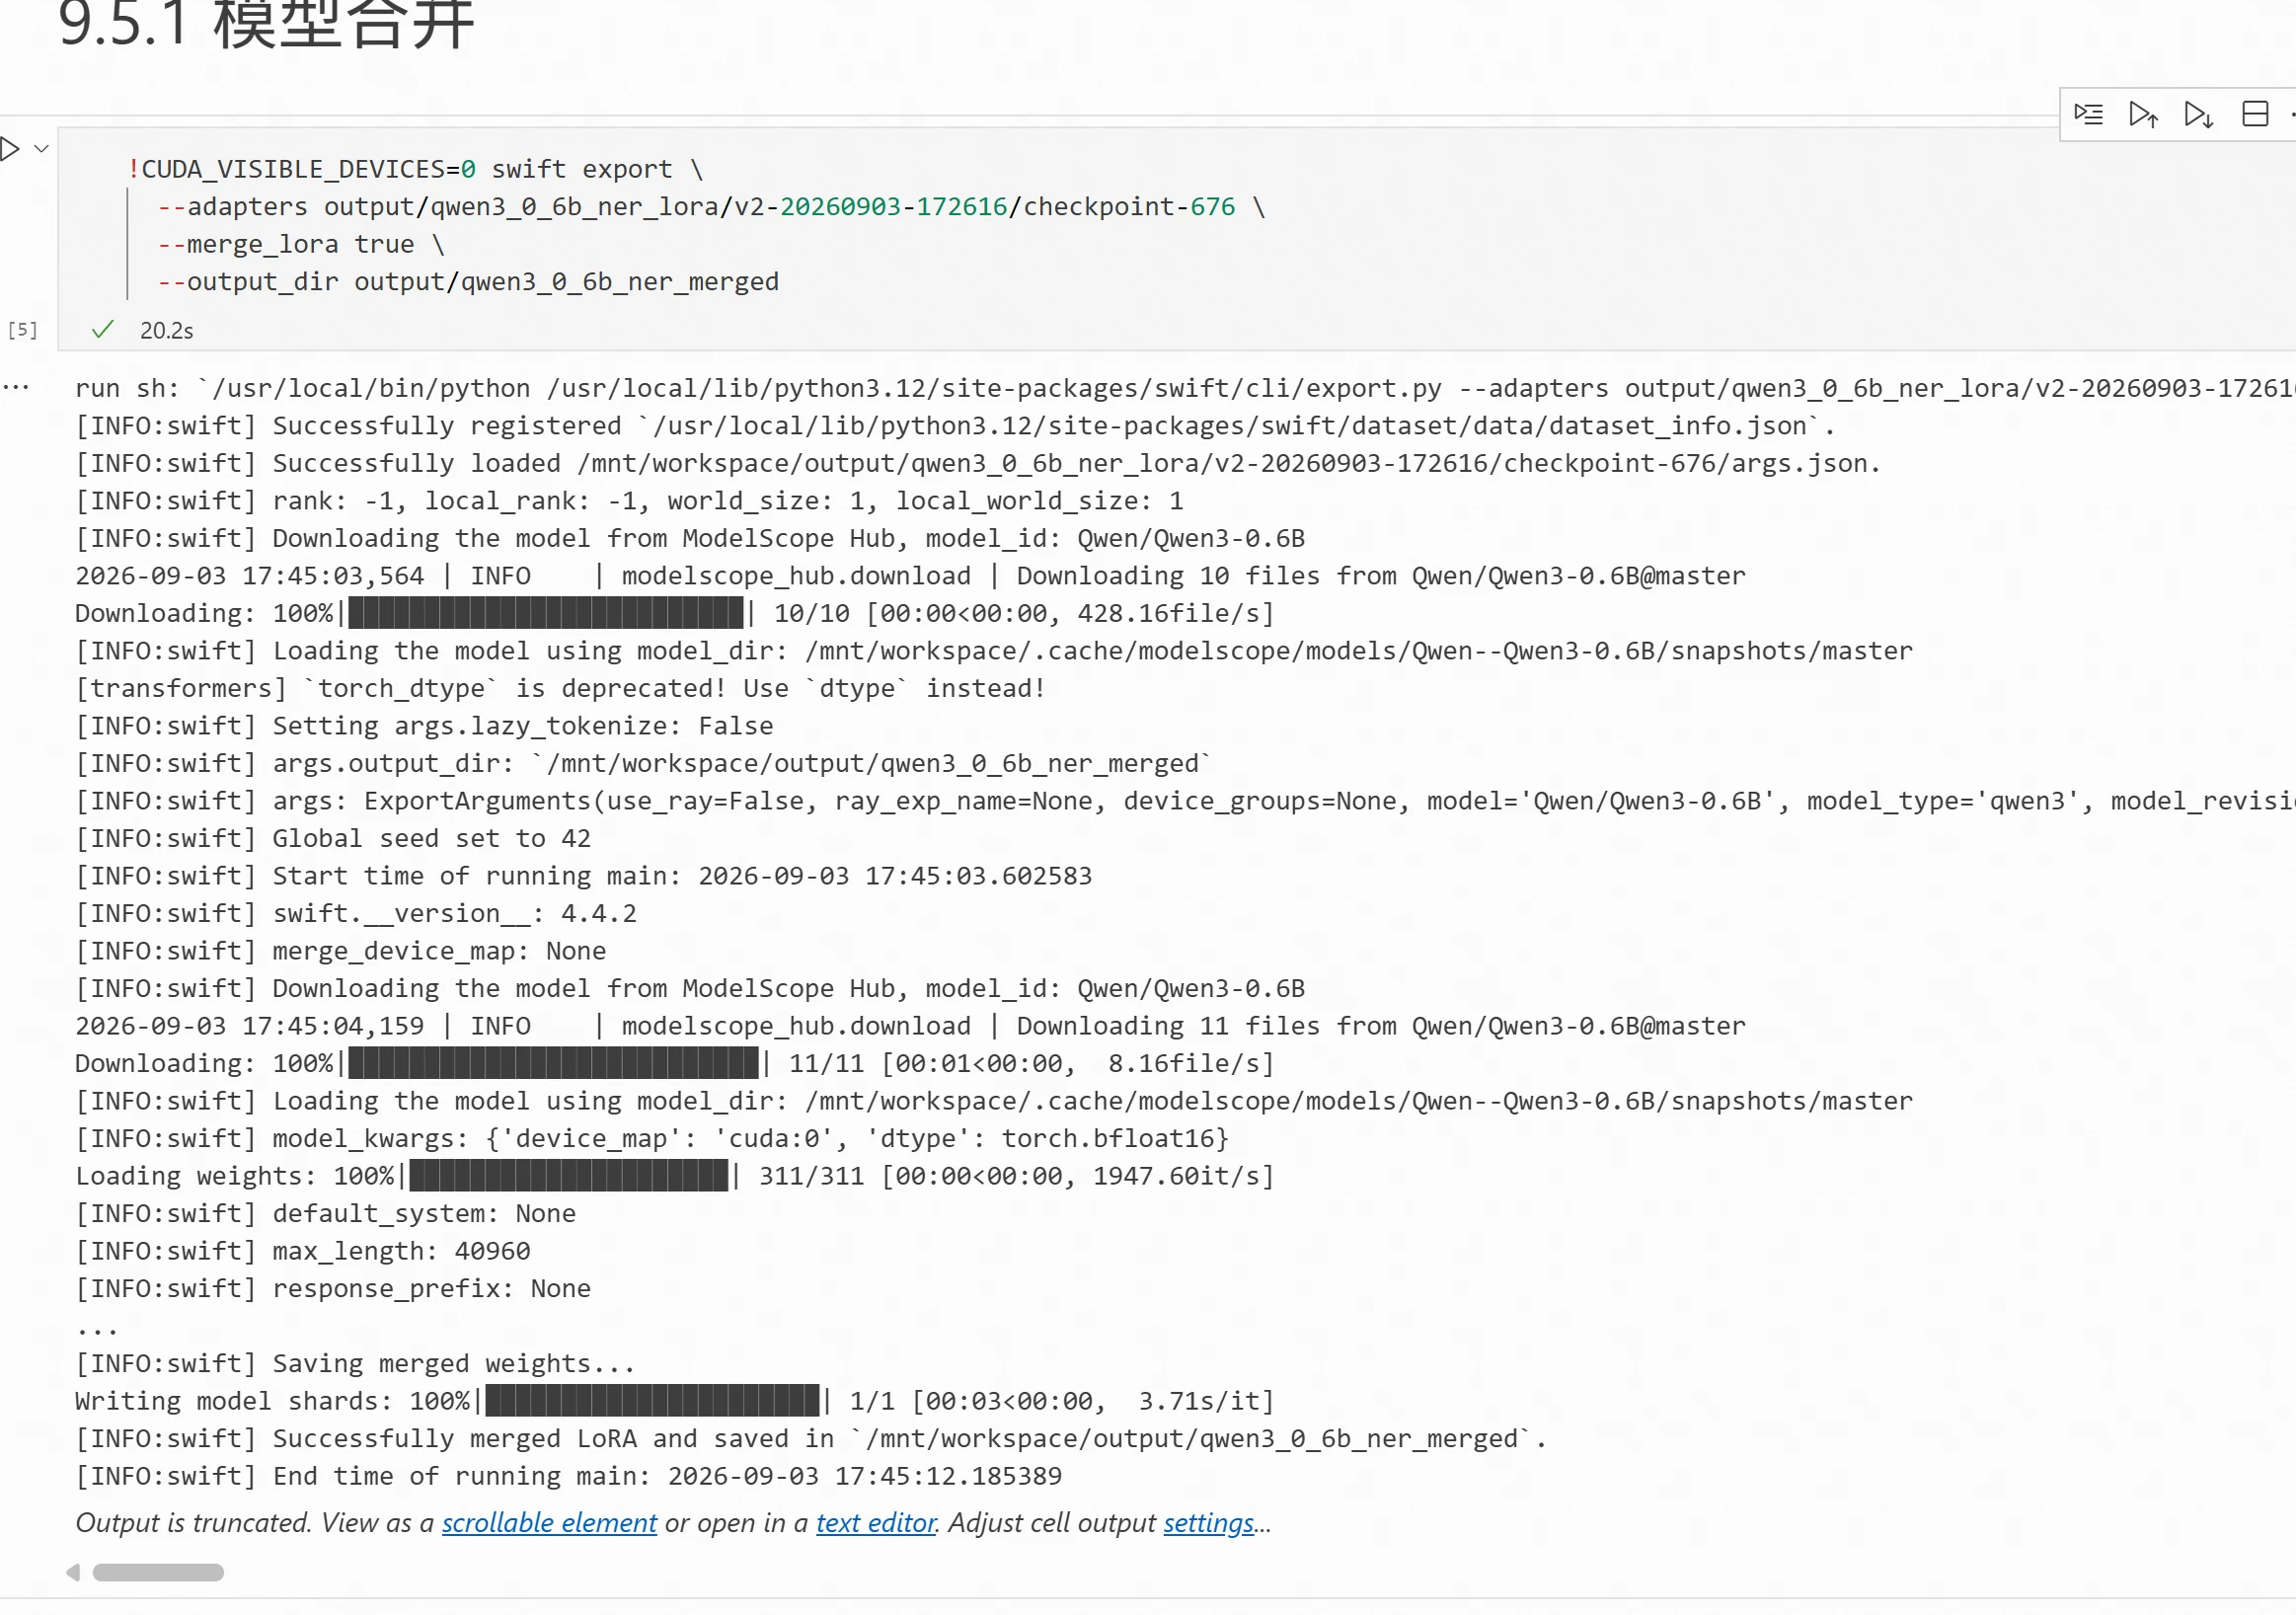
Jahan, --adapters training se prapt LoRA checkpoint ka path deta hai, --merge_lora true darshata hai ki LoRA parameters ko base model mein merge karna hai, aur --output_dir merge kiye gaye model ki save directory specify karta hai.
Result ye raha:
Fine-tuned model load karein — vastavik parinaam dekhein
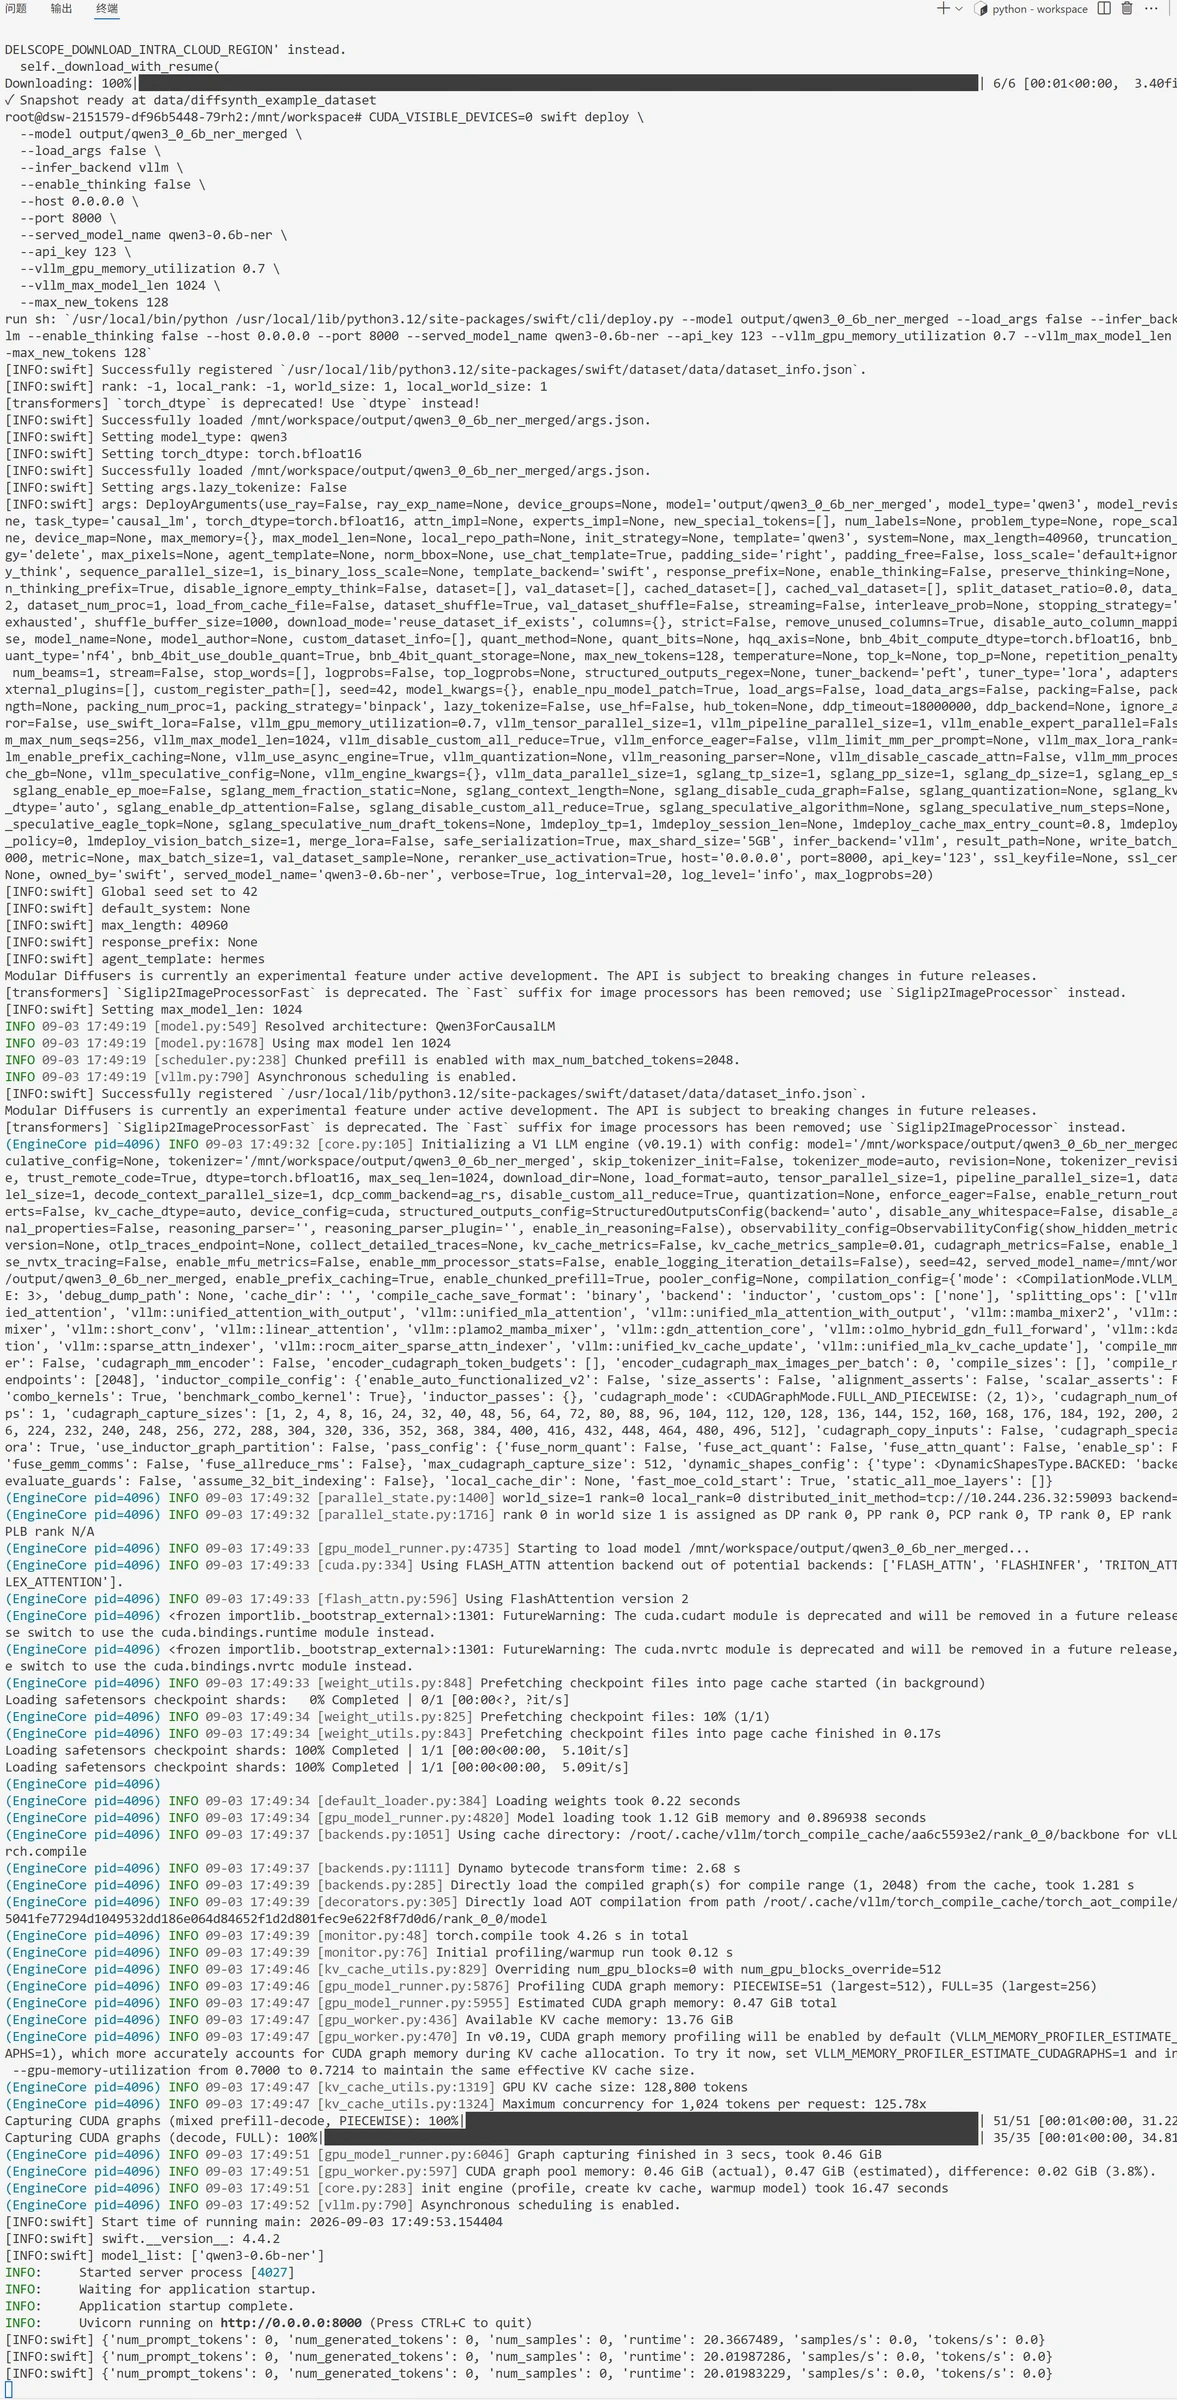
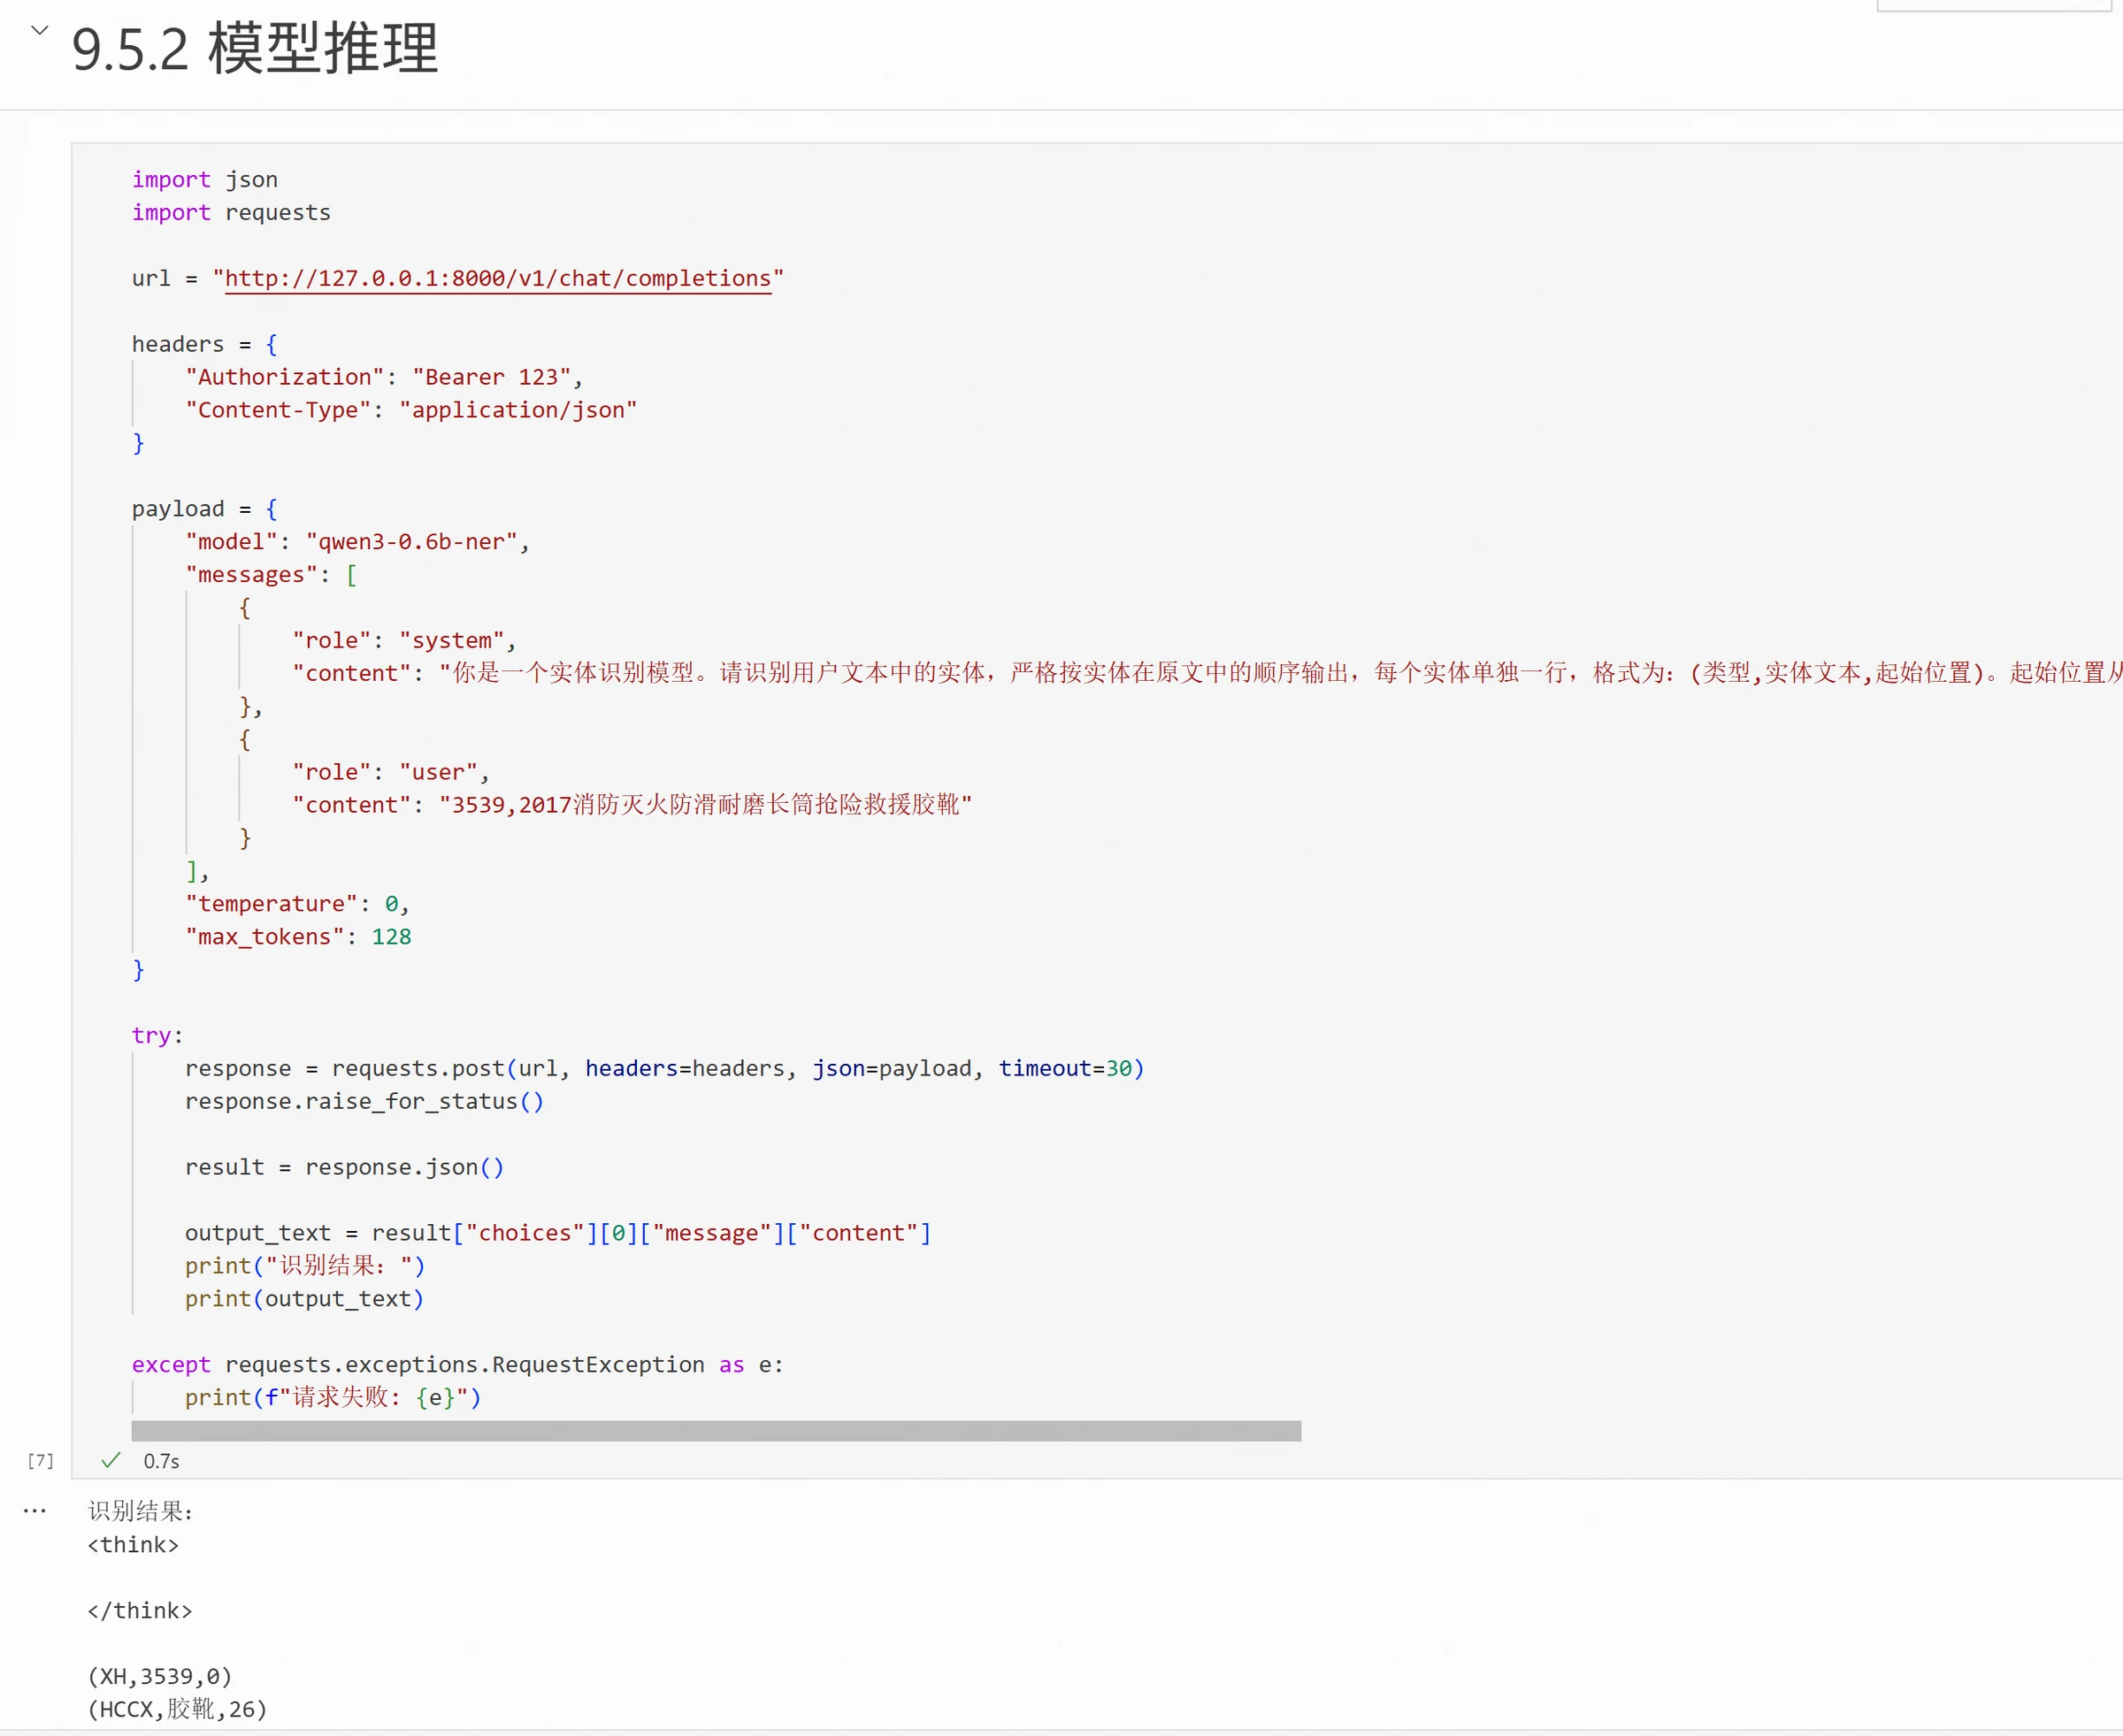
Merge poori hone ke baad, poora model seedhe load karke inference kar sakte hain. Application integration ke liye, model ko OpenAI-compatible interface ke roop mein bhi start kar sakte hain aur API ke madhyam se fine-tuned model tak pahunch sakte hain. Ye ek persistent service hai jo terminal mein start karni hoti hai — chhate chapter mein padhein ki terminal mein command kaise start karte hain. Command ye hai: