AIUnlimited
🌳

AI की नींव

🌱
AI Seeds

शून्य से शुरू करें

🌿
AI Sprouts

नींव बनाएं

🌳
AI Branches

व्यवहार में लागू करें

🏕️
AI Canopy

गहराई में जाएं

🌲
AI Forest

AI में महारत हासिल करें

🔨

AI में महारत

✏️
AI Sketch

शून्य से शुरू करें

🪨
AI Chisel

नींव बनाएं

⚒️
AI Craft

व्यवहार में लागू करें

💎
AI Polish

गहराई में जाएं

🏆
AI Masterpiece

AI में महारत हासिल करें

📘

AI व्यावहारिक

📖
ओपन-सोर्स मॉडल को समझना

ओपन-सोर्स मॉडल की बुनियादी बातें और संसाधन

🎯
समस्या से मॉडल कार्य तक

व्यावसायिक समस्याओं को मॉडल कार्यों में बदलना

⚡
अपना पहला मॉडल चलाना

30 मिनट में अपने पहले परिणाम देखें

🔧
फाइन-ट्यूनिंग और मूल्यांकन

मॉडल फाइन-ट्यून करें और प्रदर्शन का मूल्यांकन करें

🚀
अनुप्रयोग प्रणालियाँ

वास्तविक AI अनुप्रयोग बनाएं

🎨
जनरेटिव AI

ओपन-सोर्स AIGC मॉडल का अन्वेषण करें

🤖
एजेंट

एजेंट फ्रेमवर्क और MCP टूल सीखें

📐
पूरक बुनियादी बातें

LLM की बुनियादी बातें और मूल्यांकन

🎓

क्लाउड अकादमी

🤖
Claude 101

Learn AI basics with Claude

💻
Claude Code 101

Code with Claude as your pair programmer

🤝
Introduction to Claude Cowork

Collaborate with Claude on complex projects

⚙️
Claude Platform 101

Build apps with the Claude API

लैब

7 प्रयोग लोड हुए
🧬Neural Network Playground🤖AI या इंसान?🥋Prompt Engineering Dojo🏁Algorithm Race🧠AI ट्रिविया चैलेंज🏗️सिस्टम डिज़ाइन कैनवस
🎯मॉक इंटरव्यूलैब में जाएँ→
🚀

करियर विकास

🚀
इंटरव्यू लॉन्चपैड

अपनी यात्रा शुरू करें

🌟
व्यवहारिक इंटरव्यू में महारत

सॉफ्ट स्किल्स में महारत

💻
तकनीकी इंटरव्यू

कोडिंग राउंड में सफल हों

🤖
AI और ML इंटरव्यू

ML इंटरव्यू में महारत

🏆
ऑफर और उससे आगे

सबसे अच्छा ऑफर पाएं

सीखना शुरू करें - यह बुनियादी है
AIUnlimited

MIT लाइसेंस

沪ICP备18025655号-11

सीखें

  • AI बुनियादी बातें
  • AI व्यावहारिक
  • क्लाउड अकादमी
  • लैब
  • करियर विकास

समुदाय

  • हमारे बारे में
  • सामान्य प्रश्न

सहायता

  • footer.terms
  • footer.privacy
  • footer.contact
AI और इंजीनियरिंग प्रोग्राम›🔧 फाइन-ट्यूनिंग और मूल्यांकन›पाठ›Preference Alignment
🎯
फाइन-ट्यूनिंग और मूल्यांकन • शुरुआती⏱️ 20 मिनट पढ़ने का समय

Preference Alignment

मॉडल उत्तर दे सकता है, तो पर्फॉर्मेंस अलाइनमेंट क्यों करें?

मॉडल को सुपरवाइज्ड किया जाने के बाद, यह निर्देशों के अनुसार उत्तर दे सकता है, लेकिन अगर कई उत्तर एक साथ देखे जाएं, तो उनमें अच्छे और बुरे दोनों होंगे, और कुछ लोगों के उत्तर और अधिक अनुकूलित लगेंगे।

उदाहरण के लिए, वापसी आवेदन संबंधी चर्चा में, जब भी उपयोगकर्ता को अपने वापसी आवेदन करने की जगह दी जाती है, एक उत्तर केवल ऑपरेशनल इंट्रप्ट की देता है, दूसरा उसे जांच और आवेदन करने की स्थिति को बताता है। दोनों उत्तर वापसी पर चले रहे हैं, लेकिन दूसरा उपयोगकर्ता आगे के संभावित स्थितियों को बेहतर तरीके से व्यक्त करता है और असमझों को कम करता है।

अगले SFT के दौरान, हम ऐसे उत्तरों को उदाहरणों के रूप में तैयार करते हैं, ताकि मॉडल इनसे सीखे। अब हम एक ही प्रश्न के अलग-अलग उत्तरों को एक साथ रखकर, मॉडल को हम जो अधिक अनुमोदन करते हैं और इसके लिए क्या मापदण्ड हैं, यह बताएं।

यही पर्फॉर्मेंस अलाइनमेंट है, हम यहां से शुरू करते हैं।

पहले यहां तैयार करें, बाद में प्रशिक्षण के किस तरह की प्रथाएं हैं?

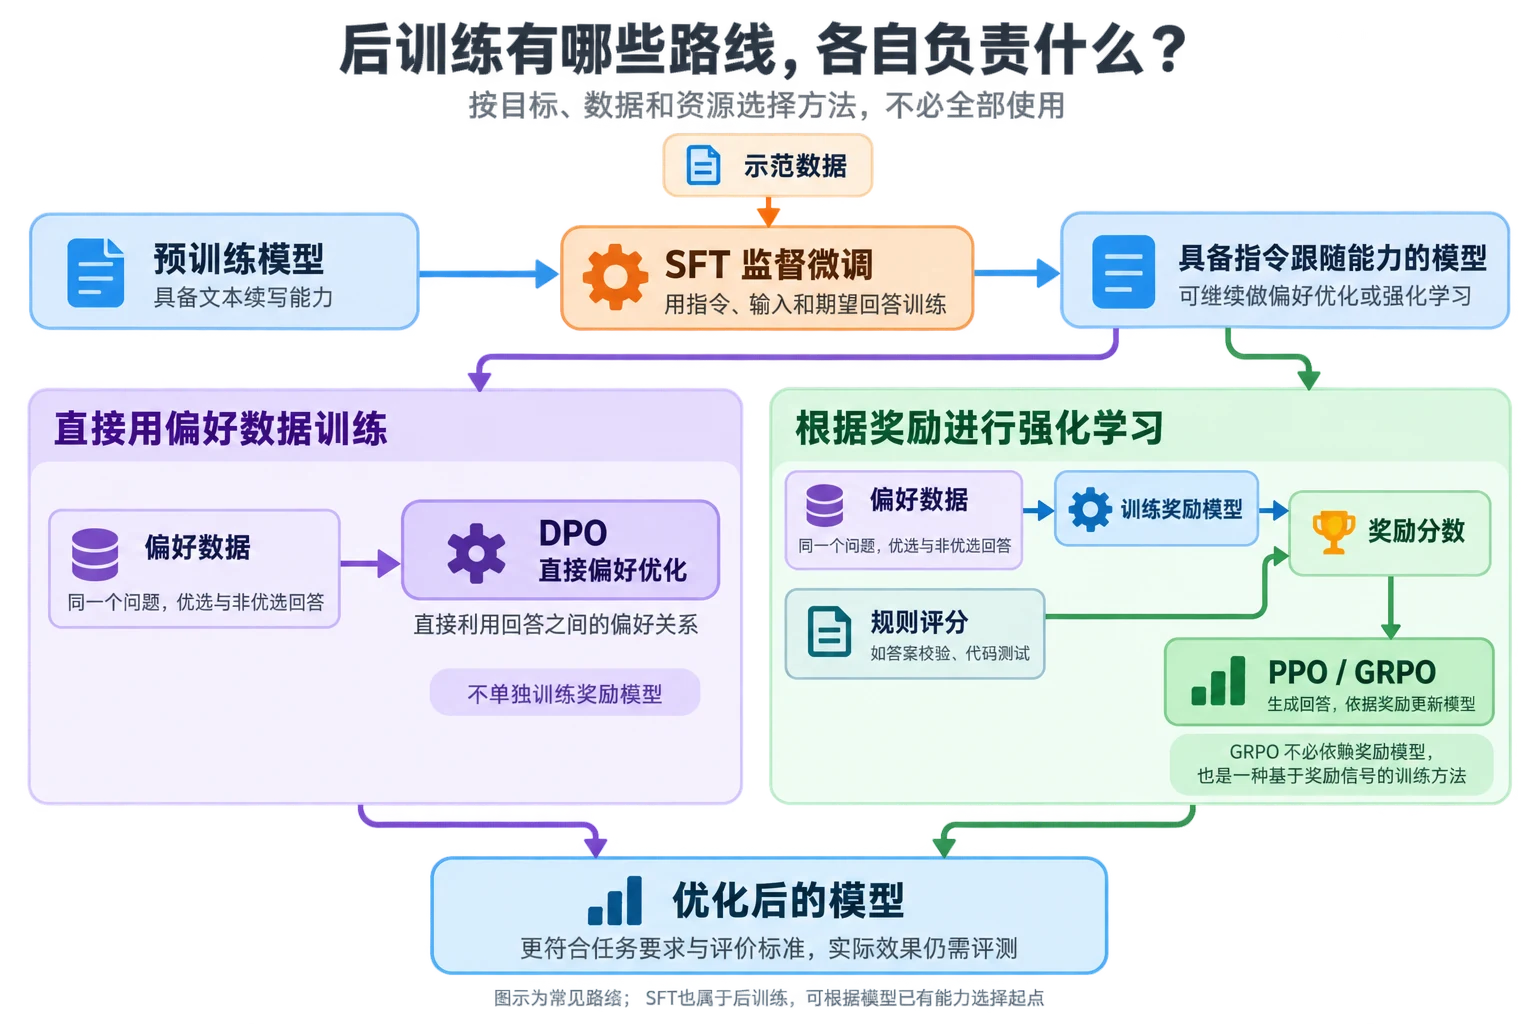
बड़े मॉडल के बाद में प्रशिक्षण का मुख्य उद्देश्य है, बुनियादी मॉडल को टेक्स्ट रिप्ले की क्षमता वाले, बेहतर रूप से सीधे संवाद, निर्देशों का पालन और कार्य पूरा करने जैसे विशिष्ट कार्यों को बेहतर बनाना। बाद में प्रशिक्षण एक निश्चित एल्गोरिथ्म नहीं है, बल्कि एक ट्रेनिंग पद्धतियों का संग्रह है, सामान्य तरीके शामिल SFT, पर्फॉर्मेंस ऑप्टिमाइजेशन, रेयर्ड मॉडल ट्रेनिंग और रीफोर्मेंट लर्निंग रिचर्लिंग लर्निंग आदि हैं, विभिन्न मॉडल अपने ट्रेनिंग लक्ष्य, डेटा शर्तें और लागत के अनुसार अलग-अलग कंबिनेशन चुनते हैं।

जिसमें SFT मुख्य रूप से "निर्देश, इनपुट और अपेक्षित उत्तर" फॉर्म के डेटा का उपयोग करता है, जिससे मॉडल यह सीखता है कि यह कैसे कार्य को समझे, निर्देशों का पालन करे और अपेक्षित फॉर्मेट और तरीके से उत्तर दे। इस आधार पर, हम आगे भी पर्फॉर्मेंस डेटा का उपयोग अलाइनमेंट के लिए कर सकते हैं, जैसे कि एक ही प्रश्न के लिए अपेक्षित उत्तर और गैर-अपेक्षित उत्तर बनाएं, ताकि मॉडल मानव या व्यापारी मूल्यांकन मापदण्ड सीखे। पर्फॉर्मेंस डेटा रेयर्ड मॉडल को ट्रेन करने में भी उपयोग किया जा सकता है, जिससे मानव पर्फॉर्मेंस को अनुकूलित रेयर्ड फ्रैंक्शन बनाया जा सकता है, फिर PPO, GRPO जैसी रीफोर्मेंट लर्निंग विधियों के साथ निरंतर मॉडल के उत्पादन रणनीति को सुधारा जा सकता है; या DPO जैसे तरीकों का उपयोग करके, अपेक्षित और गैर-अपेक्षित उत्तर के बीच की पर्फॉर्मेंस रिलेशनशिप को प्रशिक्षण लक्ष्य में सीधे लिखा जा सकता है, और रेयर्ड मॉडल को अलग ट्रेन करने की आवश्यकता नहीं होती।

इसलिए, बड़े मॉडल के बाद में प्रशिक्षण में कोई निश्चित प्रवाह नहीं है, SFT, रेयर्ड मॉडल, PPO, GRPO और DPO भी अलग-अलग भूमिकाएं निभाते हैं। SFT मुख्य रूप से आधारभूत निर्देश पालन क्षमता बनाने के लिए प्रयोग किया जाता है, रेयर्ड मॉडल उसे मापदण्डीकृत मूल्यांकन संकेत प्रदान करता है, PPO और GRPO रेयर्ड संकेत के आधार पर आगे उत्पादन रणनीति को सुधारते हैं, जबकि DPO पर्फॉर्मेंस डेटा का उपयोग करके मॉडल को अलाइनमेंट करता है। वास्तविक प्रशिक्षण के दौरान, ये तरीके निश्चित नहीं हैं, और न ही वे पूरी तरह से एक ही क्रम में कंबिनेशन किए जाते हैं, बल्कि मॉडल की क्षमता, कार्य लक्ष्य और प्रशिक्षण संसाधनों के अनुसार योग्य चुने जाते हैं।
विस्तृत विवरण
पाठ 3 / 40% पूर्ण
←Fine-Tuning with ms-swift

चर्चा

साइन इन करें चर्चा में शामिल हों

मॉडल को दिखाएं दस्तावेज़, SFT उसे क्या सिखाती है?

SFT यानी सुपरवाइज्ड माइक्रोट्यूनिंग, जो पहले से तैयार किए गए इनपुट और अपेक्षित आउटपुट का उपयोग करके मॉडल को फिर से प्रशिक्षित करता है, ताकि मॉडल समान इनपुट देखने पर अपेक्षित उत्तर बनाने की संभावना बढ़ाए।

एक SFT डेटा को निम्न रूप में लिखा जा सकता है:

{
  "instruction": "उपयोगकर्ता के प्रश्न पर कस्टमर रिप्ले बनाएं",
  "input": "मेरा सदस्य बीते दिन ऑटोमेटिक रीचार्ज हुआ, मैं वापसी आवेदन करना चाहता हूँ।",
  "output": "पहले ऑर्डर पेज पर रीचार्ज ऑर्डर की स्थिति जांचें। वापसी शर्तों के तहत, ऑर्डर डेटाइल में आवेदन दे; अगर पेज पर वापसी इनपुट नहीं है, तो लाइव कस्टमर सर्विस से संपर्क करें।"
}

प्रशिक्षण के दौरान, टोकनाइजर (Tokenizer) निर्देश, इनपुट और उत्तर को टोकन (Token) में बदलता है। मॉडल विगत के टोकन के आधार पर अगले टोकन को पूर्वानुमानित करता है, फिर पूर्वानुमानित परिणाम और अपेक्षित उत्तर के बीच के अंतर को लोस की गणना करता है। बड़े मॉडल SFT में आमतौर पर क्रॉस-एन्ट्रोपी लोस और टीचर-फोर्स्ट्रेनिंग का उपयोग किया जाता है: प्रत्येक स्थिति के दौरान, मॉडल डेटा में दिए गए सही पूर्ववर्ती देखता है, न कि अपने जल्दी उत्पन्न गलत सामग्री। कई इंस्ट्रक्शन माइक्रोट्यूनिंग निर्वहन उत्तर भाग के लिए लोस की गणना करता है, निर्देश और उपयोगकर्ता का इनपुट केवल निर्देश देने के लिए प्रयोग किए जाते हैं, लेकिन उन्हें फिर से उत्पन्न करने की आवश्यकता नहीं होती।

SFT पहले बदलता है टास्क फॉर्मेट। मॉडल बढ़ते हुए समझता है कि इनपुट एक उपयोगकर्ता के प्रश्न है, और आउटपुट को कस्टमर रिप्ले होना चाहिए, न कि उपयोगकर्ता के प्रश्न को और जोड़ना। जानकारी के निर्यास के लिए, यह उसे आउटपुट में फिक्सिएड JSON फील्ड बनाने का सीखता है; बैठक रिपोर्ट के लिए, यह बैठक जानकारी, कीरियर निष्कर्ष और कार्य आयोजन के तरीके से संगठित रखना सीखता है। SFT ने मॉडल के उत्तर तरीके को भी बदलता है। प्रशिक्षण डेटा में तुच्छता, लंबाई, अनुच्छेद विन्यास, व्याख्या की गहराई और नाकारात्मकता जैसी विशेषताएं मॉडल को अनुकरण के रूप में बनती हैं। यदि अपेक्षित उत्तर सामान्य रूप से संक्षिप्त है, मॉडल निश्चित निष्कर्ष देने की अधिक प्रवृत्ति रखता है; यदि उदाहरण बताने के बाद चरण देना आवश्यक है, मॉडल भी ऐसी व्यवस्था सीखता है। SFT ने मॉडल को क्षेत्र उदाहरणों से परिचित कराता है। कस्टमर डेटा में ऑर्डर स्थिति, वापसी शर्तें और अपग्रेड कस्टमर सर्विस, कानूनी डेटा में शर्त विन्यास, कोड डेटा में इंटरफेस उपयोग जैसी विशेषताएं मॉडल के उसी कार्य में आउटपुट पर प्रभाव डालती हैं। लेकिन यह नहीं बताता कि मॉडल उस क्षेत्र के सभी ज्ञान को आजमाने लगा है। SFT डेटा जिस टास्क, जो टर्मिनोलोजी और प्रक्रियाओं को कवर करता है, मॉडल को पैरामीटर अपडेट में इन पैटर्न को सीखने के लिए अवसर प्रदान करता है।

SFT का प्रशिक्षण लक्ष्य असली रूप से अपेक्षित आउटपुट की नकल करने के रूप में है। यह मॉडल को यह सीखता है कि इस तरह के प्रश्नों के आम तौर पर कैसे जवाब दिए जाते हैं, लेकिन यह नहीं जांचता कि उत्तर में तथ्य निश्चित रूप से विवेचित होते हैं, और न ही एक उदाहरण से बहुत से संभावित उत्तरों के बीच तुलना करने में सक्षम होता है। एक वापसी प्रश्न के लिए नीचे दो उत्तर मिलते हैं:

उत्तर A: ऑर्डर डेटाइल में वापसी आवेदन करें, अगर ऑपरेशन नहीं हो पाता, तो लाइव कस्टमर सर्विस से संपर्क करें।  

उत्तर B: आप फिर से ऑर्डर स्थिति देखें। वापसी शर्तों के तहत, ऑर्डर डेटाइल में आवेदन दे; अगर पेज पर वापसी इनपुट नहीं है, तो लाइव कस्टमर सर्विस से जांचें। वापसी परिणाम और धन आवक समय को वास्तविक जांच के अनुसार होते हैं।

दोनों उत्तर वापसी से संबंधित हैं, लेकिन उत्तर B अनुमोदन शर्तों को बताता है, और निश्चित वापसी परिणाम को विभाजित करता है। यदि व्यवसाय अधिक जानकारी पूर्ण और व्यावसायिक सीमाओं पर जोर देता है, तो उत्तर B अधिक उपयुक्त है। SFT ने उत्तर B को दस्तावेज़ के रूप में दिया, पर्फॉर्मेंस डेटा ने एक साथ A और B दिया, और स्पष्ट बताया कि वह B को अधिक पसंद करता है। यह सुपरवाइज्ड लर्निंग से पर्फॉर्मेंस अलाइनमेंट में प्रवेश का कारण है।

एक ही प्रश्न पर, कौन सा उत्तर अधिक उपयुक्त है?

पर्फॉर्मेंस अलाइनमेंट का केंद्रीय ध्यान, मॉडल को "क्या जवाब दे" से नहीं, बल्कि कई संभावित उत्तरों में से किस एक को अधिक पसंद करना चाहिए, जब वे सभी स्थितियों में सत्य हो सकते हैं। यह आमतौर पर एक ही इनपुट पर अलग-अलग उत्तरों की तुलना करके, निश्चितता, संबंधितता, मदददायकता, व्यक्तिपत्ति, सुरक्षा जैसी अपेक्षाओं को प्रशिक्षण संकेतों में परिवर्तित करता है। SFT की तुलना में, SFT मॉडल को "कैसे जवाब दे" सीखने के रूप में दिखाता है, एक इनपुट के लिए एक अपेक्षित आउटपुट का उपयोग करता है, जिससे मॉडल टास्क फॉर्मेट, आउटपुट संरचना, क्षेत्र व्यक्तिप