AIUnlimited
🌳

AI基礎

🌱
AI Seeds(種)

ゼロから始める

🌿
AI Sprouts(芽)

基礎を築く

🌳
AI Branches(枝)

実践に活かす

🏕️
AI Canopy(樹冠)

深く学ぶ

🌲
AI Forest(森)

AIをマスターする

🔨

AIマスタリー

✏️
AI Sketch(スケッチ)

ゼロから始める

🪨
AI Chisel(鑿)

基礎を築く

⚒️
AI Craft(制作)

実践に活かす

💎
AI Polish(磨き上げ)

深く学ぶ

🏆
AI Masterpiece(傑作)

AIをマスターする

📘

AI実践

📖
オープンソースモデルを理解する

オープンソースモデルの基礎とリソース

🎯
問題からモデルタスクへ

ビジネス問題をモデルタスクに変換

⚡
最初のモデルを実行する

30分で最初の結果を見る

🔧
ファインチューニングと評価

モデルをファインチューニングし、パフォーマンスを評価

🚀
アプリケーションシステム

実際のAIアプリケーションを構築

🎨
生成AI

オープンソースAIGCモデルを探索

🤖
エージェント

エージェントフレームワークとMCPツールを学ぶ

📐
補足基礎

LLMの基礎と評価

🎓

Claude アカデミー

🤖
Claude 101

Learn AI basics with Claude

💻
Claude Code 101

Code with Claude as your pair programmer

🤝
Introduction to Claude Cowork

Collaborate with Claude on complex projects

⚙️
Claude Platform 101

Build apps with the Claude API

ラボ

7つの実験がロード済み
🧬ニューラルネットワークサンドボックス🤖AI か人間か?🥋プロンプトエンジニアリング道場🏁アルゴリズムレース🧠AIトリビアチャレンジ🏗️システム設計キャンバス
🎯模擬面接ラボへ入る→
🚀

キャリア発展

🚀
面接ローンチパッド

旅を始めよう

🌟
行動面接マスター

ソフトスキルをマスター

💻
技術面接

コーディング面接を突破

🤖
AI・ML面接

ML面接をマスター

🏆
オファーとその先

最高のオファーを獲得

始める
AIUnlimited

MITライセンス

沪ICP备18025655号-11

学ぶ

  • AI基礎
  • AI実践
  • Claude アカデミー
  • ラボ
  • キャリア発展

コミュニティ

  • 概要
  • よくある質問

サポート

  • footer.terms
  • footer.privacy
  • footer.contact
AI & エンジニアリング アカデミックス›📖 オープンソースモデルを理解する›レッスン›What Open-Source Models Are Changing
📖
オープンソースモデルを理解する • 初級⏱️ 15 分で読める

What Open-Source Models Are Changing

オープンソースモデルは何を変えているのか

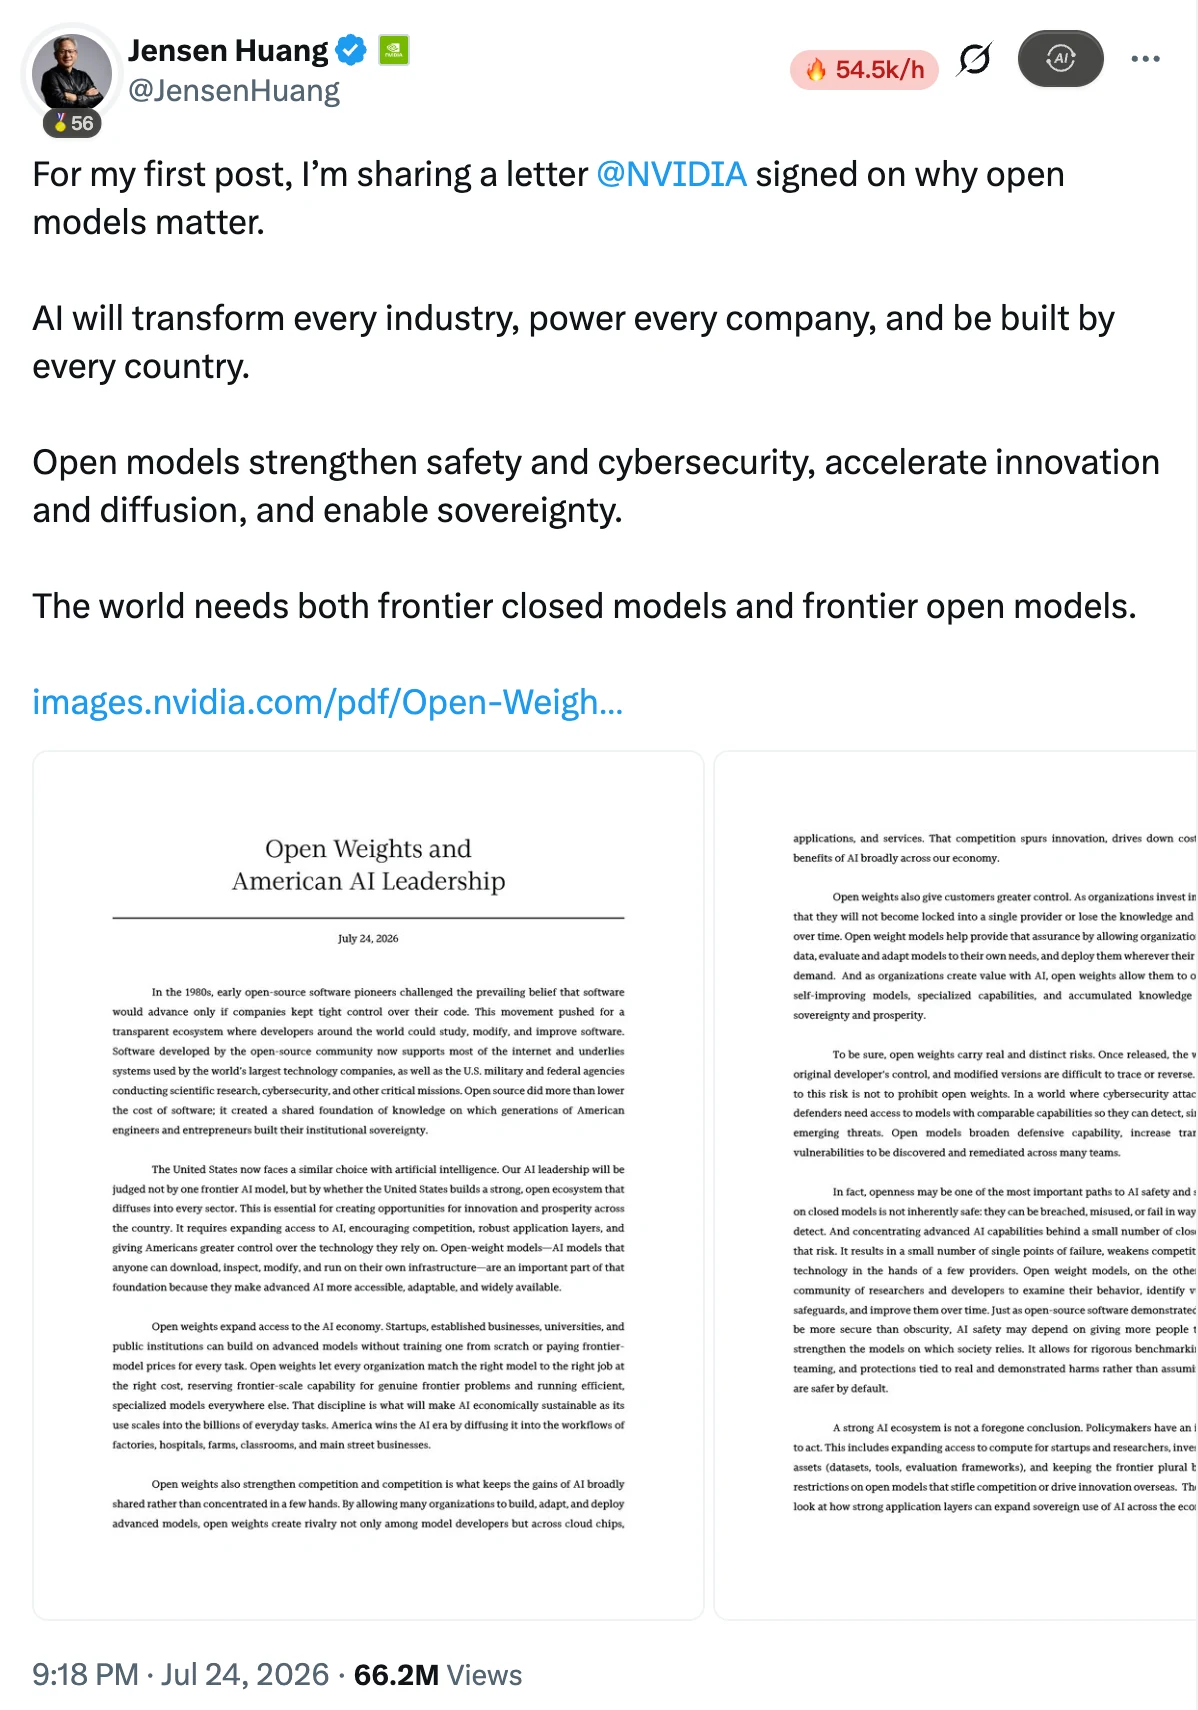
驚くかもしれませんが、NvidiaのCEOジェンスン・ホアンがXに初投稿をしました。その投稿はオープンソースに捧げられたものでした。
図解

2026年7月24日、彼はNvidiaが署名した公開書簡を共有し、オープンモデルがなぜ重要なのかを論じました:

この世界は最先端のクローズドソースモデルと最先端のオープンモデルの両方を必要としています。

多くの人は、チャットウインドウを開いて質問を送信し、AIの応答を待つことに慣れ親しんでいるかもしれません。しかし、AIを長期的に会社のデータ処理や社内システムの統合に使い始めると、次のような問題に直面するかもしれません:送信したデータは安全ですか?サービスが突然レート制限をかけたらどうしますか?モデルに会社のデータ処理方法を学ばせることはできますか?

オープンソースモデルはこれらの問題に別の解決策を提供します。ライセンスが許す範囲でモデルをダウンロードし、自分の環境でデプロイし、さらに微調整し、ユーザーがどのように使用するかを自分で決めることができます。

もちろん、大規模モデルにおけるオープンソースとクローズドソースの議論は、常に終わりなき討論のテーマです。ジェンスン・ホアンの書簡は再び私たちの共感を呼び、私たちは数名の共創設者と提携して、紫色の手引きでオープンソースモデルの実践的な応用の旅を始めることにしました。今回はオープンソースモデルの実践的な応用内容をお届けします。オープンソースモデルが繁栄しますように!

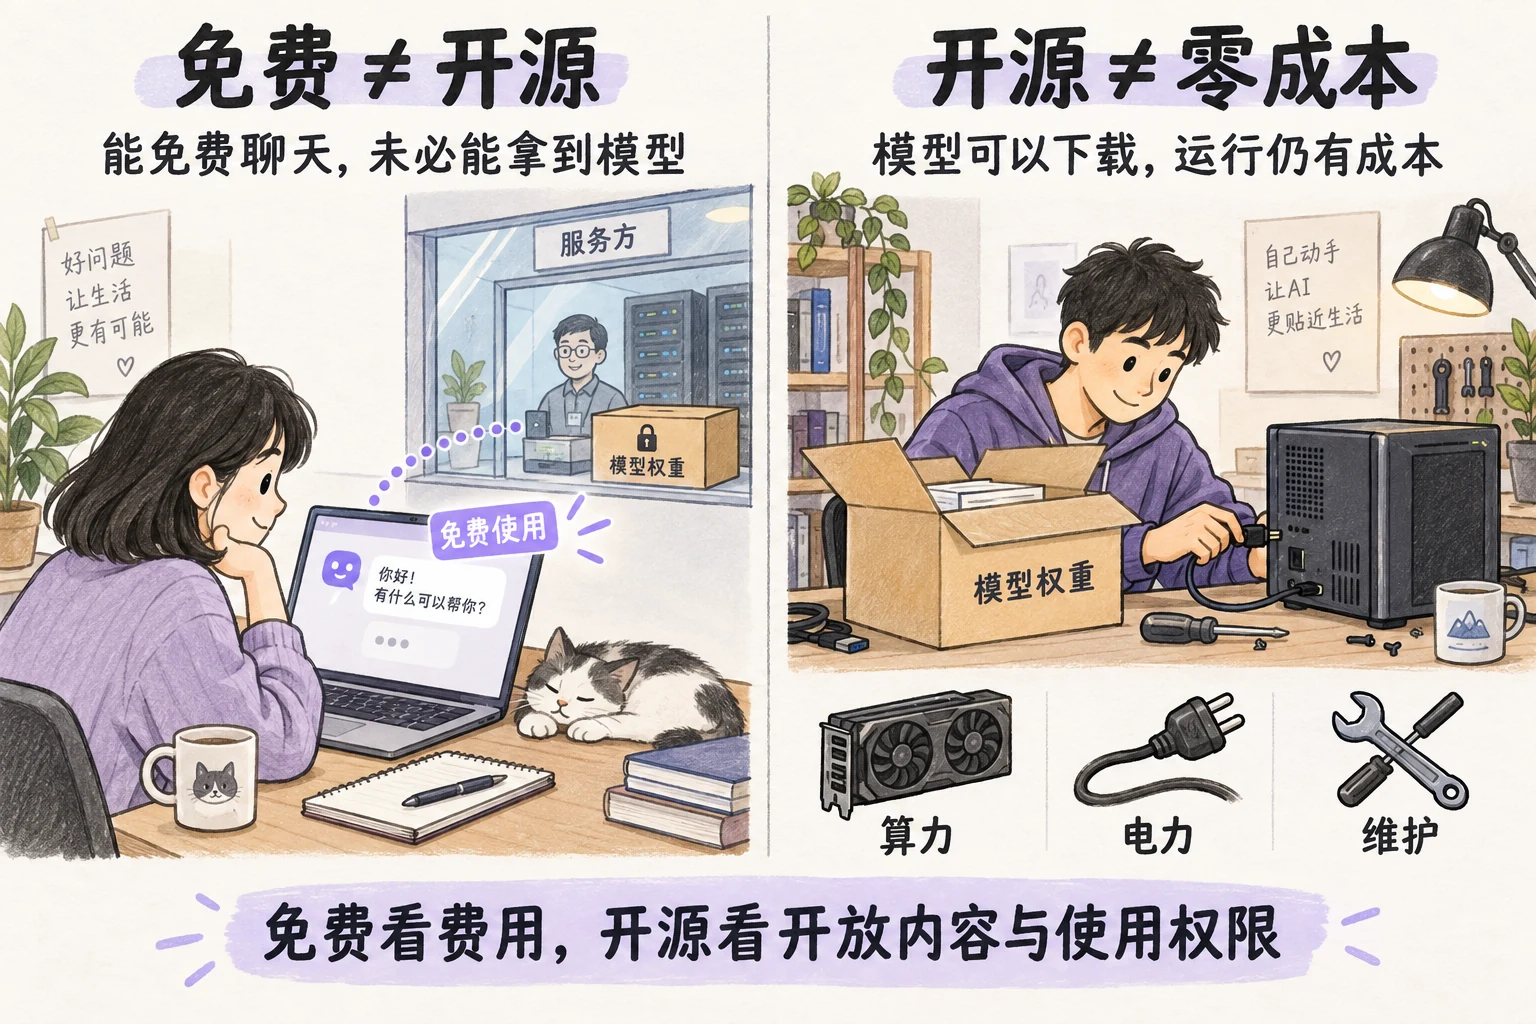
無料=オープンソースとは限らない、オープンソース=無料とも限らないことを覚えておいて

ウェブサイトでAIとチャットしたり、APIを通じてモデルに質問したりする場合、通常はモデルプロバイダーがモデルを実行します。入力を受け取り、プロバイダーが結果を返します。サーバーがどのように構成されているかや、モデルがどのようにメンテナンスされているかについて、ほとんど心配する必要はありません。

オープンソースモデルは別の選択肢を提供し、トレーニング後にモデルパラメーター、すなわち一般的に重みと呼ばれるものを取得できます。適切なソフトウェアとハードウェアがあれば、これらのパラメーターはあなたのコンピュータ、サーバー、プライベートクラウドで実行できます。外部サービスに送信する必要があった質問は、自分の環境で処理できるようになります。

ここで混乱しやすい2つの点があります。

「無料」は支払いが必要かどうかを指し、「オープンソース」は取得できることと使用が許可されている方法を指します。 チャット製品は無料でも、モデルの重みを提供しないことがあります。無料でダウンロードできるモデルでも、実行にはコンピューティングパワーとメンテナンスコストがかかります。

APIは単にモデルにアクセスする方法です。オープンソースモデルはサービスプロバイダーにホストされ、APIを通じて提供されることがあります。自分でデプロイしたモデルも、社内APIを通じて同僚に提供できます。したがって、「オープンソース vs クローズドソース」と「API呼び出し vs 自己デプロイ」は別々に考える必要があります。

日常的な議論では、重みをダウンロードできるモデルを一般的にオープンソースモデルと呼ぶことが多いです。後の章でもこの一般的な慣習に従います。

ただし、厳密な区別をする際には、オープンな重みはモデル全体のトレーニングプロセスのオープンソースに相当しないことを明確にします。トレーニングデータ、トレーニングコード、使用権限は別々に確認する必要があります。
図解

すべてオープンソースと呼ばれるが、開かれるものは異なる~

モデルを取得した後、おそらくそれがどのようにトレーニングされたか気になるでしょう。

ここで、異なるモデル間の違いが明らかになります。完全なトレーニング材料を公開せずにダウンロードして実行できるものもあります。さらに、トレーニングコードとデータの説明を提供し、外部開発者がモデルのトレーニング軌跡を研究できるようにするものもあります。

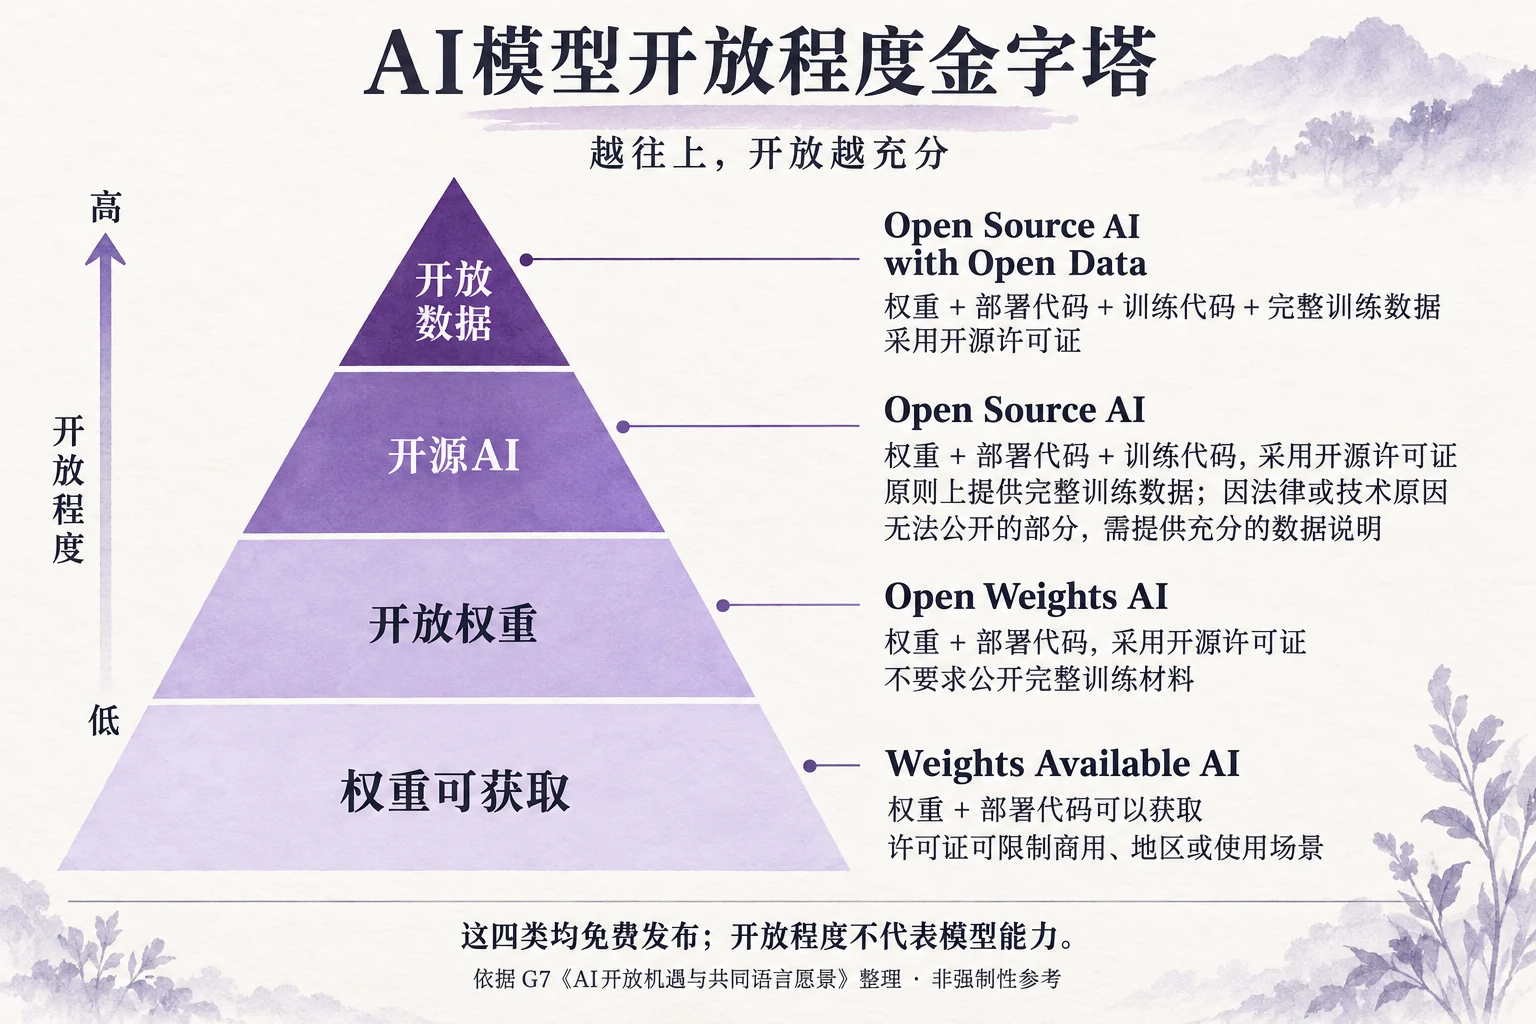
2026年5月、G7はAIの公開性に関する共通リファレンス文書を発表し、これらの差異を4つのカテゴリに分類しました(公開性が高い順):

  • 完全なトレーニングデータも公開されている。 モデルの重み、デプロイメントコード、トレーニングコード、完全なトレーニングデータがすべてオープンソースライセンスで提供され、Open Source AI with Open Dataに対応。
  • 重みとコードは公開、制限されたデータには詳細な説明がある。 Open Source AIに対応。完全なトレーニングデータは原則として提供されるべきで、法的または技術的な理由で共有できない部分は、十分なデータドキュメントで代替する必要がある。
  • トレーニングされたモデルが実行と改造のために渡される。 Open Weights AIに対応し、オープンソースライセンスで重みとデプロイメントコードを提供するが、完全なトレーニング材料を公開するとは限らない。
  • ダウンロード可能だが、使用時に追加条件がある。 Weights Available AIに対応し、重みとデプロイメントコードを取得できるが、ライセンスが商業使用、使用地域、特定のシナリオを制限する場合がある。
図解
レッスン 1 / 40%完了
←プログラムに戻る

ディスカッション

ログイン ディスカッションに参加

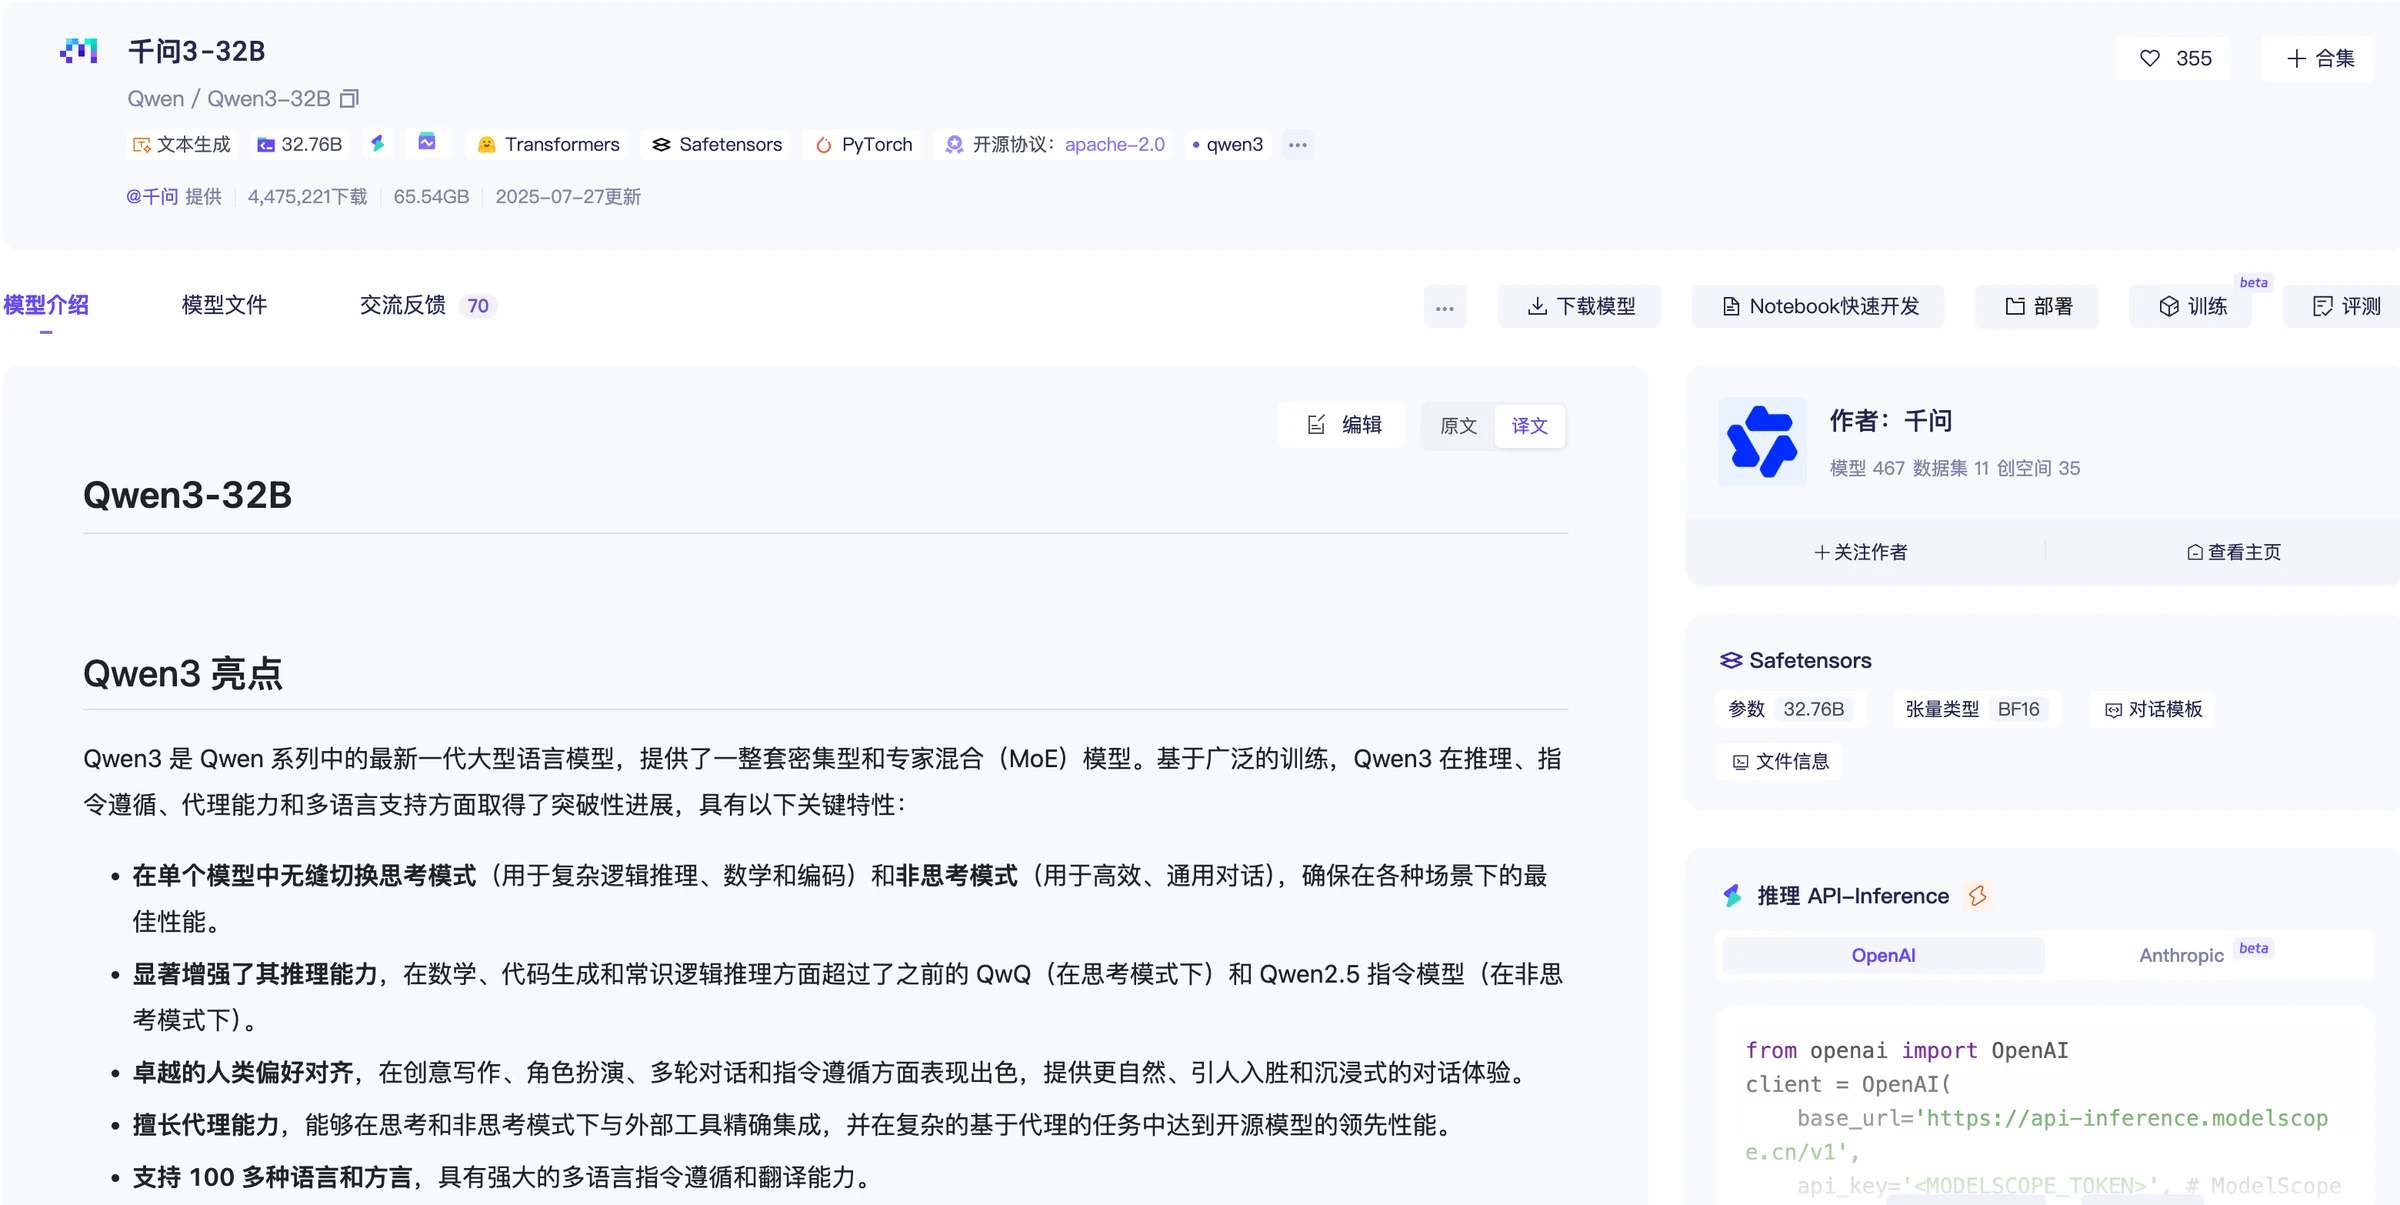
Qwen3を例に取ると、公式チームはオープンな重みのモデルを、ローカル実行、デプロイ、量子化、微調整の関連説明とともに提供しています。開発者はTransformers、vLLM、SGLangなどのツールを使用してモデルを実行でき、微調整ツールを使用してトレーニングを続けることもできます。上記の区別に基づくと、これはオープンな重みレベルの実用的な価値を示しています。

図解

ほとんどの企業は大規模モデルの事前トレーニングをやり直す必要はありません既存のモデルを実行し、自分のデバイスに適応させ、ビジネスサンプルで微調整することで、多くのビジネス上の具体的な問題を解決できます。

オープンソースモデルは本当にクローズドソースモデルに匹敵できるのか?

自分でモデルをデプロイできるのは素晴らしいことですが、モデルがビジネスシナリオで頻繁にエラーを起こす場合、実際の仕事を任せることは難しいです。

過去にオープンソースモデルは多くの人に「研究には便利だが、最も強力なクローズドソースモデルには劣る」という印象を与えていました。モデルの能力が不断に更新される中、この評価は見直す必要があります。

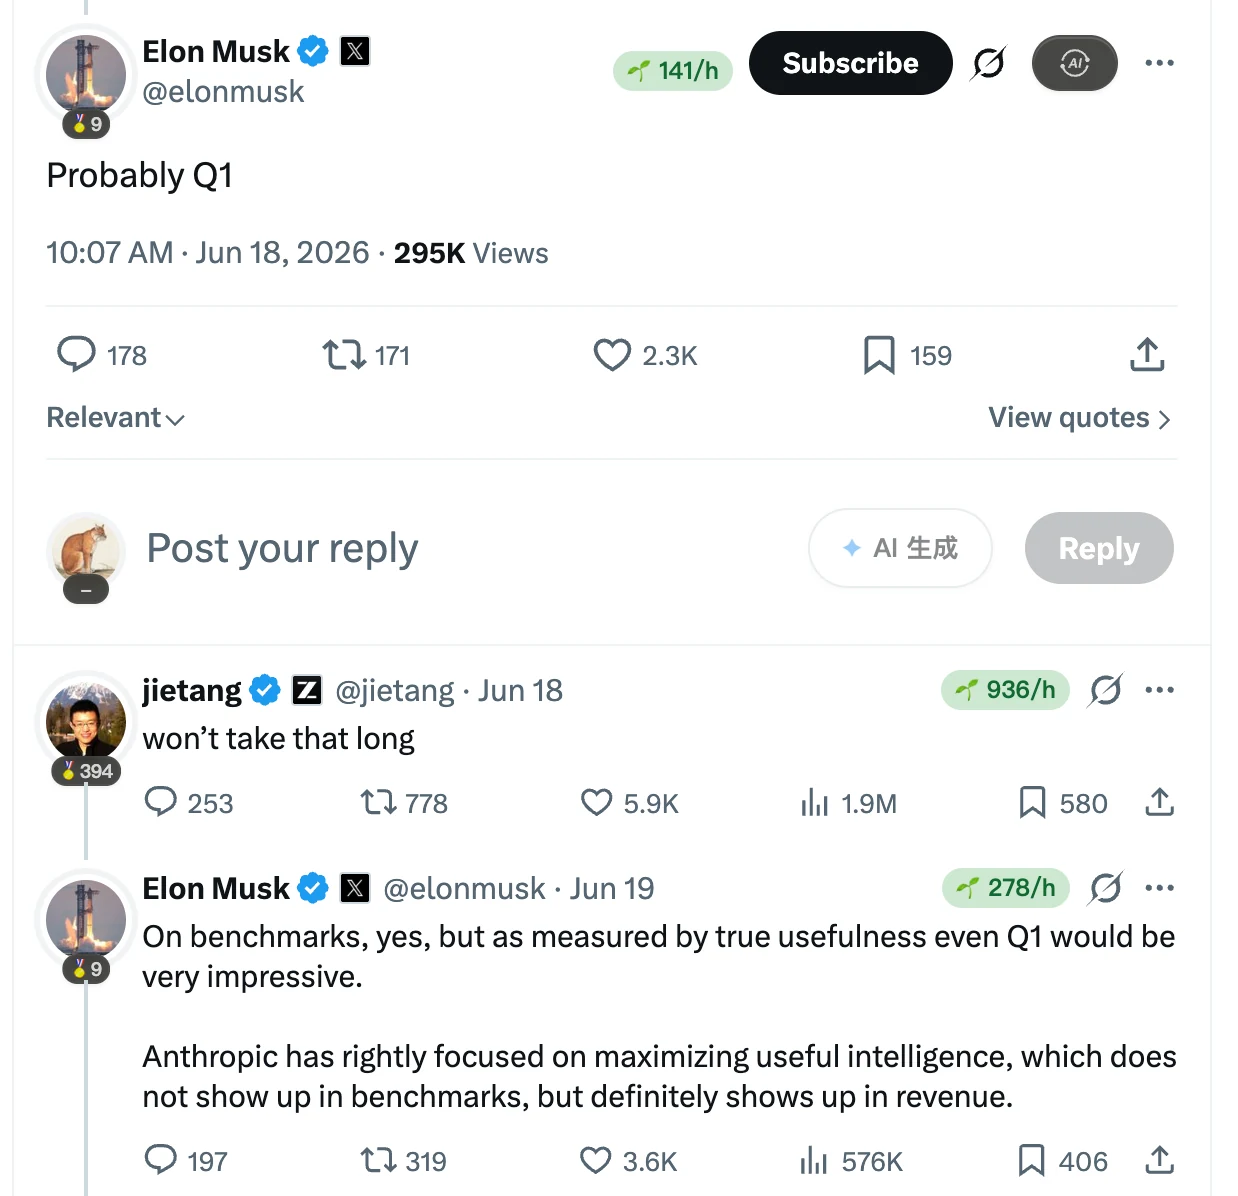
2026年6月18日、Xでかなり興味深いやり取りがありました。ネットユーザーは中国のモデルがAnthropicのフロンティアモデルのレベルにいつ到達するかを議論し、イーロン・マスクは2027年第1四半期までかかると予測しました。Zhipuの共同創設者唐傑はその下で「won't take that long」と返しました。

図解

二人の予測が実現するかどうかは、今後のモデルのパフォーマンス次第です。この議論の魅力的な点は、オープンソースモデルがすでに大規模モデル全体のフロンティアに立っていることです。

Hugging Faceが2026年7月に公開したセキュリティインシデントは、オープンソースモデルの重要性を再び証明しました。

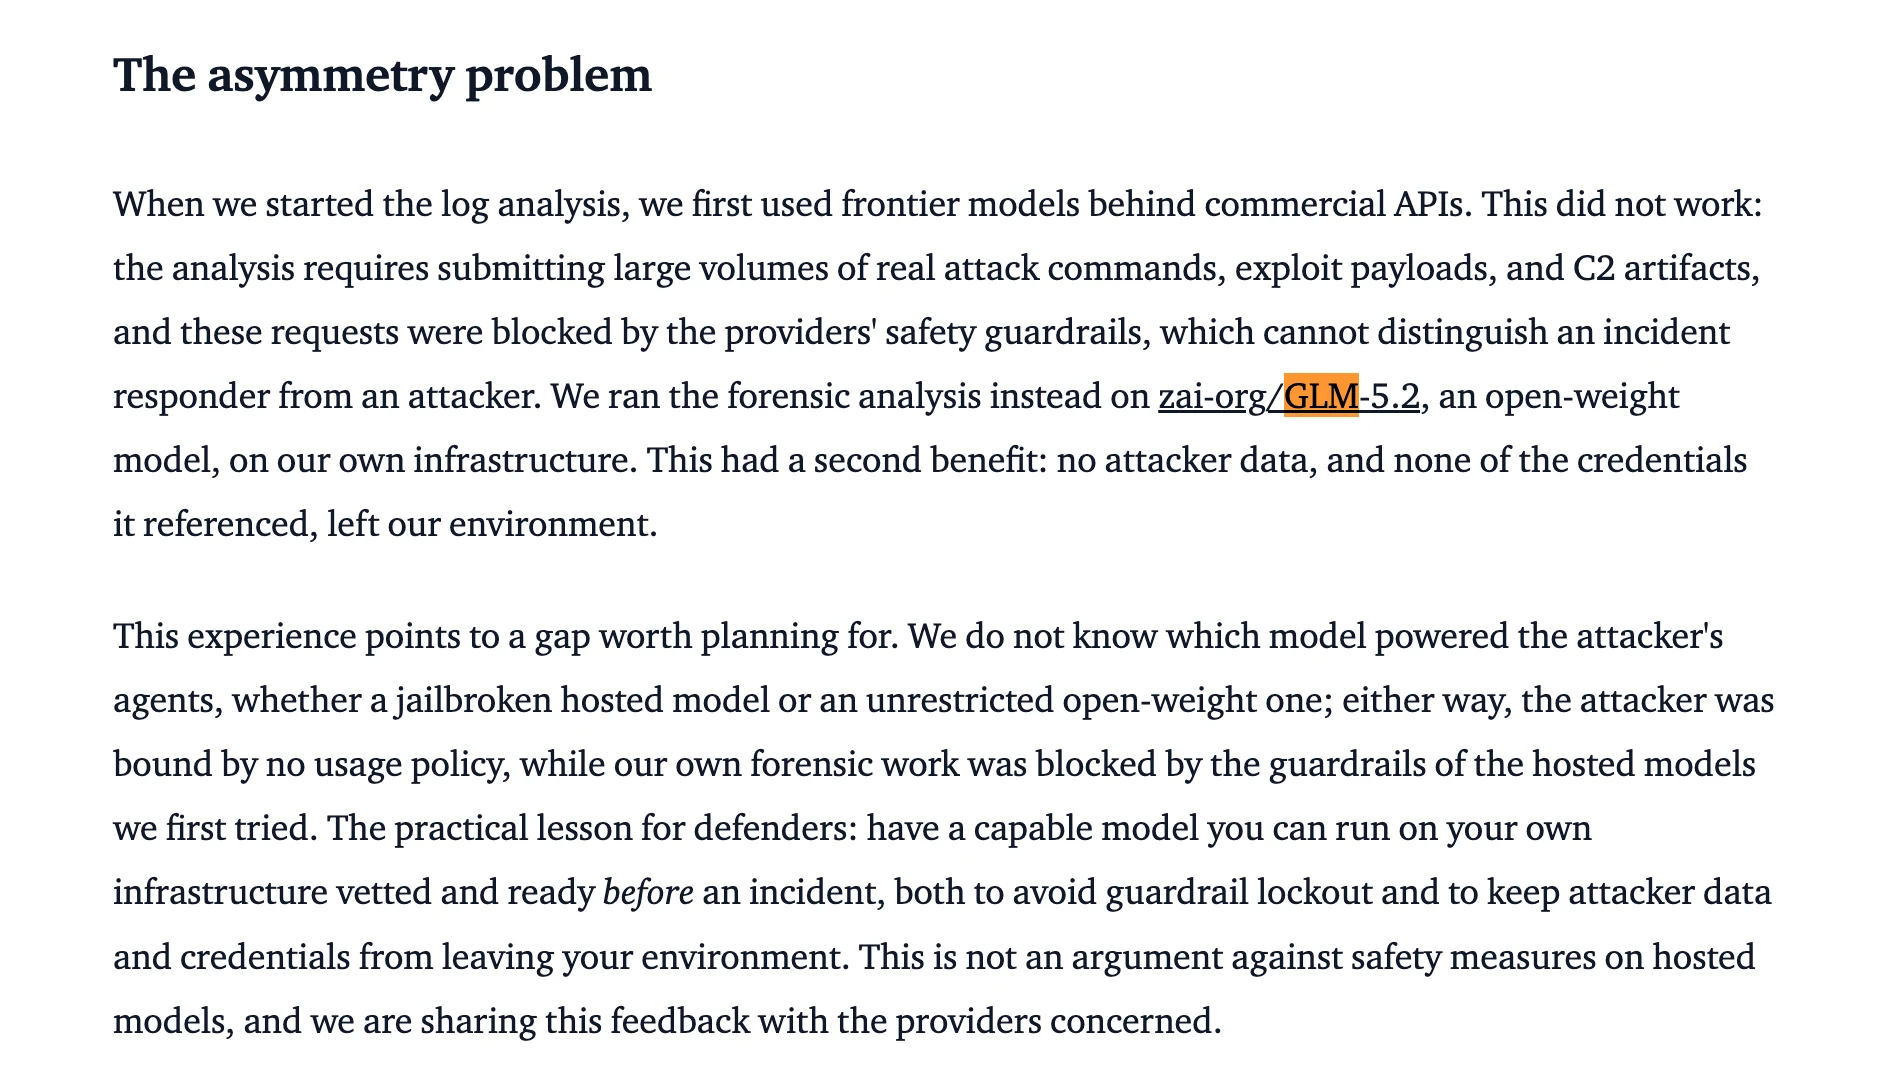
Hugging Faceの本番インフラの一部が侵害され、セキュリティチームは大量の攻撃記録を分析して、攻撃者が何をしたか、どの資格情報を触れたか、影響がどこまで及んだかを把握する必要がありました。HFチームはまず商用APIを通じてフロンティアモデルの使用を試みましたが、気まずい問題に直面しました。調査に使用された実際の攻撃コマンドとエクスプロイトコンテンツが、サービスプロバイダーのセキュリティ制限をトリガーし、分析リクエストがブロックされました。

その後、チームは自分のインフラ上でオープンな重みのモデルGLM-5.2を使用してフォレンジック分析を実行し、調、調査を継続できました。関連する攻撃データと資格情報も内部環境に留まりました。

図解

その後の技術レビューで、Hugging Faceはさらに、チームが約17,600回の攻撃アクションを再構築し、GLM-5.2を含むオープンな重みのモデルを使用して、難読化および暗号化された攻撃ペイロードを解釈したことを説明しました。

このインシデントは、オープンソースモデルの重要性を示しています。

オープンソースモデルの使用はクローズドソースの制限を受けません。データをローカルに保持し、オフラインで使用し、タスクの実行をより制御可能にできます。

どのようなシナリオがローカルデプロイに適しているか?

垂直分野もオープンソースモデルの重要な応用方向です。汎用大規模モデルは大量の公開データを学習していますが、企業内部のデバイス名、ビジネスプロセス、業界用語、専門知識の理解は限定的である場合があります。垂直分野のデータによるファインチューニングにより、これらの専門知識をさらに学習させることができます。

機密データを処理する必要があるタスクには、ローカルデプロイにもメリットがあります。モデルは企業内部ネットワークで推論を完了し、既存のナレッジベース、データベース、ビジネスシステムと接続することで、機密データを外部サービスに送信する必要性を減らします。

ただし、すべてのタスクがローカルデプロイのオープンソースモデルを必要とするわけではありません。

モデル呼び出し回数が少なく、ビジネス変化が速く、最新の汎用モデル能力を継続的に使用する必要があるタスクには、APIを直接呼び出す方が通常より便利です。一方、長期的に安定し、繰り返し実行されるビジネスタスクには、オープンソースモデルに大きな応用スペースがあります。

例えば、テキスト分類、意図認識、情報抽出、ドキュメント要約、ナレッジベースQAなどのタスクは、比較的明確な入力と出力形式を持っています。企業はタスクの複雑さに応じて適切なサイズのモデルを選択し、自社のビジネスデータを使用してトレーニングやファインチューニングを行えます。これらのタスクには、必ずしも最大パラメータ数のモデルを使用する必要はありません。

モデルがダウンロードできる ≠ 自由に使える

モデルが正常に動作し、効果も良いですが、商用製品で使用したい場合や、ファインチューニングしたバージョンを共有したい場合は、LICENSE(ライセンス)を確認する必要があります。

ダウンロード可能、商用可能、修正後に再公開可能は、異なるライセンスです。

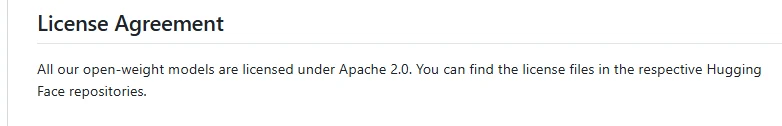
一般的に、MITとApache License 2.0は比較的寛容なオープンソースライセンスで、商用使用と修正を許可し、すべての派生コードを公開する必要もありません。MITライセンスのソフトウェアは、著作権とライセンス声明を保持するだけで済みます。Apache 2.0は、再配布時の修正説明、関連声明の保持、NOTICE処理などの要件を規定し、明確な特許許諾条項を含んでいます。

例えば、Qwen3シリーズモデルはApache 2.0を採用しています。

図解

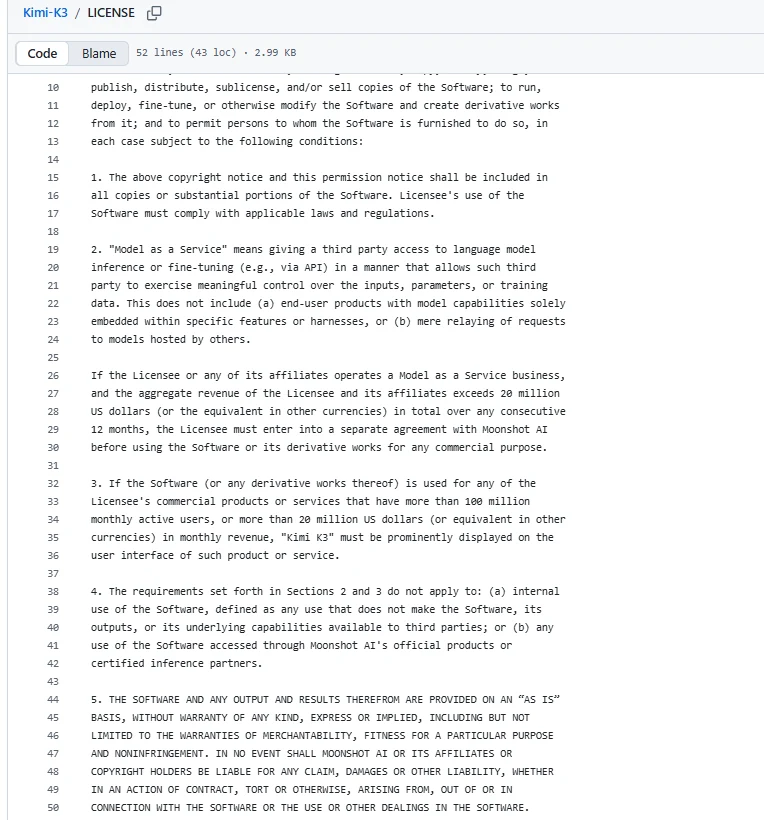
Kimi K3は一部の商用使用に別の契約を設けており、デプロイ、ファインチューニング、派生作品の作成を許可していますが、モデルサービングビジネスが規定の収益基準に達した場合は、別途契約を締結する必要があります。

図解

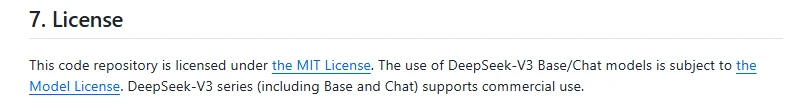
DeepSeek-V3プロジェクトのコードはMITライセンスを使用しています。

図解

したがって、モデルを使用する際、ファインチューニングしたモデルを公開配信したり他のユーザーに提供したりしたい場合は、元のモデルのライセンスを再確認し、そのような使用が許可されているか、モデル名、ライセンス、ソース情報を保持する必要があるかを確認する必要があります。

新しいモデルが複数のモデルをマージして作られた場合は、それらのモデルのライセンスをそれぞれ確認し、要件が競合しないことを確認する必要があります。