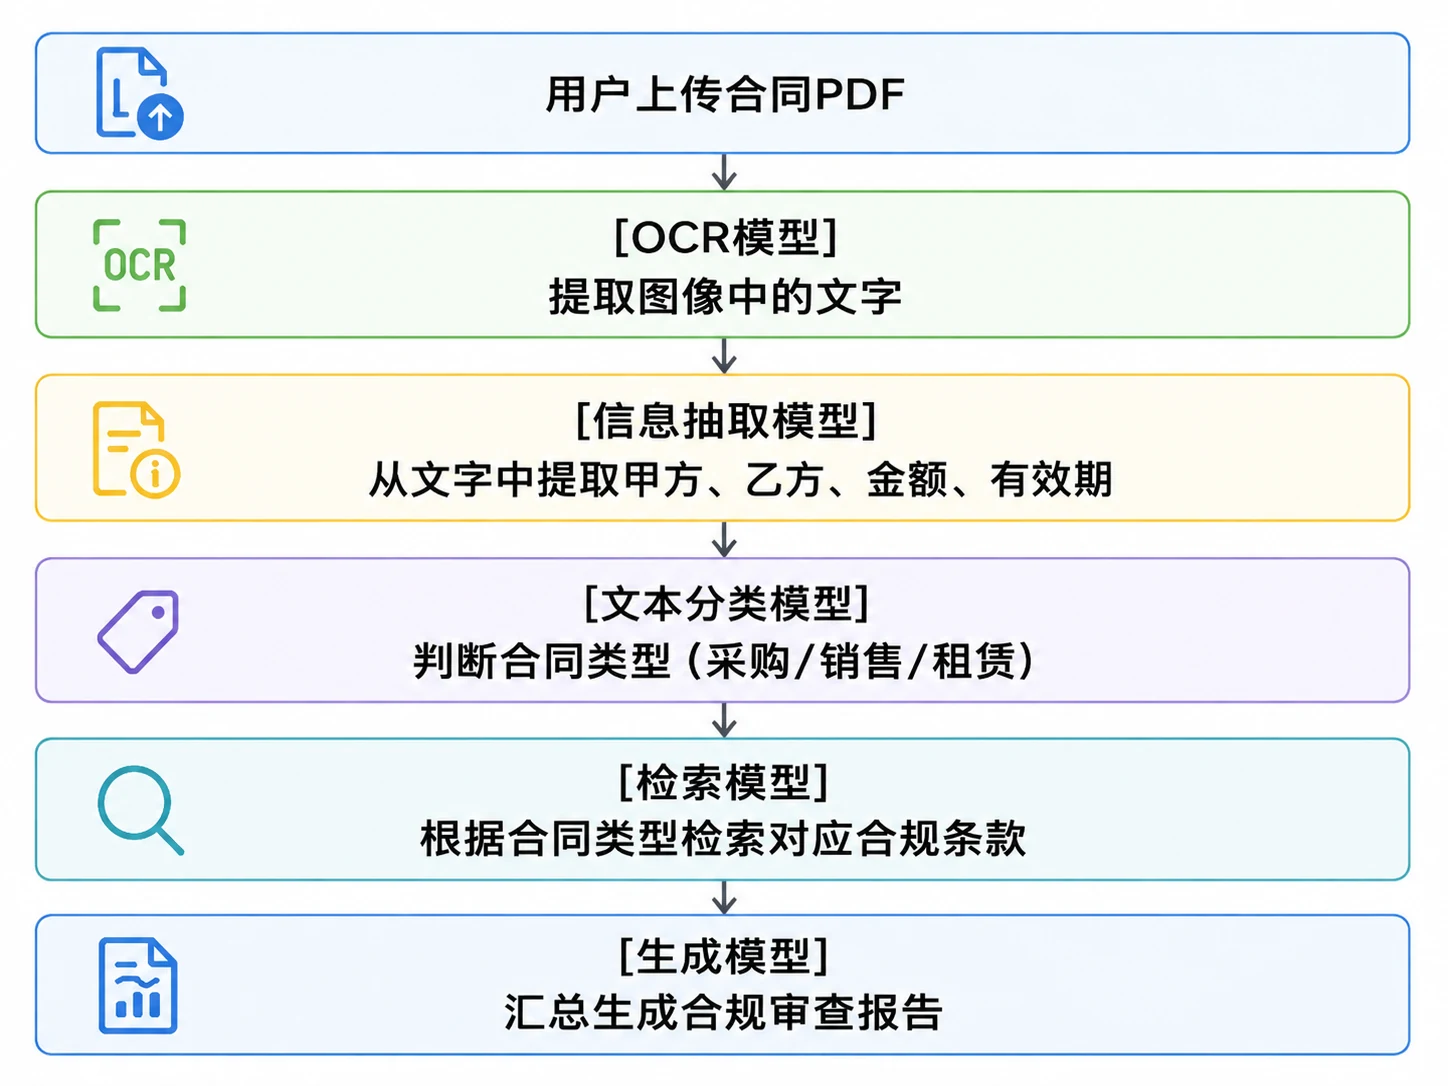
新しいモデルのリリースを見ると、最初の考えは必ずダウンロードして試してみることです。しかし、自分のビジネスになると問題は具体的になります。会社のビジネス問題を処理できるか?顧客が何を聞いているか判断できるか?こんな大きなモデルを使う必要があるか?
つまり、オープンソースモデルを選択する前に、やりたいことをはっきりさせる必要があります。同じように契約を処理するにしても、契約の分類、金額と日付の抽出、要約の生成では、注目すべき能力が異なります。目標が明確になって初めて、モデルライブラリを探してどのモデルがより適合しているかを見ることができます。
ビジネス側が要件を出す際、通常「分類モデルが必要」「情報抽出モデルが必要」とは直接言わず、実際のビジネスから出発して問題を記述します。例えば「契約書から重要な情報を抽出して」「ユーザーの質問に自動返信して」などです。
モデル選択の第一歩は、これらのビジネスニーズをモデルタスクに変換することです。タスクが確定して初めて、どのようなタイプのモデルが必要かをさらに判断できます。
ニーズがどのようなモデルタスクに属するかを判断するには、まず2つの側面から着手できます。
1)タスクの目標
モデルの作業目標に従い、一般的なタスクは以下のカテゴリに分類できます。
| タスクタイプ | 核心定義 | 一般的な理解 |
| 生成タスク | 入力内容に基づいて新しいテキスト、画像、音声などを生成 | 「新しい内容を書く」 |
| 分類タスク | 入力内容が属するカテゴリを判断 | 「どのカテゴリに属するか判断」 |
| 情報抽出タスク | 生のデータから必要な情報を抽出し、一定の形式で出力 | 「固定フィールドを抽出」 |
| 検索とソートタスク | 候補コンテンツから関連コンテンツを見つけ、関連度に応じてソート | 「最も適合するものを finds てソート」 |
| 予測タスク | 既存のデータに基づいて、将来のまたは未知の結果を判断 | 「数値やトレンドを予測」 |
2)処理するデータタイプ
異なるデータタイプ面对し、モデルの処理方法と内部構造が異なるため、専用のモデルを選択する必要があります。一般的なデータタイプは以下の通りです。
| データタイプ | 説明 | 一般的なデータ |
| テキスト | テキスト内容を処理 | 記事、契約書、チャット記録 |
| 音声 | オーディオを処理 | 録音、音声会話 |
| 画像 | 単一の画像を処理 | 写真、スキャン、商品画像 |
| 動画 | 連続する画像と音声情報を処理 | 監視動画、ショート動画 |
また、入力と出力が1種類のデータのみを含むかどうかにも注意が必要です。入出力が同じデータタイプの場合、そのデータタイプでモデルタスクを分類します。
例えば、入出力がともに画像の場合は画像タスクに属します。入出力が2つ以上のデータタイプに及ぶタスクはマルチモーダルタスクに属します。一般的なマルチモーダルタスクには、音声からテキストへの変換(入力は音声、出力はテキスト)、画像から質問への回答(入力は画像とテキスト、出力はテキスト)などがあります。
実際の判断では、まずビジネス問題の最終目標を見、次に入出力のデータタイプを確認します。例は以下の通りです:
例1:ユーザーのレビューをポジティブ、ネガティブ、ニュートラルに分類する
このビジネスの目標はカテゴリラベルを出力することです。入力はテキストなので、テキスト分類タスクです。
例2:画像をアップロードし、商品データベースから最も類似した商品を finds てソートする
このビジネスの目標は候補から最も関連性の高いアイテムをマッチングしてソートすることです。ソートタスクに属します。処理するデータタイプは画像なので、画像検索とソートタスクです。
例3:テキスト記述に基づいて、対応する画像を生成する
このビジネスの目標は画像を生成することです。生成タスクに属します。入力はテキスト、出力は画像で、入出力のデータタイプが異なるため、マルチモーダル生成タスク、いわゆるテキストから画像へのタスクです。
モデルタスクが見つかったら、モデル選択の段階に入ります。ModelScopeプラットフォームは複数のモデル絞り込み方法を提供しており、以下の方法を参考にしてモデルを選択してください。
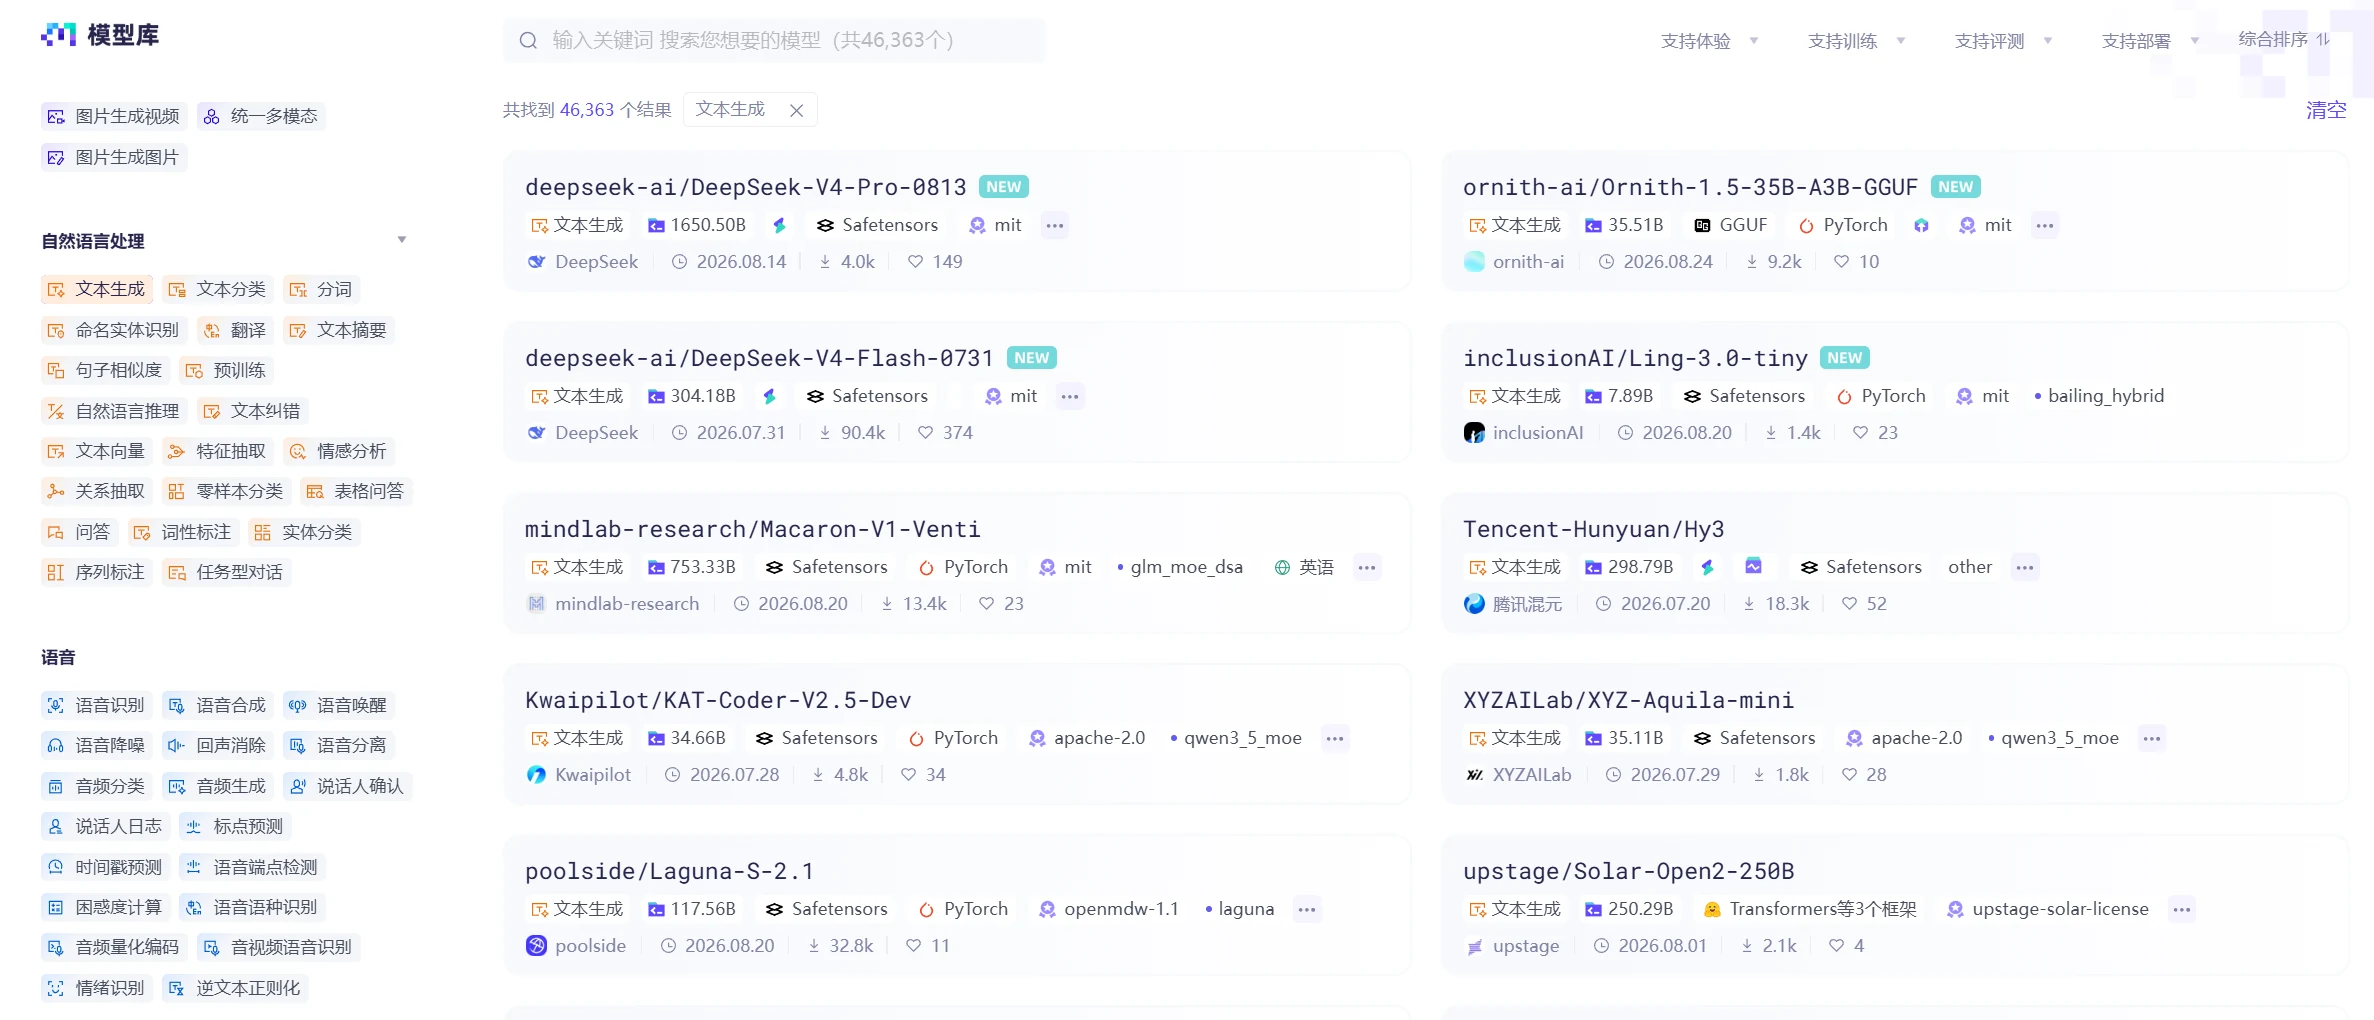
ModelScopeは各モデルにタスクタイプタグを付けています。モデルライブラリページで:
1.「モデルライブラリ」を選択してモデル閲覧ページに入ります。
2.左側の絞り込みバーで「タスクタイプ」を選択します。
3.対応するタスクカテゴリ(例:「テキスト分類」)を選択します。
プラットフォームがそのタスクタグが付けられたモデルリストを自動的に絞り出します。これは最も直接的な絞り込み方法で、優先的に使用することをお勧めします。
ログイン ディスカッションに参加
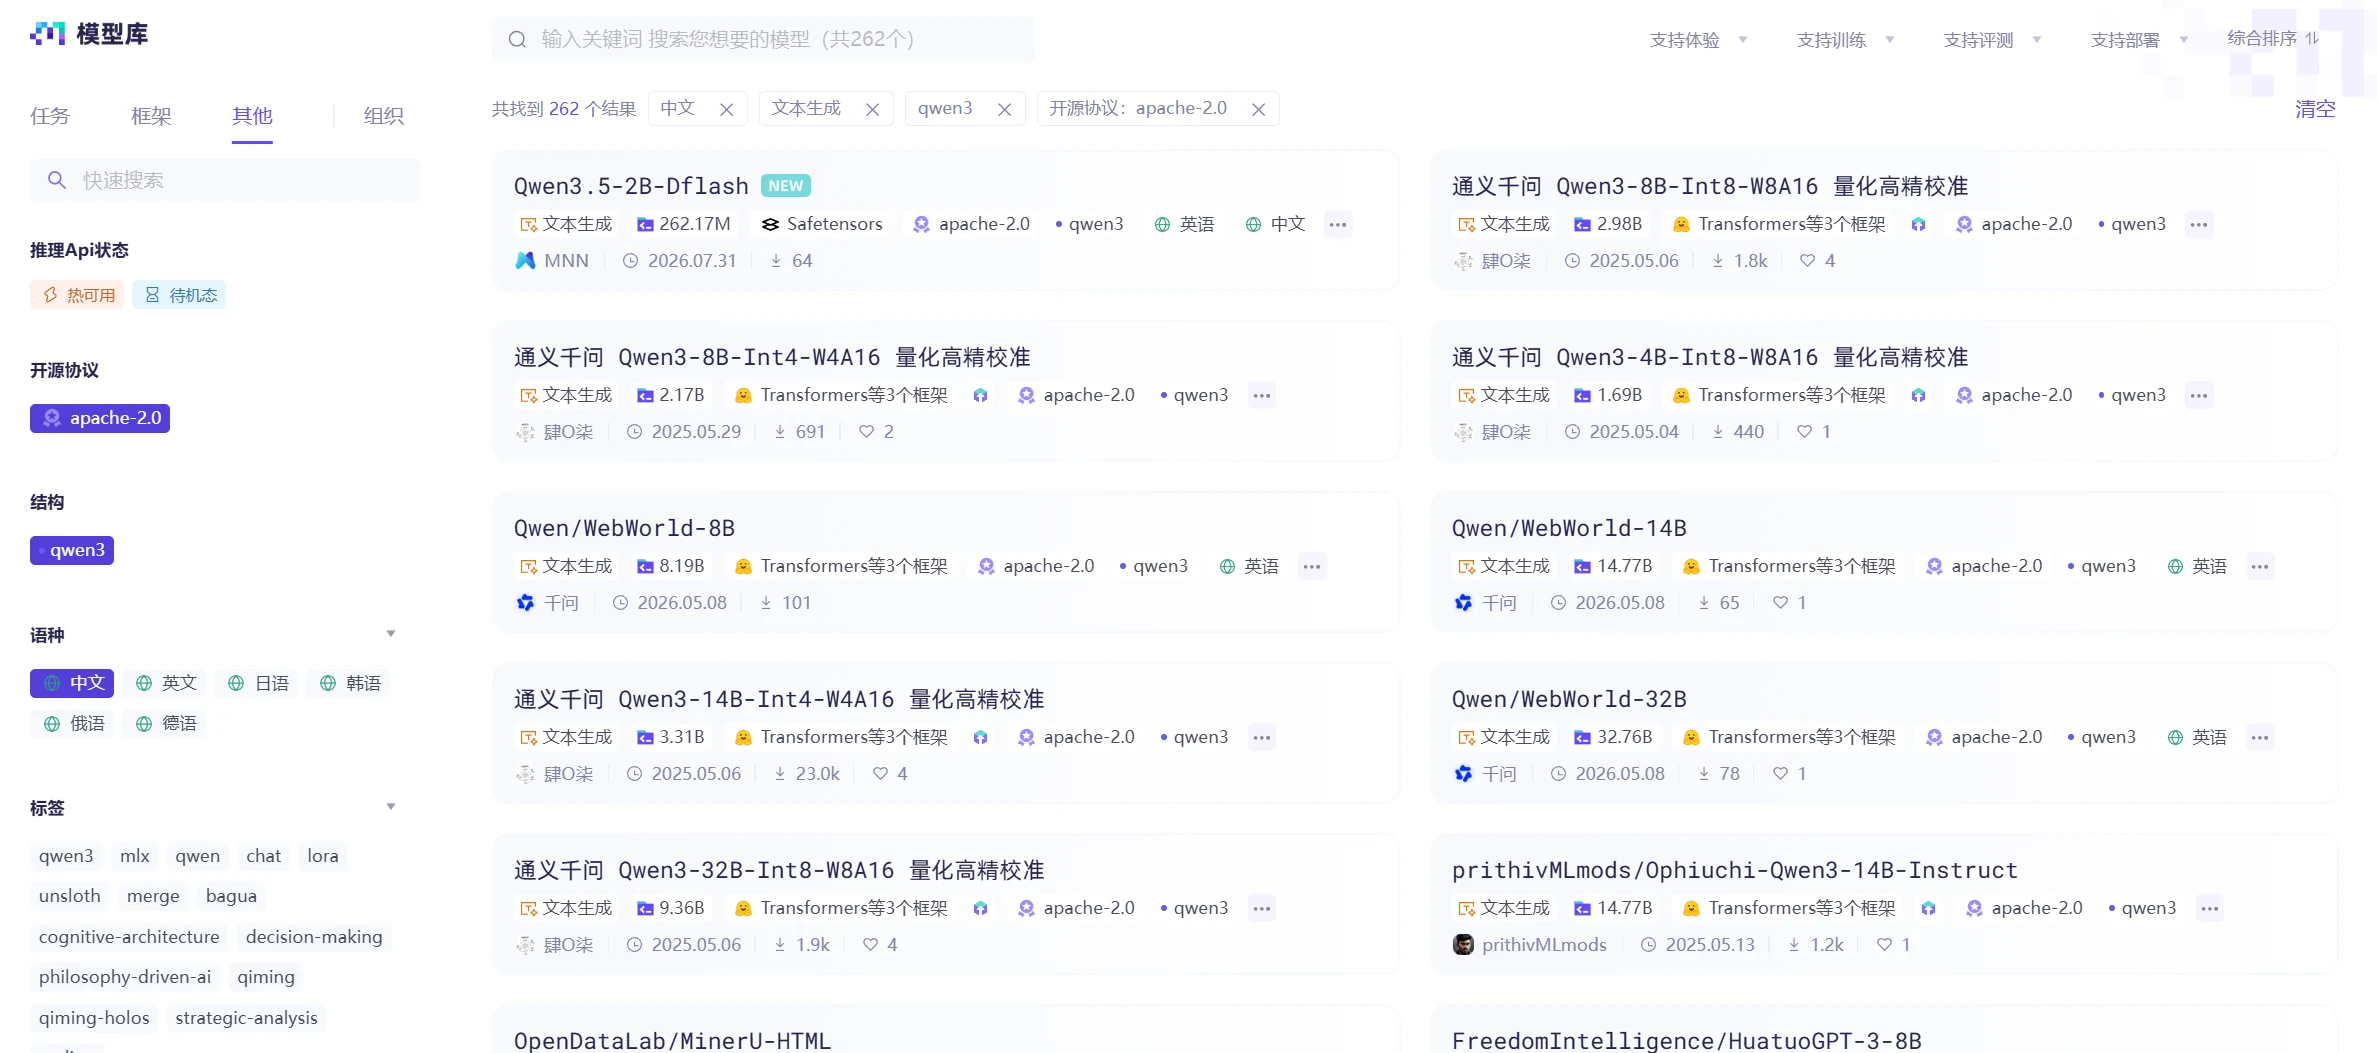
タスクタグで絞り込んでも候補モデルが多い場合、左側の「フレームワーク」および「その他」バーに他のタグを追加して範加して範囲を絞り込めます:
フレームワーク:PyTorch、TensorFlowなどの特定のフレームワークのモデルを絞り込みます。
オープンソースライセンス:商用シナリオではApache 2.0、MITなどの緩やかなライセンスを絞り込む必要があります。
構造:llama、qwen3、deepseek_v2などの構造を絞り込みます。
言語:タスクがサポートする必要がある中国語、英語、日本語、韓国語などの言語を選択します。

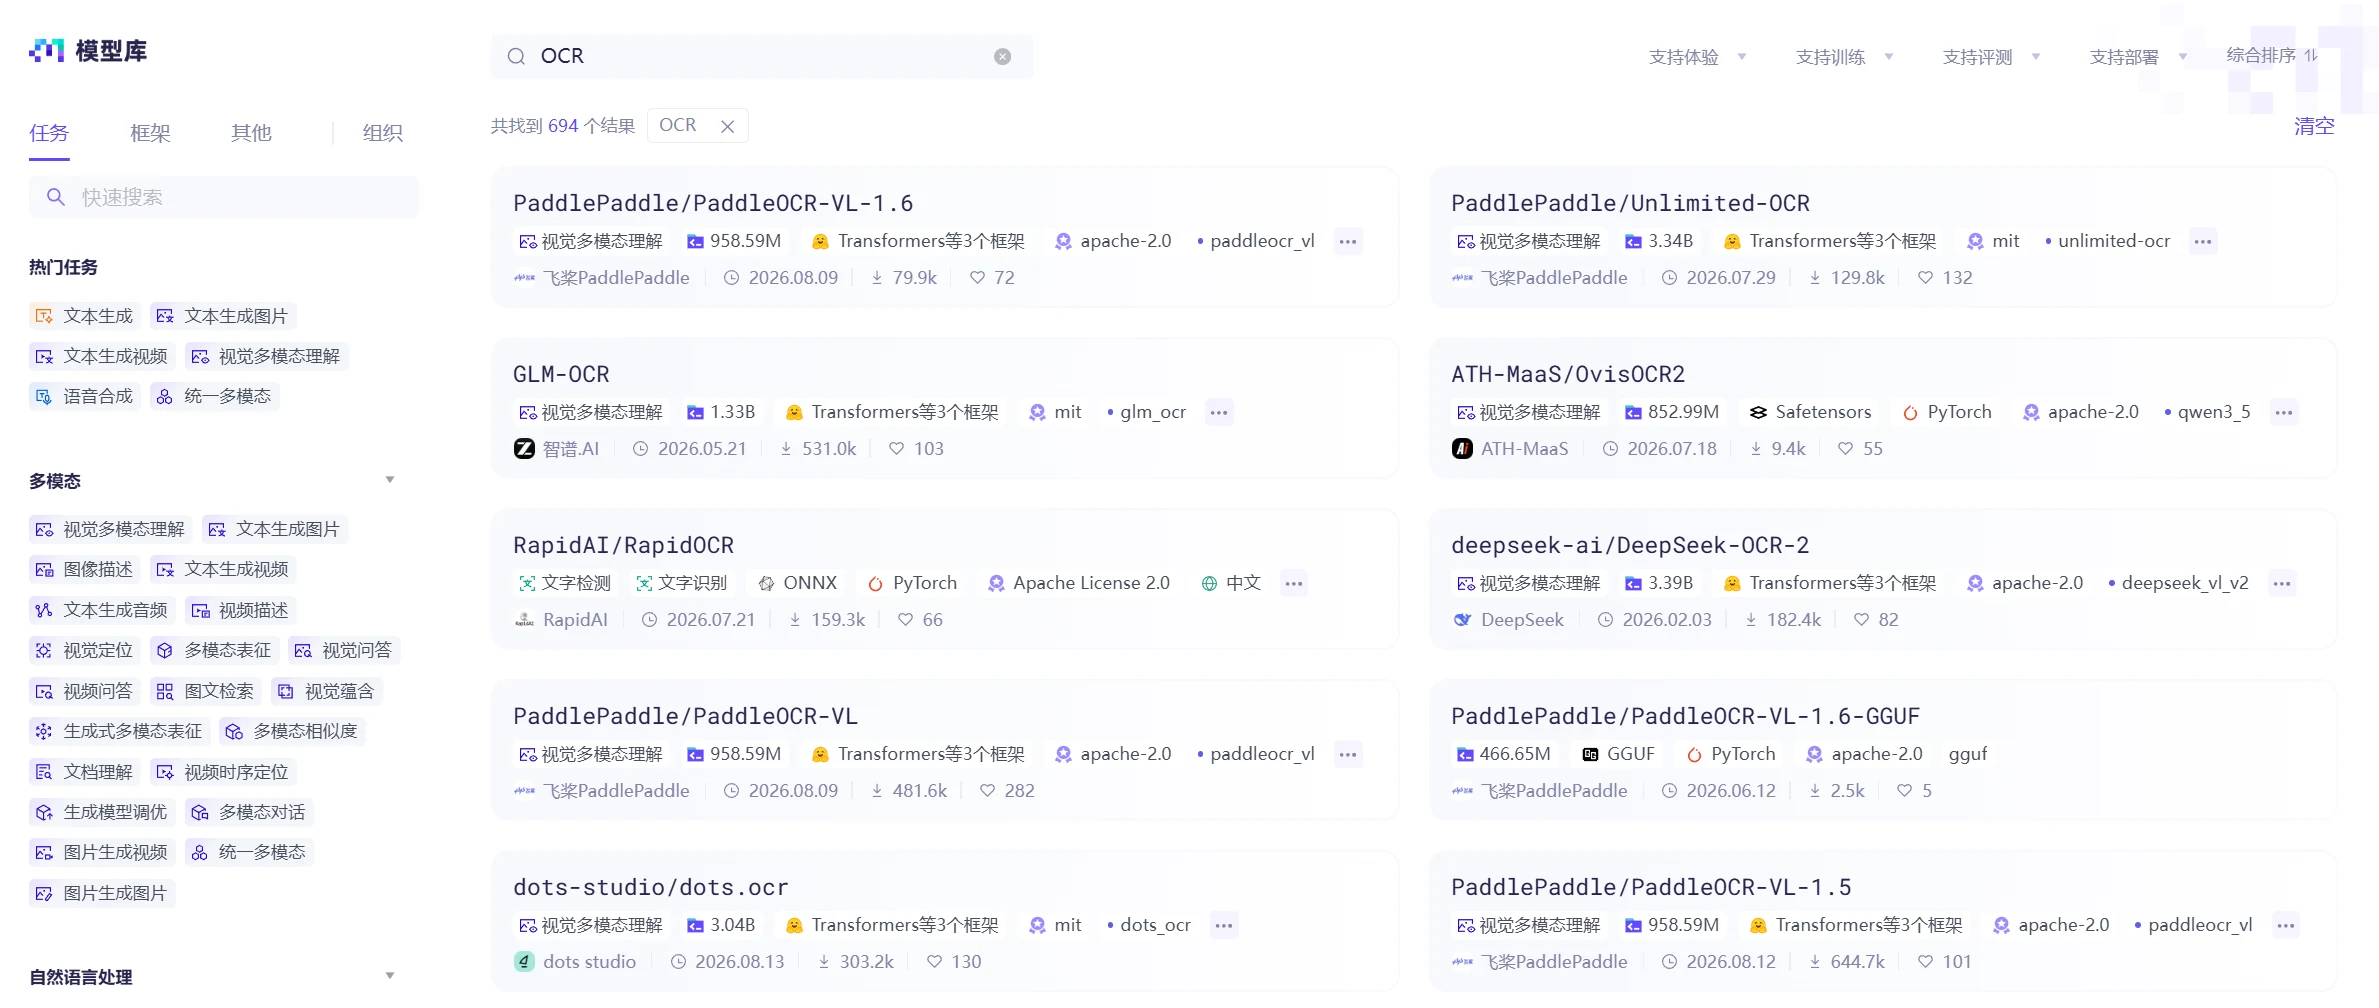
具体的なタスク名やモデル名を知っている場合、検索ボックスにキーワードを入力して直接検索できます。例:「OCR」。

ModelScopeプラットフォームでは、モデルの人気度も統計しており、参考にできる指標は以下の通りです。
指標 | 意味と用途 |
ダウンロード数 | モデルの全体的な使用頻度を反映。ダウンロード数が多いほど、多くのシナリオで検証されていることを意味します |
お気に入り数 | ユーザーによるモデルの認知度を反映。お気に入り数が多いほど、モデルの品質やシナリオ適応度が高いことを示します |
更新日時 | 最近更新されたモデルは通常、より良いパフォーマンスやより完全なエコシステムサポートを備えています。更新が古いモデルには互換性の問題がある場合があります |
コミュニティの活発度 | IssueやDiscussionのレスポンス速度、議論の活発度は、モデルのメンテナンス状態を間接的に反映します |
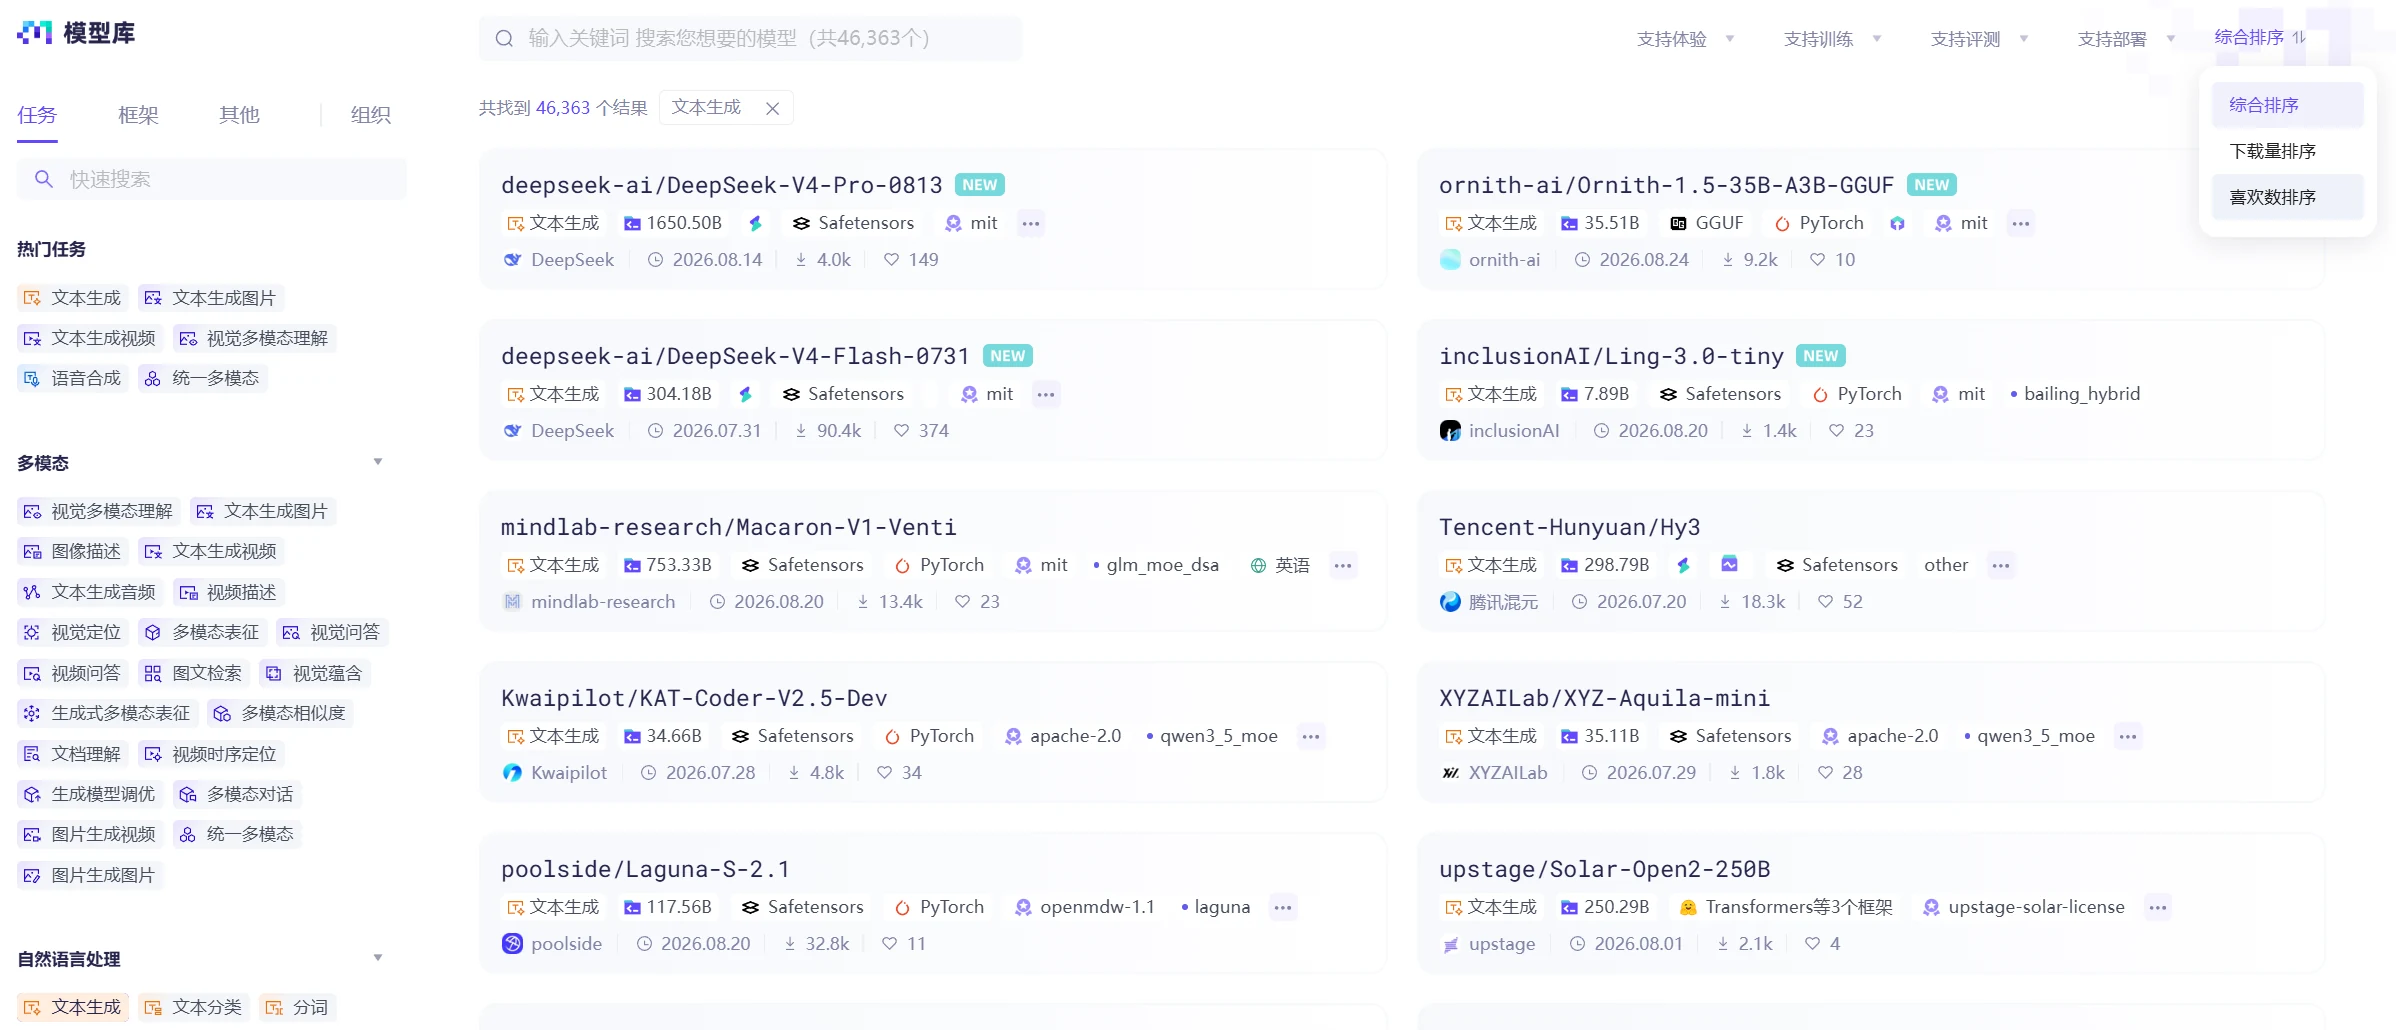
プラットフォームではダウンロード数またはお気に入り数で絞り込み后的のモデルをソートできます。モデルライブラリの右上で判断基準を選択でき、同時にモデルの更新日時も確認できます。

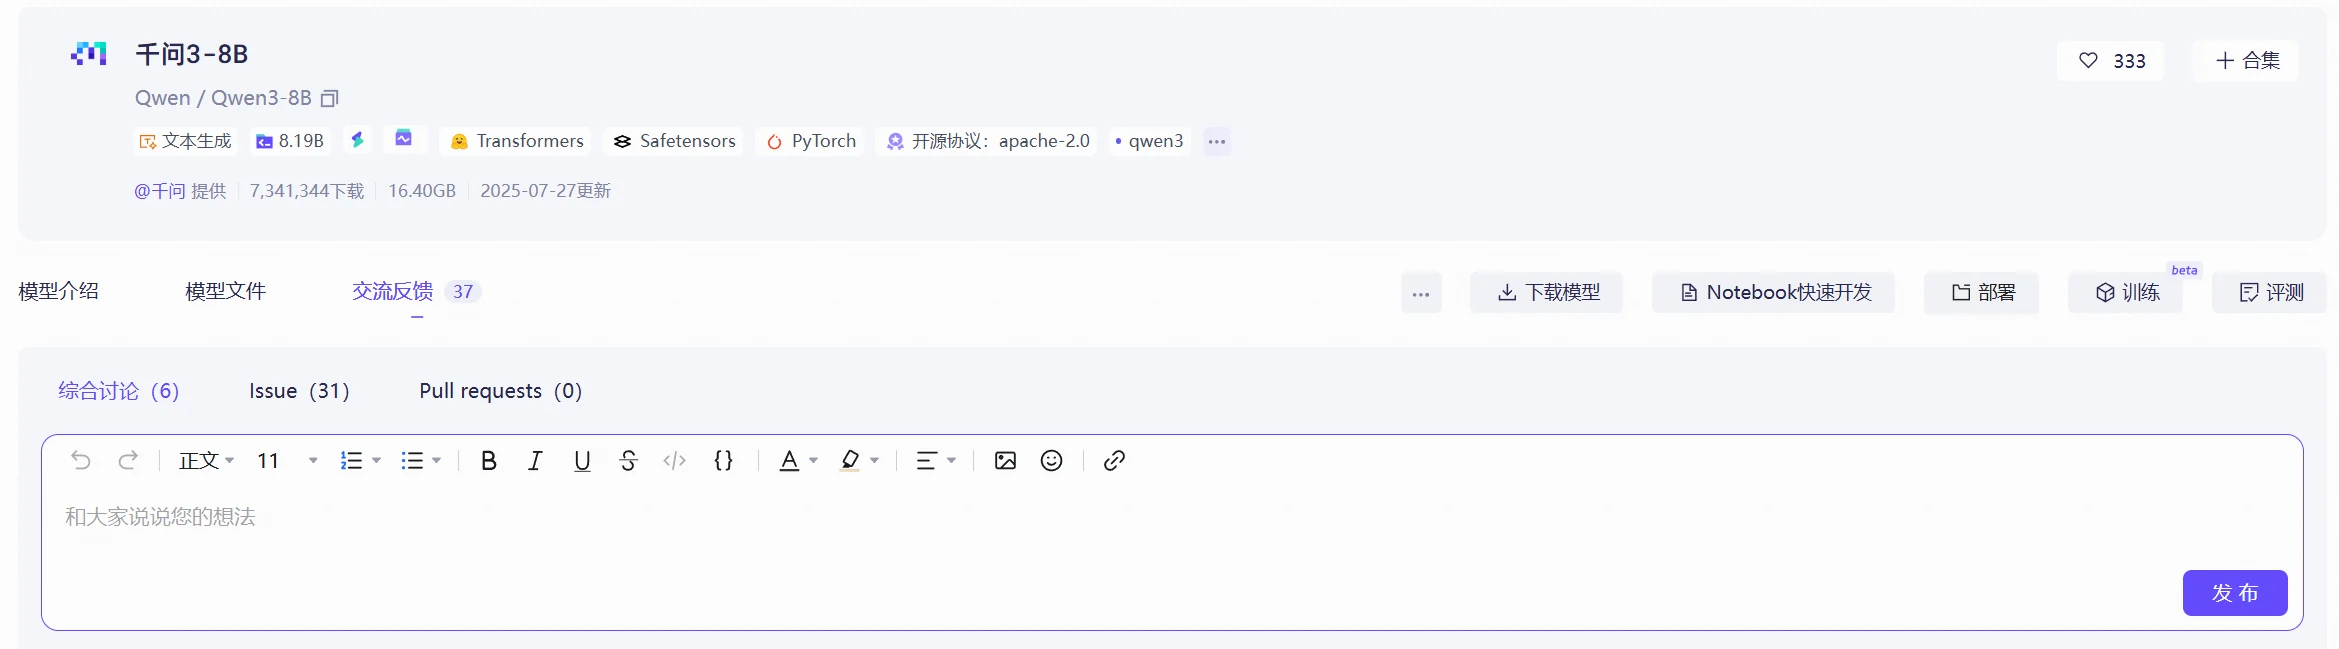
コミュニティの活発度を確認するには、モデルカードページに入り、コミュニティのフィードバック数を確認する必要があります。

汎用モデルのダウンロード数は通常、専門分野の専用モデルよりも显著に高いため、分野をまたいだ直接的な数値比較にはあまり意味がありません。同類タスクの範囲内で比較することをお勧めします。
実際の大規模モデルの使用では、よく1つの問題に直面します:汎用大規模モデルを選ぶべきか、それとも具体的なタスクのために訓練された専用モデルを選ぶべきか?
それぞれの特徴があり、選択する際は主にタスクタイプ、データ量、推論速度、デプロイコストなどの要素を見ます。
汎用大規模モデルは通常、大量の多分野データで事前訓練されており、テキスト分類、コンテンツ生成、情報抽出、QAなど、多种多様なタスクを処理できます。特定のタスクに最適化するのではなく、より多くのシナリオで使用できることを目的としています。
利点:1つのモデルで多种多様なタスクを処理でき、通常プロンプトを調整するだけで、モデルが異なる作業を完了できます。データ量の少ないタスクについては、Few-shotやZero-shotの方法で試すこともでき、必ずしも大量のアノテーションデータを準備する必要はありません。
欠点:汎用大規模モデルは通常パラメータ数が多いため、計算リソースの要件も高くなります。モデルが大きいほど、推論時のVRAMと計算リソースの消費が多くなり、同時接続シナリオでは推論速度とデプロイコストも考慮する必要があります。また、特定の明確な専門タスクについては、针对性の訓練を受けた専用モデルがより良い効果を発揮する場合があります。
汎用大規模モデルは、タスクタイプが多岐にわたり、まだ探索段階にある場合、または専用モデルを訓練するのに十分なデータがないシナリオに適しています。新しいアプリケーション方向を素早く検証する必要がある場合、汎用大規模モデルを直接使用するのが通常最も便利な選択です。
専用モデルは主に特定のタスクや分野のために訓練・最適化されています。例えば、テキスト分類、OCR、音声認識、オブジェクト検出などのタスクに使用されるモデルは、すべて専用モデルと言えます。
利点:特定のタスクに対して最適化されているため、大量の関係のないタスクを処理する必要がなく、推論速度、リソース消費、タスク効果の面で一定の優位性があります。タスクが比較的固定されているアプリケーションについては、実際のデータに基づいてさらにモデルを訓練し、自分のビジネスにより適したモデルにすることもできます。
欠点:専用モデルの適用範囲は比較的限られており、別のタスクに切り替えると直接使用できない場合があります。例えば、テキスト分類用のモデルはテキスト生成を直接完了するために使用できません。ビジネスニーズが変化した場合、元のモデルを再訓練または調整する必要がある場合があります。また、1つのシステムで多くの異なる専用モデルを使用している場合、各モデルのバージョンとデプロイ環境を個別に管理する必要があります。
専用モデルは、タスクが比較的明確でビジネスニーズが比較的安定しており、推論速度、リソース消費、デプロイコストに要件があるシナリオに適しています。既に良い訓練データを蓄積している場合、専用モデルを使用すると、具体的なタスクに対してより最適化しやすいです。
実際のプロジェクトでは、必ずしも汎用大規模モデルと専用モデルの二者択一にする必要はなく、両方を組み合わせて使用することがよくあります。
例えば、インテリジェントカスタマーサービスでは、まず汎用大規模モデルを使用してユーザーの質問を理解し、ユーザーが何を解決したいかを判断します。タスクが確定したら、対応する専用モデルに処理を委ねます。
実際の選択では、まずタスク自体から出発できます。タスクがまだ曖昧で、複数のタイプの問題を同時に処理する必要がある場合は、まず汎用大規模モデルを検討するのが良いです。タスクがすでに明確で、速度、コスト、安定性の要件が高い場合は、さらに専用モデルを検討できます。
1つのビジネスシステムは通常、1つのモデルだけを使用しません。具体的なタスクの複雑さに応じて、1つのモデルにすべての作業を完了させることも、異なるモデルを組み合わせてそれぞれのステップを担当させることもできます。例えば、インテリジェントドキュメント処理システムでは、ドキュメントの入力から最終結果の出力まで、ドキュメント分類、OCR、レイアウト分析、テーブル認識、情報抽出などの複数のステップを経ます。

このシステムでは、各モデルが異なるタスクを処理します。複数モデルの組み合わせには以下の特徴があります:
ただし、複数モデルの組み合わせにはモデル間の接続問題もあり、前のモデルの出力形式が後のモデルで正しく解析できる必要があります。システムを設計する際、異なるモデル間のデータ形式を事前に考慮する必要があります。例えばOCRが座標情報付きのテキストブロックを出力し、情報抽出モデルはプレーンテキストの処理に適している場合、中間にデータ変換ステップを追加して、OCR結果を目的の形式に変換する必要があります。
モデル選択を行う際、単に1つのモデルの効果だけでなく、処理フロー全体に適合するかも見る必要があります。単独でテストした効果が良いモデルでも、出力形式が他のモデルと接続しにくかった場合、実際のシステムでは使いにくい場合があります。