Cloud Notebooks: CPU and GPU
モデルをクラウドで動かし、NotebookでCPUとGPUを試す
ノートパソコンでモデルを動かせるようになったら、より大きなモデルを試したい、あるいは画像生成を一度やってみたいかもしれませんが、必ずしも適切なハードウェアがあるとは限りません。計算をクラウドに任せることで、サーバーにこれらの作業を承担させることができます。
クラウドサーバーは必要に応じて設定できます。ここでは引き続き魔搭Notebookを使用し、ブラウザ内でCPUまたはGPUのランタイムインスタンスを選択して、モデルをダウンロードしコードを実行します。ページは自分のパソコンで開き、モデルは接続されたクラウドインスタンス内で実行されます。
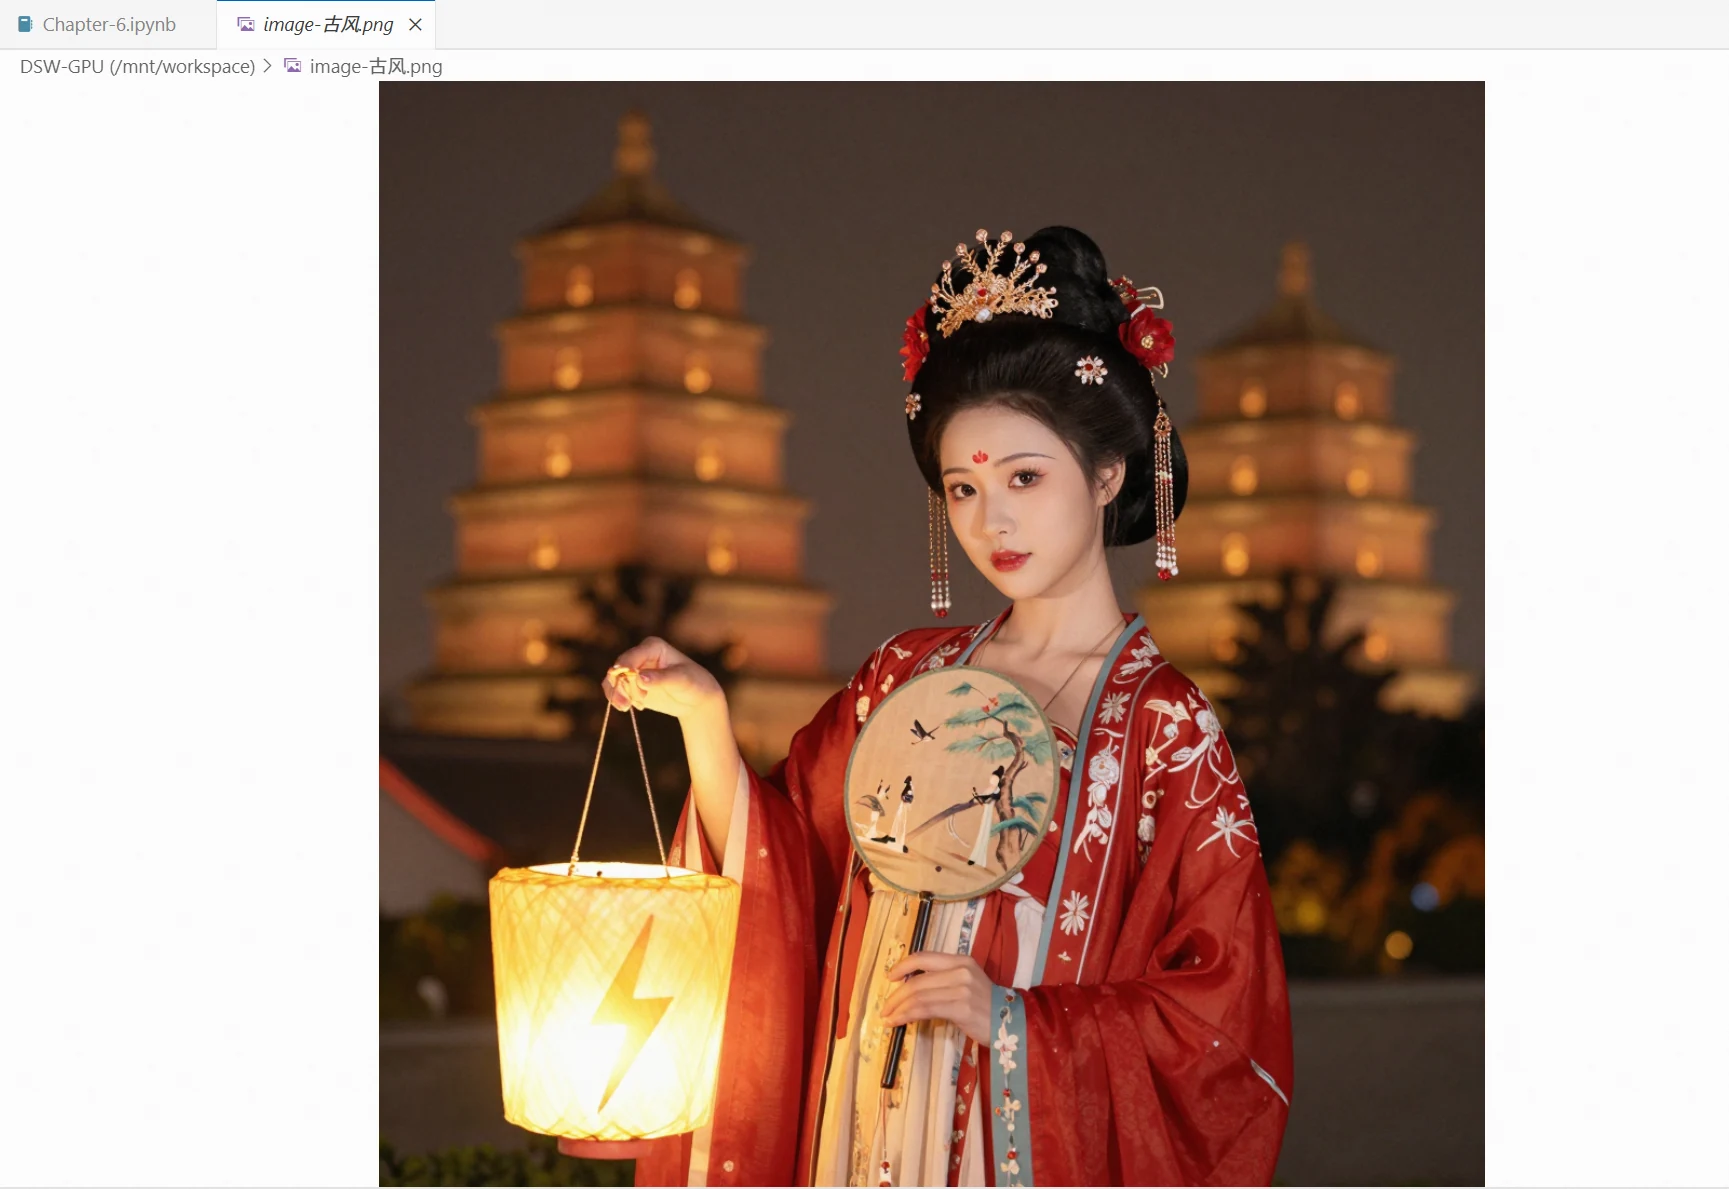
この記事では2つの実験を行います。まずCPUを使って0.5B級のモデルを実行し、ある評価文の感情を判定します。次にGPUを使って画像生成モデルを実行し、テキストの記述を画像に変換します。それぞれ異なるリソースでの使用方法、タスク、モデルを示しますので、実行時間でCPUとGPUの速さを直接比較することはできません。
その他のクラウドサーバーリソースは、後で追加予定です。Notebookを開き、今回使用するランタイムインスタンスを選択する
魔搭モデルページから「Notebook快速開発」に入り、「接続ランタイム」をクリックします。この手順ではまずCPUインスタンスを選択して感情分析を実行し、次にGPUインスタンスに切り替えて画像生成を行います。Notebookのページ操作は【30分で最初の結果を素早く見る】の内容を参照してください。
インスタンスを切り替えると、以前のPythonプロセスと読み込み済みのモデルは新しいインスタンスに自動的に移動しません。現在の環境で依存関係を再確認し、対応する実験のコードを最初から実行する必要があります。
まずCPUを使い、評価文がポジティブかネガティブかを判定する
Qwen/Qwen2.5-0.5B-Instructモデルを例に、CPU上で0.5B級のモデルを使用して感情分析タスクを行う方法を紹介します。
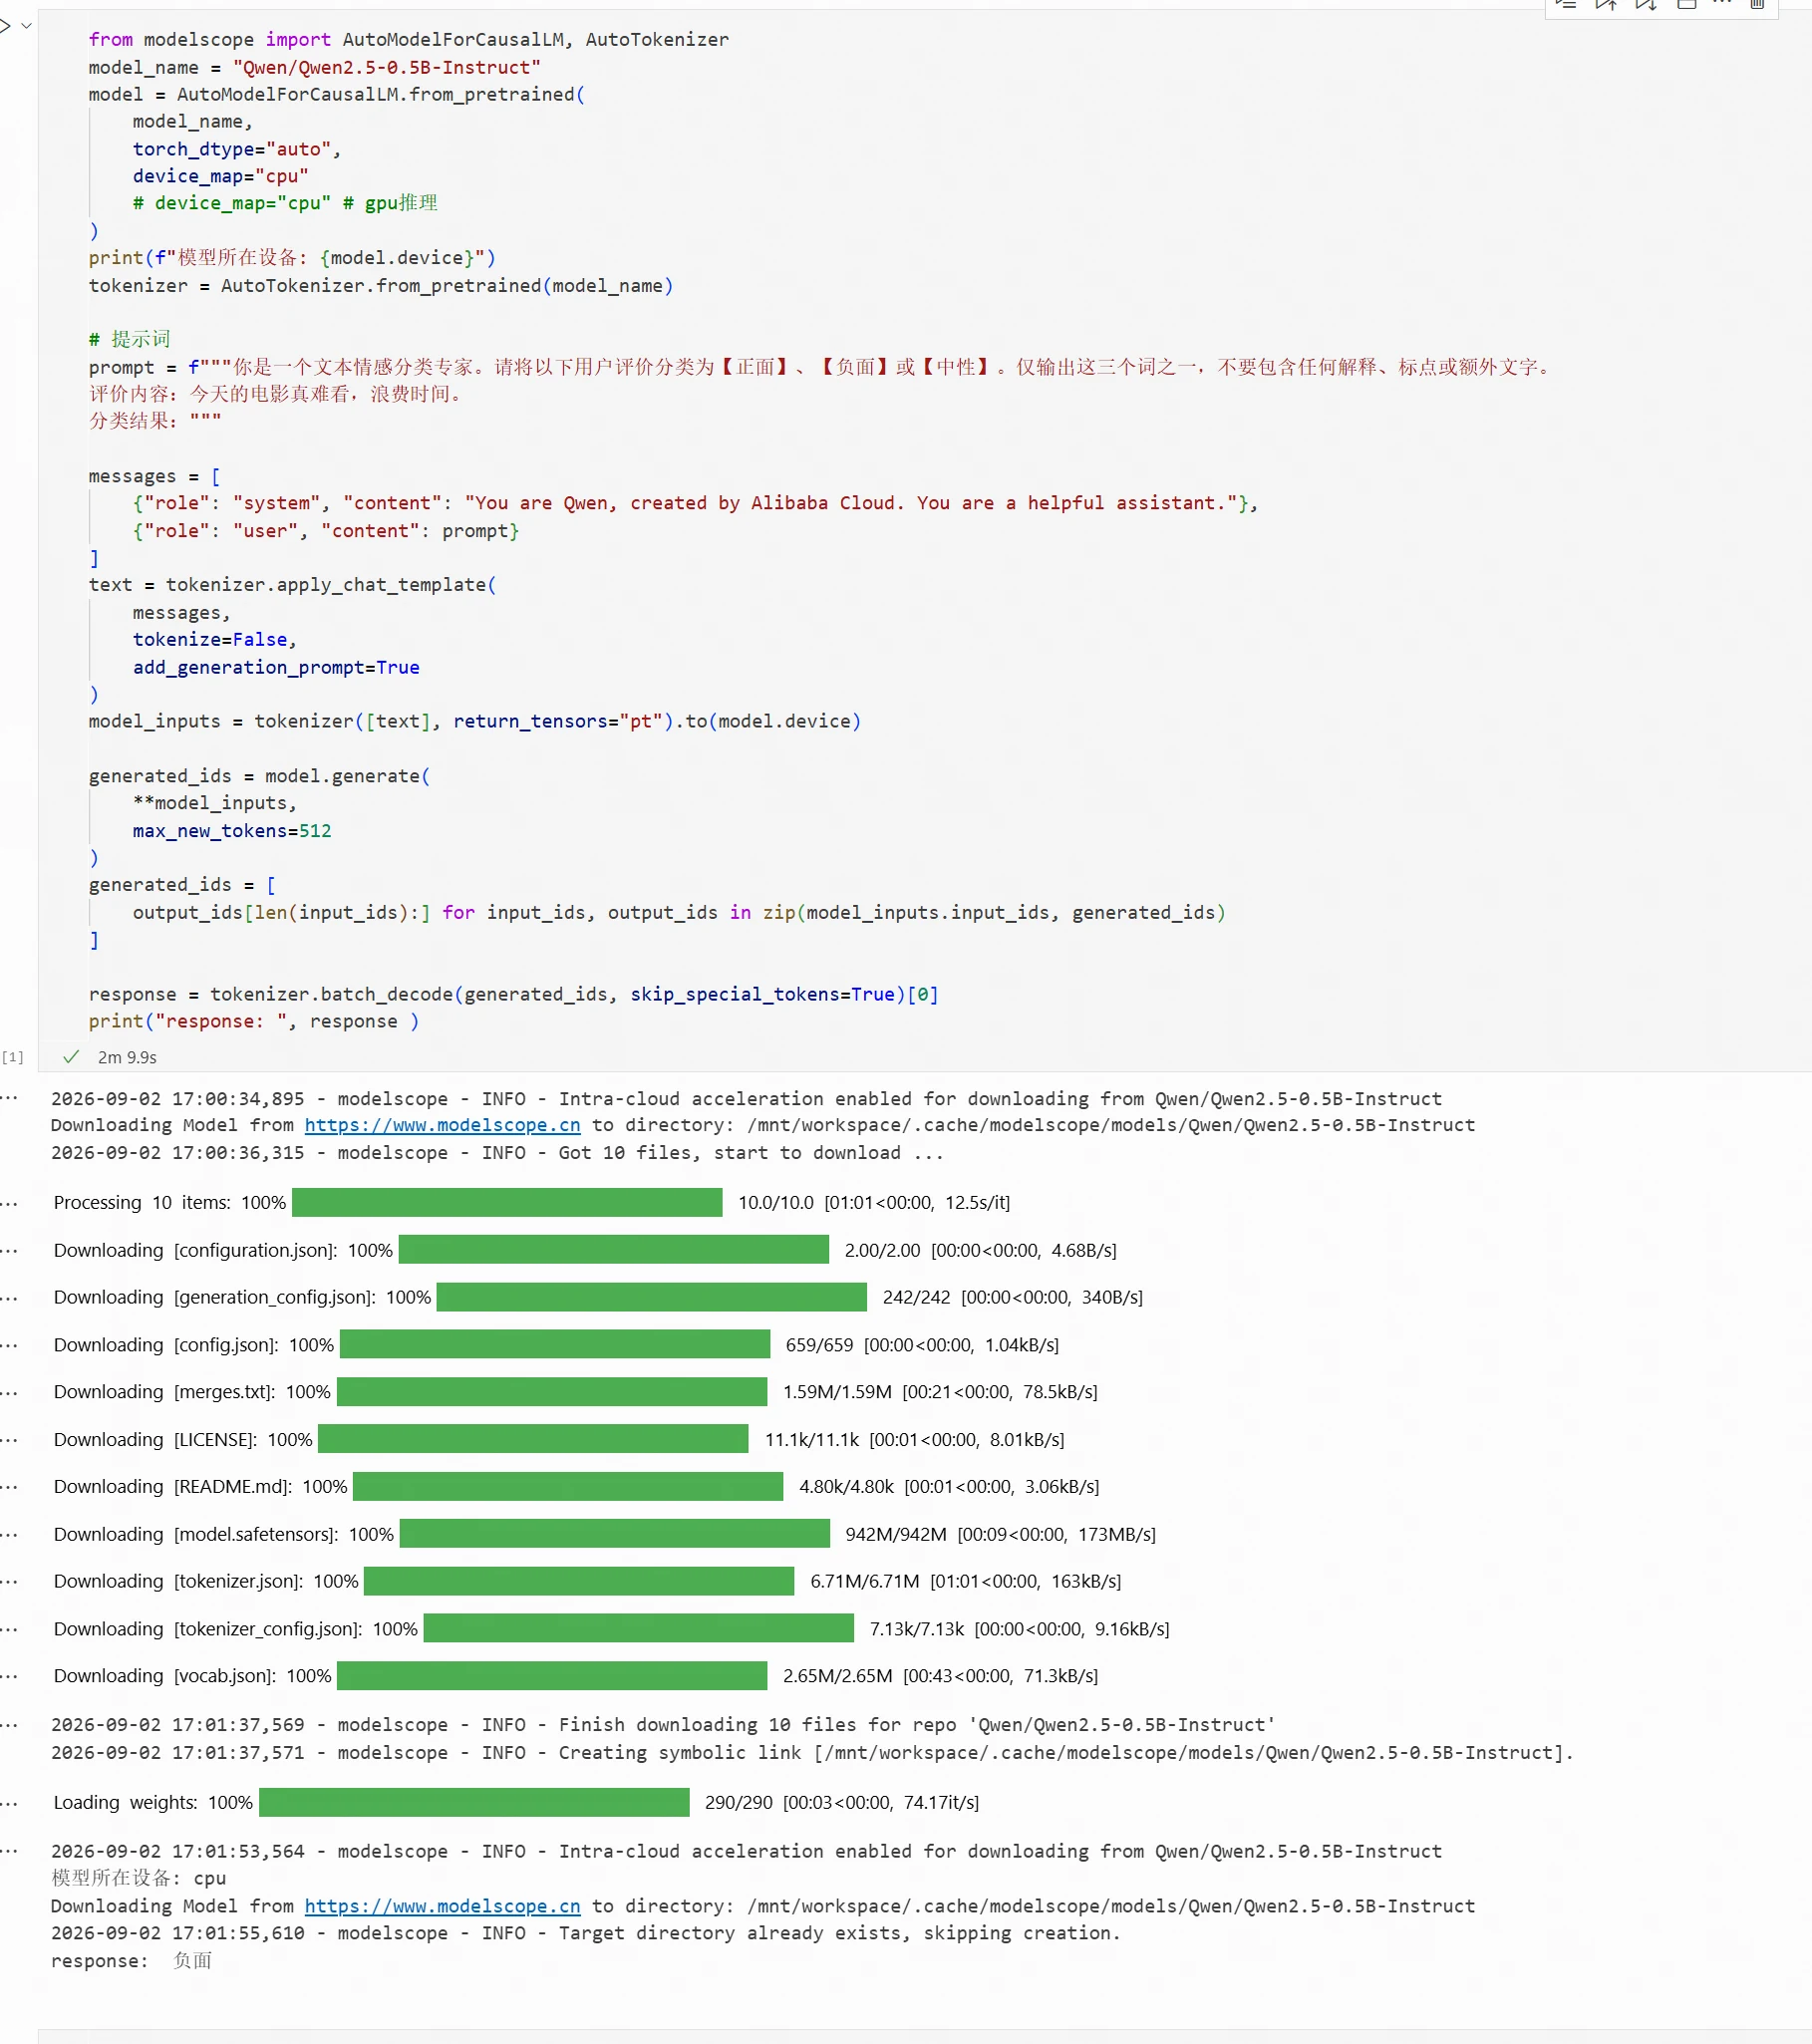
CPUインスタンスを起動した後、notebook開発環境に入ります。モデルの読み込みと推論コードは以下の通りです:
from modelscope import AutoModelForCausalLM, AutoTokenizer
model_name = "Qwen/Qwen2.5-0.5B-Instruct"
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    torch_dtype="auto",
    device_map="cpu"
    # device_map="cpu" # gpu推理
)
print(f"モデルが存在するデバイス: {model.device}")
tokenizer = AutoTokenizer.from_pretrained(model_name)

# プロンプト
prompt = f"""あなたはテキスト感情分類の専門家です。以下のユーザー評価を【ポジティブ】、【ネガティブ】、または【ニュートラル】のいずれかに分類してください。この3つの単語のうち1つだけを出力し、説明、句読点、または余分なテキストは含めないでください。
評価内容:今日の映画は本当に面白くなかった、時間を無駄にした。
分類結果:"""

messages = [
    {"role": "system", "content": "You are Qwen, created by Alibaba Cloud. You are a helpful assistant."},
    {"role": "user", "content": prompt}
]
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True
)
model_inputs = tokenizer([text], return_tensors="pt").to(model.device)

generated_ids = model.generate(
    **model_inputs,
    max_new_tokens=512
)
generated_ids = [
    output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
]

response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]
print("response: ", response )
結果の表示:
GPUに切り替え、テキスト記述を画像に変換する
Tongyi-MAI/Z-Image-Turboモデルを使用して、GPU上でモデルを読み込み、画像生成タスクを完了する方法を示します。
GPUインスタンスを起動した後、notebook開発環境に入ります。
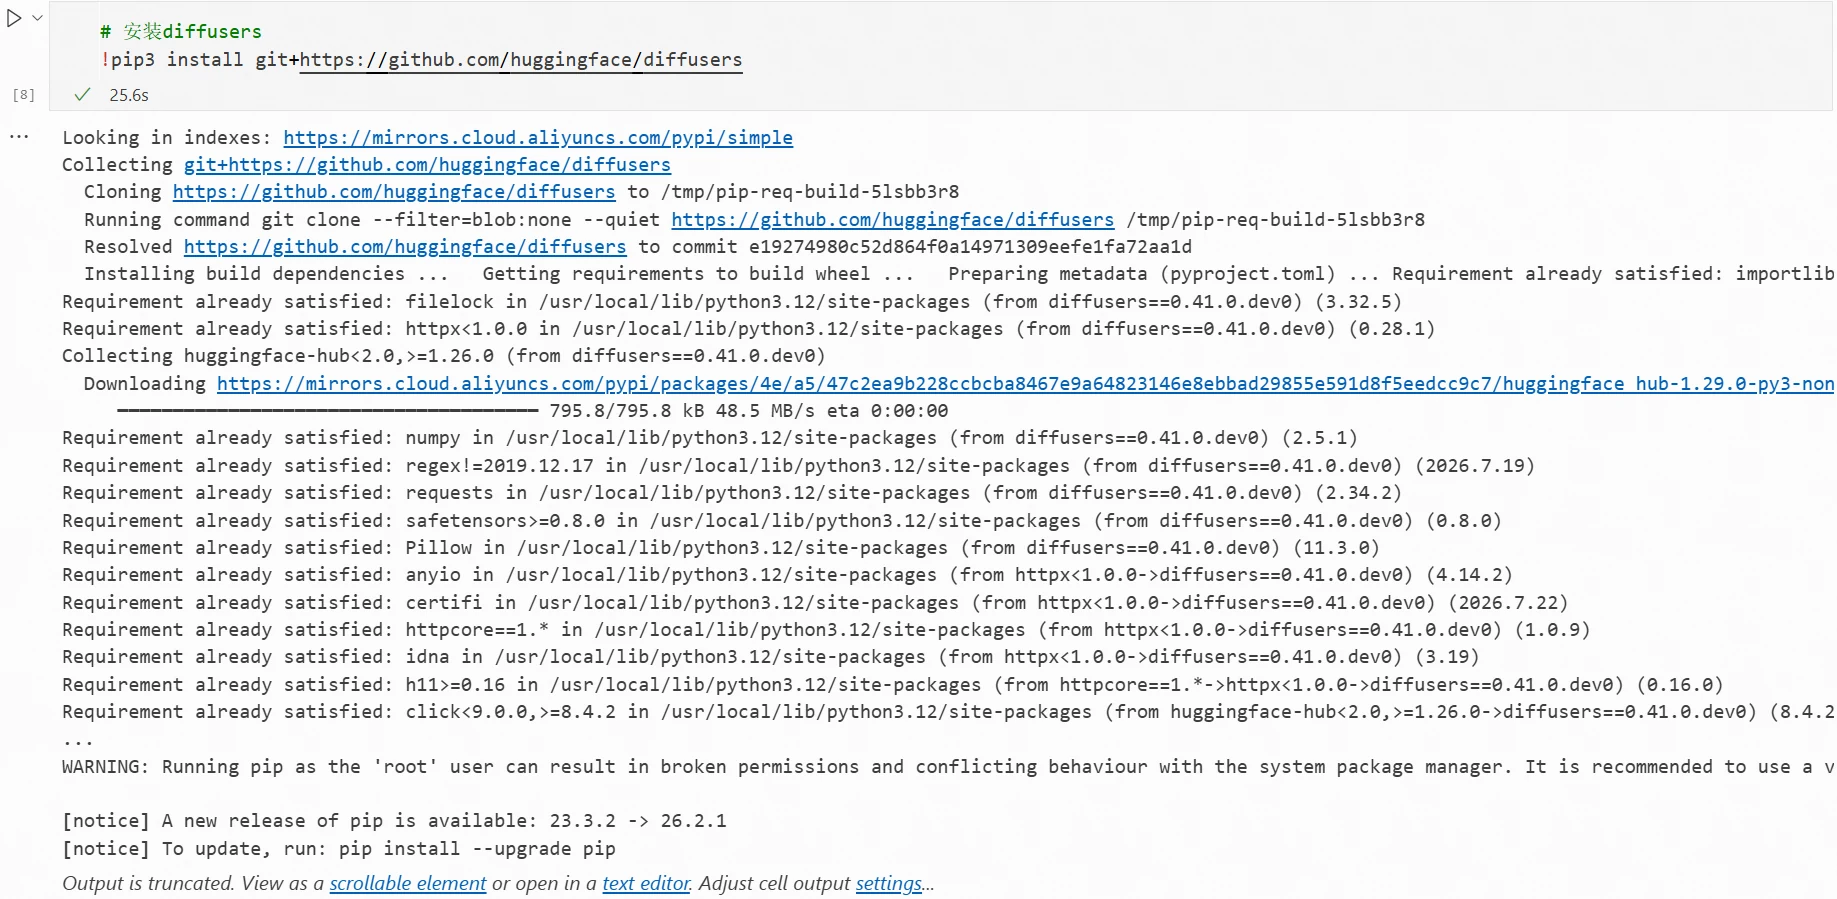
モデルカードに従い、ターミナルで最新版のdiffusersをインストールする必要があります。
!pip3 install git+https://github.com/huggingface/diffusers
インストール完了:
モデルの読み込みと推論コードは以下の通りです:
ディスカッション
ログイン ディスカッションに参加