Your First Inference in 30 Minutes
30分で最初の結果を素早く見る
オープンソースモデルをダウンロードすれば、自分のノートパソコンで実行することもできますし、クラウドサーバーを借りて、必要に応じてCPU、GPU、ランタイム環境を設定することもできます。デバイスが異なると、準備作業も異なります。
まずはモデルに何ができるか試してみたい場合、魔搭Notebookは無料の入口を提供しています。ブラウザを開いてランタイムインスタンスを選択すれば、ウェブ上でコードを書き、モデルをダウンロードし、結果を確認できます。
この記事では、Notebookの作成、環境の確認からモデルの読み込みまで、 따라 하면最初の結果を見ることができます。
Notebookを開き、まずランタイムインスタンスに接続する
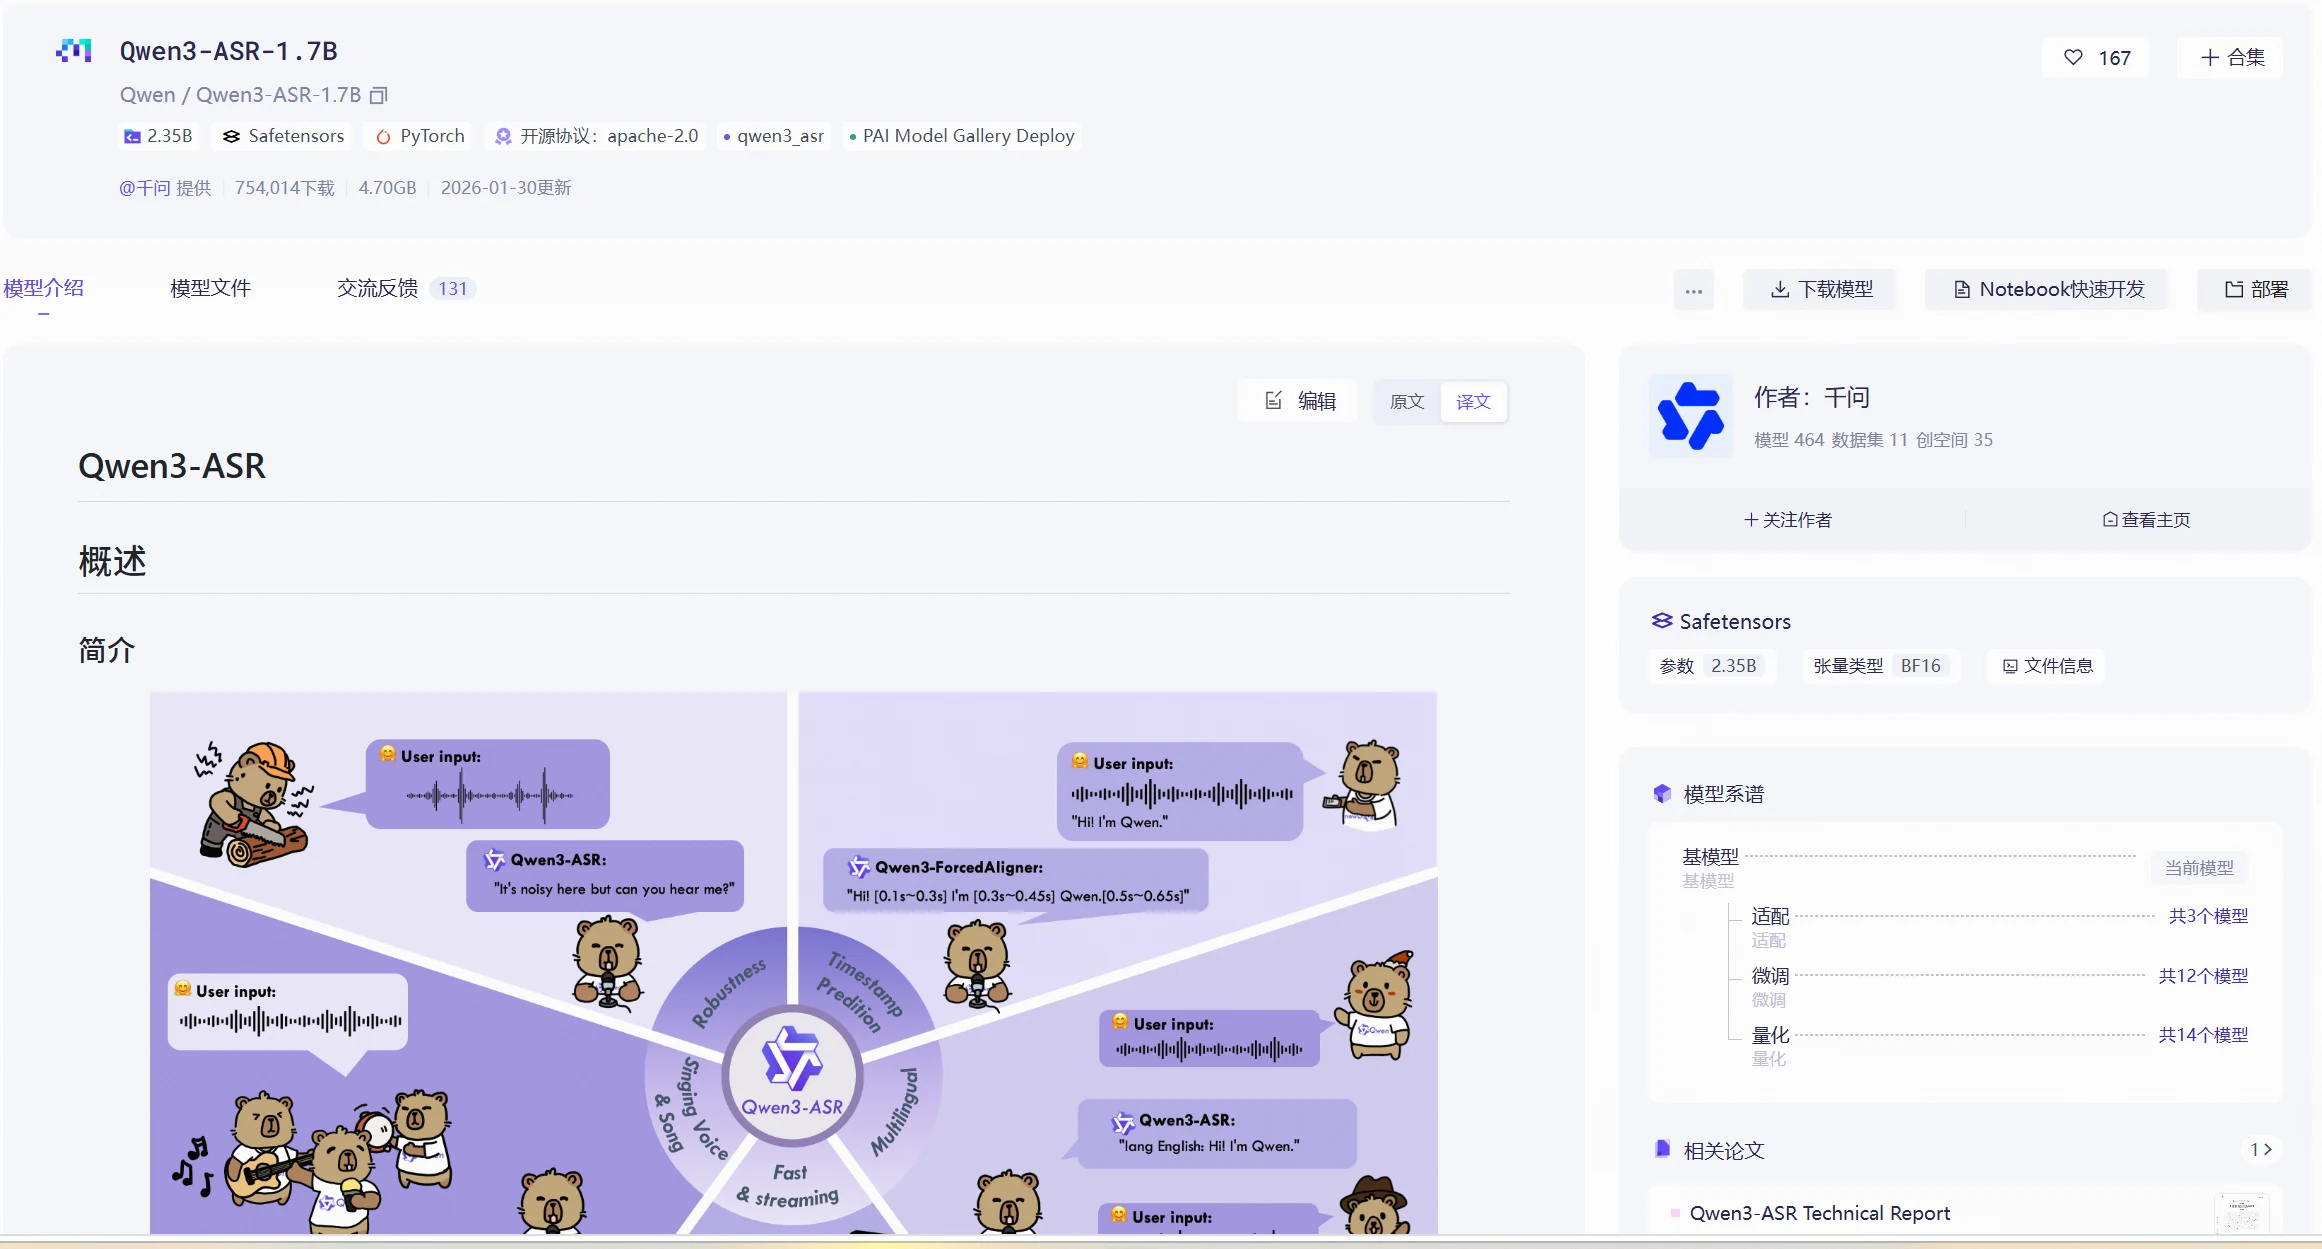
モデルライブラリに入り、Qwen/Qwen3-ASR-1.7Bモデルを見つけ、右側の「Notebook快速開発」をクリックすると魔搭Notebookを作成できます。
モデルリンク:https://www.modelscope.cn/models/Qwen/Qwen3-ASR-1.7B
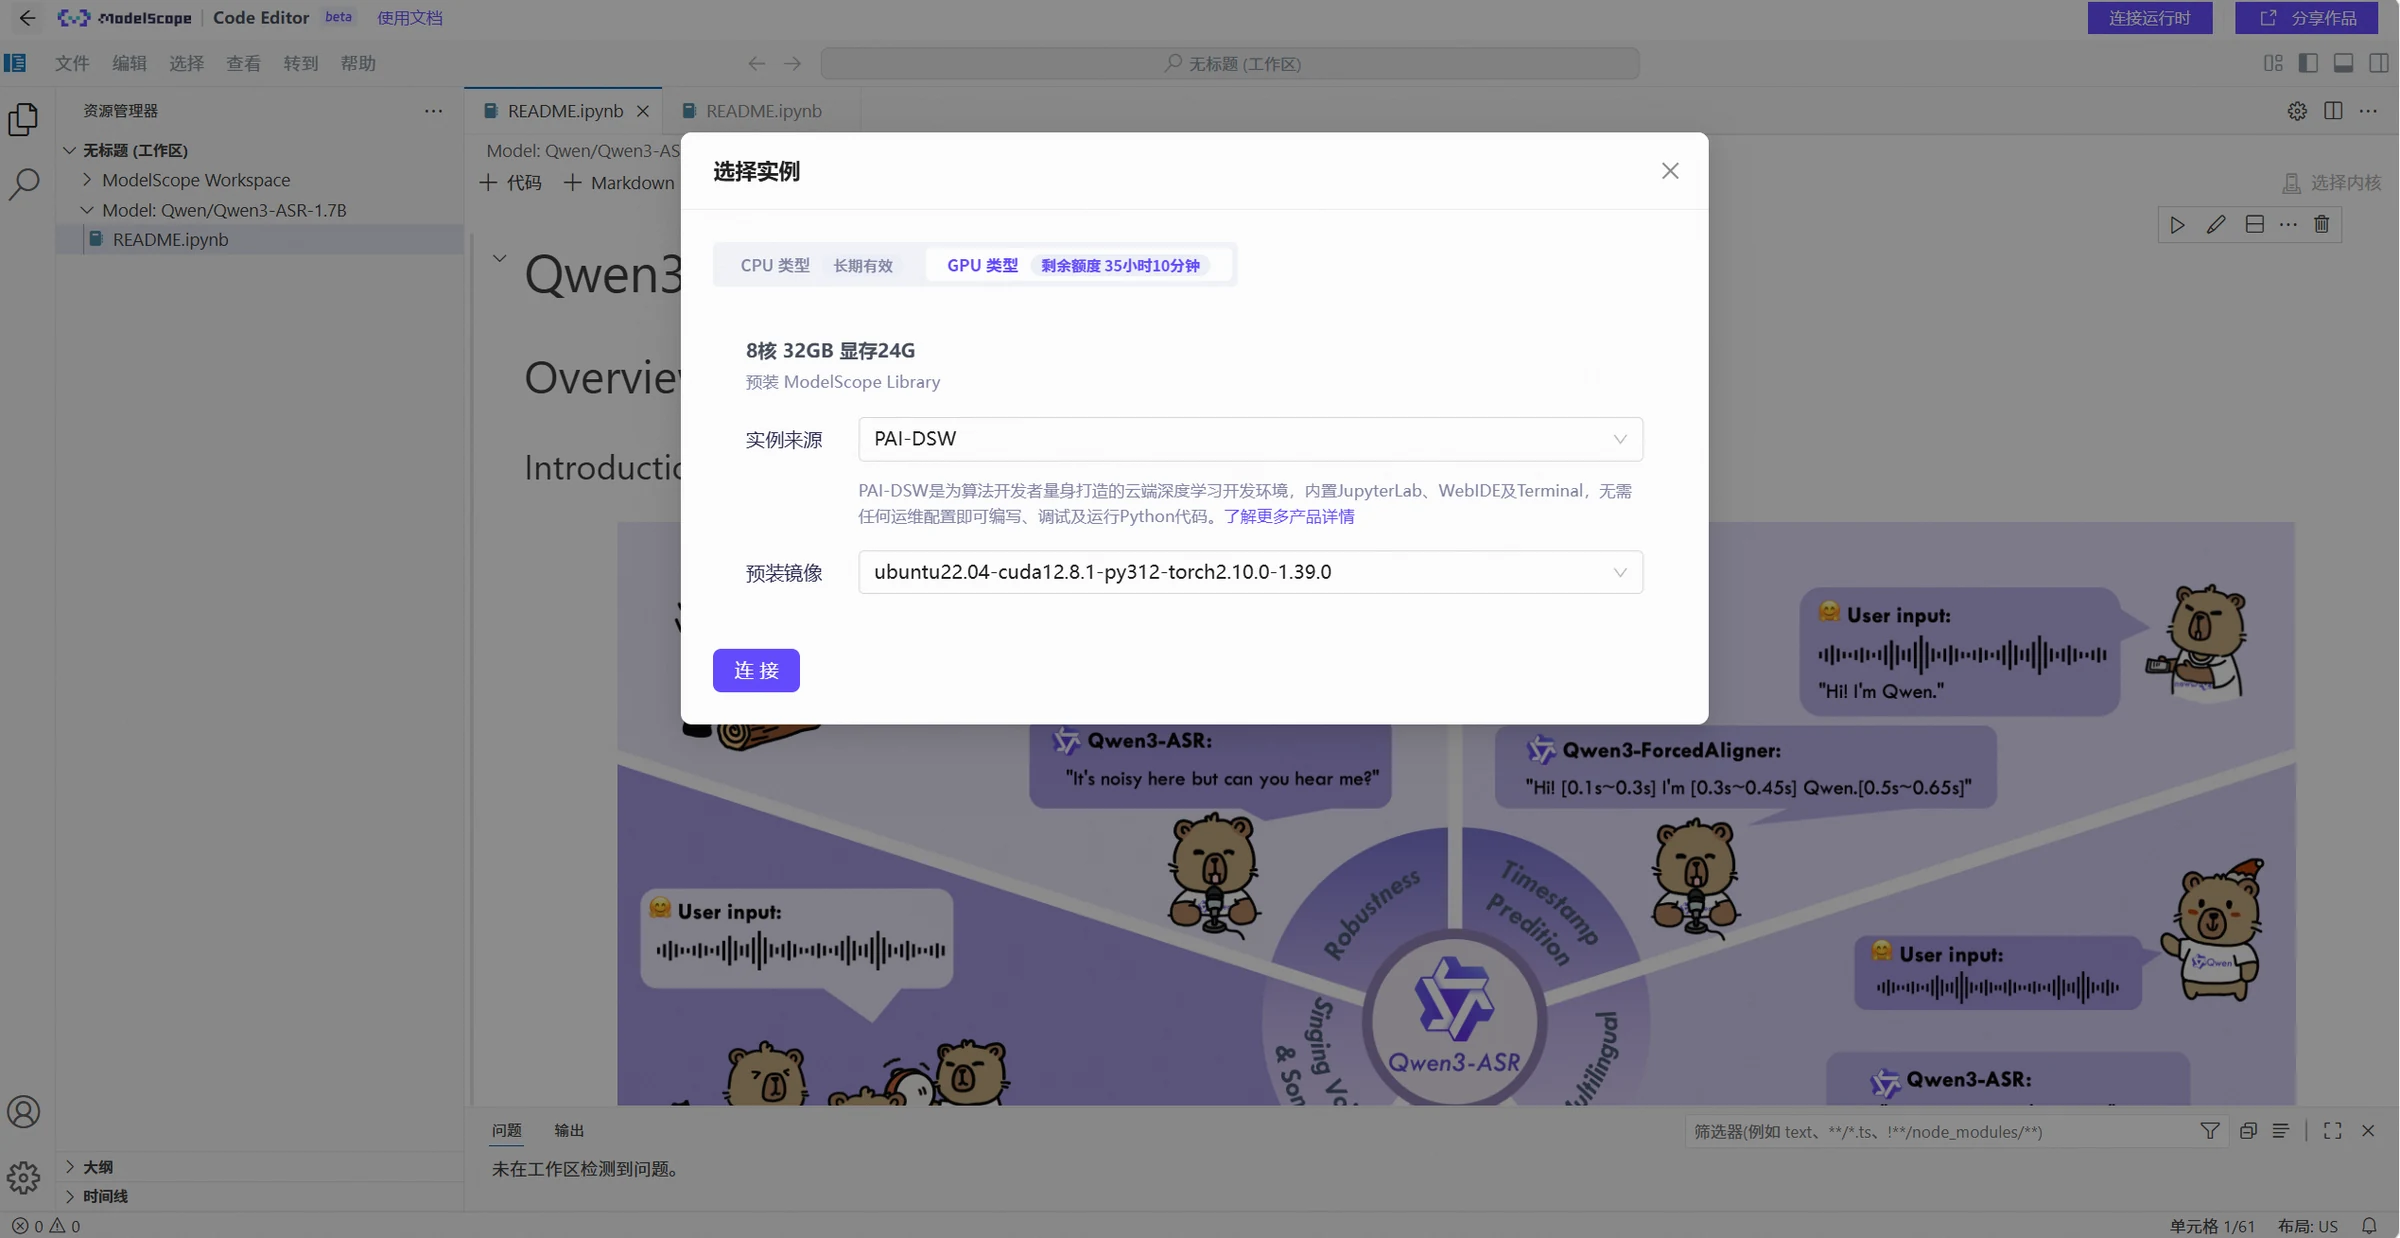
右上の「接続ランタイム」をクリックしてインスタンスを選択します。ここではデモとしてGPUを選択しますが、モデルの依存関係に応じて適切なプリインストールイメージを選択できます。
環境が準備されているか確認する
インスタンスを読み込んだ後、まず現在の環境を確認する必要があります。notebookで以下のコマンドを実行します:
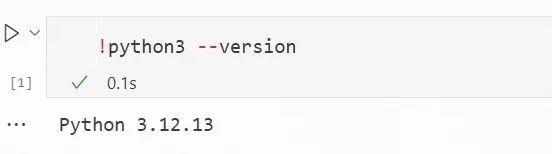
1.Pythonのバージョンを確認
!python3 --version
結果の表示:
2.関連する依存関係を確認
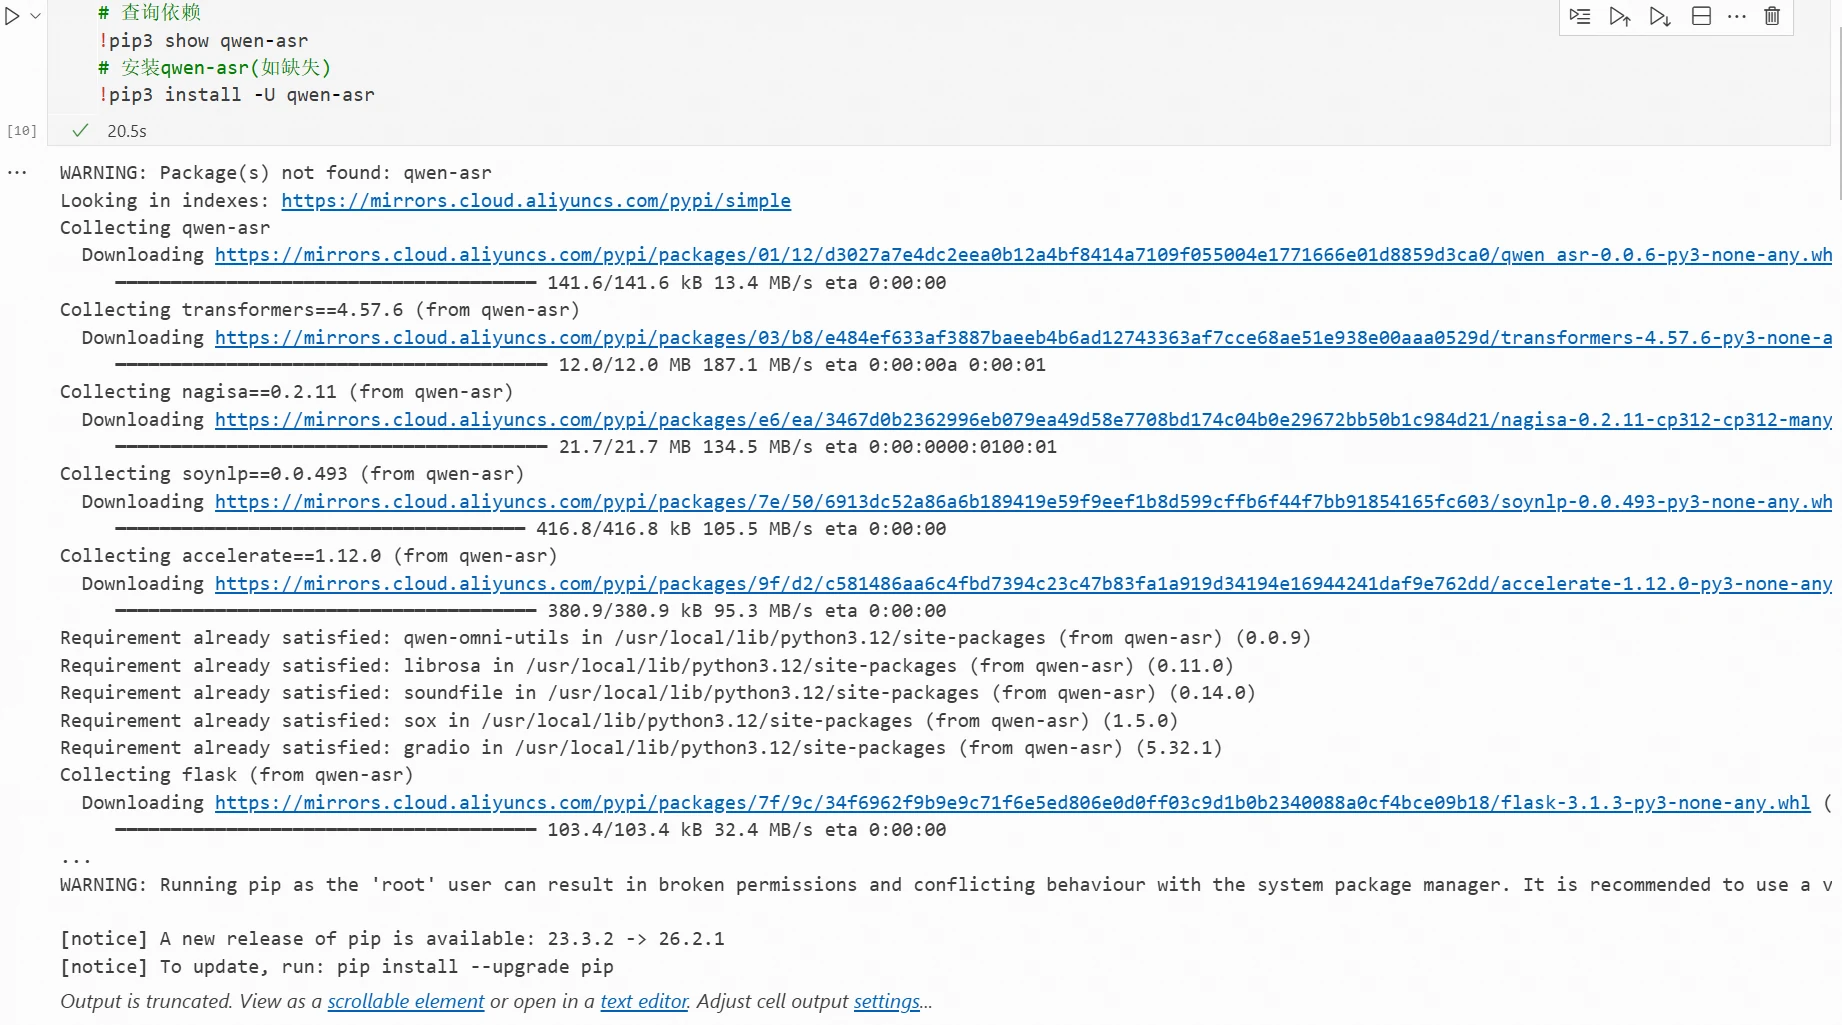
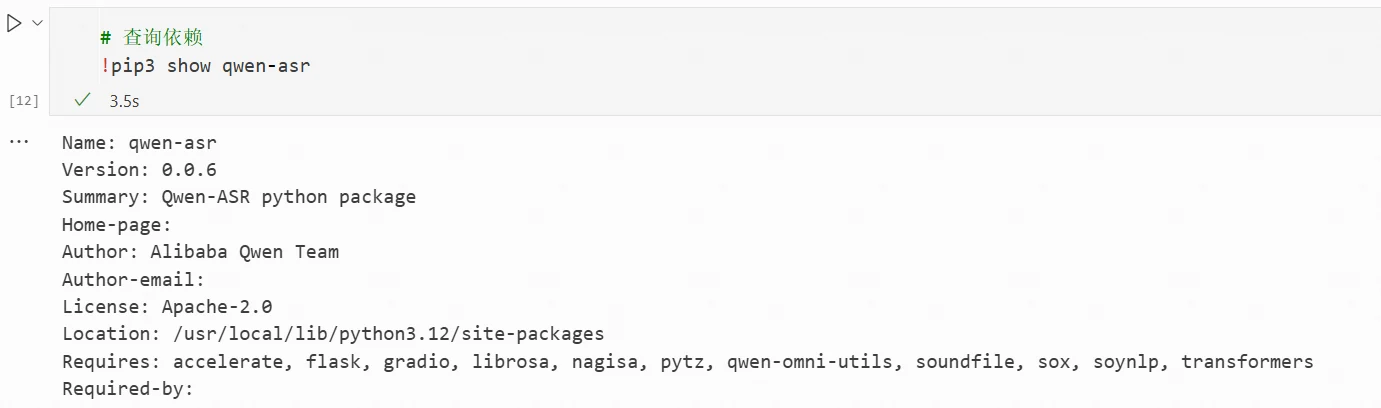
異なるモデルの依存関係は異なるため、モデルカードを確認する必要があります。Qwen3-ASR-1.7Bモデルのモデルカードによると、推論にはqwen3-asrが必要です。環境にqwen3-asrが不足している場合は、自分でインストールする必要があります
# 依存関係の確認
!pip3 show qwen-asr
# qwen-asrのインストール(不足している場合)
!pip3 install -U qwen-asr
結果の表示:
インストール成功時の確認結果:
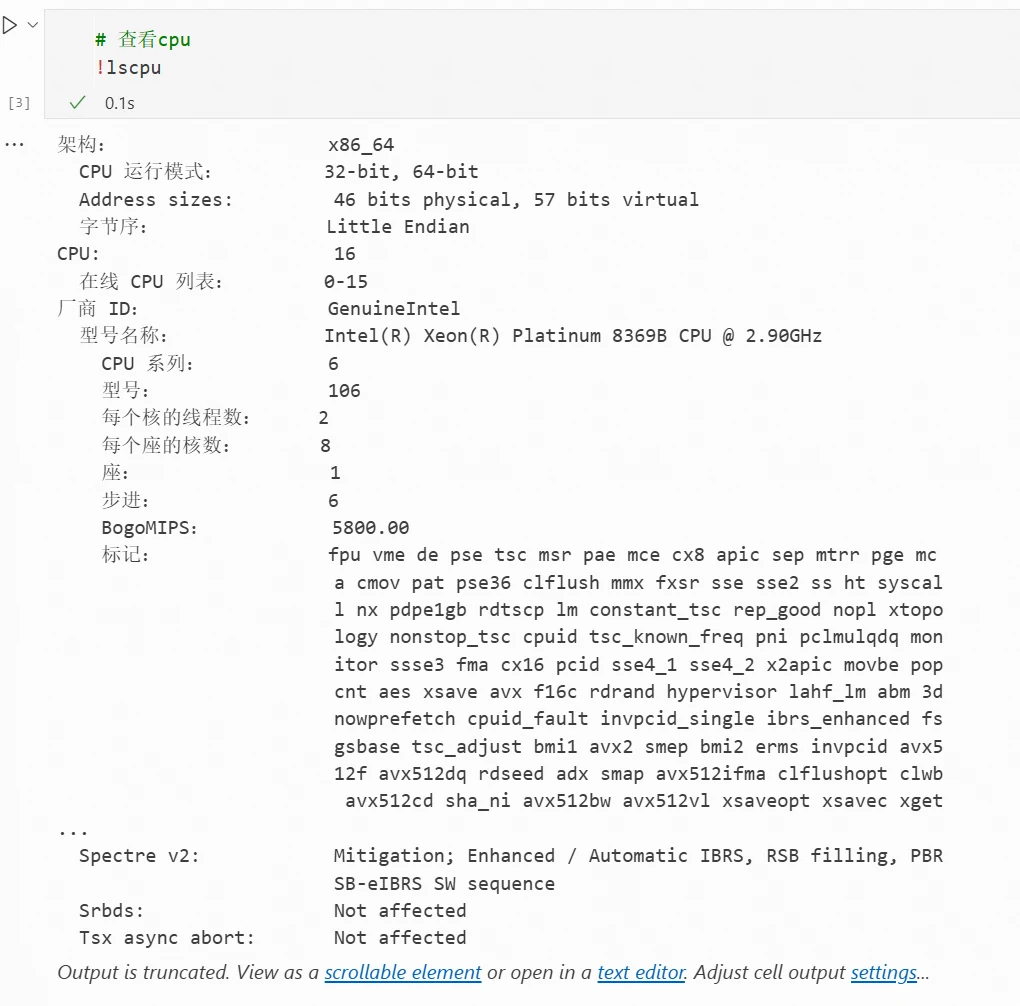
3.CPUの構成を確認
!lscpu
結果の表示:
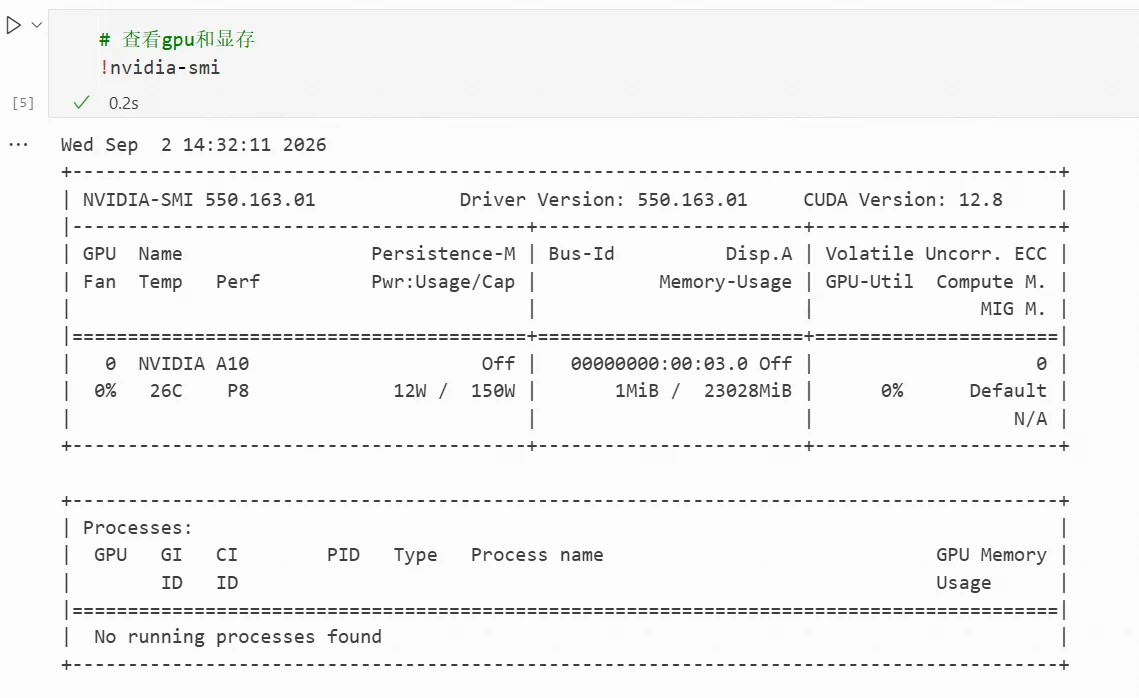
4.GPUとビデオメモリを確認
!nvidia-smi
結果の表示:
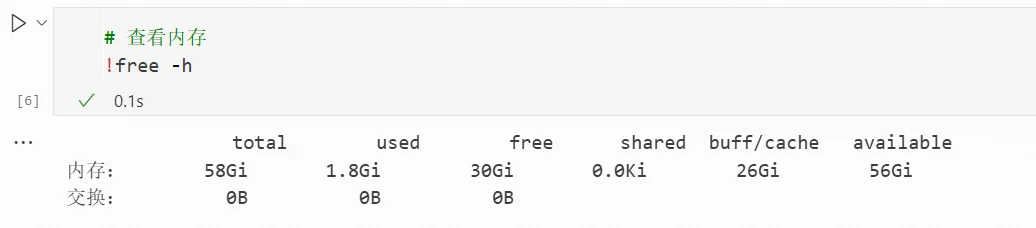
5.メモリを確認
!free -h
結果の表示:
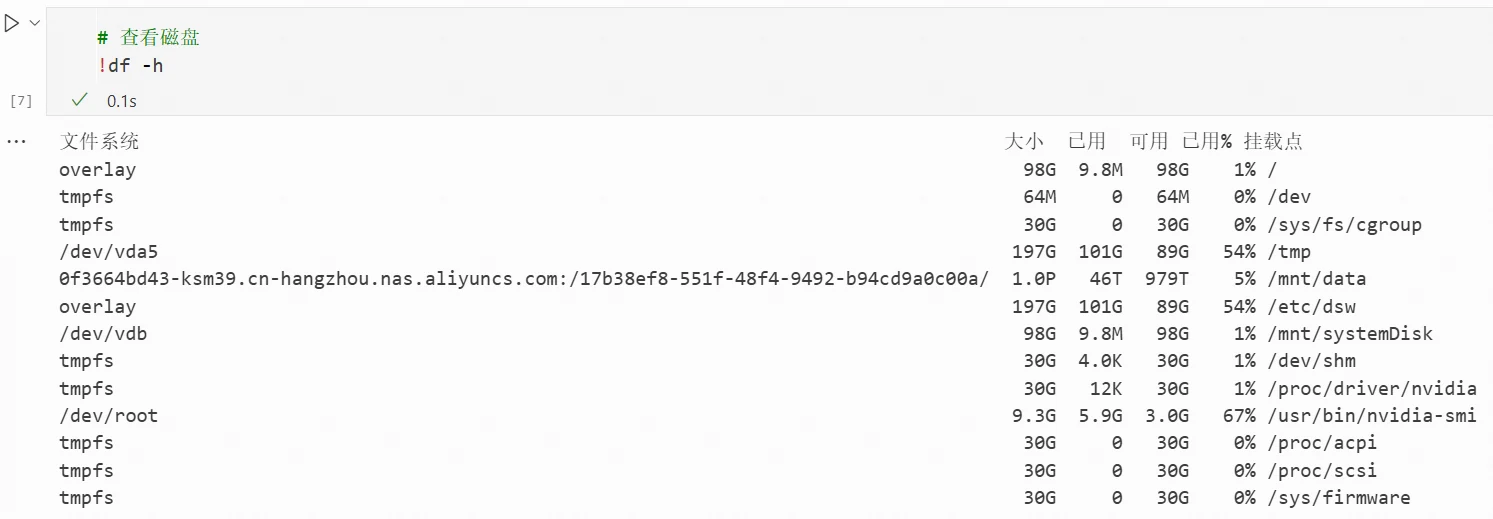
6.ディスクを確認
!df -h
結果の表示:
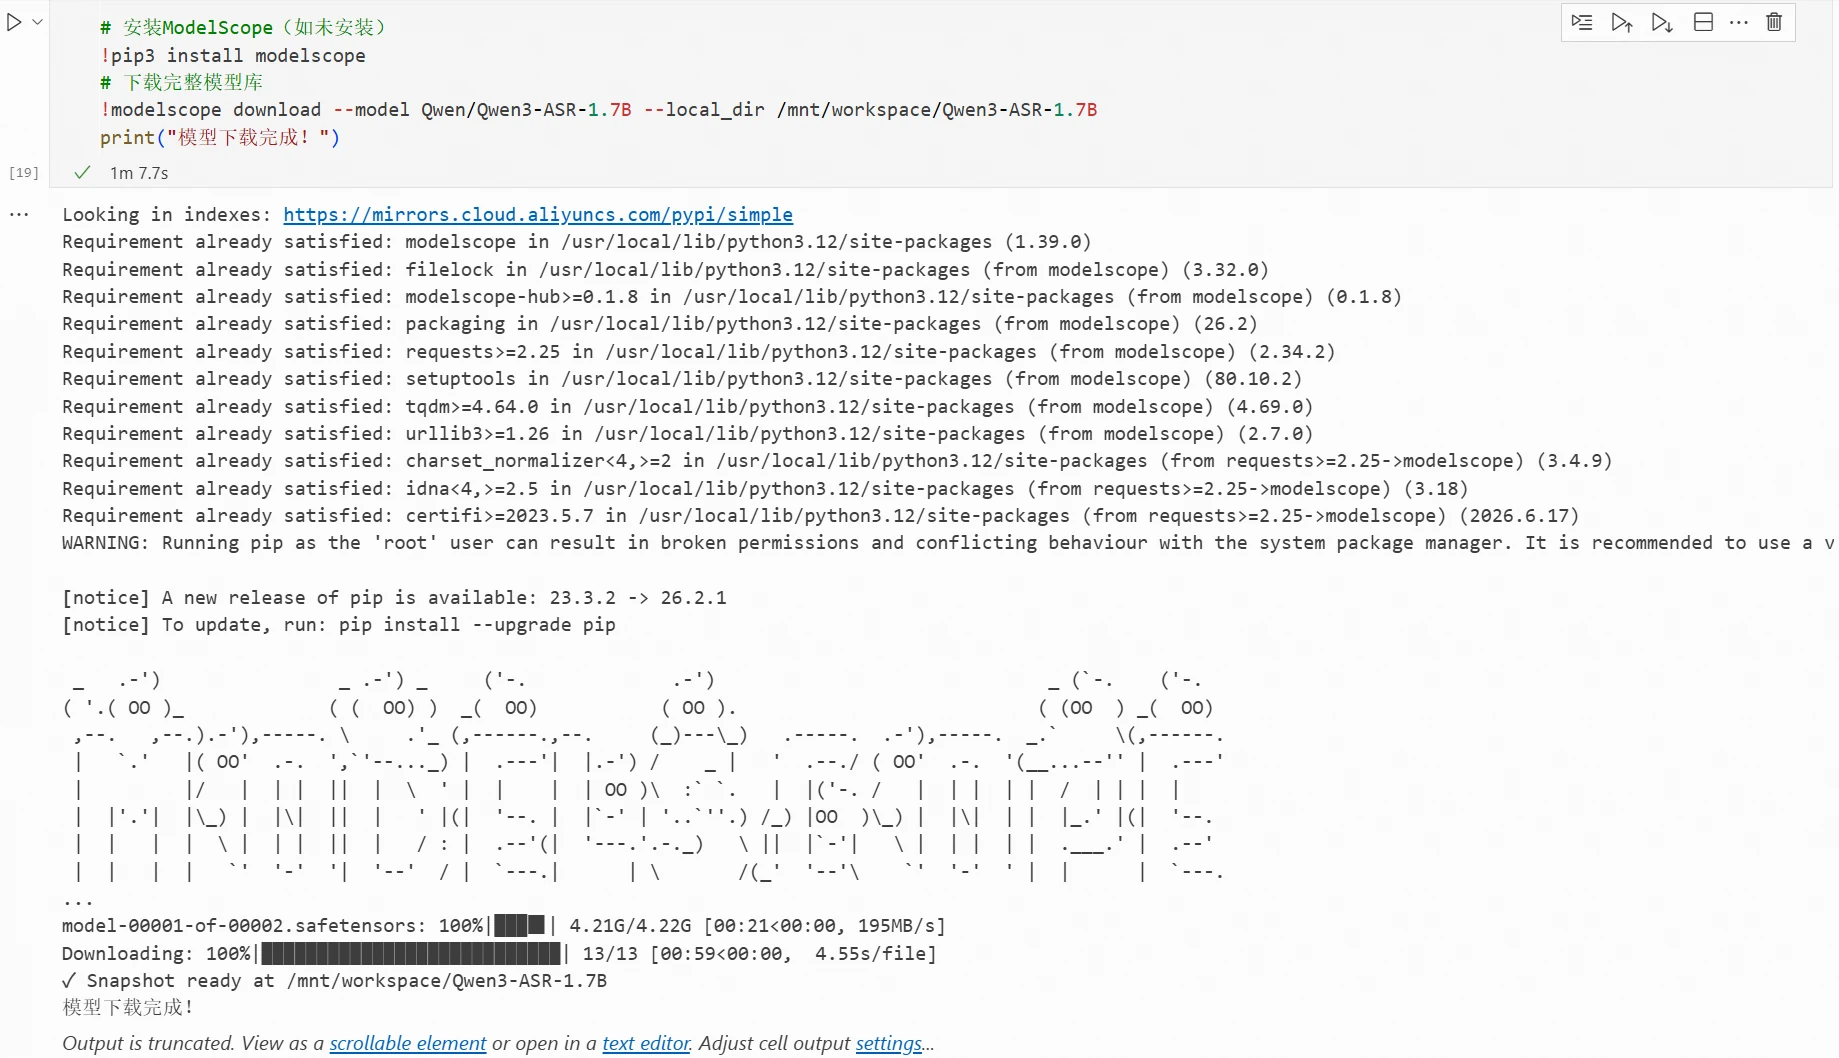
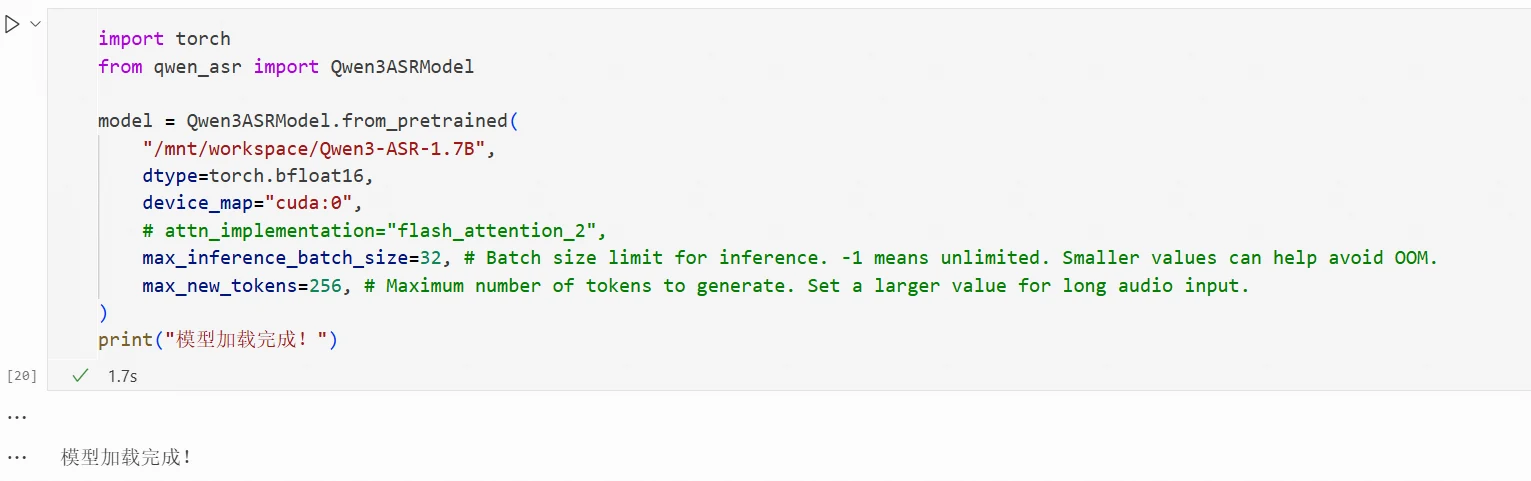
モデル名で直接モデルを読み込む
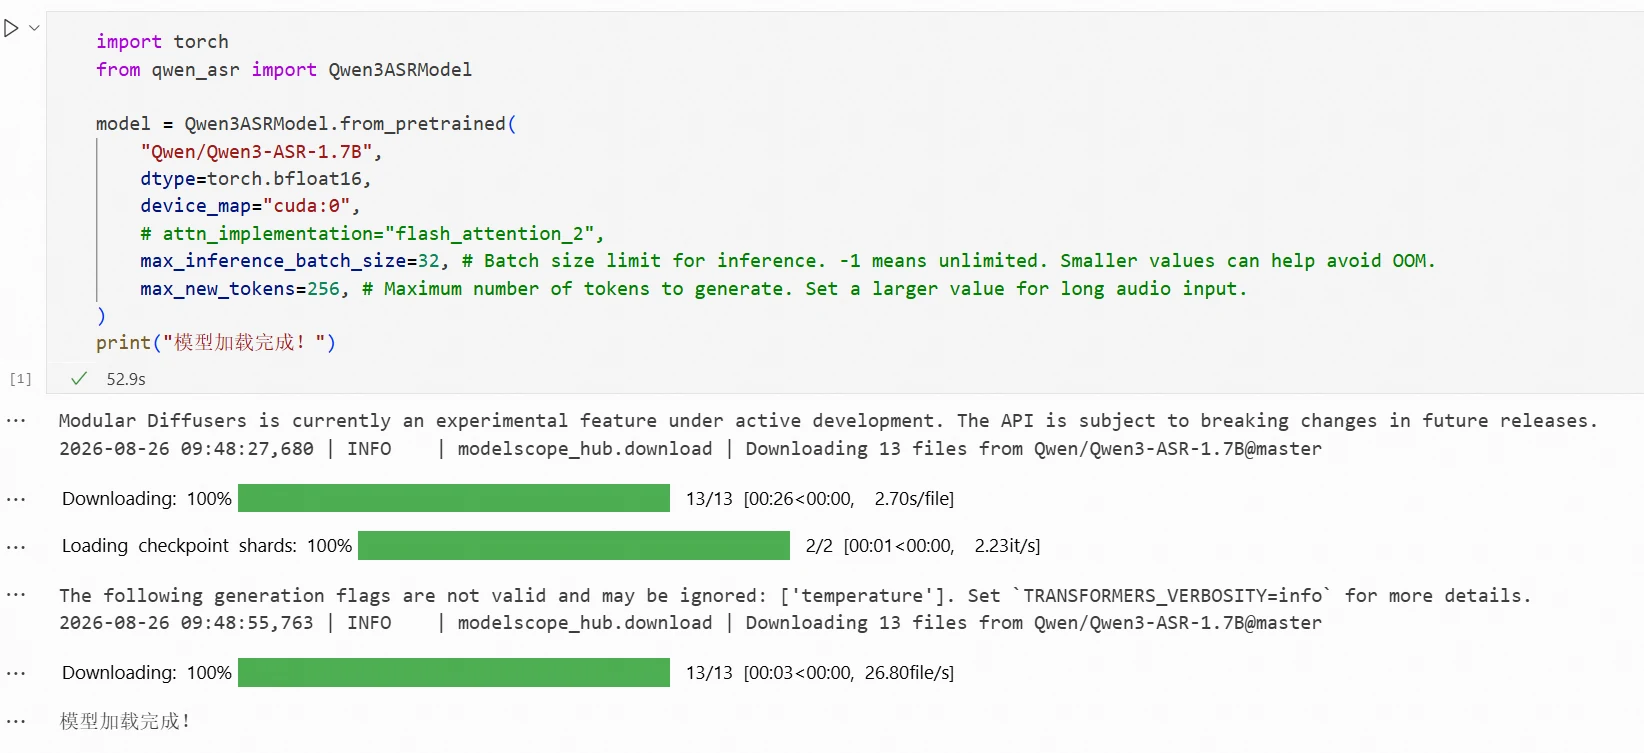
モデルカードのサンプルコードを参考にモデルを読み込みます。この場合、必要なモデルファイルは自動的にダウンロードされます。
import torch
from qwen_asr import Qwen3ASRModel

model = Qwen3ASRModel.from_pretrained(
    "Qwen/Qwen3-ASR-1.7B",
    dtype=torch.bfloat16,
    device_map="cuda:0",
    # attn_implementation="flash_attention_2",
    max_inference_batch_size=32, # 推論用のバッチサイズ上限。-1は無制限を意味します。値を小さくするとOOMを回避できます。
    max_new_tokens=256, # 生成するトークンの最大数。長い音声入力の場合はより大きな値を設定してください。
)
print("モデルの読み込みが完了しました!")
ディスカッション
ログイン ディスカッションに参加