AIUnlimited
🌳

AI基礎

🌱
AI Seeds(種)

ゼロから始める

🌿
AI Sprouts(芽)

基礎を築く

🌳
AI Branches(枝)

実践に活かす

🏕️
AI Canopy(樹冠)

深く学ぶ

🌲
AI Forest(森)

AIをマスターする

🔨

AIマスタリー

✏️
AI Sketch(スケッチ)

ゼロから始める

🪨
AI Chisel(鑿)

基礎を築く

⚒️
AI Craft(制作)

実践に活かす

💎
AI Polish(磨き上げ)

深く学ぶ

🏆
AI Masterpiece(傑作)

AIをマスターする

📘

AI実践

📖
オープンソースモデルを理解する

オープンソースモデルの基礎とリソース

🎯
問題からモデルタスクへ

ビジネス問題をモデルタスクに変換

⚡
最初のモデルを実行する

30分で最初の結果を見る

🔧
ファインチューニングと評価

モデルをファインチューニングし、パフォーマンスを評価

🚀
アプリケーションシステム

実際のAIアプリケーションを構築

🎨
生成AI

オープンソースAIGCモデルを探索

🤖
エージェント

エージェントフレームワークとMCPツールを学ぶ

📐
補足基礎

LLMの基礎と評価

🎓

Claude アカデミー

🤖
Claude 101

Learn AI basics with Claude

💻
Claude Code 101

Code with Claude as your pair programmer

🤝
Introduction to Claude Cowork

Collaborate with Claude on complex projects

⚙️
Claude Platform 101

Build apps with the Claude API

ラボ

7つの実験がロード済み
🧬ニューラルネットワークサンドボックス🤖AI か人間か?🥋プロンプトエンジニアリング道場🏁アルゴリズムレース🧠AIトリビアチャレンジ🏗️システム設計キャンバス
🎯模擬面接ラボへ入る→
🚀

キャリア発展

🚀
面接ローンチパッド

旅を始めよう

🌟
行動面接マスター

ソフトスキルをマスター

💻
技術面接

コーディング面接を突破

🤖
AI・ML面接

ML面接をマスター

🏆
オファーとその先

最高のオファーを獲得

始める
AIUnlimited

MITライセンス

沪ICP备18025655号-11

学ぶ

  • AI基礎
  • AI実践
  • Claude アカデミー
  • ラボ
  • キャリア発展

コミュニティ

  • 概要
  • よくある質問

サポート

  • footer.terms
  • footer.privacy
  • footer.contact
AI & エンジニアリング アカデミックス›🔧 ファインチューニングと評価›レッスン›Fine-Tuning with ms-swift
🚀
ファインチューニングと評価 • 初級⏱️ 25 分で読める

Fine-Tuning with ms-swift

ms-swiftを使って、オープンソースモデルの軽量な微調整を高速で実行する

一般的モデルが具体的業務要件を直接満たせない場合、自分の業務データでモデルを微調整し、モデルが特定のタスクと出力方法をさらに学習できるようにすることができます。

例えば、電子商取引(E-Commerce)の実体識別タスクについて、モデルがテキストから商品名、ブランド名、モデル名を抽出し、対応するカテゴリと位置を指定する必要があります。モデルはこれらの商品について話すことができるかもしれませんが、最終的に使用する際には、抽出された情報が漏れないこと、フィールドが統一されていること、出力形式が安定していることが求められます。

もしタスクと出力要求が明確で、整理されたサンプルデータが用意されているなら、それらのデータで微調整を試みることができます。モデルが望ましい仕事を学習できるようにするためです。パラメータ全体を更新する必要があるか、手元のグラフィックスボードが十分かは、タスクとリソースに合わせて判断する必要があります。

以下では、ms-swiftを使って、データ準備、学習、重み統合、推論の順に実行します。

微調整はモデルのどの部分を変更するのか?

一般的な大モデルは既に強力な言語理解、知識問答、テキスト生成などの汎用能力を持っています。しかし、実際の業務で一般的モデルの性能が具体的な要件を直接満たせない場合があります。

例えば、モデルが特定の情報抽出タスクを正確に完了し、規定された形式で出力するようにする必要がある、あるいは特定の質問に統一された方法で回答する必要があるといった要件があります。これらの要件を満たすために、既存モデルの基礎に特定のデータで学習を行うことで、モデルがタスク要件や回答方法をさらに学習し、このプロセスがモデル微調整(Fine-tuning)と呼ばれます。

微調整はモデルを再学習することではなく、モデルの既存能力の基礎にさらに調整を加えることで、具体的なアプリケーションシーンに適したモデルにするものです。大モデルを完全に再学習するよりも、微調整は必要なデータや計算リソースが通常少ないです。
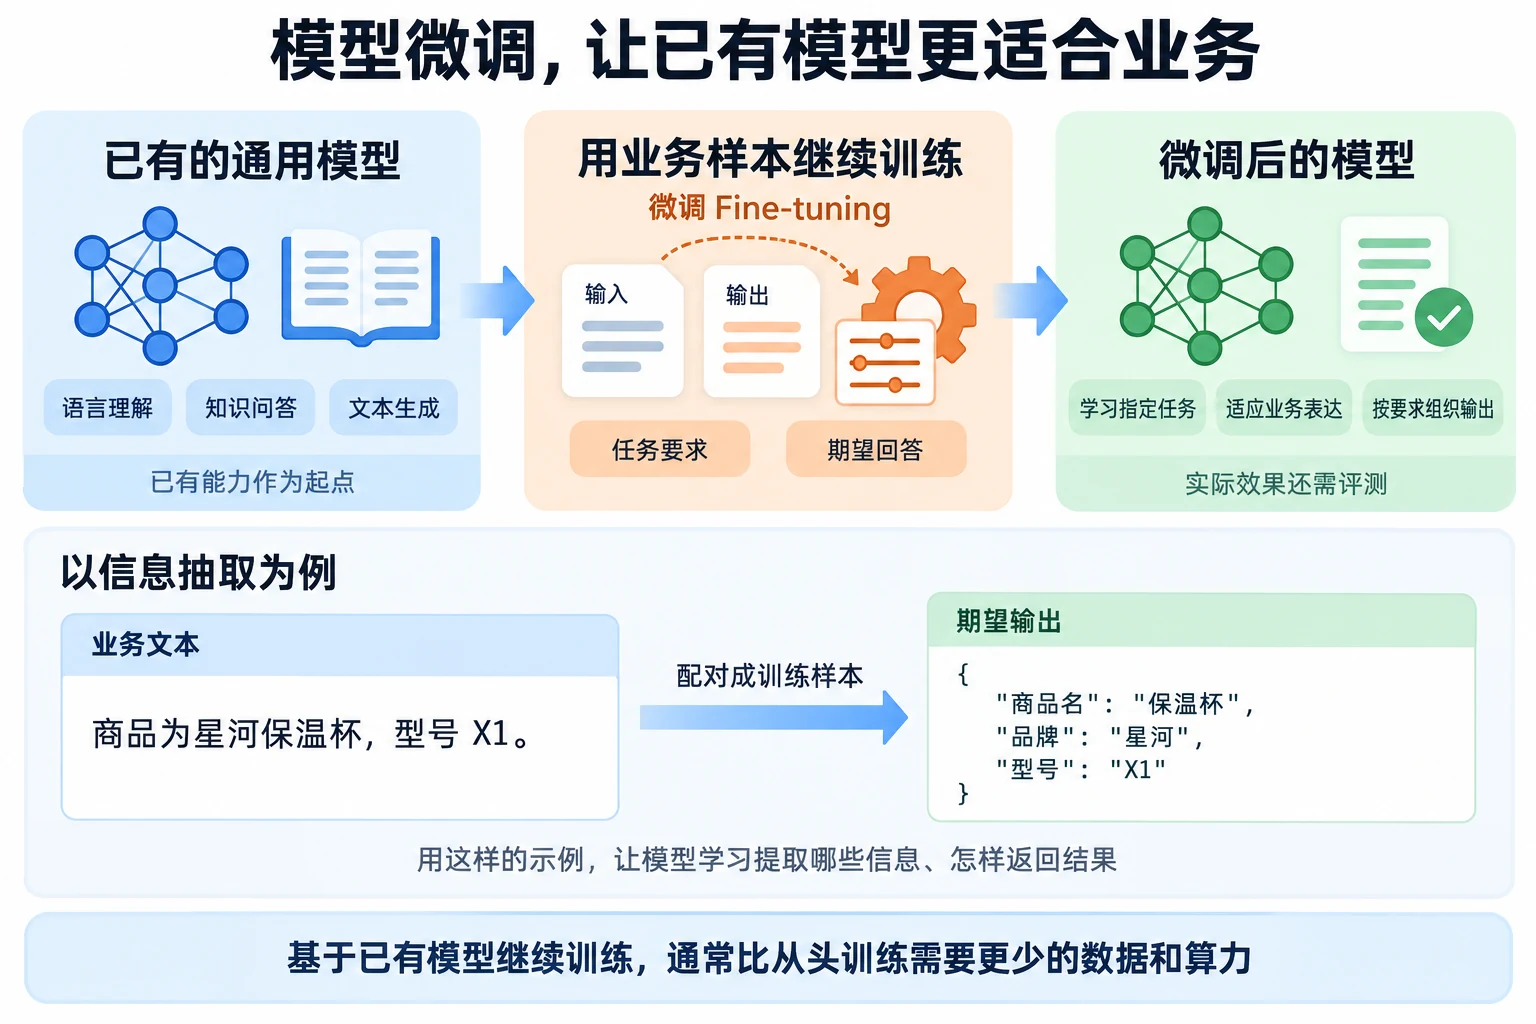
本文の補足画像

現在、大モデルの微調整で比較的一般的な方法はSFT(Supervised Fine-Tuning、監督微調整)です。SFTは標準的な答えを持つデータでモデルを学習させ、各訓練データは通常入力と対応する出力を含み、モデルが与えられた入力後に生成するべき結果を学習させます。例えば、情報抽出タスクでは、テキストを入力として、正しいフィールド抽出結果を出力とします。SFTは明確な訓練サンプルを準備できるタスク(テキスト分類、情報抽出、質問応答、固定形式生成など)に適しています。

SFT以外にも、大モデルの学習は強化学習(Reinforcement Learning、RL)も使用できます。SFTが標準的な答えを直接提供するのに対し、強化学習はモデル生成結果の評価を報酬信号で行い、報酬結果に基づいてモデルの出力行動を調整します。SFTと強化学習はどちらも大モデルの後トレーニング(Post-training)の段階に属します。後トレーニングとは、モデルが大規模な事前学習を完了した後、指令フォローの改善、推論能力の向上、特定のタスク能力の向上を目的とした一連の学習です。大モデルの学習ではまずSFTで指令に従ってタスクを実行する方法を学習し、さらに強化学習などの方法でモデルの回答品質と行動を最適化します。

全パラメータ、LoRAとQLoRA、それぞれの違いは?

訓練方式やハードウェアリソースの違いに基づき、LoRA、QLoRA、あるいは全パラメータ微調整などの方法を選択できます。これらの方法は訓練パラメータ数、VRAM使用量、計算コストなどで若干の違いがあります。

1、全パラメータ微調整(Full Fine-Tuning):訓練中にモデルの全パラメータが更新に参加するため、モデルがより十分な調整が行われます。全パラメータ微調整は必要なVRAMと計算リソースも顕著に増加し、訓練コストも高くなります。

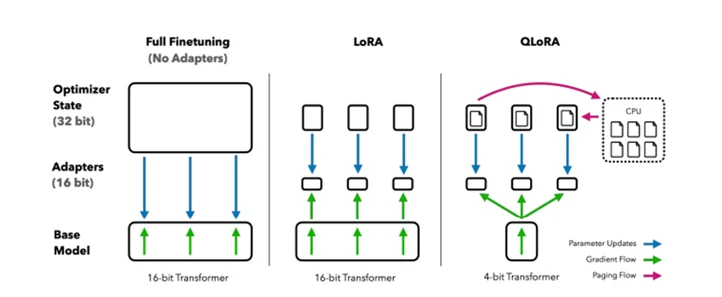
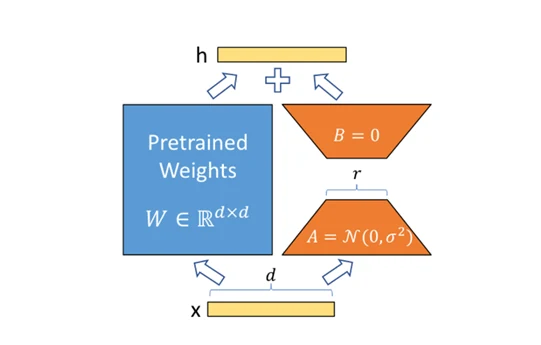
2、LoRA微調整(Low-Rank Adaptation):大モデルの微調整に必要なハードウェアリソースを低減するために、LoRAの核心思想は予訓練モデルの重みを凍結し、Transformerアーキテクチャの各層に可変のランク分解行列を注入することです。これにより、下流タスク中の可変パラメータの数を著しく減少させます。訓練中には、元のモデルのパラメータを固定し、降次行列Aと昇次行列Bを訓練します。LoRAの関連図は図に示す通りです。
本文の補足画像

具体には、予訓練の行列を$W_0 \in \mathbb{R}^{d \times k}$とすると、その更新は以下のように表されます:

W = W_0 + \Delta W = W_0 + BA 

ここで、$\Delta W$は微調整中に学習が必要な重みの変化を示します,

B \in \mathbb{R}^{d \times r}, \quad
A \in \mathbb{R}^{r \times k}, \quad
r \ll \min(d,k)

AとBはLoRAが追加し訓練に参加するパラメータです。モデル訓練が完了すると、個別のLoRA Adapterファイルが作成され、今回の微調整で得られたパラメータが保存されます。使用時には、基本モデルと対応するAdapterを一緒にロードする必要があります。

3、QLoRA微調整(Quantized LoRA):LoRAは訓練パラメータによるリソースコストを低減しますが、基本モデル自体はVRAMにロードされる必要があります。モデル規模が大きい場合、基本モデルのロードも多くのVRAMを占める可能性があります。さらにVRAM使用量を低減するために、QLoRA微調整を使用できます。

レッスン 2 / 40%完了
←Training Data Preparation

ディスカッション

ログイン ディスカッションに参加

関連モデルアーキテクチャは図に示す通りです。図からわかるように、QLoRAはLoRAの改良であり、主に4ビット精度とページ最適化によってモデルのVRAM消費を減少させるものです。

本文の補足画像

QLoRAは簡単に言うと、量子化とLoRAの組み合わせです。基本モデルは低精度で量子化され、QLoRAの主な創造性は以下の通りです:

1)4bit NormalFloat(NF4):NF4は正規分布の重みにとって情報理論上の最適なデータ型です。

2)ダブル量子化技術:ダブル量子化は平均メモリ使用量を減少させ、量子化済みの定数を再量子化することで実現されます。

3)ページ最適化エンジン:ページ最適化エンジンはメモリピークを管理し、勾配チェックポイント時にメモリ不足のエラーを防ぐのに役立ちます。

微調整方式を選ぶには、タスクとグラフィックスボードを見る

どの微調整方式を選ぶかは、モデル規模、タスク要件、GPUリソース、訓練コストなどを総合的に考慮する必要があります。各方式は適したシーンがあり、モデルパラメータを更新するほど、微調整効果が必ずしも良いとは限りません。ほとんどの微調整タスクではLoRAを優先して試みるのが良いでしょう。LoRAは追加で学習するパラメータが少ないため、GPU VRAMと計算リソースの要件が低く、訓練で得られるAdapterファイルも小さく、保存しやすいです。

基本モデル規模が大きくても、LoRAを使用してもモデルをロードした後、訓練に十分なVRAMがない場合は、QLoRAをさらに考慮できます。QLoRAは基本モデルのVRAM使用量を量子化によって低減し、大きなモデルも限られたGPUリソースで微調整が可能になります。QLoRAはモデル規模が大きく、GPU VRAMが限られているシーンに適しています。

GPUリソースが十分で、モデルにより十分な調整が必要な場合は、全パラメータ微調整を考慮できます。訓練中にモデルの全パラメータを更新するため、全パラメータ微調整はVRAM、計算リソース、訓練データの要件が高く、モデルの訓練と保存のコストも大きくなります。したがって、実際のタスクに合わせて全パラメータ微調整を使用する必要があるか判断する必要があります。

実際のプロジェクトでは、低コストで効果を検証し、実際の要件に合わせて訓練コストを増やすかどうかを決定します。LoRAが予期された効果を達成できれば、全パラメータ微調整を選択するだけにしてしまう必要はありません。

ms-swiftを使って、微調整を一通り実行する

ms-swiftが省くべき作業は?

ms-swift(SWIFT、Scalable lightWeight Infrastructure for Fine-Tuning)はModelScopeコミュニティがオープンソースで提供する大モデルの訓練とデプロイ用フレームワークです。主に大言語モデルと多モダル大モデルを対象に、モデル訓練、微調整から推論、評価、デプロイまでの一連のツールを提供します。

本文の補足画像

現在はQwen、DeepSeek、Llama、GLM、InternLMといった主流の大言語モデル、Qwen-VL、InternVLといった多モダルモデル、Embedding、Reranker、テキスト分類モデルやタスクの訓練にも対応しています。

ms-swiftでより詳しい使い方を確認できます。

訓練以外にも、ms-swiftは比較的完全なモデル使用フローを提供します。訓練が完了すると、swift inferでモデルの推論が可能で、swift deployでモデルをOpenAI互換のAPIサービスとしてデプロイすることもできます。推論やデプロイでは、vLLM、SGLang、LMDeployなどの推論エンジンを組み合わせて加速させることができます。

初心者にとって、ms-swiftの特徴の一つは大モデル訓練プロセスで複雑な設定を統一して封印している点です。基本モデル、訓練データ、微調整方式、訓練パラメータをコマンドライン引数で指定するだけで、一度にモデル微調整が完了します。以下の実験では、ms-swiftを使って完全なモデル微調整フローを完了し、訓練データ準備、LoRA訓練の開始、訓練結果の確認、LoRA重みの統合、微調整後モデルのロードによる推論とデプロイまでを実行します。

実体識別タスクから始め、手動で訓練する

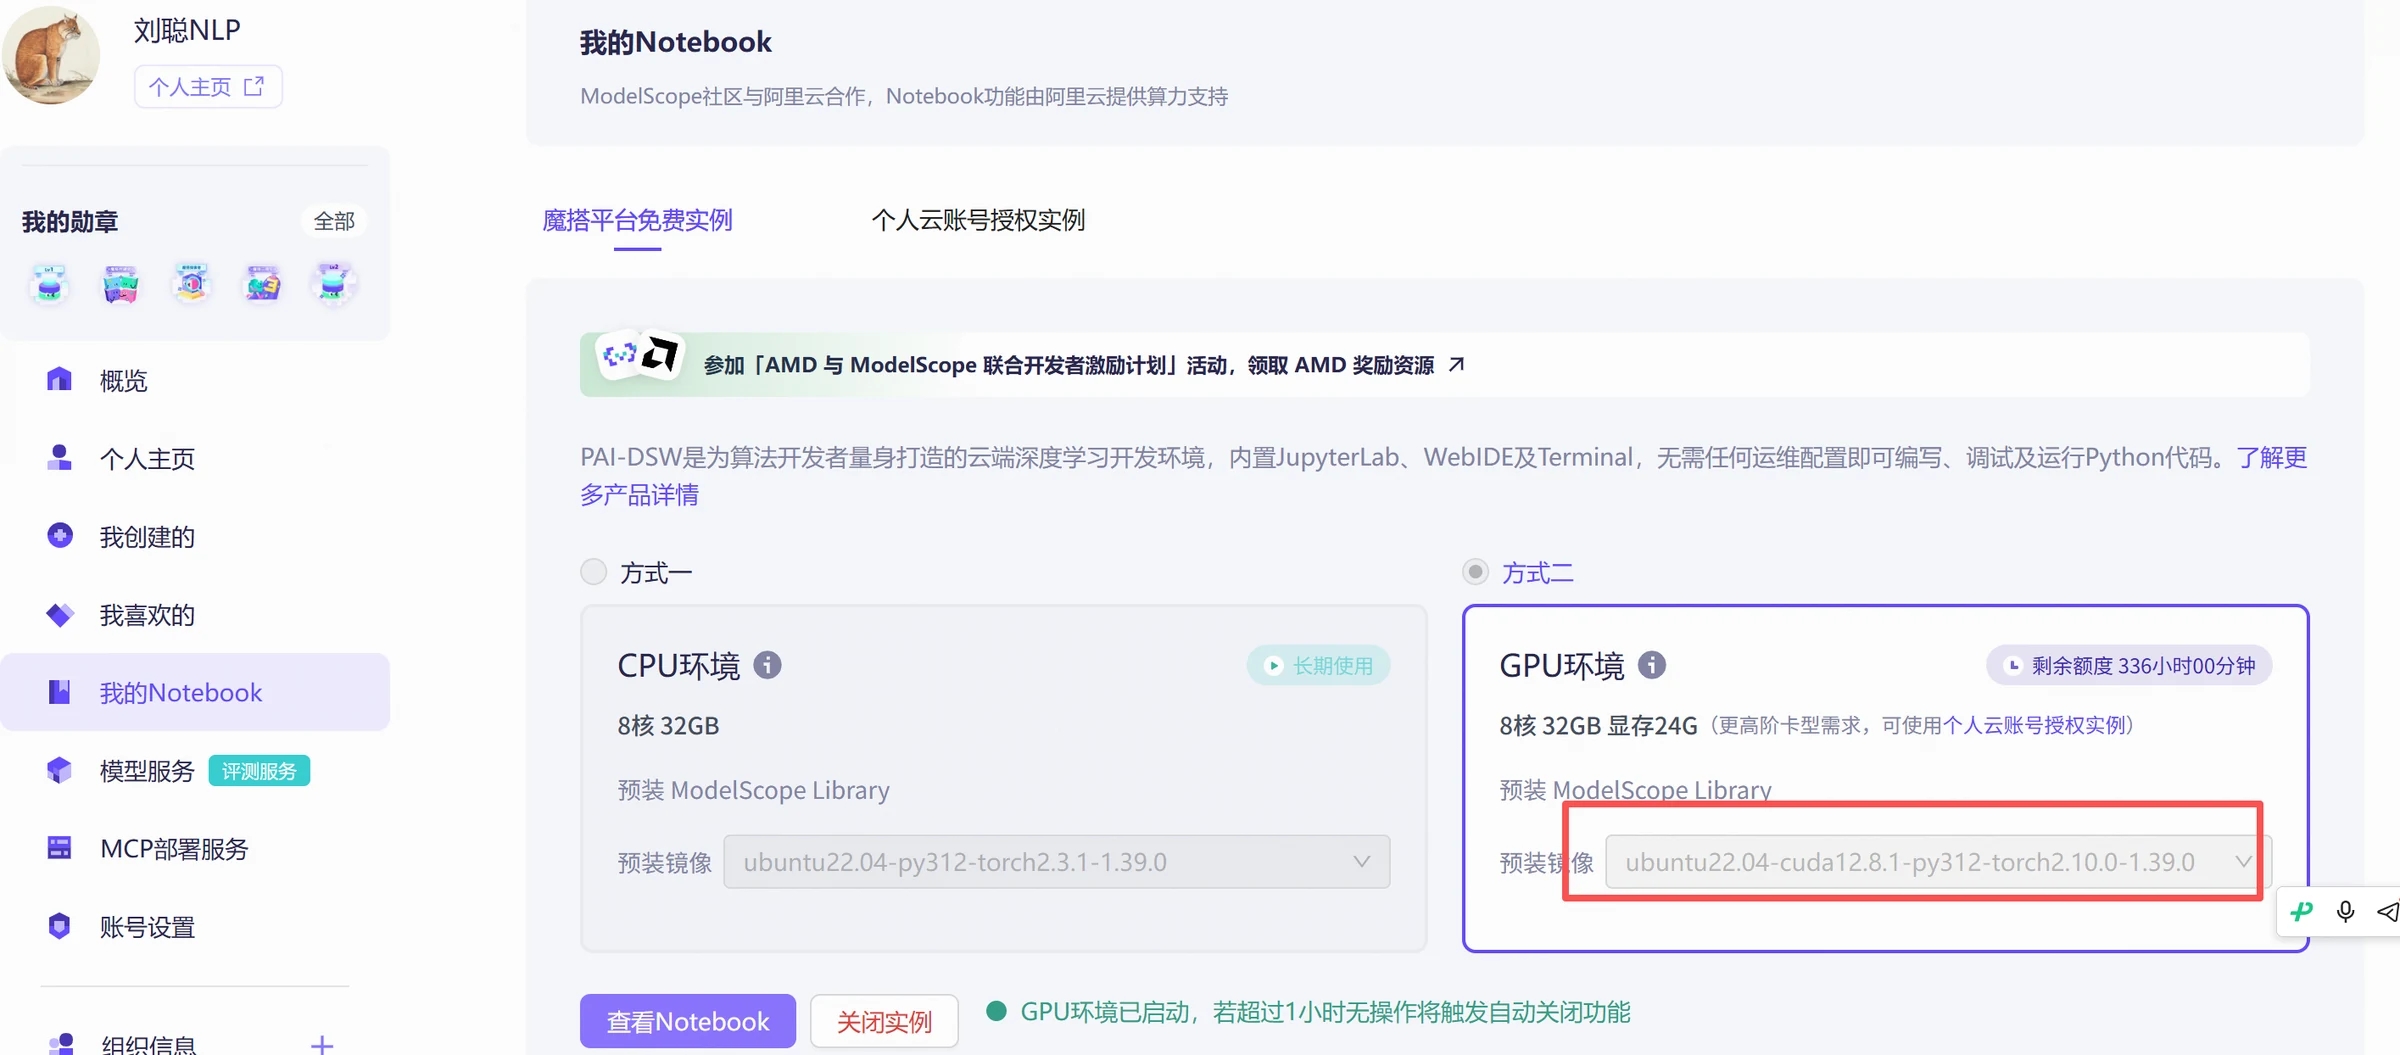
以下、実体識別タスクを例に、ModelScope Notebook環境でモデル微調整の完全なフローをデモンストレーションします。データ準備、モデル訓練、微調整後モデルの推論などの一連のステップを含みます。この例で、ms-swiftを使ってゼロから大モデル微調整が完了する方法を理解できます。本実験ではubuntu22.04-cuda12.8.1-py312-torch2.10.0-1.39.0のイメージを運用環境として使用します。

本文の補足画像

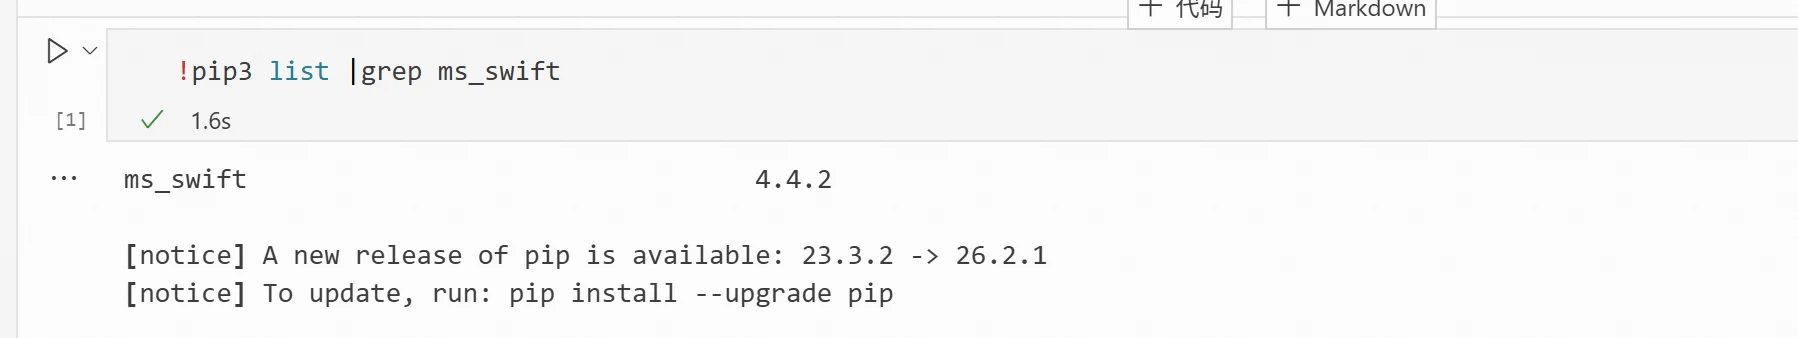
1) 環境にms-swiftが既にインストールされているか確認します。インストールパッケージはms_swiftです

!pip3 list |grep ms_swift

以下のような形式で表示されれば、ms-swiftがインストールされていることを示します

本文の補足画像

もしインストールされていない場合は以下を実行します

!pip3 install ms-swift

2)データ準備:今回の実験で使用するデータはオープンソースの電子商取引実体識別データセットです。データセットには4種類の実体タイプが含まれます:HCCX(商品名)、HPPX(ブランド名)、XH(商品モデル)、MISC(その他実体、国、サイズ容量、人物、作品及び活動名などが含まれます)。

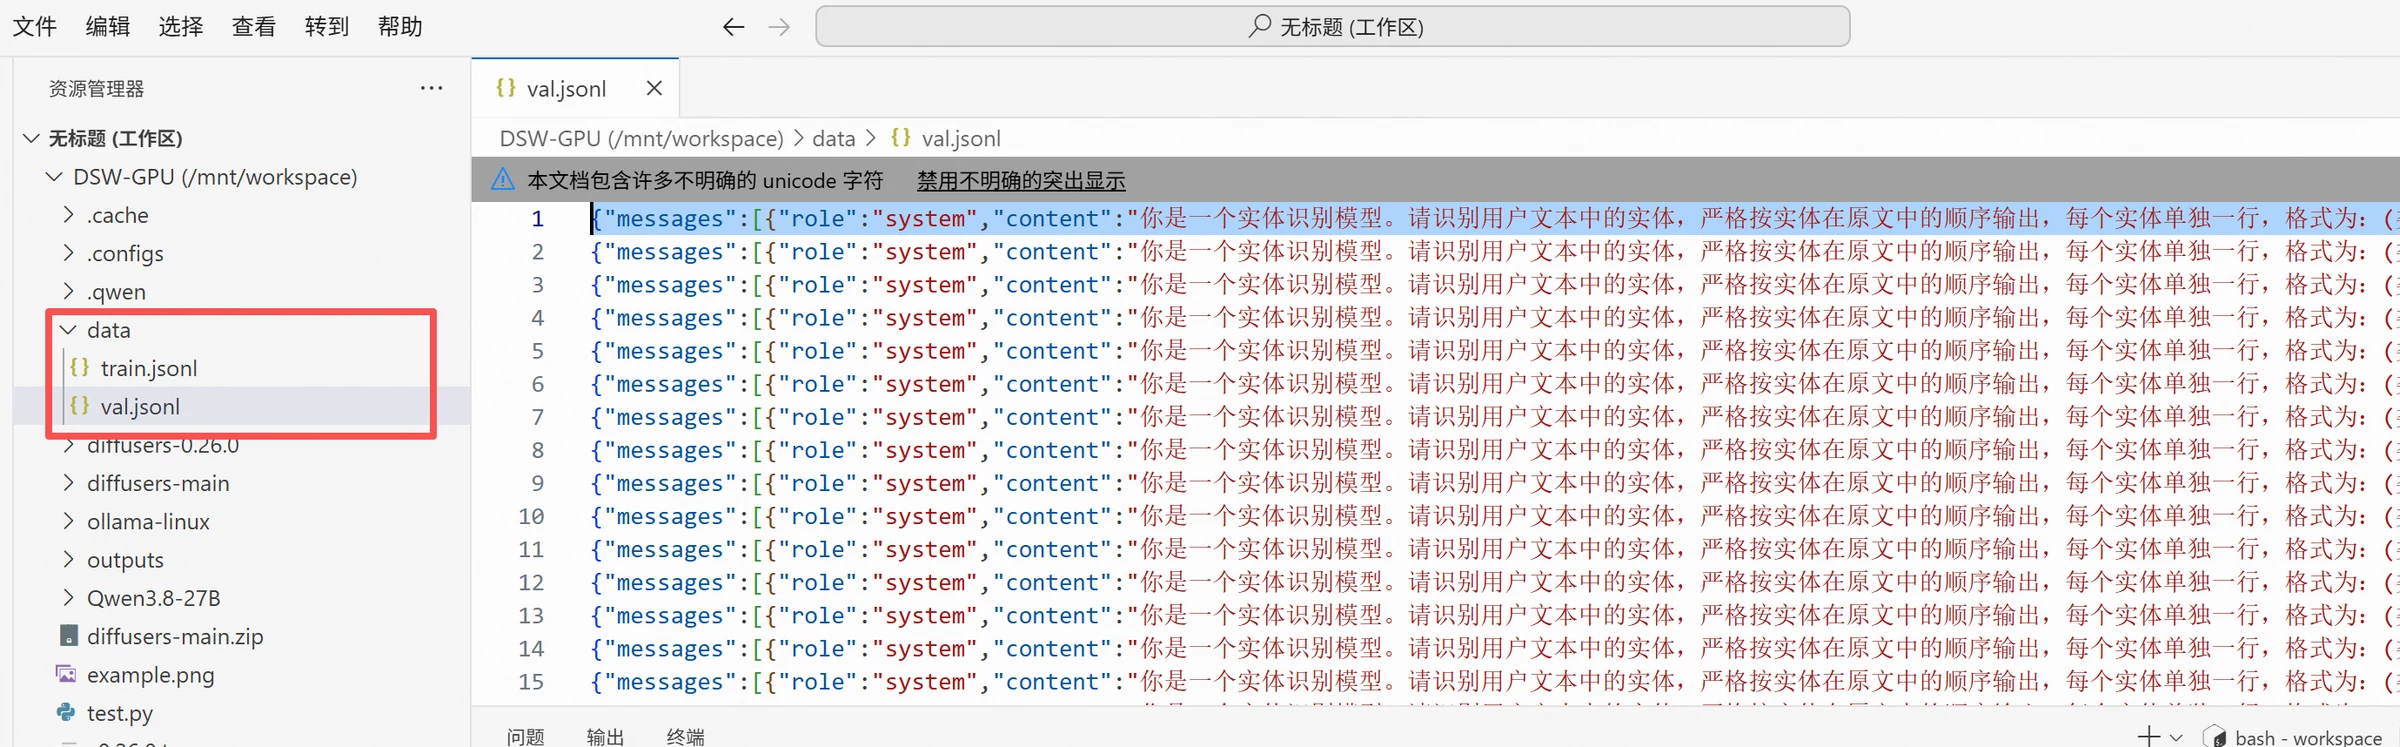
3)dataディレクトリを作成し、データを右クリックしてアップロードします。データ形式は以下の通りです。このタスクはモデルが出力する実体のカテゴリ、実体、テキスト中の対応する開始位置を要求します。データは訓練セットとテストセットに分割され、train.jsonlは5400件、val.jsonlは600件です。

{"messages":[{"role":"system","content":"你是一个实体识别模型。请识别用户文本中的实体,严格按实体在原文中的顺序输出,每个实体单独一行,格式为:(类型,实体文本,起始位置)。起始位置从0开始;类型只能是HCCX、HPPX、MISC、XH之一。没有实体时只输出:无实体。不要输出解释、Markdown或其他内容。"},{"role":"user","content":"推bb护肤刮痧l背疗橄榄油全身按开背足体按油身m油5摩油摩精00"},{"role":"assistant","content":"(HCCX,橄榄油,10)\n(HCCX,按油,20)\n(HCCX,油,24)\n(HCCX,油,27)"}]}

ディレクトリ形式は以下の通り

本文の補足画像

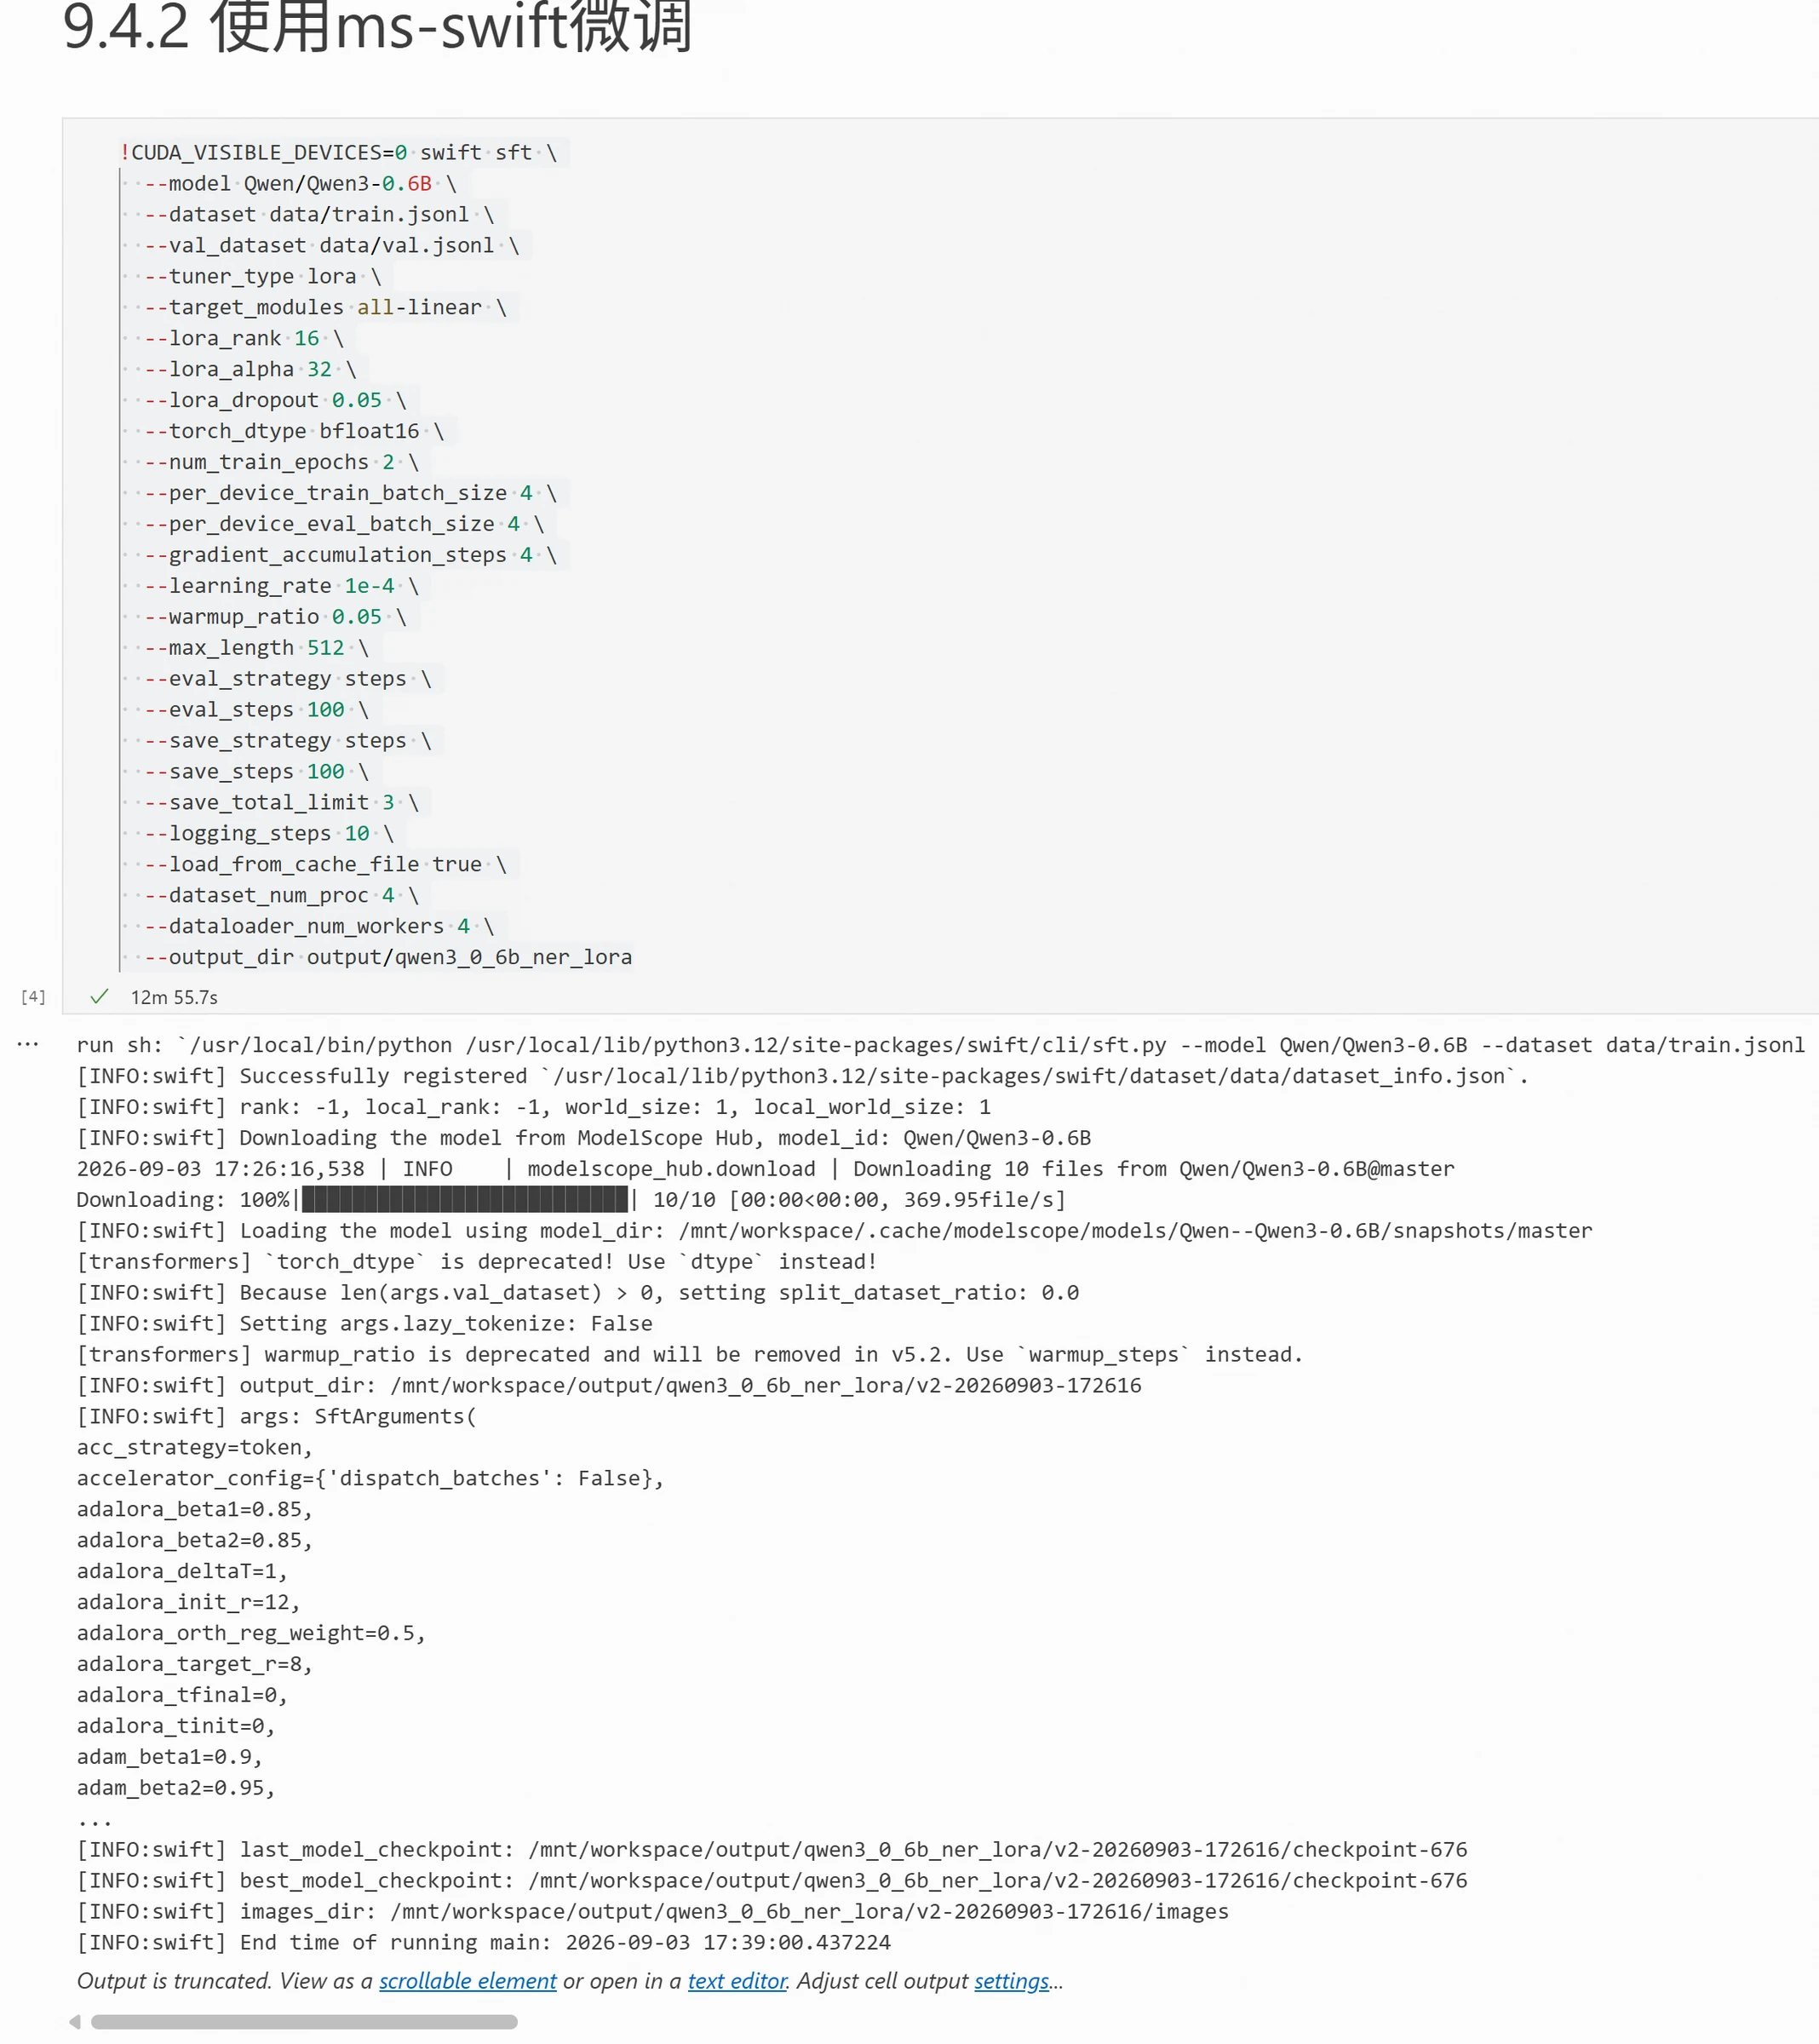
4)モデル訓練:この部分ではQwen/Qwen3-0.6Bを用いて微調整を行い、端末で以下のコマンドを直接入力することで訓練が開始します

!CUDA_VISIBLE_DEVICES=0 swift sft \
  --model Qwen/Qwen3-0.6B \
  --dataset data/train.jsonl \
  --val_dataset data/val.jsonl \
  --tuner_type lora \
  --target_modules all-linear \
  --lora_rank 16 \
  --lora_alpha 32 \
  --lora_dropout 0.05 \
  --torch_dtype bfloat16 \
  --num_train_epochs 2 \
  --per_device_train_batch_size 4 \
  --per_device_eval_batch_size 4 \
  --gradient_accumulation_steps 4 \
  --learning_rate 1e-4 \
  --warmup_ratio 0.05 \
  --max_length 512 \
  --eval_strategy steps \
  --eval_steps 100 \
  --save_strategy steps \
  --save_steps 100 \
  --save_total_limit 3 \
  --logging_steps 10 \
  --load_from_cache_file true \
  --dataset_num_proc 4 \
  --dataloader_num_workers 4 \
  --output_dir output/qwen3_0_6b_ner_lora

核心パラメータの説明:

パラメータ意味
--model Qwen/Qwen3-0.6BQwen3-0.6B基本モデルを使用
--tuner_type loraLoRA微調整を使用
--target_modules all-linear全ての線形層にLoRAを追加
--lora_rank 16LoRA容量
--lora_alpha 32LoRAスケール係数
--num_train_epochs 2訓練エポック数
--per_device_train_batch_size 4単卡毎ステップ4件のデータ
--gradient_accumulation_steps 44ステップごとにパラメータ更新
--learning_rate 1e-4LoRA学習率
--max_length 512単一サンプルの最大長
--eval_steps 100100ステップごとに評価
--save_steps 100100ステップごとに保存
--save_total_limit 3最大3つのチェックポイントを保存
--output_dirモデルとログの保存パス

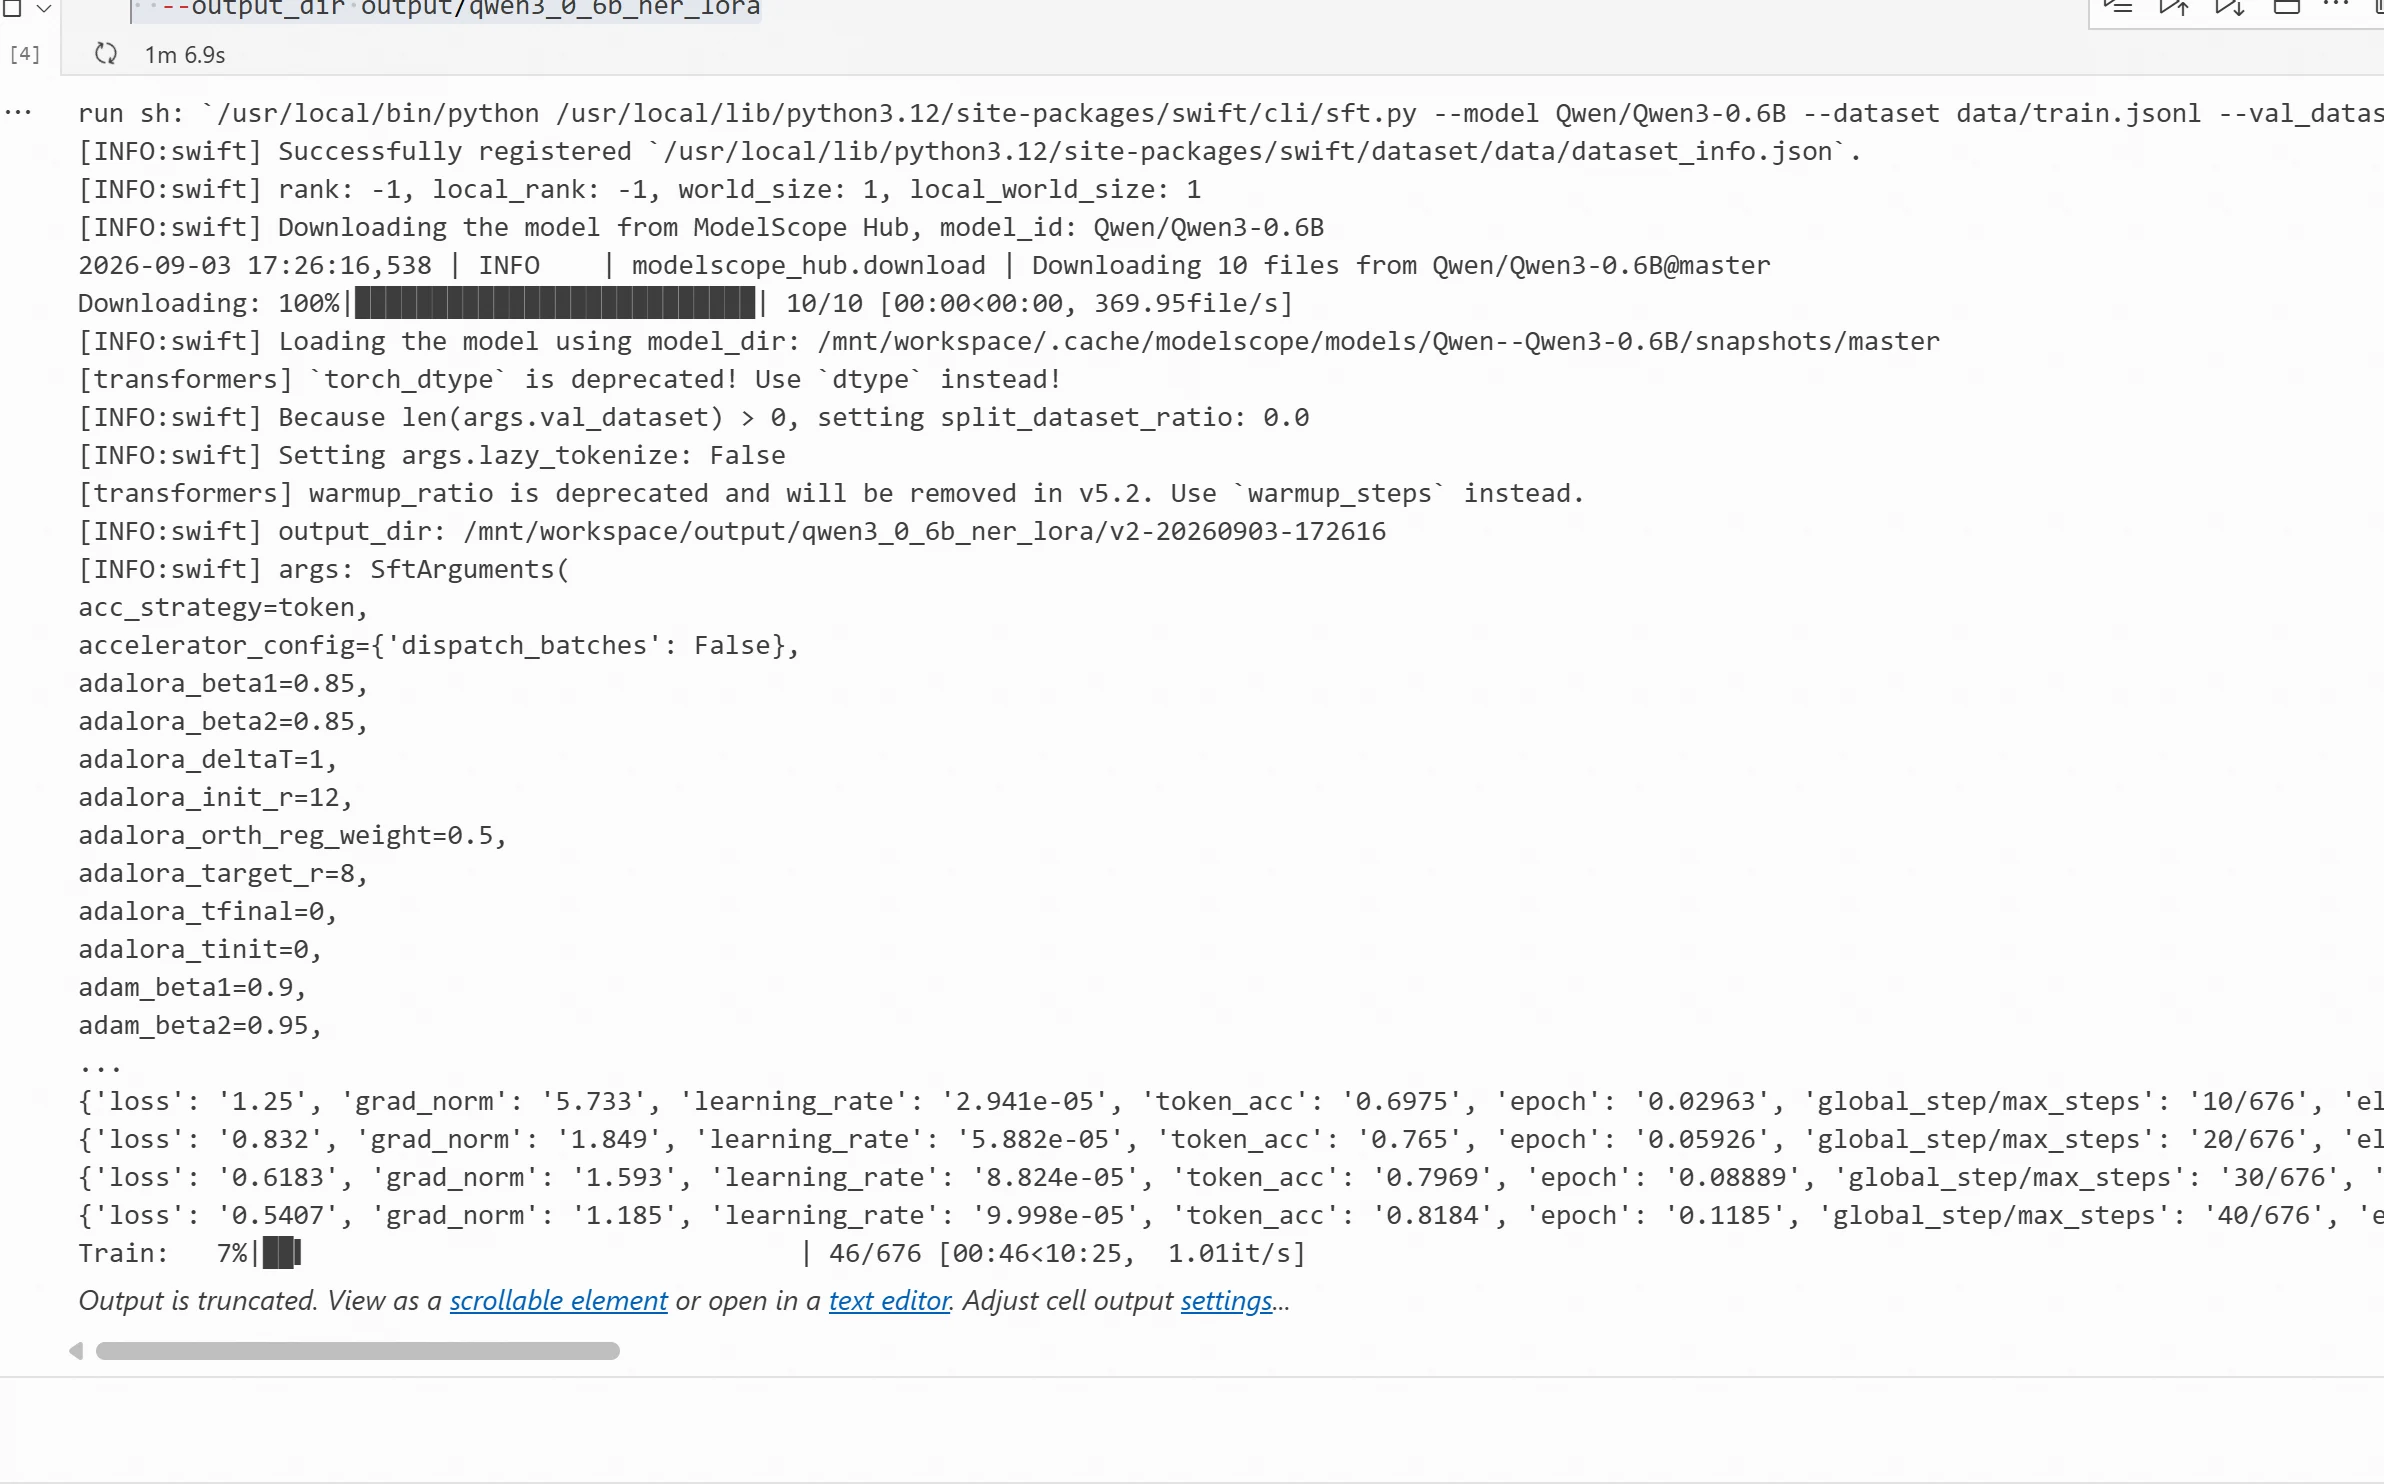
訓練が開始されると、ms-swiftは現在の訓練情報を連続して出力します。以下の通りです:

本文の補足画像
本文の補足画像

訓練が完了したら、モデルはどう使うか?

LoRA重みを基本モデルに統合する

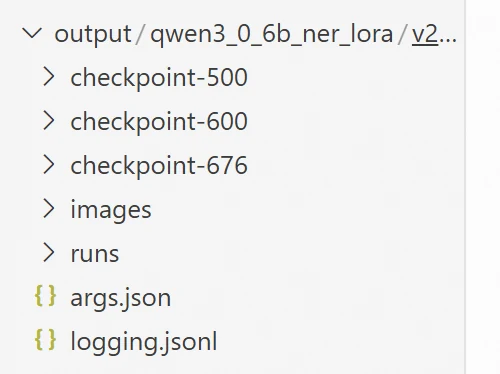
LoRA訓練が完了すると、対応するLoRA Adapterが保存されます。Adapterは完全な大モデルではなく、使用するためには元の基本モデルをロードする必要があります。訓練スクリプト中のoutput_dirから、ディレクトリ内のcheckpointおよび対応するAdapterファイルを見つけることができます。実際のデプロイ時には、LoRA Adapterを基本モデルに統合することで、完全なモデルを作成し、オフラインデプロイやモデル移行時に便利です。モデル訓練後のディレクトリ形式は以下の通り:

本文の補足画像

モデル統合コマンドは以下の通り:

!CUDA_VISIBLE_DEVICES=0 swift export \
  --adapters output/qwen3_0_6b_ner_lora/v2-20260903-172616/checkpoint-676 \
  --merge_lora true \
  --output_dir output/qwen3_0_6b_ner_merged

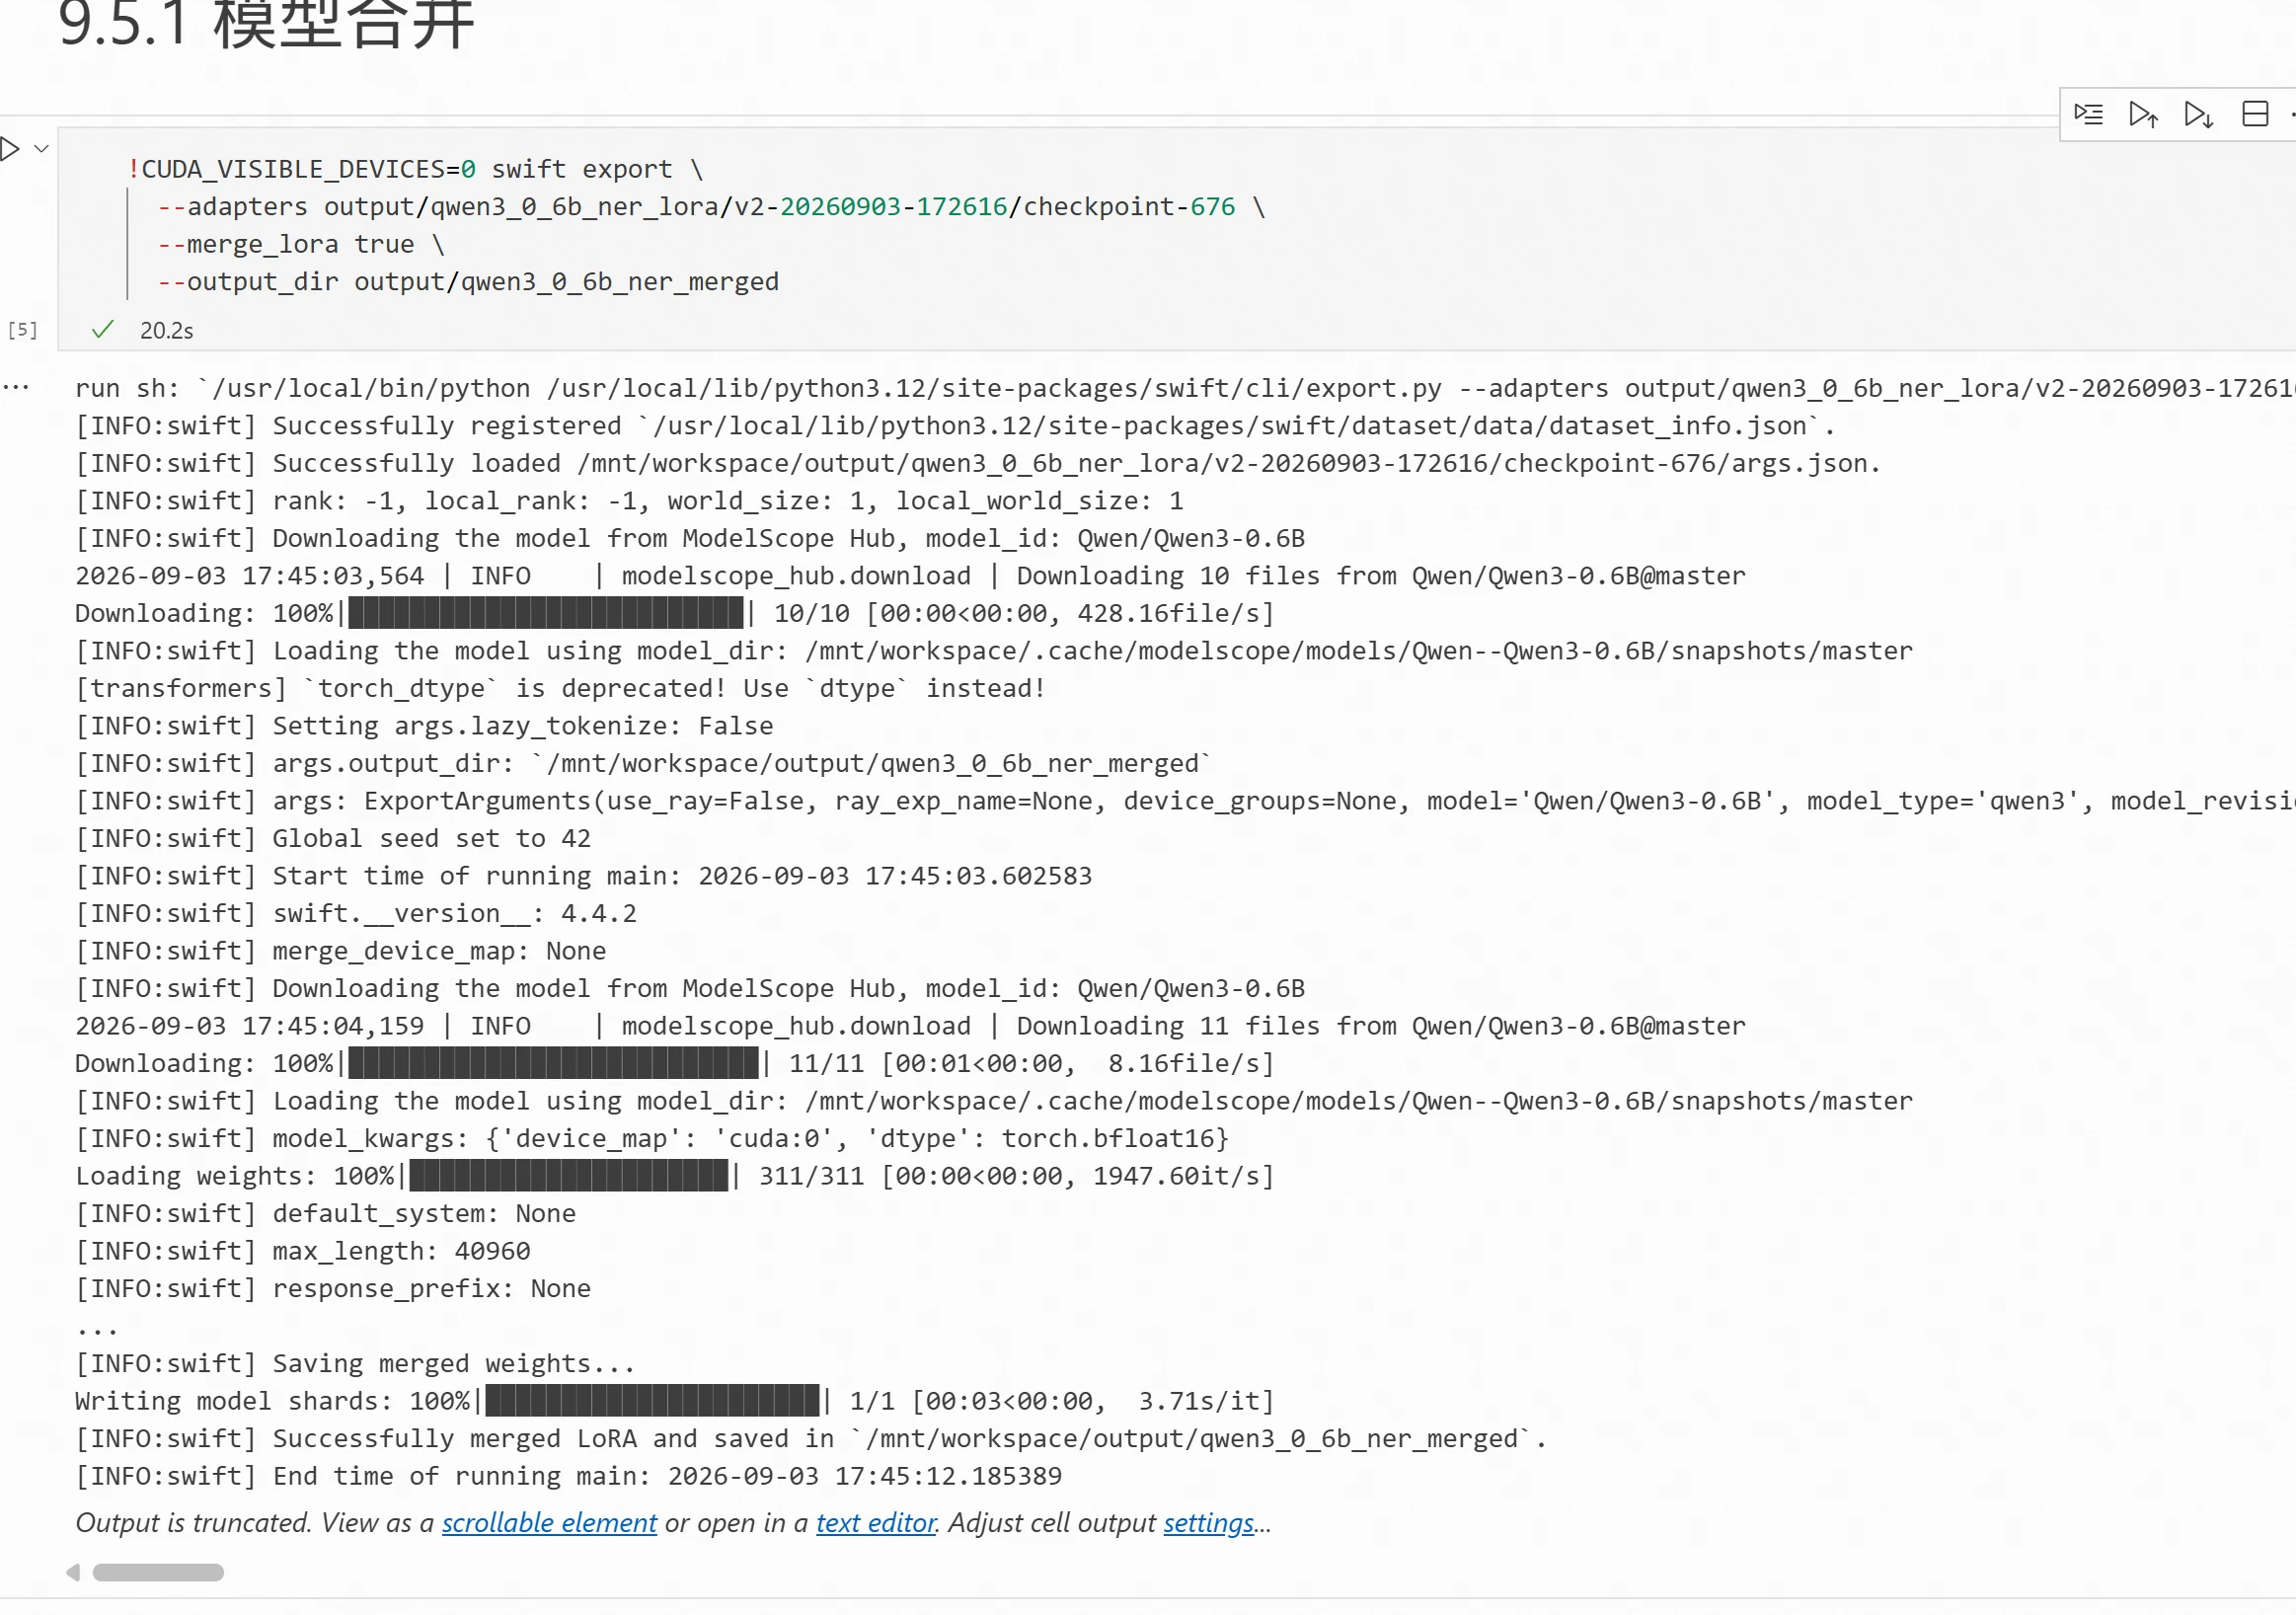
ここで、--adaptersは訓練で得られたLoRA checkpointパスを指定し、--merge_lora trueはLoRAパラメータを基本モデルに統合する意味を示し、--output_dirは統合後モデルの保存先ディレクトリを指定します。

実行結果は以下の通り:

本文の補足画像

微調整後モデルをロードし、実際の効果を試す

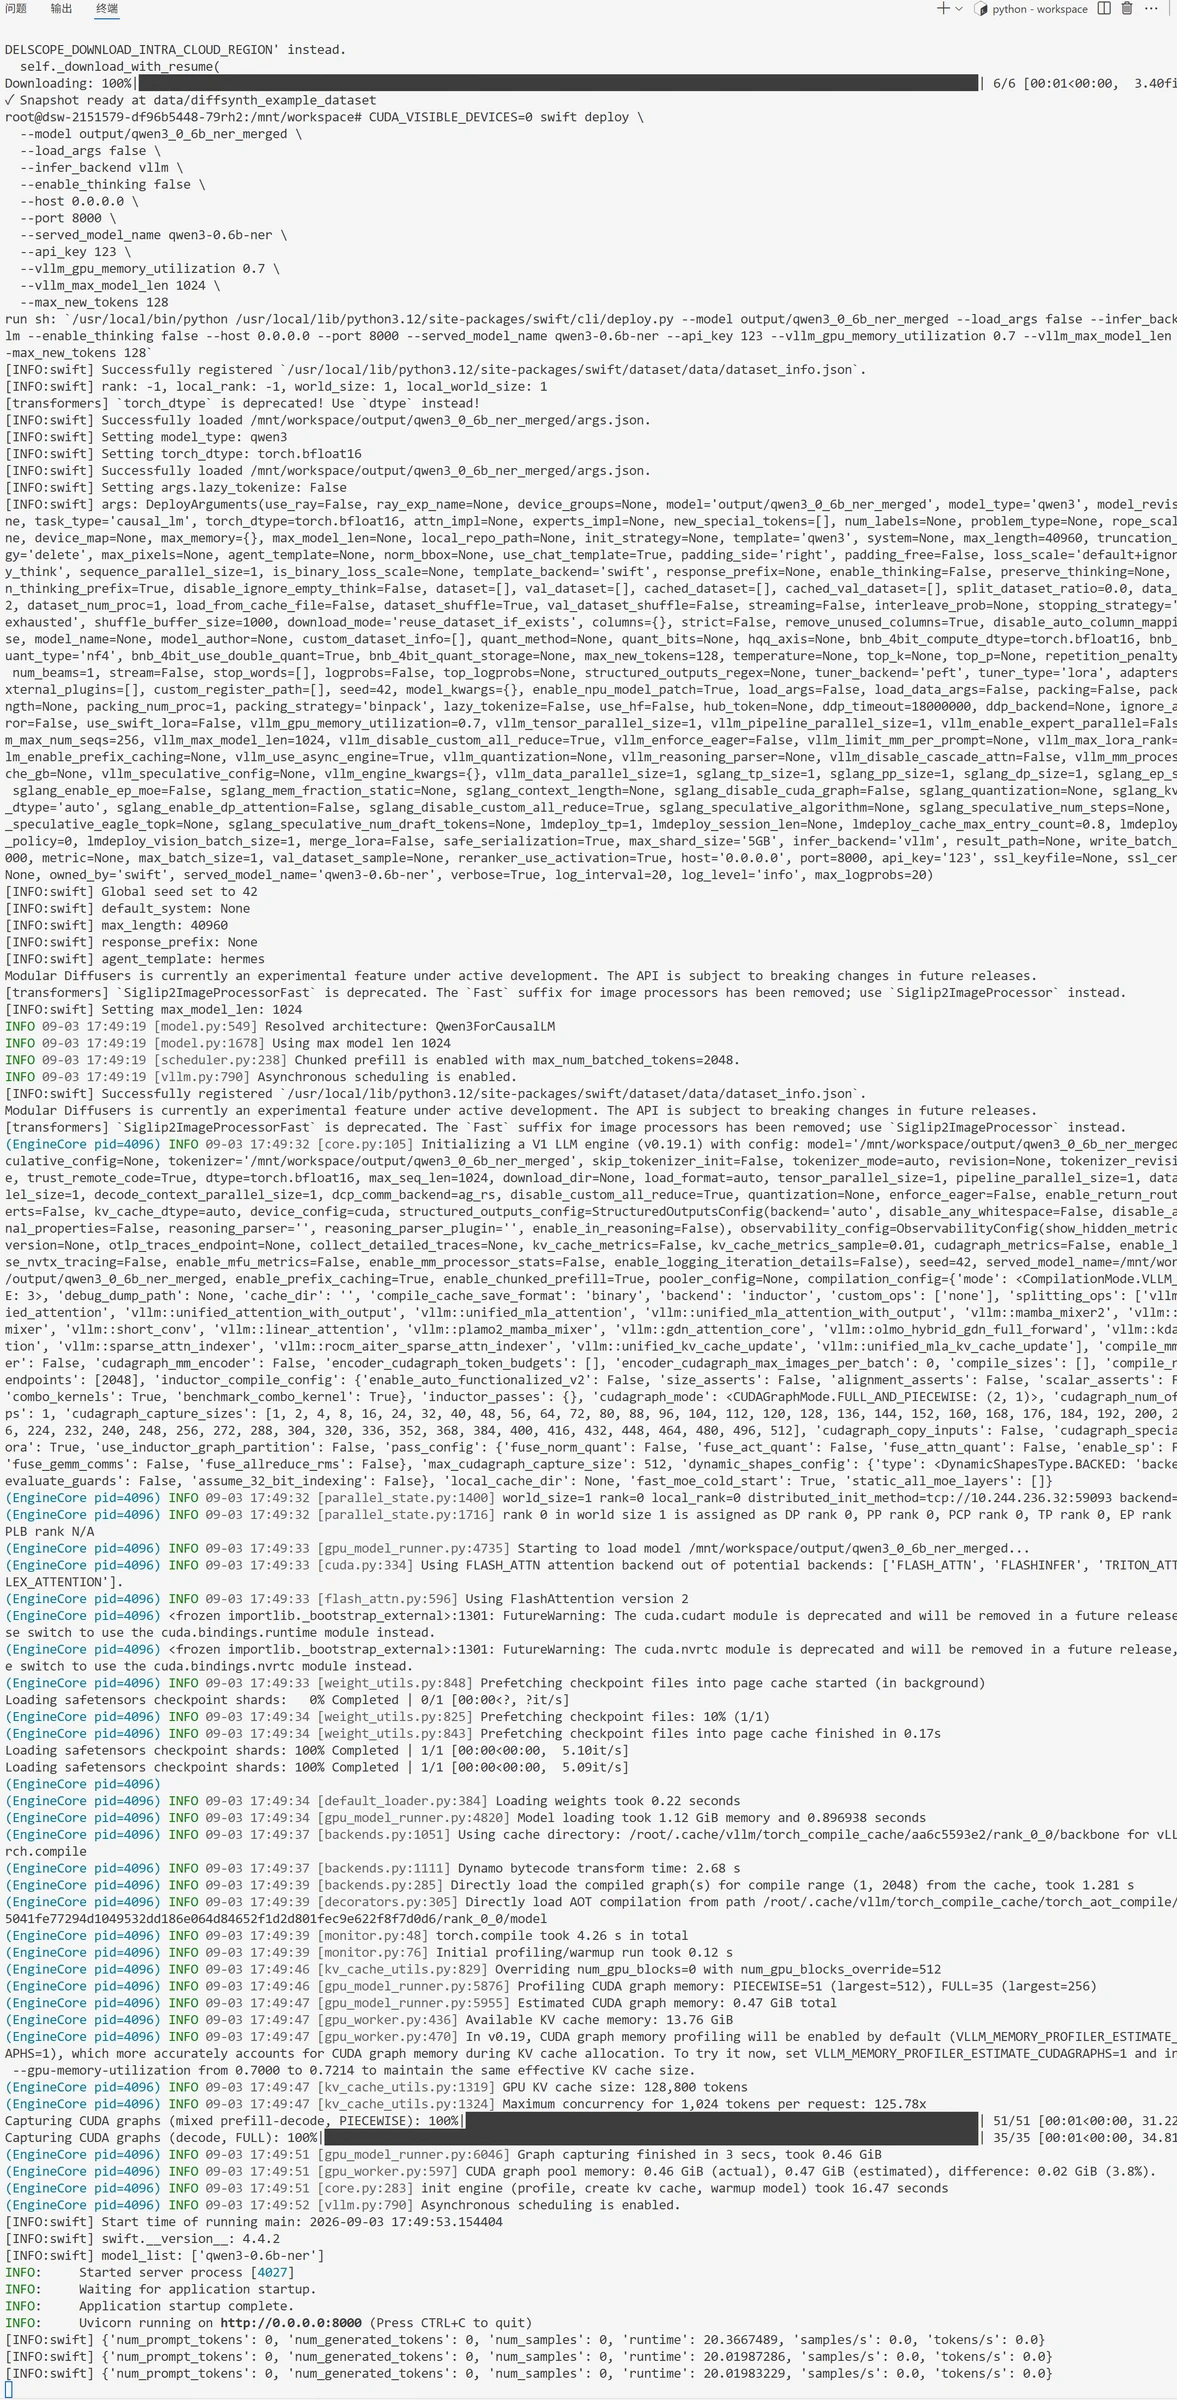
統合が完了すると、生成された完全モデルをロードして推論が可能です。アプリケーションからの呼び出しを容易にするため、モデルを端末でOpenAI互換インターフェースとして起動し、API経由で微調整後モデルにアクセスすることも可能です。これは常駐サービスであり、端末で起動する必要があります。第7章「どうやって端末でコマンドを起動するか」を参考に、起動コマンドは以下の通り:

CUDA_VISIBLE_DEVICES=0 swift deploy \
  --model output/qwen3_0_6b_ner_merged \
  --load_args false \
  --infer_backend vllm \
  --enable_thinking false \
  --host 0.0.0.0 \
  --port 8000 \
  --served_model_name qwen3-0.6b-ner \
  --api_key 123 \
  --vllm_gpu_memory_utilization 0.7 \
  --vllm_max_model_len 1024 \
  --max_new_tokens 128

パラメータの説明は以下の通り:

パラメータ意味
swift deployms-swiftのOpenAI互換サービスを起動
--model統合後の完全モデルディレクトリを指定
--load_argsモデルディレクトリ中のargs.jsonパラメータをロードしない
--infer_backendvLLM推論エンジンを使用
--enable_thinkingQwen3の思考モードを無効化
--hostインターフェースIP
--portポート
--served_model_nameインターフェースでアクセスするモデル名を設定
--api_keyインターフェースアクセスキーを設定
--vllm_gpu_memory_utilizationモデルが約70%のVRAMを使用
--vllm_max_model_len最大トークン数
--max_new_tokens最大出力長

モデル起動が完了すると、以下の通りです:

本文の補足画像

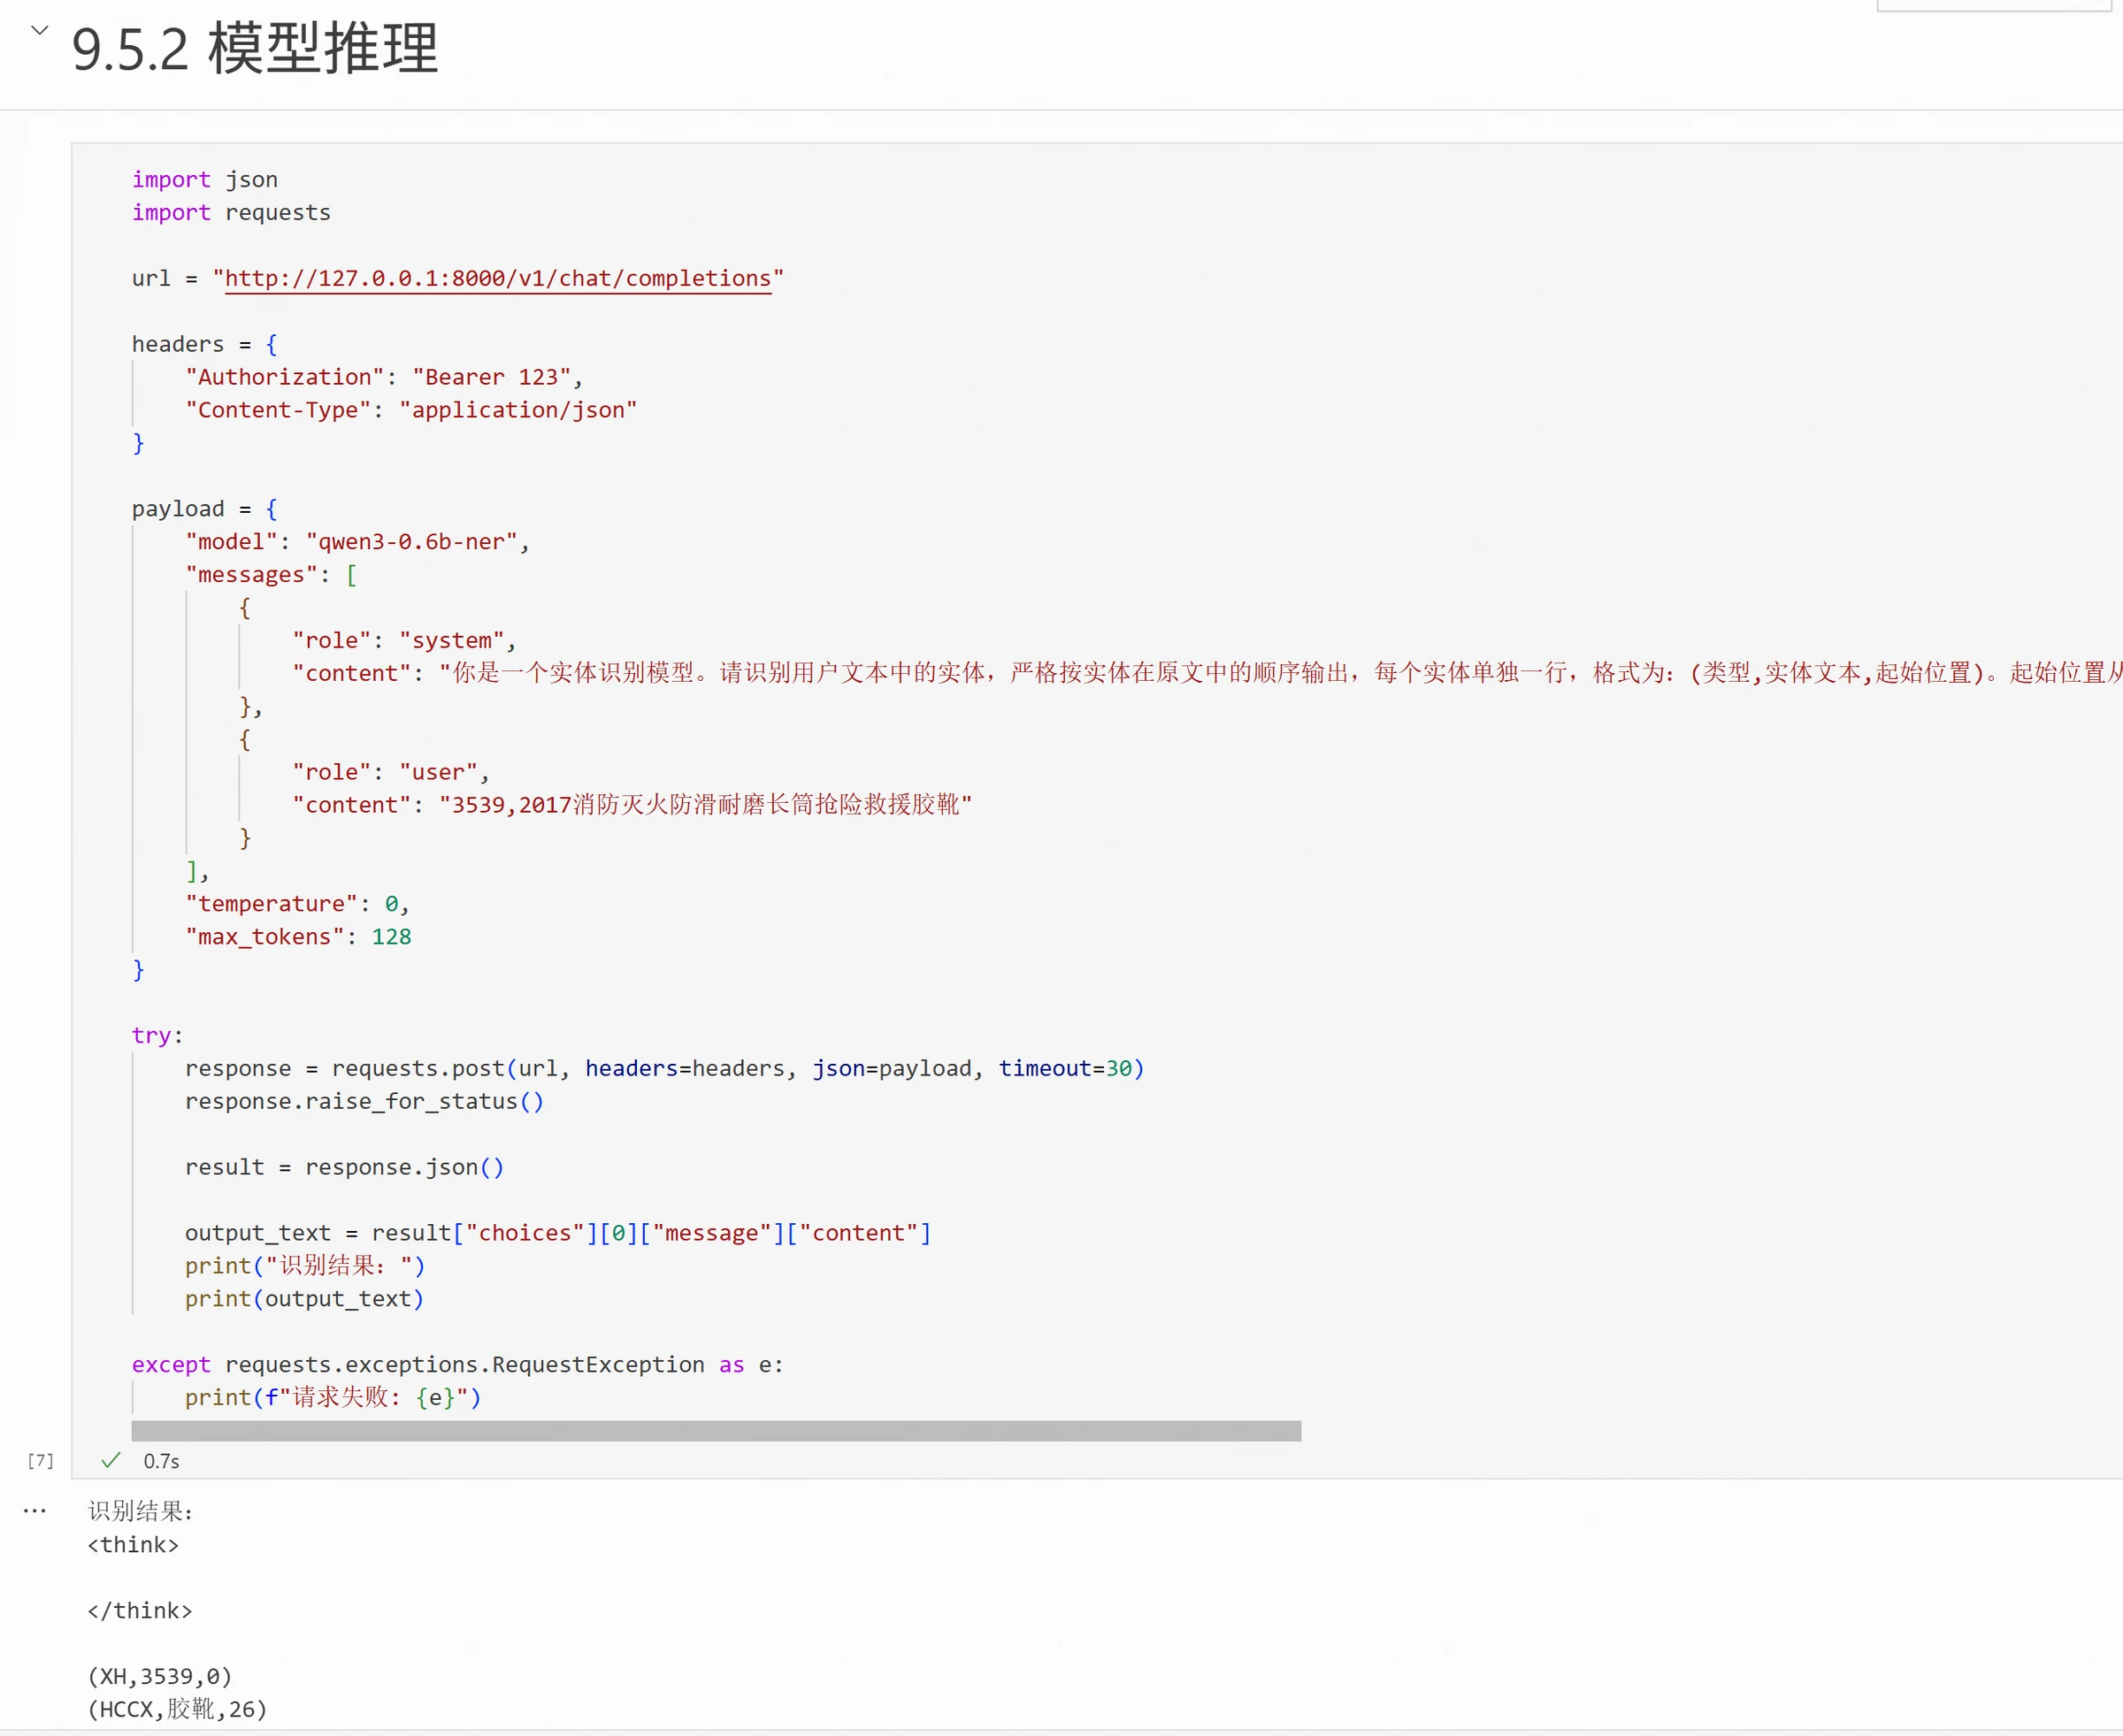
モデル起動が完了すると、インターフェースの接続を確認するために以下のコードを実行します:

import json
import requests

url = "http://127.0.0.1:8000/v1/chat/completions"

headers = {
    "Authorization": "Bearer 123",
    "Content-Type": "application/json"
}

payload = {
    "model": "qwen3-0.6b-ner",
    "messages": [
        {
            "role": "system",
            "content": "你是一个实体识别模型。请识别用户文本中的实体,严格按实体在原文中的顺序输出,每个实体单独一行,格式为:(类型,实体文本,起始位置)。起始位置从0开始;类型只能是HCCX、HPPX、MISC、XH之一。没有实体时只输出:无实体。不要输出解释、Markdown、think标记或其他内容。"
        },
        {
            "role": "user",
            "content": "3539,2017消防灭火防滑耐磨长筒抢险救援胶靴"
        }
    ],
    "temperature": 0,
    "max_tokens": 128
}

try:
    response = requests.post(url, headers=headers, json=payload, timeout=30)
    response.raise_for_status()  
    
    result = response.json()

    output_text = result["choices"][0]["message"]["content"]
    print("识别结果:")
    print(output_text)

except requests.exceptions.RequestException as e:
    print(f"请求失败: {e}")

モデルの出力結果は以下の通り、thinkラベルを正規表現で除去することも可能です。

本文の補足画像

本章の全ての実験データとコードは以下のURLで参照できます:https://modelscope.cn/gallery/liucong/ab458cbd-b47f-4830-91b6-314ea2036fc6