一通の顧客サポート電話が終わった後、ユーザーの問題が解決されたか、顧客サポートが重要な条件を漏らさなかったか。録音が少ない場合は、一つ一つ聴くことができますが、録音が多い場合は、人間がサンプリングして聞くだけでなく、すべての電話に対応するのは難しくなります。
伝統的な顧客サポートの品質評価は主に人間によるサンプリングでの聴き取りに依存しており、多くの時間を投入するだけでなく、すべての通話をカバーするのは難しいです。音声認識と音声多モダルモデルを利用して、電話録音から通話内容、話者、感情、サービスの口調、そして双方の相互作用を分析し、大言語モデルが品質評価ルールに基づいてスコアリングを行い、品質評価レポートを生成します。
この章では、言語訓練機関の顧客サポート電話録音の記録を使用し、録音から品質評価レポートまでのプロセスを走らせます。
異なる業務シーンで顧客サポートのサービス品質の要件が異なります。自動品質評価の前に、品質評価に注目すべき問題が何かを明確にし、実際の業務要件に基づいて品質評価ルールを策定する必要があります。
言語訓練機関の顧客サポートは通常、電話を通じてコースの質問、開講通知、欠席、コースの調整、学習フィードバック、および後払いなどの業務を処理する必要があります。
品質評価の際には、顧客サポートが顧客のニーズを正しく理解したか、回答が完全で正確か、すぐに決定できない問題に対して後続の処理方法を示したか、不当な約束をしたかどうかをチェックする必要があります。また、電話でのサービス態度やコミュニケーションプロセスもサービス品質に影響します。例えば、顧客サポートが不満げ、軽んじる、非難する、顧客を中断する、顧客が明らかな不満を示すなどが、サービス品質に影響します。
これらの情報は、電話転写テキストだけでは得られないため、話者と電話録音の中の感情、口調、双方の相互作用などの情報を組み合わせて分析する必要があります。
シーンの要件が確定した後、これらの要件をさらに具体的な品質評価ルールとして整理し、一通の電話で何をチェックするか、および問題ごとのスコアリング基準を明確にする必要があります。これにより、後続の自動判断とスコアリングに基礎を提供します。
言語訓練機関の電話顧客サポートのサービス要件に基づき、要求応答、情報の正確性、問題解決、サービス態度、通話行動、顧客の感情などについて品質評価ルールを以下の表に示します。
| 品質評価項目 | 主要チェック内容 | 点数 |
| 開場と自己紹介 | はい、挨拶をし、機関と本人の身分を説明し、顧客のニーズを尋ねるか | 5 |
| 要求の識別と応答の完全性 | 顧客が提出した問題を識別し、一つ一つ有効に応答するか | 20 |
| 情報の正確性とリスク管理 | 不確かな情報を捏造するか、学習効果など不当な約束があるか | 15 |
| 問題解決と約束の閉じ方 | 顧客の核心問題が解決されたか、すぐに解決できない場合は後続の処理方法を説明したか | 15 |
| サービス態度と専門的な表現 | 不満げ、軽んじる、非難する、辱め、責任転嫁などの表現があるか | 15 |
| 打ち断ちと通話のリズム | 顧客を頻繁に打ち断ち、口を奪う、またはコミュニケーションに影響を与える異常なリズムがあるか | 10 |
| 顧客の感情とサービスの修復 | 顧客が明らかな不満を示すか、顧客サポートが適切に説明や慰めを行ったか | 10 |
| 終わりの言葉と待機確認 | 丁寧に終わるか、未完了の事項を確認するか | 10 |
| 合計 | 100 |
後続の自動品質評価はこれらのルールに基づいて一項目ごとに判断し、スコアリングを行います。異なる品質評価項目ごとの必要な情報は異なります。例えば、要求応答、情報の正確性、問題解決状況は通話内容を基に判断し、サービス態度、顧客の感情、打ち断ちなどの状況は電話録音を分析することで判断し、最後にこれらの分析結果を基に総合的な品質評価を完了します。
前のシーン要件に基づき、システムはまず電話録音から通話テキストと話者情報を取得し、録音を分析して顧客の感情、顧客サポートのサービス口調、そして双方の相互作用を分析します。最後に、これらの分析結果と顧客サポートの品質評価ルールを一緒に大言語モデルに渡し、総合的な判断、スコアリング、そして品質評価レポートの生成を行います。自動品質評価プロセスは以下の図に示す通りです。
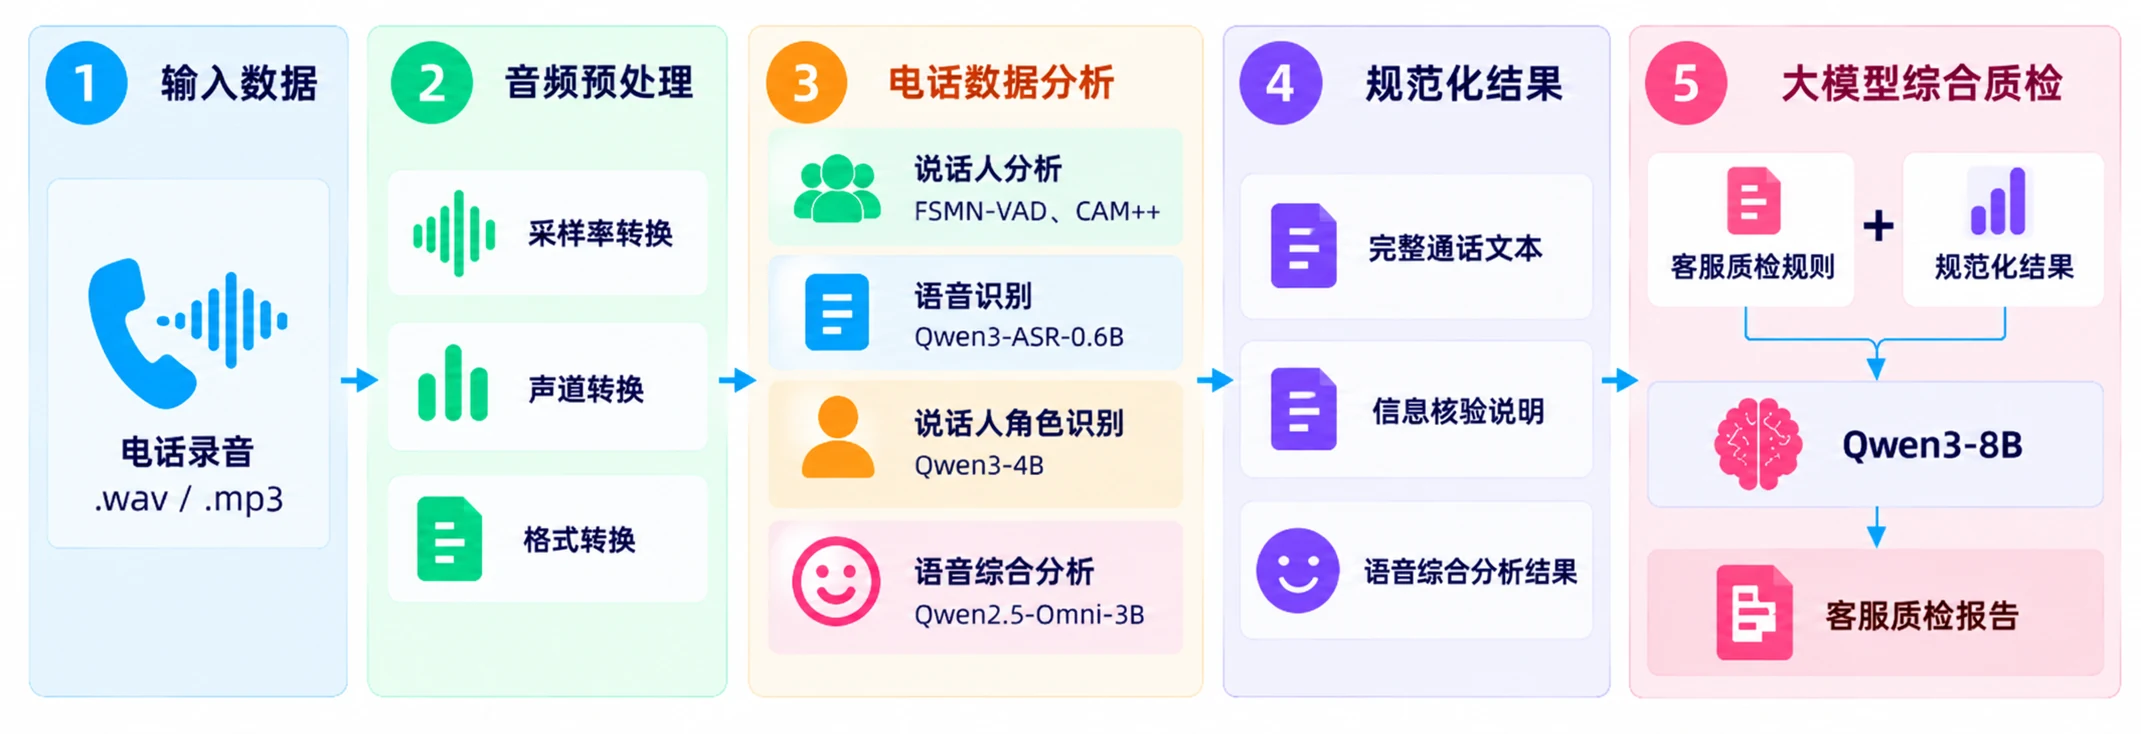
全プロセスは電話データ分析と総合品質評価の二つの部分に分かれます。
電話録音がシステムに入力されると、まず音声形式を統一し、サンプリングレートとチャンネルを後続のモデルが処理できる形式に変換します。
処理後の音声はFSMN-VADで有効な音声領域を検出し、CAM++と組み合わせて異なる話者を区別し、それぞれの話者の発話時間を取得します。この時点で得られるのは、などの話者番号ですが、その身分はまだ特定できません。
ログイン ディスカッションに参加
spk0spk1音声認識はQwen3-ASR-0.6Bで行います。モデルは録音をテキストに変換し、タイムスタンプで各セグメントの時間を記録します。音声認識結果と話者分析結果を時間で合わせると、話者番号と時間情報を含んだ通話テキストが得られます。その後、異なる話者の対話内容に基づき、パラメータ数が少ないQwen3-4Bで話者の役割を判断し、話者番号を「顧客サポート」と「顧客」に変換します。最終的に「役割」と「時間情報」を含んだ完全な通話テキストが得られます。例えば:
第1回 [顧客サポート] 0.00-4.82秒:……
第2回 [顧客] 5.10-10.36秒:……
電話の中の音声にはテキストだけでは直接反映されない情報も含まれます。例えば、顧客サポートの感情とサービス口調、顧客の感情の変化、双方の相互作用などです。Qwen2.5-Omni-3Bで電話録音を分析し、通話テキストと組み合わせて、顧客サポートが不満げ、軽んじる、非難する、口調が生硬な状況があるか、顧客が明らかな不満を示すか、顧客サポートが適切に説明や慰めを行ったかを判断します。また、通話プロセス中に明らかな口を奪う、顧客を打ち断ち、その他の異常な問題があるかも分析します。
主要な分析モジュールは以下の表に示す通りです。
| 分析タスク | モデルまたはコンポーネント | 主要出力 |
| 音声認識 | Qwen3-ASR-0.6B | 時間情報付きの認識テキスト |
| 話者分析 | FSMN-VAD、CAM++ | 複数の話者及び話し時間 |
| 話者役割識別 | Qwen3-4B | 顧客サポート、顧客の役割 |
| 音声総合分析 | Qwen2.5-Omni-3B | 顧客サポートの感情とサービス口調、顧客の感情と顧客サポートの対応、通話相互作用 |
これらの分析結果は、後続の大言語モデルが直接読み取れるように統一された形式に整理する必要があります。例えば:
【通話転写】
第1回 [顧客サポート] XX.XX-XX.XX秒:……
第2回 [顧客] XX.XX-XX.XX秒:……
【情報確認説明】
今回の分析では、企業の業務ルールや標準的な答えが提供されていません。
コース時間、欠席規則などの業務情報については、顧客サポートが明確に応答したかどうかを判断できますが、その内容が正しいかどうかを確認することはできません。
【音声総合分析】
顧客サポートの感情とサービス口調:
感情の表現:……
サービス口調:……
異常事項:……
顧客の感情と顧客サポートの対応:
顧客の感情:……
感情の変化:……
顧客サポートの対応:……
通話相互作用:
口を奪う:……
顧客を打ち断ち:……
その他の異常:……
分析説明:……
標準化された結果には完全な通話テキスト、話者役割、および音声総合分析結果を保持します。顧客の要求、回答の完全性、問題解決、約束、規則など業務内容は、後続の総合品質評価で大言語モデルが完全な通話内容と合わせて判断するため、ここでは事前に単独で分析しません。
電話データ分析が完了すると、20.1.2節で定義した顧客サポートの品質評価ルールと標準化された分析結果をQwen3-8Bに入力します。モデルは完全な通話テキストを基に、顧客が何の要求をしたか、顧客サポートがどのように応答したか、問題が解決されたかを判断し、顧客サポートの感情とサービス口調、顧客の感情と顧客サポートの対応、通話相互作用などの情報を組み合わせて、各品質評価項目を判断し、スコアリングを行います。
コース時間、欠席規則など企業の業務ルールでしか確認できない情報については、その基準が提供されていない場合は、顧客サポートが明確に応答したかどうかを判断するだけで、その内容が正しいかどうかを直接判断せず、レポートに「現有情報では核証できない」と記載します。
品質評価は20.1.2節のルールに基づいて一項目ごとにスコアリングを行います。各品質評価項目では、得点だけでなく判断結果と主要な根拠も示す必要があります。問題が見つかった場合は、対応する通話回、顧客サポートの原話、音声総合分析結果などを証拠として引用し、「サービス態度が悪い」「問題処理が不十分」など根拠のない結論を避けます。
最終的に生成される顧客サポートの品質評価レポートは以下の形式を取ります:
顧客サポート品質評価レポート
総合得点:XX/100
品質評価結論:……
一、総体評価
……
二、品質評価結果
1. 開場と自己紹介:X/5
判断結果:……
主要根拠:……
扣分理由:無/具体的な理由
2. 要求の識別と応答の完全性:X/20
判断結果:……
主要根拠:……
扣分理由:無/具体的な理由
3. 情報の正確性とリスク管理:X/15
判断結果:……
主要根拠:……
扣分理由:無/具体的な理由
4. 問題解決と約束の閉じ方:X/15
判断結果:……
主要根拠:……
扣分理由:無/具体的な理由
5. サービス態度と専門的な表現:X/15
判断結果:……
主要根拠:……
扣分理由:無/具体的な理由
6. 打ち断ちと通話のリズム:X/10
判断結果:……
主要根拠:……
扣分理由:無/具体的な理由
7. 顧客の感情とサービスの修復:X/10
判断結果:……
主要根拠:……
扣分理由:無/具体的な理由
8. 終わりの言葉と待機確認:X/10
判断結果:……
主要根拠:……
扣分理由:無/具体的な理由
三、主要問題
1. ……
2. ……
四、改善提案
1. ……
2. ……
前の技術案に基づきプログラムを記述し、段階的に電話顧客サポートの自動品質評価を実現します。
必要な依存ライブラリをインストールします。
!pip3 install modelscope transformers accelerate
!pip3 install funasr qwen-asr qwen-omni-utils
!pip3 install soundfile scipy

必要なモデルを事前にダウンロードし、後続のロード時にローカルキャッシュを使用できるようにします。
from modelscope import snapshot_download
snapshot_download("iic/speech_fsmn_vad_zh-cn-16k-common-pytorch")
snapshot_download("iic/speech_campplus_sv_zh-cn_16k-common")
snapshot_download("Qwen/Qwen3-ASR-0.6B")
snapshot_download("Qwen/Qwen3-ForcedAligner-0.6B")
snapshot_download("Qwen/Qwen3-4B")
snapshot_download("Qwen/Qwen3-8B")
snapshot_download("Qwen/Qwen2.5-Omni-3B")

インストールが完了したら、後続のプログラムで使用する依存ライブラリを統一してインポートします。
import os
import gc
import json
import torch
import soundfile as sf
from scipy.signal import resample_poly
from funasr import AutoModel
from qwen_asr import Qwen3ASRModel
from modelscope import AutoTokenizer, AutoModelForCausalLM, snapshot_download
from transformers import Qwen2_5OmniForConditionalGeneration, Qwen2_5OmniProcessor
from qwen_omni_utils import process_mm_info
テスト用の音声ファイル:
入力録音を統一して16 kHz単チャンネルWAV音声に変換します。
def preprocess_audio(audio_path, output_path="./customer_service/preprocessed.wav",
target_sr=16000):
audio, sr = sf.read(audio_path)
# 単チャンネルに
if audio.ndim > 1:
audio = audio.mean(axis=1)
# 重サンプリング
if sr != target_sr:
audio = resample_poly(audio, target_sr, sr)
sr = target_sr
# 統一したwav形式で保存
os.makedirs(os.path.dirname(output_path), exist_ok=True)
sf.write(output_path, audio, sr)
return output_path
FunASRを組み合わせてFSMN-VADとCAM++を使用し、異なる話者の音声セグメント及び時間情報を取得します。
def analyze_speakers(audio_path):
model = AutoModel(
model="paraformer-zh",
vad_model="fsmn-vad",
punc_model="ct-punc",
spk_model="cam++",
device="cuda:0"
)
result = model.generate(
input=audio_path,
batch_size_s=60,
sentence_timestamp=True
)
sentence_info = result[0].get("sentence_info", [])
segments = []
for item in sentence_info:
segments.append({
"speaker": f"spk{item['spk']}",
"start": round(item["start"] / 1000, 2),
"end": round(item["end"] / 1000, 2)
})
del model
gc.collect()