汎用の大規模言語モデルは高い知識Q&A能力を持っていますが、企業の実際の応用シーンでは、多くの質問が社内の製品資料、技術文書、業務ルール、操作マニュアルなどの内容に関わります。これらの知識は通常、モデルの学習データには含まれておらず、さらに業務に合わせて継続的に更新されます。
RAG(Retrieval-Augmented Generation、検索拡張生成)は一つの解決策を提供します。大規模言語モデルが質問に答える前に、まず企業ナレッジベースから質問に関連する内容を検索し、その検索結果を大規模言語モデルに与えて回答を生成させます。
RAGの核心的な考え方は、まず検索してから回答すると要約できます。従来の大規模言語モデルによる問答は、主にモデルのパラメータにすでに学習された知識に依存します。例えば、ユーザーが質問すると、モデルは学習段階で得た情報に基づいて直接回答を生成します。RAGはこのプロセスに知識検索のステップを追加します。ユーザーが質問した後、システムはまず外部ナレッジベースから質問に関連する内容を探し、次にユーザーの質問と検索された知識を一緒に大規模言語モデルへ送り、モデルがこれらの内容を組み合わせて最終的な回答を生成します。
基本的なRAGのフローは、ユーザーの質問 → 知識検索 → 関連内容の取得 → LLMによる回答生成 → 結果の返却と表せます。RAGはモデルにこれらの知識を再学習させるのではなく、モデルが質問に答える際に、現在の質問に必要な参考資料を一時的にモデルへ提供するものです。
RAGはすべての大規模言語モデルアプリケーションで必須ではありませんが、企業知識Q&A、インテリジェントカスタマーサービス、ドキュメントアシスタントなどのシナリオでは非常によく使われます。
ビジネス知識を継続的に更新する必要がある場合、通常はRAGの使用が適しています。例えば、企業の製品説明、業務ルール、運用規範は頻繁に調整されることがあります。これらの知識をモデル学習の方法でモデルに書き込むと、知識が変わるたびにモデルを再学習する必要があり、コストが高く、メンテナンスも不便です。
RAGは外部ナレッジベースを直接更新できます。ドキュメントが変更されたら、関連ドキュメントを再処理してインデックスを更新するだけで、大規模言語モデル全体を再学習する必要はありません。回答に出典根拠を示す必要がある場合もRAGが適しています。モデルの回答は検索されたドキュメントに基づいて生成されるため、ドキュメント名、章、ページ番号、または原文の断片を同時に返すことができ、ユーザーは回答がどこから来たのかを知ることができます。
RAGとモデルのファインチューニングはどちらも大規模言語モデルの実際のビジネスにおけるパフォーマンス向上に使えますが、問題の解決アプローチは異なります。RAGは主に「モデルが関連知識を欠いている」問題を解決し、ファインチューニングは主に「モデルが要求どおりにタスクを完了できない」問題を解決します。
RAGはモデル自体のパラメータを変更するのではなく、モデルが質問に答える前に、まず外部ナレッジベースから質問に関連する内容を検索し、それを回答の根拠としてモデルに提供します。
モデルのファインチューニングは異なります。ファインチューニングでは、特定の学習データを使用してモデルをさらに学習させ、学習の過程でモデルパラメータを調整し、モデルが特定タスクの処理方法を徐々に習得します。例えば第9章で紹介した固有表現認識タスクでは、モデルが固定形式の回答を出力する必要があります。タスク要件が大きく変わった場合は、通常、新しい学習データを準備して再びファインチューニングを行う必要があります。
実際の応用では、解決すべき問題に応じて異なる方法を選択できます。知識を補充・更新したい場合はRAGが適し、モデルのタスク能力、出力形式、行動様式を調整したい場合はファインチューニングが適しています。RAGとファインチューニングは組み合わせて使えます。例えば、ファインチューニングでモデルに問答や指示追従の能力を習得させ、RAGでドメイン知識を提供すれば、モデルはビジネス要件に沿ってタスクを完了でき、同時に最新のドメイン知識に基づいて回答を生成できます。
完全なRAGシステムは通常、2つの主要な段階に分けられます:ナレッジベースの構築とオンライン問答です。ナレッジベースの構築は、PDF、Word、Markdown、Webページなどの一次資料を、検索可能な知識に処理する役割を担います。オンライン問答は、ユーザーが質問した後に、すでに構築されたナレッジベースから関連内容を探すものです。今回の実験では、インターネットで公開されている「中華人民共和国道路交通安全法実施条例」をドキュメントベースのソースとして使用し、道路交通安全法に関するQ&AのRAGシステムを構築します。
企業知識は通常、PDF、Word、Excel、Markdown、Webページなど、さまざまな種類のファイルに分散しています。ファイルごとに形式や内部構造が大きく異なるため、RAGナレッジベースを構築する前に、これらのドキュメントを統一された処理可能なテキストまたは構造化データに変換する必要があります。このプロセスはドキュメント解析と呼ばれます。RAGシステムにおいて、優れたドキュメント解析ツールはテキスト内の文字を認識するだけでなく、可能な限り元のドキュメントの構造情報——たとえばドキュメントタイトル、段落、表、画像、数式など——を認識して保持する必要があります。
現在、ドキュメント解析に使えるオープンソースツールは多数あり、代表的なものは次のとおりです:
1)MinerU は複雑なドキュメント向けのオープンソース解析ツールで、PDF、画像、Word、PPT、ExcelなどのドキュメントをMarkdown、JSONなどの機械可読形式に変換できます。タイトル、本文、表、画像、数式などの内容を認識し、可能な限り人間の読む順序に従ってドキュメント構造を復元するため、RAGシステムのドキュメント前処理ツールとして適しています。opendatalab/MinerU
ログイン ディスカッションに参加
2)MonkeyOCR はマルチモーダルモデルに基づくドキュメント解析プロジェクトで、構造認識、内容認識、関係モデリングによってドキュメントを解析し、テキスト、表、数式などの複雑な内容を処理でき、中国語と英語のドキュメントに対応します。レイアウトが複雑で、従来のテキスト抽出ツールの効果が芳しくないPDFには、このような視覚モデルに基づく解析方法の利用を検討できます。Yuliang-Liu/MonkeyOCR
3)Dolphin はByteDanceがオープンソース公開したドキュメント画像解析モデルで、「まず分析し、次に解析する」方式でドキュメントを処理します。まずページのレイアウトと読む順序を認識し、その後テキスト、表、数式、コードなどのさまざまなドキュメント要素をさらに解析します。レイアウトの複雑なPDFやスキャン文書の処理に適しています。ByteDance/Dolphin
4)PaddleOCR はPaddlePaddleがオープンソース公開したOCR・ドキュメント解析ツールです。一般的な文字認識に加えて、レイアウト解析、表認識、ドキュメント構造化解析などの機能を提供し、PDFや画像内の内容を、後続のAIシステムが処理しやすい構造化データに変換できます。スキャンPDF、画像型ドキュメント、大量の中国語テキストを含むドキュメントにとって、PaddleOCRは一般的な選択肢です。PaddlePaddle/PaddleOCR
ドキュメント解析ツールにはそれぞれ特徴があり、すべてのドキュメントに適用できる万能なツールは存在しません。実際にRAGシステムを構築する際は、ドキュメントの種類、レイアウトの複雑さ、解析精度、デプロイコストなどの要素に応じて適切なツールを選択できます。
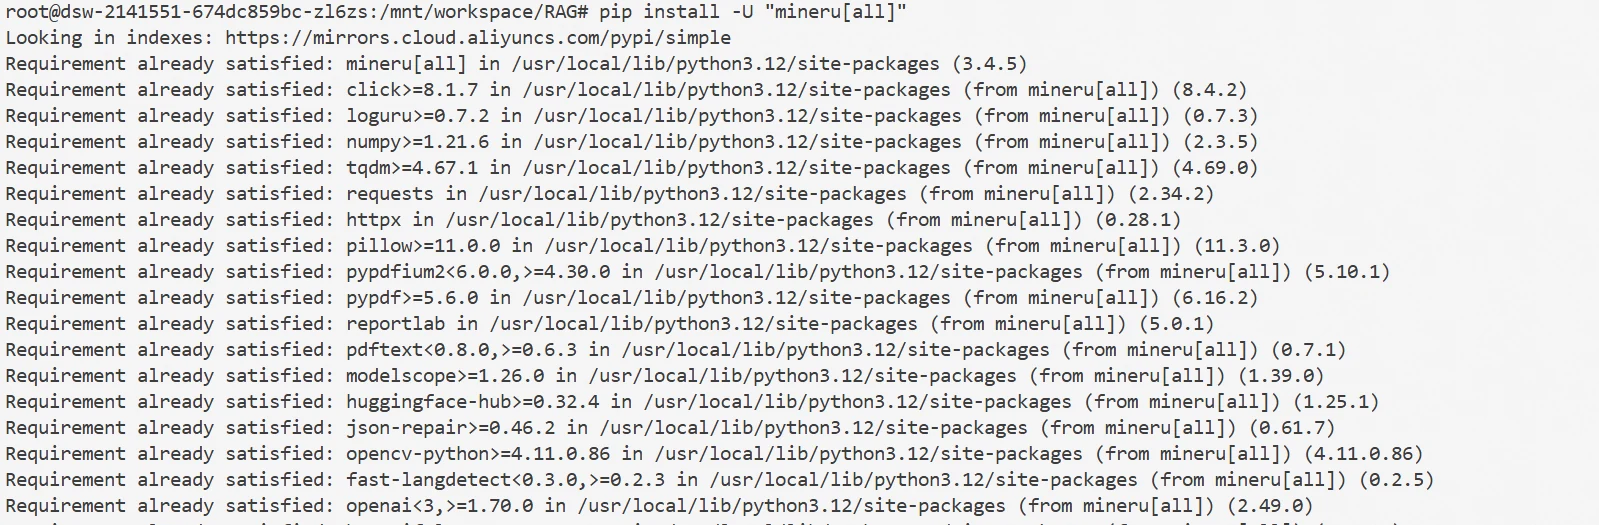
今回の実験ではMinerUでドキュメント解析を行います。まずModelScopeのNotebook環境にMinerUをインストールし、次のコマンドを実行します:
pip install -U "mineru[all]"
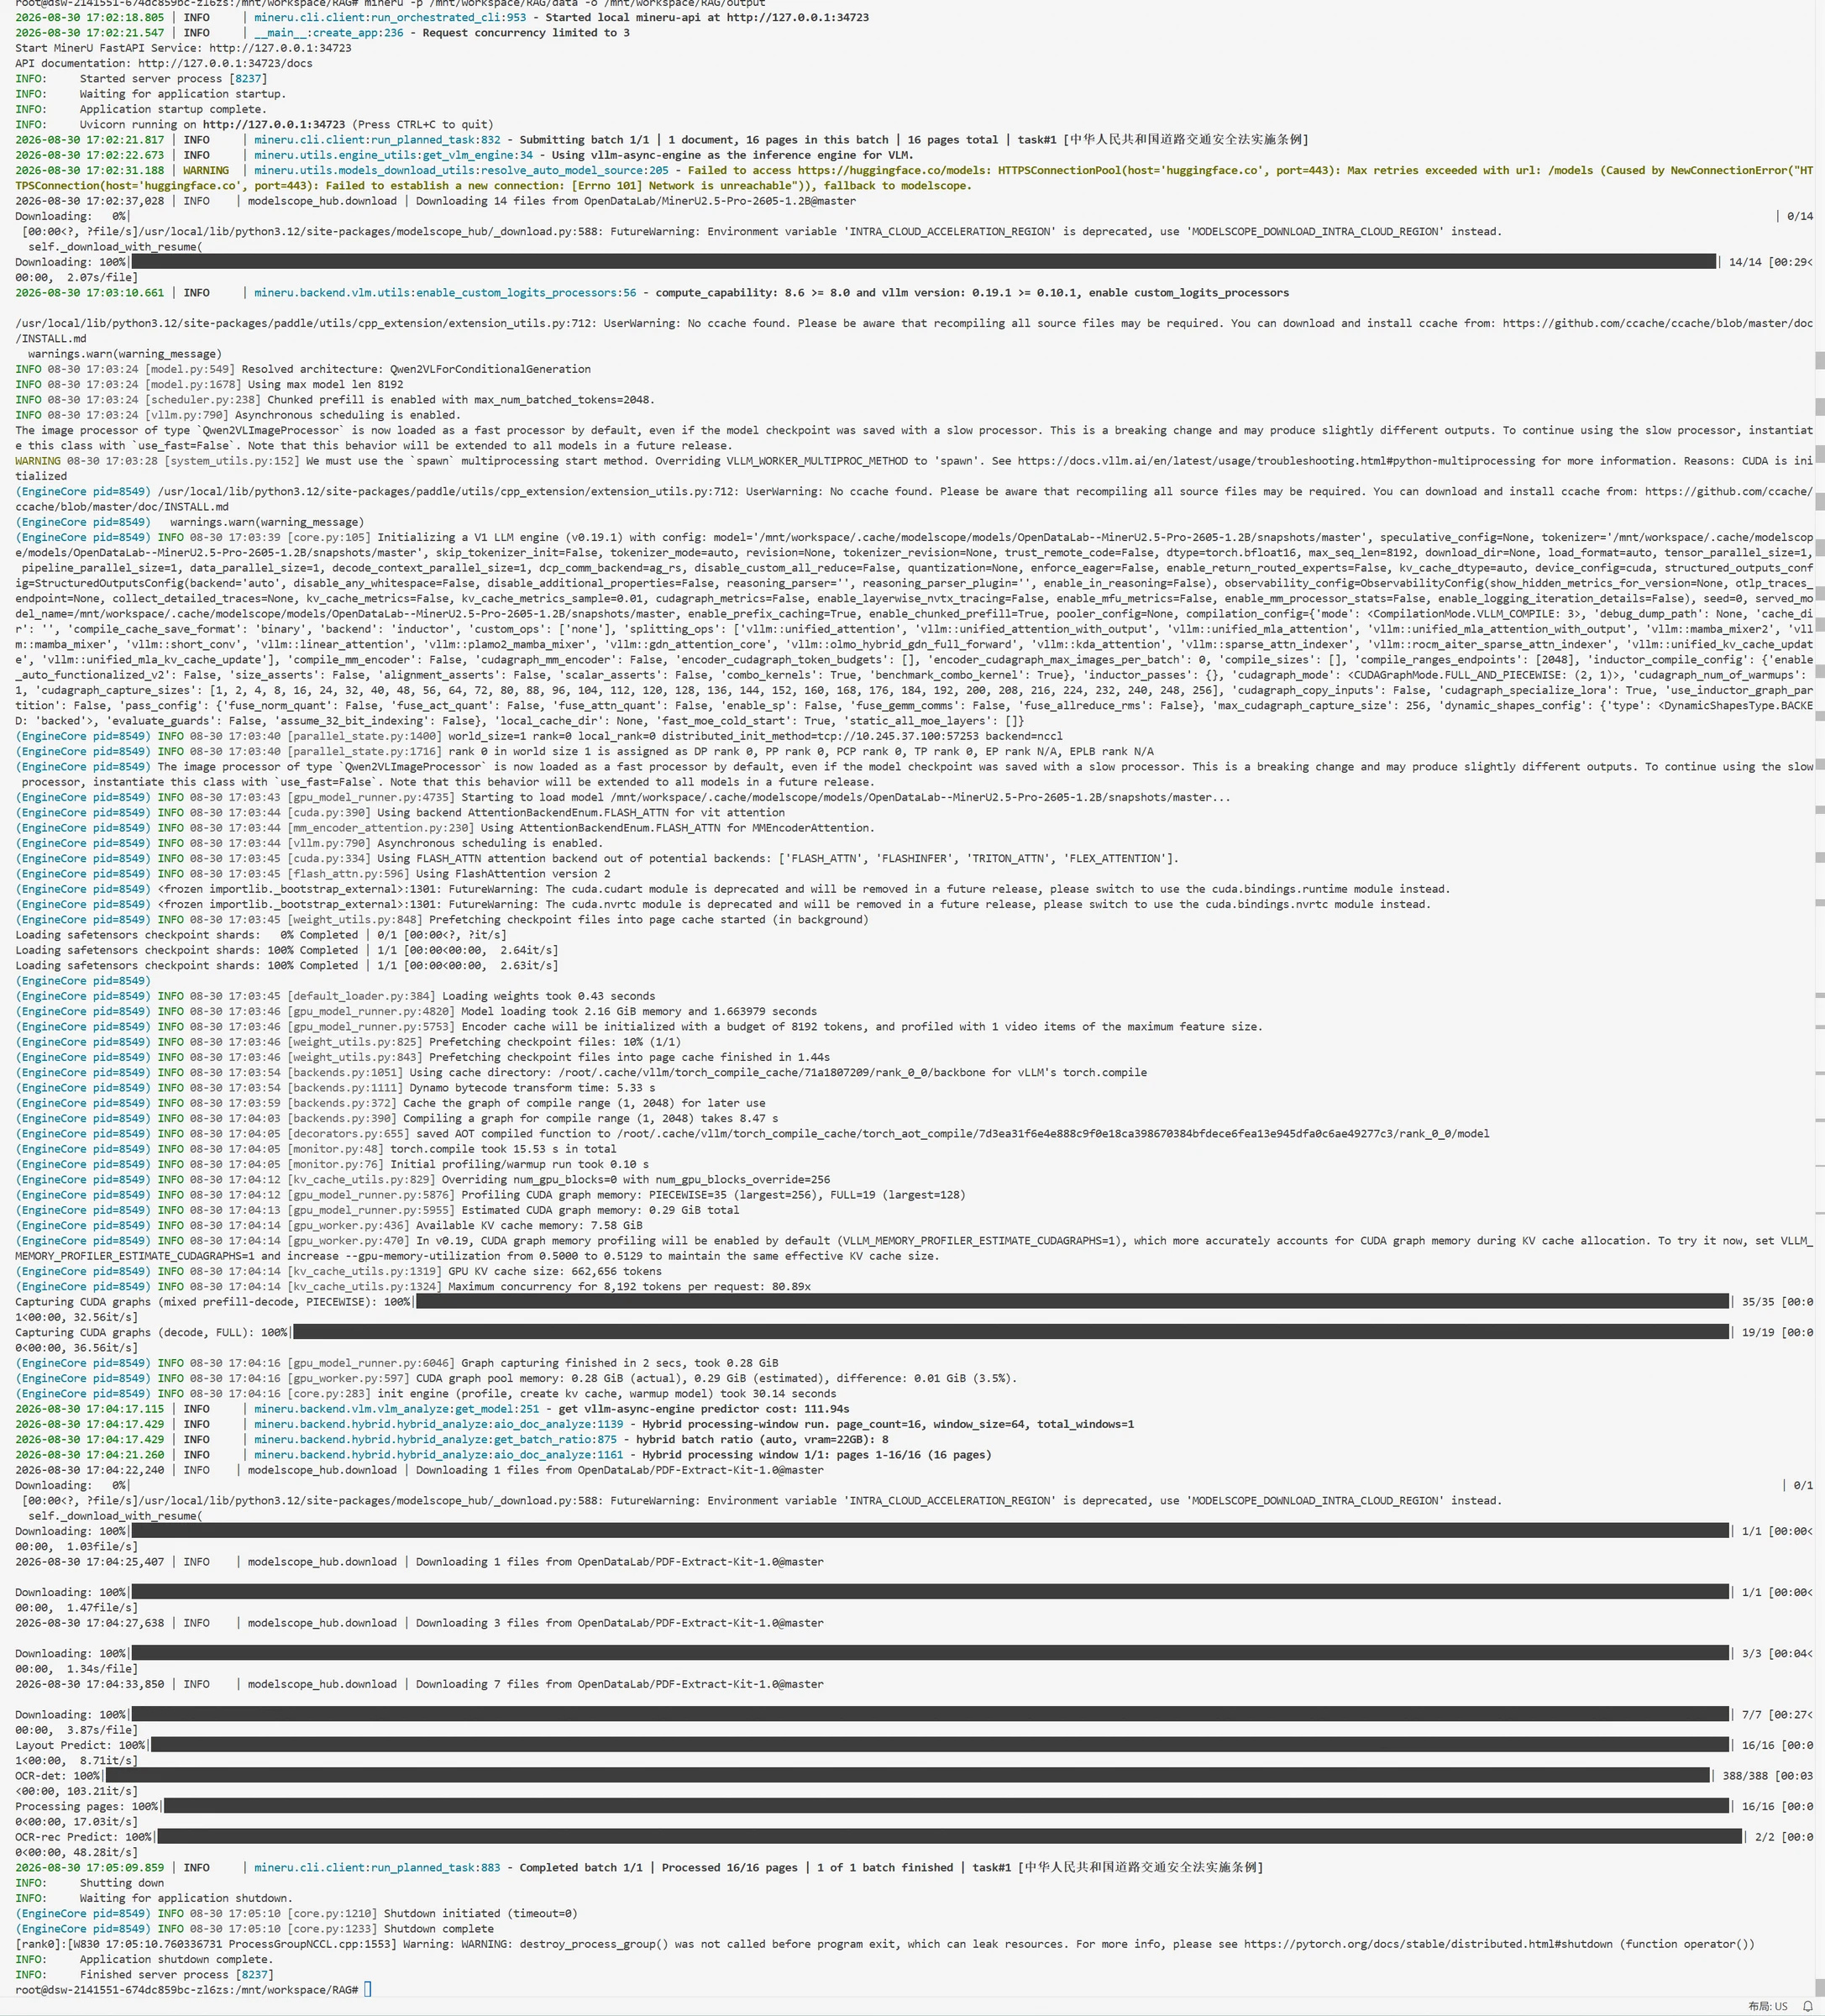
インストール完了後、ドキュメントを直接解析できます。解析したいファイルパスを入力し、次のコマンドを実行します:
mineru -p /mnt/workspace/RAG/data -o /mnt/workspace/RAG/output
ここで -p は入力ファイルのパス、-o はモデルが出力するファイルのパス、つまり解析後のテキストです。
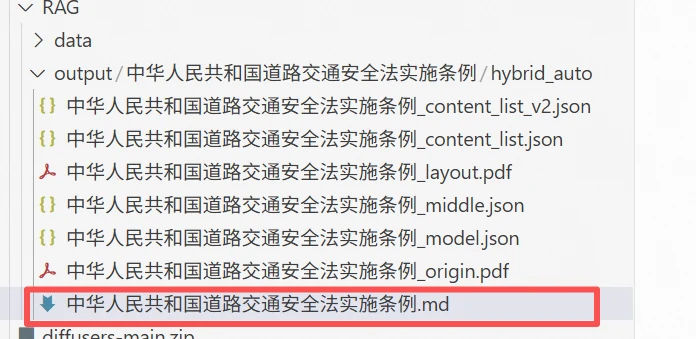
解析後のファイルは以下のとおりで、多くの中間ファイルが含まれます。必要に応じて選択できます。今回の実験ではmdファイルをドキュメントソースとして選びました。テキストの段落形式情報が含まれています。
ドキュメント解析が完了したら、長いドキュメントを複数のより小さいテキスト片に分割する必要があります。これらのテキスト片は通常Chunkと呼ばれます。RAGシステムでは、Embeddingと検索は通常Chunkを基本単位とするため、ドキュメントの適切な分割は後続の検索精度の向上に役立ちます。
解析済みのMarkdownドキュメントについては、まず空行で内容を段落に分割し、次に設定した chunk_size に従って隣接する段落を順に結合します。内容が指定長を超えた場合、新しいChunkを生成します。
分割位置によって文脈情報が失われないよう、chunk_overlap を設定して、隣接するChunk間にわずかな重複内容を残すこともできます。例えば:chunk_size = 500、chunk_overlap = 50 は、各Chunkを約500文字に抑え、隣接するChunk間に約50文字の重複内容を残すことを意味します。分割完了後、各Chunkに id、content、file などの情報を保存しておくと、後続のベクトル化、検索、回答の出典特定が容易になります。
以下はChunkを分割するコードです
import os
import json
def load_markdown(file_path):
    with open(file_path, "r", encoding="utf-8") as f:
        return f.read()

def split_markdown(text, chunk_size=500, chunk_overlap=50):
    """
    Markdownテキストを複数のChunkに分割する
    chunk_size:各Chunkに概ね含まれる文字数
    chunk_overlap:隣接するChunk間に残す重複文字数
    """
    paragraphs = text.split("\n\n")

    chunks = []
    current_chunk = ""

    for paragraph in paragraphs:
        paragraph = paragraph.strip()
        if not paragraph:
            continue
        if len(current_chunk) + len(paragraph) <= chunk_size:
            if current_chunk:
                current_chunk += "\n\n" + paragraph
            else:
                current_chunk = paragraph

        else:

            if current_chunk:
                chunks.append(current_chunk)
            overlap_text = current_chunk[-chunk_overlap:] if current_chunk else ""

            current_chunk = overlap_text + "\n\n" + paragraph
    if current_chunk:
        chunks.append(current_chunk)

    return chunks

def save_chunks(chunks, source_file, output_file):
    """
    ChunkをJSONLファイルとして保存する
    """
    file_name = os.path.basename(source_file)

    with open(output_file, "w", encoding="utf-8") as f:
        for i, chunk in enumerate(chunks):
            data = {"id": i,"content": chunk,"file": file_name
            }

            f.write(
                json.dumps(data, ensure_ascii=False) + "\n"
            )

if __name__ == "__main__":

    file_path = "./output/中華人民共和国道路交通安全法実施条例/hybrid_auto/中華人民共和国道路交通安全法実施条例.md"

    text = load_markdown(file_path)
    chunks = split_markdown(
        text,
        chunk_size=500,
        chunk_overlap=50
    )
    print("Chunkの数:", len(chunks)
    save_chunks(
        chunks,
        source_file=file_path,
        output_file="output/chunks.jsonl"
    )
実行後、先ほど解析したmdファイルから、合計39個のChunkに分割されたことが確認できます。

ドキュメントの分割が完了したら、さらに検索可能なドキュメントライブラリを構築する必要があります。コンピュータは自然言語の意味に基づいて直接検索できないため、Embeddingモデルを使用して各Chunkをベクトル表現に変換する必要があります。Embeddingモデルはテキストを高次元ベクトル空間に写像でき、意味が近いテキストほどベクトル間の距離が近くなります。したがって、ユーザーが質問した後に、質問も同样でなくベクトルに変換し、ドキュメントライブラリのChunkベクトルと比較することで、質問の意味と最も関連する内容を検索できます。
現在、オープンソースコミュニティではBGE-M3やQwen3-Embeddingなど、さまざまなEmbeddingモデルが提供されています。BGE-M3はBAAIが発表した多言語Embeddingモデルで、100以上の言語と最長8192トークンのテキスト入力に対応します。一般的なDense Embeddingモデルと比べ、BGE-M3は高密度検索、疎検索、Multi-Vector検索を同時にサポートするため、一般的なベクトル意味検索だけでなく、ハイブリッド検索などのシナリオにも使えます。FlagEmbedding。
Qwen3-EmbeddingはQwenチームが発表したテキストベクトルモデルシリーズで、Qwen3アーキテクチャに基づいて構築され、主にテキスト検索、テキストクラスタリング、テキスト分類、コード検索などのタスクを対象としています。Qwen3-Embeddingは0.6B、4B、8Bなど異なるパラメータ規模を提供し、モデルの効果と計算資源に応じて選択できます。また、優れた多言語・長文処理能力も持っています。Qwen3-Embedding。
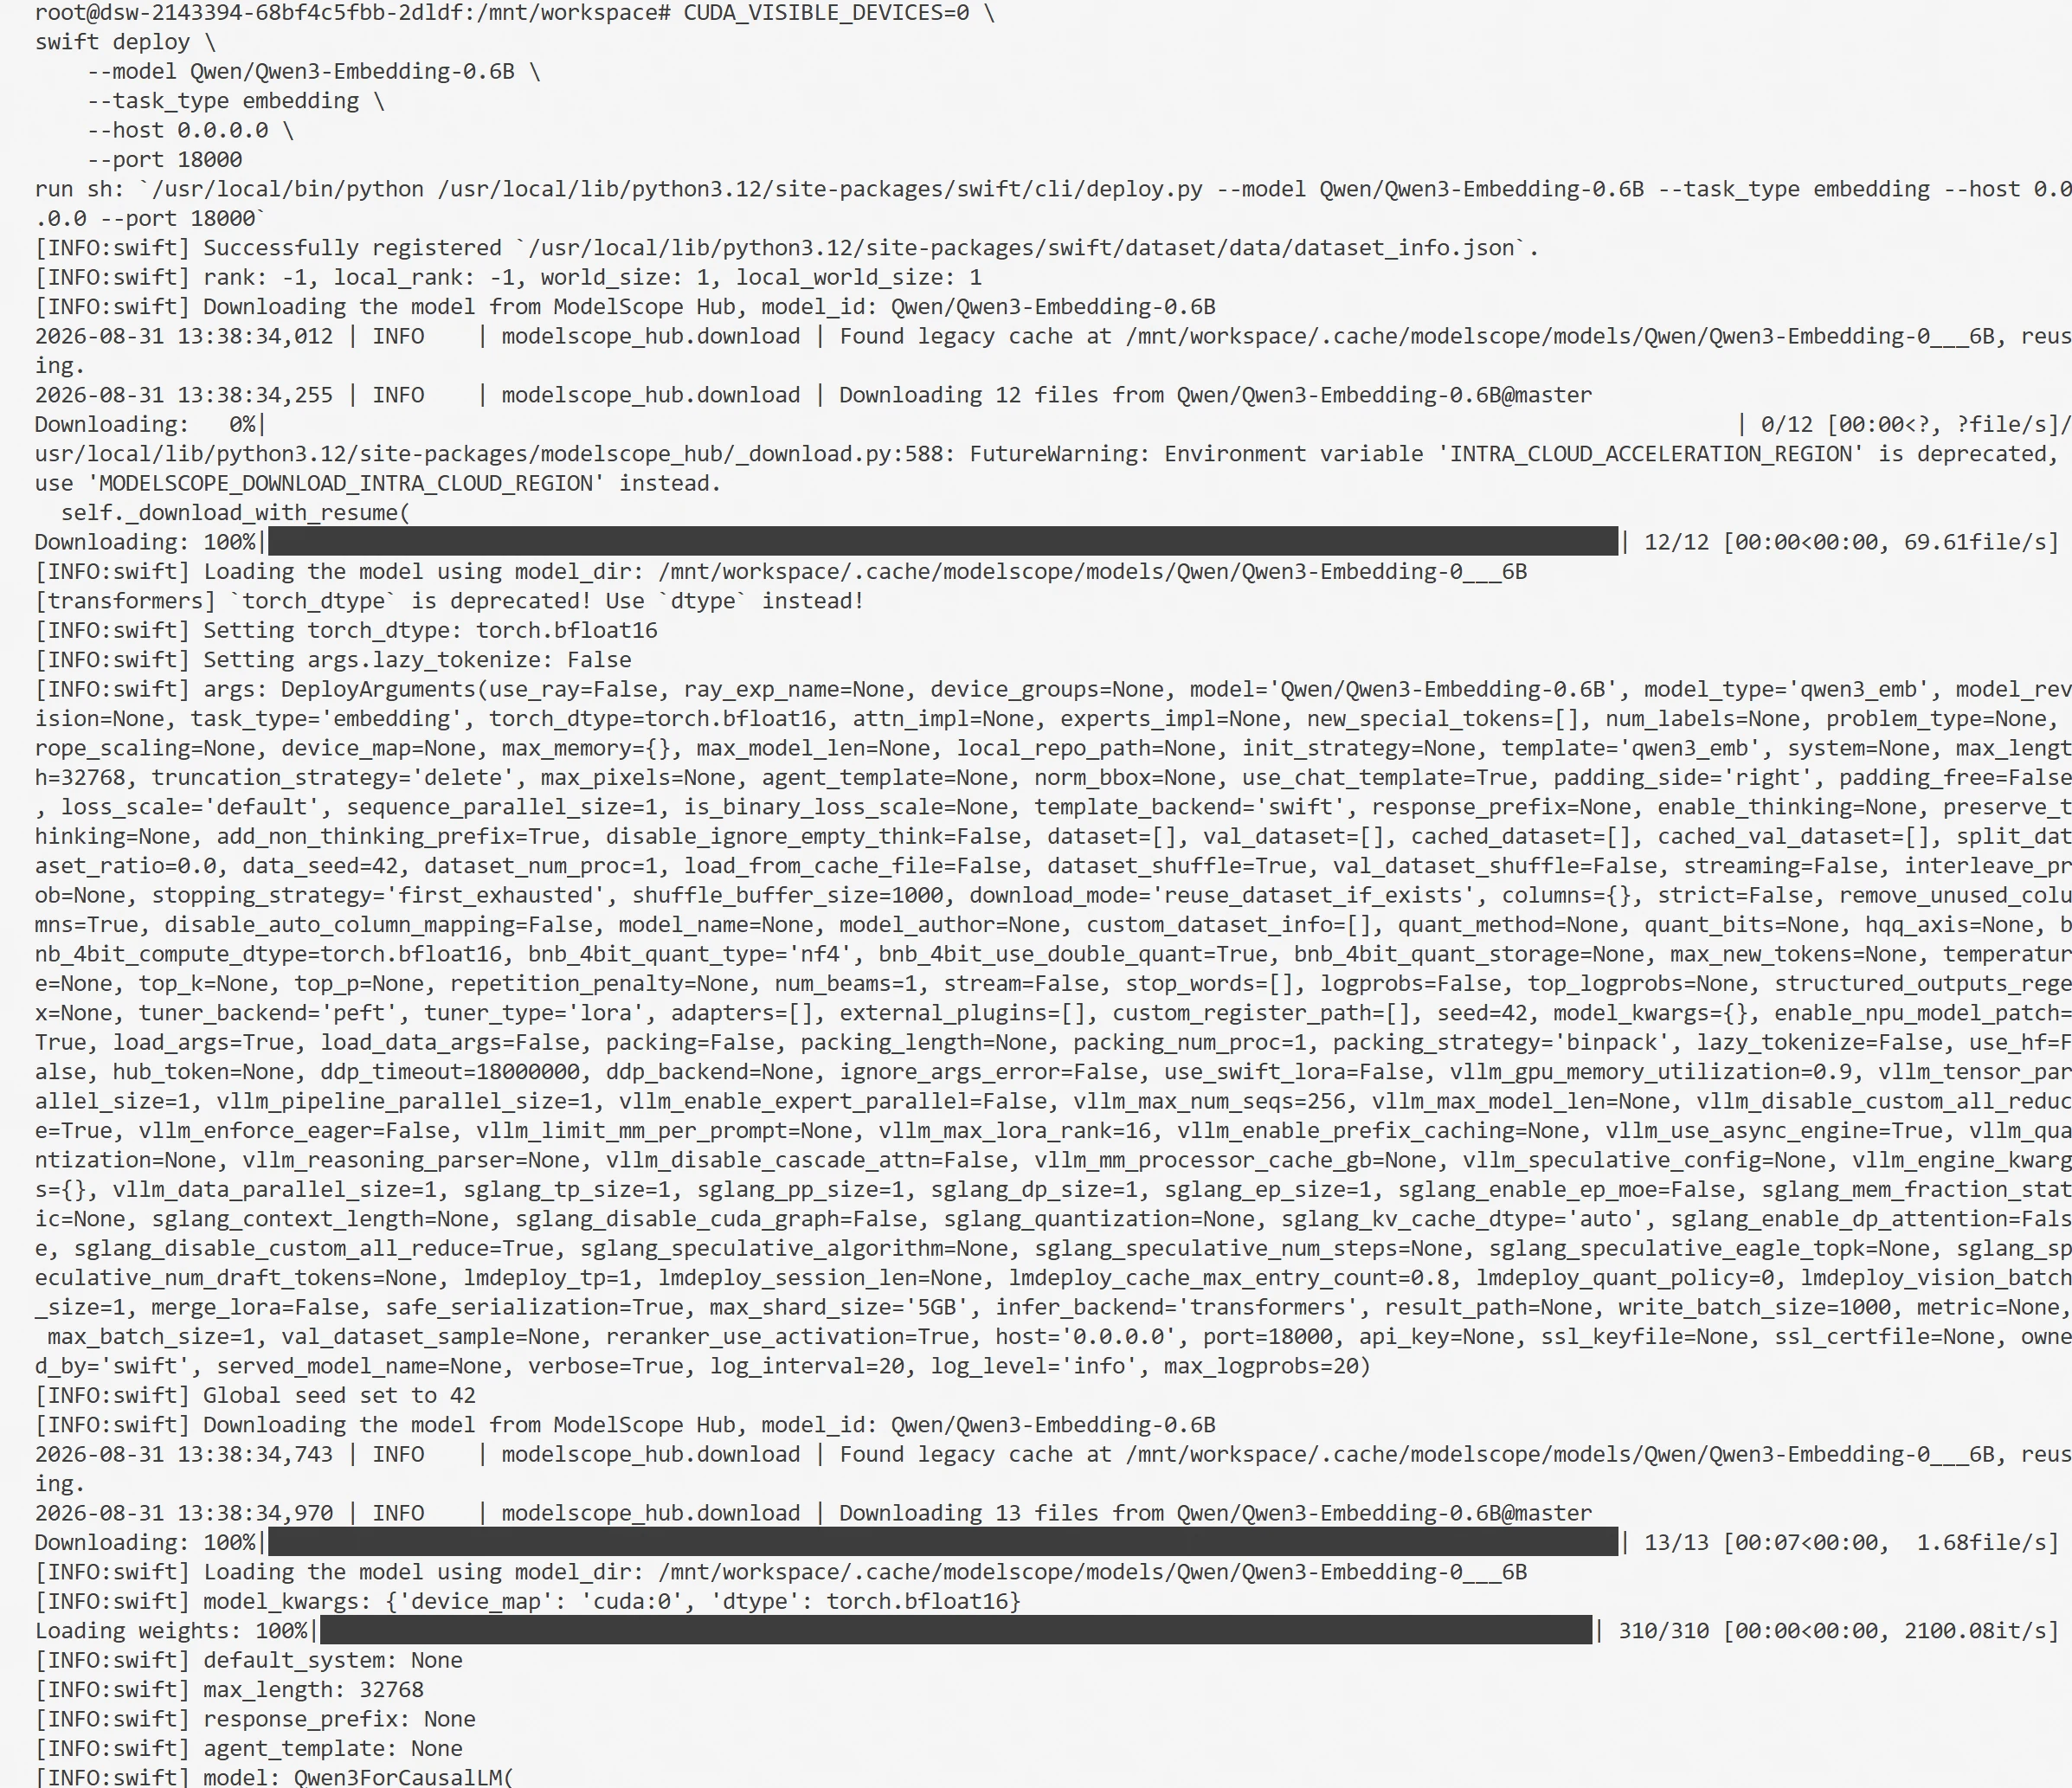
本節ではEmbeddingモデルとしてQwen3-Embedding-0.6Bを使用して実験します。第9章でms-swiftを紹介済みですが、大規模言語モデルの学習・ファインチューニングに加えて、ms-swiftはQwen3-Embeddingシリーズの学習・推論もサポートしています。そのため、本節でもms-swiftを使ってQwen3-Embedding-0.6Bを起動し、インターフェース経由でドキュメントChunkとユーザーの質問のベクトル化を行います。
次のコマンドでEmbeddingサービスを起動できます:
CUDA_VISIBLE_DEVICES=0 \
swift deploy \
    --model Qwen/Qwen3-Embedding-0.6B \
    --task_type embedding \
    --vllm_gpu_memory_utilization 0.2 \
    --vllm_max_model_len 512 \
    --host 0.0.0.0 \
    --port 18000
サービス起動後、以下のような情報が表示されます:
現在よく使われるベクトル検索ツールにはFaissとMilvusがあります。FaissはMetaがオープンソース公開したベクトル類似度検索ライブラリで、主に効率的なベクトルインデックス構築と近傍探索に使われます。デプロイが簡単で、データベースサービスを単体で起動する必要はなく、Pythonプログラムから直接使えるため、学習、実験、中小規模のRAGシステムに適しています。Milvusは大規模ベクトルデータ向けのベクトルデータベースで、ベクトル検索に加え、データ永続化、分散ストレージ、インデックス管理、さまざまなクエリ機能も提供し、データ規模が大きく、長期稼働とエンジニアリング的なデプロイが必要なシナリオに更适合します。Faissと比べてMilvusは機能がより完全ですが、デプロイと利用のプロセスも相対的に複雑です。
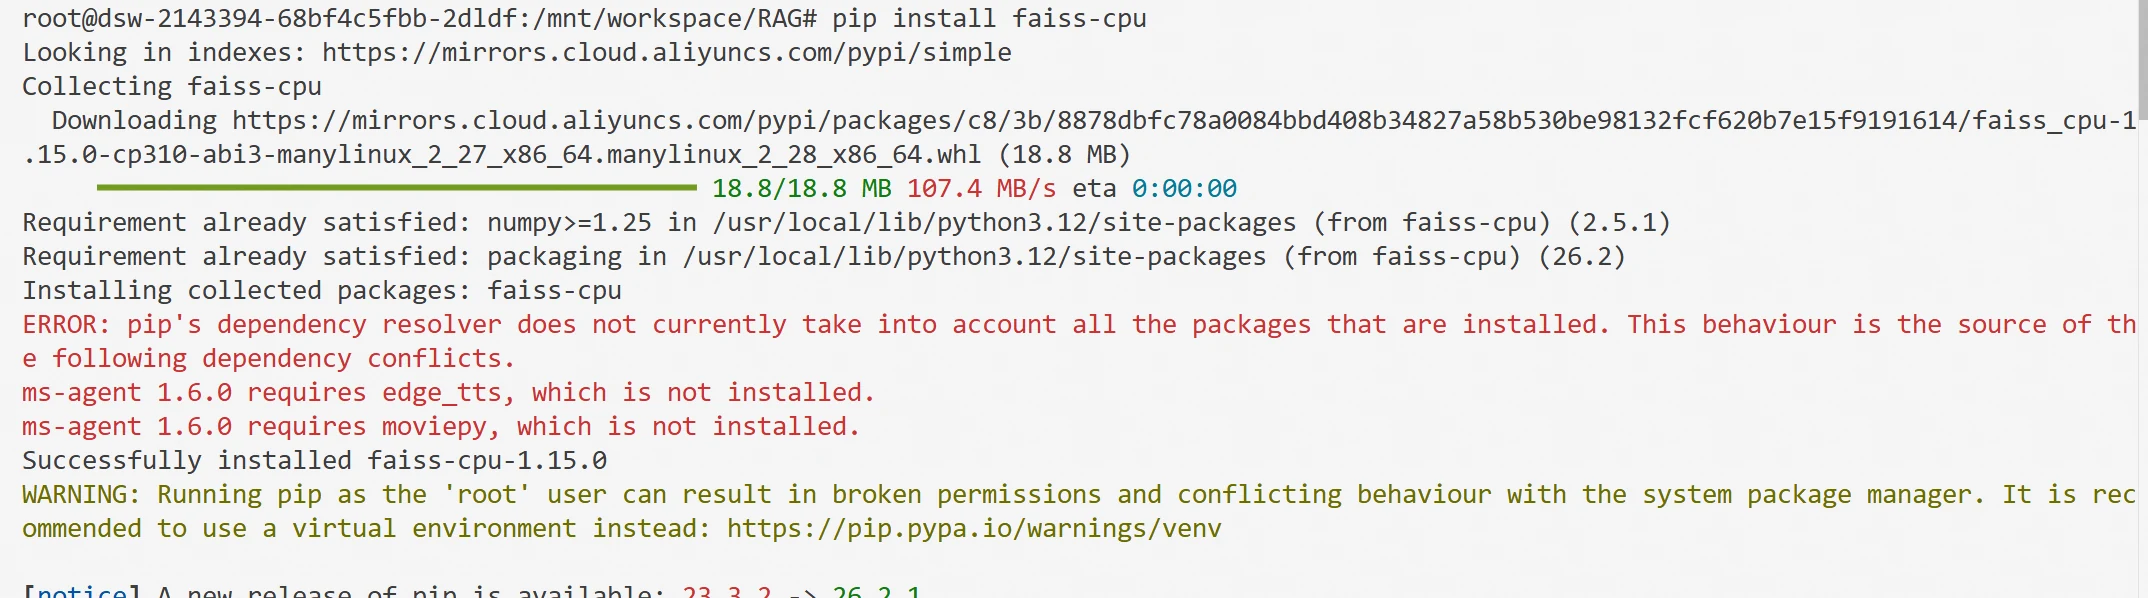
今回の実験ではFaissでベクトル保存と類似度検索を行います。まずfaissライブラリをインストールし、次のコマンドを実行します:
pip install faiss-cpu
インストール完了後、前節で生成したChunkをEmbeddingインターフェースに順次送り、対応するベクトルを取得し、ベクトルとChunkの id、content、file などの情報を対応付けます。後続で類似度計算と知識検索を迅速に完了できるようにするためです。
インデックス作成コードbuild_index.pyは以下のとおりです:
import json
import requests
import numpy as np
import faiss

EMBEDDING_URL = "http://localhost:18000/v1/embeddings"
MODEL_NAME = "Qwen3-Embedding-0.6B"

def get_embedding(text):
    payload = {"model": MODEL_NAME,"input": text}
    response = requests.post(
        EMBEDDING_URL,
        json=payload,
        timeout=60
    )
    response.raise_for_status()
    data = response.json()
    embedding = data["data"][0]["embedding"]
    return np.array(embedding, dtype="float32")

def load_chunks(file_path):
    chunks = []
    with open(file_path, "r", encoding="utf-8") as f:
        for line in f:
            chunks.append(json.loads(line)
    return chunks
def build_faiss_index(chunks,index_path="faiss.index", metadata_path="metadata.json"):

    embeddings = []
    for i, chunk in enumerate(chunks):
        text = chunk["content"]
        embedding = get_embedding(text)
        embeddings.append(embedding)
        print(f"処理済み {i + 1}/{len(chunks)}")
    embeddings = np.array(embeddings, dtype="float32")
    faiss.normalize_L2(embeddings)
    dimension = embeddings.shape[1]
    index = faiss.IndexFlatIP(dimension)
    index.add(embeddings)
    print("ベクトル数:", index.ntotal)
    print("ベクトル次元:", dimension)
    faiss.write_index(index, index_path)
    with open(metadata_path, "w", encoding="utf-8") as f:
        json.dump(chunks,f,ensure_ascii=False,indent=2
        )
    print(f"Faissインデックスを保存しました: {index_path}")
    print(f"Chunk情報を保存しました: {metadata_path}")

if __name__ == "__main__":

    chunks = load_chunks("output/chunks.jsonl")

    build_faiss_index(
        chunks,
        index_path="output/faiss.index",
        metadata_path="output/metadata.json"
    )
実行後、対応するインデックスファイルとベクトルが出力されます
Embeddingモデルはユーザーの質問とドキュメントChunkをそれぞれベクトルに変換し、ベクトル間の距離や類似度で検索できます。この方式の利点は、ドキュメントベクトルを事前に計算・保存でき、ユーザーが質問した際は質問ベクトルを一度計算するだけで、大量のドキュメントから関連内容を迅速にリコールできることです。ただし、この効率的な検索方式にも限界があります。EmbeddingモデルはQueryとChunkをそれぞれエンコードし、関連性を計算する際に、2つのベクトルのベクトル空間における類似度を比較します。一方、Rerankerモデルはインタラクティブなマッチングです。Queryと候補Chunkを同時にモデルに入力し、モデルが2つのテキスト間の関連関係を直接分析するため、よりきめ細やかな意味マッチングができます。
したがって、RAGシステムでは通常、Embeddingリコール + Rerankerリランキングの2段階検索方式を採用します。まずEmbeddingで大量のChunkから一連の候補結果を迅速に絞り込み、次にRerankerで少数の候補結果に対してより精緻な関連性判定と並べ替えを行います。これにより検索効率を保ちつつ、最終的に大規模言語モデルへ提供されるコンテキストの品質をさらに高められます。
本節ではリランキングモデルとしてQwen3-Reranker-0.6Bを使用し、ms-swiftでサービスを起動できます:
CUDA_VISIBLE_DEVICES=0 \
swift deploy \
    --model Qwen/Qwen3-Reranker-0.6B \
    --task_type generative_reranker \
    --infer_backend transformers \
    --host 0.0.0.0 \
    --port 18001
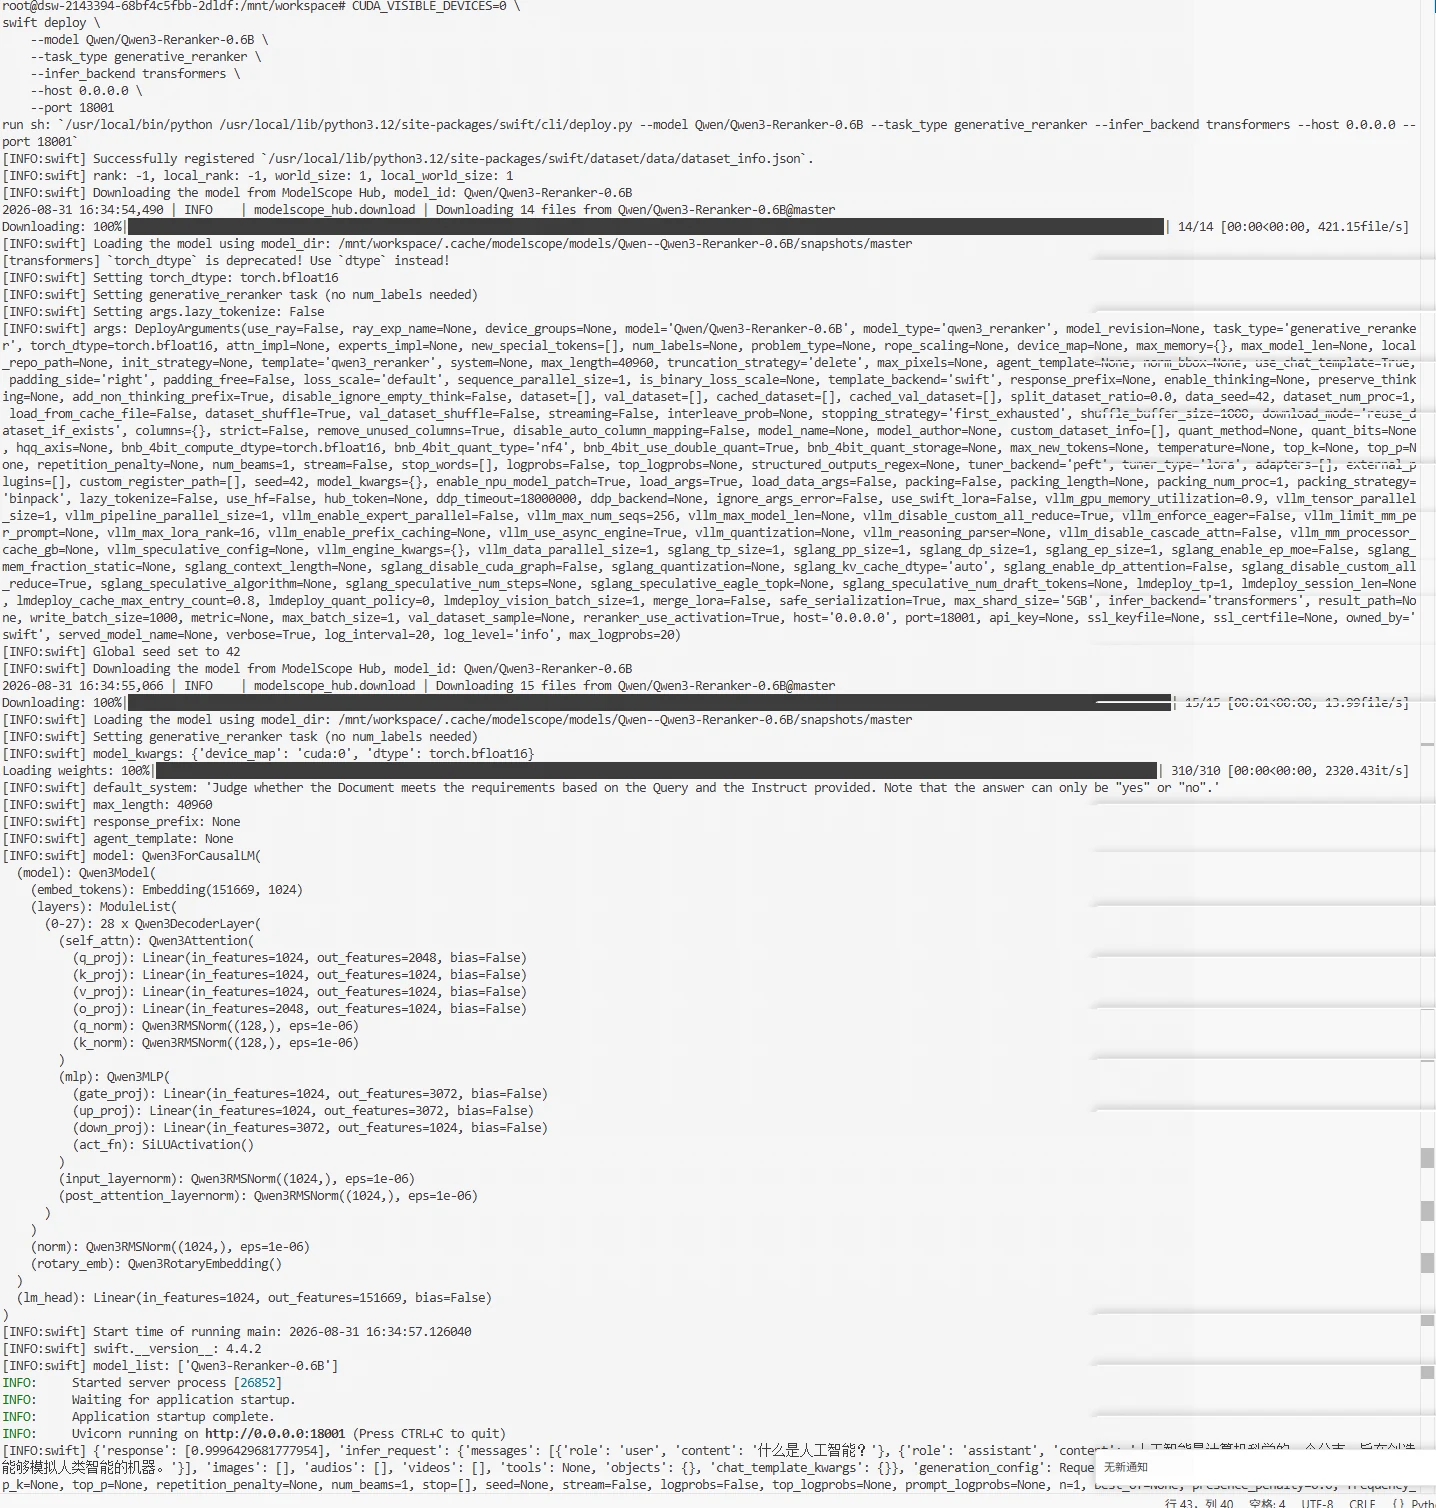
サービス起動後、ユーザーの質問とEmbedding検索で得られた候補ChunkをRerankerに入力し、モデルが計算した関連性スコアに基づいて並べ替え、上位のChunkを選んで、後続の大規模言語モデルが回答を生成する際の参考内容とします。
前面ではEmbeddingサービス、Rerankerサービス、Faissベクトルインデックスの構築を完了しました。これに基づき、前述のEmbeddingリコール + Rerankerリランキングの2段階検索方式で候補Chunkを絞り込みます。
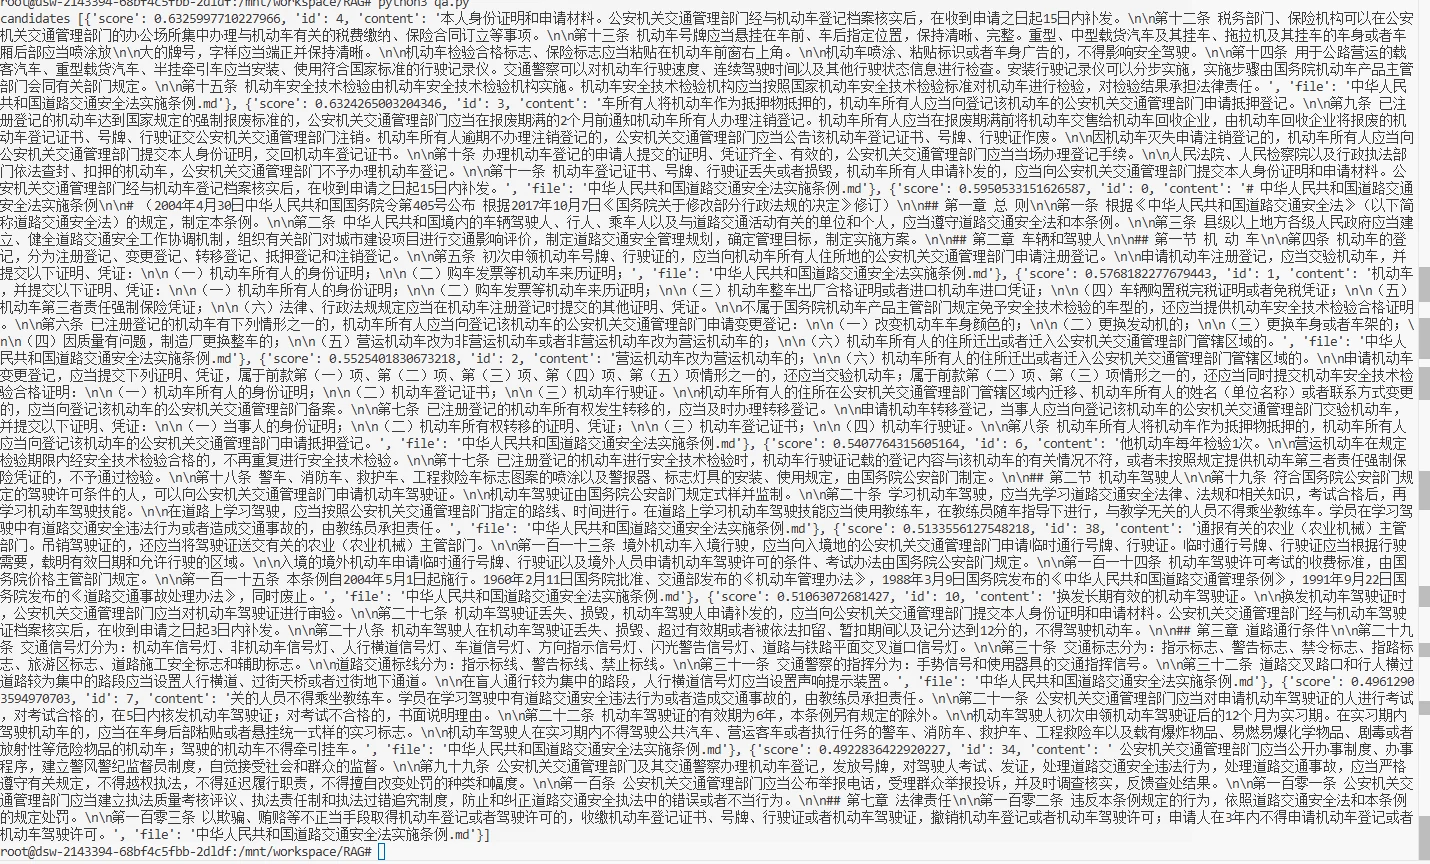
第1段階ではFaissでナレッジベースからベクトル検索を行い、類似度上位10件の候補Chunkを取得します。以下は質問「自動車のナンバープレートと運転免許証の初回申請は、どの部門に登録申請すべきか?」に対するベクトル検索top10の結果です。
import json
import faiss
from build_index import get_embedding
def load_faiss_index(index_path="faiss.index",
                     metadata_path="metadata.json"):

    index = faiss.read_index(index_path)

    with open(metadata_path, "r", encoding="utf-8") as f:
        metadata = json.load(f)

    return index, metadata
def search(query,index,metadata,top_k=10):

    query_embedding = get_embedding(query)
    query_embedding = query_embedding.reshape(1, -1)
    faiss.normalize_L2(query_embedding)
    scores, indices = index.search(query_embedding,top_k)
    results = []
    for score, idx in zip(scores[0], indices[0]):
        if idx == -1:
            continue
        chunk = metadata[idx]
        results.append({
            "score": float(score),
            "id": chunk.get("id"),
            "content": chunk.get("content"),
            "file": chunk.get("file")
        })

    return results
index, metadata = load_faiss_index(
        "output/faiss.index",
        "output/metadata.json"
    )
query="自動車のナンバープレートと運転免許証の初回申請は、どの部門に登録申請すべきか?"
candidates = search(
    query=query,
    index=index,
    metadata=metadata,
    top_k=10
)

print("candidates",candidates)
第2段階ではRerankerで候補結果を並べ替えます。ユーザーの質問とリコールされた候補ChunkをRerankerに送り、両者の関連性スコアを再計算し、スコアの高い順に並べ替えます。
def rerank(query, candidates):
    results = []
    for candidate in candidates:
        response = rerank_client.chat.completions.create(
            model="Qwen3-Reranker-0.6B",
            messages=[
                {
                    "role": "user",
                    "content": query
                },
                {
                    "role": "assistant",
                    "content": candidate["content"]
                }
            ]
        )

        score = response.choices[0].message.content[0]
        item = candidate.copy()
        item["rerank_score"] = float(score)
        results.append(item)
    results.sort(
        key=lambda x: x["rerank_score"],
        reverse=True
    )
    for rank, item in enumerate(results, start=1):
        item["rerank_rank"] = rank

    return results
以下は質問「自動車のナンバープレートと運転免許証の初回申請は、どの部門に登録申請すべきか?」に、Rerankerモデルで並べ替えた後の結果です:
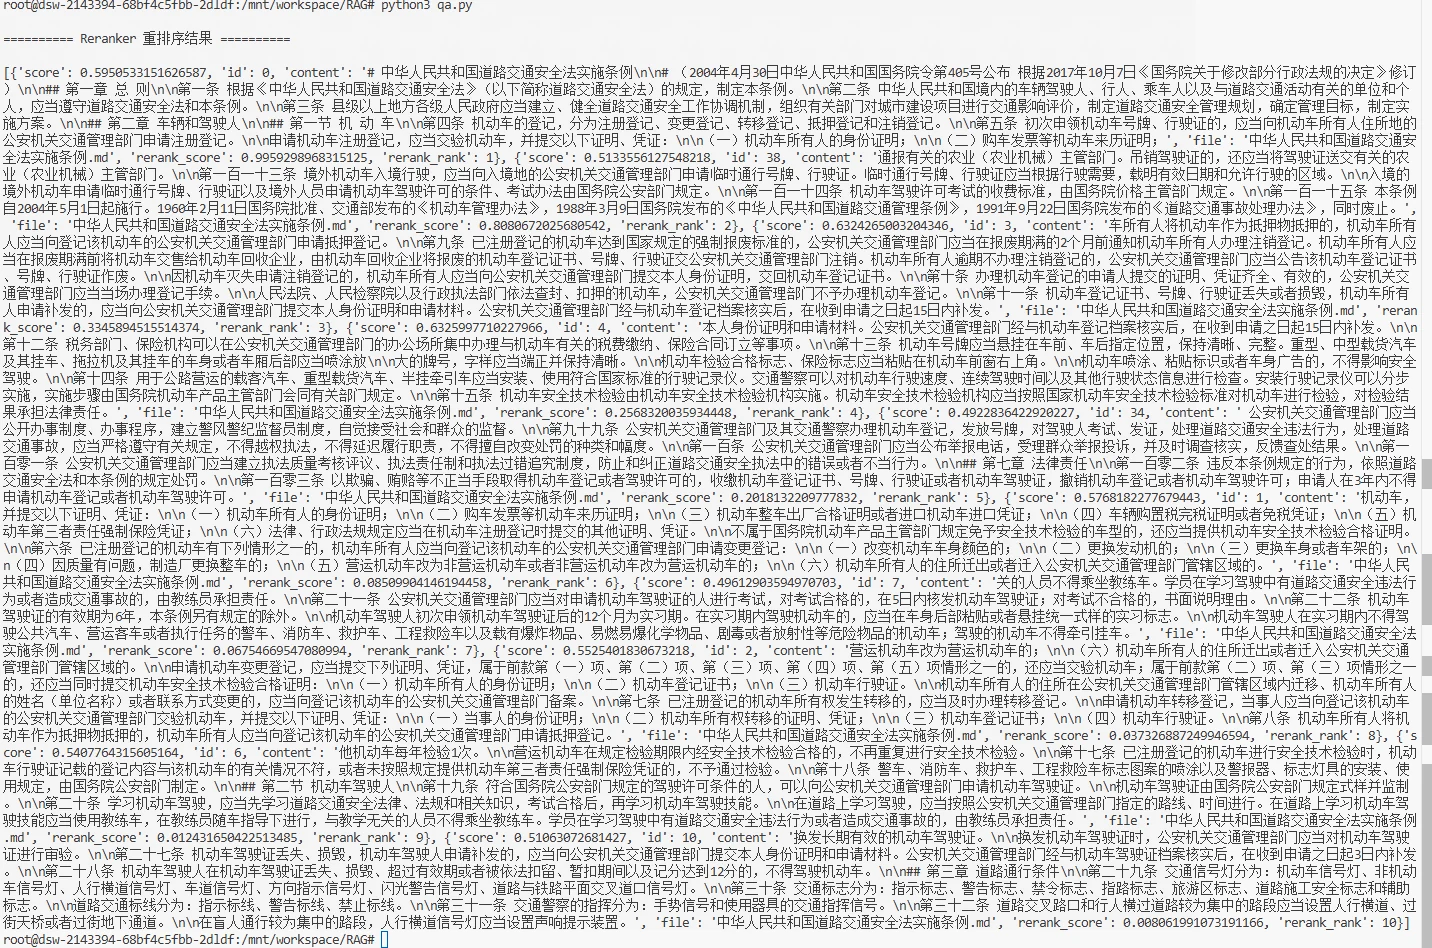
上の2つの結果からわかるように、リランキング後のChunkの順序は明確に変化しました。実際のアプリケーション・実プロジェクトでは、ナレッジベースの規模、Chunkの長さ、質問の複長さ、質問の複雑さ、実際の検索効果に応じて調整できます。例えば、回答が複数のドキュメント片に分散している質問では、最終的に保持するChunk数を適度に増やすこともできます。Rerankerのスコアに関連性閾値を設定して、関連性の低い内容をさらにフィルタリングすることもできます。上記の方法以外、実際のRAGシステムではハイブリッド検索(Hybrid Search)を採用し、ベクトル検索とBM25などのキーワード検索を組み合わせ、複数経路のリコール結果を融合してからリランキングすることもできます。
検索とリランキングが完了すると、ユーザーの質問と高い関連性を持つ複数のChunkが得られます。次にこれらの内容を参考資料として、ユーザーの質問と一緒にLLMへ送ります。関連性が要件を満たす場合は、検索内容を大規模言語モデルに送って回答を生成させます。ナレッジベースに十分に関連する内容が見つからない場合は、拒否回答を直接返し、モデルが根拠のない状態で回答を生成することを防ぎます。
まずNotebookで大規模言語モデルサービスを起動します。今回の実験ではQwen3-4Bモデルを使用し、起動方法は以下のとおりです:
CUDA_VISIBLE_DEVICES=0 swift deploy \
  --model Qwen/Qwen3-4B \
  --load_args false \
  --infer_backend vllm \
  --enable_thinking false \
  --host 0.0.0.0 \
  --port 18002 \
  --api_key 123 \
  --vllm_gpu_memory_utilization 0.8 \
  --vllm_max_model_len 8000 \
  --max_new_tokens 2000
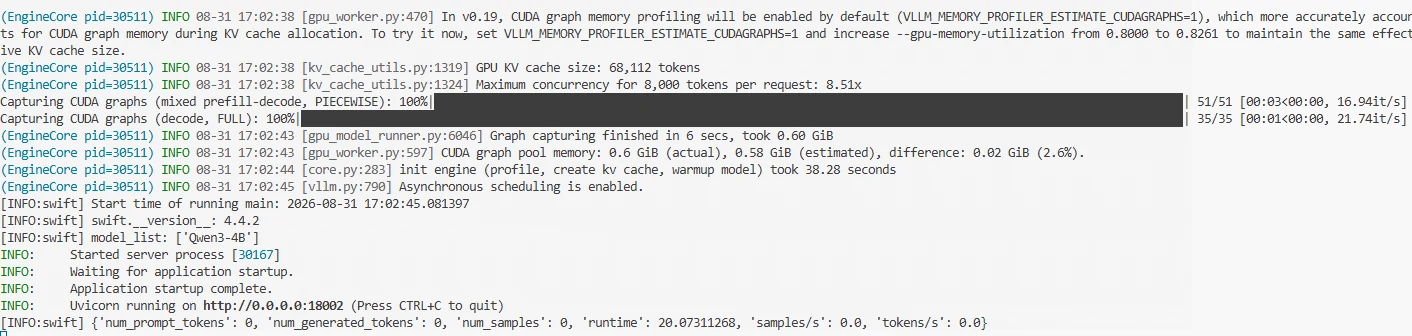
起動後、以下のように表示されればモデルの起動成功を意味します。サービス起動後は、18002ポート経由でQwen3-4Bを呼び出せます。
Rerankerはユーザーの質問と候補Chunkの関連度に応じて並べ替えを調整します。本実験では、上位5件のChunkをそのままLLMの参考資料として選択します。モデルができるだけナレッジベースの内容に基づいて回答するよう、Promptで回答範囲を明確に限定できます。また、提供した参考資料でユーザーの質問に答えられない場合は、モデル自身の知識で回答を補うのではなく、直接拒否回答するよう要求します。promptは以下のとおりです:
prompt = f"""
以下の参考資料に基づいてユーザーの質問に答えてください。

参考資料:
{context}

ユーザーの質問:
{query}

要件:
1. 参考資料のみに基づいて質問に答えること;
2. 回答は正確かつ簡潔にすること;
3. 参考資料に存在しない情報を補わないこと;
4. 参考資料ではこの質問に答えられない場合は、次のように回答すること:
   「現在のナレッジベースでは、当該質問には回答できません。」
"""
大規模言語モデルが回答を生成した後、ユーザーに最終回答を返すだけでなく、今回の回答が参照したドキュメントの出典も同時に返せます。企業知識Q&Aのシナリオでは、出典情報によってユーザーは回答がどのナレッジベースドキュメントから来たのかを知ることができ、进一步確認が必要な場合は元のドキュメントに戻って関連内容を確認できます。出典情報は大規模言語モデルに生成させる必要はなく、検索結果のメタデータから直接取得します。前面でナレッジベースを構築した際、各Chunkには対応する file フィールドが保持されているため、Reranker上位5件のChunkからファイル名を抽出し、重複するファイルを除去できます。
以下は大規模言語モデルを呼び出してQ&Aを実現するコアコードです:
llm_client = OpenAI(
    api_key="123",
    base_url="http://127.0.0.1:18002/v1"
)
LLM_MODEL = "Qwen3-4B"

def generate_answer(query, top_chunks):

    context = "\n\n".join(
        [
            f"[参考資料{i + 1}]\n{item['content']}"
            for i, item in enumerate(top_chunks)
        ]
    )
    prompt = f"""
以下の参考資料に基づいてユーザーの質問に答えてください。

参考資料:
{context}

ユーザーの質問:
{query}

要件:
1. 参考資料の内容のみに基づいて質問に答えること;
2. 回答は正確かつ簡潔にし、参考資料に存在しない情報を補わないこと;
3. 参考資料に質問と関連する回答がない場合は、次のように回答すること:
   「現在のナレッジベースでは、当該質問には回答できません。」
"""
    response = llm_client.chat.completions.create(
        model=LLM_MODEL,
        messages=[{"role": "user","content": prompt }],
        temperature=0.1,
        max_tokens=512
    )

    return response.choices[0].message.content
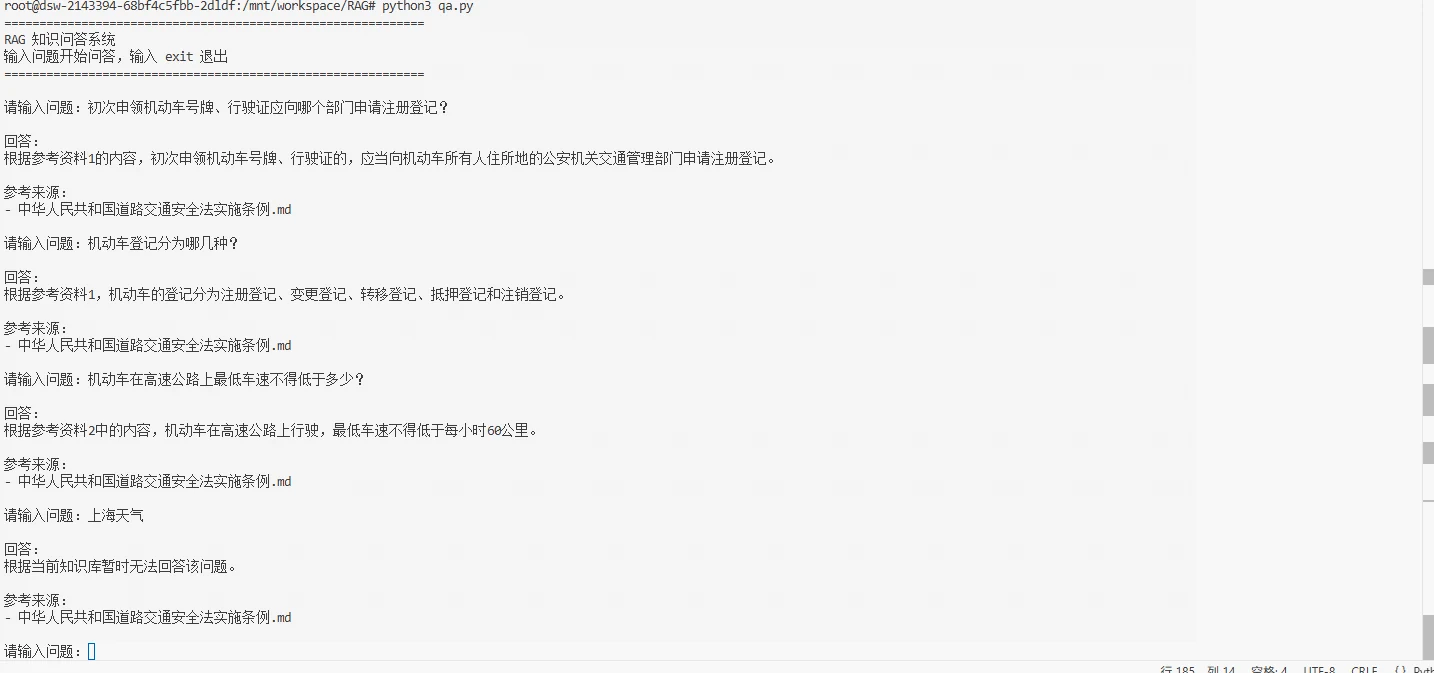
これで企業Q&Aアシスタントの構築が完了しました。次にターミナルで簡単なテストを行い、テスト結果は以下のとおりです:
RAGシステム完成后も、評価を通じて問答フロー全体が本当に有効かどうかを判断する必要があります。通常の大規模言語モデル問答と異なり、RAGの結果は知識検索と回答生成という2つの段階の影響を同時に受けます。そのため、RAGの評価も通常、この2つの側面から別々に行う必要があります。
1) 検索効果の評価
検索段階の評価基準は、ユーザーの質問に対してリコールされたChunk内で答えが見つかるかどうかで、一般的な指標はRecall@Kです。Recall@Kは比較的直感的な指標で、上位K件の検索結果がどれだけの関連文書をカバーしたかを測定します:
Recall@K:正しい文書が上位K件の検索結果に現れているか。
Recall@K =
\frac{\text{Top K 中で検索された関連文書の数}}
{\text{全関連文書の数}}
例えば、ある質問に対して正しい知識片が2つあり、Top 5の検索結果のうち2つ見つかった場合、Recall@5は100%です。
2) 生成効果の評価
関連知識を検索できても、最終回答が必ず正しいわけではなく、さらにLLMの生成結果を評価する必要があります。生成段階では、回答の正確性、完全性、関連性、引用の正確性、そしてハルシネーションに重点的に注目できます。この部分は第12章の12.3 生成タスク評価指標を参照してください。これらの指標により、モデルが検索された知識を正確に活用して回答を生成できるかを判断でき、さらに回答の欠落、内容のずれ、根拠のない生成などの問題を発見できます。実際の応用では、検索結果がすでに比較的正確であるにもかかわらず、生成効果がまだ要件を満たさない場合は、能力がより強くパラメータ規模のより大きいモデルを選択してRAGの生成モデルとし、複雑な質問の理解と回答能力を高めることを検討できます。
この章の実験データおよび実験コードは、こちらを参照してください:https://modelscope.cn/gallery/liucong/a895ace8-420c-4421-ba43-4e3194392a95