現在最も強力な画像・動画生成モデルは、おそらくGPT Images 2.5とSeedance 2.5であり、画像・動画生成の限界をさらに押し上げています。
これらをクローズドソースモデルの第一線と見なすと、オープンソースモデルは現在どのレベルにあるのでしょうか?玩具でしょうか?本当に生産力をもたらすことができるのでしょうか?
この記事では、阿里巴巴のZ-Imageを画像生成に、MiniMax H3を動画生成に使用して、オープンソースモデルでエキスパートが何を達成できるかを直接見ていきます。
Z-ImageはApache 2.0ライセンスで公開された6B画像生成モデルです。完全版のZ-Imageは非蒸留ベースモデルで、CFG、ネガティブプロンプト、ファインチューニングをサポートしています。コミュニティではより一般的にZ-Image-Turboが使用されており、わずか8ステップで速度を重視しています。
MiniMax H3は33Bの音声・動画生成モデルで、4~15秒、24fps、ステレオ音声付きのビデオを出力できます。厳密には、MiniMax H3 Community Licenseを使用するオープンウェイトモデルです。公開されたH3-Baseはローカルで768pの音声・動画を生成できますが、複雑な入力の理解を担当する公式のContext-IRモジュールと2K再生成パイプラインは完全にはオープンソース化されていません。
今日の多くの画像生成モデルは美しい顔を生成できます。1枚の修正済み顔を見るだけでは正直あまり印象に残りません。真に困難なタスクは:テキストは正しく書かれているか?数量は正確か?同じ製品が異なるビューで一貫性を保てるか?複雑な空間関係は正しく理解されているか?
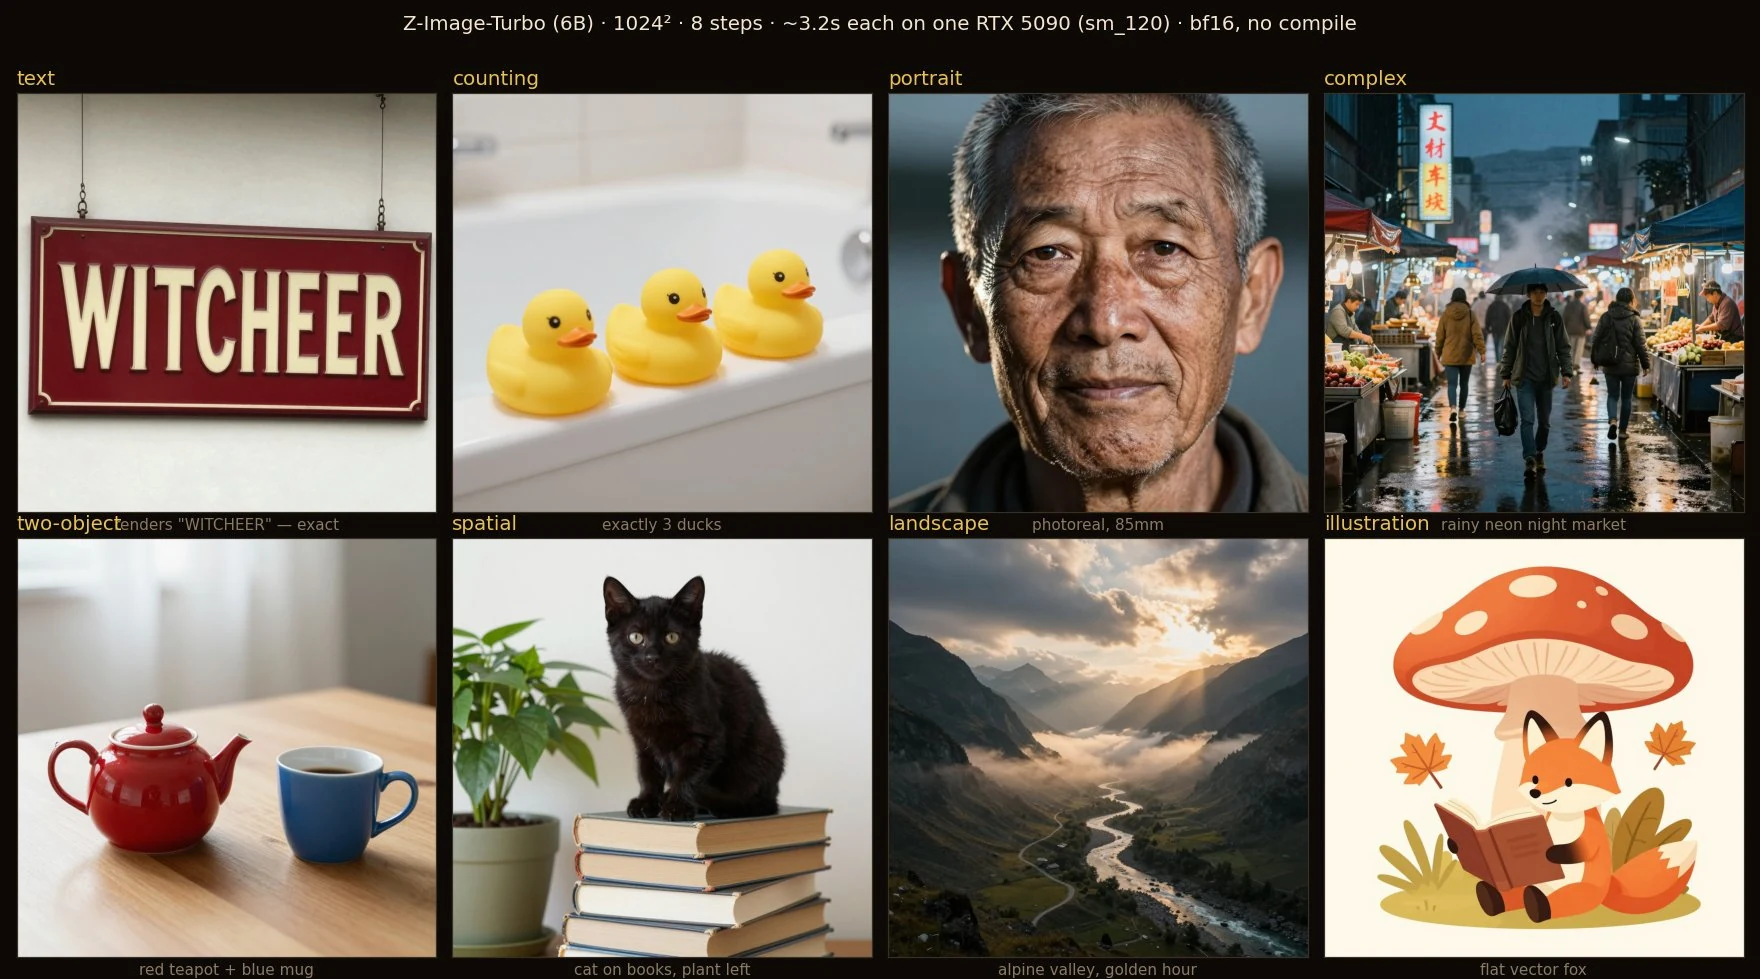
まず@witcheerのローカルテスト群を見てみましょう。
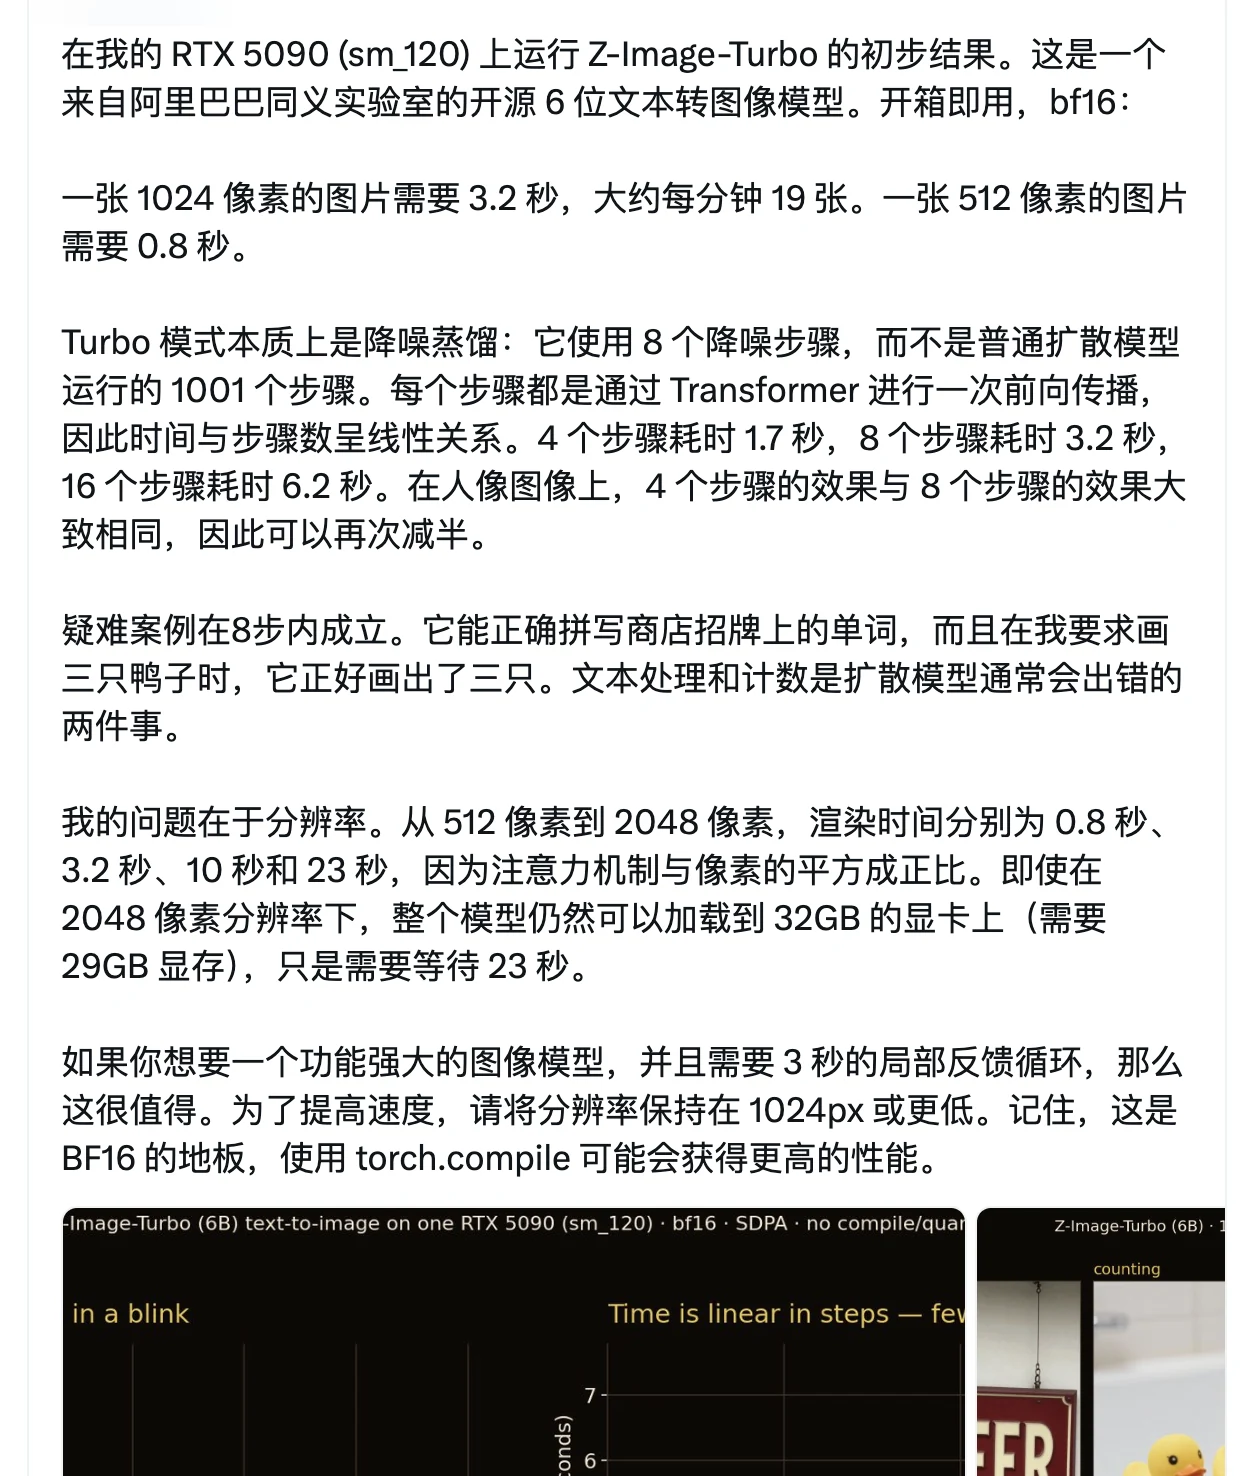
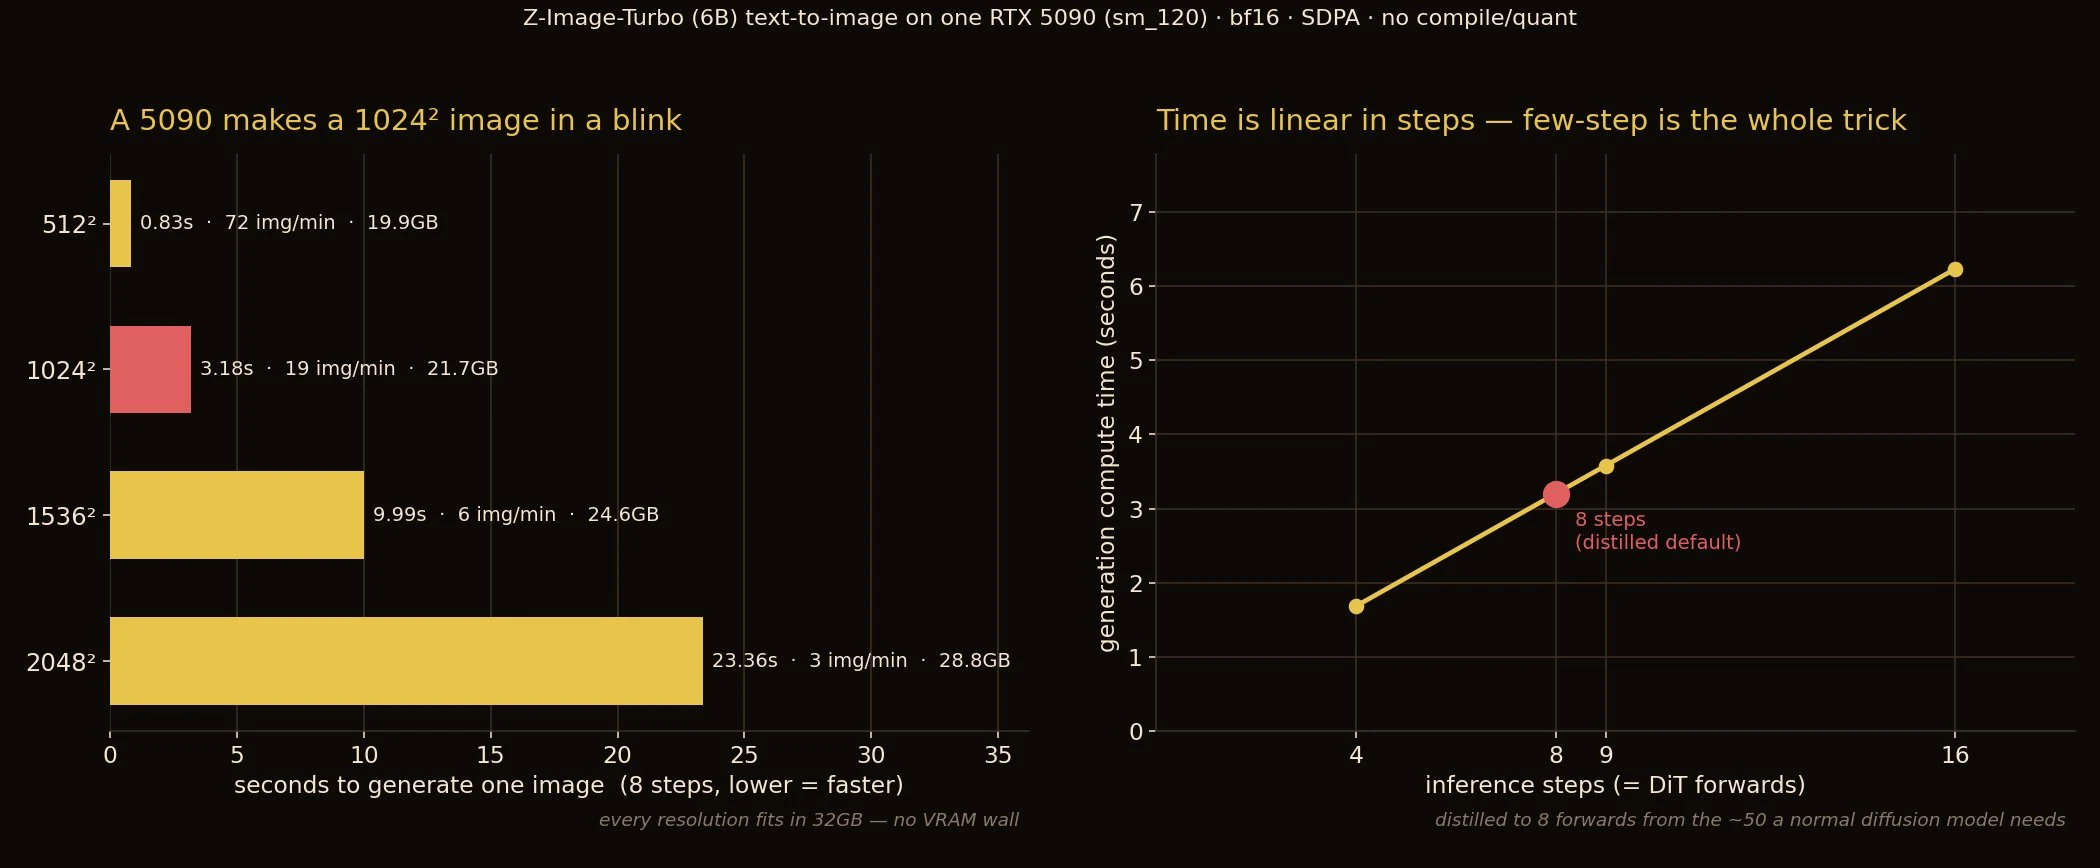
彼はRTX 5090でZ-Image-Turboを実行し、1024px画像を約3.2秒で1枚生成しました。プロンプトでは指定された単語を書いた店舗の看板に加え、「ちょうど3羽のアヒル」を要求し、テキストと数量の両方が正しかった。
この2つのタスクは単純に見えますが、実は拡散モデルにとって長年の課題でした。文字はぼやけやすく、3羽のアヒルはしばしば奇妙に4羽や5羽になります。
元の投稿:https://x.com/witcheer/status/2074020722972758139
次は、eコマースの納品に近いケースです。
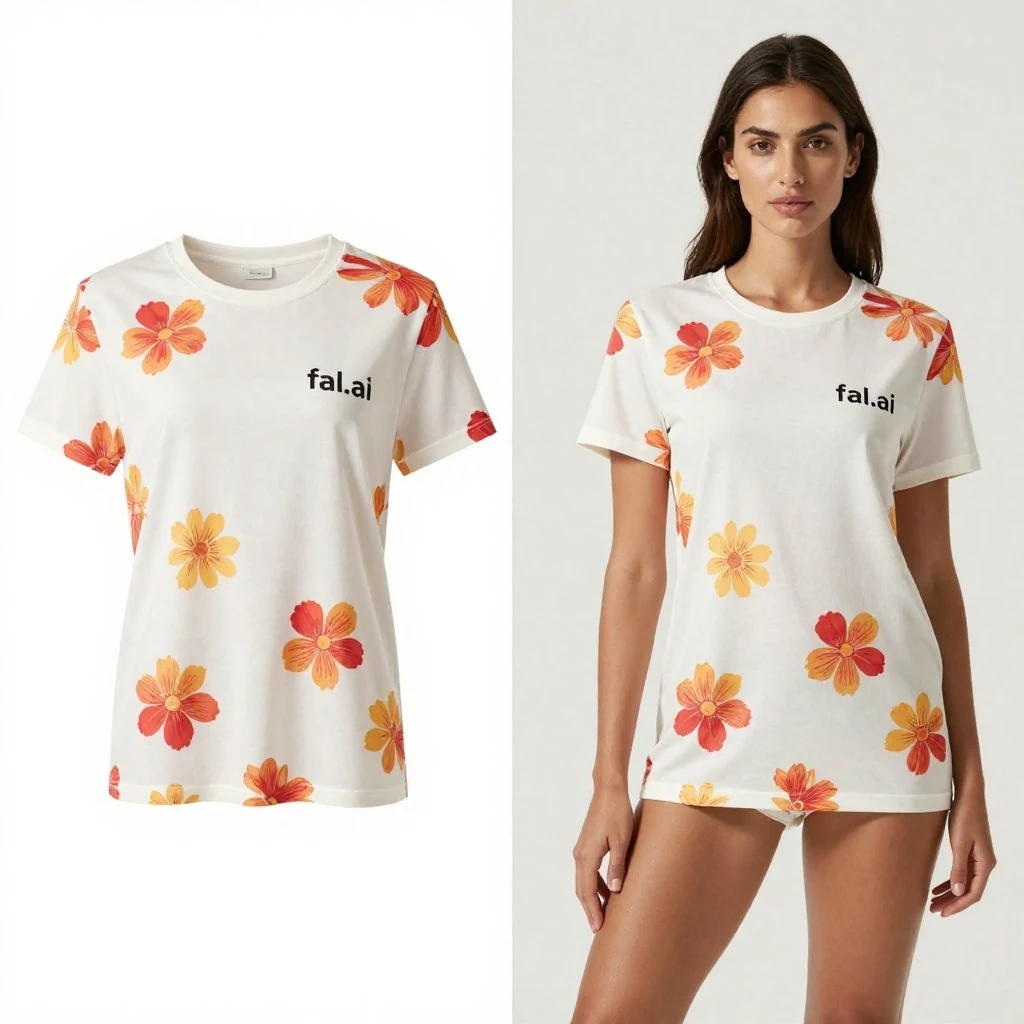
@rizaveliogluはモデルに左右分割画像の生成を依頼しました:左には白い模様のTシャツ1枚のみ、右には同じ服を着た実在のモデル。プロンプトではプリント、テキスト、生地、縫製、型を保持することも要求されました。
最終結果では、両側の服は独立して生成されず、模様とスタイルはほぼ一致しました。eコマースチームにとっては、単に「きれいなモデル写真」を生成するよりもはるかに価値があります。商品画像、着用画像、マーケティング画像はすべて同じデザインから継続できます。
もちろん、これは1つの成功したサンプルであり、安定したバッチ生成にはまだ距離があります。しかし、少なくとも方向性が機能することを証明しています。
元の投稿:https://x.com/rizavelioglu/status/2000012841525649621
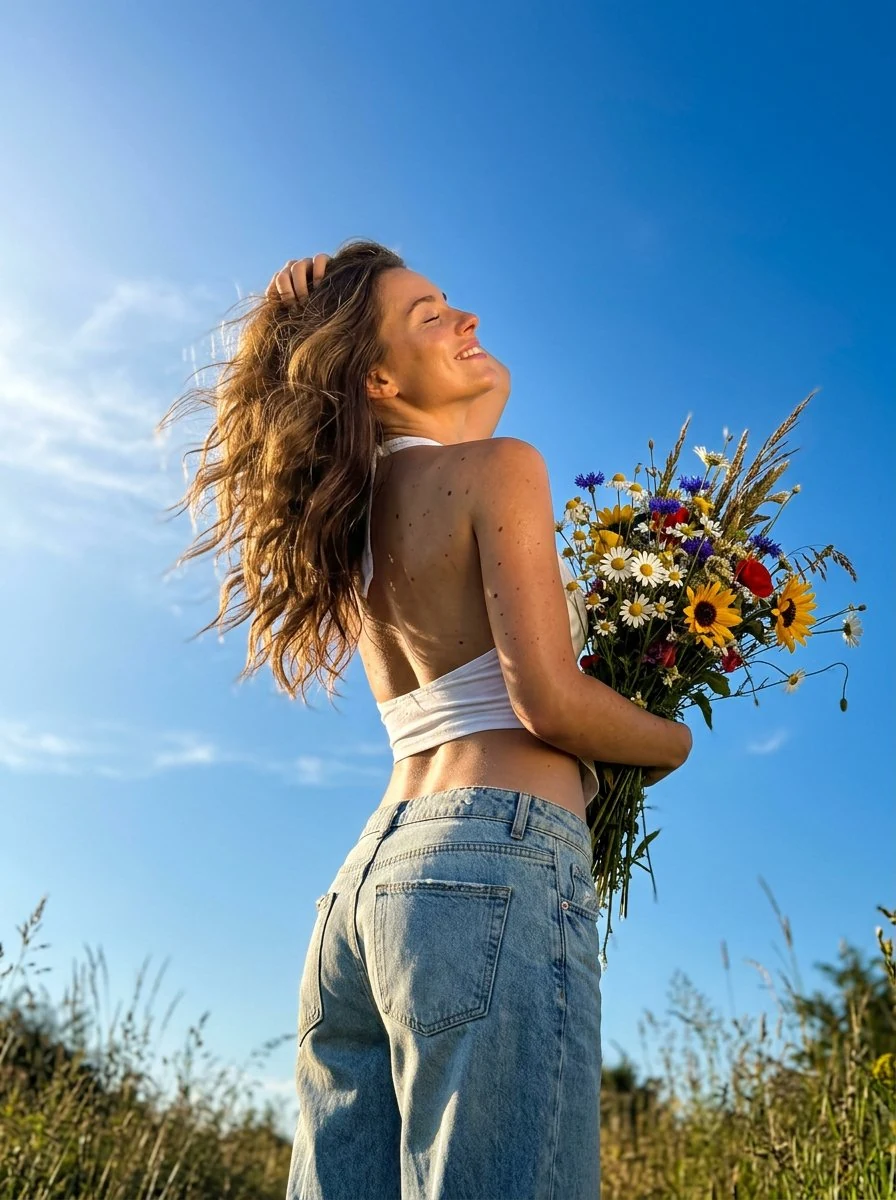
リアルなポートレートについては、@dreamydigiartsが同じプロンプトでの比較を作成しました。
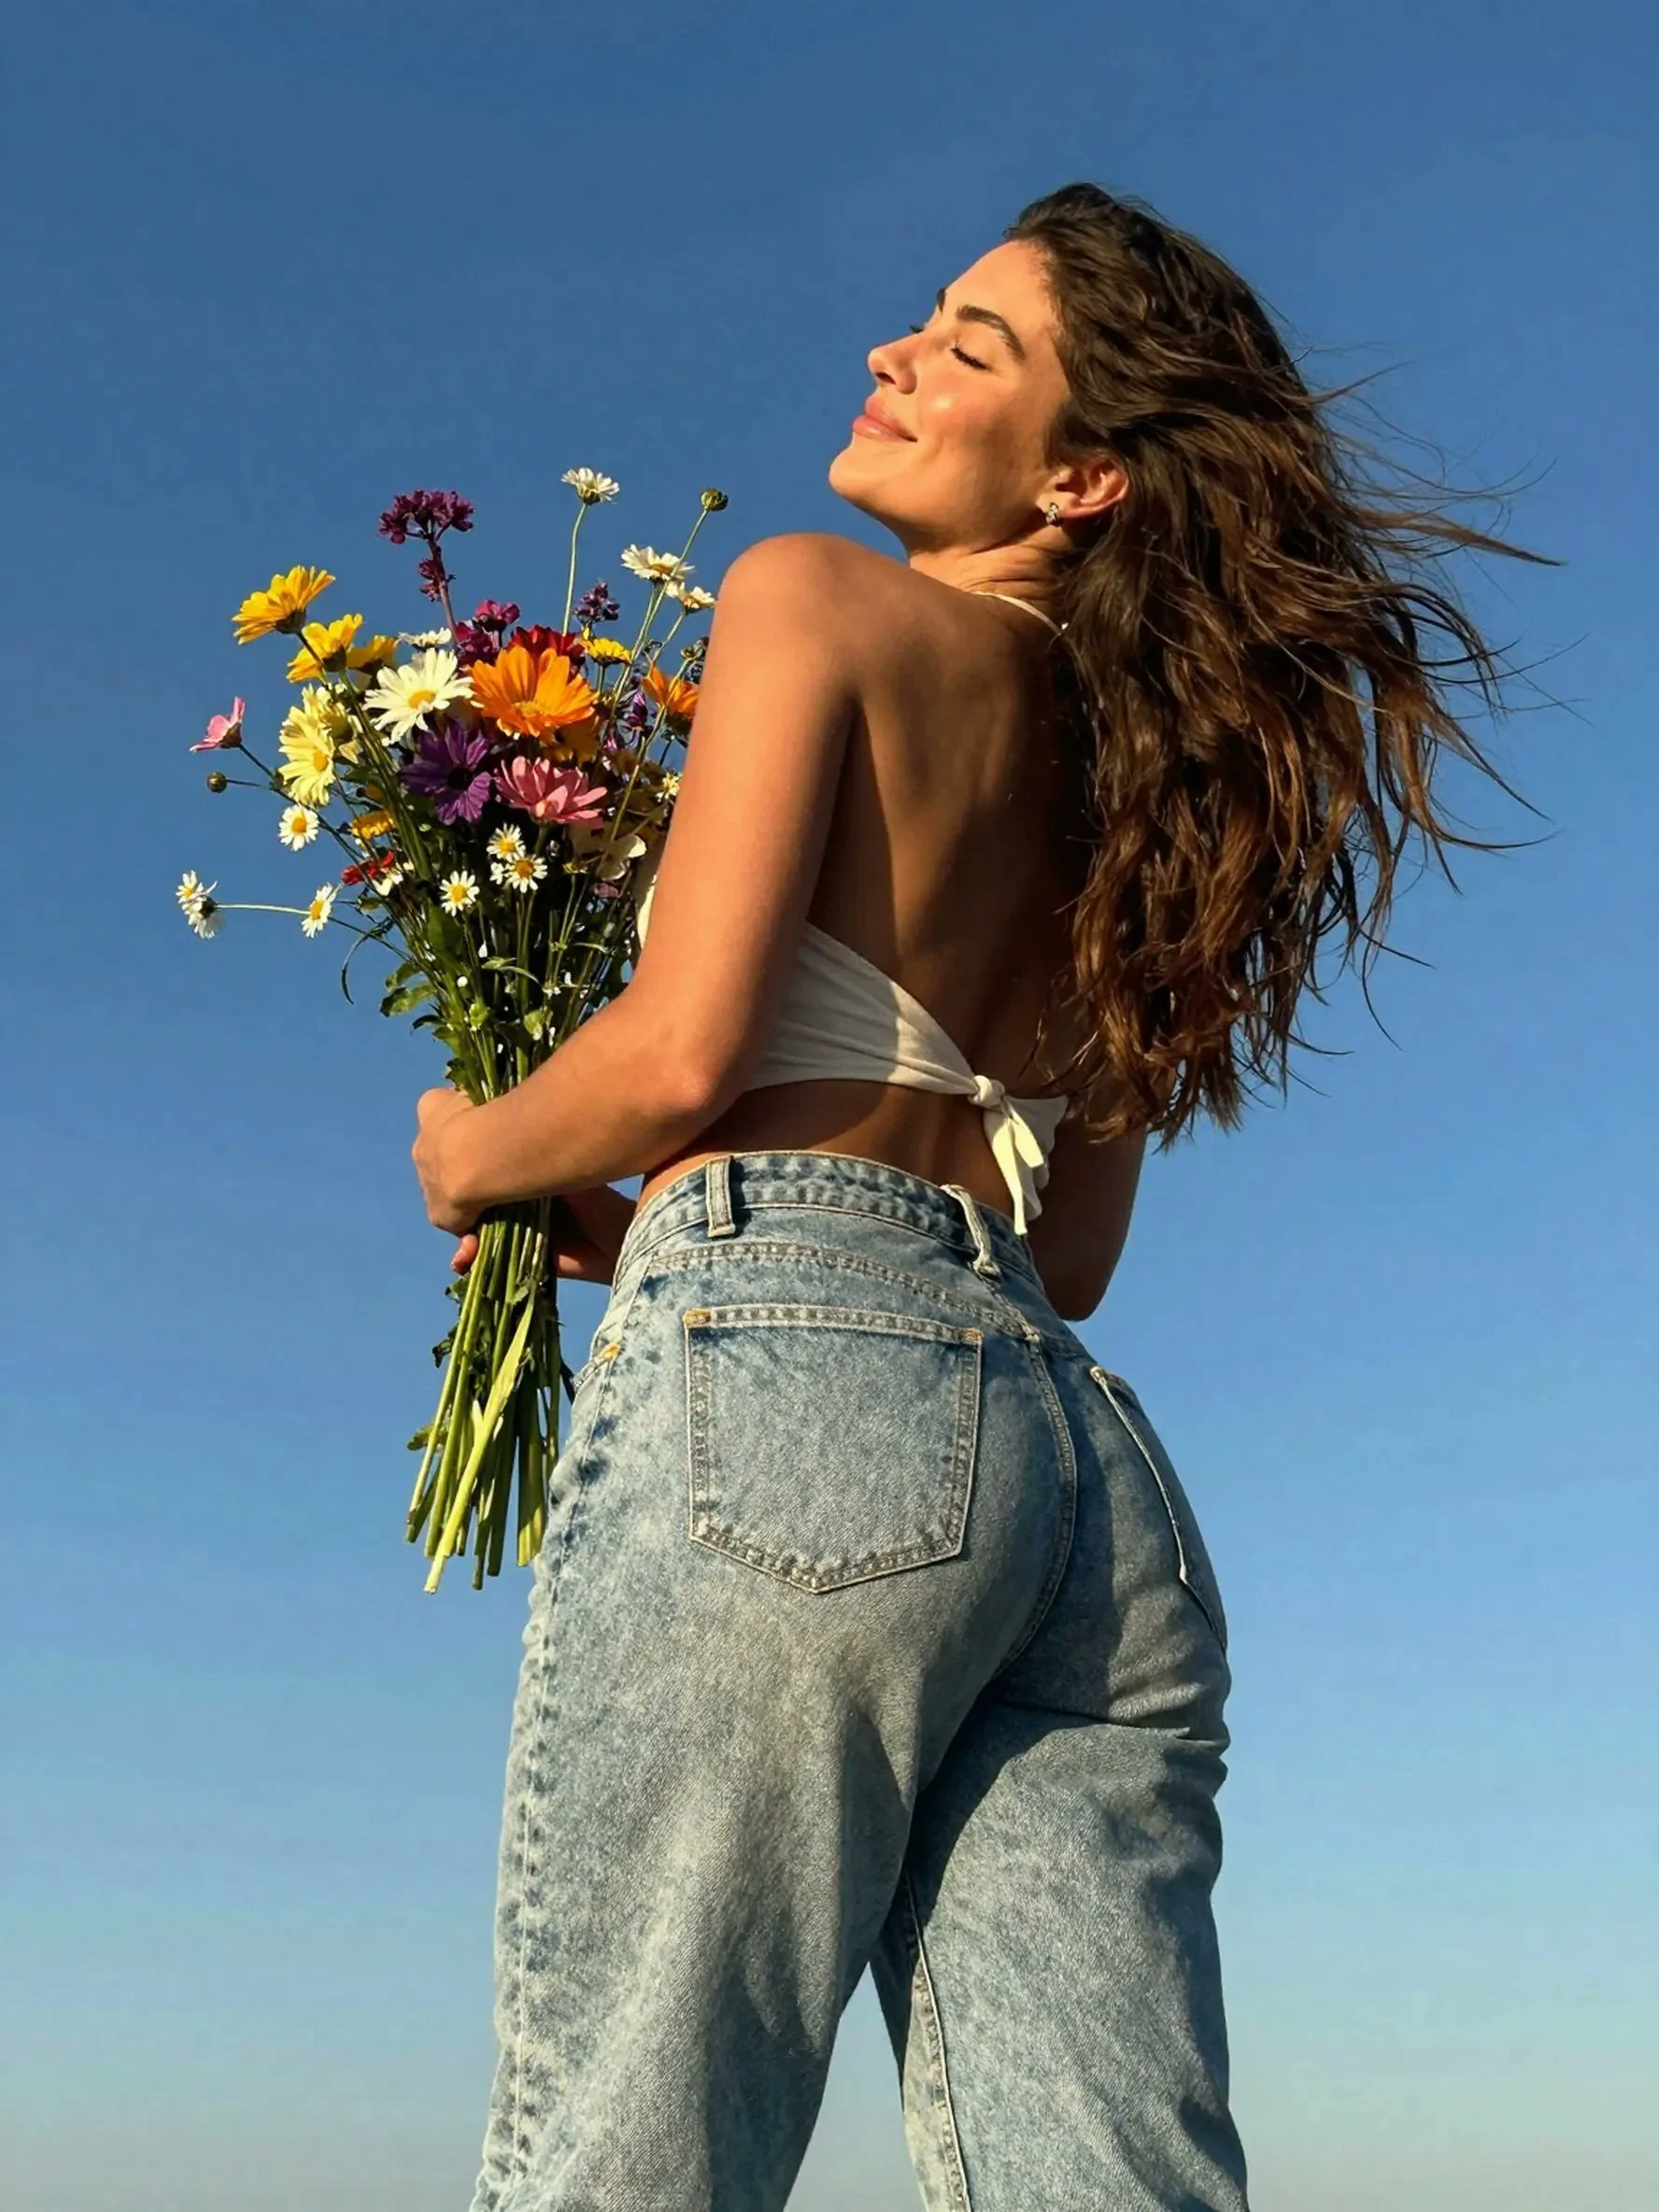
彼はZ-Image-TurboとNano Banana 2に同じスマートフォンアングルの写真を生成させました:青空、逆光、体を後ろに傾けた人物、大きな野生花の束を抱え、風に髪をなびかせ、スマートフォン写真のわずかな粒度を保持。
Z-Imageの結果はすでに強いスナップショット感がありました。ジーンズ、肌、逆光がプラスチックの層に滲むことはなく、アングルの構図も堅実です。雰囲気のあるキャラクターショットやソーシャルメディア画像には、すでに完全に玩具レベルを超えています。
元の投稿:https://x.com/dreamydigiarts/status/2084233075245171142
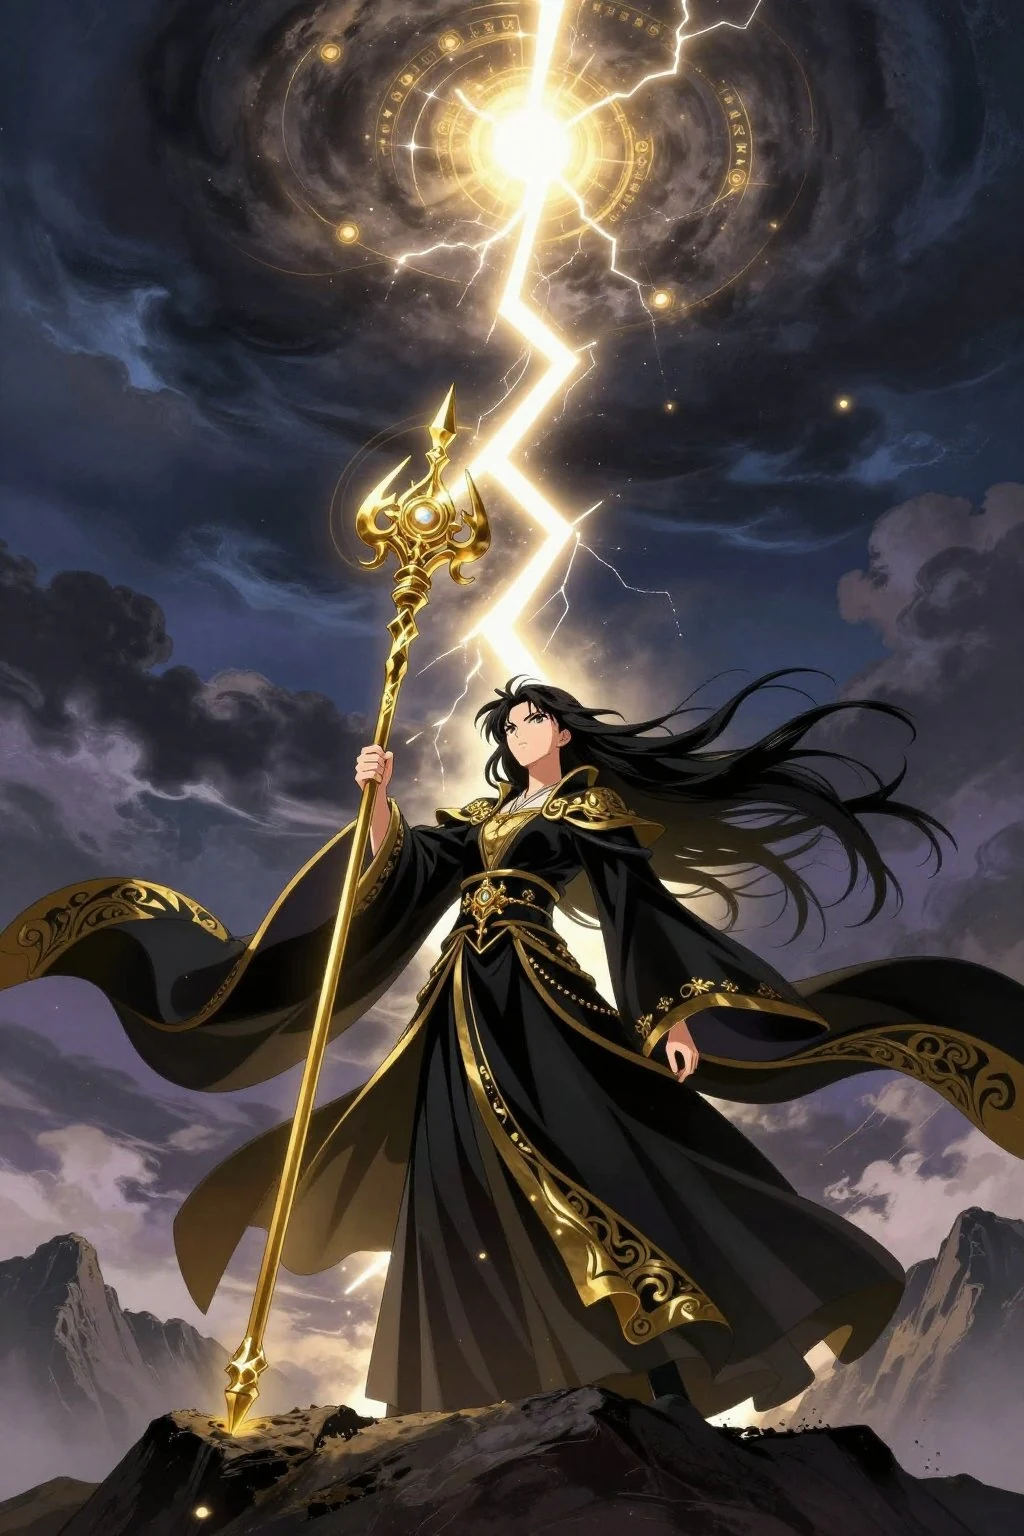
Z-Imageはリアリズムに限定されません。@tisch_einsはBoogu、Flux 2 Klein、Z-Image-Turboを同じプロンプトでテストしました。シーンでは、嵐の山顶に立つ黒髪の女性魔術師、金の杖が手から先端まで完全に見え、杖先から雲に向かって雷が落ち、さらにローアングル、全身構図、マント、ルーン、電弧、強い金色のリムライティングを要求。
このタイプのプロンプトは見落としやすい:杖が切れ、雷が間違った位置につながり、キャラクターが大きな頭だけになる可能性があります。Z-Imageの結果は主要な関係すべてを保持し、複雑なイラスト構図に対する強い制御力があることを示しています。
ログイン ディスカッションに参加

元の投稿:https://x.com/tisch_eins/status/2081490372405174375
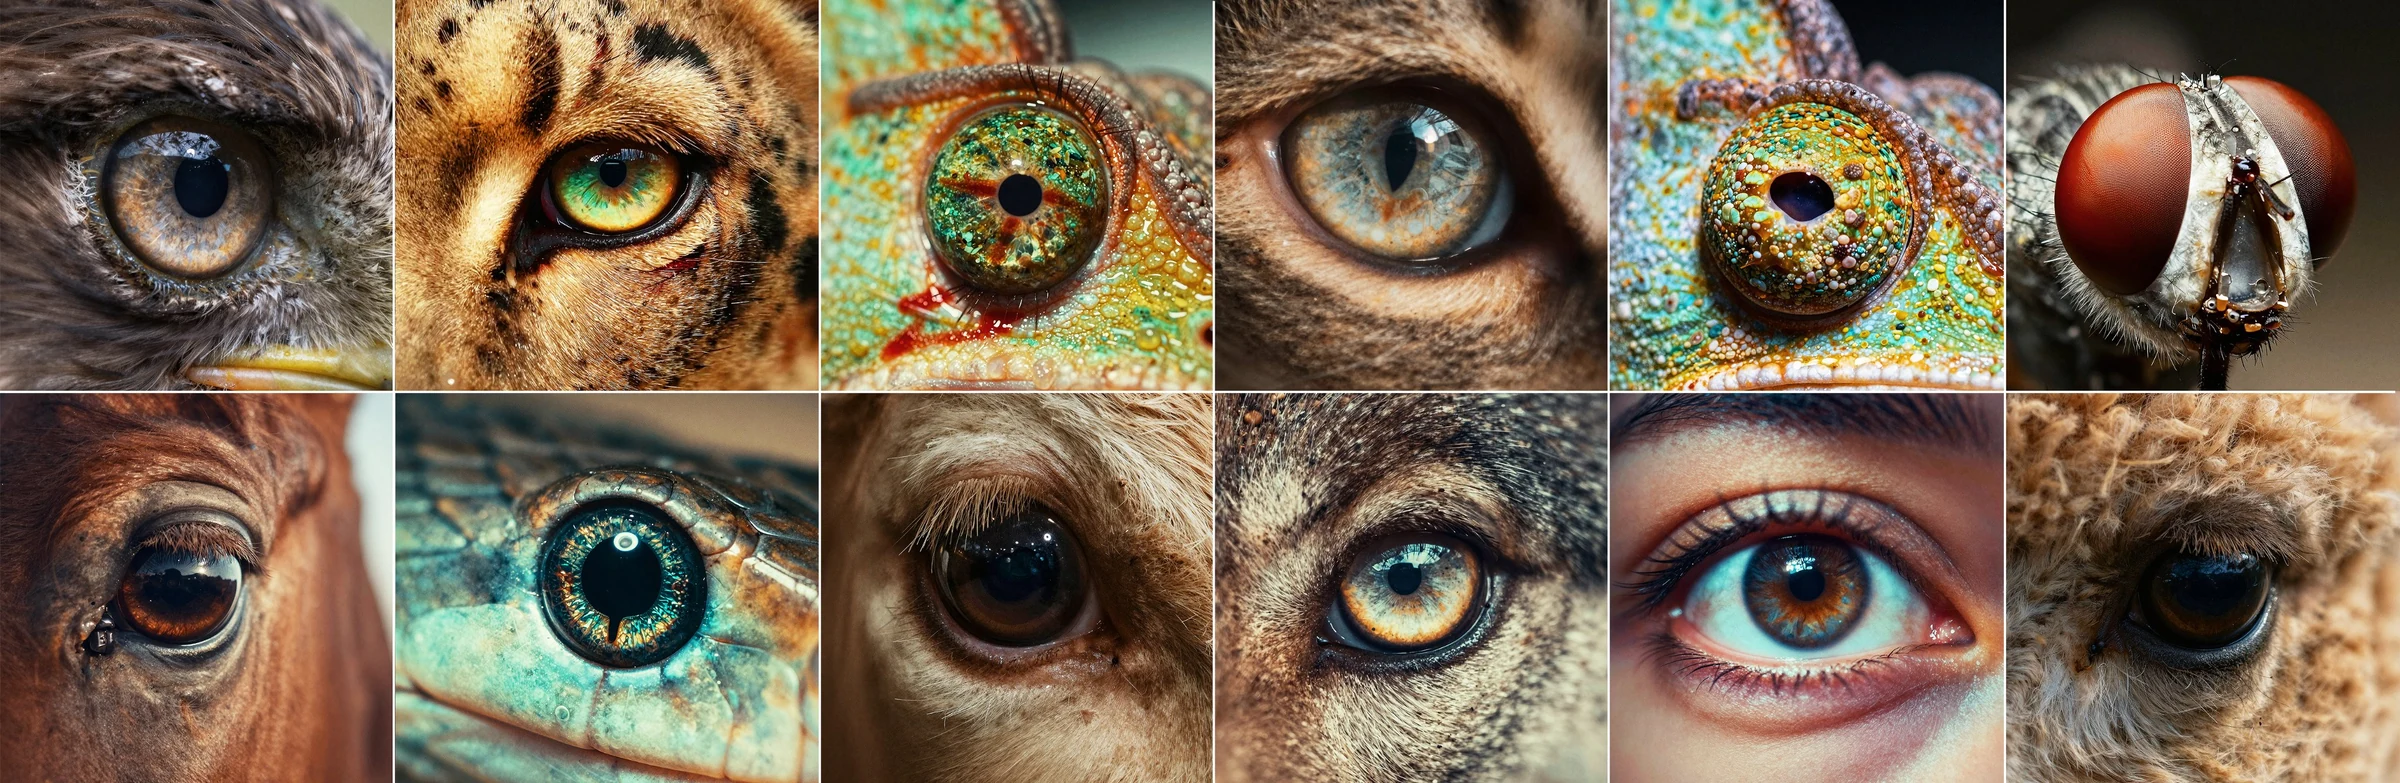
最後は極端なマクロ。@aisthetiicのプロンプトはとても短く:ある動物の瞳孔がフレームの主体を占め、左上からのドラマチックな照明が虹彩のテクスチャを照らし、背景は暗から明るいボケへのグラデーション。
より興味深いのは、画像が崩れなかったことです。視線は瞳にしっかりとロックされ、光、影、背景すべてが同じ主体に奉仕しています。ポスターキービジュアルや感情的なカバーを作成する場合、この構図準拠性は「8K、傑作、超詳細」を1万個重ねるよりも有用です。

元の投稿:https://x.com/aisthetiic/status/1994424107451007336
これら5つのケースを総合すると、Z-Imageの優位性はかなり明確です:
モデルは小さく、速く、リアリズムに優れており、比較的長い自然言語プロンプトを理解できます。完全なベースモデルはLoRA、ControlNet、業界別ファインチューニングにも使用できます。
動画生成は画像生成よりはるかに難しい。画像で1本の指を間違えて描いても、切り取ることができます。しかし動画では、キャラクターの顔が15秒で変わったり、カメラがタイムラインを追わなかったり、セリフがキャラクター間で混ざったり、効果音がアクションと合わなかったり—1つのミスで全体が台無しになります。
H3のケースで最初に検証する価値があるのは、デュアルキャラクターの一貫性です。
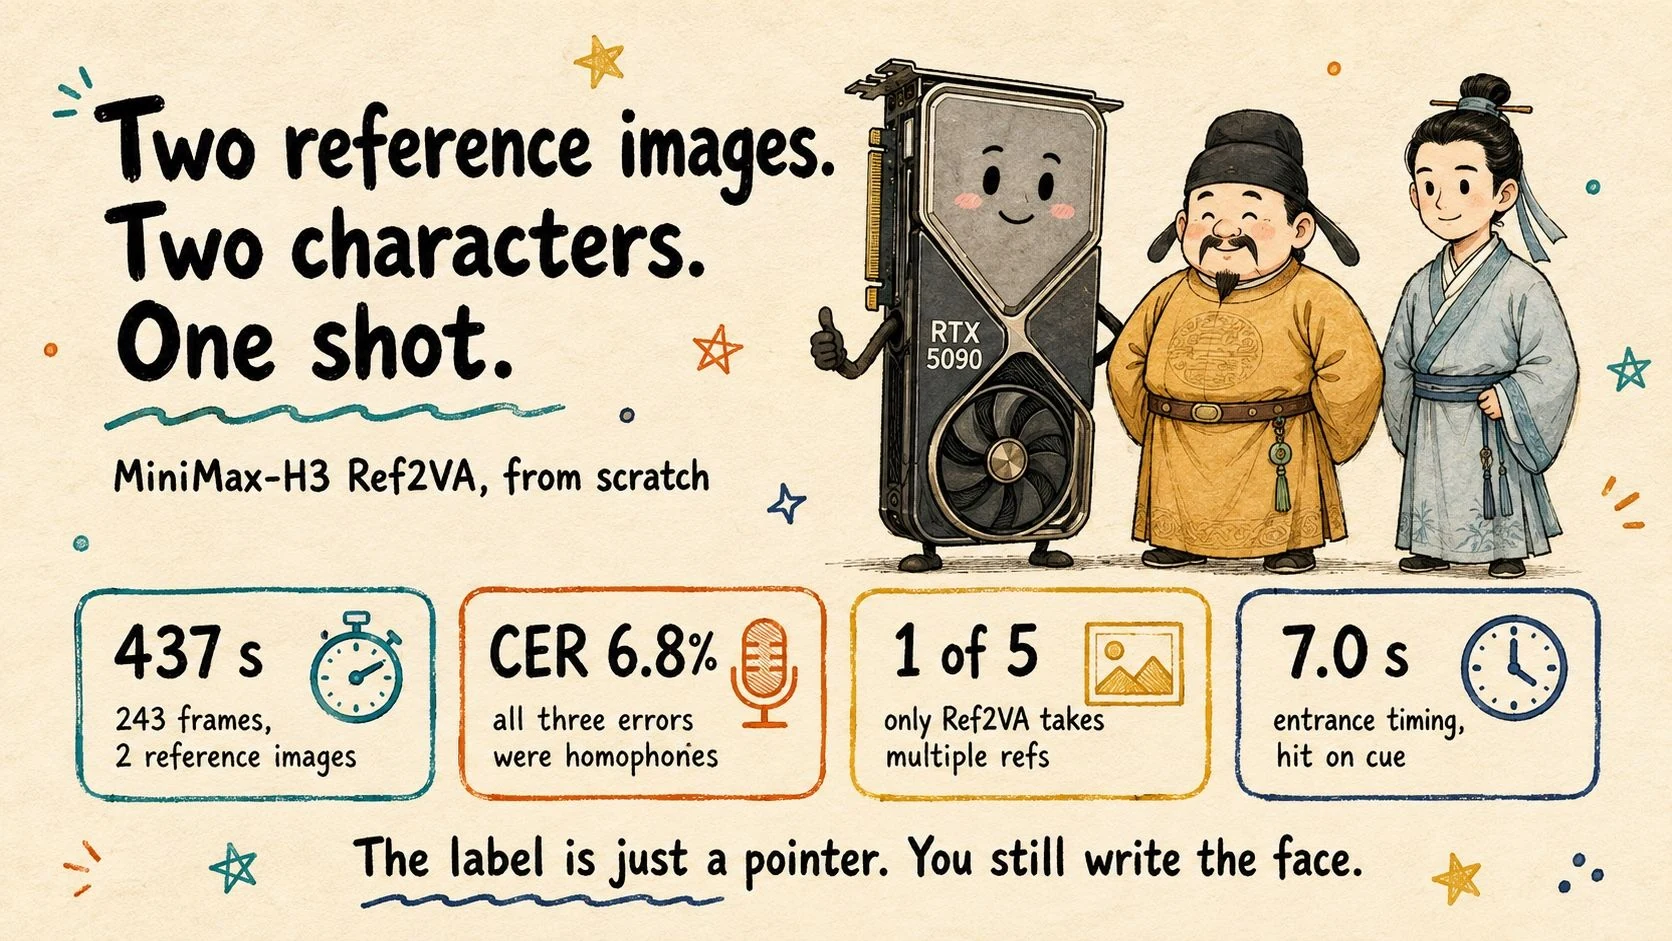
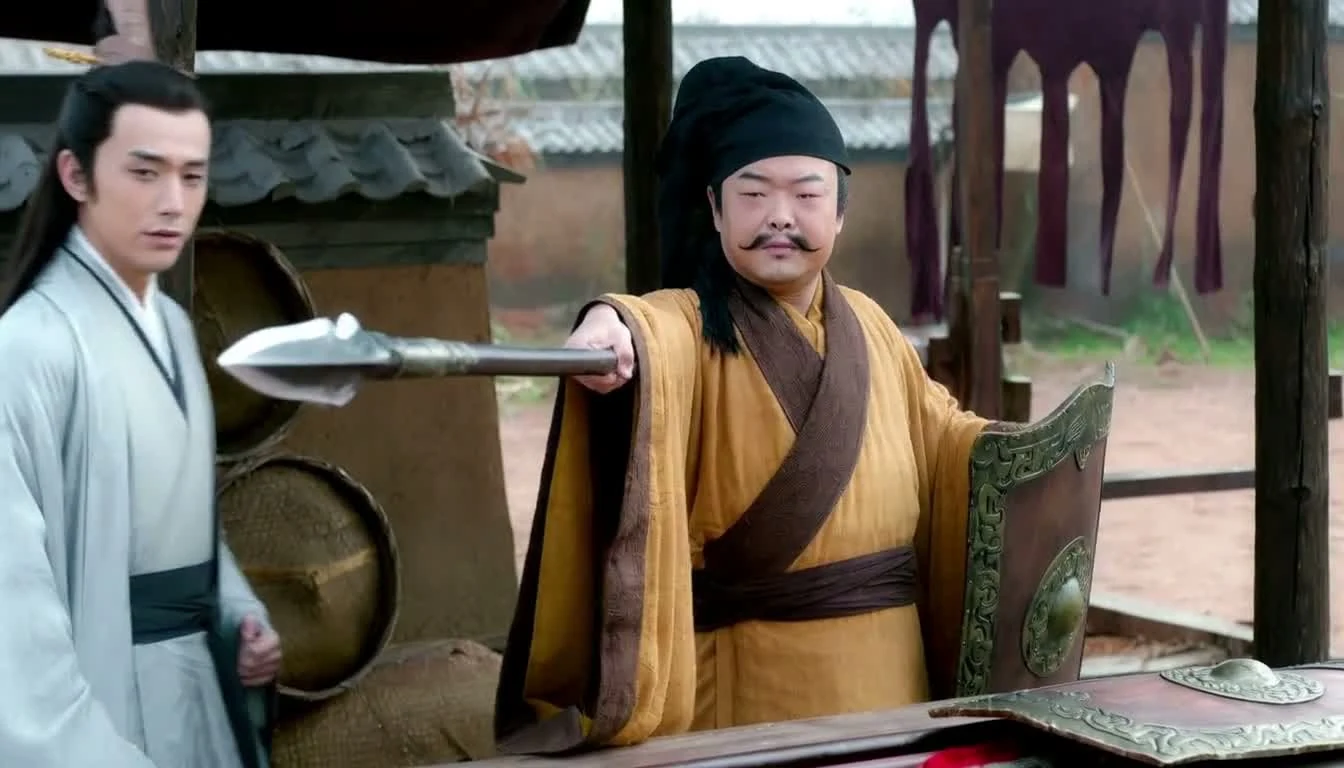
@coolthorはZ-Image生成のキャラクターデザイン画像2枚をH3のRef2VAモードに供給しました。1人はochre色のローブを着、もう1人は青灰色の服装で、外見を意図的に差別化。プロンプトでは1人のキャラクターが6秒から8秒の間に入場し、中国語のセリフ3行を含みました。
10.125秒の動画で、2人のキャラクターは顔や服を交換しませんでした。入場予定のキャラクターは前半に現れず、7秒あたりでようやく画面に入りました。著者はその後ASRで44漢字を検証し、文字誤り率6.8%を達成し、誤りは同音異字でした。
これは単一のRTX 5090で実行され、243フレームで437秒かかりました。速度は非常に速くはありませんが、キャラクター、タイミング、セリフを同時に制御できるのはすでに非常に優れています。


元の投稿:https://x.com/coolthor/status/2096779996320719307
もう1つのローカルケースは@Lumosousからのものです。
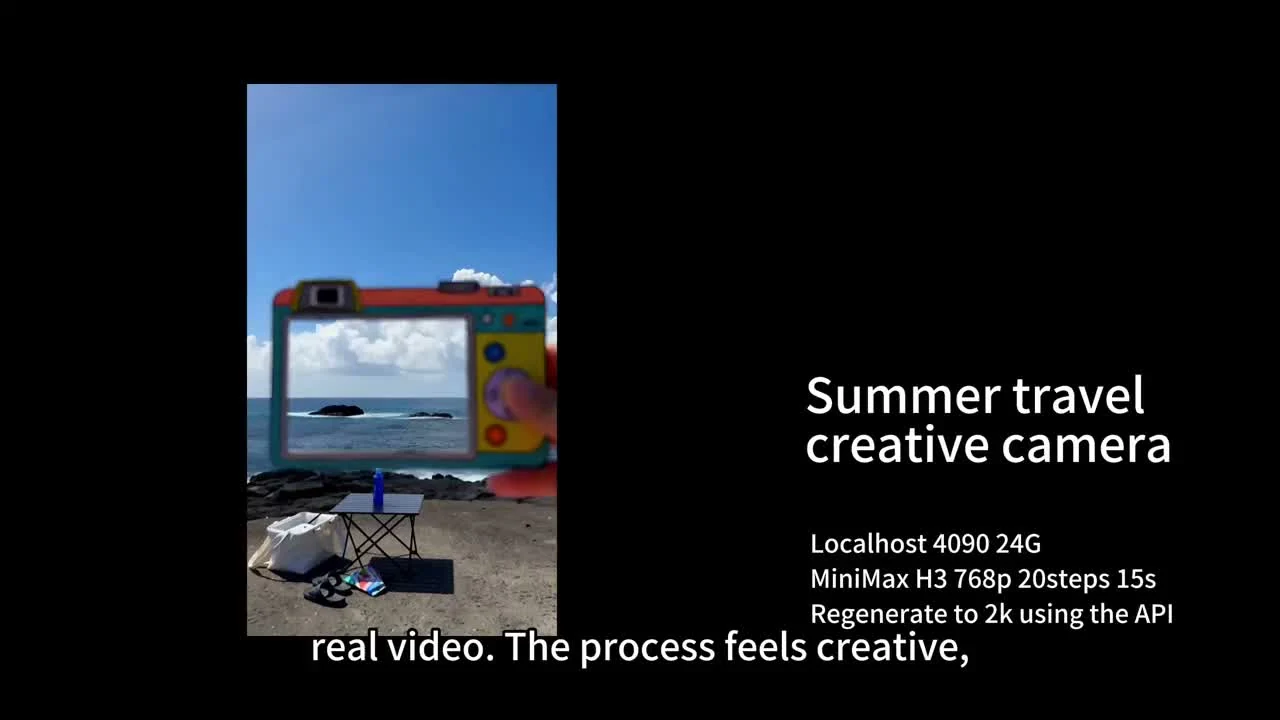
RTX 4090とComfyUIを使用して、3つの試行を行いました:4シーンのトラベルショートフィルム、ドラムビートに合わせてシーンが切り替わるミュージックビデオ、4ショットと環境音付きの海辺の物語。最初のアイデアはまずMiniMaxの公式Prompt Writing Skillに送られ、ショット、タイミング、アクション、音声を含む構造化プロンプトに整理されてからH3に渡されました。
このケースで最も有用なのは、単に「きれいな画像」を作っただけではないことです。ドラムビートが来ると、シーンは実際に変わります;海辺のクリップでは、4ショット、雰囲気、背景音が1ラウンドで全て同時に生成されました。
ベンチマークデータ:4090は15秒、20ステップの低解像度動画に200秒以上;768pにアップグレードすると1000秒以上かかります。オープンソースは繰り返し反復を可能にしますが、無料はコストゼロを意味しません—電気代、VRAM、待機時間もコストです。

元の投稿:https://x.com/Lumosous/status/2089351551361937490
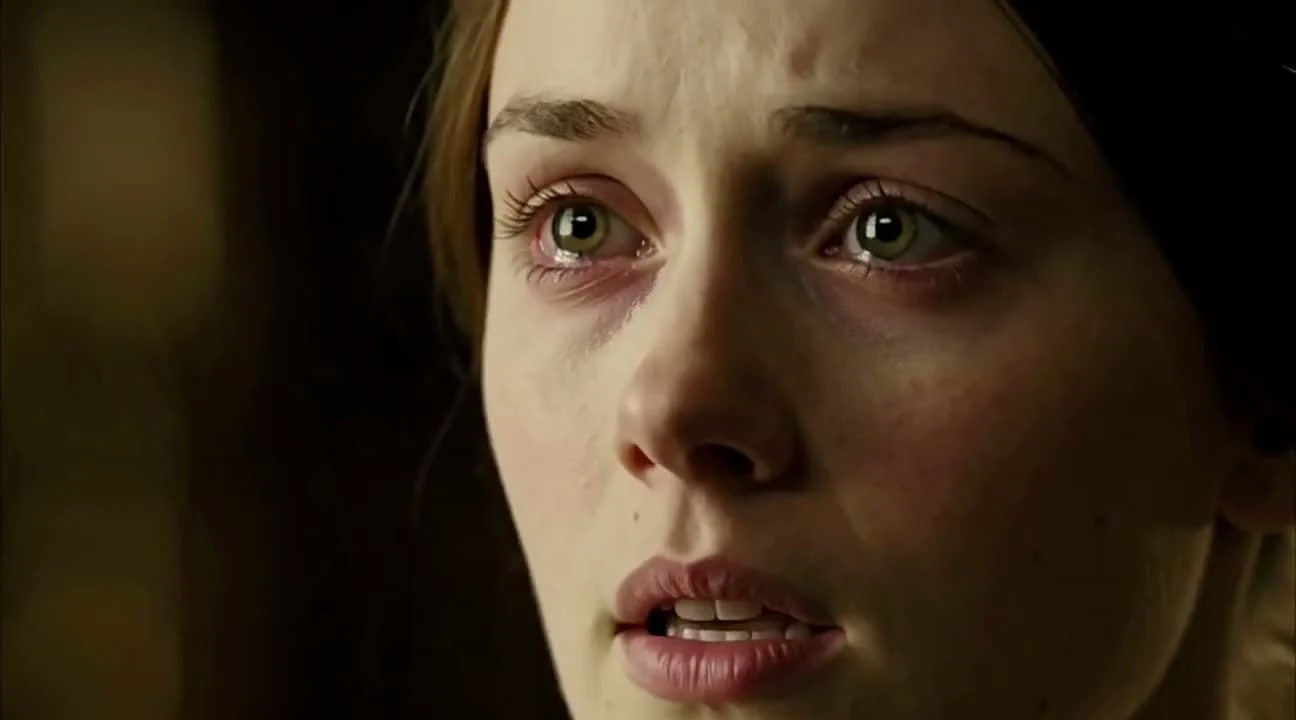
@PixelAigcの30秒「ジェーン・エア」風英国邸宅セグメントはさらに素晴らしいです。
プロンプトは30秒を直接4ショットに分割しました。各セグメントは焦点距離、カメラアングル、キャラクターポジショニング、マイクロエクスプレッション、セリフ、呼吸、環境音、禁止アイテムを指定。キャラクターの感情はためらいから反論へと進み、男性声と女性声にそれぞれ制約をかけました。
この作品はローカルComfyUIとH3 Turbo LoRAを使用し、最初480pを生成し、Topazで1080pにアップスケールしました。著者は25秒が約13〜15分かかると報告。公式モデルの素の性能を代表するものではありませんが、オープンソースエコシステムの最も興味深い側面を示しています:モデルリリースから1ヶ月で、コミュニティはすでに速度の変更、長尺動画の作成、自動スーパーリゾリューションの統合を行っています。

元の投稿:https://x.com/PixelAigc/status/2093563293306929579
H3の公式シングルセグメント上限は15秒です。では、より長い動画はどうやって作るのでしょうか?
@superaleshaは4台のRTX 3090を使用して、30秒のファーストパーソンアクション映画を実行しました。2つの15秒セグメントをチェーンし、最初のセグメントを意図的に安定した画像で止め、2番目のセグメントで同じ画像から生成を継続し、重複フレームをカットし、オーディオを続行させました。
継ぎ目は15秒目に隠されており、通常の視聴ではほとんど気づきません。全体は生成から完成まで44分かかりました。このケースの価値は、H3が突然制限時間を突破したことではなく、誰かが制限を理解し、ワークフローで回避したことにあるのです。

元の投稿:https://x.com/superalesha/status/2086171185134686509
「動画プロンプトをどのように書くべきか」を研究するのに特に有用なケースもあります。
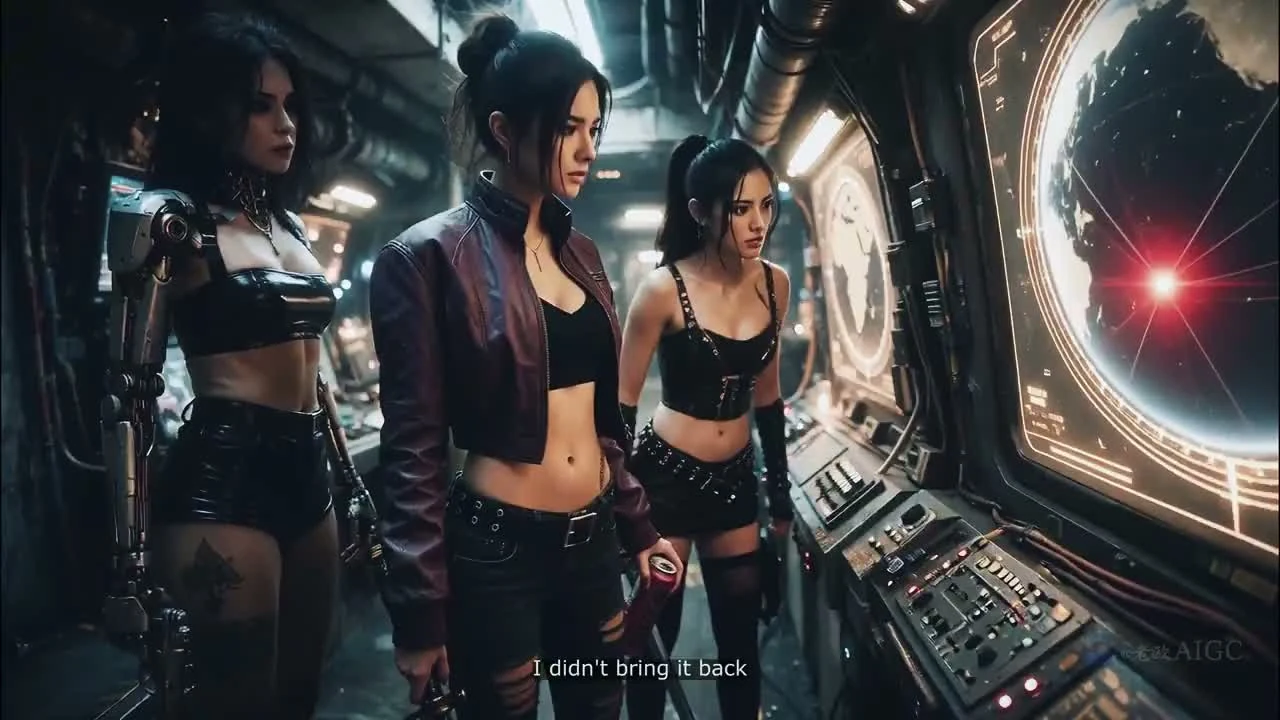
@ou_zhen599はローカルComfyUIを使用して、15秒のサイバースペースシップの短編映画を作成しました。シーンには3人の女性キャラクターが登場:左に座っている1人、中央にナイフを持って立っている1人、右前方にソーダ缶を持って立っている1人。プロンプトはストーリーだけでなく、誰が何秒に発言するか、無言のキャラクターは口を動かすべきでない、ソーダ缶は常に右手に残る、レッドトラッキングポイントが画面上にいつ出現するか、最後に舷窓の外の影が迫るタイミングを指定。
このタイプのケースで最も難しいのは、空間を安定させ、小道具を失わず、セリフを混ぜず、無言のキャラクターに本当に黙らせることです。H3はすでにこれらの制約をすべて15秒の短編映画に詰め込むことに成功しました。オープンソース動画のゲームは明らかに変わりました。

元の投稿:https://x.com/ou_zhen599/status/2097988690102390893
全体的に:
迅速に完成した動画を制作したいだけなら、クローズドソースモデルがまだ最も簡単な選択肢です。
しかし、繰り返し反復し、バッチ生成し、独自のスタイルをトレーニングし、ローカルワークフローに能力を統合したいなら、Z-ImageとH3は真剣に研究する価値があります。まずオープンソースモデルでショットと素材を素早くプロトタイピングし、本当に詰まったときだけクローズドソースモデルを呼び出せば—コストははるかに低くなります。
オープンソースモデルは以前、待ち人のための慰めのように感じられました。今では本物のクリエイティブワークに参加できるのです。
毎日画像や動画を作成する必要がある人にとって、最良の変更は、今後アイデアが浮かぶたびに、まずこのラウンドでいくらのクレジットを消費するか計算する必要がなくなることです。