AIUnlimited
🌳

AI基礎

🌱
AI Seeds(種)

ゼロから始める

🌿
AI Sprouts(芽)

基礎を築く

🌳
AI Branches(枝)

実践に活かす

🏕️
AI Canopy(樹冠)

深く学ぶ

🌲
AI Forest(森)

AIをマスターする

🔨

AIマスタリー

✏️
AI Sketch(スケッチ)

ゼロから始める

🪨
AI Chisel(鑿)

基礎を築く

⚒️
AI Craft(制作)

実践に活かす

💎
AI Polish(磨き上げ)

深く学ぶ

🏆
AI Masterpiece(傑作)

AIをマスターする

📘

AI実践

📖
オープンソースモデルを理解する

オープンソースモデルの基礎とリソース

🎯
問題からモデルタスクへ

ビジネス問題をモデルタスクに変換

⚡
最初のモデルを実行する

30分で最初の結果を見る

🔧
ファインチューニングと評価

モデルをファインチューニングし、パフォーマンスを評価

🚀
アプリケーションシステム

実際のAIアプリケーションを構築

🎨
生成AI

オープンソースAIGCモデルを探索

🤖
エージェント

エージェントフレームワークとMCPツールを学ぶ

📐
補足基礎

LLMの基礎と評価

🎓

Claude アカデミー

🤖
Claude 101

Learn AI basics with Claude

💻
Claude Code 101

Code with Claude as your pair programmer

🤝
Introduction to Claude Cowork

Collaborate with Claude on complex projects

⚙️
Claude Platform 101

Build apps with the Claude API

ラボ

7つの実験がロード済み
🧬ニューラルネットワークサンドボックス🤖AI か人間か?🥋プロンプトエンジニアリング道場🏁アルゴリズムレース🧠AIトリビアチャレンジ🏗️システム設計キャンバス
🎯模擬面接ラボへ入る→
🚀

キャリア発展

🚀
面接ローンチパッド

旅を始めよう

🌟
行動面接マスター

ソフトスキルをマスター

💻
技術面接

コーディング面接を突破

🤖
AI・ML面接

ML面接をマスター

🏆
オファーとその先

最高のオファーを獲得

始める
AIUnlimited

MITライセンス

沪ICP备18025655号-11

学ぶ

  • AI基礎
  • AI実践
  • Claude アカデミー
  • ラボ
  • キャリア発展

コミュニティ

  • 概要
  • よくある質問

サポート

  • footer.terms
  • footer.privacy
  • footer.contact
AI & エンジニアリング アカデミックス›🎨 生成AI›レッスン›Product Marketing Visuals
📸
生成AI • 初級⏱️ 25 分で読める

Product Marketing Visuals

商品のマーケティング画像:生成から修正までの方法

過去、商品の宣伝ポスターを作成するには、素材準備、背景デザイン、商品配置、文章追加、サイズ調整といった多くのステップが必要でした。同じ商品を複数のプラットフォームに投下する場合、デザイン担当者は通常、異なるサイズに合わせて画面を再調整する必要がありました。

現在、テキストから画像生成(文生图)、画像から画像生成(图生图)、部分編集、モデル微調整といった技術を活用することで、クリエイティブ生成、商品デザイン、画像修正、サイズ適合を連携させることができ、比較的完結したマーケティングコンテンツ生産プロセスを形成できます。

例えば、リキュールの「夏日マーケティング」テーマのポスターを作成する場合、氷、水しぶき、レモン、緑の葉などの要素を画面に含めたいとします。まず、テキストで説明することで初期のマーケティング画像を素早く生成し、商品画像を組み合わせて画像から画像生成で編集し、ブランドロゴを追加し、実際のニーズに応じて部分要素を修正し続けることができます。最後に、同じマーケティング画像を異なるサイズに拡張し、ソーシャルメディア、動画配信、ウェブ広告などの異なるシーンで使用することも可能です。

本章では、FRESH DAY 夏日リキュールのマーケティング画像を例に取り、ModelScope内のオープンソースの画像生成モデルを用いて、簡易なAIGCマーケティングコンテンツ生産ラインを構築する方法を紹介します。実験はテキストから画像生成から始まり、画像から画像生成、商品主体保持、部分編集、サイズ適合、ブランドスタイルLoRAなどの内容を順に紹介します。

文字を使って、マーケティングクリエイティブを描き出す

テキストから画像生成(Text-to-Image)とは、テキストの説明に基づいて直接画像を生成することです。ユーザーは完全なデザイン素材を準備する必要はなく、Promptで希望する画面の内容(テーマ、主体、背景、色、構成、視覚的なスタイルなど)を説明するだけで、モデルはこれらの情報に基づいて対応する画像を生成できます。

マーケティングコンテンツ生産において、テキストから画像生成はクリエイティブの探索や初期の視覚的な提案生成に適しています。例えば、夏日リキュールポスターを作成する前に、「清涼な夏日の雰囲気、氷、水しぶき、レモン、青緑の色調、商業写真のスタイル」などの要求をモデルに伝えることで、モデルが速やかに完全なマーケティング画像を生成できます。空のキャンバスからデザインを開始するよりも、この方法で異なるクリエイティブパターンをより早く見ることができます。

現在、オープンソースコミュニティはStable Diffusion、FLUX、Qwen-Image、Z-Image-Turboなどの多种類の画像生成モデルを提供しています。各モデルは画面品質、Promptの理解、テキスト生成能力、ハードウェアリソース要件などで差異があります

本節ではModelScope上のZ-Image-Turboモデルでテキストから画像生成の実験を行います。Turboバージョンは生成効率を重点的に最適化しており、少ない推論ステップで画像生成が可能です。そのため、個人開発者やGPUリソースが限られた実験環境に適しています。

1)安装环境

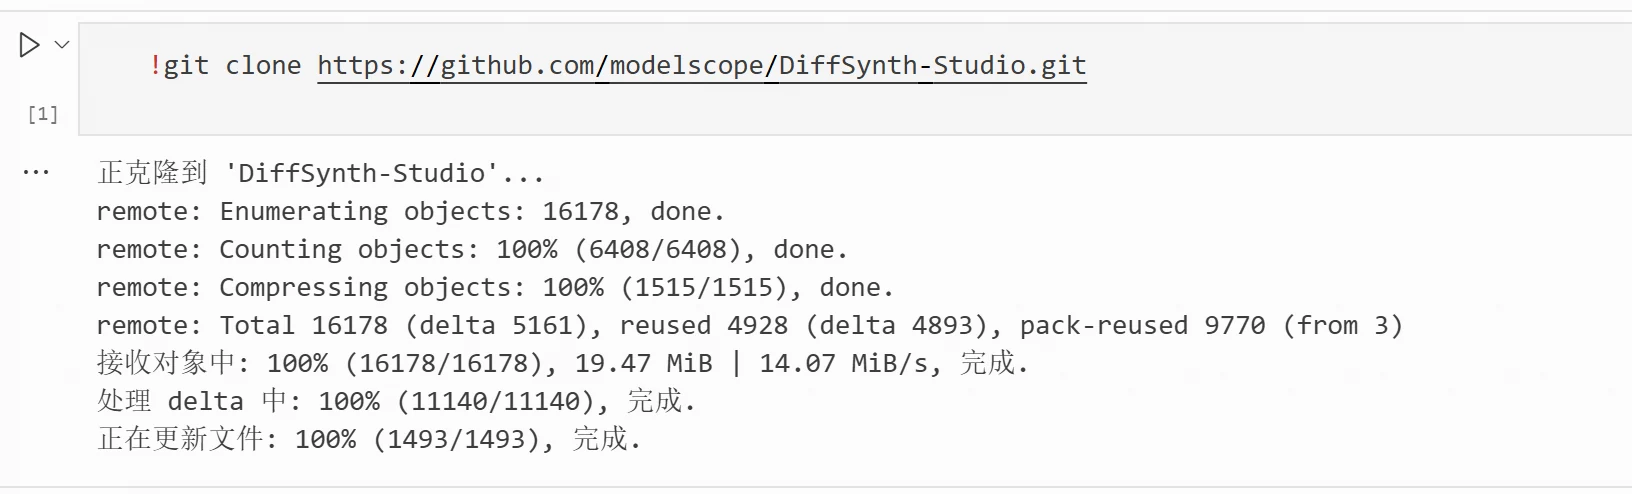
DiffSynth-Studioフレームワークを使用して文生图、DiffSynth-Studioをダウンロードします

!git clone https://github.com/modelscope/DiffSynth-Studio.git  
正文配图

2)进入DiffSynth-Studio目录

%cd DiffSynth-Studio
正文配图

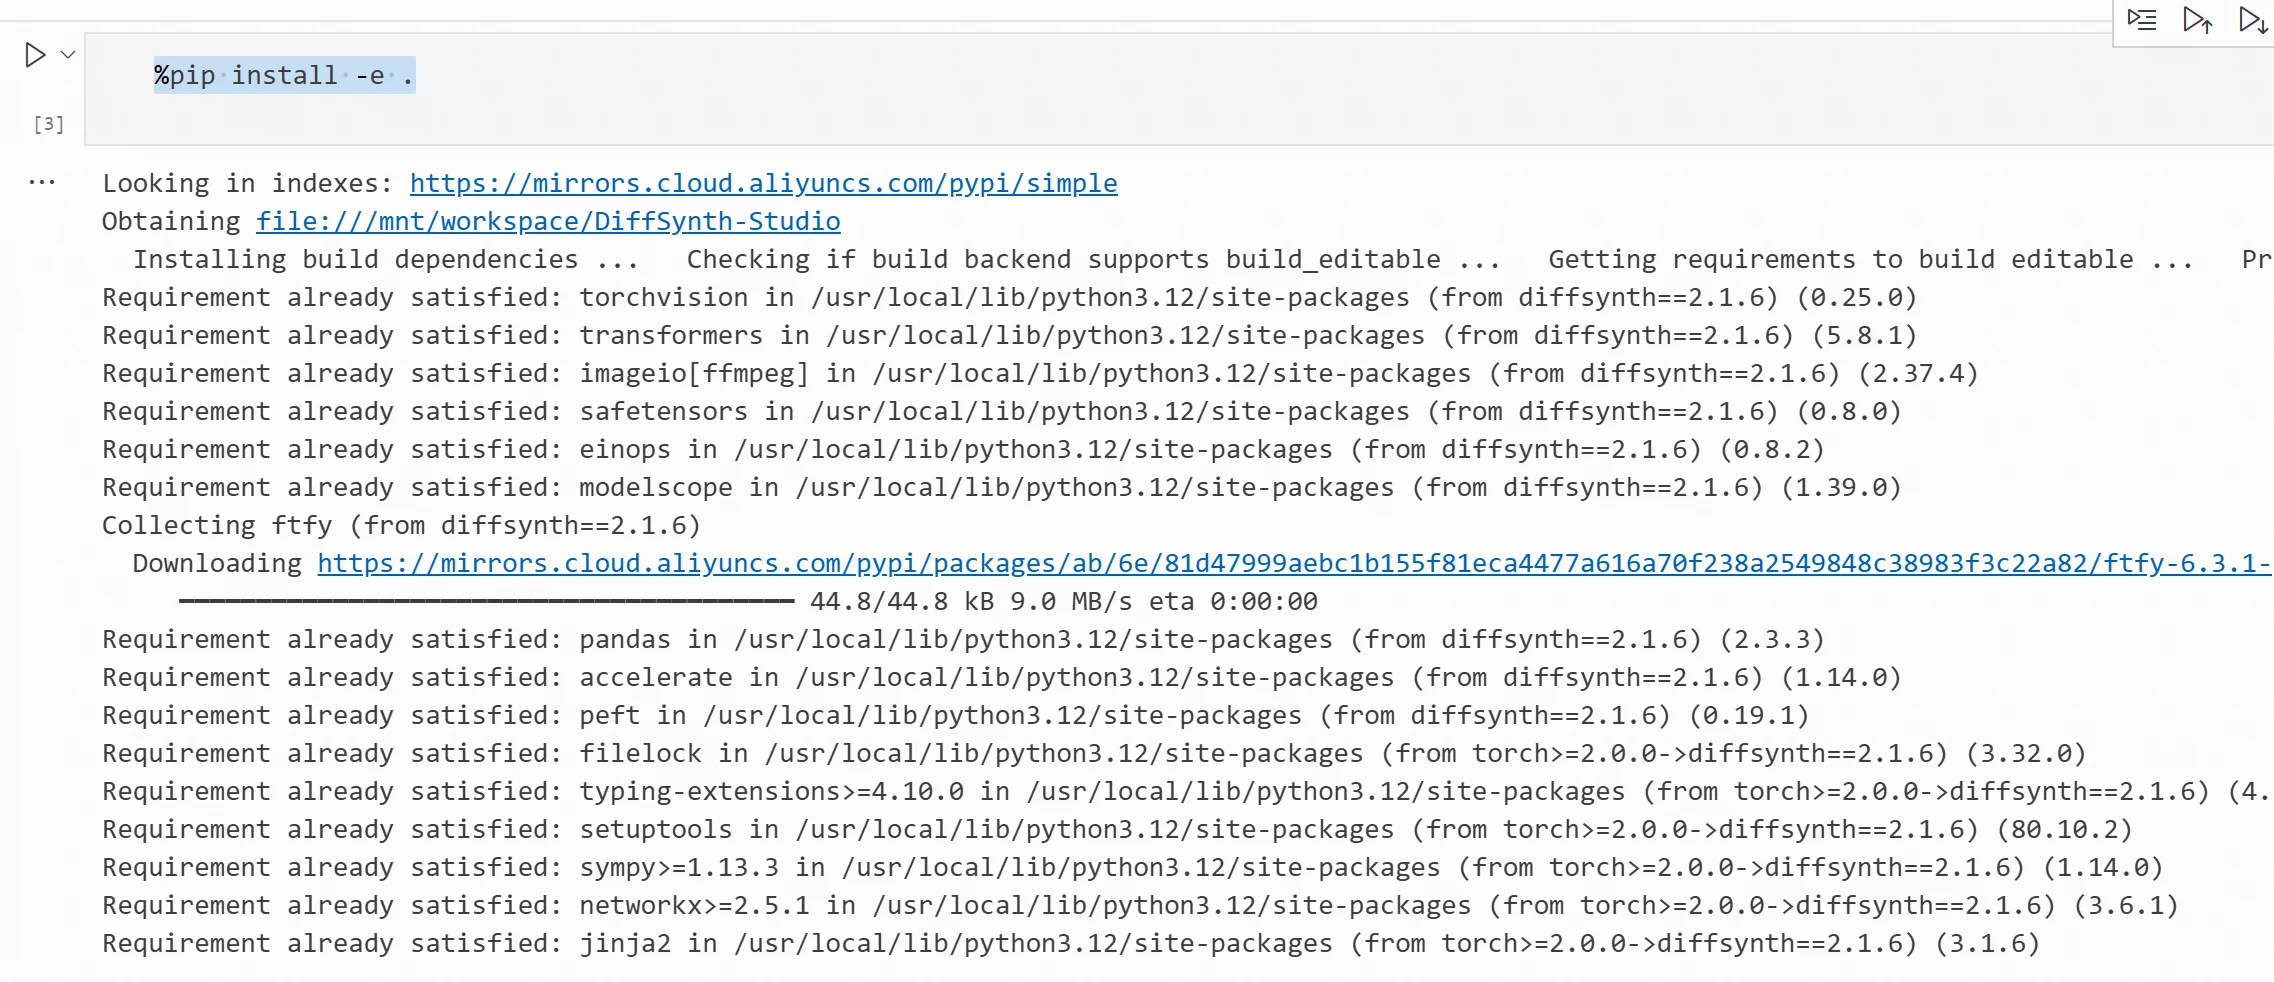
3) 安装

%pip install -e .
正文配图

4) Cell单元中に以下のコードを入力し、文生图を実行します。

import torch
from modelscope import ZImagePipeline
pipe = ZImagePipeline.from_pretrained(
    "Tongyi-MAI/Z-Image-Turbo",
    torch_dtype=torch.bfloat16,
    low_cpu_mem_usage=False,
)
pipe.to("cuda")
print(f"モデル所在装置: {pipe.device}")

prompt = """ 夏日リキュール商業宣伝ポスター,
 清涼明るい夏日の雰囲気、 背景に氷、水しぶき、レモンと緑の葉を含める、 青緑の清涼色調、 商業広告写真のスタイル、 画面中央にリキュール商品表示エリアを残す、 背景はシンプルで、光と影は自然、 高品質で、詳細が明確。 """
image = pipe(
    prompt=prompt,
    height=1024,
    width=1024,
    num_inference_steps=9, 
    guidance_scale=0.0, 
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]

print("88888888888888888888888")
#display(image)
image.save("summer_drink_poster.png")

実行後、ワークスペースで保存された画像を見ることができます。
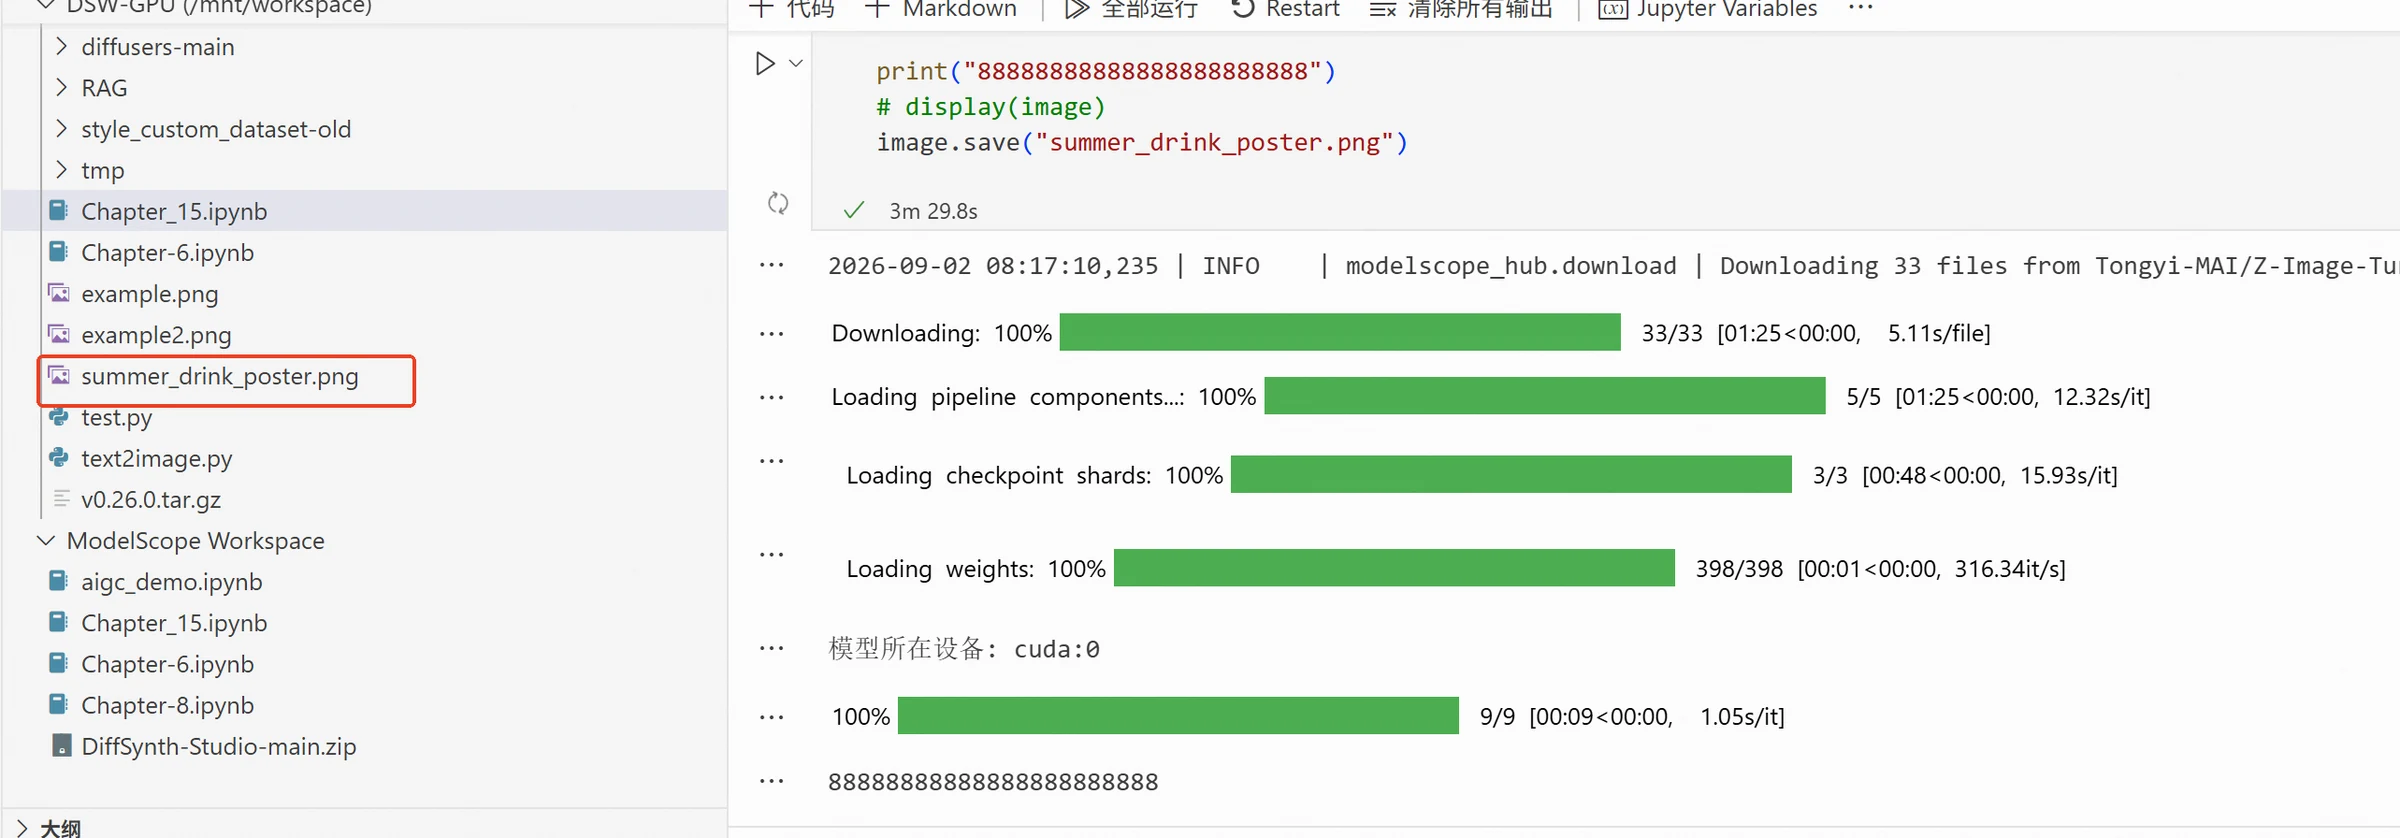
正文配图
レッスン 3 / 50%完了
←Image LoRA with DiffSynth

ディスカッション

ログイン ディスカッションに参加

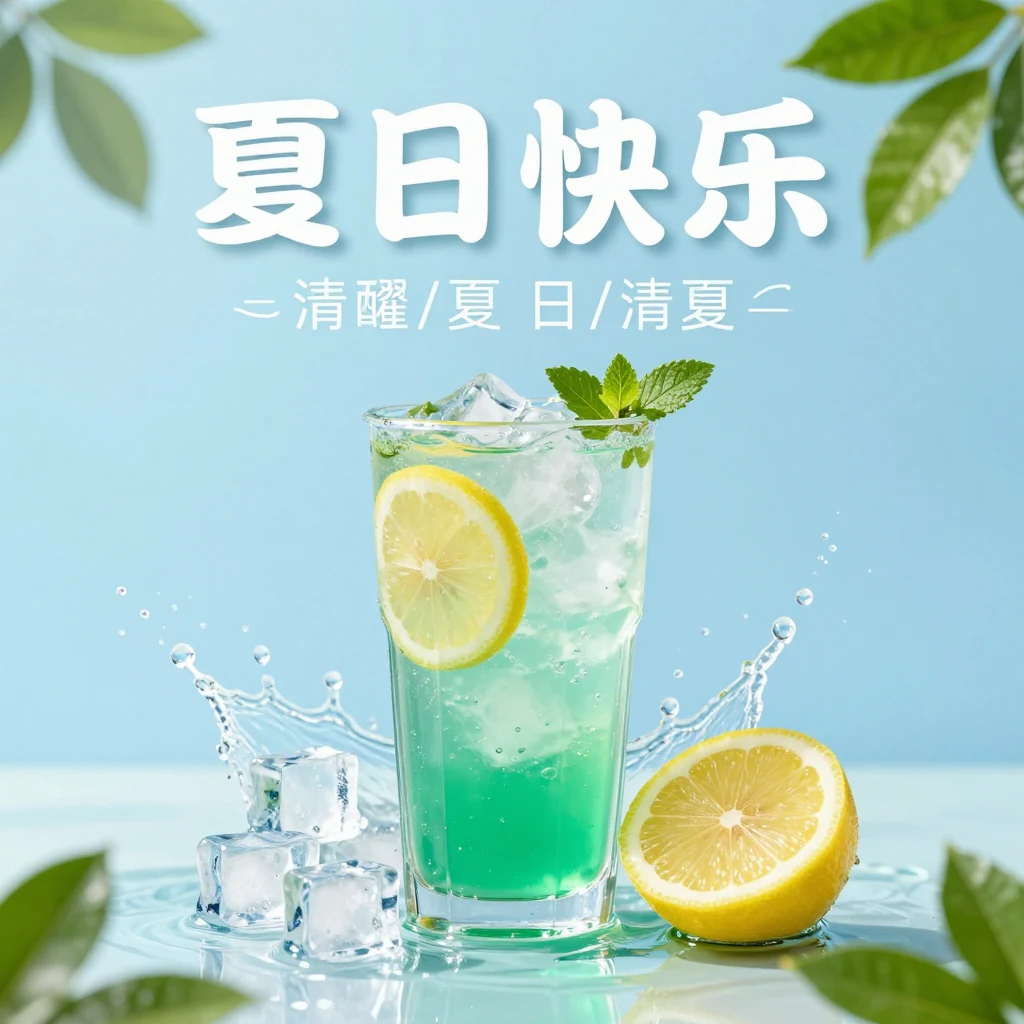
生成された画像の効果は以下の通り:

正文配图

初心者にとって、最初に非常に複雑なPromptを記述する必要はありません。必要な内容を明確に伝え、生成結果に基づいて段階的に詳細を追加すればよいです。

参照画像があれば、ブランドとマーケティング要素を追加する

テキストから画像生成はマーケティングクリエイティブや背景の提案を素早く生成するのに適していますが、明らかな問題があります。モデルに特定の商品を直接生成要求した場合、商品パッケージ、ロゴ、テキストが実際の商品と異なる可能性があります。公式の商品マーケティングシーンでは、実際の商品画像を組み合わせてさらに処理する必要があります。

テキストから画像生成は主にテキストの説明に依存しますが、画像から画像生成(Image-to-Image)は参照画像とテキストの説明を同時に入力します。モデルは入力画像中の商品主体、パッケージ、構成を参考にし、Promptに基づいて背景、光と影、マーケティング要素を調整できます。

本節ではSenseNova-U1.5-8B-MoTを画像編集モデルとして選択します。このモデルはテキストから画像生成や画像編集などのタスクをサポートし、入力画像とテキストの指示を同時に理解し、Promptに基づいて入力画像中の指定された内容を調整できます。テキストに基づいて画像を生成するだけでなく、入力画像中の視覚情報を利用し、既存の主体と全体構造を保持したまま、商品パッケージ、背景、色、装飾要素などを修正できるため、商品マーケティング画像の生成と編集に適しています。

実験部分では前節で生成した夏日リキュール画像を入力として、画像から画像生成モデルで編集を行います。リキュールボトルの主体と全体構造をできるだけ保持した上で、ボトルに「FRESH DAY」ブランドロゴを追加し、氷、水しぶき、レモンなどの夏日要素を追加し、より完全な商品マーケティング広告画像を生成します。デフォルトのSenseNova-U1.5-8B-MoTのロード方法ではメモリ不足となり、本コードでは低メモリロード方式を採用し、メモリ消費を低減します。

コードは以下の通り:

from diffsynth.pipelines.sensenova_u1_image import (
    SenseNovaU1ImagePipeline,
    ModelConfig
)
from PIL import Image
import torch
import os

MODEL_ID = "SenseNova/SenseNova-U1.5-8B-MoT"
INPUT_IMAGE = "/mnt/workspace/summer_drink_poster.png"
OUTPUT_IMAGE = "/mnt/workspace/drink_fresh_day_ad.png"

vram_config = {
    "offload_dtype": "disk",
    "offload_device": "disk",
    "onload_dtype": "disk",
    "onload_device": "disk",

    # 真正に計算が必要になる時点でBF16でGPUにロード
    "preparing_dtype": torch.bfloat16,
    "preparing_device": "cuda",

    "computation_dtype": torch.bfloat16,
    "computation_device": "cuda",
}

print("SenseNova-U1.5-8B-MoTをロード中...")

pipe = SenseNovaU1ImagePipeline.from_pretrained(
    torch_dtype=torch.bfloat16,
    device="cuda",

    model_configs=[
        ModelConfig(
            model_id=MODEL_ID,
            origin_file_pattern="model*.safetensors",
            **vram_config
        ),
    ],

    tokenizer_config=ModelConfig(
        model_id=MODEL_ID,
        origin_file_pattern="./"
    ),
    vram_limit=(
        torch.cuda.mem_get_info("cuda")[1] / (1024 ** 3)
        - 0.5
    ),
)

print("モデルロード完了。")

if not os.path.exists(INPUT_IMAGE):
    raise FileNotFoundError(
        f"入力画像が見つかりません: {INPUT_IMAGE}"
    )

edit_image = Image.open(INPUT_IMAGE).convert("RGB")

print(
    f"入力画像サイズ:"
    f"{edit_image.width} × {edit_image.height}"
)

prompt = """
这是一项饮料商品图像编辑任务。

请基于输入的饮料瓶商品图,生成一张专业、清爽的夏日饮料营销广告图。

请重点保留原图中的饮料瓶主体。
尽量保持饮料瓶原有的瓶身形状、瓶盖、包装结构、瓶身比例、
材质质感和整体商品外观,不要重新生成或替换成另一款饮料瓶。
饮料瓶应保持清晰完整,并作为画面的视觉中心。

在饮料瓶正面的标签区域,为这款饮料增加一个新的品牌标识:
“FRESH DAY”。

“FRESH DAY”はこのリキュールのブランド名です。
ブランドロゴを商品パッケージに印刷された真のブランド識別マークのように、画面上で浮かぶ普通のテキストではなく、自然にデザインしてください。ブランドロゴは簡潔で、現代的で、清涼な視覚デザインスタイルを用います。
使用明確で目立つ英語フォント、そして簡素な小さな葉のグラフィックを組み合わせて、自然、健康、清涼、若々しさを表現するブランドの感覚を伝えましょう。

“FRESH DAY”文字はできるだけ完全で、明確で、識別しやすいように。
他のブランド名を生成しないでください。関連しないテキストを追加しないでください。
ボトル外にも「FRESH DAY」を複数回表示しないでください。

リキュールボトルの主体を保持したまま、周囲のマーケティングシーンを最適化してください。

リキュールボトルの周囲に少し透明な氷、清涼で自然な水しぶき、ボトル表面の冷凝水滴、そして少量の新鮮なレモン片を追加し、リキュールが冷やし、清涼で新鮮な感じを強調してください。

明るく自然な商業製品写真の光を用いて、ボトルの透明感、冷凝水滴、製品の質感を強調してください。
背景はシンプルで、清潔で、複雑な要素を多く含めないでください。

全体の画面は清涼で、明るく、高級な夏日商業広告スタイルを用います。
主体が目立つ、構成がシンプルで、真の商業製品写真の質感を持つように。
最終的な効果は、リアルなリキュールブランドの発表用のプロフェッショナルな夏日マーケティング広告のようであって、イラスト、キャラクター、または再デザインされたリキュール製品ではない。

"""

print("夏日リキュールマーケティング画像の生成を開始します...")

image = pipe(
    prompt=prompt,

    # 原始商品画像
    edit_image=edit_image,

    # 固定ランダムシード、実験の再現性を確保
    seed=42,

    # 3:4 縦版マーケティング画像
    height=1536,
    width=1152,

    num_inference_steps=50,
    cfg_scale=4.0,
    shift=3.0,
)

image.save(OUTPUT_IMAGE)

print(
    f"生成完了、画像は保存先:{OUTPUT_IMAGE}"
)

実行結果は以下の通り